Share
Embed
Recommender Systems
Kevin Patrick Murphy 先生の著書 「Probabilistic Machine Learning: An Introduction」22 節の日本語まとめスライドです.
yusumi
August 11, 2022
Transcript
44 slides
-
はじめに 推薦システムはユーザの様々な情報から item を推薦する手法である. Facebook, Amazon, Netflix, Google などの多くの企業で活用されている. ユーザの様々な情報
• 過去の閲覧履歴: 商品のクリックなど • 過去の購買履歴: 商品の購入, 映画の評価など • 補助情報: 年齢, 性別, 商品自体の特性など item の種類 • 商品, 映画, 広告など 1 -
推薦システムの種類 推薦システムを行う上で, ユーザの行動履歴は大きく分けて 2 種類存在する. Explicit feedback item に対してユーザの評価が明確に与えられている. e.g.)
Amazon の商品評価 (星 1∼ 星 5), Youtube 動画の評価 (Good or Bad) など. Implicit feedback item に対してユーザの評価が明確に与えられていない. e.g.) 商品の閲覧履歴, 購買履歴など. これら 2 種類に応じて, 推薦手法は異なる. 2 -
Table of contents 1. Explicit feedback 2. Implicit feedback 3.
Leveraging side information 4. Exploration-exploitation tradeoff 3 -
22.1 Explicit feedback Explicit feedback におけるユーザの行動履歴 item に対してユーザの評価が明確に与えられている. e.g.) Amazon
の商品評価 (星 1∼ 星 5), Youtube 動画の評価 (Good or Bad) など. はじめに, 記号の定義を行う. • ユーザ u が item i に付けた評価値を Yui ∈ R とする. • 全ユーザ数を M, 全 item 数を N とする. Yui を要素とする行列 (評価行列) は通常スパースである. (現実に存在するユーザは一部の item のみを評価するため) 4 -
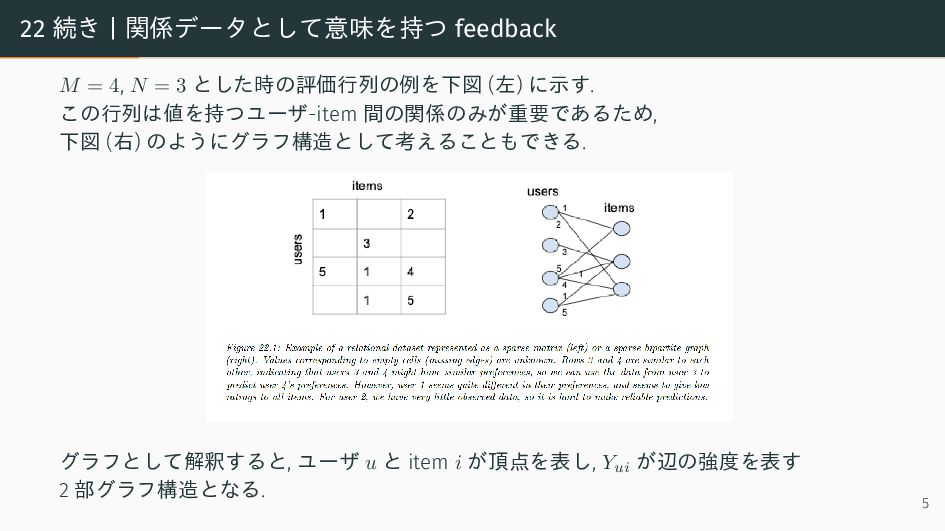
22 続き | 関係データとして意味を持つ feedback M = 4, N =
3 とした時の評価行列の例を下図 (左) に示す. この行列は値を持つユーザ-item 間の関係のみが重要であるため, 下図 (右) のようにグラフ構造として考えることもできる. グラフとして解釈すると, ユーザ u と item i が頂点を表し, Yui が辺の強度を表す 2 部グラフ構造となる. 5 -
22.1 続き | 欠損値として考えられる可能性 理想的には, 全ての item についてユーザの評価値が得られることが望ましい. → しかし,
現実ではほぼ不可能. 多くの item でユーザの評価値は欠損するが, その原因は主に 2 種類考えられる. 1. ユーザ u が item i に接触していない. (ユーザはその item の存在をそもそも知らない) 2. ユーザ u が item i に初めから興味が無く, 意図的に評価していない. 1. はランダムに一部の item 評価値が欠損していると考えることができる. 以降では, 単純化のため 1. を仮定してモデル化を行う. 6 -
22.1.1 Datasets モデルの説明に入る前に, この分野の有名なデータセットをいくつか紹介する. • Netflix の映画評価 [2] : 現在は扱うことができない.
2006 年に 1 から 5 点が付いた 480,507 件の映画評価データをコンペ形式で公開した. このデータセットは 480,189 人 のユーザと 17,770 件の映画で構成されていたが, 評価行列の 99% は欠損していた. • MovieLens [3] : 匿名化したユーザの 1 から 5 点が付いた映画評価データ. • Jester [4] : 匿名ユーザによる 650 万件のジョーク評価. • BookCrossing [5] : Book-Crossing 運営から 4 週間かけて収集したユーザの本に対する 評価. 7 -
22.1.2 Collaborative filtering 協調フィルタリング (Collaborative filtering) [6] あるユーザの評価値を他のユーザと共有することで, 共同で item
を推薦する手法. ユーザ u が item i に興味があるかどうかを知るためには, 似ているユーザ u′ が i に付けた 評価値を参考に加重平均を求める. ˆ Yui = ∑ u′ :Y u ′ ,i ̸=NULL sim(u, u′ )Yu′ ,i (22.1) • Yu′ ,i ̸= NULL : item i に対するユーザ u′ の評価値が欠損していない. • sim(u, u′ ): ユーザ間の類似度を表す関数. 類似度はユーザが付けた評価値の集合 Su , Su′ を相関係数などで比較する. Su = {Yu,i ̸= NULL : i ∈ I}, Su′ = {Yu′ ,i ̸= NULL : i ∈ I} 9 -
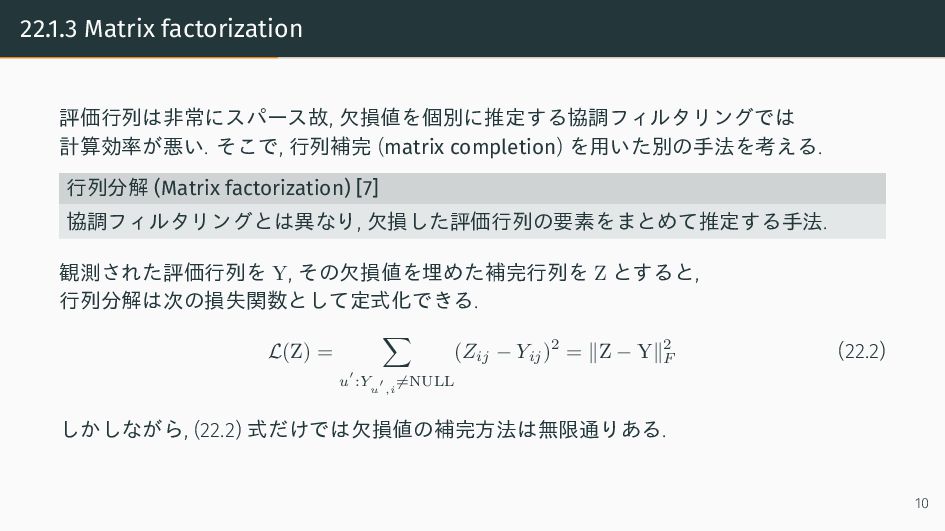
22.1.3 Matrix factorization 評価行列は非常にスパース故, 欠損値を個別に推定する協調フィルタリングでは 計算効率が悪い. そこで, 行列補完 (matrix completion)
を用いた別の手法を考える. 行列分解 (Matrix factorization) [7] 協調フィルタリングとは異なり, 欠損した評価行列の要素をまとめて推定する手法. 観測された評価行列を Y, その欠損値を埋めた補完行列を Z とすると, 行列分解は次の損失関数として定式化できる. L(Z) = ∑ u′ :Y u ′ ,i ̸=NULL (Zij − Yij )2 = ∥Z − Y∥2 F (22.2) しかしながら, (22.2) 式だけでは欠損値の補完方法は無限通りある. 10 -
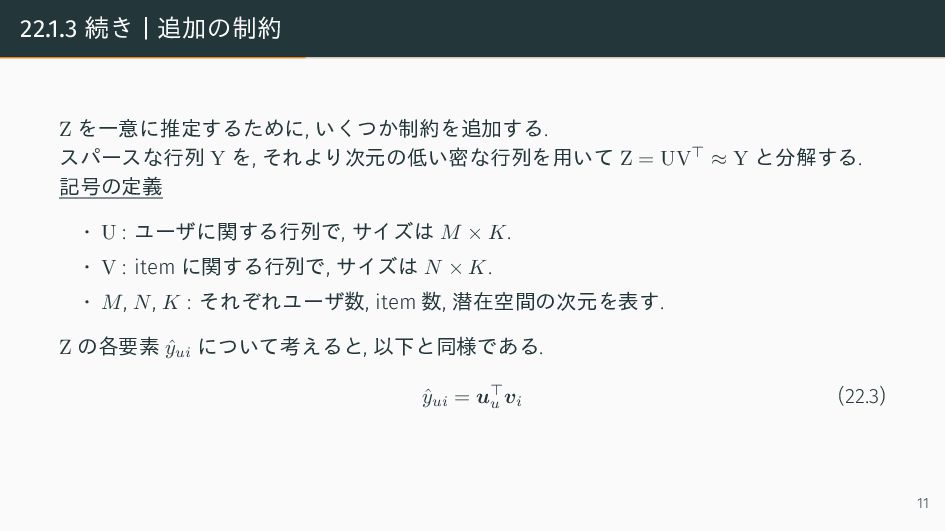
22.1.3 続き | 追加の制約 Z を一意に推定するために, いくつか制約を追加する. スパースな行列 Y を,
それより次元の低い密な行列を用いて Z = UV⊤ ≈ Y と分解する. 記号の定義 • U : ユーザに関する行列で, サイズは M × K. • V : item に関する行列で, サイズは N × K. • M, N, K : それぞれユーザ数, item 数, 潜在空間の次元を表す. Z の各要素 ˆ yui について考えると, 以下と同様である. ˆ yui = u⊤ u vi (22.3) 11 -
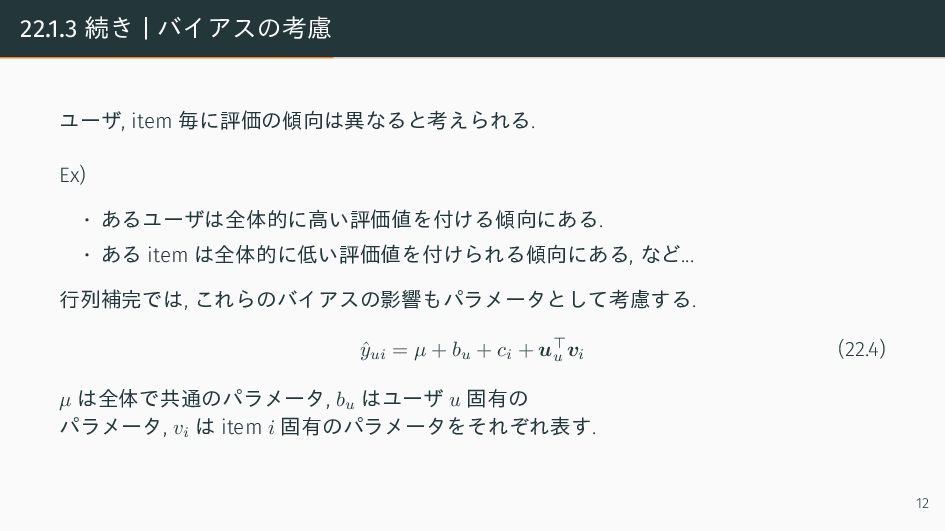
22.1.3 続き | バイアスの考慮 ユーザ, item 毎に評価の傾向は異なると考えられる. Ex) • あるユーザは全体的に高い評価値を付ける傾向にある.
• ある item は全体的に低い評価値を付けられる傾向にある, など... 行列補完では, これらのバイアスの影響もパラメータとして考慮する. ˆ yui = µ + bu + ci + u⊤ u vi (22.4) µ は全体で共通のパラメータ, bu はユーザ u 固有の パラメータ, vi は item i 固有のパラメータをそれぞれ表す. 12 -
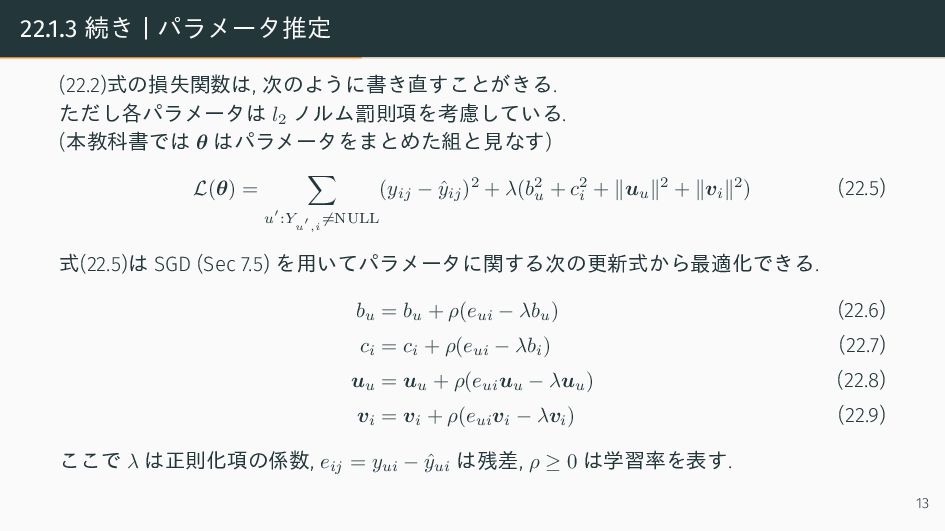
22.1.3 続き | パラメータ推定 (22.2)式の損失関数は, 次のように書き直すことがきる. ただし各パラメータは l2 ノルム罰則項を考慮している. (本教科書では
θ はパラメータをまとめた組と見なす) L(θ) = ∑ u′ :Y u ′ ,i ̸=NULL (yij − ˆ yij )2 + λ(b2 u + c2 i + ∥uu ∥2 + ∥vi ∥2) (22.5) 式(22.5)は SGD (Sec 7.5) を用いてパラメータに関する次の更新式から最適化できる. bu = bu + ρ(eui − λbu ) (22.6) ci = ci + ρ(eui − λbi ) (22.7) uu = uu + ρ(eui uu − λuu ) (22.8) vi = vi + ρ(eui vi − λvi ) (22.9) ここで λ は正則化項の係数, eij = yui − ˆ yui は残差, ρ ≥ 0 は学習率を表す. 13 -
22.1.3.1 Probabilistic matrix factorization (PMF) MF を次式のように確率モデルとして扱うこともできる [8]. p(yui =
y) = N(y|µ + bu + ci + u⊤ u vi , σ2) (22.10) 確率的な視点を導入することで, ユーザの評価値が整数である事実を ポアソン分布や二項分布を仮定することで捉えることができる. 14 -
22.1.3.2 Examples: Netflix 潜在空間の次元を K = 2 として, PMF を
Netflix のデータに適用した例を示す. 上図は映画 (item) i に関する潜在変数 vi を可視化している. ユーザに関する潜在変数 uu も同じ空間に埋め込まれるため, 両者の類似度 u⊤ u vi から 評価値を推定できる. 15 -
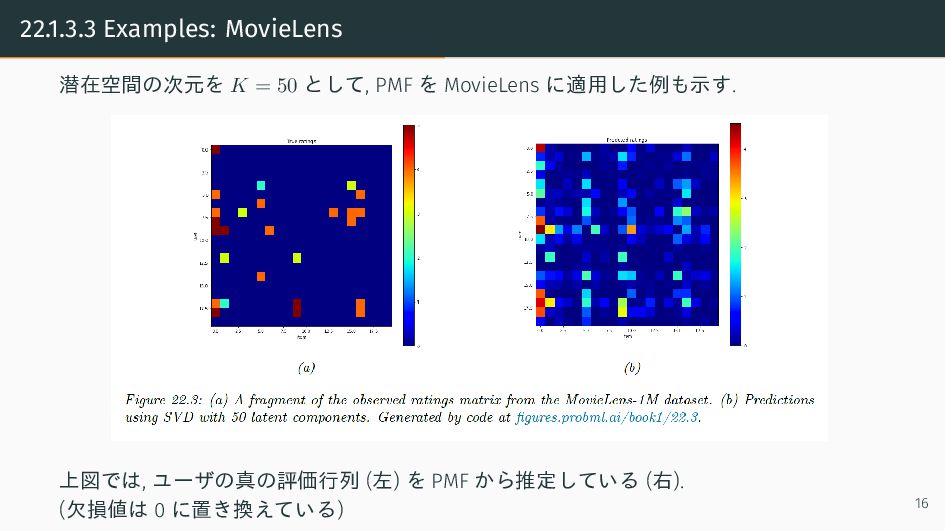
22.1.3.3 Examples: MovieLens 潜在空間の次元を K = 50 として, PMF を
MovieLens に適用した例も示す. 上図では, ユーザの真の評価行列 (左) を PMF から推定している (右). (欠損値は 0 に置き換えている) 16 -
22.1.3.3 続き | item の推薦 あるユーザが付けた映画の評価値から, 未観測の別を映画を推薦する. 上図の (a) (左)
はユーザが付けた評価値の高い映画 Top10. (b) (右) は未観測 の中で推定された評価値の高い映画 Top10 を表す. この結果から, 両者のジャンル (Genres) が近い傾向にあることが分かる. 推薦する際は, 推 定評価値の高い未観測の映画が候補になる. 17 -
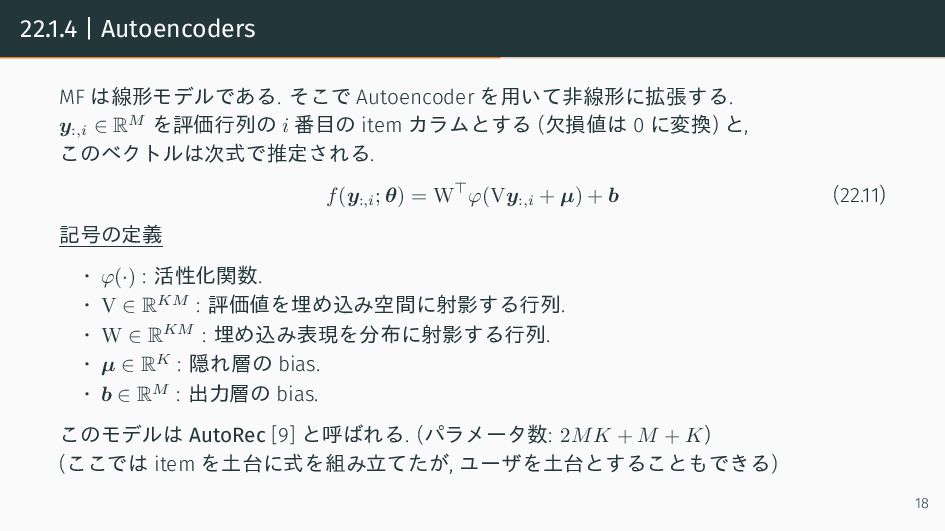
22.1.4 | Autoencoders MF は線形モデルである. そこで Autoencoder を用いて非線形に拡張する. y:,i ∈
RM を評価行列の i 番目の item カラムとする (欠損値は 0 に変換) と, このベクトルは次式で推定される. f(y:,i ; θ) = W⊤φ(Vy:,i + µ) + b (22.11) 記号の定義 • φ(·) : 活性化関数. • V ∈ RKM : 評価値を埋め込み空間に射影する行列. • W ∈ RKM : 埋め込み表現を分布に射影する行列. • µ ∈ RK : 隠れ層の bias. • b ∈ RM : 出力層の bias. このモデルは AutoRec [9] と呼ばれる. (パラメータ数: 2MK + M + K) (ここでは item を土台に式を組み立てたが, ユーザを土台とすることもできる) 18 -
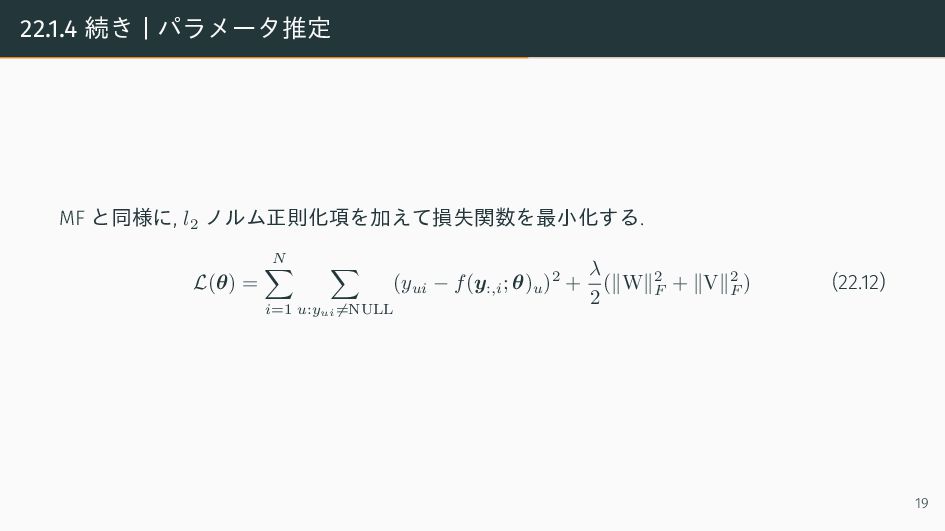
22.1.4 続き | パラメータ推定 MF と同様に, l2 ノルム正則化項を加えて損失関数を最小化する. L(θ) =
N ∑ i=1 ∑ u:yui̸=NULL (yui − f(y:,i ; θ)u )2 + λ 2 (∥W∥2 F + ∥V∥2 F ) (22.12) 19 -
22.2 Implicit feedback Implicit feedback におけるユーザの行動履歴 item に対してユーザの評価が明確に与えられていない. e.g.) 商品の閲覧履歴,
購買履歴など. Explicit feedback による推薦手法は, 事前にユーザの評価が与えられる必要があった. しかし, 評価を得ずとも閲覧履歴だけで推薦できる手法の方が広く活用できるだろう. ユーザの興味の仮定 • 例 1 ) ユーザ u が見た全ての映画を positive, それ以外を negative とする. • 例 2 ) 映画 i と映画 j を推薦した時, ユーザ u が i を見れば, j より i を好むとする. 例 2 ) での結果は, yn = (u, i, j) のタプル構造として定義する. ここで (u, i) は positive な組, (u, j) は negative または欠損な組を表す. 20 -
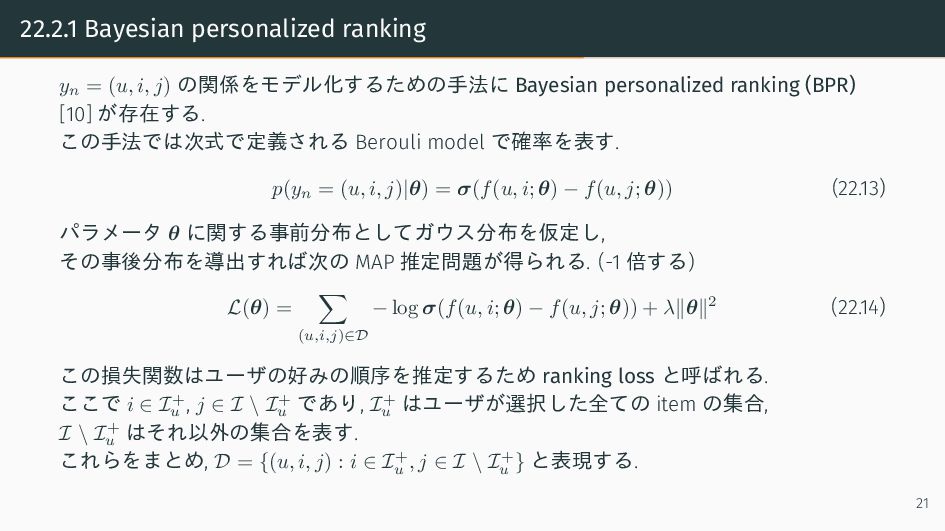
22.2.1 Bayesian personalized ranking yn = (u, i, j) の関係をモデル化するための手法に
Bayesian personalized ranking (BPR) [10] が存在する. この手法では次式で定義される Berouli model で確率を表す. p(yn = (u, i, j)|θ) = σ(f(u, i; θ) − f(u, j; θ)) (22.13) パラメータ θ に関する事前分布としてガウス分布を仮定し, その事後分布を導出すれば次の MAP 推定問題が得られる. (-1 倍する) L(θ) = ∑ (u,i,j)∈D − log σ(f(u, i; θ) − f(u, j; θ)) + λ∥θ∥2 (22.14) この損失関数はユーザの好みの順序を推定するため ranking loss と呼ばれる. ここで i ∈ I+ u , j ∈ I \ I+ u であり, I+ u はユーザが選択した全ての item の集合, I \ I+ u はそれ以外の集合を表す. これらをまとめ, D = {(u, i, j) : i ∈ I+ u , j ∈ I \ I+ u } と表現する. 21 -
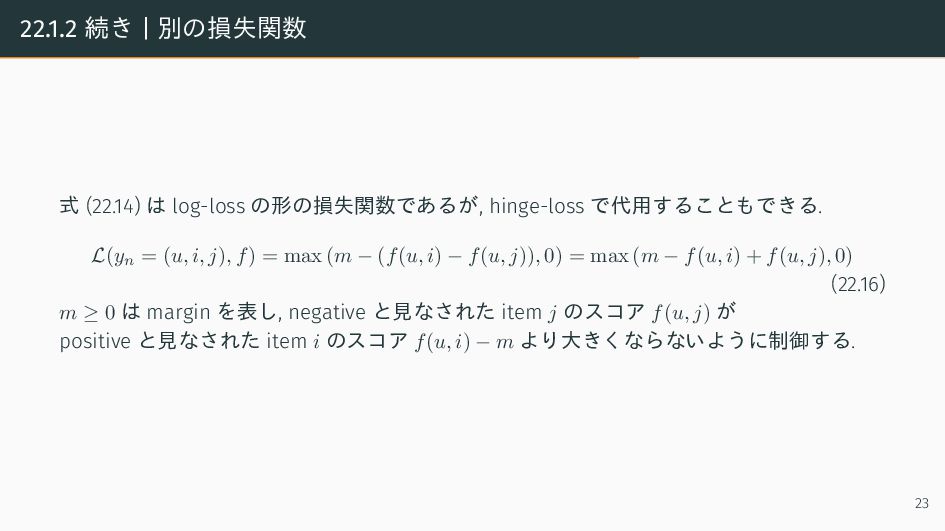
22.1.2 続き | 別の損失関数 式 (22.14) は log-loss の形の損失関数であるが, hinge-loss
で代用することもできる. L(yn = (u, i, j), f) = max (m − (f(u, i) − f(u, j)), 0) = max (m − f(u, i) + f(u, j), 0) (22.16) m ≥ 0 は margin を表し, negative と見なされた item j のスコア f(u, j) が positive と見なされた item i のスコア f(u, i) − m より大きくならないように制御する. 23 -
22.2.2 Factorization machines Factorization machines [11] は, ユーザと item の相互作用を考慮したモデルである.
ユーザ u と item i のペア x = [one − hot(u), one − hot(i)] が与えられた時, その評価値を予測する. f(x) = µ + D ∑ i=1 wi xi + D ∑ i=1 D ∑ j=i+1 (v⊤ i vj )xi xj (22.17) 記号の定義 • x ∈ RD: 入力データ • D = M + N: 入力データの次元 (ユーザ数 +item 数) • V ∈ RD×K: 潜在変数を要素とする重み行列 • w ∈ RD: 重みベクトル • µ: 共通のバイアス (v⊤ i vj )xi xj の項が入力データ間の相互作用を表す. 24 -
22.2.2 続き | 出力のための計算量 式(22.17)は全てのユーザ, item ペアを考慮する必要があるため計算量は O(KD2). ただし スパースなデータの場合は非ゼロ成分のみを計算すればよく,
O(KD) まで下げられる. D ∑ i=1 D ∑ j=i+1 (v⊤ i vj )xi xj = 1 2 D ∑ i=1 D ∑ j=1 (v⊤ i vj )xi xj − 1 2 D ∑ i=1 (v⊤ i vi )xi xi (22.18) = 1 2 D ∑ i=1 D ∑ j=1 K ∑ k=1 vik vjk xi xj − D ∑ i=1 K ∑ k=1 vik vik xi xi (22.19) = 1 2 K ∑ k=1 ( D ∑ i=1 vik xi )2 − D ∑ i=1 v2 ik x2 i (22.20) x は one-hot encoding の形式であるため, 式(22.20)の計算量は実質 O(K) である. このモデルは目的に応じた損失関数で fit させることができる. 例えば Implicit feedback であれば ranking loss, Explicit feedback であれば MSE など. 25 -
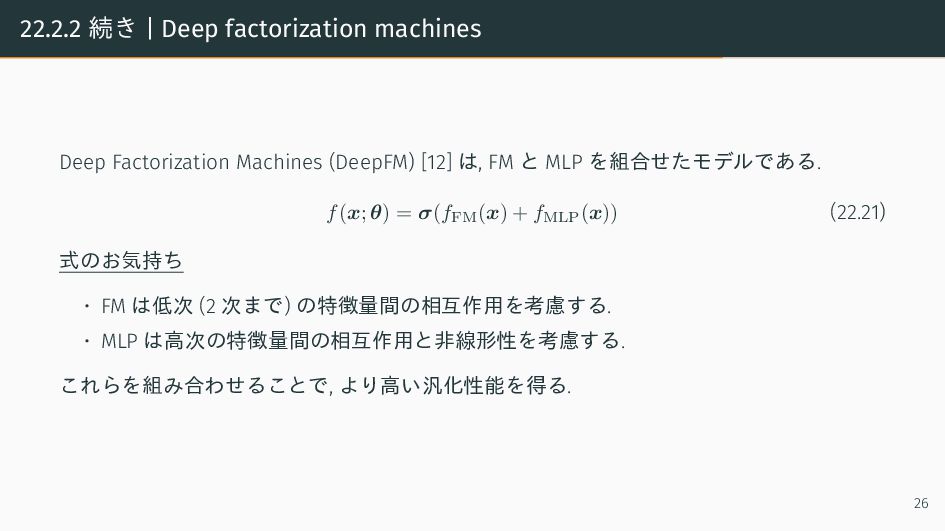
22.2.2 続き | Deep factorization machines Deep Factorization Machines (DeepFM)
[12] は, FM と MLP を組合せたモデルである. f(x; θ) = σ(fFM (x) + fMLP (x)) (22.21) 式のお気持ち • FM は低次 (2 次まで) の特徴量間の相互作用を考慮する. • MLP は高次の特徴量間の相互作用と非線形性を考慮する. これらを組み合わせることで, より高い汎化性能を得る. 26 -
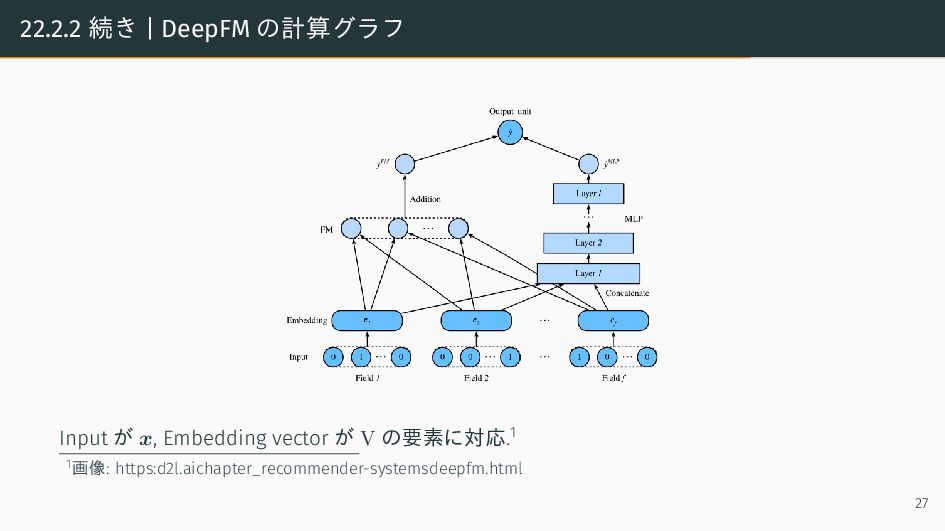
22.2.2 続き | DeepFM の計算グラフ Input が x, Embedding vector
が V の要素に対応.1 1画像: https:d2l.aichapter_recommender-systemsdeepfm.html 27 -
22.2.2 続き | Cold Start 問題 MF では一度もインタラクションを行ったことのないユーザやアイテムに対して推薦を行 うことができない. これは
Cold Start 問題として知られている. Cold Start 問題 サービスに登録したばかりのユーザや新登場の item は, 行動履歴がある程度付くまでレコメンドの対象にならない問題. この問題の解決策として, 事前にユーザや item の属性を基に類似度を計算する コンテンツベースの推薦手法が用いられる. 28 -
22.2.3 Neural matrix factorization Neural matrix factorization (NeuMF) [13] は
Cold Start 問題を解決できる手法の1つ. → Generalized Matrix Factorization (GMF) と MLP の2つのコンポーネントから構成される. 29 -
22.2.3 続き | NeuMF の構成 GMF では, ユーザ埋め込み行列 P ∈
RMK と item 埋め込み行列 Q ∈ RNK の要素毎の積 (Element-wise Product) z1 ui から評価値を推定する. z1 ui = Pu,; ⊙ Qi,; (22.22) 一方 MLP では, ユーザの埋め込み行列 ˜ U と item の埋め込み行列 ˜ V を結合し, MLP に通して得られる z2 ui から評価値を推定する. z2 ui = MLP([˜ Uu,: , ˜ Vi,: ]) (22.23) ˜ U, ˜ V はそれぞれ P, Q の複製である. 最終的に, これら 2 つのベクトルを結合して CTR (クリック率) を予測する. f(u, i; θ) = σ(w⊤[z1 ui , z2 ui ]) (22.24) 30 -
22.2.3 続き | Cold Start 問題に対する工夫 NeuMF の論文では, 入力はユーザ ID
と item ID の one-hot vector で表し, それに対する embedding を学習している (前ページの図). 一方で, 入力をコンテンツの特徴ベクトルとしても学習することができる. 例えば, 特徴ベ クトルとしてプロフィール情報の出現単語をベクトルで表したものや, 要素を one-hot ベ クトルで表したものなどが使用できる. 結果として l2 正則化やパラメータの調整を行うことで, テスト誤差や top-k で評価を行い 精度が出る事を確認した.これにより Cold Start 問題を解決し, 新規のアイテム推薦を行 う事ができるようになった. 31 -
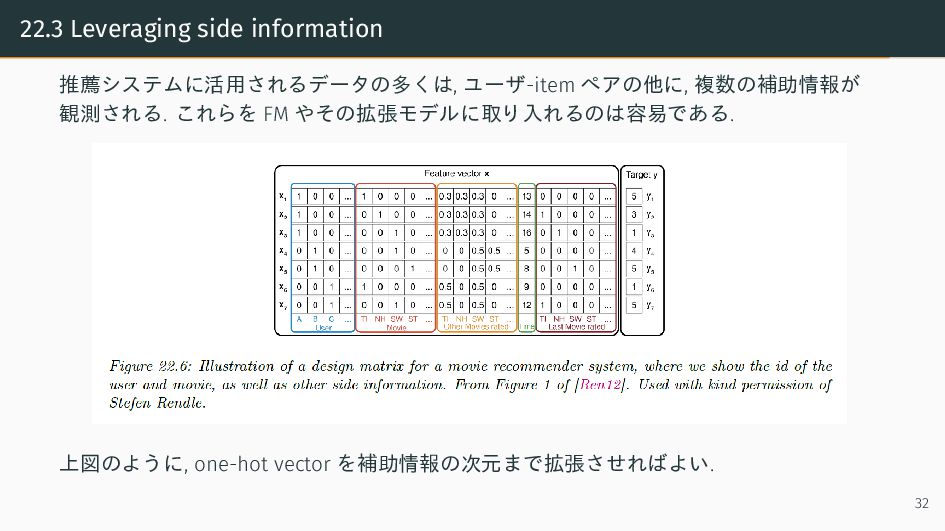
22.3 Leveraging side information 推薦システムに活用されるデータの多くは, ユーザ-item ペアの他に, 複数の補助情報が 観測される. これらを
FM やその拡張モデルに取り入れるのは容易である. 上図のように, one-hot vector を補助情報の次元まで拡張させればよい. 32 -
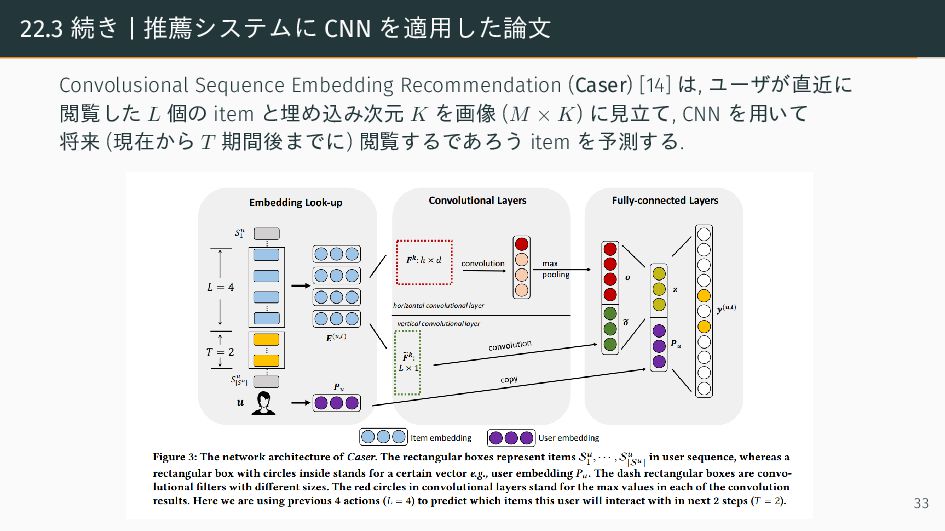
22.3 続き | 推薦システムに CNN を適用した論文 Convolusional Sequence Embedding Recommendation
(Caser) [14] は, ユーザが直近に 閲覧した L 個の item と埋め込み次元 K を画像 (M × K) に見立て, CNN を用いて 将来 (現在から T 期間後までに) 閲覧するであろう item を予測する. 33 -
22.4 Exploration-exploitation tradeoff 重要なので和訳をそのまま引用 他の種類の予測問題にはない, 推薦システムの興味深い「ひねり」は, システムが学習する データは, 以前のバージョンのシステムによってなされた推薦の結果であるという事実で ある.
つまり, フィードバック・ループが存在する. 例えば, YouTube の動画推薦システム [15] を考えてみよう. このサイトには何百万ものビデオがあるので, システムはユーザに見 せるべきビデオのショートリスト, つまり「slate」を考え出し, ユーザが欲しいものを見 つけられるようにしなければならない. もしユーザがこれらのビデオの 1 つを視聴すれば, システムは良い推薦をしたというポジティブなフィードバックとみなすことができ, それ に応じてモデルのパラメータを更新することができる. しかし, もしかしたら, もっと気に 入る動画があったかもしれない? この反実仮想に答えるには, ユーザの反応が不確かなも のを思い切って見せるしかない. これは, 探索と利用のトレードオフの一例である. 探索が 必要なことに加え, システムは推薦方針を変更したことが有益であったかどうかを検出で きるまで長い時間待たなければならないかもしれない. このような場合, 強化学習を用い て長期的な報酬を最適化する方針を学習することが一般的である. 詳しくは本書の続編を 参照せよ. 34 -
References i [1] Kevin P. Murphy. Probabilistic Machine Learning: An
introduction. MIT Press, 2022. [2] Yehuda Koren. The bellkor solution to the netflix grand prize. Netflix prize documentation, Vol. 81, No. 2009, pp. 1–10, 2009. [3] F Maxwell Harper and Joseph A Konstan. The movielens datasets: History and context. Acm transactions on interactive intelligent systems (tiis), Vol. 5, No. 4, pp. 1–19, 2015. [4] Ken Goldberg, Theresa Roeder, Dhruv Gupta, and Chris Perkins. Eigentaste: A constant time collaborative filtering algorithm. information retrieval, Vol. 4, No. 2, pp. 133–151, 2001. -
References ii [5] Cai-Nicolas Ziegler, Sean M McNee, Joseph A
Konstan, and Georg Lausen. Improving recommendation lists through topic diversification. In Proceedings of the 14th international conference on World Wide Web, pp. 22–32, 2005. [6] David Goldberg, David Nichols, Brian M Oki, and Douglas Terry. Using collaborative filtering to weave an information tapestry. Communications of the ACM, Vol. 35, No. 12, pp. 61–70, 1992. [7] Yehuda Koren, Robert Bell, and Chris Volinsky. Matrix factorization techniques for recommender systems. Computer, Vol. 42, No. 8, pp. 30–37, 2009. [8] Andriy Mnih and Russ R Salakhutdinov. Probabilistic matrix factorization. Advances in neural information processing systems, Vol. 20, , 2007. -
References iii [9] Suvash Sedhain, Aditya Krishna Menon, Scott Sanner,
and Lexing Xie. Autorec: Autoencoders meet collaborative filtering. In Proceedings of the 24th international conference on World Wide Web, pp. 111–112, 2015. [10] Steffen Rendle, Christoph Freudenthaler, Zeno Gantner, and Lars Schmidt-Thieme. Bpr: Bayesian personalized ranking from implicit feedback. arXiv preprint arXiv:1205.2618, 2012. [11] Steffen Rendle. Factorization machines with libfm. ACM Transactions on Intelligent Systems and Technology (TIST), Vol. 3, No. 3, pp. 1–22, 2012. -
References iv [12] Huifeng Guo, Ruiming Tang, Yunming Ye, Zhenguo
Li, and Xiuqiang He. Deepfm: a factorization-machine based neural network for ctr prediction. arXiv preprint arXiv:1703.04247, 2017. [13] Xiangnan He, Lizi Liao, Hanwang Zhang, Liqiang Nie, Xia Hu, and Tat-Seng Chua. Neural collaborative filtering. In Proceedings of the 26th international conference on world wide web, pp. 173–182, 2017. [14] Jiaxi Tang and Ke Wang. Personalized top-n sequential recommendation via convolutional sequence embedding. In Proceedings of the eleventh ACM international conference on web search and data mining, pp. 565–573, 2018. -
References v [15] Paul Covington, Jay Adams, and Emre Sargin.
Deep neural networks for youtube recommendations. In Proceedings of the 10th ACM conference on recommender systems, pp. 191–198, 2016.