Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
会社でMLモデルを作るとは @電気通信大学 データアントレプレナーフェロープログラム
Search
yuto16
September 21, 2025
Science
850
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
会社でMLモデルを作るとは @電気通信大学 データアントレプレナーフェロープログラム
下記登壇時の発表資料です。
https://www.de.uec.ac.jp/
yuto16
September 21, 2025
More Decks by yuto16
See All by yuto16
Snowflakeで実現する全社横断の顧客の声(VOC)分析・活用基盤@Snowflake World Tour Tokyo 2026
yuto16
0
260
Streamlit in Snowflakeで加速する 不動産テック企業のデータ活用@Tech業界ネットワーキングイベント
yuto16
0
210
Snowflakeで実現する広告画像評価の自動化と属人化解消 @Snowflake MEATup
yuto16
0
410
GA technologiesでのAI-Readyの取り組み@DataOps Night
yuto16
0
820
Cortexで加速する AI不動産投資 RENOSYのデータ活用 @Snowflake ACCELERATE
yuto16
0
600
Streamlit in Snowflakeで加速する不動産テック企業のデータ活用 @Snowflake WESTユーザー会
yuto16
1
850
Other Decks in Science
See All in Science
明治薬科大学講義_ビッグデータ解析を支えるデータベース技術とクラウドコンピューティング
ktatsuya
1
200
バランスって大事だね
akasan
1
160
機械学習 - K-means & 階層的クラスタリング
trycycle
PRO
0
2.2k
[NLP2026 参加報告会] AI for Science まとめ / NLP2026
lychee1223
0
2k
Cross-Media Technologies, Information Science and Human-Information Interaction
signer
PRO
3
33k
Webinaire : Valorisez les résultats de vos projets européens avec EU-FarmBook
institutdelelevage
PRO
0
180
Utiliser Bitcoin sans Internet
rlifchitz
0
400
AI bij literatuuronderzoek in de wetenschap
voginip
0
270
データベース11: 正規化(1/2) - 望ましくない関係スキーマ
trycycle
PRO
0
1.8k
Wet Active Matter
rajeshrinet
0
260
データベース05: SQL(2/3) 結合質問
trycycle
PRO
0
1.4k
ゲームと人工知能
miyayou
0
260
Featured
See All Featured
The Power of CSS Pseudo Elements
geoffreycrofte
82
6.6k
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
260
Put a Button on it: Removing Barriers to Going Fast.
kastner
60
4.6k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
Agile that works and the tools we love
rasmusluckow
331
22k
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
430
Utilizing Notion as your number one productivity tool
mfonobong
4
620
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.2k
How STYLIGHT went responsive
nonsquared
100
6.3k
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
43k
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.7k
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
Transcript
会社でMLモデルを作るとは? ~入社1ヶ月目でMLモデルを作成した話 ~ @電気通信大学 データアントレプレナーフェロープログラム GA technologies Data本部
Applied ML部 酒井悠斗 Data Scientist 2025/09/13
1. 登壇者紹介 / 会社紹介 2. 会社でMLモデルを作るとは? ~具体例ともに ~ 3. まとめ
アジェンダ
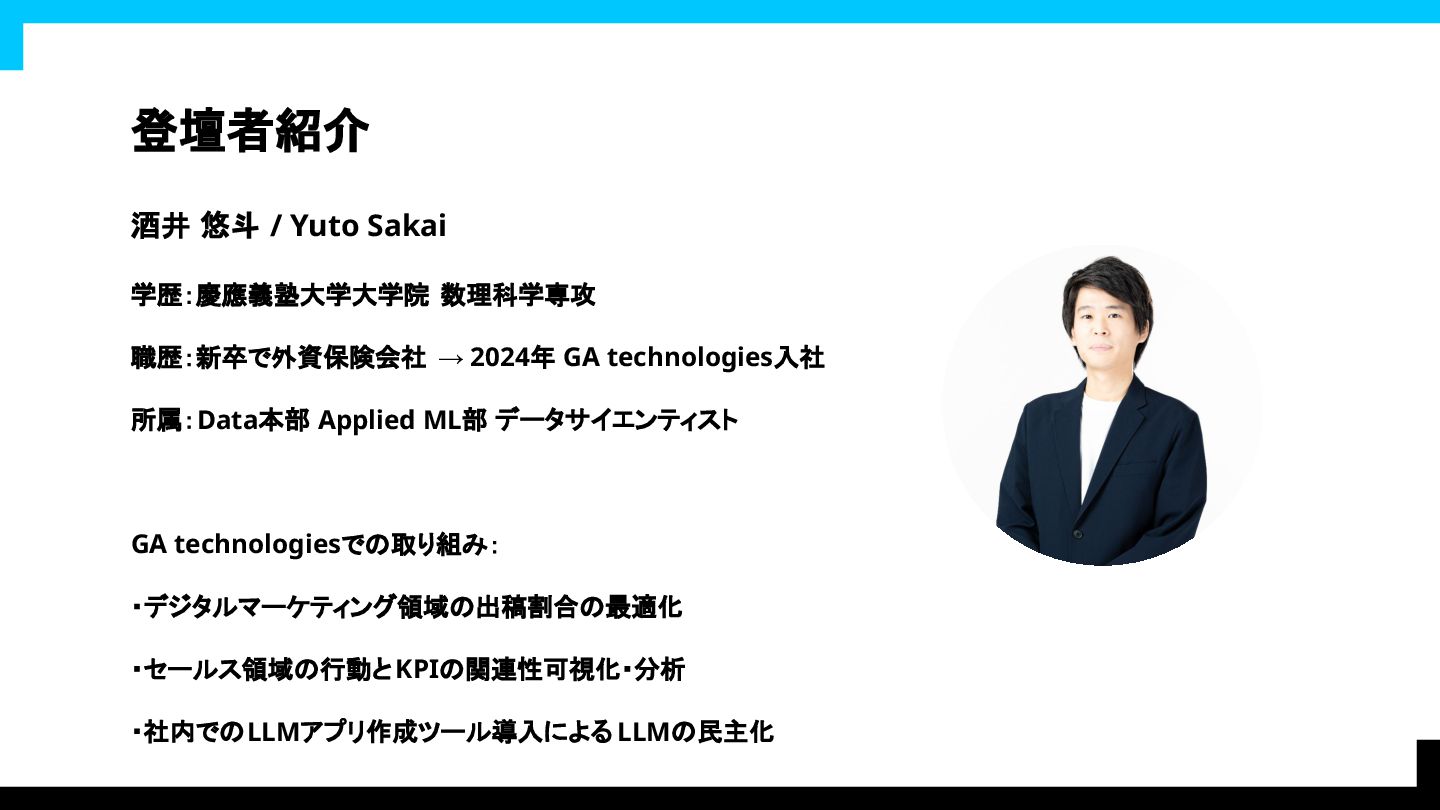
登壇者紹介 酒井 悠斗 / Yuto Sakai 学歴:慶應義塾大学大学院 数理科学専攻 職歴:新卒で外資保険会社
→ 2024年 GA technologies入社 所属:Data本部 Applied ML部 データサイエンティスト GA technologiesでの取り組み: ・デジタルマーケティング領域の出稿割合の最適化 ・セールス領域の行動とKPIの関連性可視化・分析 ・社内でのLLMアプリ作成ツール導入による LLMの民主化
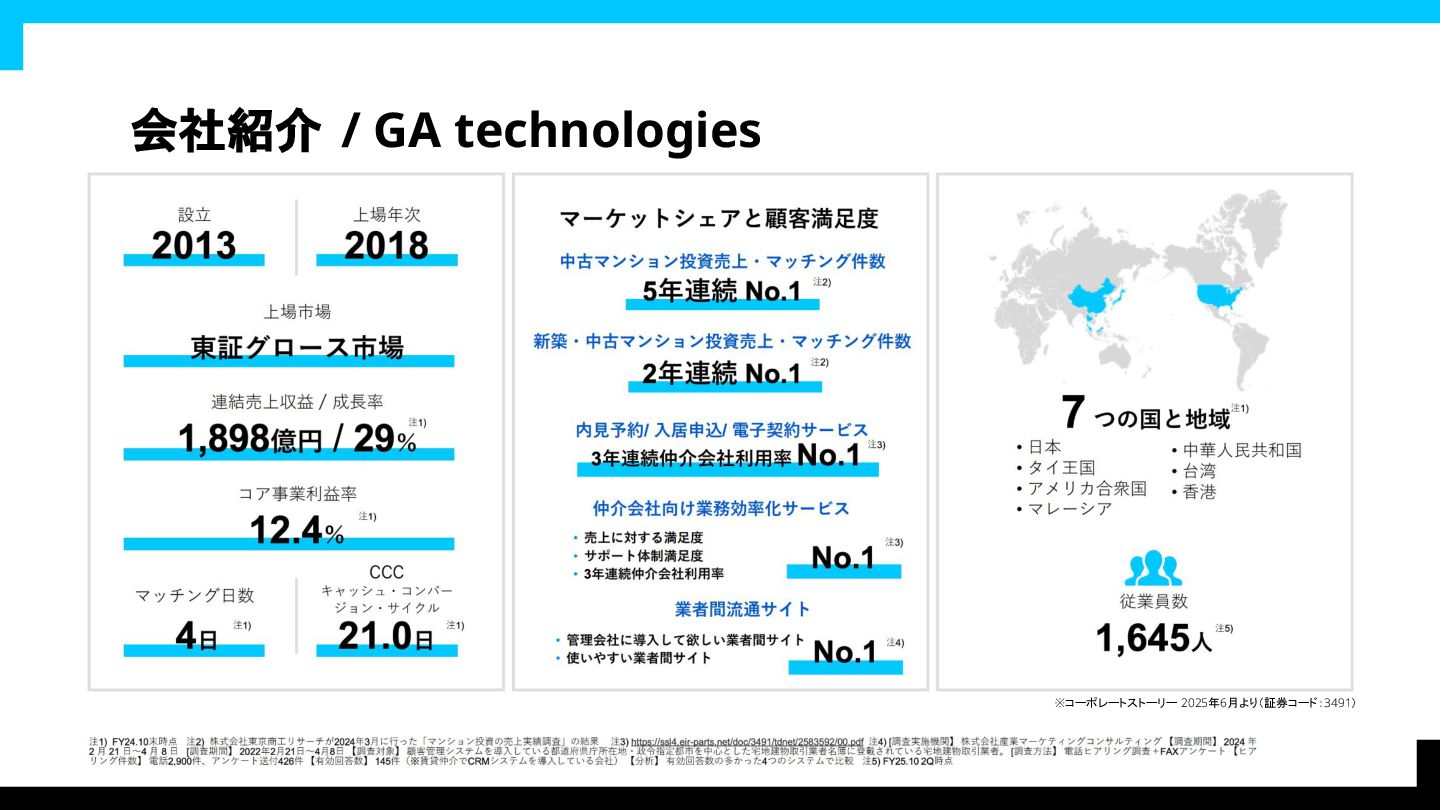
会社紹介 / GA technologies ※コーポレートストーリー 2025年6月より(証券コード:3491)
事業紹介 / RENOSY ※1 東京商工リサーチによる投資用不動産の売上実績(2025年3月調べ) ※2 東京商工リサーチによる投資用不動産会社の売上原価調査(2024年10月調べ)
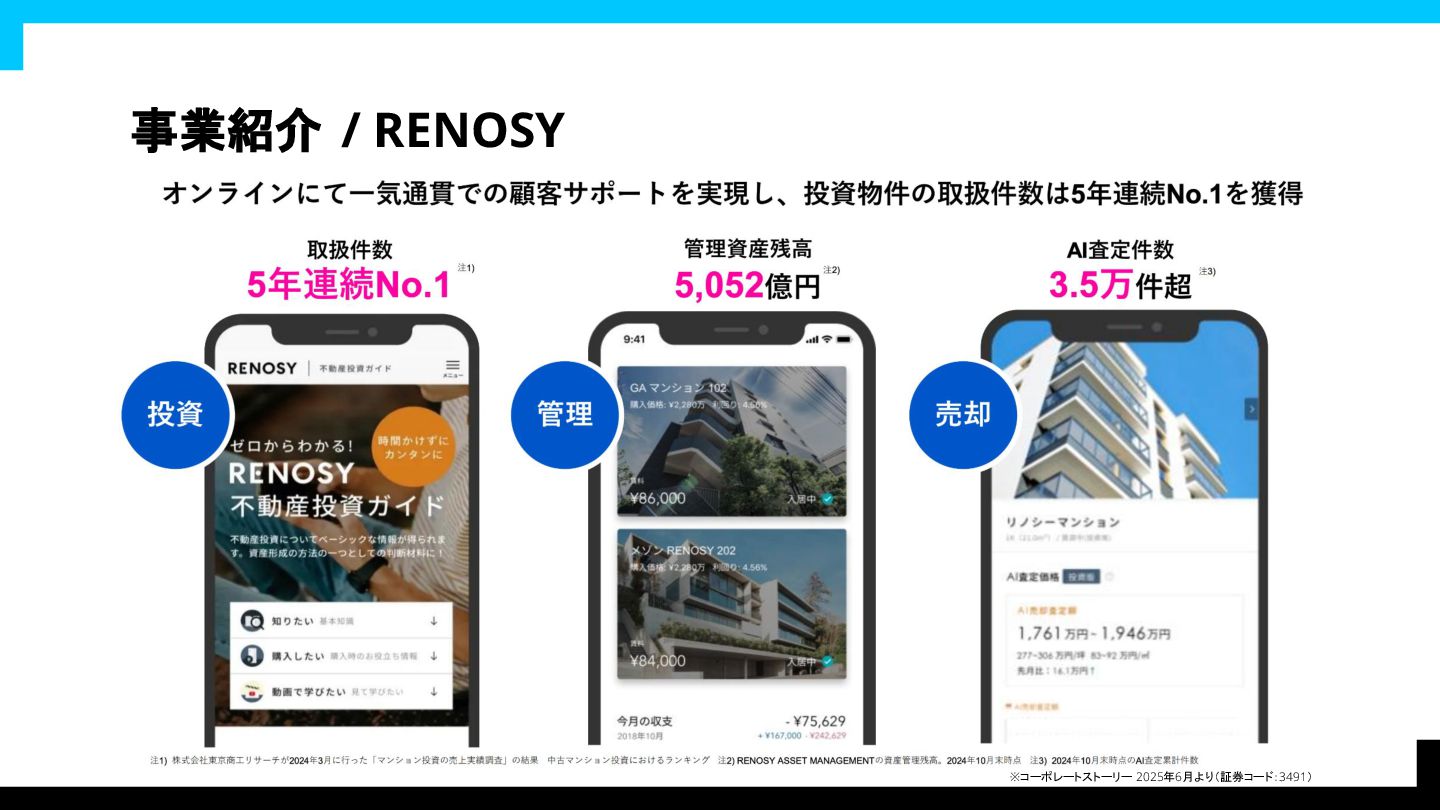
事業紹介 / RENOSY ※コーポレートストーリー 2025年6月より(証券コード:3491)
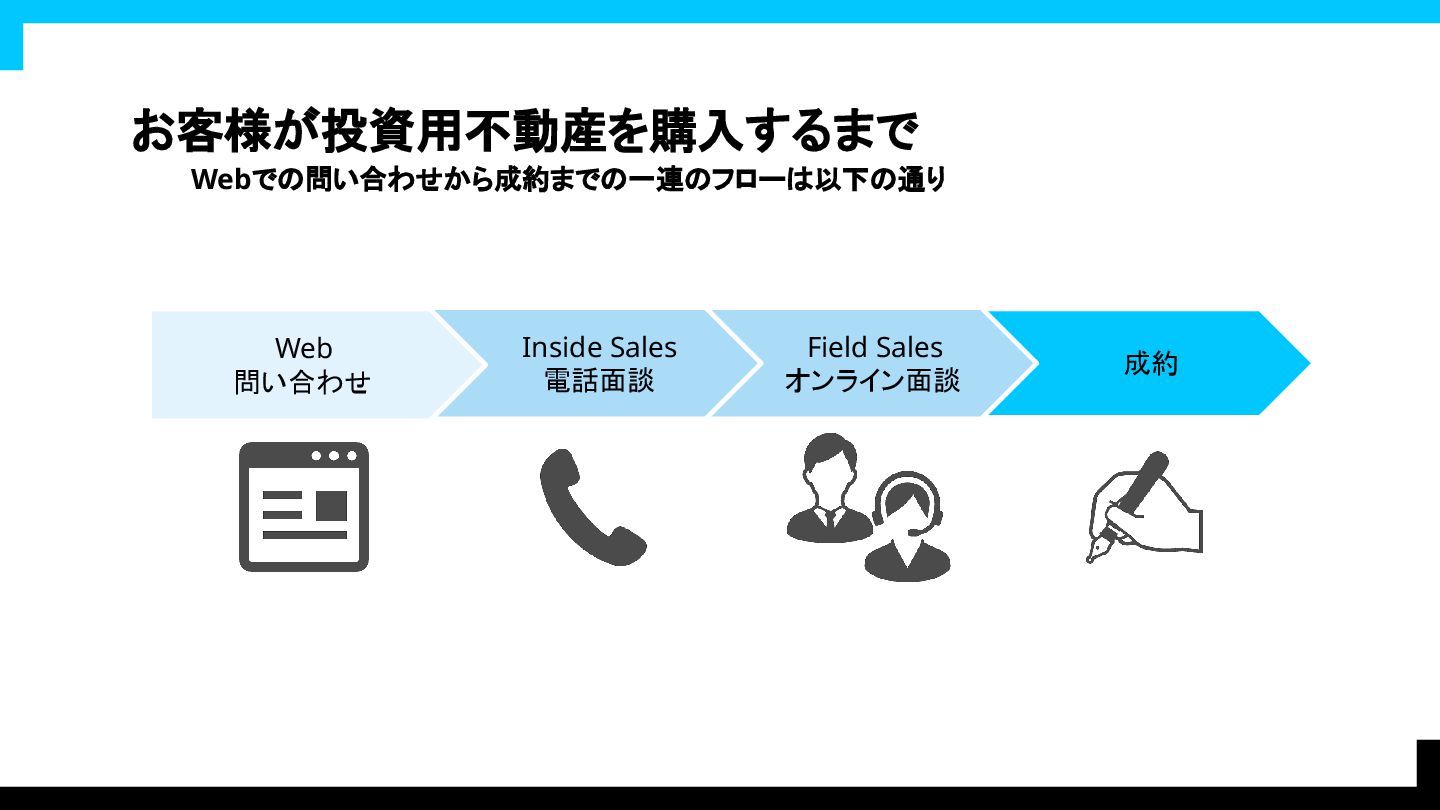
お客様が投資用不動産を購入するまで Webでの問い合わせから成約までの一連のフローは以下の通り 成約 Field Sales オンライン面談 Inside Sales
電話面談 Web 問い合わせ
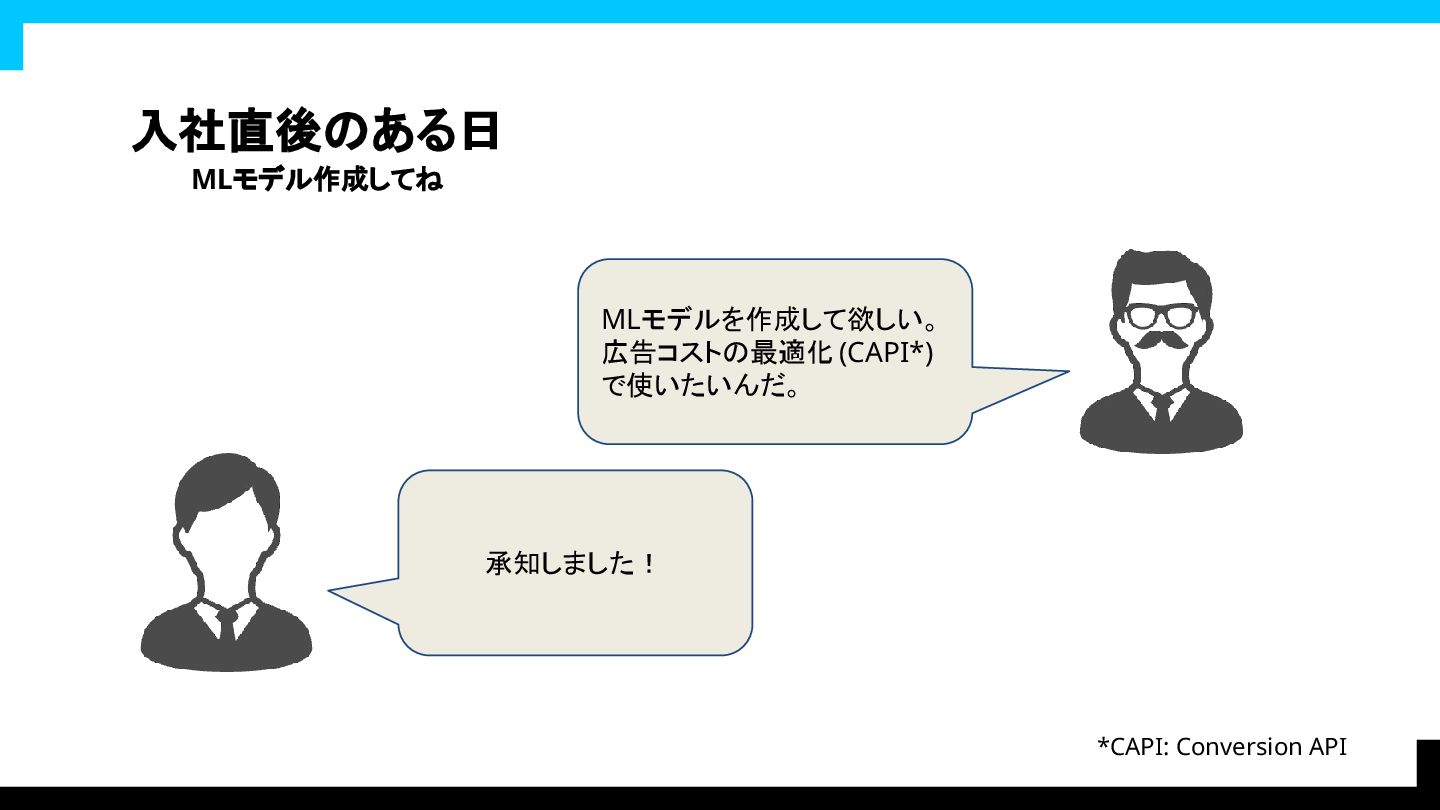
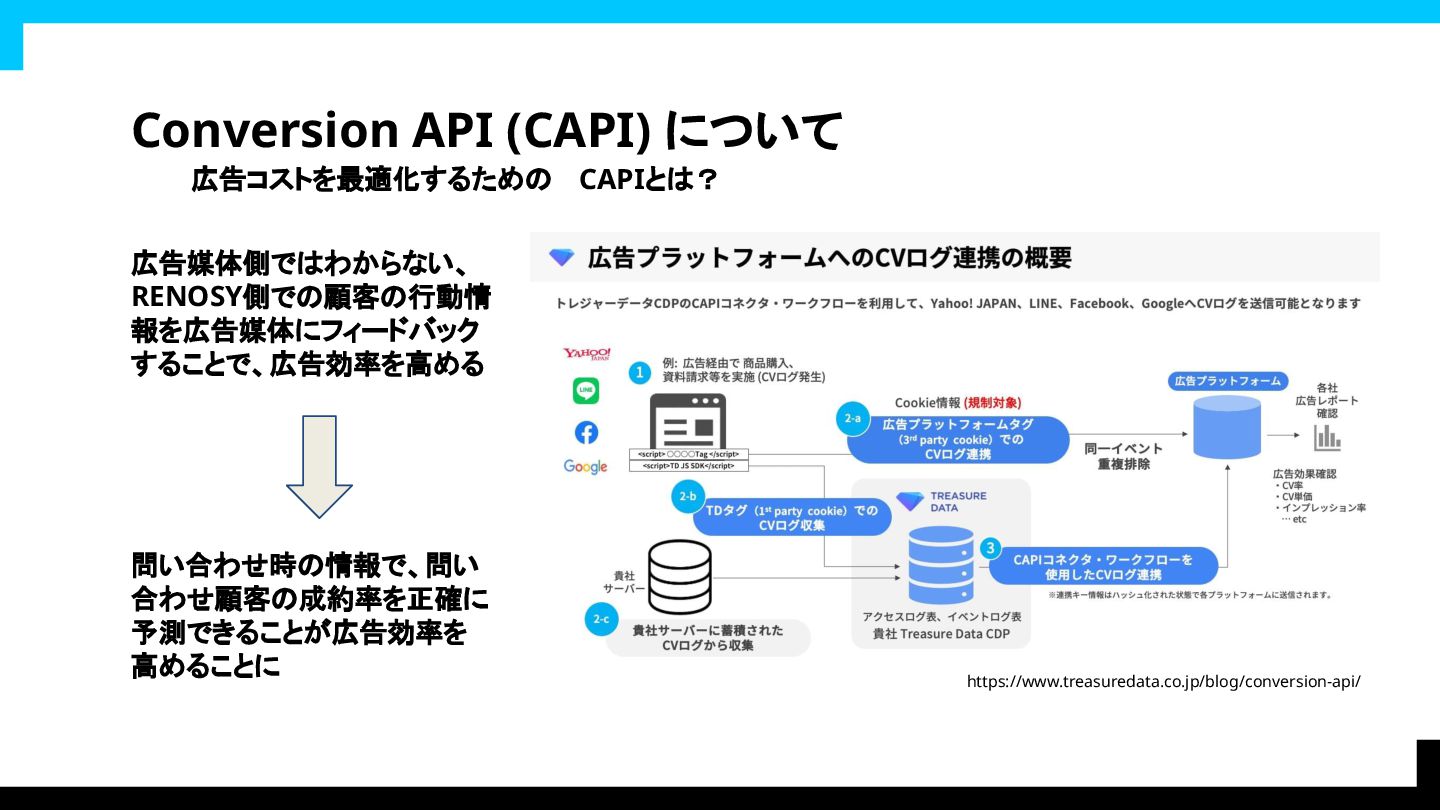
入社直後のある日 MLモデル作成してね 承知しました! MLモデルを作成して欲しい。 広告コストの最適化 (CAPI*) で使いたいんだ。 *CAPI:
Conversion API
Conversion API (CAPI) について 広告コストを最適化するための CAPIとは? https://www.treasuredata.co.jp/blog/conversion-api/ 広告媒体側ではわからない、 RENOSY側での顧客の行動情 報を広告媒体にフィードバック
することで、広告効率を高める 問い合わせ時の情報で、問い 合わせ顧客の成約率を正確に 予測できることが広告効率を 高めることに
入社直後のある日 いざMLモデル作り よし!がんばるぞ!あれ・・・?
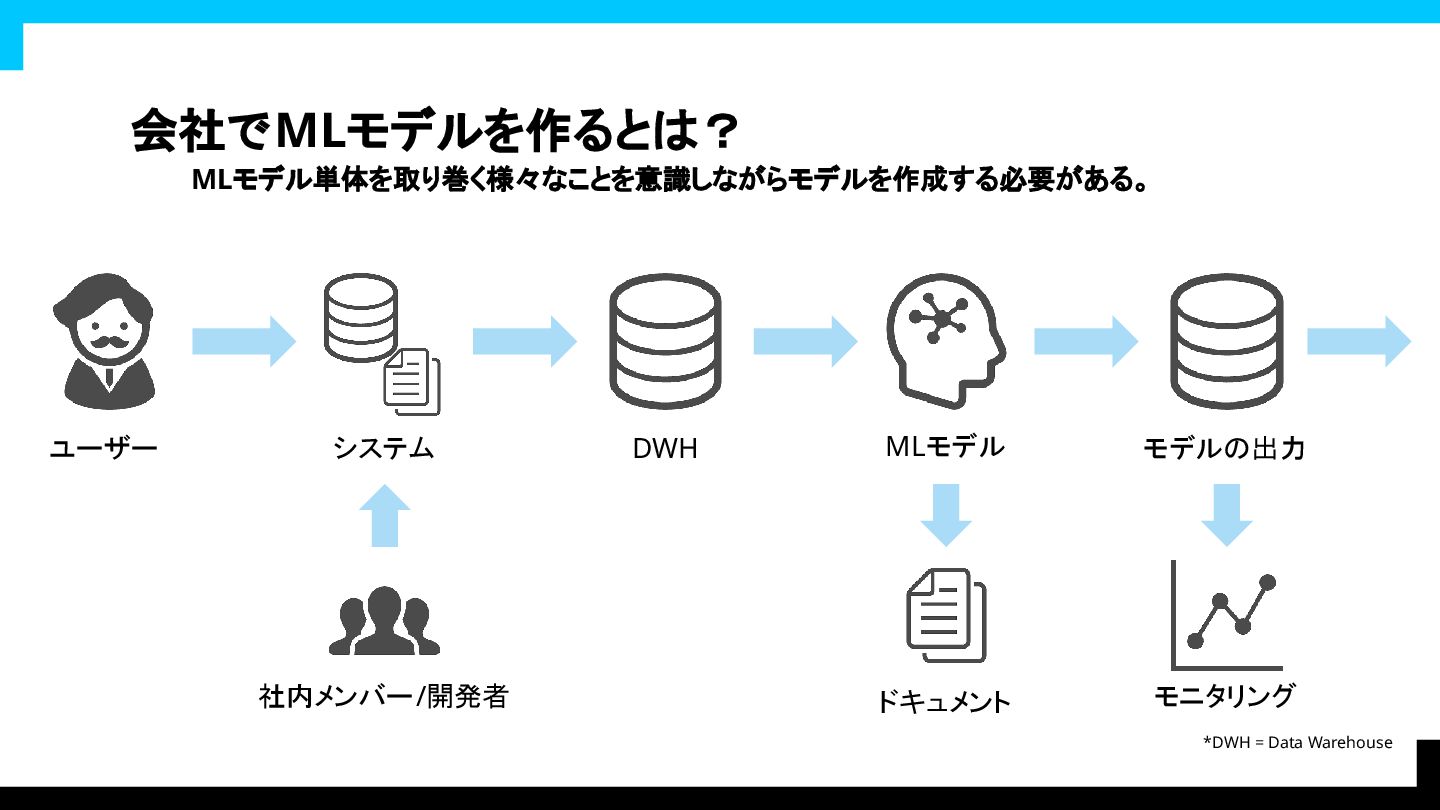
会社でMLモデルを作るとは? MLモデル単体を取り巻く様々なことを意識しながらモデルを作成する必要がある。 ユーザー 社内メンバー/開発者 システム DWH *DWH =
Data Warehouse MLモデル ドキュメント モデルの出力 モニタリング
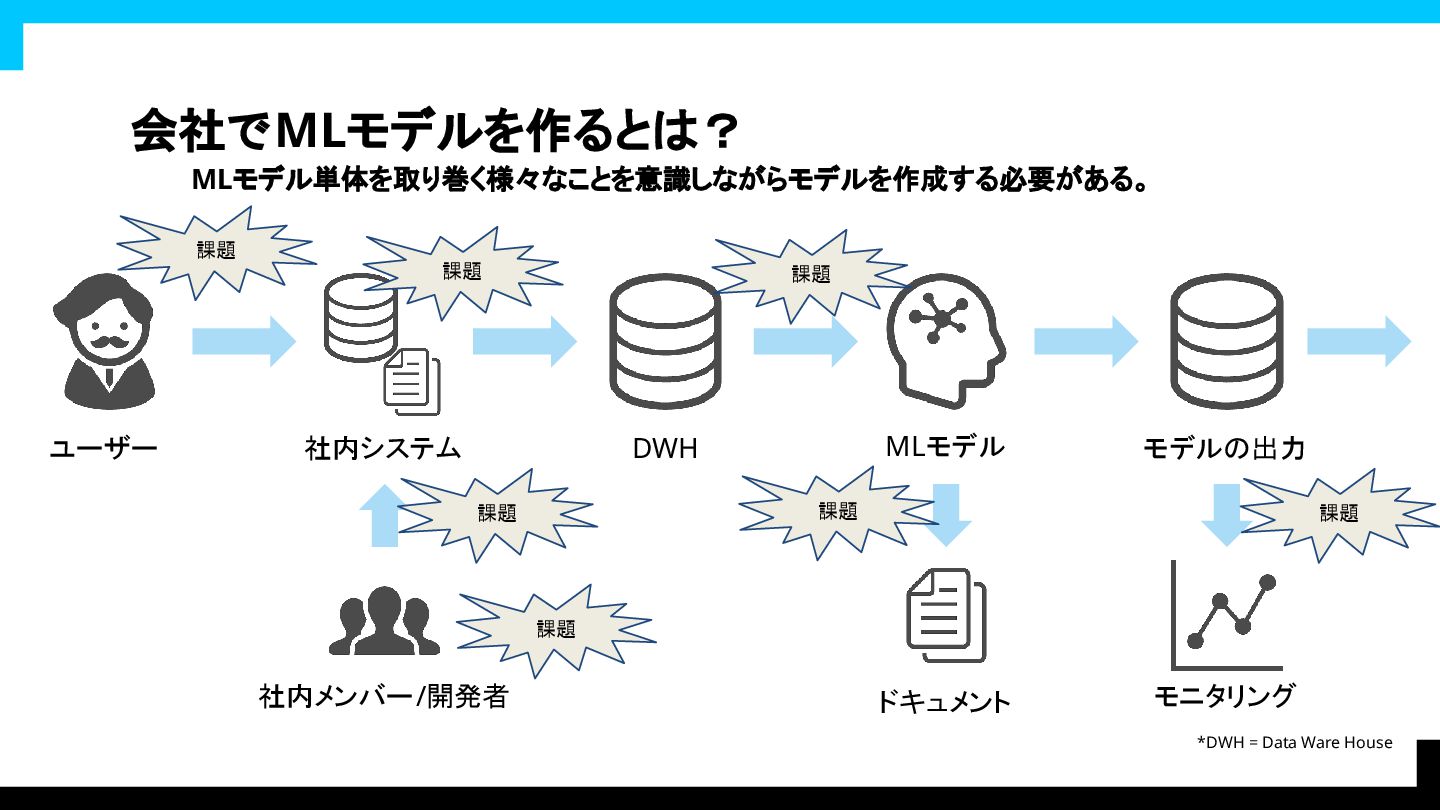
会社でMLモデルを作るとは? MLモデル単体を取り巻く様々なことを意識しながらモデルを作成する必要がある。 ユーザー 社内メンバー/開発者 社内システム DWH *DWH =
Data Ware House MLモデル ドキュメント モデルの出力 モニタリング 課題 課題 課題 課題 課題 課題 課題
どんな変数使えそうかな? 変数の意味調べてみよう! モデル作成段階
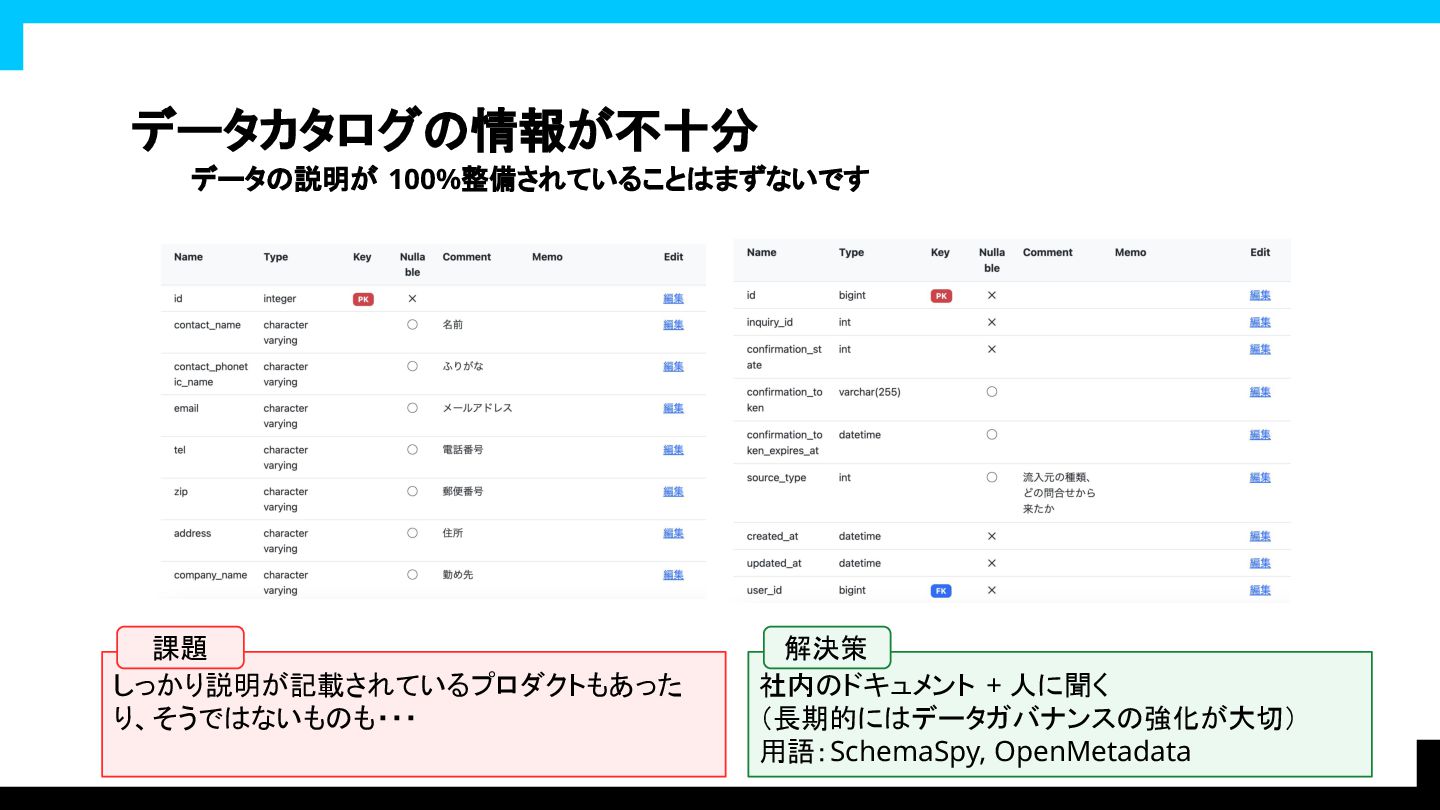
データカタログの情報が不十分 データの説明が 100%整備されていることはまずないです しっかり説明が記載されているプロダクトもあった り、そうではないものも・・・ 社内のドキュメント +
人に聞く (長期的にはデータガバナンスの強化が大切) 用語:SchemaSpy, OpenMetadata 課題 解決策
変数の時系列での分布がおかしいぞ? モデル作成段階
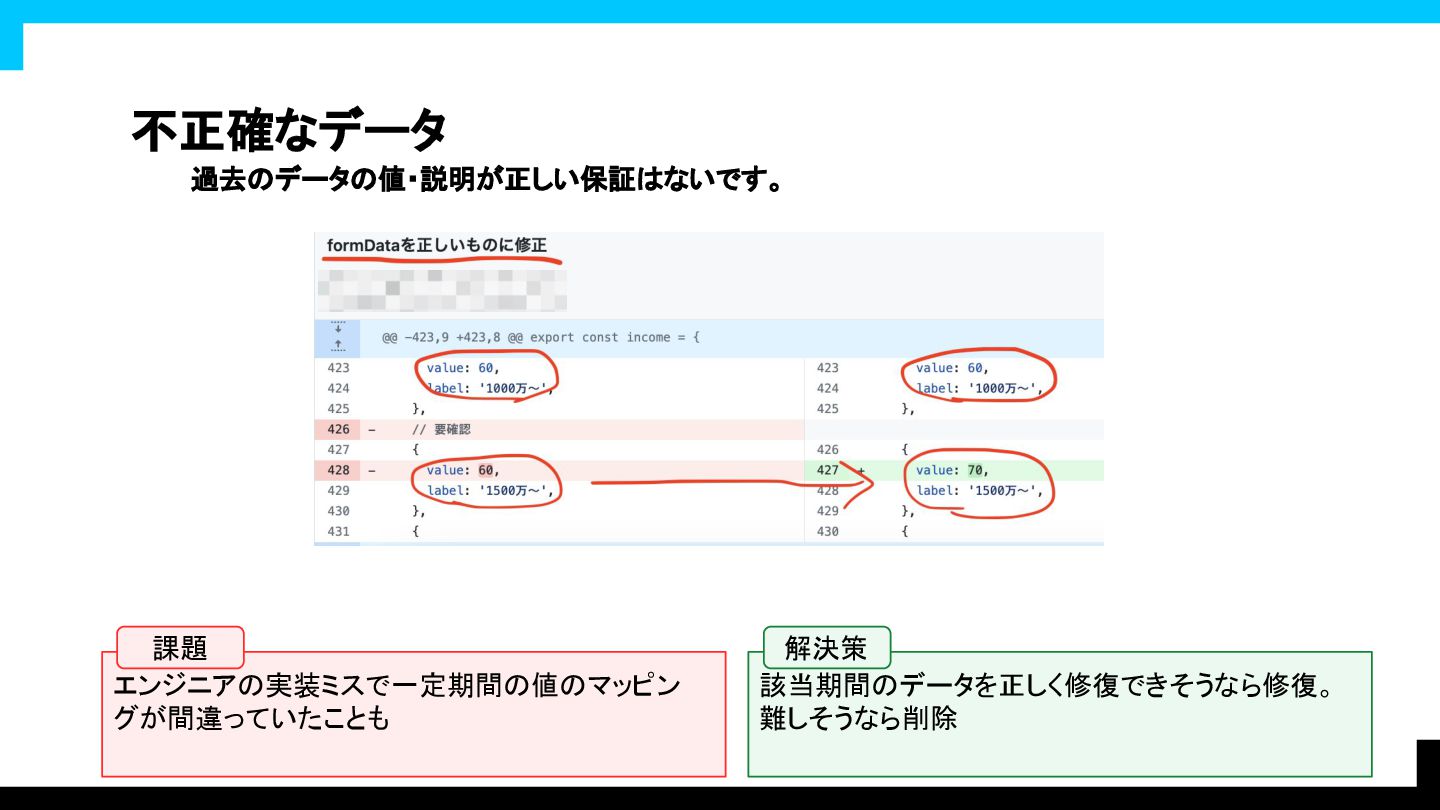
不正確なデータ 過去のデータの値・説明が正しい保証はないです。 エンジニアの実装ミスで一定期間の値のマッピン グが間違っていたことも 該当期間のデータを正しく修復できそうなら修復。 難しそうなら削除
課題 解決策
あれ、ありえないデータが? モデル作成段階
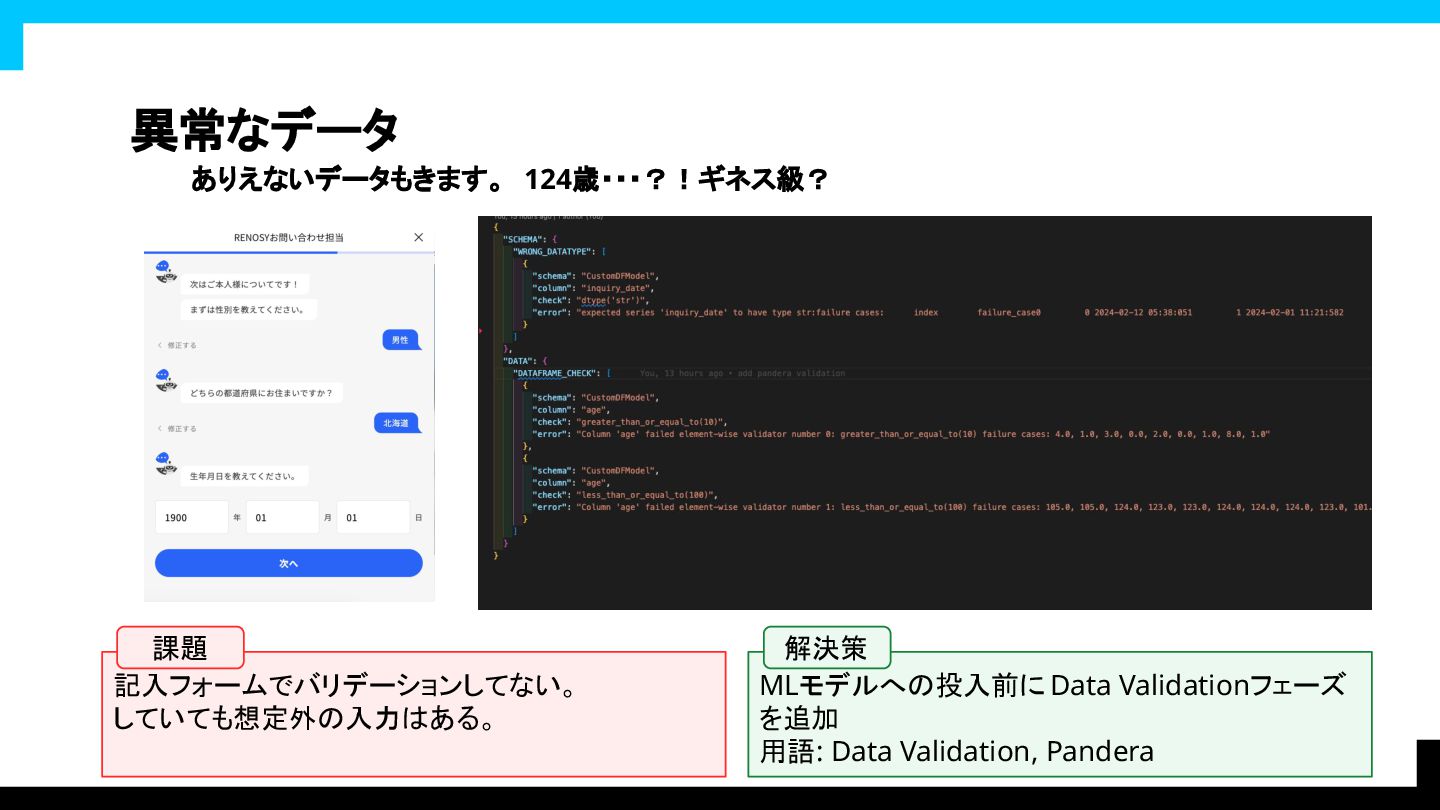
異常なデータ ありえないデータもきます。 124歳・・・?!ギネス級? 記入フォームでバリデーションしてない。 していても想定外の入力はある。 MLモデルへの投入前に
Data Validationフェーズ を追加 用語: Data Validation, Pandera 課題 解決策
リリース直後: モデルうまく動いているかな・・・ ドキドキ・・・ モデルリリース
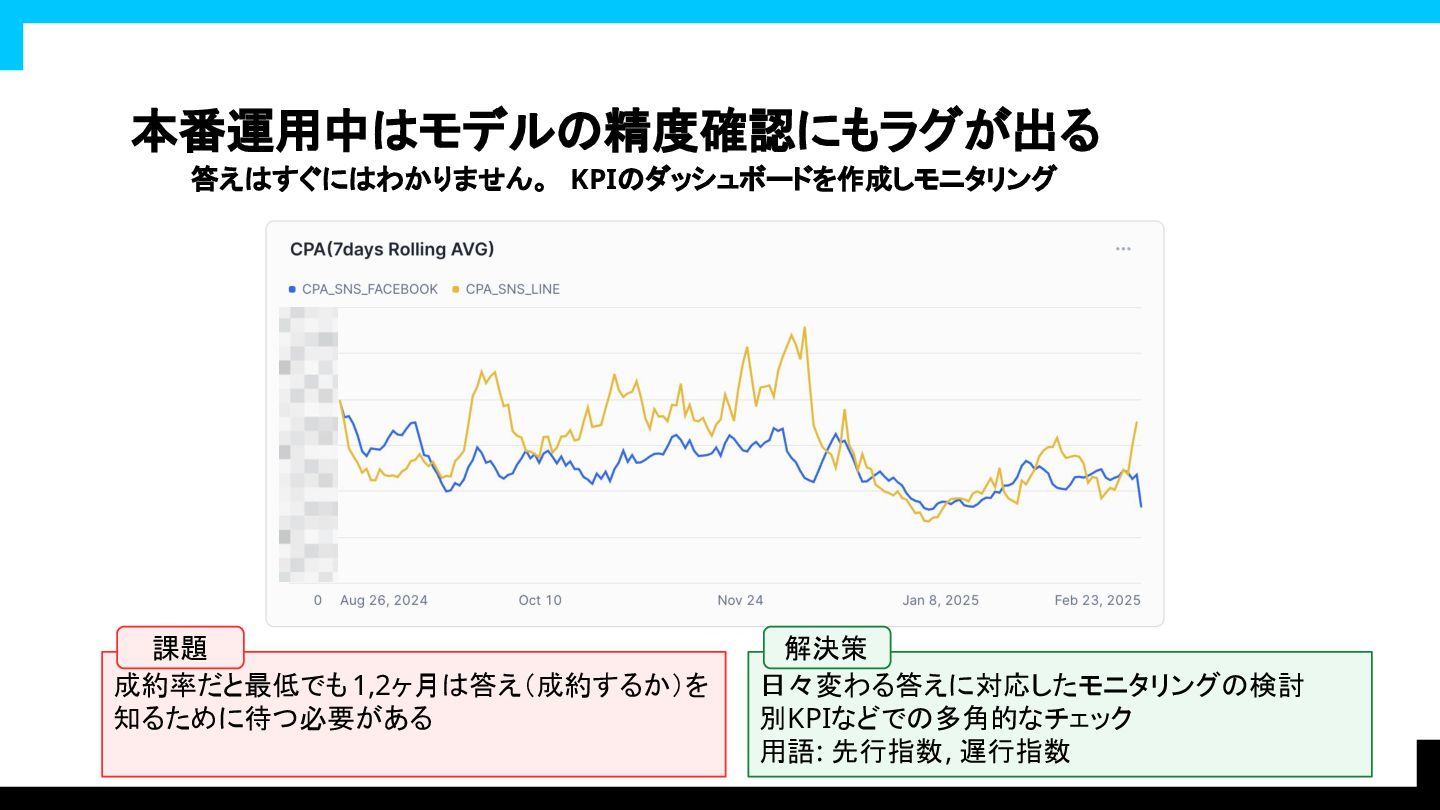
本番運用中はモデルの精度確認にもラグが出る 答えはすぐにはわかりません。 KPIのダッシュボードを作成しモニタリング 成約率だと最低でも 1,2ヶ月は答え(成約するか)を 知るために待つ必要がある 日々変わる答えに対応したモニタリングの検討
別KPIなどでの多角的なチェック 用語: 先行指数, 遅行指数 課題 解決策
リリース後のある日: あれ、今日の分のMLモデルの出力が 無い?! リリース後
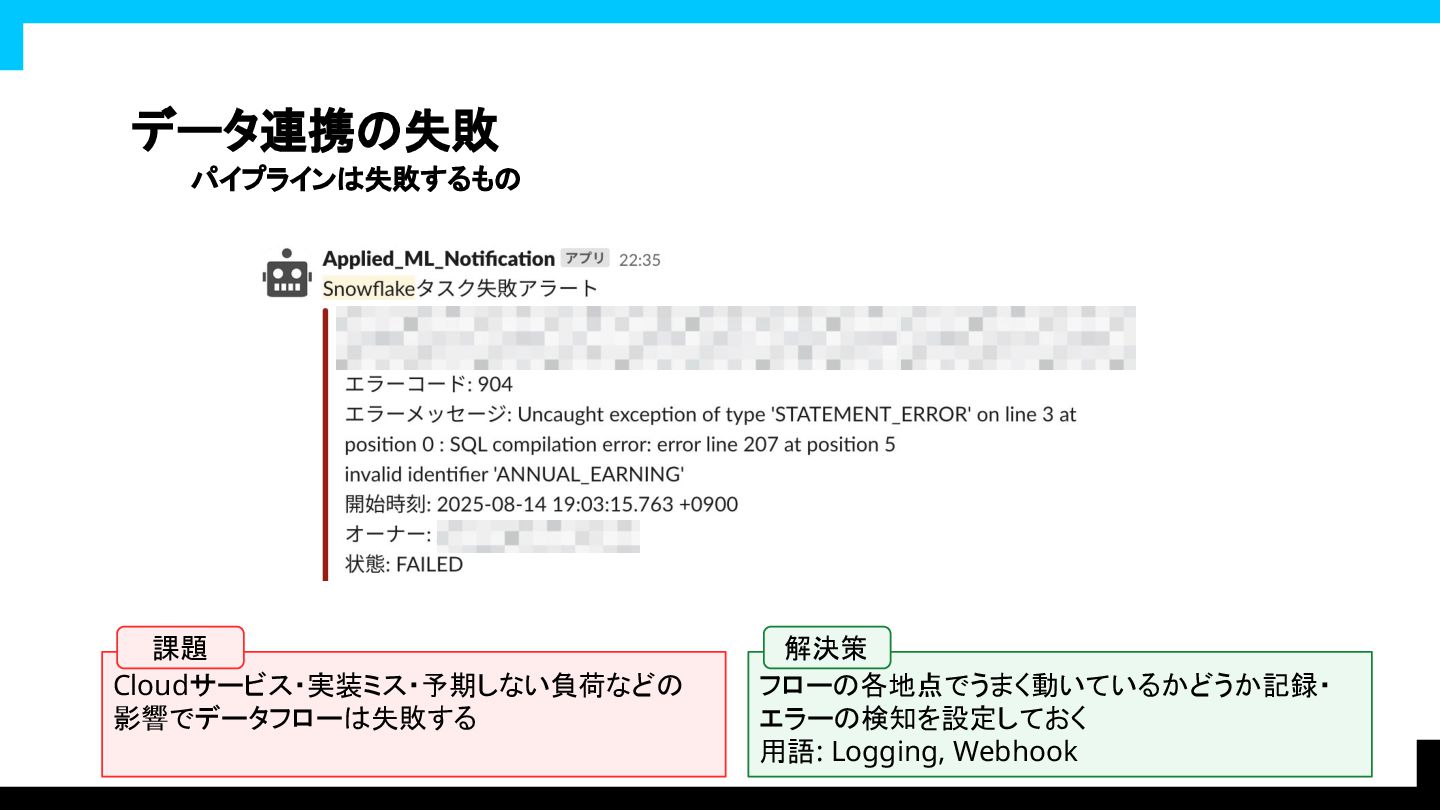
データ連携の失敗 パイプラインは失敗するもの Cloudサービス・実装ミス・予期しない負荷などの 影響でデータフローは失敗する フローの各地点でうまく動いているかどうか記録・ エラーの検知を設定しておく
用語: Logging, Webhook 課題 解決策
リリース後のある日: あれ、MLモデルの出力おかしいぞ * *フィクションです。実際この時は事前に 社内で情報共有がありました。 リリース後
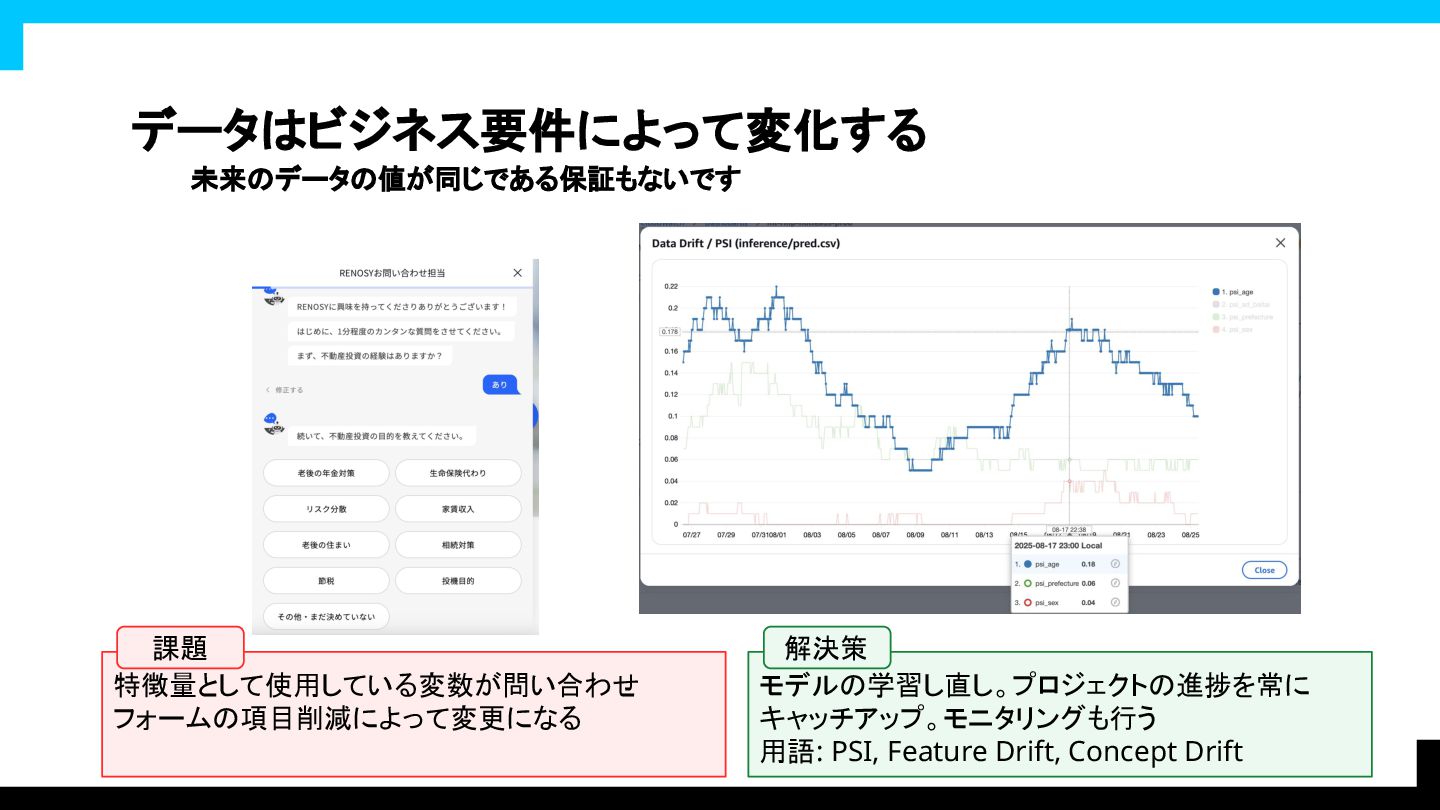
データはビジネス要件によって変化する 未来のデータの値が同じである保証もないです 特徴量として使用している変数が問い合わせ フォームの項目削減によって変更になる モデルの学習し直し。プロジェクトの進捗を常に キャッチアップ。モニタリングも行う
用語: PSI, Feature Drift, Concept Drift 課題 解決策
他にも気にする点あります
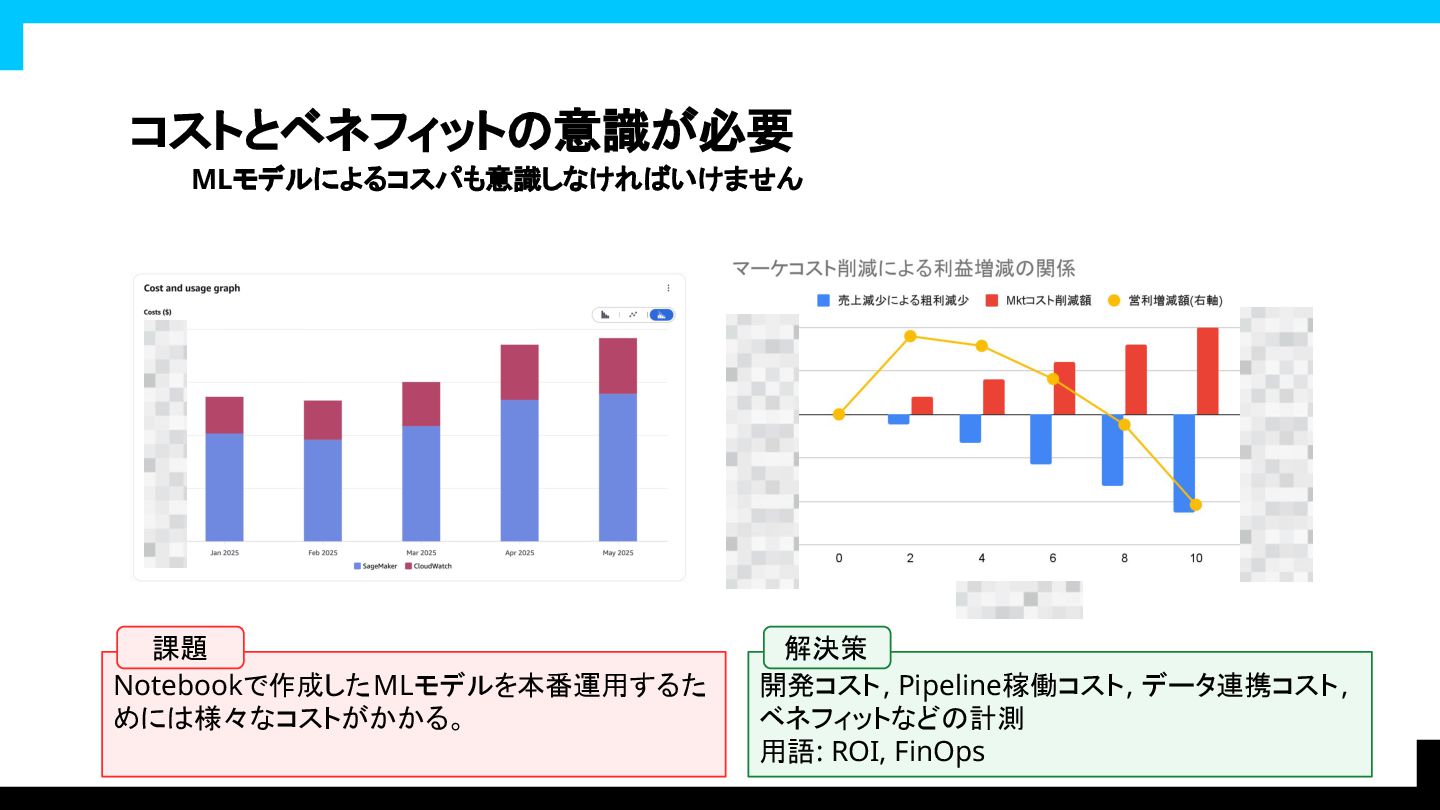
コストとベネフィットの意識が必要 MLモデルによるコスパも意識しなければいけません Notebookで作成したMLモデルを本番運用するた めには様々なコストがかかる。 開発コスト, Pipeline稼働コスト, データ連携コスト,
ベネフィットなどの計測 用語: ROI, FinOps 課題 解決策
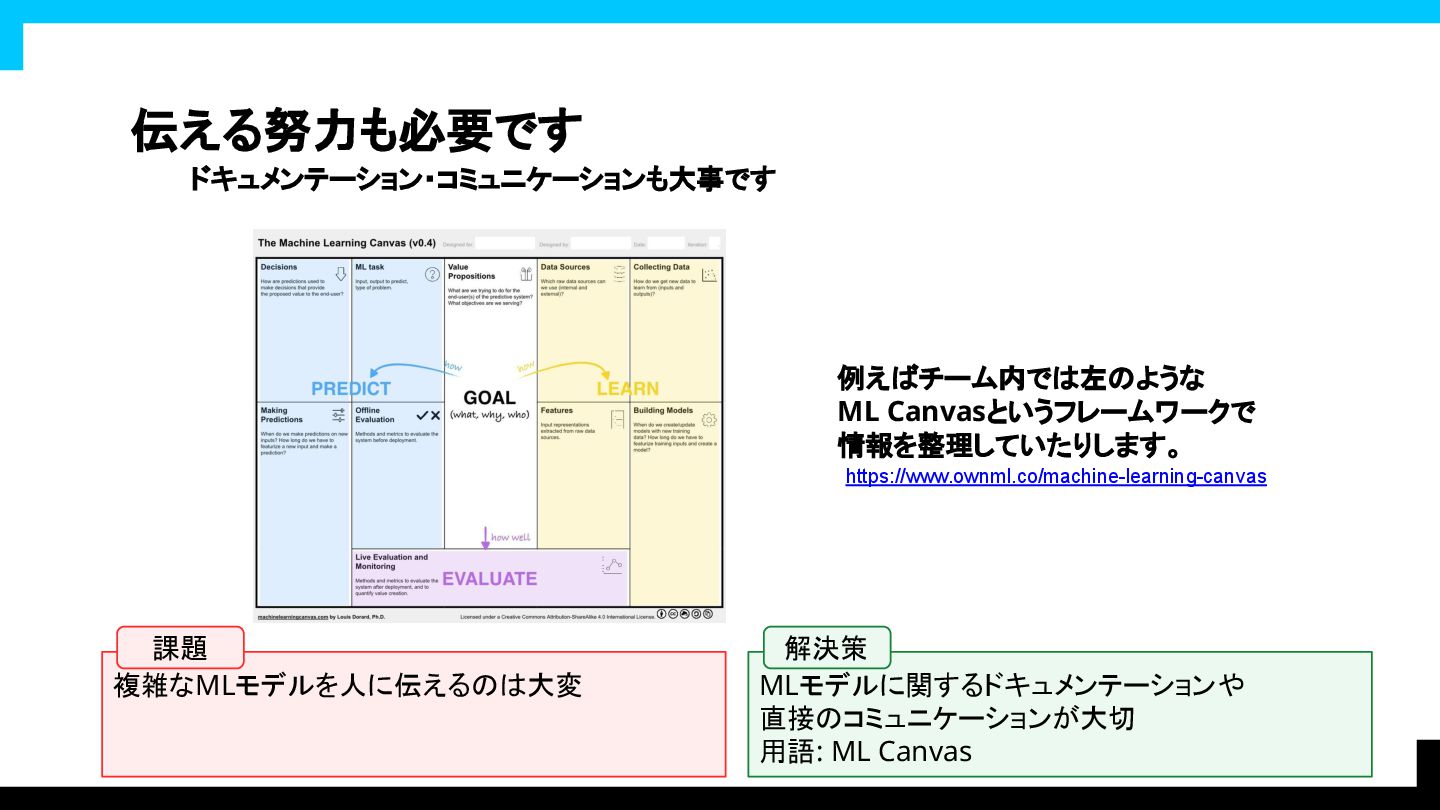
伝える努力も必要です ドキュメンテーション・コミュニケーションも大事です https://www.ownml.co/machine-learning-canvas 例えばチーム内では左のような ML Canvasというフレームワークで 情報を整理していたりします。
複雑なMLモデルを人に伝えるのは大変 MLモデルに関するドキュメンテーションや 直接のコミュニケーションが大切 用語: ML Canvas 課題 解決策
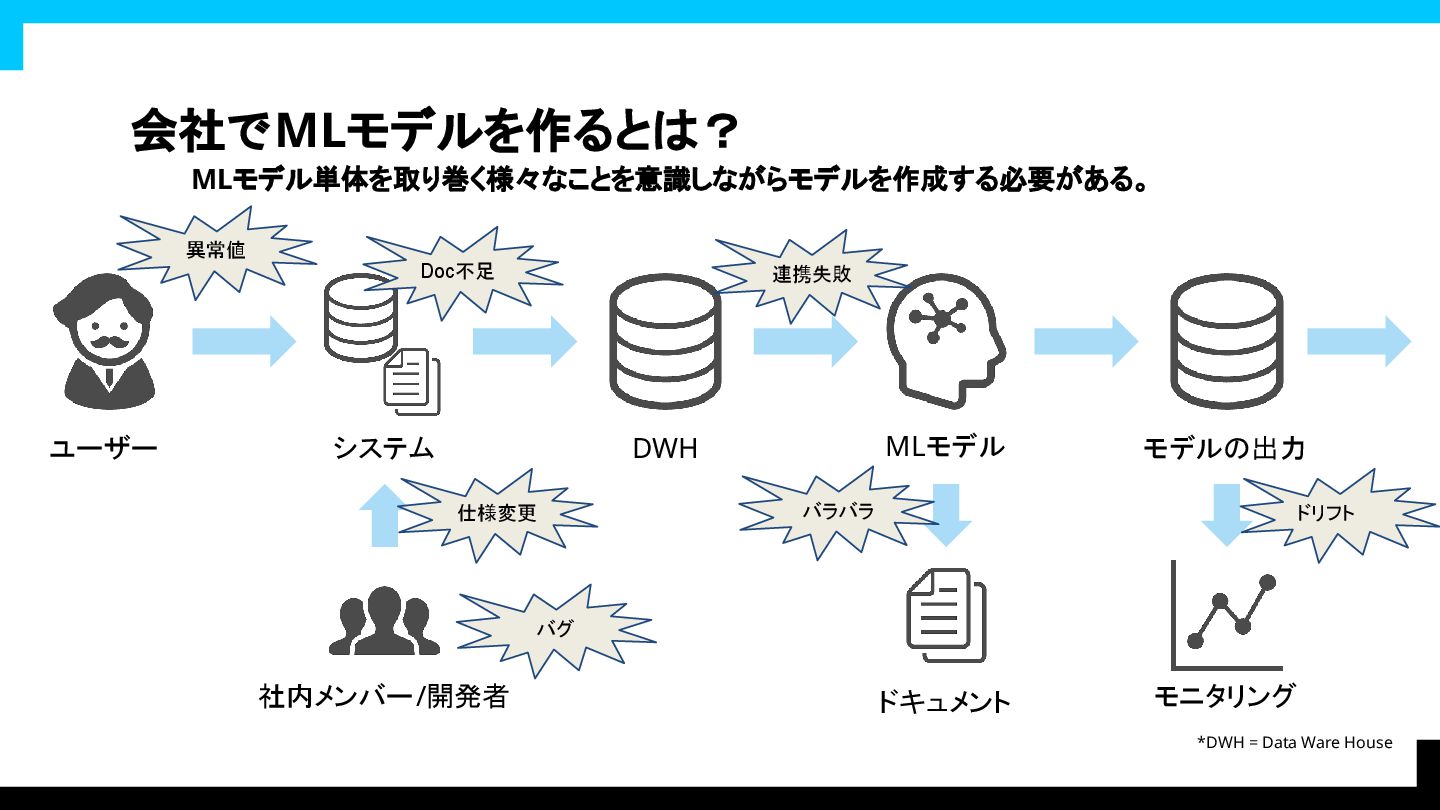
会社でMLモデルを作るとは? MLモデル単体を取り巻く様々なことを意識しながらモデルを作成する必要がある。 ユーザー 社内メンバー/開発者 システム DWH *DWH =
Data Ware House MLモデル ドキュメント モデルの出力 モニタリング 仕様変更 異常値 バグ 連携失敗 Doc不足 ドリフト バラバラ
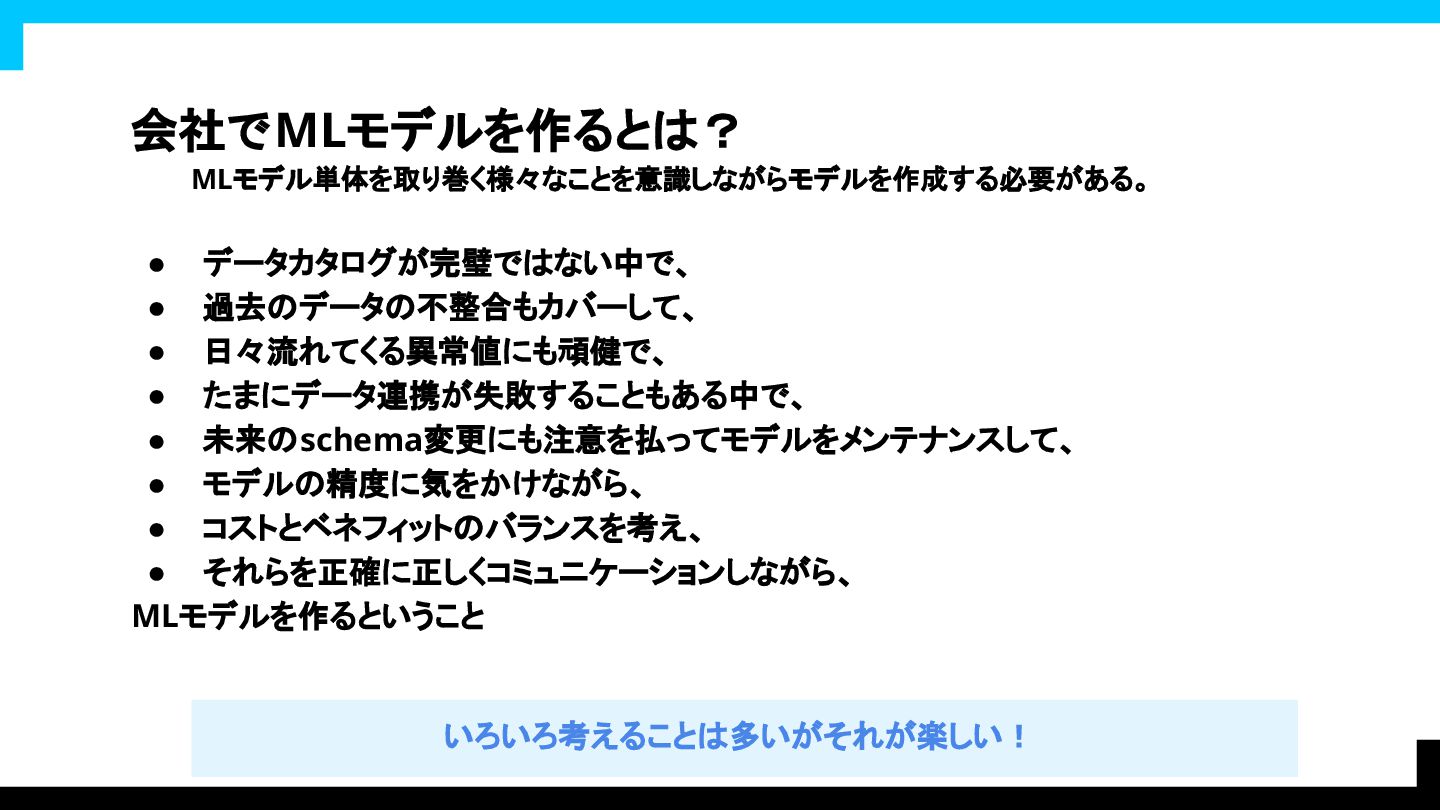
会社でMLモデルを作るとは? MLモデル単体を取り巻く様々なことを意識しながらモデルを作成する必要がある。 • データカタログが完璧ではない中で、 • 過去のデータの不整合もカバーして、
• 日々流れてくる異常値にも頑健で、 • たまにデータ連携が失敗することもある中で、 • 未来のschema変更にも注意を払ってモデルをメンテナンスして、 • モデルの精度に気をかけながら、 • コストとベネフィットのバランスを考え、 • それらを正確に正しくコミュニケーションしながら、 MLモデルを作るということ いろいろ考えることは多いがそれが楽しい!
MLモデルを作成するだけでも ... 前述のような前後のこと、 • データがどのように集められてくるか • MLモデルの出力をどのように活用するか
にも思いをめぐらせることで、より良い分析・モデリングができ ると思います!
最近のはなし LLMアプリ作成してね 承知しました! LLMでアプリケーションを 作って欲しい。営業社員 の効率化のために使いた いんだ。
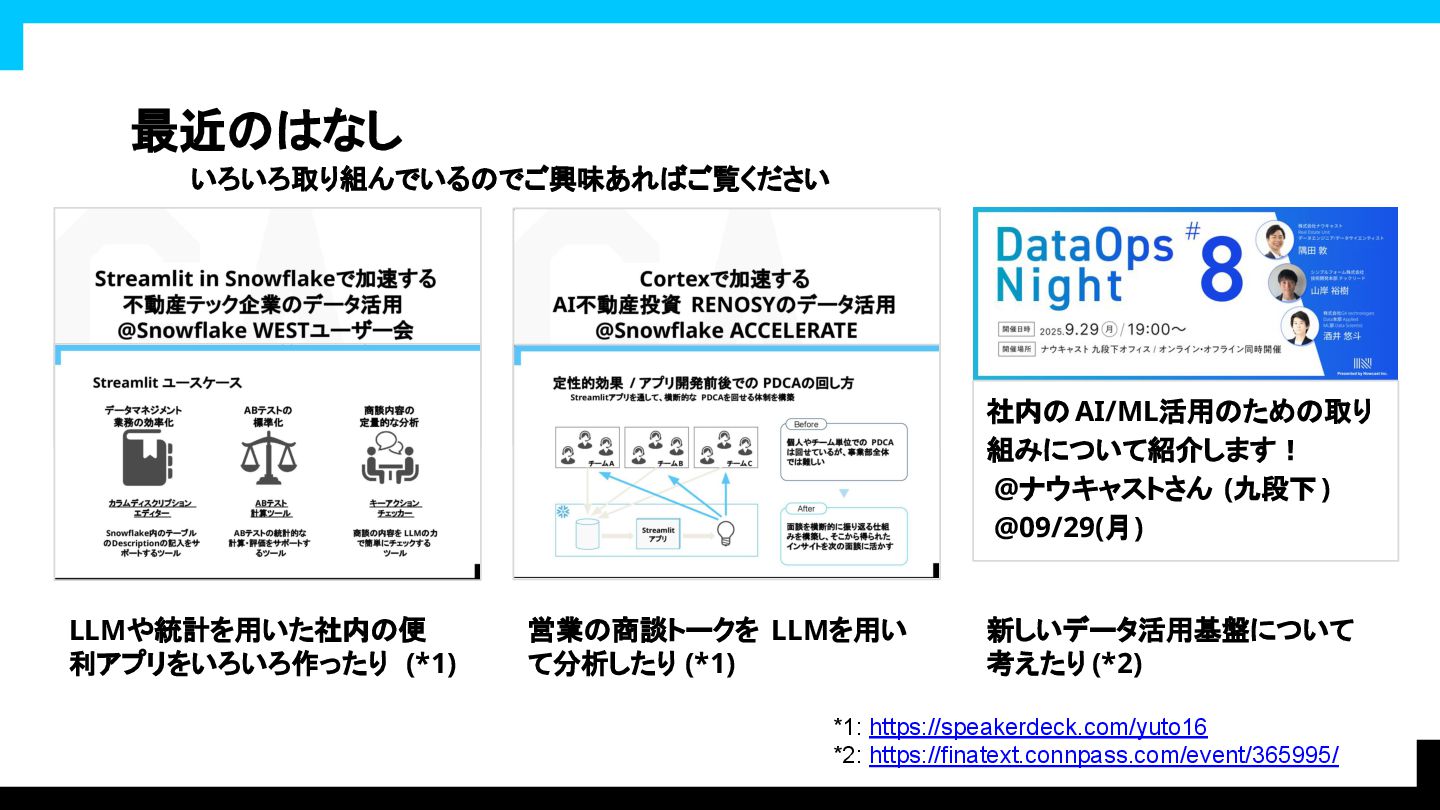
最近のはなし いろいろ取り組んでいるのでご興味あればご覧ください 社内のAI/ML活用のための取り 組みについて紹介します! @ナウキャストさん (九段下) @09/29(月)
LLMや統計を用いた社内の便 利アプリをいろいろ作ったり (*1) 営業の商談トークを LLMを用い て分析したり (*1) 新しいデータ活用基盤について 考えたり (*2) *1: https://speakerdeck.com/yuto16 *2: https://finatext.connpass.com/event/365995/
ご清聴ありがとうございました!


 yuto16
 ktatsuya
 akasan
 trycycle
 lychee1223
 signer
 institutdelelevage
 rlifchitz
 voginip
 rajeshrinet
 miyayou
 geoffreycrofte
 stuffmc
 kastner
 honnibal
 rasmusluckow
 marketingsoph
 mfonobong
 aleyda
 nonsquared
 akihiro_kokubo
 eileencodes