Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
【AWS AIF対策】責任あるAI
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
赤神青空
PRO
October 04, 2026
Video
Programming
13
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
【AWS AIF対策】責任あるAI
赤神青空
PRO
October 04, 2026
Video
More Decks by 赤神青空
See All by 赤神青空
【AIニュース】OpenAI の「dots」とは何か
akagami
PRO
0
4
【AWS AIF対策】基盤モデルの評価
akagami
PRO
0
19
【AWS AIF対策】モデルの学習とファインチューニング
akagami
PRO
0
10
【AWS AIF対策】プロンプトエンジニアリング
akagami
PRO
0
15
【AWS AIF対策】RAGとベクトルデータベース
akagami
PRO
0
14
【AWS AIF対策】基盤モデルの選び方と推論パラメータ
akagami
PRO
0
18
【AWS AIF対策】AWSの生成AIサービスの全体像
akagami
PRO
0
26
【AWS AIF対策】エージェント型AIとMCP
akagami
PRO
0
26
【AWS AIF対策】生成AIの得意・不得意とコスト
akagami
PRO
0
25
Other Decks in Programming
See All in Programming
巨大モノリシックアプリ モダン化大作戦
ktcryomm
1
1.2k
AgentCore CLI で進化した AWS での AI エージェントの作り方 : 必要な機能を必要な時に
icoxfog417
PRO
4
410
Streamlitで実現する自然言語データアプリ開発
ayumu_yamaguchi
1
330
Java 27新機能 / Java 27 new features
kishida
2
190
[2026-09-26]空論ジェネリックプロセス~テスト資産とAIで紡ぐ、再現可能なパフォーマンスチューニングの話~
tosite
0
250
難しいけど、読めた。- OSSの入口に立った話。
sts11142
0
130
JAWS-UG 東京支部が始める、JAWS-UG支部コラボ / JAWS-UG lunchtime LT Collaboration
y0hgi
0
170
Workers Cache を知る
syumai
0
320
Augmenting AI with the Power of Jakarta EE
ivargrimstad
0
460
AI が書く Go コードの品質を劇的に向上させる Linter: “declscope”
mpyw
0
470
C#の現在地 進化の歴史と、AI時代の.NET Everywhere
neuecc
5
4.8k
GemmaをJevのように使ってみる / Use Gemma like Jev
kishida
5
510
Featured
See All Featured
Are puppies a ranking factor?
jonoalderson
2
4k
Mozcon NYC 2025: Stop Losing SEO Traffic
samtorres
1
570
How to Create Impact in a Changing Tech Landscape [PerfNow 2023]
tammyeverts
56
3.5k
Design in an AI World
tapps
1
340
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
620
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
420
Sharpening the Axe: The Primacy of Toolmaking
bcantrill
46
3k
Navigating Weather and Climate Data
rabernat
0
540
Accessibility Awareness
sabderemane
1
230
What’s in a name? Adding method to the madness
productmarketing
PRO
24
4.2k
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
Templates, Plugins, & Blocks: Oh My! Creating the theme that thinks of everything
marktimemedia
31
2.9k
Transcript
2026年9月 責任あるAI AWS Certified AI Practitioner 対策 #14 赤神青空
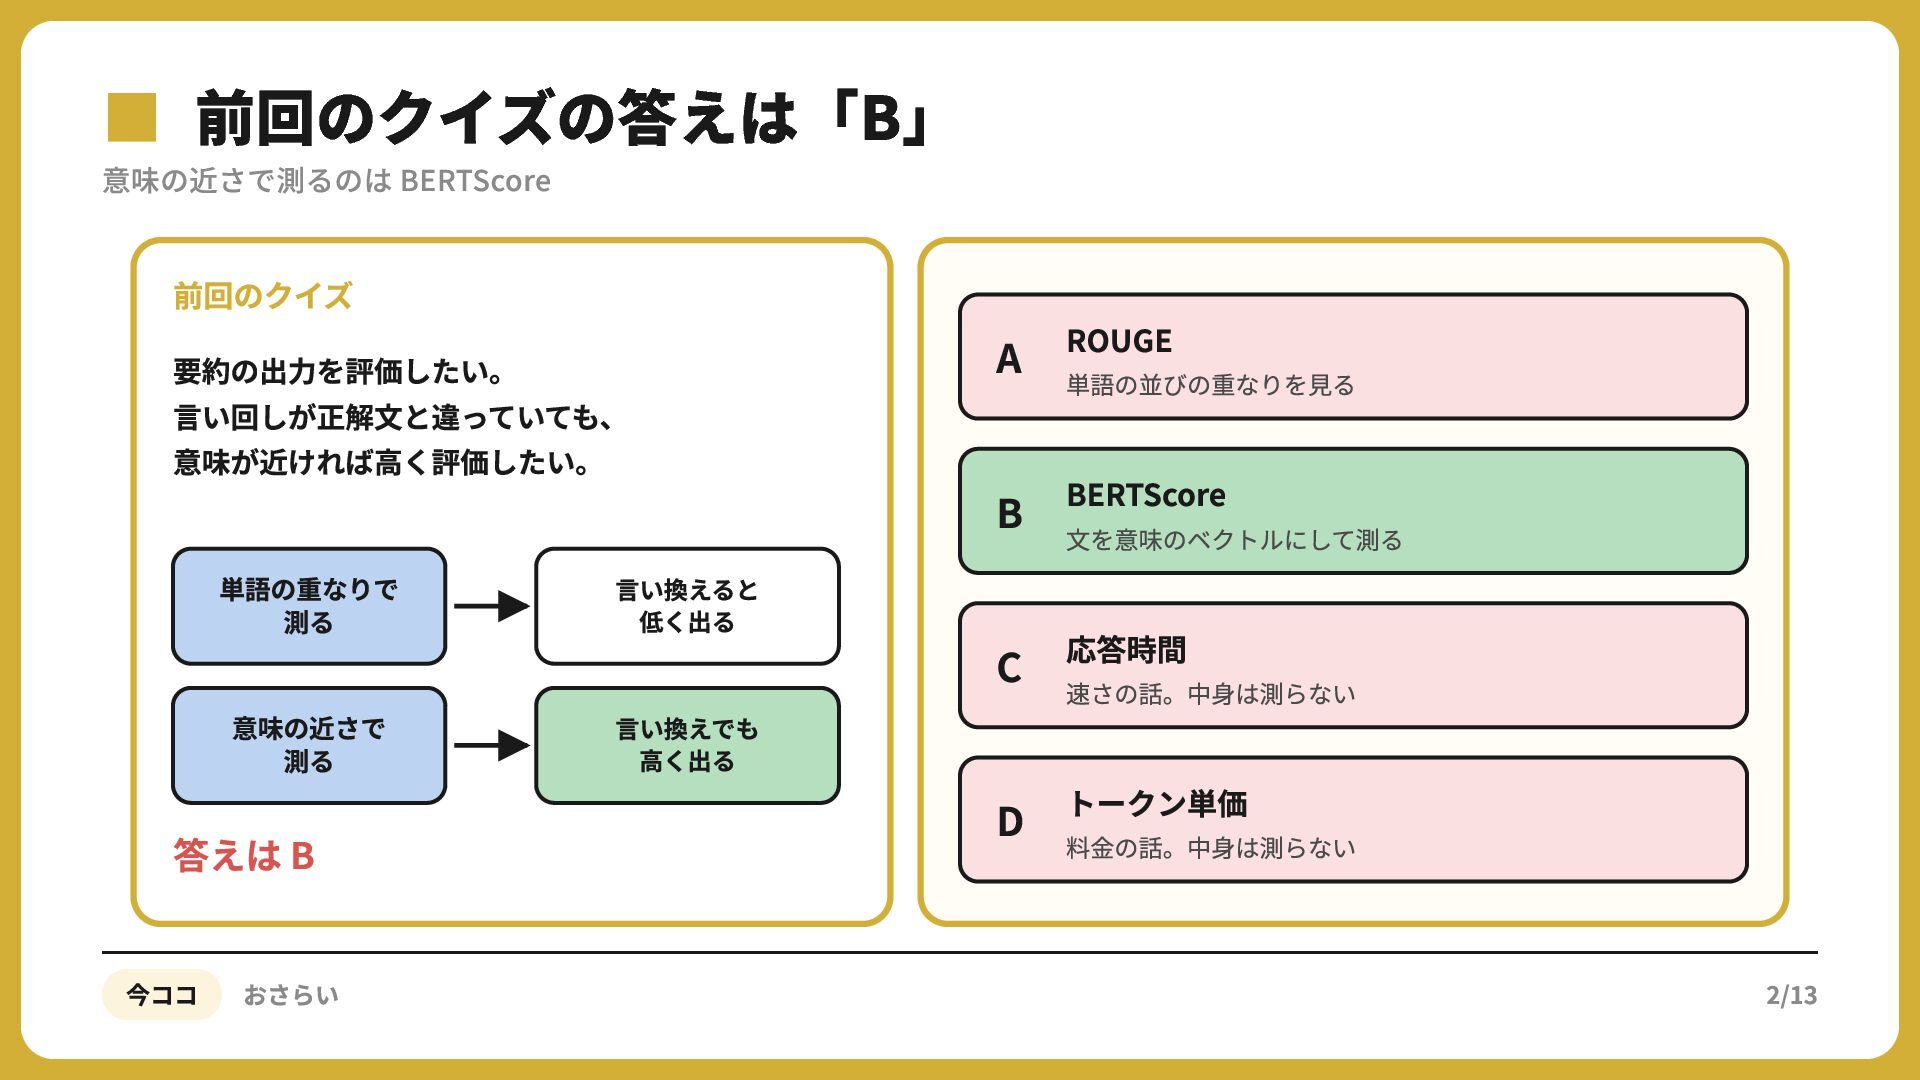
▪意味の近さで測るのは 前回のクイズの答えは「B」 BERTScore 前回のクイズ 要約の出⼒を評価したい。 ⾔い回しが正解⽂と違っていても、 意味が近ければ⾼く評価したい。 単語の重なりで 測る ⾔い換えると
低く出る 意味の近さで 測る ⾔い換えでも ⾼く出る 答えは B 今ココ おさらい A ROUGE 単語の並びの重なりを⾒る B BERTScore ⽂を意味のベクトルにして測る C 応答時間 速さの話。中⾝は測らない D トークン単価 料⾦の話。中⾝は測らない 2/13
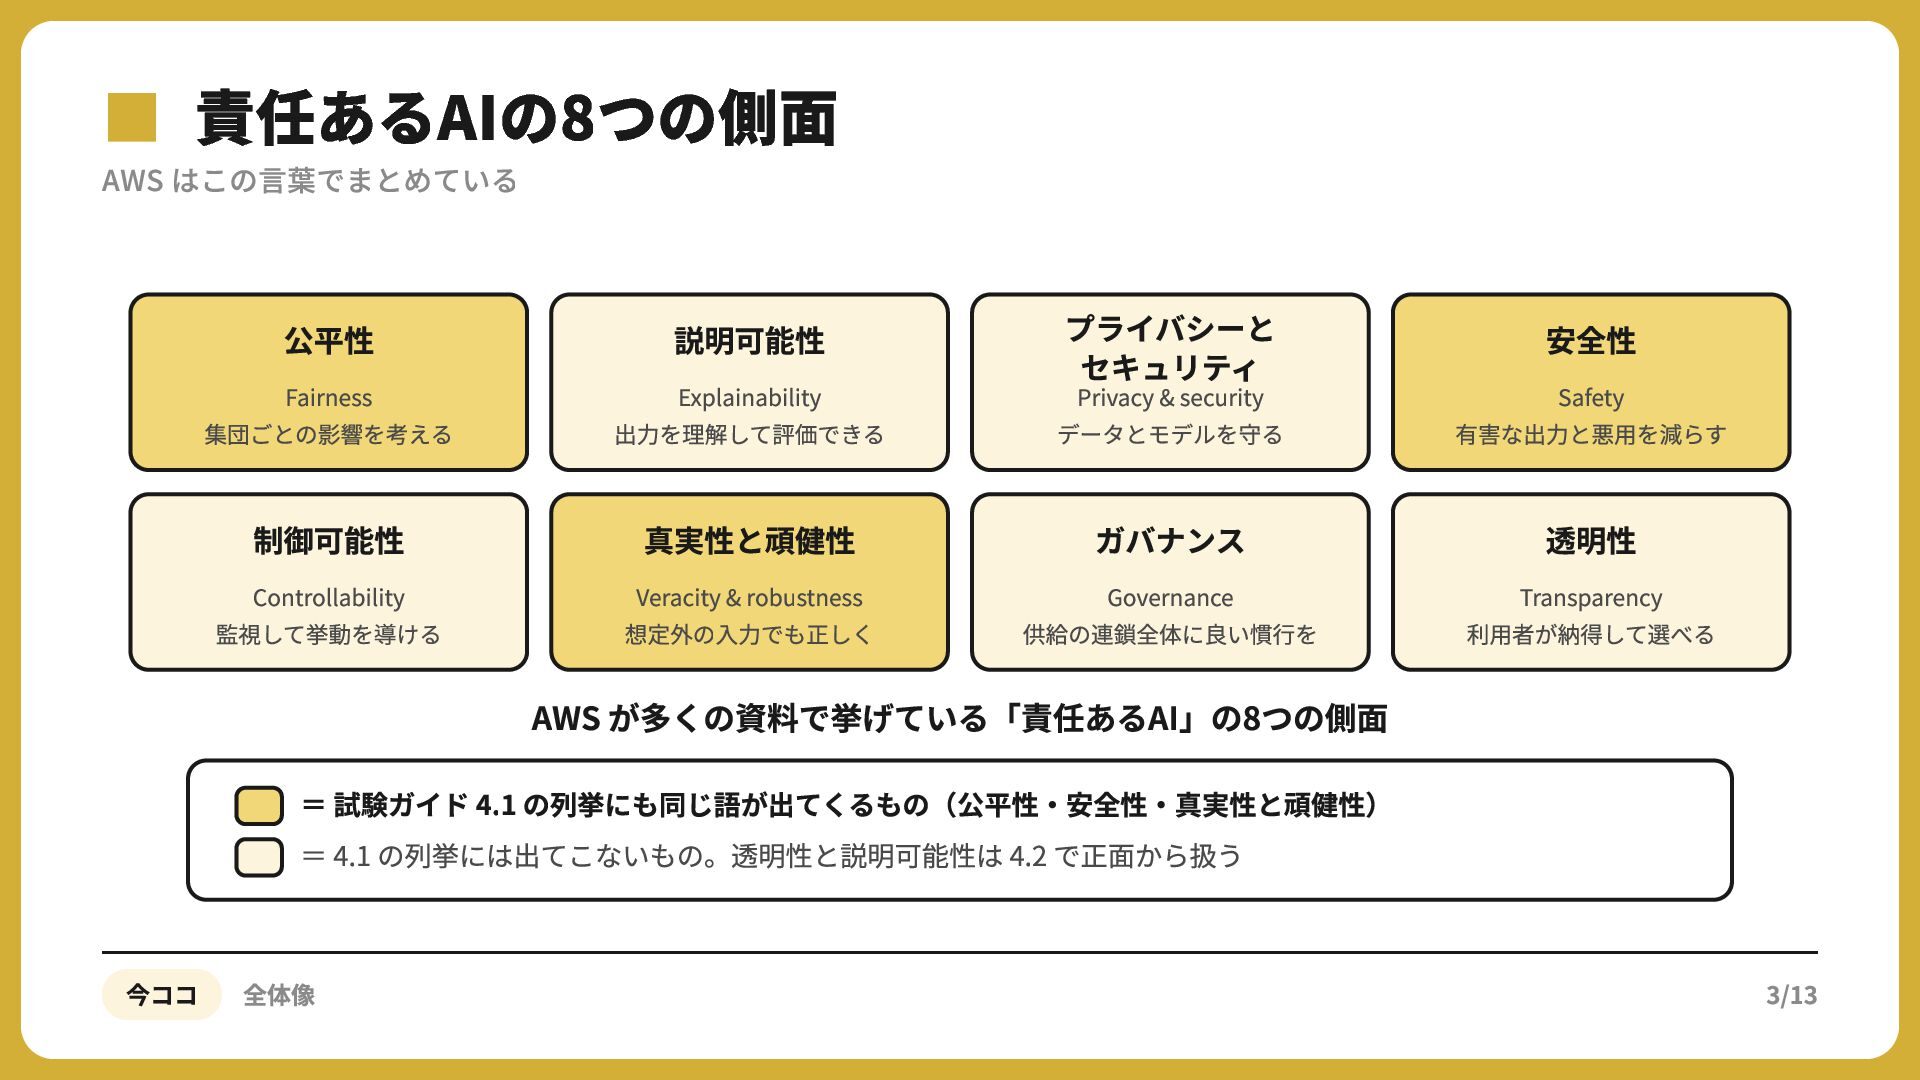
▪AWS はこの言葉でまとめている 責任あるAIの8つの側面 公平性 説明可能性 プライバシーと セキュリティ Privacy & security
安全性 Fairness 集団ごとの影響を考える Explainability 出⼒を理解して評価できる データとモデルを守る Safety 有害な出⼒と悪⽤を減らす 制御可能性 真実性と頑健性 ガバナンス 透明性 Controllability 監視して挙動を導ける Veracity & robustness 想定外の⼊⼒でも正しく Governance 供給の連鎖全体に良い慣⾏を Transparency 利⽤者が納得して選べる AWS が多くの資料で挙げている「責任あるAI」の8つの側⾯ = 試験ガイド 4.1 の列挙にも同じ語が出てくるもの(公平性‧安全性‧真実性と頑健性) = 4.1 の列挙には出てこないもの。透明性と説明可能性は 4.2 で正⾯から扱う 今ココ 全体像 3/13
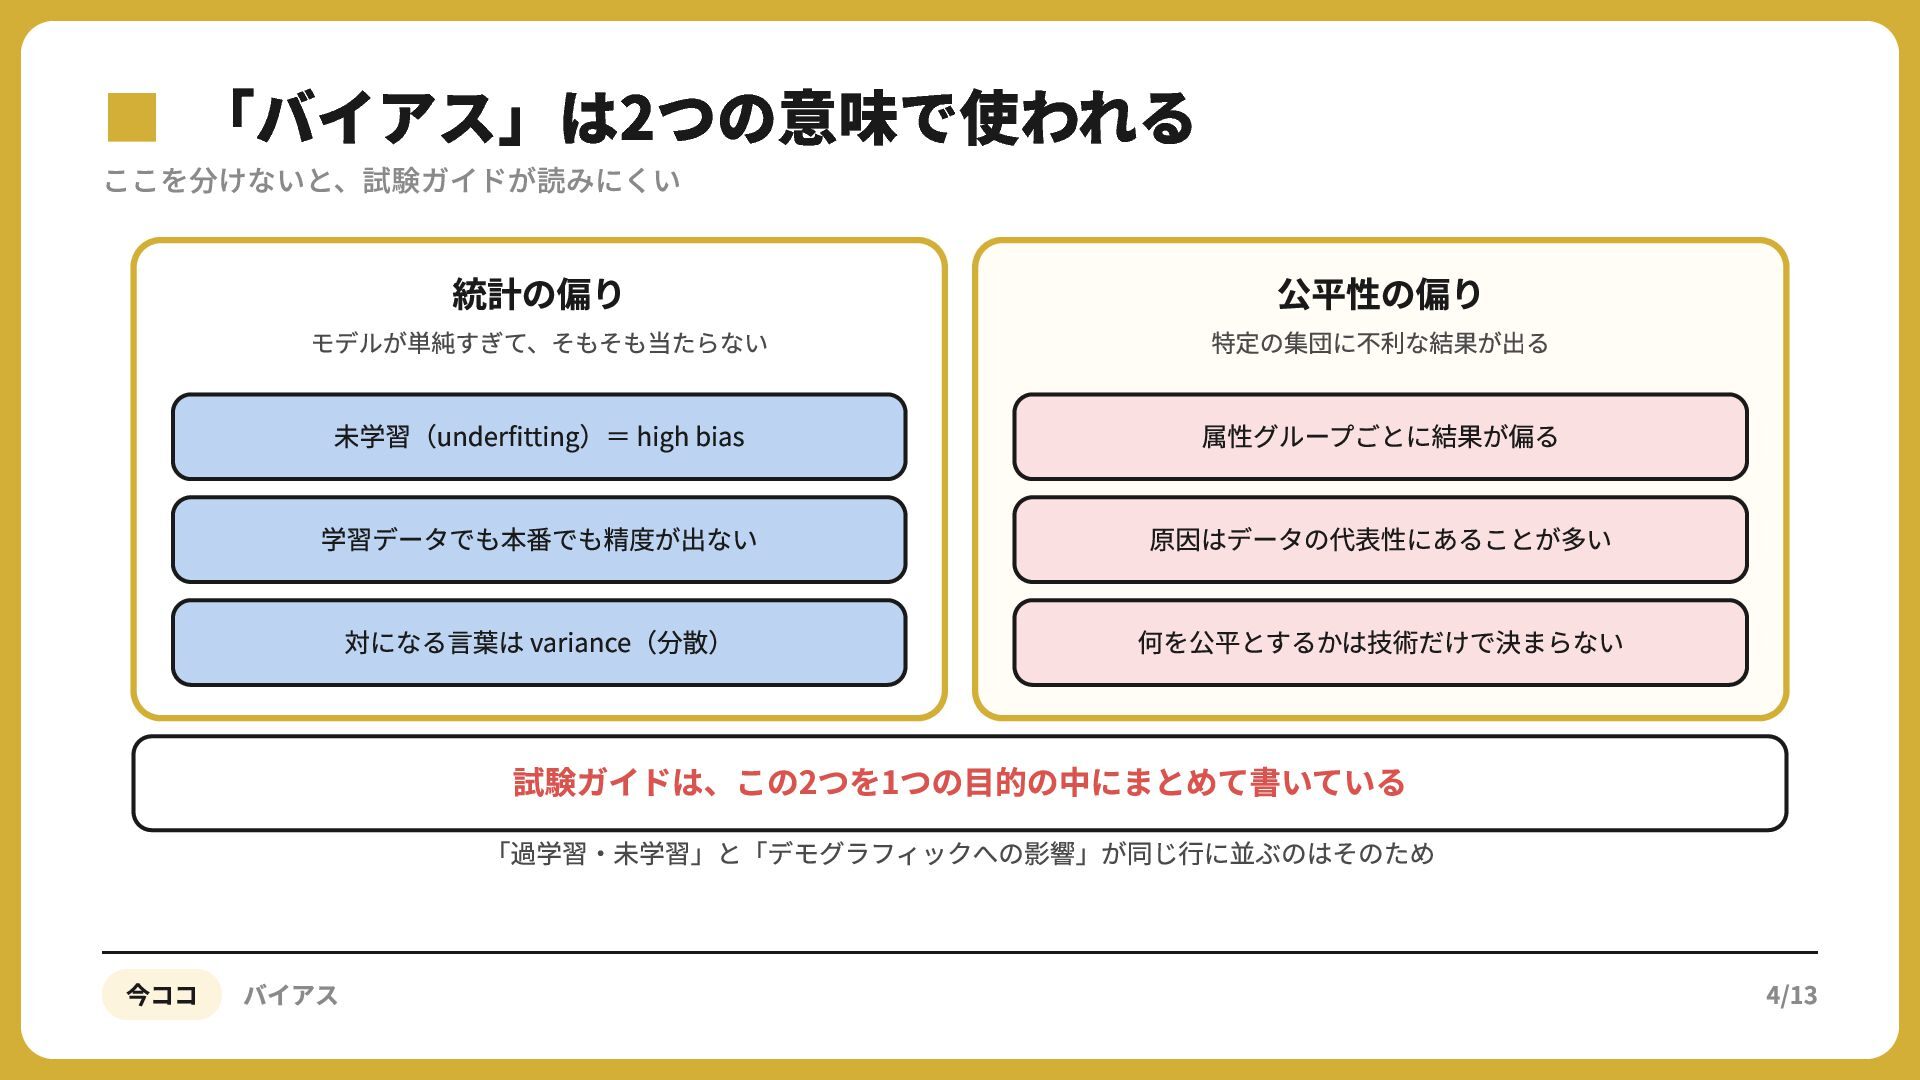
▪ここを分けないと、試験ガイドが読みにくい 「バイアス」は2つの意味で使われる 統計の偏り 公平性の偏り モデルが単純すぎて、そもそも当たらない 特定の集団に不利な結果が出る 未学習(underfitting)= high bias 属性グループごとに結果が偏る
学習データでも本番でも精度が出ない 原因はデータの代表性にあることが多い 対になる⾔葉は variance(分散) 何を公平とするかは技術だけで決まらない 試験ガイドは、この2つを1つの⽬的の中にまとめて書いている 「過学習‧未学習」と「デモグラフィックへの影響」が同じ⾏に並ぶのはそのため 今ココ バイアス 4/13
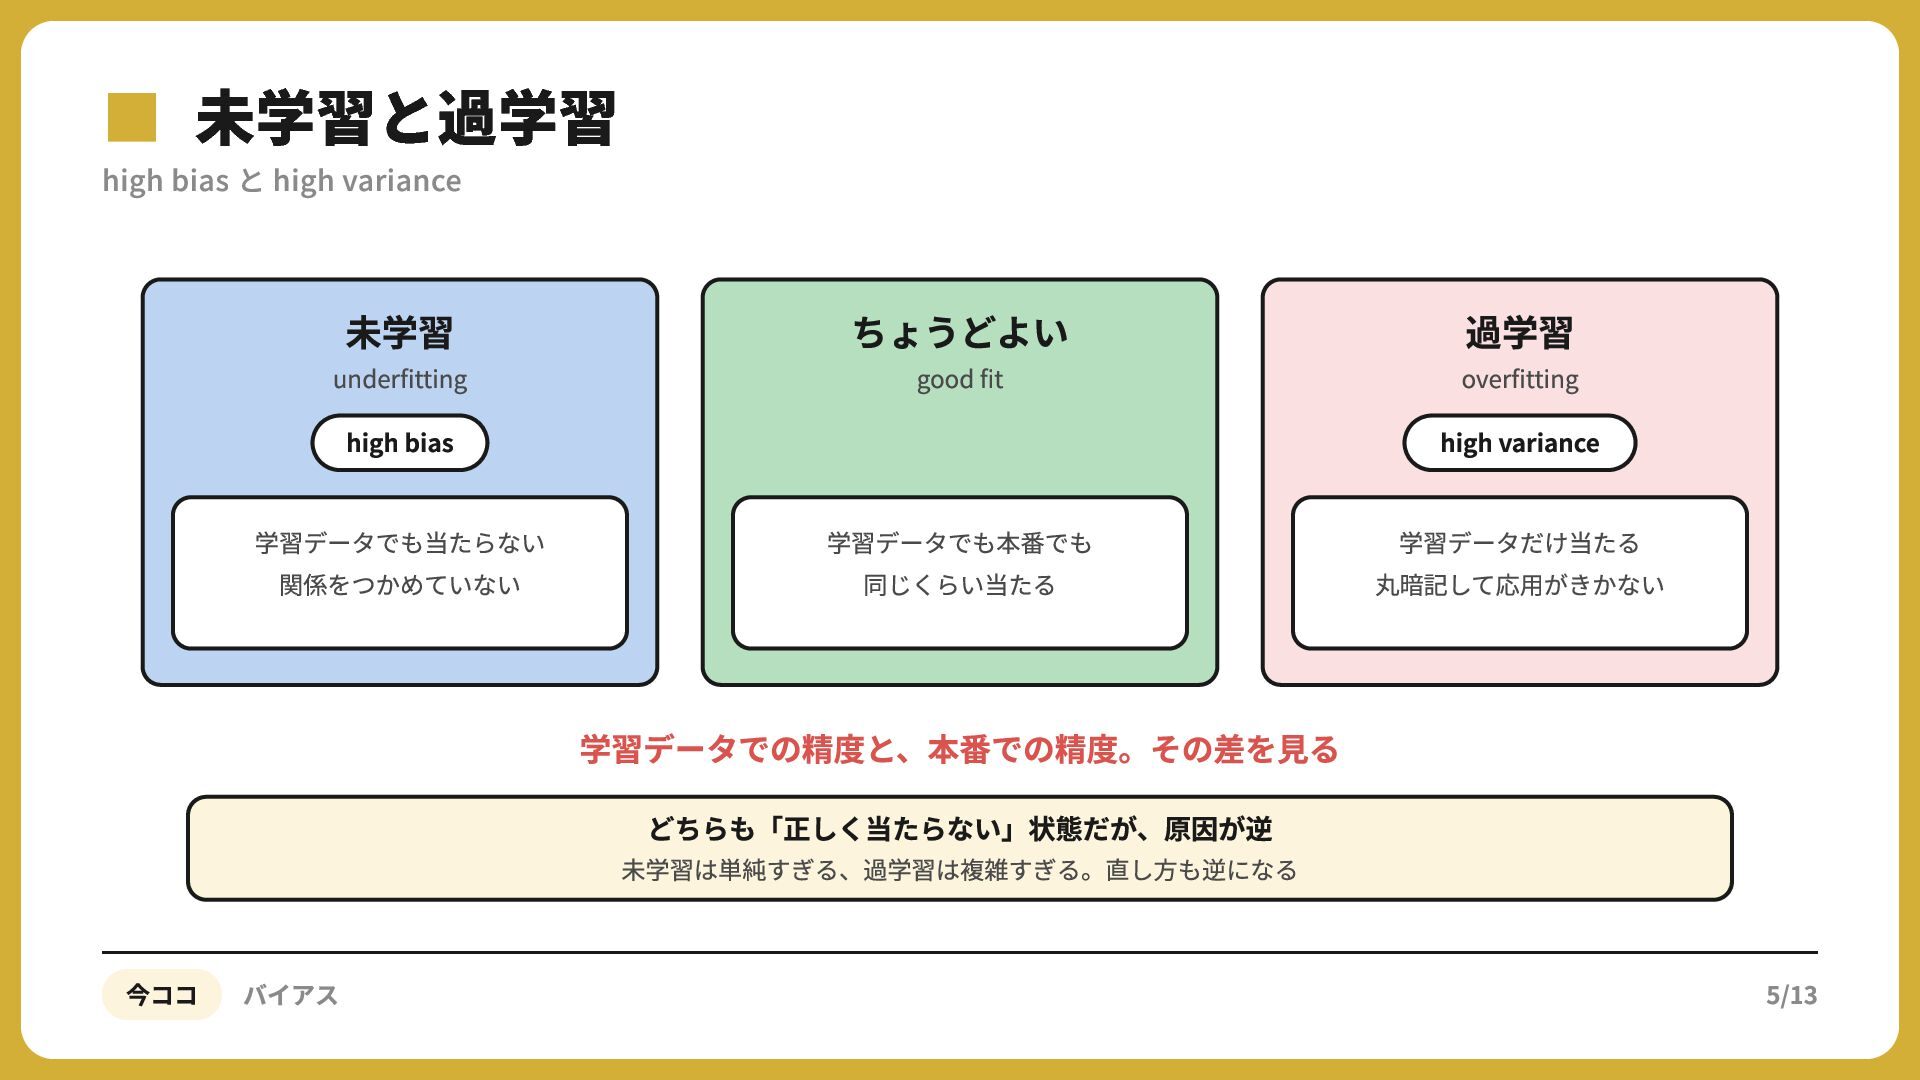
▪high bias未学習と過学習 と high variance 未学習 ちょうどよい good fit overfitting
high variance 学習データでも当たらない 関係をつかめていない 学習データでも本番でも 同じくらい当たる 学習データだけ当たる 丸暗記して応⽤がきかない underfitting high bias 過学習 学習データでの精度と、本番での精度。その差を⾒る どちらも「正しく当たらない」状態だが、原因が逆 未学習は単純すぎる、過学習は複雑すぎる。直し⽅も逆になる 今ココ バイアス 5/13
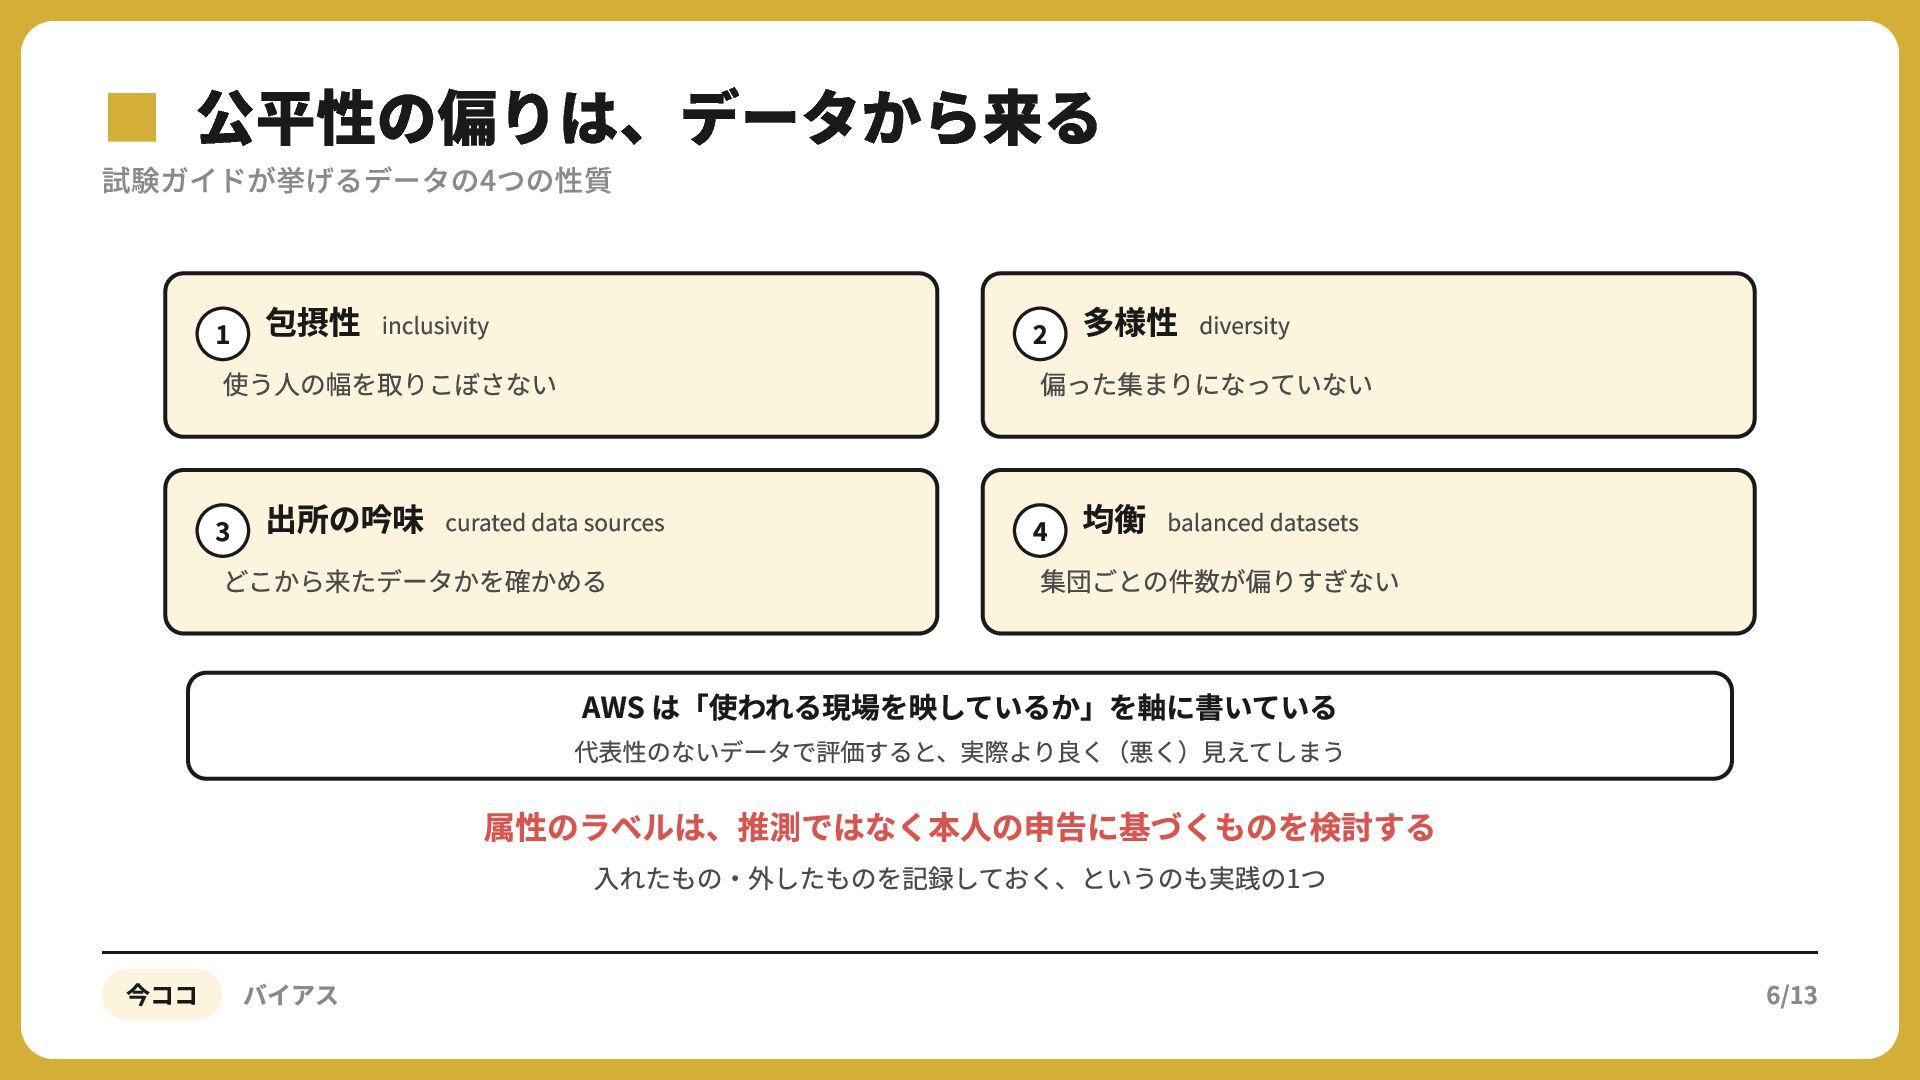
▪試験ガイドが挙げるデータの4つの性質 公平性の偏りは、データから来る 包摂性 inclusivity 多様性 diversity 使う⼈の幅を取りこぼさない 偏った集まりになっていない 出所の吟味 curated
data sources どこから来たデータかを確かめる 均衡 balanced datasets 集団ごとの件数が偏りすぎない AWS は「使われる現場を映しているか」を軸に書いている 代表性のないデータで評価すると、実際より良く(悪く)⾒えてしまう 属性のラベルは、推測ではなく本⼈の申告に基づくものを検討する ⼊れたもの‧外したものを記録しておく、というのも実践の1つ 今ココ バイアス 6/13
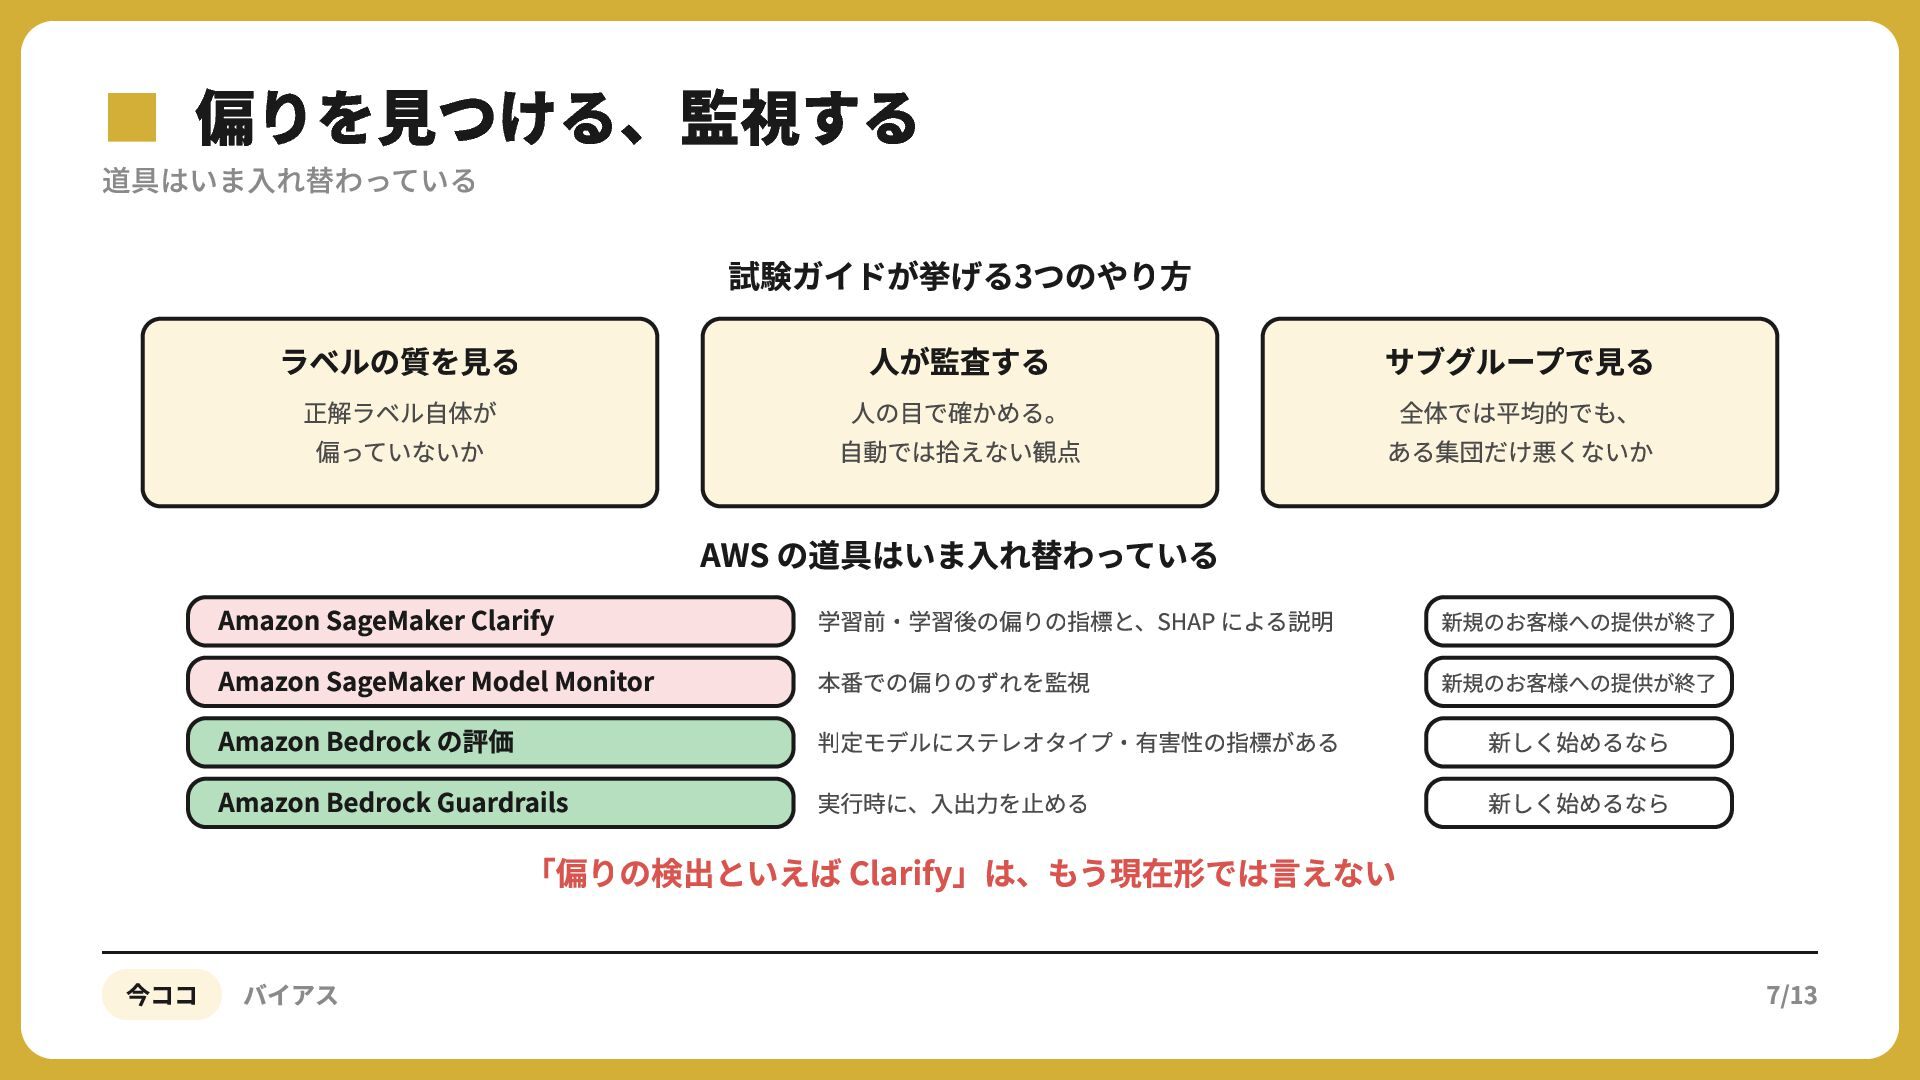
▪道具はいま入れ替わっている 偏りを見つける、監視する 試験ガイドが挙げる3つのやり⽅ ⼈が監査する ラベルの質を⾒る 正解ラベル⾃体が 偏っていないか ⼈の⽬で確かめる。 ⾃動では拾えない観点 Amazon
SageMaker Clarify Amazon SageMaker Model Monitor Amazon Bedrock の評価 Amazon Bedrock Guardrails サブグループで⾒る 全体では平均的でも、 ある集団だけ悪くないか AWS の道具はいま⼊れ替わっている 学習前‧学習後の偏りの指標と、SHAP による説明 本番での偏りのずれを監視 判定モデルにステレオタイプ‧有害性の指標がある 実⾏時に、⼊出⼒を⽌める 「偏りの検出といえば Clarify」は、もう現在形では⾔えない 今ココ バイアス 新規のお客様への提供が終了 新規のお客様への提供が終了 新しく始めるなら 新しく始めるなら 7/13
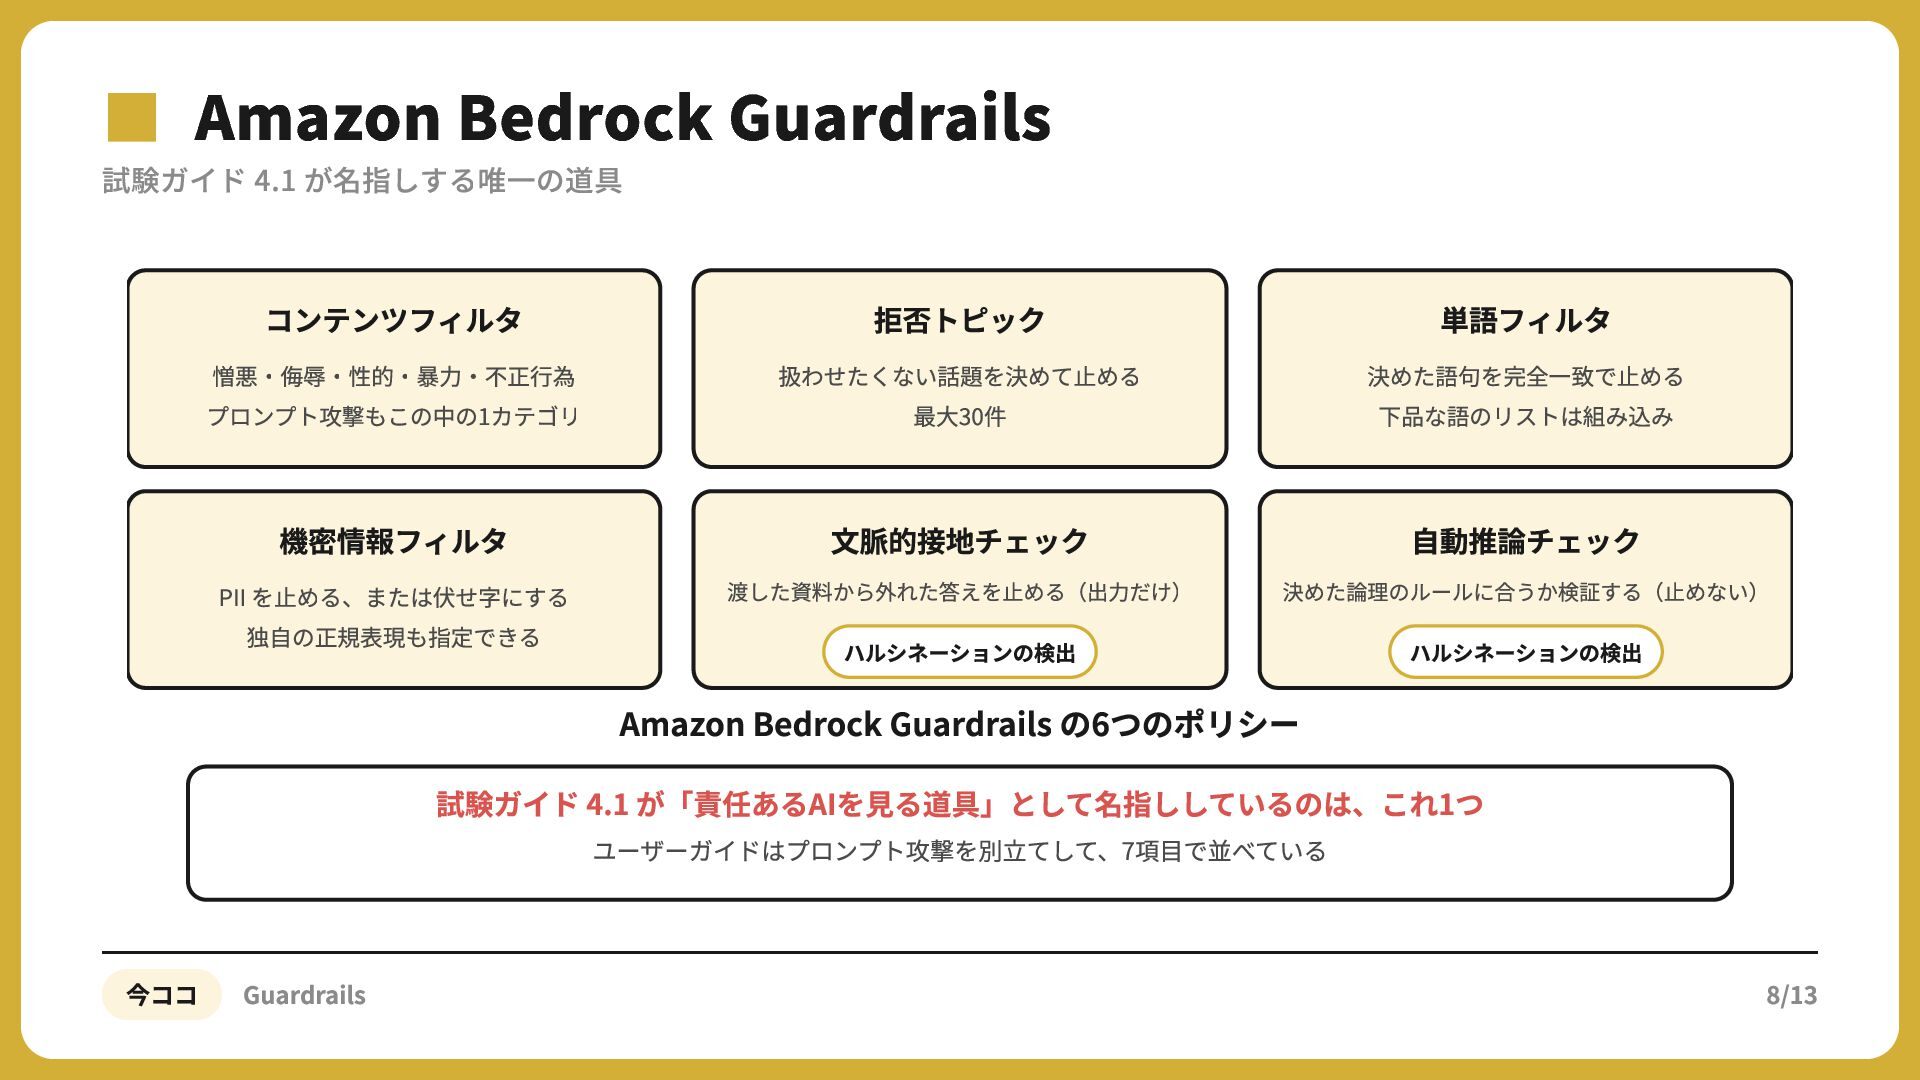
▪試験ガイドAmazon Bedrock Guardrails 4.1 が名指しする唯一の道具 コンテンツフィルタ 拒否トピック 単語フィルタ 憎悪‧侮辱‧性的‧暴⼒‧不正⾏為 プロンプト攻撃もこの中の1カテゴリ
扱わせたくない話題を決めて⽌める 最⼤30件 決めた語句を完全⼀致で⽌める 下品な語のリストは組み込み 機密情報フィルタ ⽂脈的接地チェック ⾃動推論チェック PII を⽌める、または伏せ字にする 独⾃の正規表現も指定できる 渡した資料から外れた答えを⽌める(出⼒だけ) ハルシネーションの検出 決めた論理のルールに合うか検証する(⽌めない) ハルシネーションの検出 Amazon Bedrock Guardrails の6つのポリシー 試験ガイド 4.1 が「責任あるAIを⾒る道具」として名指ししているのは、これ1つ ユーザーガイドはプロンプト攻撃を別⽴てして、7項⽬で並べている 今ココ Guardrails 8/13
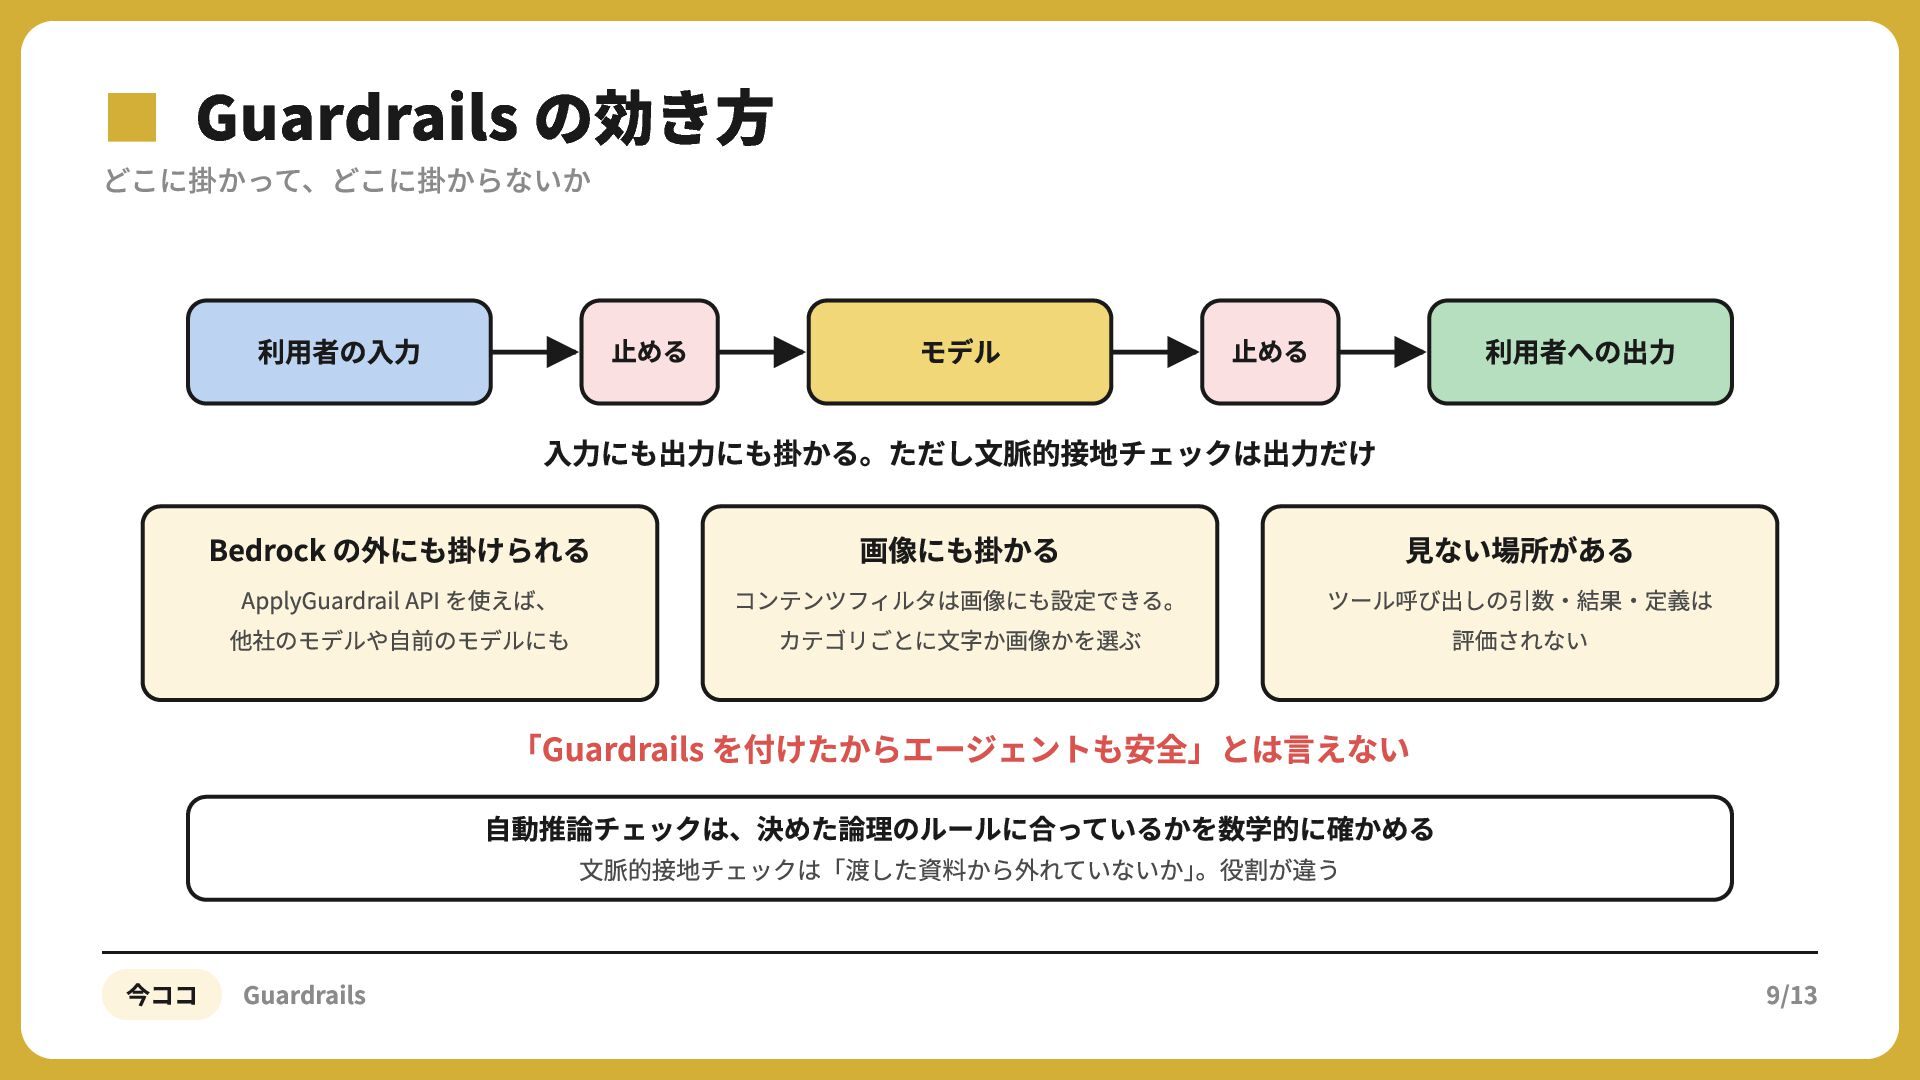
▪どこに掛かって、どこに掛からないか Guardrails の効き方 利⽤者の⼊⼒ ⽌める モデル 利⽤者への出⼒ ⽌める ⼊⼒にも出⼒にも掛かる。ただし⽂脈的接地チェックは出⼒だけ Bedrock
の外にも掛けられる ApplyGuardrail API を使えば、 他社のモデルや⾃前のモデルにも 画像にも掛かる コンテンツフィルタは画像にも設定できる。 カテゴリごとに⽂字か画像かを選ぶ ⾒ない場所がある ツール呼び出しの引数‧結果‧定義は 評価されない 「Guardrails を付けたからエージェントも安全」とは⾔えない ⾃動推論チェックは、決めた論理のルールに合っているかを数学的に確かめる ⽂脈的接地チェックは「渡した資料から外れていないか」。役割が違う 今ココ Guardrails 9/13
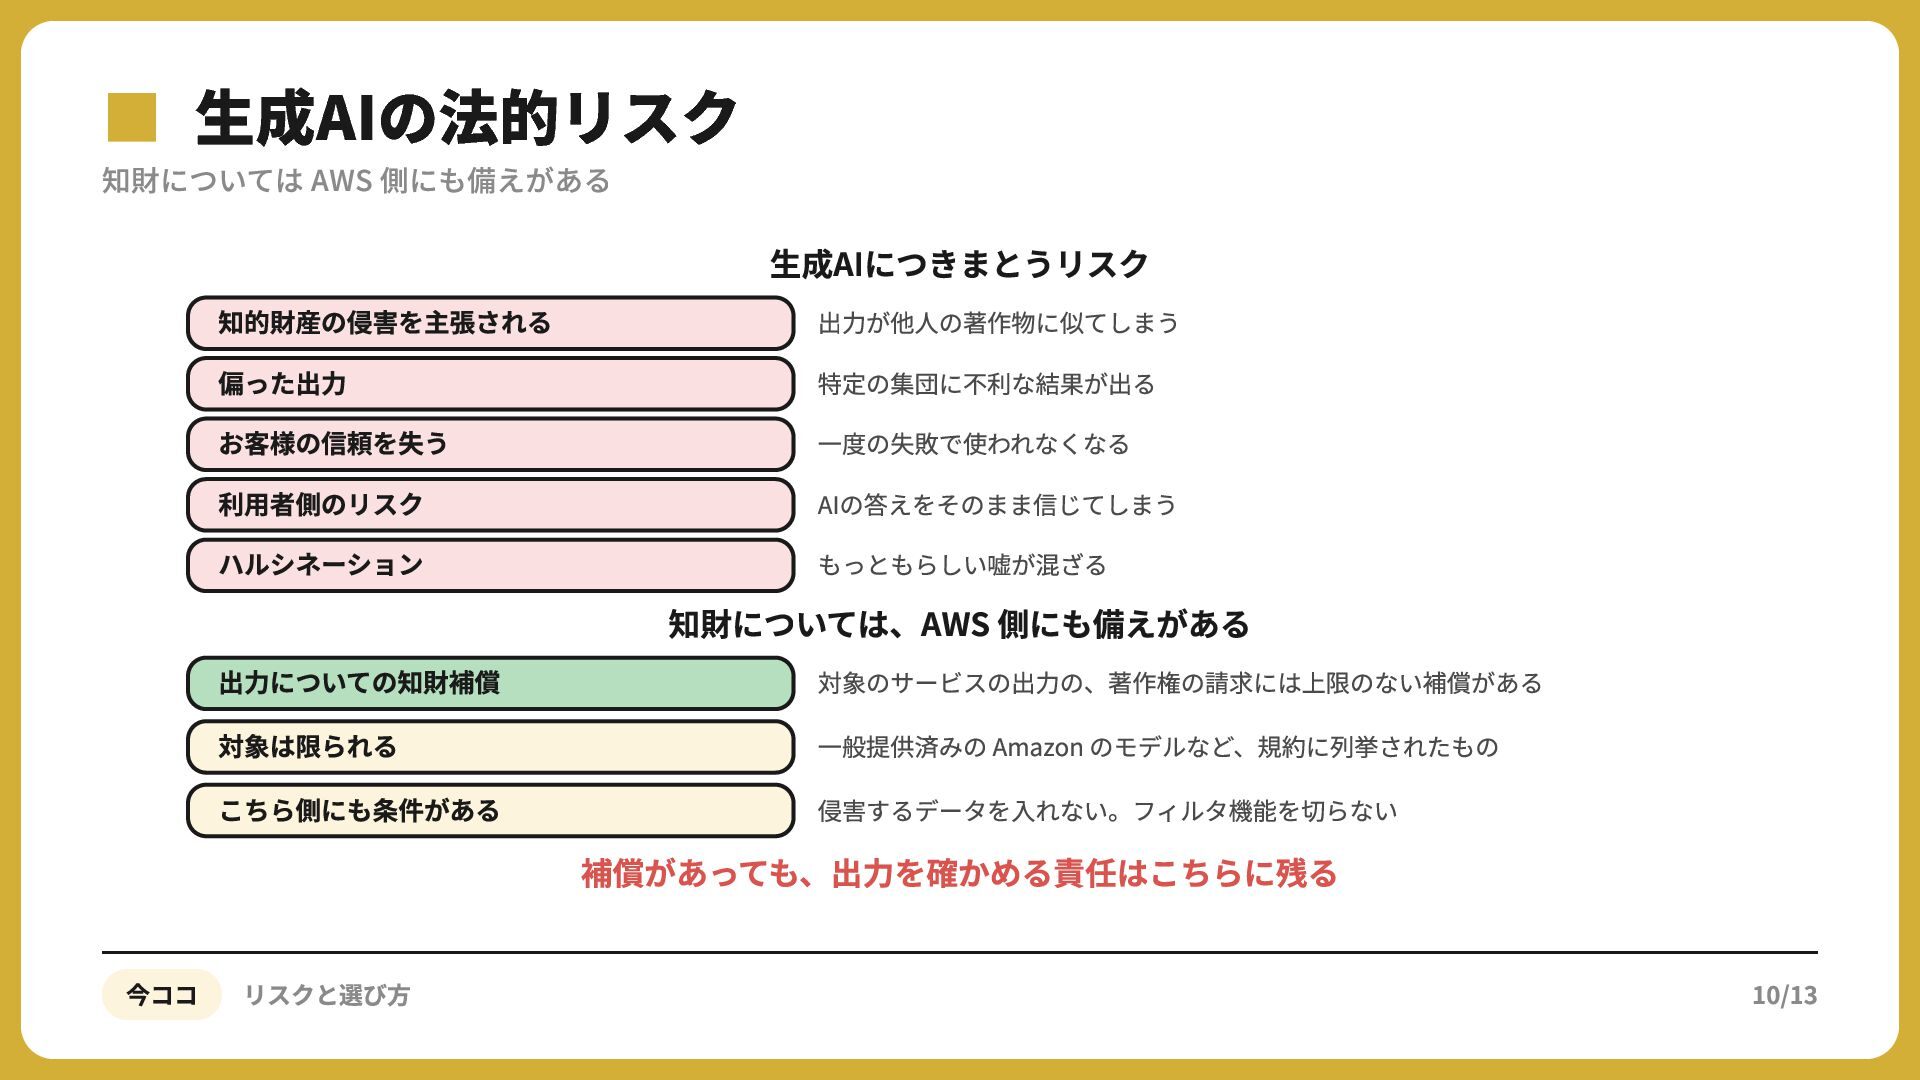
▪知財については 生成AIの法的リスク AWS 側にも備えがある 知的財産の侵害を主張される 偏った出⼒ お客様の信頼を失う 利⽤者側のリスク ハルシネーション 出⼒についての知財補償
対象は限られる こちら側にも条件がある 今ココ リスクと選び方 ⽣成AIにつきまとうリスク 出⼒が他⼈の著作物に似てしまう 特定の集団に不利な結果が出る ⼀度の失敗で使われなくなる AIの答えをそのまま信じてしまう もっともらしい嘘が混ざる 知財については、AWS 側にも備えがある 対象のサービスの出⼒の、著作権の請求には上限のない補償がある ⼀般提供済みの Amazon のモデルなど、規約に列挙されたもの 侵害するデータを⼊れない。フィルタ機能を切らない 補償があっても、出⼒を確かめる責任はこちらに残る 10/13
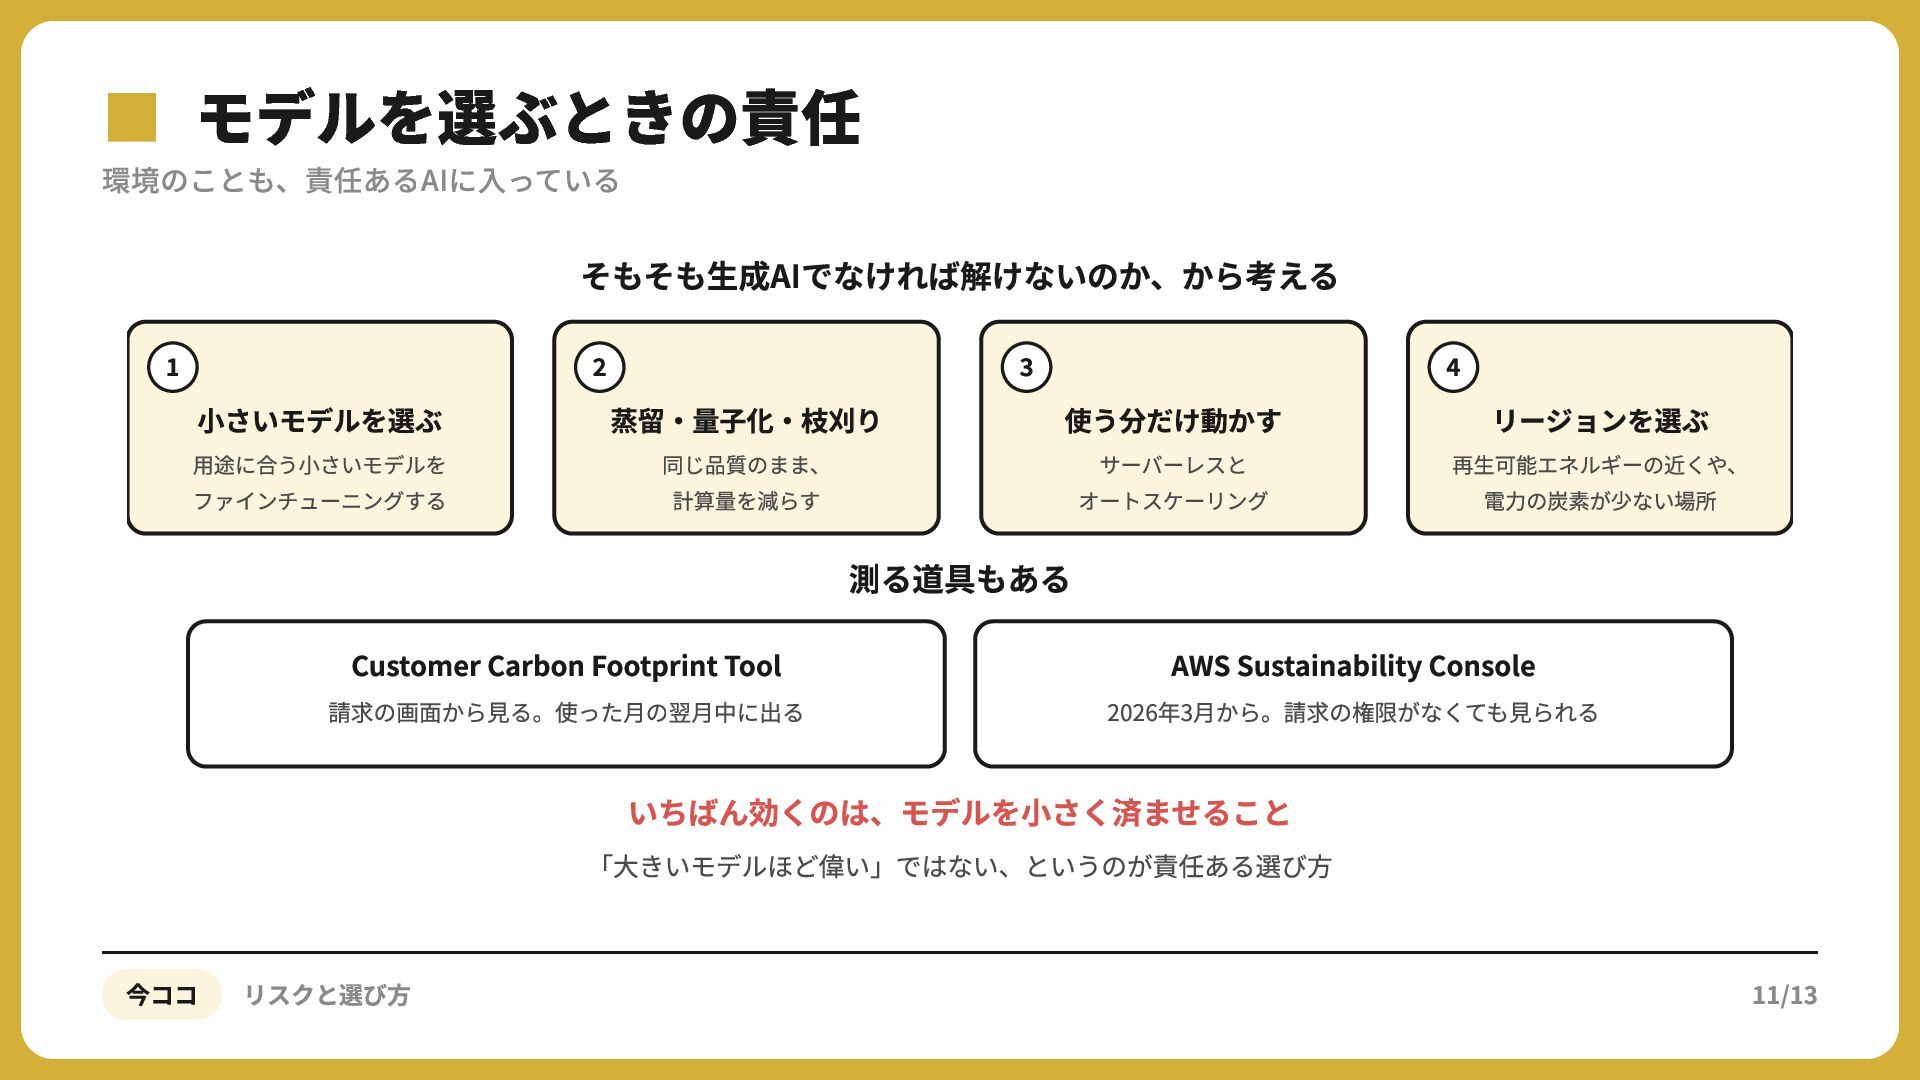
▪環境のことも、責任あるAIに入っている モデルを選ぶときの責任 そもそも⽣成AIでなければ解けないのか、から考える ⼩さいモデルを選ぶ ⽤途に合う⼩さいモデルを ファインチューニングする 蒸留‧量⼦化‧枝刈り 同じ品質のまま、 計算量を減らす 使う分だけ動かす
サーバーレスと オートスケーリング リージョンを選ぶ 再⽣可能エネルギーの近くや、 電⼒の炭素が少ない場所 測る道具もある Customer Carbon Footprint Tool 請求の画⾯から⾒る。使った⽉の翌⽉中に出る AWS Sustainability Console 2026年3⽉から。請求の権限がなくても⾒られる いちばん効くのは、モデルを⼩さく済ませること 「⼤きいモデルほど偉い」ではない、というのが責任ある選び⽅ 今ココ リスクと選び方 11/13
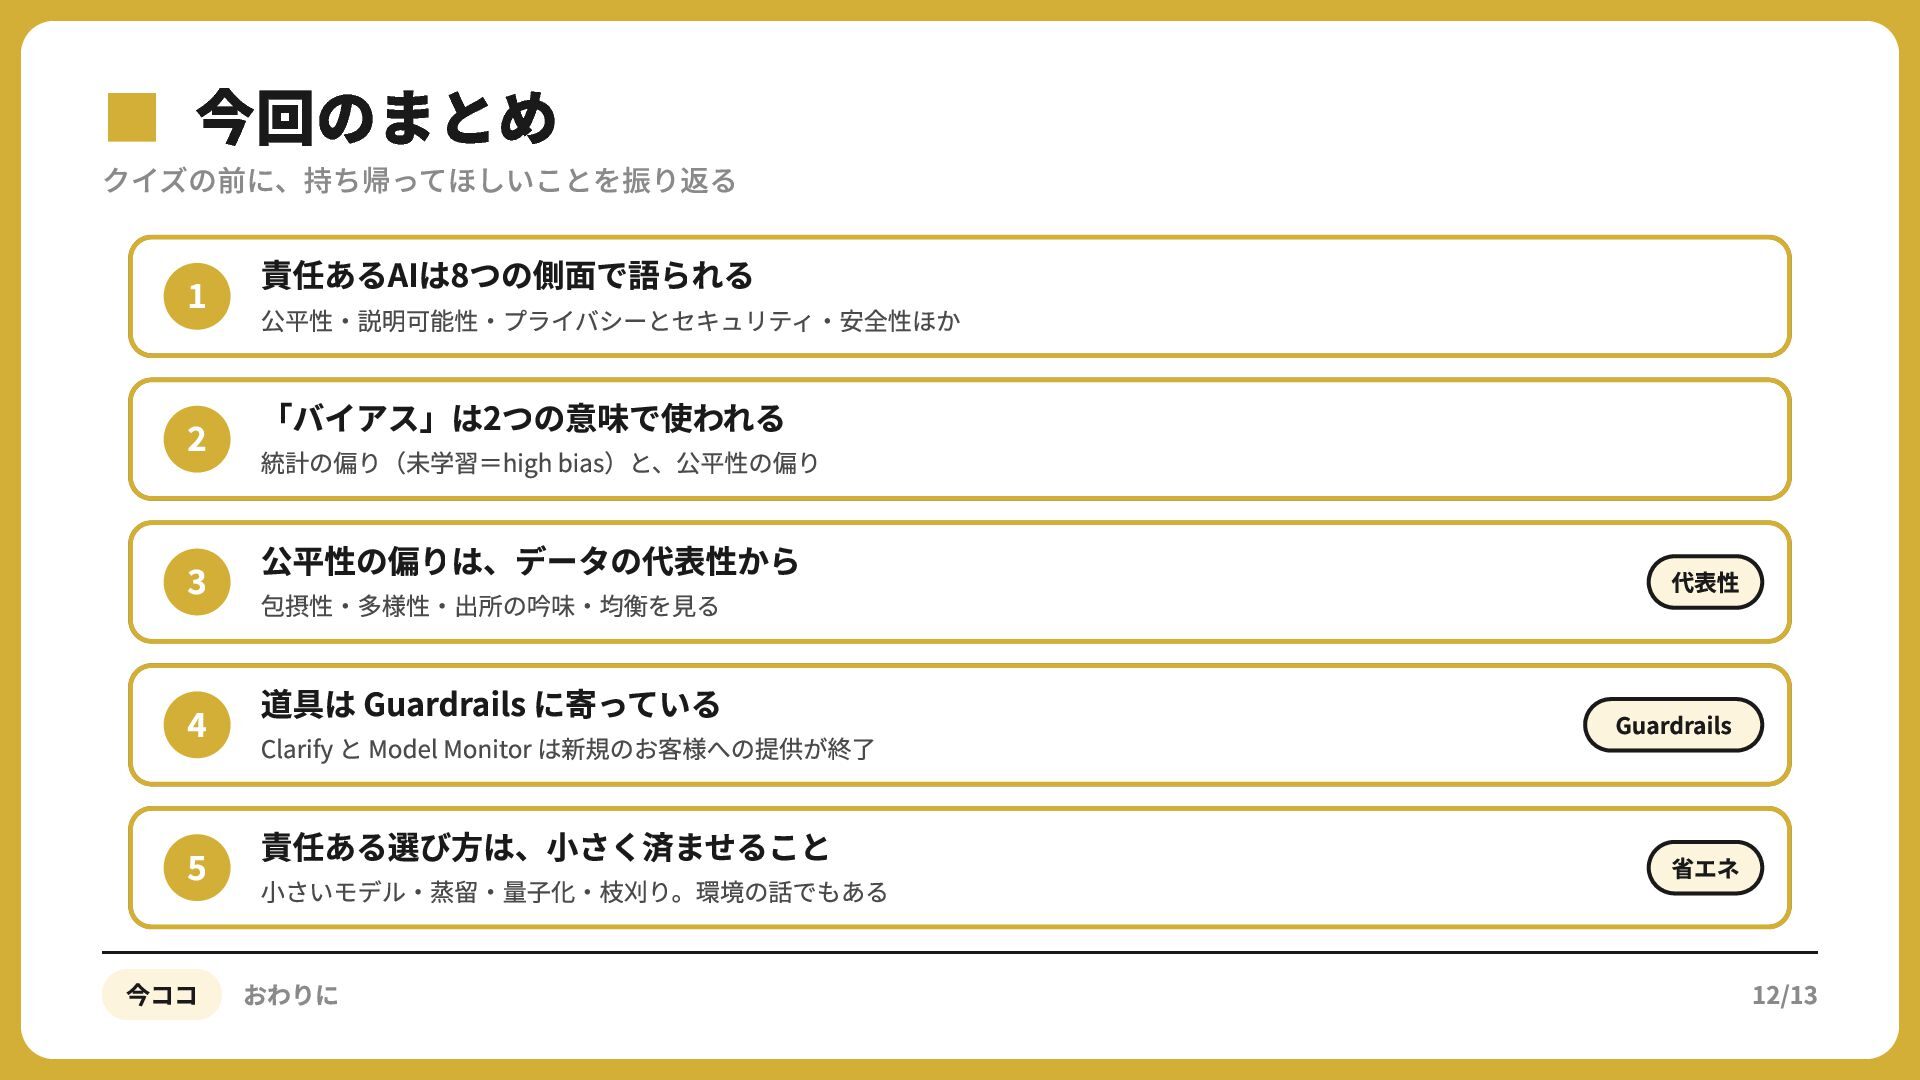
▪クイズの前に、持ち帰ってほしいことを振り返る 今回のまとめ 責任あるAIは8つの側⾯で語られる 公平性‧説明可能性‧プライバシーとセキュリティ‧安全性ほか 「バイアス」は2つの意味で使われる 統計の偏り(未学習=high bias)と、公平性の偏り 公平性の偏りは、データの代表性から 包摂性‧多様性‧出所の吟味‧均衡を⾒る 道具は
Guardrails に寄っている Clarify と Model Monitor は新規のお客様への提供が終了 責任ある選び⽅は、⼩さく済ませること ⼩さいモデル‧蒸留‧量⼦化‧枝刈り。環境の話でもある 今ココ おわりに 代表性 Guardrails 省エネ 12/13
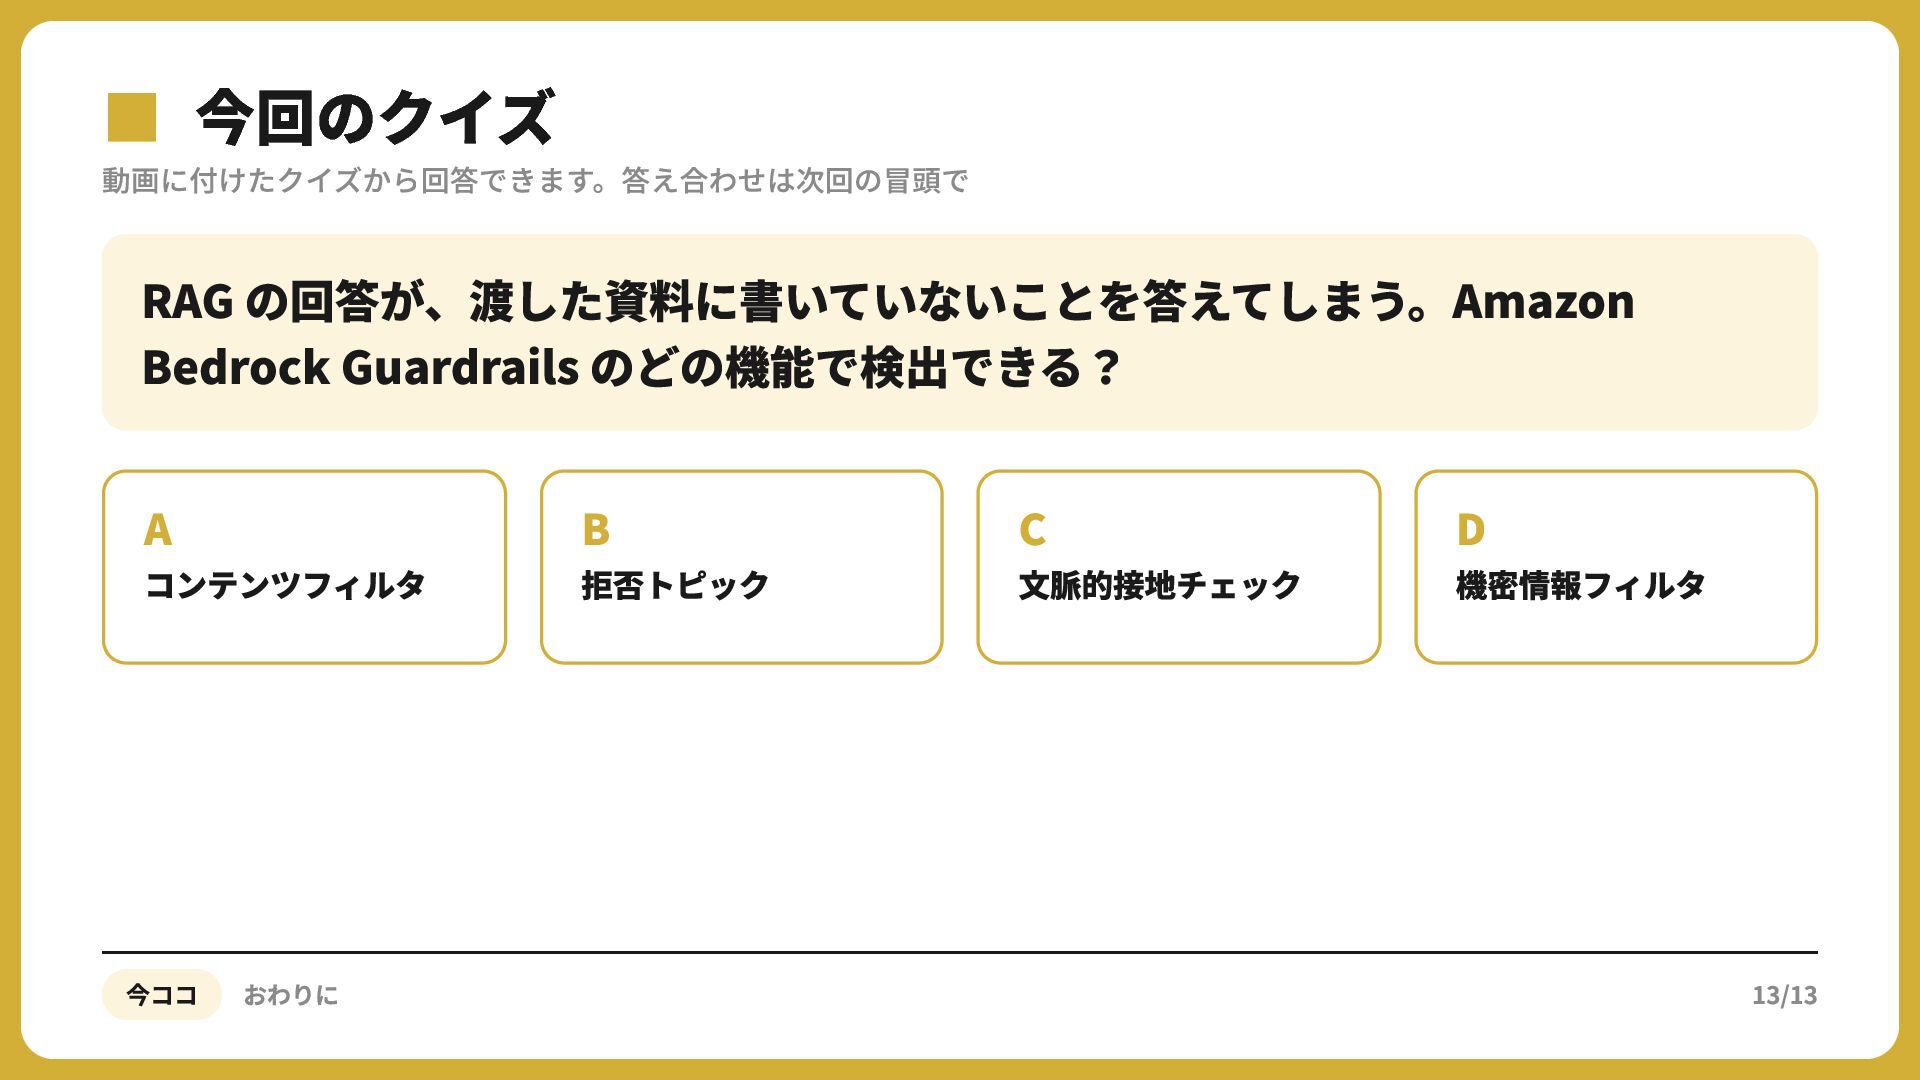
▪動画に付けたクイズから回答できます。答え合わせは次回の冒頭で 今回のクイズ RAG の回答が、渡した資料に書いていないことを答えてしまう。Amazon Bedrock Guardrails のどの機能で検出できる? A コンテンツフィルタ 今ココ
おわりに B 拒否トピック C 文脈的接地チェック D 機密情報フィルタ 13/13


 akagami
 ktcryomm
 icoxfog417
 ayumu_yamaguchi
 kishida
 tosite
 sts11142
 y0hgi
 syumai
 ivargrimstad
 mpyw
 neuecc
 jonoalderson
 samtorres
 tammyeverts
 tapps
 reverentgeek
 marketingsoph
 bcantrill
 rabernat
 sabderemane
 productmarketing
 destraynor
 marktimemedia