Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
【AWS AIF対策】基盤モデルの評価
Search
赤神青空
PRO
October 03, 2026
Video
Programming
19
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
【AWS AIF対策】基盤モデルの評価
赤神青空
PRO
October 03, 2026
Video
More Decks by 赤神青空
See All by 赤神青空
【AIニュース】OpenAI の「dots」とは何か
akagami
PRO
0
4
【AWS AIF対策】責任あるAI
akagami
PRO
0
13
【AWS AIF対策】モデルの学習とファインチューニング
akagami
PRO
0
10
【AWS AIF対策】プロンプトエンジニアリング
akagami
PRO
0
15
【AWS AIF対策】RAGとベクトルデータベース
akagami
PRO
0
14
【AWS AIF対策】基盤モデルの選び方と推論パラメータ
akagami
PRO
0
18
【AWS AIF対策】AWSの生成AIサービスの全体像
akagami
PRO
0
26
【AWS AIF対策】エージェント型AIとMCP
akagami
PRO
0
26
【AWS AIF対策】生成AIの得意・不得意とコスト
akagami
PRO
0
25
Other Decks in Programming
See All in Programming
速習iPhone Duo対応
yuukiw00w
2
930
機械に任せるテスト、人が見るテスト ⽣成AIで引き直した、運⽤保守フェーズの線引き
dske104
0
140
スマートフォンでモールス信号を送受信する 〜スマートフォンのLEDとカメラで作る光通信の設計と実装〜
atsuki_seo
0
220
市販E-Readerを乗っ取れ 〜Embedded Swiftで電子ペーパーガジェットを制御する〜
trickart
0
230
モバイル交通系ICへのチャージ実例から考える、クロスプラットフォーム開発におけるiOS実機テスト設計とCI運用
yusuga
1
570
Augmenting AI with the Power of Jakarta EE
ivargrimstad
0
390
Findy - エンジニア向け会社紹介/Findy Company Deck
findyinc
6
400k
Webの地図
yosuke_furukawa
PRO
6
5k
AHC070解法紹介
eijirou
0
150
大喜利で理解するLLM as a Judge / Understanding LLM-as-a-Judge through Ogiri
rockname
0
190
Apple Intelligence を用いた個人情報誤送信防止、及びユーザーリクエスト体験の改善について
yukiny
0
270
技術的負債の返済は、AI時代の複利で効く投資 — 経営としての意思決定とその遂行
curekoshimizu
1
2.1k
Featured
See All Featured
RailsConf 2023
tenderlove
30
1.6k
StorybookのUI Testing Handbookを読んだ
zakiyama
31
6.9k
Accessibility Awareness
sabderemane
1
230
Balancing Empowerment & Direction
lara
6
1.3k
How to Talk to Developers About Accessibility
jct
2
560
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
240
Building the Perfect Custom Keyboard
takai
2
890
A better future with KSS
kneath
240
18k
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
How to Build an AI Search Optimization Roadmap - Criteria and Steps to Take #SEOIRL
aleyda
1
2.2k
The Illustrated Guide to Node.js - THAT Conference 2024
reverentgeek
1
550
Designing for humans not robots
tammielis
254
26k
Transcript
2026年9月 基盤モデルの評価 AWS Certified AI Practitioner 対策 #13 赤神青空
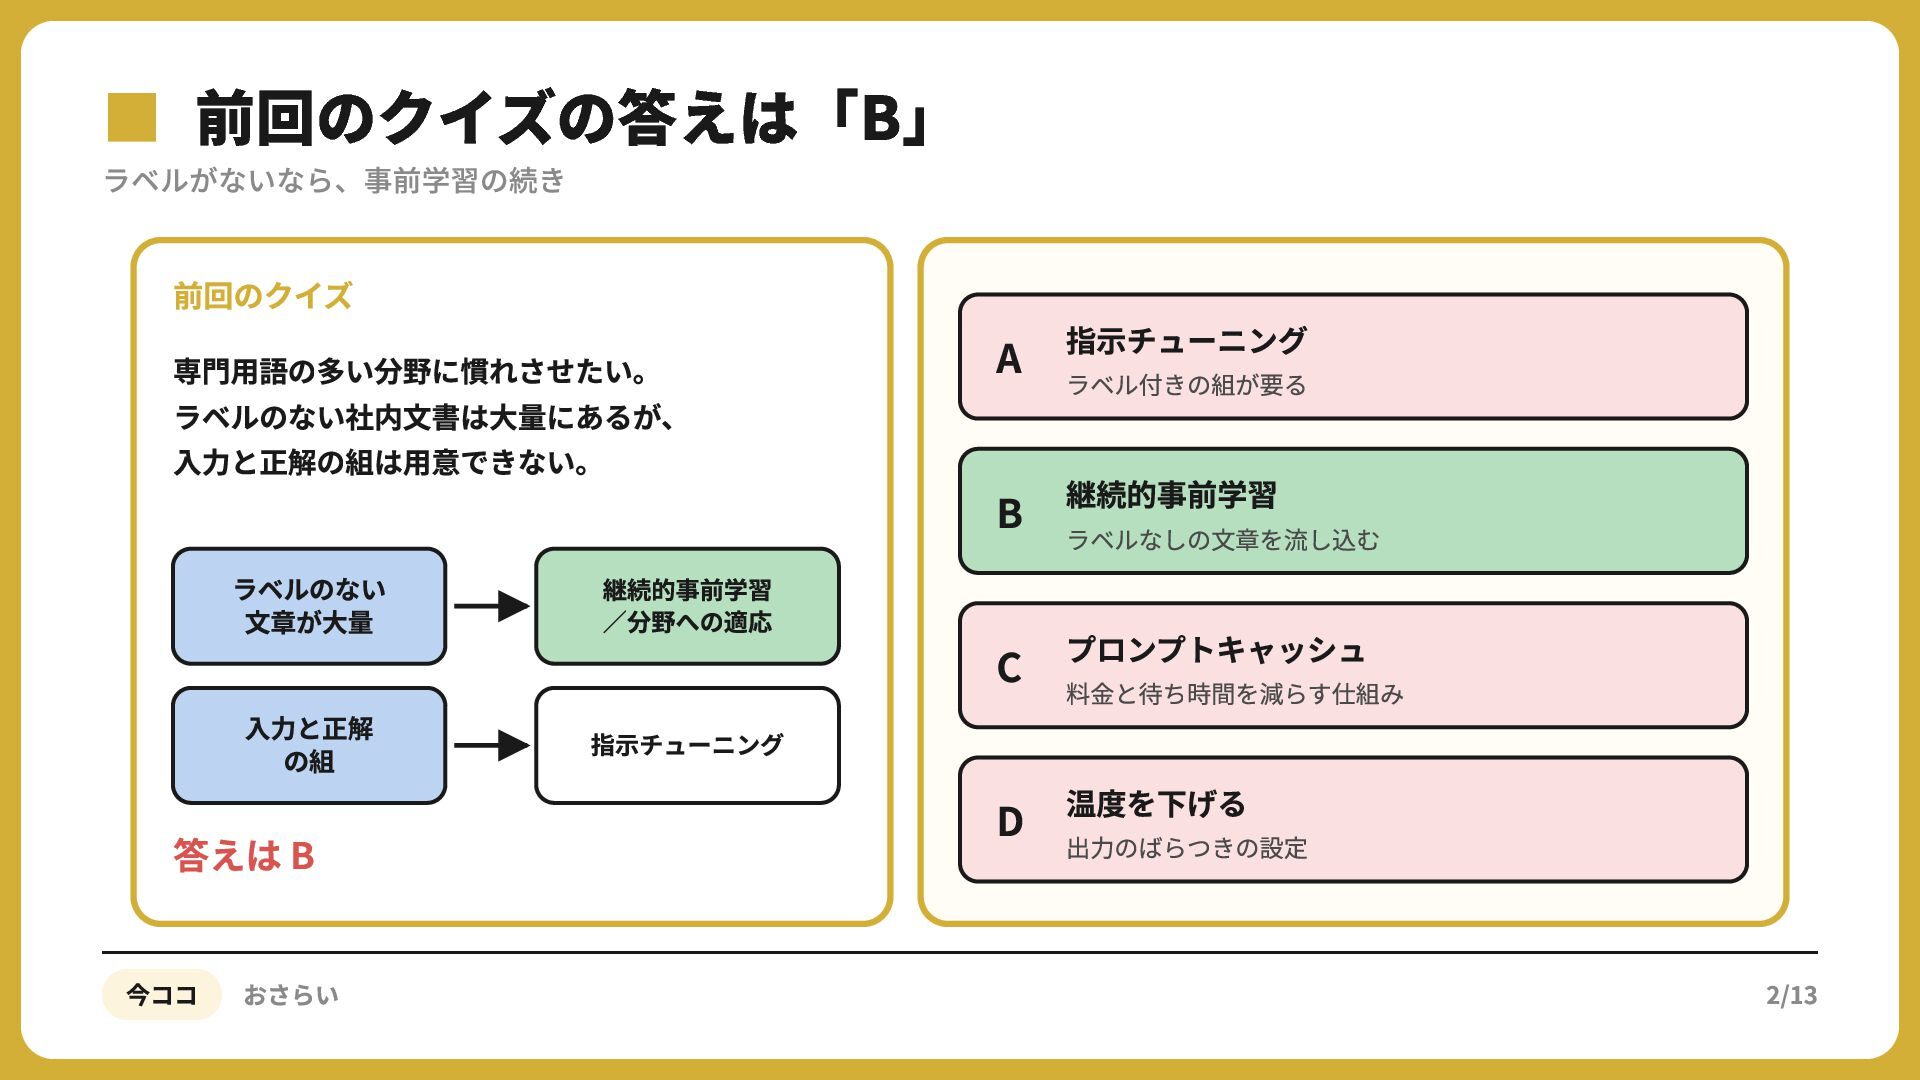
▪ラベルがないなら、事前学習の続き 前回のクイズの答えは「B」 前回のクイズ 専⾨⽤語の多い分野に慣れさせたい。 ラベルのない社内⽂書は⼤量にあるが、 ⼊⼒と正解の組は⽤意できない。 ラベルのない ⽂章が⼤量 継続的事前学習 ∕分野への適応
⼊⼒と正解 の組 指⽰チューニング 答えは B 今ココ おさらい A 指⽰チューニング ラベル付きの組が要る B 継続的事前学習 ラベルなしの⽂章を流し込む C プロンプトキャッシュ 料⾦と待ち時間を減らす仕組み D 温度を下げる 出⼒のばらつきの設定 2/13
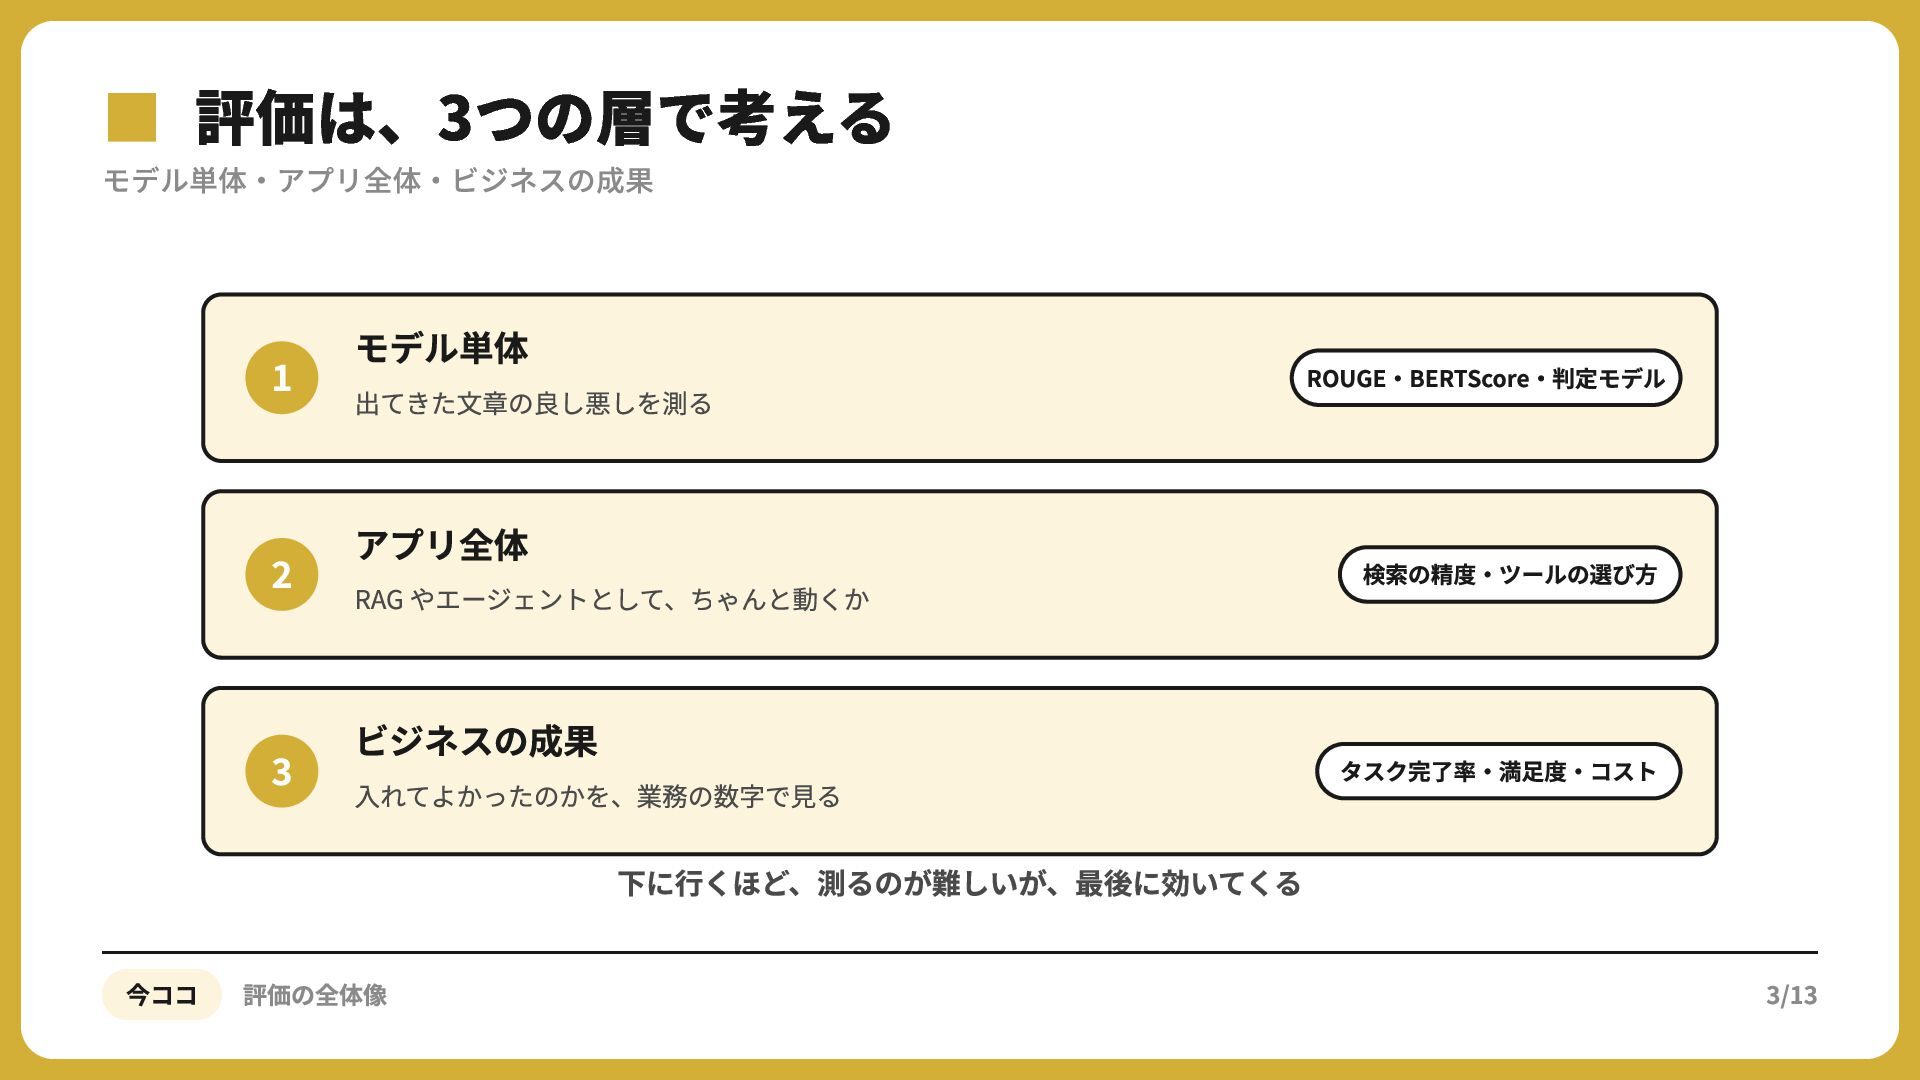
▪モデル単体・アプリ全体・ビジネスの成果 評価は、3つの層で考える モデル単体 ROUGE‧BERTScore‧判定モデル アプリ全体 検索の精度‧ツールの選び⽅ ビジネスの成果 タスク完了率‧満⾜度‧コスト 出てきた⽂章の良し悪しを測る RAG
やエージェントとして、ちゃんと動くか ⼊れてよかったのかを、業務の数字で⾒る 下に⾏くほど、測るのが難しいが、最後に効いてくる 今ココ 評価の全体像 3/13
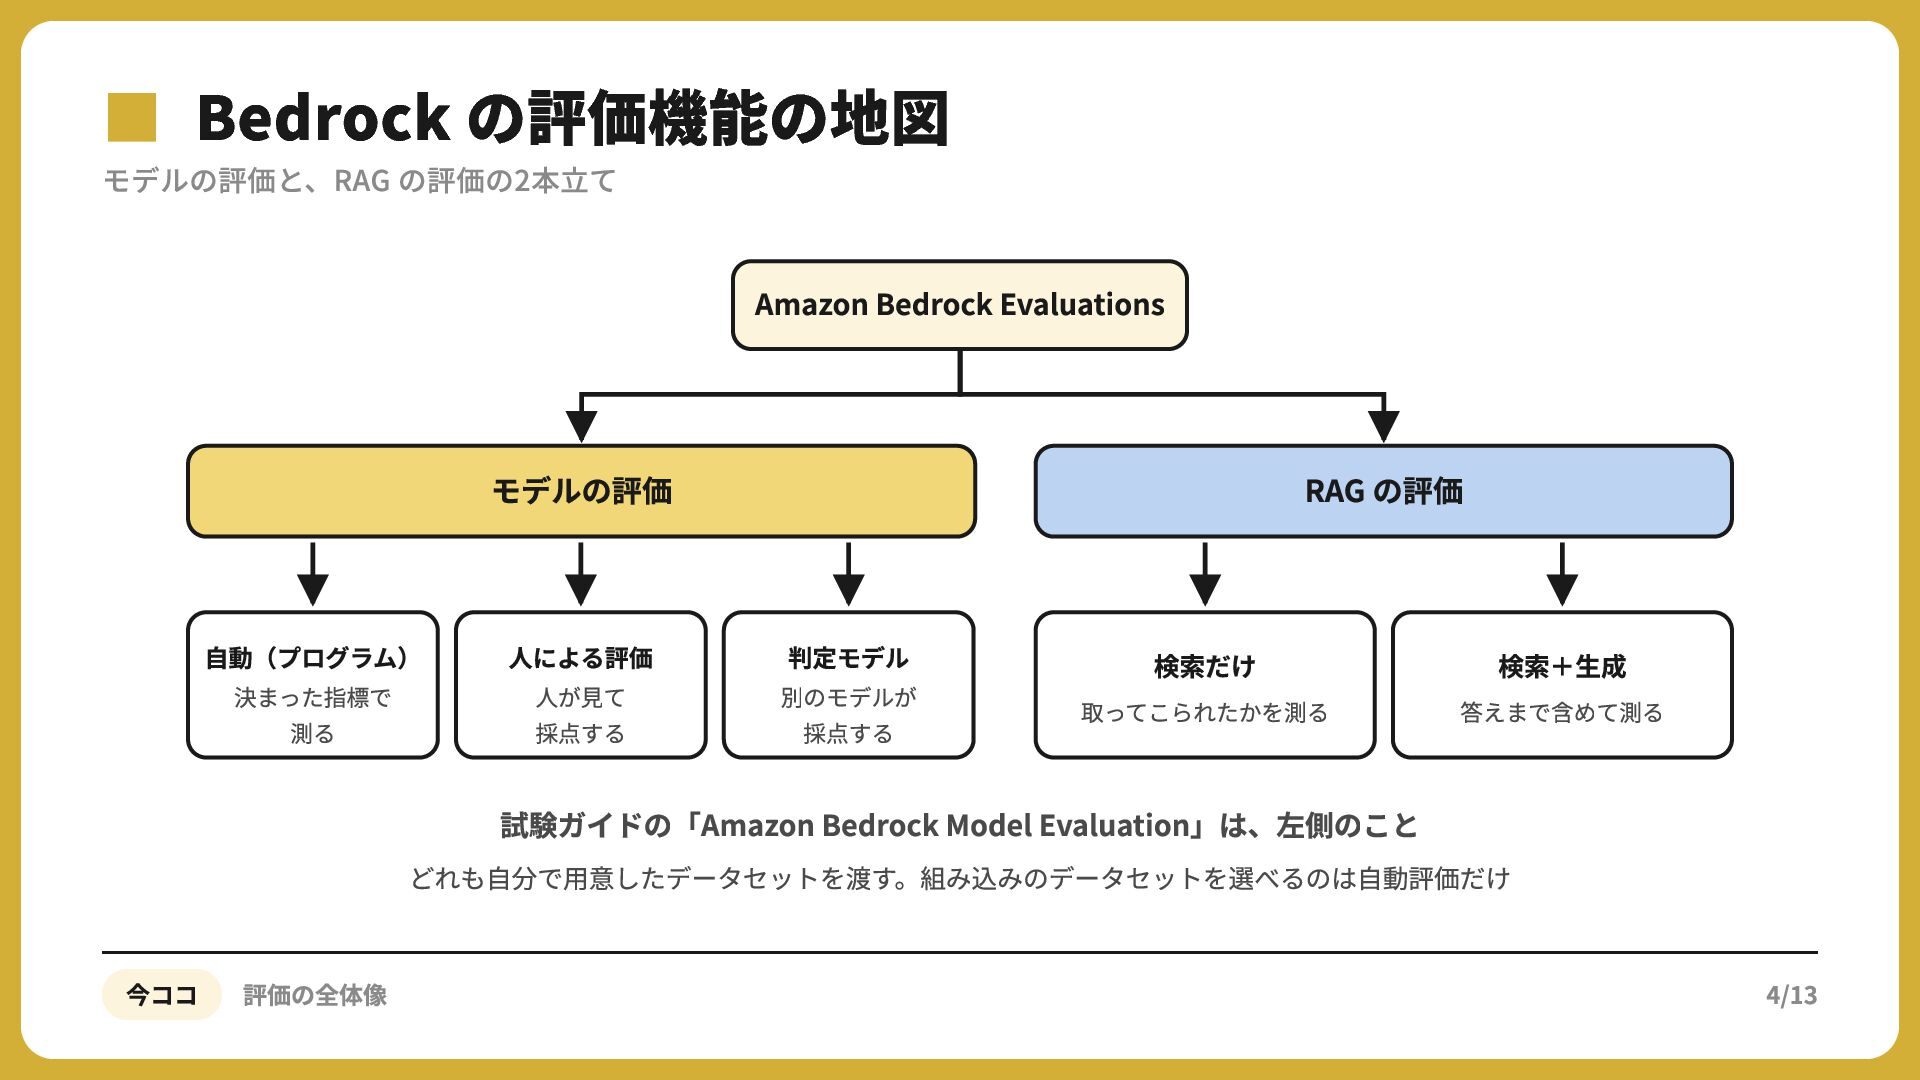
▪モデルの評価と、RAG Bedrockの評価の2本立て の評価機能の地図 Amazon Bedrock Evaluations モデルの評価 ⾃動(プログラム) 決まった指標で 測る
⼈による評価 ⼈が⾒て 採点する RAG の評価 判定モデル 別のモデルが 採点する 検索だけ 取ってこられたかを測る 検索+⽣成 答えまで含めて測る 試験ガイドの「Amazon Bedrock Model Evaluation」は、左側のこと どれも⾃分で⽤意したデータセットを渡す。組み込みのデータセットを選べるのは⾃動評価だけ 今ココ 評価の全体像 4/13
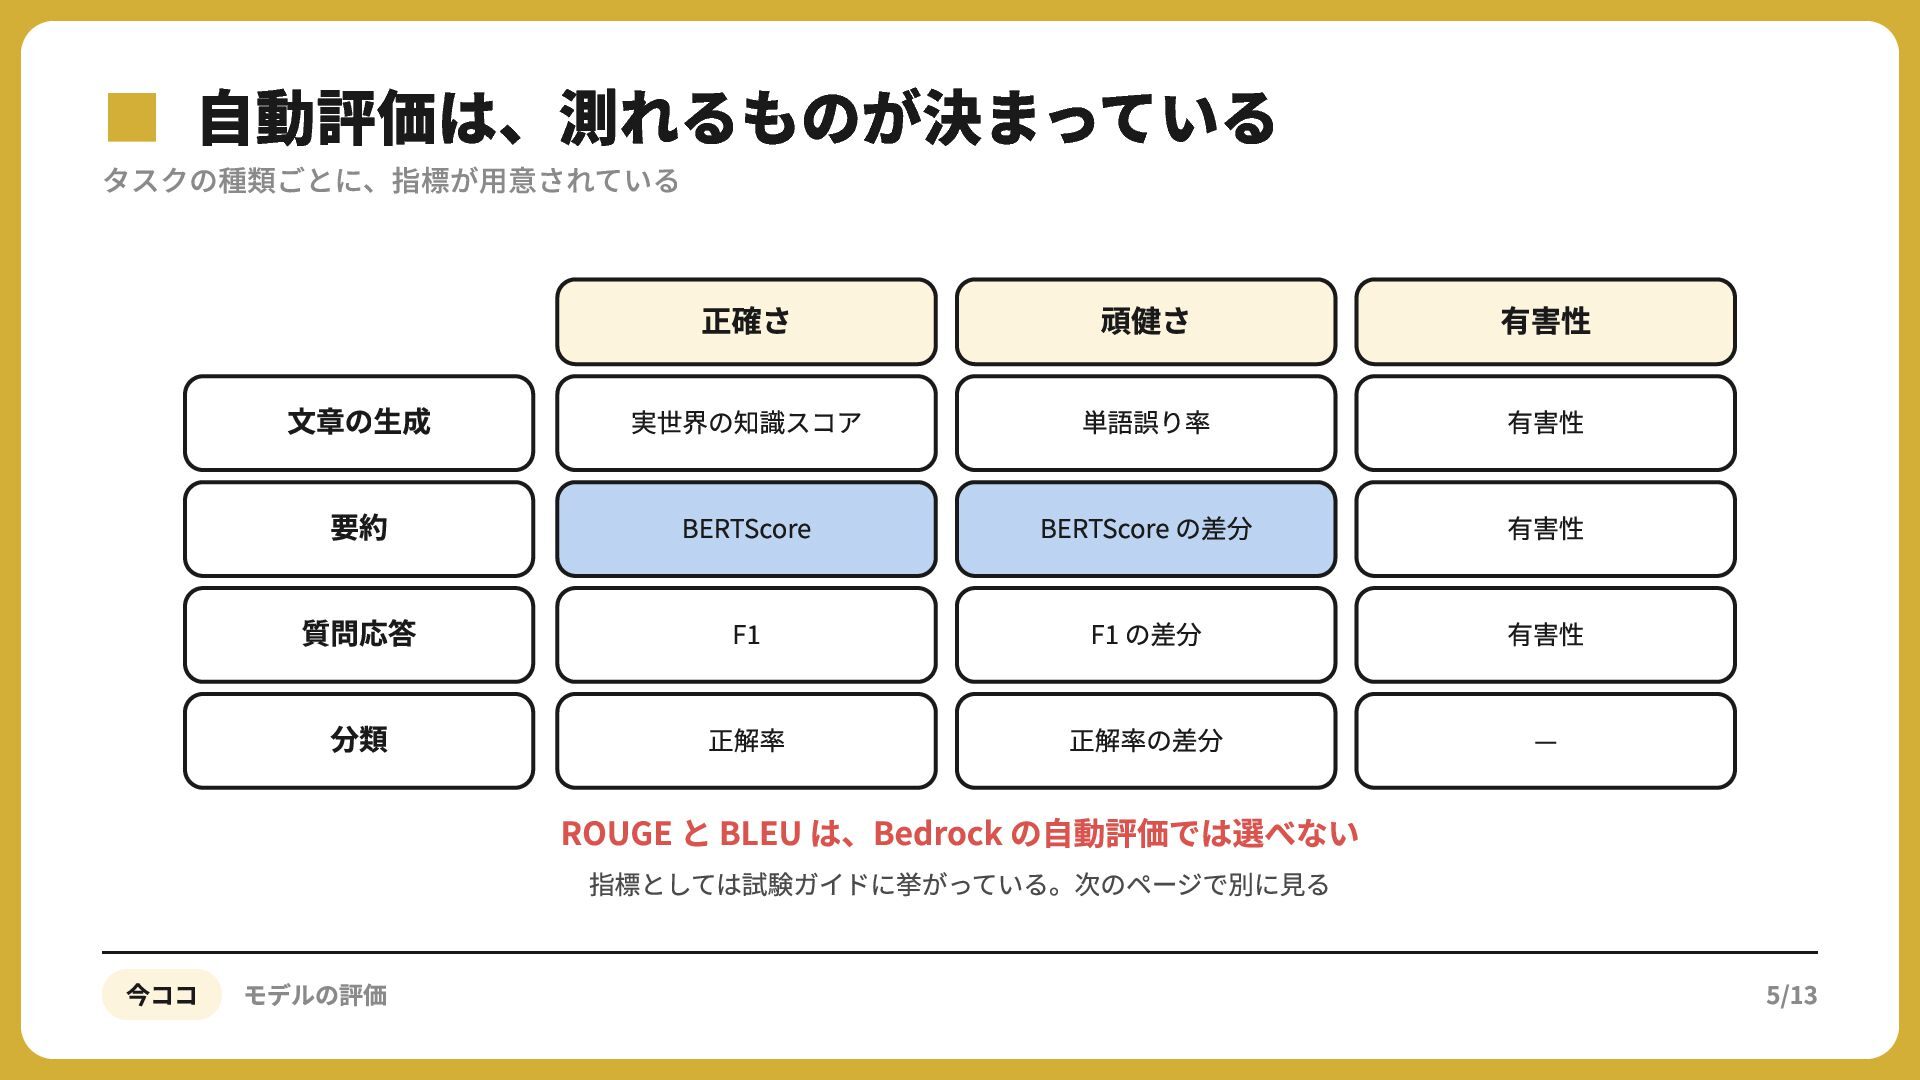
▪タスクの種類ごとに、指標が用意されている 自動評価は、測れるものが決まっている 正確さ 頑健さ 有害性 ⽂章の⽣成 実世界の知識スコア 単語誤り率 有害性 要約
BERTScore BERTScore の差分 有害性 質問応答 F F の差分 有害性 分類 正解率 正解率の差分 — ROUGE と BLEU は、Bedrock の⾃動評価では選べない 指標としては試験ガイドに挙がっている。次のページで別に⾒る 今ココ モデルの評価 5/13
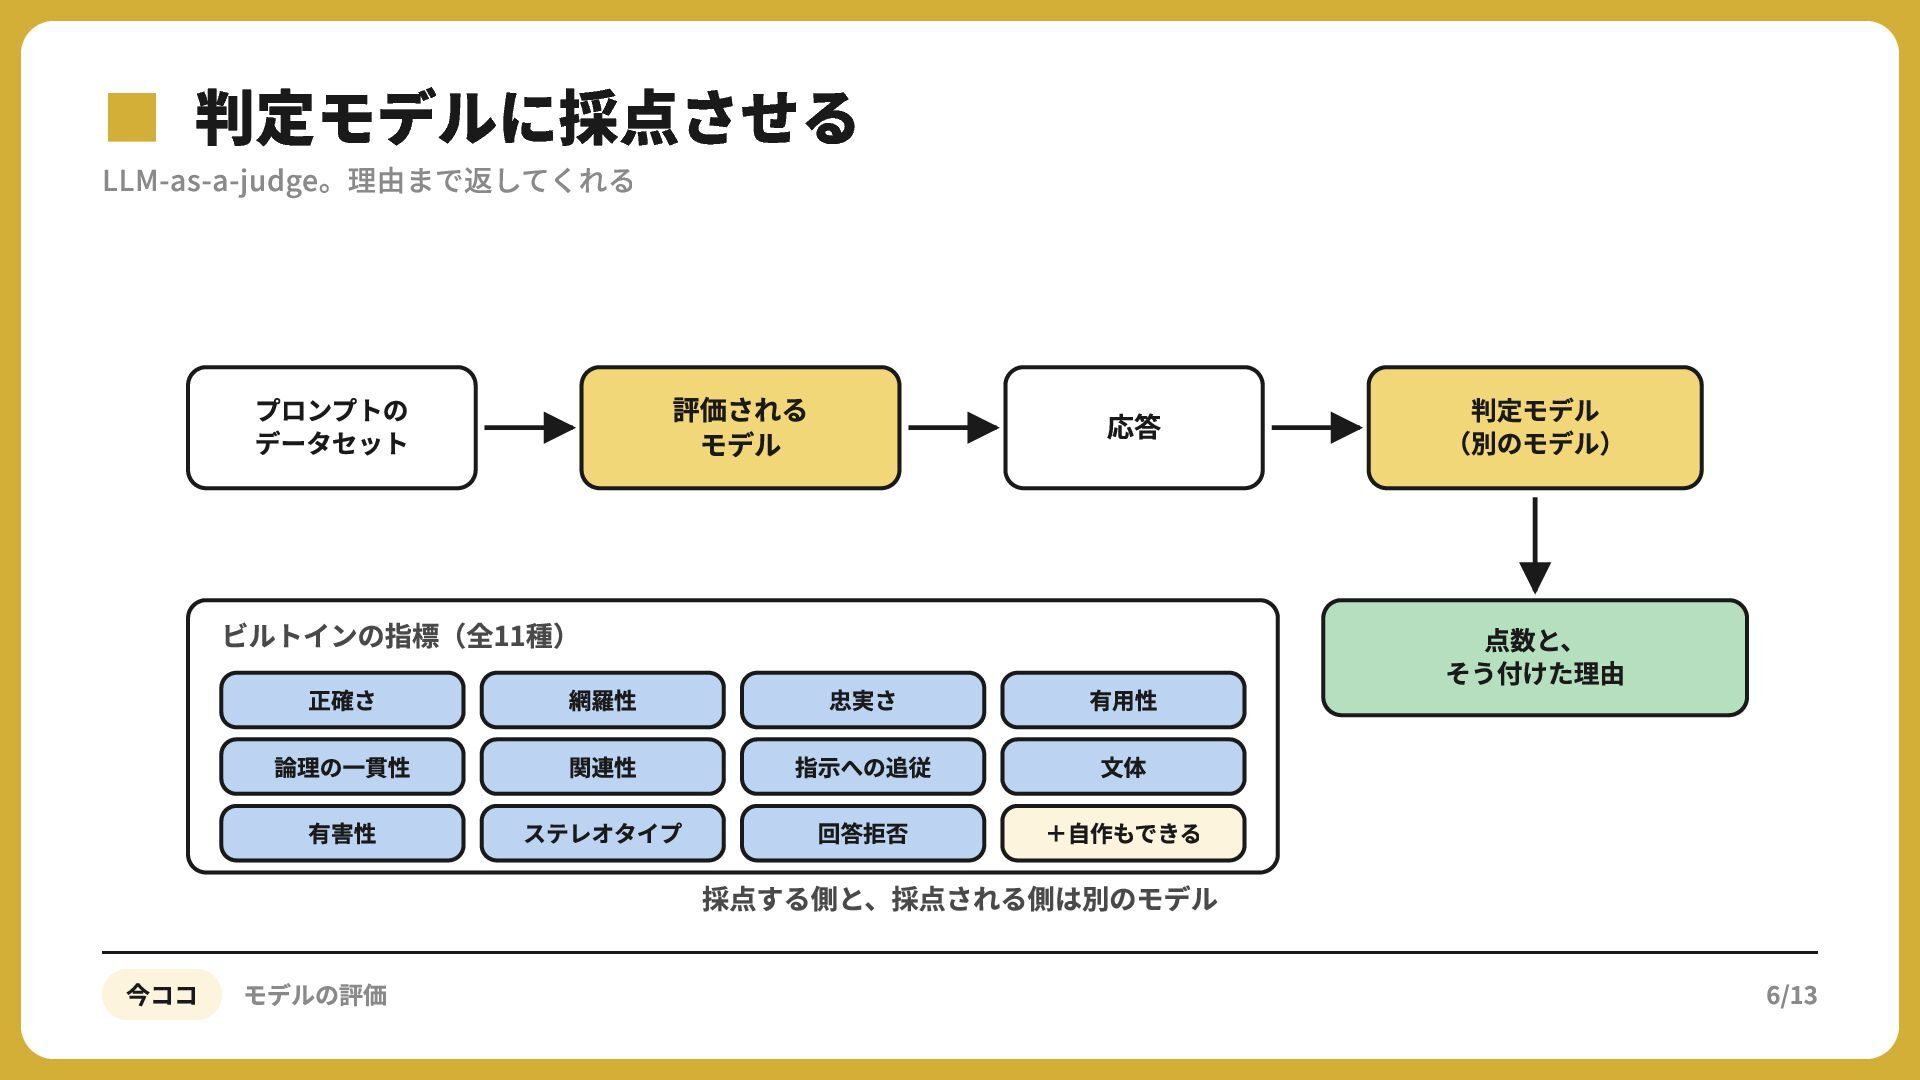
▪LLM-as-a-judge。理由まで返してくれる 判定モデルに採点させる 評価される モデル プロンプトの データセット 応答 ビルトインの指標(全11種) 正確さ 論理の⼀貫性
有害性 今ココ モデルの評価 網羅性 関連性 ステレオタイプ 忠実さ 指⽰への追従 回答拒否 有⽤性 ⽂体 +⾃作もできる 判定モデル (別のモデル) 点数と、 そう付けた理由 採点する側と、採点される側は別のモデル 6/13
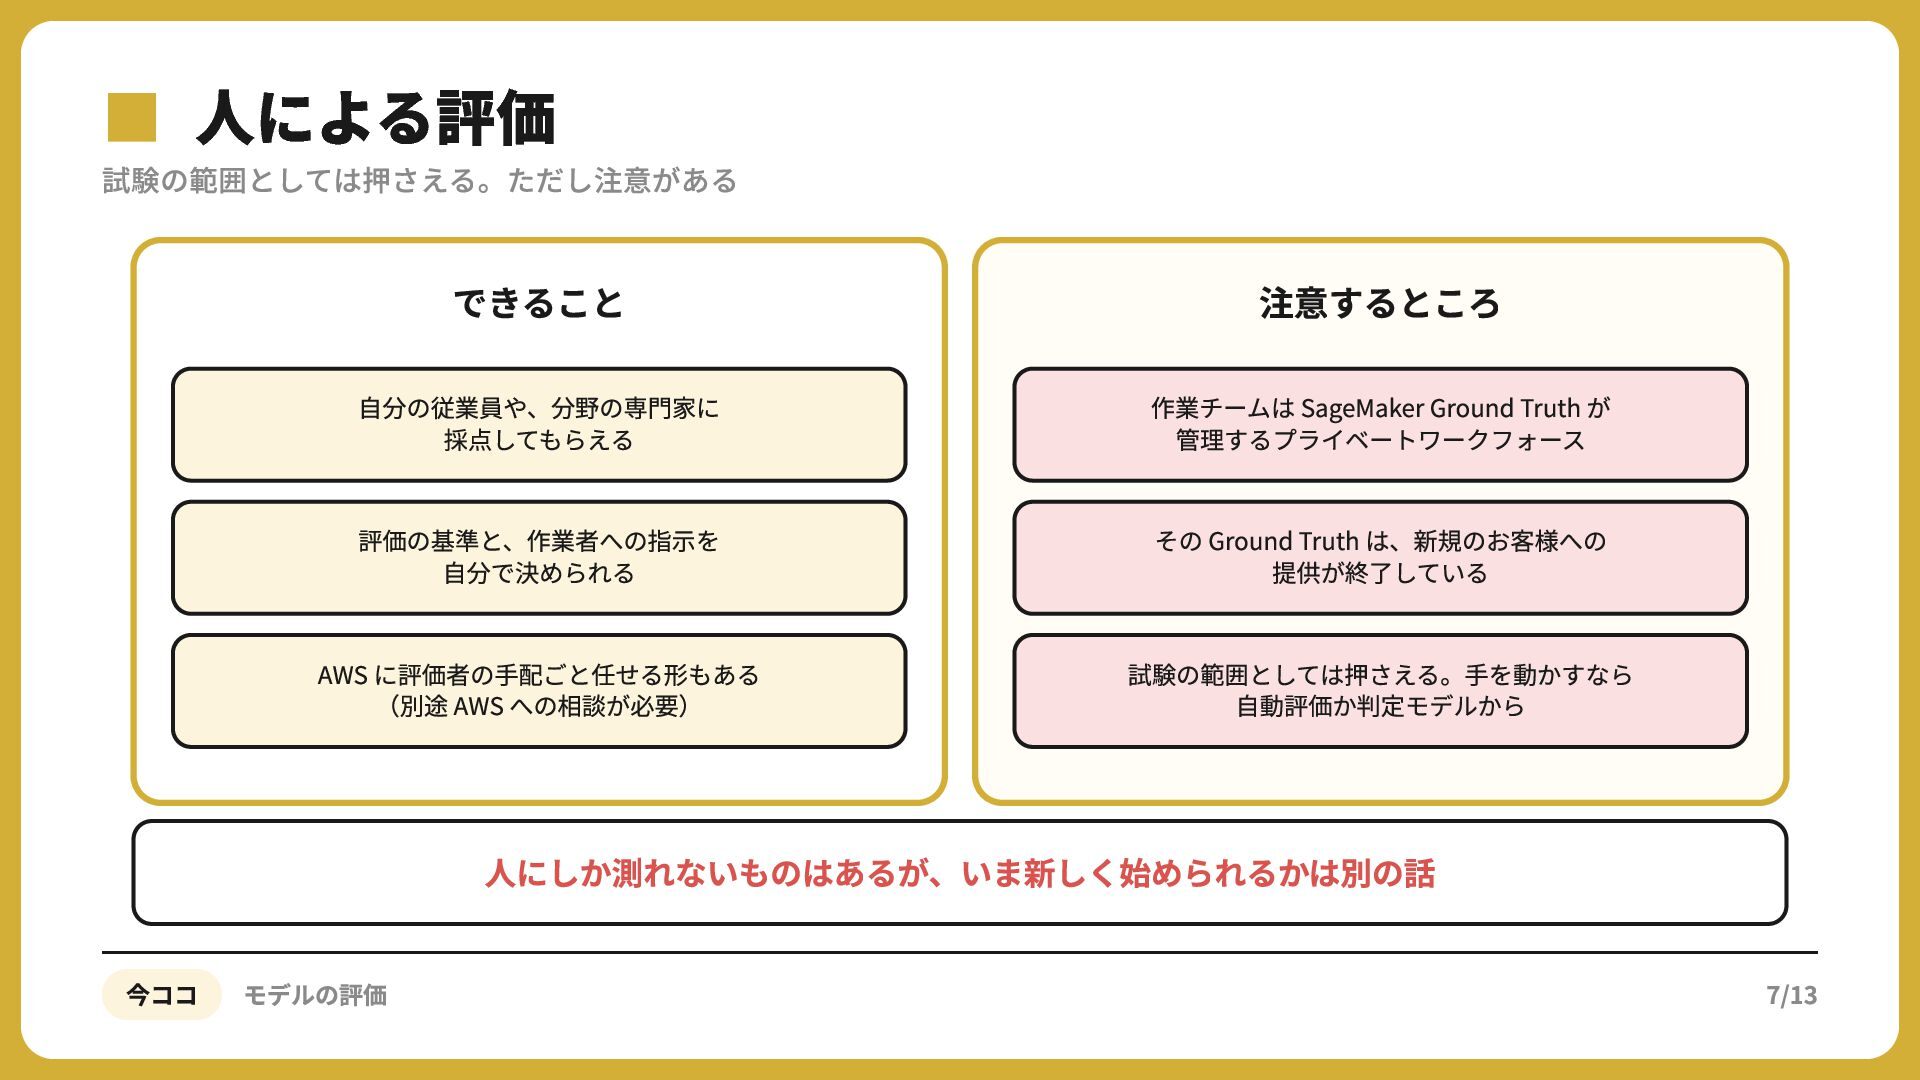
▪試験の範囲としては押さえる。ただし注意がある 人による評価 できること 注意するところ ⾃分の従業員や、分野の専⾨家に 採点してもらえる 作業チームは SageMaker Ground Truth
が 管理するプライベートワークフォース 評価の基準と、作業者への指⽰を ⾃分で決められる その Ground Truth は、新規のお客様への 提供が終了している AWS に評価者の⼿配ごと任せる形もある (別途 AWS への相談が必要) 試験の範囲としては押さえる。⼿を動かすなら ⾃動評価か判定モデルから ⼈にしか測れないものはあるが、いま新しく始められるかは別の話 今ココ モデルの評価 7/13
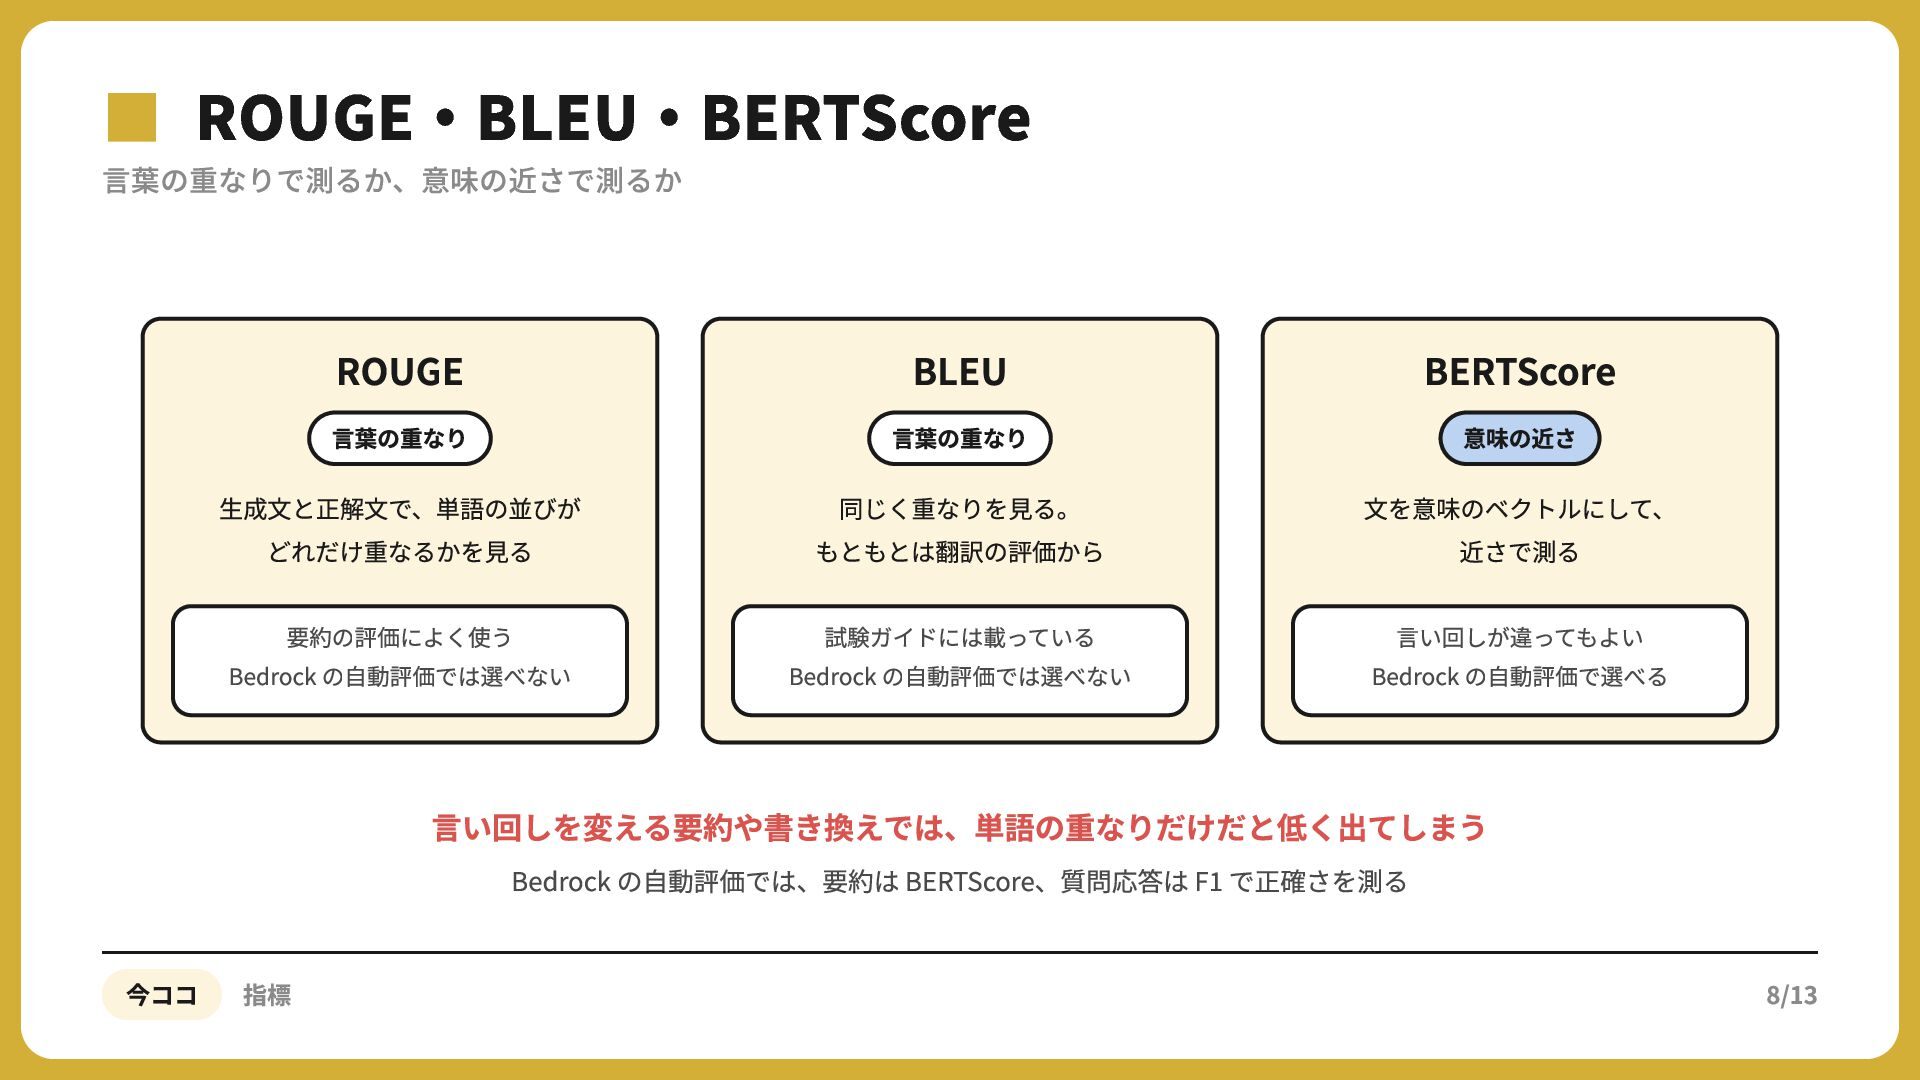
▪言葉の重なりで測るか、意味の近さで測るか ROUGE・BLEU・BERTScore ROUGE ⾔葉の重なり BLEU ⾔葉の重なり BERTScore ⽣成⽂と正解⽂で、単語の並びが どれだけ重なるかを⾒る 同じく重なりを⾒る。
もともとは翻訳の評価から ⽂を意味のベクトルにして、 近さで測る 要約の評価によく使う Bedrock の⾃動評価では選べない 試験ガイドには載っている Bedrock の⾃動評価では選べない ⾔い回しが違ってもよい Bedrock の⾃動評価で選べる 意味の近さ ⾔い回しを変える要約や書き換えでは、単語の重なりだけだと低く出てしまう Bedrock の⾃動評価では、要約は BERTScore、質問応答は F で正確さを測る 今ココ 指標 8/13
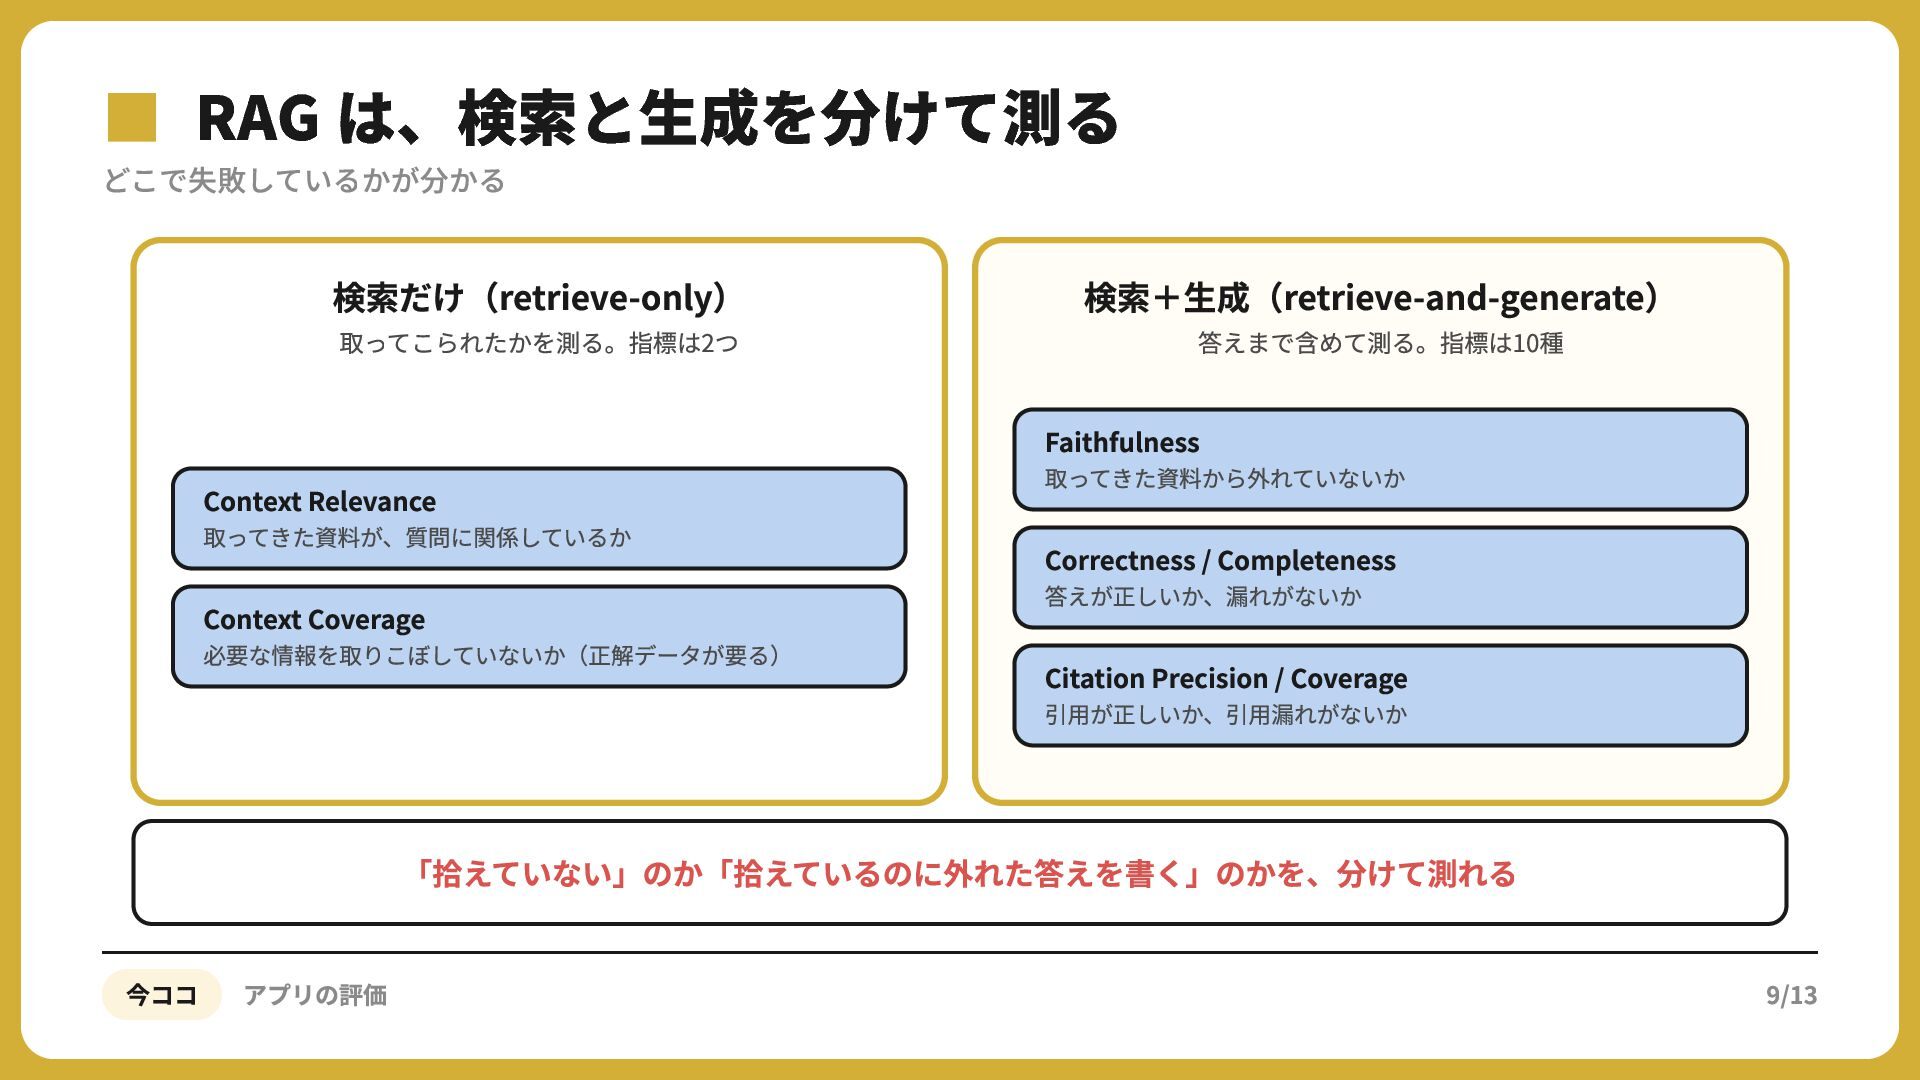
▪どこで失敗しているかが分かる RAG は、検索と生成を分けて測る 検索だけ(retrieve-only) 取ってこられたかを測る。指標は2つ Context Relevance 取ってきた資料が、質問に関係しているか Context Coverage
必要な情報を取りこぼしていないか(正解データが要る) 検索+⽣成(retrieve-and-generate) 答えまで含めて測る。指標は10種 Faithfulness 取ってきた資料から外れていないか Correctness / Completeness 答えが正しいか、漏れがないか Citation Precision / Coverage 引⽤が正しいか、引⽤漏れがないか 「拾えていない」のか「拾えているのに外れた答えを書く」のかを、分けて測れる 今ココ アプリの評価 9/13
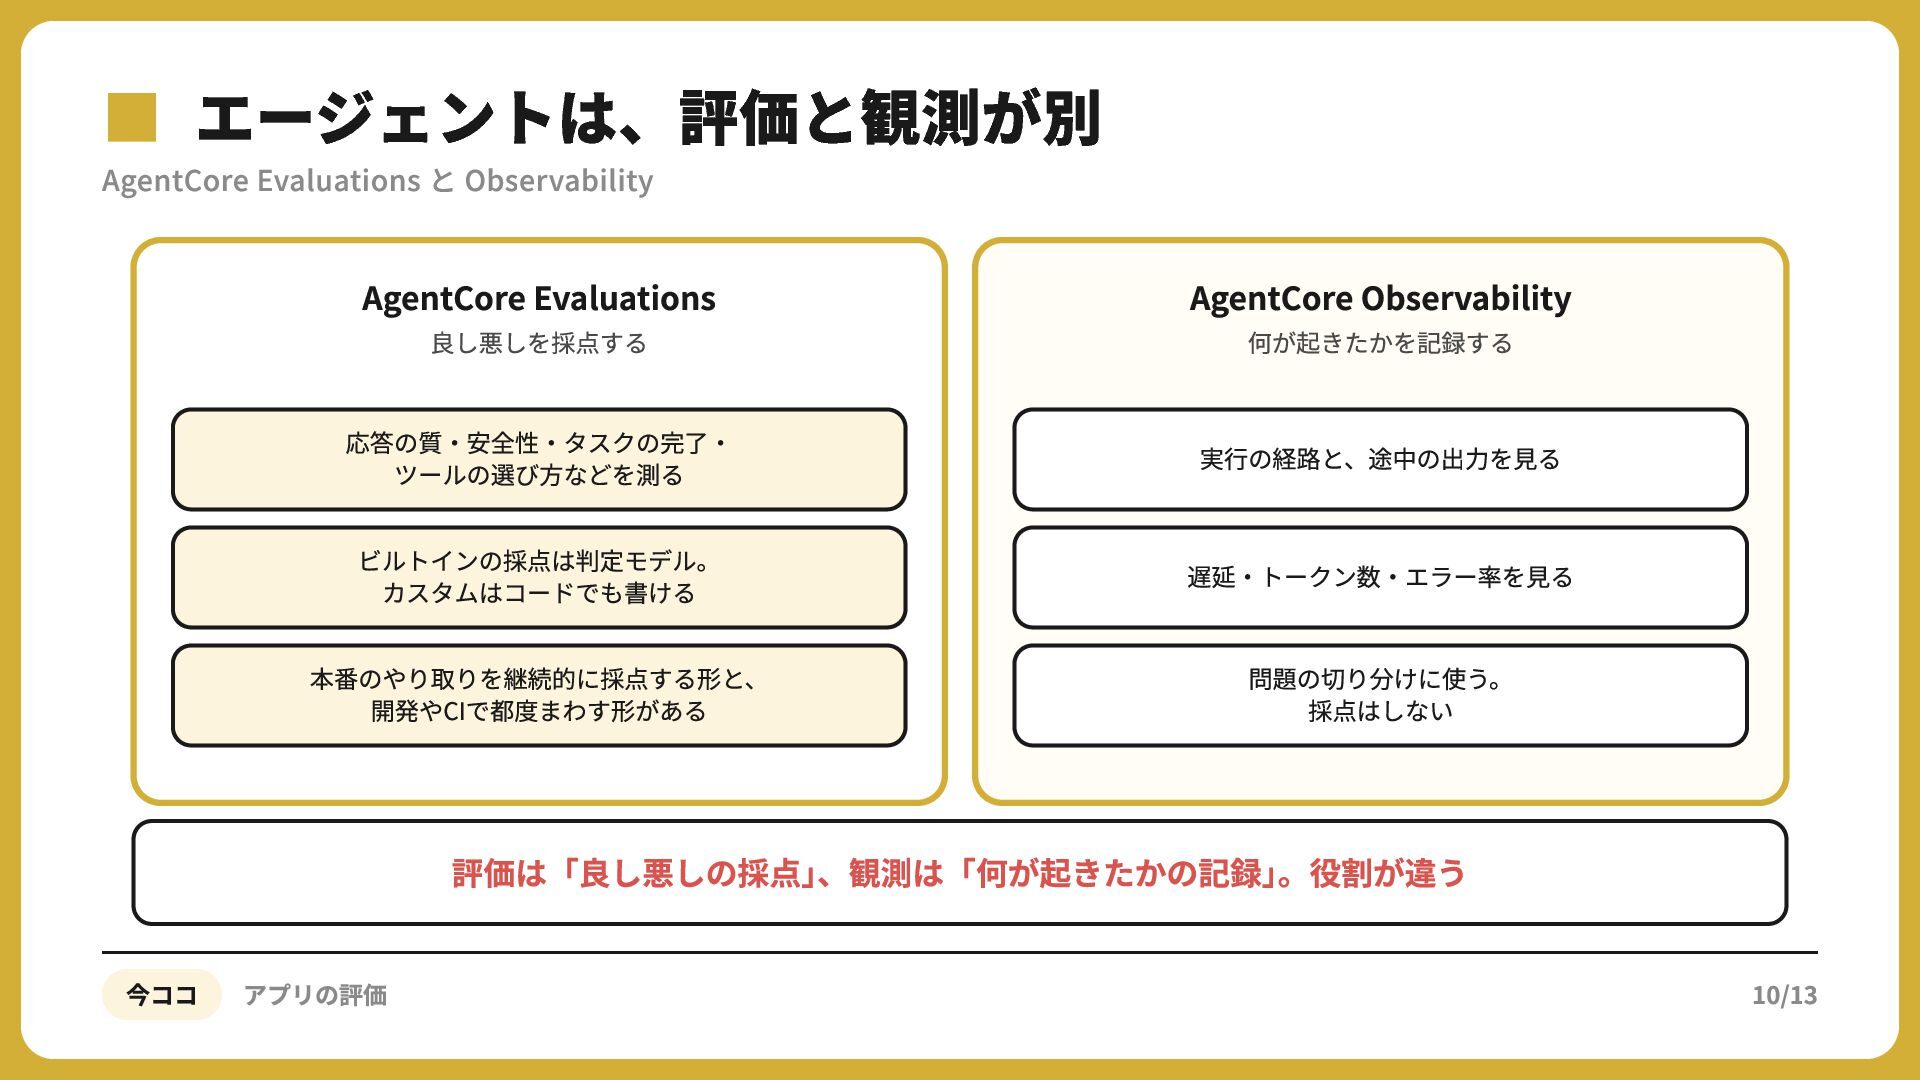
▪AgentCoreエージェントは、評価と観測が別 Evaluations と Observability AgentCore Evaluations AgentCore Observability 応答の質‧安全性‧タスクの完了‧ ツールの選び⽅などを測る
実⾏の経路と、途中の出⼒を⾒る ビルトインの採点は判定モデル。 カスタムはコードでも書ける 遅延‧トークン数‧エラー率を⾒る 本番のやり取りを継続的に採点する形と、 開発やCIで都度まわす形がある 問題の切り分けに使う。 採点はしない 良し悪しを採点する 何が起きたかを記録する 評価は「良し悪しの採点」、観測は「何が起きたかの記録」。役割が違う 今ココ アプリの評価 10/13
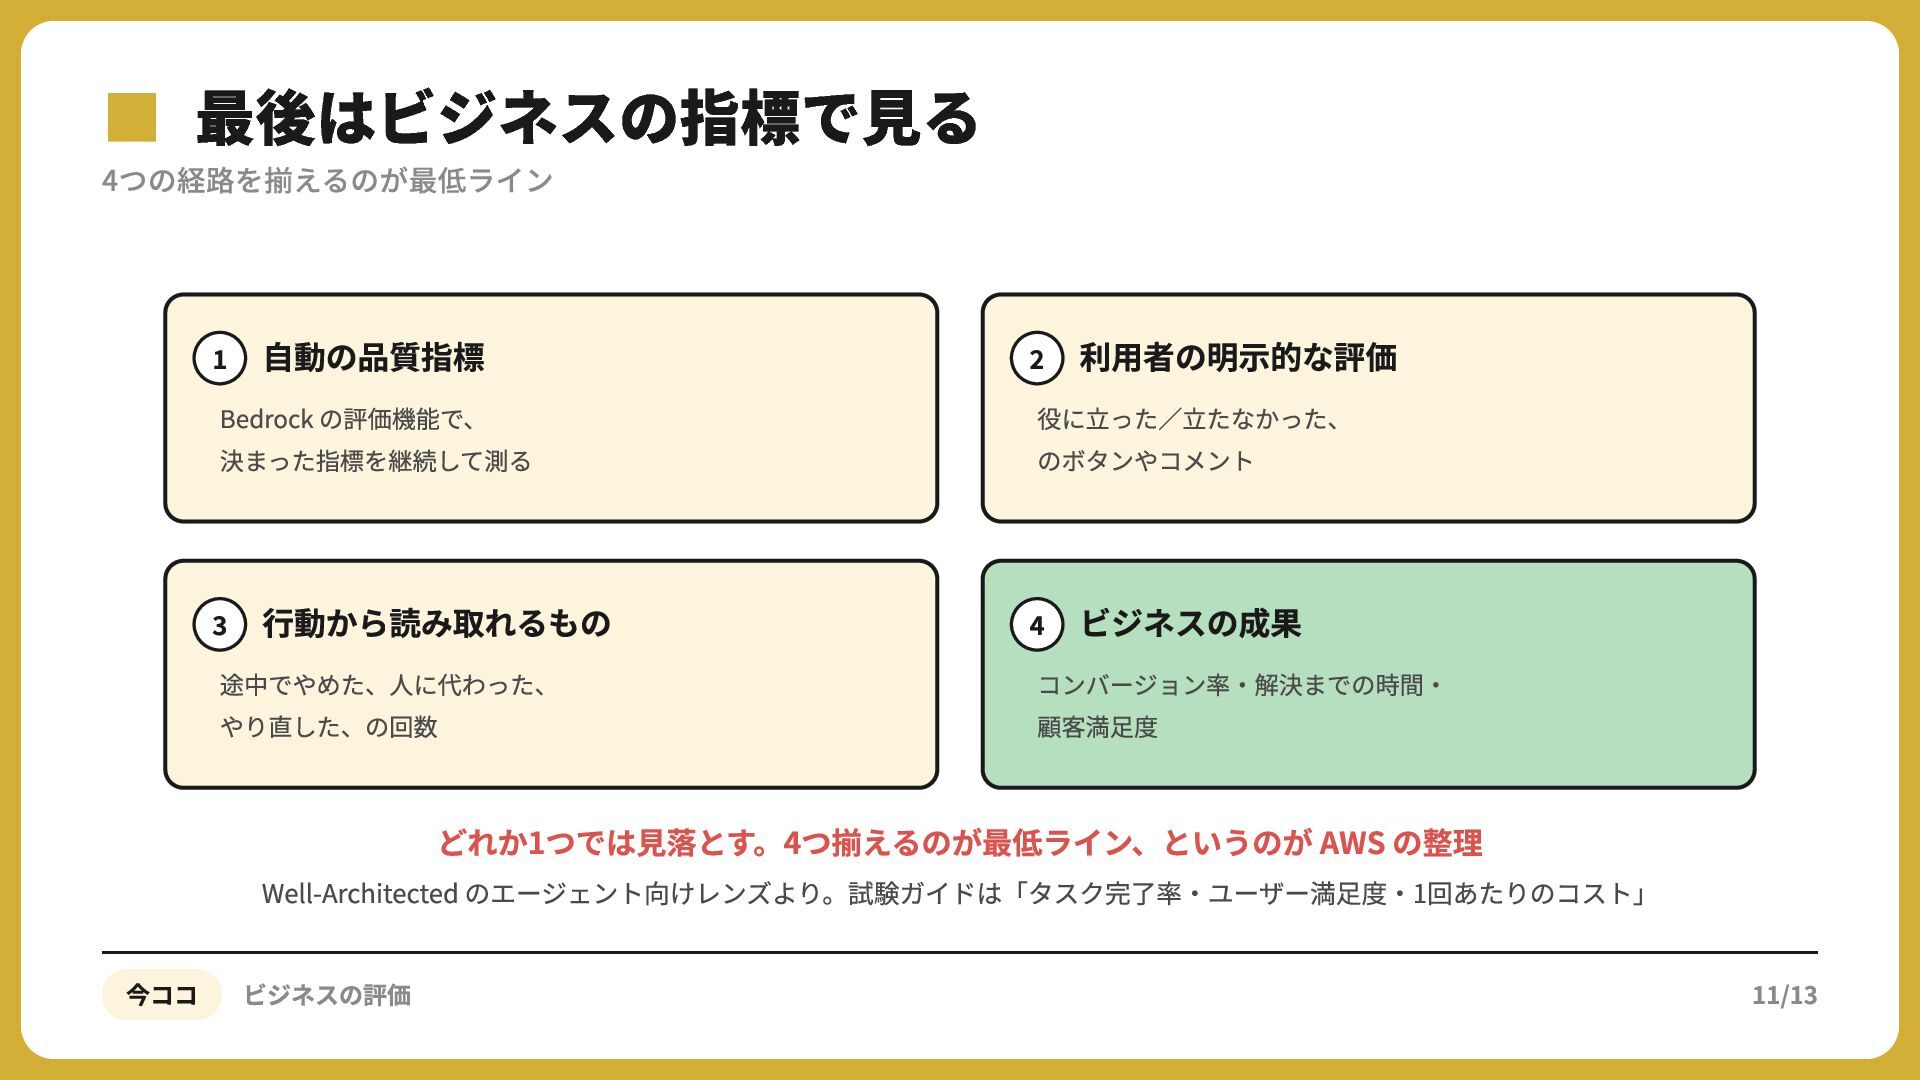
▪4つの経路を揃えるのが最低ライン 最後はビジネスの指標で見る ⾃動の品質指標 Bedrock の評価機能で、 決まった指標を継続して測る ⾏動から読み取れるもの 途中でやめた、⼈に代わった、 やり直した、の回数 利⽤者の明⽰的な評価
役に⽴った∕⽴たなかった、 のボタンやコメント ビジネスの成果 コンバージョン率‧解決までの時間‧ 顧客満⾜度 どれか1つでは⾒落とす。4つ揃えるのが最低ライン、というのが AWS の整理 Well-Architected のエージェント向けレンズより。試験ガイドは「タスク完了率‧ユーザー満⾜度‧1回あたりのコスト」 今ココ ビジネスの評価 11/13
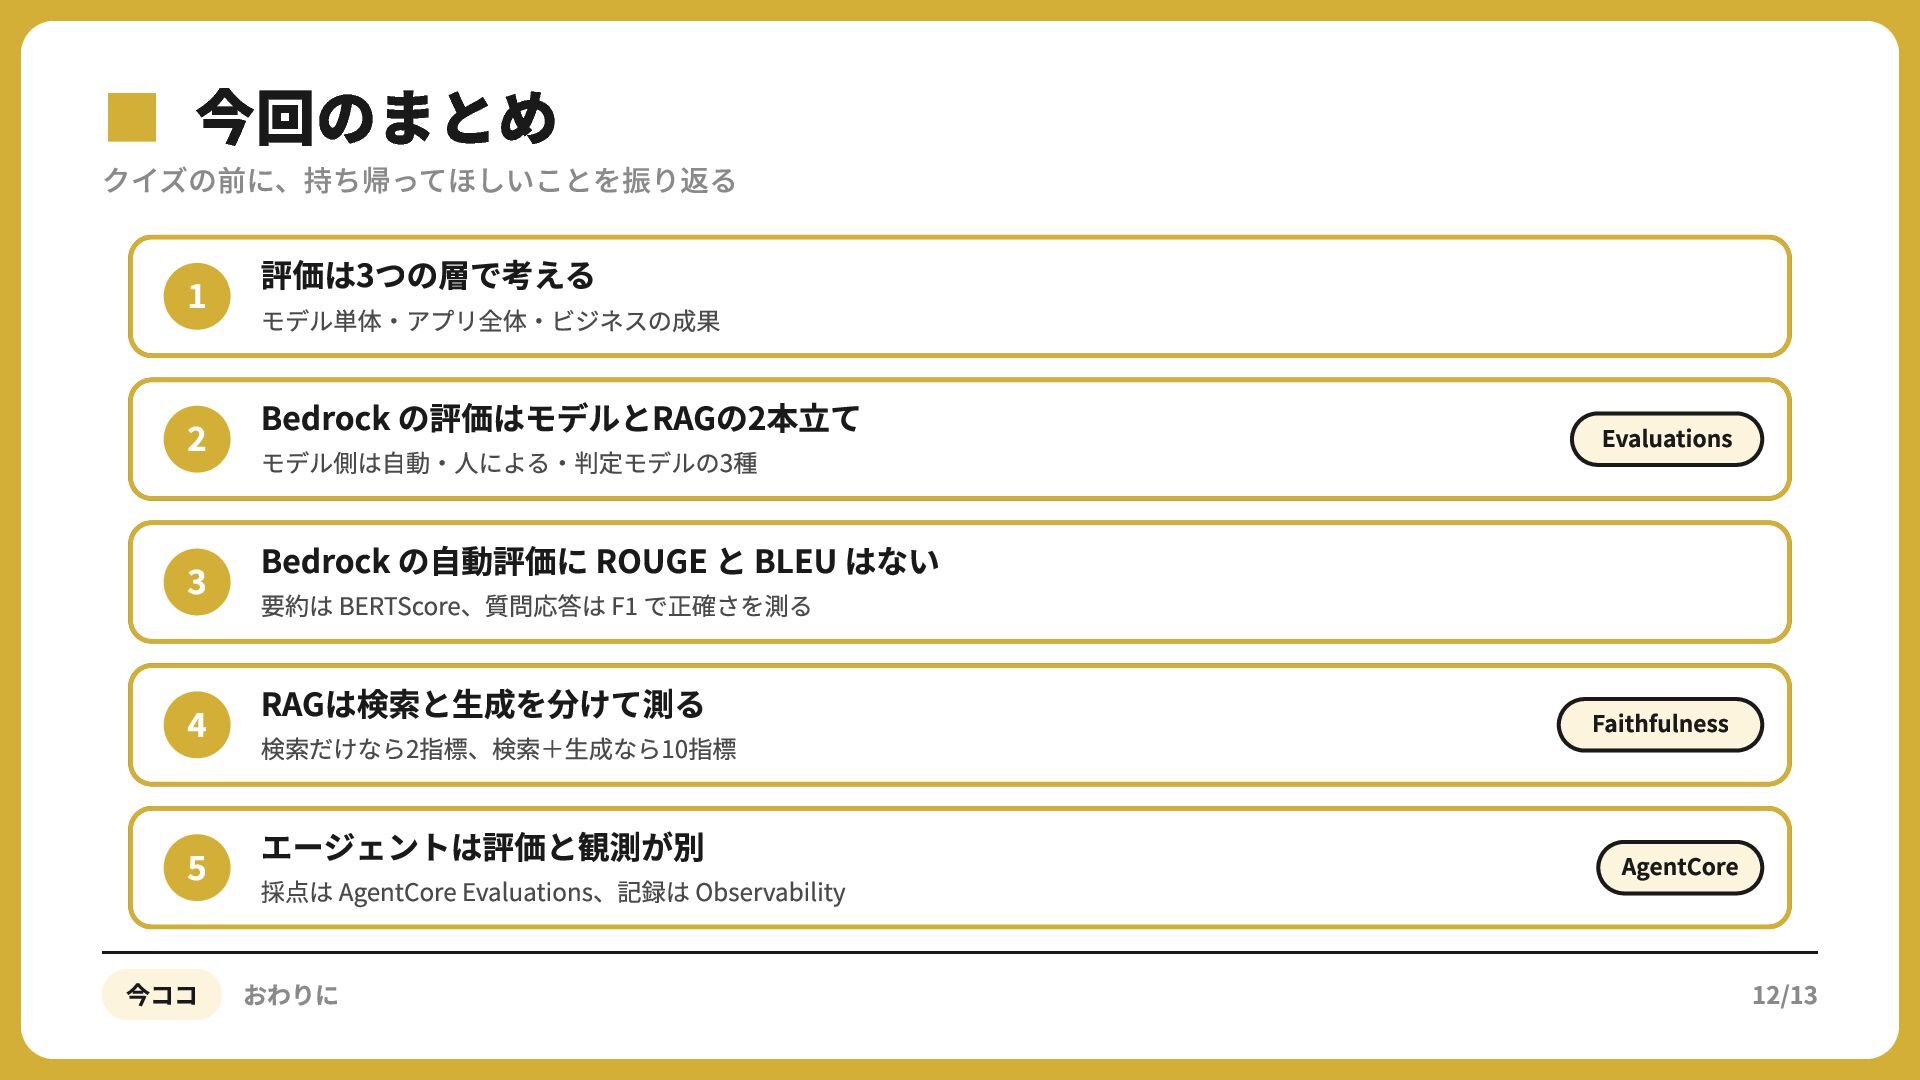
▪クイズの前に、持ち帰ってほしいことを振り返る 今回のまとめ 評価は3つの層で考える モデル単体‧アプリ全体‧ビジネスの成果 Bedrock の評価はモデルとRAGの2本⽴て モデル側は⾃動‧⼈による‧判定モデルの3種 Evaluations Bedrock の⾃動評価に
ROUGE と BLEU はない 要約は BERTScore、質問応答は F で正確さを測る RAGは検索と⽣成を分けて測る Faithfulness エージェントは評価と観測が別 AgentCore 検索だけなら2指標、検索+⽣成なら10指標 採点は AgentCore Evaluations、記録は Observability 今ココ おわりに 12/13
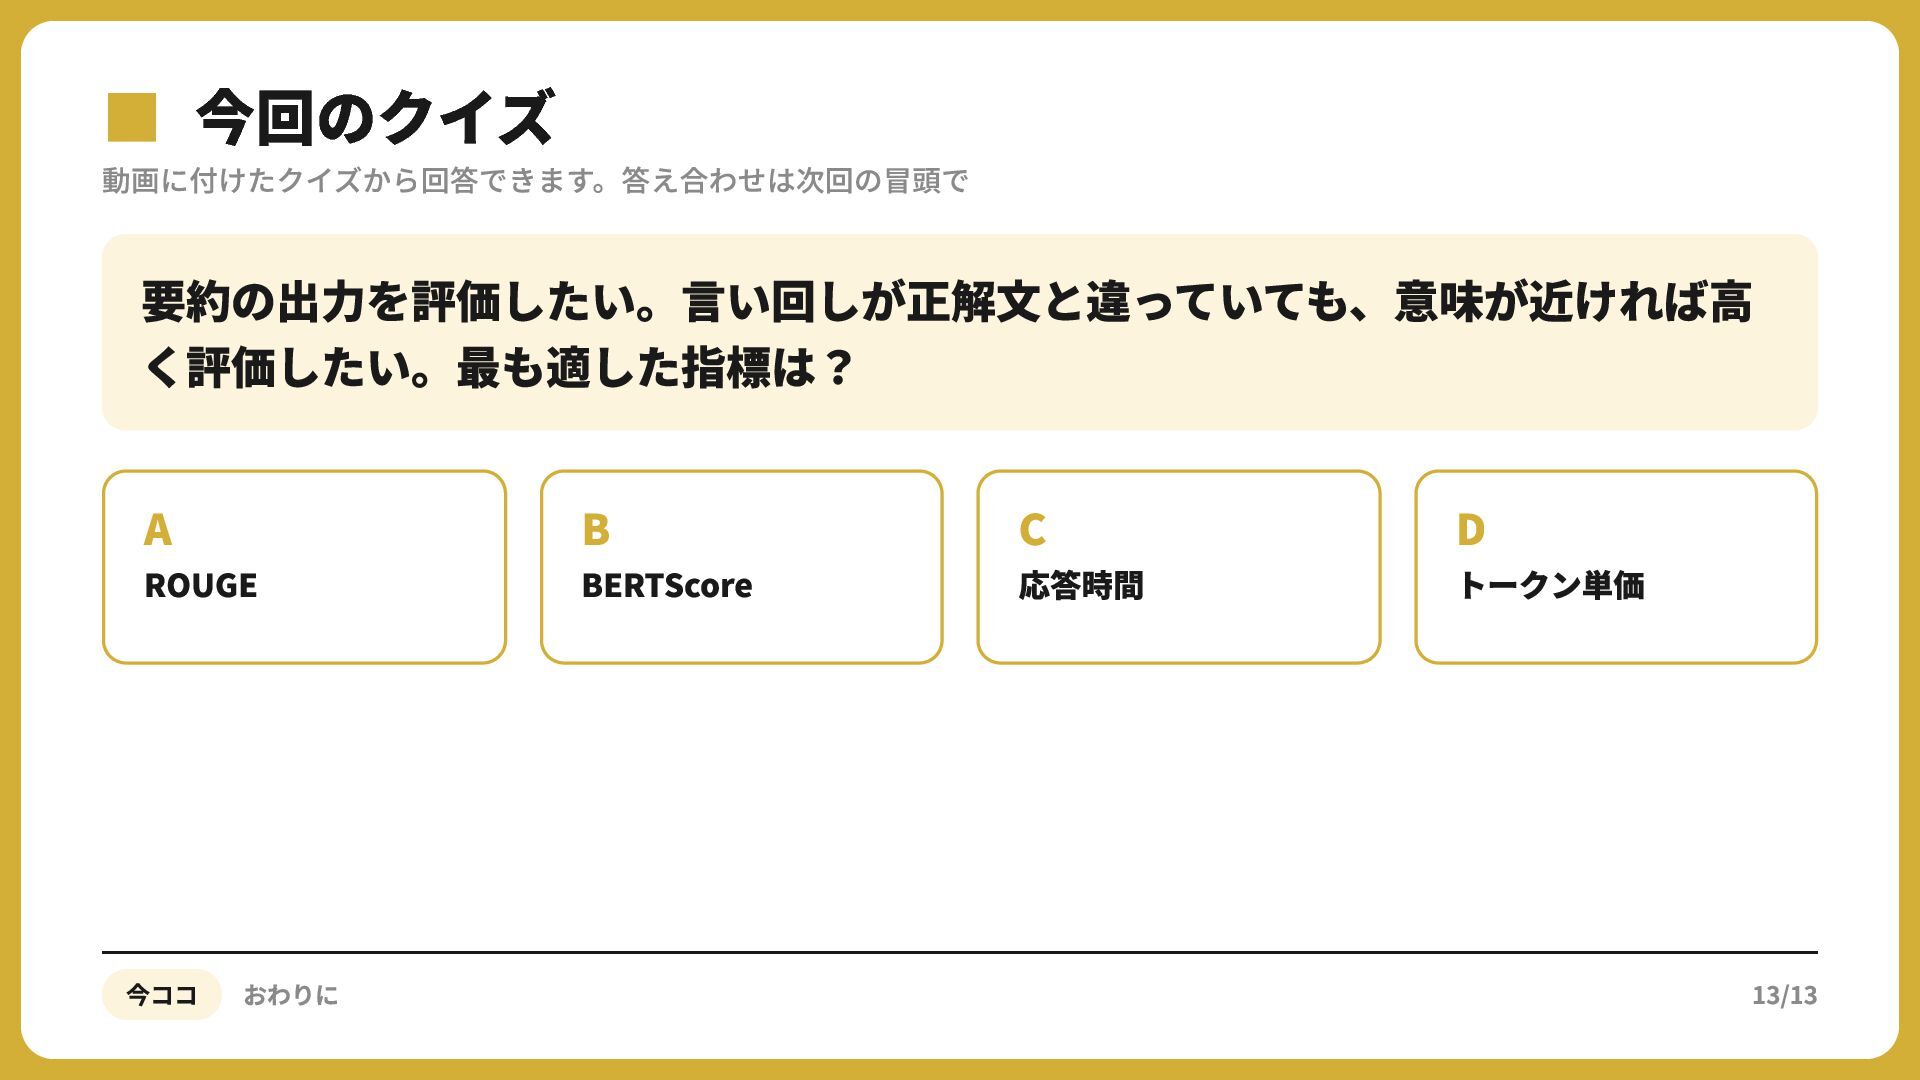
▪動画に付けたクイズから回答できます。答え合わせは次回の冒頭で 今回のクイズ 要約の出力を評価したい。言い回しが正解文と違っていても、意味が近ければ高 く評価したい。最も適した指標は? A ROUGE 今ココ おわりに B BERTScore
C 応答時間 D トークン単価 13/13


 akagami
 yuukiw00w
 dske104
 atsuki_seo
 trickart
 yusuga
 ivargrimstad
 findyinc
 yosuke_furukawa
 eijirou
 rockname
 yukiny
 curekoshimizu
 tenderlove
 zakiyama
 sabderemane
 lara
 jct
 stuffmc
 takai
 kneath
 marcduiker
 aleyda
 reverentgeek
 tammielis