Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
【AWS AIF対策】モデルの学習とファインチューニング
Search
赤神青空
PRO
October 02, 2026
Video
Programming
6
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
【AWS AIF対策】モデルの学習とファインチューニング
赤神青空
PRO
October 02, 2026
Video
More Decks by 赤神青空
See All by 赤神青空
【AWS AIF対策】プロンプトエンジニアリング
akagami
PRO
0
11
【AWS AIF対策】RAGとベクトルデータベース
akagami
PRO
0
10
【AWS AIF対策】基盤モデルの選び方と推論パラメータ
akagami
PRO
0
16
【AWS AIF対策】AWSの生成AIサービスの全体像
akagami
PRO
0
26
【AWS AIF対策】エージェント型AIとMCP
akagami
PRO
0
24
【AWS AIF対策】生成AIの得意・不得意とコスト
akagami
PRO
0
25
【AWS AIF対策】生成AIの基本用語
akagami
PRO
0
31
【AWS AIF対策】ML開発の流れと評価指標
akagami
PRO
0
28
【AWS AIF対策】AWSのAIサービスの使い分け
akagami
PRO
0
36
Other Decks in Programming
See All in Programming
AI Agent時代のリアーキテクチャ戦略と実践
hokaccha
9
5.2k
Webの地図
yosuke_furukawa
PRO
6
5k
IBM Bob Dojo #1 仕様駆動開発入門
oniak3ibm
PRO
0
320
速く作れる。その次は、速く確かめられる開発へ 〜AIネイティブ開発を支える、Shift Down〜 / Can build fast. Next, moving to development where we can verify fast.
rkaga
8
5.2k
thread_parallel_with_free-threaded_Python_and_NumPy.pdf
riku_sakamoto
0
370
Ghostty + Neovimで作る 透明でカッコ良い開発環境
j341nono
0
150
iOSDCのペンライトを自動制御したい!
akkeylab
0
270
C#の現在地 進化の歴史と、AI時代の.NET Everywhere
neuecc
5
4.5k
モジュールの視点からSwiftを読み解く #iosdc
s_shimotori
0
280
コードレビューのボトルネックを"する側"と"される側"の両面から解消する
yub0n
1
710
JAWS-UG 東京支部が始める、JAWS-UG支部コラボ / JAWS-UG lunchtime LT Collaboration
y0hgi
0
170
Heart of Swift Concurrency
koher
0
1.1k
Featured
See All Featured
The Mindset for Success: Future Career Progression
greggifford
PRO
0
520
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
250
Hiding What from Whom? A Critical Review of the History of Programming languages for Music
tomoyanonymous
3
1.3k
The Director’s Chair: Orchestrating AI for Truly Effective Learning
tmiket
1
310
How People are Using Generative and Agentic AI to Supercharge Their Products, Projects, Services and Value Streams Today
helenjbeal
1
340
Done Done
chrislema
187
17k
Navigating the Design Leadership Dip - Product Design Week Design Leaders+ Conference 2024
apolaine
2
450
BBQ
matthewcrist
89
10k
Digital Ethics as a Driver of Design Innovation
axbom
PRO
1
440
GitHub's CSS Performance
jonrohan
1033
470k
Improving Core Web Vitals using Speculation Rules API
sergeychernyshev
21
1.6k
Speed Design
sergeychernyshev
33
2.1k
Transcript
2026年9月 モデルの学習とファインチューニング AWS Certified AI Practitioner 対策 #12 赤神青空
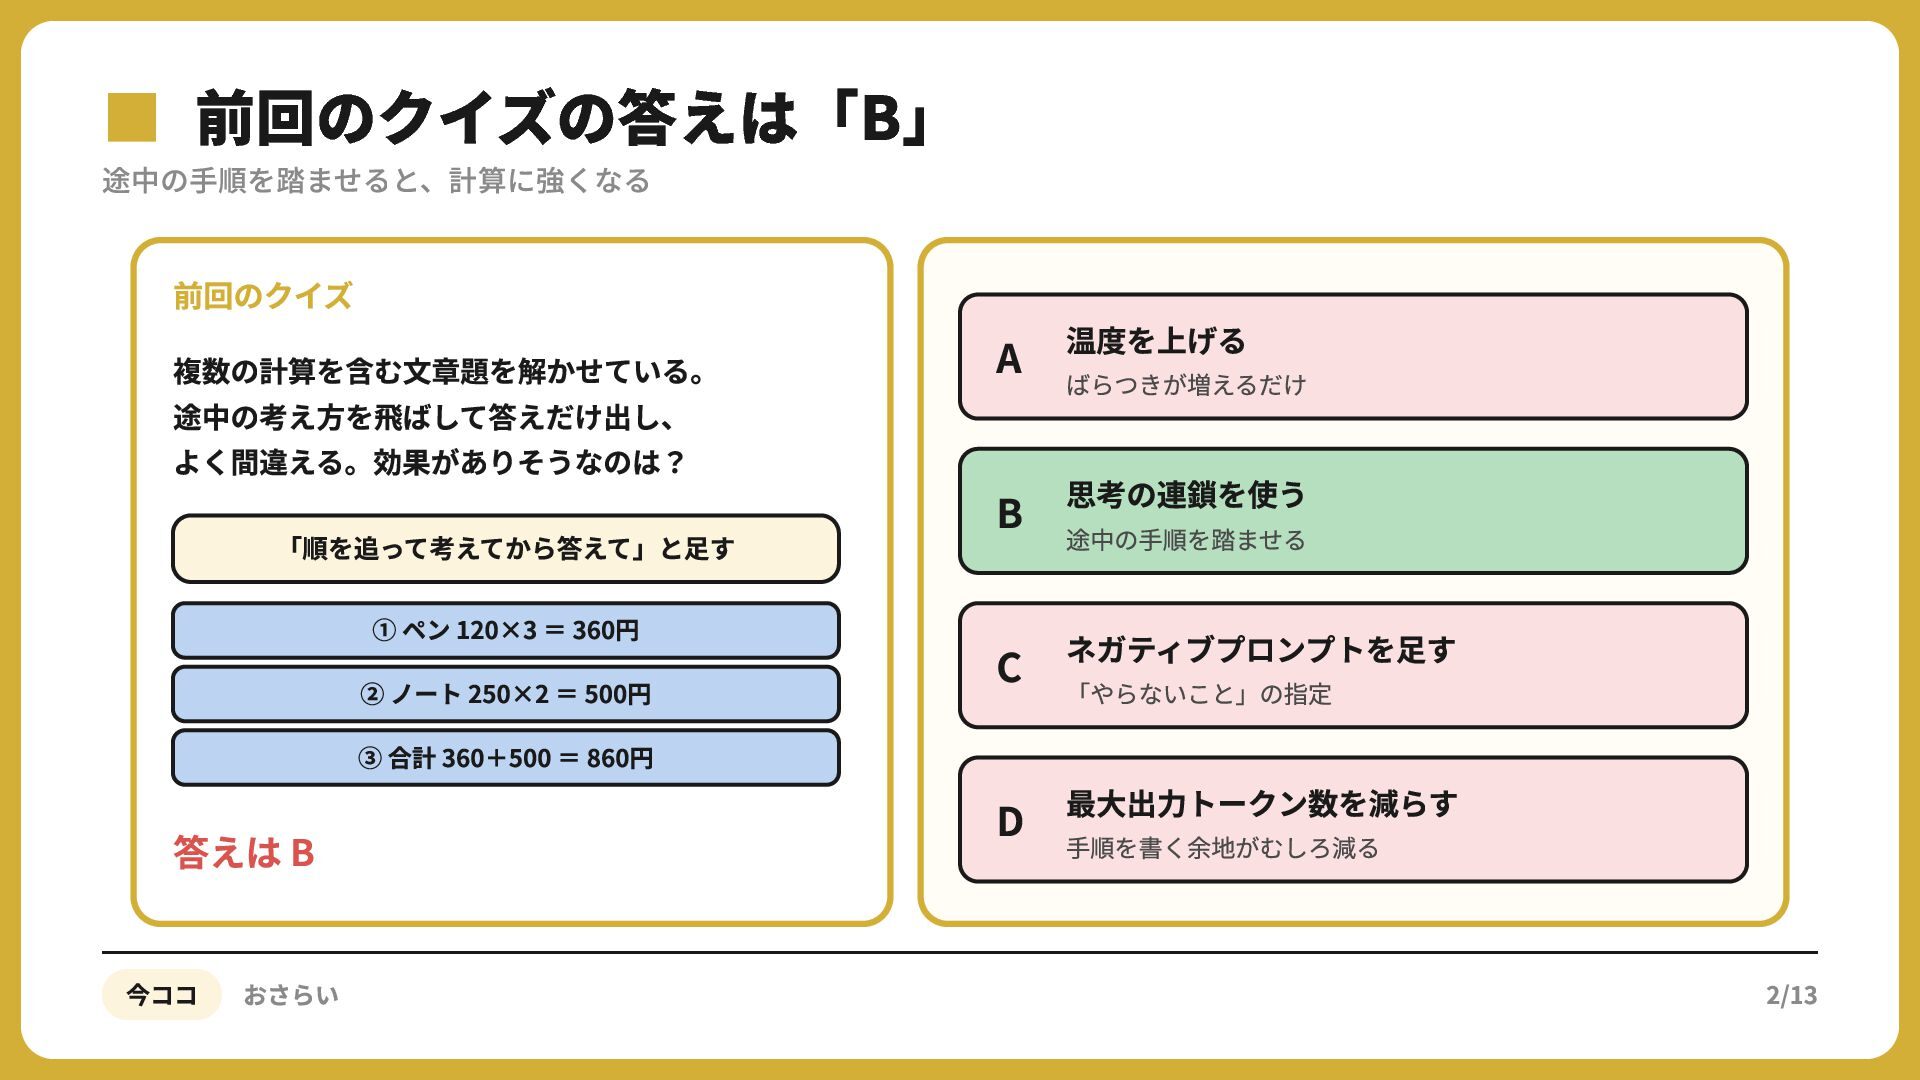
▪途中の手順を踏ませると、計算に強くなる 前回のクイズの答えは「B」 前回のクイズ 複数の計算を含む⽂章題を解かせている。 途中の考え⽅を⾶ばして答えだけ出し、 よく間違える。効果がありそうなのは? 「順を追って考えてから答えて」と⾜す ① ペン 120×3
= 360円 ② ノート 250×2 = 500円 ③ 合計 360+500 = 860円 答えは B 今ココ おさらい A 温度を上げる ばらつきが増えるだけ B 思考の連鎖を使う 途中の⼿順を踏ませる C ネガティブプロンプトを⾜す 「やらないこと」の指定 D 最⼤出⼒トークン数を減らす ⼿順を書く余地がむしろ減る 2/13
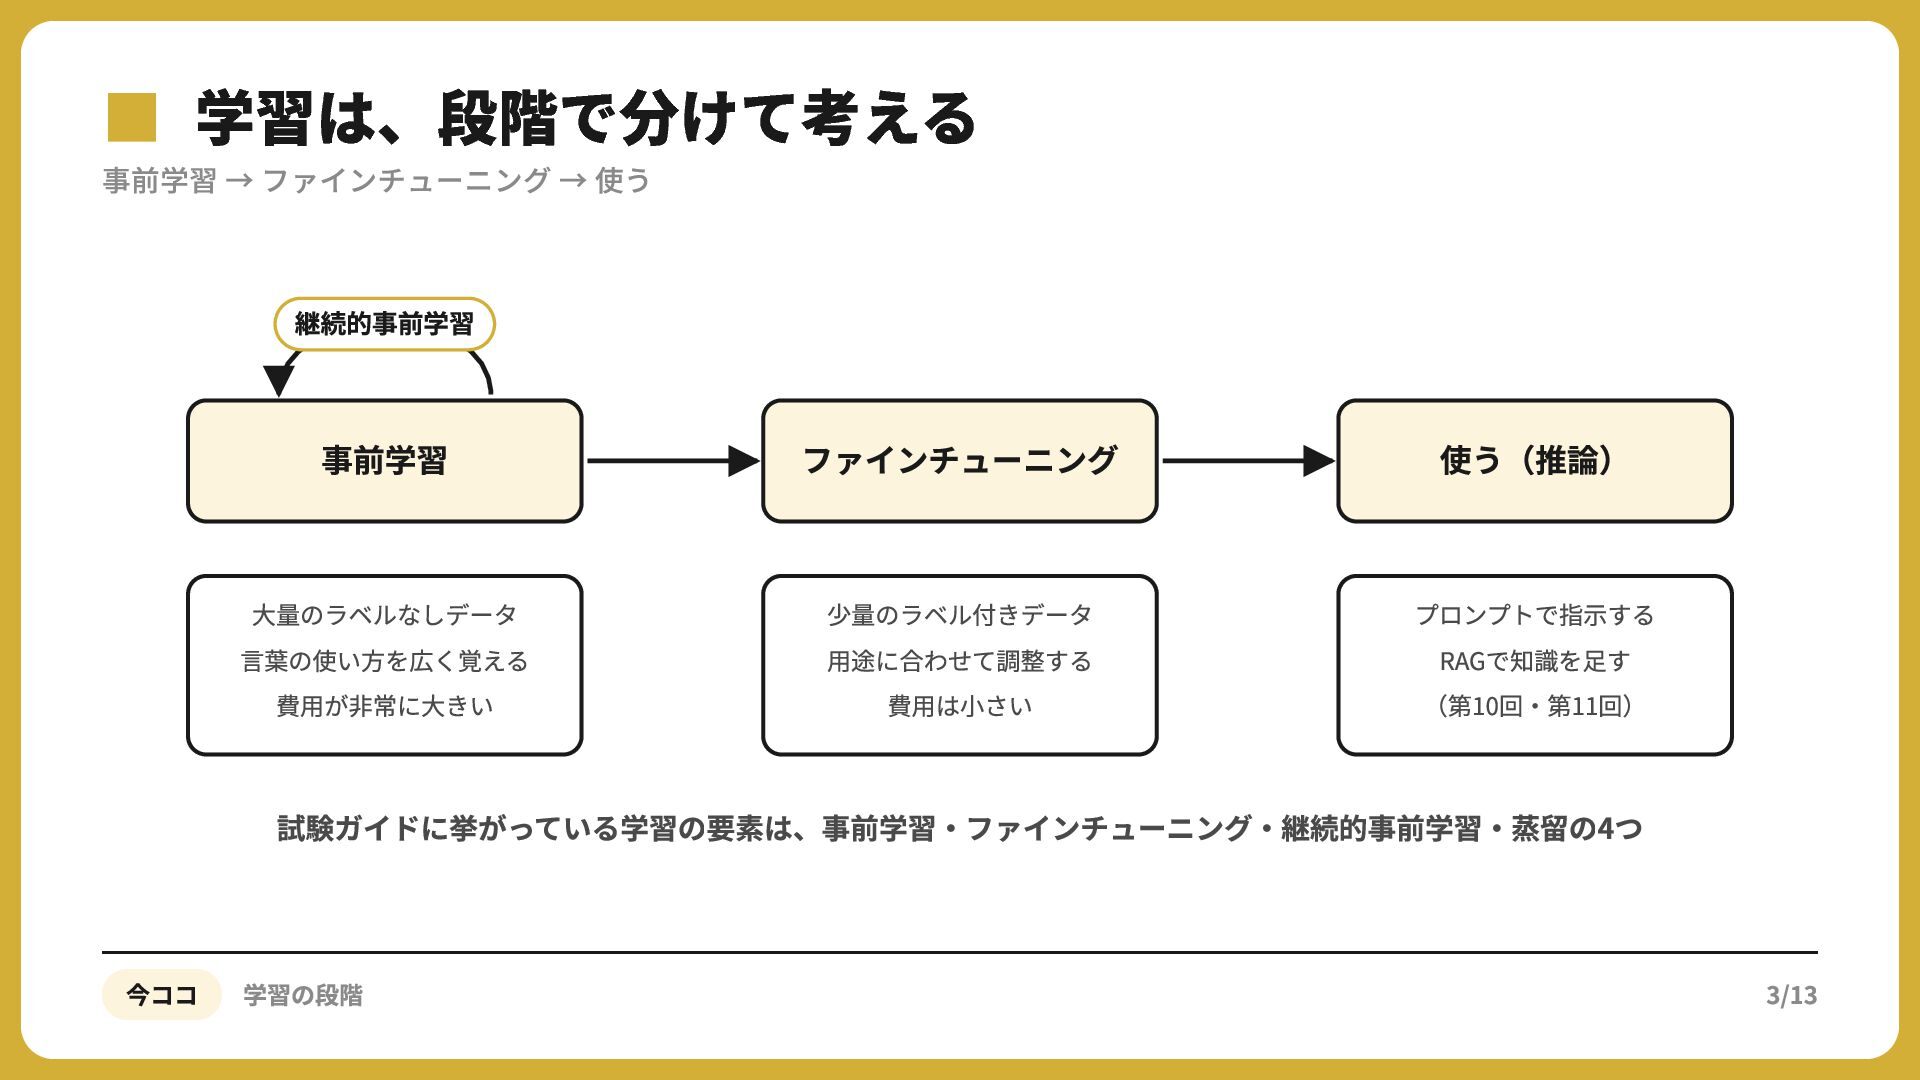
▪事前学習学習は、段階で分けて考える → ファインチューニング → 使う 継続的事前学習 事前学習 ファインチューニング 使う(推論) ⼤量のラベルなしデータ
⾔葉の使い⽅を広く覚える 費⽤が⾮常に⼤きい 少量のラベル付きデータ ⽤途に合わせて調整する 費⽤は⼩さい プロンプトで指⽰する RAGで知識を⾜す (第10回‧第11回) 試験ガイドに挙がっている学習の要素は、事前学習‧ファインチューニング‧継続的事前学習‧蒸留の4つ 今ココ 学習の段階 3/13
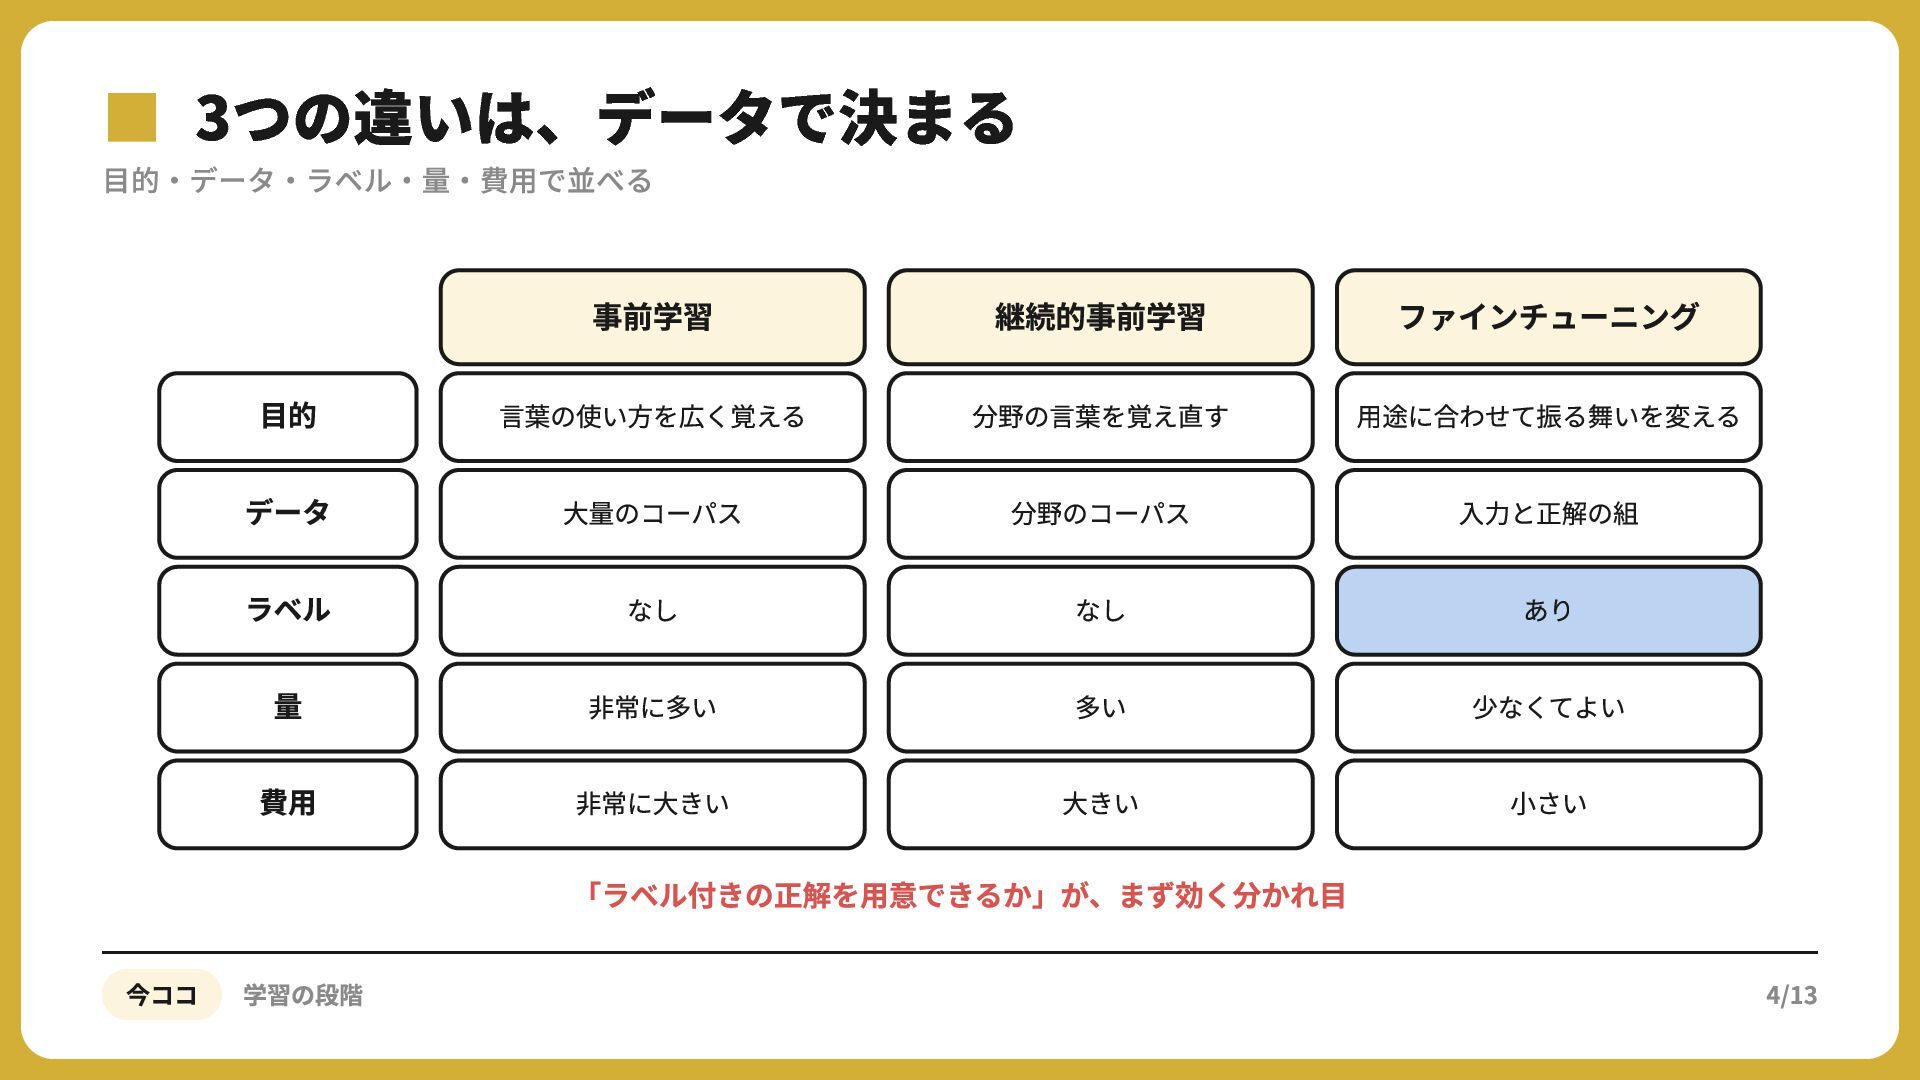
▪目的・データ・ラベル・量・費用で並べる 3つの違いは、データで決まる 事前学習 継続的事前学習 ファインチューニング ⽬的 ⾔葉の使い⽅を広く覚える 分野の⾔葉を覚え直す ⽤途に合わせて振る舞いを変える データ
⼤量のコーパス 分野のコーパス ⼊⼒と正解の組 ラベル なし なし あり 量 ⾮常に多い 多い 少なくてよい 費⽤ ⾮常に⼤きい ⼤きい ⼩さい 「ラベル付きの正解を⽤意できるか」が、まず効く分かれ⽬ 今ココ 学習の段階 4/13
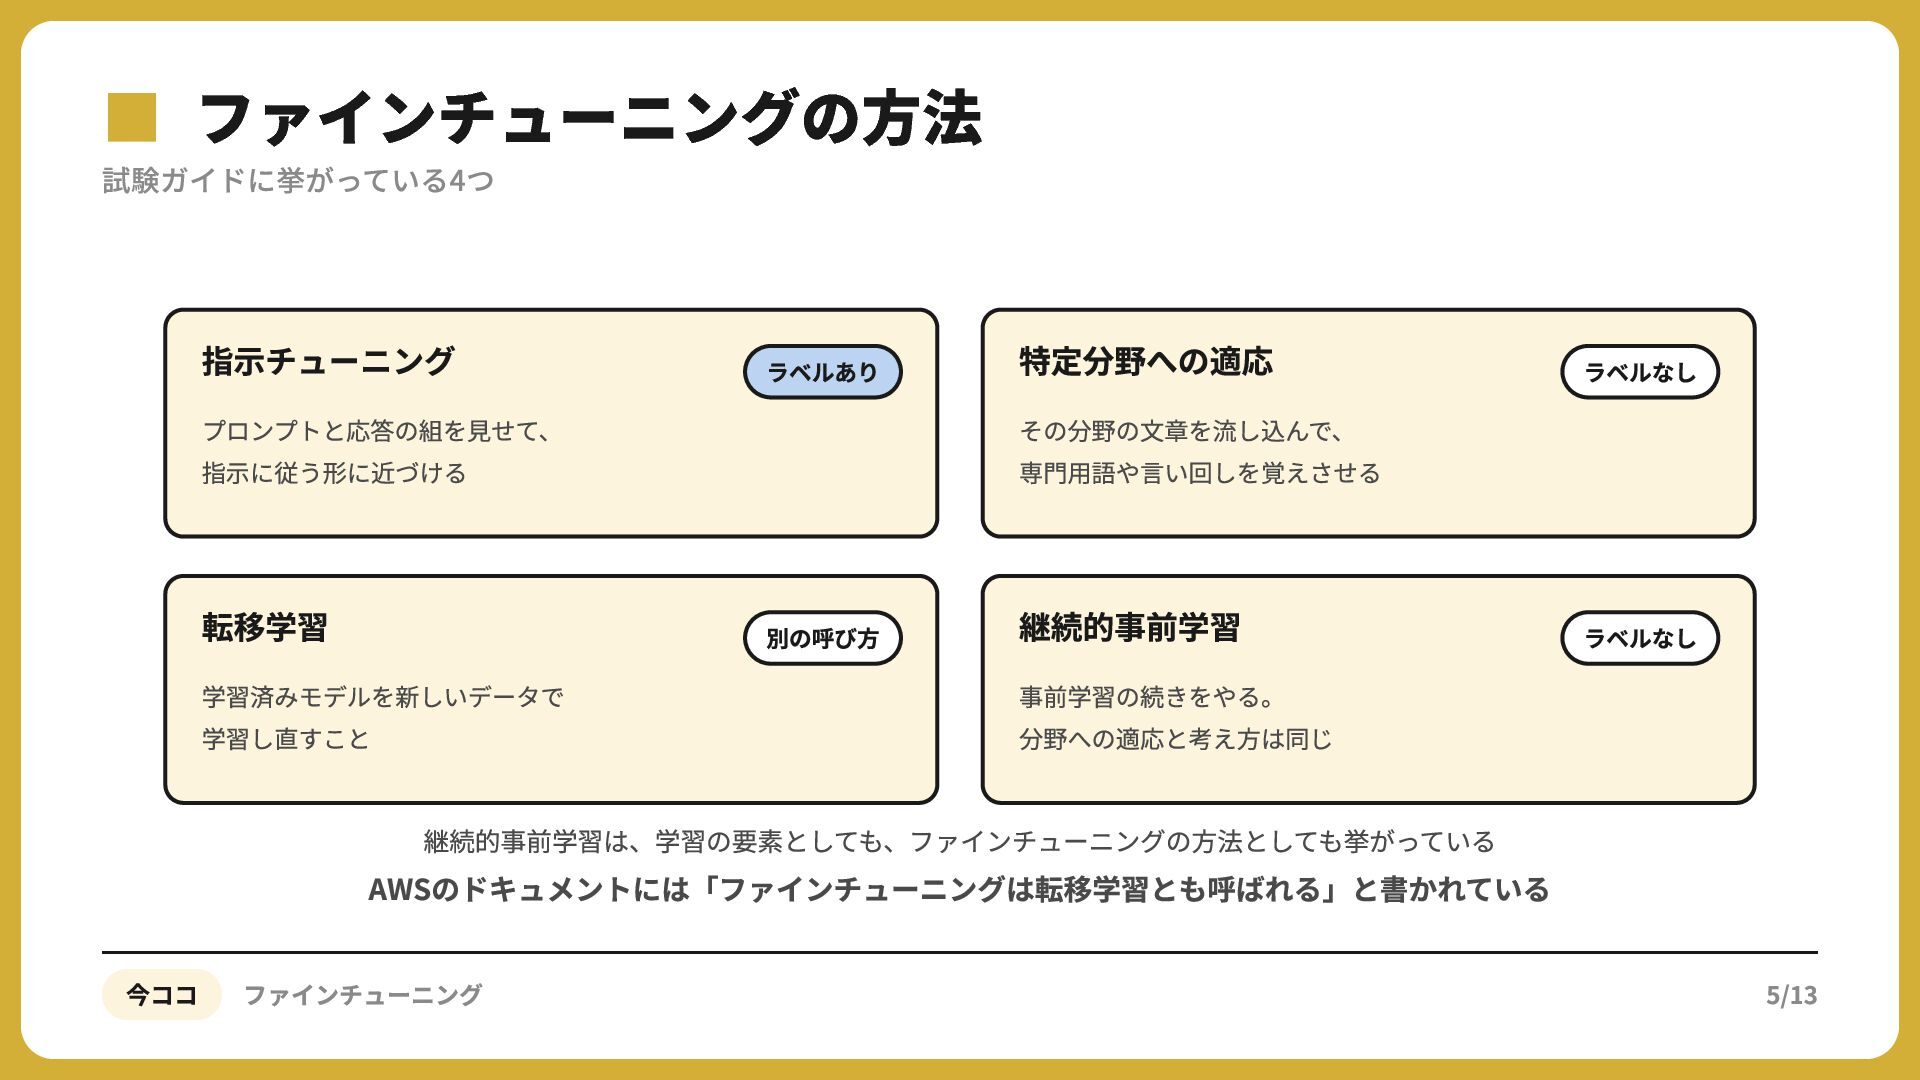
▪試験ガイドに挙がっている4つ ファインチューニングの方法 指⽰チューニング ラベルあり 特定分野への適応 ラベルなし 転移学習 別の呼び⽅ 継続的事前学習 ラベルなし
プロンプトと応答の組を⾒せて、 指⽰に従う形に近づける 学習済みモデルを新しいデータで 学習し直すこと その分野の⽂章を流し込んで、 専⾨⽤語や⾔い回しを覚えさせる 事前学習の続きをやる。 分野への適応と考え⽅は同じ 継続的事前学習は、学習の要素としても、ファインチューニングの⽅法としても挙がっている AWSのドキュメントには「ファインチューニングは転移学習とも呼ばれる」と書かれている 今ココ ファインチューニング 5/13
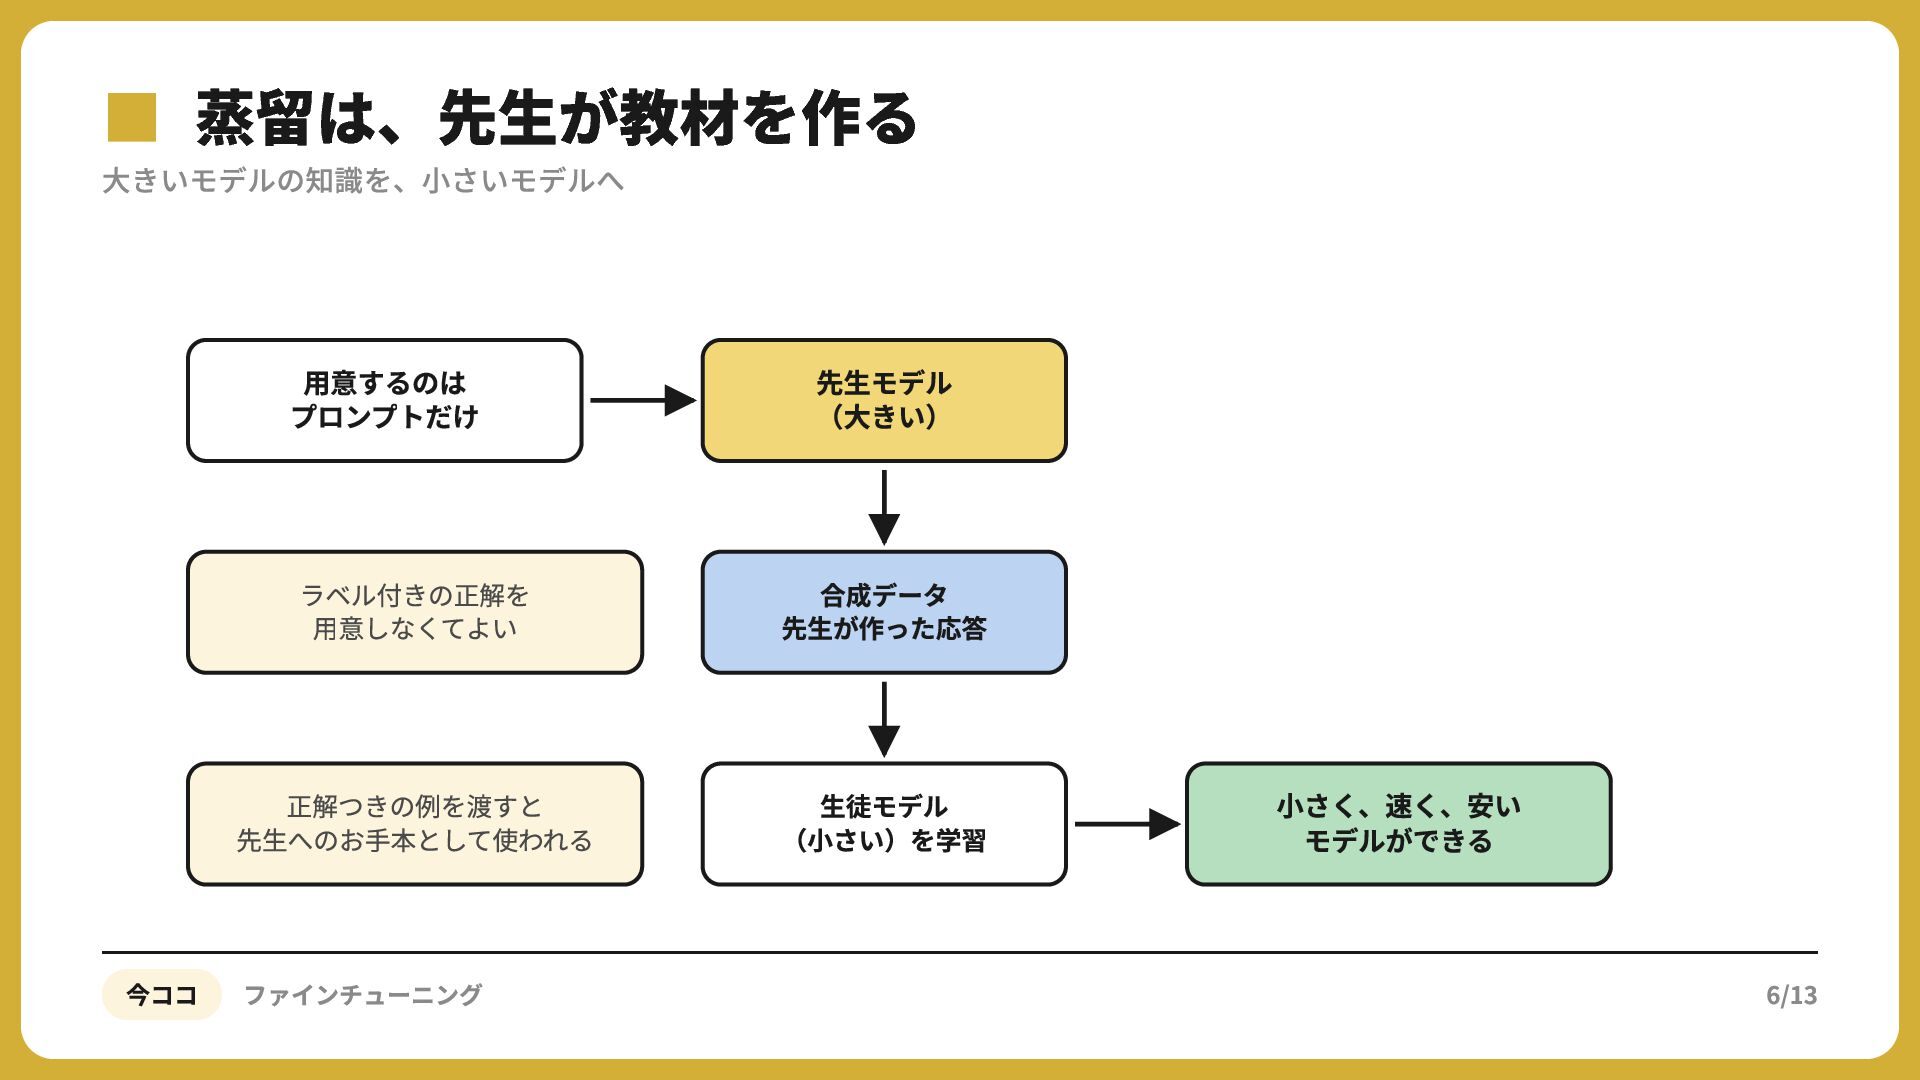
▪大きいモデルの知識を、小さいモデルへ 蒸留は、先生が教材を作る ⽤意するのは プロンプトだけ 先⽣モデル (⼤きい) ラベル付きの正解を ⽤意しなくてよい 合成データ 先⽣が作った応答
正解つきの例を渡すと 先⽣へのお⼿本として使われる ⽣徒モデル (⼩さい)を学習 今ココ ファインチューニング ⼩さく、速く、安い モデルができる 6/13
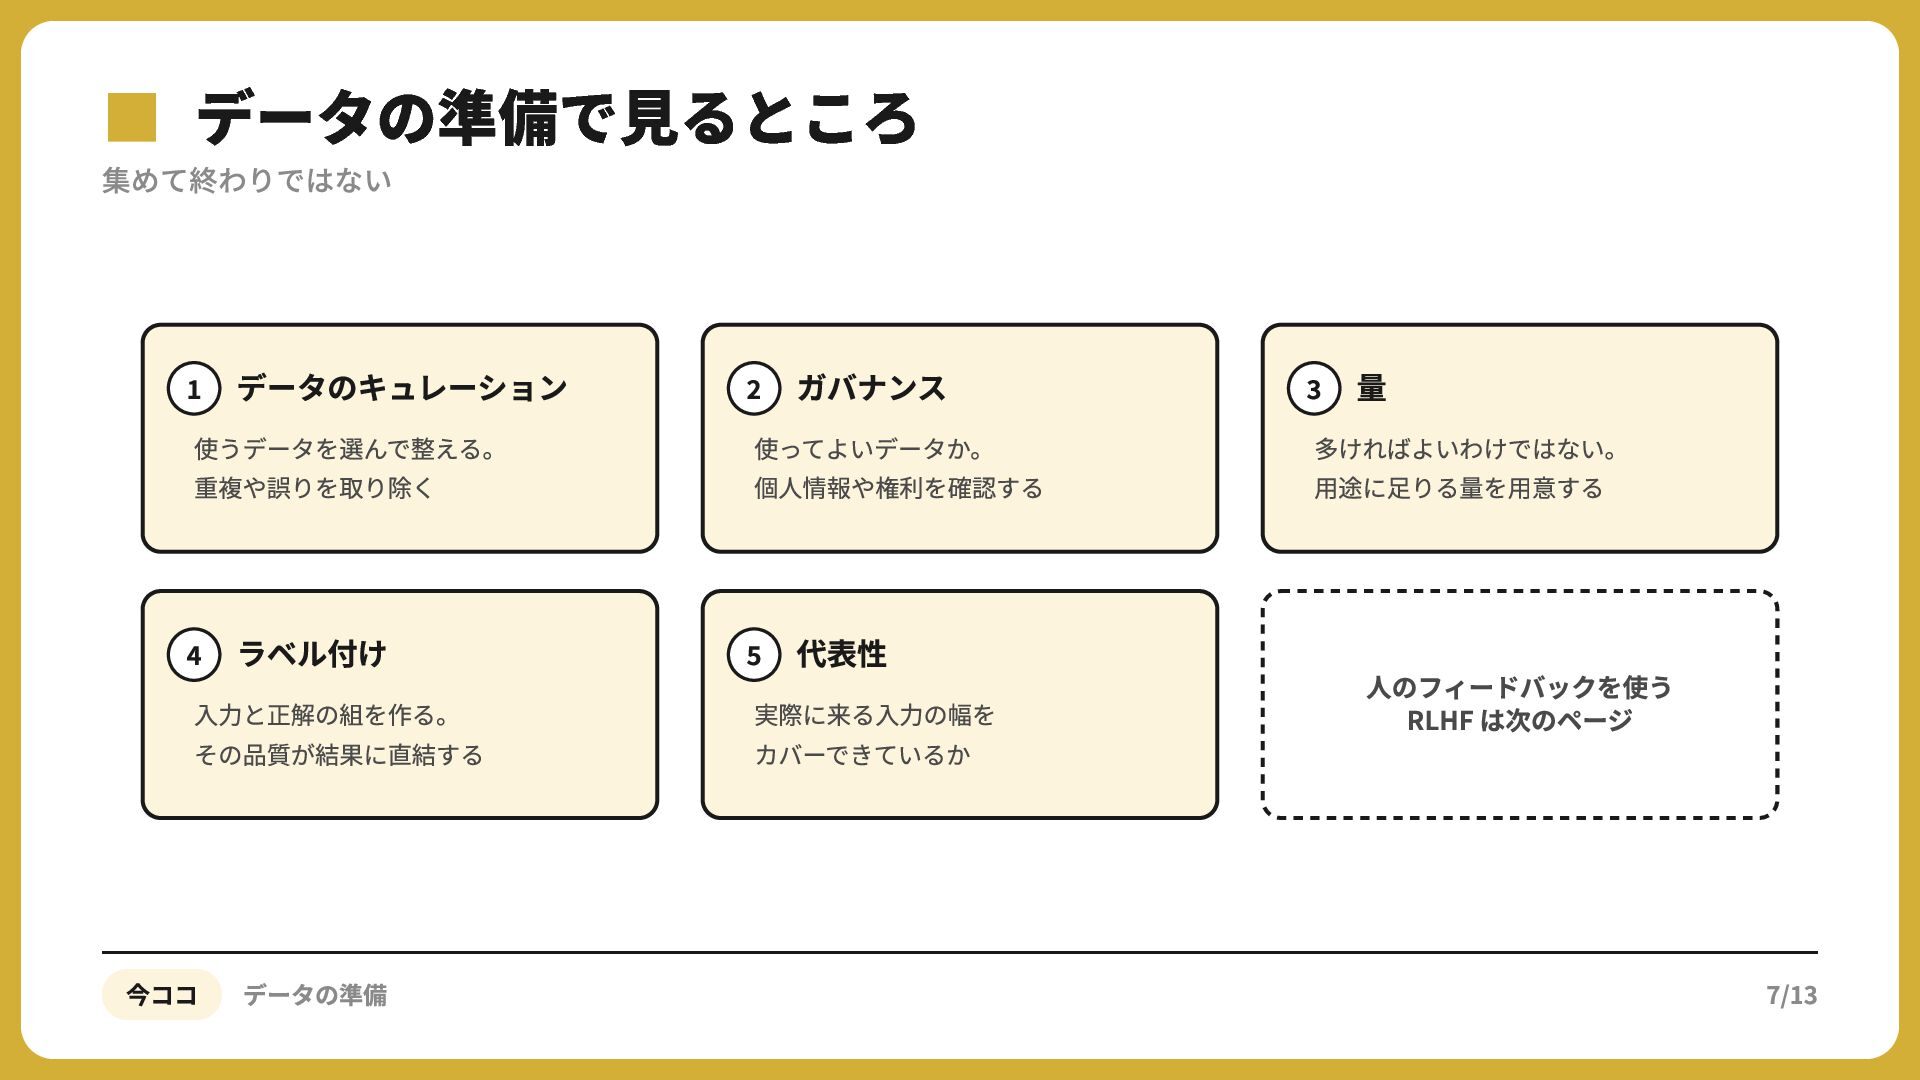
▪集めて終わりではない データの準備で見るところ データのキュレーション 使うデータを選んで整える。 重複や誤りを取り除く ラベル付け ⼊⼒と正解の組を作る。 その品質が結果に直結する 今ココ データの準備
ガバナンス 使ってよいデータか。 個⼈情報や権利を確認する 代表性 実際に来る⼊⼒の幅を カバーできているか 量 多ければよいわけではない。 ⽤途に⾜りる量を⽤意する ⼈のフィードバックを使う RLHF は次のページ 7/13
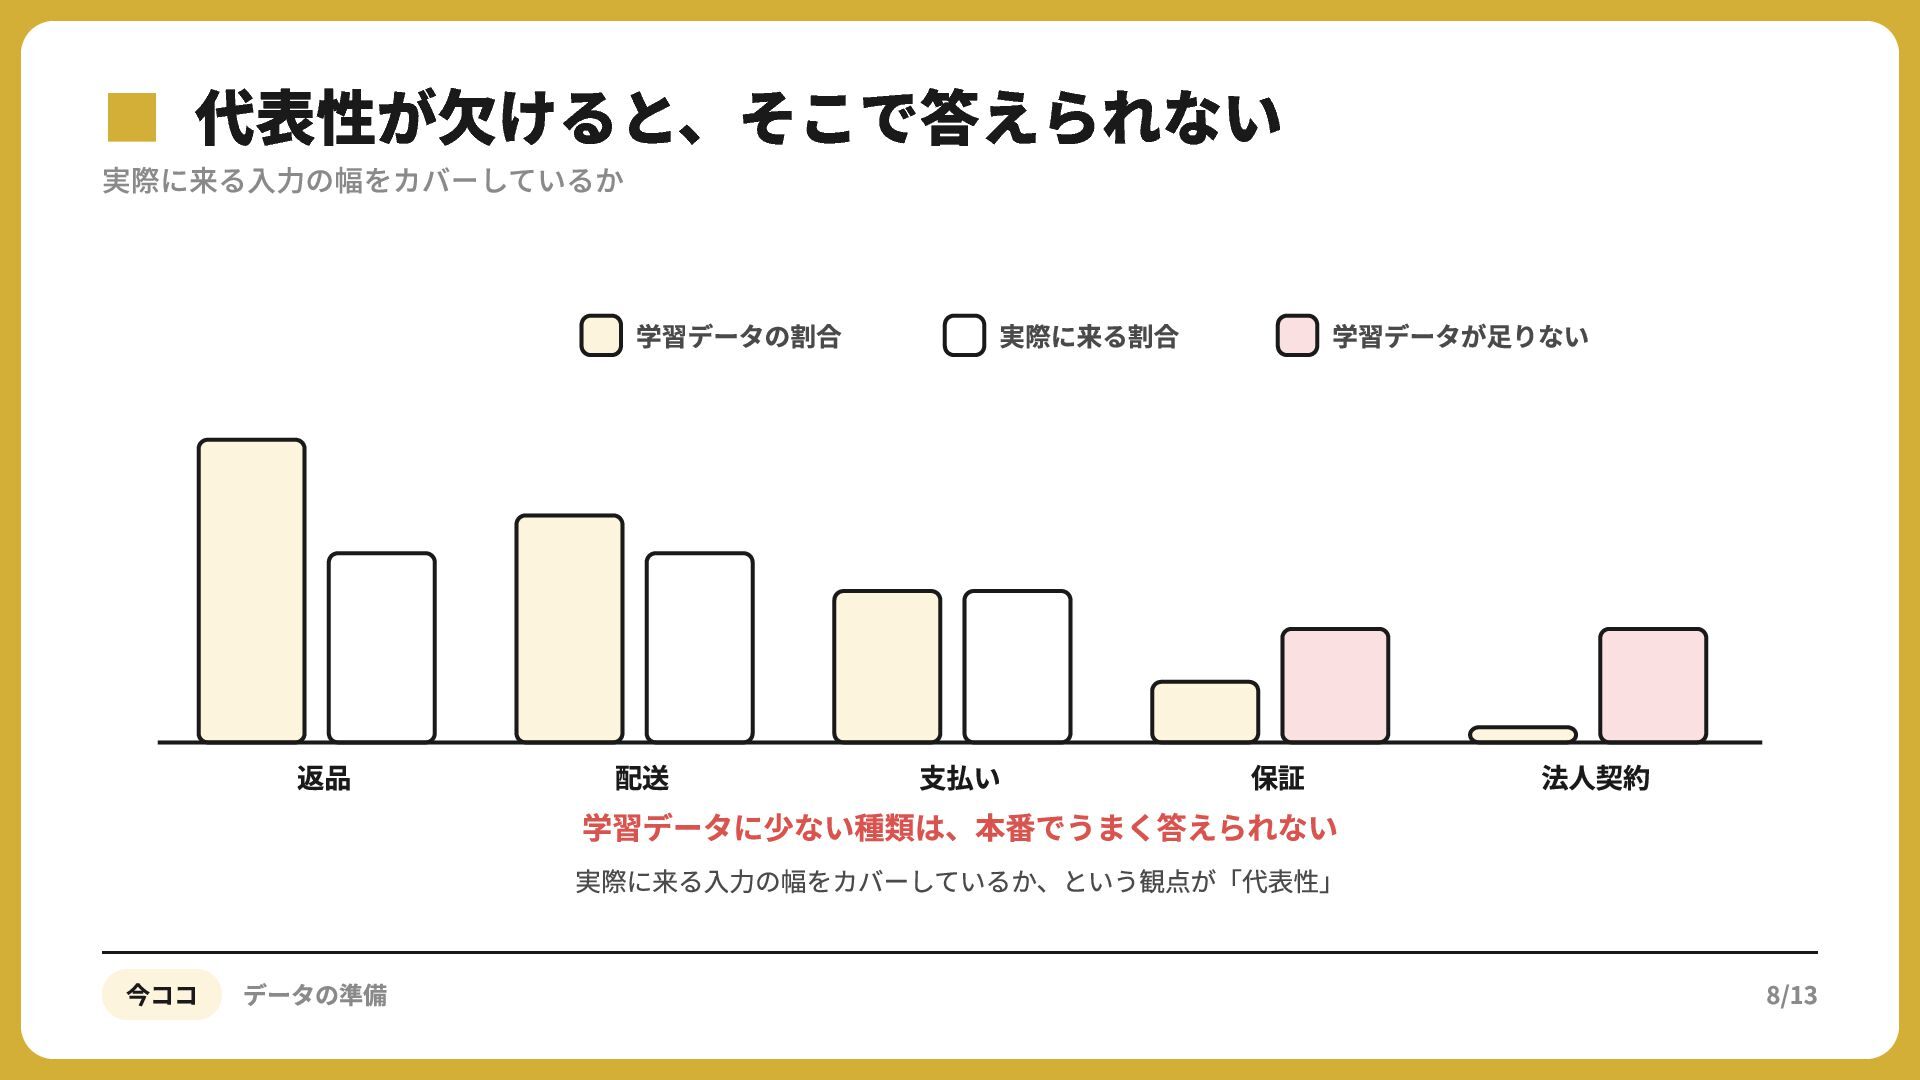
▪実際に来る入力の幅をカバーしているか 代表性が欠けると、そこで答えられない 学習データの割合 返品 配送 実際に来る割合 ⽀払い 学習データが⾜りない 保証 学習データに少ない種類は、本番でうまく答えられない
法⼈契約 実際に来る⼊⼒の幅をカバーしているか、という観点が「代表性」 今ココ データの準備 8/13
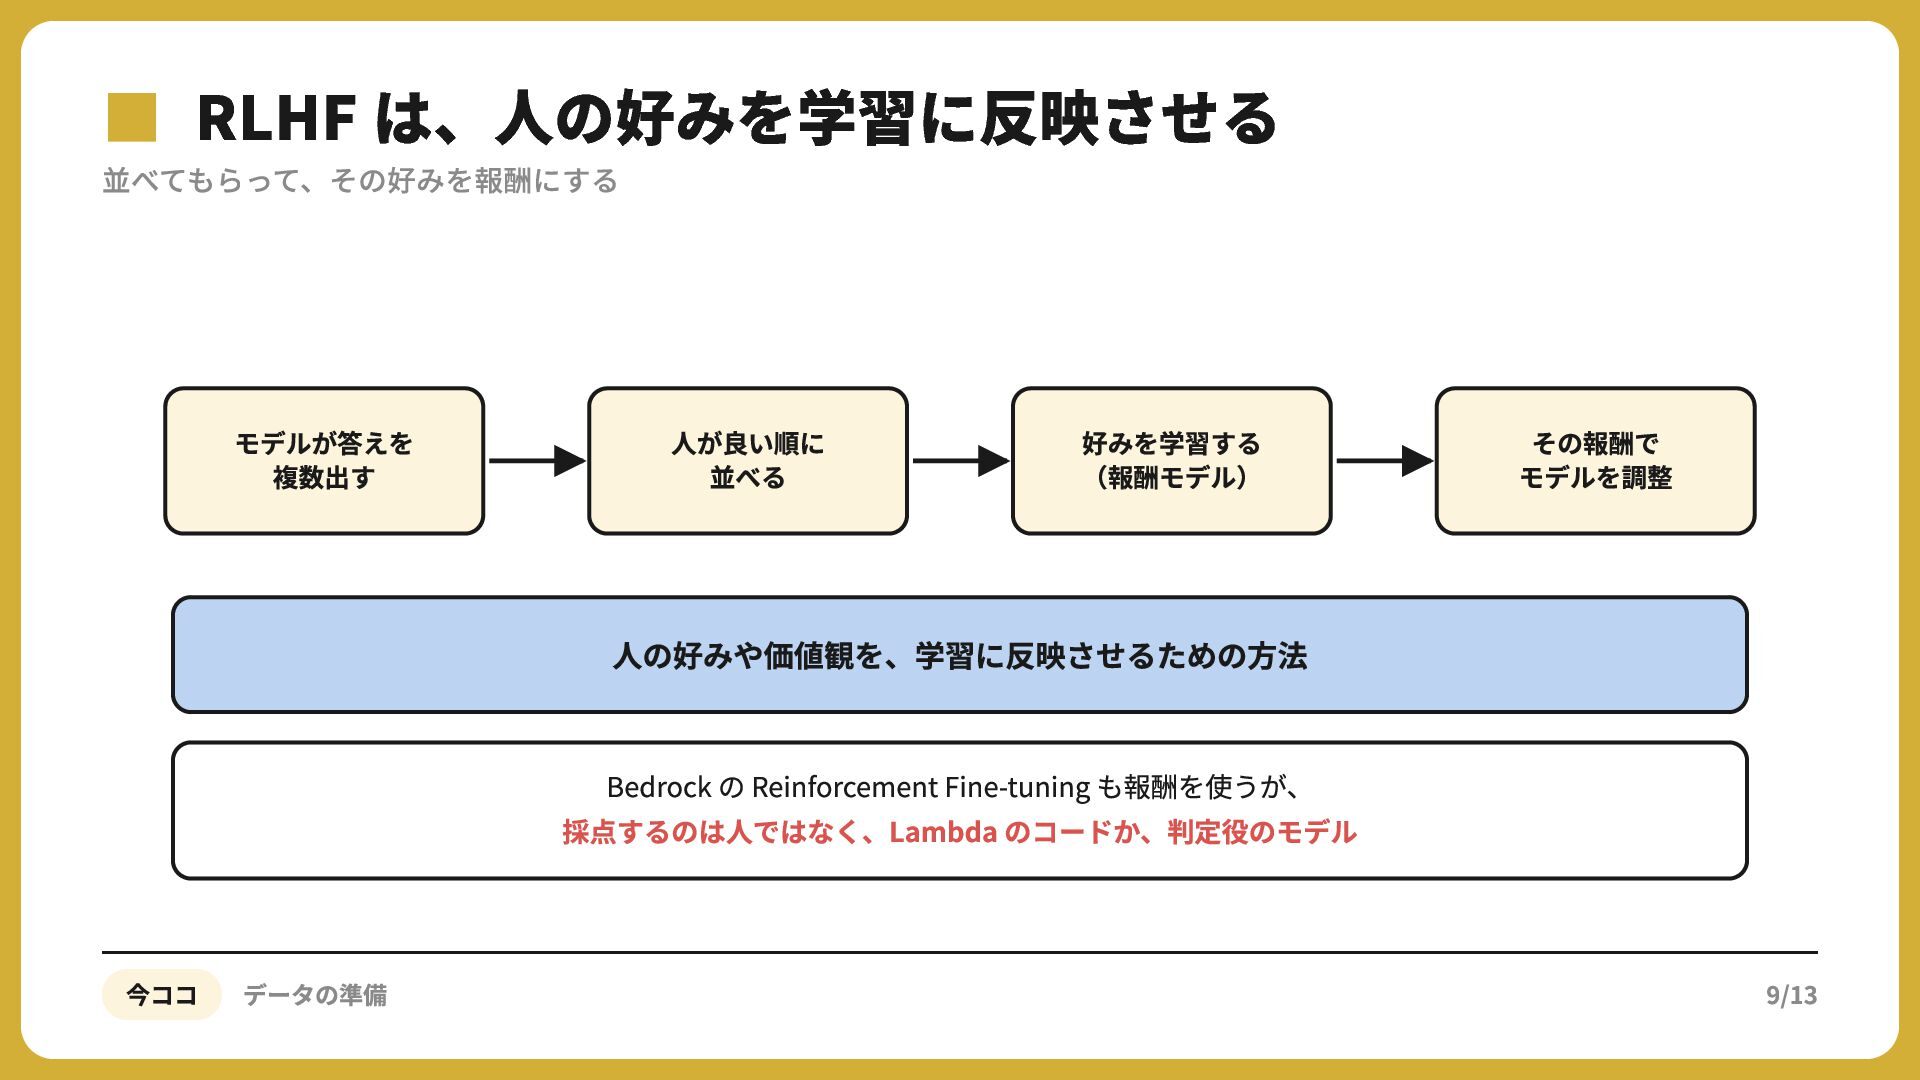
▪並べてもらって、その好みを報酬にする RLHF は、人の好みを学習に反映させる モデルが答えを 複数出す ⼈が良い順に 並べる 好みを学習する (報酬モデル) その報酬で
モデルを調整 ⼈の好みや価値観を、学習に反映させるための⽅法 Bedrock の Reinforcement Fine-tuning も報酬を使うが、 採点するのは⼈ではなく、Lambda のコードか、判定役のモデル 今ココ データの準備 9/13
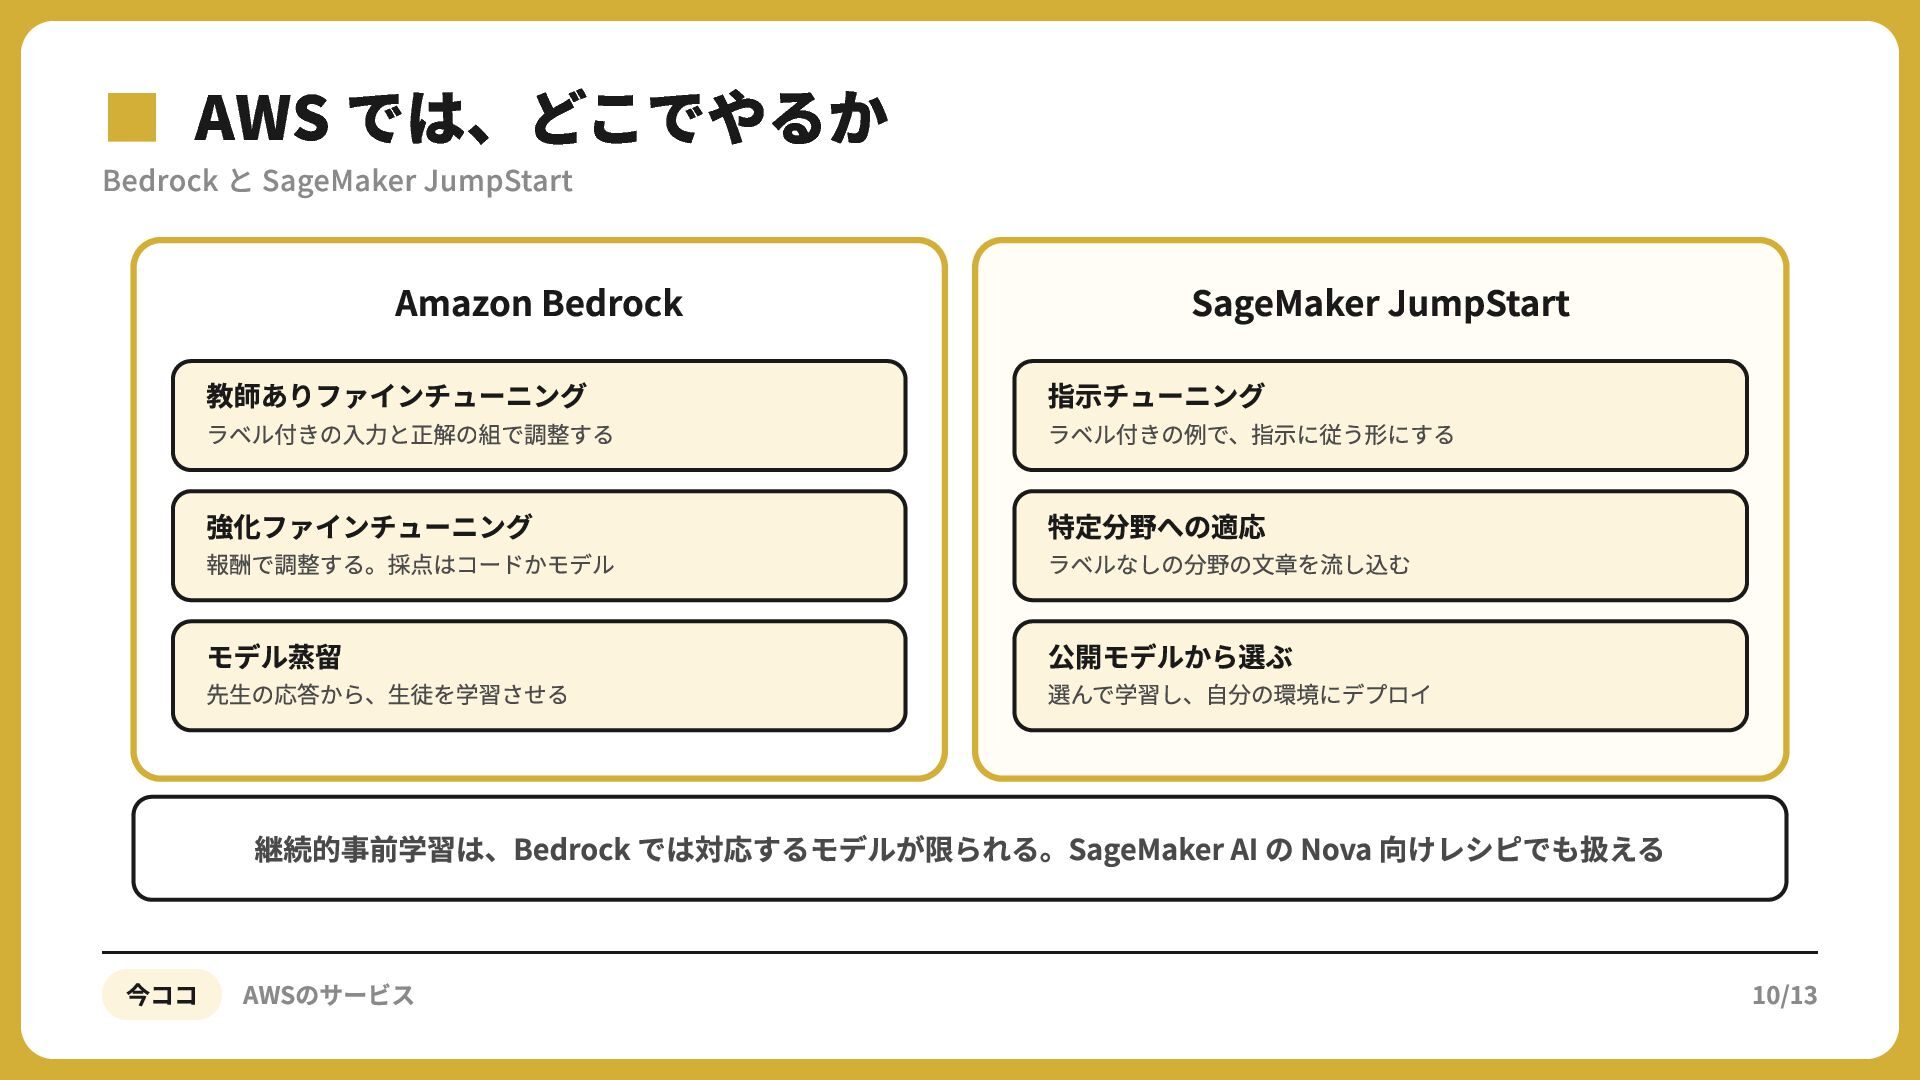
▪BedrockAWS では、どこでやるか と SageMaker JumpStart Amazon Bedrock SageMaker JumpStart 教師ありファインチューニング
指⽰チューニング 強化ファインチューニング 特定分野への適応 モデル蒸留 公開モデルから選ぶ ラベル付きの⼊⼒と正解の組で調整する 報酬で調整する。採点はコードかモデル 先⽣の応答から、⽣徒を学習させる ラベル付きの例で、指⽰に従う形にする ラベルなしの分野の⽂章を流し込む 選んで学習し、⾃分の環境にデプロイ 継続的事前学習は、Bedrock では対応するモデルが限られる。SageMaker AI の Nova 向けレシピでも扱える 今ココ AWSのサービス 10/13
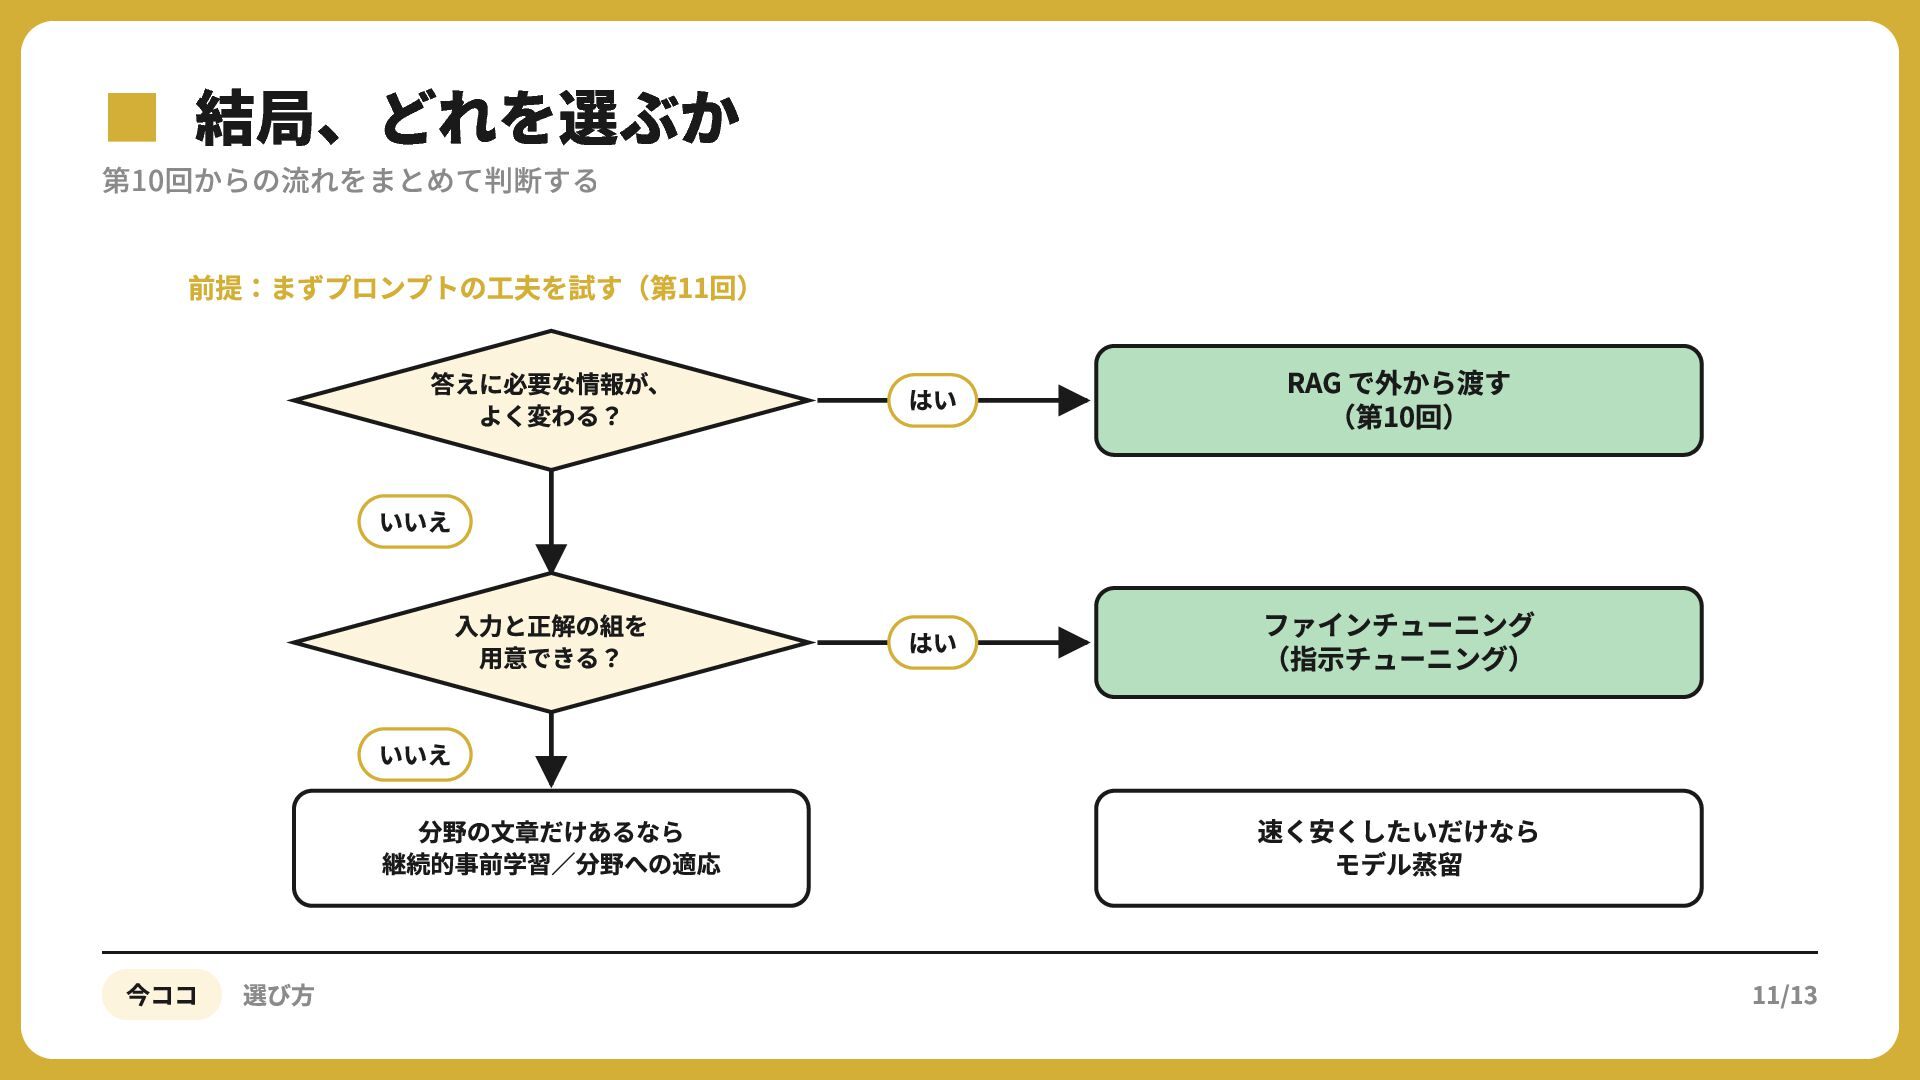
▪第10回からの流れをまとめて判断する 結局、どれを選ぶか 前提:まずプロンプトの⼯夫を試す(第11回) 答えに必要な情報が、 よく変わる? はい RAG で外から渡す (第10回) はい
ファインチューニング (指⽰チューニング) いいえ ⼊⼒と正解の組を ⽤意できる? いいえ 分野の⽂章だけあるなら 継続的事前学習∕分野への適応 今ココ 選び方 速く安くしたいだけなら モデル蒸留 11/13
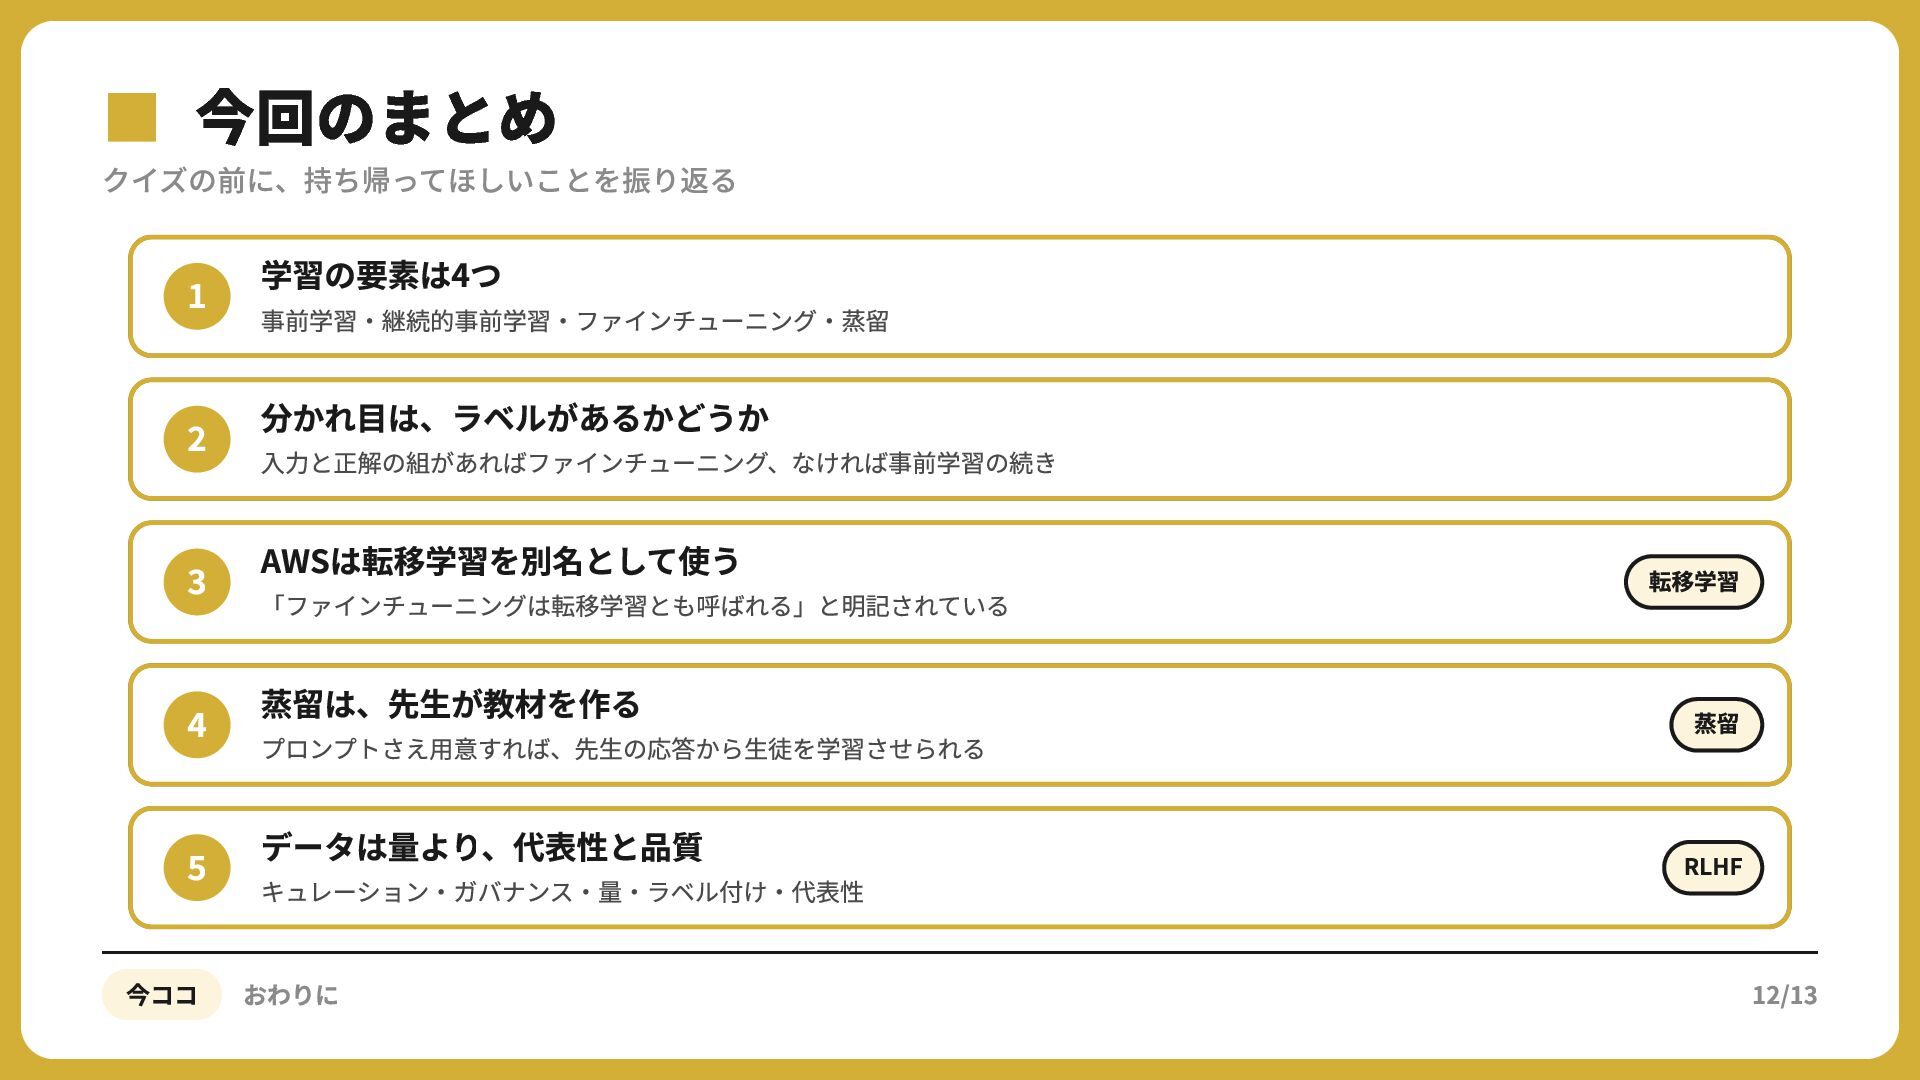
▪クイズの前に、持ち帰ってほしいことを振り返る 今回のまとめ 学習の要素は4つ 事前学習‧継続的事前学習‧ファインチューニング‧蒸留 分かれ⽬は、ラベルがあるかどうか ⼊⼒と正解の組があればファインチューニング、なければ事前学習の続き AWSは転移学習を別名として使う 「ファインチューニングは転移学習とも呼ばれる」と明記されている 転移学習 蒸留は、先⽣が教材を作る
蒸留 データは量より、代表性と品質 RLHF プロンプトさえ⽤意すれば、先⽣の応答から⽣徒を学習させられる キュレーション‧ガバナンス‧量‧ラベル付け‧代表性 今ココ おわりに 12/13
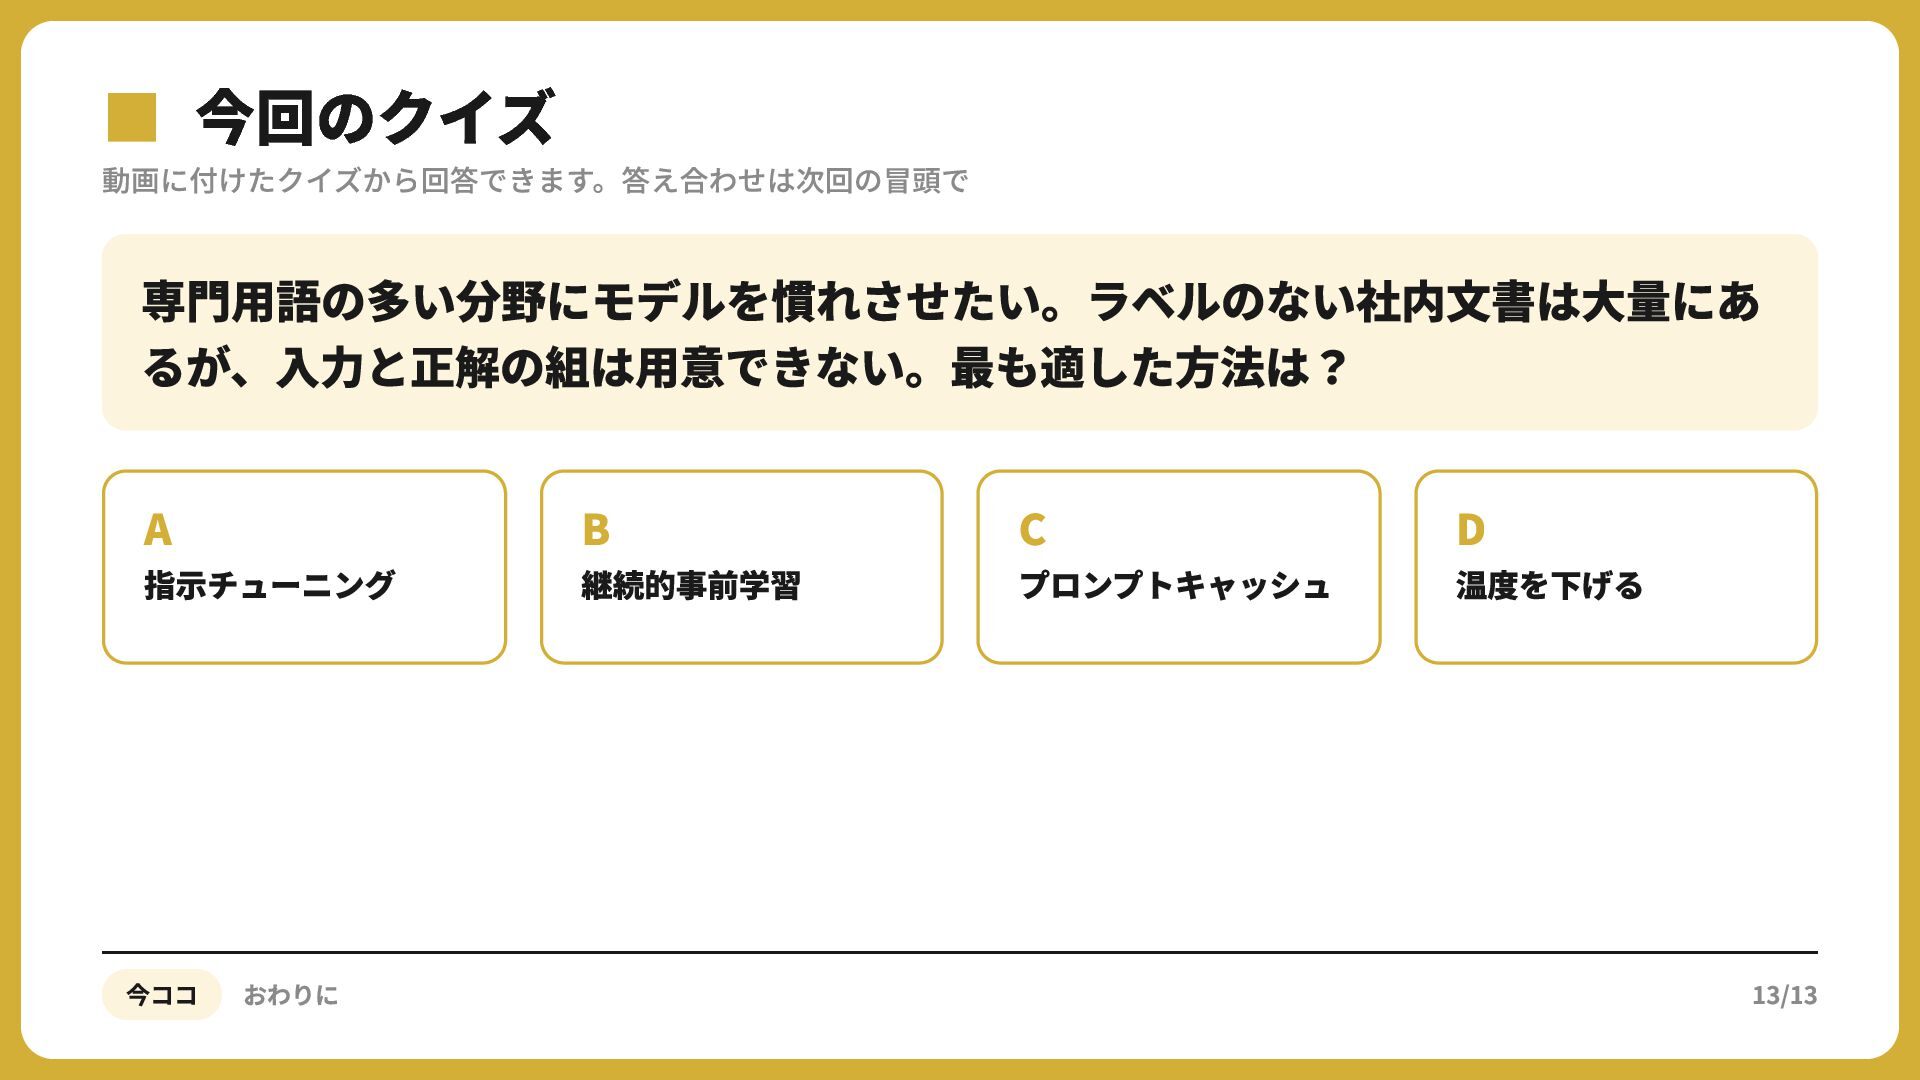
▪動画に付けたクイズから回答できます。答え合わせは次回の冒頭で 今回のクイズ 専門用語の多い分野にモデルを慣れさせたい。ラベルのない社内文書は大量にあ るが、入力と正解の組は用意できない。最も適した方法は? A 指示チューニング 今ココ おわりに B 継続的事前学習
C プロンプトキャッシュ D 温度を下げる 13/13


 akagami
 hokaccha
 yosuke_furukawa
 oniak3ibm
 rkaga
 riku_sakamoto
 j341nono
 akkeylab
 neuecc
 s_shimotori
 yub0n
 y0hgi
 koher
 greggifford
 tmiket
 tomoyanonymous
 helenjbeal
 chrislema
 apolaine
 matthewcrist
 axbom
 jonrohan
 sergeychernyshev