Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
【基本情報対策】稼働率と冗長化
Search
赤神青空
PRO
October 27, 2026
Video
Programming
7
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
【基本情報対策】稼働率と冗長化
赤神青空
PRO
October 27, 2026
Video
More Decks by 赤神青空
See All by 赤神青空
【AWSの新サービス】AWS Lambda Web Functions とは何か
akagami
PRO
0
13
【AIニュース】Anthropic が METR に社員並みのアクセスを渡した理由
akagami
PRO
0
12
TOTPとメールOTP、どっちが安全?
akagami
PRO
0
21
【基本情報対策】OSのプロセスと仮想記憶
akagami
PRO
0
17
【AIニュース】Muse Spark Open とは何か
akagami
PRO
0
23
【AIニュース】Jev とは何か
akagami
PRO
0
40
【基本情報対策】CPU・メモリ・キャッシュ
akagami
PRO
0
26
【AIニュース】Anthropic が Git から Scion に移った理由
akagami
PRO
0
34
【AIニュース】Grok Voice 3.0 とは何か
akagami
PRO
0
25
Other Decks in Programming
See All in Programming
Jetpack Compose Mechanisms
skydoves
3
870
ジョジョの世界をXRで再現する
mofurune
0
180
PumaからFalconに移行したRailsアプリケーションでの実践
falcon8823
0
200
Coding with AI: How to trust the storyteller (AWS Community Day Adria, Ljubljana 2026)
slobodan
0
120
Augmenting AI with the Power of Jakarta EE
ivargrimstad
0
390
クラウドゲーミングのパフォーマンス最適化に挑む / Cloud Gaming Performance Tuning
vivion
0
180
クラウドエージェントは、 何がそんなに便利なのか / what makes cloud agents so useful
rkaga
2
270
Long Living Tokens, Die, Die, Die! (or: The One Ring is Banned in Modern)
sylph01
0
370
パスワード再設定メールのURLについて知っておこう
uyuki234
0
180
Herb in Rails 8.2: Your ERB views, now HTML-aware @ Kaigi on Rails 2026, Tokyo, Japan
marcoroth
2
330
dotNET_vulnclicker_intro.pdf
deka_morita
0
150
全ての永続トークンを、生まれる前に消し去りたい!
sylph01
2
1.2k
Featured
See All Featured
svc-hook: hooking system calls on ARM64 by binary rewriting
retrage
2
640
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
270
Fantastic passwords and where to find them - at NoRuKo
philnash
53
4k
The Language of Interfaces
destraynor
162
27k
Design of three-dimensional binary manipulators for pick-and-place task avoiding obstacles (IECON2024)
konakalab
0
630
Everyday Curiosity
cassininazir
0
360
CoffeeScript is Beautiful & I Never Want to Write Plain JavaScript Again
sstephenson
162
16k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
960
The Psychology of Web Performance [Beyond Tellerrand 2023]
tammyeverts
49
3.6k
Technical Leadership for Architectural Decision Making
baasie
3
610
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
1
460
Transcript
2026年10月 稼働率と冗長化 基本情報技術者試験 対策 #8 赤神青空
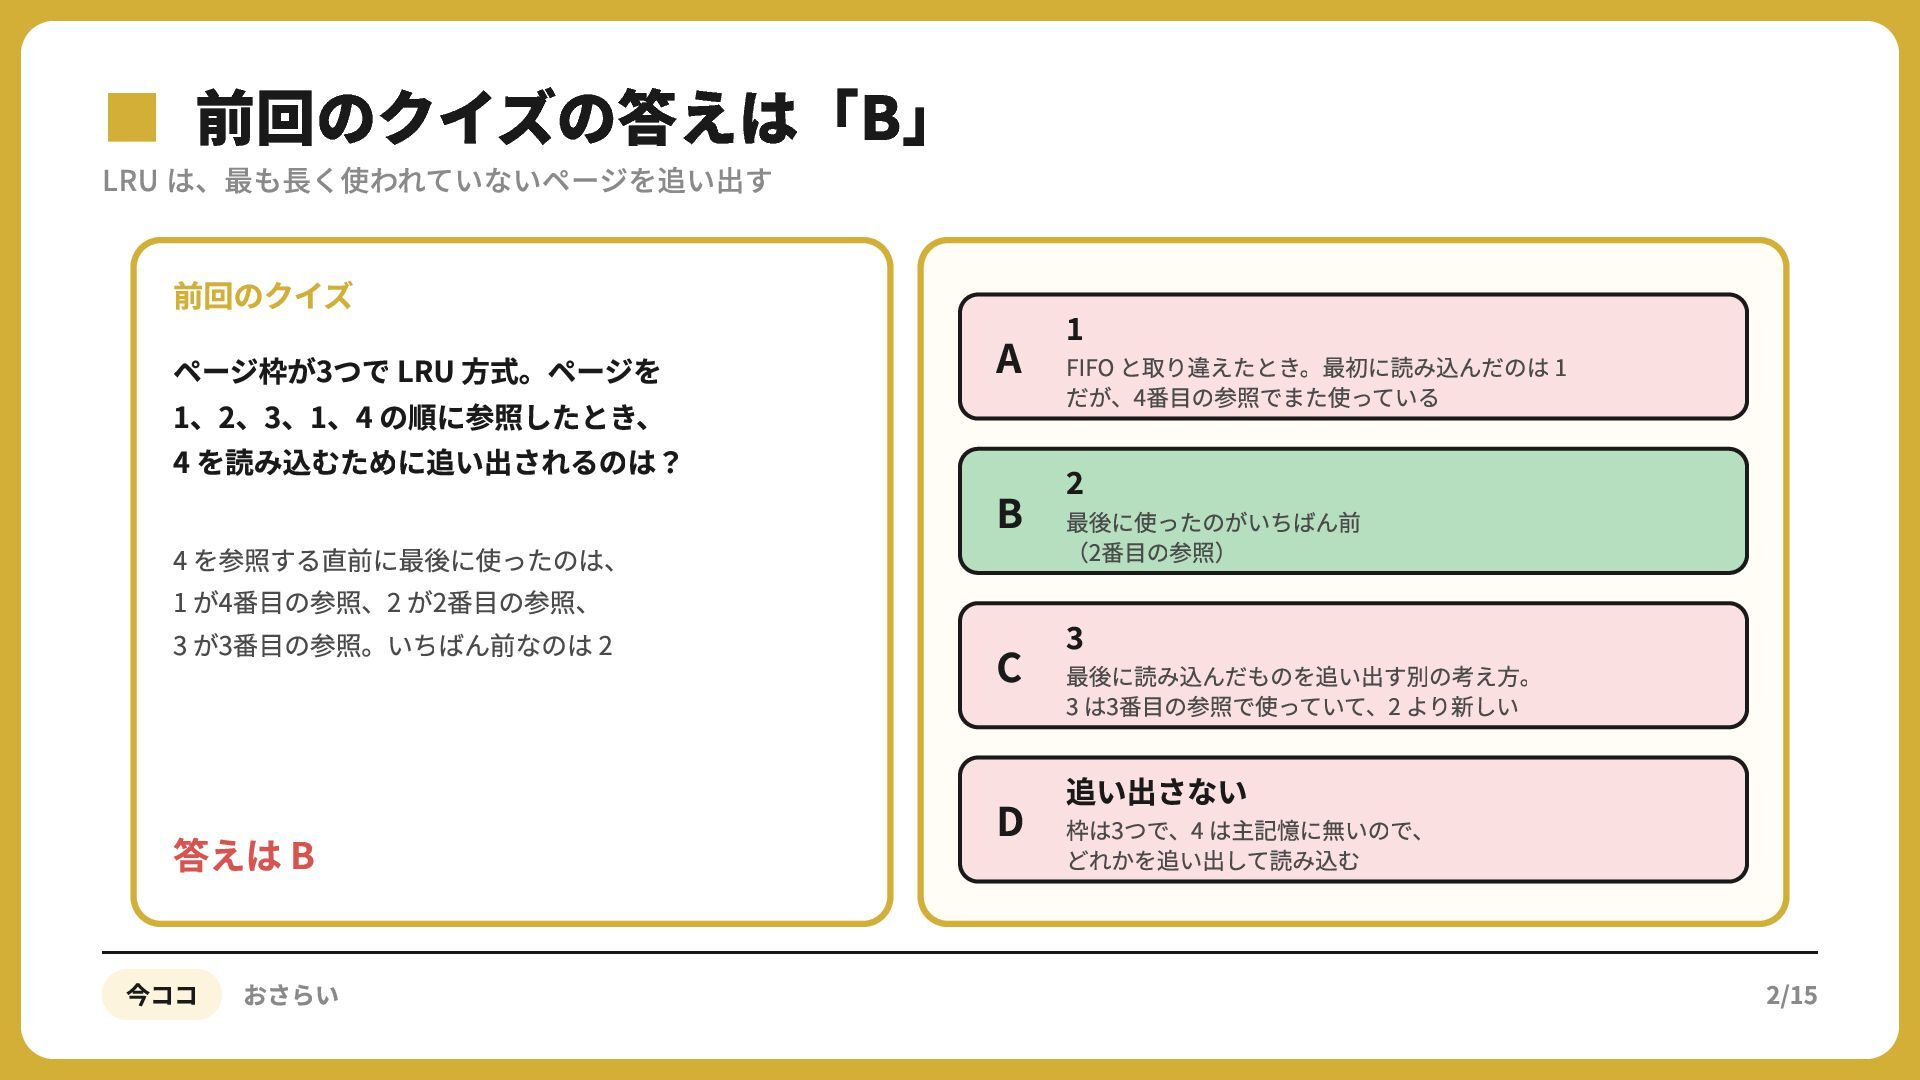
▪LRU は、最も長く使われていないページを追い出す 前回のクイズの答えは「B」 前回のクイズ ページ枠が3つで LRU ⽅式。ページを 1、2、3、1、4 の順に参照したとき、 4
を読み込むために追い出されるのは? 4 を参照する直前に最後に使ったのは、 1 が4番⽬の参照、2 が2番⽬の参照、 3 が3番⽬の参照。いちばん前なのは 2 答えは B 今ココ おさらい A FIFO と取り違えたとき。最初に読み込んだのは 1 だが、4番⽬の参照でまた使っている B 最後に使ったのがいちばん前 (2番⽬の参照) C 最後に読み込んだものを追い出す別の考え⽅。 3 は3番⽬の参照で使っていて、2 より新しい 追い出さない D 枠は3つで、4 は主記憶に無いので、 どれかを追い出して読み込む 2/15
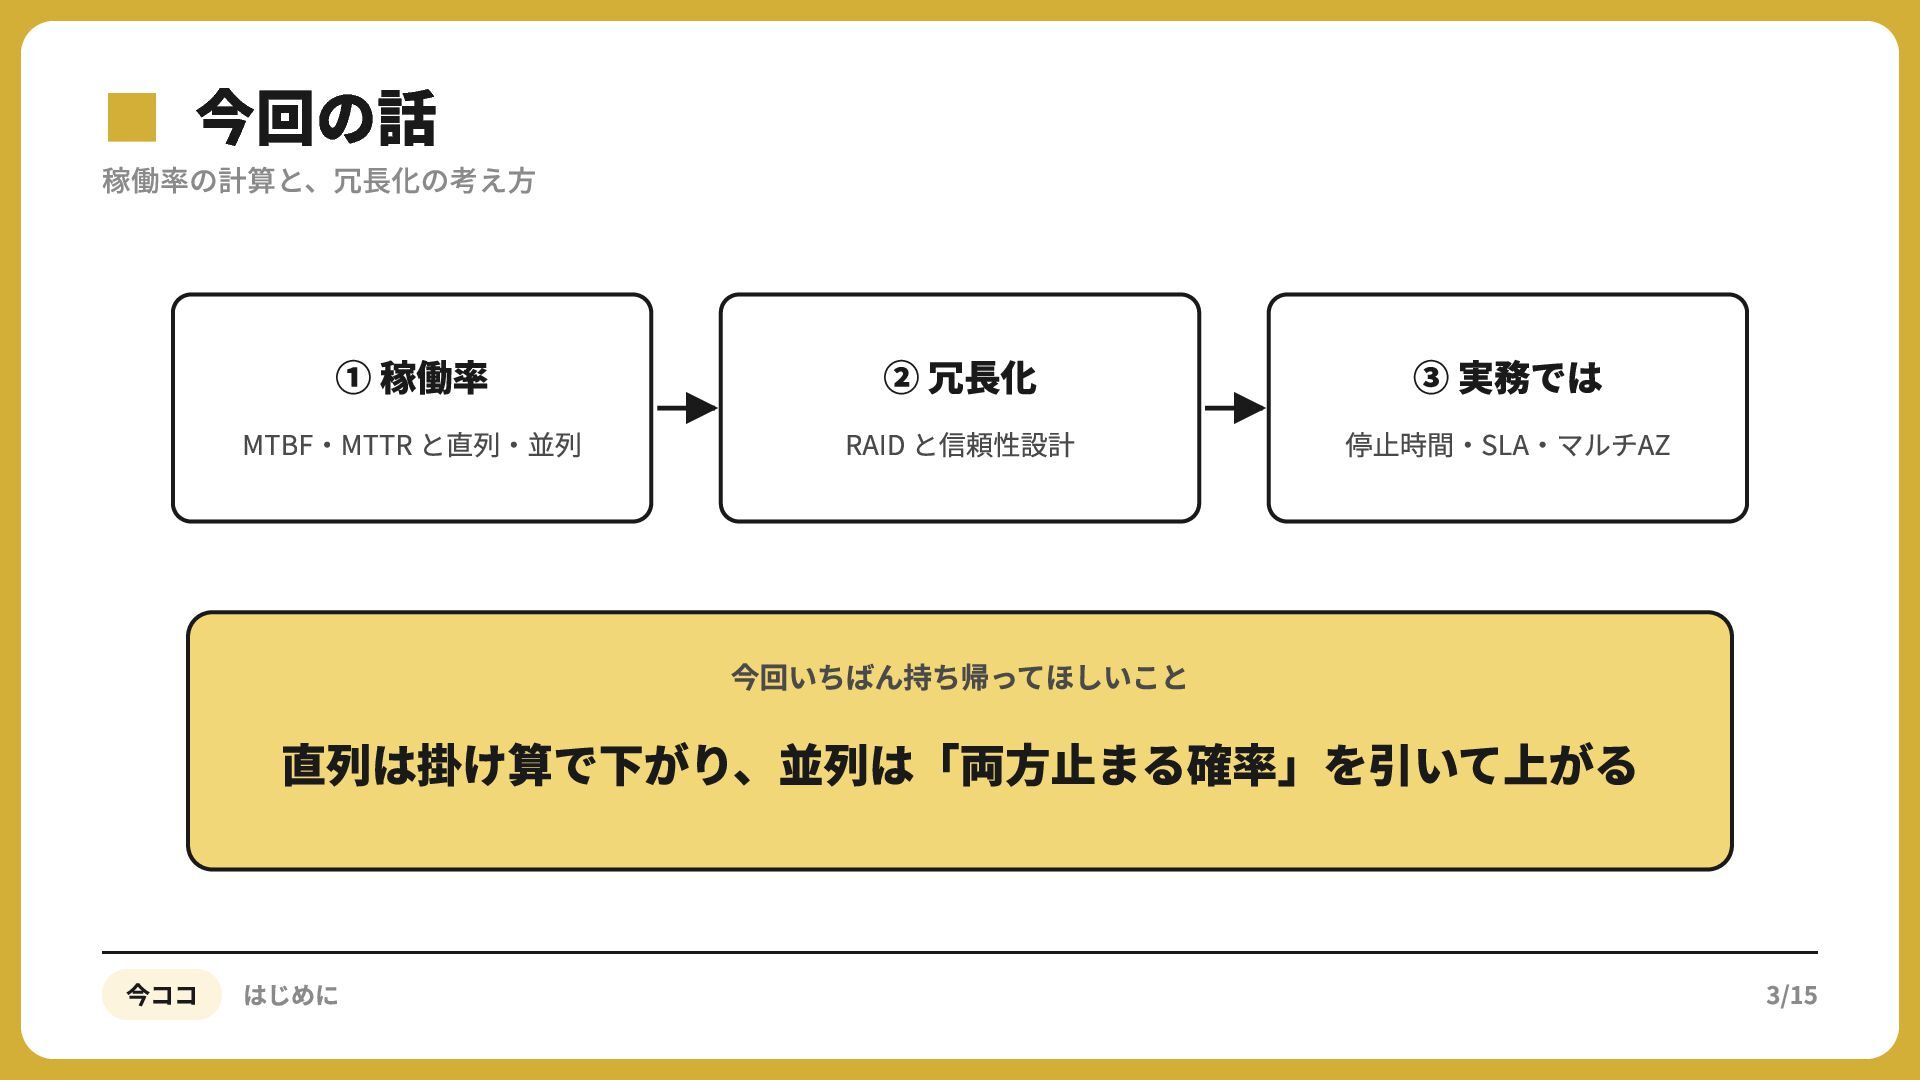
▪稼働率の計算と、冗長化の考え方 今回の話 ① 稼働率 MTBF‧MTTR と直列‧並列 ② 冗⻑化 RAID と信頼性設計
③ 実務では 停⽌時間‧SLA‧マルチAZ 今回いちばん持ち帰ってほしいこと 直列は掛け算で下がり、並列は「両⽅⽌まる確率」を引いて上がる 今ココ はじめに 3/15
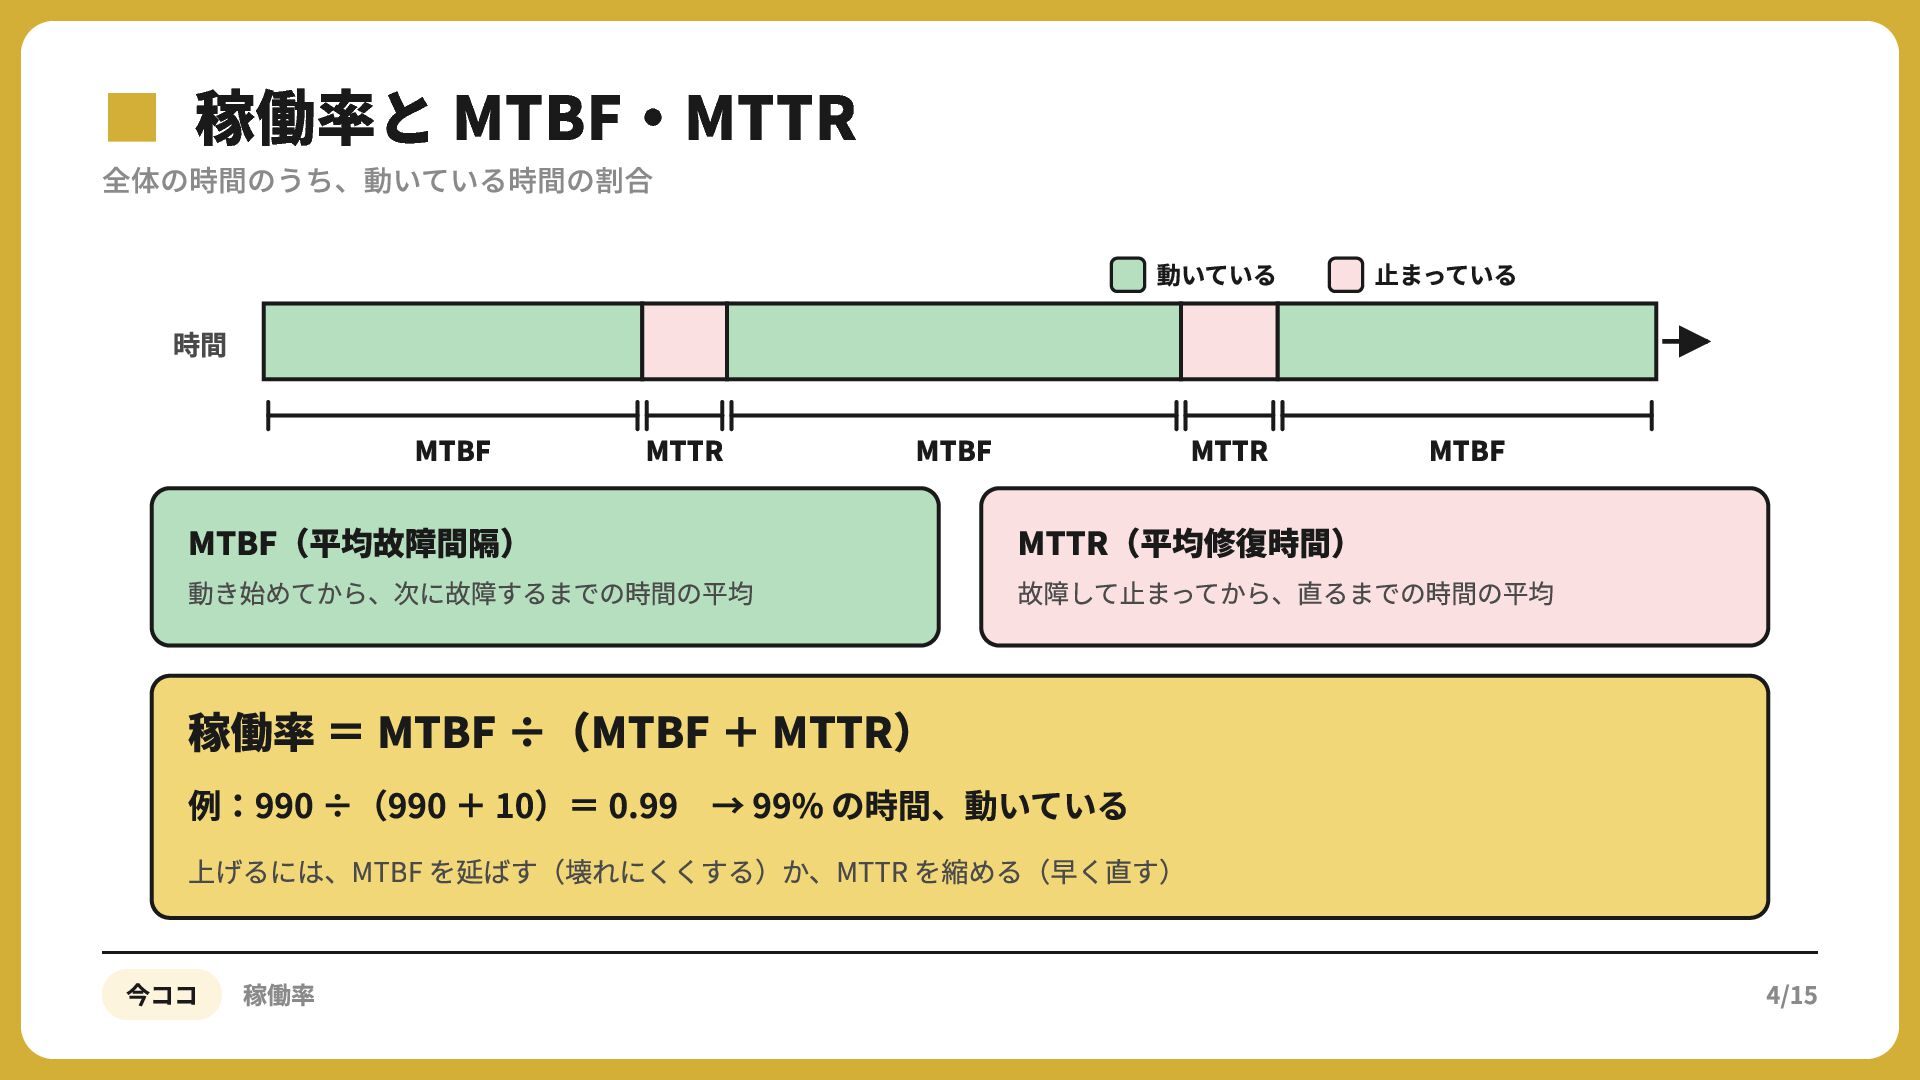
▪全体の時間のうち、動いている時間の割合 稼働率と MTBF・MTTR 動いている ⽌まっている MTTR MTBF 時間 MTBF MTTR
MTBF MTBF(平均故障間隔) 動き始めてから、次に故障するまでの時間の平均 MTTR(平均修復時間) 故障して⽌まってから、直るまでの時間の平均 稼働率 = MTBF ÷(MTBF + MTTR) 例:990 ÷(990 + 10)= 0.99 → 99% の時間、動いている 上げるには、MTBF を延ばす(壊れにくくする)か、MTTR を縮める(早く直す) 今ココ 稼働率 4/15
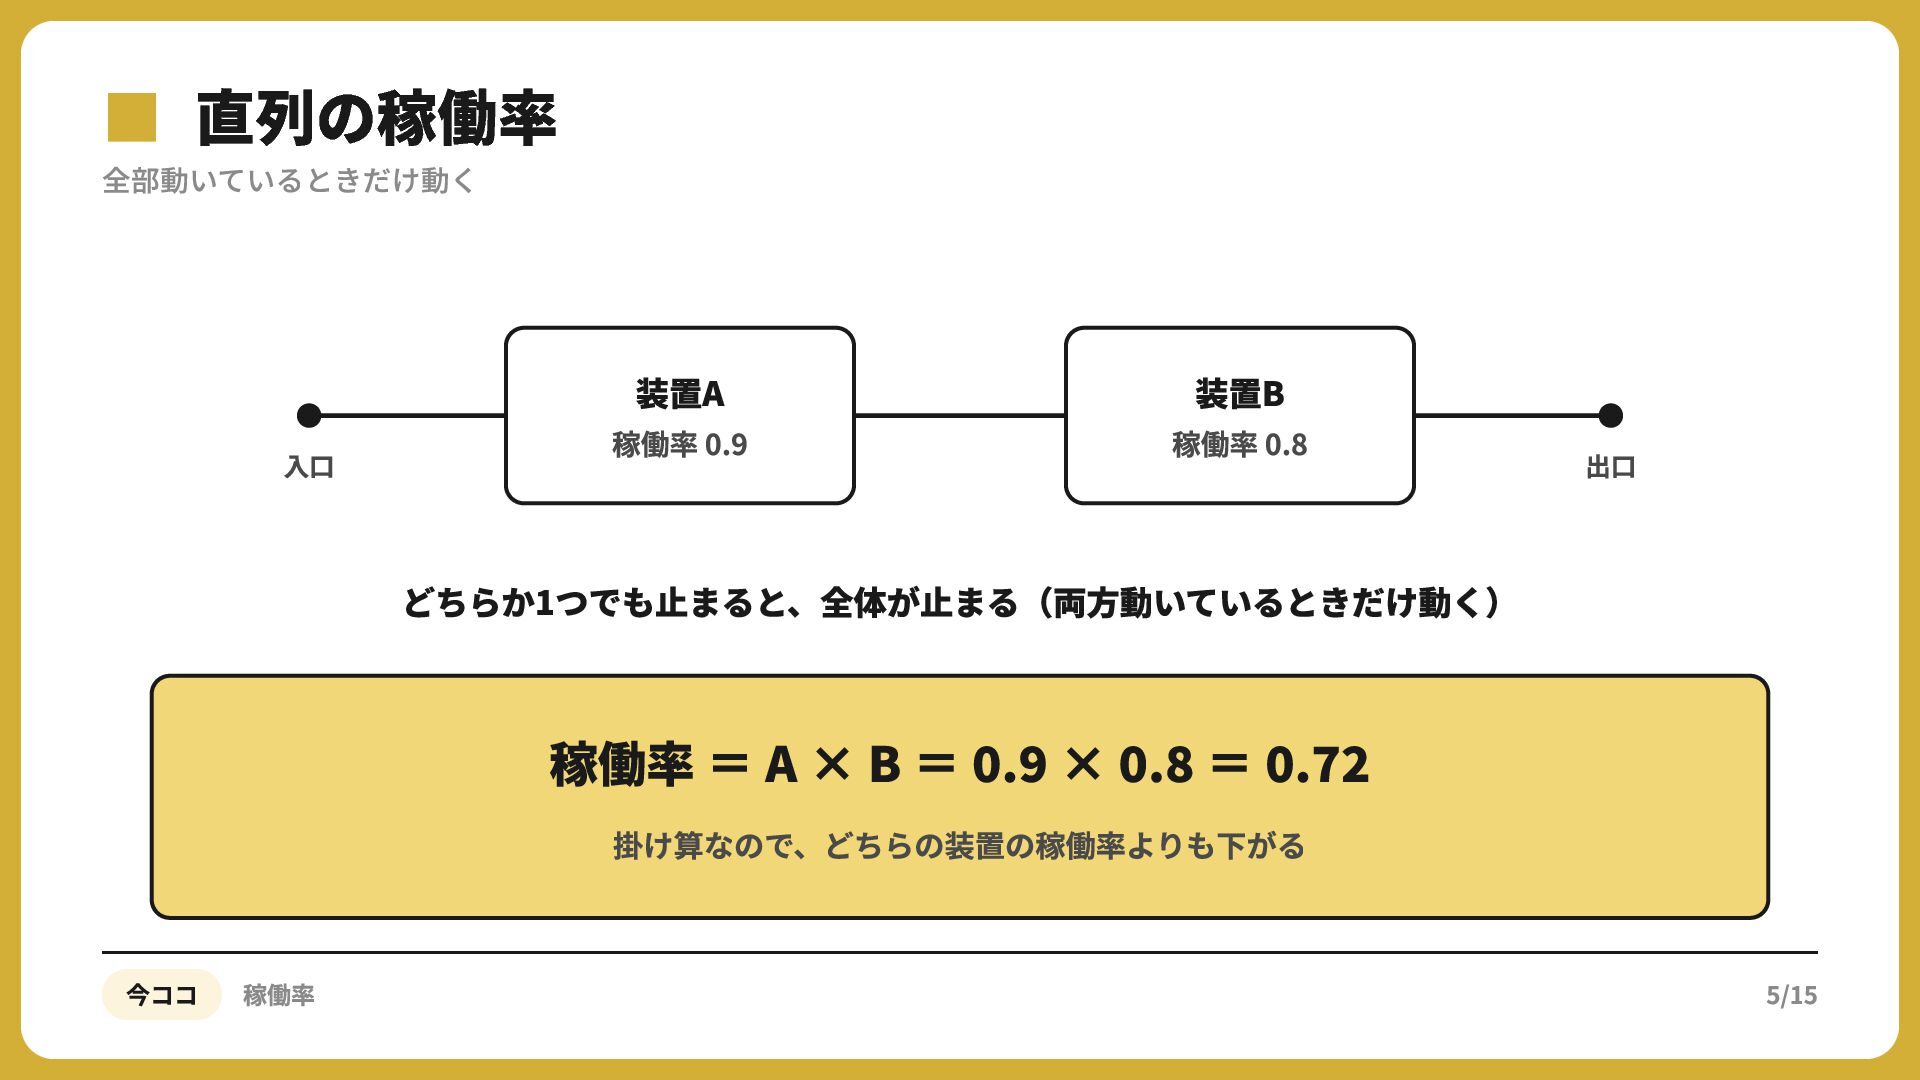
▪全部動いているときだけ動く 直列の稼働率 ⼊⼝ 装置A 稼働率 0.9 装置B 稼働率 0.8 出⼝
どちらか1つでも⽌まると、全体が⽌まる(両⽅動いているときだけ動く) 稼働率 = A × B = . × . = . 掛け算なので、どちらの装置の稼働率よりも下がる 今ココ 稼働率 5/15
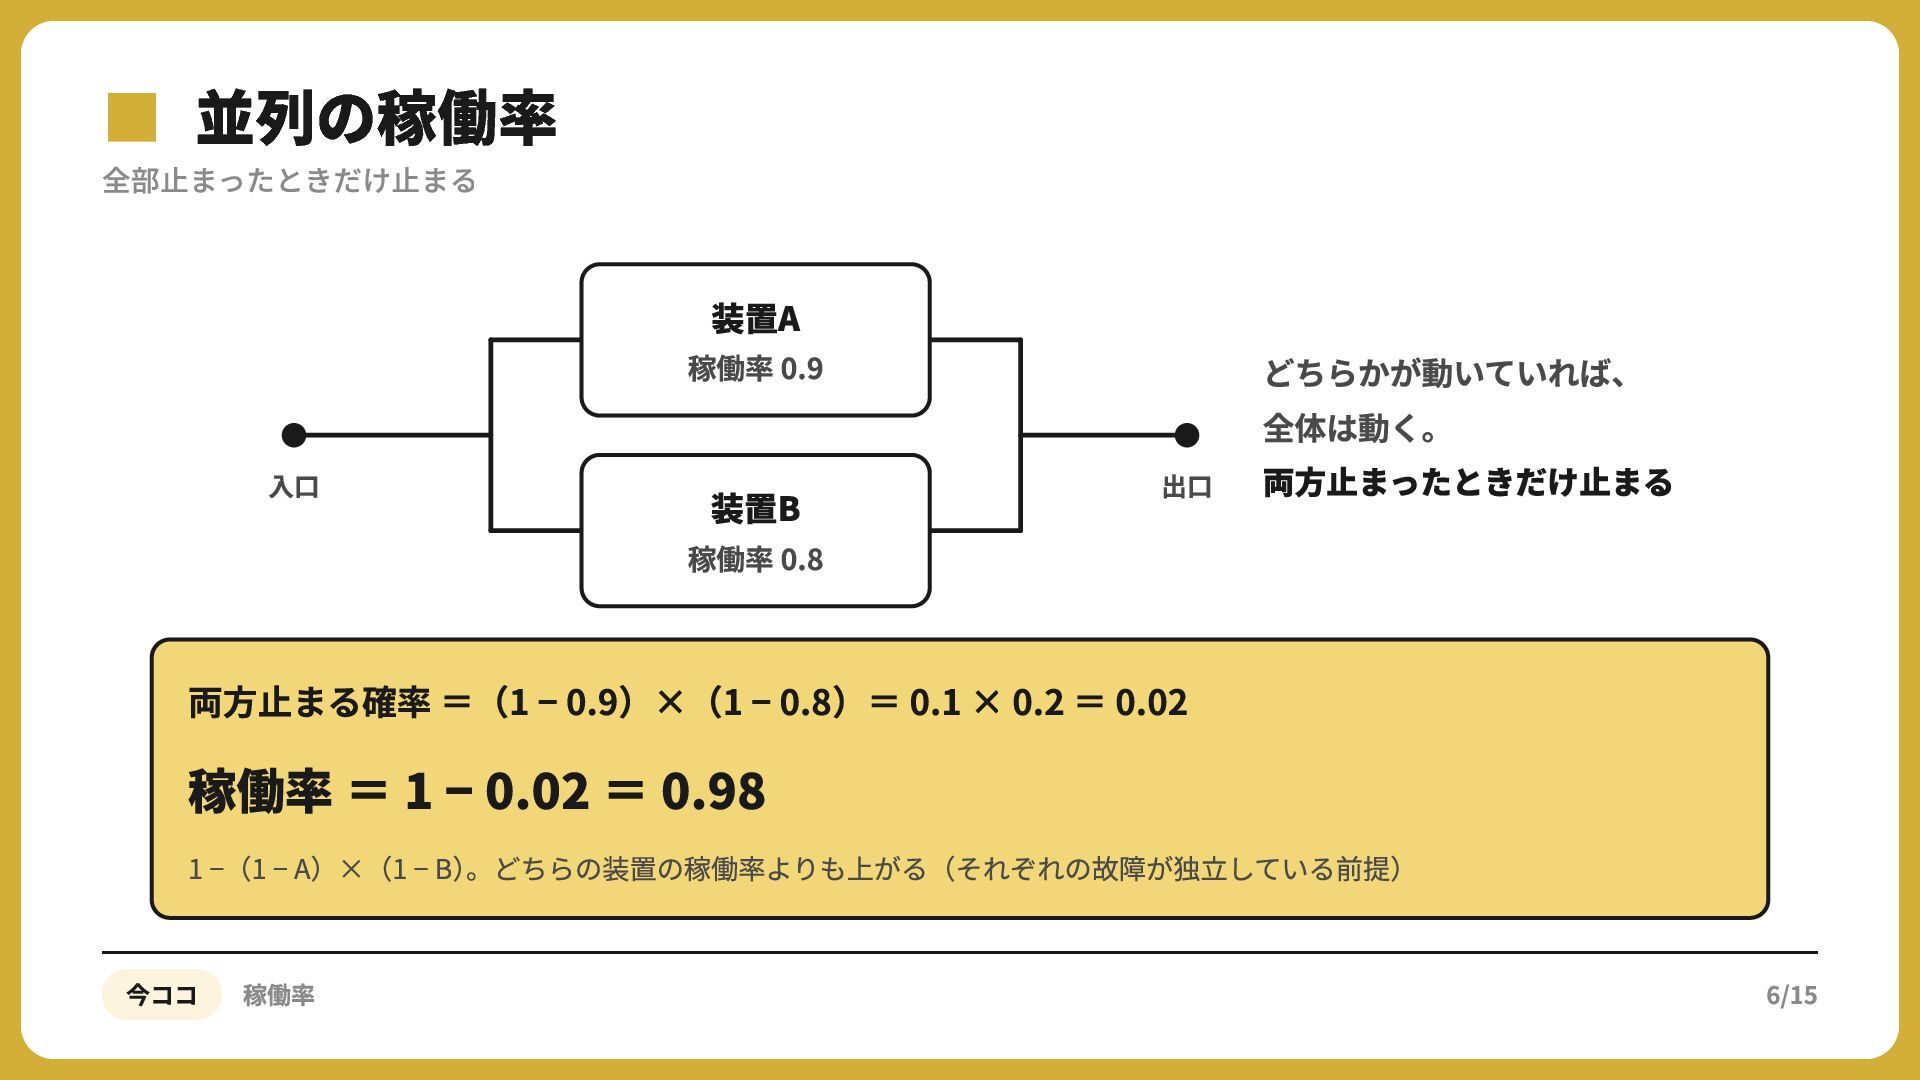
▪全部止まったときだけ止まる 並列の稼働率 装置A 稼働率 0.9 ⼊⼝ 装置B 稼働率 0.8 どちらかが動いていれば、
全体は動く。 出⼝ 両⽅⽌まったときだけ⽌まる 両⽅⽌まる確率 =(1 − 0.9)×(1 − 0.8)= 0.1 × 0.2 = 0.02 稼働率 = 1 − 0.02 = 0.98 1 −(1 − A)×(1 − B)。どちらの装置の稼働率よりも上がる(それぞれの故障が独⽴している前提) 今ココ 稼働率 6/15
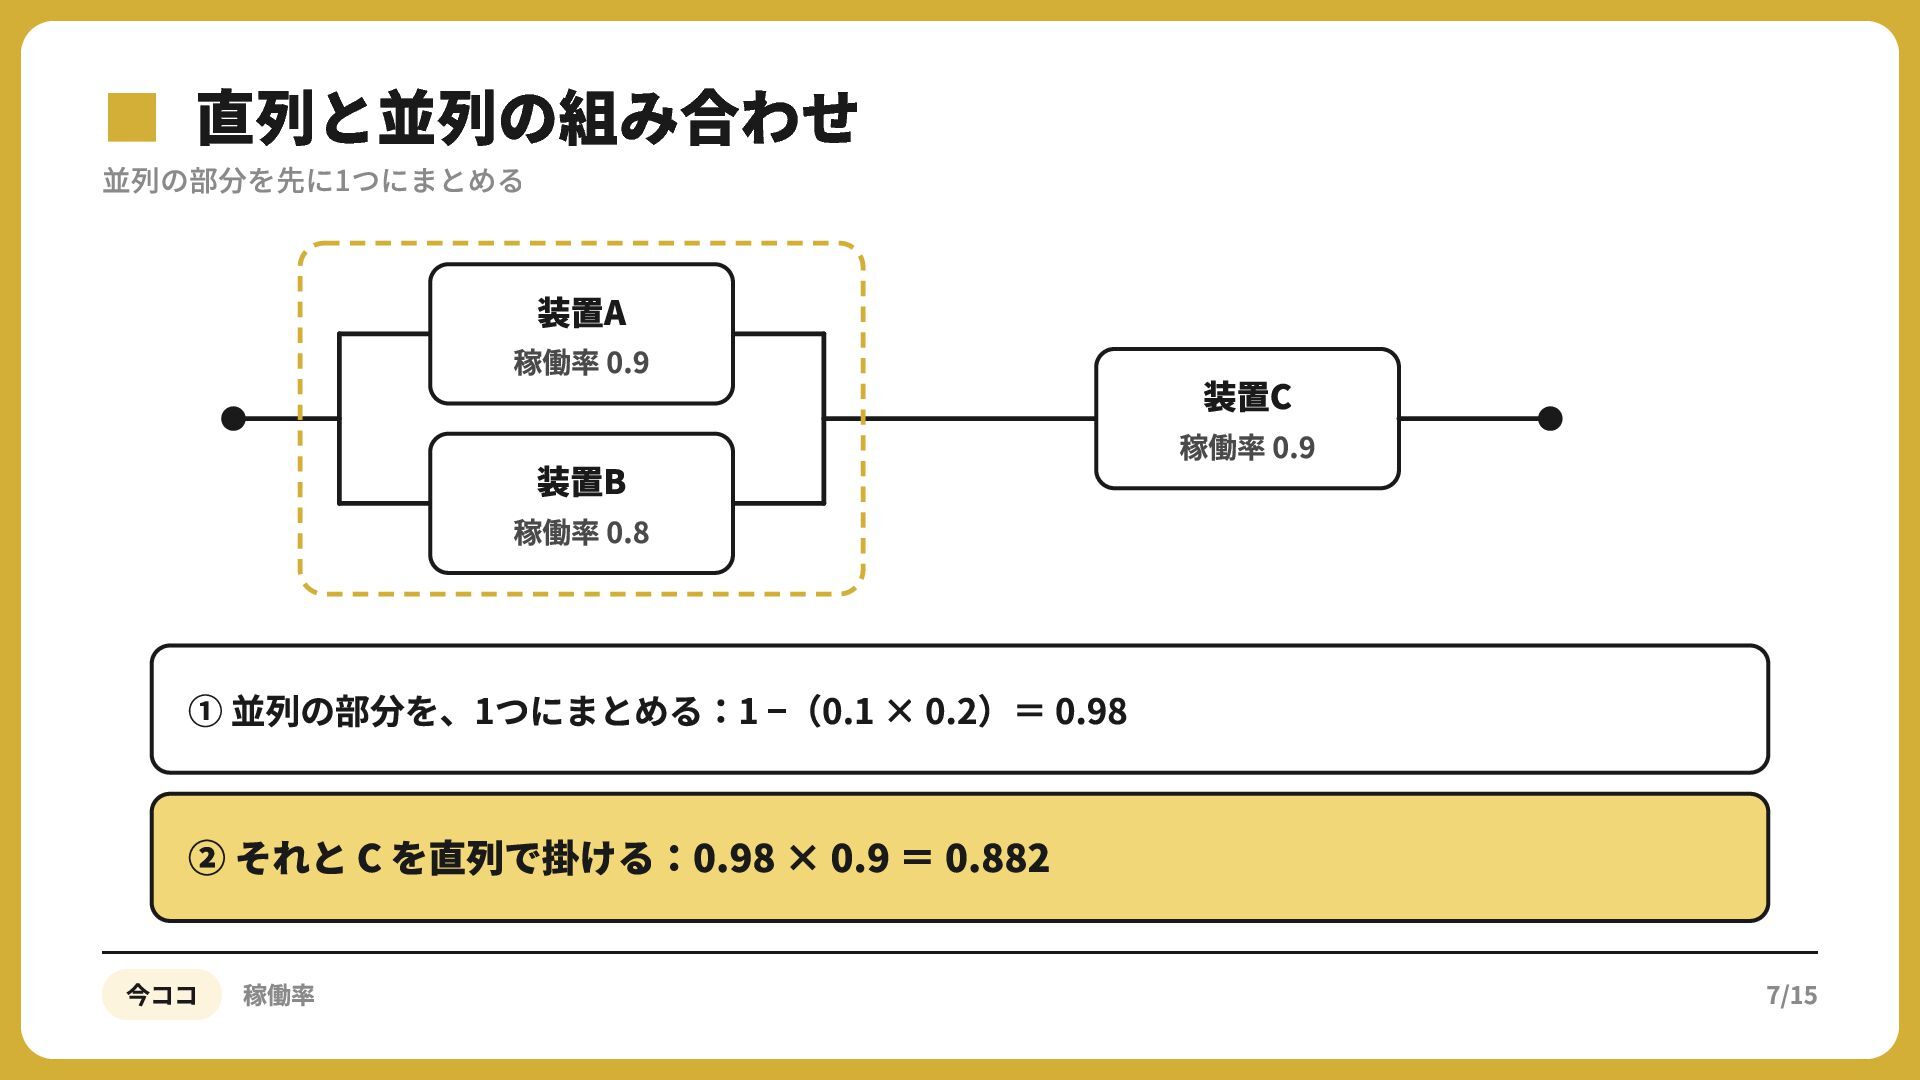
▪並列の部分を先に1つにまとめる 直列と並列の組み合わせ 装置A 稼働率 0.9 装置B 装置C 稼働率 0.9 稼働率
0.8 ① 並列の部分を、1つにまとめる:1 −(0.1 × 0.2)= 0.98 ② それと C を直列で掛ける:0.98 × 0.9 = 0.882 今ココ 稼働率 7/15
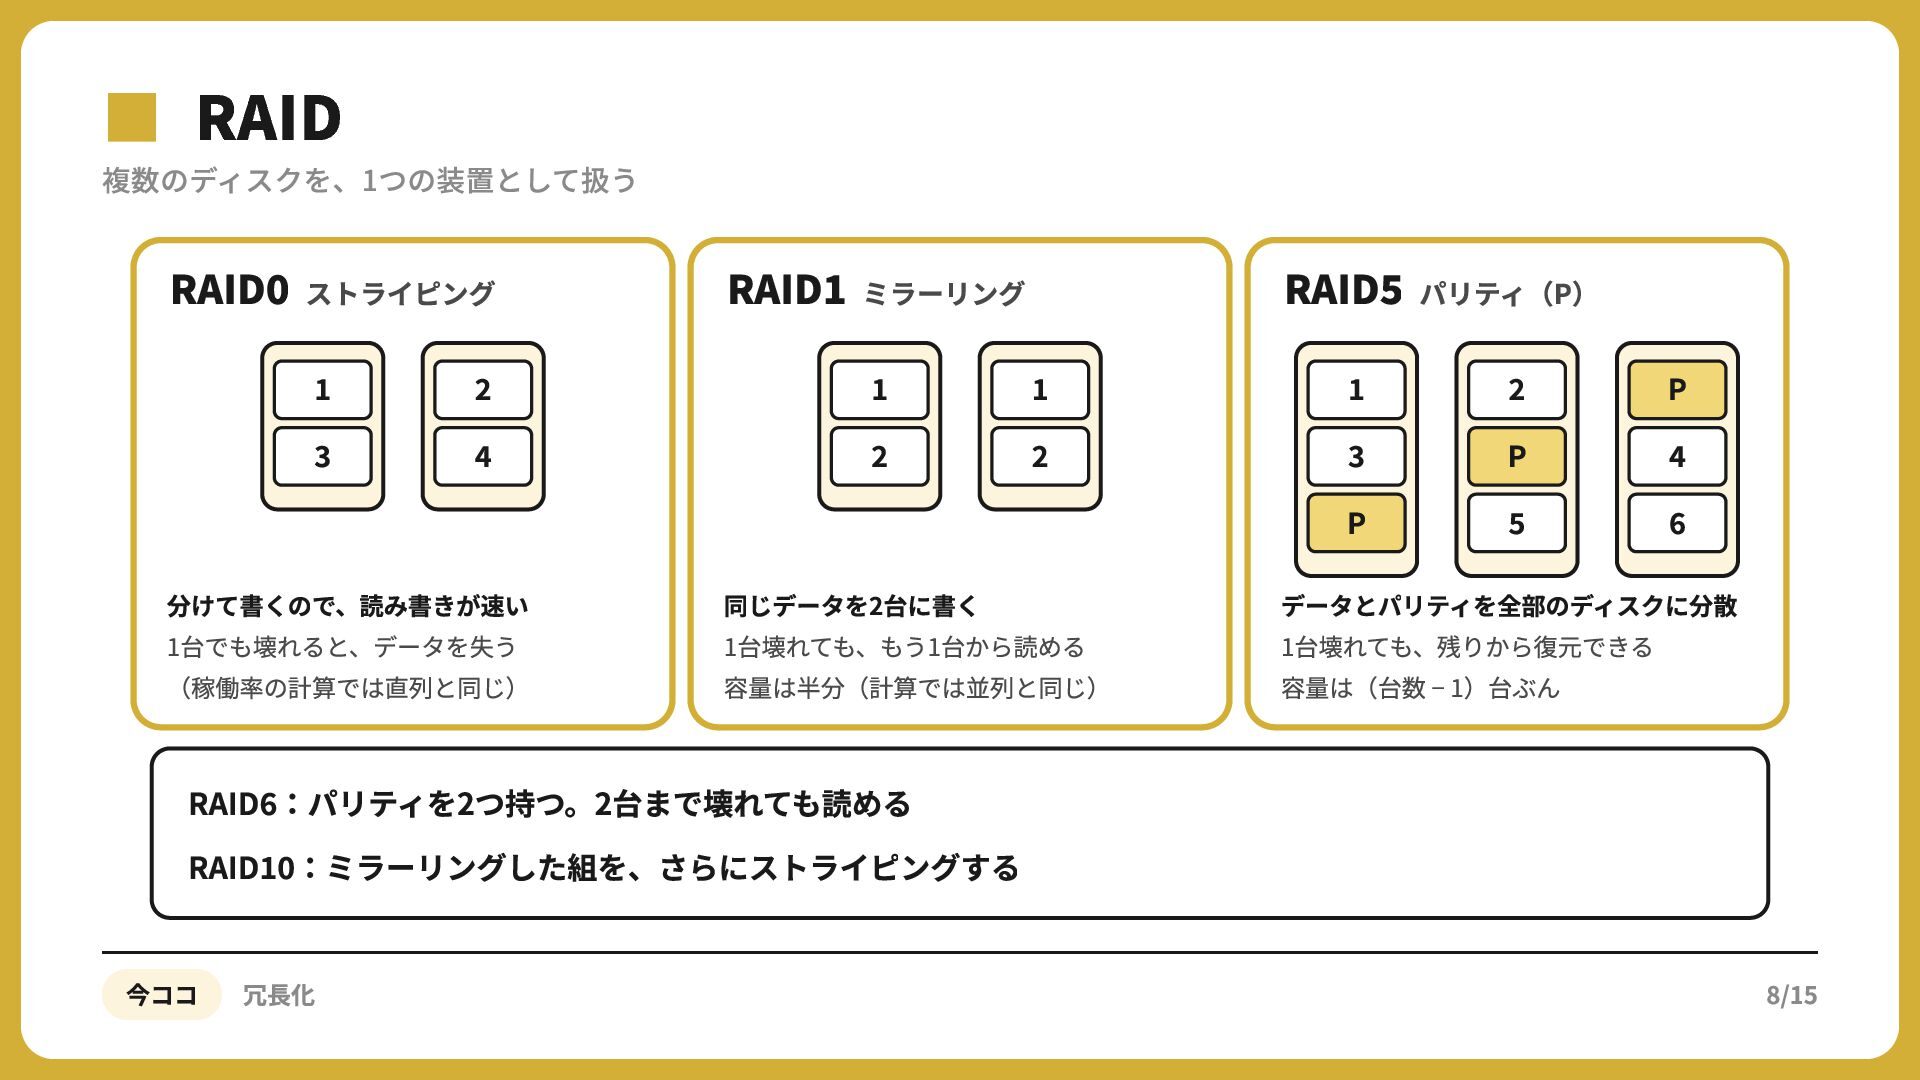
▪複数のディスクを、1つの装置として扱う RAID RAID ストライピング RAID ミラーリング RAID パリティ(P) P 分けて書くので、読み書きが速い
1台でも壊れると、データを失う (稼働率の計算では直列と同じ) 同じデータを2台に書く 1台壊れても、もう1台から読める 容量は半分(計算では並列と同じ) P P データとパリティを全部のディスクに分散 1台壊れても、残りから復元できる 容量は(台数 − 1)台ぶん RAID :パリティを2つ持つ。2台まで壊れても読める RAID :ミラーリングした組を、さらにストライピングする 今ココ 冗長化 8/15
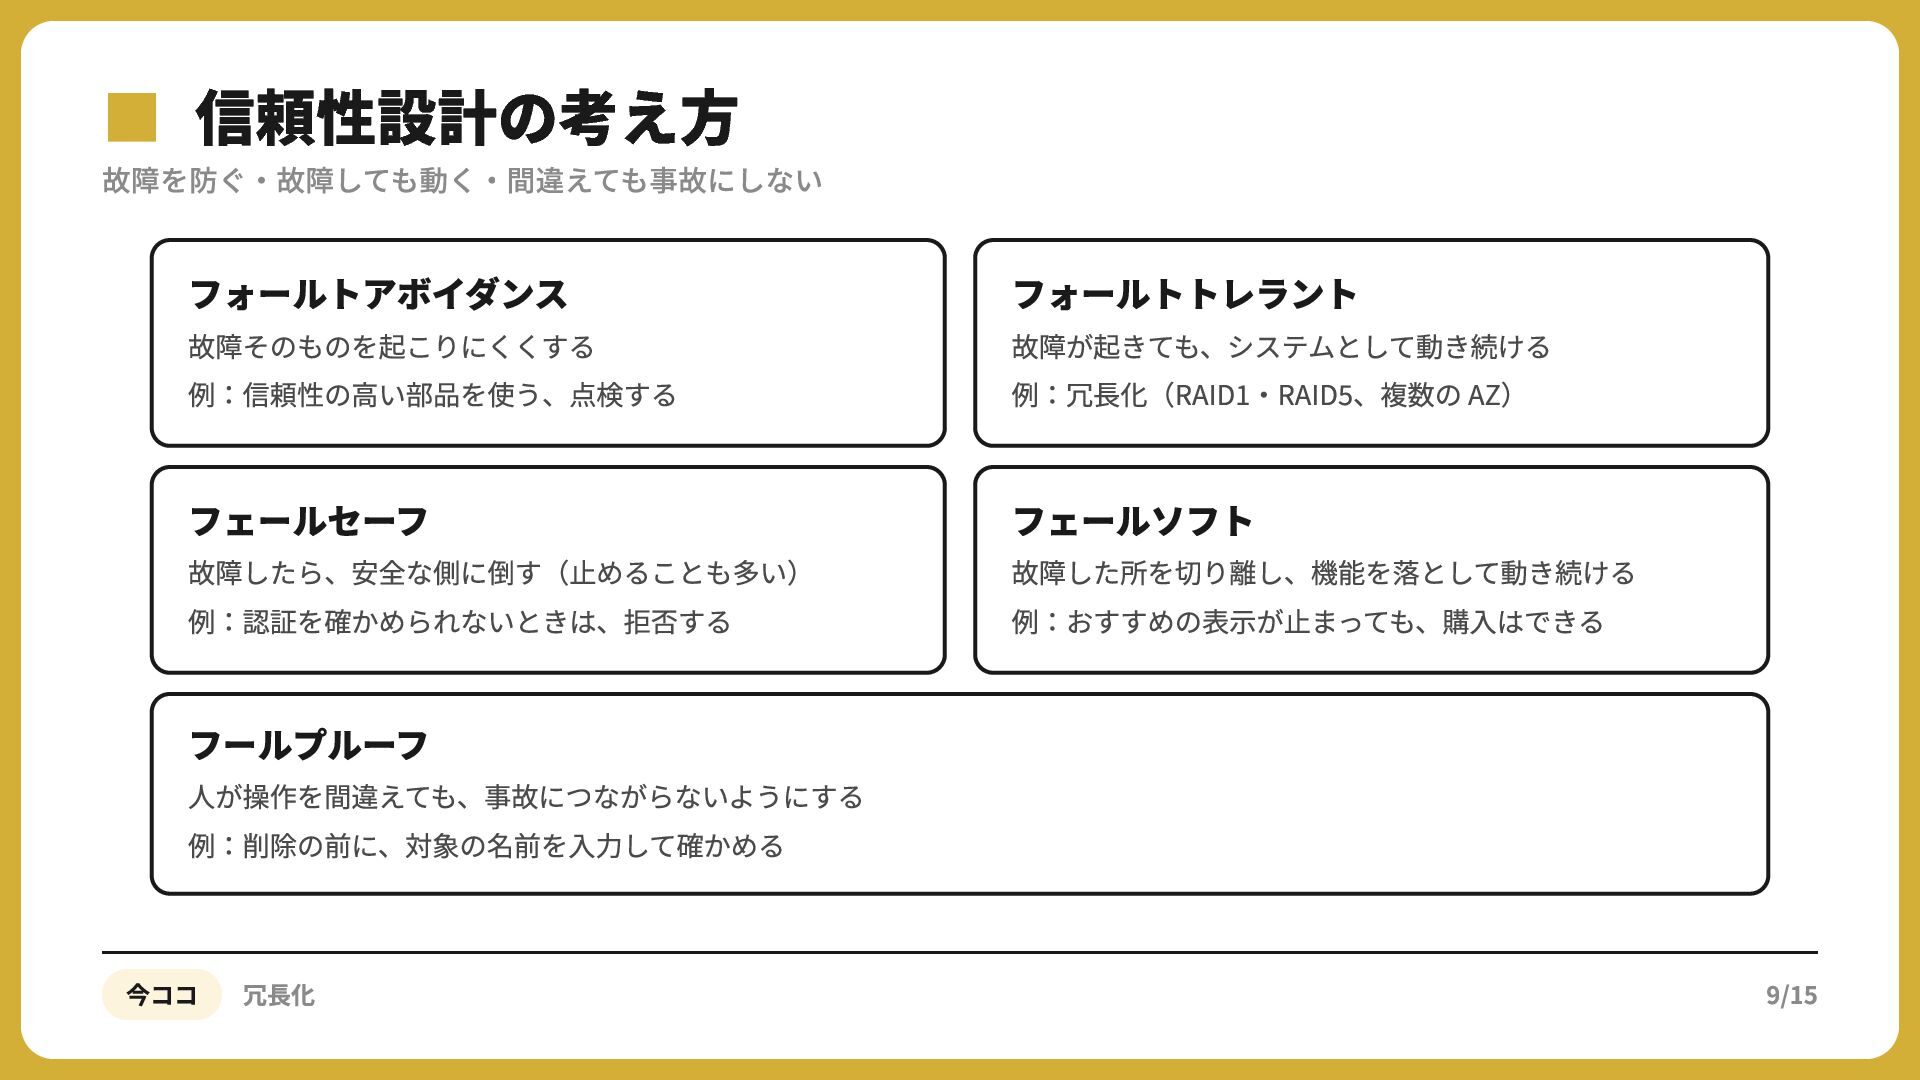
▪故障を防ぐ・故障しても動く・間違えても事故にしない 信頼性設計の考え方 フォールトアボイダンス フォールトトレラント フェールセーフ フェールソフト 故障そのものを起こりにくくする 例:信頼性の⾼い部品を使う、点検する 故障したら、安全な側に倒す(⽌めることも多い) 例:認証を確かめられないときは、拒否する
故障が起きても、システムとして動き続ける 例:冗⻑化(RAID ‧RAID 、複数の AZ) 故障した所を切り離し、機能を落として動き続ける 例:おすすめの表⽰が⽌まっても、購⼊はできる フールプルーフ ⼈が操作を間違えても、事故につながらないようにする 例:削除の前に、対象の名前を⼊⼒して確かめる 今ココ 冗長化 9/15
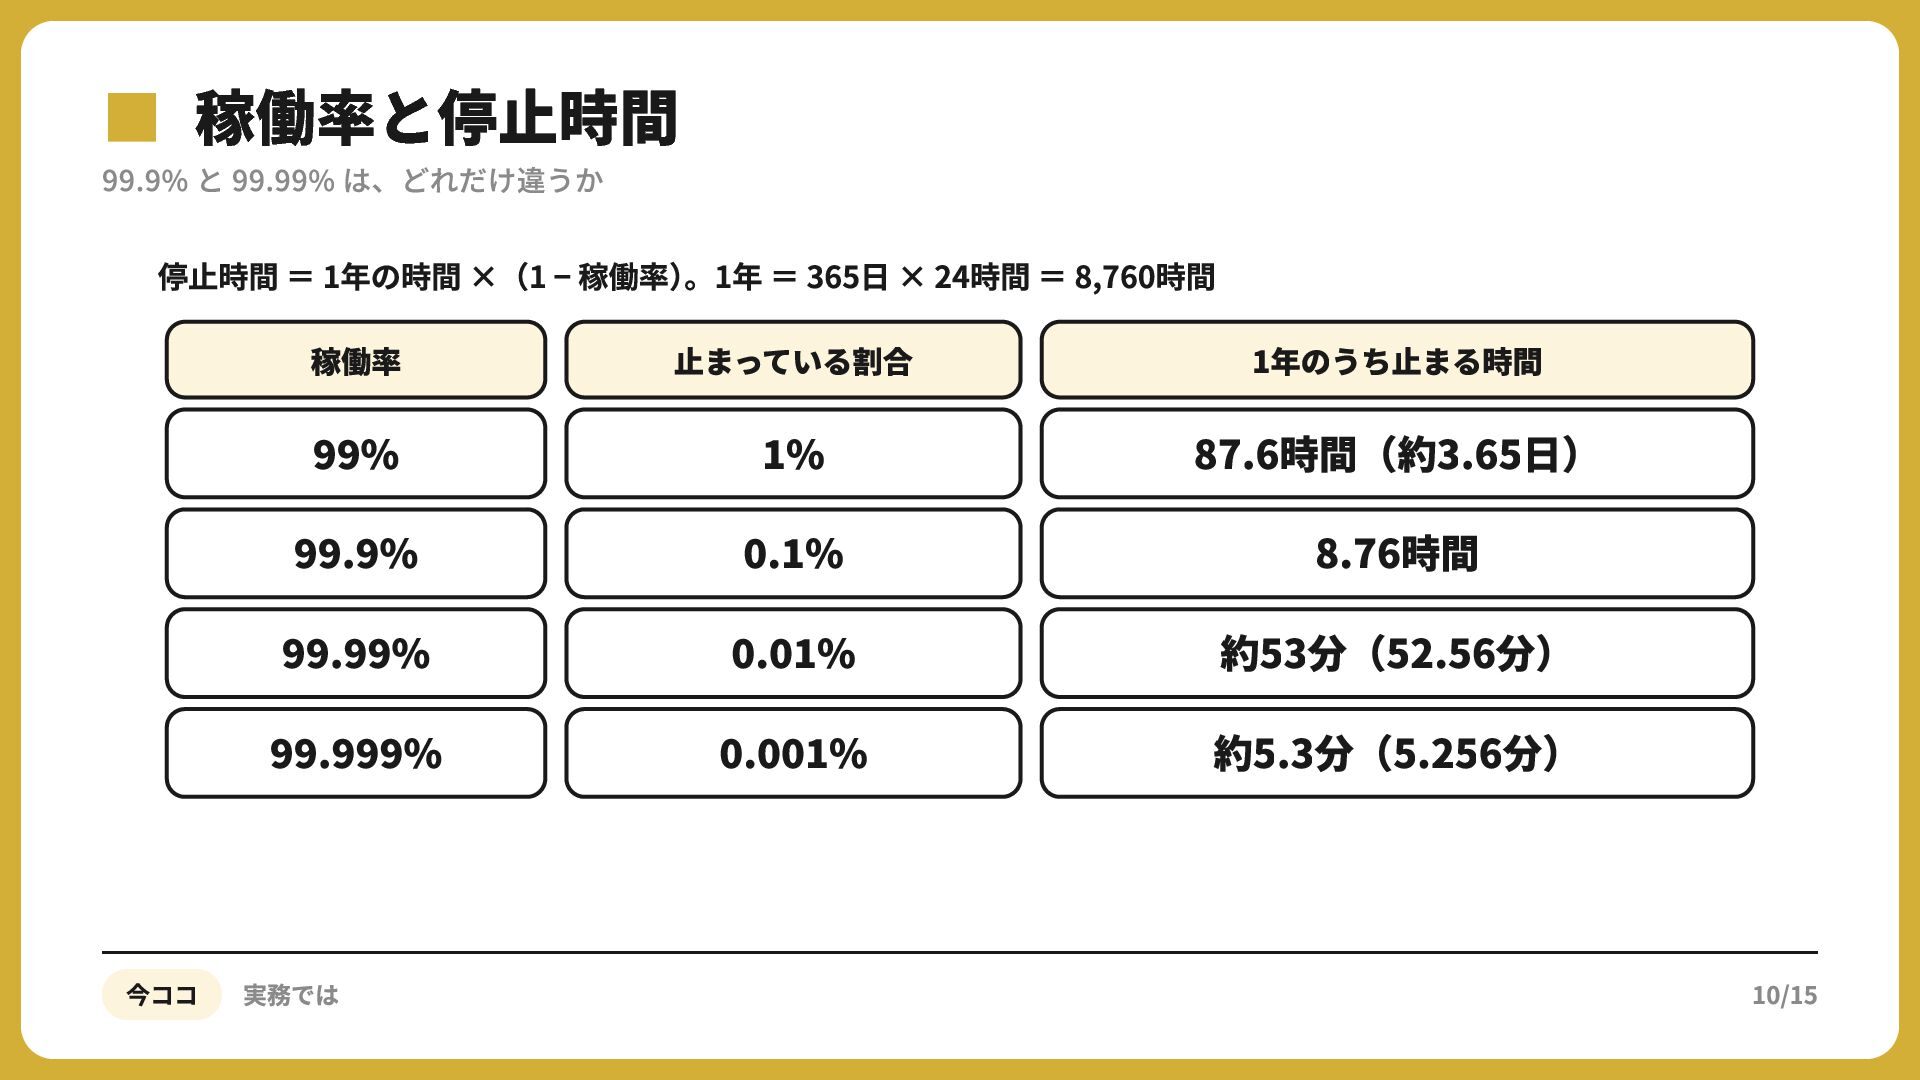
▪99.9% 稼働率と停止時間 と 99.99% は、どれだけ違うか 停⽌時間 = 1年の時間 ×(1 −
稼働率)。1年 = 365⽇ × 24時間 = 8,760時間 稼働率 ⽌まっている割合 1年のうち⽌まる時間 % .% . % . % 今ココ 実務では % .% . % . % 87.6時間(約3.65⽇) 8.76時間 約53分(52.56分) 約5.3分(5.256分) 10/15
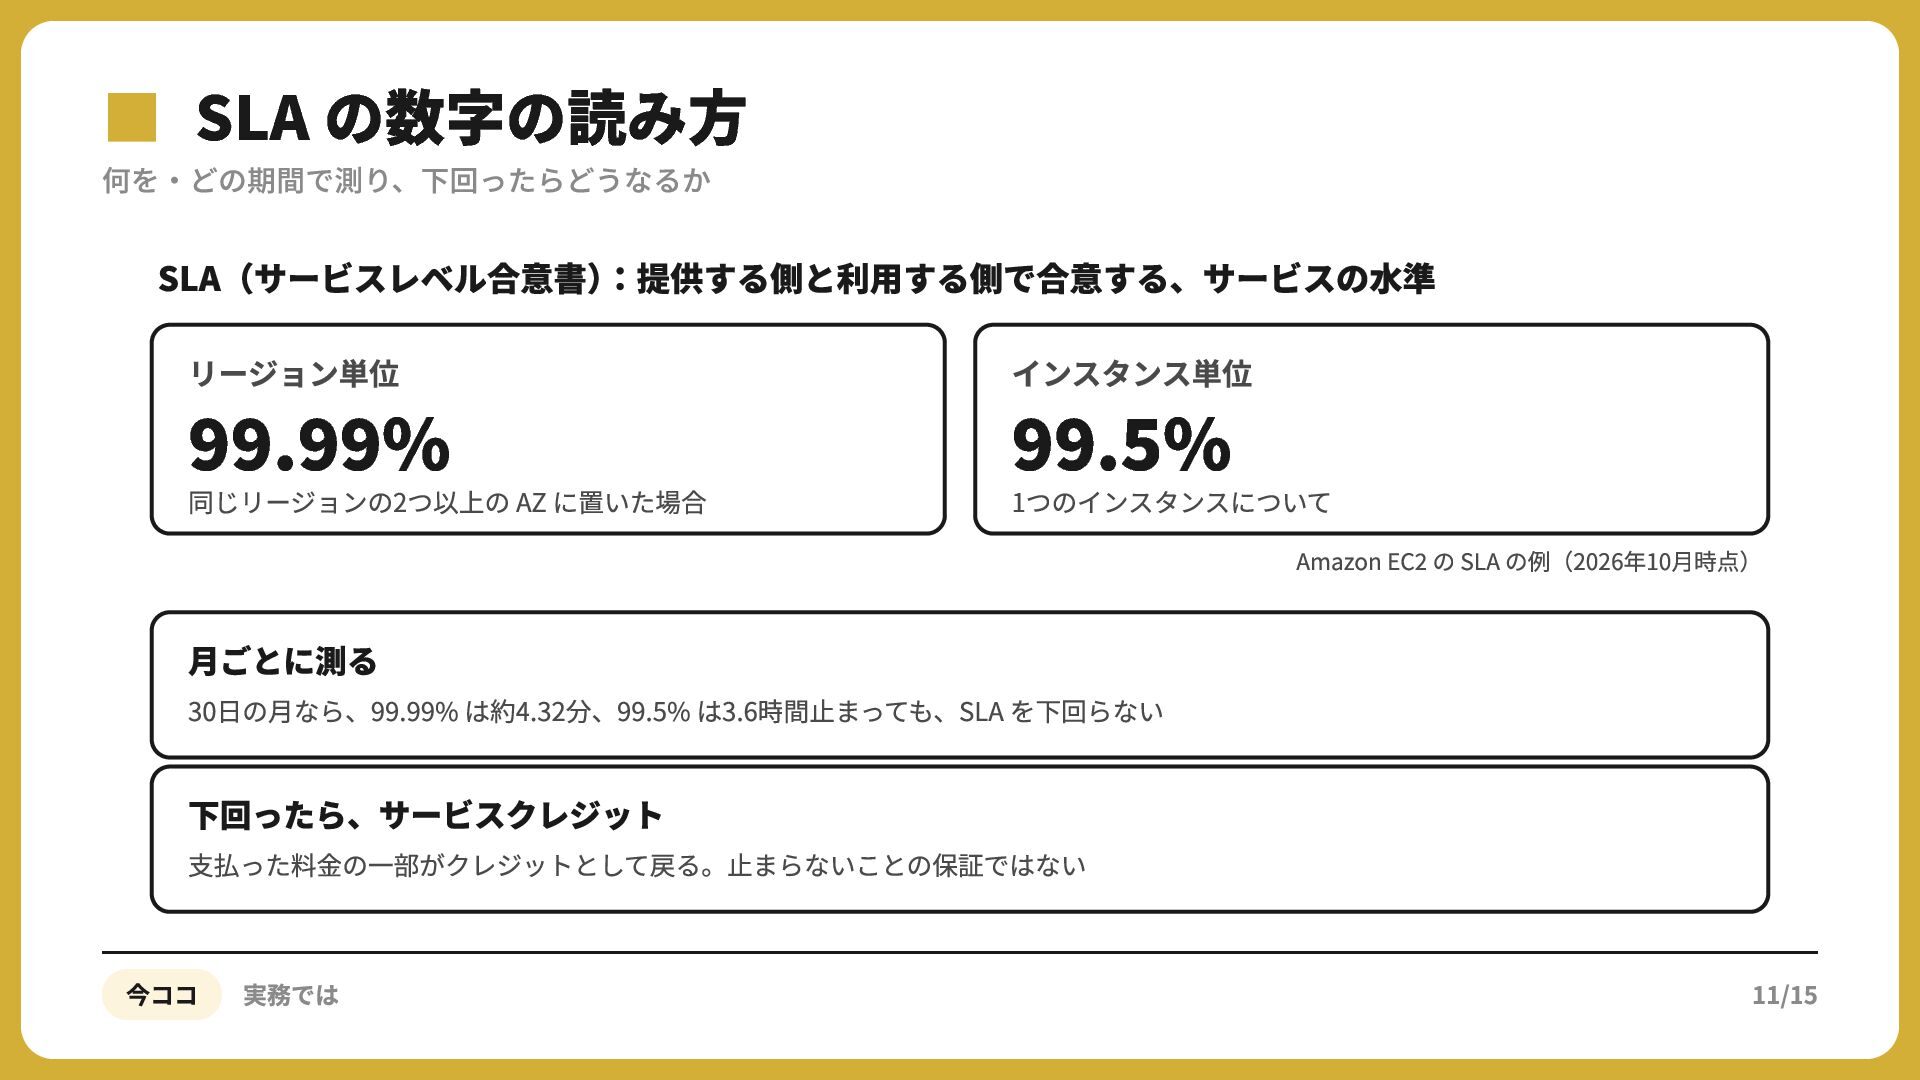
▪何を・どの期間で測り、下回ったらどうなるか SLA の数字の読み方 SLA(サービスレベル合意書):提供する側と利⽤する側で合意する、サービスの⽔準 リージョン単位 インスタンス単位 同じリージョンの2つ以上の AZ に置いた場合 1つのインスタンスについて
. % .% Amazon EC の SLA の例(2026年10⽉時点) ⽉ごとに測る 30⽇の⽉なら、99.99% は約4.32分、99.5% は3.6時間⽌まっても、SLA を下回らない 下回ったら、サービスクレジット ⽀払った料⾦の⼀部がクレジットとして戻る。⽌まらないことの保証ではない 今ココ 実務では 11/15
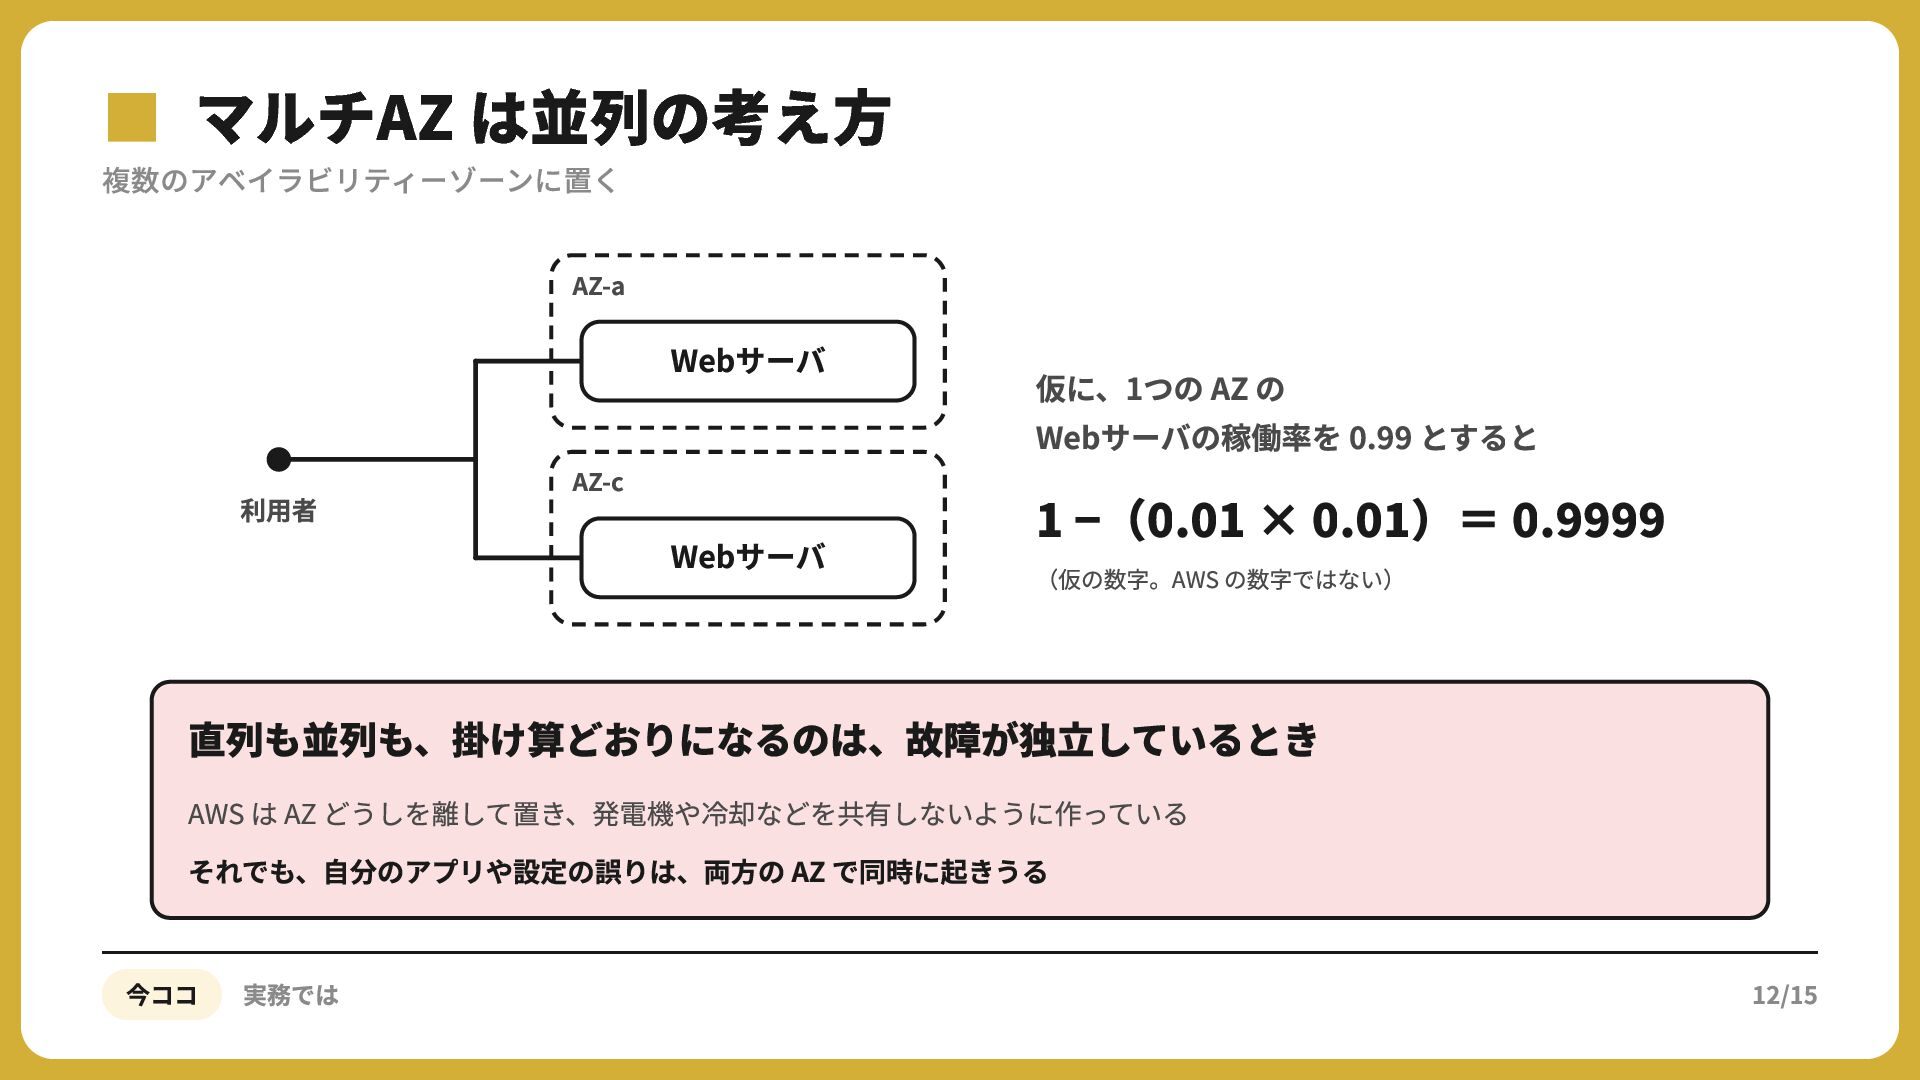
▪複数のアベイラビリティーゾーンに置く マルチAZ は並列の考え方 AZ-a Webサーバ 利⽤者 AZ-c Webサーバ 仮に、1つの AZ
の Webサーバの稼働率を 0.99 とすると 1 −(0.01 × 0.01)= 0.9999 (仮の数字。AWS の数字ではない) 直列も並列も、掛け算どおりになるのは、故障が独⽴しているとき AWS は AZ どうしを離して置き、発電機や冷却などを共有しないように作っている それでも、⾃分のアプリや設定の誤りは、両⽅の AZ で同時に起きうる 今ココ 実務では 12/15
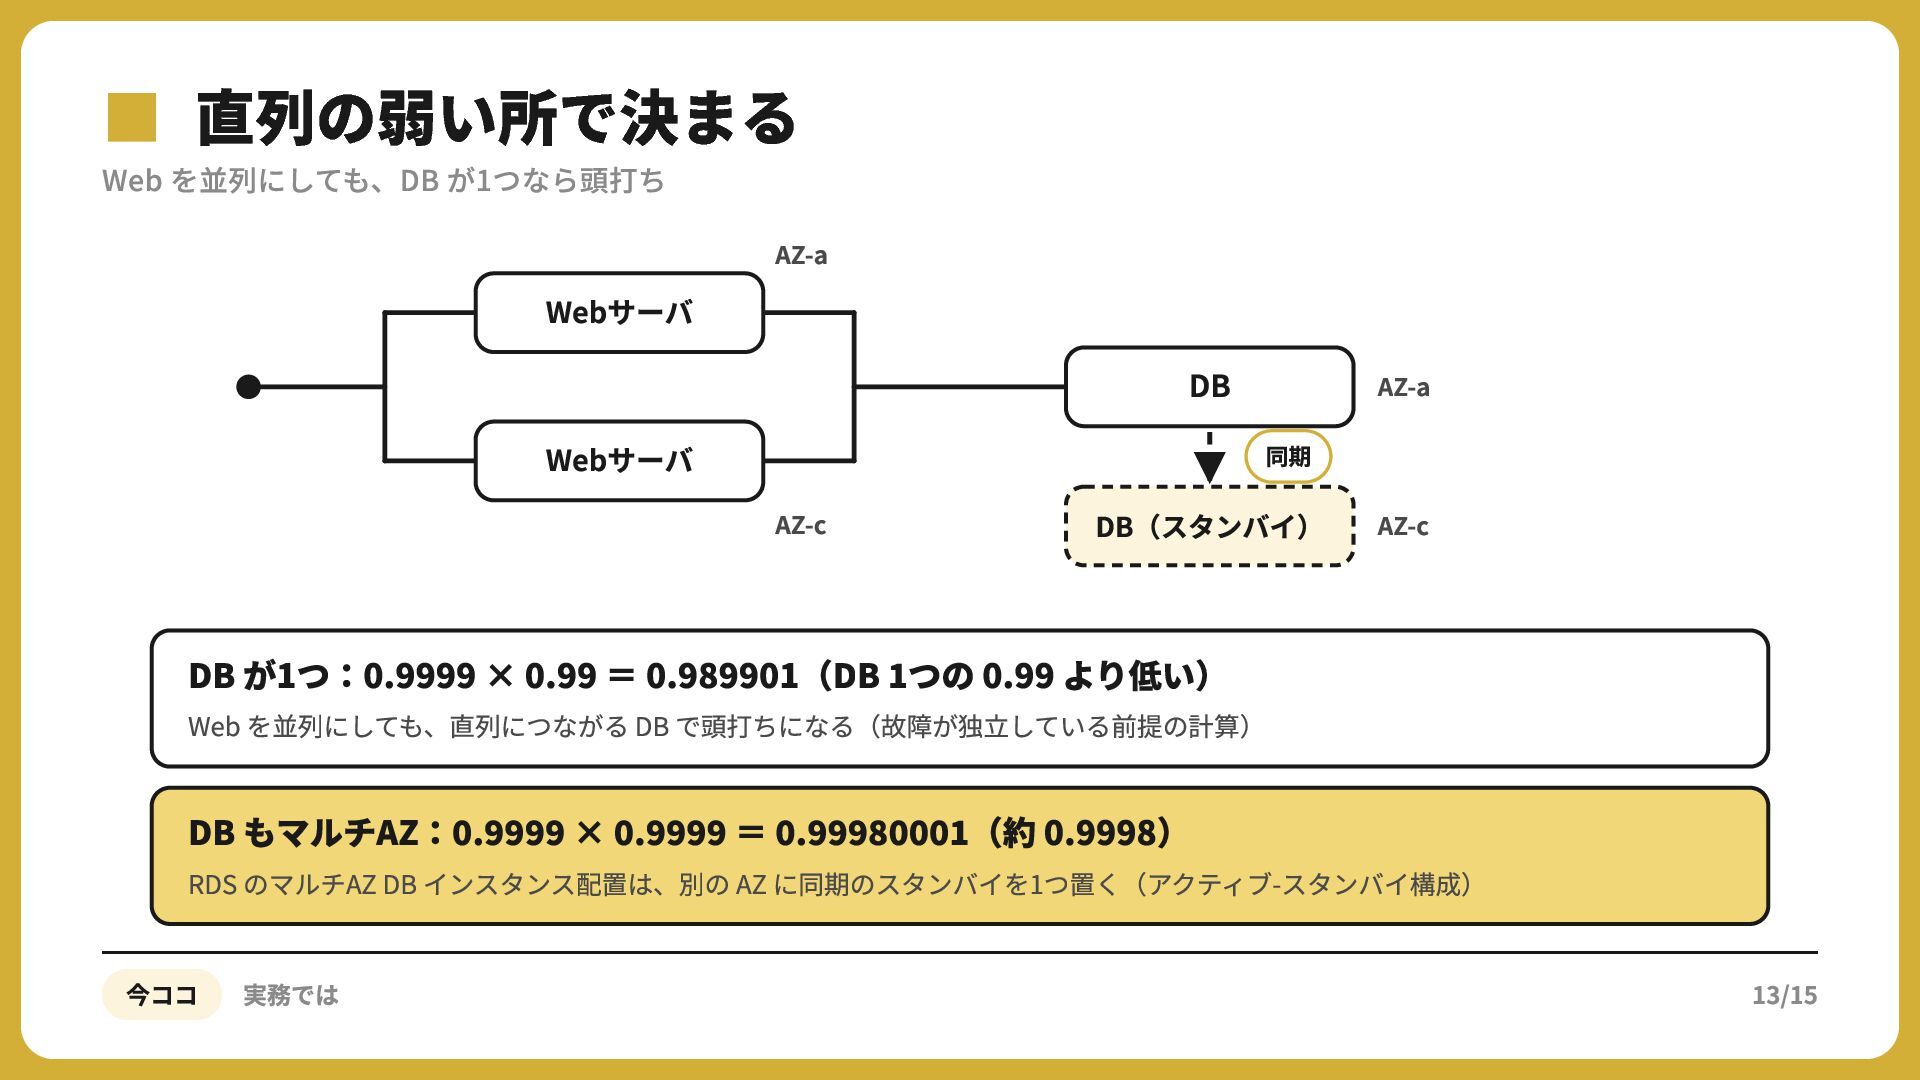
▪Web を並列にしても、DB 直列の弱い所で決まる が1つなら頭打ち Webサーバ Webサーバ AZ-a DB AZ-a 同期
AZ-c DB(スタンバイ) AZ-c DB が1つ:0.9999 × 0.99 = 0.989901(DB つの 0.99 より低い) Web を並列にしても、直列につながる DB で頭打ちになる(故障が独⽴している前提の計算) DB もマルチAZ: . × . = . (約 0.9998) RDS のマルチAZ DB インスタンス配置は、別の AZ に同期のスタンバイを1つ置く(アクティブ-スタンバイ構成) 今ココ 実務では 13/15
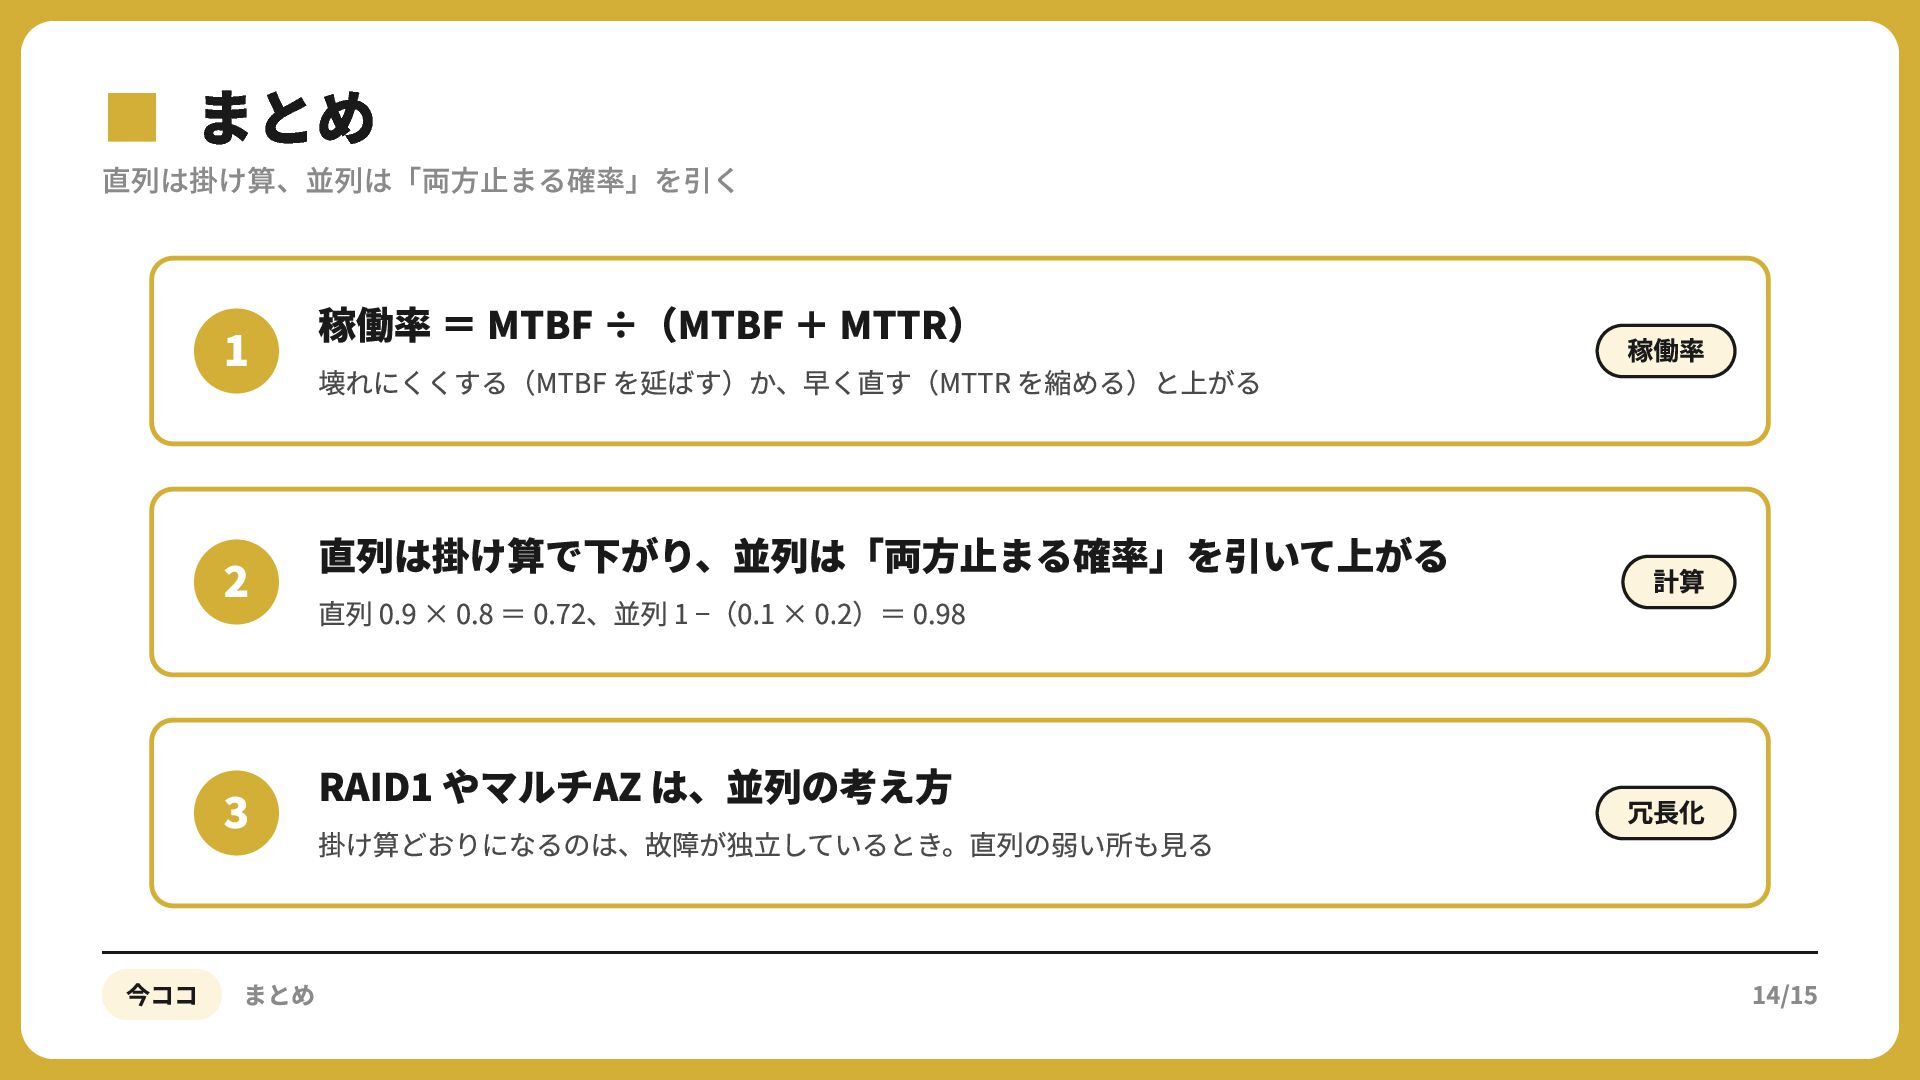
▪直列は掛け算、並列は「両方止まる確率」を引く まとめ 稼働率 = MTBF ÷(MTBF + MTTR) 稼働率 直列は掛け算で下がり、並列は「両⽅⽌まる確率」を引いて上がる
計算 RAID やマルチAZ は、並列の考え⽅ 冗⻑化 壊れにくくする(MTBF を延ばす)か、早く直す(MTTR を縮める)と上がる 直列 0.9 × 0.8 = 0.72、並列 1 −(0.1 × 0.2)= 0.98 掛け算どおりになるのは、故障が独⽴しているとき。直列の弱い所も⾒る 今ココ まとめ 14/15
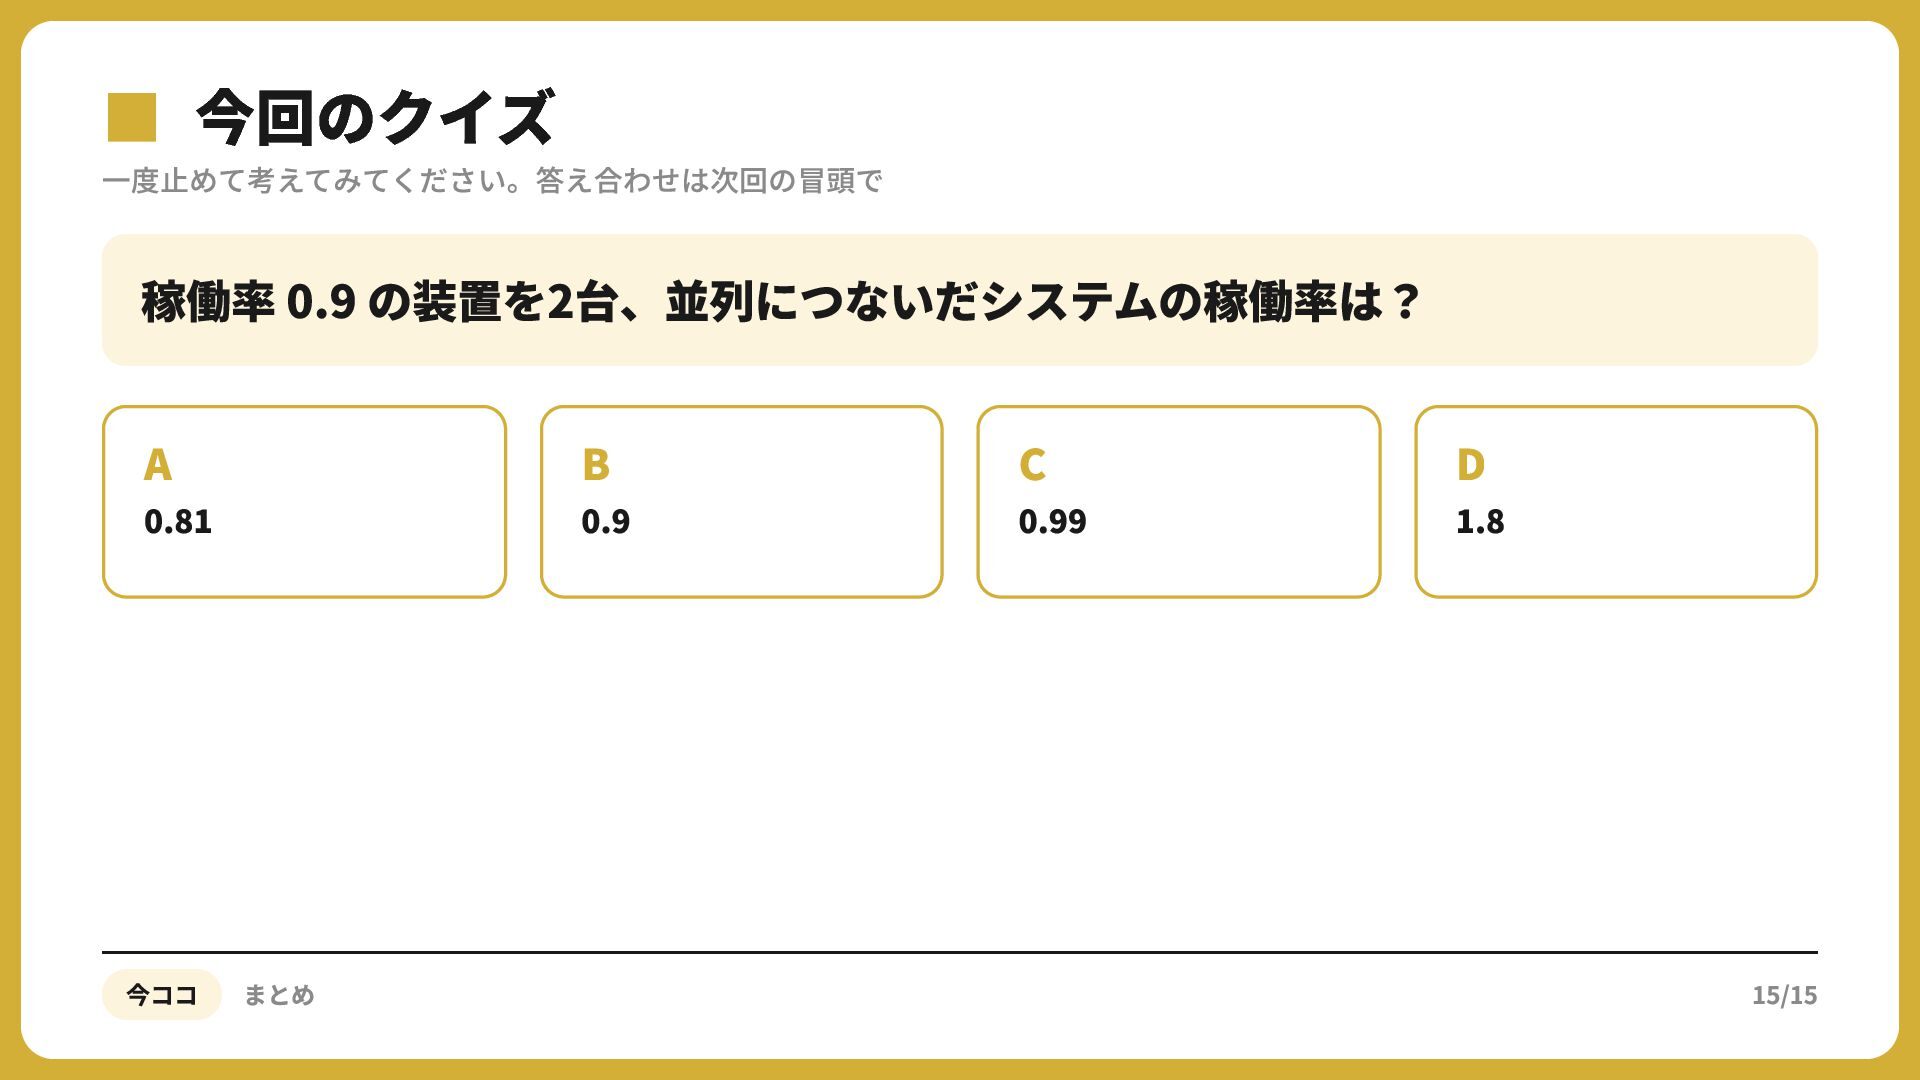
▪一度止めて考えてみてください。答え合わせは次回の冒頭で 今回のクイズ 稼働率 0.9 の装置を2台、並列につないだシステムの稼働率は? A 0.81 今ココ まとめ B
0.9 C 0.99 D 1.8 15/15


 akagami
 skydoves
 mofurune
 falcon8823
 slobodan
 ivargrimstad
 vivion
 rkaga
 sylph01
 uyuki234
 marcoroth
 deka_morita
 retrage
 stuffmc
 philnash
 destraynor
 konakalab
 cassininazir
 sstephenson
 nmsamuel
 tammyeverts
 baasie
 honnibal
 uxyall