Upgrade to Pro — share decks privately, control downloads, hide ads and more …

KServeで始めるLLM_Serving___vLLMからllm-dまで.pdf

Avatar for ii ii
September 08, 2026

 KServeで始めるLLM_Serving___vLLMからllm-dまで.pdf

こちらは2026年8月27日開催のKubernetes Novice Tokyo #41セッション枠にて発表した内容になります。
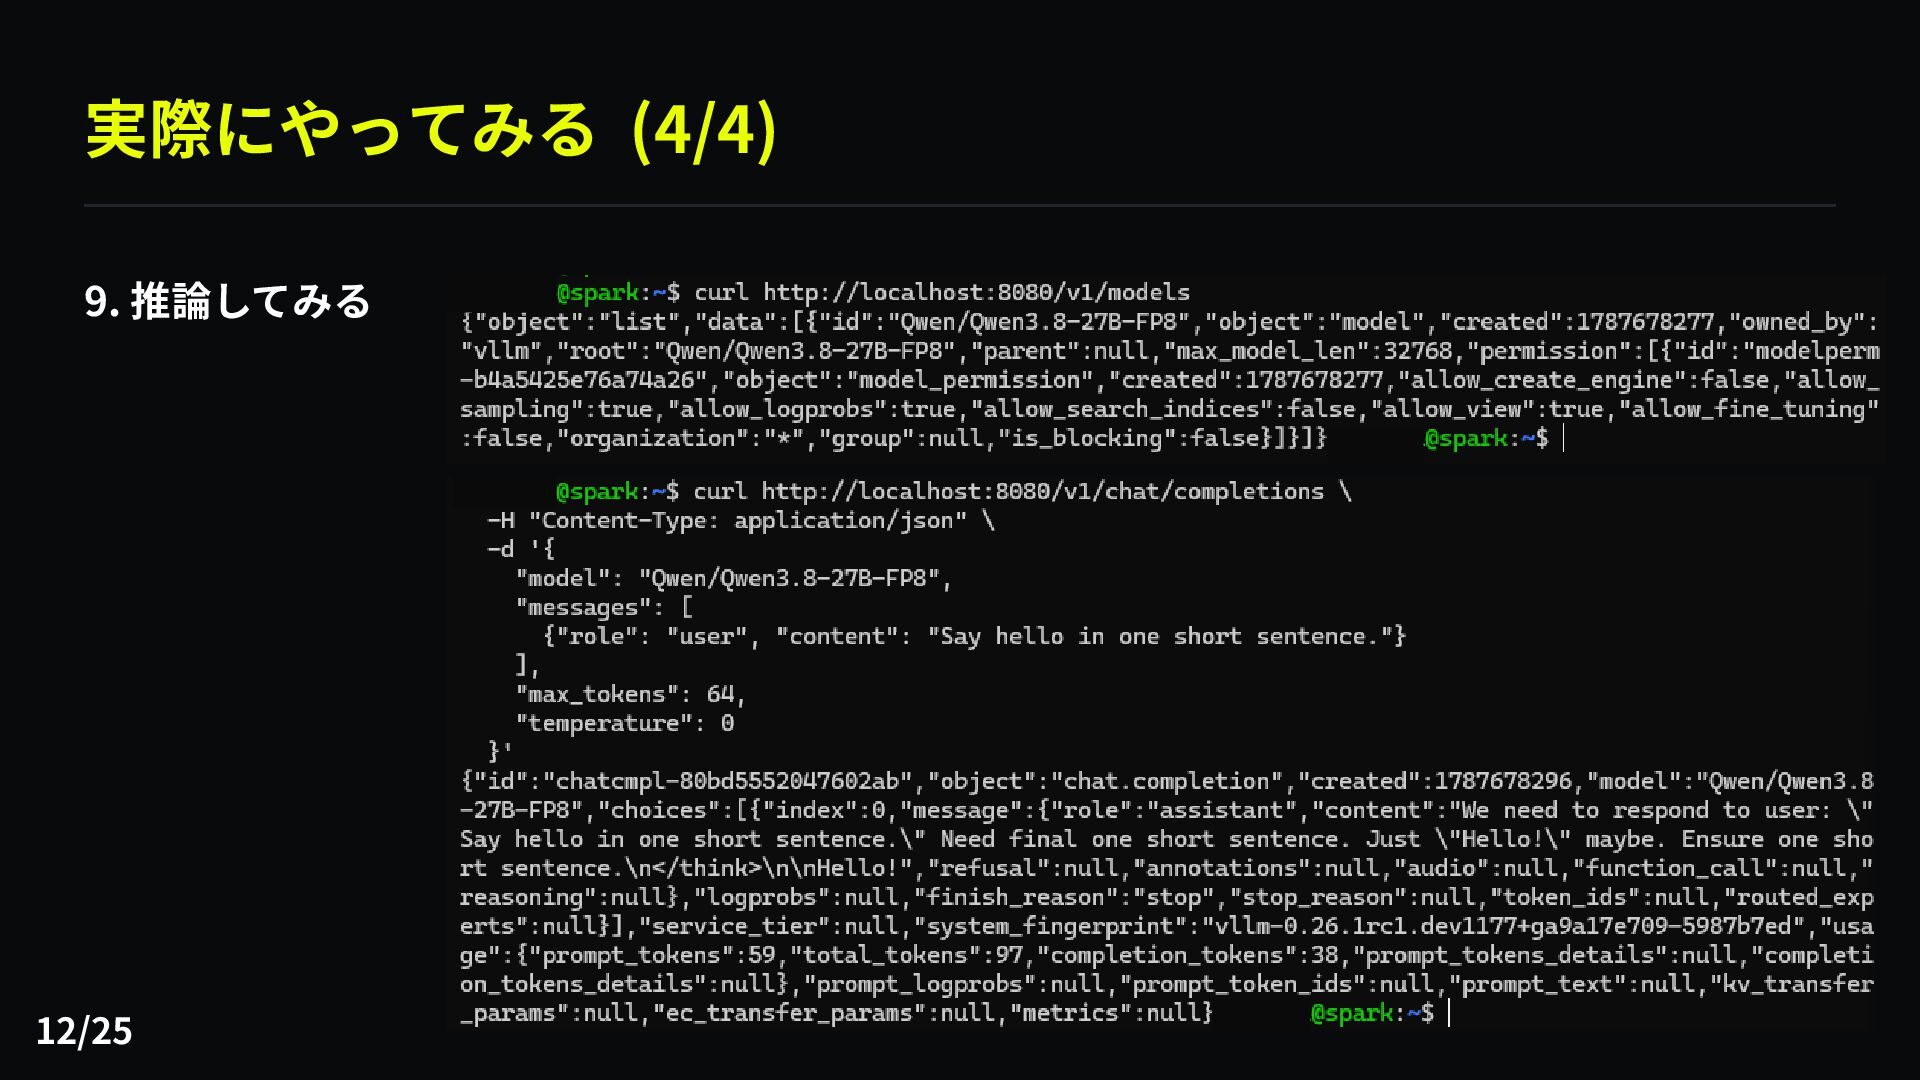
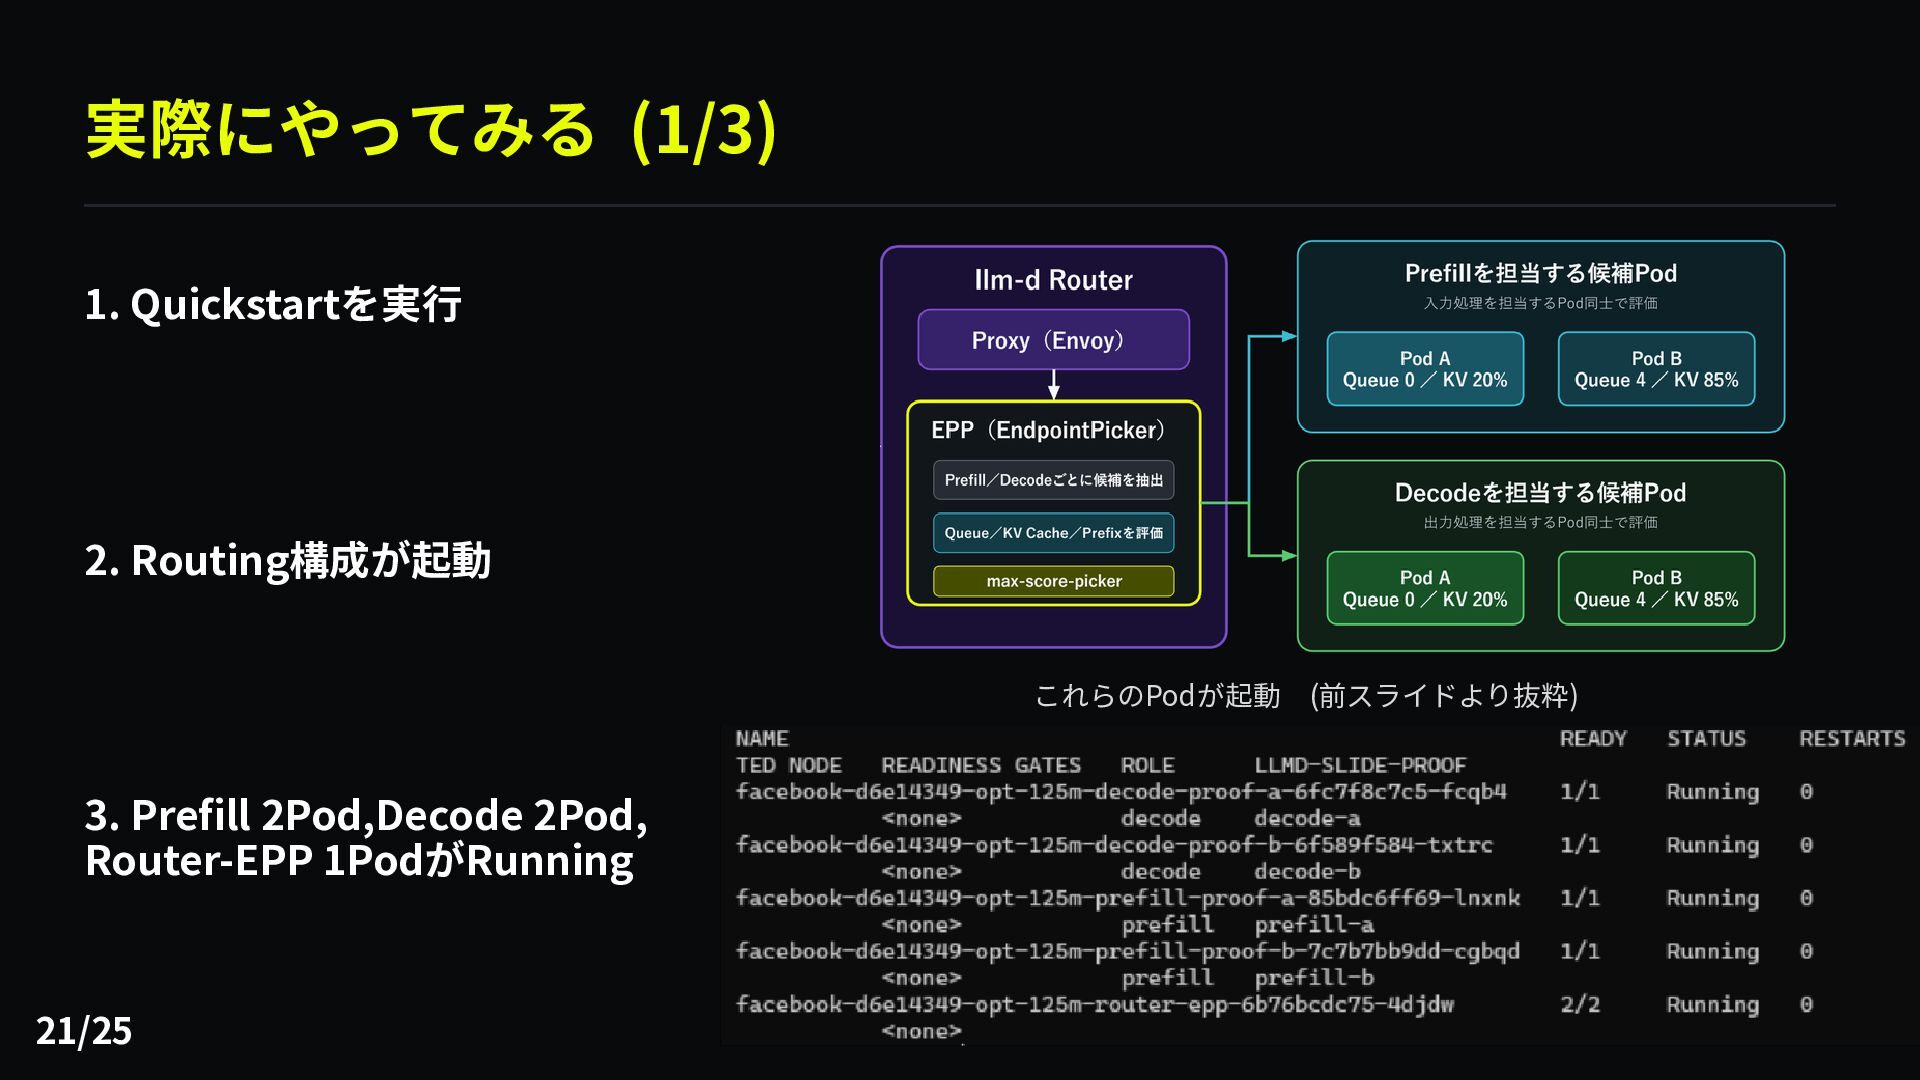
本セッションでは、vLLMをKServeでKubernetes上にデプロイし、Qwen3.8-27B-FP8をAPIとして提供し、実推論までを検証した過程を紹介します。 さらに、複数PodでLLMを提供する場面を想定し、llm-dによるルーティング構成と、その動作も確認しました。

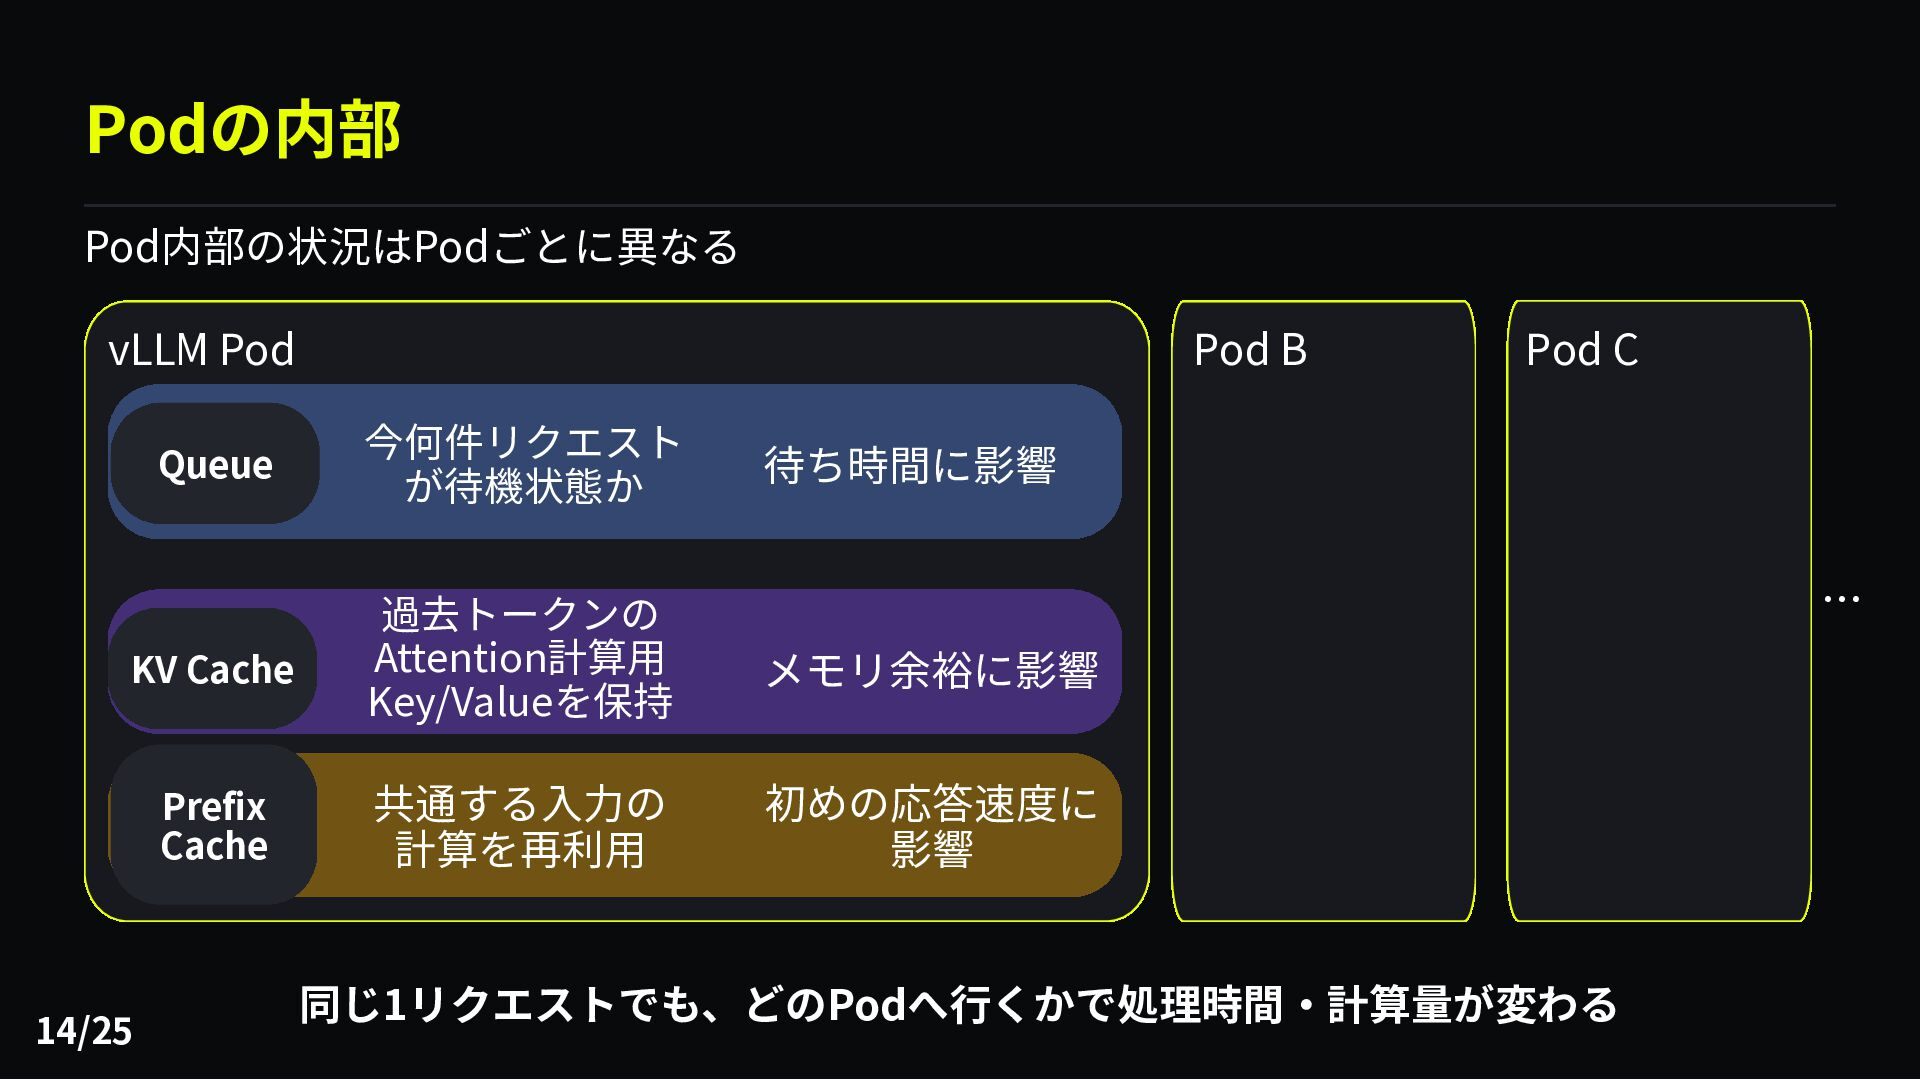
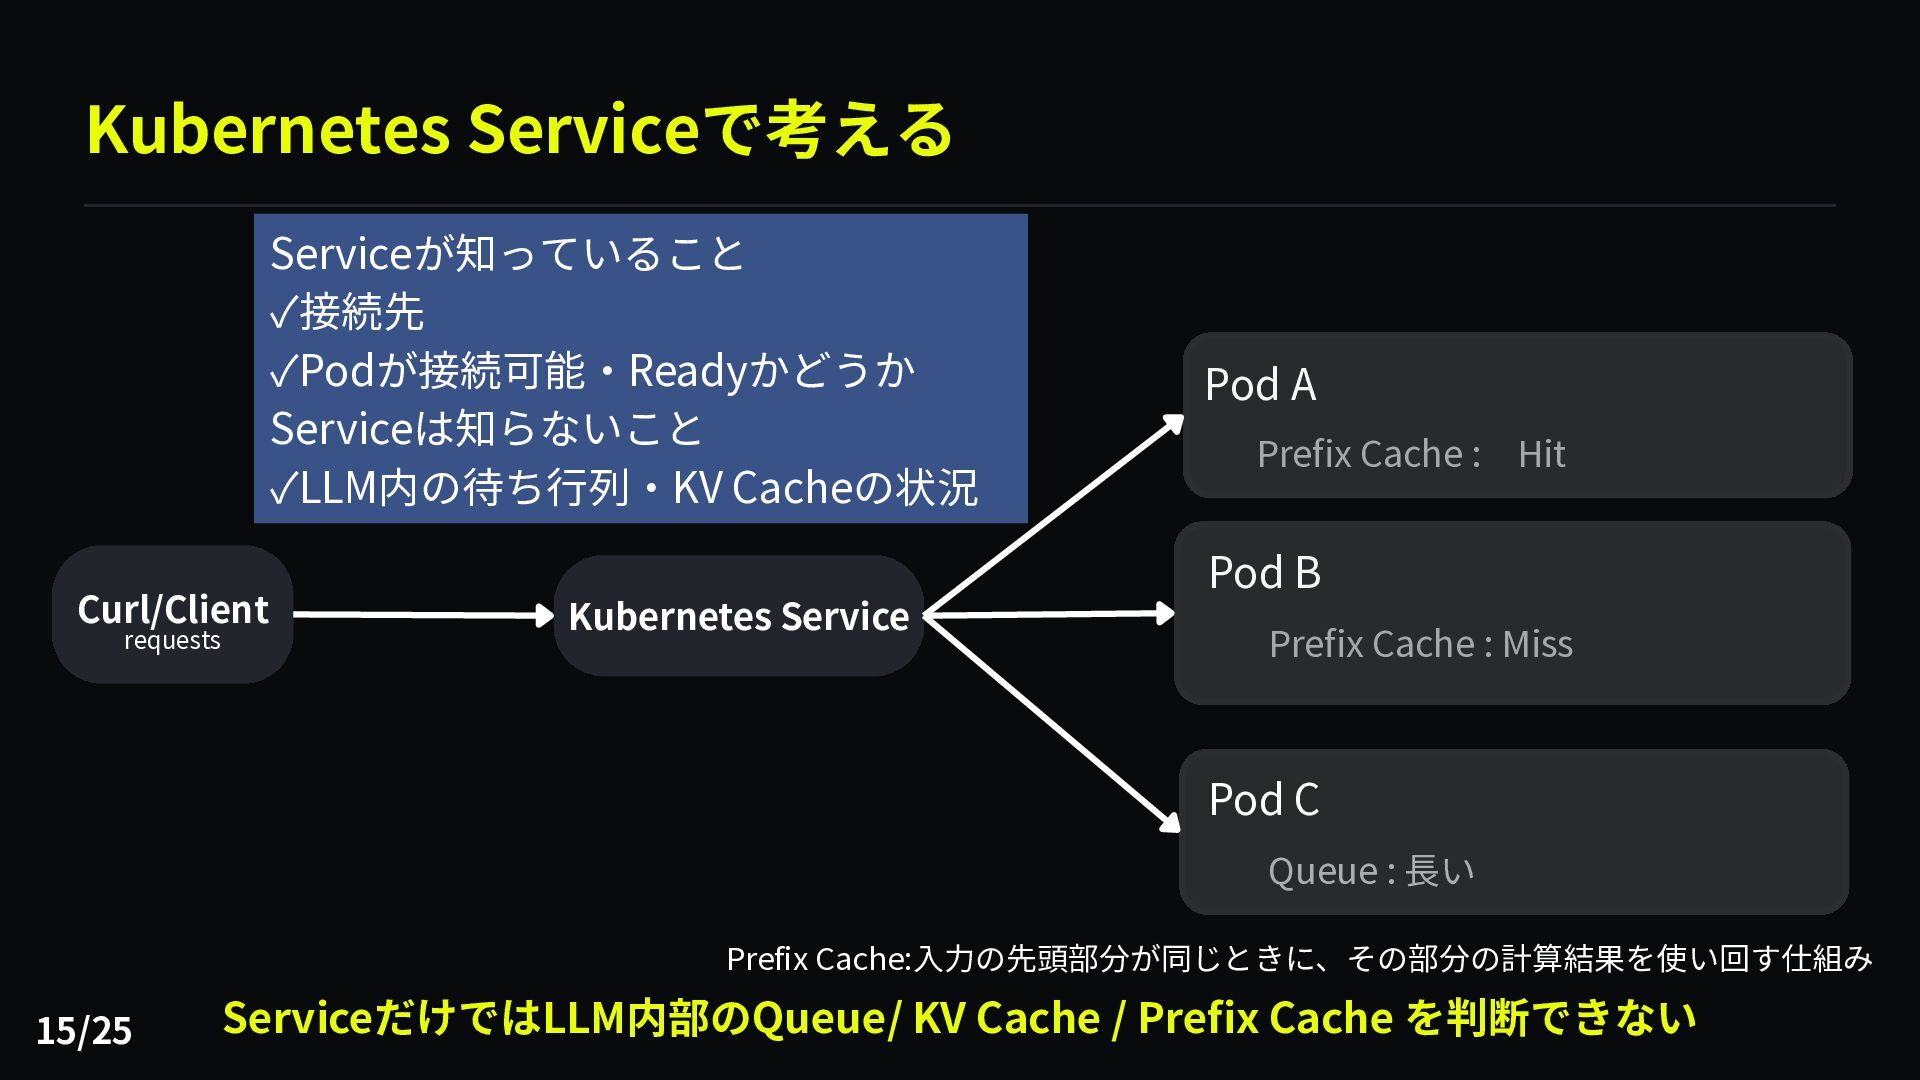
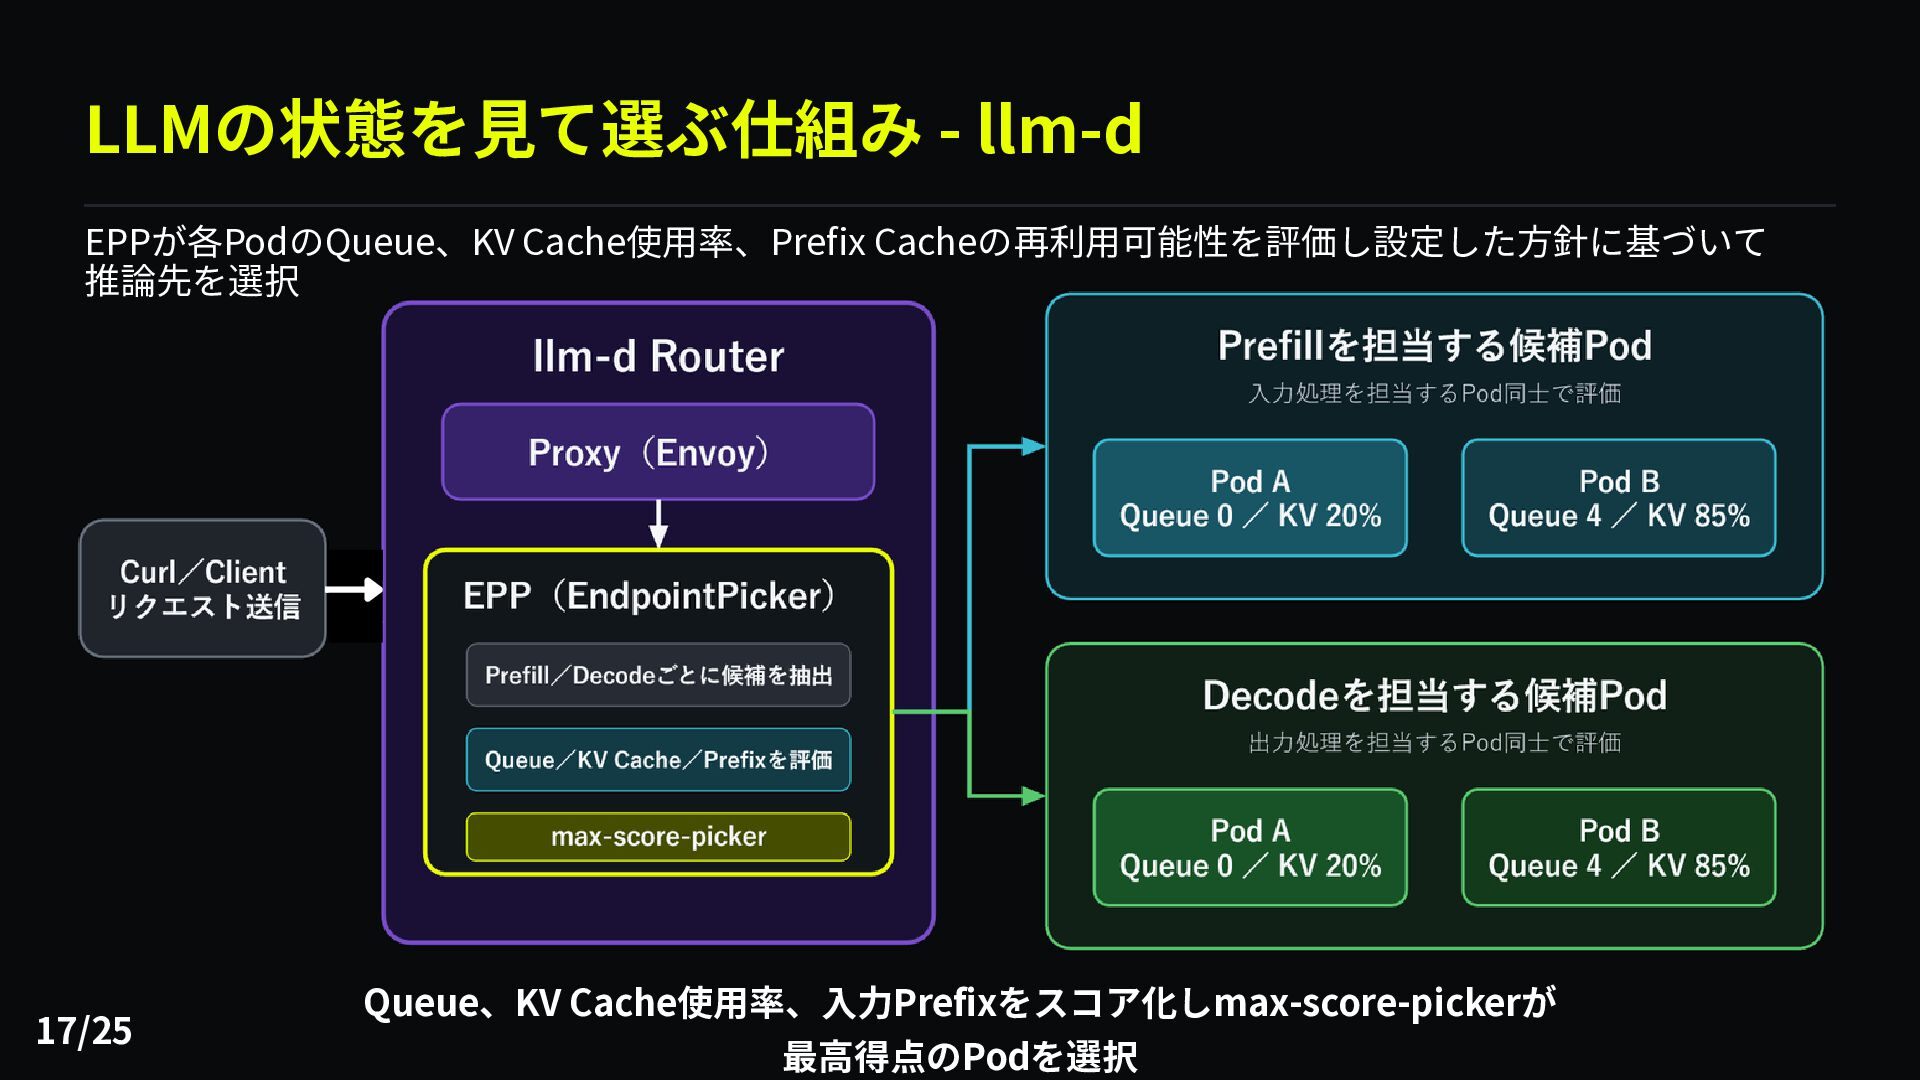
LLM Servingでは、Podごとの待ち行列やKV Cacheの状態によって、同じリクエストでも処理速度が変わります。通常のServiceは接続先を選べても、LLM内部の状態までは判断できません。llm-dは、Queue・KV Cache・Prefix Cacheなどの状態を基に推論先を選びます。本セッションでは、vLLM・KServe・llm-dの役割分担と、LLM Servingを次の段階へ進める考え方を紹介します。

Avatar for ii

ii

September 08, 2026

Other Decks in Technology

Transcript

  1. 自己紹介 ii (akane) @__n0978a55 ▪所属:株式会社NTTデータ 2年目 ▪業務内容:PrivateAI(閉域網向け生成AIプラットフォーム) 開発・社内向けGPU基盤サービス維持・運用 ▪興味があること:LLM,Physical AI

    その他最新技術 etc ▪趣味:国内外旅行、楽器演奏、読書、ランニングetc ▪ひとこと:Kubernetes、その他IT知識ド初心者ですので お手柔らかにお願いいたします… これから精進し続けていくつもりです (現在進行形) 1/25
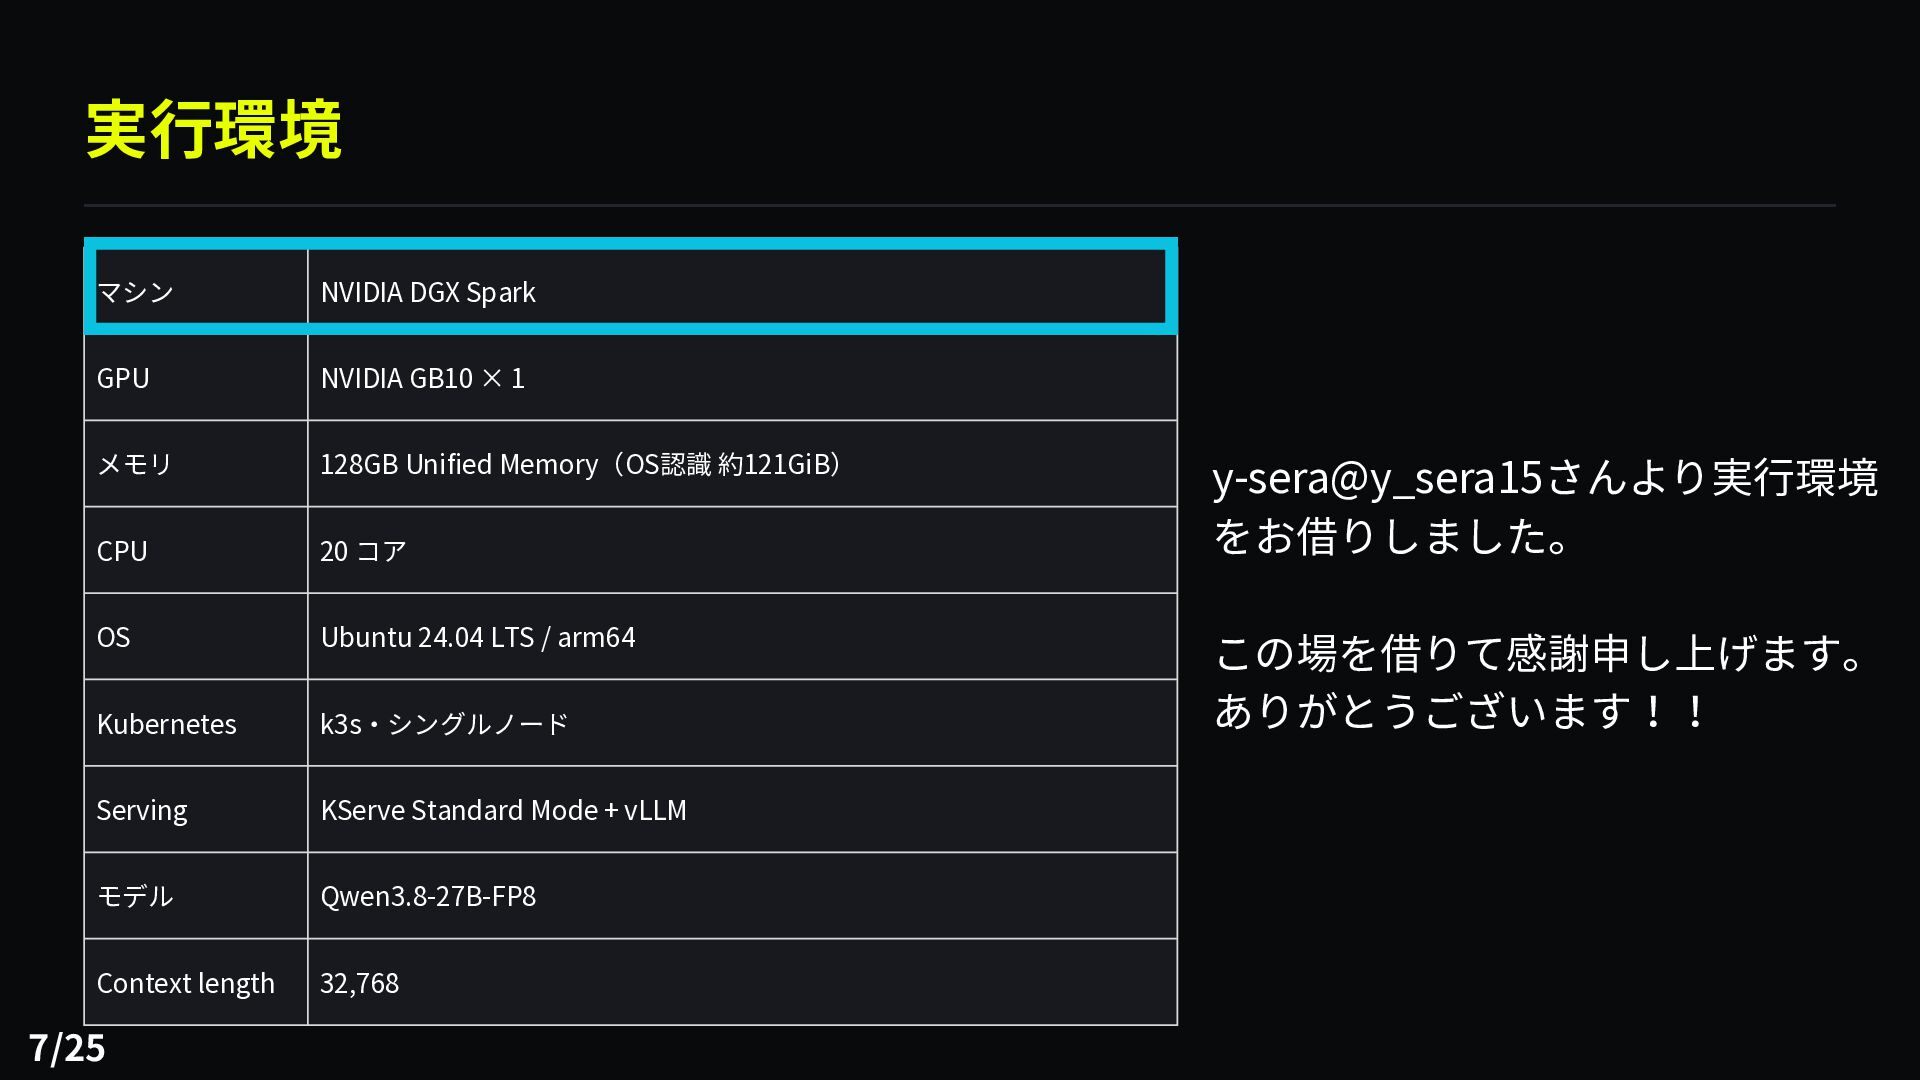
  2. 実行環境 マシン NVIDIA DGX Spark GPU NVIDIA GB10 × 1

    メモリ 128GB Unified Memory(OS認識 約121GiB) CPU 20 コア OS Ubuntu 24.04 LTS / arm64 Kubernetes k3s・シングルノード Serving KServe Standard Mode + vLLM モデル Qwen3.8-27B-FP8 Context length 32,768 7/25 y-sera@y_sera15さんより実行環境 をお借りしました。 この場を借りて感謝申し上げます。 ありがとうございます!!
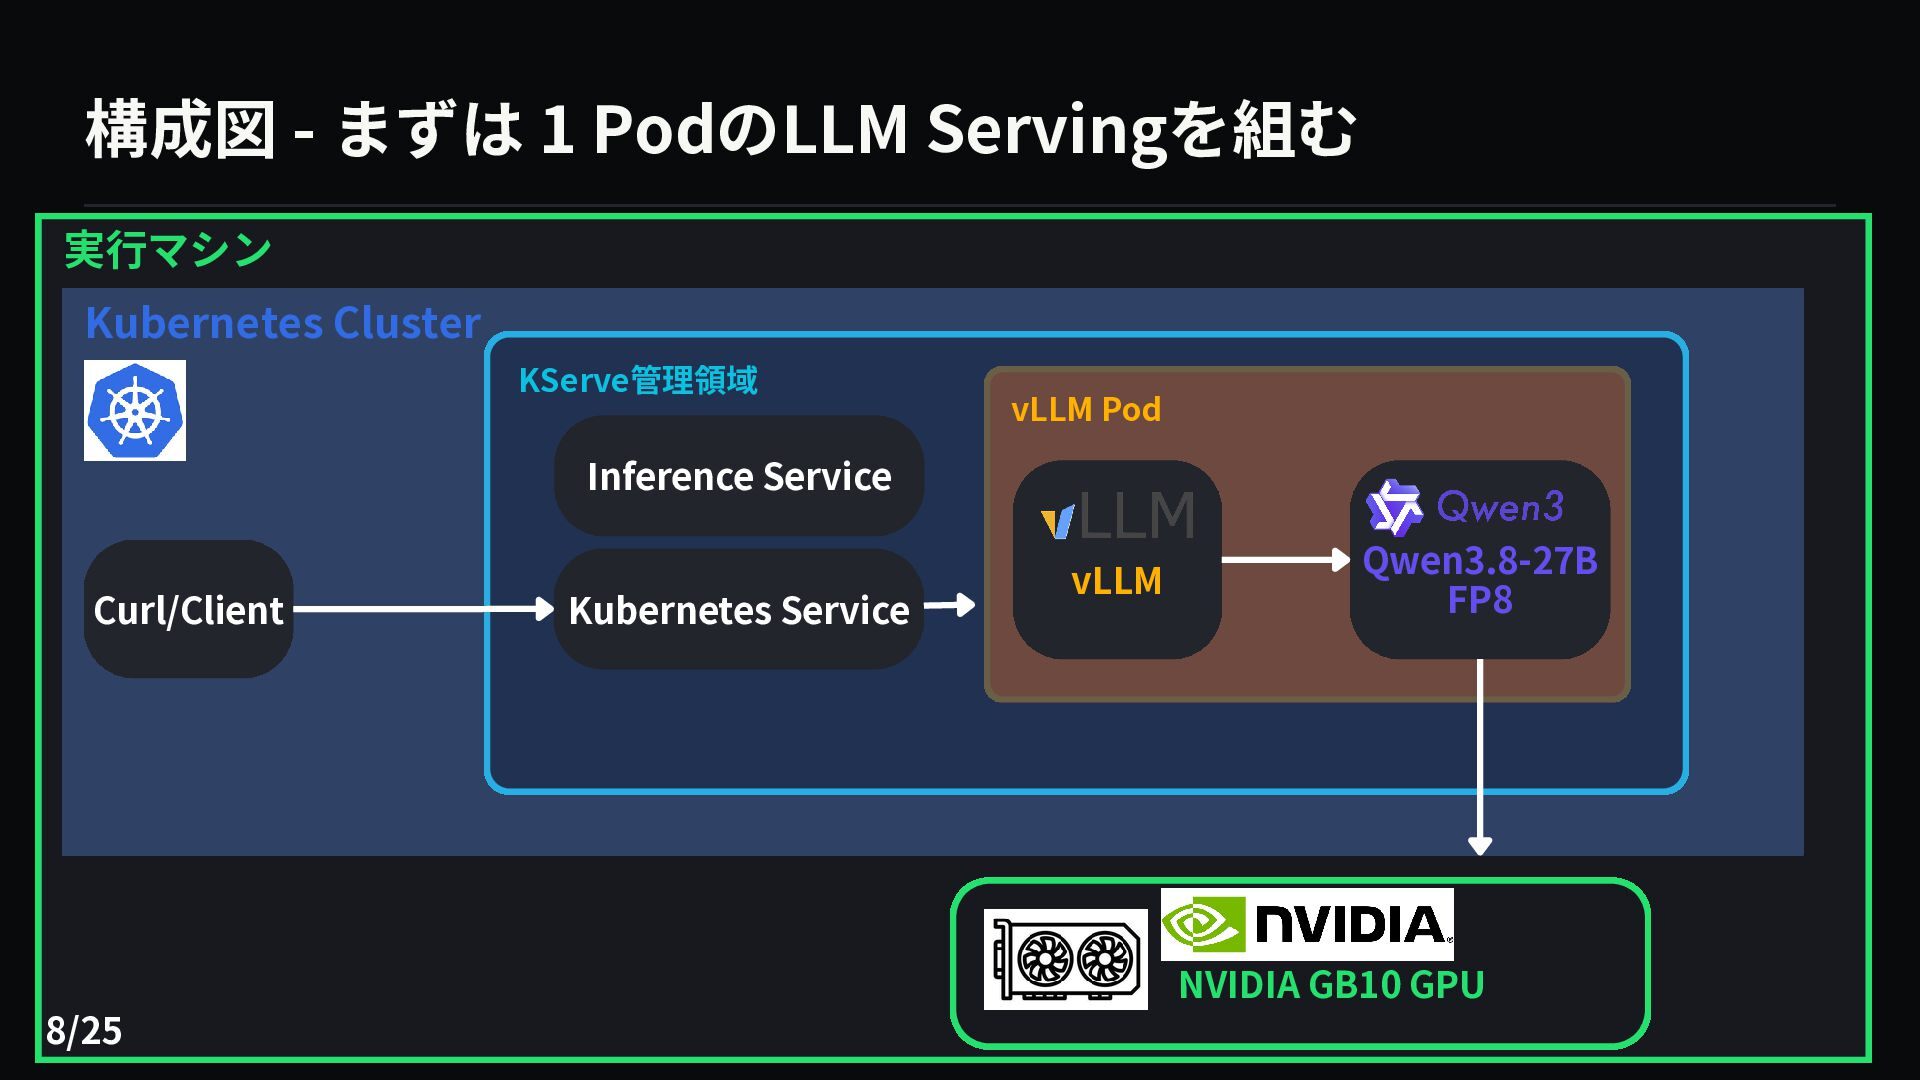
  3. 構成図 - まずは 1 PodのLLM Servingを組む 実行マシン Kubernetes Cluster KServe管理領域

    vLLM Pod Inference Service Curl/Client 8/25 Kubernetes Service vLLM Qwen3.8-27B FP8 NVIDIA GB10 GPU
  4. Podの内部 Pod内部の状況はPodごとに異なる vLLM Pod Pod B Queue 今何件リクエスト が待機状態か KV

    Cache 過去トークンの Attention計算用 Key/Valueを保持 メモリ余裕に影響 Prefix Cache 共通する入力の 計算を再利用 初めの応答速度に 影響 14/25 Pod C 待ち時間に影響 … 同じ1リクエストでも、どのPodへ行くかで処理時間・計算量が変わる
  5. Kubernetes Serviceで考える Serviceが知っていること ✓接続先 ✓Podが接続可能・Readyかどうか Serviceは知らないこと ✓LLM内の待ち行列・KV Cacheの状況 Curl/Client requests

    Kubernetes Service Pod A Prefix Cache : Hit Pod B Prefix Cache : Miss Pod C Queue : 長い Prefix Cache:入力の先頭部分が同じときに、その部分の計算結果を使い回す仕組み 15/25 ServiceだけではLLM内部のQueue/ KV Cache / Prefix Cache を判断できない
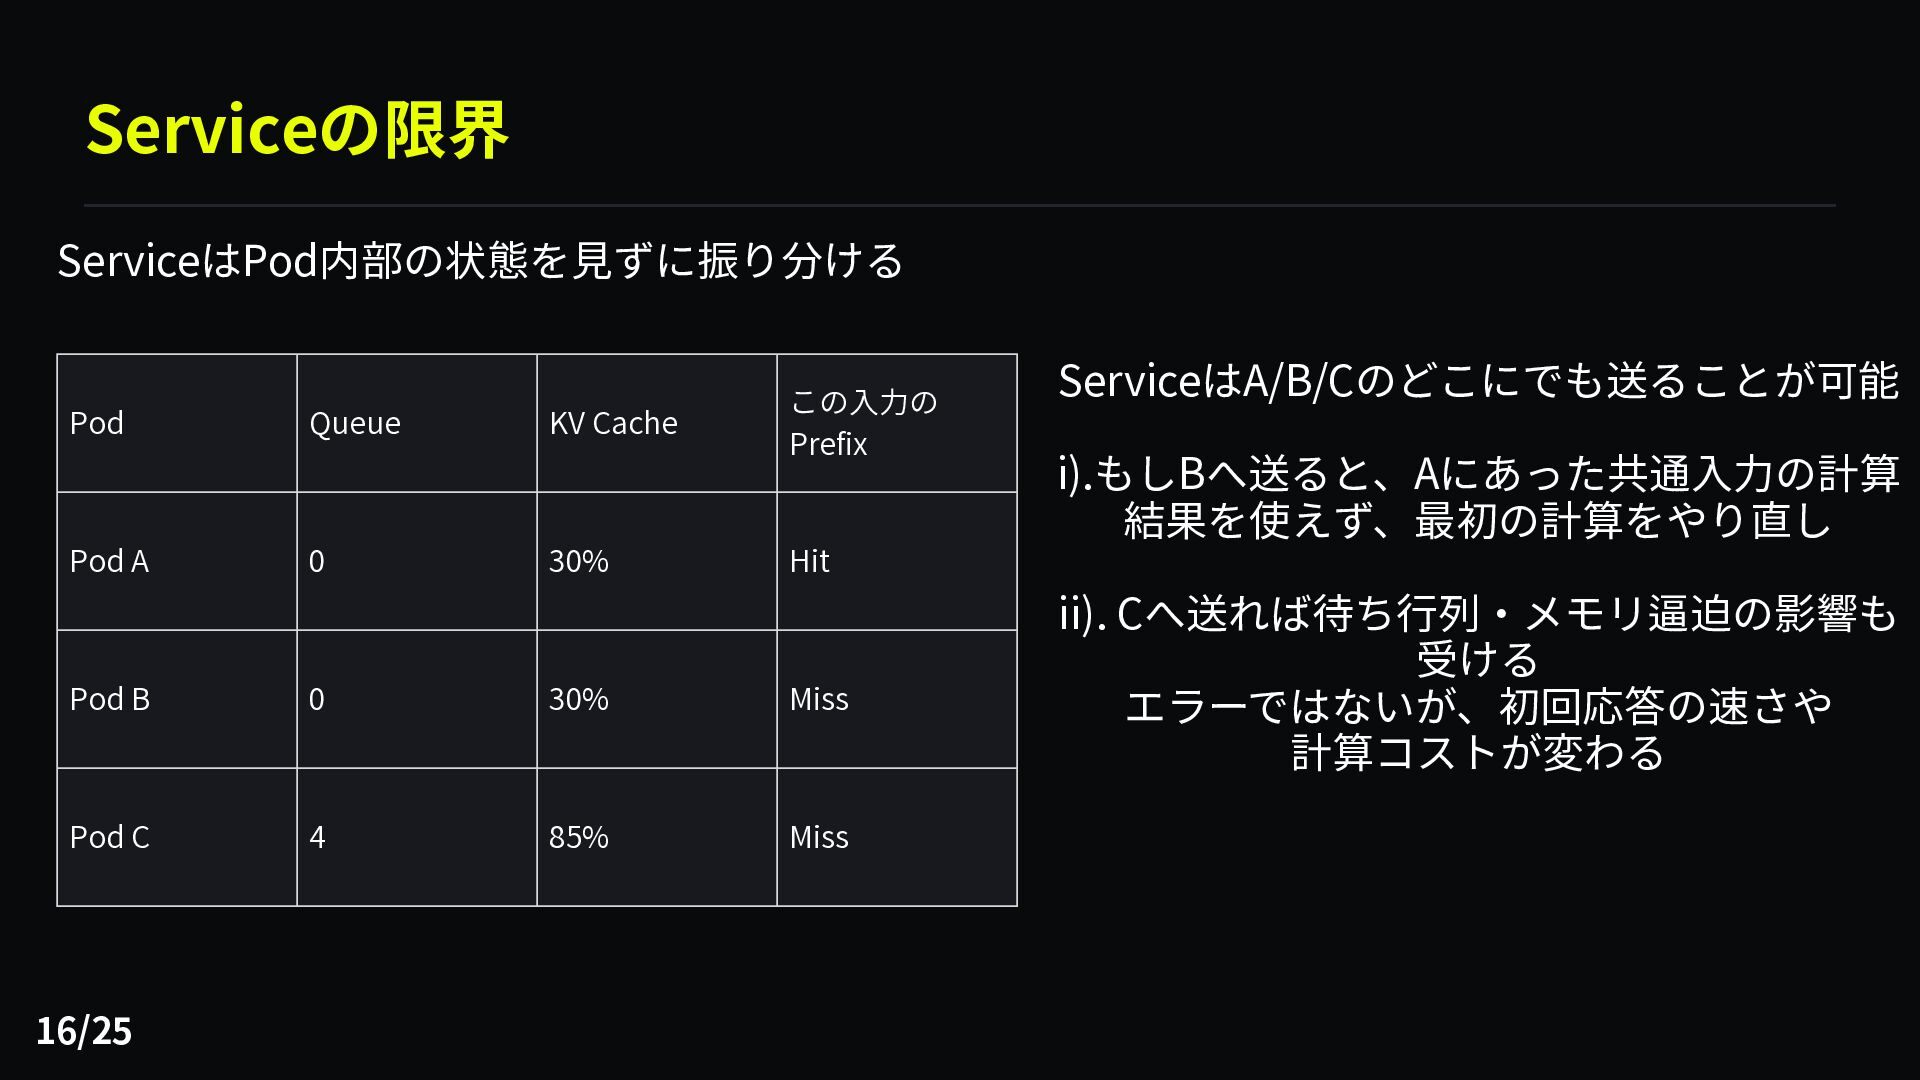
  6. Serviceの限界 ServiceはPod内部の状態を見ずに振り分ける Pod Queue KV Cache この入力の Prefix Pod A

    0 30% Hit Pod B 0 30% Miss Pod C 4 85% Miss 16/25 ServiceはA/B/Cのどこにでも送ることが可能 i).もしBへ送ると、Aにあった共通入力の計算 結果を使えず、最初の計算をやり直し ii). Cへ送れば待ち行列・メモリ逼迫の影響も 受ける エラーではないが、初回応答の速さや 計算コストが変わる
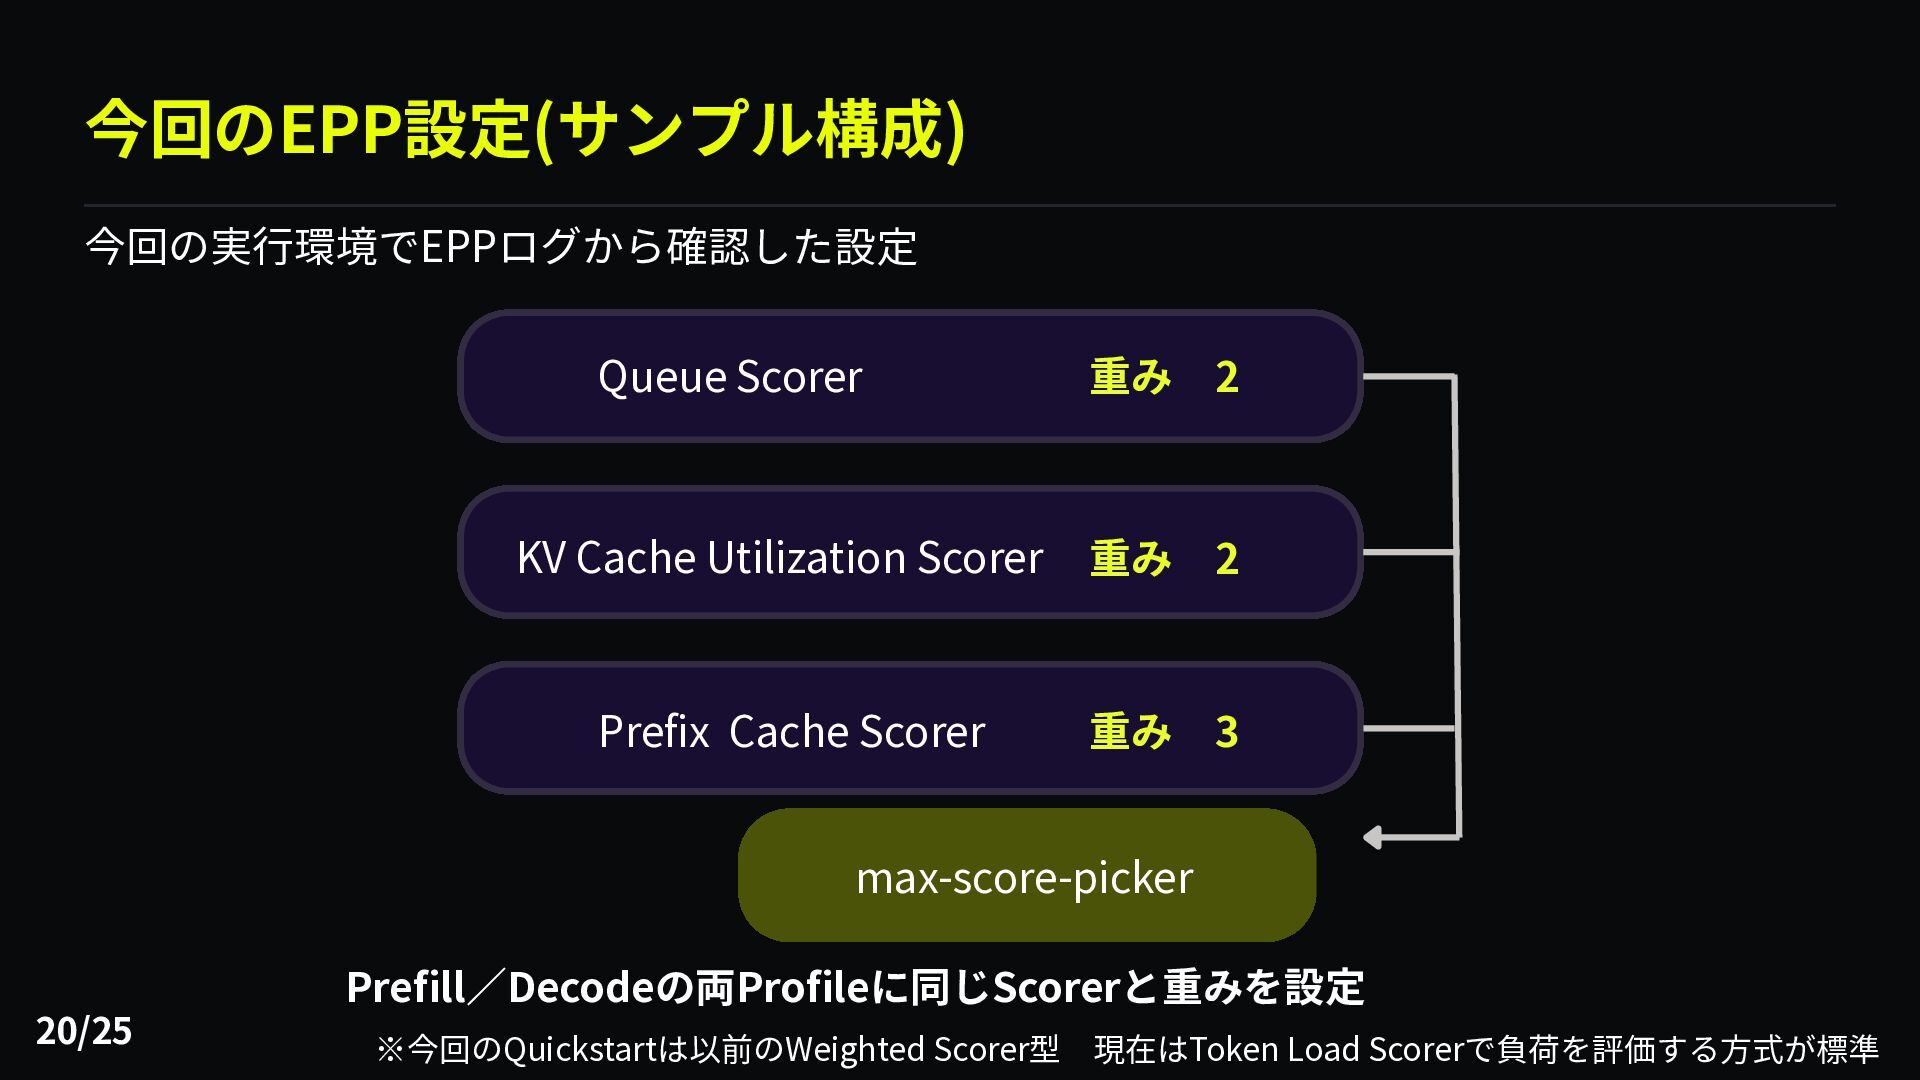
  7. 今回のEPP設定(サンプル構成) 今回の実行環境でEPPログから確認した設定 Queue Scorer 重み 2 KV Cache Utilization Scorer

    重み 2 Prefix Cache Scorer 重み 3 max-score-picker 20/25 Prefill/Decodeの両Profileに同じScorerと重みを設定 ※今回のQuickstartは以前のWeighted Scorer型 現在はToken Load Scorerで負荷を評価する方式が標準
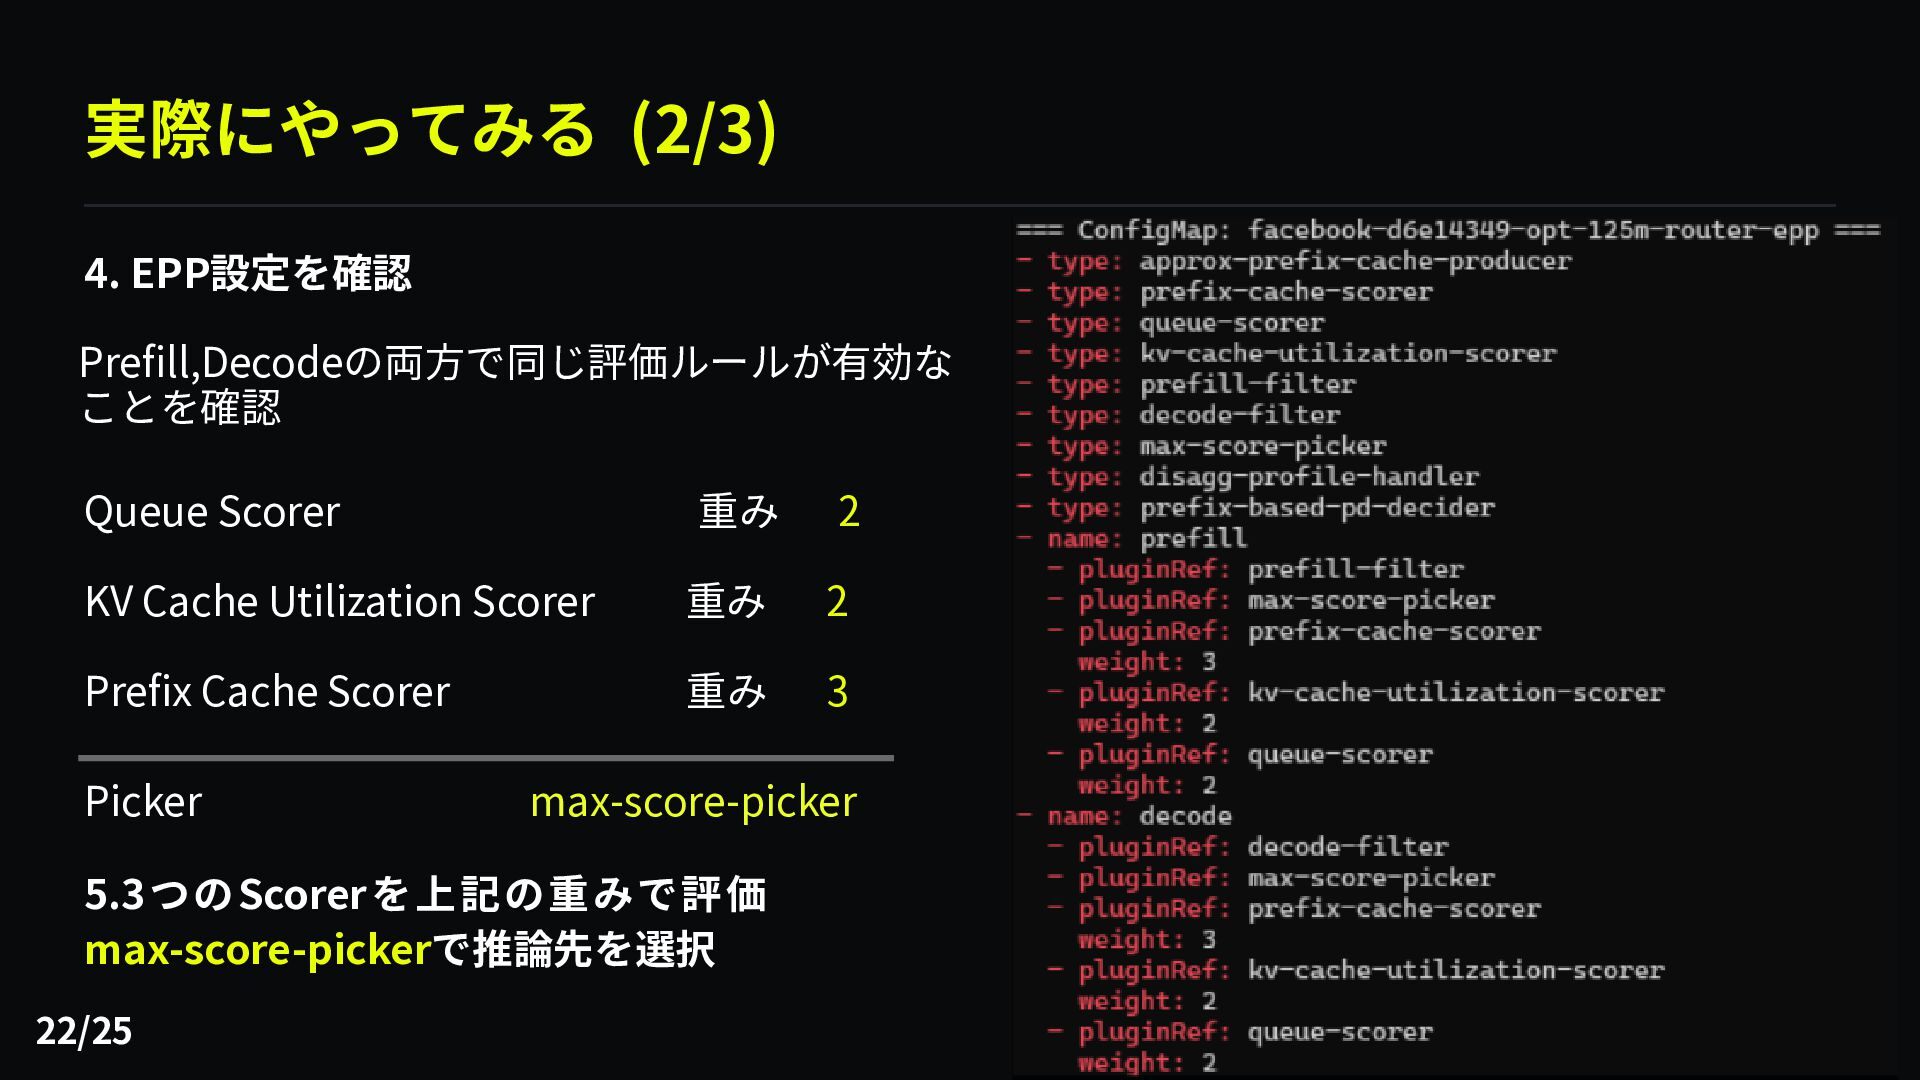
  8. 実際にやってみる (2/3) 4. EPP設定を確認 Prefill,Decodeの両方で同じ評価ルールが有効な ことを確認 Queue Scorer 重み 2

    KV Cache Utilization Scorer 重み 2 Prefix Cache Scorer 重み 3 Picker max-score-picker 5.3つのScorerを上記の重みで評価 max-score-pickerで推論先を選択 22/25
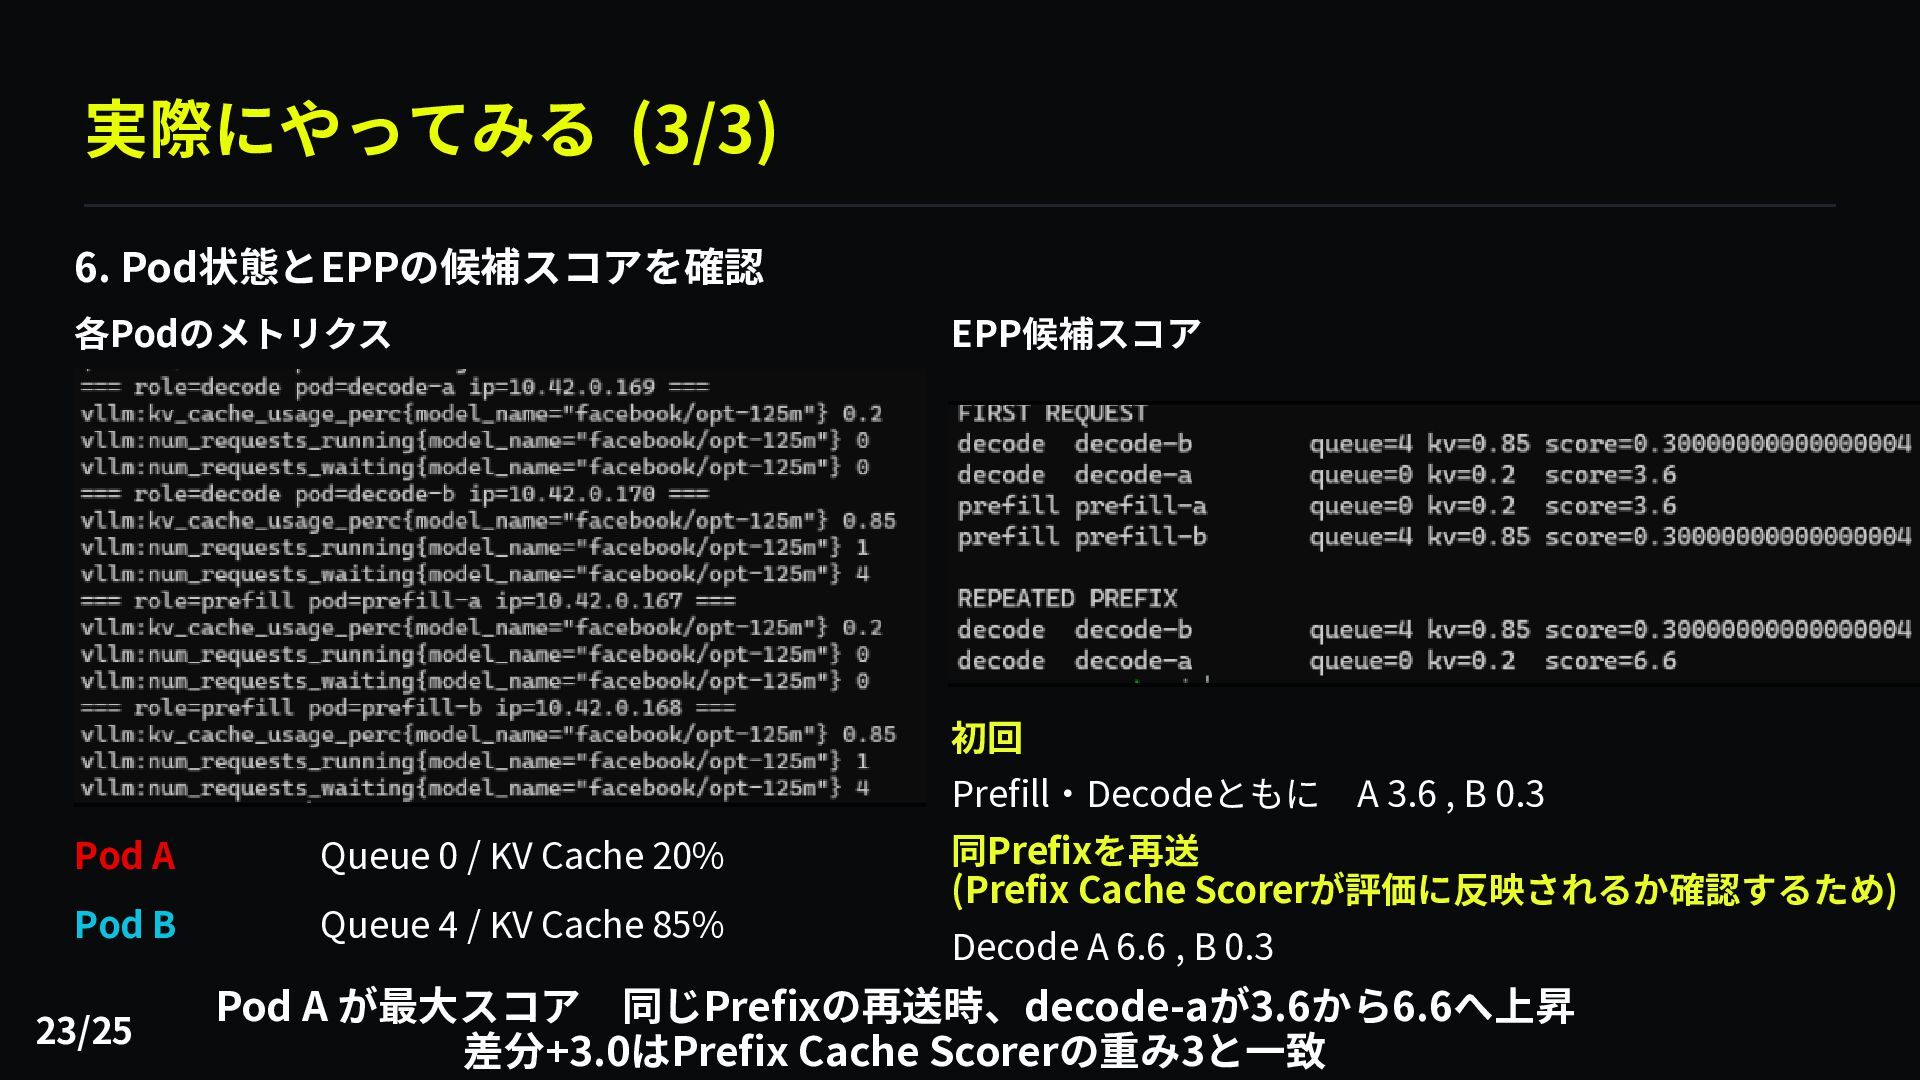
  9. 実際にやってみる (3/3) 6. Pod状態とEPPの候補スコアを確認 各Podのメトリクス EPP候補スコア 初回 Prefill・Decodeともに A 3.6

    , B 0.3 Pod A Queue 0 / KV Cache 20% Pod B Queue 4 / KV Cache 85% 23/25 同Prefixを再送 (Prefix Cache Scorerが評価に反映されるか確認するため) Decode A 6.6 , B 0.3 Pod A が最大スコア 同じPrefixの再送時、decode-aが3.6から6.6へ上昇 差分+3.0はPrefix Cache Scorerの重み3と一致
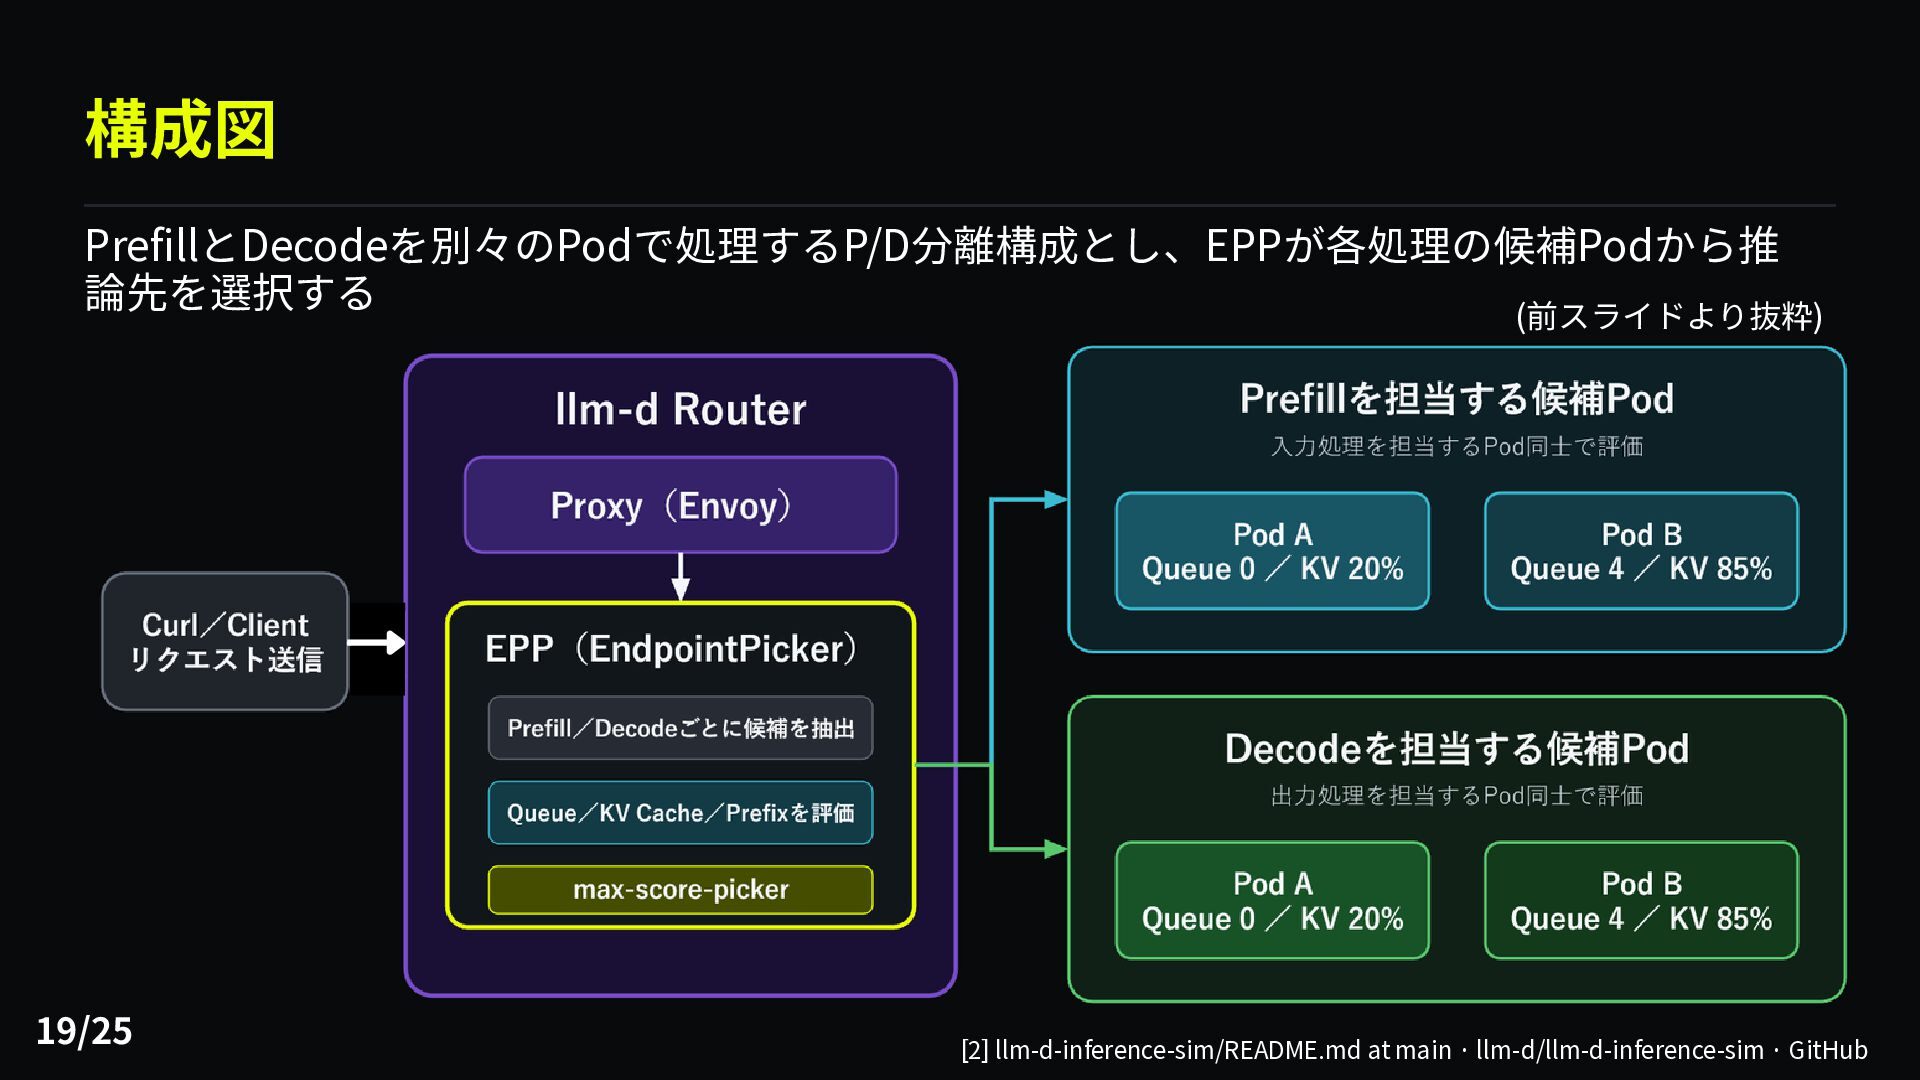
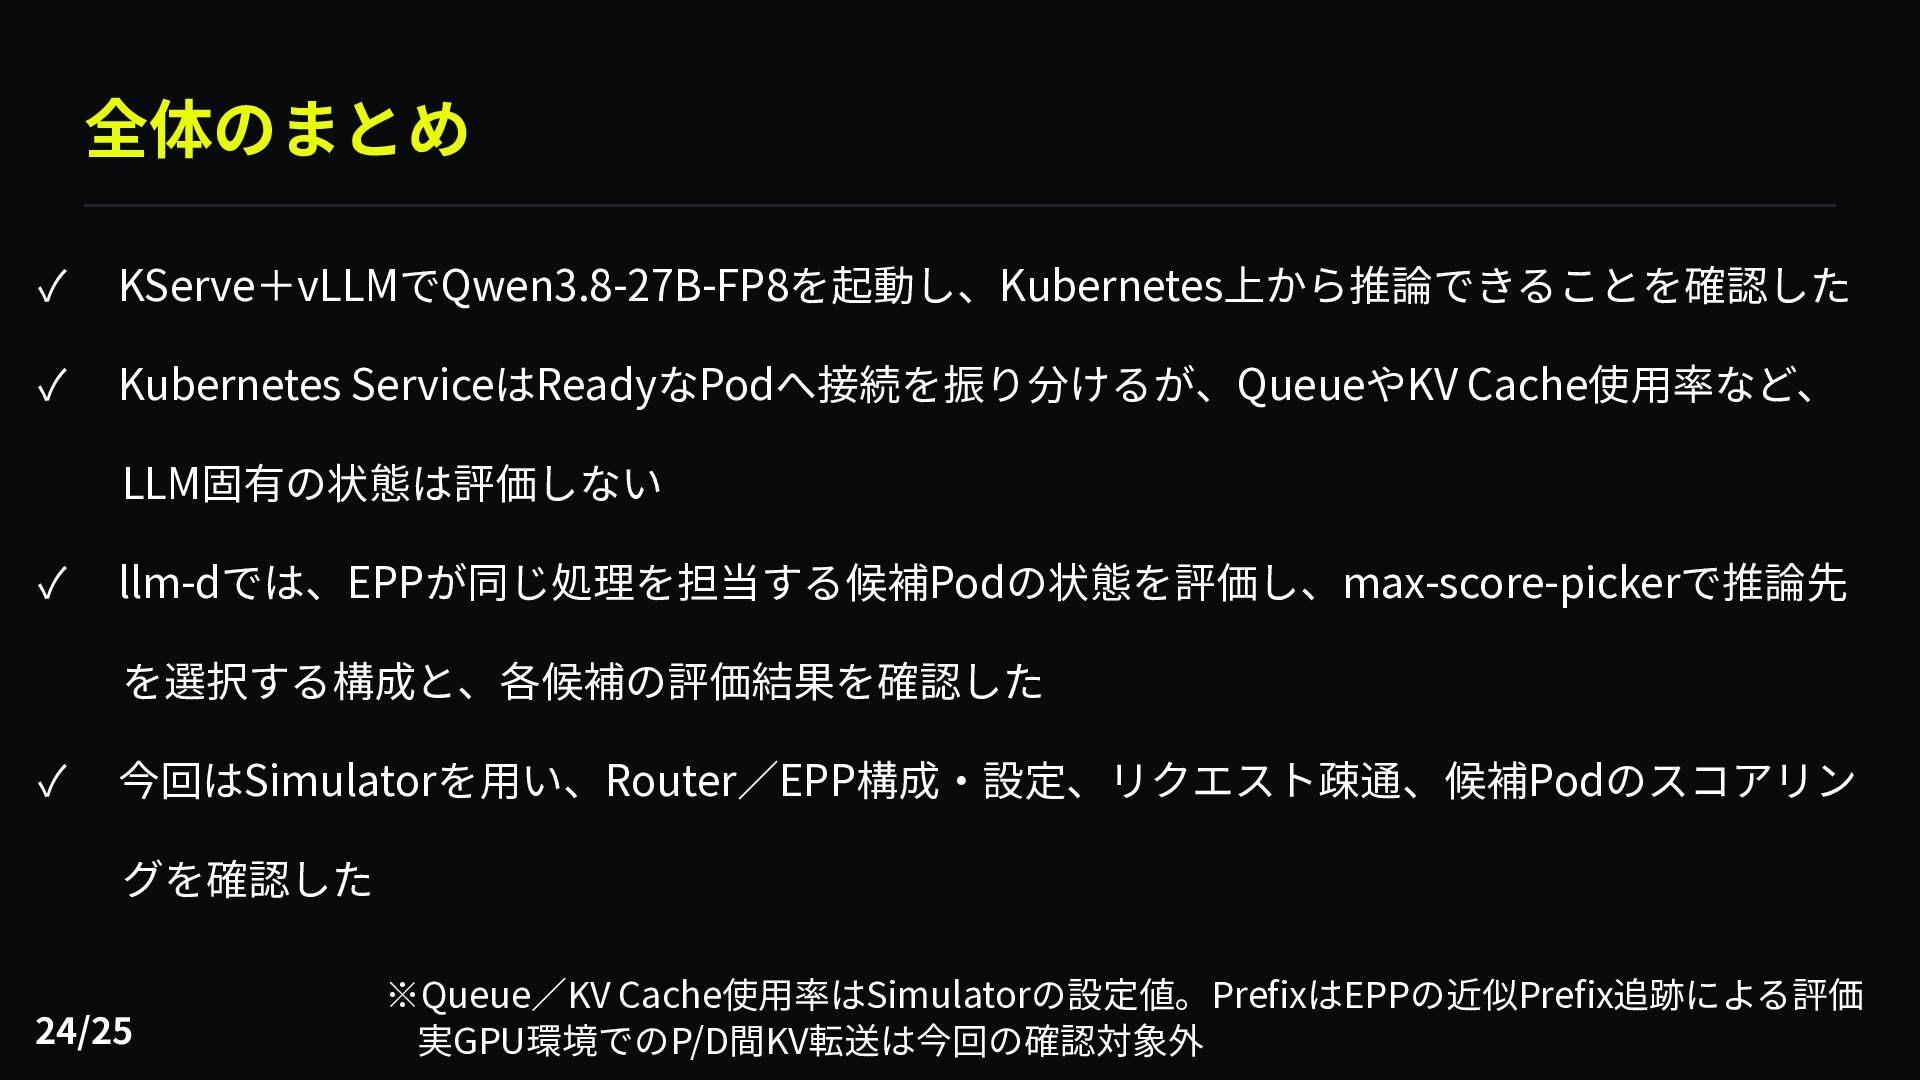
  10. 全体のまとめ ✓ KServe+vLLMでQwen3.8-27B-FP8を起動し、Kubernetes上から推論できることを確認した ✓ Kubernetes ServiceはReadyなPodへ接続を振り分けるが、QueueやKV Cache使用率など、 LLM固有の状態は評価しない ✓ llm-dでは、EPPが同じ処理を担当する候補Podの状態を評価し、max-score-pickerで推論先

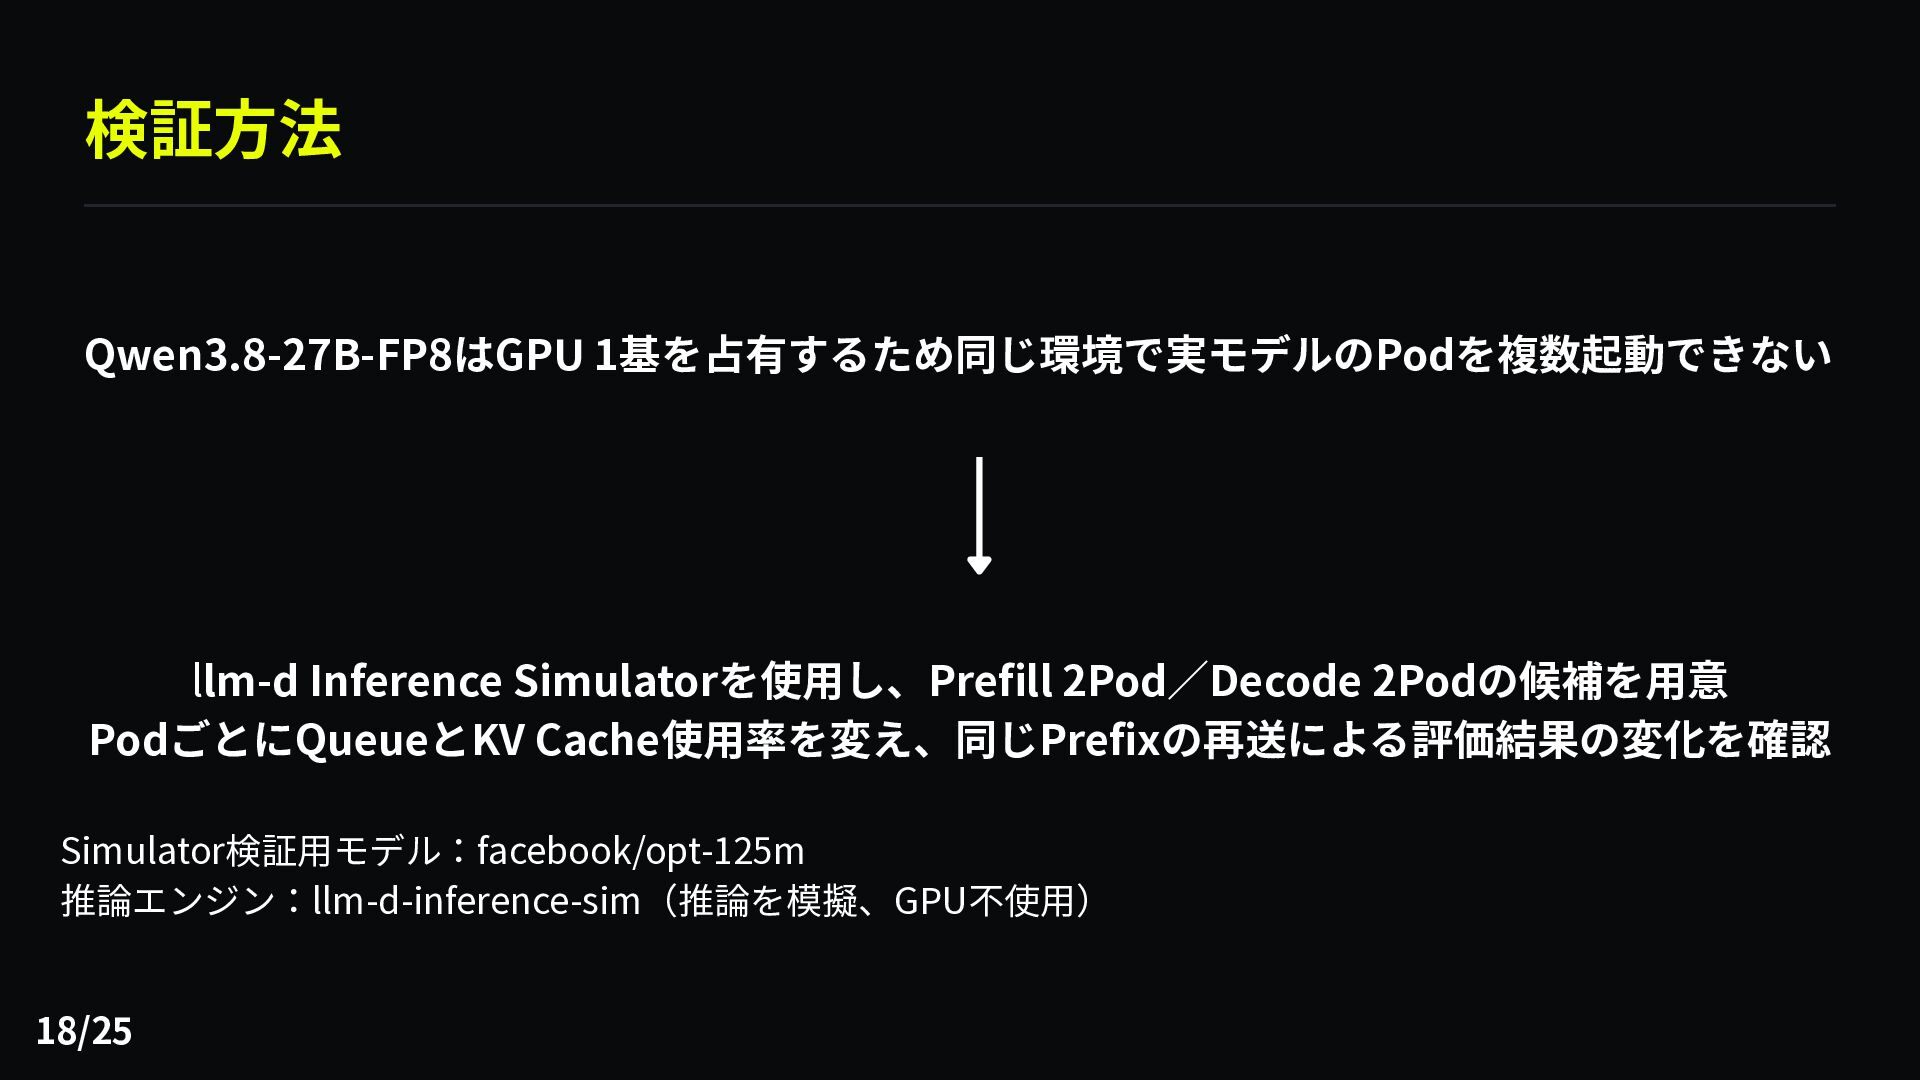
    を選択する構成と、各候補の評価結果を確認した ✓ 今回はSimulatorを用い、Router/EPP構成・設定、リクエスト疎通、候補Podのスコアリン グを確認した 24/25 ※Queue/KV Cache使用率はSimulatorの設定値。PrefixはEPPの近似Prefix追跡による評価 実GPU環境でのP/D間KV転送は今回の確認対象外