Share
Embed
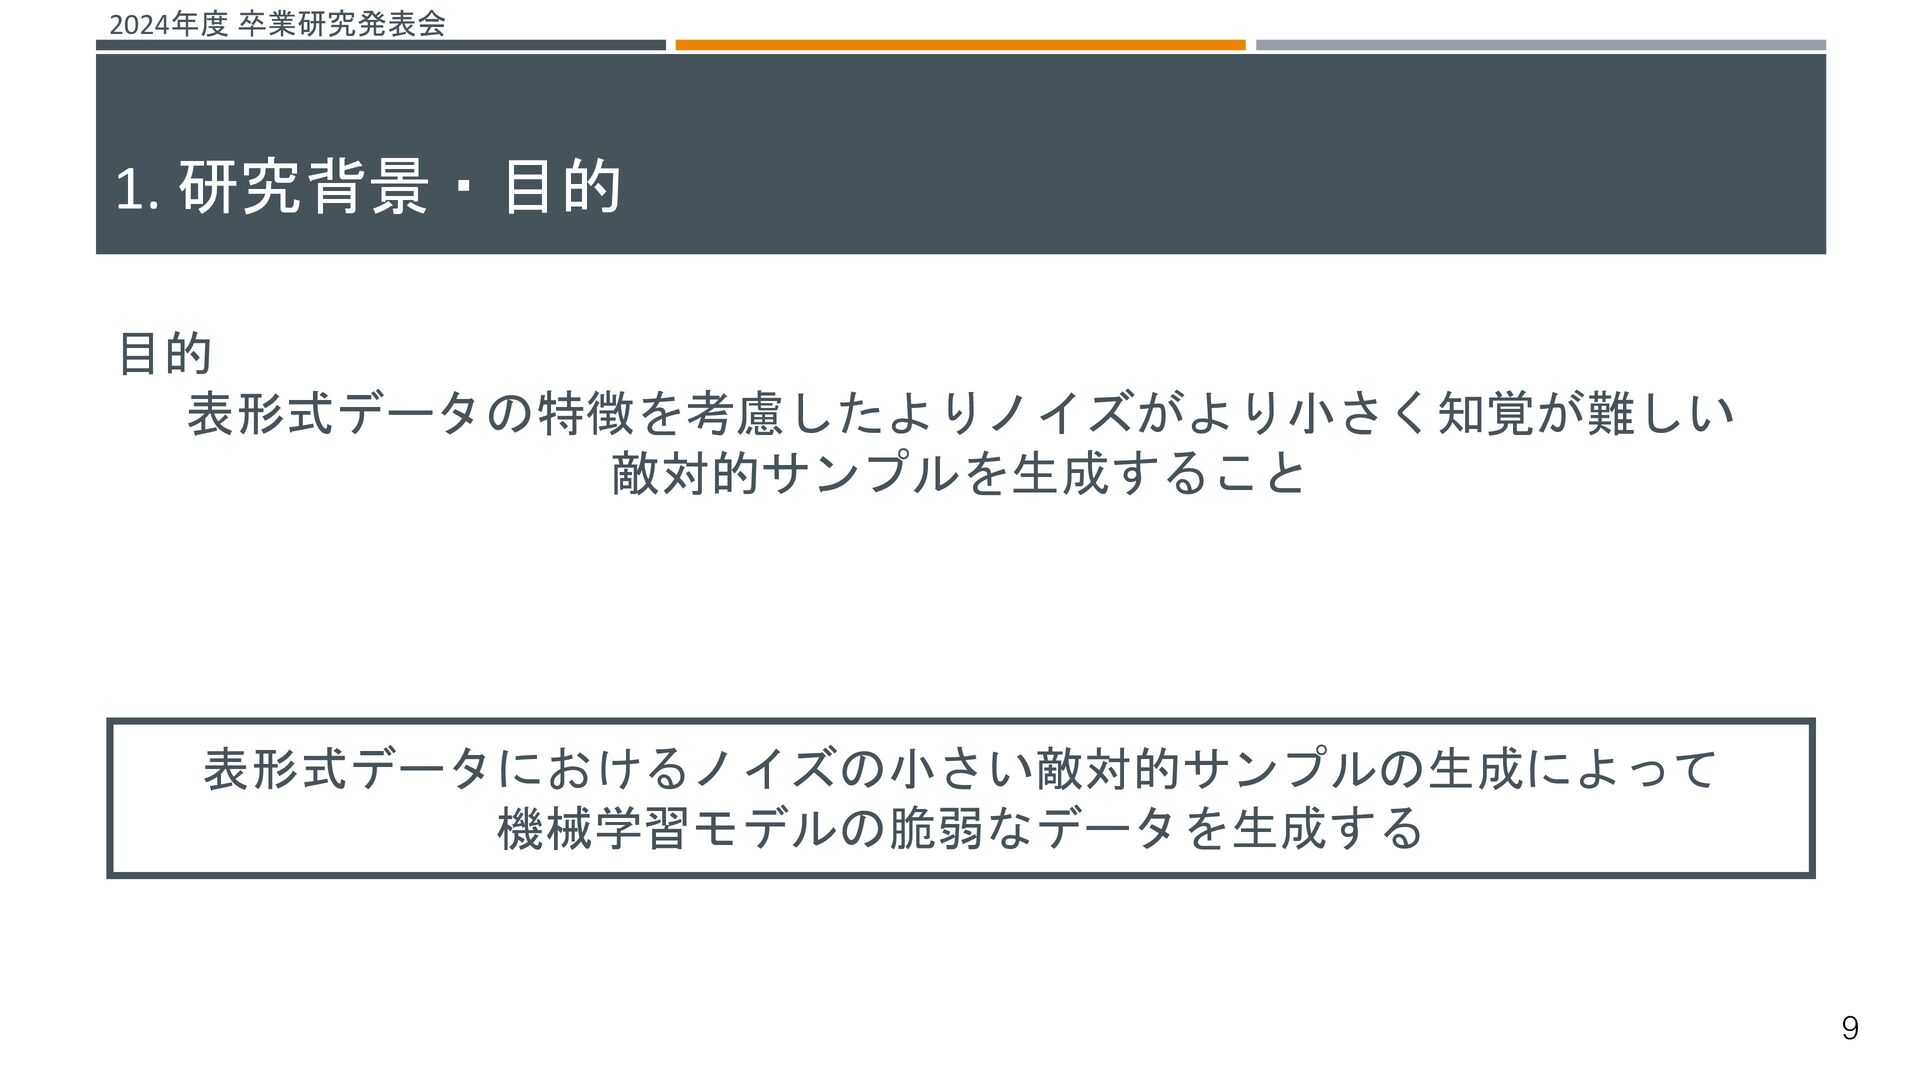
卒業研究発表会_入力データの構造を考慮したLowProFoolアルゴリズムによる敵対的サンプルの生成に関する研究
title : 入力データの構造を考慮したLowProFoolアルゴリズムによる敵対的サンプルの生成に関する研究
presen at 13.02.2025
東京都市大学 メディア情報学部 情報システム学科 卒業研究発表会登壇資料
Arishow
February 19, 2025
Transcript
34 slides
-
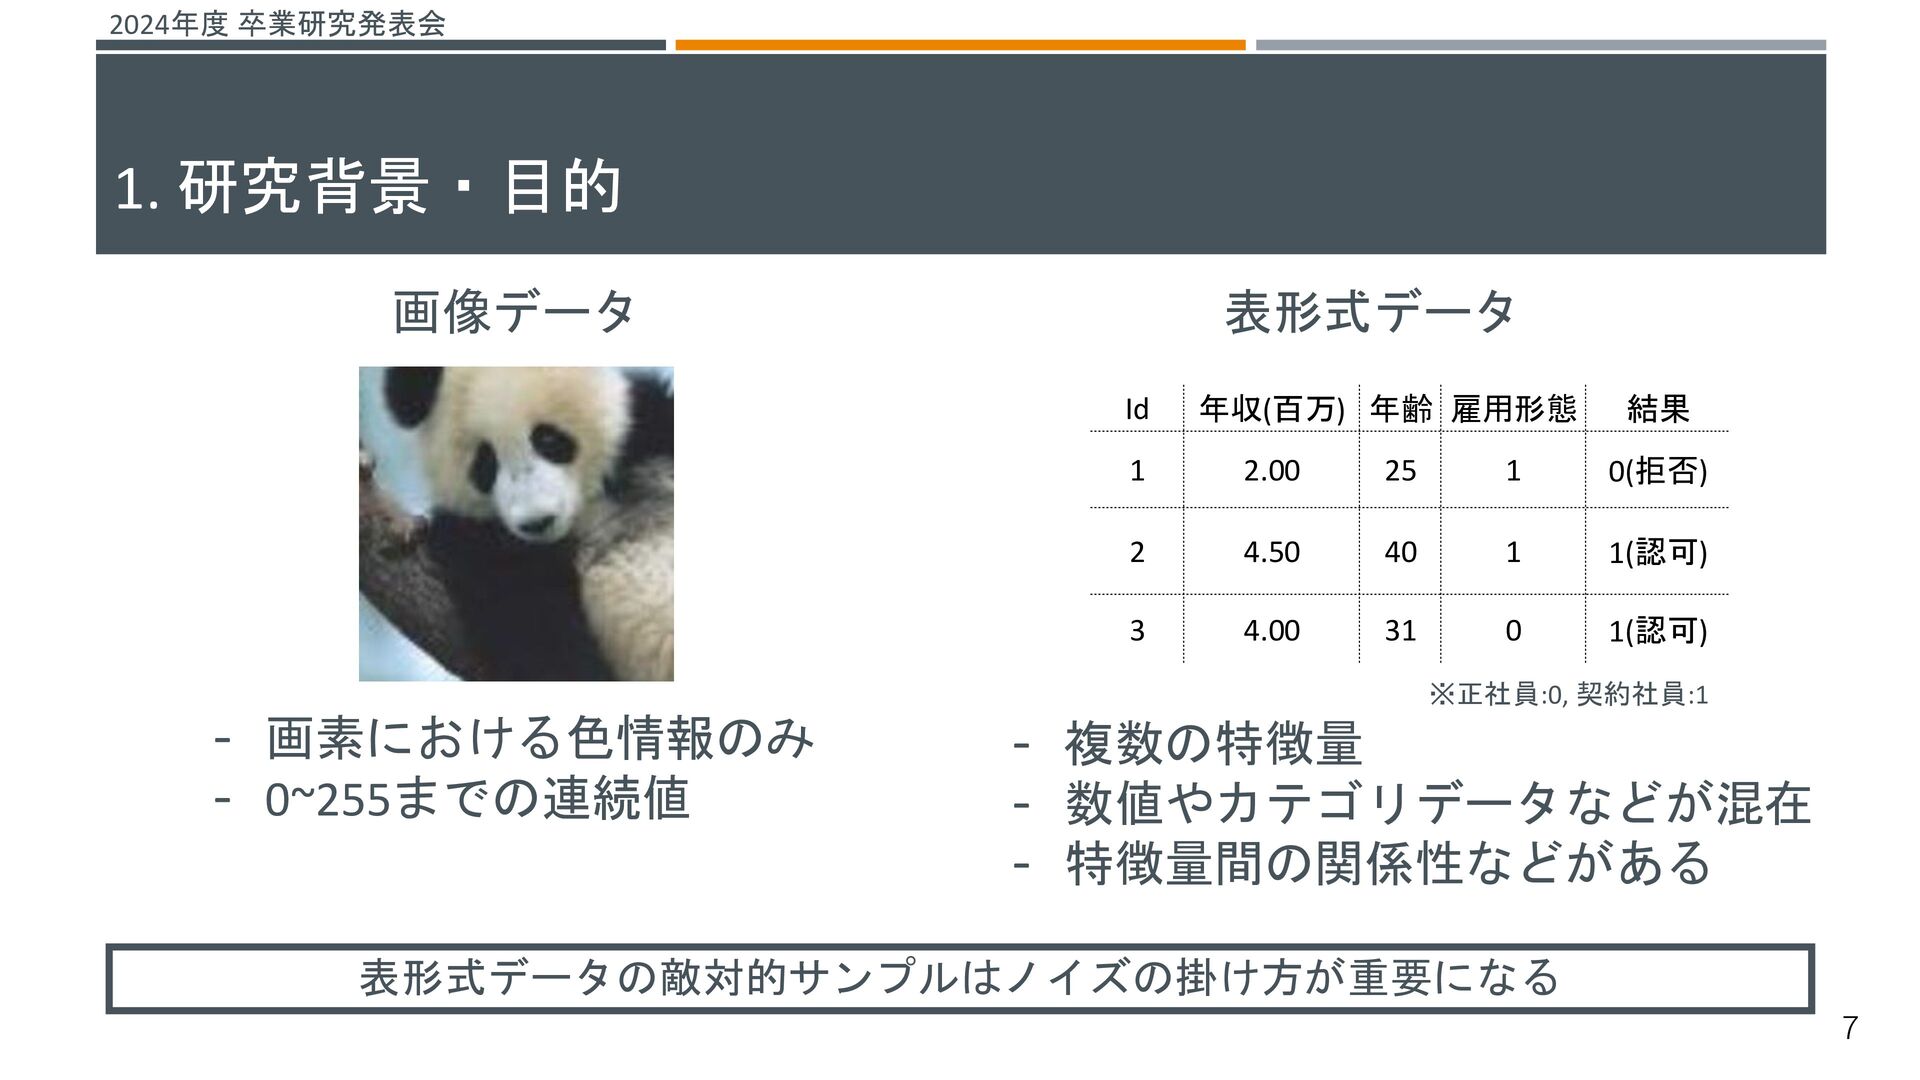
2024年度 卒業研究発表会 表形式データの敵対的サンプルはノイズの掛け方が重要になる 1. 研究背景・目的 7 - 複数の特徴量 - 数値やカテゴリデータなどが混在
- 特徴量間の関係性などがある - 画素における色情報のみ - 0~255までの連続値 画像データ 表形式データ ※正社員:0, 契約社員:1 Id 年収(百万) 年齢 雇用形態 結果 1 2.00 25 1 0(拒否) 2 4.50 40 1 1(認可) 3 4.00 31 0 1(認可) -
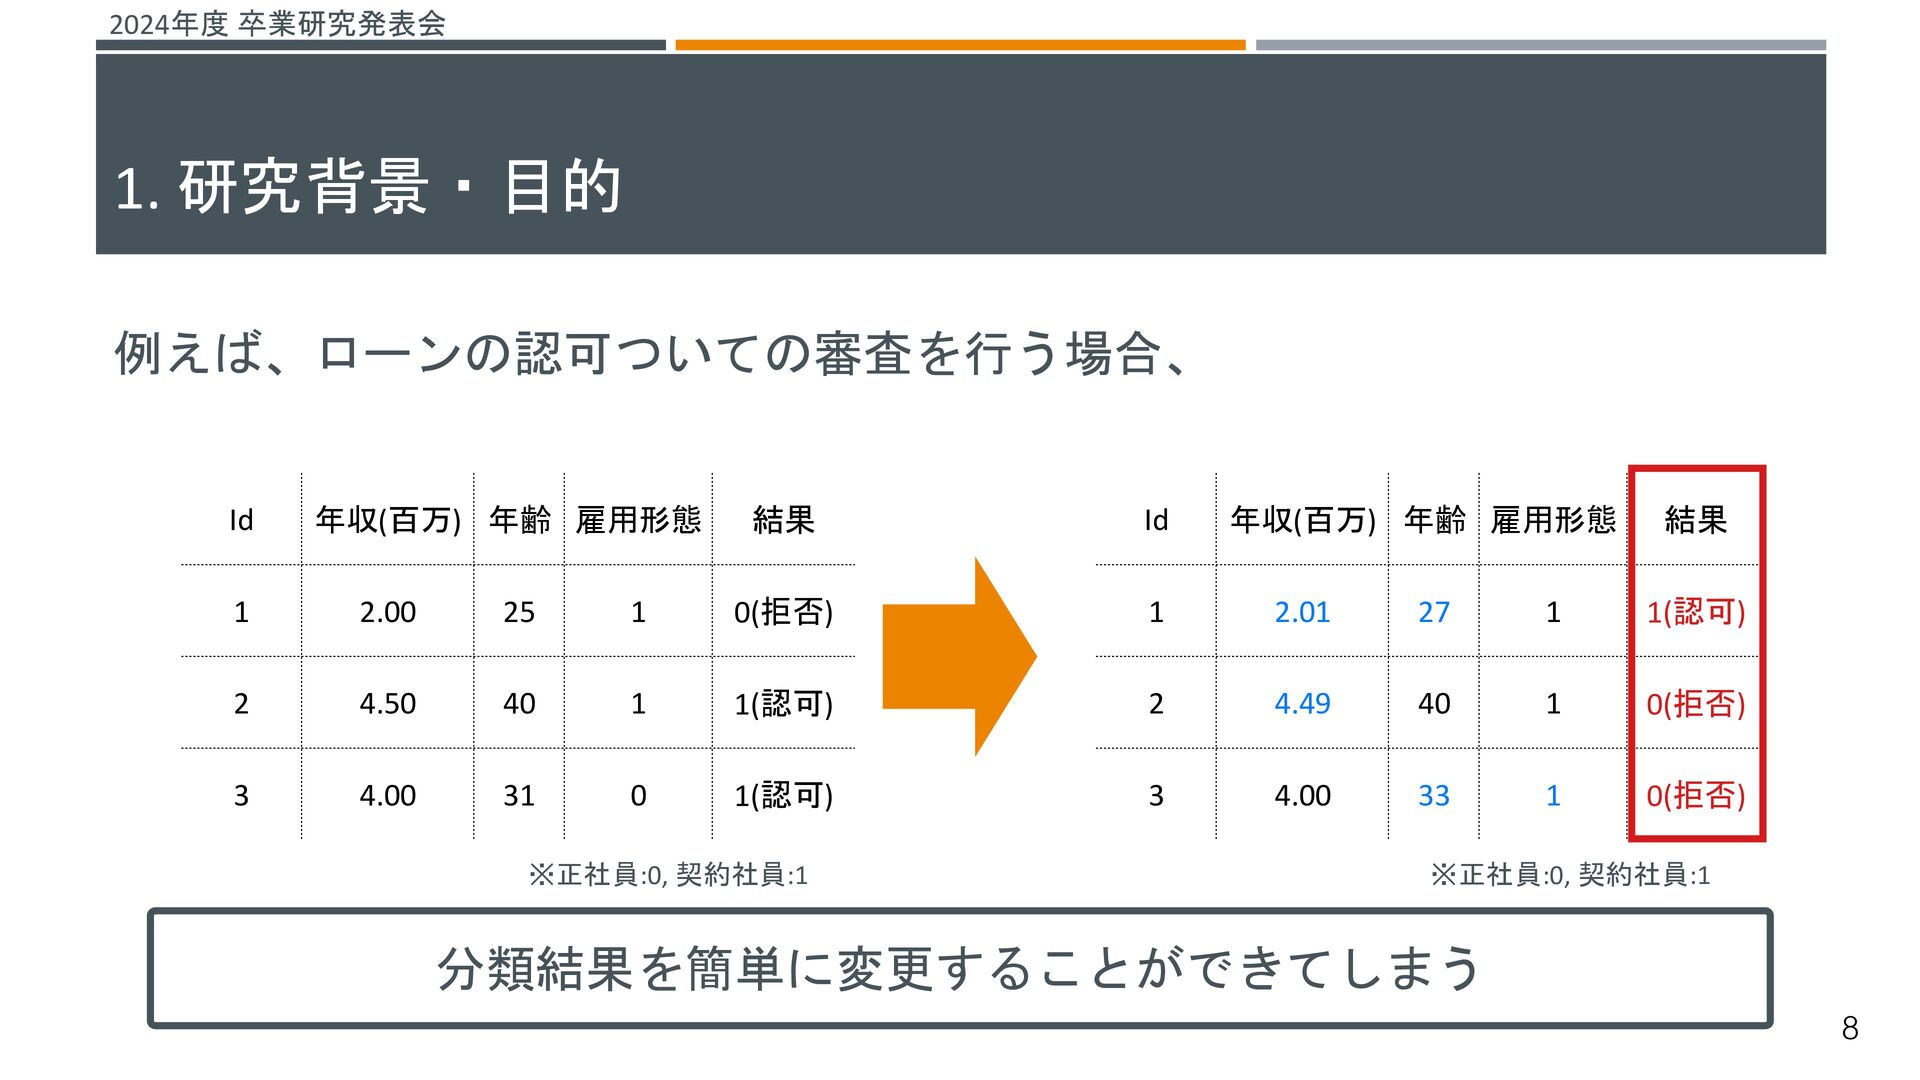
2024年度 卒業研究発表会 例えば、ローンの認可ついての審査を行う場合、 1. 研究背景・目的 8 Id 年収(百万) 年齢 雇用形態
結果 1 2.00 25 1 0(拒否) 2 4.50 40 1 1(認可) 3 4.00 31 0 1(認可) ※正社員:0, 契約社員:1 ※正社員:0, 契約社員:1 Id 年収(百万) 年齢 雇用形態 結果 1 2.01 27 1 1(認可) 2 4.49 40 1 0(拒否) 3 4.00 33 1 0(拒否) 分類結果を簡単に変更することができてしまう -
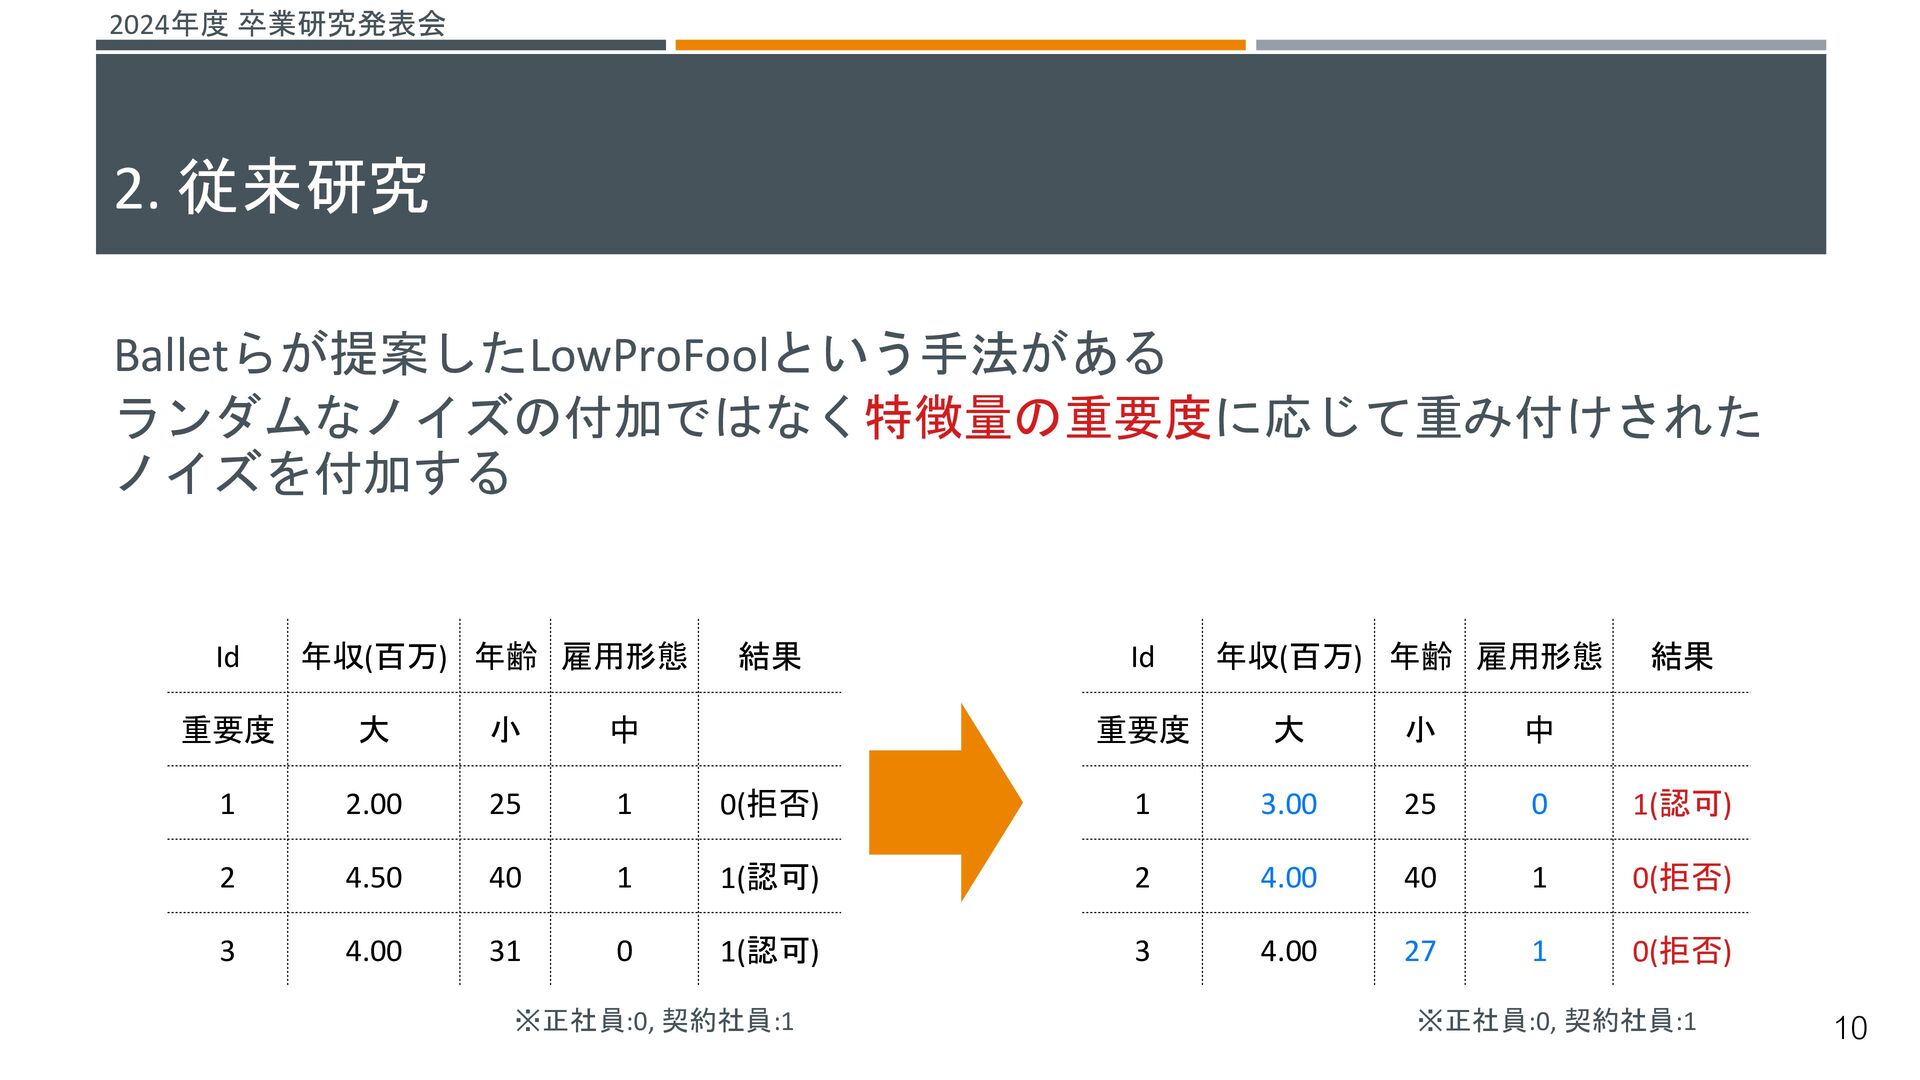
2024年度 卒業研究発表会 Balletらが提案したLowProFoolという手法がある ランダムなノイズの付加ではなく特徴量の重要度に応じて重み付けされた ノイズを付加する 2. 従来研究 10 Id 年収(百万)
年齢 雇用形態 結果 重要度 大 小 中 1 2.00 25 1 0(拒否) 2 4.50 40 1 1(認可) 3 4.00 31 0 1(認可) ※正社員:0, 契約社員:1 ※正社員:0, 契約社員:1 Id 年収(百万) 年齢 雇用形態 結果 重要度 大 小 中 1 3.00 25 0 1(認可) 2 4.00 40 1 0(拒否) 3 4.00 27 1 0(拒否) -
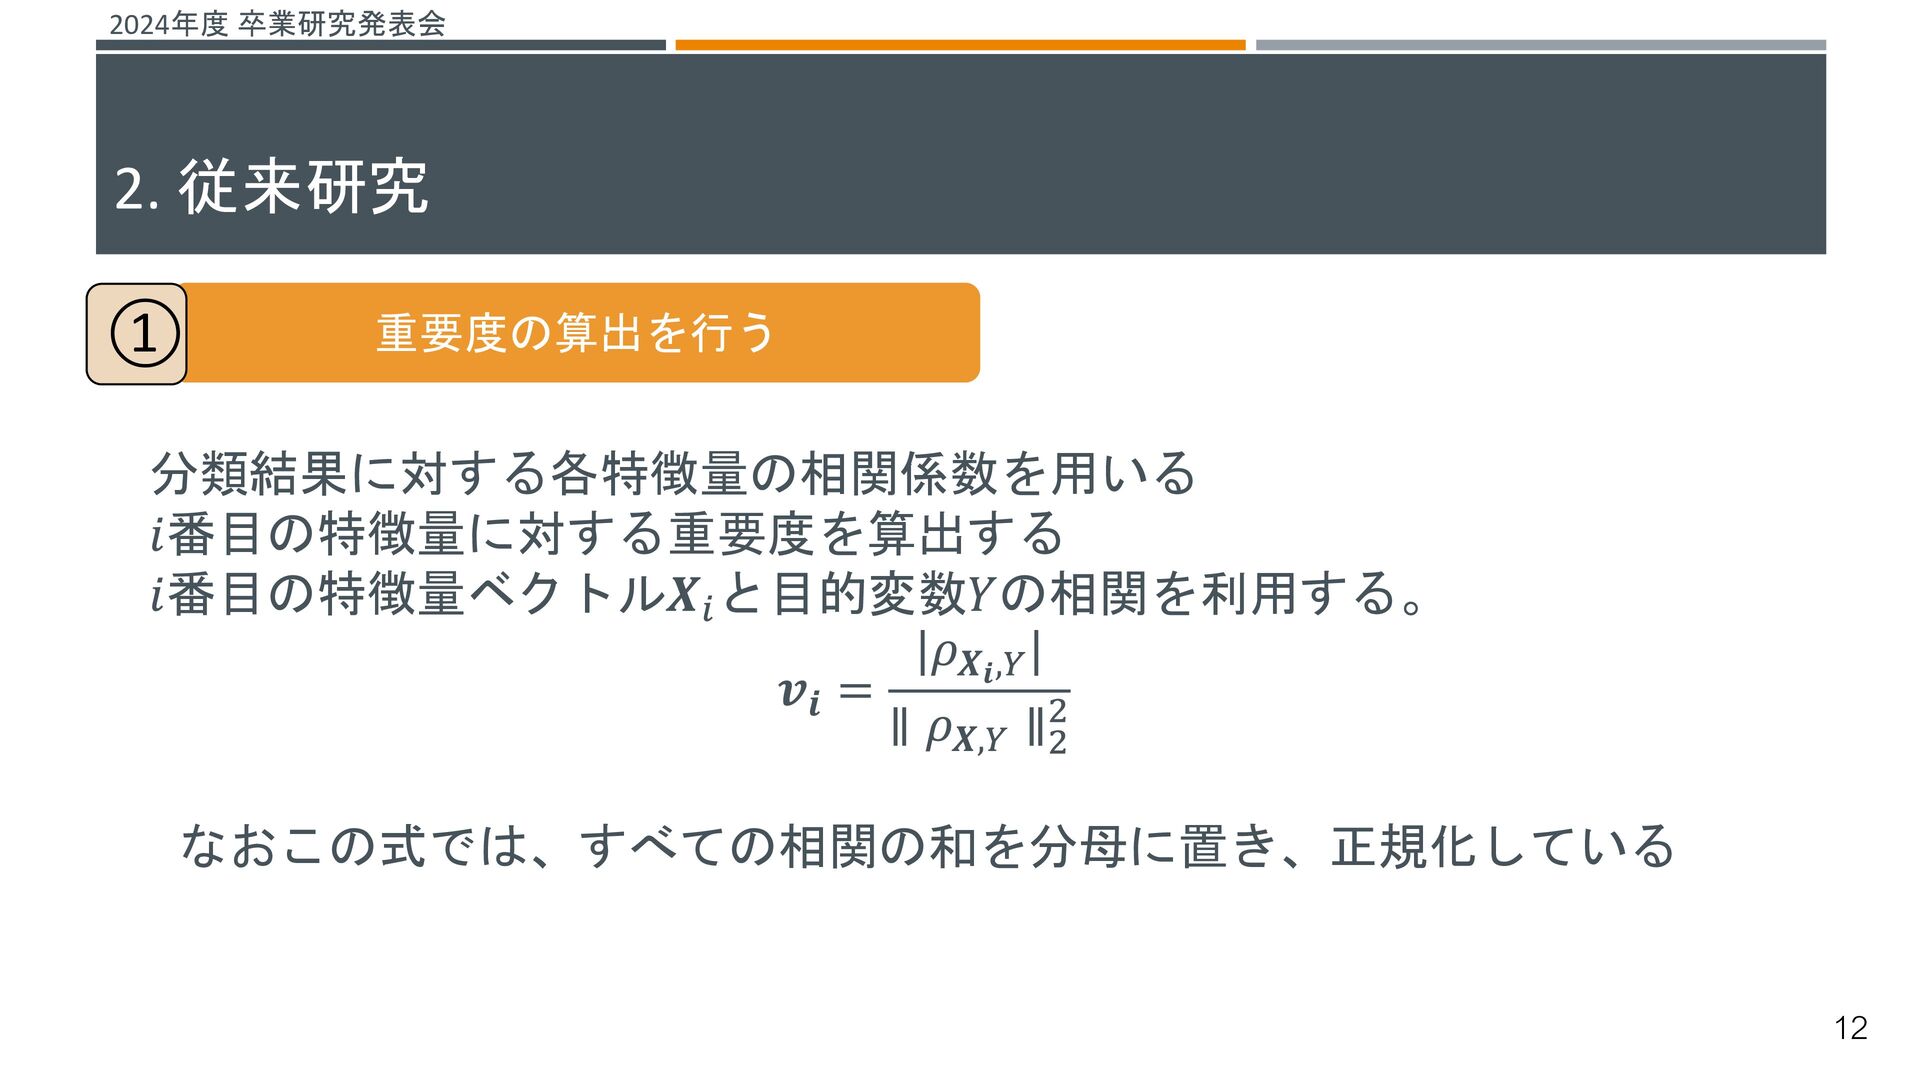
2024年度 卒業研究発表会 重要度の算出方法につ 分類結果に対する各特徴量の相関係数を用いる 𝑖番目の特徴量に対する重要度を算出する 𝑖番目の特徴量ベクトル𝑿𝑖 と目的変数𝑌の相関を利用する。 𝒗𝒊 = |𝜌𝑿𝒊,𝑌
| ∥ 𝜌𝑿,𝑌 ∥2 2 なおこの式では、すべての相関の和を分母に置き、正規化している 2. 従来研究 12 重要度の算出を行う ① -
2024年度 卒業研究発表会 特徴量の重要度 ノ イ ズ の 大 き さ
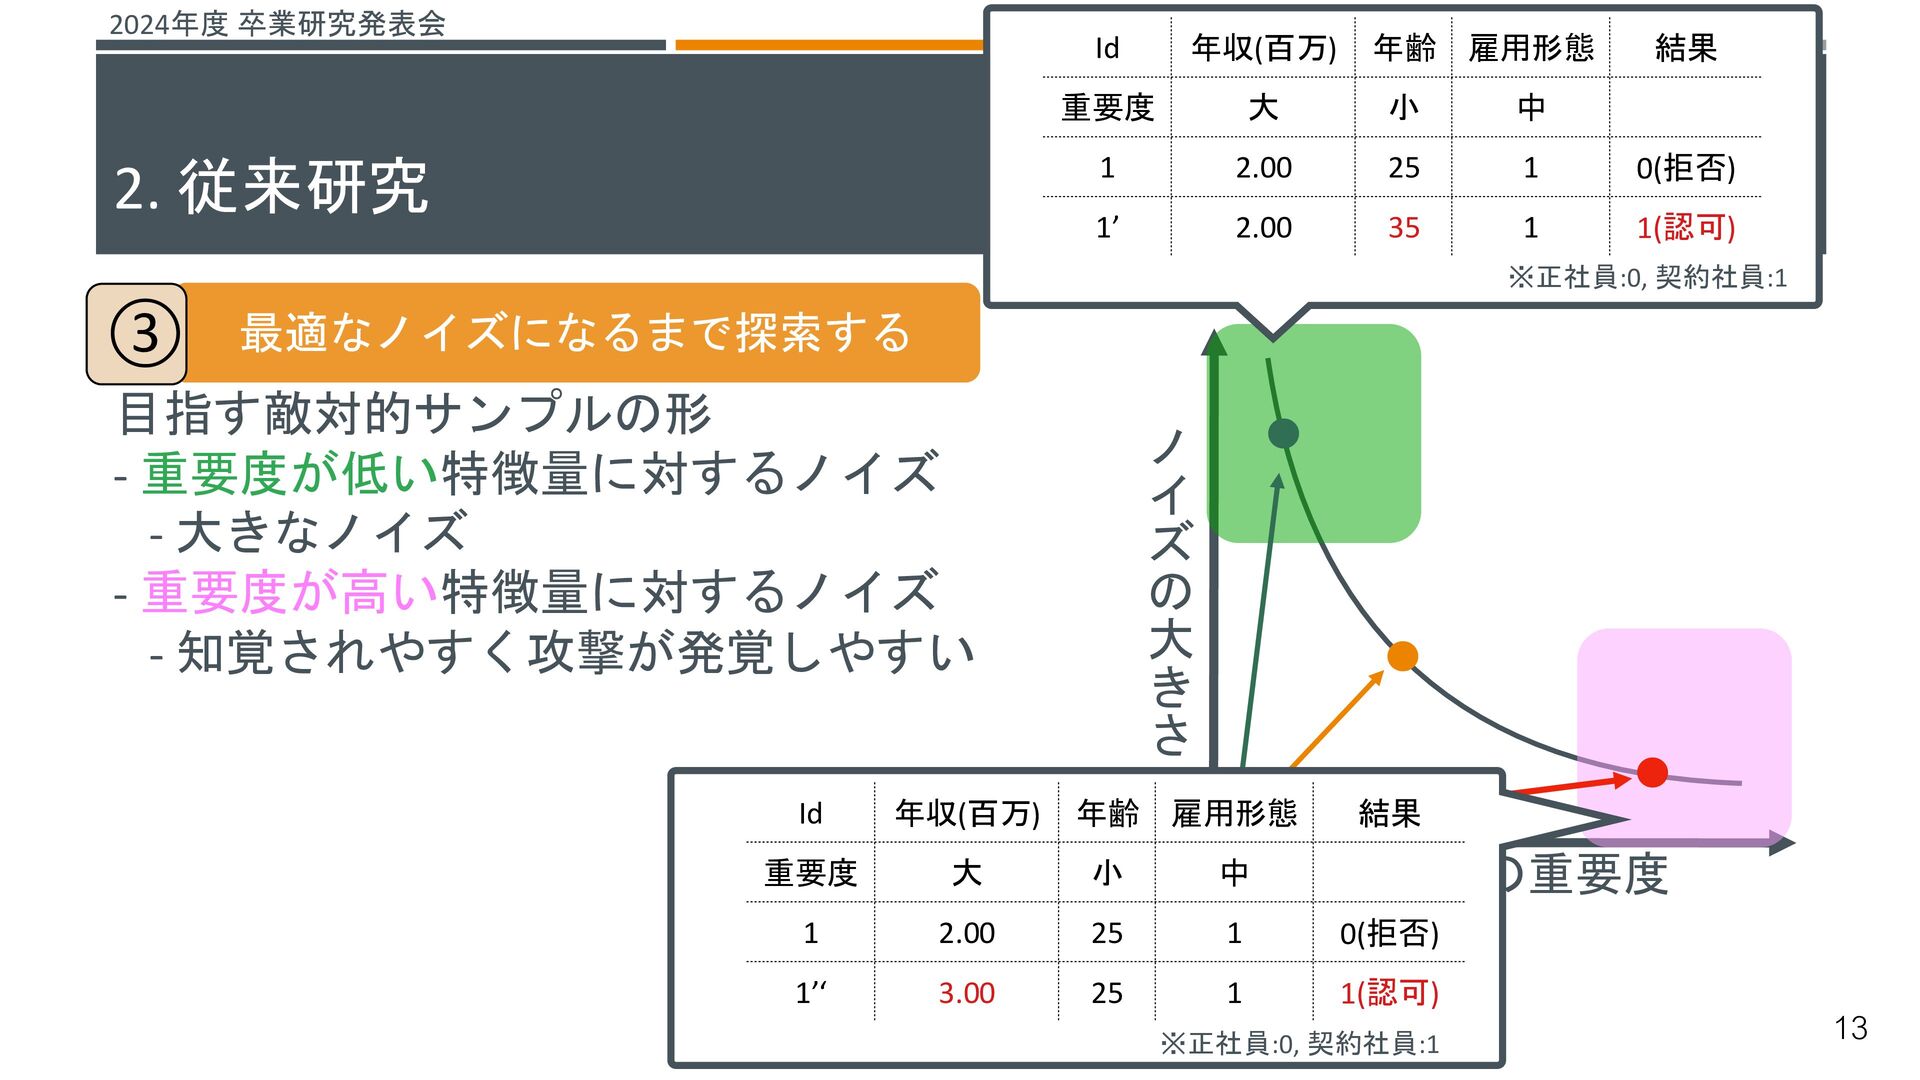
目指す敵対的サンプルの形 - 重要度が低い特徴量に対するノイズ - 大きなノイズ - 重要度が高い特徴量に対するノイズ - 知覚されやすく攻撃が発覚しやすい 2. 従来研究 13 Id 年収(百万) 年齢 雇用形態 結果 重要度 大 小 中 1 2.00 25 1 0(拒否) 1’ 2.00 35 1 1(認可) ※正社員:0, 契約社員:1 Id 年収(百万) 年齢 雇用形態 結果 重要度 大 小 中 1 2.00 25 1 0(拒否) 1’‘ 3.00 25 1 1(認可) ※正社員:0, 契約社員:1 最適なノイズになるまで探索する ③ -
2024年度 卒業研究発表会 従来手法によって実際に敵対的サンプルした 2. 従来研究 14 特徴量 重要度 元データ 従来手法
checking_status 0.718 0 0.09115 duration 0.384 14 8.89098 credit_amount 0.293 8978 7153.84454 saving_status 0.253 0 0.08376 employment 0.243 4 3.94764 installment_commitment 0.165 1 1.07192 residence_since 0.046 4 4.00000 age 0.230 45 44.41327 existing_credits 0.076 1 1.00000 num_dependents 0.040 1 1.00000 own_telephone 0.095 1 0.99231 foreign_worker 0.171 1 1.00000 checking_statusに対するノイズを強く避けたため、 credit_amountへのノイズが大きくなっている 重要度が3番目に大きいcredit_amountに 対するノイズが極端に大きい 出力が連続値である -
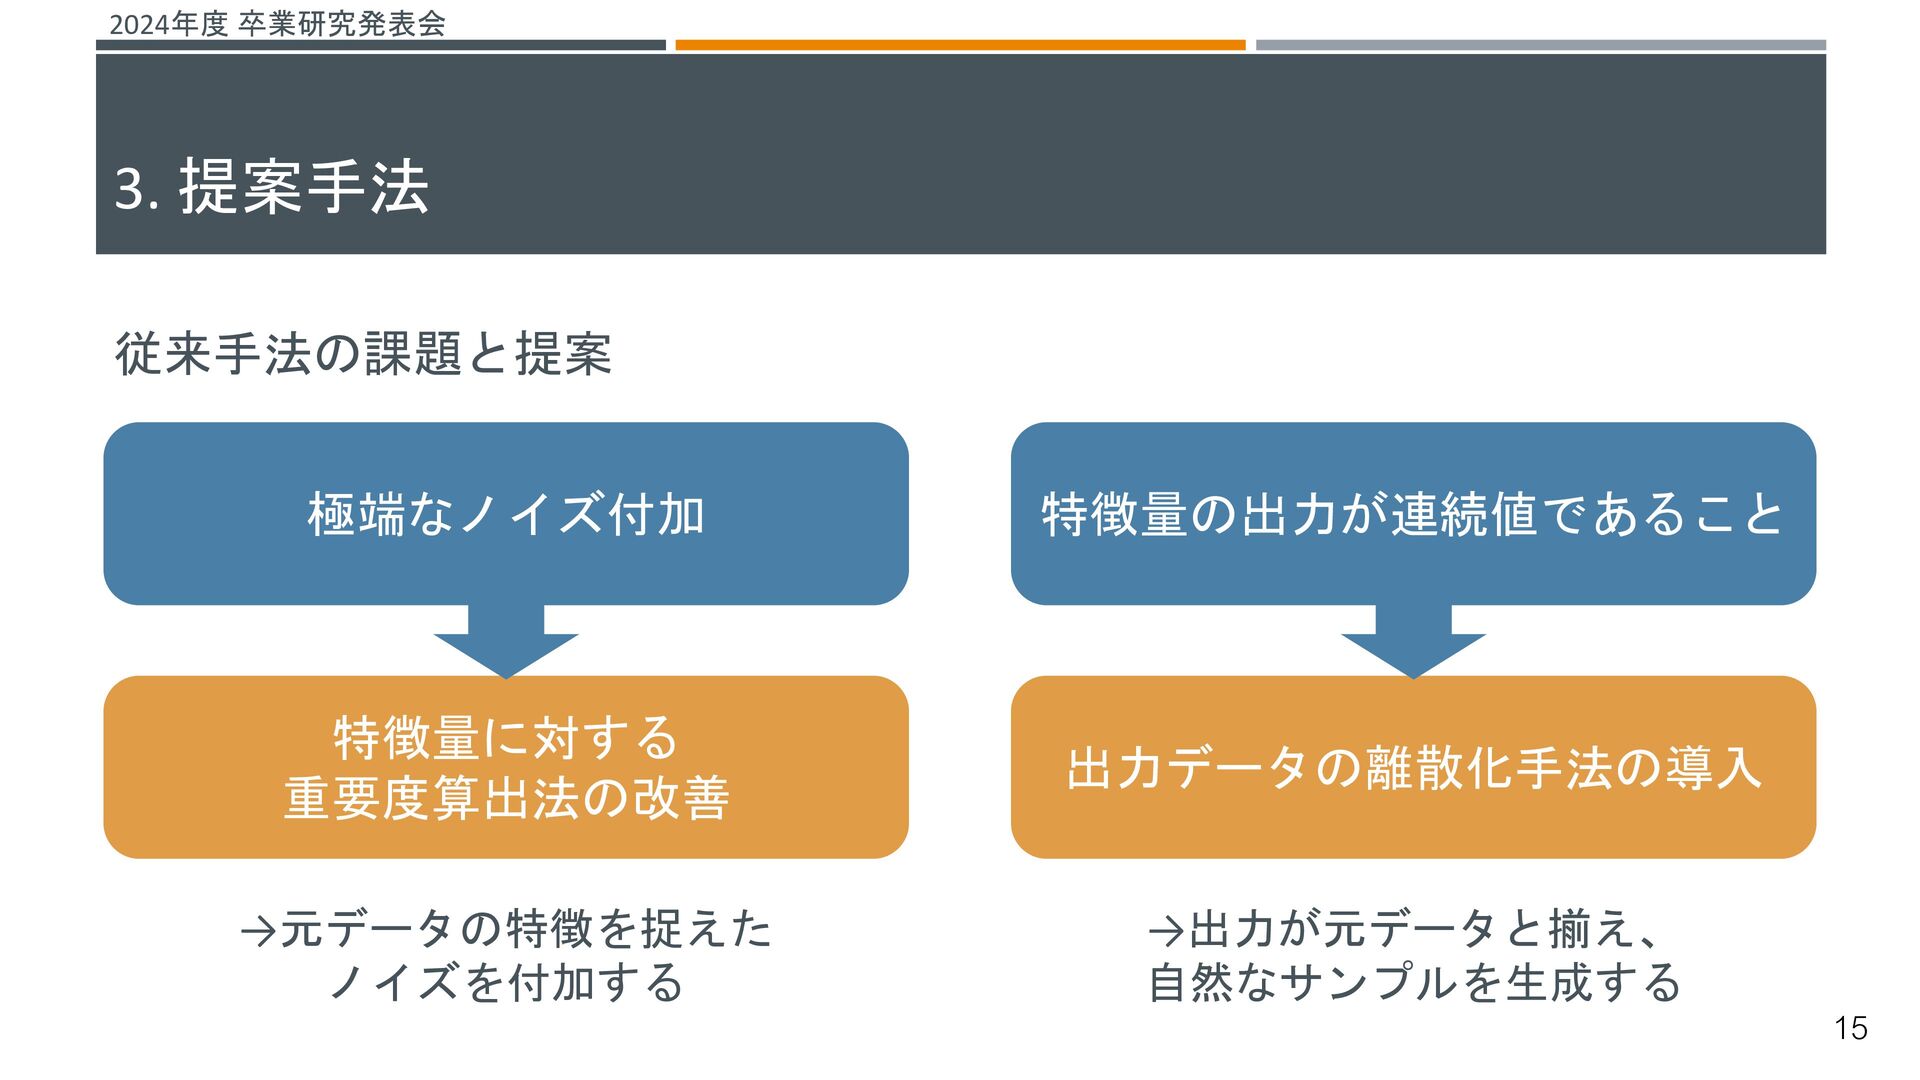
2024年度 卒業研究発表会 従来手法の課題と提案 3. 提案手法 15 極端なノイズ付加 特徴量の出力が連続値であること 特徴量に対する 重要度算出法の改善
出力データの離散化手法の導入 →元データの特徴を捉えた ノイズを付加する →出力が元データと揃え、 自然なサンプルを生成する -
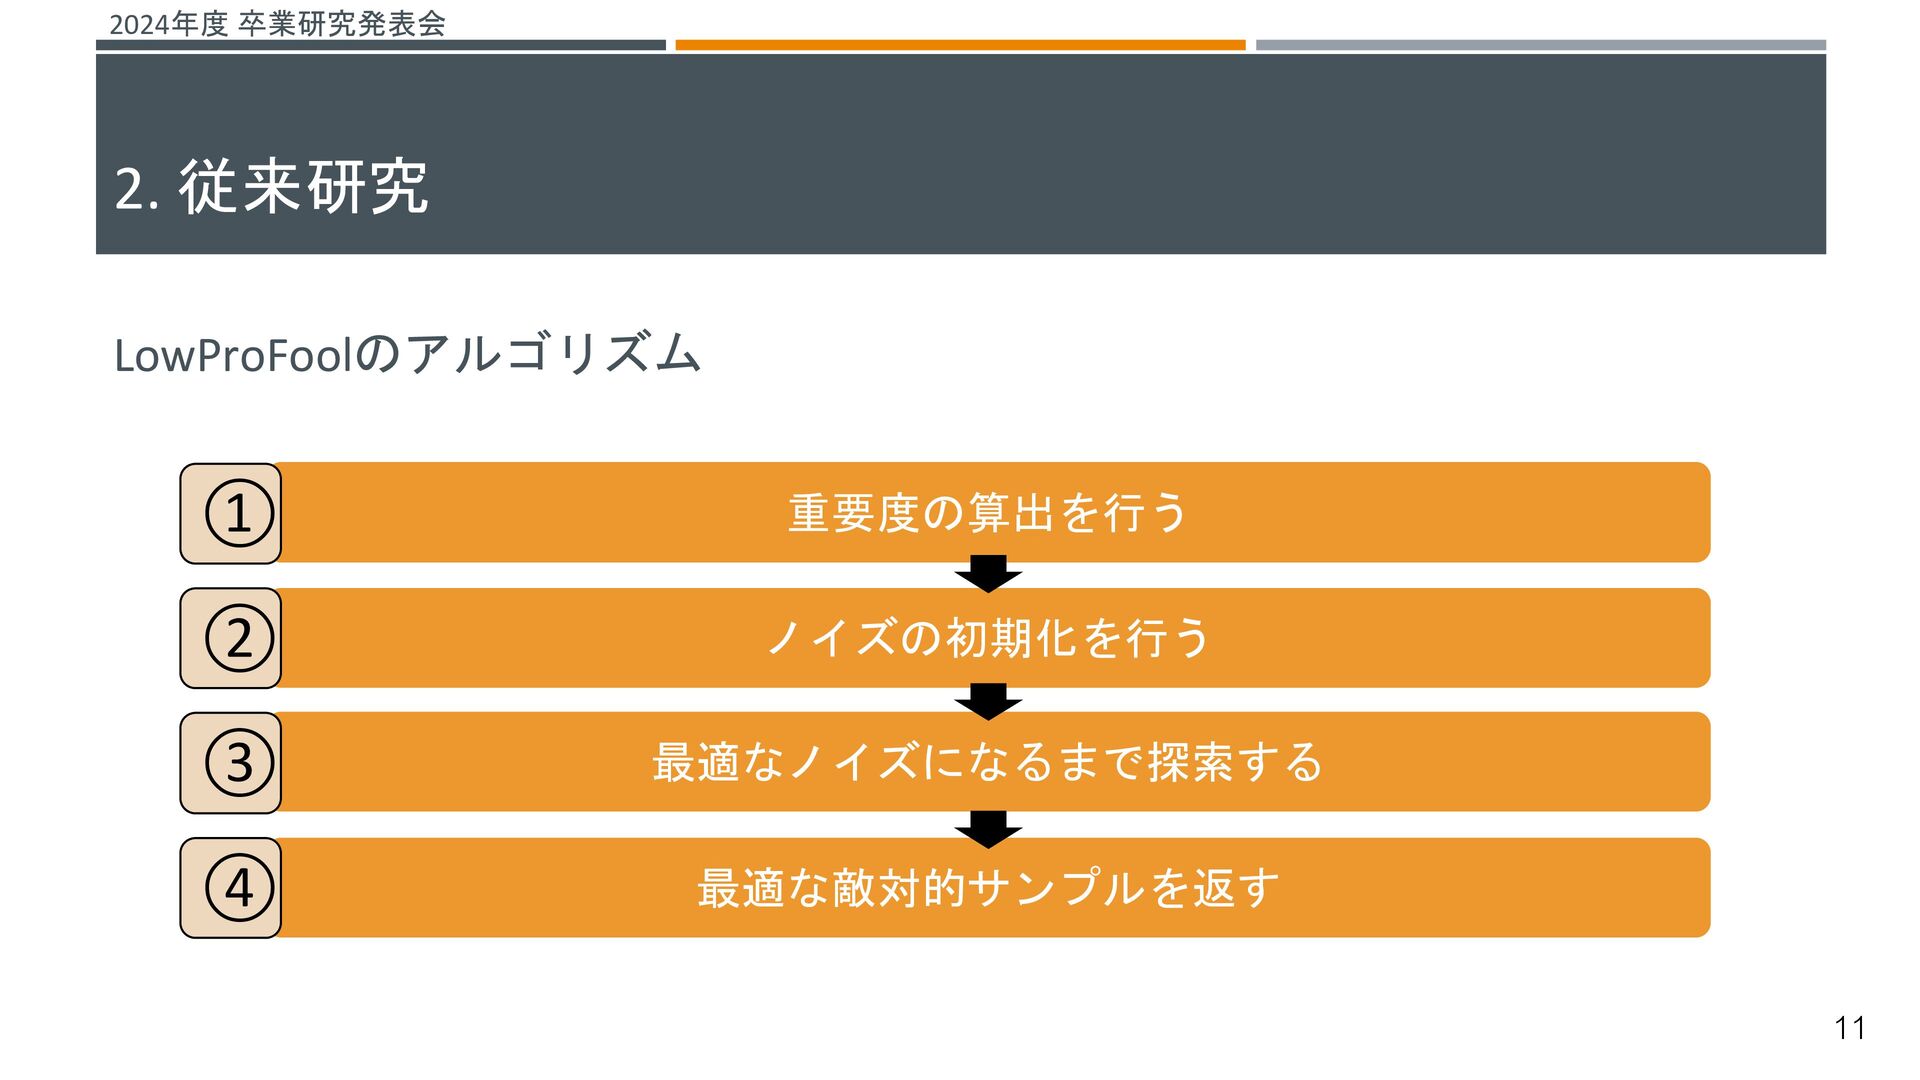
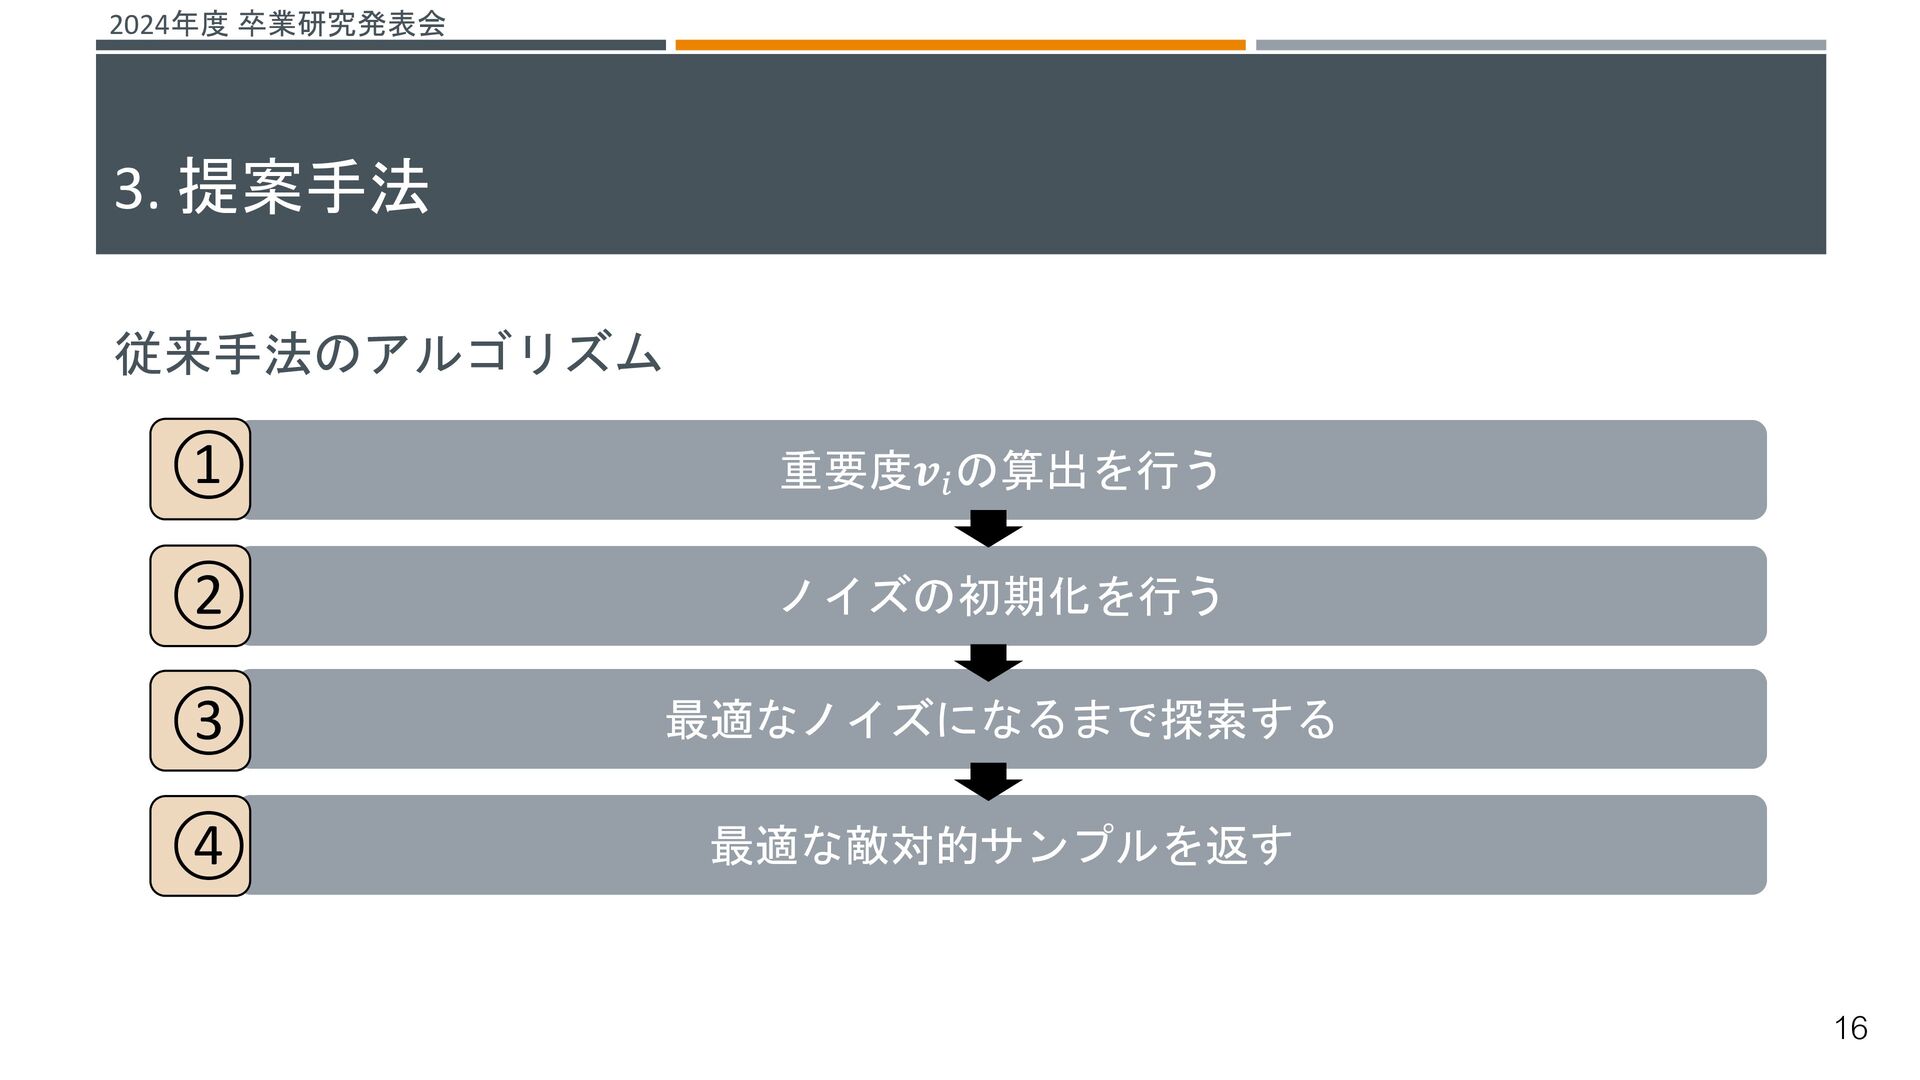
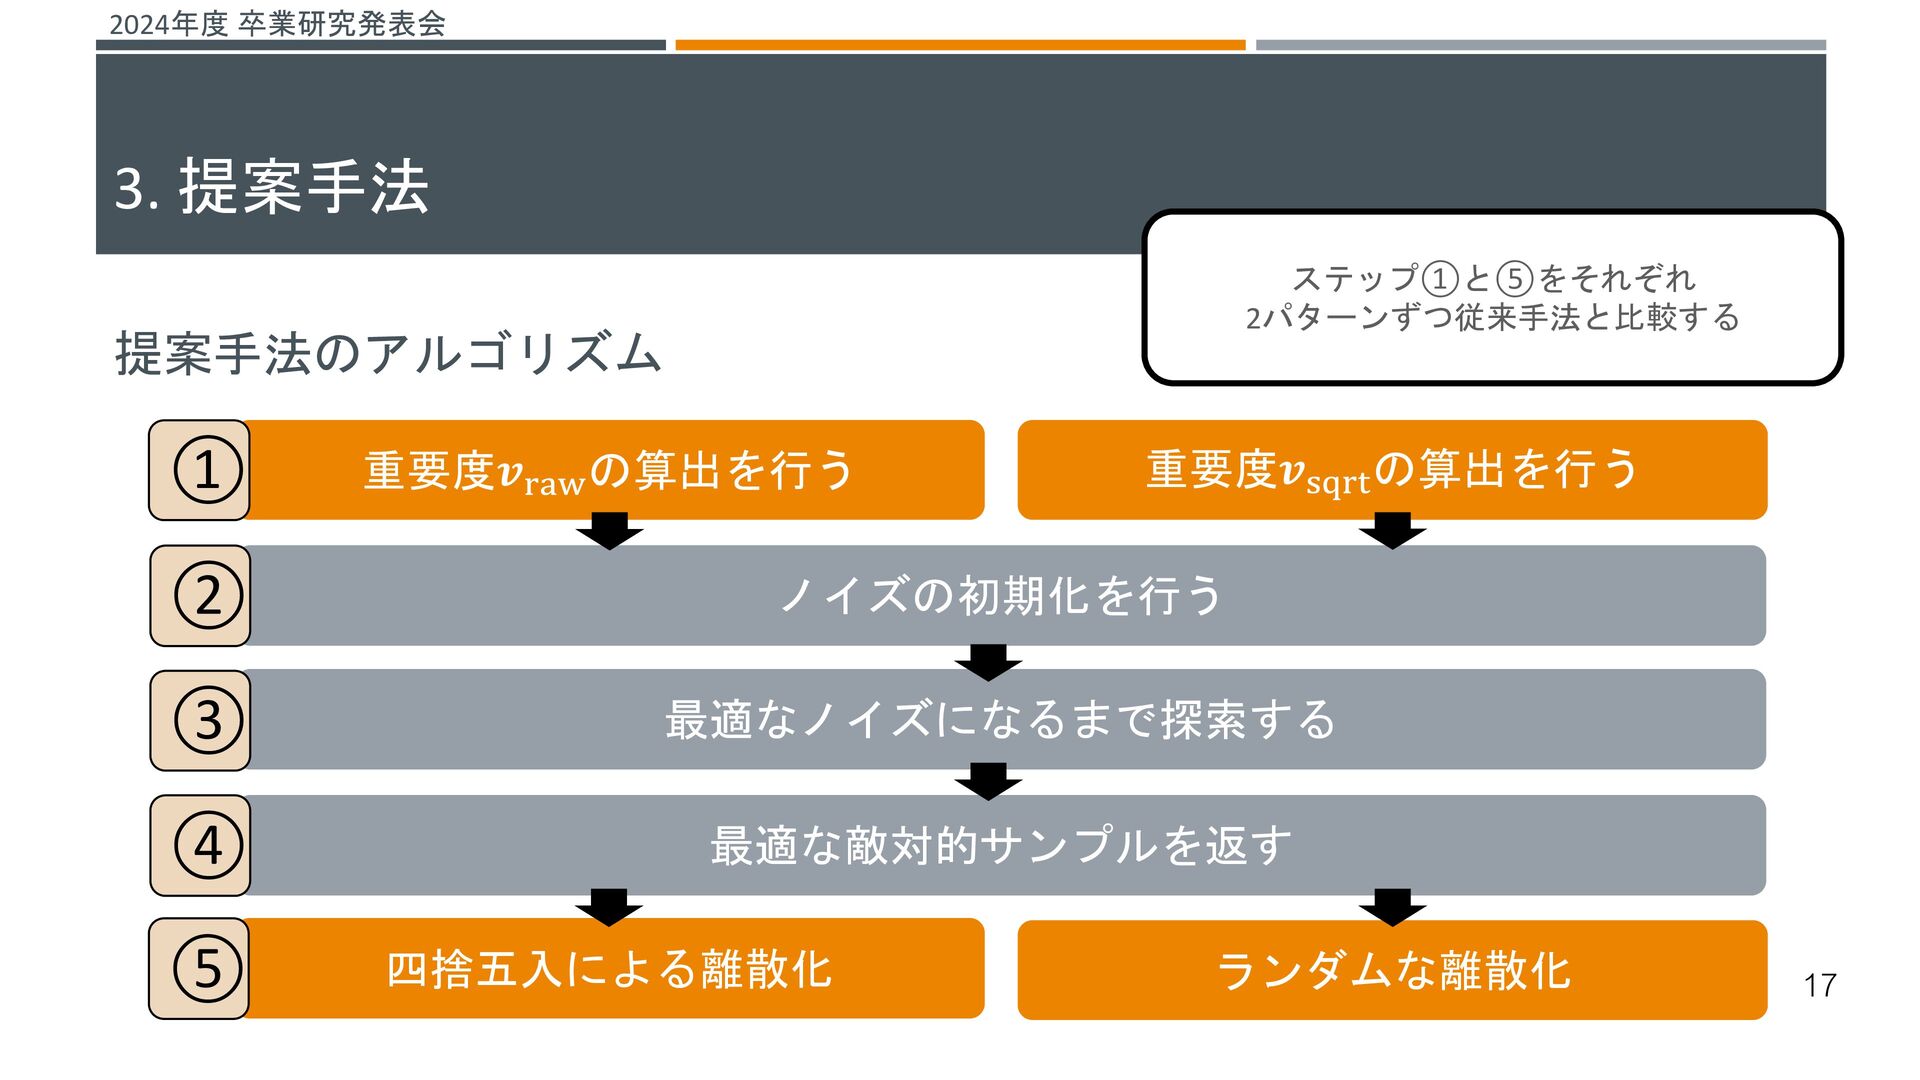
2024年度 卒業研究発表会 ノイズの初期化を行う 最適なノイズになるまで探索する 最適な敵対的サンプルを返す 提案手法のアルゴリズム 3. 提案手法 17 ②
③ ④ 重要度𝒗raw の算出を行う ① 重要度𝒗sqrt の算出を行う 四捨五入による離散化 ⑤ ランダムな離散化 ステップ①と⑤をそれぞれ 2パターンずつ従来手法と比較する -
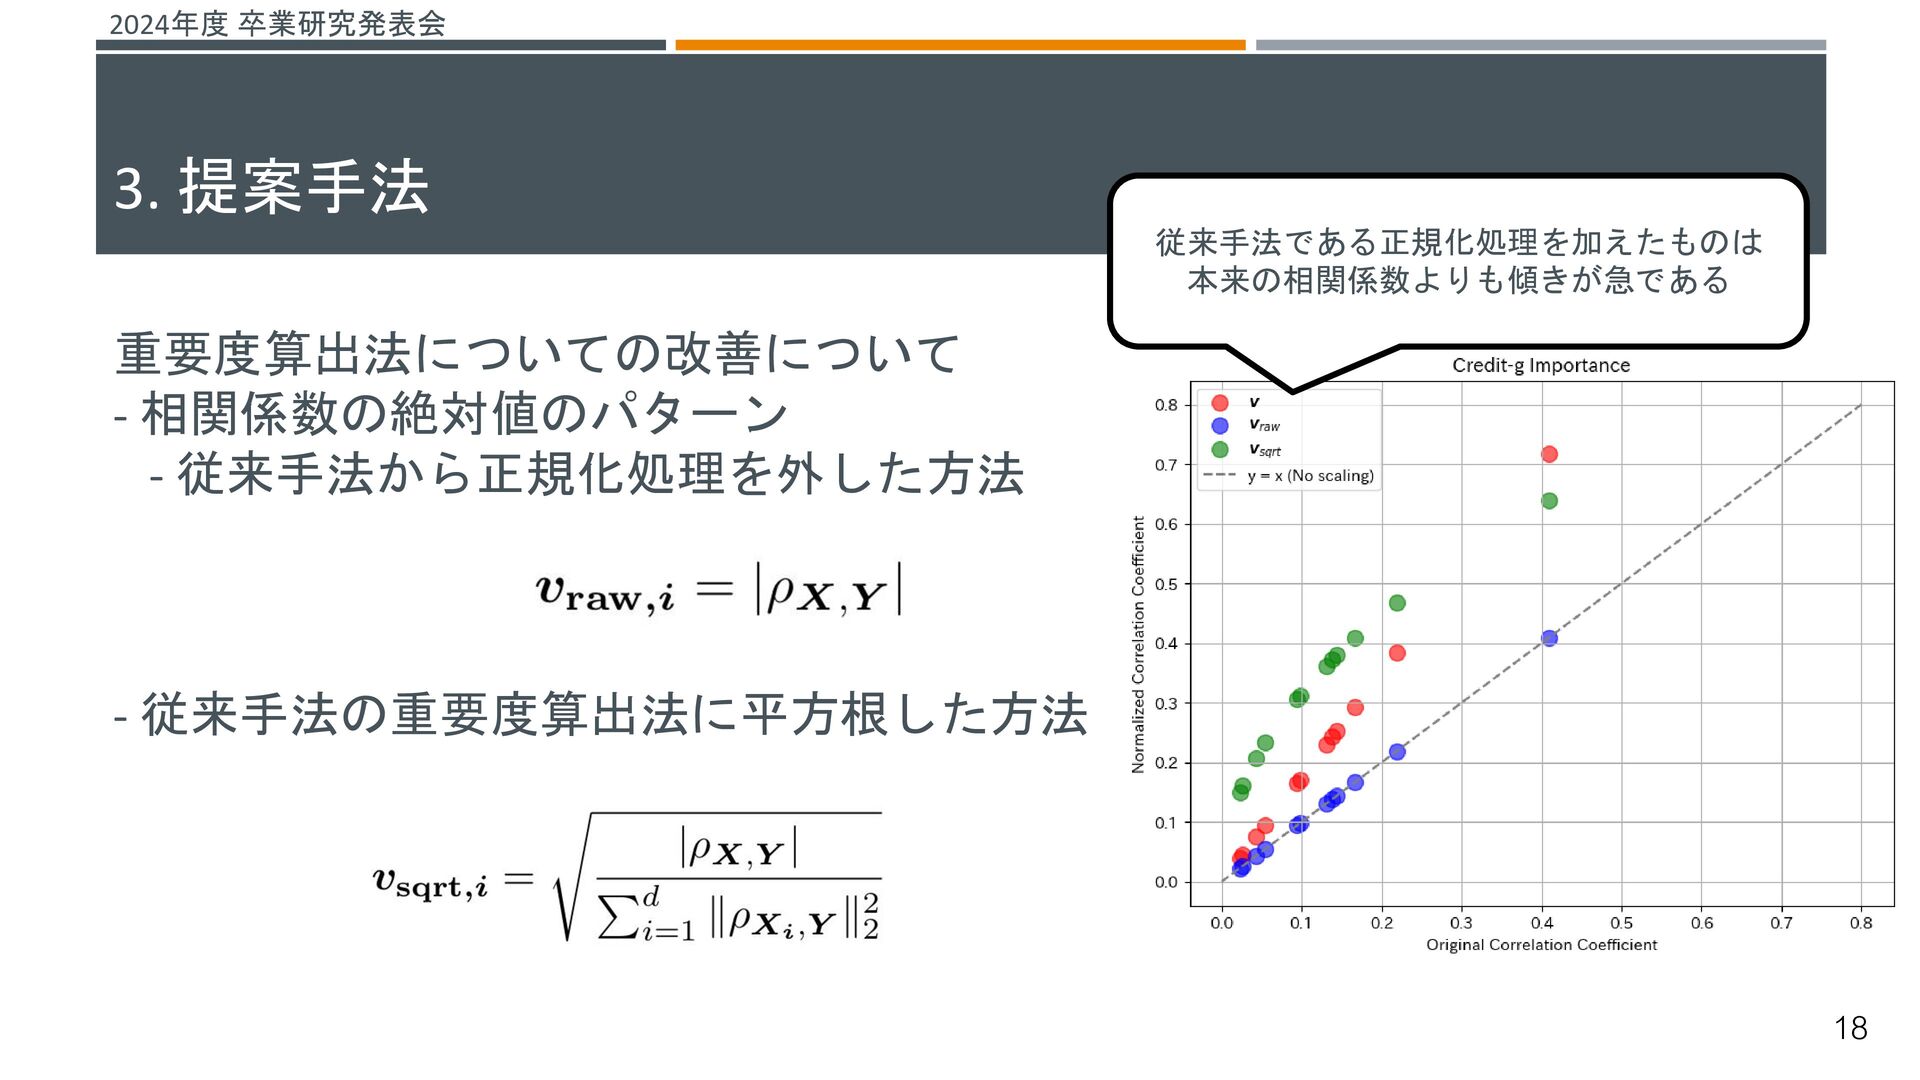
2024年度 卒業研究発表会 重要度算出法についての改善について - 相関係数の絶対値のパターン - 従来手法から正規化処理を外した方法 - 従来手法の重要度算出法に平方根した方法 3.
提案手法 18 従来手法である正規化処理を加えたものは 本来の相関係数よりも傾きが急である -
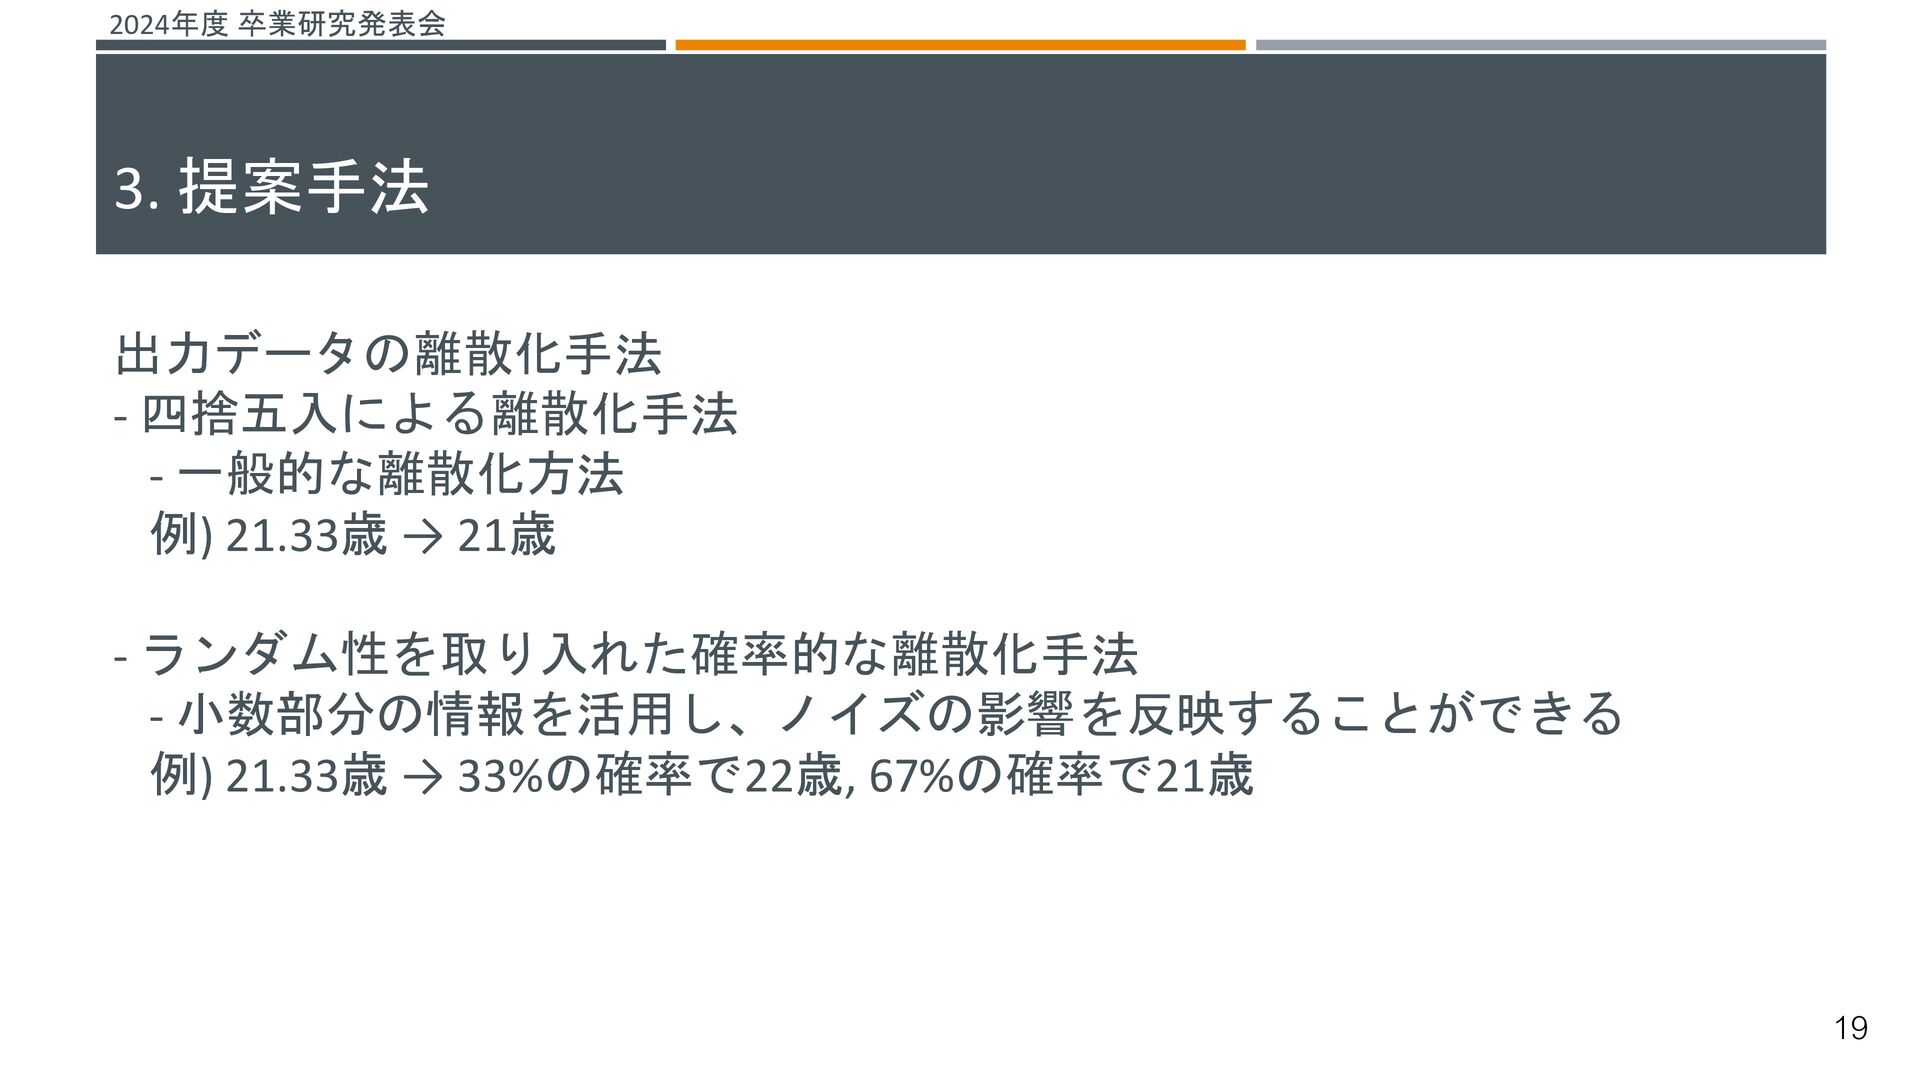
2024年度 卒業研究発表会 出力データの離散化手法 - 四捨五入による離散化手法 - 一般的な離散化方法 例) 21.33歳 →
21歳 - ランダム性を取り入れた確率的な離散化手法 - 小数部分の情報を活用し、ノイズの影響を反映することができる 例) 21.33歳 → 33%の確率で22歳, 67%の確率で21歳 3. 提案手法 19 -
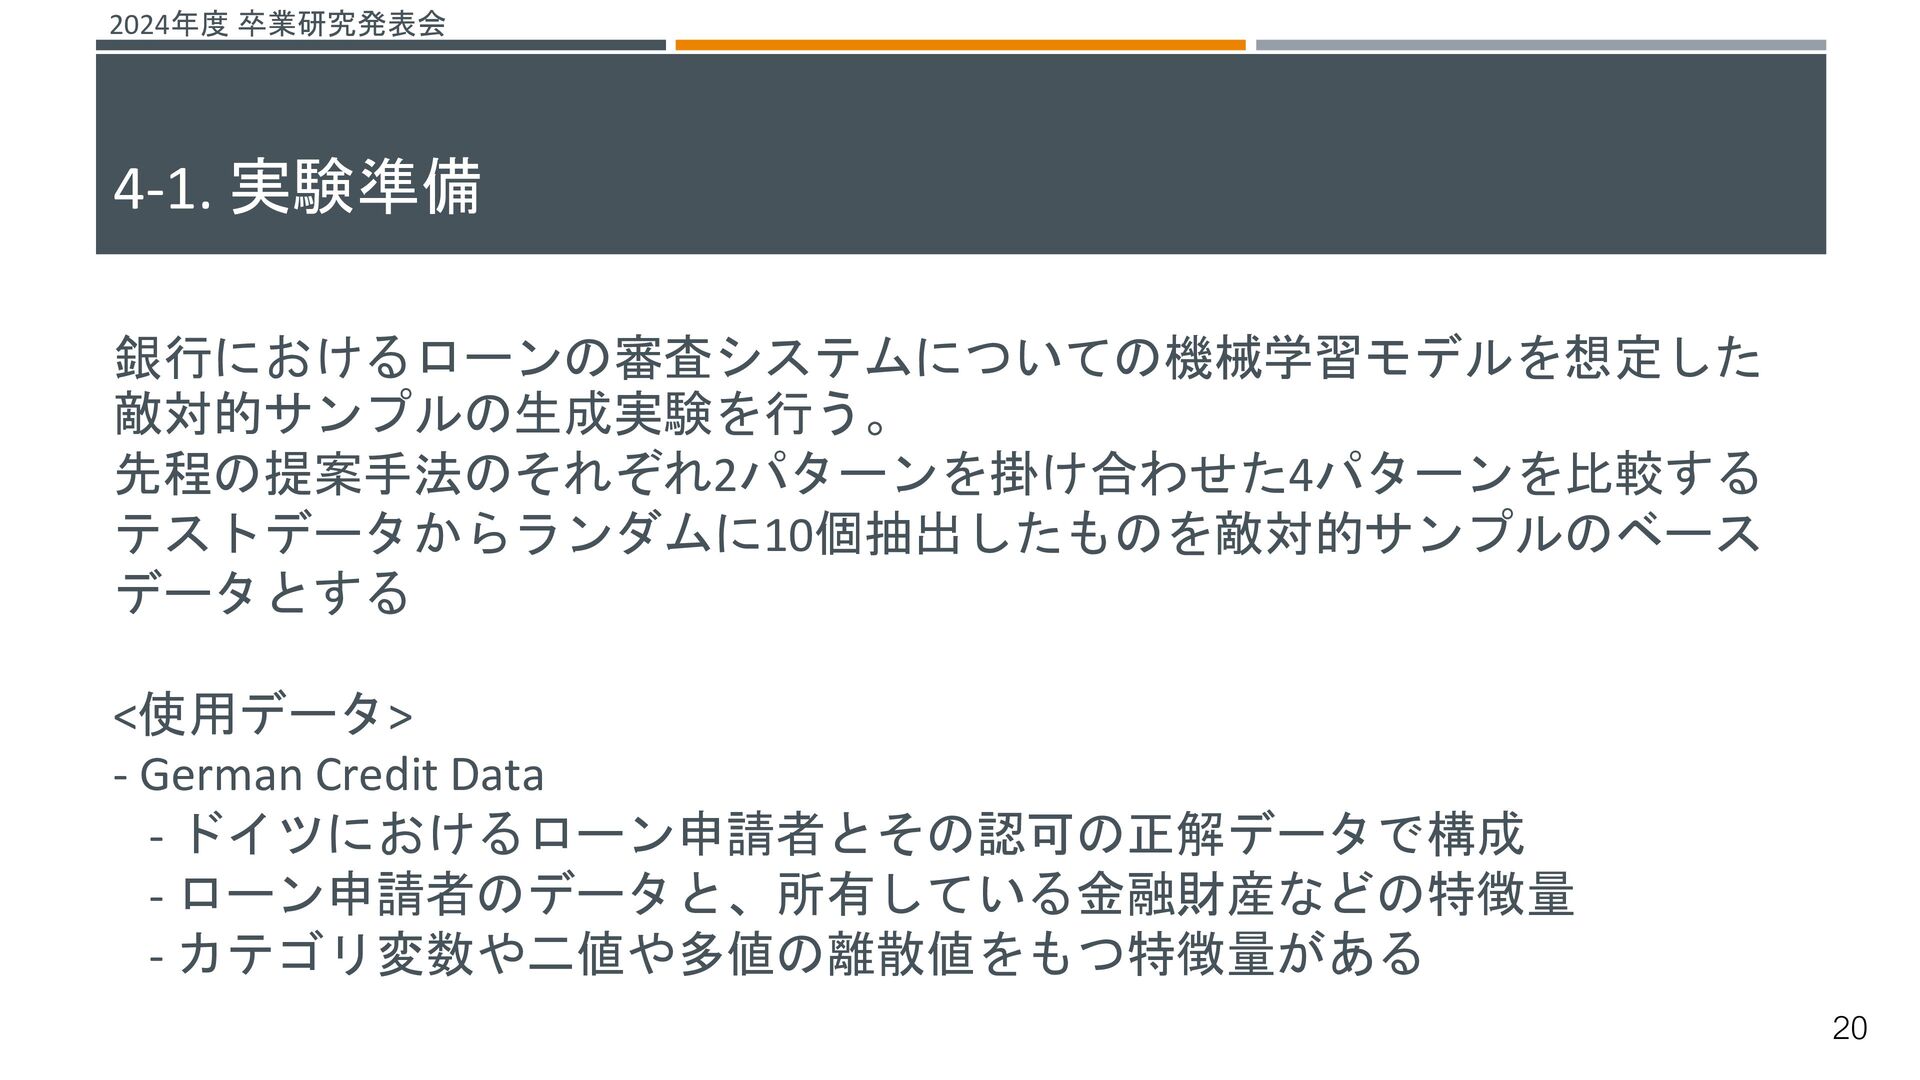
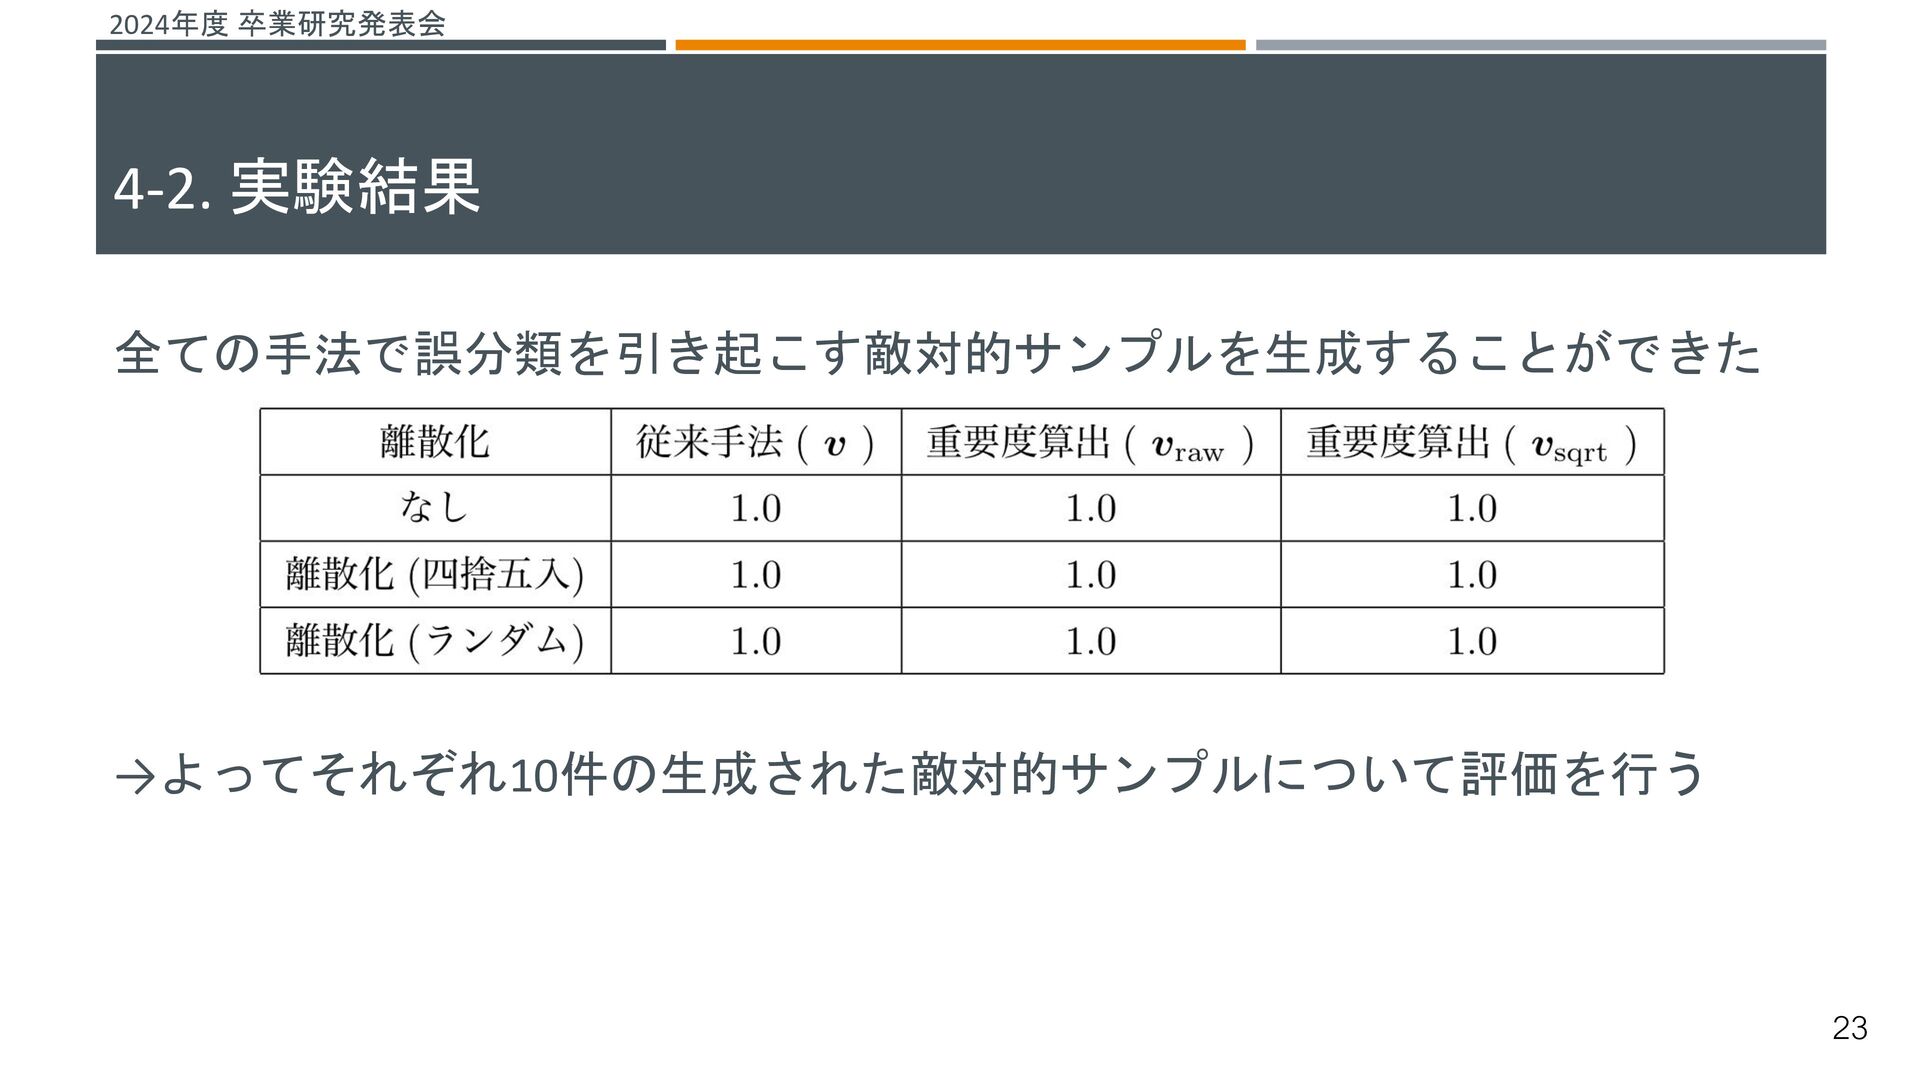
2024年度 卒業研究発表会 銀行におけるローンの審査システムについての機械学習モデルを想定した 敵対的サンプルの生成実験を行う。 先程の提案手法のそれぞれ2パターンを掛け合わせた4パターンを比較する テストデータからランダムに10個抽出したものを敵対的サンプルのベース データとする <使用データ> - German
Credit Data - ドイツにおけるローン申請者とその認可の正解データで構成 - ローン申請者のデータと、所有している金融財産などの特徴量 - カテゴリ変数や二値や多値の離散値をもつ特徴量がある 4-1. 実験準備 20 -
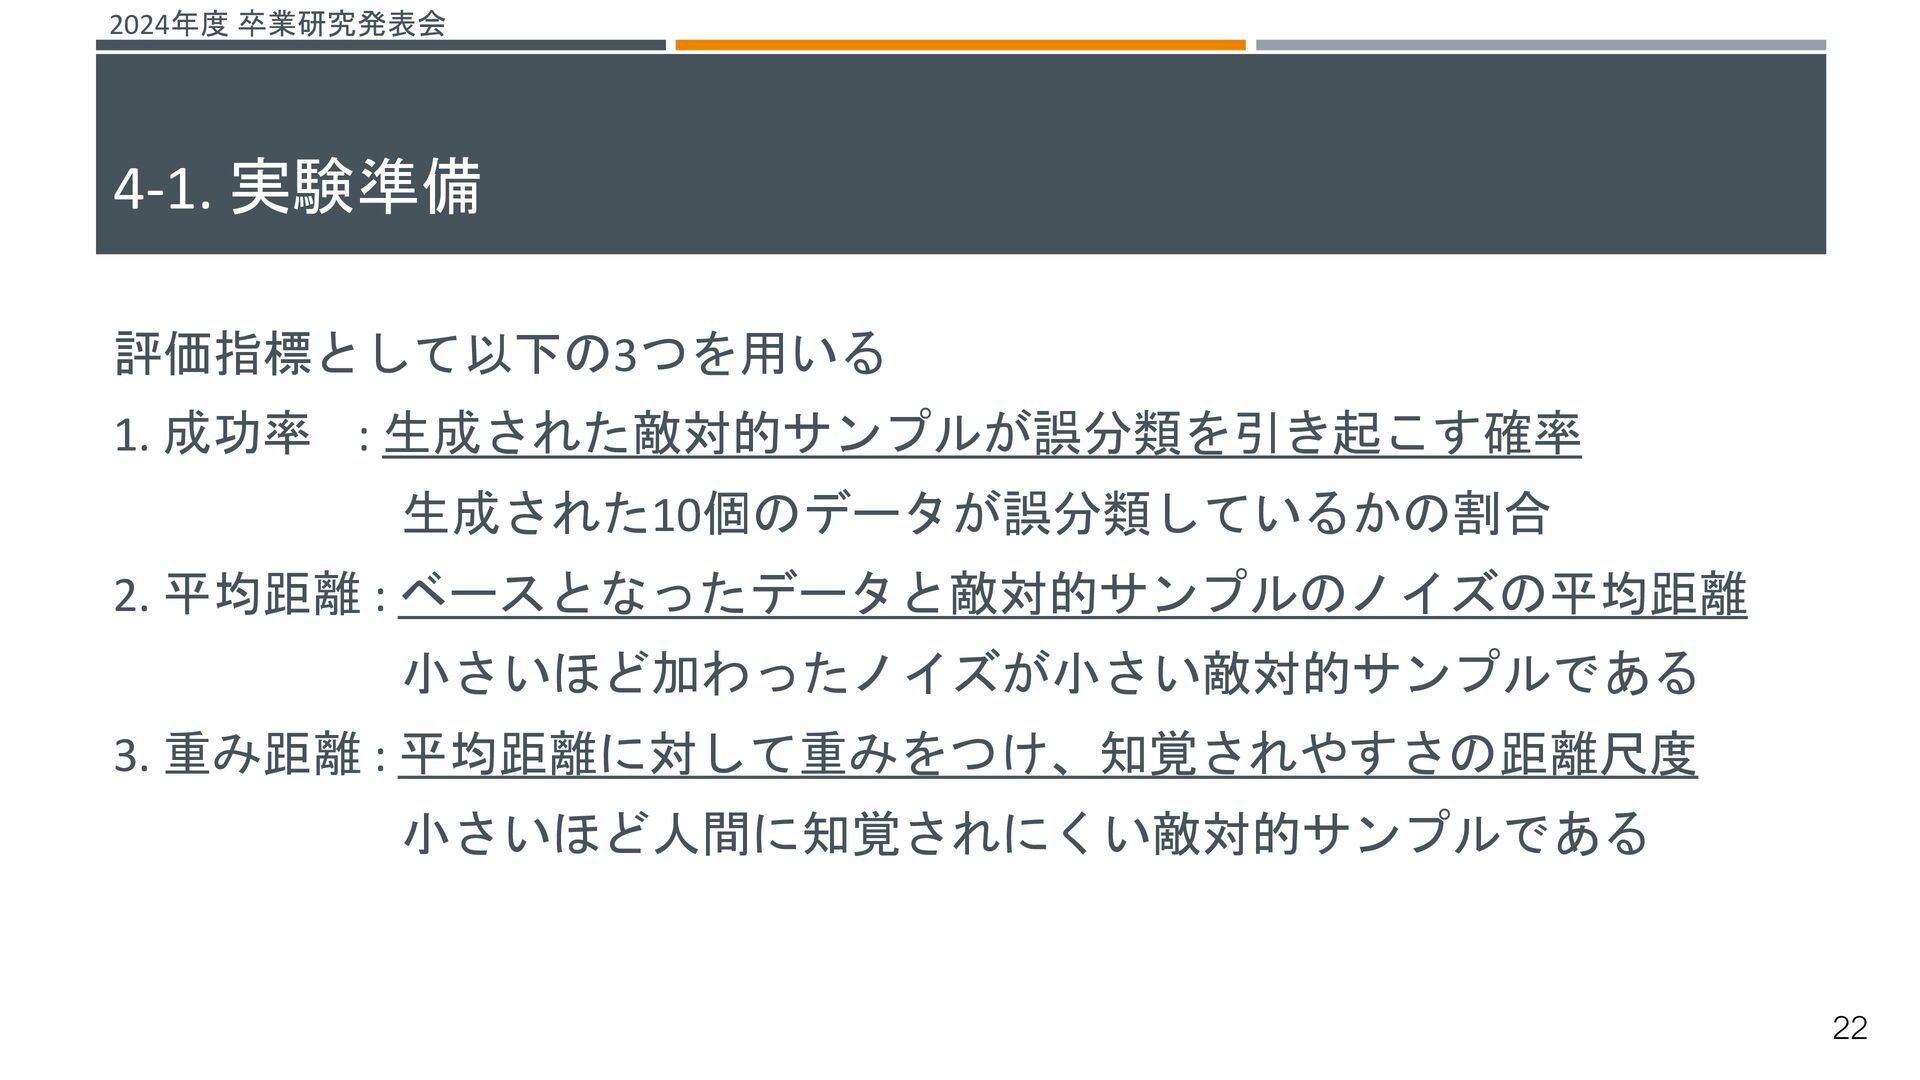
2024年度 卒業研究発表会 評価指標として以下の3つを用いる 1. 成功率 : 生成された敵対的サンプルが誤分類を引き起こす確率 生成された10個のデータが誤分類しているかの割合 2. 平均距離
: ベースとなったデータと敵対的サンプルのノイズの平均距離 小さいほど加わったノイズが小さい敵対的サンプルである 3. 重み距離 : 平均距離に対して重みをつけ、知覚されやすさの距離尺度 小さいほど人間に知覚されにくい敵対的サンプルである 4-1. 実験準備 22 -
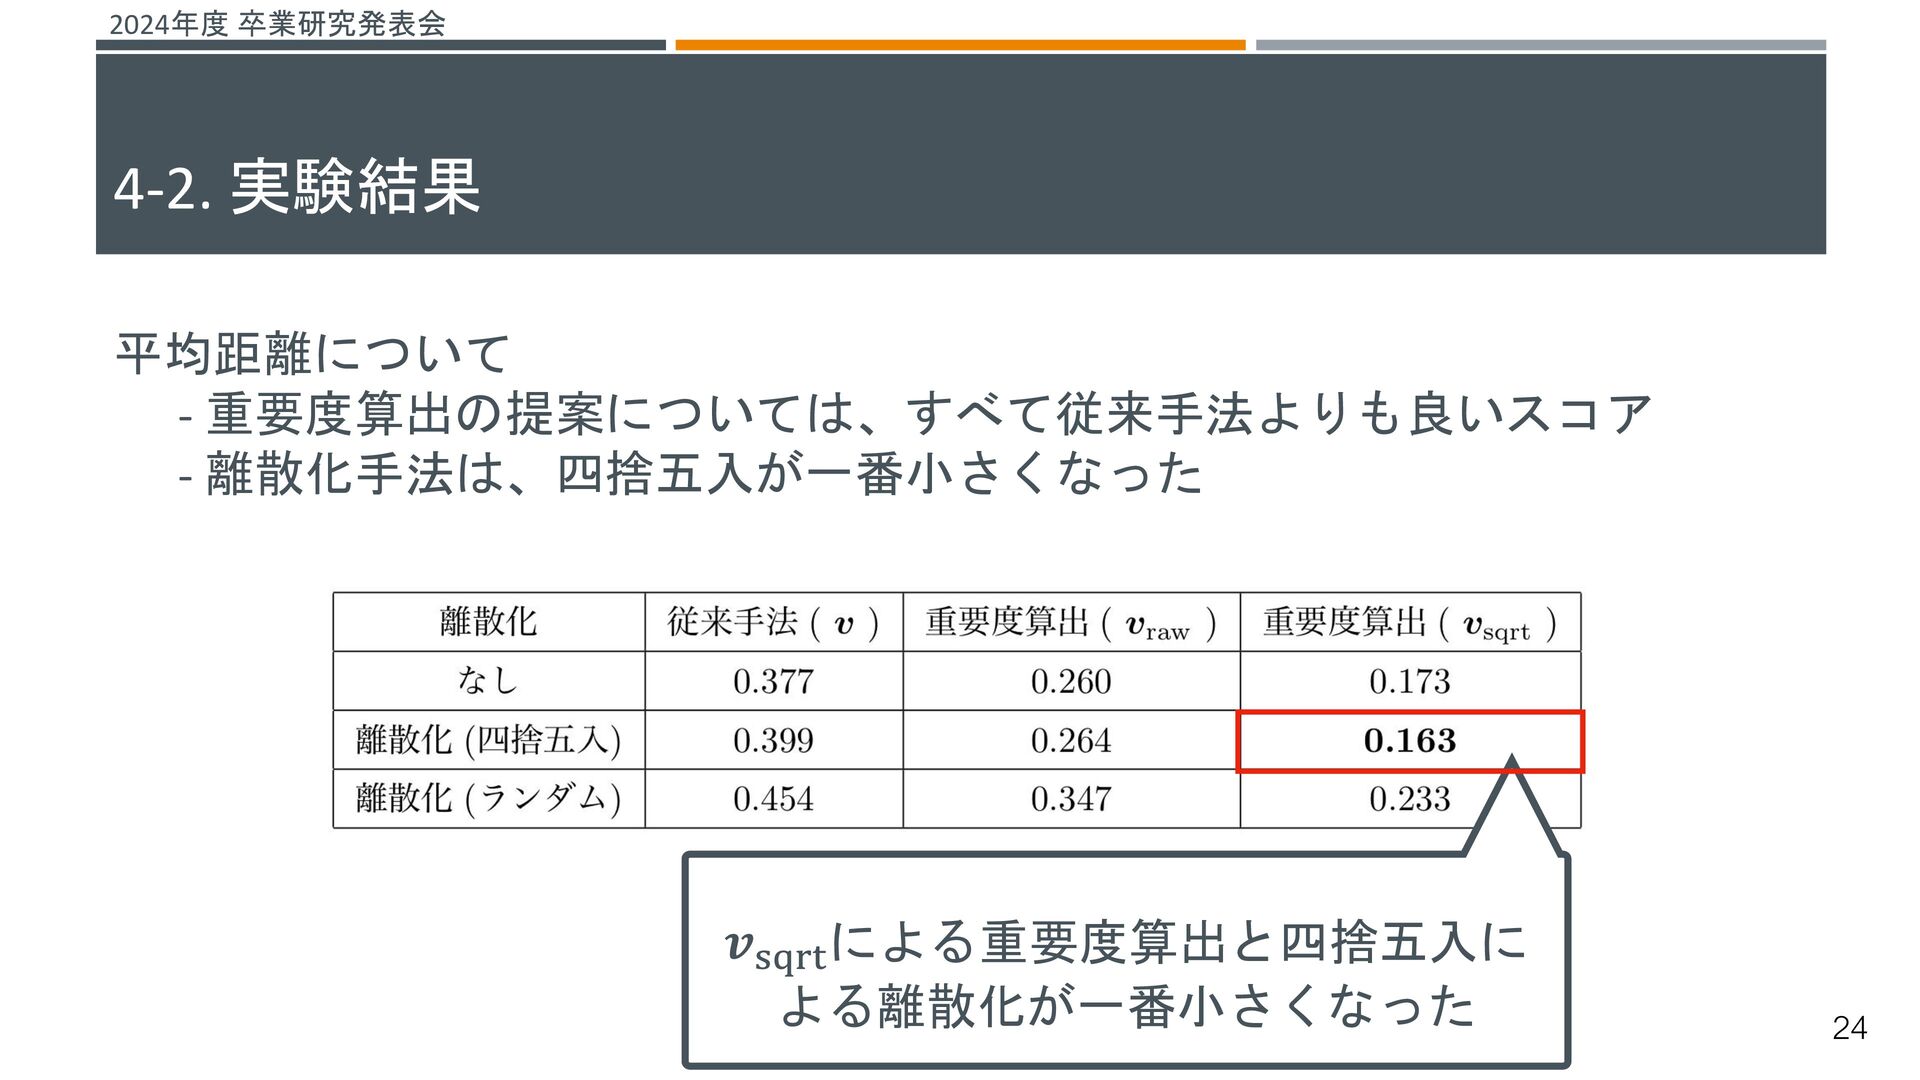
2024年度 卒業研究発表会 平均距離について - 重要度算出の提案については、すべて従来手法よりも良いスコア - 離散化手法は、四捨五入が一番小さくなった 4-2. 実験結果 24
𝒗sqrt による重要度算出と四捨五入に よる離散化が一番小さくなった -
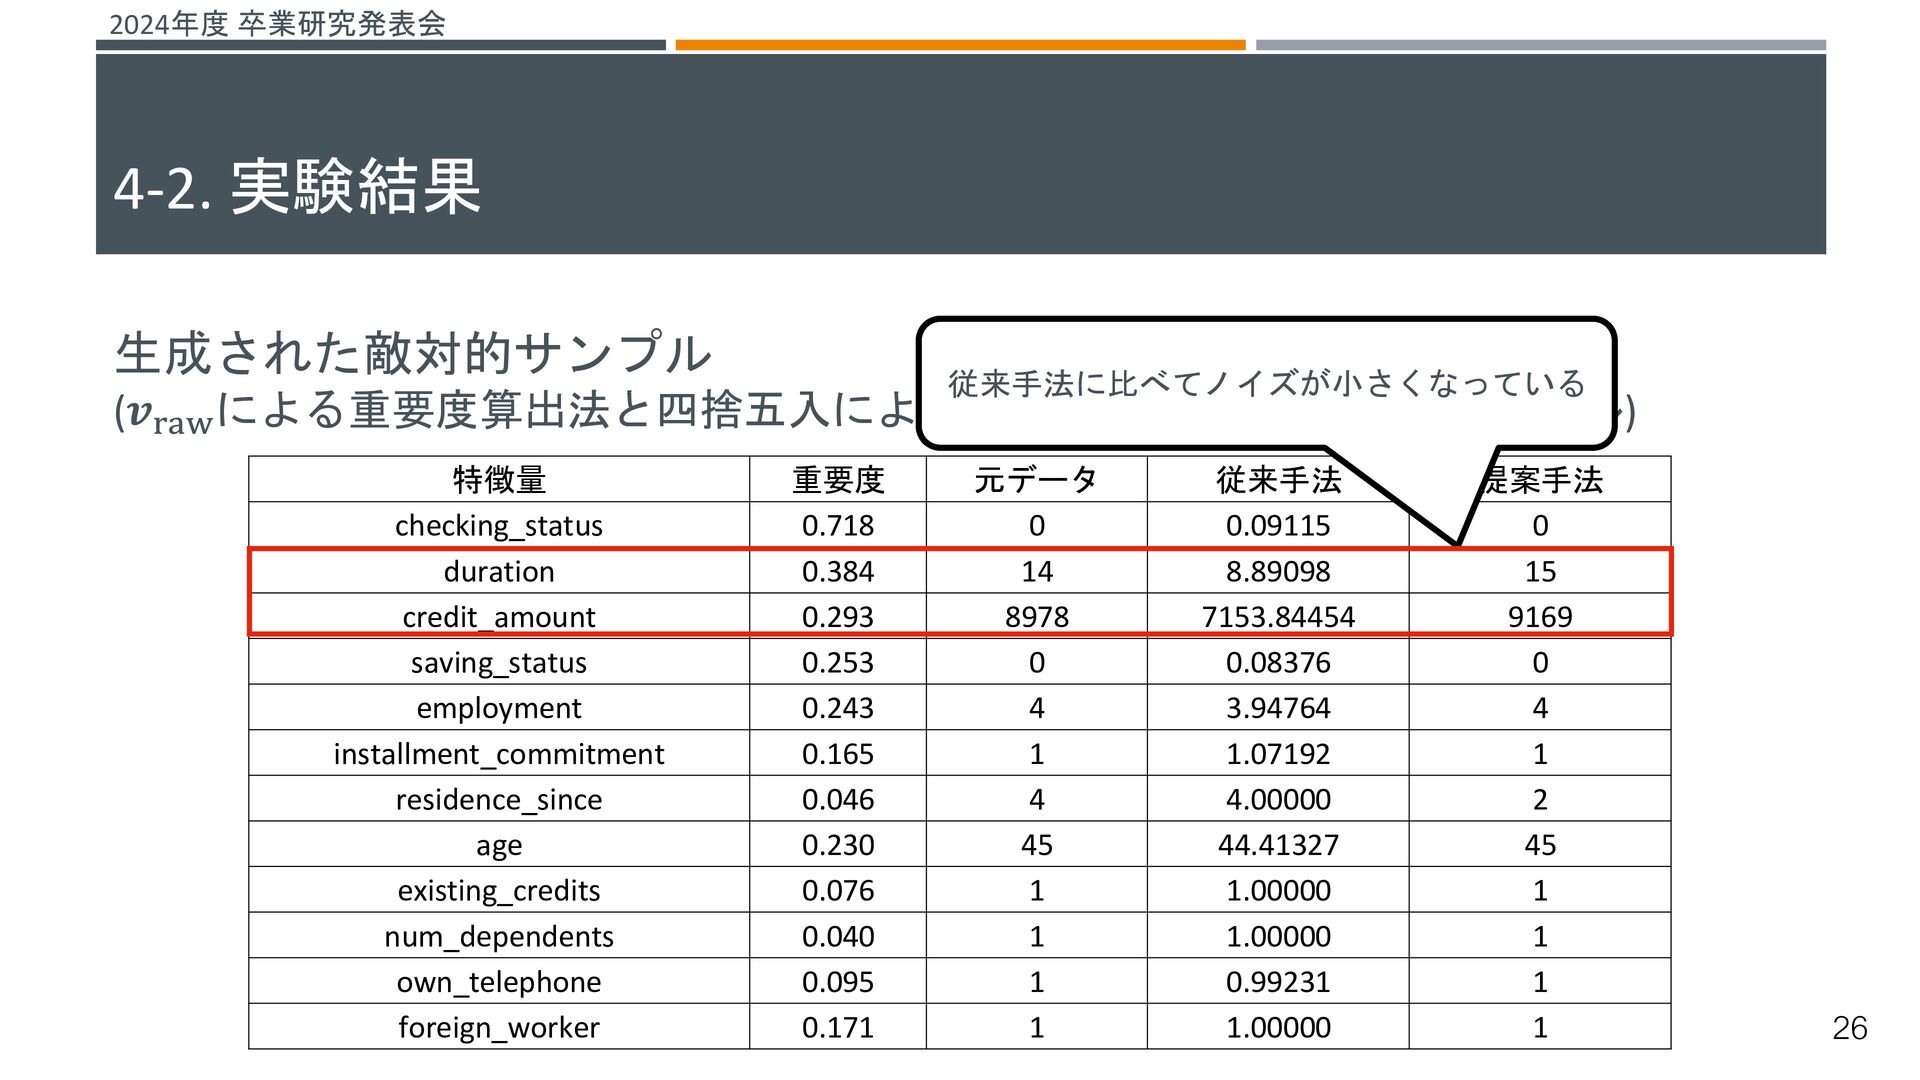
2024年度 卒業研究発表会 生成された敵対的サンプル (𝒗raw による重要度算出法と四捨五入による離散化手法による敵対的サンプル) 4-2. 実験結果 26 特徴量 重要度
元データ 従来手法 提案手法 checking_status 0.718 0 0.09115 0 duration 0.384 14 8.89098 15 credit_amount 0.293 8978 7153.84454 9169 saving_status 0.253 0 0.08376 0 employment 0.243 4 3.94764 4 installment_commitment 0.165 1 1.07192 1 residence_since 0.046 4 4.00000 2 age 0.230 45 44.41327 45 existing_credits 0.076 1 1.00000 1 num_dependents 0.040 1 1.00000 1 own_telephone 0.095 1 0.99231 1 foreign_worker 0.171 1 1.00000 1 従来手法に比べてノイズが小さくなっている -
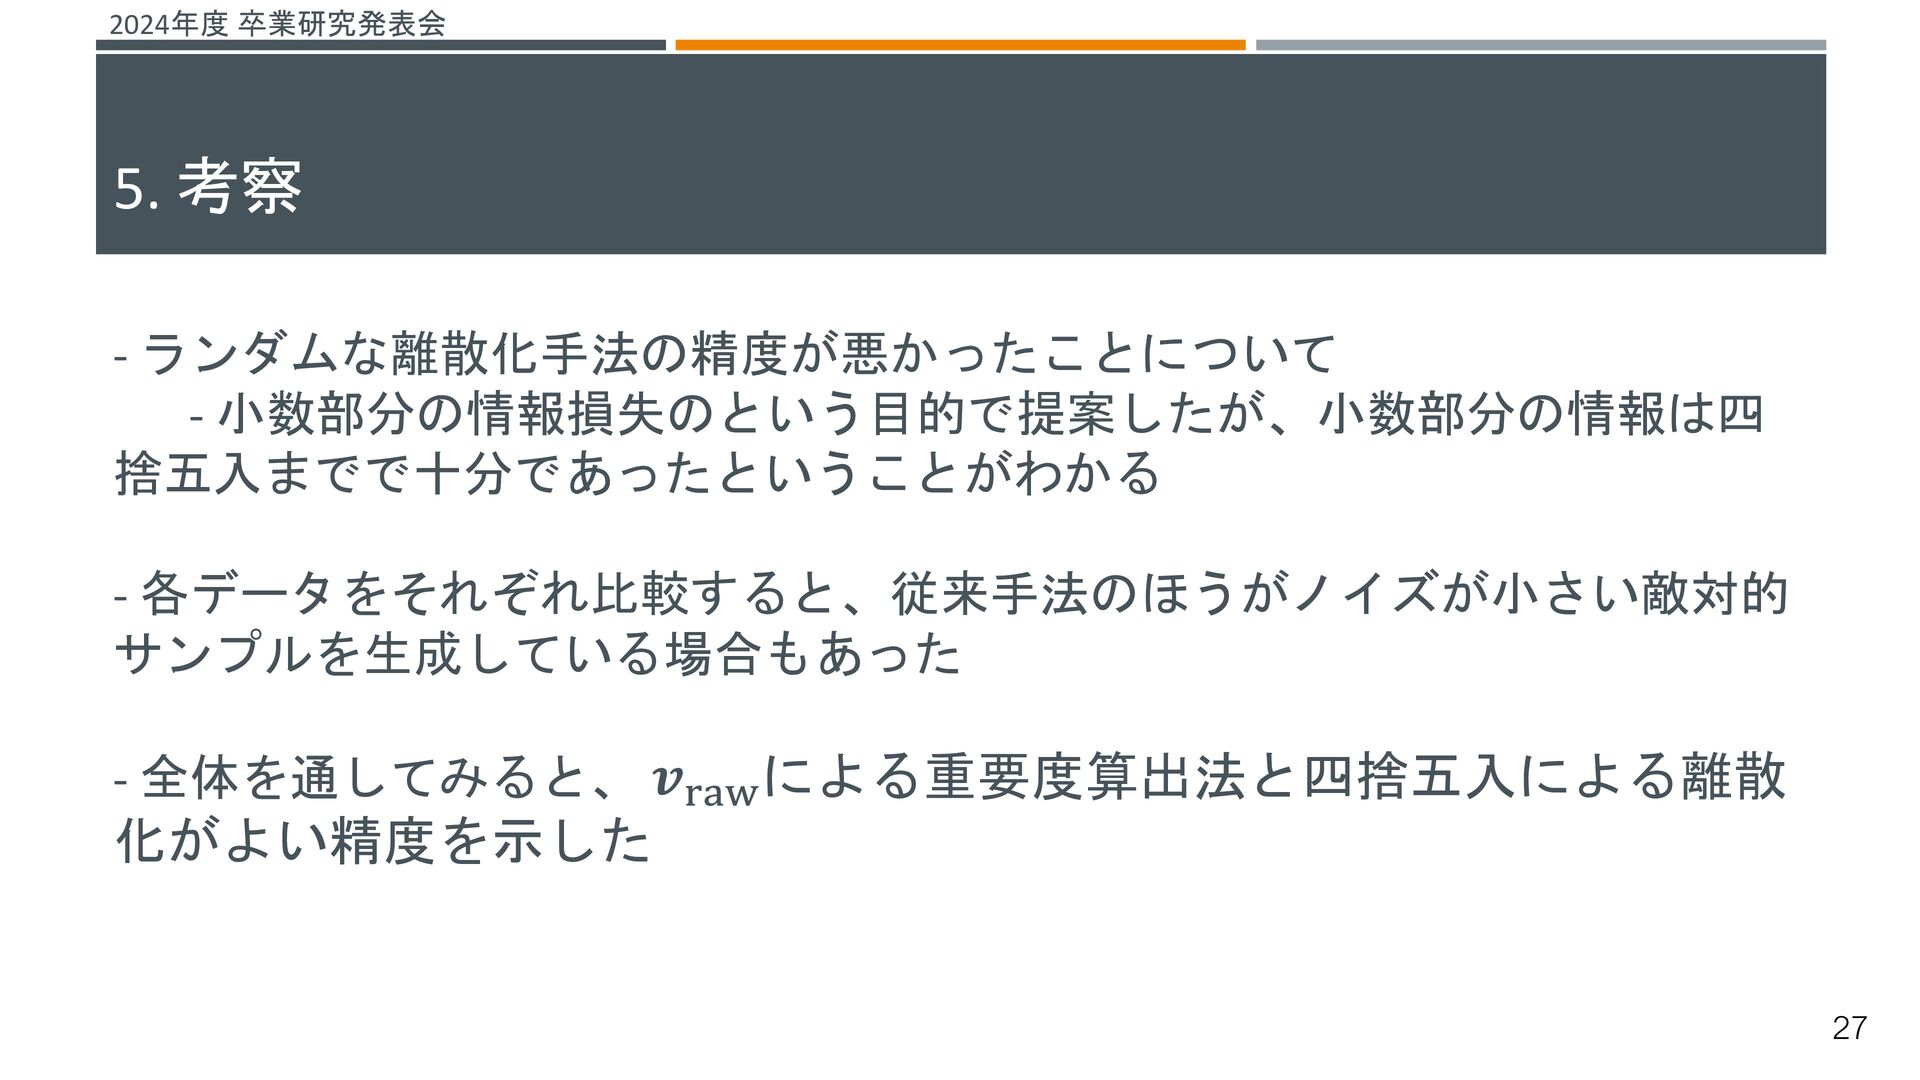
2024年度 卒業研究発表会 - ランダムな離散化手法の精度が悪かったことについて - 小数部分の情報損失のという目的で提案したが、小数部分の情報は四 捨五入までで十分であったということがわかる - 各データをそれぞれ比較すると、従来手法のほうがノイズが小さい敵対的 サンプルを生成している場合もあった
- 全体を通してみると、 𝒗raw による重要度算出法と四捨五入による離散 化がよい精度を示した 5. 考察 27 -
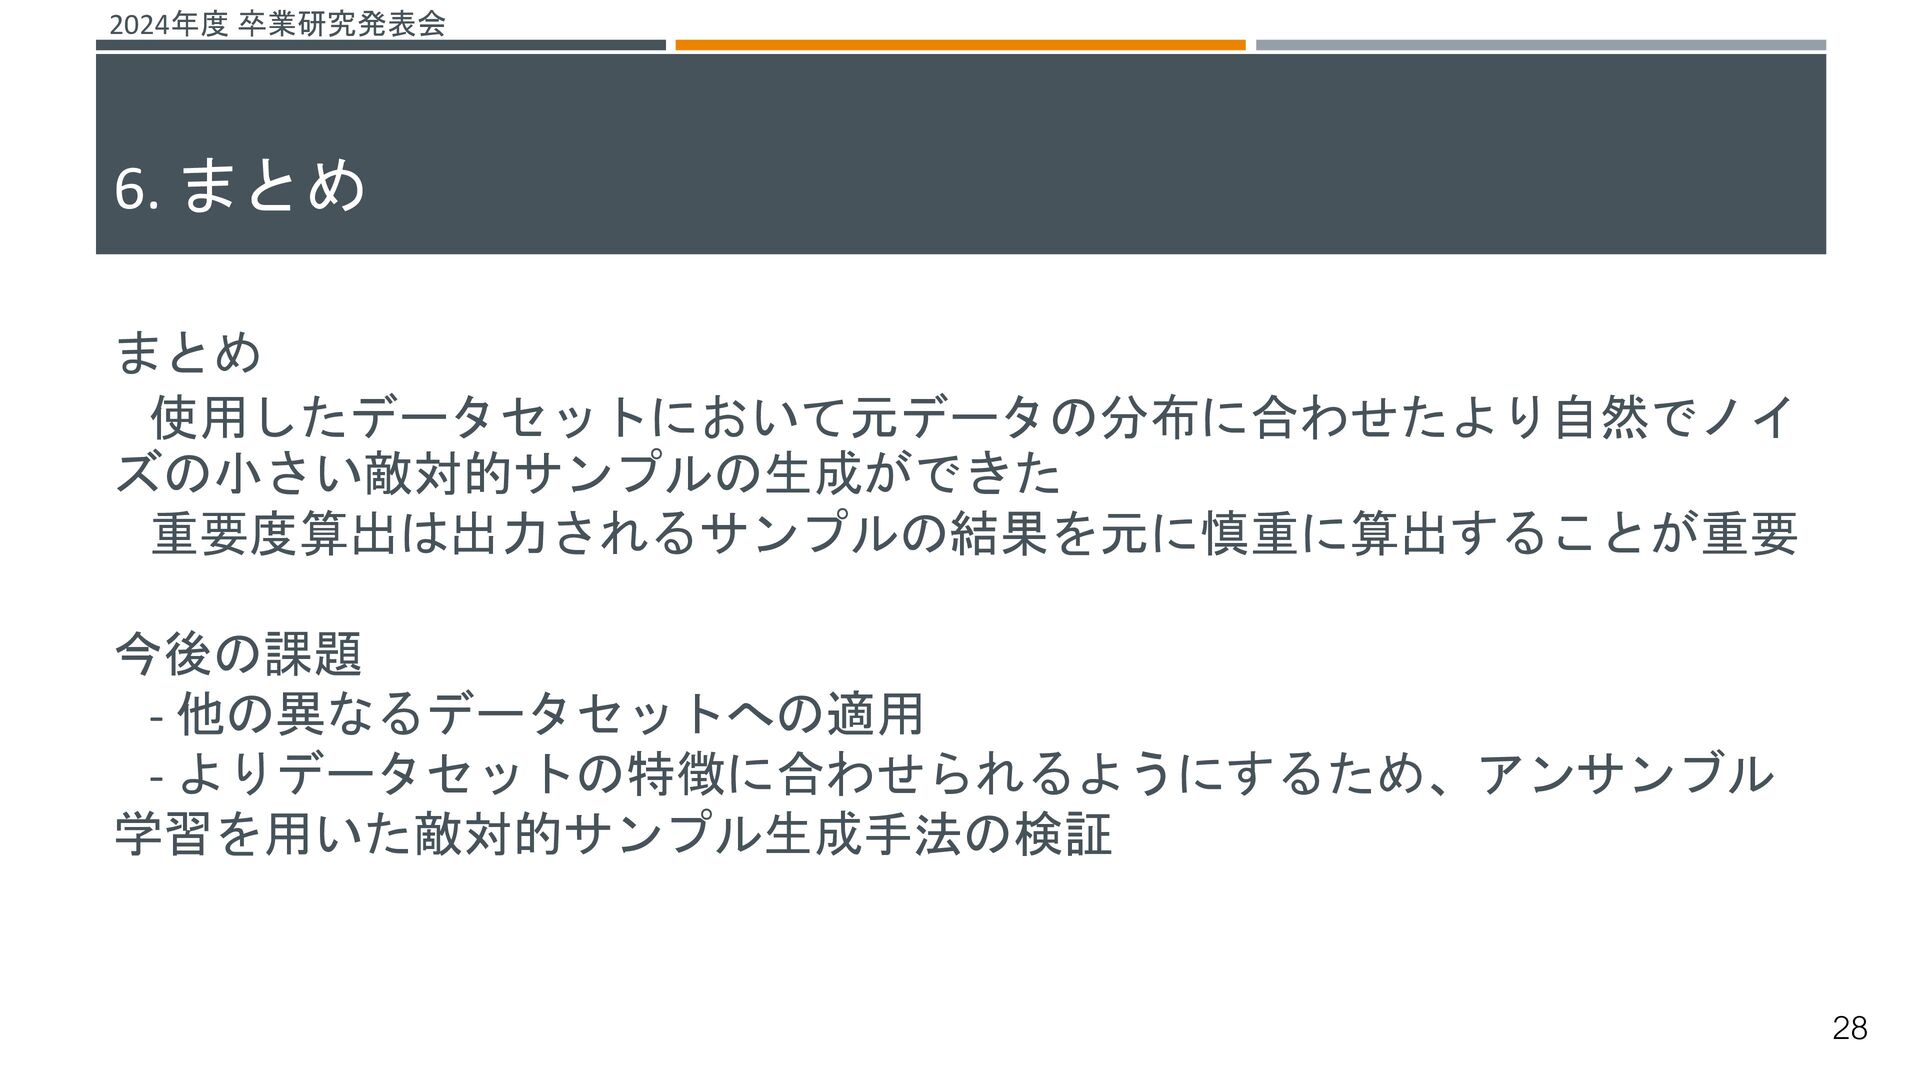
2024年度 卒業研究発表会 まとめ 使用したデータセットにおいて元データの分布に合わせたより自然でノイ ズの小さい敵対的サンプルの生成ができた 重要度算出は出力されるサンプルの結果を元に慎重に算出することが重要 今後の課題 - 他の異なるデータセットへの適用 -
よりデータセットの特徴に合わせられるようにするため、アンサンブル 学習を用いた敵対的サンプル生成手法の検証 6. まとめ 28