Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Fine-Tuningっていつ使うの?〜小さなLLMをモデルルーターにして分かったこと〜

Avatar for Tkoya Tkoya
September 18, 2026

 Fine-Tuningっていつ使うの?〜小さなLLMをモデルルーターにして分かったこと〜

「第10回 InfiniStudy(AI活用・Fine tuning):静岡中部のITエンジニア勉強会」で発表した内容です。

小さなLLMを、質問に応じて適切なモデルを選ぶ「モデルルーター」としてFine-Tuning。Promptとの比較実験を通して、分類精度の変化や誤分類、データセットの限界を紹介します。さらに、Prompt・RAG・Fine-Tuningの役割の違いを整理し、どんな場面でFine-Tuningを検討すべきか、初学者向けに解説します。

connpass:https://infini-study.connpass.com/event/404899/
実験環境:https://github.com/ayano-yuki/lt-InfiniStudy10/tree/main

Avatar for Tkoya

Tkoya

September 18, 2026

More Decks by Tkoya

Other Decks in Technology

Transcript

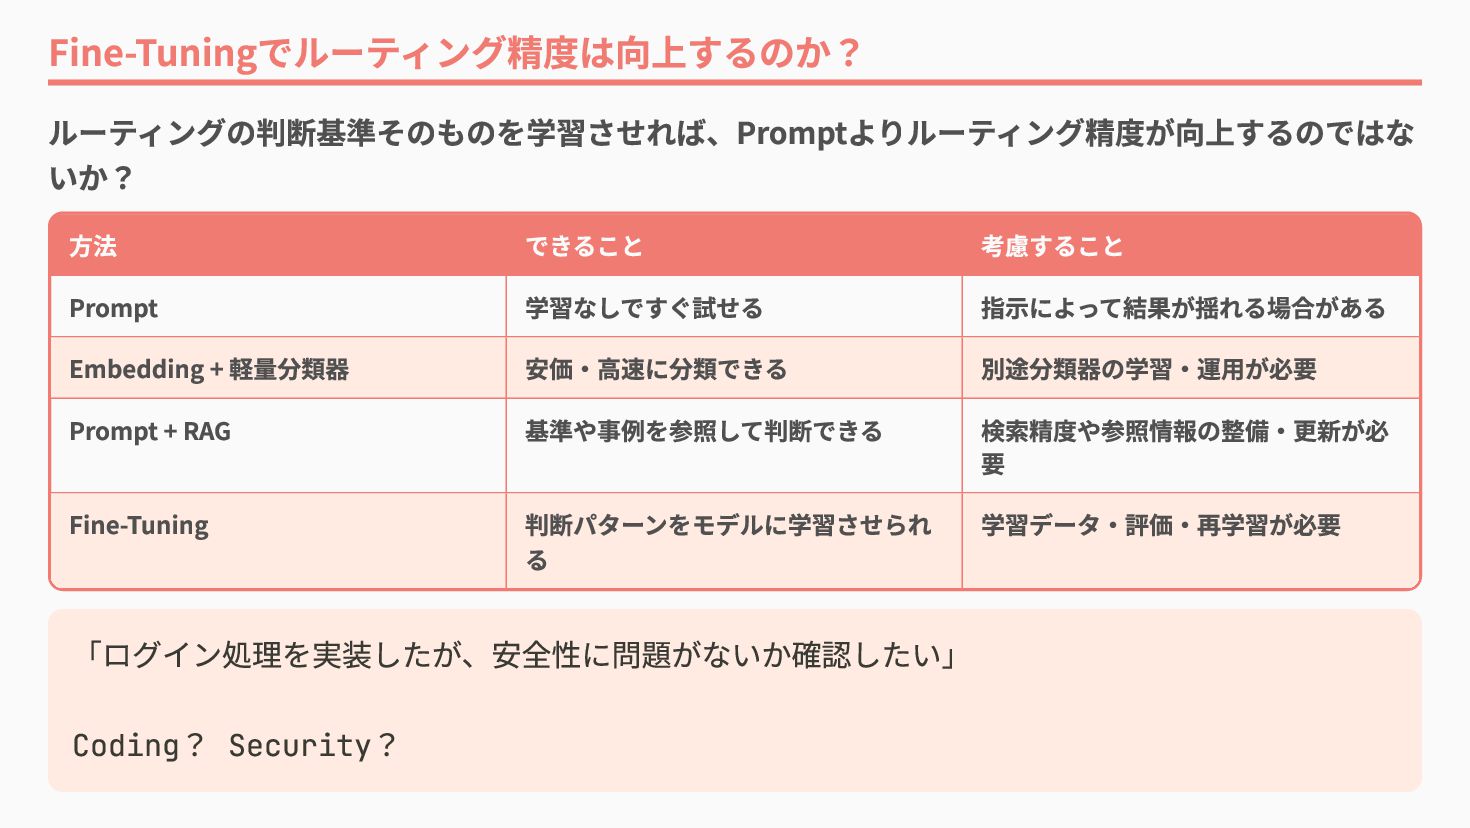
  1. Fine-Tuningでルーティング精度は向上するのか? ルーティングの判断基準そのものを学習させれば、Promptよりルーティング精度が向上するのではな いか? 方法 Prompt Embedding + 軽量分類器 Prompt +

    RAG できること 学習なしですぐ試せる 安価・高速に分類できる 基準や事例を参照して判断できる Fine-Tuning 判断パターンをモデルに学習させられ る 「ログイン処理を実装したが、安全性に問題がないか確認したい」 Coding? Security? 考慮すること 指示によって結果が揺れる場合がある 別途分類器の学習・運用が必要 検索精度や参照情報の整備・更新が必 要 学習データ・評価・再学習が必要
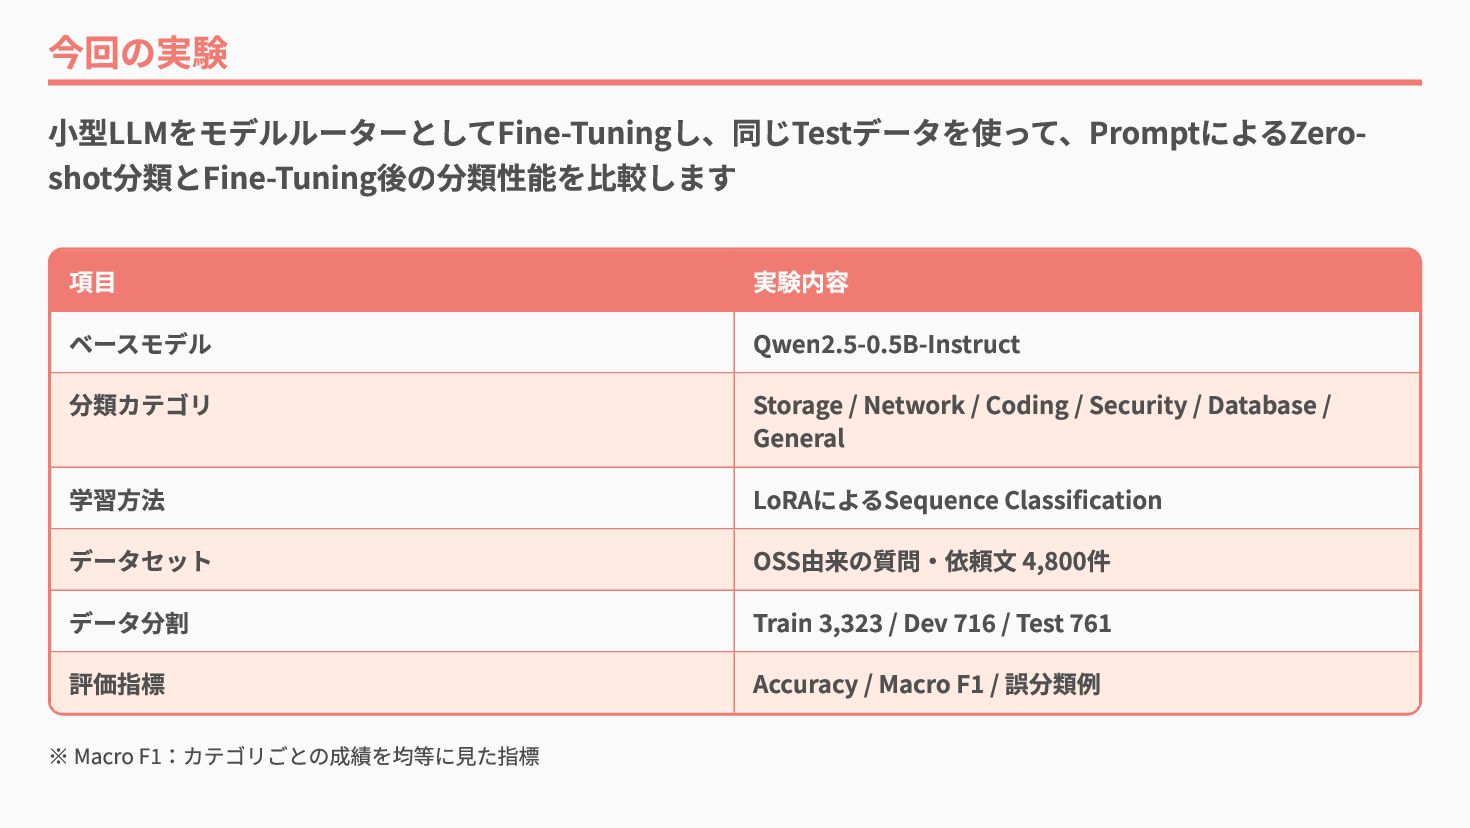
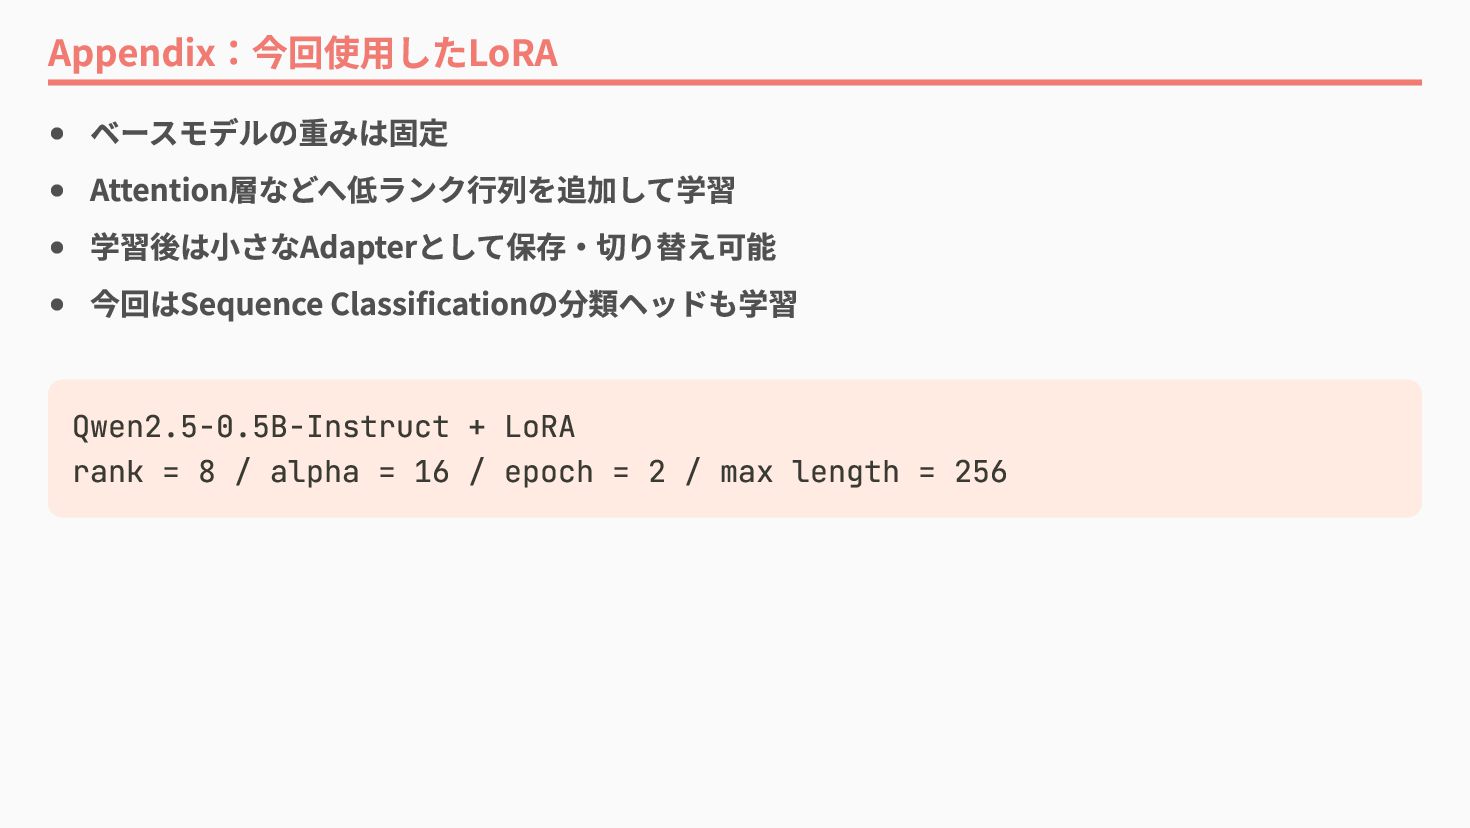
  2. 今回の実験 小型LLMをモデルルーターとしてFine-Tuningし、同じTestデータを使って、PromptによるZeroshot分類とFine-Tuning後の分類性能を比較します 項目 ベースモデル 分類カテゴリ 学習方法 データセット データ分割 評価指標 ※

    Macro F1:カテゴリごとの成績を均等に見た指標 実験内容 Qwen2.5-0.5B-Instruct Storage / Network / Coding / Security / Database / General LoRAによるSequence Classification OSS由来の質問・依頼文 4,800件 Train 3,323 / Dev 716 / Test 761 Accuracy / Macro F1 / 誤分類例
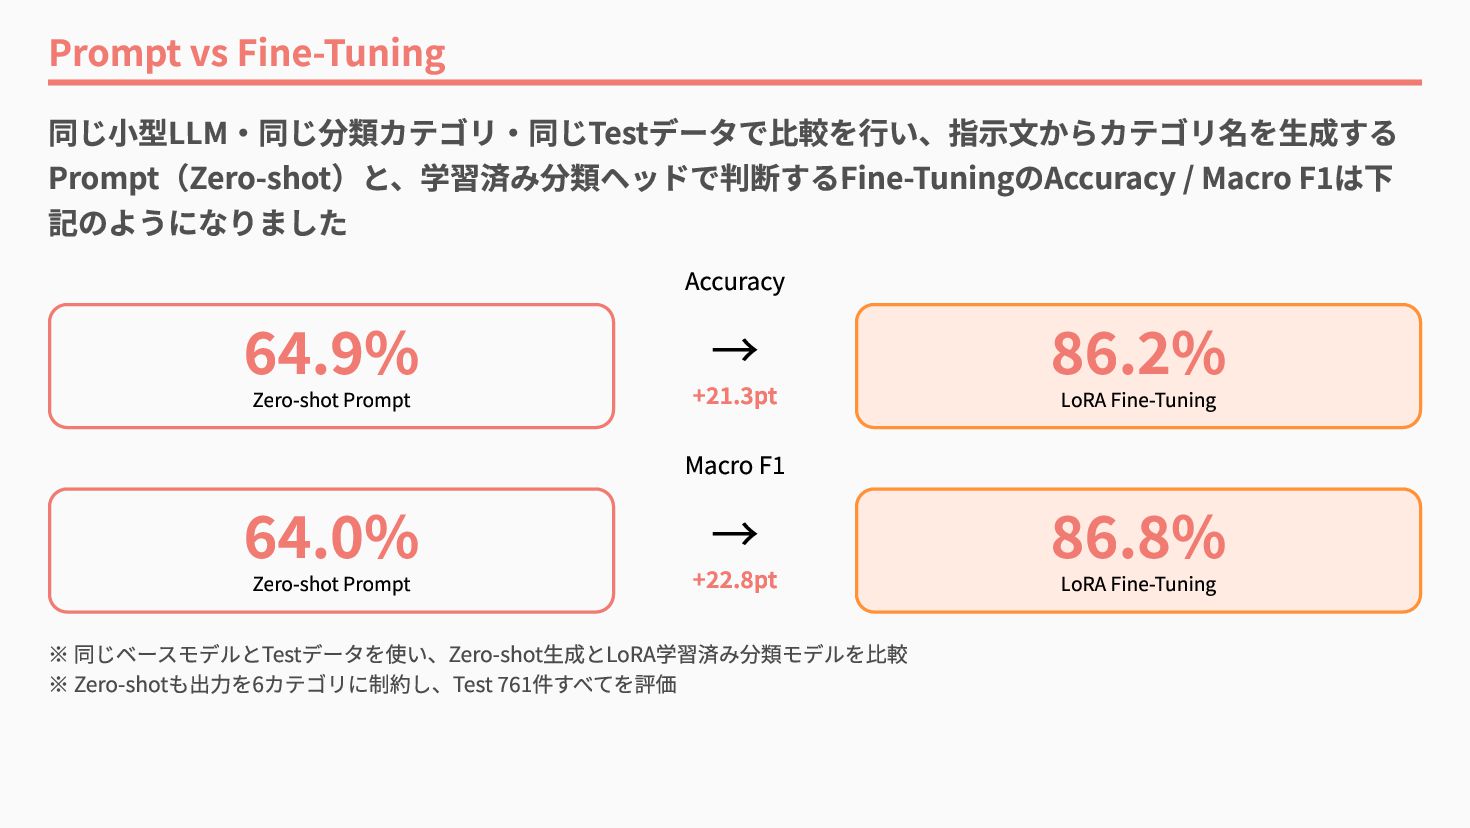
  3. Prompt vs Fine-Tuning 同じ小型LLM・同じ分類カテゴリ・同じTestデータで比較を行い、指示文からカテゴリ名を生成する Prompt(Zero-shot)と、学習済み分類ヘッドで判断するFine-TuningのAccuracy / Macro F1は下 記のようになりました 64.9%

    Accuracy → +21.3pt 86.2% 64.0% Macro F1 86.8% Zero-shot Prompt Zero-shot Prompt → +22.8pt ※ 同じベースモデルとTestデータを使い、Zero-shot生成とLoRA学習済み分類モデルを比較 ※ Zero-shotも出力を6カテゴリに制約し、Test 761件すべてを評価 LoRA Fine-Tuning LoRA Fine-Tuning
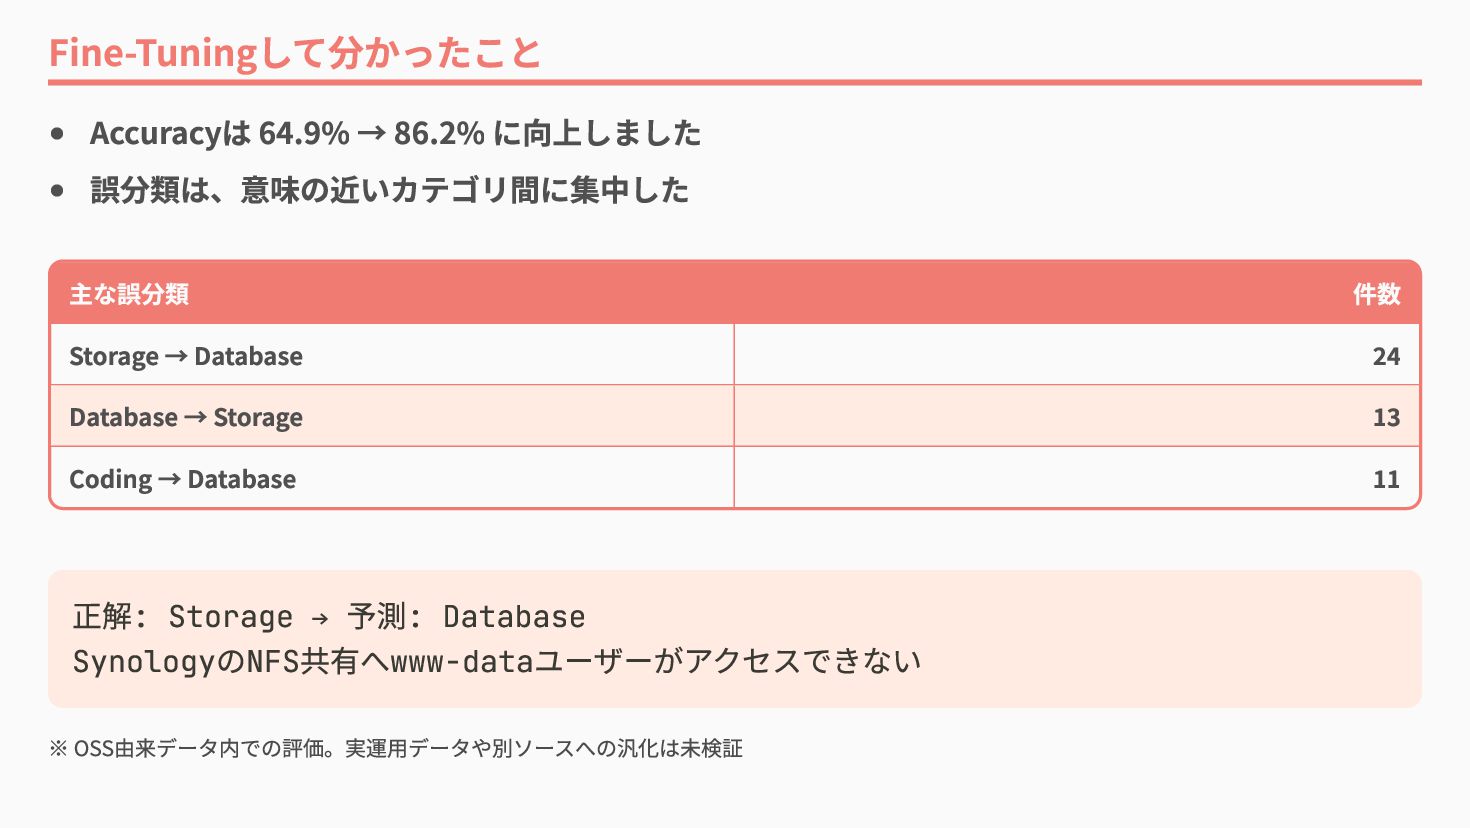
  4. Fine-Tuningして分かったこと Accuracyは 64.9% → 86.2% に向上しました 誤分類は、意味の近いカテゴリ間に集中した 主な誤分類 Storage →

    Database Database → Storage Coding → Database 正解: Storage → 予測: Database SynologyのNFS共有へwww-dataユーザーがアクセスできない ※ OSS由来データ内での評価。実運用データや別ソースへの汎化は未検証 件数 24 13 11
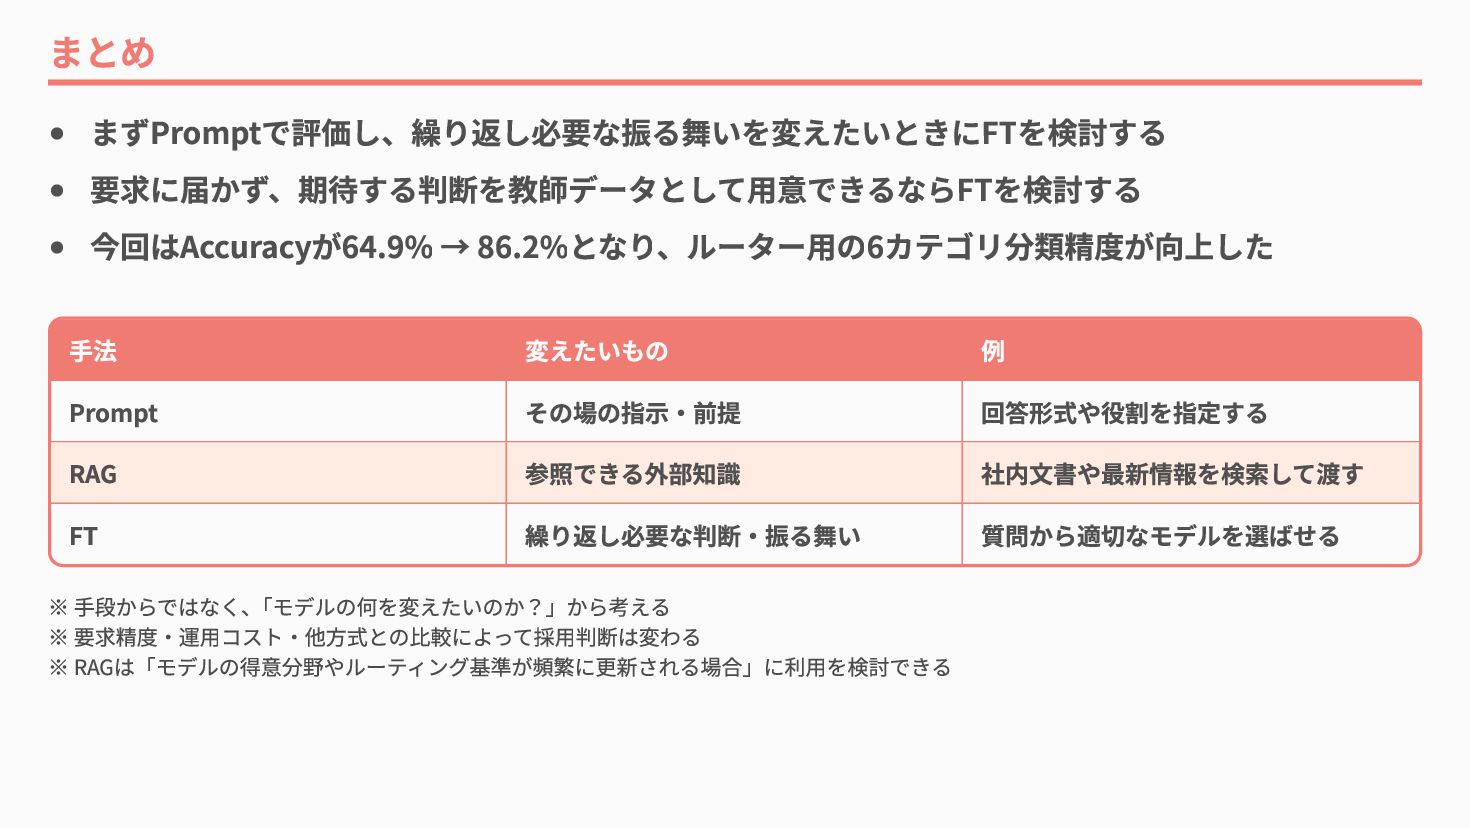
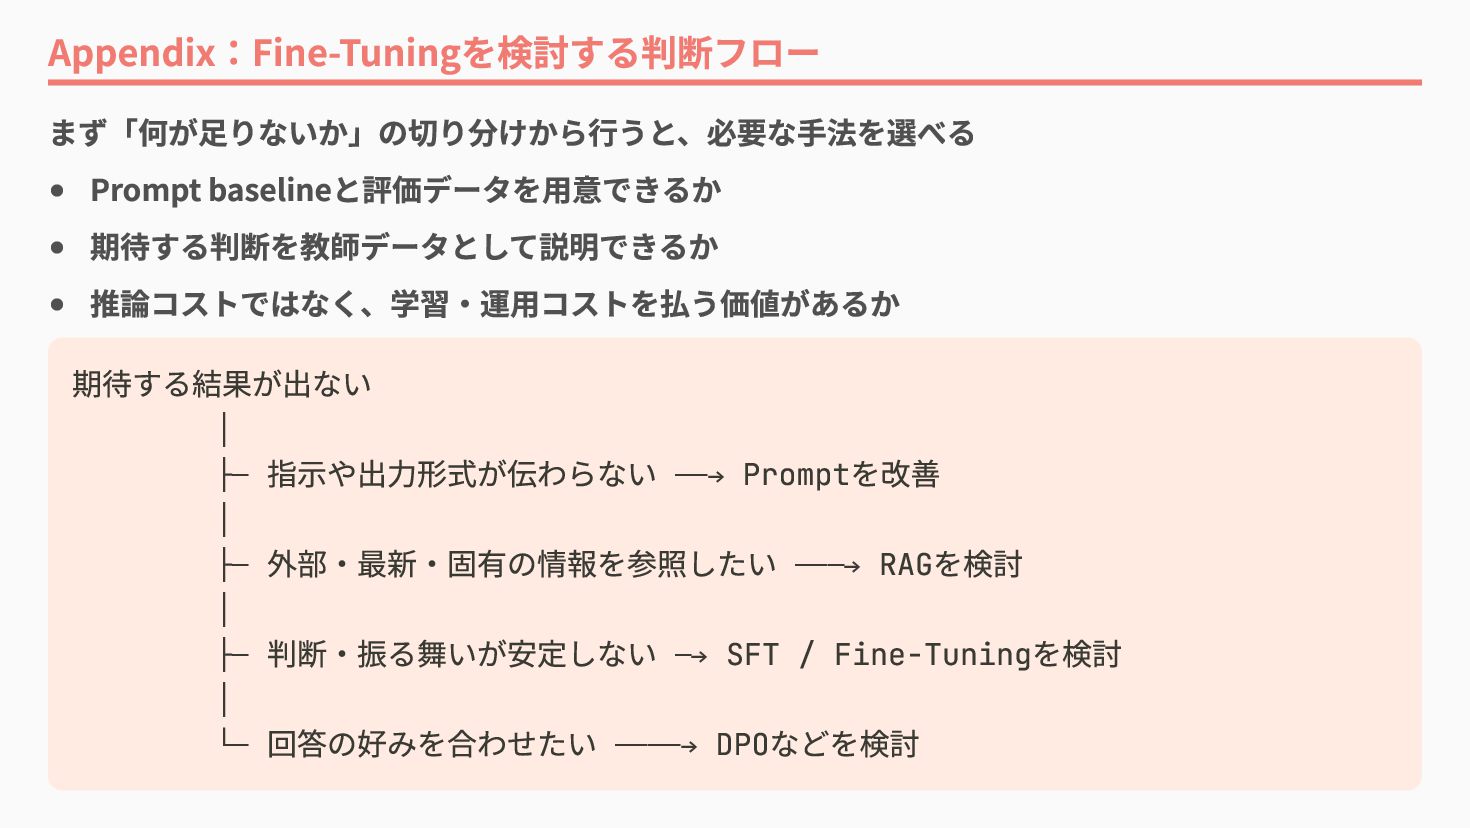
  5. まとめ まずPromptで評価し、繰り返し必要な振る舞いを変えたいときにFTを検討する 要求に届かず、期待する判断を教師データとして用意できるならFTを検討する 今回はAccuracyが64.9% → 86.2%となり、ルーター用の6カテゴリ分類精度が向上した 手法 Prompt RAG FT

    変えたいもの その場の指示・前提 参照できる外部知識 繰り返し必要な判断・振る舞い ※ 手段からではなく、「モデルの何を変えたいのか?」から考える ※ 要求精度・運用コスト・他方式との比較によって採用判断は変わる ※ RAGは「モデルの得意分野やルーティング基準が頻繁に更新される場合」に利用を検討できる 例 回答形式や役割を指定する 社内文書や最新情報を検索して渡す 質問から適切なモデルを選ばせる
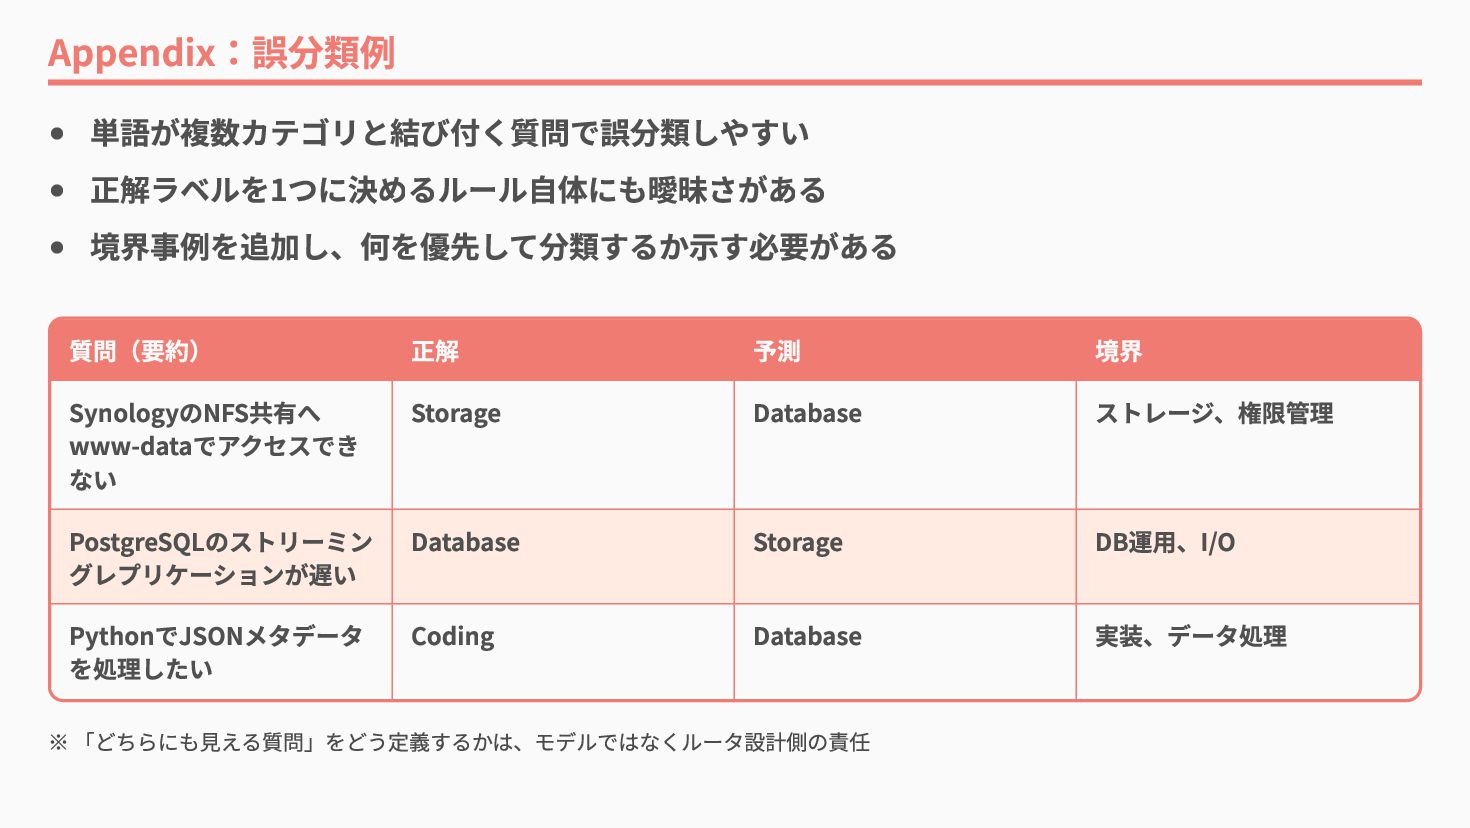
  6. Appendix:誤分類例 単語が複数カテゴリと結び付く質問で誤分類しやすい 正解ラベルを1つに決めるルール自体にも曖昧さがある 境界事例を追加し、何を優先して分類するか示す必要がある 質問(要約) SynologyのNFS共有へ www-dataでアクセスでき ない PostgreSQLのストリーミン グレプリケーションが遅い

    PythonでJSONメタデータ を処理したい 正解 Storage 予測 Database 境界 ストレージ、権限管理 Database Storage DB運用、I/O Coding Database 実装、データ処理 ※ 「どちらにも見える質問」をどう定義するかは、モデルではなくルータ設計側の責任
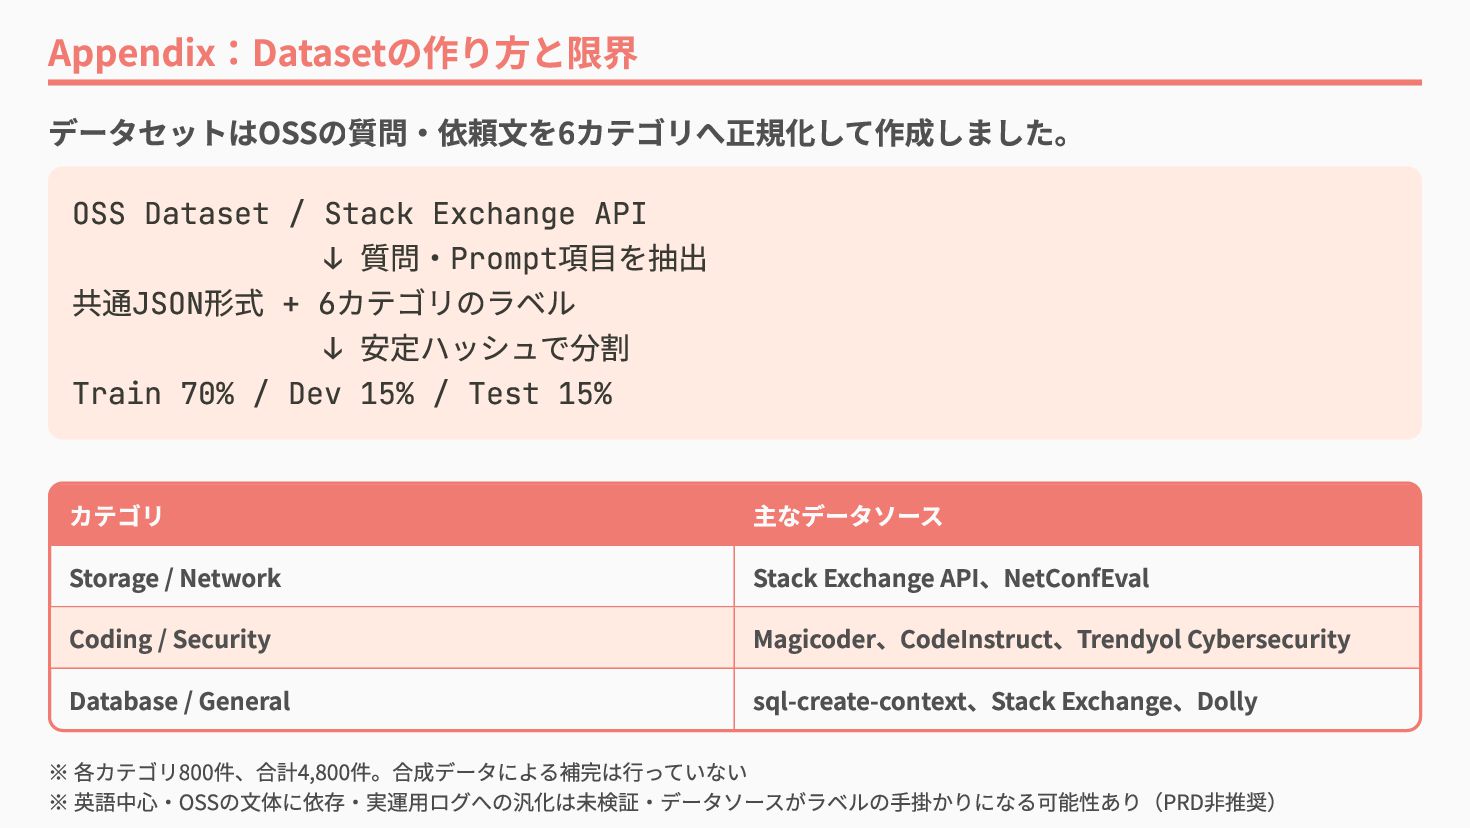
  7. Appendix:Datasetの作り方と限界 データセットはOSSの質問・依頼文を6カテゴリへ正規化して作成しました。 OSS Dataset / Stack Exchange API ↓ Prompt

    JSON + 6 ↓ Train 70% / Dev 15% / Test 15% 共通 形式 カテゴリ Storage / Network Coding / Security Database / General 質問・ 項目を抽出 カテゴリのラベル 安定ハッシュで分割 主なデータソース Stack Exchange API、NetConfEval Magicoder、CodeInstruct、Trendyol Cybersecurity sql-create-context、Stack Exchange、Dolly ※ 各カテゴリ800件、合計4,800件。合成データによる補完は行っていない ※ 英語中心・OSSの文体に依存・実運用ログへの汎化は未検証・データソースがラベルの手掛かりになる可能性あり(PRD非推奨)
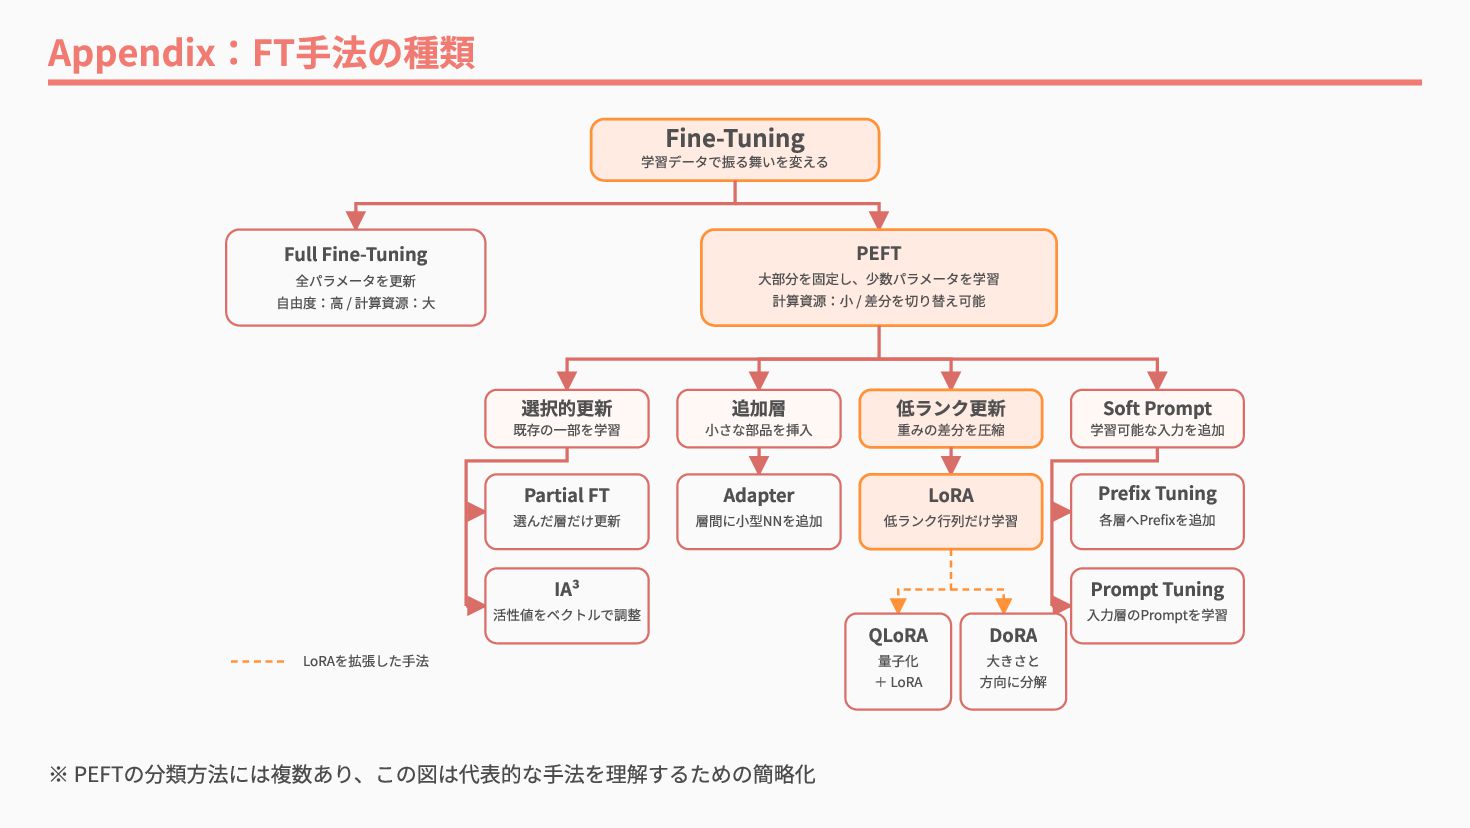
  8. Appendix:FT手法の種類 Fine-Tuning 学習データで振る舞いを変える PEFT Full Fine-Tuning ⼤部分を固定し、少数パラメータを学習 計算資源:⼩ / 差分を切り替え可能

    全パラメータを更新 ⾃由度:⾼ / 計算資源:⼤ 選択的更新 既存の⼀部を学習 Partial FT 選んだ層だけ更新 追加層 ⼩さな部品を挿⼊ Adapter 層間に⼩型NNを追加 IA³ 活性値をベクトルで調整 LoRAを拡張した⼿法 ※ PEFTの分類方法には複数あり、この図は代表的な手法を理解するための簡略化 低ランク更新 Soft Prompt 重みの差分を圧縮 学習可能な⼊⼒を追加 LoRA Prefix Tuning 低ランク⾏列だけ学習 QLoRA 量⼦化 + LoRA DoRA ⼤きさと ⽅向に分解 各層へPrefixを追加 Prompt Tuning ⼊⼒層のPromptを学習
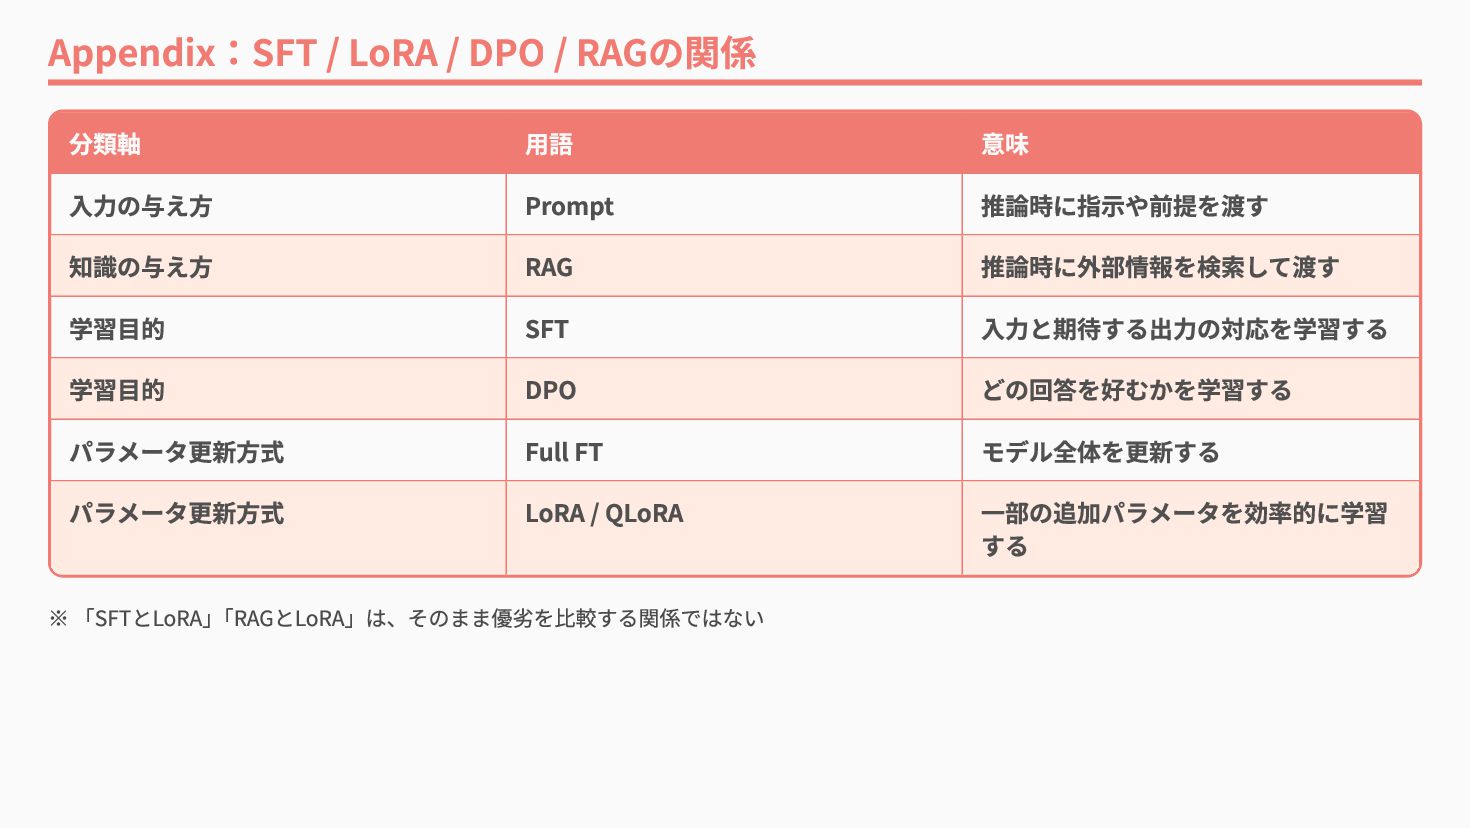
  9. Appendix:SFT / LoRA / DPO / RAGの関係 分類軸 入力の与え方 知識の与え方

    学習目的 学習目的 パラメータ更新方式 パラメータ更新方式 用語 Prompt RAG SFT DPO Full FT LoRA / QLoRA ※ 「SFTとLoRA」「RAGとLoRA」は、そのまま優劣を比較する関係ではない 意味 推論時に指示や前提を渡す 推論時に外部情報を検索して渡す 入力と期待する出力の対応を学習する どの回答を好むかを学習する モデル全体を更新する 一部の追加パラメータを効率的に学習 する