Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Scaling your data infrastructure
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
barrachri
April 20, 2018
Technology
240
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Scaling your data infrastructure
Scaling your data infrastructure @ PyConNove
barrachri
April 20, 2018
More Decks by barrachri
See All by barrachri
Will Tech Save Us?
barrachri
0
130
How software can feed the World
barrachri
1
200
How to fight with yourself and win.
barrachri
0
360
Introduction to Statistics with Python
barrachri
0
460
EuroPython 2015 and the future
barrachri
2
130
Start with Flask
barrachri
3
210
Django & Docker
barrachri
6
1.1k
Other Decks in Technology
See All in Technology
エージェントはローカル、検証はMicroVM — Lambda MicroVMsでつくるServerless CI
fujioka6789
3
830
Apache Iceberg が拓く AI 時代のオープンレイクハウス
tomtanaka
0
120
AIは推し活である。
kurazuuuuuu
2
990
AI Agent入門〜今更聞けないAgentの話〜
hiromimaganuma
0
120
PQC移行の今 -- IETF からみた現在地
satokan
4
520
品質と信頼性を地続きにする
grimoh
3
1.3k
AI臭い文章とは何なのか
nasuvitz
9
4.4k
「今盗んで、後で解く」に備える ― AWSのポスト量子暗号入門
yama3133
2
260
Lambda MicroVMsは常駐サーバーの代わりに なるか? Kiro Crew を動かして検証してみた / Kiro Crew on Lambda MicroVMs
k_adachi_01
2
280
HacobuにおけるFDEとは/登壇資料(戸井田 裕貴)
hacobu
PRO
1
130
【データ横丁主催】AI Agentがコンテキストを使って仕事をした後、何が残るのか― 組織の経験を次の判断に引き継ぐ「Agent Memory」
shisyu_gaku
2
100
TiDBファミリーにDWHが新登場!! TiDB最新情報 / TiDB update 202609
yoshiakiyamasaki
0
130
Featured
See All Featured
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
410
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Fantastic passwords and where to find them - at NoRuKo
philnash
52
3.9k
Self-Hosted WebAssembly Runtime for Runtime-Neutral Checkpoint/Restore in Edge–Cloud Continuum
chikuwait
0
840
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
Designing Experiences People Love
moore
143
24k
Evolving SEO for Evolving Search Engines
ryanjones
0
300
Lightning Talk: Beautiful Slides for Beginners
inesmontani
PRO
2
700
The Hidden Cost of Media on the Web [PixelPalooza 2025]
tammyeverts
2
510
Design and Strategy: How to Deal with People Who Don’t "Get" Design
morganepeng
133
19k
Exploring the Power of Turbo Streams & Action Cable | RailsConf2023
kevinliebholz
37
6.6k
Git: the NoSQL Database
bkeepers
PRO
432
67k
Transcript
Scaling your data infrastructure C H R I S T
I A N B A R R A @ P Y C O N N O V E
THE AGENDA 2 3 START THE DATA SCIENCE WORKFLOW SCALING
IS NOT JUST A MATTER OF MACHINE WHEN THE SIZE OF YOUR DATA MATTERS 1
THE AGENDA 4 5 CONTAINERIZED DATA SCIENCE CASSINY: PUT ALL
THE THINGS TOGETHER END
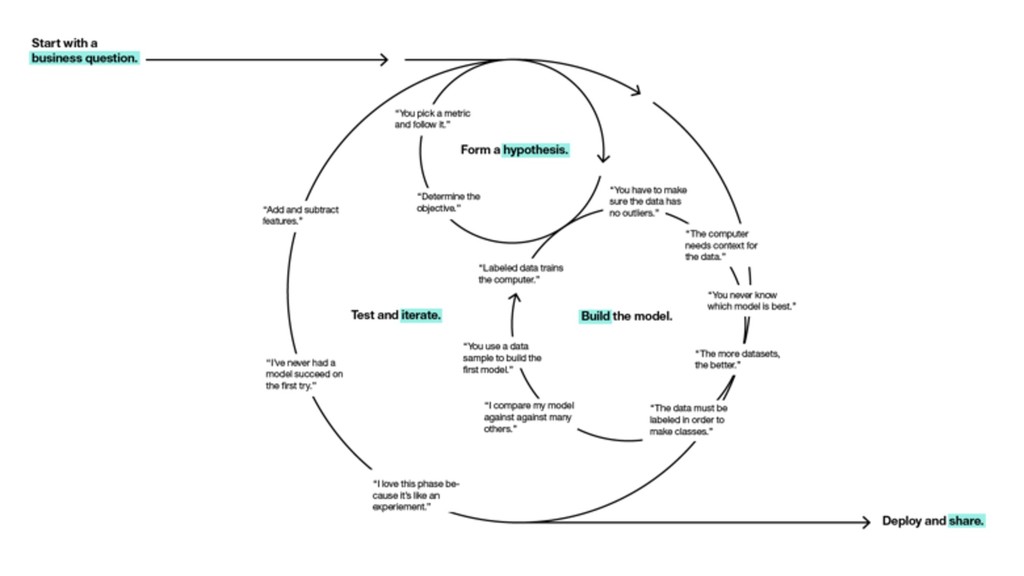
THE DATA SCIENCE WORKFLOW
HEXAGON PRESENTATION TEMPLATE
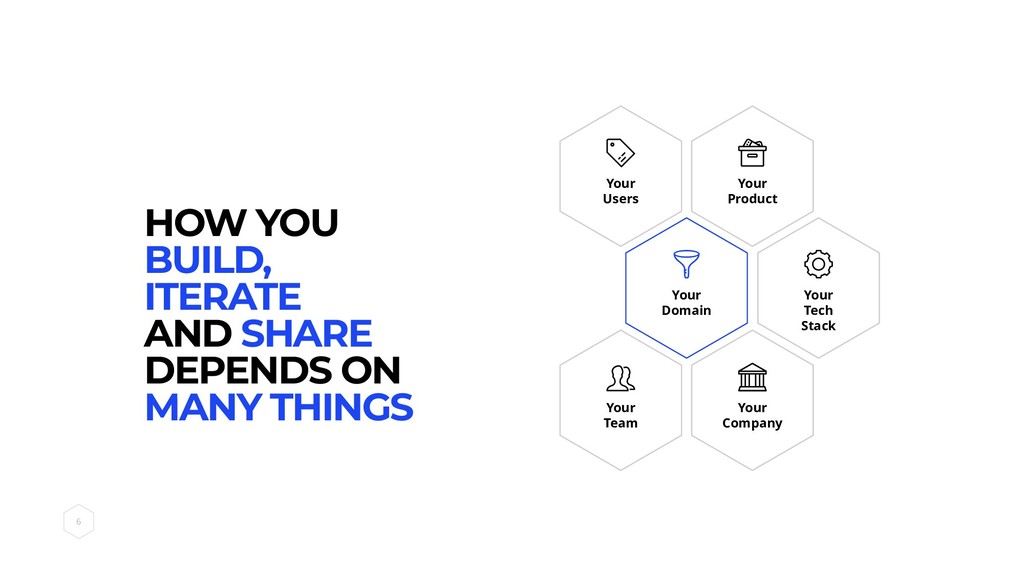
HOW YOU BUILD, ITERATE AND SHARE DEPENDS ON MANY THINGS
Your Users Your Product Your Team Your Company Your Tech Stack Your Domain
SCIKIT-LEARN DOCKER DATA SCIENCE TOOLBELT PANDAS JUPYTER RAY
SCALING IS NOT JUST A MATTER OF MACHINES
We all use it.
We really care about versioning. We have Untitled_1.ipynb, Untitled_2.ipynb and
Untitled_3.ipynb. HOMER SIMPSON C H I E F D A T A S C I E N T I S T D A T A B E E R I N C
Since JSON is a plain text format, they can be
version-controlled and shared with colleagues. E X I P Y T H O N N O T E B O O K D O C U M E N T A T I O N
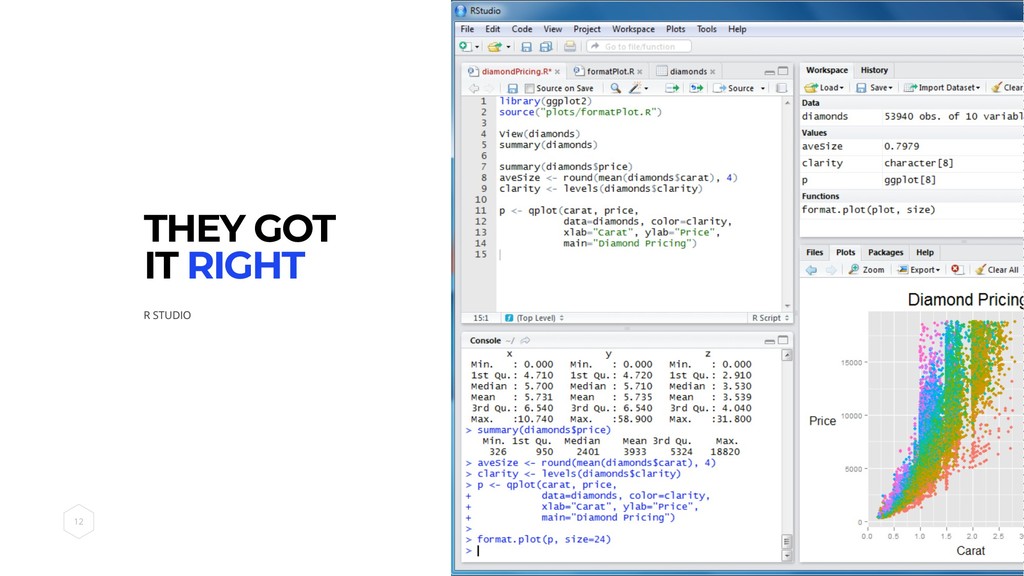
THEY GOT IT RIGHT
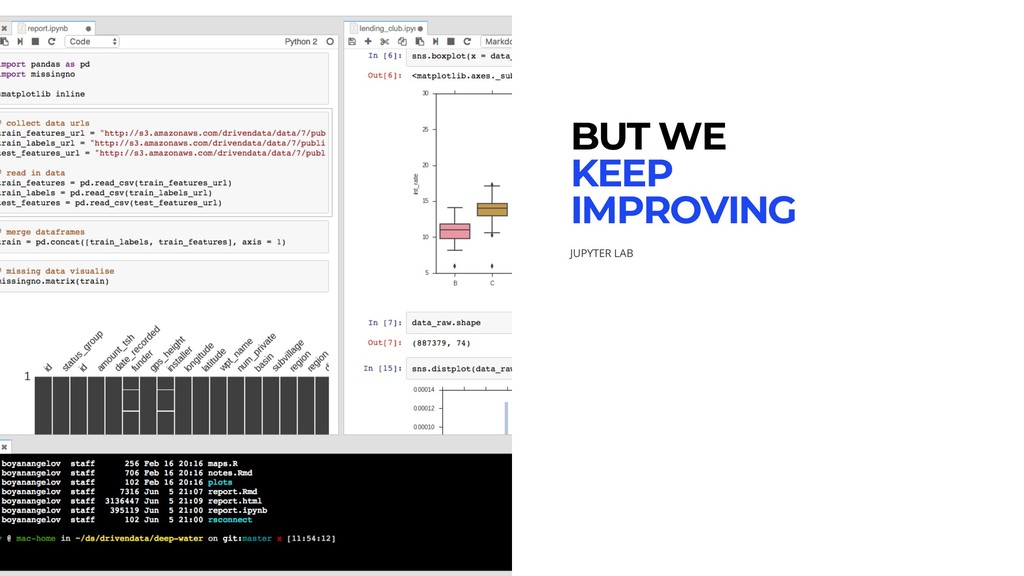
BUT WE KEEP IMPROVING
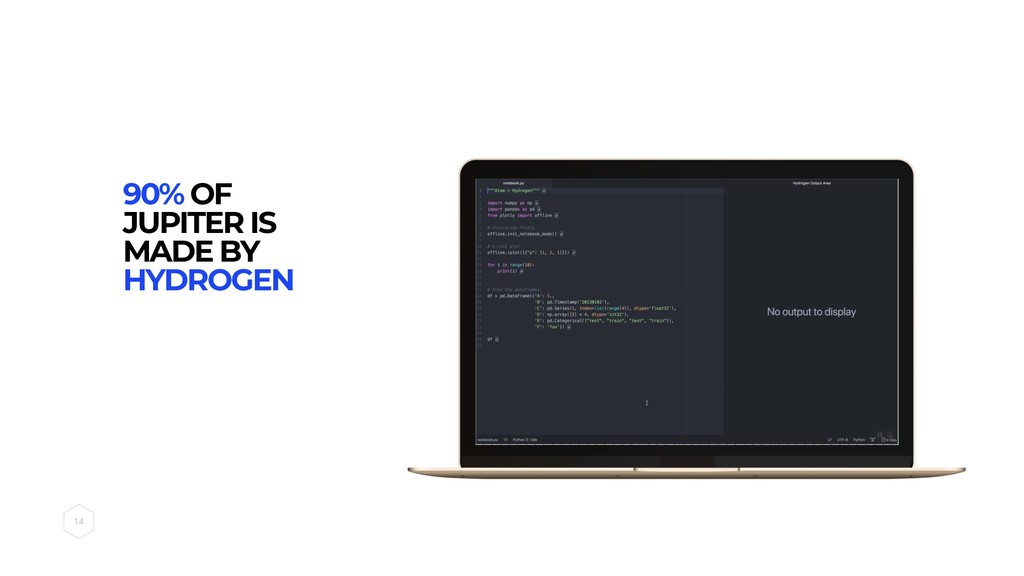
90% OF JUPITER IS MADE BY HYDROGEN
THE HARD THING ABOUT STORAGE
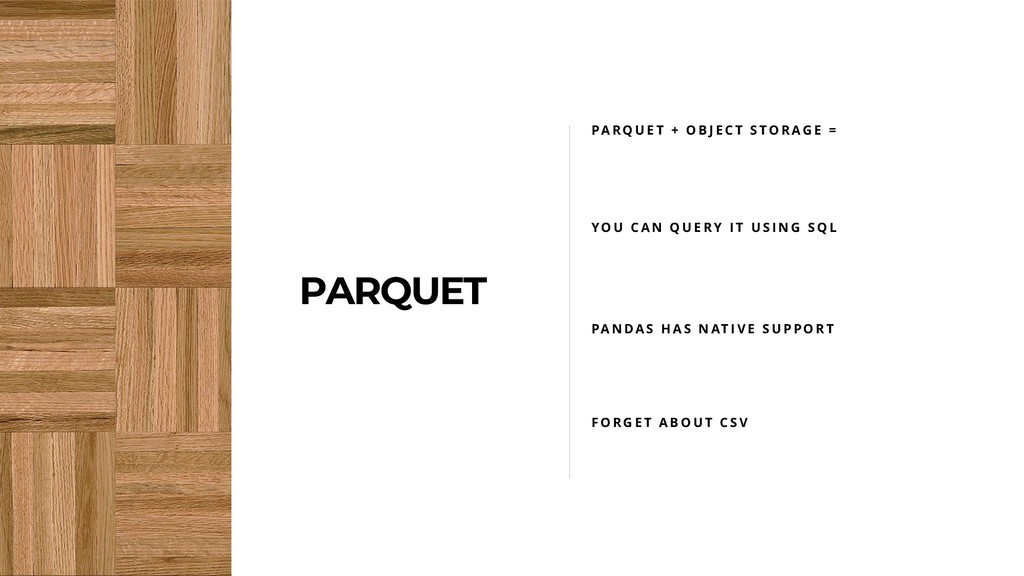
PARQUET P A R Q U E T + O
B J E C T S T O R A G E = YO U C A N Q U E R Y I T U S I N G S Q L PA N DA S H A S N AT I V E S U P P O R T F O R G E T A B O U T C S V
WHEN THE SIZE OF YOUR DATA MATTERS
IT’S TOO SLOW DOESN’T FIT IN YOUR RAM
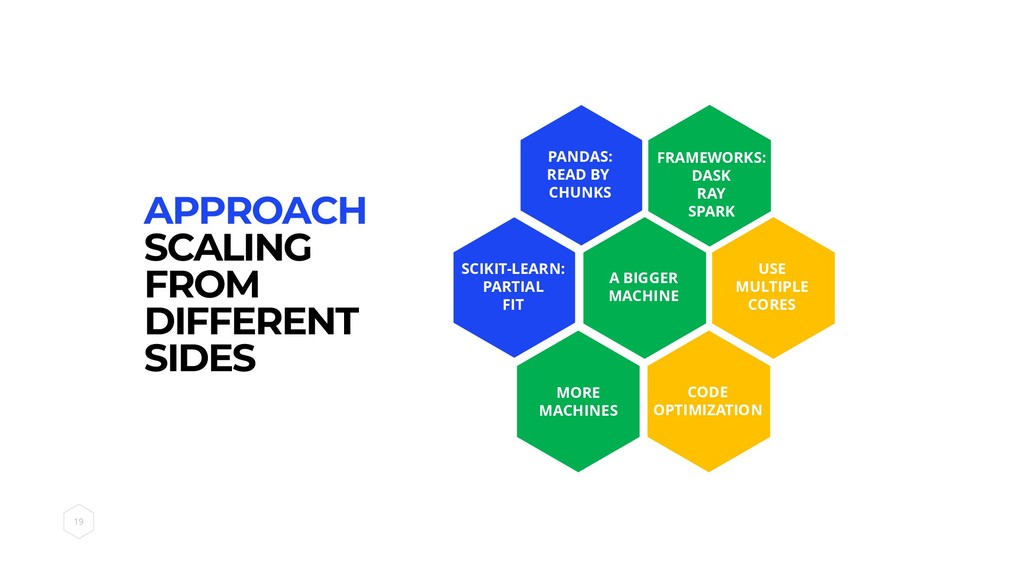
CODE OPTIMIZATION APPROACH SCALING FROM DIFFERENT SIDES A BIGGER MACHINE
USE MULTIPLE CORES MORE MACHINES FRAMEWORKS: DASK RAY SPARK PANDAS: READ BY CHUNKS SCIKIT-LEARN: PARTIAL FIT
chunks & partial_fit 1 M A C H I N
E
Multiple machines. n M A C H I N E
S
I don’t want to use Spark/JVM, what do you have
for me? H A P P Y P Y T H O N U S E R
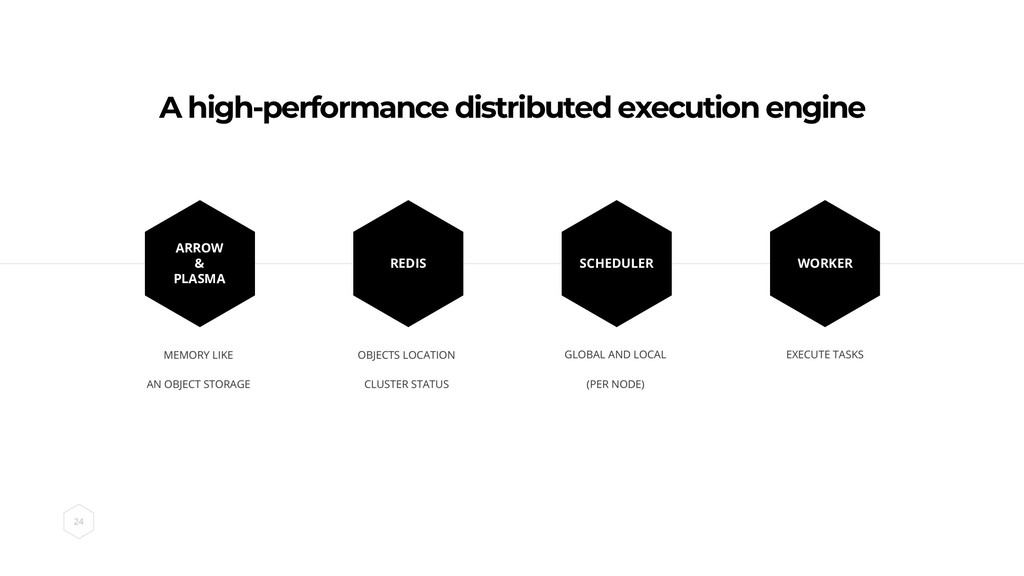
WHAT IS RAY?
A high-performance distributed execution engine REDIS SCHEDULER WORKER ARROW &
PLASMA
Use pandas through ray to query parquet files in an
object storage. W O R K I N P R O G R E S S
CONTAINERIZED DATA SCIENCE
If you trained a model with scikit-learn 0.18.1, will the
same model work with 0.19.1? P R O B L E M # 1
How do you share your models? P R O B
L E M # 2
How do you put your models in production? P R
O B L E M # 3
Containerize everything. T H E A N S W E
R
1. It’s damn easy to move things around 2. You
get versioning for free 3. Stack agnostic 4. Move Docker images around T O R E C A P
CASSINY: PUT ALL THE THINGS TOGETHER
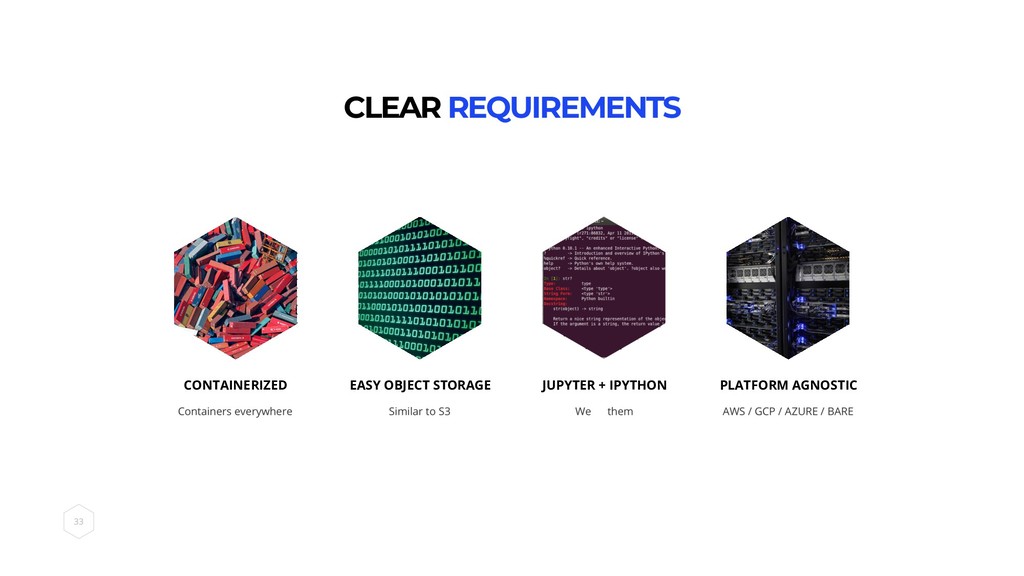
CLEAR REQUIREMENTS CONTAINERIZED EASY OBJECT STORAGE JUPYTER + IPYTHON PLATFORM
AGNOSTIC
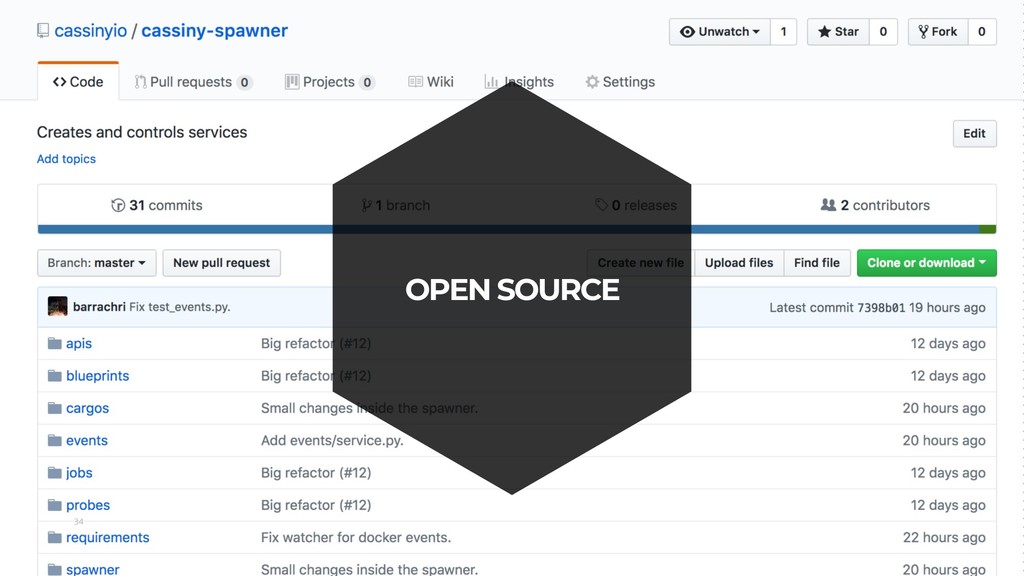
OPEN SOURCE
DEMO
TAKEAWAYS UNIFIED DATA WAREHOUSE KEEP YOUR CODE RUNNING ON ONE
MACHINE USE DOCKER TRY RAY BRING CI/CD TO YOUR DATASCIENCE WORKFLOW OBJECT STORAGE IS COOL DISTRIBUTED COMPUTING IS HARD I DIDN’T HAVE ANOTHER POINT
None


 barrachri
 fujioka6789
 tomtanaka
 kurazuuuuuu
 hiromimaganuma
 satokan
 grimoh
 nasuvitz
 yama3133
 k_adachi_01
 hacobu
 shisyu_gaku
 yoshiakiyamasaki
 marketingsoph
 sugarenia
 philnash
 chikuwait
 honnibal
 moore
 ryanjones
 inesmontani
 tammyeverts
 morganepeng
 kevinliebholz
 bkeepers