Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
SpotLight_260824.pdf
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
君野史明(Fumiaki Kimino)
August 27, 2026
11
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
SpotLight_260824.pdf
君野史明(Fumiaki Kimino)
August 27, 2026
More Decks by 君野史明(Fumiaki Kimino)
See All by 君野史明(Fumiaki Kimino)
understanding_deep_contrastive_learning_260929.pdf
fk001jp
0
5
GCFormer_260727.pdf
fk001jp
0
13
universality_label_efficiency_jp_260629.pdf
fk001jp
0
20
Graph_Invariant_Learning_260525_1.pdf
fk001jp
0
9
DRAGON_260427_1.pdf
fk001jp
0
12
HANG_GNN_robustness_260330_1.pdf
fk001jp
0
7
Reconstruction_for_Powerful_Graph_Representations_260225_1.pdf
fk001jp
0
11
HYPERION_260205_1.pdf
fk001jp
0
11
Mitigating_Local_Cohesion_251222_1.pdf
fk001jp
0
13
Featured
See All Featured
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
Claude Code どこまでも/ Claude Code Everywhere
nwiizo
68
59k
Sam Torres - BigQuery for SEOs
techseoconnect
PRO
0
580
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
Designing Experiences People Love
moore
143
24k
VelocityConf: Rendering Performance Case Studies
addyosmani
331
25k
Navigating Team Friction
lara
192
16k
The Invisible Side of Design
smashingmag
301
52k
The Curse of the Amulet
leimatthew05
3
16k
10 Git Anti Patterns You Should be Aware of
lemiorhan
PRO
659
62k
Testing 201, or: Great Expectations
jmmastey
46
8.3k
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
600
Transcript
SpotLight: Detecting Anomalies in Streaming Graphs (KDD 2018) の紹介 君野
史明 SOKENDAI 1 SOKENDAI
⾃⼰紹介 n 名前︓君野 史明(きみの ふみあき) n 所属︓総合研究⼤学院⼤学 情報学コース D1 n
2 専⾨︓ グラフ対照学習 グラフ表現学習 SOKENDAI
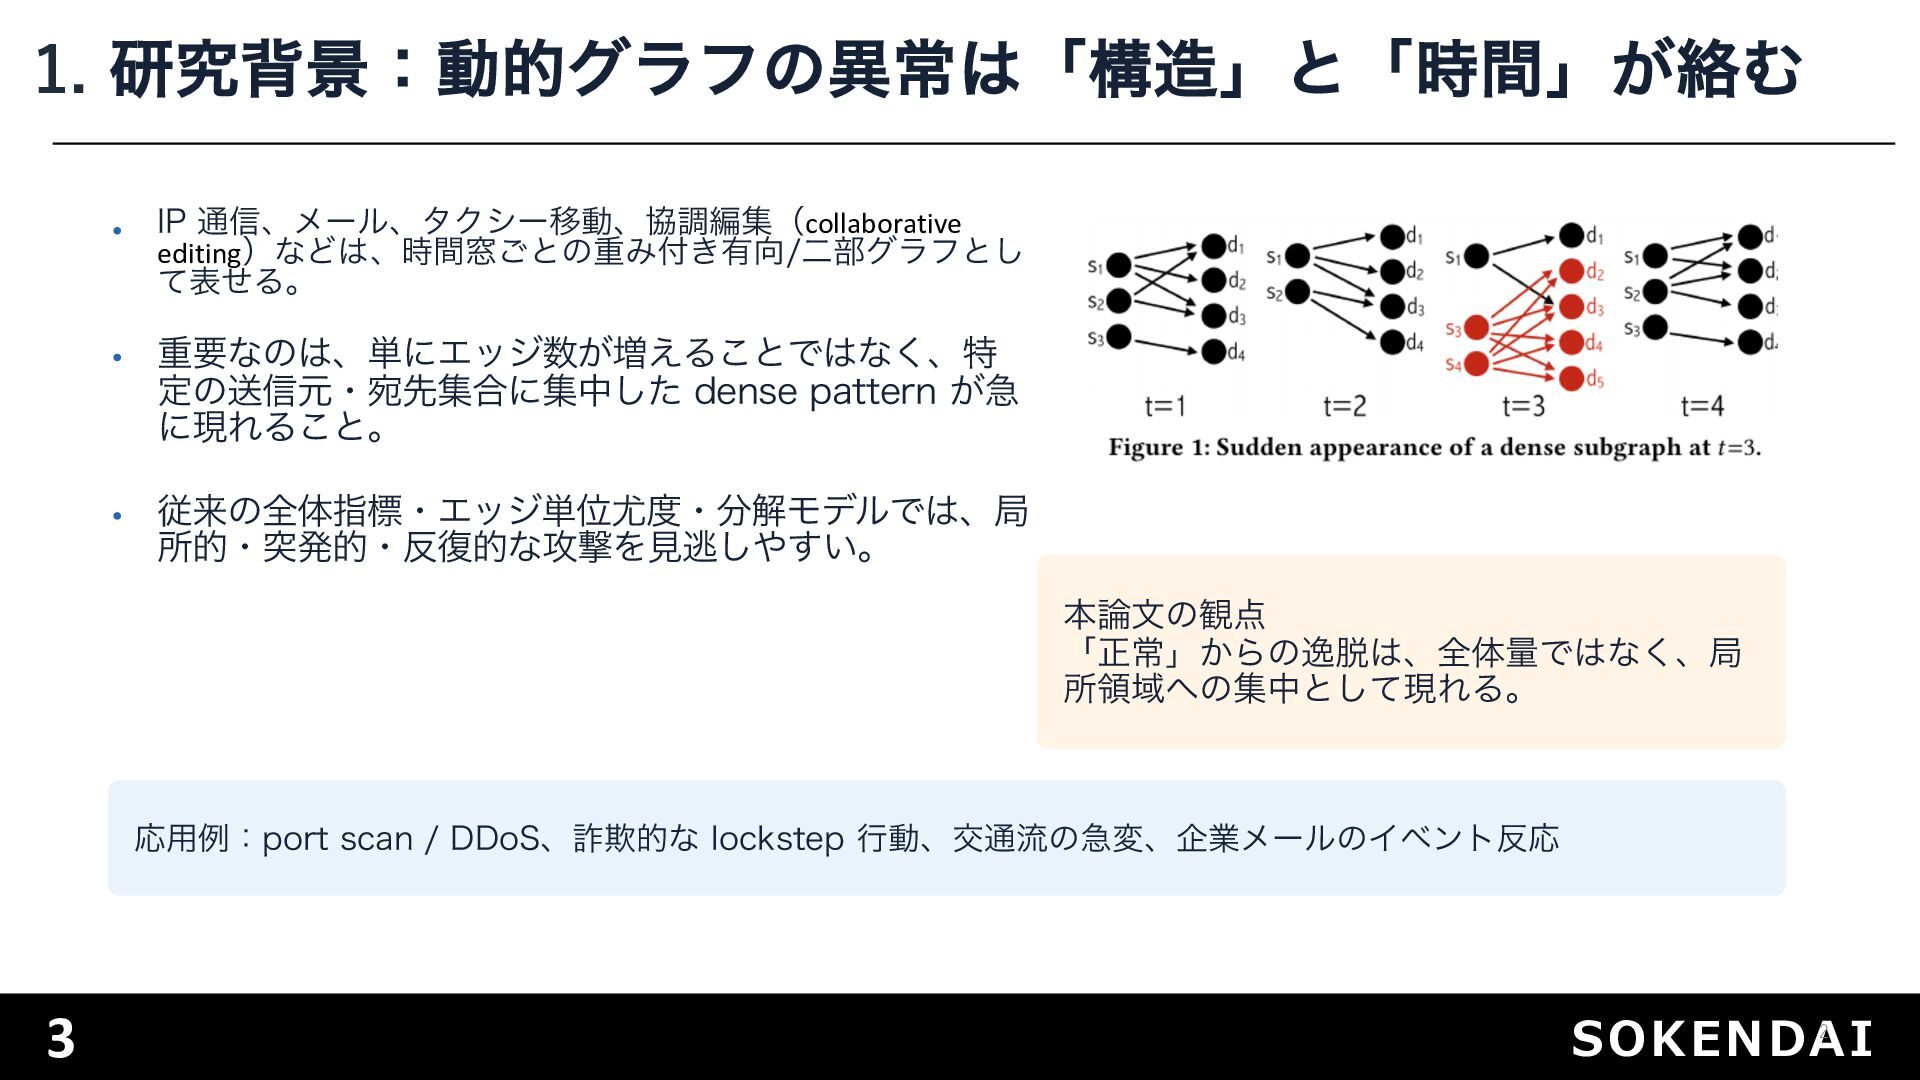
1. 研究背景:動的グラフの異常は「構造」と「時間」が絡む • IP 通信、メール、タクシー移動、協調編集(collaborative editing)などは、時間窓ごとの重み付き有向/二部グラフとし て表せる。 • 重要なのは、単にエッジ数が増えることではなく、特 定の送信元・宛先集合に集中した
dense pattern が急 に現れること。 • 従来の全体指標・エッジ単位尤度・分解モデルでは、局 所的・突発的・反復的な攻撃を見逃しやすい。 本論文の観点 「正常」からの逸脱は、全体量ではなく、局 所領域への集中として現れる。 応用例:port scan / DDoS、詐欺的な lockstep 行動、交通流の急変、企業メールのイベント反応 3 SOKENDAI 2
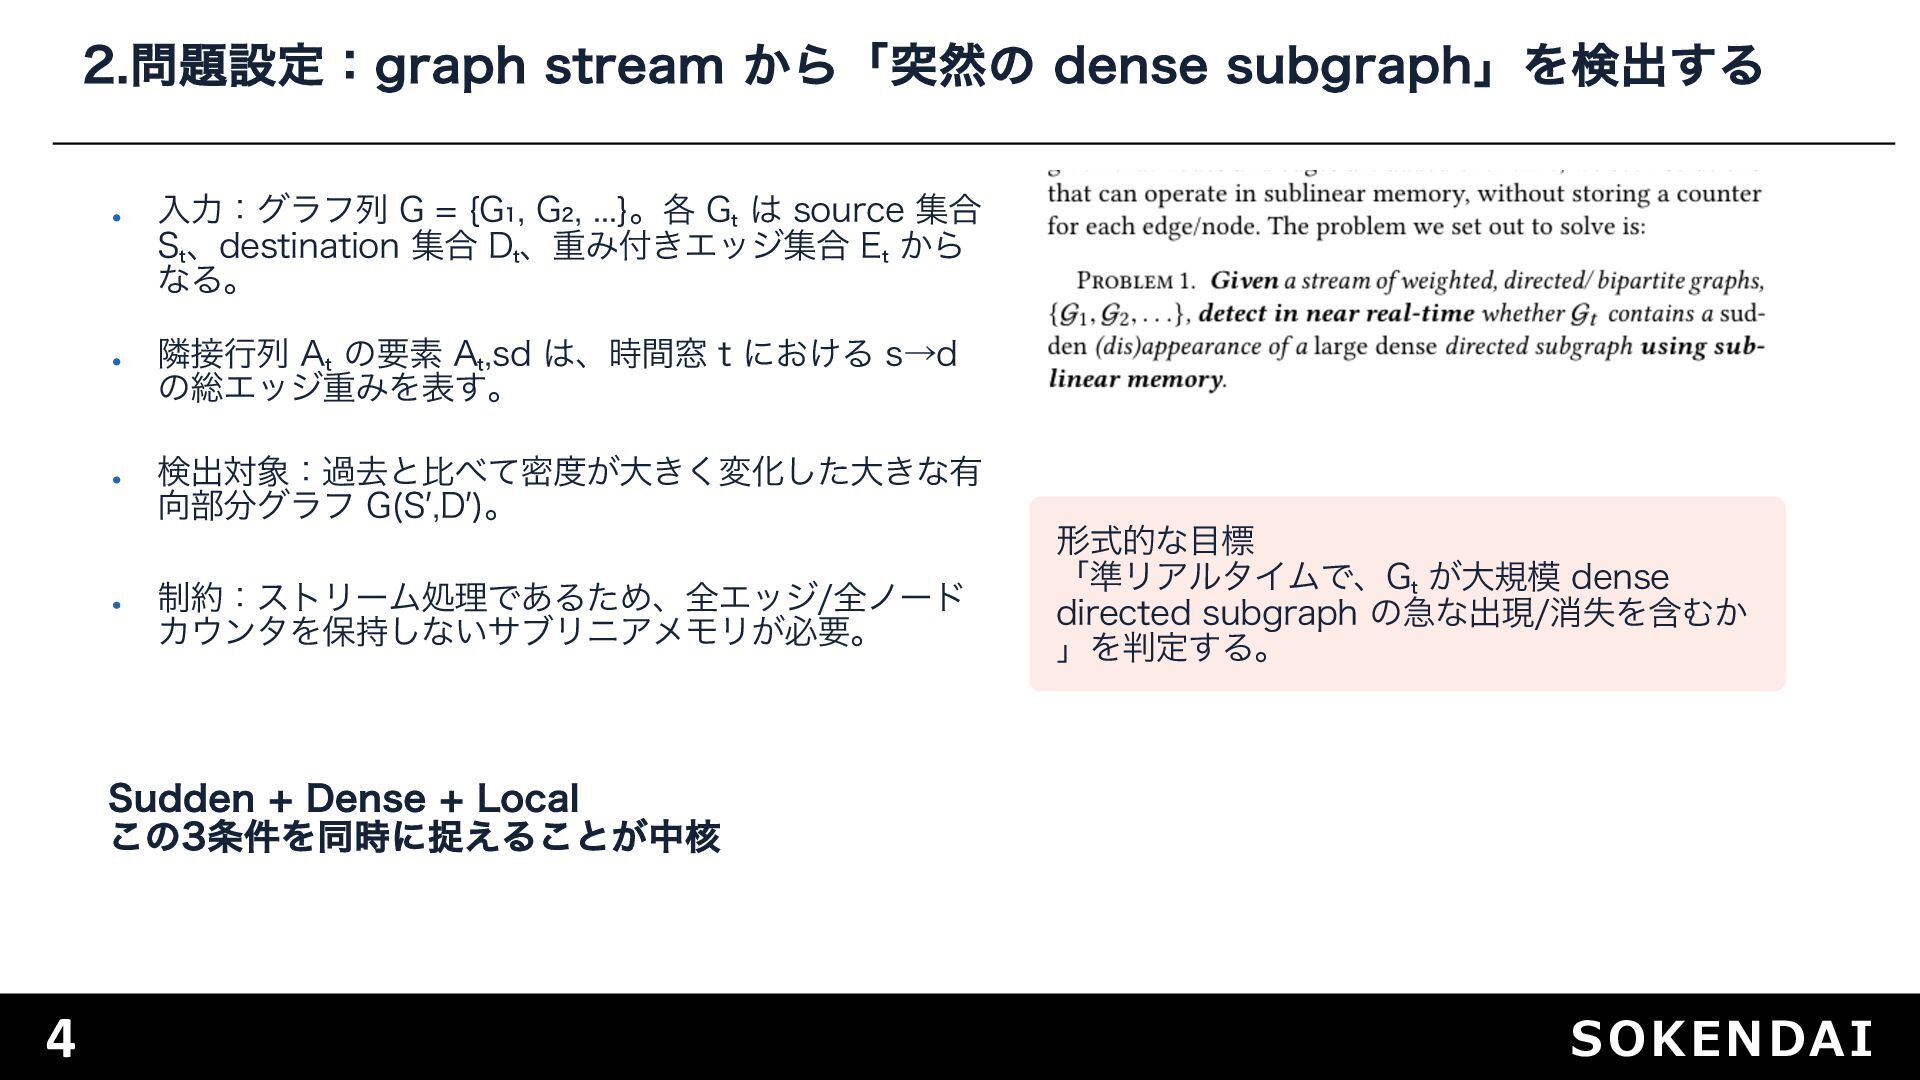
2.問題設定:graph stream から「突然の dense subgraph」を検出する • 入力:グラフ列 G = {G₁,
G₂, ...}。各 Gₜ は source 集合 Sₜ、destination 集合 Dₜ、重み付きエッジ集合 Eₜ から なる。 • 隣接行列 Aₜ の要素 Aₜ,sd は、時間窓 t における s→d の総エッジ重みを表す。 • 検出対象:過去と比べて密度が大きく変化した大きな有 向部分グラフ G(S ,D )。 • 制約:ストリーム処理であるため、全エッジ/全ノード カウンタを保持しないサブリニアメモリが必要。 形式的な目標 「準リアルタイムで、Gₜ が大規模 dense directed subgraph の急な出現/消失を含むか 」を判定する。 Sudden + Dense + Local この3条件を同時に捉えることが中核 4 SOKENDAI
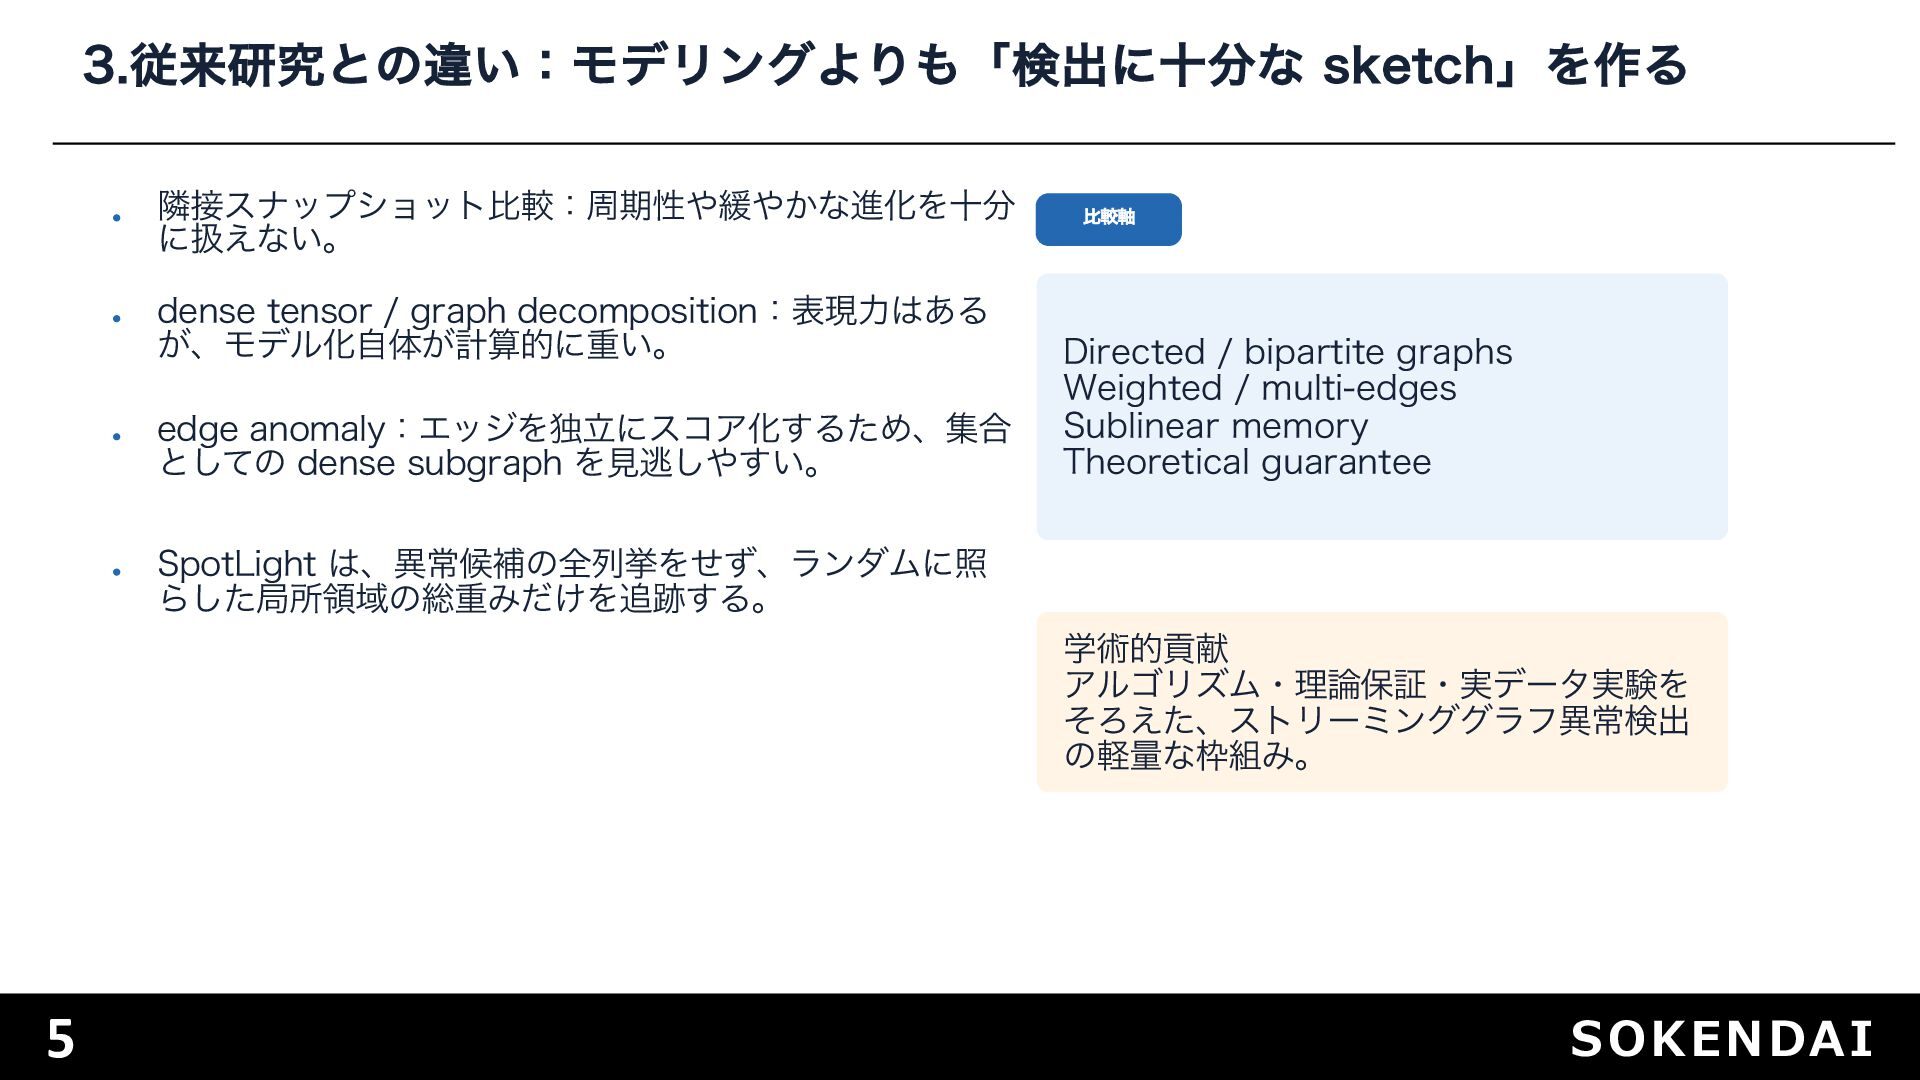
3.従来研究との違い:モデリングよりも「検出に十分な sketch」を作る • 隣接スナップショット比較:周期性や緩やかな進化を十分 に扱えない。 • dense tensor / graph
decomposition:表現力はある が、モデル化自体が計算的に重い。 • edge anomaly:エッジを独立にスコア化するため、集合 としての dense subgraph を見逃しやすい。 • SpotLight は、異常候補の全列挙をせず、ランダムに照 らした局所領域の総重みだけを追跡する。 5 比較軸 Directed / bipartite graphs Weighted / multi-edges Sublinear memory Theoretical guarantee 学術的貢献 アルゴリズム・理論保証・実データ実験を そろえた、ストリーミンググラフ異常検出 の軽量な枠組み。 SOKENDAI
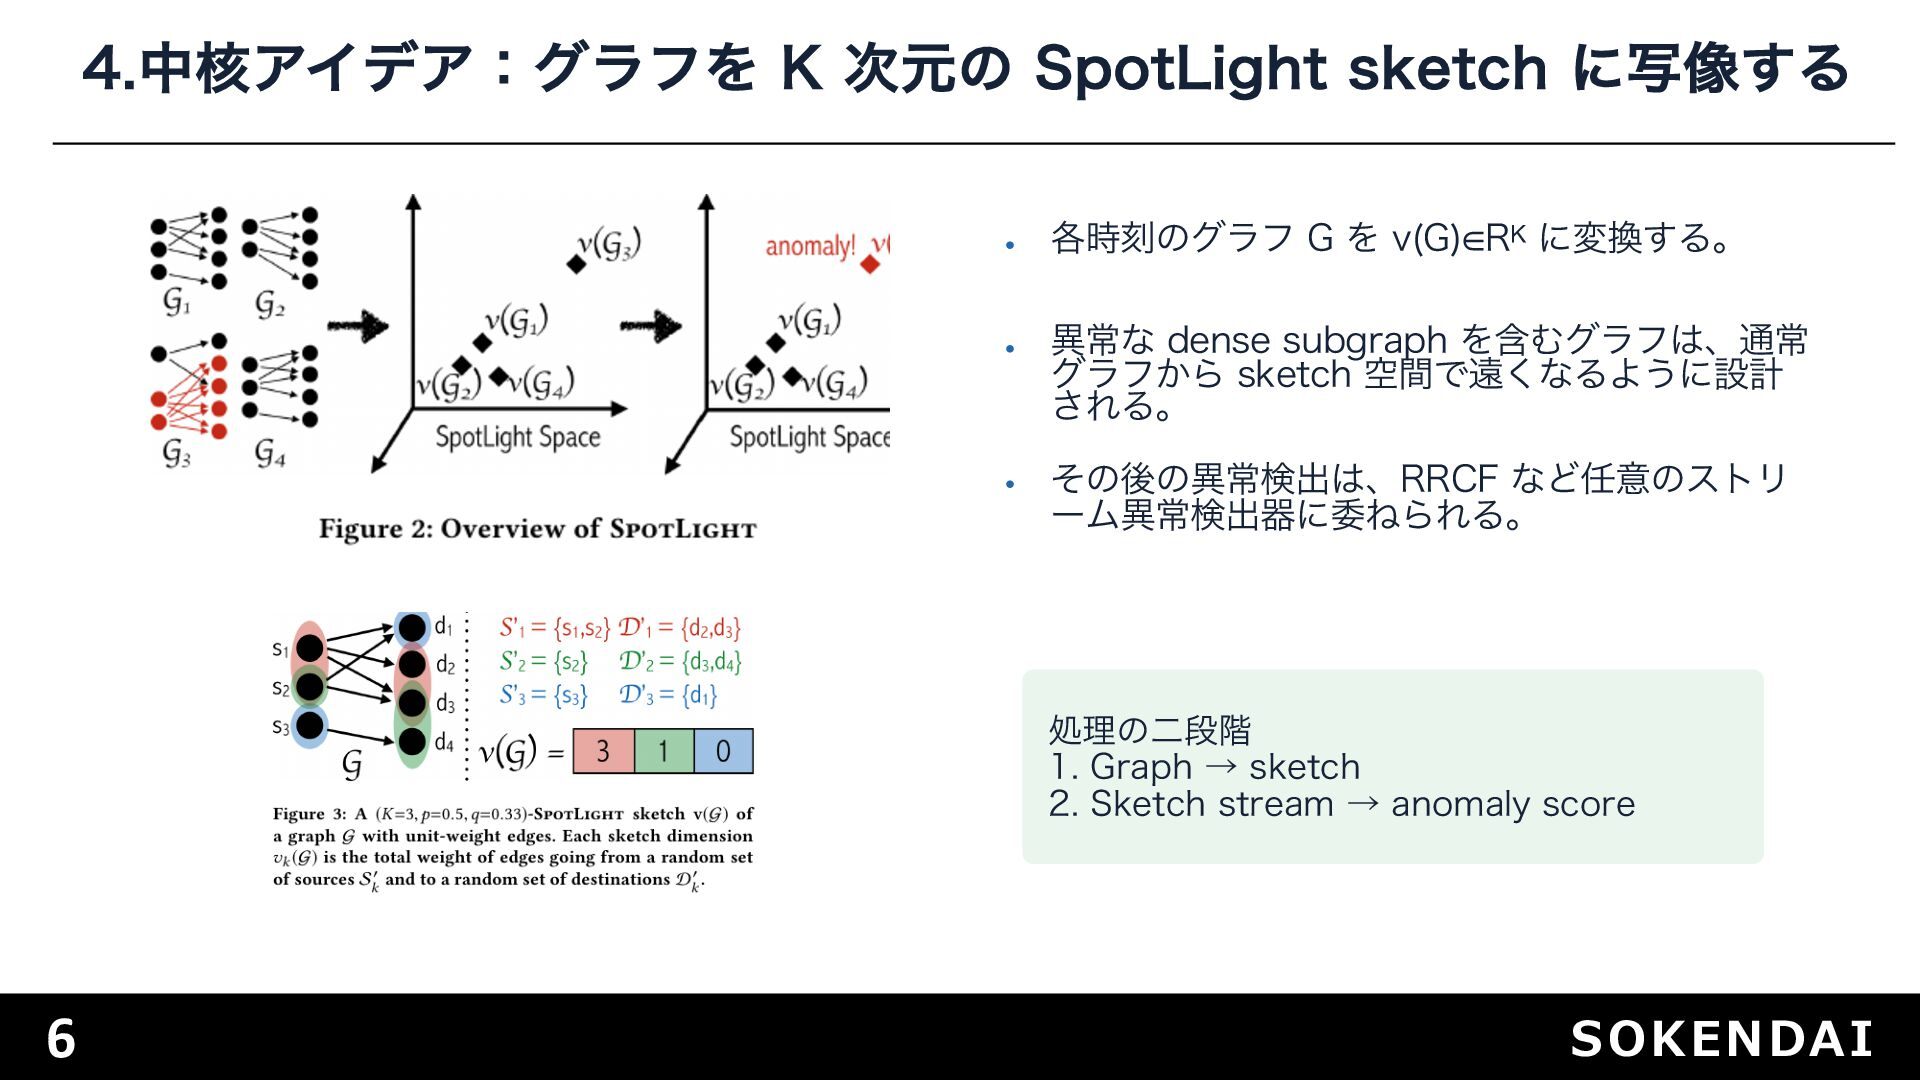
4.中核アイデア:グラフを K 次元の SpotLight sketch に写像する • 各時刻のグラフ G を
v(G) Rᴷ に変換する。 • 異常な dense subgraph を含むグラフは、通常 グラフから sketch 空間で遠くなるように設計 される。 • その後の異常検出は、RRCF など任意のストリ ーム異常検出器に委ねられる。 処理の二段階 1. Graph → sketch 2. Sketch stream → anomaly score 6 SOKENDAI
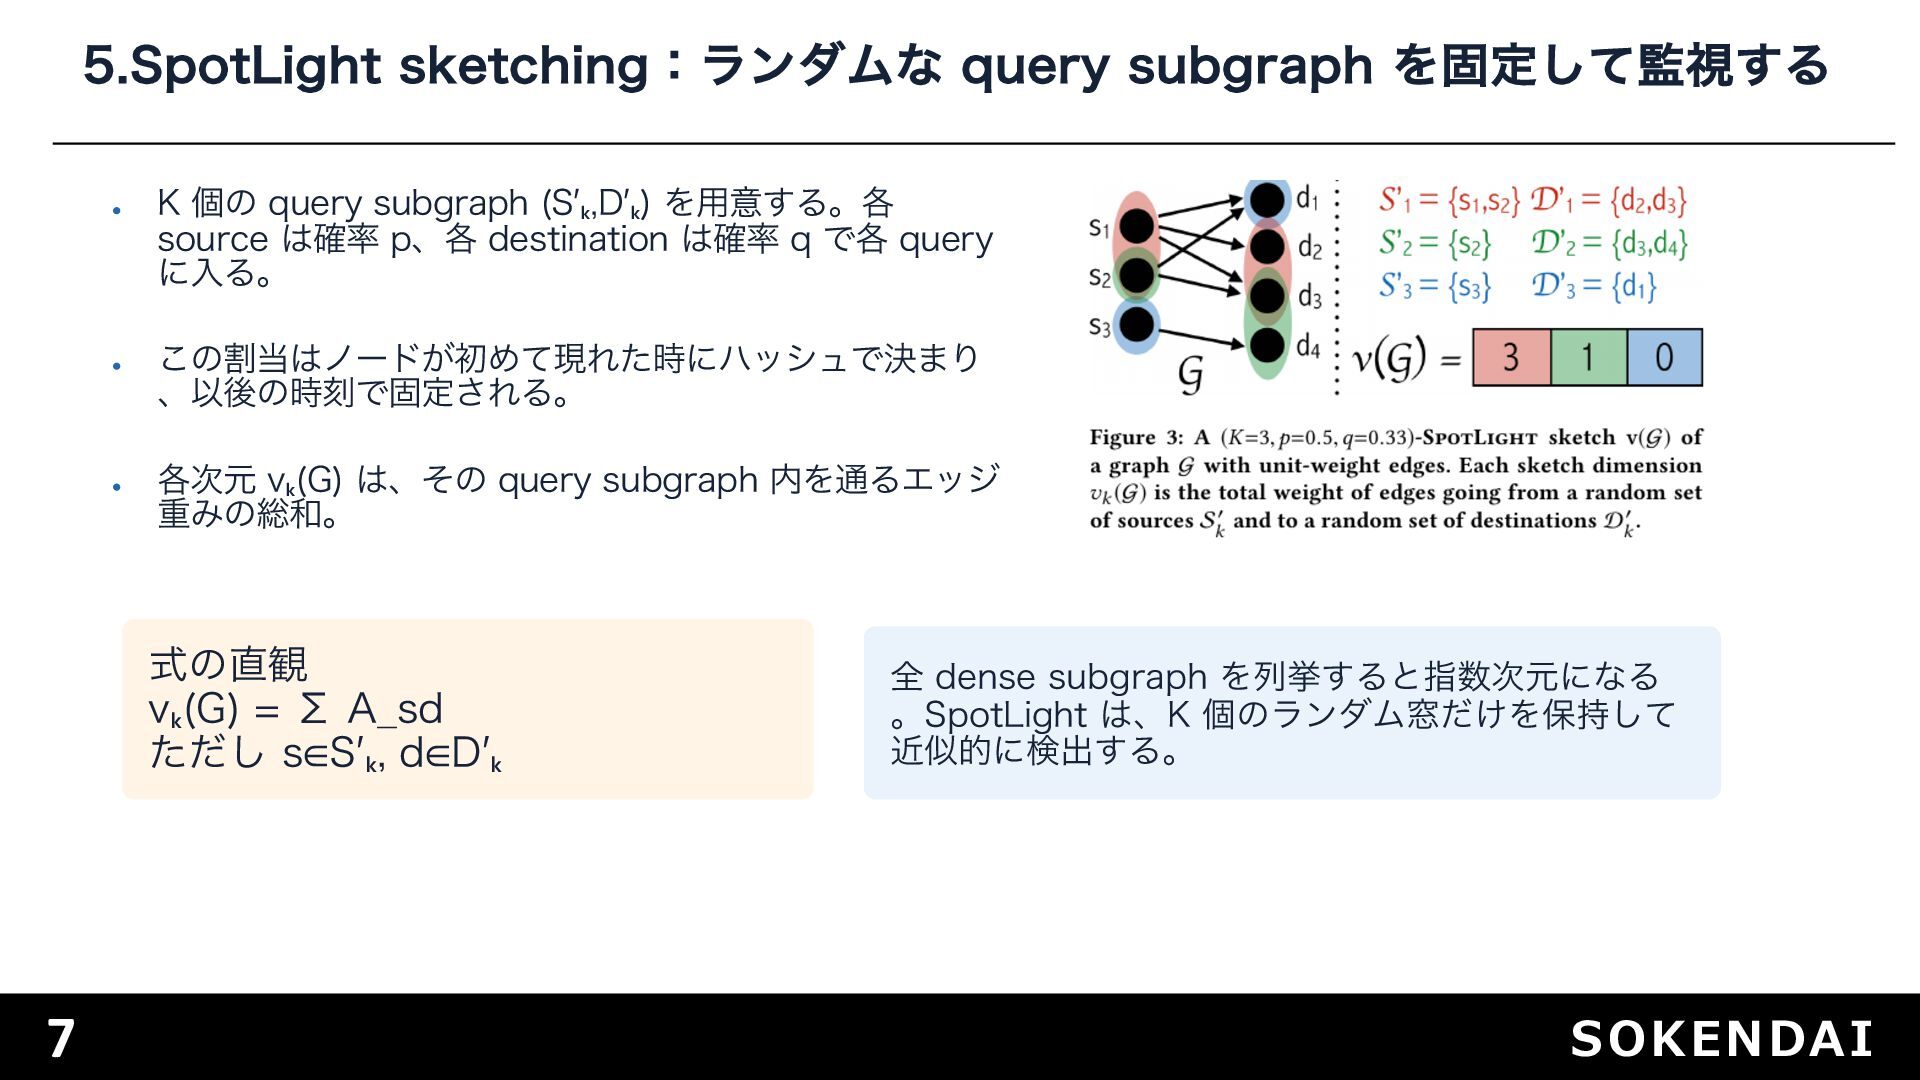
5.SpotLight sketching:ランダムな query subgraph を固定して監視する • K 個の query subgraph
(S ₖ,D ₖ) を用意する。各 source は確率 p、各 destination は確率 q で各 query に入る。 • この割当はノードが初めて現れた時にハッシュで決まり 、以後の時刻で固定される。 • 各次元 vₖ(G) は、その query subgraph 内を通るエッジ 重みの総和。 式の直観 vₖ(G) = Σ A̲sd ただし s S ₖ, d D ₖ 7 全 dense subgraph を列挙すると指数次元になる 。SpotLight は、K 個のランダム窓だけを保持して 近似的に検出する。 SOKENDAI
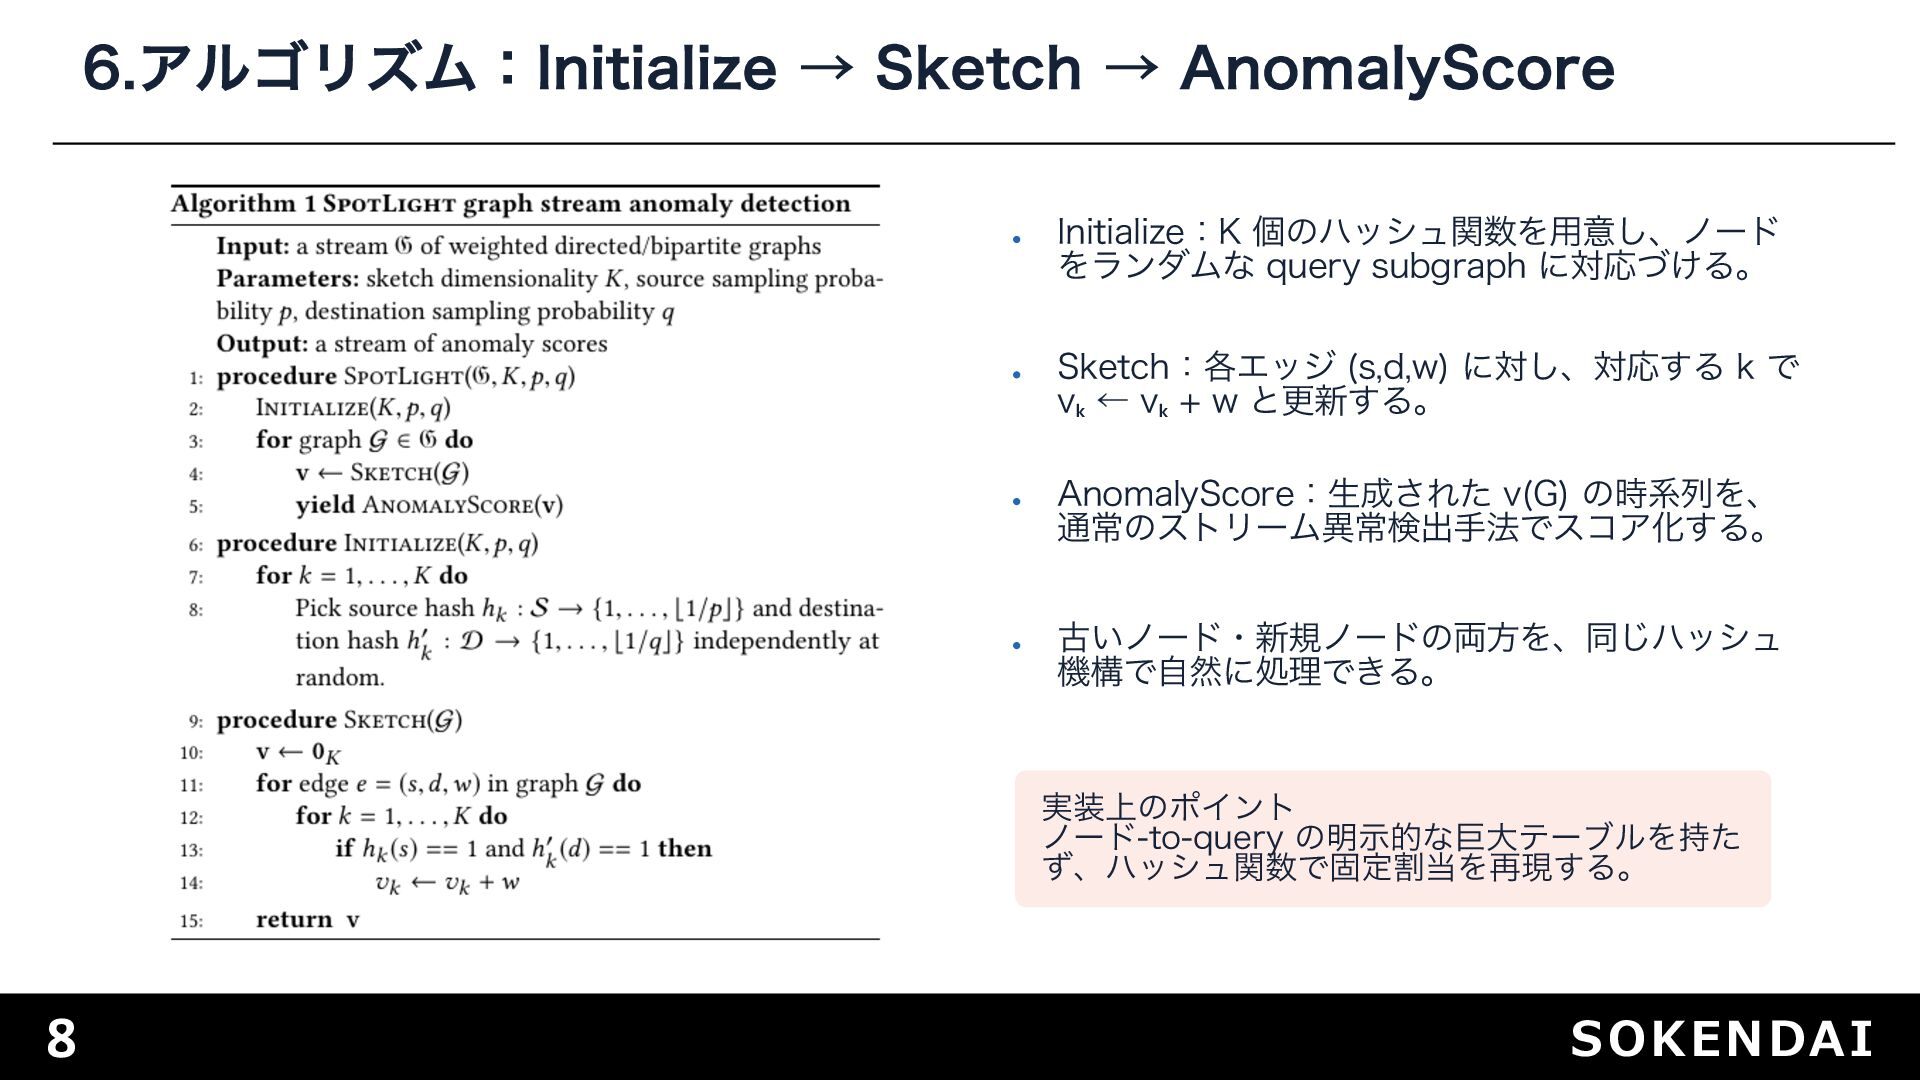
6.アルゴリズム:Initialize → Sketch → AnomalyScore • Initialize:K 個のハッシュ関数を用意し、ノード をランダムな query
subgraph に対応づける。 • Sketch:各エッジ (s,d,w) に対し、対応する k で vₖ ← vₖ + w と更新する。 • AnomalyScore:生成された v(G) の時系列を、 通常のストリーム異常検出手法でスコア化する。 • 古いノード・新規ノードの両方を、同じハッシュ 機構で自然に処理できる。 実装上のポイント ノード-to-query の明示的な巨大テーブルを持た ず、ハッシュ関数で固定割当を再現する。 8 SOKENDAI
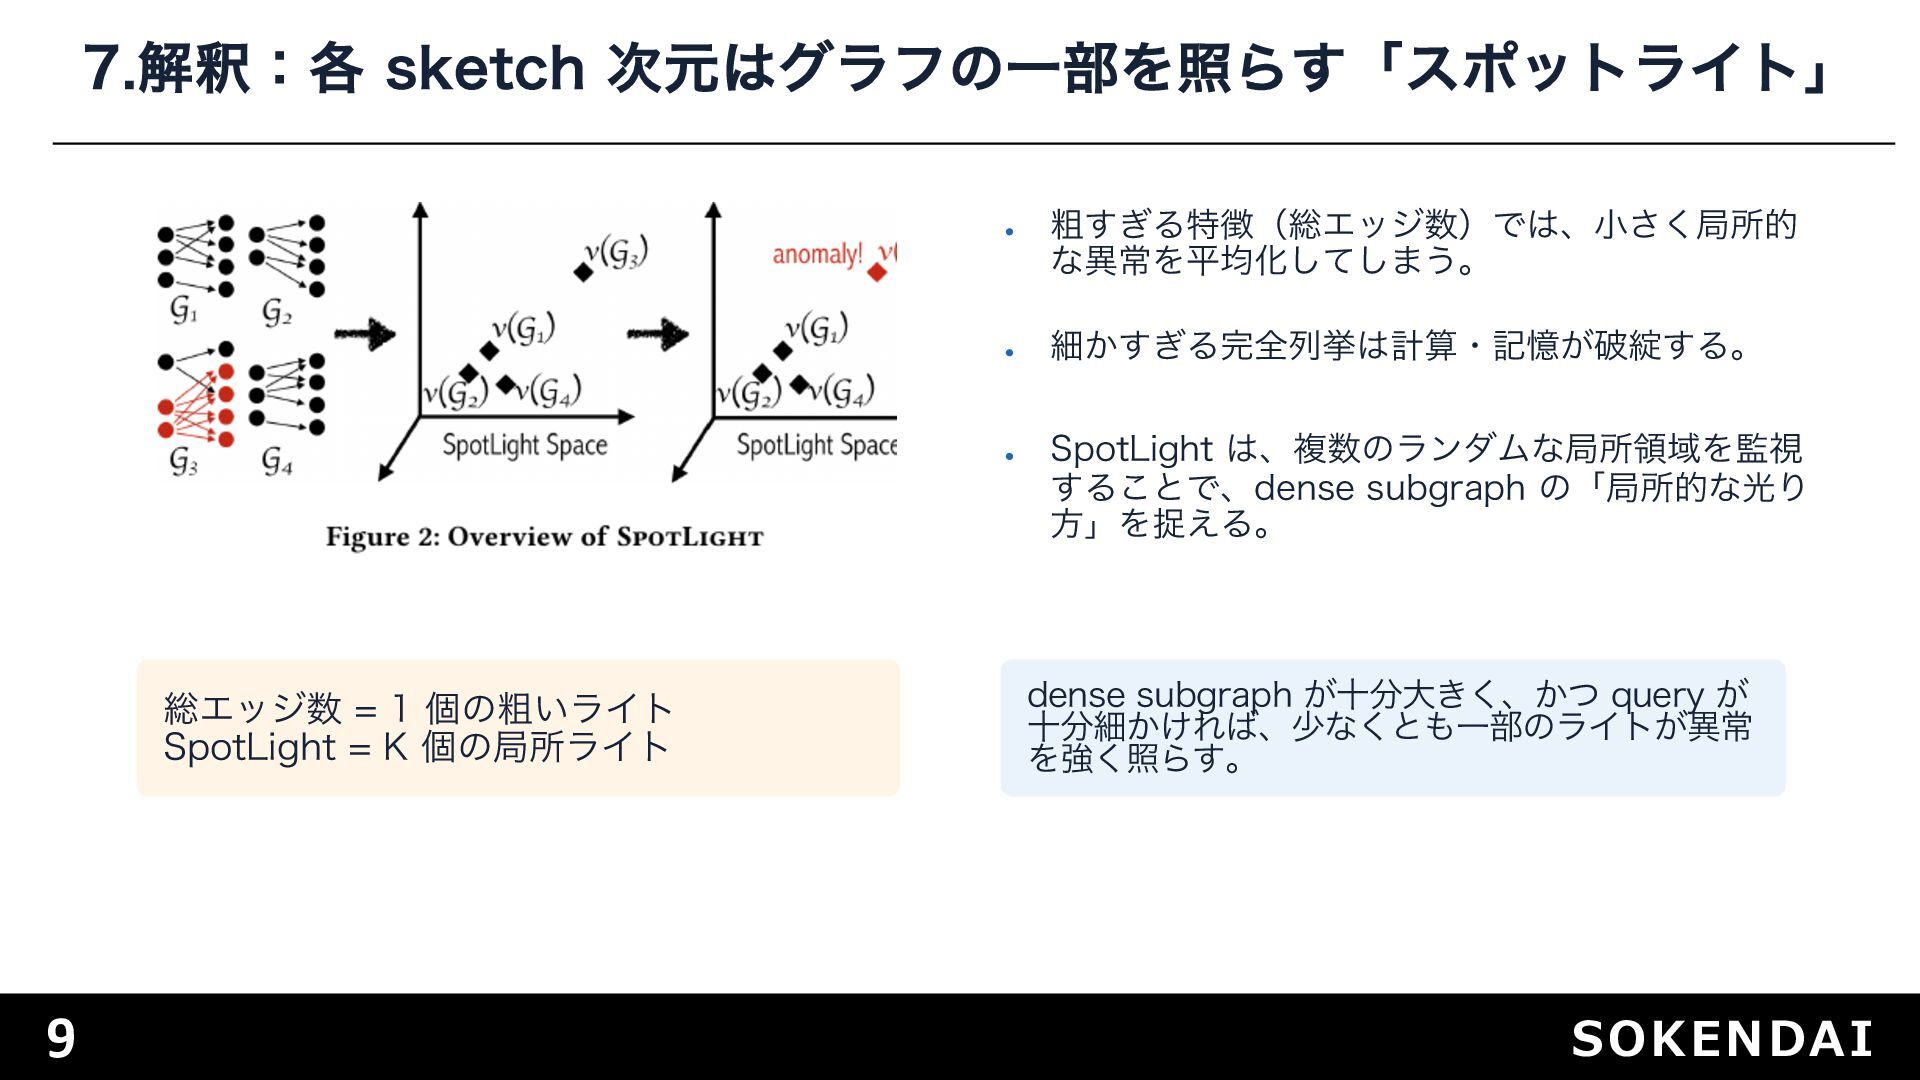
7.解釈:各 sketch 次元はグラフの一部を照らす「スポットライト」 • 粗すぎる特徴(総エッジ数)では、小さく局所的 な異常を平均化してしまう。 • 細かすぎる完全列挙は計算・記憶が破綻する。 • SpotLight
は、複数のランダムな局所領域を監視 することで、dense subgraph の「局所的な光り 方」を捉える。 総エッジ数 = 1 個の粗いライト SpotLight = K 個の局所ライト 9 dense subgraph が十分大きく、かつ query が 十分細かければ、少なくとも一部のライトが異常 を強く照らす。 SOKENDAI
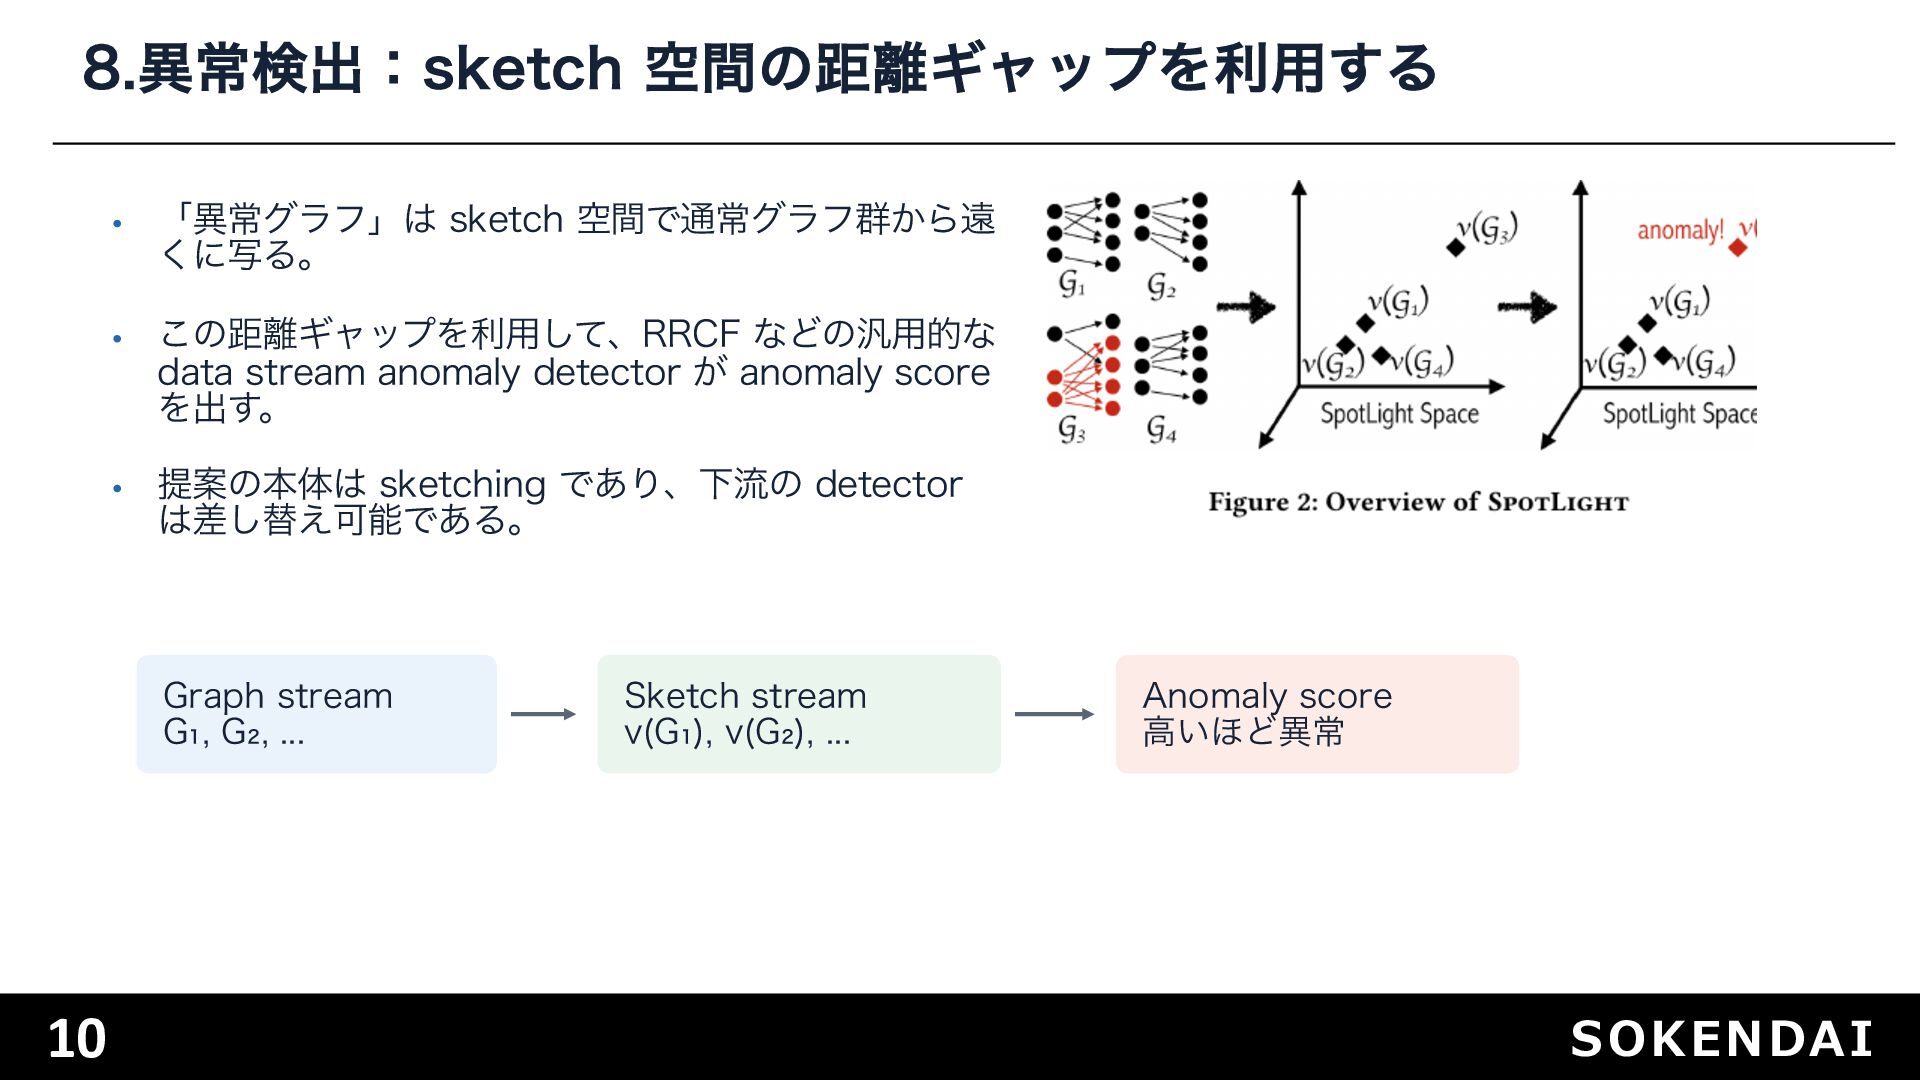
8.異常検出:sketch 空間の距離ギャップを利用する • 「異常グラフ」は sketch 空間で通常グラフ群から遠 くに写る。 • この距離ギャップを利用して、RRCF などの汎用的な
data stream anomaly detector が anomaly score を出す。 • 提案の本体は sketching であり、下流の detector は差し替え可能である。 Graph stream G₁, G₂, ... 10 Sketch stream v(G₁), v(G₂), ... Anomaly score 高いほど異常 SOKENDAI
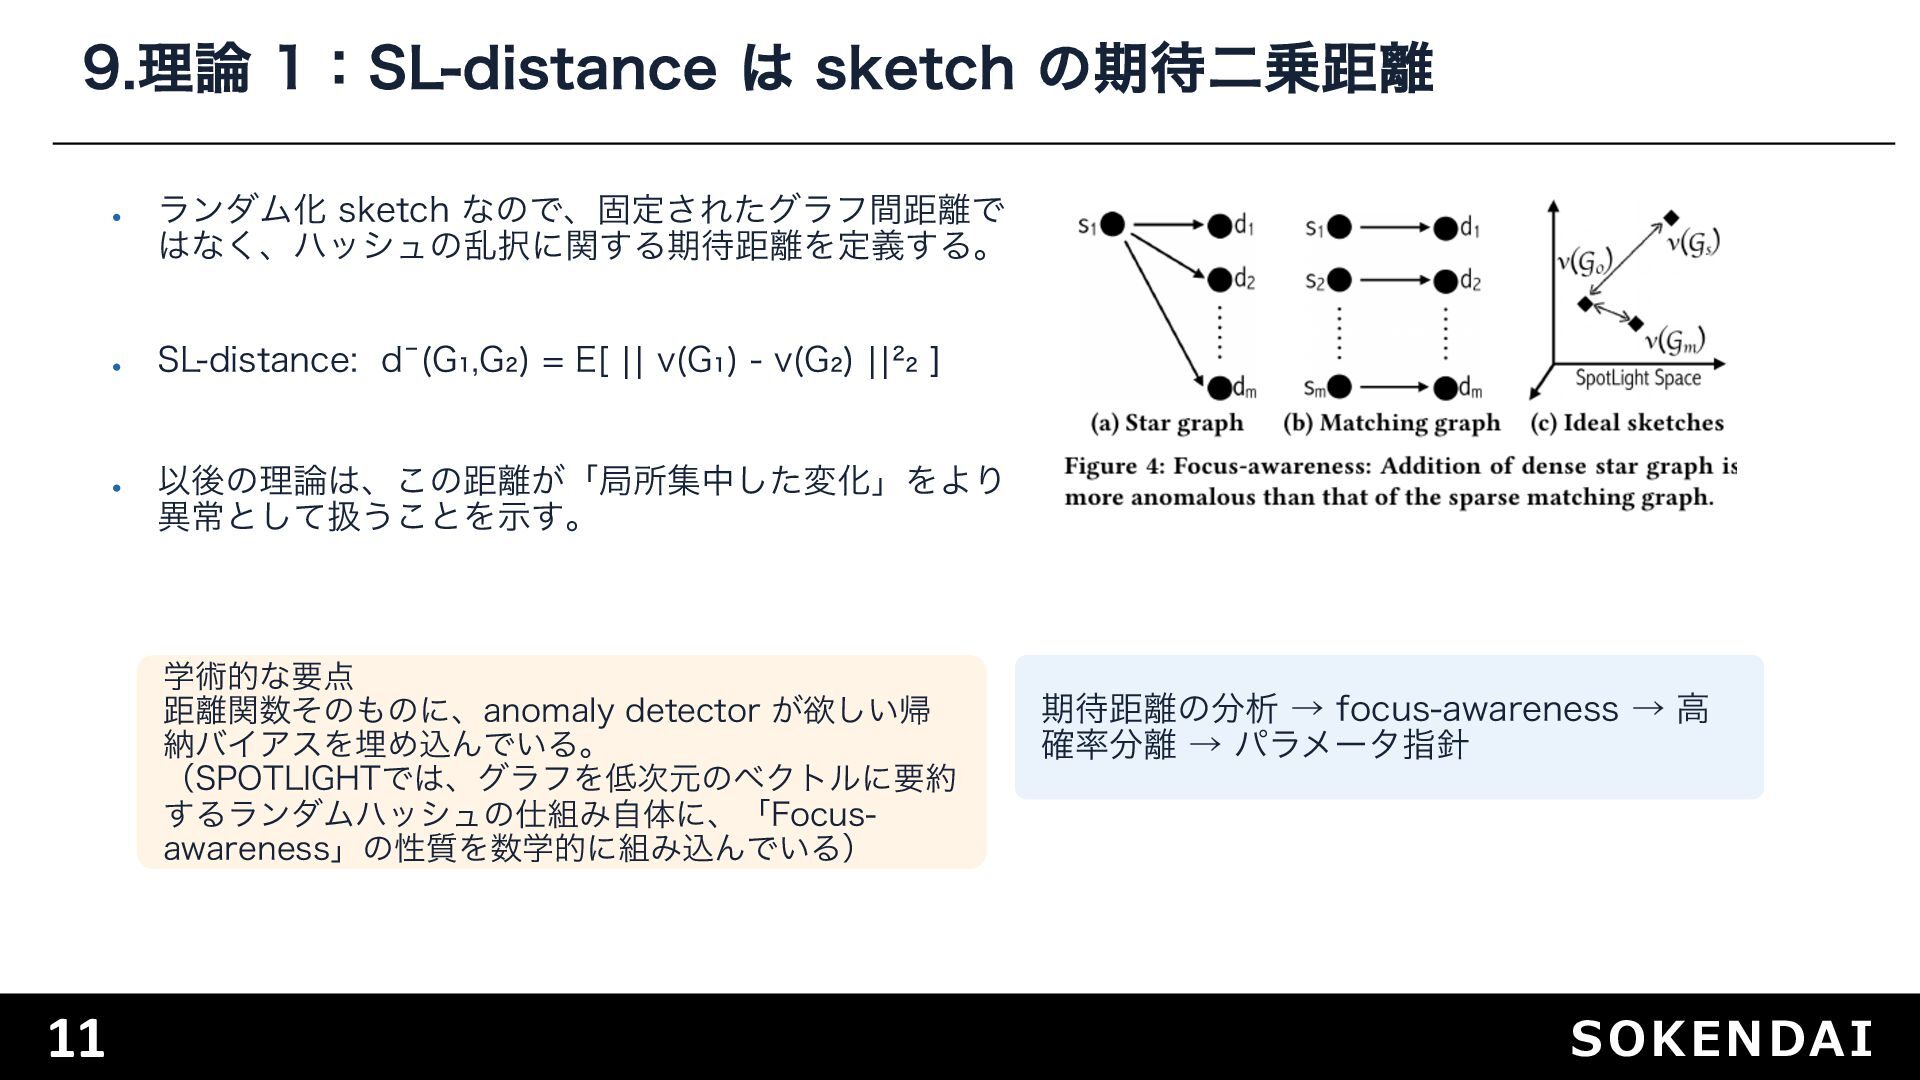
9.理論 1:SL-distance は sketch の期待二乗距離 • ランダム化 sketch なので、固定されたグラフ間距離で はなく、ハッシュの乱択に関する期待距離を定義する。
• SL-distance: d¯(G₁,G₂) = E[ || v(G₁) - v(G₂) ||²₂ ] • 以後の理論は、この距離が「局所集中した変化」をより 異常として扱うことを示す。 学術的な要点 距離関数そのものに、anomaly detector が欲しい帰 納バイアスを埋め込んでいる。 (SPOTLIGHTでは、グラフを低次元のベクトルに要約 するランダムハッシュの仕組み自体に、「Focusawareness」の性質を数学的に組み込んでいる) 11 期待距離の分析 → focus-awareness → 高 確率分離 → パラメータ指針 SOKENDAI
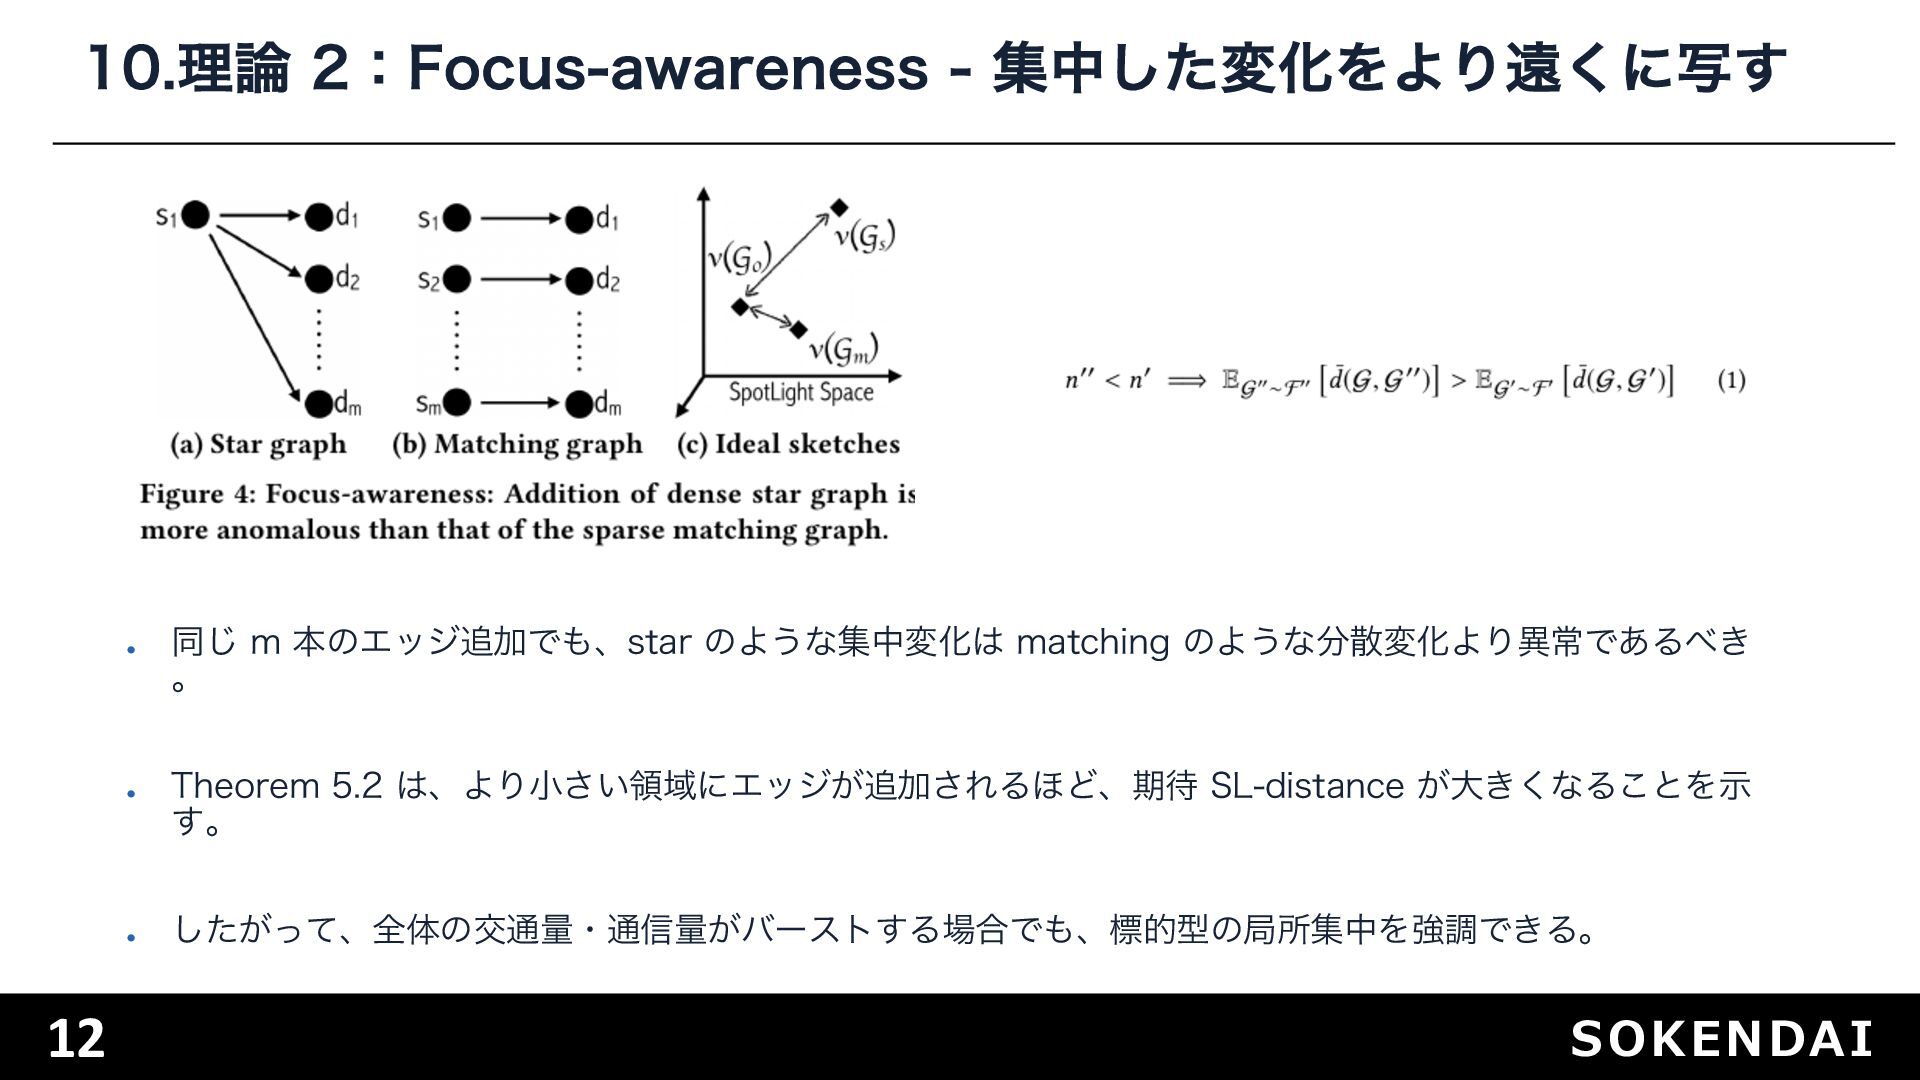
10.理論 2:Focus-awareness - 集中した変化をより遠くに写す • 同じ m 本のエッジ追加でも、star のような集中変化は matching
のような分散変化より異常であるべき 。 • Theorem 5.2 は、より小さい領域にエッジが追加されるほど、期待 SL-distance が大きくなることを示 す。 • したがって、全体の交通量・通信量がバーストする場合でも、標的型の局所集中を強調できる。 12 SOKENDAI
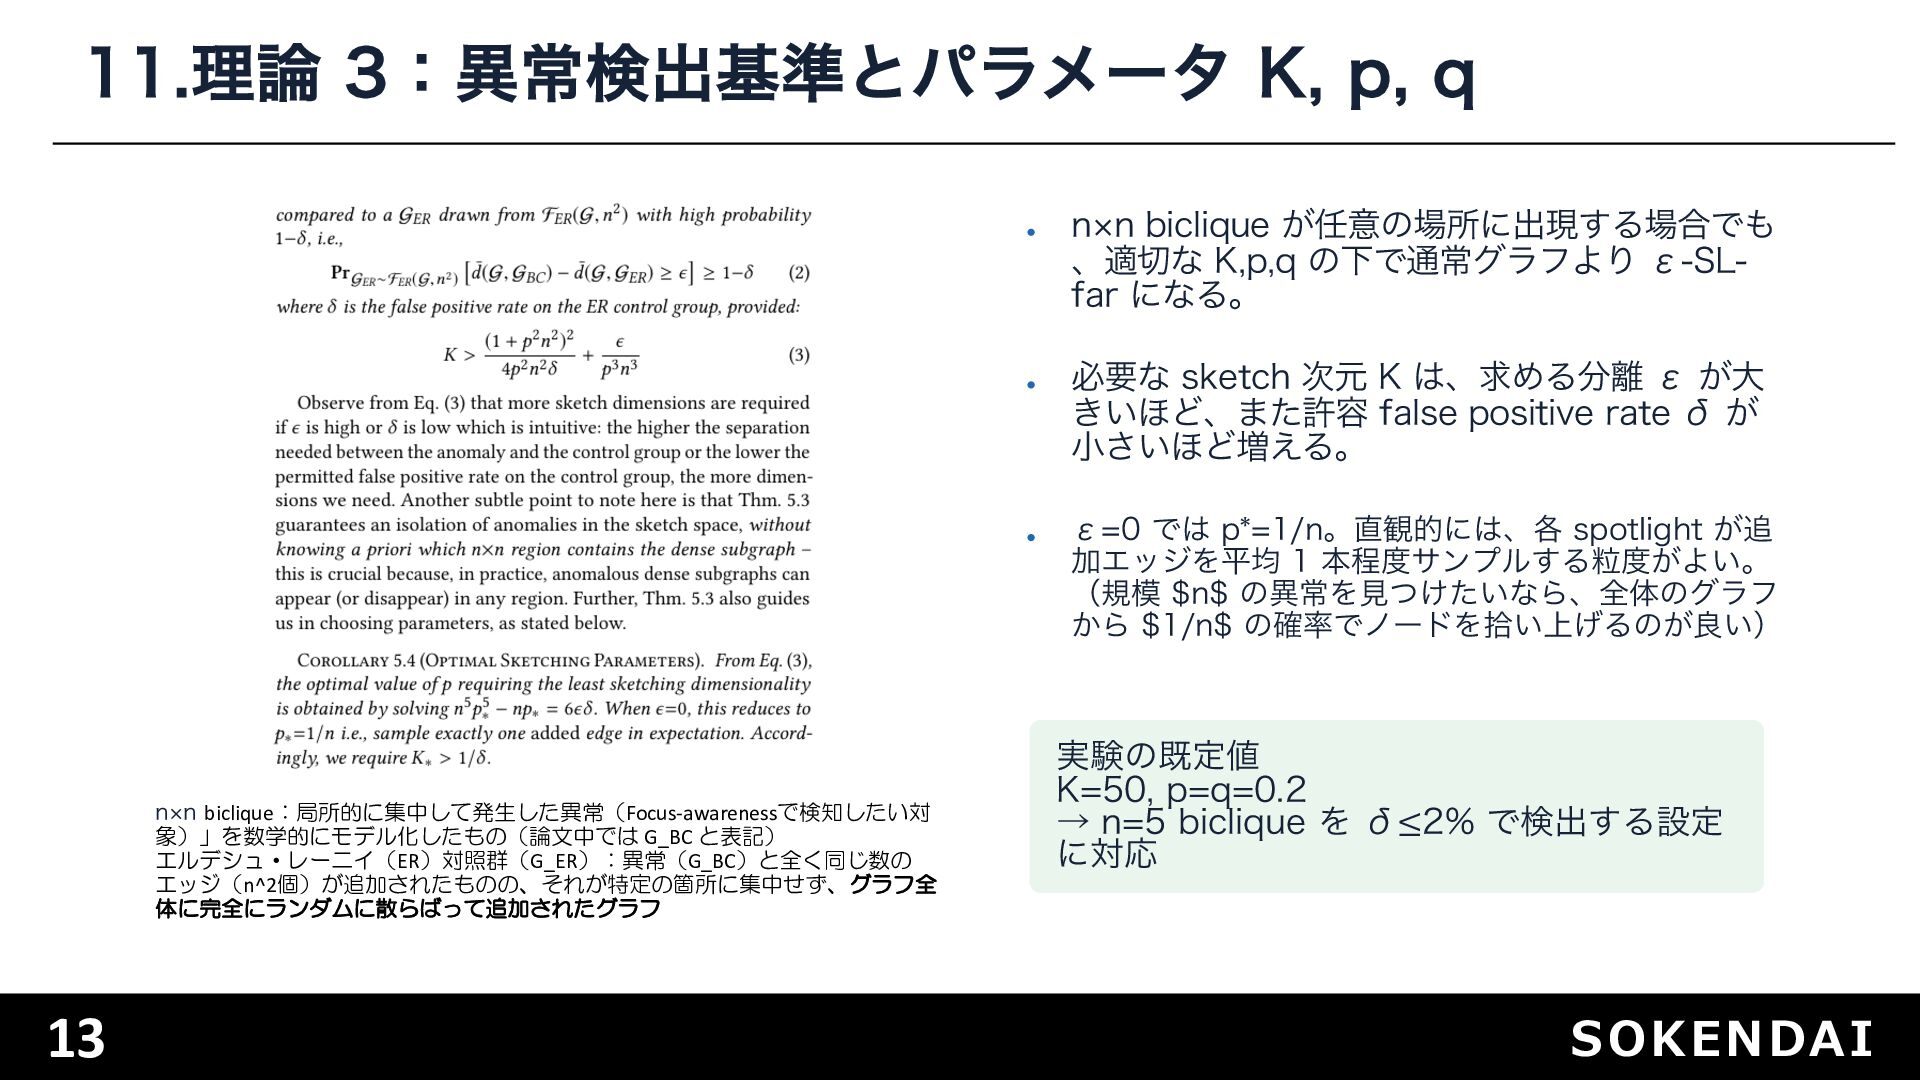
11.理論 3:異常検出基準とパラメータ K, p, q • n n biclique が任意の場所に出現する場合でも
、適切な K,p,q の下で通常グラフより ε-SLfar になる。 • 必要な sketch 次元 K は、求める分離 ε が大 きいほど、また許容 false positive rate δ が 小さいほど増える。 • ε=0 では p*=1/n。直観的には、各 spotlight が追 加エッジを平均 1 本程度サンプルする粒度がよい。 (規模 $n$ の異常を見つけたいなら、全体のグラフ から $1/n$ の確率でノードを拾い上げるのが良い) n n biclique:局所的に集中して発生した異常(Focus-awarenessで検知したい対 象)」を数学的にモデル化したもの(論文中では G_BC と表記) エルデシュ・レーニイ(ER)対照群(G_ER):異常(G_BC)と全く同じ数の エッジ(n^2個)が追加されたものの、それが特定の箇所に集中せず、グラフ全 体に完全にランダムに散らばって追加されたグラフ 13 実験の既定値 K=50, p=q=0.2 → n=5 biclique を δ≤2% で検出する設定 に対応 SOKENDAI
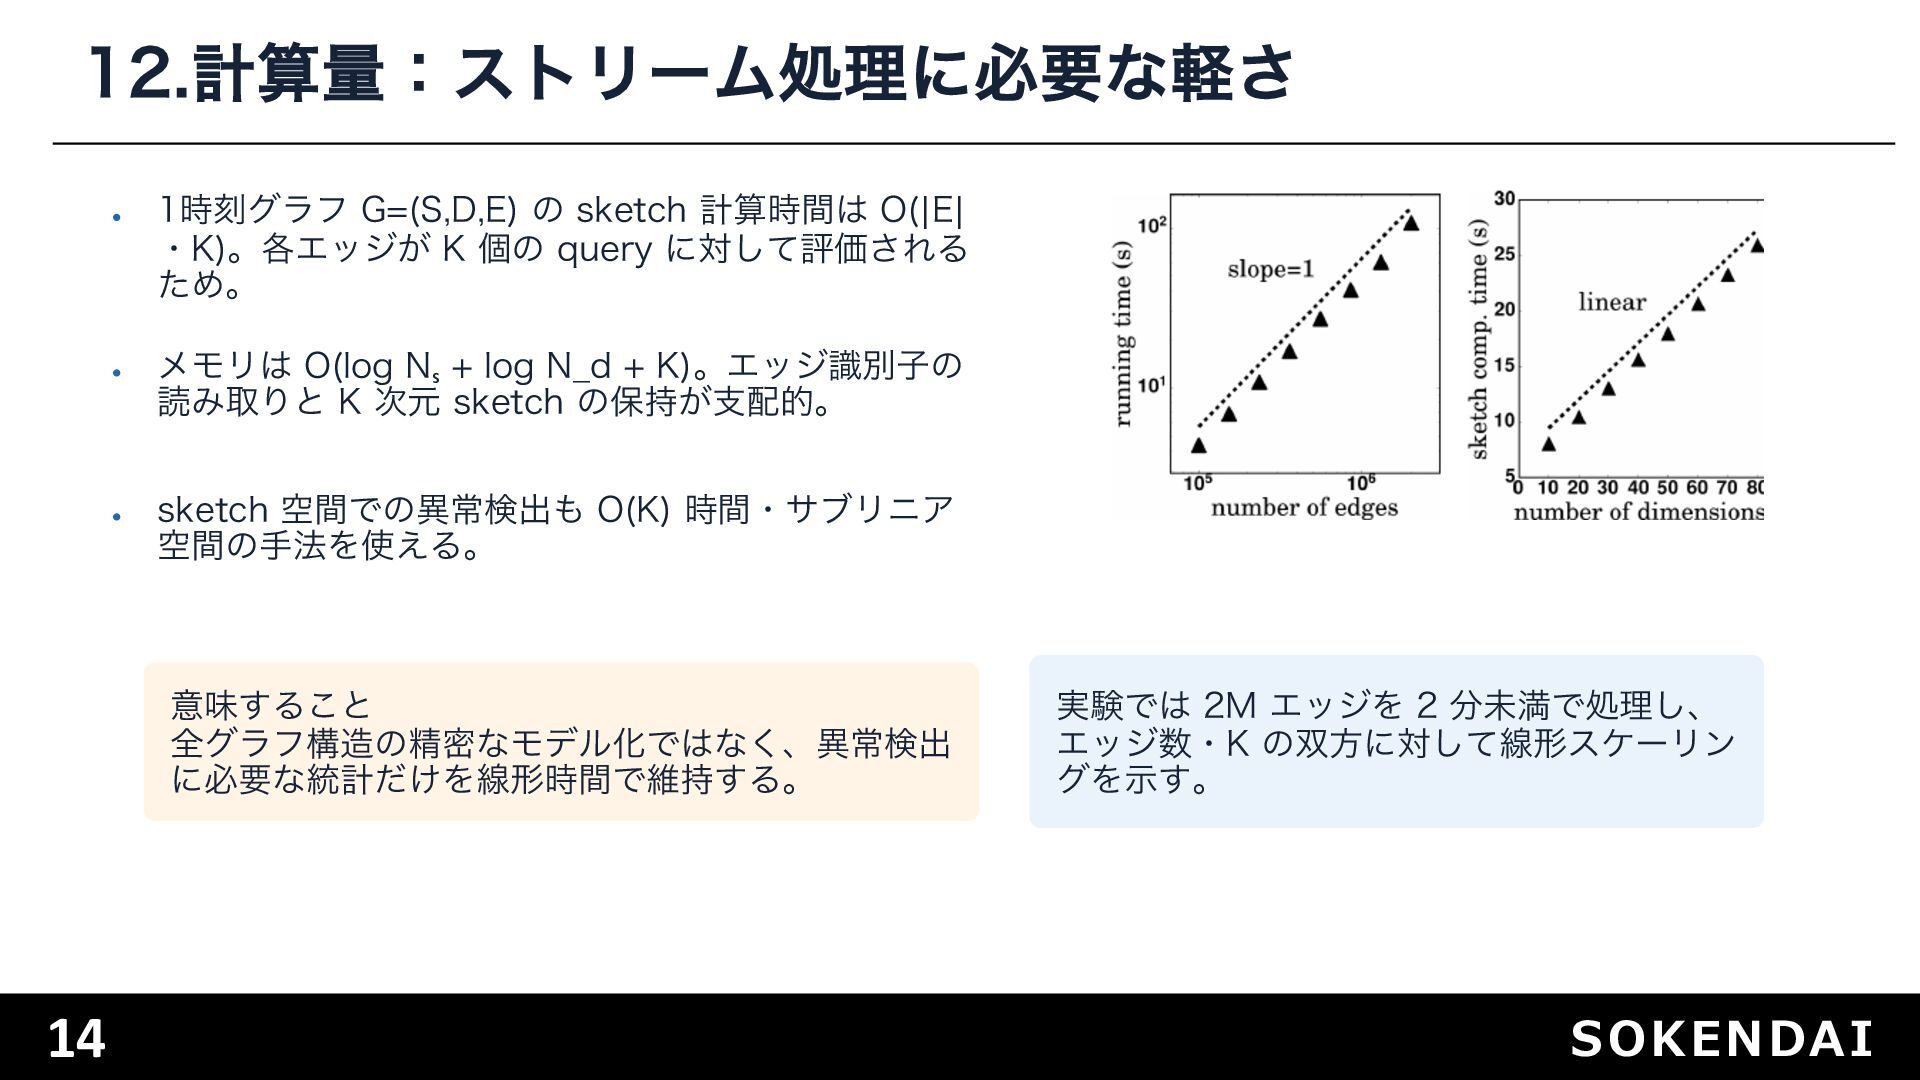
12.計算量:ストリーム処理に必要な軽さ • 1時刻グラフ G=(S,D,E) の sketch 計算時間は O(|E| ・K)。各エッジが K
個の query に対して評価される ため。 • メモリは O(log Nₛ + log N̲d + K)。エッジ識別子の 読み取りと K 次元 sketch の保持が支配的。 • sketch 空間での異常検出も O(K) 時間・サブリニア 空間の手法を使える。 意味すること 全グラフ構造の精密なモデル化ではなく、異常検出 に必要な統計だけを線形時間で維持する。 14 実験では 2M エッジを 2 分未満で処理し、 エッジ数・K の双方に対して線形スケーリン グを示す。 SOKENDAI
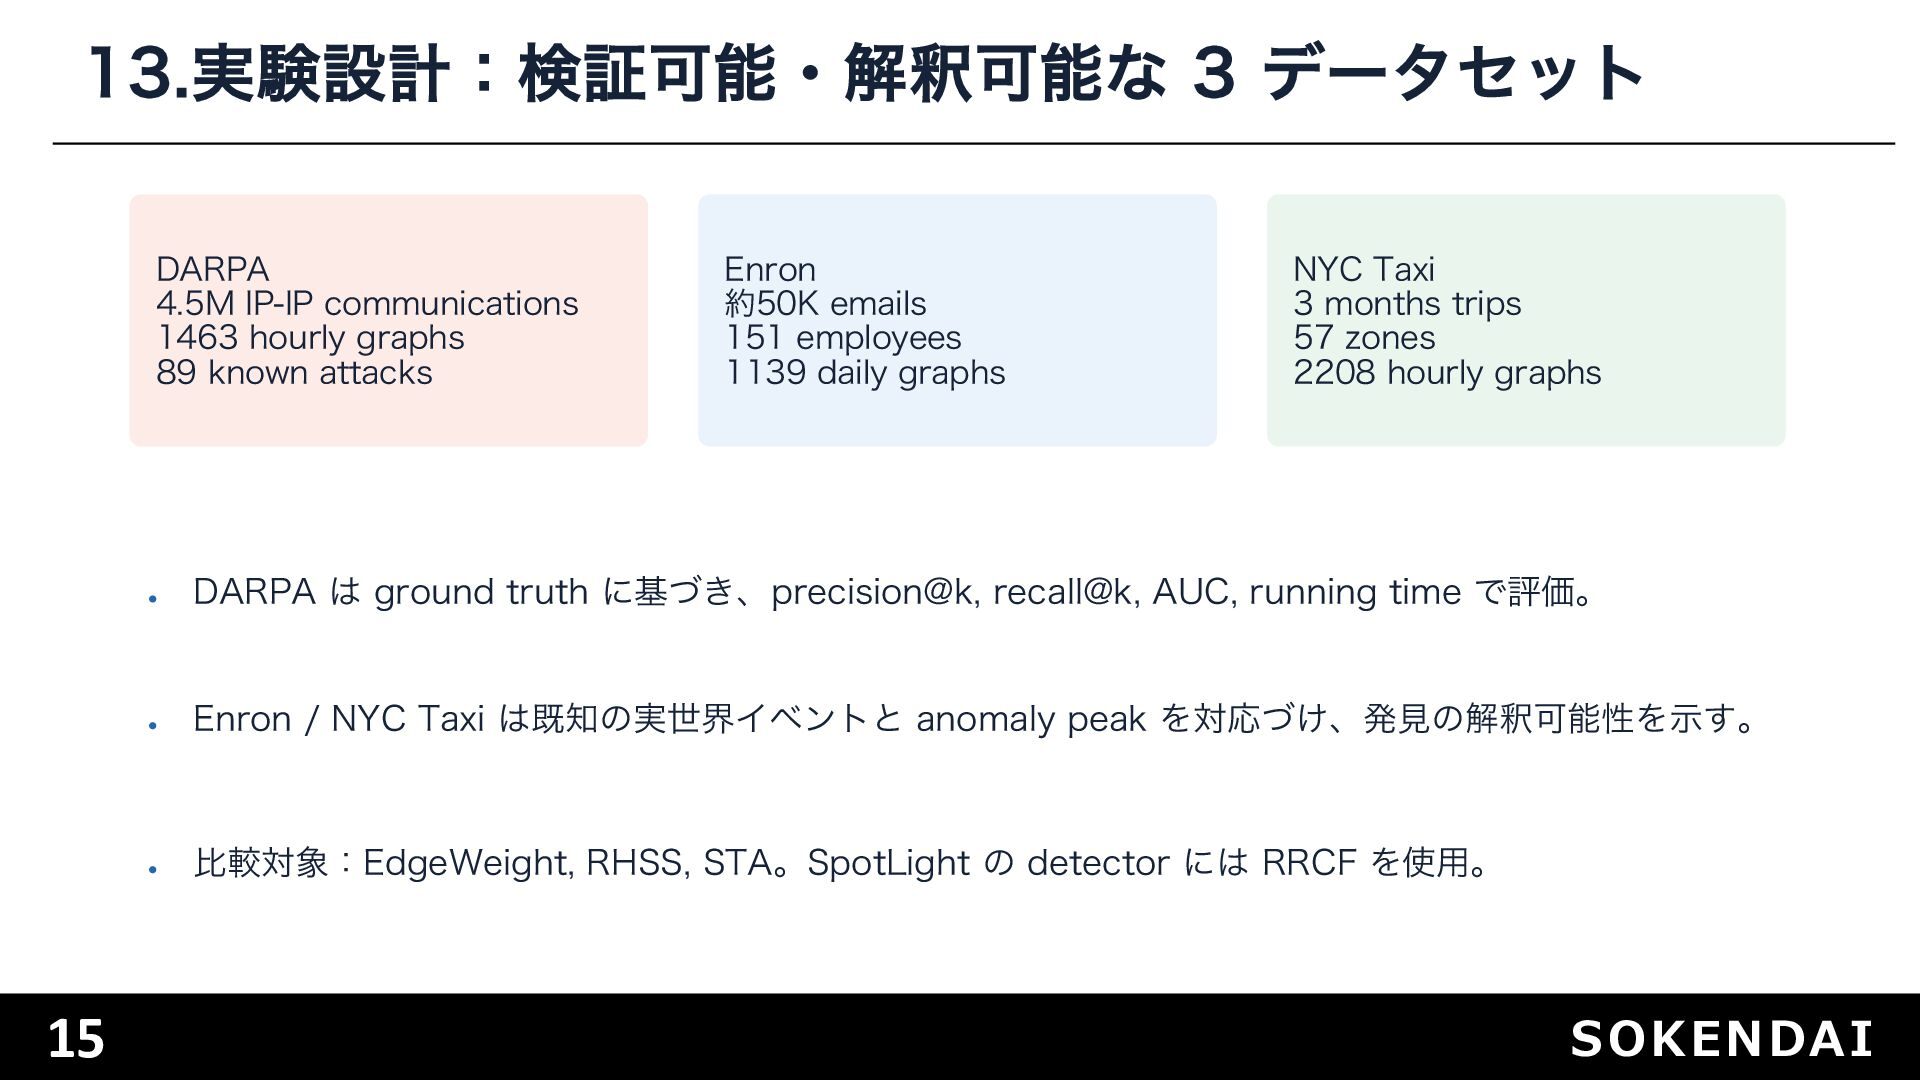
13.実験設計:検証可能・解釈可能な 3 データセット DARPA 4.5M IP-IP communications 1463 hourly graphs
89 known attacks Enron 約50K emails 151 employees 1139 daily graphs NYC Taxi 3 months trips 57 zones 2208 hourly graphs • DARPA は ground truth に基づき、precision@k, recall@k, AUC, running time で評価。 • Enron / NYC Taxi は既知の実世界イベントと anomaly peak を対応づけ、発見の解釈可能性を示す。 • 比較対象:EdgeWeight, RHSS, STA。SpotLight の detector には RRCF を使用。 15 SOKENDAI
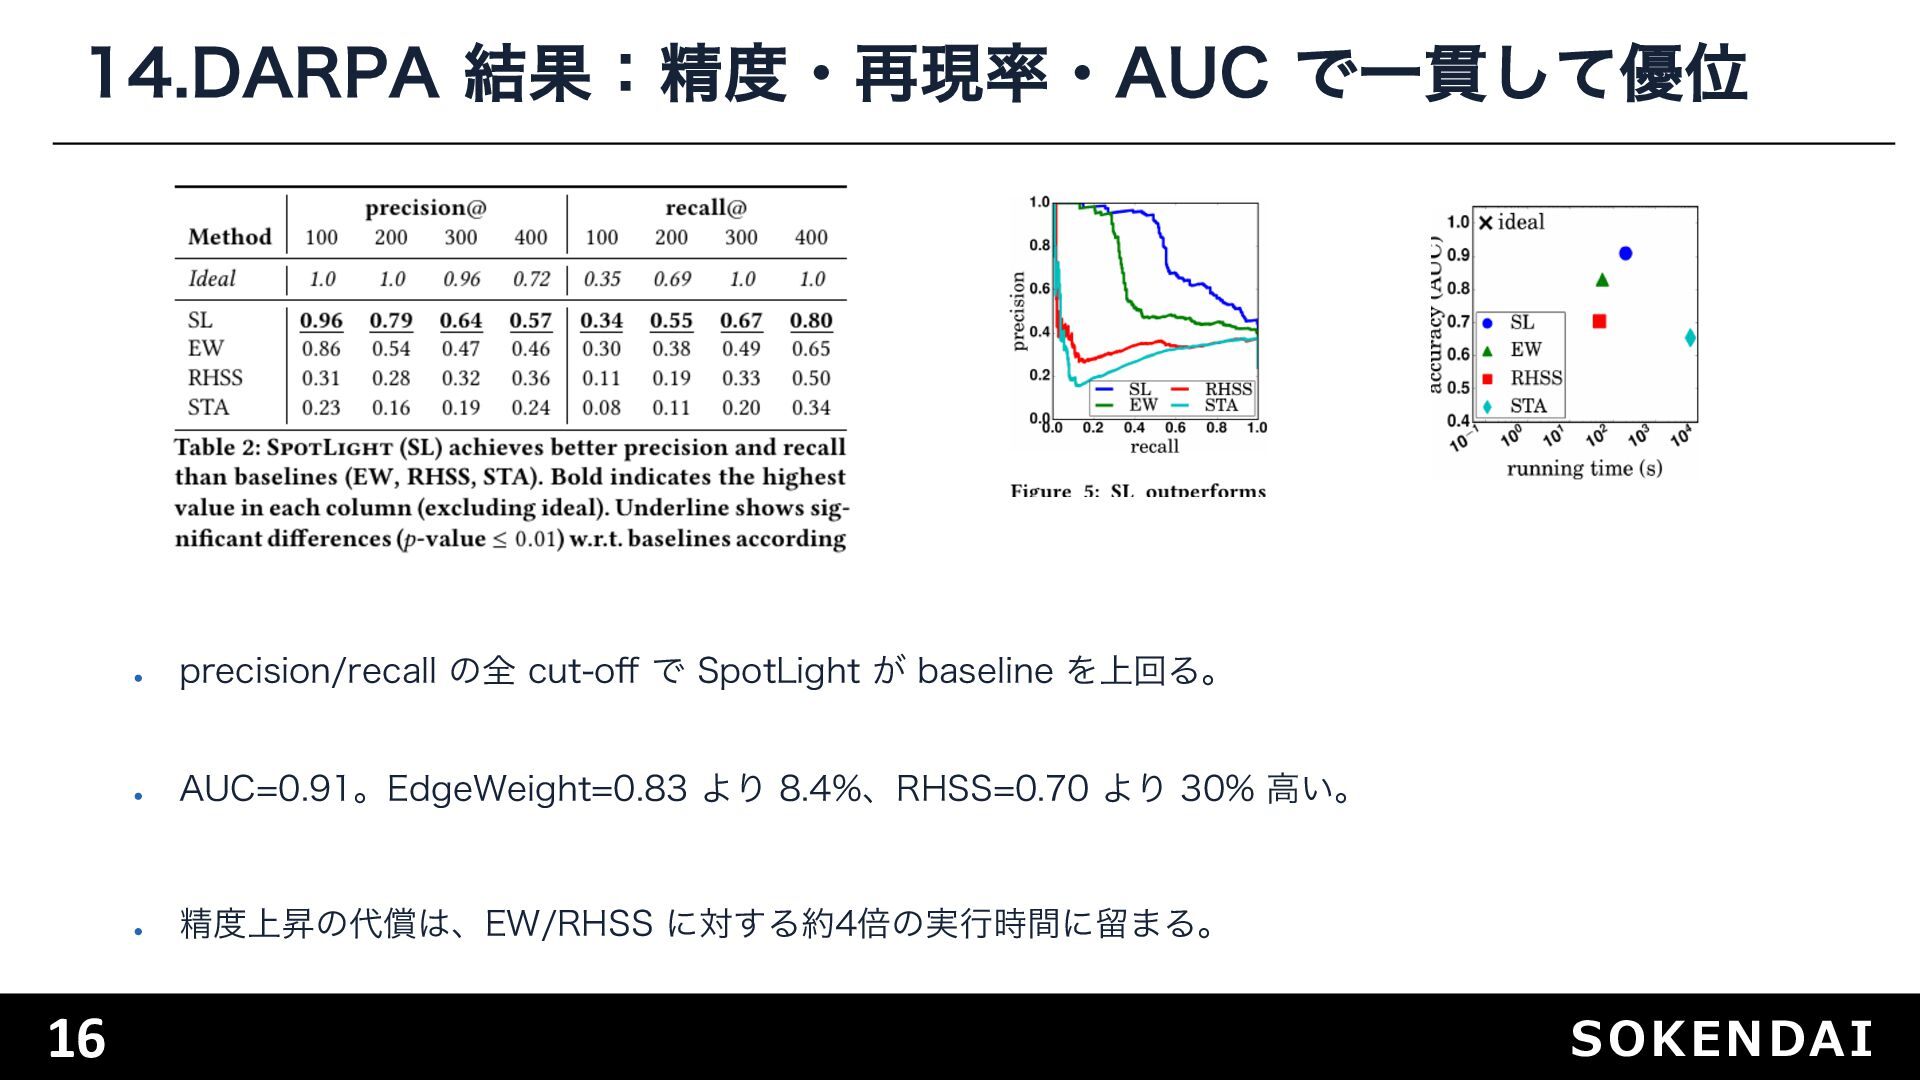
14.DARPA 結果:精度・再現率・AUC で一貫して優位 • precision/recall の全 cut-off で SpotLight が
baseline を上回る。 • AUC=0.91。EdgeWeight=0.83 より 8.4%、RHSS=0.70 より 30% 高い。 • 精度上昇の代償は、EW/RHSS に対する約4倍の実行時間に留まる。 16 SOKENDAI
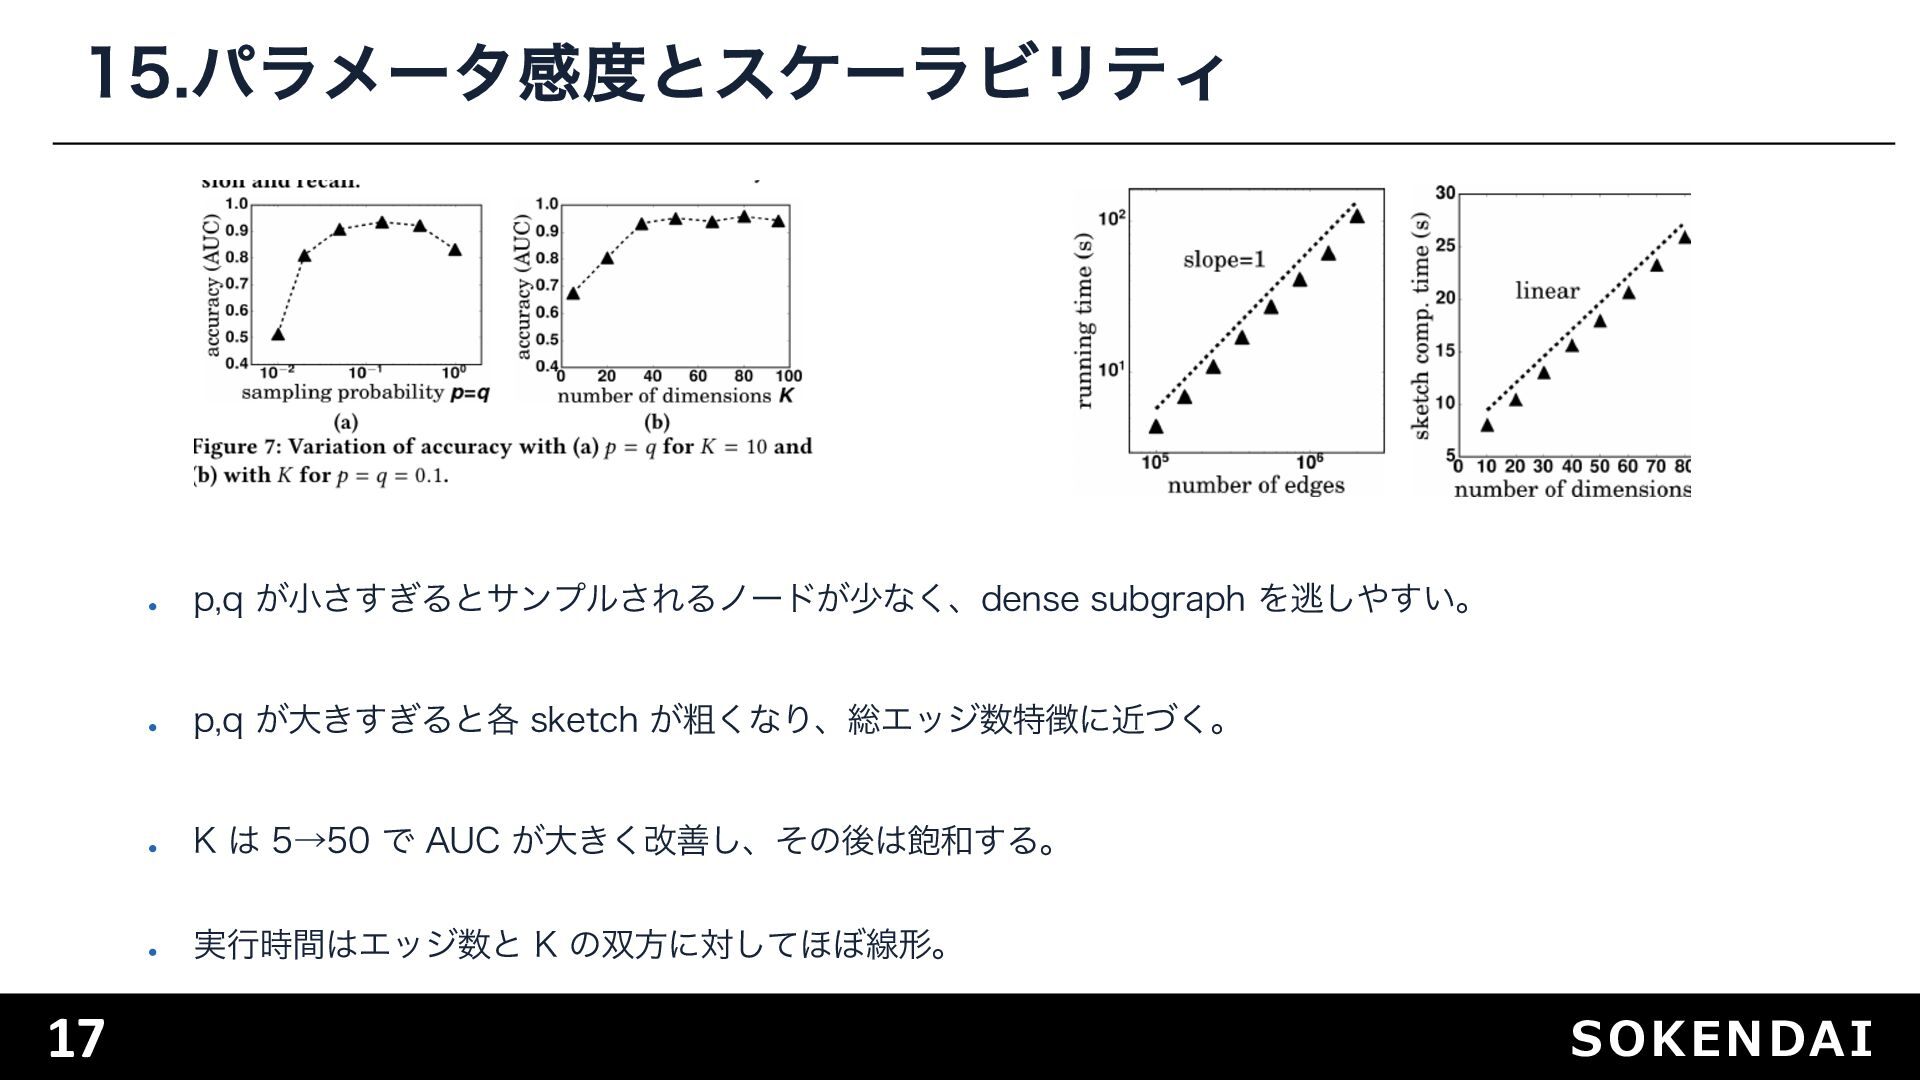
15.パラメータ感度とスケーラビリティ • p,q が小さすぎるとサンプルされるノードが少なく、dense subgraph を逃しやすい。 • p,q が大きすぎると各 sketch
が粗くなり、総エッジ数特徴に近づく。 • K は 5→50 で AUC が大きく改善し、その後は飽和する。 • 実行時間はエッジ数と K の双方に対してほぼ線形。 17 SOKENDAI
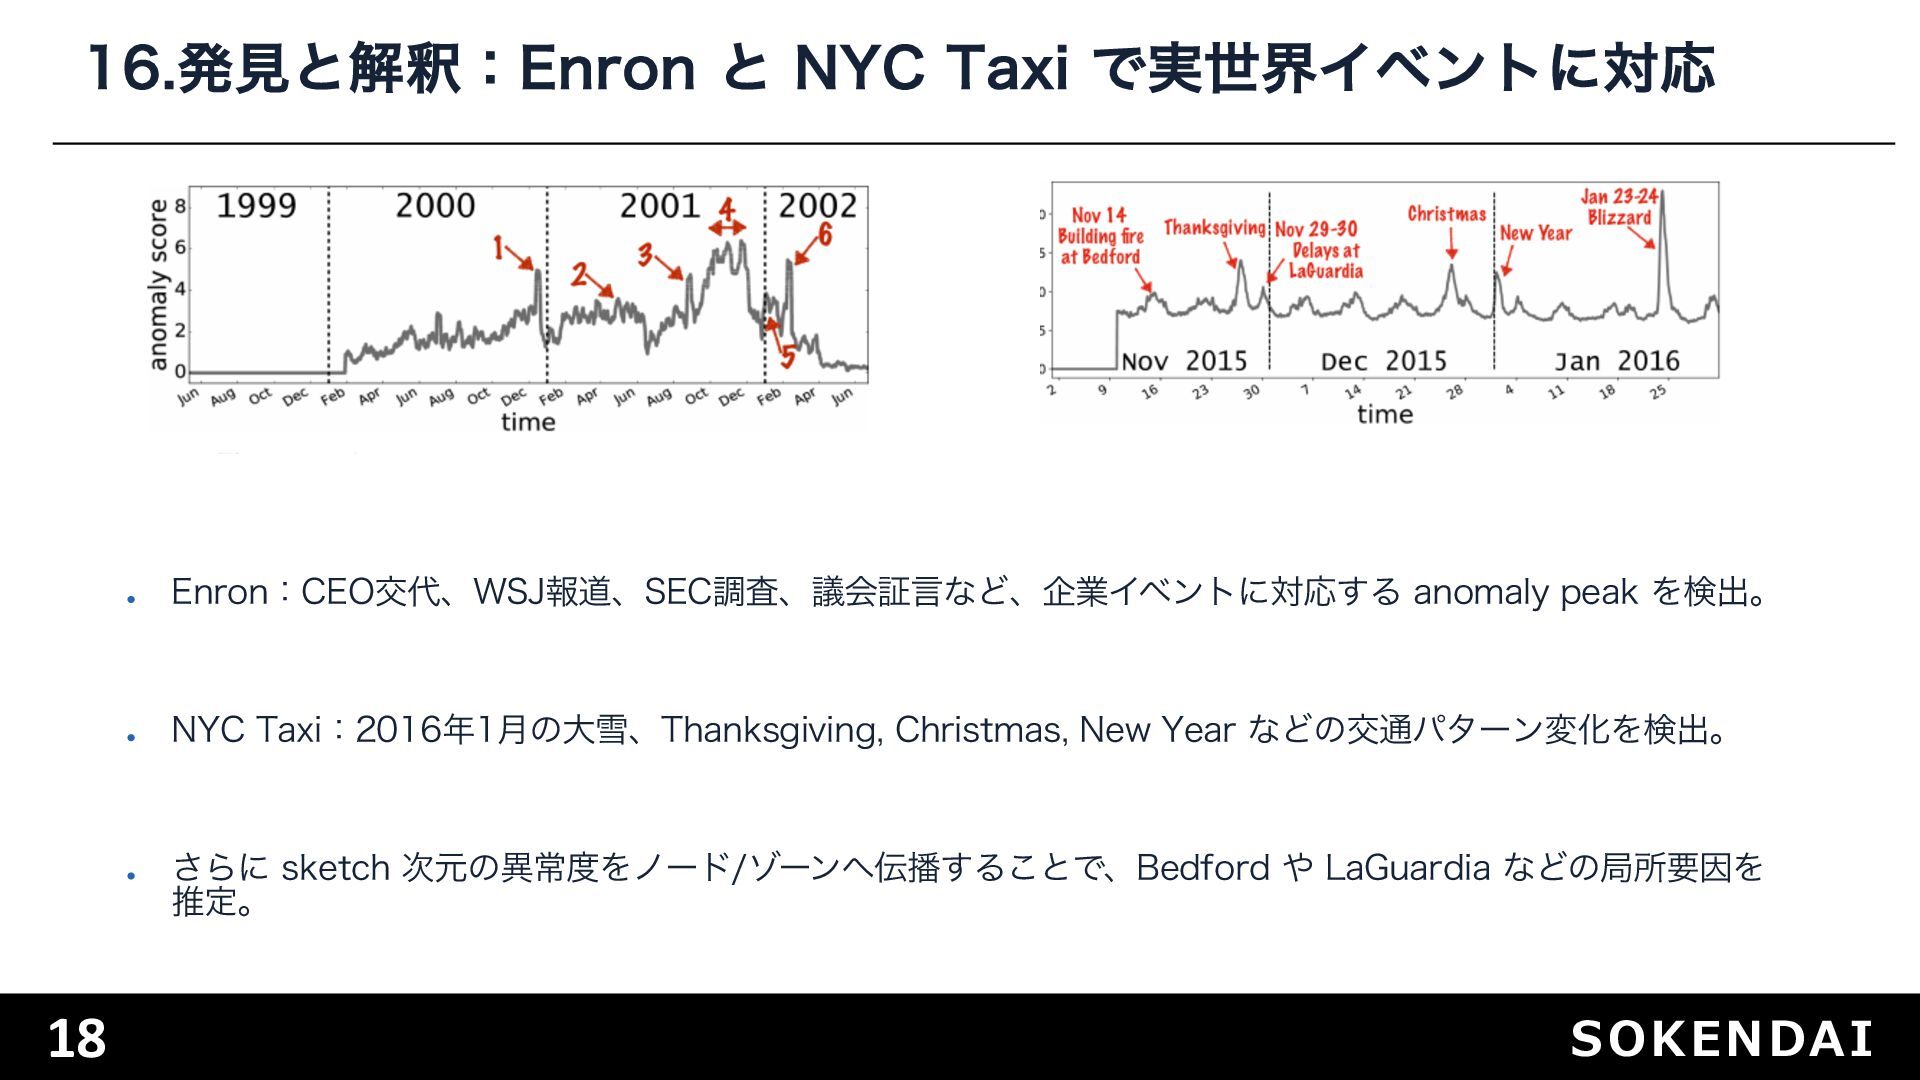
16.発見と解釈:Enron と NYC Taxi で実世界イベントに対応 • Enron:CEO交代、WSJ報道、SEC調査、議会証言など、企業イベントに対応する anomaly peak を検出。
• NYC Taxi:2016年1月の大雪、Thanksgiving, Christmas, New Year などの交通パターン変化を検出。 • さらに sketch 次元の異常度をノード/ゾーンへ伝播することで、Bedford や LaGuardia などの局所要因を 推定。 18 SOKENDAI
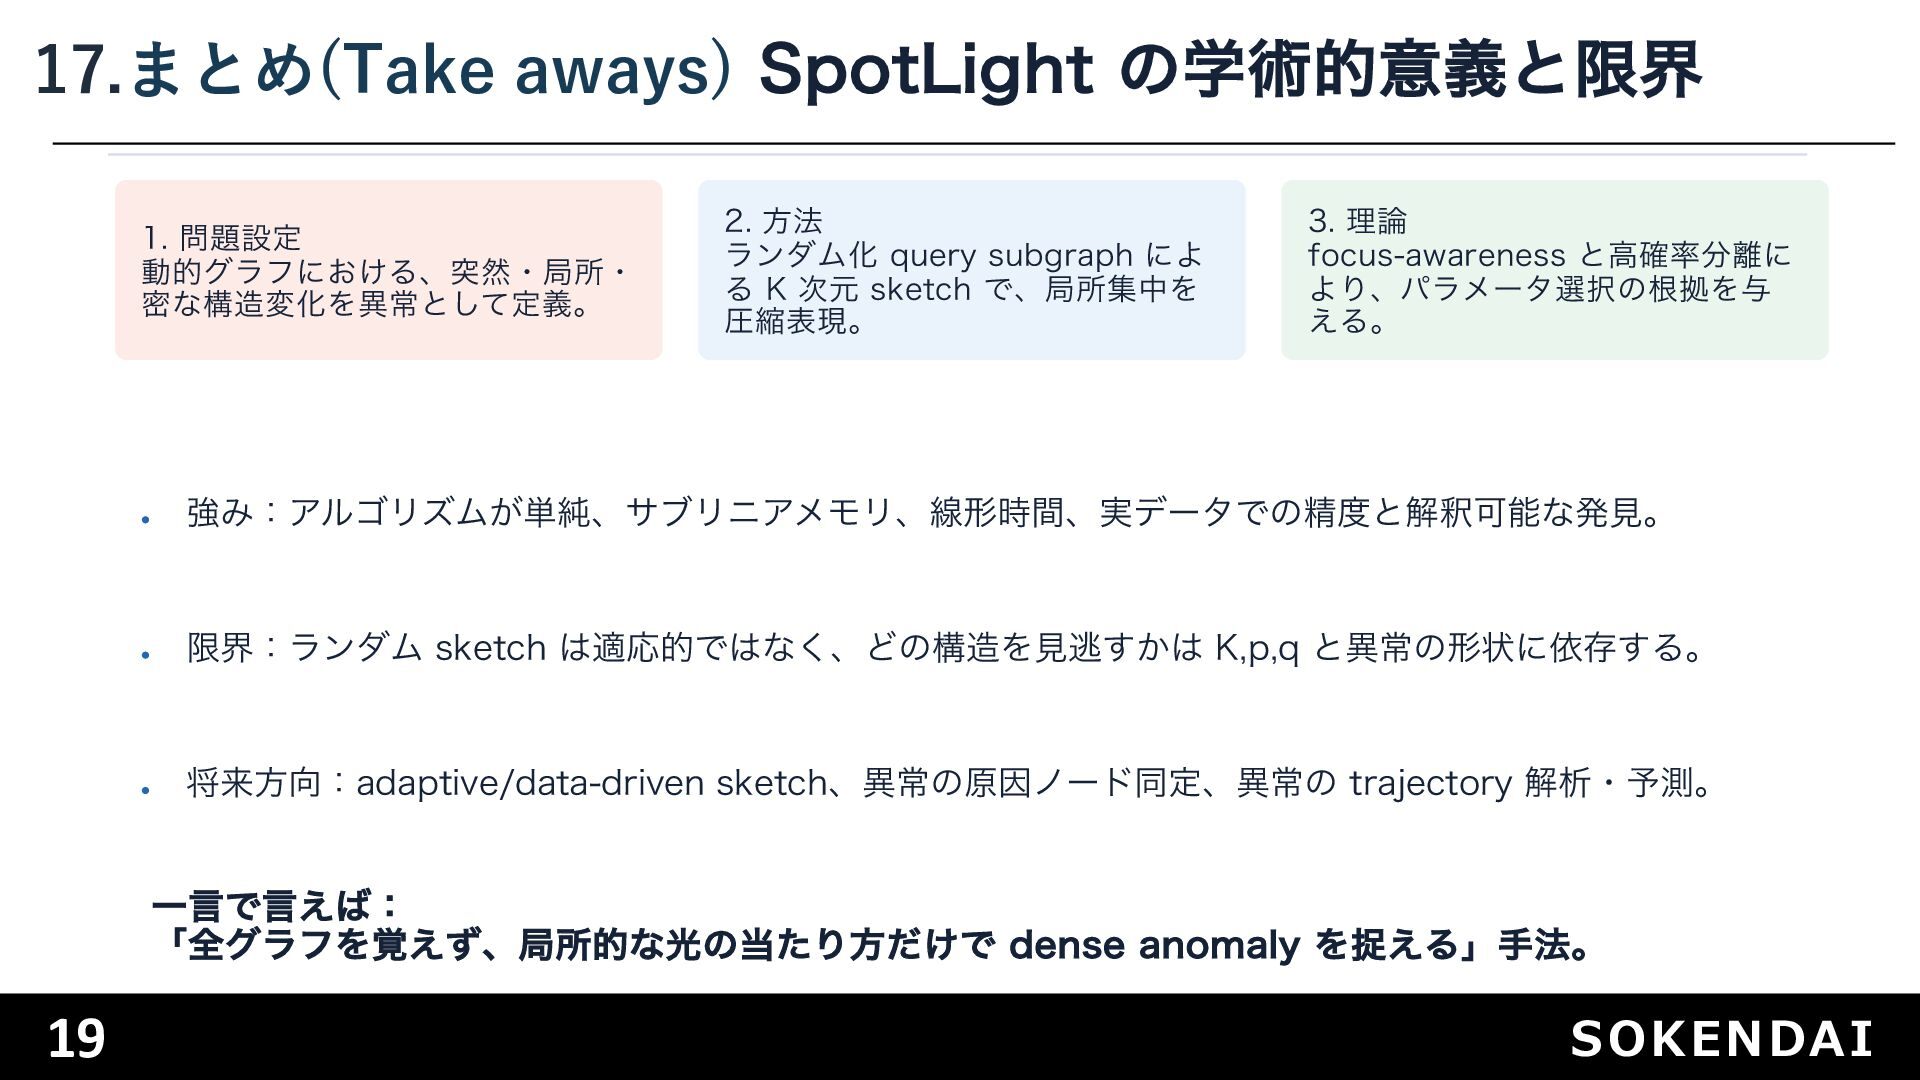
17.まとめ(Take aways) SpotLight の学術的意義と限界 1. 問題設定 動的グラフにおける、突然・局所・ 密な構造変化を異常として定義。 2. 方法
ランダム化 query subgraph によ る K 次元 sketch で、局所集中を 圧縮表現。 3. 理論 focus-awareness と高確率分離に より、パラメータ選択の根拠を与 える。 • 強み:アルゴリズムが単純、サブリニアメモリ、線形時間、実データでの精度と解釈可能な発見。 • 限界:ランダム sketch は適応的ではなく、どの構造を見逃すかは K,p,q と異常の形状に依存する。 • 将来方向:adaptive/data-driven sketch、異常の原因ノード同定、異常の trajectory 解析・予測。 一言で言えば: 「全グラフを覚えず、局所的な光の当たり方だけで dense anomaly を捉える」手法。 19 SOKENDAI


 fk001jp
 maggiecrowley
 nwiizo
 techseoconnect
 twada
 moore
 addyosmani
 lara
 smashingmag
 leimatthew05
 lemiorhan
 jmmastey
 reverentgeek