Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Graph_Invariant_Learning_260525_1.pdf
Search
君野史明(Fumiaki Kimino)
May 26, 2026
9
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Graph_Invariant_Learning_260525_1.pdf
君野史明(Fumiaki Kimino)
May 26, 2026
More Decks by 君野史明(Fumiaki Kimino)
See All by 君野史明(Fumiaki Kimino)
understanding_deep_contrastive_learning_260929.pdf
fk001jp
0
5
SpotLight_260824.pdf
fk001jp
0
11
GCFormer_260727.pdf
fk001jp
0
13
universality_label_efficiency_jp_260629.pdf
fk001jp
0
20
DRAGON_260427_1.pdf
fk001jp
0
12
HANG_GNN_robustness_260330_1.pdf
fk001jp
0
7
Reconstruction_for_Powerful_Graph_Representations_260225_1.pdf
fk001jp
0
11
HYPERION_260205_1.pdf
fk001jp
0
11
Mitigating_Local_Cohesion_251222_1.pdf
fk001jp
0
13
Featured
See All Featured
Data-driven link building: lessons from a $708K investment (BrightonSEO talk)
szymonslowik
1
1.4k
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
Product Roadmaps are Hard
iamctodd
55
13k
Exploring the Power of Turbo Streams & Action Cable | RailsConf2023
kevinliebholz
37
6.6k
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3.1k
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
990
What Being in a Rock Band Can Teach Us About Real World SEO
427marketing
0
1.1k
How to Ace a Technical Interview
jacobian
280
24k
Ethics towards AI in product and experience design
skipperchong
2
430
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
600
Taking LLMs out of the black box: A practical guide to human-in-the-loop distillation
inesmontani
PRO
3
2.5k
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
280
Transcript
1 SOKENDAI SOKENDAI Learning Invariant Graph Representations for Out-of-Distribution Generalization
(NeurIPS 2022) の紹介 君野 史明
2 SOKENDAI ⾃⼰紹介 n 名前︓君野 史明(きみの ふみあき) n 所属︓総合研究⼤学院⼤学 情報学コース
D1 n 専⾨︓ グラフ対照学習 グラフ表現学習
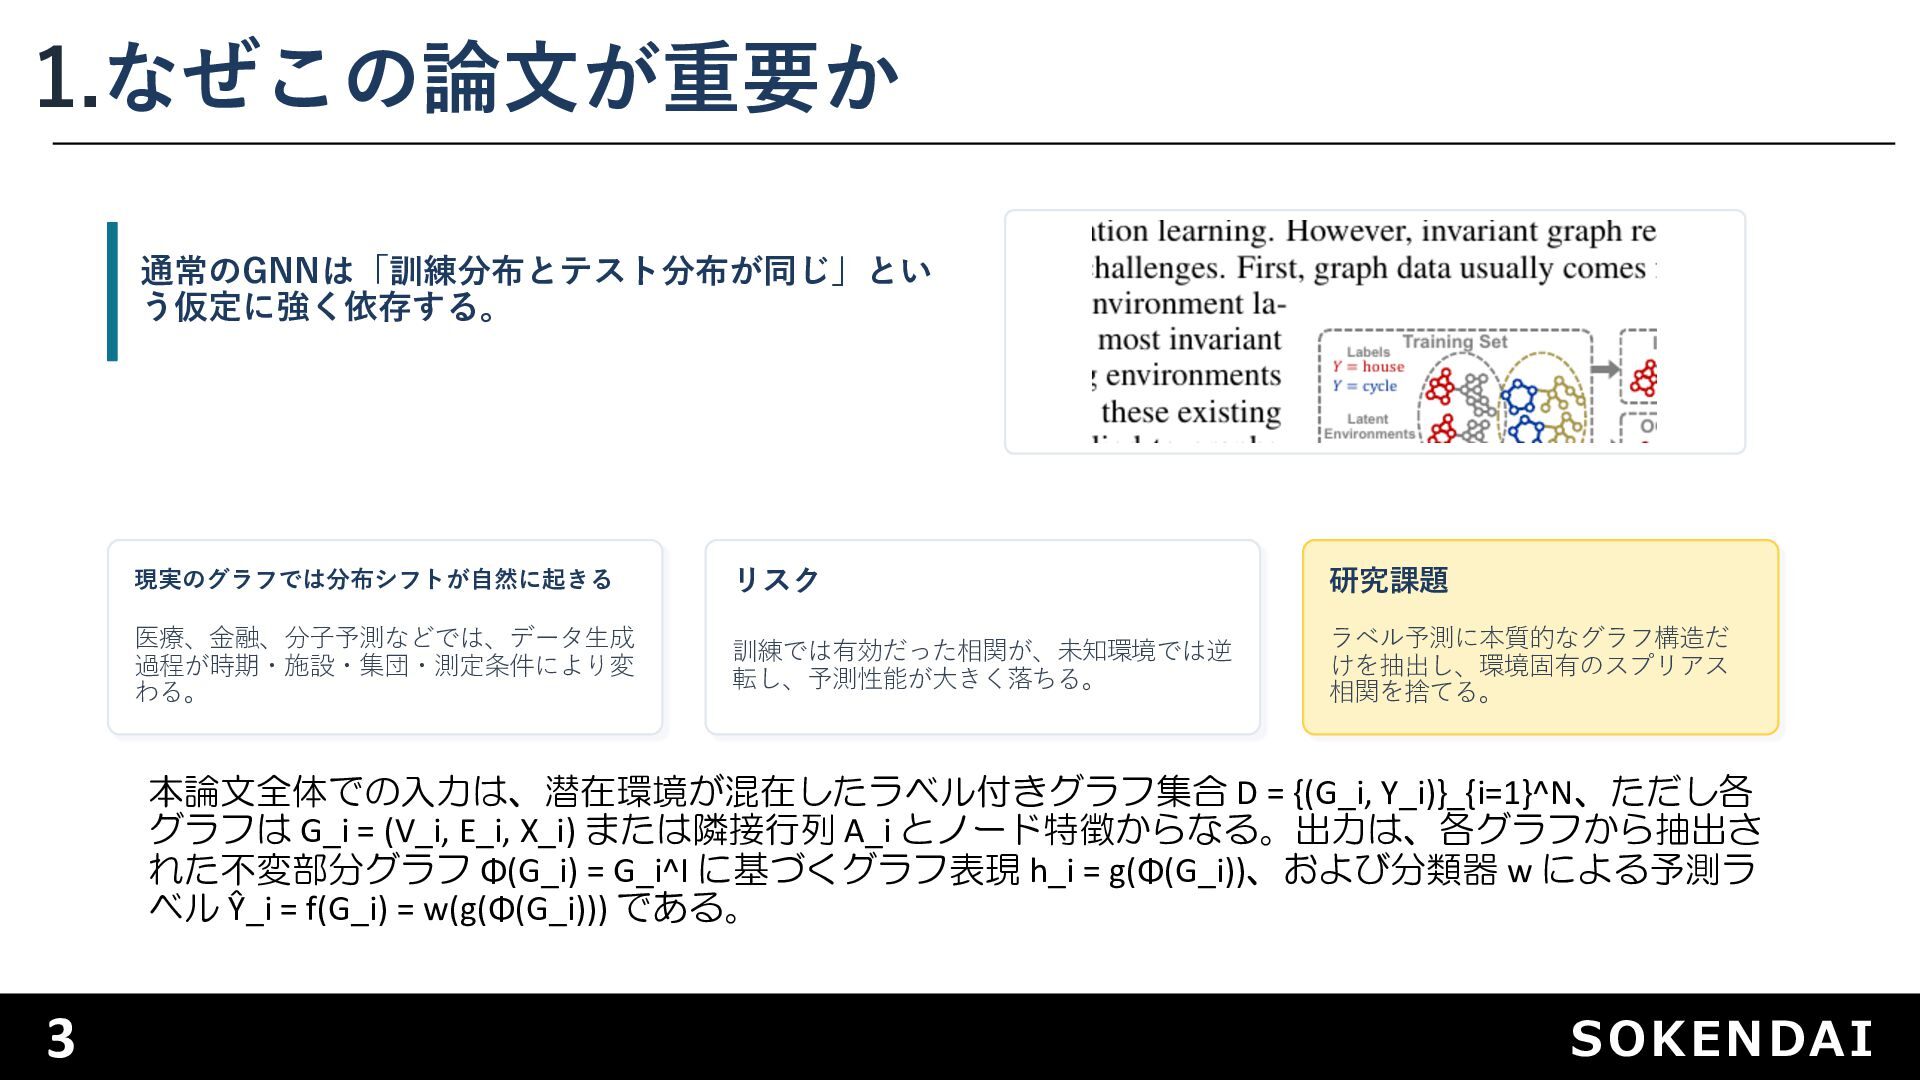
3 SOKENDAI 1.なぜこの論⽂が重要か 通常のGNNは「訓練分布とテスト分布が同じ」とい う仮定に強く依存する。 現実のグラフでは分布シフトが⾃然に起きる 医療、⾦融、分⼦予測などでは、データ⽣成 過程が時期・施設・集団・測定条件により変 わる。 リスク
訓練では有効だった相関が、未知環境では逆 転し、予測性能が⼤きく落ちる。 研究課題 ラベル予測に本質的なグラフ構造だ けを抽出し、環境固有のスプリアス 相関を捨てる。 本論文全体での入力は、潜在環境が混在したラベル付きグラフ集合 D = {(G_i, Y_i)}_{i=1}^N、ただし各 グラフは G_i = (V_i, E_i, X_i) または隣接行列 A_i とノード特徴からなる。出力は、各グラフから抽出さ れた不変部分グラフ Φ(G_i) = G_i^I に基づくグラフ表現 h_i = g(Φ(G_i))、および分類器 w による予測ラ ベル Ŷ_i = f(G_i) = w(g(Φ(G_i))) である。
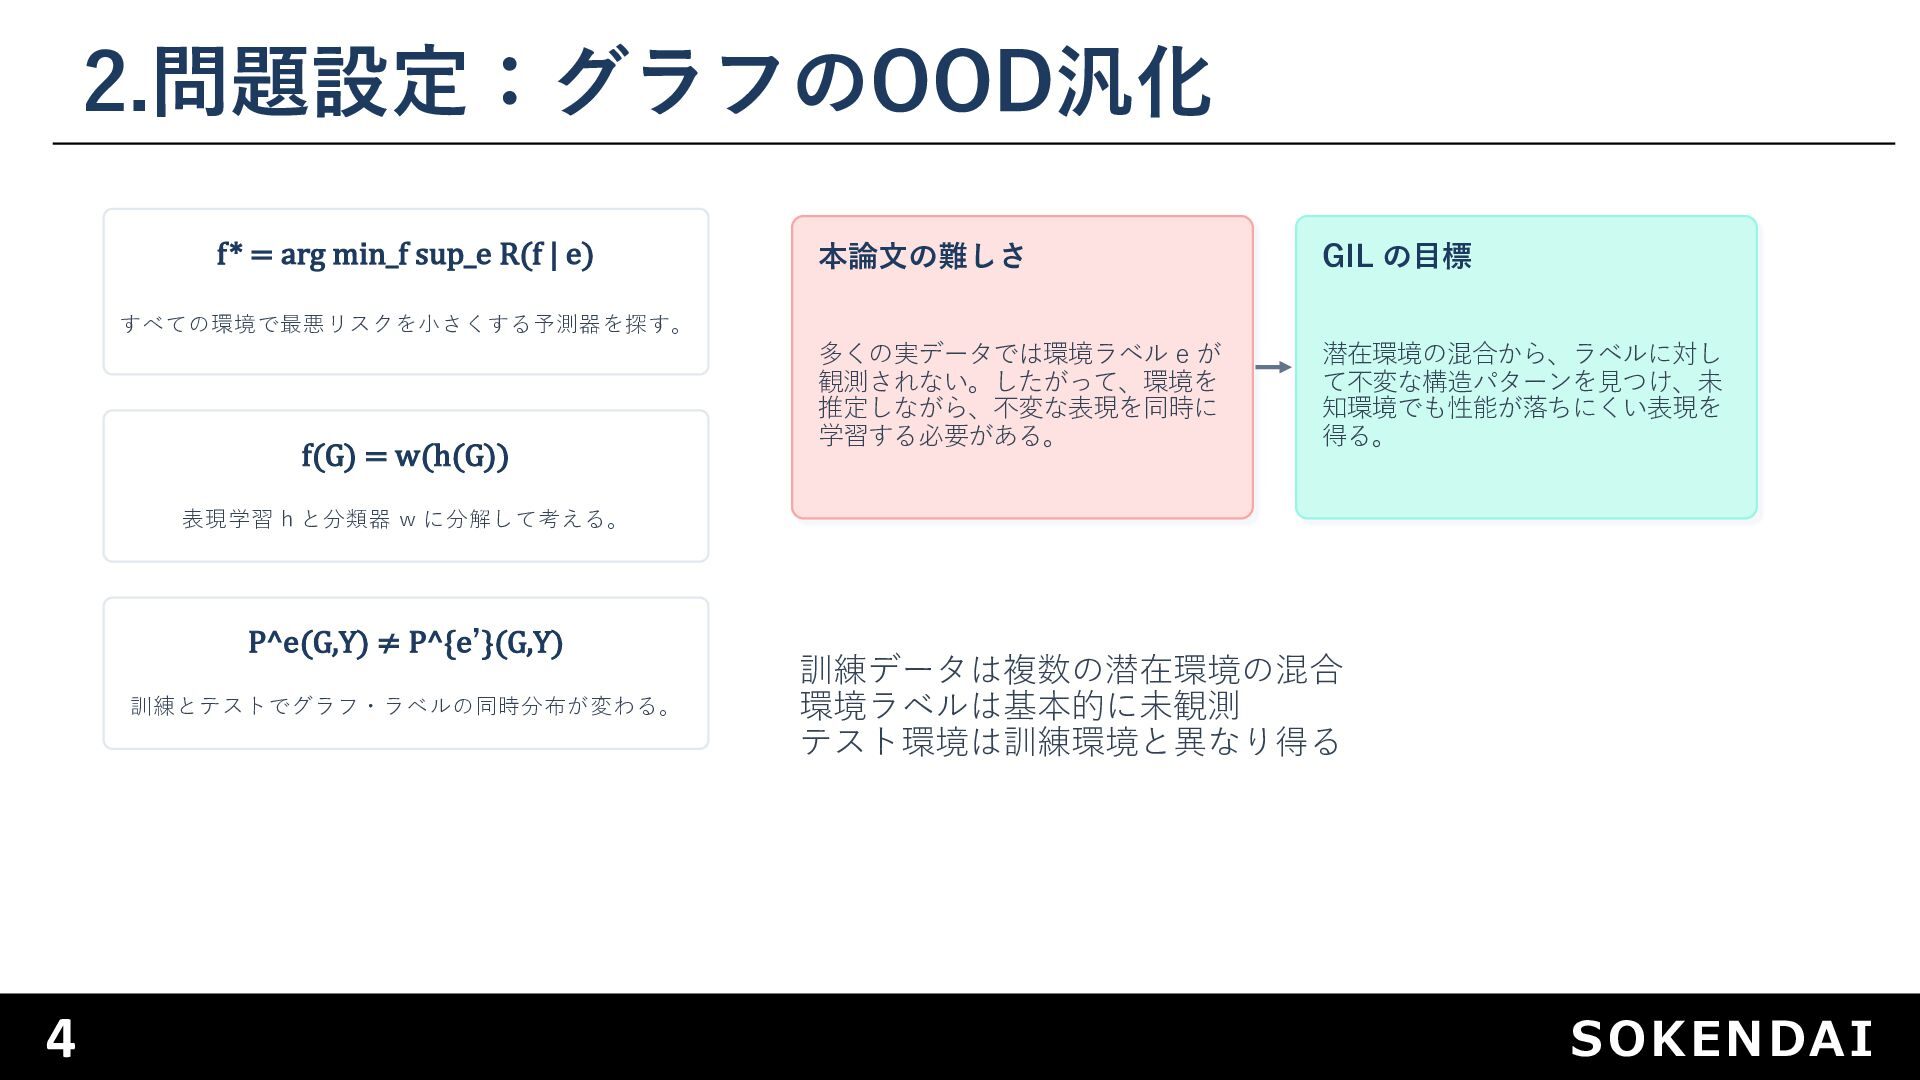
4 SOKENDAI 2.問題設定:グラフのOOD汎化 f* = arg min_f sup_e R(f |
e) すべての環境で最悪リスクを⼩さくする予測器を探す。 f(G) = w(h(G)) 表現学習 h と分類器 w に分解して考える。 P^e(G,Y) ≠ P^{eʼ}(G,Y) 訓練とテストでグラフ・ラベルの同時分布が変わる。 本論⽂の難しさ 多くの実データでは環境ラベル e が 観測されない。したがって、環境を 推定しながら、不変な表現を同時に 学習する必要がある。 GIL の⽬標 潜在環境の混合から、ラベルに対し て不変な構造パターンを⾒つけ、未 知環境でも性能が落ちにくい表現を 得る。 訓練データは複数の潜在環境の混合 環境ラベルは基本的に未観測 テスト環境は訓練環境と異なり得る
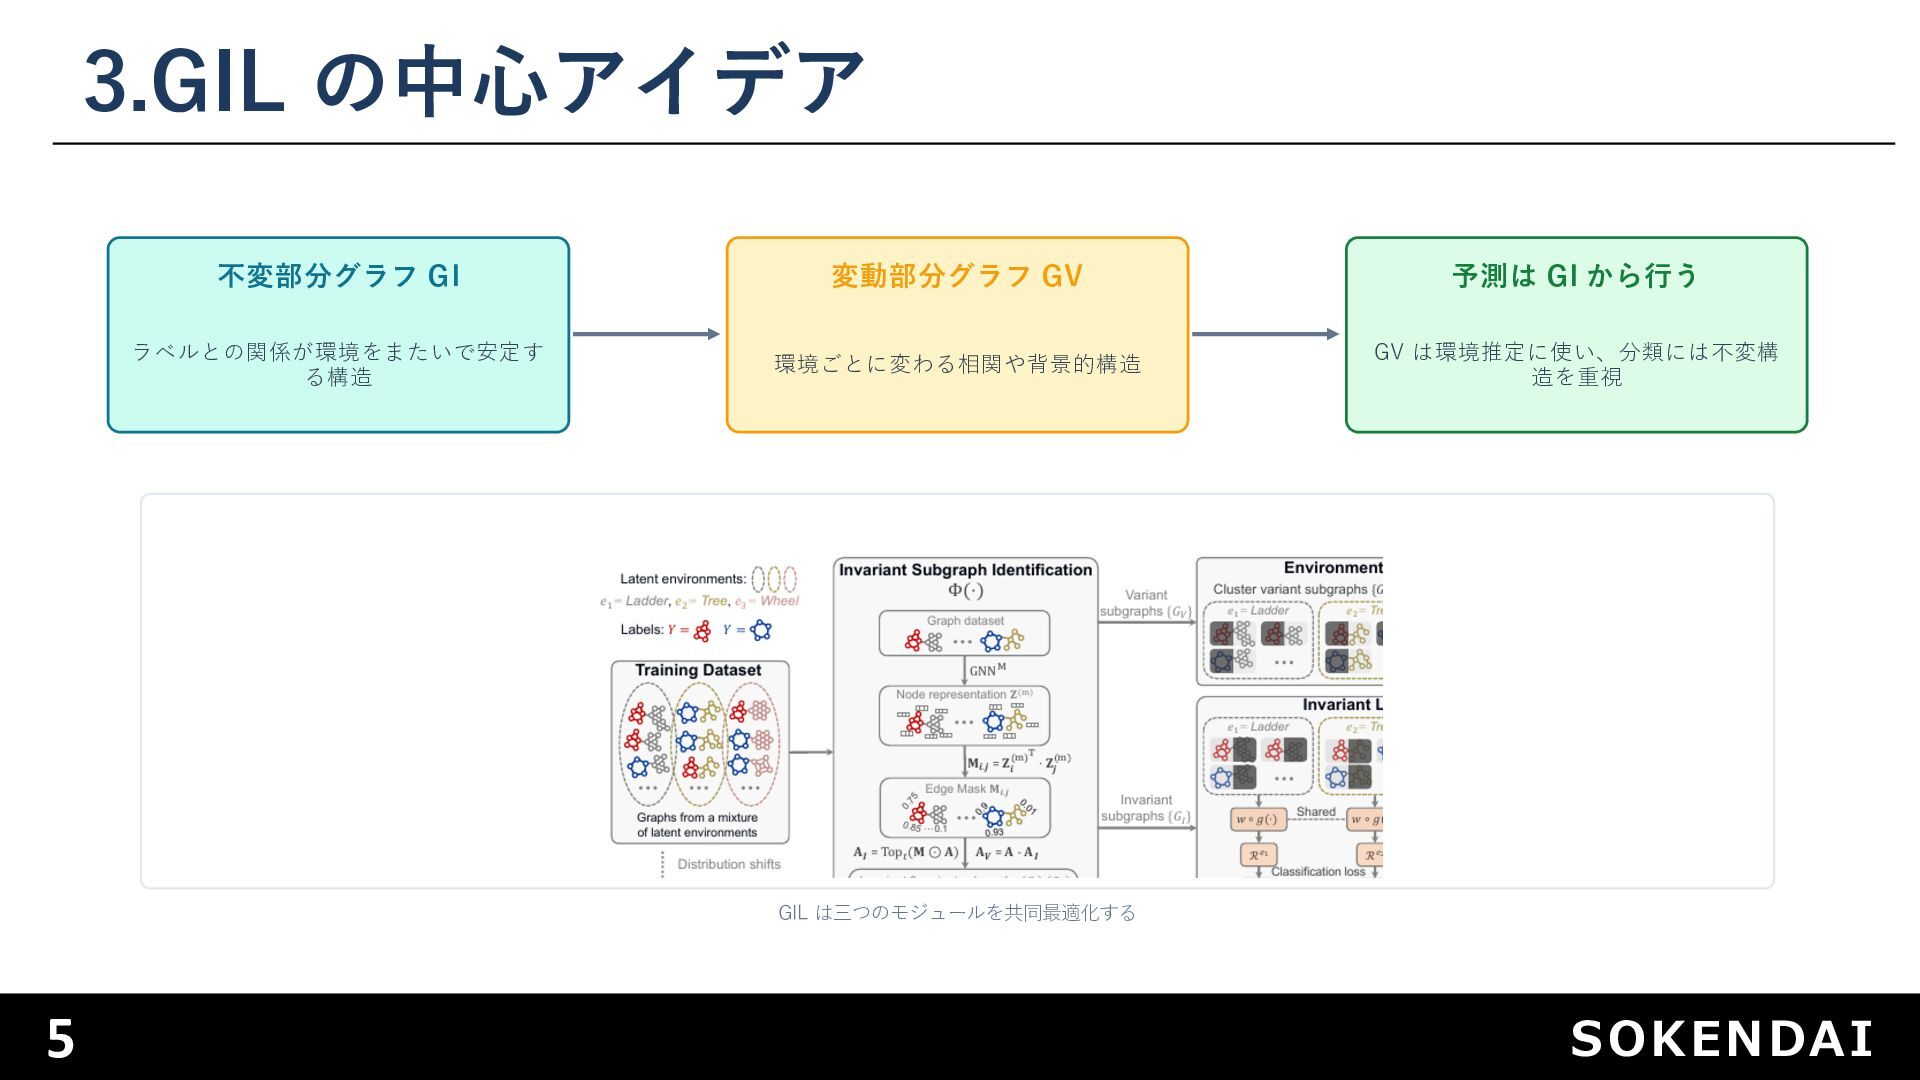
5 SOKENDAI 3.GIL の中⼼アイデア 不変部分グラフ GI ラベルとの関係が環境をまたいで安定す る構造 変動部分グラフ GV
環境ごとに変わる相関や背景的構造 予測は GI から⾏う GV は環境推定に使い、分類には不変構 造を重視 GIL は三つのモジュールを共同最適化する
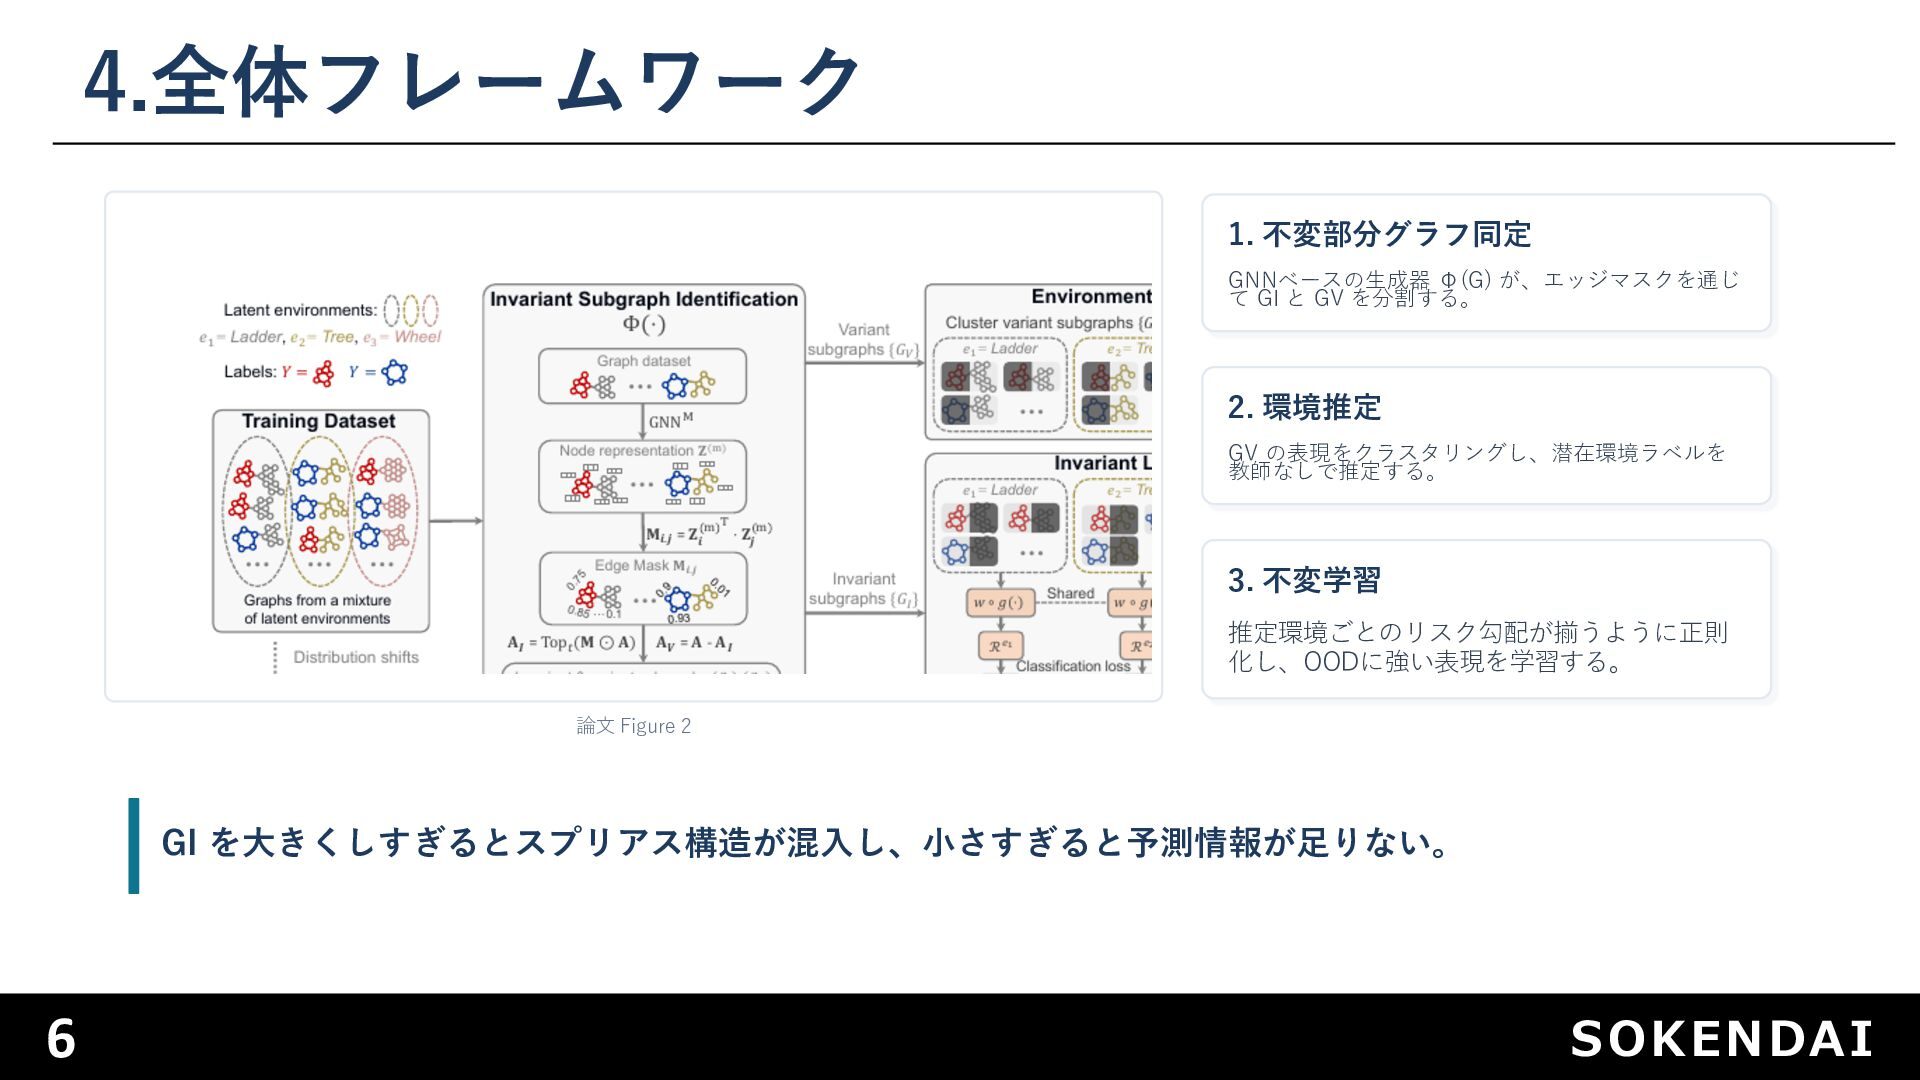
6 SOKENDAI 4.全体フレームワーク 論⽂ Figure 2 1. 不変部分グラフ同定 GNNベースの⽣成器 Φ(G)
が、エッジマスクを通じ て GI と GV を分割する。 2. 環境推定 GV の表現をクラスタリングし、潜在環境ラベルを 教師なしで推定する。 3. 不変学習 推定環境ごとのリスク勾配が揃うように正則 化し、OODに強い表現を学習する。 GI を⼤きくしすぎるとスプリアス構造が混⼊し、⼩さすぎると予測情報が⾜りない。
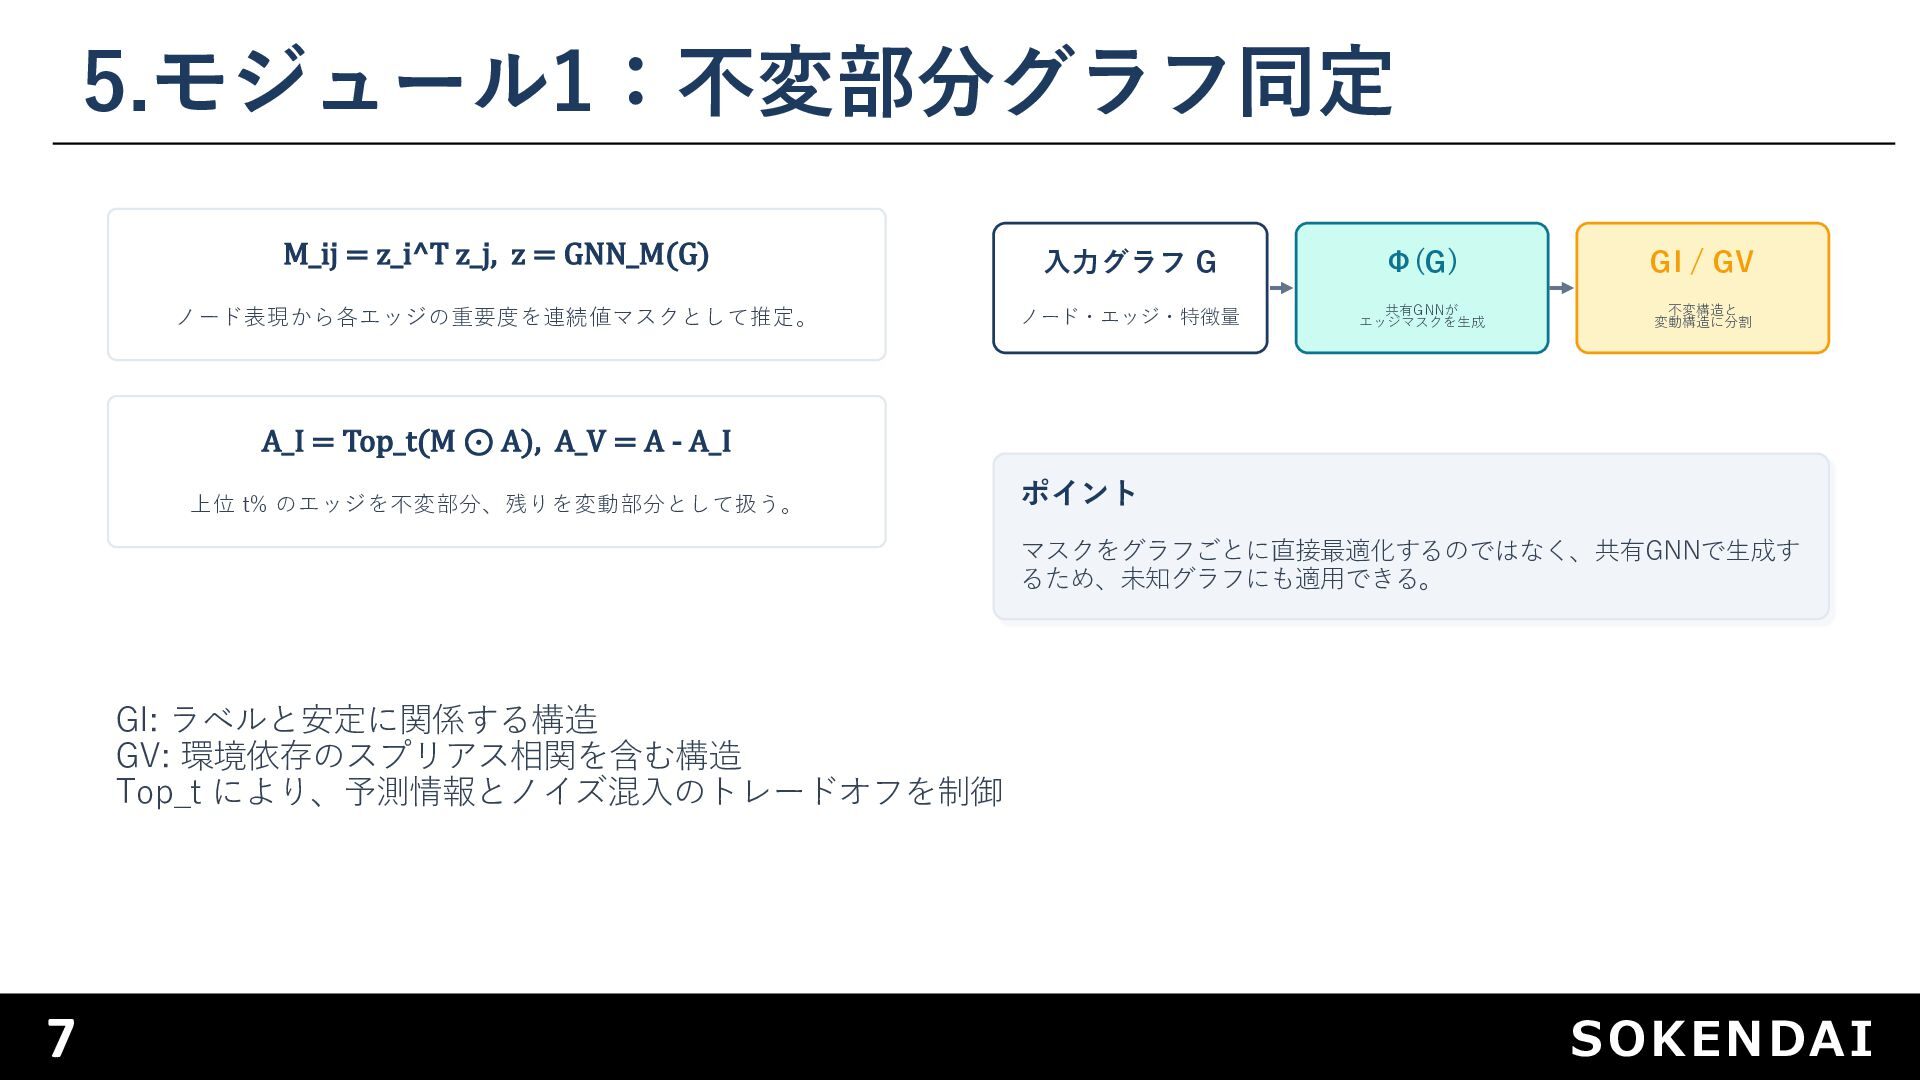
7 SOKENDAI 5.モジュール1:不変部分グラフ同定 M_ij = z_i^T z_j, z = GNN_M(G)
ノード表現から各エッジの重要度を連続値マスクとして推定。 A_I = Top_t(M ⊙ A), A_V = A - A_I 上位 t% のエッジを不変部分、残りを変動部分として扱う。 ⼊⼒グラフ G ノード・エッジ・特徴量 Φ(G) 共有GNNが エッジマスクを⽣成 GI / GV 不変構造と 変動構造に分割 ポイント マスクをグラフごとに直接最適化するのではなく、共有GNNで⽣成す るため、未知グラフにも適⽤できる。 GI: ラベルと安定に関係する構造 GV: 環境依存のスプリアス相関を含む構造 Top_t により、予測情報とノイズ混⼊のトレードオフを制御
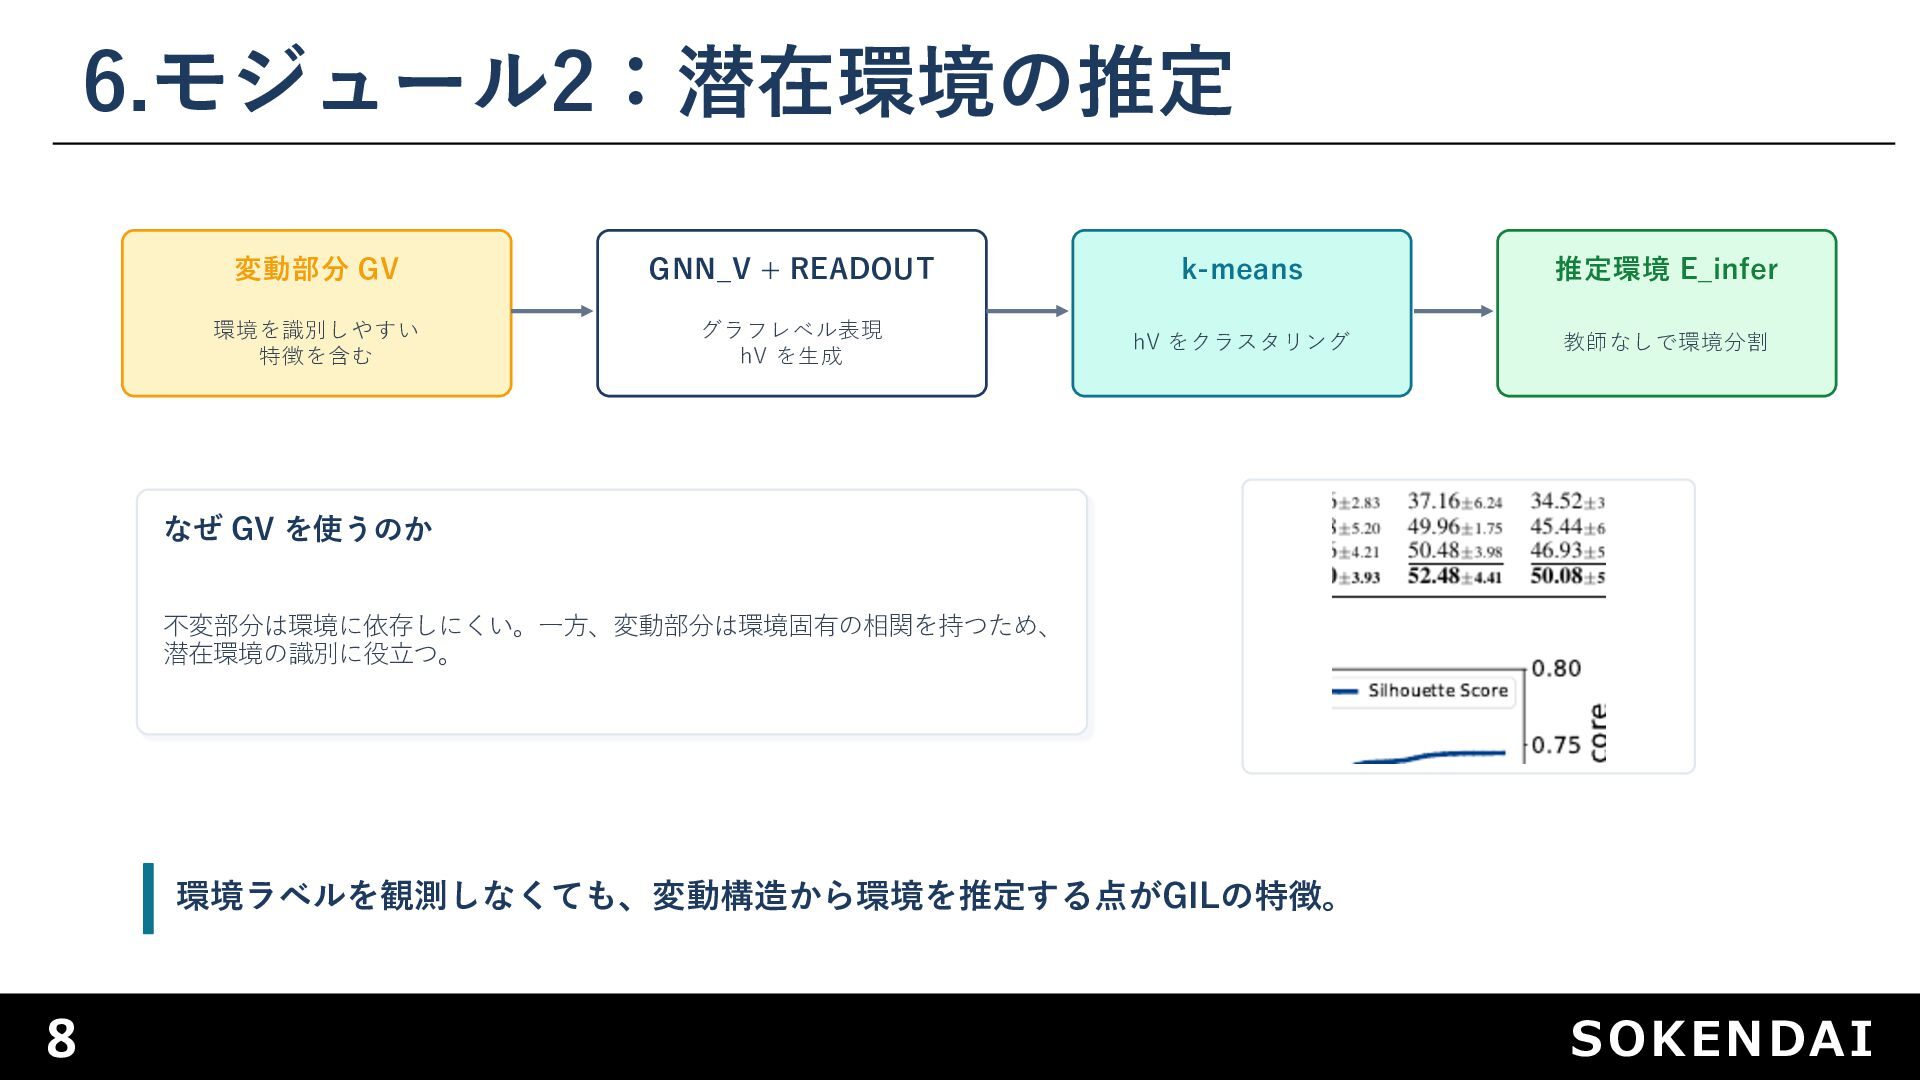
8 SOKENDAI 6.モジュール2:潜在環境の推定 変動部分 GV 環境を識別しやすい 特徴を含む GNN_V + READOUT
グラフレベル表現 hV を⽣成 k-means hV をクラスタリング 推定環境 E_infer 教師なしで環境分割 なぜ GV を使うのか 不変部分は環境に依存しにくい。⼀⽅、変動部分は環境固有の相関を持つため、 潜在環境の識別に役⽴つ。 環境ラベルを観測しなくても、変動構造から環境を推定する点がGILの特徴。
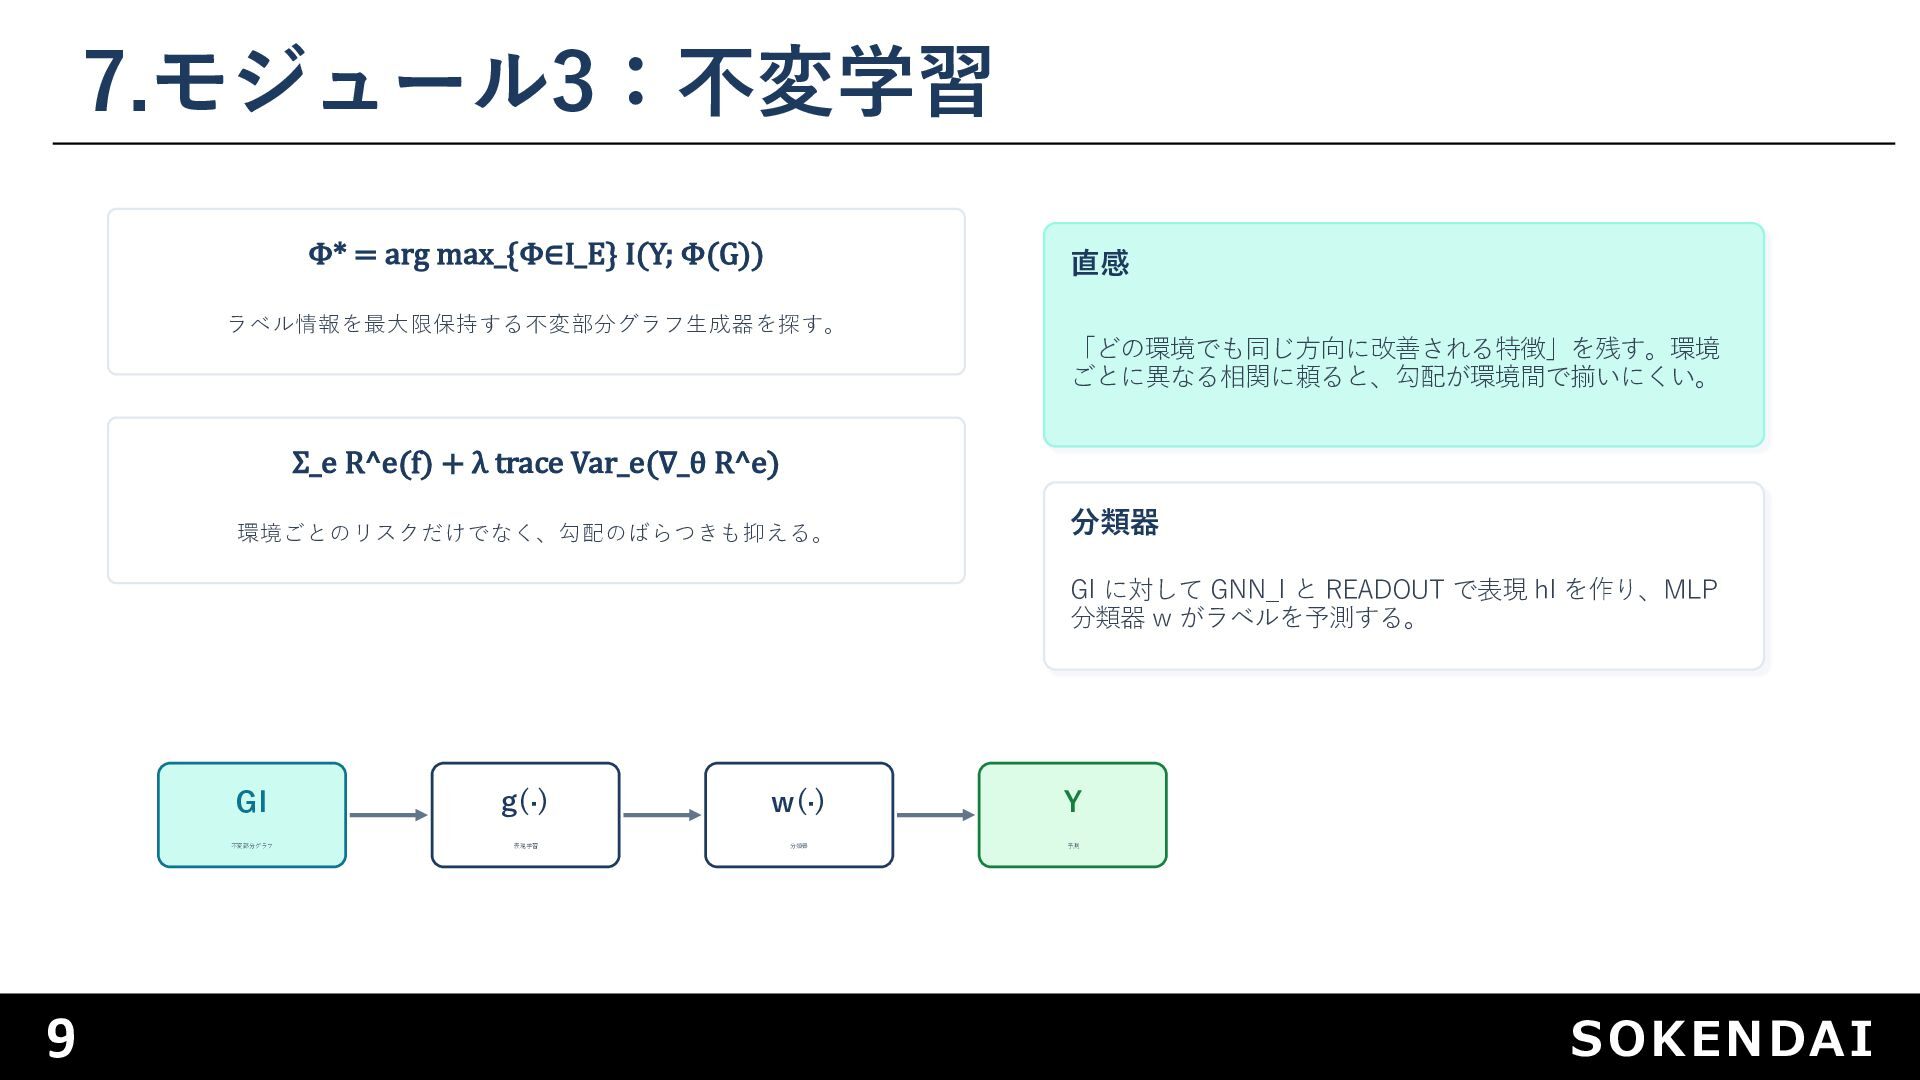
9 SOKENDAI 7.モジュール3:不変学習 Φ* = arg max_{Φ∈I_E} I(Y; Φ(G)) ラベル情報を最⼤限保持する不変部分グラフ⽣成器を探す。
Σ_e R^e(f) + λ trace Var_e(∇_θ R^e) 環境ごとのリスクだけでなく、勾配のばらつきも抑える。 直感 「どの環境でも同じ⽅向に改善される特徴」を残す。環境 ごとに異なる相関に頼ると、勾配が環境間で揃いにくい。 分類器 GI に対して GNN_I と READOUT で表現 hI を作り、MLP 分類器 w がラベルを予測する。 GI 不変部分グラフ g(·) 表現学習 w(·) 分類器 Y 予測
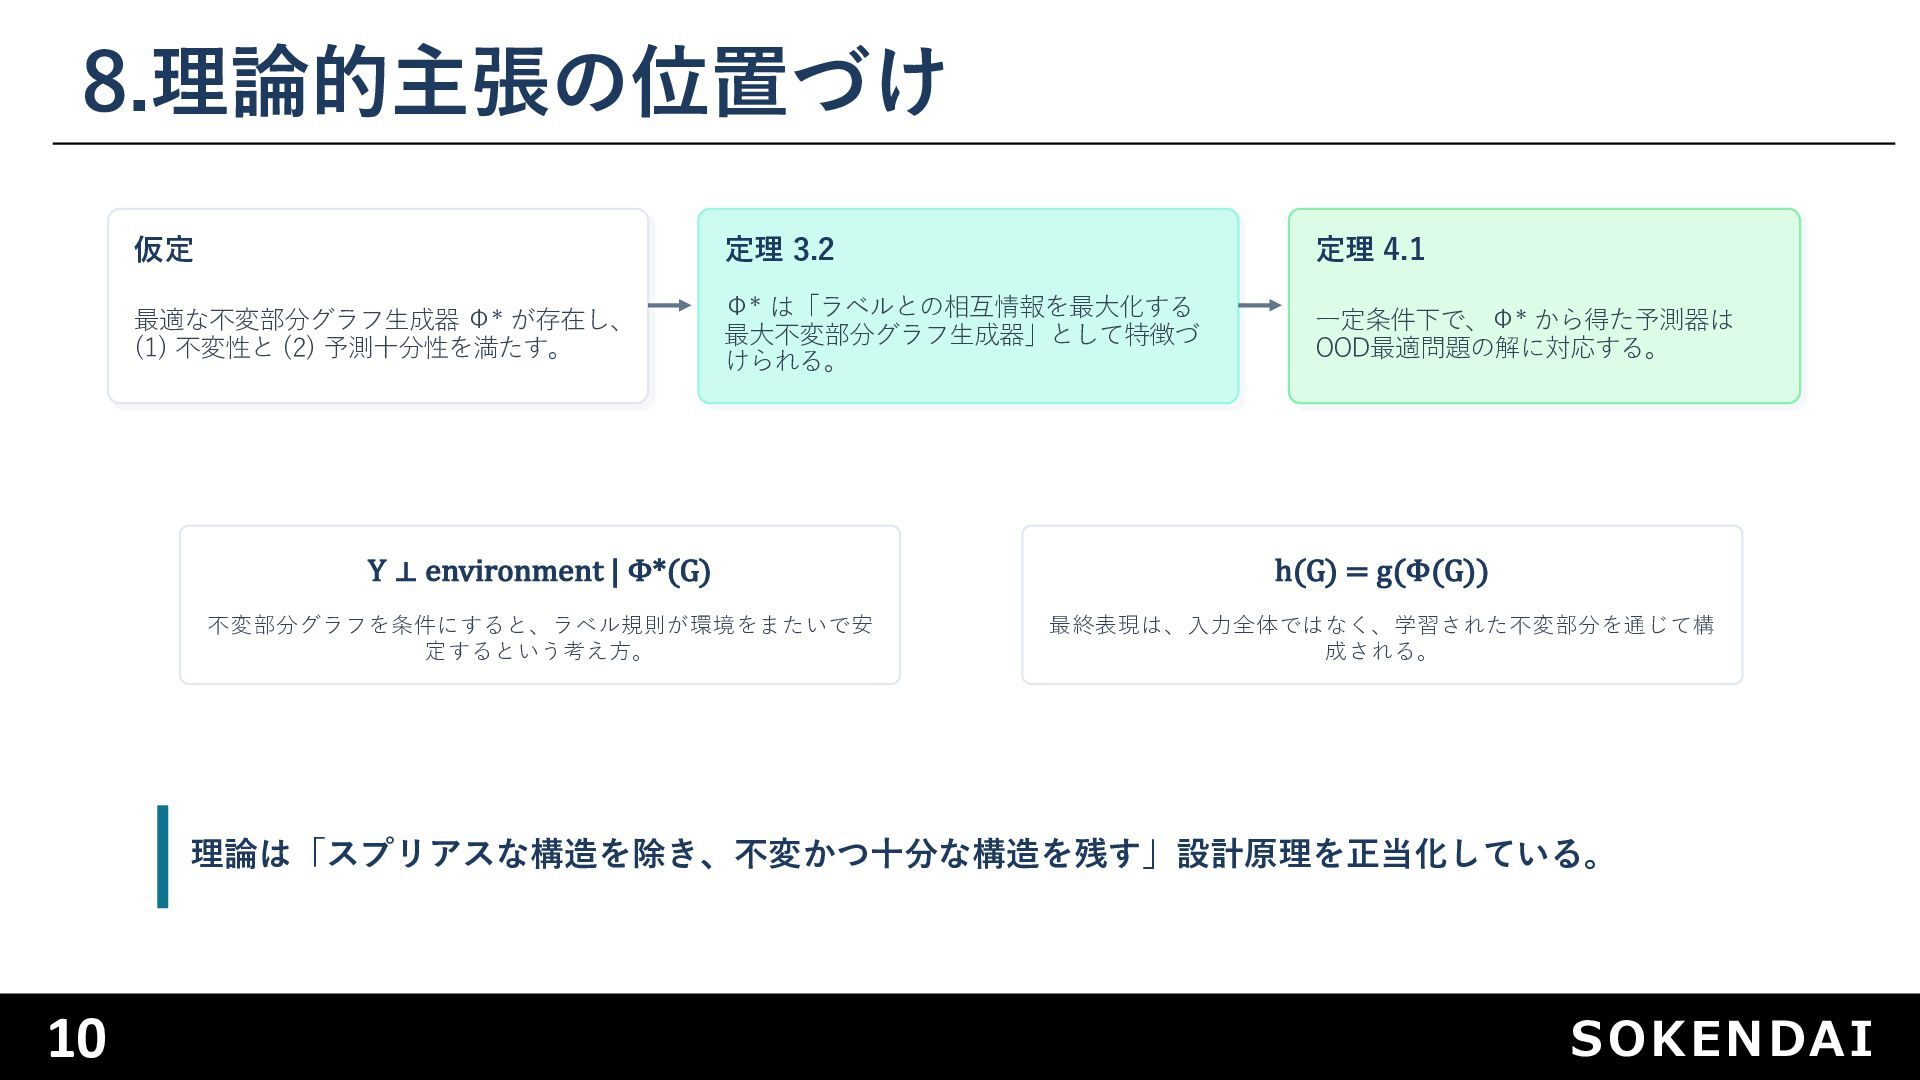
10 SOKENDAI 8.理論的主張の位置づけ 仮定 最適な不変部分グラフ⽣成器 Φ* が存在し、 (1) 不変性と (2)
予測⼗分性を満たす。 定理 3.2 Φ* は「ラベルとの相互情報を最⼤化する 最⼤不変部分グラフ⽣成器」として特徴づ けられる。 定理 4.1 ⼀定条件下で、Φ* から得た予測器は OOD最適問題の解に対応する。 Y ⟂ environment | Φ*(G) 不変部分グラフを条件にすると、ラベル規則が環境をまたいで安 定するという考え⽅。 h(G) = g(Φ(G)) 最終表現は、⼊⼒全体ではなく、学習された不変部分を通じて構 成される。 理論は「スプリアスな構造を除き、不変かつ⼗分な構造を残す」設計原理を正当化している。
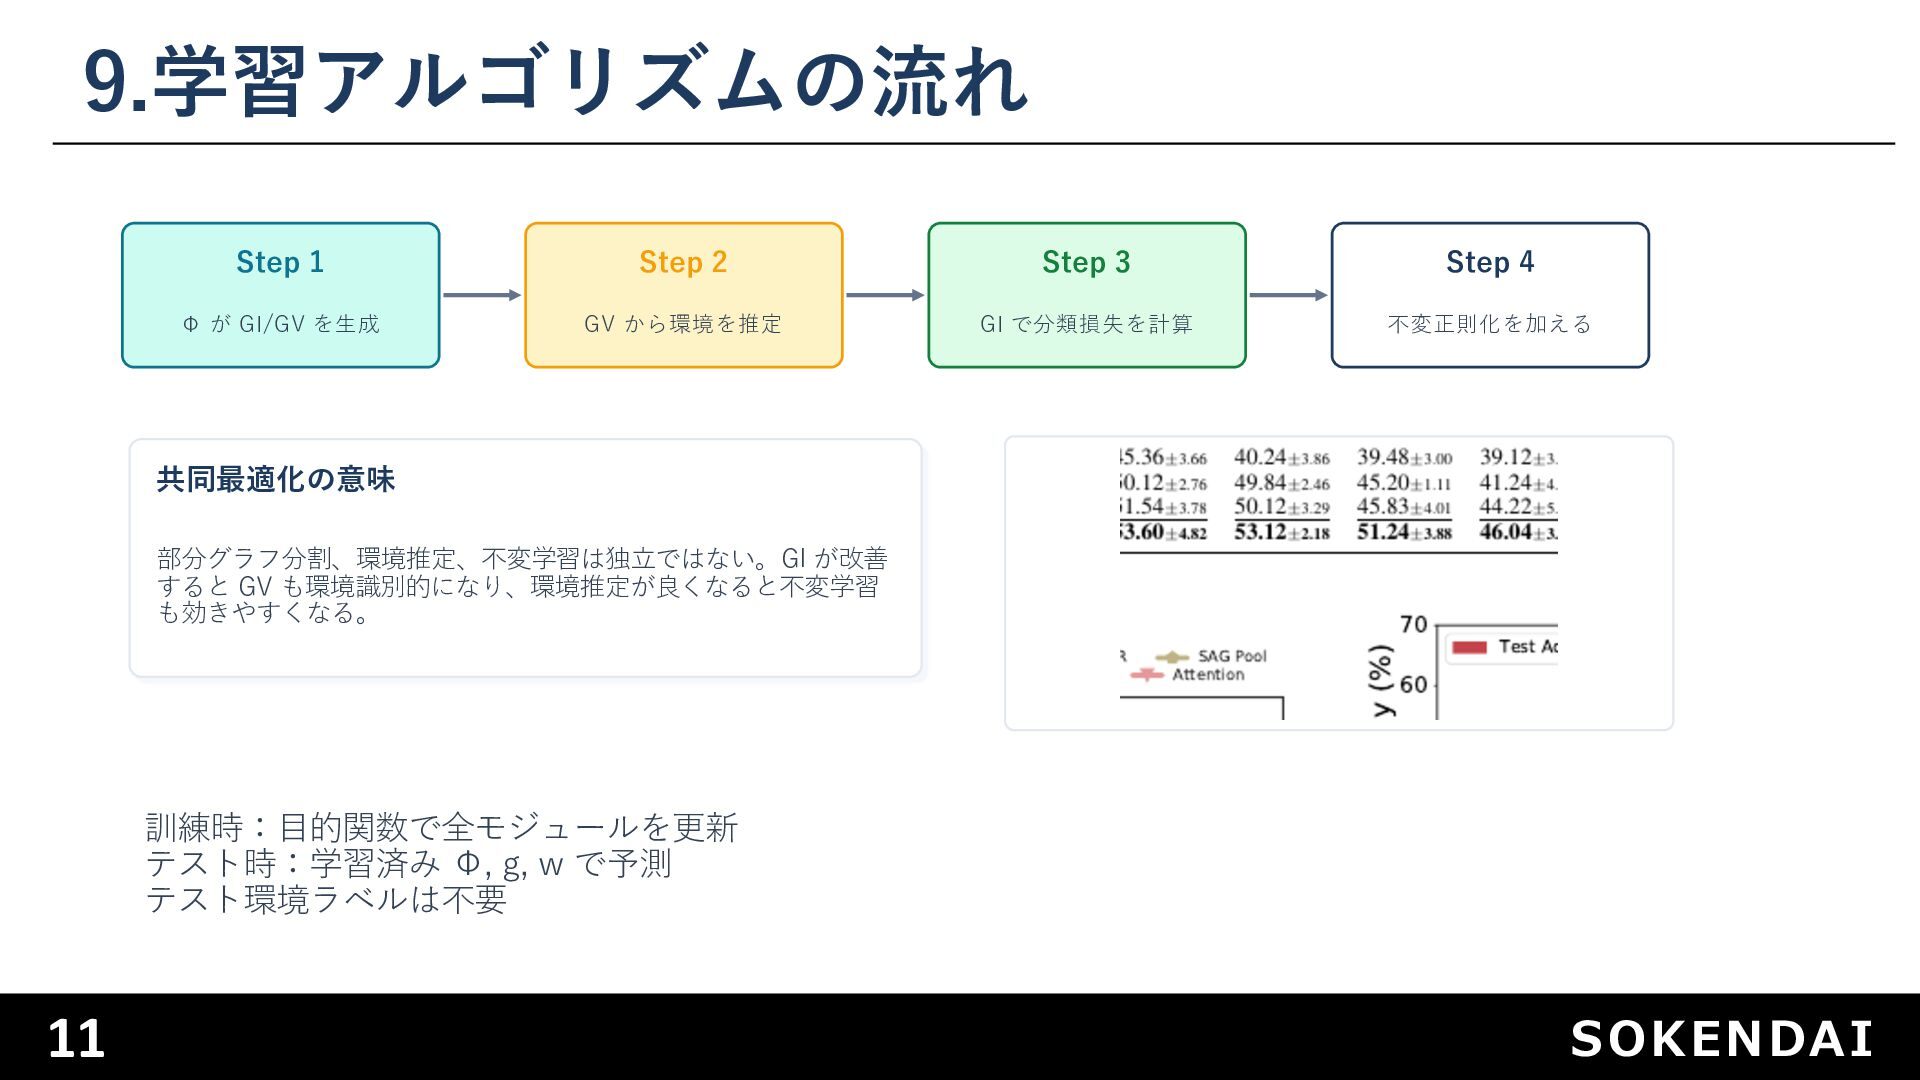
11 SOKENDAI 9.学習アルゴリズムの流れ Step 1 Φ が GI/GV を⽣成 Step
2 GV から環境を推定 Step 3 GI で分類損失を計算 Step 4 不変正則化を加える 共同最適化の意味 部分グラフ分割、環境推定、不変学習は独⽴ではない。GI が改善 すると GV も環境識別的になり、環境推定が良くなると不変学習 も効きやすくなる。 訓練時:⽬的関数で全モジュールを更新 テスト時:学習済み Φ, g, w で予測 テスト環境ラベルは不要
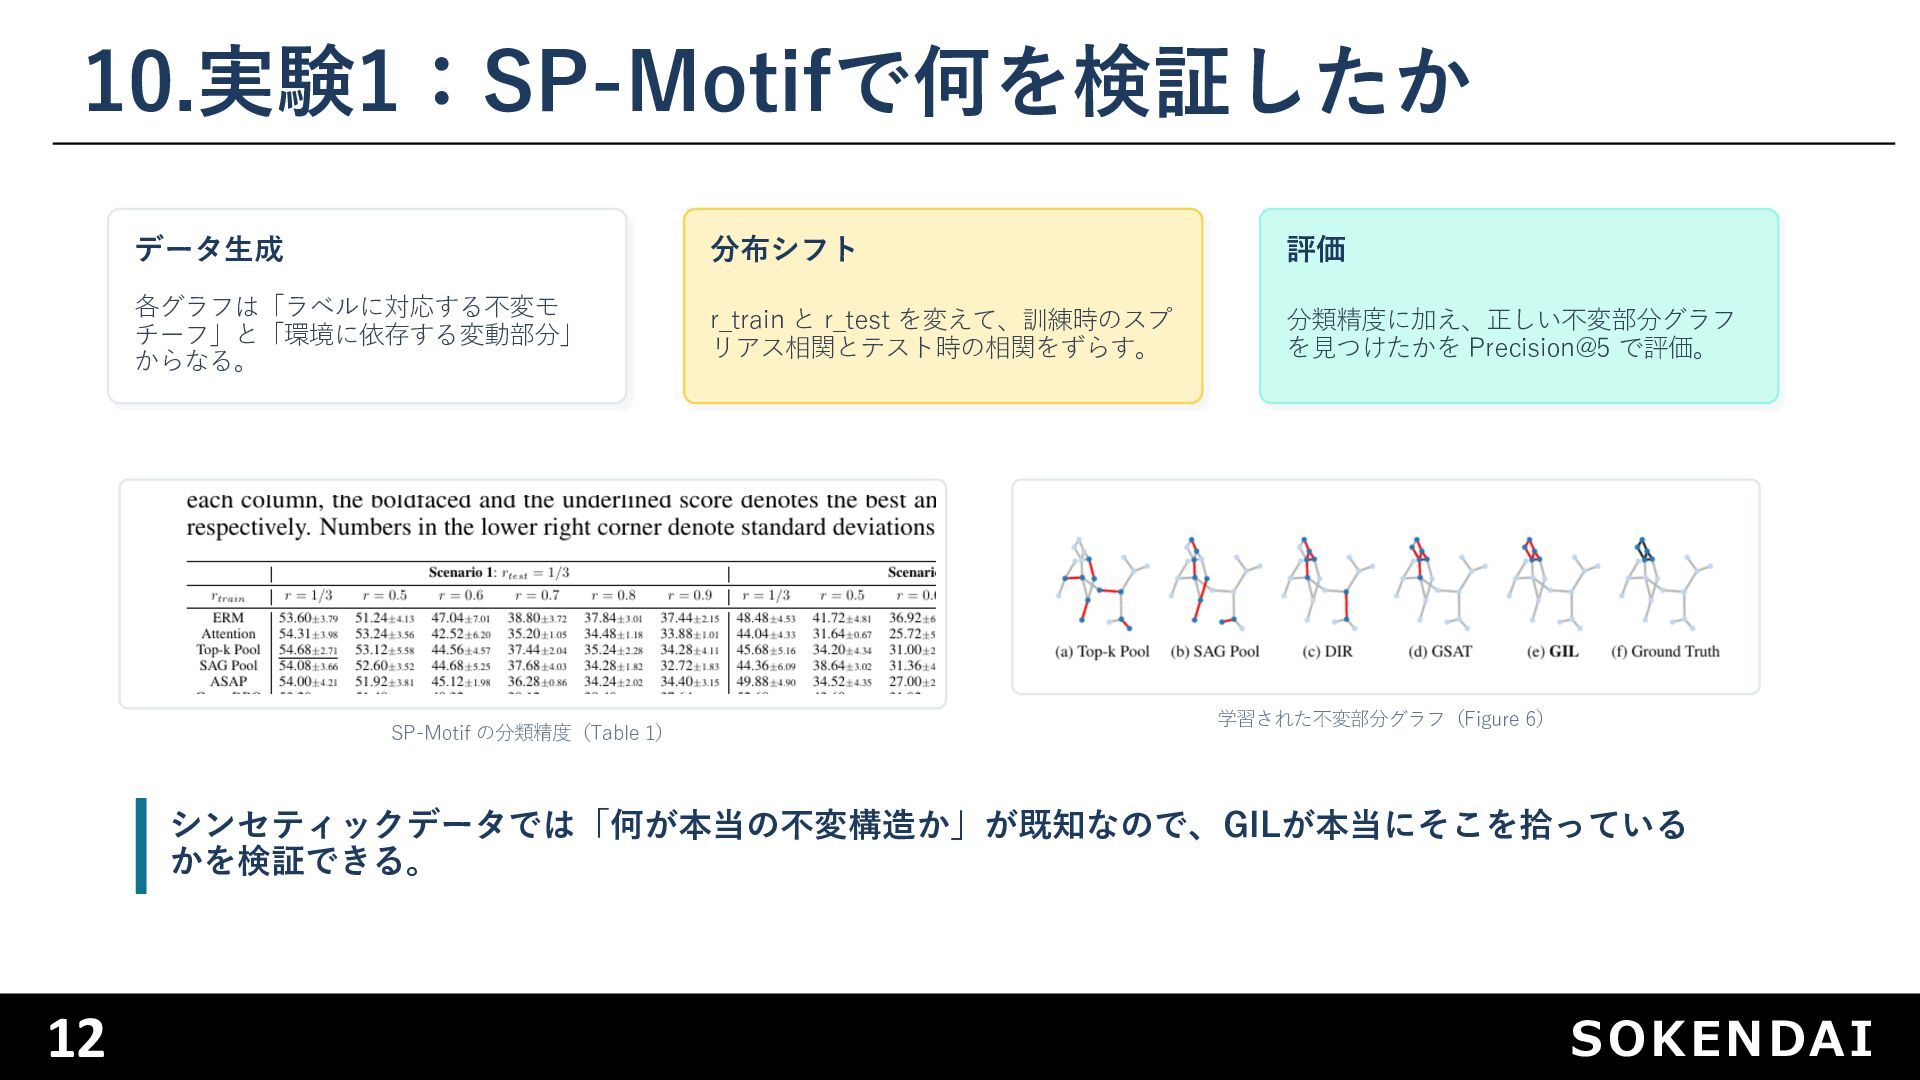
12 SOKENDAI 10.実験1:SP-Motifで何を検証したか データ⽣成 各グラフは「ラベルに対応する不変モ チーフ」と「環境に依存する変動部分」 からなる。 分布シフト r_train と
r_test を変えて、訓練時のスプ リアス相関とテスト時の相関をずらす。 評価 分類精度に加え、正しい不変部分グラフ を⾒つけたかを Precision@5 で評価。 SP-Motif の分類精度(Table 1) 学習された不変部分グラフ(Figure 6) シンセティックデータでは「何が本当の不変構造か」が既知なので、GILが本当にそこを拾っている かを検証できる。
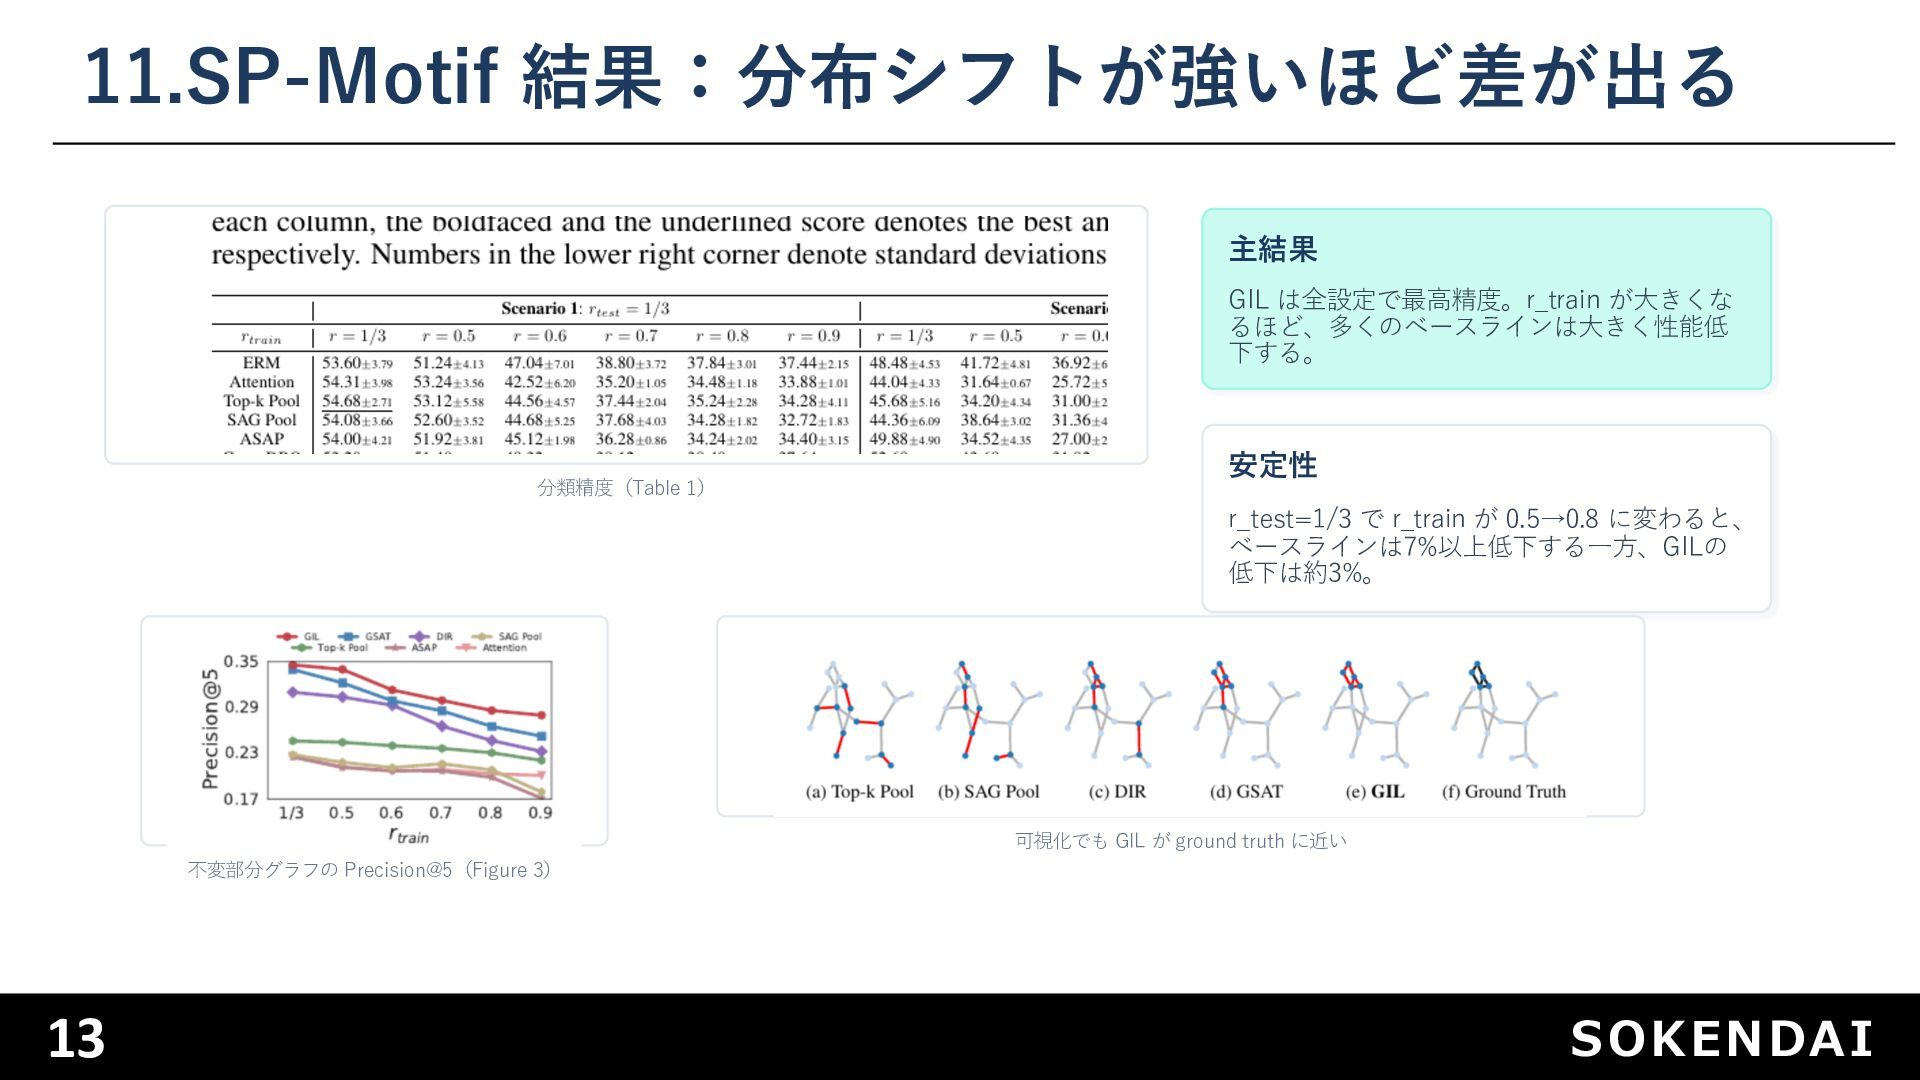
13 SOKENDAI 11.SP-Motif 結果:分布シフトが強いほど差が出る 分類精度(Table 1) 主結果 GIL は全設定で最⾼精度。r_train が⼤きくな
るほど、多くのベースラインは⼤きく性能低 下する。 安定性 r_test=1/3 で r_train が 0.5→0.8 に変わると、 ベースラインは7%以上低下する⼀⽅、GILの 低下は約3%。 不変部分グラフの Precision@5(Figure 3) 可視化でも GIL が ground truth に近い
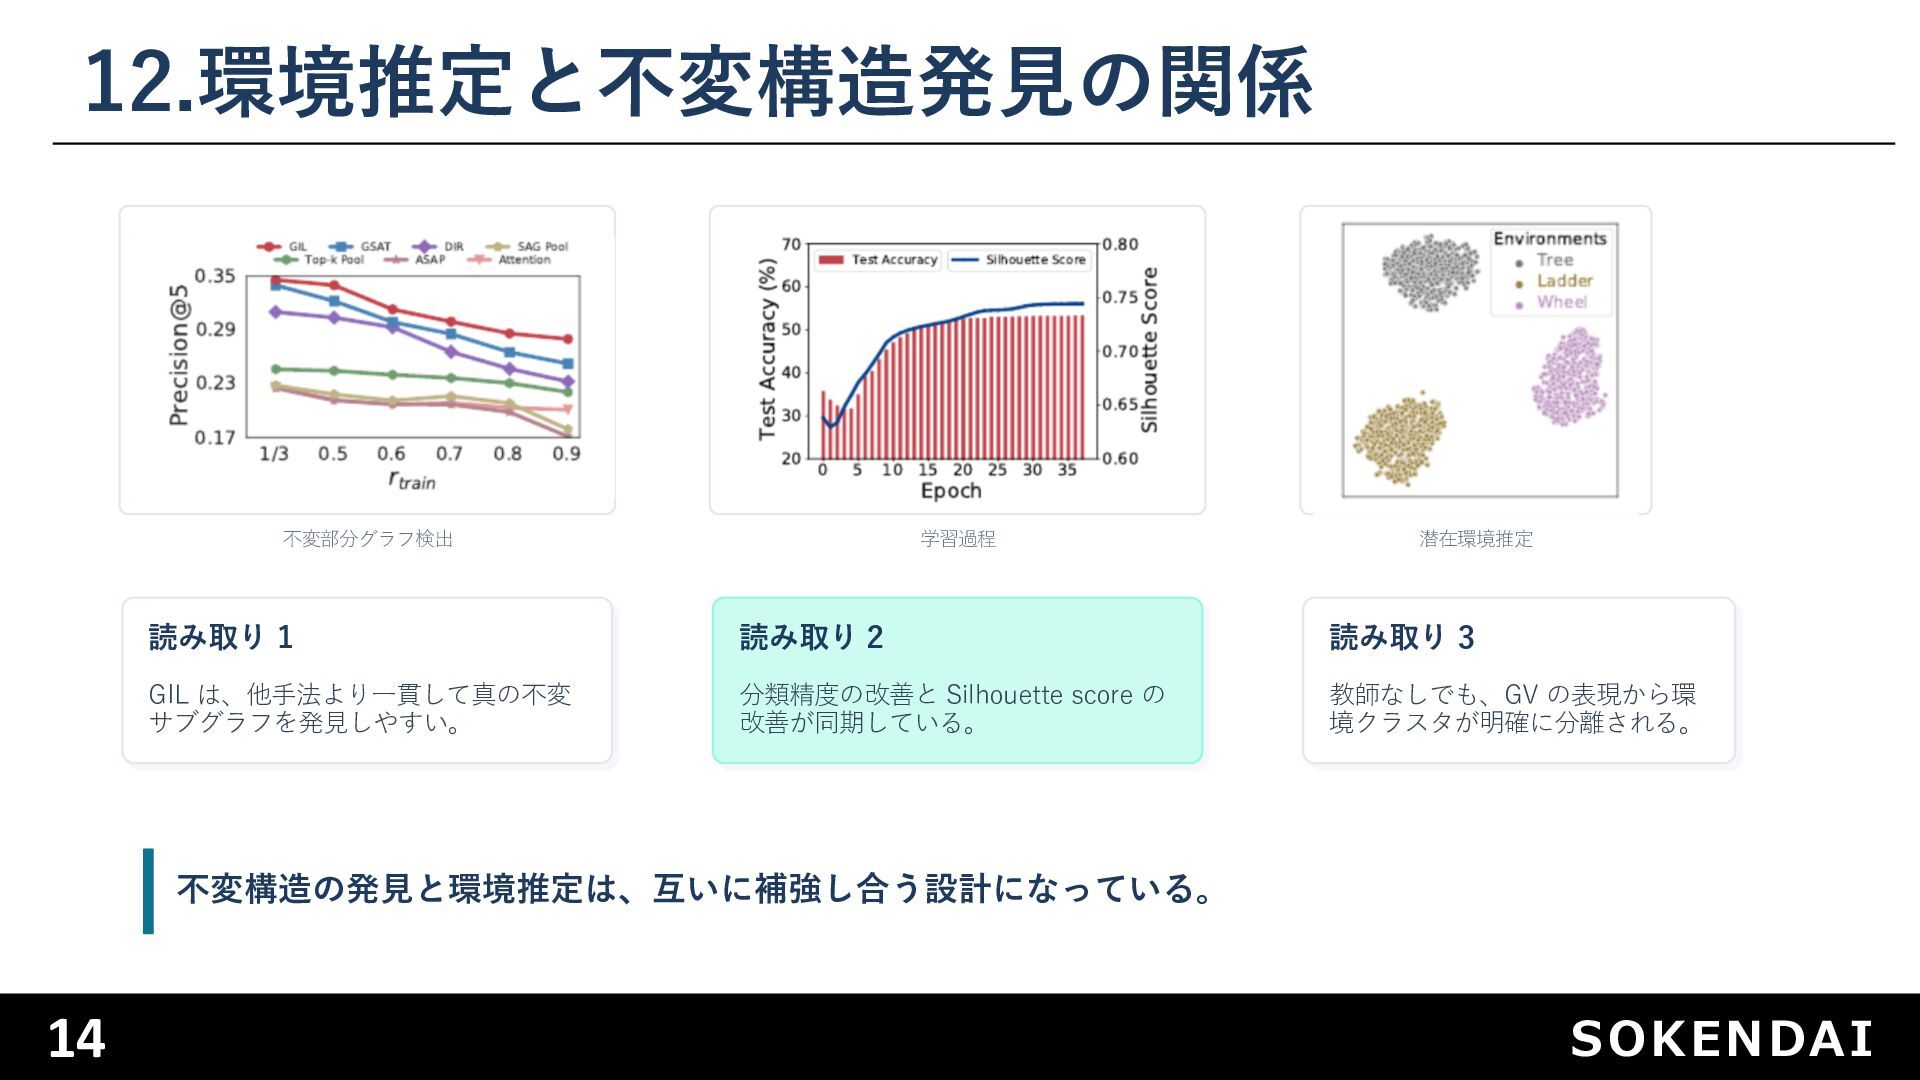
14 SOKENDAI 12.環境推定と不変構造発⾒の関係 不変部分グラフ検出 学習過程 潜在環境推定 読み取り 1 GIL は、他⼿法より⼀貫して真の不変
サブグラフを発⾒しやすい。 読み取り 2 分類精度の改善と Silhouette score の 改善が同期している。 読み取り 3 教師なしでも、GV の表現から環 境クラスタが明確に分離される。 不変構造の発⾒と環境推定は、互いに補強し合う設計になっている。
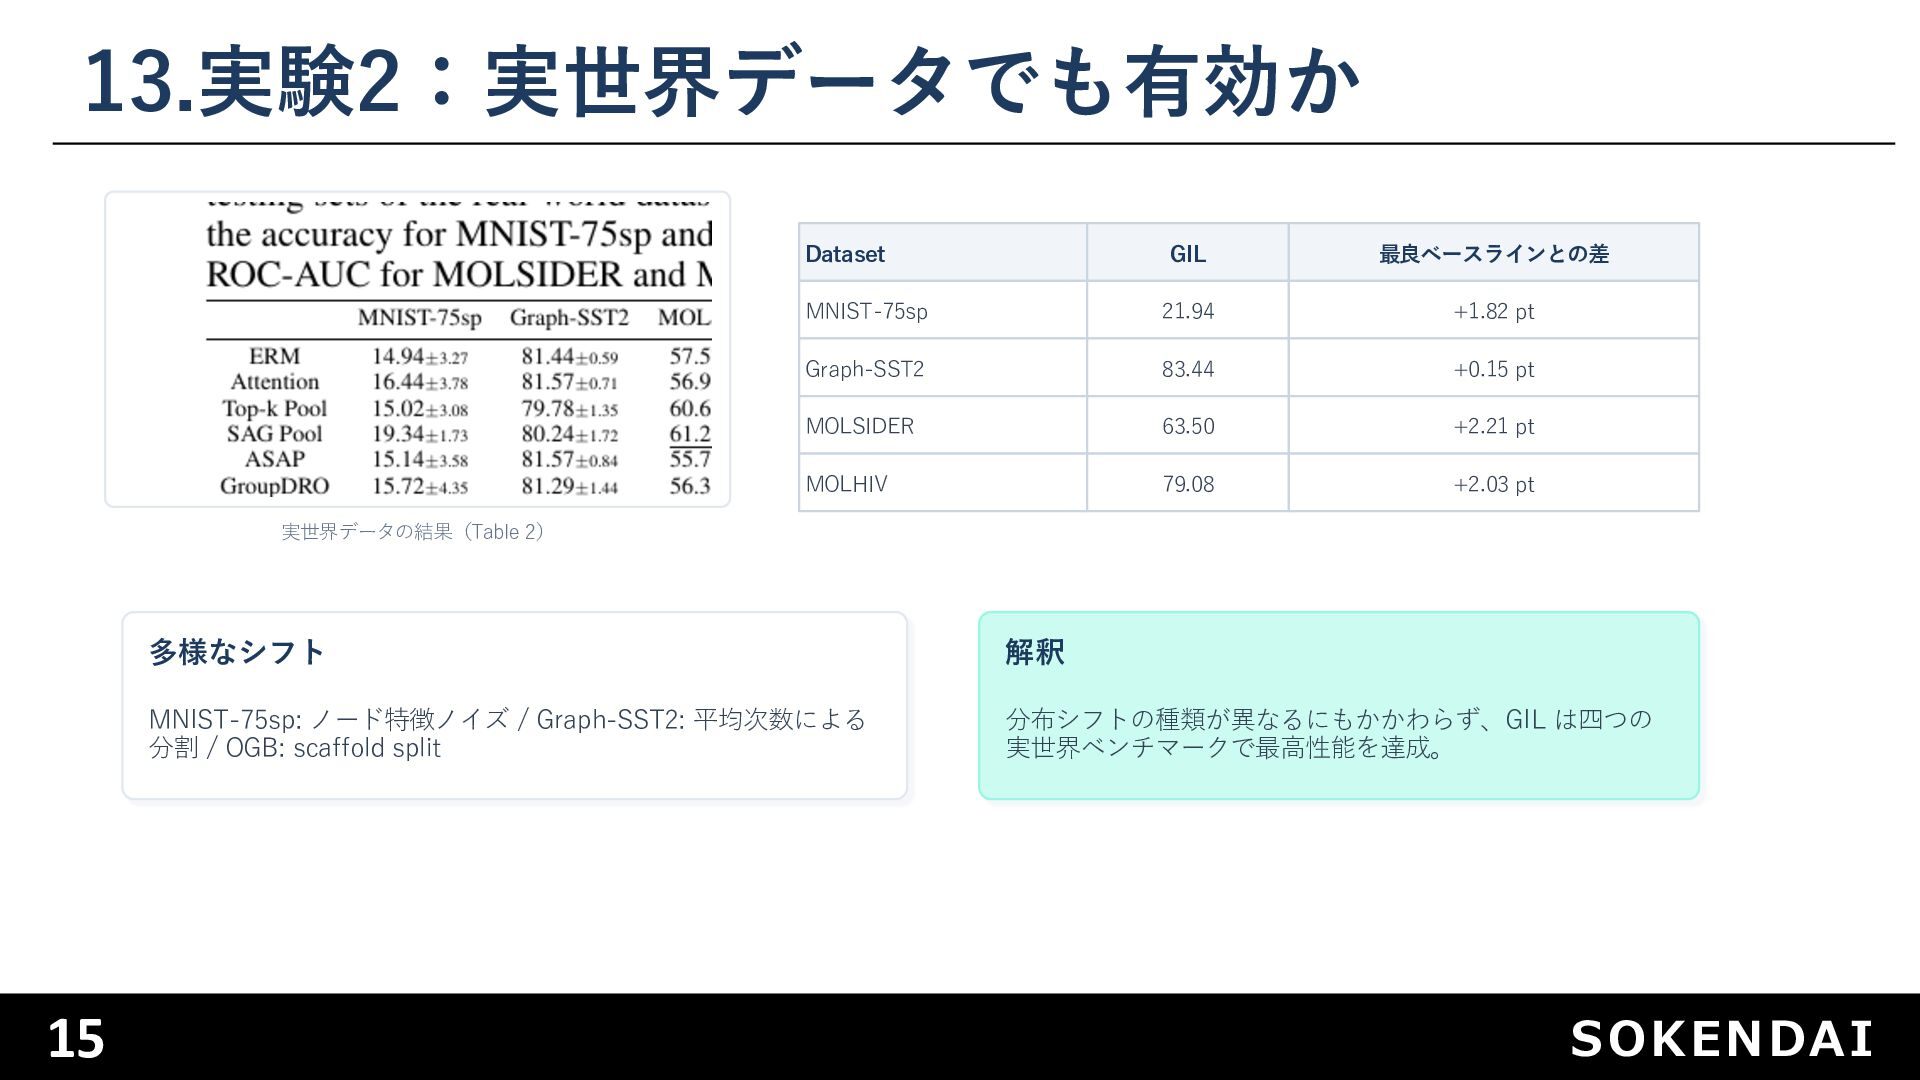
15 SOKENDAI 13.実験2:実世界データでも有効か 実世界データの結果(Table 2) Dataset GIL 最良ベースラインとの差 MNIST-75sp 21.94
+1.82 pt Graph-SST2 83.44 +0.15 pt MOLSIDER 63.50 +2.21 pt MOLHIV 79.08 +2.03 pt 多様なシフト MNIST-75sp: ノード特徴ノイズ / Graph-SST2: 平均次数による 分割 / OGB: scaffold split 解釈 分布シフトの種類が異なるにもかかわらず、GIL は四つの 実世界ベンチマークで最⾼性能を達成。
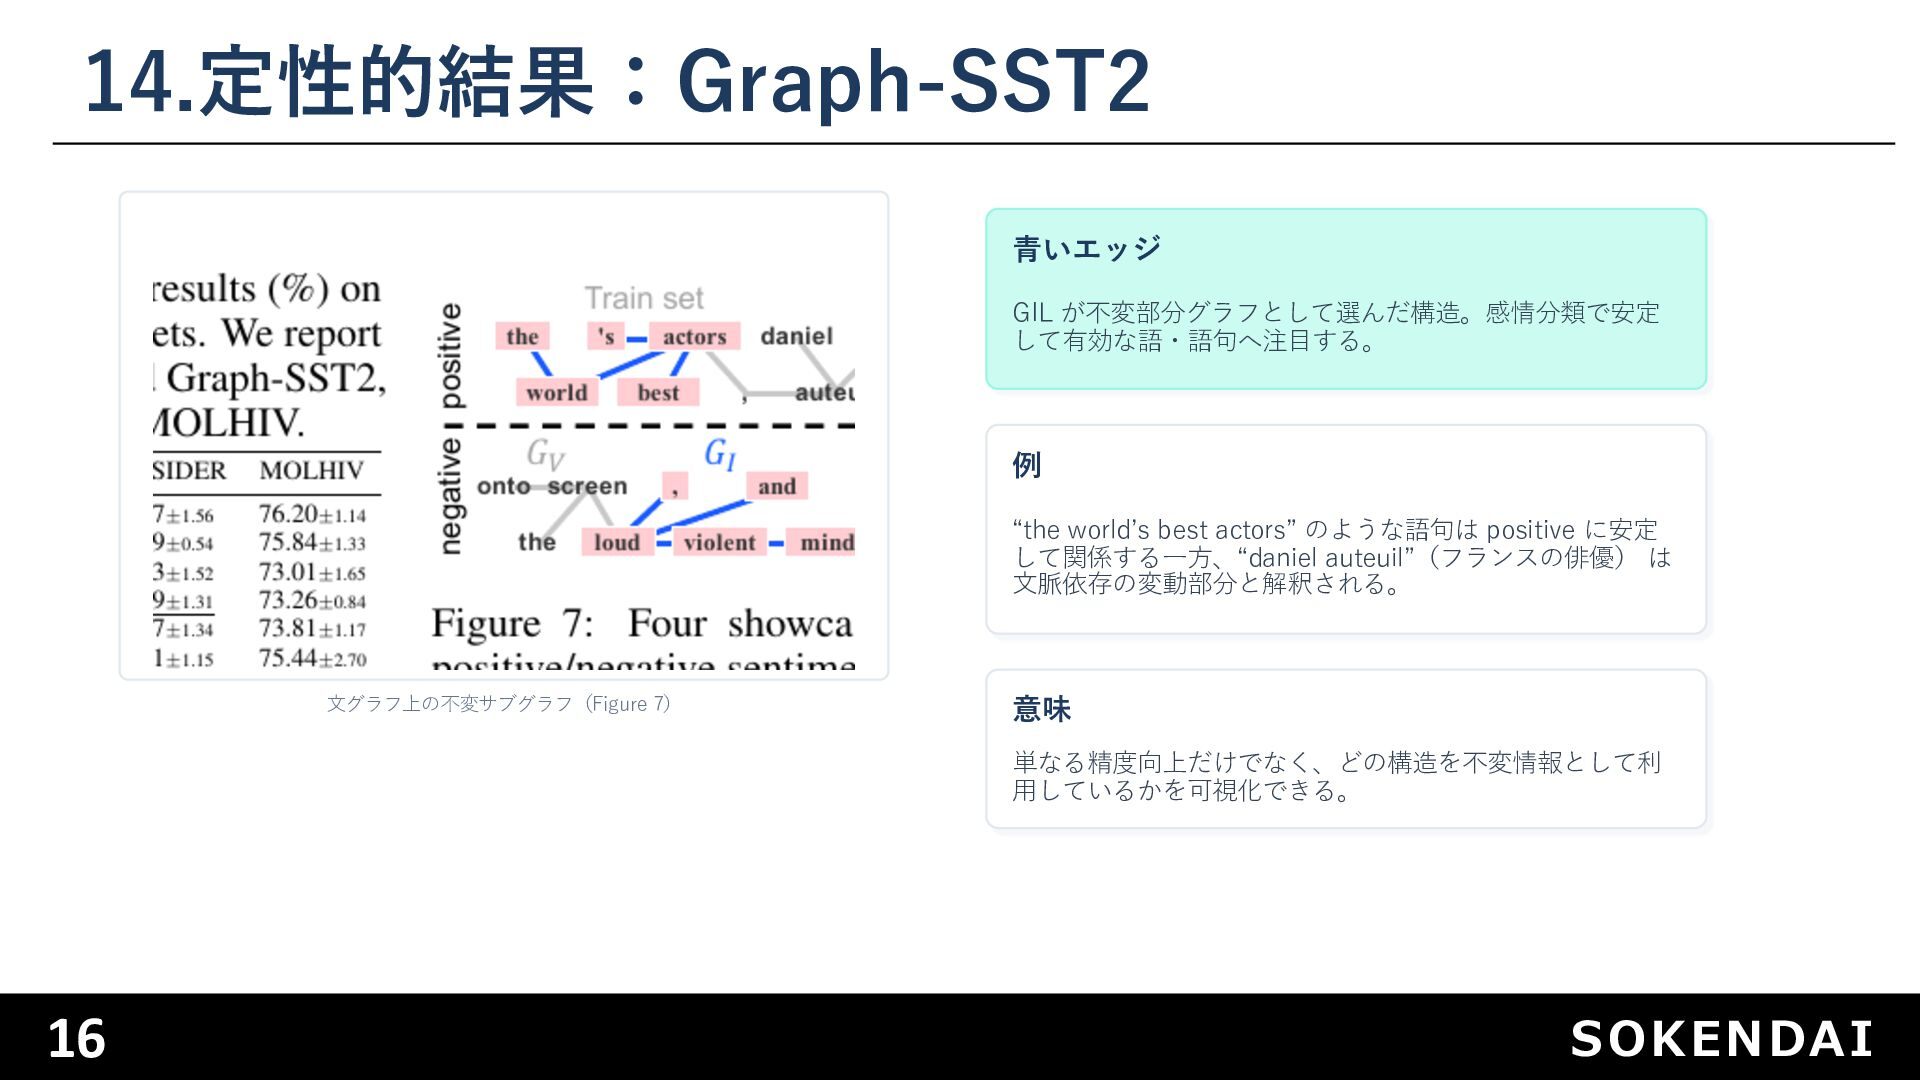
16 SOKENDAI 14.定性的結果:Graph-SST2 ⽂グラフ上の不変サブグラフ(Figure 7) ⻘いエッジ GIL が不変部分グラフとして選んだ構造。感情分類で安定 して有効な語・語句へ注⽬する。 例
“the worldʼs best actors” のような語句は positive に安定 して関係する⼀⽅、“daniel auteuil”(フランスの俳優) は ⽂脈依存の変動部分と解釈される。 意味 単なる精度向上だけでなく、どの構造を不変情報として利 ⽤しているかを可視化できる。
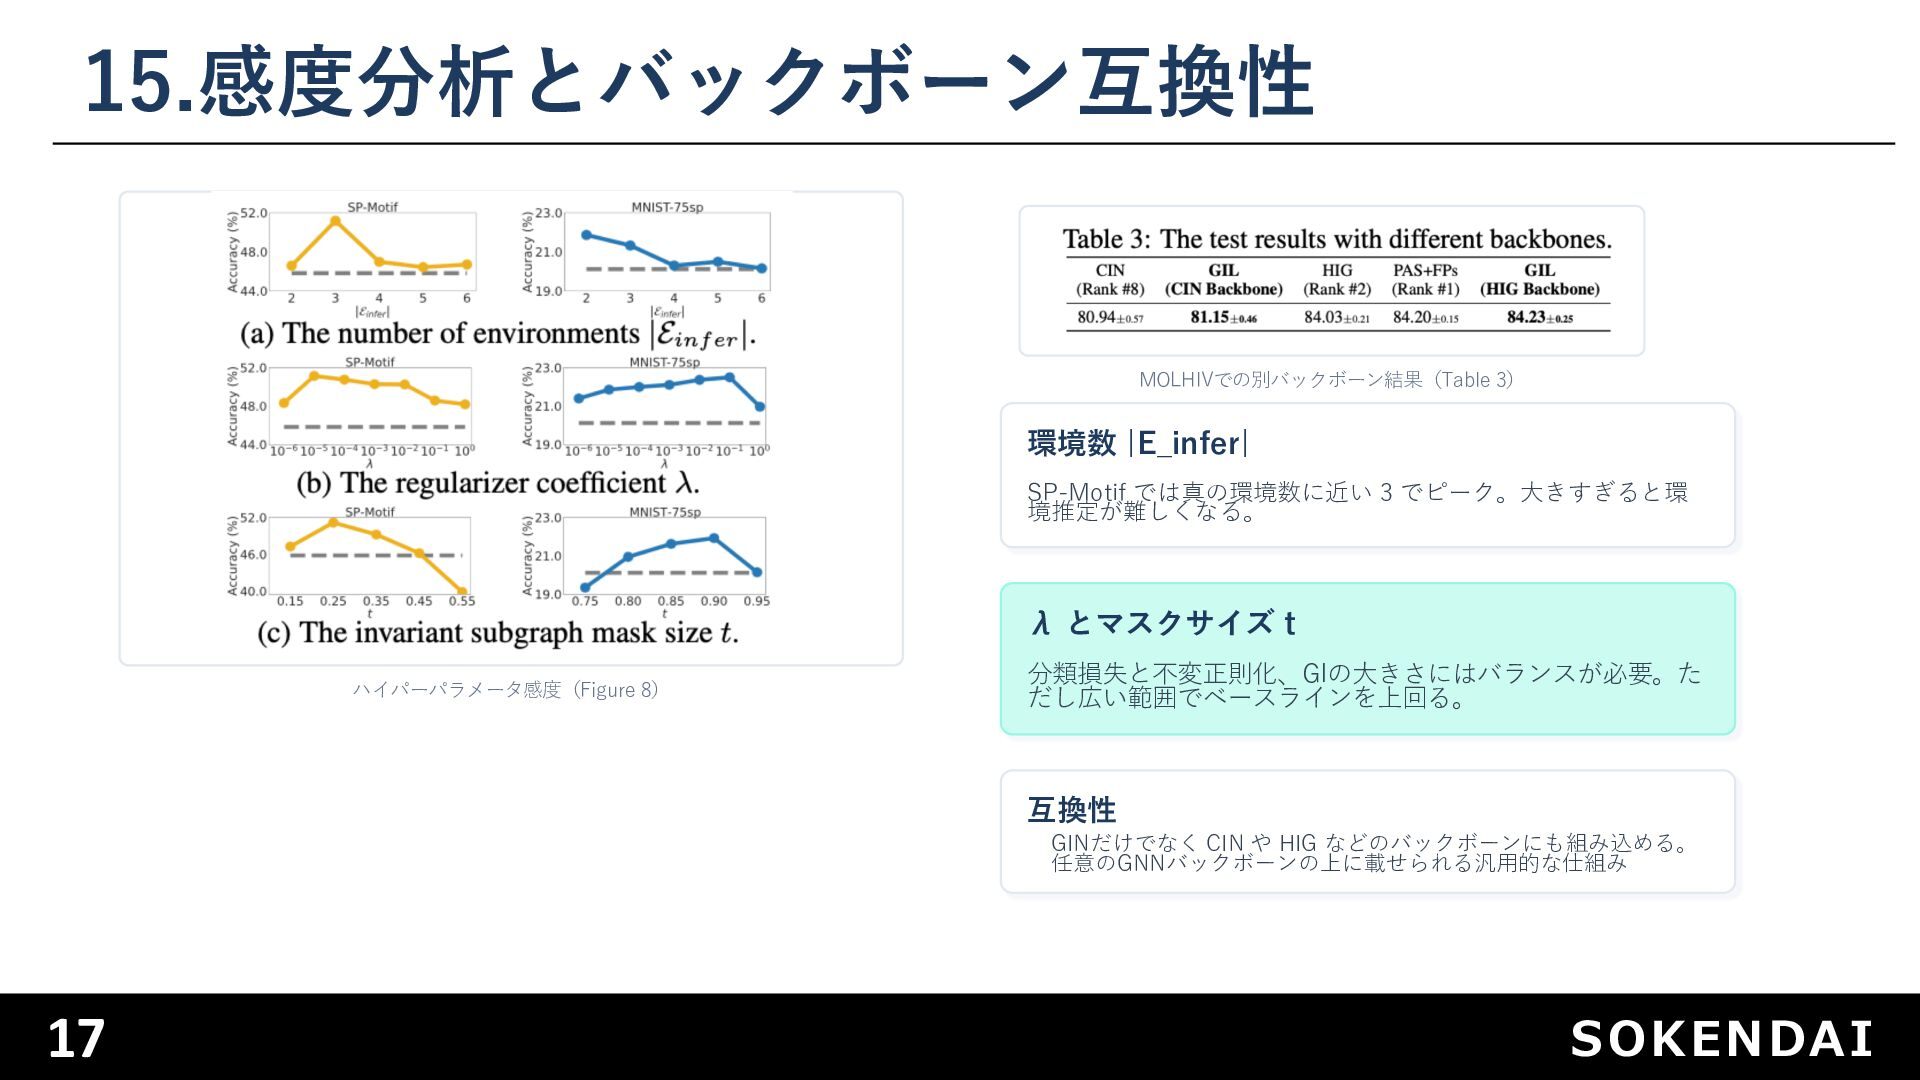
17 SOKENDAI 15.感度分析とバックボーン互換性 ハイパーパラメータ感度(Figure 8) MOLHIVでの別バックボーン結果(Table 3) 環境数 |E_infer| SP-Motif
では真の環境数に近い 3 でピーク。⼤きすぎると環 境推定が難しくなる。 λ とマスクサイズ t 分類損失と不変正則化、GIの⼤きさにはバランスが必要。た だし広い範囲でベースラインを上回る。 互換性 GINだけでなく CIN や HIG などのバックボーンにも組み込める。 任意のGNNバックボーンの上に載せられる汎⽤的な仕組み
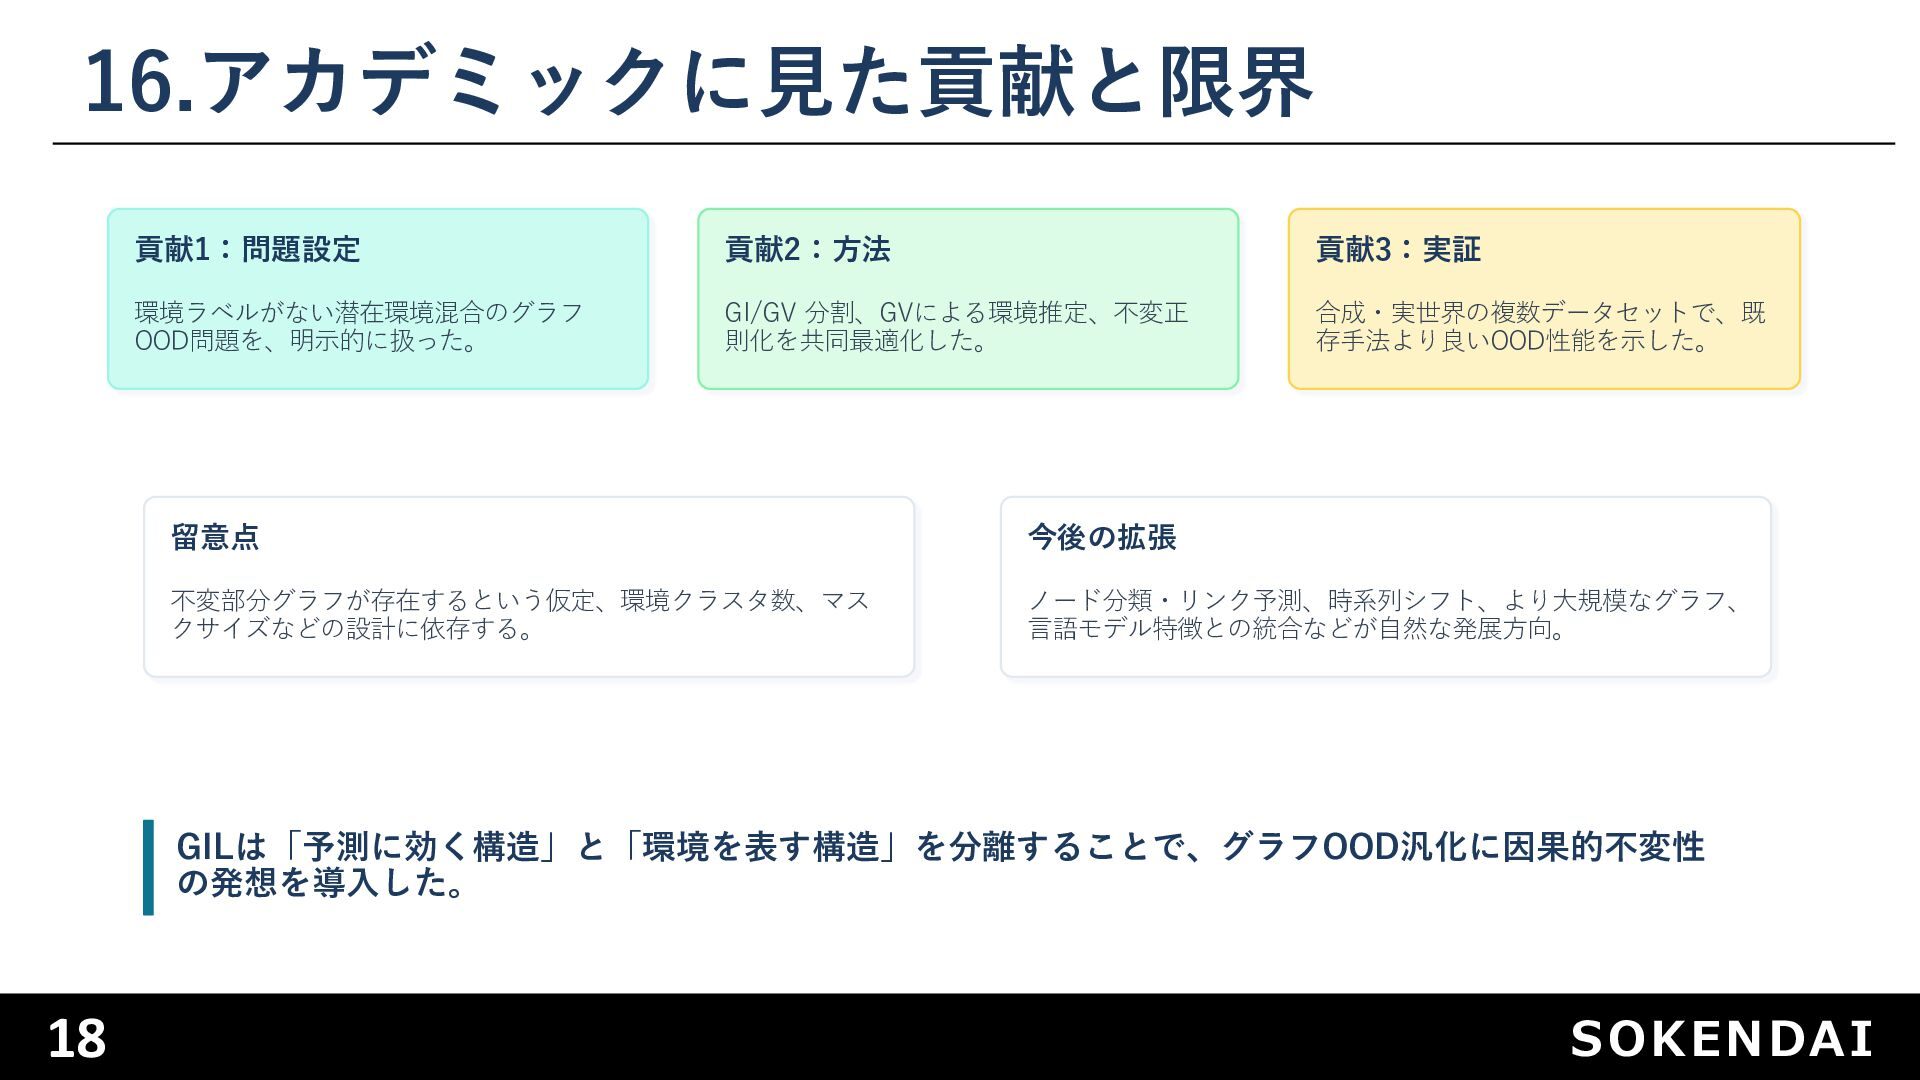
18 SOKENDAI 16.アカデミックに⾒た貢献と限界 貢献1:問題設定 環境ラベルがない潜在環境混合のグラフ OOD問題を、明⽰的に扱った。 貢献2:⽅法 GI/GV 分割、GVによる環境推定、不変正 則化を共同最適化した。
貢献3:実証 合成・実世界の複数データセットで、既 存⼿法より良いOOD性能を⽰した。 留意点 不変部分グラフが存在するという仮定、環境クラスタ数、マス クサイズなどの設計に依存する。 今後の拡張 ノード分類・リンク予測、時系列シフト、より⼤規模なグラフ、 ⾔語モデル特徴との統合などが⾃然な発展⽅向。 GILは「予測に効く構造」と「環境を表す構造」を分離することで、グラフOOD汎化に因果的不変性 の発想を導⼊した。
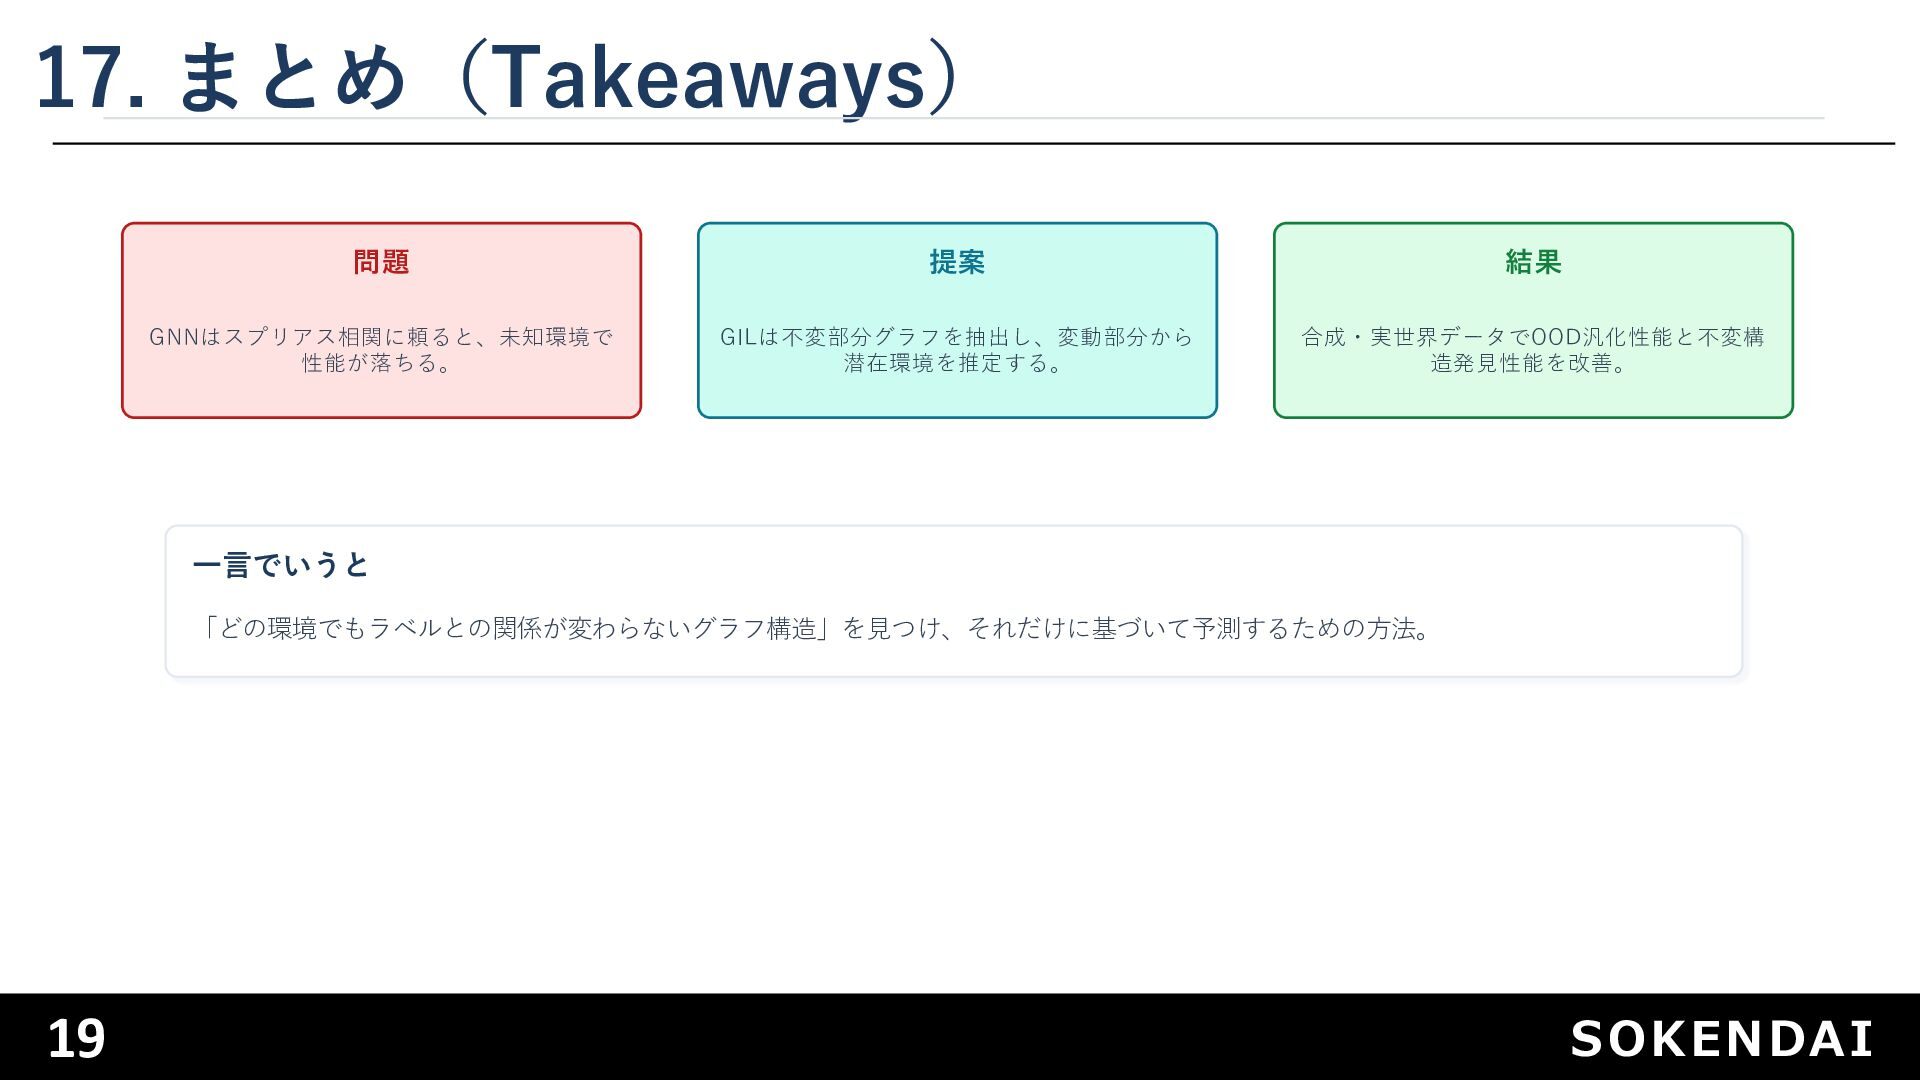
19 SOKENDAI 17. まとめ(Takeaways) 問題 GNNはスプリアス相関に頼ると、未知環境で 性能が落ちる。 提案 GILは不変部分グラフを抽出し、変動部分から 潜在環境を推定する。
結果 合成・実世界データでOOD汎化性能と不変構 造発⾒性能を改善。 ⼀⾔でいうと 「どの環境でもラベルとの関係が変わらないグラフ構造」を⾒つけ、それだけに基づいて予測するための⽅法。


 fk001jp
 szymonslowik
 bermonpainter
 iamctodd
 kevinliebholz
 eileencodes
 frankvandijk
 427marketing
 jacobian
 skipperchong
 reverentgeek
 inesmontani
 davidcarrasco