Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
understanding_deep_contrastive_learning_260929.pdf
Search
君野史明(Fumiaki Kimino)
September 28, 2026
5
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
understanding_deep_contrastive_learning_260929.pdf
君野史明(Fumiaki Kimino)
September 28, 2026
More Decks by 君野史明(Fumiaki Kimino)
See All by 君野史明(Fumiaki Kimino)
SpotLight_260824.pdf
fk001jp
0
11
GCFormer_260727.pdf
fk001jp
0
13
universality_label_efficiency_jp_260629.pdf
fk001jp
0
20
Graph_Invariant_Learning_260525_1.pdf
fk001jp
0
9
DRAGON_260427_1.pdf
fk001jp
0
12
HANG_GNN_robustness_260330_1.pdf
fk001jp
0
7
Reconstruction_for_Powerful_Graph_Representations_260225_1.pdf
fk001jp
0
11
HYPERION_260205_1.pdf
fk001jp
0
11
Mitigating_Local_Cohesion_251222_1.pdf
fk001jp
0
13
Featured
See All Featured
Context Engineering - Making Every Token Count
addyosmani
9
1.2k
GraphQLの誤解/rethinking-graphql
sonatard
75
12k
No one is an island. Learnings from fostering a developers community.
thoeni
21
3.9k
Ruling the World: When Life Gets Gamed
codingconduct
0
400
Heart Work Chapter 1 - Part 1
lfama
PRO
10
37k
Scaling GitHub
holman
464
140k
How to Ace a Technical Interview
jacobian
280
24k
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.1k
The Cult of Friendly URLs
andyhume
79
7k
Odyssey Design
rkendrick25
PRO
2
870
How to optimise 3,500 product descriptions for ecommerce in one day using ChatGPT
katarinadahlin
PRO
3
3.9k
How STYLIGHT went responsive
nonsquared
100
6.3k
Transcript
Understanding Deep Contrastive Learning via Coordinate-wise Optimization (NeurIPS 2022) の紹介
君野 史明 SOKENDAI 1 SOKENDAI
⾃⼰紹介 n 名前︓君野 史明(きみの ふみあき) n 所属︓総合研究⼤学院⼤学 情報学コース D1 n
2 専⾨︓ グラフ対照学習 グラフ表現学習 SOKENDAI
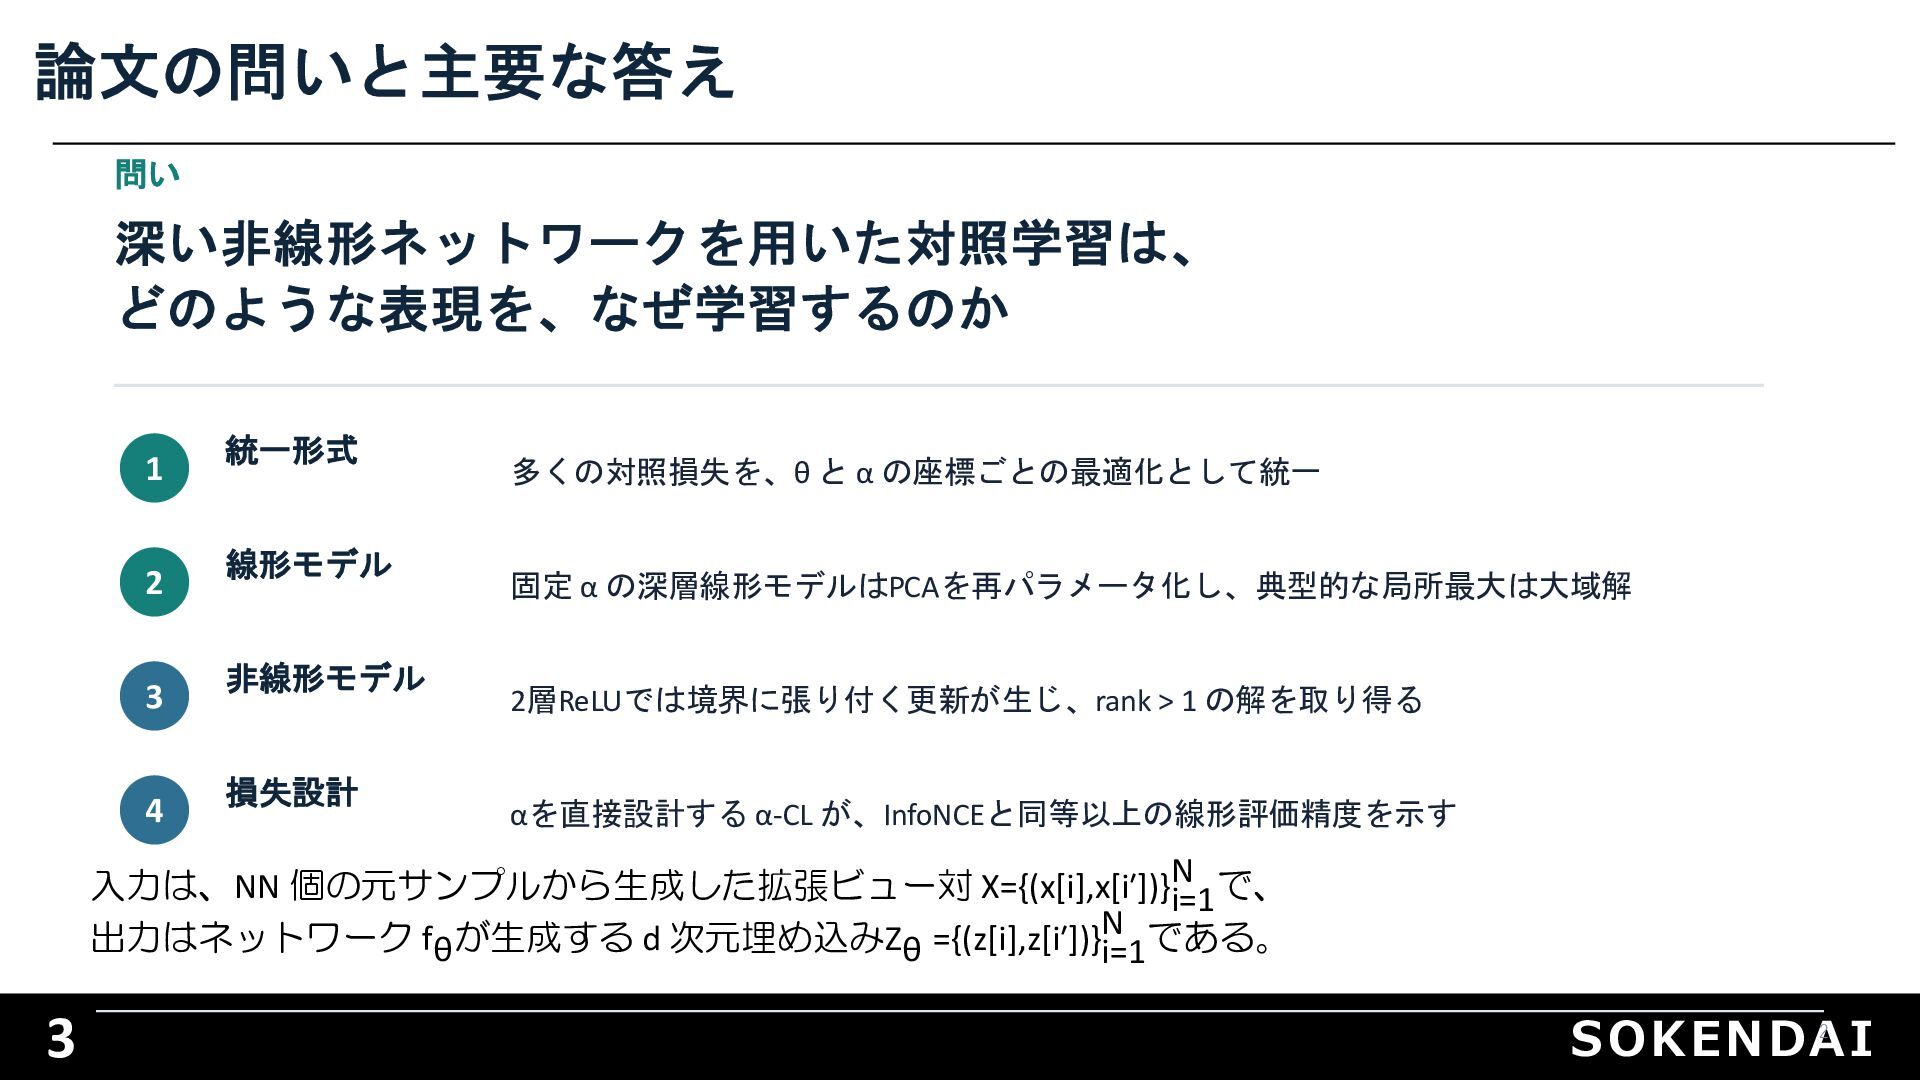
論文の問いと主要な答え 問い 深い非線形ネットワークを用いた対照学習は、 どのような表現を、なぜ学習するのか 1 統一形式 2 線形モデル 3 非線形モデル
4 損失設計 多くの対照損失を、θ と α の座標ごとの最適化として統一 固定 α の深層線形モデルはPCAを再パラメータ化し、典型的な局所最大は大域解 2層ReLUでは境界に張り付く更新が生じ、rank > 1 の解を取り得る αを直接設計する α-CL が、InfoNCEと同等以上の線形評価精度を示す 入力は、NN 個の元サンプルから生成した拡張ビュー対 X={(x[i],x[iʹ])}N i=1 で、 出力はネットワーク fθ が生成する d 次元埋め込みZθ ={(z[i],z[iʹ])}N i=1 である。 3 SOKENDAI 2
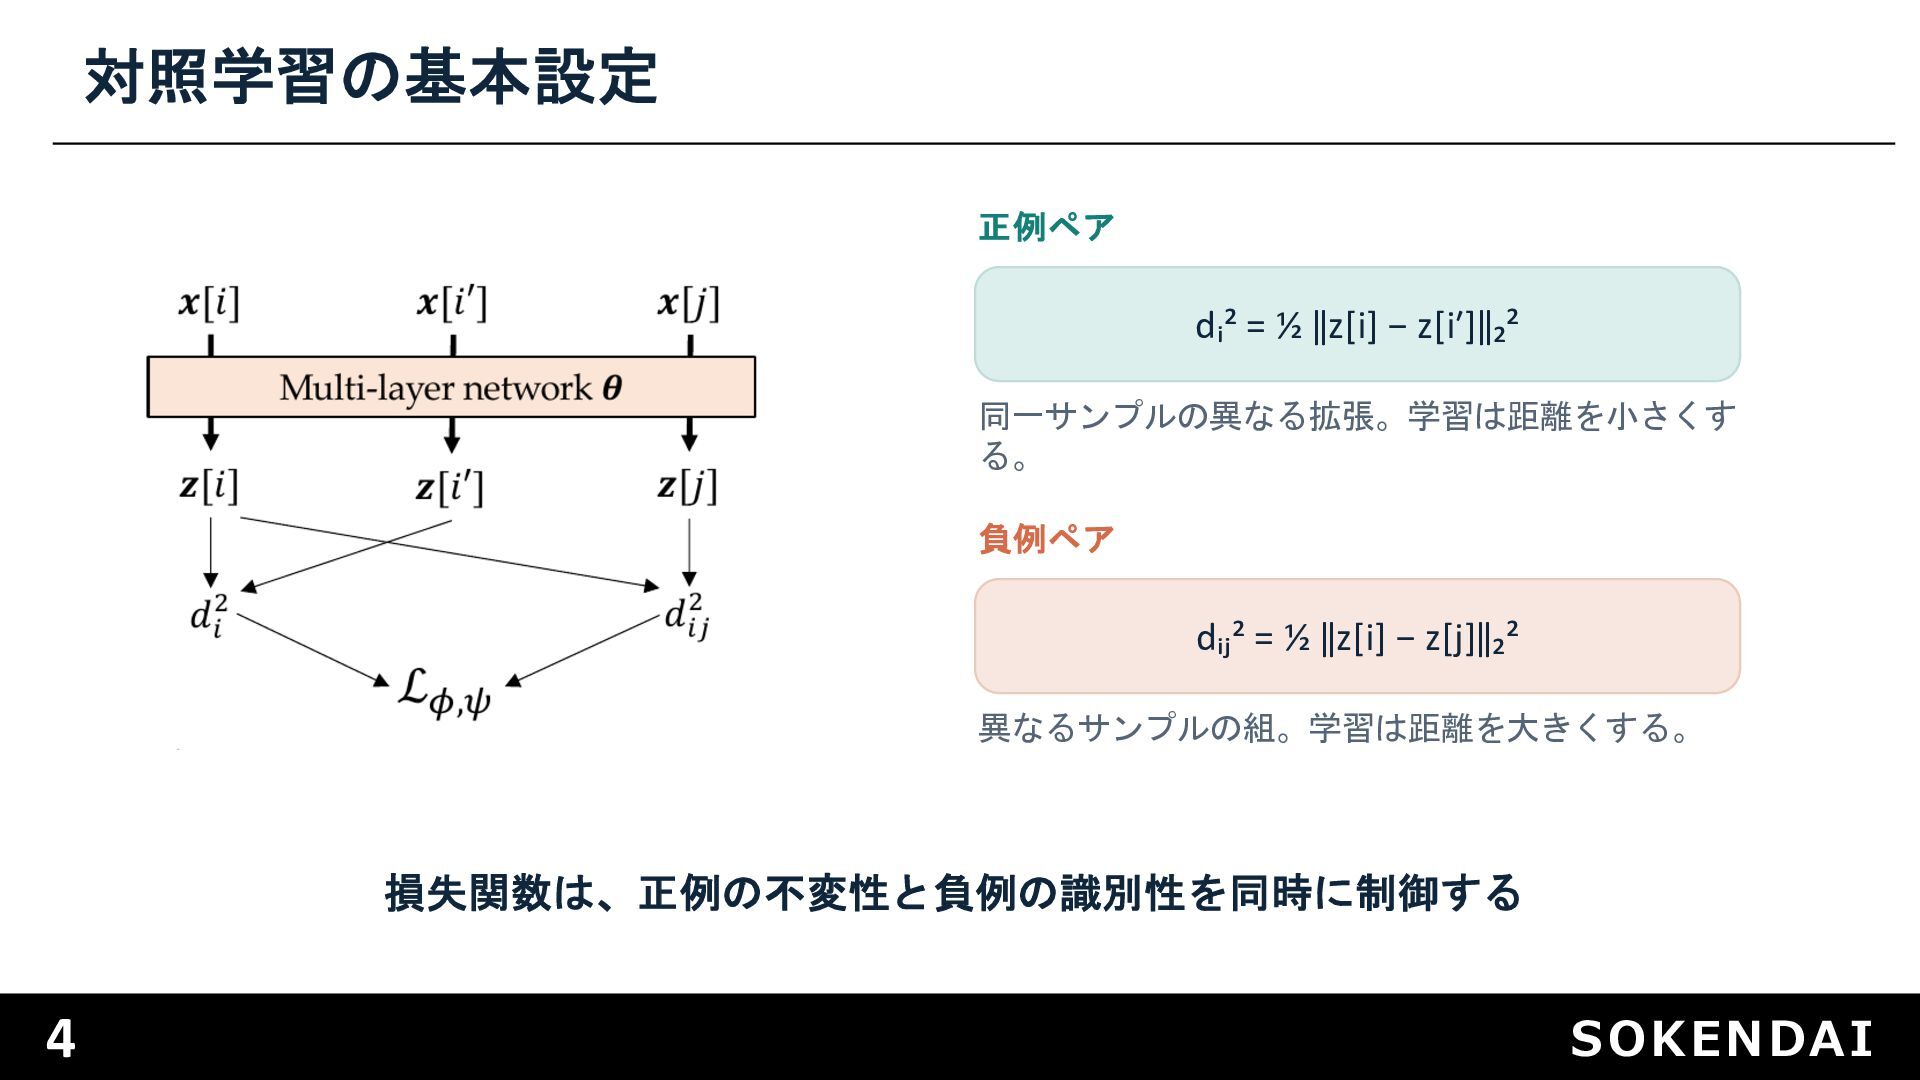
対照学習の基本設定 正例ペア dᵢ² = ½ ‖z[i] − z[iʹ]‖₂² 同一サンプルの異なる拡張。学習は距離を小さくす る。
負例ペア dᵢⱼ² = ½ ‖z[i] − z[j]‖₂² 異なるサンプルの組。学習は距離を大きくする。 損失関数は、正例の不変性と負例の識別性を同時に制御する 4 SOKENDAI
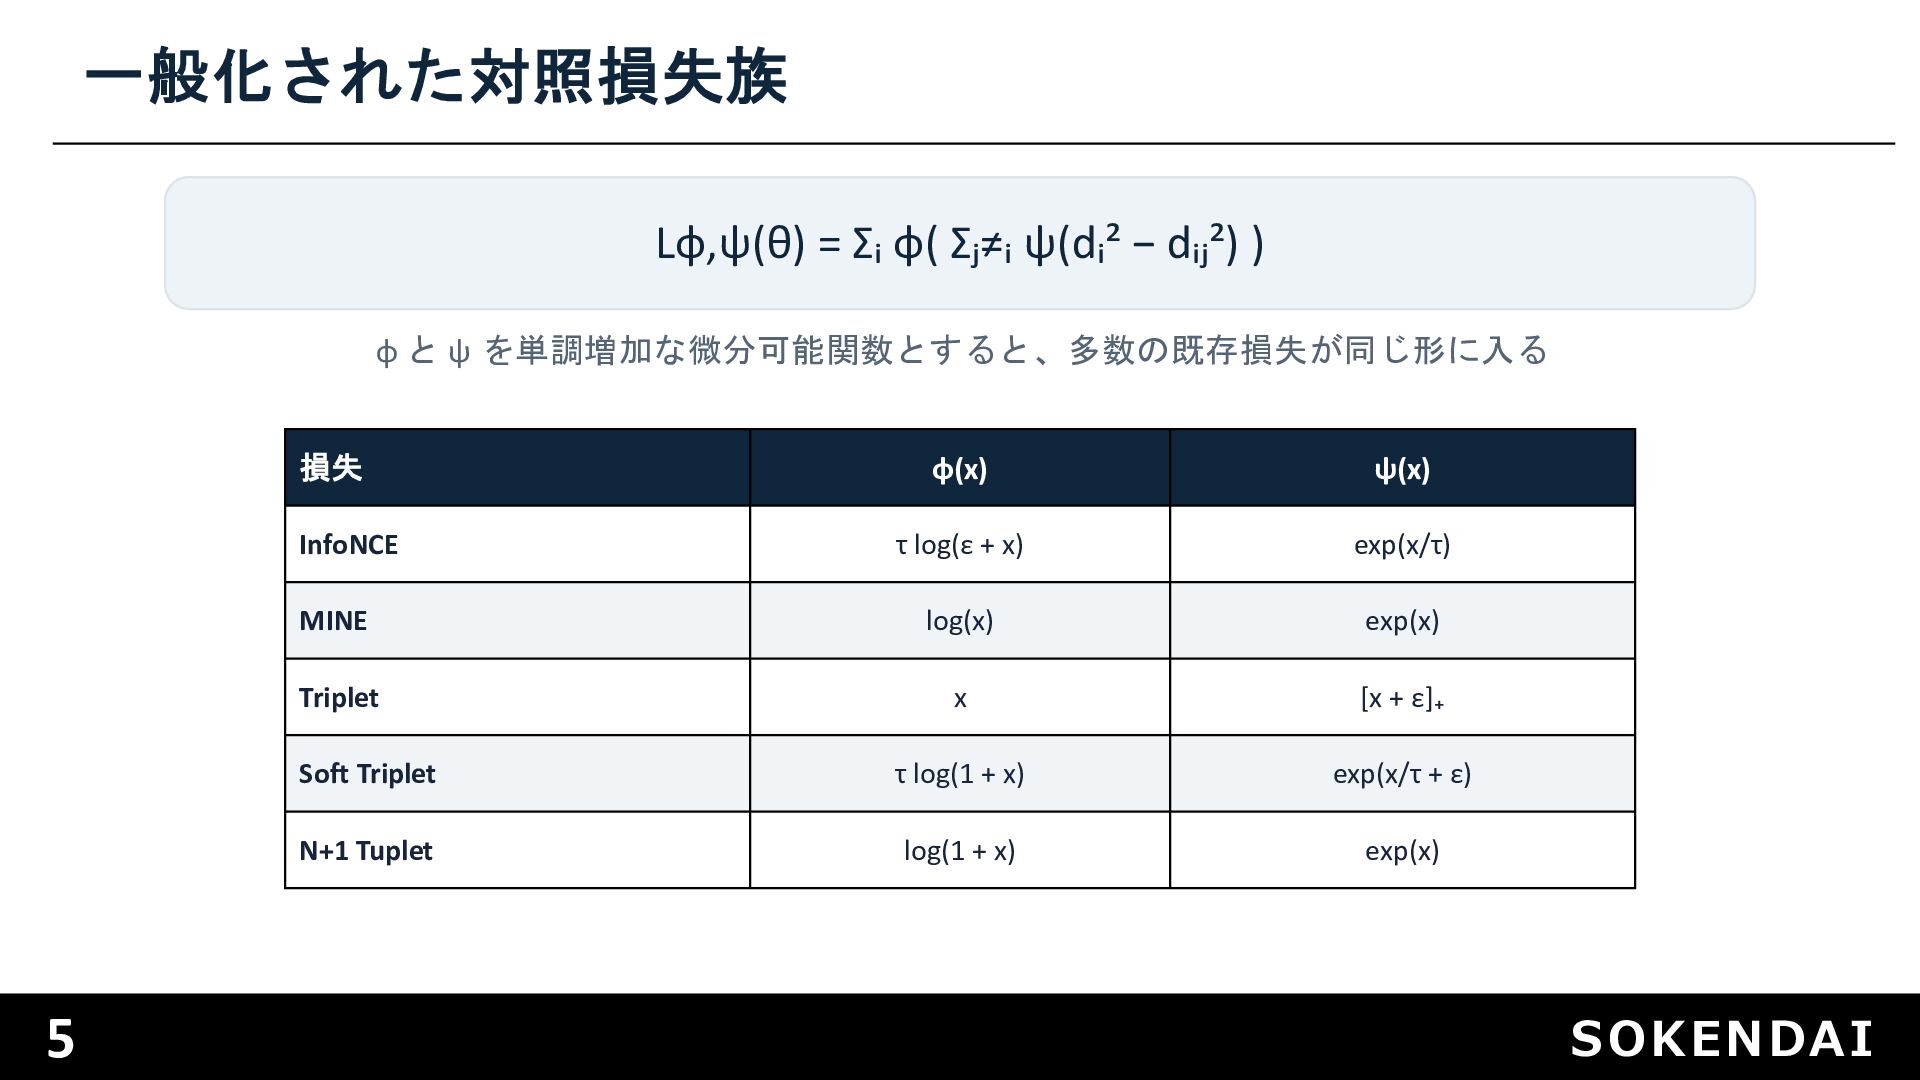
一般化された対照損失族 Lφ,ψ(θ) = Σᵢ φ( Σⱼ≠ᵢ ψ(dᵢ² − dᵢⱼ²) )
φ と ψ を単調増加な微分可能関数とすると、多数の既存損失が同じ形に入る 5 損失 φ(x) ψ(x) InfoNCE τ log(ε + x) exp(x/τ) MINE log(x) exp(x) Triplet x [x + ε]₊ Soft Triplet τ log(1 + x) exp(x/τ + ε) N+1 Tuplet log(1 + x) exp(x) SOKENDAI
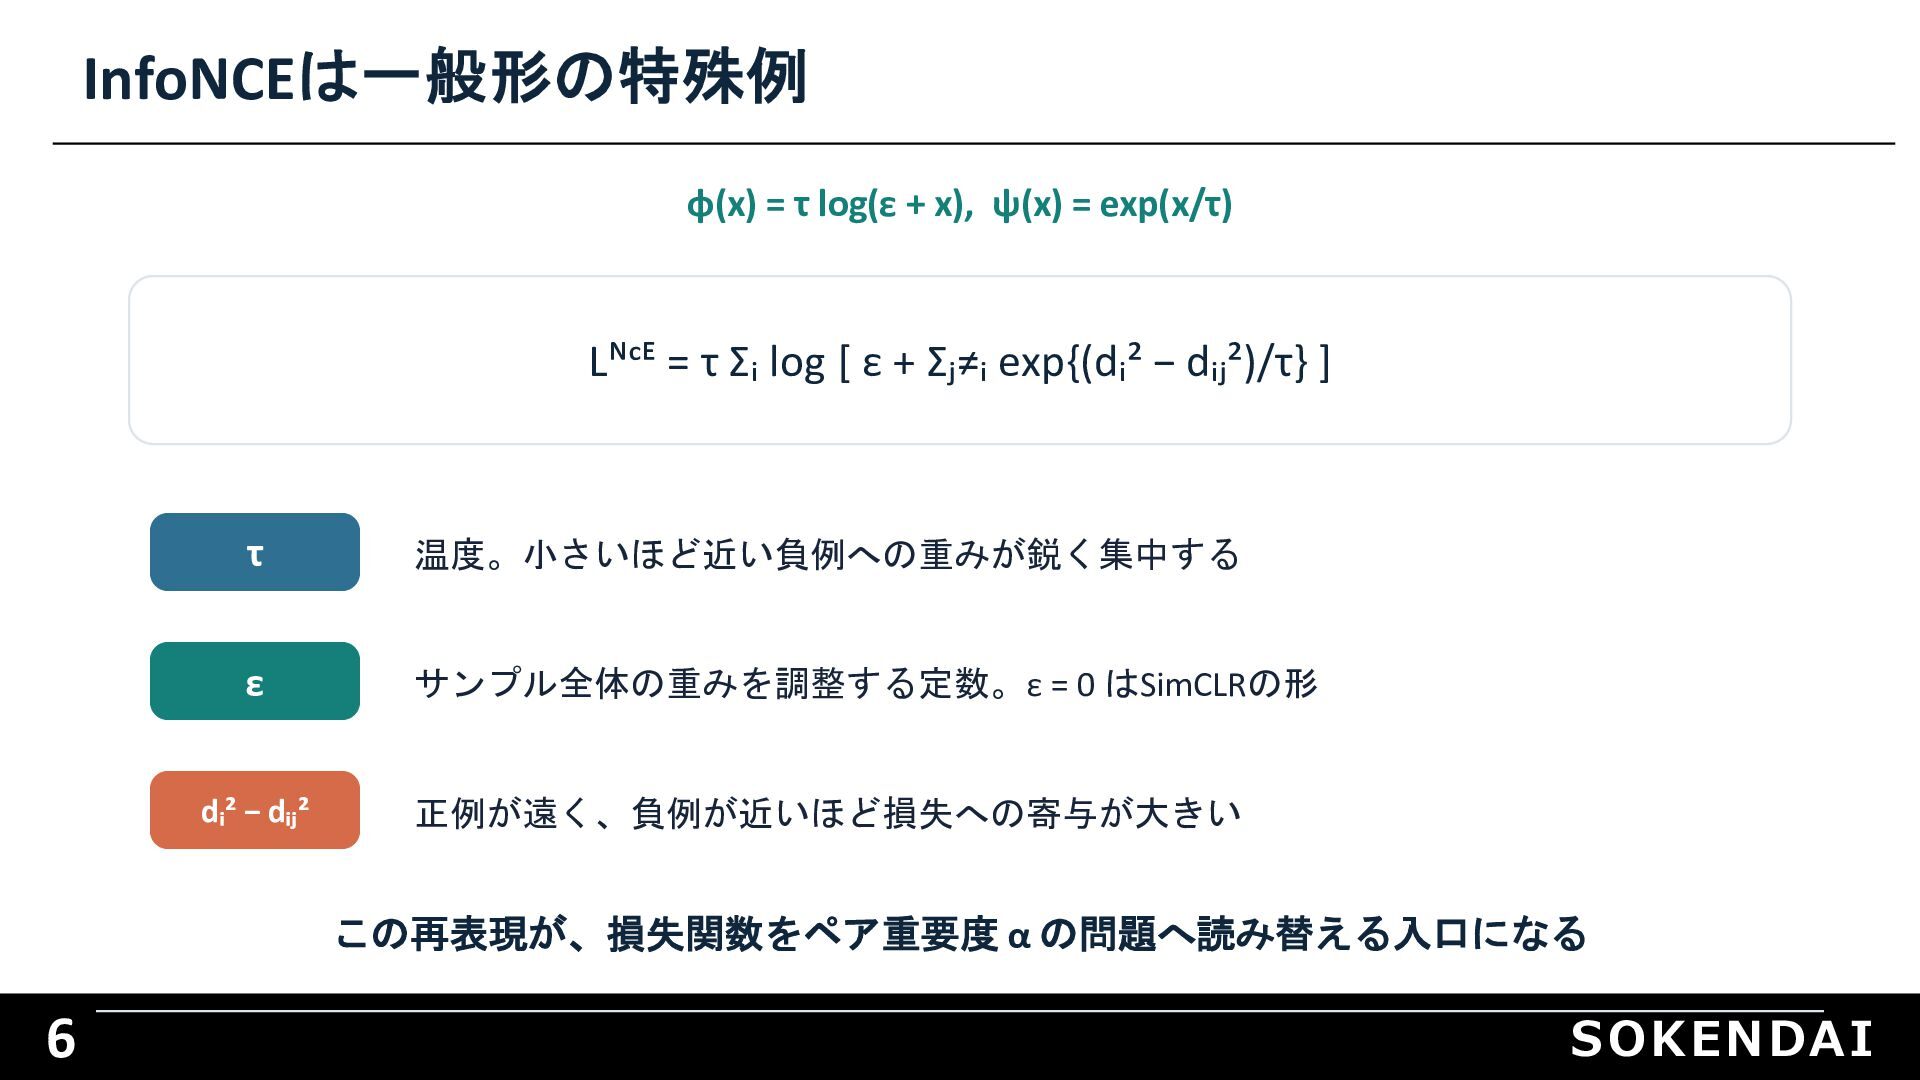
InfoNCEは一般形の特殊例 φ(x) = τ log(ε + x), ψ(x) = exp(x/τ)
Lᴺᶜᴱ = τ Σᵢ log [ ε + Σⱼ≠ᵢ exp{(dᵢ² − dᵢⱼ²)/τ} ] τ 温度。小さいほど近い負例への重みが鋭く集中する ε サンプル全体の重みを調整する定数。ε = 0 はSimCLRの形 dᵢ² − dᵢⱼ² 正例が遠く、負例が近いほど損失への寄与が大きい この再表現が、損失関数をペア重要度 α の問題へ読み替える入口になる 6 SOKENDAI
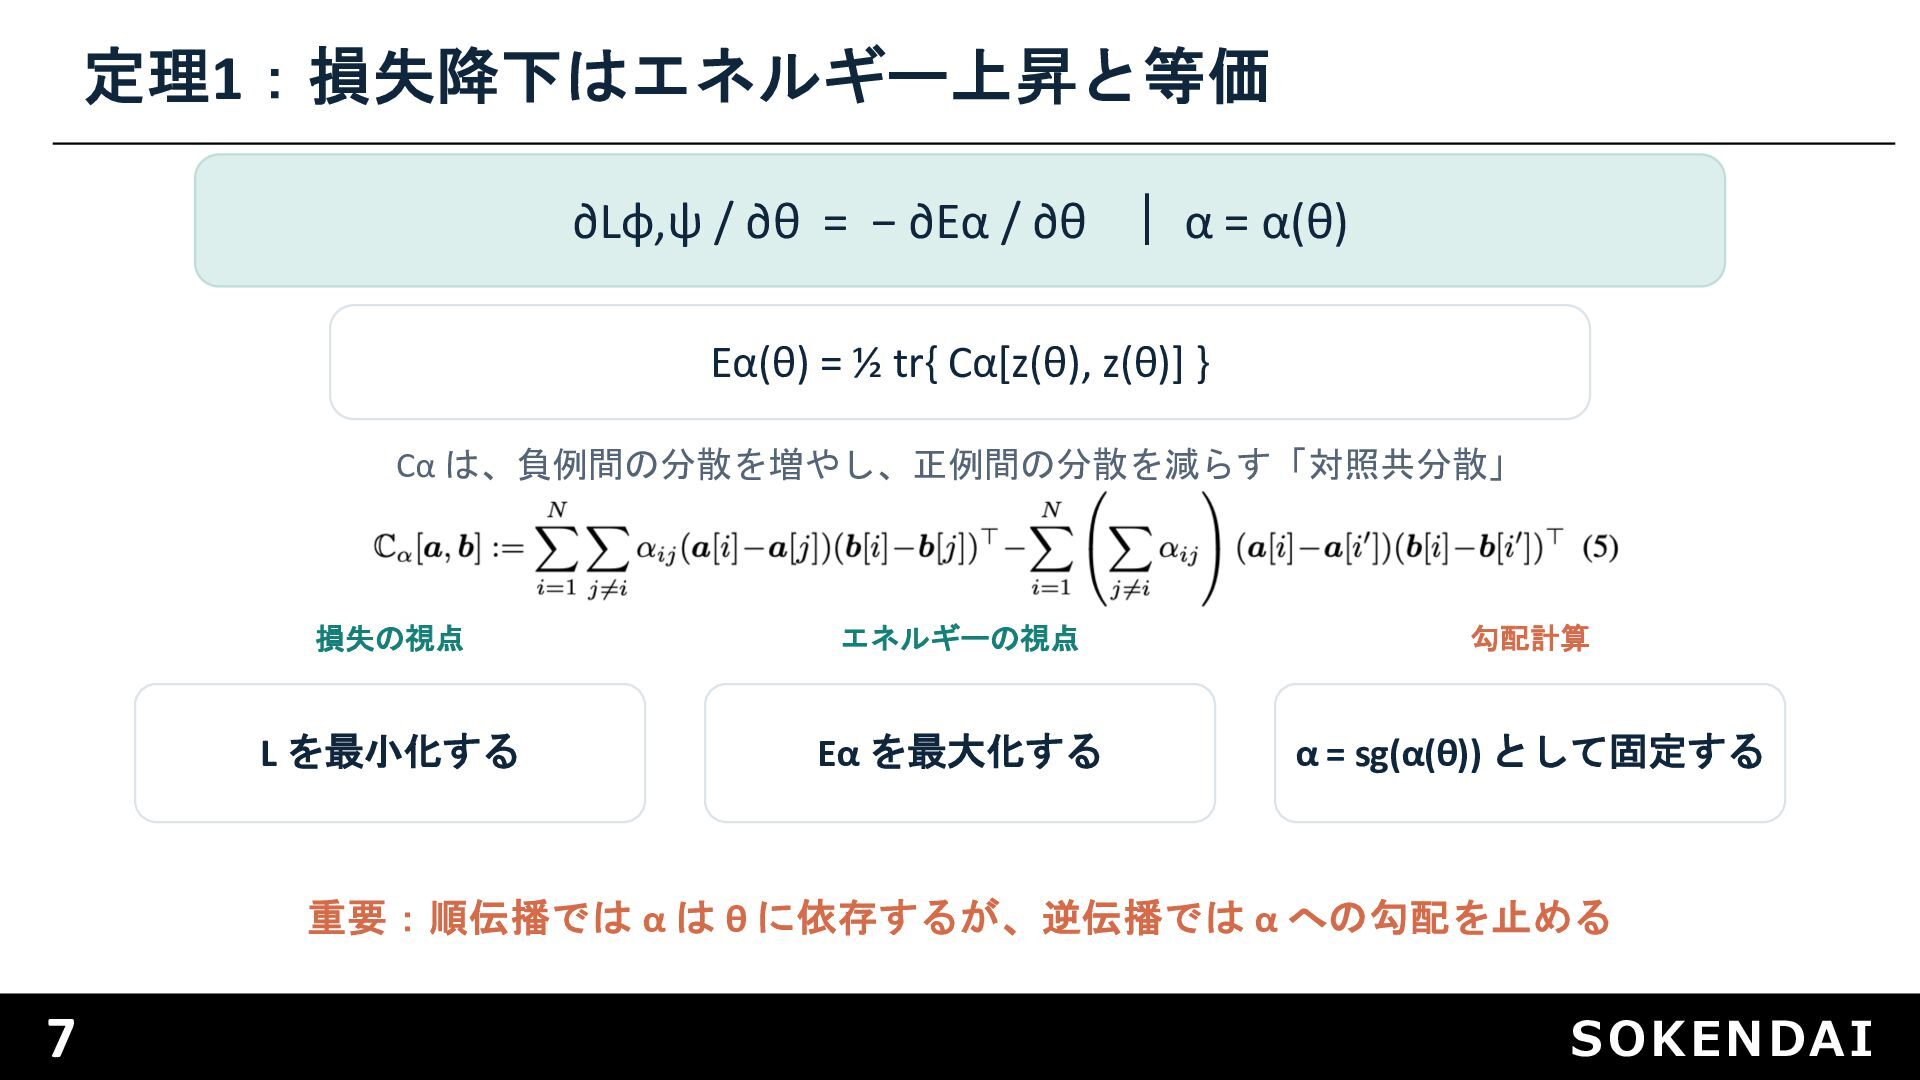
定理1:損失降下はエネルギー上昇と等価 ∂Lφ,ψ / ∂θ = − ∂Eα / ∂θ |
α = α(θ) Eα(θ) = ½ tr{ Cα[z(θ), z(θ)] } Cα は、負例間の分散を増やし、正例間の分散を減らす「対照共分散」 損失の視点 エネルギーの視点 勾配計算 L を最小化する Eα を最大化する α = sg(α(θ)) として固定する 重要:順伝播では α は θ に依存するが、逆伝播では α への勾配を止める 7 SOKENDAI
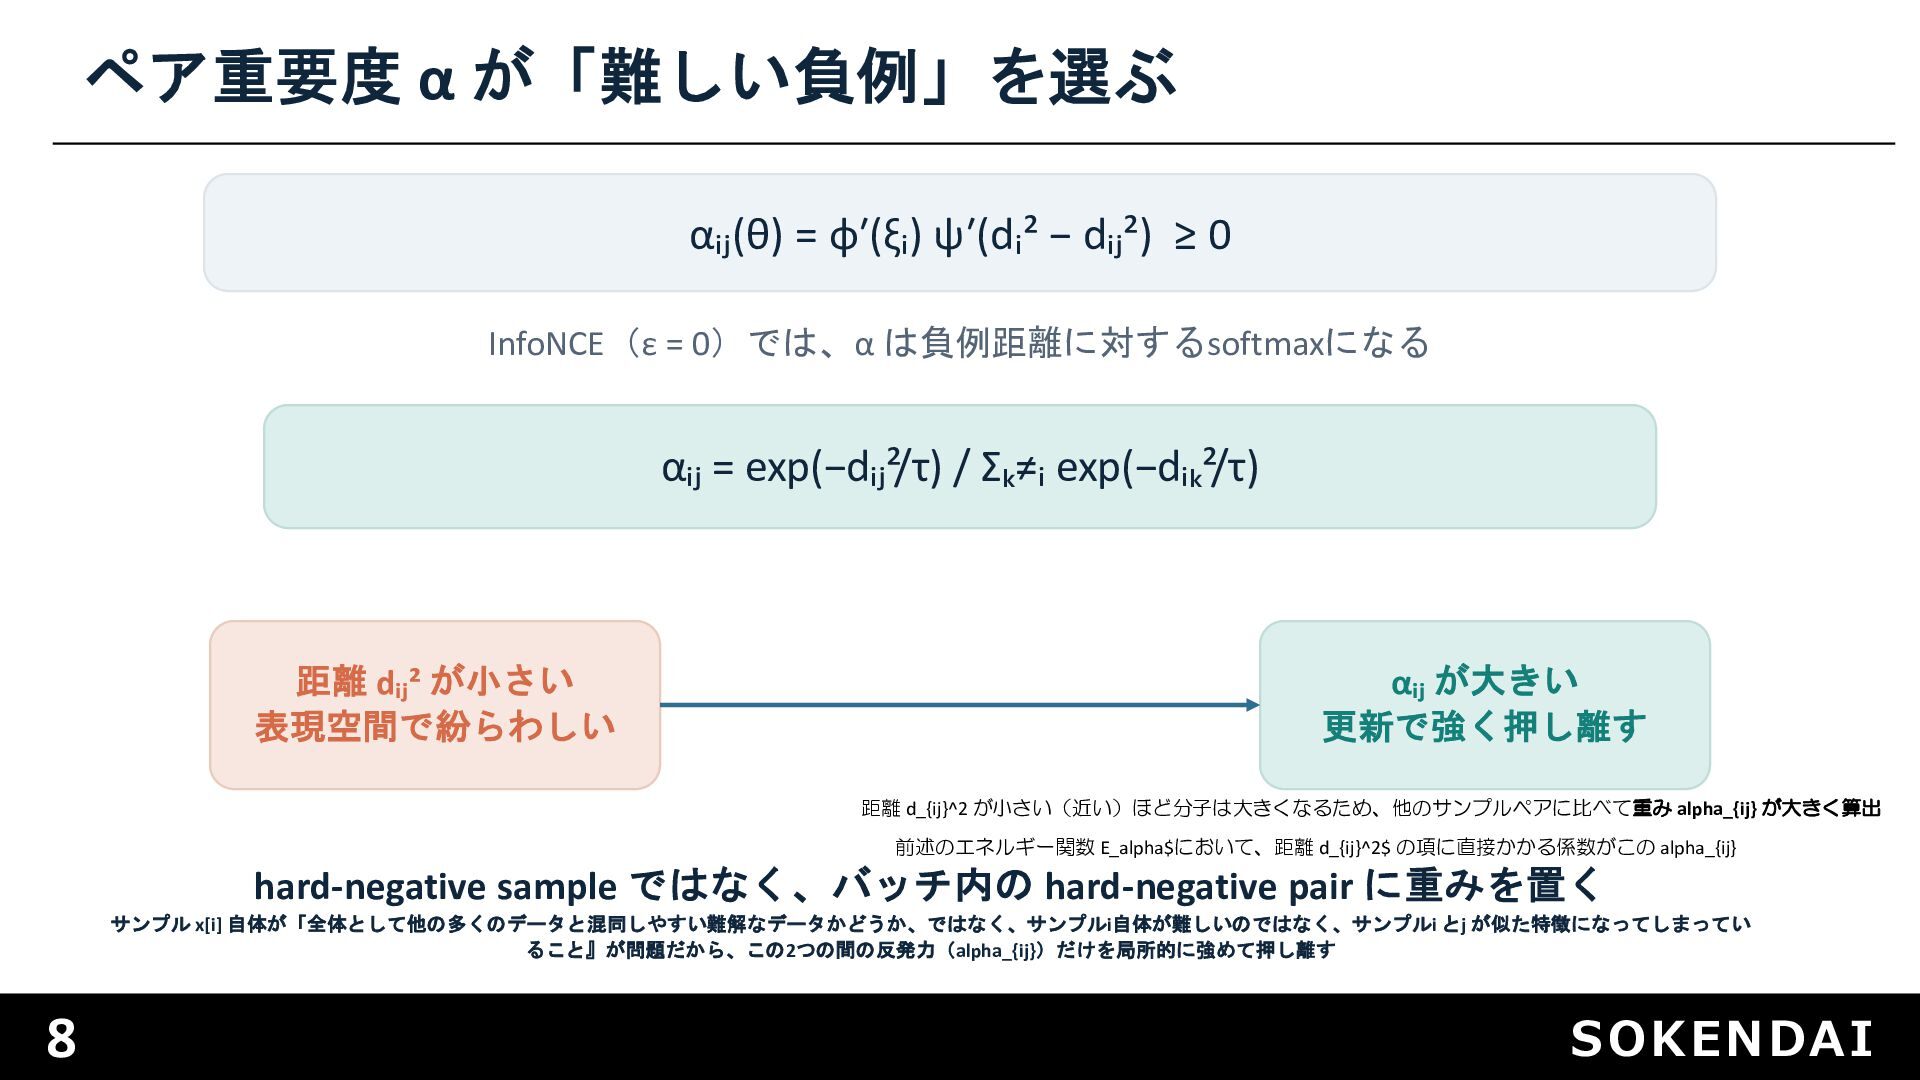
ペア重要度 α が「難しい負例」を選ぶ αᵢⱼ(θ) = φʹ(ξᵢ) ψʹ(dᵢ² − dᵢⱼ²) ≥
0 InfoNCE(ε = 0)では、α は負例距離に対するsoftmaxになる αᵢⱼ = exp(−dᵢⱼ²/τ) / Σₖ≠ᵢ exp(−dᵢₖ²/τ) 距離 dᵢⱼ² が小さい 表現空間で紛らわしい αᵢⱼ が大きい 更新で強く押し離す 距離 d_{ij}^2 が小さい(近い)ほど分子は大きくなるため、他のサンプルペアに比べて重み alpha_{ij} が大きく算出 前述のエネルギー関数 E_alpha$において、距離 d_{ij}^2$ の項に直接かかる係数がこの alpha_{ij} hard-negative sample ではなく、バッチ内の hard-negative pair に重みを置く サンプル x[i] 自体が「全体として他の多くのデータと混同しやすい難解なデータかどうか、ではなく、サンプルi自体が難しいのではなく、サンプルi とj が似た特徴になってしまってい ること』が問題だから、この2つの間の反発力(alpha_{ij})だけを局所的に強めて押し離す 8 SOKENDAI
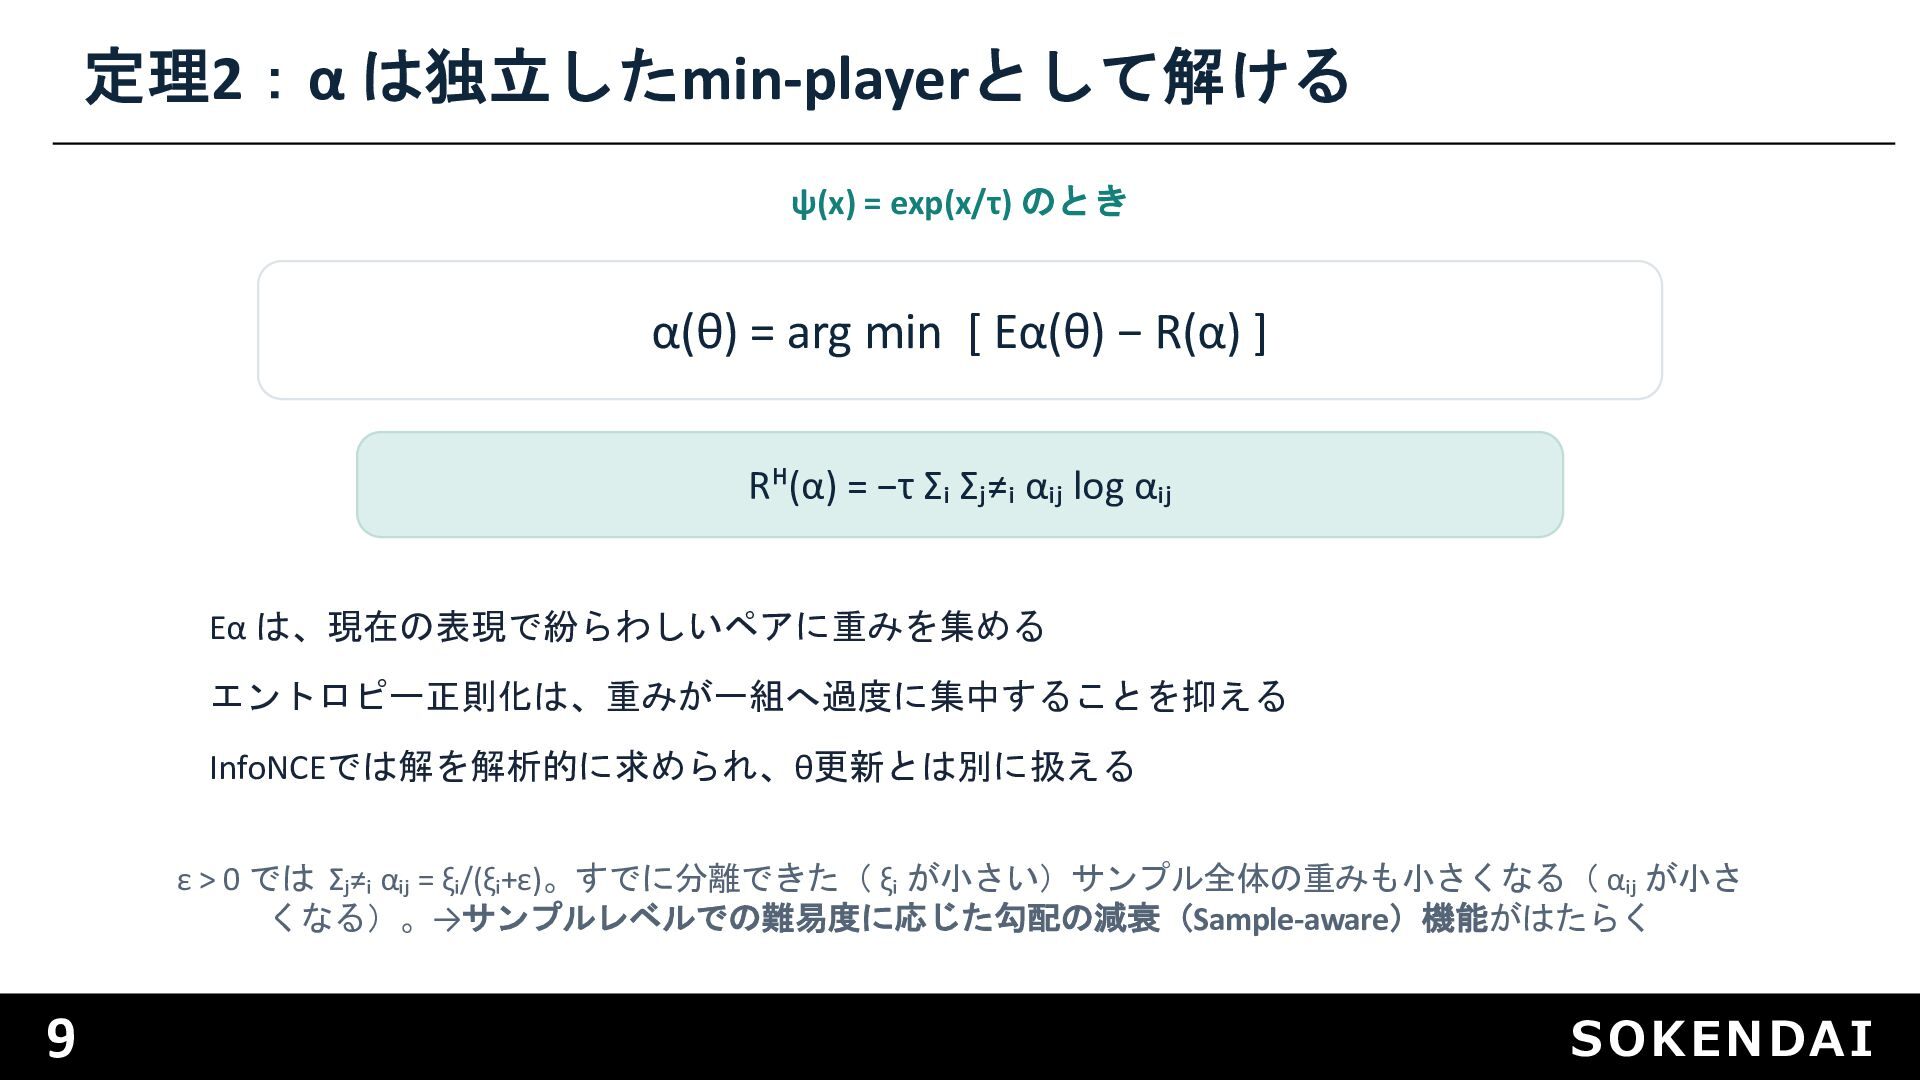
定理2:α は独立したmin-playerとして解ける ψ(x) = exp(x/τ) のとき α(θ) = arg min
[ Eα(θ) − R(α) ] Rᴴ(α) = −τ Σᵢ Σⱼ≠ᵢ αᵢⱼ log αᵢⱼ Eα は、現在の表現で紛らわしいペアに重みを集める エントロピー正則化は、重みが一組へ過度に集中することを抑える InfoNCEでは解を解析的に求められ、θ更新とは別に扱える ε > 0 では Σⱼ≠ᵢ αᵢⱼ = ξᵢ/(ξᵢ+ε)。すでに分離できた( ξᵢ が小さい)サンプル全体の重みも小さくなる( αᵢⱼ が小さ くなる)。→サンプルレベルでの難易度に応じた勾配の減衰(Sample-aware)機能がはたらく 9 SOKENDAI
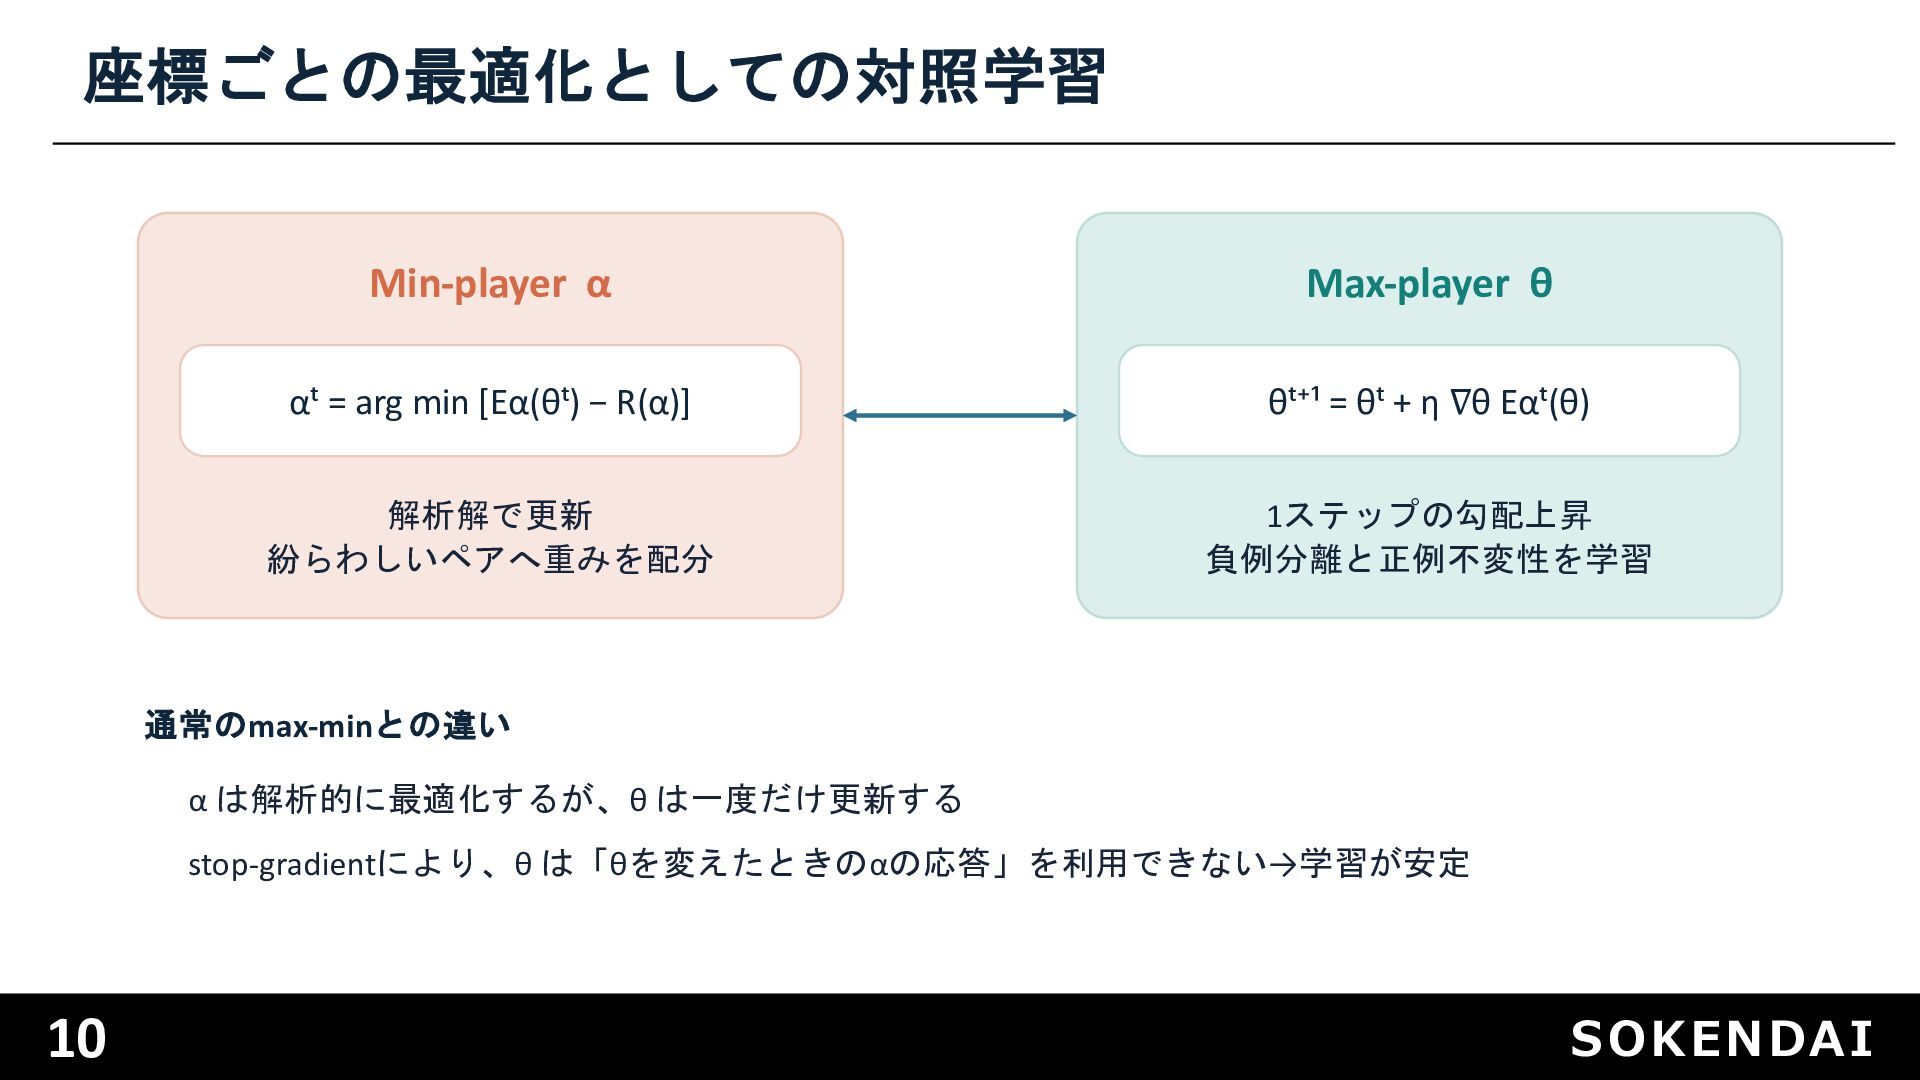
座標ごとの最適化としての対照学習 Min-player α Max-player θ αᵗ = arg min [Eα(θᵗ)
− R(α)] θᵗ⁺¹ = θᵗ + η ∇θ Eαᵗ(θ) 解析解で更新 紛らわしいペアへ重みを配分 1ステップの勾配上昇 負例分離と正例不変性を学習 通常のmax-minとの違い α は解析的に最適化するが、θ は一度だけ更新する stop-gradientにより、θ は「θを変えたときのαの応答」を利用できない→学習が安定 10 SOKENDAI
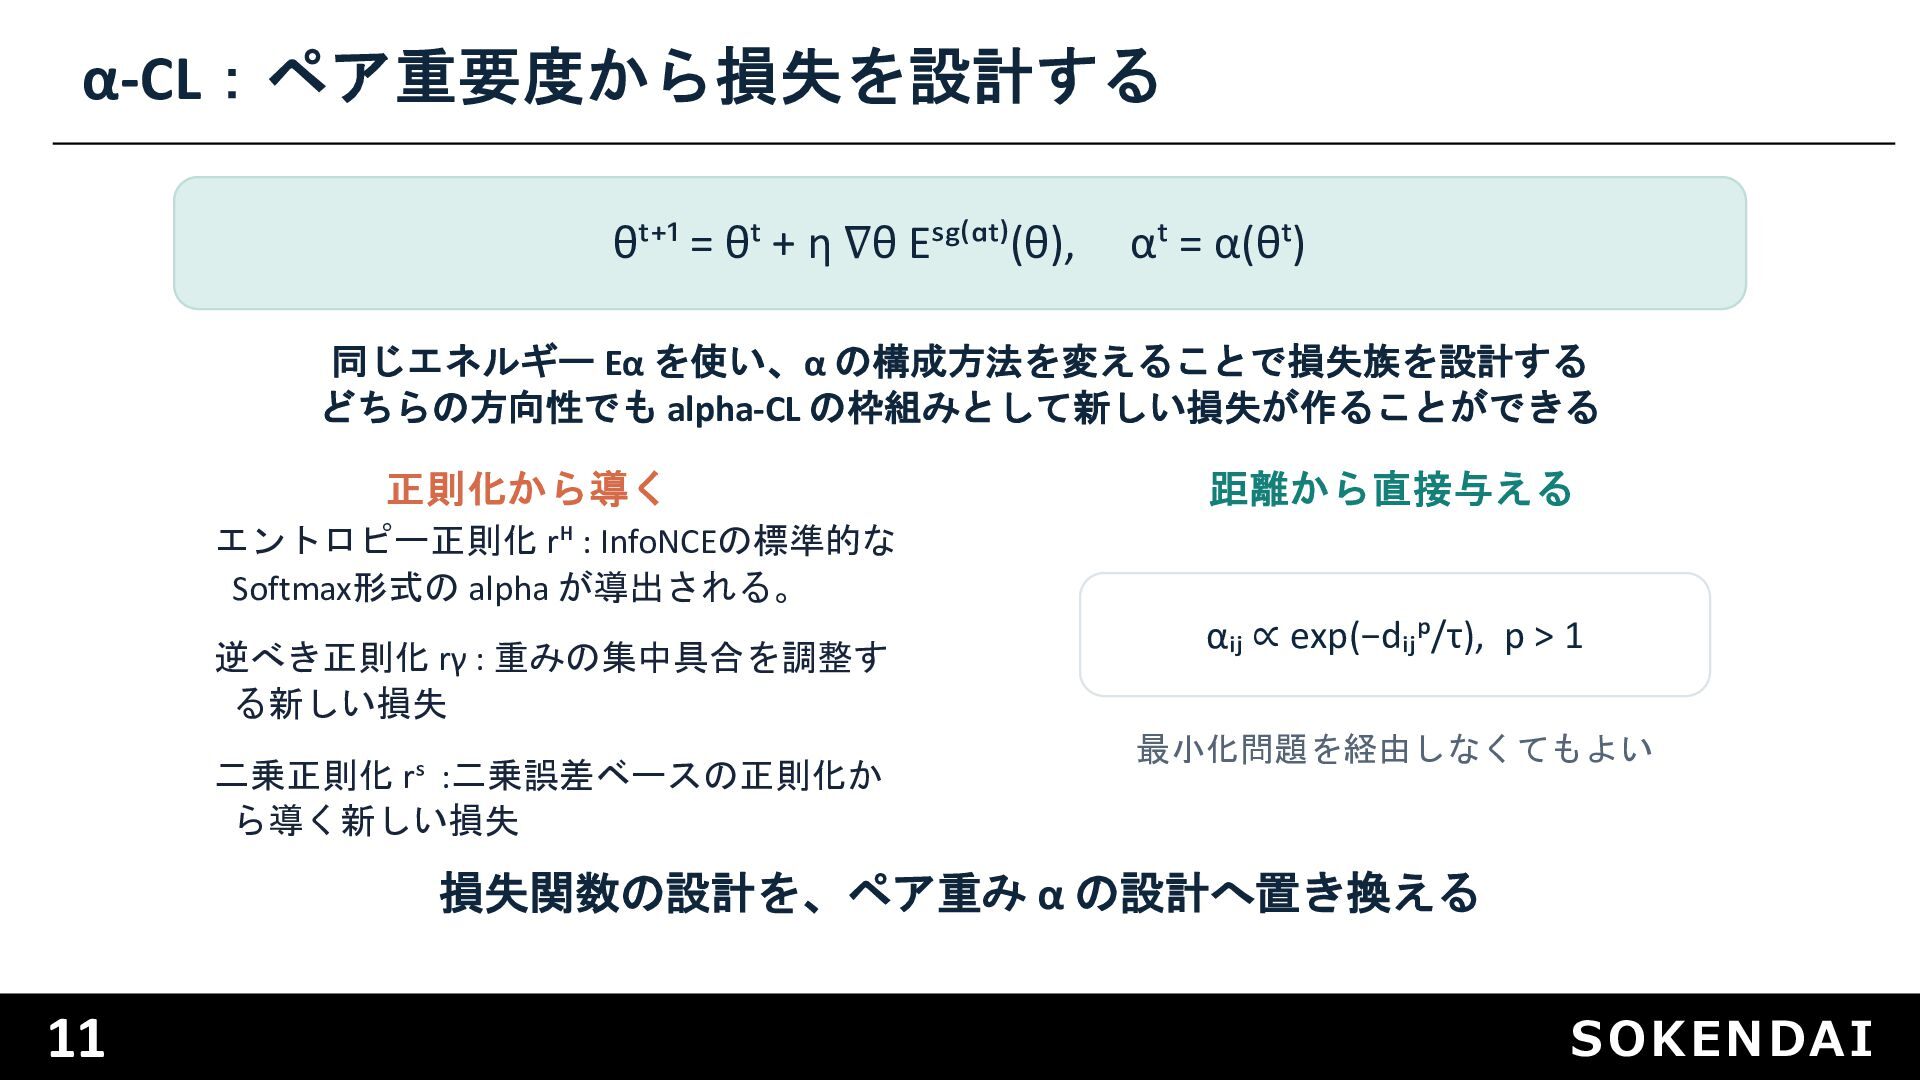
α-CL:ペア重要度から損失を設計する θᵗ⁺¹ = θᵗ + η ∇θ Eˢᵍ⁽ᵅᵗ⁾(θ), αᵗ =
α(θᵗ) 同じエネルギー Eα を使い、α の構成方法を変えることで損失族を設計する どちらの方向性でも alpha-CL の枠組みとして新しい損失が作ることができる 正則化から導く 距離から直接与える エントロピー正則化 rᴴ : InfoNCEの標準的な Softmax形式の alpha が導出される。 逆べき正則化 rγ : 重みの集中具合を調整す る新しい損失 二乗正則化 rˢ :二乗誤差ベースの正則化か ら導く新しい損失 αᵢⱼ ∝ exp(−dᵢⱼᵖ/τ), p > 1 最小化問題を経由しなくてもよい 損失関数の設計を、ペア重み α の設計へ置き換える 11 SOKENDAI
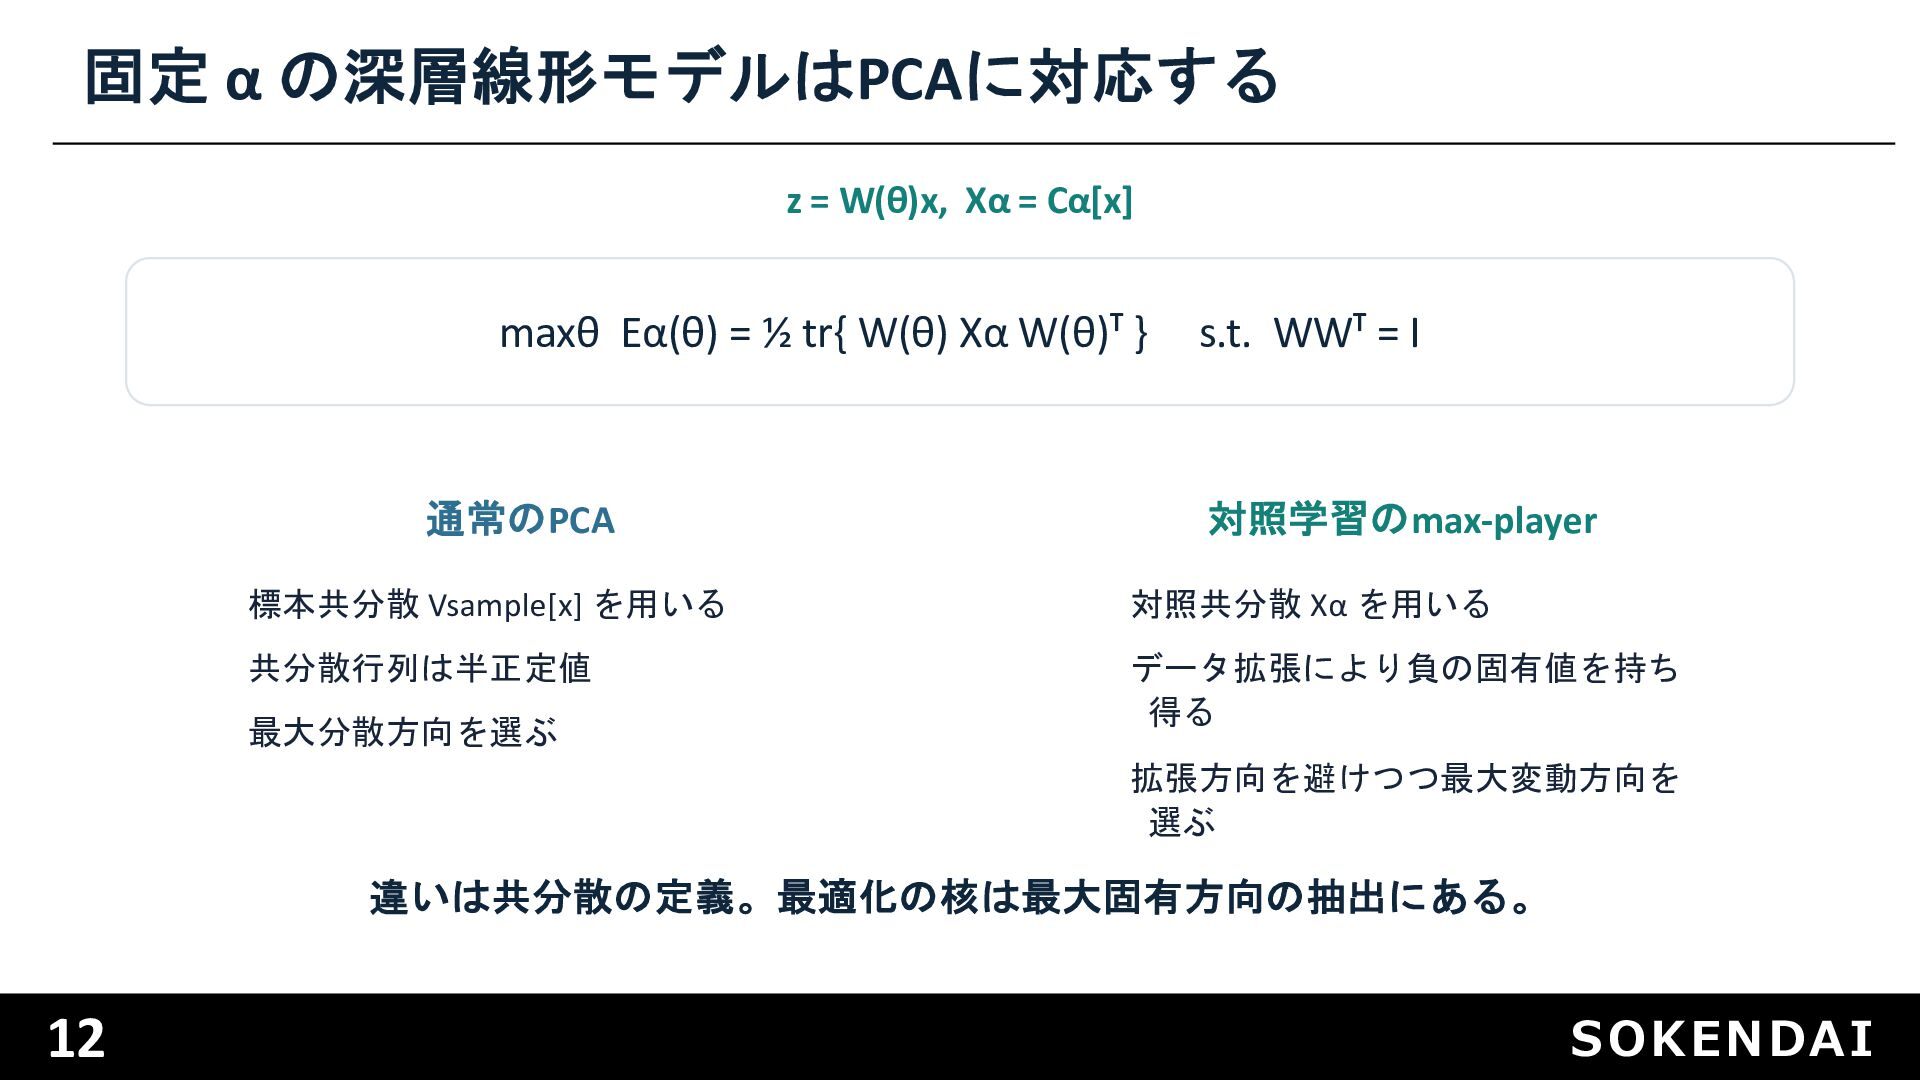
固定 α の深層線形モデルはPCAに対応する z = W(θ)x, Xα = Cα[x] maxθ
Eα(θ) = ½ tr{ W(θ) Xα W(θ)ᵀ } 通常のPCA s.t. WWᵀ = I 対照学習のmax-player 標本共分散 Vsample[x] を用いる 対照共分散 Xα を用いる 共分散行列は半正定値 データ拡張により負の固有値を持ち 得る 最大分散方向を選ぶ 拡張方向を避けつつ最大変動方向を 選ぶ 違いは共分散の定義。最適化の核は最大固有方向の抽出にある。 12 SOKENDAI
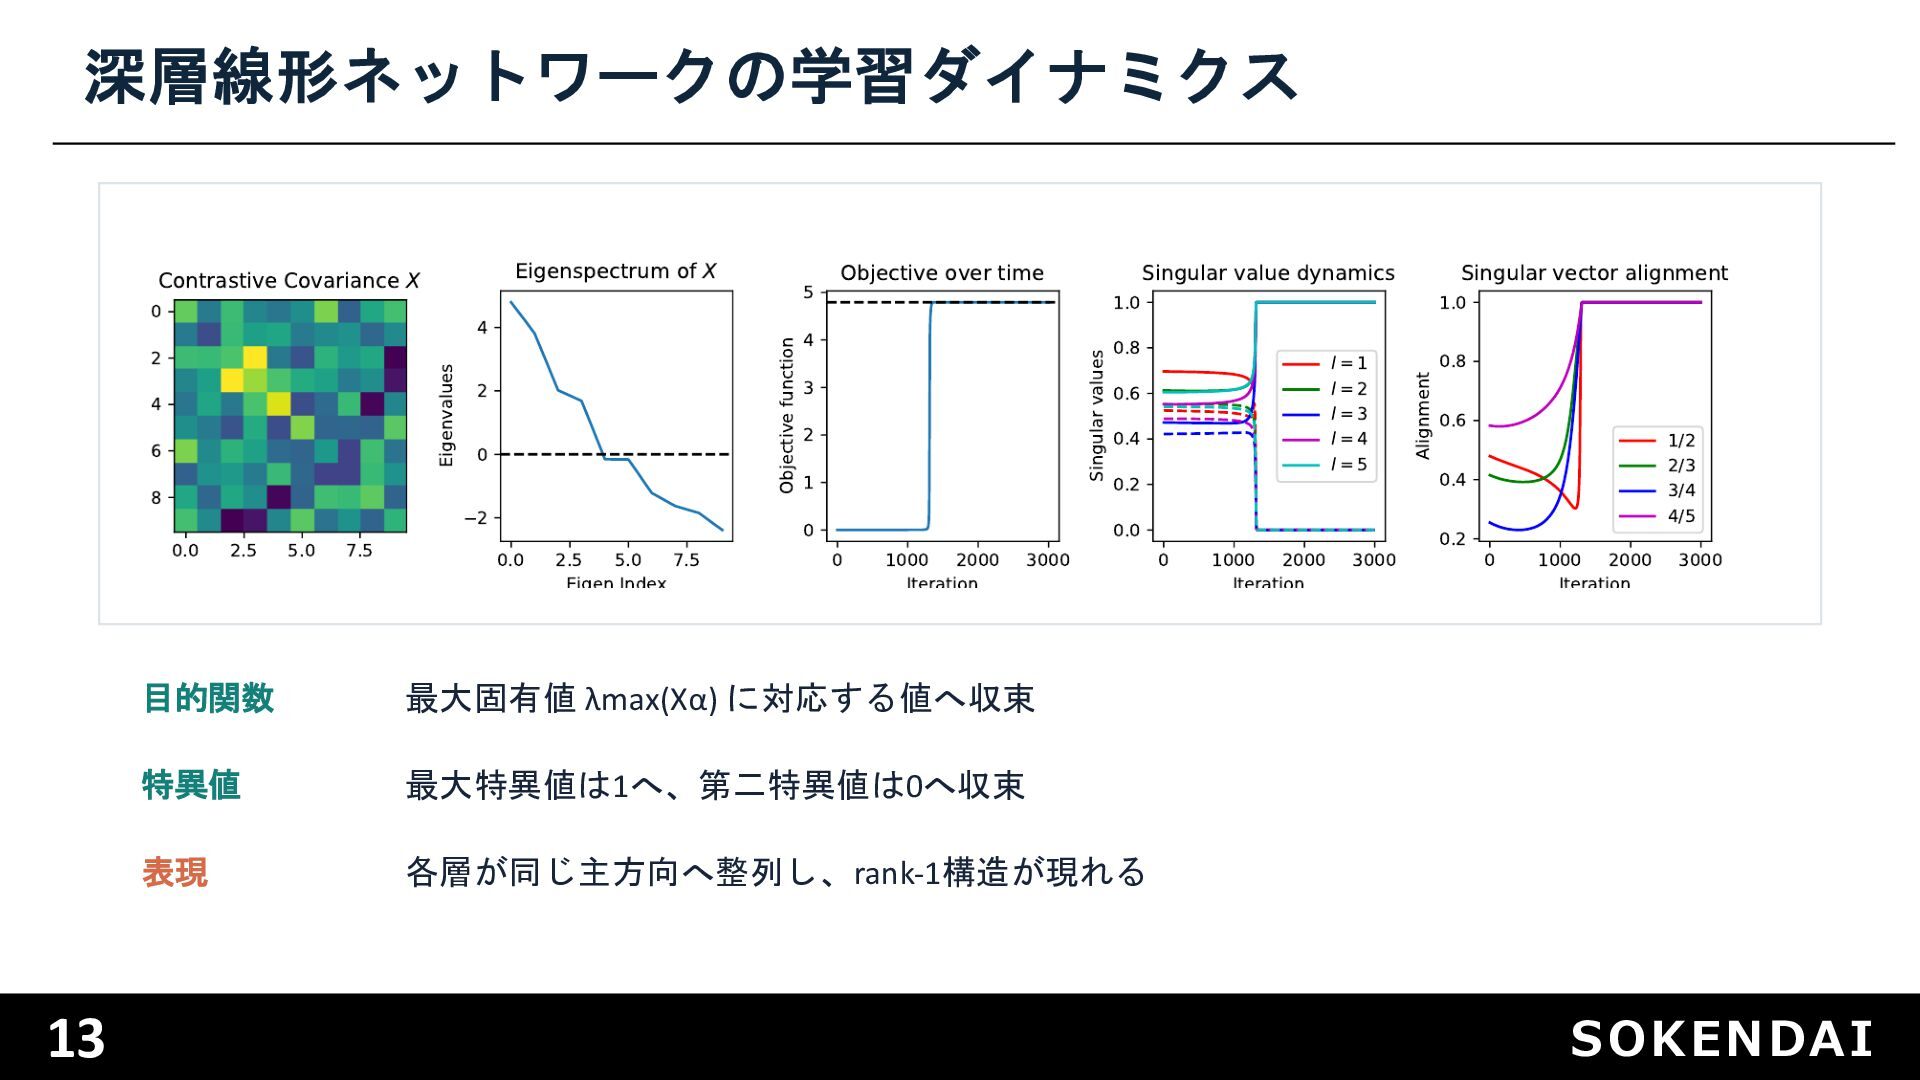
深層線形ネットワークの学習ダイナミクス 13 目的関数 最大固有値 λmax(Xα) に対応する値へ収束 特異値 最大特異値は1へ、第二特異値は0へ収束 表現 各層が同じ主方向へ整列し、rank-1構造が現れる
SOKENDAI
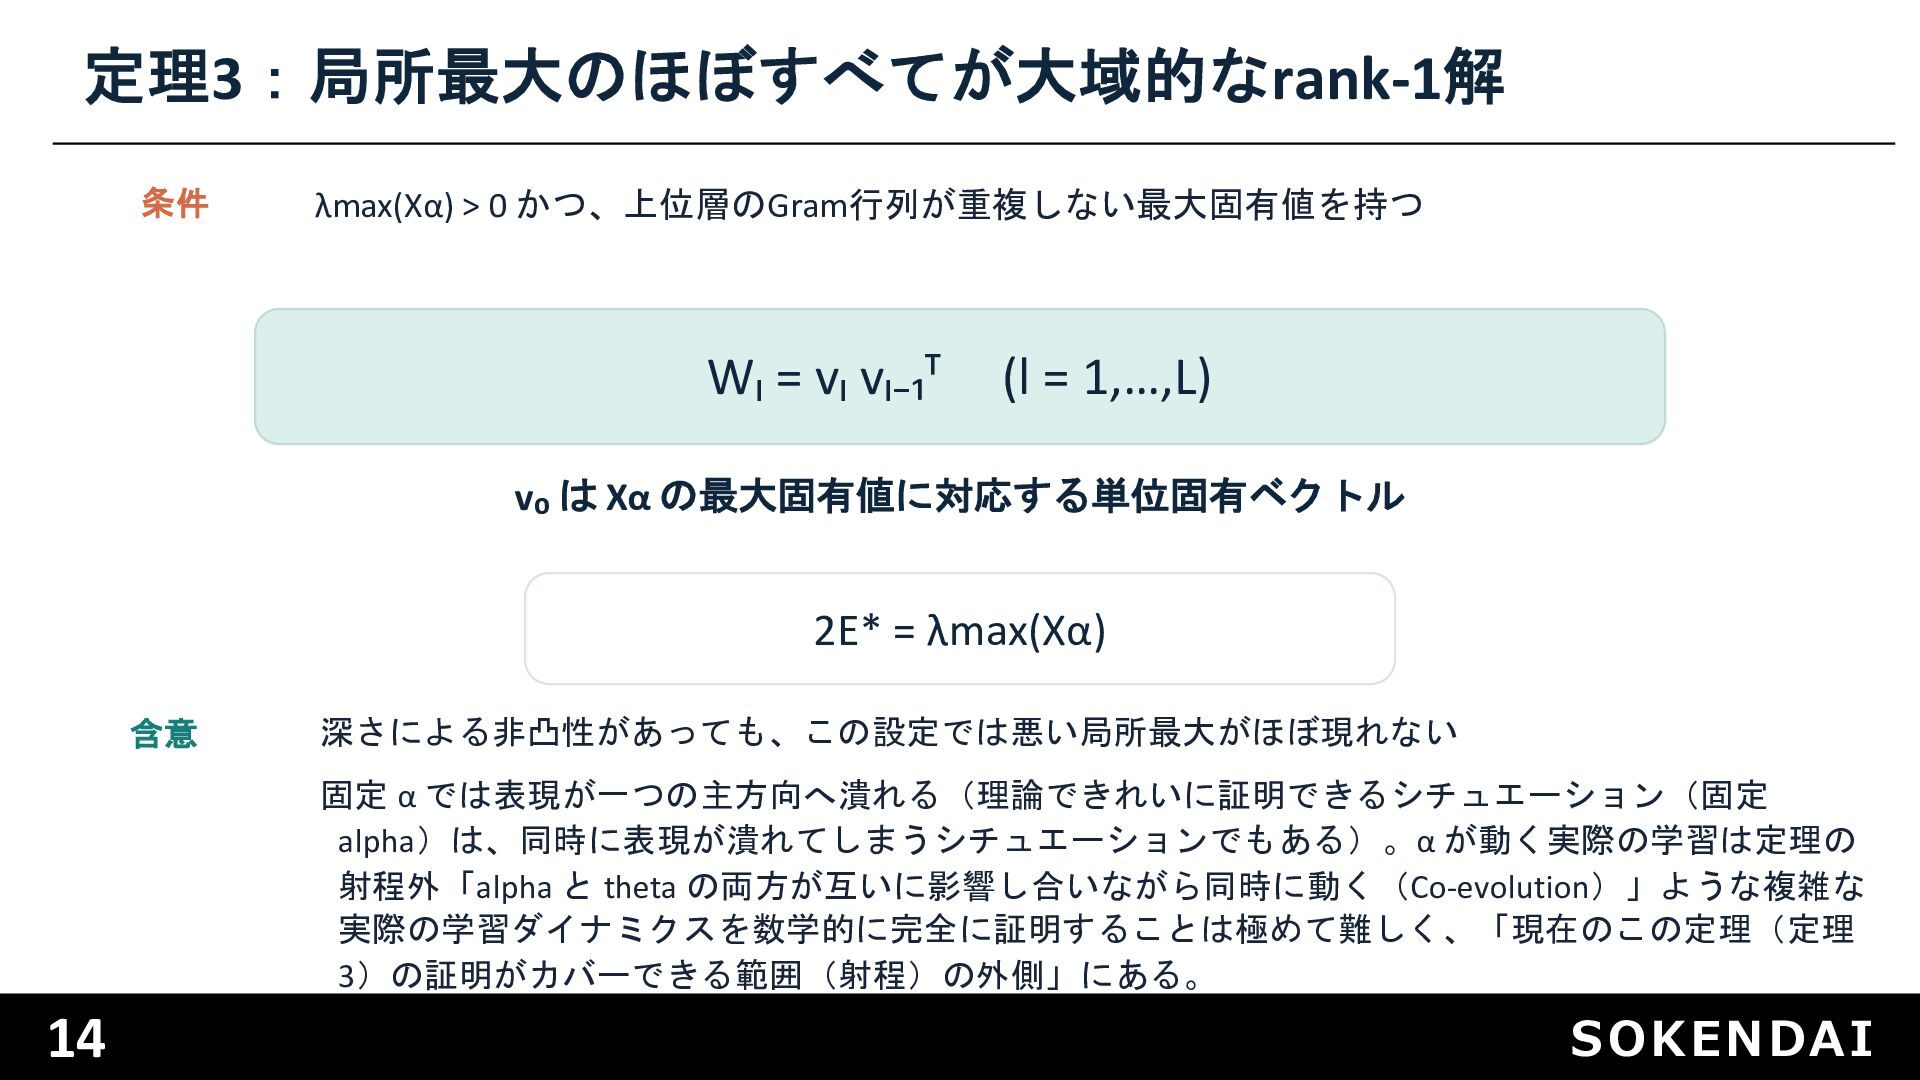
定理3:局所最大のほぼすべてが大域的なrank-1解 条件 λmax(Xα) > 0 かつ、上位層のGram行列が重複しない最大固有値を持つ Wₗ = vₗ vₗ₋₁ᵀ
(l = 1,…,L) v₀ は Xα の最大固有値に対応する単位固有ベクトル 2E* = λmax(Xα) 含意 深さによる非凸性があっても、この設定では悪い局所最大がほぼ現れない 固定 α では表現が一つの主方向へ潰れる(理論できれいに証明できるシチュエーション(固定 alpha)は、同時に表現が潰れてしまうシチュエーションでもある)。α が動く実際の学習は定理の 射程外「alpha と theta の両方が互いに影響し合いながら同時に動く(Co-evolution)」ような複雑な 実際の学習ダイナミクスを数学的に完全に証明することは極めて難しく、「現在のこの定理(定理 3)の証明がカバーできる範囲(射程)の外側」にある。 14 SOKENDAI
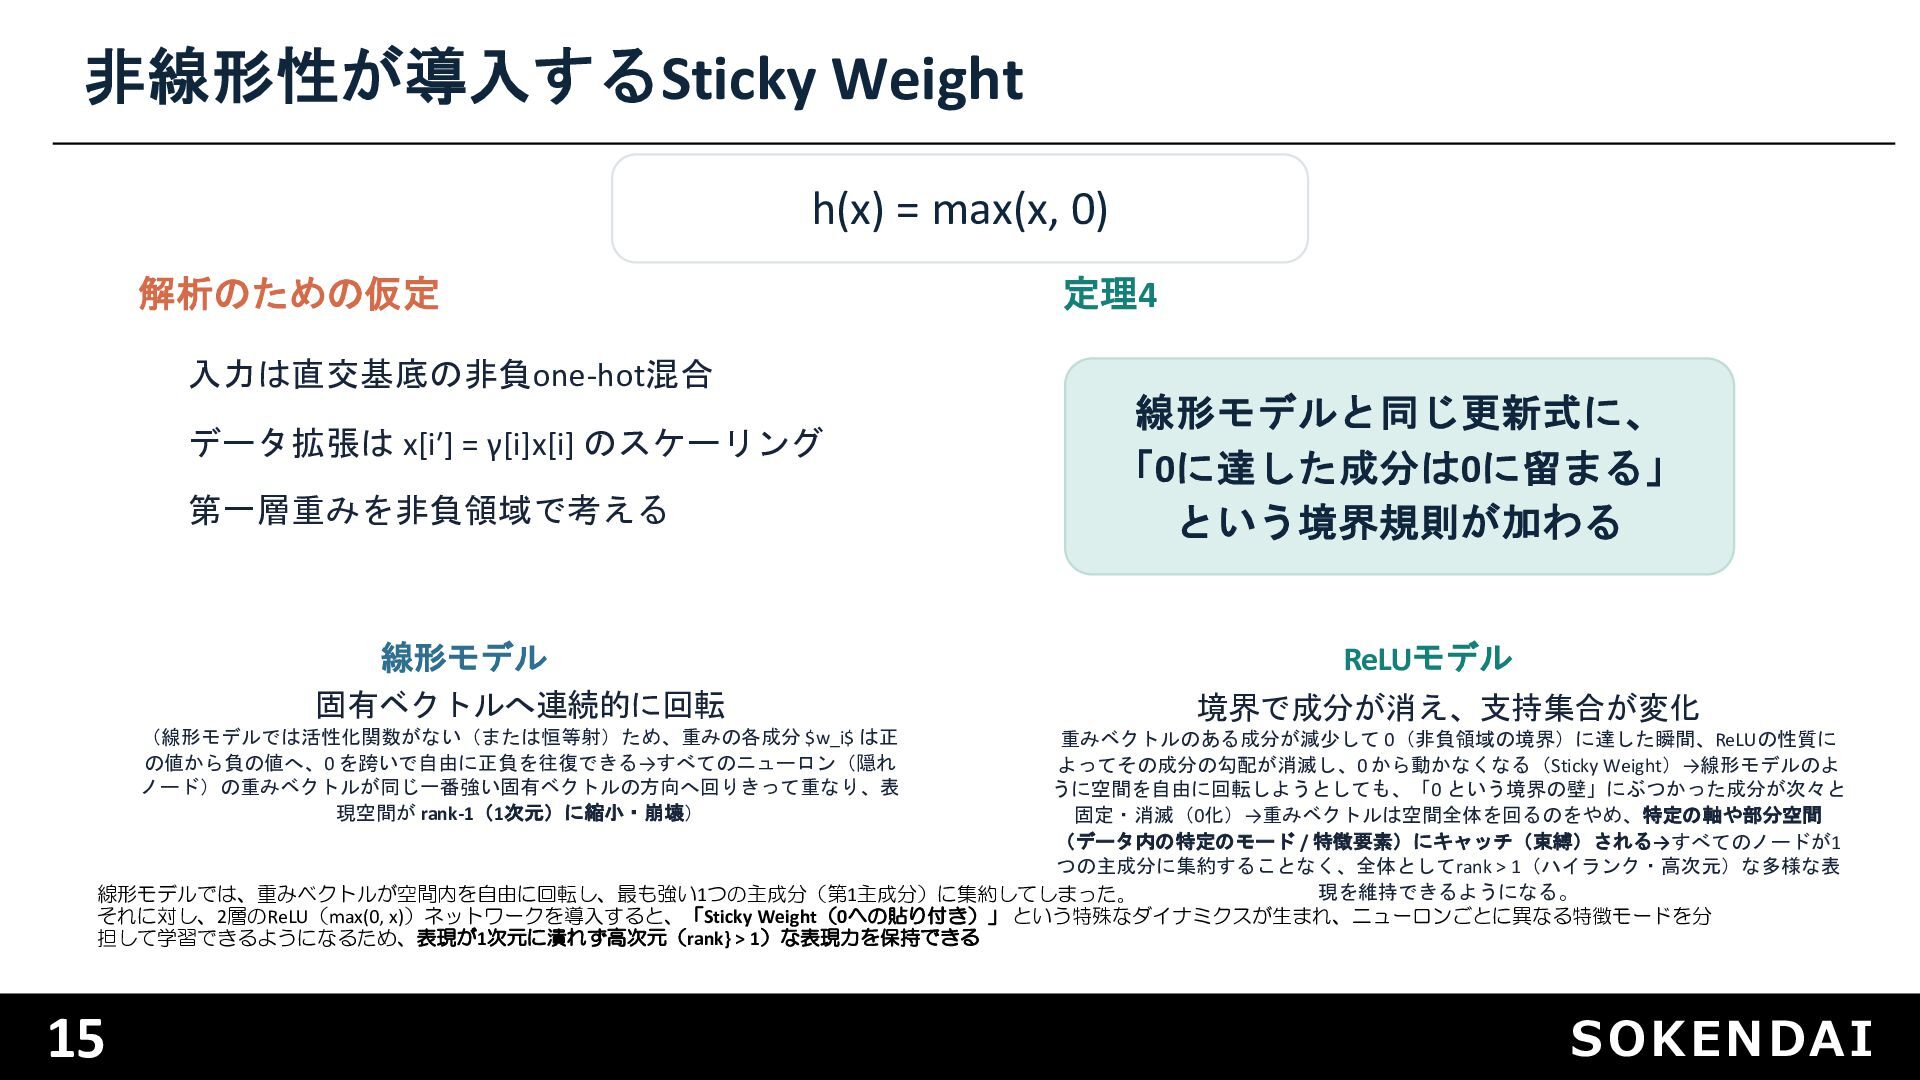
非線形性が導入するSticky Weight h(x) = max(x, 0) 解析のための仮定 定理4 入力は直交基底の非負one-hot混合 データ拡張は
x[iʹ] = γ[i]x[i] のスケーリング 第一層重みを非負領域で考える 線形モデル 固有ベクトルへ連続的に回転 線形モデルと同じ更新式に、 「0に達した成分は0に留まる」 という境界規則が加わる ReLUモデル 境界で成分が消え、支持集合が変化 (線形モデルでは活性化関数がない(または恒等射)ため、重みの各成分 $w_i$ は正 の値から負の値へ、0 を跨いで自由に正負を往復できる→すべてのニューロン(隠れ ノード)の重みベクトルが同じ一番強い固有ベクトルの方向へ回りきって重なり、表 現空間が rank-1(1次元)に縮小・崩壊) 重みベクトルのある成分が減少して 0(非負領域の境界)に達した瞬間、ReLUの性質に よってその成分の勾配が消滅し、0 から動かなくなる(Sticky Weight)→線形モデルのよ うに空間を自由に回転しようとしても、「0 という境界の壁」にぶつかった成分が次々と 固定・消滅(0化)→重みベクトルは空間全体を回るのをやめ、特定の軸や部分空間 (データ内の特定のモード / 特徴要素)にキャッチ(束縛)される→すべてのノードが1 つの主成分に集約することなく、全体としてrank > 1(ハイランク・高次元)な多様な表 現を維持できるようになる。 線形モデルでは、重みベクトルが空間内を自由に回転し、最も強い1つの主成分(第1主成分)に集約してしまった。 それに対し、2層のReLU(max(0, x))ネットワークを導入すると、「Sticky Weight(0への貼り付き)」 という特殊なダイナミクスが生まれ、ニューロンごとに異なる特徴モードを分 担して学習できるようになるため、表現が1次元に潰れず高次元(rank} > 1)な表現力を保持できる 15 SOKENDAI
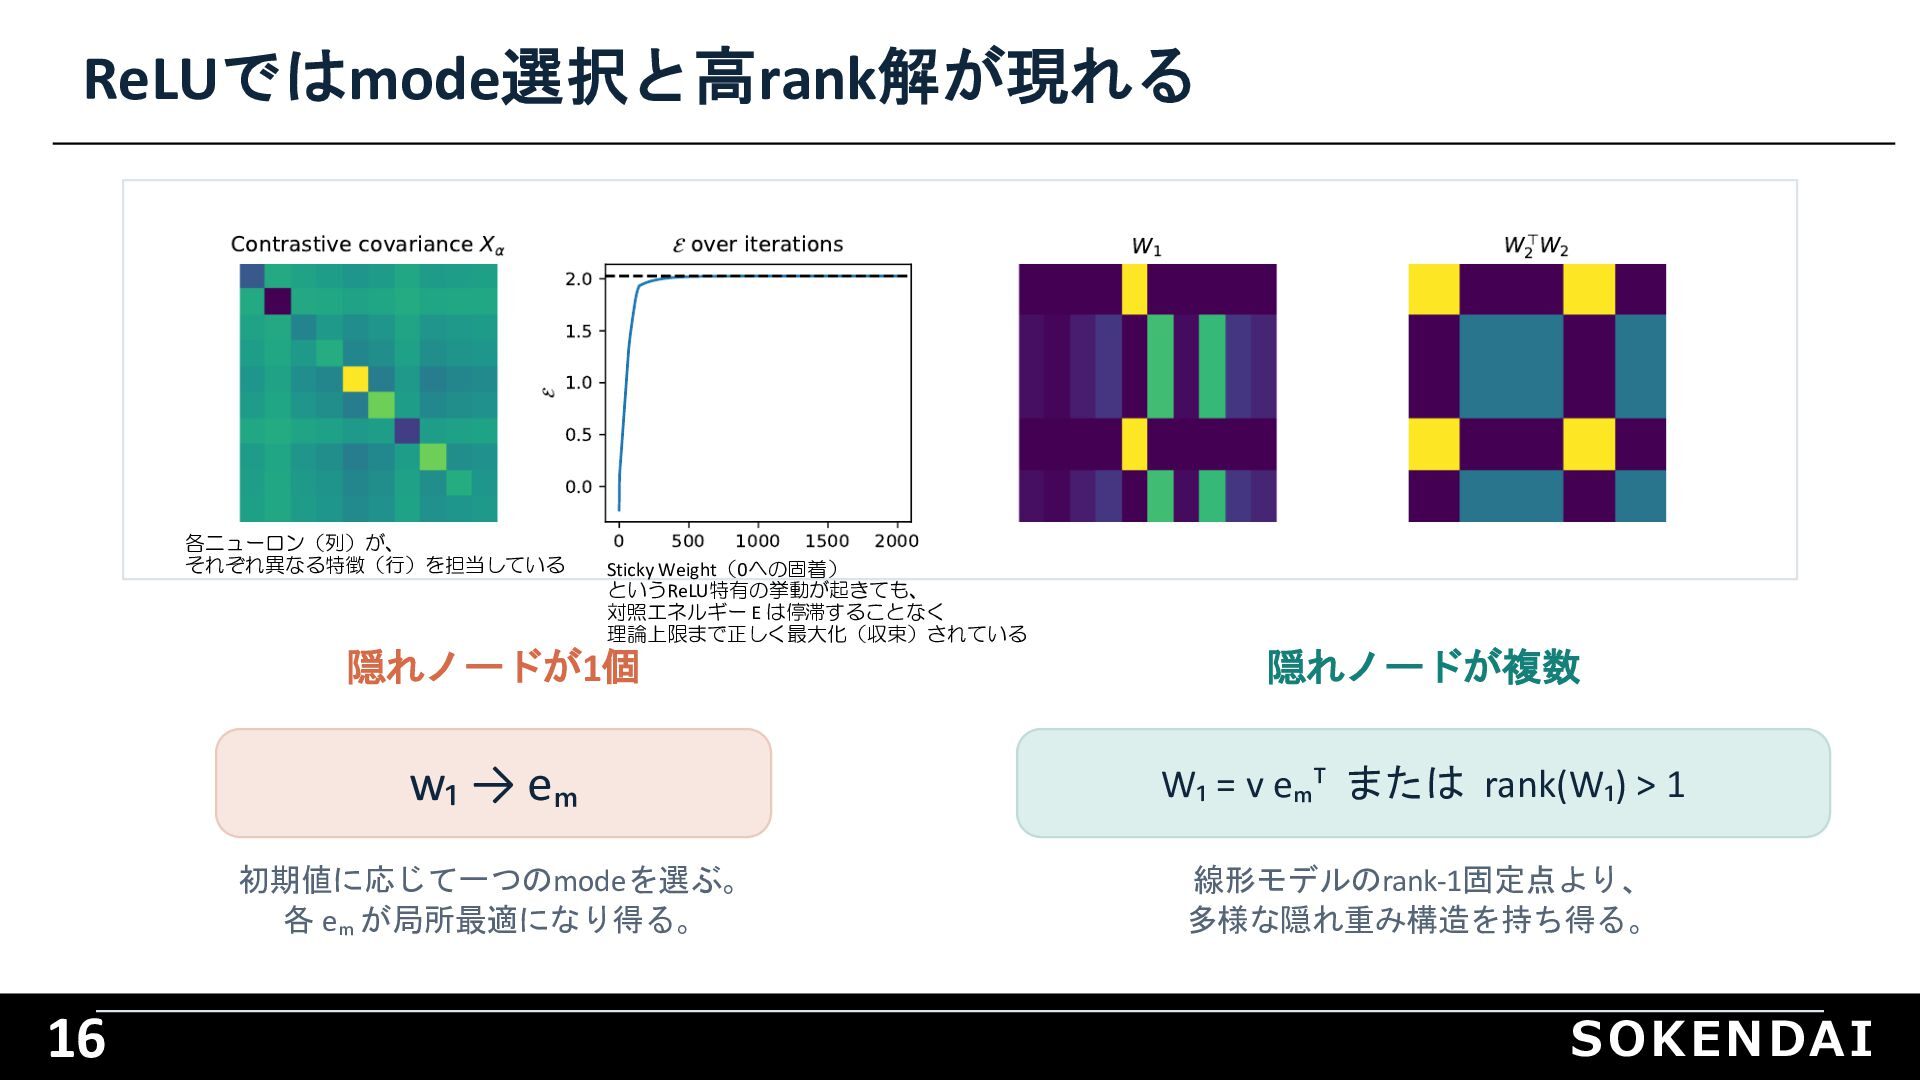
ReLUではmode選択と高rank解が現れる 各ニューロン(列)が、 それぞれ異なる特徴(行)を担当している 16 Sticky Weight(0への固着) というReLU特有の挙動が起きても、 対照エネルギー E は停滞することなく
理論上限まで正しく最大化(収束)されている 隠れノードが1個 隠れノードが複数 w₁ → eₘ W₁ = v eₘᵀ または rank(W₁) > 1 初期値に応じて一つのmodeを選ぶ。 各 eₘ が局所最適になり得る。 線形モデルのrank-1固定点より、 多様な隠れ重み構造を持ち得る。 SOKENDAI
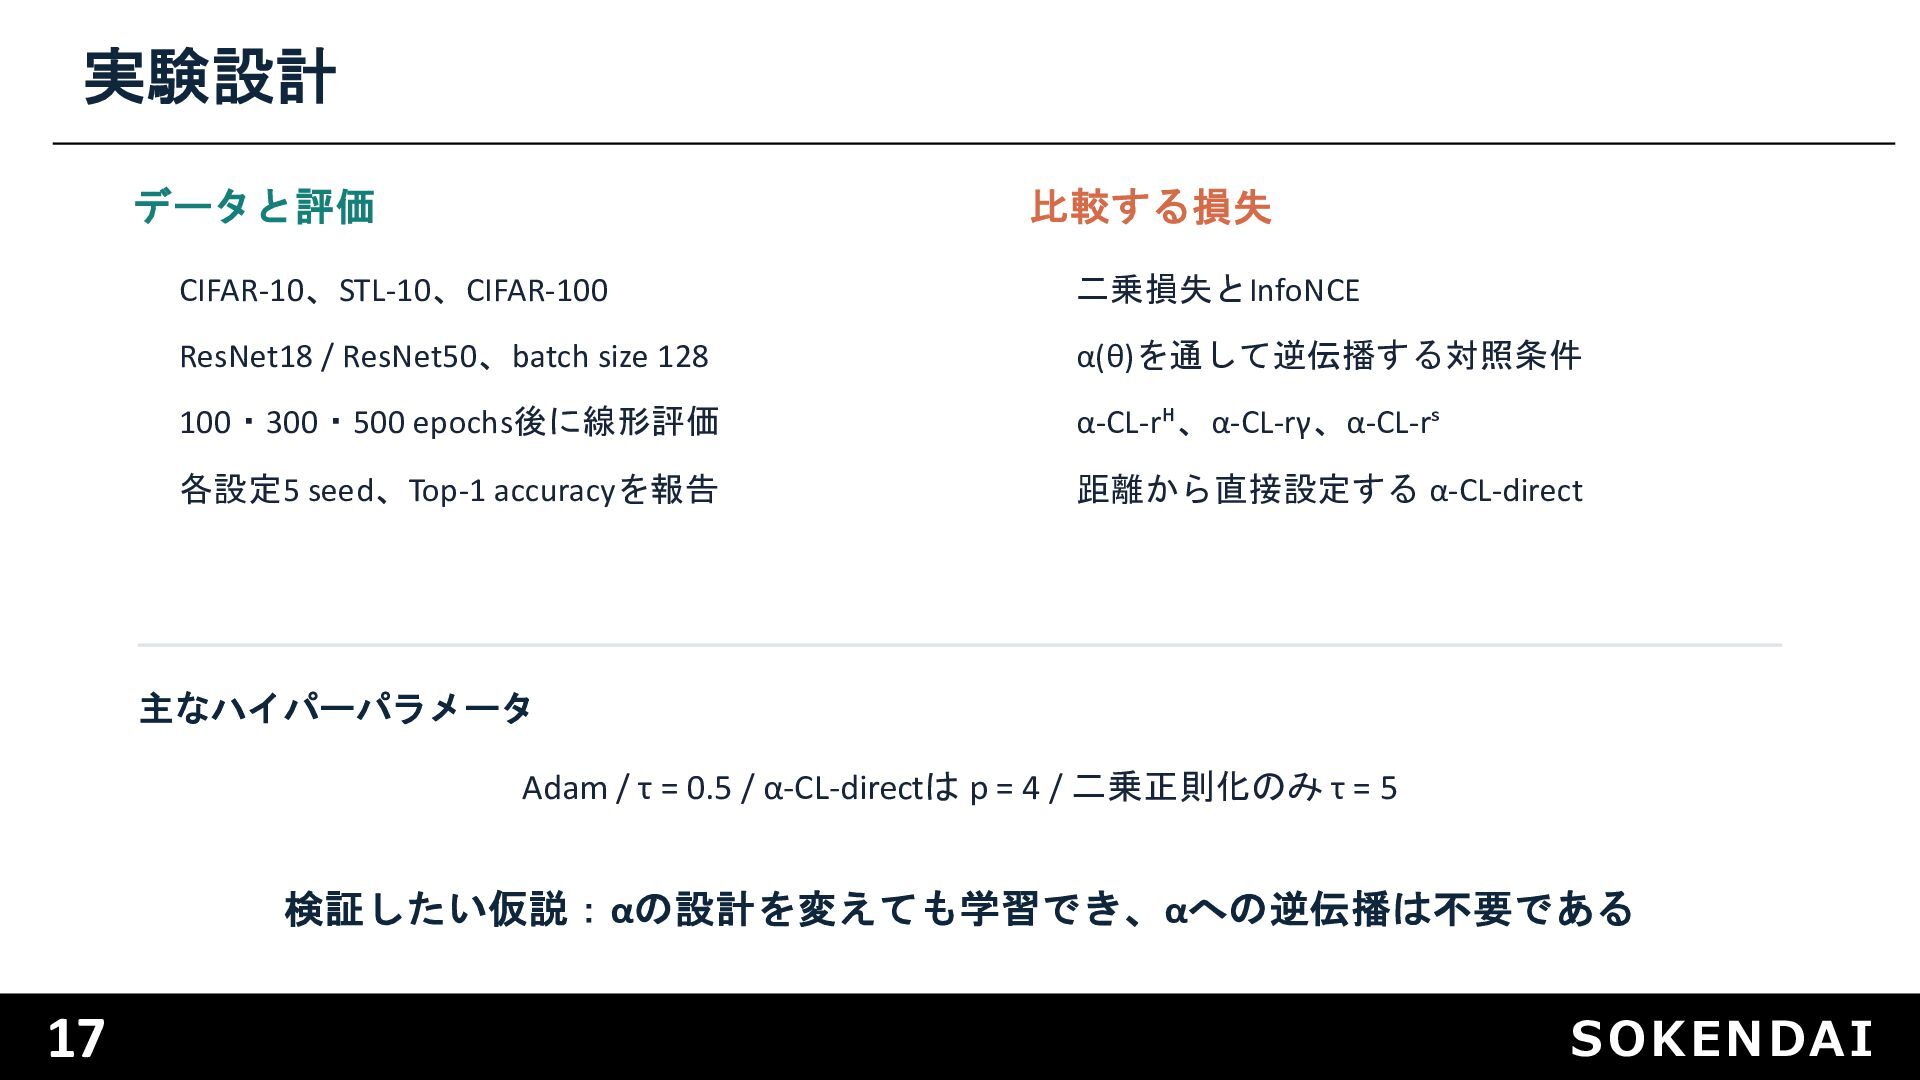
実験設計 データと評価 比較する損失 CIFAR-10、STL-10、CIFAR-100 二乗損失とInfoNCE ResNet18 / ResNet50、batch size 128
α(θ)を通して逆伝播する対照条件 100・300・500 epochs後に線形評価 α-CL-rᴴ、α-CL-rγ、α-CL-rˢ 各設定5 seed、Top-1 accuracyを報告 距離から直接設定する α-CL-direct 主なハイパーパラメータ Adam / τ = 0.5 / α-CL-directは p = 4 / 二乗正則化のみ τ = 5 検証したい仮説:αの設計を変えても学習でき、αへの逆伝播は不要である 17 SOKENDAI
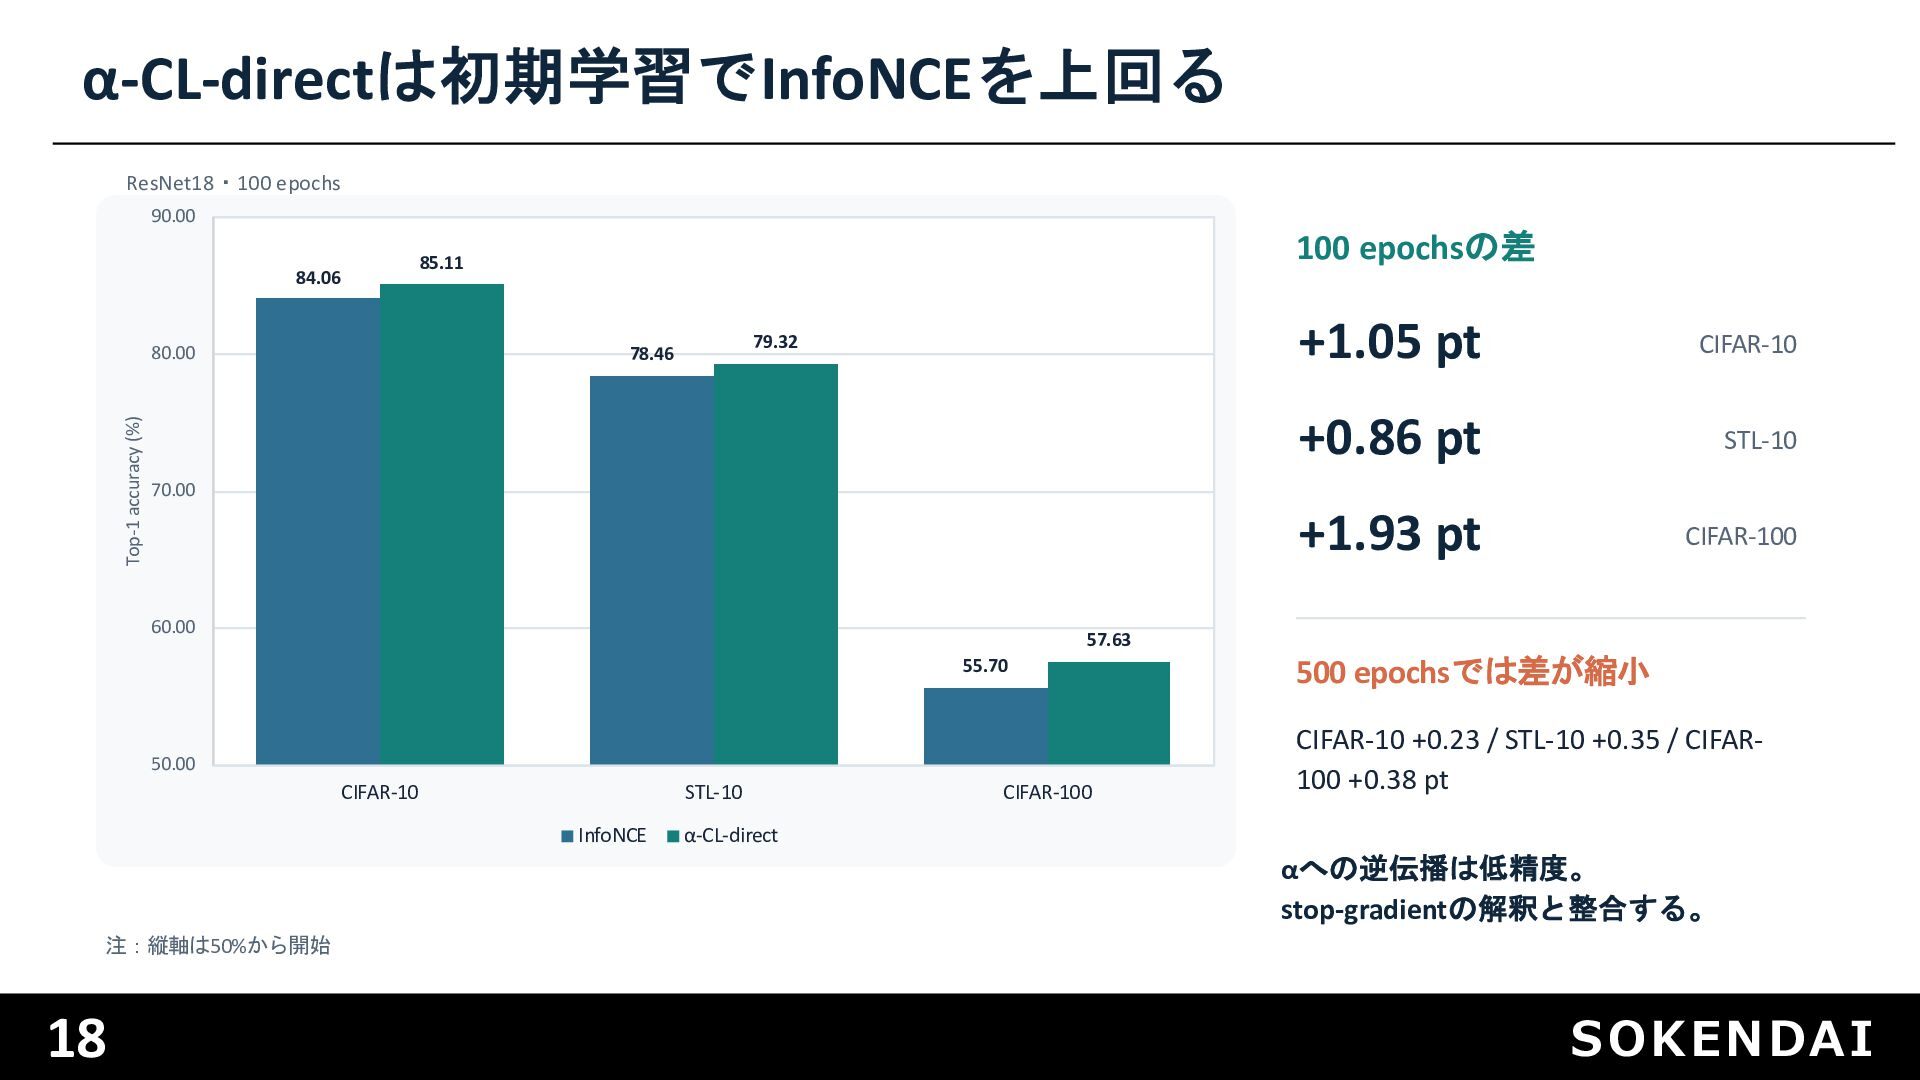
α-CL-directは初期学習でInfoNCEを上回る ResNet18・100 epochs 90.00 80.00 Top-1 accuracy (%) 100 epochsの差
85.11 84.06 79.32 78.46 70.00 60.00 57.63 55.70 50.00 CIFAR-10 STL-10 InfoNCE CIFAR-100 +1.05 pt CIFAR-10 +0.86 pt STL-10 +1.93 pt CIFAR-100 500 epochsでは差が縮小 CIFAR-10 +0.23 / STL-10 +0.35 / CIFAR100 +0.38 pt α-CL-direct αへの逆伝播は低精度。 stop-gradientの解釈と整合する。 注:縦軸は50%から開始 18 SOKENDAI
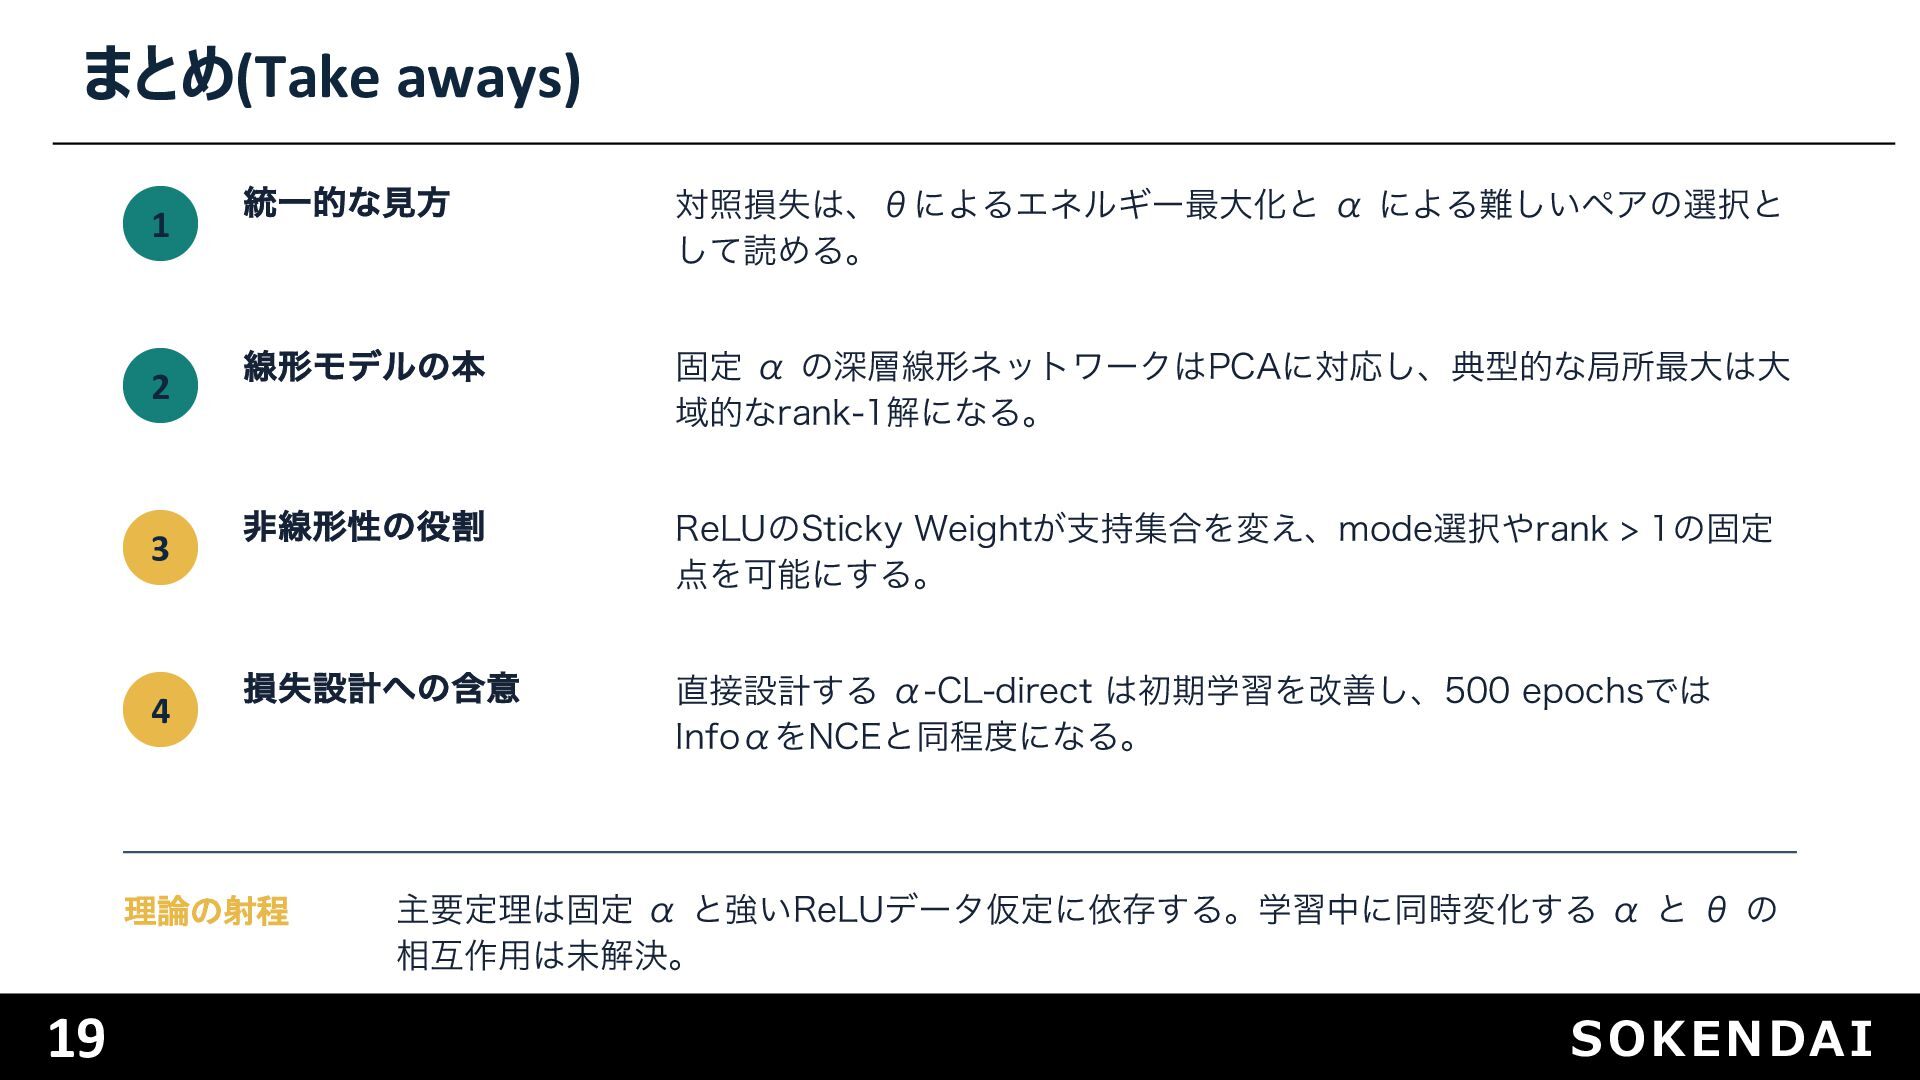
まとめ(Take aways) 1 2 3 4 統一的な見方 対照損失は、θによるエネルギー最大化と α による難しいペアの選択と
して読める。 線形モデルの本質 固定 α の深層線形ネットワークはPCAに対応し、典型的な局所最大は大 域的なrank-1解になる。 非線形性の役割 ReLUのSticky Weightが支持集合を変え、mode選択やrank > 1の固定 点を可能にする。 損失設計への含意 直接設計する α-CL-direct は初期学習を改善し、500 epochsでは InfoαをNCEと同程度になる。 理論の射程 19 主要定理は固定 α と強いReLUデータ仮定に依存する。学習中に同時変化する α と θ の 相互作用は未解決。 SOKENDAI


 fk001jp
 addyosmani
 sonatard
 thoeni
 codingconduct
 lfama
 holman
 jacobian
 reverentgeek
 andyhume
 rkendrick25
 katarinadahlin
 nonsquared