Upgrade to Pro — share decks privately, control downloads, hide ads and more …

universality_label_efficiency_jp_260629.pdf

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →

 universality_label_efficiency_jp_260629.pdf

Transcript

  1. 1 SOKENDAI SOKENDAI THE TRADE-OFF BETWEEN UNIVERSALITY AND LABEL EFFICIENCY

    OF REPRESENTATIONS FROM CONTRASTIVE LEARNING (ICML 2023) の紹介 君野 史明
  2. 3 SOKENDAI 1.問題意識: Foundation Model の⼆つの要求 2 ⼤規模な無ラベル事前学習表現を、少量ラベルで下流タスクに適⽤する状況を考える。 • 近年の表現学習では、まず⼤規模な無ラベルデータで表現を事

    前学習し、その上に単純な予測器を載せる。 • 望ましい性質は⼆つある。第⼀に、少量のラベルで⾼精度に学 習できるラベル効率。 • 第⼆に、多様な下流タスクに使える普遍性である。 • 論⽂は、この⼆つが常に両⽴するわけではないことを理論と実 験で⽰す。 事前学習 ⼤規模・無ラベル ↓ 表現 phi(x) ↓ Linear Probe 少量ラベルで予測 焦点: Contrastive Learning + Linear Probing
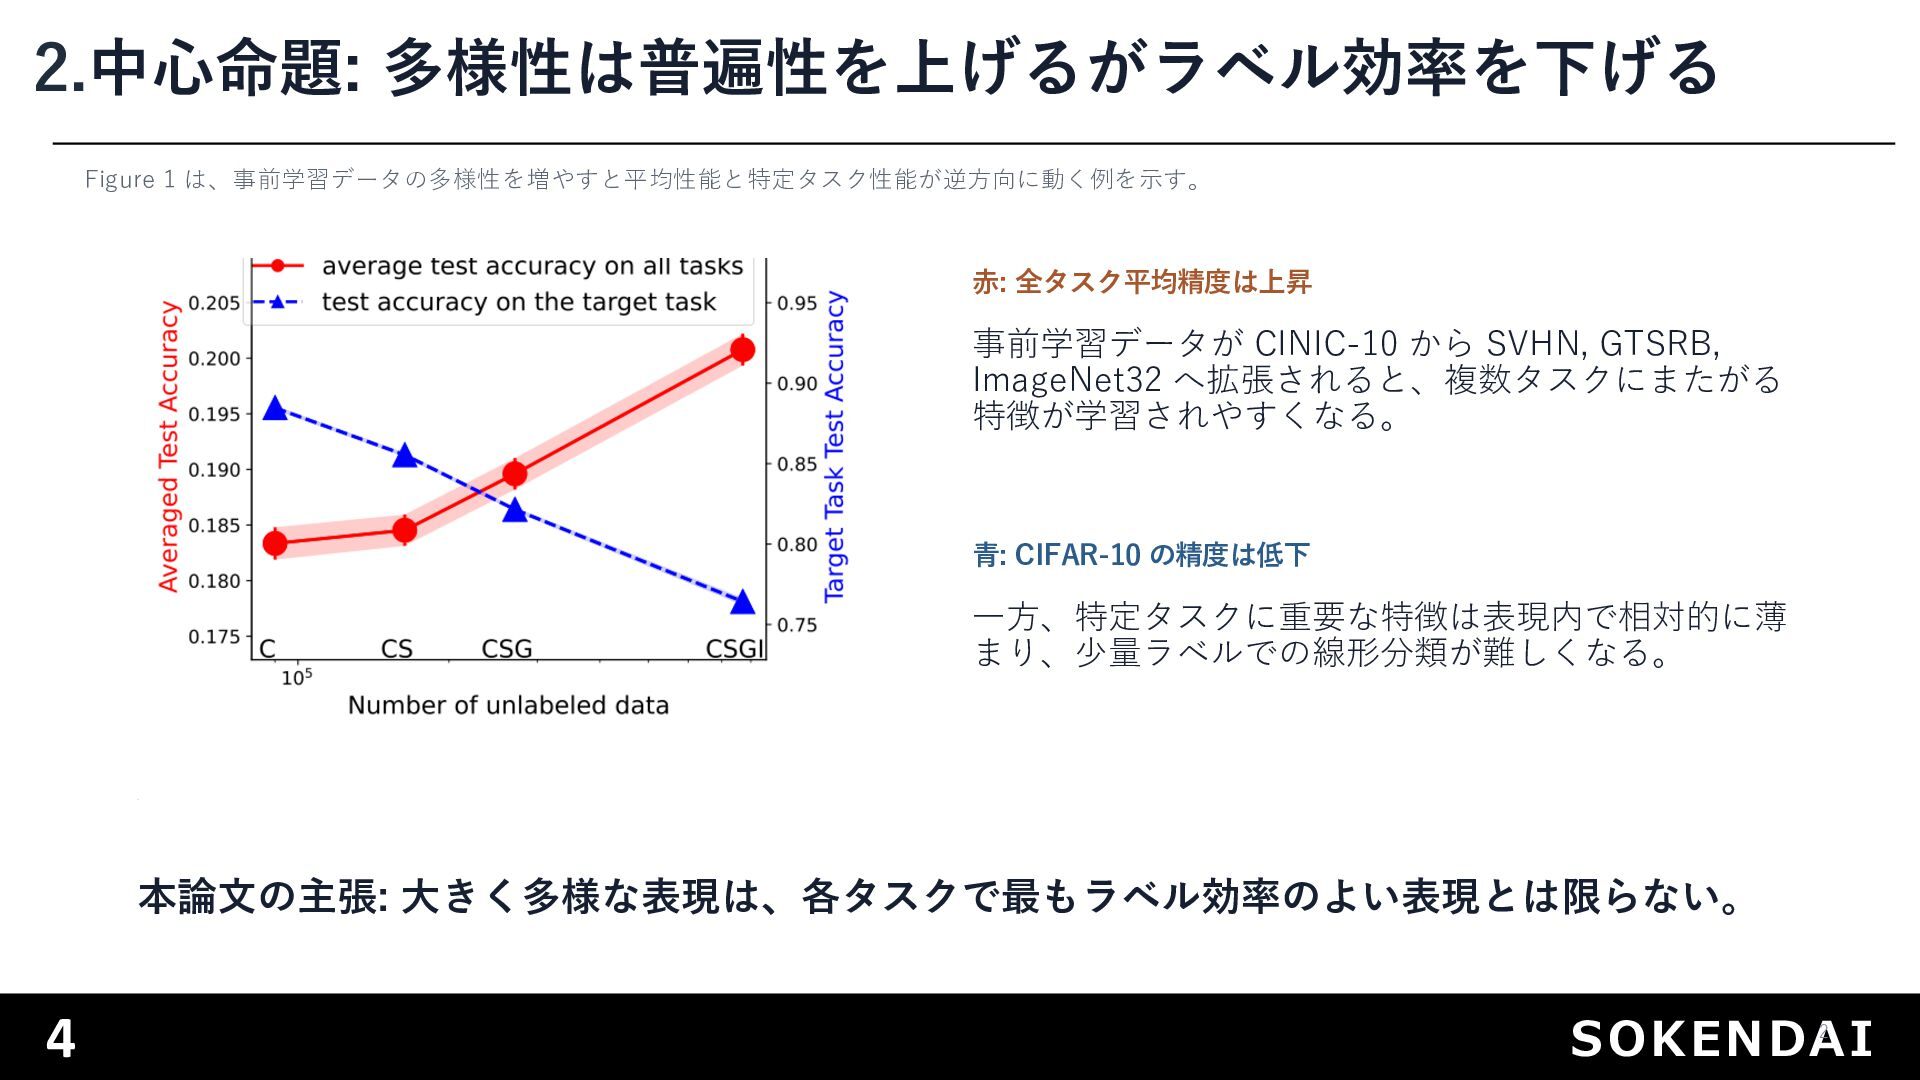
  3. 4 SOKENDAI 2.中⼼命題: 多様性は普遍性を上げるがラベル効率を下げる 2 Figure 1 は、事前学習データの多様性を増やすと平均性能と特定タスク性能が逆⽅向に動く例を⽰す。 ⾚: 全タスク平均精度は上昇

    事前学習データが CINIC-10 から SVHN, GTSRB, ImageNet32 へ拡張されると、複数タスクにまたがる 特徴が学習されやすくなる。 ⻘: CIFAR-10 の精度は低下 ⼀⽅、特定タスクに重要な特徴は表現内で相対的に薄 まり、少量ラベルでの線形分類が難しくなる。 本論⽂の主張: ⼤きく多様な表現は、各タスクで最もラベル効率のよい表現とは限らない。
  4. 5 SOKENDAI 3.論⽂の貢献 2 理論モデル、形式的証明、実証、改善⼿法を⼀続きのストーリーとして提⽰する。 • 隠れ表現データモデルを導⼊し、⼊⼒の背後にある意味特徴を不変特徴とスプリアス特徴に分け る。 • Contrastive

    Learning が、変換で変わらない不変特徴を抽出し、スプリアス特徴を除くことを⽰ す。 • 多様な事前学習データでは、多くのタスク特徴を詰め込む代わりに、特定タスク特徴が down- weight されることを解析する。 • 実データでトレードオフを観察し、対照正則化による改善法を提案する。
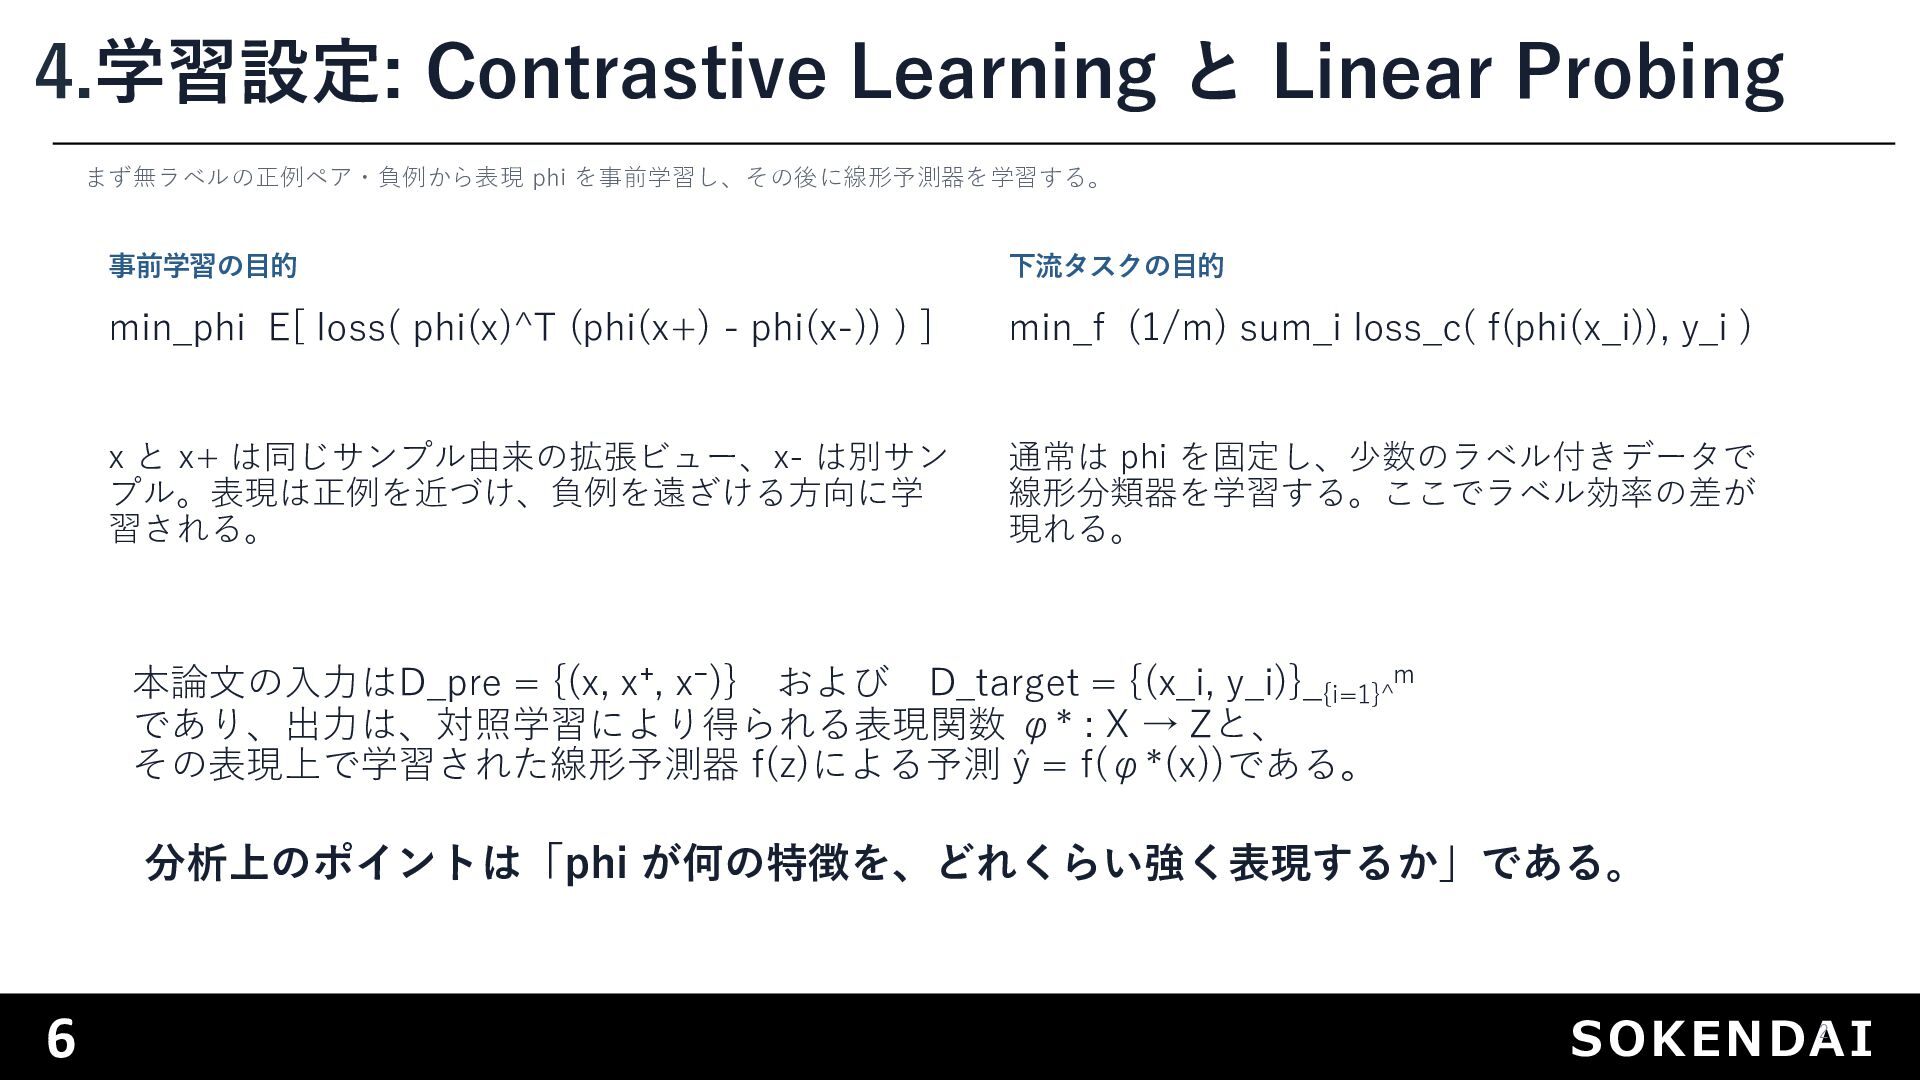
  5. 6 SOKENDAI 4.学習設定: Contrastive Learning と Linear Probing 2 まず無ラベルの正例ペア・負例から表現

    phi を事前学習し、その後に線形予測器を学習する。 事前学習の⽬的 min_phi E[ loss( phi(x)^T (phi(x+) - phi(x-)) ) ] x と x+ は同じサンプル由来の拡張ビュー、x- は別サン プル。表現は正例を近づけ、負例を遠ざける⽅向に学 習される。 下流タスクの⽬的 min_f (1/m) sum_i loss_c( f(phi(x_i)), y_i ) 通常は phi を固定し、少数のラベル付きデータで 線形分類器を学習する。ここでラベル効率の差が 現れる。 分析上のポイントは「phi が何の特徴を、どれくらい強く表現するか」である。 本論⽂の⼊⼒はD_pre = {(x, x⁺, x⁻)} および D_target = {(x_i, y_i)}_{i=1}^ m であり、出⼒は、対照学習により得られる表現関数 ϕ* : X → Zと、 その表現上で学習された線形予測器 f(z)による予測 ŷ = f(ϕ*(x))である。
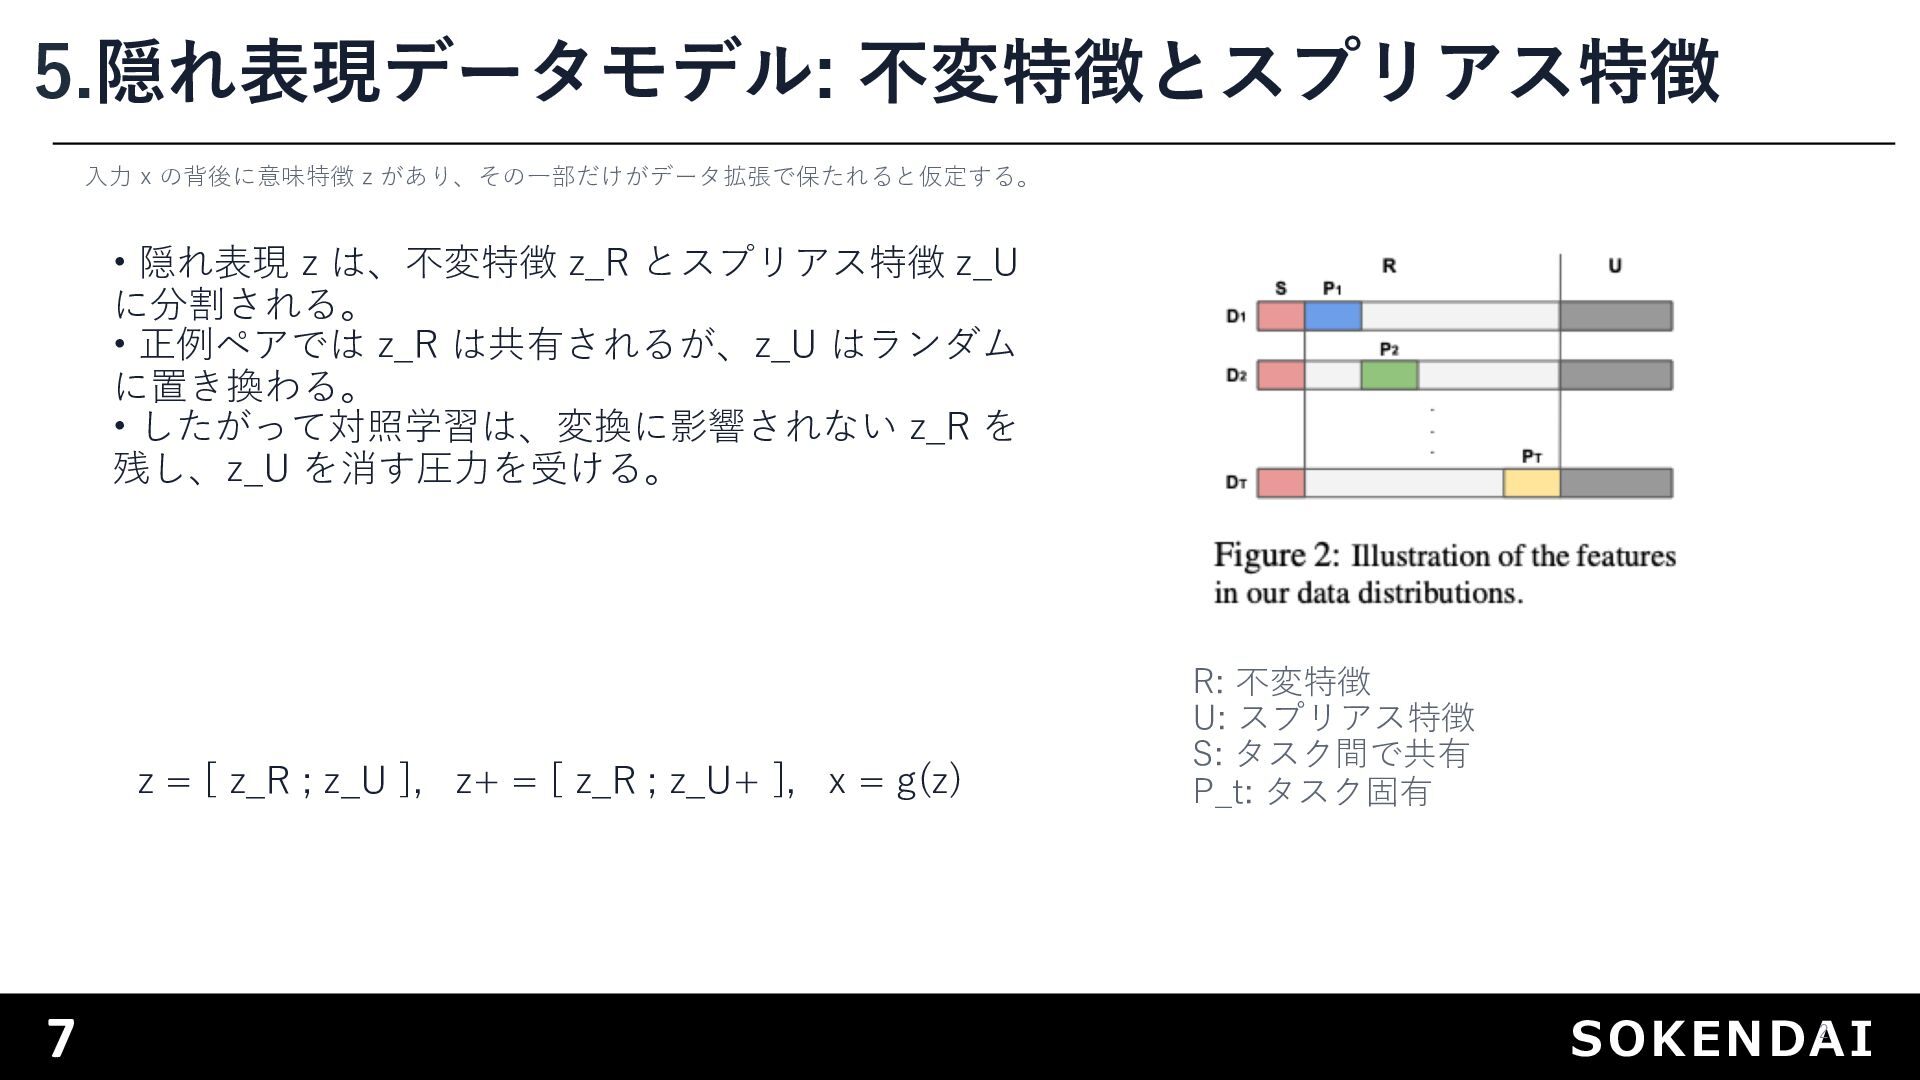
  6. 7 SOKENDAI 5.隠れ表現データモデル: 不変特徴とスプリアス特徴 2 ⼊⼒ x の背後に意味特徴 z があり、その⼀部だけがデータ拡張で保たれると仮定する。

    • 隠れ表現 z は、不変特徴 z_R とスプリアス特徴 z_U に分割される。 • 正例ペアでは z_R は共有されるが、z_U はランダム に置き換わる。 • したがって対照学習は、変換に影響されない z_R を 残し、z_U を消す圧⼒を受ける。 z = [ z_R ; z_U ], z+ = [ z_R ; z_U+ ], x = g(z) R: 不変特徴 U: スプリアス特徴 S: タスク間で共有 P_t: タスク固有
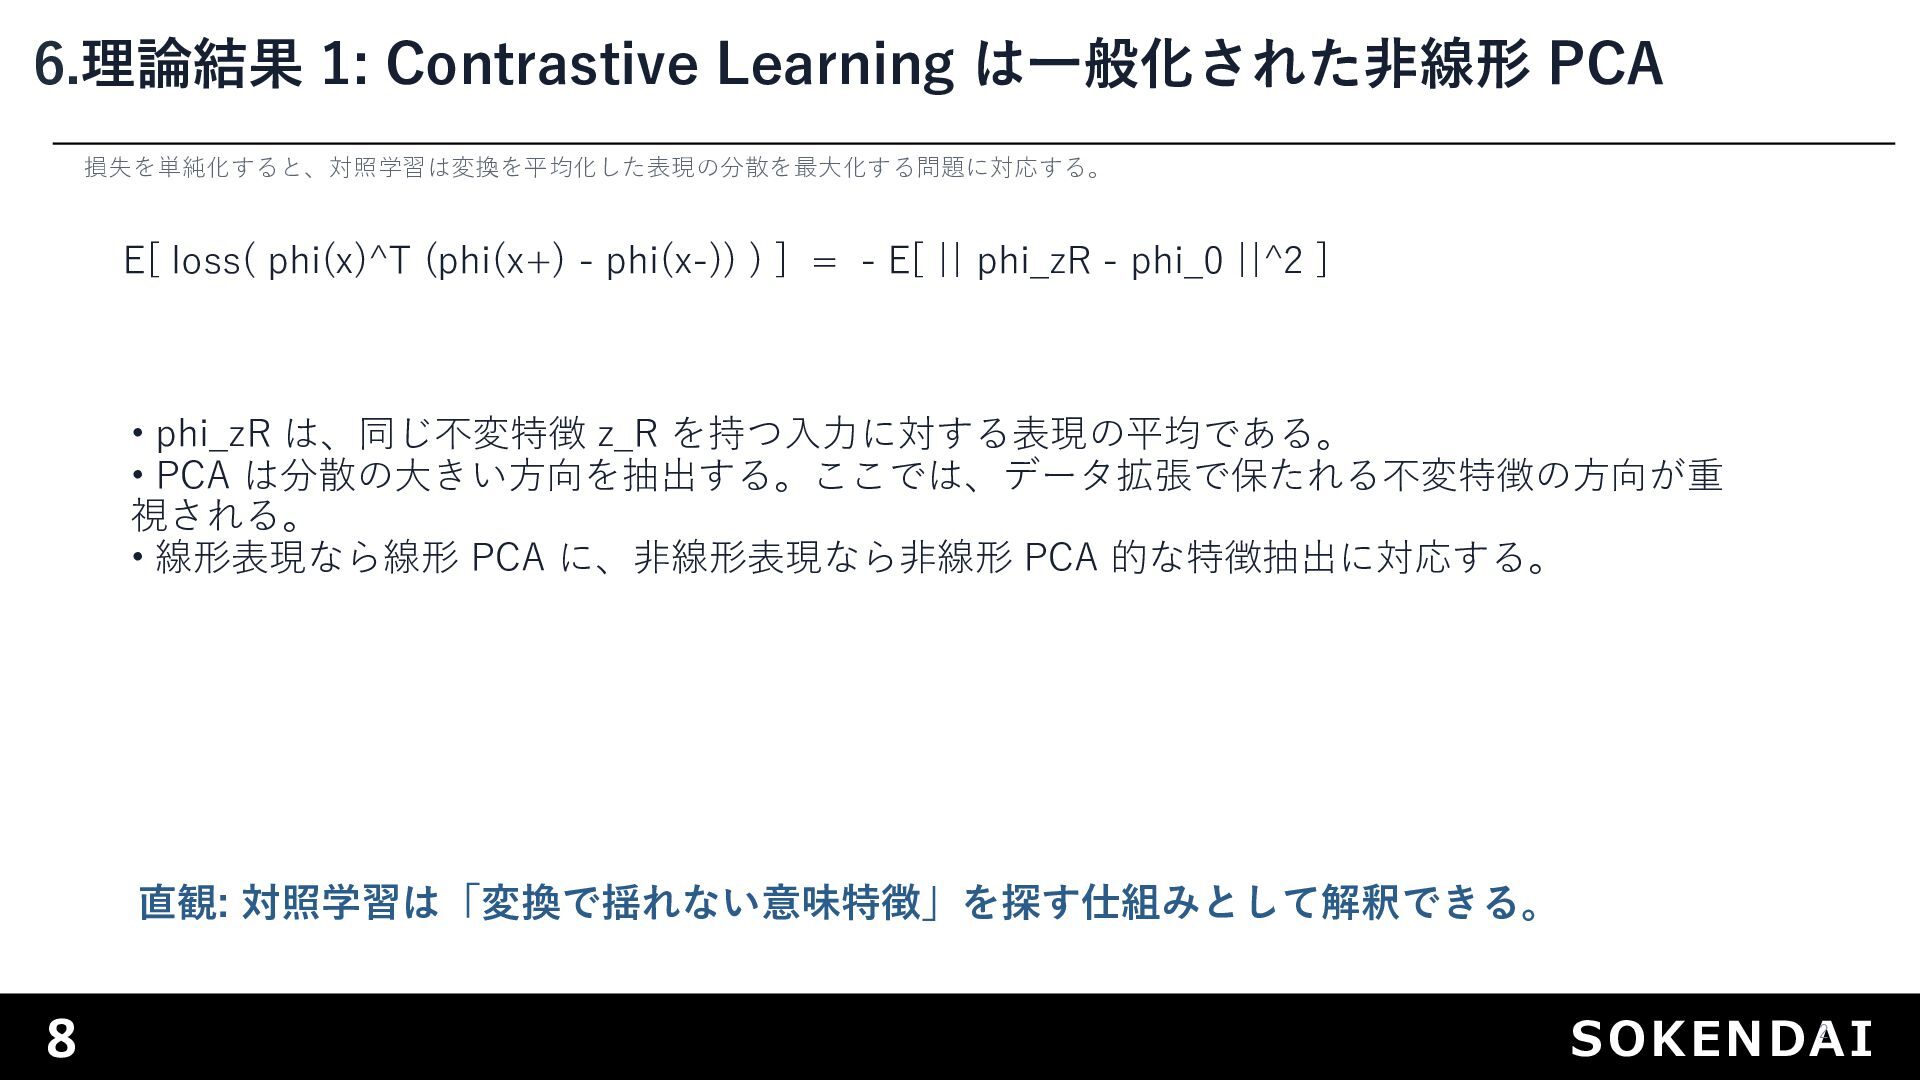
  7. 8 SOKENDAI 6.理論結果 1: Contrastive Learning は⼀般化された⾮線形 PCA 2 損失を単純化すると、対照学習は変換を平均化した表現の分散を最⼤化する問題に対応する。

    E[ loss( phi(x)^T (phi(x+) - phi(x-)) ) ] = - E[ || phi_zR - phi_0 ||^2 ] • phi_zR は、同じ不変特徴 z_R を持つ⼊⼒に対する表現の平均である。 • PCA は分散の⼤きい⽅向を抽出する。ここでは、データ拡張で保たれる不変特徴の⽅向が重 視される。 • 線形表現なら線形 PCA に、⾮線形表現なら⾮線形 PCA 的な特徴抽出に対応する。 直観: 対照学習は「変換で揺れない意味特徴」を探す仕組みとして解釈できる。
  8. 9 SOKENDAI 7.理論結果 2: 不変特徴は残り、スプリアス特徴は除かれる 2 Theorem 2.2 は、最適表現がスプリアス特徴を符号化しないことを⽰す。 •

    変換で変わる z_U は、正例ペア内でも⼀致しないため、表現に残す利得が⼩さい。 • 変換で保たれる z_R は、正例ペアを識別するための安定した⼿がかりになる。 • 表現容量が増えるほど、より多くの不変特徴を符号化できる。 • ただし、どの不変特徴が強く表現されるかは、事前学習データの分布に依存する。
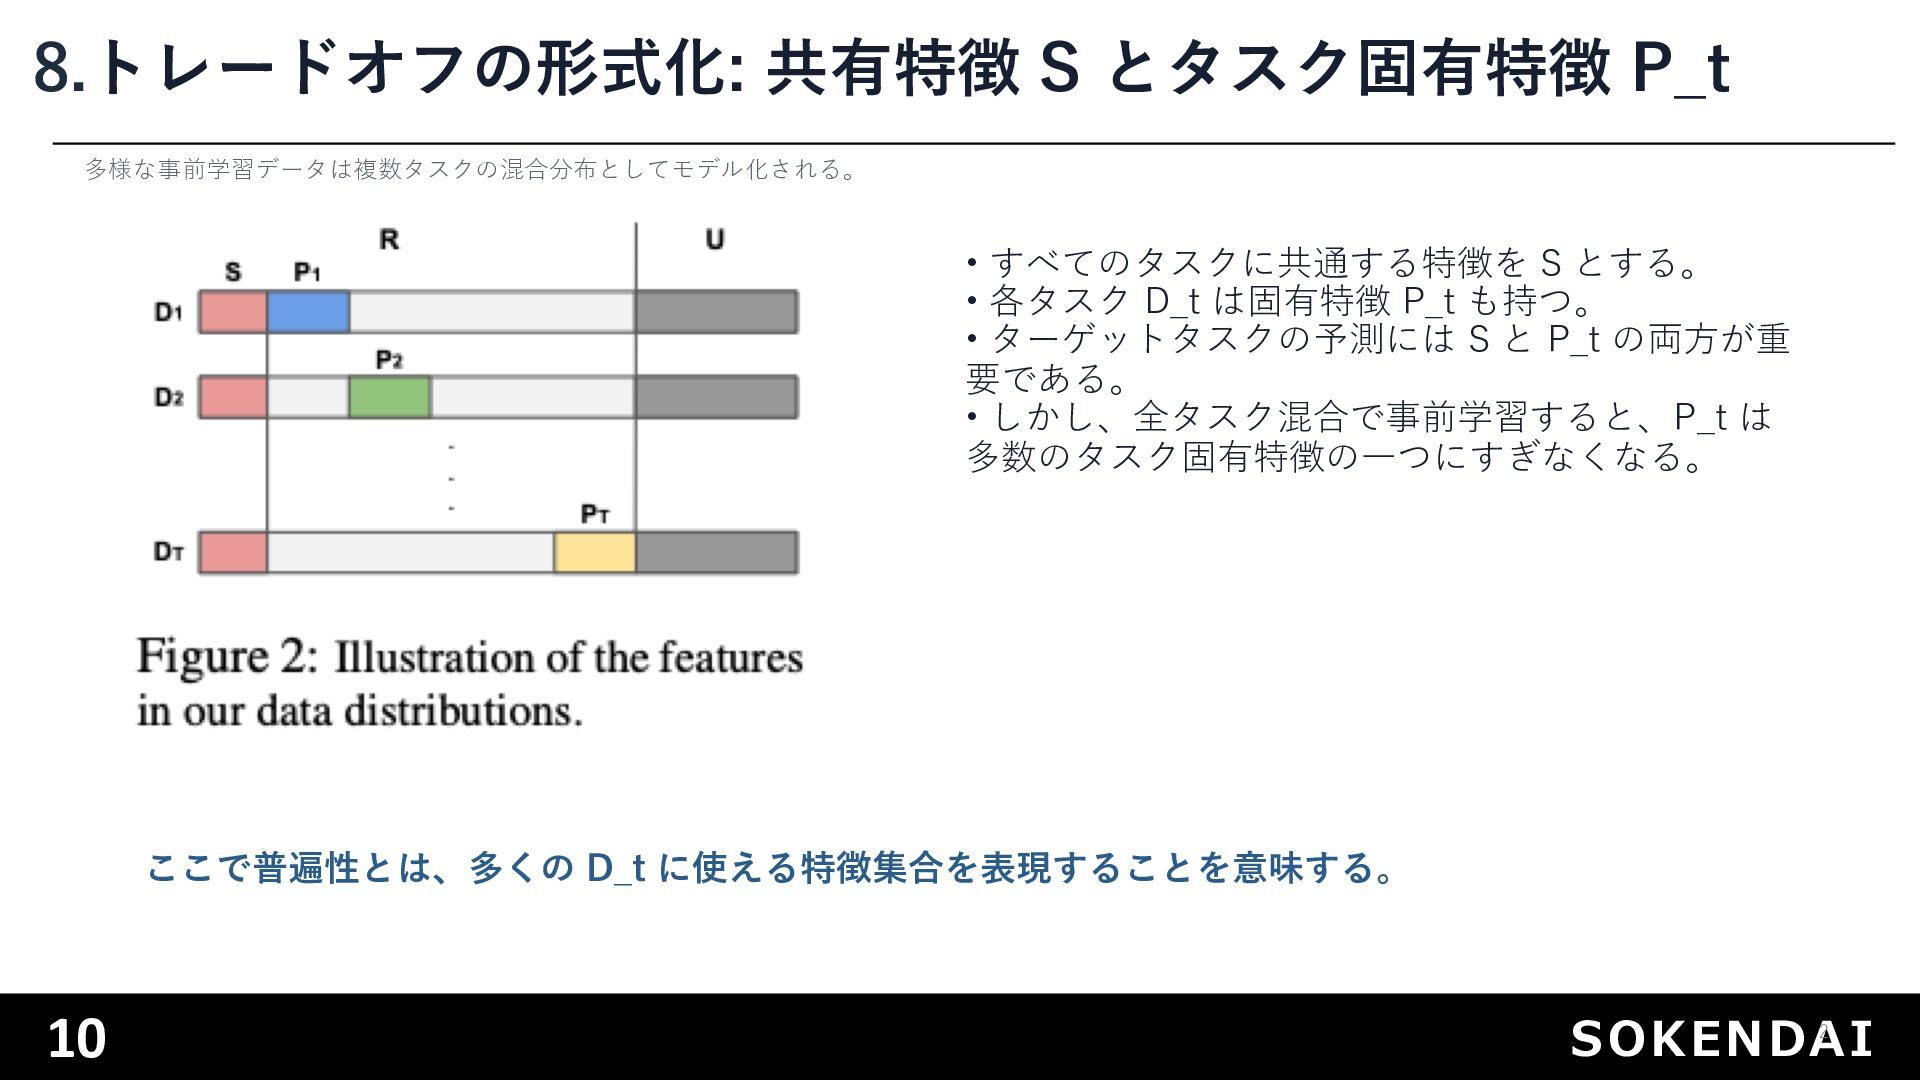
  9. 10 SOKENDAI 8.トレードオフの形式化: 共有特徴 S とタスク固有特徴 P_t 2 多様な事前学習データは複数タスクの混合分布としてモデル化される。 •

    すべてのタスクに共通する特徴を S とする。 • 各タスク D_t は固有特徴 P_t も持つ。 • ターゲットタスクの予測には S と P_t の両⽅が重 要である。 • しかし、全タスク混合で事前学習すると、P_t は 多数のタスク固有特徴の⼀つにすぎなくなる。 ここで普遍性とは、多くの D_t に使える特徴集合を表現することを意味する。
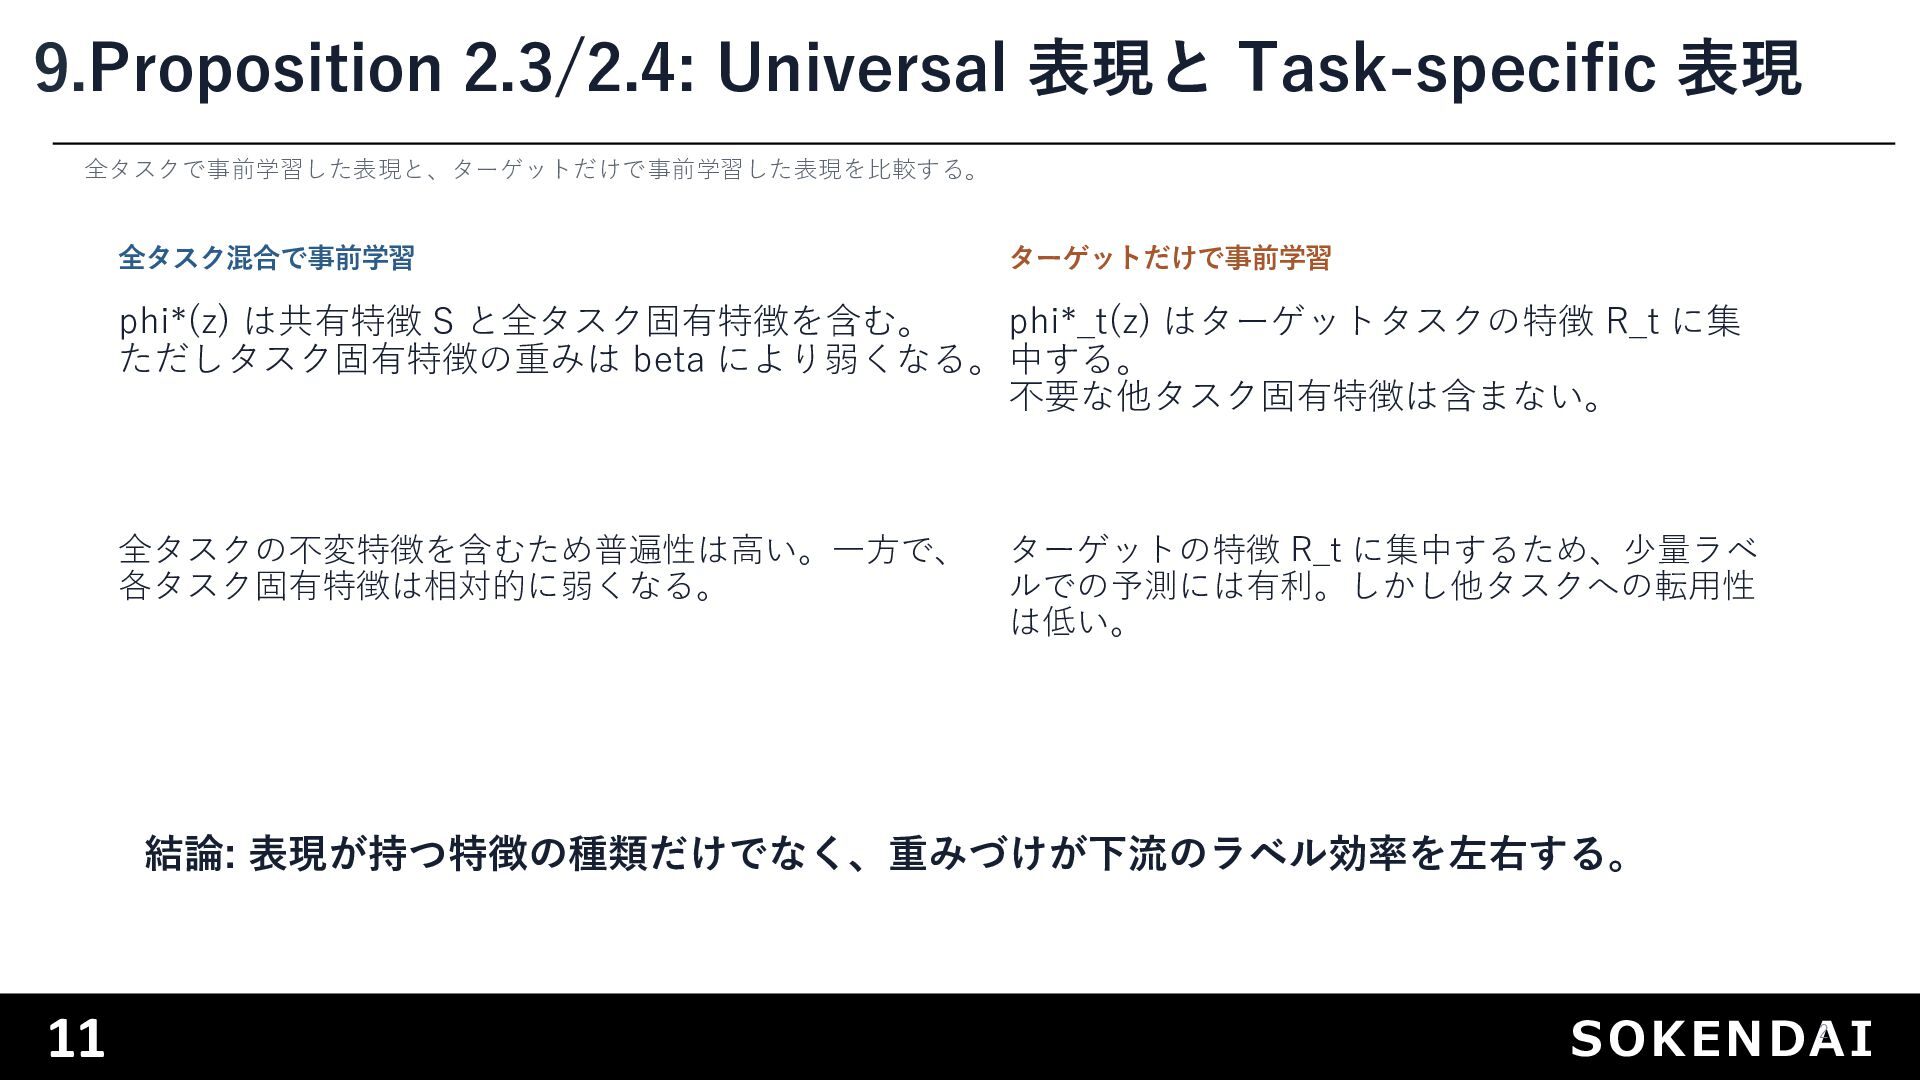
  10. 11 SOKENDAI 9.Proposition 2.3/2.4: Universal 表現と Task-specific 表現 2 全タスクで事前学習した表現と、ターゲットだけで事前学習した表現を⽐較する。

    全タスク混合で事前学習 phi*(z) は共有特徴 S と全タスク固有特徴を含む。 ただしタスク固有特徴の重みは beta により弱くなる。 全タスクの不変特徴を含むため普遍性は⾼い。⼀⽅で、 各タスク固有特徴は相対的に弱くなる。 ターゲットだけで事前学習 phi*_t(z) はターゲットタスクの特徴 R_t に集 中する。 不要な他タスク固有特徴は含まない。 ターゲットの特徴 R_t に集中するため、少量ラベ ルでの予測には有利。しかし他タスクへの転⽤性 は低い。 結論: 表現が持つ特徴の種類だけでなく、重みづけが下流のラベル効率を左右する。
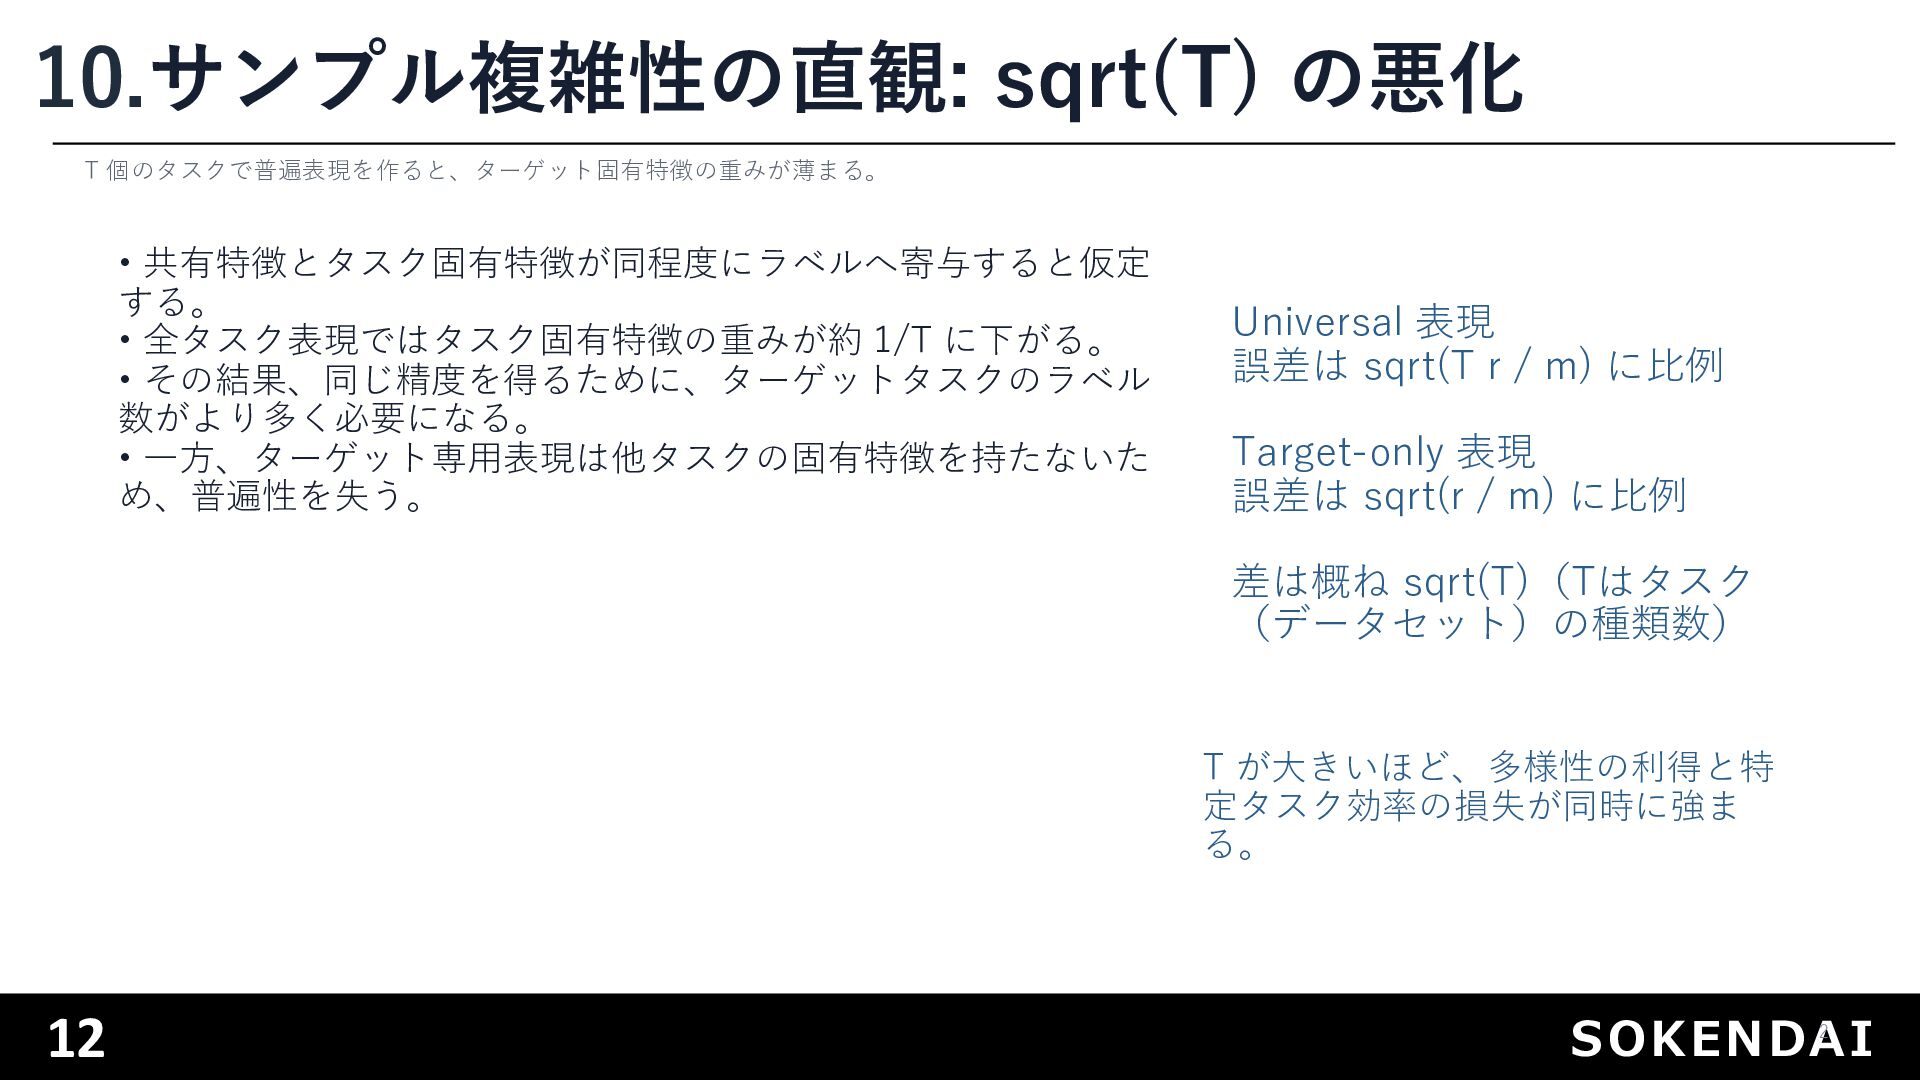
  11. 12 SOKENDAI 10.サンプル複雑性の直観: sqrt(T) の悪化 2 T 個のタスクで普遍表現を作ると、ターゲット固有特徴の重みが薄まる。 • 共有特徴とタスク固有特徴が同程度にラベルへ寄与すると仮定

    する。 • 全タスク表現ではタスク固有特徴の重みが約 1/T に下がる。 • その結果、同じ精度を得るために、ターゲットタスクのラベル 数がより多く必要になる。 • ⼀⽅、ターゲット専⽤表現は他タスクの固有特徴を持たないた め、普遍性を失う。 Universal 表現 誤差は sqrt(T r / m) に⽐例 Target-only 表現 誤差は sqrt(r / m) に⽐例 差は概ね sqrt(T)(Tはタスク (データセット)の種類数) T が⼤きいほど、多様性の利得と特 定タスク効率の損失が同時に強ま る。
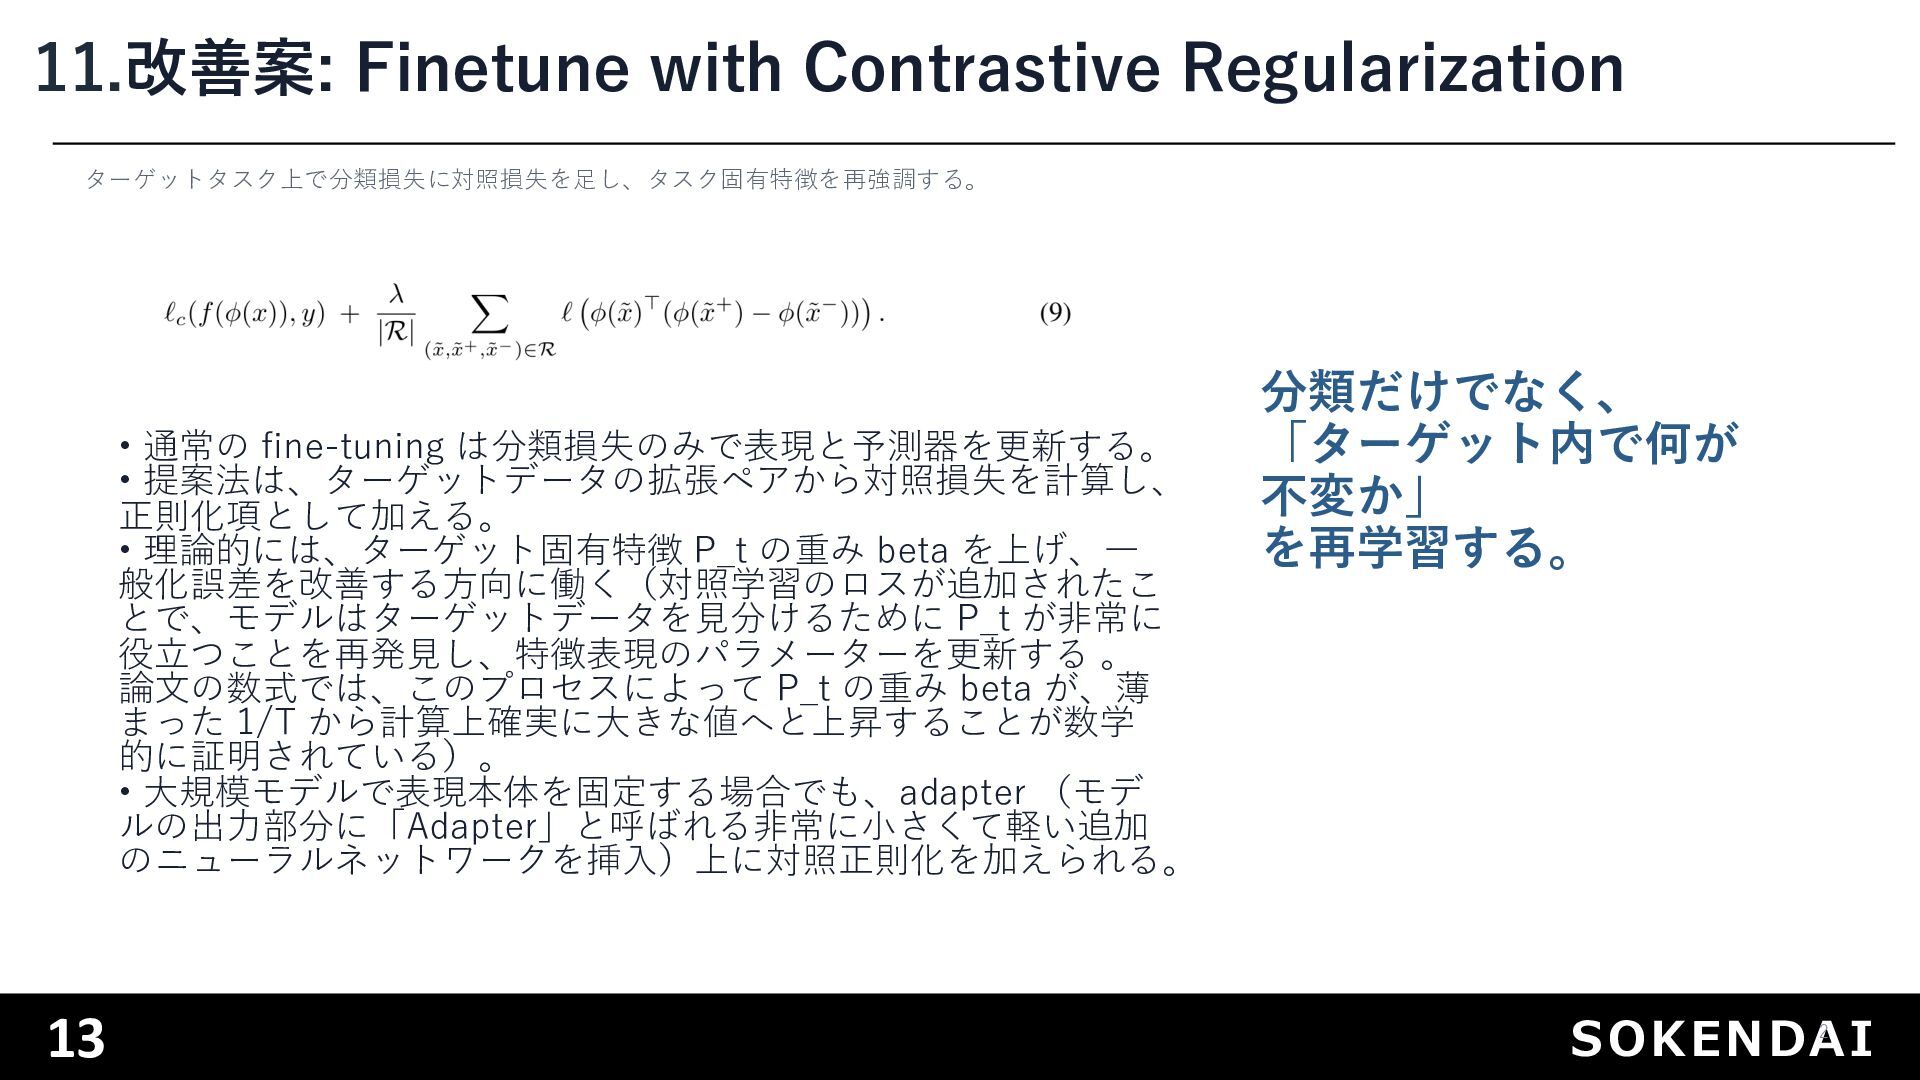
  12. 13 SOKENDAI 11.改善案: Finetune with Contrastive Regularization 2 ターゲットタスク上で分類損失に対照損失を⾜し、タスク固有特徴を再強調する。 •

    通常の fine-tuning は分類損失のみで表現と予測器を更新する。 • 提案法は、ターゲットデータの拡張ペアから対照損失を計算し、 正則化項として加える。 • 理論的には、ターゲット固有特徴 P_t の重み beta を上げ、⼀ 般化誤差を改善する⽅向に働く(対照学習のロスが追加されたこ とで、モデルはターゲットデータを⾒分けるために P_t が⾮常に 役⽴つことを再発⾒し、特徴表現のパラメーターを更新する 。 論⽂の数式では、このプロセスによって P_t の重み beta が、薄 まった 1/T から計算上確実に⼤きな値へと上昇することが数学 的に証明されている)。 • ⼤規模モデルで表現本体を固定する場合でも、adapter (モデ ルの出⼒部分に「Adapter」と呼ばれる⾮常に⼩さくて軽い追加 のニューラルネットワークを挿⼊)上に対照正則化を加えられる。 分類だけでなく、 「ターゲット内で何が 不変か」 を再学習する。
  13. 14 SOKENDAI 12.実験設計: 三つの問い 2 論⽂は理論から導いた仮説を、制御実験と実モデルで検証する。 • Q1: 実データでも普遍性とラベル効率のトレードオフは起きるか。 •

    Q2: 何がトレードオフを⽣むのか。異なるデータセットがどれほど異なる特徴を学ばせるか。 • Q3: 対照正則化でこのトレードオフを緩和できるか。 • 評価は Linear Probing, Fine-tuning, Fine-tuning with Contrastive Regularization を⽐較する。
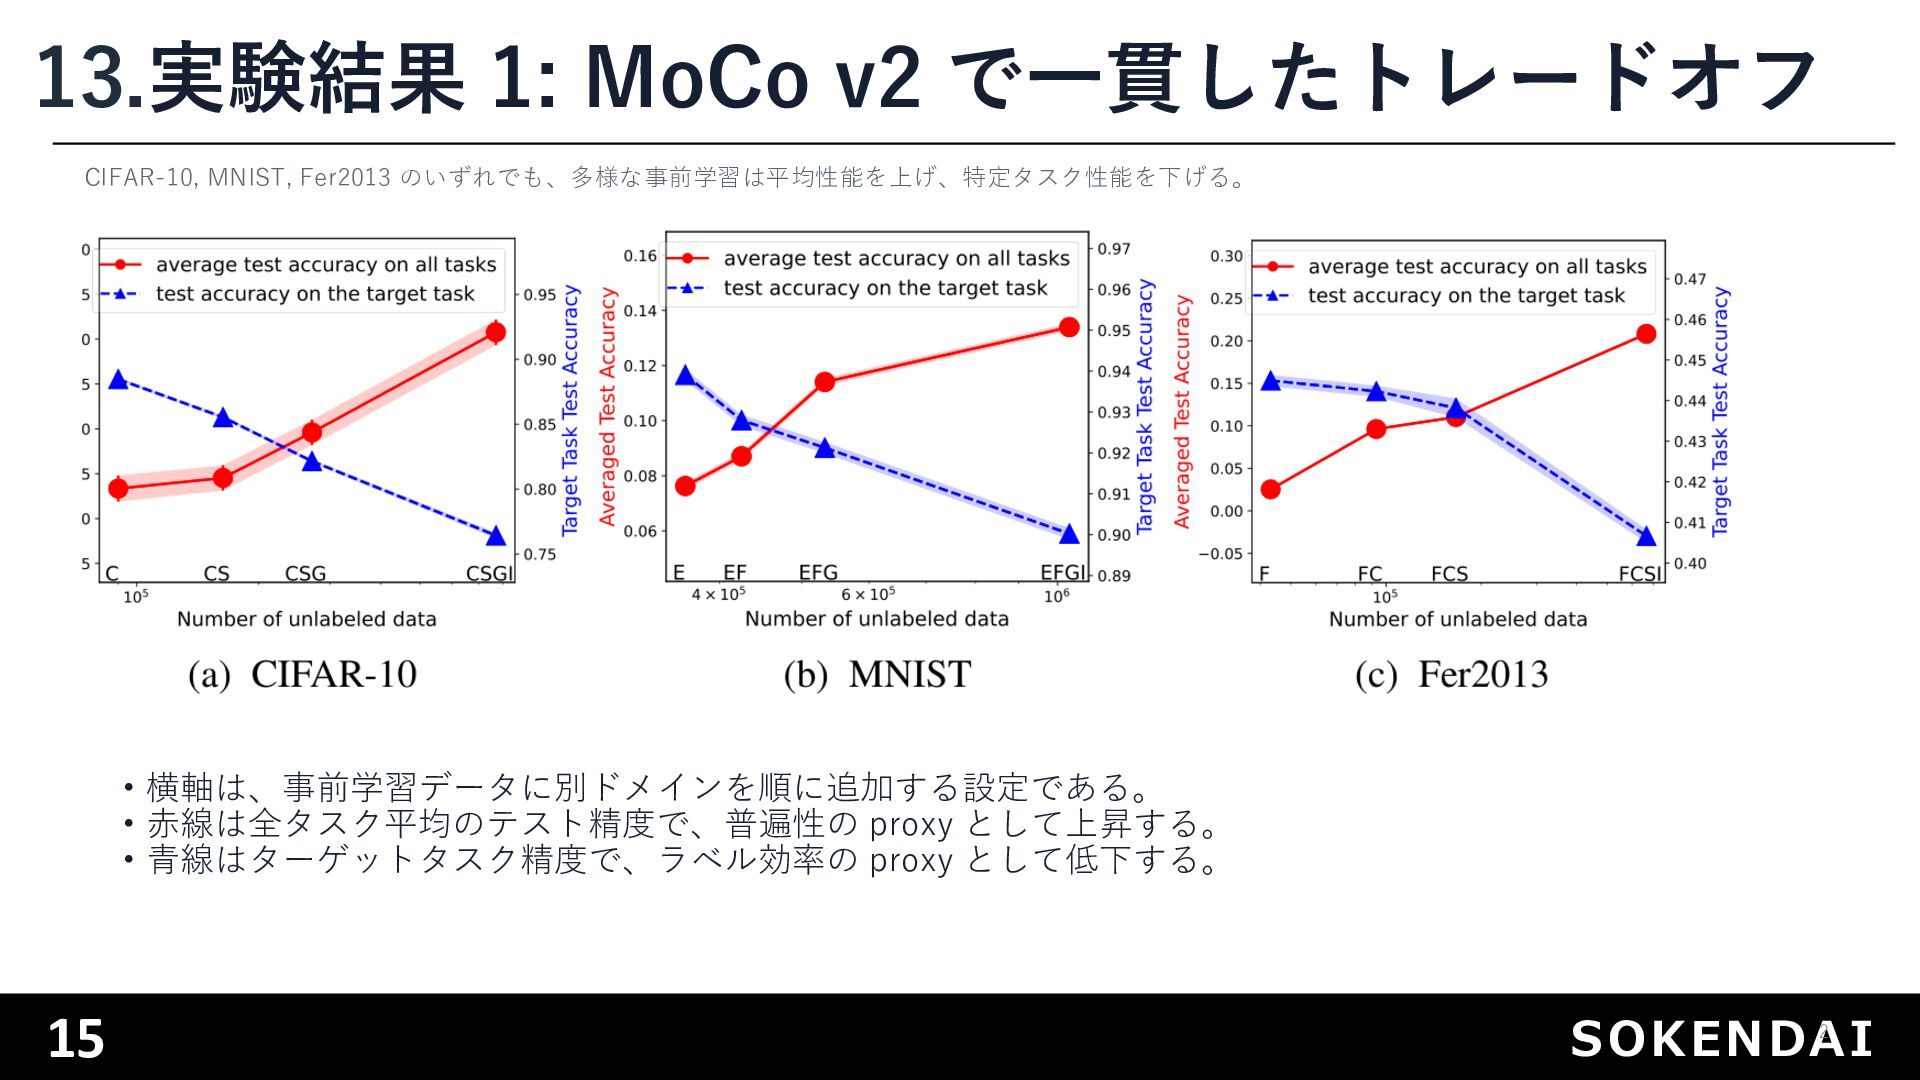
  14. 15 SOKENDAI 13.実験結果 1: MoCo v2 で⼀貫したトレードオフ 2 CIFAR-10, MNIST,

    Fer2013 のいずれでも、多様な事前学習は平均性能を上げ、特定タスク性能を下げる。 • 横軸は、事前学習データに別ドメインを順に追加する設定である。 • ⾚線は全タスク平均のテスト精度で、普遍性の proxy として上昇する。 • ⻘線はターゲットタスク精度で、ラベル効率の proxy として低下する。
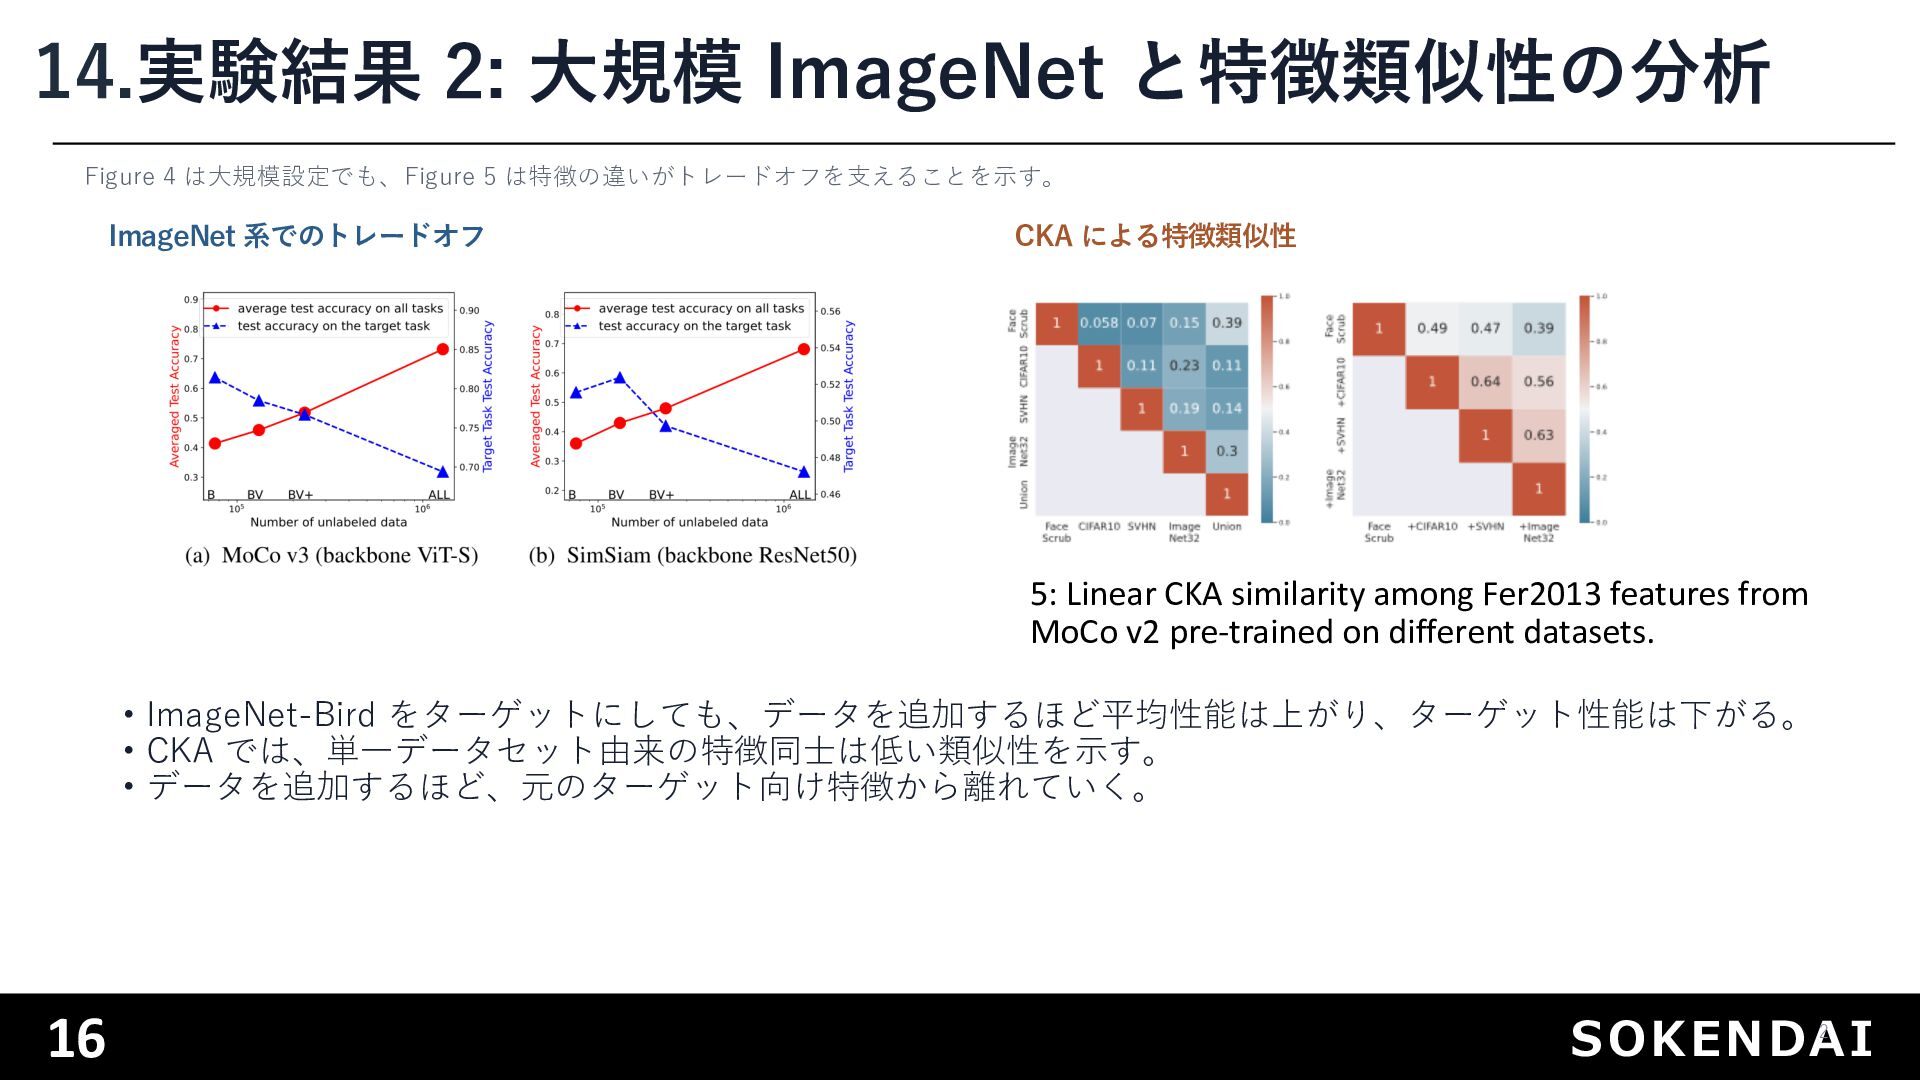
  15. 16 SOKENDAI 14.実験結果 2: ⼤規模 ImageNet と特徴類似性の分析 2 Figure 4

    は⼤規模設定でも、Figure 5 は特徴の違いがトレードオフを⽀えることを⽰す。 ImageNet 系でのトレードオフ CKA による特徴類似性 • ImageNet-Bird をターゲットにしても、データを追加するほど平均性能は上がり、ターゲット性能は下がる。 • CKA では、単⼀データセット由来の特徴同⼠は低い類似性を⽰す。 • データを追加するほど、元のターゲット向け特徴から離れていく。 5: Linear CKA similarity among Fer2013 features from MoCo v2 pre-trained on different datasets.
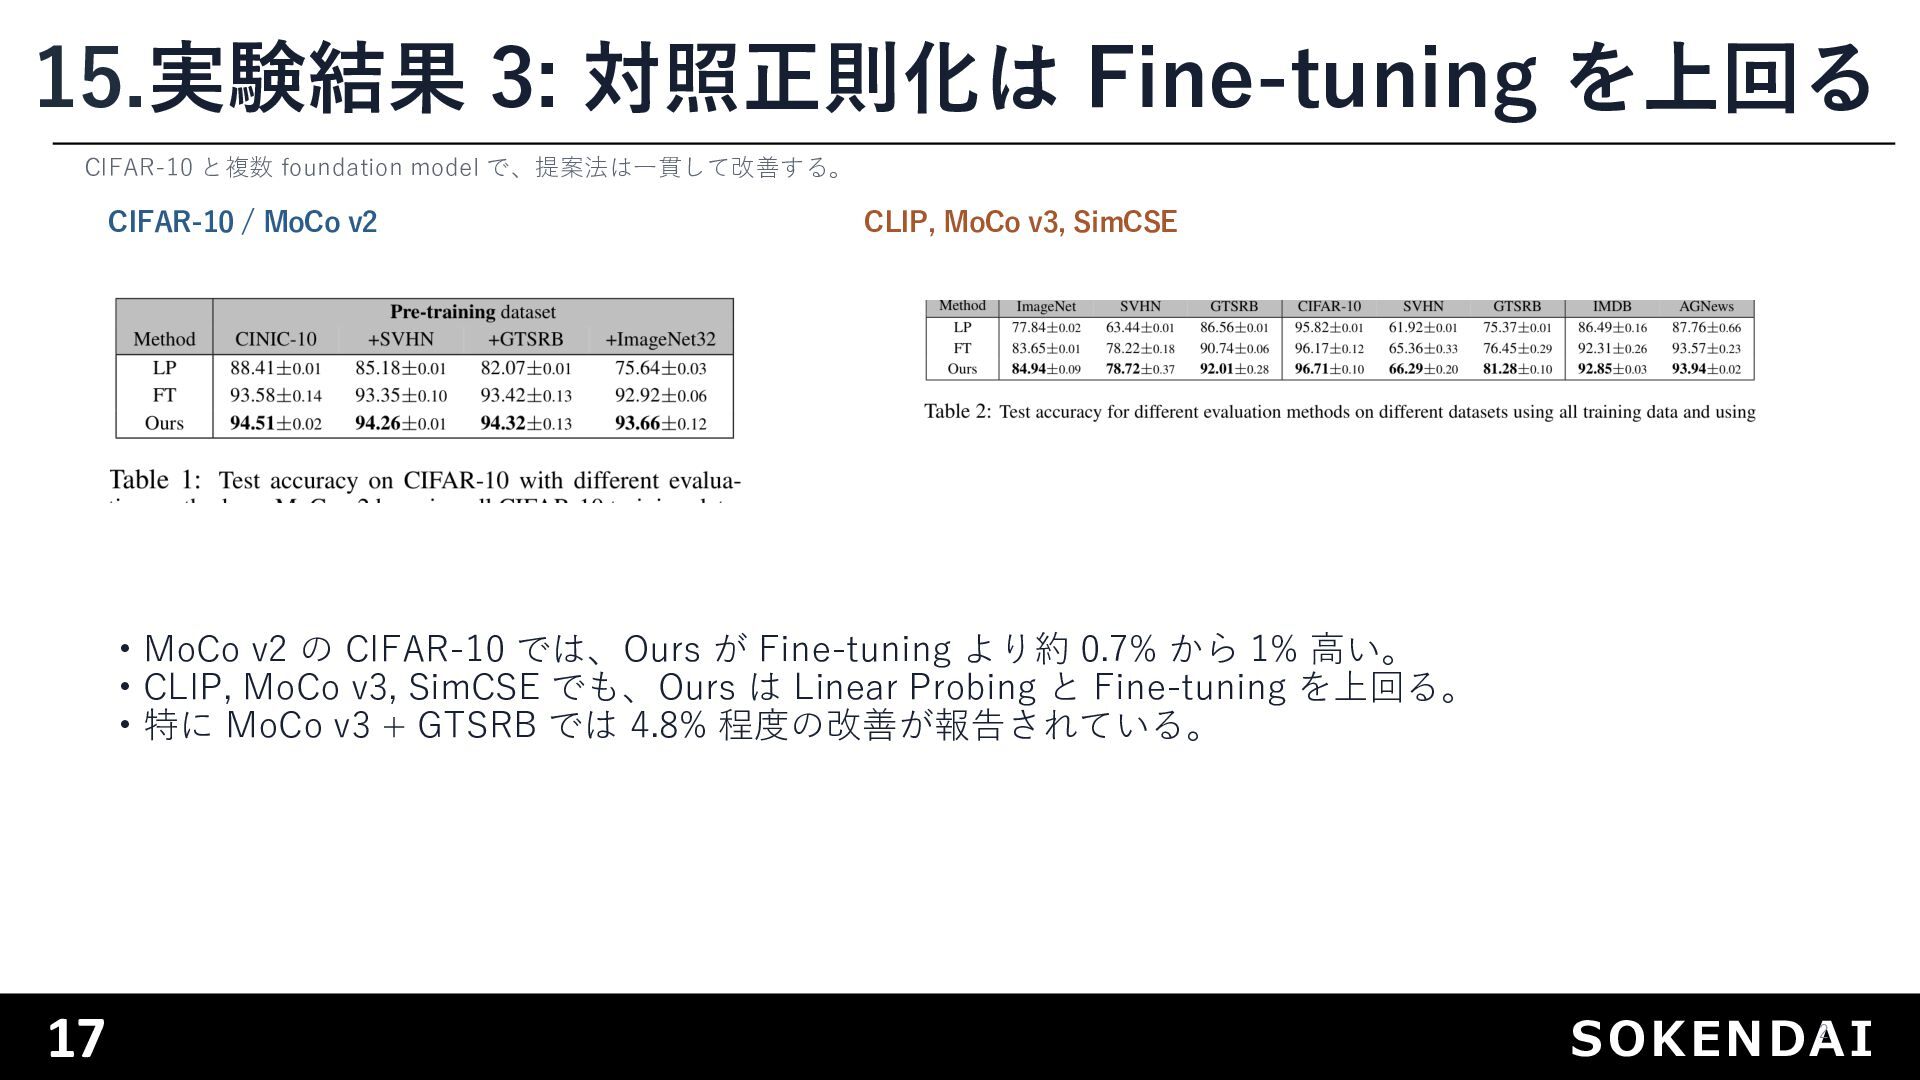
  16. 17 SOKENDAI 15.実験結果 3: 対照正則化は Fine-tuning を上回る 2 CIFAR-10 と複数

    foundation model で、提案法は⼀貫して改善する。 CIFAR-10 / MoCo v2 CLIP, MoCo v3, SimCSE • MoCo v2 の CIFAR-10 では、Ours が Fine-tuning より約 0.7% から 1% ⾼い。 • CLIP, MoCo v3, SimCSE でも、Ours は Linear Probing と Fine-tuning を上回る。 • 特に MoCo v3 + GTSRB では 4.8% 程度の改善が報告されている。
  17. 18 SOKENDAI 15.アカデミックな含意と限界 2 ⼤規模事前学習の「多様であるほどよい」という直観に、タスク適応の観点から条件を付ける。 • 含意 1: 事前学習データの多様性は、普遍性を⾼める⼀⽅で、ターゲット固有特徴を弱める可能性が ある。

    • 含意 2: Linear Probing の性能低下は、表現が役に⽴たないというより、必要特徴の重みが⼩さいこ とを⽰す場合がある。 • 含意 3: ターゲット上の⾃⼰教師あり信号を fine-tuning に残すことは、表現の再重みづけとして有 効である。 • 限界: 理論の中⼼は線形データモデルであり、⾮線形・マルチモーダル・⼤規模⽣成モデルへの拡張 は今後の課題である。
  18. 19 SOKENDAI 16.まとめ(Take aways) 本論⽂は、Contrastive Learning 表現の普遍性とラベル効率の両⽴可能性を問い直す。 • 多様な事前学習データは、幅広い下流タスクに有⽤な特徴を獲得させる。 •

    しかし、特定タスク固有の特徴は相対的に弱くなり、少量ラベルでの予測性能が落ちうる。 • この現象は、隠れ表現モデルと線形データ解析により、特徴の重みづけの問題として説明できる。 • 対照正則化は、ターゲットタスク内の不変性を再強調し、トレードオフを緩和する実践的⼿法で ある。 • 今後の論点は、⾮線形特徴、他の⾃⼰教師あり学習、より強い普遍性とラベル効率の同時達成で ある。 Key message: 汎⽤表現は万能ではなく、下流タスクの少量ラベル性能には再適応の設計が重要で ある。