Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
GCFormer_260727.pdf
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
君野史明(Fumiaki Kimino)
July 27, 2026
13
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
GCFormer_260727.pdf
君野史明(Fumiaki Kimino)
July 27, 2026
More Decks by 君野史明(Fumiaki Kimino)
See All by 君野史明(Fumiaki Kimino)
understanding_deep_contrastive_learning_260929.pdf
fk001jp
0
5
SpotLight_260824.pdf
fk001jp
0
11
universality_label_efficiency_jp_260629.pdf
fk001jp
0
20
Graph_Invariant_Learning_260525_1.pdf
fk001jp
0
9
DRAGON_260427_1.pdf
fk001jp
0
12
HANG_GNN_robustness_260330_1.pdf
fk001jp
0
7
Reconstruction_for_Powerful_Graph_Representations_260225_1.pdf
fk001jp
0
11
HYPERION_260205_1.pdf
fk001jp
0
11
Mitigating_Local_Cohesion_251222_1.pdf
fk001jp
0
13
Featured
See All Featured
sira's awesome portfolio website redesign presentation
elsirapls
0
460
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
750
BBQ
matthewcrist
90
10k
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
380
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
How to build a perfect <img>
jonoalderson
1
6.1k
The World Runs on Bad Software
bkeepers
PRO
72
12k
How to optimise 3,500 product descriptions for ecommerce in one day using ChatGPT
katarinadahlin
PRO
3
3.9k
Stewardship and Sustainability of Urban and Community Forests
pwiseman
0
550
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
77k
Jamie Indigo - Trashchat’s Guide to Black Boxes: Technical SEO Tactics for LLMs
techseoconnect
PRO
0
710
Amusing Abliteration
ianozsvald
1
350
Transcript
Leveraging Contrastive Learning for Enhanced Node Representations in Tokenized Graph
Transformers (NeurIPS 2024) の紹介 君野 史明 SOKENDAI 1 SOKENDAI
⾃⼰紹介 n 名前︓君野 史明(きみの ふみあき) n 所属︓総合研究⼤学院⼤学 情報学コース D1 n
2 専⾨︓ グラフ対照学習 グラフ表現学習 SOKENDAI
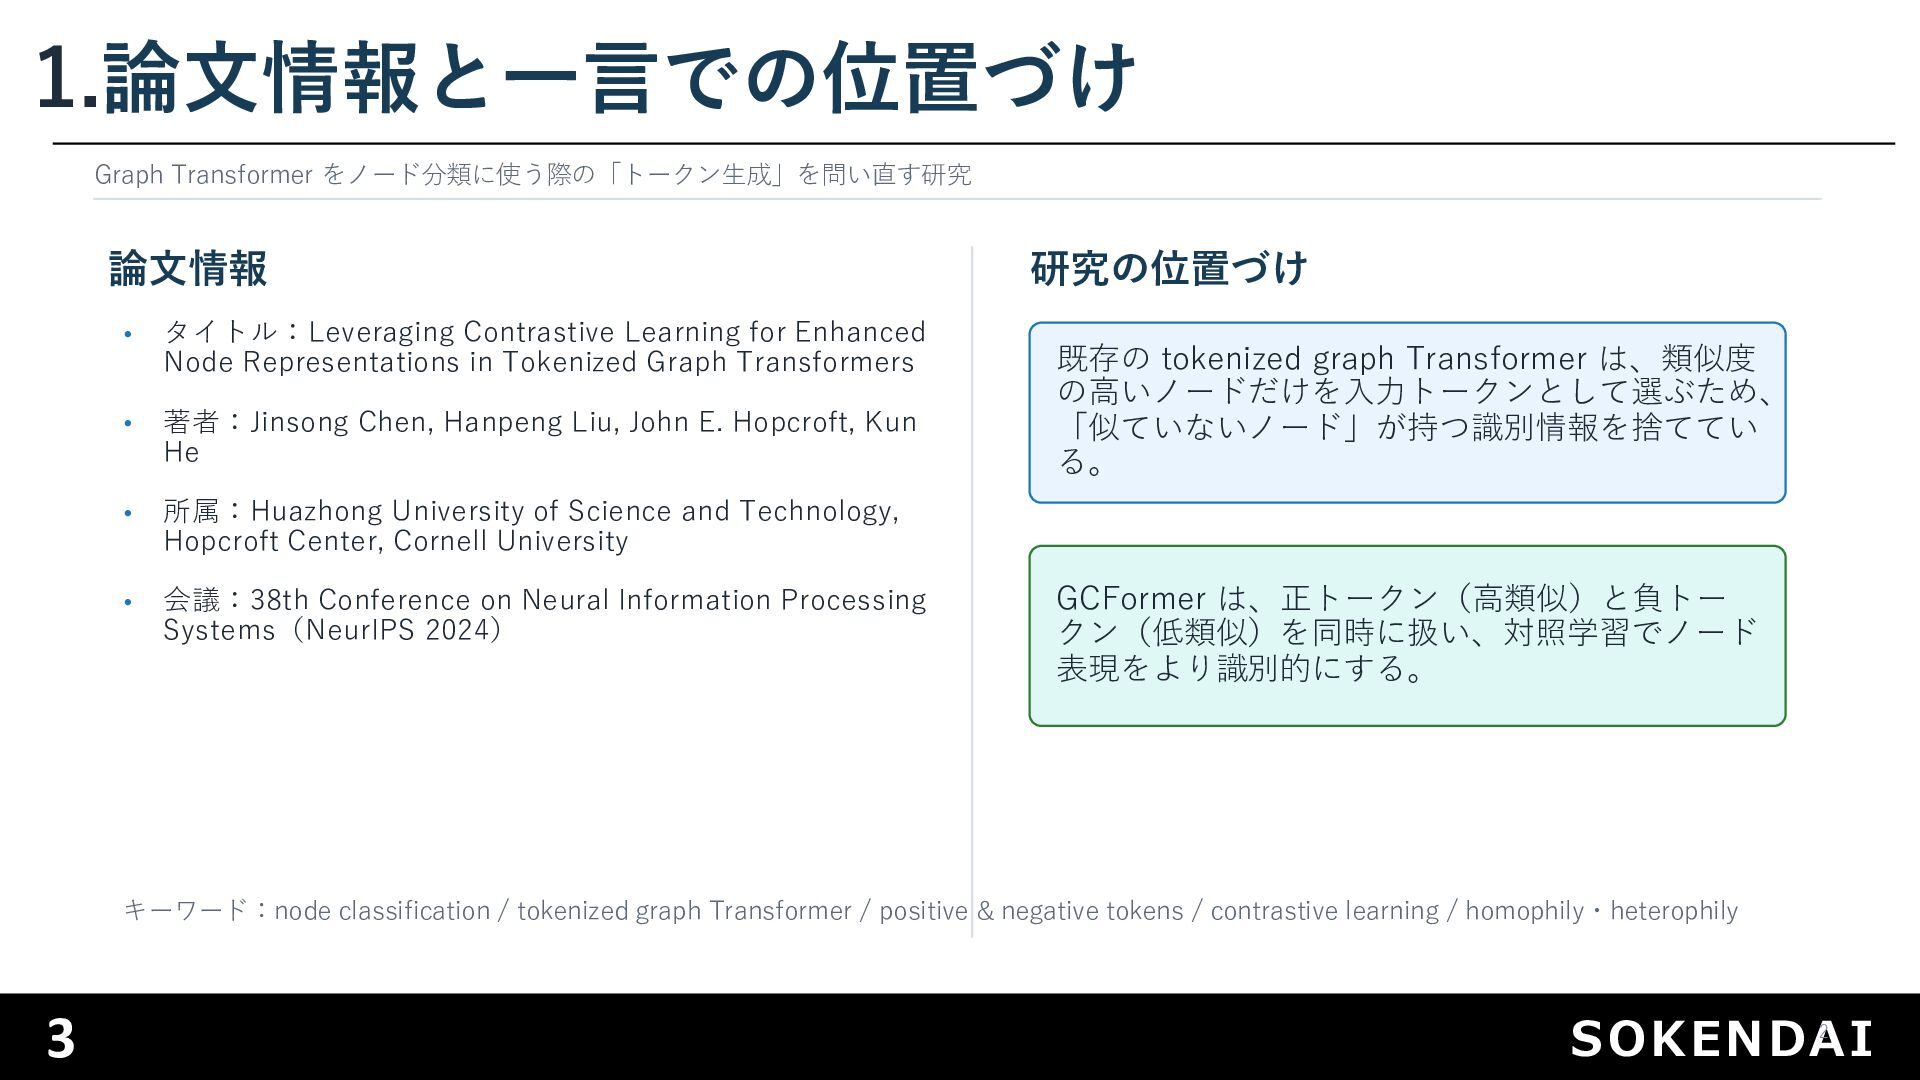
1.論⽂情報と⼀⾔での位置づけ Graph Transformer をノード分類に使う際の「トークン⽣成」を問い直す研究 論⽂情報 • タイトル:Leveraging Contrastive Learning for
Enhanced Node Representations in Tokenized Graph Transformers • 著者:Jinsong Chen, Hanpeng Liu, John E. Hopcroft, Kun He • 所属:Huazhong University of Science and Technology, Hopcroft Center, Cornell University • 会議:38th Conference on Neural Information Processing Systems(NeurIPS 2024) 研究の位置づけ 既存の tokenized graph Transformer は、類似度 の⾼いノードだけを⼊⼒トークンとして選ぶため、 「似ていないノード」が持つ識別情報を捨ててい る。 GCFormer は、正トークン(⾼類似)と負トー クン(低類似)を同時に扱い、対照学習でノード 表現をより識別的にする。 キーワード:node classification / tokenized graph Transformer / positive & negative tokens / contrastive learning / homophily・heterophily 3 SOKENDAI 2
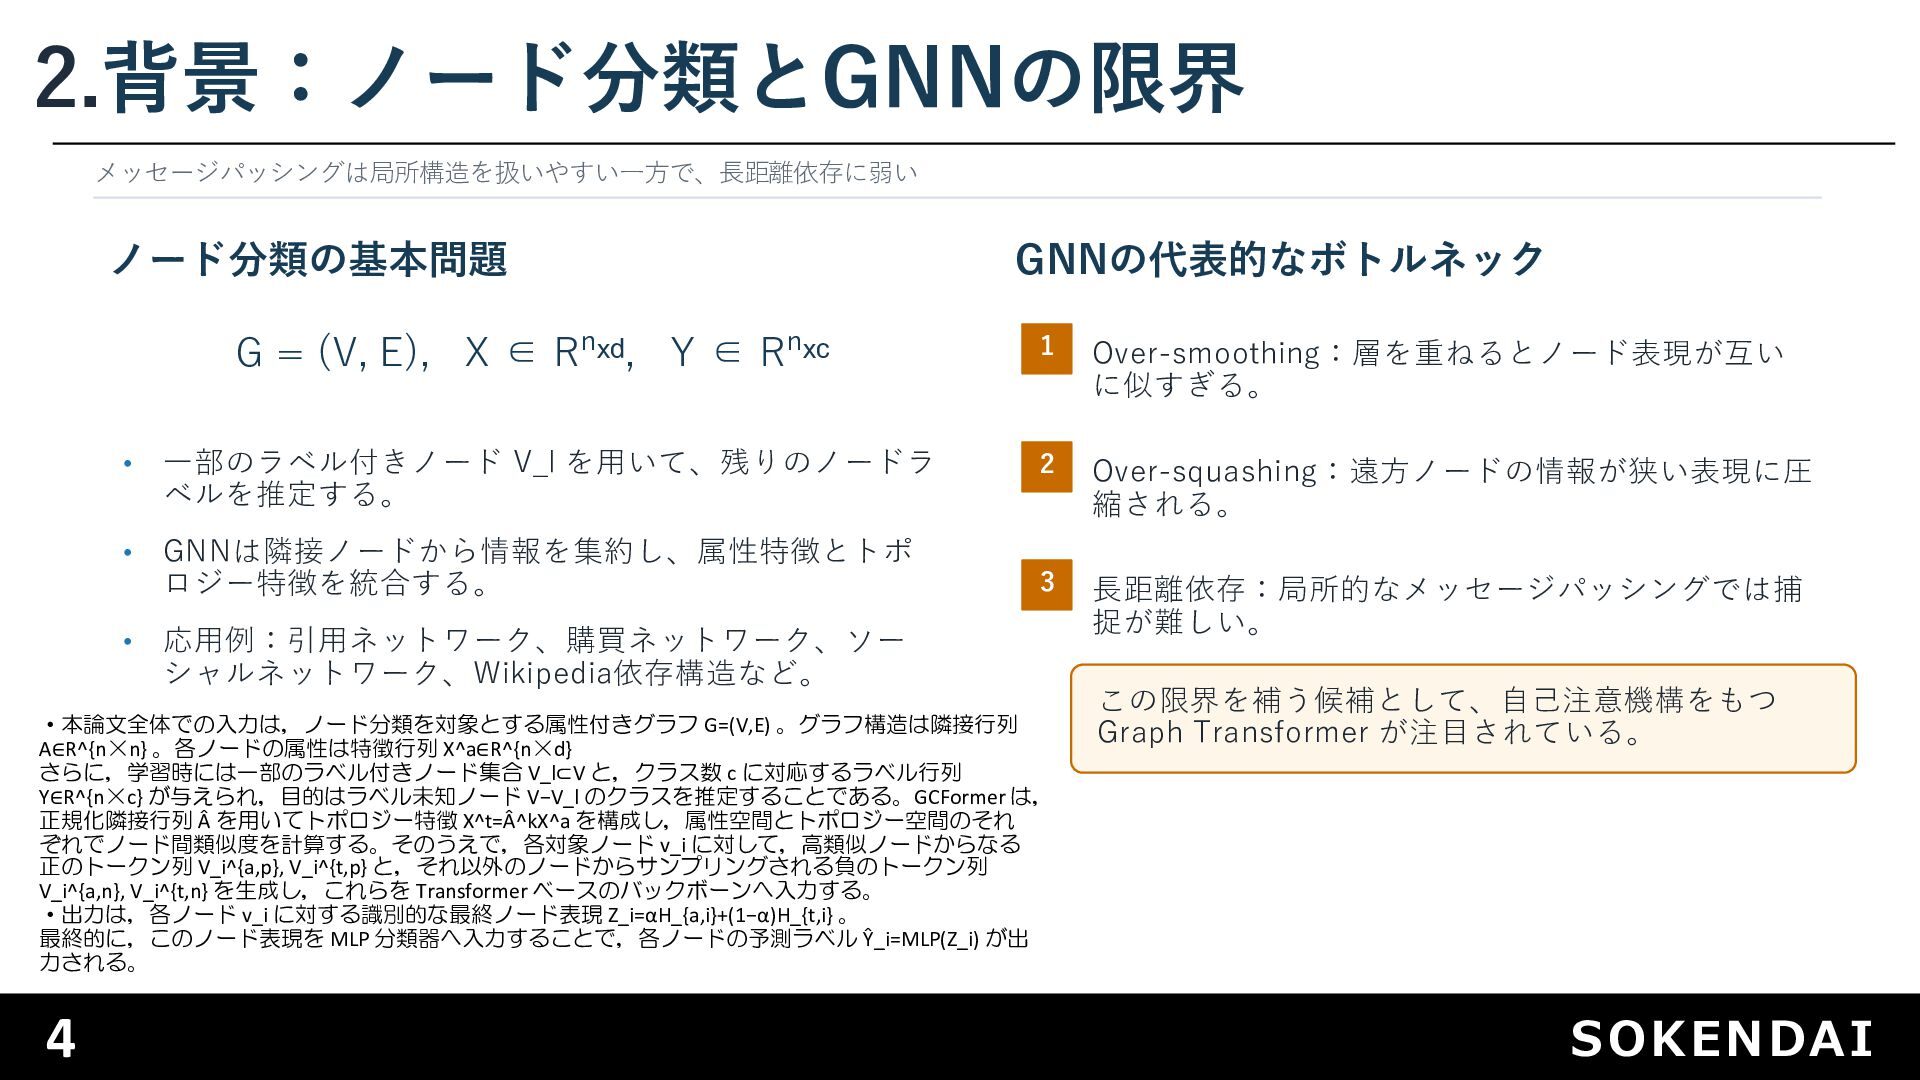
2.背景:ノード分類とGNNの限界 メッセージパッシングは局所構造を扱いやすい⼀⽅で、⻑距離依存に弱い ノード分類の基本問題 GNNの代表的なボトルネック G = (V, E), X ∈
Rⁿˣᵈ, Y ∈ Rⁿˣᶜ 1 Over-smoothing:層を重ねるとノード表現が互い に似すぎる。 • ⼀部のラベル付きノード V_l を⽤いて、残りのノードラ ベルを推定する。 2 Over-squashing:遠⽅ノードの情報が狭い表現に圧 縮される。 3 ⻑距離依存:局所的なメッセージパッシングでは捕 捉が難しい。 • GNNは隣接ノードから情報を集約し、属性特徴とトポ ロジー特徴を統合する。 • 応⽤例:引⽤ネットワーク、購買ネットワーク、ソー シャルネットワーク、Wikipedia依存構造など。 ・本論文全体での入力は,ノード分類を対象とする属性付きグラフ G=(V,E) 。グラフ構造は隣接行列 A∈R^{n×n} 。各ノードの属性は特徴行列 X^a∈R^{n×d} さらに,学習時には一部のラベル付きノード集合 V_l⊂V と,クラス数 c に対応するラベル行列 Y∈R^{n×c} が与えられ,目的はラベル未知ノード V−V_l のクラスを推定することである。GCFormer は, 正規化隣接行列 Â を用いてトポロジー特徴 X^t=Â^kX^a を構成し,属性空間とトポロジー空間のそれ ぞれでノード間類似度を計算する。そのうえで,各対象ノード v_i に対して,高類似ノードからなる 正のトークン列 V_i^{a,p}, V_i^{t,p} と,それ以外のノードからサンプリングされる負のトークン列 V_i^{a,n}, V_i^{t,n} を生成し,これらを Transformer ベースのバックボーンへ入力する。 ・出力は,各ノード v_i に対する識別的な最終ノード表現 Z_i=αH_{a,i}+(1−α)H_{t,i} 。 最終的に,このノード表現を MLP 分類器へ入力することで,各ノードの予測ラベル Ŷ_i=MLP(Z_i) が出 力される。 4 この限界を補う候補として、⾃⼰注意機構をもつ Graph Transformer が注⽬されている。 SOKENDAI
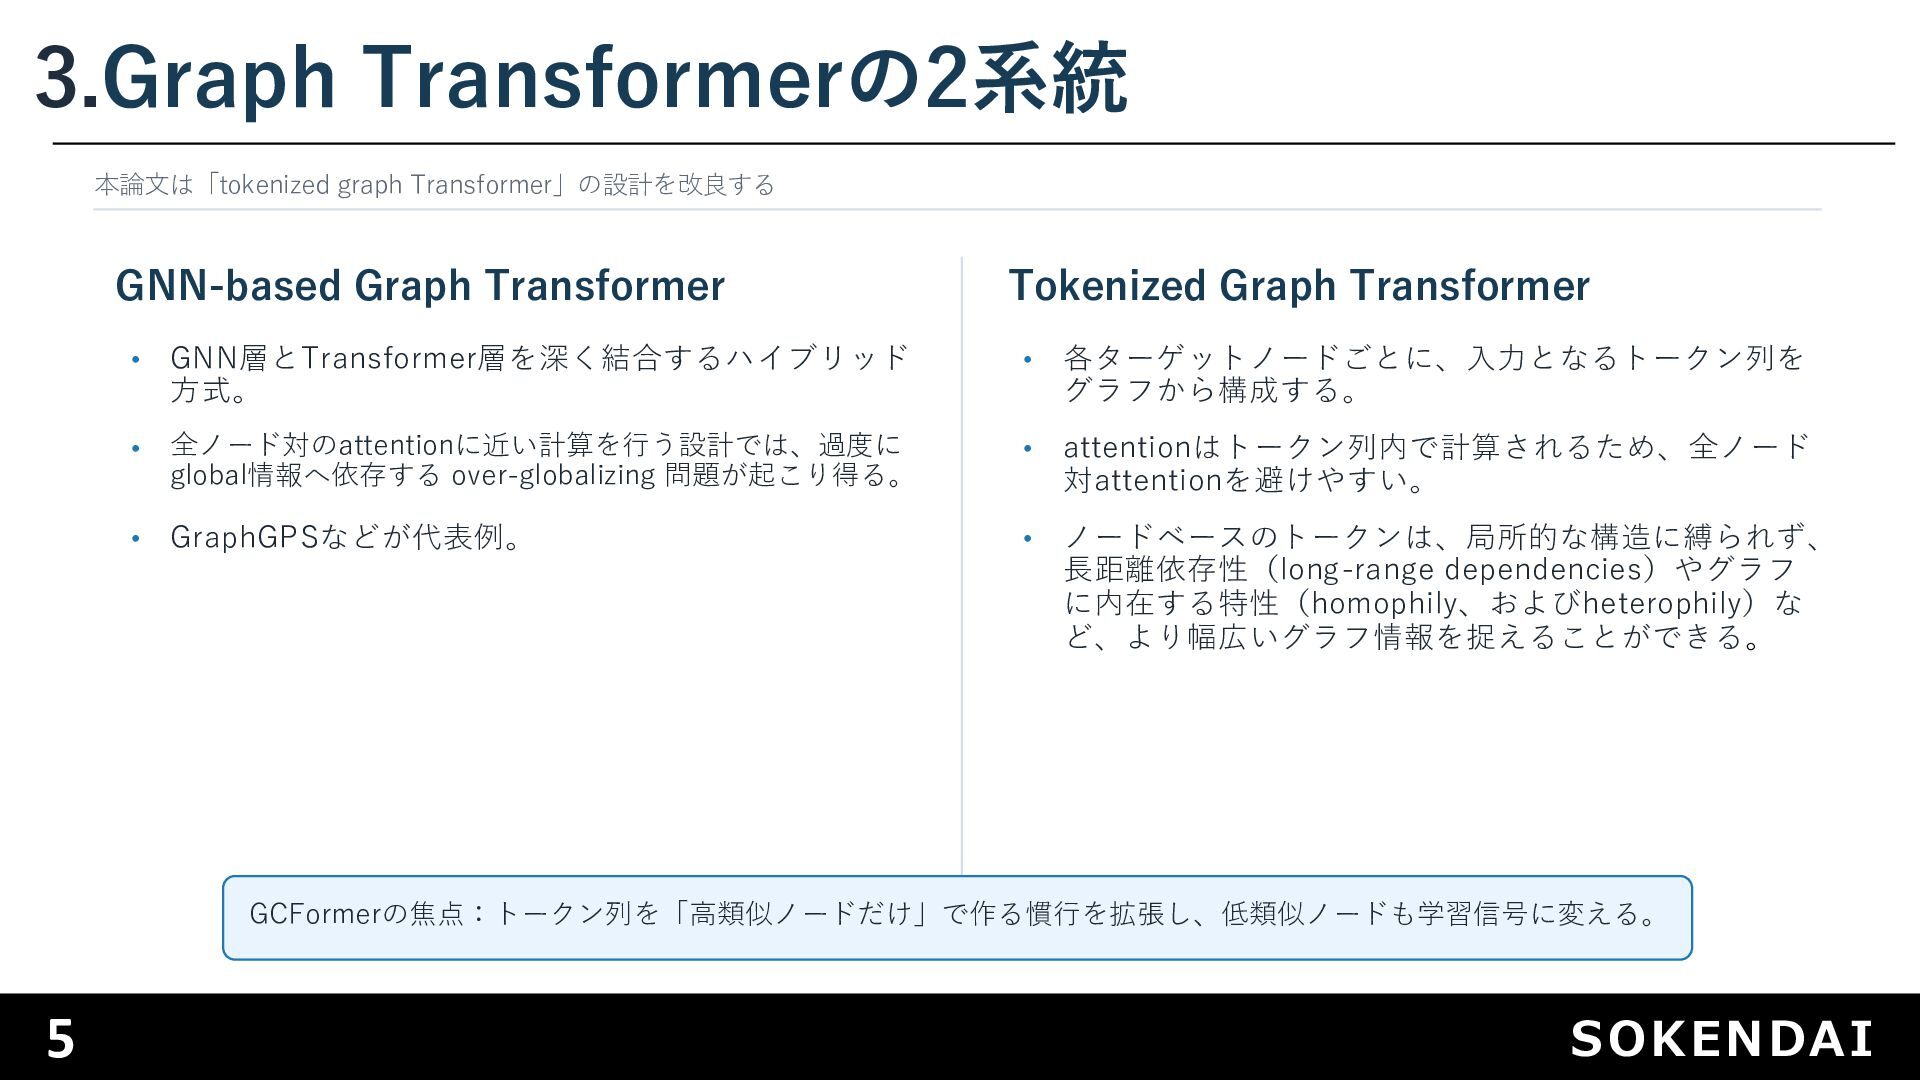
3.Graph Transformerの2系統 本論⽂は「tokenized graph Transformer」の設計を改良する GNN-based Graph Transformer Tokenized Graph
Transformer • GNN層とTransformer層を深く結合するハイブリッド ⽅式。 • 各ターゲットノードごとに、⼊⼒となるトークン列を グラフから構成する。 • 全ノード対のattentionに近い計算を⾏う設計では、過度に • attentionはトークン列内で計算されるため、全ノード 対attentionを避けやすい。 • GraphGPSなどが代表例。 • ノードベースのトークンは、局所的な構造に縛られず、 ⻑距離依存性(long-range dependencies)やグラフ に内在する特性(homophily、およびheterophily)な ど、より幅広いグラフ情報を捉えることができる。 global情報へ依存する over-globalizing 問題が起こり得る。 GCFormerの焦点:トークン列を「⾼類似ノードだけ」で作る慣⾏を拡張し、低類似ノードも学習信号に変える。 5 SOKENDAI
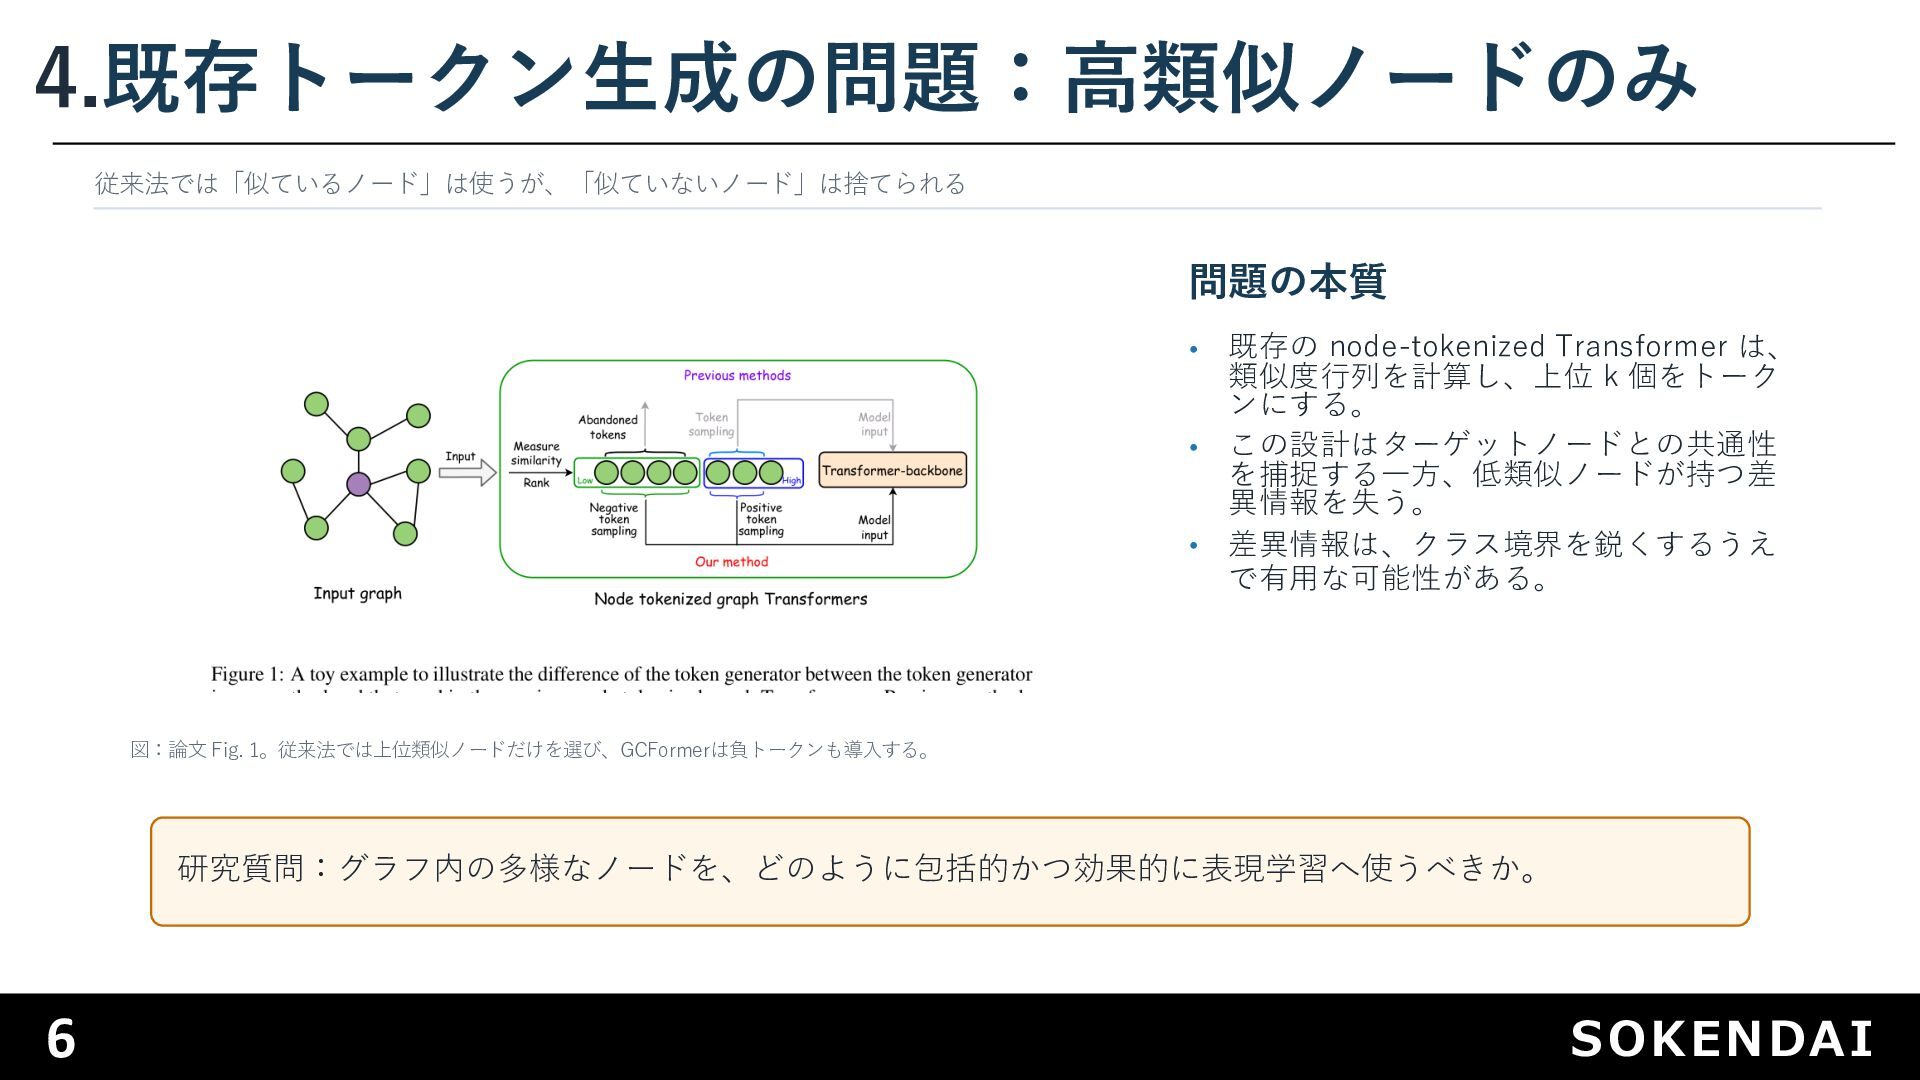
4.既存トークン⽣成の問題:⾼類似ノードのみ 従来法では「似ているノード」は使うが、「似ていないノード」は捨てられる 問題の本質 • 既存の node-tokenized Transformer は、 類似度⾏列を計算し、上位 k
個をトーク ンにする。 • この設計はターゲットノードとの共通性 を捕捉する⼀⽅、低類似ノードが持つ差 異情報を失う。 • 差異情報は、クラス境界を鋭くするうえ で有⽤な可能性がある。 図:論⽂ Fig. 1。従来法では上位類似ノードだけを選び、GCFormerは負トークンも導⼊する。 研究質問:グラフ内の多様なノードを、どのように包括的かつ効果的に表現学習へ使うべきか。 6 SOKENDAI
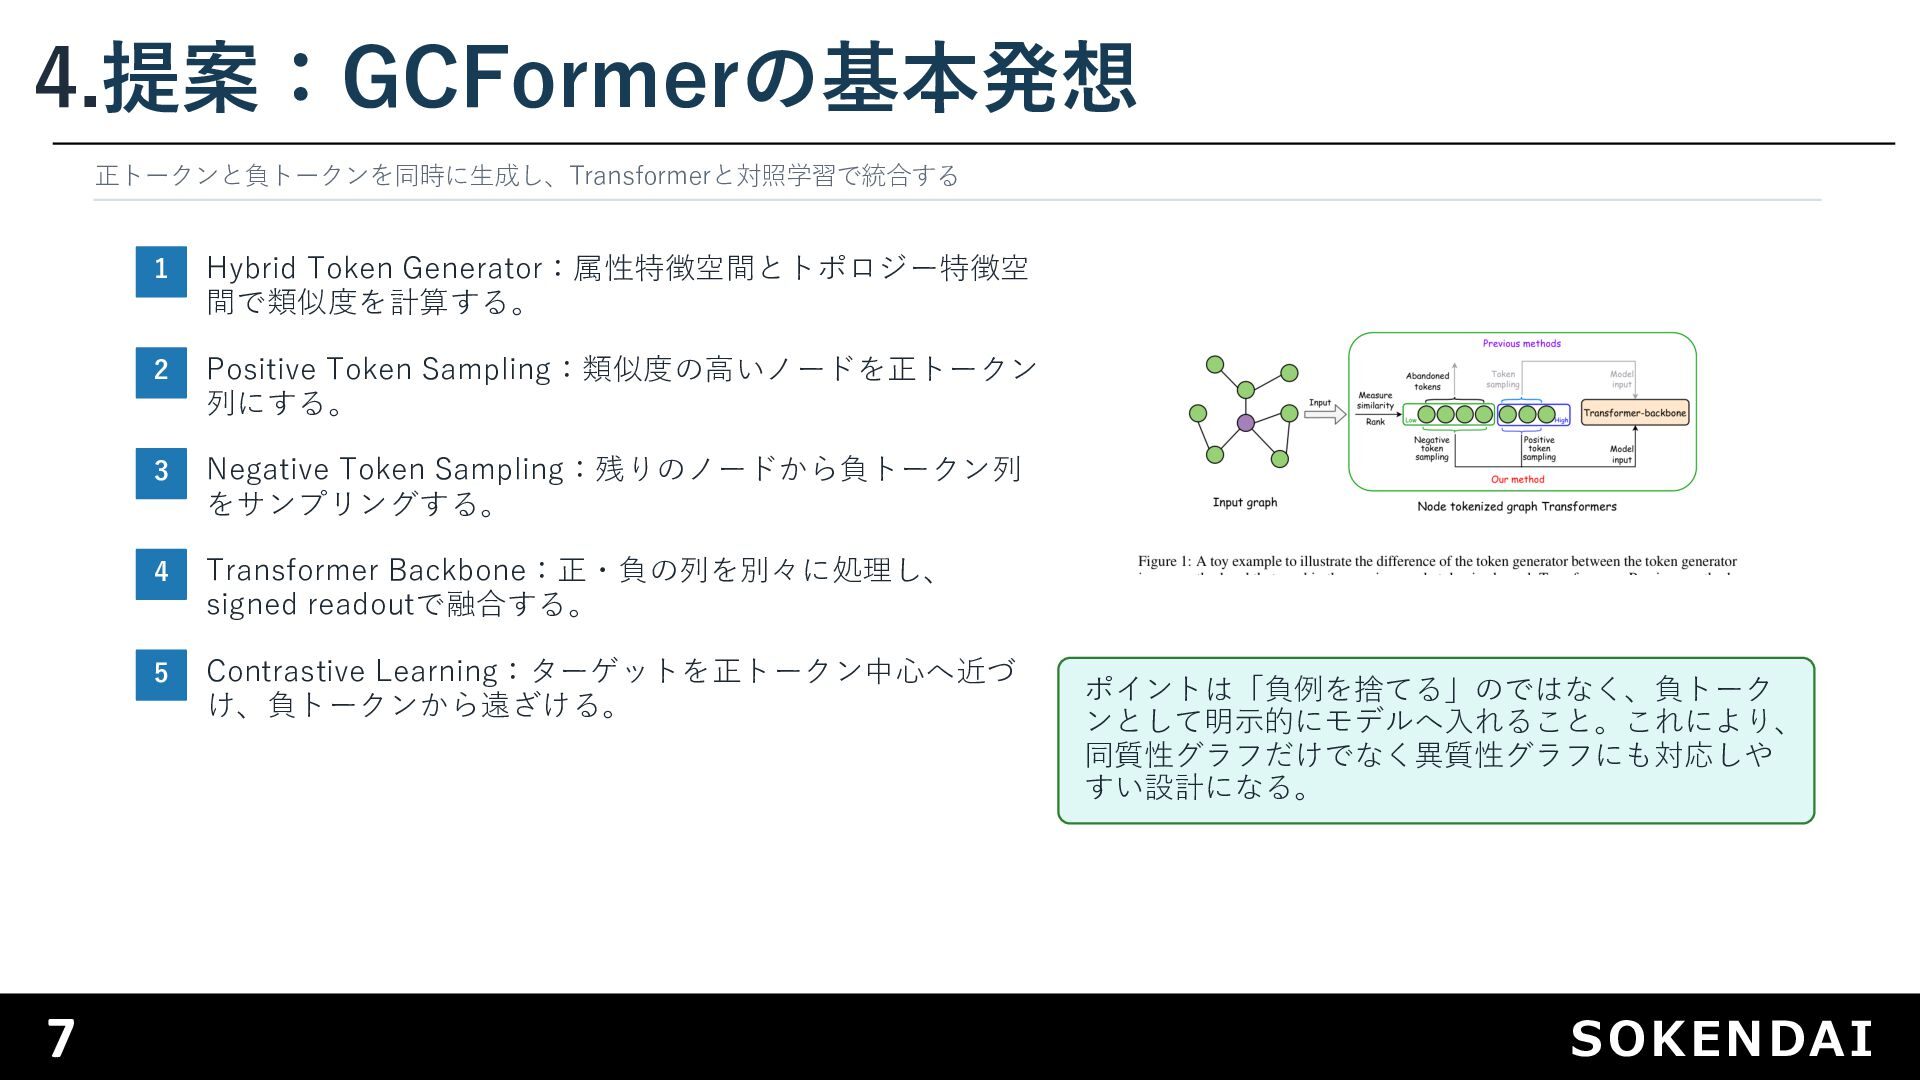
4.提案:GCFormerの基本発想 正トークンと負トークンを同時に⽣成し、Transformerと対照学習で統合する 7 1 Hybrid Token Generator:属性特徴空間とトポロジー特徴空 間で類似度を計算する。 2 Positive
Token Sampling:類似度の⾼いノードを正トークン 列にする。 3 Negative Token Sampling:残りのノードから負トークン列 をサンプリングする。 4 Transformer Backbone:正・負の列を別々に処理し、 signed readoutで融合する。 5 Contrastive Learning:ターゲットを正トークン中⼼へ近づ け、負トークンから遠ざける。 ポイントは「負例を捨てる」のではなく、負トーク ンとして明⽰的にモデルへ⼊れること。これにより、 同質性グラフだけでなく異質性グラフにも対応しや すい設計になる。 SOKENDAI
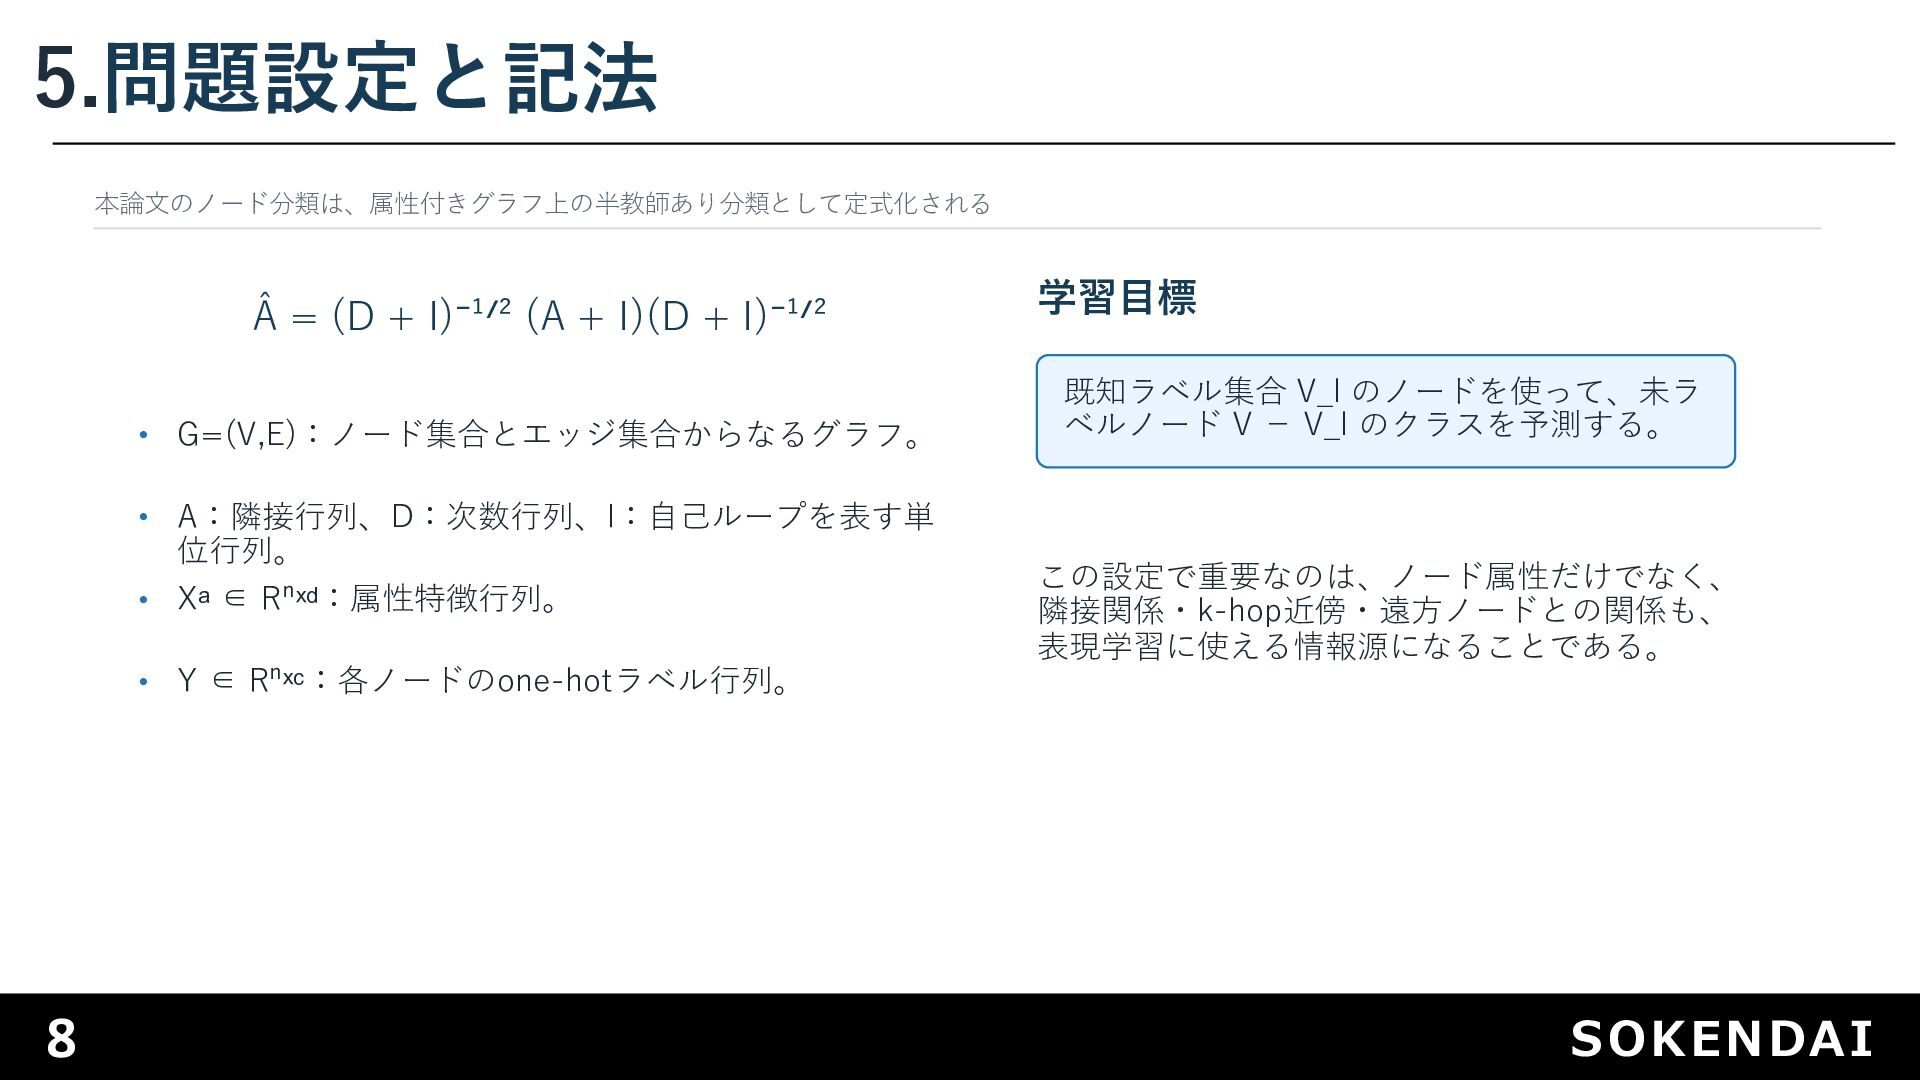
5.問題設定と記法 本論⽂のノード分類は、属性付きグラフ上の半教師あり分類として定式化される Â = (D + I)⁻¹ᐟ² (A + I)(D
+ I)⁻¹ᐟ² • G=(V,E):ノード集合とエッジ集合からなるグラフ。 • A:隣接⾏列、D:次数⾏列、I:⾃⼰ループを表す単 位⾏列。 • Xᵃ ∈ Rⁿˣᵈ:属性特徴⾏列。 • Y ∈ Rⁿˣᶜ:各ノードのone-hotラベル⾏列。 8 学習⽬標 既知ラベル集合 V_l のノードを使って、未ラ ベルノード V − V_l のクラスを予測する。 この設定で重要なのは、ノード属性だけでなく、 隣接関係・k-hop近傍・遠⽅ノードとの関係も、 表現学習に使える情報源になることである。 SOKENDAI
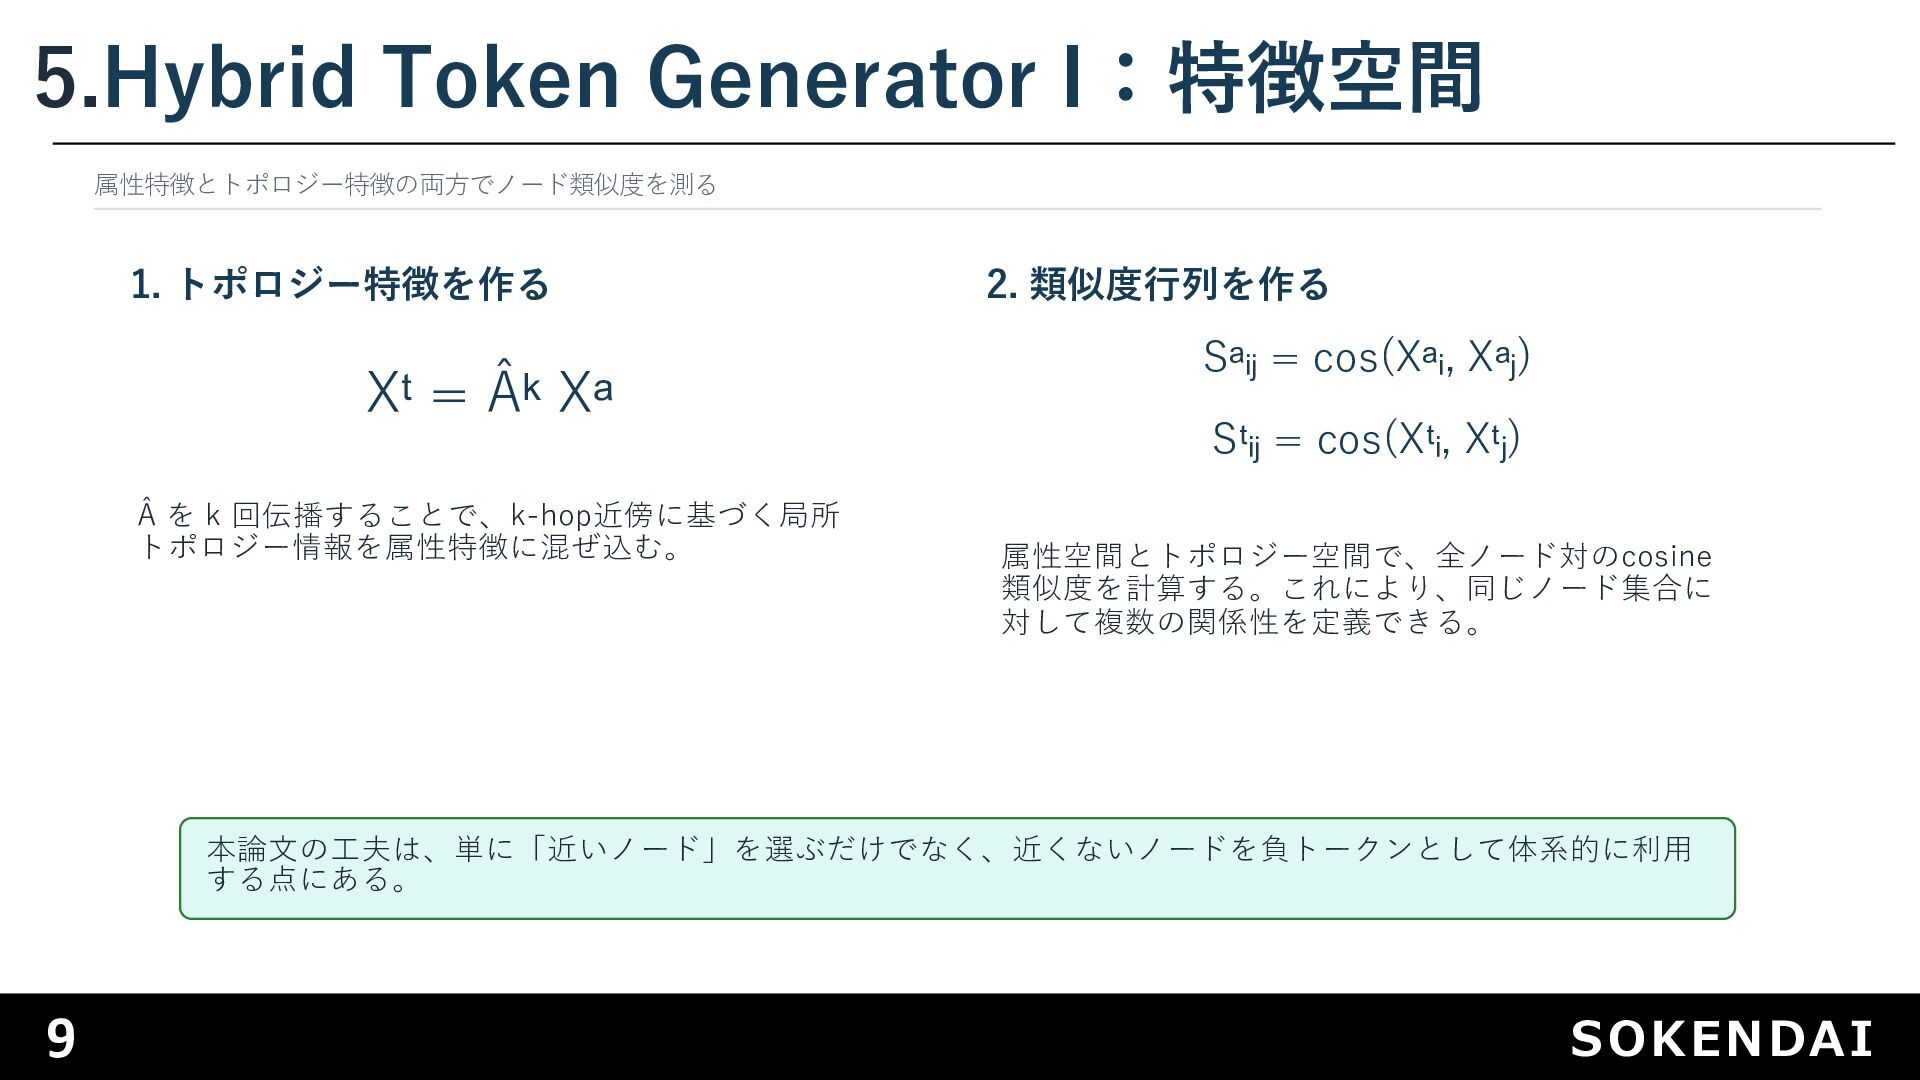
5.Hybrid Token Generator I:特徴空間 属性特徴とトポロジー特徴の両⽅でノード類似度を測る 1. トポロジー特徴を作る Xᵗ = Âᵏ
Xᵃ Â を k 回伝播することで、k-hop近傍に基づく局所 トポロジー情報を属性特徴に混ぜ込む。 2. 類似度⾏列を作る Sᵃᵢⱼ = cos(Xᵃᵢ, Xᵃⱼ) Sᵗᵢⱼ = cos(Xᵗᵢ, Xᵗⱼ) 属性空間とトポロジー空間で、全ノード対のcosine 類似度を計算する。これにより、同じノード集合に 対して複数の関係性を定義できる。 本論⽂の⼯夫は、単に「近いノード」を選ぶだけでなく、近くないノードを負トークンとして体系的に利⽤ する点にある。 9 SOKENDAI
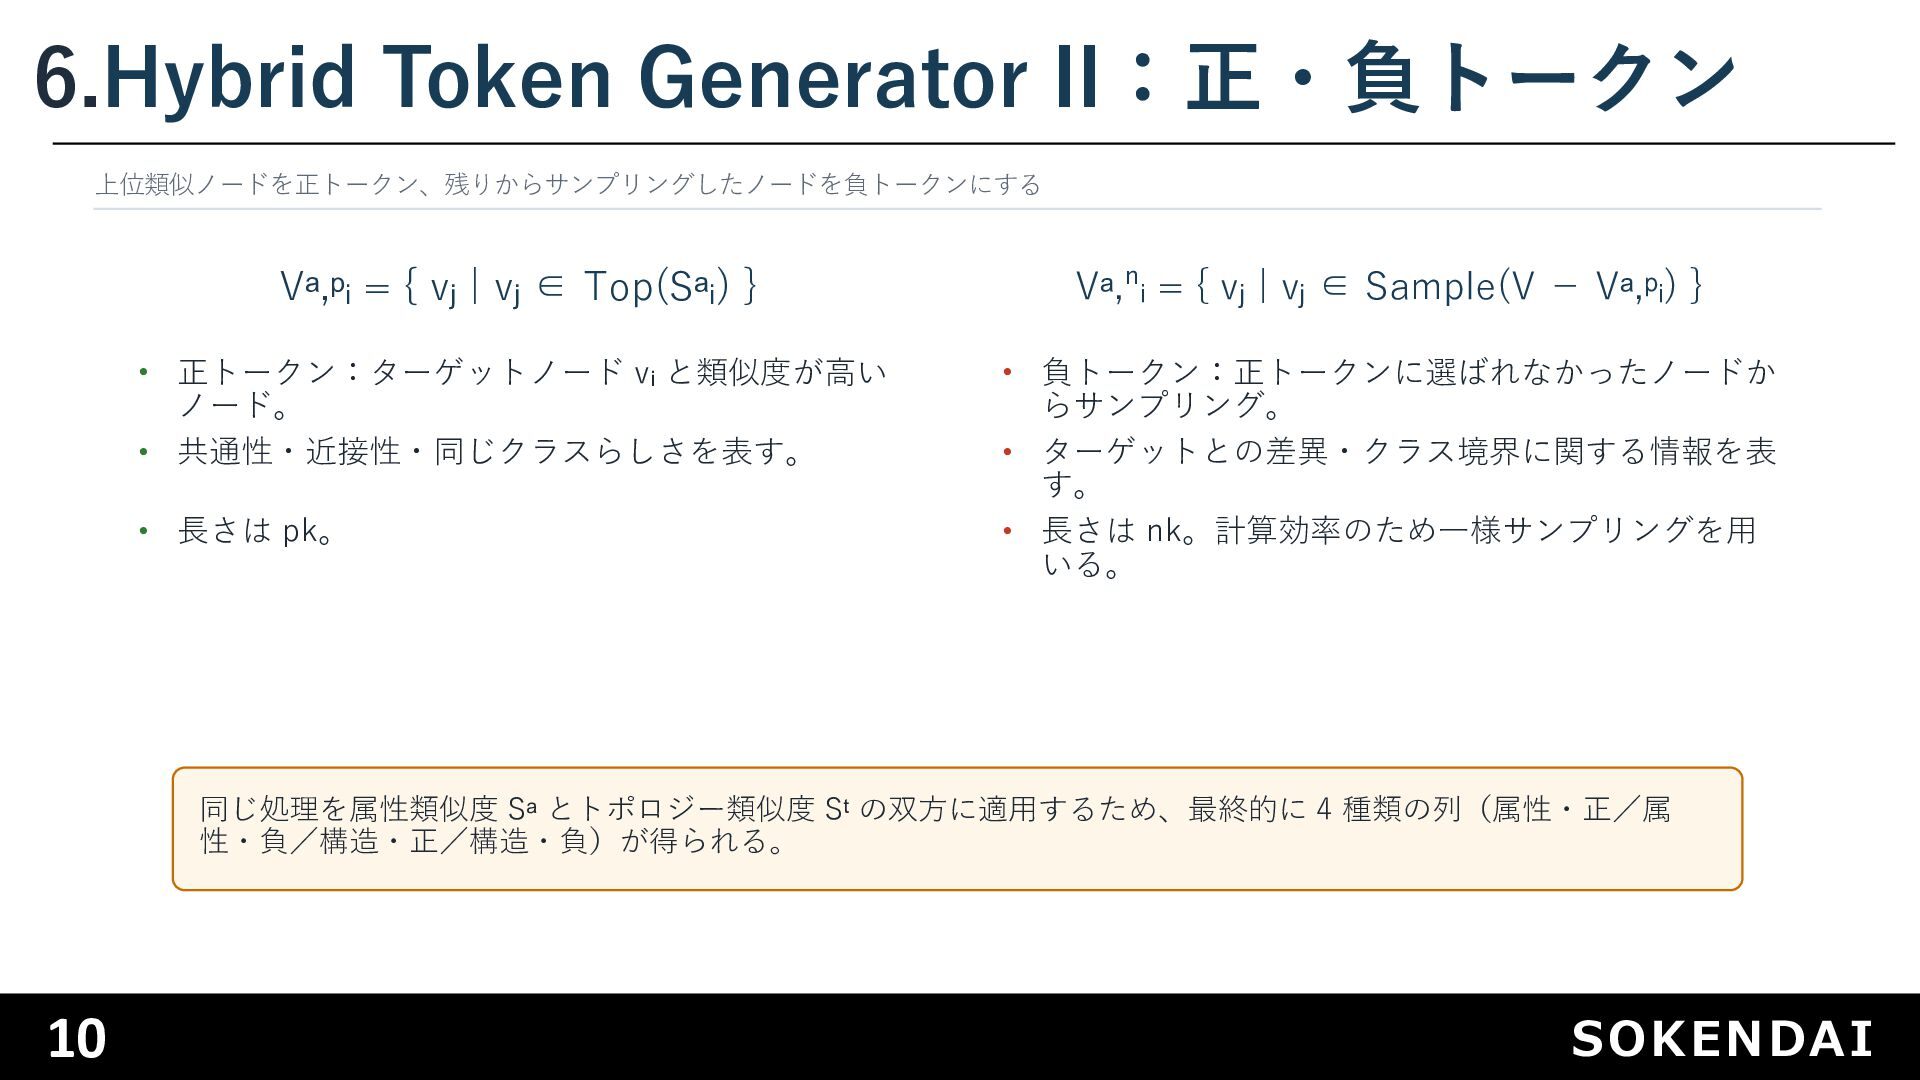
6.Hybrid Token Generator II:正・負トークン 上位類似ノードを正トークン、残りからサンプリングしたノードを負トークンにする Vᵃ,ᵖᵢ = { vⱼ |
vⱼ ∈ Top(Sᵃᵢ) } Vᵃ,ⁿᵢ = { vⱼ | vⱼ ∈ Sample(V − Vᵃ,ᵖᵢ) } • 正トークン:ターゲットノード vᵢ と類似度が⾼い ノード。 • 共通性・近接性・同じクラスらしさを表す。 • 負トークン:正トークンに選ばれなかったノードか らサンプリング。 • ターゲットとの差異・クラス境界に関する情報を表 す。 • ⻑さは nk。計算効率のため⼀様サンプリングを⽤ いる。 • ⻑さは pk。 同じ処理を属性類似度 Sᵃ とトポロジー類似度 Sᵗ の双⽅に適⽤するため、最終的に 4 種類の列(属性・正/属 性・負/構造・正/構造・負)が得られる。 10 SOKENDAI
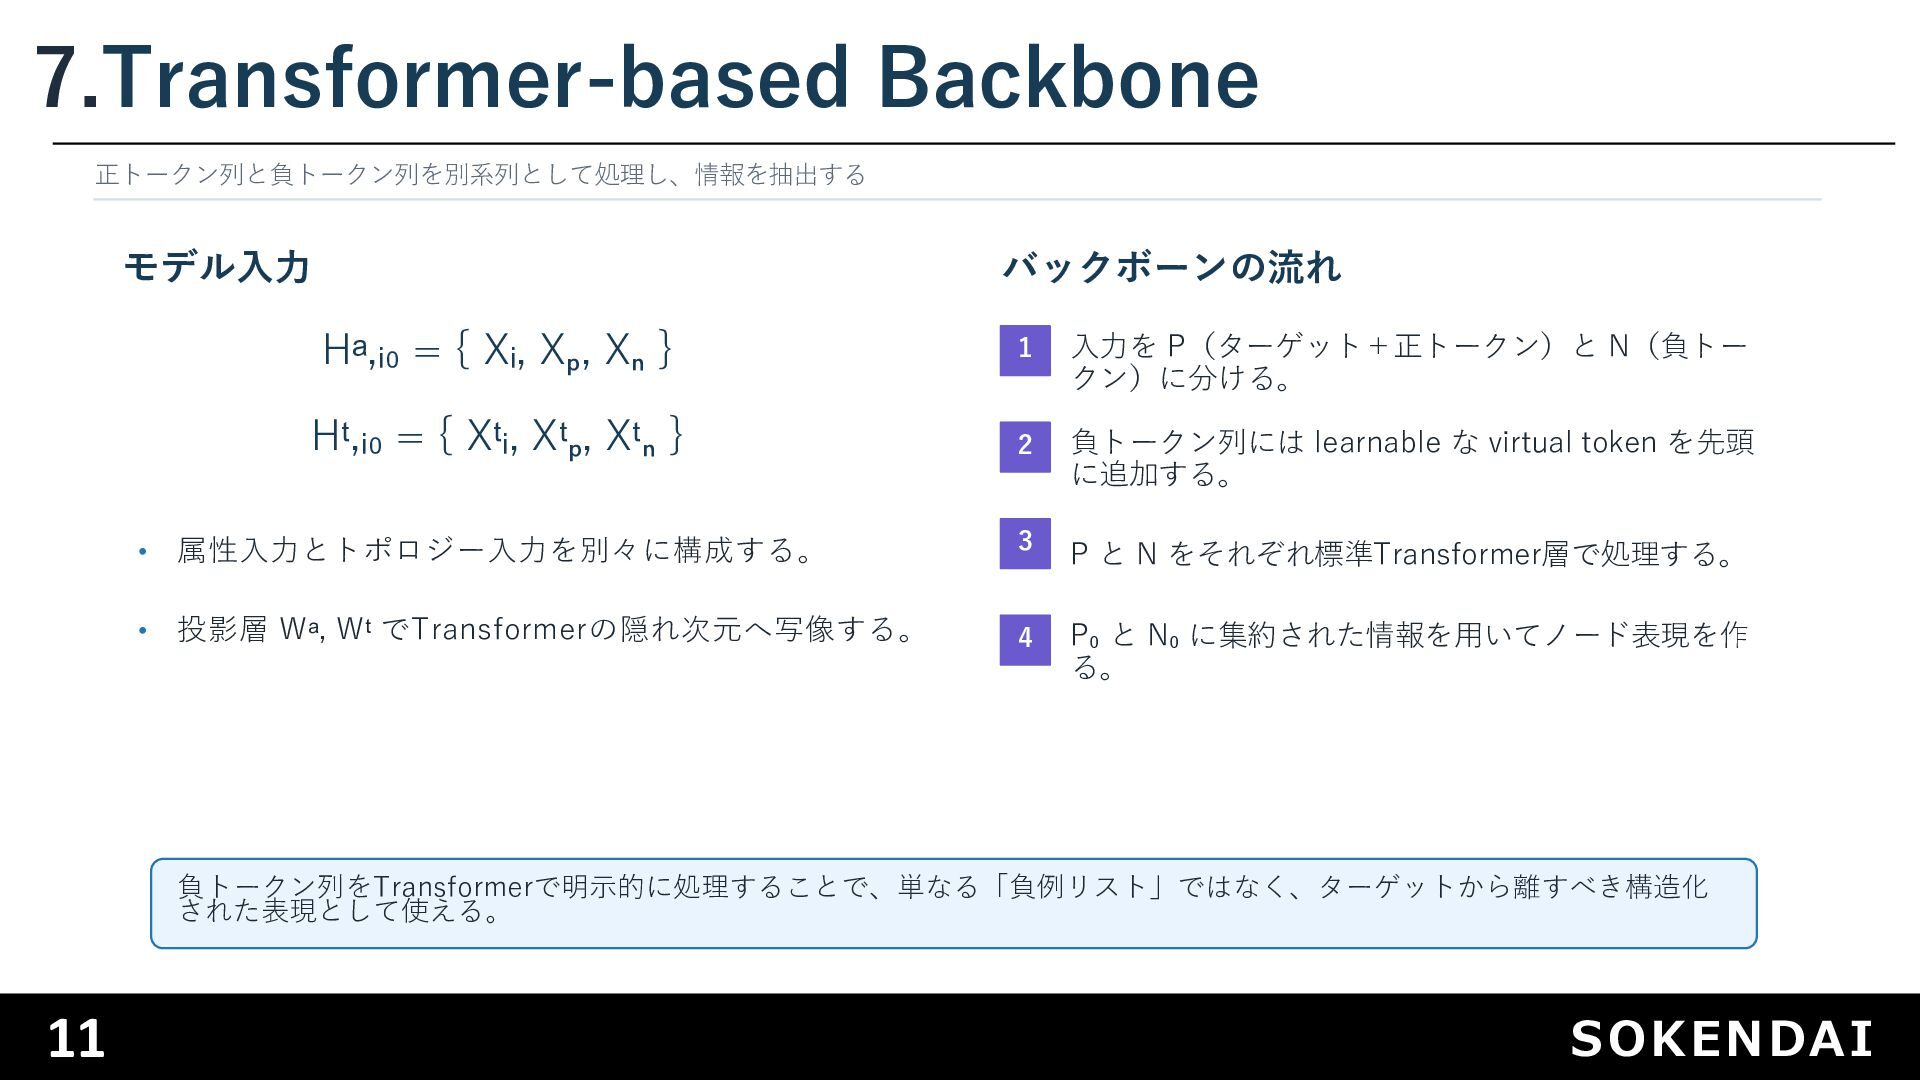
7.Transformer-based Backbone 正トークン列と負トークン列を別系列として処理し、情報を抽出する モデル⼊⼒ バックボーンの流れ Hᵃ,ᵢ₀ = { Xᵢ, Xₚ,
Xₙ } 1 ⼊⼒を P(ターゲット+正トークン)と N(負トー クン)に分ける。 Hᵗ,ᵢ₀ = { Xᵗᵢ, Xᵗₚ, Xᵗₙ } 2 負トークン列には learnable な virtual token を先頭 に追加する。 • 属性⼊⼒とトポロジー⼊⼒を別々に構成する。 3 P と N をそれぞれ標準Transformer層で処理する。 • 投影層 Wᵃ, Wᵗ でTransformerの隠れ次元へ写像する。 4 P₀ と N₀ に集約された情報を⽤いてノード表現を作 る。 負トークン列をTransformerで明⽰的に処理することで、単なる「負例リスト」ではなく、ターゲットから離すべき構造化 された表現として使える。 11 SOKENDAI
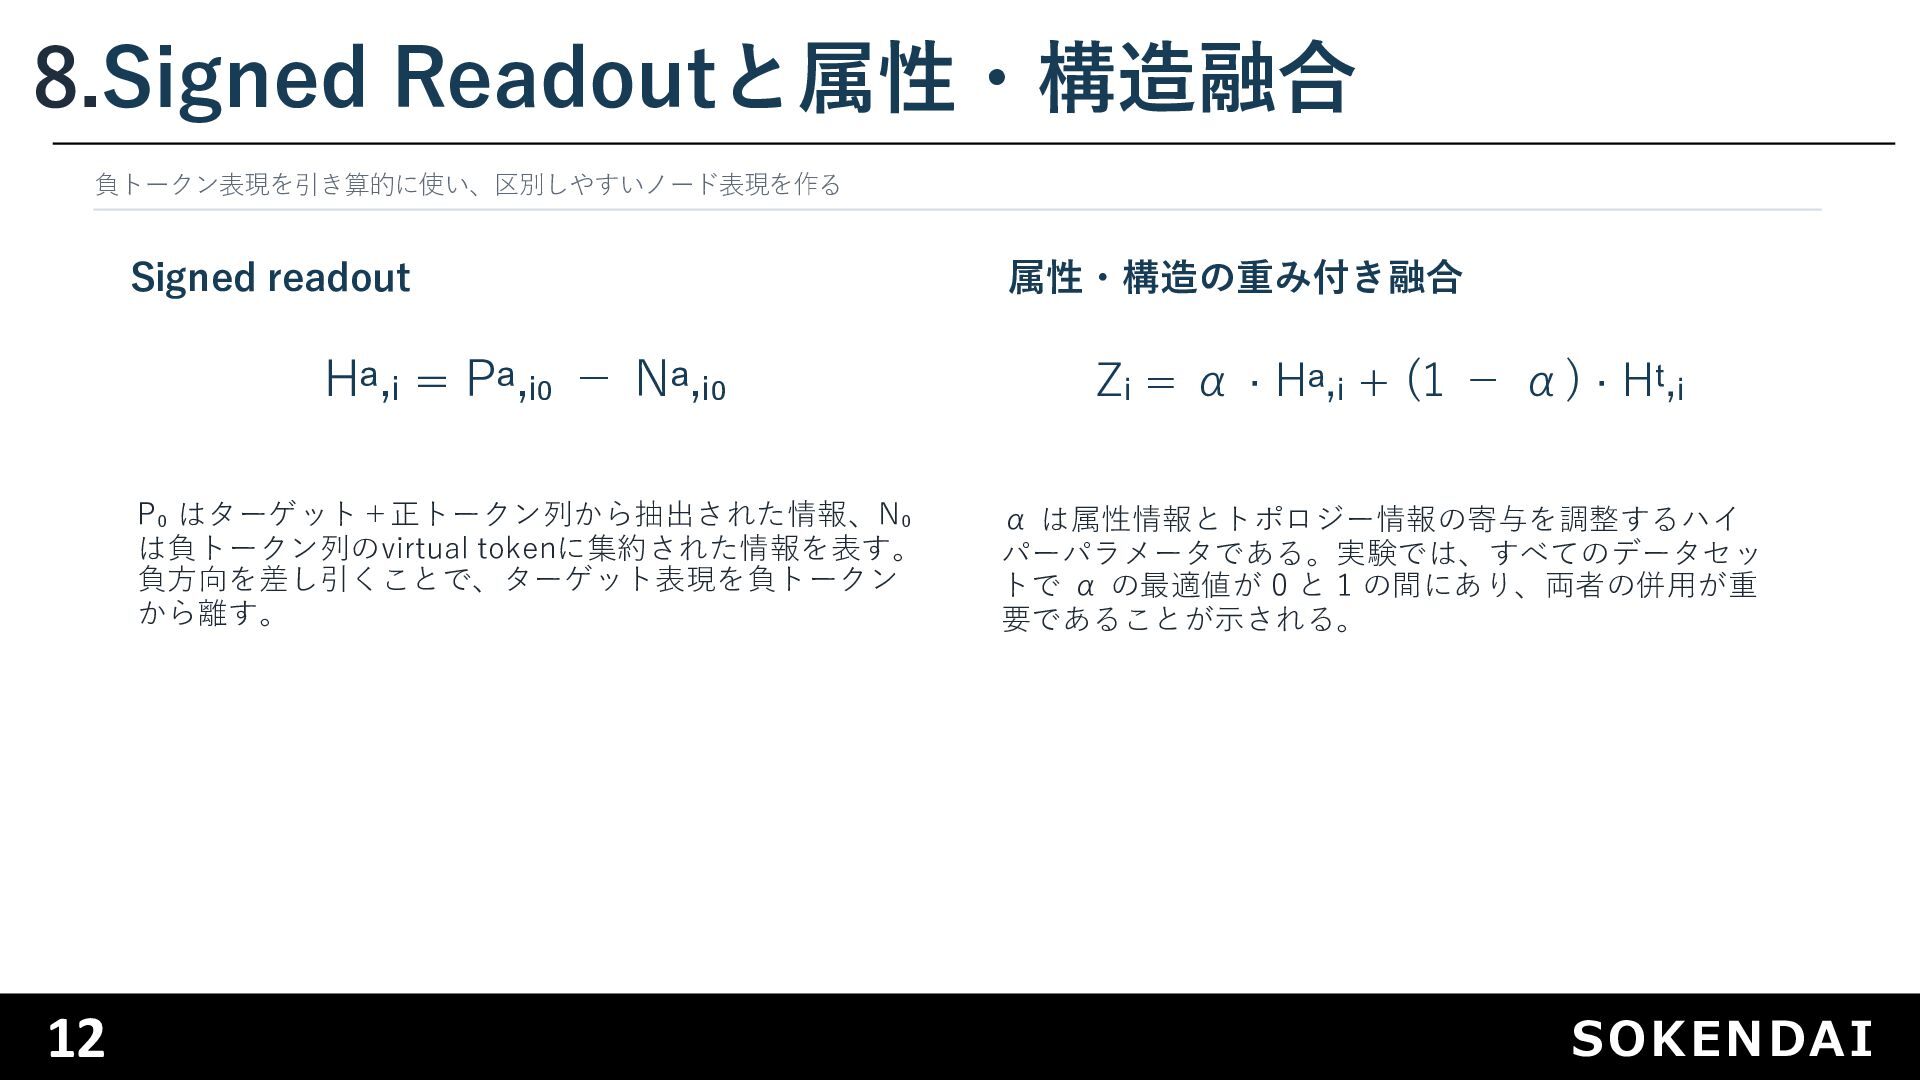
8.Signed Readoutと属性・構造融合 負トークン表現を引き算的に使い、区別しやすいノード表現を作る Signed readout 12 属性・構造の重み付き融合 Hᵃ,ᵢ = Pᵃ,ᵢ₀
− Nᵃ,ᵢ₀ Zᵢ = α · Hᵃ,ᵢ + (1 − α) · Hᵗ,ᵢ P₀ はターゲット+正トークン列から抽出された情報、N₀ は負トークン列のvirtual tokenに集約された情報を表す。 負⽅向を差し引くことで、ターゲット表現を負トークン から離す。 α は属性情報とトポロジー情報の寄与を調整するハイ パーパラメータである。実験では、すべてのデータセッ トで α の最適値が 0 と 1 の間にあり、両者の併⽤が重 要であることが⽰される。 SOKENDAI
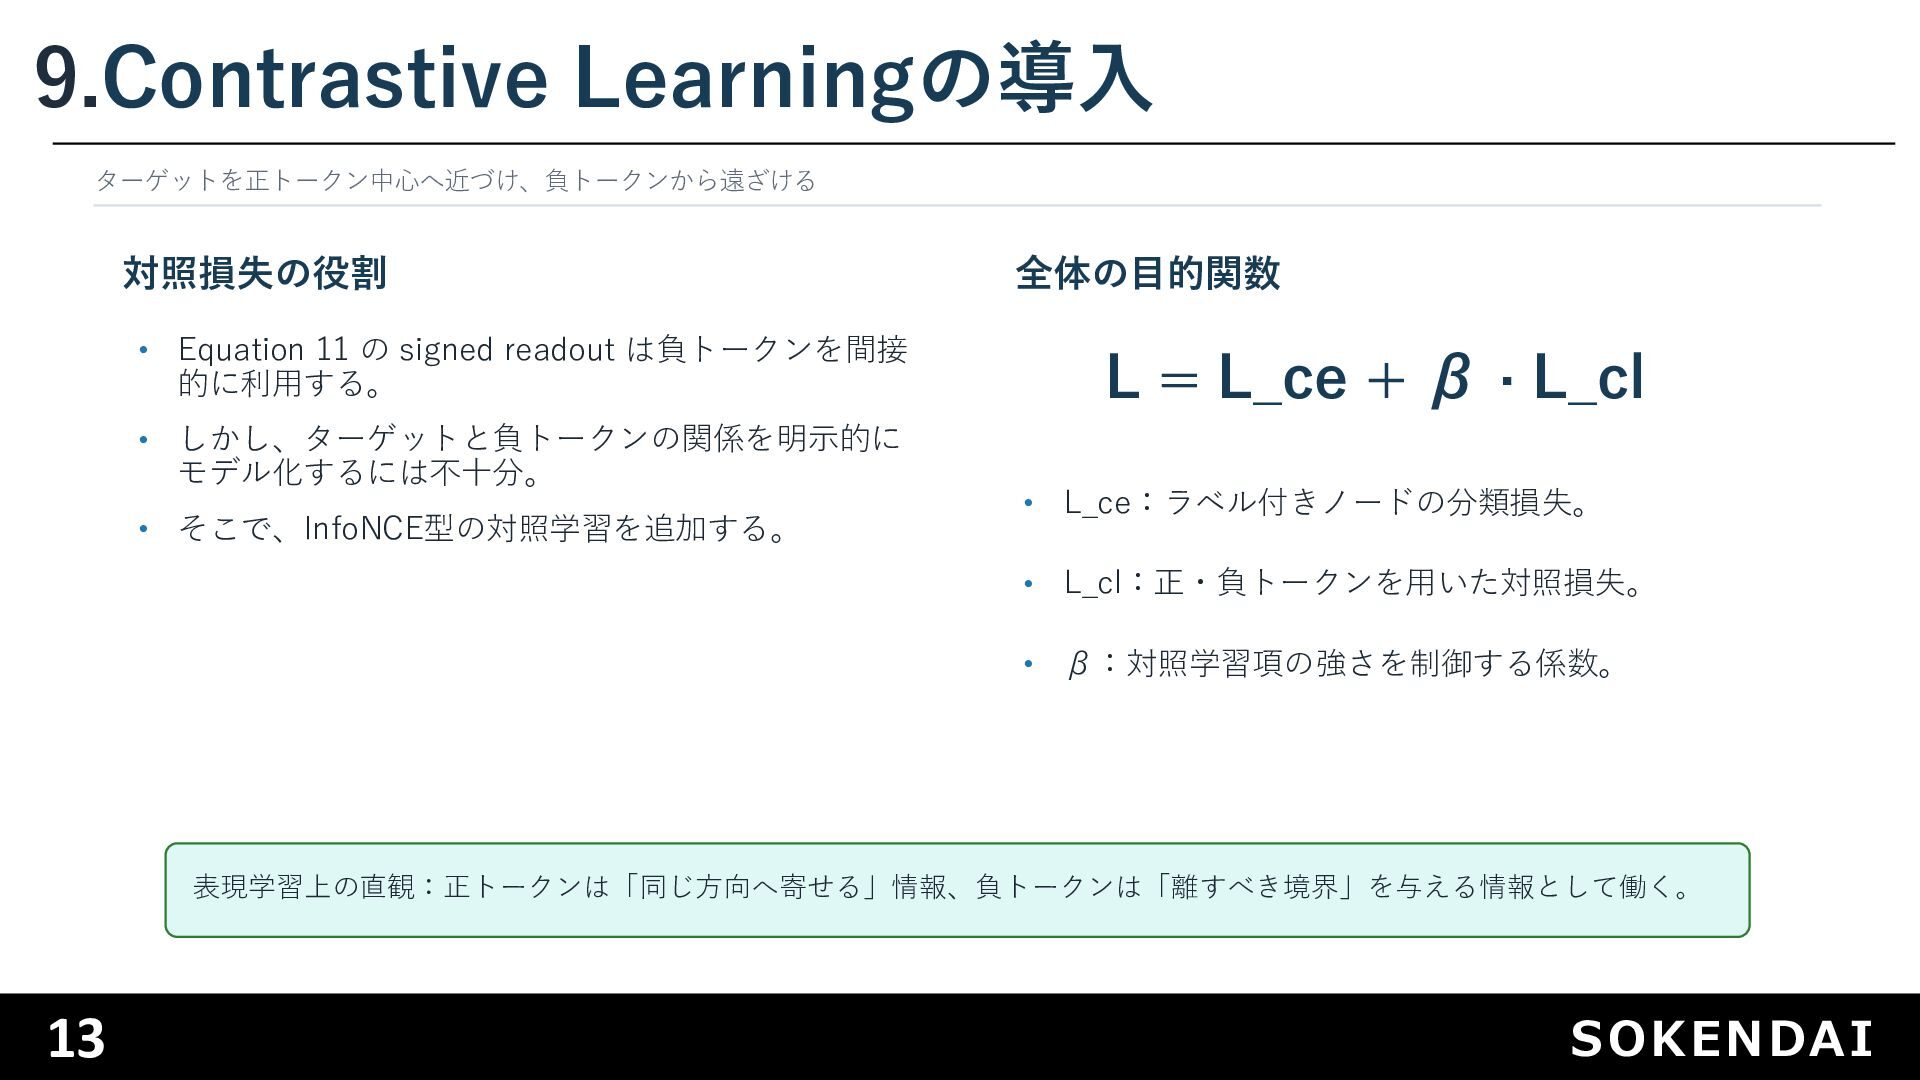
9.Contrastive Learningの導⼊ ターゲットを正トークン中⼼へ近づけ、負トークンから遠ざける 対照損失の役割 • Equation 11 の signed readout
は負トークンを間接 的に利⽤する。 • しかし、ターゲットと負トークンの関係を明⽰的に モデル化するには不⼗分。 • そこで、InfoNCE型の対照学習を追加する。 全体の⽬的関数 L = L_ce + β · L_cl • L_ce:ラベル付きノードの分類損失。 • L_cl:正・負トークンを⽤いた対照損失。 • β:対照学習項の強さを制御する係数。 表現学習上の直観:正トークンは「同じ⽅向へ寄せる」情報、負トークンは「離すべき境界」を与える情報として働く。 13 SOKENDAI
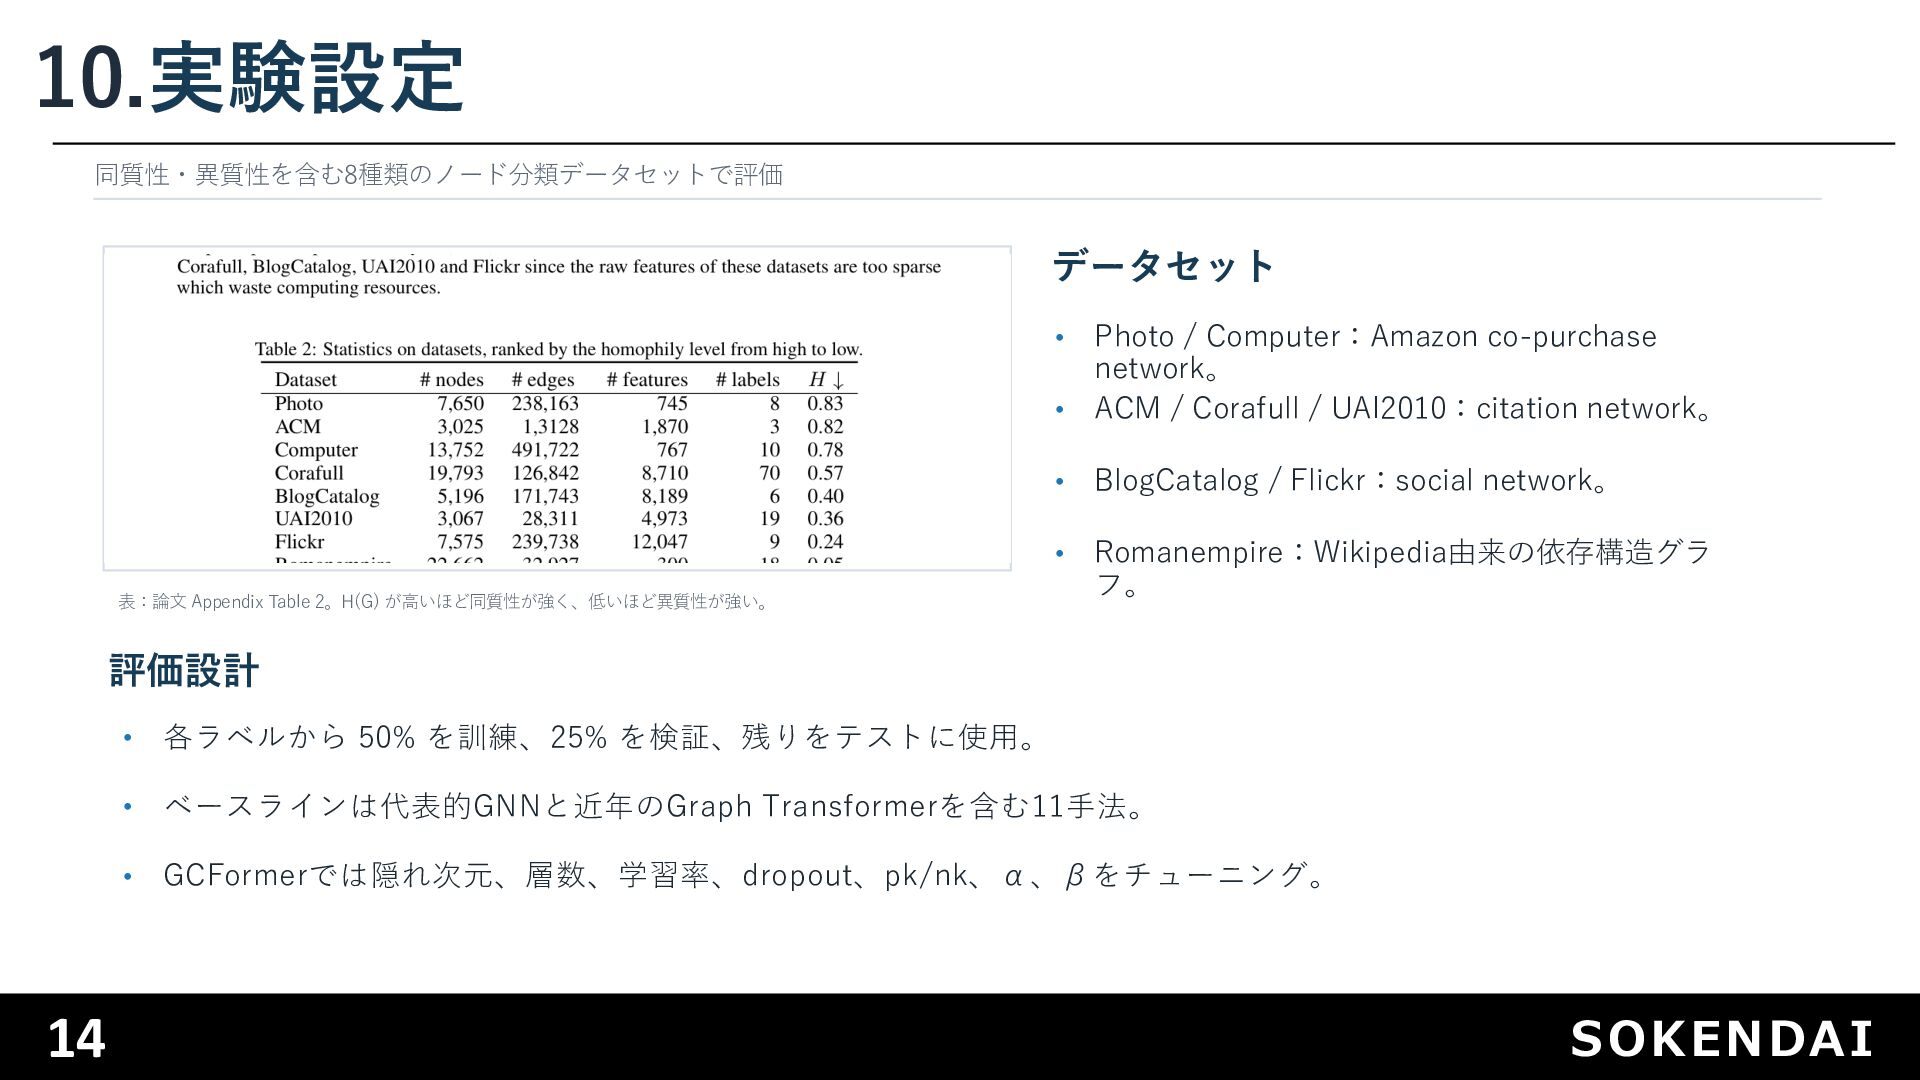
10.実験設定 同質性・異質性を含む8種類のノード分類データセットで評価 データセット • Photo / Computer:Amazon co-purchase network。 •
ACM / Corafull / UAI2010:citation network。 • BlogCatalog / Flickr:social network。 表:論⽂ Appendix Table 2。H(G) が⾼いほど同質性が強く、低いほど異質性が強い。 • Romanempire:Wikipedia由来の依存構造グラ フ。 評価設計 • 各ラベルから 50% を訓練、25% を検証、残りをテストに使⽤。 • ベースラインは代表的GNNと近年のGraph Transformerを含む11⼿法。 • GCFormerでは隠れ次元、層数、学習率、dropout、pk/nk、α、βをチューニング。 14 SOKENDAI
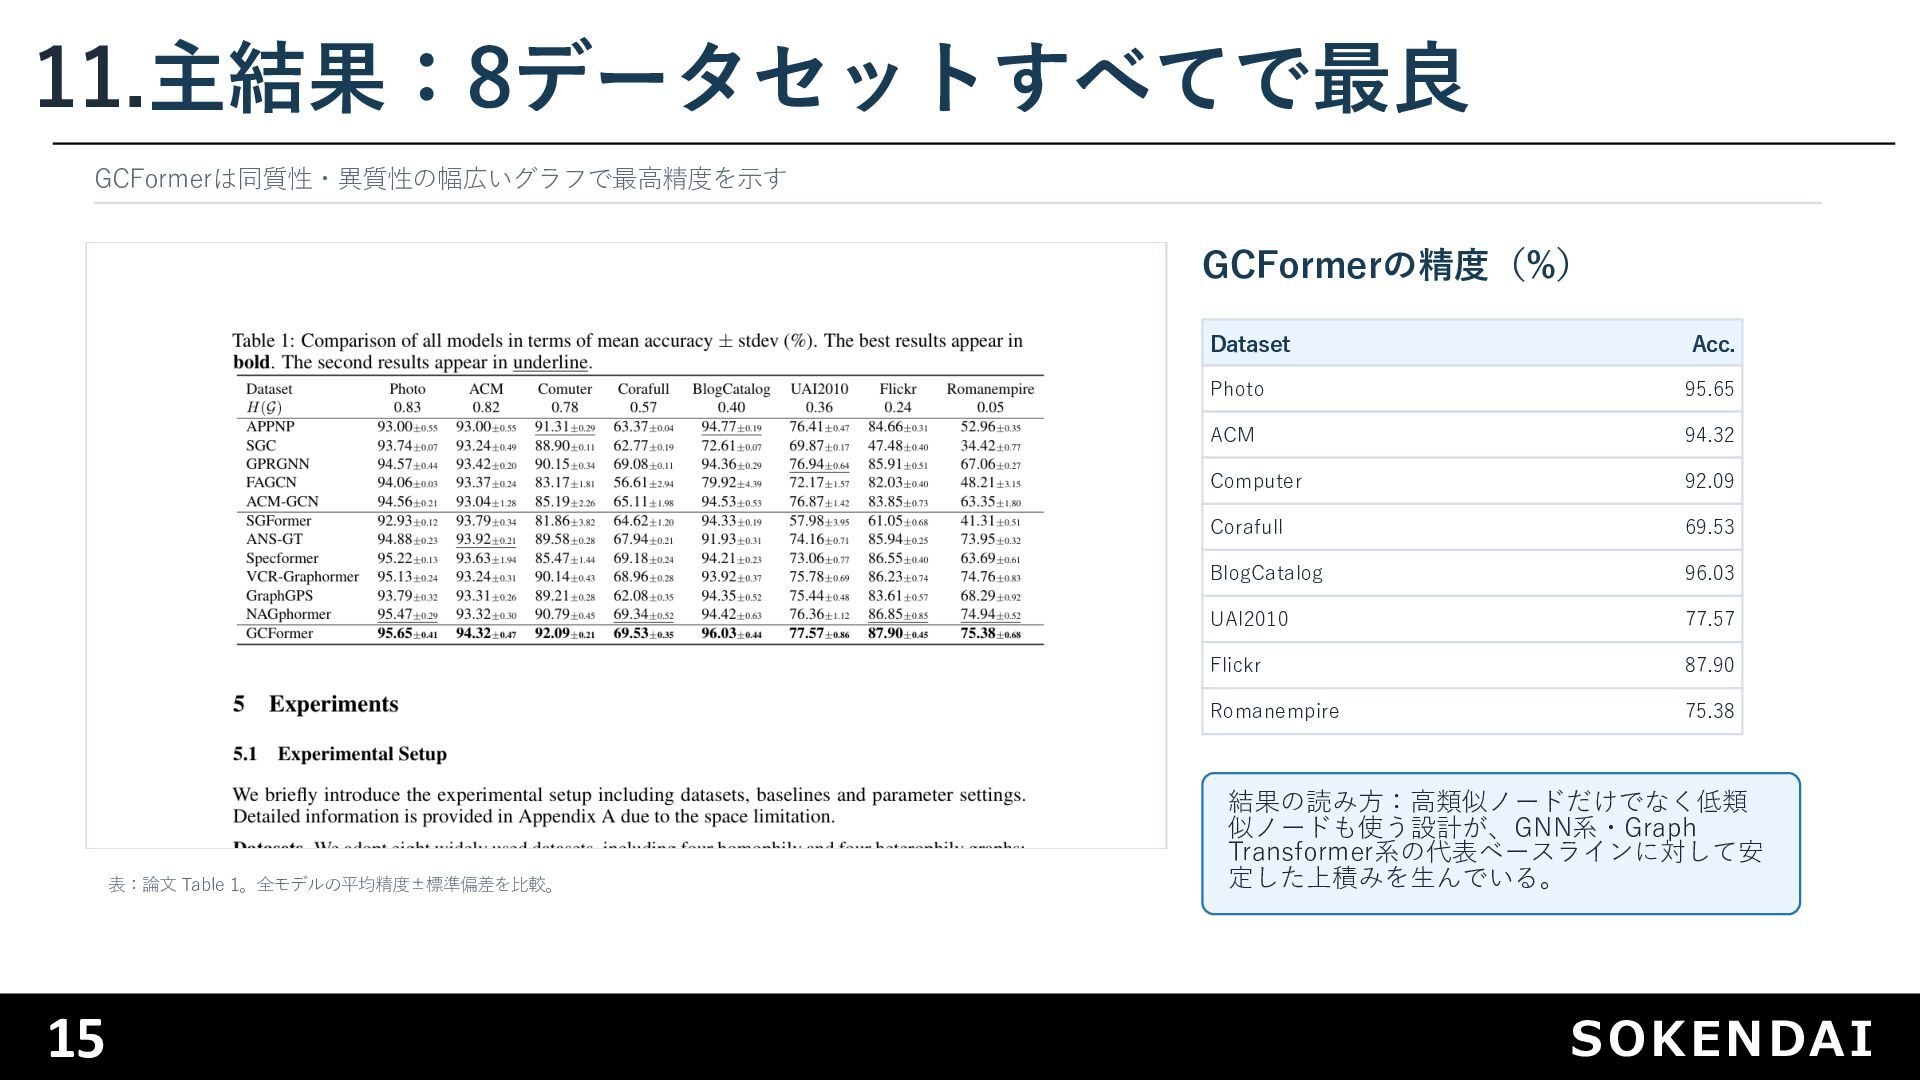
11.主結果:8データセットすべてで最良 GCFormerは同質性・異質性の幅広いグラフで最⾼精度を⽰す GCFormerの精度(%) 表:論⽂ Table 1。全モデルの平均精度±標準偏差を⽐較。 15 Dataset Acc. Photo
95.65 ACM 94.32 Computer 92.09 Corafull 69.53 BlogCatalog 96.03 UAI2010 77.57 Flickr 87.90 Romanempire 75.38 結果の読み⽅:⾼類似ノードだけでなく低類 似ノードも使う設計が、GNN系・Graph Transformer系の代表ベースラインに対して安 定した上積みを⽣んでいる。 SOKENDAI
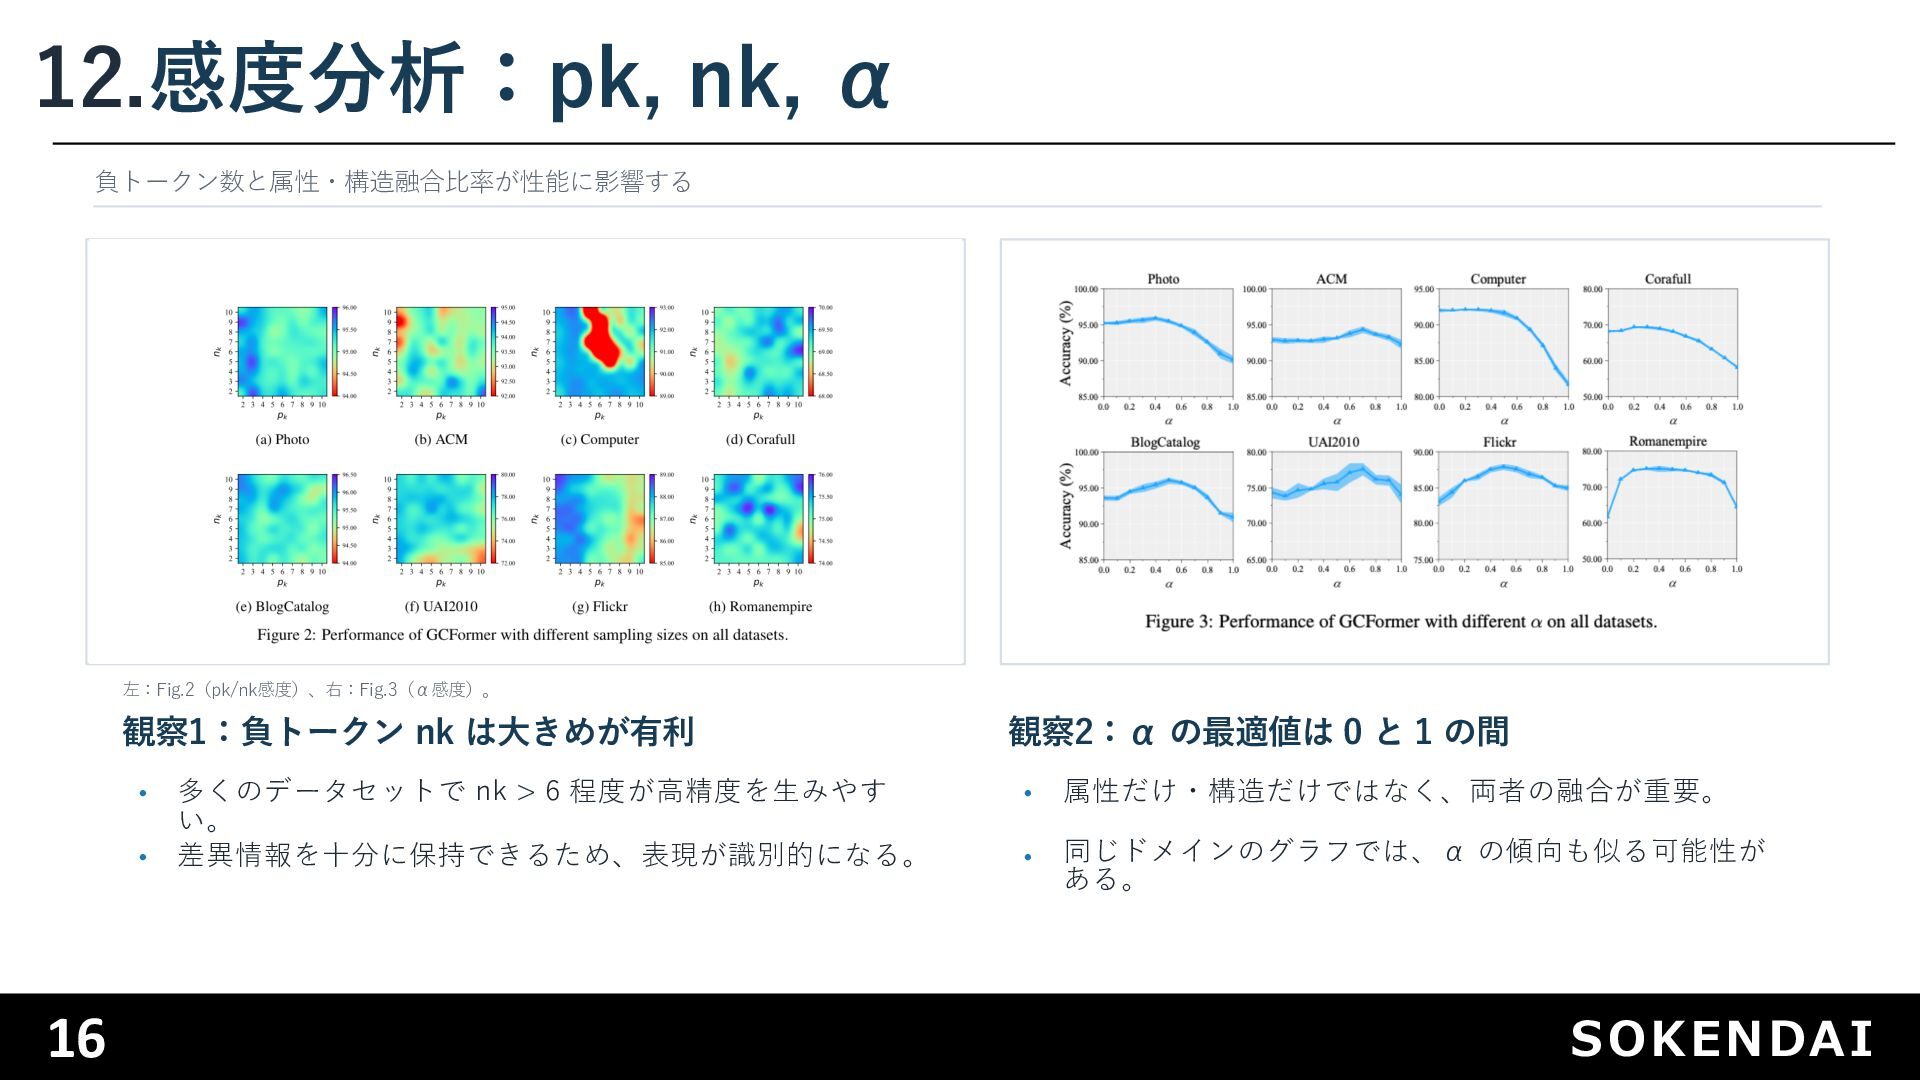
12.感度分析:pk, nk, α 負トークン数と属性・構造融合⽐率が性能に影響する 左:Fig.2(pk/nk感度)、右:Fig.3(α感度)。 観察1:負トークン nk は⼤きめが有利 • •
16 多くのデータセットで nk > 6 程度が⾼精度を⽣みやす い。 差異情報を⼗分に保持できるため、表現が識別的になる。 観察2:α の最適値は 0 と 1 の間 • 属性だけ・構造だけではなく、両者の融合が重要。 • 同じドメインのグラフでは、α の傾向も似る可能性が ある。 SOKENDAI
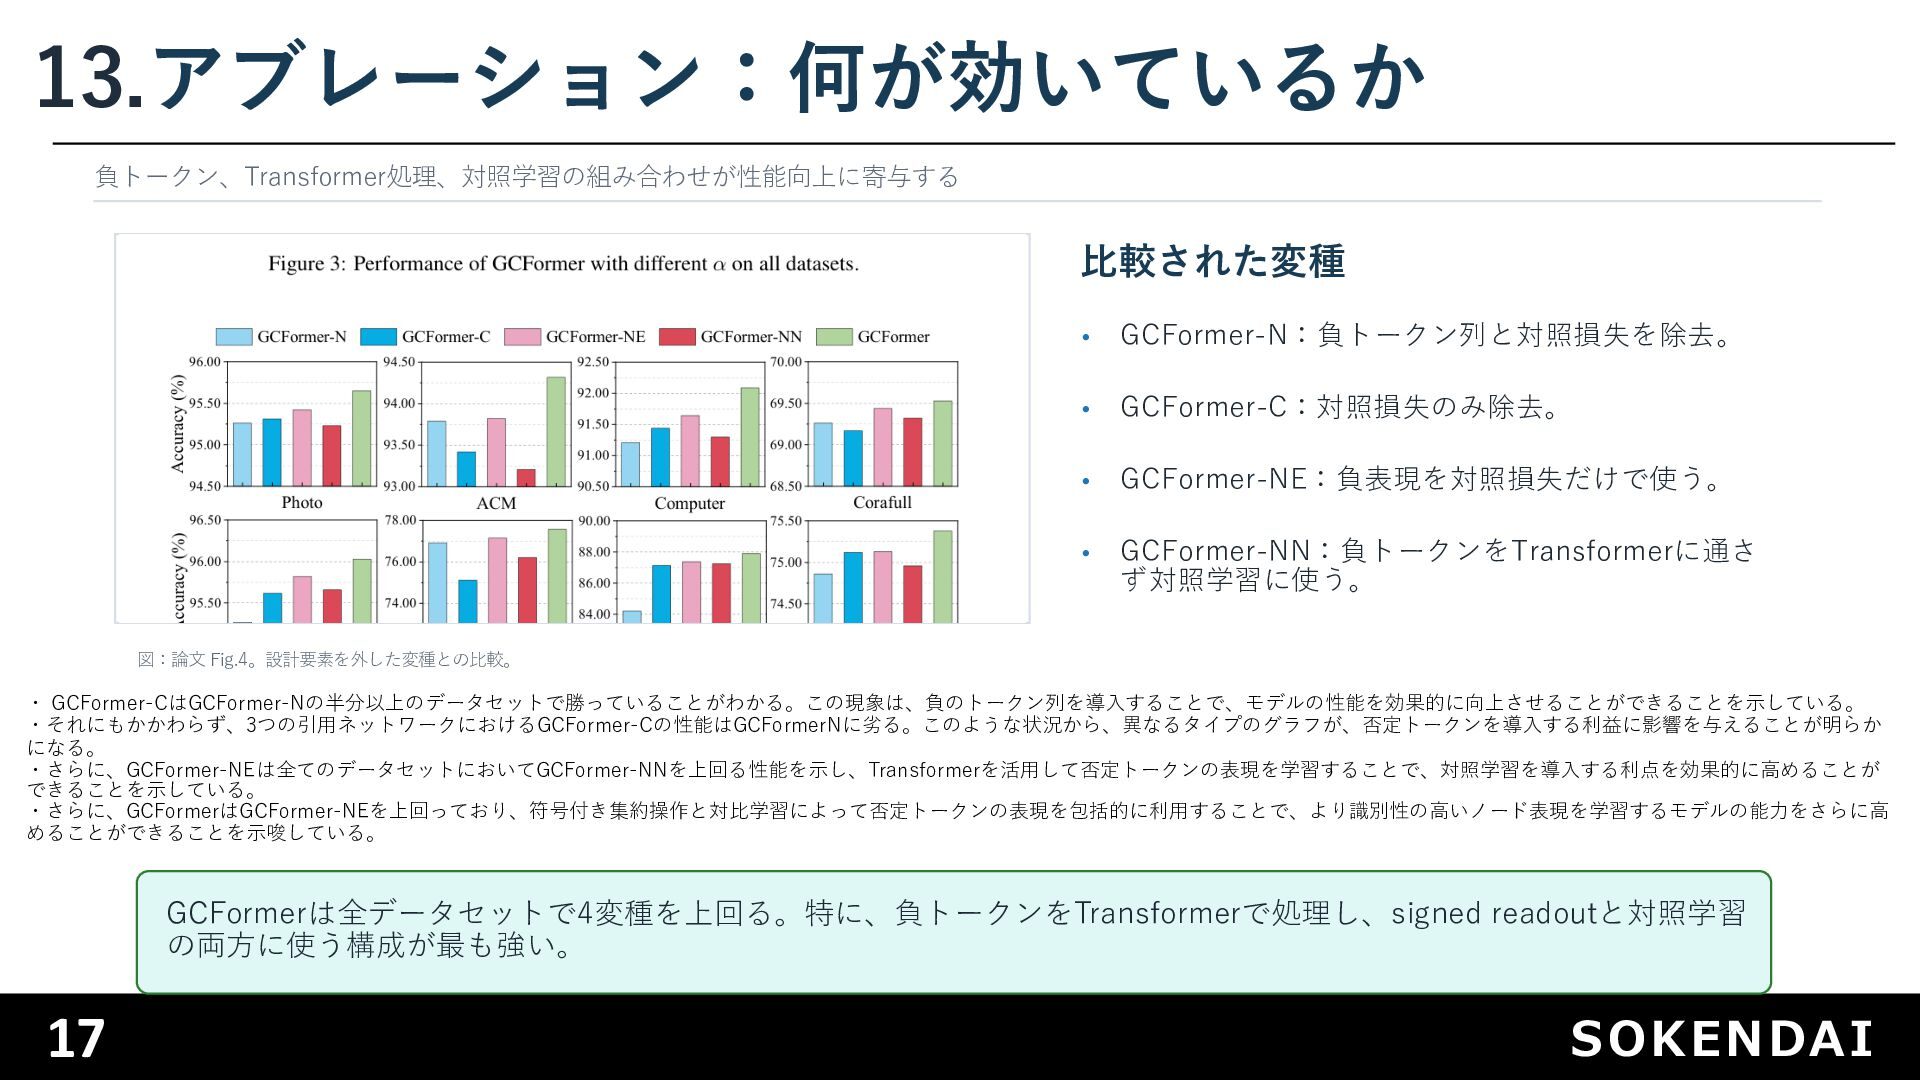
13.アブレーション:何が効いているか 負トークン、Transformer処理、対照学習の組み合わせが性能向上に寄与する ⽐較された変種 • GCFormer-N:負トークン列と対照損失を除去。 • GCFormer-C:対照損失のみ除去。 • GCFormer-NE:負表現を対照損失だけで使う。 •
GCFormer-NN:負トークンをTransformerに通さ ず対照学習に使う。 図:論⽂ Fig.4。設計要素を外した変種との⽐較。 ・ GCFormer-CはGCFormer-Nの半分以上のデータセットで勝っていることがわかる。この現象は、負のトークン列を導⼊することで、モデルの性能を効果的に向上させることができることを⽰している。 ・それにもかかわらず、3つの引⽤ネットワークにおけるGCFormer-Cの性能はGCFormerNに劣る。このような状況から、異なるタイプのグラフが、否定トークンを導⼊する利益に影響を与えることが明らか になる。 ・さらに、GCFormer-NEは全てのデータセットにおいてGCFormer-NNを上回る性能を⽰し、Transformerを活⽤して否定トークンの表現を学習することで、対照学習を導⼊する利点を効果的に⾼めることが できることを⽰している。 ・さらに、GCFormerはGCFormer-NEを上回っており、符号付き集約操作と対⽐学習によって否定トークンの表現を包括的に利⽤することで、より識別性の⾼いノード表現を学習するモデルの能⼒をさらに⾼ めることができることを⽰唆している。 GCFormerは全データセットで4変種を上回る。特に、負トークンをTransformerで処理し、signed readoutと対照学習 の両⽅に使う構成が最も強い。 17 SOKENDAI
14.学術的含意・限界・今後 GCFormerは「低類似ノードをどう使うか」という設計論を提⽰する 学術的含意 限界と今後 • tokenized graph Transformerでは、トークン選択そのも のが性能を⼤きく左右する。 •
主要な限界は、グラフ種別に応じたサンプリング戦略 が統⼀的・固定的である点。 • 低類似ノードはノイズではなく、クラス境界を形成する 負例情報になり得る。 • pk/nk の感度が⽰す通り、データセットごとに最適な 正・負トークン数は変わる。 • 属性空間と構造空間の双⽅を⽤いることで、同質性・異 質性グラフの両⽅に対応しやすい。 • 今後は、異なるタイプのグラフに対する統⼀的なサンプリ ング戦略や信頼度に基づく負例選択が⾃然な拡張になる。 議論点:低類似ノードを「本当に負例」とみなせる条件は何か。同じクラス内多様性が⼤きい場合、負トークンは 誤った分離圧⼒にもなり得る。 18 SOKENDAI
15.まとめ(Take aways) 1 2 3 GCFormerは、tokenized graph Transformer のトークン⽣成を「⾼類似ノードのみ」から「正・負トーク ンの併⽤」へ拡張した。
属性特徴とトポロジー特徴の両⽅で類似度を計算し、4種類のトークン列からノード表現を学習する。 負トークンは signed readout と対照学習の両⾯から使われ、ターゲット表現をより識別的にする。 4 8データセットすべてで代表的GNN・Graph Transformerを上回り、同質性・異質性グラフの双⽅で有効性 を⽰した。 5 ⼀⽅で、性能はサンプリングサイズに敏感であり、グラフごとの適応的な正・負トークン選択が今後の課 題である。 要するに、本論⽂の貢献は「似ているノードから学ぶ」だけでなく、「似ていないノードをどう表現学習に組み 込むか」を、Graph Transformerの設計原理として明確化した点にある。 19 SOKENDAI


 fk001jp
 elsirapls
 inesmontani
 matthewcrist
 jdejongh
 destraynor
 jonoalderson
 bkeepers
 katarinadahlin
 pwiseman
 soudai
 techseoconnect
 ianozsvald