Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
@cosmeにおけるビッグデータのこれまでとこれから
Search
grassy-48
July 31, 2019
Technology
4.5k
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
@cosmeにおけるビッグデータのこれまでとこれから
データ分析基盤
Developers Night #3 発表資料
grassy-48
July 31, 2019
Other Decks in Technology
See All in Technology
AI 時代のスタートアップエコシステ厶から考究する技術的負債との向き合い方
m3m0r7
PRO
2
1.5k
Claude Code本って、 読む必要あるの?
oikon48
2
450
Sigmaユーザーのための有用リソース一挙公開 & Sigmaで使えるMCP #sigma_ucj /useful-resources-for-sigma-computing-users-and-mcps-with-sigma
shinyaa31
0
230
安心して変更できるWebフロントエンドの作り方
pirosikick
4
2.2k
空間オーディオで過去の 自分(ゴースト)と競うランニング 〜HealthKitのルートを足音に変える実装〜
nao_randd
0
170
技術的負債から考える、AI時代のエンジニアリング投資 — ビズリーチの技術的負債と向き合った経験から、変更し続けられるソフトウェアを考える/ technical-debt-con2026
visional_engineering_and_design
1
1.4k
Deploying a Full-Stack Bun-Native Framework on Cloudflare Workers
7nohe
0
160
越境するなら専門用語を使うな高校校歌 / If you wanna cross border, you shouldn't use jargon
vtryo
0
130
2026-09-11 【Snowflake World Tour Tokyo 2026】Snowflakeを起点に、AI Agentが自律稼働し続ける未来へ / Driving AI Agents with Snowflake
civitaspo
0
390
生成AIエージェントを用いた、 手動テスト手順書から自動テストへの 変換手法の検討
magicpod
0
150
「守り」で活用するオンデバイスLLM 〜写ってはいけないを総力戦で防ぐ〜 / iOSDC Japan 2026
nakamuuu
0
150
synctest時代のhttptest Go 1.27で変わるHTTPサーバテストの裏側 / go conference2026 synctest and httptest
budougumi0617
1
2.8k
Featured
See All Featured
Claude Code どこまでも/ Claude Code Everywhere
nwiizo
67
58k
Prompt Engineering for Job Search
mfonobong
0
450
Lessons Learnt from Crawling 1000+ Websites
charlesmeaden
PRO
1
1.6k
Design in an AI World
tapps
1
310
Abbi's Birthday
coloredviolet
3
10k
16th Malabo Montpellier Forum Presentation
akademiya2063
PRO
0
380
Sam Torres - BigQuery for SEOs
techseoconnect
PRO
0
540
Information Architects: The Missing Link in Design Systems
soysaucechin
1
1.1k
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
240
Producing Creativity
orderedlist
PRO
348
41k
Deep Space Network (abreviated)
tonyrice
0
300
DBのスキルで生き残る技術 - AI時代におけるテーブル設計の勘所
soudai
PRO
68
57k
Transcript
株式会社アイスタイル @cosmeにおけるビッグデータの これまでとこれから テクノロジー本部 R&D部 芝 星帆
自己紹介 芝 星帆(SHIBA SEIHO) 株式会社アイスタイル テクノロジー本部 R&D部 技術開発グループ所属 @cosmeアプリのバックエンドAPIの開発 スマホ版@cosmeの速度改善プロジェクト 今後のビッグデータ統括に向け収集基盤の開発 言語 Go/PHP/Scala
アジェンダ • istyleとは • istyleにおけるビッグデータ基盤 • istyleにおけるビッグデータ活用例 • これからのビッグデータ活用
• istyleとは • istyleにおけるビッグデータ基盤 • istyleにおけるビッグデータ活用例 • これからのビッグデータ活用
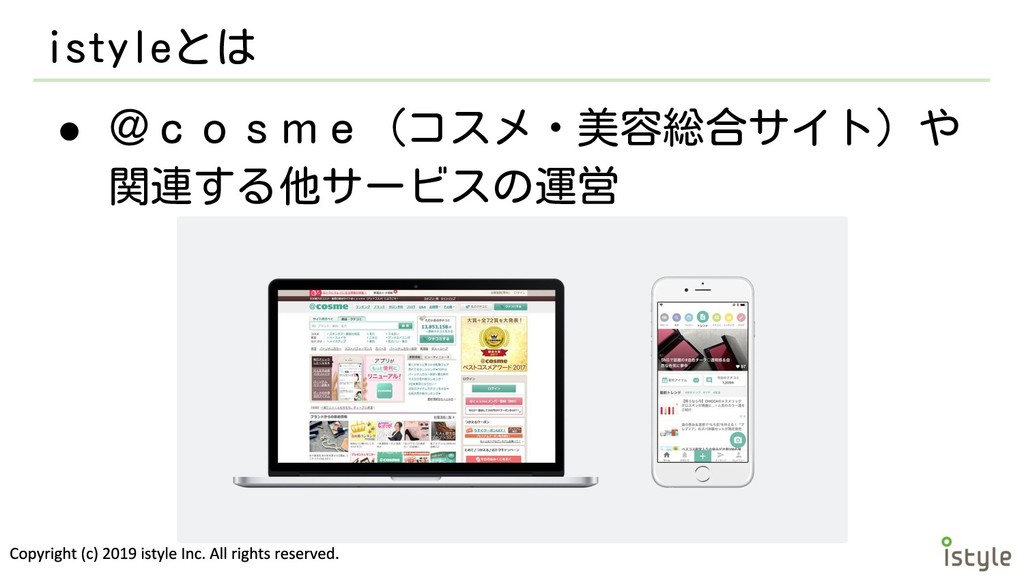
istyleとは • @cosme(コスメ・美容総合サイト)や 関連する他サービスの運営
istyleとは • @cosme以外にもこんなことをやっています ◦ ECサイト(@cosme shopping)運営 ◦ 全国の小売店(@cosme store)や プライベートブランドの展開
◦ 海外の化粧品サイトとの連携 ◦ 海外への小売店の展開
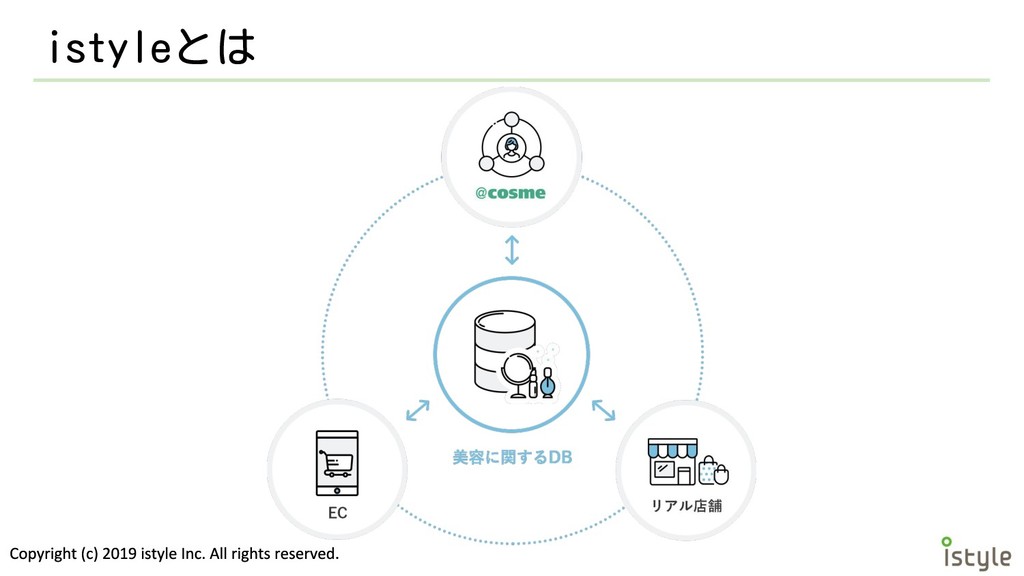
istyleとは
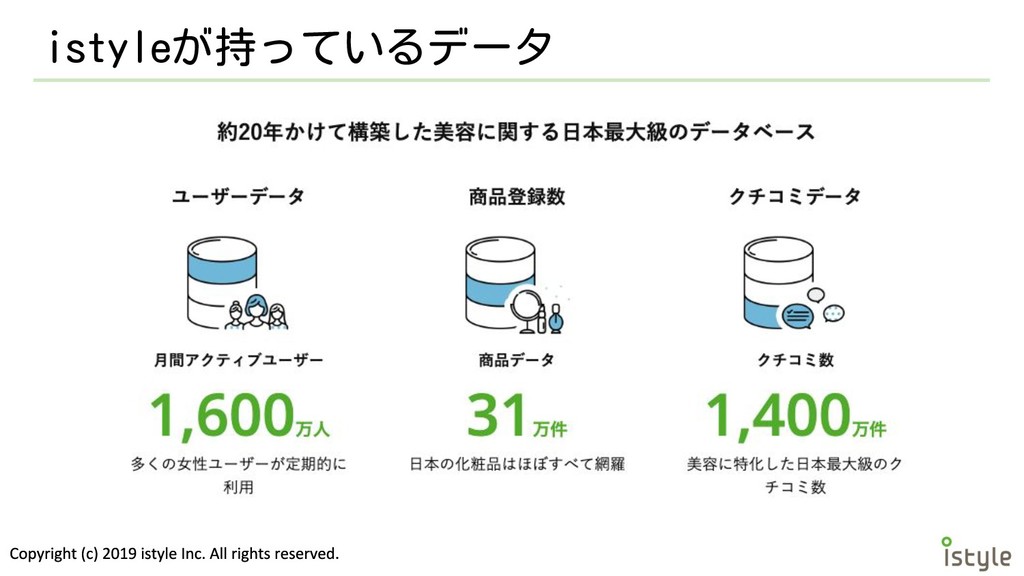
istyleが持っているデータ
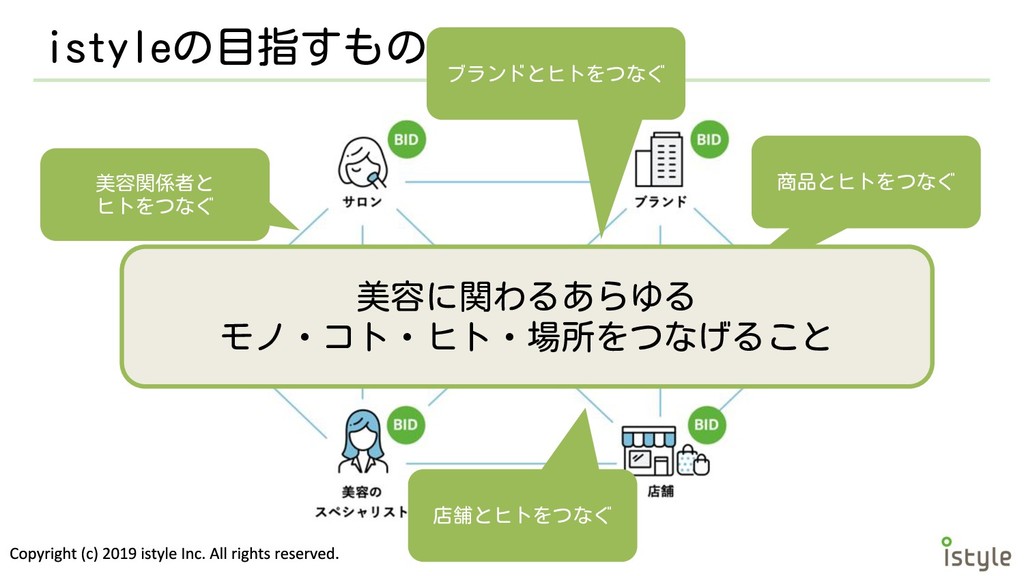
istyleの目指すもの 商品とヒトをつなぐ ブランドとヒトをつなぐ 店舗とヒトをつなぐ 美容関係者と ヒトをつなぐ 美容に関わるあらゆる モノ・コト・ヒト・場所をつなげること
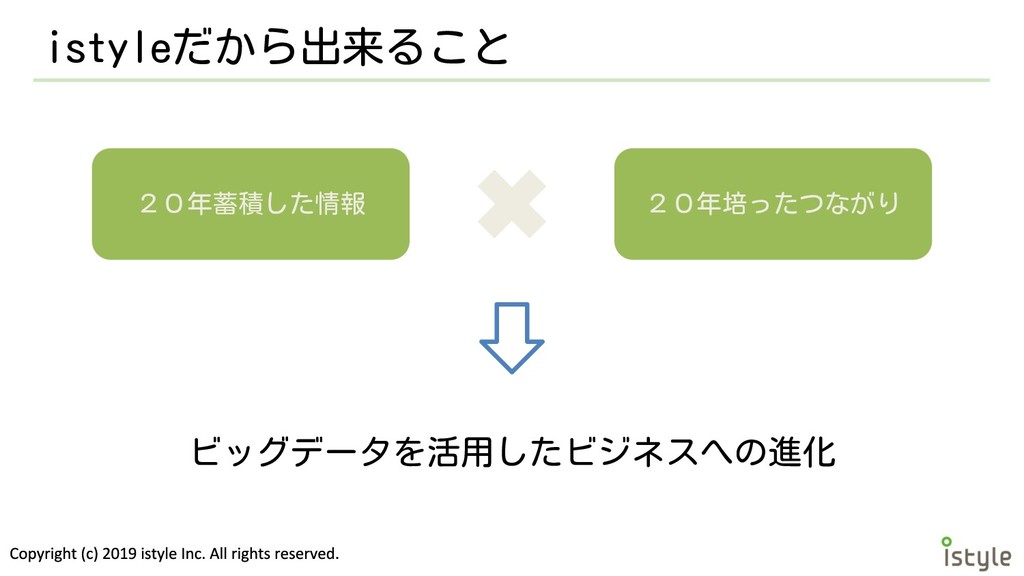
istyleだから出来ること 20年蓄積した情報 20年培ったつながり ビッグデータを活用したビジネスへの進化
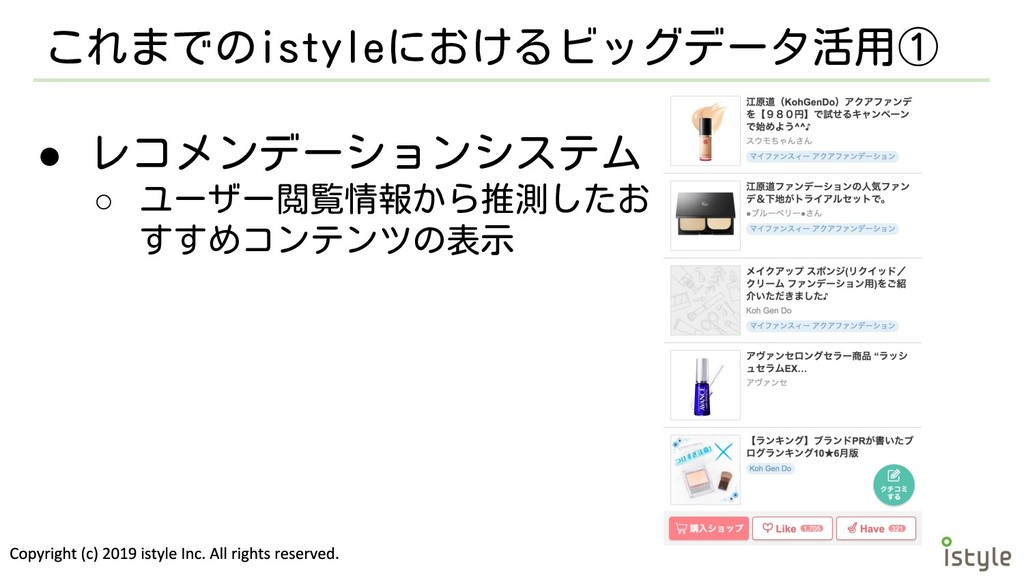
これまでのistyleにおけるビッグデータ活用① • レコメンデーションシステム ◦ ユーザー閲覧情報から推測したお すすめコンテンツの表示
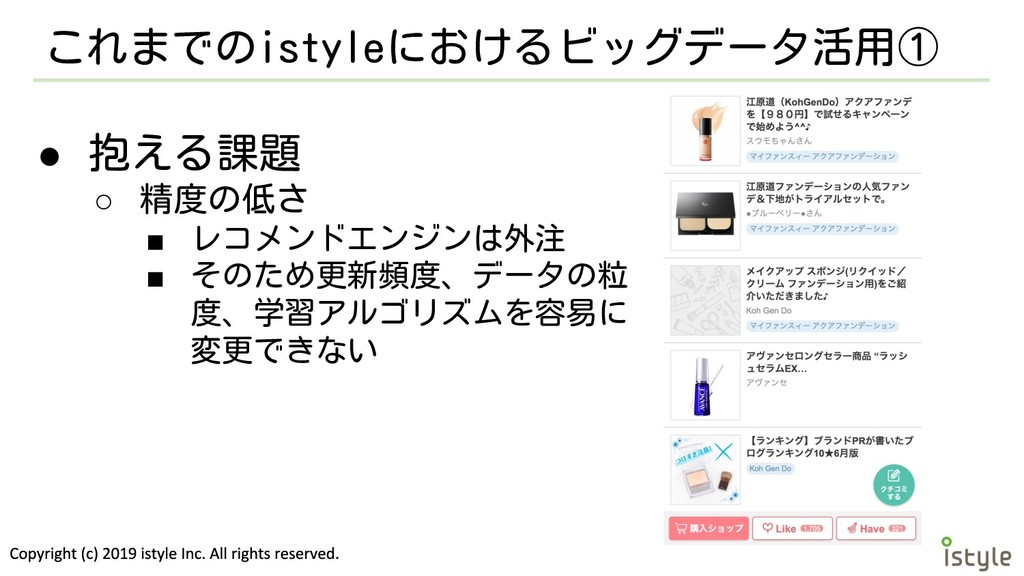
これまでのistyleにおけるビッグデータ活用① • 抱える課題 ◦ 精度の低さ ▪ レコメンドエンジンは外注 ▪ そのため更新頻度、データの粒 度、学習アルゴリズムを容易に
変更できない
これまでのistyleにおけるビッグデータ活用② • ブランド向けユーザーデータ解析ツールの展開 ◦ ALCOS ▪ Analyzer for Cosmetics の略。@cosmeのデータ
とソーシャルメディア情報を連携した、美容特化のASP 型の⾏活者⾏動分析ツール
これまでのistyleにおけるビッグデータ活用② • 抱える課題 ◦ データの取得範囲 ▪ 今まではSNSへの連携・投稿と、アクセス行動から割り 出せる範囲でのユーザーデータ分析 ▪ 期間・コンテンツも限定的
ユーザーとブランドやメーカーとのつながりを強めるには より多くのデータと、より多彩な分析が必要!
課題を解決するために • 社内でもビッグデータ収集が開始 ◦ サービスを超えたログデータ収集基盤の構築 ◦ ユーザー行動トラッキングデータの収集 ▪ アクセス数から算出されるフィードの表示数が理論値で は100億を超える。そのためGoogleAnalyticsは使用でき
ず、独自イベントでの計測を行う
• istyleとは • istyleにおけるビッグデータ基盤 • istyleにおけるビッグデータ活用例 • これからのビッグデータ活用
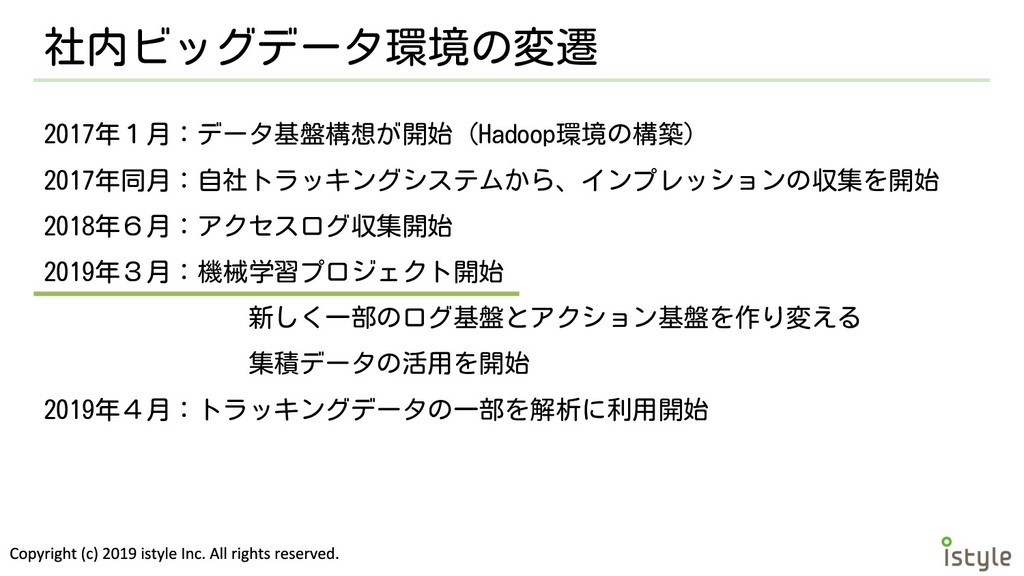
社内ビッグデータ環境の変遷 2017年1月:データ基盤構想が開始(Hadoop環境の構築) 2017年同月:自社トラッキングシステムから、インプレッションの収集を開始 2018年6月:アクセスログ収集開始 2019年3月:機械学習プロジェクト開始 新しく一部のログ基盤とアクション基盤を作り変える 集積データの活用を開始 2019年4月:トラッキングデータの一部を解析に利用開始
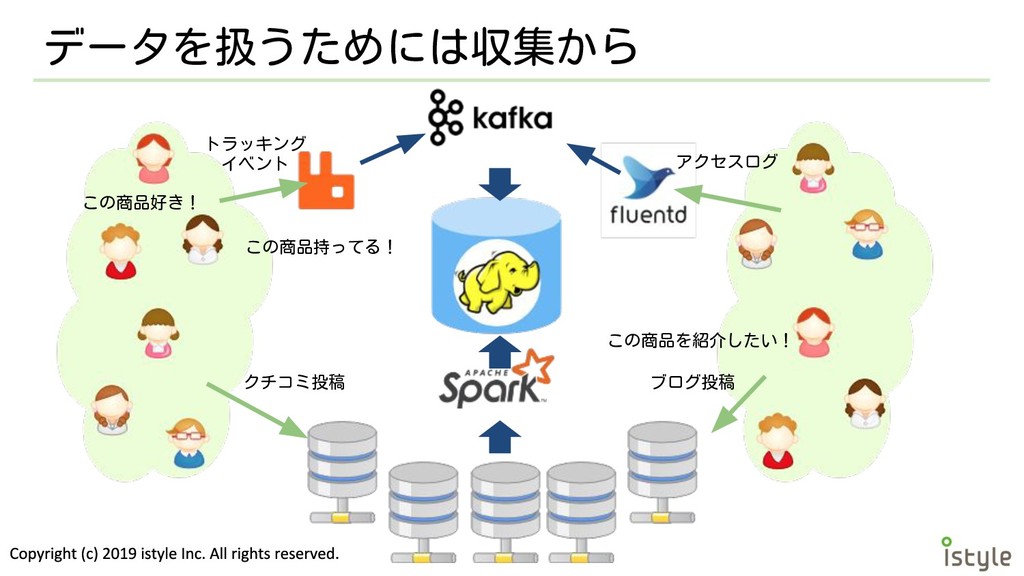
データを扱うためには収集から この商品好き! この商品持ってる! アクセスログ クチコミ投稿 ブログ投稿 この商品を紹介したい! トラッキング イベント
使った技術 • Spark ◦ 巨大なデータに対して高速に分散処理を行う ためのフレームワーク ◦ Resilient Distributed Datasetsによって分
散共有メモリを実現し、インメモリでデータ にアクセスする ◦ Hadoop上のYARNによってSparkのリソースを 管理している
使った技術 • Apache Kafka ◦ 分散メッセージキューを行うミドル ウェア ◦ リアルタイムアプリケーションとマ イクロサービスを実現する
◦ スケーラブルでユースケース規模に よらず高い耐障害性で利用可能 ◦ 個別の処理用クラスタが不要 ◦ Java、Scalaアプリケーションの作成 ができれば誰でも使える
データ集約からデータ活用のフェーズへ • Hadoop上にログ基盤、ユーザーアクション データ基盤を構築 • 4ヶ月で集約したデータサイズ:11TB程度 • データ活用のフェーズへと移行
• istyleとは • istyleにおけるビッグデータ基盤 • istyleにおけるビッグデータ活用例 • これからのビッグデータ活用
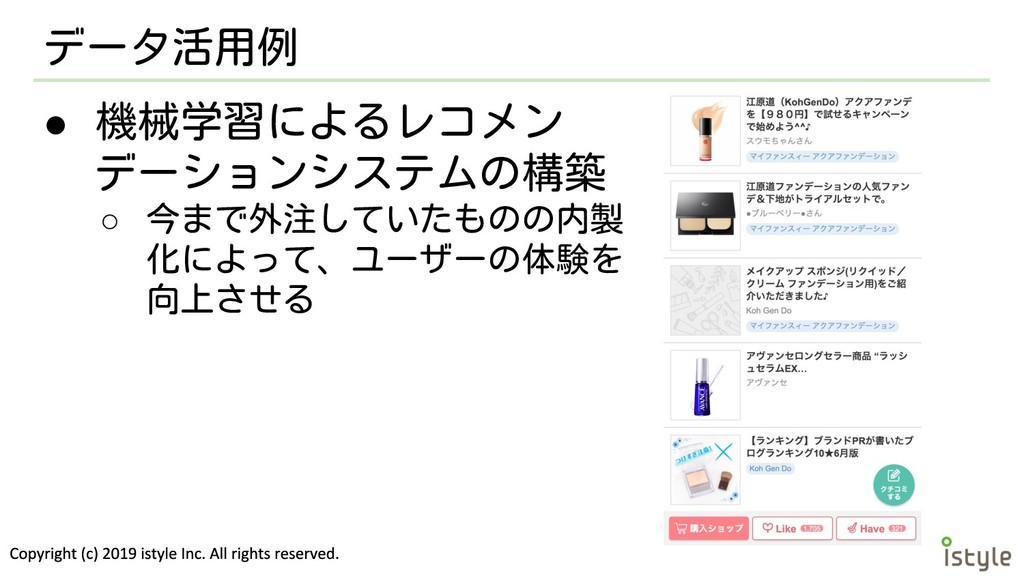
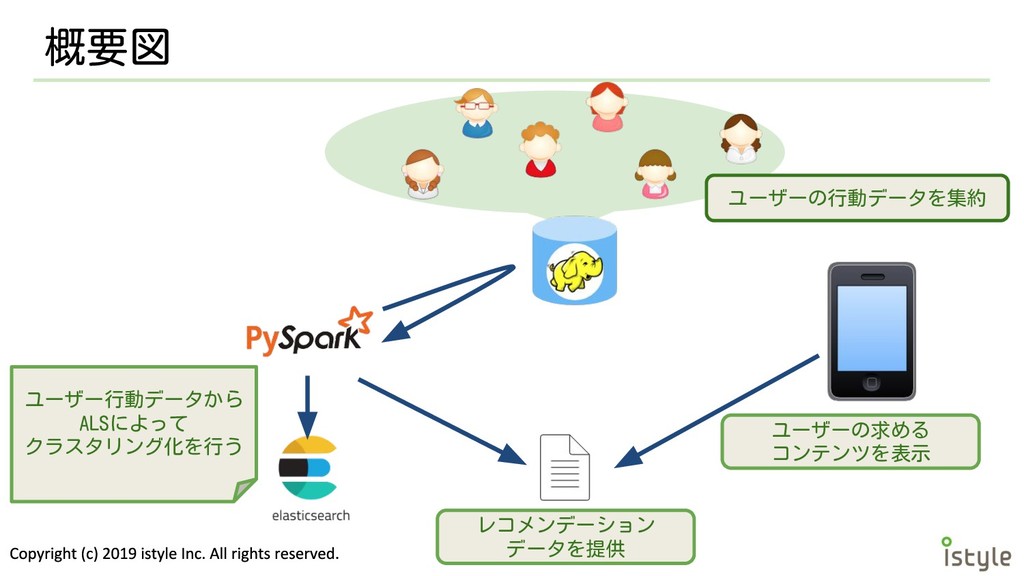
データ活用例 • 機械学習によるレコメン デーションシステムの構築 ◦ 今まで外注していたものの内製 化によって、ユーザーの体験を 向上させる
レコメンデーションの改善 • 内製化することで得られるメリット ◦ 学習に扱えるデータの多様性が増す ◦ パラメータ調整やアルゴリズム検証が容易となる ◦ データ更新頻度を上げることができる
概要図 ユーザーの行動データを集約 ユーザー行動データから ALSによって クラスタリング化を行う レコメンデーション データを提供 ユーザーの求める コンテンツを表示
使った技術 • PySpark ◦ Sparkを実行するためのPythonAPI ◦ ワーカーノードでの処理をPythonプロセス で実行する ◦ PyDataのライブラリと組み合わせて実行で
きる ◦ MLのライブラリもほぼ使用できる
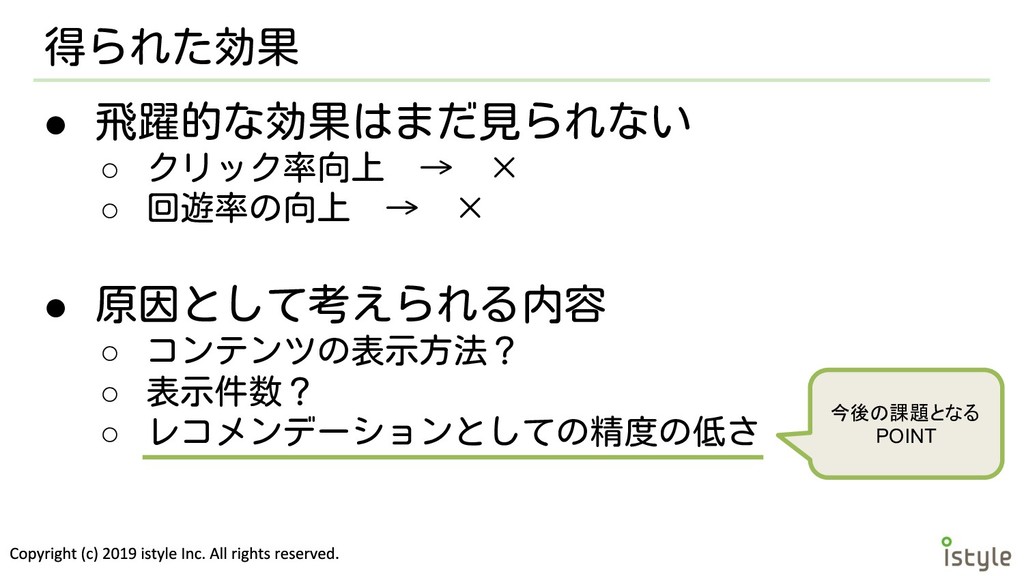
得られた効果 • 飛躍的な効果はまだ見られない ◦ クリック率向上 → × ◦ 回遊率の向上 → × • 原因として考えられる内容 ◦
コンテンツの表示方法? ◦ 表示件数? ◦ レコメンデーションとしての精度の低さ 今後の課題となる POINT
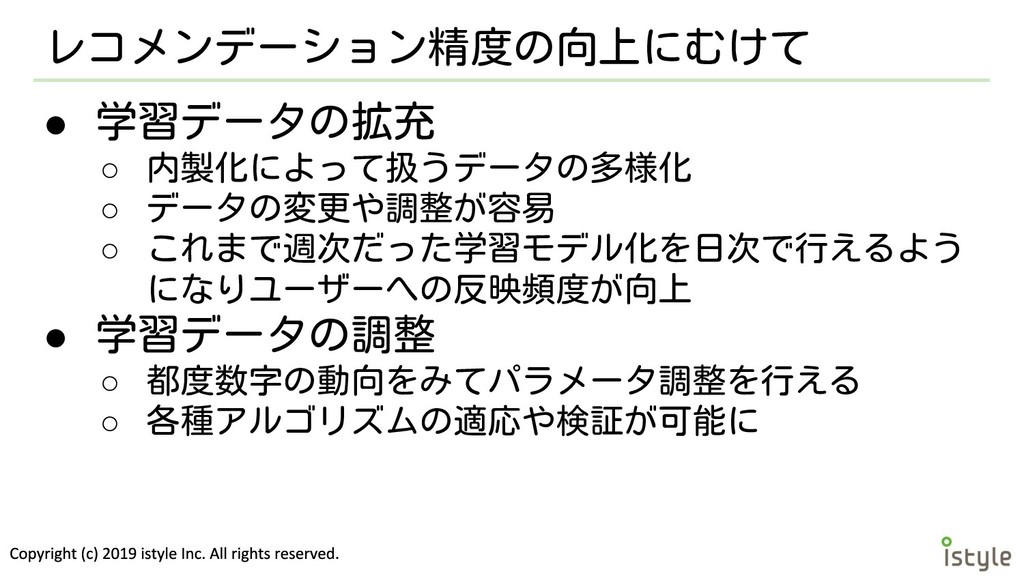
レコメンデーション精度の向上にむけて • 学習データの拡充 ◦ 内製化によって扱うデータの多様化 ◦ データの変更や調整が容易 ◦ これまで週次だった学習モデル化を日次で行えるよう になりユーザーへの反映頻度が向上
• 学習データの調整 ◦ 都度数字の動向をみてパラメータ調整を行える ◦ 各種アルゴリズムの適応や検証が可能に
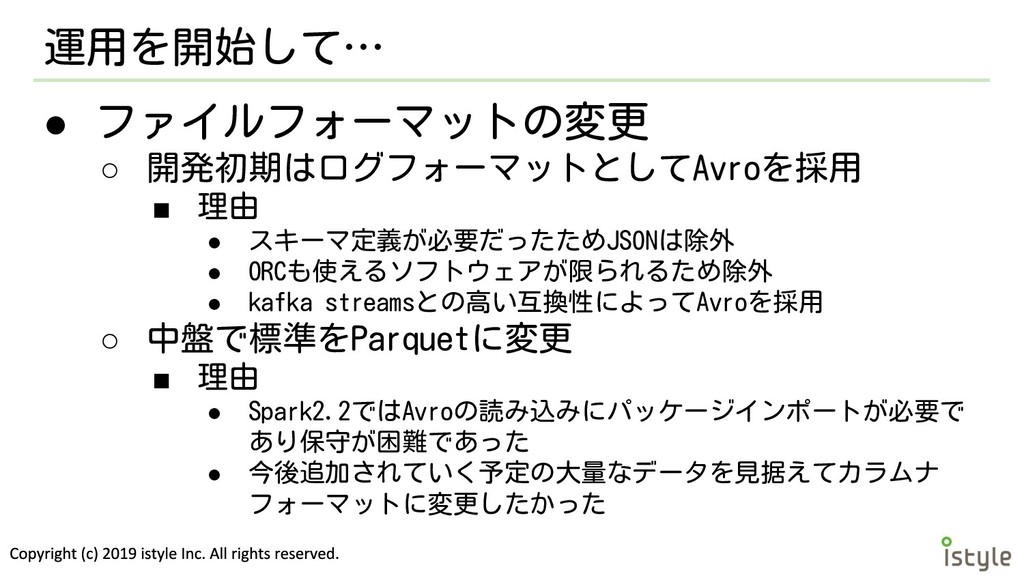
運用を開始して… • ファイルフォーマットの変更 ◦ 開発初期はログフォーマットとしてAvroを採用 ▪ 理由 • スキーマ定義が必要だったためJSONは除外 •
ORCも使えるソフトウェアが限られるため除外 • kafka streamsとの高い互換性によってAvroを採用 ◦ 中盤で標準をParquetに変更 ▪ 理由 • Spark2.2ではAvroの読み込みにパッケージインポートが必要で あり保守が困難であった • 今後追加されていく予定の大量なデータを見据えてカラムナ フォーマットに変更したかった
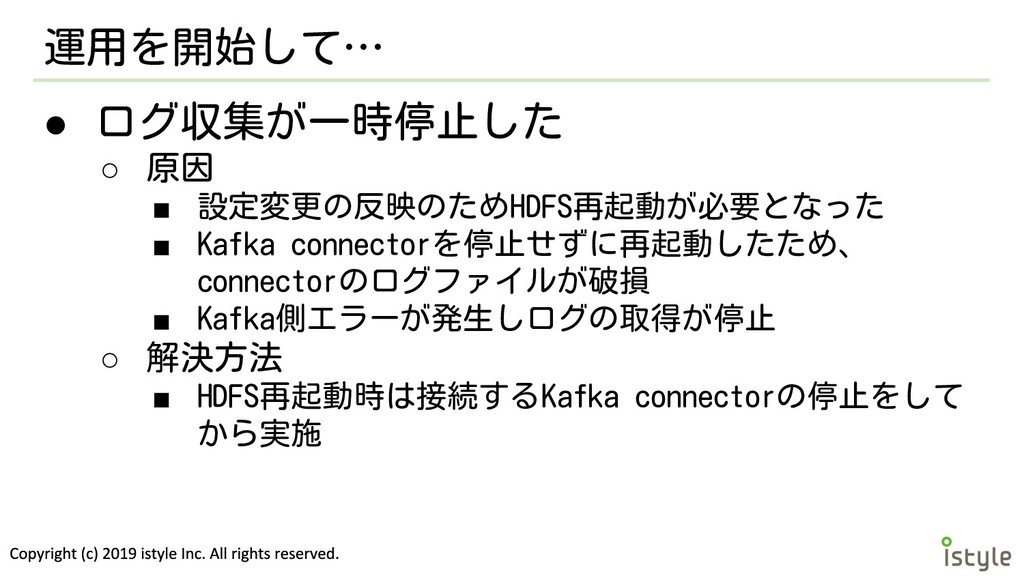
運用を開始して… • ログ収集が一時停止した ◦ 原因 ▪ 設定変更の反映のためHDFS再起動が必要となった ▪ Kafka connectorを停止せずに再起動したため、
connectorのログファイルが破損 ▪ Kafka側エラーが発生しログの取得が停止 ◦ 解決方法 ▪ HDFS再起動時は接続するKafka connectorの停止をして から実施
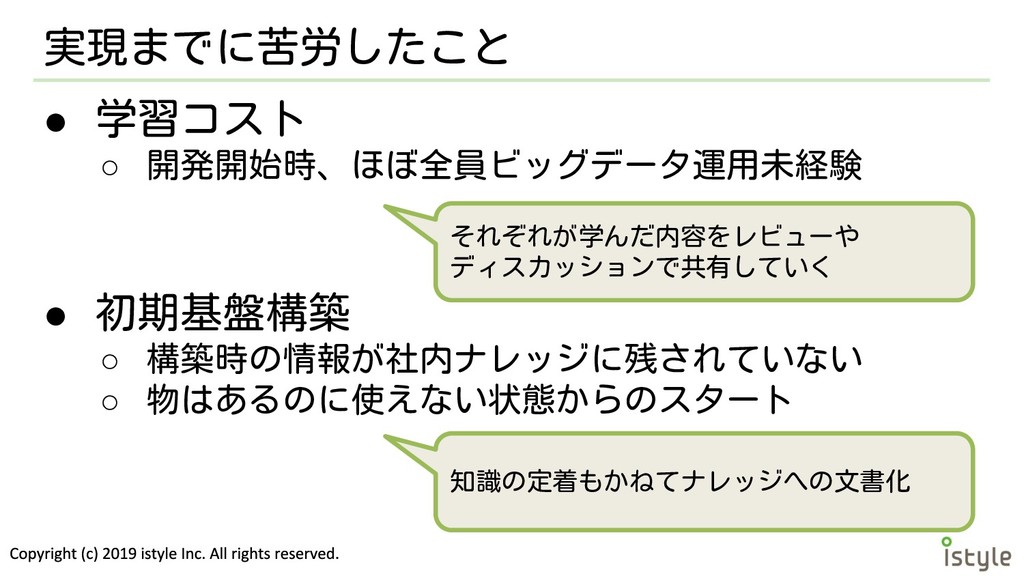
実現までに苦労したこと • 学習コスト ◦ 開発開始時、ほぼ全員ビッグデータ運用未経験 • 初期基盤構築 ◦ 構築時の情報が社内ナレッジに残されていない ◦
物はあるのに使えない状態からのスタート それぞれが学んだ内容をレビューや ディスカッションで共有していく 知識の定着もかねてナレッジへの文書化
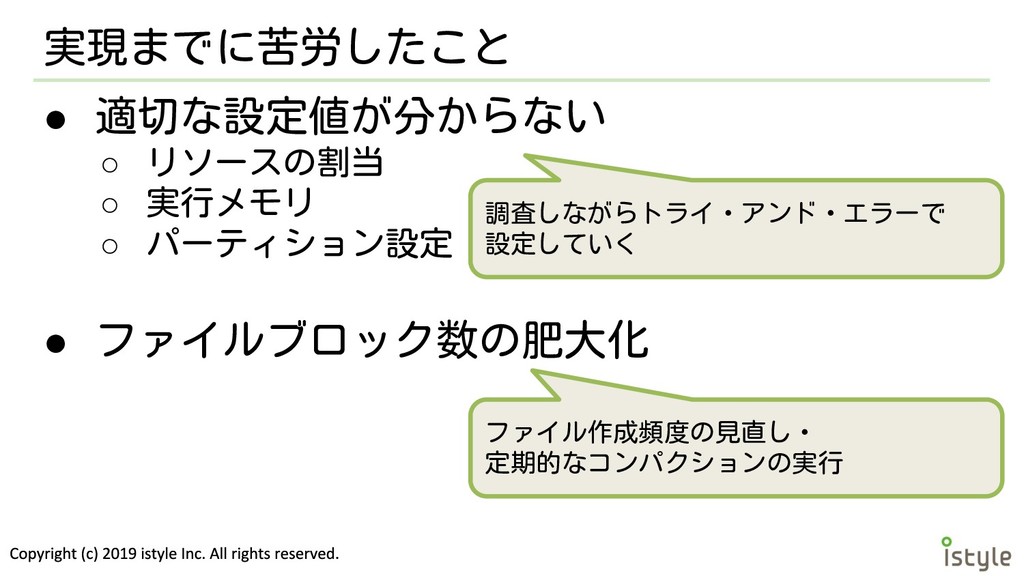
実現までに苦労したこと • 適切な設定値が分からない ◦ リソースの割当 ◦ 実行メモリ ◦ パーティション設定 •
ファイルブロック数の肥大化 調査しながらトライ・アンド・エラーで 設定していく ファイル作成頻度の見直し・ 定期的なコンパクションの実行
• istyleとは • istyleにおけるビッグデータ基盤 • istyleにおけるビッグデータ活用例 • これからのビッグデータ活用
これからのデータ活用方法 • ユーザーに対しておすすめできるのはコンテ ンツだけではない ◦ 肌質や髪質、年代といったユーザー固有の情報から より高精度な商品とのマッチング ◦ ユーザーの行動からリアルタイムなデータの活用に よってサロンや美容スペシャリストとのデータ連携
◦ つながりを活かしてその瞬間ユーザーが求めている情 報を提供する
これからのデータ活用方法 • ビジネスパートナーへの展開 ◦ @cosmeに集まるデータをビジネスパートナーの ニーズに合わせて集約 ◦ これまでのデータ解析ツールでは実現しなかった情報 を分析できるようにする ◦
そのためにはより多くの情報を集積や、分析方法の確 立をおこなう
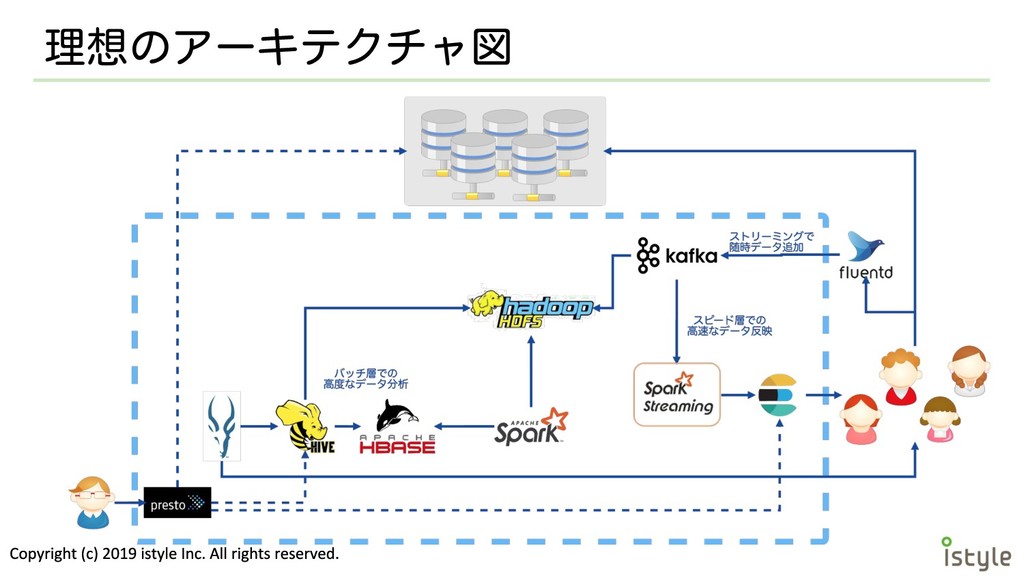
目指すところ • 社内でバラバラに存在しているデータを集約 して一元化されたデータレイクを構築 • サービス内でどんな変化があったかをリアル タイムに蓄積し続ける • より多彩な分析・解析や機械学習を行うため の基盤となる
理想のアーキテクチャ図
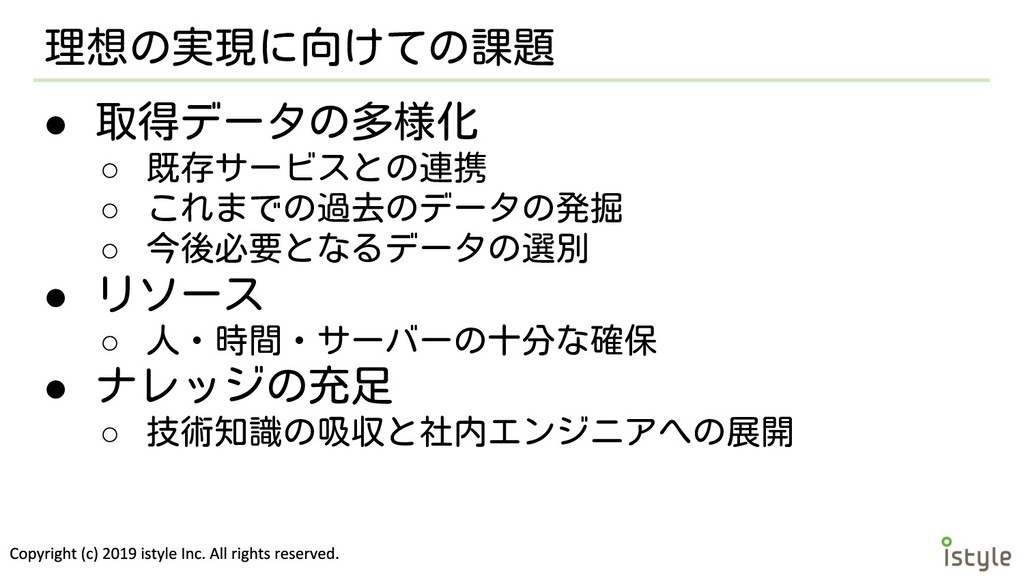
理想の実現に向けての課題 • 取得データの多様化 ◦ 既存サービスとの連携 ◦ これまでの過去のデータの発掘 ◦ 今後必要となるデータの選別 •
リソース ◦ 人・時間・サーバーの十分な確保 • ナレッジの充足 ◦ 技術知識の吸収と社内エンジニアへの展開
今日お話したこと • istyleとは ◦ 事業紹介、これまでのistyleについて • istyleにおけるビッグデータ基盤 ◦ データ集約基盤と使った技術について •
istyleにおけるビッグデータ活用例 ◦ レコメンデーションシステムのための機械学習による データ活用について • これからのビッグデータ活用 ◦ 今後のVisionについて
istyleでは下記のような方を募集しています! これからのビッグデータ基盤を支えたい! ビッグデータ基盤を一緒に作り上げたい! ビッグデータについて新しく学びたい!


 m3m0r7
 oikon48
 shinyaa31
 pirosikick
 nao_randd
 visional_engineering_and_design
 7nohe
 vtryo
 civitaspo
 magicpod
 nakamuuu
 budougumi0617
 nwiizo
 mfonobong
 charlesmeaden
 tapps
 coloredviolet
 akademiya2063
 techseoconnect
 soysaucechin
 tmiket
 orderedlist
 tonyrice
 soudai