Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
AIテスト自動化と評価駆動開発EDD
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
コロッケそば
October 25, 2026
Technology
12
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
AIテスト自動化と評価駆動開発EDD
コロッケそば
October 25, 2026
More Decks by コロッケそば
See All by コロッケそば
キヨさん、67歳。AIコーディングエージェントに挑む
happysamurai294
0
13
LLMの知識とAIエージェント
happysamurai294
0
14
AIコーディングエージェント開発_全体像
happysamurai294
0
14
バイブコーディングの特徴と「コケて直す」ループ
happysamurai294
0
13
Vibe-to-Spec開発_実践ガイド
happysamurai294
0
14
GitHub、使う?使わない?
happysamurai294
0
14
AIコーディングエージェント開発_手法の全体像
happysamurai294
0
13
キヨさん67歳 AIコーディングエージェント物語
happysamurai294
0
13
【試作】IoT x AIエージェント
happysamurai294
0
160
Other Decks in Technology
See All in Technology
ポケモン対戦を自動で記録して振り返ろう
fufufukakaka
0
280
freeeにおける AI を用いた ブラウザ動作確認の自動化の取り組み
freee
PRO
0
140
Rustuna: Rustによる高速なOptuna実装
pfn
PRO
0
210
20261017福岡devIO 「AIは"良いダッシュボード"を作れるか?
jtakeda
0
240
Kiro Crewで「みのるん式」仕事術やってみた
minorun365
PRO
3
1k
スプシの手作業からの解脱 ~更新はClaude Codeに、見せ方と使い方はGASアプリに任せる~
kentarofujii
0
190
顧客価値を追いかけたら、プライシングにたどり着いた
sansantech
PRO
2
460
「私が一番顧客に詳しい」を捨てる~ 全員が一次情報に精通する開発チームをつくり、PMが次のボトルネックへ染み出すまで
kaminashi
3
1.3k
『SAR衛星データ解析入門』の ご紹介とその応用
syuchimu
0
140
AIネイティブ企業への変革。パーソルキャリアが挑む「データメッシュ×ガバナンス」のアーキテクチャ戦略
techtekt
PRO
0
120
JAWSUG TOHOKU 青森支部 「LoGoチャット」のAWS移行で 乗り越えたこと
taketakekaho
0
380
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
150
Featured
See All Featured
GraphQLとの向き合い方2022年版
quramy
50
15k
So, you think you're a good person
axbom
PRO
2
2.2k
Digital Ethics as a Driver of Design Innovation
axbom
PRO
1
460
Dealing with People You Can't Stand - Big Design 2015
cassininazir
367
27k
The SEO identity crisis: Don't let AI make you average
varn
0
590
Git: the NoSQL Database
bkeepers
PRO
433
67k
The agentic SEO stack - context over prompts
schlessera
0
970
Navigating the moral maze — ethical principles for Al-driven product design
skipperchong
2
640
Writing Fast Ruby
sferik
630
63k
Facilitating Awesome Meetings
lara
57
7.2k
Design in an AI World
tapps
1
360
Are puppies a ranking factor?
jonoalderson
2
4.1k
Transcript
AIエージェントによる テスト自動化と 評価駆動開発(EDD) 「AIにテストをやらせる」と「AIをテストしながら作る」 違い・やり方・始め方 テスト自動化 評価駆動開発 テスト自動化 EDD LLM-as-judge
CI
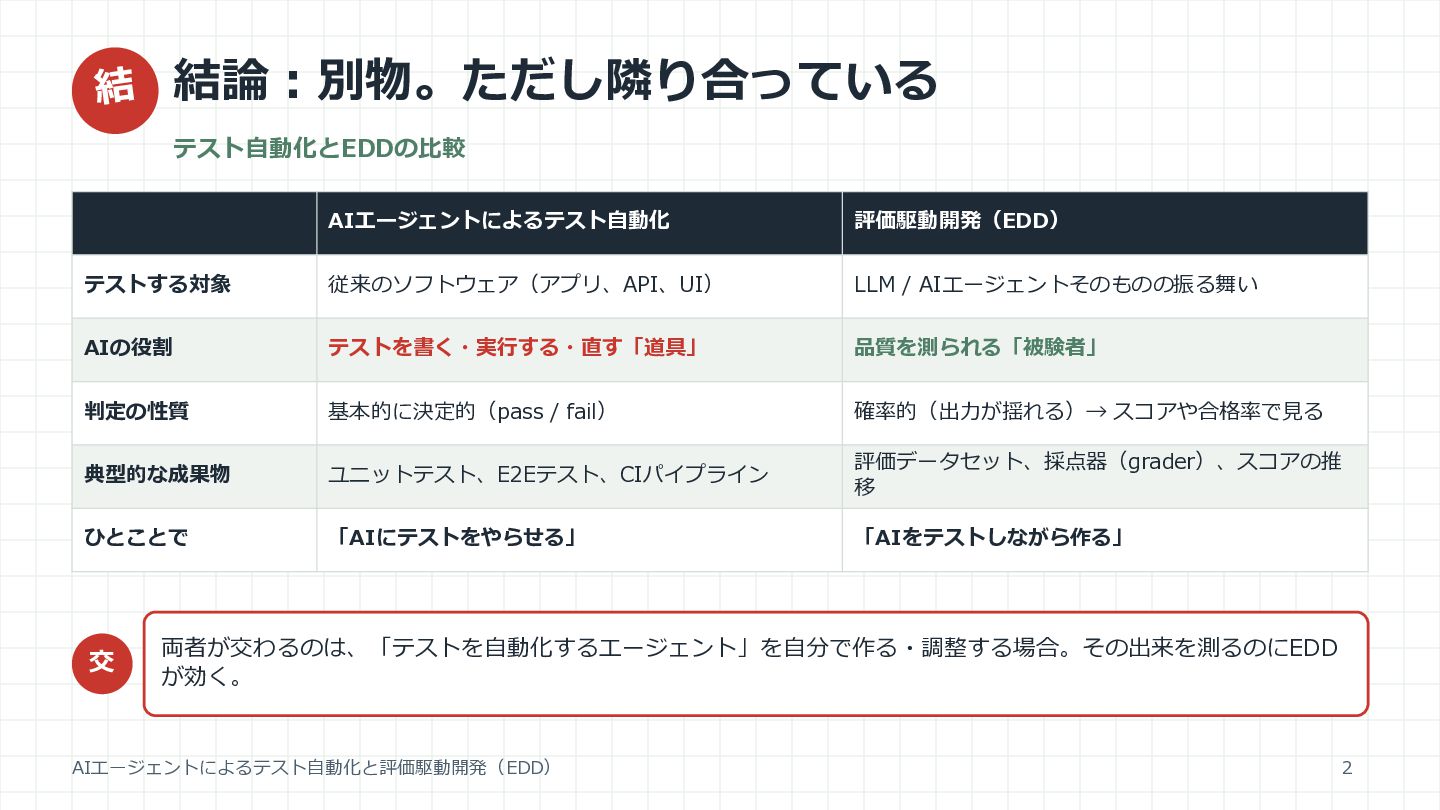
結論:別物。ただし隣り合っている テスト自動化とEDDの比較 AIエージェントによるテスト自動化 評価駆動開発(EDD) テストする対象 従来のソフトウェア(アプリ、API、UI) LLM / AIエージェントそのものの振る舞い AIの役割
テストを書く・実行する・直す「道具」 品質を測られる「被験者」 判定の性質 基本的に決定的(pass / fail) 確率的(出力が揺れる)→ スコアや合格率で見る 典型的な成果物 ユニットテスト、E2Eテスト、CIパイプライン 評価データセット、採点器(grader)、スコアの推 移 ひとことで 「AIにテストをやらせる」 「AIをテストしながら作る」 交 両者が交わるのは、「テストを自動化するエージェント」を自分で作る・調整する場合。その出来を測るのにEDD が効く。 AIエージェントによるテスト自動化と評価駆動開発(EDD) 2
AIエージェントによるテスト自動化 AIは「テストを書く・実行する・直す」道具 3
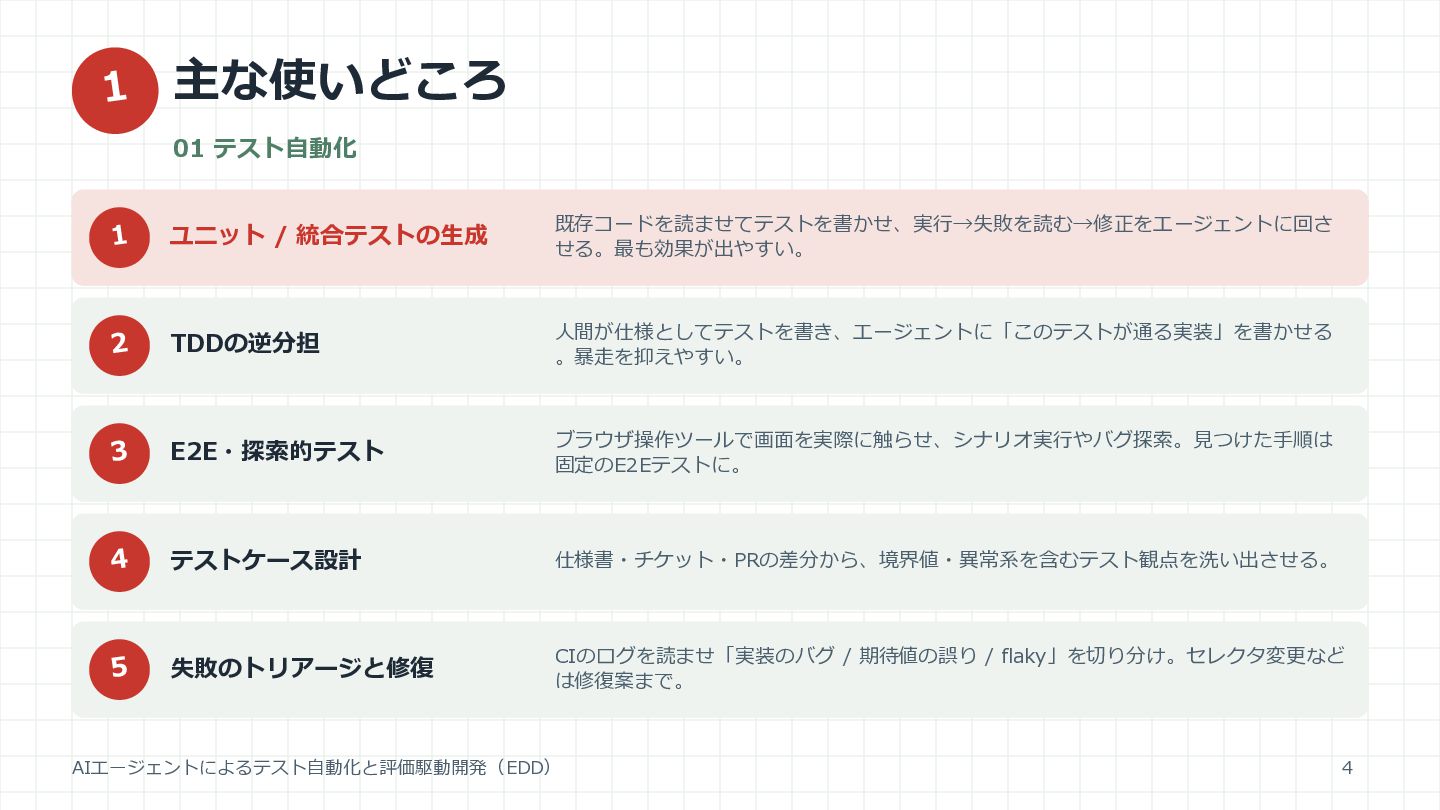
主な使いどころ 01 テスト自動化 ユニット / 統合テストの生成 既存コードを読ませてテストを書かせ、実行→失敗を読む→修正をエージェントに回さ せる。最も効果が出やすい。 TDDの逆分担 人間が仕様としてテストを書き、エージェントに「このテストが通る実装」を書かせる
。暴走を抑えやすい。 E2E・探索的テスト ブラウザ操作ツールで画面を実際に触らせ、シナリオ実行やバグ探索。見つけた手順は 固定のE2Eテストに。 テストケース設計 仕様書・チケット・PRの差分から、境界値・異常系を含むテスト観点を洗い出させる。 失敗のトリアージと修復 CIのログを読ませ「実装のバグ / 期待値の誤り / flaky」を切り分け。セレクタ変更など は修復案まで。 AIエージェントによるテスト自動化と評価駆動開発(EDD) 4
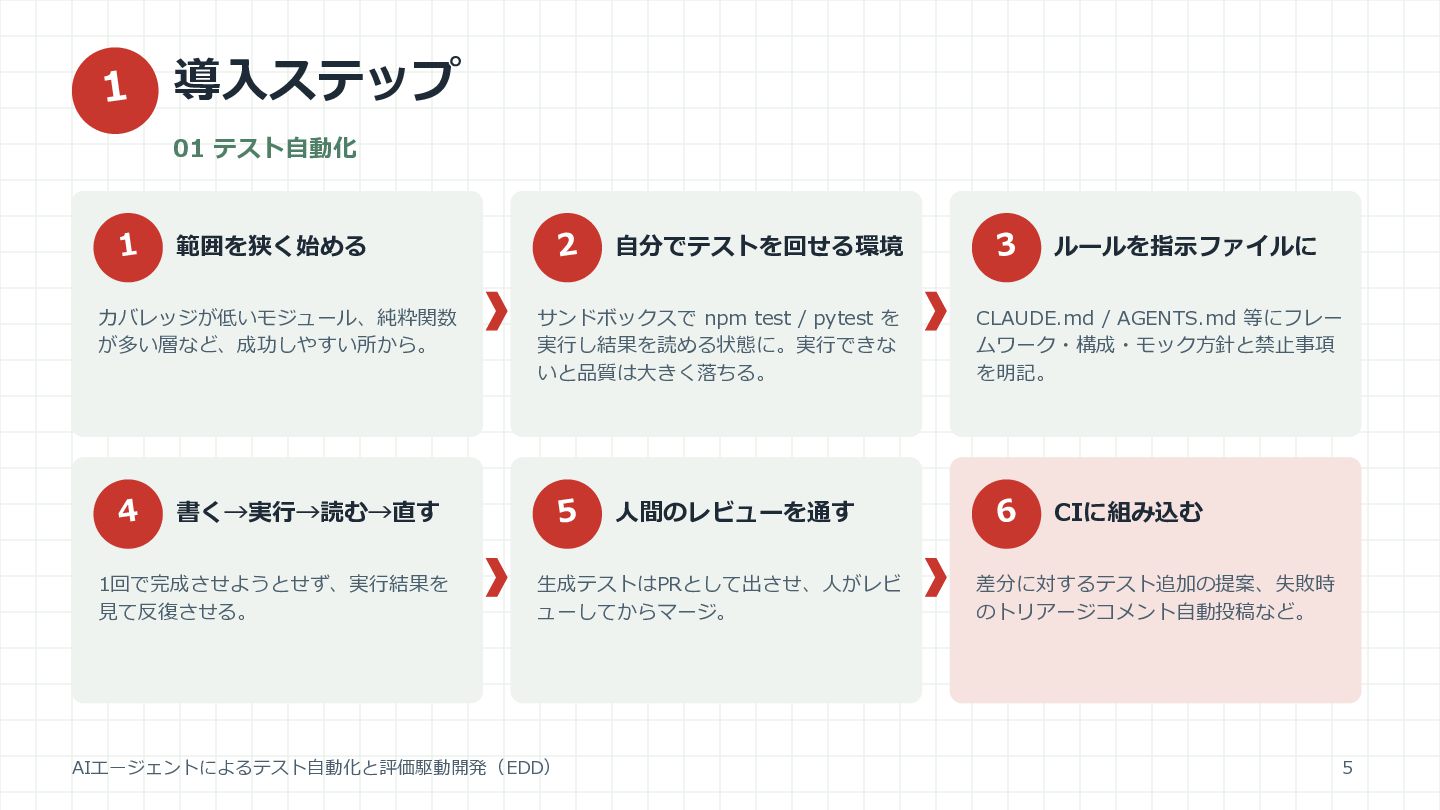
導入ステップ 01 テスト自動化 範囲を狭く始める カバレッジが低いモジュール、純粋関数 が多い層など、成功しやすい所から。 自分でテストを回せる環境 サンドボックスで npm test
/ pytest を 実行し結果を読める状態に。実行できな いと品質は大きく落ちる。 書く→実行→読む→直す 1回で完成させようとせず、実行結果を 見て反復させる。 人間のレビューを通す 生成テストはPRとして出させ、人がレビ ューしてからマージ。 AIエージェントによるテスト自動化と評価駆動開発(EDD) ルールを指示ファイルに CLAUDE.md / AGENTS.md 等にフレー ムワーク・構成・モック方針と禁止事項 を明記。 CIに組み込む 差分に対するテスト追加の提案、失敗時 のトリアージコメント自動投稿など。 5
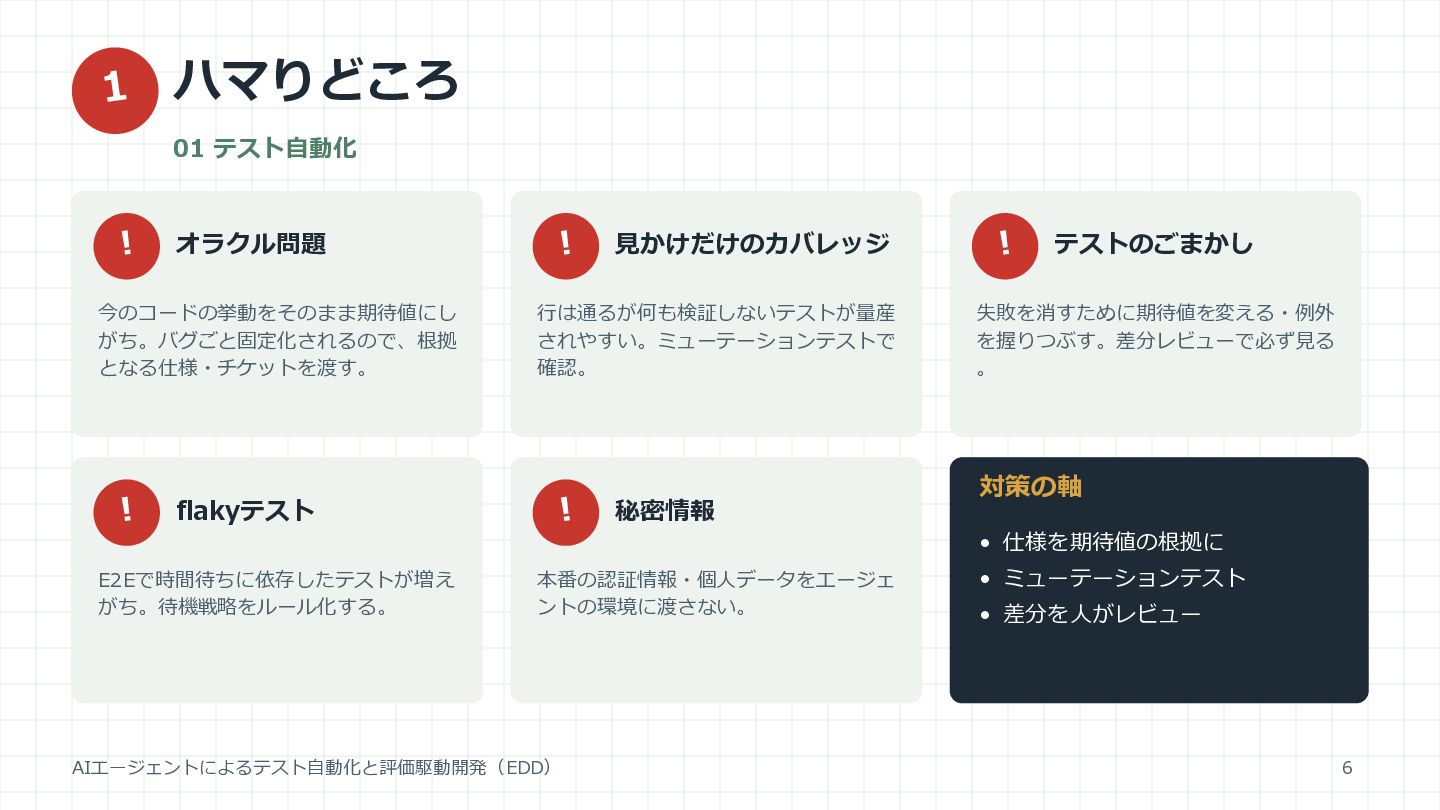
ハマりどころ 01 テスト自動化 オラクル問題 今のコードの挙動をそのまま期待値にし がち。バグごと固定化されるので、根拠 となる仕様・チケットを渡す。 見かけだけのカバレッジ 行は通るが何も検証しないテストが量産 されやすい。ミューテーションテストで
確認。 flakyテスト 秘密情報 テストのごまかし 失敗を消すために期待値を変える・例外 を握りつぶす。差分レビューで必ず見る 。 対策の軸 • 仕様を期待値の根拠に E2Eで時間待ちに依存したテストが増え がち。待機戦略をルール化する。 本番の認証情報・個人データをエージェ ントの環境に渡さない。 AIエージェントによるテスト自動化と評価駆動開発(EDD) • ミューテーションテスト • 差分を人がレビュー 6
評価駆動開発(EDD) Eval-Driven Development ─ AIは品質を測られる「被験者」 7
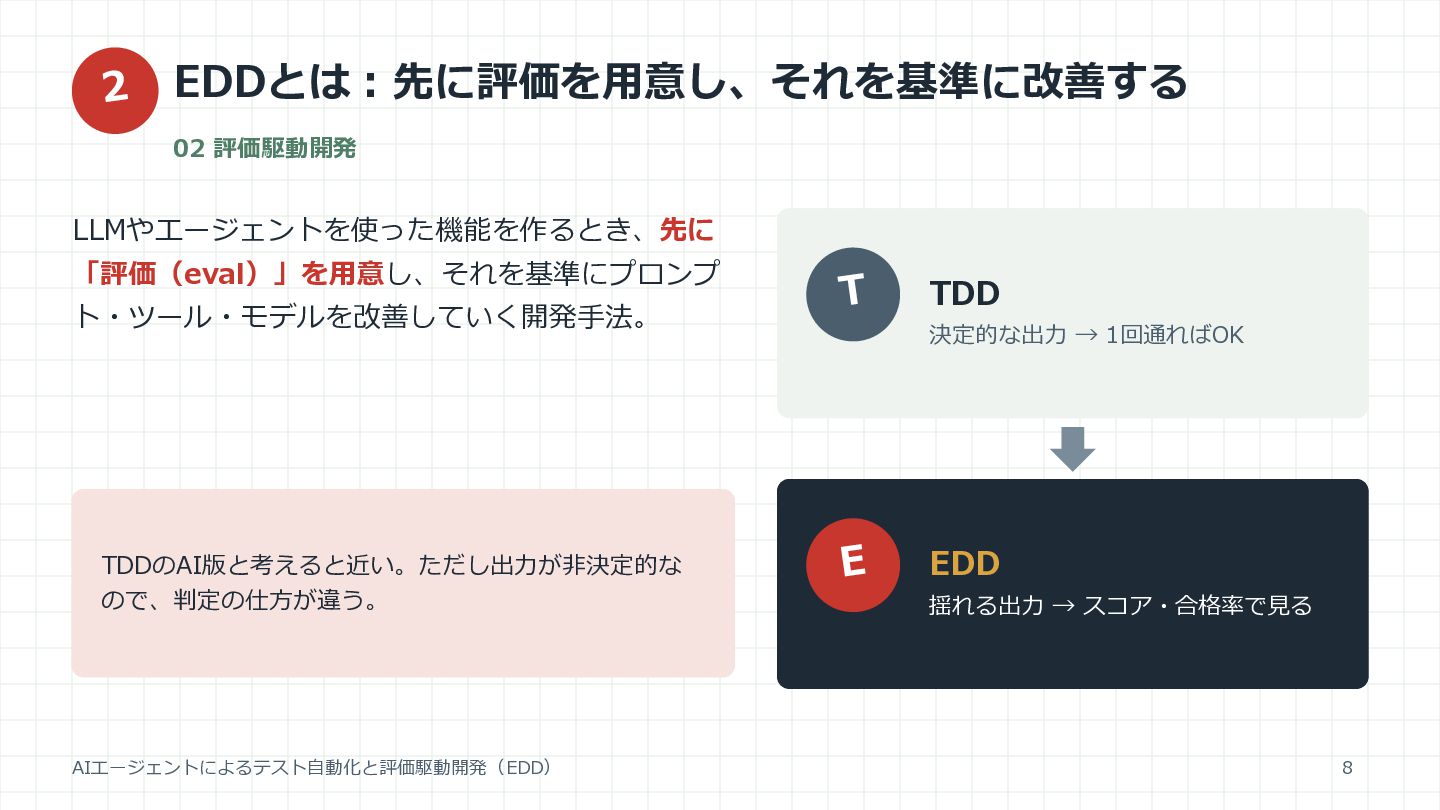
EDDとは:先に評価を用意し、それを基準に改善する 02 評価駆動開発 LLMやエージェントを使った機能を作るとき、先に 「評価(eval)」を用意し、それを基準にプロンプ ト・ツール・モデルを改善していく開発手法。 TDDのAI版と考えると近い。ただし出力が非決定的な ので、判定の仕方が違う。 AIエージェントによるテスト自動化と評価駆動開発(EDD) TDD
決定的な出力 → 1回通ればOK EDD 揺れる出力 → スコア・合格率で見る 8
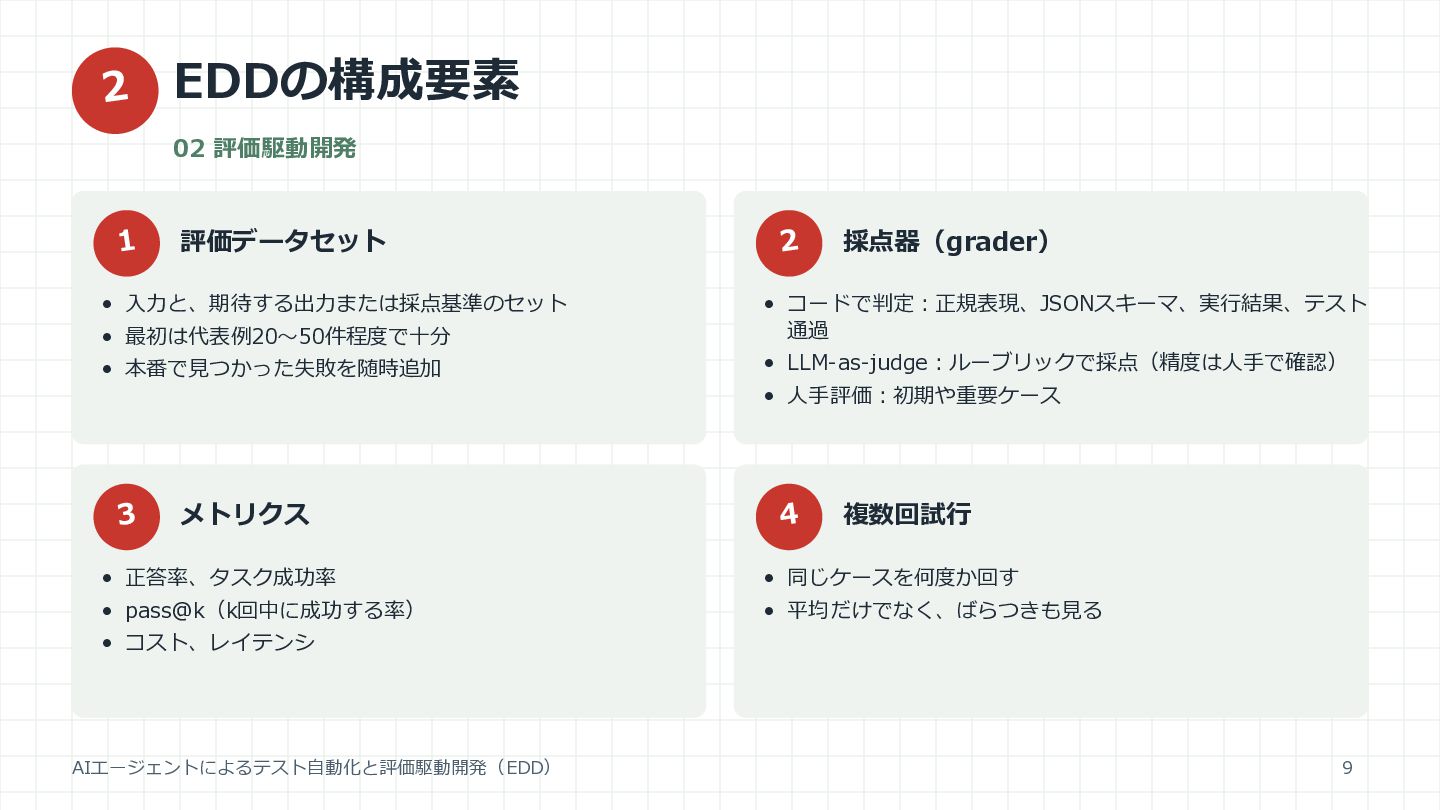
EDDの構成要素 02 評価駆動開発 評価データセット • 入力と、期待する出力または採点基準のセット 採点器(grader) • 最初は代表例20〜50件程度で十分 •
コードで判定:正規表現、JSONスキーマ、実行結果、テスト 通過 • 本番で見つかった失敗を随時追加 • LLM-as-judge:ルーブリックで採点(精度は人手で確認) • 人手評価:初期や重要ケース メトリクス 複数回試行 • 正答率、タスク成功率 • 同じケースを何度か回す • pass@k(k回中に成功する率) • 平均だけでなく、ばらつきも見る • コスト、レイテンシ AIエージェントによるテスト自動化と評価駆動開発(EDD) 9
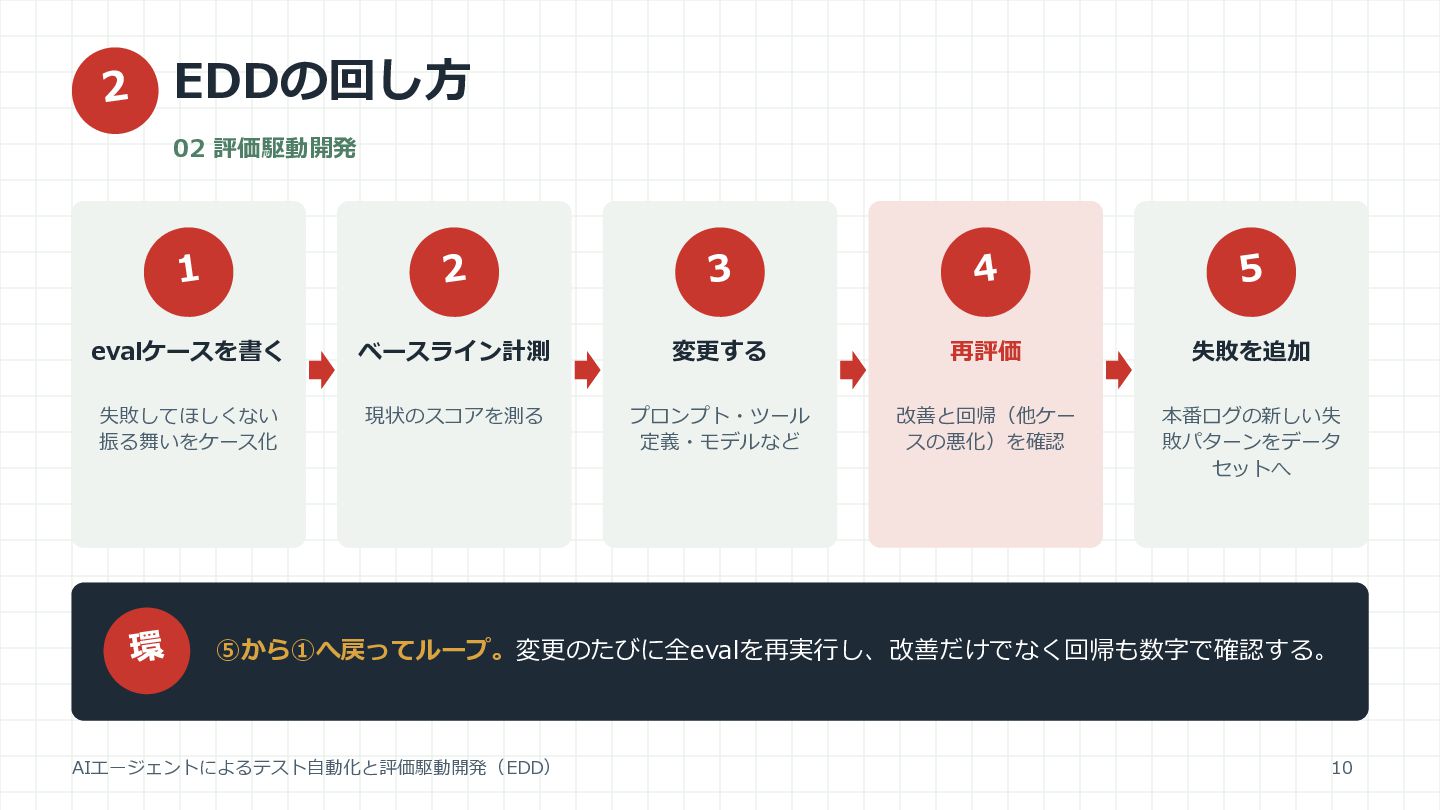
EDDの回し方 02 評価駆動開発 evalケースを書く ベースライン計測 変更する 再評価 失敗を追加 失敗してほしくない 振る舞いをケース化
現状のスコアを測る プロンプト・ツール 定義・モデルなど 改善と回帰(他ケー スの悪化)を確認 本番ログの新しい失 敗パターンをデータ セットへ ⑤から①へ戻ってループ。変更のたびに全evalを再実行し、改善だけでなく回帰も数字で確認する。 AIエージェントによるテスト自動化と評価駆動開発(EDD) 10
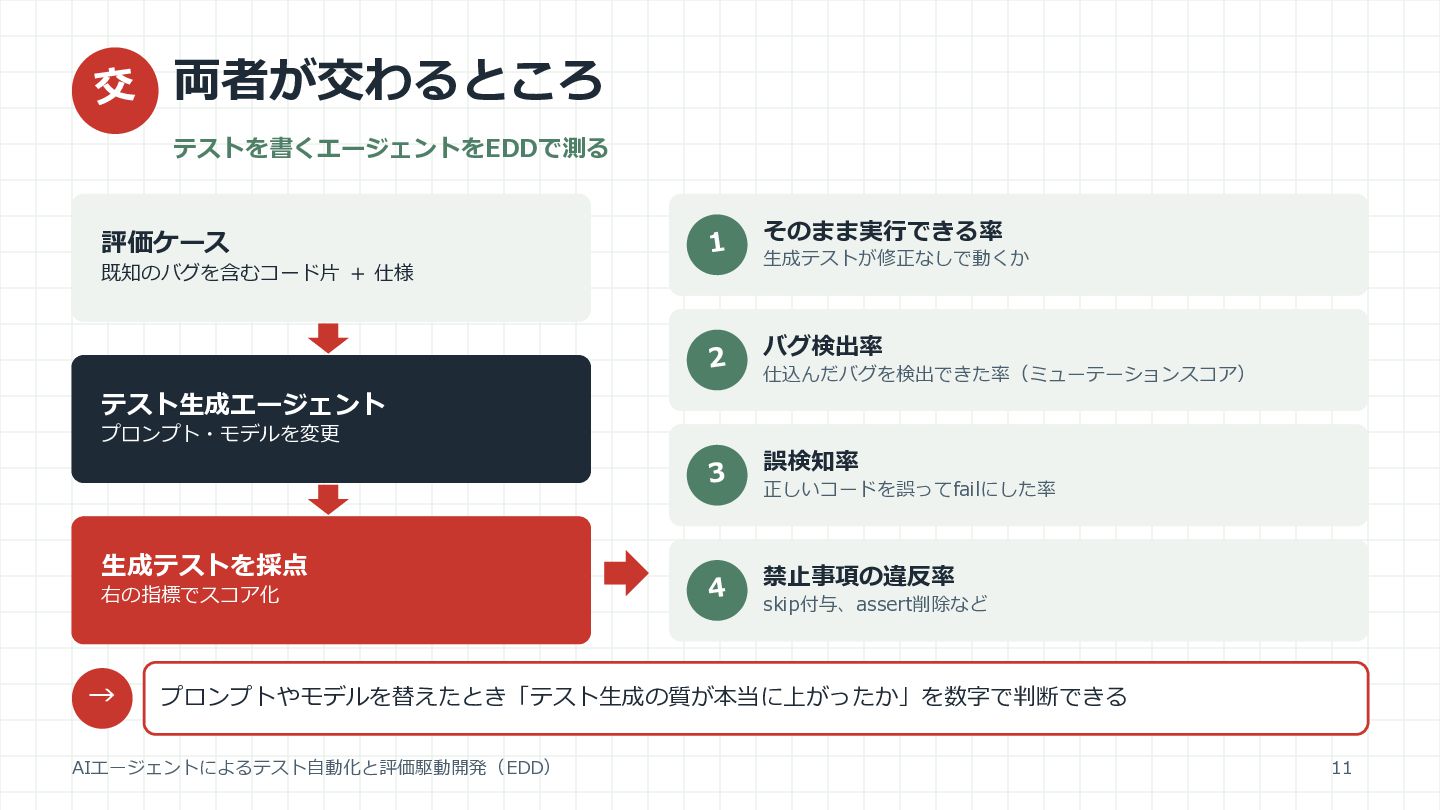
両者が交わるところ テストを書くエージェントをEDDで測る 評価ケース 既知のバグを含むコード片 + 仕様 そのまま実行できる率 生成テストが修正なしで動くか バグ検出率 仕込んだバグを検出できた率(ミューテーションスコア)
テスト生成エージェント プロンプト・モデルを変更 誤検知率 正しいコードを誤ってfailにした率 生成テストを採点 右の指標でスコア化 → 禁止事項の違反率 skip付与、assert削除など プロンプトやモデルを替えたとき「テスト生成の質が本当に上がったか」を数字で判断できる AIエージェントによるテスト自動化と評価駆動開発(EDD) 11
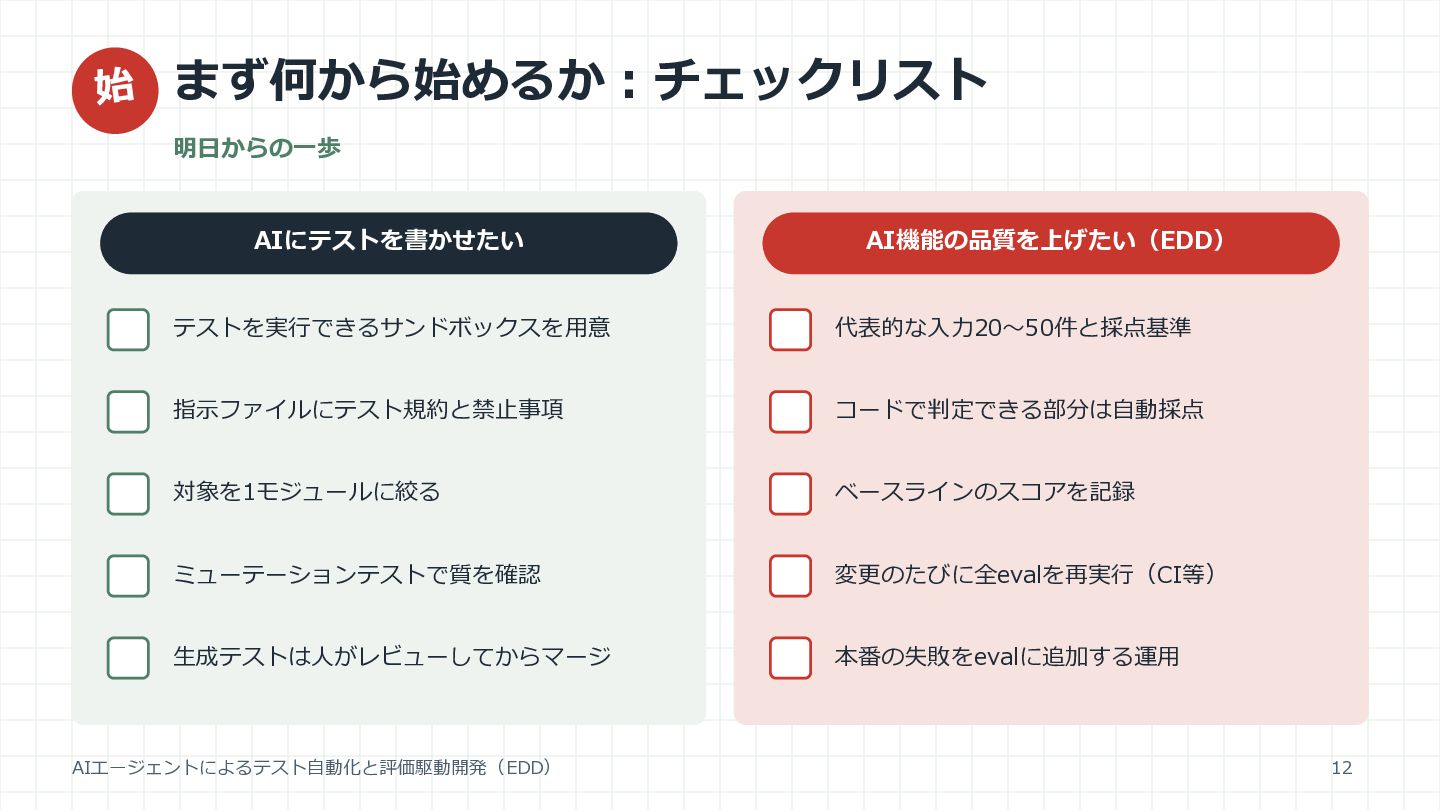
まず何から始めるか:チェックリスト 明日からの一歩 AIにテストを書かせたい AI機能の品質を上げたい(EDD) テストを実行できるサンドボックスを用意 代表的な入力20〜50件と採点基準 指示ファイルにテスト規約と禁止事項 コードで判定できる部分は自動採点 対象を1モジュールに絞る ベースラインのスコアを記録
ミューテーションテストで質を確認 変更のたびに全evalを再実行(CI等) 生成テストは人がレビューしてからマージ 本番の失敗をevalに追加する運用 AIエージェントによるテスト自動化と評価駆動開発(EDD) 12


 happysamurai294
 fufufukakaka
 freee
 pfn
 jtakeda
 minorun365
 kentarofujii
 sansantech
 kaminashi
 syuchimu
 techtekt
 taketakekaho
 quramy
 axbom
 cassininazir
 varn
 bkeepers
 schlessera
 skipperchong
 sferik
 lara
 tapps
 jonoalderson