Upgrade to Pro — share decks privately, control downloads, hide ads and more …

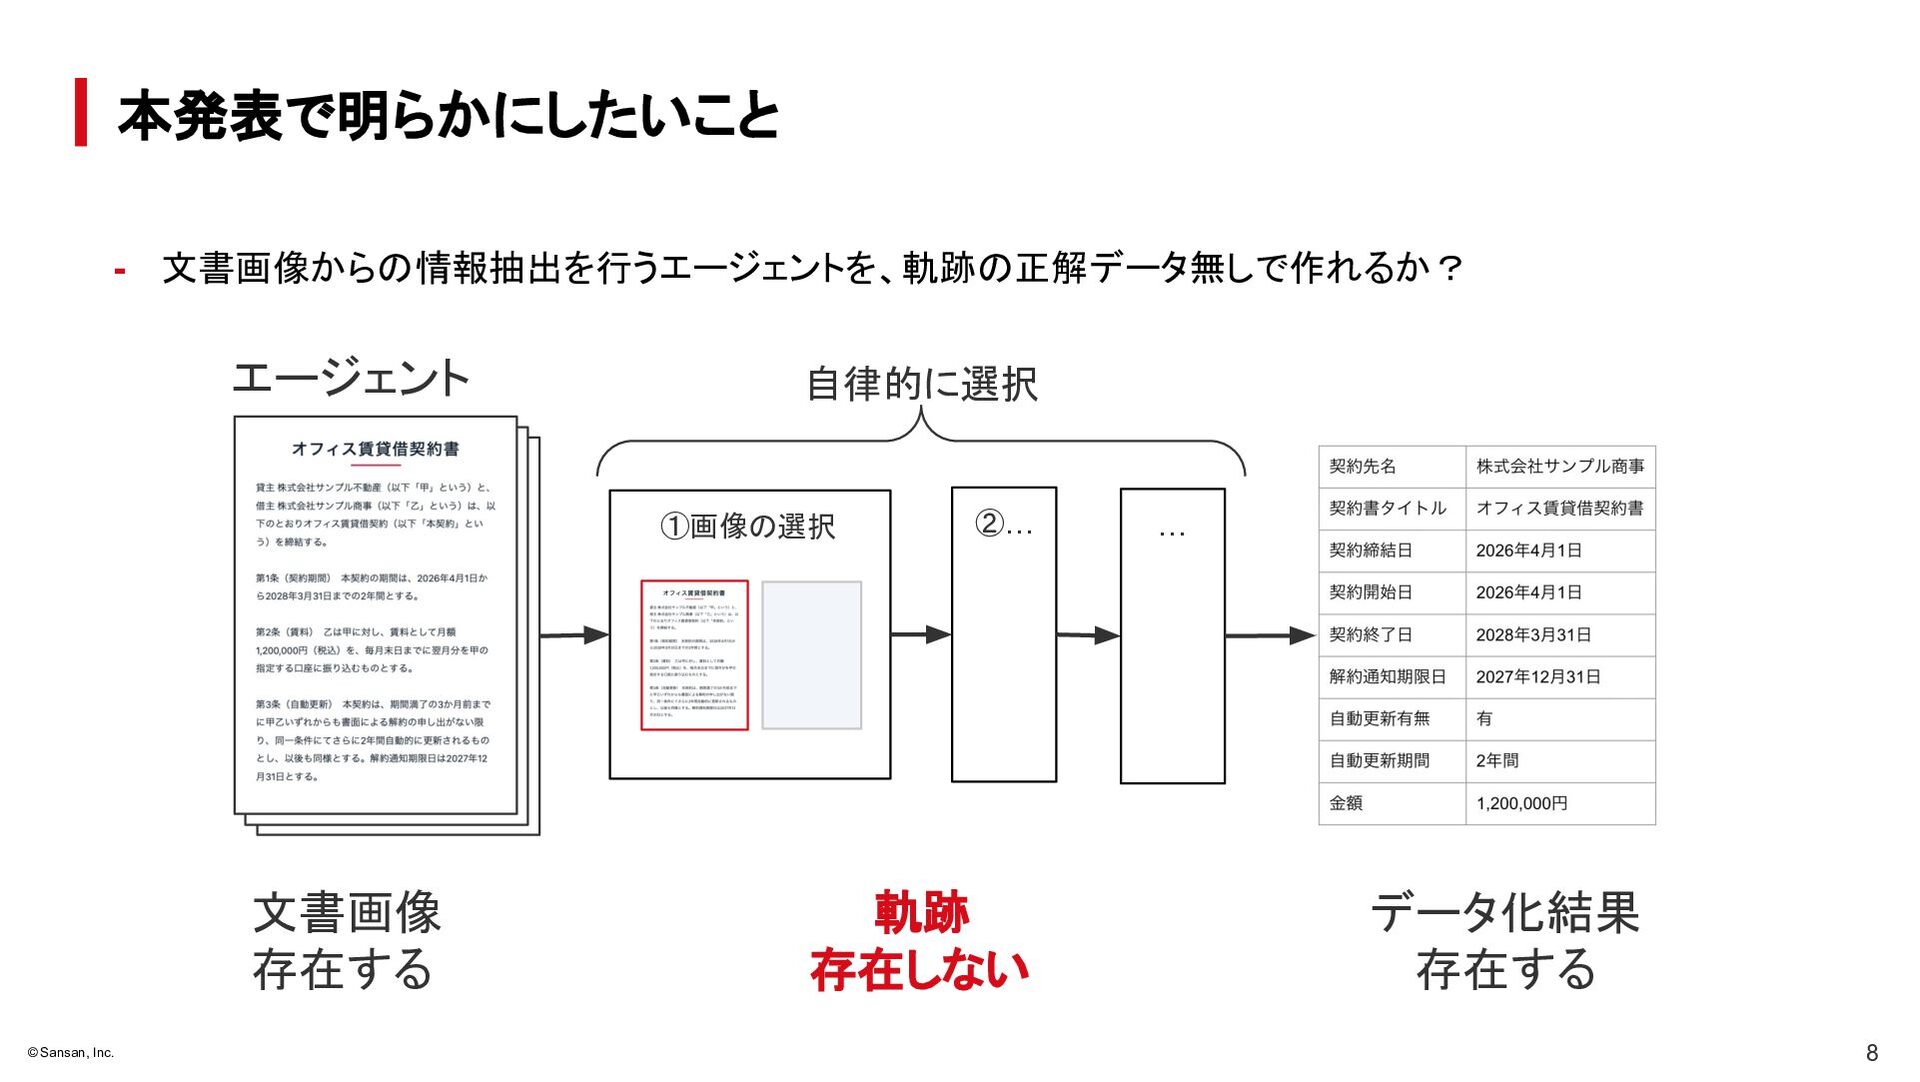
文書画像からの情報抽出を行うエージェントを、軌跡の正解データ無しで作れるか

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

 文書画像からの情報抽出を行うエージェントを、軌跡の正解データ無しで作れるか

■イベント
AIをプロダクトにどう活かす? 実践共有会 in Kyoto
https://sansan.connpass.com/event/408198/

■登壇概要
タイトル:文書画像からの情報抽出を行うエージェントを、軌跡の正解データ無しで作れるか
登壇者:技術本部 研究開発部 齋藤 慎一朗

■ 技術本部 採用情報
https://media.sansan-engineering.com

SansanTech PRO

November 13, 2026

Transcript

27 slides
  1. 齋藤 慎一朗 @sinchir0 X(旧Twitter) Sansan株式会社 技術本部 研究開発部 シニアリサーチャー - 業務

    - 文書データから 情報抽出や、契約 AXサービス 「Contract One」 - - サービス開発 趣味 - Kaggle(2x Master) - ランニング(サブ 5.25) 書籍 - Kaggleで - Polarsとpandasで学ぶ じめる大規模言語モデル入門 データ処理アイデアレシピ 55
  2. 本発表 概要 - 文書画像と最終的なデータ化結果だけが存在し、軌跡 正解データが存在しない状況で、文書画像から 情報を抽出するエージェントを構築できるかを検証した - 実験 結果、情報抽出 精度で

    VLM ベースラインを上回ることができなかった - 一方、期待するフォーマットで回答し、複数 ※ 軌跡:ツール 使い方など、エージェント © Sansan, Inc. 一連 ツールやページを利用する行動 学習できた 行動を記録したデータ。 3
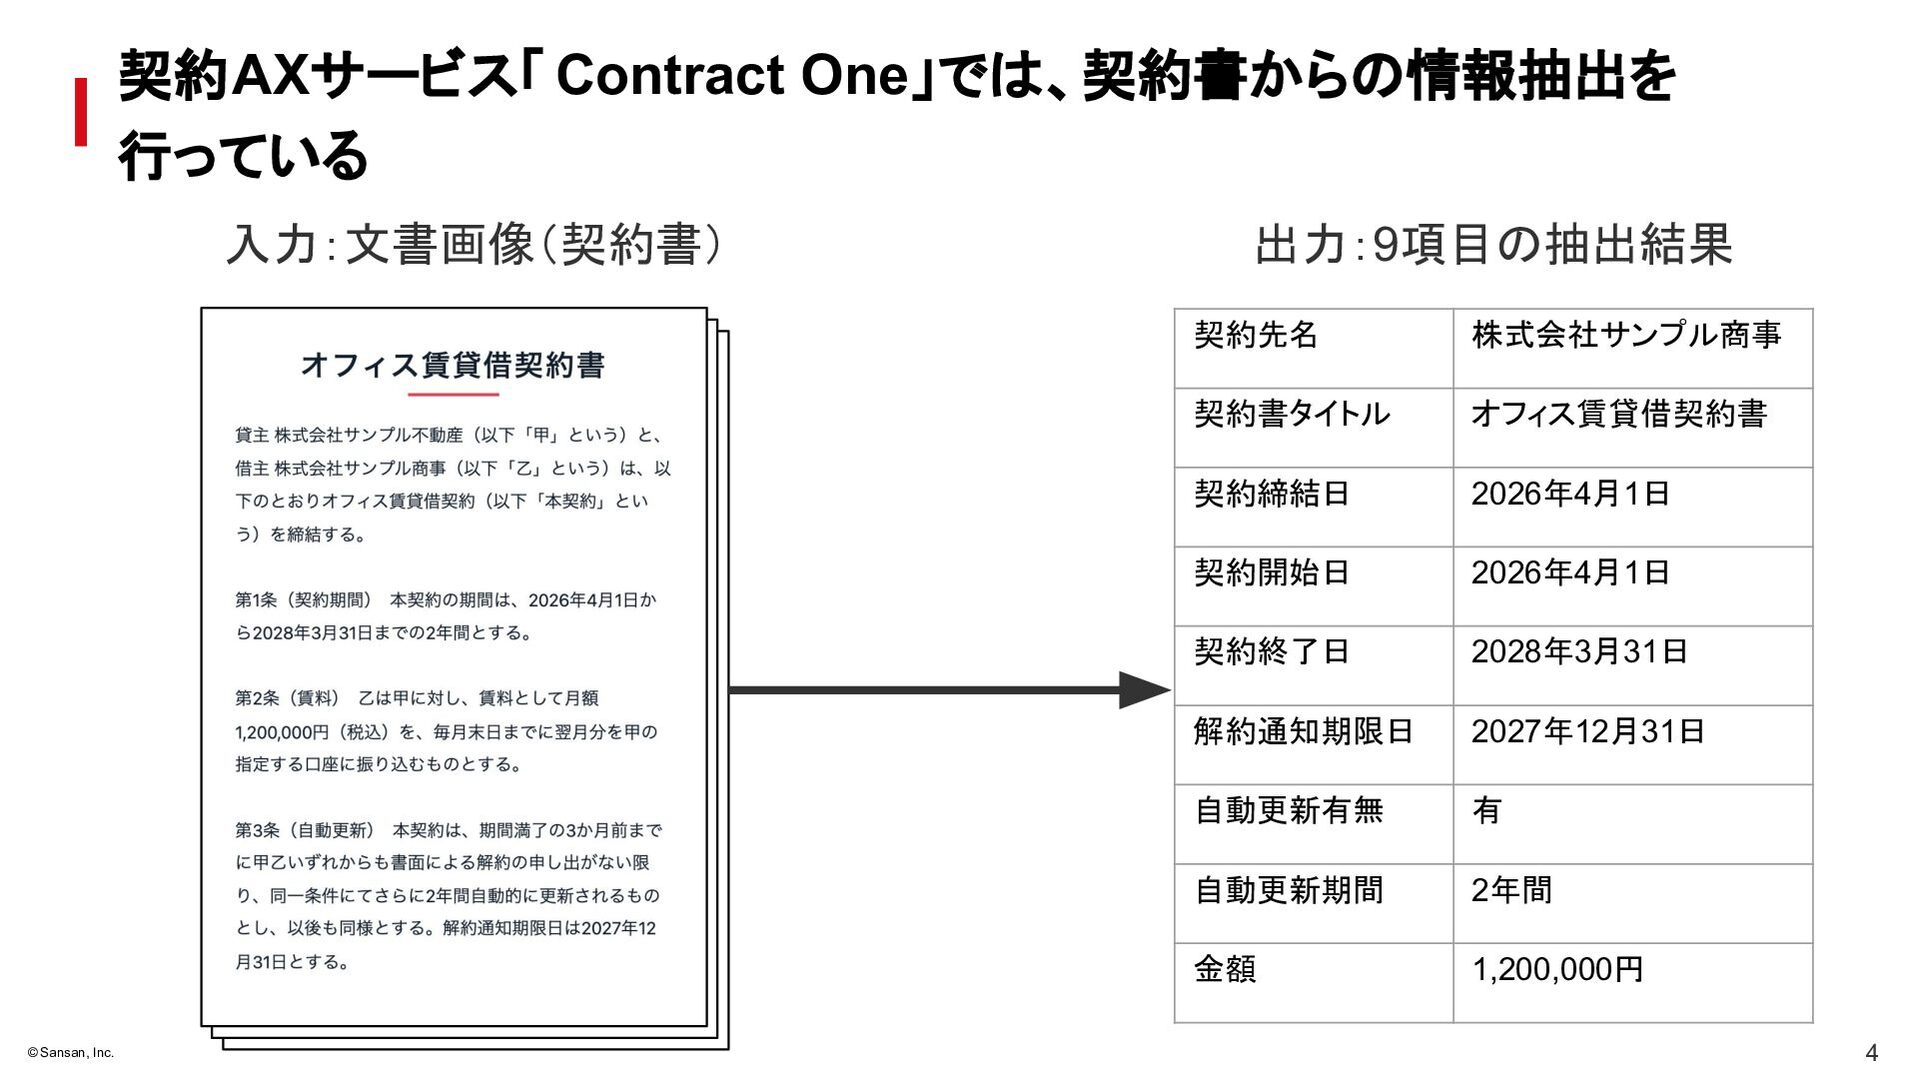
  3. 契約AXサービス「 Contract One」で 行っている 入力:文書画像(契約書) © Sansan, Inc. 、契約書から 情報抽出を

    出力:9項目 抽出結果 契約先名 株式会社サンプル商事 契約書タイトル オフィス賃貸借契約書 契約締結日 2026年4月1日 契約開始日 2026年4月1日 契約終了日 2028年3月31日 解約通知期限日 2027年12月31日 自動更新有無 有 自動更新期間 2年間 金額 1,200,000円 4
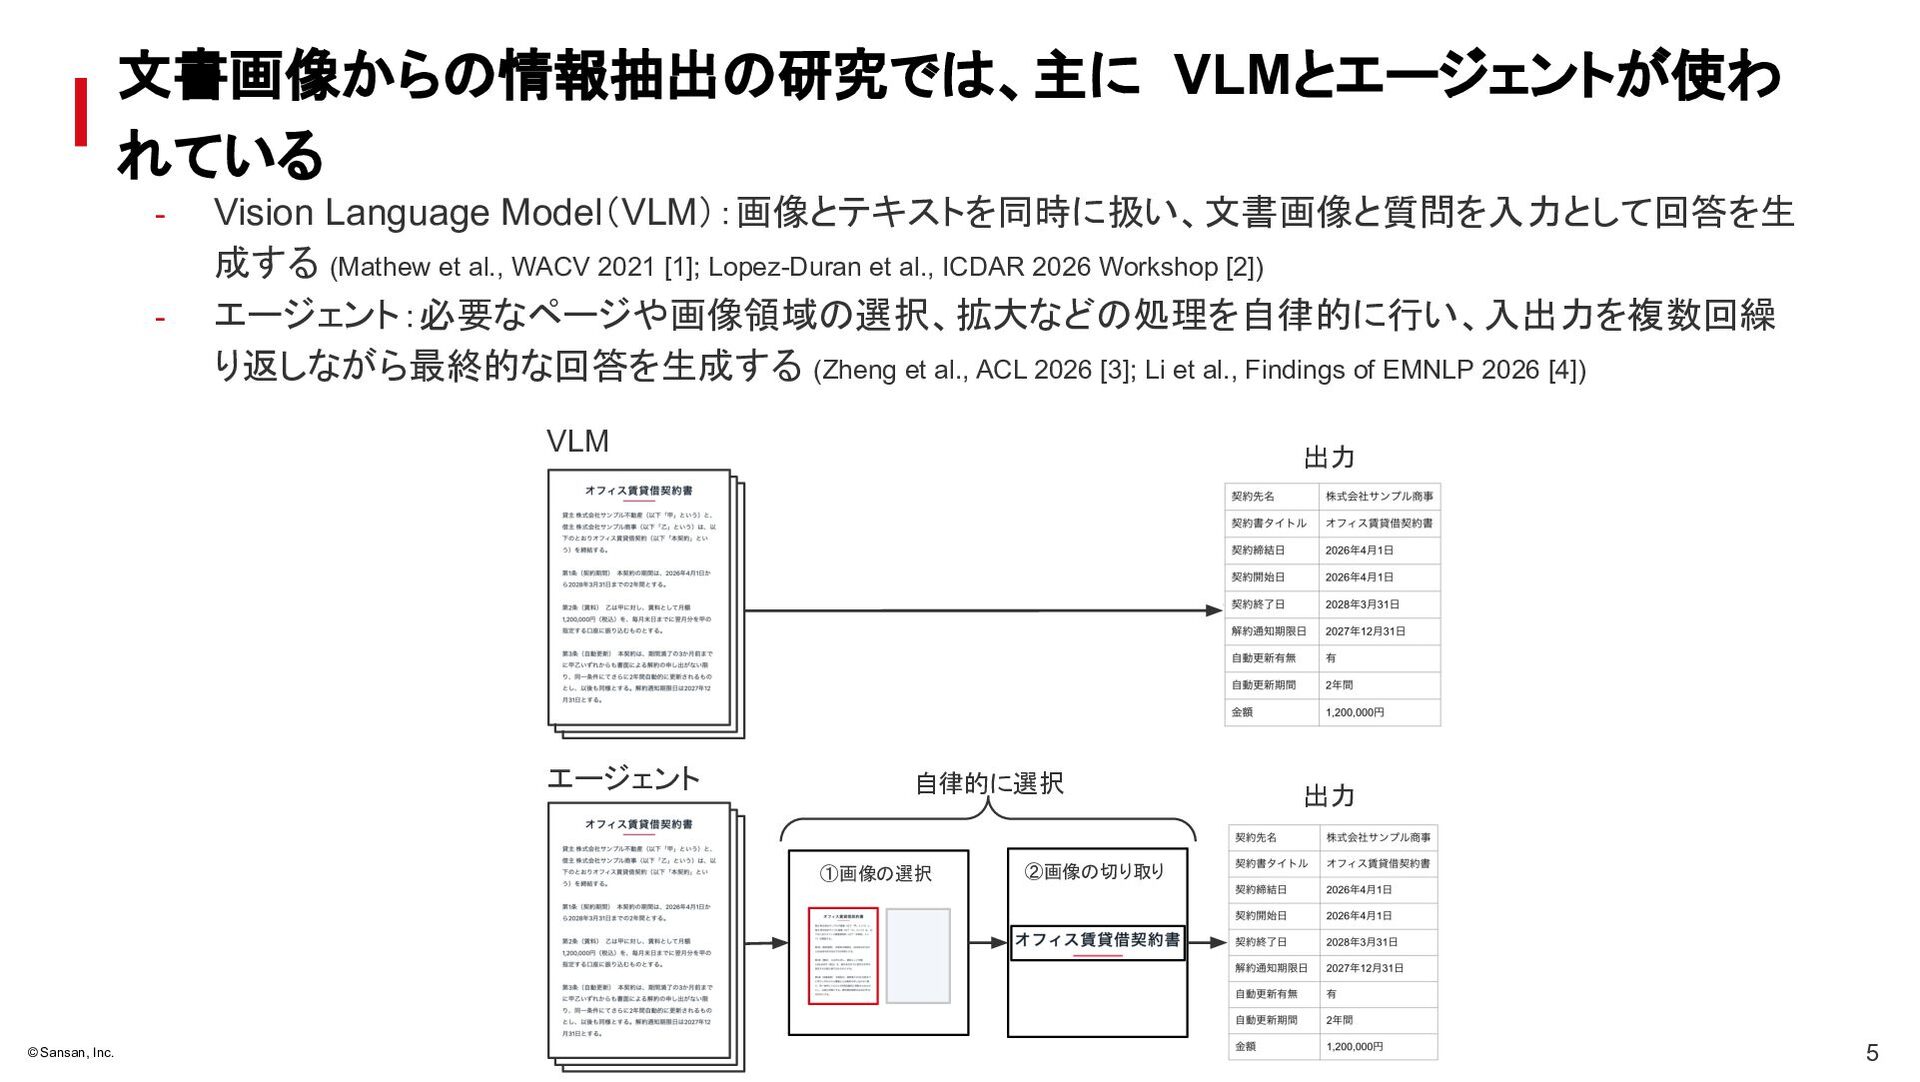
  4. 文書画像から 情報抽出 れている - 研究で 、主に VLMとエージェントが使わ Vision Language Model(VLM):画像とテキストを同時に扱い、文書画像と質問を入力として回答を生

    成する (Mathew et al., WACV 2021 [1]; Lopez-Duran et al., ICDAR 2026 Workshop [2]) エージェント:必要なページや画像領域 選択、拡大など 処理を自律的に行い、入出力を複数回繰 り返しながら最終的な回答を生成する (Zheng et al., ACL 2026 [3]; Li et al., Findings of EMNLP 2026 [4]) VLM 出力 エージェント 自律的に選択 ①画像 © Sansan, Inc. 選択 ②画像 出力 切り取り 5
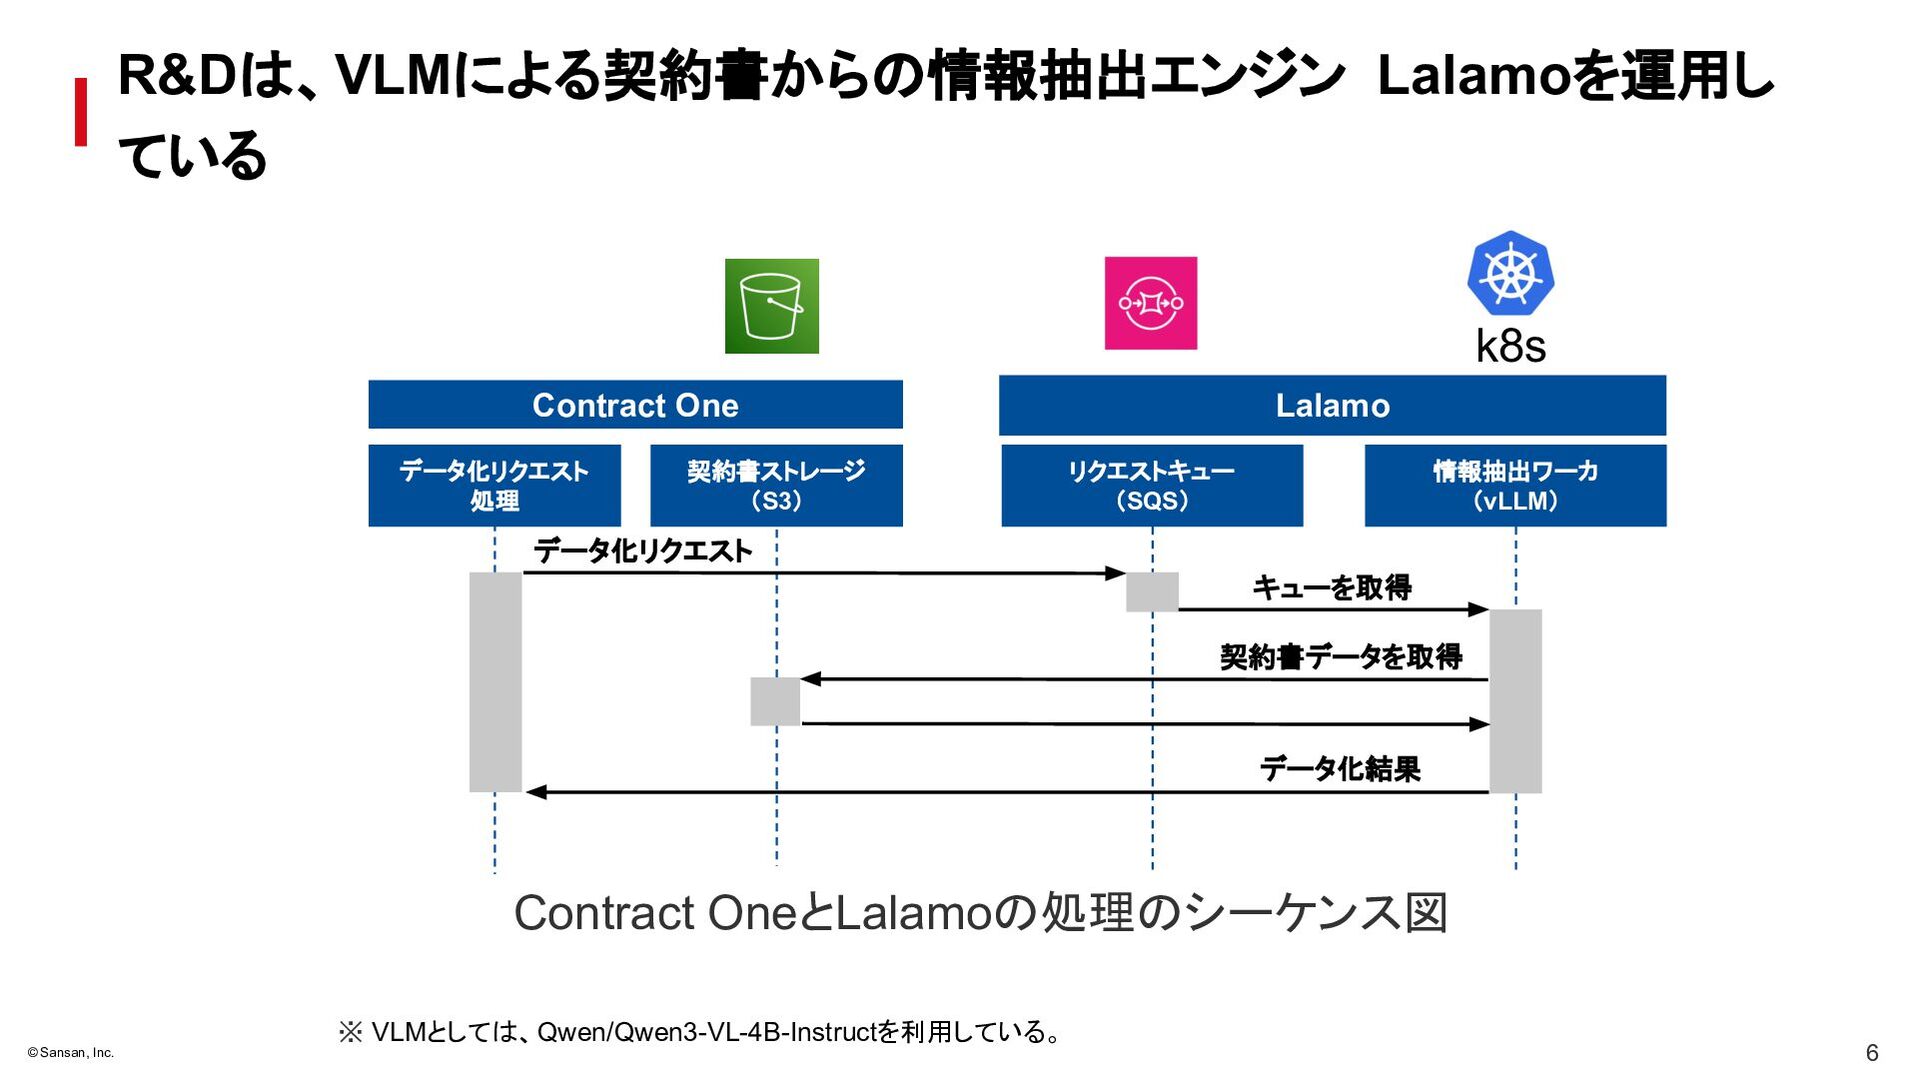
  5. R&D 、VLMによる契約書から 情報抽出エンジン Lalamoを運用し ている k8s Contract One データ化リクエスト 処理

    Lalamo リクエストキュー (SQS) 契約書ストレージ (S3) 情報抽出ワーカ (vLLM) データ化リクエスト キューを取得 契約書データを取得 データ化結果 Contract OneとLalamo © Sansan, Inc. ※ VLMとして 処理 、Qwen/Qwen3-VL-4B-Instructを利用している。 シーケンス図 6
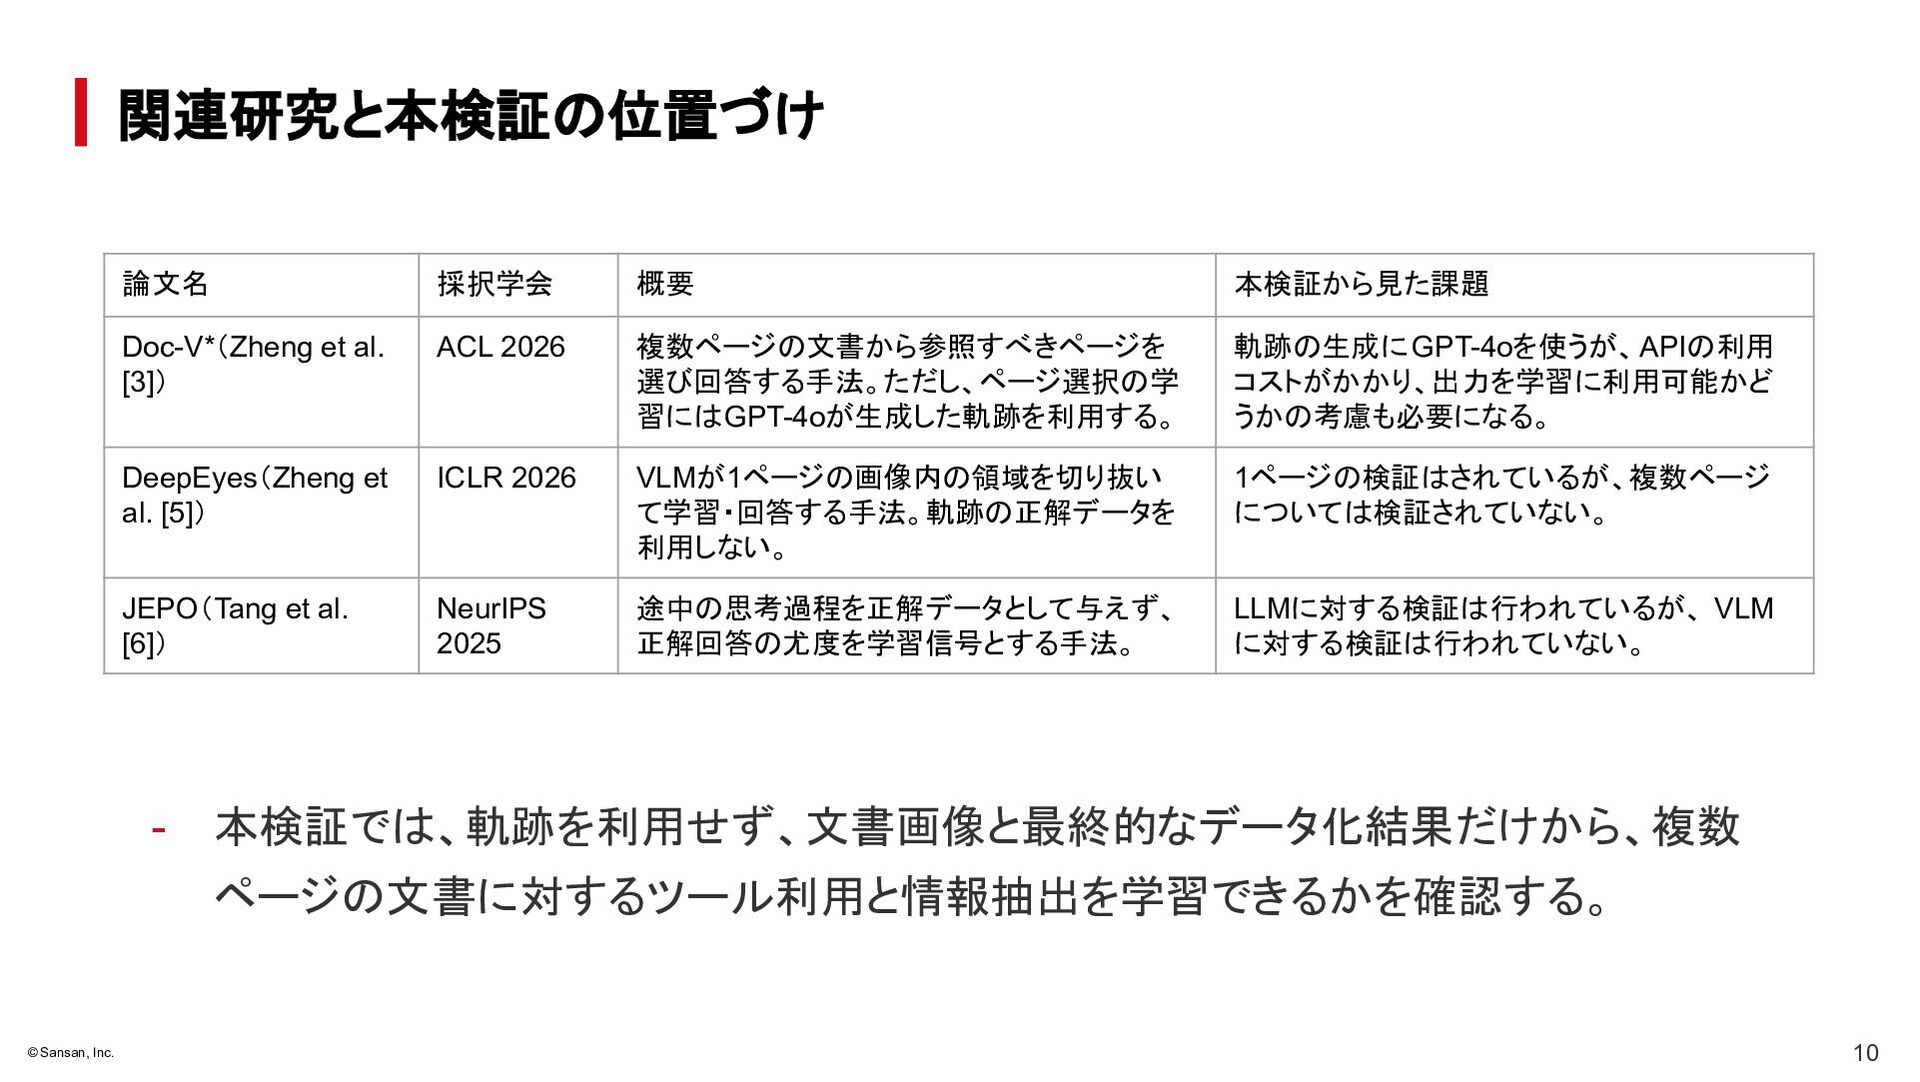
  6. 関連研究と本検証 位置づけ 論文名 採択学会 概要 本検証から見た課題 Doc-V*(Zheng et al. [3])

    ACL 2026 複数ページ 文書から参照すべきページを 選び回答する手法。ただし、ページ選択 学 習に GPT-4oが生成した軌跡を利用する。 軌跡 生成に GPT-4oを使うが、API 利用 コストがかかり、出力を学習に利用可能かど うか 考慮も必要になる。 DeepEyes(Zheng et al. [5]) ICLR 2026 VLMが1ページ 画像内 領域を切り抜い て学習・回答する手法。軌跡 正解データを 利用しない。 1ページ 検証 されているが、複数ページ について 検証されていない。 JEPO(Tang et al. [6]) NeurIPS 2025 途中 思考過程を正解データとして与えず、 正解回答 尤度を学習信号とする手法。 LLMに対する検証 行われているが、 VLM に対する検証 行われていない。 - 本検証で 、軌跡を利用せず、文書画像と最終的なデータ化結果だけから、複数 ページ 文書に対するツール利用と情報抽出を学習できるかを確認する。 © Sansan, Inc. 10
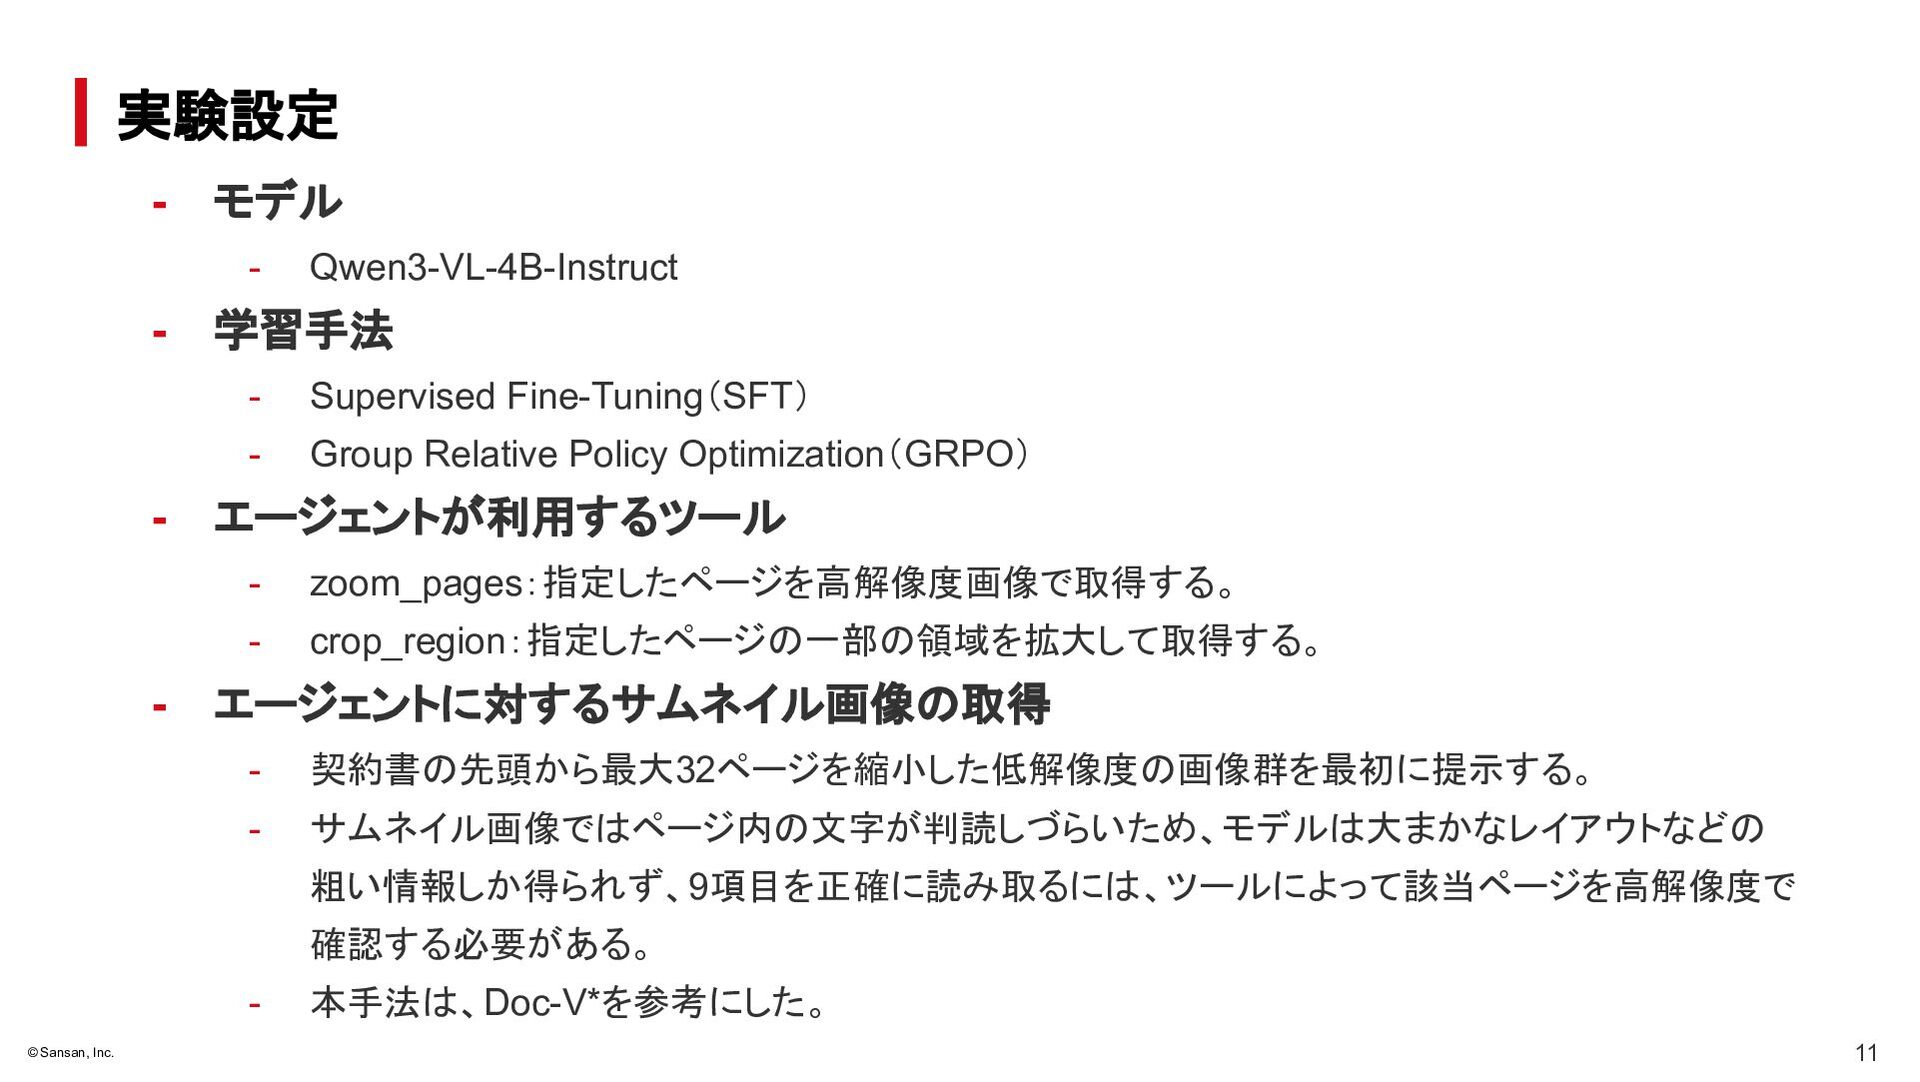
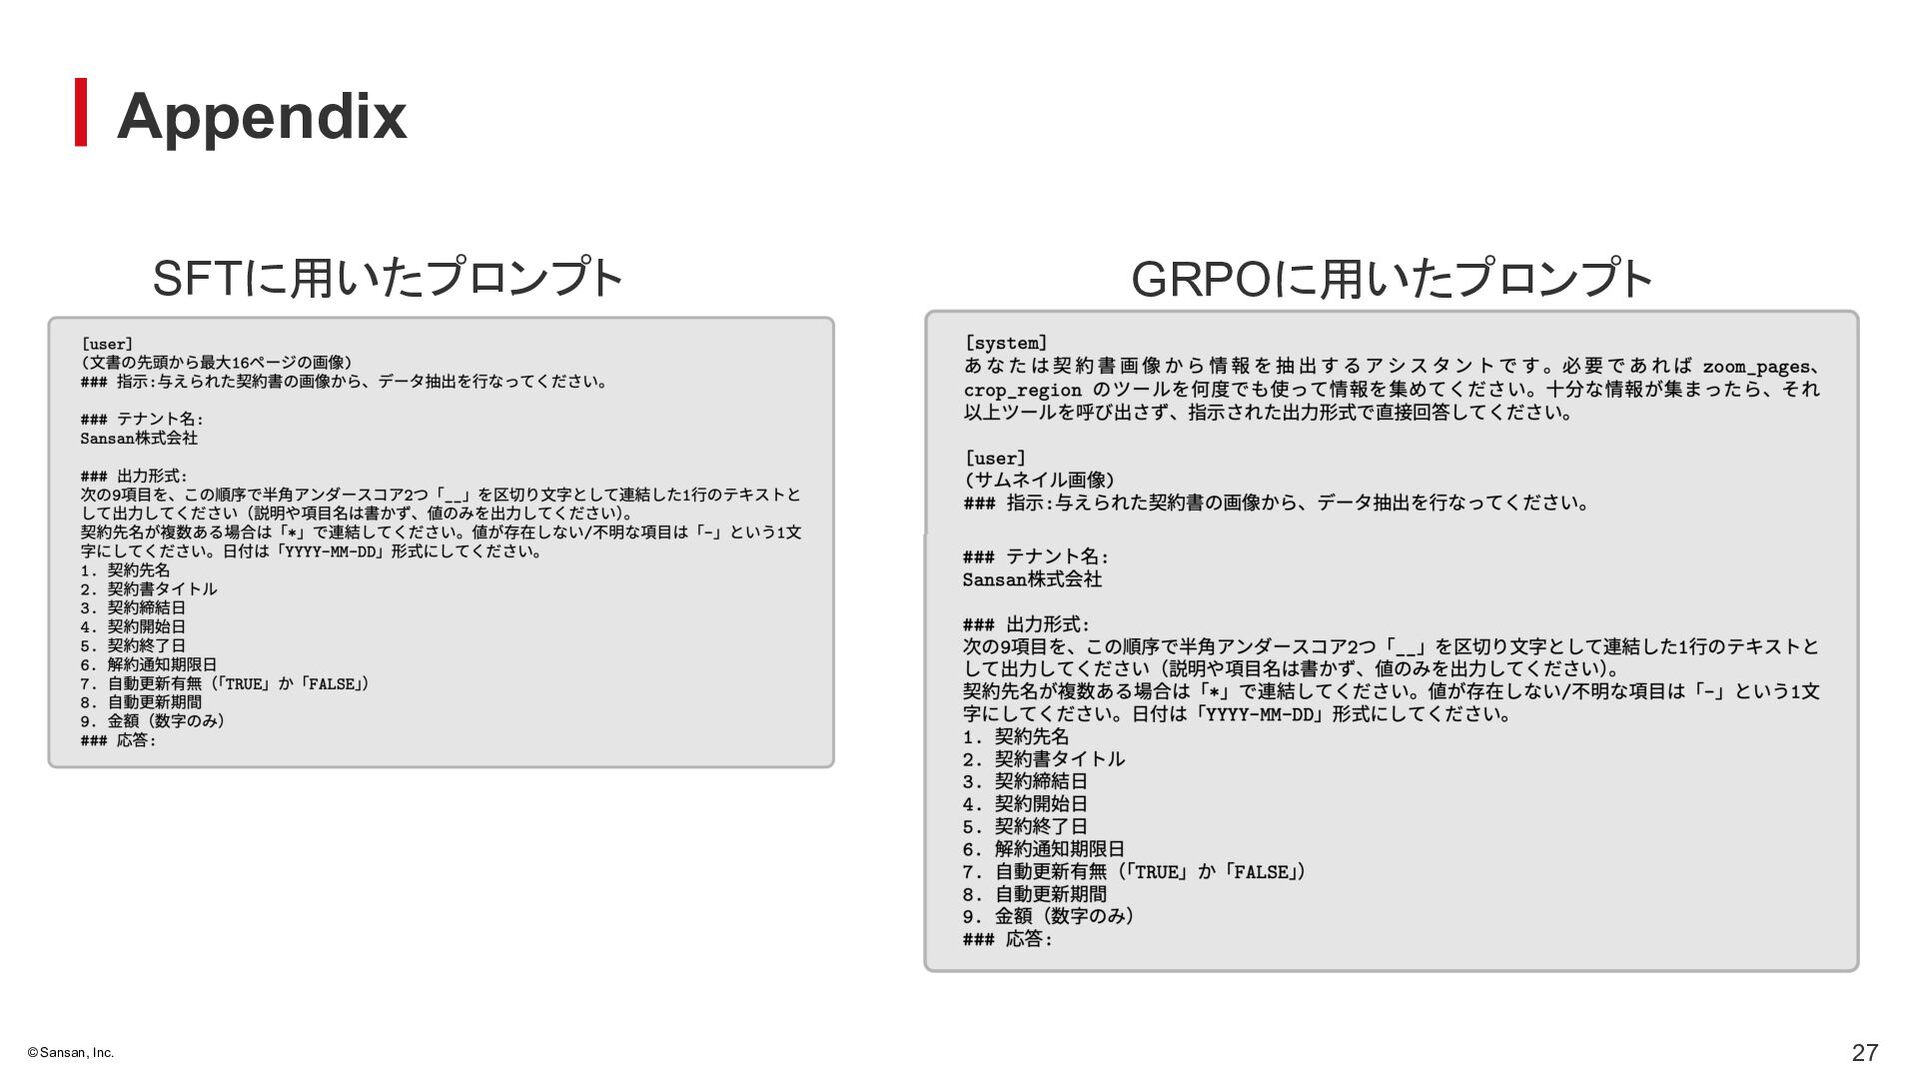
  7. 実験設定 - モデル - - - - Qwen3-VL-4B-Instruct 学習手法 -

    Supervised Fine-Tuning(SFT) - Group Relative Policy Optimization(GRPO) エージェントが利用するツール - zoom_pages:指定したページを高解像度画像で取得する。 - crop_region:指定したページ 一部 エージェントに対するサムネイル画像 - 契約書 - サムネイル画像で 領域を拡大して取得する。 取得 先頭から最大32ページを縮小した低解像度 画像群を最初に提示する。 ページ内 文字が判読しづらいため、モデル 大まかなレイアウトなど 粗い情報しか得られず、9項目を正確に読み取るに 、ツールによって該当ページを高解像度で 確認する必要がある。 © Sansan, Inc. 本手法 、Doc-V*を参考にした。 11
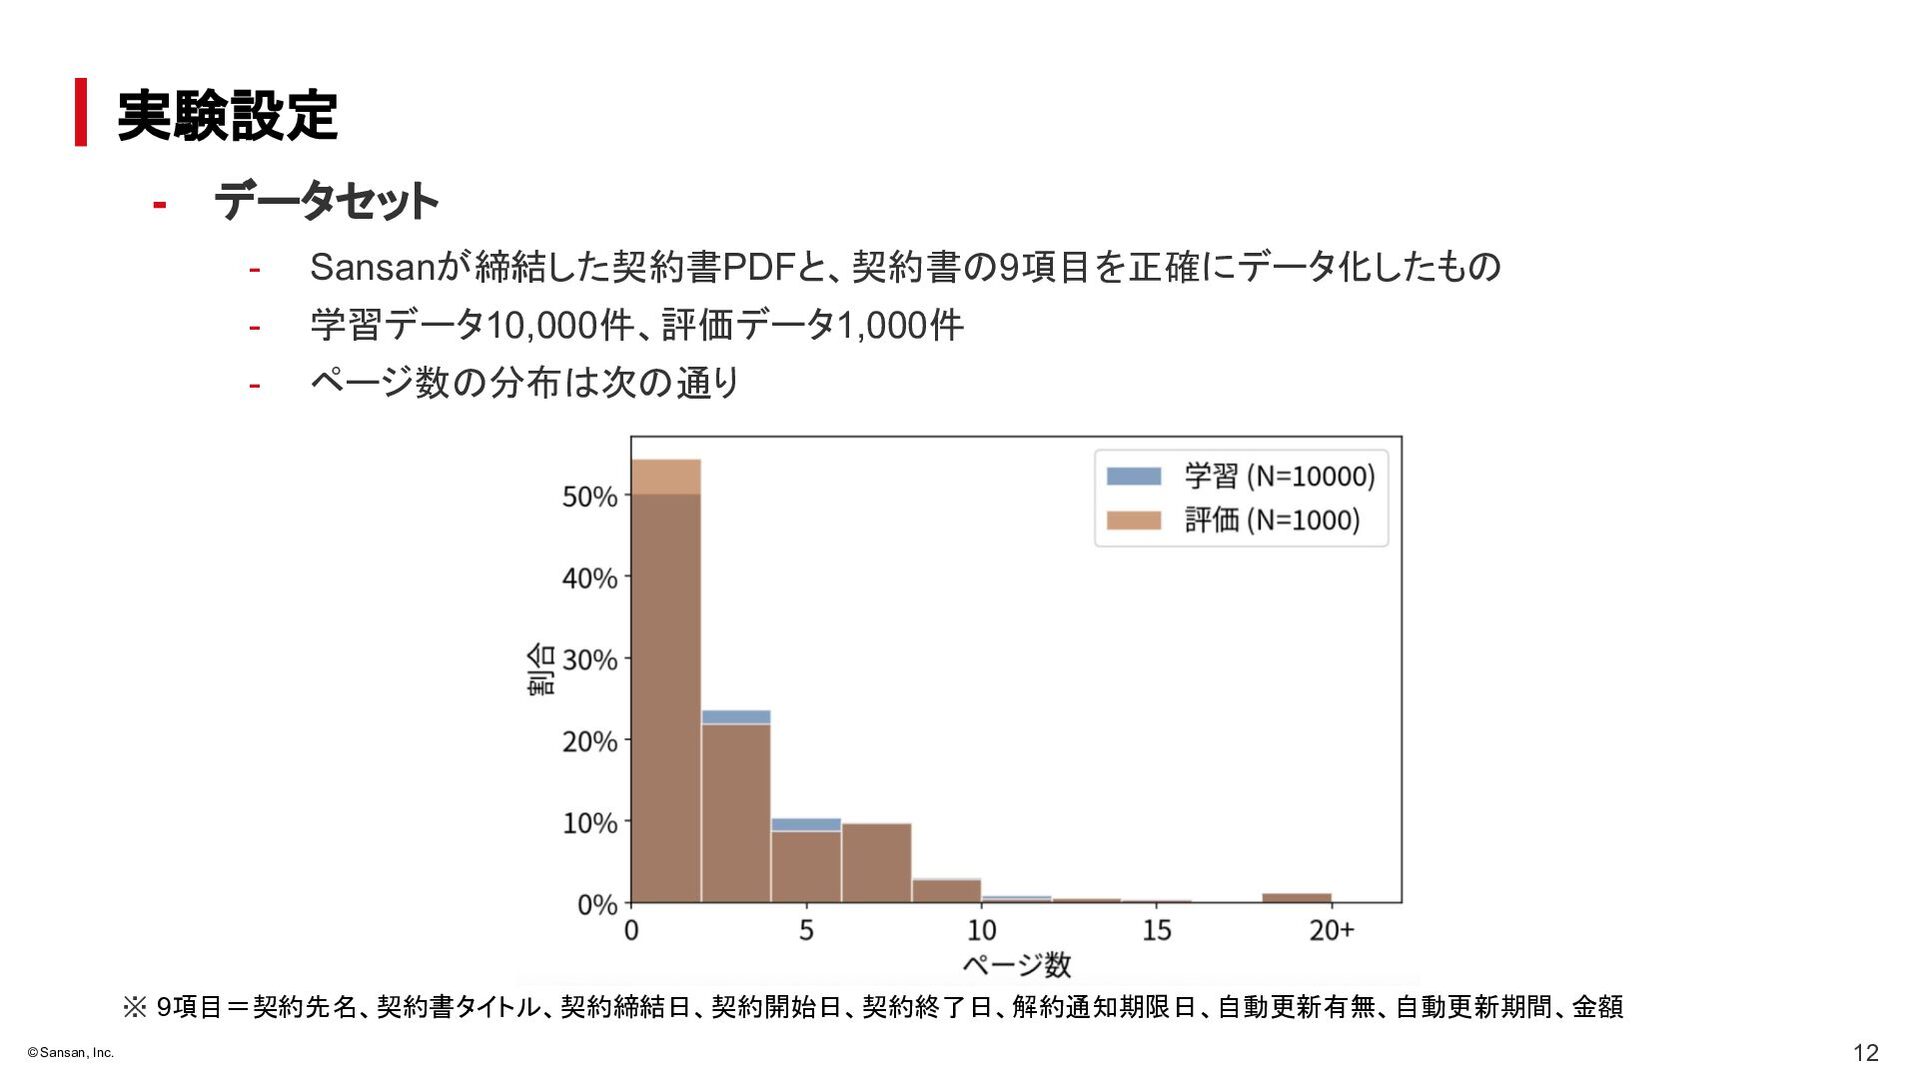
  8. 実験設定 - データセット - Sansanが締結した契約書PDFと、契約書 9項目を正確にデータ化したも - 学習データ10,000件、評価データ1,000件 - ページ数

    分布 次 通り ※ 9項目=契約先名、契約書タイトル、契約締結日、契約開始日、契約終了日、解約通知期限日、自動更新有無、自動更新期間、金額 © Sansan, Inc. 12
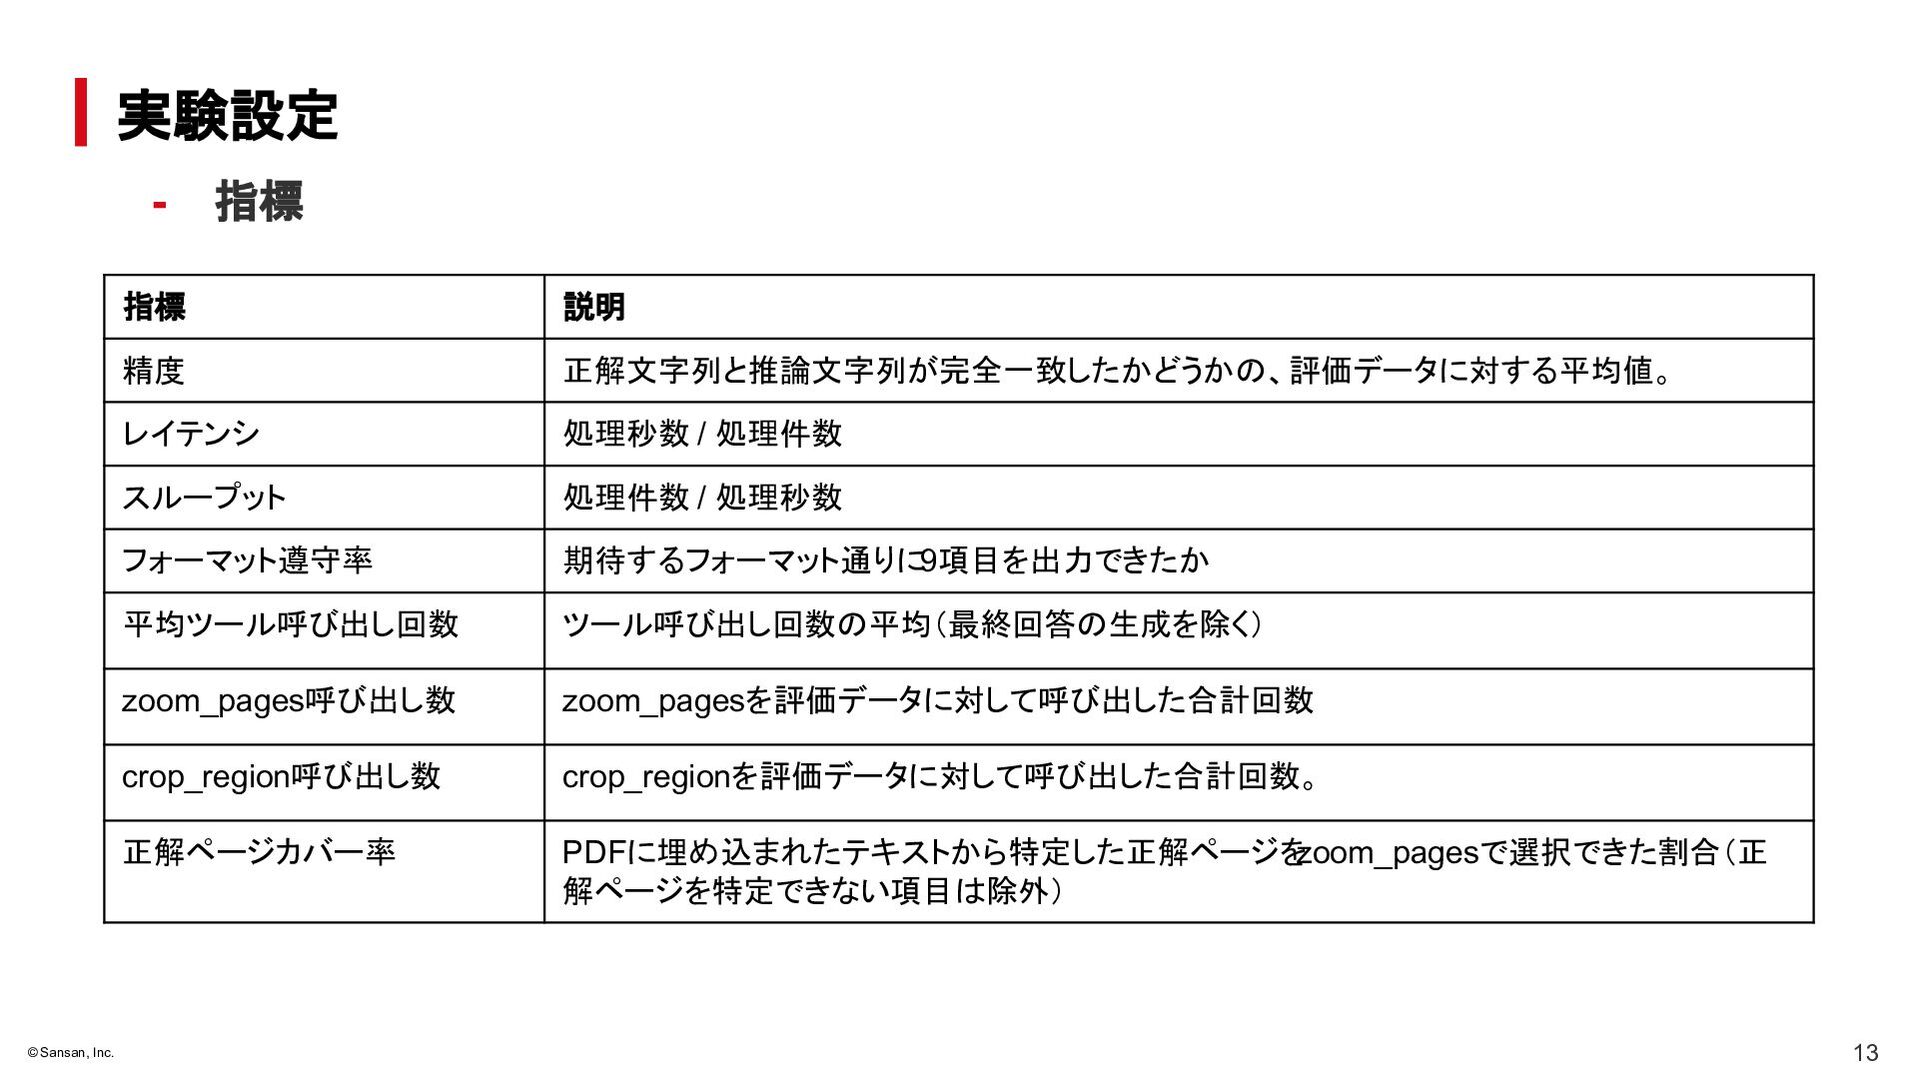
  9. 実験設定 - © Sansan, Inc. 指標 指標 説明 精度 正解文字列と推論文字列が完全一致したかどうか

    レイテンシ 処理秒数 / 処理件数 スループット 処理件数 / 処理秒数 フォーマット遵守率 期待するフォーマット通りに9項目を出力できたか 平均ツール呼び出し回数 ツール呼び出し回数 zoom_pages呼び出し数 zoom_pagesを評価データに対して呼び出した合計回数 crop_region呼び出し数 crop_regionを評価データに対して呼び出した合計回数。 正解ページカバー率 PDFに埋め込まれたテキストから特定した正解ページをzoom_pagesで選択できた割合(正 解ページを特定できない項目 除外) 平均(最終回答 、評価データに対する平均値。 生成を除く) 13
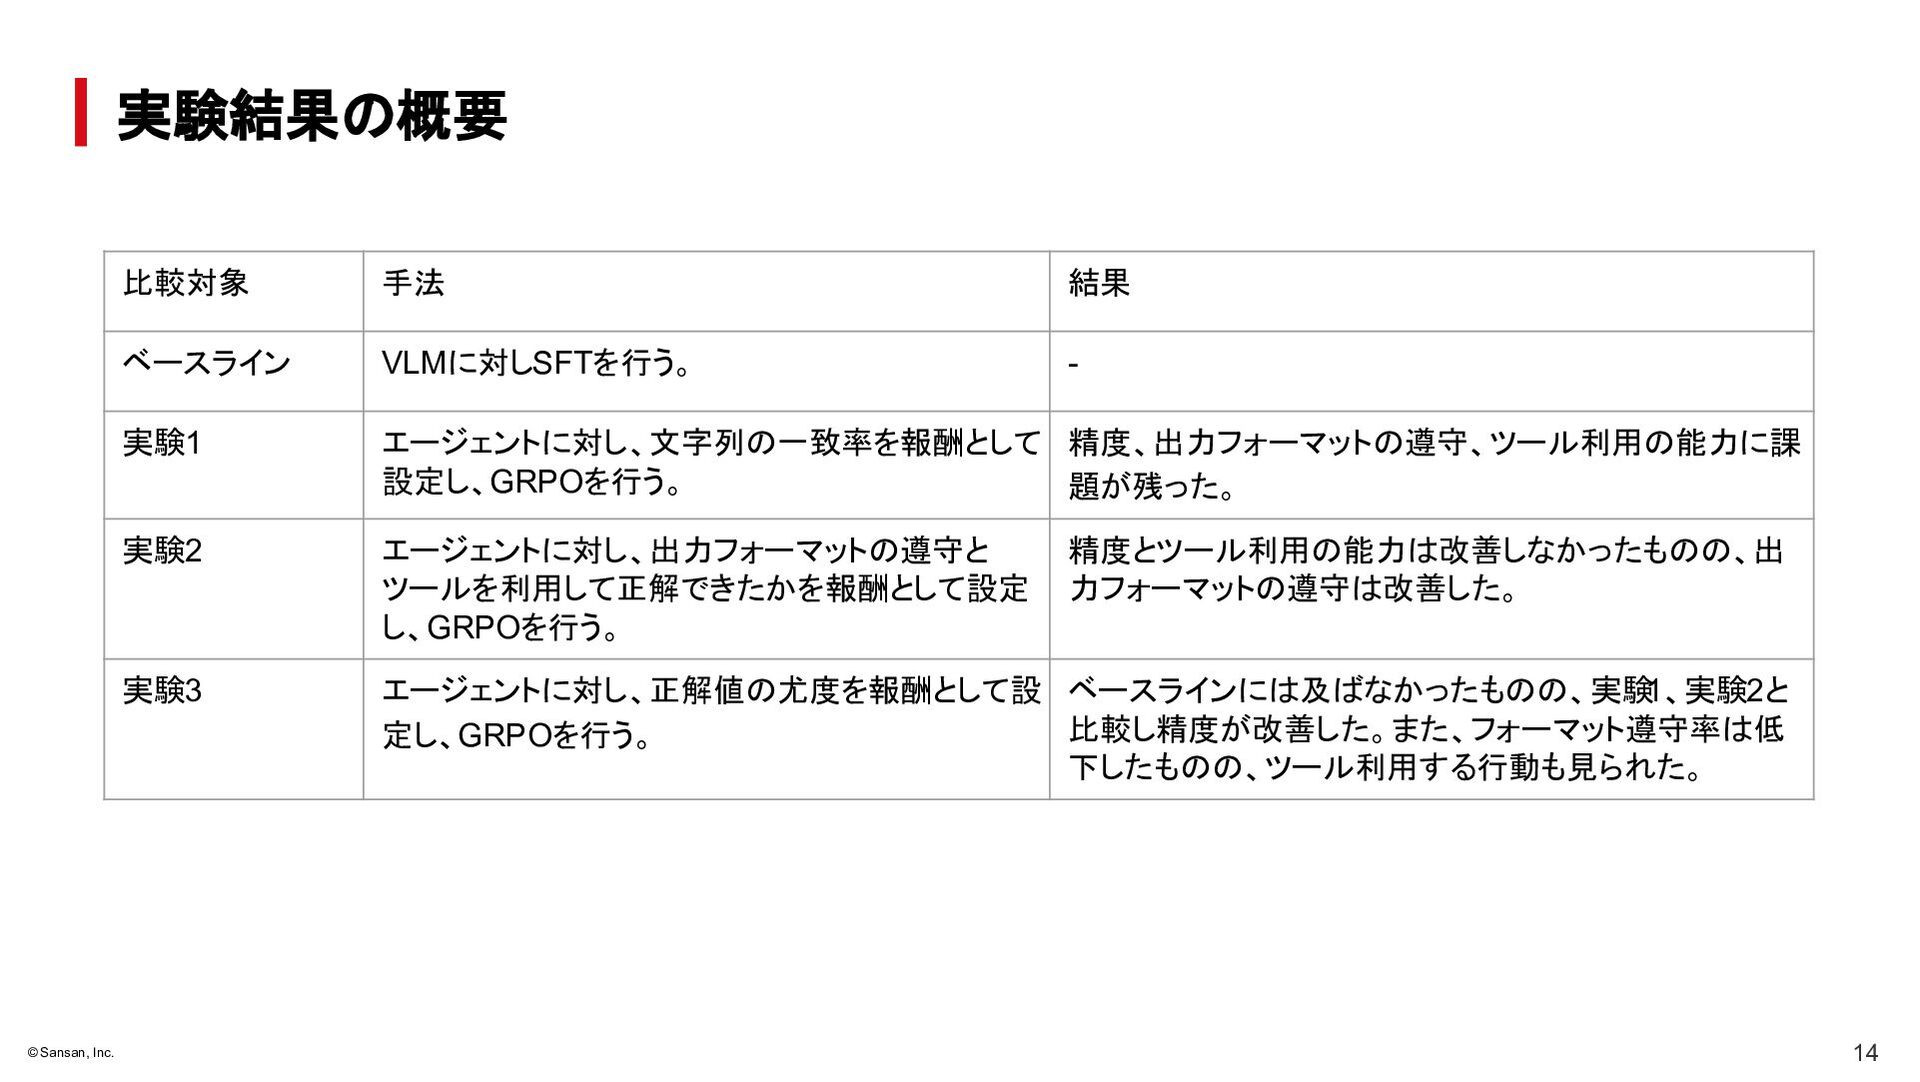
  10. © Sansan, Inc. 実験結果 概要 比較対象 手法 結果 ベースライン VLMに対しSFTを行う。

    - 実験1 エージェントに対し、文字列 設定し、GRPOを行う。 実験2 エージェントに対し、出力フォーマット 遵守と ツールを利用して正解できたかを報酬として設定 し、GRPOを行う。 実験3 エージェントに対し、正解値 定し、GRPOを行う。 一致率を報酬として 精度、出力フォーマット 題が残った。 遵守、ツール利用 精度とツール利用 能力 改善しなかったも 力フォーマット 遵守 改善した。 能力に課 、出 尤度を報酬として設 ベースラインに 及 なかったも 、実験1、実験2と 比較し精度が改善した。また、フォーマット遵守率 低 下したも 、ツール利用する行動も見られた。 14
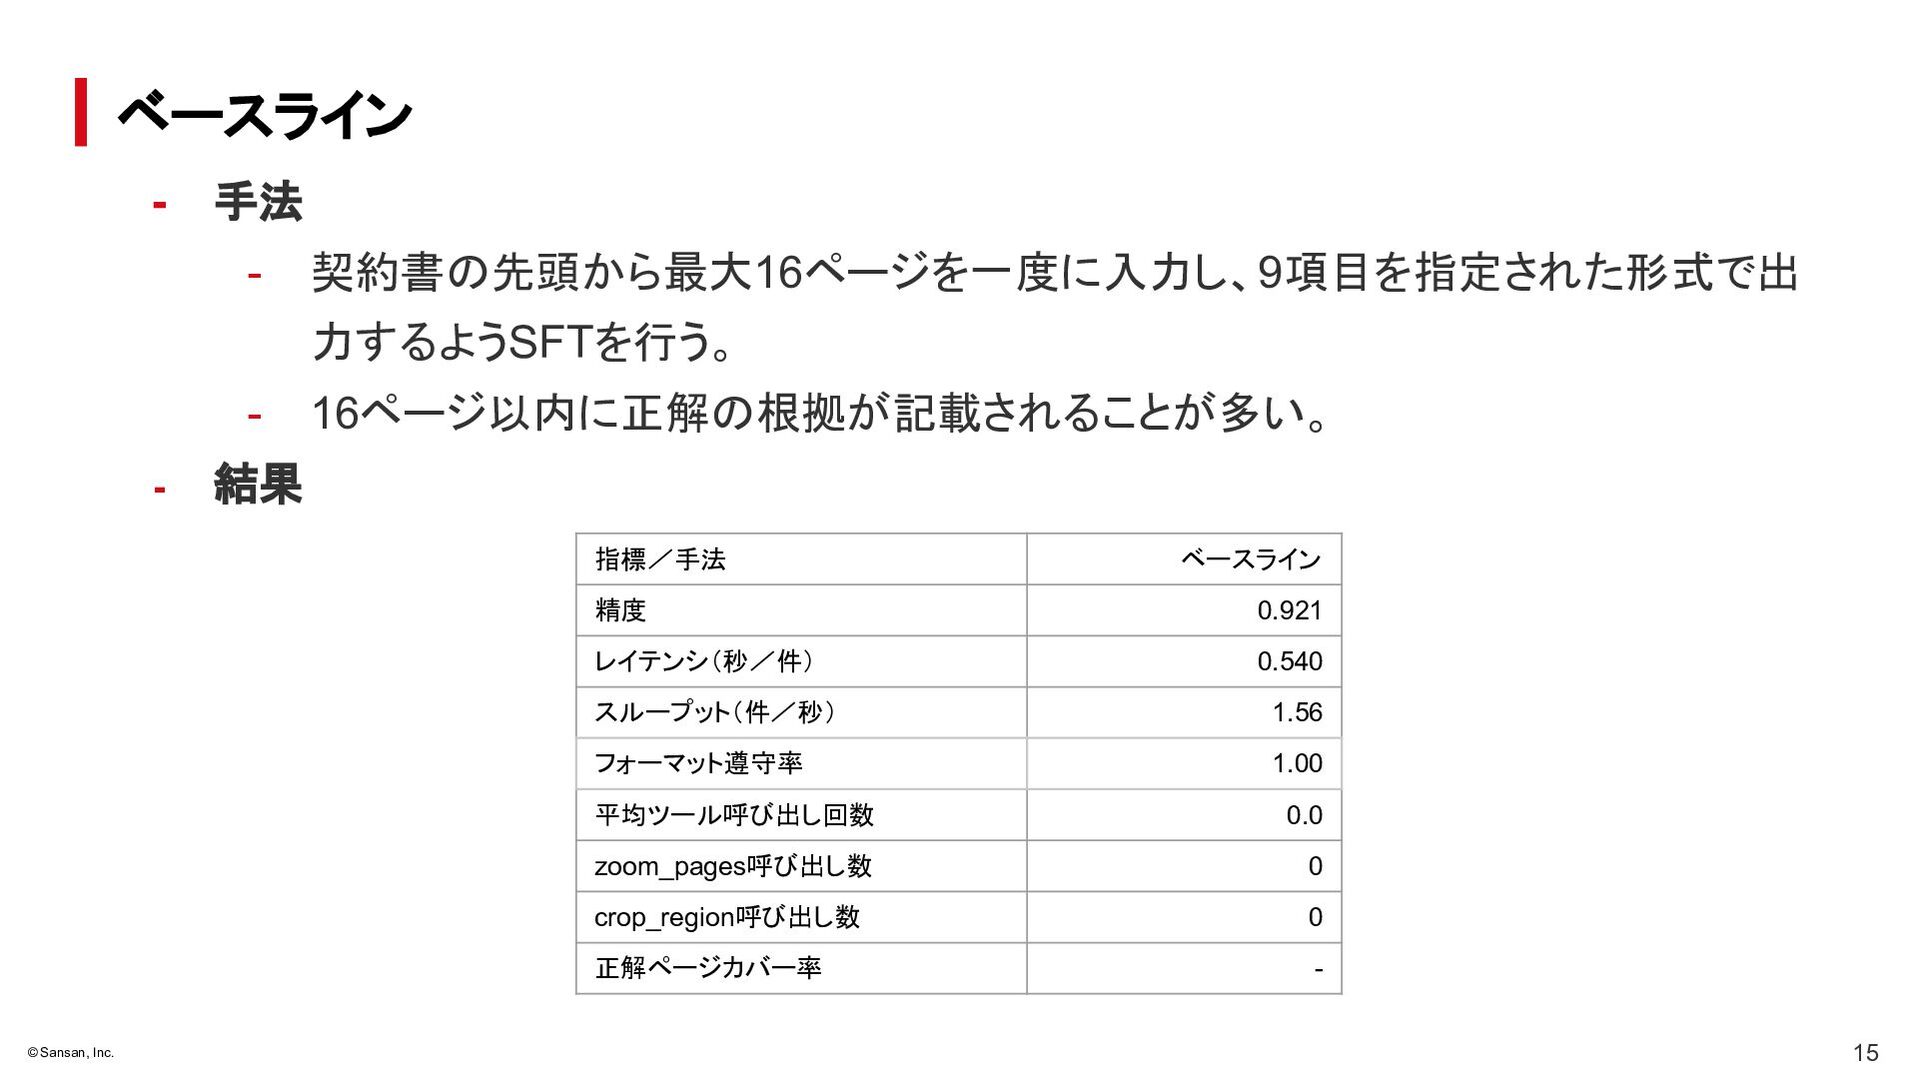
  11. ベースライン - 手法 - 契約書 先頭から最大16ページを一度に入力し、9項目を指定された形式で出 力するようSFTを行う。 - © Sansan,

    Inc. 16ページ以内に正解 根拠が記載されることが多い。 指標/手法 ベースライン 結果 精度 0.921 レイテンシ(秒/件) 0.540 スループット(件/秒) 1.56 フォーマット遵守率 1.00 平均ツール呼び出し回数 0.0 zoom_pages呼び出し数 0 crop_region呼び出し数 0 正解ページカバー率 15
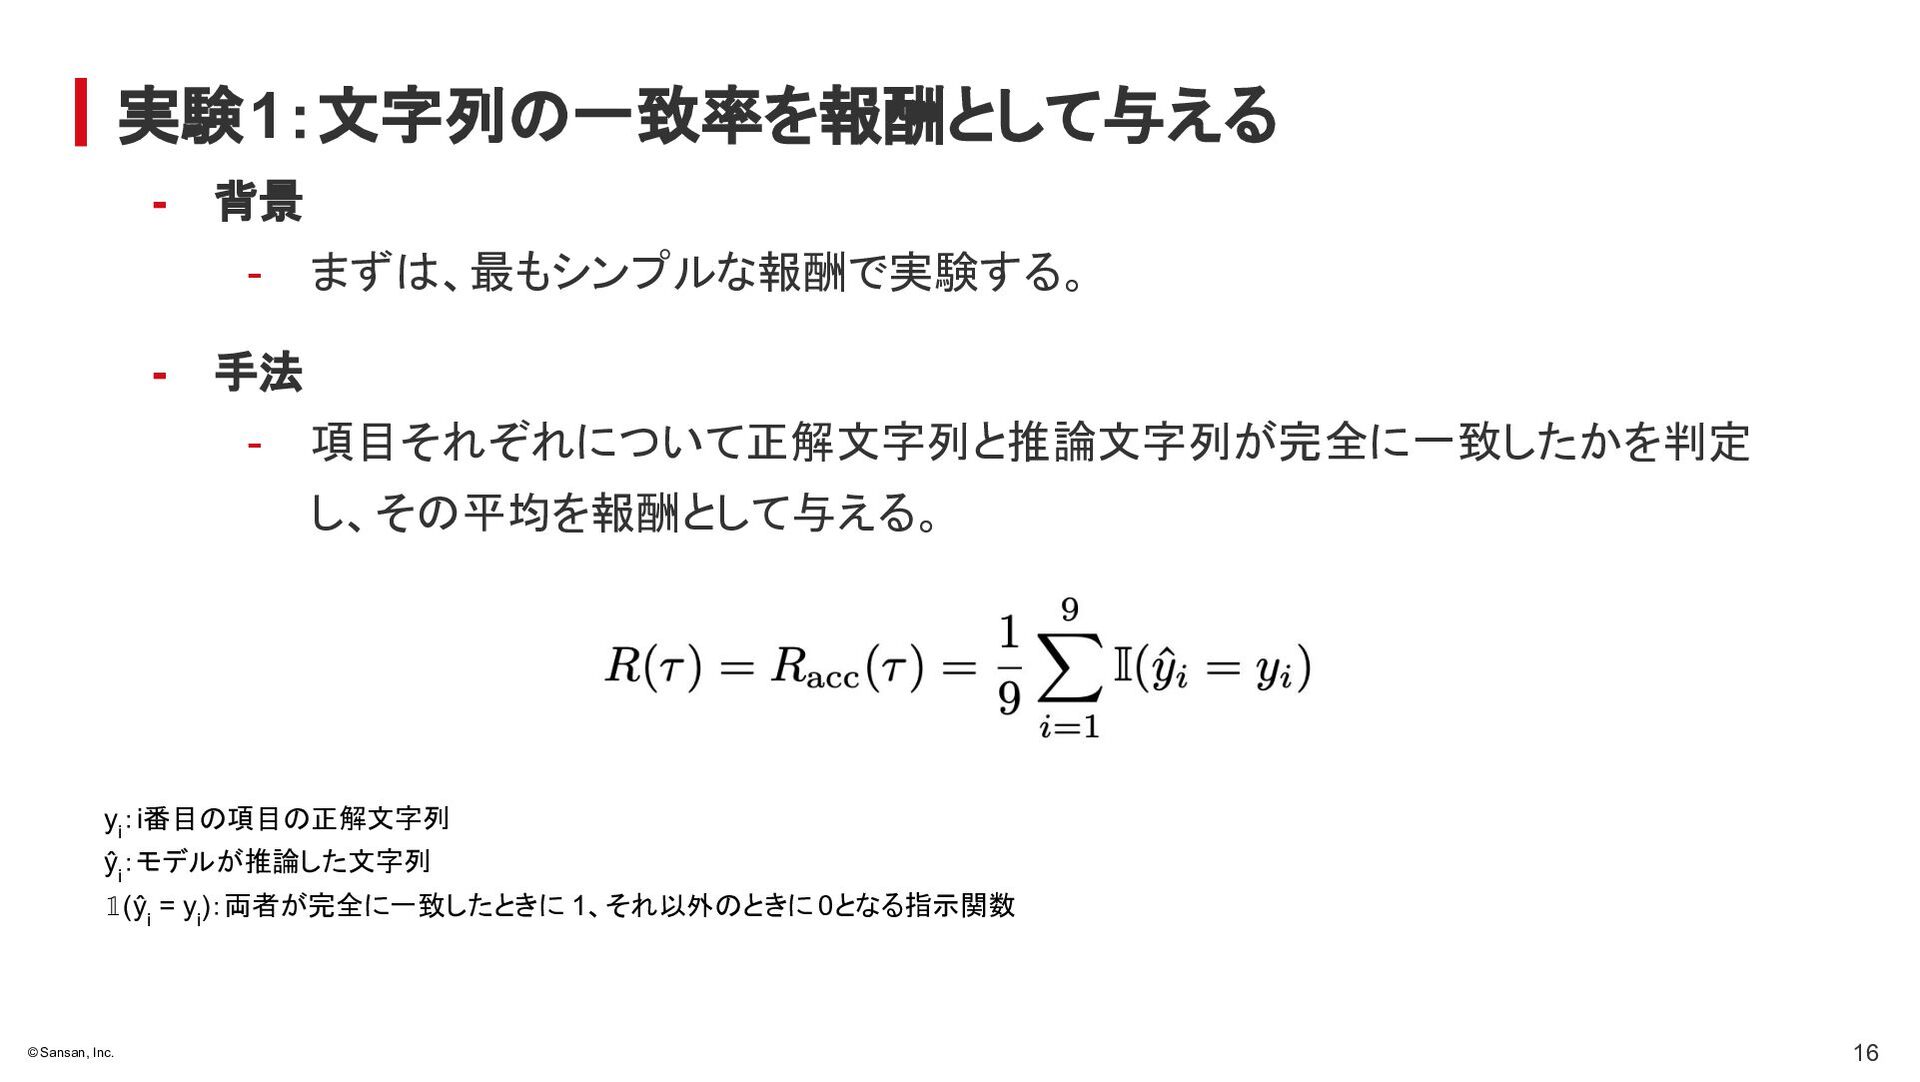
  12. 実験1:文字列 - 背景 - - 一致率を報酬として与える まず 、最もシンプルな報酬で実験する。 手法 -

    項目それぞれについて正解文字列と推論文字列が完全に一致したかを判定 し、そ 平均を報酬として与える。 yi:i番目 項目 正解文字列 ŷi:モデルが推論した文字列 𝟙(ŷi = yi):両者が完全に一致したときに 1、それ以外 © Sansan, Inc. ときに 0となる指示関数 16
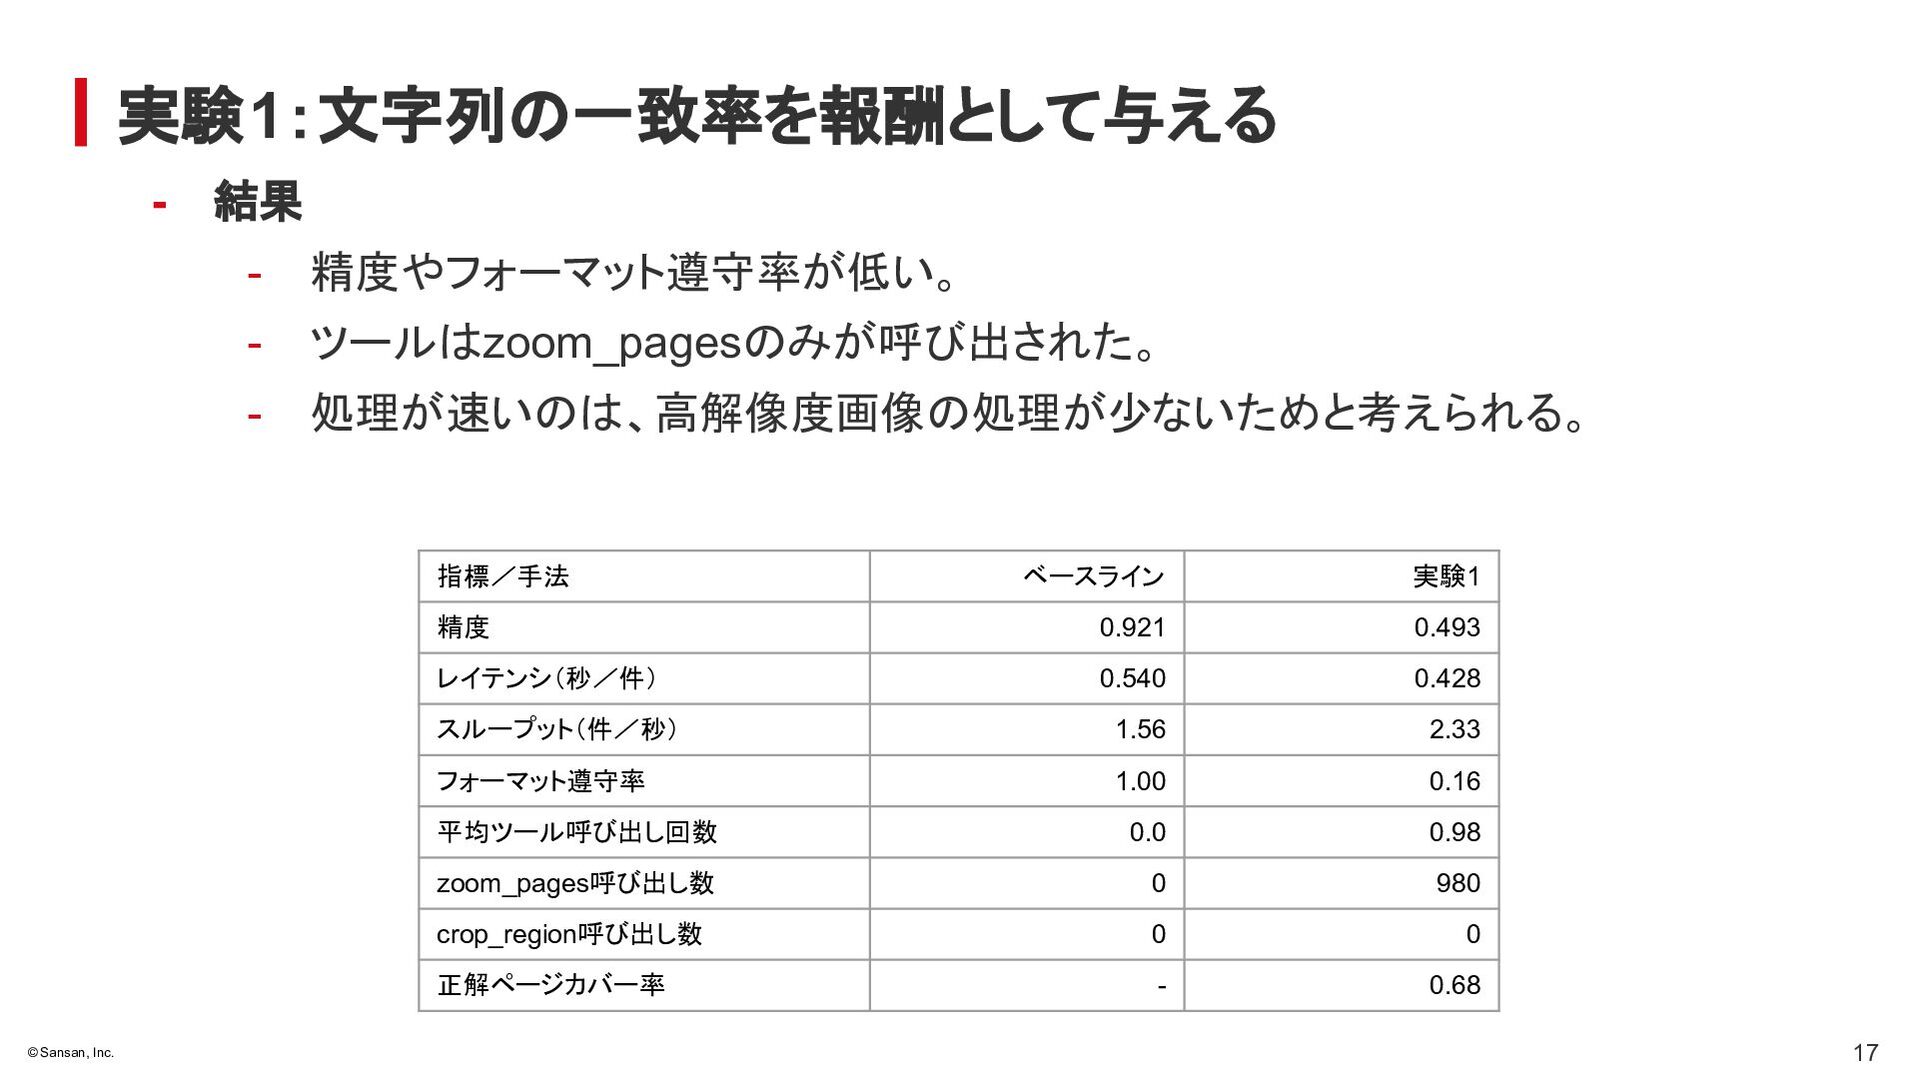
  13. 実験1:文字列 - 一致率を報酬として与える 結果 - 精度やフォーマット遵守率が低い。 - ツール - 処理が速い

    zoom_pages 、高解像度画像 指標/手法 © Sansan, Inc. みが呼び出された。 処理が少ないためと考えられる。 ベースライン 実験1 精度 0.921 0.493 レイテンシ(秒/件) 0.540 0.428 スループット(件/秒) 1.56 2.33 フォーマット遵守率 1.00 0.16 平均ツール呼び出し回数 0.0 0.98 zoom_pages呼び出し数 0 980 crop_region呼び出し数 0 0 正解ページカバー率 - 0.68 17
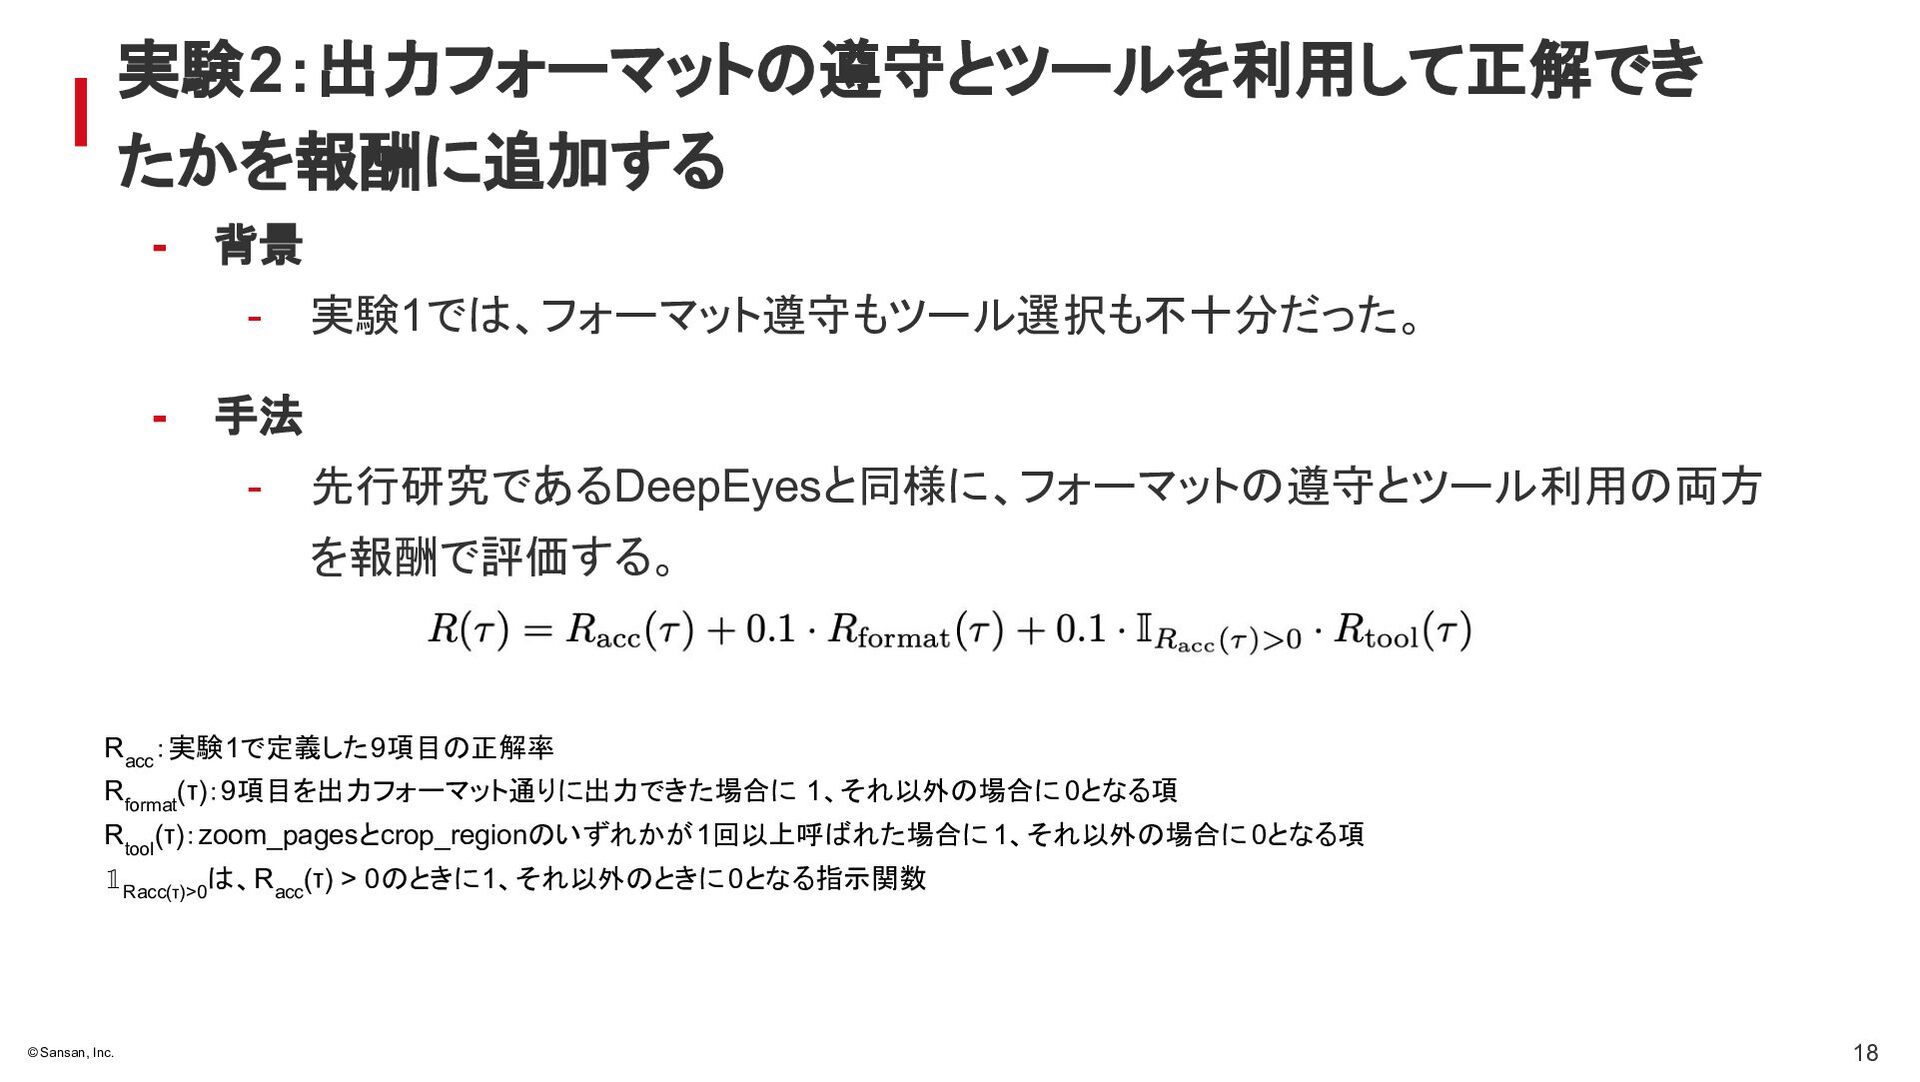
  14. 実験2:出力フォーマット たかを報酬に追加する - 背景 - - 遵守とツールを利用して正解でき 実験1で 、フォーマット遵守もツール選択も不十分だった。 手法

    - 先行研究であるDeepEyesと同様に、フォーマット 遵守とツール利用 両方 を報酬で評価する。 Racc:実験1で定義した9項目 正解率 Rformat(τ):9項目を出力フォーマット通りに出力できた場合に 1、それ以外 場合に 0となる項 Rtool(τ):zoom_pagesとcrop_region いずれかが 1回以上呼 𝟙Racc(τ)>0 、Racc(τ) > 0 © Sansan, Inc. ときに1、それ以外 れた場合に 1、それ以外 場合に 0となる項 ときに 0となる指示関数 18
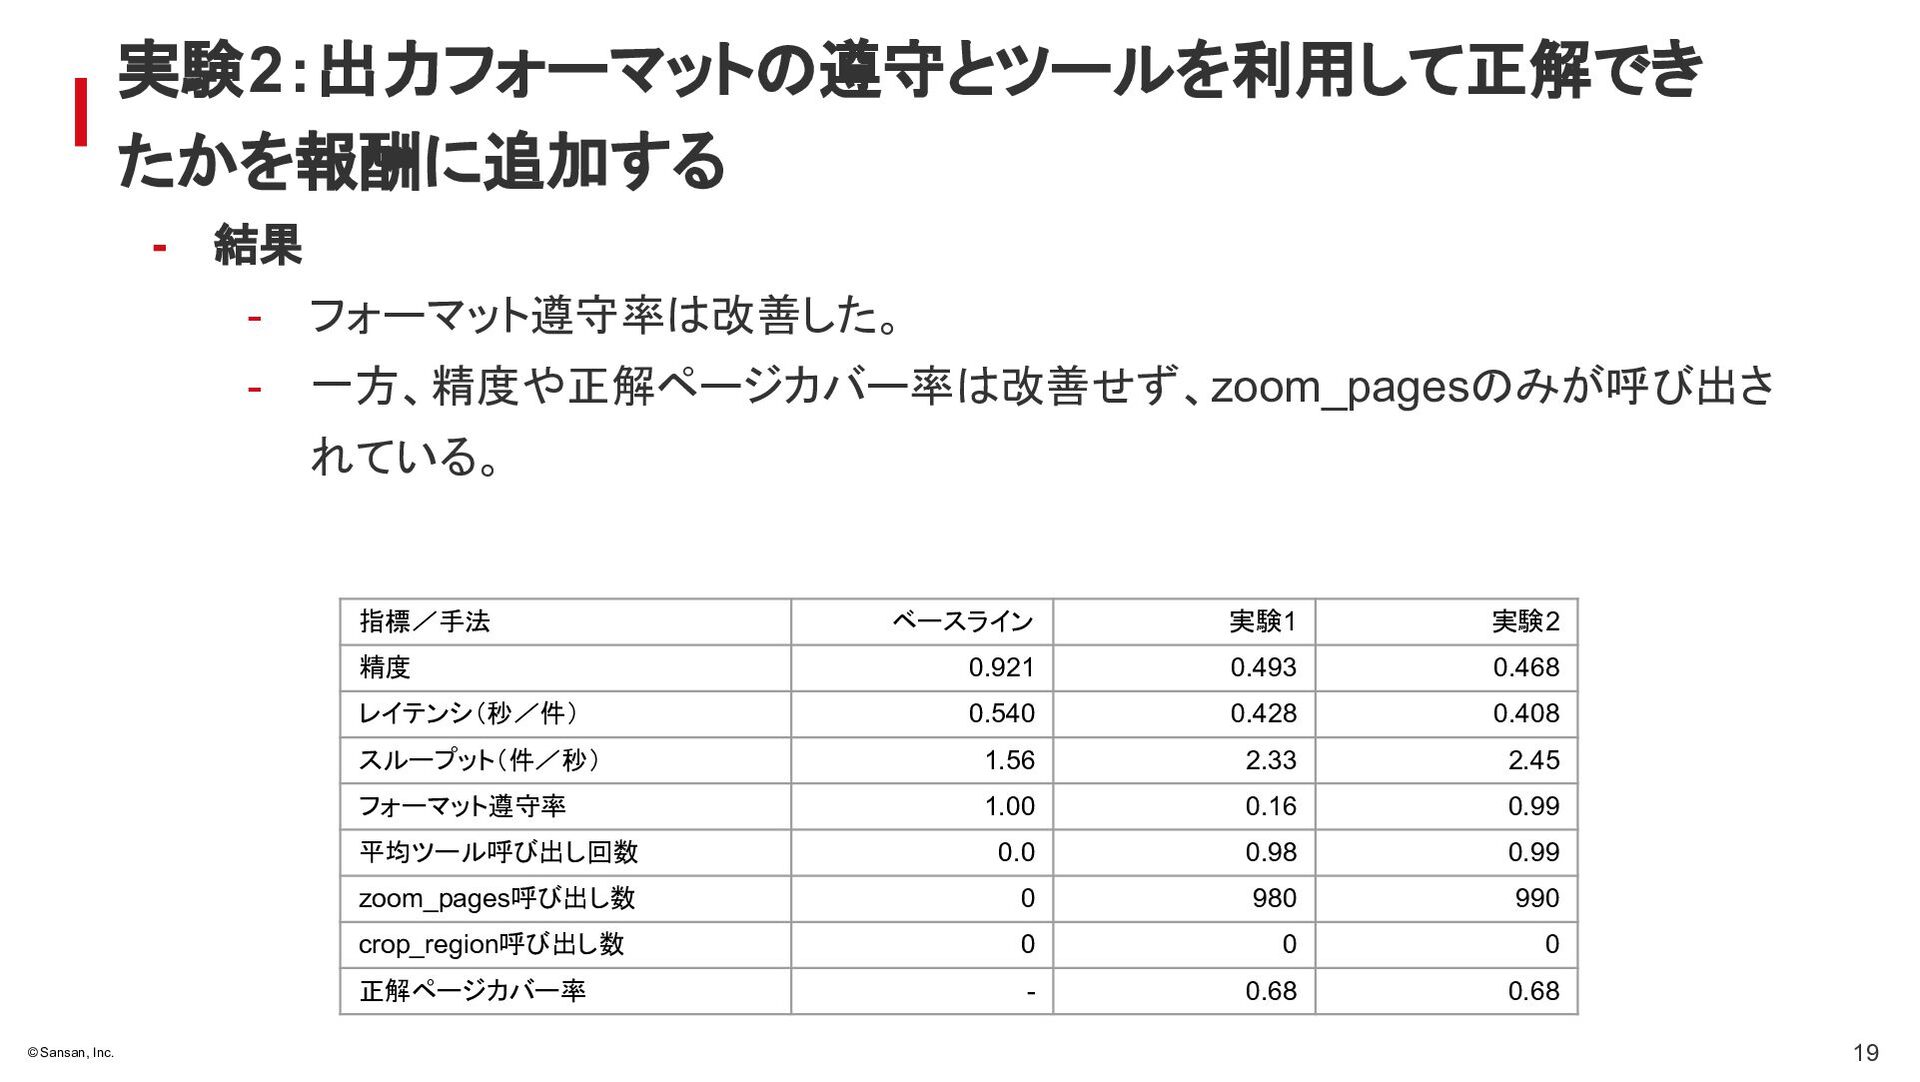
  15. 実験2:出力フォーマット たかを報酬に追加する - 遵守とツールを利用して正解でき 結果 - フォーマット遵守率 - 一方、精度や正解ページカバー率 改善した。

    改善せず、zoom_pages みが呼び出さ れている。 指標/手法 © Sansan, Inc. ベースライン 実験1 実験2 精度 0.921 0.493 0.468 レイテンシ(秒/件) 0.540 0.428 0.408 スループット(件/秒) 1.56 2.33 2.45 フォーマット遵守率 1.00 0.16 0.99 平均ツール呼び出し回数 0.0 0.98 0.99 zoom_pages呼び出し数 0 980 990 crop_region呼び出し数 0 0 0 正解ページカバー率 - 0.68 0.68 19
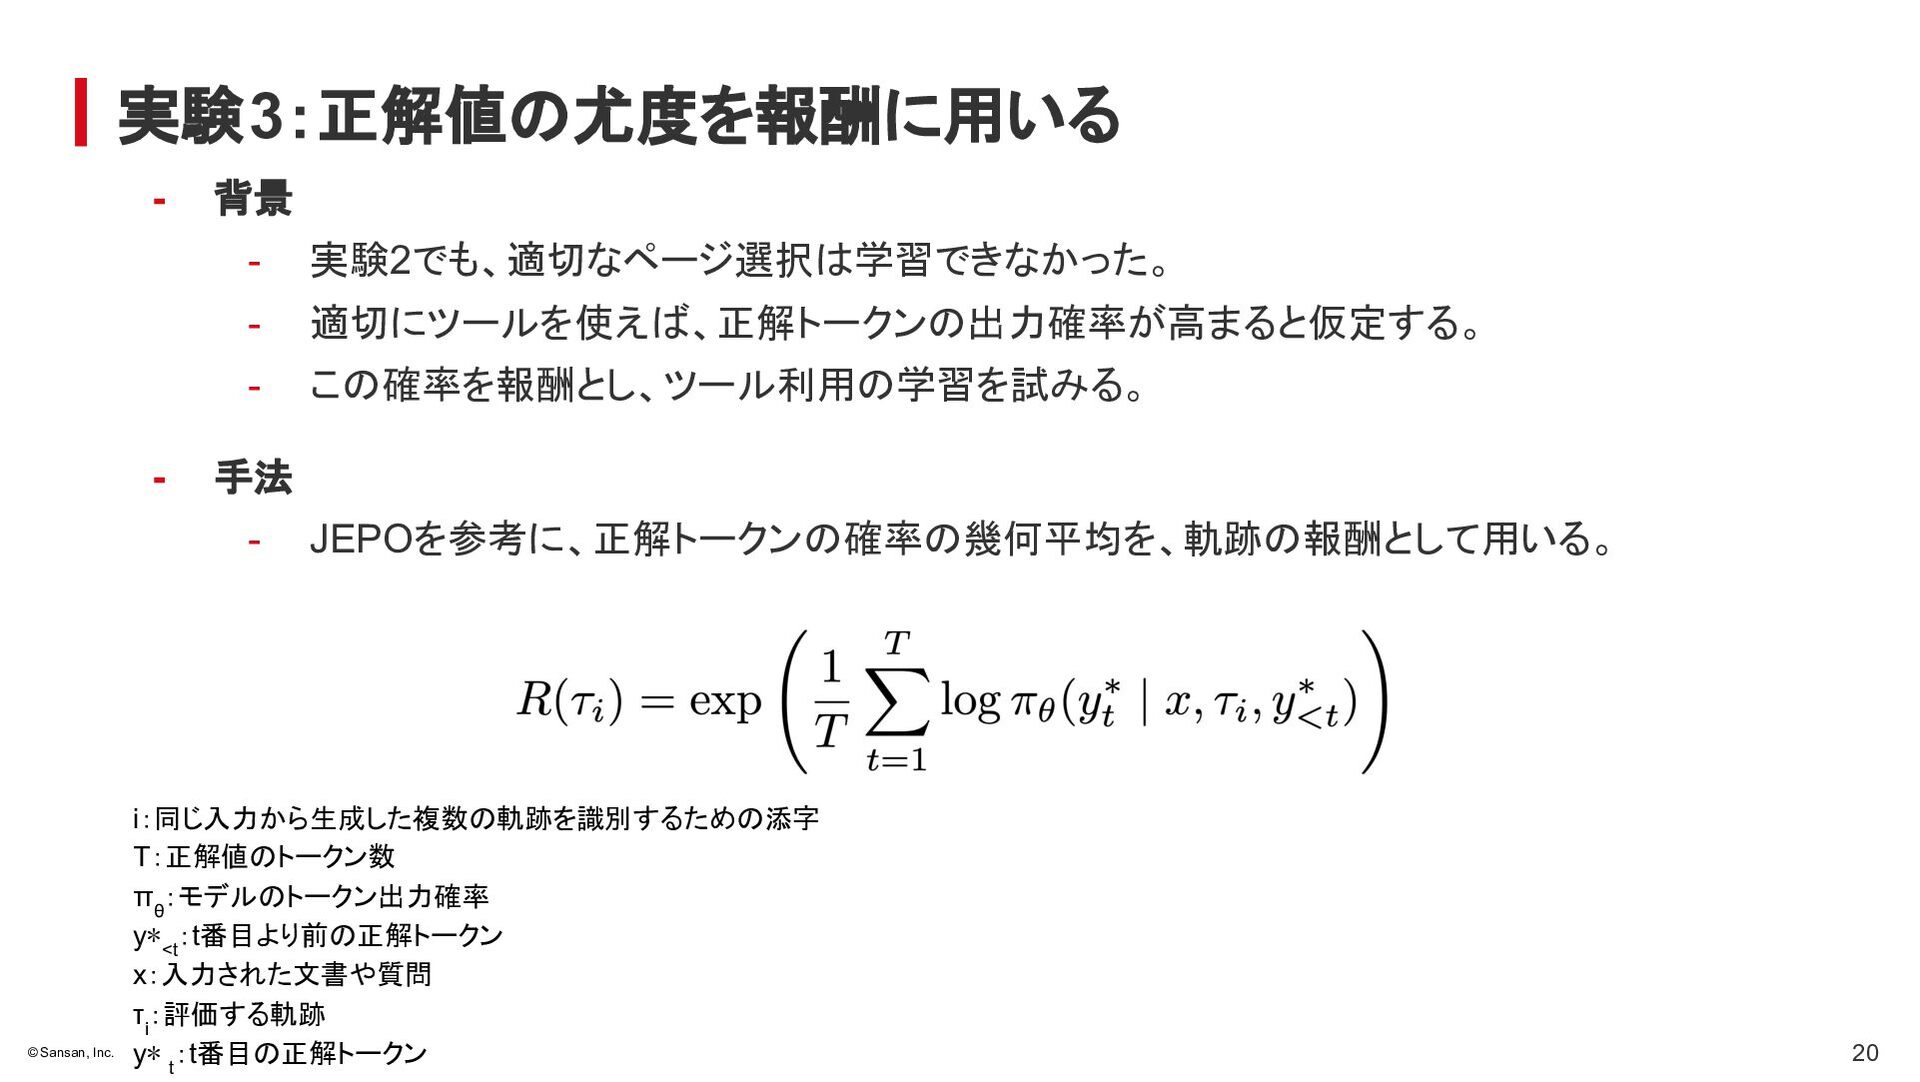
  16. 実験3:正解値 - - 尤度を報酬に用いる 背景 - 実験2でも、適切なページ選択 - 適切にツールを使え -

    こ 確率を報酬とし、ツール利用 学習できなかった。 、正解トークン 出力確率が高まると仮定する。 学習を試みる。 手法 - JEPOを参考に、正解トークン i:同じ入力から生成した複数 軌跡を識別するため T:正解値 トークン数 πθ:モデル トークン出力確率 y∗<t:t番目より前 正解トークン x:入力された文書や質問 τi:評価する軌跡 © Sansan, Inc. y∗ :t番目 正解トークン t 確率 幾何平均を、軌跡 報酬として用いる。 添字 20
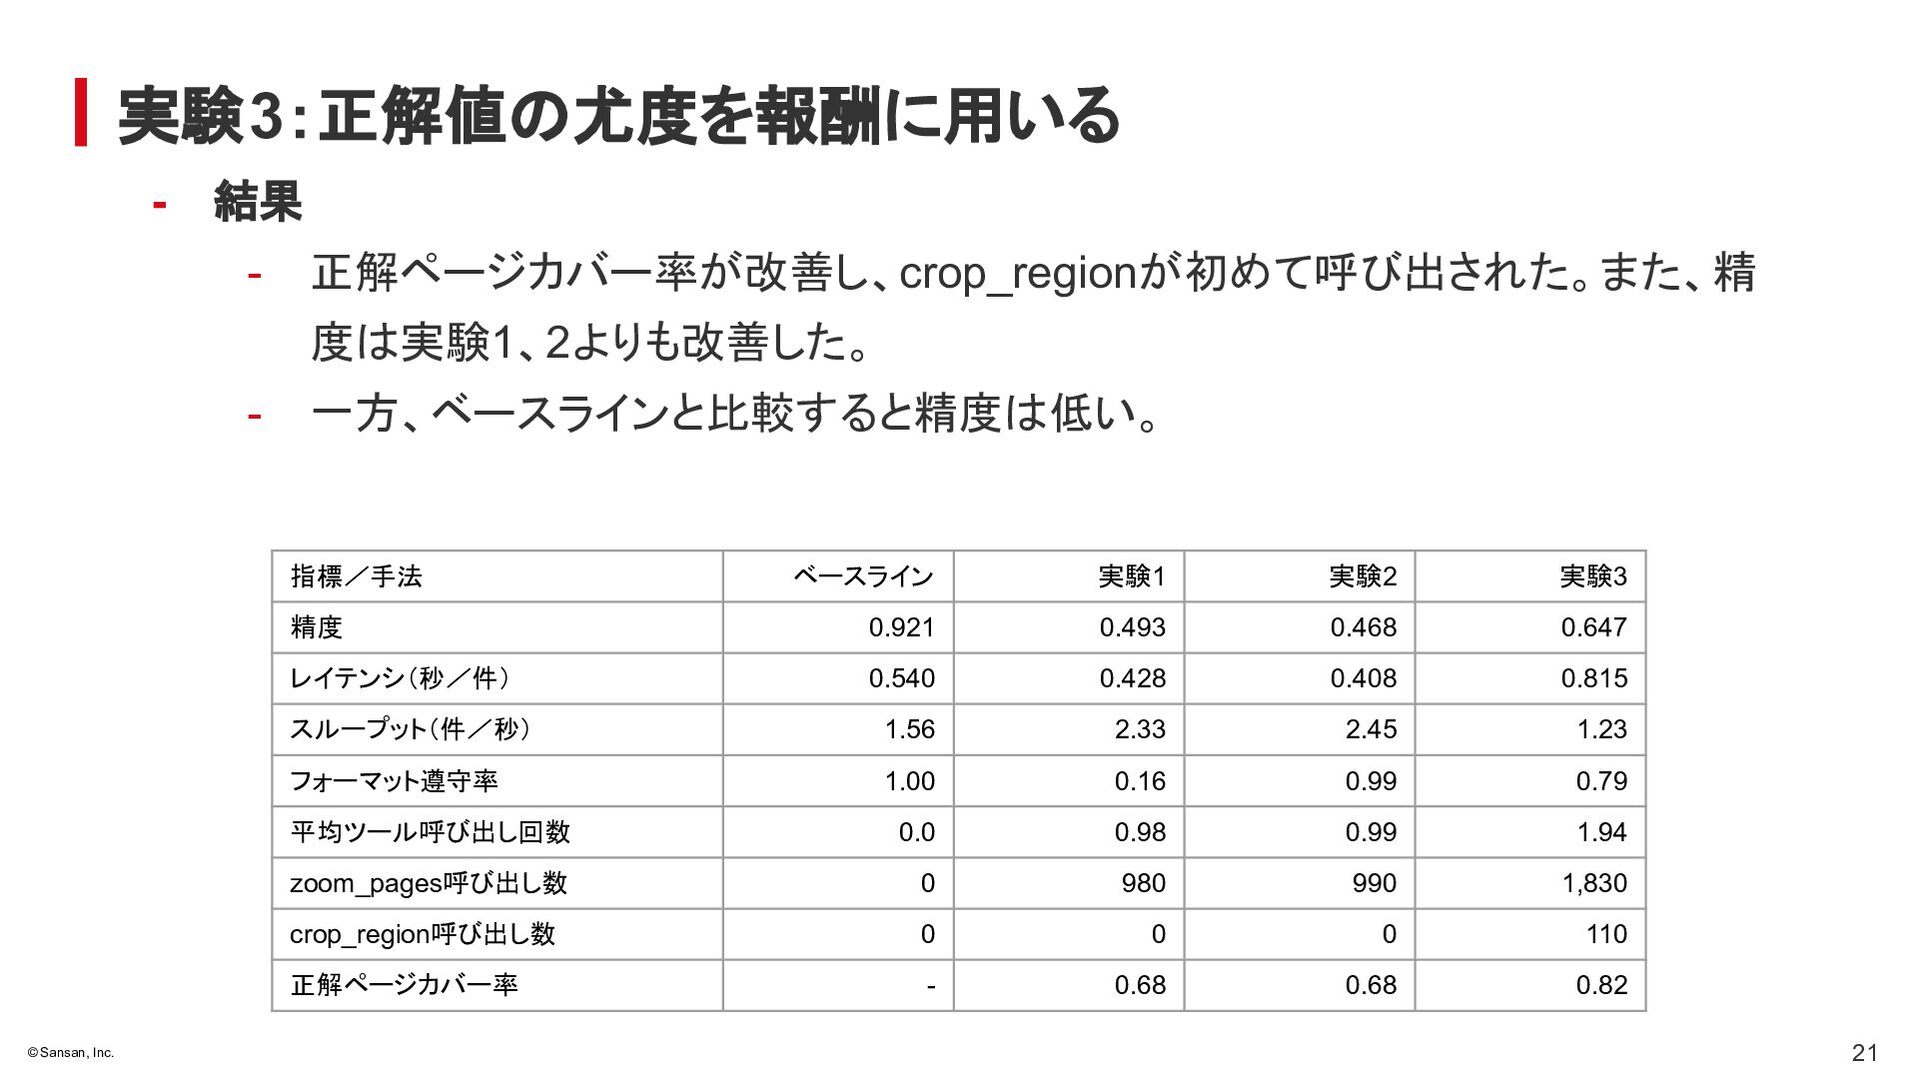
  17. 実験3:正解値 - 尤度を報酬に用いる 結果 - 正解ページカバー率が改善し、crop_regionが初めて呼び出された。また、精 度 実験1、2よりも改善した。 - 一方、ベースラインと比較すると精度

    指標/手法 © Sansan, Inc. 低い。 ベースライン 実験1 実験2 実験3 精度 0.921 0.493 0.468 0.647 レイテンシ(秒/件) 0.540 0.428 0.408 0.815 スループット(件/秒) 1.56 2.33 2.45 1.23 フォーマット遵守率 1.00 0.16 0.99 0.79 平均ツール呼び出し回数 0.0 0.98 0.99 1.94 zoom_pages呼び出し数 0 980 990 1,830 crop_region呼び出し数 0 0 0 110 正解ページカバー率 - 0.68 0.68 0.82 21
  18. 実験3 追加実験:視覚トークン数を近づけた VLMと 比較 - 背景 - これまで 実験で 、ベースラインであるVLMに

    最大16ページ 高解像度 画像を一度に入力する に対し、エージェントに サムネイル画像に加え、 zoom_pagesおよびcrop_regionが返した画像を入力している。 - そ ため、両者に入力される視覚トークン数に 大きな差がある。 目的 - 公平な比較 ために、入力される視覚トークン数が近い条件にて再比較を行 う。 © Sansan, Inc. 22
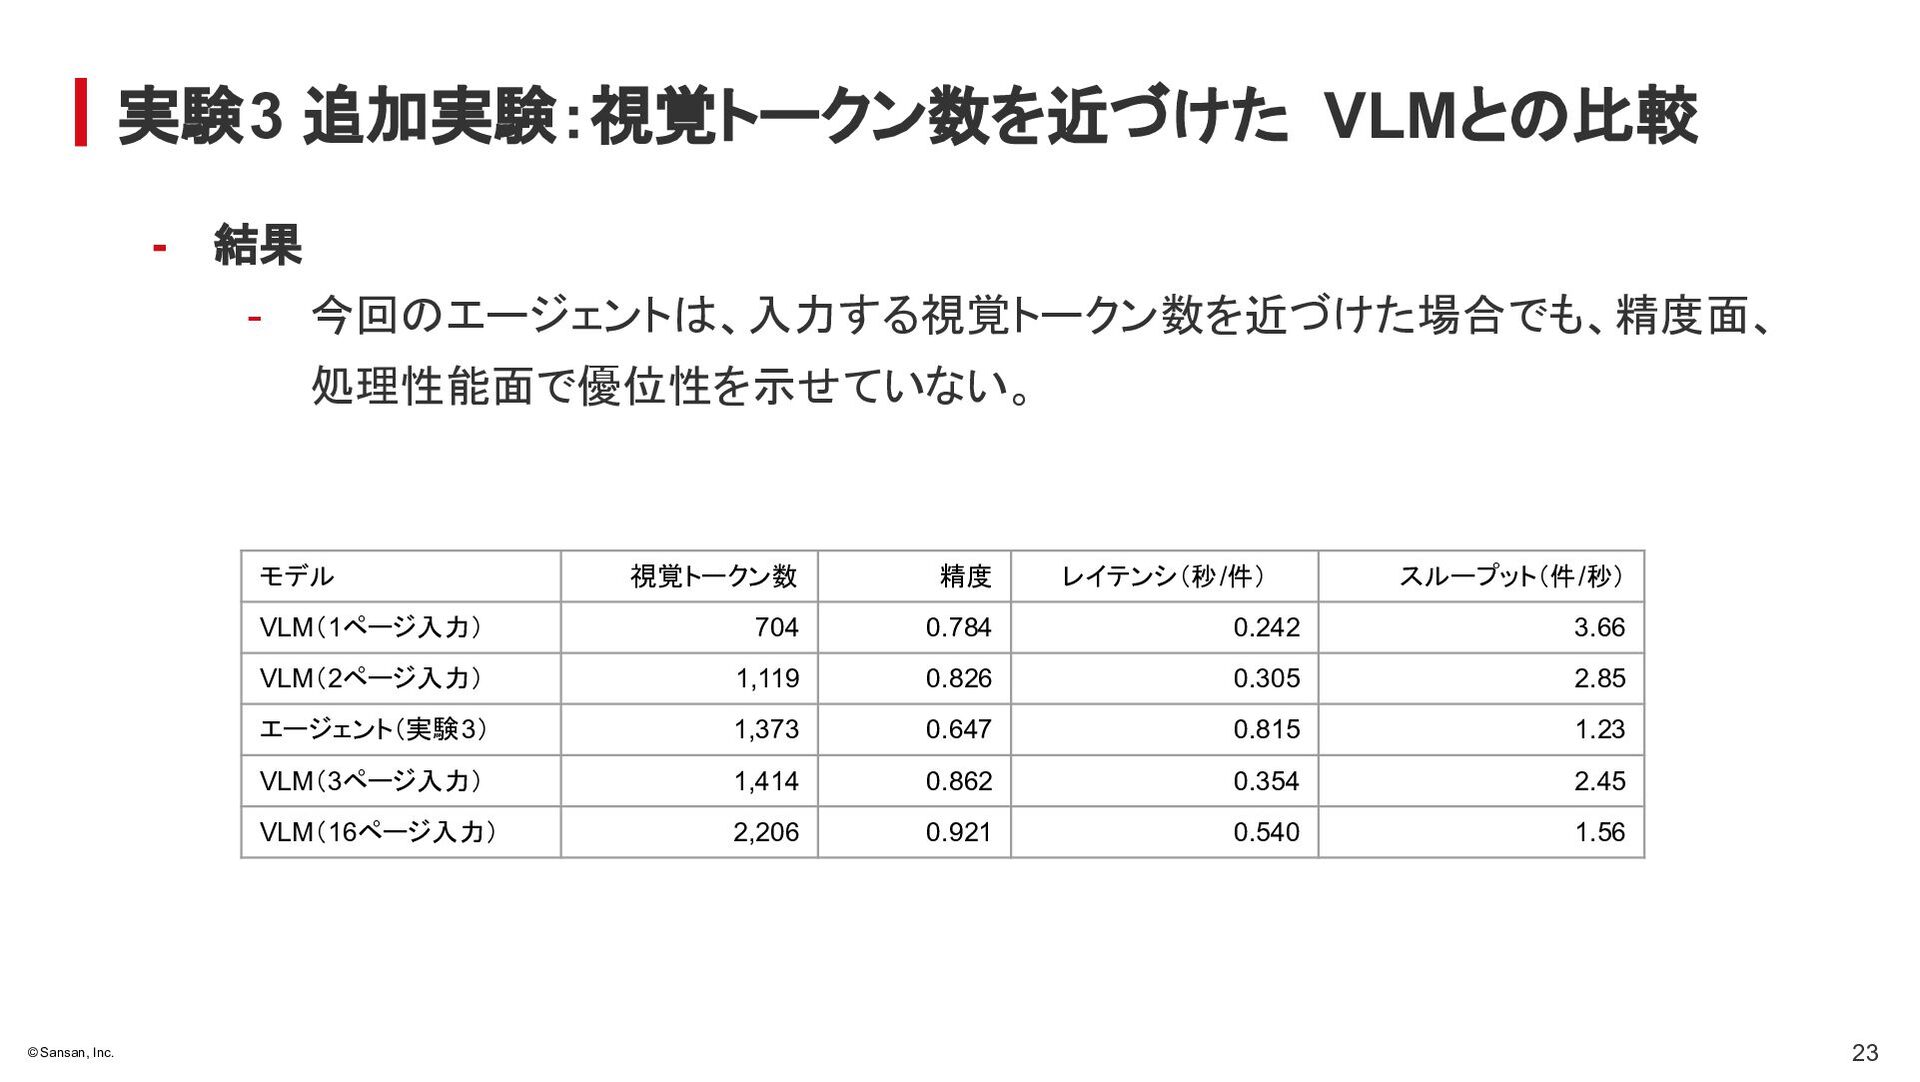
  19. 実験3 追加実験:視覚トークン数を近づけた VLMと 比較 - 結果 - 今回 エージェント 、入力する視覚トークン数を近づけた場合でも、精度面、

    処理性能面で優位性を示せていない。 モデル © Sansan, Inc. 視覚トークン数 精度 レイテンシ(秒/件) スループット(件/秒) VLM(1ページ入力) 704 0.784 0.242 3.66 VLM(2ページ入力) 1,119 0.826 0.305 2.85 エージェント(実験3) 1,373 0.647 0.815 1.23 VLM(3ページ入力) 1,414 0.862 0.354 2.45 VLM(16ページ入力) 2,206 0.921 0.540 1.56 23
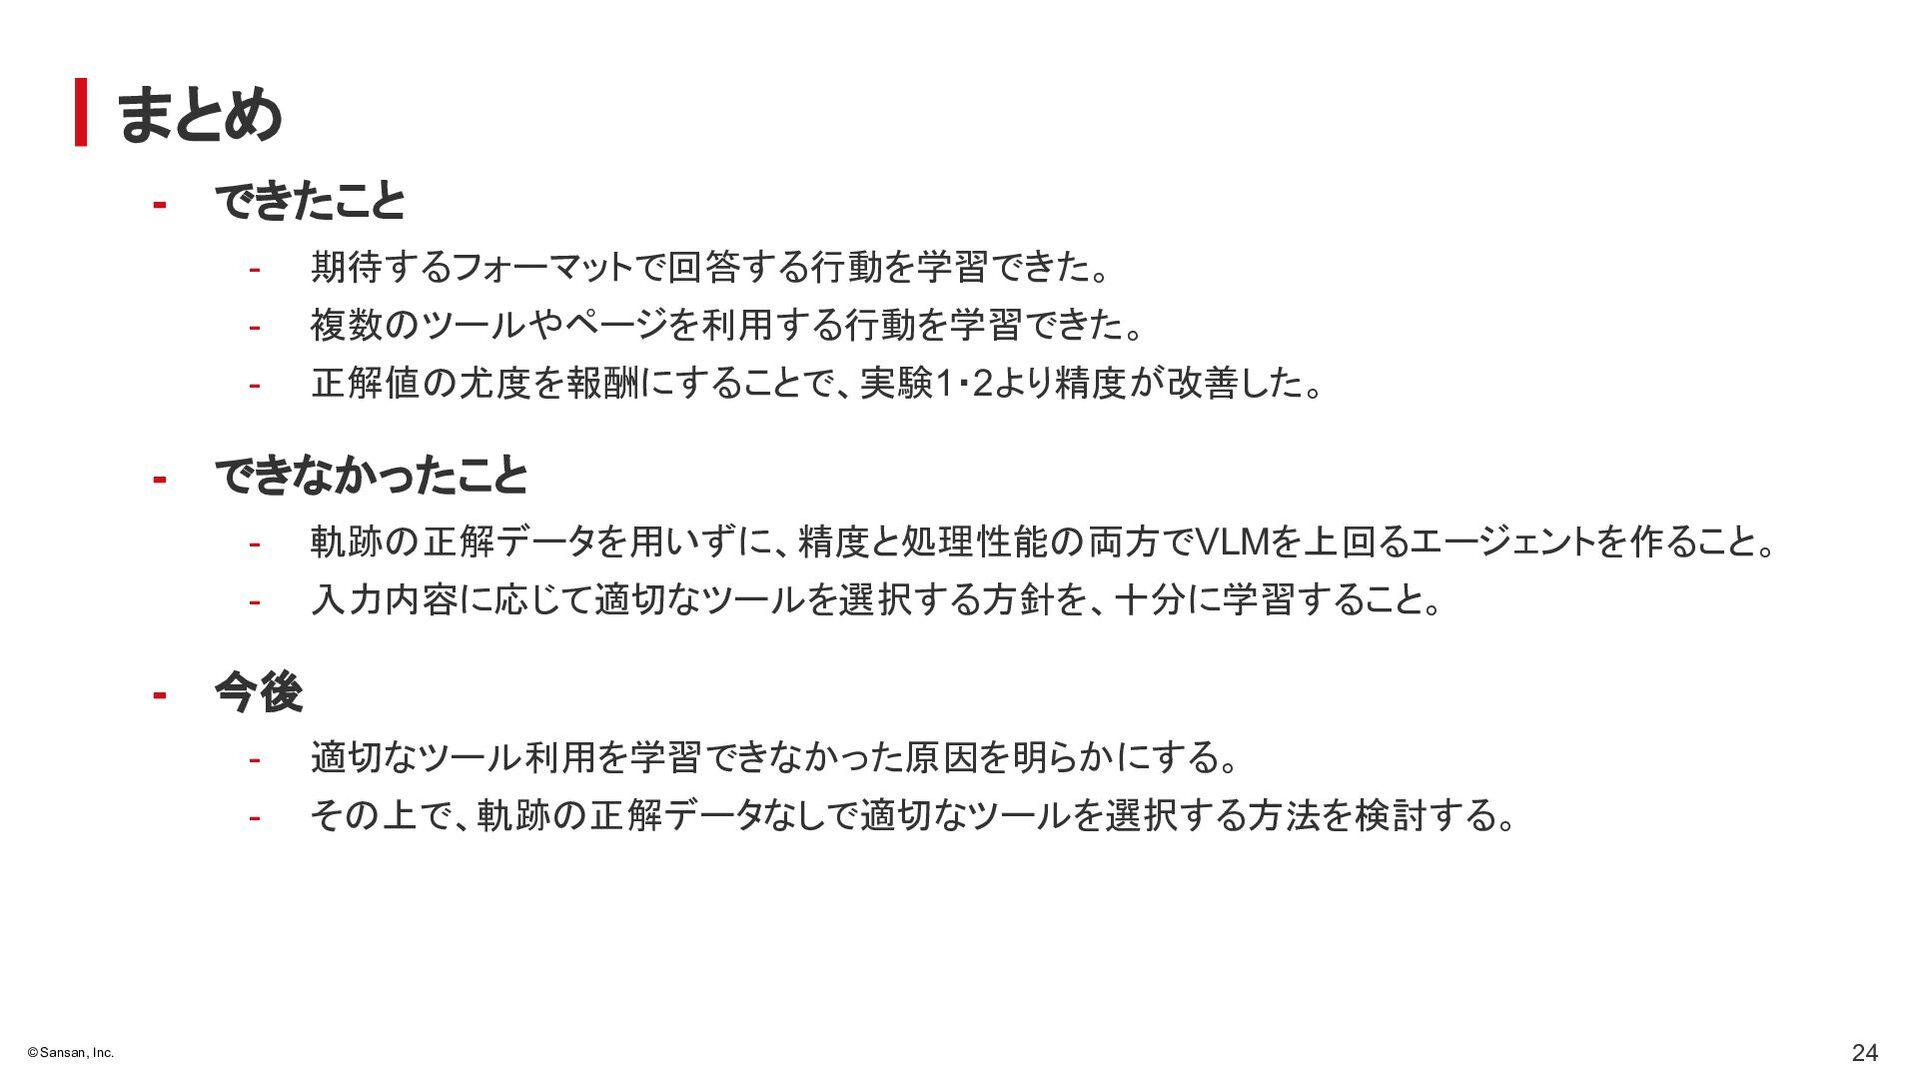
  20. まとめ - - - © Sansan, Inc. できたこと - 期待するフォーマットで回答する行動を学習できた。

    - 複数 ツールやページを利用する行動を学習できた。 - 正解値 尤度を報酬にすることで、実験1・2より精度が改善した。 できなかったこと - 軌跡 正解データを用いずに、精度と処理性能 両方でVLMを上回るエージェントを作ること。 - 入力内容に応じて適切なツールを選択する方針を、十分に学習すること。 今後 - 適切なツール利用を学習できなかった原因を明らかにする。 - そ 上で、軌跡 正解データなしで適切なツールを選択する方法を検討する。 24
  21. 参考文献 [1] Minesh Mathew, Dimosthenis Karatzas, and C. V. Jawahar.

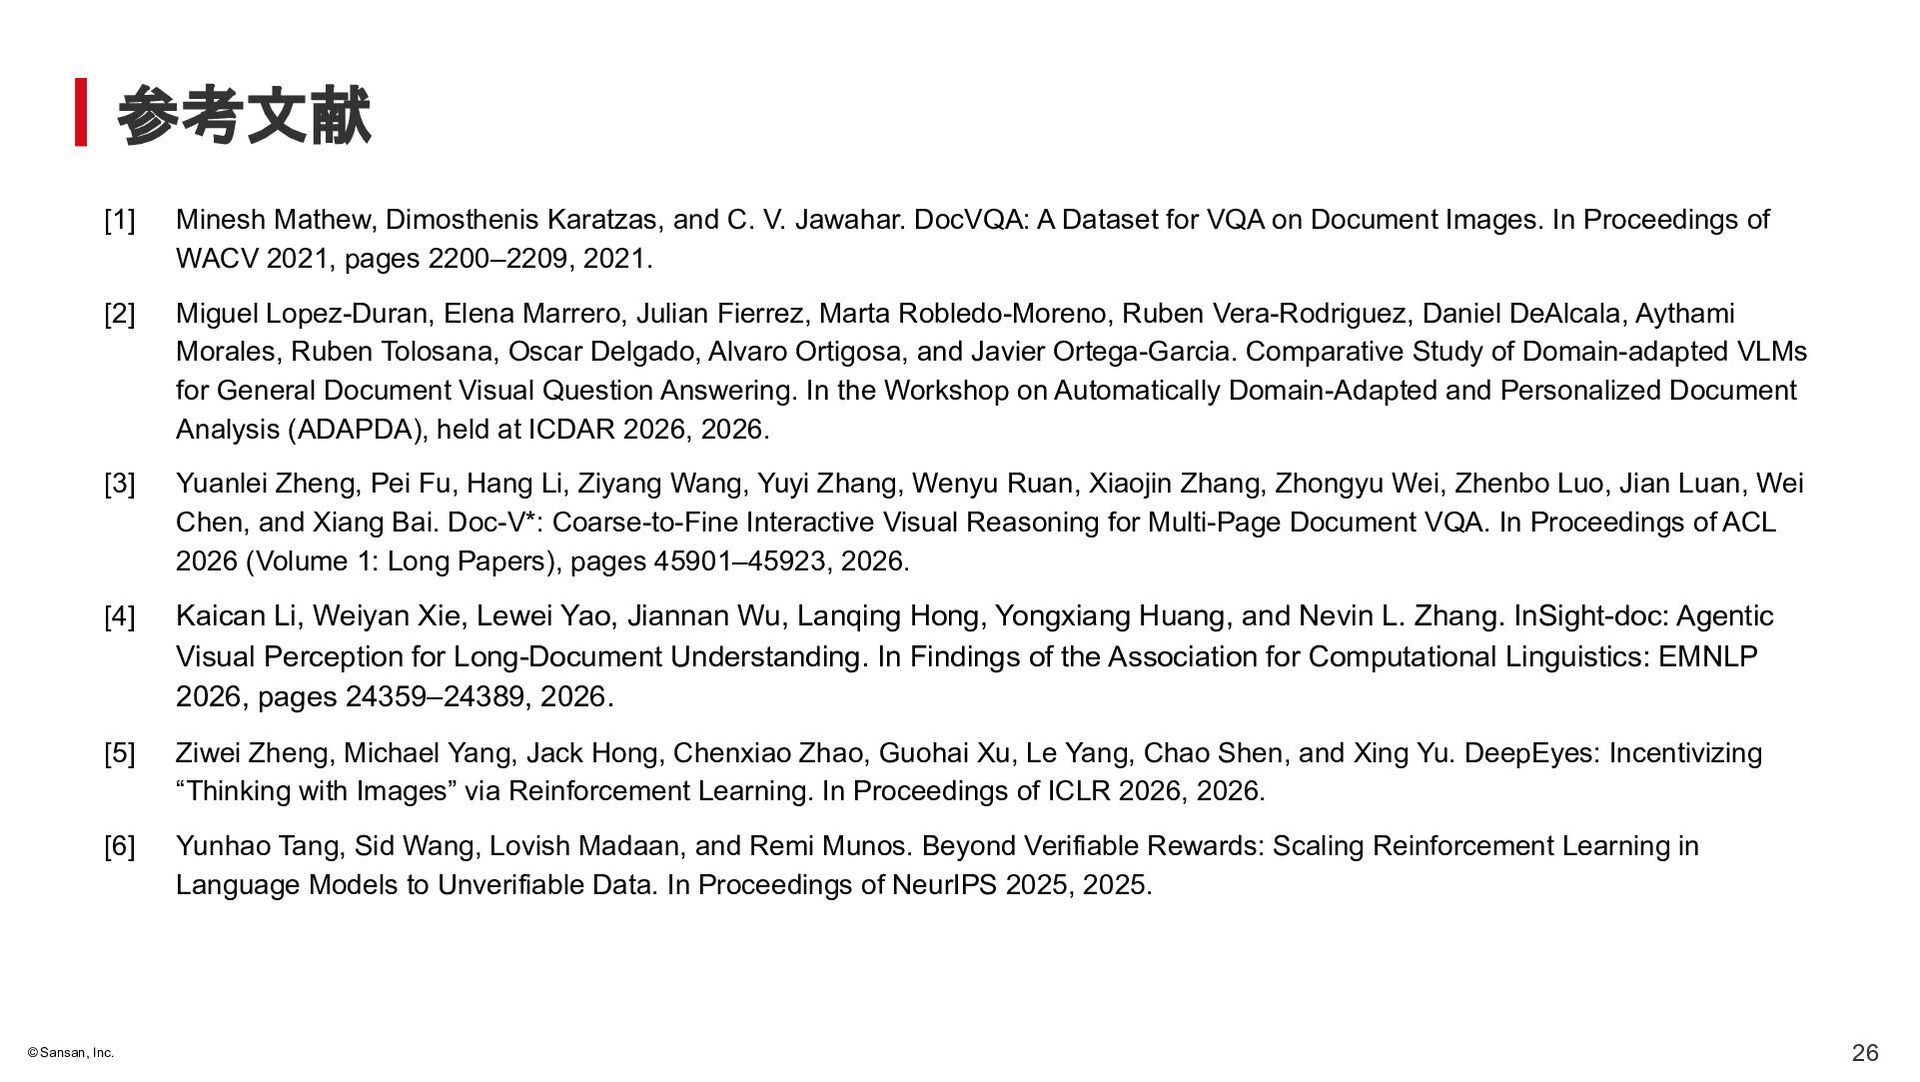
    DocVQA: A Dataset for VQA on Document Images. In Proceedings of WACV 2021, pages 2200–2209, 2021. [2] Miguel Lopez-Duran, Elena Marrero, Julian Fierrez, Marta Robledo-Moreno, Ruben Vera-Rodriguez, Daniel DeAlcala, Aythami Morales, Ruben Tolosana, Oscar Delgado, Alvaro Ortigosa, and Javier Ortega-Garcia. Comparative Study of Domain-adapted VLMs for General Document Visual Question Answering. In the Workshop on Automatically Domain-Adapted and Personalized Document Analysis (ADAPDA), held at ICDAR 2026, 2026. [3] Yuanlei Zheng, Pei Fu, Hang Li, Ziyang Wang, Yuyi Zhang, Wenyu Ruan, Xiaojin Zhang, Zhongyu Wei, Zhenbo Luo, Jian Luan, Wei Chen, and Xiang Bai. Doc-V*: Coarse-to-Fine Interactive Visual Reasoning for Multi-Page Document VQA. In Proceedings of ACL 2026 (Volume 1: Long Papers), pages 45901–45923, 2026. [4] Kaican Li, Weiyan Xie, Lewei Yao, Jiannan Wu, Lanqing Hong, Yongxiang Huang, and Nevin L. Zhang. InSight-doc: Agentic Visual Perception for Long-Document Understanding. In Findings of the Association for Computational Linguistics: EMNLP 2026, pages 24359–24389, 2026. [5] Ziwei Zheng, Michael Yang, Jack Hong, Chenxiao Zhao, Guohai Xu, Le Yang, Chao Shen, and Xing Yu. DeepEyes: Incentivizing “Thinking with Images” via Reinforcement Learning. In Proceedings of ICLR 2026, 2026. [6] Yunhao Tang, Sid Wang, Lovish Madaan, and Remi Munos. Beyond Verifiable Rewards: Scaling Reinforcement Learning in Language Models to Unverifiable Data. In Proceedings of NeurIPS 2025, 2025. © Sansan, Inc. 26

More Decks by SansanTech

Other Decks in Technology