Upgrade to Pro — share decks privately, control downloads, hide ads and more …

フィジカルAIの社会実装に向けて -AIエージェントからAgentic Roboticsへ-

フィジカルAIの社会実装に向けて -AIエージェントからAgentic Roboticsへ-

1. AIの現在地 - 生成AIからエージェントAIへ
2. フィジカルAIの最前線
3. MPRGでの取り組み
4. フィジカルAIの今後 -Agentic Robotics-

Avatar for Hironobu Fujiyoshi

Hironobu Fujiyoshi

October 15, 2026

More Decks by Hironobu Fujiyoshi

Other Decks in Research

Transcript

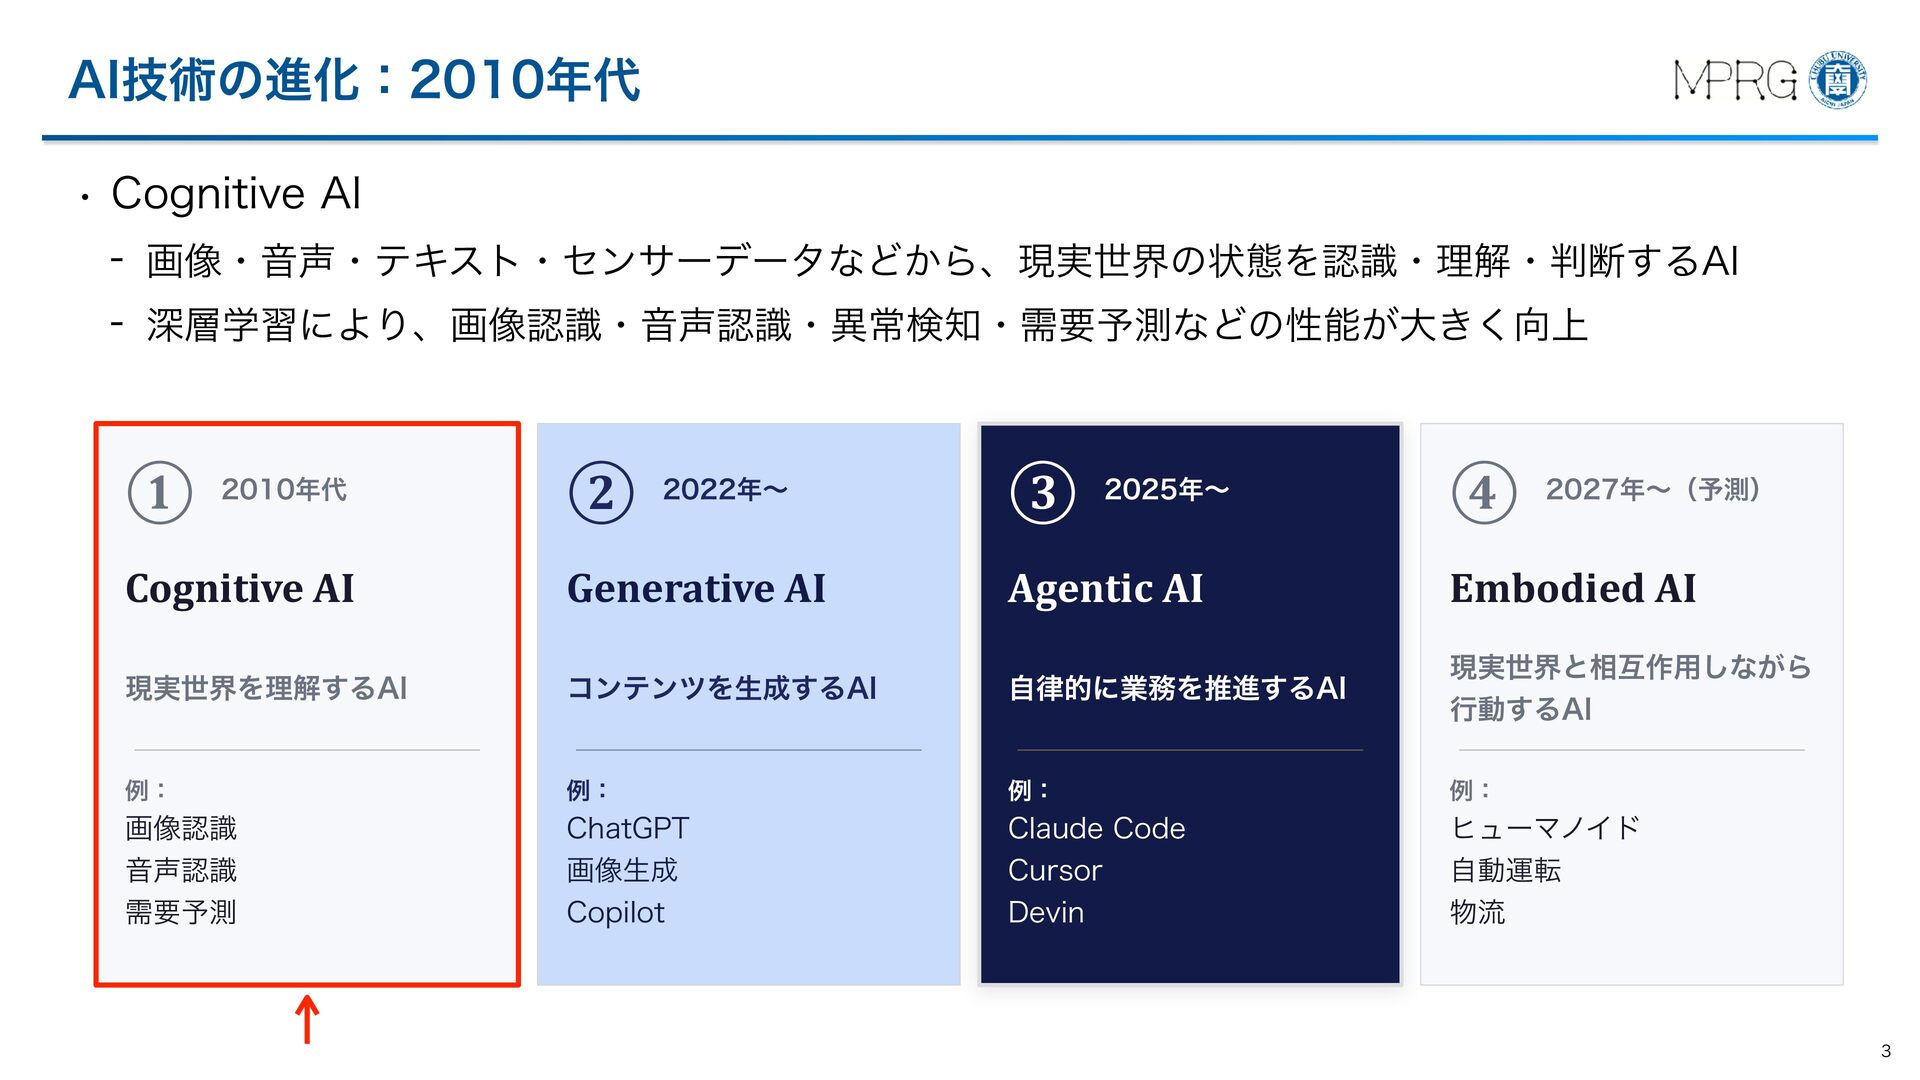
  1. AI技術の進化:2010年代 • Cognitive AI - 画像・音声・テキスト・センサーデータなどから、現実世界の状態を認識・理解・判断するAI - 深層学習により、画像認識・音声認識・異常検知・需要予測などの性能が大きく向上 ① 2010年代

    ② 2022年〜 ③ 2025年〜 ④ 2027年〜(予測) Cognitive AI Generative AI Agentic AI Embodied AI 現実世界を理解するAI コンテンツを生成するAI 自律的に業務を推進するAI 現実世界と相互作用しながら 行動するAI 例: 例: 例: 例: 画像認識 音声認識 需要予測 ChatGPT 画像生成 Copilot Claude Code Cursor Devin ヒューマノイド 自動運転 物流 3
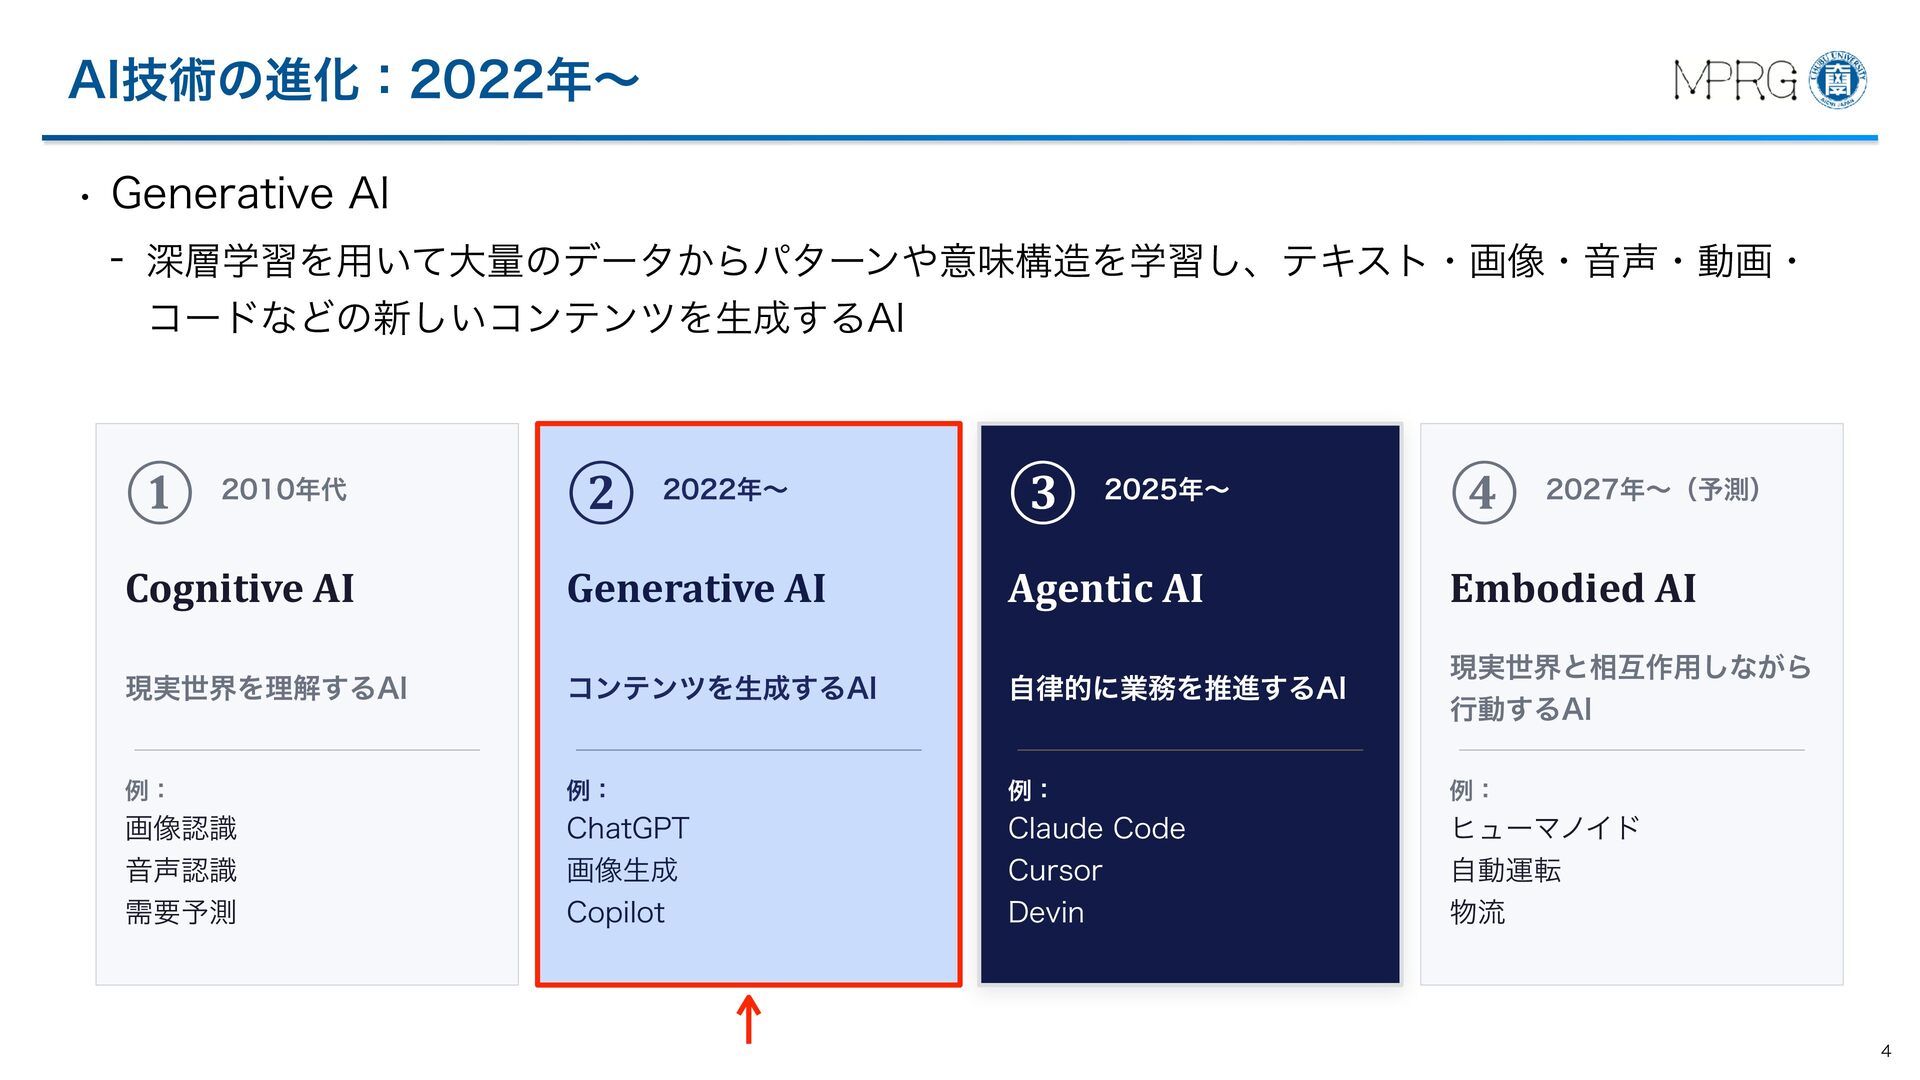
  2. AI技術の進化:2022年〜 • Generative AI - 深層学習を用いて大量のデータからパターンや意味構造を学習し、テキスト・画像・音声・動画・ コードなどの新しいコンテンツを生成するAI ① 2010年代 ②

    2022年〜 ③ 2025年〜 ④ 2027年〜(予測) Cognitive AI Generative AI Agentic AI Embodied AI 現実世界を理解するAI コンテンツを生成するAI 自律的に業務を推進するAI 現実世界と相互作用しながら 行動するAI 例: 例: 例: 例: 画像認識 音声認識 需要予測 ChatGPT 画像生成 Copilot Claude Code Cursor Devin ヒューマノイド 自動運転 物流 4
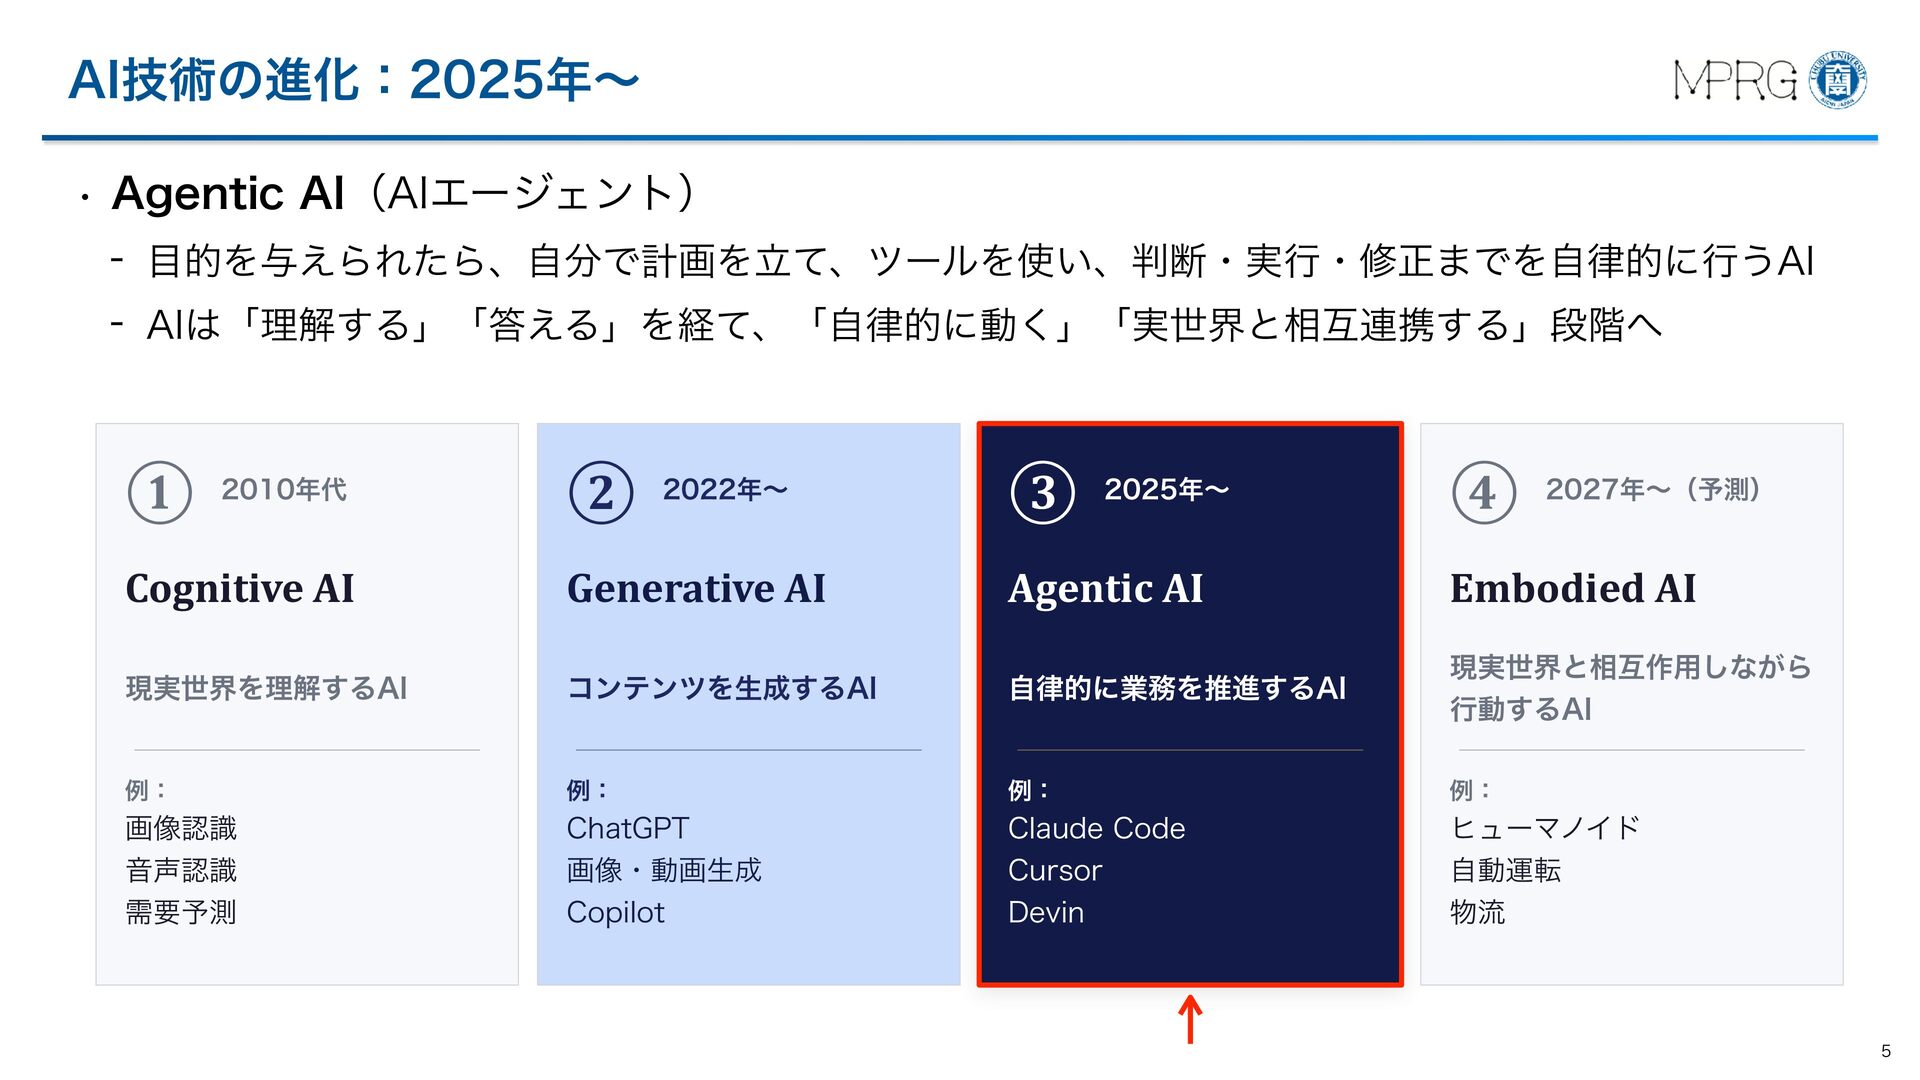
  3. AI技術の進化:2025年〜 • Agentic AI(AIエージェント) - 目的を与えられたら、自分で計画を立て、ツールを使い、判断・実行・修正までを自律的に行うAI - AIは「理解する」「答える」を経て、「自律的に動く」「実世界と相互連携する」段階へ ① 2010年代

    ② 2022年〜 ③ 2025年〜 ④ 2027年〜(予測) Cognitive AI Generative AI Agentic AI Embodied AI 現実世界を理解するAI コンテンツを生成するAI 自律的に業務を推進するAI 現実世界と相互作用しながら 行動するAI 例: 例: 例: 例: 画像認識 音声認識 需要予測 ChatGPT 画像・動画生成 Copilot Claude Code Cursor Devin ヒューマノイド 自動運転 物流 5
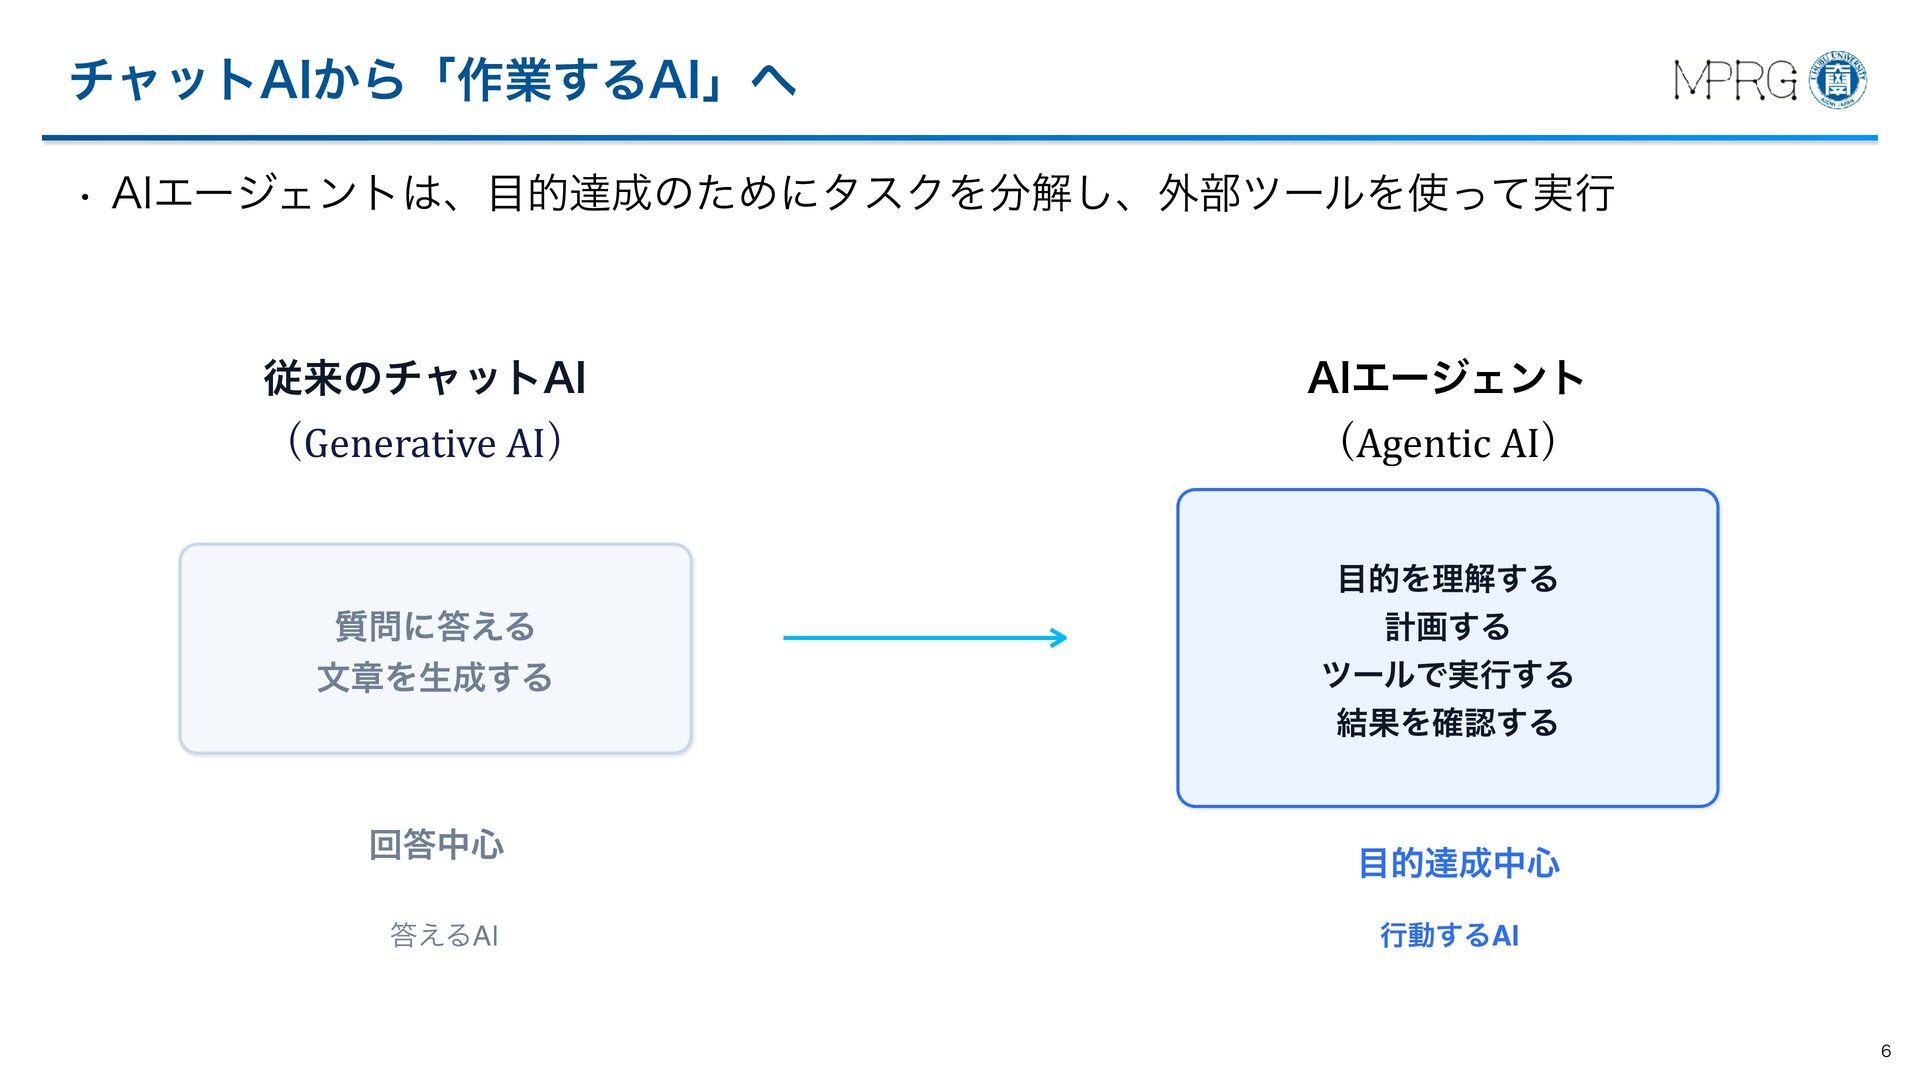
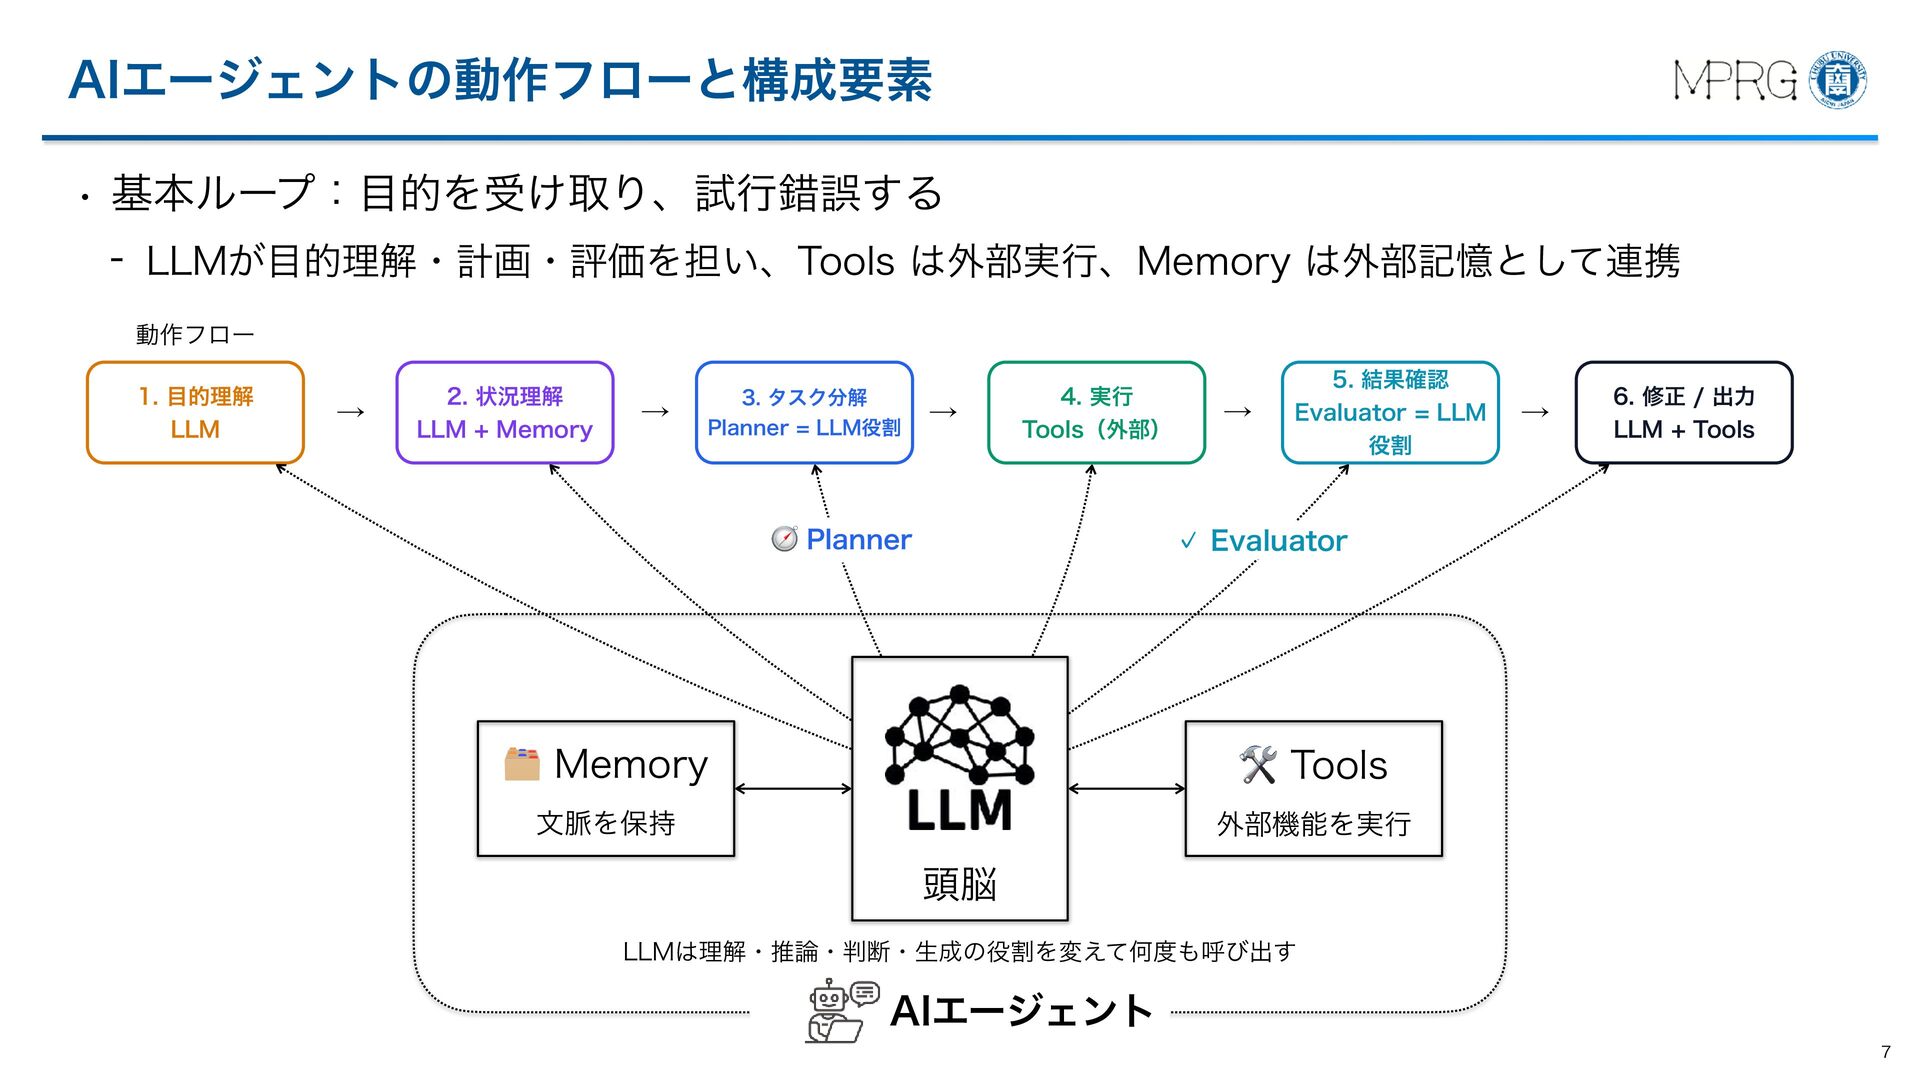
  4. AIエージェントの動作フローと構成要素 • 基本ループ:目的を受け取り、試行錯誤する - LLMが目的理解・計画・評価を担い、Tools は外部実行、Memory は外部記憶として連携 動作フロー 1. 目的理解

    LLM → 2. 状況理解 LLM + Memory → 3. タスク分解 Planner = LLM役割 → 4. 実行 Tools(外部) 🧭 Planner 🗂 Memory → 5. 結果確認 Evaluator = LLM 役割 → 6. 修正 / 出力 LLM + Tools ✓ Evaluator LLM 頭脳 文脈を保持 🛠 Tools 外部機能を実行 頭脳 LLMは理解・推論・判断・生成の役割を変えて何度も呼び出す AIエージェント 7
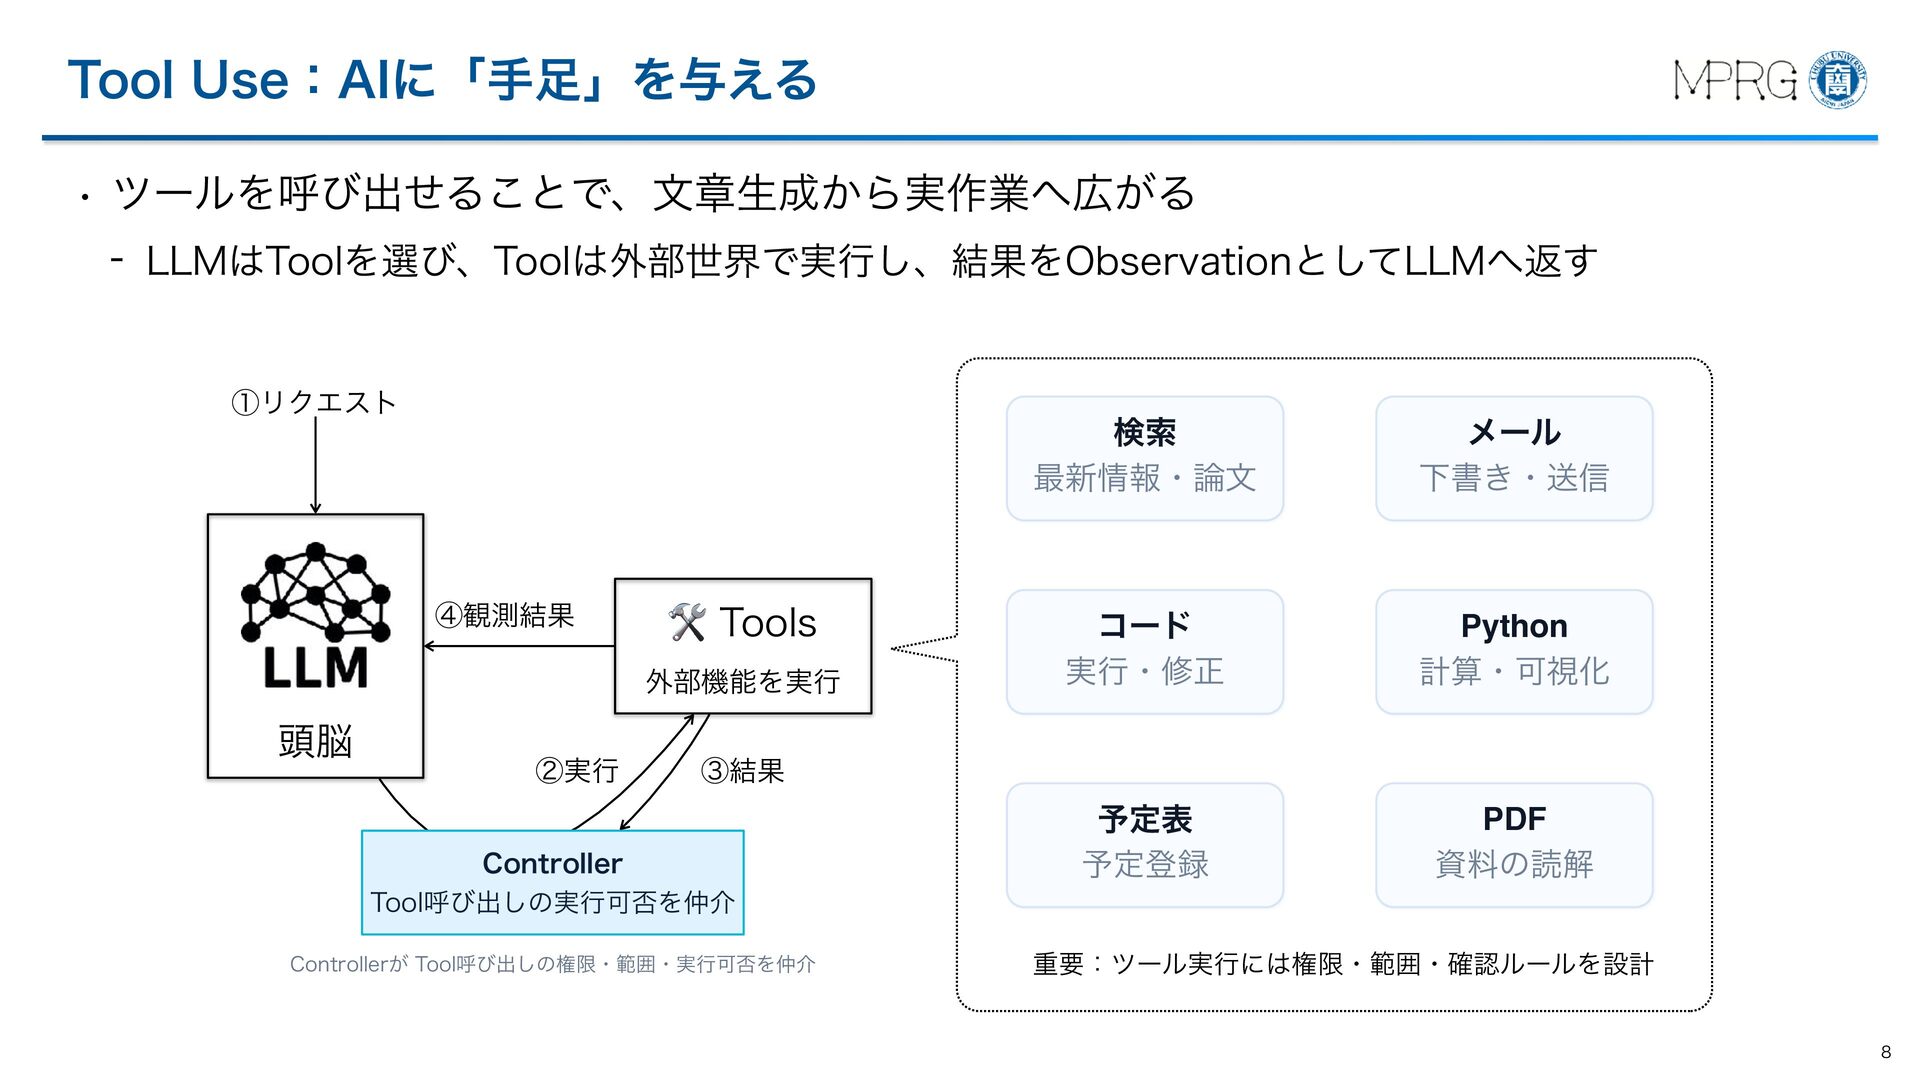
  5. Tool Use:AIに「手足」を与える • ツールを呼び出せることで、文章生成から実作業へ広がる - LLMはToolを選び、Toolは外部世界で実行し、結果をObservationとしてLLMへ返す ①リクエスト ④観測結果 🛠 Tools

    外部機能を実行 頭脳 ②実行 検索 最新情報・論文 メール 下書き・送信 コード 実行・修正 Python 計算・可視化 予定表 予定登録 PDF 資料の読解 ③結果 Controller Tool呼び出しの実行可否を仲介 Controllerが Tool呼び出しの権限・範囲・実行可否を仲介 重要:ツール実行には権限・範囲・確認ルールを設計 8
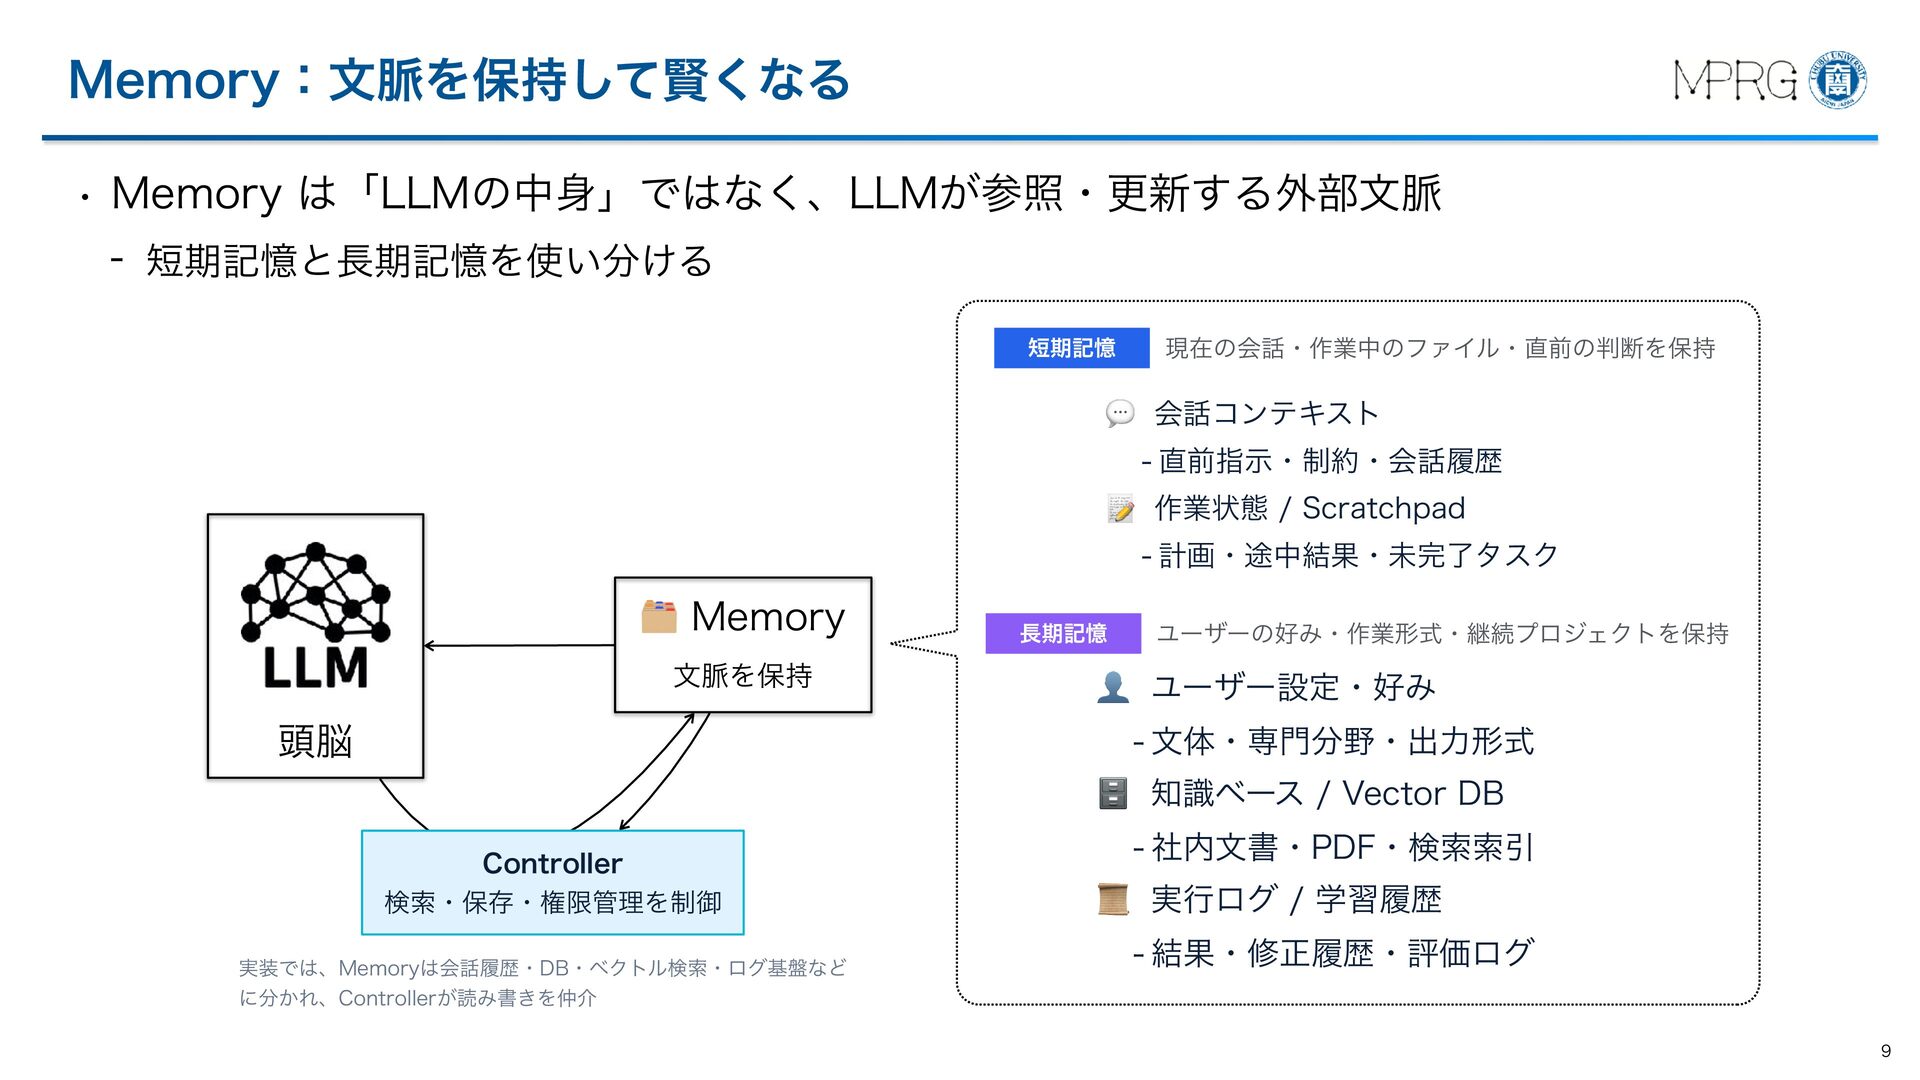
  6. Memory:文脈を保持して賢くなる • Memory は「LLMの中身」ではなく、LLMが参照・更新する外部文脈 - 短期記憶と長期記憶を使い分ける 短期記憶 現在の会話・作業中のファイル・直前の判断を保持 💬 会話コンテキスト

    - 直前指示・制約・会話履歴 📝 作業状態 / Scratchpad - 計画・途中結果・未完了タスク 🗂 Memory 文脈を保持 頭脳 長期記憶 ユーザーの好み・作業形式・継続プロジェクトを保持 👤 ユーザー設定・好み - 文体・専門分野・出力形式 🗄 知識ベース / Vector DB Controller 検索・保存・権限管理を制御 実装では、Memoryは会話履歴・DB・ベクトル検索・ログ基盤など に分かれ、Controllerが読み書きを仲介 - 社内文書・PDF・検索索引 📜 実行ログ / 学習履歴 - 結果・修正履歴・評価ログ 9
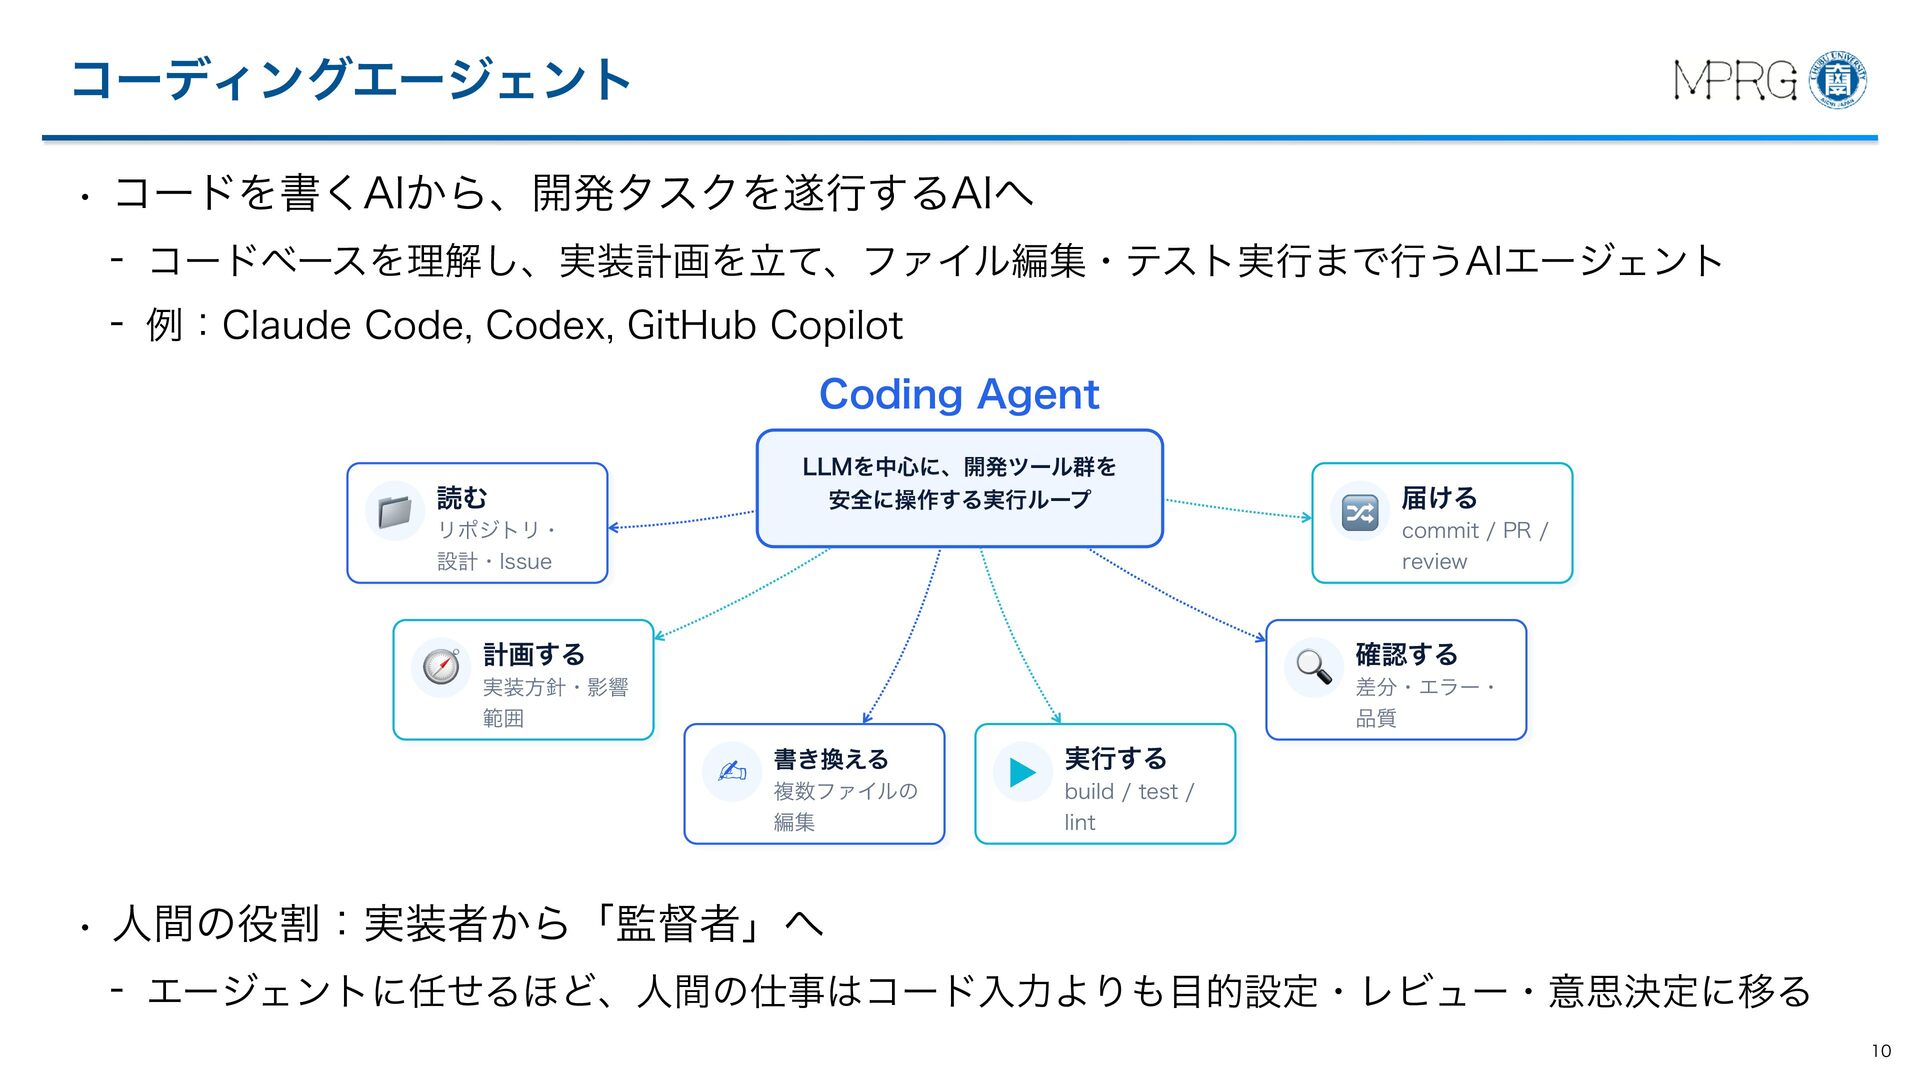
  7. コーディングエージェント • コードを書くAIから、開発タスクを遂行するAIへ - コードベースを理解し、実装計画を立て、ファイル編集・テスト実行まで行うAIエージェント - 例:Claude Code, Codex, GitHub

    Copilot Coding Agent LLMを中心に、開発ツール群を 安全に操作する実行ループ 読む 📁 リポジトリ・ 届ける 🔀 commit / PR / 設計・Issue review 🧭 計画する 実装方針・影響 🔍 確認する 差分・エラー・ 範囲 品質 ✍ 書き換える 複数ファイルの 編集 ▶ 実行する build / test / lint • 人間の役割:実装者から「監督者」へ - エージェントに任せるほど、人間の仕事はコード入力よりも目的設定・レビュー・意思決定に移る 10
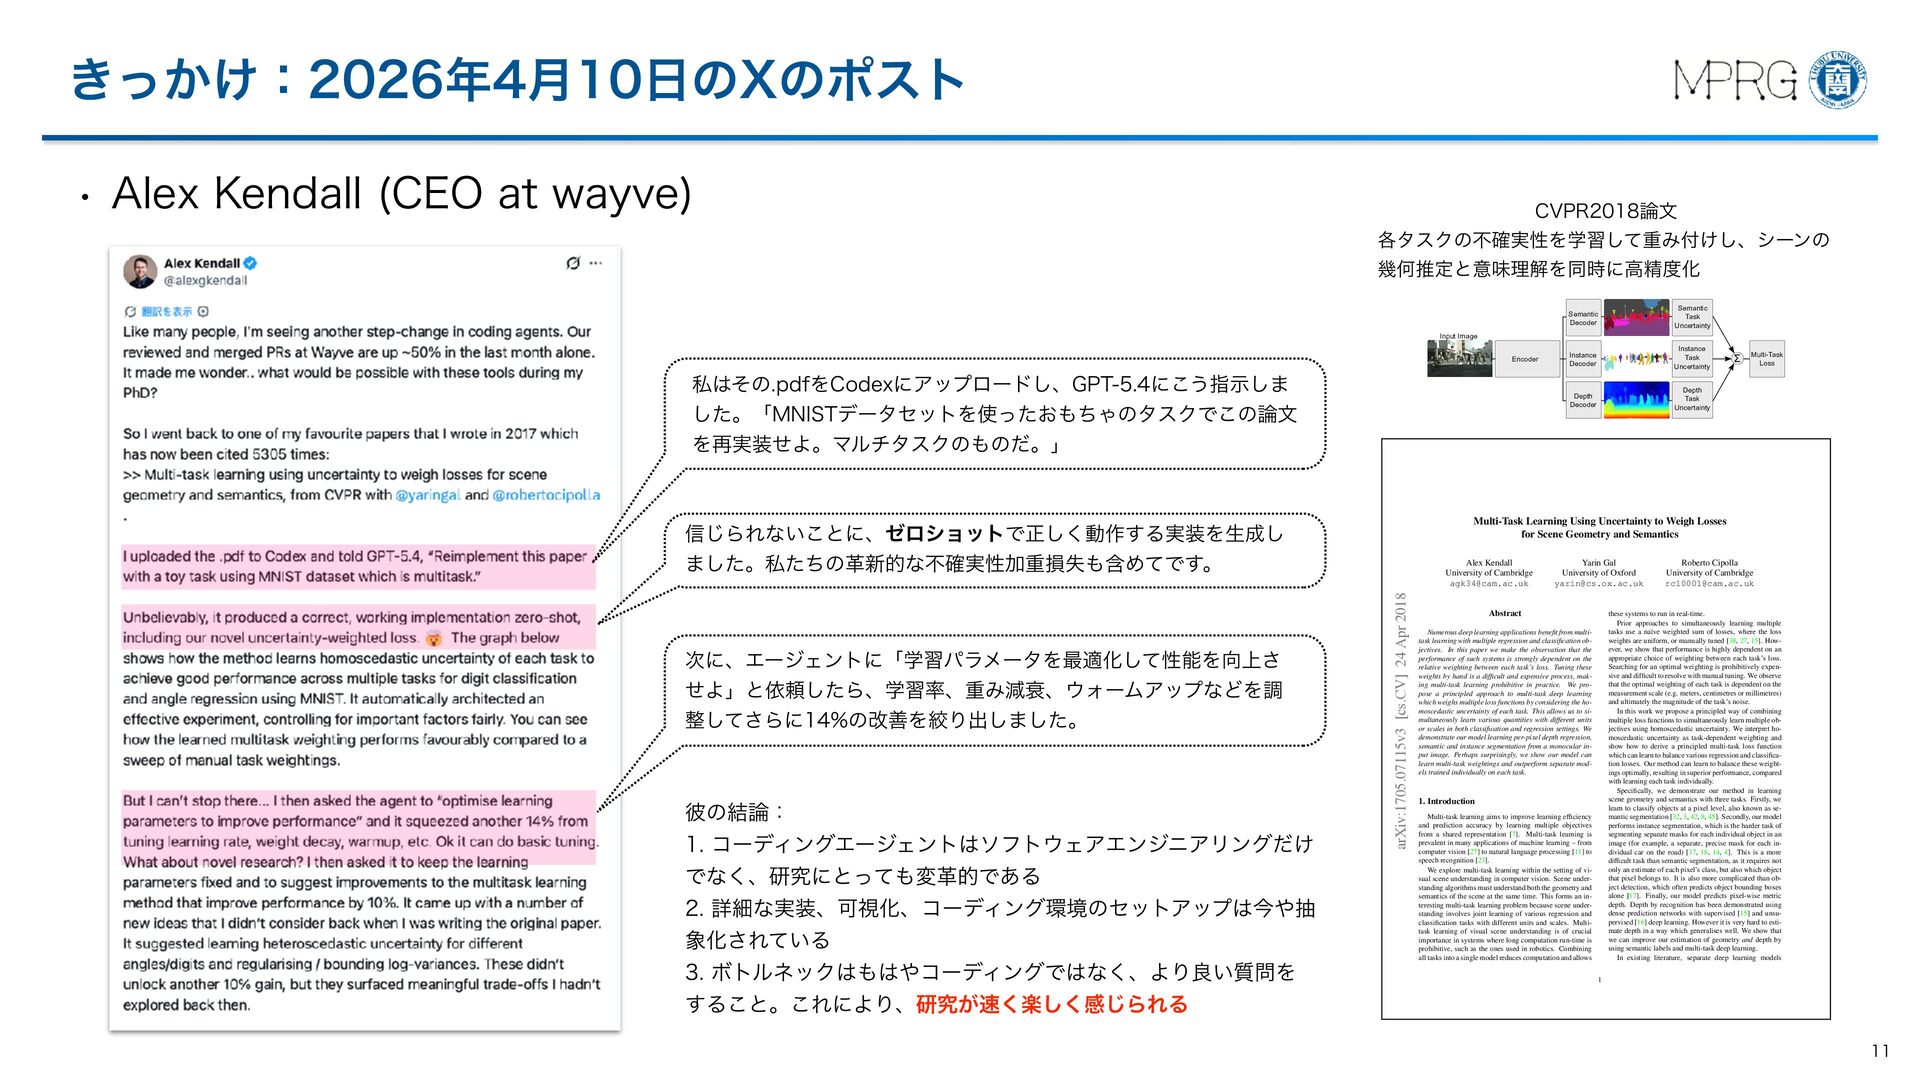
  8. きっかけ:2026年4月10日のXのポスト • Alex Kendall (CEO at wayve) CVPR2018論文 各タスクの不確実性を学習して重み付けし、シーンの 幾何推定と意味理解を同時に高精度化

    Semantic Decoder Semantic Task Uncertainty Instance Decoder Instance Task Uncertainty Depth Decoder Depth Task Uncertainty Input Image Encoder 私はその.pdfをCodexにアップロードし、GPT-5.4にこう指示しま した。「MNISTデータセットを使ったおもちゃのタスクでこの論文 を再実装せよ。マルチタスクのものだ。」 1. コーディングエージェントはソフトウェアエンジニアリングだけ でなく、研究にとっても変革的である 2. 詳細な実装、可視化、コーディング環境のセットアップは今や抽 象化されている 3. ボトルネックはもはやコーディングではなく、より良い質問を arXiv:1705.07115v3 [cs.CV] 24 Apr 2018 彼の結論: Multi-Task Loss Figure 1: Multi-task deep learning. We derive a principled way of combining multiple regression and classification loss functions for multi-task learning. Our architecture takes a single monocular RGB image as input and produces a pixel-wise classification, an instance semantic segmentation and an estimate of per pixel depth. Multi-task learning can improve accuracy over separately trained models because cues from one task, such as depth, are used to regularize and improve the generalization of another domain, such as segmentation. 信じられないことに、ゼロショットで正しく動作する実装を生成し ました。私たちの革新的な不確実性加重損失も含めてです。 次に、エージェントに「学習パラメータを最適化して性能を向上さ せよ」と依頼したら、学習率、重み減衰、ウォームアップなどを調 整してさらに14%の改善を絞り出しました。 Σ would be used to learn depth regression, semantic segmenone task can help learn other tasks [7]. tation and instance segmentation to create a complete scene Fine-tuning [1, 36] is a basic example of multi-task understanding system. Given a single monocular input imlearning, where we can leverage different learning tasks by age, our system is the first to produce a semantic segmentaconsidering them as a pre-training step. Other models altion, a dense estimate of metric depth and an instance level ternate learning between each training task, for example in segmentation jointly (Figure 1). While other vision modnatural language processing [11]. Multi-task learning can Multi-Task Learning Using els have demonstrated multi-task learning, we show how toUncertainty to Weigh Losses also be used in a data streaming setting [40], or to prevent learn to combine semantics and geometry. Combining these for Scene Geometry and Semantics forgetting previously learned tasks in reinforcement learntasks into a single model ensures that the model agrees being [26]. It can also be used to learn unsupervised features tween the separate task outputs while reducing computafrom various data sources with an auto-encoder [35]. tion. Finally,Alex we show that using a shared representation Kendall Yarin Gal Roberto Cipolla In computer vision there are many examples of methods with multi-task learning improves performance on various University of Cambridge University of Oxford University of Cambridge for multi-task learning. Many focus on semantic tasks, such metrics, making the models more effective. [email protected] [email protected] [email protected] as classification and semantic segmentation [30] or classifiIn summary, the key contributions of this paper are: cation and detection [38]. MultiNet [39] proposes an archi1. a novel and principled multi-task loss to simultanetecture for detection, classification and semantic segmentaously learn various classification and regression losses tion.systems CrossStitch [34] explore methods to comof varying quantities and units using homoscedastic these Abstract to run networks in real-time. bine neural Uhrig et al. [41] learn task uncertainty, Priormulti-task approaches to activations. simultaneously learning multiple semantic instance segmentations underwhere a classification 2. a unified for semantic segmentation, use a and naı̈ve weighted sum of losses, the loss Numerous deeparchitecture learning applications benefit from multi-in- tasks setting.are Multi-task learningtuned has also for gestancewith segmentation and depthand regression, weights uniform, deep or manually [38,been 27, used 15]. Howtask learning multiple regression classification obometry and regression tasks. [15] show how to learn se3. demonstrating of loss weighting jectives. In this paperthe we importance make the observation that the in ever, we show that performance is highly dependent on an mantic segmentation, depth andbetween surface normals. PoseNet appropriate choice of weighting each task’s loss. multi-task deep learning and howdependent to obtain on superior performance of such systems is strongly the [25] is a for model which learns camera position and expenorientacompared to equivalent trained Searching an optimal weighting is prohibitively relative performance weighting between each task’s loss.separately Tuning these tion. UberNet [27] learns a number of different regression sive and difficult to resolve with manual tuning. We observe weights models. by hand is a difficult and expensive process, makand classification tasks under a single architecture. In this that the optimal weighting of each task is dependent on the ing multi-task learning prohibitive in practice. We prowork we are the first to propose a method for jointly learn2. aRelated Work measurement scale (e.g. meters, centimetres or millimetres) pose principled approach to multi-task deep learning ing depth regression, semantic and instance segmentation. and ultimately the magnitude of the task’s noise. which weighs multiple loss functions by considering the hoMulti-task learning aims to improve learning efficiency Like the model of [15], our model learns both semantic and moscedastic uncertainty of each task. This allows us to siIn this work we propose a principled way of combining and prediction accuracy for each task, when compared to geometry representations, which is important for scene unmultaneously learn various quantities with different units multiple loss functions to simultaneously learn multiple obtraining a separate model for each task [40, 5]. It can be conderstanding. However, our model learns the much harder or scales in both classification and regression settings. We homoscedastic uncertainty. We interpret ho-of sidered an approach to inductive knowledge transfer which jectives task ofusing instance segmentation which requires knowledge demonstrate our model learning per-pixel depth regression, uncertainty as task-dependent weighting and improves generalisation by sharing the domain information moscedastic both semantics and geometry. This is because our model semantic and instance segmentation from a by monocular inshow to derive principled multi-task loss function between complimentary tasks. It does this using a shared musthow determine the aclass and spatial relationship for each putrepresentation image. Perhaps surprisingly, we show ouris model learnobject to balance various segmentation. regression and classificato learn multiple tasks – what learnedcan from which pixelcan in each for instance learn multi-task weightings and outperform separate modtion losses. Our method can learn to balance these weightels trained individually on each task. ings optimally, resulting in superior performance, compared 2with learning each task individually. Specifically, we demonstrate our method in learning scene geometry and semantics with three tasks. Firstly, we 1. Introduction learn to classify objects at a pixel level, also known as seMulti-task learning aims to improve learning efficiency mantic segmentation [32, 3, 42, 8, 45]. Secondly, our model and prediction accuracy by learning multiple objectives performs instance segmentation, which is the harder task of from a shared representation [7]. Multi-task learning is segmenting separate masks for each individual object in an prevalent in many applications of machine learning – from image (for example, a separate, precise mask for each incomputer vision [27] to natural language processing [11] to dividual car on the road) [37, 18, 14, 4]. This is a more speech recognition [23]. difficult task than semantic segmentation, as it requires not only an estimate of each pixel’s class, but also which object We explore multi-task learning within the setting of vithat pixel belongs to. It is also more complicated than obsual scene understanding in computer vision. Scene underject detection, which often predicts object bounding boxes standing algorithms must understand both the geometry and alone [17]. Finally, our model predicts pixel-wise metric semantics of the scene at the same time. This forms an indepth. Depth by recognition has been demonstrated using teresting multi-task learning problem because scene underdense prediction networks with supervised [15] and unsustanding involves joint learning of various regression and pervised [16] deep learning. However it is very hard to esticlassification tasks with different units and scales. Multimate depth in a way which generalises well. We show that task learning of visual scene understanding is of crucial we can improve our estimation of geometry and depth by importance in systems where long computation run-time is using semantic labels and multi-task deep learning. prohibitive, such as the ones used in robotics. Combining all tasks into a single model reduces computation and allows In existing literature, separate deep learning models 1 すること。これにより、研究が速く楽しく感じられる 11
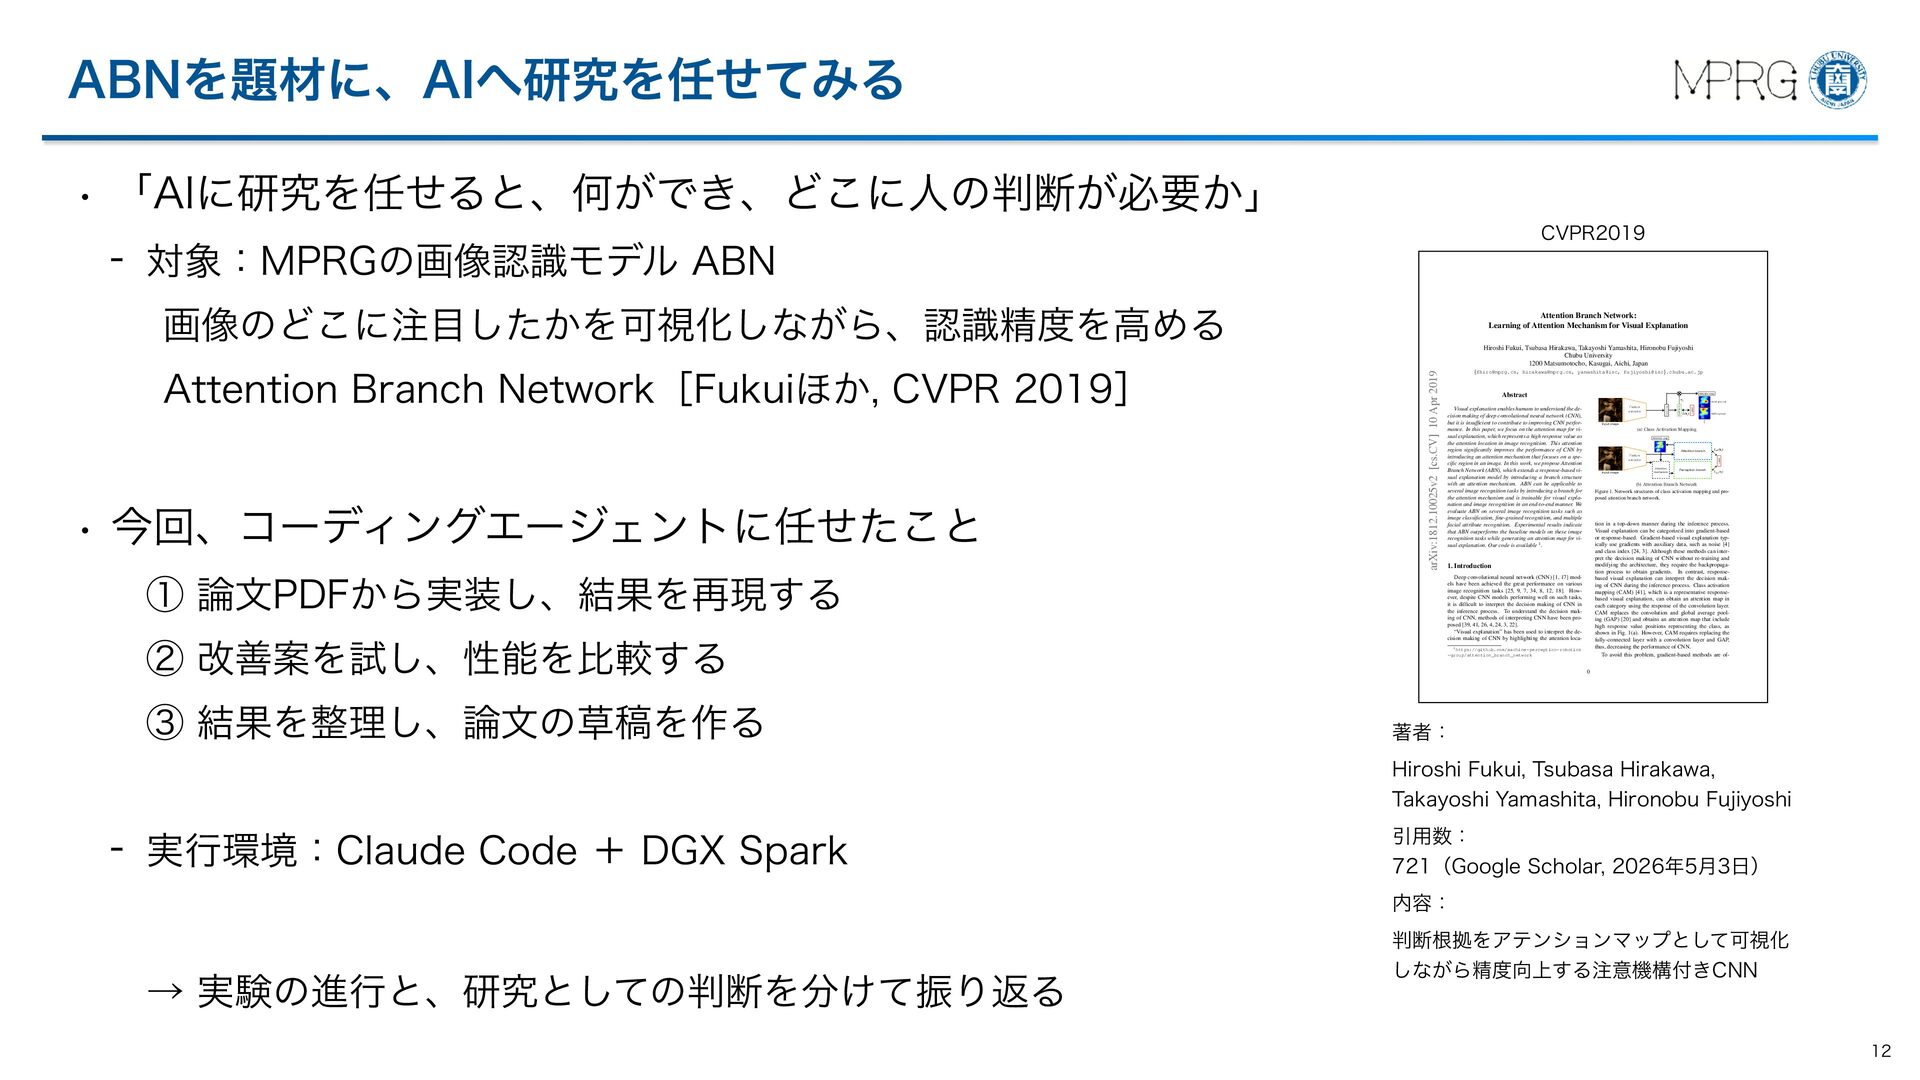
  9. ABNを題材に、AIへ研究を任せてみる • 「AIに研究を任せると、何ができ、どこに人の判断が必要か」 CVPR2019 - 対象:MPRGの画像認識モデル ABN 画像のどこに注目したかを可視化しながら、認識精度を高める ① 論文PDFから実装し、結果を再現する

    ② 改善案を試し、性能を比較する ③ 結果を整理し、論文の草稿を作る {[email protected], [email protected], yamashita@isc, fujiyoshi@isc}.chubu.ac.jp Abstract Attention map L(xi) Great grey owl Label Feature extractor GAP & fc. Visual explanation enables humans to understand the decision making of deep convolutional neural network (CNN), but it is insufficient to contribute to improving CNN performance. In this paper, we focus on the attention map for visual explanation, which represents a high response value as the attention location in image recognition. This attention region significantly improves the performance of CNN by introducing an attention mechanism that focuses on a specific region in an image. In this work, we propose Attention Branch Network (ABN), which extends a response-based visual explanation model by introducing a branch structure with an attention mechanism. ABN can be applicable to several image recognition tasks by introducing a branch for the attention mechanism and is trainable for visual explanation and image recognition in an end-to-end manner. We evaluate ABN on several image recognition tasks such as image classification, fine-grained recognition, and multiple facial attribute recognition. Experimental results indicate that ABN outperforms the baseline models on these image recognition tasks while generating an attention map for visual explanation. Our code is available 1 . Feature map wc Ruffed grouse … • 今回、コーディングエージェントに任せたこと Hiroshi Fukui, Tsubasa Hirakawa, Takayoshi Yamashita, Hironobu Fujiyoshi Chubu University 1200 Matsumotocho, Kasugai, Aichi, Japan Input image (a) Class Activation Mapping Attention map Attention branch Latt(xi) Feature Label arXiv:1812.10025v2 [cs.CV] 10 Apr 2019 Attention Branch Network[Fukuiほか, CVPR 2019] Attention Branch Network: Learning of Attention Mechanism for Visual Explanation extractor Attention Input image mechanism Perception branch Lper(xi) (b) Attention Branch Network Figure 1. Network structures of class activation mapping and proposed attention branch network. tion in a top-down manner during the inference process. Visual explanation can be categorized into gradient-based or response-based. Gradient-based visual explanation typically use gradients with auxiliary data, such as noise [4] and class index [24, 3]. Although these methods can interpret the decision making of CNN without re-training and modifying the architecture, they require the backpropagation process to obtain gradients. In contrast, responsebased visual explanation can interpret the decision making of CNN during the inference process. Class activation mapping (CAM) [41], which is a representative responsebased visual explanation, can obtain an attention map in each category using the response of the convolution layer. CAM replaces the convolution and global average pooling (GAP) [20] and obtains an attention map that include high response value positions representing the class, as shown in Fig. 1(a). However, CAM requires replacing the fully-connected layer with a convolution layer and GAP, thus, decreasing the performance of CNN. To avoid this problem, gradient-based methods are of- 1. Introduction Deep convolutional neural network (CNN) [1, 17] models have been achieved the great performance on various image recognition tasks [25, 9, 7, 34, 8, 12, 18]. However, despite CNN models performing well on such tasks, it is difficult to interpret the decision making of CNN in the inference process. To understand the decision making of CNN, methods of interpreting CNN have been proposed [39, 41, 26, 4, 24, 3, 22]. “Visual explanation” has been used to interpret the decision making of CNN by highlighting the attention loca1 https://github.com/machine-perception-robotics -group/attention_branch_network 0 著者: Hiroshi Fukui, Tsubasa Hirakawa, Takayoshi Yamashita, Hironobu Fujiyoshi - 実行環境:Claude Code + DGX Spark 引用数: 721(Google Scholar, 2026年5月3日) 内容: → 実験の進行と、研究としての判断を分けて振り返る 判断根拠をアテンションマップとして可視化 しながら精度向上する注意機構付きCNN 12
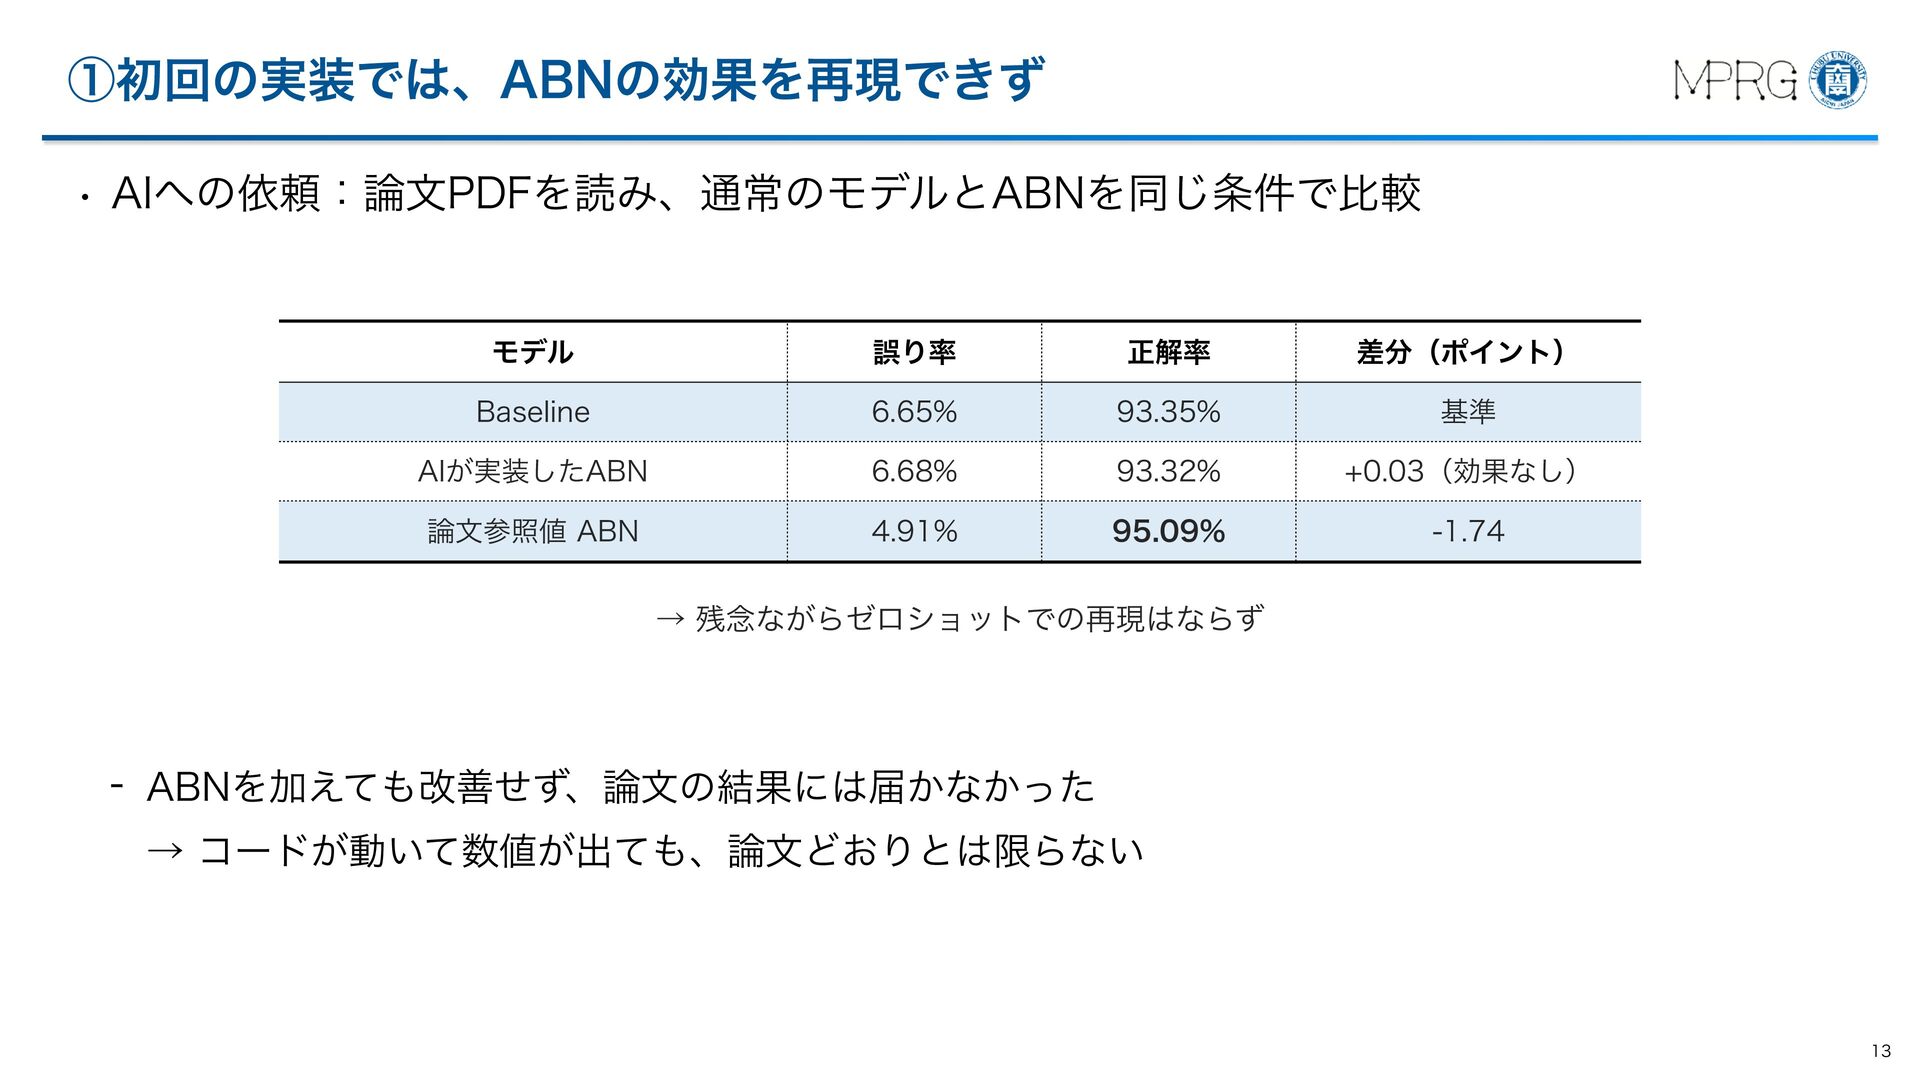
  10. ①初回の実装では、ABNの効果を再現できず • AIへの依頼:論文PDFを読み、通常のモデルとABNを同じ条件で比較 モデル 誤り率 正解率 差分(ポイント) Baseline 6.65% 93.35%

    基準 AIが実装したABN 6.68% 93.32% +0.03(効果なし) 論文参照値 ABN 4.91% 95.09% -1.74 → 残念ながらゼロショットでの再現はならず - ABNを加えても改善せず、論文の結果には届かなかった → コードが動いて数値が出ても、論文どおりとは限らない 13
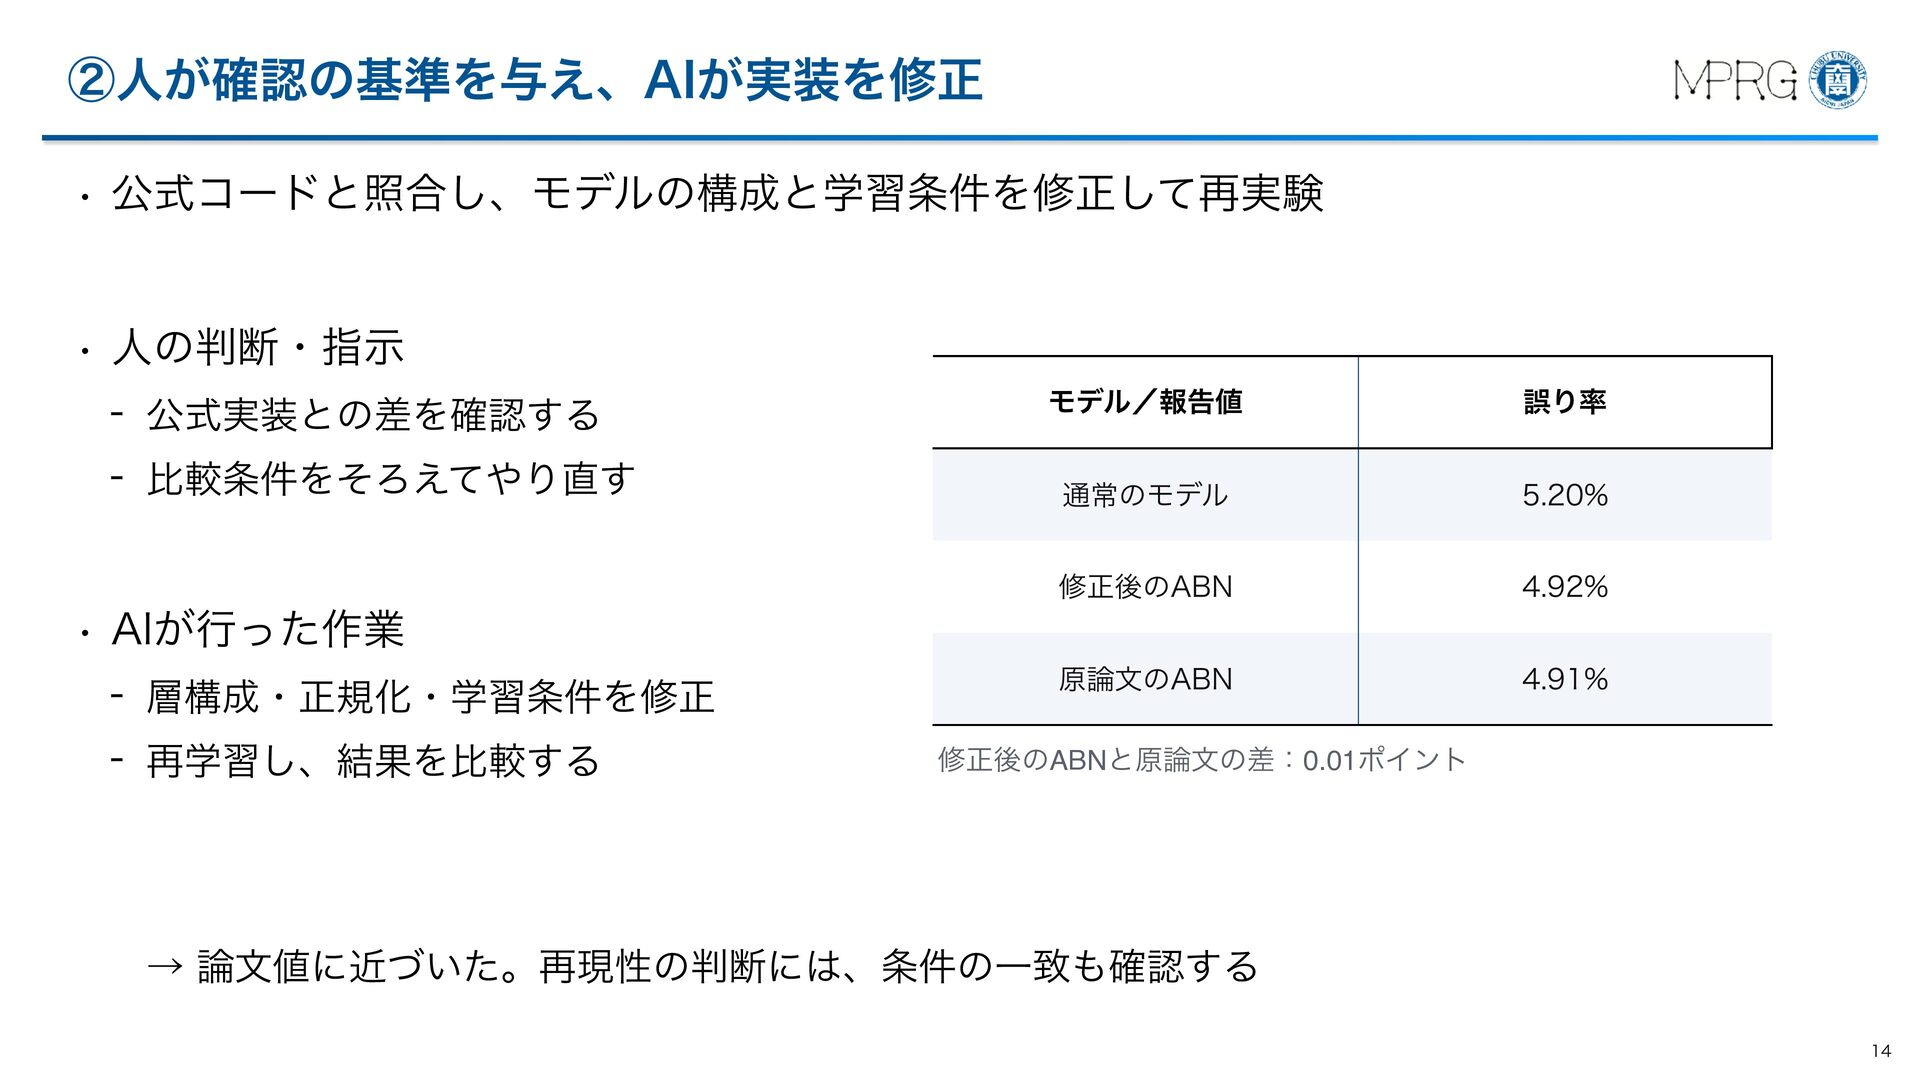
  11. ②人が確認の基準を与え、AIが実装を修正 • 公式コードと照合し、モデルの構成と学習条件を修正して再実験 • 人の判断・指示 - 公式実装との差を確認する - 比較条件をそろえてやり直す モデル/報告値

    誤り率 通常のモデル 5.20% 修正後のABN 4.92% 原論文のABN 4.91% • AIが行った作業 - 層構成・正規化・学習条件を修正 - 再学習し、結果を比較する 修正後のABNと原論文の差:0.01ポイント → 論文値に近づいた。再現性の判断には、条件の一致も確認する 14
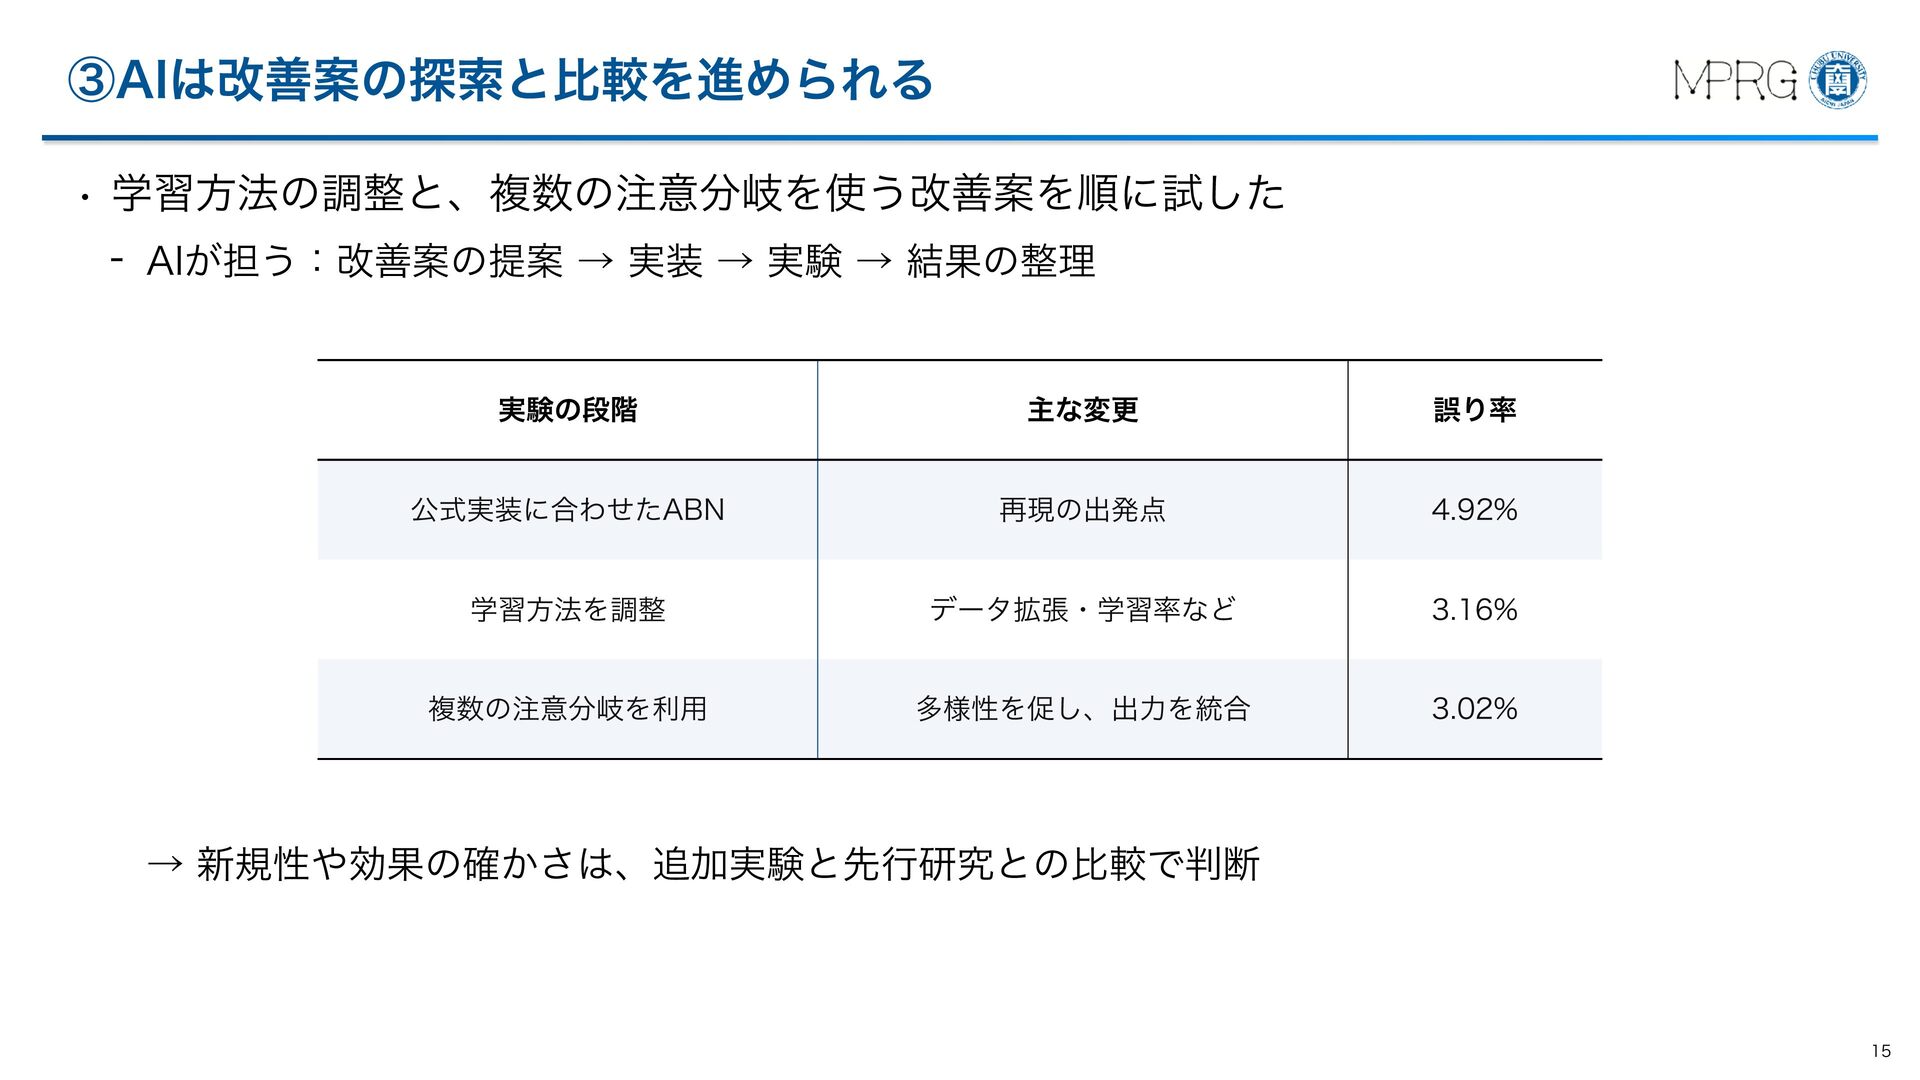
  12. ③AIは改善案の探索と比較を進められる • 学習方法の調整と、複数の注意分岐を使う改善案を順に試した - AIが担う:改善案の提案 → 実装 → 実験 →

    結果の整理 実験の段階 主な変更 誤り率 公式実装に合わせたABN 再現の出発点 4.92% 学習方法を調整 データ拡張・学習率など 3.16% 複数の注意分岐を利用 多様性を促し、出力を統合 3.02% → 新規性や効果の確かさは、追加実験と先行研究との比較で判断 15
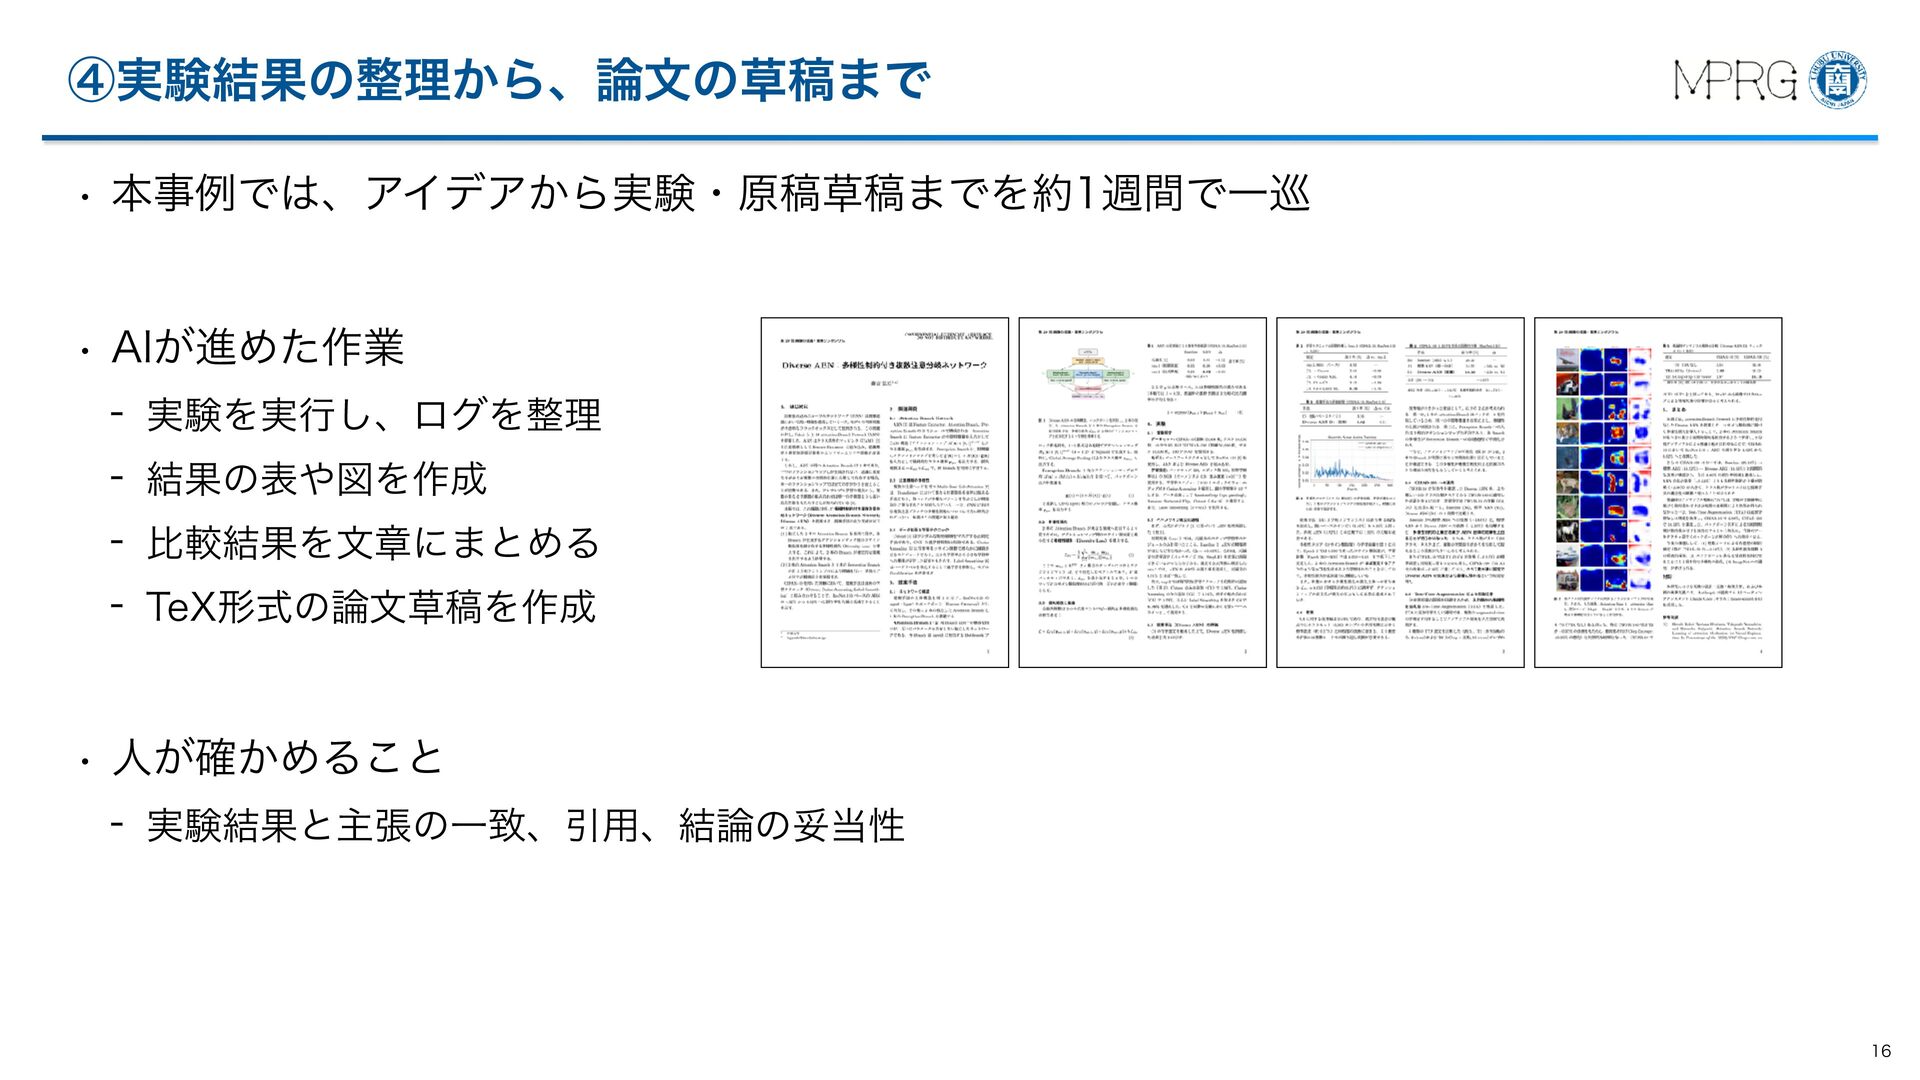
  13. ④実験結果の整理から、論文の草稿まで • 本事例では、アイデアから実験・原稿草稿までを約1週間で一巡 • AIが進めた作業 - 実験を実行し、ログを整理 - 結果の表や図を作成 -

    比較結果を文章にまとめる - TeX形式の論文草稿を作成 • 人が確かめること - 実験結果と主張の一致、引用、結論の妥当性 16
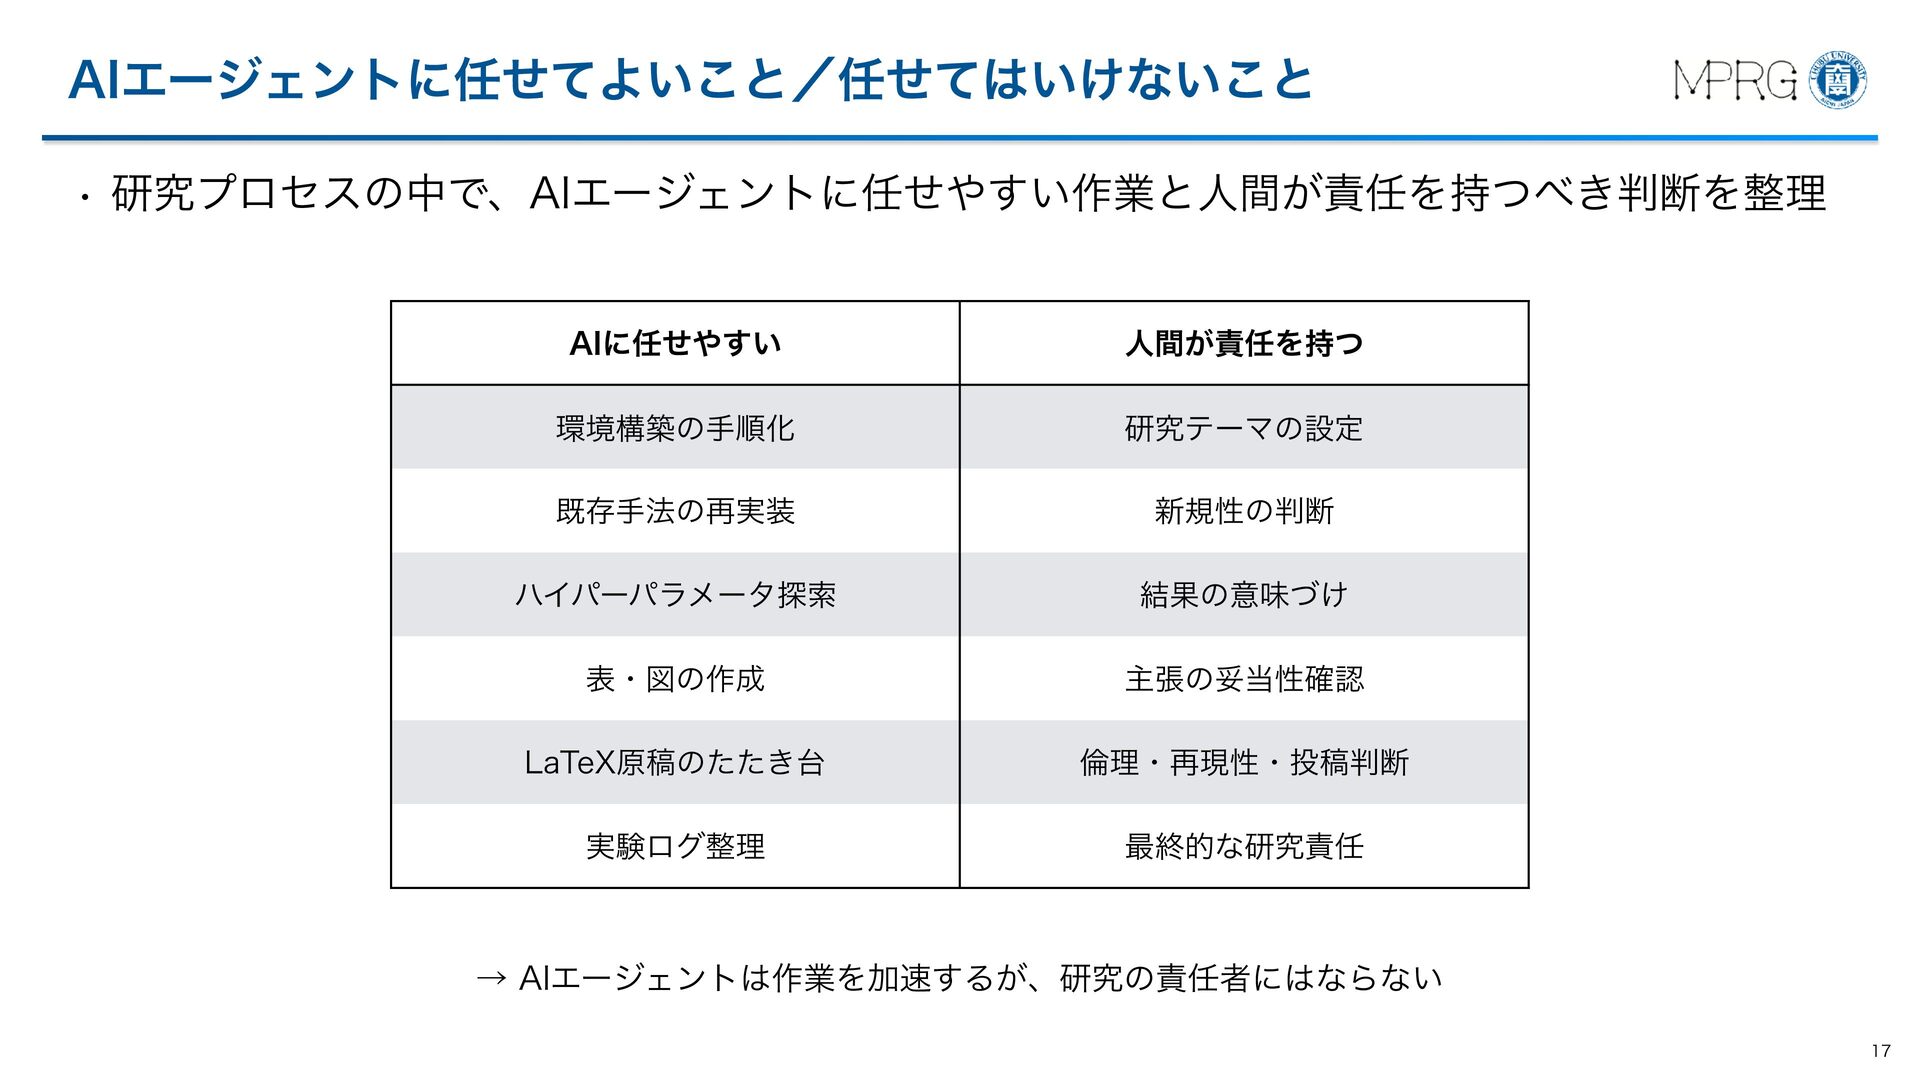
  14. AIエージェントに任せてよいこと/任せてはいけないこと • 研究プロセスの中で、AIエージェントに任せやすい作業と人間が責任を持つべき判断を整理 AIに任せやすい 人間が責任を持つ 環境構築の手順化 研究テーマの設定 既存手法の再実装 新規性の判断 ハイパーパラメータ探索

    結果の意味づけ 表・図の作成 主張の妥当性確認 LaTeX原稿のたたき台 倫理・再現性・投稿判断 実験ログ整理 最終的な研究責任 → AIエージェントは作業を加速するが、研究の責任者にはならない 17
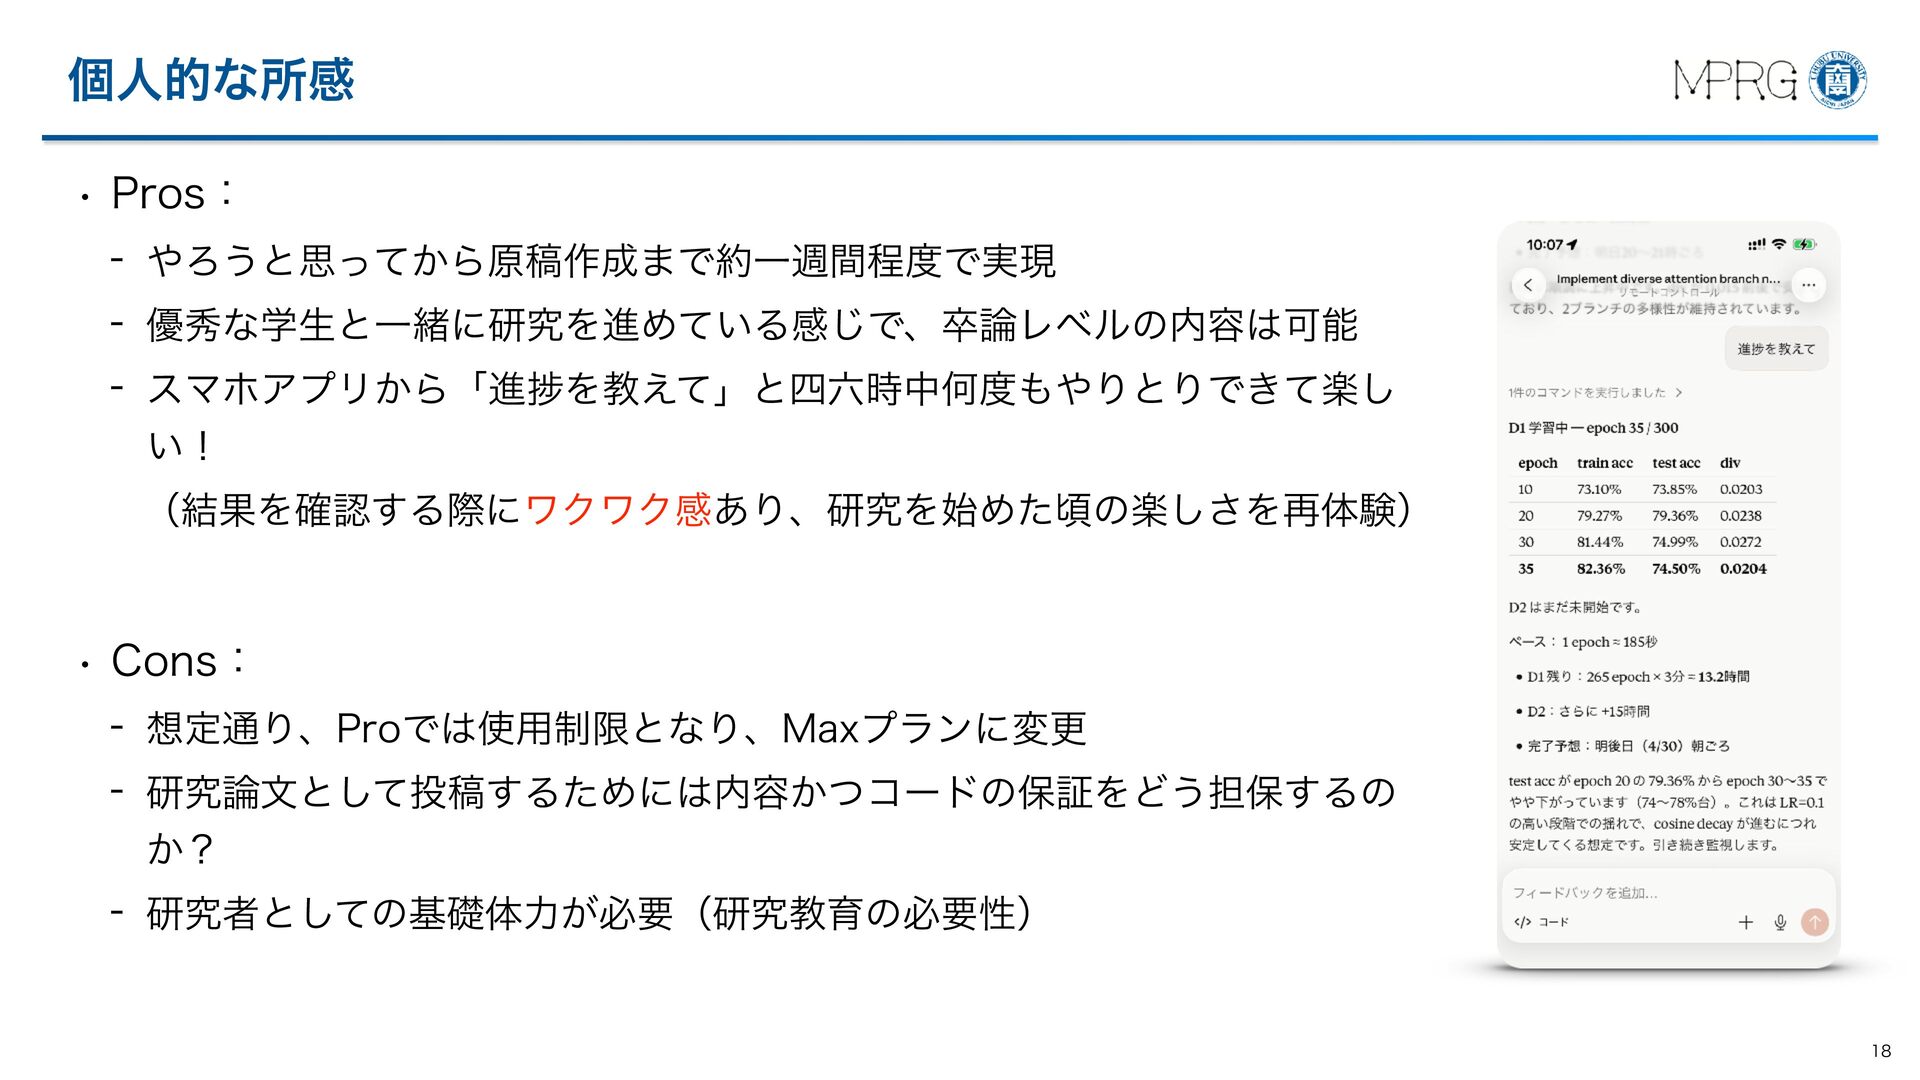
  15. 個人的な所感 • Pros: - やろうと思ってから原稿作成まで約一週間程度で実現 - 優秀な学生と一緒に研究を進めている感じで、卒論レベルの内容は可能 - スマホアプリから「進捗を教えて」と四六時中何度もやりとりできて楽し い!

    (結果を確認する際にワクワク感あり、研究を始めた頃の楽しさを再体験) • Cons: - 想定通り、Proでは使用制限となり、Maxプランに変更 - 研究論文として投稿するためには内容かつコードの保証をどう担保するの か? - 研究者としての基礎体力が必要(研究教育の必要性) 18
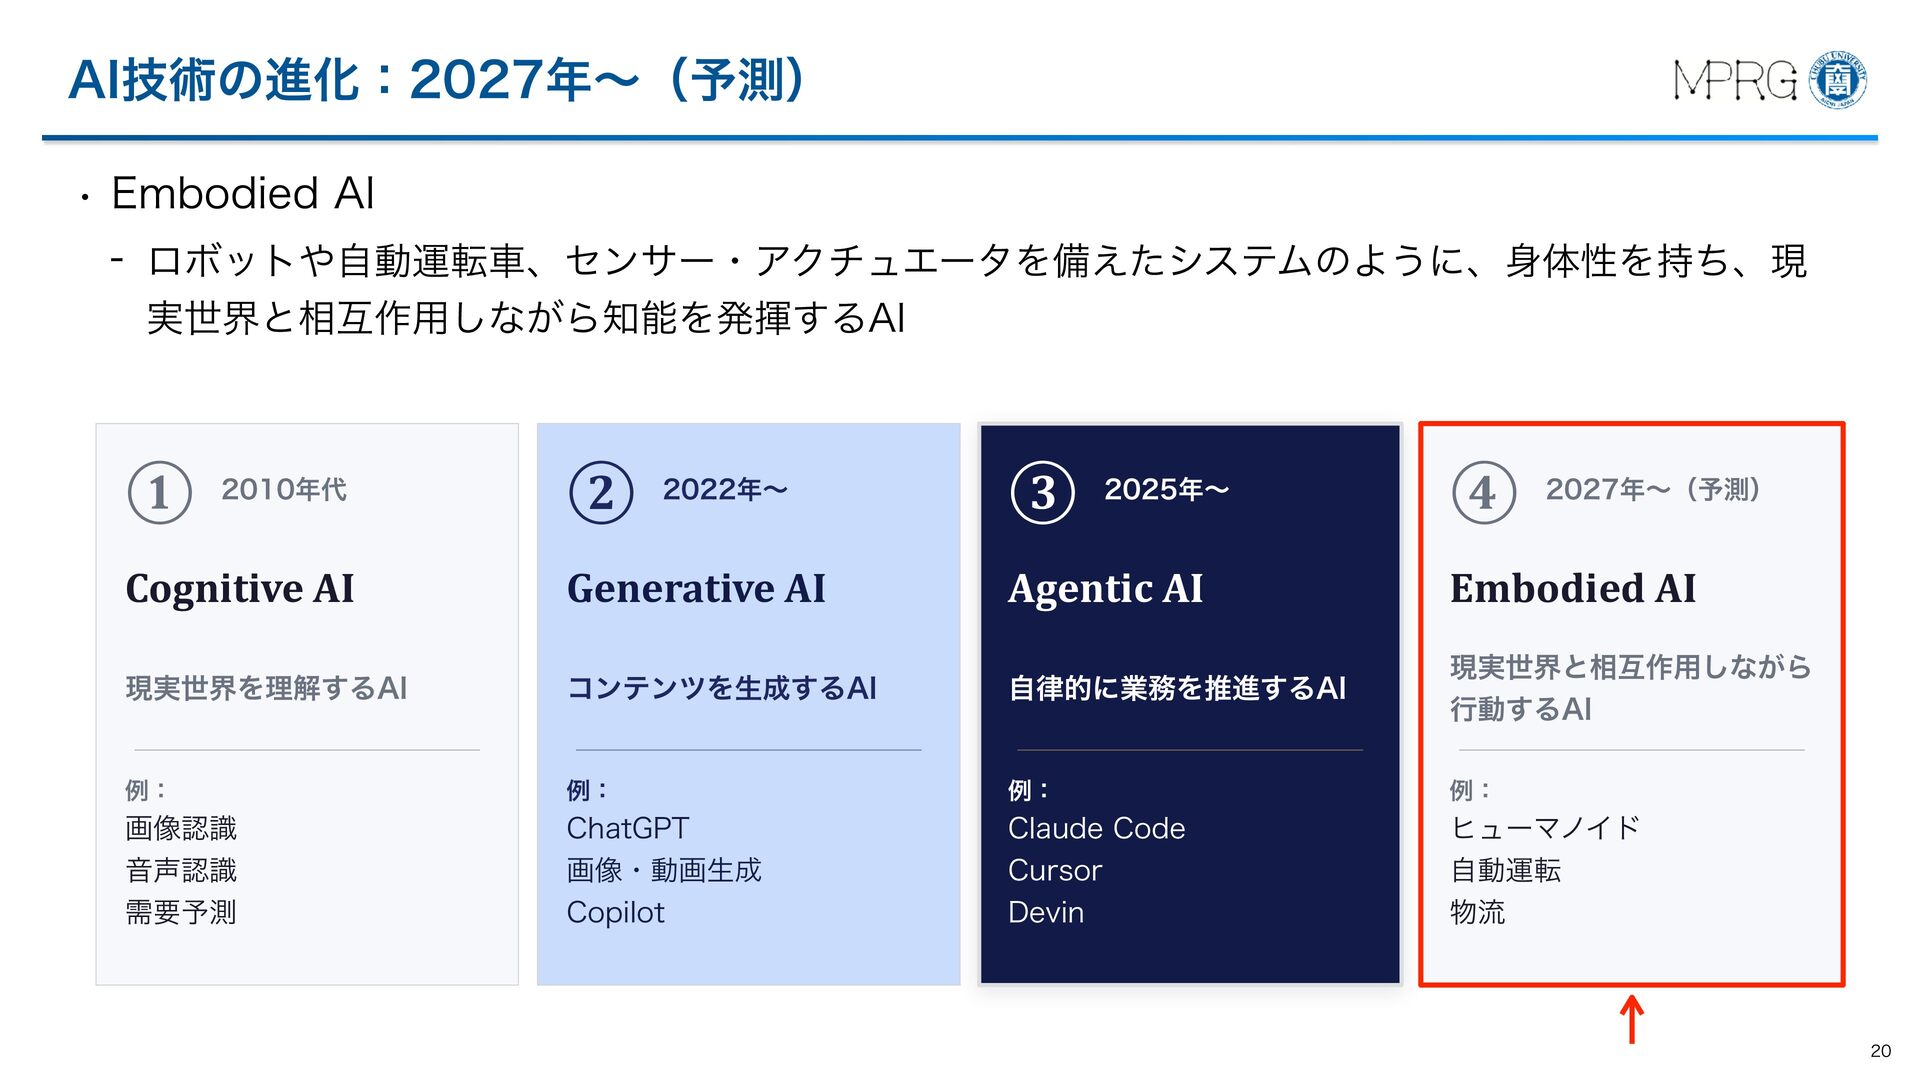
  16. AI技術の進化:2027年〜(予測) • Embodied AI - ロボットや自動運転車、センサー・アクチュエータを備えたシステムのように、身体性を持ち、現 実世界と相互作用しながら知能を発揮するAI ① 2010年代 ②

    2022年〜 ③ 2025年〜 ④ 2027年〜(予測) Cognitive AI Generative AI Agentic AI Embodied AI 現実世界を理解するAI コンテンツを生成するAI 自律的に業務を推進するAI 現実世界と相互作用しながら 行動するAI 例: 例: 例: 例: 画像認識 音声認識 需要予測 ChatGPT 画像・動画生成 Copilot Claude Code Cursor Devin ヒューマノイド 自動運転 物流 20
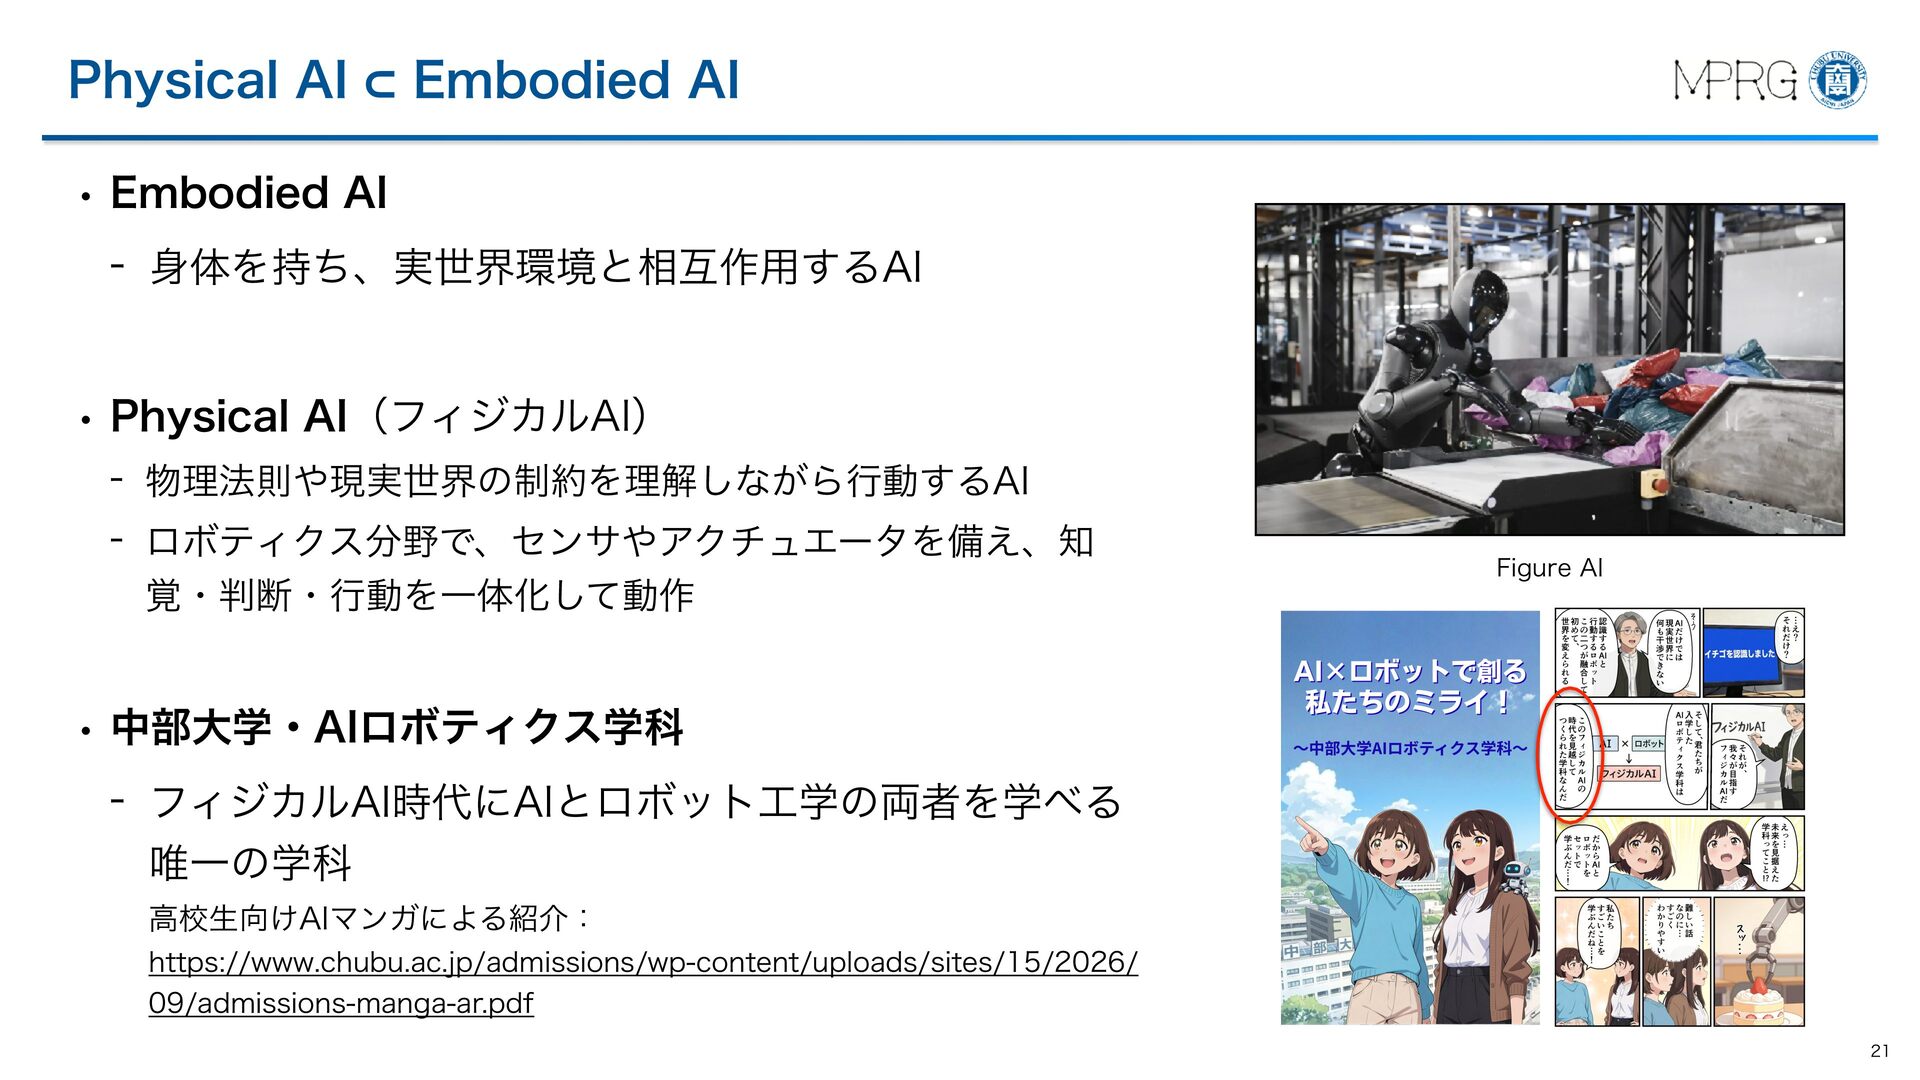
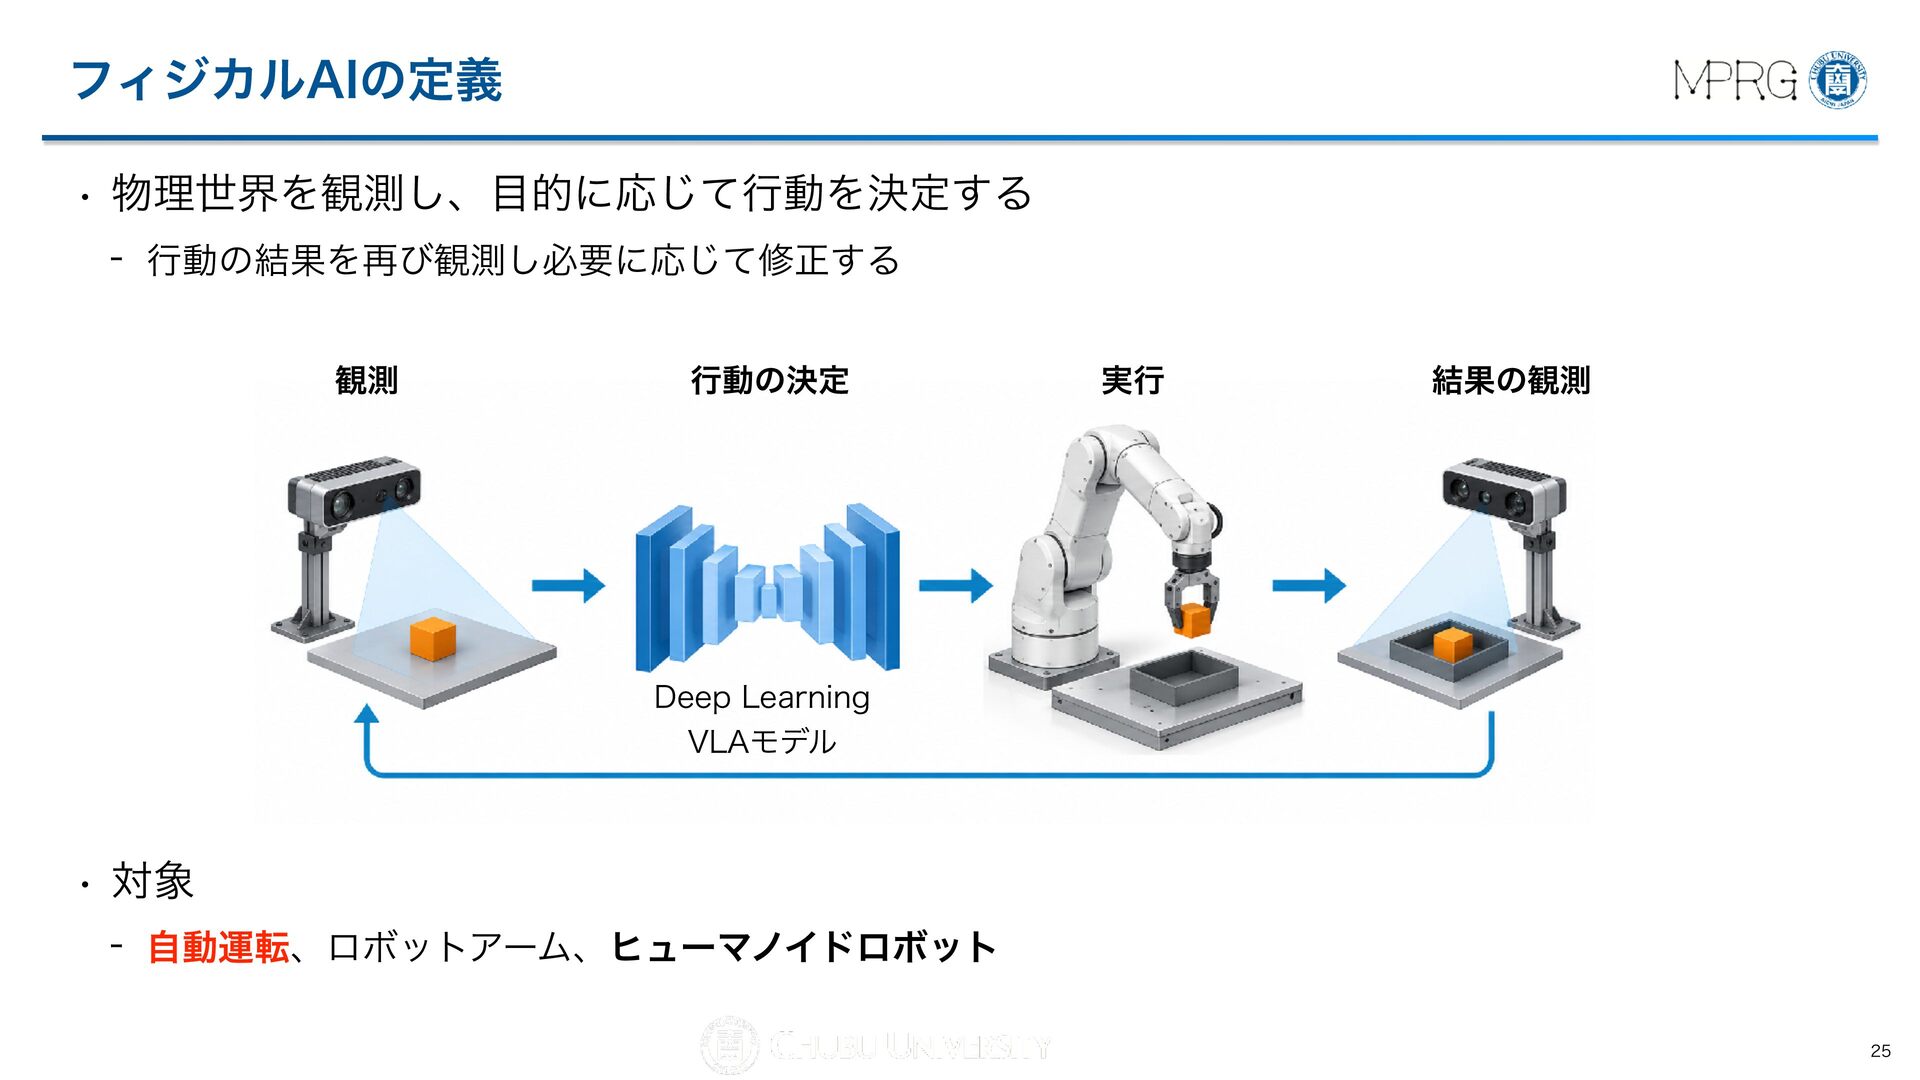
  17. Physical AI Embodied AI • Embodied AI - 身体を持ち、実世界環境と相互作用するAI •

    Physical AI(フィジカルAI) - 物理法則や現実世界の制約を理解しながら行動するAI - ロボティクス分野で、センサやアクチュエータを備え、知 覚・判断・行動を一体化して動作 Figure AI • 中部大学・AIロボティクス学科 - フィジカルAI時代にAIとロボット工学の両者を学べる 唯一の学科 高校生向けAIマンガによる紹介: https://www.chubu.ac.jp/admissions/wp-content/uploads/sites/15/2026/ 09/admissions-manga-ar.pdf 21
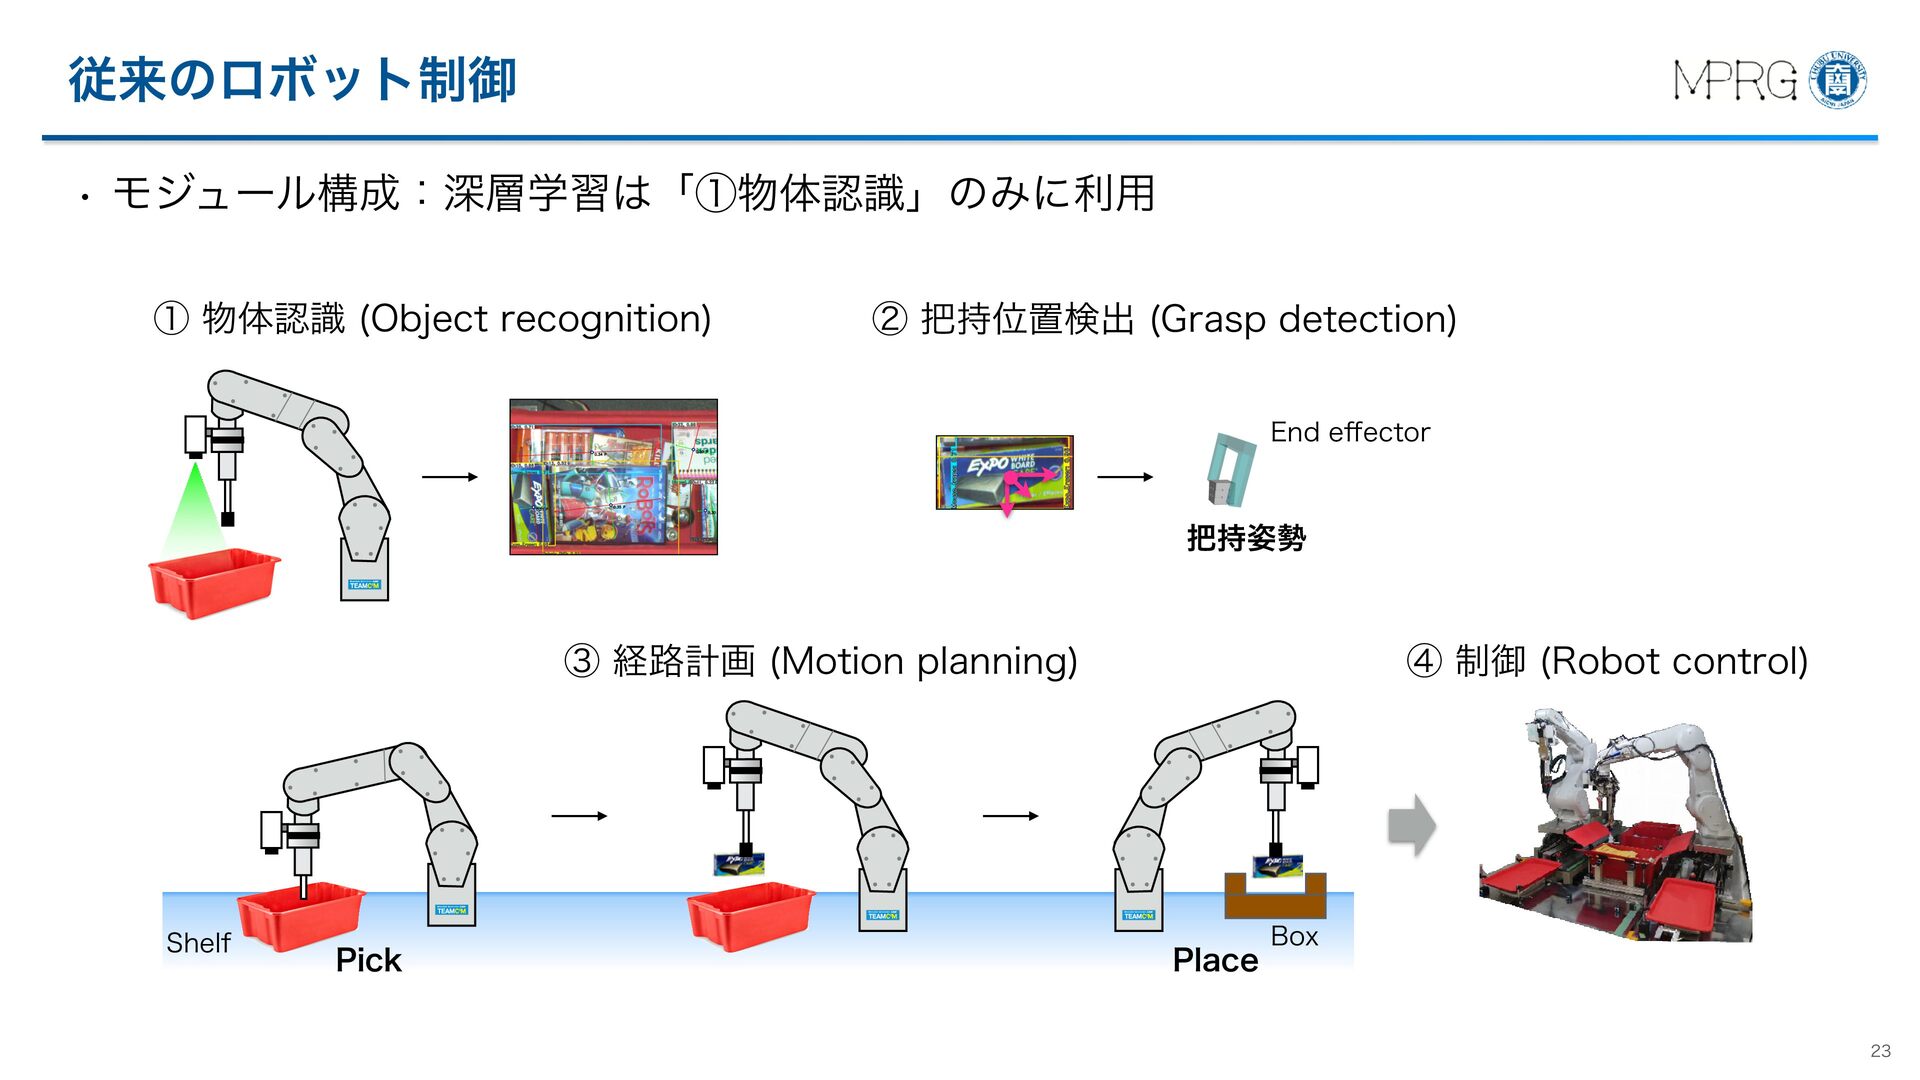
  18. 従来のロボット制御 • モジュール構成:深層学習は「①物体認識」のみに利用 ① 物体認識 (Object recognition) ② 把持位置検出 (Grasp

    detection) End e ector 把持姿勢 ③ 経路計画 (Motion planning) Shelf Pick ④ 制御 (Robot control) Place Box ff 23
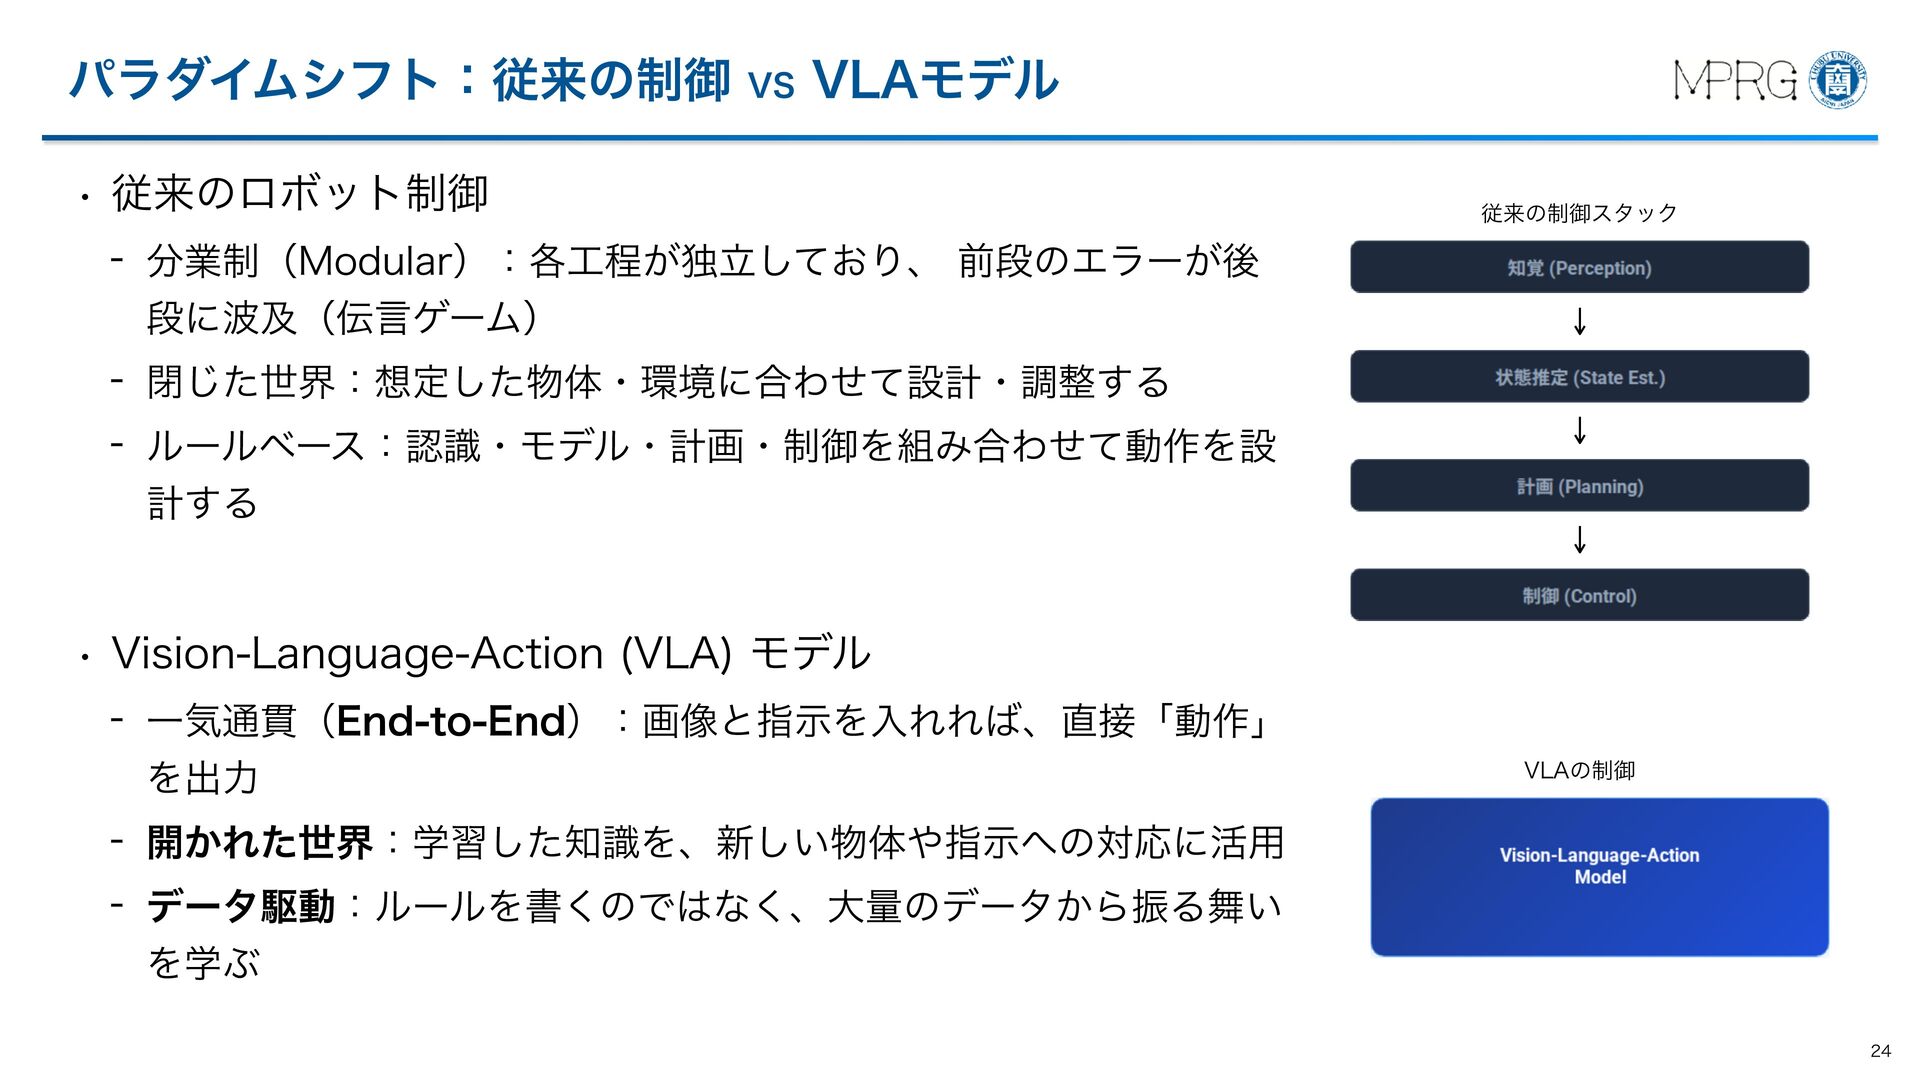
  19. パラダイムシフト:従来の制御 VS VLAモデル • 従来のロボット制御 従来の制御スタック - 分業制(Modular):各工程が独立しており、 前段のエラーが後 段に波及(伝言ゲーム)

    - 閉じた世界:想定した物体・環境に合わせて設計・調整する - ルールベース:認識・モデル・計画・制御を組み合わせて動作を設 計する • Vision-Language-Action (VLA) モデル - 一気通貫(End-to-End):画像と指示を入れれば、直接「動作」 を出力 VLAの制御 - 開かれた世界:学習した知識を、新しい物体や指示への対応に活用 - データ駆動:ルールを書くのではなく、大量のデータから振る舞い を学ぶ 24
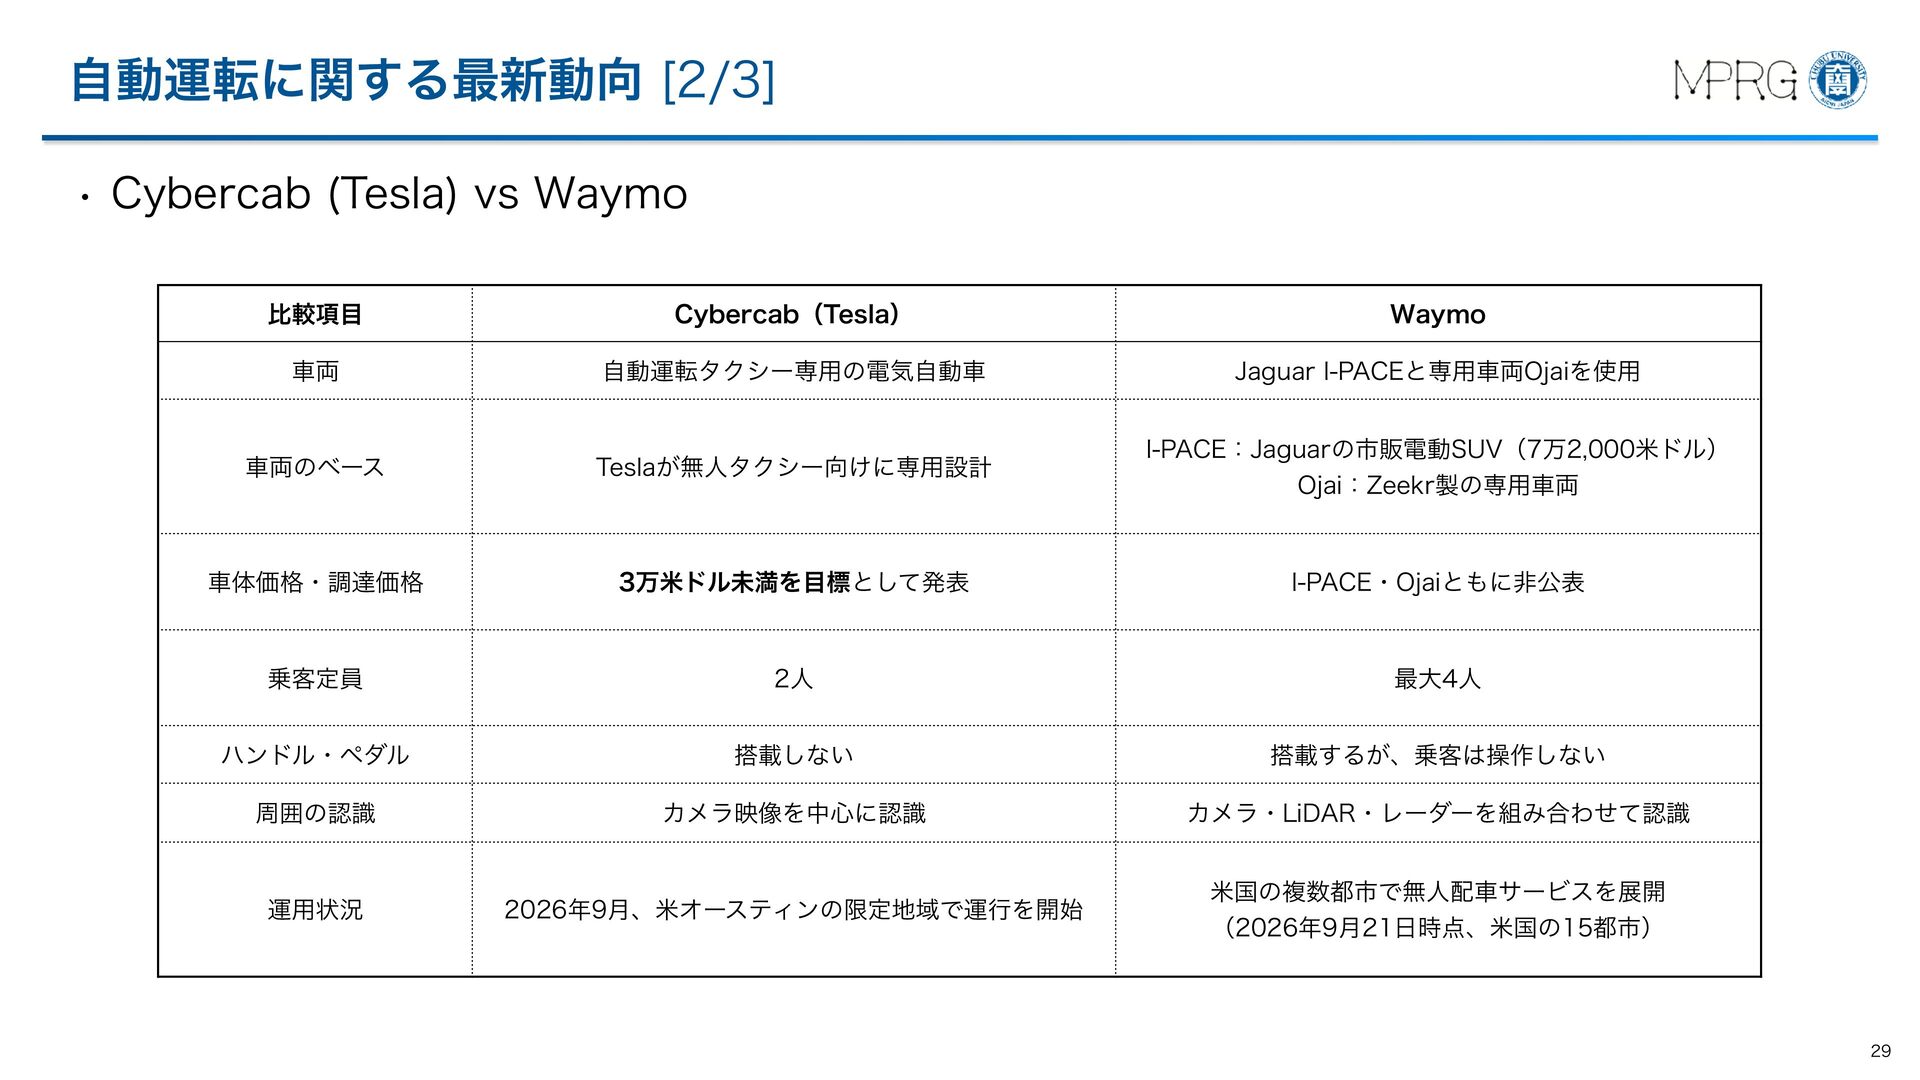
  20. 自動運転に関する最新動向 [2/3] • Cybercab (Tesla) vs Waymo 比較項目 Cybercab(Tesla) Waymo

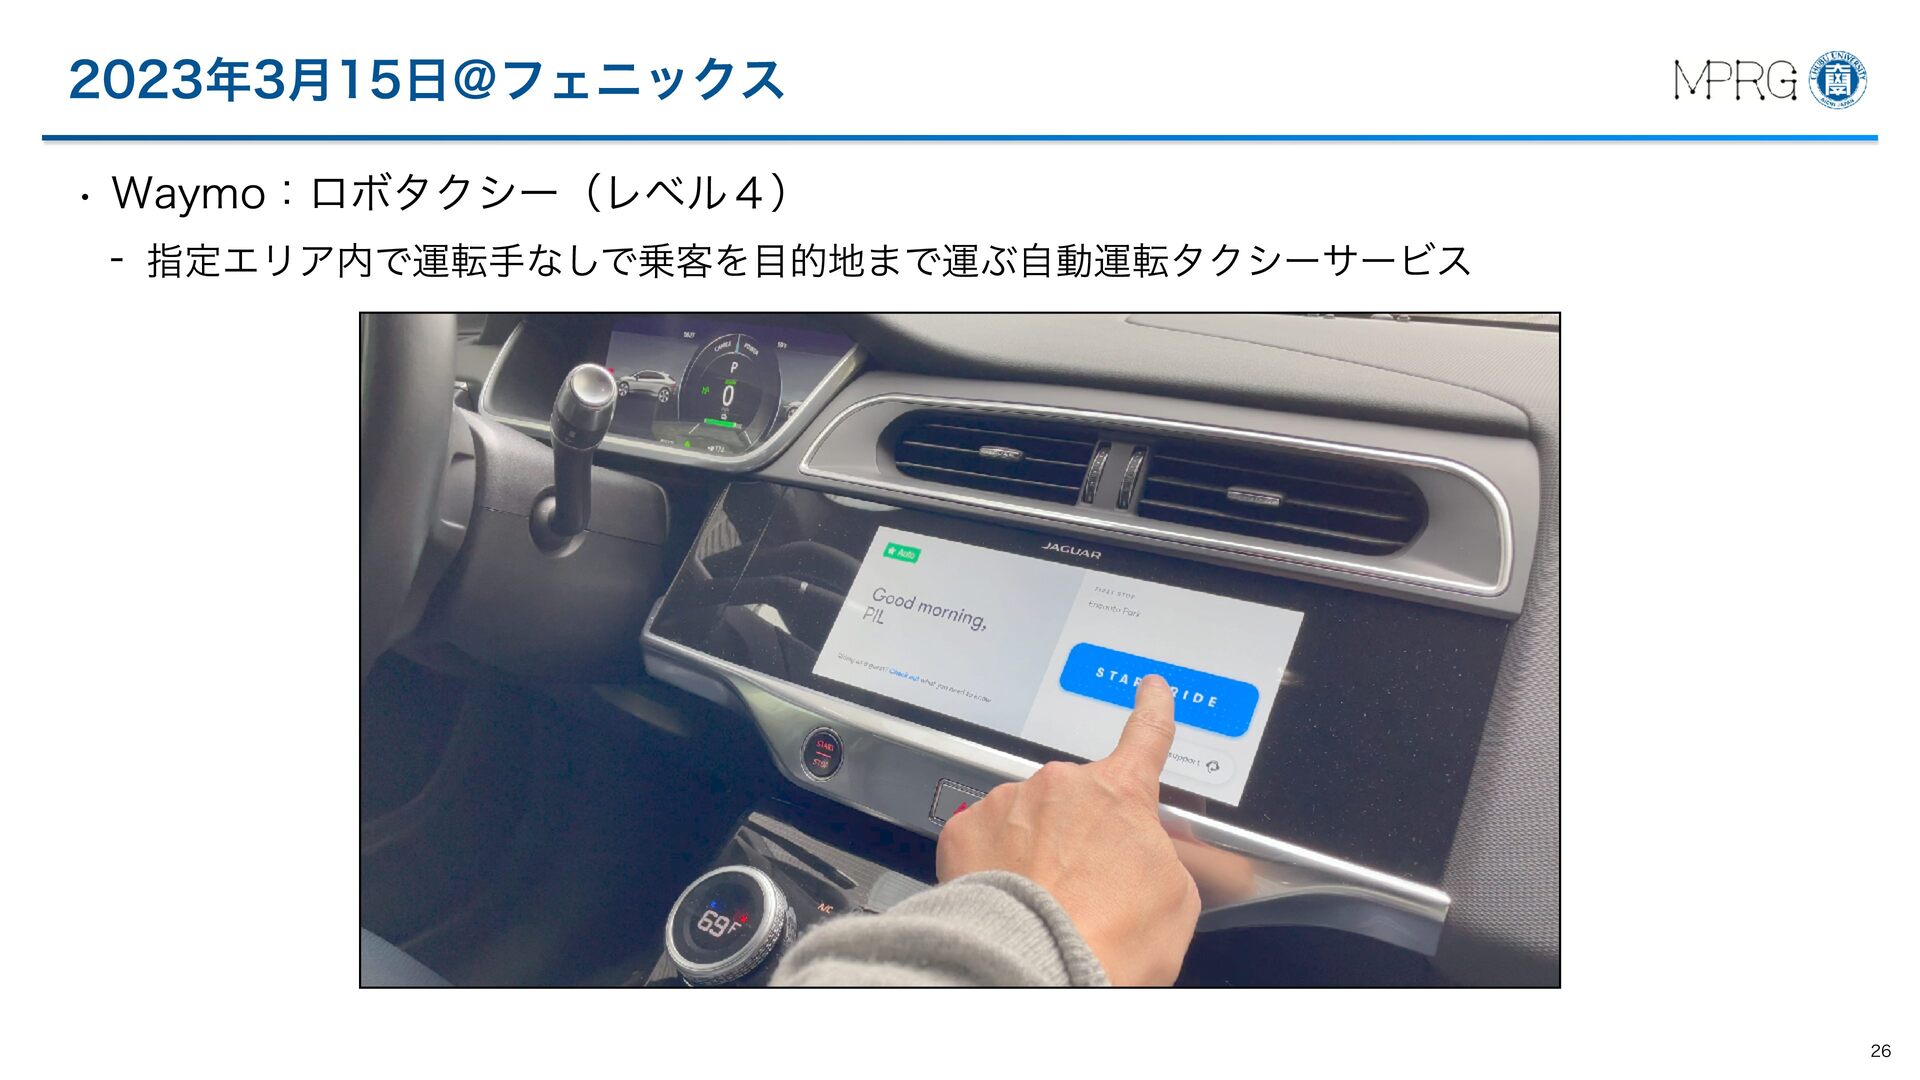
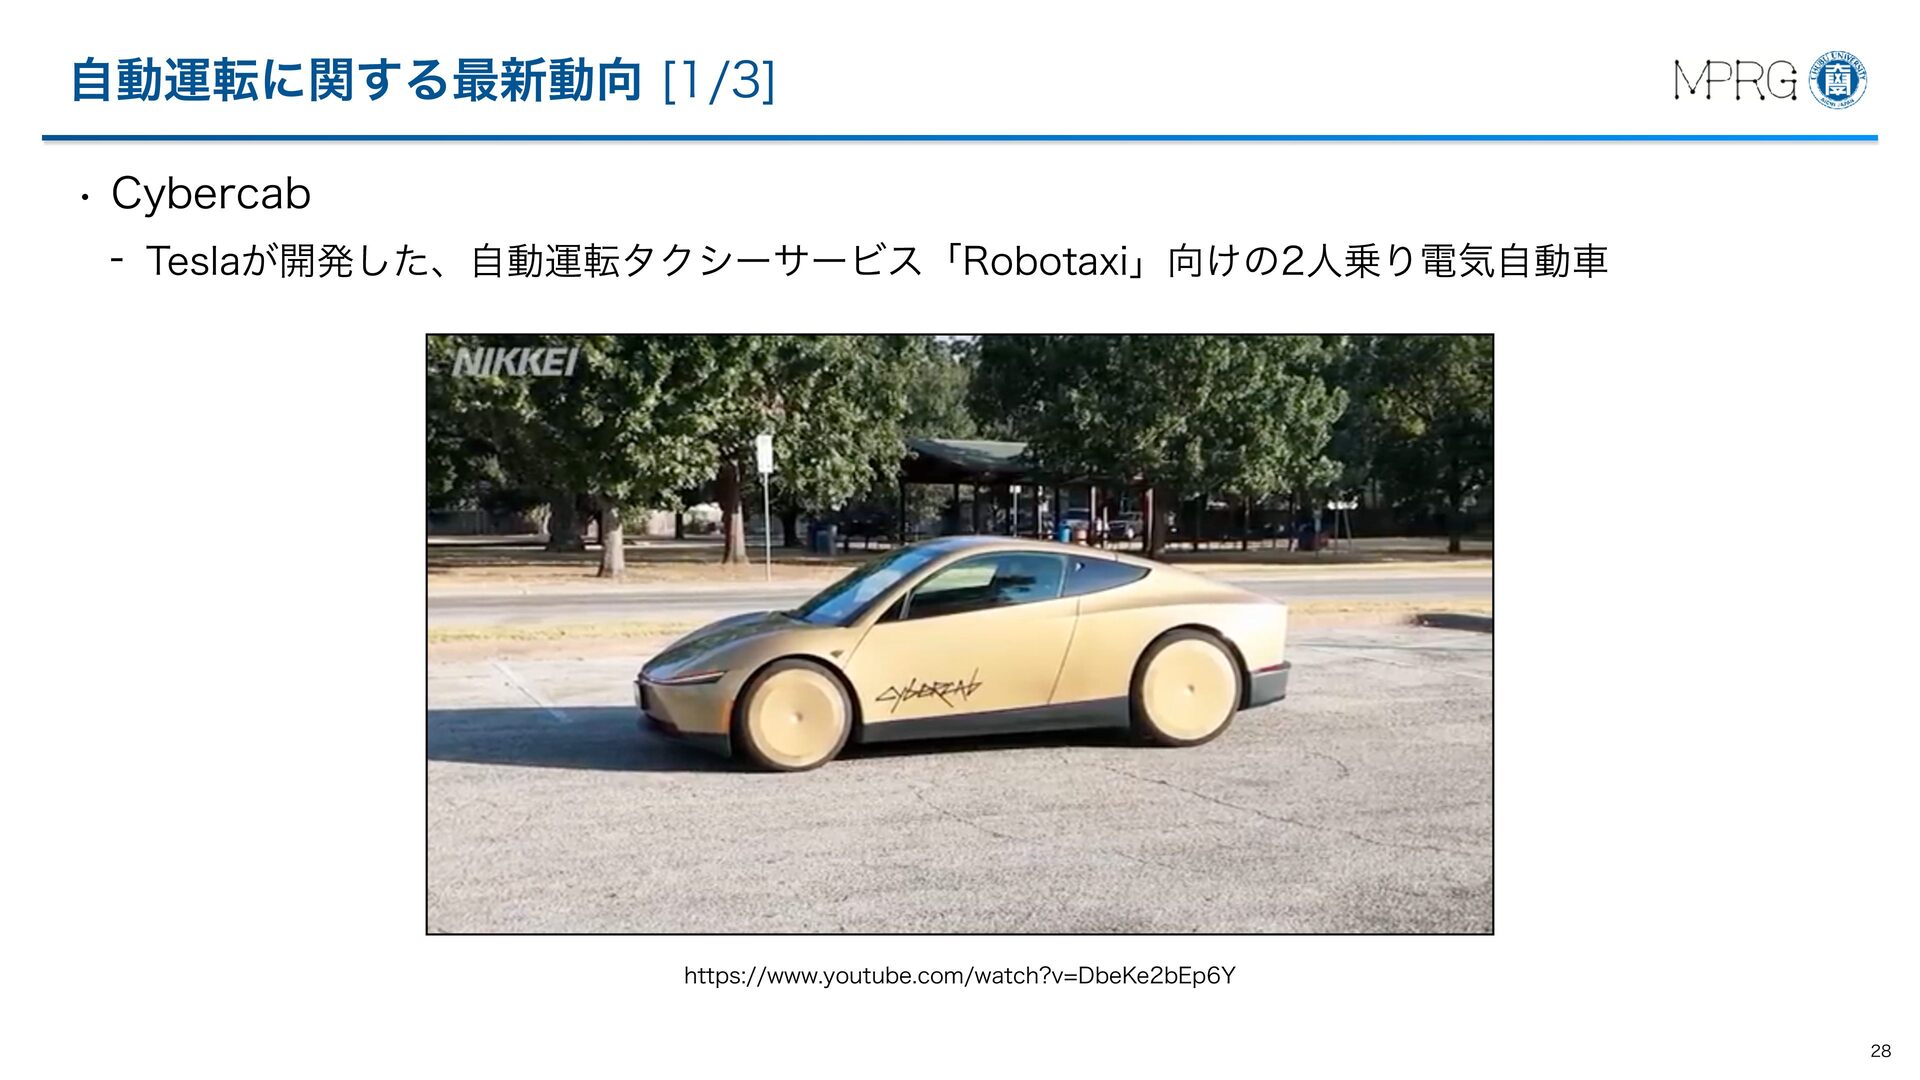
    車両 自動運転タクシー専用の電気自動車 Jaguar I-PACEと専用車両Ojaiを使用 車両のベース Teslaが無人タクシー向けに専用設計 I-PACE:Jaguarの市販電動SUV(7万2,000米ドル) Ojai:Zeekr製の専用車両 車体価格・調達価格 3万米ドル未満を目標として発表 I-PACE・Ojaiともに非公表 乗客定員 中部大学ロゴ 2人 最大4人 ハンドル・ペダル 搭載しない 中部大学ロゴ 搭載するが、乗客は操作しない 周囲の認識 カメラ映像を中心に認識 カメラ・LiDAR・レーダーを組み合わせて認識 2026年9月、米オースティンの限定地域で運行を開始 米国の複数都市で無人配車サービスを展開 (2026年9月21日時点、米国の15都市) 運用状況 29 29
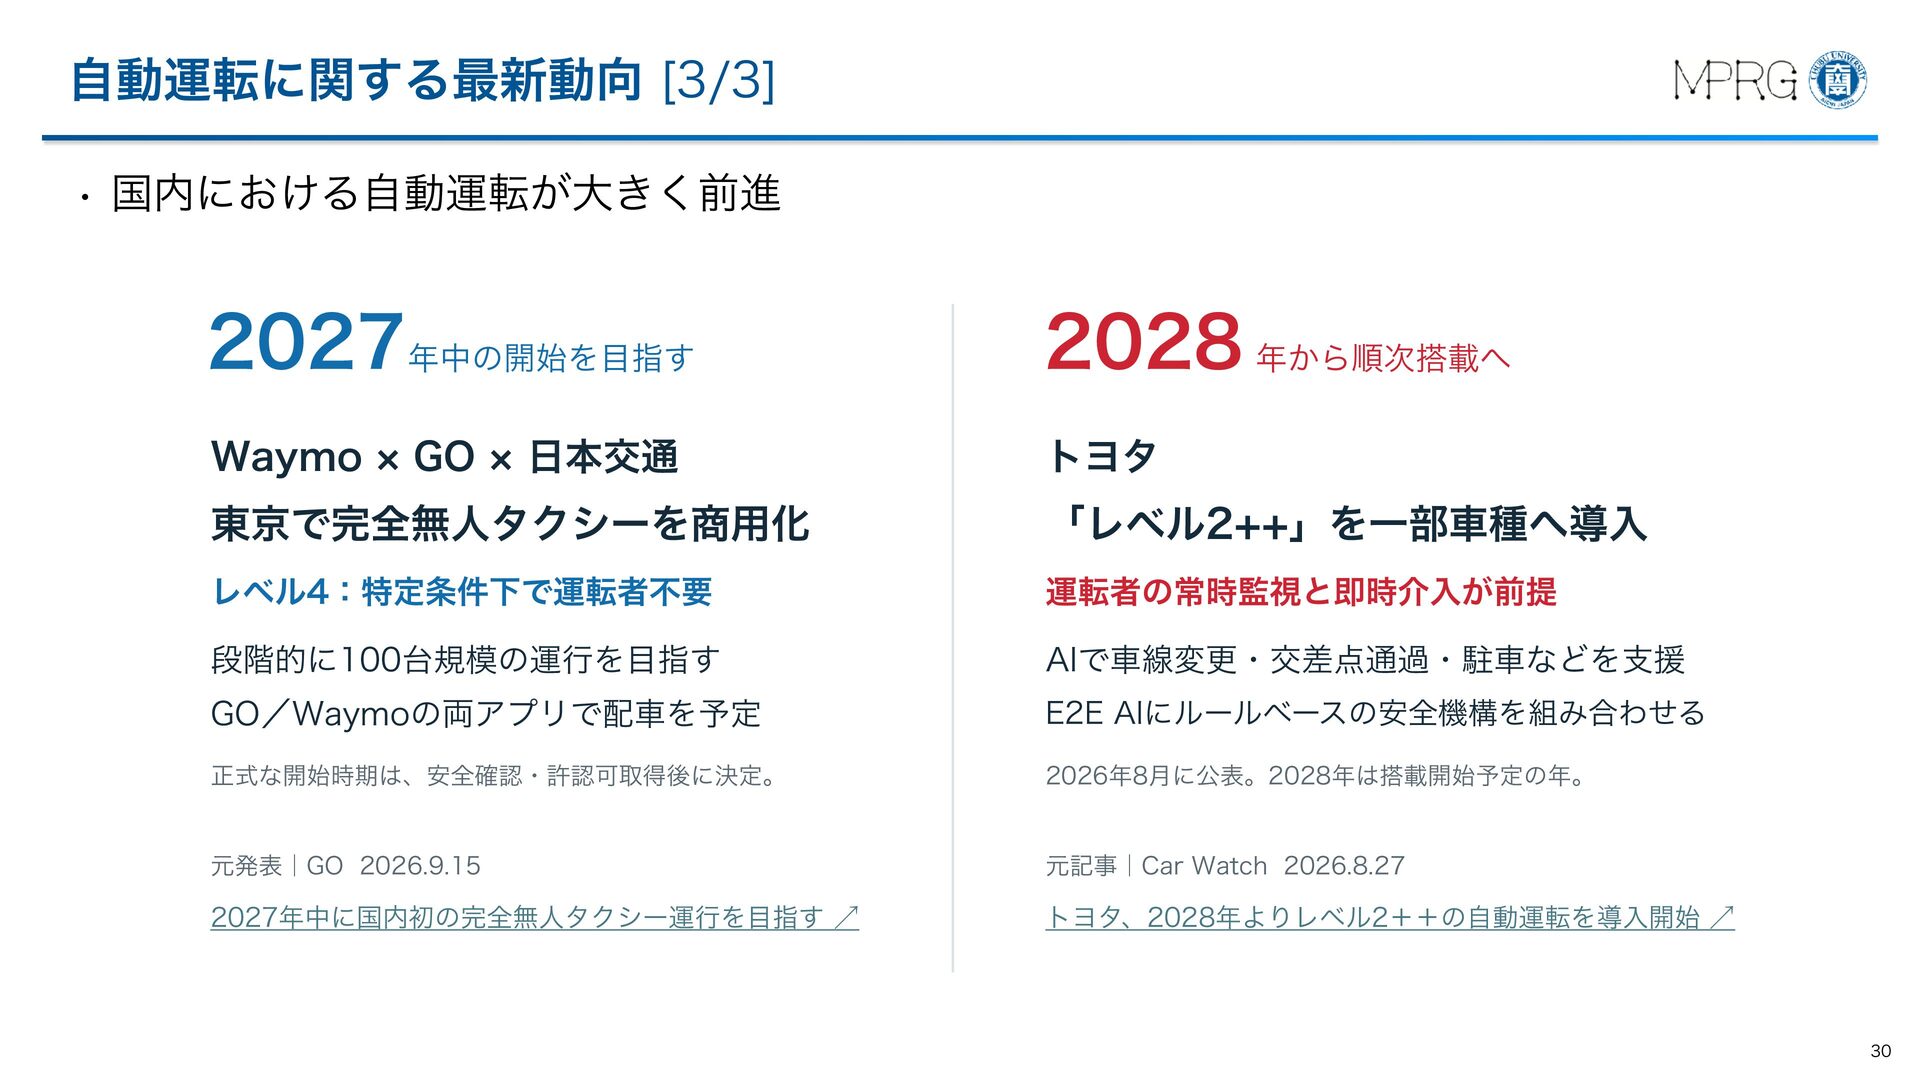
  21. 自動運転に関する最新動向 [3/3] • 国内における自動運転が大きく前進 2027年中の開始を目指す 2028 年から順次搭載へ Waymo トヨタ GO

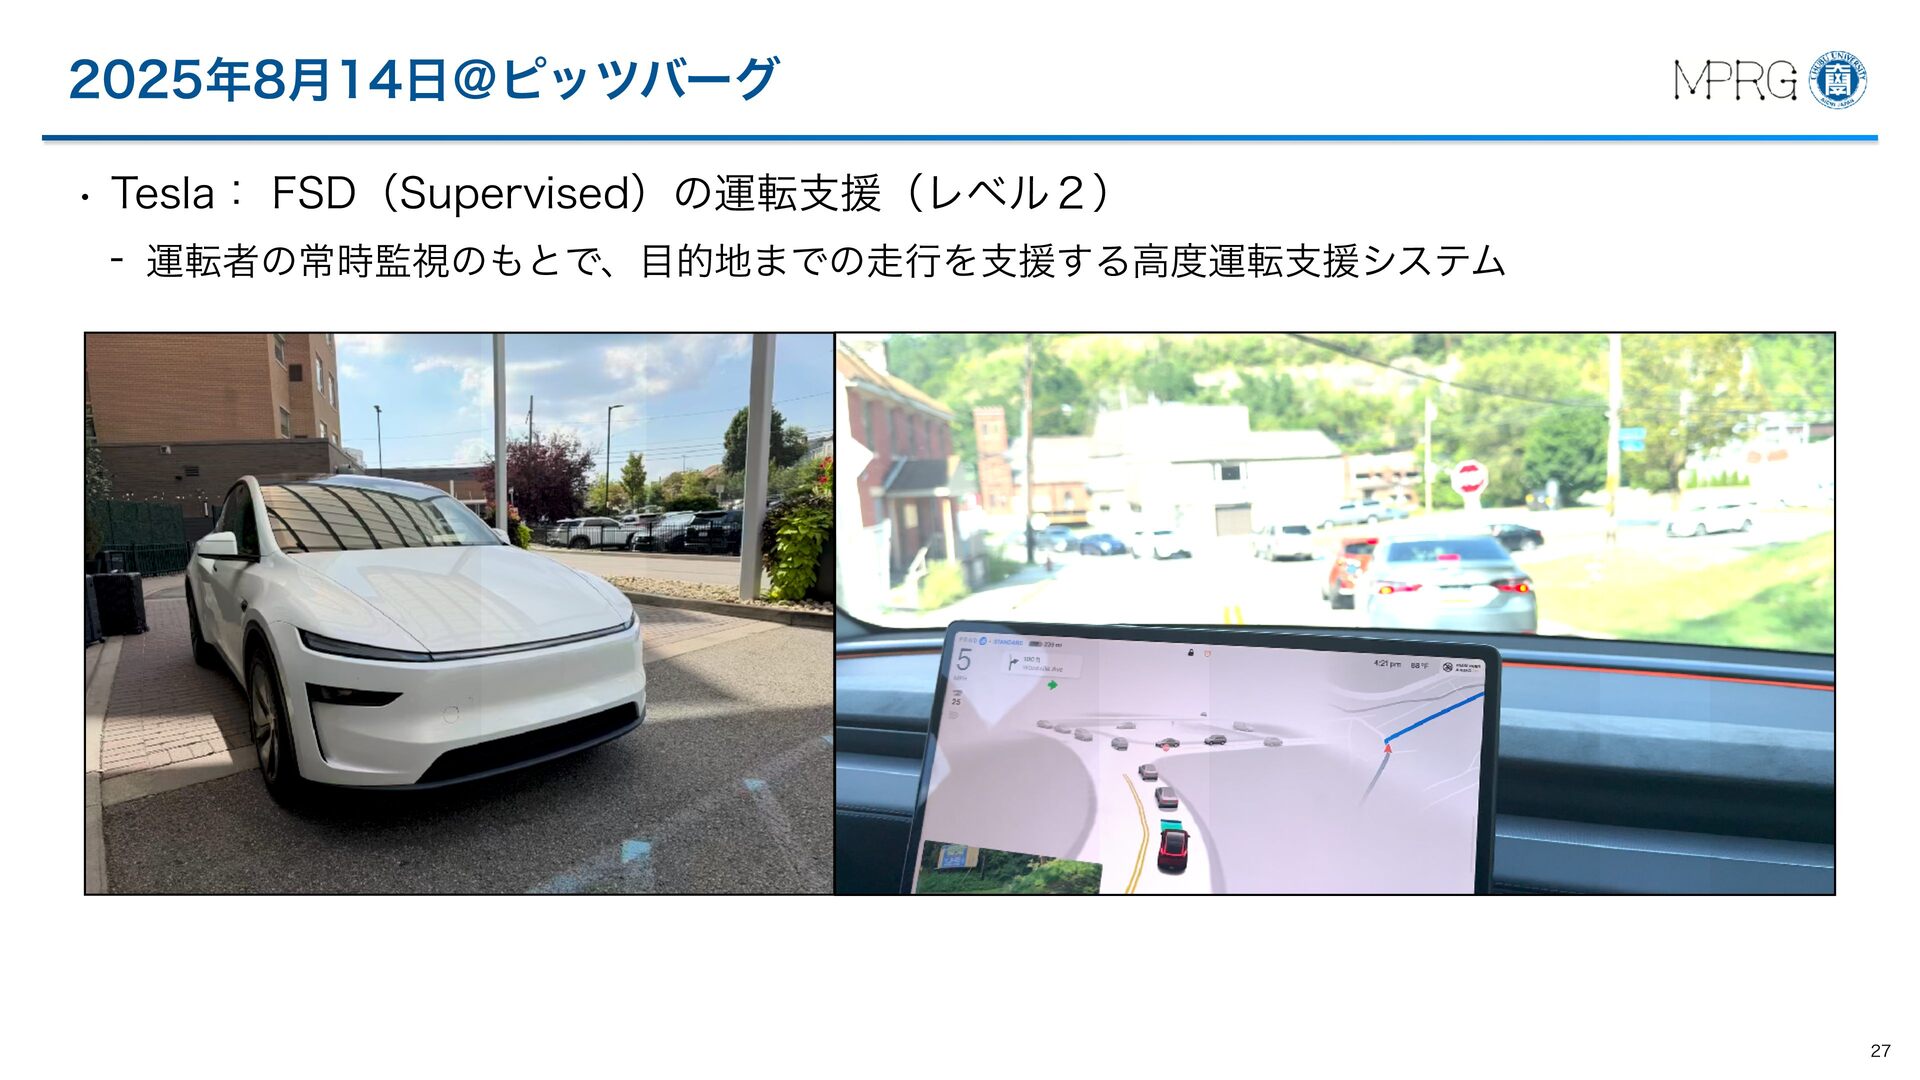
    日本交通 東京で完全無人タクシーを商用化 「レベル2++」を一部車種へ導入 レベル4:特定条件下で運転者不要 運転者の常時監視と即時介入が前提 中部大学ロゴ 段階的に100台規模の運行を目指す AIで車線変更・交差点通過・駐車などを支援 GO/Waymoの両アプリで配車を予定 E2E AIにルールベースの安全機構を組み合わせる 正式な開始時期は、安全確認・許認可取得後に決定。 中部大学ロゴ 2026年8月に公表。2028年は搭載開始予定の年。 元発表|GO 2026.9.15 元記事|Car Watch 2026.8.27 2027年中に国内初の完全無人タクシー運行を目指す ↗ トヨタ、2028年よりレベル2++の自動運転を導入開始 ↗ 30 30
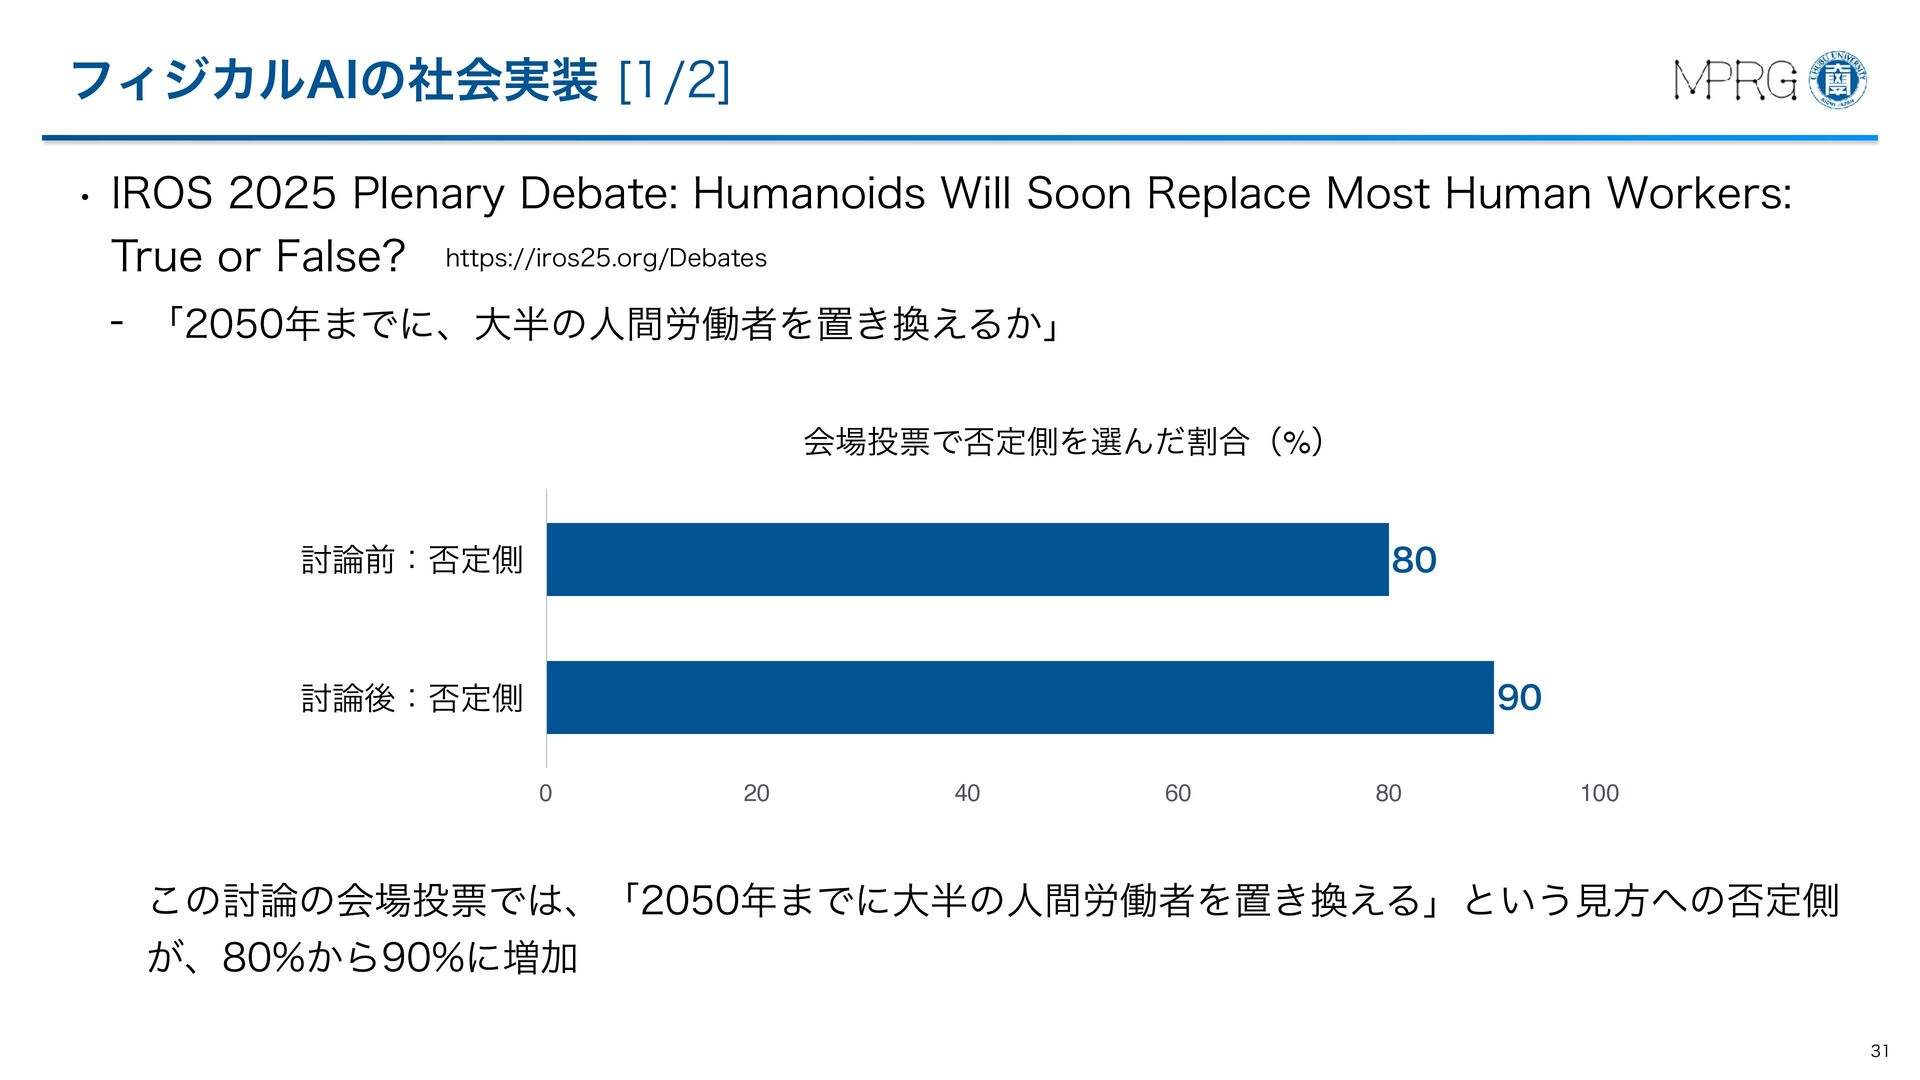
  22. フィジカルAIの社会実装 [1/2] • IROS 2025 Plenary Debate: Humanoids Will Soon

    Replace Most Human Workers: True or False? https://iros25.org/Debates - 「2050年までに、大半の人間労働者を置き換えるか」 会場投票で否定側を選んだ割合(%) 討論前:否定側 80 中部大学ロゴ 討論後:否定側 0 中部大学ロゴ 20 90 40 60 80 100 この討論の会場投票では、「2050年までに大半の人間労働者を置き換える」という見方への否定側 が、80%から90%に増加 31 31
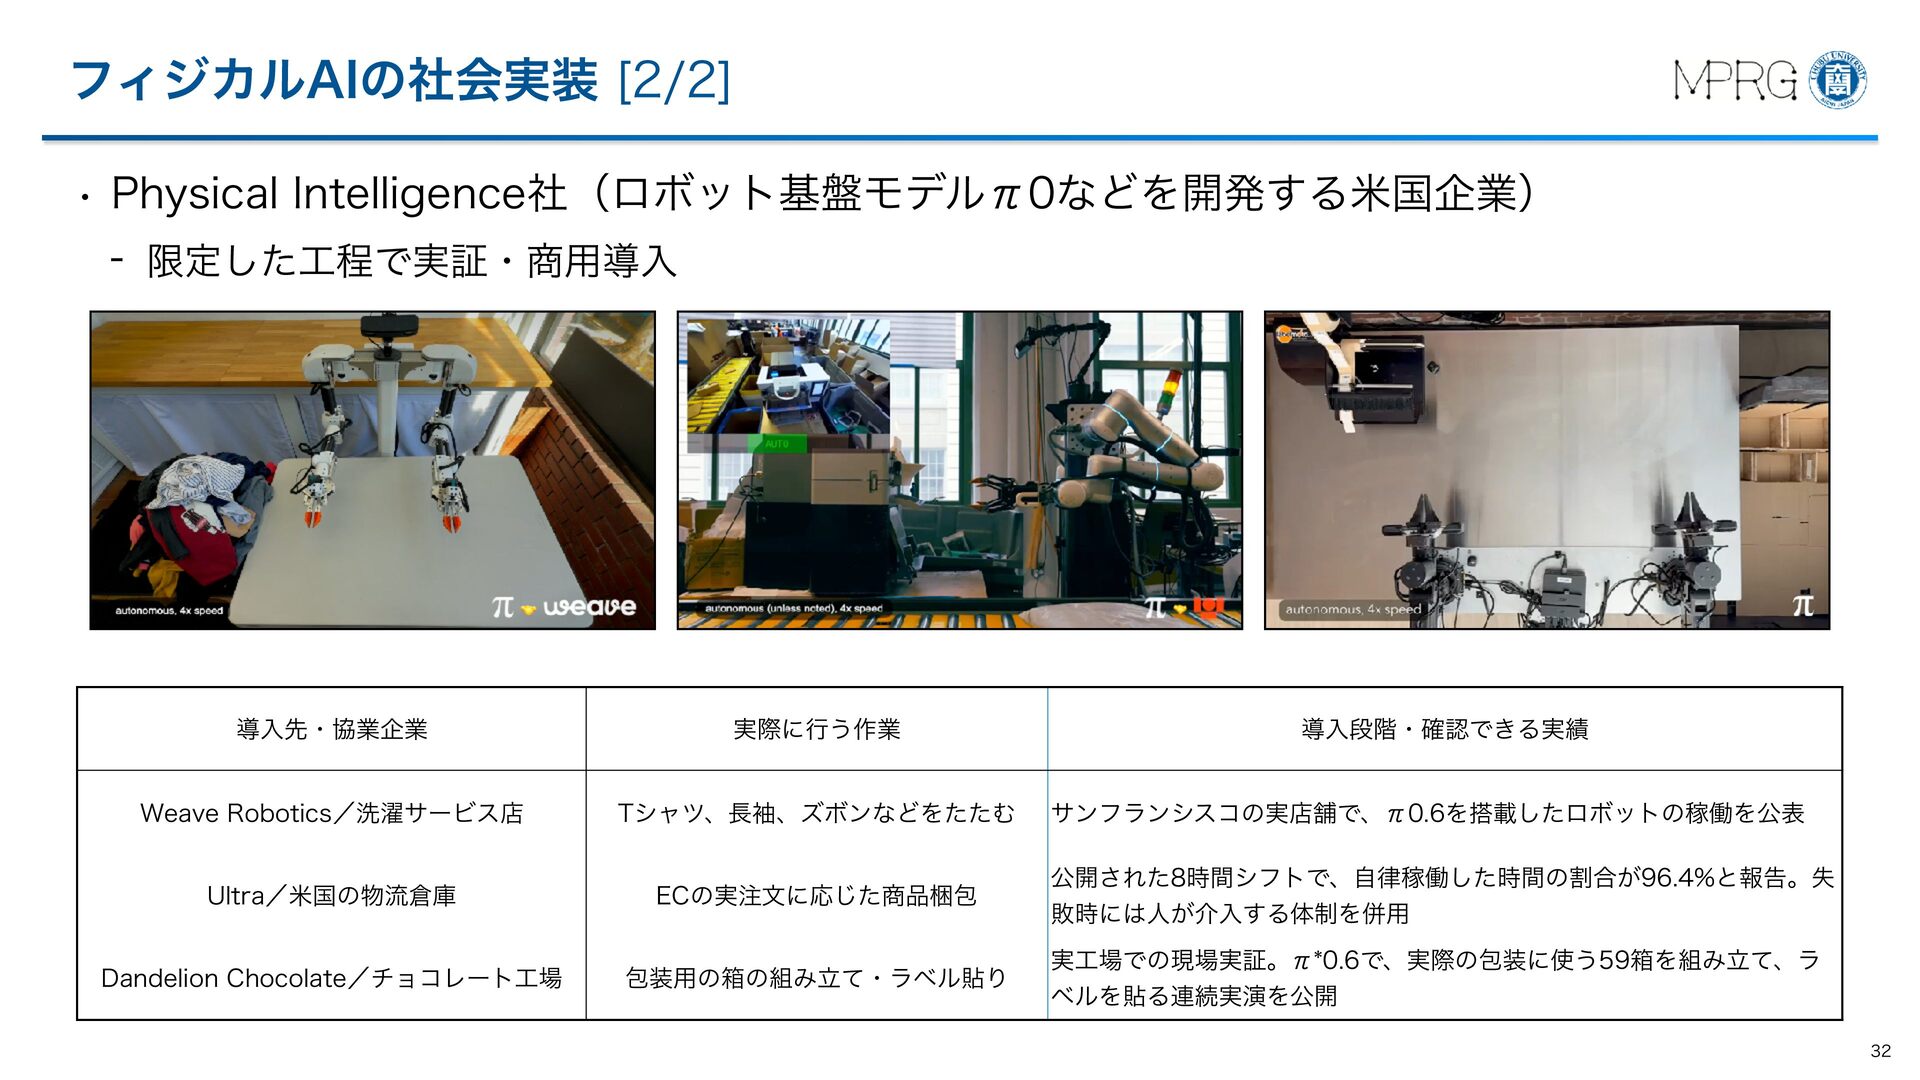
  23. フィジカルAIの社会実装 [2/2] • Physical Intelligence社(ロボット基盤モデルπ0などを開発する米国企業) - 限定した工程で実証・商用導入 中部大学ロゴ 導入先・協業企業 実際に行う作業

    導入段階・確認できる実績 中部大学ロゴ Weave Robotics/洗濯サービス店 Ultra/米国の物流倉庫 Dandelion Chocolate/チョコレート工場 Tシャツ、長袖、ズボンなどをたたむ サンフランシスコの実店舗で、π0.6を搭載したロボットの稼働を公表 ECの実注文に応じた商品梱包 公開された8時間シフトで、自律稼働した時間の割合が96.4%と報告。失 敗時には人が介入する体制を併用 包装用の箱の組み立て・ラベル貼り 実工場での現場実証。π*0.6で、実際の包装に使う59箱を組み立て、ラ ベルを貼る連続実演を公開 32 32
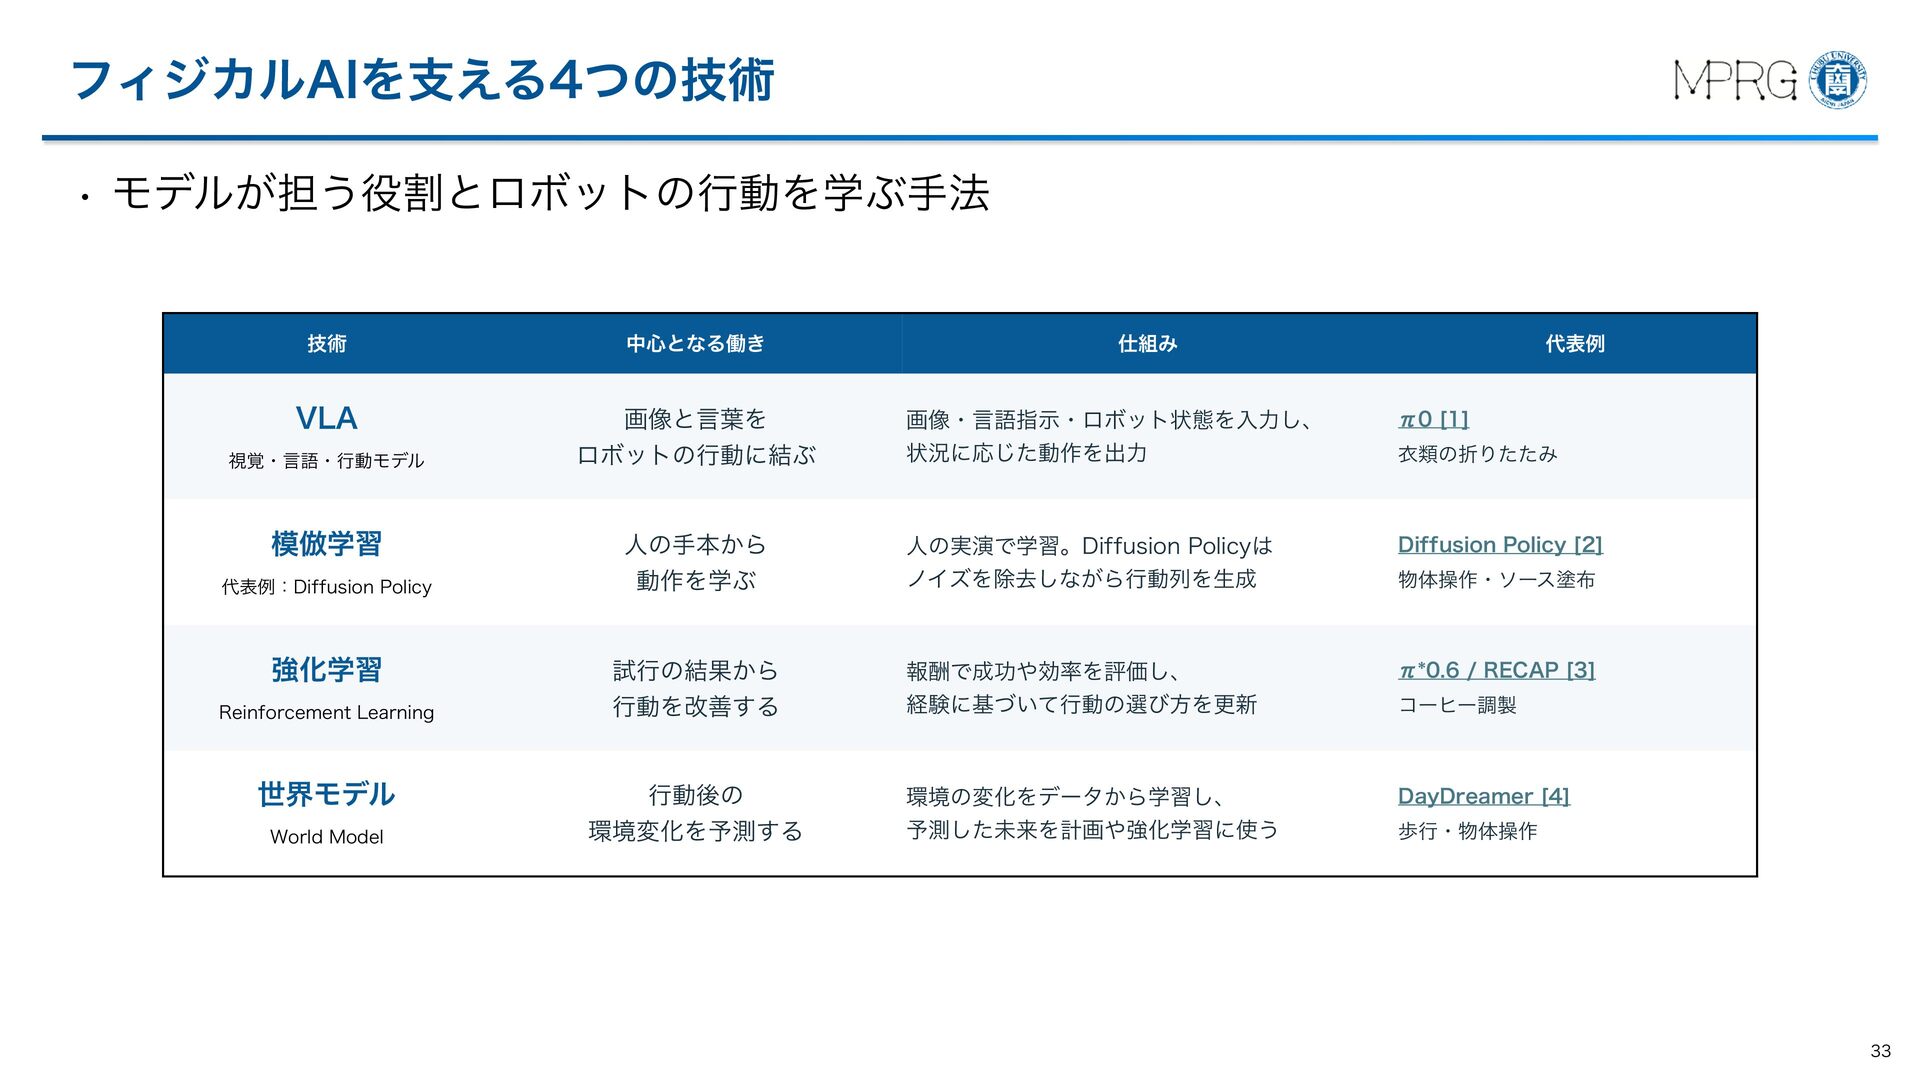
  24. フィジカルAIを支える4つの技術 • モデルが担う役割とロボットの行動を学ぶ手法 技術 中心となる働き VLA 画像と言葉を ロボットの行動に結ぶ 視覚・言語・行動モデル 模倣学習

    代表例:Diffusion Policy 強化学習 Reinforcement Learning 世界モデル World Model 人の手本から 動作を学ぶ 仕組み 画像・言語指示・ロボット状態を入力し、 状況に応じた動作を出力 π0 [1] 人の実演で学習。Diffusion Policyは ノイズを除去しながら行動列を生成 Diffusion Policy [2] 中部大学ロゴ 報酬で成功や効率を評価し、 試行の結果から 行動を改善する 中部大学ロゴ 行動後の 環境変化を予測する 代表例 衣類の折りたたみ 物体操作・ソース塗布 π*0.6 / RECAP [3] 経験に基づいて行動の選び方を更新 コーヒー調製 環境の変化をデータから学習し、 予測した未来を計画や強化学習に使う DayDreamer [4] 歩行・物体操作 33 33
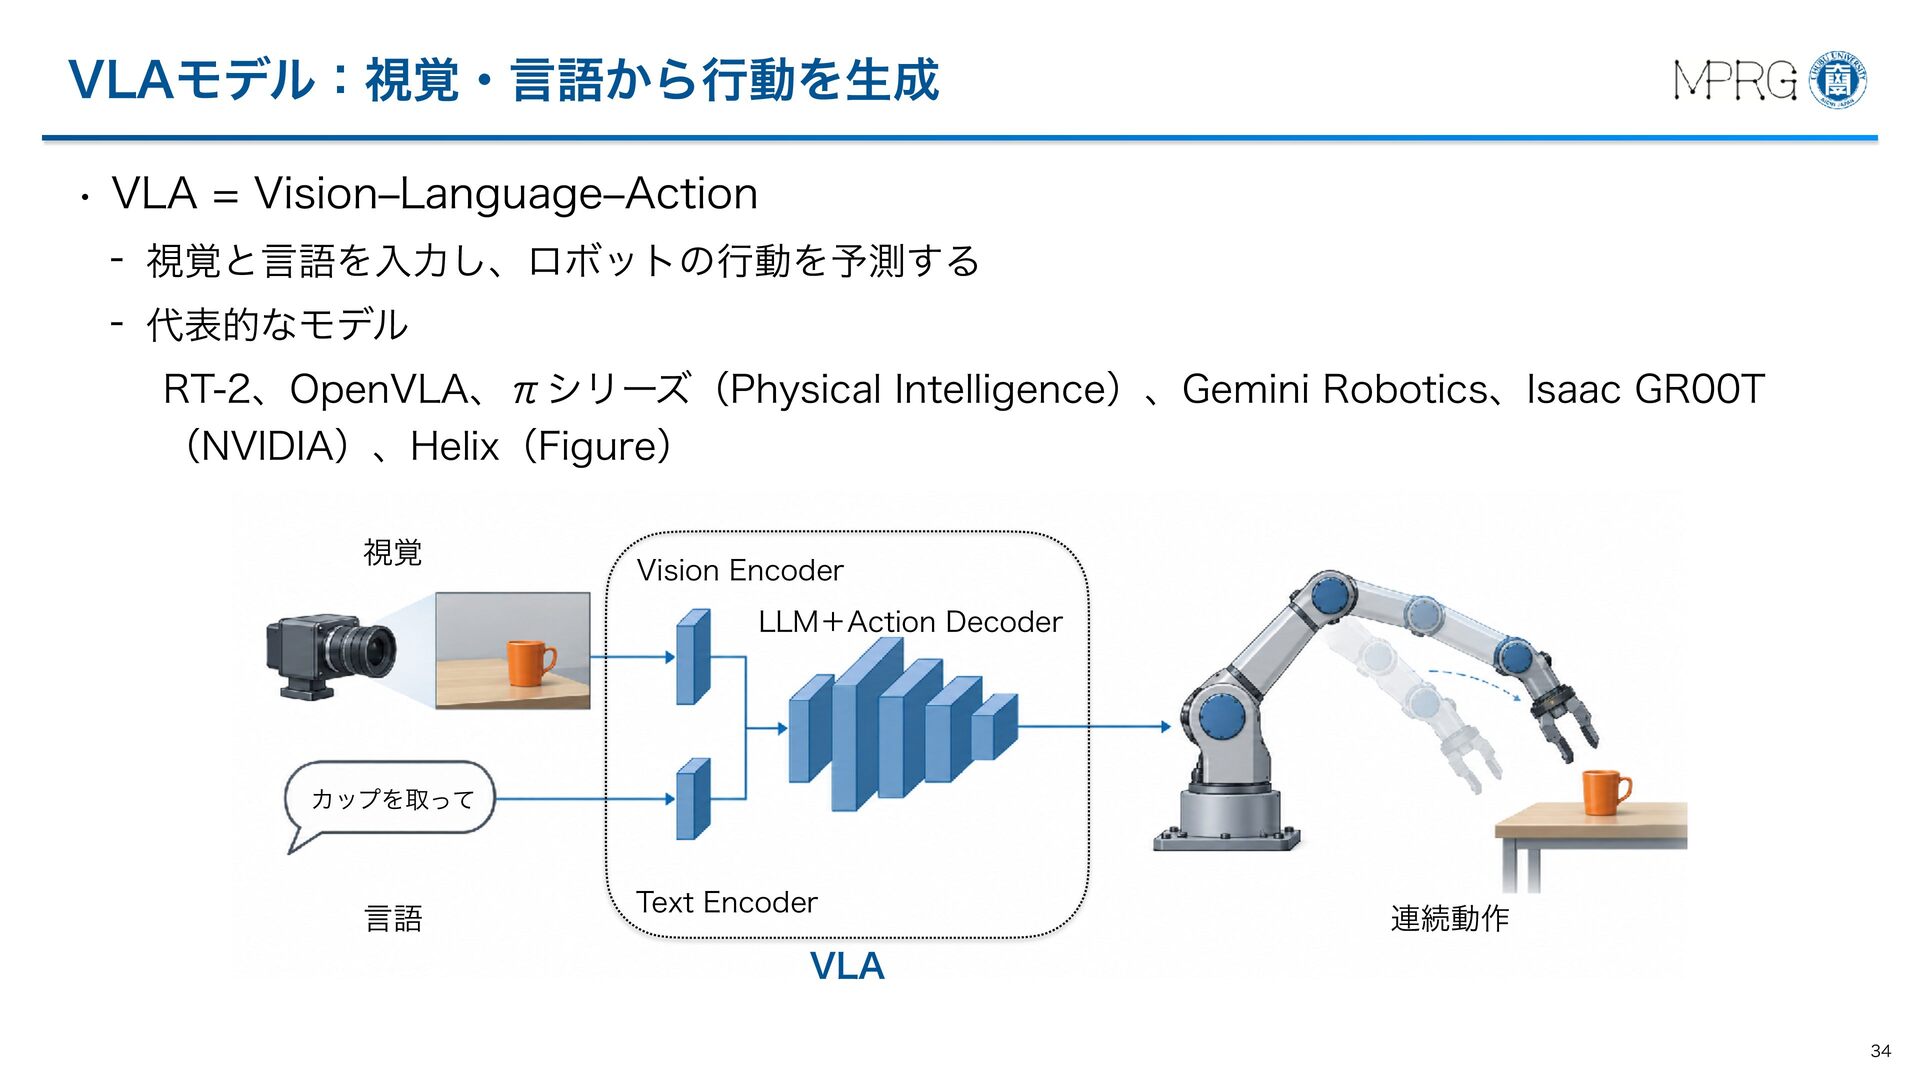
  25. VLAモデル:視覚・言語から行動を生成 • VLA = Vision‒Language‒Action - 視覚と言語を入力し、ロボットの行動を予測する - 代表的なモデル RT-2、OpenVLA、πシリーズ(Physical

    Intelligence)、Gemini Robotics、Isaac GR00T (NVIDIA)、Helix(Figure) 視覚 Vision Encoder LLM+Action Decoder 中部大学ロゴ カップを取って 言語 中部大学ロゴ Text Encoder 連続動作 VLA 34 34
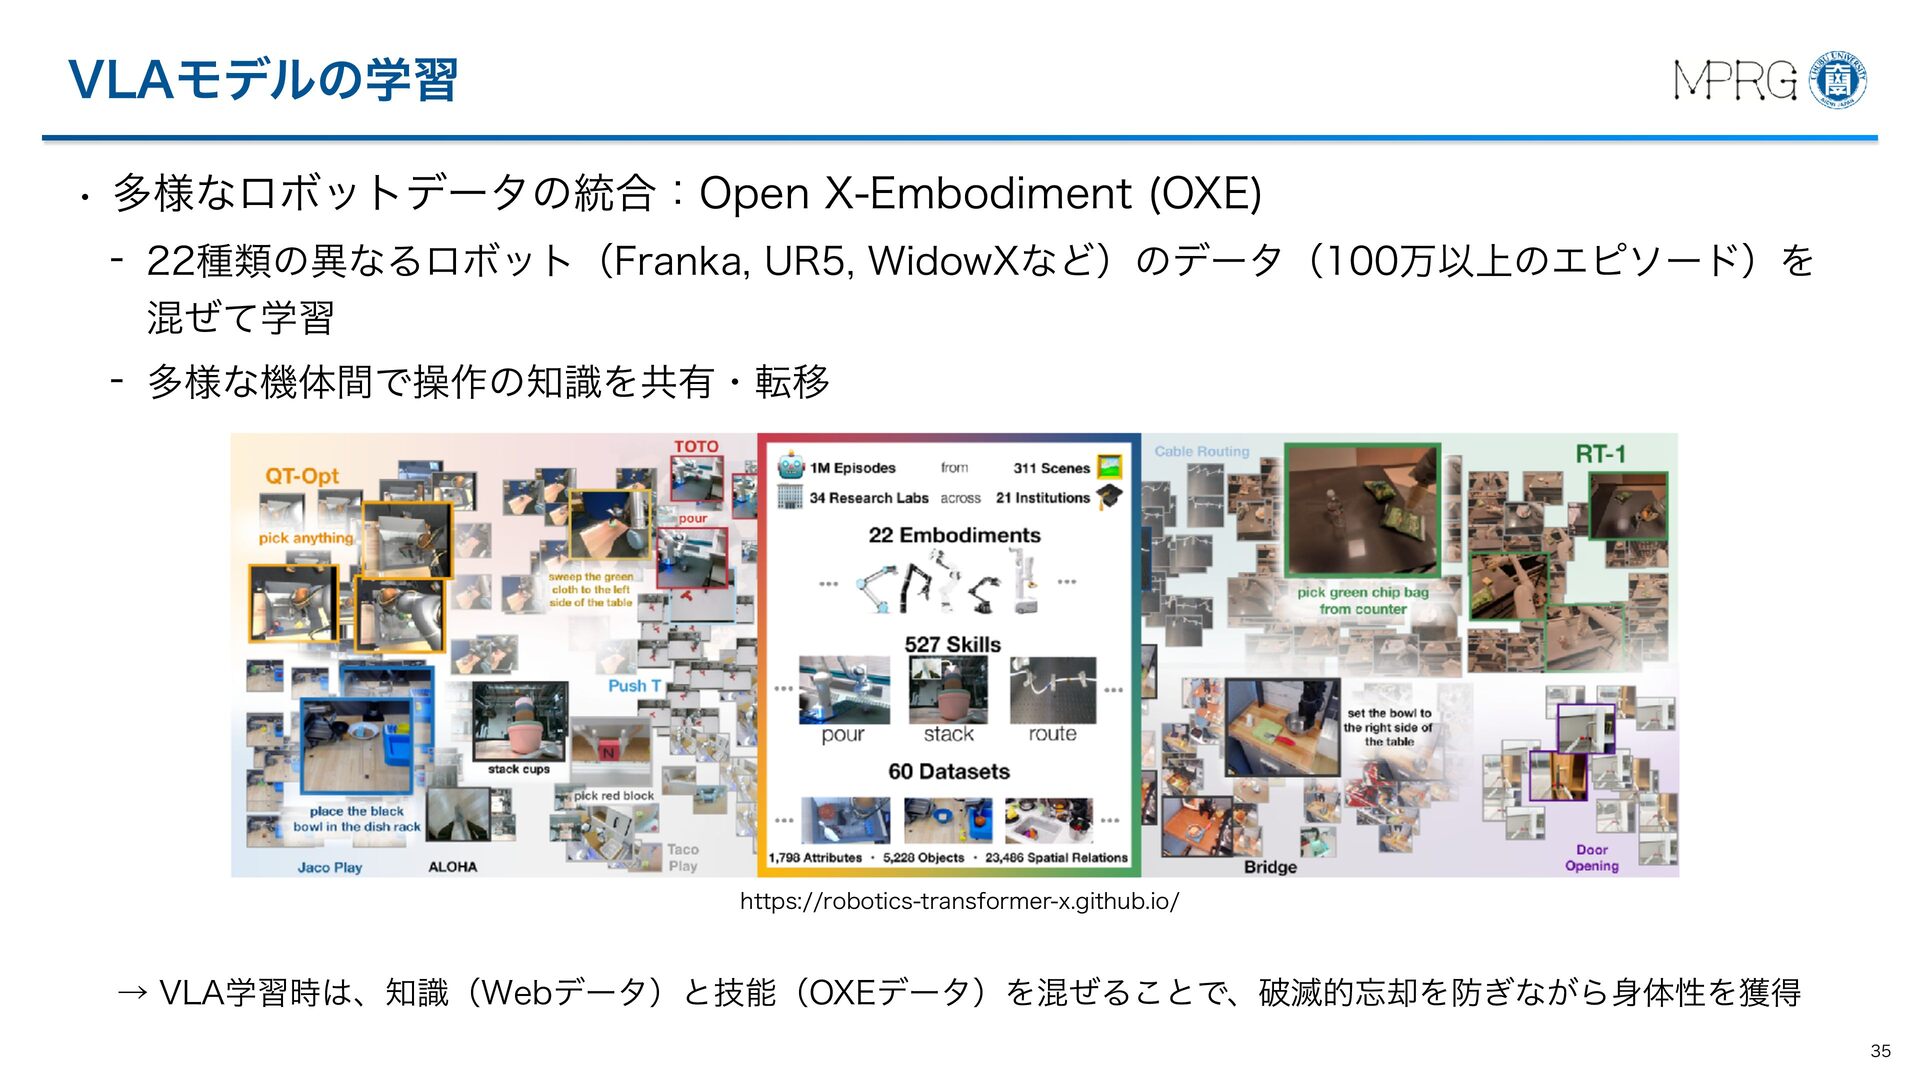
  26. VLAモデルの学習 • 多様なロボットデータの統合:Open X-Embodiment (OXE) - 22種類の異なるロボット(Franka, UR5, WidowXなど)のデータ(100万以上のエピソード)を 混ぜて学習

    - 多様な機体間で操作の知識を共有・転移 https://robotics-transformer-x.github.io/ → VLA学習時は、知識(Webデータ)と技能(OXEデータ)を混ぜることで、破滅的忘却を防ぎながら身体性を獲得 35
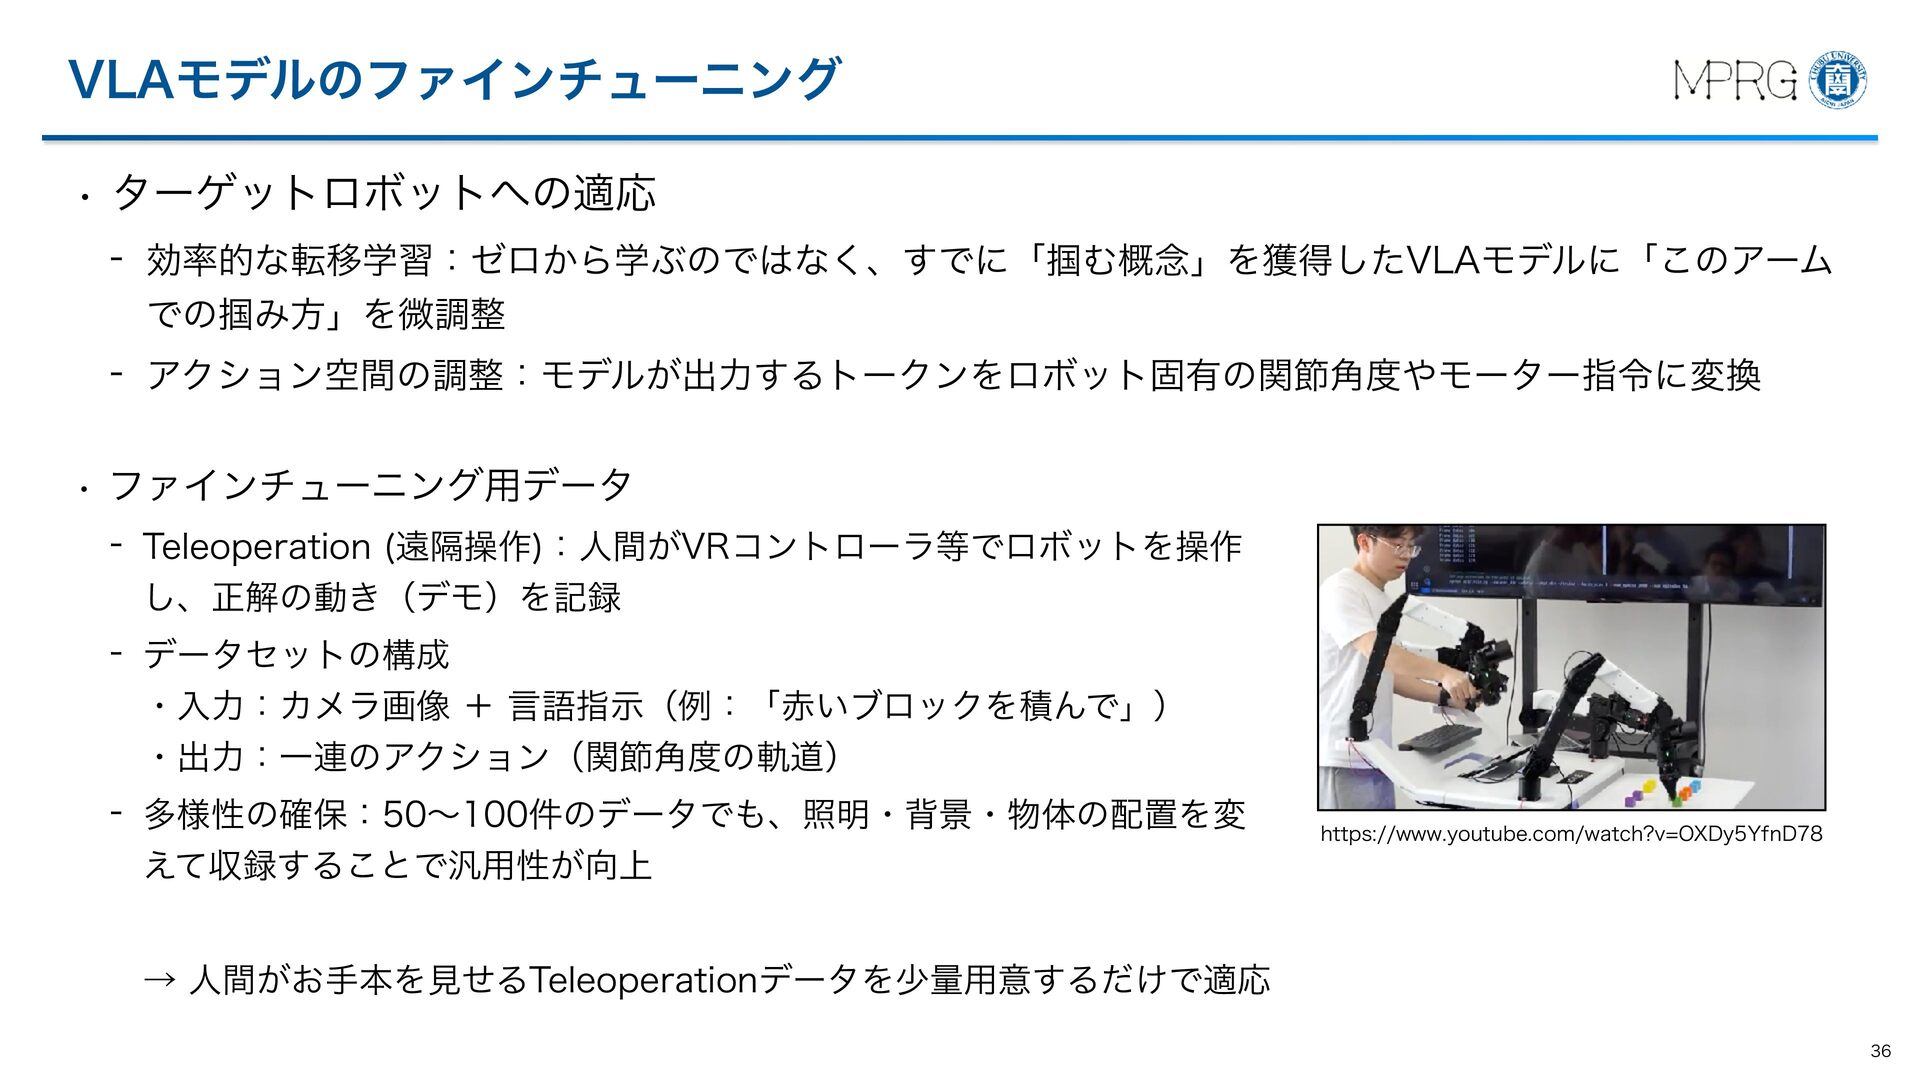
  27. VLAモデルのファインチューニング • ターゲットロボットへの適応 - 効率的な転移学習:ゼロから学ぶのではなく、すでに「掴む概念」を獲得したVLAモデルに「このアーム での掴み方」を微調整 - アクション空間の調整:モデルが出力するトークンをロボット固有の関節角度やモーター指令に変換 • ファインチューニング用データ

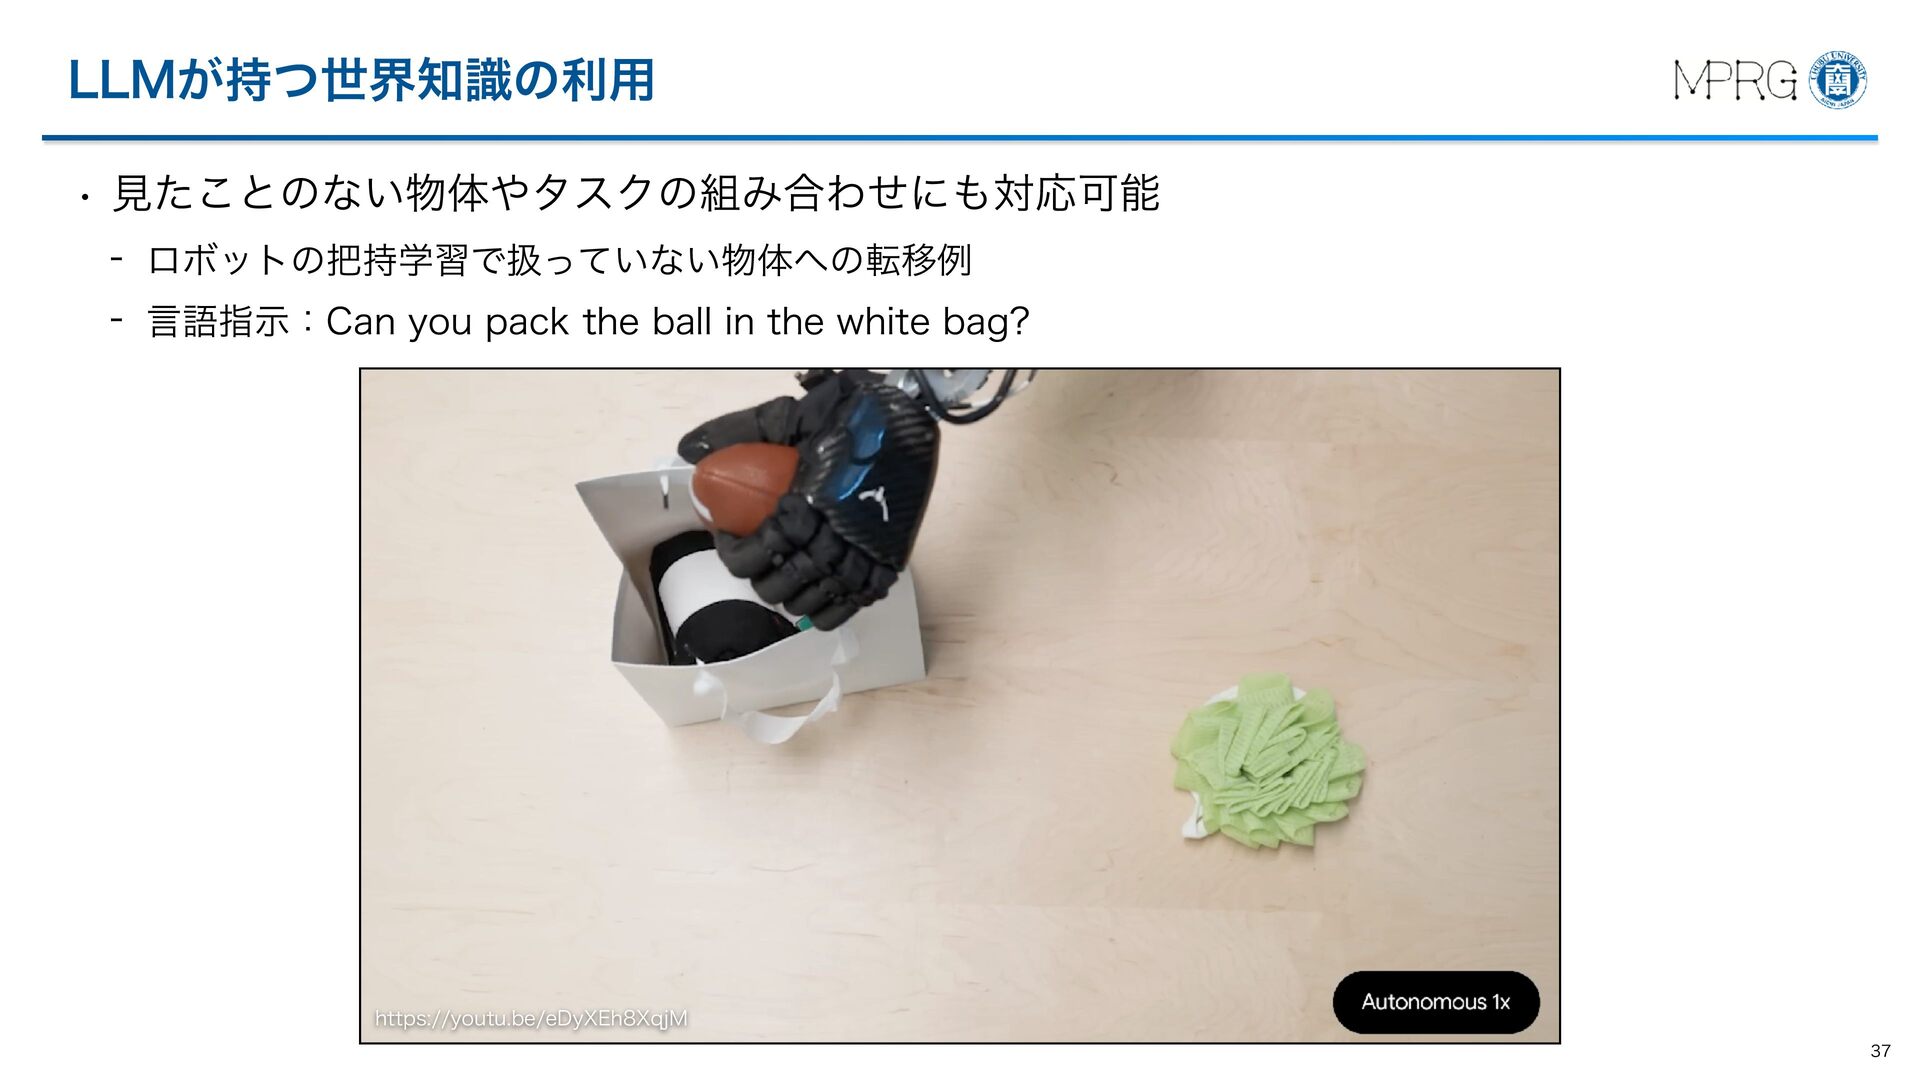
    - Teleoperation (遠隔操作):人間がVRコントローラ等でロボットを操作 し、正解の動き(デモ)を記録 - データセットの構成 ・入力:カメラ画像 + 言語指示(例:「赤いブロックを積んで」) ・出力:一連のアクション(関節角度の軌道) - 多様性の確保:50〜100件のデータでも、照明・背景・物体の配置を変 https://www.youtube.com/watch?v=OXDy5YfnD78 えて収録することで汎用性が向上 → 人間がお手本を見せるTeleoperationデータを少量用意するだけで適応 36
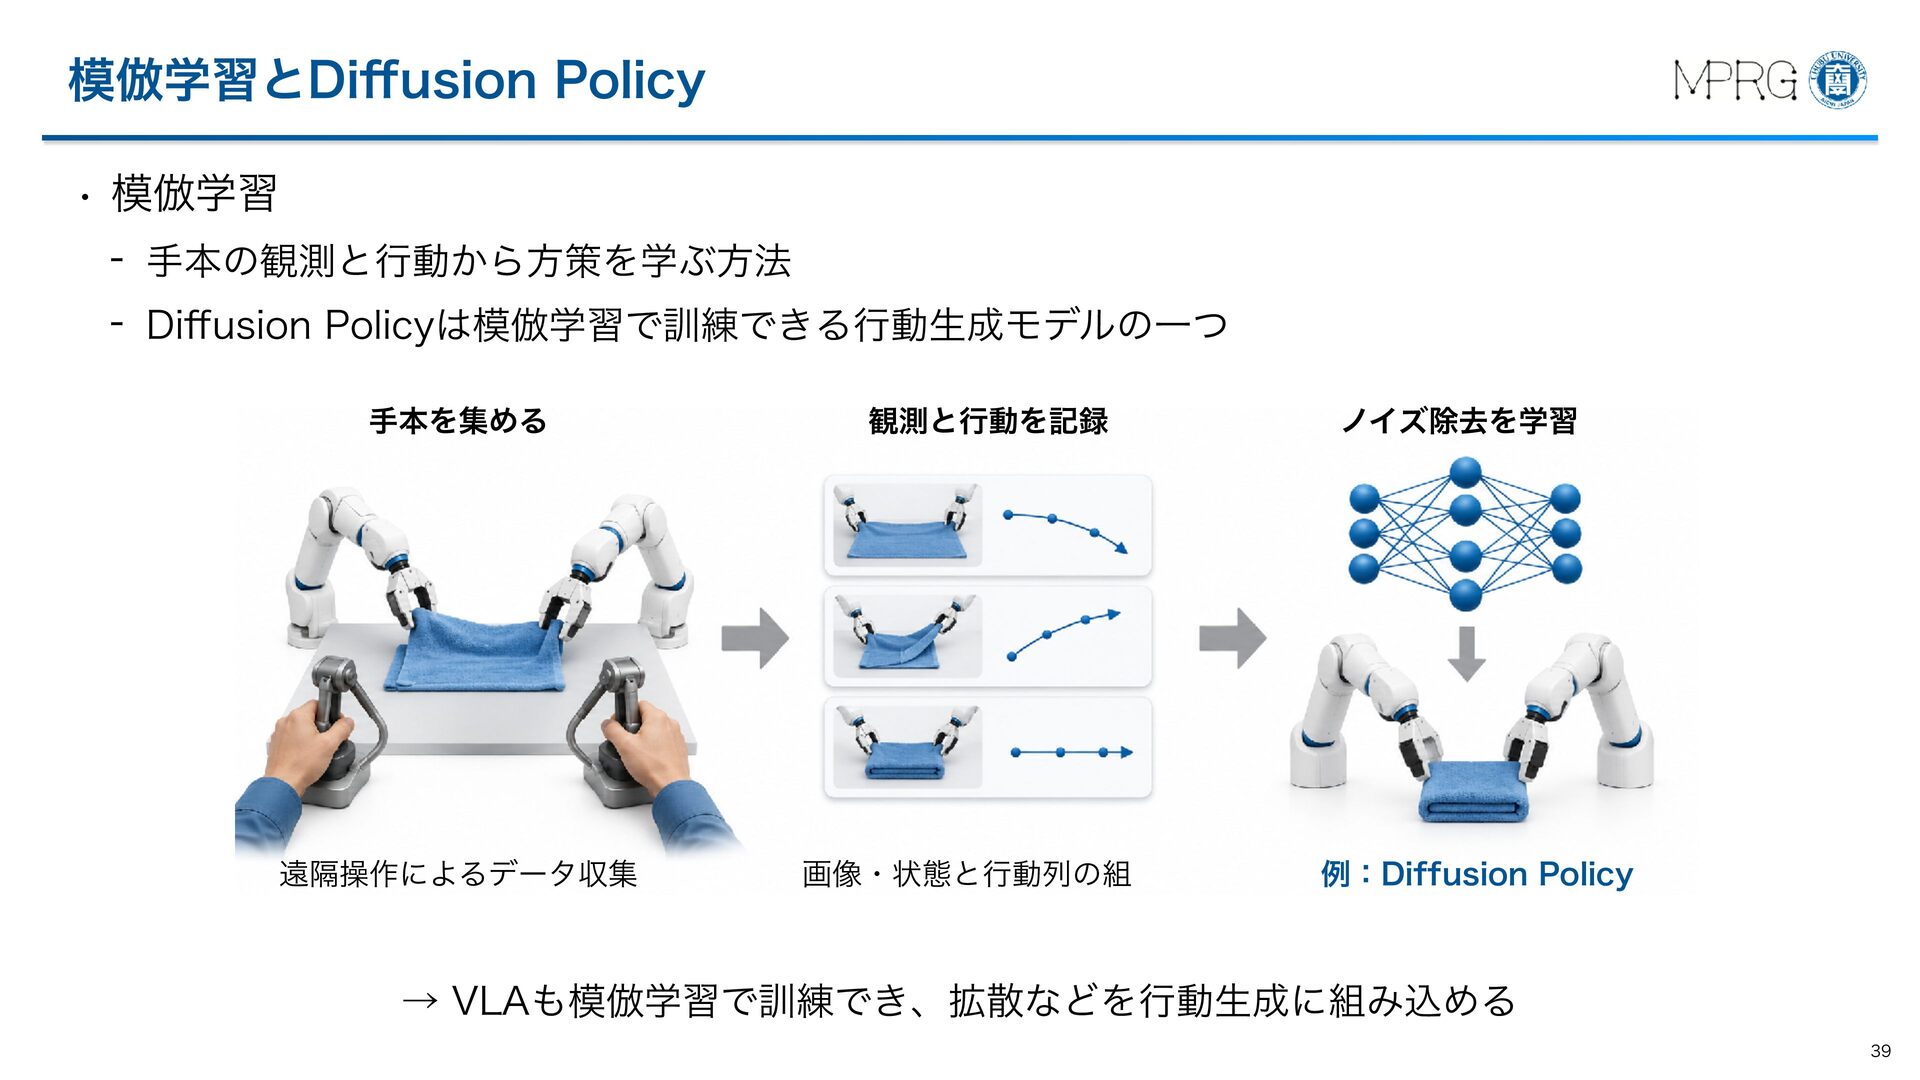
  28. 模倣学習とDi usion Policy • 模倣学習 - 手本の観測と行動から方策を学ぶ方法 - Di usion

    Policyは模倣学習で訓練できる行動生成モデルの一つ 手本を集める 遠隔操作によるデータ収集 観測と行動を記録 画像・状態と行動列の組 ノイズ除去を学習 例:Diffusion Policy → VLAも模倣学習で訓練でき、拡散などを行動生成に組み込める ff ff 39
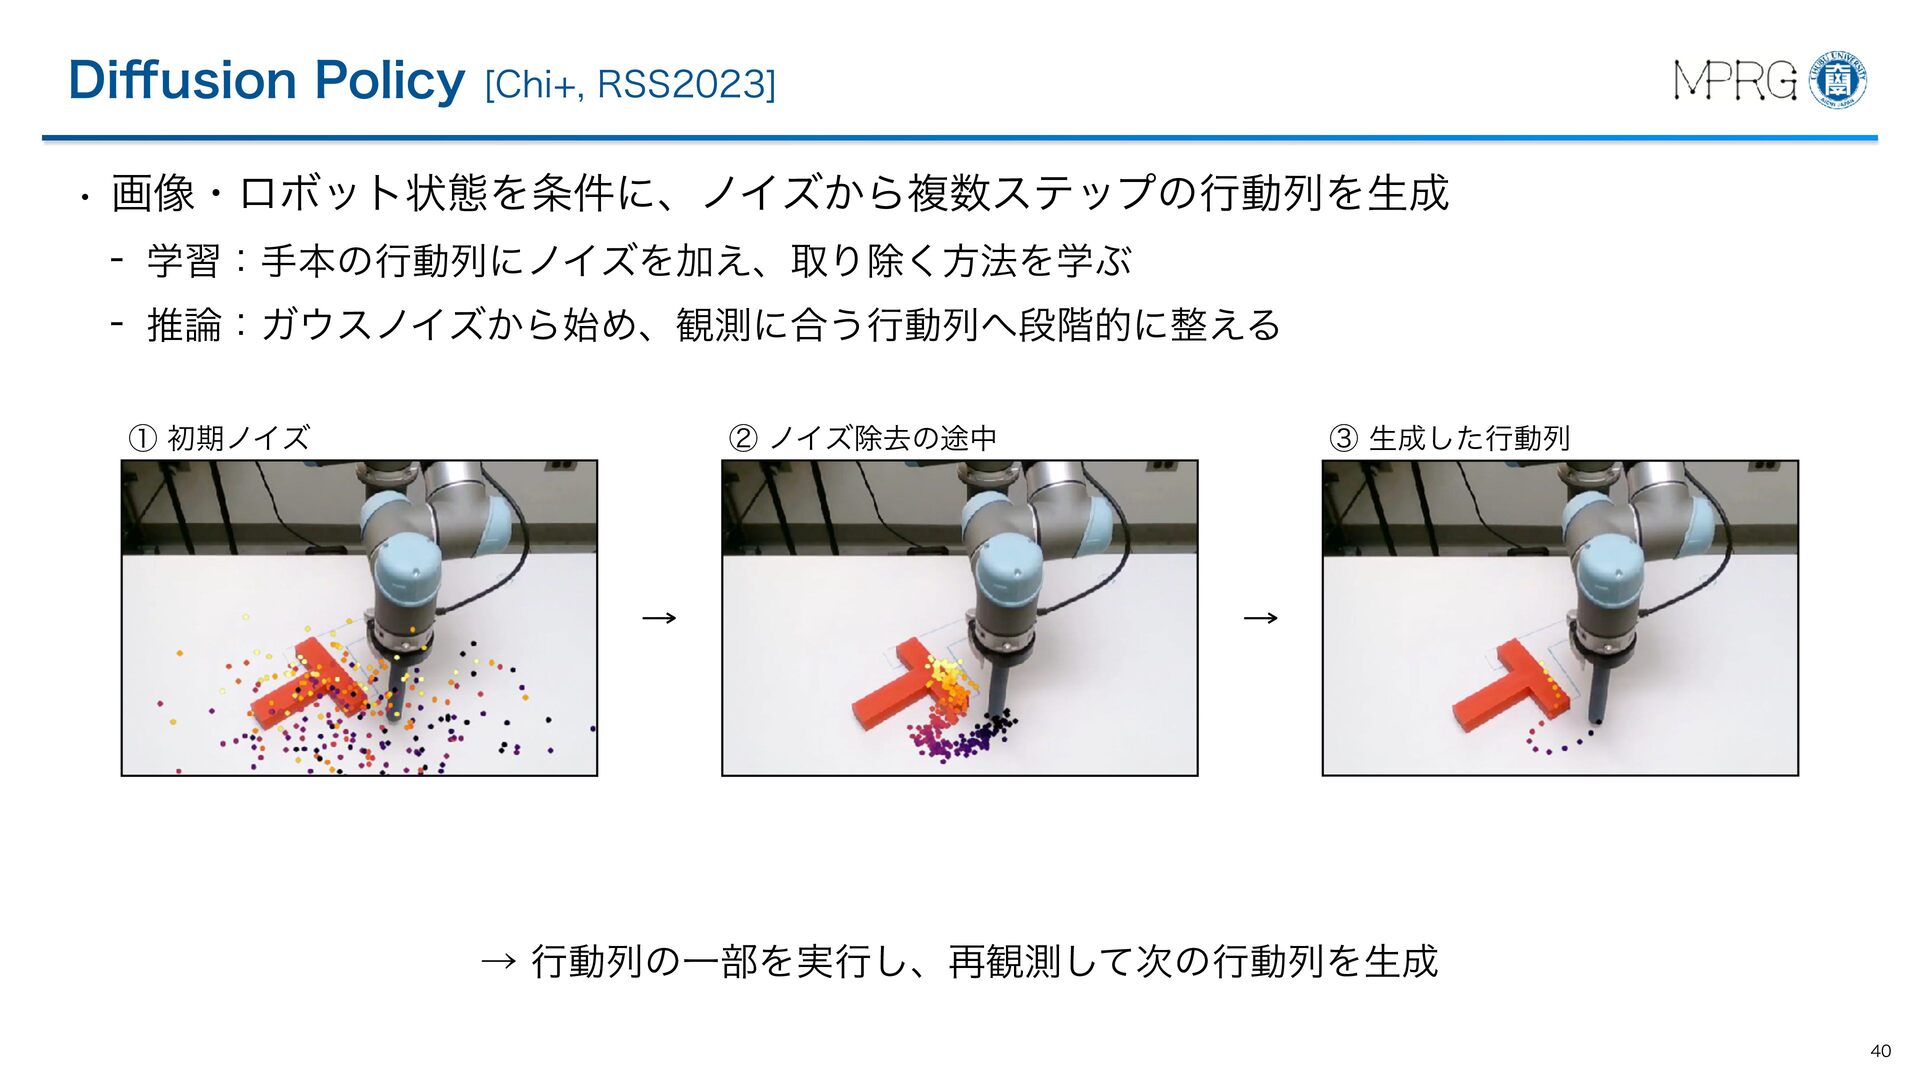
  29. Di usion Policy [Chi+, RSS2023] • 画像・ロボット状態を条件に、ノイズから複数ステップの行動列を生成 - 学習:手本の行動列にノイズを加え、取り除く方法を学ぶ -

    推論:ガウスノイズから始め、観測に合う行動列へ段階的に整える ① 初期ノイズ ② ノイズ除去の途中 ③ 生成した行動列 → 行動列の一部を実行し、再観測して次の行動列を生成 ff 40
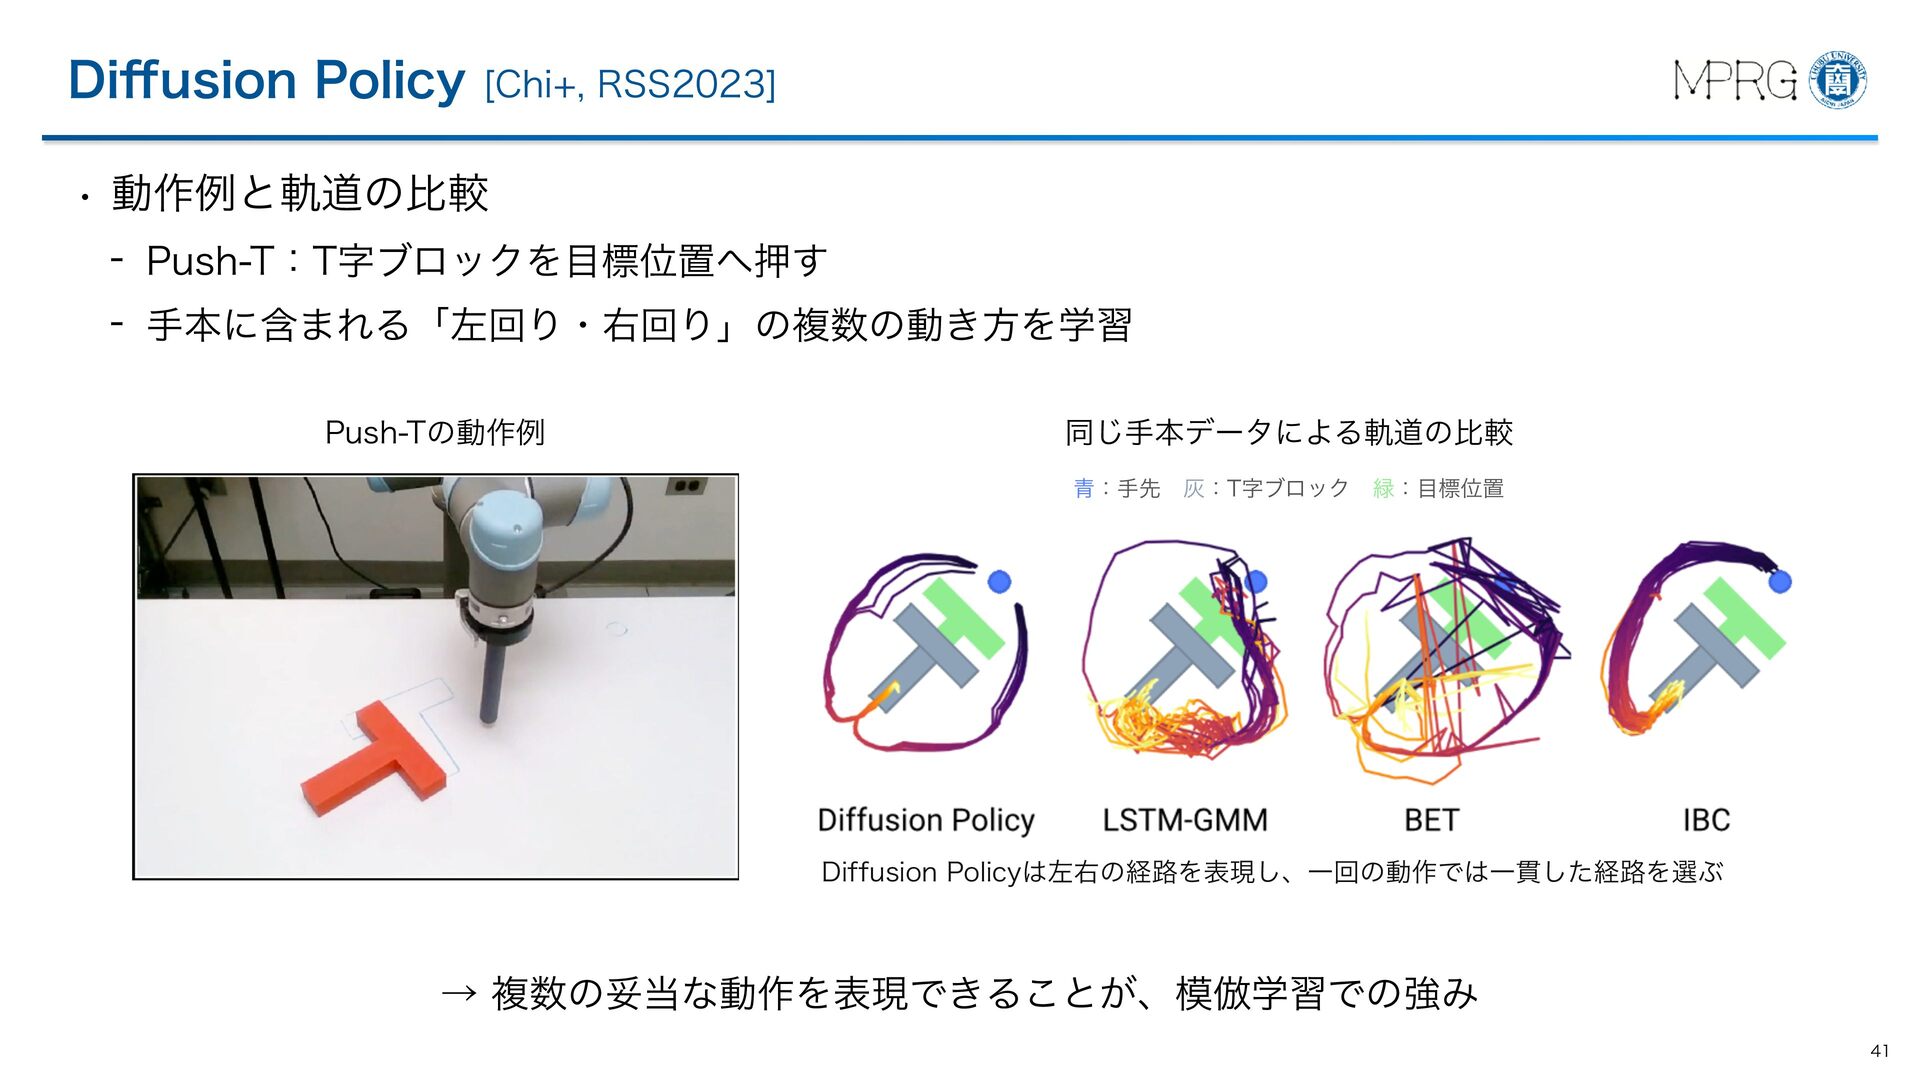
  30. Di usion Policy [Chi+, RSS2023] • 動作例と軌道の比較 - Push-T:T字ブロックを目標位置へ押す -

    手本に含まれる「左回り・右回り」の複数の動き方を学習 Push-Tの動作例 同じ手本データによる軌道の比較 青:手先 灰:T字ブロック 緑:目標位置 Diffusion Policyは左右の経路を表現し、一回の動作では一貫した経路を選ぶ → 複数の妥当な動作を表現できることが、模倣学習での強み ff 41
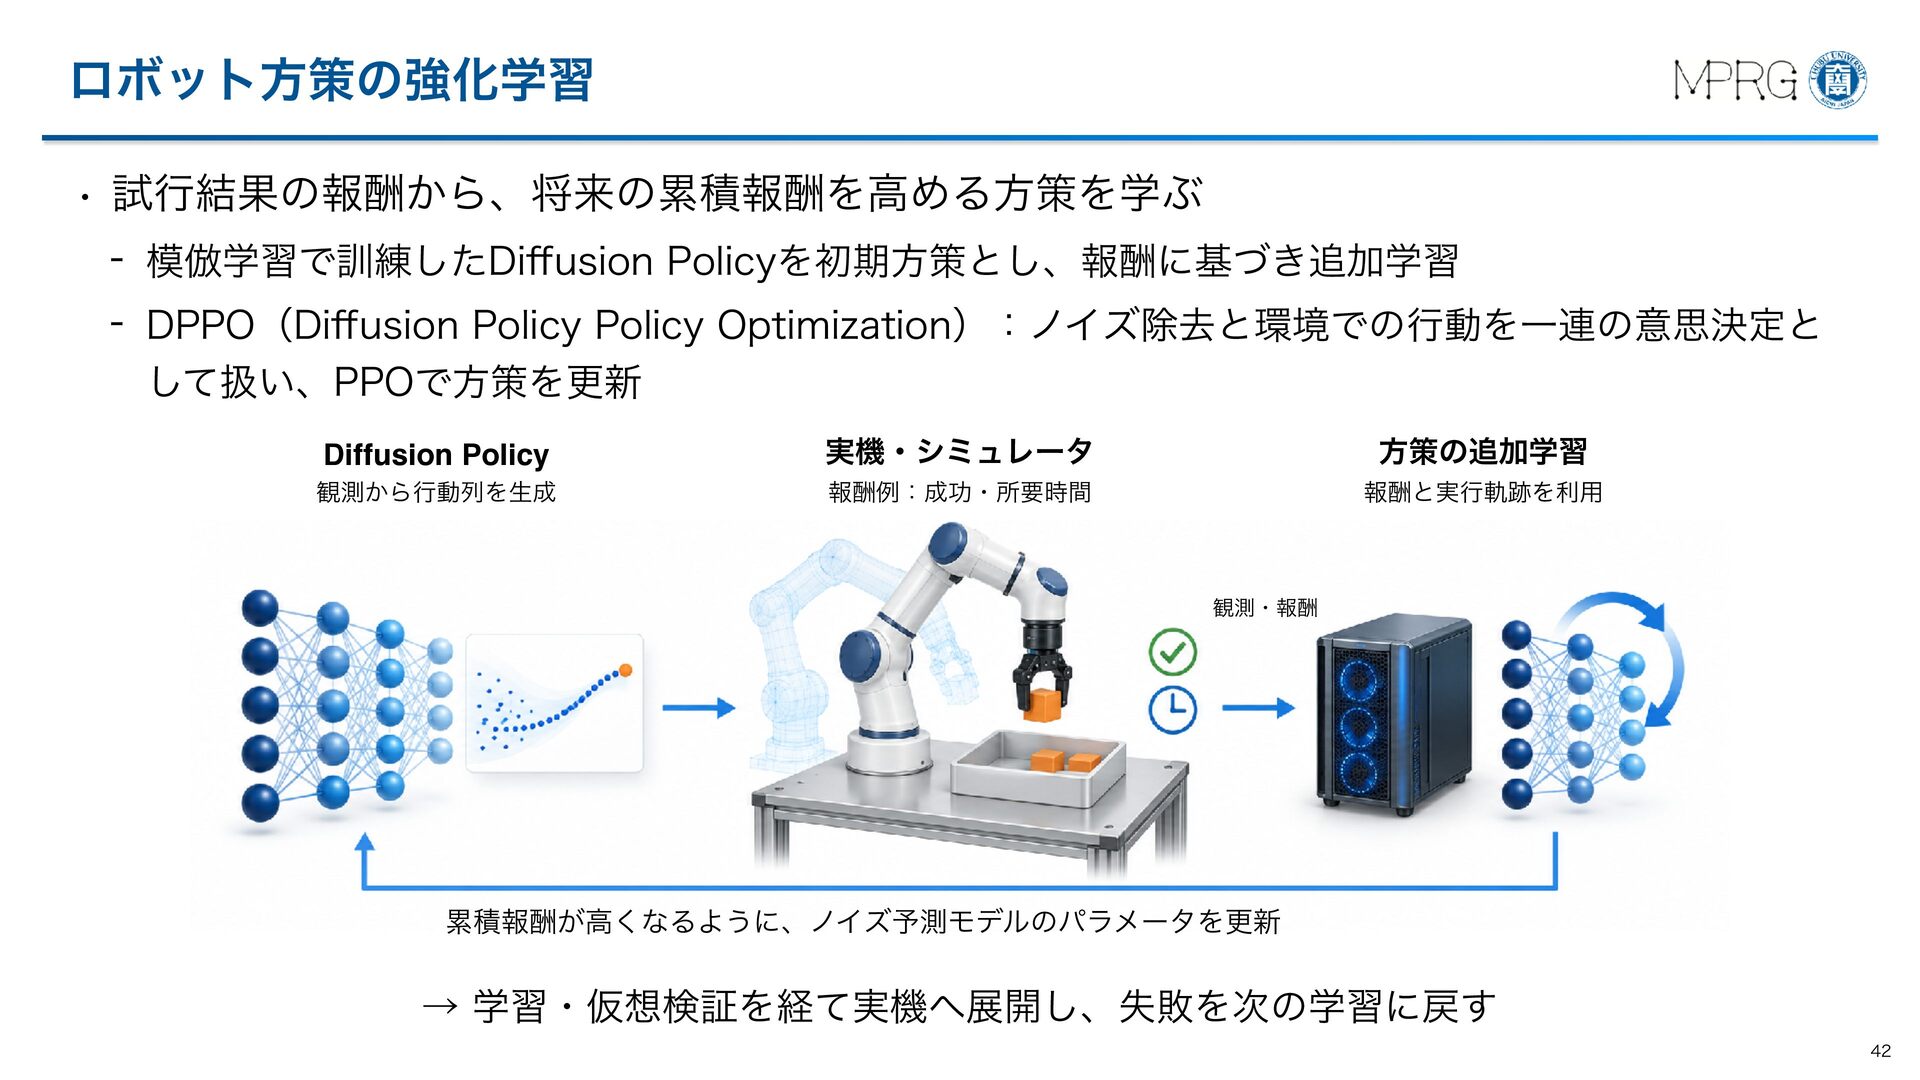
  31. ロボット方策の強化学習 • 試行結果の報酬から、将来の累積報酬を高める方策を学ぶ - 模倣学習で訓練したDi usion Policyを初期方策とし、報酬に基づき追加学習 - DPPO(Di usion

    Policy Policy Optimization):ノイズ除去と環境での行動を一連の意思決定と して扱い、PPOで方策を更新 Diffusion Policy 実機・シミュレータ 方策の追加学習 観測から行動列を生成 報酬例:成功・所要時間 報酬と実行軌跡を利用 観測・報酬 累積報酬が高くなるように、ノイズ予測モデルのパラメータを更新 → 学習・仮想検証を経て実機へ展開し、失敗を次の学習に戻す ff ff 42
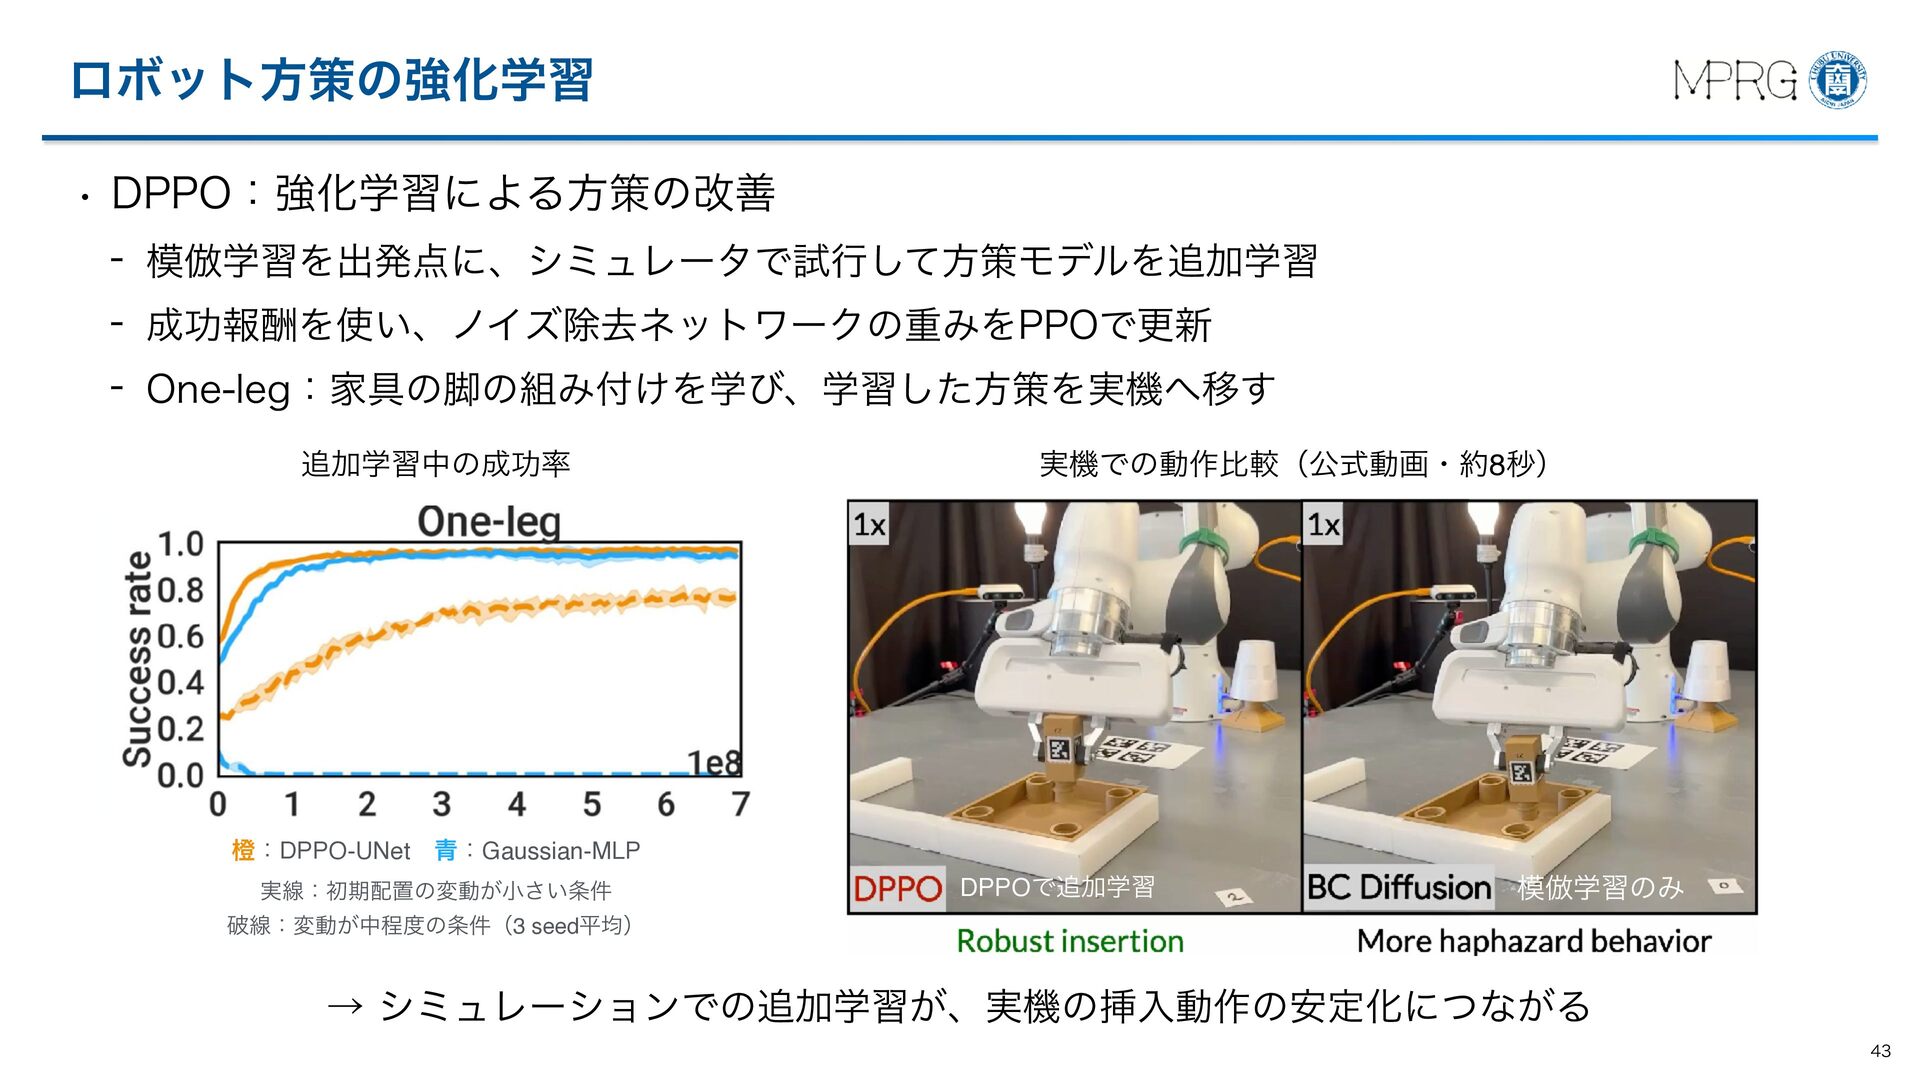
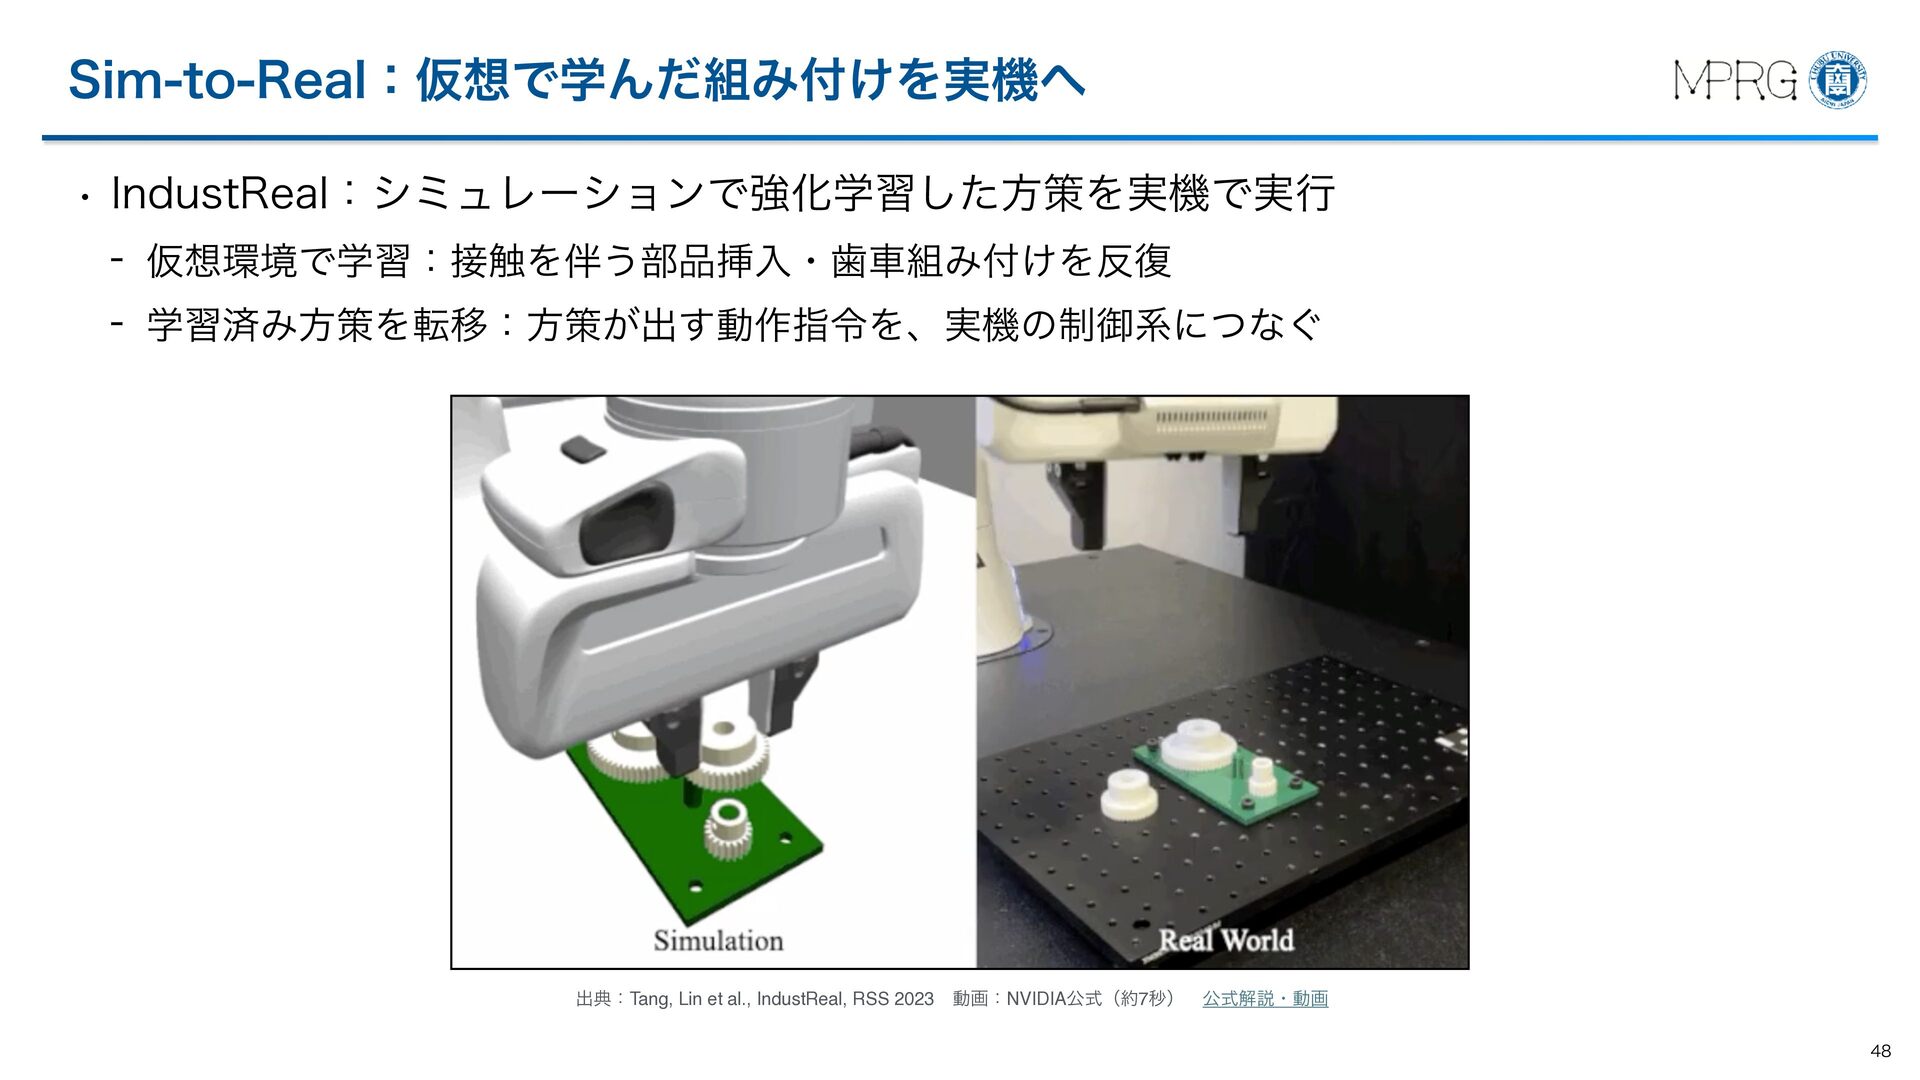
  32. ロボット方策の強化学習 • DPPO:強化学習による方策の改善 - 模倣学習を出発点に、シミュレータで試行して方策モデルを追加学習 - 成功報酬を使い、ノイズ除去ネットワークの重みをPPOで更新 - One-leg:家具の脚の組み付けを学び、学習した方策を実機へ移す 追加学習中の成功率

    実機での動作比較(公式動画・約8秒) 橙:DPPO-UNet 青:Gaussian-MLP 実線:初期配置の変動が小さい条件 DPPOで追加学習 模倣学習のみ 破線:変動が中程度の条件(3 seed平均) → シミュレーションでの追加学習が、実機の挿入動作の安定化につながる 43
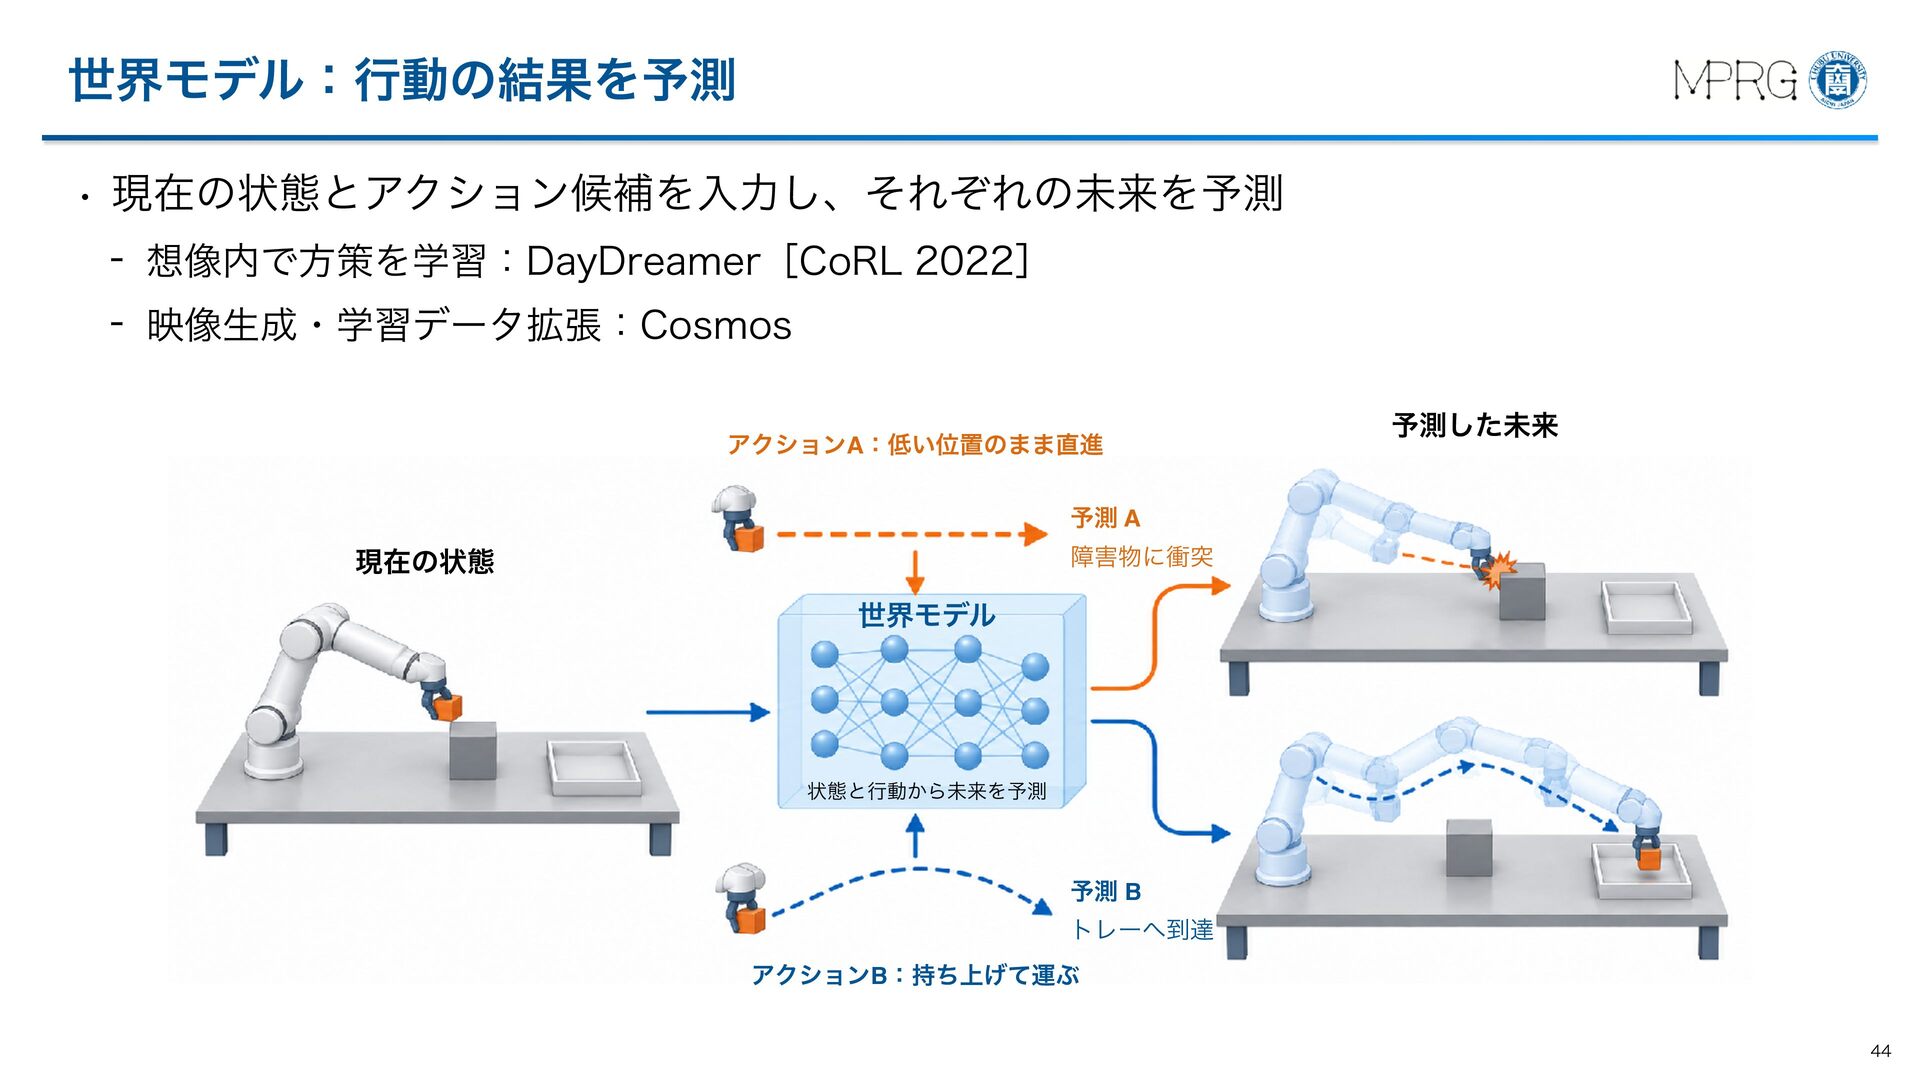
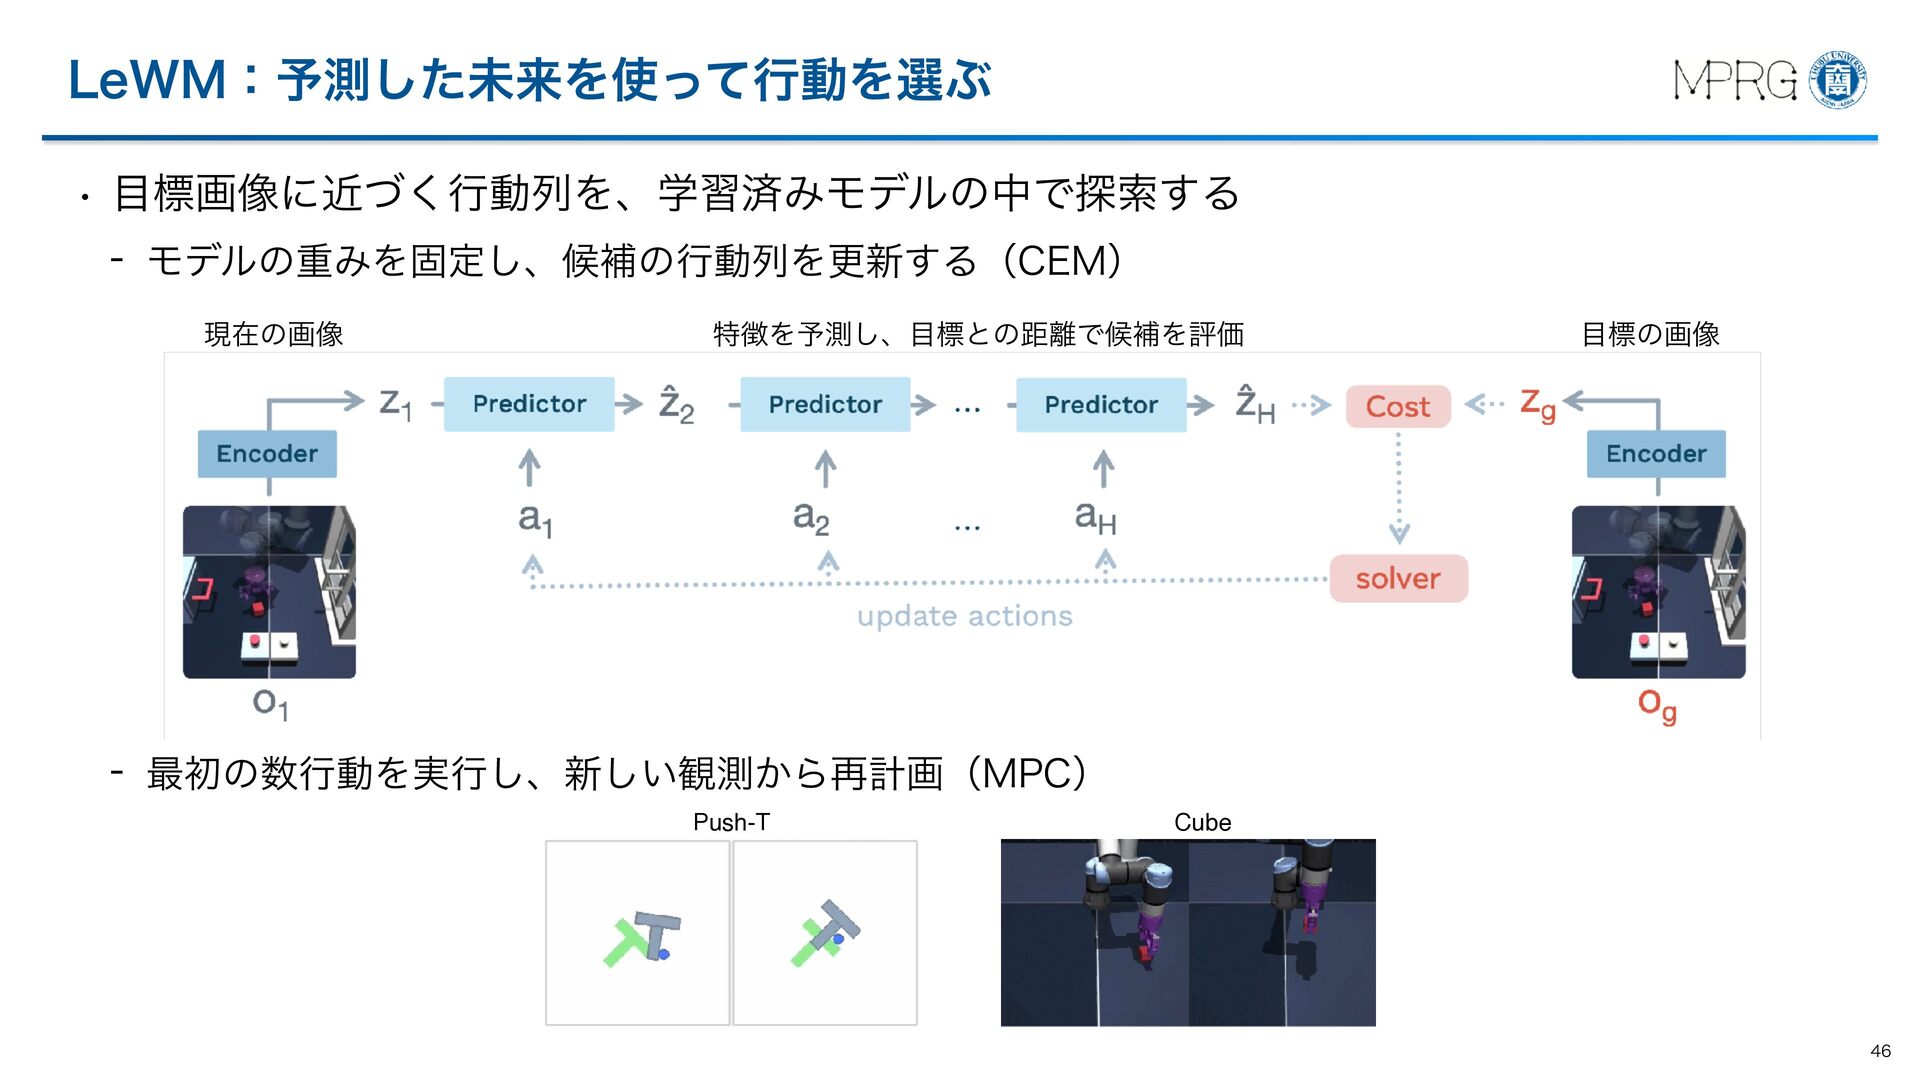
  33. 世界モデル:行動の結果を予測 • 現在の状態とアクション候補を入力し、それぞれの未来を予測 - 想像内で方策を学習:DayDreamer[CoRL 2022] - 映像生成・学習データ拡張:Cosmos アクションA:低い位置のまま直進 予測した未来

    予測 A 障害物に衝突 現在の状態 世界モデル 状態と行動から未来を予測 予測 B 累積報酬が高くなるように、ノイズ予測モデルのパラメータを更新 トレーへ到達 アクションB:持ち上げて運ぶ 44
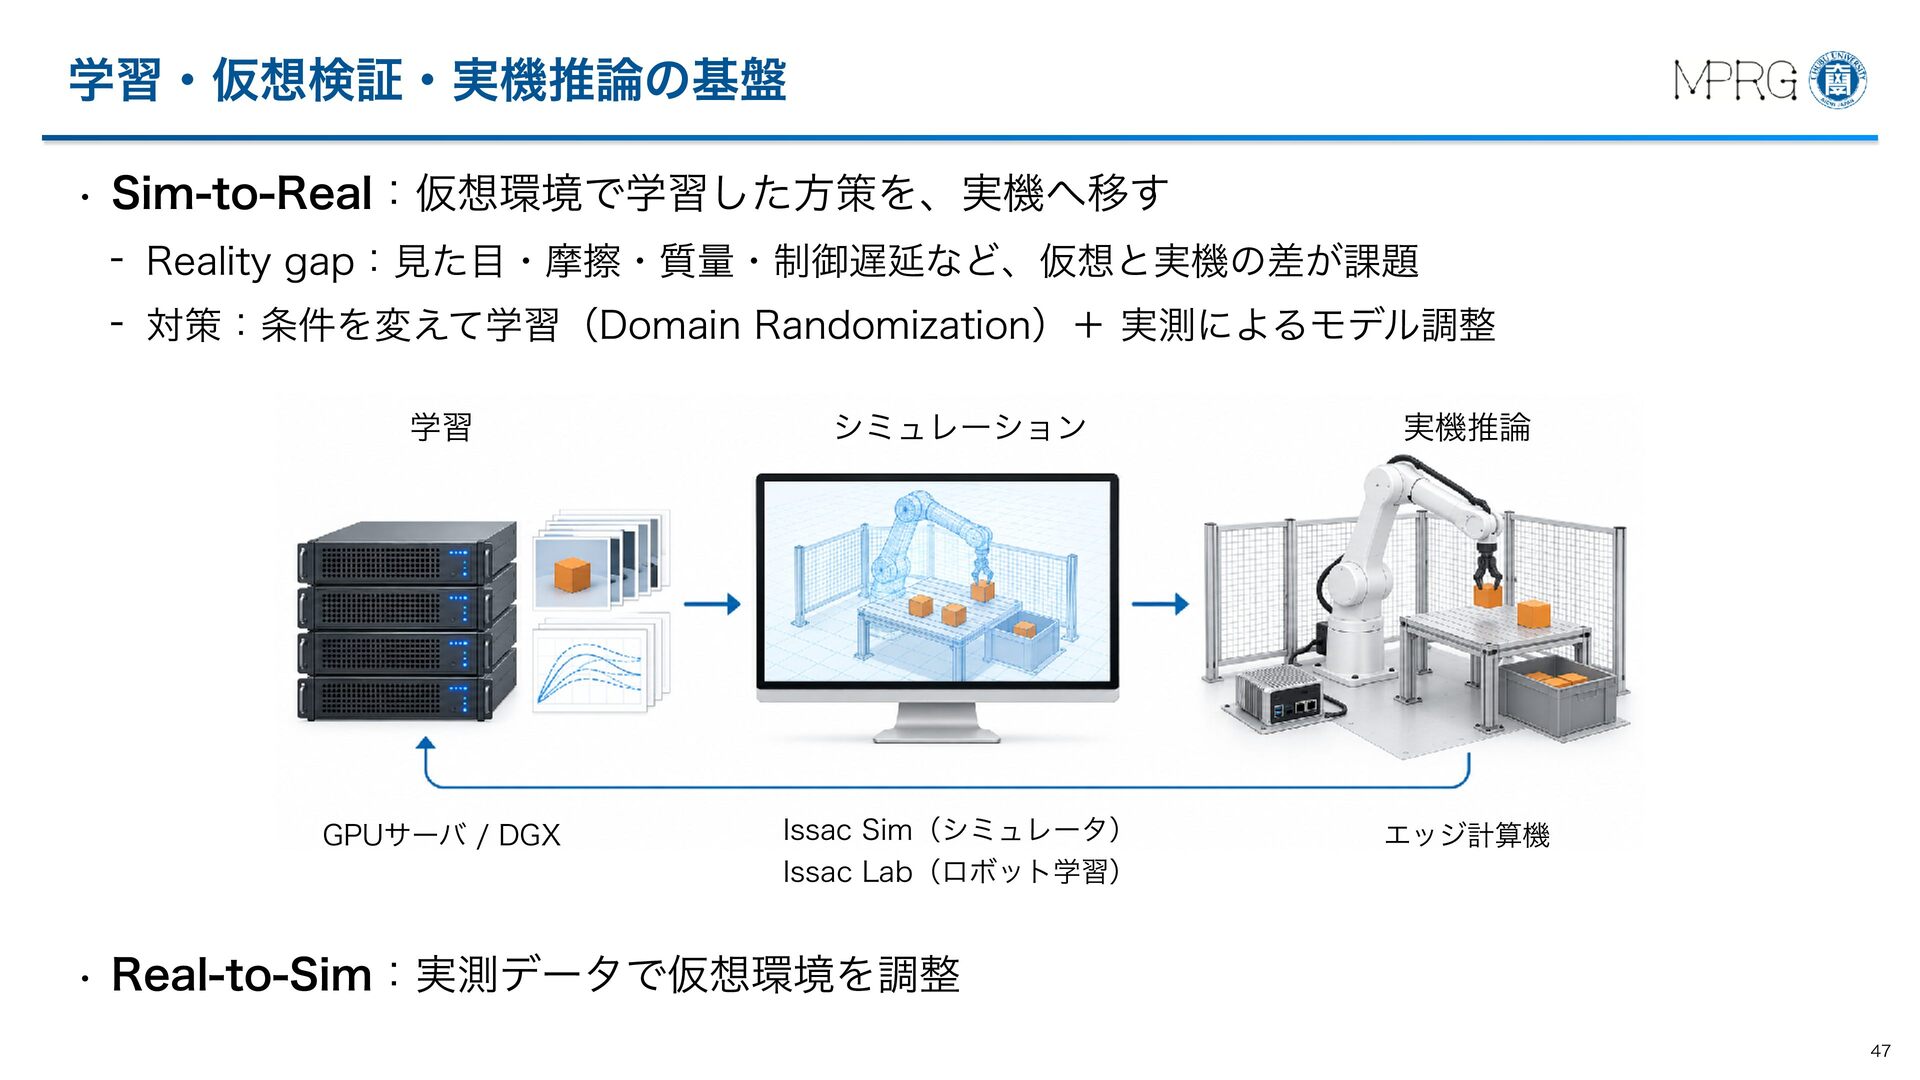
  34. 学習・仮想検証・実機推論の基盤 • Sim-to-Real:仮想環境で学習した方策を、実機へ移す - Reality gap:見た目・摩擦・質量・制御遅延など、仮想と実機の差が課題 - 対策:条件を変えて学習(Domain Randomization)+ 実測によるモデル調整

    学習 シミュレーション 実機推論 GPUサーバ / DGX Issac Sim(シミュレータ) Issac Lab(ロボット学習) エッジ計算機 • Real-to-Sim:実測データで仮想環境を調整 47
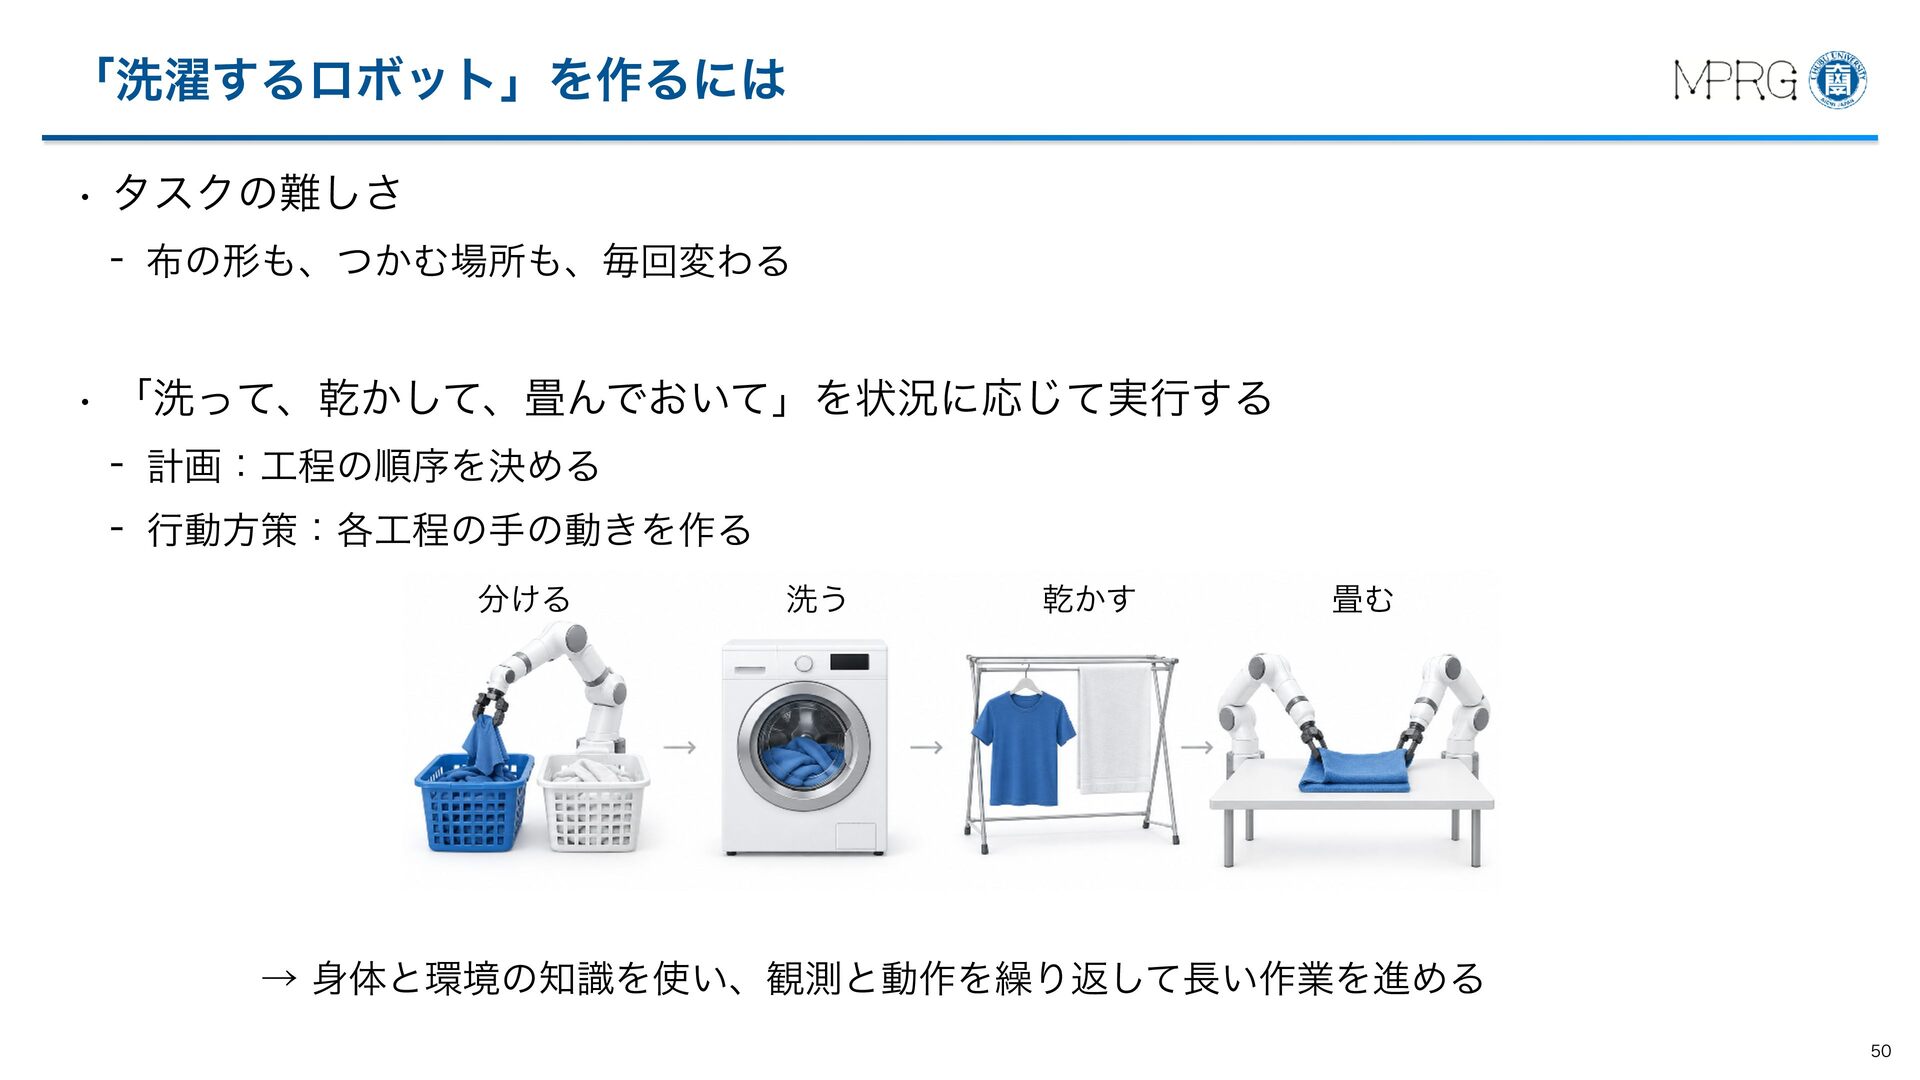
  35. 「洗濯するロボット」を作るには • タスクの難しさ - 布の形も、つかむ場所も、毎回変わる • 「洗って、乾かして、畳んでおいて」を状況に応じて実行する - 計画:工程の順序を決める -

    行動方策:各工程の手の動きを作る 分ける 洗う 中部大学ロゴ 乾かす 畳む 中部大学ロゴ → 身体と環境の知識を使い、観測と動作を繰り返して長い作業を進める 50 50
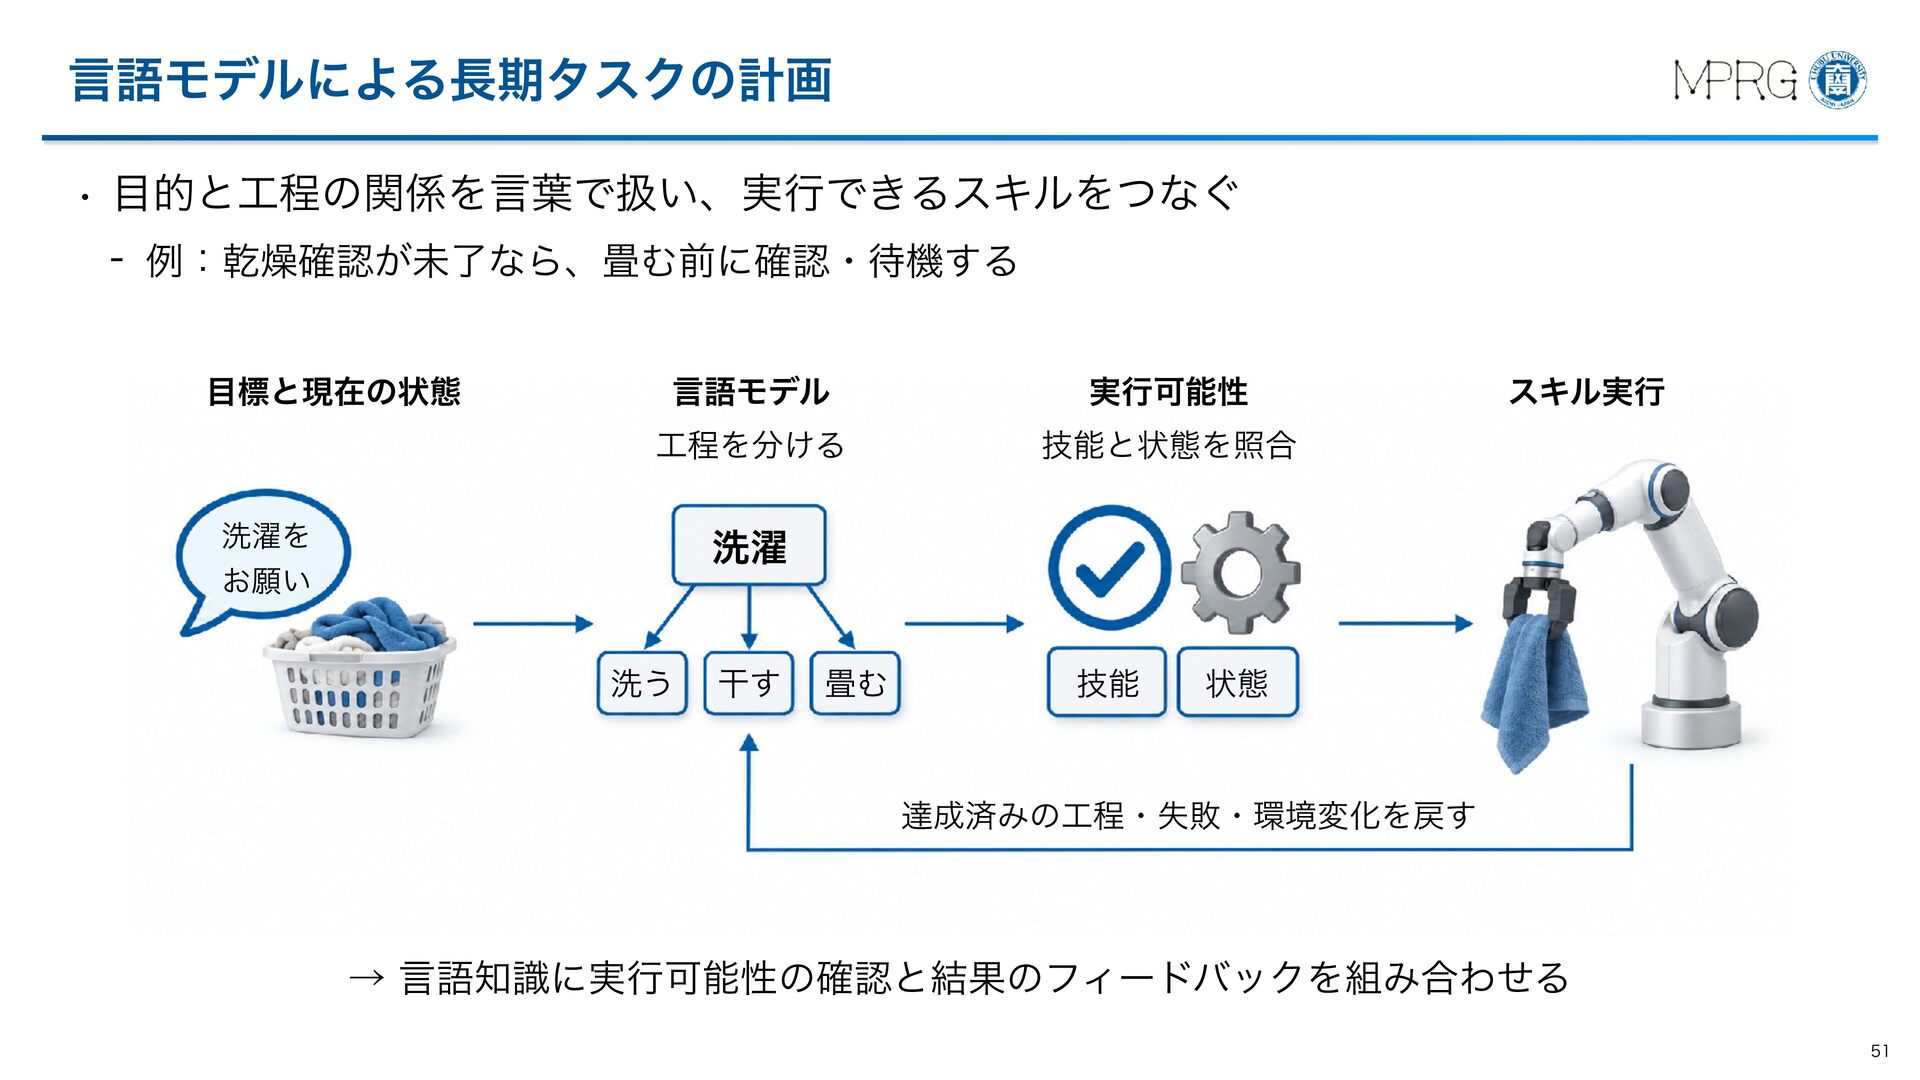
  36. 言語モデルによる長期タスクの計画 • 目的と工程の関係を言葉で扱い、実行できるスキルをつなぐ - 例:乾燥確認が未了なら、畳む前に確認・待機する 目標と現在の状態 言語モデル 実行可能性 工程を分ける 技能と状態を照合

    洗濯を お願い スキル実行 洗濯 洗う 中部大学ロゴ 干す 畳む 技能 状態 中部大学ロゴ 達成済みの工程・失敗・環境変化を戻す → 言語知識に実行可能性の確認と結果のフィードバックを組み合わせる 51 51
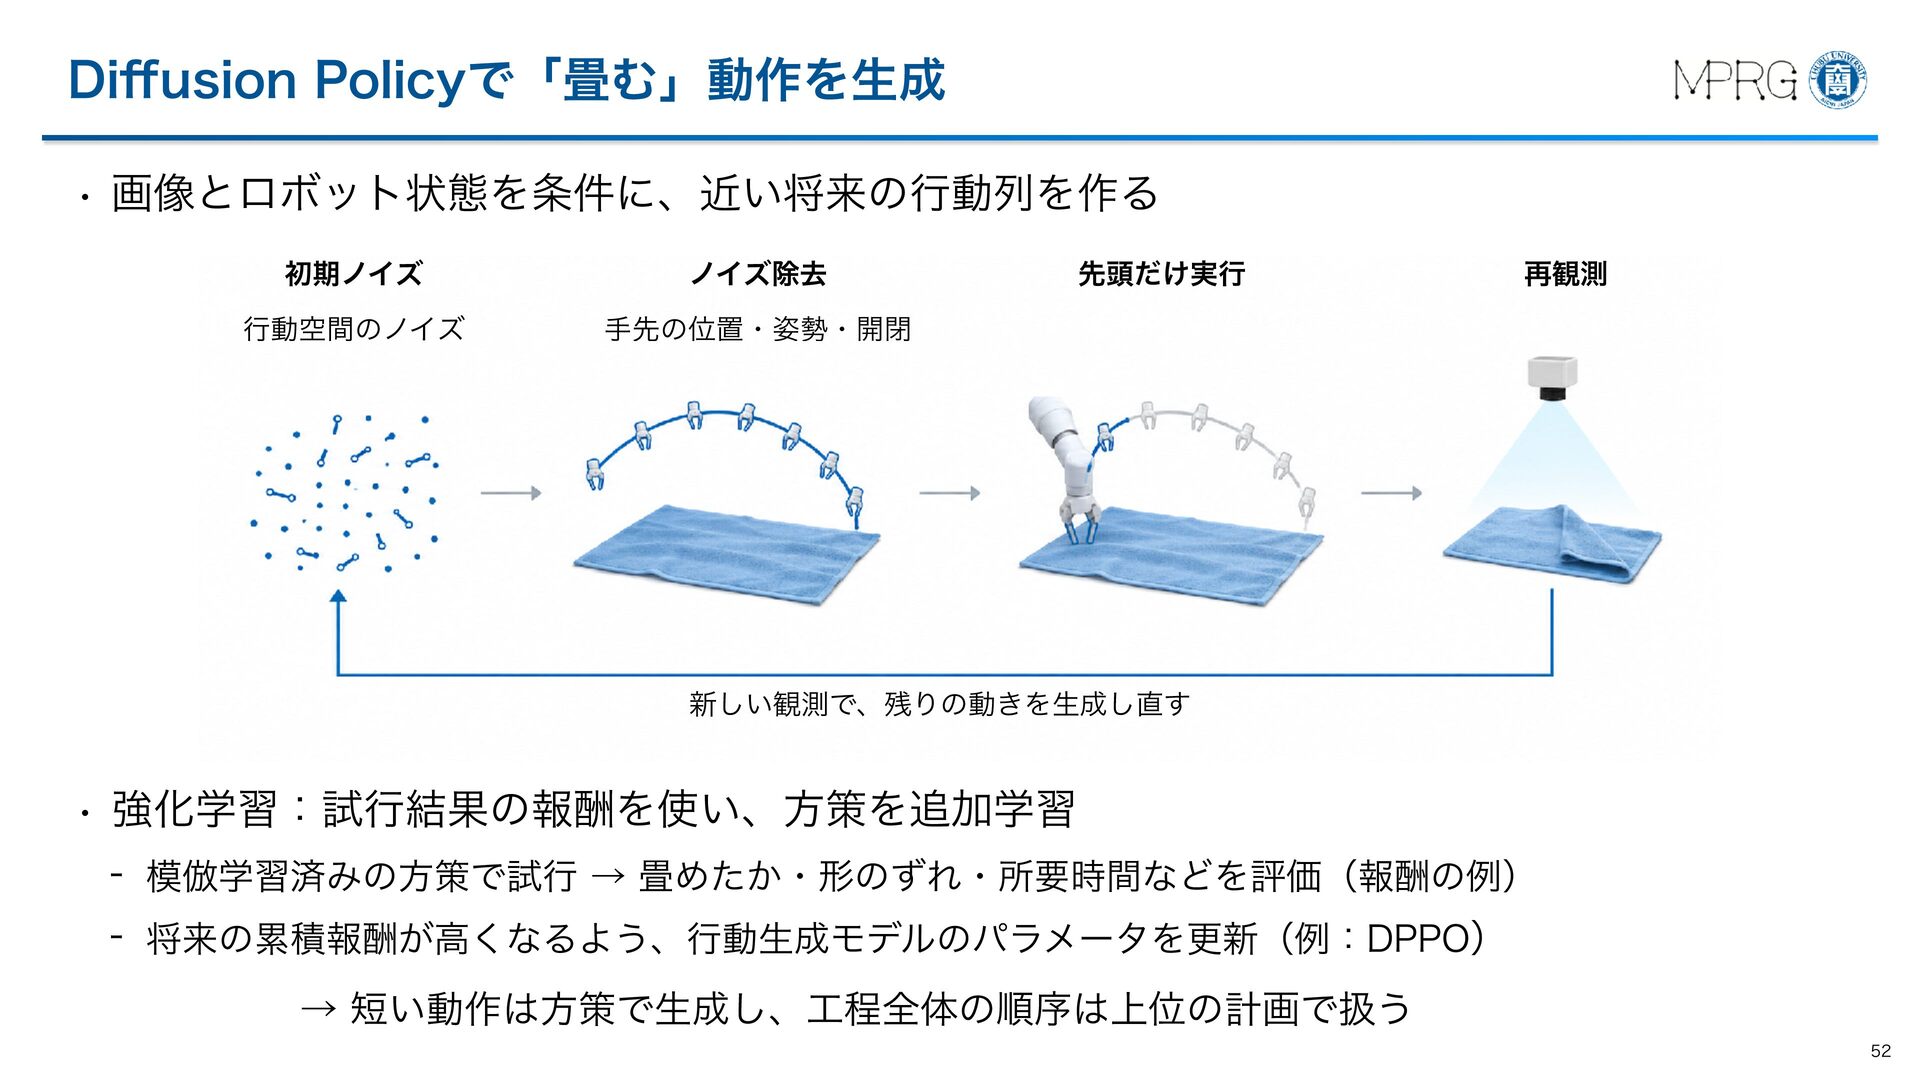
  37. Di usion Policyで「畳む」動作を生成 • 画像とロボット状態を条件に、近い将来の行動列を作る 初期ノイズ ノイズ除去 行動空間のノイズ 手先の位置・姿勢・開閉 先頭だけ実行

    再観測 中部大学ロゴ 新しい観測で、残りの動きを生成し直す 中部大学ロゴ • 強化学習:試行結果の報酬を使い、方策を追加学習 - 模倣学習済みの方策で試行 → 畳めたか・形のずれ・所要時間などを評価(報酬の例) - 将来の累積報酬が高くなるよう、行動生成モデルのパラメータを更新(例:DPPO) → 短い動作は方策で生成し、工程全体の順序は上位の計画で扱う ff 52 52
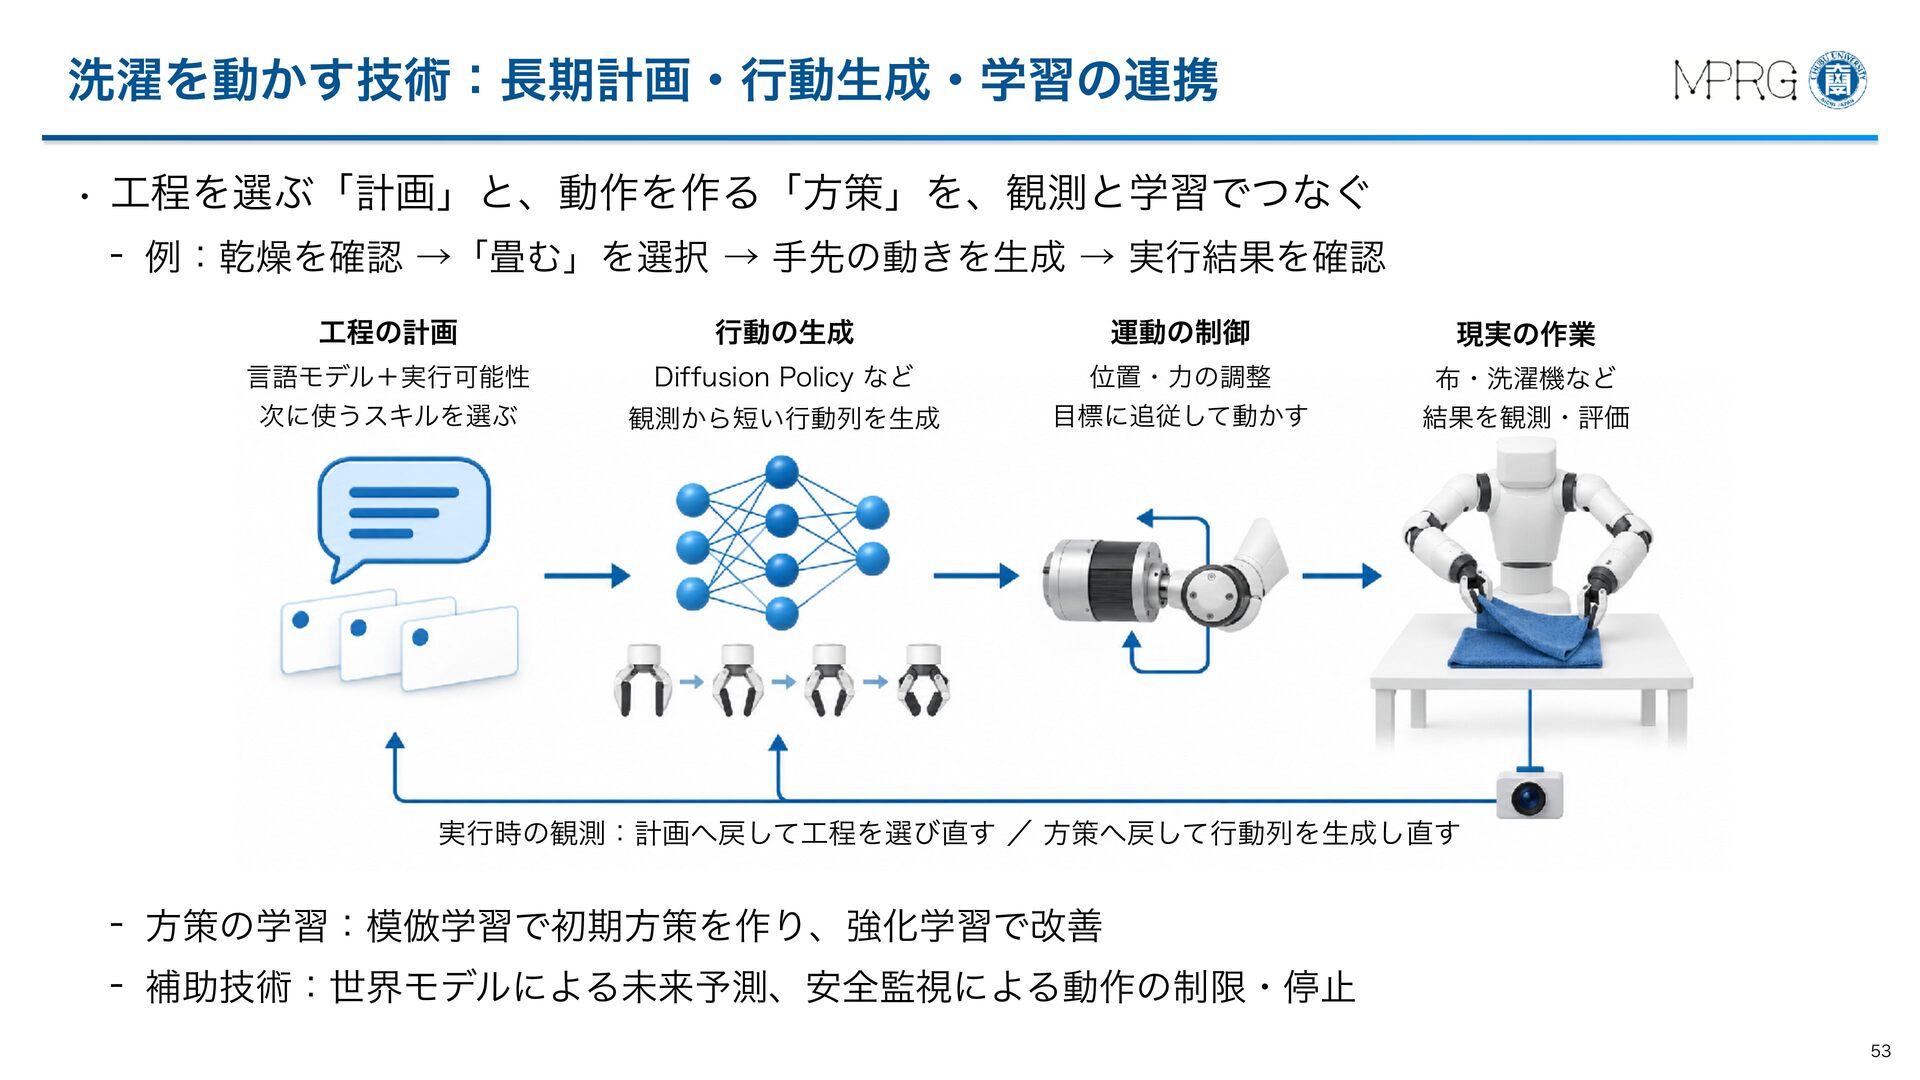
  38. 洗濯を動かす技術:長期計画・行動生成・学習の連携 • 工程を選ぶ「計画」と、動作を作る「方策」を、観測と学習でつなぐ - 例:乾燥を確認 →「畳む」を選択 → 手先の動きを生成 → 実行結果を確認

    工程の計画 行動の生成 運動の制御 現実の作業 言語モデル+実行可能性 次に使うスキルを選ぶ Diffusion Policy など 位置・力の調整 目標に追従して動かす 布・洗濯機など 結果を観測・評価 観測から短い行動列を生成 中部大学ロゴ 中部大学ロゴ 実行時の観測:計画へ戻して工程を選び直す / 方策へ戻して行動列を生成し直す - 方策の学習:模倣学習で初期方策を作り、強化学習で改善 - 補助技術:世界モデルによる未来予測、安全監視による動作の制限・停止 53 53
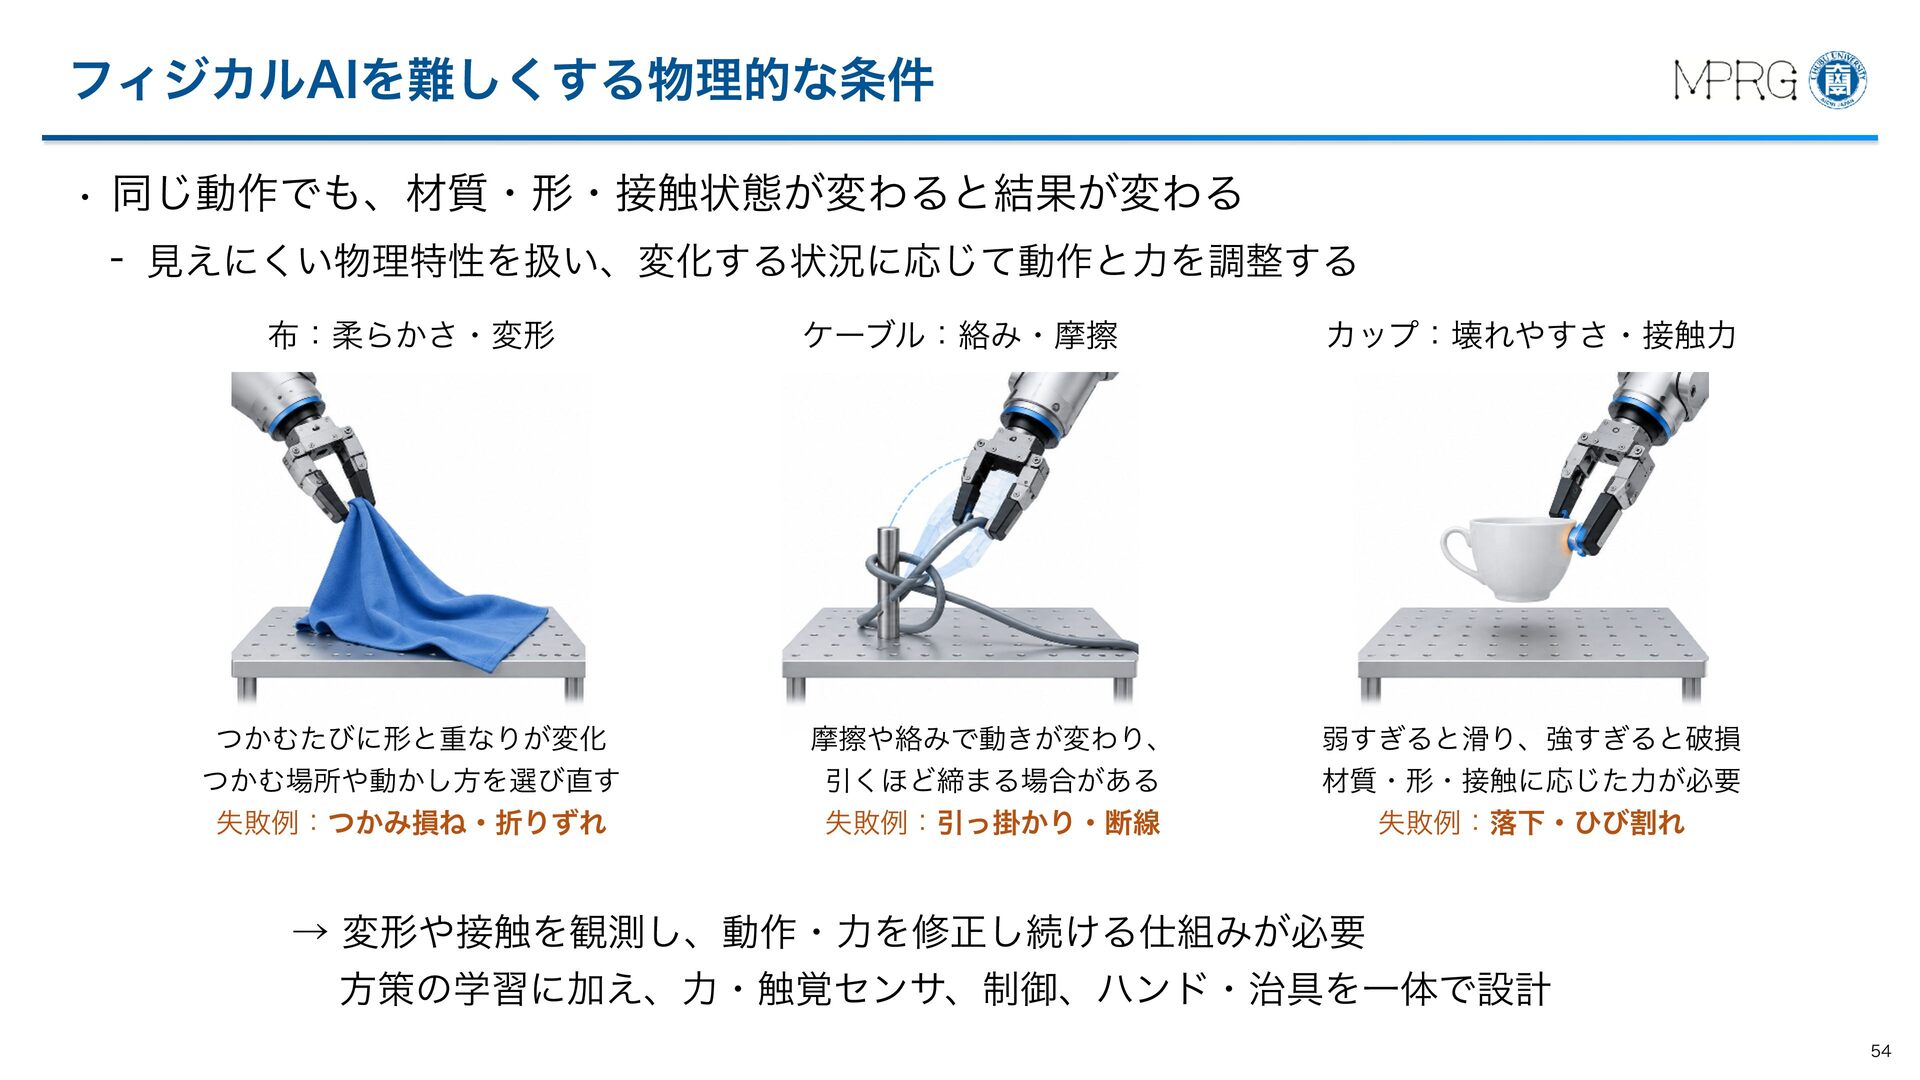
  39. フィジカルAIを難しくする物理的な条件 • 同じ動作でも、材質・形・接触状態が変わると結果が変わる - 見えにくい物理特性を扱い、変化する状況に応じて動作と力を調整する 布:柔らかさ・変形 ケーブル:絡み・摩擦 カップ:壊れやすさ・接触力 中部大学ロゴ つかむたびに形と重なりが変化

    つかむ場所や動かし方を選び直す 失敗例:つかみ損ね・折りずれ 摩擦や絡みで動きが変わり、 中部大学ロゴ 引くほど締まる場合がある 失敗例:引っ掛かり・断線 弱すぎると滑り、強すぎると破損 材質・形・接触に応じた力が必要 失敗例:落下・ひび割れ → 変形や接触を観測し、動作・力を修正し続ける仕組みが必要 方策の学習に加え、力・触覚センサ、制御、ハンド・治具を一体で設計 54 54
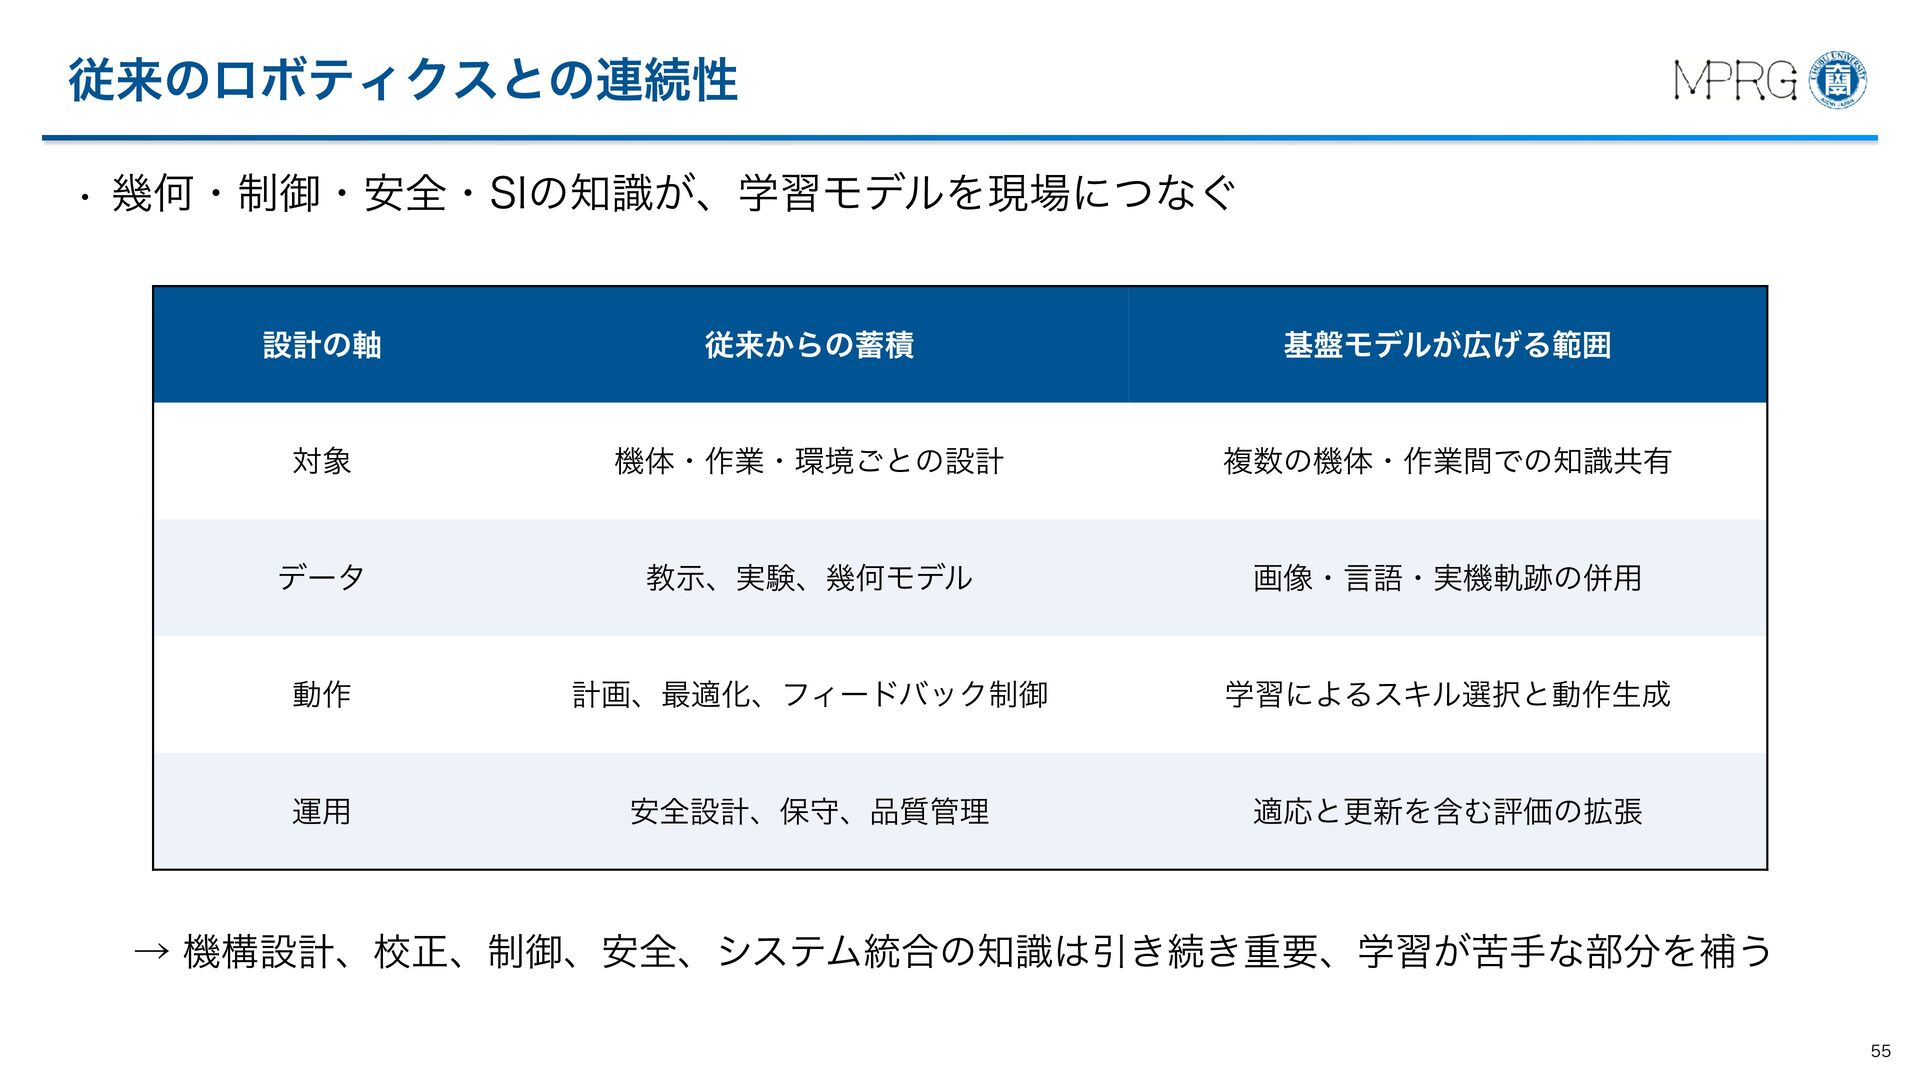
  40. 従来のロボティクスとの連続性 • 幾何・制御・安全・SIの知識が、学習モデルを現場につなぐ 設計の軸 従来からの蓄積 基盤モデルが広げる範囲 対象 機体・作業・環境ごとの設計 複数の機体・作業間での知識共有 データ

    教示、実験、幾何モデル 画像・言語・実機軌跡の併用 動作 運用 中部大学ロゴ 計画、最適化、フィードバック制御 中部大学ロゴ 安全設計、保守、品質管理 学習によるスキル選択と動作生成 適応と更新を含む評価の拡張 → 機構設計、校正、制御、安全、システム統合の知識は引き続き重要、学習が苦手な部分を補う 55 55
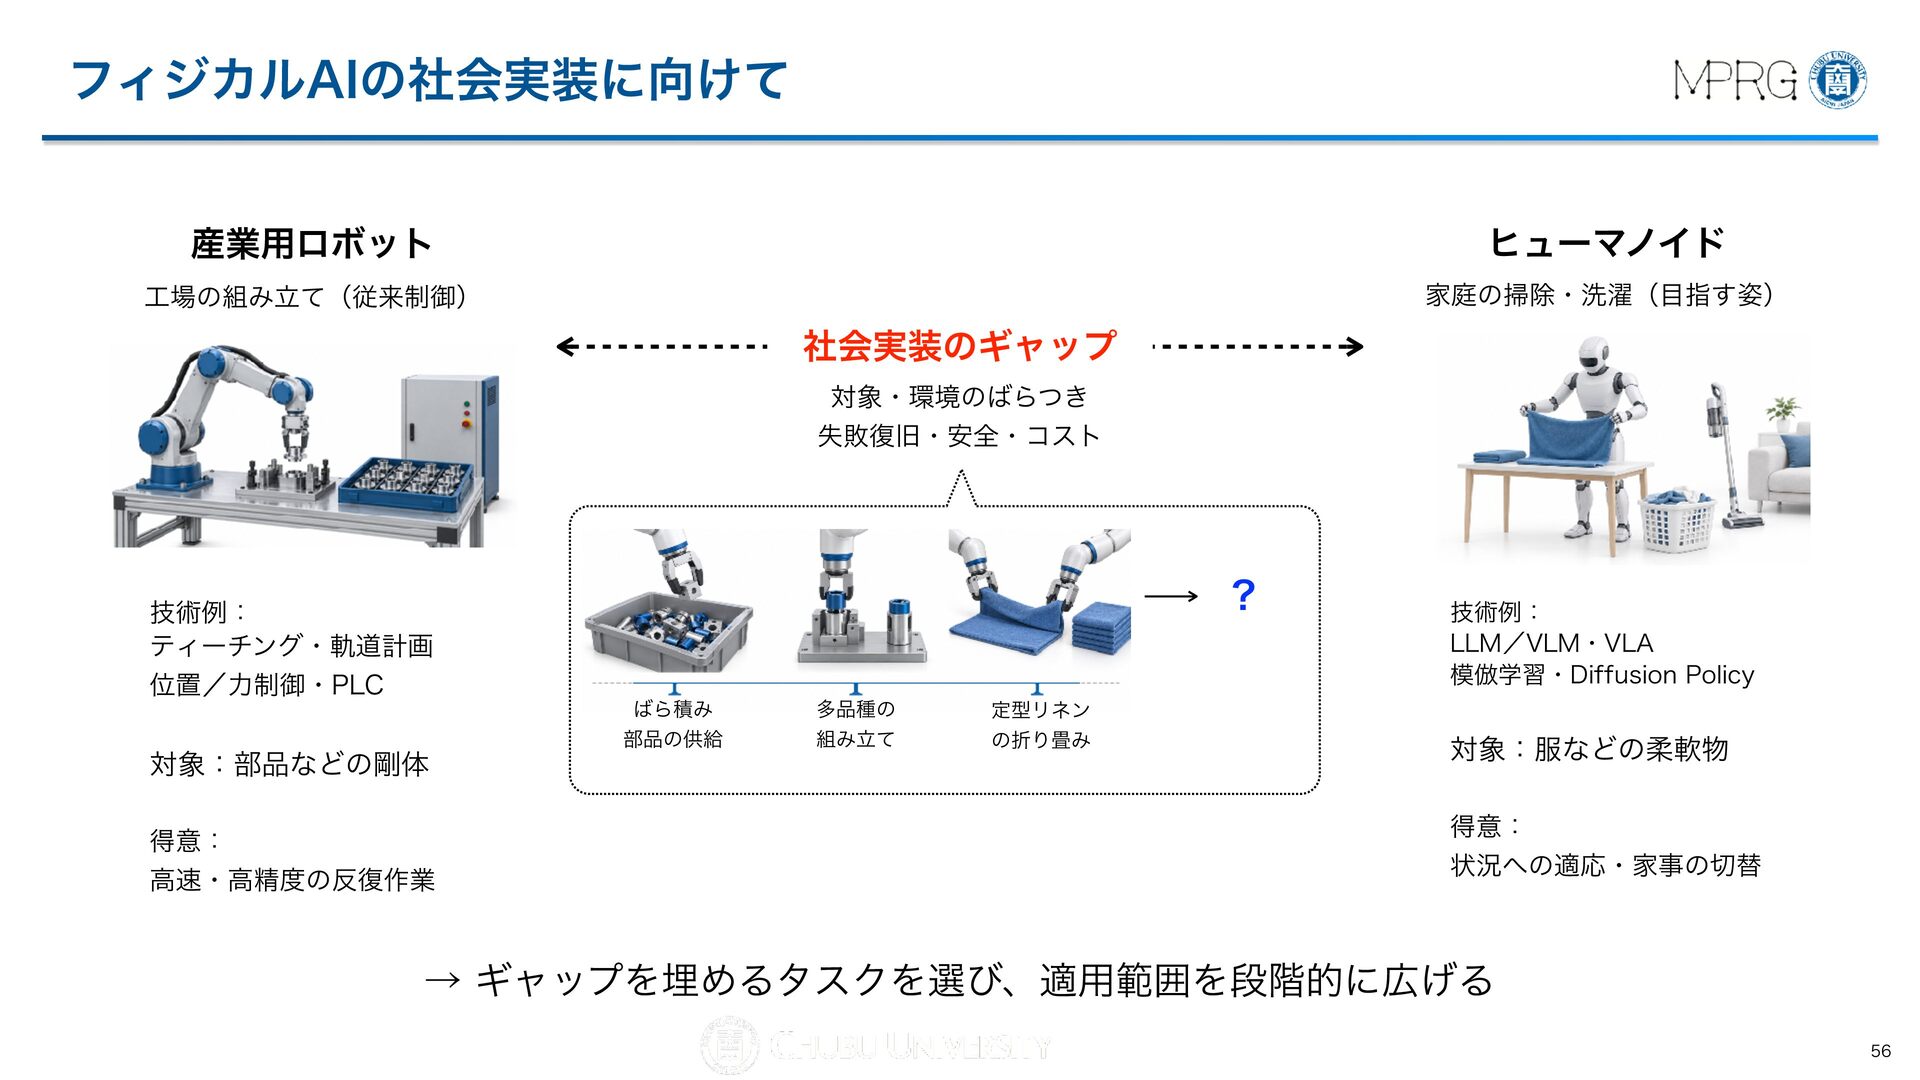
  41. フィジカルAIの社会実装に向けて 産業用ロボット ヒューマノイド 工場の組み立て(従来制御) 家庭の掃除・洗濯(目指す姿) 社会実装のギャップ 対象・環境のばらつき 失敗復旧・安全・コスト ? 技術例:

    ティーチング・軌道計画 位置/力制御・PLC ばら積み 部品の供給 対象:部品などの剛体 多品種の 組み立て 定型リネン の折り畳み 技術例: LLM/VLM・VLA 模倣学習・Diffusion Policy 対象:服などの柔軟物 得意: 得意: 高速・高精度の反復作業 状況への適応・家事の切替 → ギャップを埋めるタスクを選び、適用範囲を段階的に広げる 56
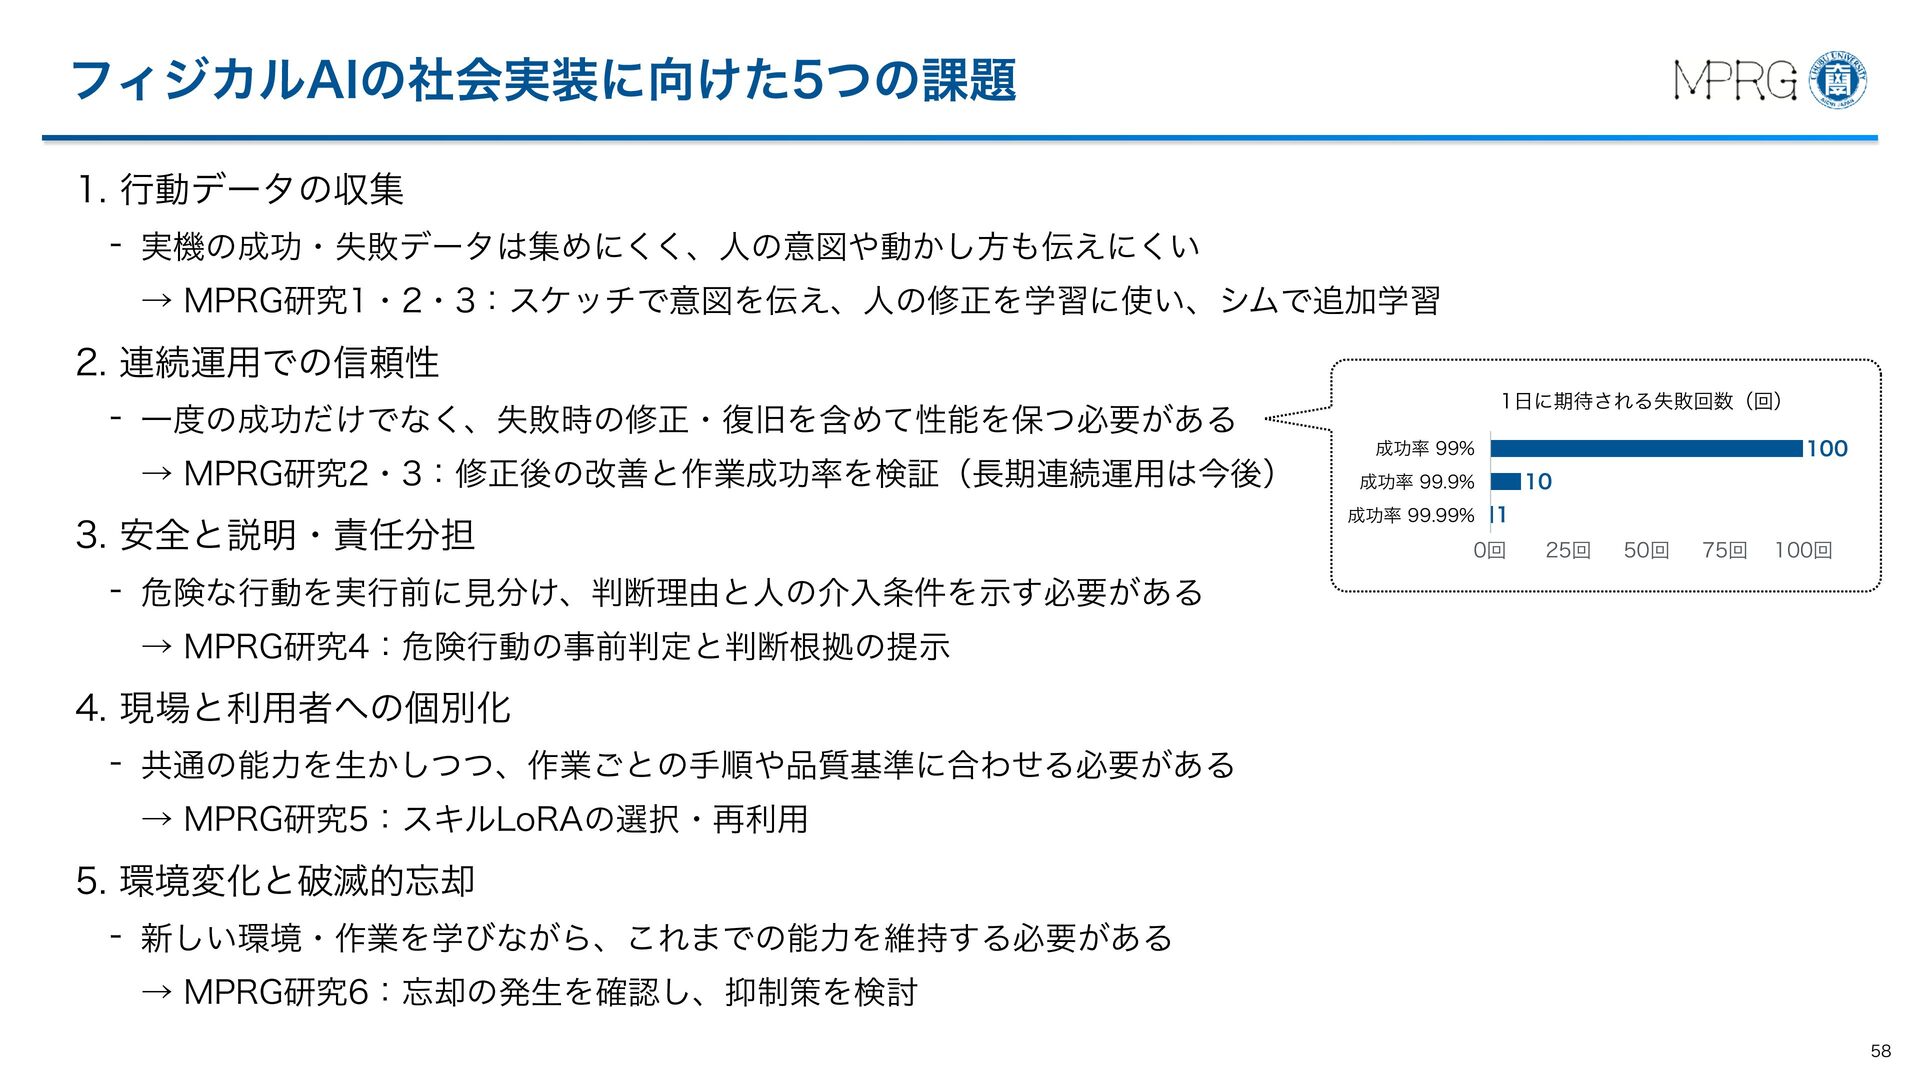
  42. フィジカルAIの社会実装に向けた5つの課題 1. 行動データの収集 - 実機の成功・失敗データは集めにくく、人の意図や動かし方も伝えにくい → MPRG研究1・2・3:スケッチで意図を伝え、人の修正を学習に使い、シムで追加学習 2. 連続運用での信頼性 1日に期待される失敗回数(回)

    - 一度の成功だけでなく、失敗時の修正・復旧を含めて性能を保つ必要がある 100 成功率 99% → MPRG研究2・3:修正後の改善と作業成功率を検証(長期連続運用は今後) 3. 安全と説明・責任分担 10 成功率 99.9% 成功率 99.99% 1 0回 25回 50回 75回 100回 - 危険な行動を実行前に見分け、判断理由と人の介入条件を示す必要がある → MPRG研究4:危険行動の事前判定と判断根拠の提示 中部大学ロゴ 4. 現場と利用者への個別化 - 共通の能力を生かしつつ、作業ごとの手順や品質基準に合わせる必要がある 中部大学ロゴ → MPRG研究5:スキルLoRAの選択・再利用 5. 環境変化と破滅的忘却 - 新しい環境・作業を学びながら、これまでの能力を維持する必要がある → MPRG研究6:忘却の発生を確認し、抑制策を検討 58 58
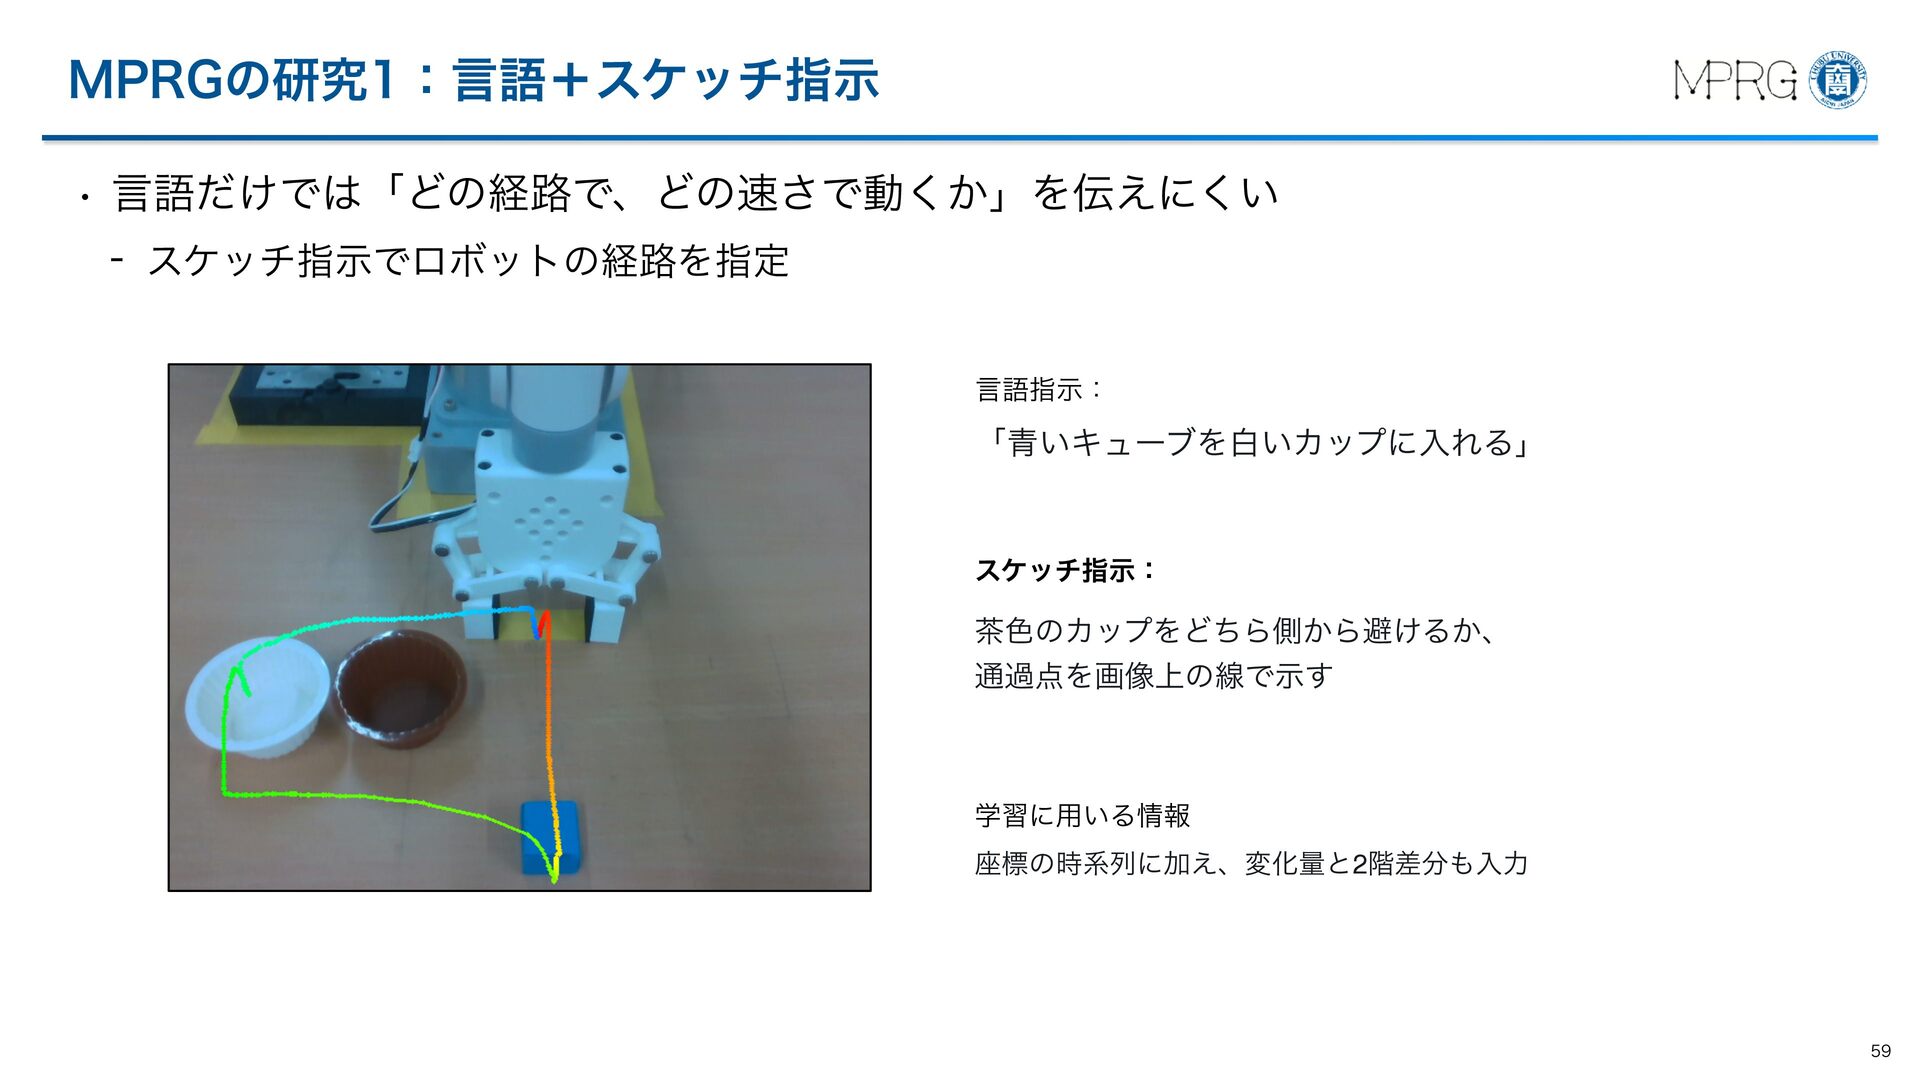
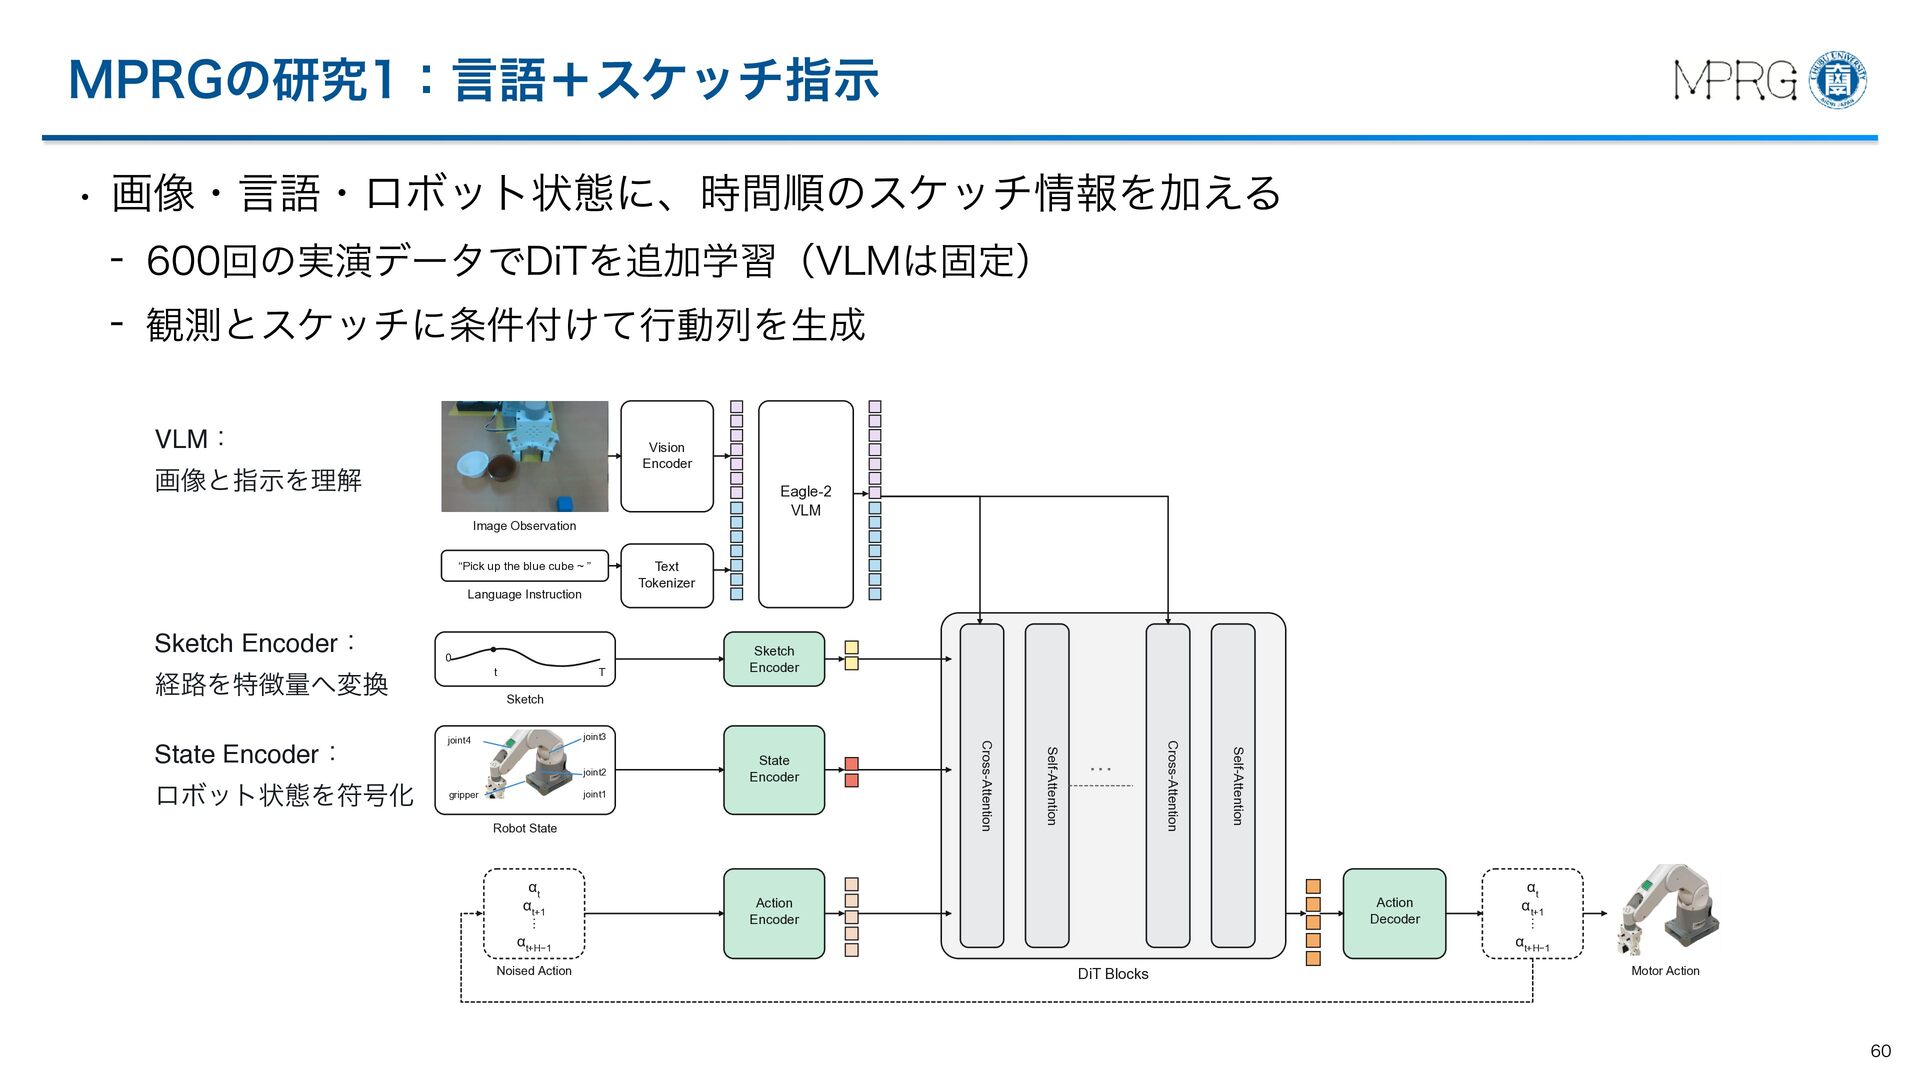
  43. MPRGの研究1:言語+スケッチ指示 • 画像・言語・ロボット状態に、時間順のスケッチ情報を加える - 600回の実演データでDiTを追加学習(VLMは固定) - 観測とスケッチに条件付けて行動列を生成 VLM: Vision Encoder

    画像と指示を理解 Eagle-2 VLM Image Observation Text Tokenizer “Pick up the blue cube ~ ” Language Instruction Sketch Encoder: 0 t 経路を特徴量へ変換 Sketch joint1 gripper 中部大学ロゴ State Encoder Robot State αt αt+1 ⋮ αt+H−1 Noised Action ··· Self-Attention joint2 Cross-Attention joint3 joint4 Self-Attention ロボット状態を符号化 中部大学ロゴ Cross-Attention State Encoder: T Sketch Encoder Action Decoder Action Encoder DiT Blocks αt αt+1 ⋮ αt+H−1 Motor Action 60 60
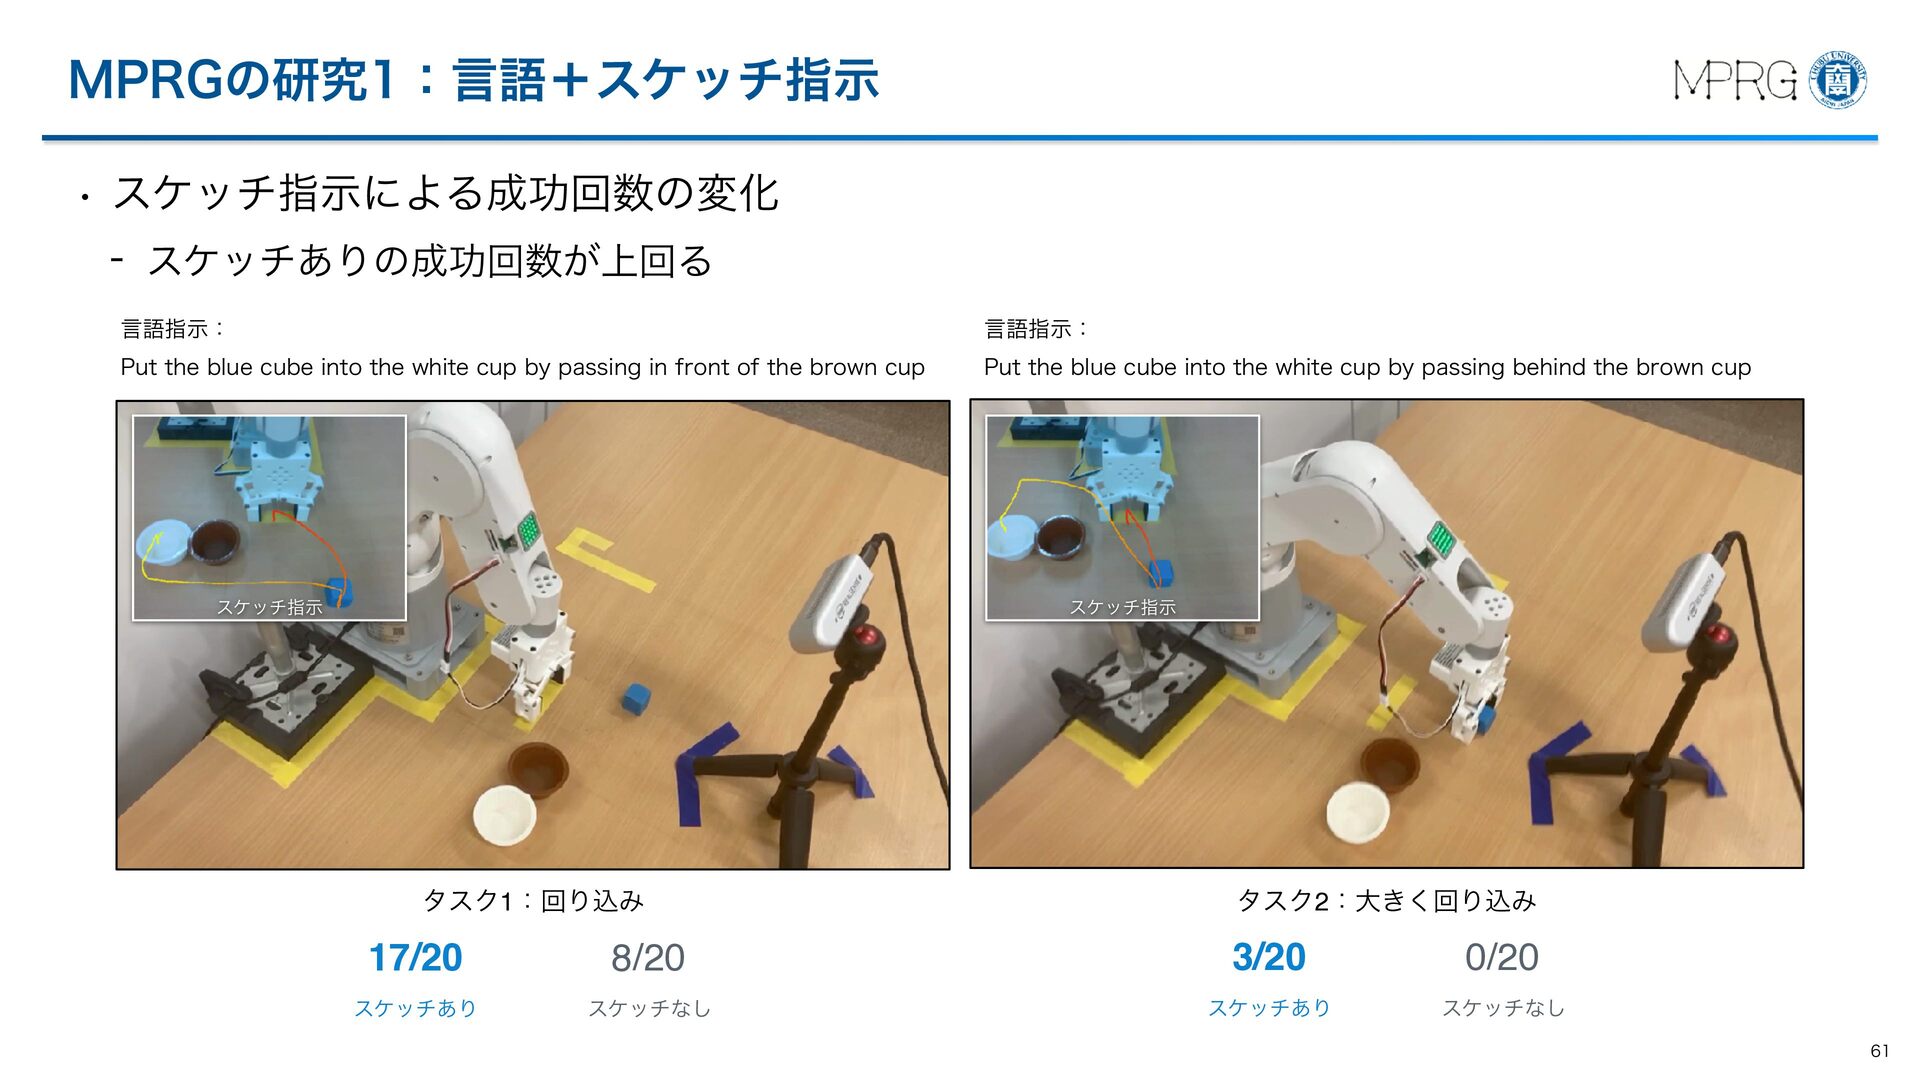
  44. MPRGの研究1:言語+スケッチ指示 • スケッチ指示による成功回数の変化 - スケッチありの成功回数が上回る 言語指示: 言語指示: Put the blue

    cube into the white cup by passing in front of the brown cup Put the blue cube into the white cup by passing behind the brown cup スケッチ指示 中部大学ロゴ スケッチ指示 中部大学ロゴ タスク1:回り込み タスク2:大きく回り込み 17/20 8/20 3/20 0/20 スケッチあり スケッチなし スケッチあり スケッチなし 61 61
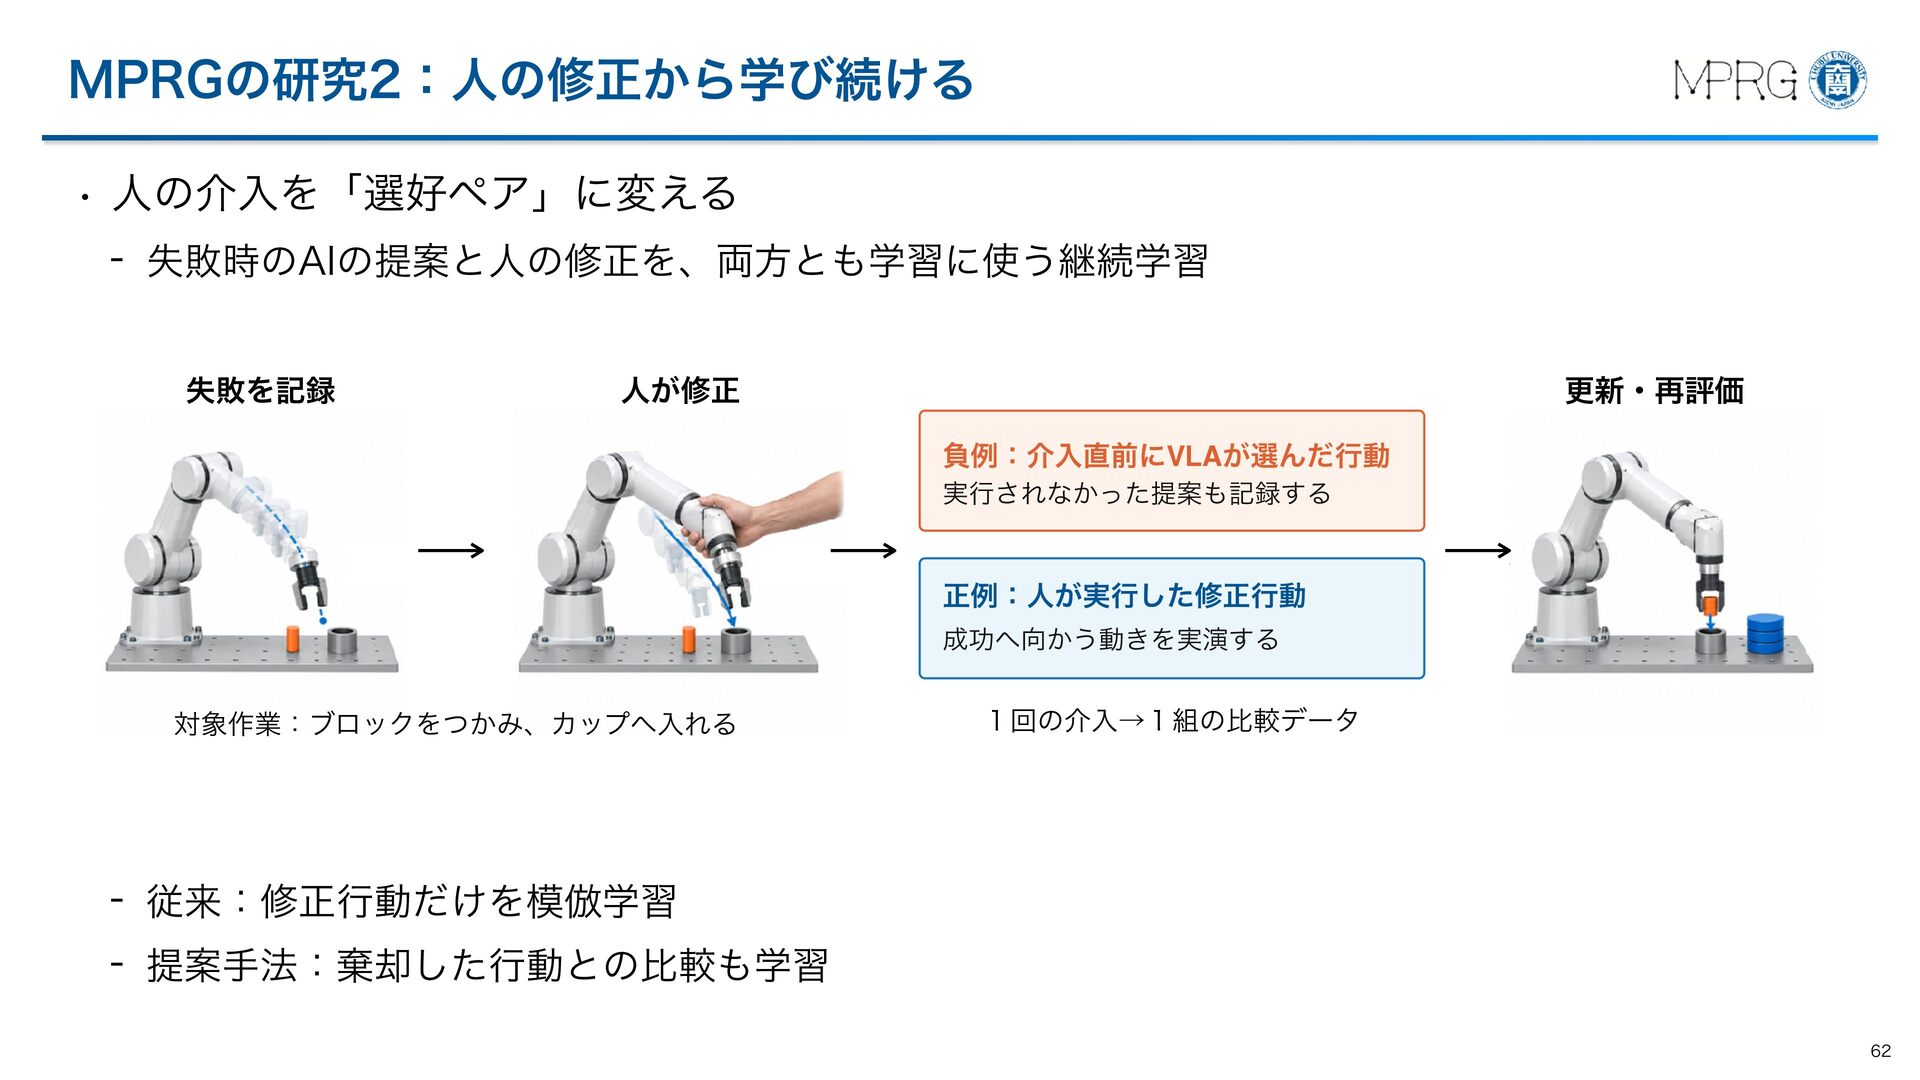
  45. MPRGの研究2:人の修正から学び続ける • 人の介入を「選好ペア」に変える - 失敗時のAIの提案と人の修正を、両方とも学習に使う継続学習 失敗を記録 人が修正 更新・再評価 負例:介入直前にVLAが選んだ行動 実行されなかった提案も記録する

    正例:人が実行した修正行動 中部大学ロゴ 対象作業:ブロックをつかみ、カップへ入れる 成功へ向かう動きを実演する 1回の介入→1組の比較データ 中部大学ロゴ - 従来:修正行動だけを模倣学習 - 提案手法:棄却した行動との比較も学習 62 62
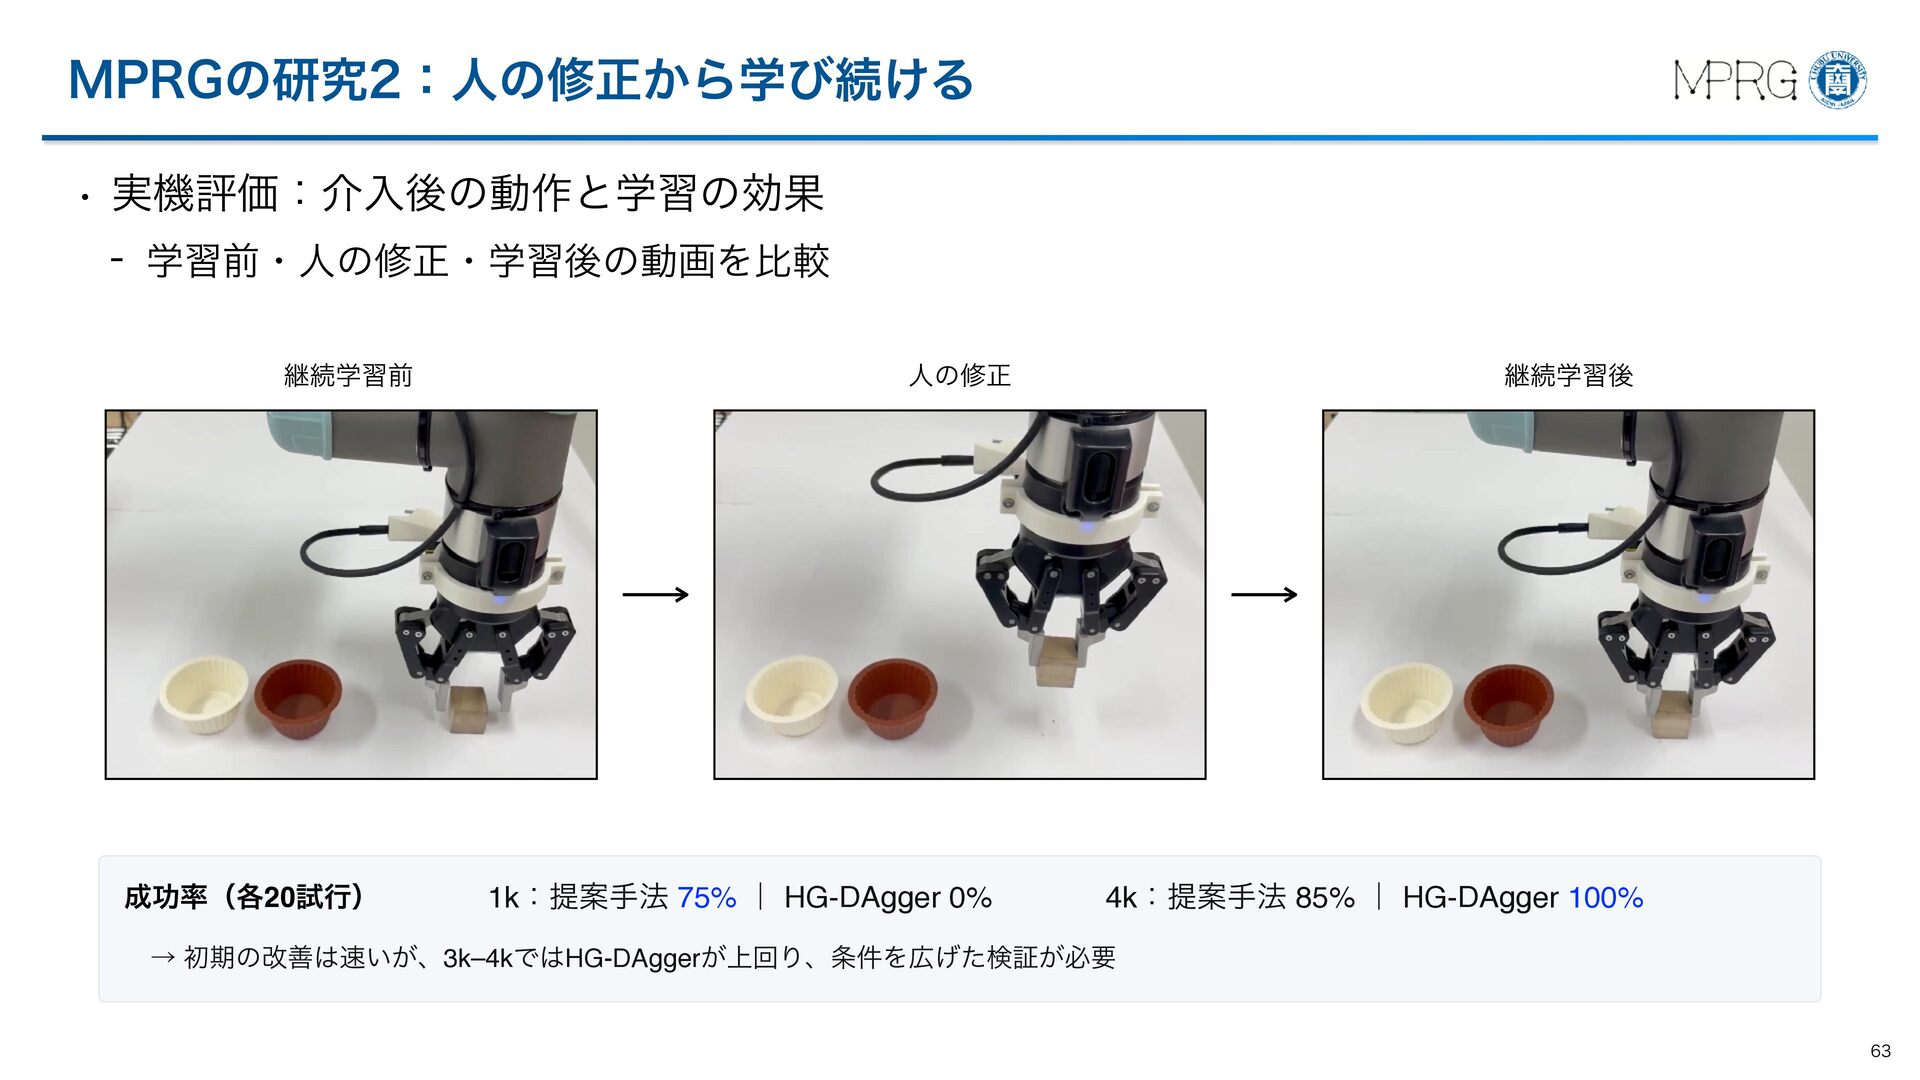
  46. MPRGの研究2:人の修正から学び続ける • 実機評価:介入後の動作と学習の効果 - 学習前・人の修正・学習後の動画を比較 継続学習前 人の修正 継続学習後 中部大学ロゴ 中部大学ロゴ

    成功率(各20試行) 1k:提案手法 75% | HG-DAgger 0% 4k:提案手法 85% | HG-DAgger 100% → 初期の改善は速いが、3k–4kではHG-DAggerが上回り、条件を広げた検証が必要 63 63
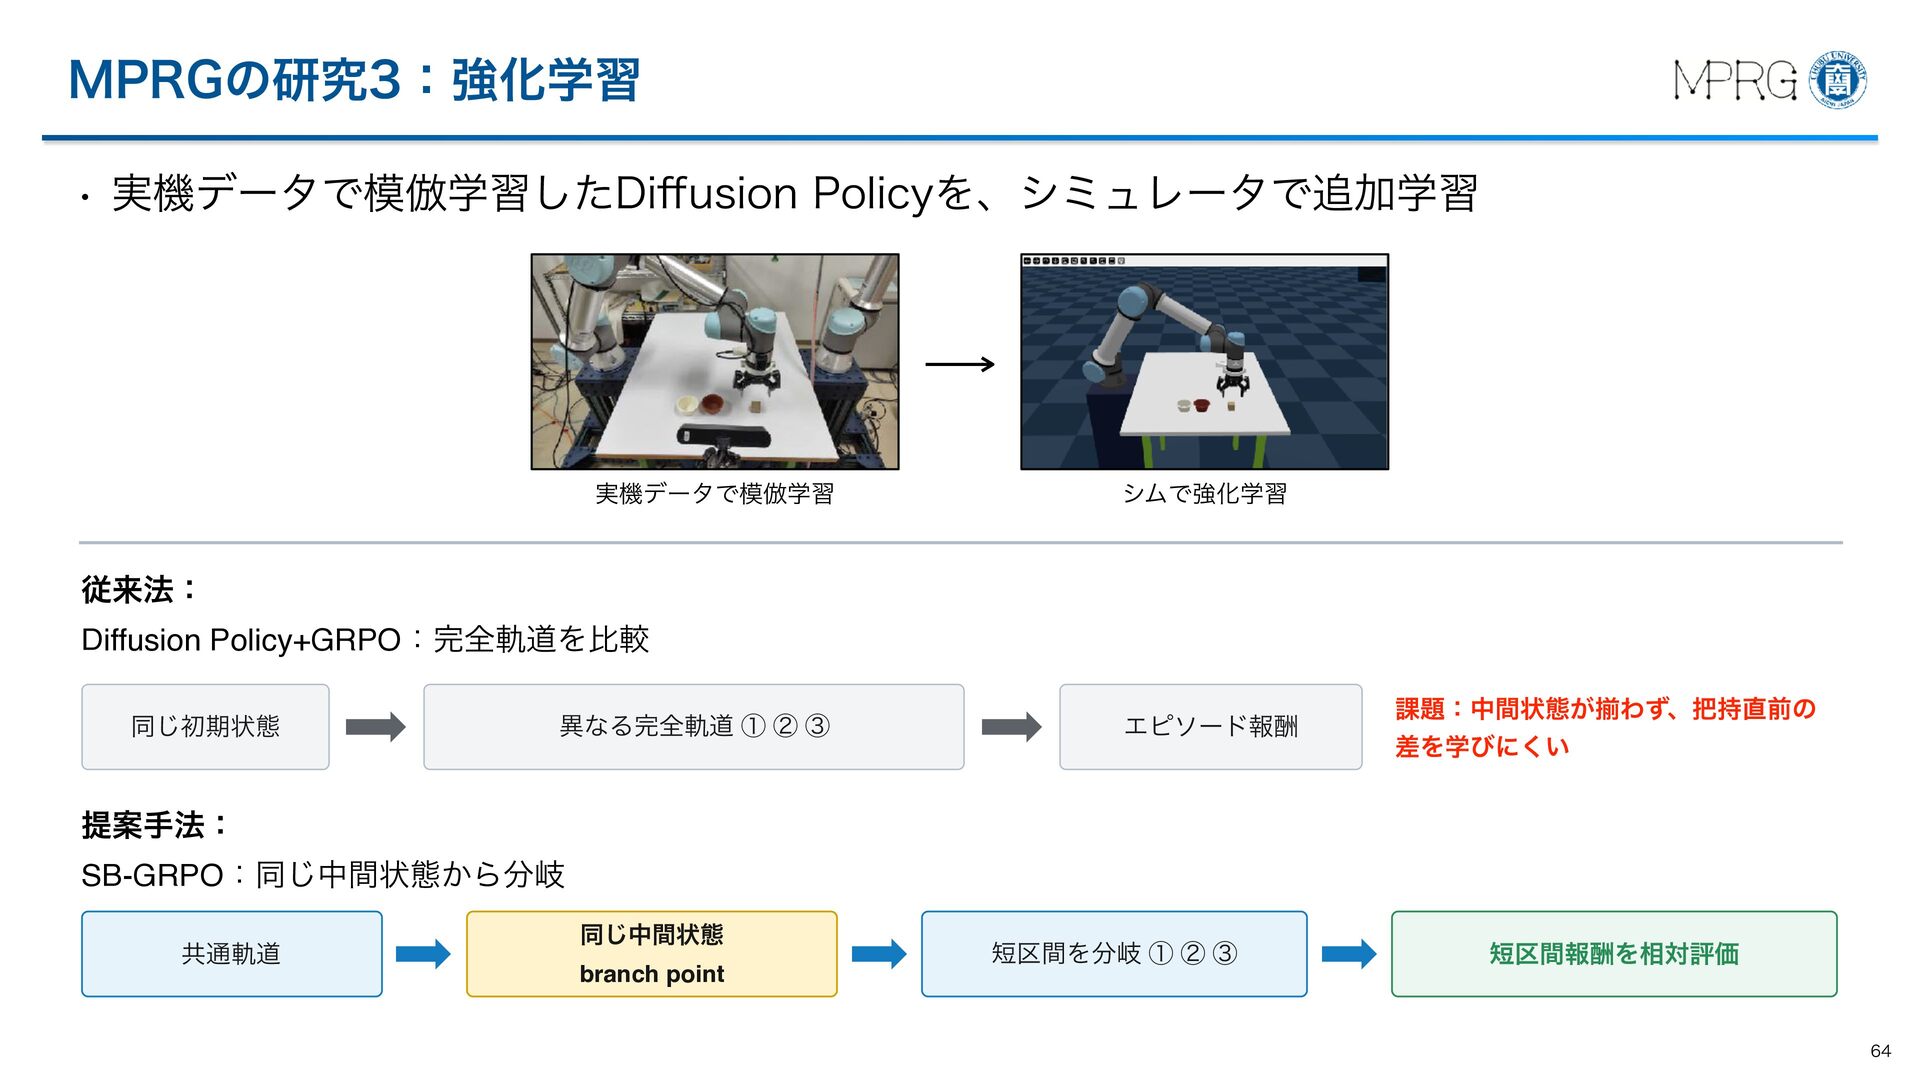
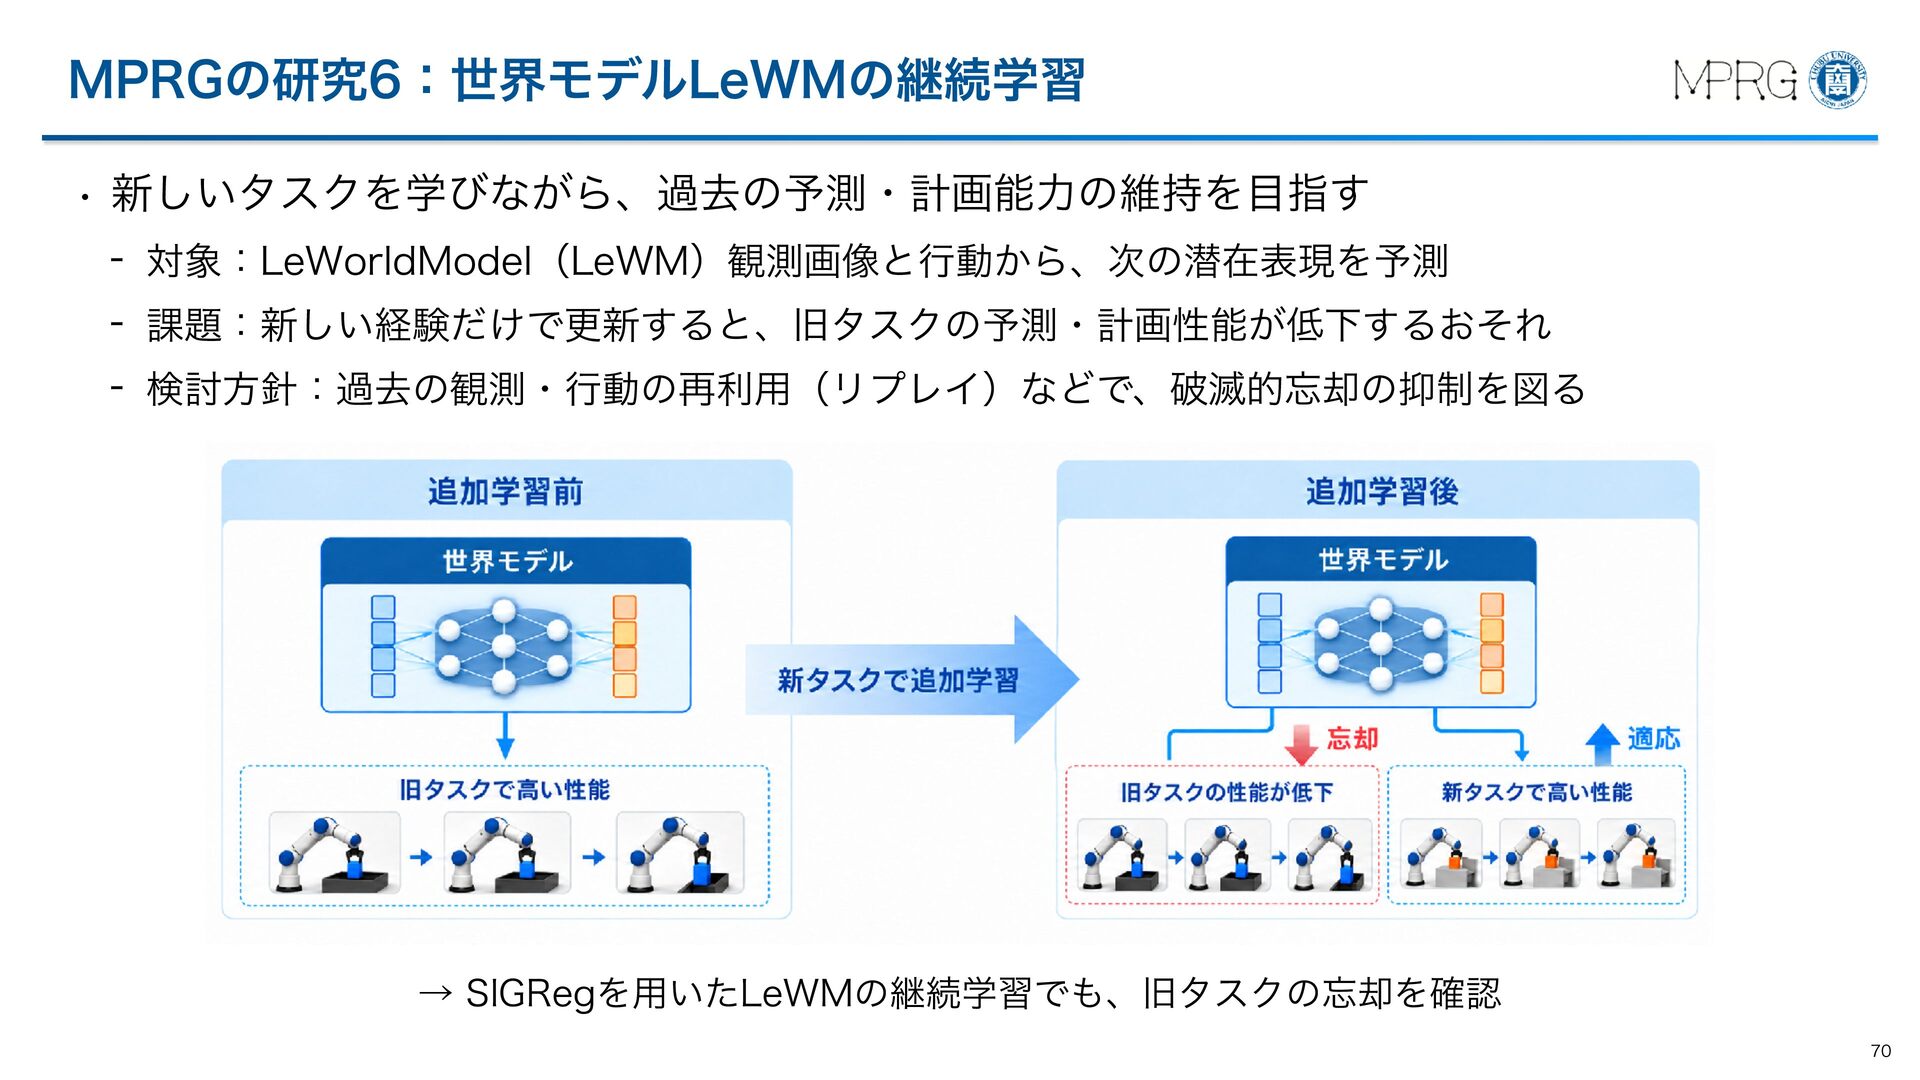
  47. MPRGの研究3:強化学習 • 実機データで模倣学習したDi usion Policyを、シミュレータで追加学習 実機データで模倣学習 シムで強化学習 従来法: Diffusion Policy+GRPO:完全軌道を比較

    中部大学ロゴ 異なる完全軌道 ① ② ③ 同じ初期状態 エピソード報酬 中部大学ロゴ 課題:中間状態が揃わず、把持直前の 差を学びにくい 提案手法: SB-GRPO:同じ中間状態から分岐 同じ中間状態 共通軌道 branch point 短区間を分岐 ① ② ③ 短区間報酬を相対評価 ff 64 64
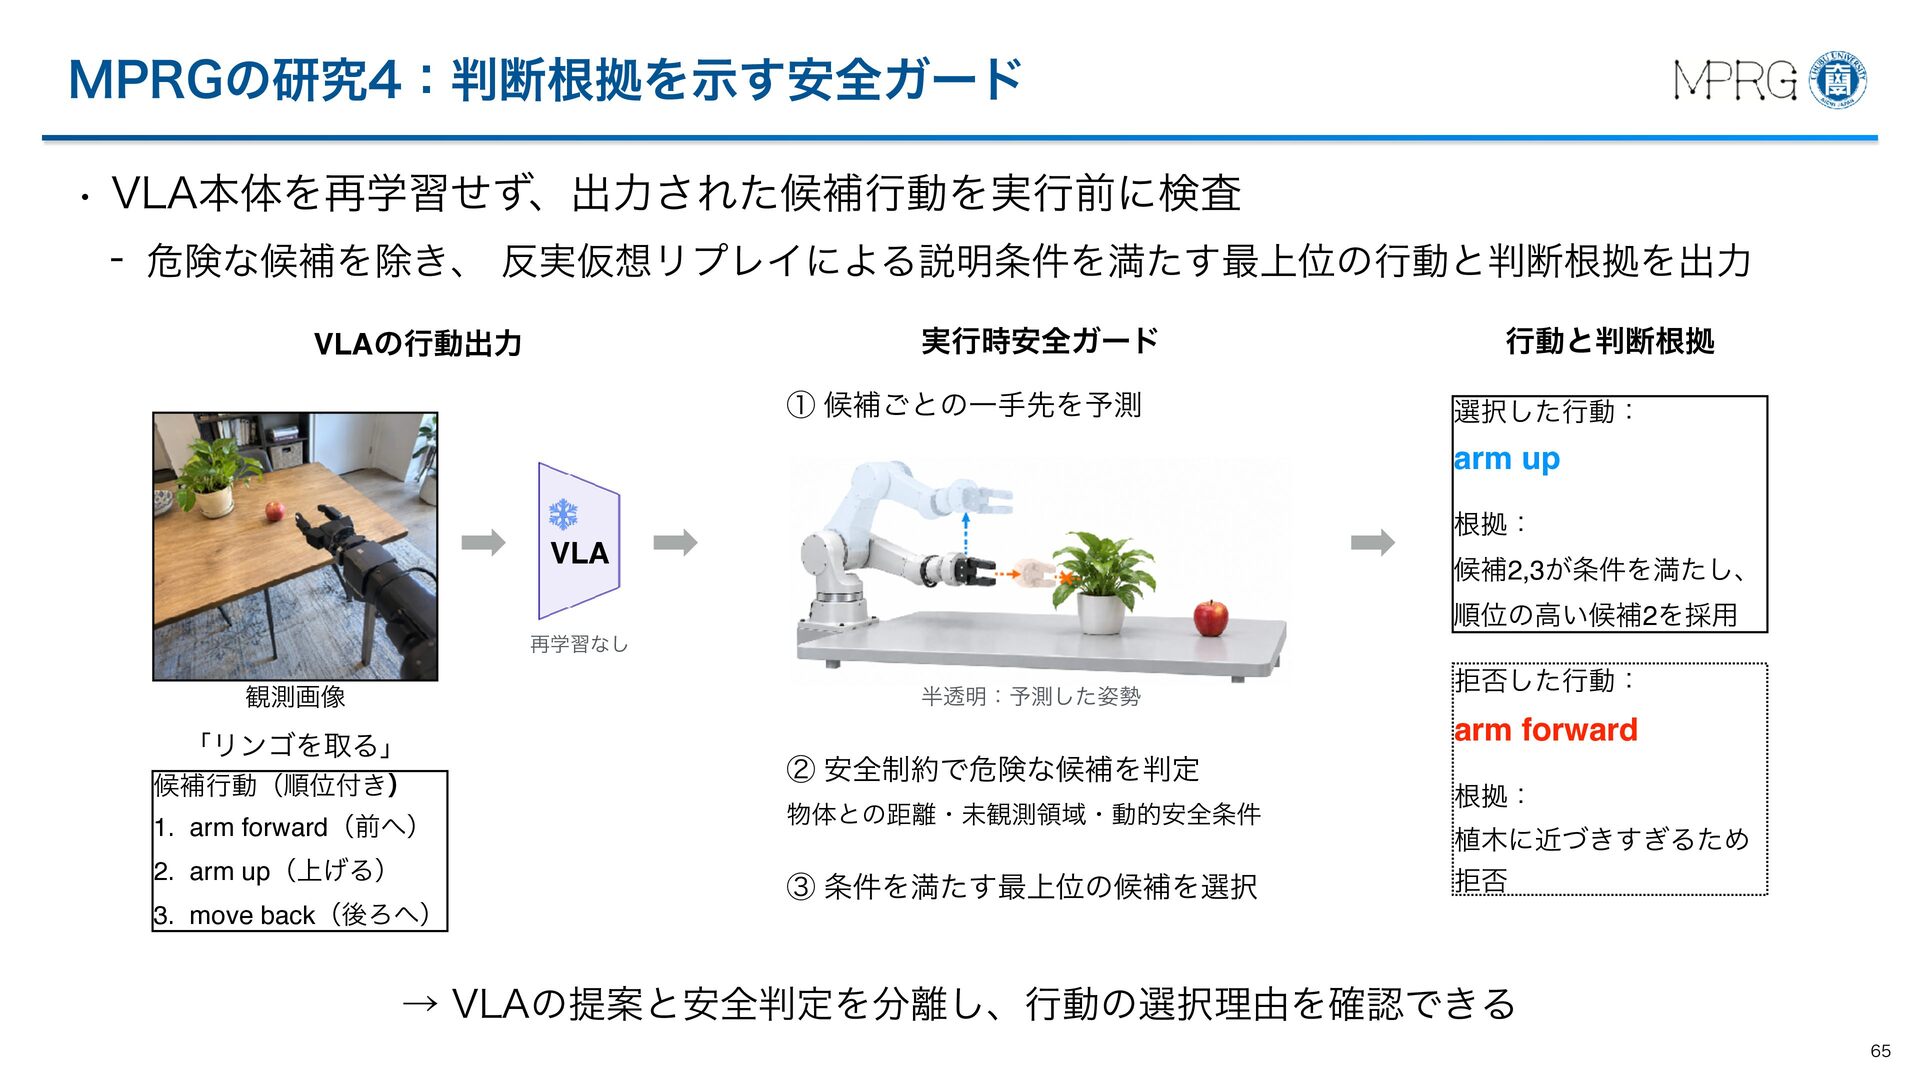
  48. MPRGの研究4:判断根拠を示す安全ガード • VLA本体を再学習せず、出力された候補行動を実行前に検査 - 危険な候補を除き、 反実仮想リプレイによる説明条件を満たす最上位の行動と判断根拠を出力 実行時安全ガード VLAの行動出力 ① 候補ごとの一手先を予測

    行動と判断根拠 選択した行動: arm up 根拠: VLA 再学習なし 観測画像 候補2,3が条件を満たし、 順位の高い候補2を採用 中部大学ロゴ 半透明:予測した姿勢 「リンゴを取る」 候補行動(順位付き) 1. arm forward(前へ) 2. arm up(上げる) 拒否した行動: arm forward ② 安全制約で危険な候補を判定 中部大学ロゴ 物体との距離・未観測領域・動的安全条件 ③ 条件を満たす最上位の候補を選択 根拠: 植木に近づきすぎるため 拒否 3. move back(後ろへ) → VLAの提案と安全判定を分離し、行動の選択理由を確認できる 65 65
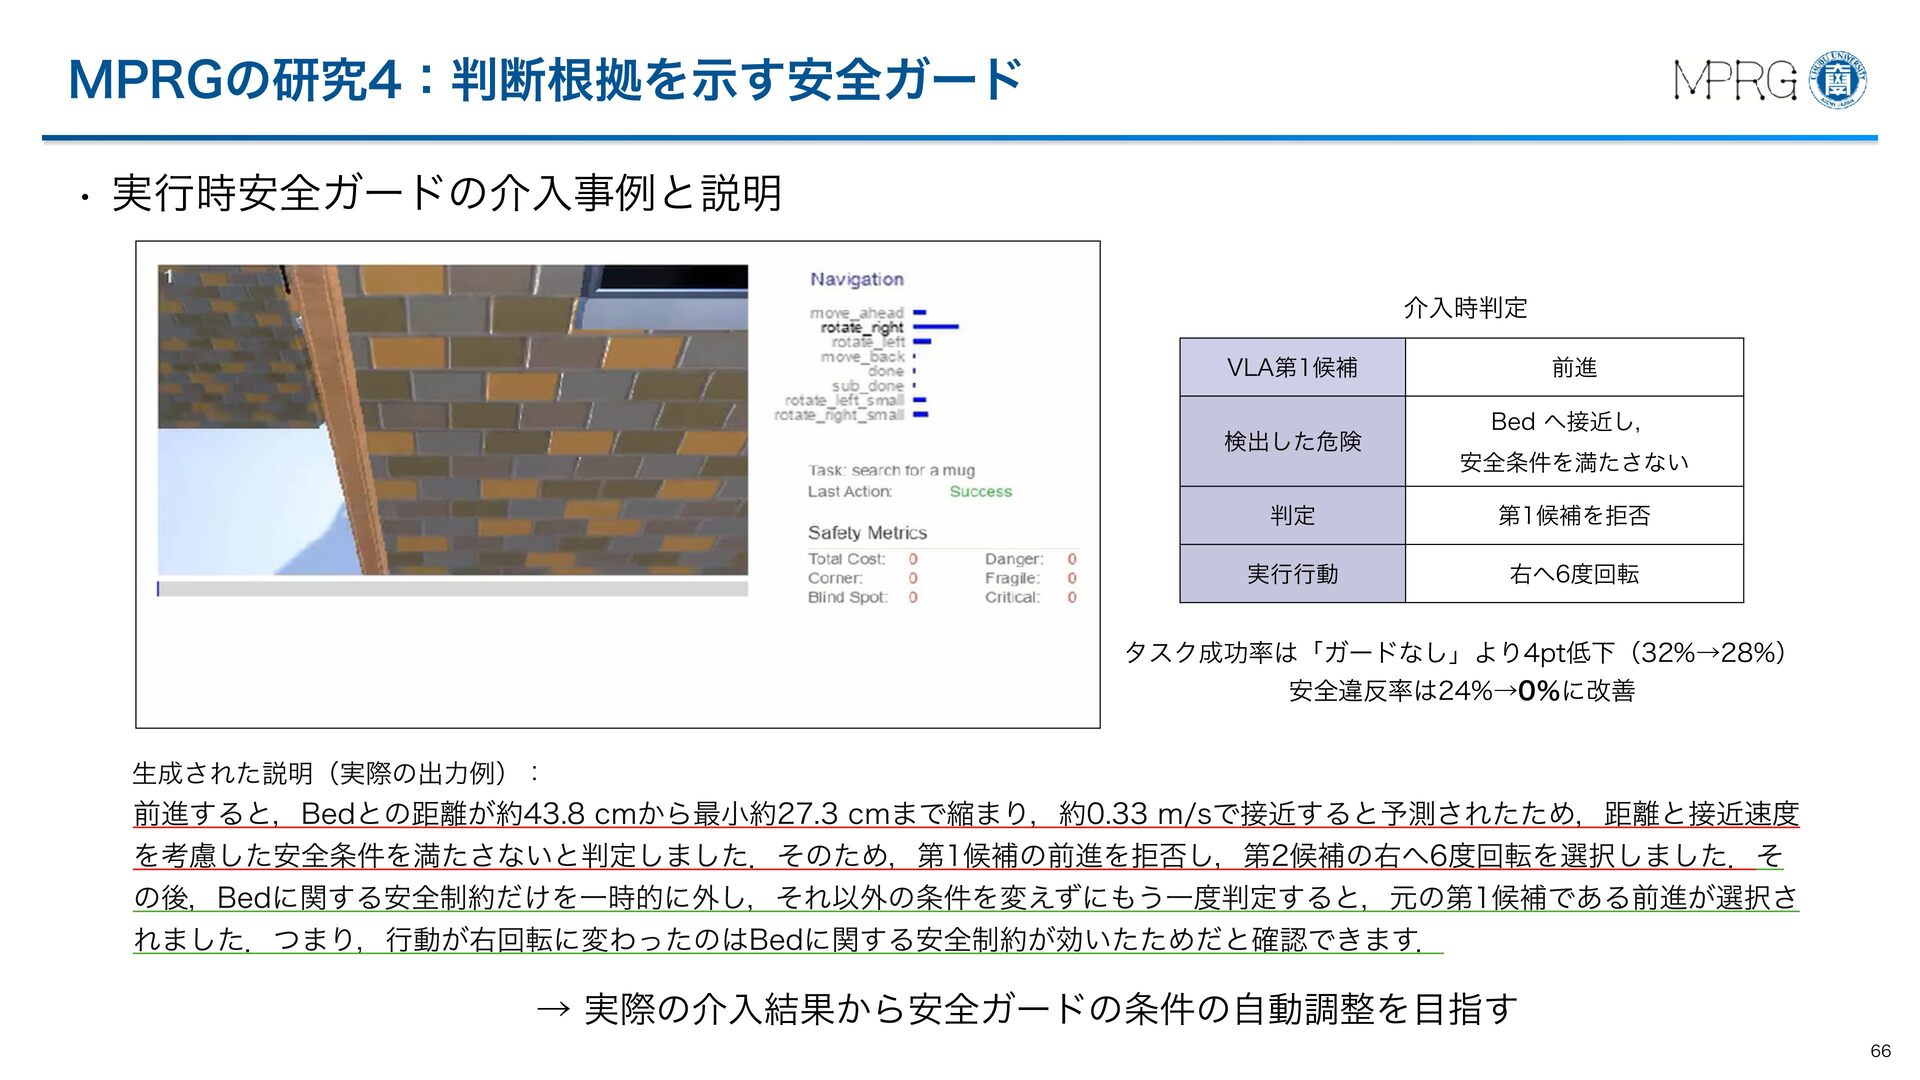
  49. MPRGの研究4:判断根拠を示す安全ガード • 実行時安全ガードの介入事例と説明 介入時判定 VLA第1候補 検出した危険 中部大学ロゴ 前進 Bed へ接近し,

    安全条件を満たさない 判定 第1候補を拒否 実行行動 右へ6度回転 タスク成功率は「ガードなし」より4pt低下(32%→28%) 安全違反率は24%→0%に改善 中部大学ロゴ 前進すると,Bedとの距離が約43.8 cmから最小約27.3 cmまで縮まり,約0.33 m/sで接近すると予測されたため,距離と接近速度 生成された説明(実際の出力例): を考慮した安全条件を満たさないと判定しました.そのため,第1候補の前進を拒否し,第2候補の右へ6度回転を選択しました.そ の後,Bedに関する安全制約だけを一時的に外し,それ以外の条件を変えずにもう一度判定すると,元の第1候補である前進が選択さ れました.つまり,行動が右回転に変わったのはBedに関する安全制約が効いたためだと確認できます. → 実際の介入結果から安全ガードの条件の自動調整を目指す 66 66
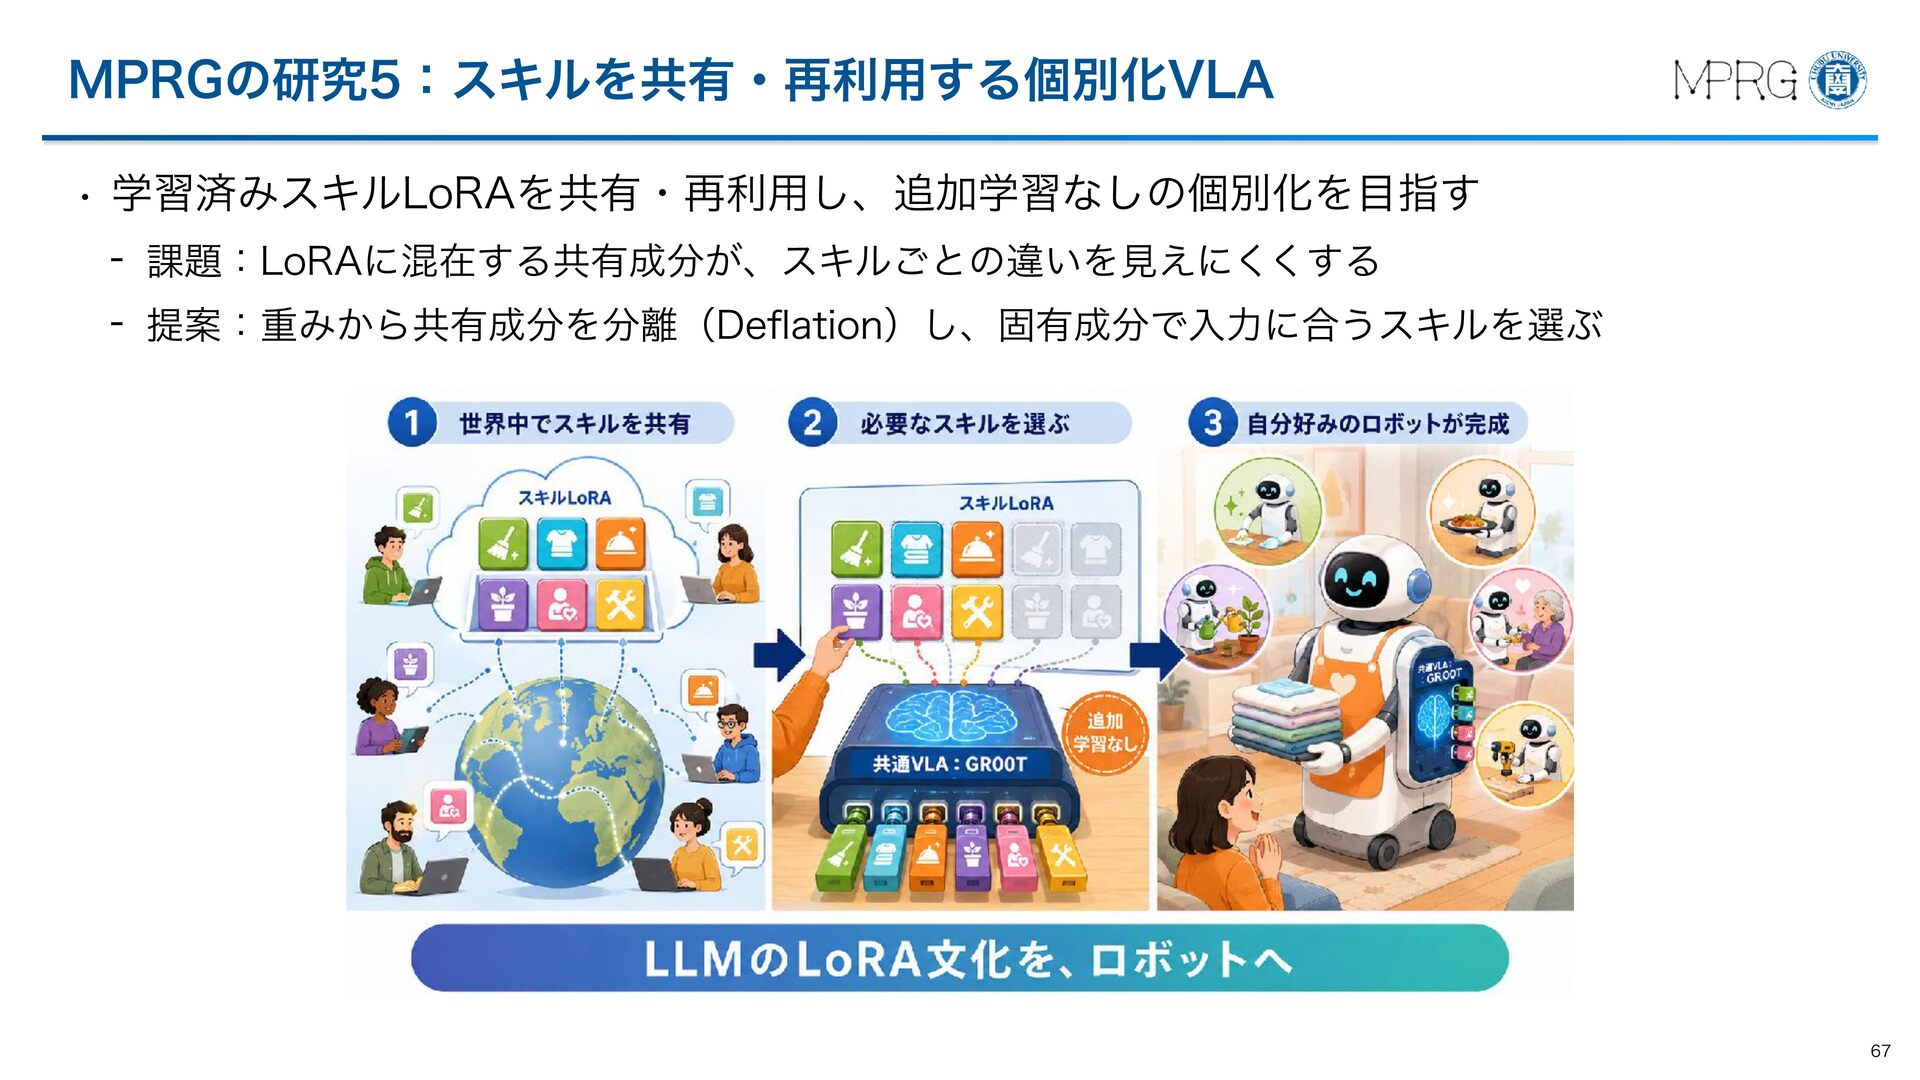
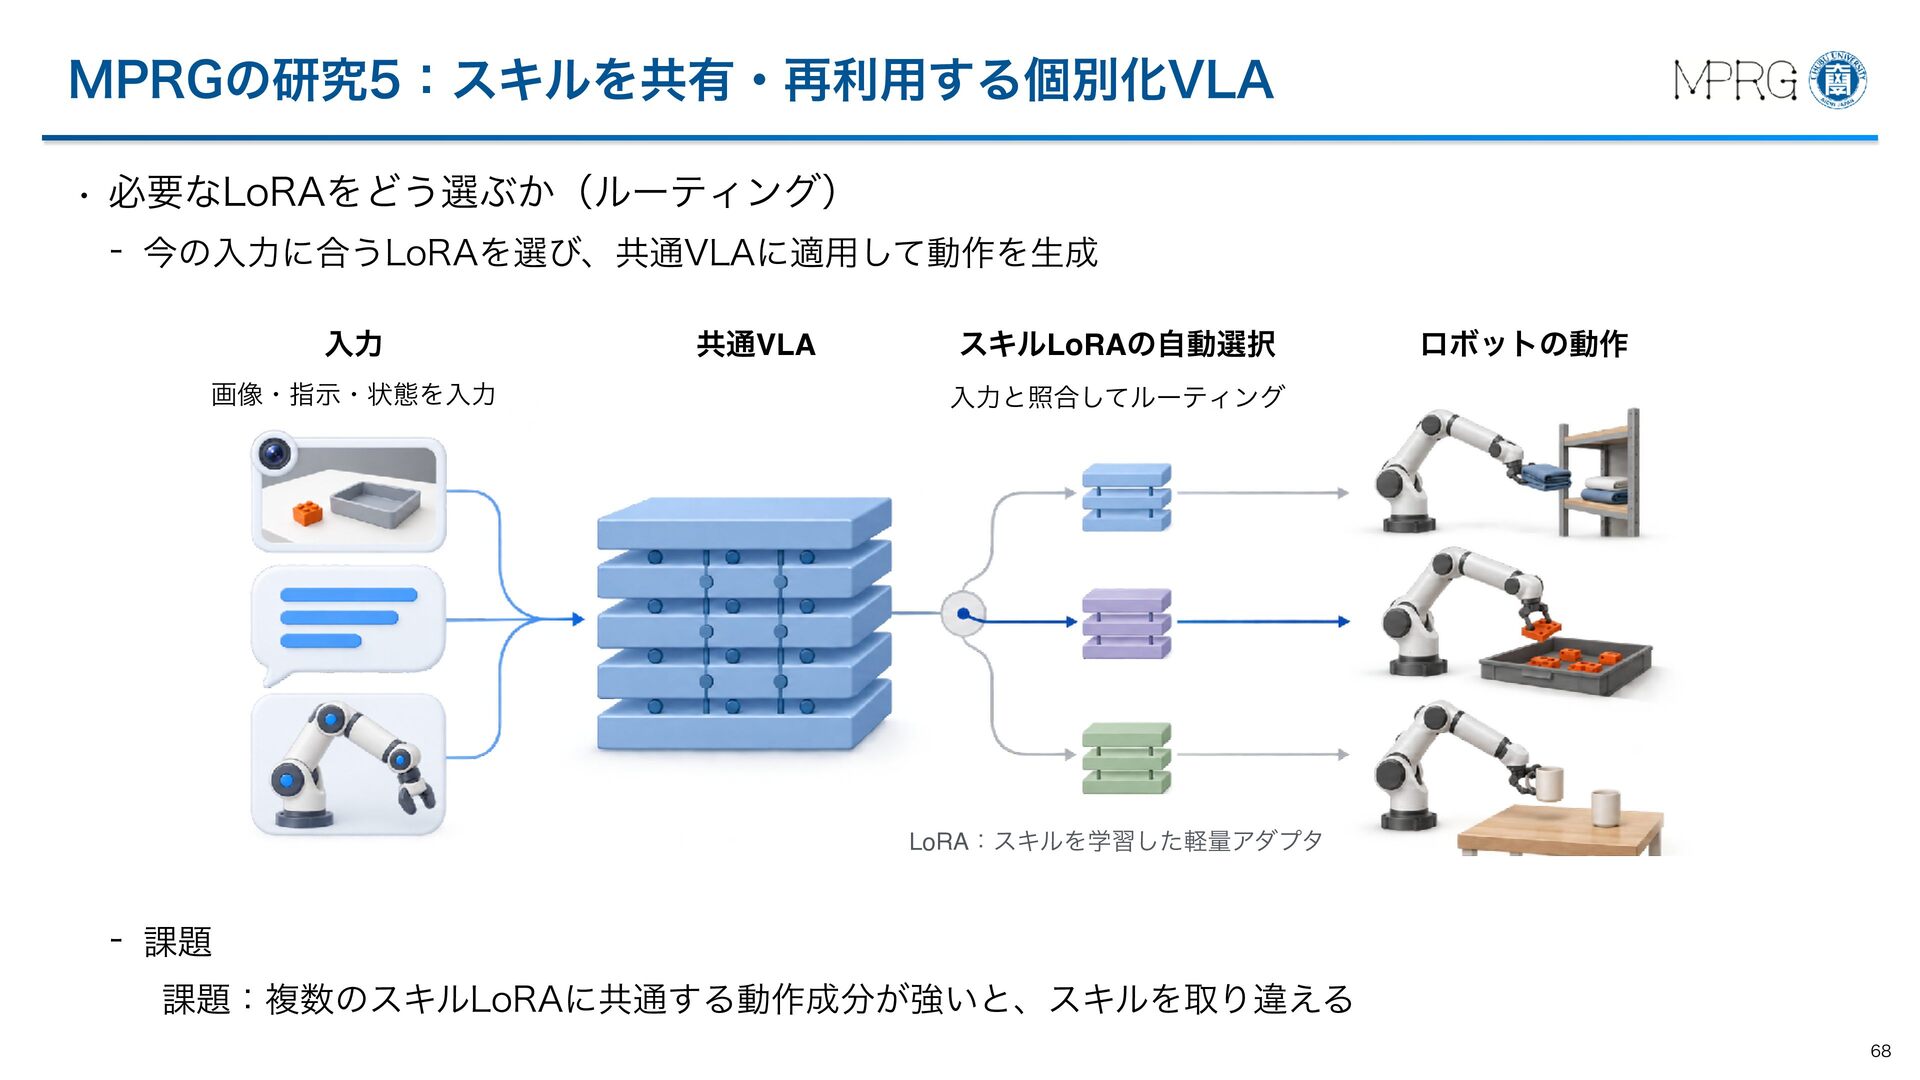
  50. MPRGの研究5:スキルを共有・再利用する個別化VLA • 必要なLoRAをどう選ぶか(ルーティング) - 今の入力に合うLoRAを選び、共通VLAに適用して動作を生成 入力 共通VLA 画像・指示・状態を入力 スキルLoRAの自動選択 ロボットの動作

    入力と照合してルーティング 中部大学ロゴ 中部大学ロゴ LoRA:スキルを学習した軽量アダプタ - 課題 課題:複数のスキルLoRAに共通する動作成分が強いと、スキルを取り違える 68 68
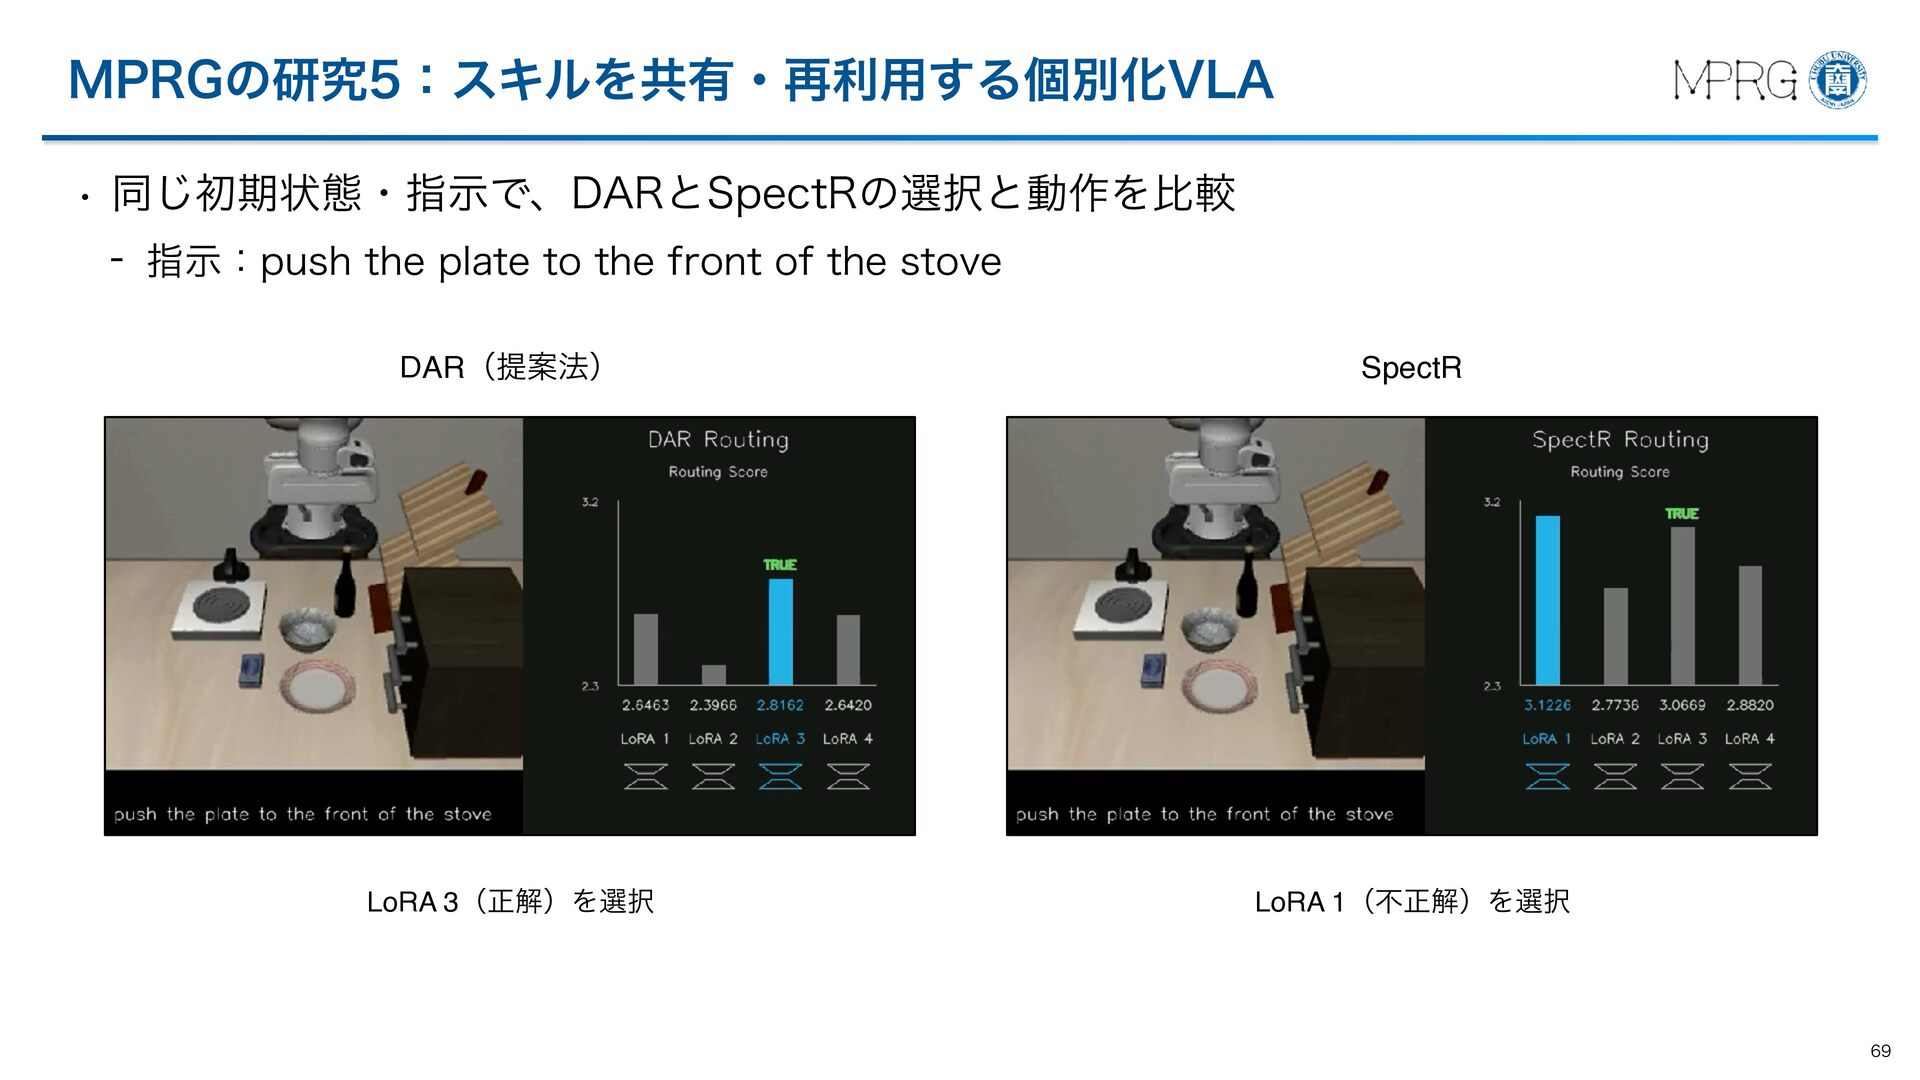
  51. MPRGの研究5:スキルを共有・再利用する個別化VLA • 同じ初期状態・指示で、DARとSpectRの選択と動作を比較 - 指示:push the plate to the front

    of the stove DAR(提案法) SpectR 中部大学ロゴ 中部大学ロゴ LoRA 3(正解)を選択 LoRA 1(不正解)を選択 69 69
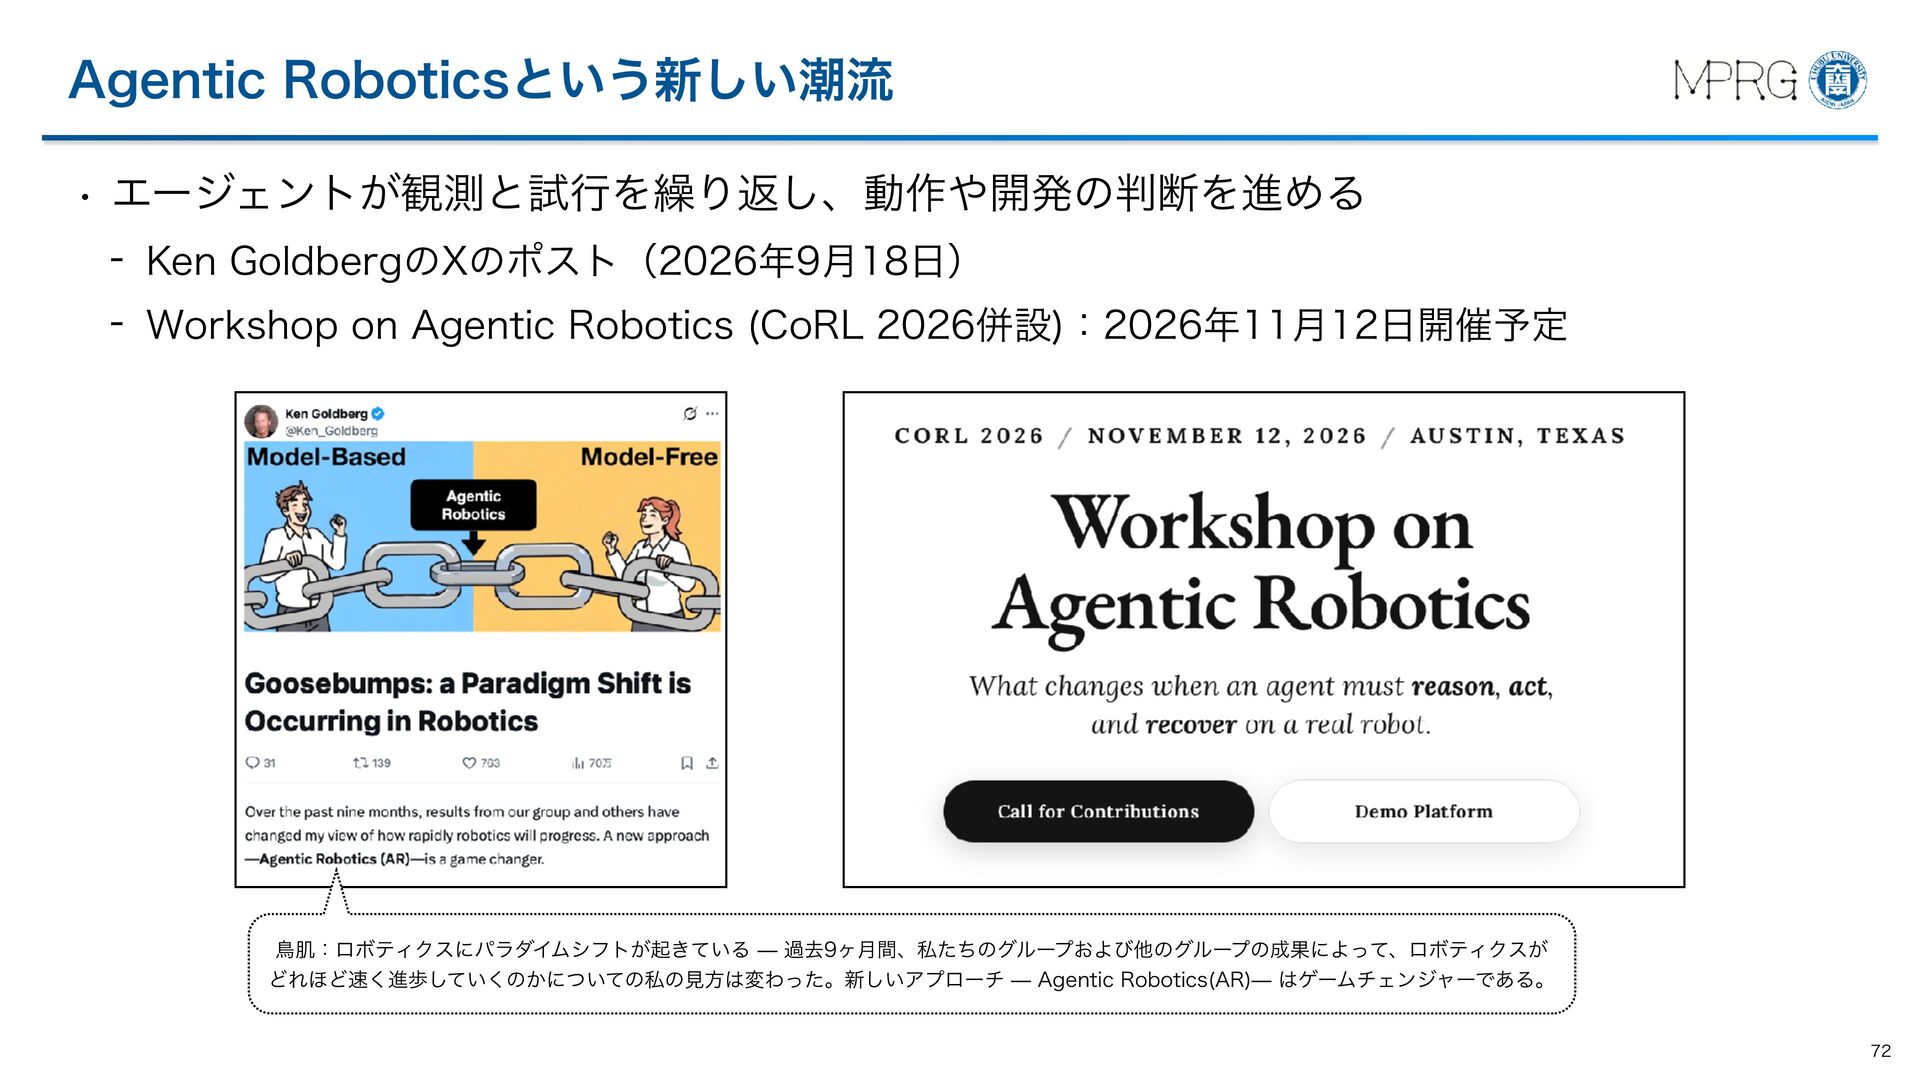
  52. Agentic Roboticsという新しい潮流 • エージェントが観測と試行を繰り返し、動作や開発の判断を進める - Ken GoldbergのXのポスト(2026年9月18日) - Workshop on

    Agentic Robotics (CoRL 2026併設):2026年11月12日開催予定 中部大学ロゴ 中部大学ロゴ 鳥肌:ロボティクスにパラダイムシフトが起きている ̶ 過去9ヶ月間、私たちのグループおよび他のグループの成果によって、ロボティクスが どれほど速く進歩していくのかについての私の見方は変わった。新しいアプローチ ̶ Agentic Robotics(AR)̶ はゲームチェンジャーである。 72 72
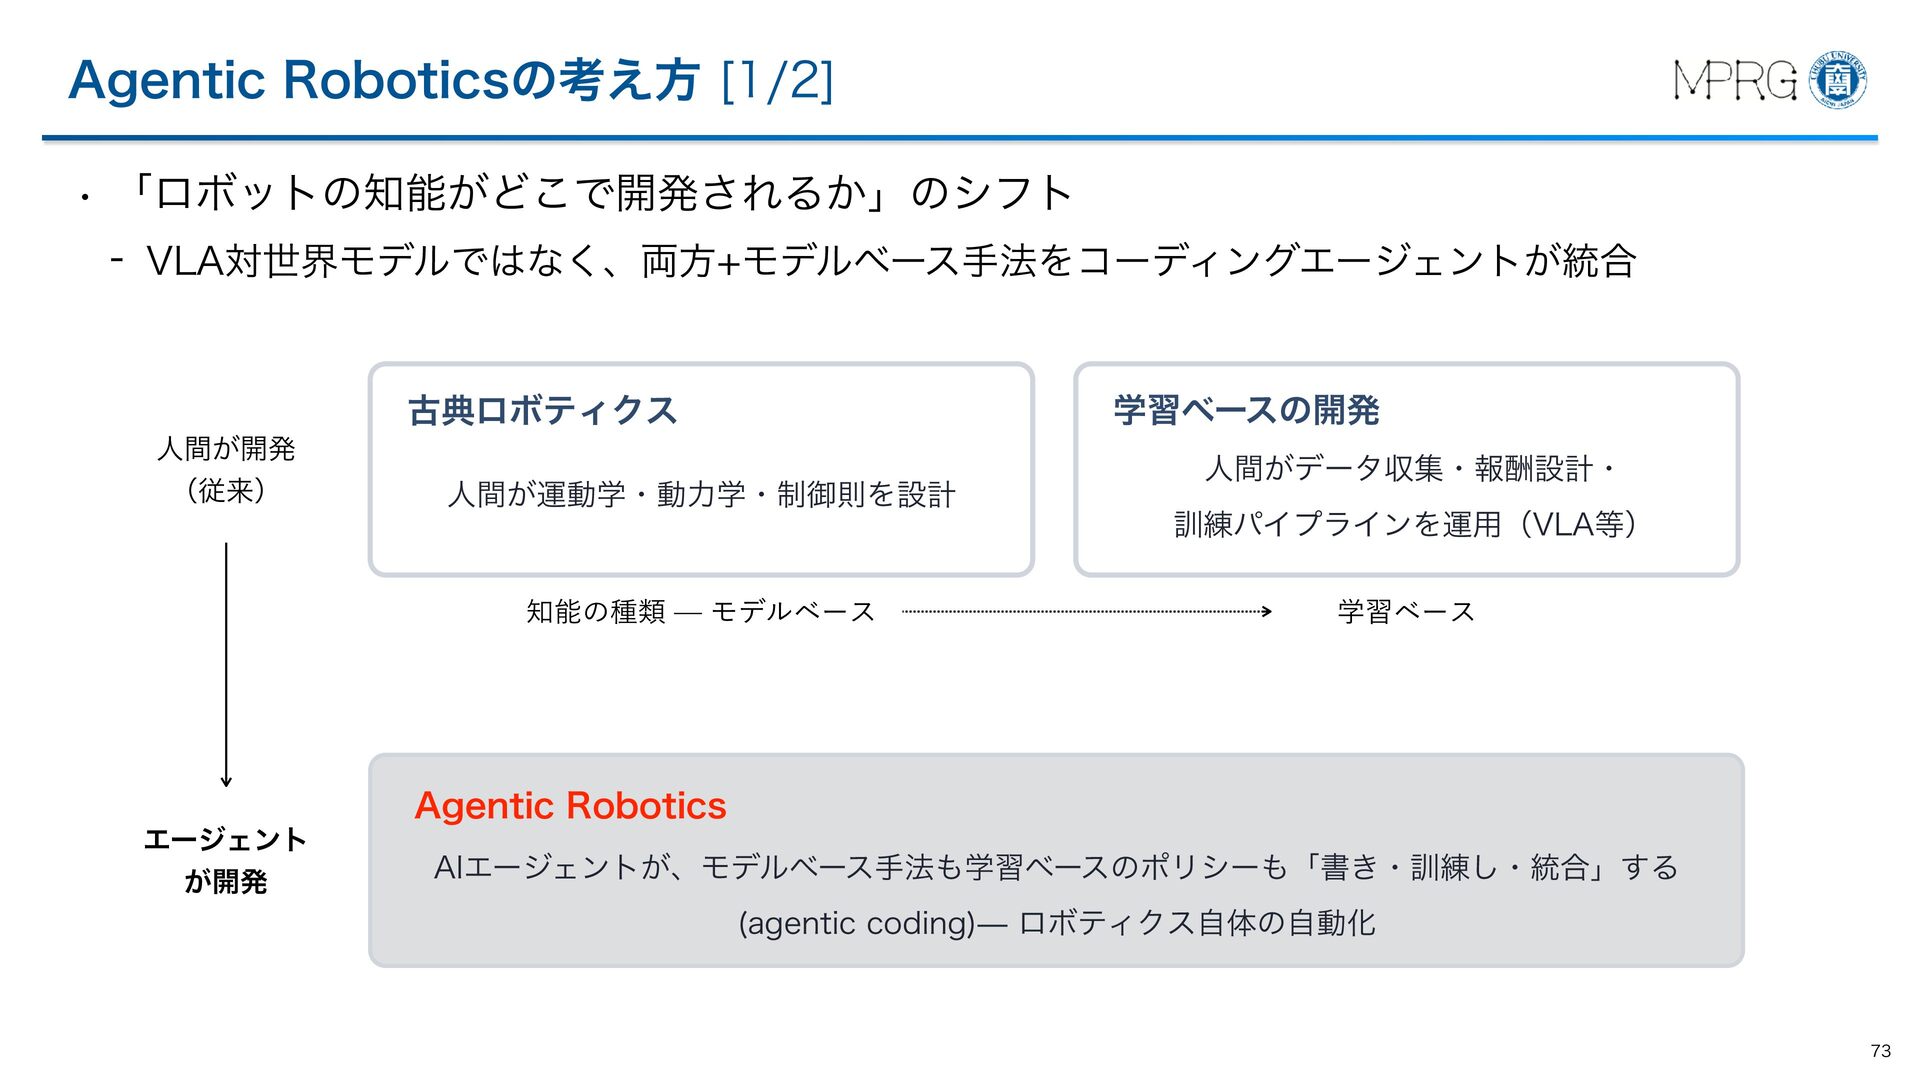
  53. Agentic Roboticsの考え方 [1/2] • 「ロボットの知能がどこで開発されるか」のシフト - VLA対世界モデルではなく、両方+モデルベース手法をコーディングエージェントが統合 学習ベースの開発 古典ロボティクス 人間が開発

    (従来) 人間が運動学・動力学・制御則を設計 知能の種類 ̶ モデルベース 中部大学ロゴ 人間がデータ収集・報酬設計・ 訓練パイプラインを運用(VLA等) 学習ベース 中部大学ロゴ Agentic Robotics エージェント が開発 AIエージェントが、モデルベース手法も学習ベースのポリシーも「書き・訓練し・統合」する (agentic coding)̶ ロボティクス自体の自動化 73 73
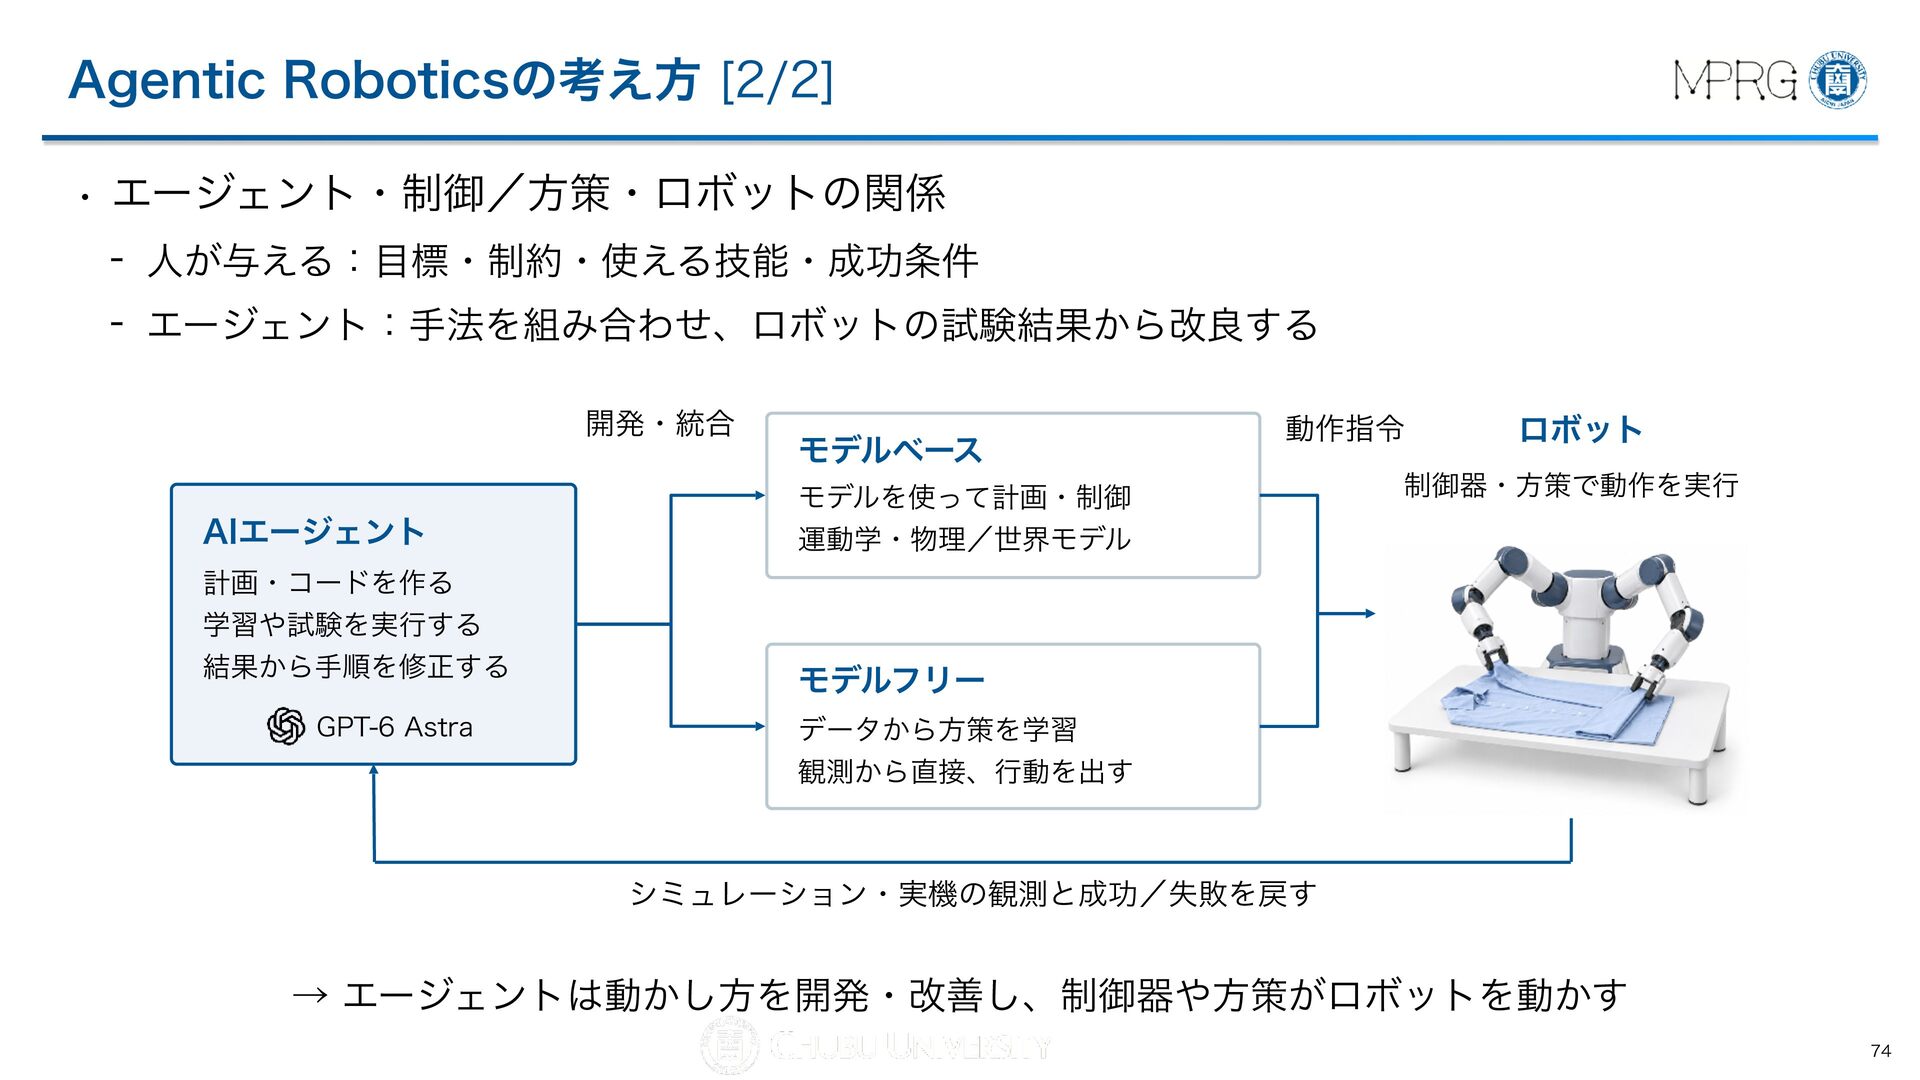
  54. Agentic Roboticsの考え方 [2/2] • エージェント・制御/方策・ロボットの関係 - 人が与える:目標・制約・使える技能・成功条件 - エージェント:手法を組み合わせ、ロボットの試験結果から改良する 開発・統合

    AIエージェント 計画・コードを作る 学習や試験を実行する 結果から手順を修正する GPT-6 Astra モデルベース 動作指令 モデルを使って計画・制御 運動学・物理/世界モデル ロボット 制御器・方策で動作を実行 モデルフリー データから方策を学習 観測から直接、行動を出す シミュレーション・実機の観測と成功/失敗を戻す → エージェントは動かし方を開発・改善し、制御器や方策がロボットを動かす 74
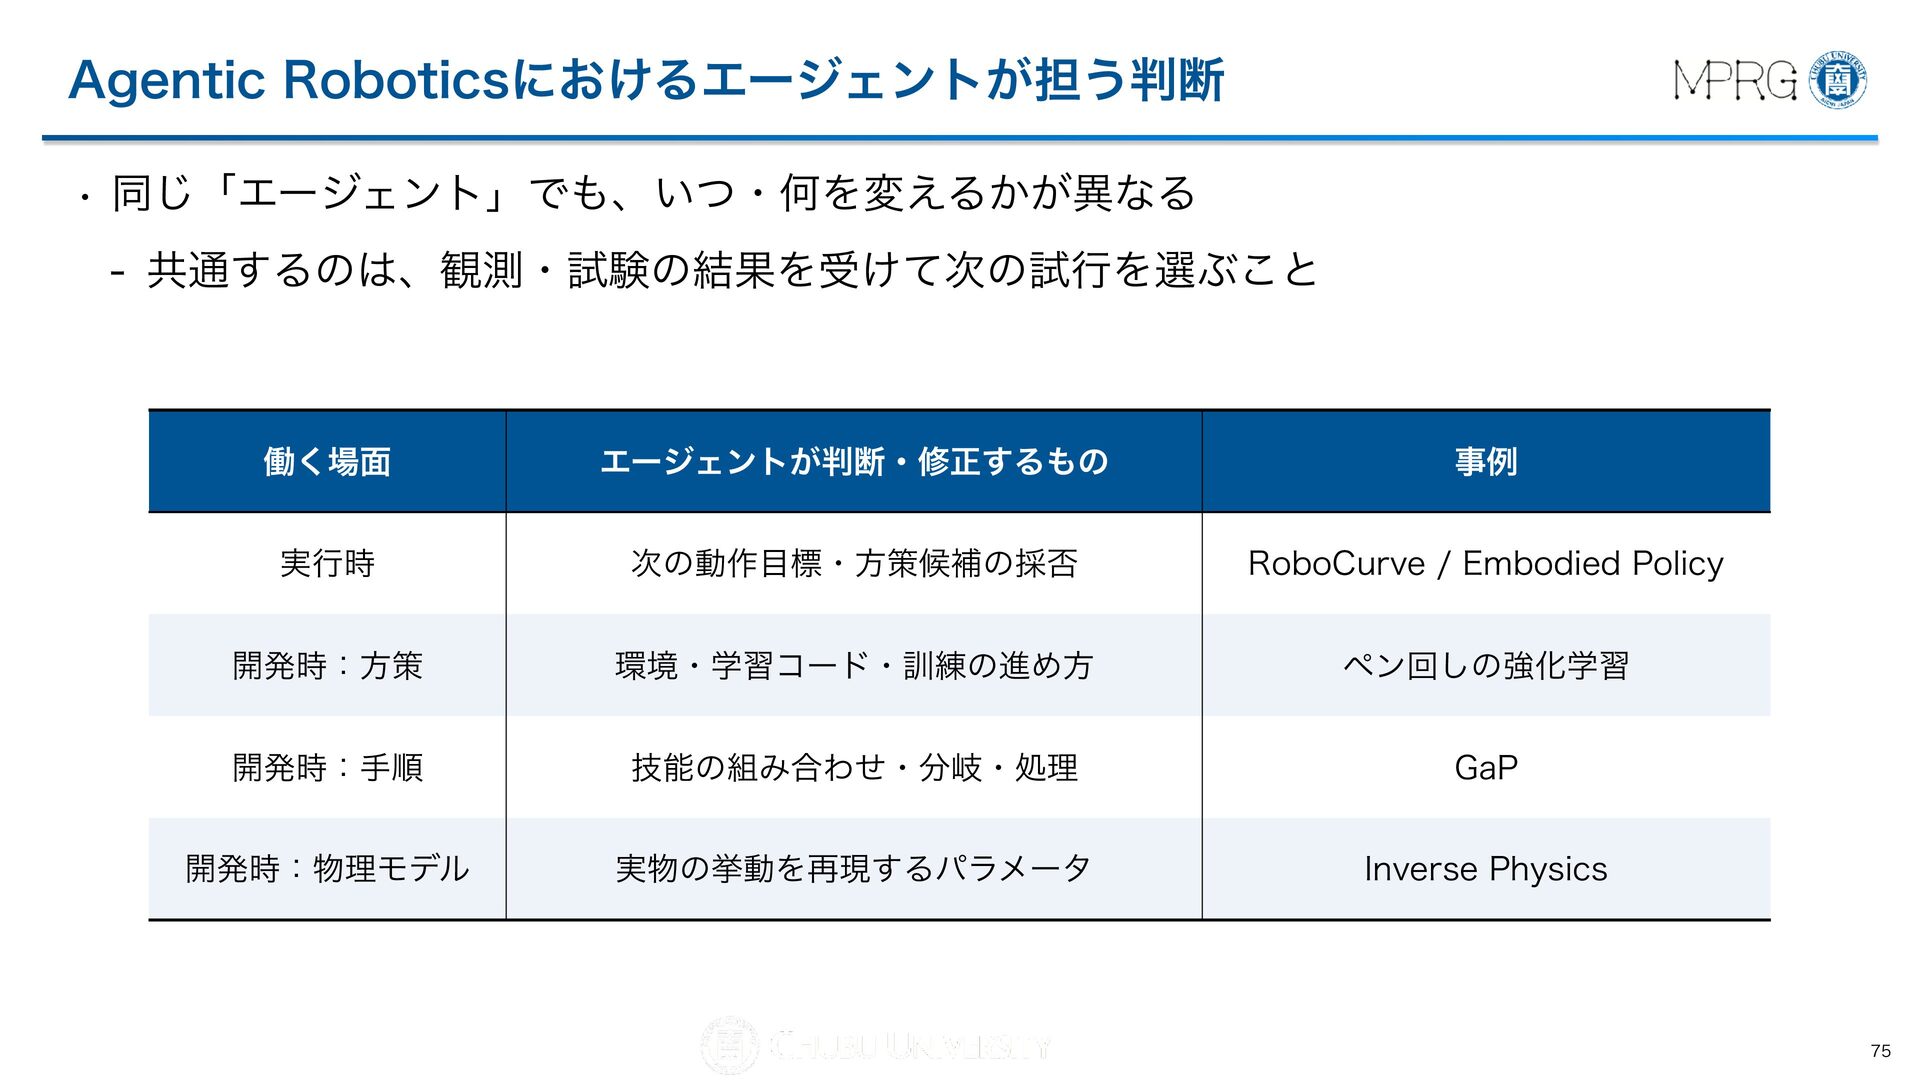
  55. Agentic Roboticsにおけるエージェントが担う判断 • 同じ「エージェント」でも、いつ・何を変えるかが異なる - 共通するのは、観測・試験の結果を受けて次の試行を選ぶこと 働く場面 エージェントが判断・修正するもの 事例 実行時

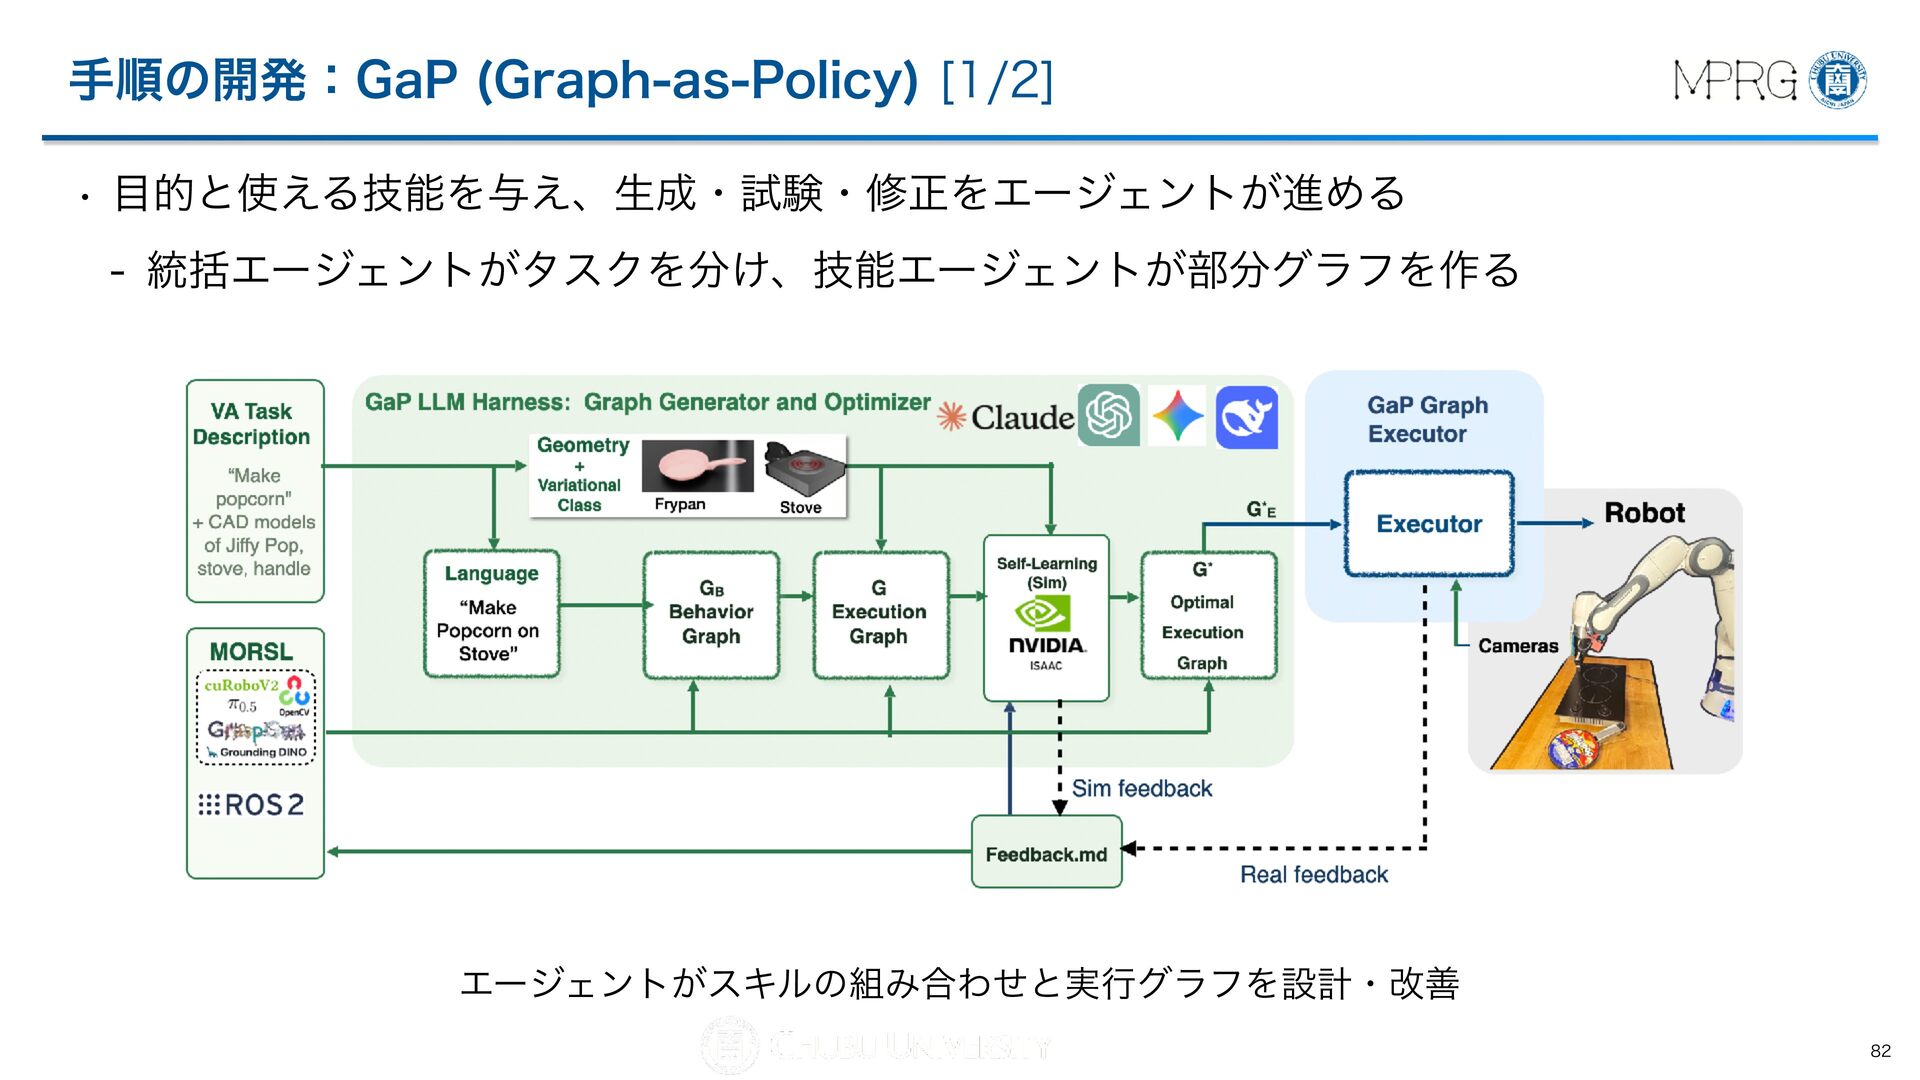
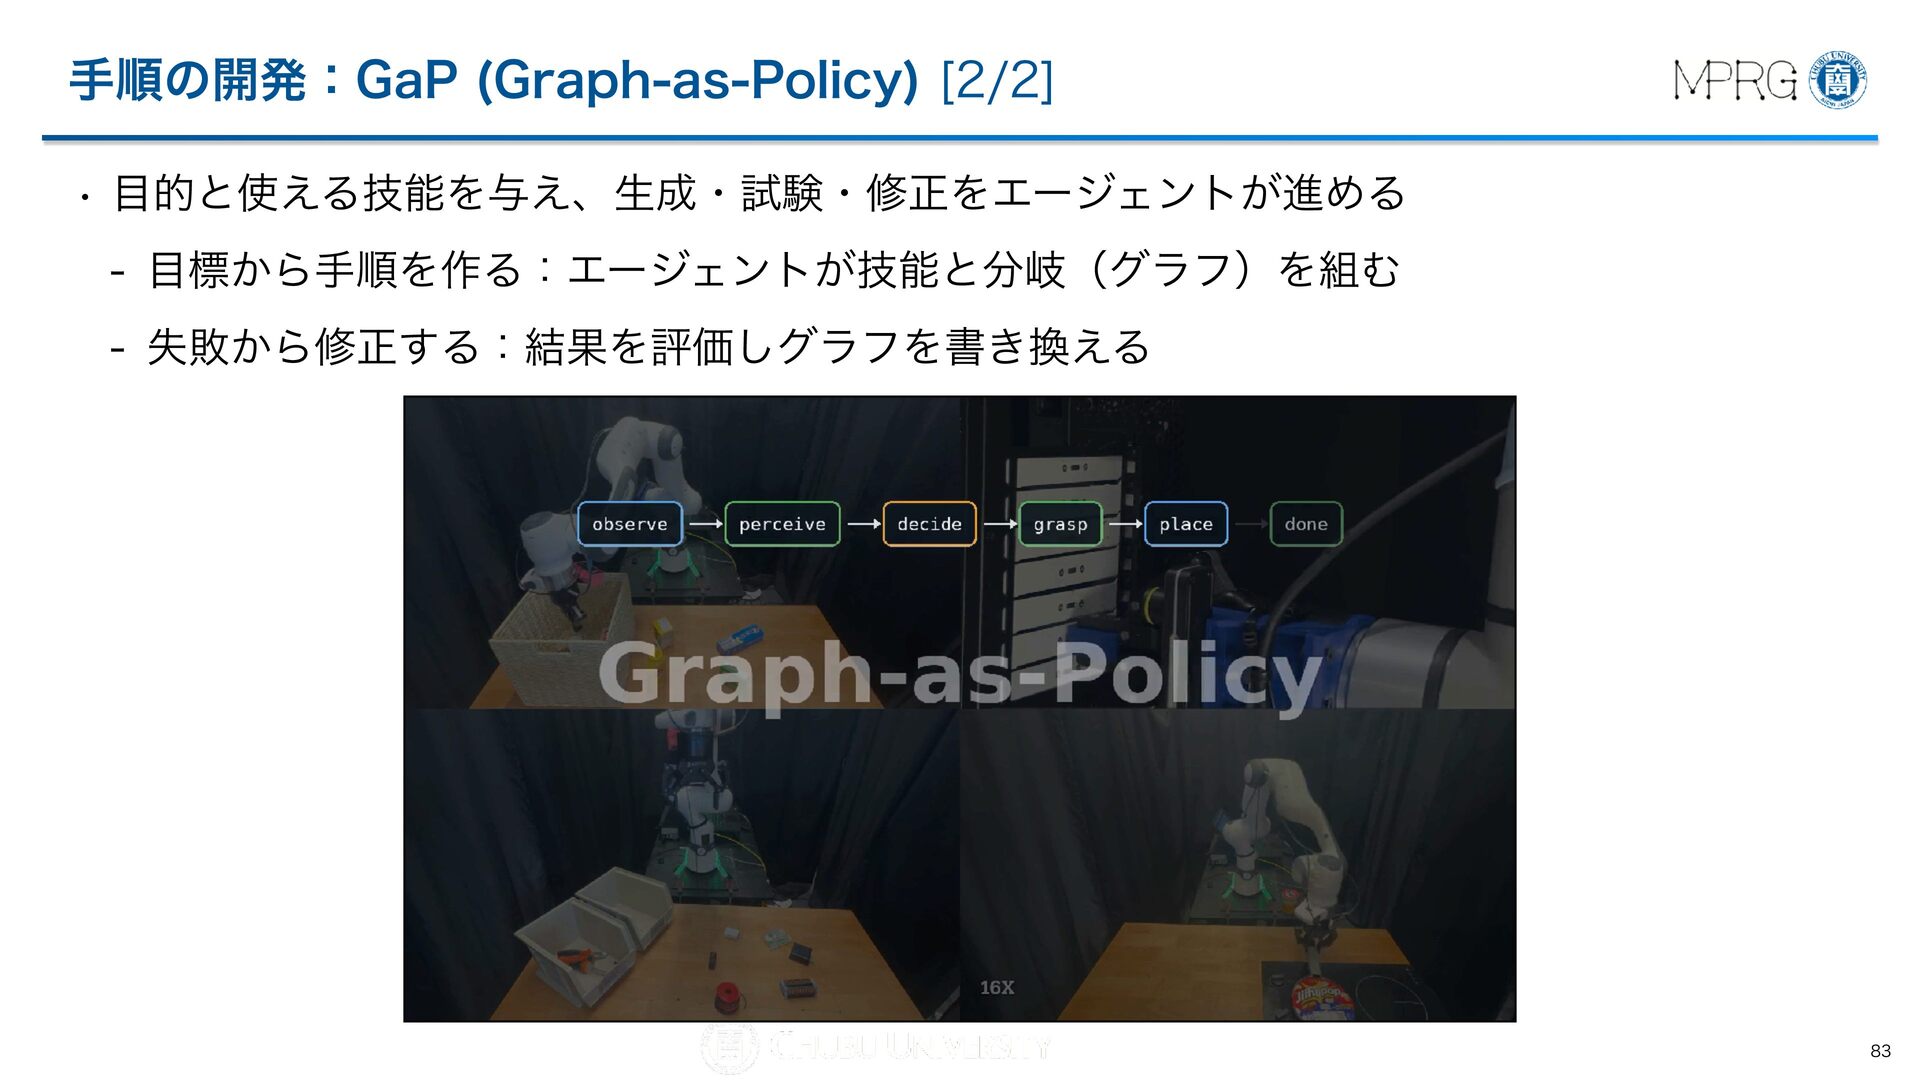
    次の動作目標・方策候補の採否 RoboCurve / Embodied Policy 開発時:方策 環境・学習コード・訓練の進め方 ペン回しの強化学習 開発時:手順 技能の組み合わせ・分岐・処理 GaP 開発時:物理モデル 実物の挙動を再現するパラメータ Inverse Physics 75
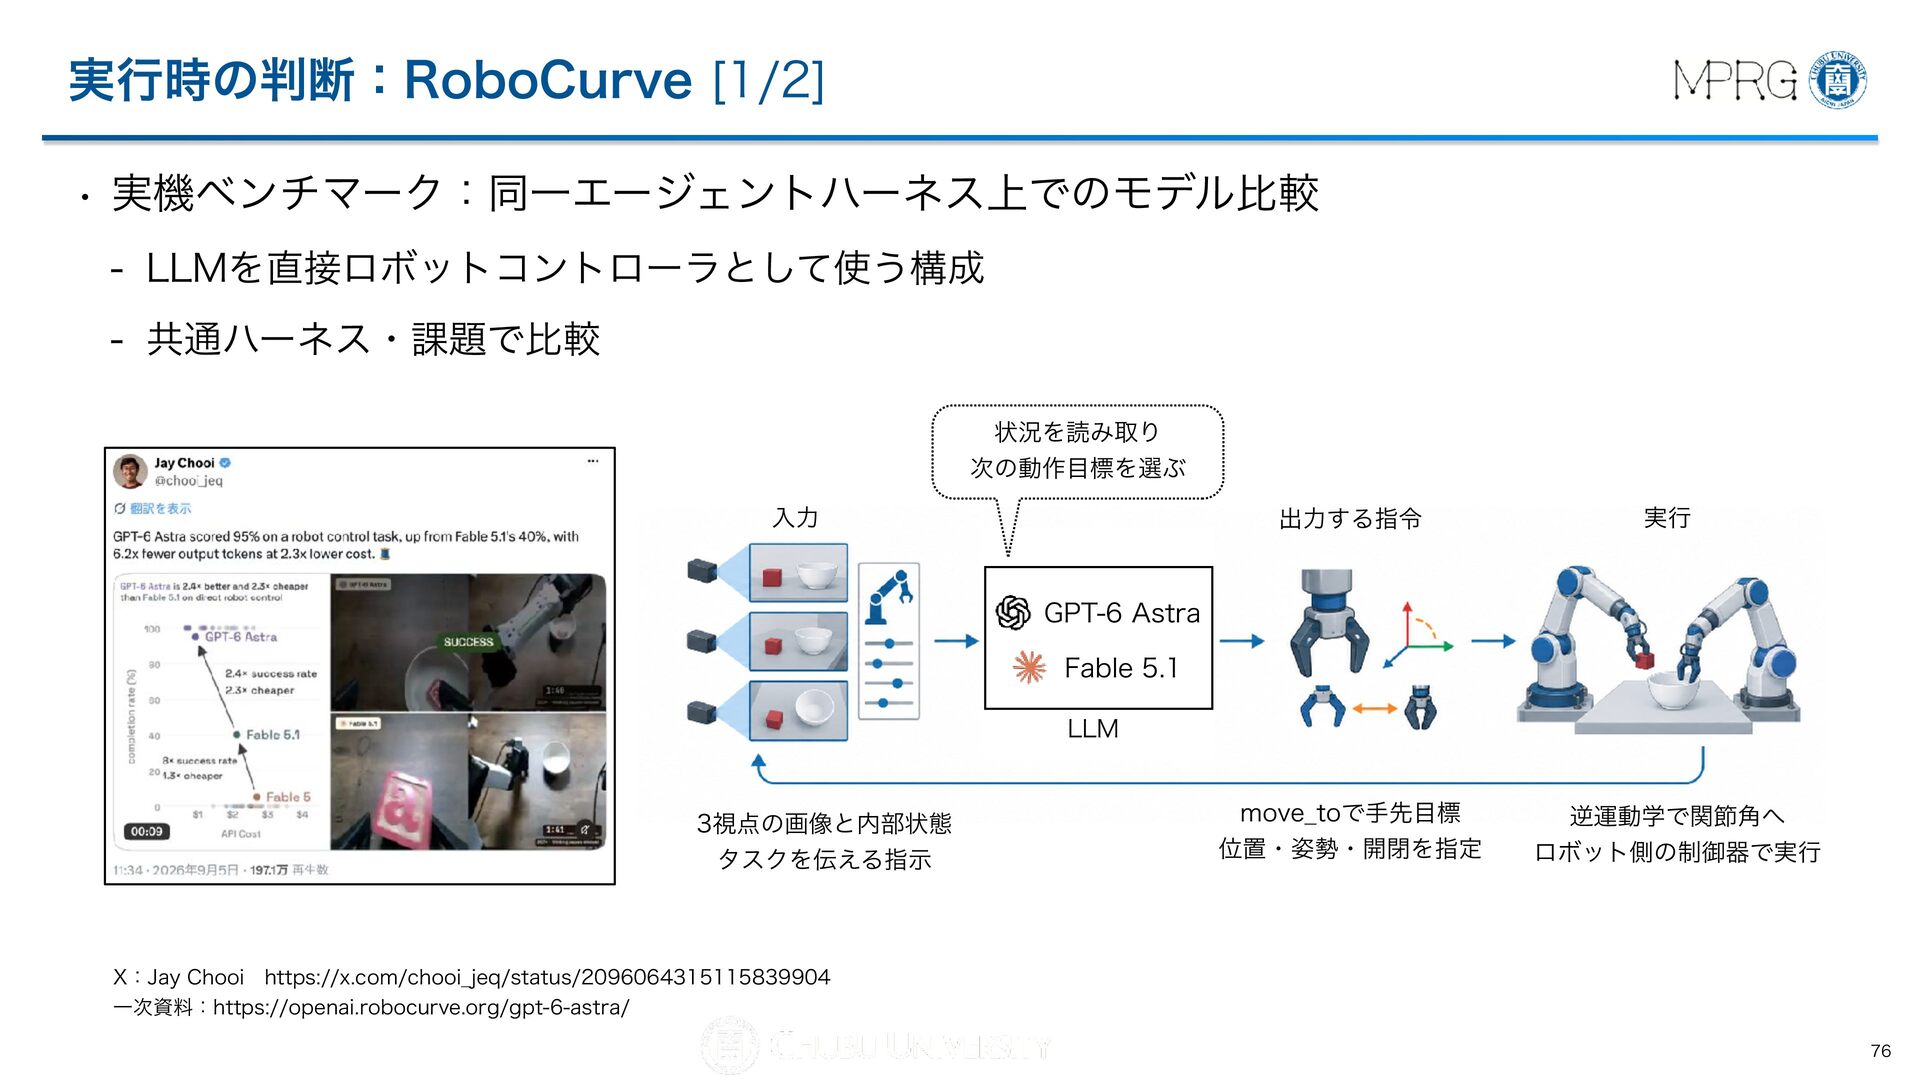
  56. 実行時の判断:RoboCurve [1/2] • 実機ベンチマーク:同一エージェントハーネス上でのモデル比較 - LLMを直接ロボットコントローラとして使う構成 - 共通ハーネス・課題で比較 状況を読み取り 次の動作目標を選ぶ

    入力 出力する指令 実行 move̲toで手先目標 位置・姿勢・開閉を指定 逆運動学で関節角へ ロボット側の制御器で実行 GPT-6 Astra Fable 5.1 LLM 3視点の画像と内部状態 タスクを伝える指示 X:Jay Chooi https://x.com/chooi̲jeq/status/2096064315115839904 一次資料:https://openai.robocurve.org/gpt-6-astra/ 76
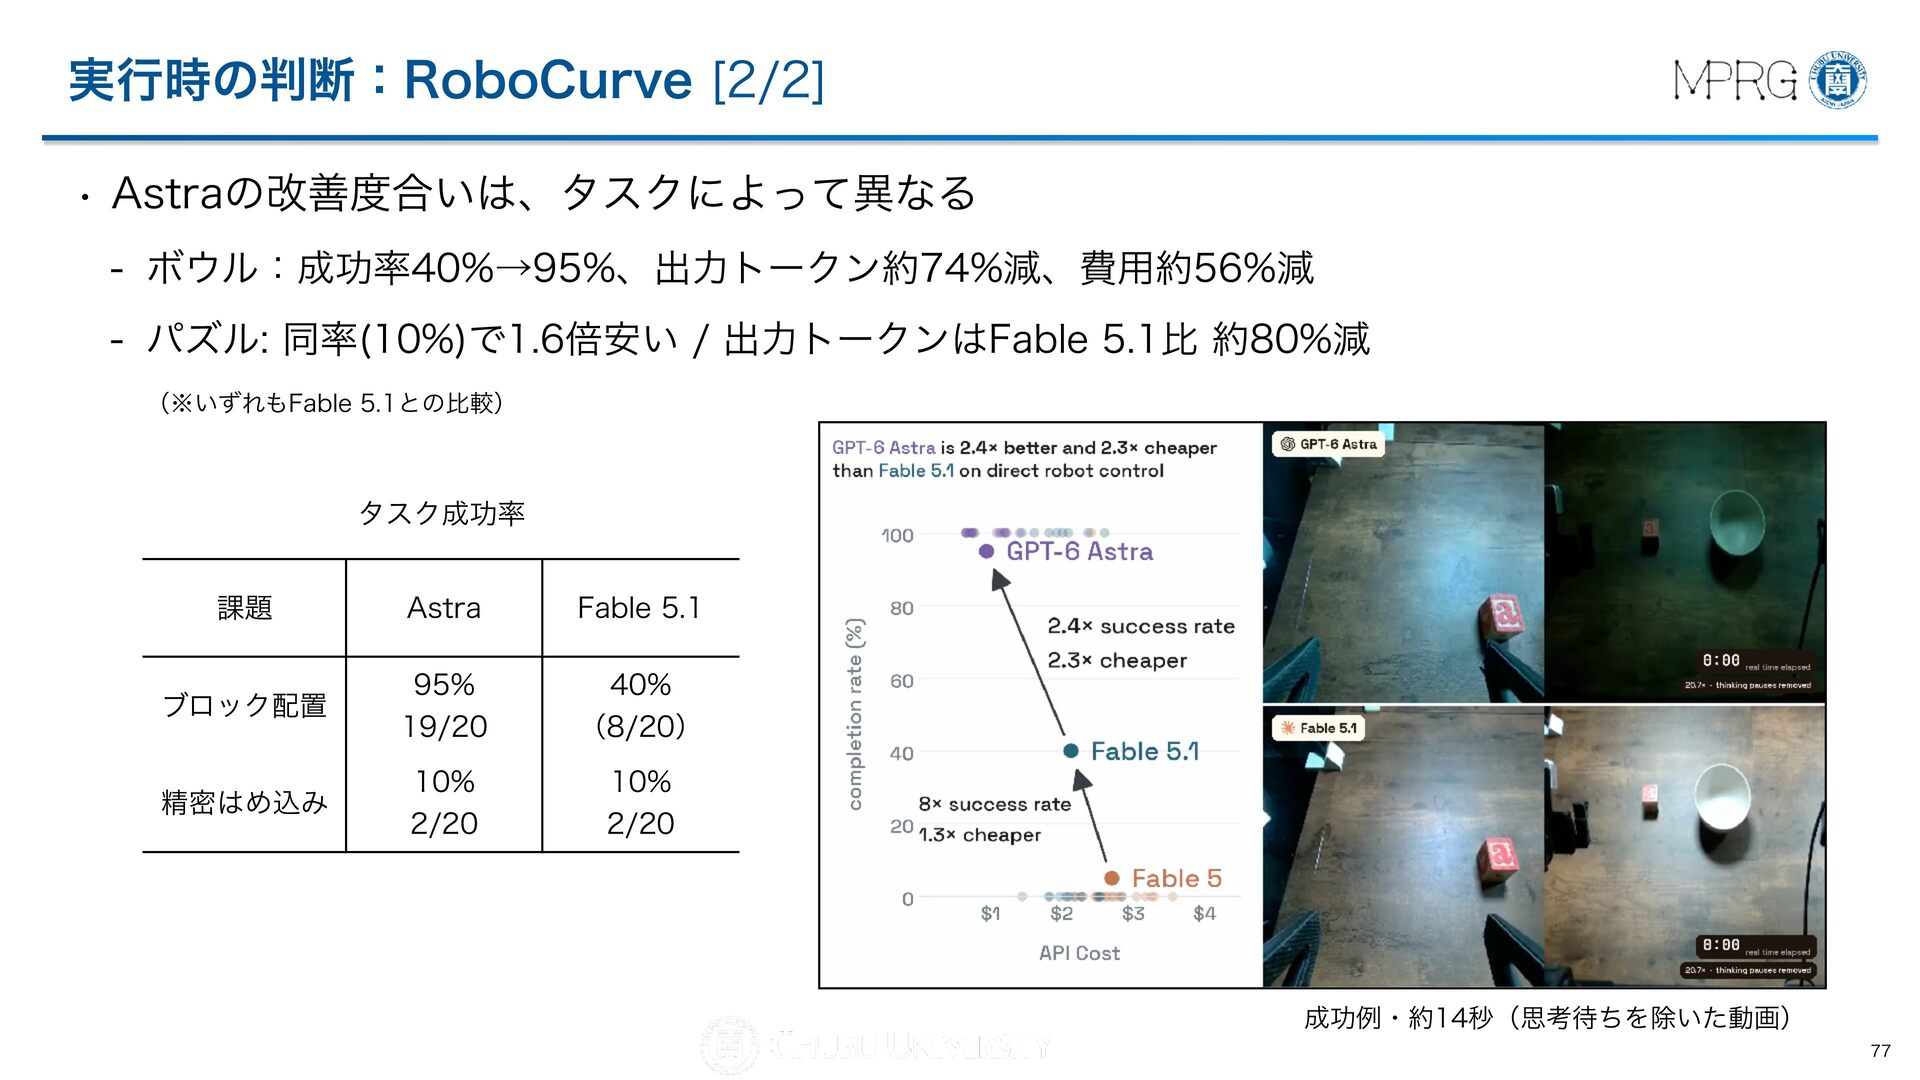
  57. 実行時の判断:RoboCurve [2/2] • Astraの改善度合いは、タスクによって異なる - ボウル:成功率40%→95%、出力トークン約74%減、費用約56%減 - パズル: 同率(10%)で1.6倍安い /

    出力トークンはFable 5.1比 約80%減 (※いずれもFable 5.1との比較) タスク成功率 課題 Astra Fable 5.1 ブロック配置 95% 19/20 40% (8/20) 精密はめ込み 10% 2/20 10% 2/20 成功例・約14秒(思考待ちを除いた動画) 77
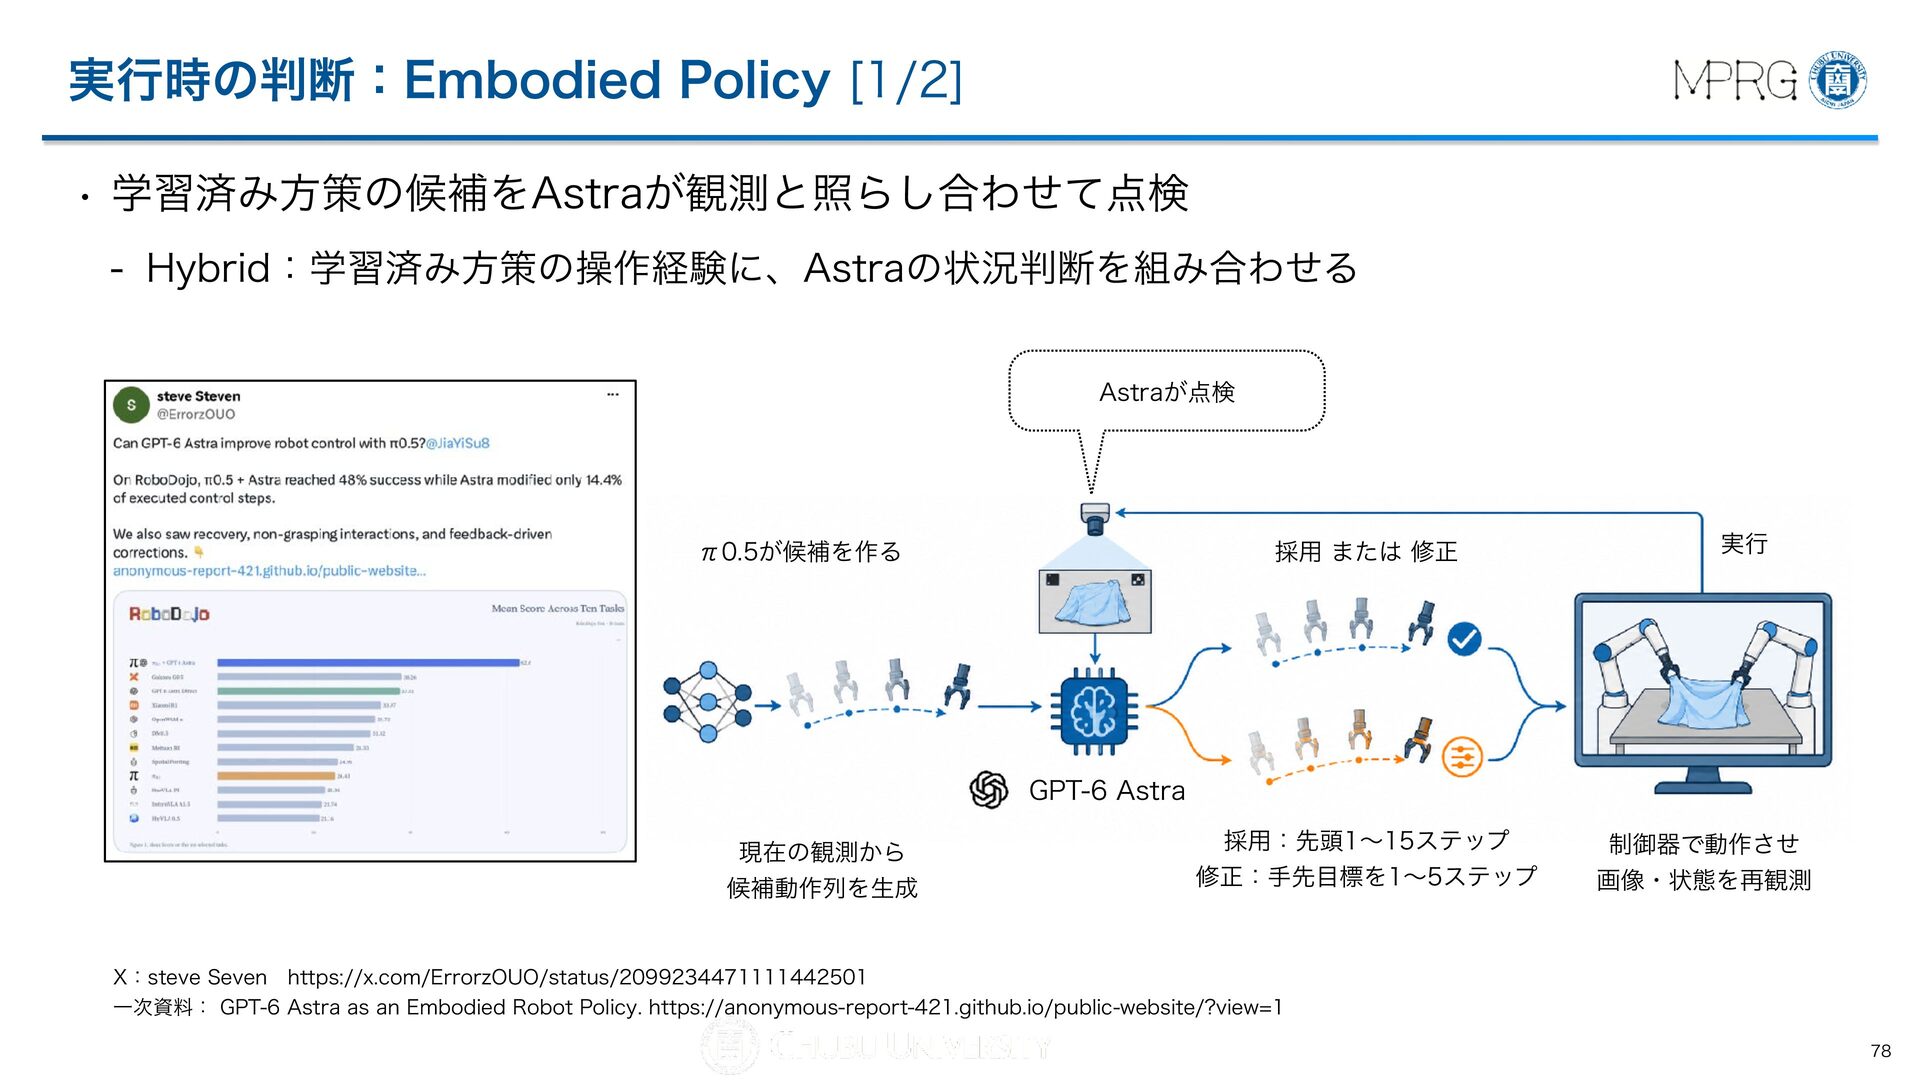
  58. 実行時の判断:Embodied Policy [1/2] • 学習済み方策の候補をAstraが観測と照らし合わせて点検 - Hybrid:学習済み方策の操作経験に、Astraの状況判断を組み合わせる Astraが点検 π0.5が候補を作る 採用

    または 修正 実行 GPT-6 Astra 現在の観測から 候補動作列を生成 採用:先頭1〜15ステップ 修正:手先目標を1〜5ステップ 制御器で動作させ 画像・状態を再観測 X:steve Seven https://x.com/ErrorzOUO/status/2099234471111442501 一次資料: GPT-6 Astra as an Embodied Robot Policy. https://anonymous-report-421.github.io/public-website/?view=1 78
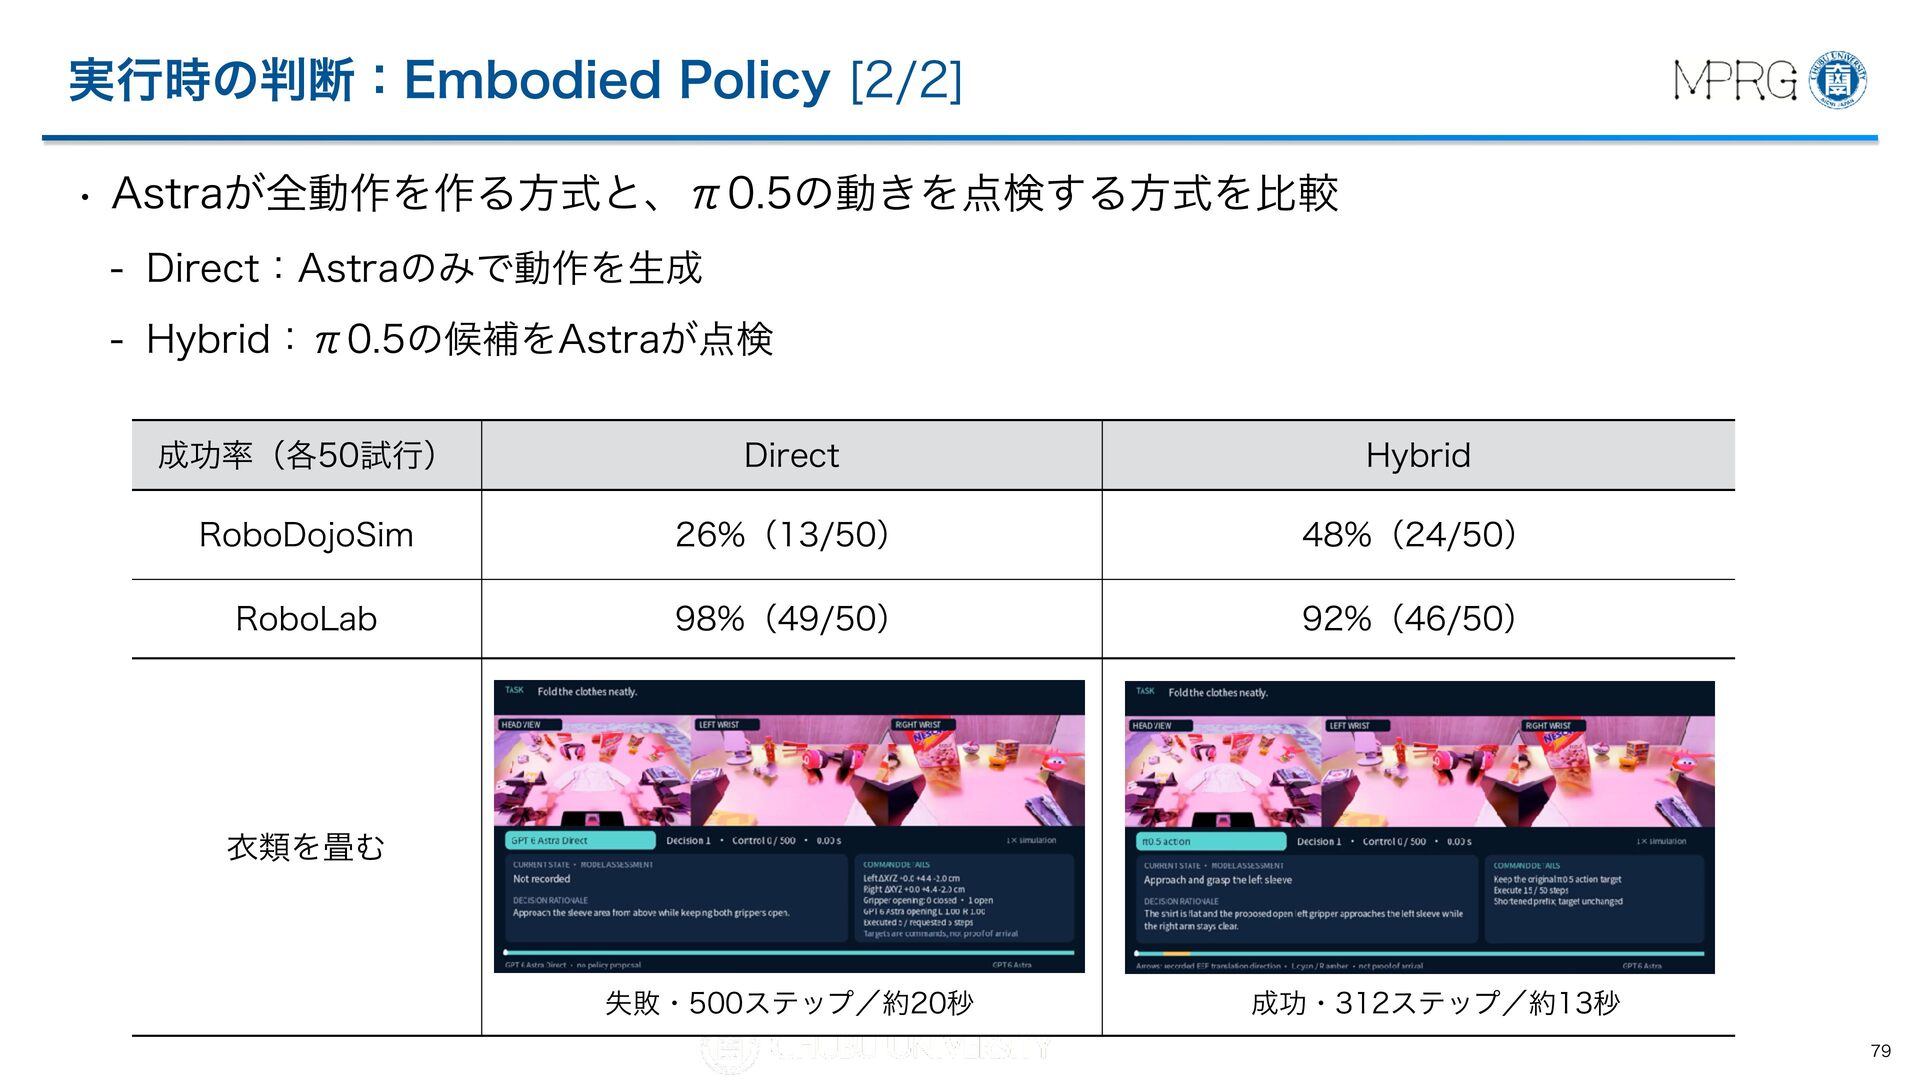
  59. 実行時の判断:Embodied Policy [2/2] • Astraが全動作を作る方式と、π0.5の動きを点検する方式を比較 - Direct:Astraのみで動作を生成 - Hybrid:π0.5の候補をAstraが点検 成功率(各50試行)

    Direct Hybrid RoboDojoSim 26%(13/50) 48%(24/50) RoboLab 98%(49/50) 92%(46/50) 失敗・500ステップ/約20秒 成功・312ステップ/約13秒 衣類を畳む 79
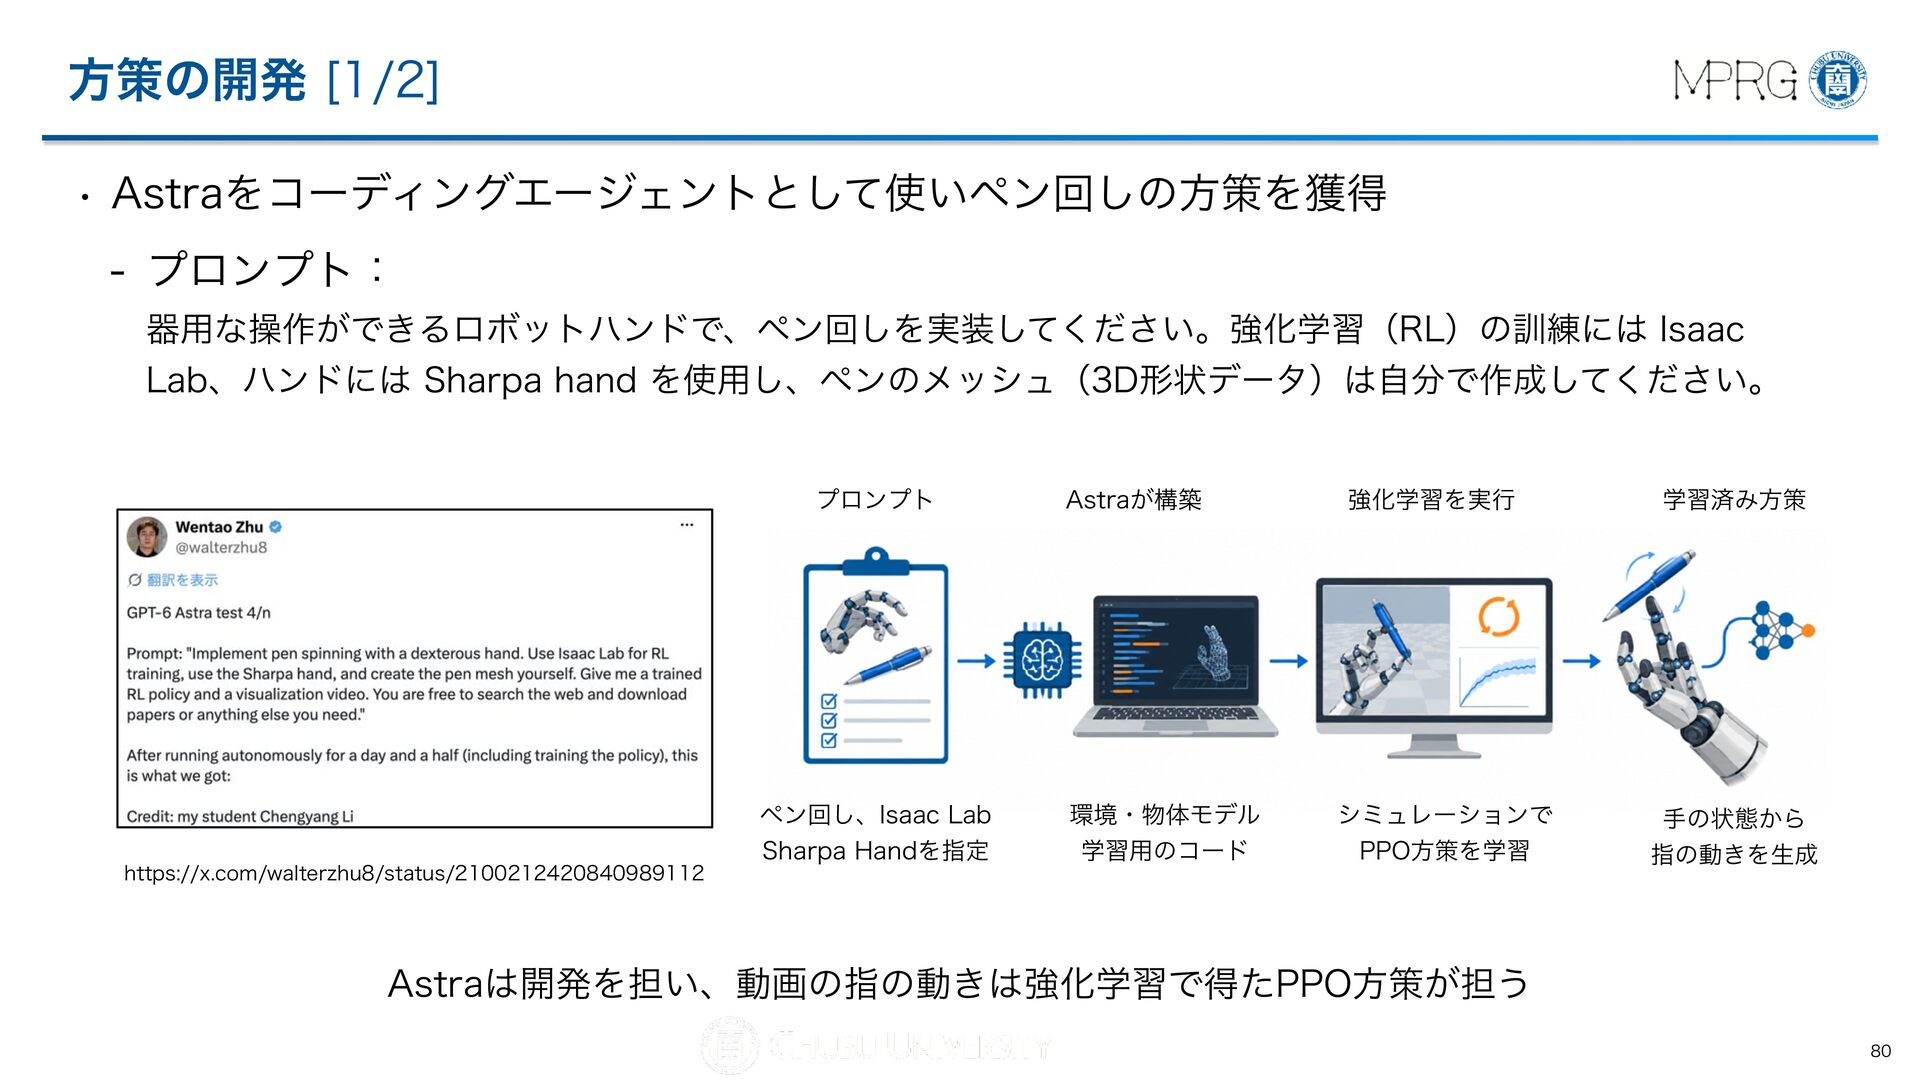
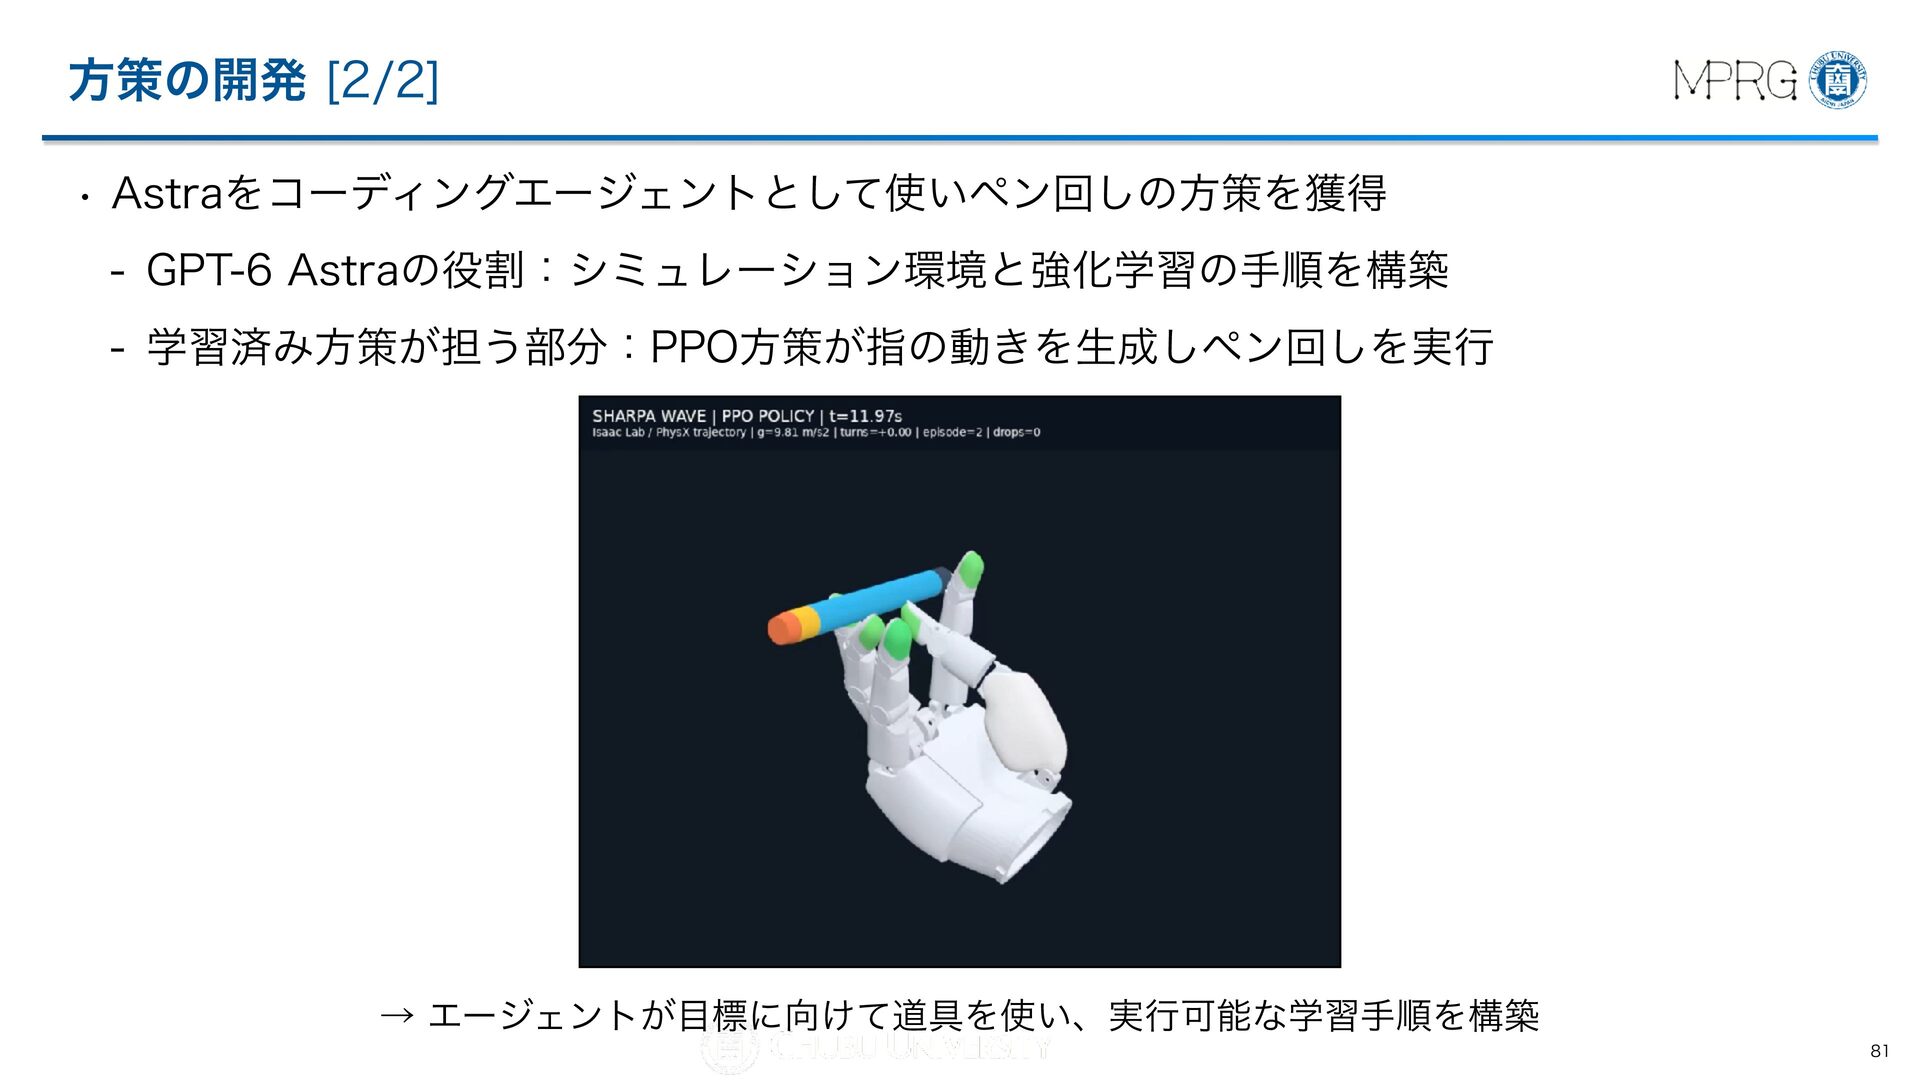
  60. 方策の開発 [1/2] • Astraをコーディングエージェントとして使いペン回しの方策を獲得 - プロンプト: 器用な操作ができるロボットハンドで、ペン回しを実装してください。強化学習(RL)の訓練には Isaac Lab、ハンドには Sharpa

    hand を使用し、ペンのメッシュ(3D形状データ)は自分で作成してください。 プロンプト ペン回し、Isaac Lab Sharpa Handを指定 Astraが構築 強化学習を実行 学習済み方策 環境・物体モデル 学習用のコード シミュレーションで PPO方策を学習 手の状態から 指の動きを生成 https://x.com/walterzhu8/status/2100212420840989112 Astraは開発を担い、動画の指の動きは強化学習で得たPPO方策が担う 80
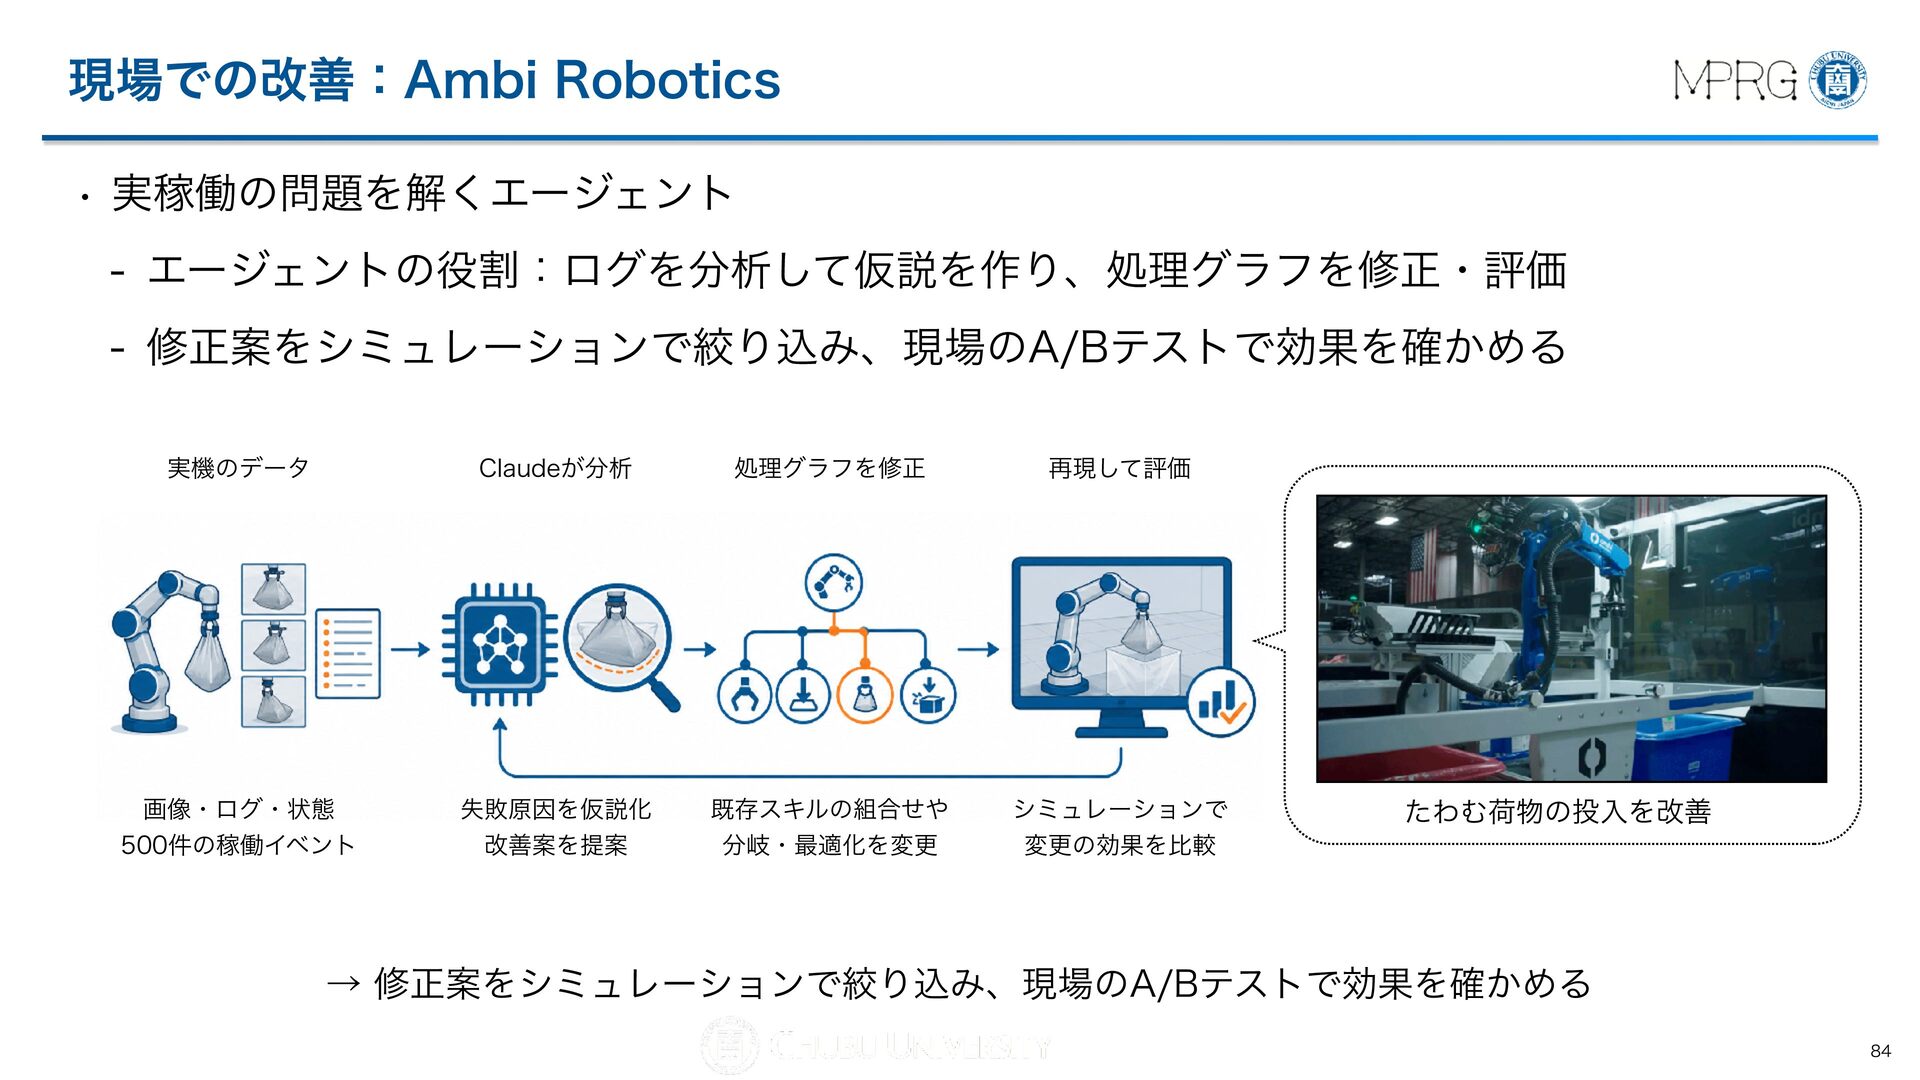
  61. 現場での改善:Ambi Robotics • 実稼働の問題を解くエージェント - エージェントの役割:ログを分析して仮説を作り、処理グラフを修正・評価 - 修正案をシミュレーションで絞り込み、現場のA/Bテストで効果を確かめる 実機のデータ Claudeが分析

    処理グラフを修正 再現して評価 画像・ログ・状態 500件の稼働イベント 失敗原因を仮説化 改善案を提案 既存スキルの組合せや 分岐・最適化を変更 シミュレーションで 変更の効果を比較 たわむ荷物の投入を改善 → 修正案をシミュレーションで絞り込み、現場のA/Bテストで効果を確かめる 84
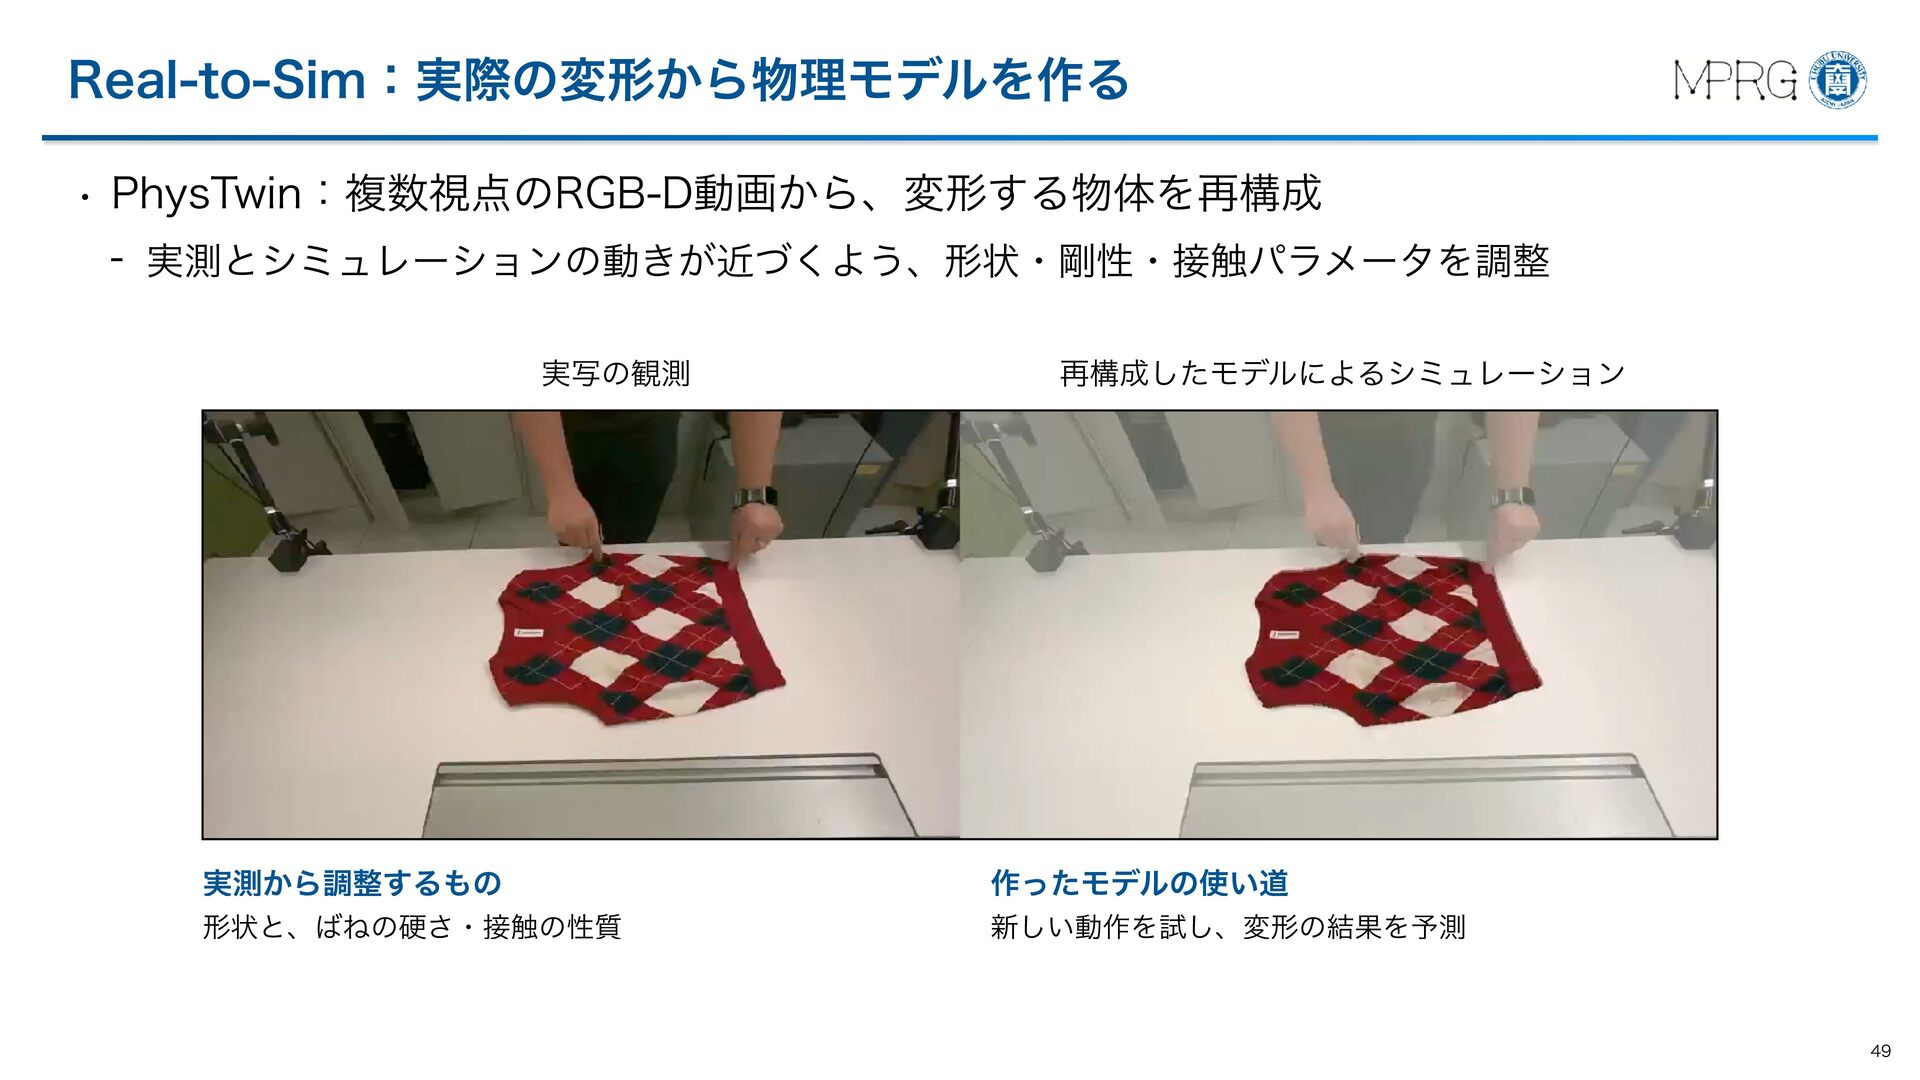
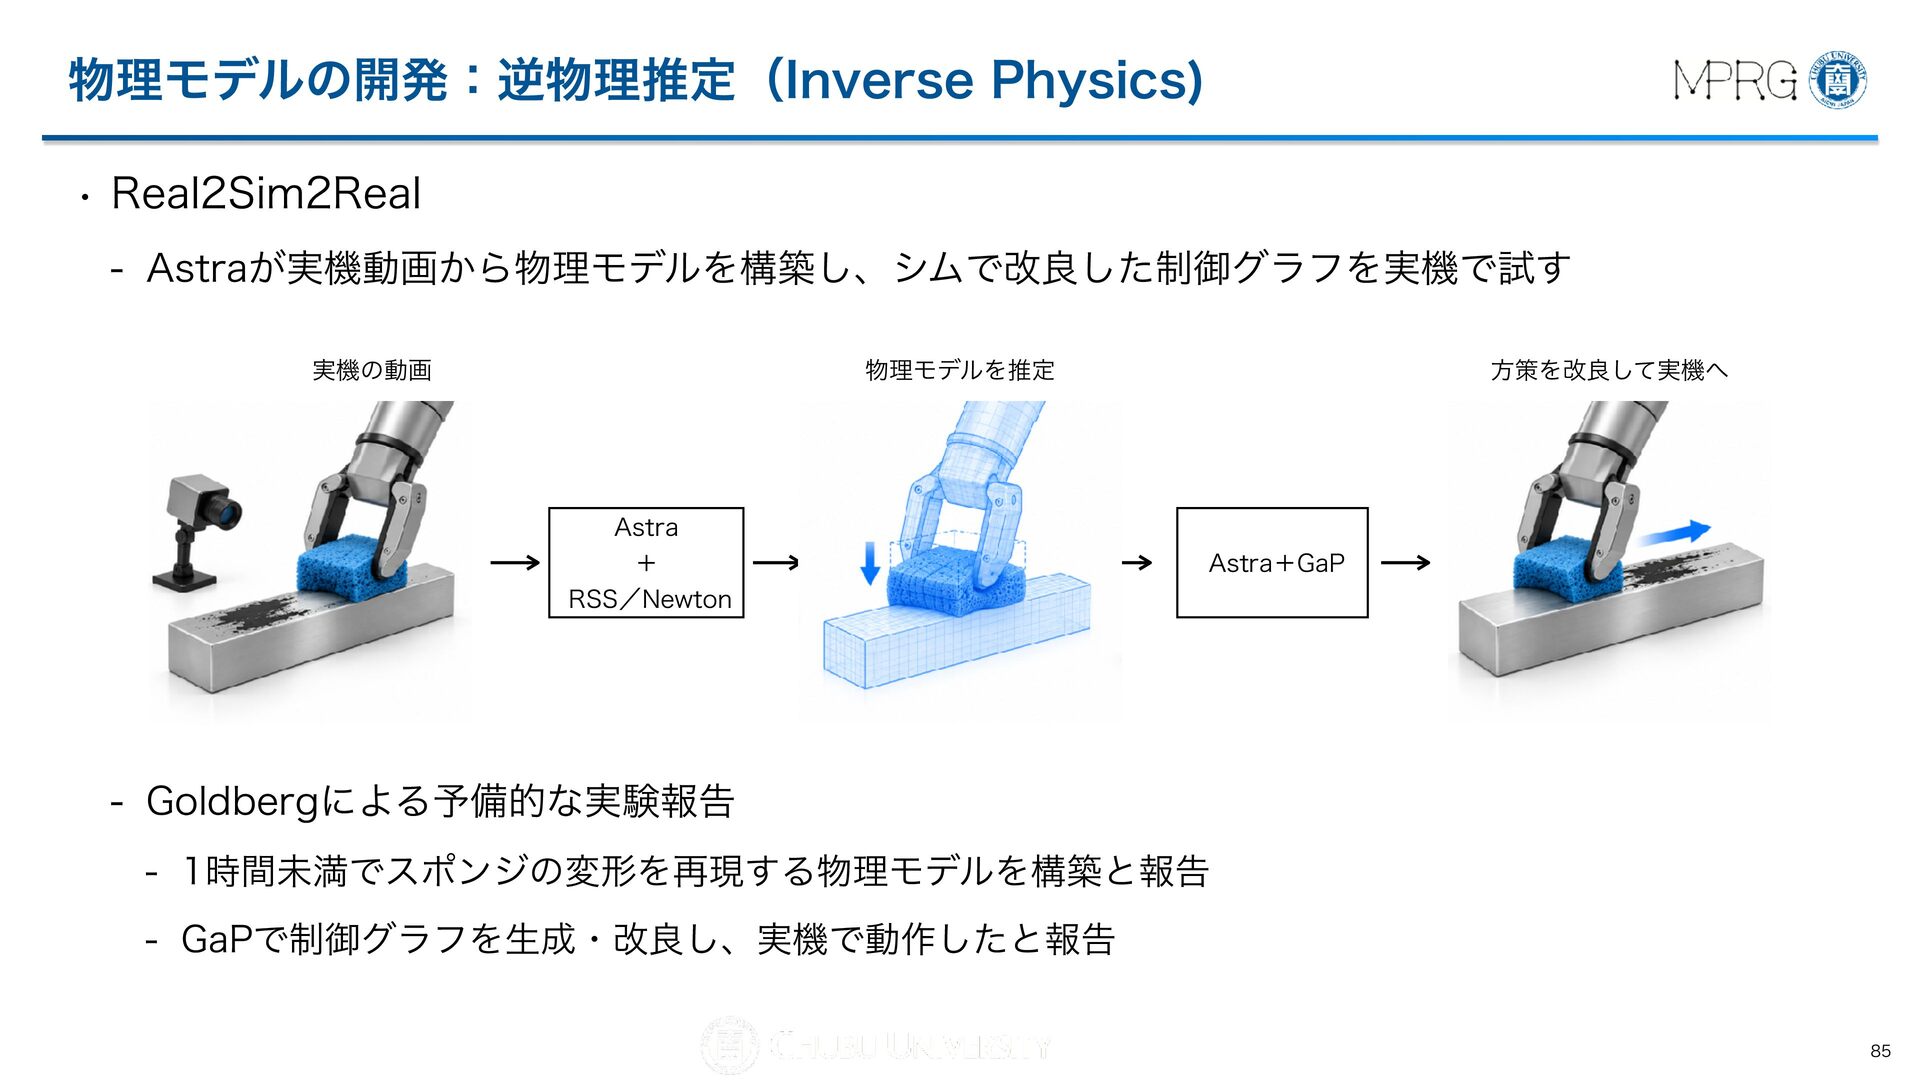
  62. 物理モデルの開発:逆物理推定(Inverse Physics) • Real2Sim2Real - Astraが実機動画から物理モデルを構築し、シムで改良した制御グラフを実機で試す 実機の動画 物理モデルを推定 Astra +

    RSS/Newton 方策を改良して実機へ Astra+GaP - Goldbergによる予備的な実験報告 - 1時間未満でスポンジの変形を再現する物理モデルを構築と報告 - GaPで制御グラフを生成・改良し、実機で動作したと報告 85
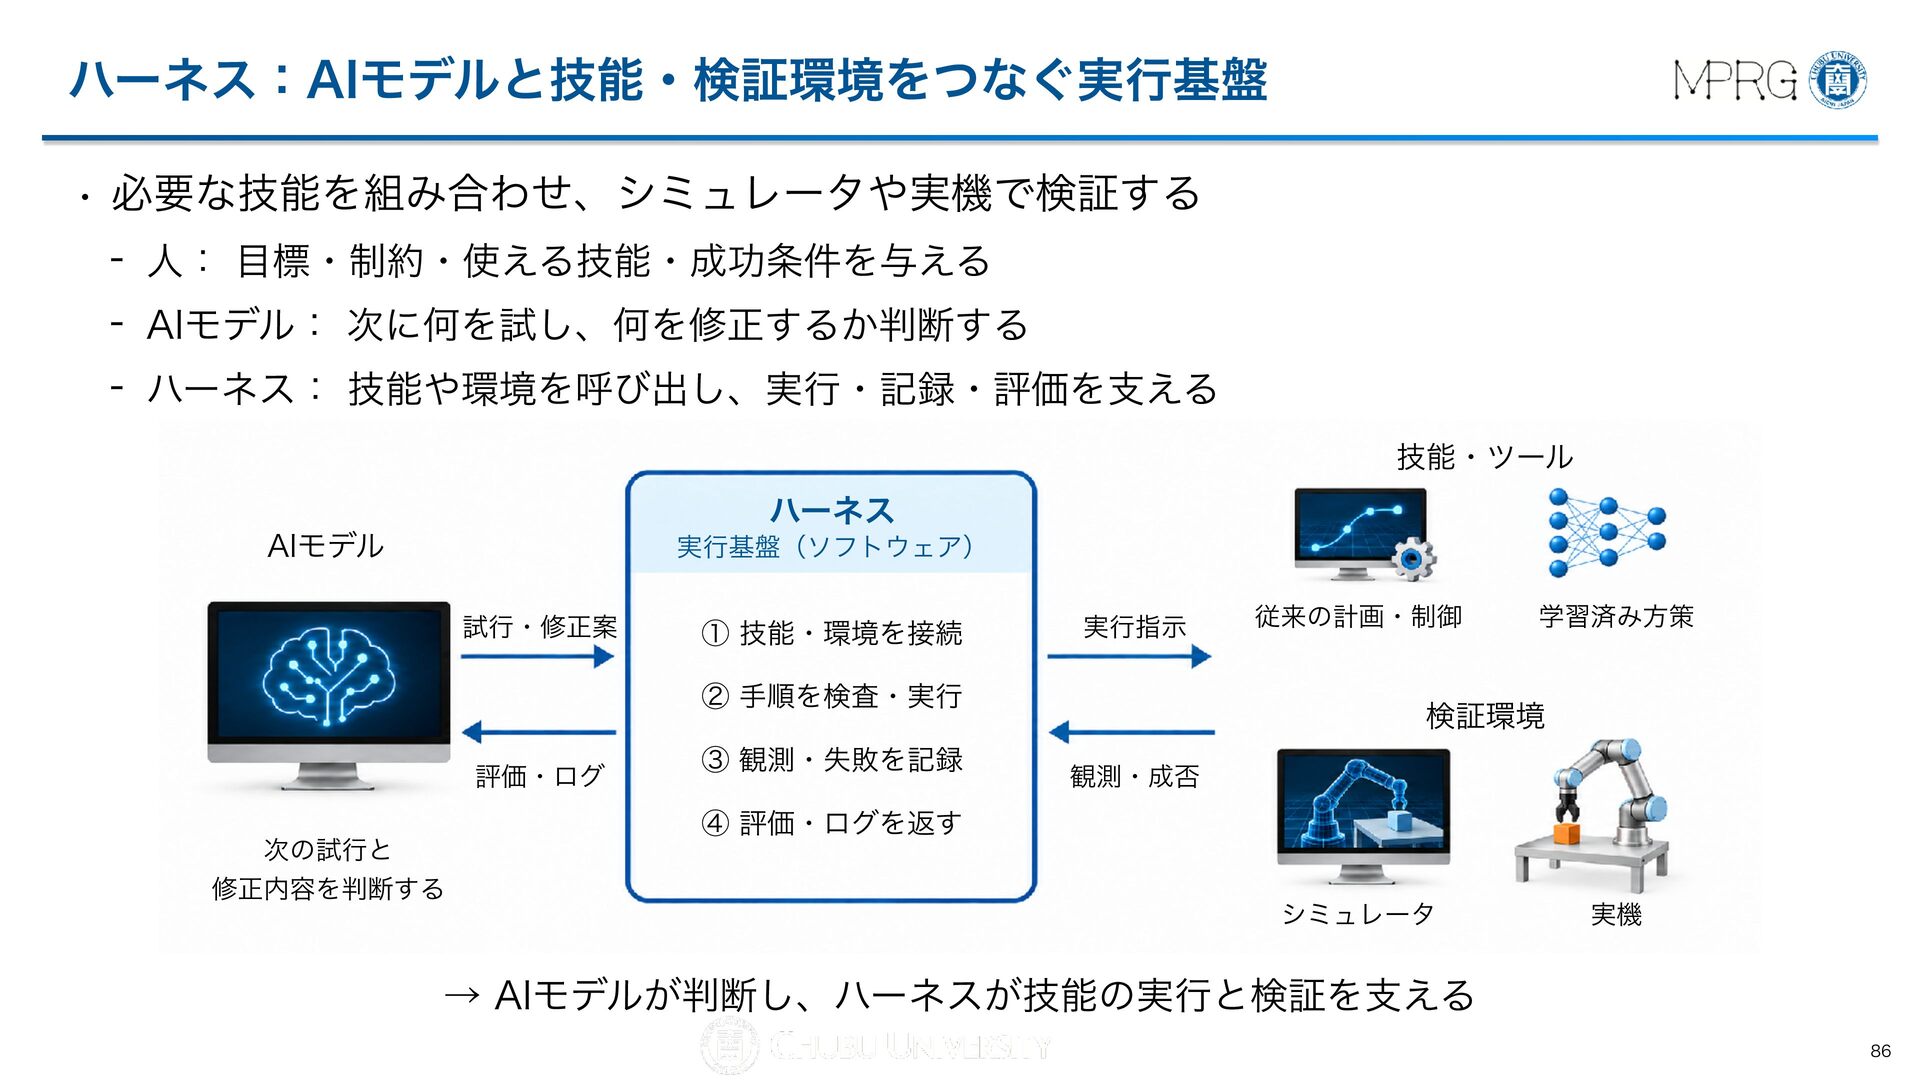
  63. ハーネス:AIモデルと技能・検証環境をつなぐ実行基盤 • 必要な技能を組み合わせ、シミュレータや実機で検証する - 人: 目標・制約・使える技能・成功条件を与える - AIモデル: 次に何を試し、何を修正するか判断する -

    ハーネス: 技能や環境を呼び出し、実行・記録・評価を支える 技能・ツール ハーネス AIモデル 実行基盤(ソフトウェア) 試行・修正案 ① 技能・環境を接続 実行指示 ② 手順を検査・実行 評価・ログ 次の試行と 修正内容を判断する ③ 観測・失敗を記録 従来の計画・制御 学習済み方策 検証環境 観測・成否 ④ 評価・ログを返す シミュレータ 実機 → AIモデルが判断し、ハーネスが技能の実行と検証を支える 86
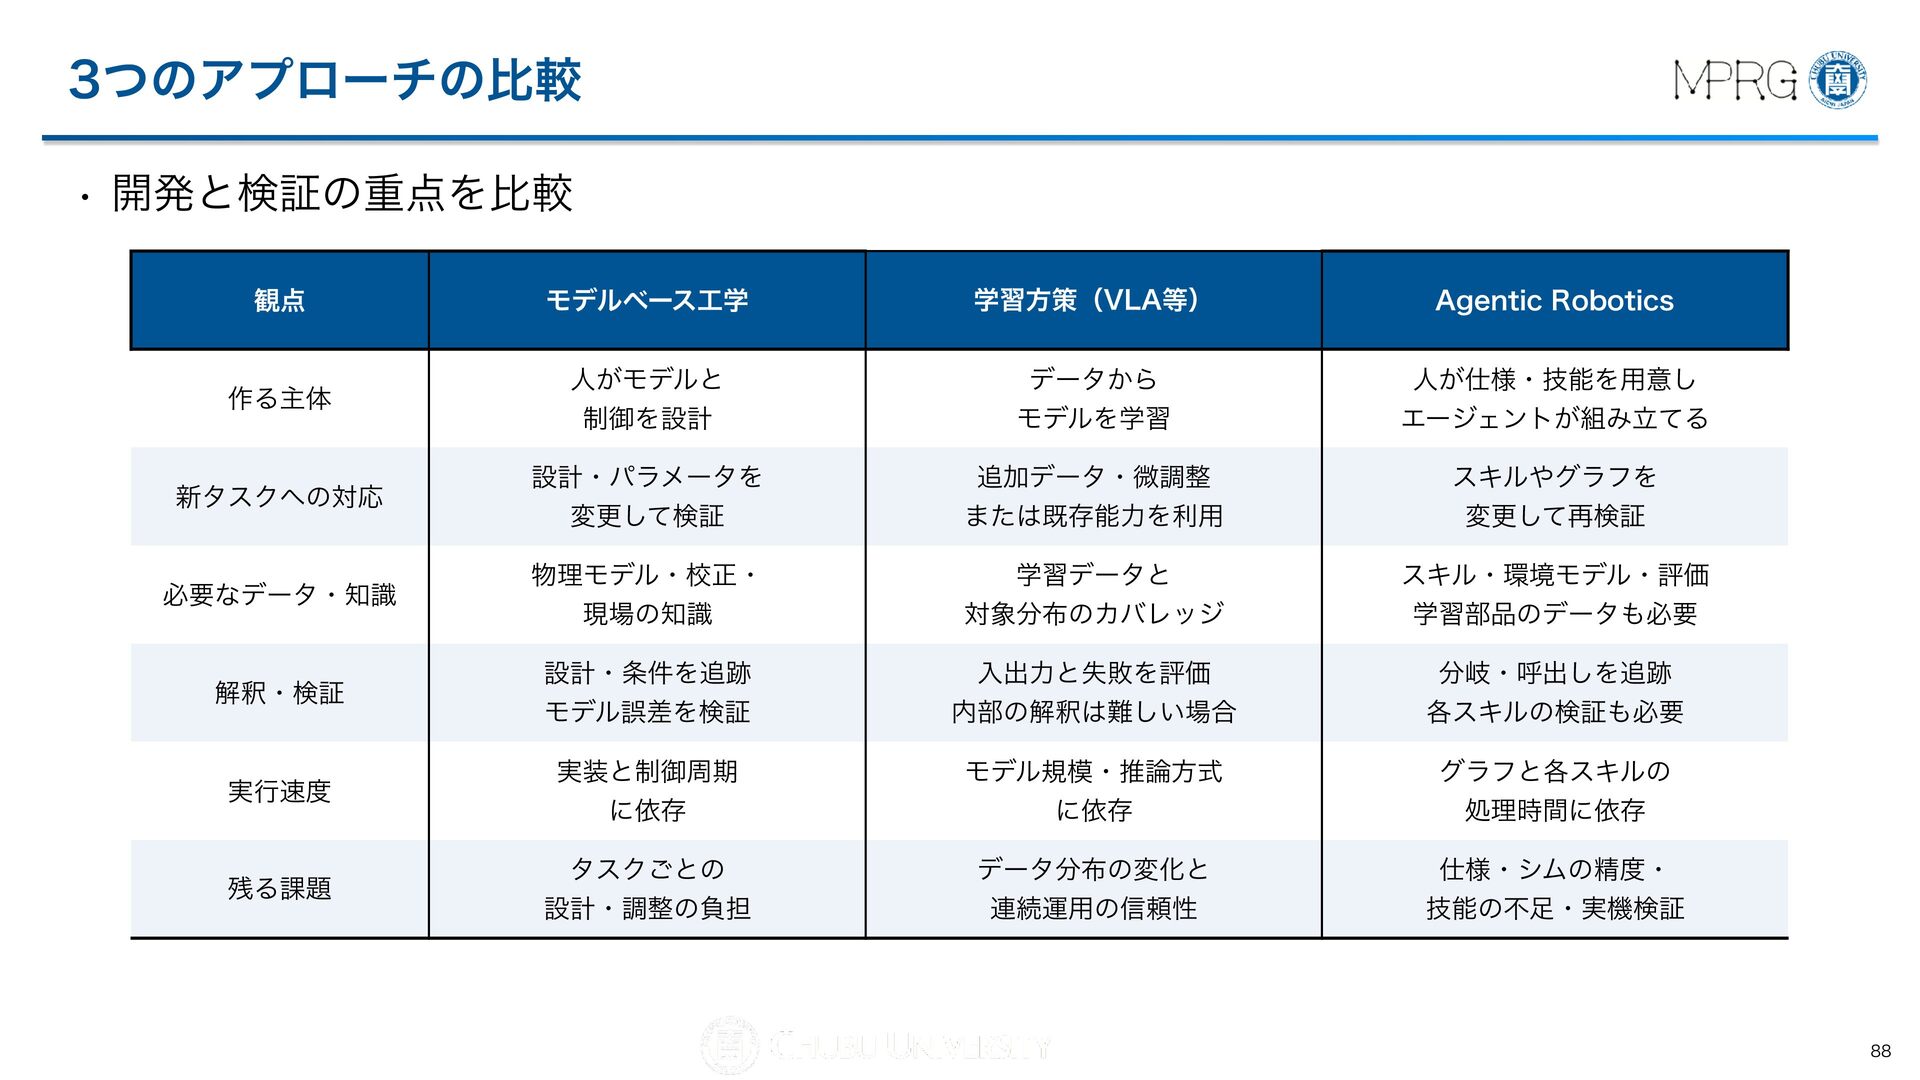
  64. 3つのアプローチの比較 • 開発と検証の重点を比較 観点 モデルベース工学 学習方策(VLA等) Agentic Robotics 作る主体 人がモデルと

    制御を設計 データから モデルを学習 人が仕様・技能を用意し エージェントが組み立てる 新タスクへの対応 設計・パラメータを 変更して検証 追加データ・微調整 または既存能力を利用 スキルやグラフを 変更して再検証 必要なデータ・知識 物理モデル・校正・ 現場の知識 学習データと 対象分布のカバレッジ スキル・環境モデル・評価 学習部品のデータも必要 解釈・検証 設計・条件を追跡 モデル誤差を検証 入出力と失敗を評価 内部の解釈は難しい場合 分岐・呼出しを追跡 各スキルの検証も必要 実行速度 実装と制御周期 に依存 モデル規模・推論方式 に依存 グラフと各スキルの 処理時間に依存 残る課題 タスクごとの 設計・調整の負担 データ分布の変化と 連続運用の信頼性 仕様・シムの精度・ 技能の不足・実機検証 88
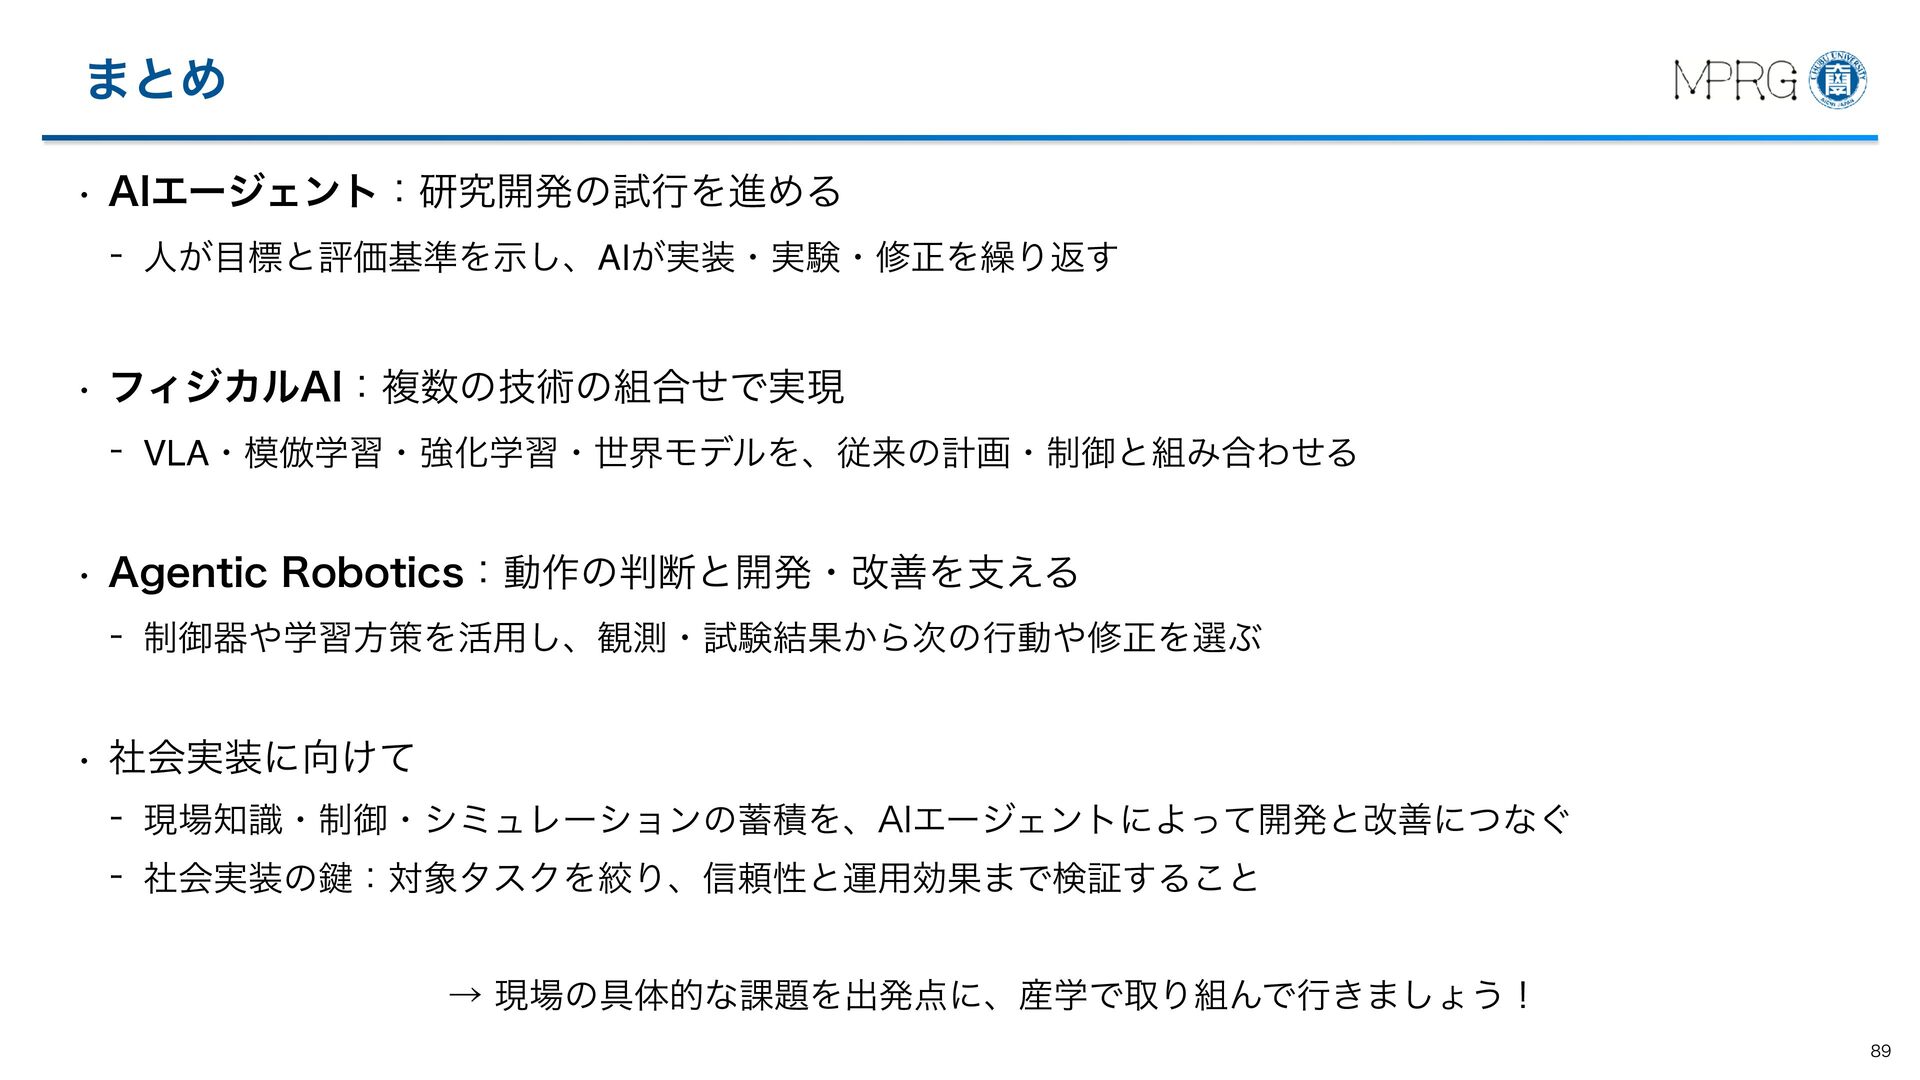
  65. まとめ • AIエージェント:研究開発の試行を進める - 人が目標と評価基準を示し、AIが実装・実験・修正を繰り返す • フィジカルAI:複数の技術の組合せで実現 - VLA・模倣学習・強化学習・世界モデルを、従来の計画・制御と組み合わせる •

    Agentic Robotics:動作の判断と開発・改善を支える - 制御器や学習方策を活用し、観測・試験結果から次の行動や修正を選ぶ • 社会実装に向けて - 現場知識・制御・シミュレーションの蓄積を、AIエージェントによって開発と改善につなぐ - 社会実装の鍵:対象タスクを絞り、信頼性と運用効果まで検証すること → 現場の具体的な課題を出発点に、産学で取り組んで行きましょう! 89