Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
機械学習を無理なく広告システムに導入する
Search
hiroaki
February 05, 2020
Technology
6.4k
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
機械学習を無理なく広告システムに導入する
https://m3-engineer.connpass.com/event/159721/
の登壇資料
hiroaki
February 05, 2020
More Decks by hiroaki
See All by hiroaki
BigQueryで行う、 機械学習のための データ前処理
hiroaki8388
4
2.7k
Pythonで、処理をより効率化するためのTips集
hiroaki8388
15
12k
Other Decks in Technology
See All in Technology
2026-09-18 gotanda.sre Terraformで複数環境作ったり、複数Stateに分割したりそれとTerragrunt / Terraform multi envs and multi states
masasuzu
2
510
おい、エージェントを使って終わらせろ
nwiizo
1
660
技術的負債から考える、AI時代のエンジニアリング投資 — ビズリーチの技術的負債と向き合った経験から、変更し続けられるソフトウェアを考える/ technical-debt-con2026
visional_engineering_and_design
4
3.2k
AIエージェントの自己改善をどう設計するか / How to Design Self-Improvement for AI Agents
22mi
25
16k
積み重なった技術負債への挑戦 〜初手としての全社ゴト化〜
techtekt
PRO
0
1.3k
beyond jj: config & tools ecosystem
indirect
0
3.8k
絵ではじめるKubernetesセキュリティ
aoi1
4
670
あるけみー式LTスライド作成術
alchemy1115
2
220
10Xに技術的負債をもたらした「2つの境界の歪み」その構造と解消への営み
10xinc
0
2.1k
白金鉱業Meetup Vol.25 アウトカムが二値のデータに対するCausal Impact
brainpadpr
0
240
AgentCore Runtime上にAgentic Coding基盤を構築・展開する際の設計ポイントと限界点 / Design considerations and limitations when building an agentic coding platform on AgentCore Runtime
har1101
4
300
リアーキテクチャ後の障害ゼロを目指したShadow Testingの取り組み
nihonbuson
PRO
1
150
Featured
See All Featured
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
240
Building Adaptive Systems
keathley
44
3.2k
Navigating Algorithm Shifts & AI Overviews - #SMXNext
aleyda
1
1.6k
The Impact of AI in SEO - AI Overviews June 2024 Edition
aleyda
6
1.2k
What does AI have to do with Human Rights?
axbom
PRO
1
2.4k
The Limits of Empathy - UXLibs8
cassininazir
1
680
The Psychology of Web Performance [Beyond Tellerrand 2023]
tammyeverts
49
3.6k
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
240
Faster Mobile Websites
deanohume
310
32k
Git: the NoSQL Database
bkeepers
PRO
432
67k
Collaborative Software Design: How to facilitate domain modelling decisions
baasie
1
320
Transcript
機械学習を 無理なく広告システム に導⼊する MLOps勉強会 Fringe81 ⻑⾕川⼤耀
⾃⼰紹介 ⻑⾕川⼤耀(@Hase8388) で、機械学習の開発やってます 物理学(⼤腸菌)=> 広告配信(Scala)=> 広告配信(ML)
広告配信のビジネスモデル • ユーザー情報を元に、興味がありそうな広告を配信する • お⾦が⼊ってくるのは、広告をclickしたときなので、 よりユーザーが興味がある広告を優先的に表⽰すれば、それだけ 利益に繋がる
• ユーザー情報を元に、興味がありそうな広告を配信する • お⾦が⼊ってくるのは、広告をclickしたときなので、 よりユーザーが興味がある広告を優先的に表⽰すれば、それだけ 利益に繋がる 広告配信のビジネスモデル 機械学習でclickする確率(CTR)をより正確に予測すれば 売上に貢献しうる
もっと単純なロジックでも良いのでは? 機械学習にすることでメリットは⾮常に多い • メディアなどの傾向が変わってもすぐに柔軟に対応できる • 多くの情報(特徴量)を、より柔軟に予測に活⽤できる • 特徴量やパラメータなど、改善できる⾃由度が増える
今⽇話すこと 話さないこと • アルゴリズムのガッツリとした話 • 特定のライブラリ、フレームワークの話 など 機械学習を広告配信システム 上で安定的に動かすための 実装、運⽤⽅法
その上で機械学習システムを 確実に運⽤と改善を ⾏っていくための⼯夫
None
広告配信は、ビジネス上の制約も多い 配信側で、モデルを復元/予測を⾏う必要が あるため、配信側(アプリケーション側)のエンジニアと 密な連携が不可⽋ 配信側の開発を⾏うエンジニアと、 どのように齟齬なく、開発をおこなうか? 20ms以内に、最適な広告を決定 し、返却する必要がある
1. チーム間で開発前に認識合わせを⾏う • 懸念されるリスクを整理し、対策を考える • 正常/異常のパターンを洗い出し、どちら側で対応するかを決める • ex モデルのメトリクスがおかしい場合、ML側で更新を停⽌します •
配信側でできること/できないことの整理 • 仕様に落とし⽳がないかをチェック • ex xxGBまでは配信のメモリに乗せれるけど、それ以上だと厳しいです • それぞれチームでの⽤語についての認識を合わせる • ⼀番重要! 意味がズレると予測も当然ズレる • ex この数値、パーセンテージで表してるんじゃないの!?
特に、ログに落とせる(せない)モノを確認 ML側でテストと検証を⾏いやすいように、 ログの仕様については予めシステム側のエンジニアと協議 • A/Bテストや、性能確認のために、必ず落としたい値 • 配信パフォーマンスや設計上、どうしてもムリな値 • メトリクス観点で、ロジックid, 予測値、clickしたか、落札額など
• テスト観点で、1000回に⼀回だけ、重み値、特徴量の種類、など 出⼒するログは、
2. それぞれの実装を相互レビュー • 配信側にMLがわかるエンジニア、ML側に配信サーバー がわかるエンジニア(私)がいたので相互レビュー • 詳細に確認したのは、 • 配信側エンジニア: 読み込む重みファイルのフォーマット
• ML側エンジニア: 予測計算の式と、ログのフォーマット 向こう側の、ここがズレてると死ぬ! という観点をお互い認識して、確認し合う
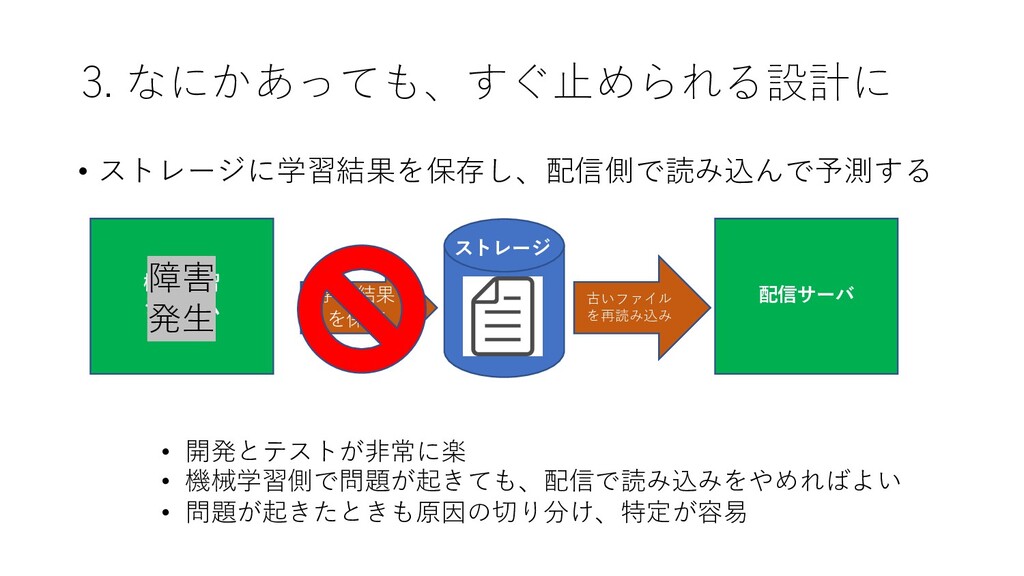
3. なにかあっても、すぐ⽌められる設計に • ストレージに学習結果を保存し、配信側で読み込んで予測する 機械学習 システム ストレージ • 開発とテストが⾮常に楽 •
機械学習側で問題が起きても、配信で読み込みをやめればよい • 問題が起きたときも原因の切り分け、特定が容易 学習結果 を保存 配信サーバ 読み込み
3. なにかあっても、すぐ⽌められる設計に • ストレージに学習結果を保存し、配信側で読み込んで予測する 機械学習 システム • 開発とテストが⾮常に楽 • 機械学習側で問題が起きても、配信で読み込みをやめればよい
• 問題が起きたときも原因の切り分け、特定が容易 配信サーバ 古いファイル を再読み込み 学習結果 を保存 障害 発⽣ ストレージ
さらに配信側の負荷をより減らすために モデルを復元するための、 重み値をすべて配信サーバーのメモリで持つ必要がある 巨⼤なファイルだとGCが⾛って、配信の処理が⽌まる そのため、精度を担保しつつ、 重みファイルの容量をなるべく⼩さくする必要がある
• カテゴリの数が⼤きい特徴量は使わない • モデルを数週間に⼀回、洗い替え • もう使われなくなったCreativeなどの重み値を削除する • ファイルの容量が閾値異常なら、エラーを吐く • (やらなかったけど)L1正則化で、影響が⼩さいカテゴリは消す
さらに配信側の負荷をより減らすために
4. あと細々したコード上の⼯夫とか • 塵も積もればの精神で諸々⼯夫 • メモリの最適化、処理の効率化などなど • このあたりは、別のタイミングで発表したので、もしご興味あれば https://speakerdeck.com/hiroaki838 8/pythonde-chu-li-woyorixiao-lu-
hua-surutamefalsetipsji
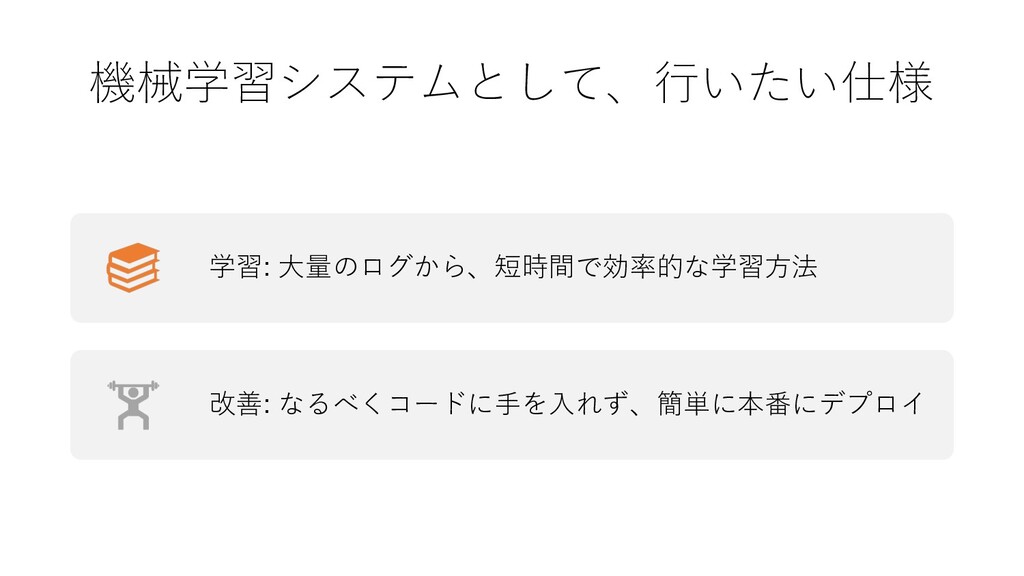
機械学習システムとして、⾏いたい仕様 学習: ⼤量のログから、短時間で効率的な学習⽅法 改善: なるべくコードに⼿を⼊れず、簡単に本番にデプロイ
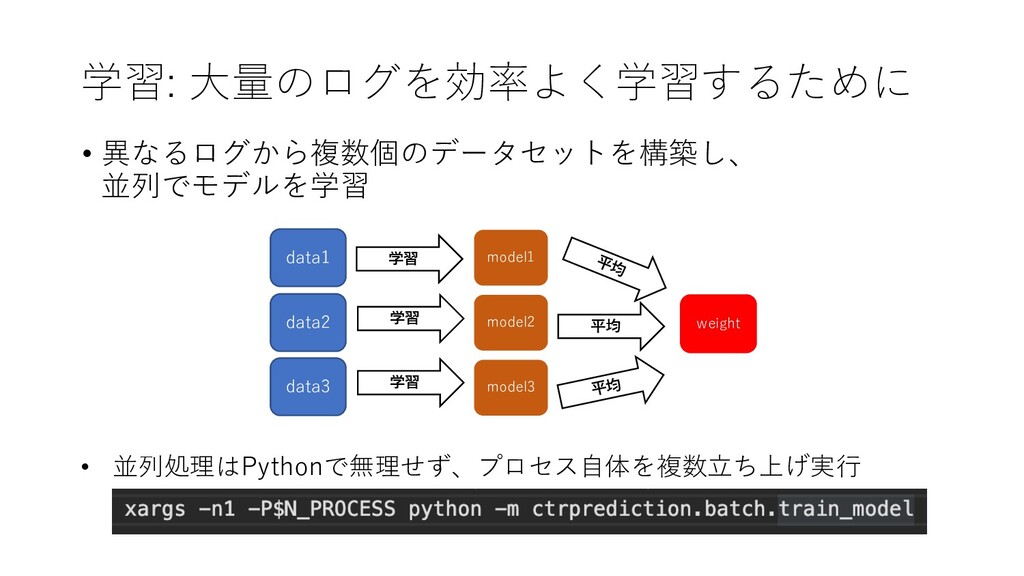
学習: ⼤量のログを効率よく学習するために • 異なるログから複数個のデータセットを構築し、 並列でモデルを学習 • 並列処理はPythonで無理せず、プロセス⾃体を複数⽴ち上げ実⾏ data1 model1 model3
data2 data3 model2 学習 学習 学習 weight 平均 平均 平均
改善: AWS Cloud Foramtion + Step Functions で素早くデプロイ • Cloud
Formationを利⽤し、⼀発で環境構築、更新 • インスタンスタイプなどの、実⾏環境を容易に変更可能 • Step Functionsで、job flowを定義 • 処理がどこまで実⾏されているかがConsole上から確認できる
おわりに • 広告配信のように 、MLとシステムが密になるなら、 • 設計段階から配信側と連携 • ここが⾷い違っているとヤバいポイントを予めお互い把握 • テストや責任範囲も明確にしておくとリリース後もスムーズ
• 機械学習モジュール⾃体は、 • ⼤量のログを効率的に(スケーラブルに)さばけるように⼯夫 • リリース後、なにか起きることを前提に、容易に修正できる設計
None


 hiroaki8388
 masasuzu
 nwiizo
 visional_engineering_and_design
 22mi
 techtekt
 indirect
 aoi1
 alchemy1115
 10xinc
 brainpadpr
 har1101
 nihonbuson
 davidcarrasco
 keathley
 aleyda
 axbom
 cassininazir
 tammyeverts
 lindahogenes
 tmiket
 deanohume
 bkeepers
 baasie