Upgrade to Pro — share decks privately, control downloads, hide ads and more …

IBM DataStage

Avatar for zui kaku zui kaku
November 13, 2025
34

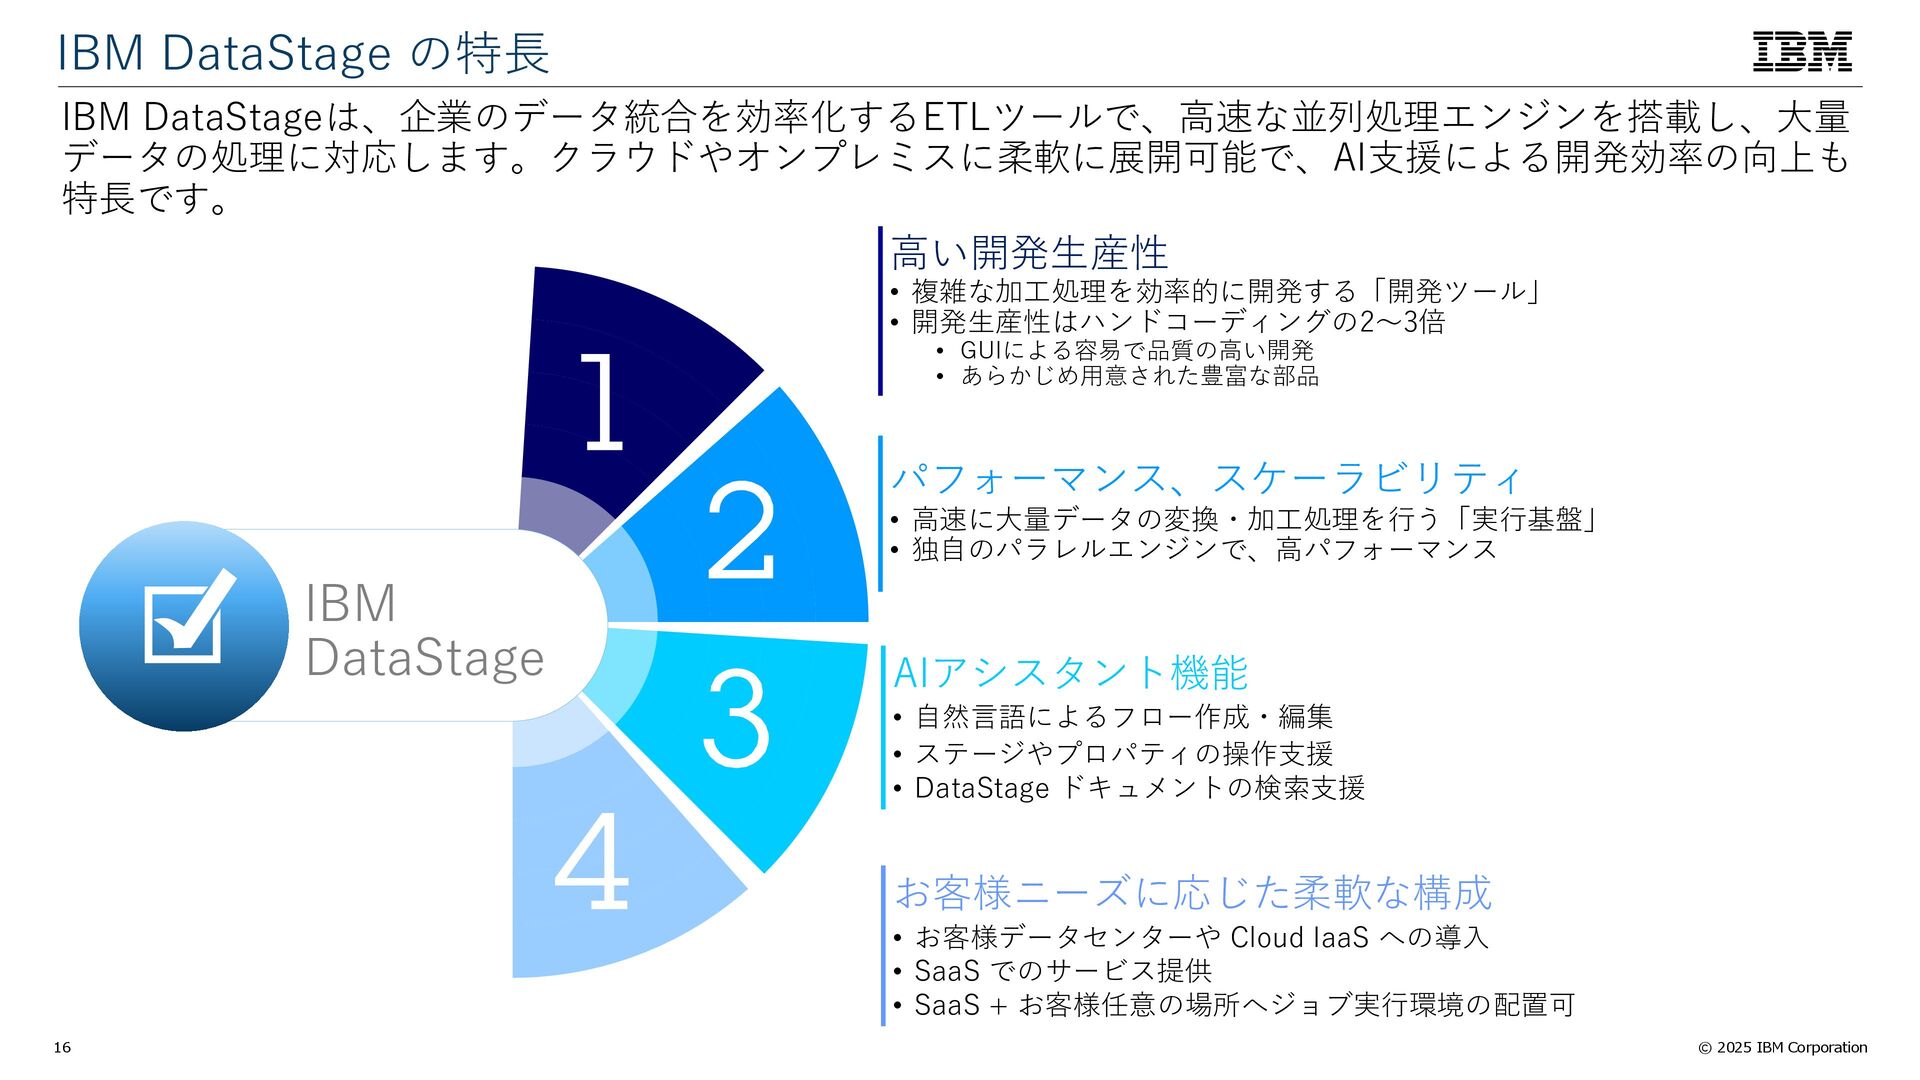
IBM DataStage

Avatar for zui kaku

zui kaku

November 13, 2025

Transcript

  1. 本日の内容 • IBM DataStageの位置付けと概要 • デモ • IBM DataStageの特徴 •

    ユースケースのご紹介 • QA IBM Data Platform / © 2025 IBM Corporation 1
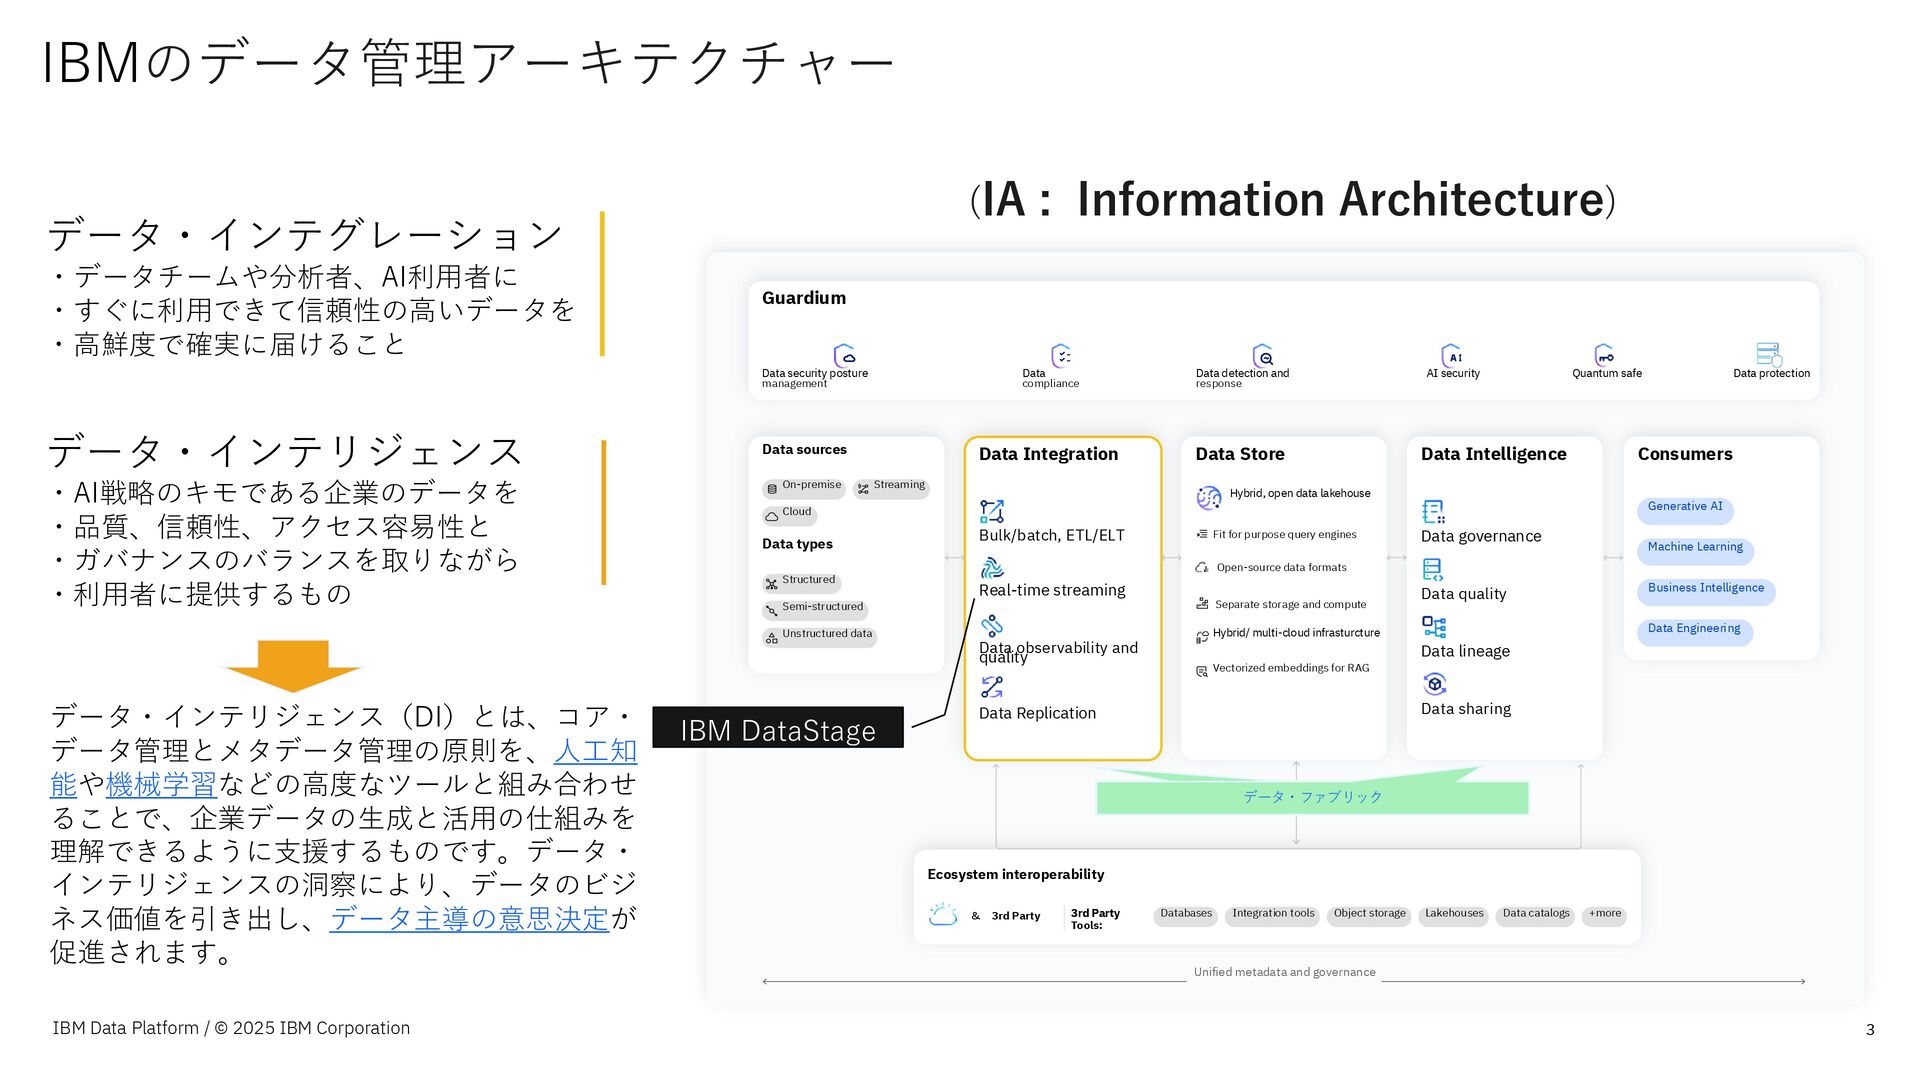
  2. 3 IBM Data Platform / © 2025 IBM Corporation Data

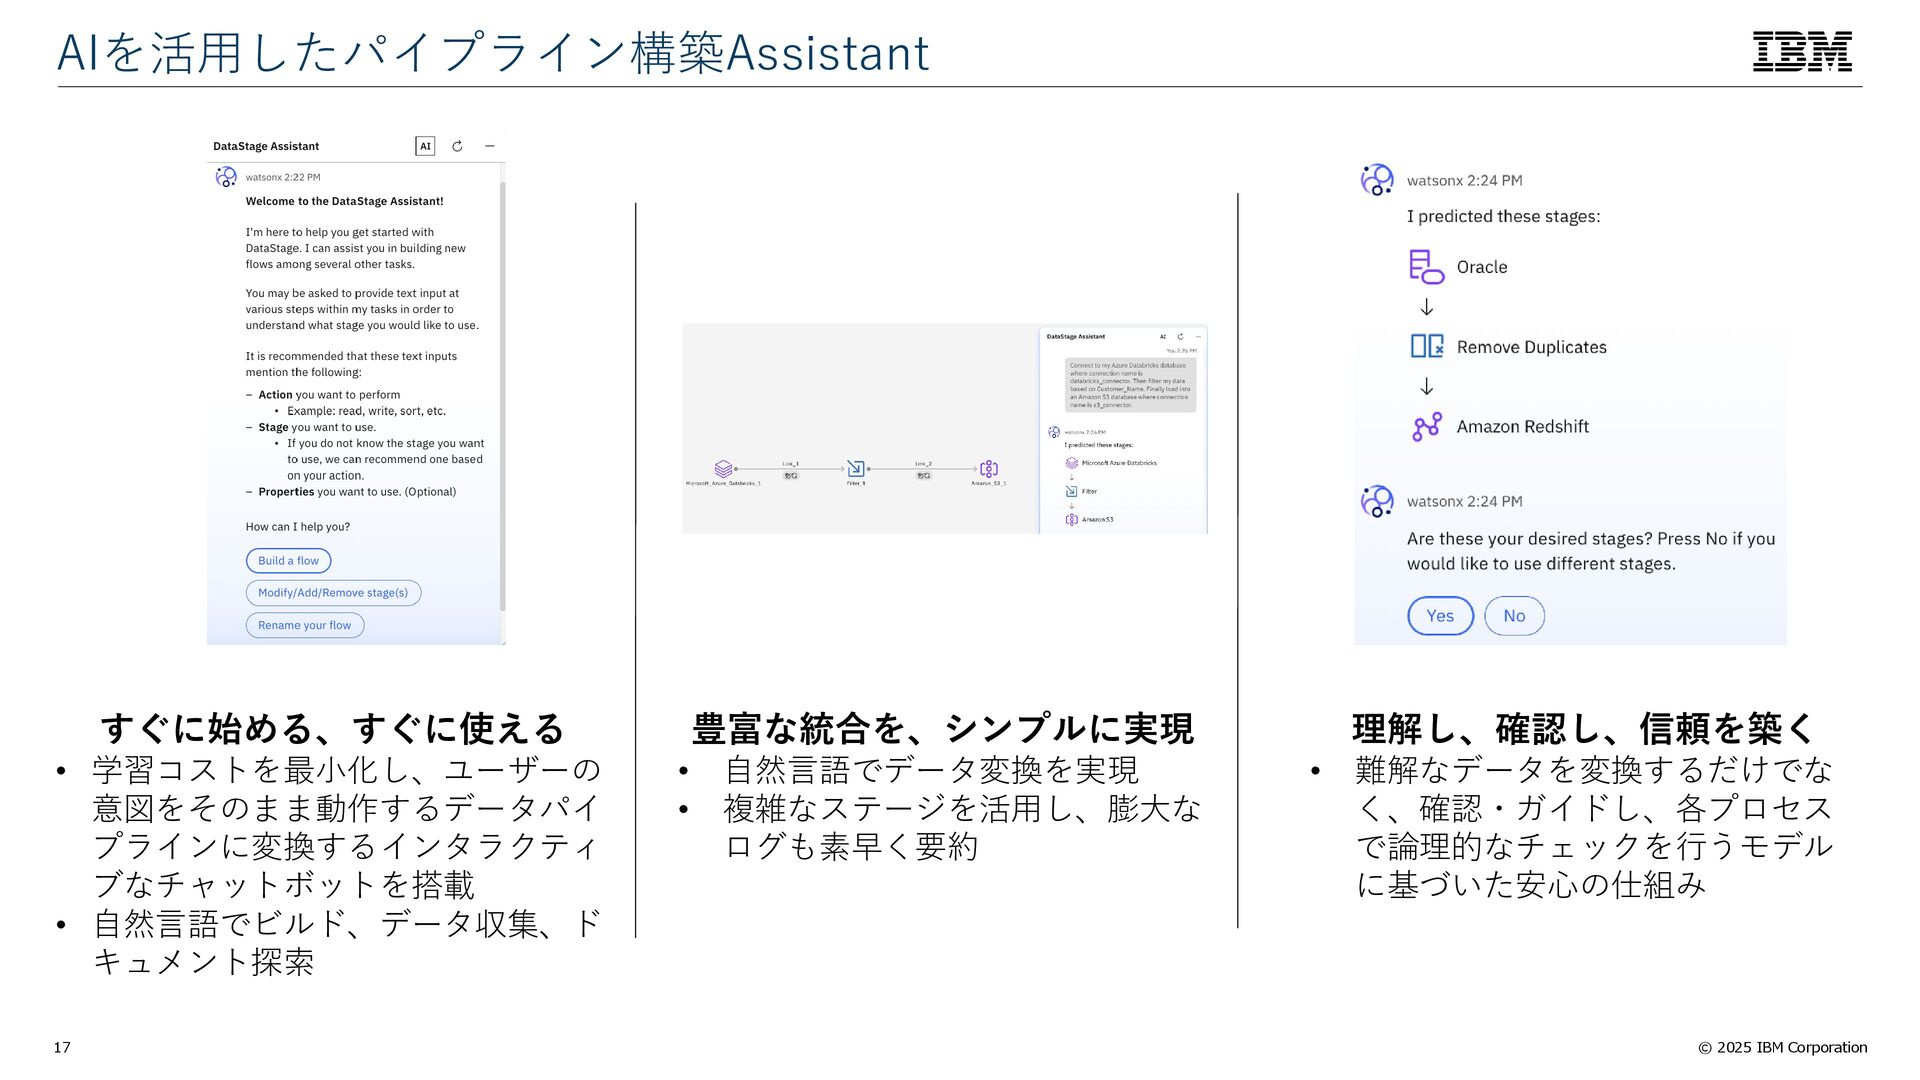
    sources On-premise Streaming Cloud Data types Structured Semi-structured Unstructured data Data Integration Bulk/batch, ETL/ELT Real-time streaming Data observability and quality Data Replication Data Store Hybrid, open data lakehouse Fit for purpose query engines Open-source data formats Separate storage and compute Hybrid/ multi-cloud infrasturcture Vectorized embeddings for RAG Data Intelligence Data governance Data quality Data lineage Data sharing Consumers Generative AI Machine Learning Business Intelligence Data Engineering Ecosystem interoperability 3rd Party Tools: Databases Integration tools Object storage Lakehouses Data catalogs +more Unified metadata and governance Guardium Data security posture management Data compliance Data detection and response AI security Quantum safe Data protection データ・ファブリック IBMのデータ管理アーキテクチャー データ・インテグレーション ・データチームや分析者、AI利用者に ・すぐに利用できて信頼性の高いデータを ・高鮮度で確実に届けること データ・インテリジェンス ・AI戦略のキモである企業のデータを ・品質、信頼性、アクセス容易性と ・ガバナンスのバランスを取りながら ・利用者に提供するもの データ・インテリジェンス(DI)とは、コア・ データ管理とメタデータ管理の原則を、人工知 能や機械学習などの高度なツールと組み合わせ ることで、企業データの生成と活用の仕組みを 理解できるように支援するものです。データ・ インテリジェンスの洞察により、データのビジ ネス価値を引き出し、データ主導の意思決定が 促進されます。 (IA : Information Architecture) IBM DataStage & 3rd Party
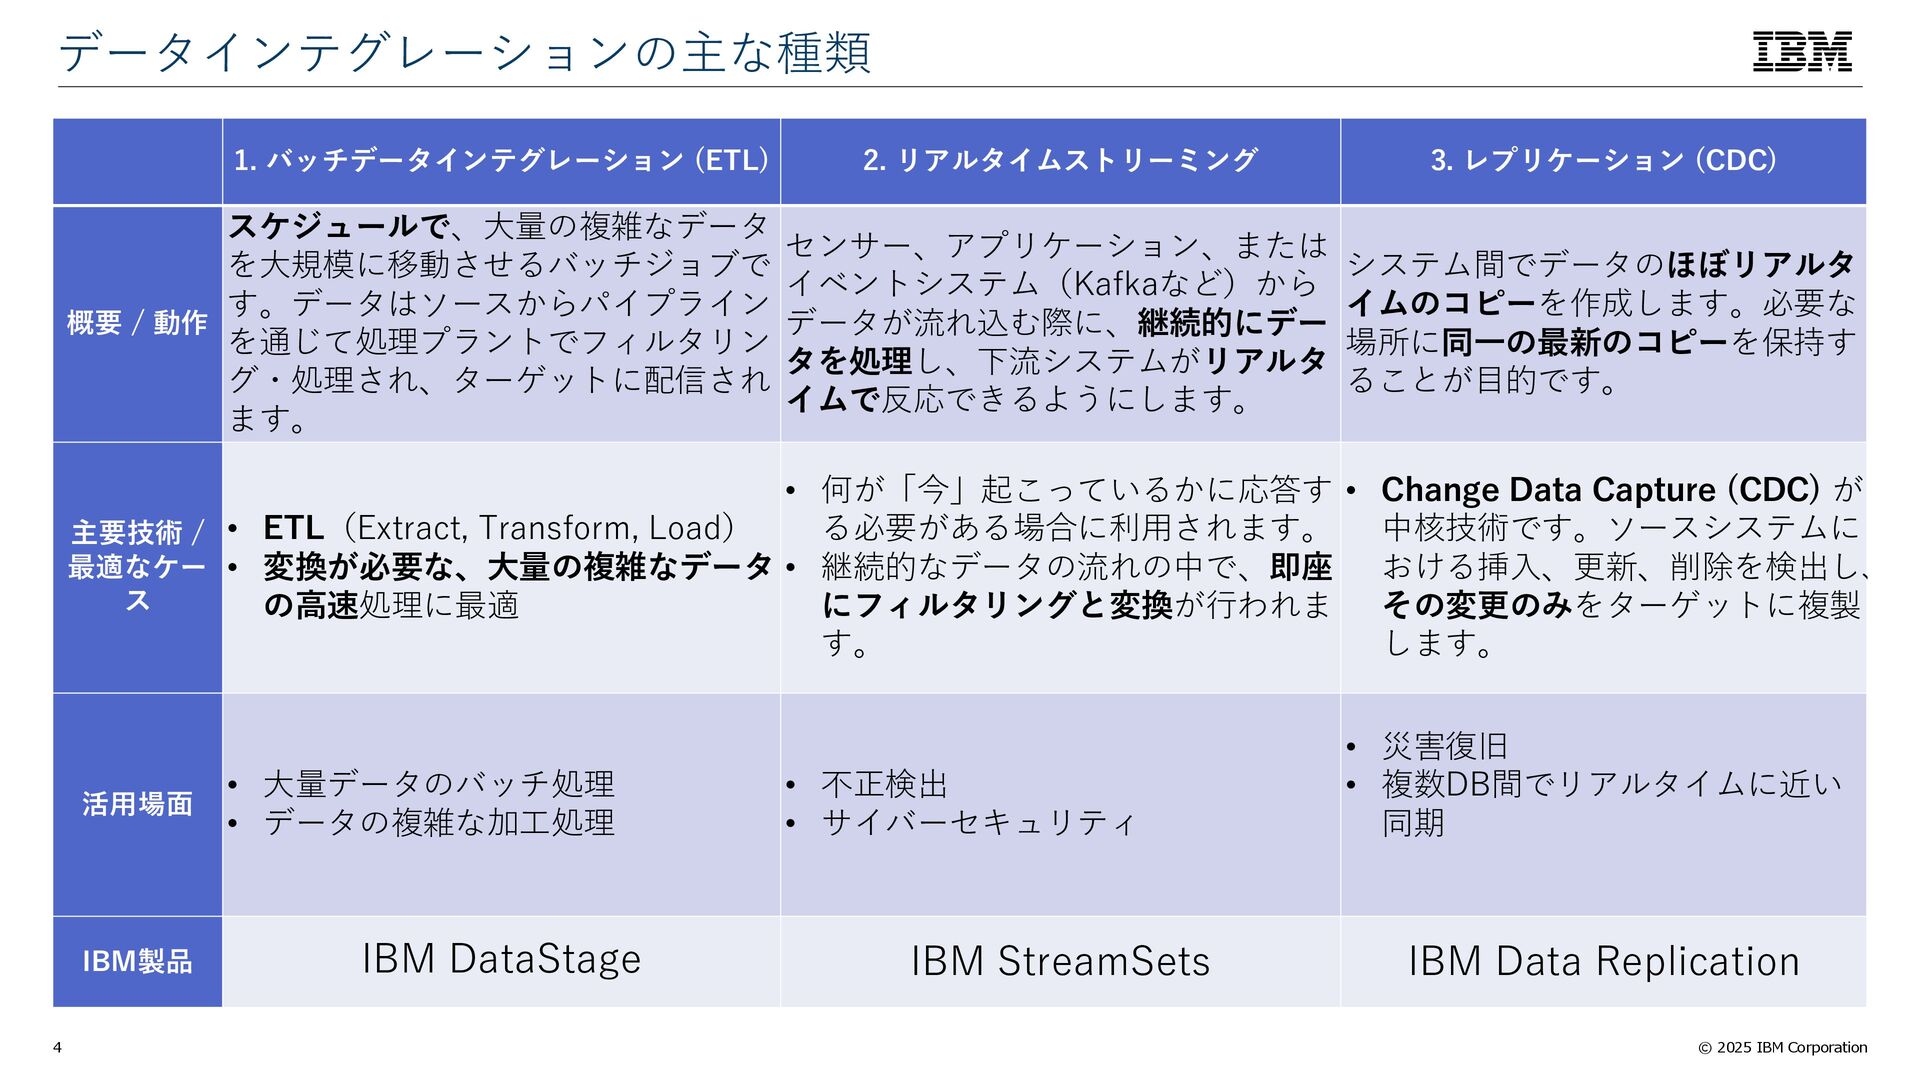
  3. © 2025 IBM Corporation 4 データインテグレーションの主な種類 1. バッチデータインテグレーション (ETL) 2.

    リアルタイムストリーミング 3. レプリケーション (CDC) 概要 / 動作 スケジュールで、大量の複雑なデータ を大規模に移動させるバッチジョブで す。データはソースからパイプライン を通じて処理プラントでフィルタリン グ・処理され、ターゲットに配信され ます。 センサー、アプリケーション、または イベントシステム(Kafkaなど)から データが流れ込む際に、継続的にデー タを処理し、下流システムがリアルタ イムで反応できるようにします。 システム間でデータのほぼリアルタ イムのコピーを作成します。必要な 場所に同一の最新のコピーを保持す ることが目的です。 主要技術 / 最適なケー ス • ETL(Extract, Transform, Load) • 変換が必要な、大量の複雑なデータ の高速処理に最適 • 何が「今」起こっているかに応答す る必要がある場合に利用されます。 • 継続的なデータの流れの中で、即座 にフィルタリングと変換が行われま す。 • Change Data Capture (CDC) が 中核技術です。ソースシステムに おける挿入、更新、削除を検出し、 その変更のみをターゲットに複製 します。 活用場面 • 大量データのバッチ処理 • データの複雑な加工処理 • 不正検出 • サイバーセキュリティ • 災害復旧 • 複数DB間でリアルタイムに近い 同期 IBM製品 IBM DataStage IBM StreamSets IBM Data Replication
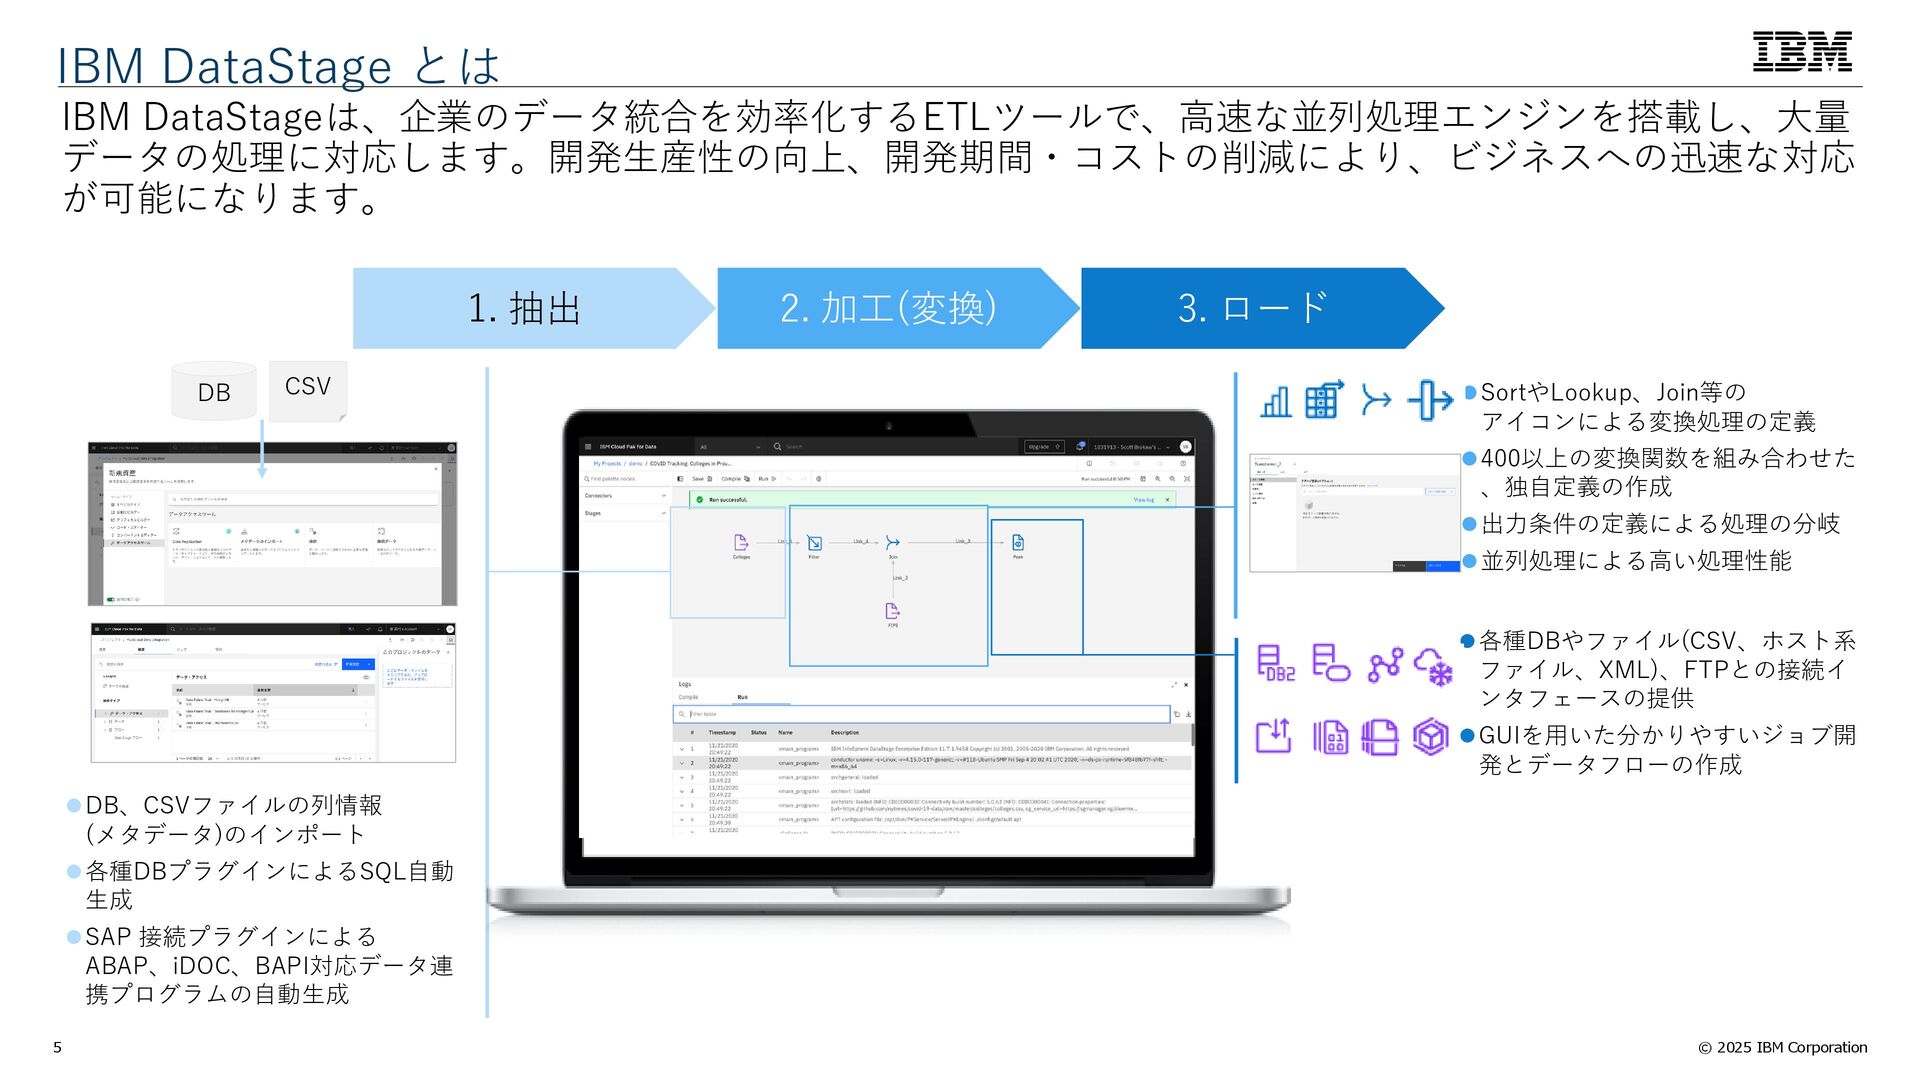
  4. © 2025 IBM Corporation 5 IBM DataStageは、企業のデータ統合を効率化するETLツールで、高速な並列処理エンジンを搭載し、大量 データの処理に対応します。開発生産性の向上、開発期間・コストの削減により、ビジネスへの迅速な対応 が可能になります。 IBM

    DataStage とは ⚫DB、CSVファイルの列情報 (メタデータ)のインポート ⚫各種DBプラグインによるSQL自動 生成 ⚫SAP 接続プラグインによる ABAP、iDOC、BAPI対応データ連 携プログラムの自動生成 DB CSV 1. 抽出 2. 加工(変換) 3. ロード ⚫SortやLookup、Join等の アイコンによる変換処理の定義 ⚫400以上の変換関数を組み合わせた 、独自定義の作成 ⚫出力条件の定義による処理の分岐 ⚫並列処理による高い処理性能 ⚫各種DBやファイル(CSV、ホスト系 ファイル、XML)、FTPとの接続イ ンタフェースの提供 ⚫GUIを用いた分かりやすいジョブ開 発とデータフローの作成
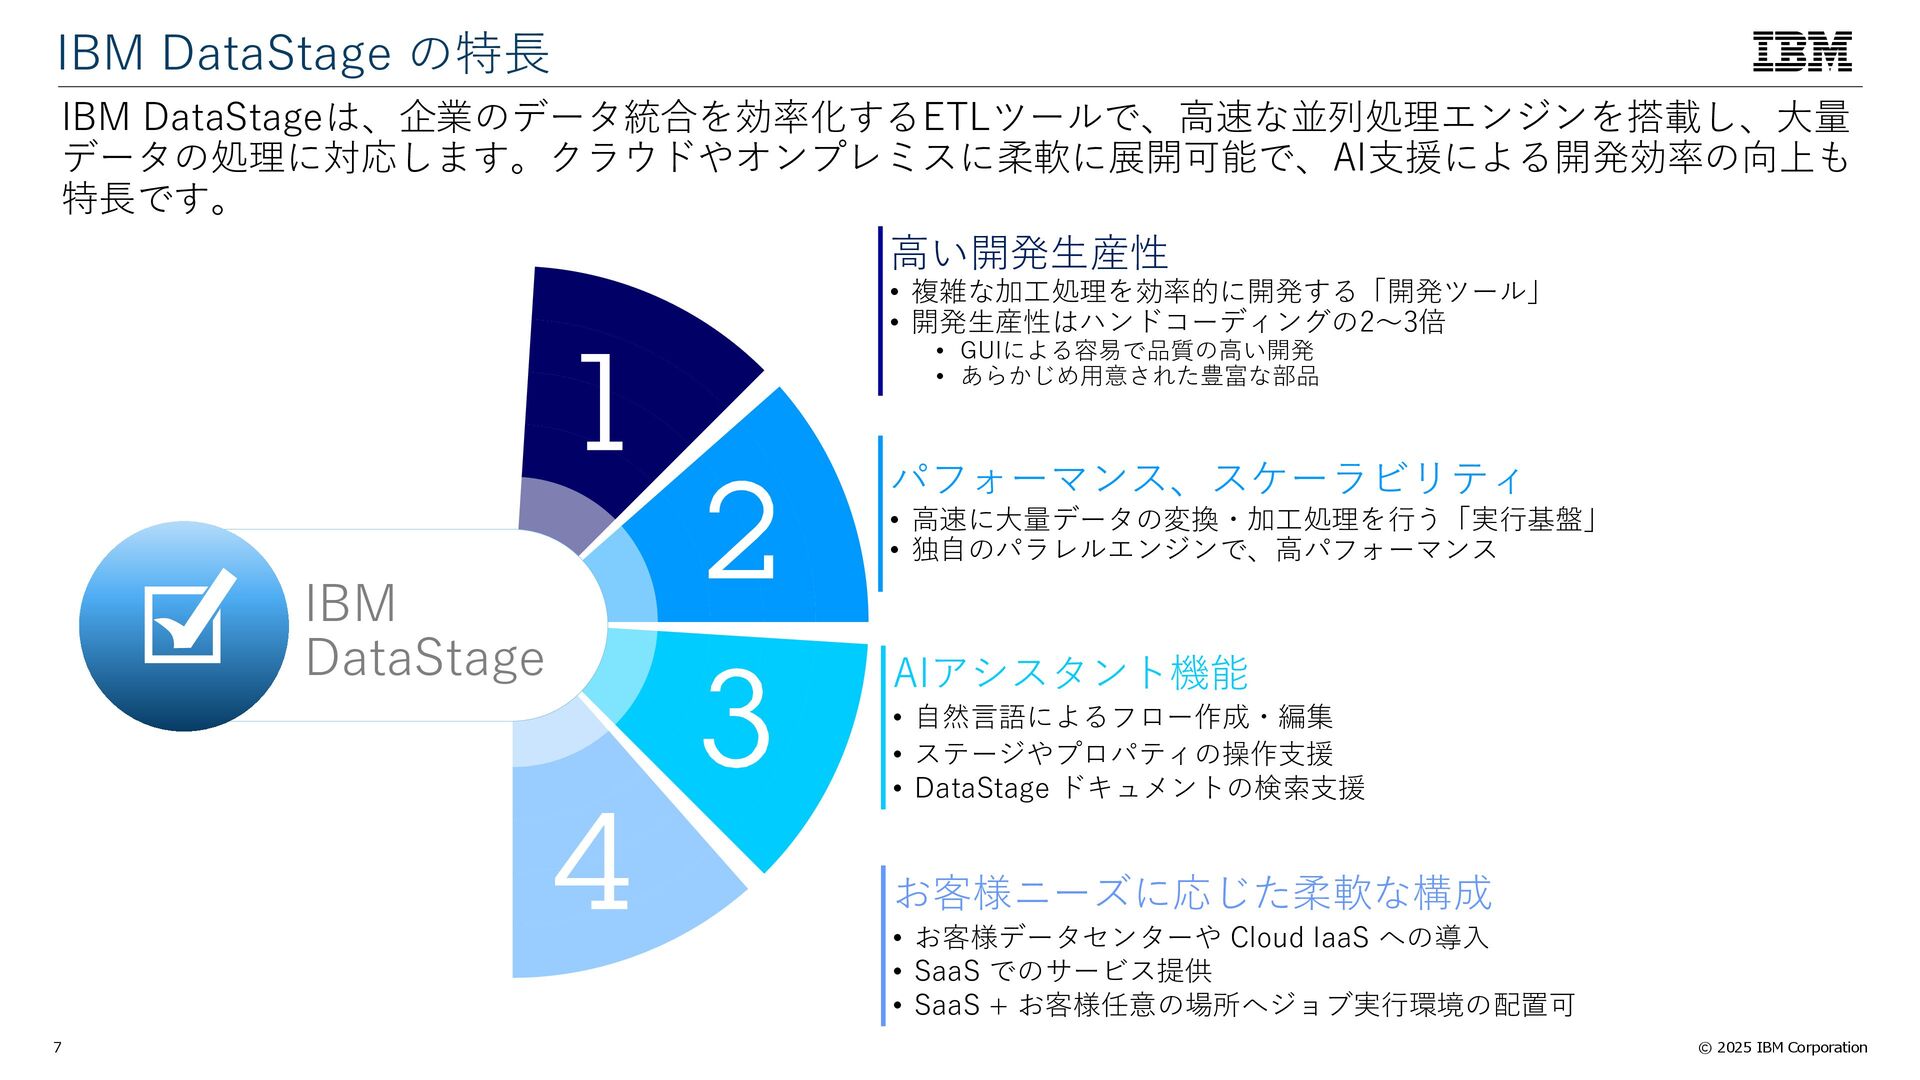
  5. © 2025 IBM Corporation 7 IBM DataStageは、企業のデータ統合を効率化するETLツールで、高速な並列処理エンジンを搭載し、大量 データの処理に対応します。クラウドやオンプレミスに柔軟に展開可能で、AI支援による開発効率の向上も 特長です。 IBM

    DataStage の特長 高い開発生産性 • 複雑な加工処理を効率的に開発する「開発ツール」 • 開発生産性はハンドコーディングの2~3倍 • GUIによる容易で品質の高い開発 • あらかじめ用意された豊富な部品 AIアシスタント機能 • 自然言語によるフロー作成・編集 • ステージやプロパティの操作支援 • DataStage ドキュメントの検索支援 お客様ニーズに応じた柔軟な構成 • お客様データセンターや Cloud IaaS への導入 • SaaS でのサービス提供 • SaaS + お客様任意の場所へジョブ実行環境の配置可 パフォーマンス、スケーラビリティ • 高速に大量データの変換・加工処理を行う「実行基盤」 • 独自のパラレルエンジンで、高パフォーマンス IBM DataStage
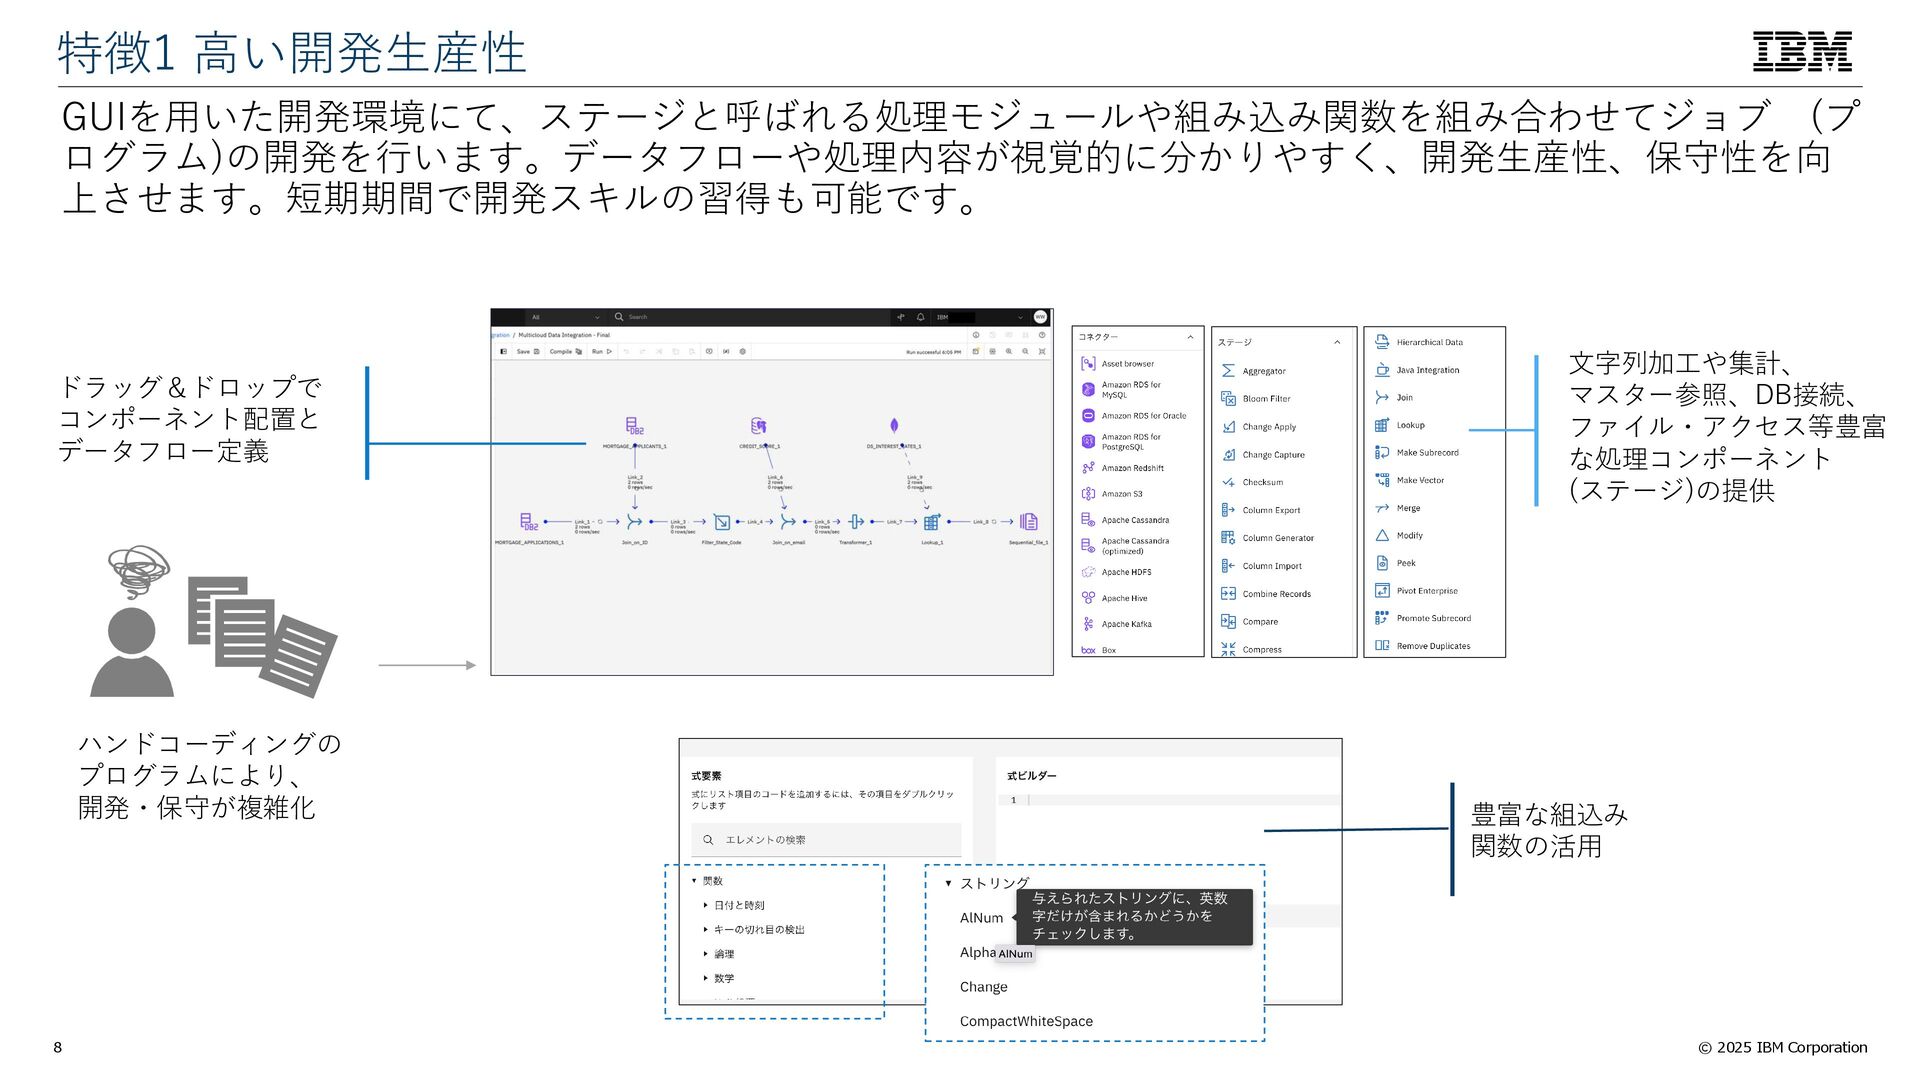
  6. © 2025 IBM Corporation 8 GUIを用いた開発環境にて、ステージと呼ばれる処理モジュールや組み込み関数を組み合わせてジョブ (プ ログラム)の開発を行います。データフローや処理内容が視覚的に分かりやすく、開発生産性、保守性を向 上させます。短期期間で開発スキルの習得も可能です。 特徴1

    高い開発生産性 ドラッグ&ドロップで コンポーネント配置と データフロー定義 ハンドコーディングの プログラムにより、 開発・保守が複雑化 豊富な組込み 関数の活用 文字列加工や集計、 マスター参照、DB接続、 ファイル・アクセス等豊富 な処理コンポーネント (ステージ)の提供
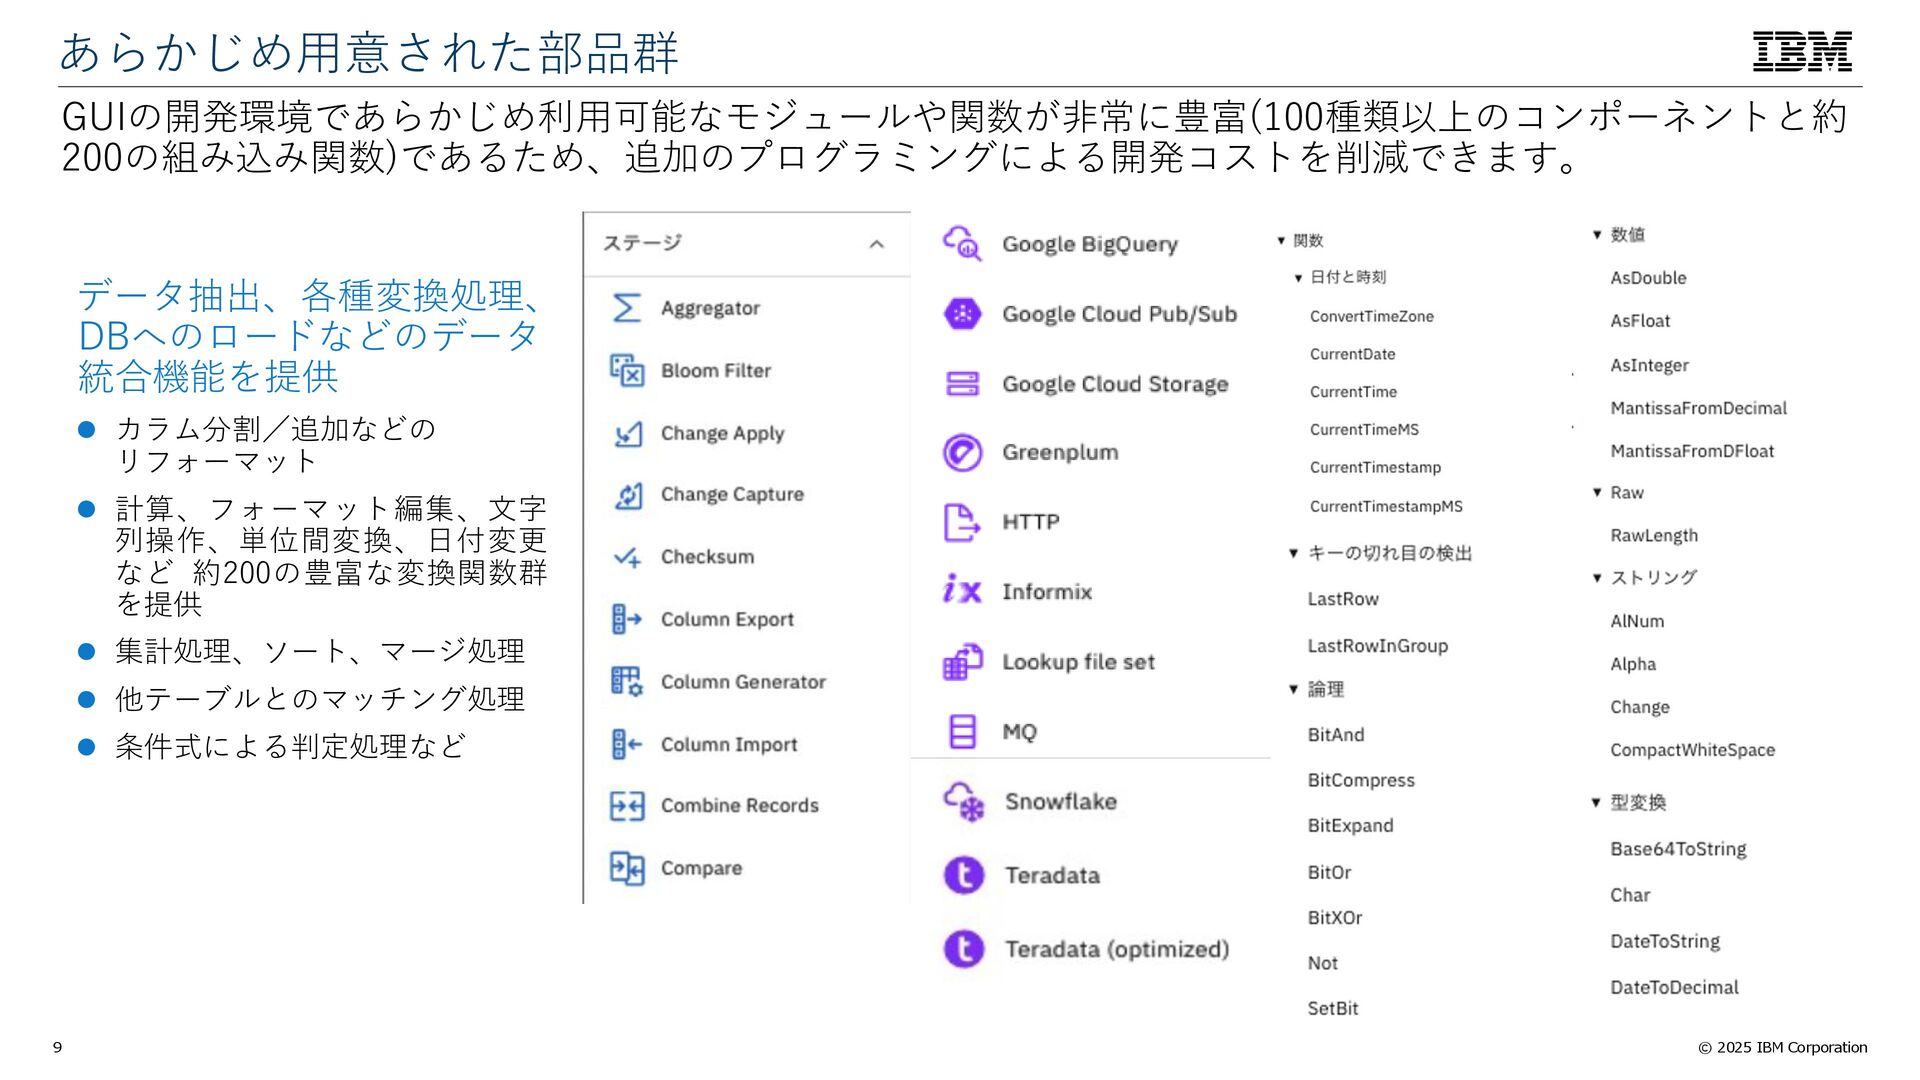
  7. © 2025 IBM Corporation 9 GUIの開発環境であらかじめ利用可能なモジュールや関数が非常に豊富(100種類以上のコンポーネントと約 200の組み込み関数)であるため、追加のプログラミングによる開発コストを削減できます。 あらかじめ用意された部品群 データ抽出、各種変換処理、 DBへのロードなどのデータ

    統合機能を提供 ⚫ カラム分割/追加などの リフォーマット ⚫ 計算、フォーマット編集、文字 列操作、単位間変換、日付変更 など 約200の豊富な変換関数群 を提供 ⚫ 集計処理、ソート、マージ処理 ⚫ 他テーブルとのマッチング処理 ⚫ 条件式による判定処理など
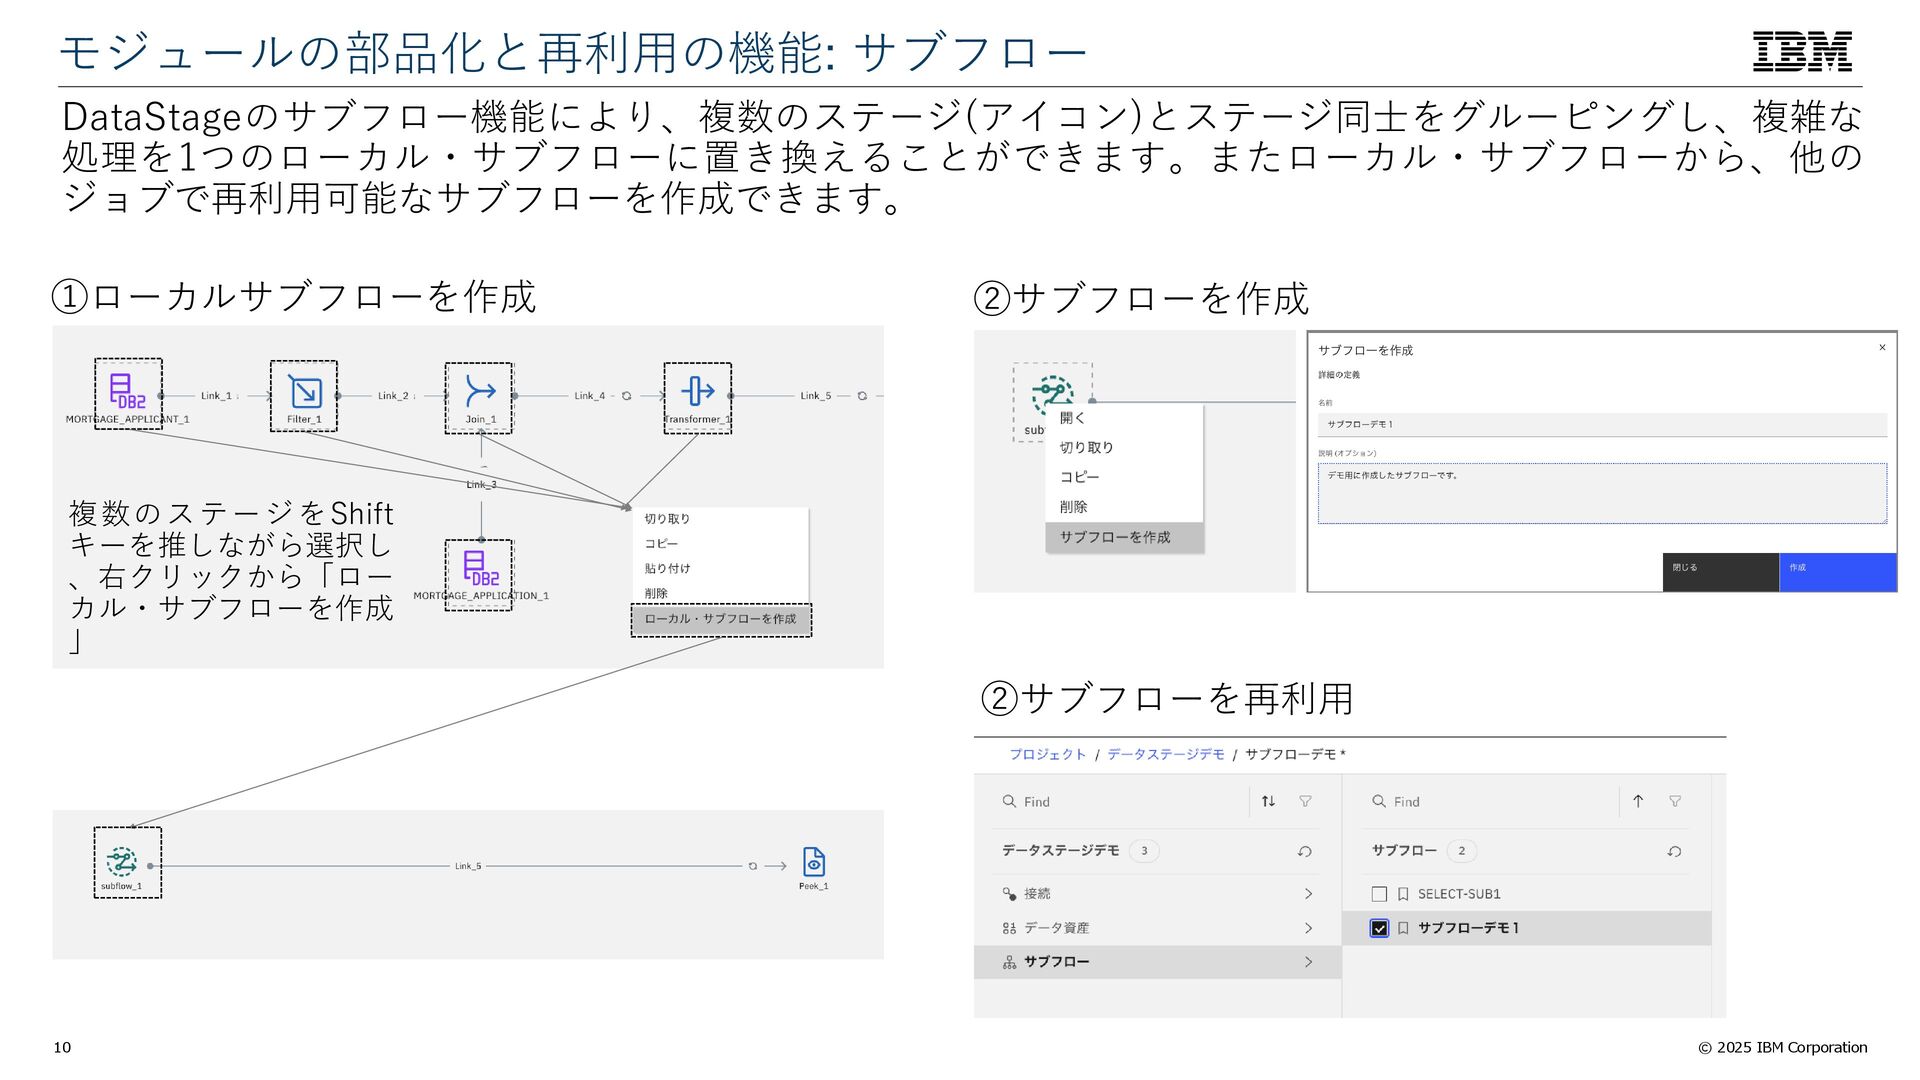
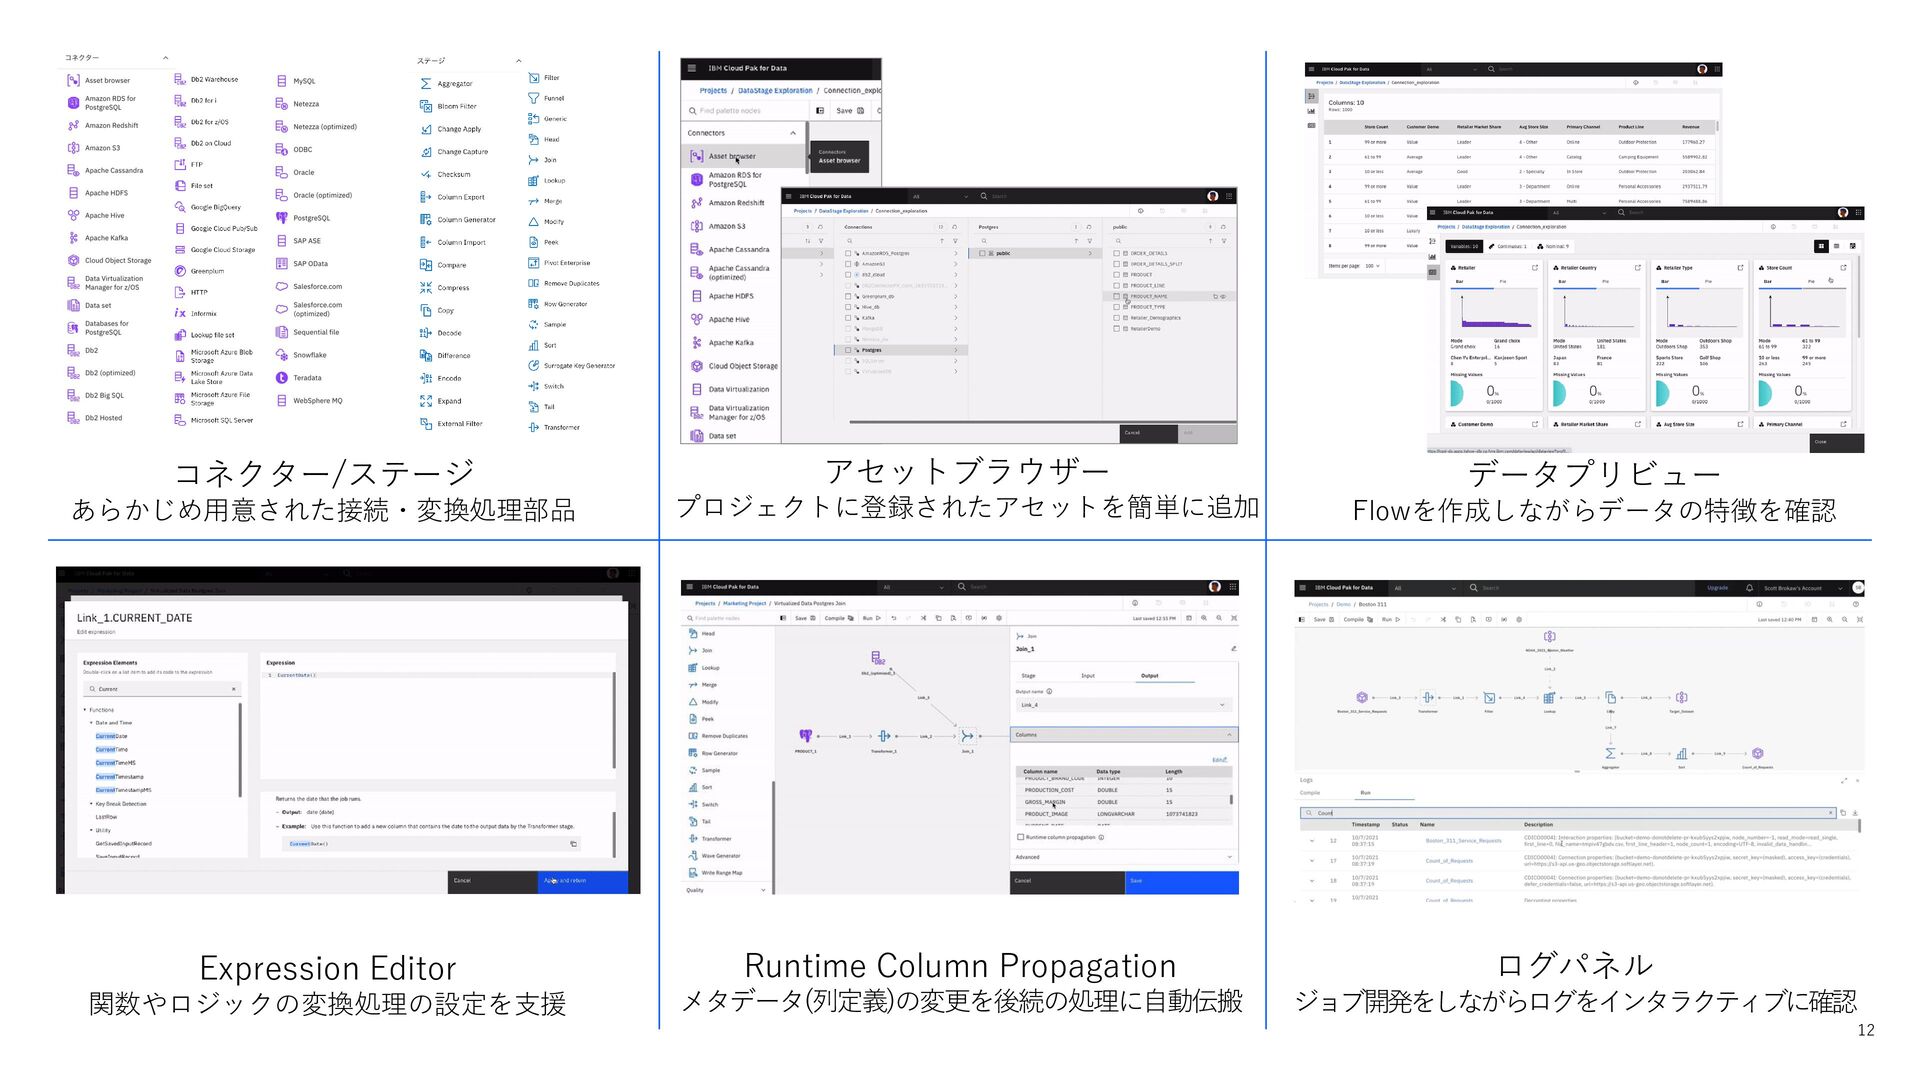
  8. 12 アセットブラウザー プロジェクトに登録されたアセットを簡単に追加 データプリビュー Flowを作成しながらデータの特徴を確認 コネクター/ステージ あらかじめ用意された接続・変換処理部品 Runtime Column Propagation

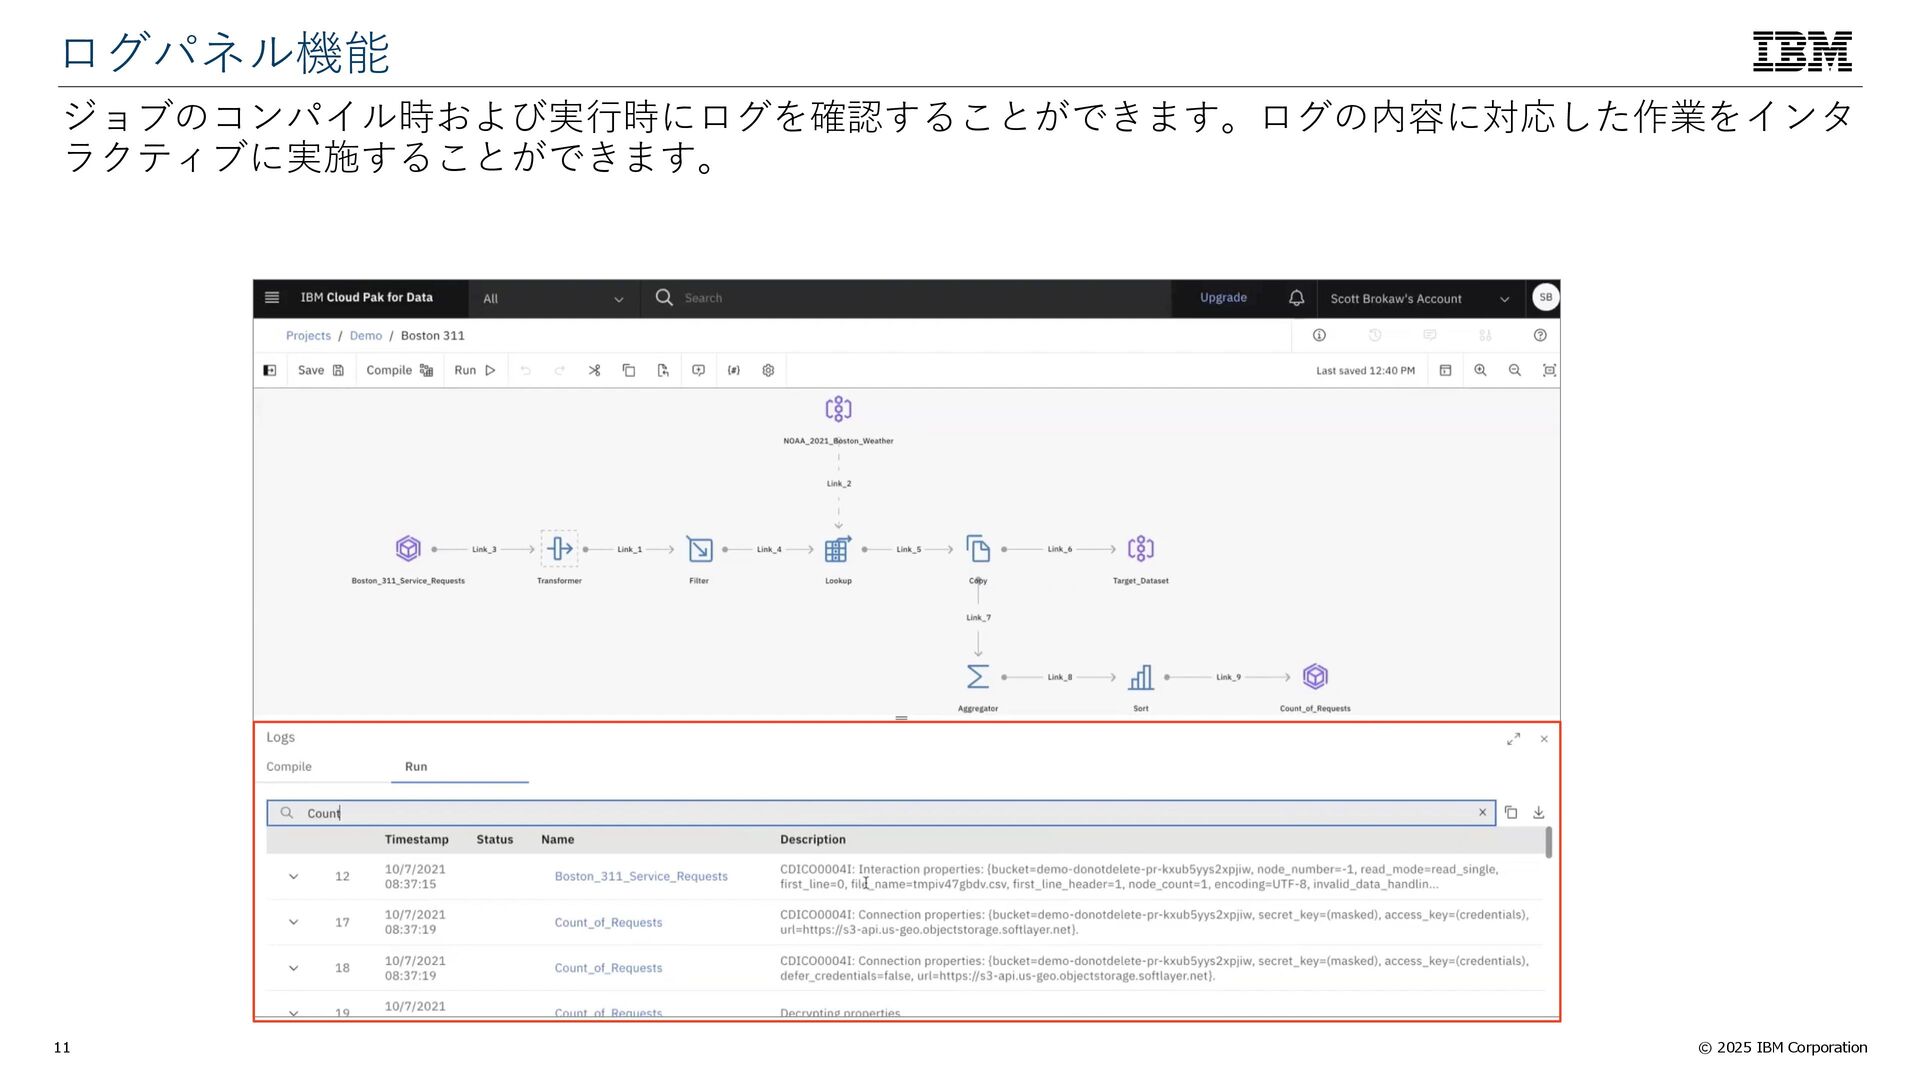
    メタデータ(列定義)の変更を後続の処理に自動伝搬 Expression Editor 関数やロジックの変換処理の設定を支援 ログパネル ジョブ開発をしながらログをインタラクティブに確認
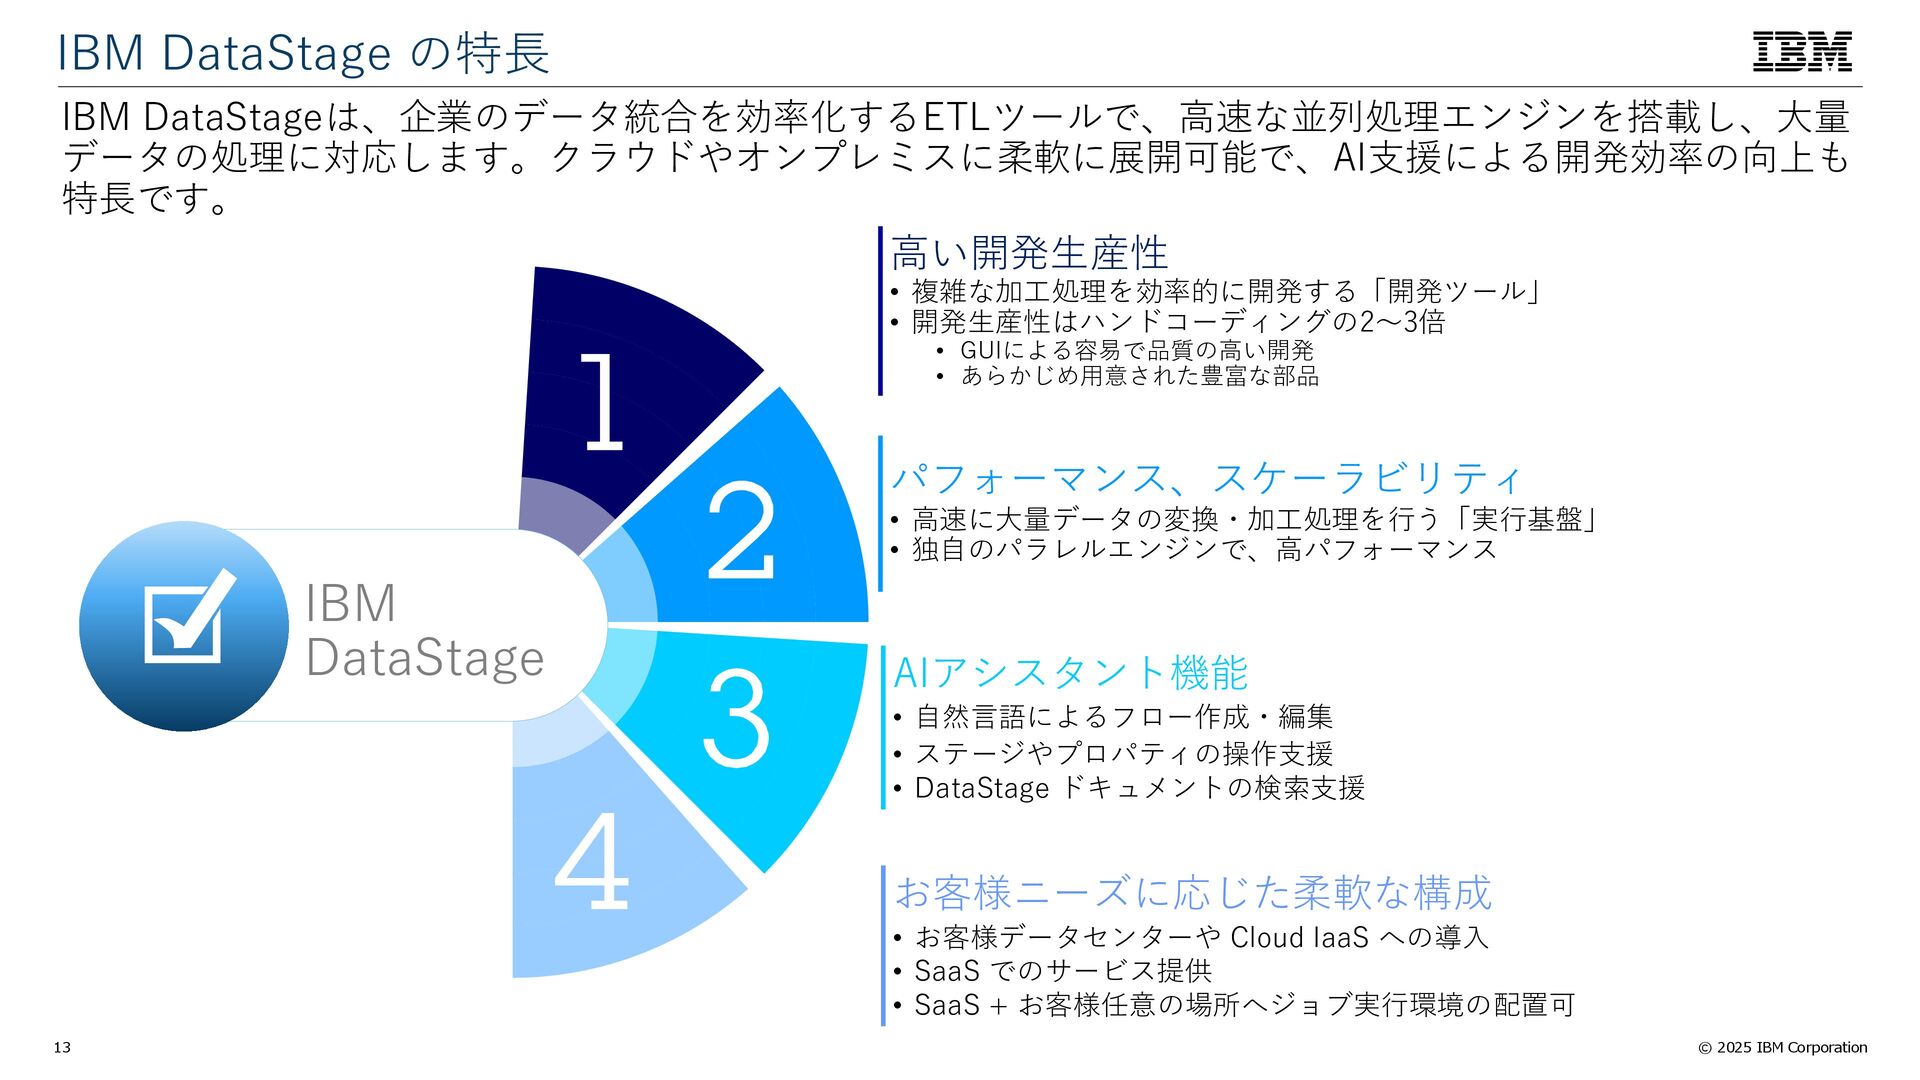
  9. © 2025 IBM Corporation 13 IBM DataStageは、企業のデータ統合を効率化するETLツールで、高速な並列処理エンジンを搭載し、大量 データの処理に対応します。クラウドやオンプレミスに柔軟に展開可能で、AI支援による開発効率の向上も 特長です。 IBM

    DataStage の特長 高い開発生産性 • 複雑な加工処理を効率的に開発する「開発ツール」 • 開発生産性はハンドコーディングの2~3倍 • GUIによる容易で品質の高い開発 • あらかじめ用意された豊富な部品 AIアシスタント機能 • 自然言語によるフロー作成・編集 • ステージやプロパティの操作支援 • DataStage ドキュメントの検索支援 お客様ニーズに応じた柔軟な構成 • お客様データセンターや Cloud IaaS への導入 • SaaS でのサービス提供 • SaaS + お客様任意の場所へジョブ実行環境の配置可 パフォーマンス、スケーラビリティ • 高速に大量データの変換・加工処理を行う「実行基盤」 • 独自のパラレルエンジンで、高パフォーマンス IBM DataStage
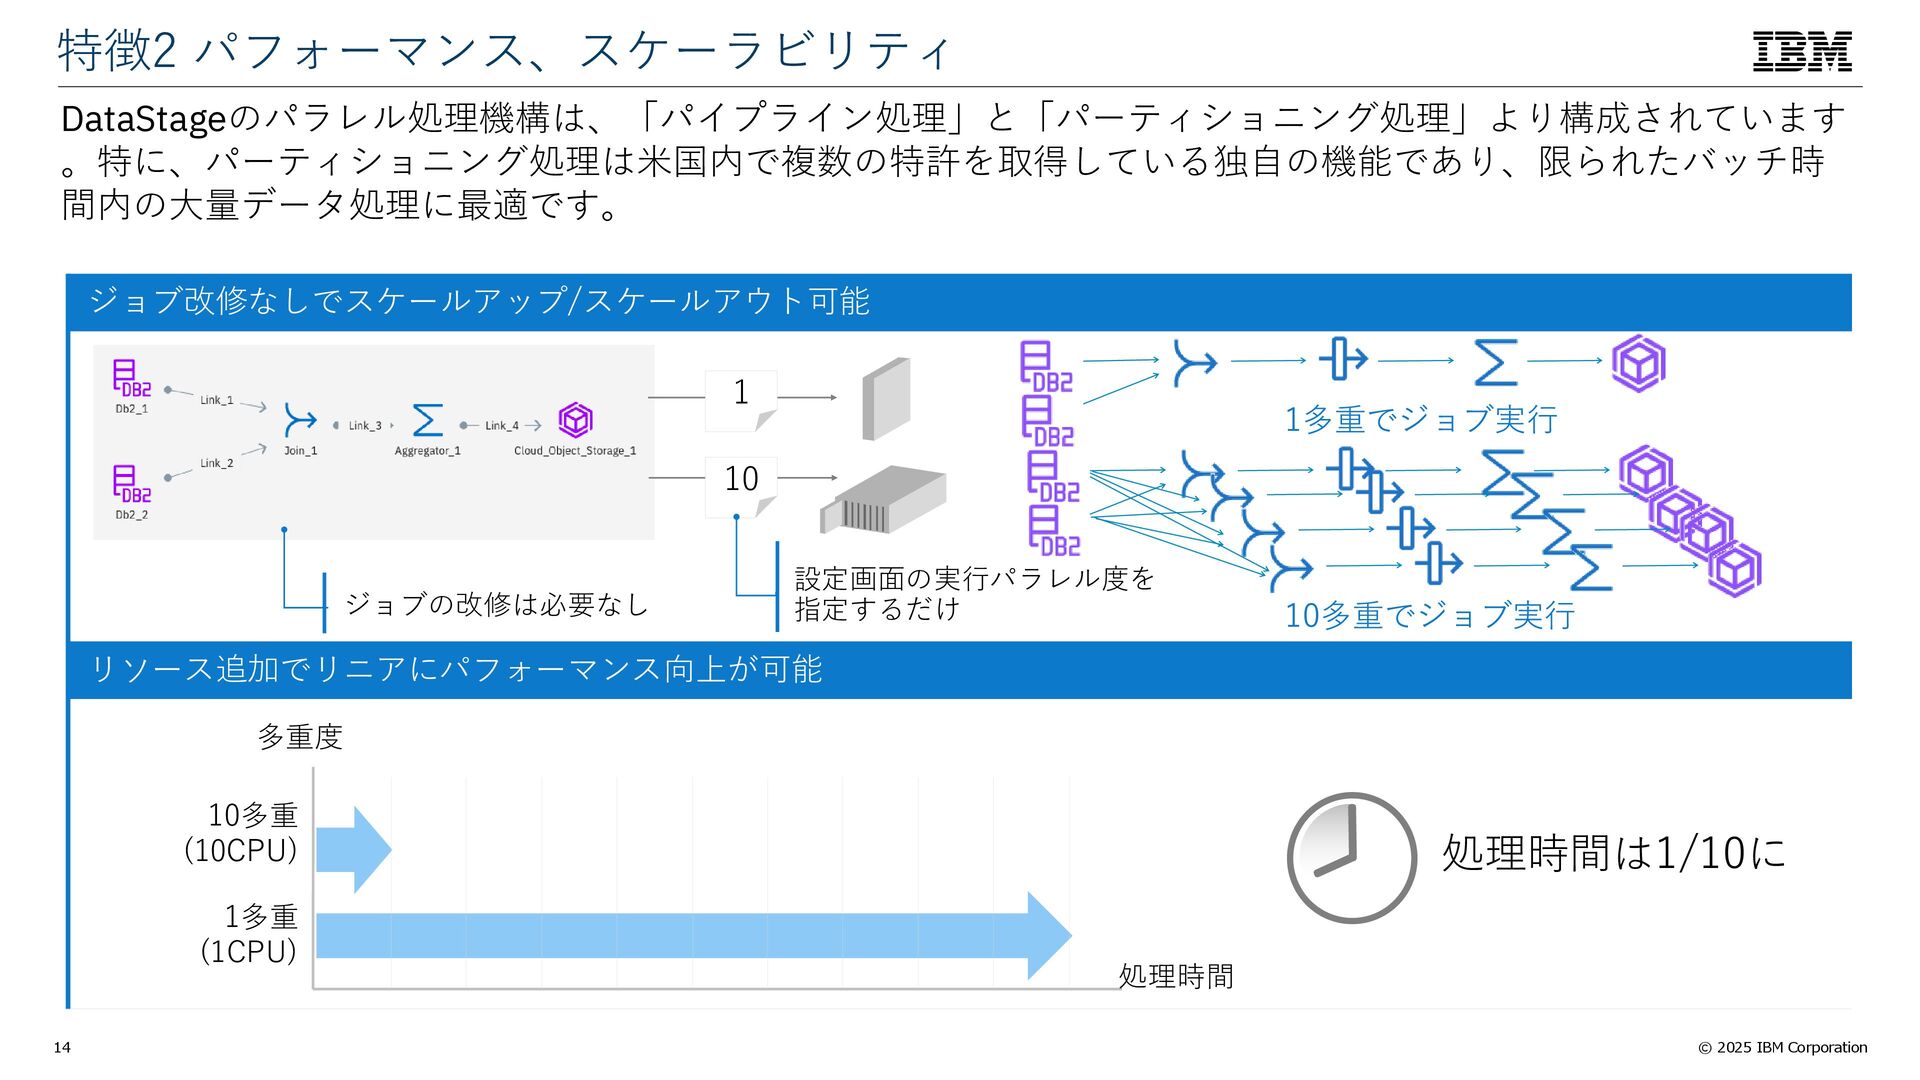
  10. © 2025 IBM Corporation 14 特徴2 パフォーマンス、スケーラビリティ DataStageのパラレル処理機構は、「パイプライン処理」と「パーティショニング処理」より構成されています 。特に、パーティショニング処理は米国内で複数の特許を取得している独自の機能であり、限られたバッチ時 間内の大量データ処理に最適です。

    ジョブ改修なしでスケールアップ/スケールアウト可能 リソース追加でリニアにパフォーマンス向上が可能 多重度 10多重 (10CPU) 1多重 (1CPU) 処理時間 処理時間は1/10に 設定画面の実行パラレル度を 指定するだけ ジョブの改修は必要なし 10 1
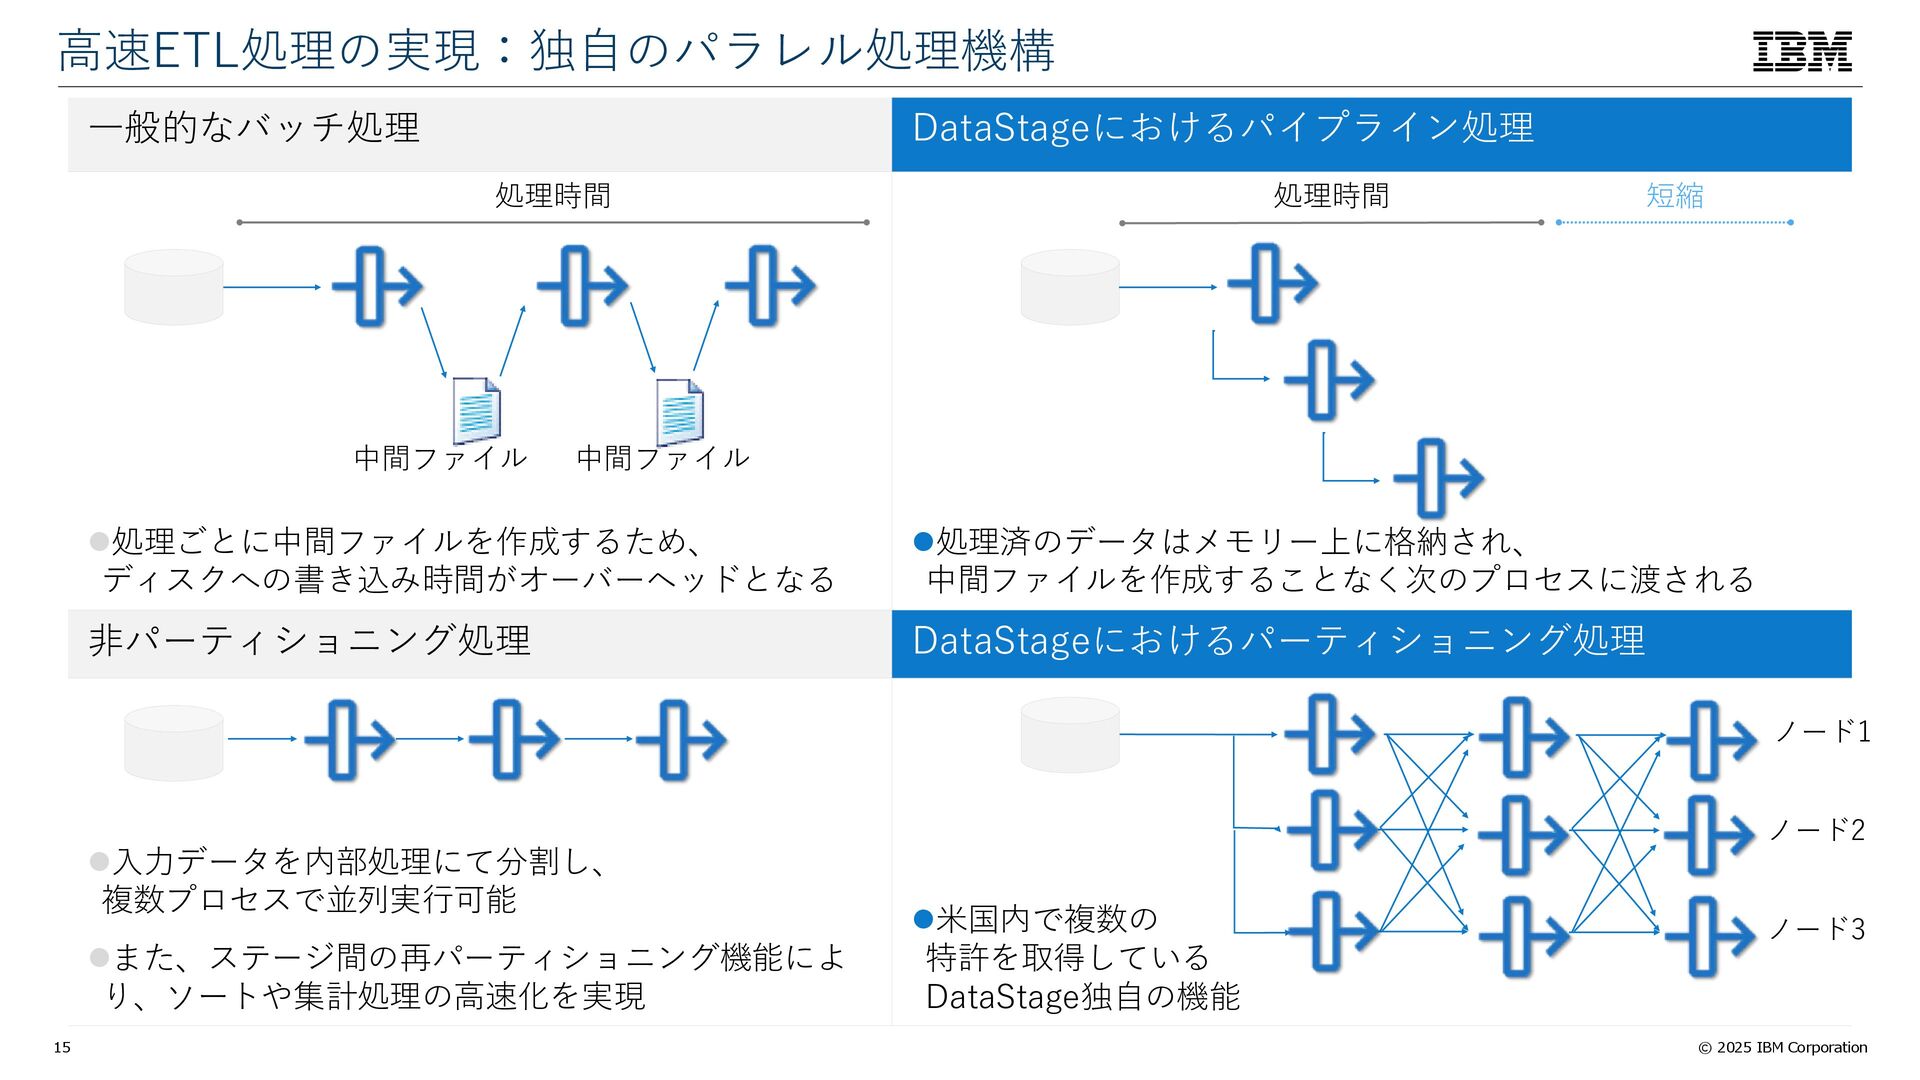
  11. © 2025 IBM Corporation 15 高速ETL処理の実現:独自のパラレル処理機構 一般的なバッチ処理 DataStageにおけるパイプライン処理 ⚫処理ごとに中間ファイルを作成するため、 ディスクへの書き込み時間がオーバーヘッドとなる

    ⚫処理済のデータはメモリー上に格納され、 中間ファイルを作成することなく次のプロセスに渡される 非パーティショニング処理 DataStageにおけるパーティショニング処理 ⚫入力データを内部処理にて分割し、 複数プロセスで並列実行可能 ⚫また、ステージ間の再パーティショニング機能によ り、ソートや集計処理の高速化を実現 ⚫米国内で複数の 特許を取得している DataStage独自の機能 中間ファイル 中間ファイル 処理時間 処理時間 短縮 ノード1 ノード2 ノード3
  12. © 2025 IBM Corporation 16 IBM DataStageは、企業のデータ統合を効率化するETLツールで、高速な並列処理エンジンを搭載し、大量 データの処理に対応します。クラウドやオンプレミスに柔軟に展開可能で、AI支援による開発効率の向上も 特長です。 IBM

    DataStage の特長 高い開発生産性 • 複雑な加工処理を効率的に開発する「開発ツール」 • 開発生産性はハンドコーディングの2~3倍 • GUIによる容易で品質の高い開発 • あらかじめ用意された豊富な部品 AIアシスタント機能 • 自然言語によるフロー作成・編集 • ステージやプロパティの操作支援 • DataStage ドキュメントの検索支援 お客様ニーズに応じた柔軟な構成 • お客様データセンターや Cloud IaaS への導入 • SaaS でのサービス提供 • SaaS + お客様任意の場所へジョブ実行環境の配置可 パフォーマンス、スケーラビリティ • 高速に大量データの変換・加工処理を行う「実行基盤」 • 独自のパラレルエンジンで、高パフォーマンス IBM DataStage
  13. © 2025 IBM Corporation 17 AIを活用したパイプライン構築Assistant すぐに始める、すぐに使える • 学習コストを最小化し、ユーザーの 意図をそのまま動作するデータパイ

    プラインに変換するインタラクティ ブなチャットボットを搭載 • 自然言語でビルド、データ収集、ド キュメント探索 理解し、確認し、信頼を築く • 難解なデータを変換するだけでな く、確認・ガイドし、各プロセス で論理的なチェックを行うモデル に基づいた安心の仕組み 豊富な統合を、シンプルに実現 • 自然言語でデータ変換を実現 • 複雑なステージを活用し、膨大な ログも素早く要約
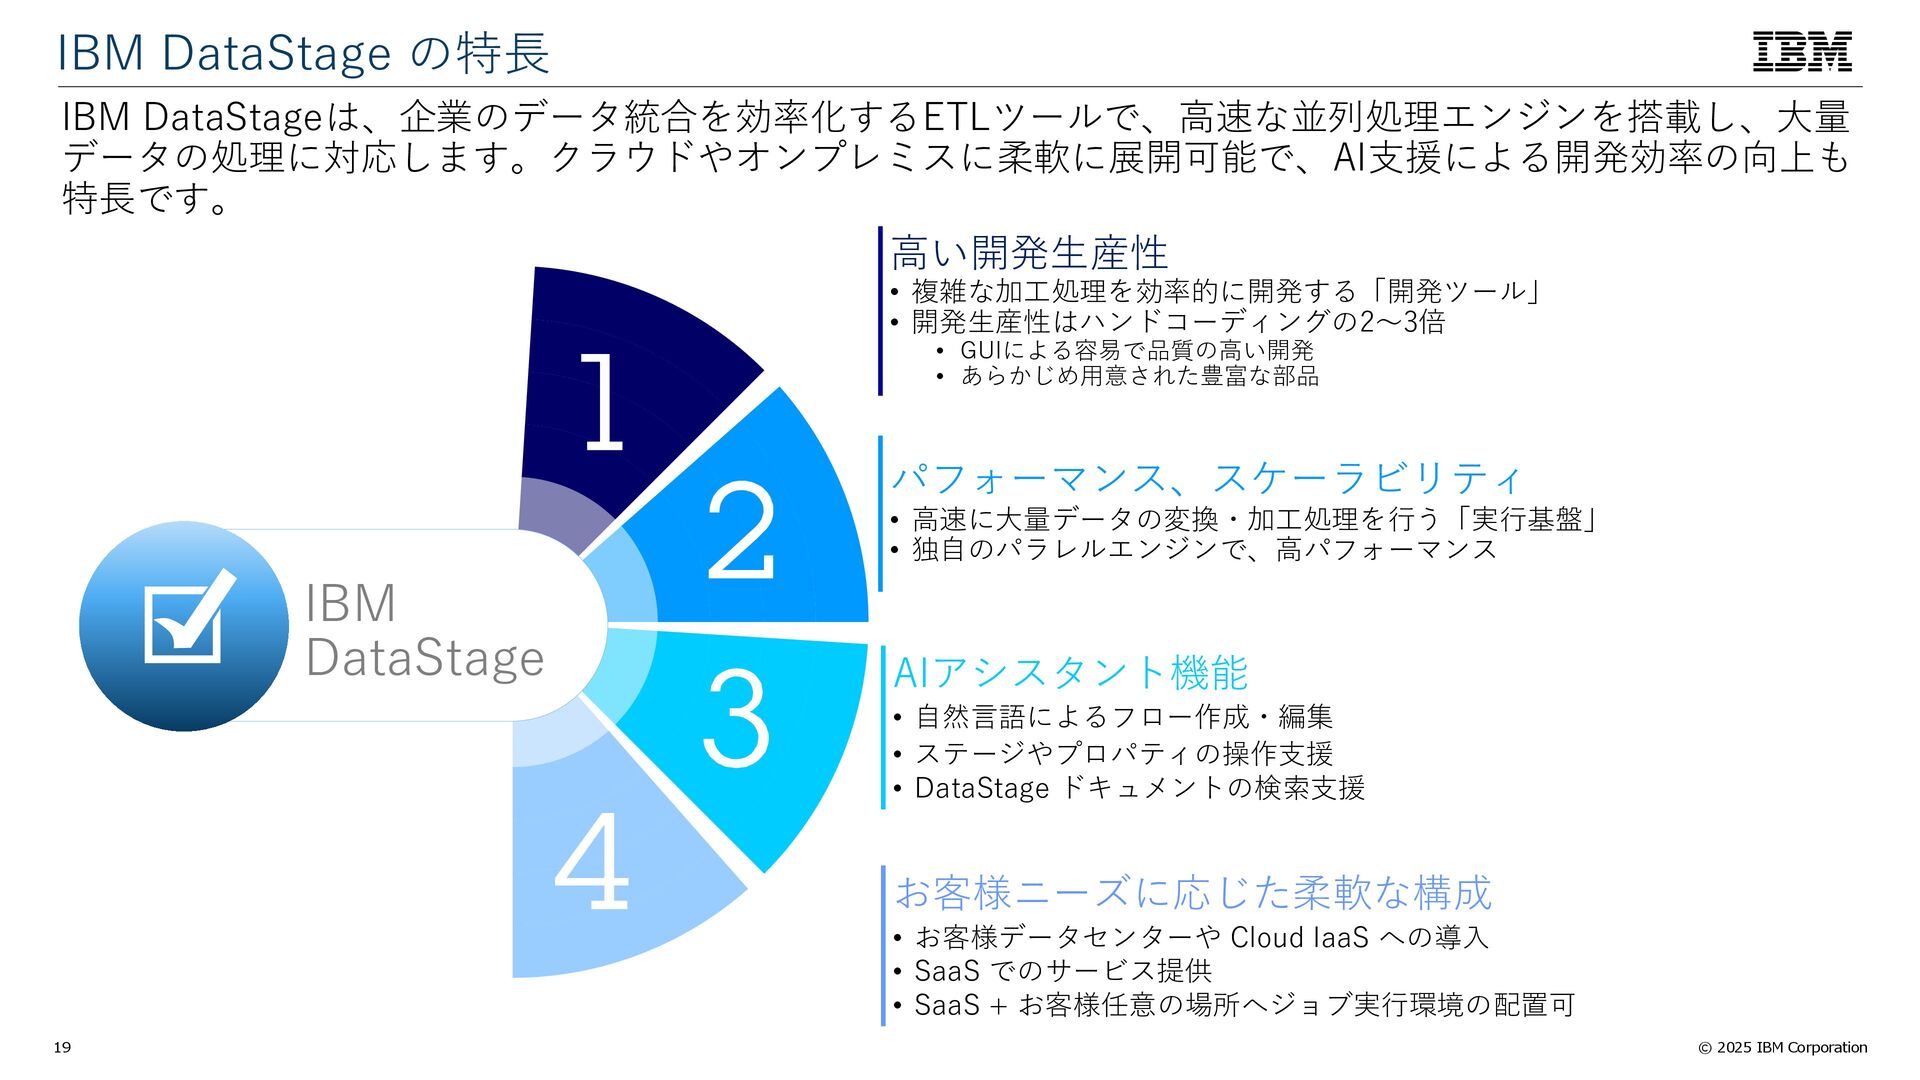
  14. © 2025 IBM Corporation 19 IBM DataStageは、企業のデータ統合を効率化するETLツールで、高速な並列処理エンジンを搭載し、大量 データの処理に対応します。クラウドやオンプレミスに柔軟に展開可能で、AI支援による開発効率の向上も 特長です。 IBM

    DataStage の特長 高い開発生産性 • 複雑な加工処理を効率的に開発する「開発ツール」 • 開発生産性はハンドコーディングの2~3倍 • GUIによる容易で品質の高い開発 • あらかじめ用意された豊富な部品 AIアシスタント機能 • 自然言語によるフロー作成・編集 • ステージやプロパティの操作支援 • DataStage ドキュメントの検索支援 お客様ニーズに応じた柔軟な構成 • お客様データセンターや Cloud IaaS への導入 • SaaS でのサービス提供 • SaaS + お客様任意の場所へジョブ実行環境の配置可 パフォーマンス、スケーラビリティ • 高速に大量データの変換・加工処理を行う「実行基盤」 • 独自のパラレルエンジンで、高パフォーマンス IBM DataStage
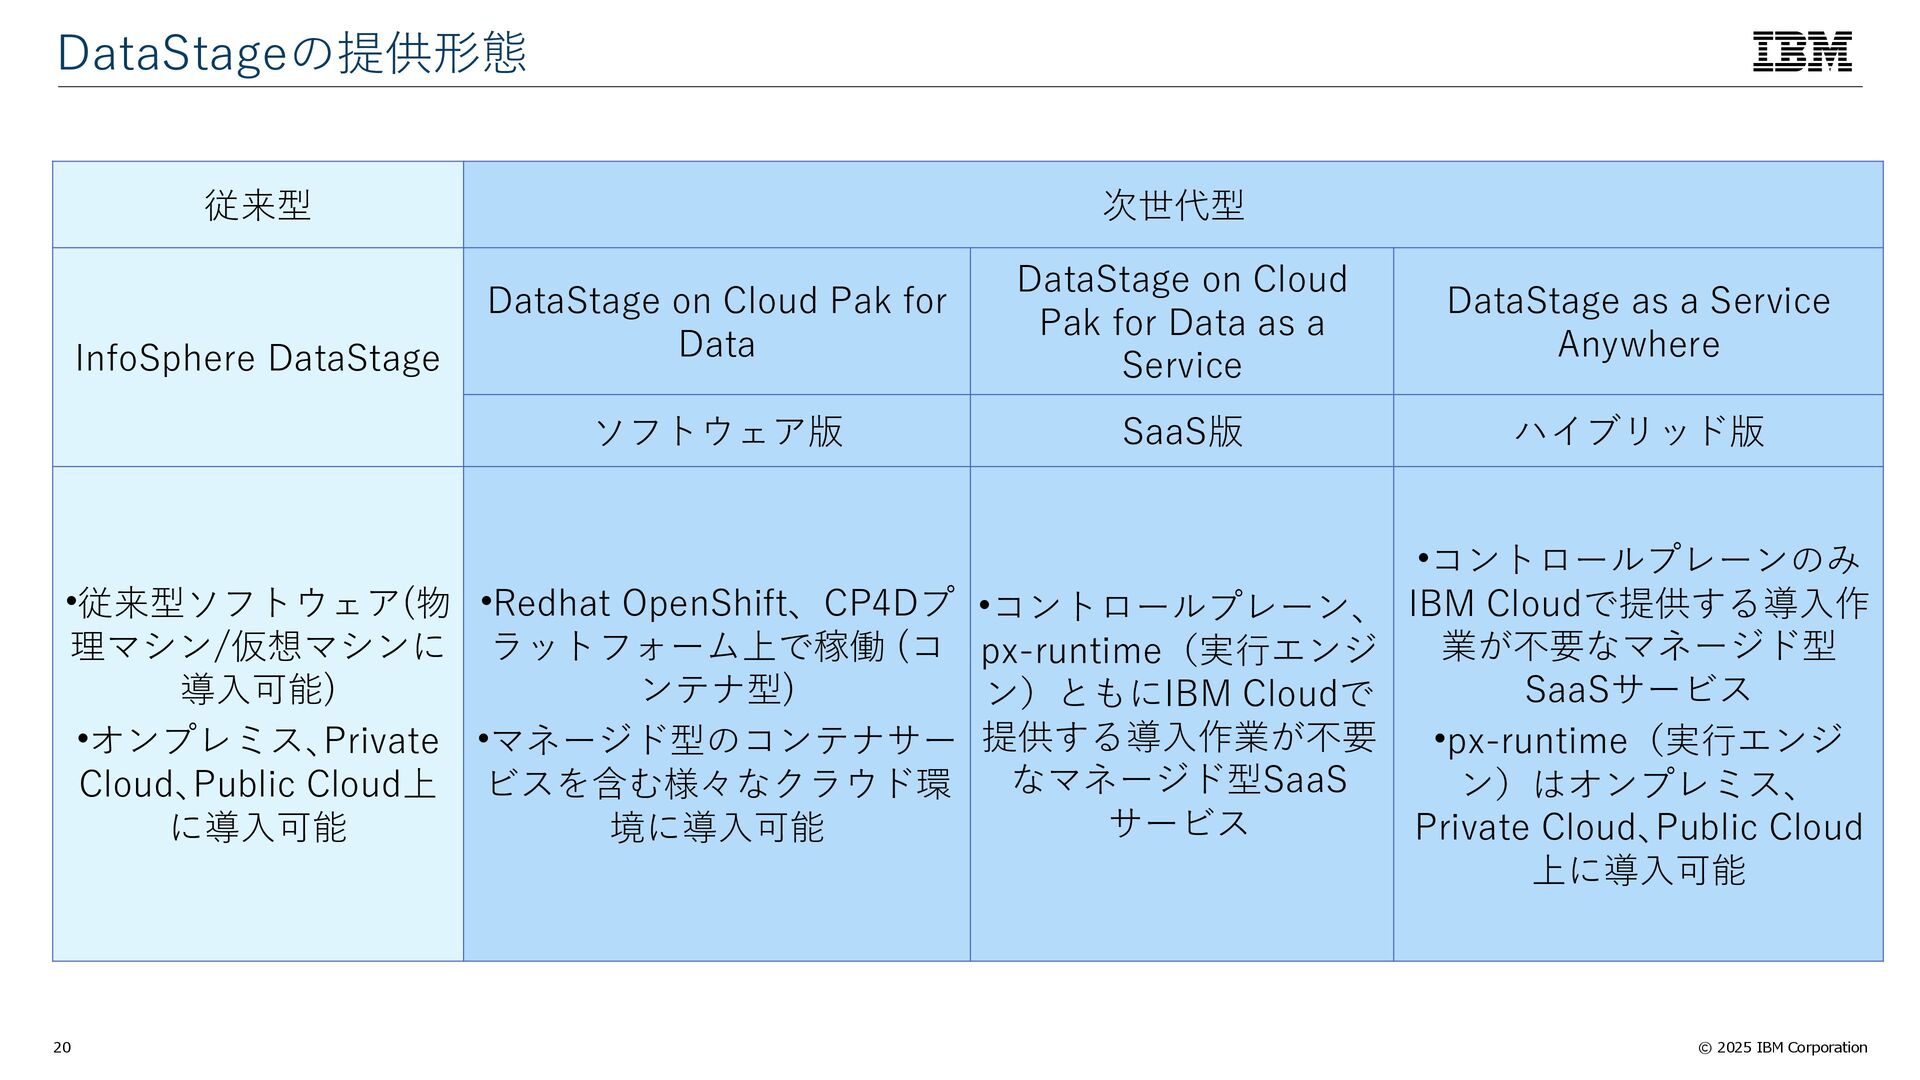
  15. © 2025 IBM Corporation 20 DataStageの提供形態 従来型 次世代型 InfoSphere DataStage

    DataStage on Cloud Pak for Data DataStage on Cloud Pak for Data as a Service DataStage as a Service Anywhere ソフトウェア版 SaaS版 ハイブリッド版 •従来型ソフトウェア(物 理マシン/仮想マシンに 導入可能) •オンプレミス、Private Cloud、Public Cloud上 に導入可能 •Redhat OpenShift、CP4Dプ ラットフォーム上で稼働 (コ ンテナ型) •マネージド型のコンテナサー ビスを含む様々なクラウド環 境に導入可能 •コントロールプレーン、 px-runtime(実行エンジ ン)ともにIBM Cloudで 提供する導入作業が不要 なマネージド型SaaS サービス •コントロールプレーンのみ IBM Cloudで提供する導入作 業が不要なマネージド型 SaaSサービス •px-runtime(実行エンジ ン)はオンプレミス、 Private Cloud、Public Cloud 上に導入可能
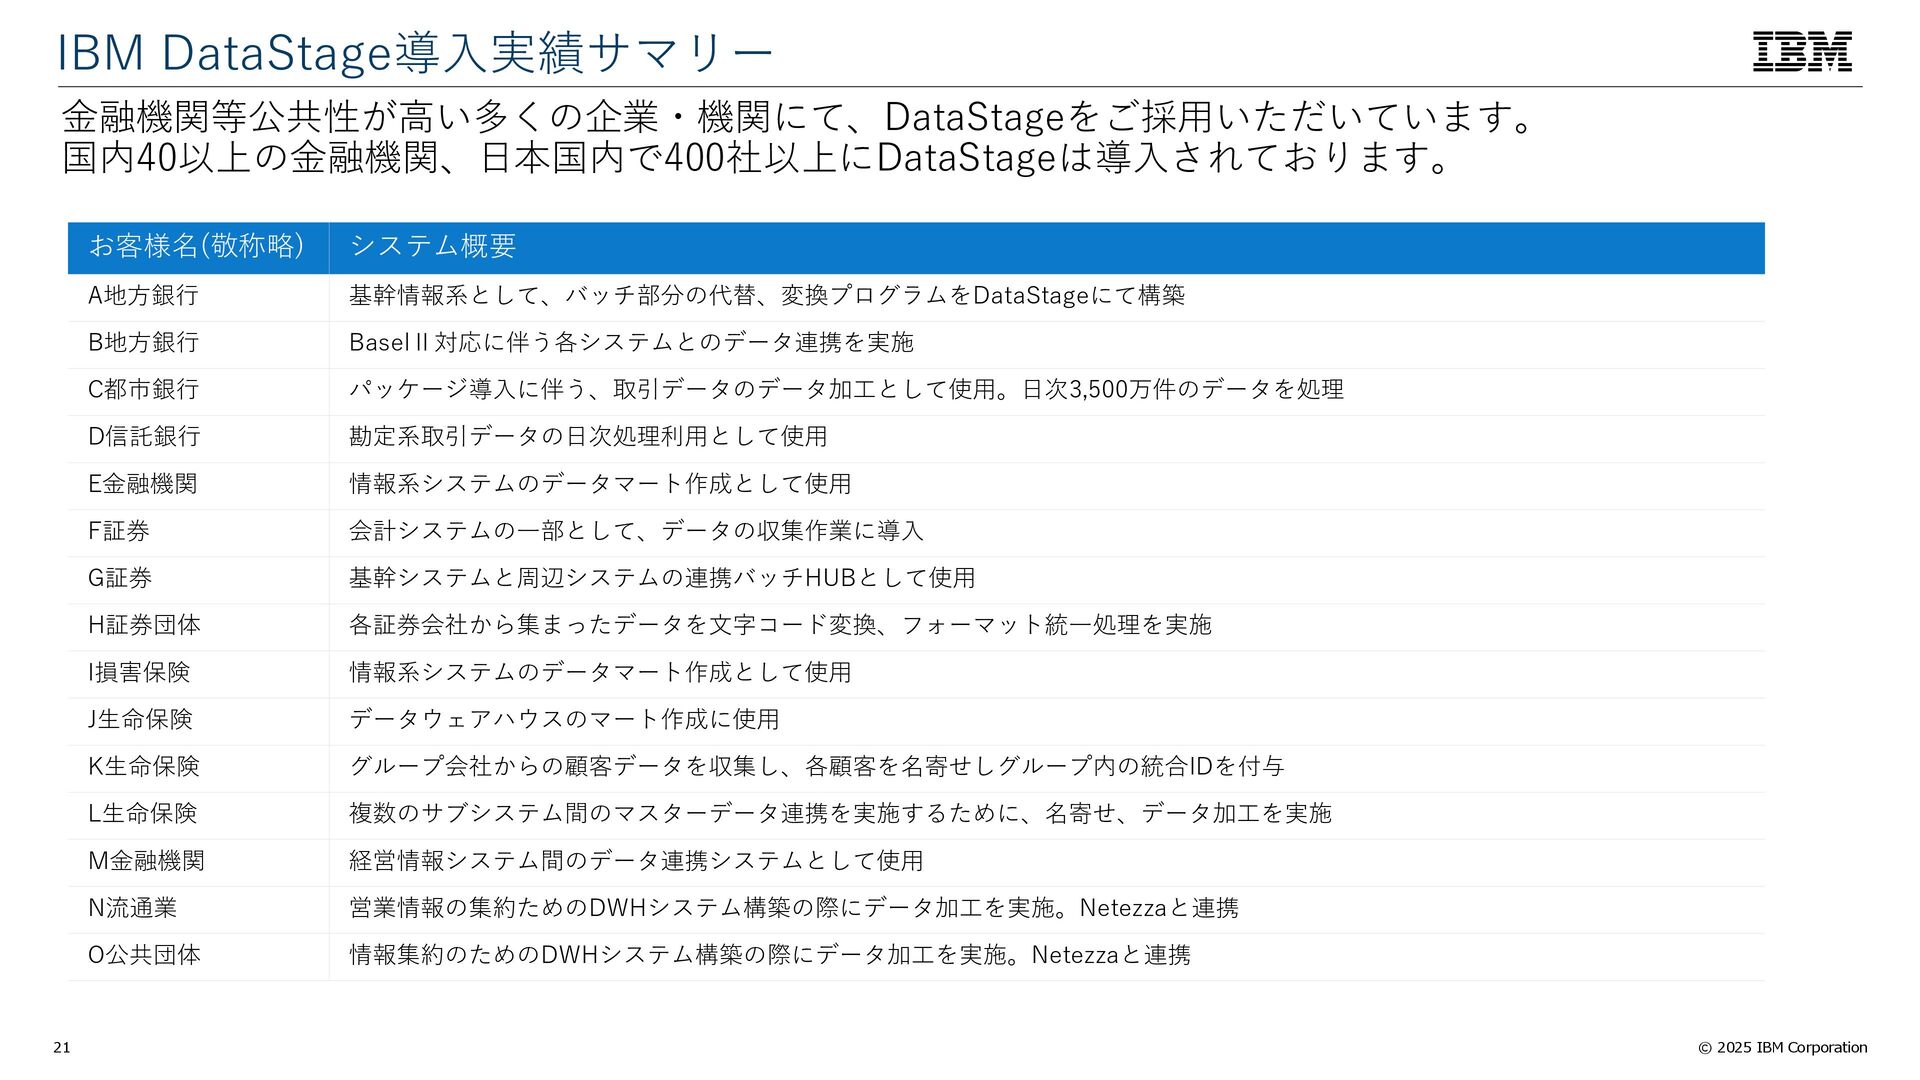
  16. © 2025 IBM Corporation 21 金融機関等公共性が高い多くの企業・機関にて、DataStageをご採用いただいています。 国内40以上の金融機関、日本国内で400社以上にDataStageは導入されております。 IBM DataStage導入実績サマリー お客様名(敬称略)

    システム概要 A地方銀行 基幹情報系として、バッチ部分の代替、変換プログラムをDataStageにて構築 B地方銀行 BaselⅡ対応に伴う各システムとのデータ連携を実施 C都市銀行 パッケージ導入に伴う、取引データのデータ加工として使用。日次3,500万件のデータを処理 D信託銀行 勘定系取引データの日次処理利用として使用 E金融機関 情報系システムのデータマート作成として使用 F証券 会計システムの一部として、データの収集作業に導入 G証券 基幹システムと周辺システムの連携バッチHUBとして使用 H証券団体 各証券会社から集まったデータを文字コード変換、フォーマット統一処理を実施 I損害保険 情報系システムのデータマート作成として使用 J生命保険 データウェアハウスのマート作成に使用 K生命保険 グループ会社からの顧客データを収集し、各顧客を名寄せしグループ内の統合IDを付与 L生命保険 複数のサブシステム間のマスターデータ連携を実施するために、名寄せ、データ加工を実施 M金融機関 経営情報システム間のデータ連携システムとして使用 N流通業 営業情報の集約ためのDWHシステム構築の際にデータ加工を実施。Netezzaと連携 O公共団体 情報集約のためのDWHシステム構築の際にデータ加工を実施。Netezzaと連携
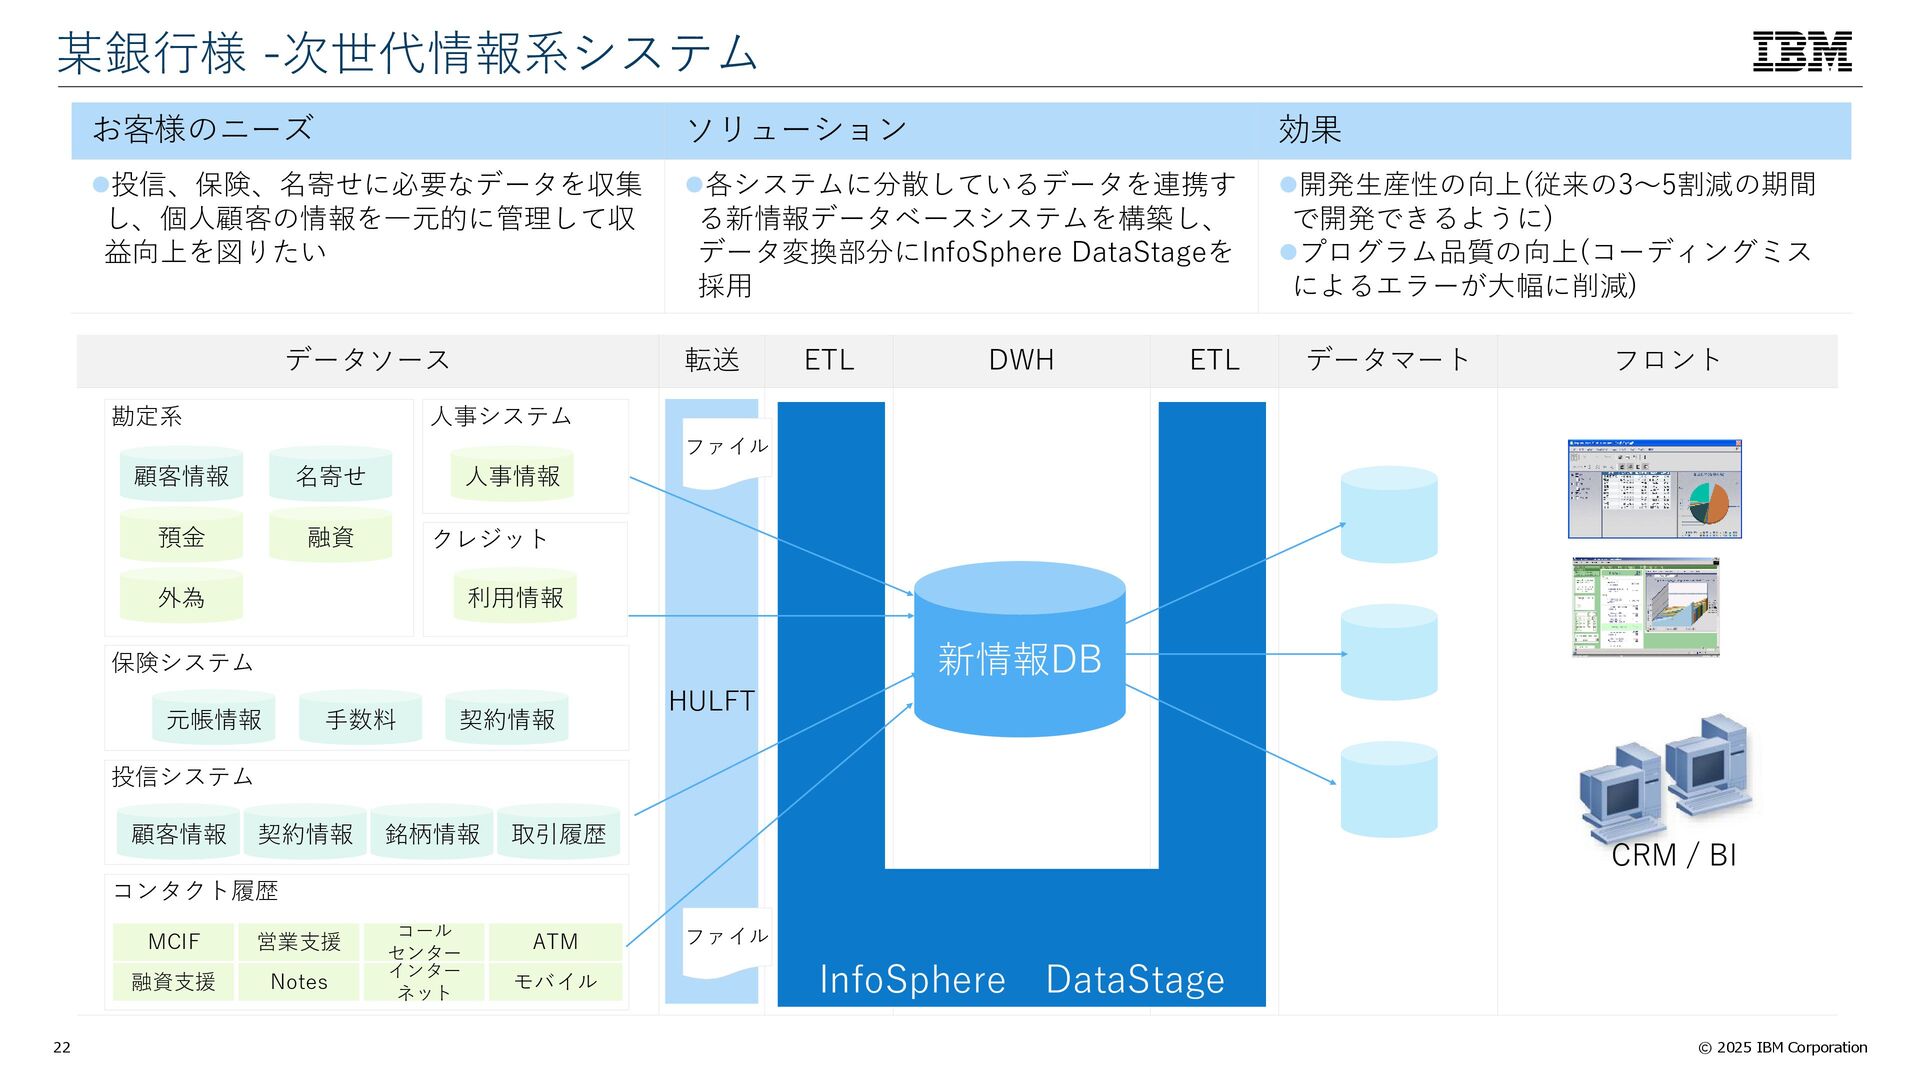
  17. © 2025 IBM Corporation 22 データソース 転送 ETL DWH ETL

    データマート フロント 某銀行様 -次世代情報系システム お客様のニーズ ソリューション 効果 ⚫投信、保険、名寄せに必要なデータを収集 し、個人顧客の情報を一元的に管理して収 益向上を図りたい ⚫各システムに分散しているデータを連携す る新情報データベースシステムを構築し、 データ変換部分にInfoSphere DataStageを 採用 ⚫開発生産性の向上(従来の3~5割減の期間 で開発できるように) ⚫プログラム品質の向上(コーディングミス によるエラーが大幅に削減) 勘定系 名寄せ 顧客情報 預金 融資 外為 人事システム 人事情報 クレジット 利用情報 保険システム 元帳情報 手数料 契約情報 投信システム 顧客情報 契約情報 銘柄情報 取引履歴 コンタクト履歴 MCIF 営業支援 融資支援 Notes コール センター ATM インター ネット モバイル HULFT ファイル ファイル 新情報DB InfoSphere DataStage CRM / BI
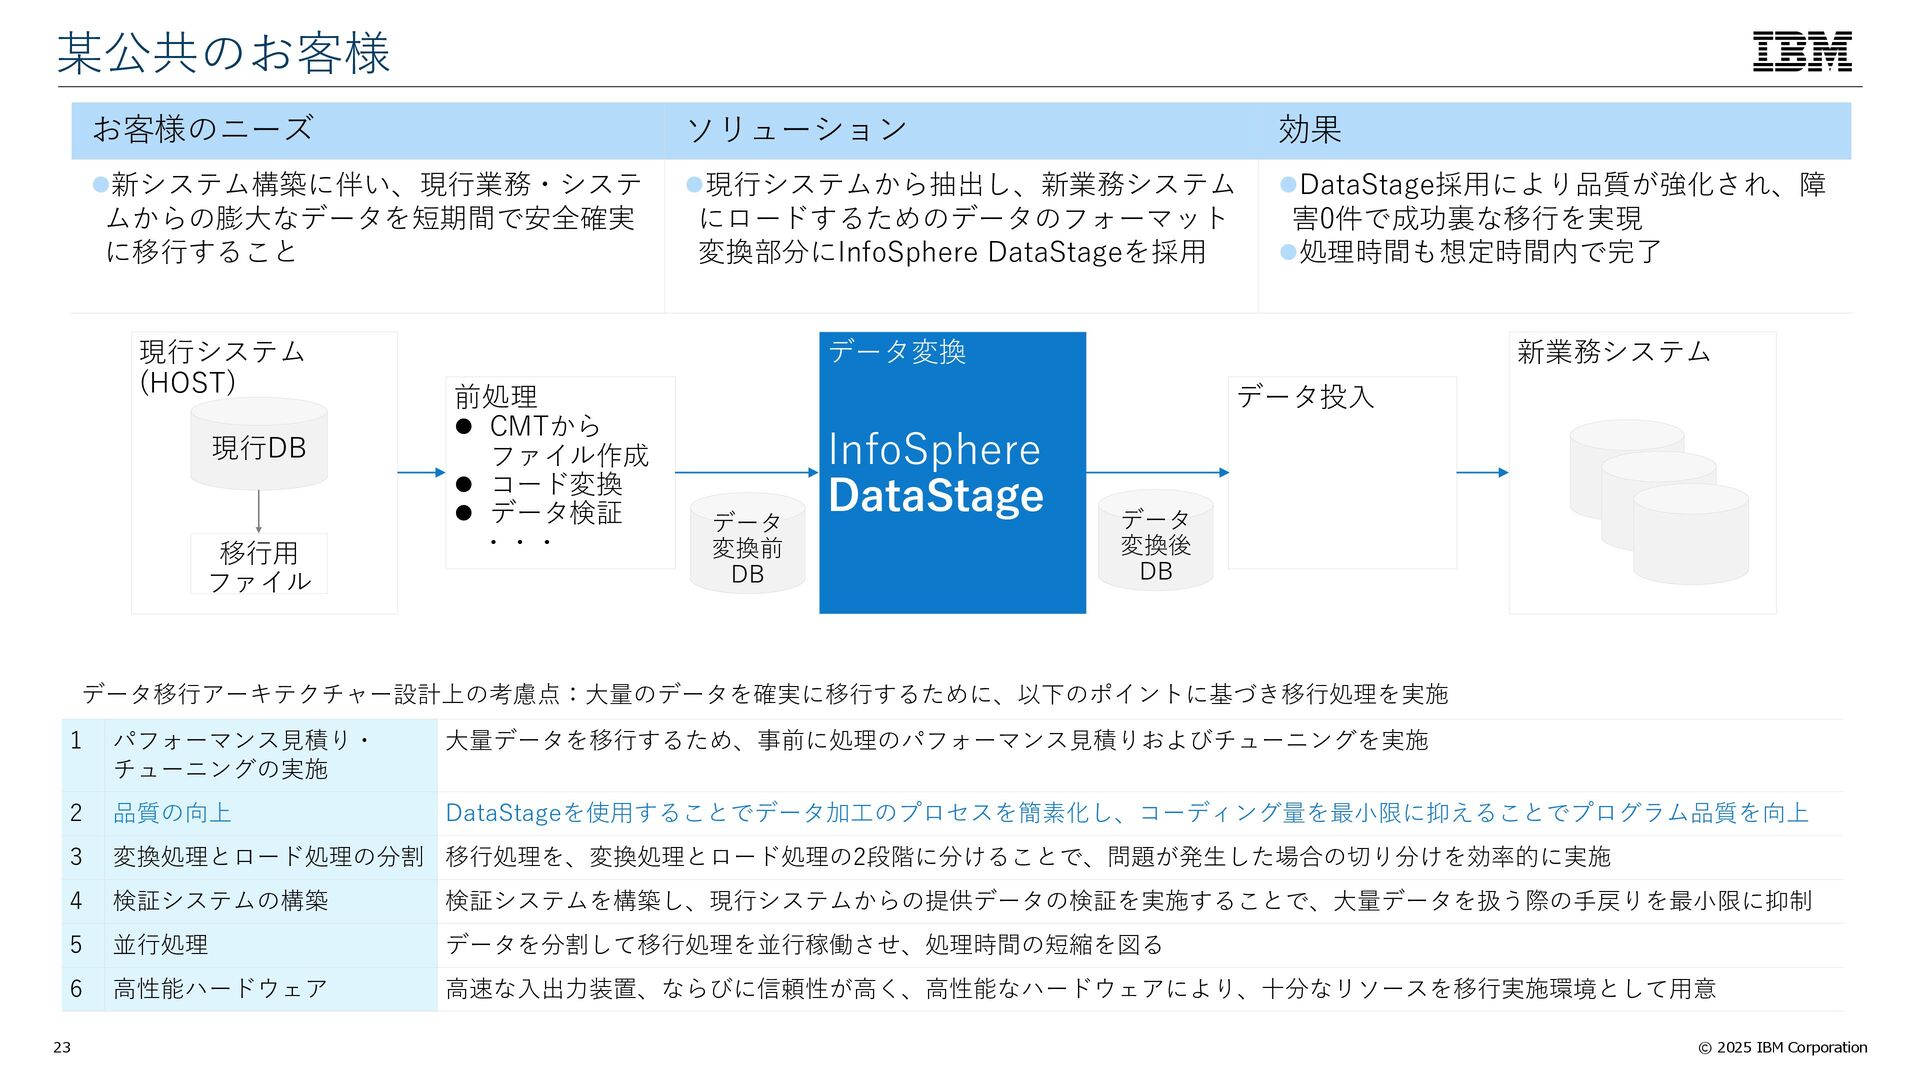
  18. © 2025 IBM Corporation 23 某公共のお客様 お客様のニーズ ソリューション 効果 ⚫新システム構築に伴い、現行業務・システ

    ムからの膨大なデータを短期間で安全確実 に移行すること ⚫現行システムから抽出し、新業務システム にロードするためのデータのフォーマット 変換部分にInfoSphere DataStageを採用 ⚫DataStage採用により品質が強化され、障 害0件で成功裏な移行を実現 ⚫処理時間も想定時間内で完了 現行システム (HOST) 前処理 ⚫ CMTから ファイル作成 ⚫ コード変換 ⚫ データ検証 ・・・ データ変換 InfoSphere DataStage データ投入 新業務システム 現行DB 移行用 ファイル データ 変換前 DB データ 変換後 DB データ移行アーキテクチャー設計上の考慮点:大量のデータを確実に移行するために、以下のポイントに基づき移行処理を実施 1 パフォーマンス見積り・ チューニングの実施 大量データを移行するため、事前に処理のパフォーマンス見積りおよびチューニングを実施 2 品質の向上 DataStageを使用することでデータ加工のプロセスを簡素化し、コーディング量を最小限に抑えることでプログラム品質を向上 3 変換処理とロード処理の分割 移行処理を、変換処理とロード処理の2段階に分けることで、問題が発生した場合の切り分けを効率的に実施 4 検証システムの構築 検証システムを構築し、現行システムからの提供データの検証を実施することで、大量データを扱う際の手戻りを最小限に抑制 5 並行処理 データを分割して移行処理を並行稼働させ、処理時間の短縮を図る 6 高性能ハードウェア 高速な入出力装置、ならびに信頼性が高く、高性能なハードウェアにより、十分なリソースを移行実施環境として用意
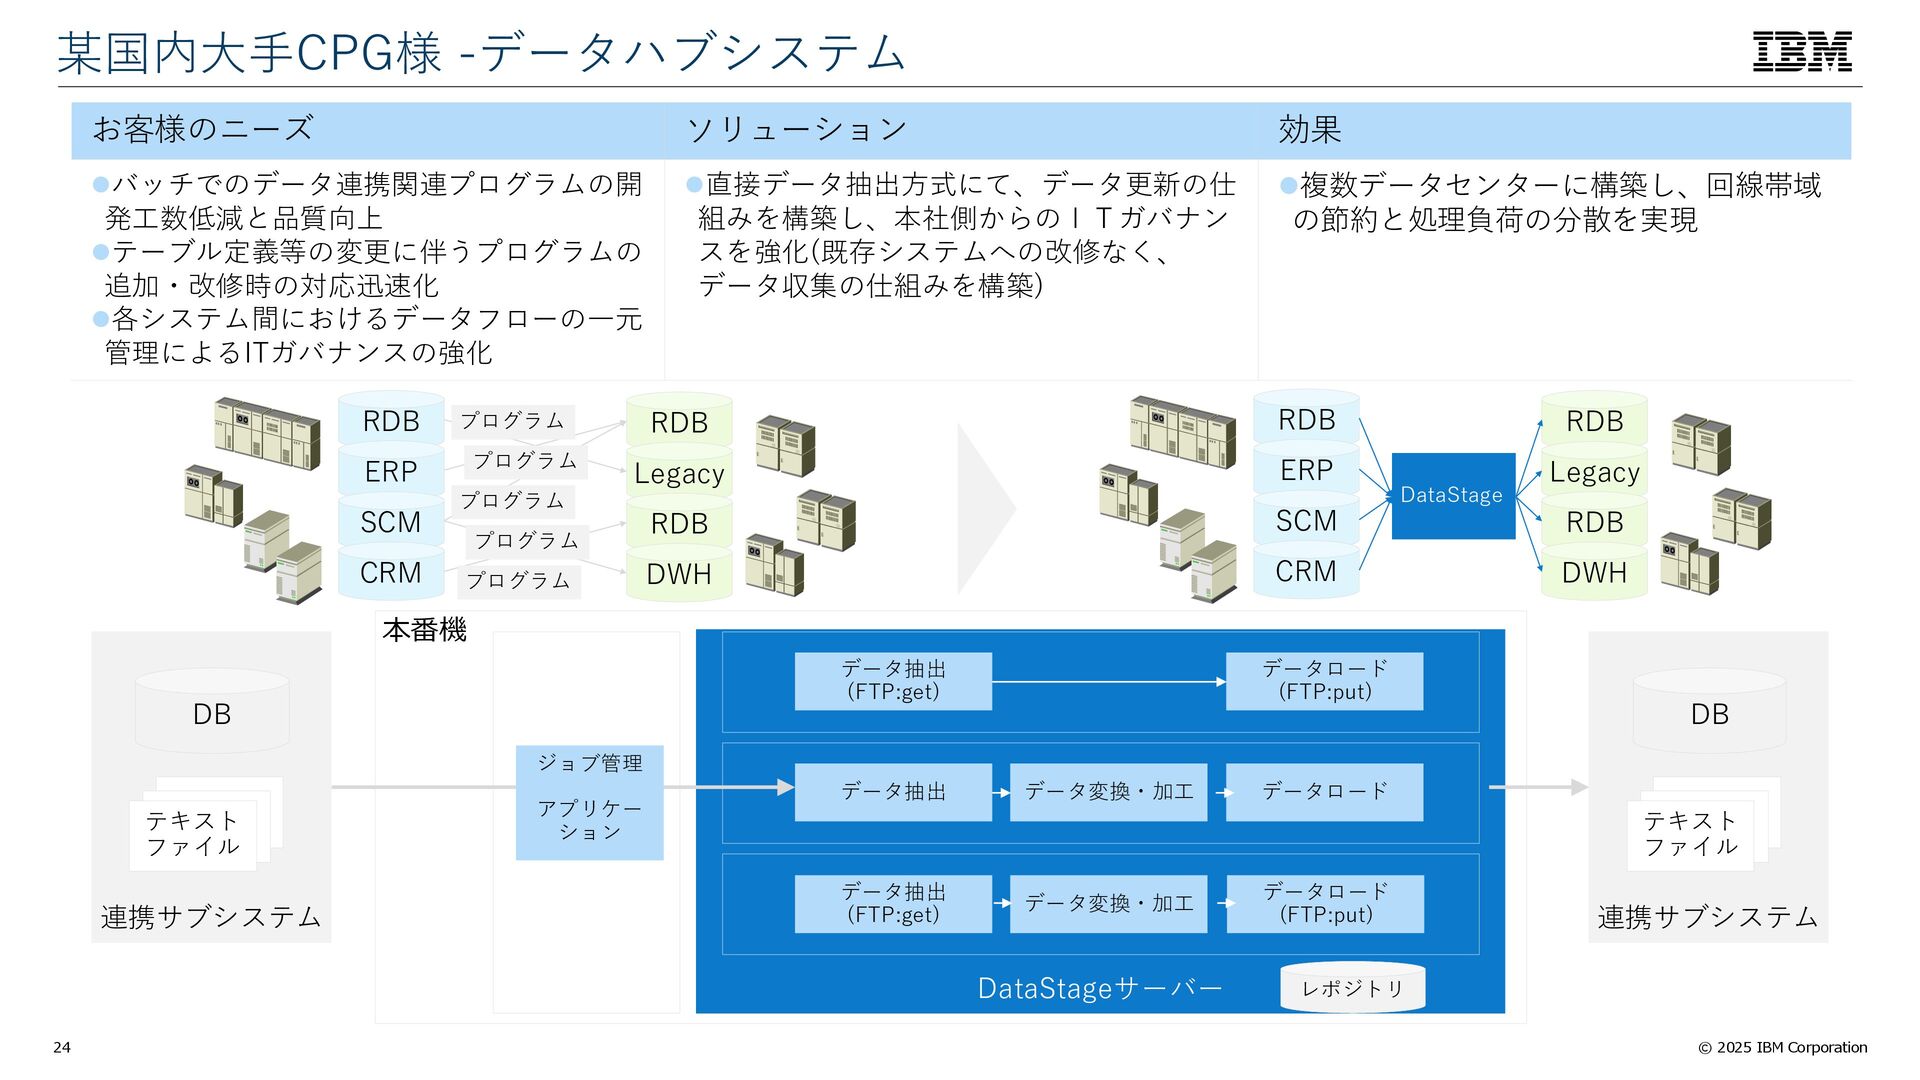
  19. © 2025 IBM Corporation 24 本番機 某国内大手CPG様 -データハブシステム お客様のニーズ ソリューション

    効果 ⚫バッチでのデータ連携関連プログラムの開 発工数低減と品質向上 ⚫テーブル定義等の変更に伴うプログラムの 追加・改修時の対応迅速化 ⚫各システム間におけるデータフローの一元 管理によるITガバナンスの強化 ⚫直接データ抽出方式にて、データ更新の仕 組みを構築し、本社側からのITガバナン スを強化(既存システムへの改修なく、 データ収集の仕組みを構築) ⚫複数データセンターに構築し、回線帯域 の節約と処理負荷の分散を実現 連携サブシステム DataStageサーバー 連携サブシステム DB テキスト ファイル DB テキスト ファイル データ抽出 データロード (FTP:put) データ抽出 (FTP:get) データ変換・加工 データロード データ抽出 (FTP:get) データロード (FTP:put) データ変換・加工 ジョブ管理 アプリケー ション レポジトリ RDB ERP SCM CRM RDB Legacy RDB DWH RDB ERP SCM CRM RDB Legacy RDB DWH プログラム プログラム プログラム プログラム プログラム DataStage
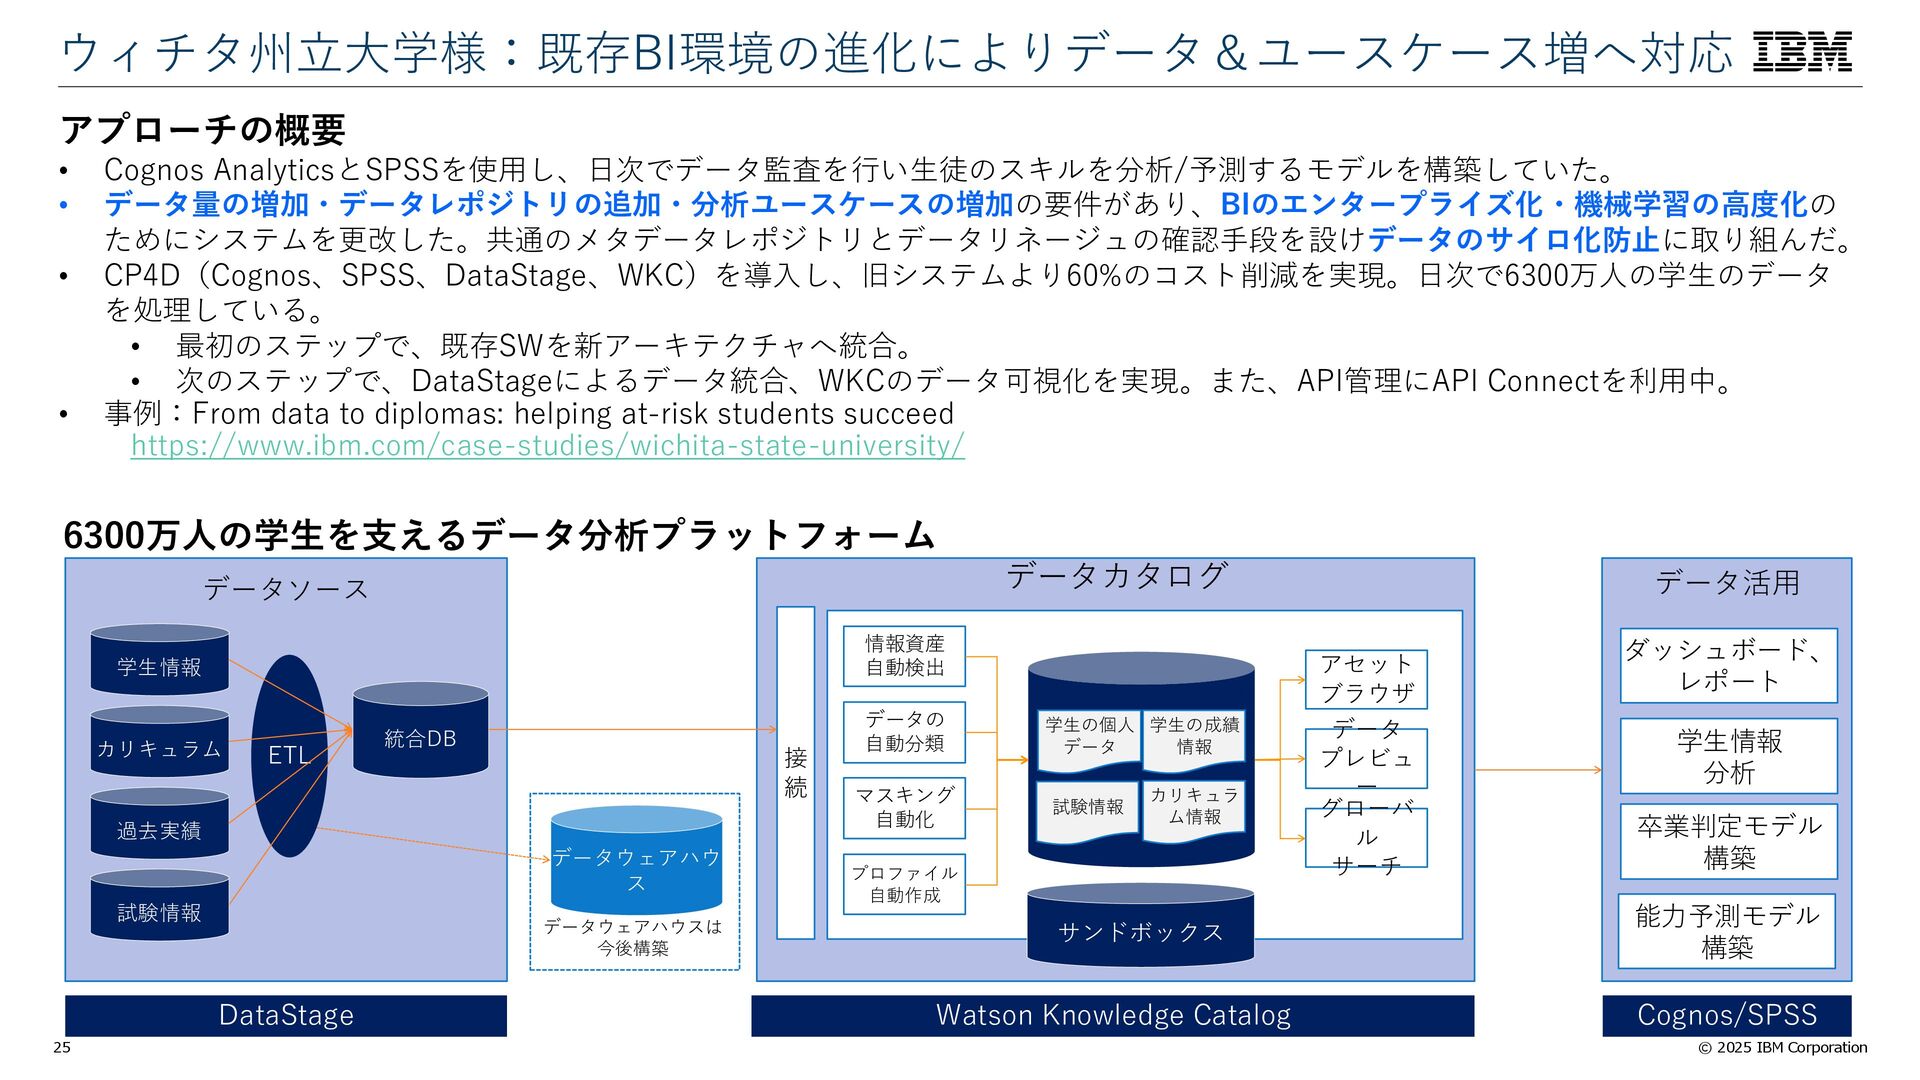
  20. © 2025 IBM Corporation 25 ウィチタ州立大学様:既存BI環境の進化によりデータ&ユースケース増へ対応 データカタログ データ活用 データソース ETL

    過去実績 学生情報 データの 自動分類 マスキング 自動化 プロファイル 自動作成 情報資産 自動検出 接 続 アセット ブラウザ グローバ ル サーチ データ プレビュ ー サンドボックス データウェアハウ ス 学生の個人 データ 学生の成績 情報 試験情報 カリキュラ ム情報 ダッシュボード、 レポート 卒業判定モデル 構築 能力予測モデル 構築 学生情報 分析 DataStage Watson Knowledge Catalog Cognos/SPSS アプローチの概要 • Cognos AnalyticsとSPSSを使用し、日次でデータ監査を行い生徒のスキルを分析/予測するモデルを構築していた。 • データ量の増加・データレポジトリの追加・分析ユースケースの増加の要件があり、BIのエンタープライズ化・機械学習の高度化の ためにシステムを更改した。共通のメタデータレポジトリとデータリネージュの確認手段を設けデータのサイロ化防止に取り組んだ。 • CP4D(Cognos、SPSS、DataStage、WKC)を導入し、旧システムより60%のコスト削減を実現。日次で6300万人の学生のデータ を処理している。 • 最初のステップで、既存SWを新アーキテクチャへ統合。 • 次のステップで、DataStageによるデータ統合、WKCのデータ可視化を実現。また、API管理にAPI Connectを利用中。 • 事例:From data to diplomas: helping at-risk students succeed https://www.ibm.com/case-studies/wichita-state-university/ 6300万人の学生を支えるデータ分析プラットフォーム 統合DB 試験情報 カリキュラム データウェアハウスは 今後構築
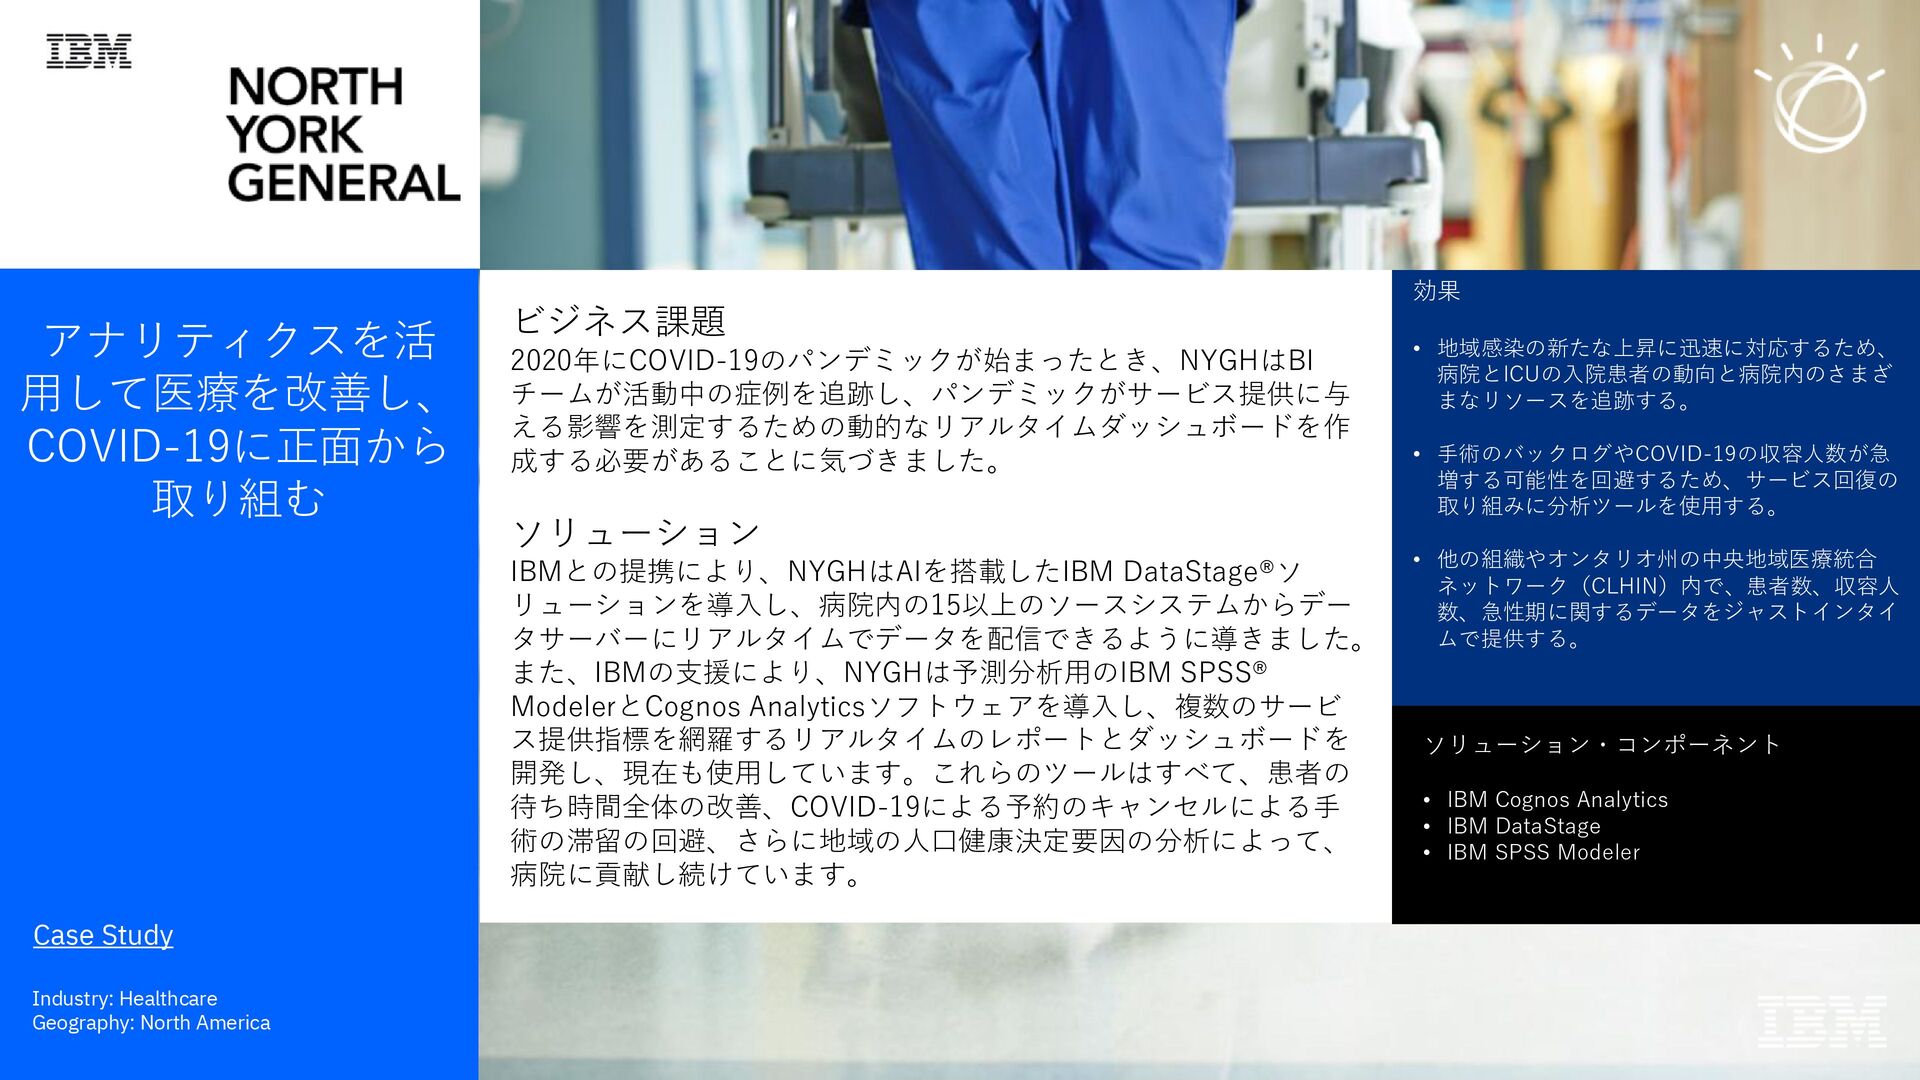
  21. ビジネス課題 2020年にCOVID-19のパンデミックが始まったとき、NYGHはBI チームが活動中の症例を追跡し、パンデミックがサービス提供に与 える影響を測定するための動的なリアルタイムダッシュボードを作 成する必要があることに気づきました。 ソリューション IBMとの提携により、NYGHはAIを搭載したIBM DataStage®ソ リューションを導入し、病院内の15以上のソースシステムからデー タサーバーにリアルタイムでデータを配信できるように導きました。

    また、IBMの支援により、NYGHは予測分析用のIBM SPSS® ModelerとCognos Analyticsソフトウェアを導入し、複数のサービ ス提供指標を網羅するリアルタイムのレポートとダッシュボードを 開発し、現在も使用しています。これらのツールはすべて、患者の 待ち時間全体の改善、COVID-19による予約のキャンセルによる手 術の滞留の回避、さらに地域の人口健康決定要因の分析によって、 病院に貢献し続けています。 効果 • 地域感染の新たな上昇に迅速に対応するため、 病院とICUの入院患者の動向と病院内のさまざ まなリソースを追跡する。 • 手術のバックログやCOVID-19の収容人数が急 増する可能性を回避するため、サービス回復の 取り組みに分析ツールを使用する。 • 他の組織やオンタリオ州の中央地域医療統合 ネットワーク(CLHIN)内で、患者数、収容人 数、急性期に関するデータをジャストインタイ ムで提供する。 ソリューション・コンポーネント • IBM Cognos Analytics • IBM DataStage • IBM SPSS Modeler アナリティクスを活 用して医療を改善し、 COVID-19に正面から 取り組む Industry: Healthcare Geography: North America Case Study Case Study
  22. 本日のまとめ • IBM DataStageの位置付けと概要 • デモ • IBM DataStageの特徴 •

    ユースケースのご紹介 IBM Data Platform / © 2025 IBM Corporation
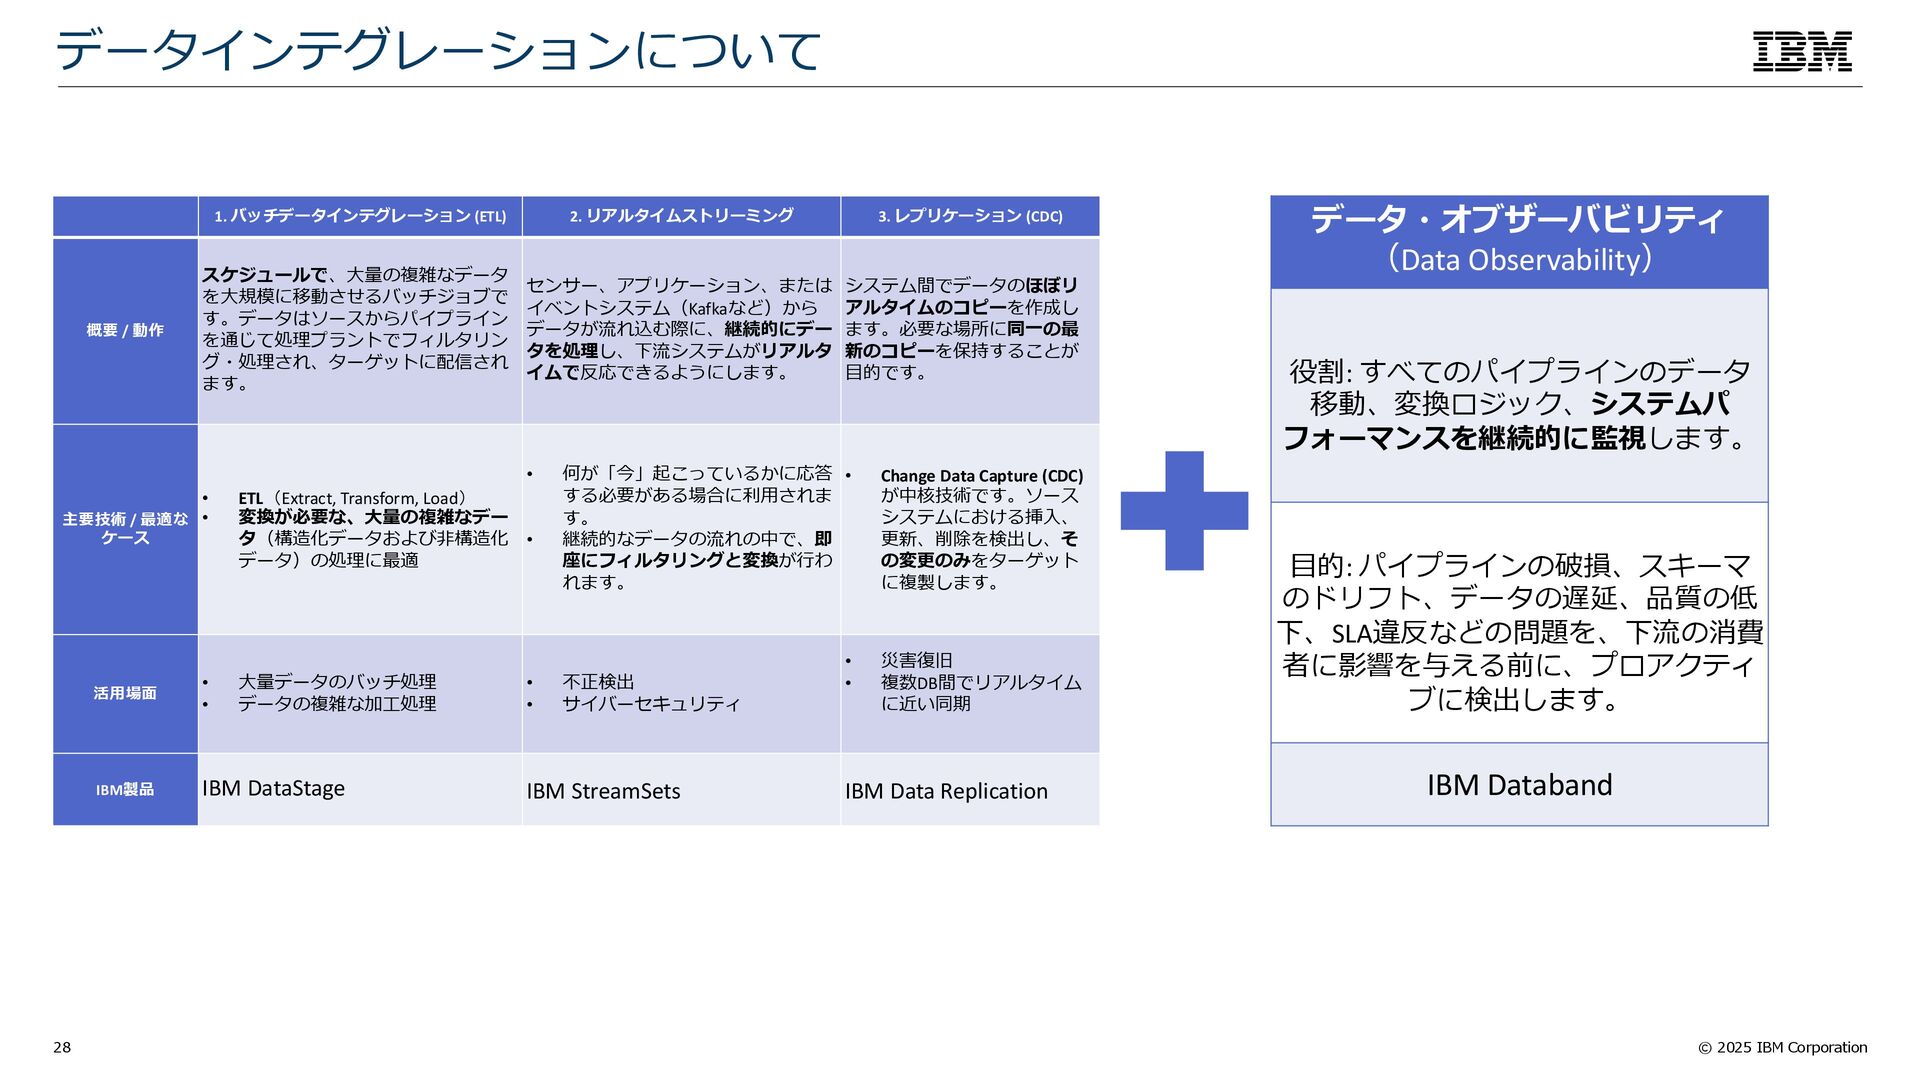
  23. © 2025 IBM Corporation 28 データインテグレーションについて 1. バッチデータインテグレーション (ETL) 2.

    リアルタイムストリーミング 3. レプリケーション (CDC) 概要 / 動作 スケジュールで、大量の複雑なデータ を大規模に移動させるバッチジョブで す。データはソースからパイプライン を通じて処理プラントでフィルタリン グ・処理され、ターゲットに配信され ます。 センサー、アプリケーション、または イベントシステム(Kafkaなど)から データが流れ込む際に、継続的にデー タを処理し、下流システムがリアルタ イムで反応できるようにします。 システム間でデータのほぼリ アルタイムのコピーを作成し ます。必要な場所に同一の最 新のコピーを保持することが 目的です。 主要技術 / 最適な ケース • ETL(Extract, Transform, Load) • 変換が必要な、大量の複雑なデー タ(構造化データおよび非構造化 データ)の処理に最適 • 何が「今」起こっているかに応答 する必要がある場合に利用されま す。 • 継続的なデータの流れの中で、即 座にフィルタリングと変換が行わ れます。 • Change Data Capture (CDC) が中核技術です。ソース システムにおける挿入、 更新、削除を検出し、そ の変更のみをターゲット に複製します。 活用場面 • 大量データのバッチ処理 • データの複雑な加工処理 • 不正検出 • サイバーセキュリティ • 災害復旧 • 複数DB間でリアルタイム に近い同期 IBM製品 IBM DataStage IBM StreamSets IBM Data Replication データ・オブザーバビリティ (Data Observability) 役割: すべてのパイプラインのデータ 移動、変換ロジック、システムパ フォーマンスを継続的に監視します。 目的: パイプラインの破損、スキーマ のドリフト、データの遅延、品質の低 下、SLA違反などの問題を、下流の消費 者に影響を与える前に、プロアクティ ブに検出します。 IBM Databand
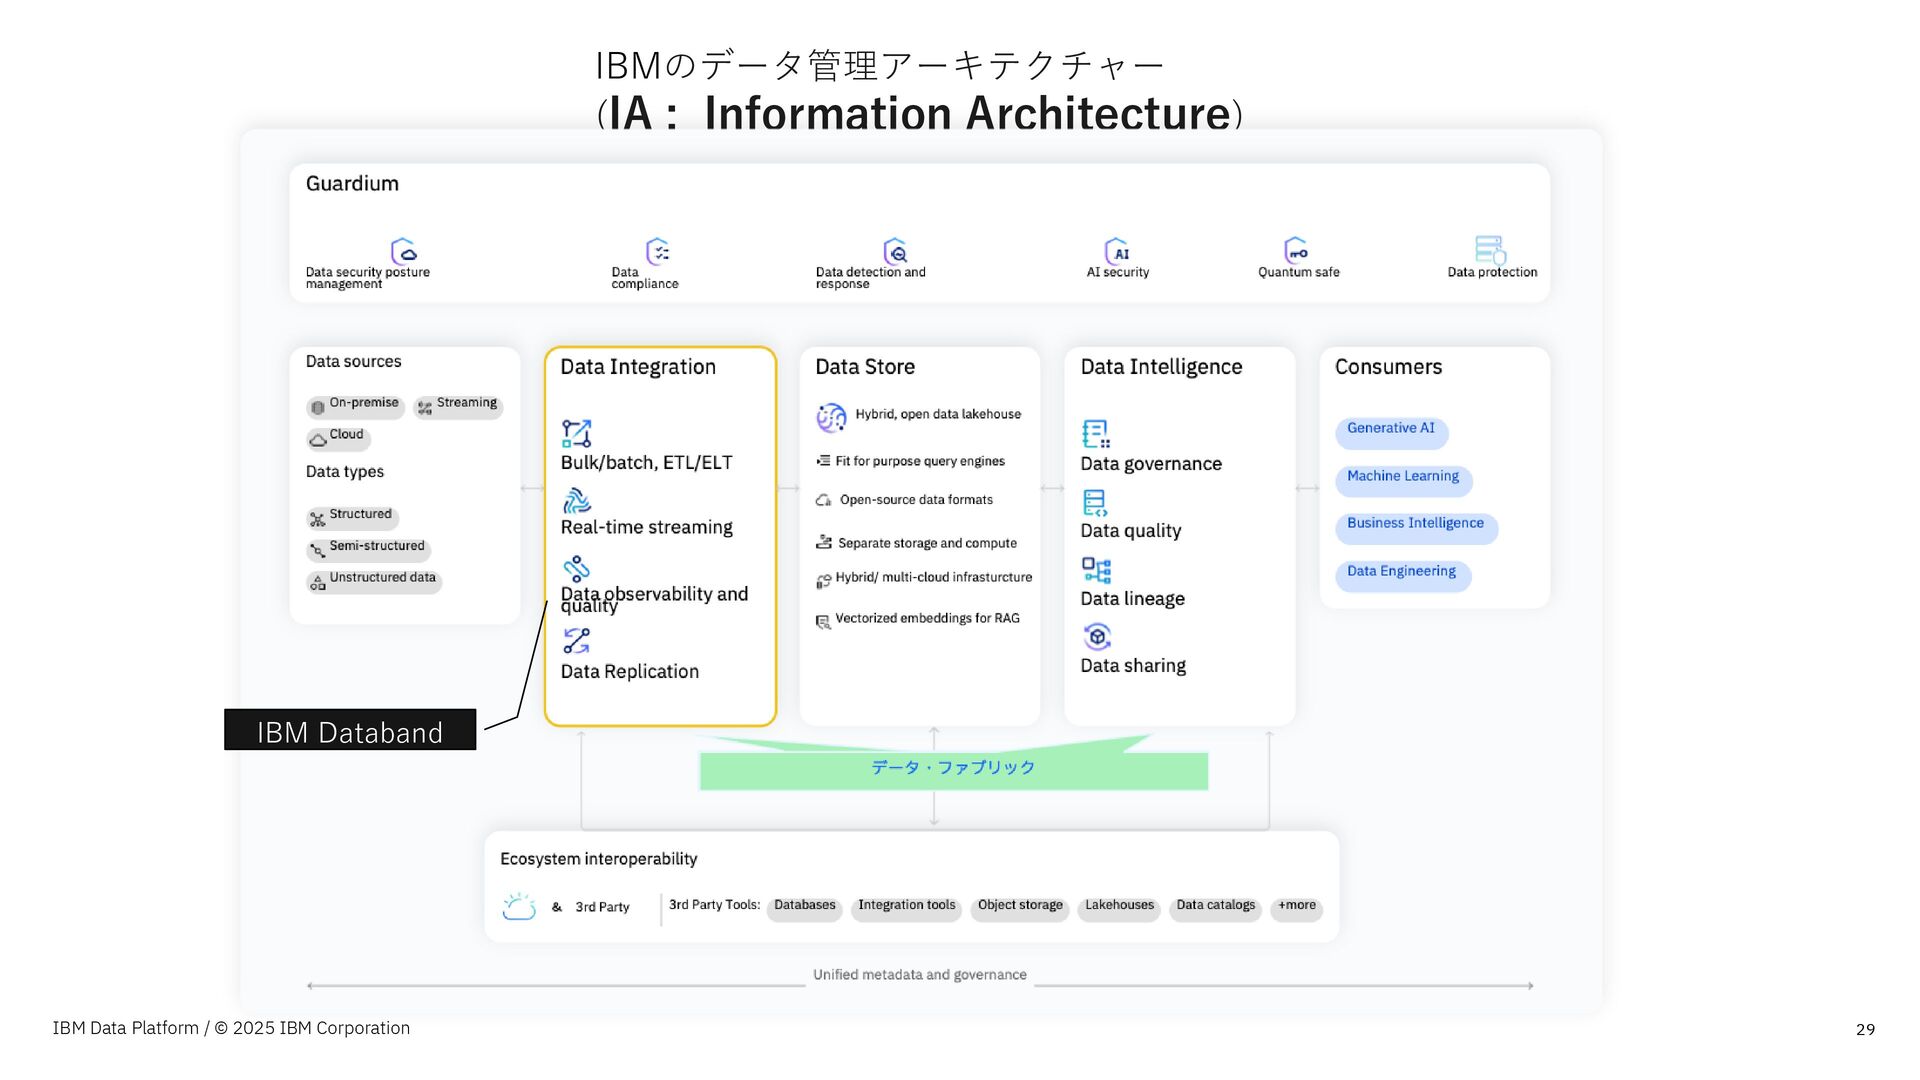
  24. 29 IBM Data Platform / © 2025 IBM Corporation Data

    sources On-premise Streaming Cloud Data types Structured Semi-structured Unstructured data Data Integration Bulk/batch, ETL/ELT Real-time streaming Data observability and quality Data Replication Data Store Hybrid, open data lakehouse Fit for purpose query engines Open-source data formats Separate storage and compute Hybrid/ multi-cloud infrasturcture Vectorized embeddings for RAG Data Intelligence Data governance Data quality Data lineage Data sharing Consumers Generative AI Machine Learning Business Intelligence Data Engineering Ecosystem interoperability 3rd Party Tools: Databases Integration tools Object storage Lakehouses Data catalogs +more Unified metadata and governance Guardium Data security posture management Data compliance Data detection and response AI security Quantum safe Data protection データ・ファブリック IBMのデータ管理アーキテクチャー (IA : Information Architecture) & 3rd Party IBM Databand
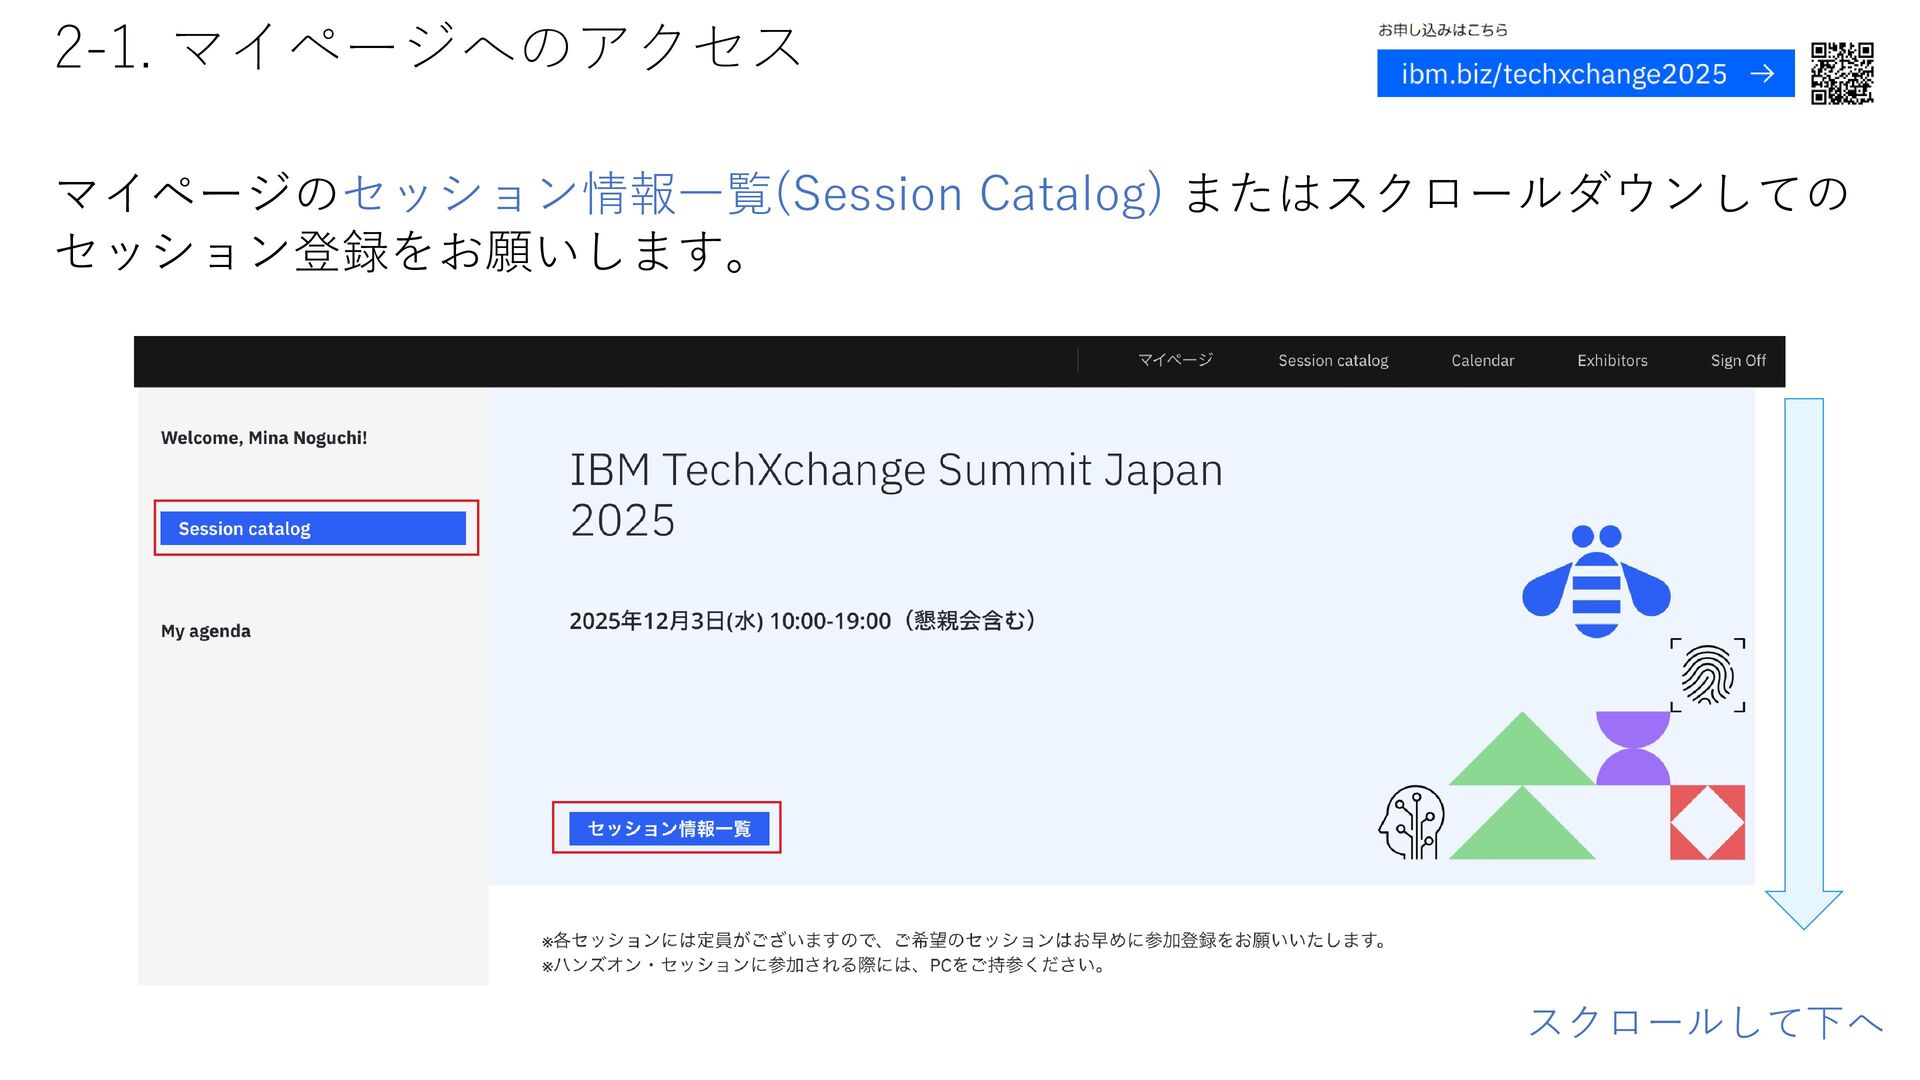
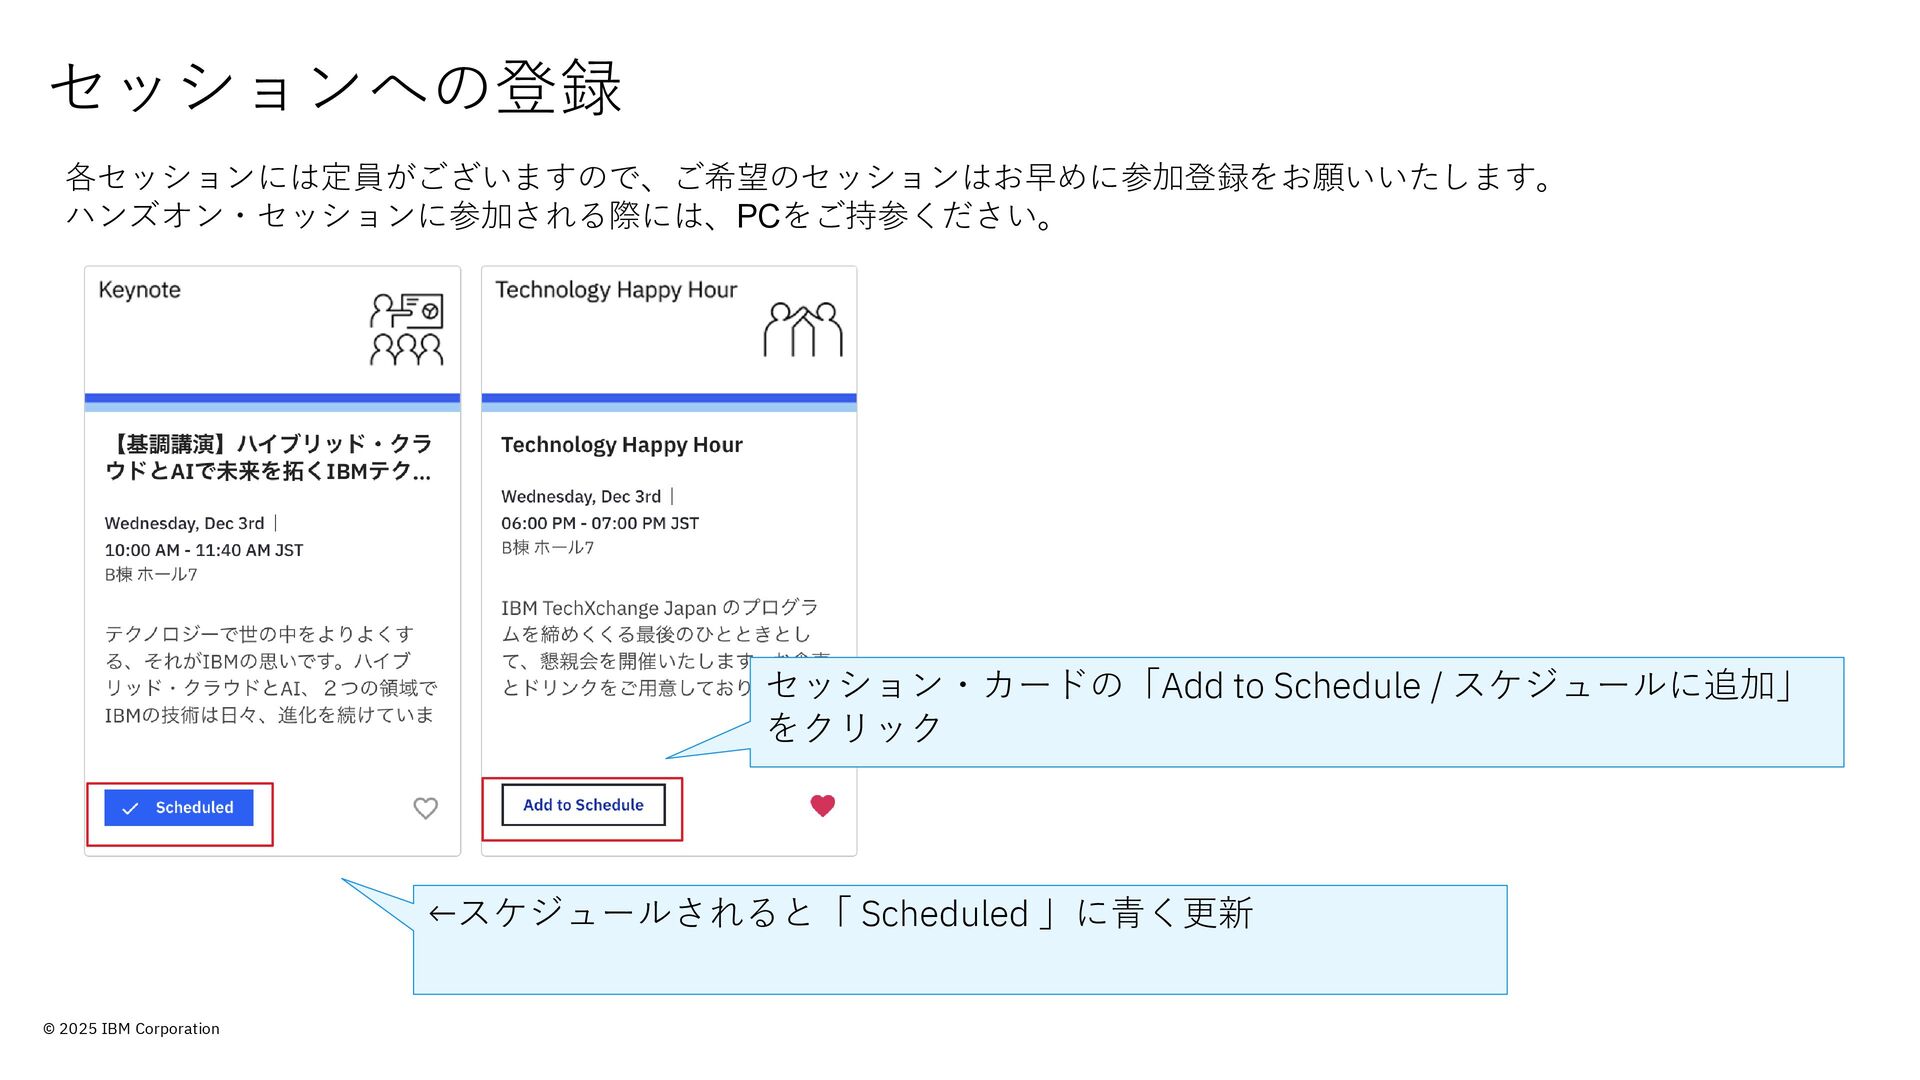
  25. © 2025 IBM Corporation セッションへの登録 セッション・カードの「Add to Schedule / スケジュールに追加」

    をクリック 各セッションには定員がございますので、ご希望のセッションはお早めに参加登録をお願いいたします。 ハンズオン・セッションに参加される際には、PCをご持参ください。 ←スケジュールされると「 Scheduled 」に青く更新
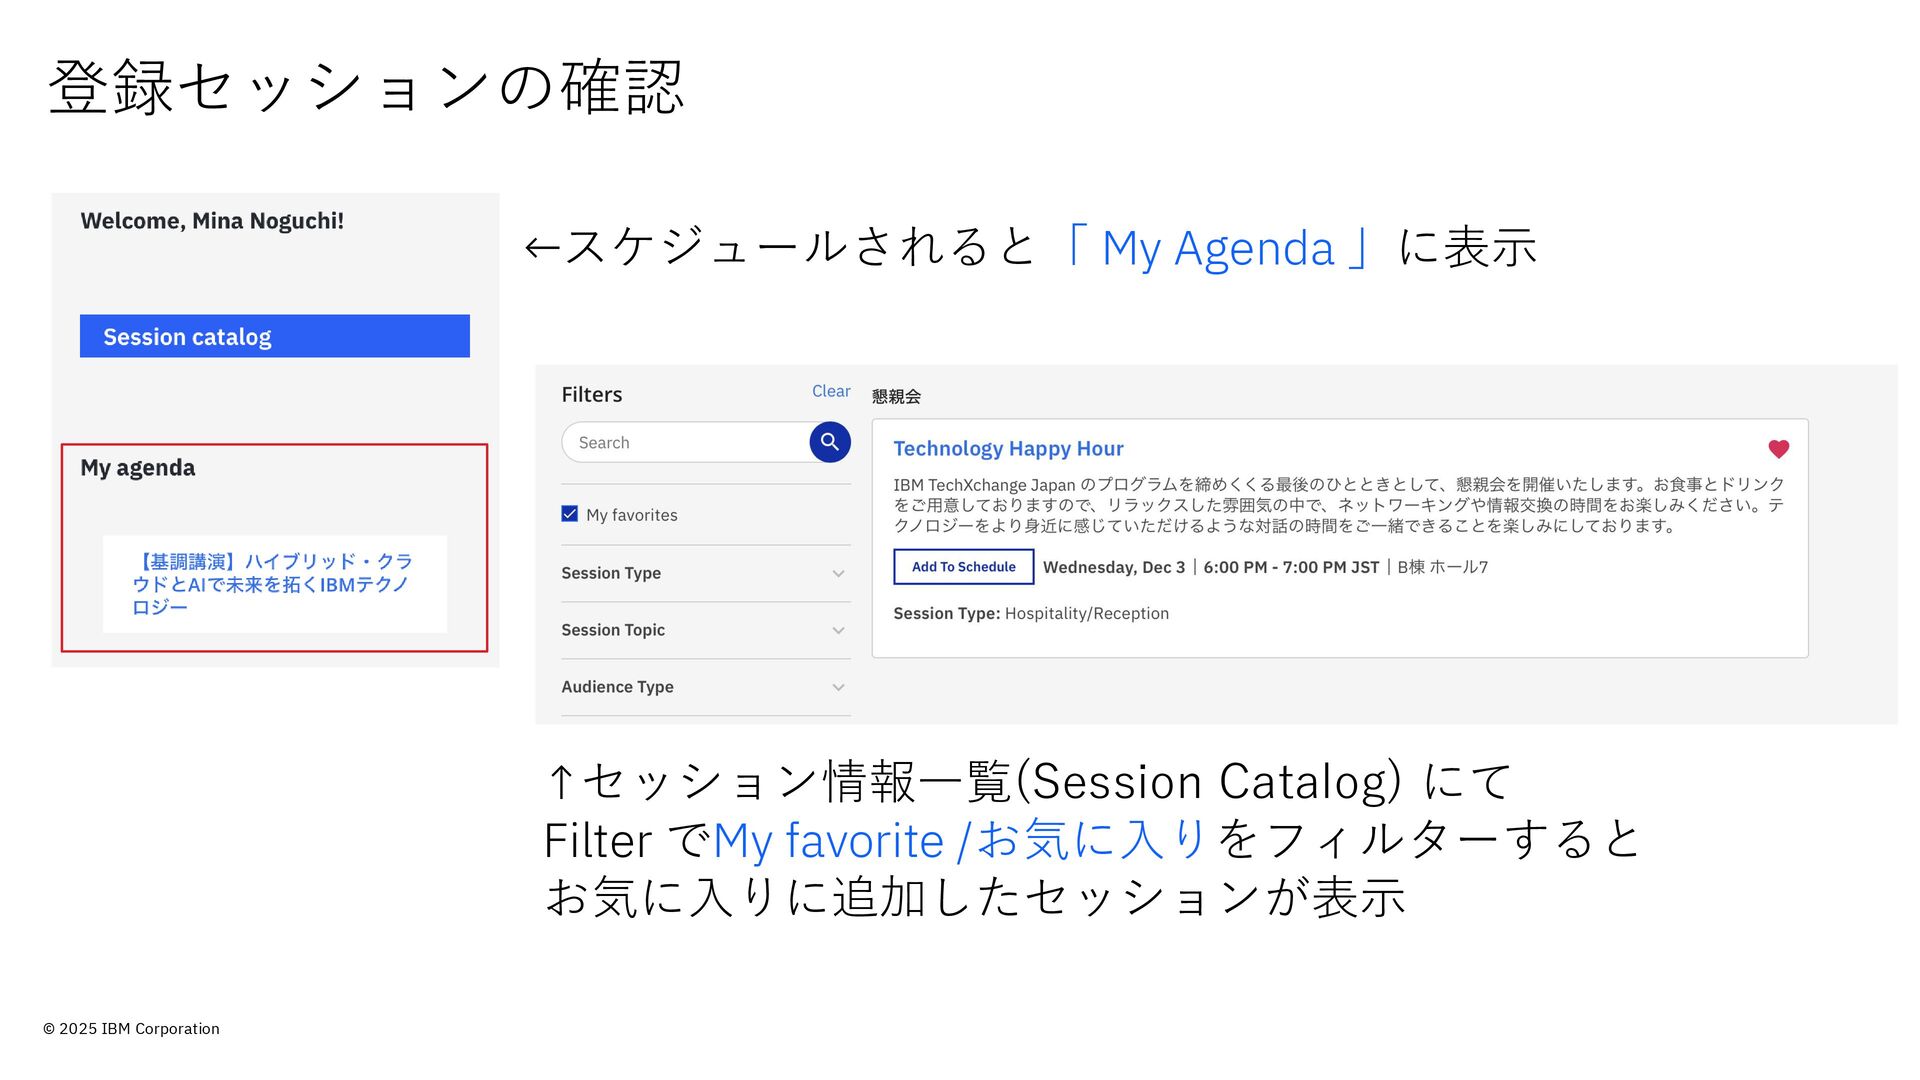
  26. © 2025 IBM Corporation 登録セッションの確認 ←スケジュールされると「 My Agenda 」に表示 ↑セッション情報一覧(Session

    Catalog) にて Filter でMy favorite /お気に入りをフィルターすると お気に入りに追加したセッションが表示
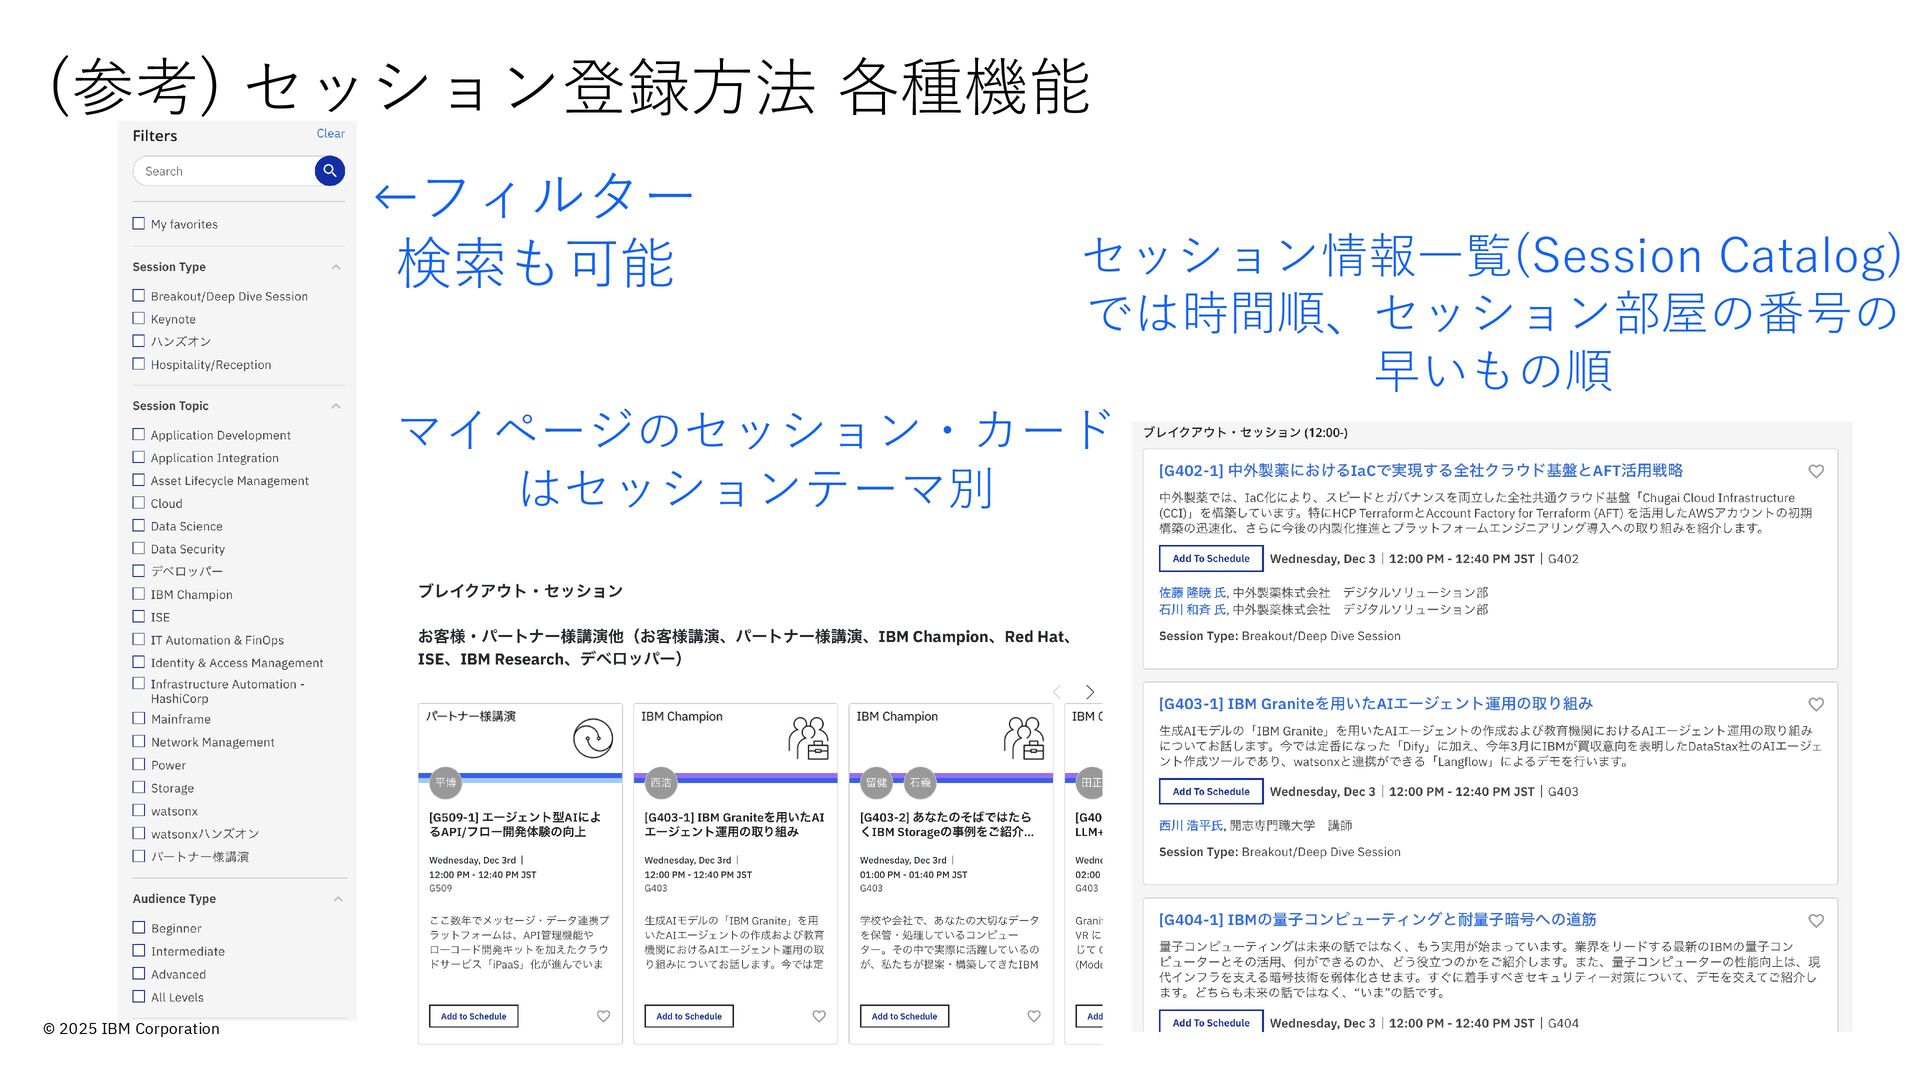
  27. © 2025 IBM Corporation (参考) セッション登録方法 各種機能 ←フィルター 検索も可能 マイページのセッション・カード

    はセッションテーマ別 セッション情報一覧(Session Catalog) では時間順、セッション部屋の番号の 早いもの順
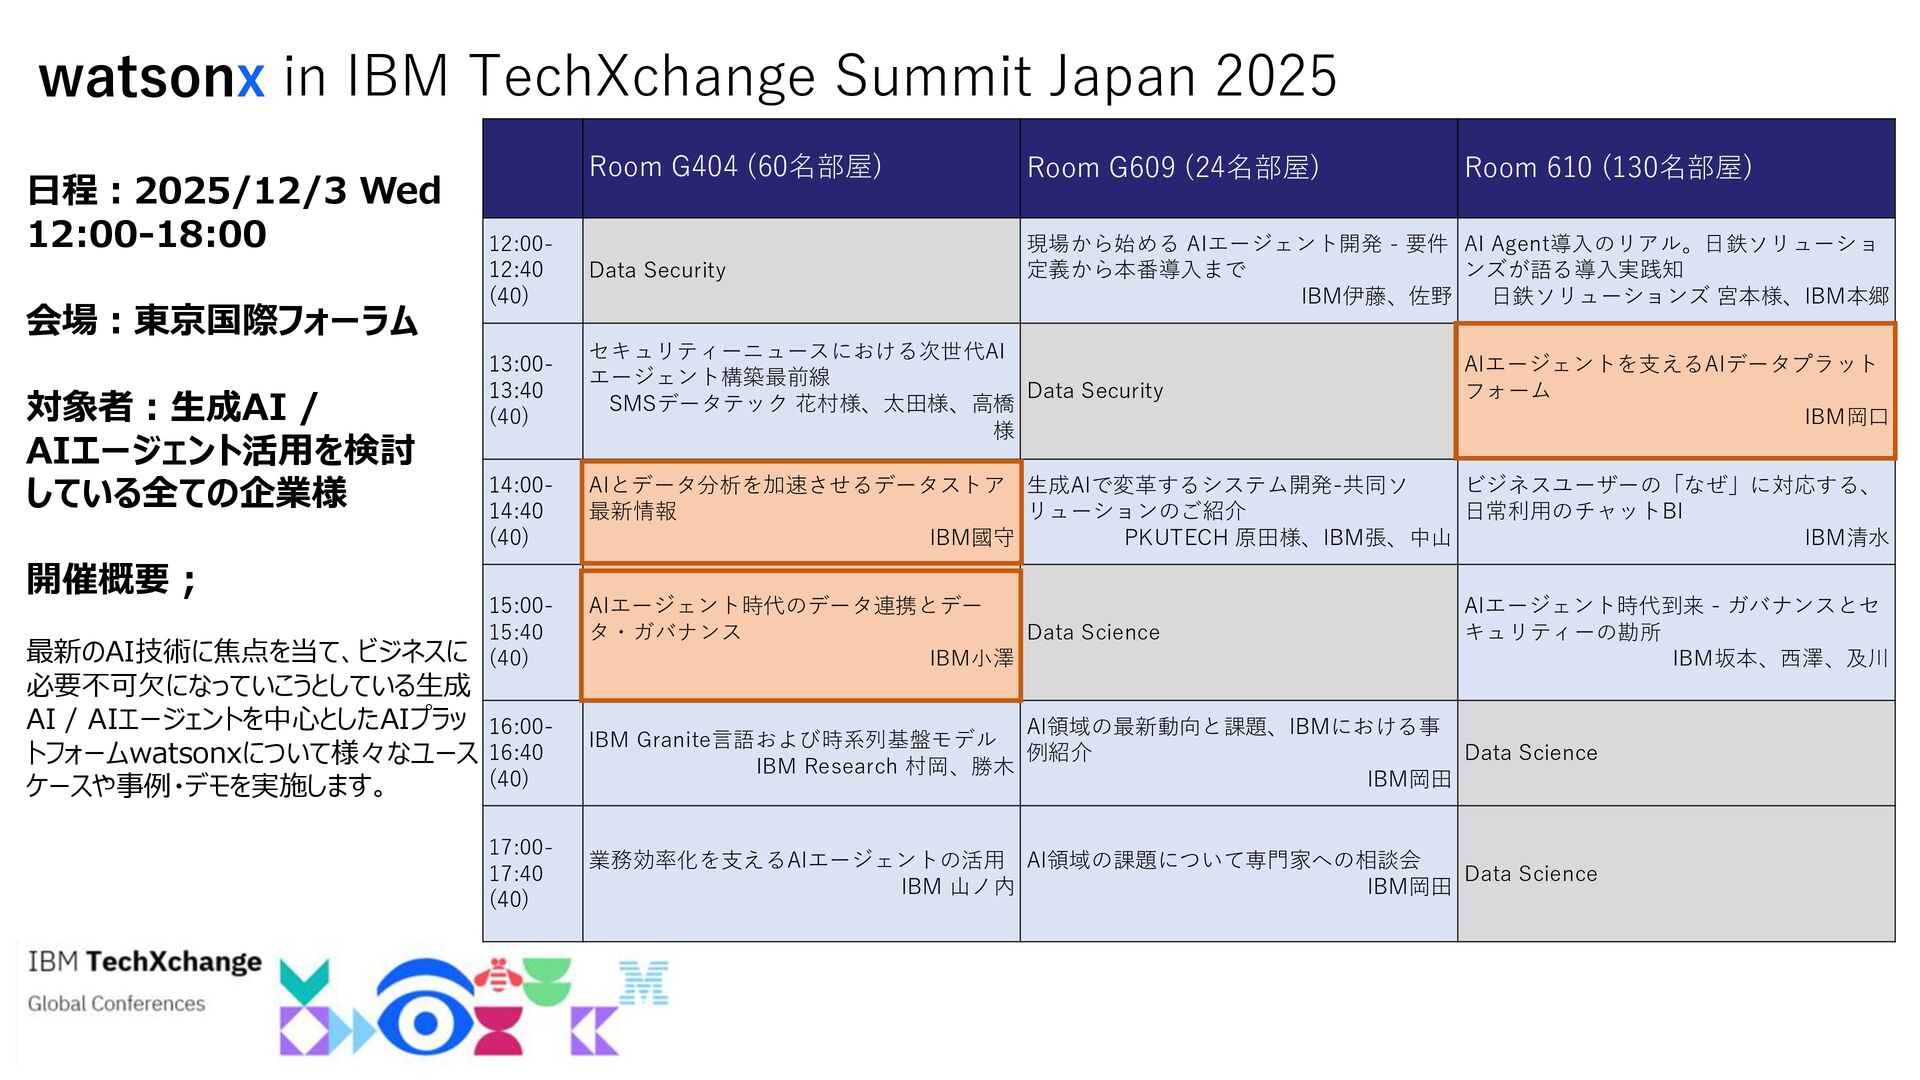
  28. 日程:2025/12/3 Wed 12:00-18:00 会場:東京国際フォーラム 対象者:生成AI / AIエージェント活用を検討 している全ての企業様 開催概要 ;

    最新のAI技術に焦点を当て、ビジネスに 必要不可欠になっていこうとしている生成 AI / AIエージェントを中心としたAIプラッ トフォームwatsonxについて様々なユース ケースや事例・デモを実施します。 watsonx in IBM TechXchange Summit Japan 2025 Room G404 (60名部屋) Room G609 (24名部屋) Room 610 (130名部屋) 12:00- 12:40 (40) Data Security 現場から始める AIエージェント開発 - 要件 定義から本番導入まで IBM伊藤、佐野 AI Agent導入のリアル。日鉄ソリューショ ンズが語る導入実践知 日鉄ソリューションズ 宮本様、IBM本郷 13:00- 13:40 (40) セキュリティーニュースにおける次世代AI エージェント構築最前線 SMSデータテック 花村様、太田様、高橋 様 Data Security AIエージェントを支えるAIデータプラット フォーム IBM岡口 14:00- 14:40 (40) AIとデータ分析を加速させるデータストア 最新情報 IBM國守 生成AIで変革するシステム開発-共同ソ リューションのご紹介 PKUTECH 原田様、IBM張、中山 ビジネスユーザーの「なぜ」に対応する、 日常利用のチャットBI IBM清水 15:00- 15:40 (40) AIエージェント時代のデータ連携とデー タ・ガバナンス IBM小澤 Data Science AIエージェント時代到来 - ガバナンスとセ キュリティーの勘所 IBM坂本、西澤、及川 16:00- 16:40 (40) IBM Granite言語および時系列基盤モデル IBM Research 村岡、勝木 AI領域の最新動向と課題、IBMにおける事 例紹介 IBM岡田 Data Science 17:00- 17:40 (40) 業務効率化を支えるAIエージェントの活用 IBM 山ノ内 AI領域の課題について専門家への相談会 IBM岡田 Data Science
  29. ワークショップ、セッション、および資料は、IBMまたはセッション発表者によって準備され、それぞれ独自の見解を反映したものです。それらは情報提供の目的のみで 提供されており、いかなる参加者に対しても法律的またはその他の指導や助言を意図したものではなく、またIBM製品やサービスがお客様に適用ある特定の法令に適合す ることを保証するものでもありません。本講演資料に含まれている情報については、完全性と正確性を期するよう努めておりますが、「現状のまま」提供され、明示また は黙示にかかわらず、商業性、特定の目的への適合性、非侵害性を含め、いかなる保証も伴わないものとします。本講演資料またはその他の資料の使用によって、あるい はその他の関連によって、いかなる損害が生じた場合も、IBMは責任を負わないものとします。 本講演資料で言及されるIBM製品、プログラム、またはサービスは、IBM がビジネスを行っているすべての国・地域でご提供可能なわけではありません。本講演資料で言及される将来の展望(製品リリース日付や製品機能を含む)は、市場機会 またはその他の要因に基づいてIBM独自の決定権をもっていつでも変更できるものとし、将来の製品または機能が使用可能になること、もしくは特定の結果を確約するこ とを意図するものではありません。本講演資料は、言及される IBM製品またはサービスに適用ある契約条件を変更するものでも、追加の表明または保証を意図するもので

    もありません。 本講演資料に含まれている内容は、参加者の活動によって特定の結果が生じると述べる、または暗示することを意図したものでも、またそのような結果を生むものでもあ りません。 パフォーマンスは、管理された環境において標準的なIBMベンチマークを使用した測定と予測に基づいています。ユーザーが経験する実際のスループットやパ フォーマンスは、ユーザーのジョブ・ストリームにおけるマルチプログラミングの量、入出力構成、ストレージ構成、および処理されるワークロードなどの考慮事項を含 む、数多くの要因に応じて変化します。したがって、個々のユーザーがここで述べられているものと同様の結果を得られると確約するものではありません。記述されてい るすべてのお客様事例は、それらのお客様がどのようにIBM製品を使用したか、またそれらのお客様が達成した結果の実例として示されたものです。実際の環境コストお よびパフォーマンス特性は、お客様ごとに異なる場合があります。 IBM、IBMのロゴ、ibm.comは、世界の多くの国で法的に登録された、International Business Machines Corporationの商標です。その他の製品名・サービス名はIBMま たは他社の商標である可能性があります。IBM商標の最新リストは、ウェブ上の「著作権および商標情報」( www.ibm.com/jp-ja/legal/copytrade.shtml )でご確認いた だけます。 通知と免責事項