Upgrade to Pro — share decks privately, control downloads, hide ads and more …

StreamSets

Avatar for zui kaku zui kaku
September 04, 2025

 StreamSets

Avatar for zui kaku

zui kaku

September 04, 2025

More Decks by zui kaku

Other Decks in Technology

Transcript

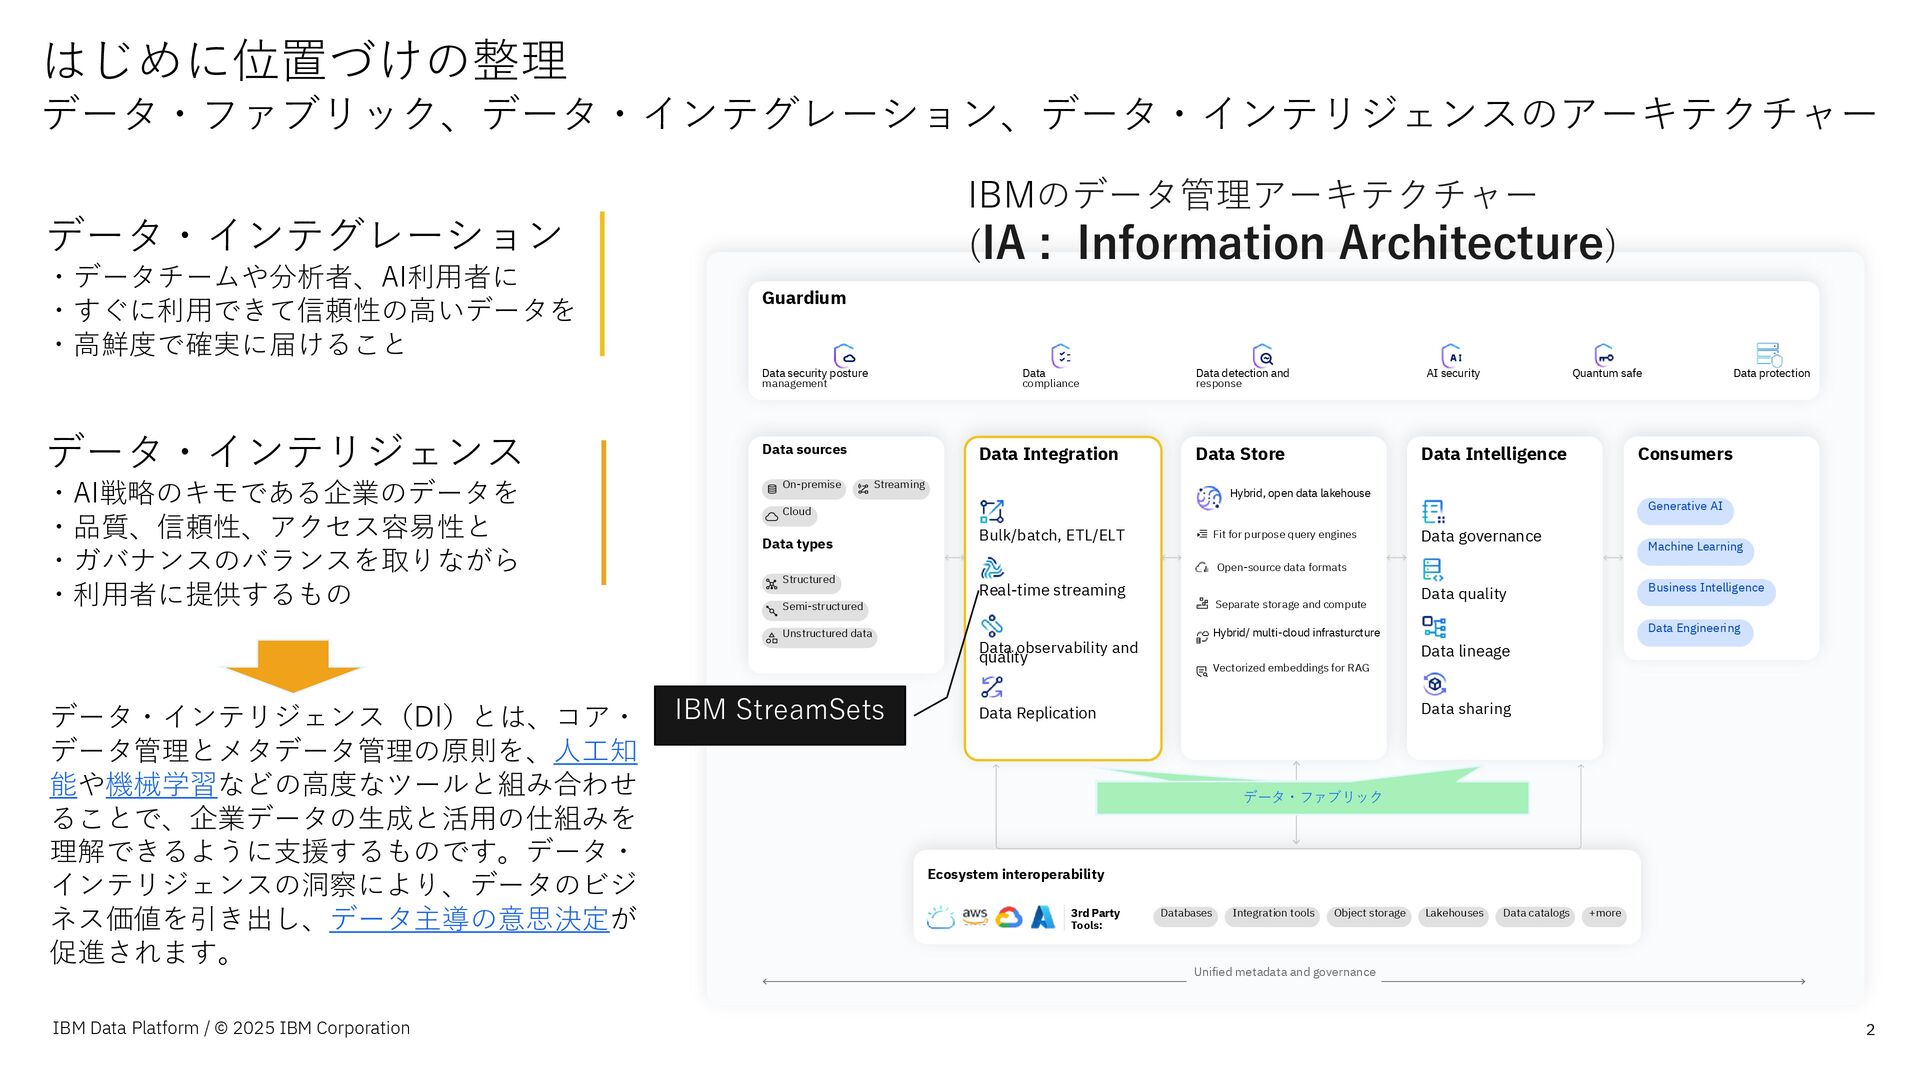
  1. 2 IBM Data Platform / © 2025 IBM Corporation Data

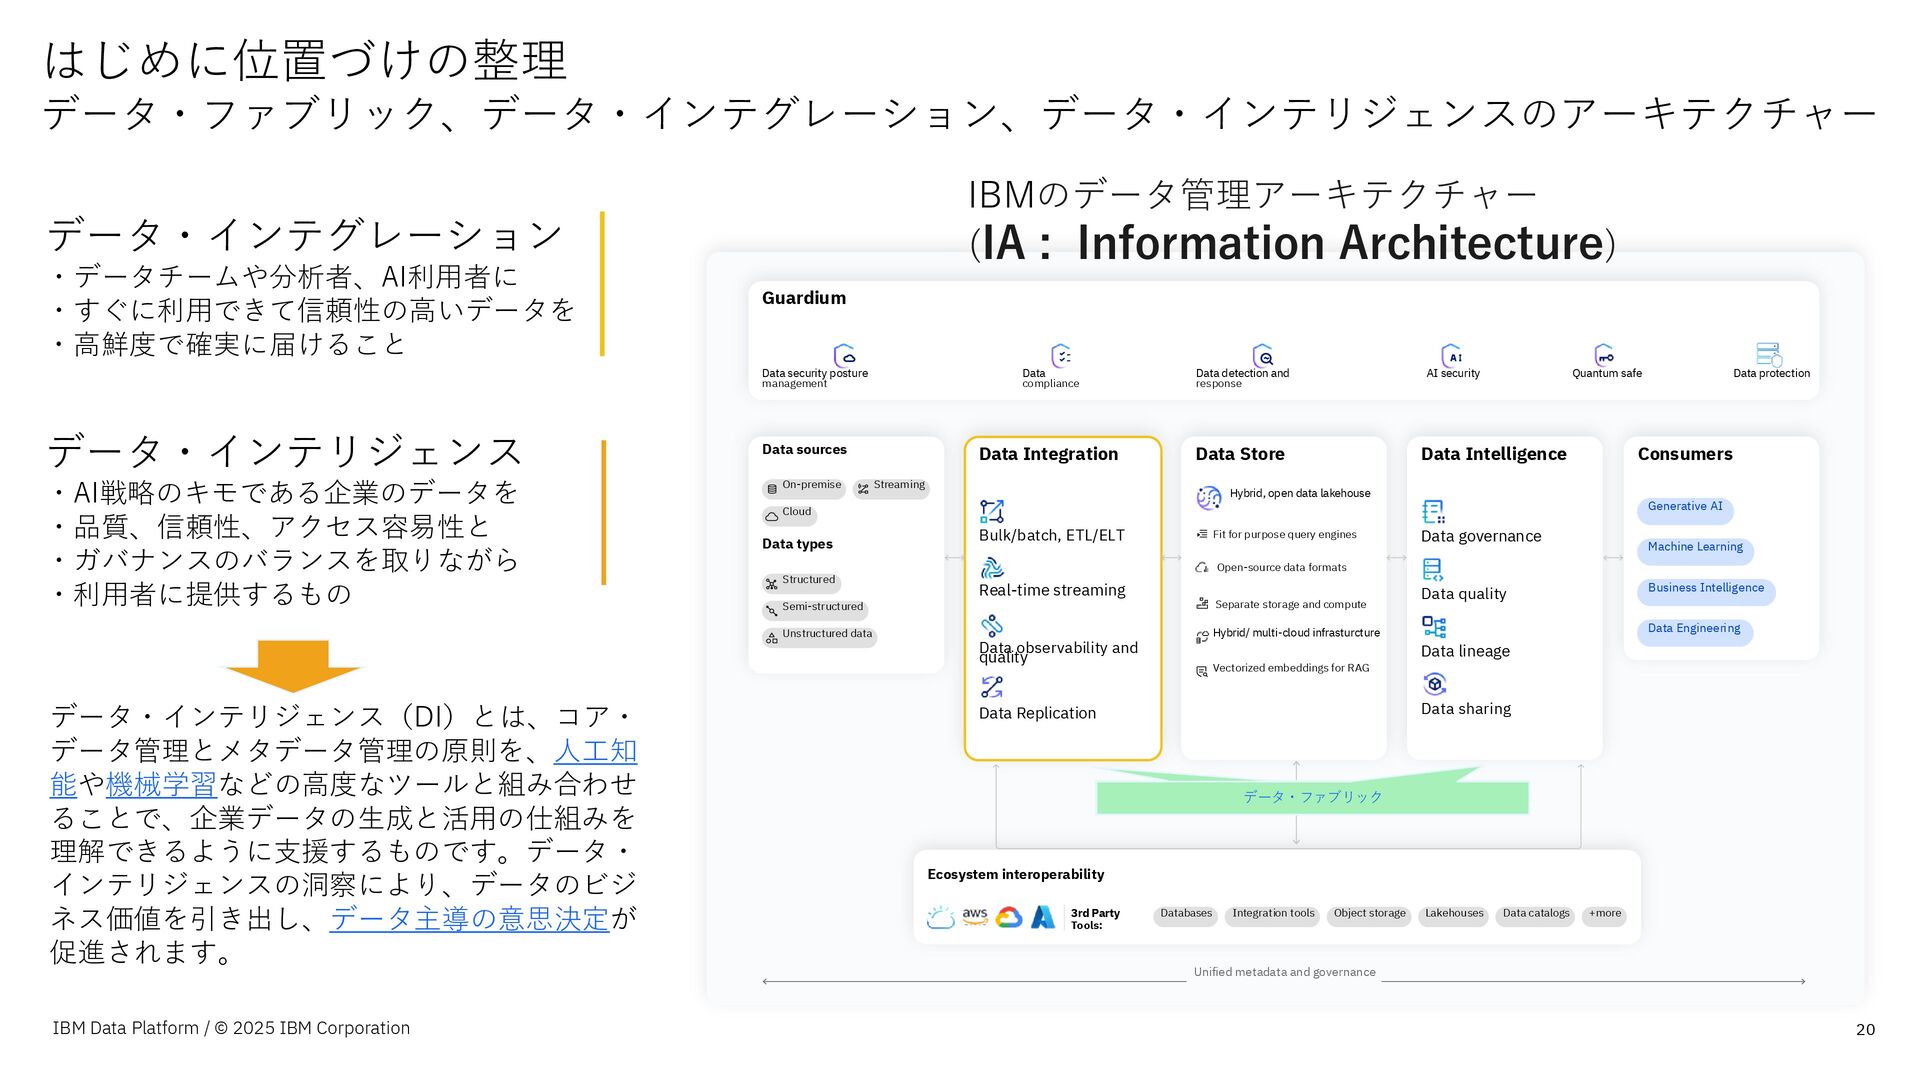
    sources On-premise Streaming Cloud Data types Structured Semi-structured Unstructured data Data Integration Bulk/batch, ETL/ELT Real-time streaming Data observability and quality Data Replication Data Store Hybrid, open data lakehouse Fit for purpose query engines Open-source data formats Separate storage and compute Hybrid/ multi-cloud infrasturcture Vectorized embeddings for RAG Data Intelligence Data governance Data quality Data lineage Data sharing Consumers Generative AI Machine Learning Business Intelligence Data Engineering Ecosystem interoperability 3rd Party Tools: Databases Integration tools Object storage Lakehouses Data catalogs +more Unified metadata and governance Guardium Data security posture management Data compliance Data detection and response AI security Quantum safe Data protection データ・ファブリック はじめに位置づけの整理 データ・ファブリック、データ・インテグレーション、データ・インテリジェンスのアーキテクチャー データ・インテグレーション ・データチームや分析者、AI利用者に ・すぐに利用できて信頼性の高いデータを ・高鮮度で確実に届けること データ・インテリジェンス ・AI戦略のキモである企業のデータを ・品質、信頼性、アクセス容易性と ・ガバナンスのバランスを取りながら ・利用者に提供するもの データ・インテリジェンス(DI)とは、コア・ データ管理とメタデータ管理の原則を、人工知 能や機械学習などの高度なツールと組み合わせ ることで、企業データの生成と活用の仕組みを 理解できるように支援するものです。データ・ インテリジェンスの洞察により、データのビジ ネス価値を引き出し、データ主導の意思決定が 促進されます。 IBMのデータ管理アーキテクチャー (IA : Information Architecture) IBM StreamSets
  2. IBM Data Platform / © 2025 IBM Corporation 4 IBM

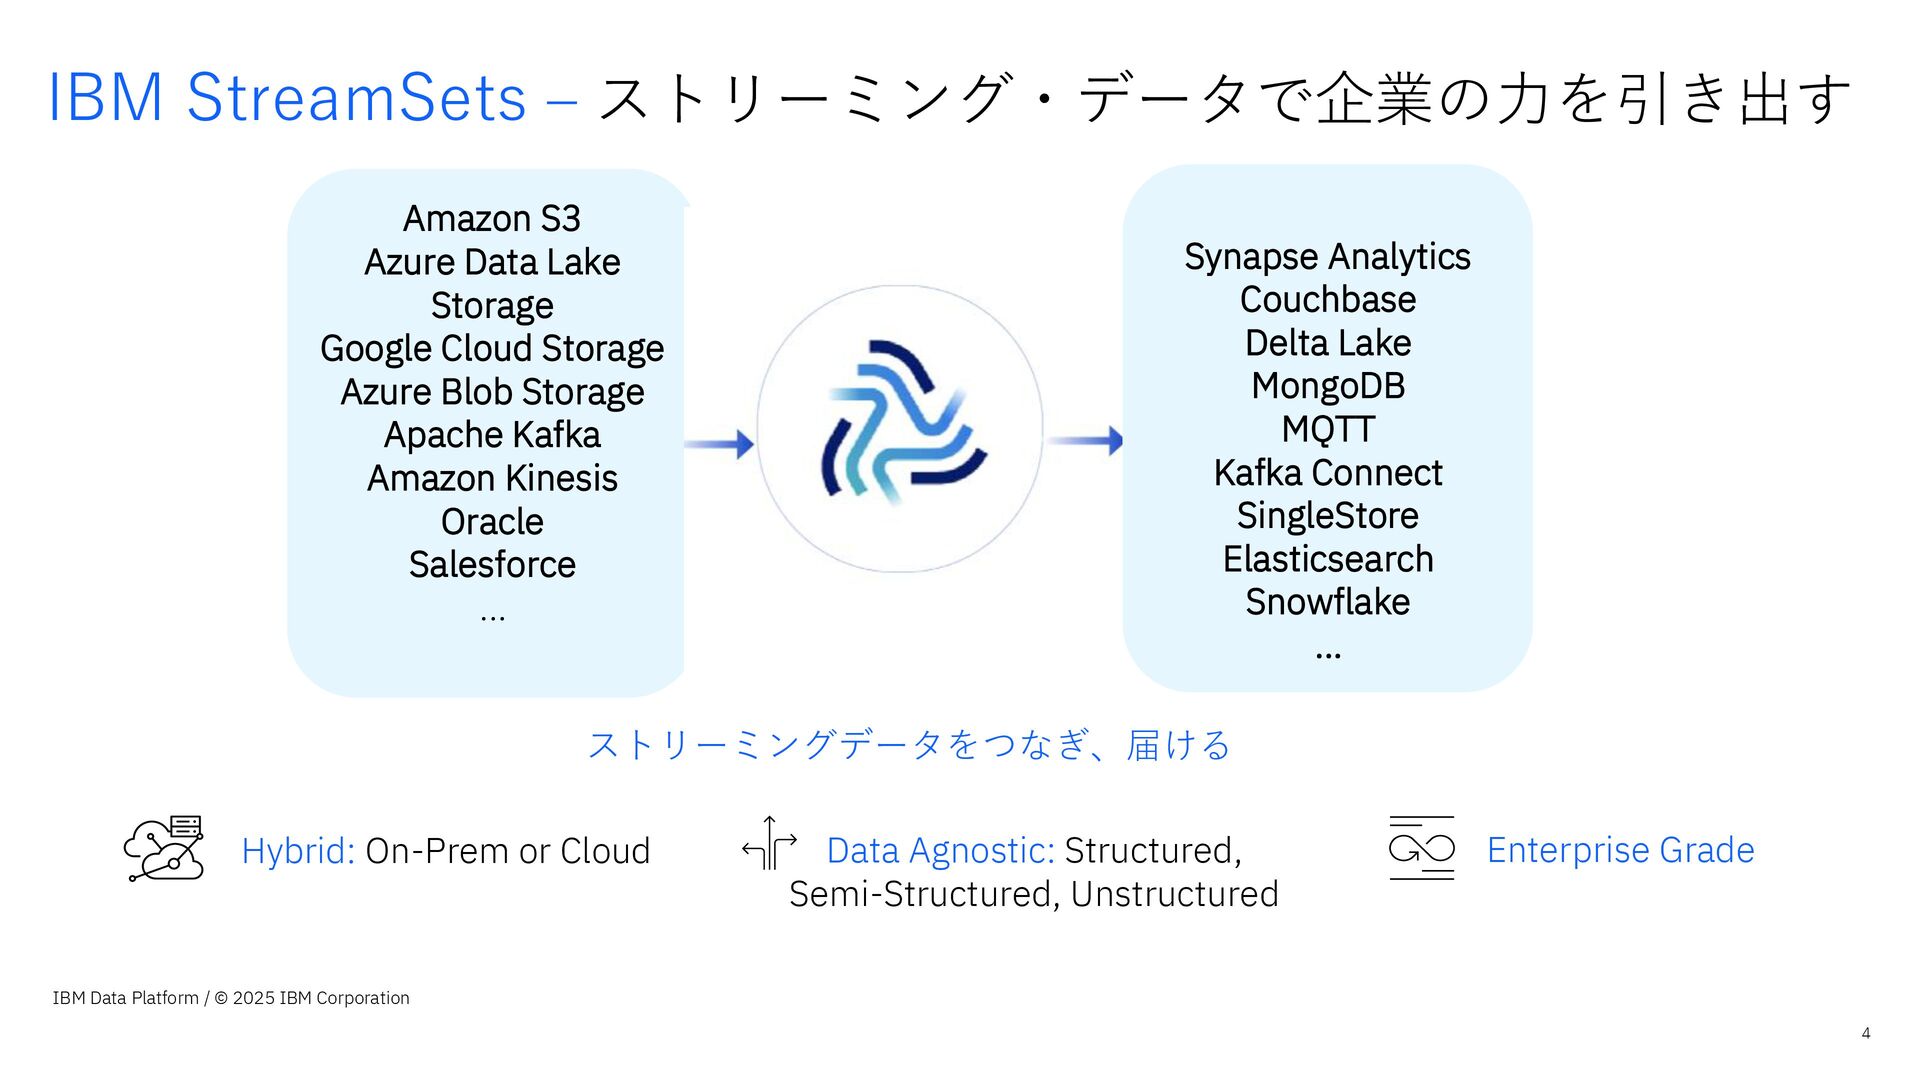
    StreamSets – ストリーミング・データで企業の力を引き出す ストリーミングデータをつなぎ、届ける Hybrid: On-Prem or Cloud Data Agnostic: Structured, Semi-Structured, Unstructured Enterprise Grade Amazon S3 Azure Data Lake Storage Google Cloud Storage Azure Blob Storage Apache Kafka Amazon Kinesis Oracle Salesforce … Synapse Analytics Couchbase Delta Lake MongoDB MQTT Kafka Connect SingleStore Elasticsearch Snowflake …
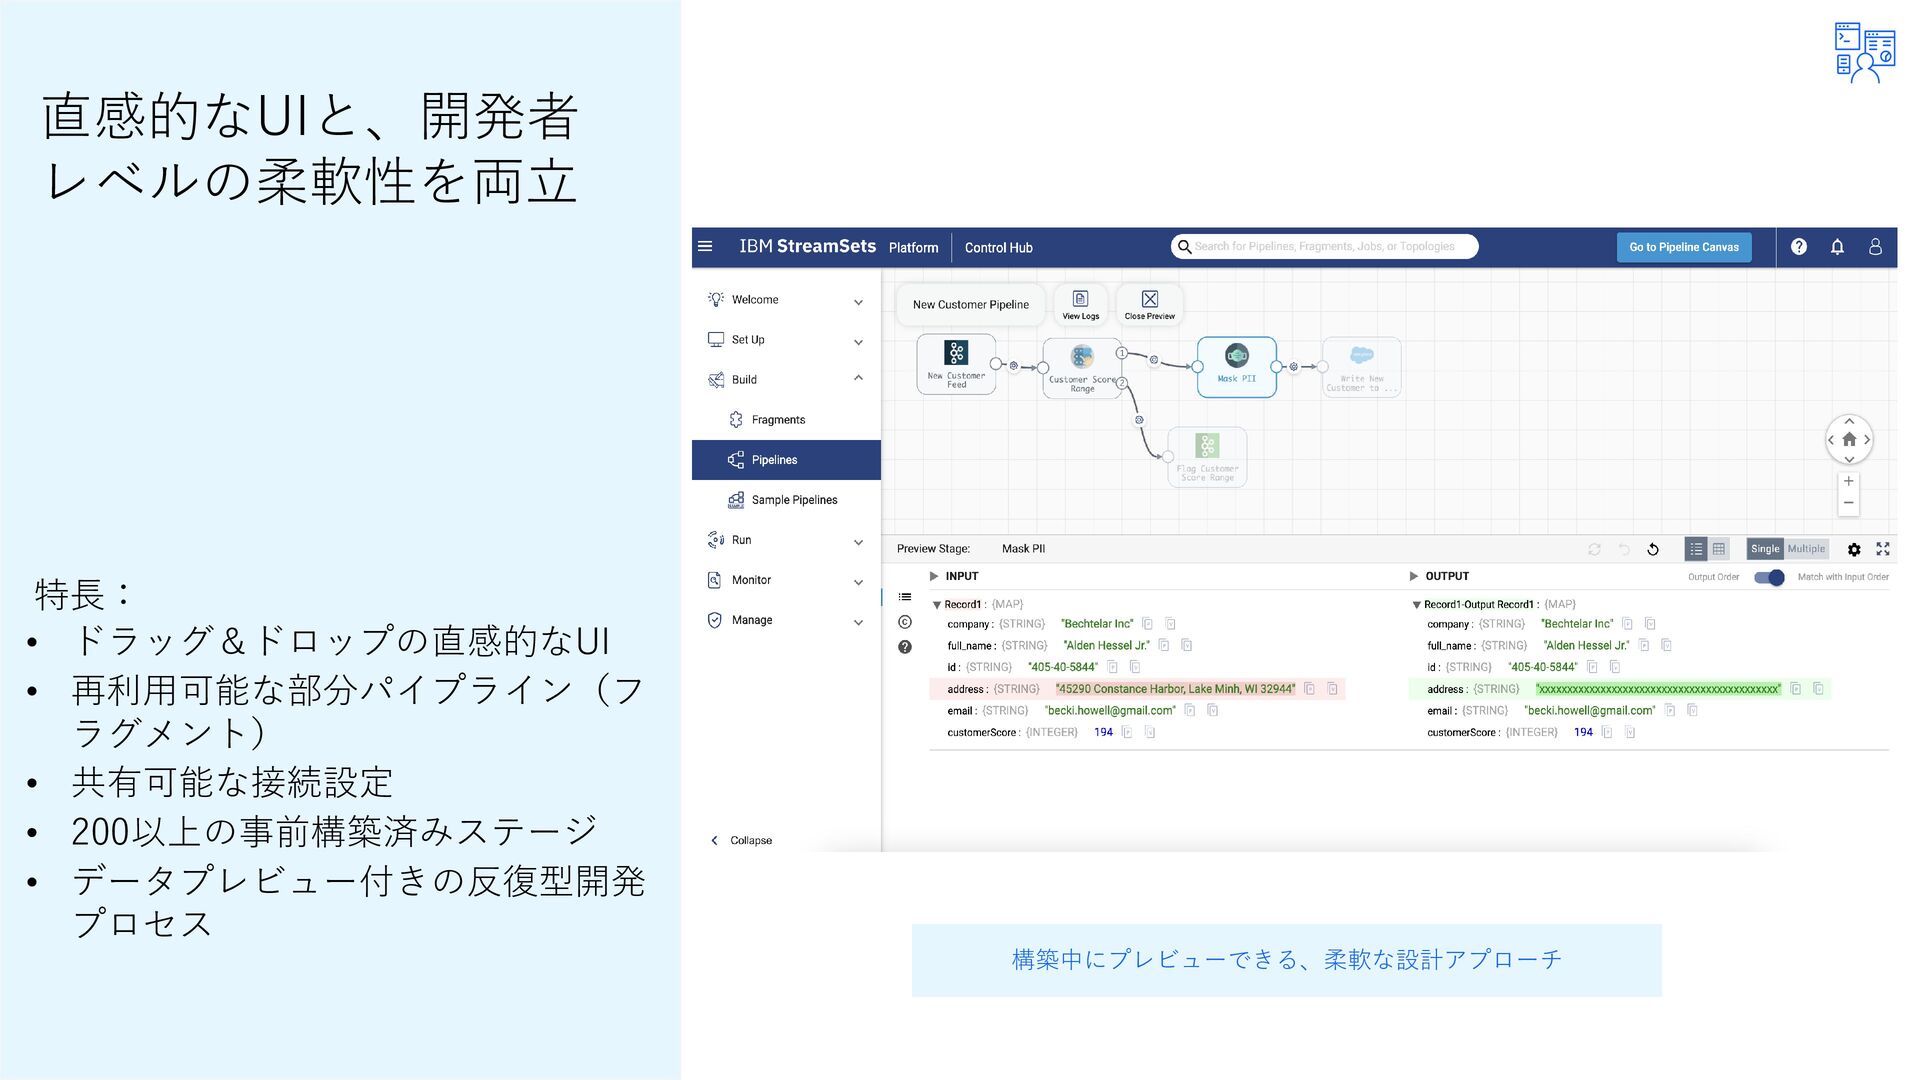
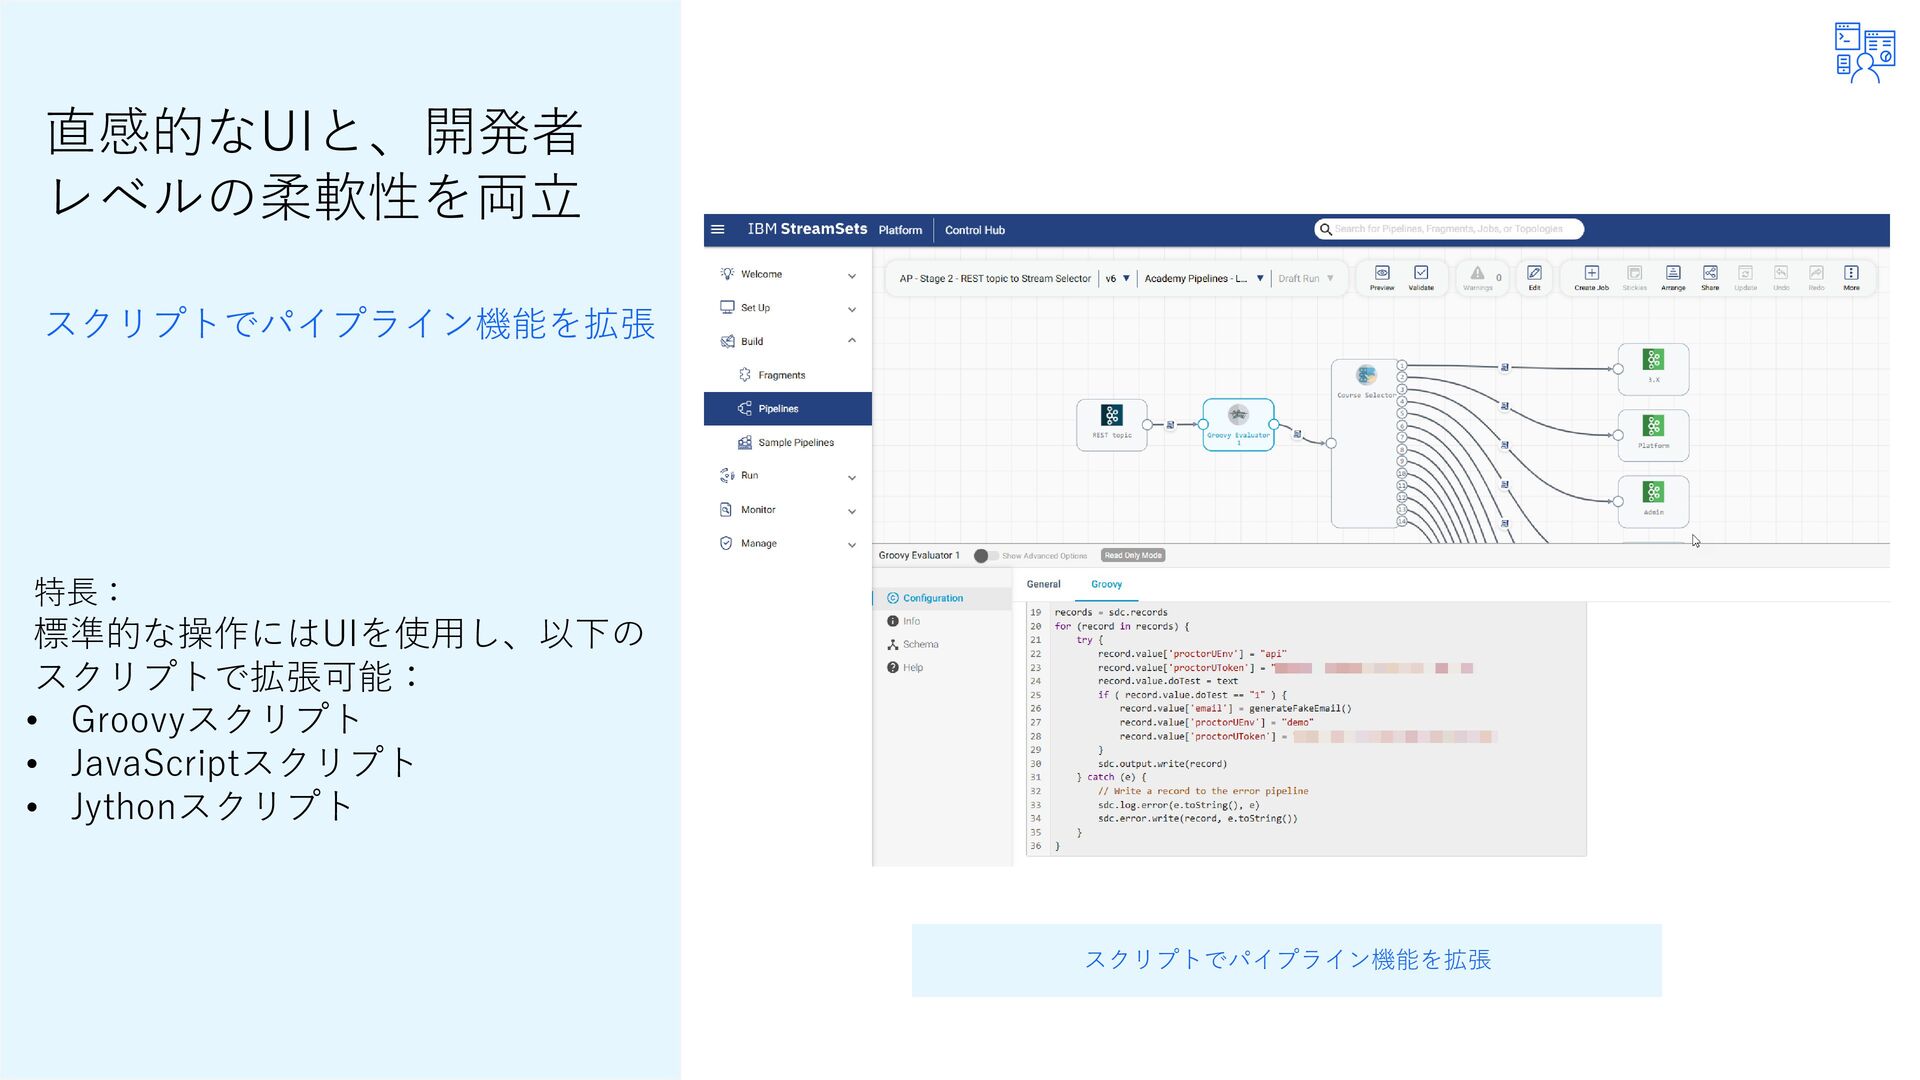
  3. 特長: • ドラッグ&ドロップの直感的なUI • 再利用可能な部分パイプライン(フ ラグメント) • 共有可能な接続設定 • 200以上の事前構築済みステージ

    • データプレビュー付きの反復型開発 プロセス 直感的なUIと、開発者 レベルの柔軟性を両立 構築中にプレビューできる、柔軟な設計アプローチ
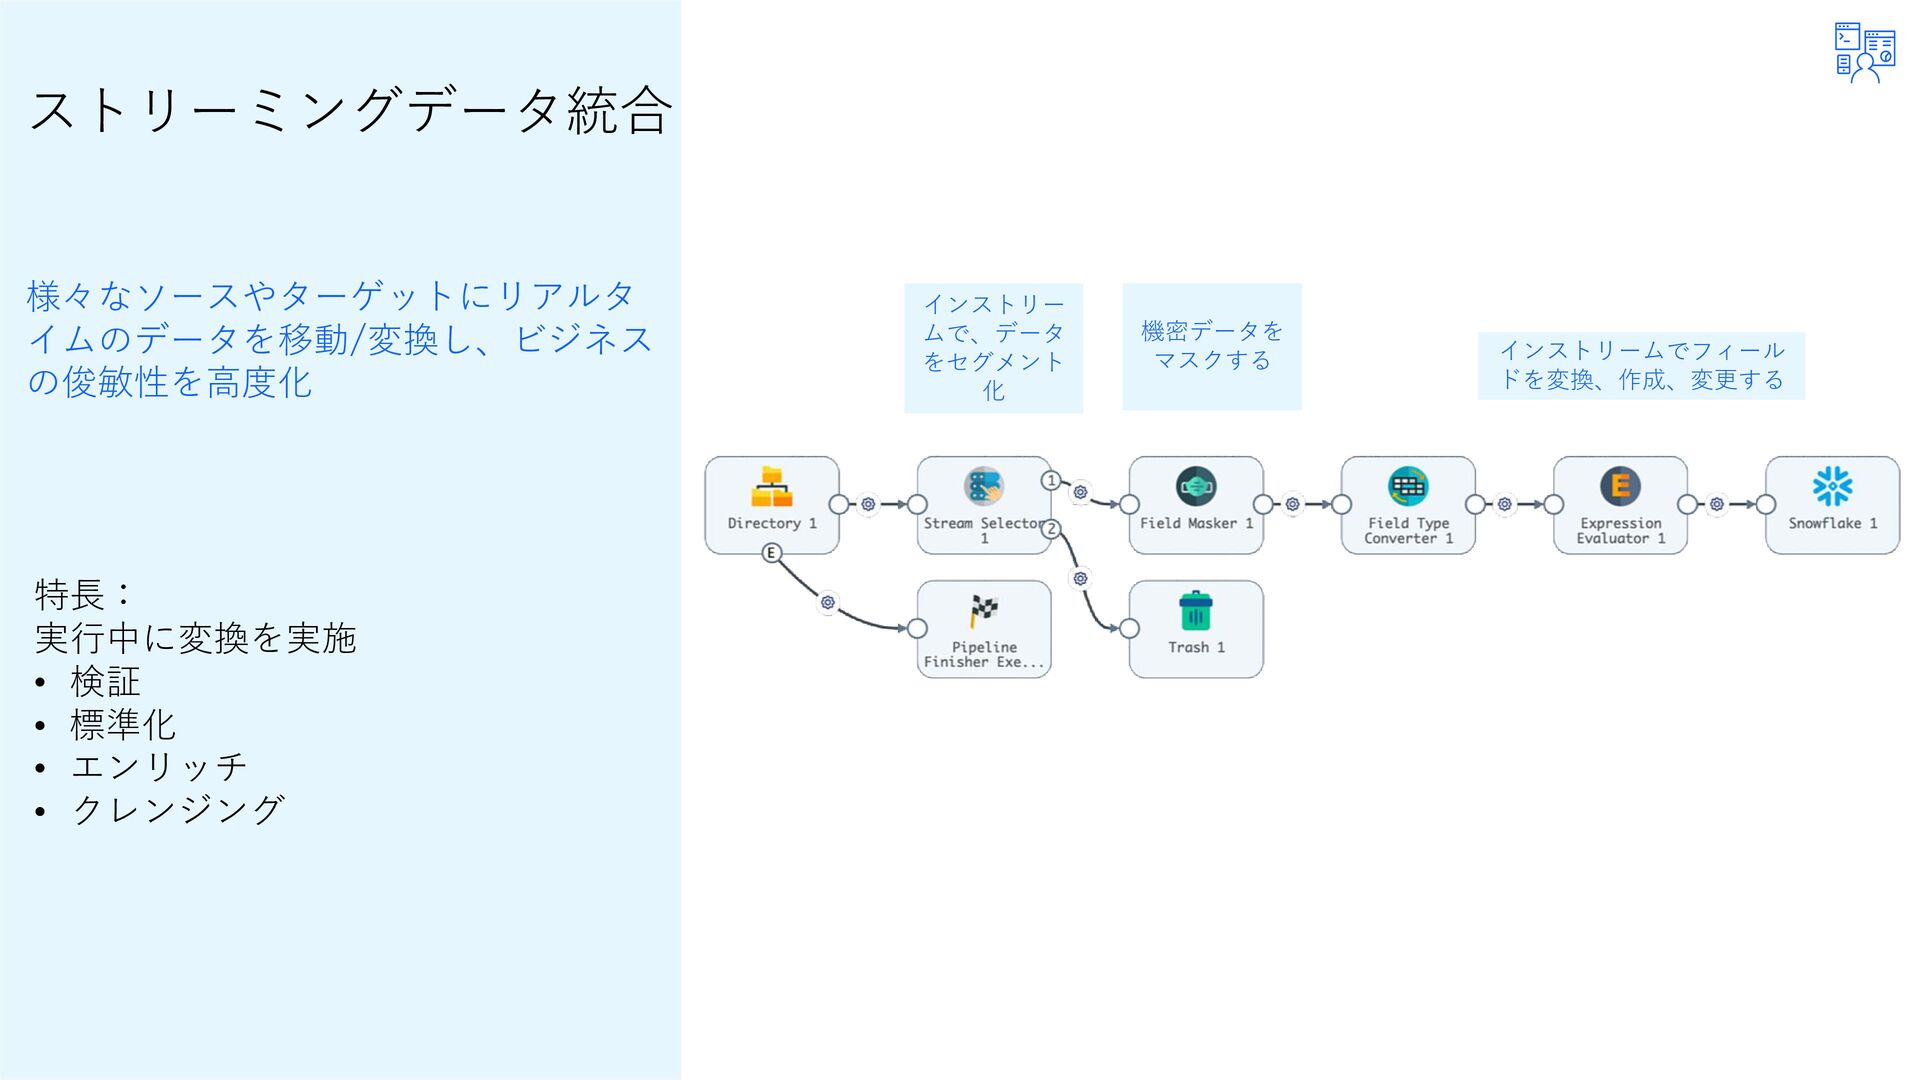
  4. 特長: 実行中に変換を実施 • 検証 • 標準化 • エンリッチ • クレンジング

    ストリーミングデータ統合 様々なソースやターゲットにリアルタ イムのデータを移動/変換し、ビジネス の俊敏性を高度化 インストリー ムで、データ をセグメント 化 機密データを マスクする インストリームでフィール ドを変換、作成、変更する
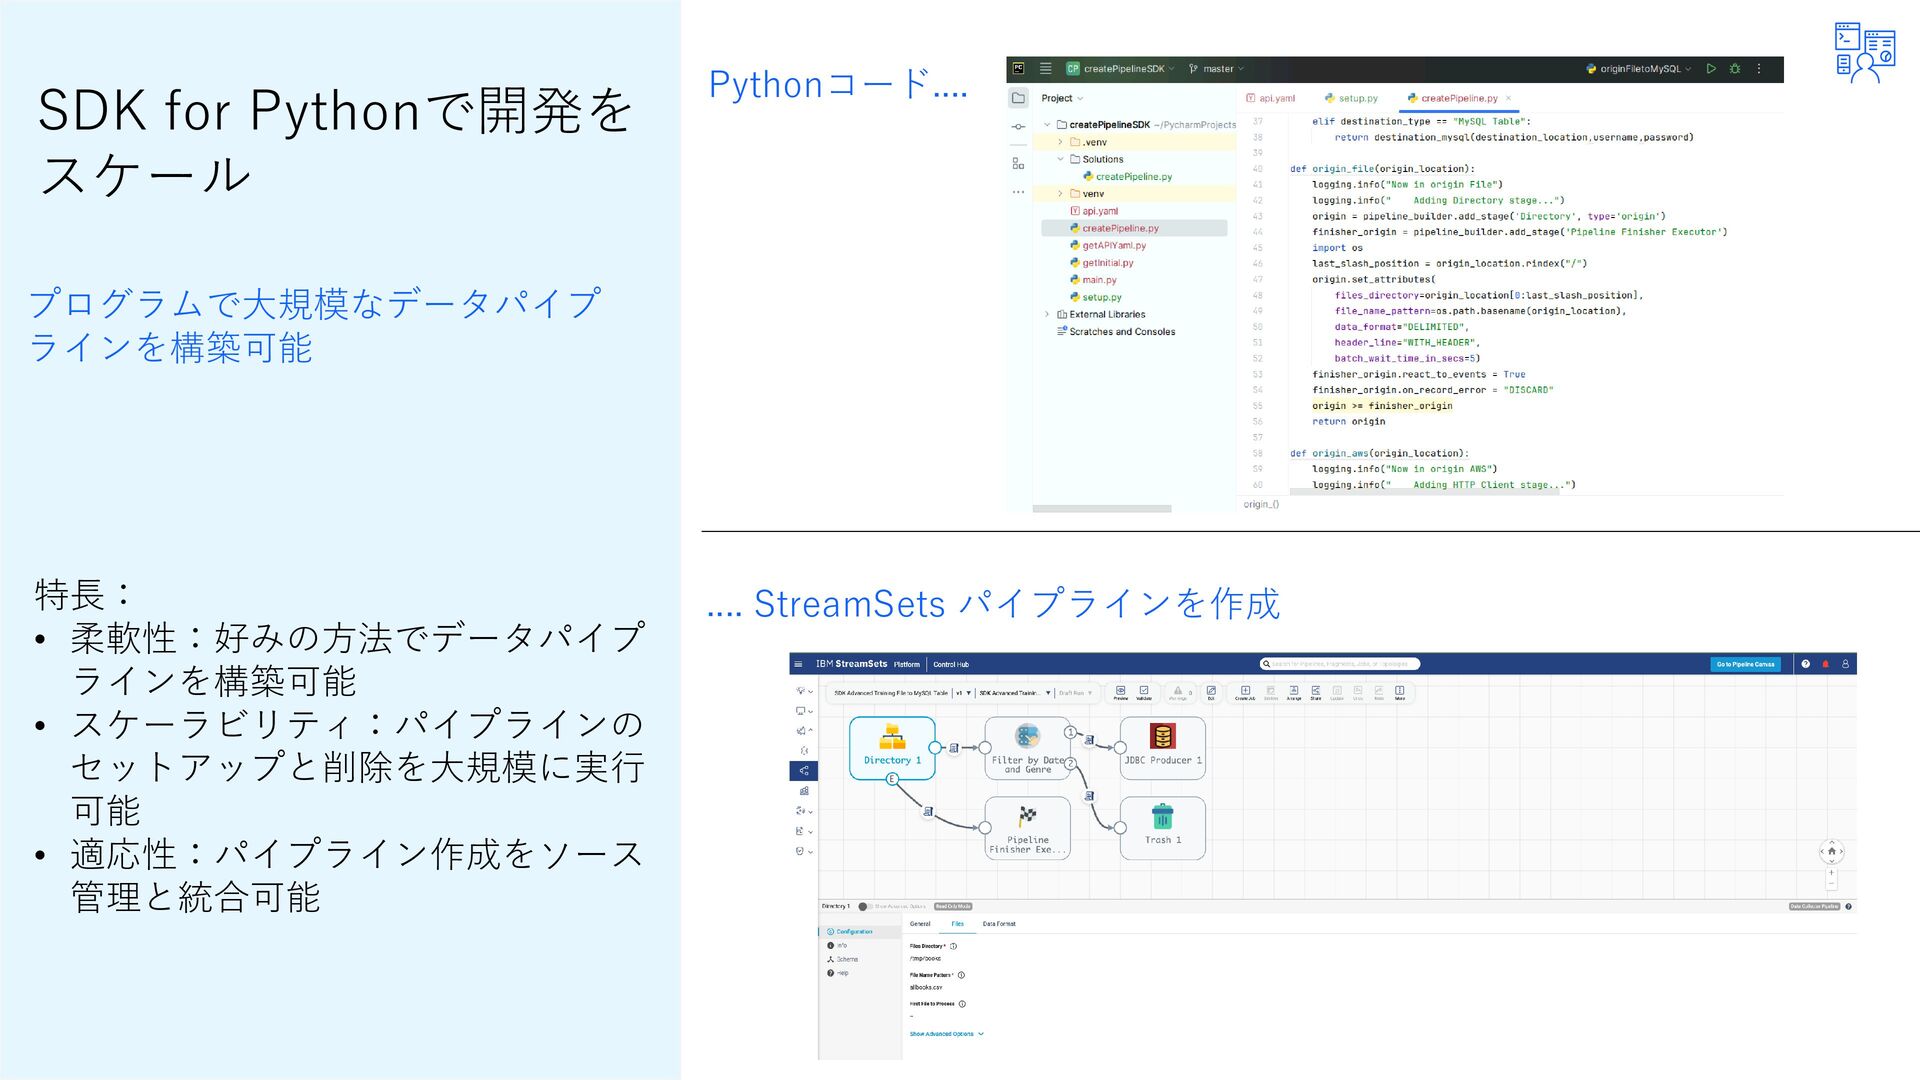
  5. 特長: • 柔軟性:好みの方法でデータパイプ ラインを構築可能 • スケーラビリティ:パイプラインの セットアップと削除を大規模に実行 可能 • 適応性:パイプライン作成をソース

    管理と統合可能 SDK for Pythonで開発を スケール プログラムで大規模なデータパイプ ラインを構築可能 Pythonコード.... .... StreamSets パイプラインを作成
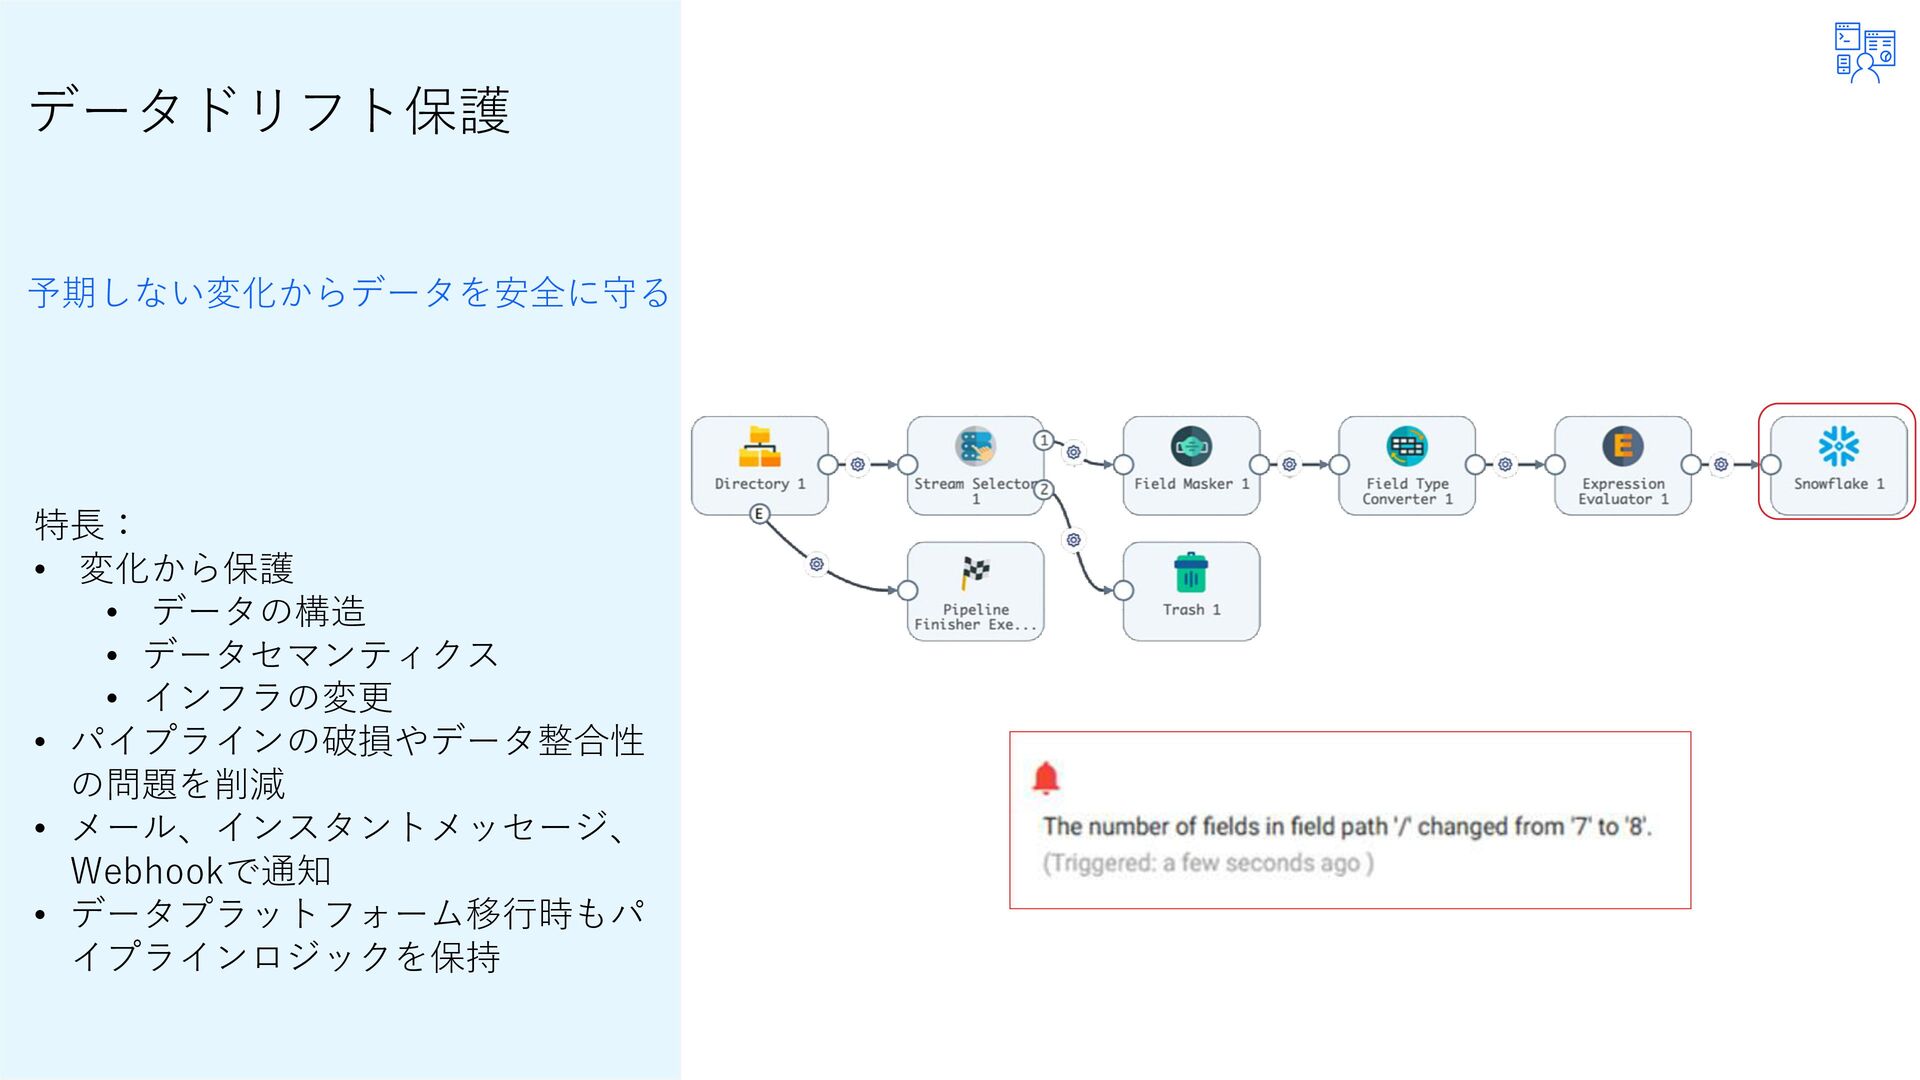
  6. 特長: • 変化から保護 • データの構造 • データセマンティクス • インフラの変更 •

    パイプラインの破損やデータ整合性 の問題を削減 • メール、インスタントメッセージ、 Webhookで通知 • データプラットフォーム移行時もパ イプラインロジックを保持 データドリフト保護 予期しない変化からデータを安全に守る
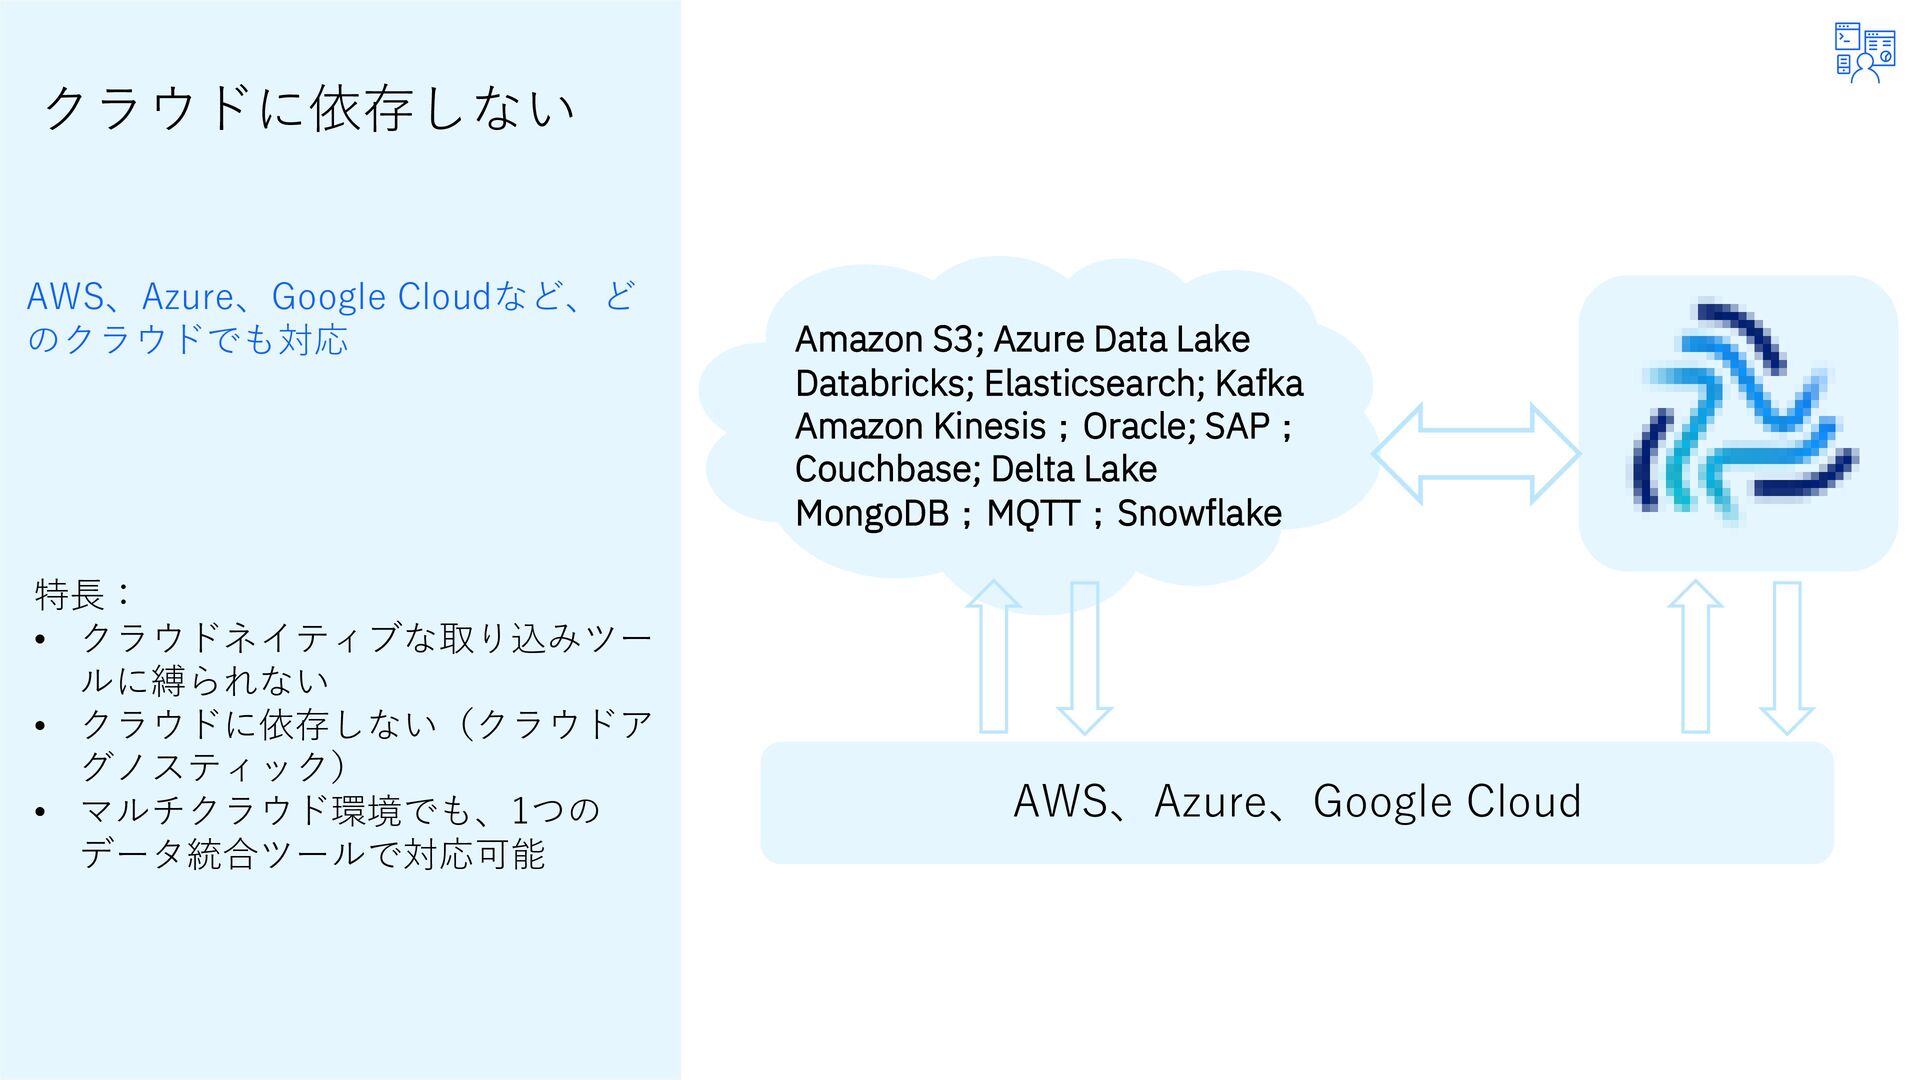
  7. 特長: • クラウドネイティブな取り込みツー ルに縛られない • クラウドに依存しない(クラウドア グノスティック) • マルチクラウド環境でも、1つの データ統合ツールで対応可能

    クラウドに依存しない AWS、Azure、Google Cloudなど、ど のクラウドでも対応 Amazon S3; Azure Data Lake Databricks; Elasticsearch; Kafka Amazon Kinesis;Oracle; SAP; Couchbase; Delta Lake MongoDB;MQTT;Snowflake AWS、Azure、Google Cloud
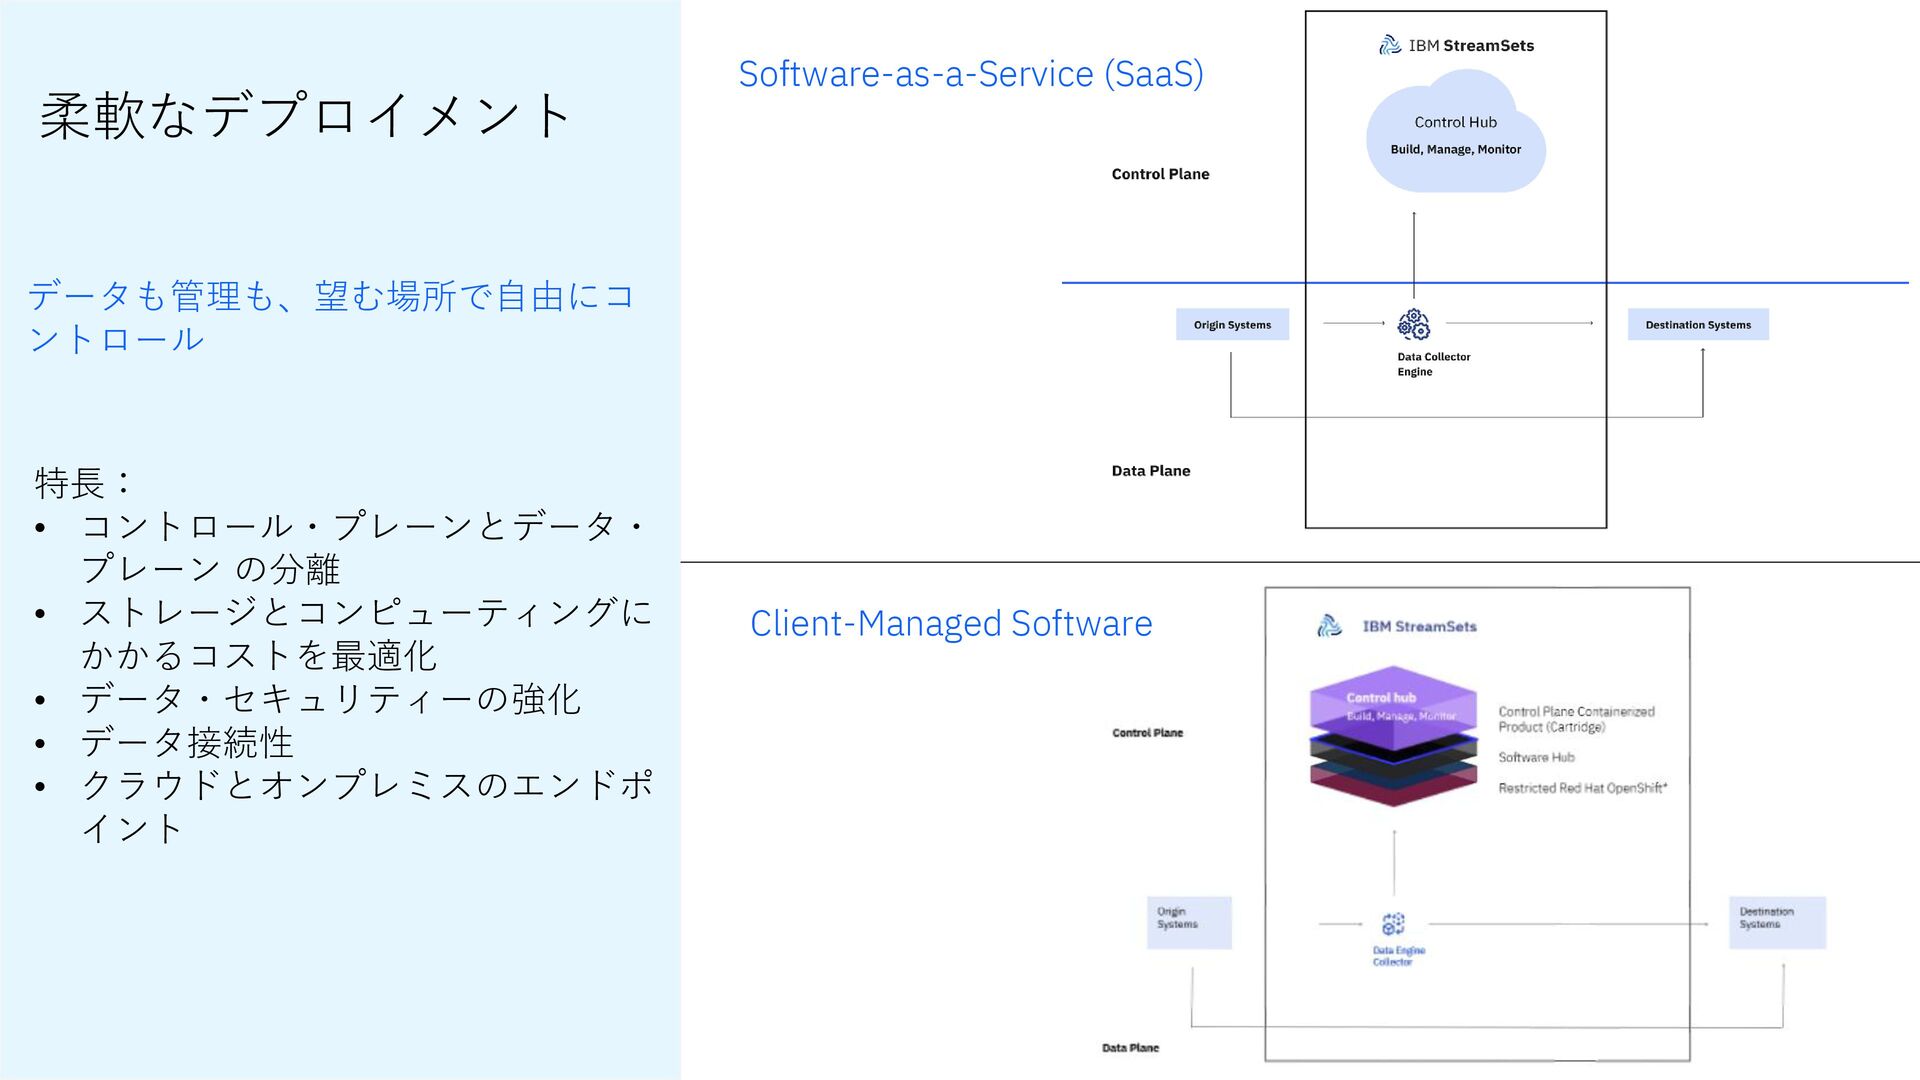
  8. 特長: • コントロール・プレーンとデータ・ プレーン の分離 • ストレージとコンピューティングに かかるコストを最適化 • データ・セキュリティーの強化

    • データ接続性 • クラウドとオンプレミスのエンドポ イント 柔軟なデプロイメント データも管理も、望む場所で自由にコ ントロール Software-as-a-Service (SaaS) Client-Managed Software
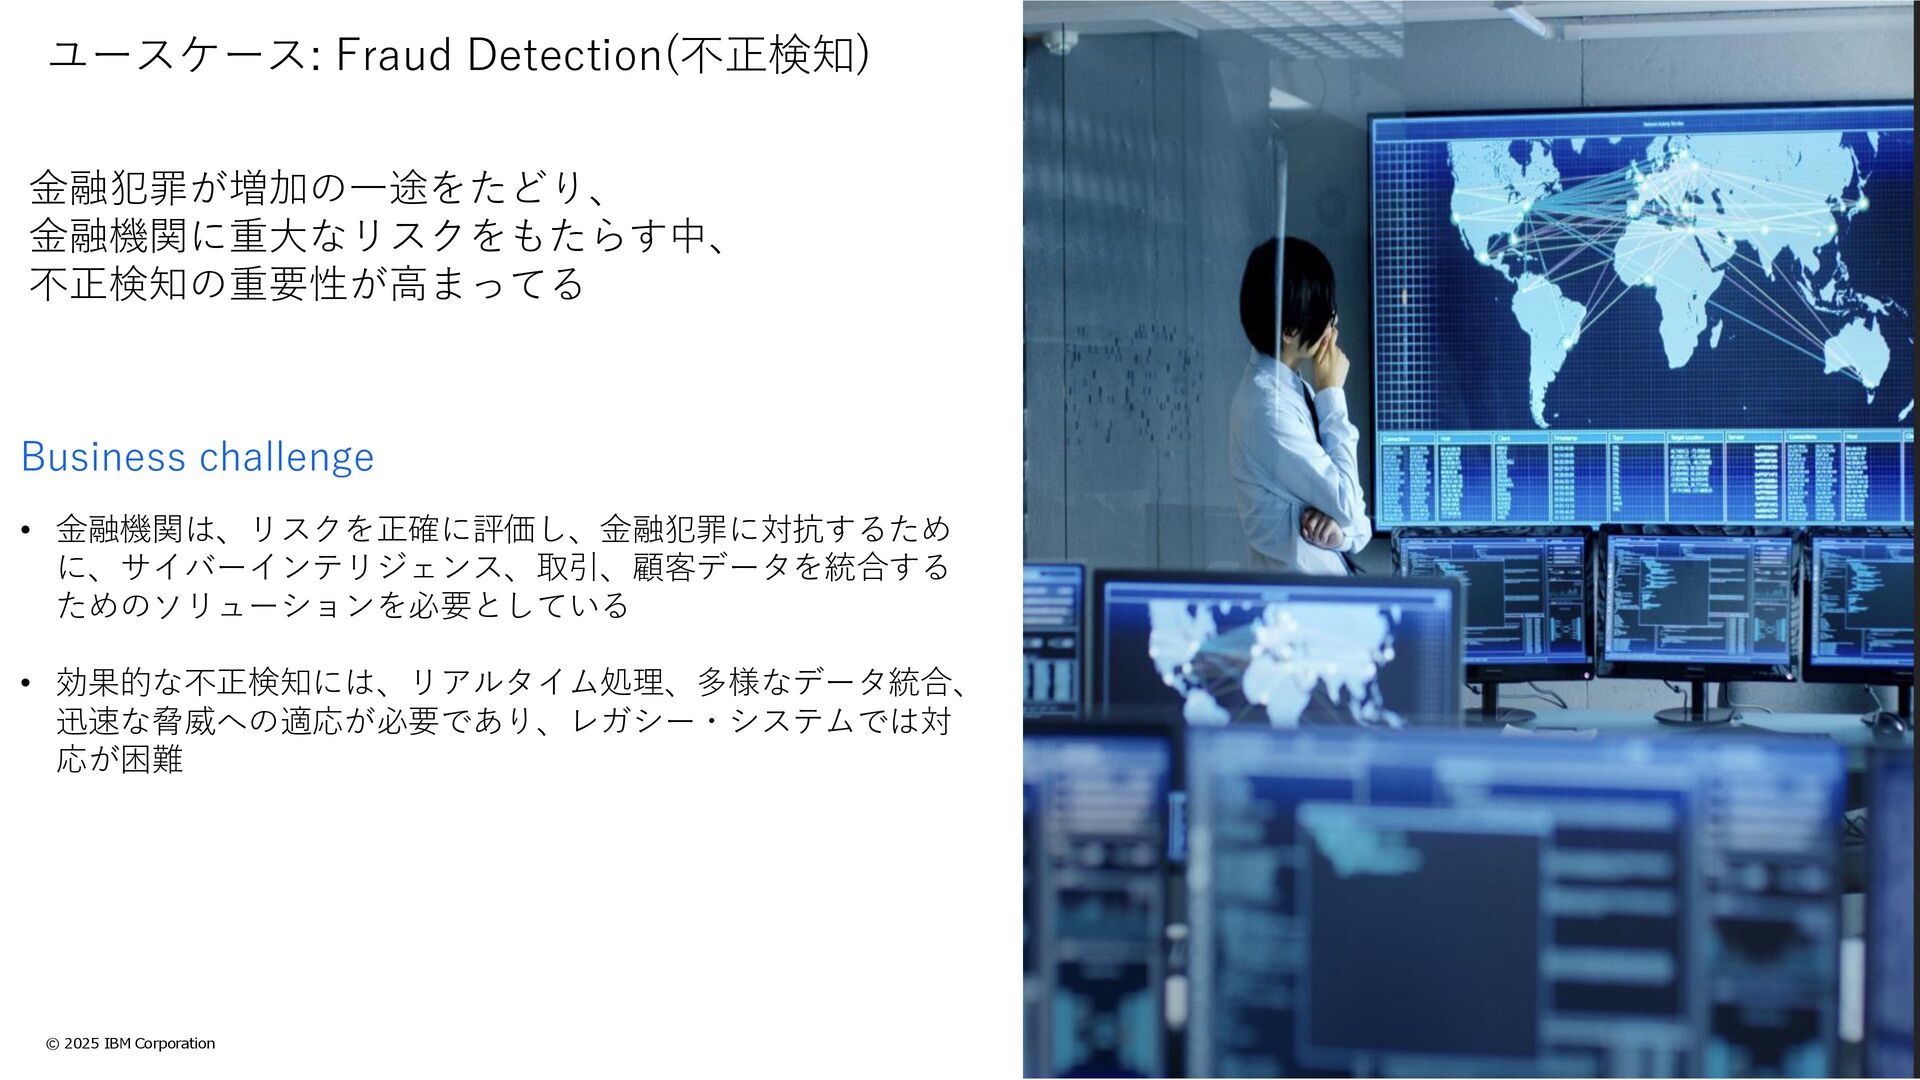
  9. © 2025 IBM Corporation 金融犯罪が増加の一途をたどり、 金融機関に重大なリスクをもたらす中、 不正検知の重要性が高まってる Business challenge •

    金融機関は、リスクを正確に評価し、金融犯罪に対抗するため に、サイバーインテリジェンス、取引、顧客データを統合する ためのソリューションを必要としている • 効果的な不正検知には、リアルタイム処理、多様なデータ統合、 迅速な脅威への適応が必要であり、レガシー・システムでは対 応が困難 ユースケース: Fraud Detection(不正検知) Will change image
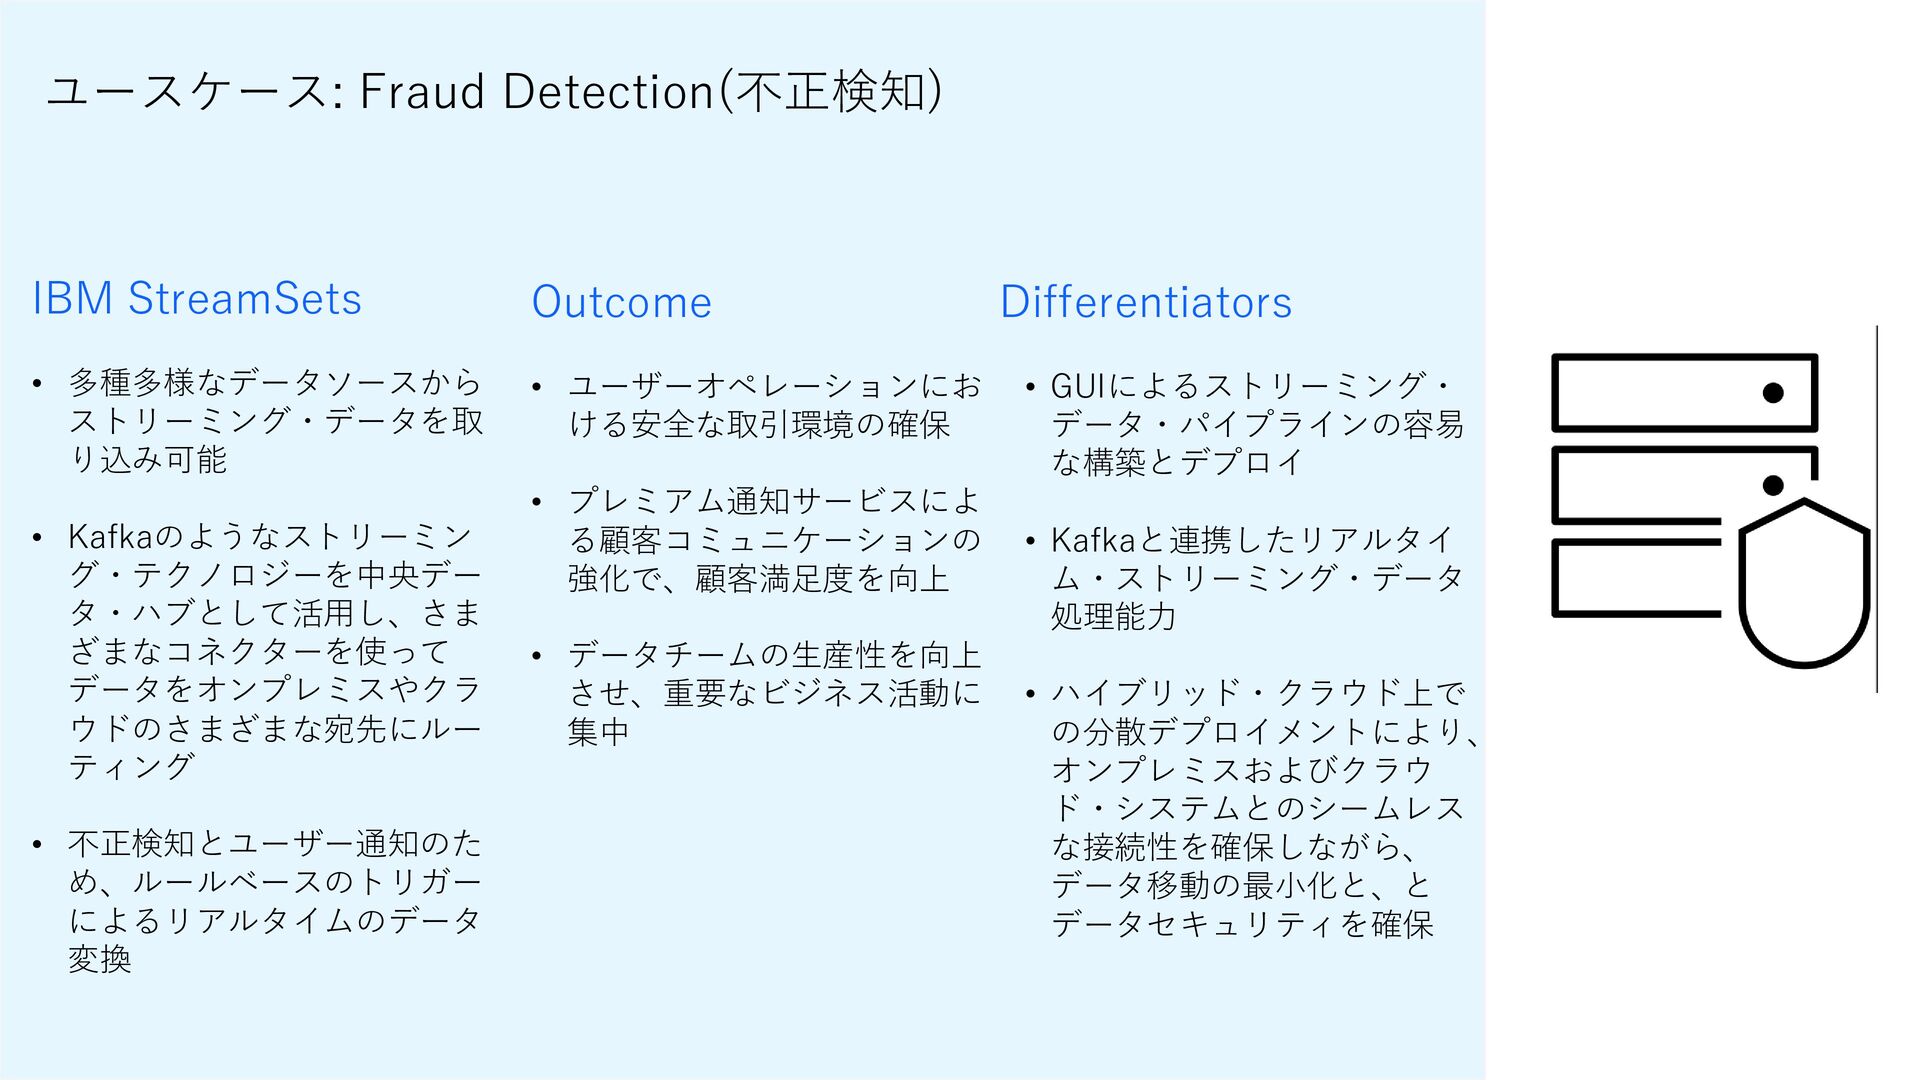
  10. ユースケース: Fraud Detection(不正検知) IBM StreamSets • 多種多様なデータソースから ストリーミング・データを取 り込み可能 •

    Kafkaのようなストリーミン グ・テクノロジーを中央デー タ・ハブとして活用し、さま ざまなコネクターを使って データをオンプレミスやクラ ウドのさまざまな宛先にルー ティング • 不正検知とユーザー通知のた め、ルールベースのトリガー によるリアルタイムのデータ 変換 Outcome • ユーザーオペレーションにお ける安全な取引環境の確保 • プレミアム通知サービスによ る顧客コミュニケーションの 強化で、顧客満足度を向上 • データチームの生産性を向上 させ、重要なビジネス活動に 集中 Differentiators • GUIによるストリーミング・ データ・パイプラインの容易 な構築とデプロイ • Kafkaと連携したリアルタイ ム・ストリーミング・データ 処理能力 • ハイブリッド・クラウド上で の分散デプロイメントにより、 オンプレミスおよびクラウ ド・システムとのシームレス な接続性を確保しながら、 データ移動の最小化と、と データセキュリティを確保
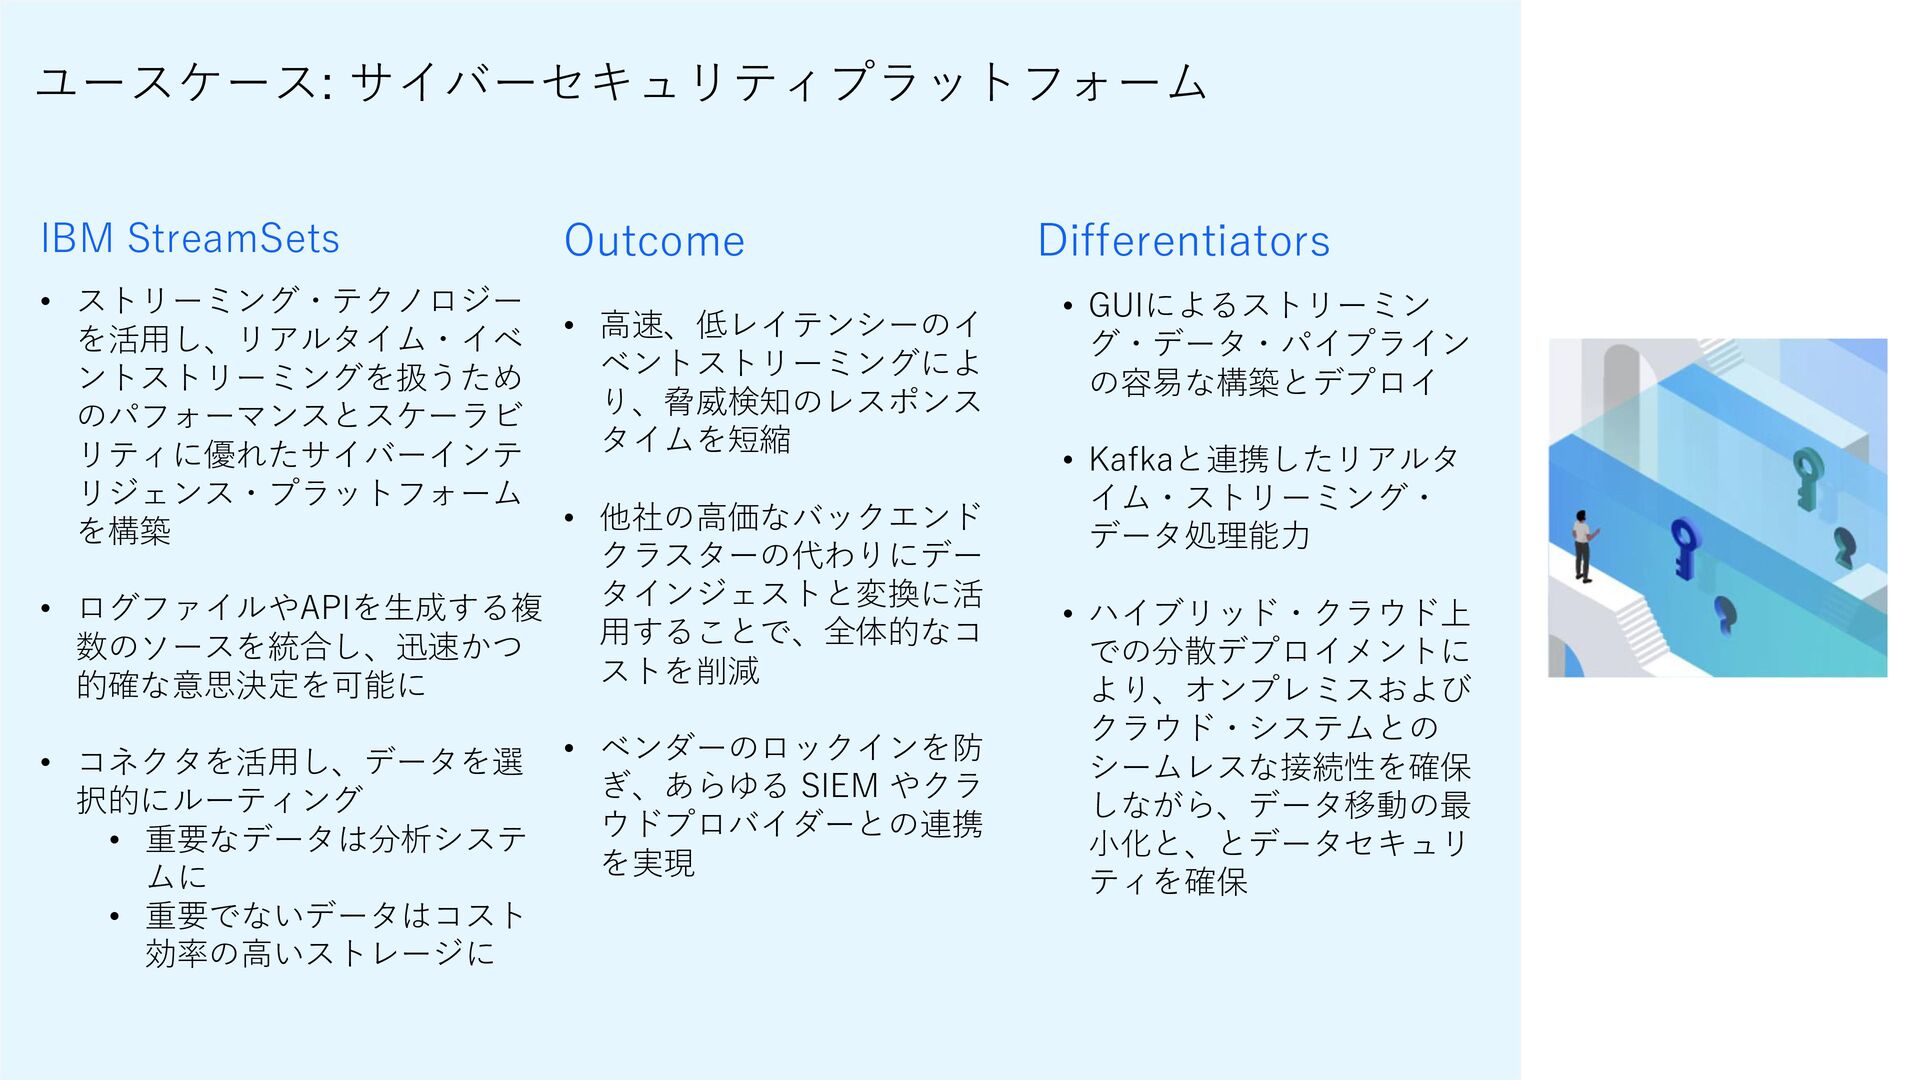
  11. © 2025 IBM Corporation IBM StreamSets • ストリーミング・テクノロジー を活用し、リアルタイム・イベ ントストリーミングを扱うため

    のパフォーマンスとスケーラビ リティに優れたサイバーインテ リジェンス・プラットフォーム を構築 • ログファイルやAPIを生成する複 数のソースを統合し、迅速かつ 的確な意思決定を可能に • コネクタを活用し、データを選 択的にルーティング • 重要なデータは分析システ ムに • 重要でないデータはコスト 効率の高いストレージに Outcome • 高速、低レイテンシーのイ ベントストリーミングによ り、脅威検知のレスポンス タイムを短縮 • 他社の高価なバックエンド クラスターの代わりにデー タインジェストと変換に活 用することで、全体的なコ ストを削減 • ベンダーのロックインを防 ぎ、あらゆる SIEM やクラ ウドプロバイダーとの連携 を実現 Differentiators • GUIによるストリーミン グ・データ・パイプライン の容易な構築とデプロイ • Kafkaと連携したリアルタ イム・ストリーミング・ データ処理能力 • ハイブリッド・クラウド上 での分散デプロイメントに より、オンプレミスおよび クラウド・システムとの シームレスな接続性を確保 しながら、データ移動の最 小化と、とデータセキュリ ティを確保 ユースケース: サイバーセキュリティプラットフォーム
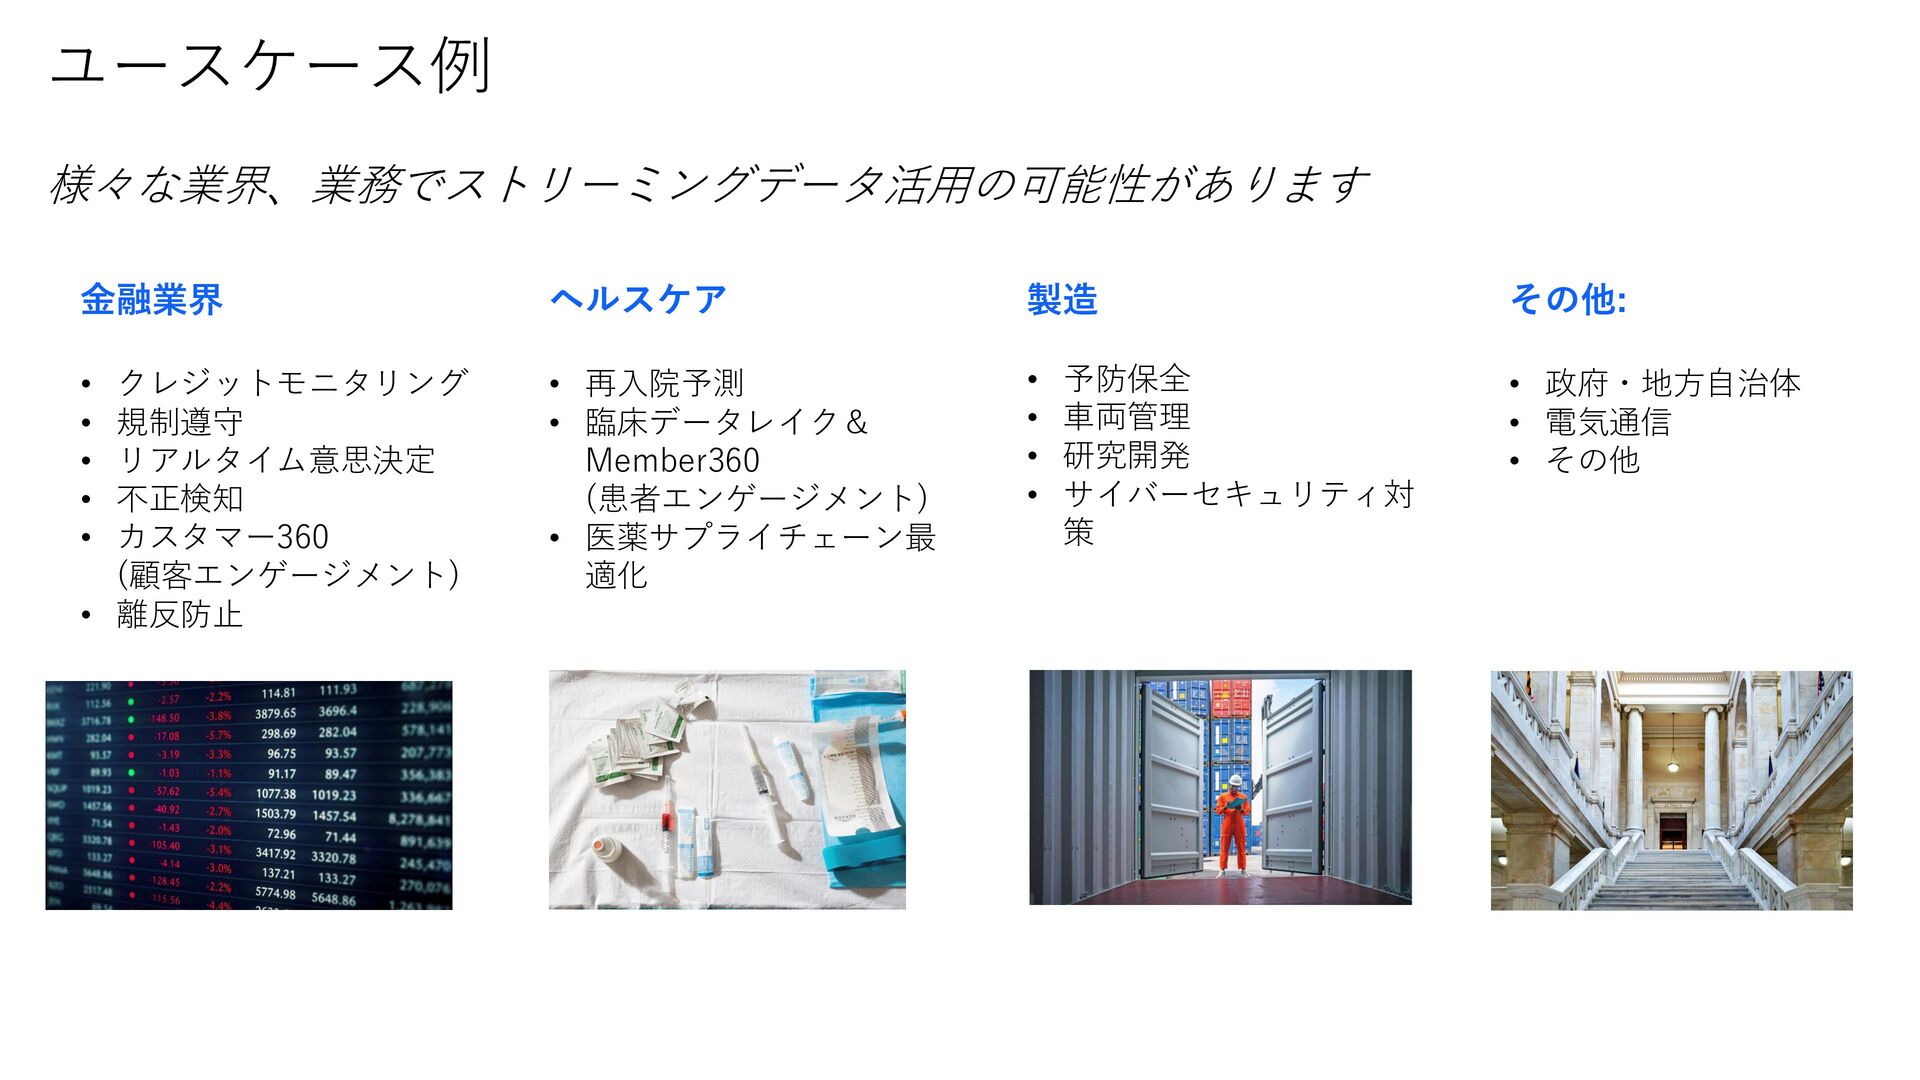
  12. ユースケース例 様々な業界、業務でストリーミングデータ活用の可能性があります ヘルスケア • 再入院予測 • 臨床データレイク& Member360 (患者エンゲージメント) •

    医薬サプライチェーン最 適化 金融業界 • クレジットモニタリング • 規制遵守 • リアルタイム意思決定 • 不正検知 • カスタマー360 (顧客エンゲージメント) • 離反防止 製造 • 予防保全 • 車両管理 • 研究開発 • サイバーセキュリティ対 策 その他: • 政府・地方自治体 • 電気通信 • その他
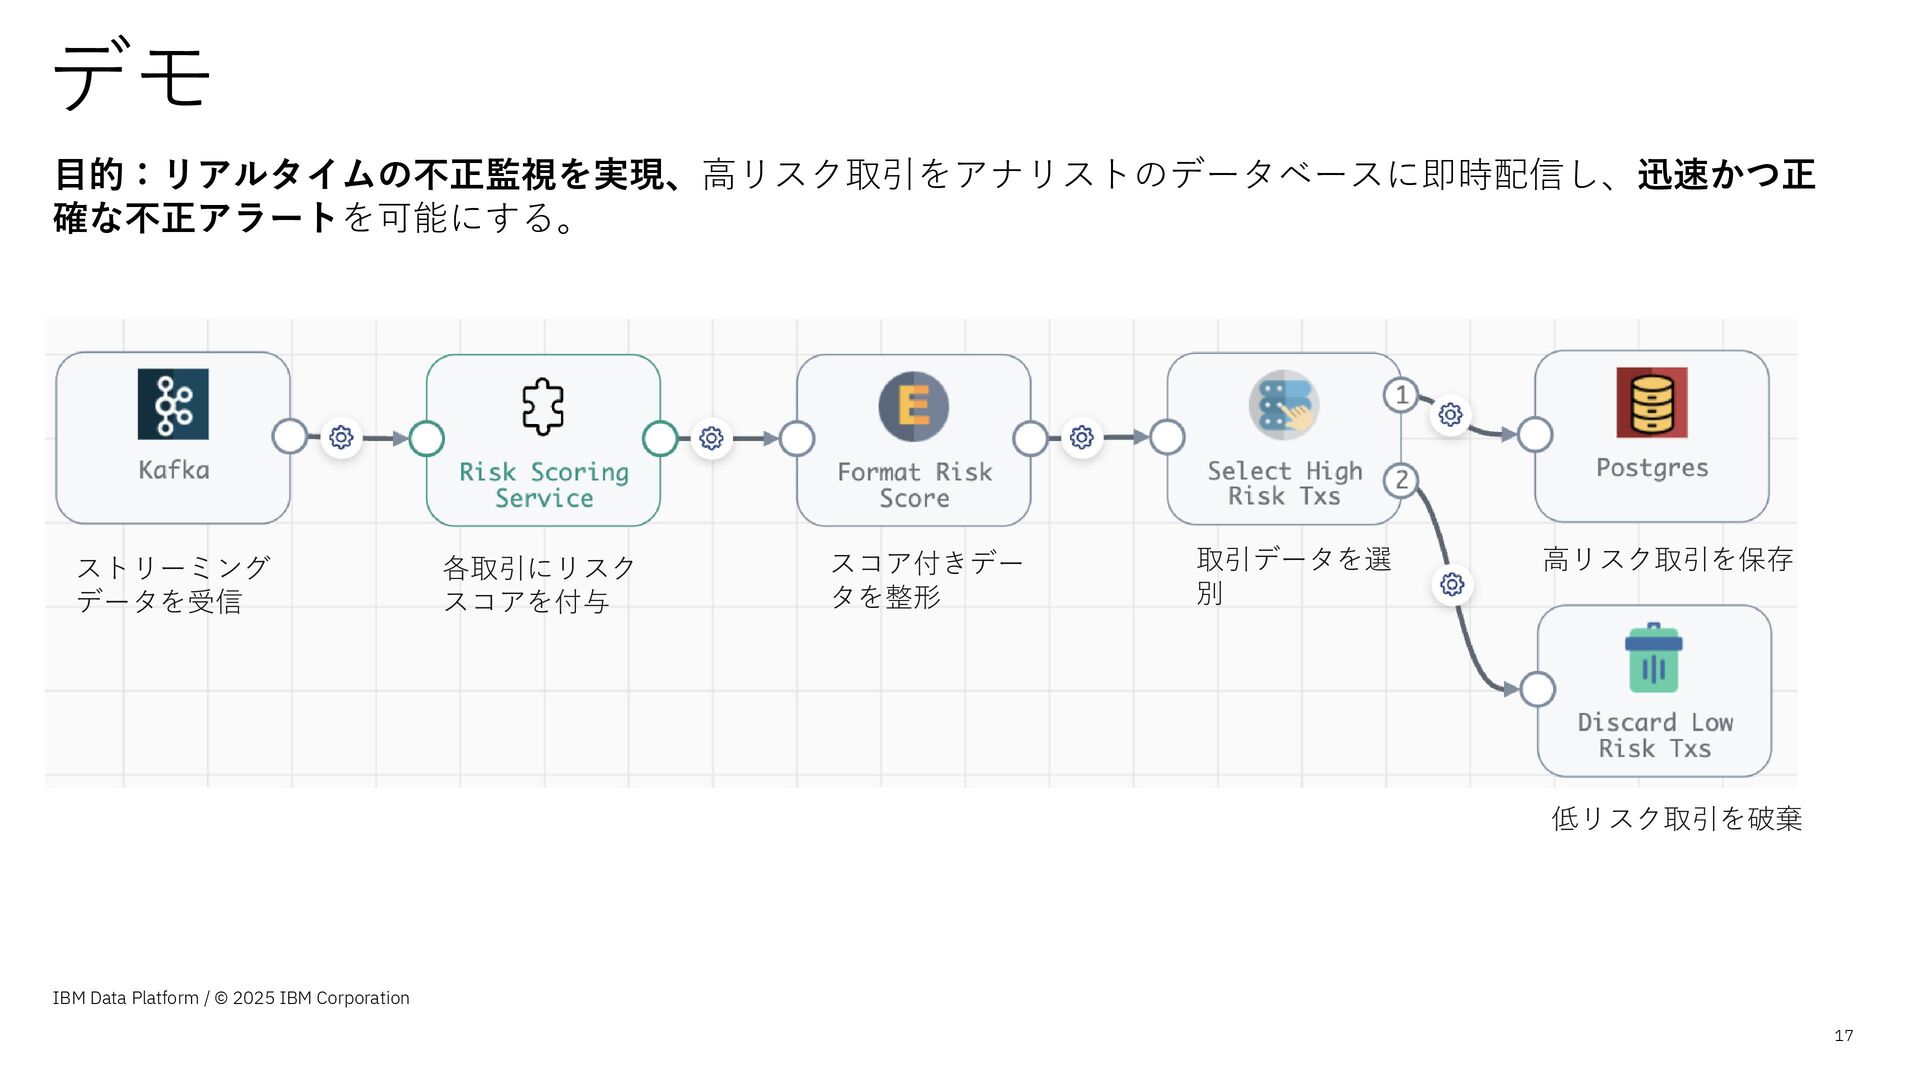
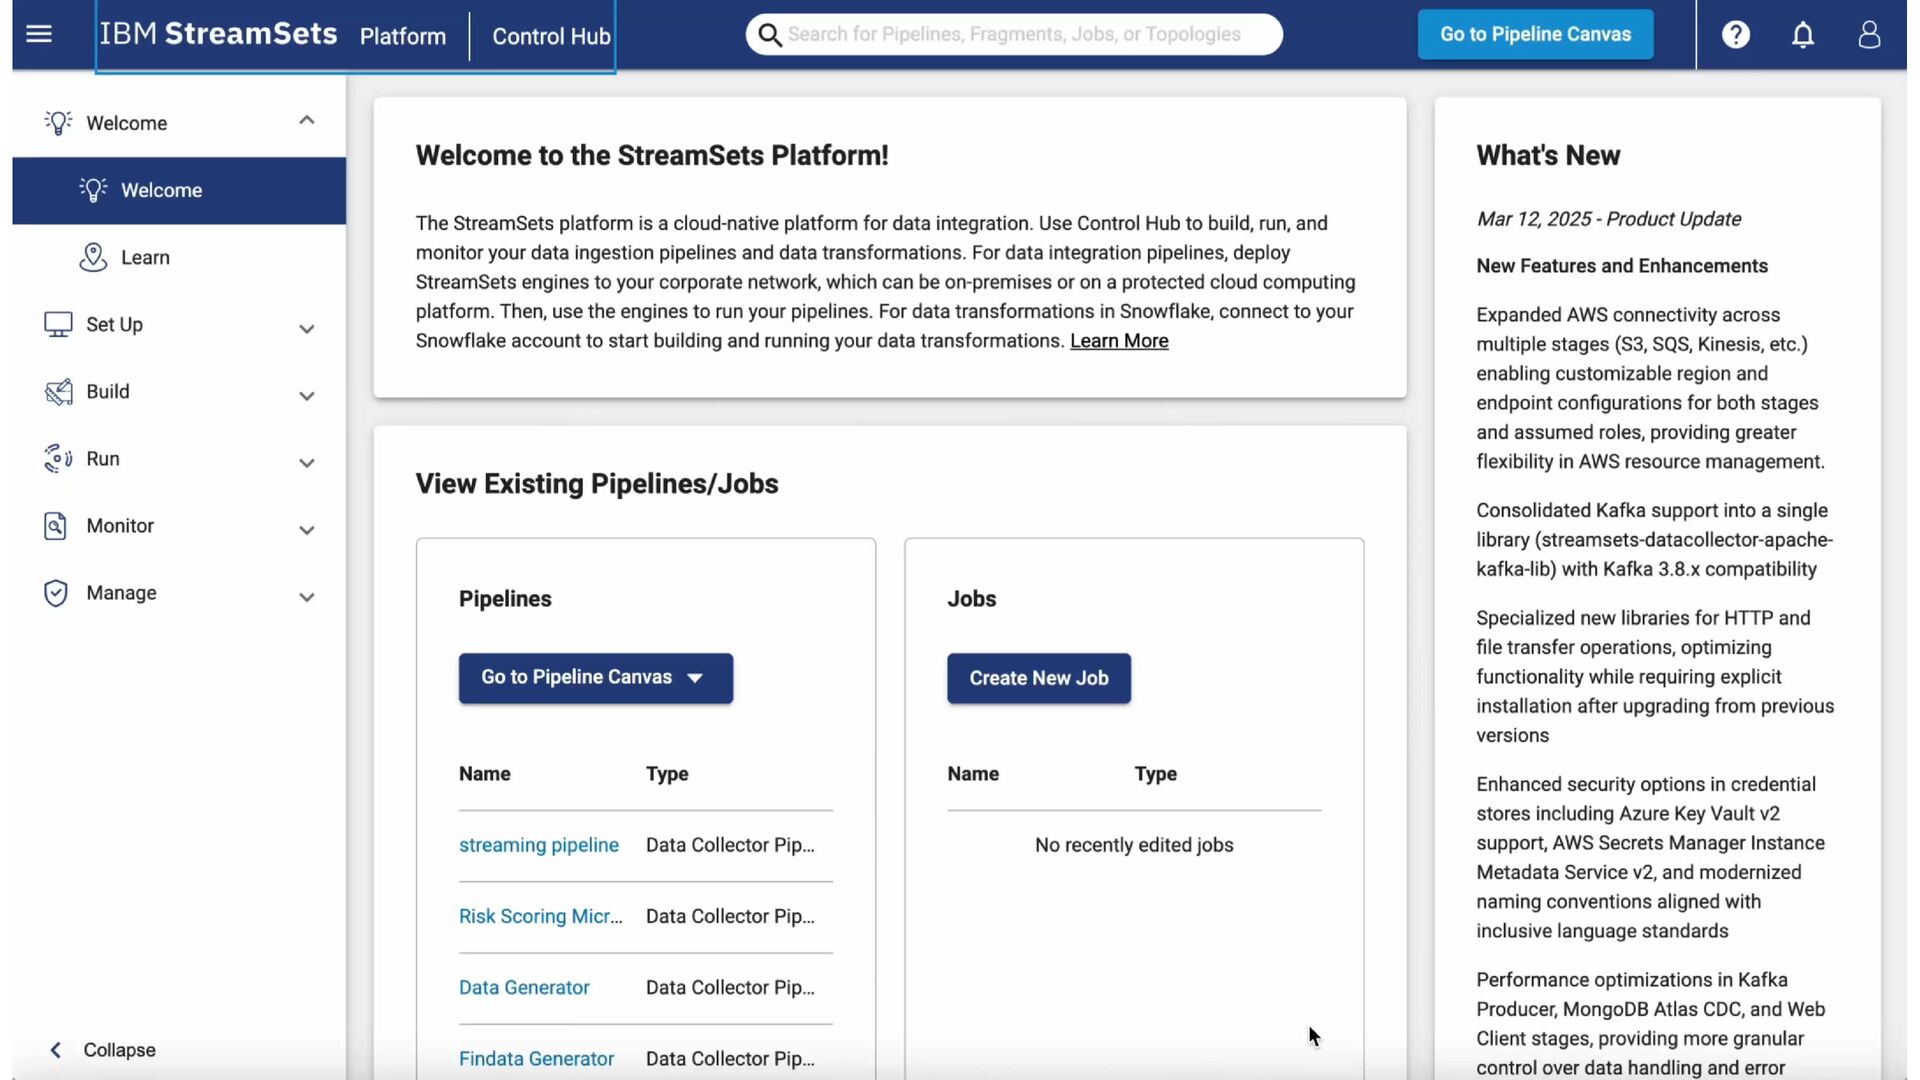
  13. IBM Data Platform / © 2025 IBM Corporation 17 デモ

    目的:リアルタイムの不正監視を実現、高リスク取引をアナリストのデータベースに即時配信し、迅速かつ正 確な不正アラートを可能にする。 ストリーミング データを受信 各取引にリスク スコアを付与 スコア付きデー タを整形 取引データを選 別 高リスク取引を保存 低リスク取引を破棄
  14. 20 IBM Data Platform / © 2025 IBM Corporation Data

    sources On-premise Streaming Cloud Data types Structured Semi-structured Unstructured data Data Integration Bulk/batch, ETL/ELT Real-time streaming Data observability and quality Data Replication Data Store Hybrid, open data lakehouse Fit for purpose query engines Open-source data formats Separate storage and compute Hybrid/ multi-cloud infrasturcture Vectorized embeddings for RAG Data Intelligence Data governance Data quality Data lineage Data sharing Consumers Generative AI Machine Learning Business Intelligence Data Engineering Ecosystem interoperability 3rd Party Tools: Databases Integration tools Object storage Lakehouses Data catalogs +more Unified metadata and governance Guardium Data security posture management Data compliance Data detection and response AI security Quantum safe Data protection データ・ファブリック はじめに位置づけの整理 データ・ファブリック、データ・インテグレーション、データ・インテリジェンスのアーキテクチャー データ・インテグレーション ・データチームや分析者、AI利用者に ・すぐに利用できて信頼性の高いデータを ・高鮮度で確実に届けること データ・インテリジェンス ・AI戦略のキモである企業のデータを ・品質、信頼性、アクセス容易性と ・ガバナンスのバランスを取りながら ・利用者に提供するもの データ・インテリジェンス(DI)とは、コア・ データ管理とメタデータ管理の原則を、人工知 能や機械学習などの高度なツールと組み合わせ ることで、企業データの生成と活用の仕組みを 理解できるように支援するものです。データ・ インテリジェンスの洞察により、データのビジ ネス価値を引き出し、データ主導の意思決定が 促進されます。 IBMのデータ管理アーキテクチャー (IA : Information Architecture)
  15. ワークショップ、セッション、および資料は、IBMまたはセッション発表者によって準備され、それぞれ独自の見解を反映したものです。それらは情報提供の目的のみで 提供されており、いかなる参加者に対しても法律的またはその他の指導や助言を意図したものではなく、またIBM製品やサービスがお客様に適用ある特定の法令に適合す ることを保証するものでもありません。本講演資料に含まれている情報については、完全性と正確性を期するよう努めておりますが、「現状のまま」提供され、明示また は黙示にかかわらず、商業性、特定の目的への適合性、非侵害性を含め、いかなる保証も伴わないものとします。本講演資料またはその他の資料の使用によって、あるい はその他の関連によって、いかなる損害が生じた場合も、IBMは責任を負わないものとします。 本講演資料で言及されるIBM製品、プログラム、またはサービスは、IBM がビジネスを行っているすべての国・地域でご提供可能なわけではありません。本講演資料で言及される将来の展望(製品リリース日付や製品機能を含む)は、市場機会 またはその他の要因に基づいてIBM独自の決定権をもっていつでも変更できるものとし、将来の製品または機能が使用可能になること、もしくは特定の結果を確約するこ とを意図するものではありません。本講演資料は、言及される IBM製品またはサービスに適用ある契約条件を変更するものでも、追加の表明または保証を意図するもので

    もありません。 本講演資料に含まれている内容は、参加者の活動によって特定の結果が生じると述べる、または暗示することを意図したものでも、またそのような結果を生むものでもあ りません。 パフォーマンスは、管理された環境において標準的なIBMベンチマークを使用した測定と予測に基づいています。ユーザーが経験する実際のスループットやパ フォーマンスは、ユーザーのジョブ・ストリームにおけるマルチプログラミングの量、入出力構成、ストレージ構成、および処理されるワークロードなどの考慮事項を含 む、数多くの要因に応じて変化します。したがって、個々のユーザーがここで述べられているものと同様の結果を得られると確約するものではありません。記述されてい るすべてのお客様事例は、それらのお客様がどのようにIBM製品を使用したか、またそれらのお客様が達成した結果の実例として示されたものです。実際の環境コストお よびパフォーマンス特性は、お客様ごとに異なる場合があります。 IBM、IBMのロゴ、ibm.comは、世界の多くの国で法的に登録された、International Business Machines Corporationの商標です。その他の製品名・サービス名はIBMま たは他社の商標である可能性があります。IBM商標の最新リストは、ウェブ上の「著作権および商標情報」( www.ibm.com/jp-ja/legal/copytrade.shtml )でご確認いた だけます。 通知と免責事項