Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
EKF日志分析平台架构方案实践
Search
成臣 Chengchen
May 10, 2021
Technology
370
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
EKF日志分析平台架构方案实践
成臣 Chengchen
May 10, 2021
Transcript
22 slides
!"#$%&'()*+,-./ 谢明轩 聚云科技大数据架构师 05/15/2021 Best Practices In EKF Stack
分享大纲 日志系统的发展与流行 协议栈介绍及体系结构 常见的日志分析平台架构及使用场景 EKF日志分析平台架构方案实践
!"#$% &'()*+,-./
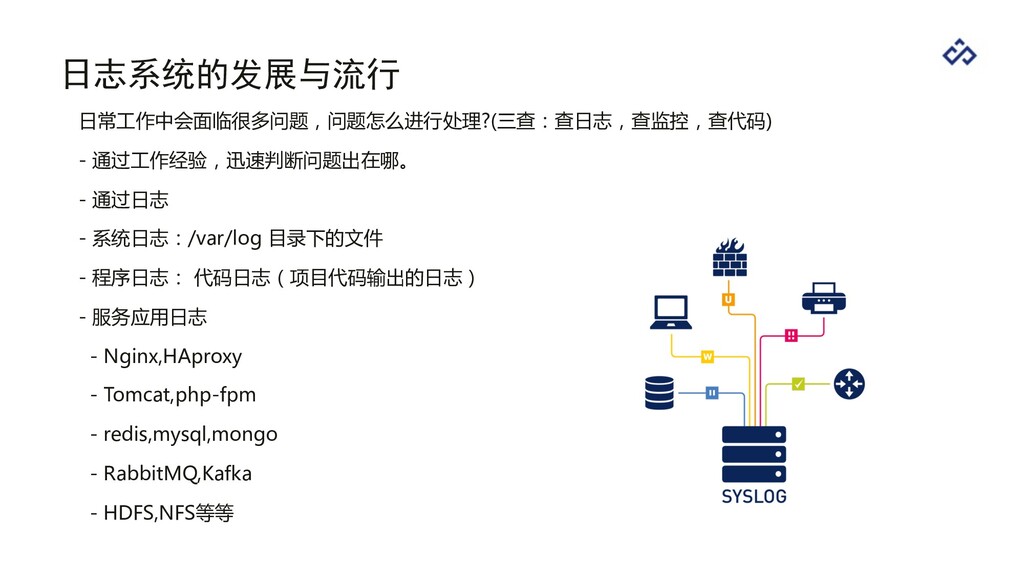
&'()*+,-./ 日常工作中会面临很多问题,问题怎么进行处理?(三查:查日志,查监控,查代码) - 通过工作经验,迅速判断问题出在哪。 - 通过日志 - 系统日志:/var/log 目录下的文件 -
程序日志: 代码日志(项目代码输出的日志) - 服务应用日志 - Nginx,HAproxy - Tomcat,php-fpm - redis,mysql,mongo - RabbitMQ,Kafka - HDFS,NFS等等
&'()*+,-./ 通过日志排除,发现问题根源解决问题 越来越多的系统需要统一进行维护的时候,就提出了建立一套集中式的方法,把不同来源的数据集中整 合到一起。 一个完整的集中式日志系统,是离不开以下几个主要特点的: - 收集-能够采集多种来源的日志数据 - 传输-能够稳定的把日志数据传输到中央系统 -
存储-如何存储日志数据 - 分析-可以支持 UI 分析 - 警告-能够提供错误报告,监控机制
&'()*+,-./ 基于上述思路,市场上出现了许多产品或方案 - 简单的有 Rsyslog,Syslog-ng - 商业化的 Splunk(The Data-to-EverythingTM Platform,
Powering Security, IT and DevOps) - 开源的 - FaceBook 公司的 Scribe - Apache 的 Chukwa - Linkedin 的 Kafka - Cloudera 的 Fluentd - ELK Tips:Splunk是一款非常优秀的产品,但是它是商业产品,价格昂贵,让人望而却步.
!"#$0 1234567(89
1234567(89 ELK其实并不是一款软件,而是一整套解决方案,是三个软件产品的首字母缩写,Elasticsearch,Logstash 和Kibana。这三款软件都是开源软件,通常是配合使用,而且又先后归于 Elastic.co 公司名下,故被简称 为ELK协议栈。
1234567(89 Elasticsearch 是一个实时的分布式搜索和分析引擎,它可以用于全文搜索,结构化搜索以及分析。它 是一个建立在全文搜索引擎 Apache Lucene基础上的搜索引擎,使用Java语言编写。 特点:分布式,零配置,自动发现,索引自动分片,索引副本机制等。
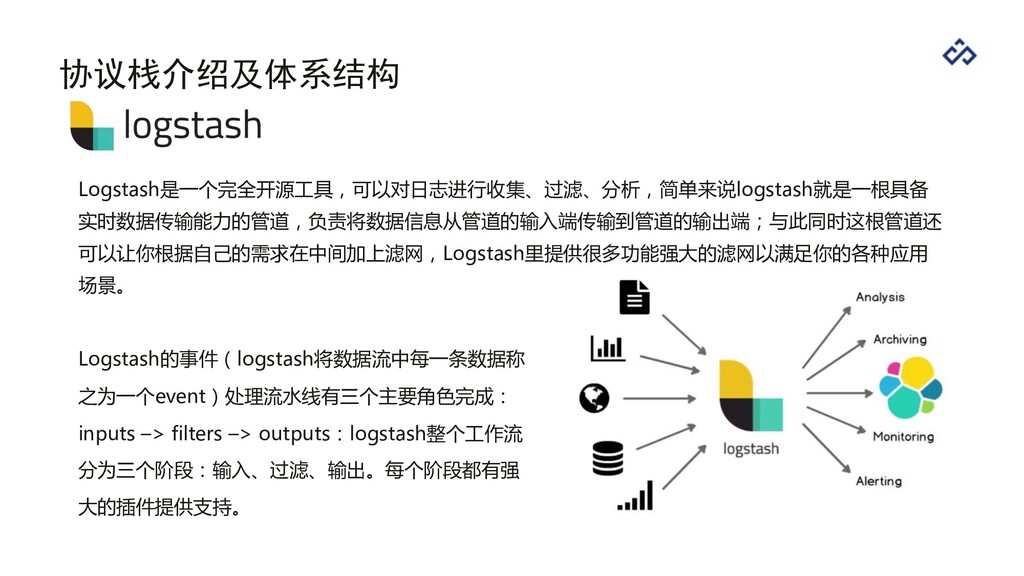
1234567(89 Logstash是一个完全开源工具,可以对日志进行收集、过滤、分析,简单来说logstash就是一根具备 实时数据传输能力的管道,负责将数据信息从管道的输入端传输到管道的输出端;与此同时这根管道还 可以让你根据自己的需求在中间加上滤网,Logstash里提供很多功能强大的滤网以满足你的各种应用 场景。 Logstash的事件(logstash将数据流中每一条数据称 之为一个event)处理流水线有三个主要角色完成: inputs –> filters
–> outputs:logstash整个工作流 分为三个阶段:输入、过滤、输出。每个阶段都有强 大的插件提供支持。
1234567(89 Kibana是一款基于 Apache开源协议,使用 JavaScript语言 编写,为Elasticsearch 提供分析和可视化的 Web 平台。他 可以在Elasticsearch 的索引中查找,交互数据,并生成各种
维度的表图。
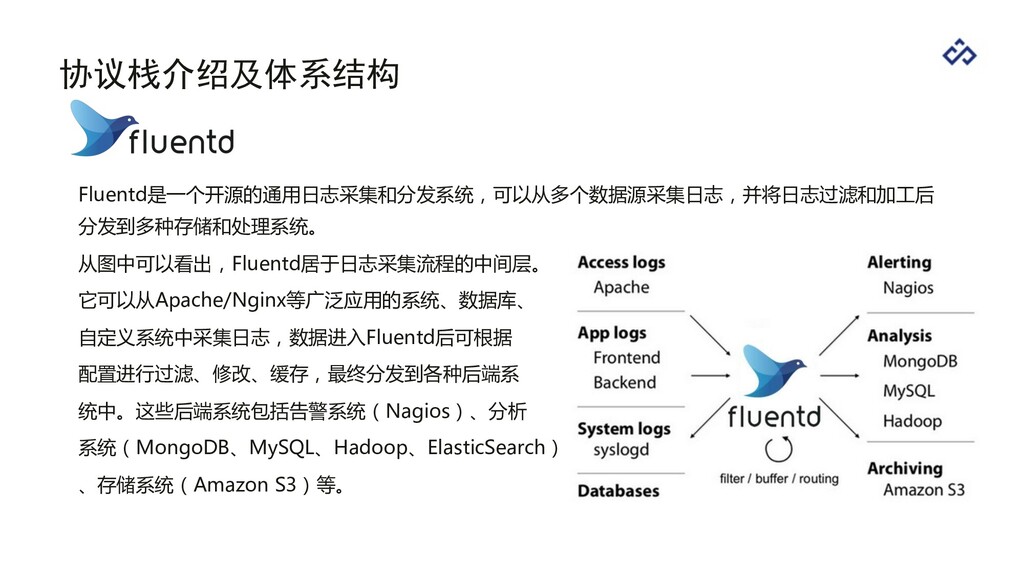
1234567(89 Fluentd是一个开源的通用日志采集和分发系统,可以从多个数据源采集日志,并将日志过滤和加工后 分发到多种存储和处理系统。 从图中可以看出,Fluentd居于日志采集流程的中间层。 它可以从Apache/Nginx等广泛应用的系统、数据库、 自定义系统中采集日志,数据进入Fluentd后可根据 配置进行过滤、修改、缓存,最终分发到各种后端系 统中。这些后端系统包括告警系统(Nagios)、分析 系统(MongoDB、MySQL、Hadoop、ElasticSearch) 、存储系统(Amazon
S3)等。
1234567(89 Tips: - Fluentd就是把通常的日志采集-缓存-分发-存储流程提炼出来,用户只需要考虑业务数据,至于数据的传输、 容错等过程细节都交给Fluentd来做。 - 为了统一处理各种日志,Fluentd把JSON作为内部数据格式,流入和流出的数据都是JSON格式。由于JSON 是一种通用的跨平台的数据格式,这给现有系统的改造带来很大便利。 - 由于对日志业务流程做了抽象,为了能支持各种日志,Fluentd将各采集分发步骤插件化,通过在各个步骤接
入合适的插件来处理对应的业务数据。 - Fluentd内置了常用的插件,比如in_tail、in_http、out_file、out_mongo等,开源社区也贡献了更丰富的插 件。通过组合各种插件,我们能够轻松搭建起自己的日志采集系统。 - Fluentd使用C作为开发语言,其插件系统的开发使用到了Ruby。C保证了系统的高效,Ruby给用户提供了一 个灵活使用插件的途径。
!"#$: ;<*&'=>?@A96BCDE
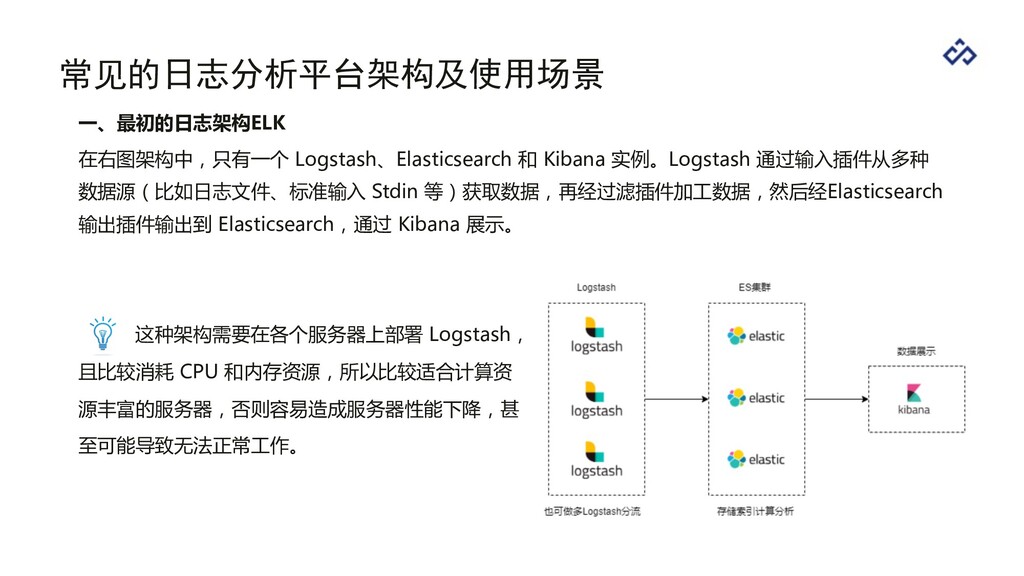
;<*&'=>?@A96BCDE 一、最初的日志架构ELK 在右图架构中,只有一个 Logstash、Elasticsearch 和 Kibana 实例。Logstash 通过输入插件从多种 数据源(比如日志文件、标准输入 Stdin
等)获取数据,再经过滤插件加工数据,然后经Elasticsearch 输出插件输出到 Elasticsearch,通过 Kibana 展示。 这种架构需要在各个服务器上部署 Logstash, 且比较消耗 CPU 和内存资源,所以比较适合计算资 源丰富的服务器,否则容易造成服务器性能下降,甚 至可能导致无法正常工作。
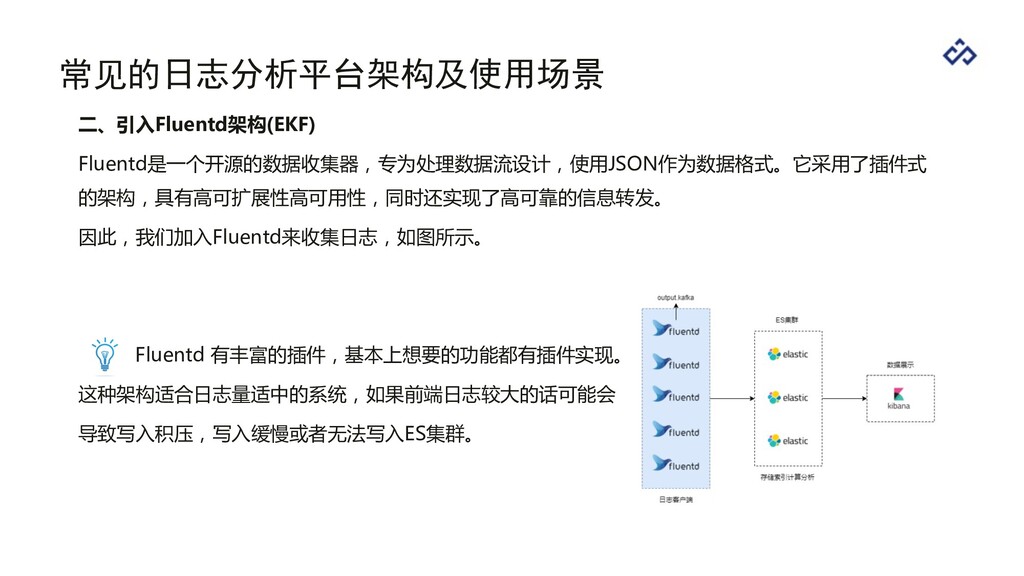
;<*&'=>?@A96BCDE 二、引入Fluentd架构(EKF) Fluentd是一个开源的数据收集器,专为处理数据流设计,使用JSON作为数据格式。它采用了插件式 的架构,具有高可扩展性高可用性,同时还实现了高可靠的信息转发。 因此,我们加入Fluentd来收集日志,如图所示。 Fluentd 有丰富的插件,基本上想要的功能都有插件实现。 这种架构适合日志量适中的系统,如果前端日志较大的话可能会 导致写入积压,写入缓慢或者无法写入ES集群。
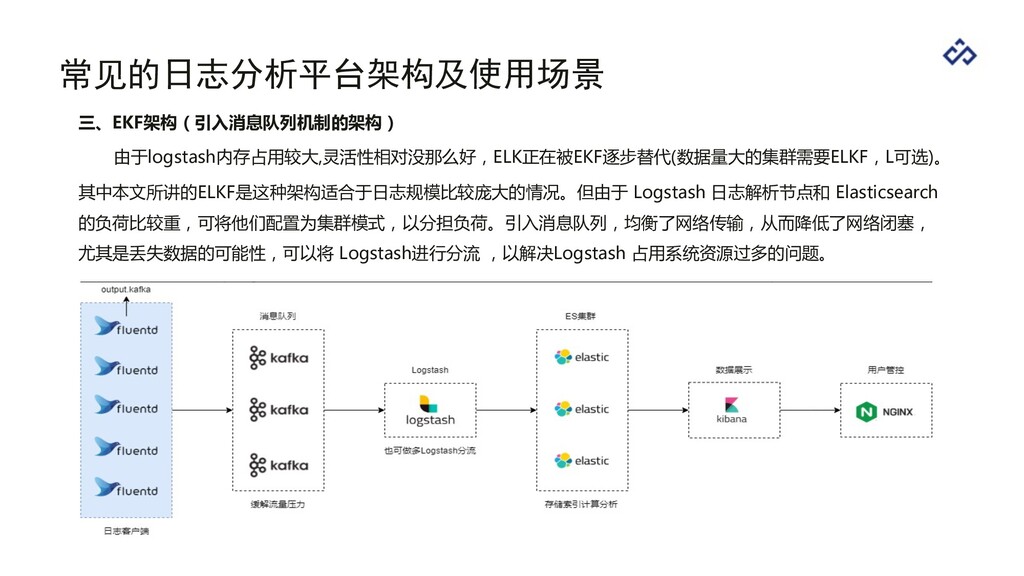
;<*&'=>?@A96BCDE 三、EKF架构(引入消息队列机制的架构) 由于logstash内存占用较大,灵活性相对没那么好,ELK正在被EKF逐步替代(数据量大的集群需要ELKF,L可选)。 其中本文所讲的ELKF是这种架构适合于日志规模比较庞大的情况。但由于 Logstash 日志解析节点和 Elasticsearch 的负荷比较重,可将他们配置为集群模式,以分担负荷。引入消息队列,均衡了网络传输,从而降低了网络闭塞, 尤其是丢失数据的可能性,可以将 Logstash进行分流
,以解决Logstash 占用系统资源过多的问题。
!"#$F GHI&'=>?@A9JKLM
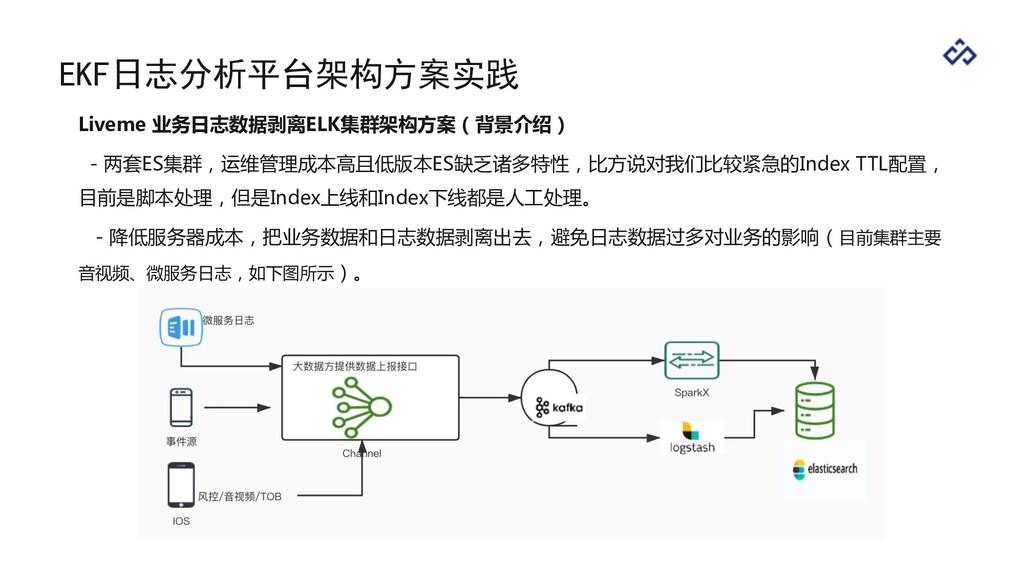
GHI&'=>?@A9JKLM Liveme 业务日志数据剥离ELK集群架构方案(背景介绍) - 两套ES集群,运维管理成本高且低版本ES缺乏诸多特性,比方说对我们比较紧急的Index TTL配置, 目前是脚本处理,但是Index上线和Index下线都是人工处理。 - 降低服务器成本,把业务数据和日志数据剥离出去,避免日志数据过多对业务的影响(目前集群主要 音视频、微服务日志,如下图所示)。
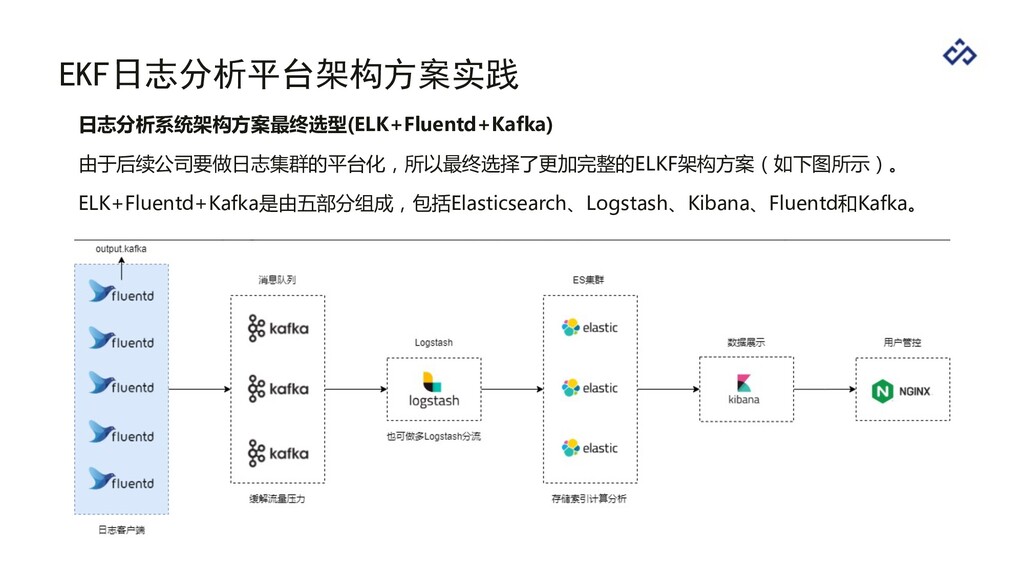
GHI&'=>?@A9JKLM 日志分析系统架构方案最终选型(ELK+Fluentd+Kafka) 由于后续公司要做日志集群的平台化,所以最终选择了更加完整的ELKF架构方案(如下图所示)。 ELK+Fluentd+Kafka是由五部分组成,包括Elasticsearch、Logstash、Kibana、Fluentd和Kafka。
GHI&'=>?@A9JKLM 主要集群部署方案实践 1.Elasticsearch集群部署选择 -服务器系统自建相应版本的ES集群 -使用云托管的ES集群(云托管集群对后续使用集成云存储及自动冷备索引都是无缝衔接的,但是对于插件支持 方面有限,比如Elastic APM应用程序性能监测是不支持的) 2.Kafka集群部署选择 - Kafka集群可通过服务器自建集群部署
- 使用云托管Kafka集群(如:AWS的MSK集群,腾讯云的ckafka集群) 3.Fluentd系统日志收集客户端部署选择 -Fluentd系统日志收集客户端部署,统一日志采集的规则及要采集的格式。 (例:收集日志目录规范:/data/*/*/*.log)
THANKS!
More Decks by 成臣 Chengchen
See All by 成臣 Chengchen
ゲーム広告でのTiDB活用事例
it2911
0
310
ChaosBlade紹介[中国語]
it2911
0
300
Chaos Engineering 紹介[中国語]
it2911
0
370
Chaos Mesh紹介[中国語]
it2911
0
420
AWS云上架构演进
it2911
0
270
Ingress 勉強会: Traefik 2.0
it2911
0
490
F5-NGINX-Ingress勉強会
it2911
0
990
JD.com Blockchain as a Service @ Tokyo in 2019
it2911
0
240
Kubernetes with JUJU
it2911
0
300
Other Decks in Technology
See All in Technology
農家は秘伝のタレを知らない - NOBODY KNOWS THE HIDDEN SOURCE - Kaggriculture 3rd Place Solution
masspeaks
3
640
Kubernetes, Agones, WebRTC, GPU で作る クラウドゲーミング基盤を本番運用に乗せるまで
vivion
0
220
Amazon Bedrock AgentCore の基礎とセキュリティ・ガバナンス
ren8k
0
210
AIネイティブ組織の作り方。1人のPOとAIから始める、自社での実験
ama_ch
2
1.3k
Dark Web - Como o Cibercrime Opera na Internet
nicholsjasper
0
100
お風呂場をサーバルームにしよう
yusuke427
0
380
Re:ゼロから始めるシェアハウスのペットな鯖
silmin_
0
260
要件定義をAIに委任!Claude Codeプラグインで作るPdM × AgentTeams
puku0x
0
120
AWS DevOps Agentの構造から読み解く運用 AI エージェントの設計原則/aws-devops-agent-design-principles
tomoki10
0
170
AWS Blocksで AIエージェント作れるの知ってます?
kmiya84377
1
130
ぼくのClaude Codeの使い方
falken
PRO
5
7.6k
From vibe coding to reliable (agentic) development
jcabot
0
130
Featured
See All Featured
Navigating Algorithm Shifts & AI Overviews - #SMXNext
aleyda
1
1.7k
Believing is Seeing
oripsolob
1
290
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.4k
The Illustrated Guide to Node.js - THAT Conference 2024
reverentgeek
1
610
Stewardship and Sustainability of Urban and Community Forests
pwiseman
0
610
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.3k
jQuery: Nuts, Bolts and Bling
dougneiner
66
8.7k
Designing for humans not robots
tammielis
254
26k
Sharpening the Axe: The Primacy of Toolmaking
bcantrill
46
3.1k
The Cost Of JavaScript in 2023
addyosmani
56
10k
BBQ
matthewcrist
90
10k
Learning to Love Humans: Emotional Interface Design
aarron
275
41k


 it2911
 masspeaks
 vivion
 ren8k
 ama_ch
 nicholsjasper
 yusuke427
 silmin_
 puku0x
 tomoki10
 kmiya84377
 falken
 jcabot
 aleyda
 oripsolob
 eileencodes
 reverentgeek
 pwiseman
 dougneiner
 tammielis
 bcantrill
 addyosmani
 matthewcrist
 aarron