Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
AWSのGPUを安く使って TensorFlowモデルを訓練する方法
Search
masa-ita
August 08, 2020
Technology
430
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
AWSのGPUを安く使って TensorFlowモデルを訓練する方法
masa-ita
August 08, 2020
More Decks by masa-ita
See All by masa-ita
Ollamaを使ったLocal Language Model活用法
itagakim
1
250
Run Instant NeRF on Docker
itagakim
1
2.4k
3D Clustering and Metric Learning
itagakim
0
420
Cloud TPUの使い方〜BigBirdの日本語学習済みモデルを作る〜
itagakim
0
770
多言語学習済みモデルmT5とは?
itagakim
1
800
最近の自然言語処理モデルの動向
itagakim
1
610
ディープラーニングで芸術はできるか? 〜生成系ネットワークの進展〜
itagakim
0
390
AWSとTerraform初心者が やってみたこと
itagakim
1
540
IntroductionToTensorFlow2_0.pdf
itagakim
1
390
Other Decks in Technology
See All in Technology
EventBridge に「合流」はない ― サーバーレスのワークフローを育てるということ / No Join in EventBridge
yusukeshimizu
2
500
顧客に向き合う開発組織へ。リアーキテクチャとフィーチャーチーム化で挑む組織改革
safie
0
2.4k
Azure Serverless 2026:Production-ready な AI エージェント基盤 / Azure Serverless 2026: Production-Ready AI Agent Platform
miyake
2
560
The Knowledge Spine: A Machine-Executable Ontology for Governed Marketing Activation
vananth22
0
120
Why Agent Cost Needs Observability
nttcom
0
150
LLMに渡さなかった仕事
nanaism
0
1.4k
時うどん〜Socket.getifaddrsで学ぶネットワーク編 / Tokiudon: The Socket.getifaddrs Edition
coe401_
4
240
What the customer really needed
kawaguti
PRO
3
220
技術的負債から考える、AI時代のエンジニアリング投資 — ビズリーチの技術的負債と向き合った経験から、変更し続けられるソフトウェアを考える/ technical-debt-con2026
visional_engineering_and_design
4
3.7k
.NET WebAssemblyで実現するクライアントサイドAI推論:NuGetからViteまで、2つのエコシステムを繋ぐビルド戦略
yamachu
1
670
フルカイテン株式会社 エンジニア向け採用資料
fullkaiten
0
12k
ソフトウェアDNAとクラウドエージェントのススメ
cloudace
0
120
Featured
See All Featured
Building Flexible Design Systems
yeseniaperezcruz
330
41k
How to make the Groovebox
asonas
2
2.4k
A Tale of Four Properties
chriscoyier
163
24k
The World Runs on Bad Software
bkeepers
PRO
72
12k
Docker and Python
trallard
47
4.2k
Easily Structure & Communicate Ideas using Wireframe
afnizarnur
194
17k
Embracing the Ebb and Flow
colly
88
5.2k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
21k
Lessons Learnt from Crawling 1000+ Websites
charlesmeaden
PRO
1
1.6k
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8k
Designing Experiences People Love
moore
143
24k
Leveraging LLMs for student feedback in introductory data science courses - posit::conf(2025)
minecr
1
410
Transcript
AWSのGPUを安く使って TensorFlowモデルを訓練する⽅法 板垣正敏@TensorFlow Users Group Niigata Meetup #3 2020/8/8
⾃⼰紹介 板垣 正敏(いたがき まさとし) 1955年 新潟県・村上市⽣まれ Python機械学習勉強会in新潟
世話⼈ NPO法⼈ 新潟オープンソース協会 理事 株式会社BSNアイネット 技術顧問 中⼩企業診断⼠ 2
アジェンダ GPUを持っていない/GPUが⾜りない︖ クラウドGPUの料⾦ Amazon SageMakerとは︖ SageMaker
トレーニングジョブの仕組み ⽤意するもの コンテナ内の標準ディレクトリ構成 訓練⽤プログラムの勘所 Docker ImageのビルドとECRへの登録 トレーニングジョブの投⼊と完了 メトリクスの監視⽅法 どれくらい節約できる︖ まとめ 3
GPUを持っていない/GPUが⾜りない︖ Google Colaboratoryは素晴らしい ⼿元にGPUがない場合に⼀番⼿軽で⼀番安い(なにせ無料)なのがGoogle Colaboratoryです(⽶国では有料プランも) GPU以外にクラウドTPUも無料で使うことができます
ただし、最⼤実⾏時間12時間の制限があるほか、⼀定時間操作を⾏わないと切断さ れます クラウドを使う GPUマシンを購⼊するほどではないが、お⾦がかかってもある程度の時間GPUを使い たいとか、たくさんのGPUが必要なモデルの訓練を⾏う場合などは、クラウドを利⽤ することになります 4
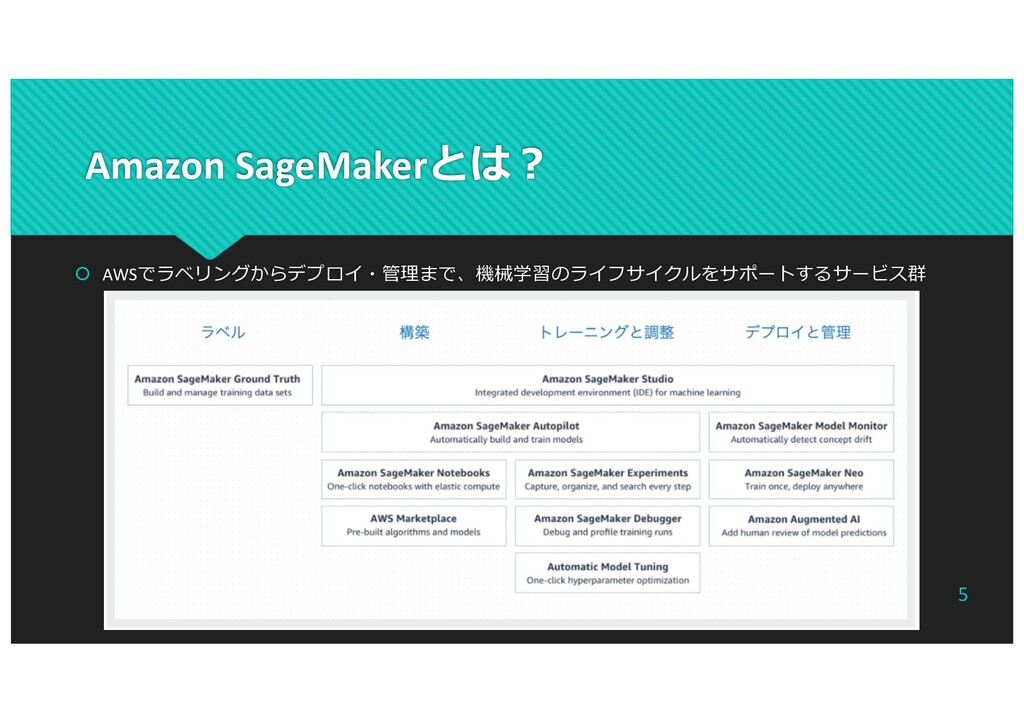
Amazon SageMakerとは︖ AWSでラベリングからデプロイ・管理まで、機械学習のライフサイクルをサポートするサービス群 5
SageMaker トレーニングジョブ の仕組み AWSのコンテナサービスを使 って機械学習モデルの訓練を 行うサービス 利用可能なモデル
AWSあるいはマーケットプレ イスのアルゴリズム カスタムアルゴリズム AWSが用意したコンテナ( TensorFlow, PyTorchなど) カスタムコンテナ(今回はコ レ) https://towardsdatascience.com/a-quick-guide-to-using-spot-instances- with-amazon-sagemaker-b9cfb3a44a68 6
⽤意するもの AWSアカウント Amazon SageMaker⽤のロール(アタッチするポリシーはAmazonSageMakerFullAccessのみで可) ECRのレジストリ S3バケット
訓練⽤プログラム 訓練⽤データ Dockerのビルド環境 7
コンテナ内の標準ディレクトリ構成 /opt/ml ├── checkpoints <= 中断に備えてチェックポイントを保存︓S3バケットにコピー ├── code │ └──
train <= 訓練⽤プログラムのエントリーポイント(既定) ├── input │ ├── config <= SageMakerトレーニングジョブから渡される │ │ ├── hyperparameters.json <= 訓練ジョブ投⼊時に設定したハイパーパラメータが⼊る │ │ └── resourceConfig.json <= Sagemakerが割り当てたリソースに関する情報 │ └── data │ └── training <= 訓練⽤データの場所(既定)︓S3バケットからコピーされる ├── model <= 学習したモデルの保存場所︓圧縮後outputにコピー └── output <= 出⼒⽤ディレクトリ︓S3バケットにコピー 8
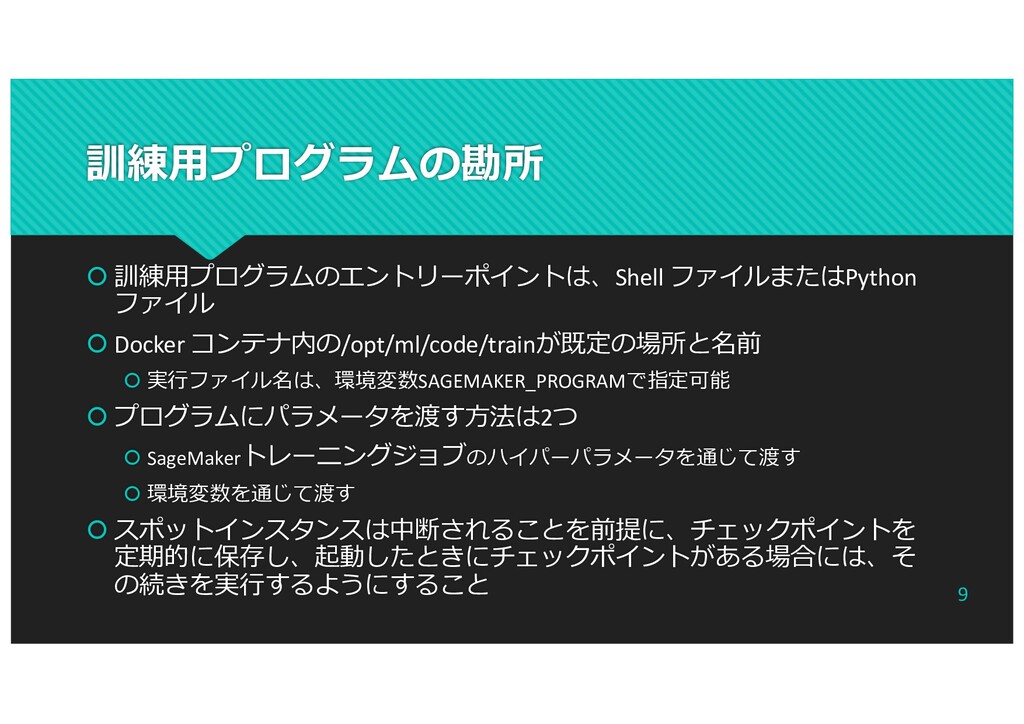
訓練⽤プログラムの勘所 訓練⽤プログラムのエントリーポイントは、Shell ファイルまたはPython ファイル Docker コンテナ内の/opt/ml/code/trainが既定の場所と名前 実⾏ファイル名は、環境変数SAGEMAKER_PROGRAMで指定可能
プログラムにパラメータを渡す⽅法は2つ SageMakerトレーニングジョブのハイパーパラメータを通じて渡す 環境変数を通じて渡す スポットインスタンスは中断されることを前提に、チェックポイントを 定期的に保存し、起動したときにチェックポイントがある場合には、そ の続きを実⾏するようにすること 9
中断に備えてチェックポイントを保存 # モデルのチェックポイントをチェックポイントディレクトリに保存する checkpoint_path = os.path.join(checkpoints_dir, 'model_checkpoint_{epoch:05d}’) model_checkpoint_callback = ModelCheckpoint(filepath=checkpoint_path,
save_weights_only=False) model.fit(train_ds, epochs=train_steps, initial_epoch=initial_epoch, validation_data=val_ds, callbacks=[model_checkpoint_callback], verbose=2) 10
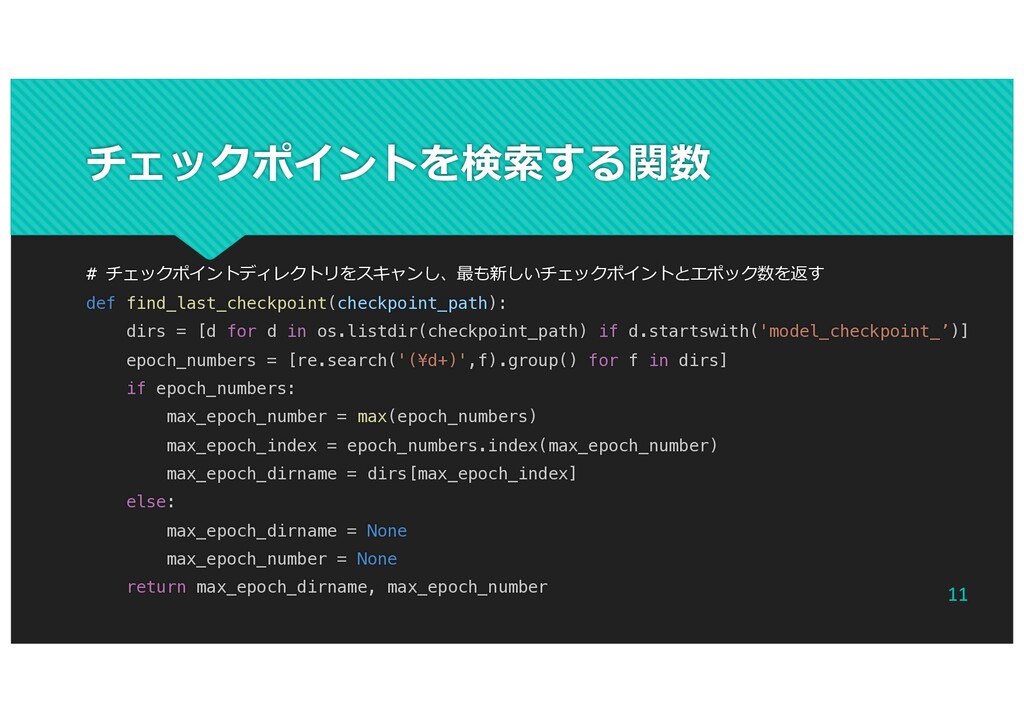
チェックポイントを検索する関数 # チェックポイントディレクトリをスキャンし、最も新しいチェックポイントとエポック数を返す def find_last_checkpoint(checkpoint_path): dirs = [d for d
in os.listdir(checkpoint_path) if d.startswith('model_checkpoint_’)] epoch_numbers = [re.search('(¥d+)',f).group() for f in dirs] if epoch_numbers: max_epoch_number = max(epoch_numbers) max_epoch_index = epoch_numbers.index(max_epoch_number) max_epoch_dirname = dirs[max_epoch_index] else: max_epoch_dirname = None max_epoch_number = None return max_epoch_dirname, max_epoch_number 11
チェックポイントがあればロード # チェックポイントを検索し、あれば最新の重みをロードし再開するエポック数をセット last_checkpoint, last_epoch = find_last_checkpoint(checkpoints_dir) if last_checkpoint: model
= models.load_model(os.path.join(checkpoints_dir, last_checkpoint)) initial_epoch = int(last_epoch) print('Model checkpoint #{} was loaded.'.format(last_epoch)) else: model = create_model(num_classes=num_classes) model.compile(loss = 'categorical_crossentropy’, optimizer = 'rmsprop’, metrics = ['accuracy’]) initial_epoch = 0 12
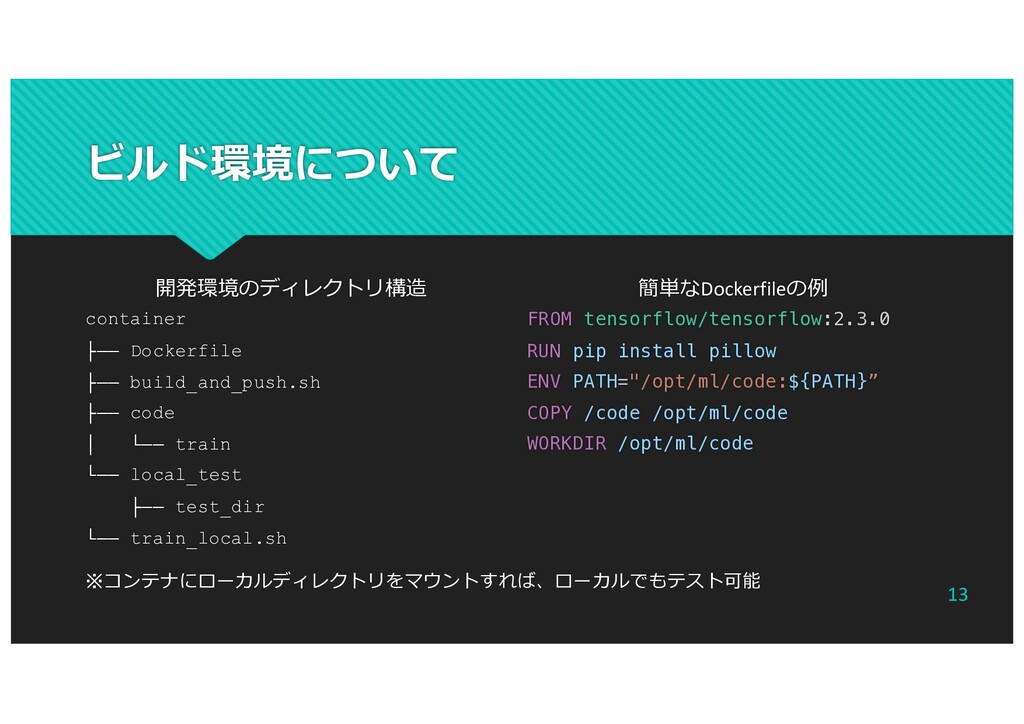
ビルド環境について 開発環境のディレクトリ構造 container ├── Dockerfile ├── build_and_push.sh ├── code │
└── train └── local_test ├── test_dir └── train_local.sh 簡単なDockerfileの例 FROM tensorflow/tensorflow:2.3.0 RUN pip install pillow ENV PATH="/opt/ml/code:${PATH}” COPY /code /opt/ml/code WORKDIR /opt/ml/code 13 ※コンテナにローカルディレクトリをマウントすれば、ローカルでもテスト可能
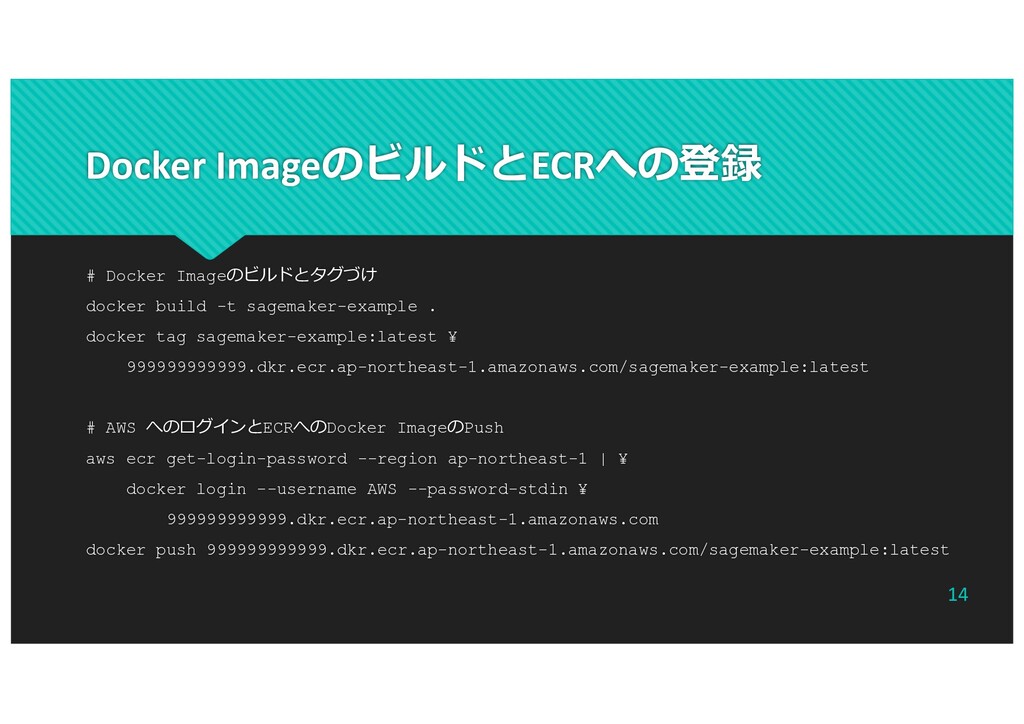
Docker ImageのビルドとECRへの登録 # Docker Imageのビルドとタグづけ docker build -t sagemaker-example .
docker tag sagemaker-example:latest ¥ 999999999999.dkr.ecr.ap-northeast-1.amazonaws.com/sagemaker-example:latest # AWS へのログインとECRへのDocker ImageのPush aws ecr get-login-password --region ap-northeast-1 | ¥ docker login --username AWS --password-stdin ¥ 999999999999.dkr.ecr.ap-northeast-1.amazonaws.com docker push 999999999999.dkr.ecr.ap-northeast-1.amazonaws.com/sagemaker-example:latest 14
トレーニングジョブの投⼊と完了 import sagemaker from sagemaker.estimator import Estimator hyperparameters = {'train-steps':
5} estimator = Estimator(image_uri=‘999999999999.dkr.ecr.ap-northeast-1.amazonaws.com/sagemaker-example:latest’, role="arn:aws:iam::999999999999:role/SagemakerJobRunner”, instance_count=1, instance_type='ml.p2.xlarge’, max_run=24 * 60 * 60, input_mode='File’, output_path='s3://sagemaker-examples.rails.to/output’, base_job_name='Sagemaker-Example’, hyperparameters=hyperparameters, use_spot_instances=True, max_wait=24 * 60 * 60, checkpoint_s3_uri='s3://sagemaker-examples.rails.to/checkpoints’) estimator.fit('s3://sagemaker-examples.rails.to/input/data/training') 15
メトリクスの監視⽅法 訓練中の標準出⼒はCloudWatchのログストリームに記録される 訓練時にメトリクス定義を正規表現で切り取るように定義しておけば、 SageMakerのアルゴリズムメトリクスおよびCloudWatchのメトリクスとし て管理できるようになる TensorFlowの場合には、Tensorboard⽤のログをチェックポイント⽤ディレ クトリに出⼒することで、実⾏終了後に検証可能
16
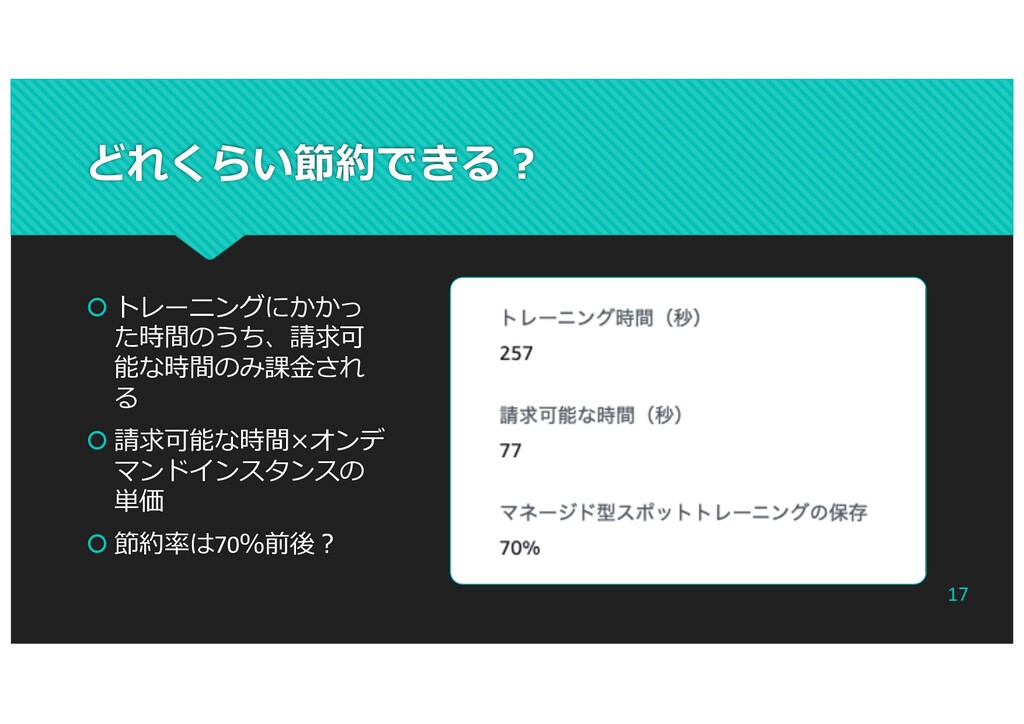
どれくらい節約できる︖ トレーニングにかかっ た時間のうち、請求可 能な時間のみ課⾦され る 請求可能な時間×オンデ マンドインスタンスの 単価
節約率は70%前後︖ 17
GPUの料⾦:オンデマンドインスタンス クラウド タイプ vCPU GPU CPUメモリ 料⾦/時間 AWS p2.xlarge 4
K80/12GB 61GB $1.542 p3.2xlarge 8 V100/16GB 61GB $4.194 p3dn.24xlarge 96 V100/32GB×8/NVLink 768GB $42.783 GCP GPUのみ K80/12GB $0.45 GPUのみ P100/16GB $1.46 GPUのみ V100/16GB $2.48 c2 カスタム構成例 4 K80/12GB 52GB $0.82252 c2 カスタム構成例 8 V100/16GB 61GB $3.0239 c2 カスタム構成例 96 V100/16GB×8 624GB $8.58128 ※AWSは東京リージョン、GCPはアイオワリージョンの料⾦ 18
まとめ Amazon Sagemakerでは、流儀にしたがったディレクトリ構造のDockerイメージを作れば、マネージ ドスポットインスタンスでの学習が可能になる データや学習済みモデルなどの受け渡しはS3経由 インスタンスの停⽌に備えるには、頻繁にチェックポイントを保存しておき、起動時に最新の チェックポイントをロードして訓練を⾏うようにする
訓練中の監視はCloudWatchで可能 訓練の実⾏はPythonプログラムからも可能 オンデマンドインスタンスを⽴てての訓練に⽐べて70%程度の節約が可能︖ GPU⾃体の料⾦はAWSよりもGCPが安いので、GCPで「プリエンプティブインスタンス」を使う⾃ 動化を⾏えば、そっちの⽅が安くあがりそう︖ 19
参考 Train a Model with Amazon SageMaker https://docs.aws.amazon.com/sagemaker/latest/dg/how-it-works-training.html
SageMaker Python SDK https://github.com/aws/sagemaker-python-sdk SageMaker Training Toolkit https://github.com/aws/sagemaker-training-toolkit Amazon SageMaker Examples https://github.com/awslabs/amazon-sagemaker-examples A quick guide to using Spot instances with Amazon SageMaker https://towardsdatascience.com/a-quick-guide-to-using-spot-instances-with-amazon-sagemaker-b9cfb3a44a68 クラスメソッドブログ︓Sagemaker特集カテゴリー https://dev.classmethod.jp/referencecat/amazon-sagemaker/ 20


 itagakim
 yusukeshimizu
 safie
 miyake
 vananth22
 nttcom
 nanaism
 coe401_
 kawaguti
 visional_engineering_and_design
 yamachu
 fullkaiten
 cloudace
 yeseniaperezcruz
 asonas
 chriscoyier
 bkeepers
 trallard
 afnizarnur
 colly
 jeffersonlam
 charlesmeaden
 aleyda
 moore
 minecr