Share
Embed
Transcript
33 slides
-
アジェンダ Cloud TPUとは︖ 今回のモチベーション Cloud TPUが使える深層学習環境
GCE上でのモデル訓練 予算枯渇と救世主の出現 BigBirdの学習結果は︖ まとめ -
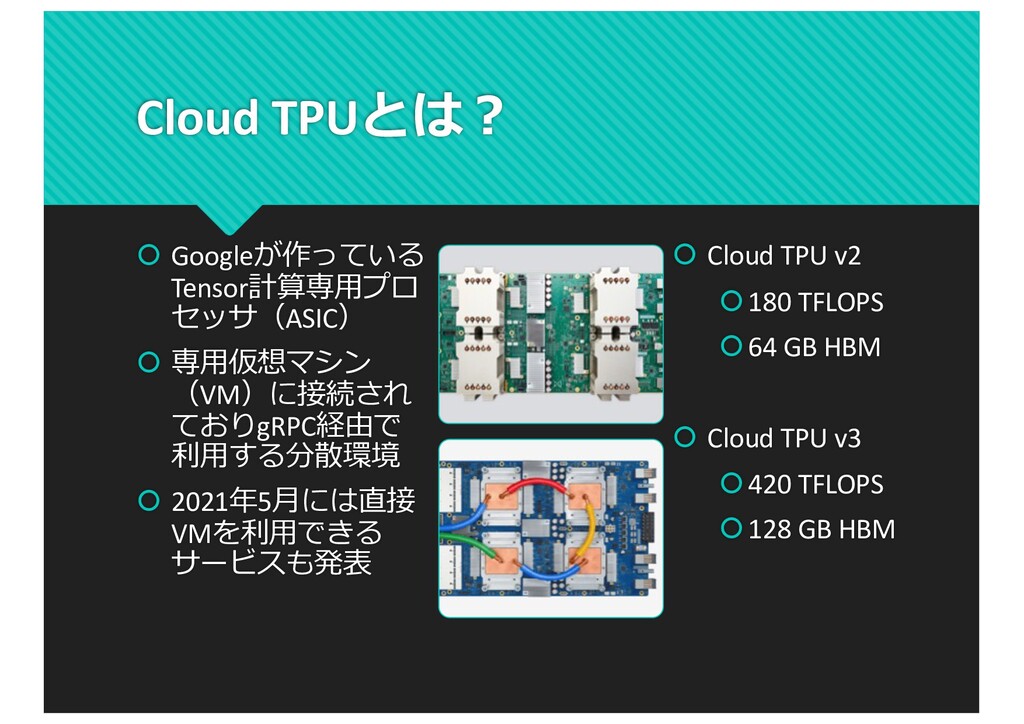
Cloud TPUとは︖ Googleが作っている Tensor計算専⽤プロ セッサ(ASIC) 専⽤仮想マシン (VM)に接続され ておりgRPC経由で
利⽤する分散環境 2021年5⽉には直接 VMを利⽤できる サービスも発表 Cloud TPU v2 180 TFLOPS 64 GB HBM Cloud TPU v3 420 TFLOPS 128 GB HBM -
TPUを使う⽅法の⼀般論 フレーム ワーク データ並列 モデル並列 TensorFlow l tf.distribute.TPUStrategy() l tf.compat.v1.estimator.tpu.T
PUEstimator l Mesh TensorFlow l ⼿動配置 PyTorch l torch_xla l torch.distributed.pipeline l ⼿動配置 l HuggingFace/Transformers では、⼀部のモデルで Attention単位の並列化 (Parallelize)が可能 -
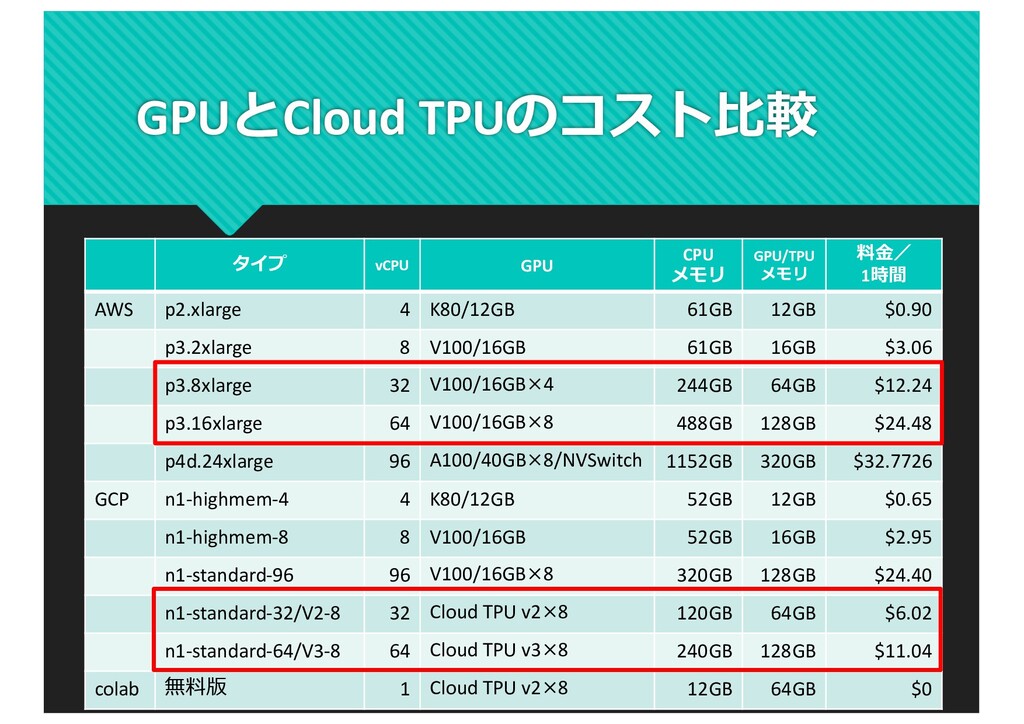
GPUとCloud TPUのコスト⽐較 タイプ vCPU GPU CPU メモリ GPU/TPU メモリ 料⾦/
1時間 AWS p2.xlarge 4 K80/12GB 61GB 12GB $0.90 p3.2xlarge 8 V100/16GB 61GB 16GB $3.06 p3.8xlarge 32 V100/16GB×4 244GB 64GB $12.24 p3.16xlarge 64 V100/16GB×8 488GB 128GB $24.48 p4d.24xlarge 96 A100/40GB×8/NVSwitch 1152GB 320GB $32.7726 GCP n1-highmem-4 4 K80/12GB 52GB 12GB $0.65 n1-highmem-8 8 V100/16GB 52GB 16GB $2.95 n1-standard-96 96 V100/16GB×8 320GB 128GB $24.40 n1-standard-32/V2-8 32 Cloud TPU v2×8 120GB 64GB $6.02 n1-standard-64/V3-8 64 Cloud TPU v3×8 240GB 128GB $11.04 colab 無料版 1 Cloud TPU v2×8 12GB 64GB $0 -
⽇本語要約処理で⻑⽂を扱いたい 会社在籍時に某⼤学と⽇本語要約の共同研究をしていた 現在の主流はTransformerを使ったモデル 巨⼤な多⾔語コーパスを使った学習済みモデルmT5も試したが、多 くのモデルが最⼤トークン数512程度 ⻑⽂を扱える⽇本語学習済みモデルがあれば…
⻑⽂を扱えるNLPモデルの例 Transformer-XL Longformer Reformer BigBird 公開されている⽇本語学習済みモデルがない…⾃分で作るしかない -
BigBirdとは︖ Transformerを使った⻑い⽂章を 扱うモデルが作りにくいのは、 中核であるAttentionが⽂章の⻑ さ(トークン数)の2乗に⽐例 して⼤きくなるから BigBird は
Full Attention を Locality/Random/Global Connections の組み合わせに変 更 さらにアテンションをブロック 化して計算⼿順を⼯夫し GPU/TPUでの計算効率を改善 https://github.com/google-research/bigbird -
訓練に使⽤したデータ TensorFlow Datasetsに含まれるWikipediaのデータで、テキスト抽出な どの前処理が終わっているWiki40bを使⽤した トークナイザはSentencepieceを使い、wiki40b/jaから抽出し⽂単位に 分割したテキストデータ(約1.9GB)で学習を⾏なった wiki40bで使われている_START_ARTICLE_,
_START_SECTION_, _START_PARAGRAPH_, _NEWLINE_をuser_defined_symbolsに指定 BERTで使われる[CLS],{SEP],[MASK]をcontrol_symbolsに指定 BigBirdの事前学習⽤データはBERTと同様なので、 https://github.com/yoheikikuta/bert-japanese の学習データ作成プログ ラムを利⽤した(サイズ約37GB) max_token_length=4096, masked_lm_prob=0.15, max_predictions_per_seq=600, dupe_factor=10 属性は、input_ids, segment_ids, masked_lm_positions, masked_lm_ids, masked_lm_weights, next_sentence_labels -
BigBirdのモデルサイズとメモリ 通常のTransformerに⽐べて8分の1のメモリ使⽤量 標準的なTransformerで512だった最⻑トークン数を4096にして もモデルサイズはメモリ16GBのGPUで訓練できるほどに でも⾃宅のGeForce RTX2080 Ti(メモリ11GB)では無理
メモリと計算時間のトレードオフもあるので、GPU1基では訓 練時間が膨⼤に そこでCloud TPUを使ったモデル並列化の出番︕ -
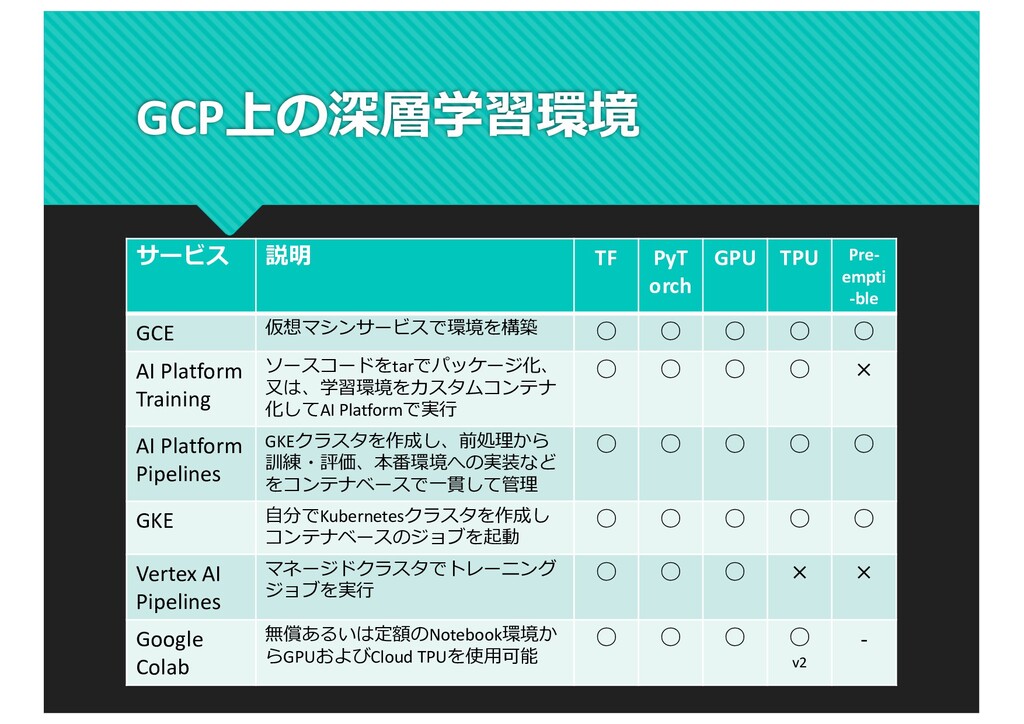
GCP上の深層学習環境 サービス 説明 TF PyT orch GPU TPU Pre- empti
-ble GCE 仮想マシンサービスで環境を構築 ◦ ◦ ◦ ◦ ◦ AI Platform Training ソースコードをtarでパッケージ化、 ⼜は、学習環境をカスタムコンテナ 化してAI Platformで実⾏ ◦ ◦ ◦ ◦ × AI Platform Pipelines GKEクラスタを作成し、前処理から 訓練・評価、本番環境への実装など をコンテナベースで⼀貫して管理 ◦ ◦ ◦ ◦ ◦ GKE ⾃分でKubernetesクラスタを作成し コンテナベースのジョブを起動 ◦ ◦ ◦ ◦ ◦ Vertex AI Pipelines マネージドクラスタでトレーニング ジョブを実⾏ ◦ ◦ ◦ × × Google Colab 無償あるいは定額のNotebook環境か らGPUおよびCloud TPUを使⽤可能 ◦ ◦ ◦ ◦ v2 - -
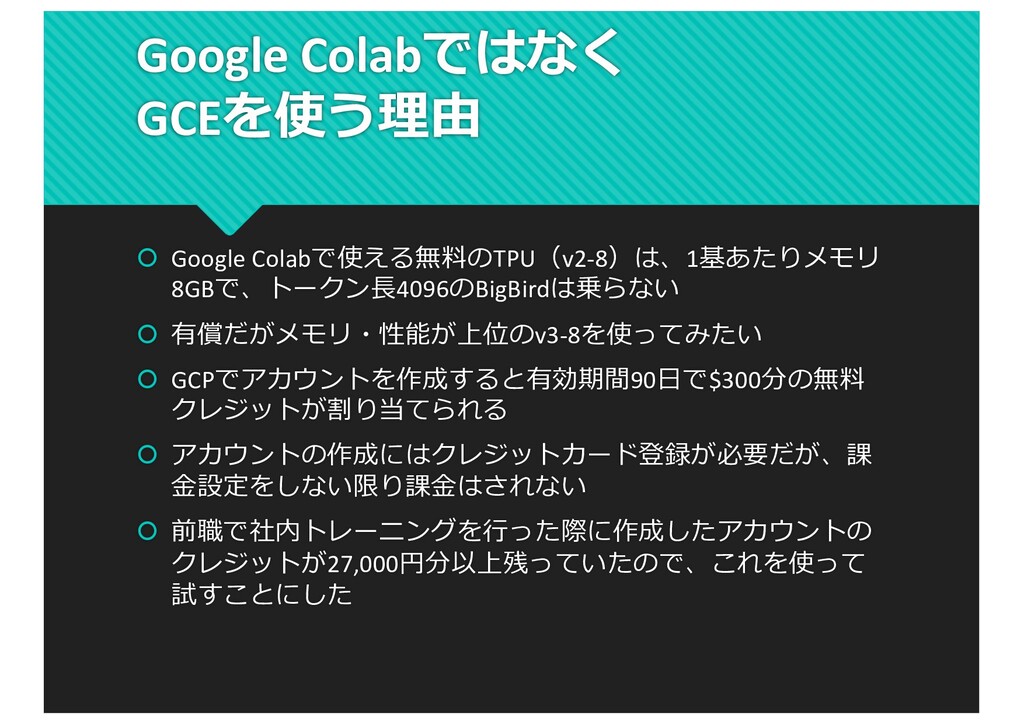
Google Colabではなく GCEを使う理由 Google Colabで使える無料のTPU(v2-8)は、1基あたりメモリ 8GBで、トークン⻑4096のBigBirdは乗らない 有償だがメモリ・性能が上位のv3-8を使ってみたい
GCPでアカウントを作成すると有効期間90⽇で$300分の無料 クレジットが割り当てられる アカウントの作成にはクレジットカード登録が必要だが、課 ⾦設定をしない限り課⾦はされない 前職で社内トレーニングを⾏った際に作成したアカウントの クレジットが27,000円分以上残っていたので、これを使って 試すことにした -
コスト削減の⽅法 Cloud TPUもGCEのVMもプリエンプティブルインスタンスを使 えばコストはさらに安くなる プリエンプティブルインスタンスはAWSのスポットインスタ ンスと同様に、空いているリソースを利⽤するもので、GCP の都合でいつ停⽌されても⽂句は⾔えないが、数分の1の料⾦ で利⽤可能(v3-8:
$2.40/時間) Cloud TPUのプリエンプティブルインスタンスは最⼤24時間で 必ず停⽌ モデルの訓練ではチェックポイントを保存しておいて、次回 はそこから再開することで、活⽤が容易 -
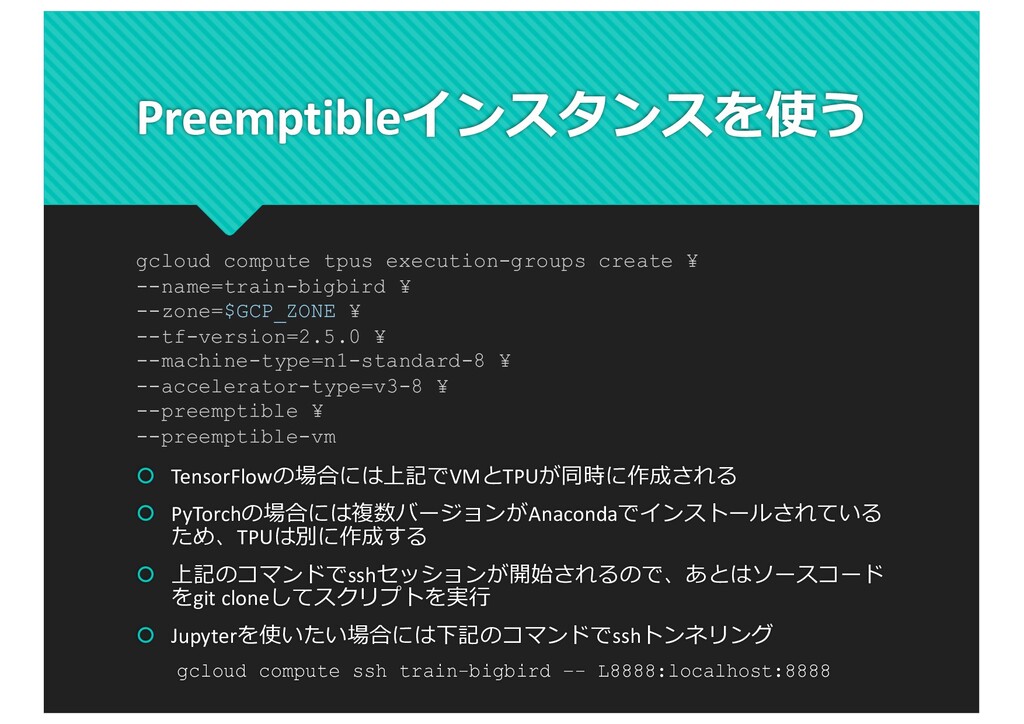
Preemptibleインスタンスを使う TensorFlowの場合には上記でVMとTPUが同時に作成される PyTorchの場合には複数バージョンがAnacondaでインストールされている ため、TPUは別に作成する 上記のコマンドでsshセッションが開始されるので、あとはソースコード をgit cloneしてスクリプトを実⾏
Jupyterを使いたい場合には下記のコマンドでsshトンネリング gcloud compute ssh train-bigbird –- L8888:localhost:8888 gcloud compute tpus execution-groups create ¥ --name=train-bigbird ¥ --zone=$GCP_ZONE ¥ --tf-version=2.5.0 ¥ --machine-type=n1-standard-8 ¥ --accelerator-type=v3-8 ¥ --preemptible ¥ --preemptible-vm -
BigBird事前学習⽤スクリプトの修正 BigBirdの事前学習⽤スクリプトbigbird/pretrain/run_pretraining.pyには、 テキストデータを⼊⼒としてマスクされた訓練データを⽣成する関 数(numpy_masking)が含まれる この関数はTensorFlowの計算グラフに組み込むために tf.compat.v1.py_func()を通じて呼ばれているが、Cloud TPU上ではエ ラーとなり実⾏ができない
このため、この機能を削除し、前処理済みのTFRecordファイルのみ を扱うように修正した なお、この関数(numpy_masking)では、[CLS], [SEP], [MASK]という 制御トークンのIDが65, 66, 67としてハードコーディングしてあるた め、GPU環境などで⾃前のSentencePieceモデルを使⽤する際には修 正が必要である -
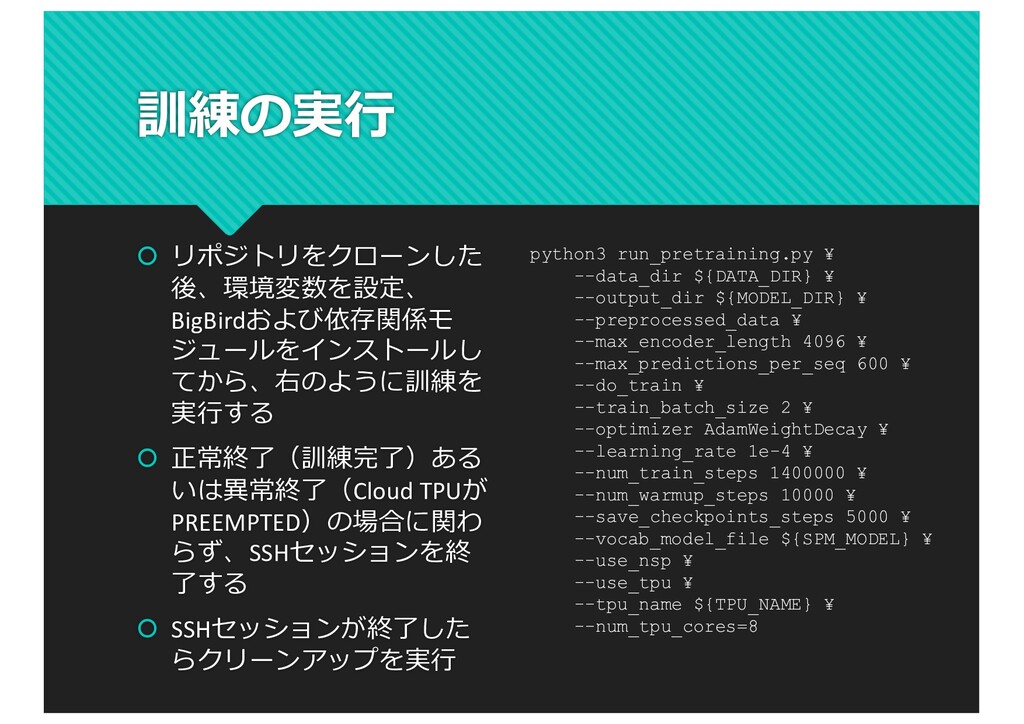
訓練の実⾏ リポジトリをクローンした 後、環境変数を設定、 BigBirdおよび依存関係モ ジュールをインストールし てから、右のように訓練を 実⾏する 正常終了(訓練完了)ある
いは異常終了(Cloud TPUが PREEMPTED)の場合に関わ らず、SSHセッションを終 了する SSHセッションが終了した らクリーンアップを実⾏ python3 run_pretraining.py ¥ --data_dir ${DATA_DIR} ¥ --output_dir ${MODEL_DIR} ¥ --preprocessed_data ¥ --max_encoder_length 4096 ¥ --max_predictions_per_seq 600 ¥ --do_train ¥ --train_batch_size 2 ¥ --optimizer AdamWeightDecay ¥ --learning_rate 1e-4 ¥ --num_train_steps 1400000 ¥ --num_warmup_steps 10000 ¥ --save_checkpoints_steps 5000 ¥ --vocab_model_file ${SPM_MODEL} ¥ --use_nsp ¥ --use_tpu ¥ --tpu_name ${TPU_NAME} ¥ --num_tpu_cores=8 -
結構⽌まる プリエンプティブルインスタンス 実際にやってみると結構短い時間で停⽌されることがわかっ た→Checkpointの頻度を上げた GCE VMとCloud TPUの両⽅をプリエンプティブルにしていたの で、どちらが停⽌されても再開の必要が出てくる
GCE VMが先に落ちると、Cloud TPUが課⾦されたままアイドル になるので注意︕(VMはPreemptibleにしない選択もあり) 訓練のプロセスが終了したらVMをシャットダウンすることに した gcloud compute tpus create execution-group はインスタンス起動 後にsshセッションを起動し、終了まで待つ仕様なので、この コマンド後にcleanupを⾏うスクリプトを使うことにした -
無償枠を使い果たし 早くも予算オーバー 実は試⾏錯誤をしていたら、無償枠がゼロに(⾃動的にス トップ) 1ヶ⽉以内に課⾦設定を有効にすれば継続利⽤可能 私の場合には課⾦アカウントがあったので、ダウンロードし てあったデータをアップロードして継続へ
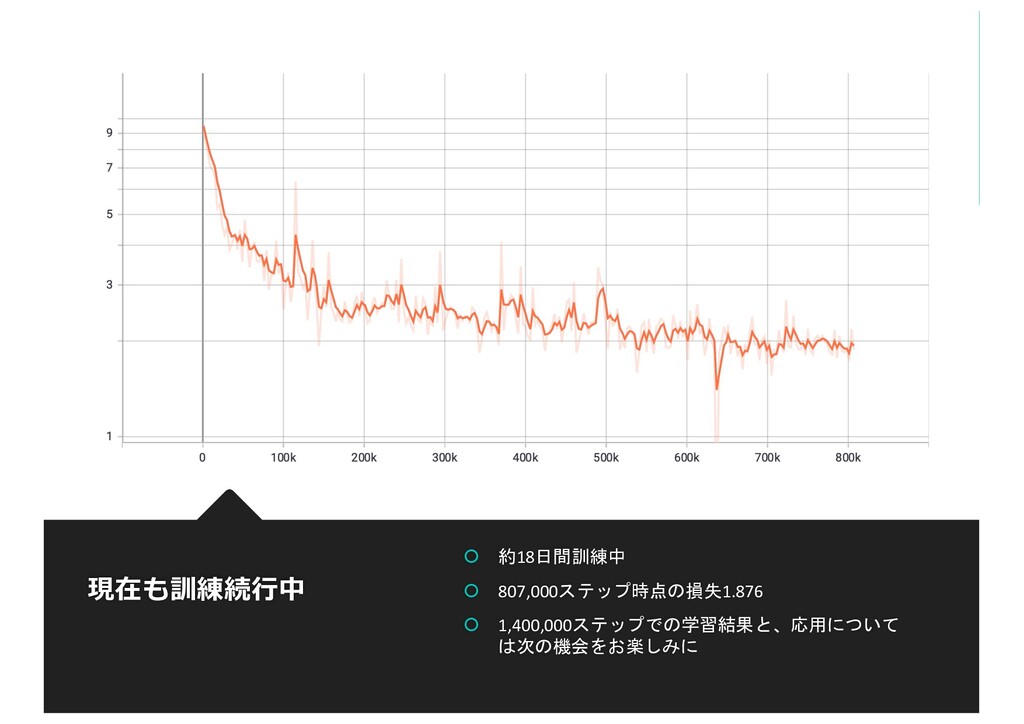
100,000ステップ学習したところで、設定してた予算枠10,000 円をオーバー -
救世主の出現 bigbird/core/flags.pyに”use_gradient_checkpointing”というフラ グを発⾒ ニューラルネットワークの訓練時に⼤量のメモリを消費する のは、バックプロパゲーション(誤差逆伝播法)のために、 計算した勾配を保持しておくため バックプロパケーションの際に勾配を再計算すれば保持する
必要なないが、その代わりに計算時間が⼤幅に増える このトレードオフをバランスするため、⼀部のレイヤのみ保 持しそれ以外を破棄する Gradient Checkpointing が考えられた GPUでこのフラグをつけてみるとメモリ使⽤量が半減 -
Google Colabでも訓練可能に use_gradient_checkpointingを有効にすることにより、コアあた り8GBしかメモリがないCloud TPU v2でも訓練が可能に GCEを使わずとも、Google Colaboratoryで訓練ができるように
なった(ただし、GCSのコストはかかる) ⽉額1,072円のGoogle Colab Proを使っているので、セッション の中断が少なくなった CAPTCHaが出てくるのは下記のスクリプトで回避 https://www.rockyourcode.com/script-to-stop-google-colab-from- disconnecting/ -
訓練が中断する環境で気をつけ るべきこと 今回のように巨⼤なデータセットを使い、訓練が中断される 環境で訓練を⾏う際、データセットのシャッフルを⾏わない と、「いつもデータセットの最初の⽅しか訓練に使われな い」という落とし⽳が…(途中で気がついた) 当初は1個の巨⼤な(34.5GB)のTFRecordファイルを使ってい たが、複数のファイルに分割することに
bigbird/pretrain/run_pretraining.pyには複数のTFRecordをシャッ フルし、tf.data.Dataset.interleave()を使って混合するコードが 含まれている 今回は、TFRecordにする前のテキストファイルをドキュメン ト数で均等分割し使⽤している(つまり、各ファイルのサン プル数には差異がある) -
まとめ ⻑⽂を扱える⾃然⾔語処理モデルBigBirdを⽇本語Wikipediaのデータ セットで事前学習させています TPUが使えるモデルであれば、GPUよりも低コストでデータ並列を 使ったモデルの訓練が可能です GCPでは、さまざまな⽅法でCloud TPUを使⽤することができますが、
コストを抑えるにはPreemptible TPUを使⽤するのが効果的です Cloud TPUを使った訓練では、GCE VMの能⼒はさほど必要ありません それでも、⼤量のデータを学習させるには時間とお⾦がかかります モデル訓練時の使⽤メモリを削減させる⼿法として、Gradient Checkpointingは有効です(ただし、訓練時間は⻑くなります) Cloud TPU v2で⼗分なモデルでは、Google Colaboratoryが最強で、Pro にすれば中断も抑えられます -
参考資料 Cloud TPU https://cloud.google.com/tpu?hl=ja BigBird https://github.com/google-research/bigbird
板垣作成スクリプト https://github.com/masa-ita/train_bigbird Gradient Checkpointing論⽂ Training Deep Nets with Sublinear Memory Cost https://arxiv.org/abs/1604.06174v2 Google Colab Pro https://colab.research.google.com/signup