Share
Embed
Boas praticas em um Projeto de Banco de Dados
Palestra ministrada no evento FTSL 2015.
Uma coleção de várias dicas e recomendações para um projeto de banco de dados bem consolidado e com boa performance, além de abandonar maus costumes.
Evento: FTSL 2015
Data: 18/09/2015,
Local: Universidade Tecnológica Federal do Paraná (UTFPR), Curitiba - PR
Juliano Atanazio
September 20, 2015
Transcript
41 slides
-
2/41 Antes de Tudo... Conheça bem: • seu hardware; •
seu sistema operacional; • as entidades tratadas na base de dados. -
3/41 Servidores • Mantenha em servidores separados a aplicação que
acessa o banco e o servidor de banco de dados; • É mais seguro e evita competição de recursos entre os serviços; • No servidor de banco de dados ter no mínimo discos separados para sistema operacional, dados e logs de transação; • Configure apropriadamente logs do servidor de aplicação e do servidor de banco de dados; • Não deixe o servidor de banco de dados exposto na Internet; • Ter estratégias de backup e alta disponibilidade. -
4/41 O Projeto de Banco de Dados • Investir não
é gastar...; • Invista seu tempo para uma modelagem e projeto de banco de dados bem feita; • Pense como uma construção de um prédio, pois o projeto de banco de dados é um dos alicerces para seu sistema; • É melhor prevenir do que remediar, pois o tempo investido para uma modelagem bem consolidada será recompensado em não ter que fazer manutenções (desnecessárias, a priori) e ter que projetar novamente mais tarde, pois aí seria gasto muito mais tempo do que o investido no início; • Para o projeto da base de dados deve-se trabalhar em conjunto DBAs, desenvolvedores e gestores de projetos. -
5/41 Nomenclaturas de Objetos • Seja qual for o padrão
adotado, siga-o até o fim!; • Prefixos / sufixos: utilizar ou não? Bases de Dados, tabelas, views, triggers, etc... adote iniciais, tais como db_, tb_, vw_, tg_... Considere os prós e contras, mas não misture!; • Utilizar nomes amigáveis para os objetos conforme a entidade tratada; • Nomes de tabelas no singular; • Jamais utilizar acentuação ou qualquer caractere especial; -
6/41 Nomenclaturas de Objetos • Não utilizar nomes com espaços
e / ou letras maiúsculas; • Para nomes de campos, se possível utilizar o mesmo nome para a chave primária em todas as tabelas, como “id” ou “cod”, por exemplo; • Campos que têm o mesmo propósito em tabelas diferentes, preferencialmente ter o mesmo nome; • Nomes de campos também devem ser padronizados; • Evite coisas como na tabela “A” há um campo “data_inicio” e na tabela “B” o campo se chama “data_ini”... -
7/41 Usuários / Grupos / Papéis • Dê o mínimo
de privilégios necessários para cada usuário conforme o objeto que acessa ou usa; • Utilize grupos de usuários para facilitar sua gestão, agrupando- os por algum setor e / ou características em comum; • Alguns parâmetros de configuração (os de sessão) podem servir de configuração para um papel (role) específico e dependendo do caso, conforme a necessidade é bom fazê-lo. Por exemplo, um usuário que precisa ser sempre auditado: ALTER ROLE foo SET log_statement = 'all'; -
8/41 Views • Views podem ser grandes aliadas; • Podem
ser utilizadas para isolar alterações da base de dados da aplicação, reduzindo a necessidade de manutenção se houver alteração na base dados; • Podem também ser utilizadas para prover acesso granular a usuários. -
9/41 ORMs • Não confie cegamente neles. • Utilize-os com
moderação, de forma que se tenha o total controle e total conhecimento sobre sua base. • Evite transações implícitas, ORMs têm o costume deixar cada comando (statement) ser tratado como uma transação resultando em perda de performance. Desabilite transações explícitas e quando precisar de uma transação faça-a explicitamente. -
10/41 Documentação • Documente o esquema da base em esquemas
de Entidade- Relacionamento; • Escreva comentários em seus scripts declarando cada ação de cada comando; • Utilize comentários de objetos (descrição de objetos). -
11/41 Tablespaces • Tabelas e índices cuja utilização e /
ou tamanho sejam muito maiores do que os outros é melhor deixar em disco(s) separado(s); • A partição de tablespace deve ser formatada com um sistema de arquivos primeiramente seguro contra falhas (crashes) e com boa performance de escrita e leitura. -
12/41 Índices • Crie índices para campos que são utilizados
em condições de consultas, ou pelo menos as consultas mais frequentes; • Crie índices para campos de chaves estrangeiras e em campos envolvidos como critérios de junção (JOIN); • Se houver uma consulta frequente utilize índices parciais com sua condição conforme a consulta; • Para consultas que buscam faixas de valores é bom ter um índice clusterizado para isso; -
13/41 Índices • Fillfactor (fator de preenchimento) para um índice
é a porcentagem que determina como o método de indexação encherá as páginas de índices. O quão cheias essas páginas ficarão em porcentagem; • Para tabelas estáticas pode-se deixar em 100 (representando 100%); • Para tabelas que sofrem muitas alterações um valor de 80 ou menos pode ser mais adequado, mas quanto menor for o fator de preenchimento, mais espaço em disco ocupará. -
14/41 Evite BLOBs • Utilize campos bytea, pois BLOBs são
armazenados em um catálogo do sistema (pg_largeobject). • Com campos bytea têm-se a flexibilidade de determinar em qual tabela de sua base de dados o objeto será armazenado. • Não criar campos bytea em tabelas muito utilizadas, crie uma tabela exclusiva para grandes objetos para ser referenciada. -
15/41 Integridade de Dados • Utilize constraints (foreign key, check,
not null), não deixe o controle total para a aplicação. • Evite dados inconsistentes em seu banco de dados, como um preço negativo de um produto, por exemplo. -
16/41 Consultas • Evite o famoso SELECT *... • Para
um melhor desempenho declare cada campo que precisar para buscar os dados; • Evite caracteres curinga com a cláusula LIKE. Isso faz com que o motor do banco de dados não use indexação para uma busca, o que leva a uma performance degradada; • Pagine sua busca, faça uso de LIMIT e OFFSET, pois não faz sentido uma busca retornar um número exorbitante de linhas. Consome muitos recursos e degrada a performance. Um número razoável é de até 100 (cem) linhas retornadas por vez. -
17/41 Chaves Primárias • Sempre tenha uma chave primária na
tabela; • Quando possível fazer uso de chaves naturais; • Prefira tipos numéricos a tipos de texto, pois consomem menos recursos e são mais rápidos para busca. -
18/41 Esquemas • Para a mesma aplicação, que trata das
mesmas coisas evite criar mais de uma base de dados; • Faça uso de schemas para organizar seus objetos. -
19/41 Tipos de Dados Não dê tiros em formiga! •
Escolha o tipo certo para sua coluna; • Consulte a documentação do PostgreSQL [1] verificando se o tipo de dados escolhido é realmente o mais adequado para não derperdiçar recursos. [1] http://www.postgresql.org/docs/current/static/datatype.html -
20/41 Tipos de Dados: pg_type_of e pg_column_size A função pg_typeof
pode te ajudar a descobrir um tipo de um dado: > SELECT pg_typeof(5874.31); pg_typeof ----------- numeric A função pg_column_size exibe em bytes o tamanho de um dado Quantos bytes em numeric?: > SELECT pg_column_size(5874.31::numeric); pg_column_size ---------------- 10 -
21/41 Tipos de Dados: pg_type_of e pg_column_size Quantos bytes em
money?: > SELECT pg_column_size(5874.31::money); pg_column_size ---------------- 8 -
22/41 Tipos de Dados: Endereço IP Como text: > SELECT
pg_column_size('192.168.7.1'::text); pg_column_size ---------------- 15 Como inet: > SELECT pg_column_size('192.168.7.1'::inet); pg_column_size ---------------- 10 -
23/41 Tipos de Dados: Endereço de Rede com Máscara Como
text: > SELECT pg_column_size('192.168.7.0/24'::text); pg_column_size ---------------- 18 Como cidr: > SELECT pg_column_size('192.168.7.0/24'::cidr); pg_column_size ---------------- 10 -
24/41 Tipos de Dados: MAC Address Como text: > SELECT
pg_column_size('00:00:00:00:00:00'::text); pg_column_size ---------------- 21 Como macaddr: > SELECT pg_column_size('00:00:00:00:00:00'::macaddr); pg_column_size ---------------- 6 -
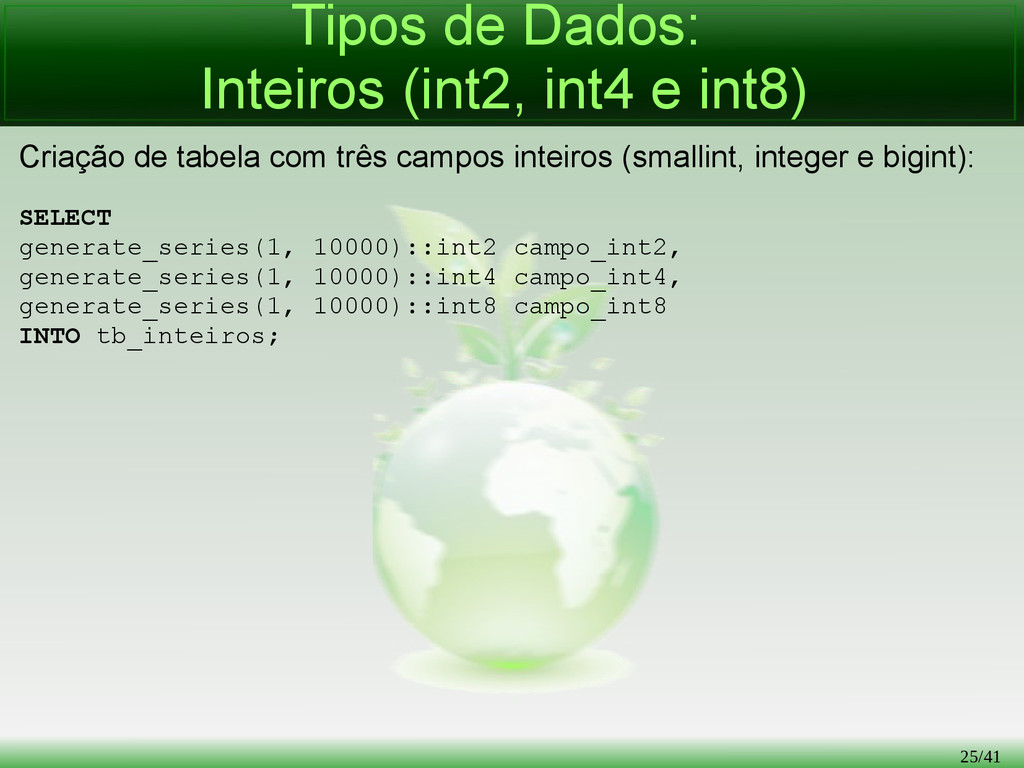
25/41 Tipos de Dados: Inteiros (int2, int4 e int8) Criação
de tabela com três campos inteiros (smallint, integer e bigint): SELECT generate_series(1, 10000)::int2 campo_int2, generate_series(1, 10000)::int4 campo_int4, generate_series(1, 10000)::int8 campo_int8 INTO tb_inteiros; -
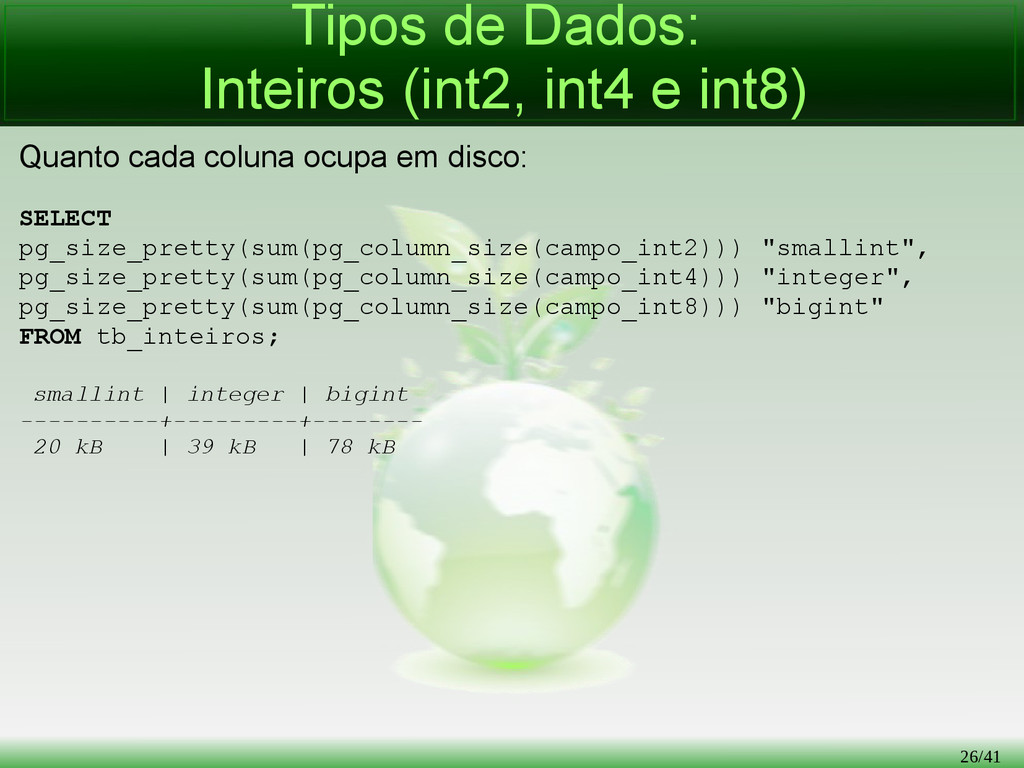
26/41 Tipos de Dados: Inteiros (int2, int4 e int8) Quanto
cada coluna ocupa em disco: SELECT pg_size_pretty(sum(pg_column_size(campo_int2))) "smallint", pg_size_pretty(sum(pg_column_size(campo_int4))) "integer", pg_size_pretty(sum(pg_column_size(campo_int8))) "bigint" FROM tb_inteiros; smallint | integer | bigint ----------+---------+-------- 20 kB | 39 kB | 78 kB -
27/41 Tipos de Dados: Inteiros vs Texto Criação de um
banco de dados de teste: > CREATE DATABASE db_teste; Conexão ao banco: > \c db_teste -
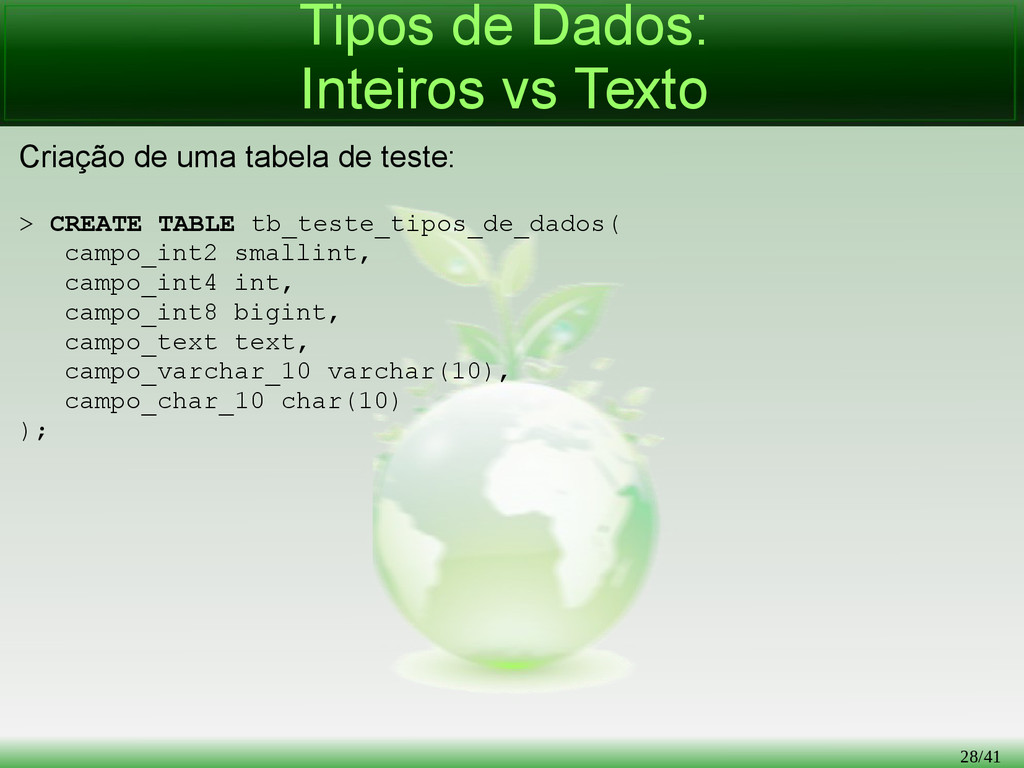
28/41 Tipos de Dados: Inteiros vs Texto Criação de uma
tabela de teste: > CREATE TABLE tb_teste_tipos_de_dados( campo_int2 smallint, campo_int4 int, campo_int8 bigint, campo_text text, campo_varchar_10 varchar(10), campo_char_10 char(10) ); -
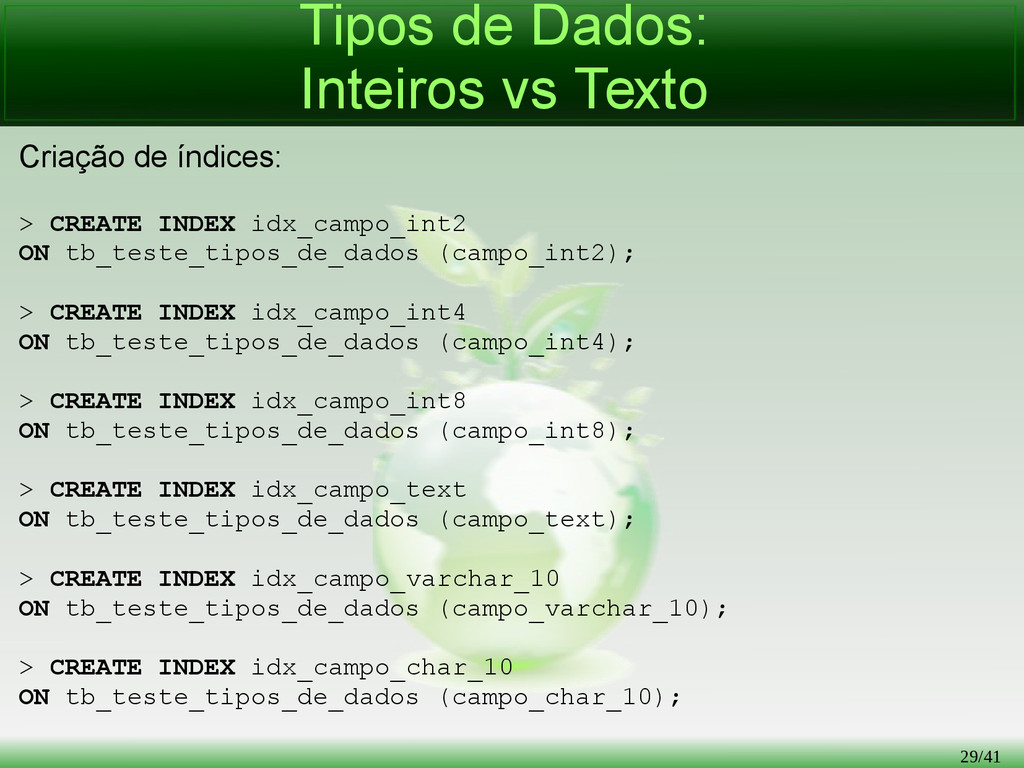
29/41 Tipos de Dados: Inteiros vs Texto Criação de índices:
> CREATE INDEX idx_campo_int2 ON tb_teste_tipos_de_dados (campo_int2); > CREATE INDEX idx_campo_int4 ON tb_teste_tipos_de_dados (campo_int4); > CREATE INDEX idx_campo_int8 ON tb_teste_tipos_de_dados (campo_int8); > CREATE INDEX idx_campo_text ON tb_teste_tipos_de_dados (campo_text); > CREATE INDEX idx_campo_varchar_10 ON tb_teste_tipos_de_dados (campo_varchar_10); > CREATE INDEX idx_campo_char_10 ON tb_teste_tipos_de_dados (campo_char_10); -
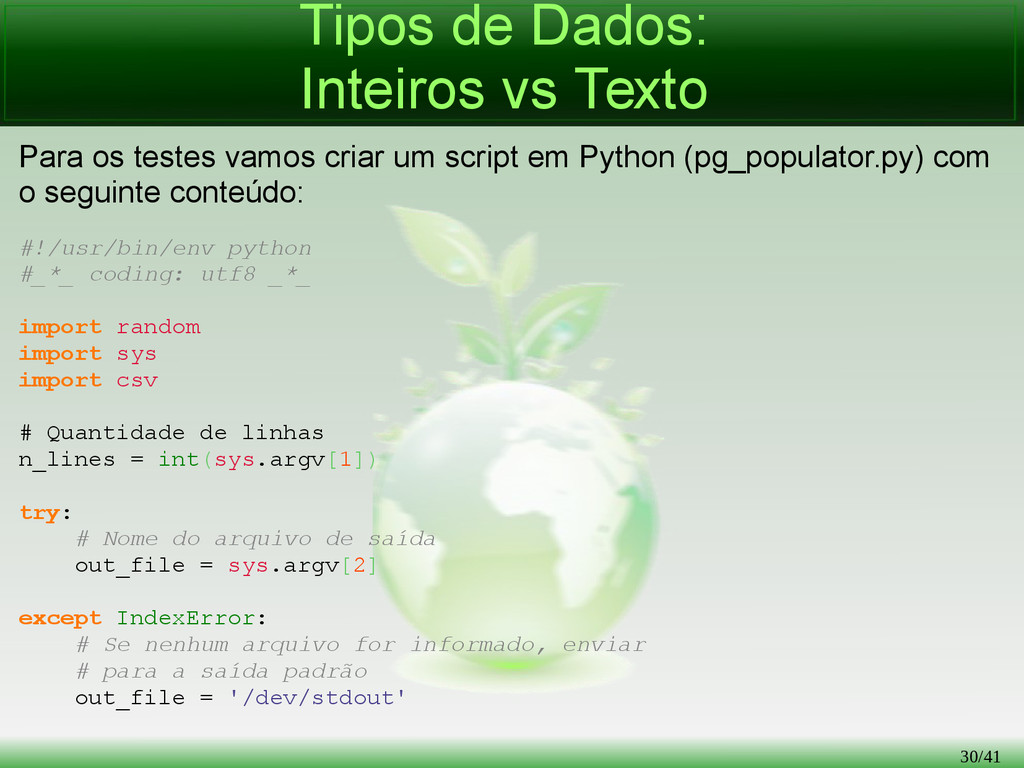
30/41 Tipos de Dados: Inteiros vs Texto Para os testes
vamos criar um script em Python (pg_populator.py) com o seguinte conteúdo: #!/usr/bin/env python #_*_ coding: utf8 _*_ import random import sys import csv # Quantidade de linhas n_lines = int(sys.argv[1]) try: # Nome do arquivo de saída out_file = sys.argv[2] except IndexError: # Se nenhum arquivo for informado, enviar # para a saída padrão out_file = '/dev/stdout' -
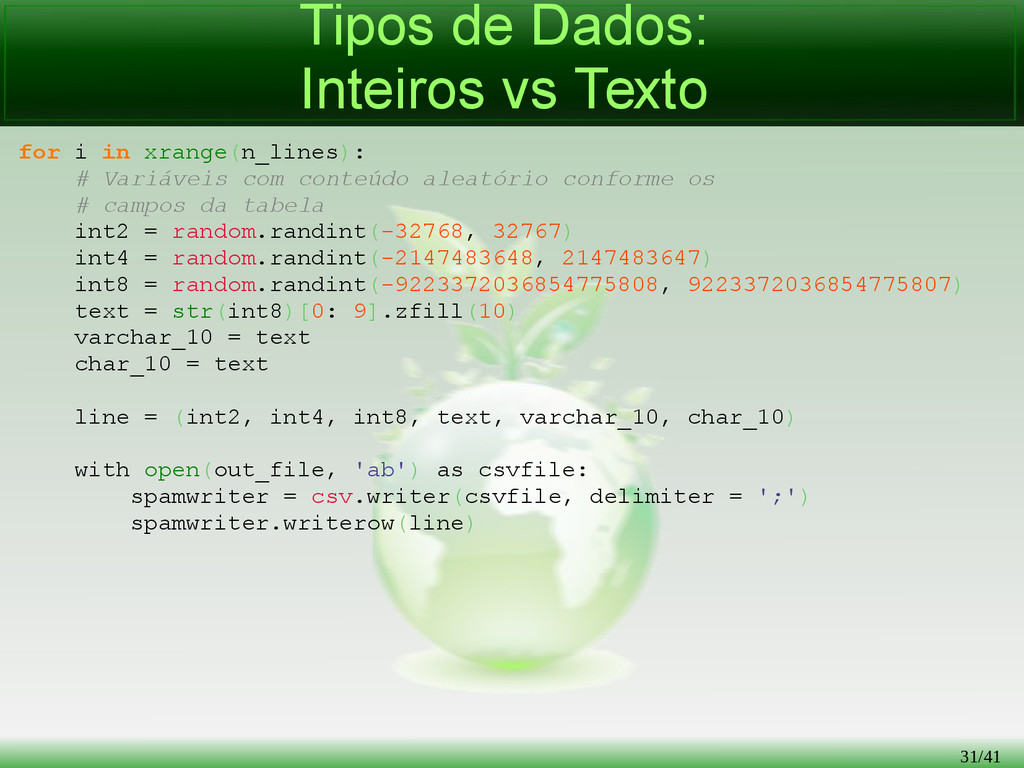
31/41 Tipos de Dados: Inteiros vs Texto for i in
xrange(n_lines): # Variáveis com conteúdo aleatório conforme os # campos da tabela int2 = random.randint(-32768, 32767) int4 = random.randint(-2147483648, 2147483647) int8 = random.randint(-9223372036854775808, 9223372036854775807) text = str(int8)[0: 9].zfill(10) varchar_10 = text char_10 = text line = (int2, int4, int8, text, varchar_10, char_10) with open(out_file, 'ab') as csvfile: spamwriter = csv.writer(csvfile, delimiter = ';') spamwriter.writerow(line) -
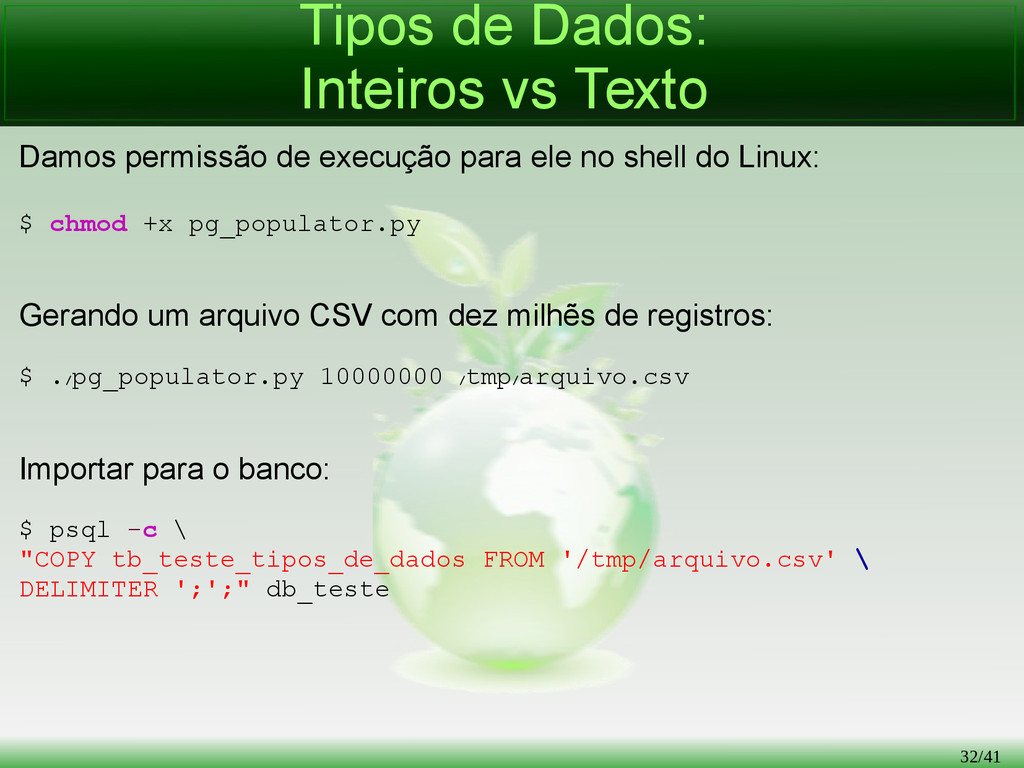
32/41 Tipos de Dados: Inteiros vs Texto Damos permissão de
execução para ele no shell do Linux: $ chmod +x pg_populator.py Gerando um arquivo CSV com dez milhẽs de registros: $ ./ pg_populator.py 10000000 / tmp/ arquivo.csv Importar para o banco: $ psql -c \ "COPY tb_teste_tipos_de_dados FROM '/tmp/arquivo.csv' \ DELIMITER ';';" db_teste -
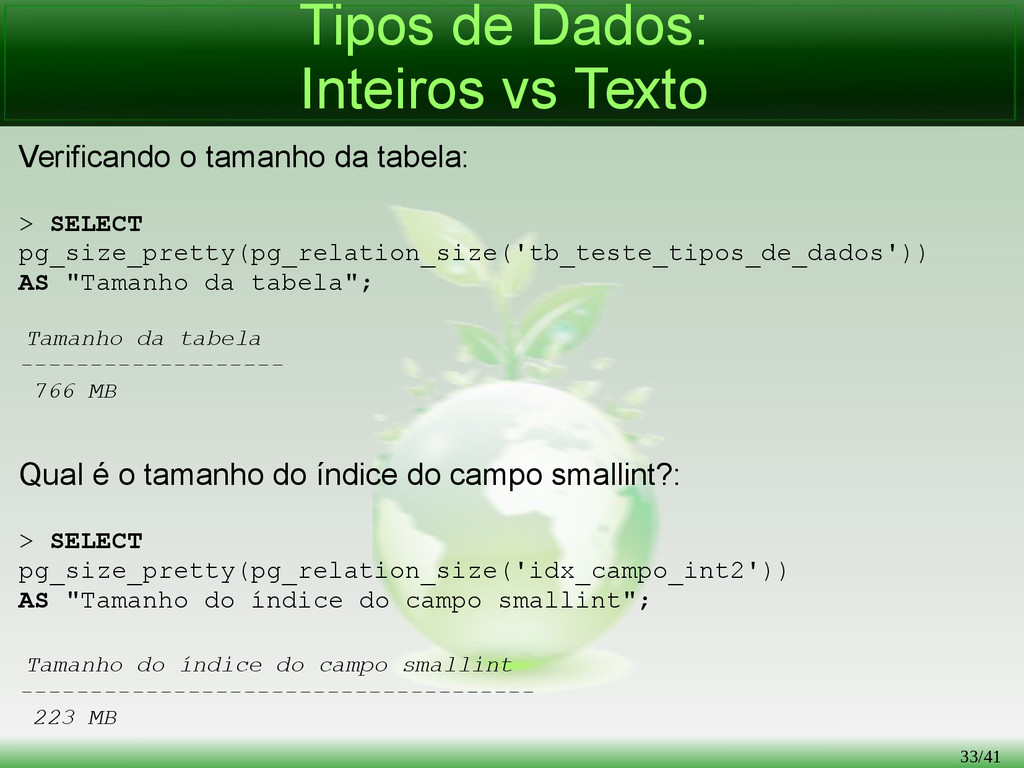
33/41 Tipos de Dados: Inteiros vs Texto Verificando o tamanho
da tabela: > SELECT pg_size_pretty(pg_relation_size('tb_teste_tipos_de_dados')) AS "Tamanho da tabela"; Tamanho da tabela ------------------- 766 MB Qual é o tamanho do índice do campo smallint?: > SELECT pg_size_pretty(pg_relation_size('idx_campo_int2')) AS "Tamanho do índice do campo smallint"; Tamanho do índice do campo smallint ------------------------------------- 223 MB -
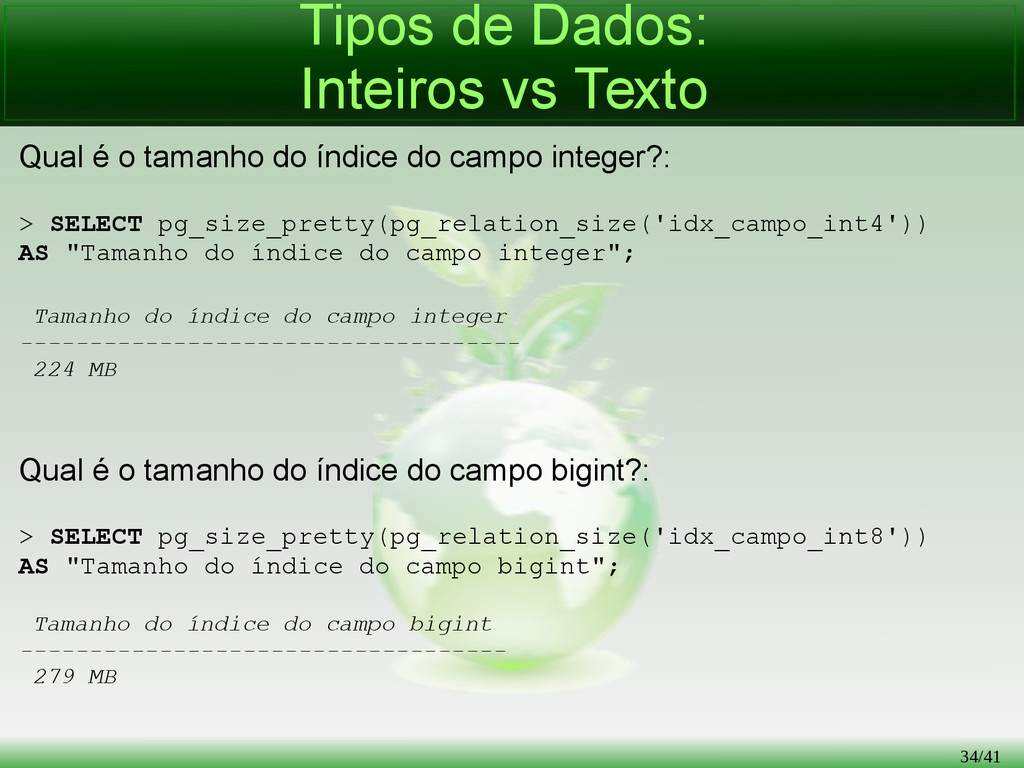
34/41 Tipos de Dados: Inteiros vs Texto Qual é o
tamanho do índice do campo integer?: > SELECT pg_size_pretty(pg_relation_size('idx_campo_int4')) AS "Tamanho do índice do campo integer"; Tamanho do índice do campo integer ------------------------------------ 224 MB Qual é o tamanho do índice do campo bigint?: > SELECT pg_size_pretty(pg_relation_size('idx_campo_int8')) AS "Tamanho do índice do campo bigint"; Tamanho do índice do campo bigint ----------------------------------- 279 MB -
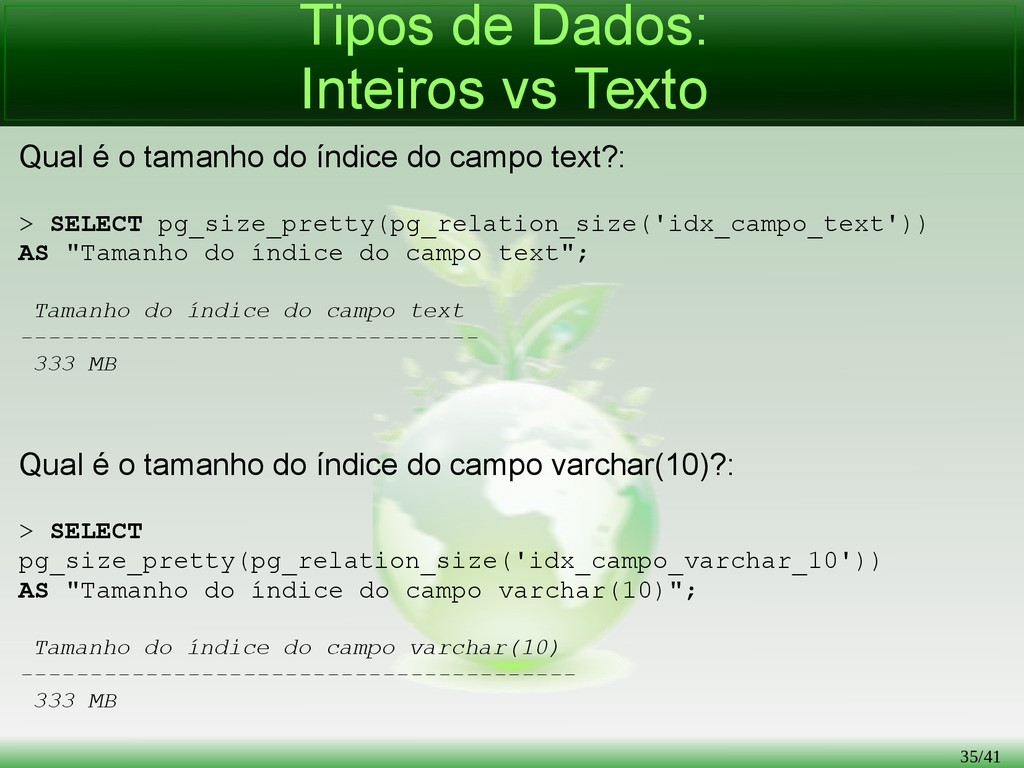
35/41 Tipos de Dados: Inteiros vs Texto Qual é o
tamanho do índice do campo text?: > SELECT pg_size_pretty(pg_relation_size('idx_campo_text')) AS "Tamanho do índice do campo text"; Tamanho do índice do campo text --------------------------------- 333 MB Qual é o tamanho do índice do campo varchar(10)?: > SELECT pg_size_pretty(pg_relation_size('idx_campo_varchar_10')) AS "Tamanho do índice do campo varchar(10)"; Tamanho do índice do campo varchar(10) ---------------------------------------- 333 MB -
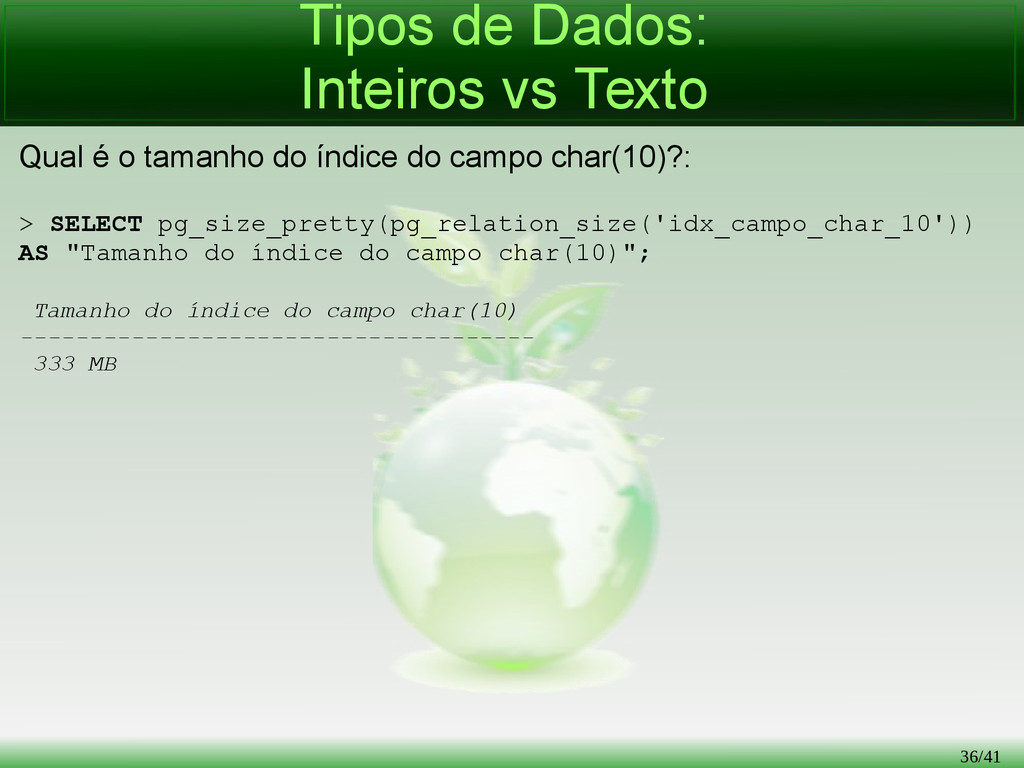
36/41 Tipos de Dados: Inteiros vs Texto Qual é o
tamanho do índice do campo char(10)?: > SELECT pg_size_pretty(pg_relation_size('idx_campo_char_10')) AS "Tamanho do índice do campo char(10)"; Tamanho do índice do campo char(10) ------------------------------------- 333 MB -
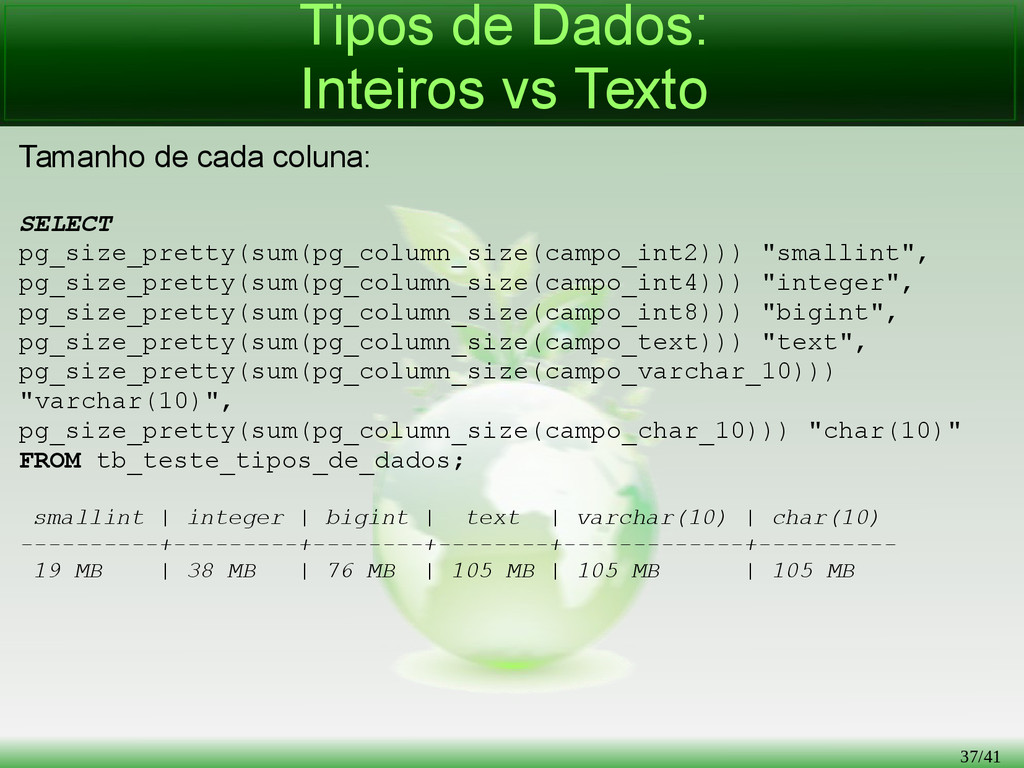
37/41 Tipos de Dados: Inteiros vs Texto Tamanho de cada
coluna: SELECT pg_size_pretty(sum(pg_column_size(campo_int2))) "smallint", pg_size_pretty(sum(pg_column_size(campo_int4))) "integer", pg_size_pretty(sum(pg_column_size(campo_int8))) "bigint", pg_size_pretty(sum(pg_column_size(campo_text))) "text", pg_size_pretty(sum(pg_column_size(campo_varchar_10))) "varchar(10)", pg_size_pretty(sum(pg_column_size(campo_char_10))) "char(10)" FROM tb_teste_tipos_de_dados; smallint | integer | bigint | text | varchar(10) | char(10) ----------+---------+--------+--------+-------------+---------- 19 MB | 38 MB | 76 MB | 105 MB | 105 MB | 105 MB -
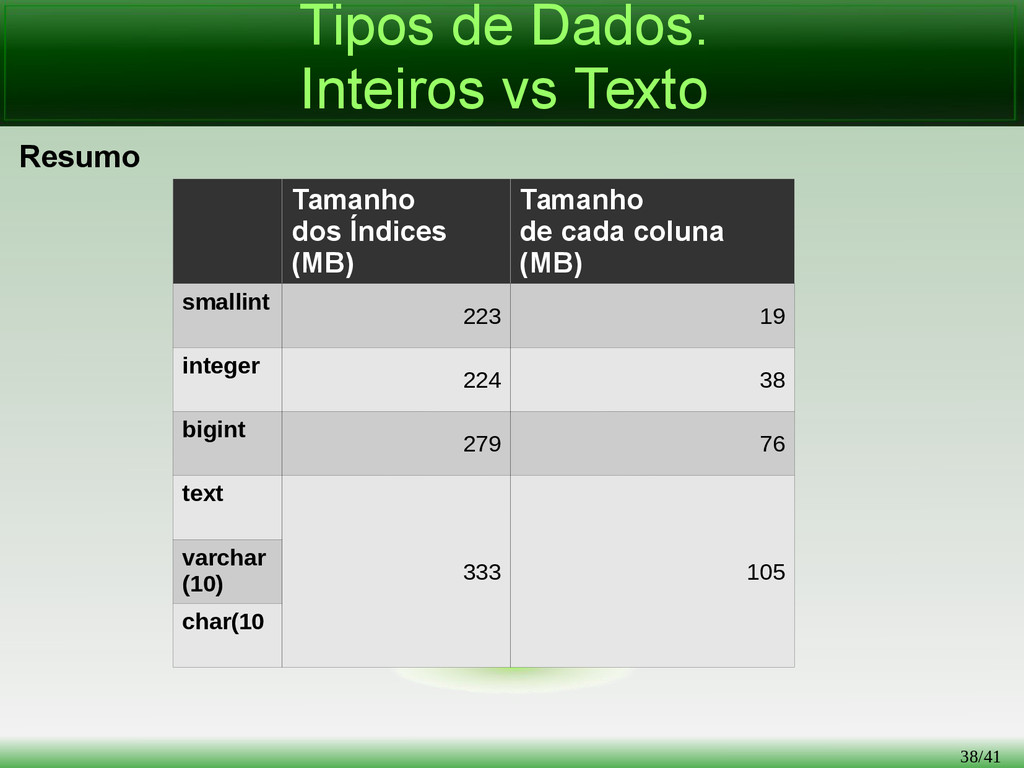
38/41 Tipos de Dados: Inteiros vs Texto Resumo Tamanho dos
Índices (MB) Tamanho de cada coluna (MB) smallint 223 19 integer 224 38 bigint 279 76 text 333 105 varchar (10) char(10 -
41/41 Até a próxima!!! :) Juliano Atanazio [email protected] https://juliano777.wordpress.com http://www.slideshare.net/spjuliano
https://speakerdeck.com/julianometalsp https://br.linkedin.com/pub/juliano-atanazio/2b/951/ab9