Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Elasticsearch
Search
KangSangUn
October 07, 2019
Programming
110
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Elasticsearch
by ogidow
GMOPEPABO
KangSangUn
October 07, 2019
More Decks by KangSangUn
See All by KangSangUn
MySQL_のお話.pdf
kangsangun
0
1.4k
Other Decks in Programming
See All in Programming
3回つくってわかった、 定期実行ジョブ基盤の本質情報
takai
0
470
Unity6 URPによる海底をテーマにしたVJシステムの解説 | Unity Shader 完全に理解した 勉強会
gam0022
0
370
Atomic Design, Enforced: Scaling Mobile Design Systems (next.app devCon / droidCon Berlin 2026)
steliosf
PRO
0
170
Starting & Sustaining Code-Based E2E Testing for Non-Coding QA Teams( #jasstniigata )
teyamagu
PRO
1
1k
[ハンズオン]AIへの指示だけで「五目並べ」を作ってみよう
satoshi256kbyte
1
380
Kotlinの15年とServer-Side Kotlin
n_takehata
1
150
Verilogで学ぶCPU自作入門
uyuki234
8
4.1k
sbt 2.0: takeoff
eed3si9n
0
160
個人開発者よ、Honoを使え(おじさんver)
tanahiro2010
2
260
Augmenting AI with the Power of Jakarta EE
ivargrimstad
0
190
IBM Bob でAI駆動開発『QC-Playbook』
ichirokano2
0
110
Rでドレミ/Do-Re-Mi_with_R
florets1
0
130
Featured
See All Featured
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
Save Time (by Creating Custom Rails Generators)
garrettdimon
PRO
33
5.2k
Design of three-dimensional binary manipulators for pick-and-place task avoiding obstacles (IECON2024)
konakalab
0
620
The Language of Interfaces
destraynor
162
27k
Faster Mobile Websites
deanohume
310
32k
Done Done
chrislema
187
17k
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
Documentation Writing (for coders)
carmenintech
77
5.6k
10 Git Anti Patterns You Should be Aware of
lemiorhan
PRO
659
62k
How to Ace a Technical Interview
jacobian
280
24k
How to Think Like a Performance Engineer
csswizardry
28
2.9k
Tips & Tricks on How to Get Your First Job In Tech
honzajavorek
1
800
Transcript
Elasticsearch minne事業部 ogidow
目的 • 全文検索の基礎を理解する • Elasticsearch の基礎を理解する
Elastisearchとは
全文検索のためのソフトウェア
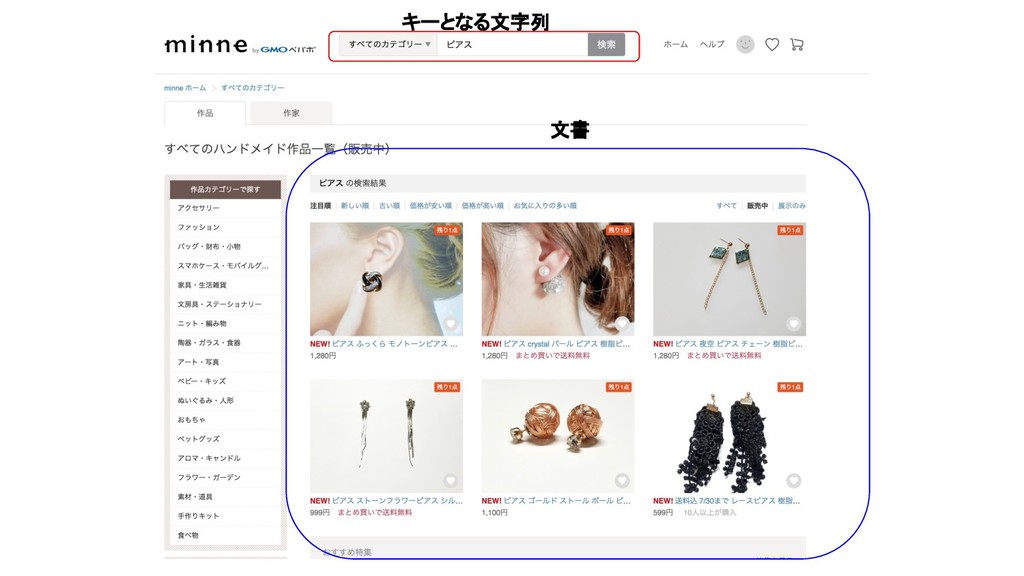
全文検索とは 複数の文書に跨って特定の文字列をキーに特定の 文書を探すための方法
キーとなる文字列 文書
全文検索の仕組み • 逐次検索 • 索引検索
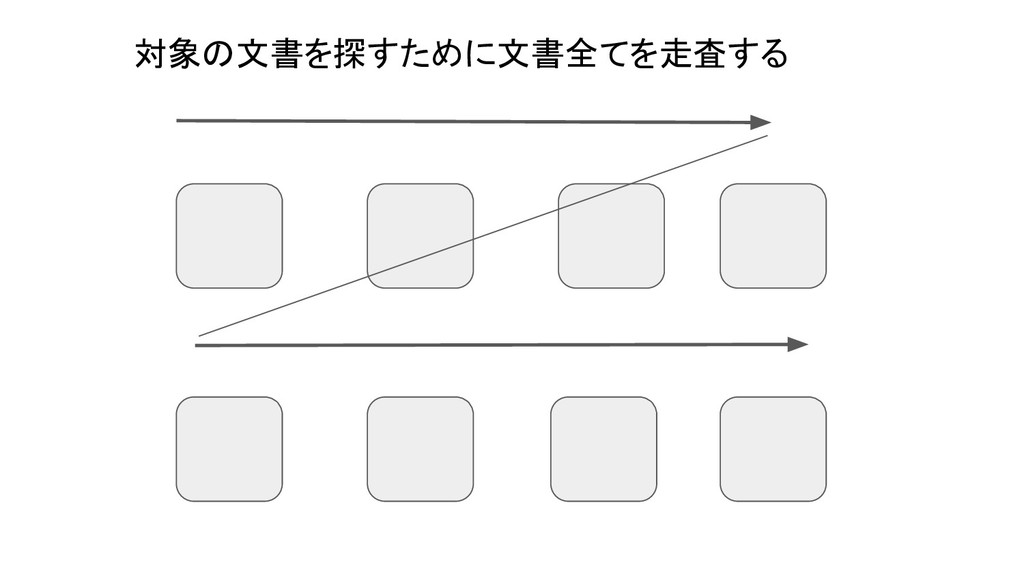
逐次検索 • 全ての文書を順に走査しながら目的の文字列を 探す方法 • grepコマンドもこれ • 実装はシンプルだが、文書が大量になると処理が 遅くなる
対象の文書を探すために文書全てを走査する
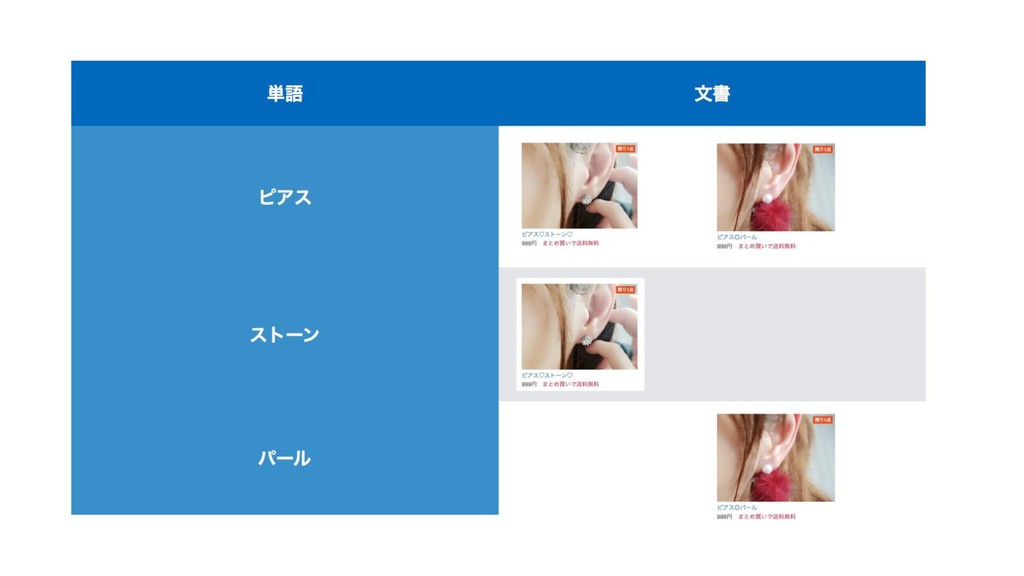
索引検索 • 事前に作品を構成しておいて、検索時には索引を利用して文 書を探す方法 • 文書の数が膨大になっても高速に動作する • 索引は「インデックス」とも呼ばれる • Elasticsearchもこの方法を利用している
None
Elasticsearchの特徴 • 高い可用性 • みんな大好き REST API によるアクセス • 柔軟性の高いドキュメント指向データベース
• Elastic Stack
高い可用性 • Elasticsearch は インデックスを複数のノードに分散配置して いる • また、各シャードに対してレプリカと呼ばれる複製を作成してい る •
これにより、高い可用性と高速な処理を実現している
高い可用性 • Elasticsearch は インデックスを複数のノードに分散配置して いる • また、各シャードに対してレプリカと呼ばれる複製を作成してい る •
これにより、高い可用性と高速な処理を実現している 詳しくは後ほど
REST API によるアクセス • 言語に依存しないAPIアクセスが可能 • REST は Rails のあれで同じみ
ドキュメント指向データベース • データ、検索クエリ、検索結果全てが JSON で表 現され、事前にスキーマを決定する必要がない • JSONで表現できるデータ構造は基本的に Elasticsearch で表現できる
• Elastic Stack と呼ばれるソフトウェア群と連携す ることで ログや各種メトリクスの収集・可視化を比 較的簡単に行うことができる Elastic Stack
Elasticsearch の基礎
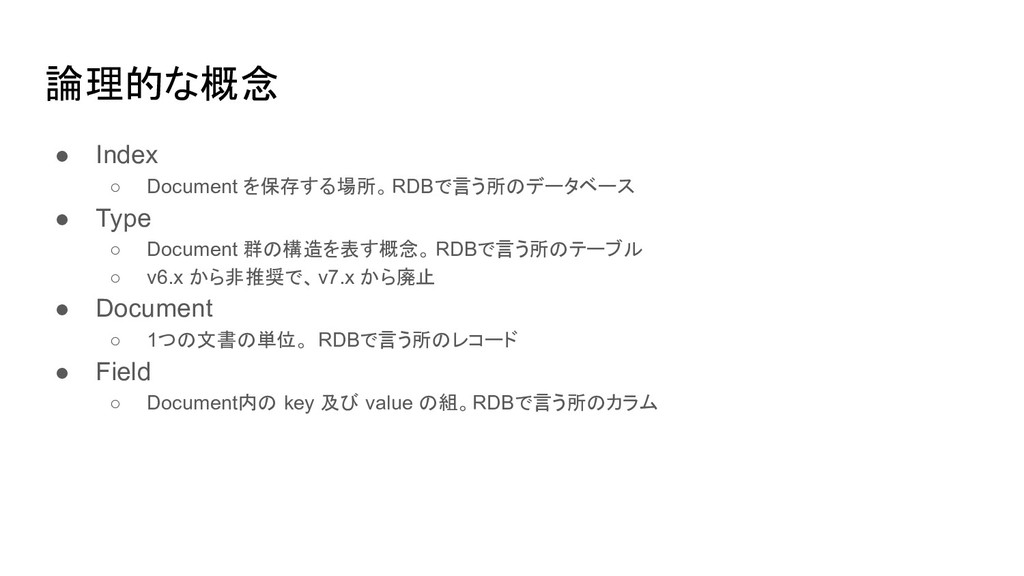
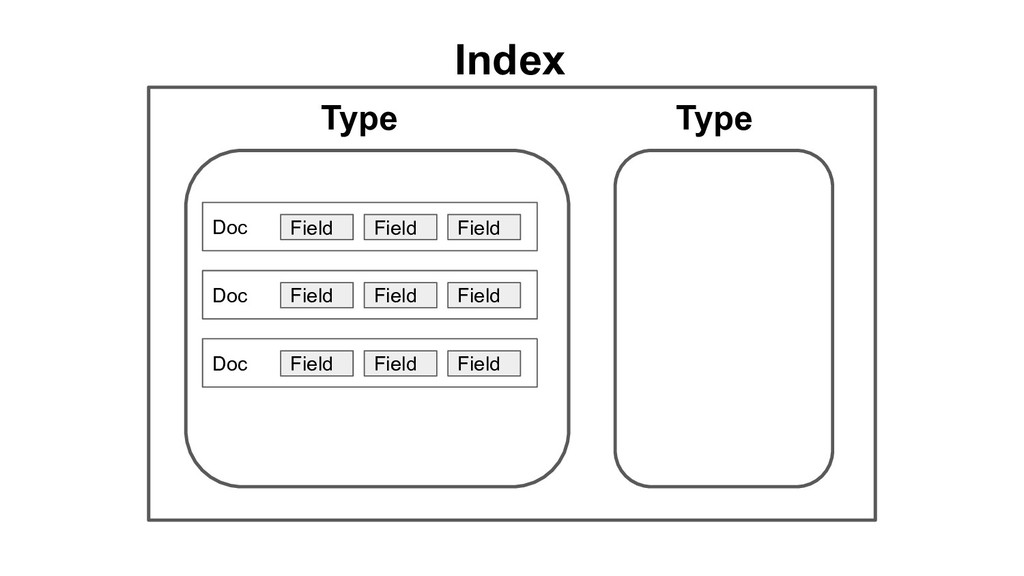
論理的な概念 • Index ◦ Document を保存する場所。RDBで言う所のデータベース • Type ◦ Document
群の構造を表す概念。 RDBで言う所のテーブル ◦ v6.x から非推奨で、v7.x から廃止 • Document ◦ 1つの文書の単位。 RDBで言う所のレコード • Field ◦ Document内の key 及び value の組。RDBで言う所のカラム
Index Type Doc Field Field Field Doc Field Field Field
Doc Field Field Field Type
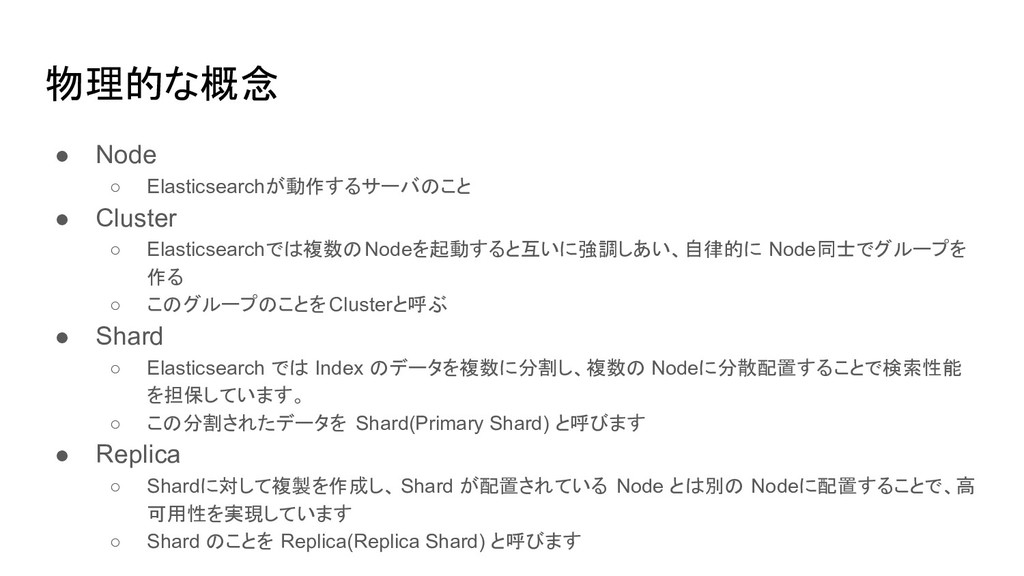
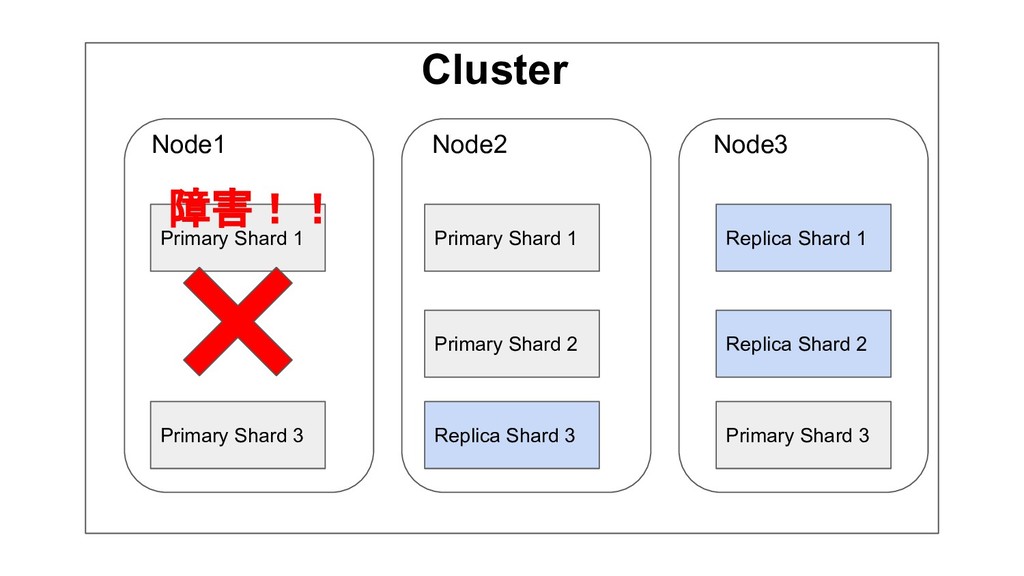
物理的な概念 • Node ◦ Elasticsearchが動作するサーバのこと • Cluster ◦ Elasticsearchでは複数のNodeを起動すると互いに強調しあい、自律的に Node同士でグループを
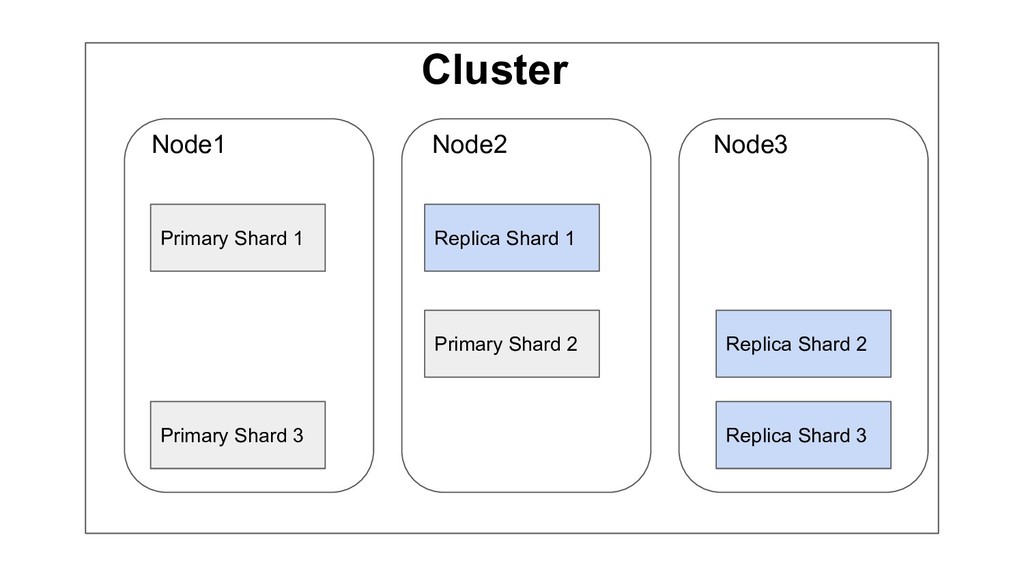
作る ◦ このグループのことを Clusterと呼ぶ • Shard ◦ Elasticsearch では Index のデータを複数に分割し、複数の Nodeに分散配置することで検索性能 を担保しています。 ◦ この分割されたデータを Shard(Primary Shard) と呼びます • Replica ◦ Shardに対して複製を作成し、 Shard が配置されている Node とは別の Nodeに配置することで、高 可用性を実現しています ◦ Shard のことを Replica(Replica Shard) と呼びます
Cluster Node1 Node2 Node3 Primary Shard 1 Replica Shard 1
Primary Shard 2 Replica Shard 2 Primary Shard 3 Replica Shard 3
Cluster Node1 Node2 Node3 Primary Shard 1 Replica Shard 1
Primary Shard 2 Replica Shard 2 Primary Shard 3 Replica Shard 3 障害!!
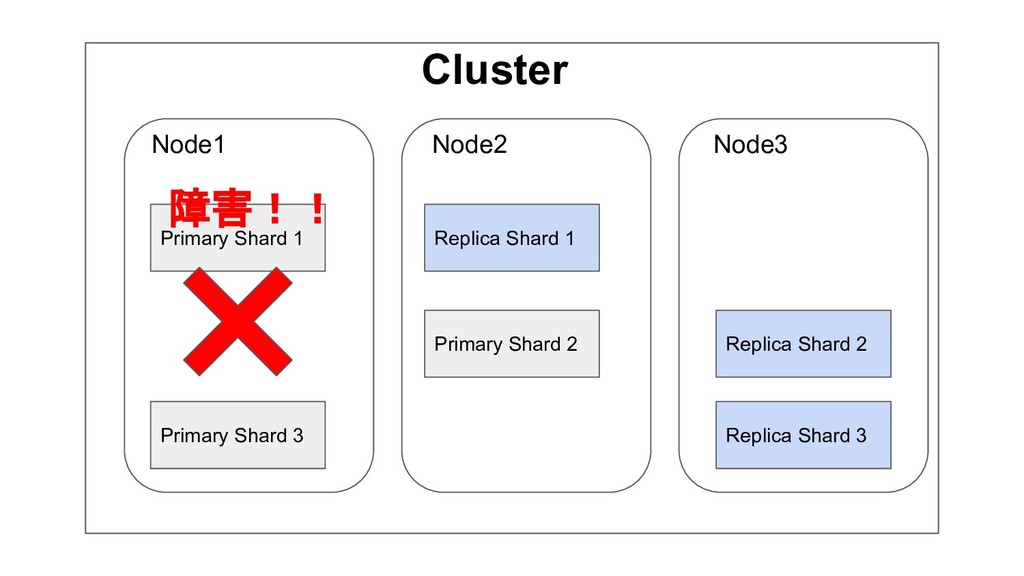
Cluster Node1 Node2 Node3 Primary Shard 1 Primary Shard 1
Primary Shard 2 Replica Shard 2 Primary Shard 3 Primary Shard 3 障害!!
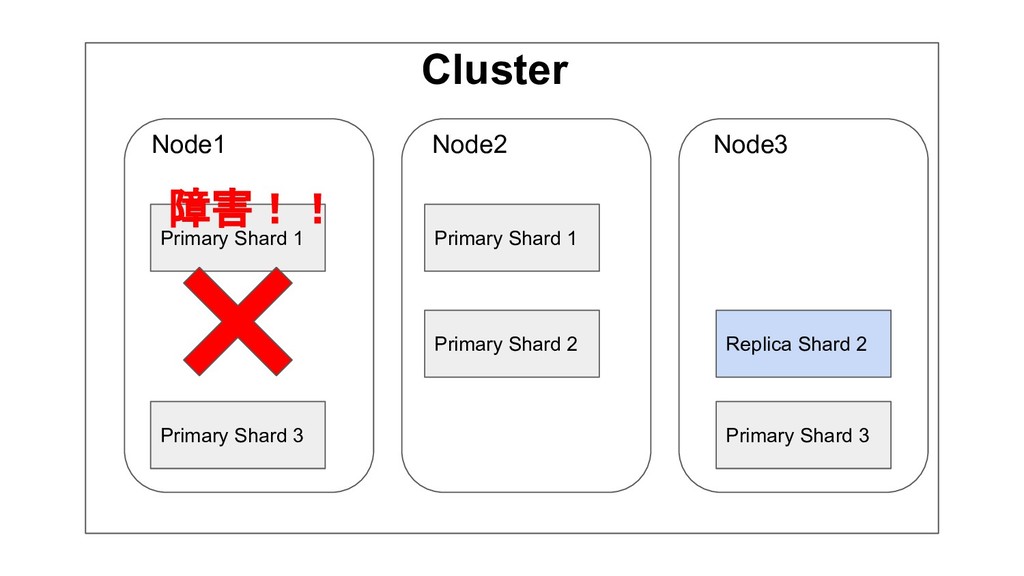
Cluster Node1 Node2 Node3 Primary Shard 1 Primary Shard 1
Primary Shard 2 Replica Shard 2 Primary Shard 3 Primary Shard 3 障害!! Replica Shard 1 Replica Shard 3
特定の Node に障害が発生してもCluster としては問題ないようなアーキテクチャ
Node の種類 • Master(Master-eligible) Node ◦ Cluster に参加している Node の管理やシャードの割当など
Cluester の状態の管理を行う ◦ Master Node はCluster に 1台のみ存在する。既存の Master Node が死んだ場合自動で次の Master が選出される。Master Node 候補となるNode を Master-eligible Node と呼ぶ • Data Node ◦ データの格納・クエリの応答などを行う Node • Coordinating Node ◦ クライアントから受け付けたリクエストのハンドリングを行う Node ◦ デフォルトで全ての Node がこの役割を持っている
Master Node と Cluster
Master Node の選定 • Master-eligible の中から選出されたNodeがクラスタのリーダとしてクラスタの状態 の管理を行う • Cluster が動作するには必ず
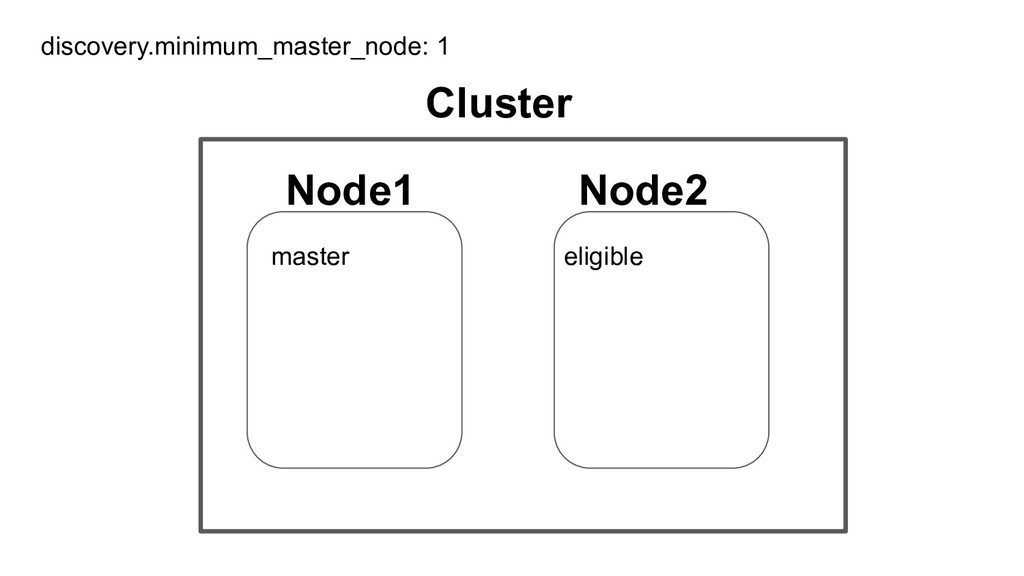
Master Node が必要。Master Node が停止しても Cluster が動作し続けるために複数台の Master-eligible Node を稼働させること が望ましい • Master Node を選出するには 「discovery.zen.minimum_master_node」で設定し た値以上のMaster-eligible Node が必要 • しかし、Master-eligible Node は奇数台で構成しないと スプリットブレインと呼ば れる問題が発生する可能性がある。
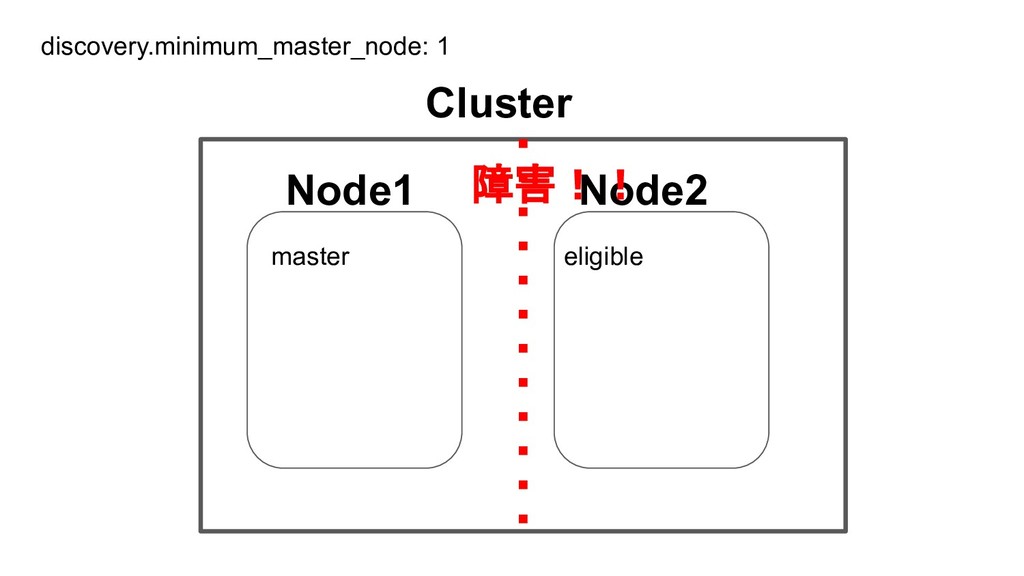
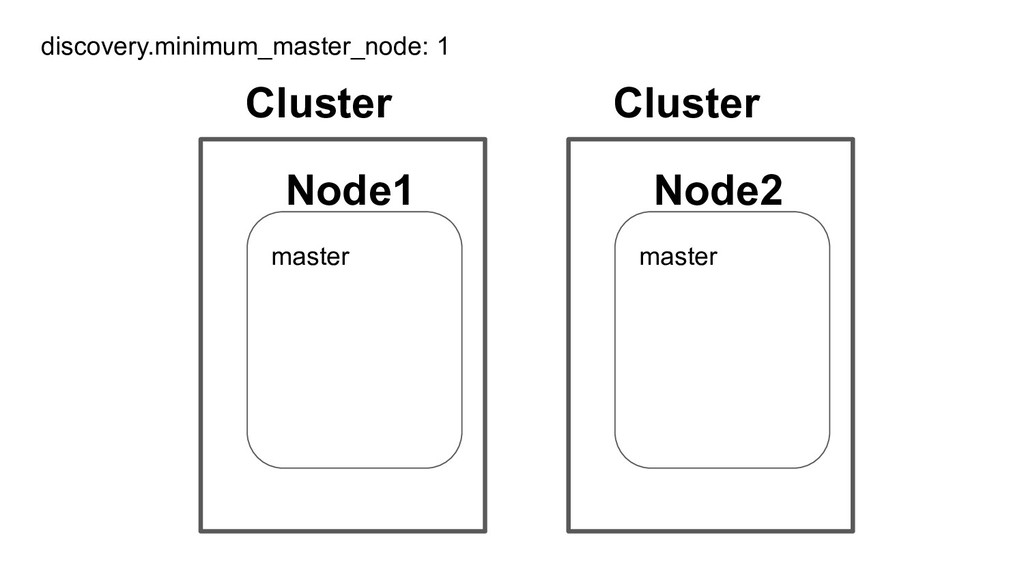
スプリットブレイン • ネットワーク障害などによりNode群が複数に分断される • この時、両方のNode 群が Master Node を選出する条件を満たすとそれぞれが Cluster
を形成してします • これをスプリットブレインと呼ぶ
Cluster Node1 Node2 master eligible discovery.minimum_master_node: 1
Cluster Node1 Node2 master eligible 障害!! discovery.minimum_master_node: 1
Cluster Node1 master discovery.minimum_master_node: 1 Cluster Node2 master
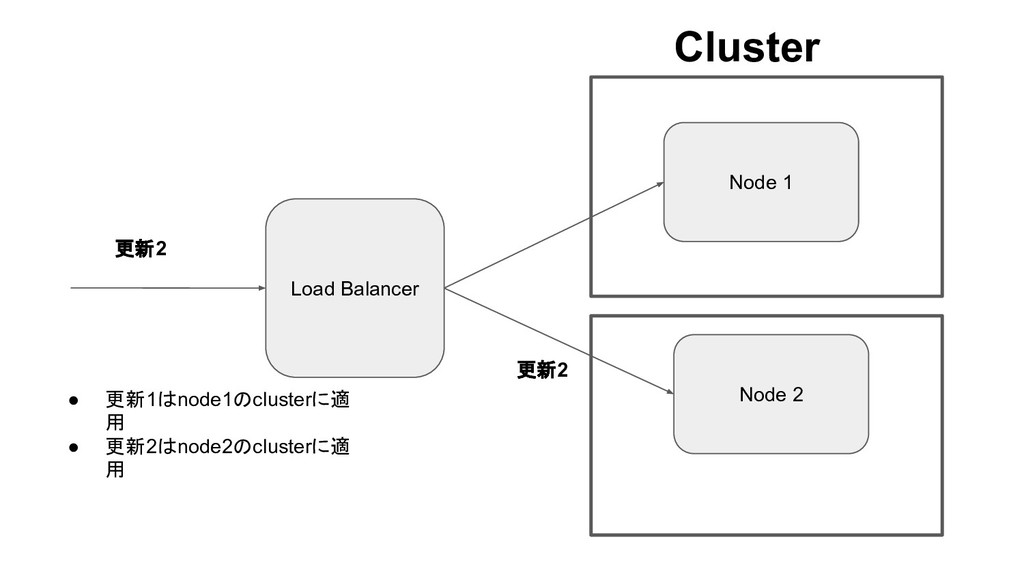
何が問題なのか
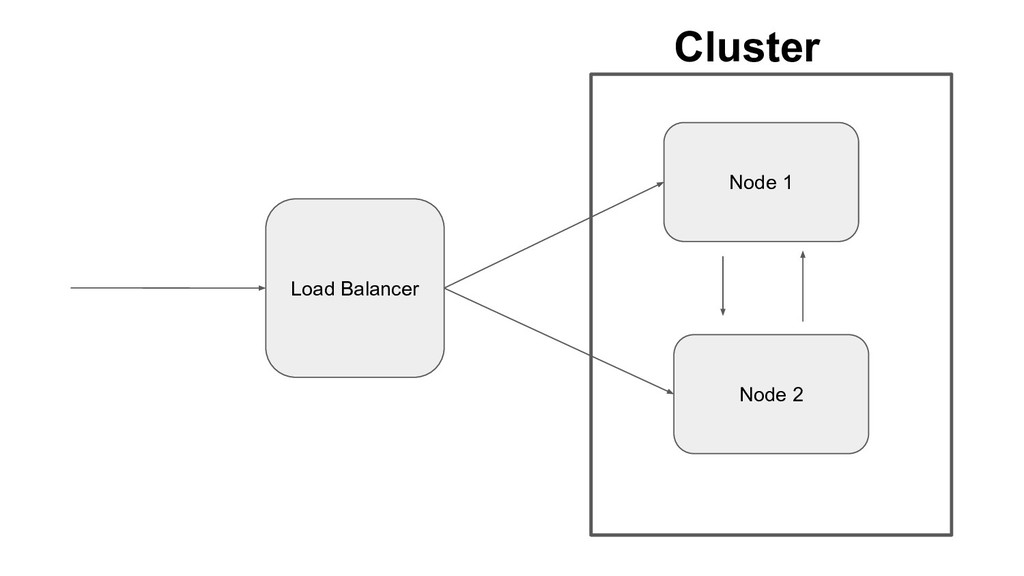
Cluster Node 1 Node 2 Load Balancer
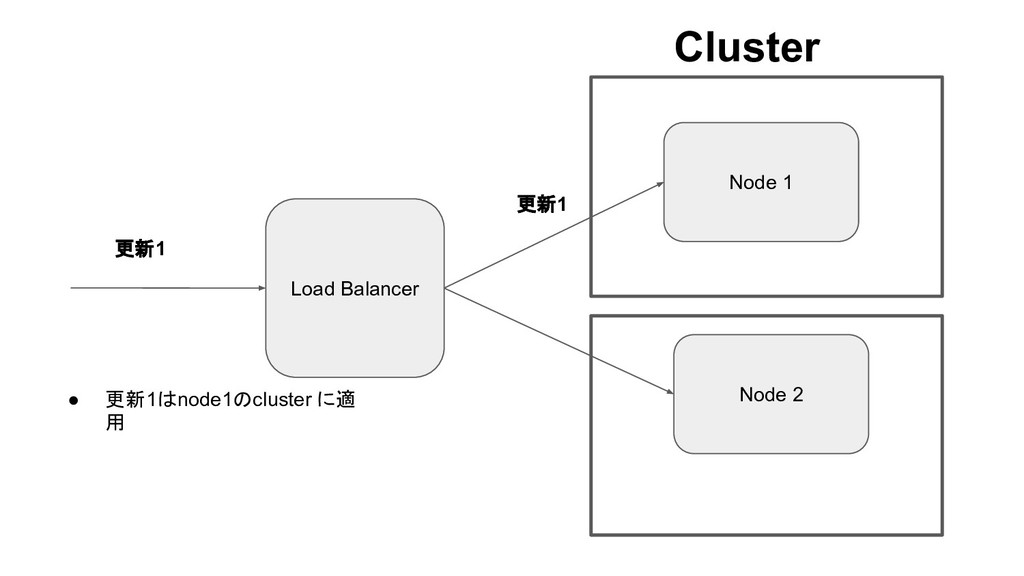
Cluster Node 1 Node 2 Load Balancer 更新1 更新1 •
更新1はnode1のcluster に適 用
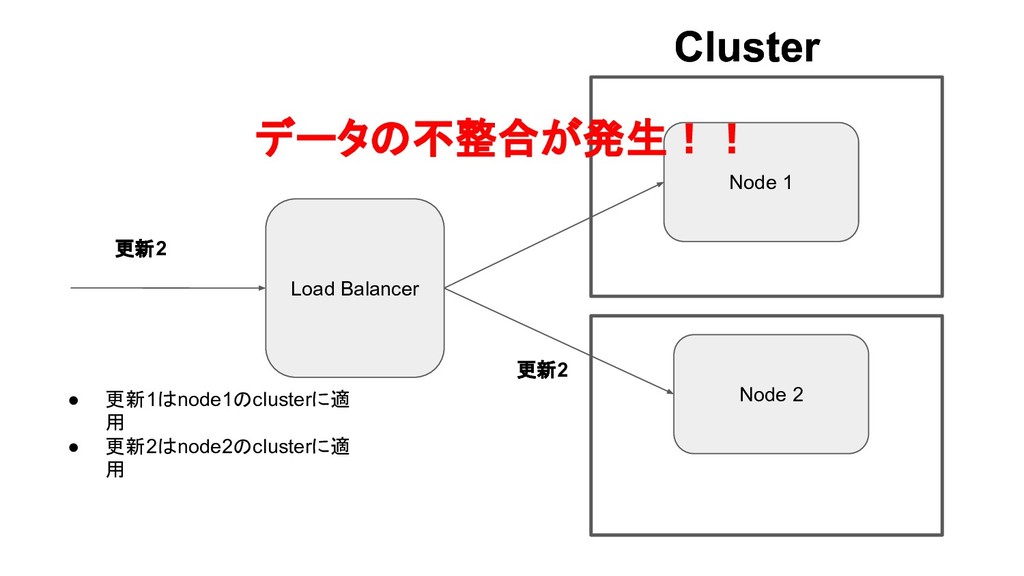
Cluster Node 1 Node 2 Load Balancer 更新2 更新2 •
更新1はnode1のclusterに適 用 • 更新2はnode2のclusterに適 用
Cluster Node 1 Node 2 Load Balancer 更新2 更新2 •
更新1はnode1のclusterに適 用 • 更新2はnode2のclusterに適 用 Cluster データの不整合が発生!!
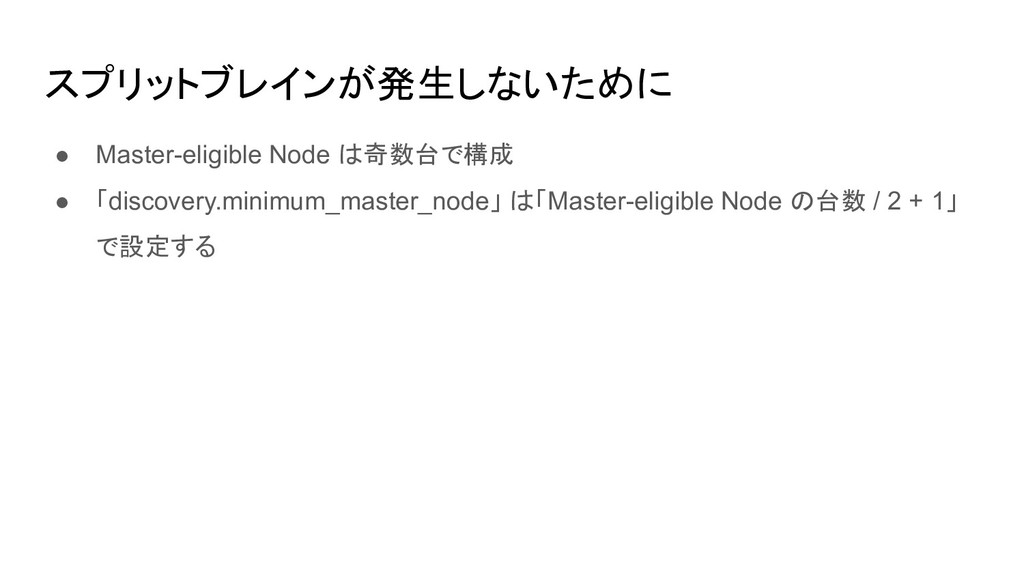
スプリットブレインが発生しないために • Master-eligible Node は奇数台で構成 • 「discovery.minimum_master_node」 は「Master-eligible Node の台数
/ 2 + 1」 で設定する
Analyzer 編
索引検索 • 事前に索引を構成しておいて、検索時には索引を利用して文 書を探す方法 • 文書の数が膨大になっても高速に動作する • 索引は「インデックス」とも呼ばれる • Elasticsearchもこの方法を利用している
再掲
再掲
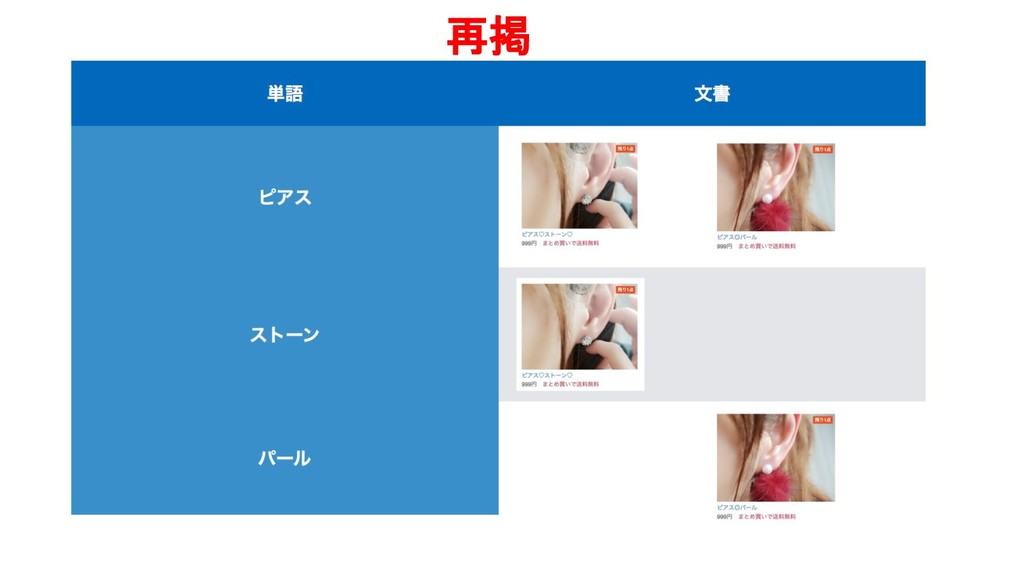
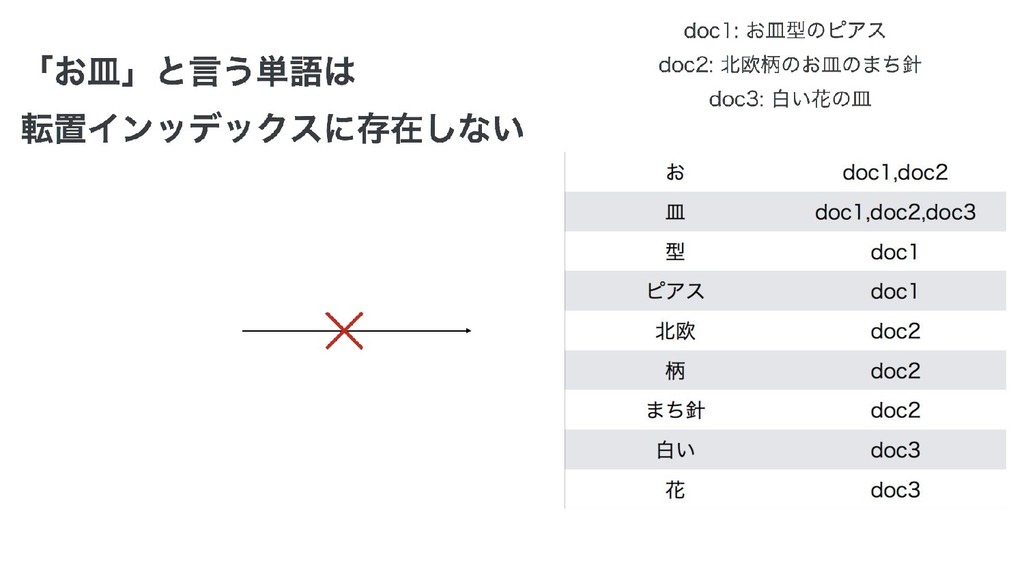
例では作品名を単語ごとに分割して索引を 作っている
どうやって単語に分割しているの
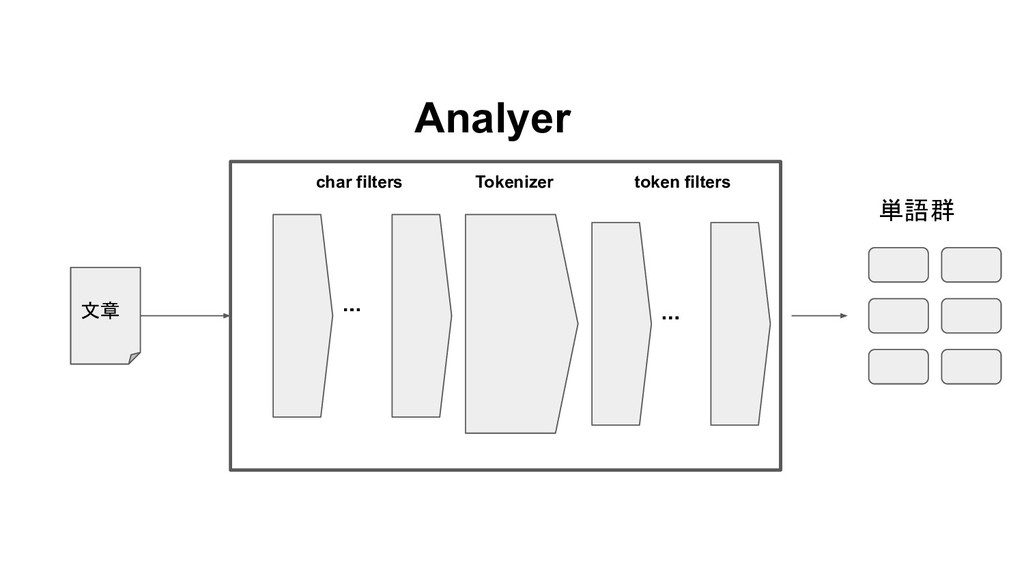
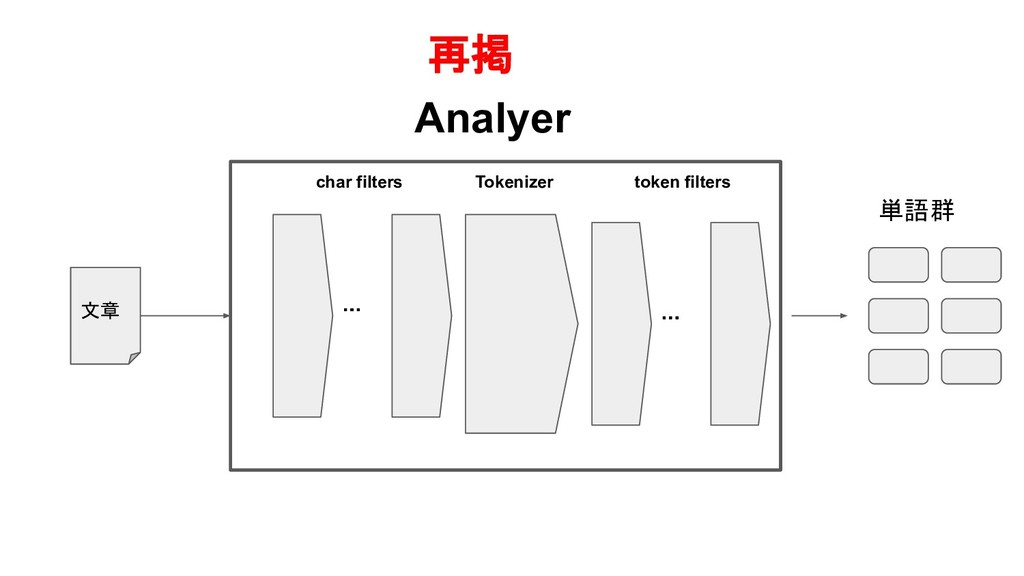
Analyerとは • 文章を単語に分割するためのElasticsearchの機能 • 「Char filter」「Tokenizer」「Token filter」から構成されている
Analyer ・・・ ・・・ char filters Tokenizer token filters 文章 単語群
Char filter • Tokenizer で単語分割を行う前に行うテキストの前処理 • 「htmlタグを除去する」「ルールに基づいて文字列を変換する」 などなど
Tokenizer • 文章を単語に分割する役割を持つ機能 • N-gram や Kuromoji による形態素解析あたりがよく使われる
分割方法のトレードオフ • より適合した結果を求めるECサービスの作品検索などでは形 態素解析が主流 • 途中まで入力されたワードから補完したワードを提供するサ ジェスト機能などでは N-gram がよく用いられる
Token filter • 分割された token に対して変換処理を行う機能 • 主に文字列の正規化やストップワードの除去、同義語の展開 などがある
ストップワード • 文書には接続詞などの検索に役に立たない単語も含まれて いる。これらの役に立たない単語をストップワードと呼ぶ • インデックスにストップワードを残すとインデックスのサイズが 肥大化する • 通常文書を単語に分割したあと、ストップワードを除外した単 語群をインデックスに保存する
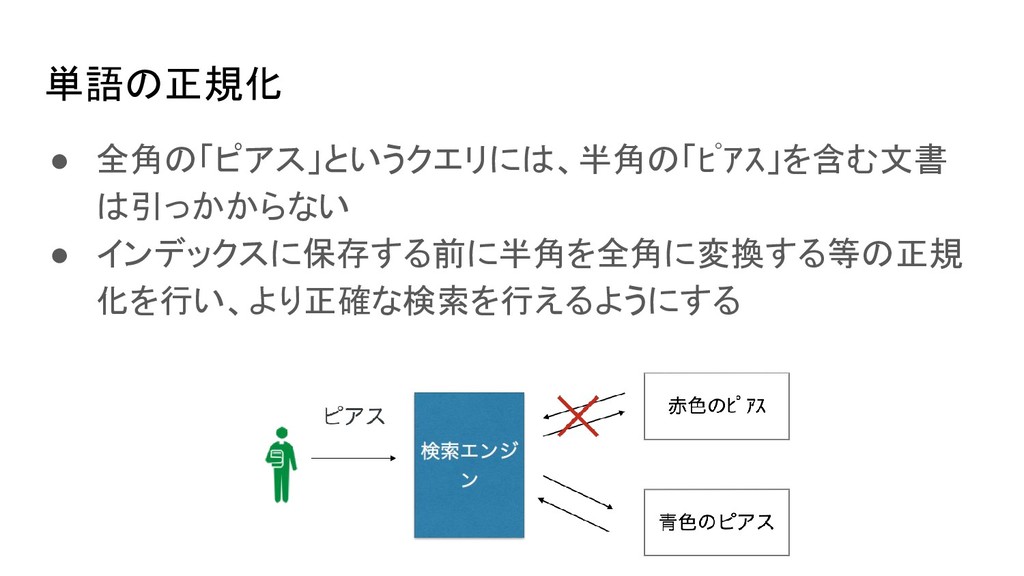
単語の正規化 • 全角の「ピアス」というクエリには、半角の「ピアス」を含む文書 は引っかからない • インデックスに保存する前に半角を全角に変換する等の正規 化を行い、より正確な検索を行えるようにする
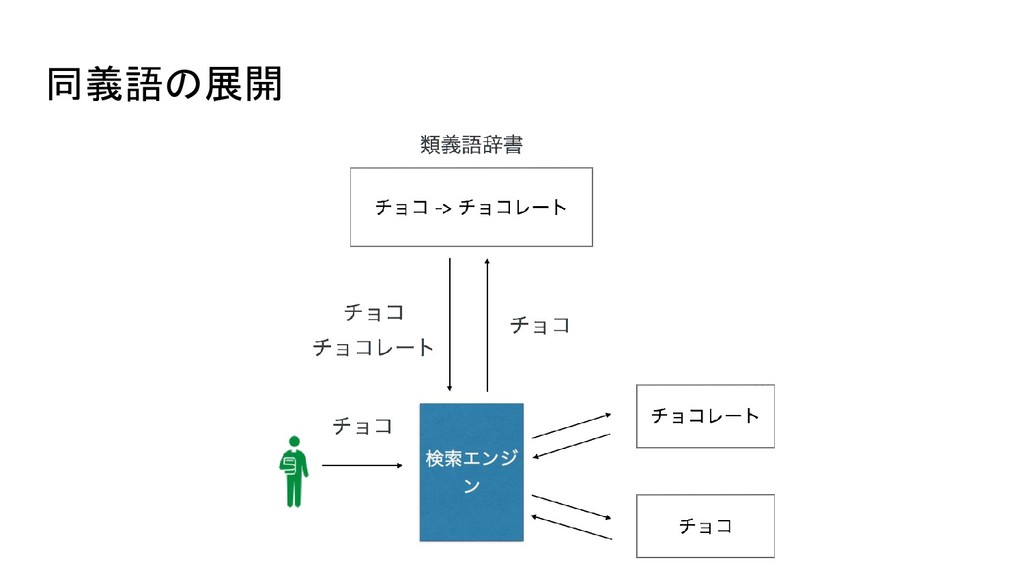
同義語の展開 • 形態素解析だと「チョコ」という検索単語では「チョコレート」は 引っかからない • だけど同じ意味なので引っかかって欲しい…
同義語の展開
API編
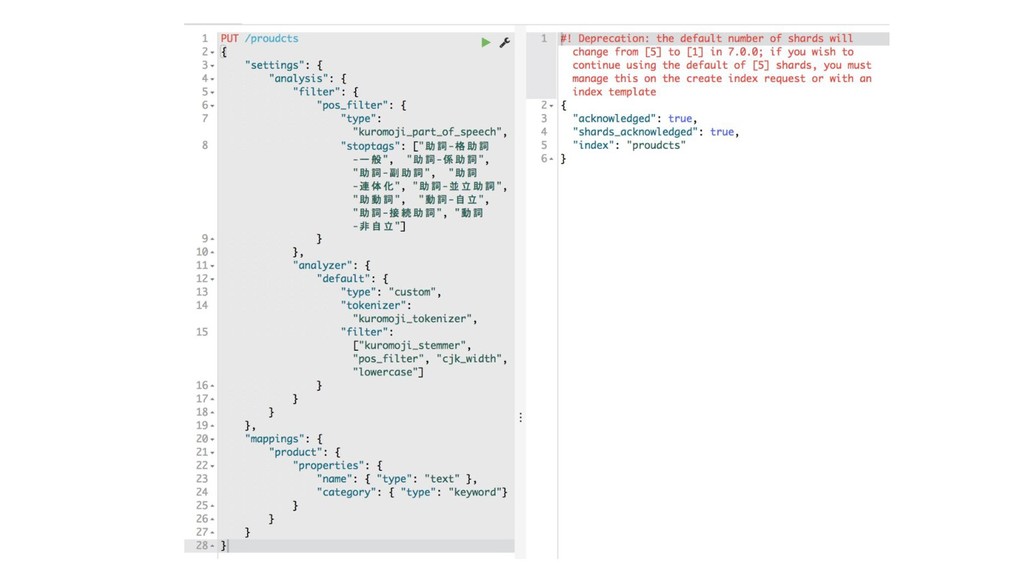
Mapping と Setting • Mapping は Indexに対する Field の定義やFieldに対する Analyzer
の設定を行う • Setting は Analyzer の定義を行う
None
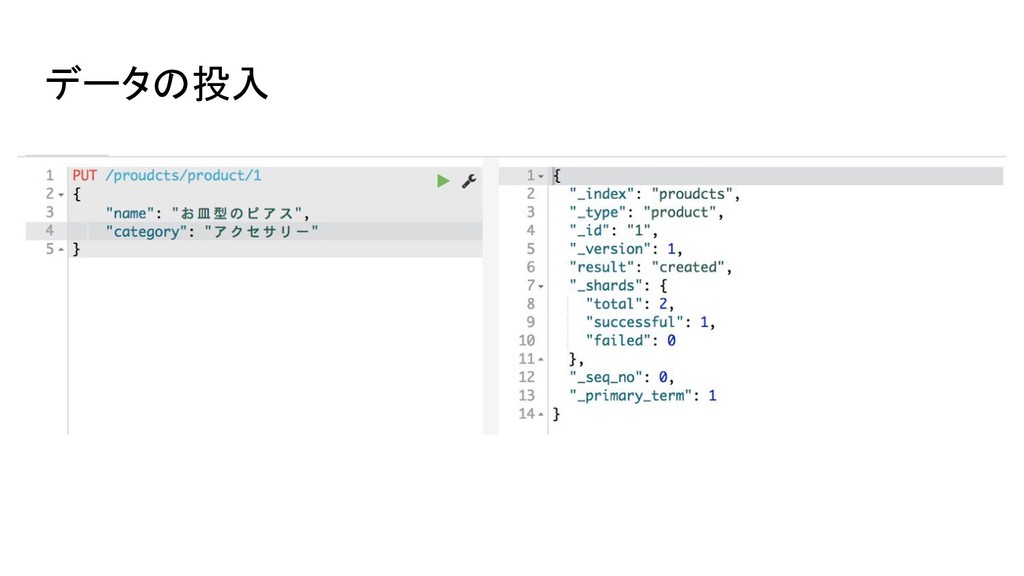
データの投入
None
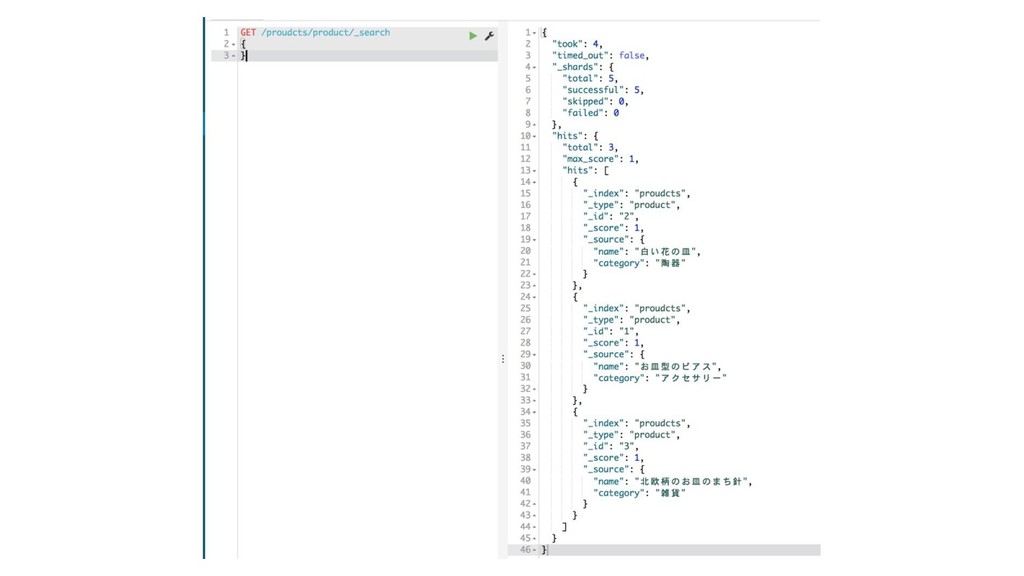
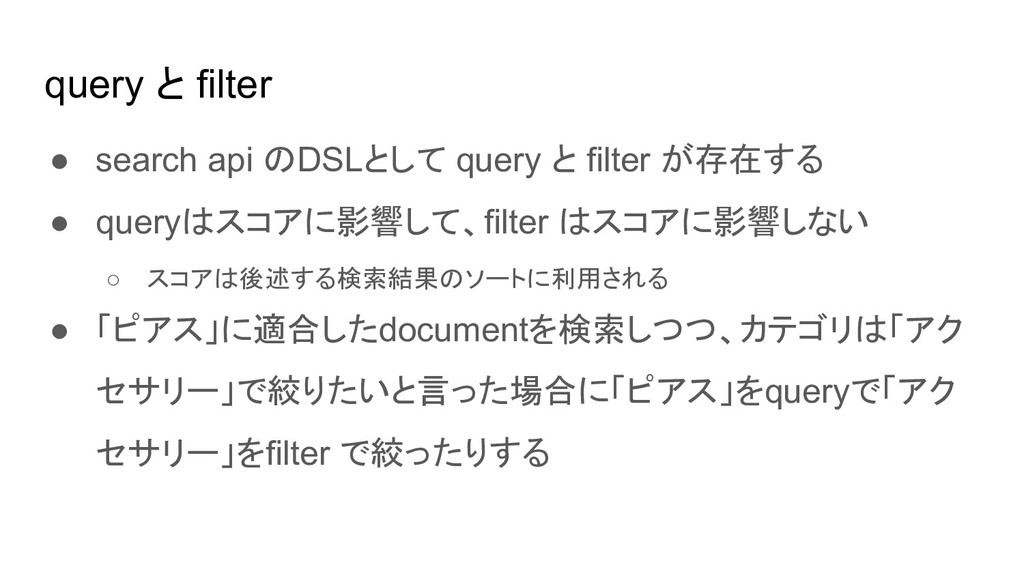
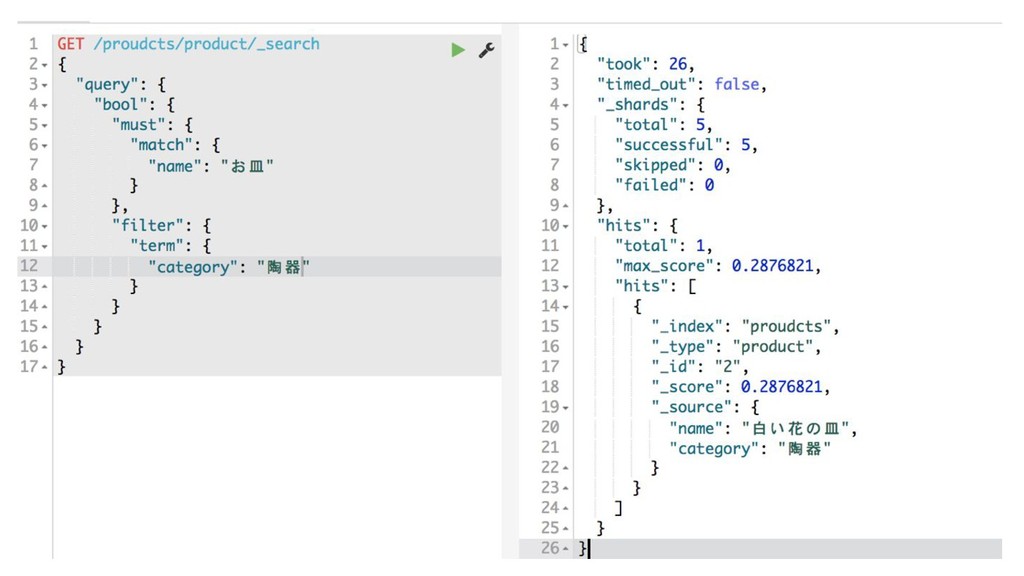
query と filter • search api のDSLとして query と filter
が存在する • queryはスコアに影響して、filter はスコアに影響しない ◦ スコアは後述する検索結果のソートに利用される • 「ピアス」に適合したdocumentを検索しつつ、カテゴリは「アク セサリー」で絞りたいと言った場合に「ピアス」をqueryで「アク セサリー」をfilter で絞ったりする
None
None
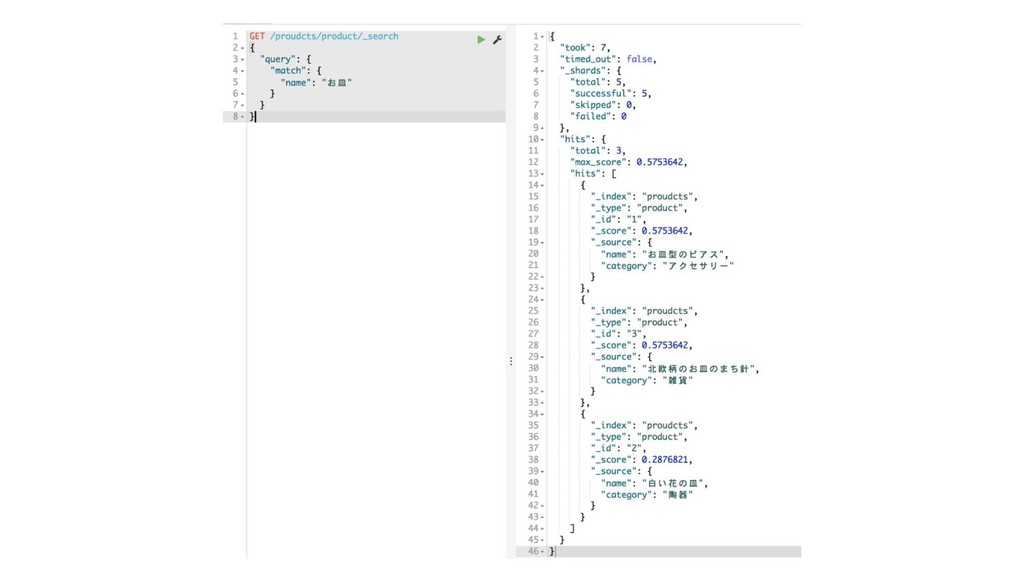
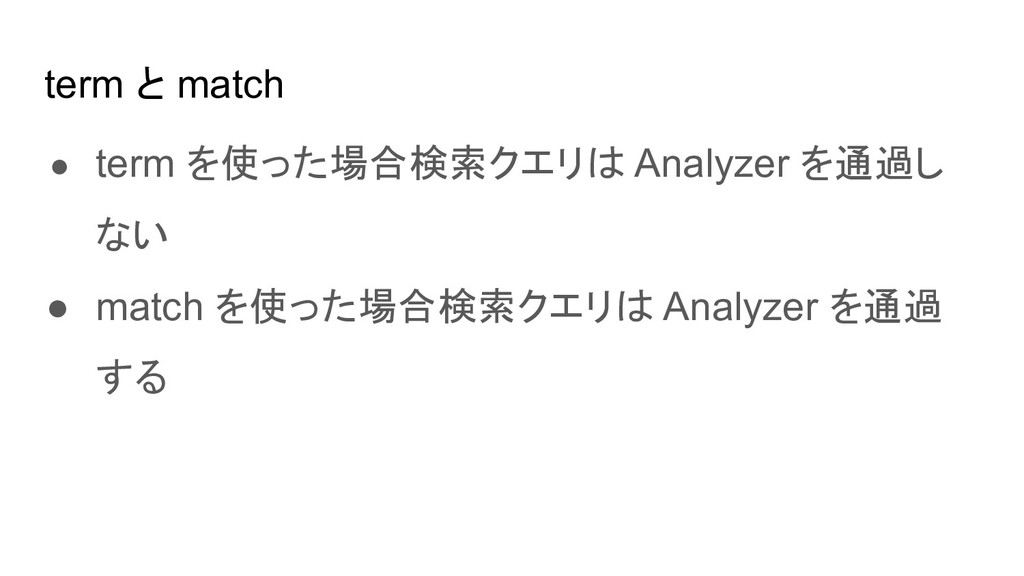
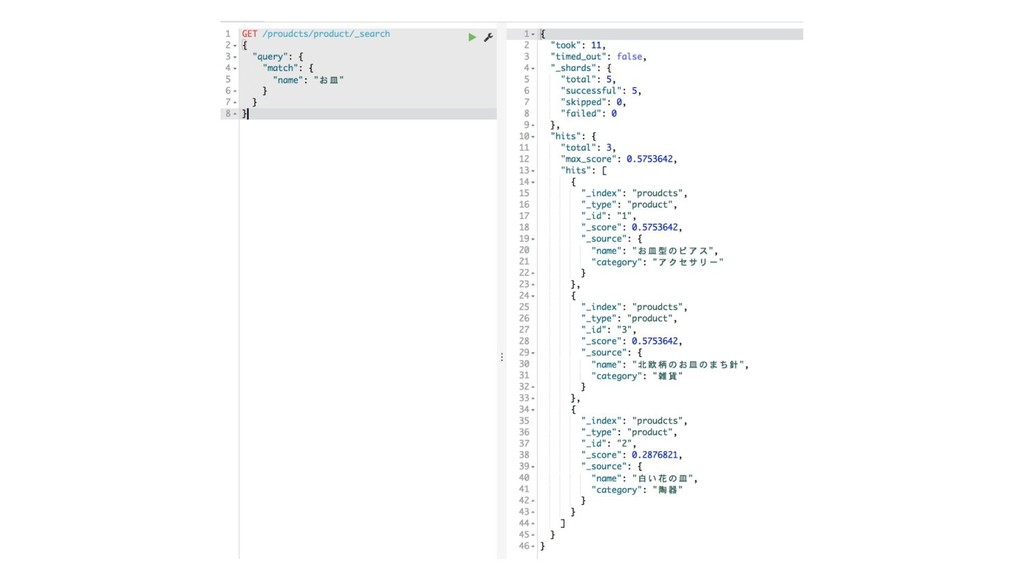
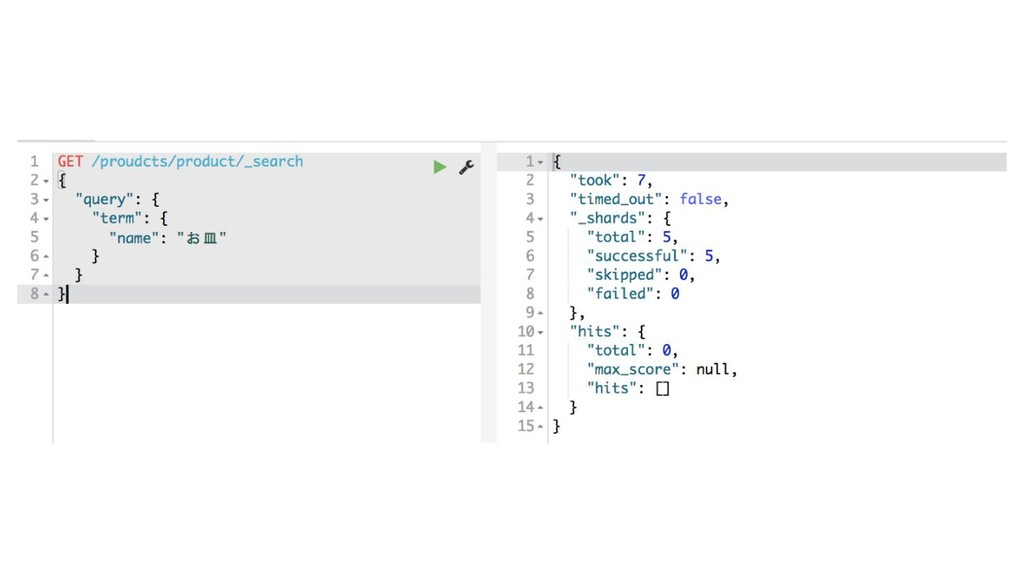
term と match • term を使った場合検索クエリは Analyzer を通過し ない •
match を使った場合検索クエリは Analyzer を通過 する
None
None
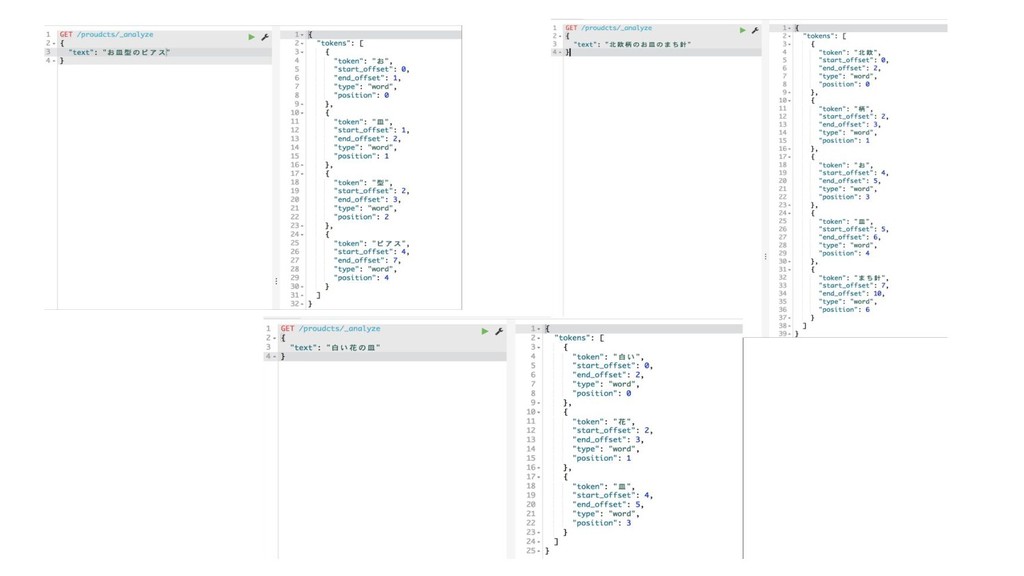
何も引っかからない!!!
Analyer ・・・ ・・・ char filters Tokenizer token filters 文章 単語群
再掲
Analize API • Analyzer を追加してどういう風に文章が通過するかを眺める ことができる
None
None
スコア編
検索結果のソート • 検索時にはDocumentにスコアが付与される • 検索結果はスコアによってソートされる • Elasticsearch は TF-IDF という方法でスコアが計算される
• もちろん Field に比較可能な値を入れてそれに基づいてソート することもできる
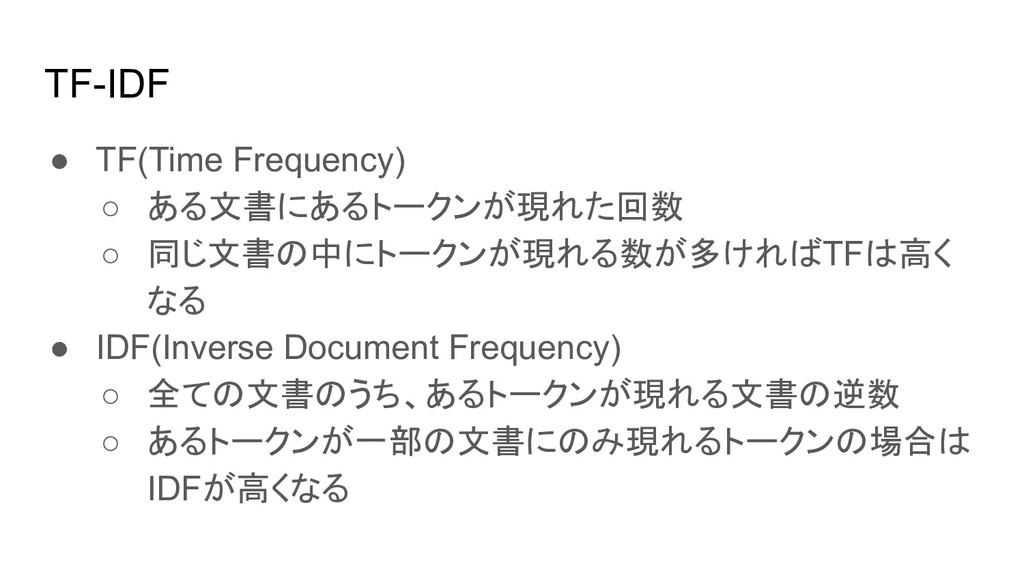
TF-IDF • TF(Time Frequency) ◦ ある文書にあるトークンが現れた回数 ◦ 同じ文書の中にトークンが現れる数が多ければTFは高く なる •
IDF(Inverse Document Frequency) ◦ 全ての文書のうち、あるトークンが現れる文書の逆数 ◦ あるトークンが一部の文書にのみ現れるトークンの場合は IDFが高くなる
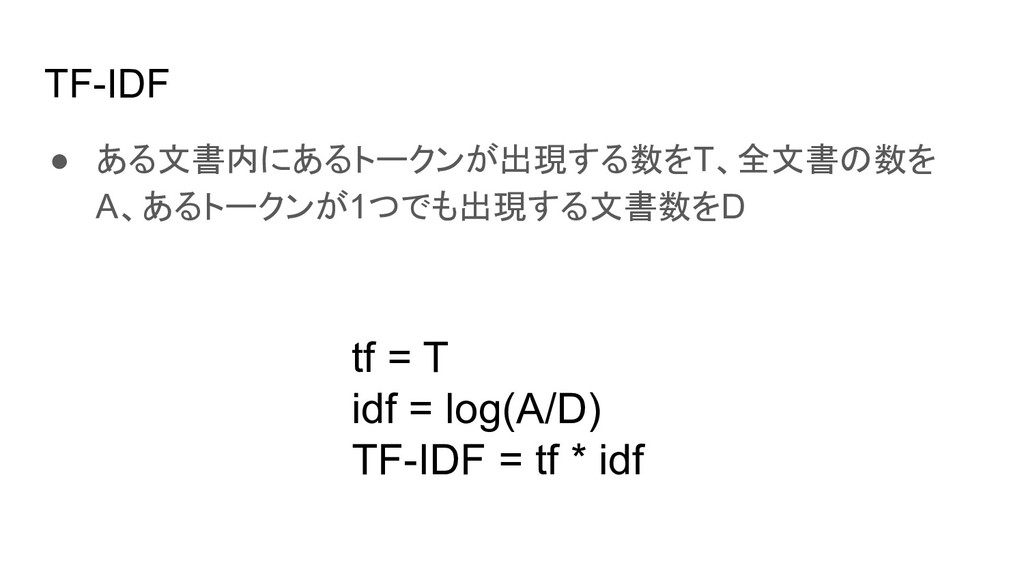
TF-IDF • ある文書内にあるトークンが出現する数をT、全文書の数を A、あるトークンが1つでも出現する文書数をD tf = T idf = log(A/D)
TF-IDF = tf * idf
TF-IDF • TD-IDF は「多くの文書には頻繁に現れないが、ある文書にお いては頻繁に現れる場合」に高くなる • 検索ワードに対して、各Document で TF-IDF を計算しそれを
Documentのスコアとする
とはいえスコアを制御したいことは多々ある
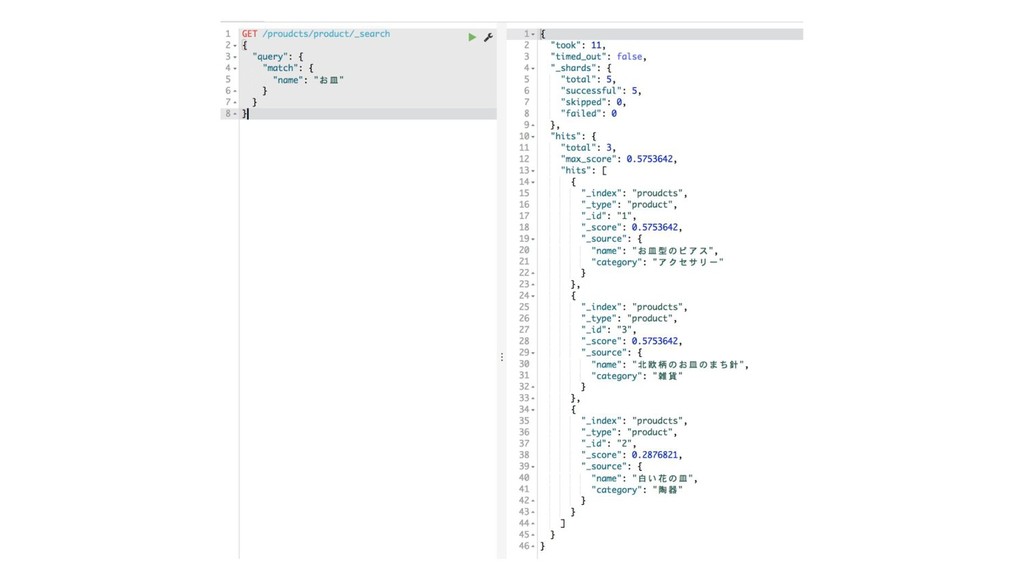
例えば • ユーザがカテゴリを指定せずに「お皿」というクエ リで検索した
None
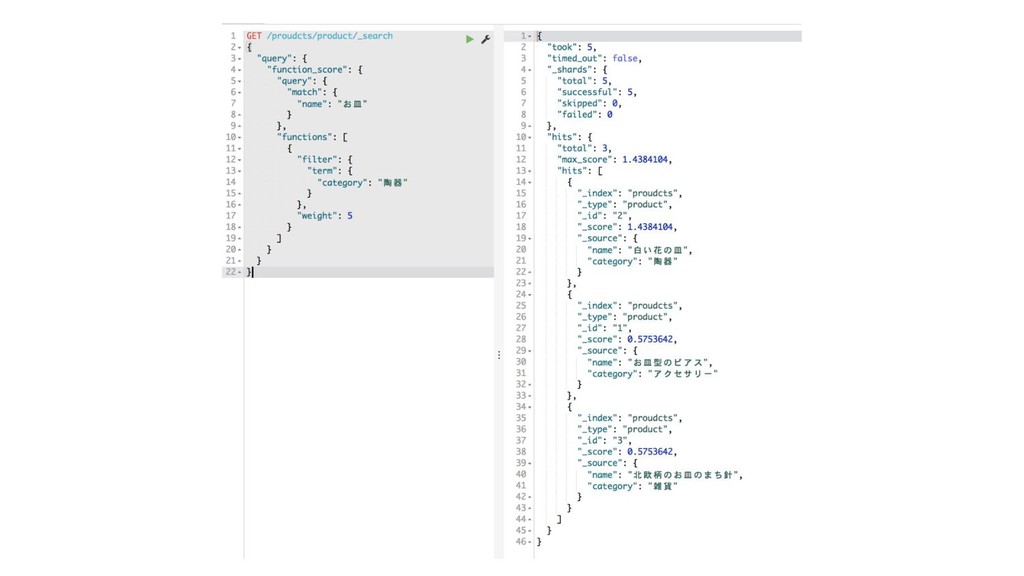
スコアの制御 • 「お皿」というクエリで検索した場合、「アクセサリー」や「雑貨」 よりも「陶器」を探している可能性が(おそらく)高い。 • でも、「陶器」以外も求めているかもしれない • 「陶器」の作品を上位に持って来て「陶器」以外も残したい
Function Score • クエリによってつけられた Document のスコアを 変更することができる • スコア関数を定義し、その関数によってスコアが 変わる
None
他にも • 登録日が古い作品のスコアを下げたい • お気に入りが多い作品のスコアを高くしたい • ある単語が含まれているものは不適切なものが 多いのでスコアを低くしたい 全部 function
score でできる
終わり


 kangsangun
 takai
 gam0022
 steliosf
 teyamagu
 satoshi256kbyte
 n_takehata
 uyuki234
 eed3si9n
 tanahiro2010
 ivargrimstad
 ichirokano2
 florets1
 inesmontani
 garrettdimon
 konakalab
 destraynor
 deanohume
 chrislema
 reverentgeek
 carmenintech
 lemiorhan
 jacobian
 csswizardry
 honzajavorek