Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[Journal club] UNITER: UNiversal Image-TExt Rep...
Search
Semantic Machine Intelligence Lab., Keio Univ.
PRO
May 20, 2022
Technology
1.6k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[Journal club] UNITER: UNiversal Image-TExt Representation Learning
Semantic Machine Intelligence Lab., Keio Univ.
PRO
May 20, 2022
More Decks by Semantic Machine Intelligence Lab., Keio Univ.
See All by Semantic Machine Intelligence Lab., Keio Univ.
[RSJ26] Building a VLA Model Based on Self-Distilled Classification
keio_smilab
PRO
0
200
[RSJ26] AnoleVLA: Lightweight Vision-Language-Action Model with Deep State Space Models for Mobile Manipulation
keio_smilab
PRO
0
140
[RSJ26] NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
keio_smilab
PRO
0
170
[RSJ26] Flow as Flow: Modeling Robot Velocity Fields as Probability Velocity Fields
keio_smilab
PRO
1
210
[RSJ26] Hierarchy-Aware Multimodal Retrieval-Augmented Generation for Embodied Question Answering
keio_smilab
PRO
1
180
[MIRU26] Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes
keio_smilab
PRO
0
200
[Journal club] Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
keio_smilab
PRO
0
49
[MIRU26] To What Extent Does MLLM-as-a-Judge Exhibit Cross-Model Preference Bias?
keio_smilab
PRO
0
290
[Journal club] FlashVID: Efficient Video Large Language Models via Training-free Tree-based Spatiotemporal Token Merging
keio_smilab
PRO
0
37
Other Decks in Technology
See All in Technology
Claude Codeを「使うほど育つ」AI秘書にするノウハウ
minorun365
PRO
6
1.3k
GoにおけるFFIのこれまでとこれから
goccy
5
2.6k
クロスボーダーM&AのValue Upを支えるプロダクト開発。日米チームのハブになったプロダクトエンジニアの実践 / Product Engineering Conference 2026
genda
0
120
「守り」で活用するオンデバイスLLM 〜写ってはいけないを総力戦で防ぐ〜 / iOSDC Japan 2026
nakamuuu
0
140
Claude in Chrome 入門 / Introduction to Claude in Chrome
cielo1985
0
710
2026-09-09 【sigma_ucj#1】Sigma を IaC 管理したい! / IaC for Sigma
civitaspo
0
130
AIで仕事のやり方を変える
matsu7874
3
1.1k
2026-09-10 【Snowflake World Tour Tokyo 2026】dbt Core と Snowflake で実現する多層的なデータガバナンス / Multi-Layered Data Governance Powered by dbt Core and Snowflake
civitaspo
0
380
2026-09-11 【Snowflake World Tour Tokyo 2026】Snowflakeを起点に、AI Agentが自律稼働し続ける未来へ / Driving AI Agents with Snowflake
civitaspo
0
390
OpenTelemetryのメトリクスをCloudWatchに送ってPromQLで見てみた
ota1022
0
150
【技術的負債conf】事業成長に伴う技術的負債の説明責任とAIによるモニタリング、認知的負債について
i35_267
1
610
synctest時代のhttptest Go 1.27で変わるHTTPサーバテストの裏側 / go conference2026 synctest and httptest
budougumi0617
1
2.8k
Featured
See All Featured
Product Roadmaps are Hard
iamctodd
55
13k
Agile Actions for Facilitating Distributed Teams - ADO2019
mkilby
0
280
A Modern Web Designer's Workflow
chriscoyier
699
190k
Side Projects
sachag
456
43k
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
Ruling the World: When Life Gets Gamed
codingconduct
0
330
YesSQL, Process and Tooling at Scale
rocio
174
15k
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.8k
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.4k
Design of three-dimensional binary manipulators for pick-and-place task avoiding obstacles (IECON2024)
konakalab
0
590
GraphQLの誤解/rethinking-graphql
sonatard
75
12k
Save Time (by Creating Custom Rails Generators)
garrettdimon
PRO
32
4.8k
Transcript
慶應義塾大学 杉浦孔明研究室 是方諒介 UNITER: UNiversal Image-TExt Representation Learning Yen-Chun Chen,
Linjie Li, Licheng Yu, Ahmed El Kholy, Faisal Ahmed, Zhe Gan, Yu Cheng, Jingjing Liu (Microsoft Dynamics 365 AI Research) ECCV 2020 Chen, Yen-Chun, et al. "UNITER: UNiversal Image-TExt Representation Learning." ECCV 2020.
概要 背景 ✓ 画像と言語の汎用的な共同表現の需要 提案 ✓ transformerを中核とした大規模な事前学習済みモデル ✓ 4種の自己教師あり事前学習タスクで共同表現を学習 結果
✓ fine-tuningにより、6種のタスクでSOTAを達成 2
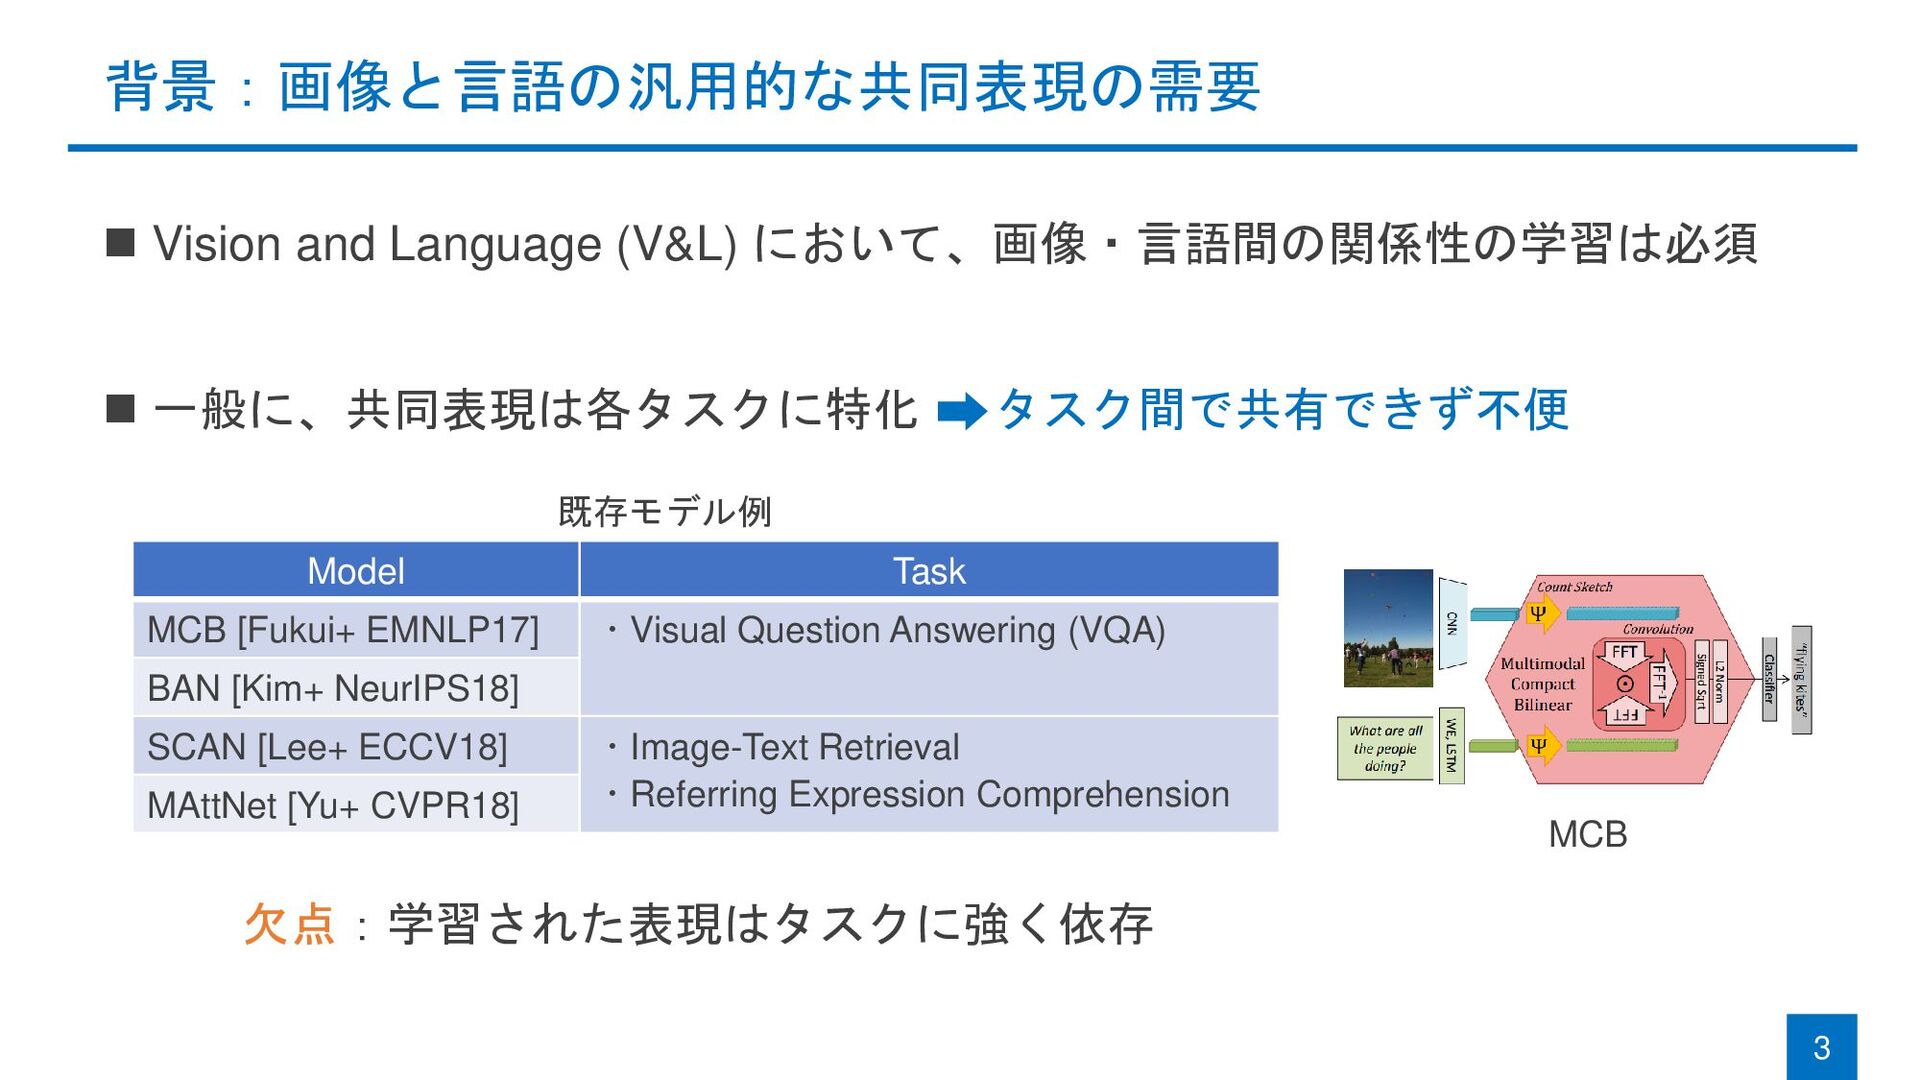
背景:画像と言語の汎用的な共同表現の需要 ◼ Vision and Language (V&L) において、画像・言語間の関係性の学習は必須 ◼ 一般に、共同表現は各タスクに特化 タスク間で共有できず不便
3 Model Task MCB [Fukui+ EMNLP17] ・Visual Question Answering (VQA) BAN [Kim+ NeurIPS18] SCAN [Lee+ ECCV18] ・Image-Text Retrieval ・Referring Expression Comprehension MAttNet [Yu+ CVPR18] 欠点:学習された表現はタスクに強く依存 既存モデル例 MCB
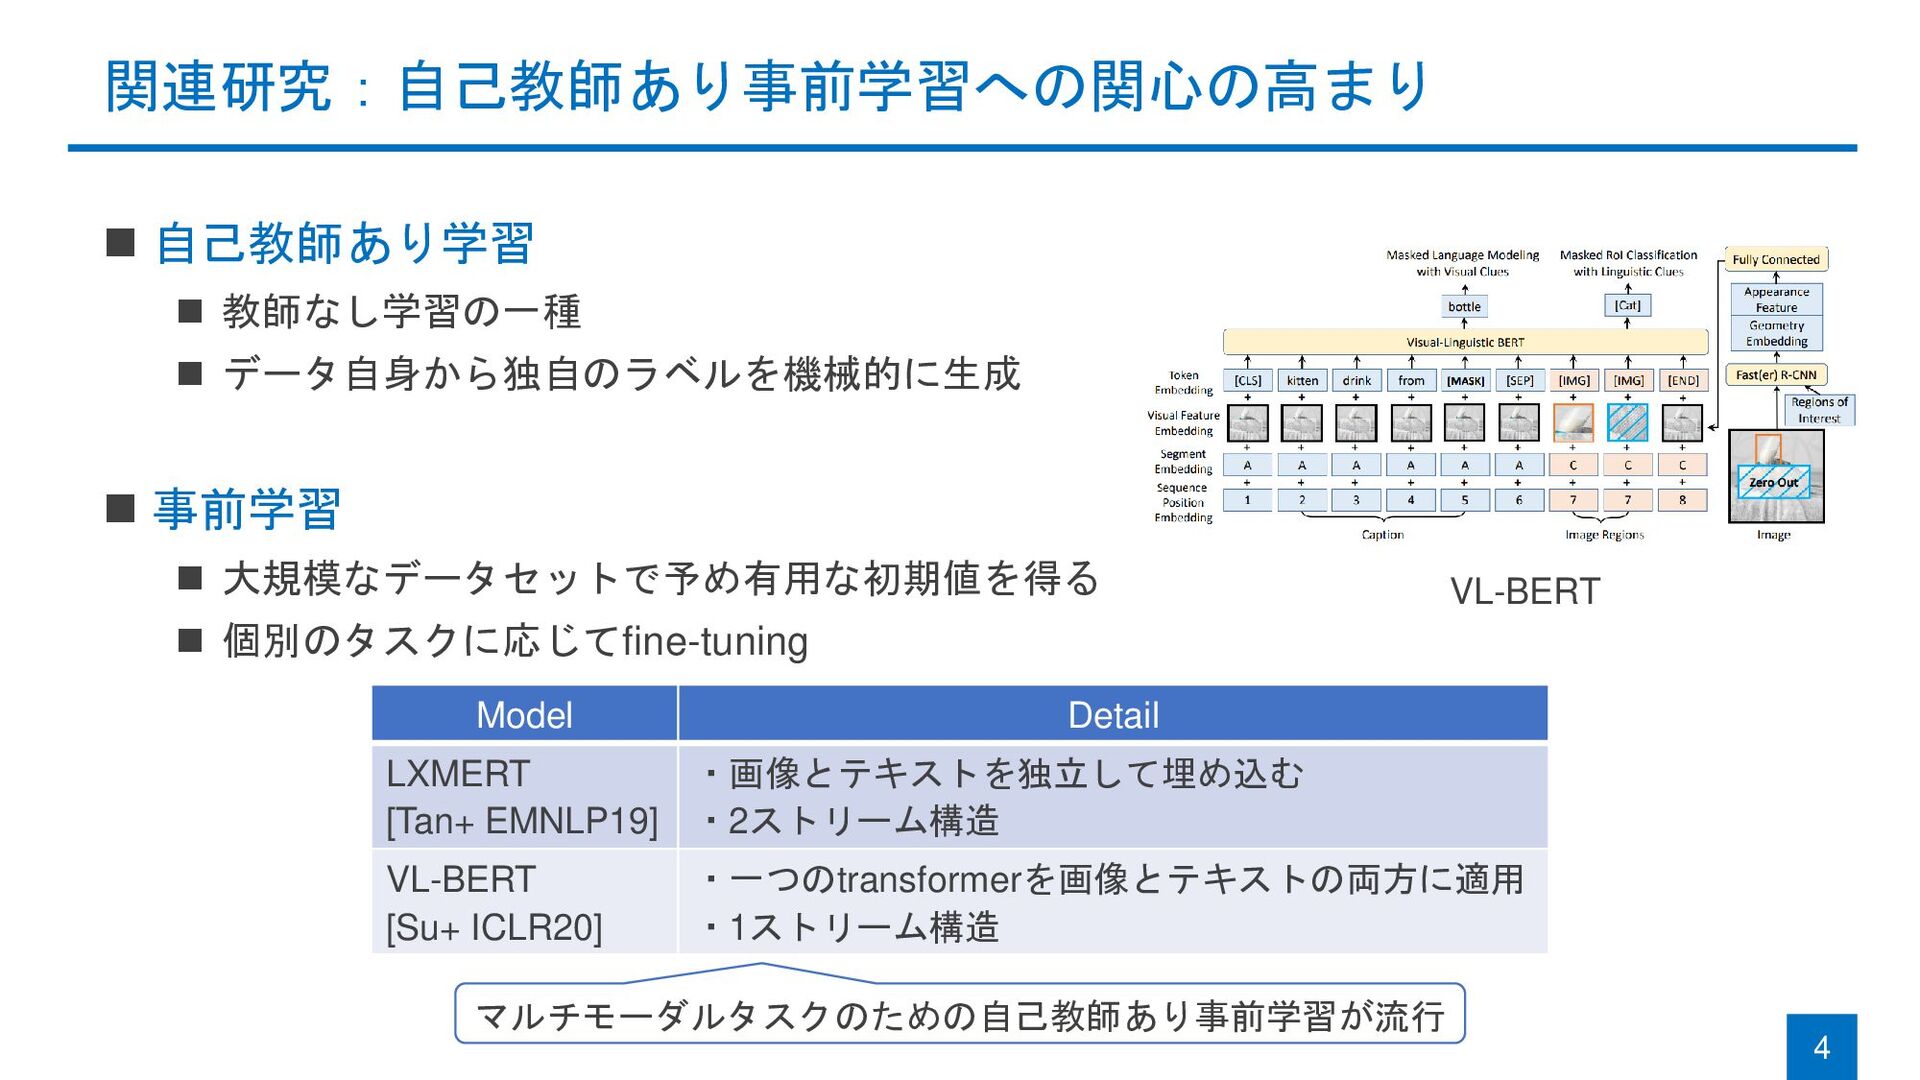
関連研究:自己教師あり事前学習への関心の高まり ◼ 自己教師あり学習 ◼ 教師なし学習の一種 ◼ データ自身から独自のラベルを機械的に生成 ◼ 事前学習 ◼
大規模なデータセットで予め有用な初期値を得る ◼ 個別のタスクに応じてfine-tuning 4 Model Detail LXMERT [Tan+ EMNLP19] ・画像とテキストを独立して埋め込む ・2ストリーム構造 VL-BERT [Su+ ICLR20] ・一つのtransformerを画像とテキストの両方に適用 ・1ストリーム構造 マルチモーダルタスクのための自己教師あり事前学習が流行 VL-BERT
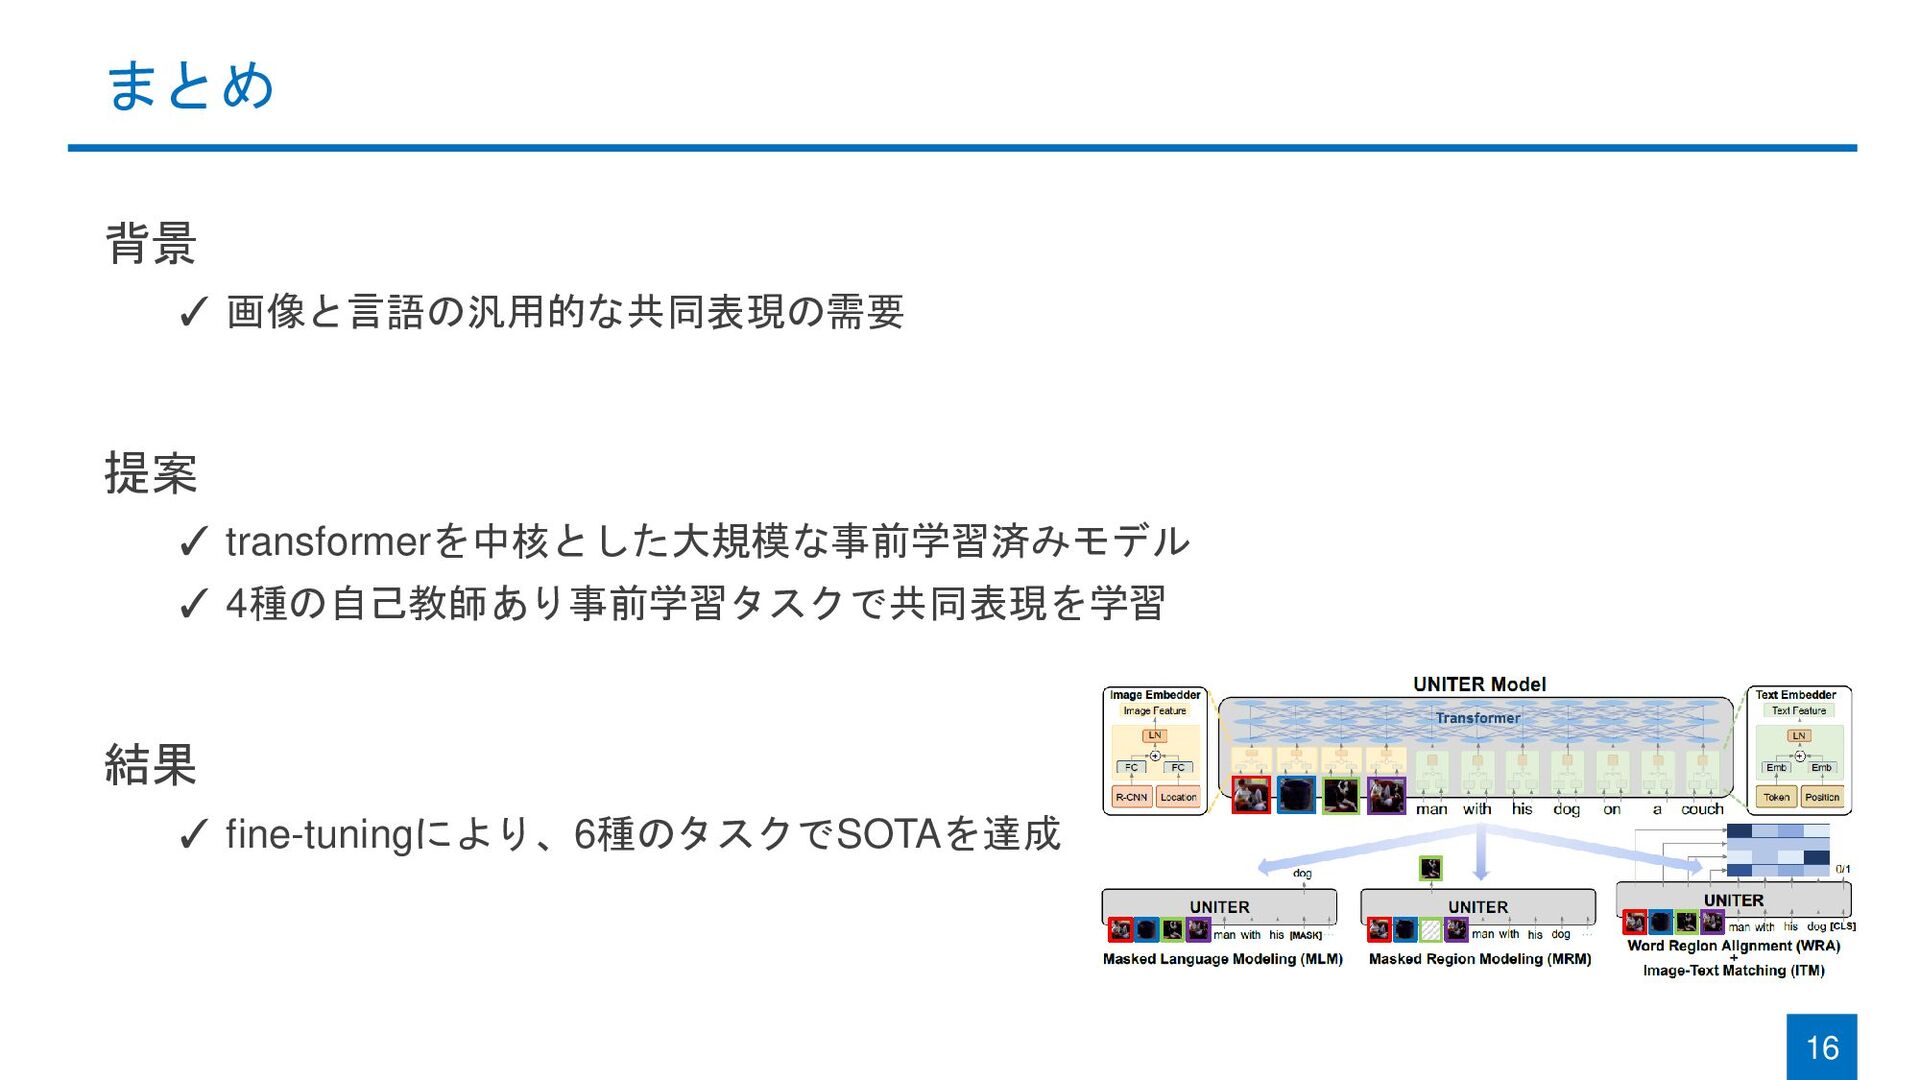
提案手法:UNITER (UNiversal Image-TExt Representation) ◼ transformer [Vaswani+ NeurIPS17] を中核とした事前学習済みモデル 1.
Image Embedder:画像特徴, 領域検出 2. Text Embedder:言語表現 3. Transformer:画像と言語の一般化可能な共同表現を学習 ◼ 4種の自己教師あり事前学習 1. Masked Language Modeling 2. Masked Region Modeling 3. Image-Text Matching 4. Word-Region Alignment 5
transformerへの入力:画像・テキストを埋め込み表現に変換 ◼ Image Embedder:Faster R-CNN [Ren+ NeurIPS15] で物体検出 ◼ 以下2つを「FC層
結合 正規化」で変換 1. 領域の特徴:ROI-pool特徴 2. 領域の位置:7次元ベクトル [𝑥1 , 𝑦1 , 𝑥2 , 𝑦2 , 𝑤, ℎ, 𝑤 × ℎ] ◼ Text Embedder:BERT [Devlin+ 18] と同様にWordPieceでトークン化 ◼ 以下2つを「結合 正規化」で変換 1. 単語埋め込み 2. 位置埋め込み 6
1. Masked Language Modeling (MLM):マスクされた単語を予測 ◼ 入力単語の15%に対して以下の処理 ◼ 80%:[MASK]に置換 ◼
10%:ランダムな単語に置換 ◼ 10%:そのまま ◼ 非マスク単語・画像領域から予測 ◼ 負の対数尤度を最小化 7 ℒMLM 𝜃 = −𝔼 𝐰,𝐯 ~𝐷 log 𝑃𝜃 (𝐰𝐦 |𝐰∖𝐦 , 𝐯) 𝐰𝐦 :マスクされた単語 𝐰∖𝐦 :それ以外の単語 𝐯 = {𝐯1 , … , 𝐯𝐾 }:画像領域 dog 例:[MASK]をdogと予測 MASKトークンに置換
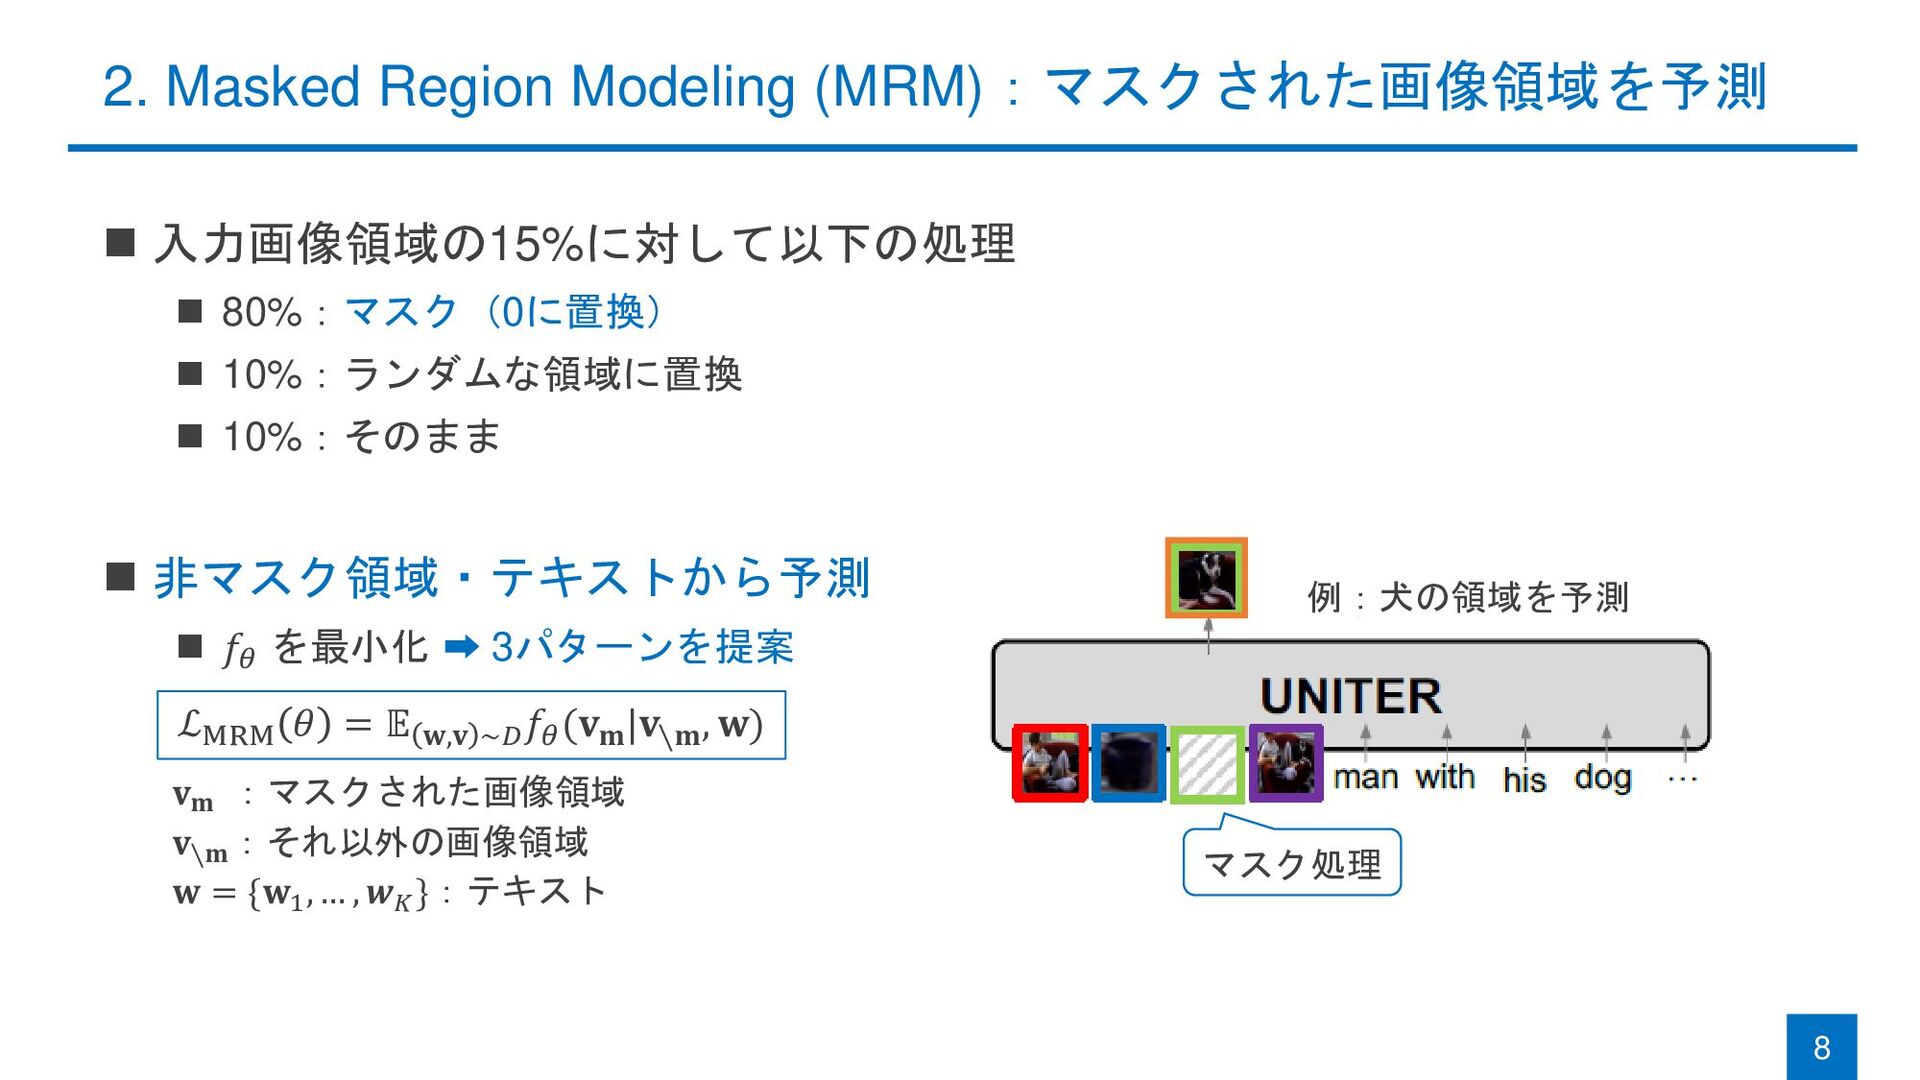
2. Masked Region Modeling (MRM):マスクされた画像領域を予測 ◼ 入力画像領域の15%に対して以下の処理 ◼ 80%:マスク(0に置換) ◼
10%:ランダムな領域に置換 ◼ 10%:そのまま ◼ 非マスク領域・テキストから予測 ◼ 𝑓𝜃 を最小化 3パターンを提案 8 ℒMRM 𝜃 = 𝔼 𝐰,𝐯 ~𝐷 𝑓𝜃 (𝐯𝐦 |𝐯∖𝐦 , 𝐰) マスク処理 例:犬の領域を予測 𝐯𝐦 :マスクされた画像領域 𝐯∖𝐦 :それ以外の画像領域 𝐰 = {𝐰1 , … , 𝒘𝐾 }:テキスト
2. 3パターンのMRM (1/2):マスク領域の特徴量へ回帰 ① Masked Region Feature Regression (MRFR) ◼
マスク領域に対するtransformerの出力 𝐯𝐦 (𝑖) をFC層で領域特徴 ℎ𝜃 𝐯𝐦 𝑖 へ変換 ◼ 領域特徴の正解 𝑟(𝐯𝐦 (𝑖)) はROI-pool特徴 ◼ L2回帰 9 𝑓𝜃 𝐯𝐦 𝐯∖𝐦 , 𝐰 = Σ𝑖=1 𝑀 ℎ𝜃 𝐯𝐦 𝑖 − 𝑟 𝐯𝐦 𝑖 2 2 Faster R-CNNの処理過程で得たもの
2. 3パターンの MRM (2/2):マスク領域のクラスへ分類 ② Masked Region Classification (MRC) ◼
𝐯𝐦 (𝑖) をFC層・softmax関数で領域のクラス予測分布 𝑔𝜃 𝐯𝐦 𝑖 へ変換 ◼ 「正解 𝑐 𝐯𝐦 𝑖 はFaster R-CNNの検出結果(one-hotベクトル)」と仮定 ◼ 両者の交差エントロピー誤差(CE)を算出 ③ Masked Region Classification with KL-Divergence (MRC-kl) ◼ ②の仮定は領域に真の正解ラベルが存在しないことに反するため、一部を変更 ◼ one-hotベクトル 𝑐 𝐯𝐦 𝑖 予測確率分布 ǁ 𝑐 𝐯𝐦 𝑖 ◼ 交差エントロピー誤差 KLダイバージェンス 10 𝑓𝜃 𝐯𝐦 𝐯∖𝐦 , 𝐰 = Σ𝑖=1 𝑀 CE 𝑐 𝐯𝐦 𝑖 , 𝑔𝜃 𝐯𝐦 𝑖 𝑓𝜃 𝐯𝐦 𝐯∖𝐦 , 𝐰 = Σ𝑖=1 𝑀 𝐷𝐾𝐿 ǁ 𝑐 𝐯𝐦 𝑖 ‖ 𝑔𝜃 𝐯𝐦 𝑖
MLM, MRM における工夫:画像・言語の片方だけマスク 11 従来:Joint Random Masking ◼ 対応する画像領域と単語が同時にマスクされる可能性 共同表現の学習に悪影響
提案:Conditional Masking ◼ 画像領域か単語のどちらかが観測できる条件下でのみ、もう一方をマスク処理
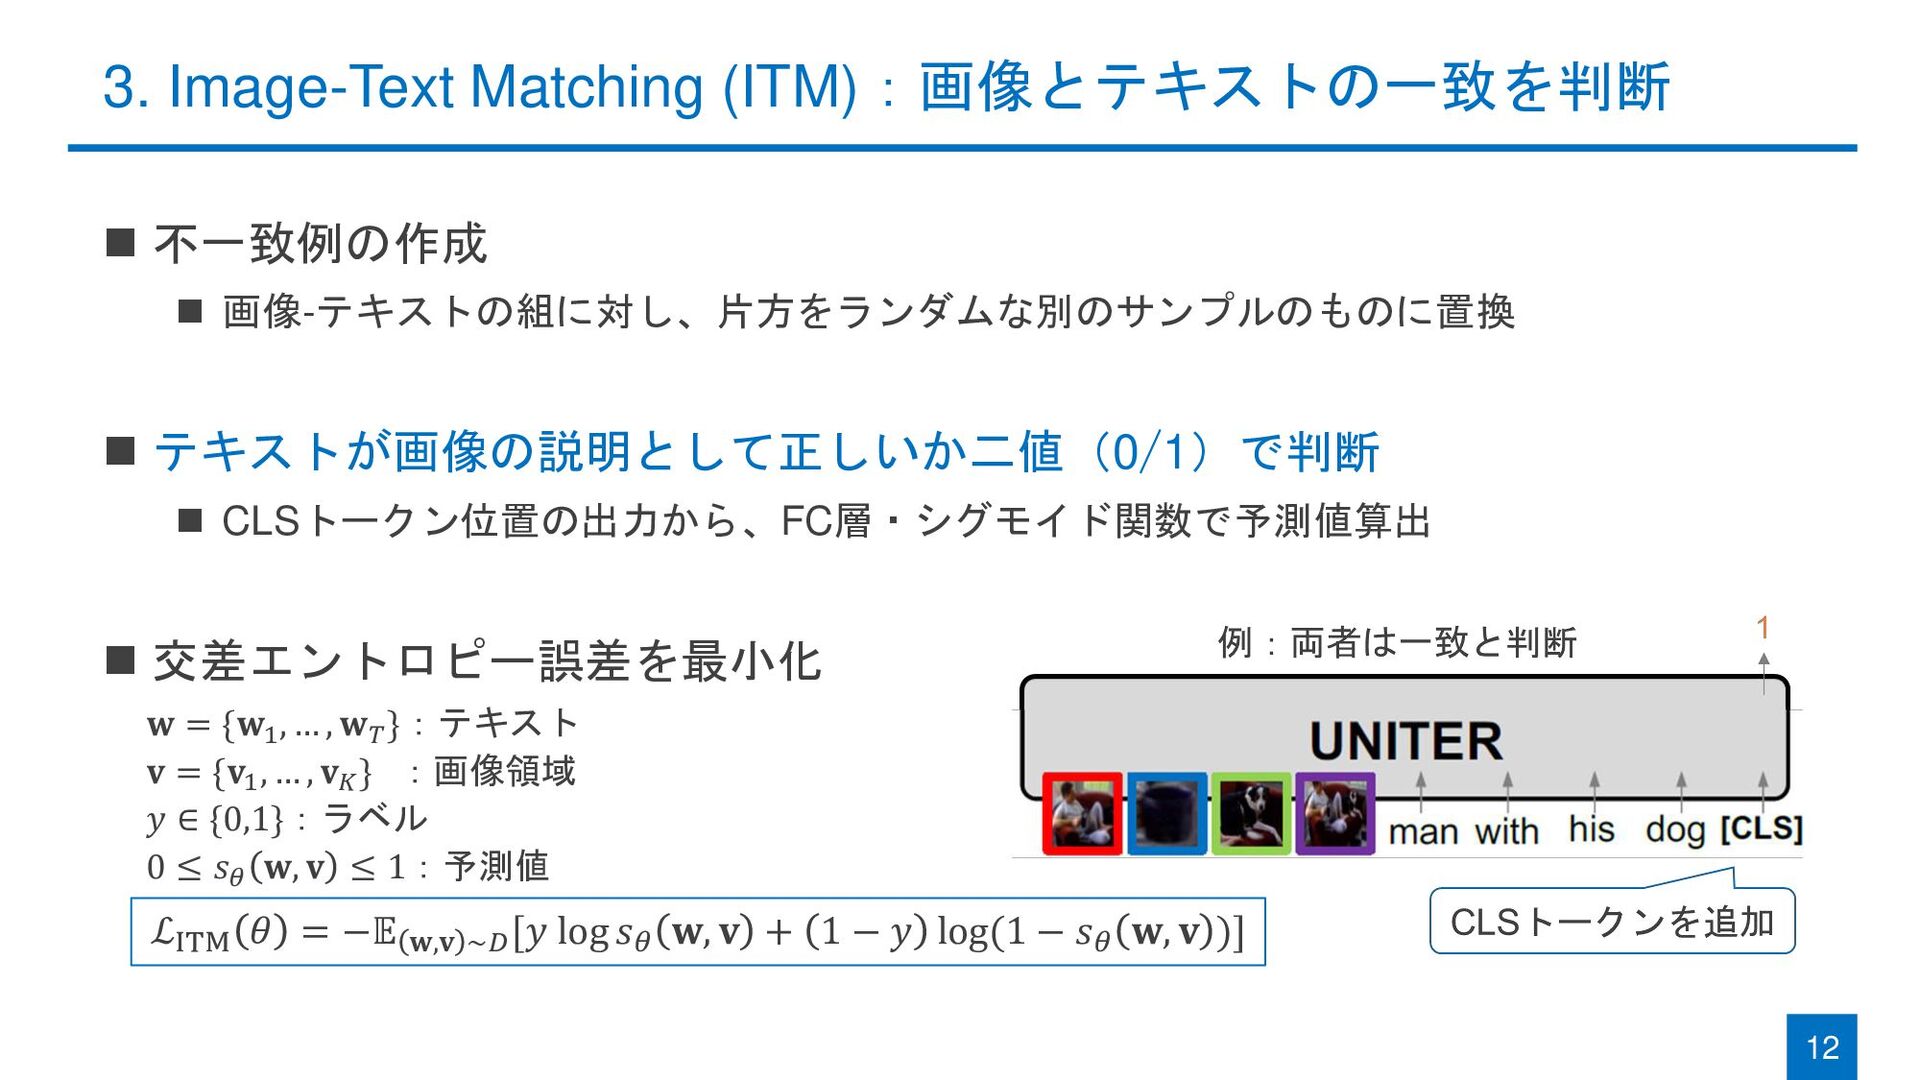
◼ 不一致例の作成 ◼ 画像-テキストの組に対し、片方をランダムな別のサンプルのものに置換 ◼ テキストが画像の説明として正しいか二値(0/1)で判断 ◼ CLSトークン位置の出力から、FC層・シグモイド関数で予測値算出 ◼ 交差エントロピー誤差を最小化
3. Image-Text Matching (ITM):画像とテキストの一致を判断 12 ℒITM 𝜃 = −𝔼 𝐰,𝐯 ~𝐷 [𝑦 log 𝑠𝜃 𝐰, 𝐯 + 1 − 𝑦 log(1 − 𝑠𝜃 𝐰, 𝐯 )] 𝐰 = {𝐰1 , … , 𝐰𝑇 }:テキスト 𝐯 = {𝐯1 , … , 𝐯𝐾 } :画像領域 𝑦 ∈ {0,1}:ラベル 0 ≤ 𝑠𝜃 𝐰, 𝐯 ≤ 1:予測値
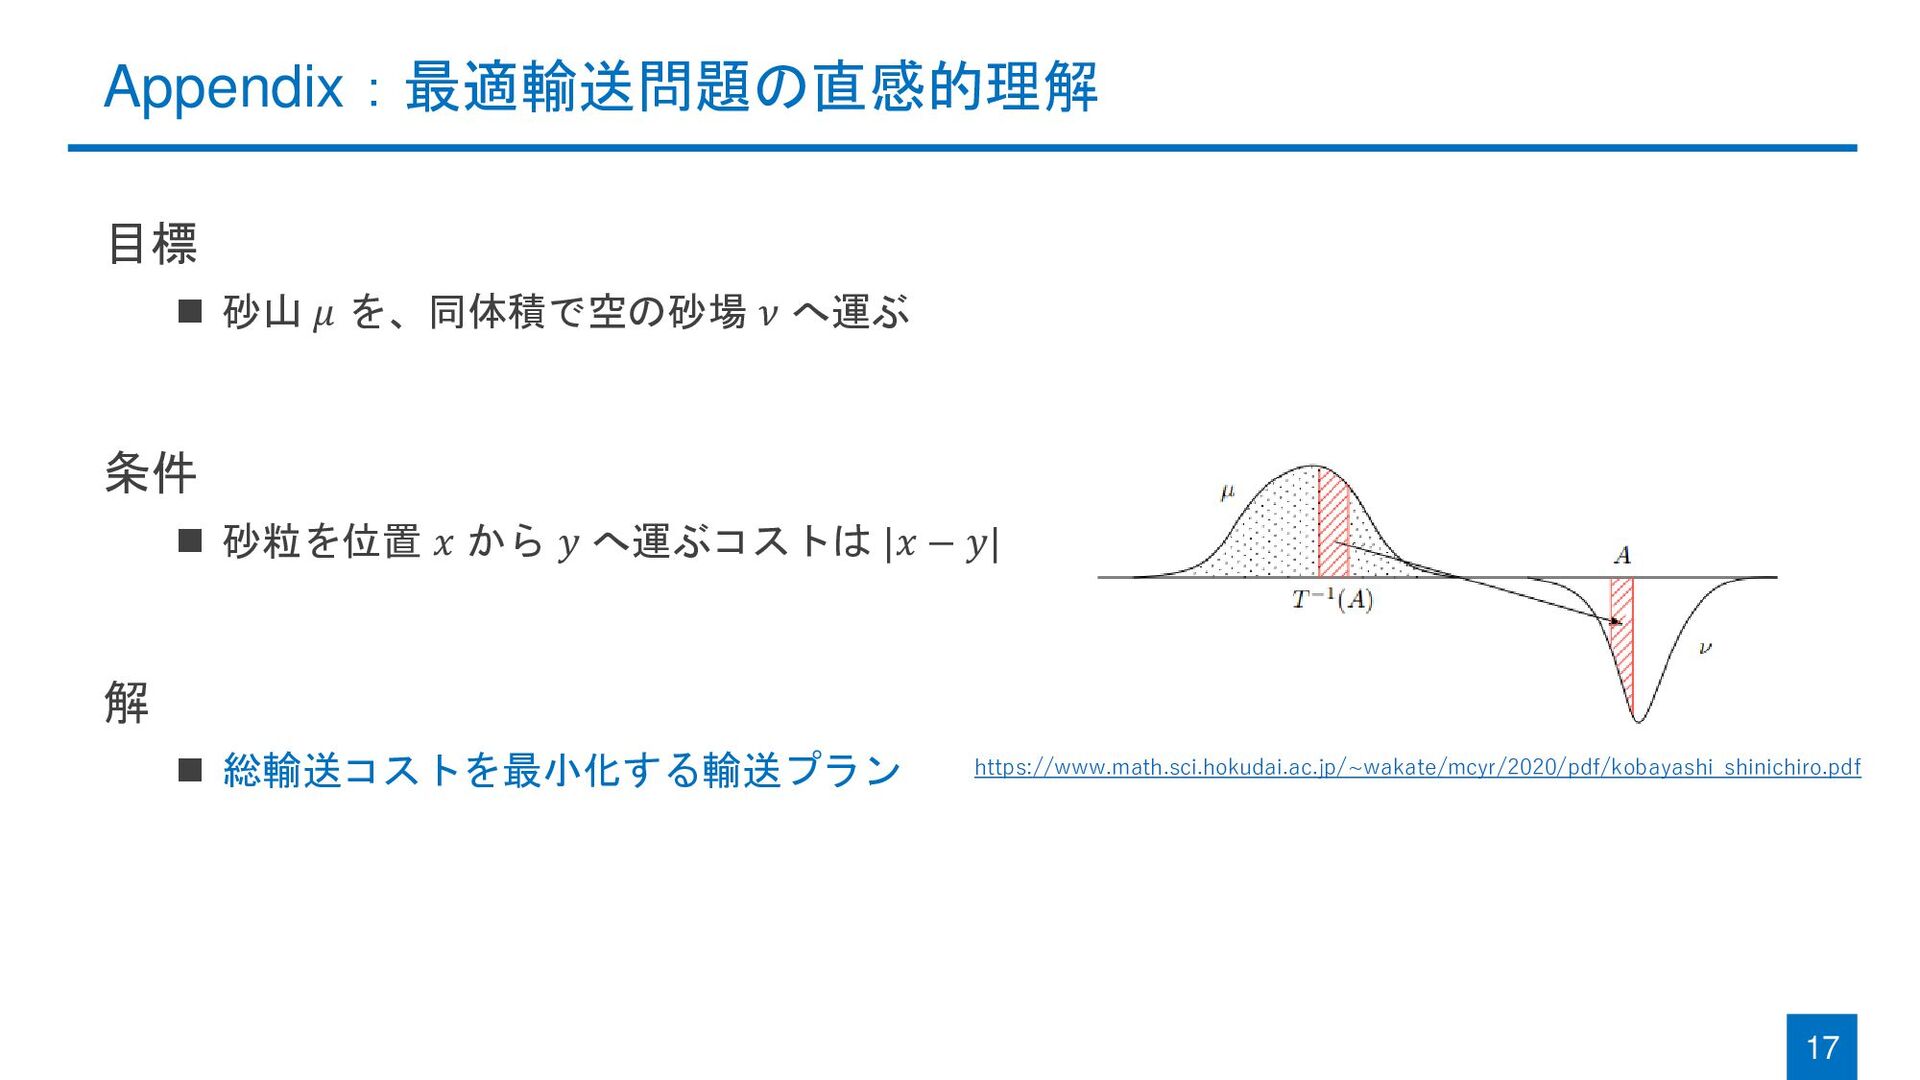
◼ 画像領域と単語の対応度合いを学習 ◼ それぞれ分布 𝝁, 𝝂 とみなし、最適輸送問題(OT [Monge 1781] )に落とし込む
◼ 総輸送コストを最小化 4. Word-Region Alignment (WRA):画像とテキストのマッチング最適化 13 ℒWRA 𝜃 = 𝒟𝑜𝑡 (𝝁, 𝝂) = min 𝐓∈𝛱(𝒂,𝒃) Σ𝑖=1 𝑇 Σ𝑗=1 𝐾 𝐓𝑖𝑗 ⋅ 𝑐(𝐰𝑖 , 𝐯𝑗 ) 𝐓 ∈ ℝ𝑇×𝐾:OTの解(最適輸送プラン) 𝑐(𝐰𝑖 , 𝐯𝑗 ) :コサイン類似度
◼ 4種の大規模データセットで事前学習 ◼ COCO, Visual Genome, Conceptual Captions, SBU Captions
◼ 6種のタスクに応じてfine-tuning ◼ UNITER-largeモデルは、 全てのベンチマークで他に勝る ◼ Base:12層 / Large:24層 定量的結果:6種のV&LタスクでSOTAを達成 14 ① ② ③ ④ ⑤ ⑥
Ablation Study:全ての事前学習タスクが有効 ◼ 4種のタスクで「事前学習タスク」について評価 ◼ 考察 ✓ 全事前学習タスクが有効 ✓ MRM3種の内では、
MRC-klが最も優位 ✓ Conditional Maskingも 精度向上に寄与 15 全タスクの総和
まとめ 16 背景 ✓ 画像と言語の汎用的な共同表現の需要 提案 ✓ transformerを中核とした大規模な事前学習済みモデル ✓ 4種の自己教師あり事前学習タスクで共同表現を学習
結果 ✓ fine-tuningにより、6種のタスクでSOTAを達成
Appendix:最適輸送問題の直感的理解 17 https://www.math.sci.hokudai.ac.jp/~wakate/mcyr/2020/pdf/kobayashi_shinichiro.pdf 目標 ◼ 砂山 𝜇 を、同体積で空の砂場 𝜈 へ運ぶ
条件 ◼ 砂粒を位置 𝑥 から 𝑦 へ運ぶコストは |𝑥 − 𝑦| 解 ◼ 総輸送コストを最小化する輸送プラン
Appendix:SOTAを達成した6種のV&Lタスク (1/3) ① Visual Question Answering (VQA) - 画像 +
それに対する質問 → 質問の答え ② Visual Commonsense Reasoning (VCR) - 画像 + それに対する質問 → 質問の答え + 根拠 18 https://openaccess.thecvf.com/content_CVPR_2019/papers/Zellers_From_Recognition_to_Cognition_Visual_Commonsense_Reasoning_CVPR_2019_paper.pdf 入力 → 出力
Appendix:SOTAを達成した6種のV&Lタスク (2/3) ③ Natural Language for Visual Reasoning for Real
2 (NLVR2) - 画像のペア + 説明文 → 説明文が正しいかどうか ④ Visual Entailment (SNLI-VE) - 画像 + 説明文 → 画像が説明文を含意しているか3段階評価 19 https://lil.nlp.cornell.edu/nlvr/NLVR2BiasAnalysis.html 入力 → 出力
Appendix:SOTAを達成した6種のV&Lタスク (3/3) ⑤ Image-Text Retrieval (IR, TR) - クエリテキスト →
ターゲット画像 - クエリ画像 → ターゲットテキスト ⑥ Referring Expression Comprehension - 参照表現 + 画像領域候補 → 指し示す画像領域 20 入力 → 出力


 keio_smilab
 minorun365
 goccy
 genda
 nakamuuu
 cielo1985
 civitaspo
 matsu7874
 ota1022
 i35_267
 budougumi0617
 iamctodd
 mkilby
 chriscoyier
 sachag
 danielanewman
 codingconduct
 rocio
 rmw
 maggiecrowley
 konakalab
 sonatard
 garrettdimon