Share
Embed
[JSAI22] Instruction Comprehension Based on Funnel UNITER for Object Manipulation Tasks by Domestic Service Robots
Semantic Machine Intelligence Lab., Keio Univ. PRO
June 12, 2022
Transcript
28 slides
-
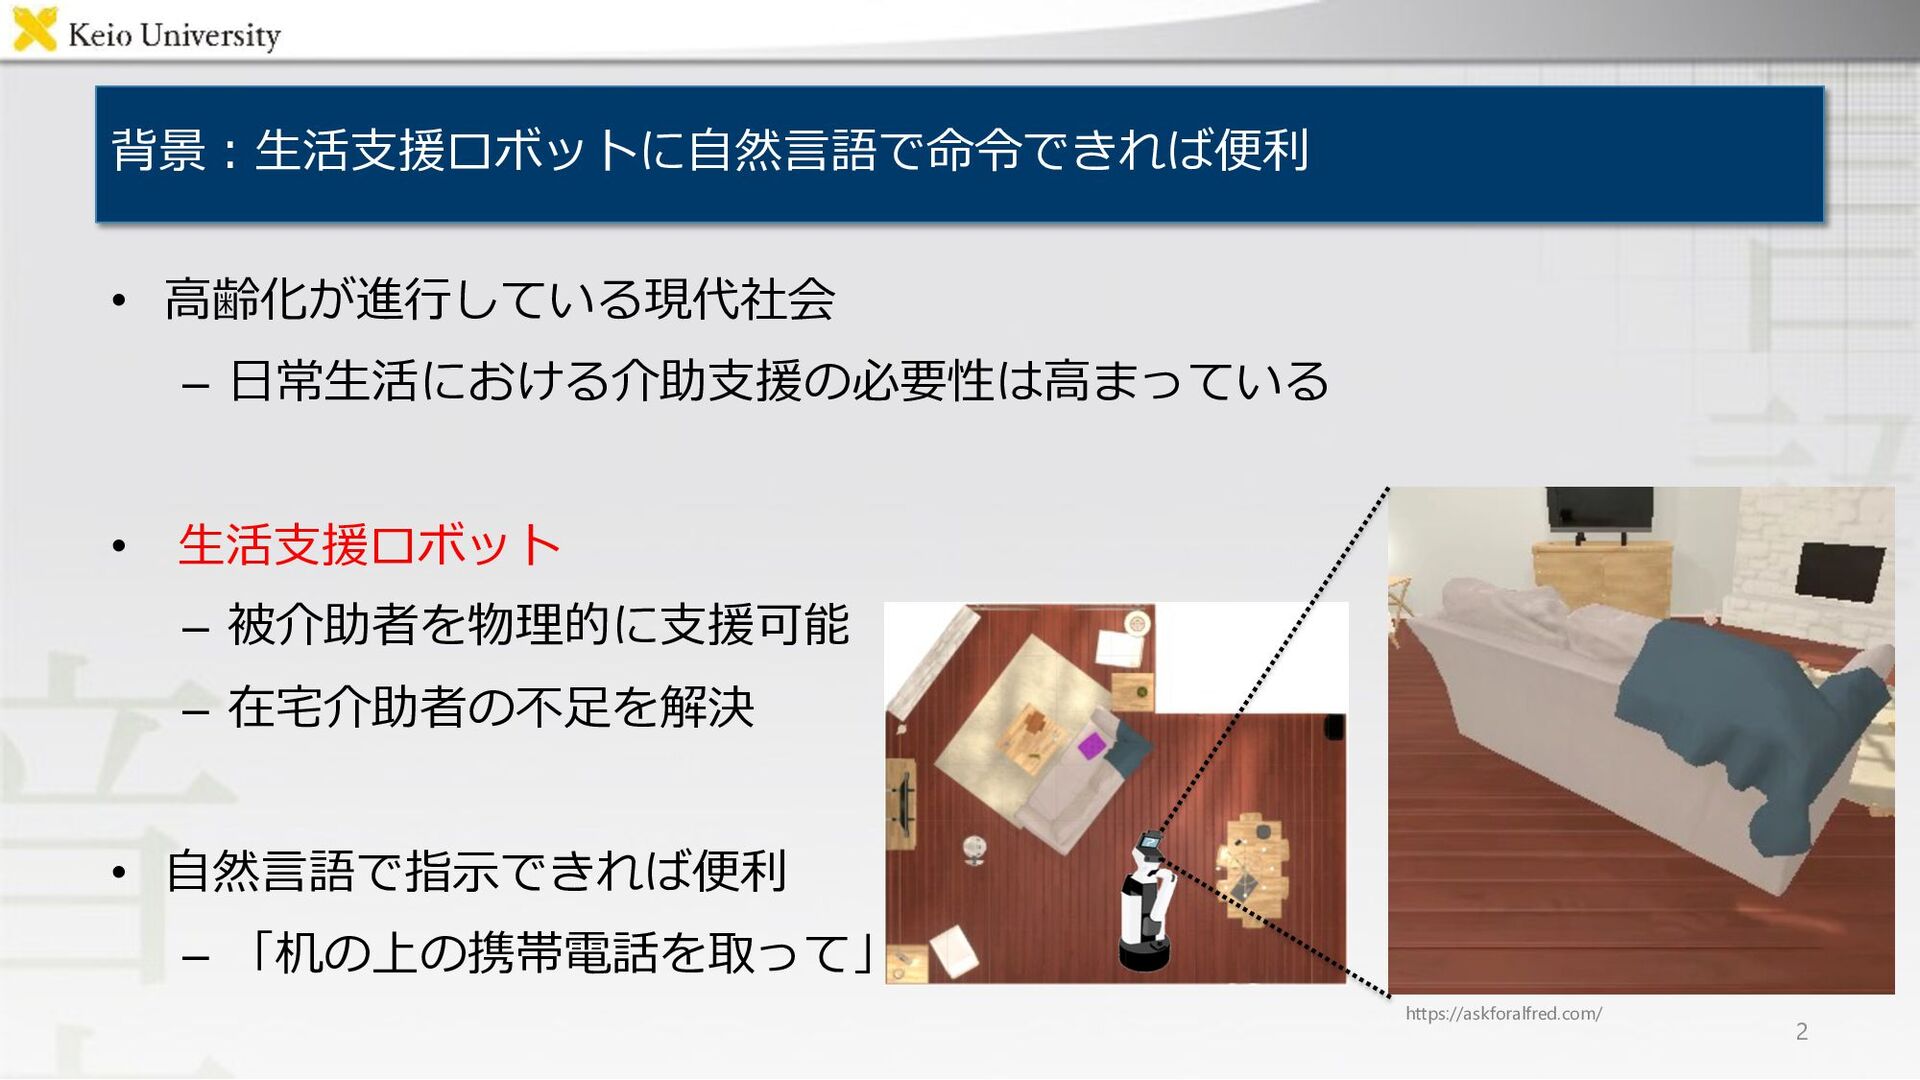
背景︓⽣活⽀援ロボットに⾃然⾔語で命令できれば便利 • ⾼齢化が進⾏している現代社会 – ⽇常⽣活における介助⽀援の必要性は⾼まっている • ⽣活⽀援ロボット – 被介助者を物理的に⽀援可能 –
在宅介助者の不⾜を解決 • ⾃然⾔語で指⽰できれば便利 – 「机の上の携帯電話を取って」 2 https://askforalfred.com/ -
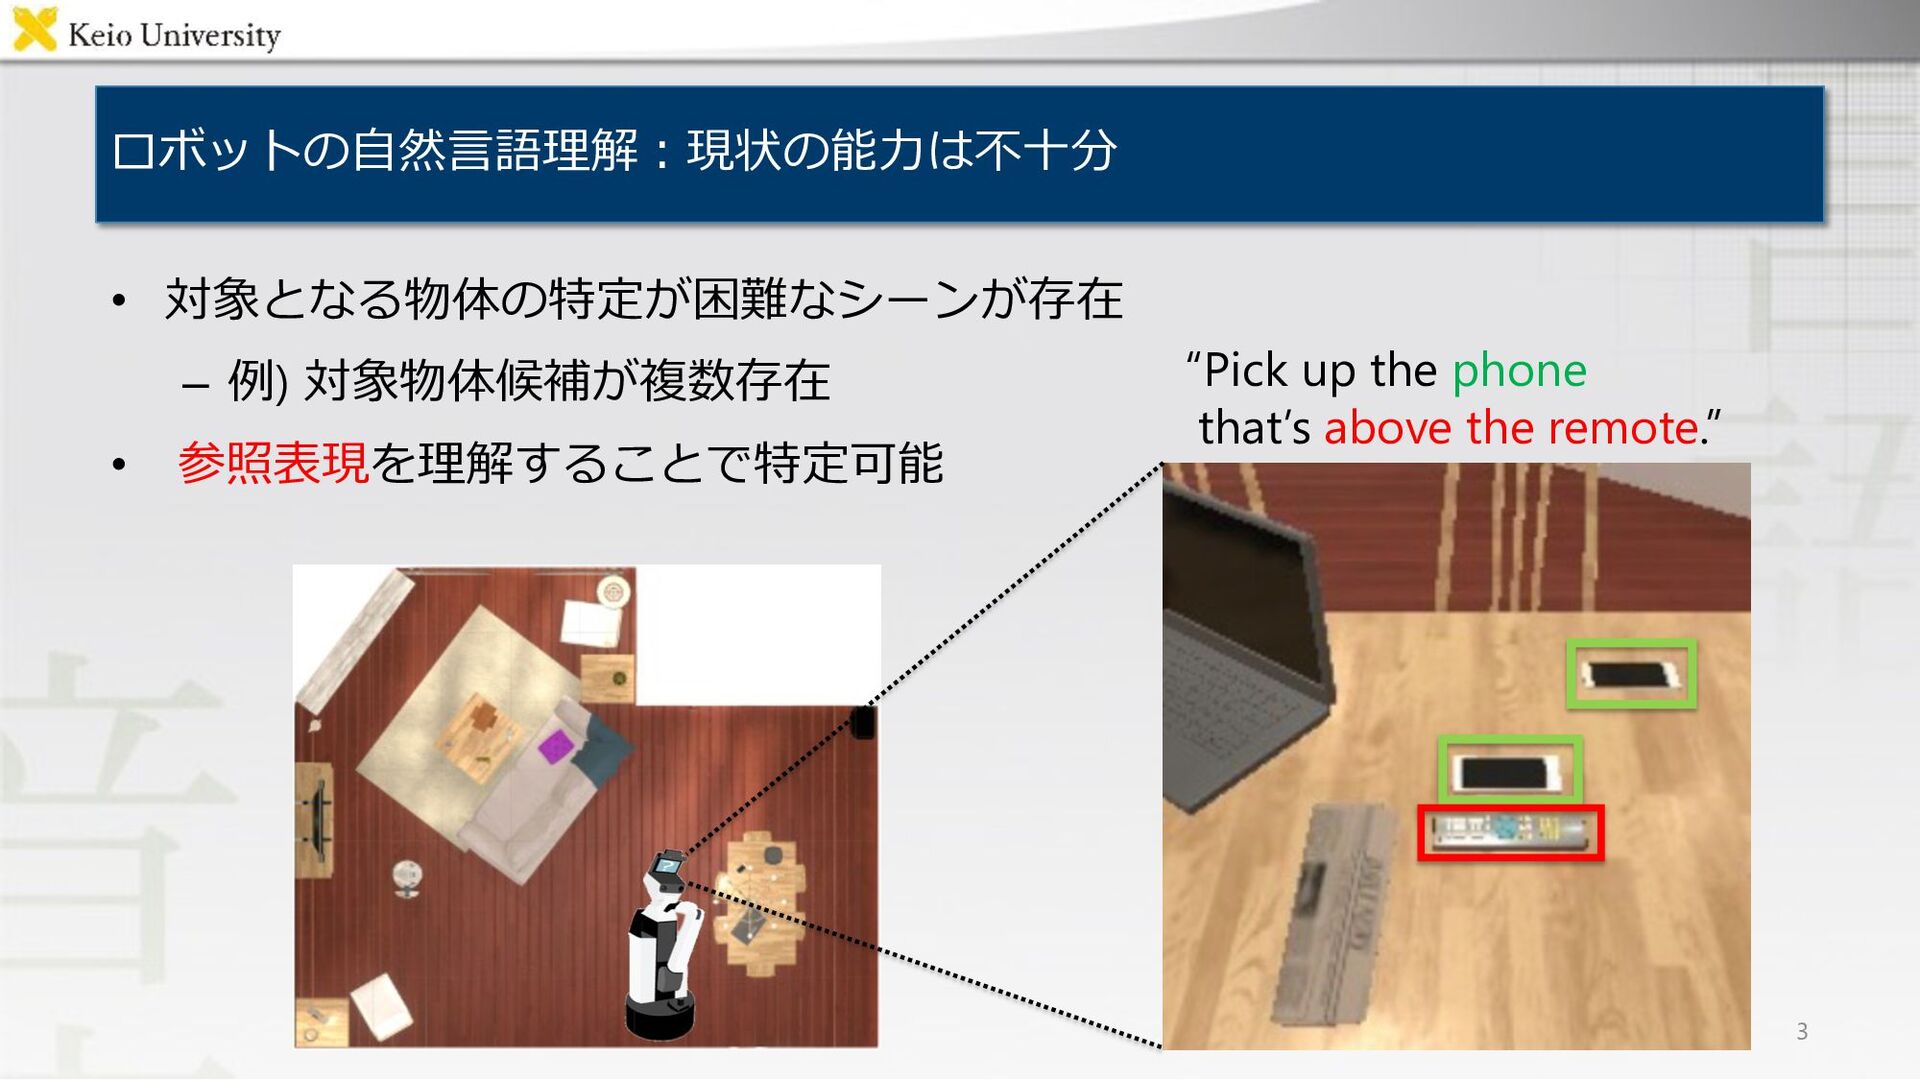
ロボットの⾃然⾔語理解︓現状の能⼒は不⼗分 • 対象となる物体の特定が困難なシーンが存在 – 例) 対象物体候補が複数存在 • 参照表現を理解することで特定可能 3 “Pick
up the phone that’s above the remote.” -
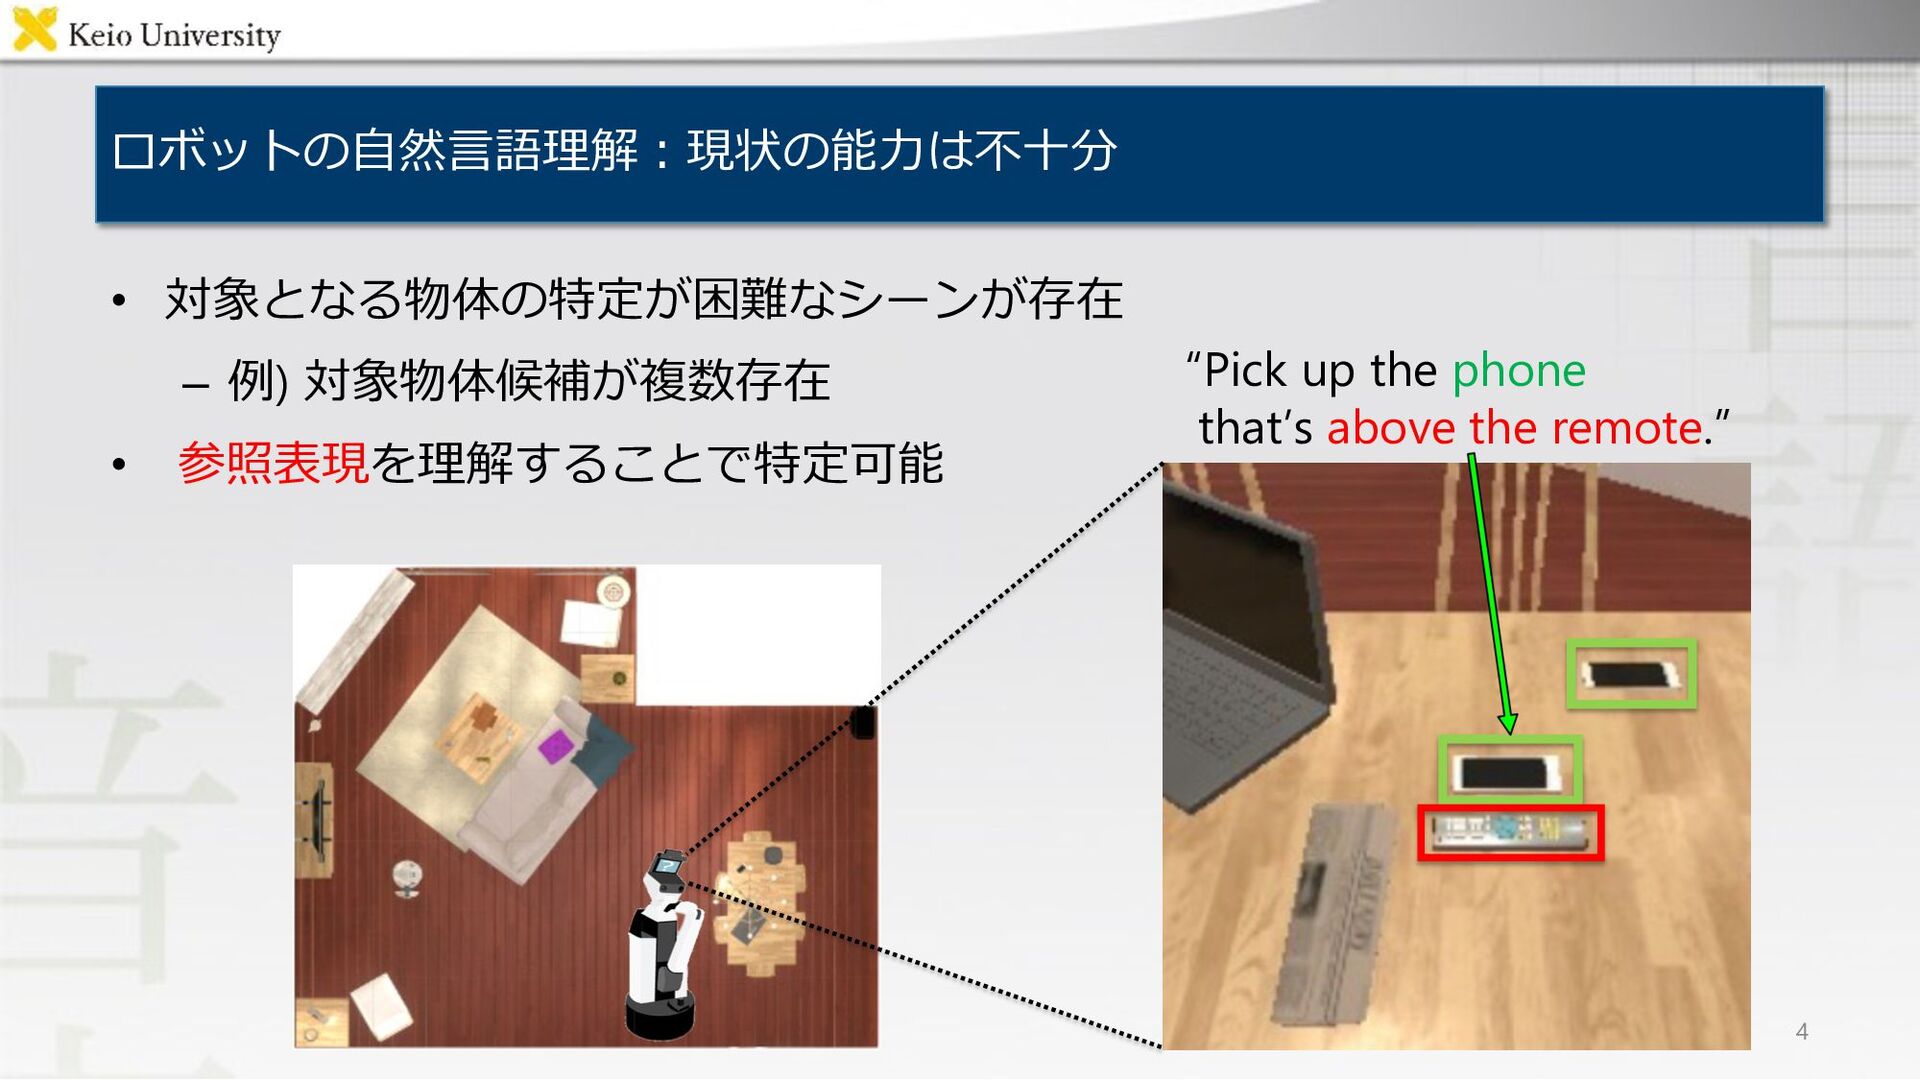
ロボットの⾃然⾔語理解︓現状の能⼒は不⼗分 • 対象となる物体の特定が困難なシーンが存在 – 例) 対象物体候補が複数存在 • 参照表現を理解することで特定可能 4 “Pick
up the phone that’s above the remote.” -
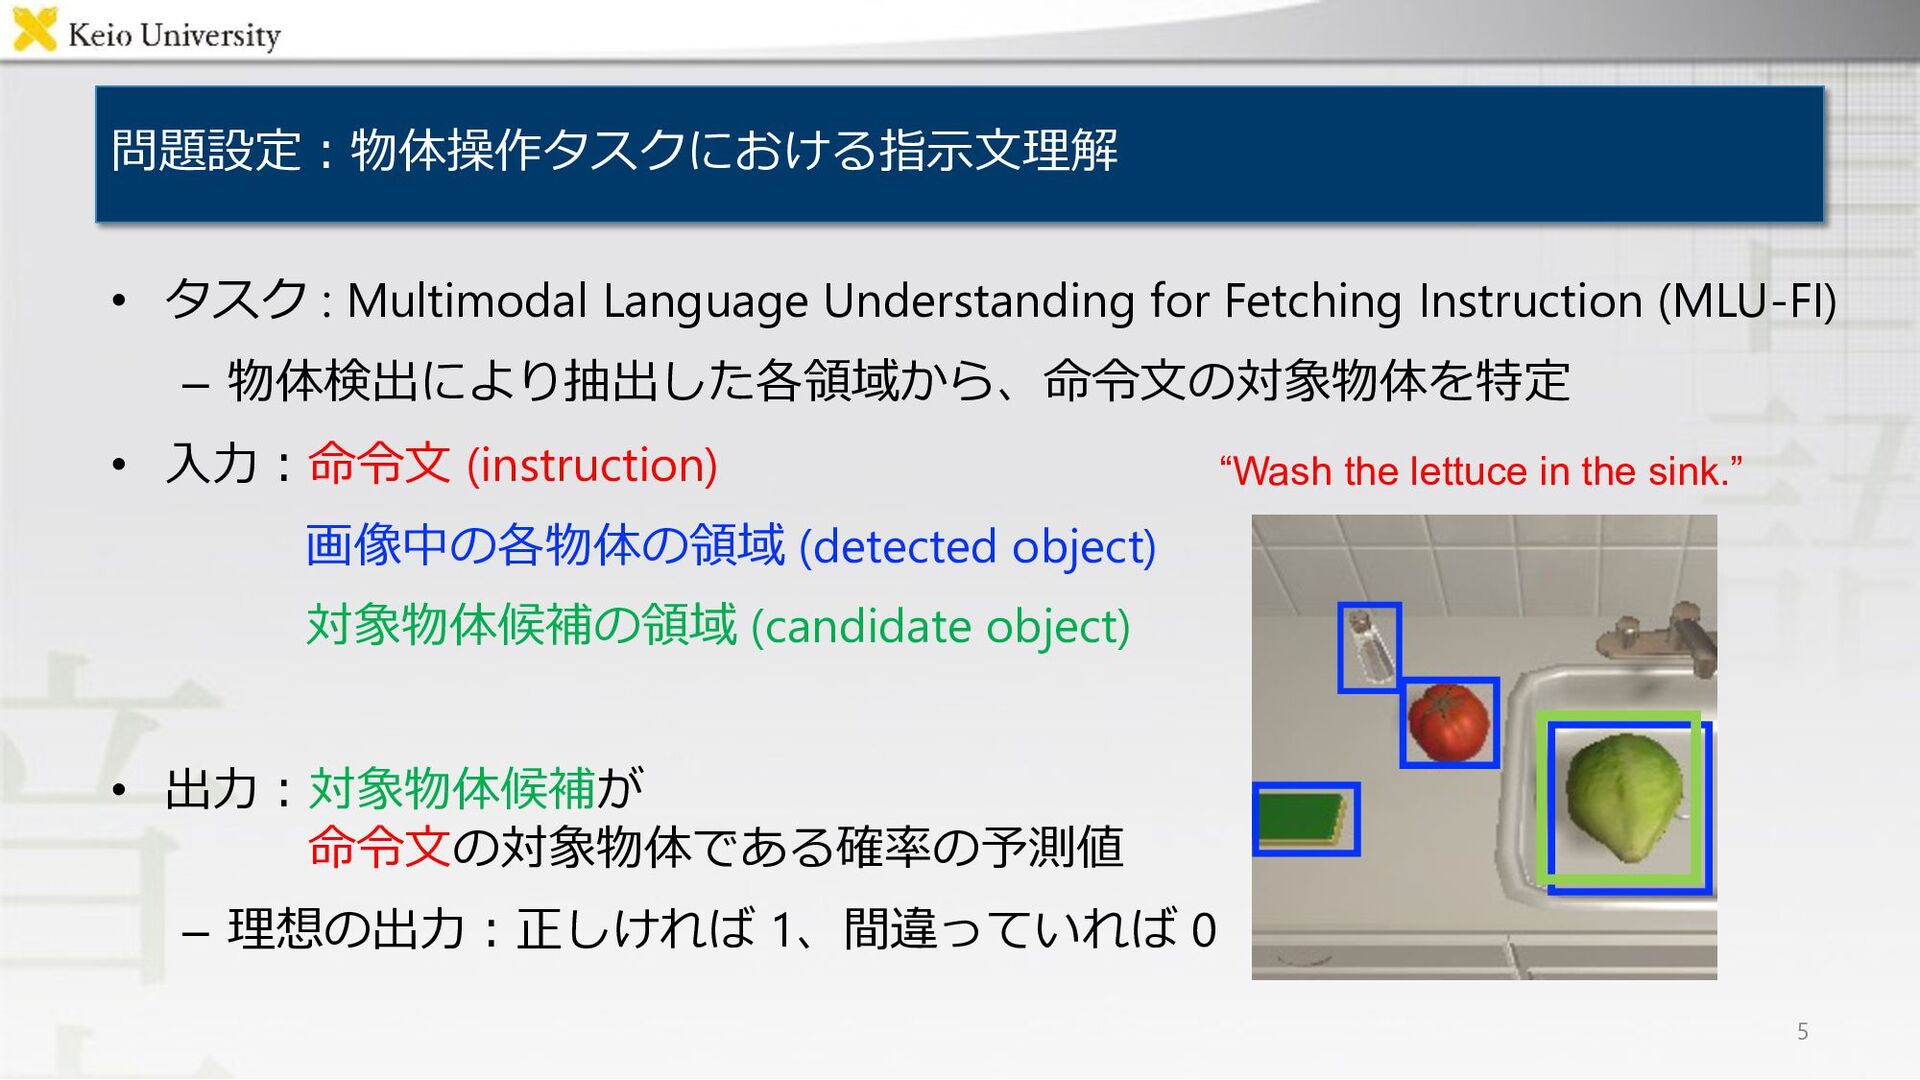
問題設定︓物体操作タスクにおける指⽰⽂理解 • タスク : Multimodal Language Understanding for Fetching Instruction
(MLU-FI) – 物体検出により抽出した各領域から、命令⽂の対象物体を特定 • ⼊⼒︓命令⽂ (instruction) 画像中の各物体の領域 (detected object) 対象物体候補の領域 (candidate object) • 出⼒︓対象物体候補が 命令⽂の対象物体である確率の予測値 – 理想の出⼒︓正しければ 1、間違っていれば 0 5 “Wash the lettuce in the sink.” -
関連研究 (1/2)︓既存⼿法は計算コストが⾼く,精度が不⼗分 • 6 MLU-FI model 概要 MTCM [Magassouba+, IROS19]
命令⽂と全体画像を⼊⼒とし、対象物体を特定 Target-dependent UNITER [Ishikawa+, IROS21] 対象物体候補を扱う新規構造を導⼊ UNITER [Chen+, ECCV20]型注意機構を使⽤ Target-dependent UNITER [Ishikawa+, IROS21] -
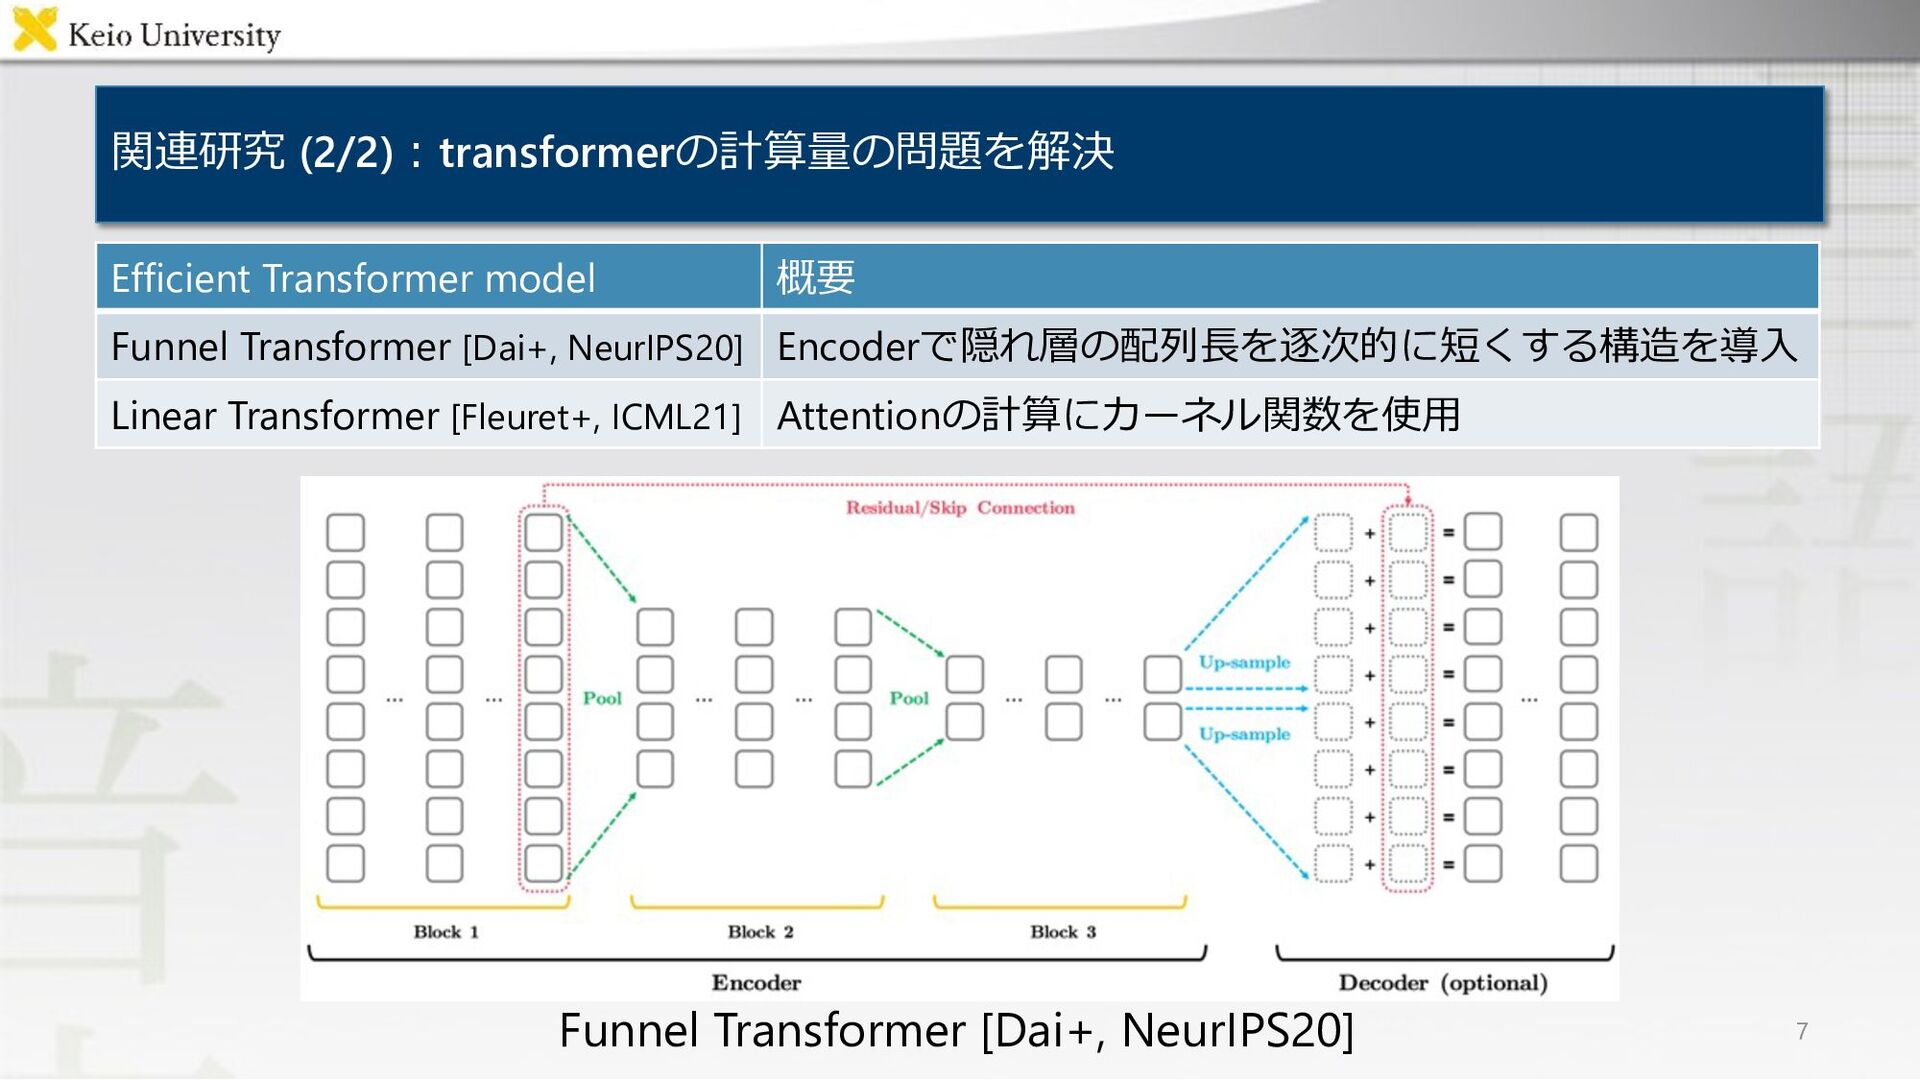
関連研究 (2/2)︓transformerの計算量の問題を解決 • 7 Efficient Transformer model 概要 Funnel Transformer
[Dai+, NeurIPS20] Encoderで隠れ層の配列⻑を逐次的に短くする構造を導⼊ Linear Transformer [Fleuret+, ICML21] Attentionの計算にカーネル関数を使⽤ Funnel Transformer [Dai+, NeurIPS20] -
Image Embedder︓画像の埋め込み処理を実⾏ • 𝑥!"#$ , 𝑥$%& ︓Faster R-CNN [Ren+, PAMI16]より抽出した領域の特徴量
• 特徴量はbackboneの ResNet101[He+, CVPR16] のfc7層の出⼒から抽出 • 𝑥!"#$'(! , 𝑥$%&'(! ︓領域の位置に関する特徴量 9 -
Image Embedder︓画像の埋め込み処理を実⾏ • 𝑥!"#$ , 𝑥$%& ︓Faster R-CNN [Ren+, PAMI16]より抽出した領域の特徴量
• 特徴量はbackboneの ResNet101[He+, CVPR16] のfc7層の出⼒から抽出 • 𝑥!"#$'(! , 𝑥$%&'(! ︓領域の位置に関する特徴量 𝑓)* ︓全結合層 𝑓+, ︓Layer Normalization ① 𝒉- !"#$ = 𝑓+,(𝑓)*(𝑥!"#$), 𝑓)*(𝑥!"#$'(!)) ② 𝒉- $%& = 𝑓+,(𝑓)*(𝑥$%&), 𝑓)*(𝑥$%&'(!)) ③ 𝒉- ./0%/1 = {𝒉- !"#$, 𝒉- $%&} 10 -
Image Embedder︓画像の埋め込み処理を実⾏ • 𝑥!"#$ , 𝑥$%& ︓Faster R-CNN [Ren+, PAMI16]より抽出した領域の特徴量
• 特徴量はbackboneの ResNet101[He+, CVPR16] のfc7層の出⼒から抽出 • 𝑥!"#$'(! , 𝑥$%&'(! ︓領域の位置に関する特徴量 𝑓)* ︓全結合層 𝑓+, ︓Layer Normalization ① 𝒉- !"#$ = 𝑓+,(𝑓)*(𝑥!"#$), 𝑓)*(𝑥!"#$'(!)) ② 𝒉- $%& = 𝑓+,(𝑓)*(𝑥$%&), 𝑓)*(𝑥$%&'(!)) ③ 𝒉- ./0%/1 = {𝒉- !"#$, 𝒉- $%&} 11 -
Image Embedder︓画像の埋め込み処理を実⾏ • 𝑥!"#$ , 𝑥$%& ︓Faster R-CNN [Ren+, PAMI16]より抽出した領域の特徴量
• 特徴量はbackboneの ResNet101[He+, CVPR16] のfc7層の出⼒から抽出 • 𝑥!"#$'(! , 𝑥$%&'(! ︓領域の位置に関する特徴量 𝑓)* ︓全結合層 𝑓+, ︓Layer Normalization ① 𝒉- !"#$ = 𝑓+,(𝑓)*(𝑥!"#$), 𝑓)*(𝑥!"#$'(!)) ② 𝒉- $%& = 𝑓+,(𝑓)*(𝑥$%&), 𝑓)*(𝑥$%&'(!)) ③ 𝒉- ./0%/1 = {𝒉- !"#$ , 𝒉- $%& } 12 -
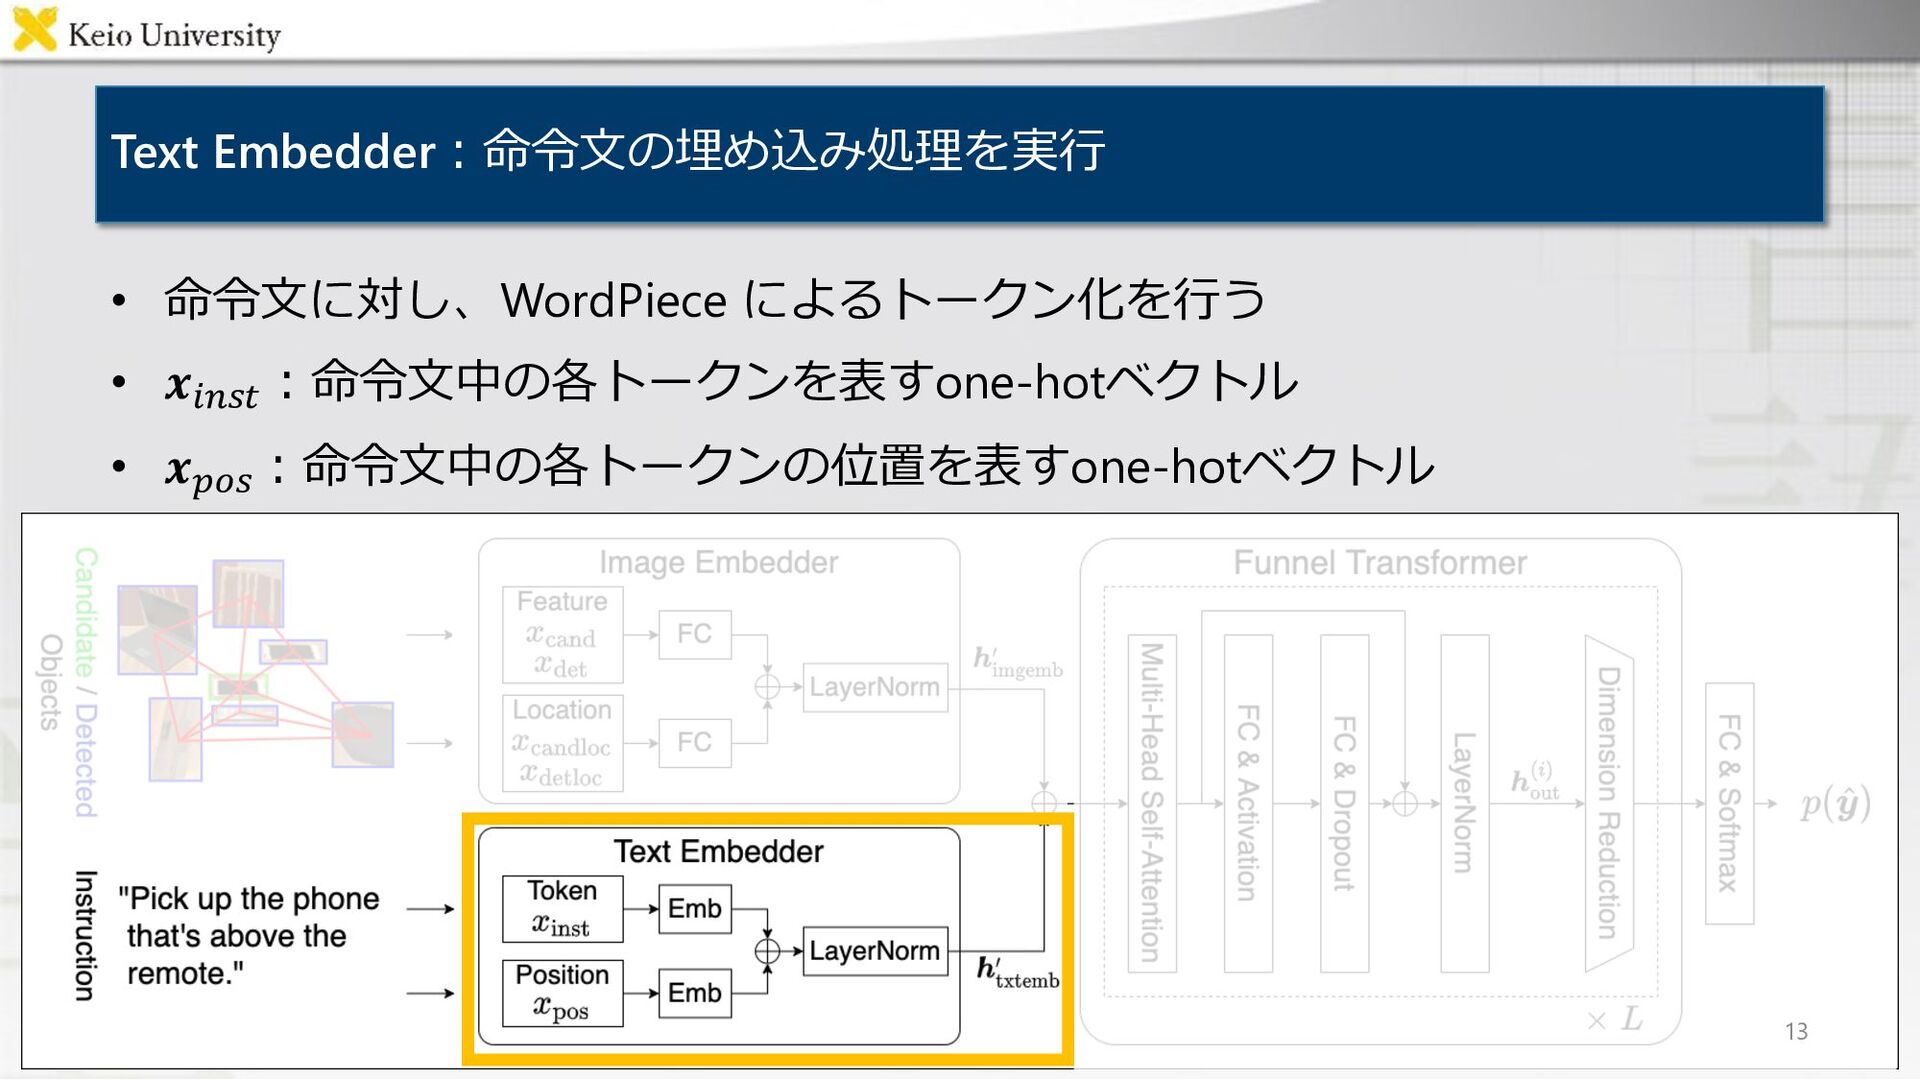
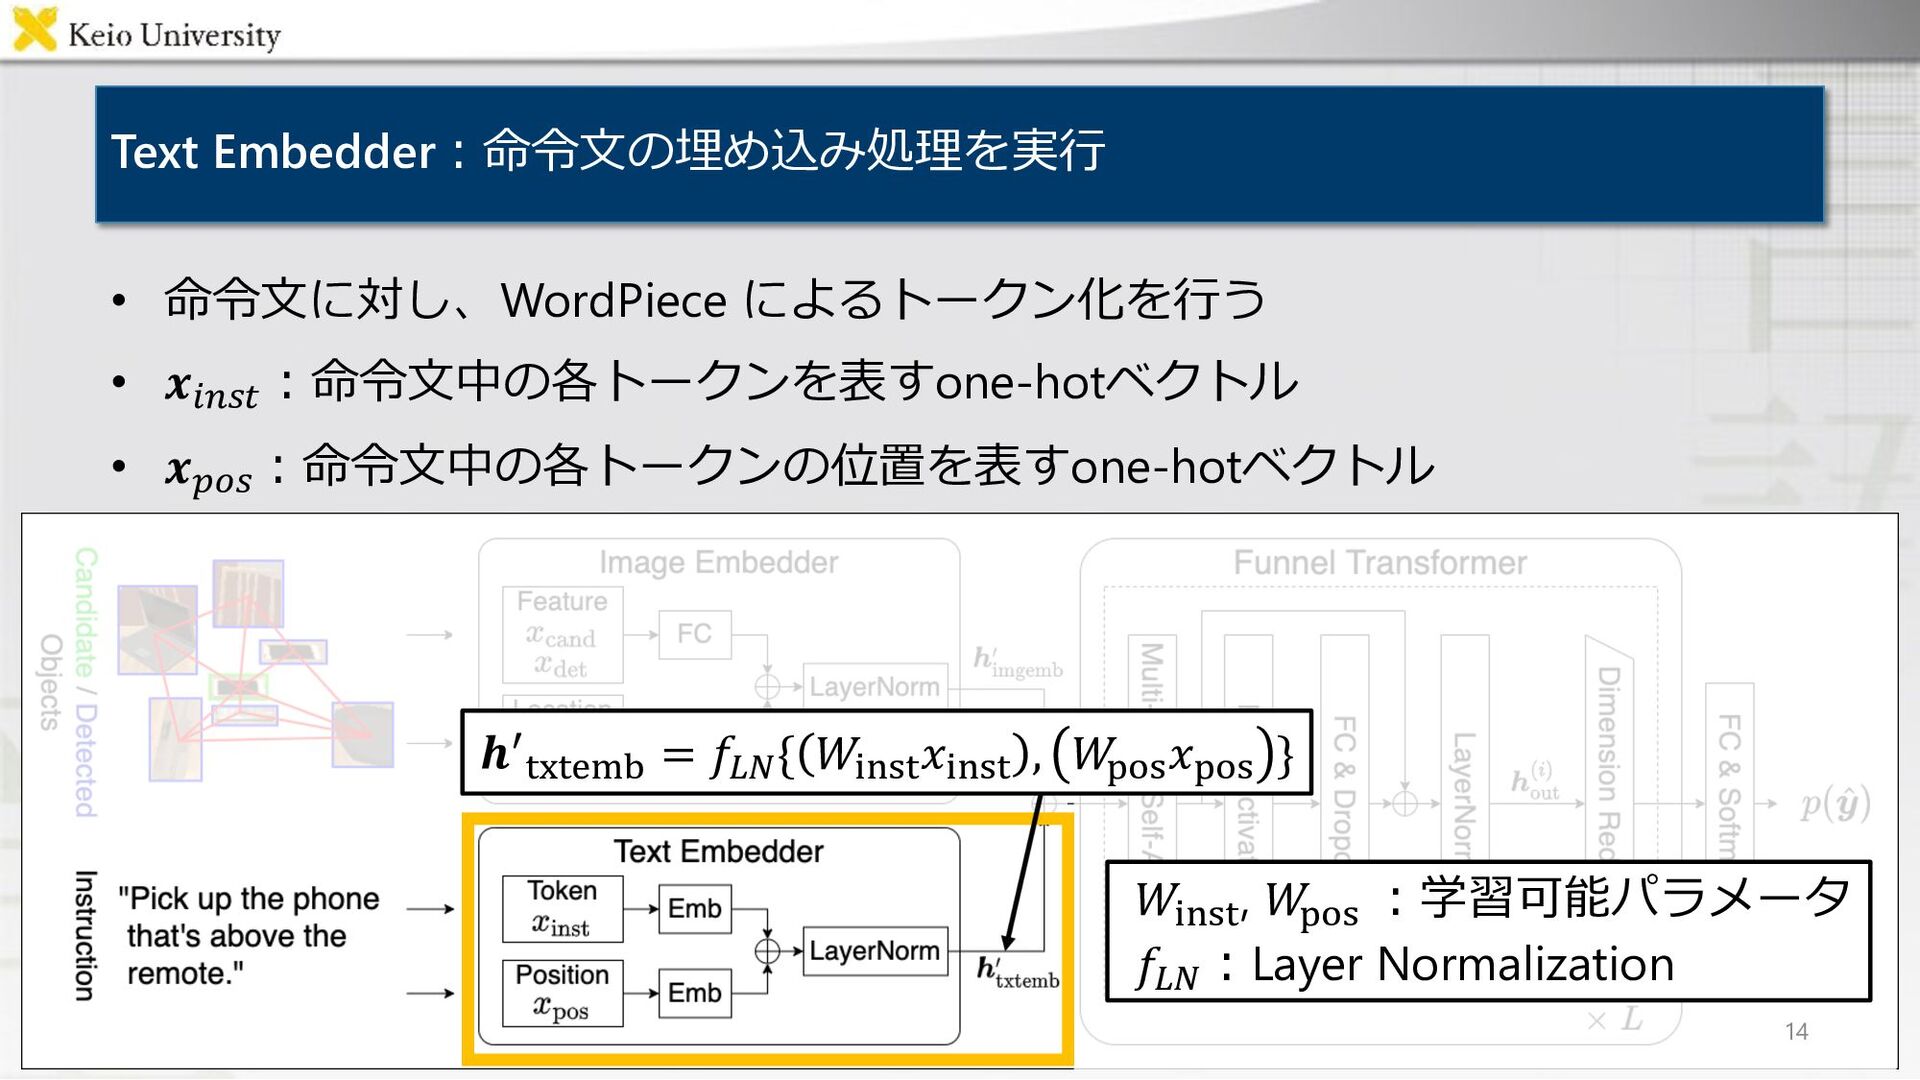
Text Embedder︓命令⽂の埋め込み処理を実⾏ • 命令⽂に対し、WordPiece によるトークン化を⾏う • 𝒙2345 ︓命令⽂中の各トークンを表すone-hotベクトル • 𝒙674
︓命令⽂中の各トークンの位置を表すone-hotベクトル 13 -
Text Embedder︓命令⽂の埋め込み処理を実⾏ • 命令⽂に対し、WordPiece によるトークン化を⾏う • 𝒙2345 ︓命令⽂中の各トークンを表すone-hotベクトル • 𝒙674
︓命令⽂中の各トークンの位置を表すone-hotベクトル 𝑊.#8& , 𝑊 9(8 ︓学習可能パラメータ 𝑓+, ︓Layer Normalization 𝒉- &:&%/1 = 𝑓+, { 𝑊.#8& 𝑥.#8& , 𝑊 9(8 𝑥9(8 } 14 -
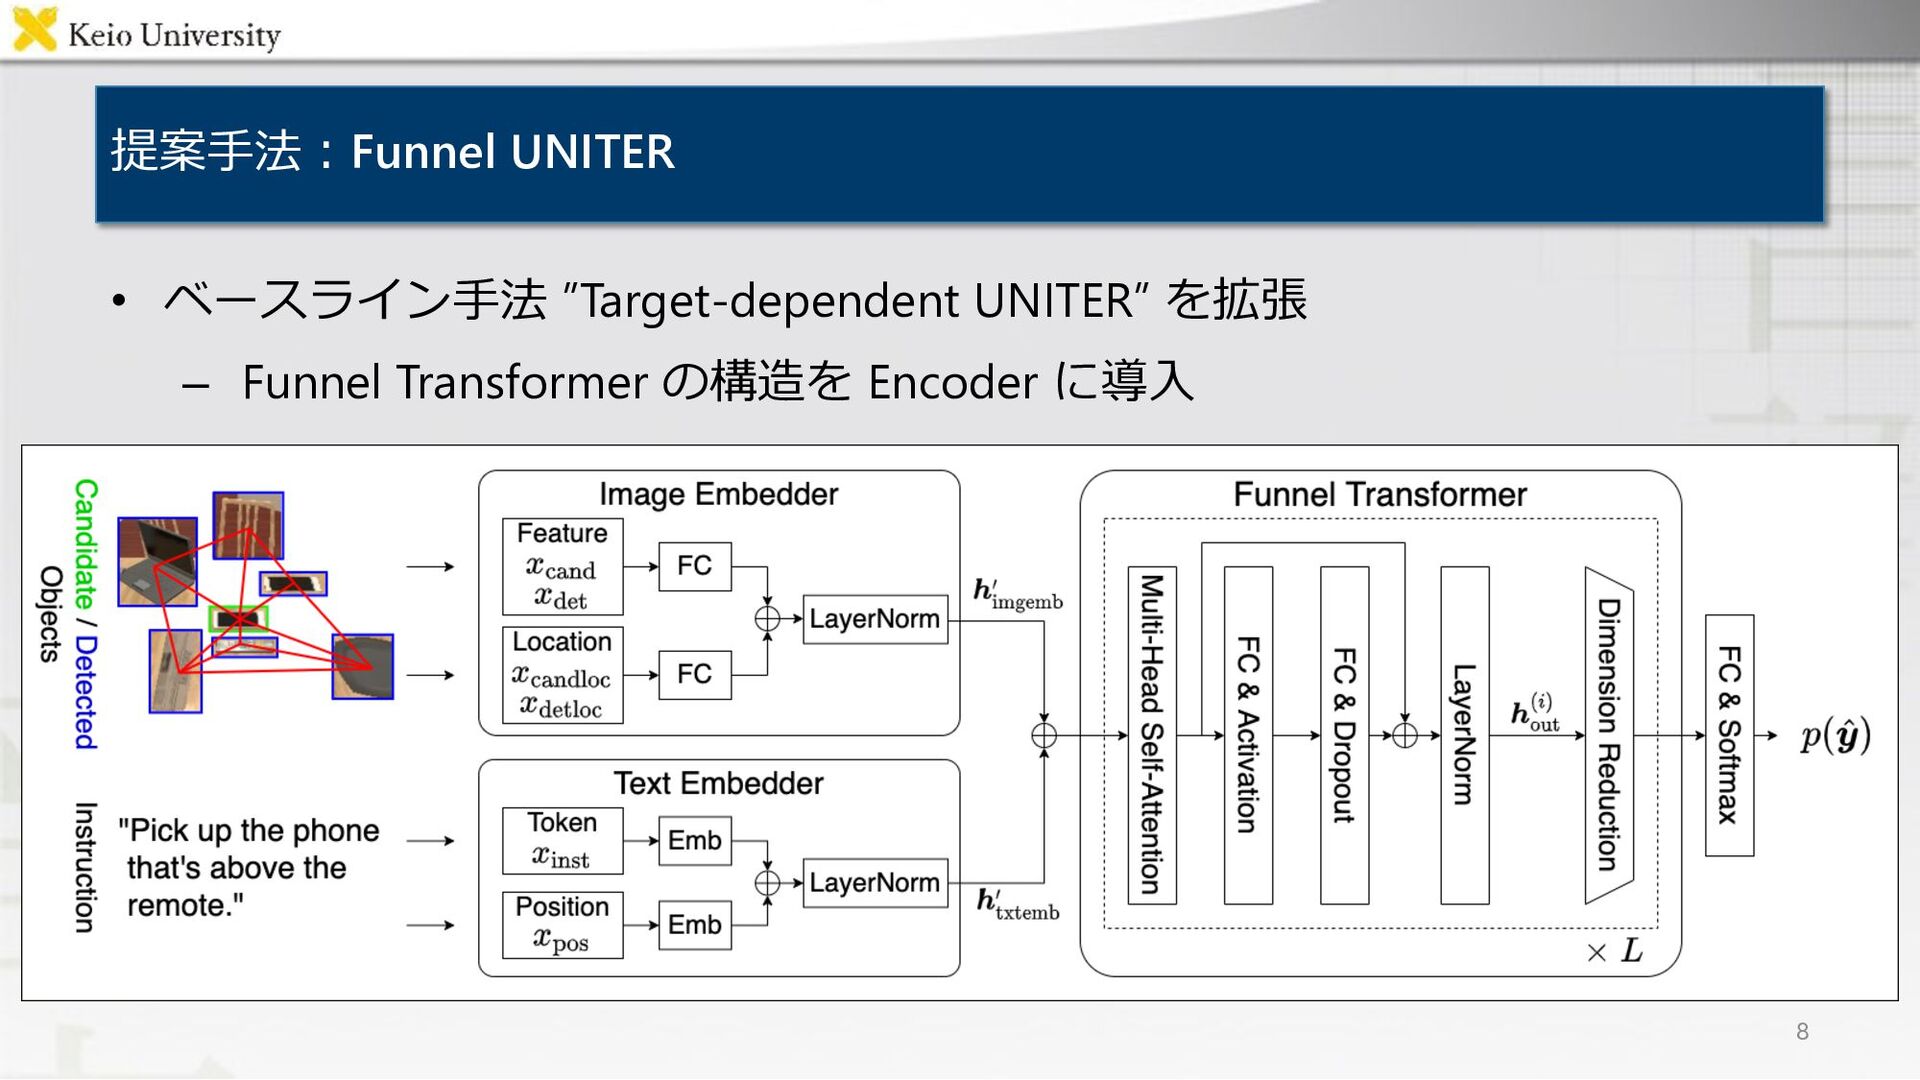
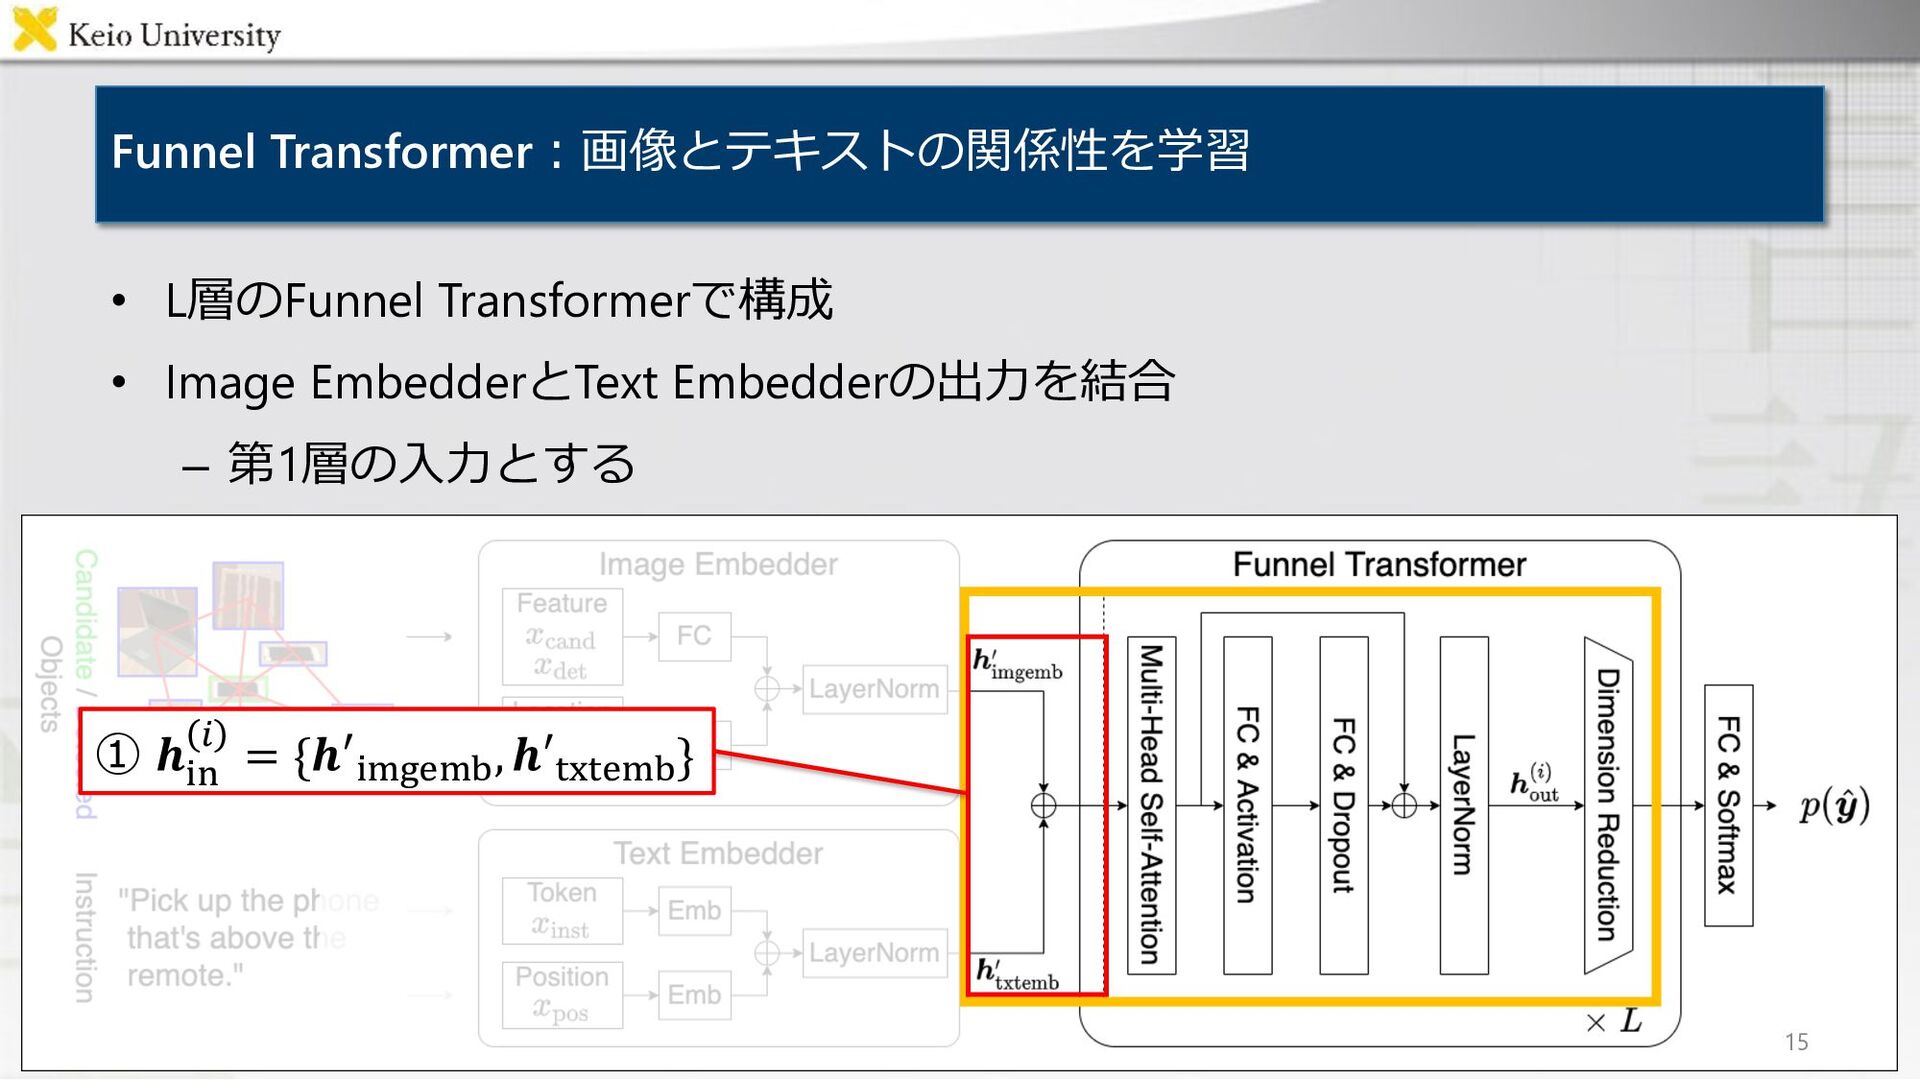
Funnel Transformer︓画像とテキストの関係性を学習 • L層のFunnel Transformerで構成 • Image EmbedderとText Embedderの出⼒を結合 –
第1層の⼊⼒とする 15 ① 𝒉.# 2 = {𝒉- ./0%/1, 𝒉′&:&%/1} -
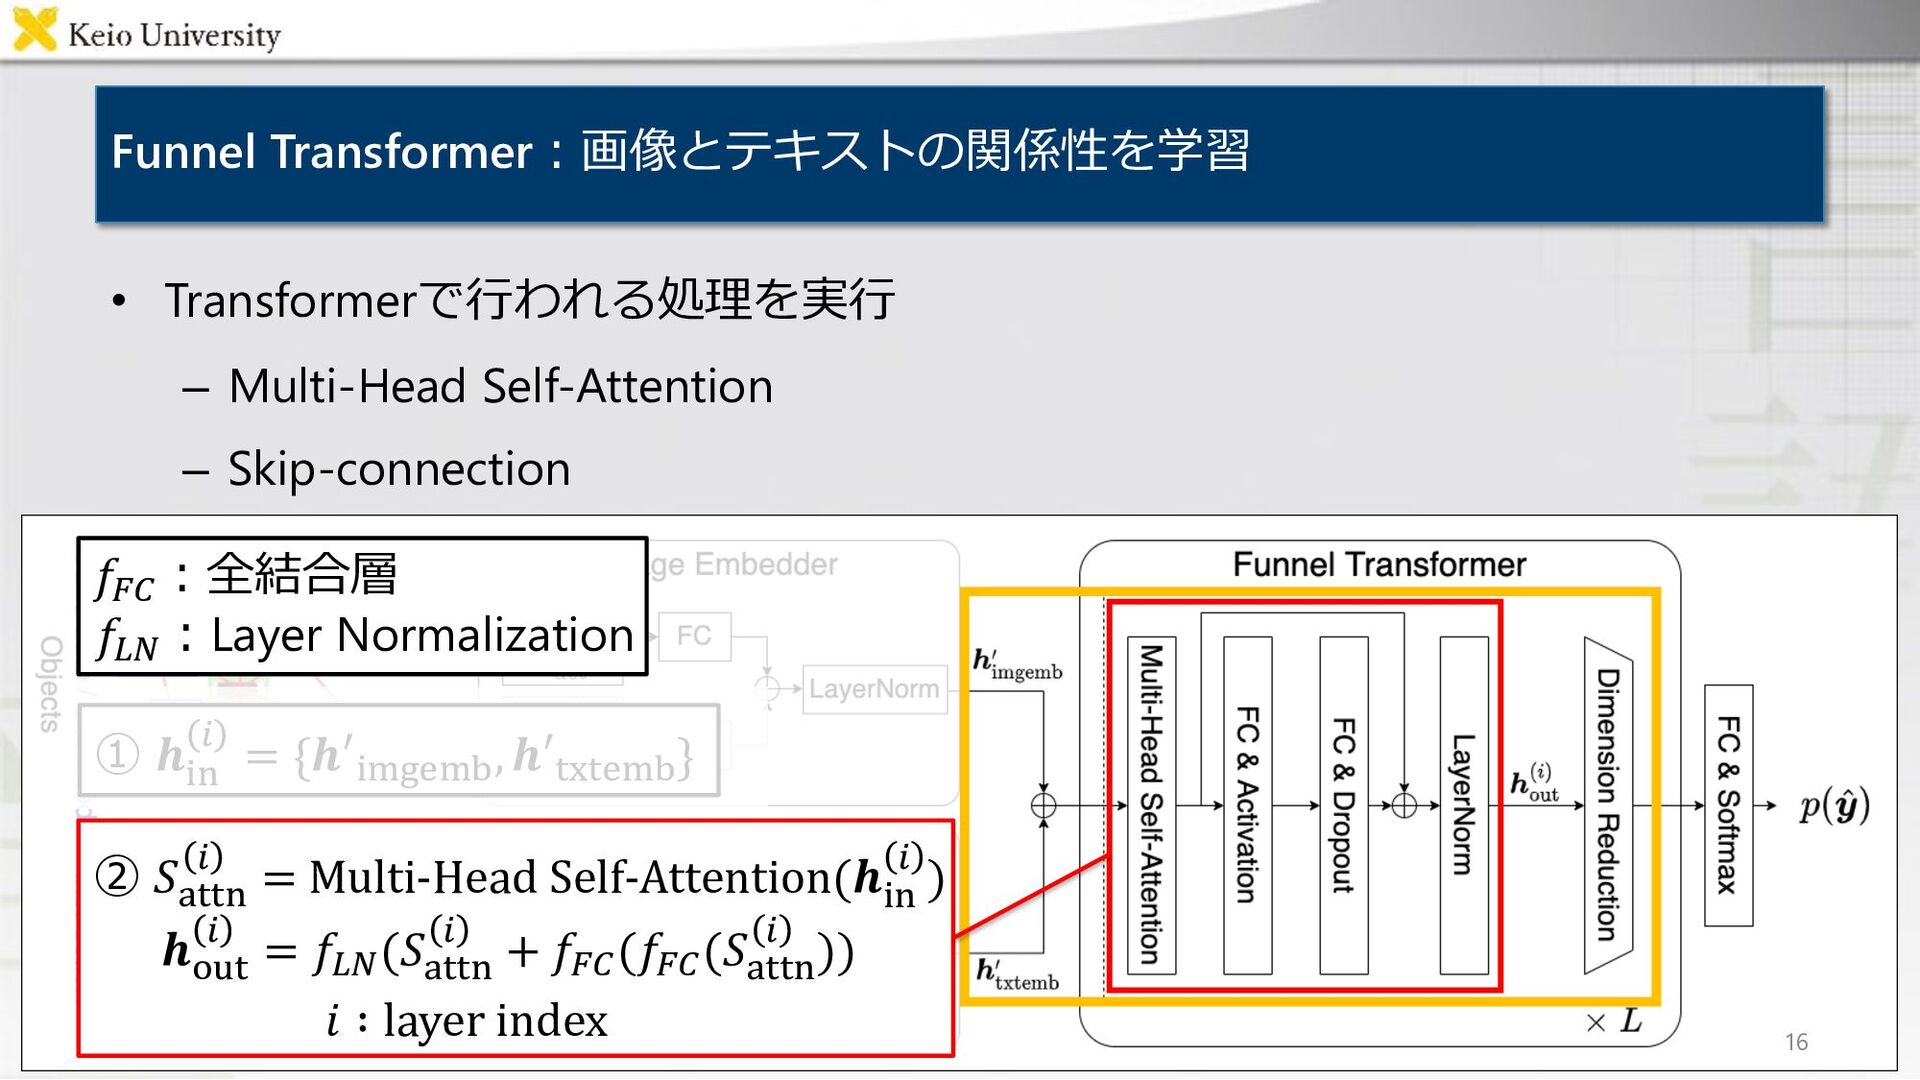
Funnel Transformer︓画像とテキストの関係性を学習 • Transformerで⾏われる処理を実⾏ – Multi-Head Self-Attention – Skip-connection 16
① 𝒉.# 2 = {𝒉- ./0%/1, 𝒉′&:&%/1} 𝒉(;& 2 = 𝑓+, (𝑆"&&# 2 + 𝑓)* (𝑓)* (𝑆"&&# 2 )) 𝑖 ∶ layer index ② 𝑆"&&# 2 = Multi-Head Self-Attention(𝒉.# 2 ) 𝑓)* ︓全結合層 𝑓+, ︓Layer Normalization -
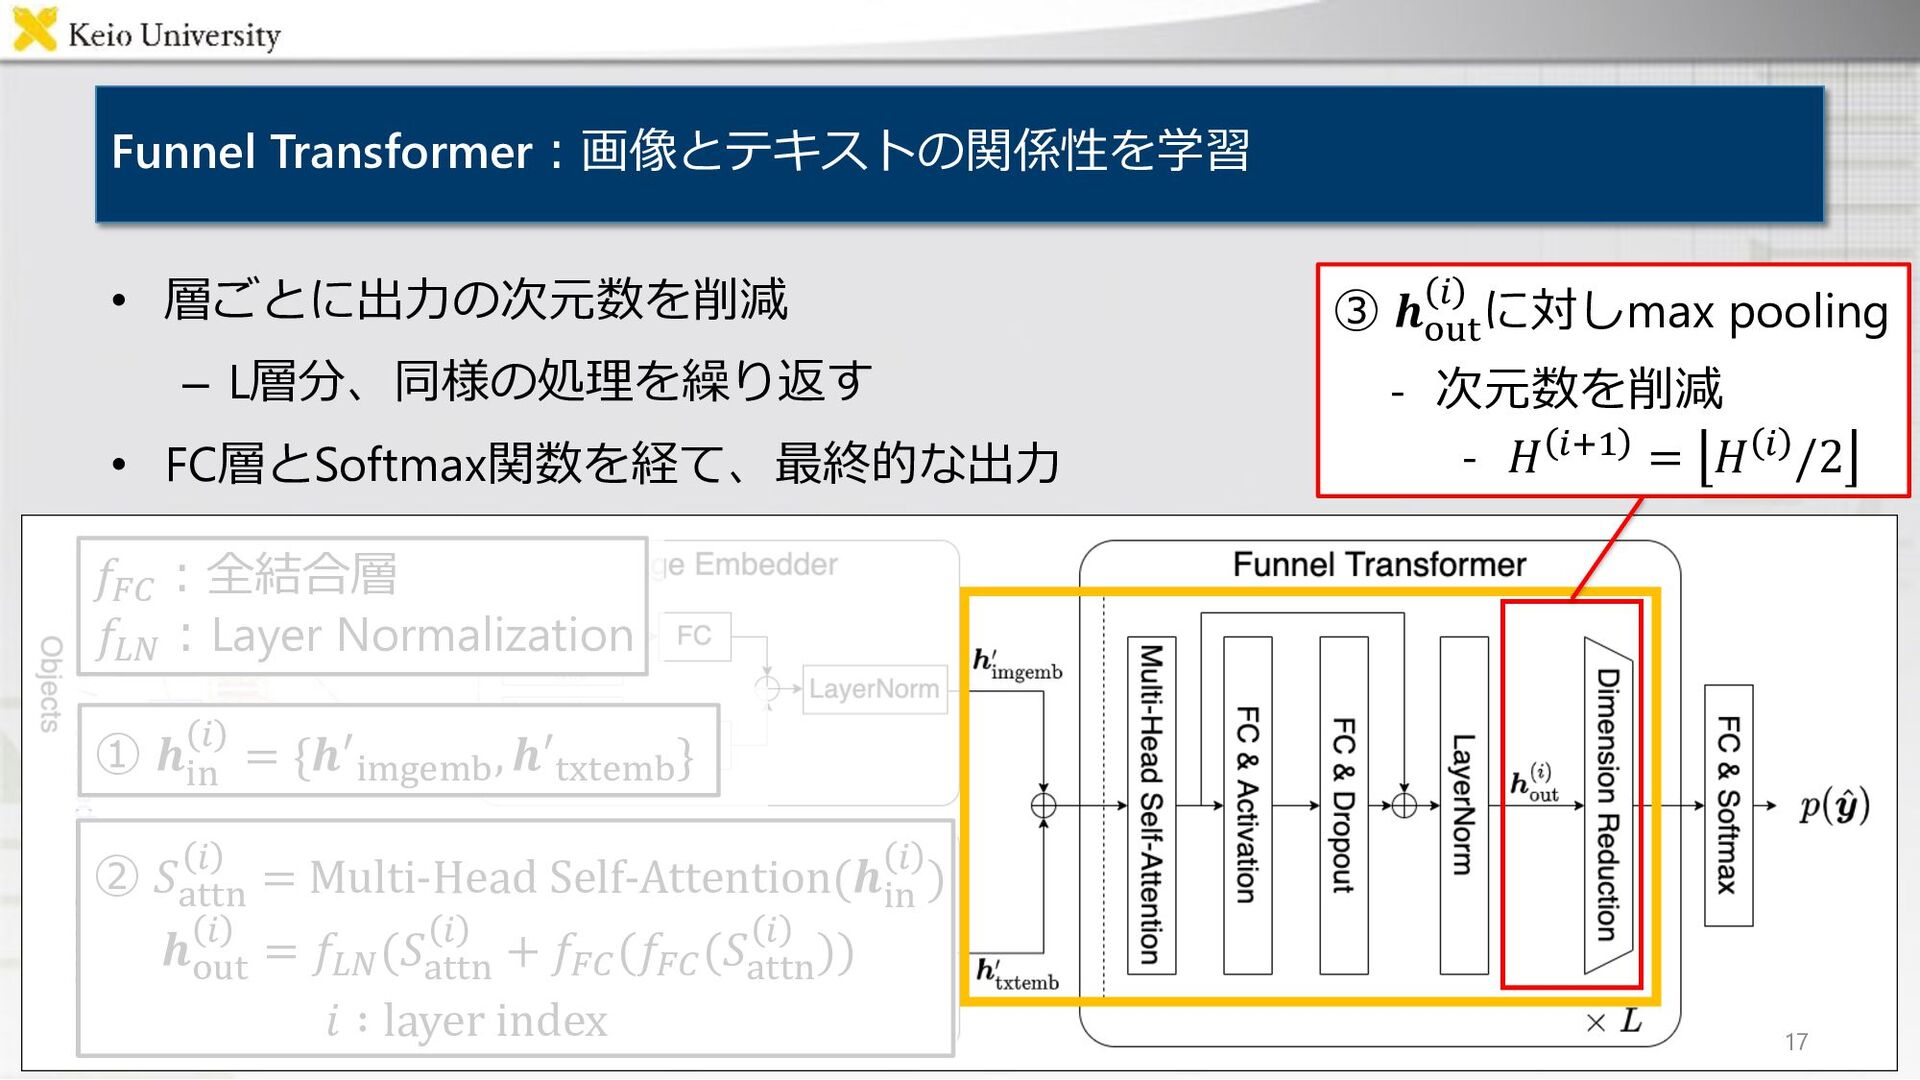
Funnel Transformer︓画像とテキストの関係性を学習 • 層ごとに出⼒の次元数を削減 – L層分、同様の処理を繰り返す • FC層とSoftmax関数を経て、最終的な出⼒ ③ 𝒉(;&
2 に対しmax pooling - 次元数を削減 - 𝐻 2<= = 𝐻 2 /2 17 ① 𝒉.# 2 = {𝒉- ./0%/1, 𝒉′&:&%/1} 𝒉(;& 2 = 𝑓+, (𝑆"&&# 2 + 𝑓)* (𝑓)* (𝑆"&&# 2 )) 𝑖 ∶ layer index ② 𝑆"&&# 2 = Multi-Head Self-Attention(𝒉.# 2 ) 𝑓)* ︓全結合層 𝑓+, ︓Layer Normalization -
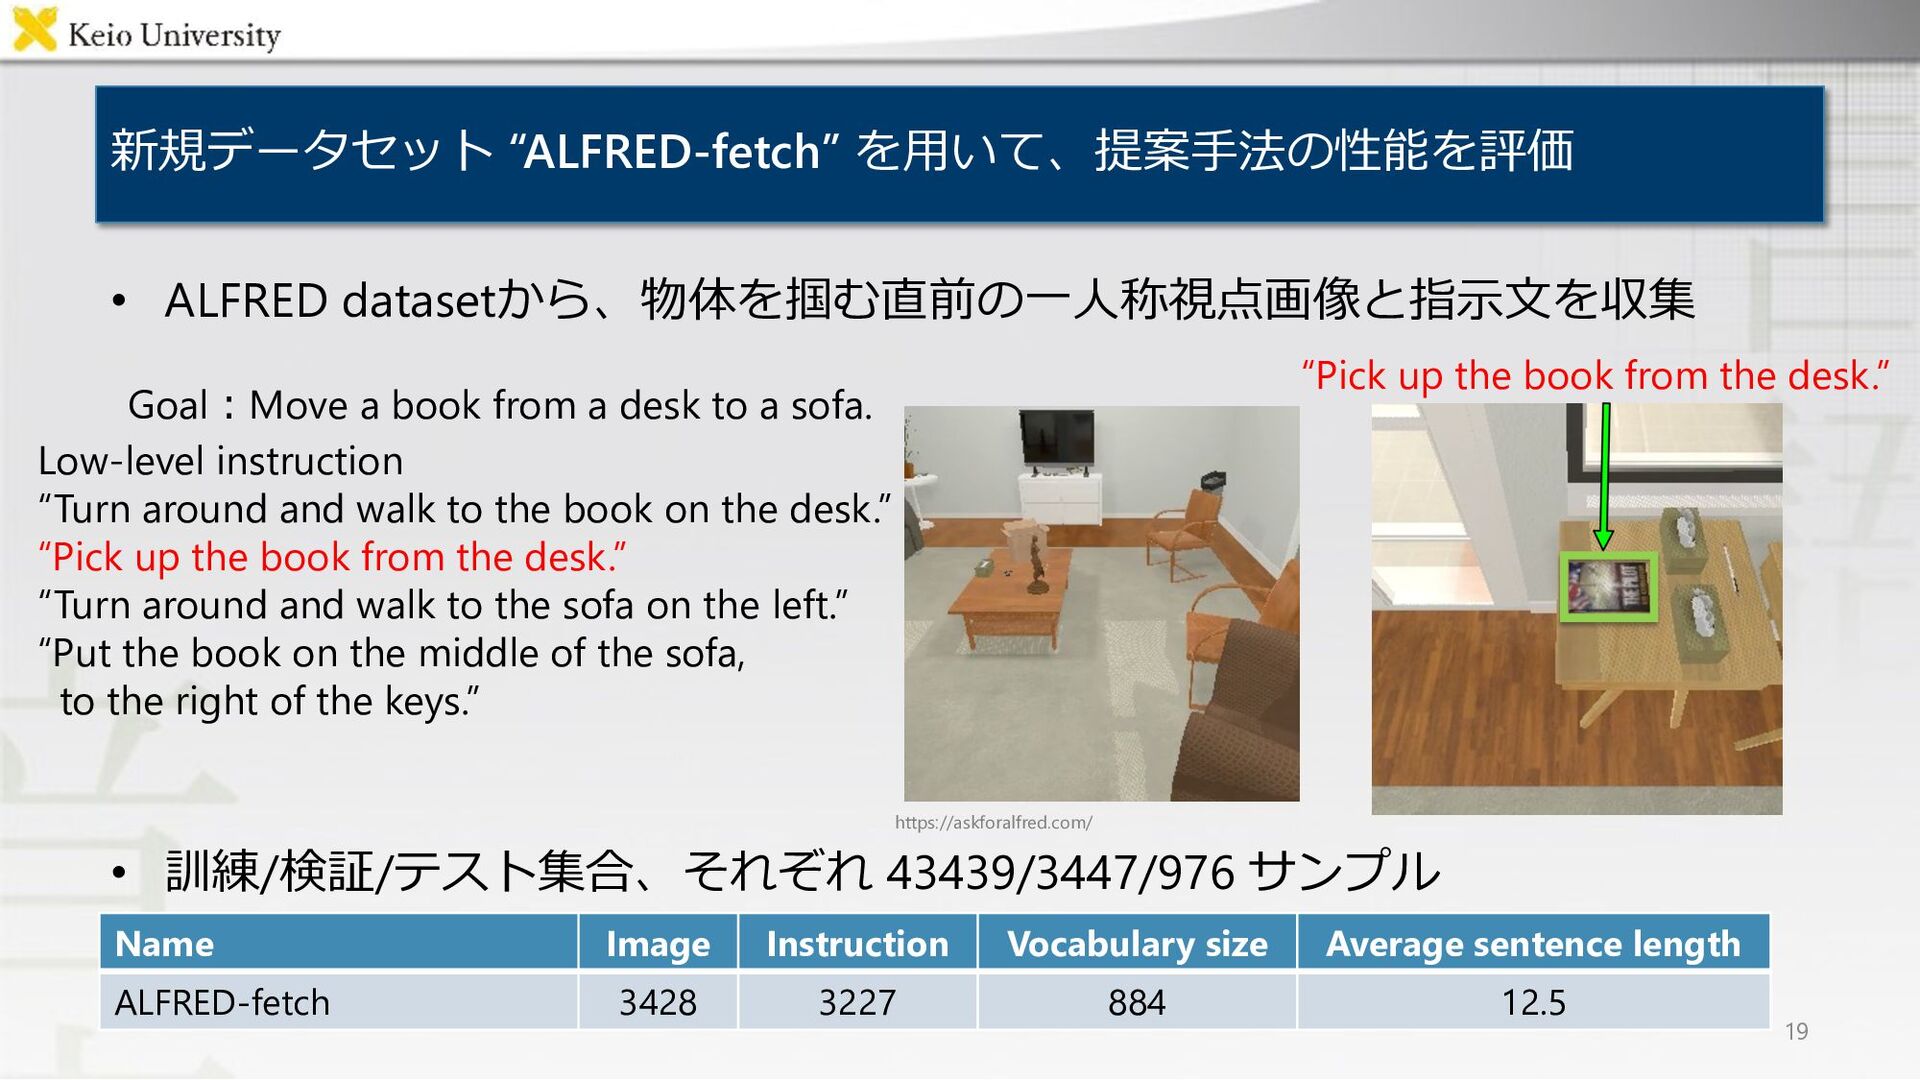
ALFRED dataset の問題点︓物体操作において不⾃然な画像が存在 • ALFRED dataset [Shridhar+, CVPR20] – ⾃然⾔語による指⽰と⼀⼈称視点からエージェントの⾏動を学習
– 複数のサブゴールが逐次的に設定、それぞれに命令⽂が存在 • 問題点︓物体を運ぶ際、カメラ画像に空中に浮かんだ物体が表⽰され不⾃然 18 Goal︓Move a book from a desk to a sofa. Low-level instruction “Turn around and walk to the book on the desk.” “Pick up the book from the desk.” “Turn around and walk to the sofa on the left.” “Put the book on the middle of the sofa, to the right of the keys.” https://askforalfred.com/ 物体運搬時の画像 -
新規データセット “ALFRED-fetch” を⽤いて、提案⼿法の性能を評価 • ALFRED datasetから、物体を掴む直前の⼀⼈称視点画像と指⽰⽂を収集 • 訓練/検証/テスト集合、それぞれ 43439/3447/976 サンプル
19 “Pick up the book from the desk.” Goal︓Move a book from a desk to a sofa. Low-level instruction “Turn around and walk to the book on the desk.” “Pick up the book from the desk.” “Turn around and walk to the sofa on the left.” “Put the book on the middle of the sofa, to the right of the keys.” https://askforalfred.com/ Name Image Instruction Vocabulary size Average sentence length ALFRED-fetch 3428 3227 884 12.5 -
定量的結果︓提案⼿法はベースライン⼿法を精度、学習時間で上回る • Binary Accuracy [%] ︓対象物体候補が対象物体か否かに関する精度 • Training Time [fps]︓学習において、1秒間で処理可能な画像の枚数
• 層数 𝐿 = 2 の時、提案⼿法は最も⾼速で⾼精度 20 Method Binary Accuracy [%]↑ Training Time [fps]↑ Target-dependent UNITER (𝐿 = 2) 82.0 ± 1.79 92.5 ± 0.26 Ours (𝐿 = 4) 86.0 ± 0.64 76.9 ± 0.39 Ours (𝐿 = 3) 85.9 ± 1.79 85.1 ± 0.38 Ours (𝐿 = 2) 86.6 ± 1.62 94.1 ± 0.71 +4.6 +1.6 -
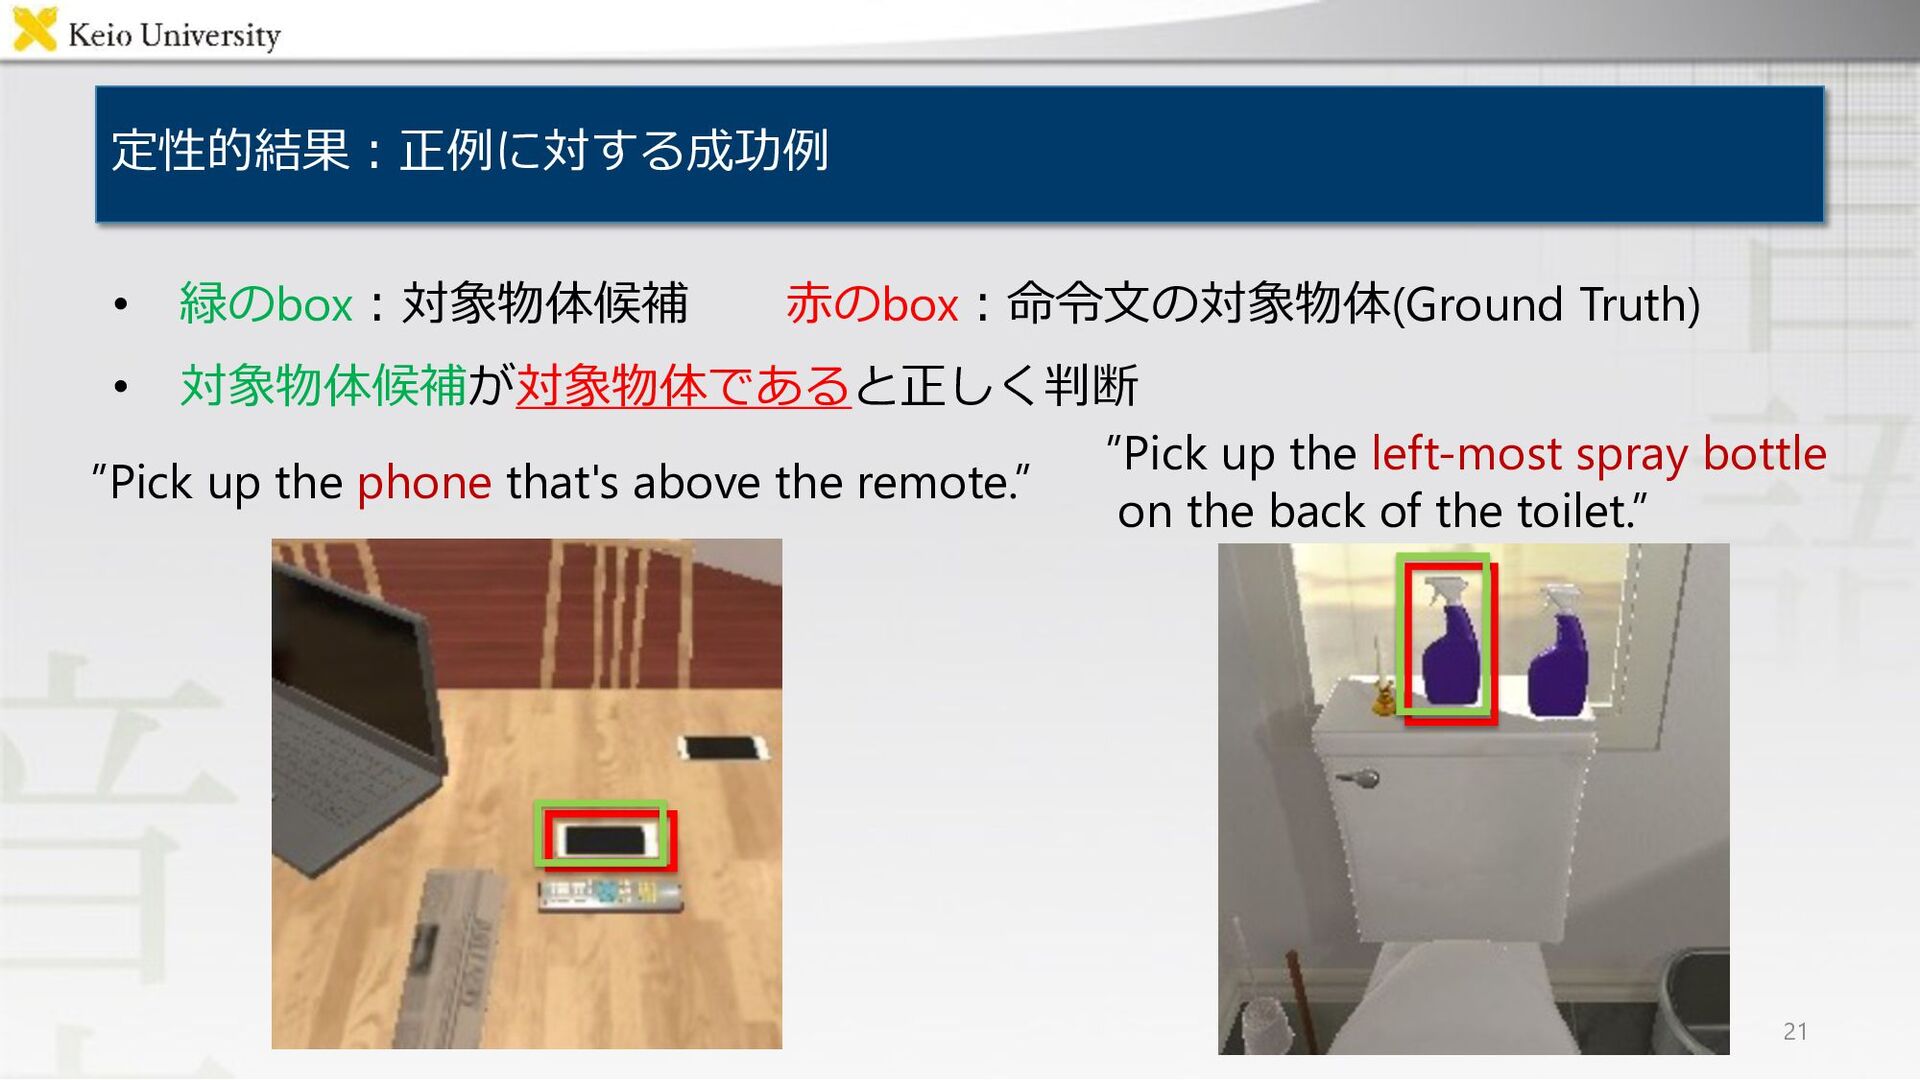
• 緑のbox︓対象物体候補 ⾚のbox︓命令⽂の対象物体(Ground Truth) • 対象物体候補が対象物体であると正しく判断 定性的結果︓正例に対する成功例 21 ”Pick up
the phone that's above the remote.” ”Pick up the left-most spray bottle on the back of the toilet.” -
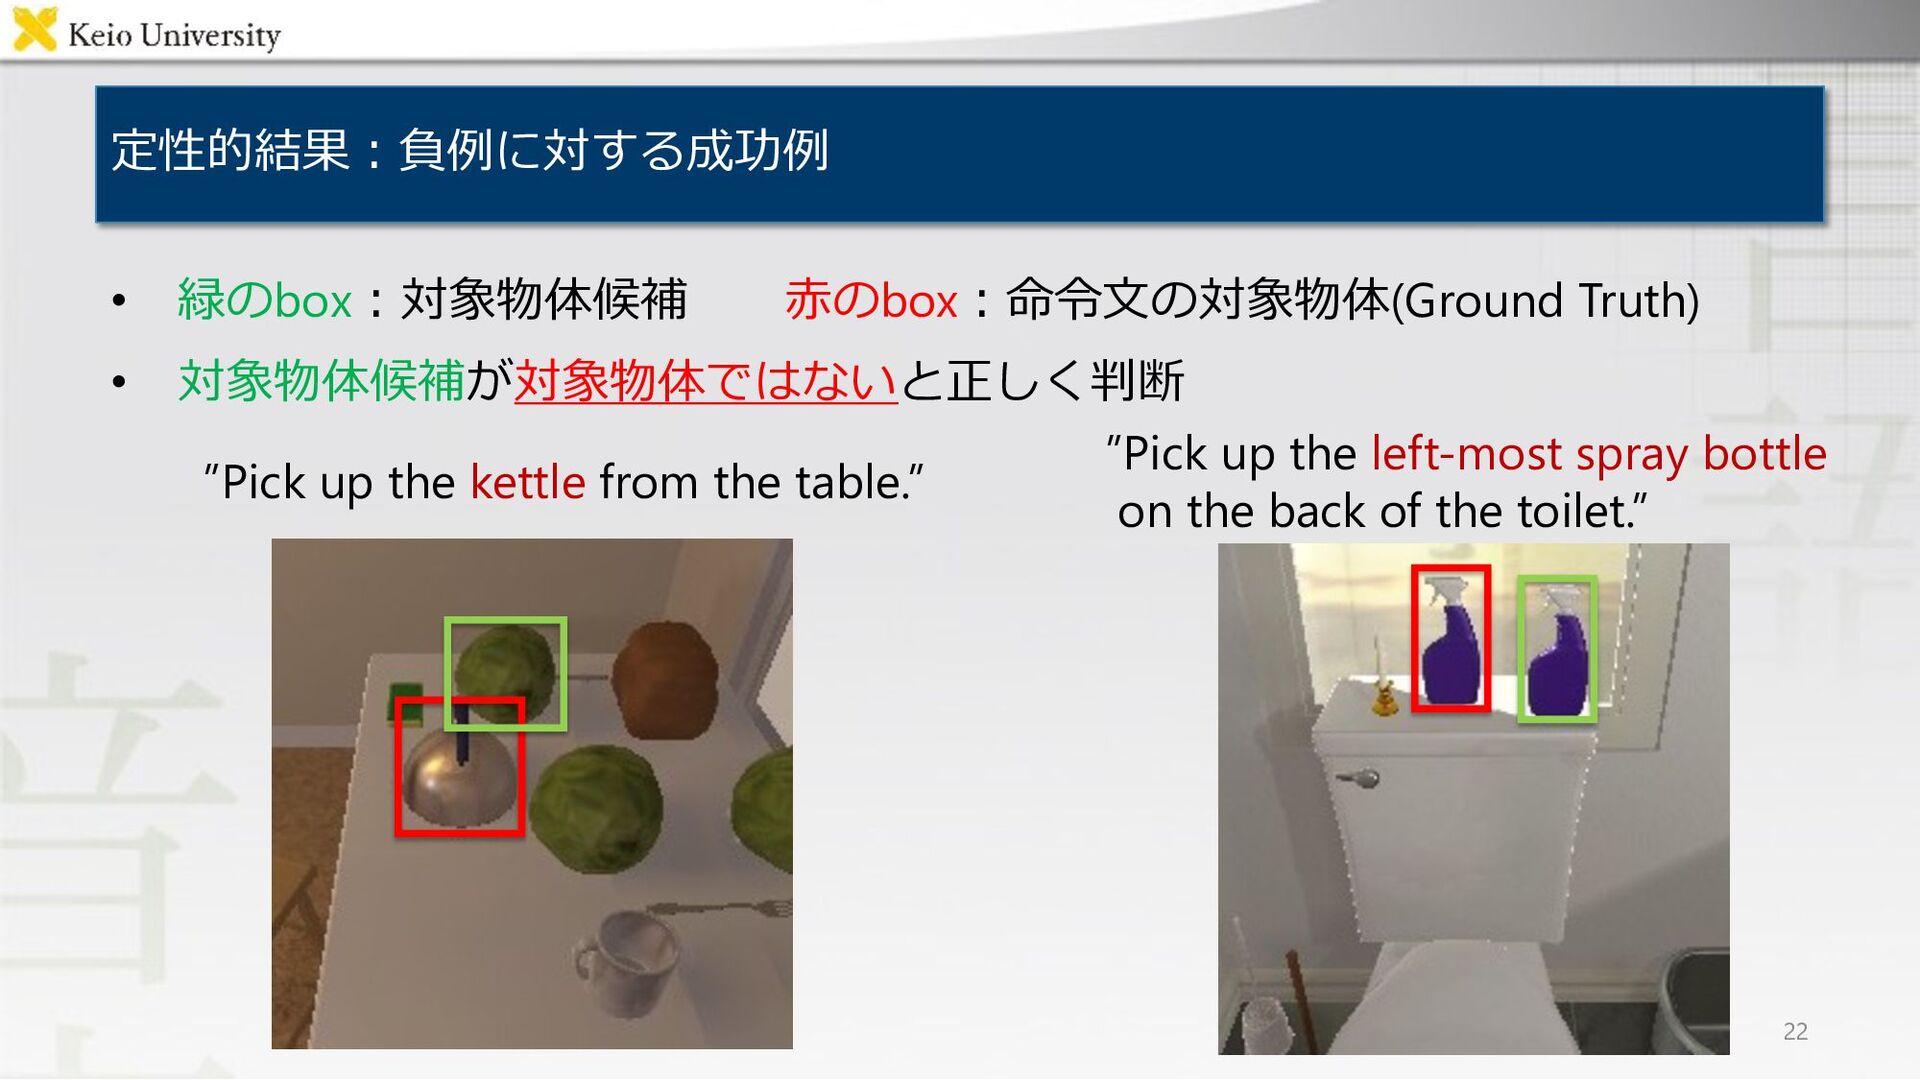
• 緑のbox︓対象物体候補 ⾚のbox︓命令⽂の対象物体(Ground Truth) • 対象物体候補が対象物体ではないと正しく判断 定性的結果︓負例に対する成功例 22 ”Pick up
the kettle from the table.” ”Pick up the left-most spray bottle on the back of the toilet.” -
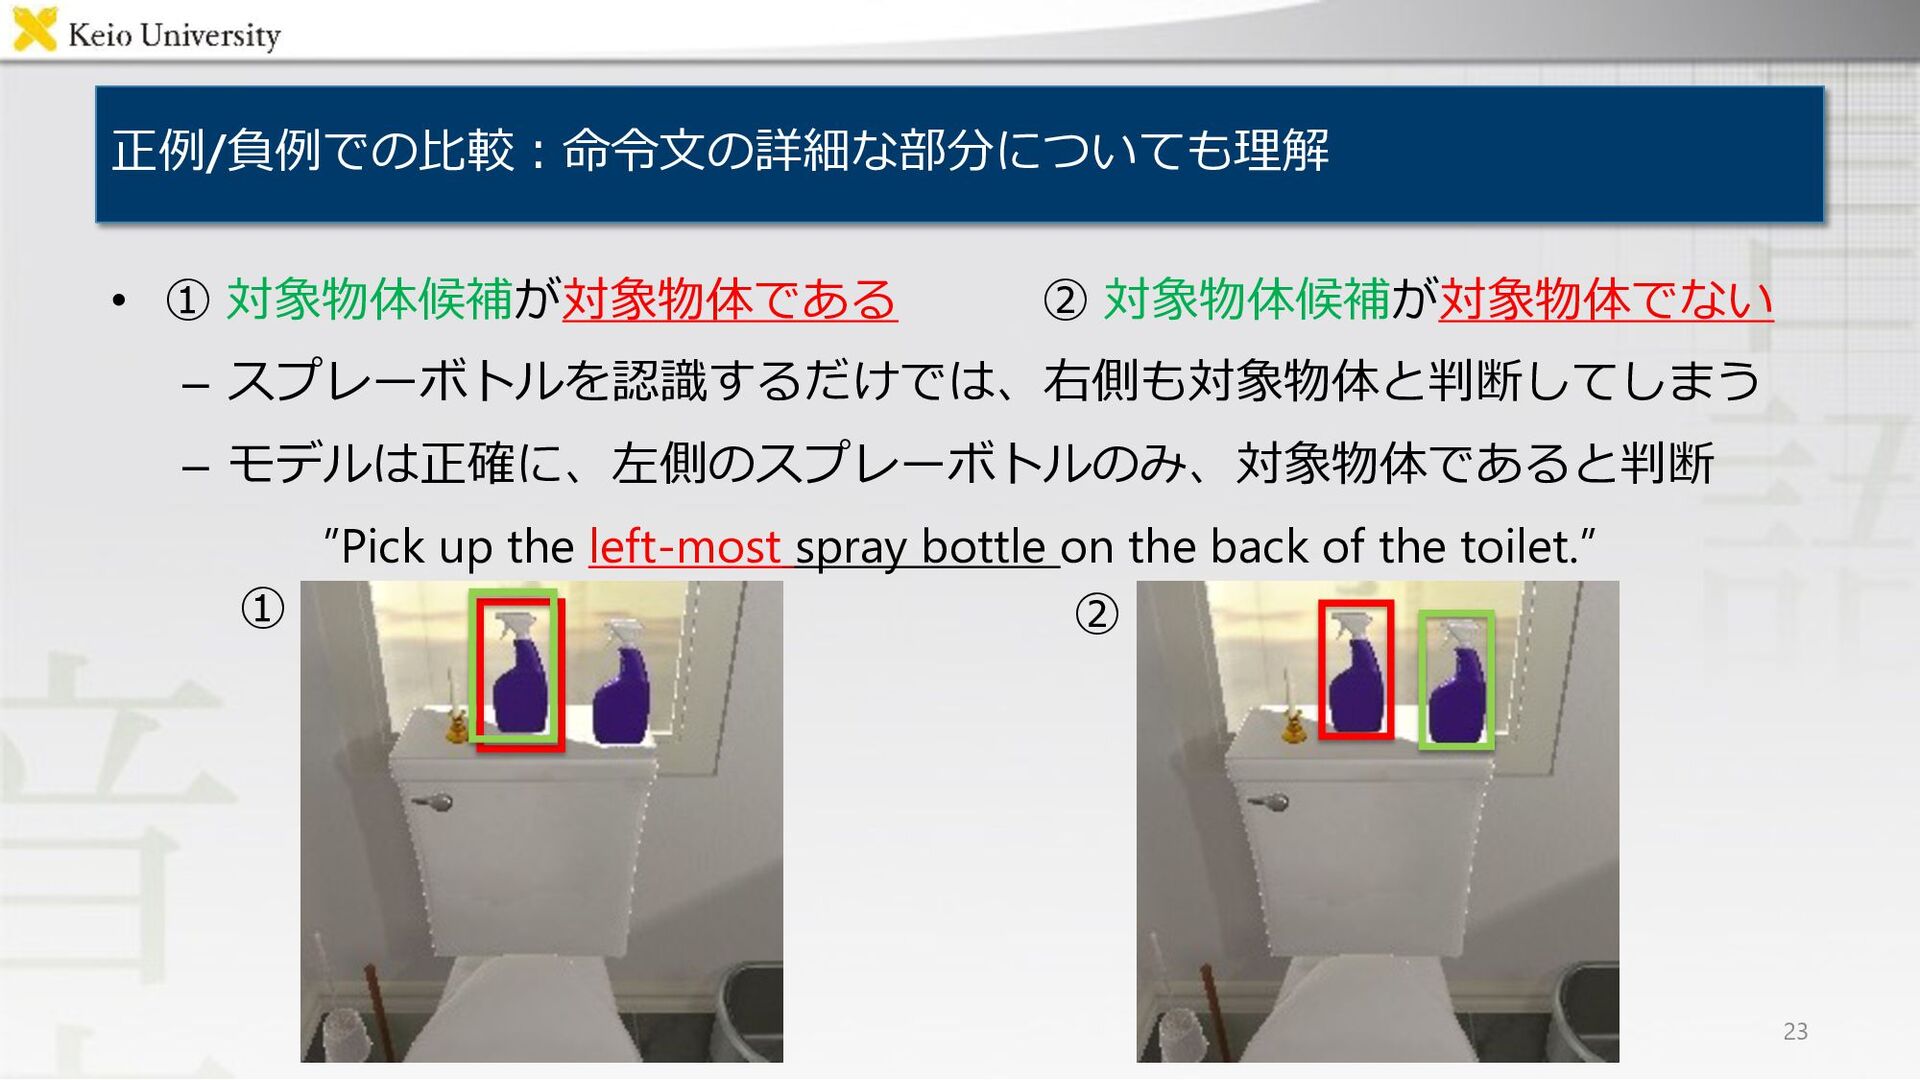
• ① 対象物体候補が対象物体である ② 対象物体候補が対象物体でない – スプレーボトルを認識するだけでは、右側も対象物体と判断してしまう – モデルは正確に、左側のスプレーボトルのみ、対象物体であると判断 正例/負例での⽐較︓命令⽂の詳細な部分についても理解
23 ”Pick up the left-most spray bottle on the back of the toilet.” ① ② -
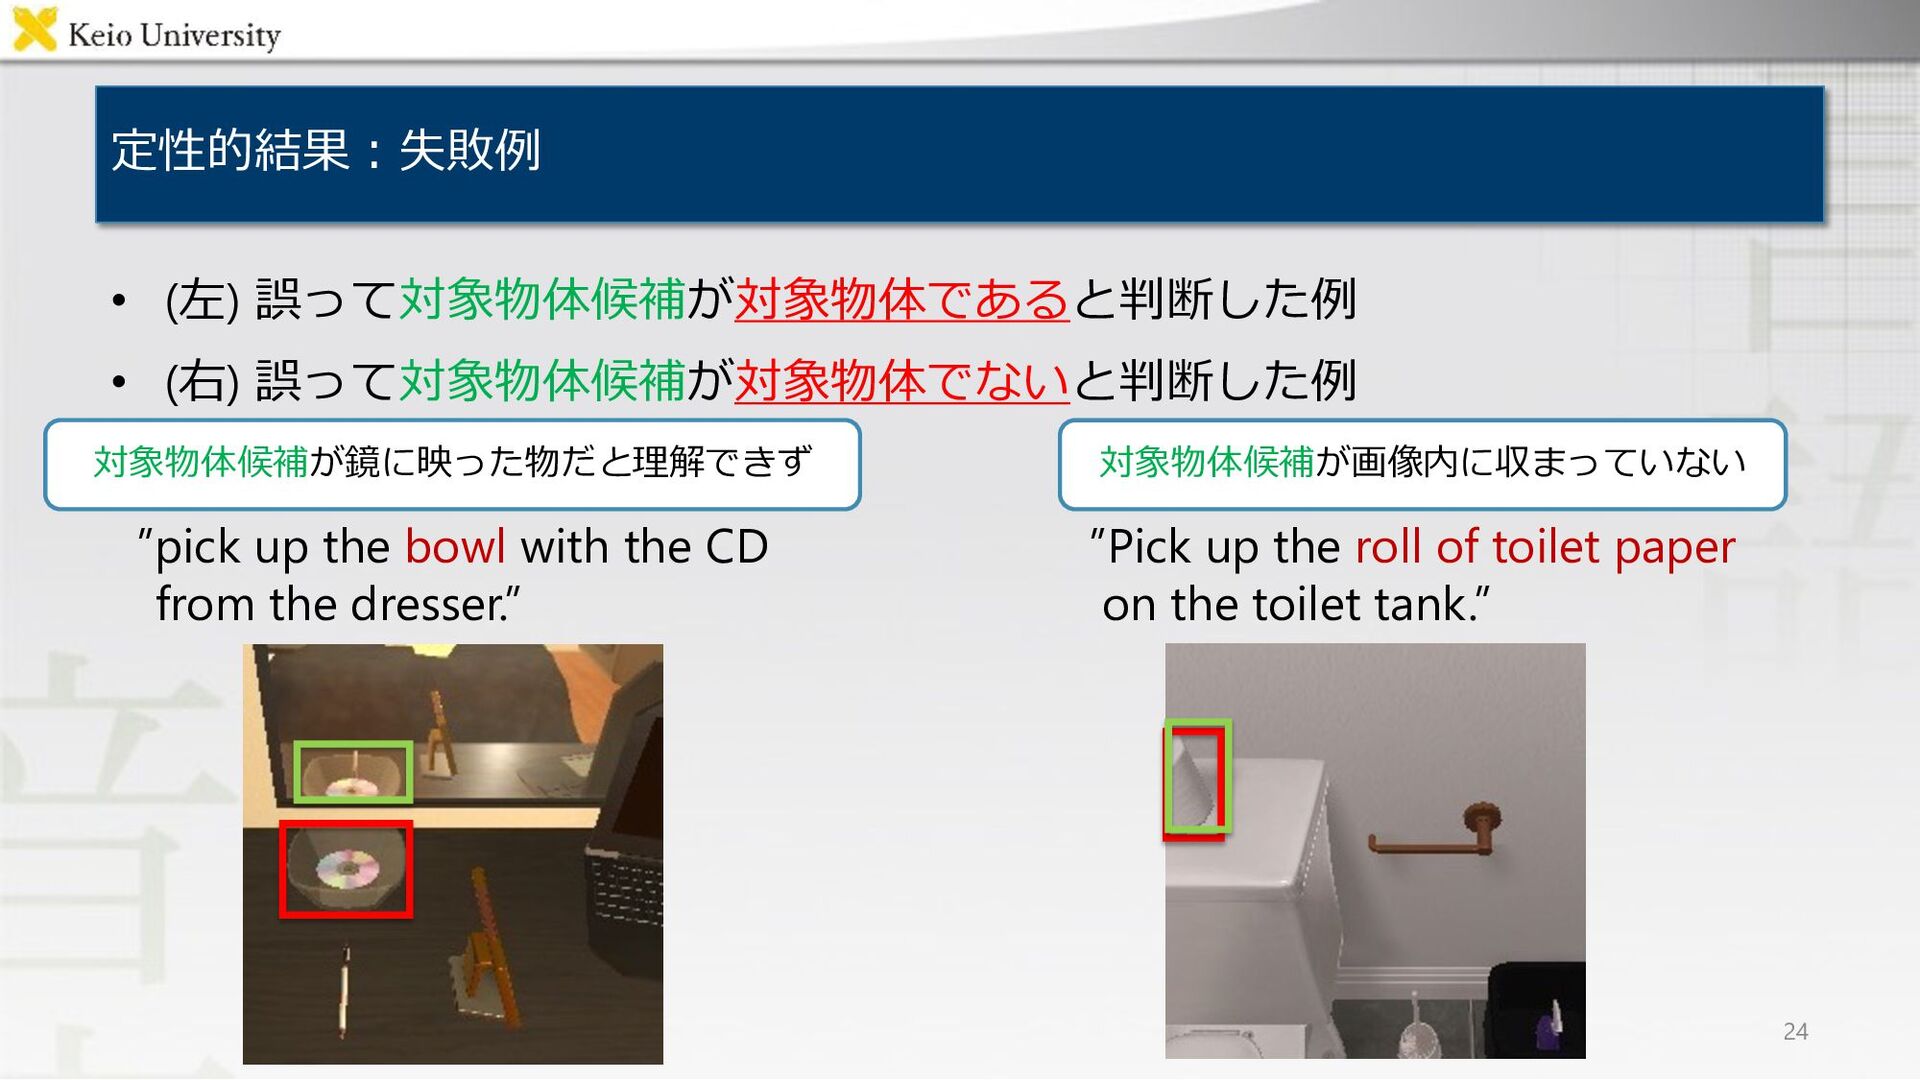
定性的結果︓失敗例 • (左) 誤って対象物体候補が対象物体であると判断した例 • (右) 誤って対象物体候補が対象物体でないと判断した例 24 ”Pick up
the roll of toilet paper on the toilet tank.” ”pick up the bowl with the CD from the dresser.” 対象物体候補が鏡に映った物だと理解できず 対象物体候補が画像内に収まっていない -
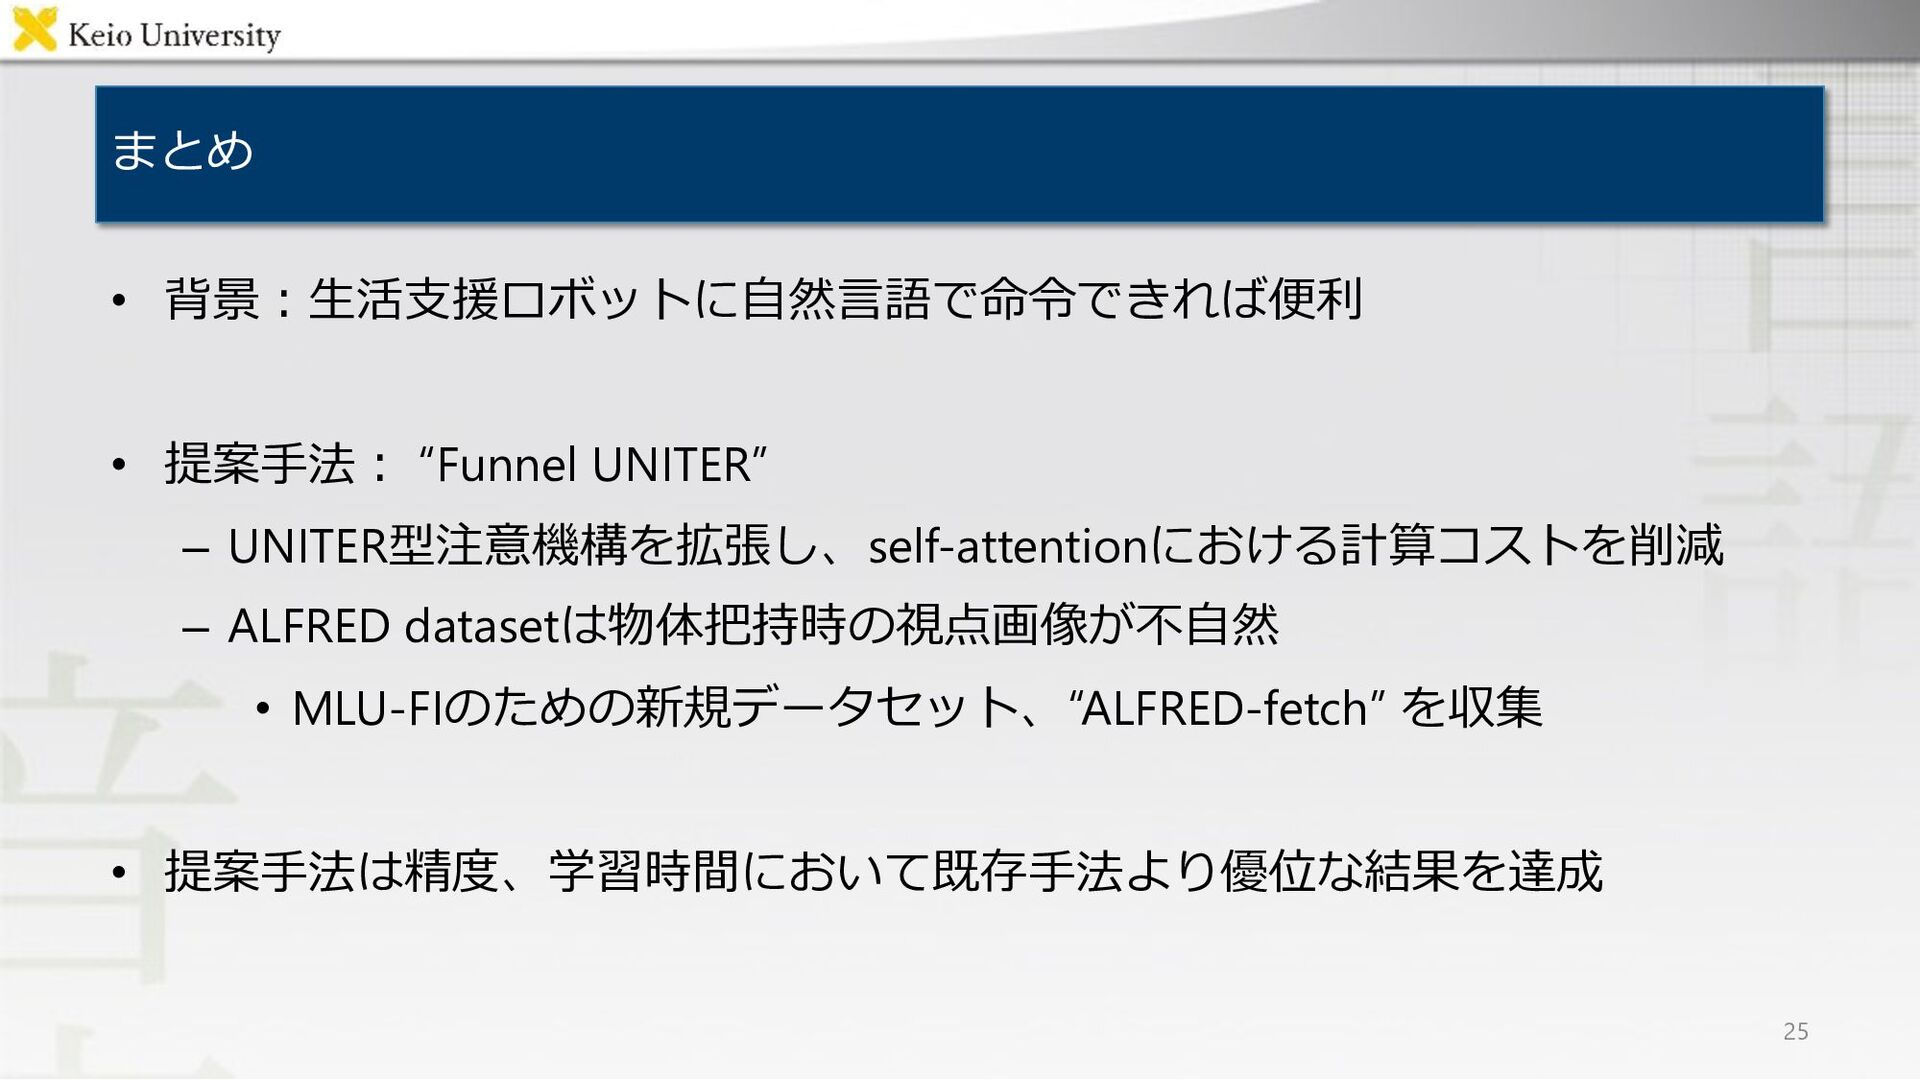
まとめ • 背景︓⽣活⽀援ロボットに⾃然⾔語で命令できれば便利 • 提案⼿法︓ “Funnel UNITER” – UNITER型注意機構を拡張し、self-attentionにおける計算コストを削減 –
ALFRED datasetは物体把持時の視点画像が不⾃然 • MLU-FIのための新規データセット、“ALFRED-fetch” を収集 • 提案⼿法は精度、学習時間において既存⼿法より優位な結果を達成 25 -
付録1︓Funnel Transformer [Dai+, NeurIPS20] • Transformerモデルの冗⻑性を検討、新たなコスト削減⼿法を提⽰ • シーケンスの⻑さを徐々に圧縮することで計算量を削減 – Encoder︓Poolingによってシーケンスを徐々に圧縮
– Decoder (optional)︓Upsamplingによってシーケンスを再構成 26 -
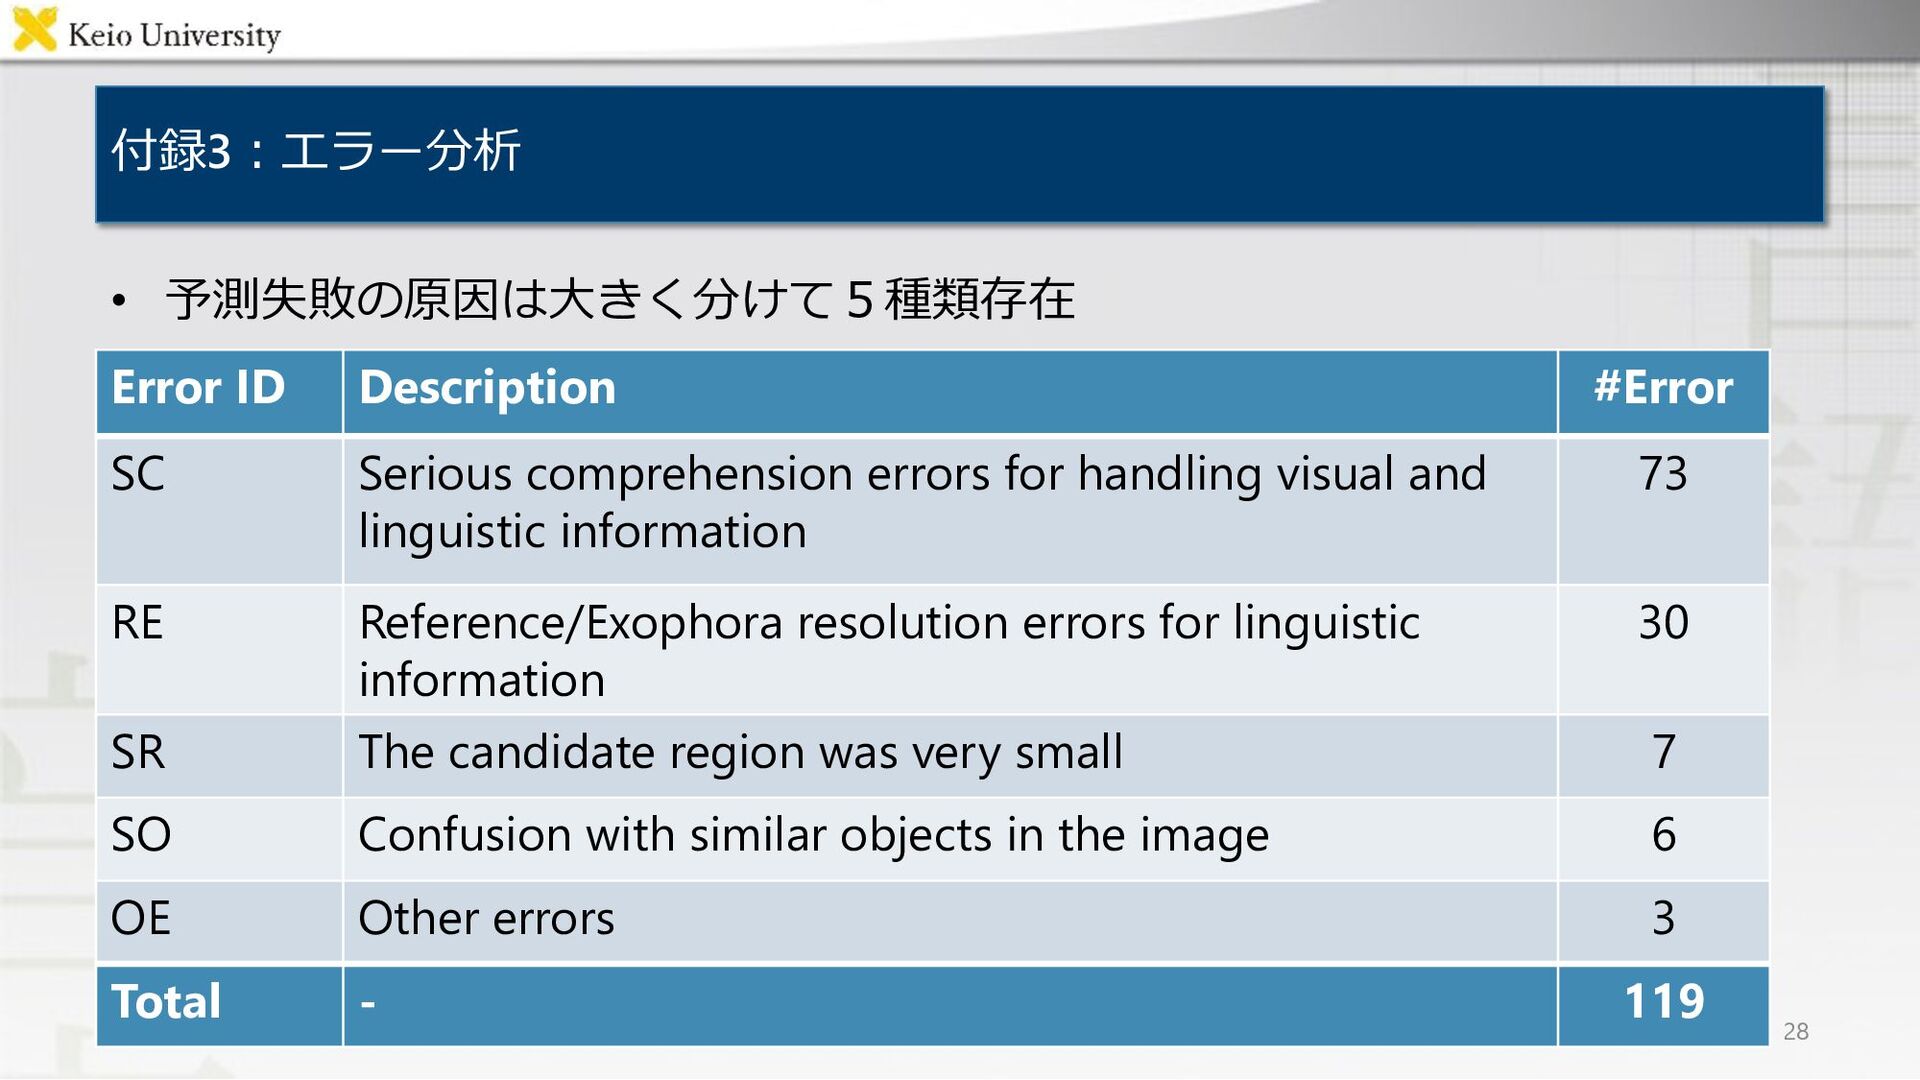
付録3︓エラー分析 • 予測失敗の原因は⼤きく分けて5種類存在 28 Error ID Description #Error SC Serious
comprehension errors for handling visual and linguistic information 73 RE Reference/Exophora resolution errors for linguistic information 30 SR The candidate region was very small 7 SO Confusion with similar objects in the image 6 OE Other errors 3 Total - 119