Share
Embed
[RSJ23] Learning-To-Rank Approach for Identifying Everyday Objects Using a Physical-World Search Engine
Semantic Machine Intelligence Lab., Keio Univ. PRO
September 08, 2023
Transcript
15 slides
-
背景: Human-in-the-Loop設定の生活支援ロボットは実用性が高い - 2 - 少子高齢化社会における介助者不足に対して、生活支援ロボットへの期待 問題点 ▪ 全自動での成功率 低
▪ Closed-vocabulary では実用性 低 本手法のアプローチ ▪ 自動化とオペレータによる介入を 組み合わせたhuman-in-the-loop設定 ▪ Open-vocabulary 指示文から 対象物体/目標領域を単一モデルで検索 2~8x 成功率 約 30% [Qi+, CVPR20] 柔軟な指示× -
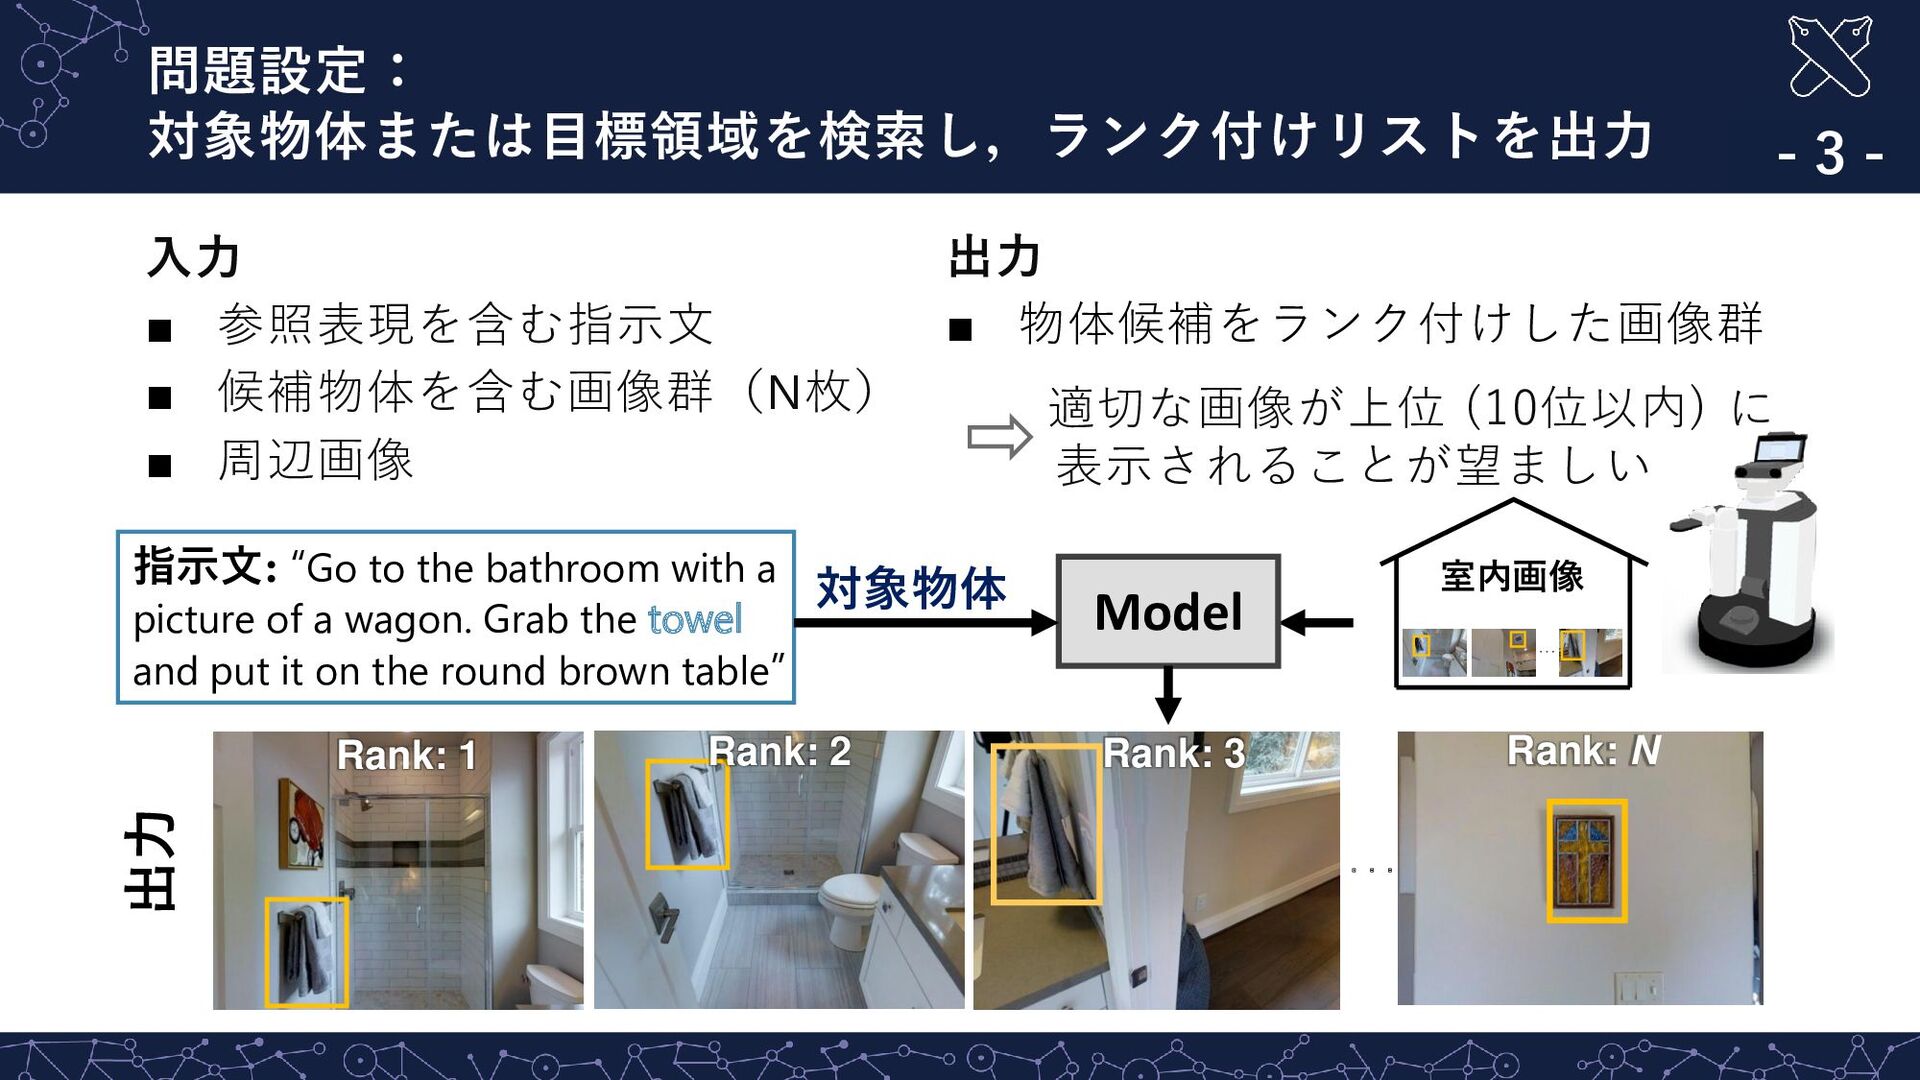
問題設定: 対象物体または目標領域を検索し,ランク付けリストを出力 - 3 - ・・・ Model Rank: N Rank:
3 Rank: 2 ・・・ 室内画像 Rank: 1 対象物体 出力 指示文: “Go to the bathroom with a picture of a wagon. Grab the towel and put it on the round brown table” 入力 ▪ 参照表現を含む指示文 ▪ 候補物体を含む画像群(N枚) ▪ 周辺画像 出力 ▪ 物体候補をランク付けした画像群 適切な画像が上位 (10位以内) に 表示されることが望ましい -
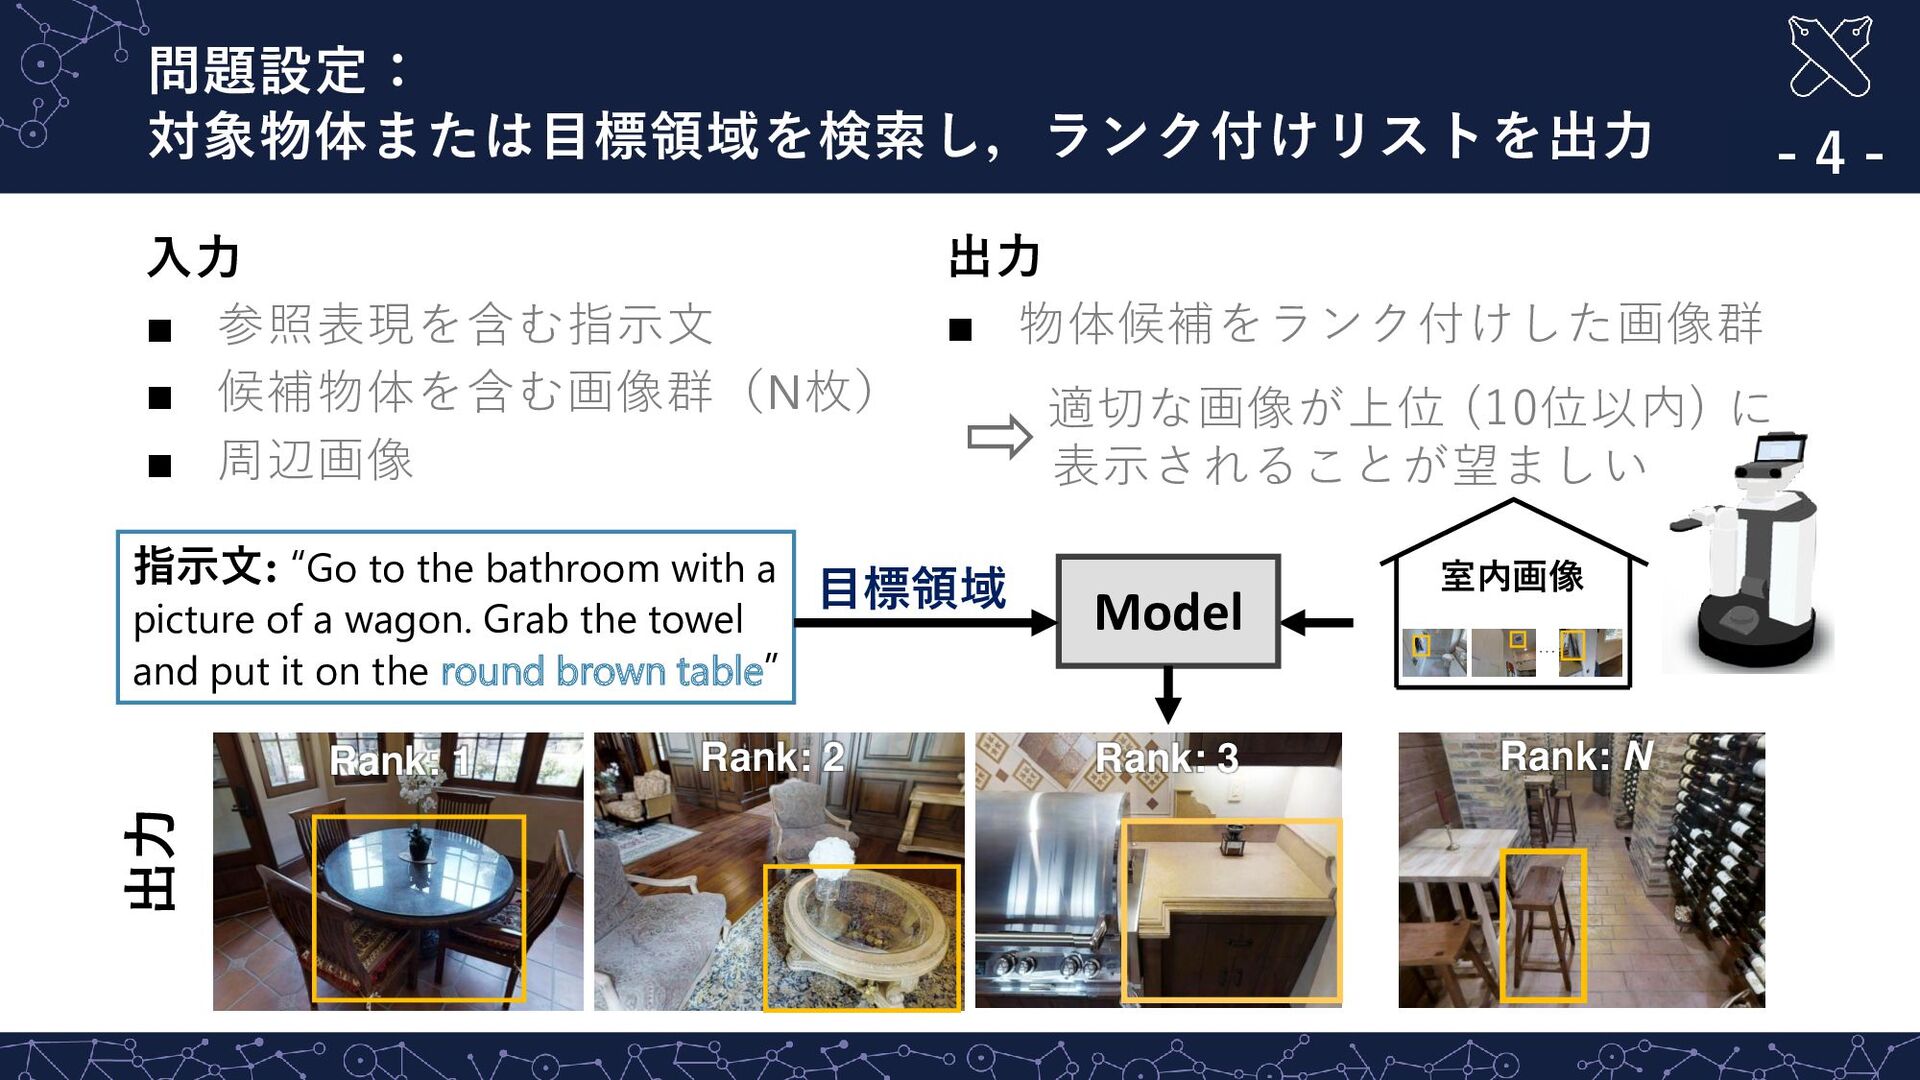
問題設定: 対象物体または目標領域を検索し,ランク付けリストを出力 - 4 - Model ・・・ 室内画像 目標領域 出力
Rank: N Rank: 3 Rank: 2 Rank: 1 指示文: “Go to the bathroom with a picture of a wagon. Grab the towel and put it on the round brown table” 入力 ▪ 参照表現を含む指示文 ▪ 候補物体を含む画像群(N枚) ▪ 周辺画像 出力 ▪ 物体候補をランク付けした画像群 適切な画像が上位 (10位以内) に 表示されることが望ましい -
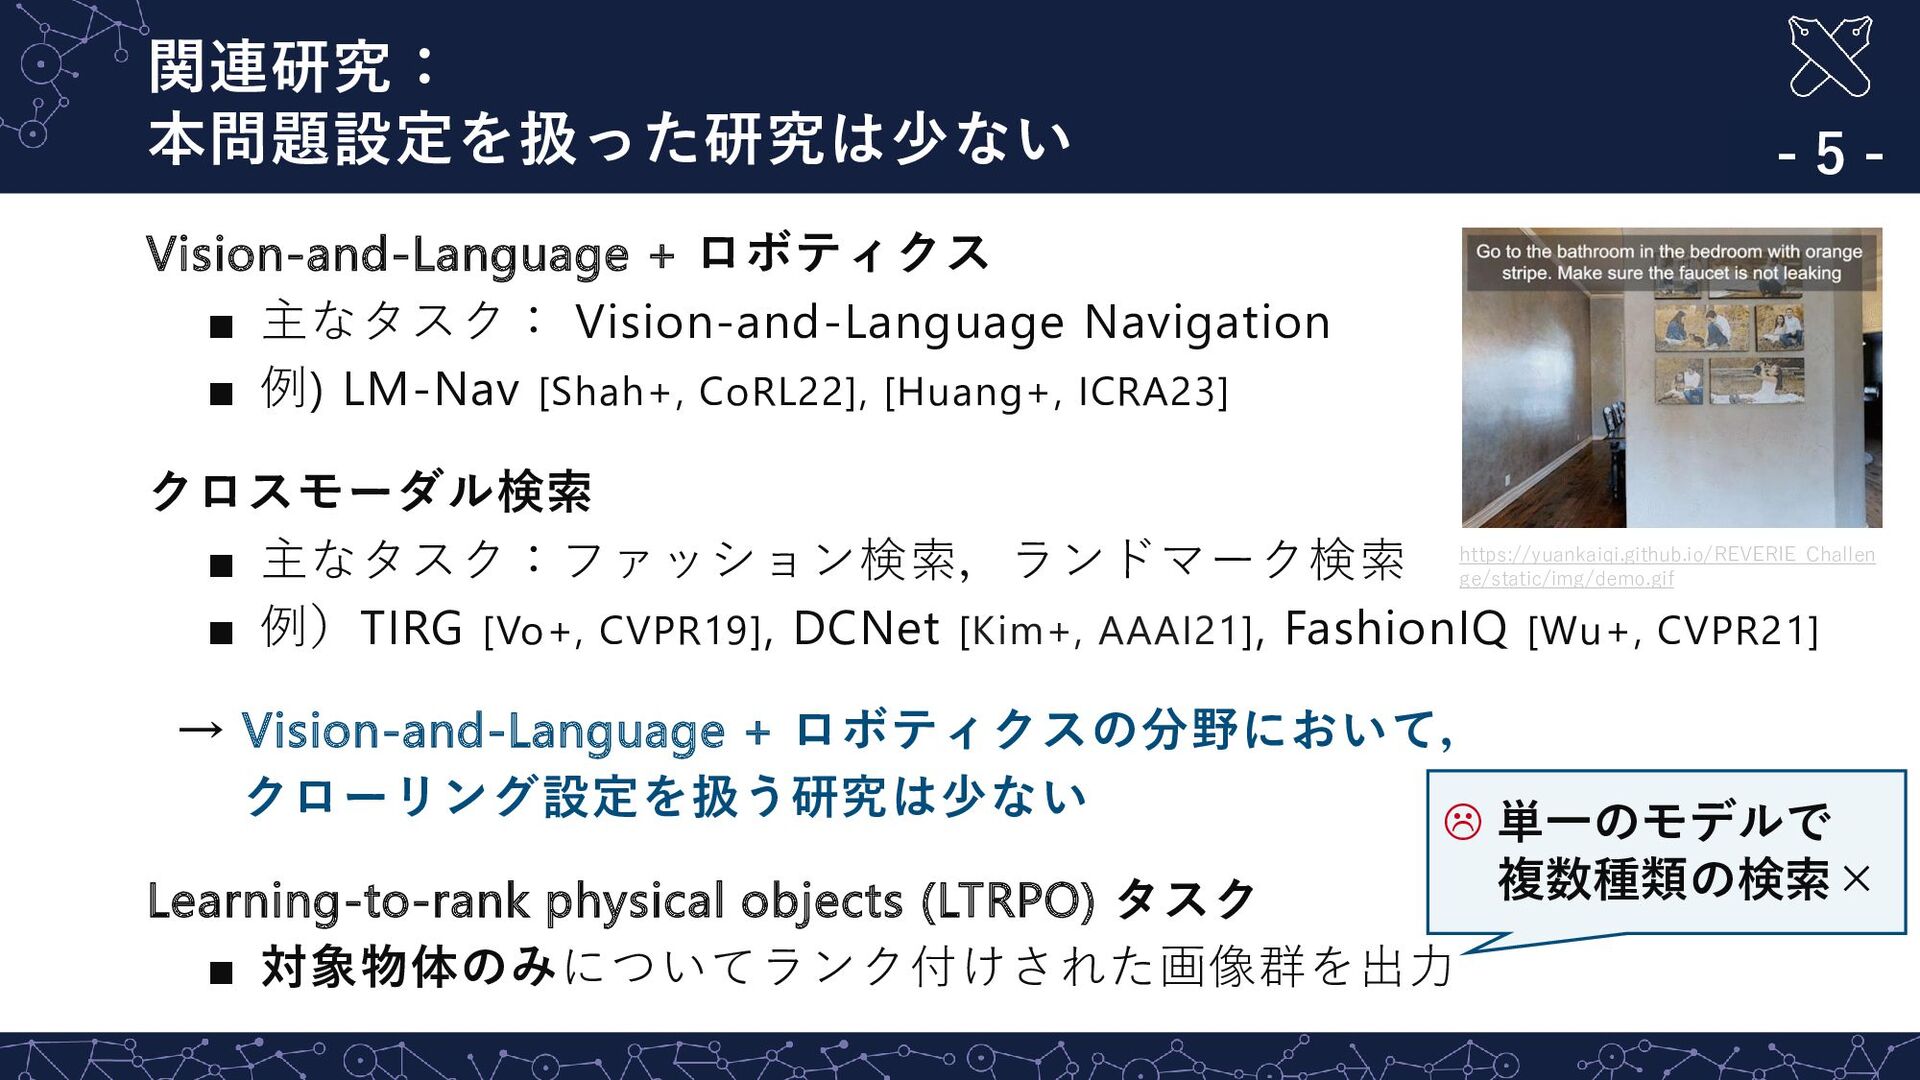
関連研究: 本問題設定を扱った研究は少ない - 5 - Vision-and-Language + ロボティクス ▪ 主なタスク:
Vision-and-Language Navigation ▪ 例) LM-Nav [Shah+, CoRL22], [Huang+, ICRA23] クロスモーダル検索 ▪ 主なタスク:ファッション検索,ランドマーク検索 ▪ 例)TIRG [Vo+, CVPR19], DCNet [Kim+, AAAI21], FashionIQ [Wu+, CVPR21] → Vision-and-Language + ロボティクスの分野において, クローリング設定を扱う研究は少ない Learning-to-rank physical objects (LTRPO) タスク ▪ 対象物体のみについてランク付けされた画像群を出力 https://yuankaiqi.github.io/REVERIE_Challen ge/static/img/demo.gif 単一のモデルで 複数種類の検索× -
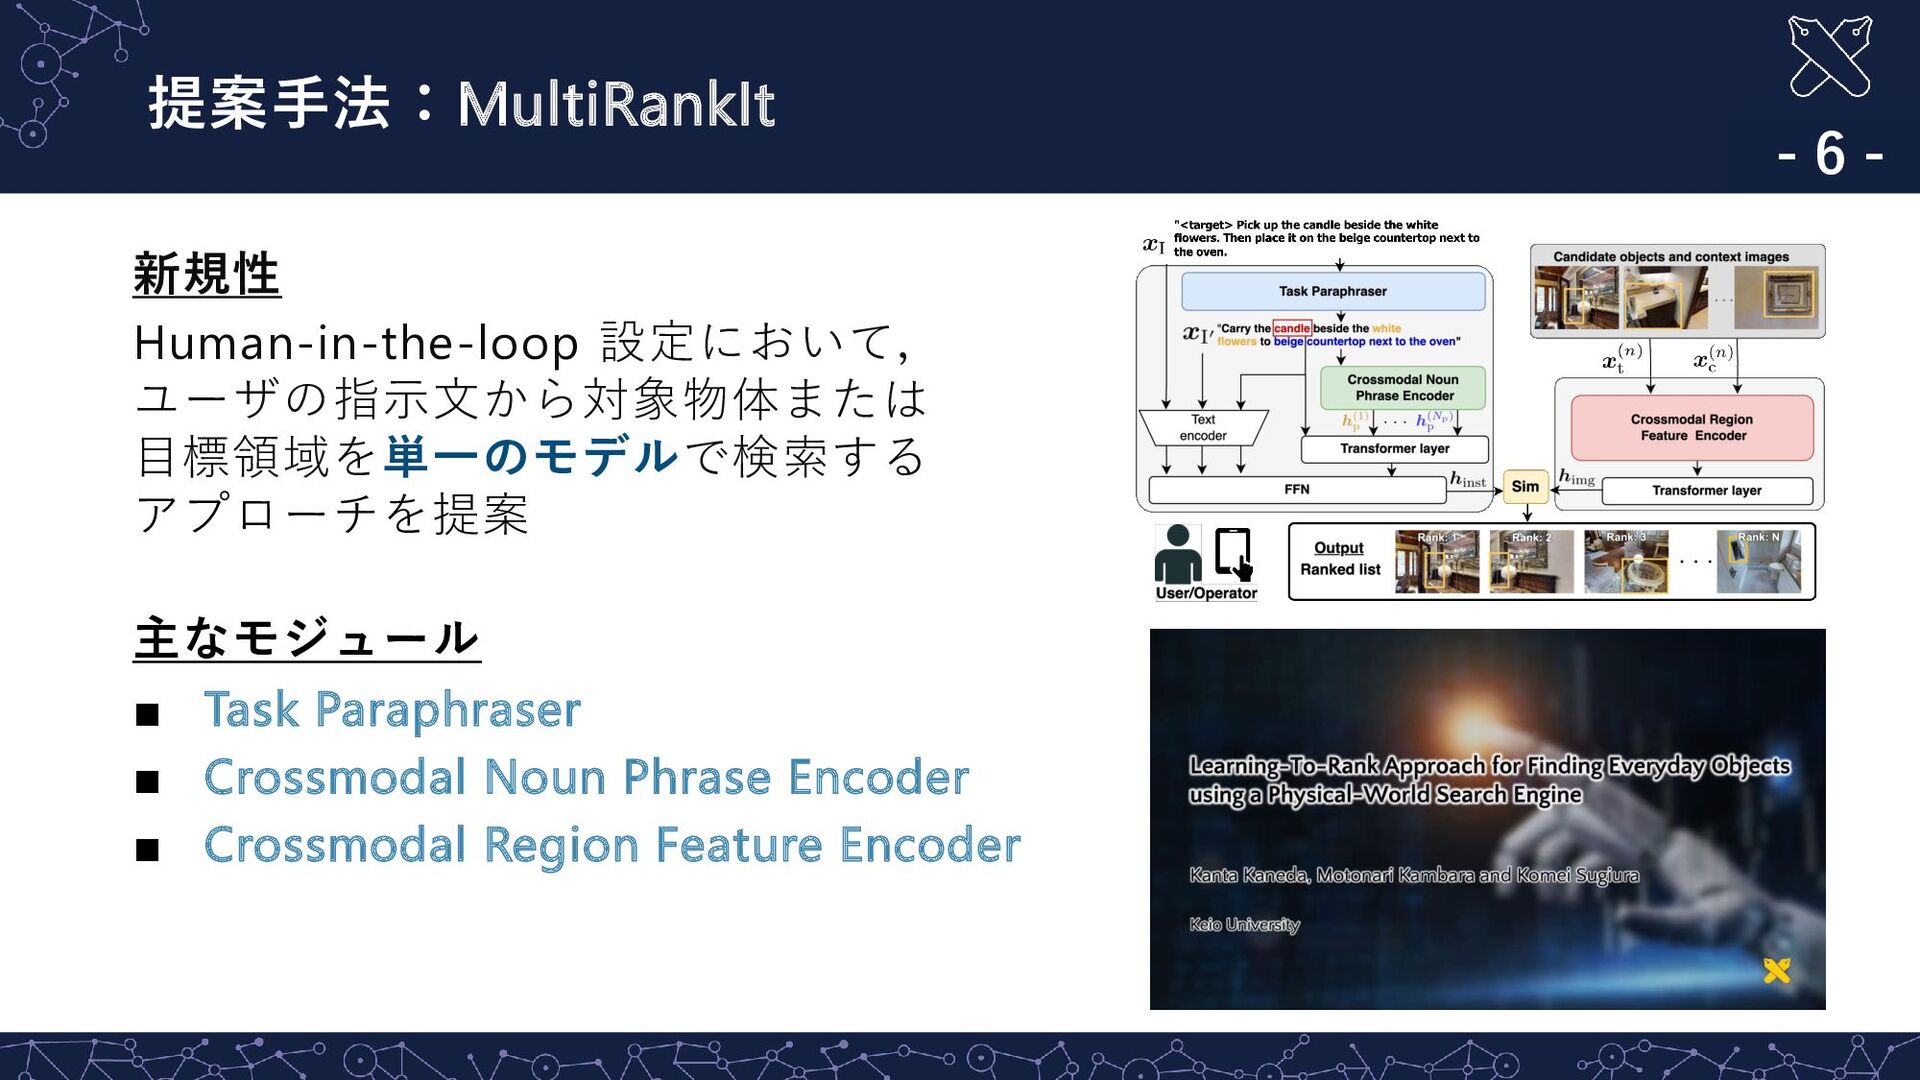
提案手法:MultiRankIt - 6 - 新規性 Human-in-the-loop 設定において, ユーザの指示文から対象物体または 目標領域を単一のモデルで検索する アプローチを提案
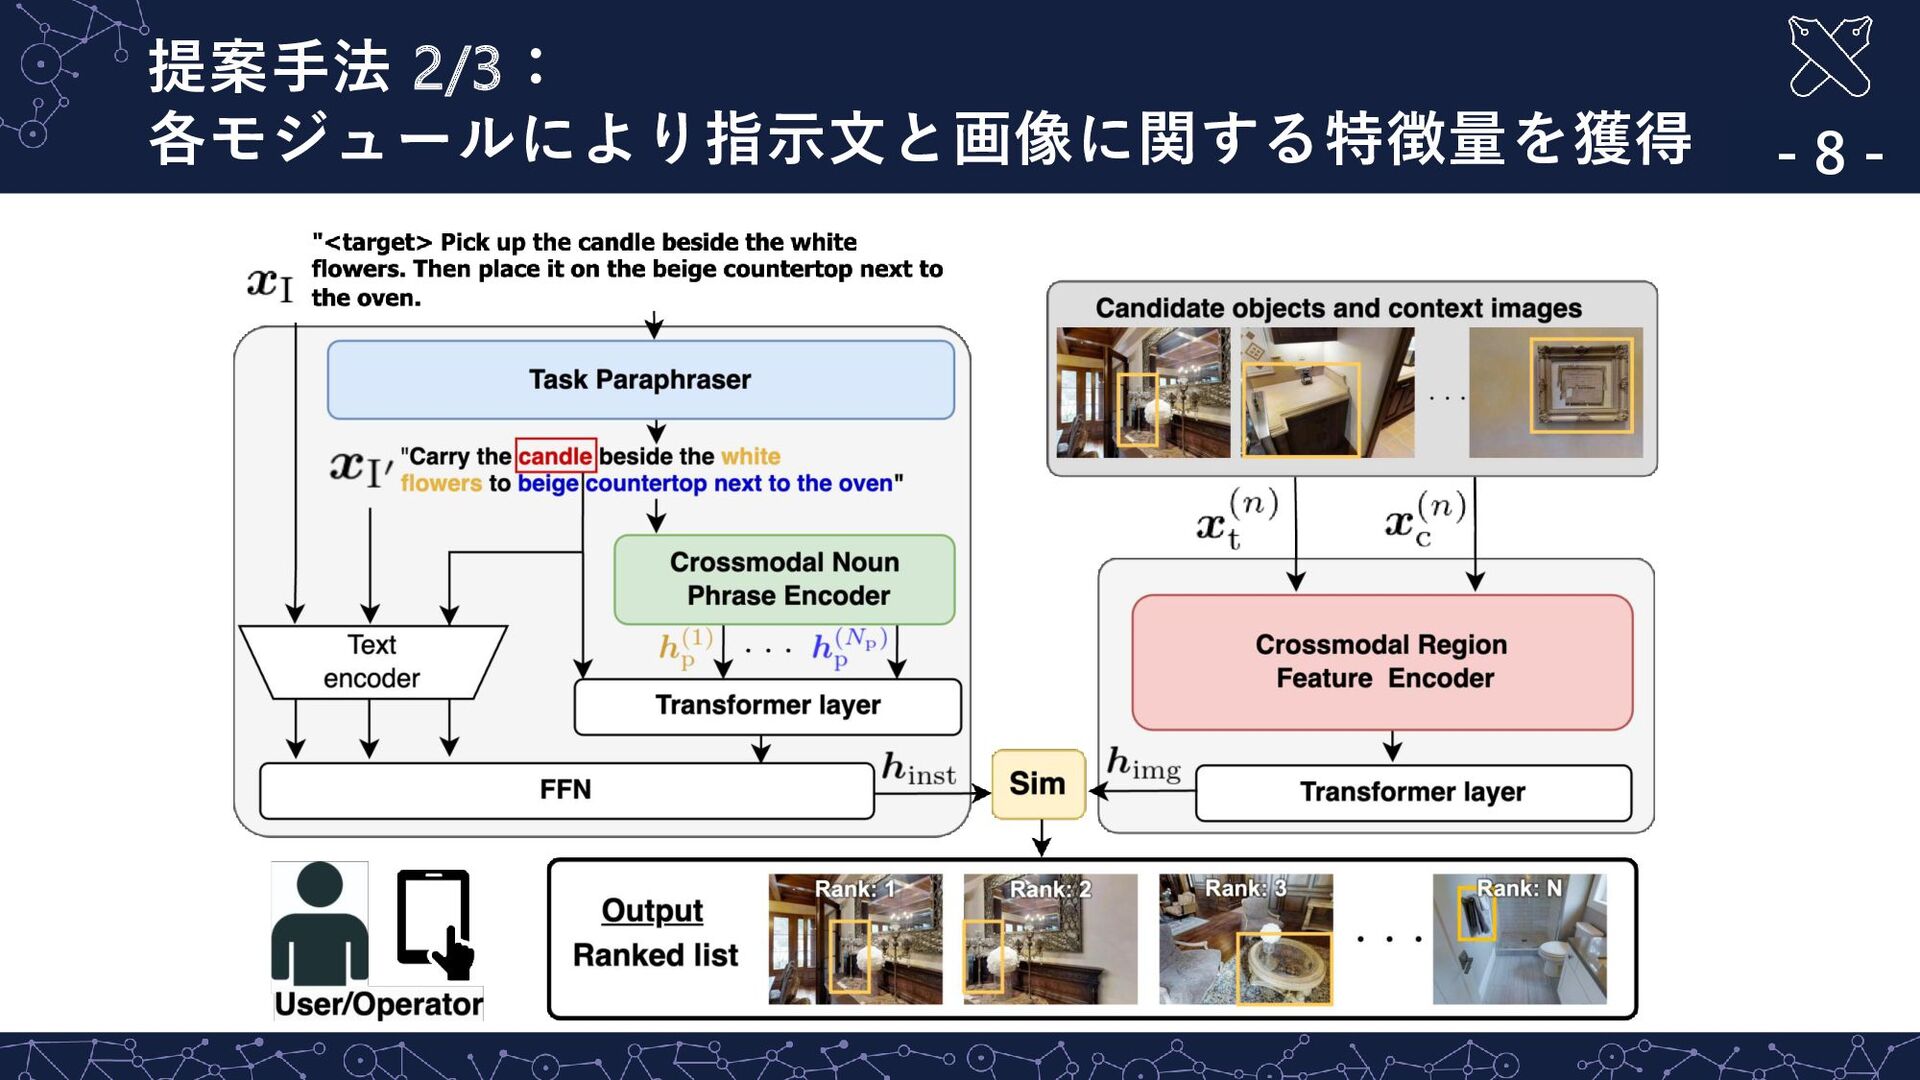
主なモジュール ▪ Task Paraphraser ▪ Crossmodal Noun Phrase Encoder ▪ Crossmodal Region Feature Encoder -
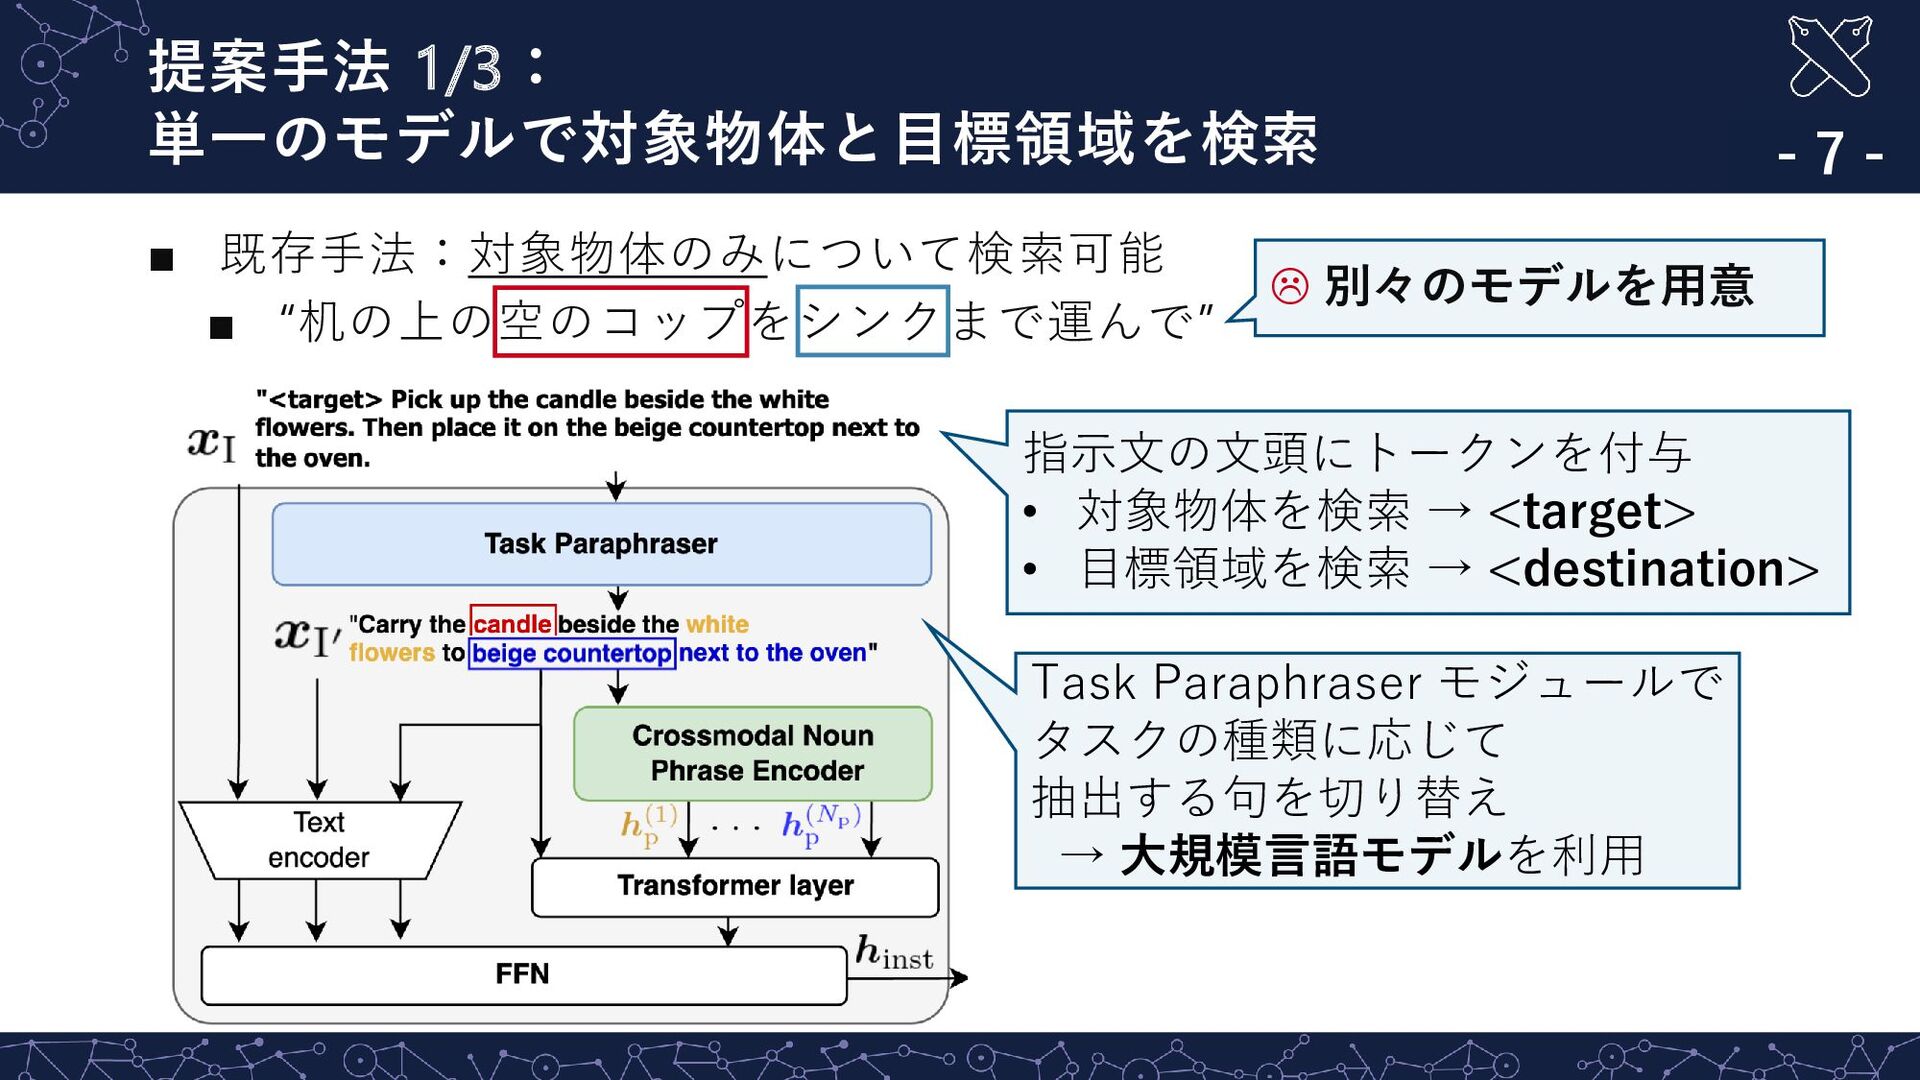
指示文の文頭にトークンを付与 • 対象物体を検索 → <target> • 目標領域を検索 → <destination> 提案手法
1/3: 単一のモデルで対象物体と目標領域を検索 - 7 - ▪ 既存手法:対象物体のみについて検索可能 ▪ “机の上の空のコップをシンクまで運んで” 別々のモデルを用意 Task Paraphraser モジュールで タスクの種類に応じて 抽出する句を切り替え → 大規模言語モデルを利用 -
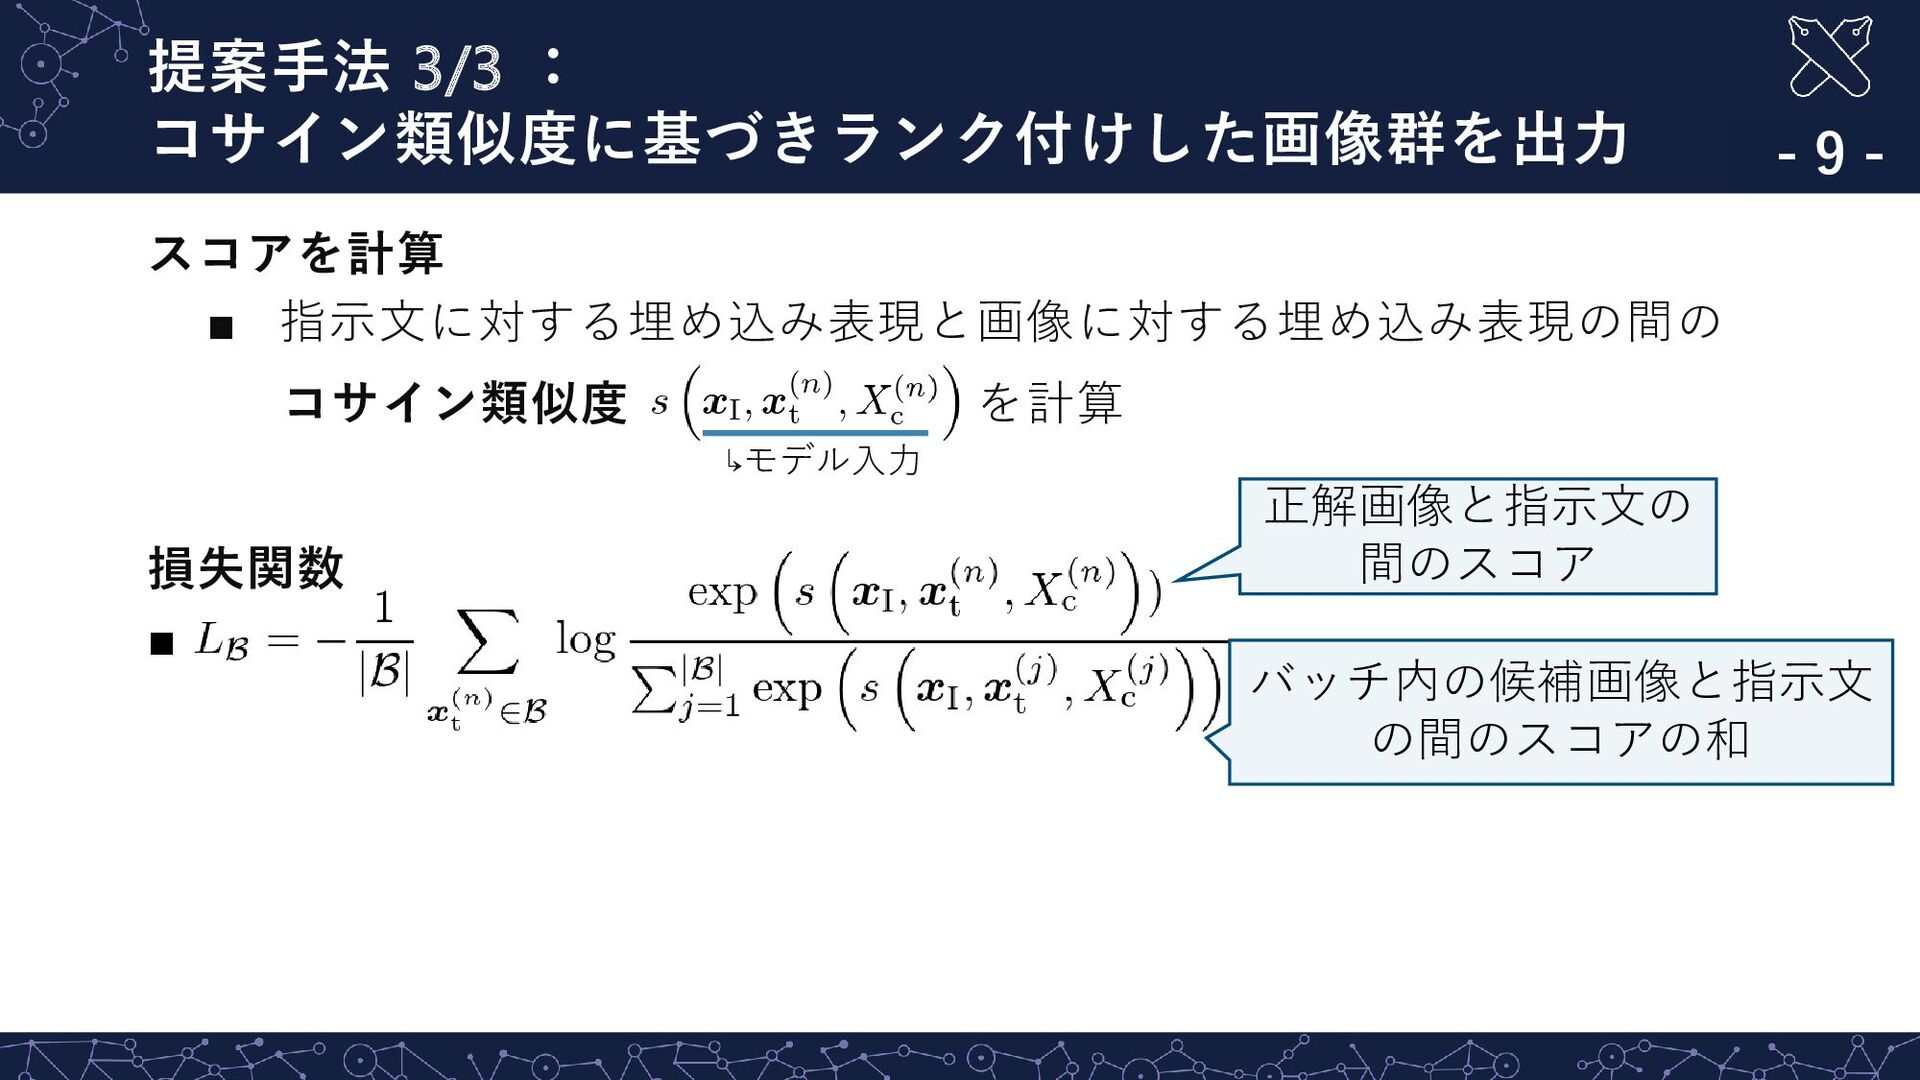
スコアを計算 ▪ 指示文に対する埋め込み表現と画像に対する埋め込み表現の間の コサイン類似度 を計算 損失関数 ▪ . 提案手法 3/3
: コサイン類似度に基づきランク付けした画像群を出力 - 9 - バッチ内の候補画像と指示文 の間のスコアの和 正解画像と指示文の 間のスコア ↳モデル入力 -
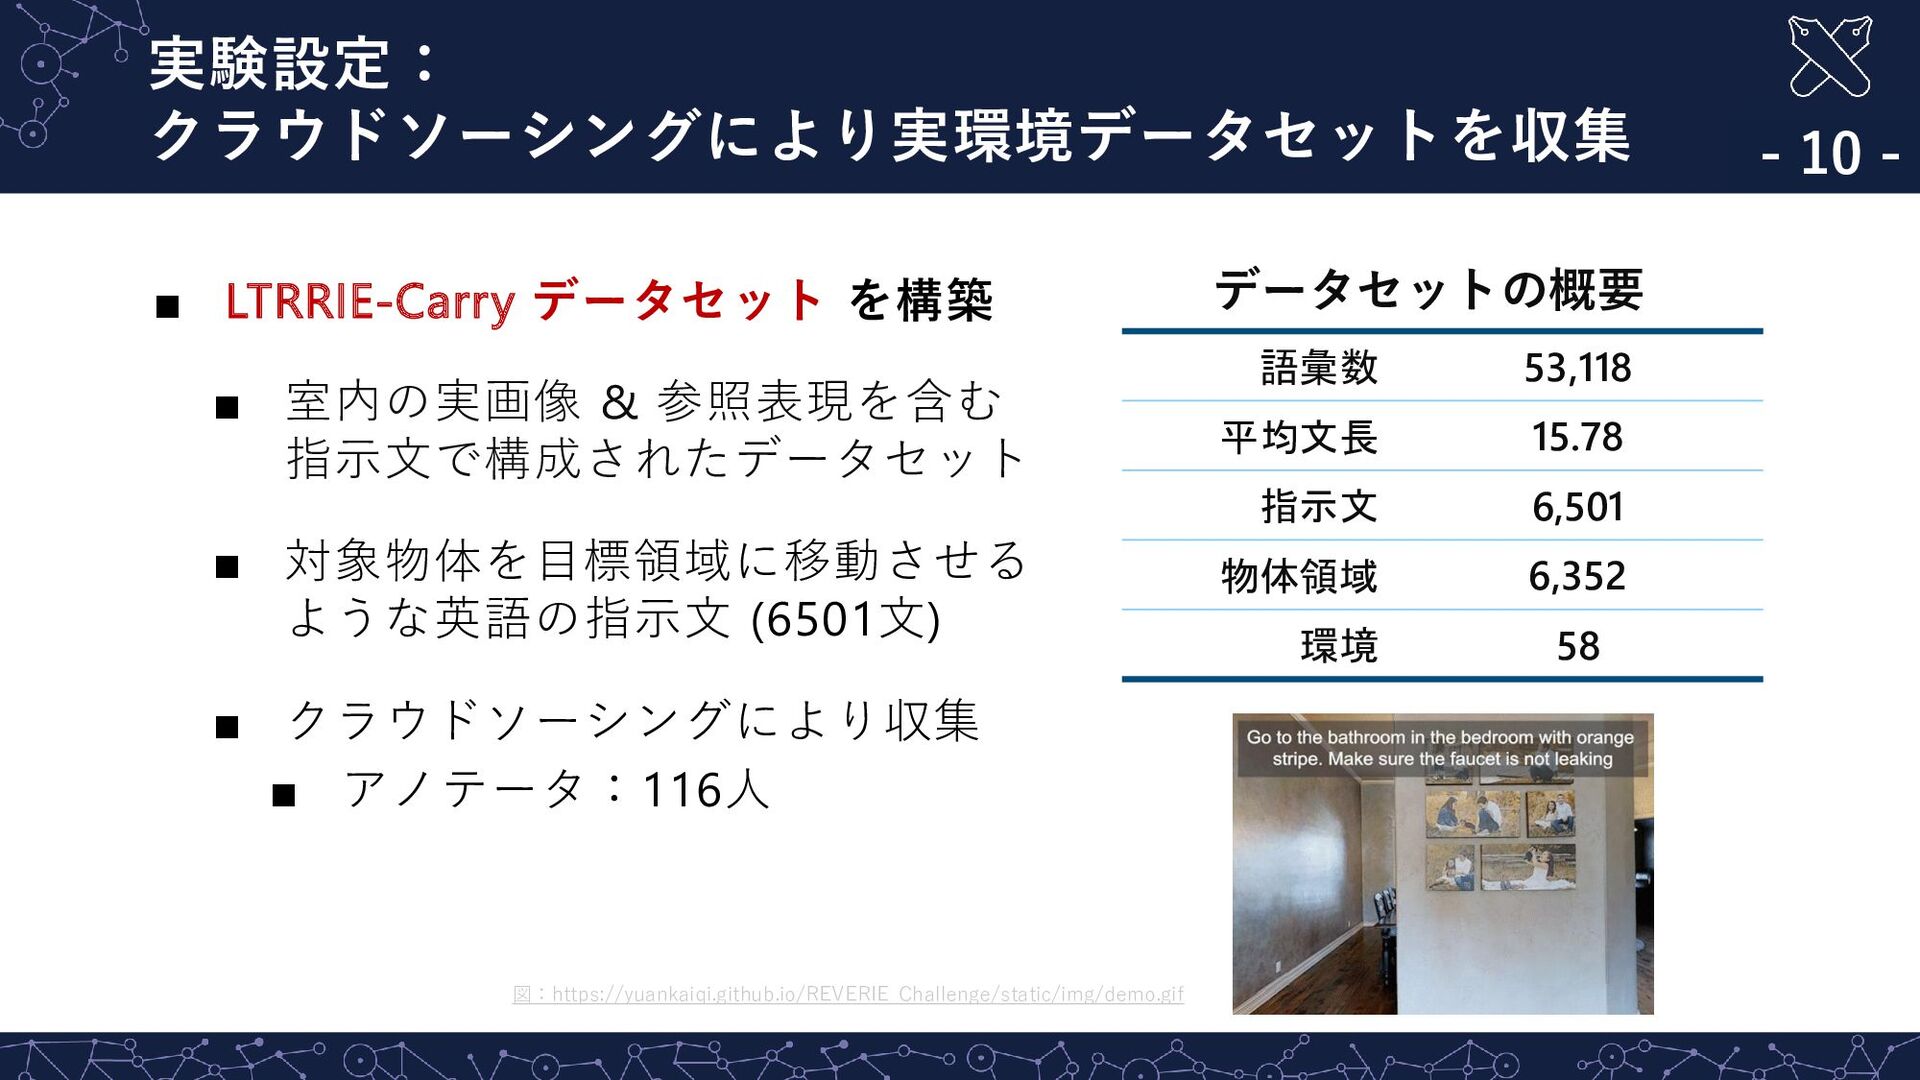
実験設定: クラウドソーシングにより実環境データセットを収集 - 10 - ▪ LTRRIE-Carry データセット を構築 ▪
室内の実画像 & 参照表現を含む 指示文で構成されたデータセット ▪ 対象物体を目標領域に移動させる ような英語の指示文 (6501文) ▪ クラウドソーシングにより収集 ▪ アノテータ:116人 語彙数 53,118 平均文長 15.78 指示文 6,501 物体領域 6,352 環境 58 データセットの概要 図:https://yuankaiqi.github.io/REVERIE_Challenge/static/img/demo.gif -
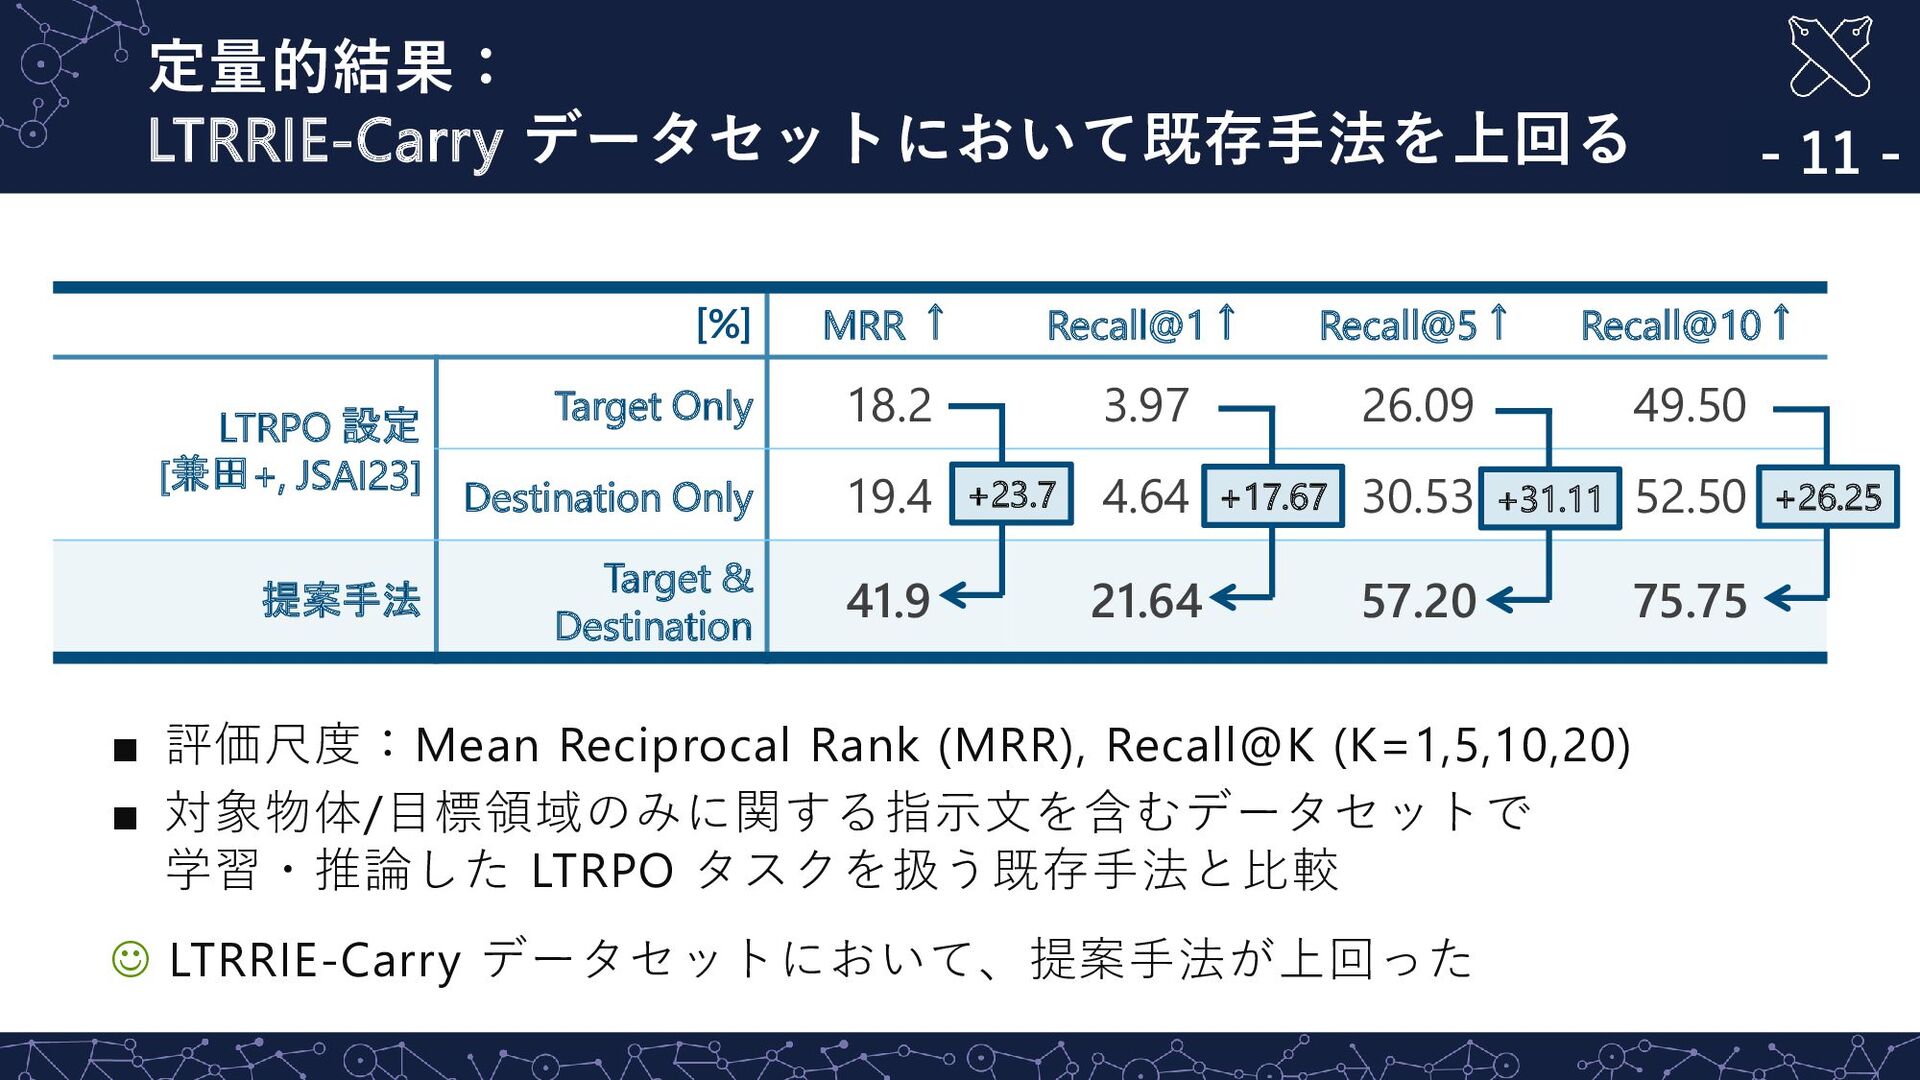
定量的結果: LTRRIE-Carry データセットにおいて既存手法を上回る - 11 - ▪ 評価尺度:Mean Reciprocal Rank
(MRR), Recall@K (K=1,5,10,20) ▪ 対象物体/目標領域のみに関する指示文を含むデータセットで 学習・推論した LTRPO タスクを扱う既存手法と比較 ☺ LTRRIE-Carry データセットにおいて、提案手法が上回った [%] MRR ↑ Recall@1↑ Recall@5↑ Recall@10↑ LTRPO 設定 [兼田+, JSAI23] Target Only 18.2 3.97 26.09 49.50 Destination Only 19.4 4.64 30.53 52.50 提案手法 Target & Destination 41.9 21.64 57.20 75.75 +23.7 +17.67 +31.11 +26.25 -
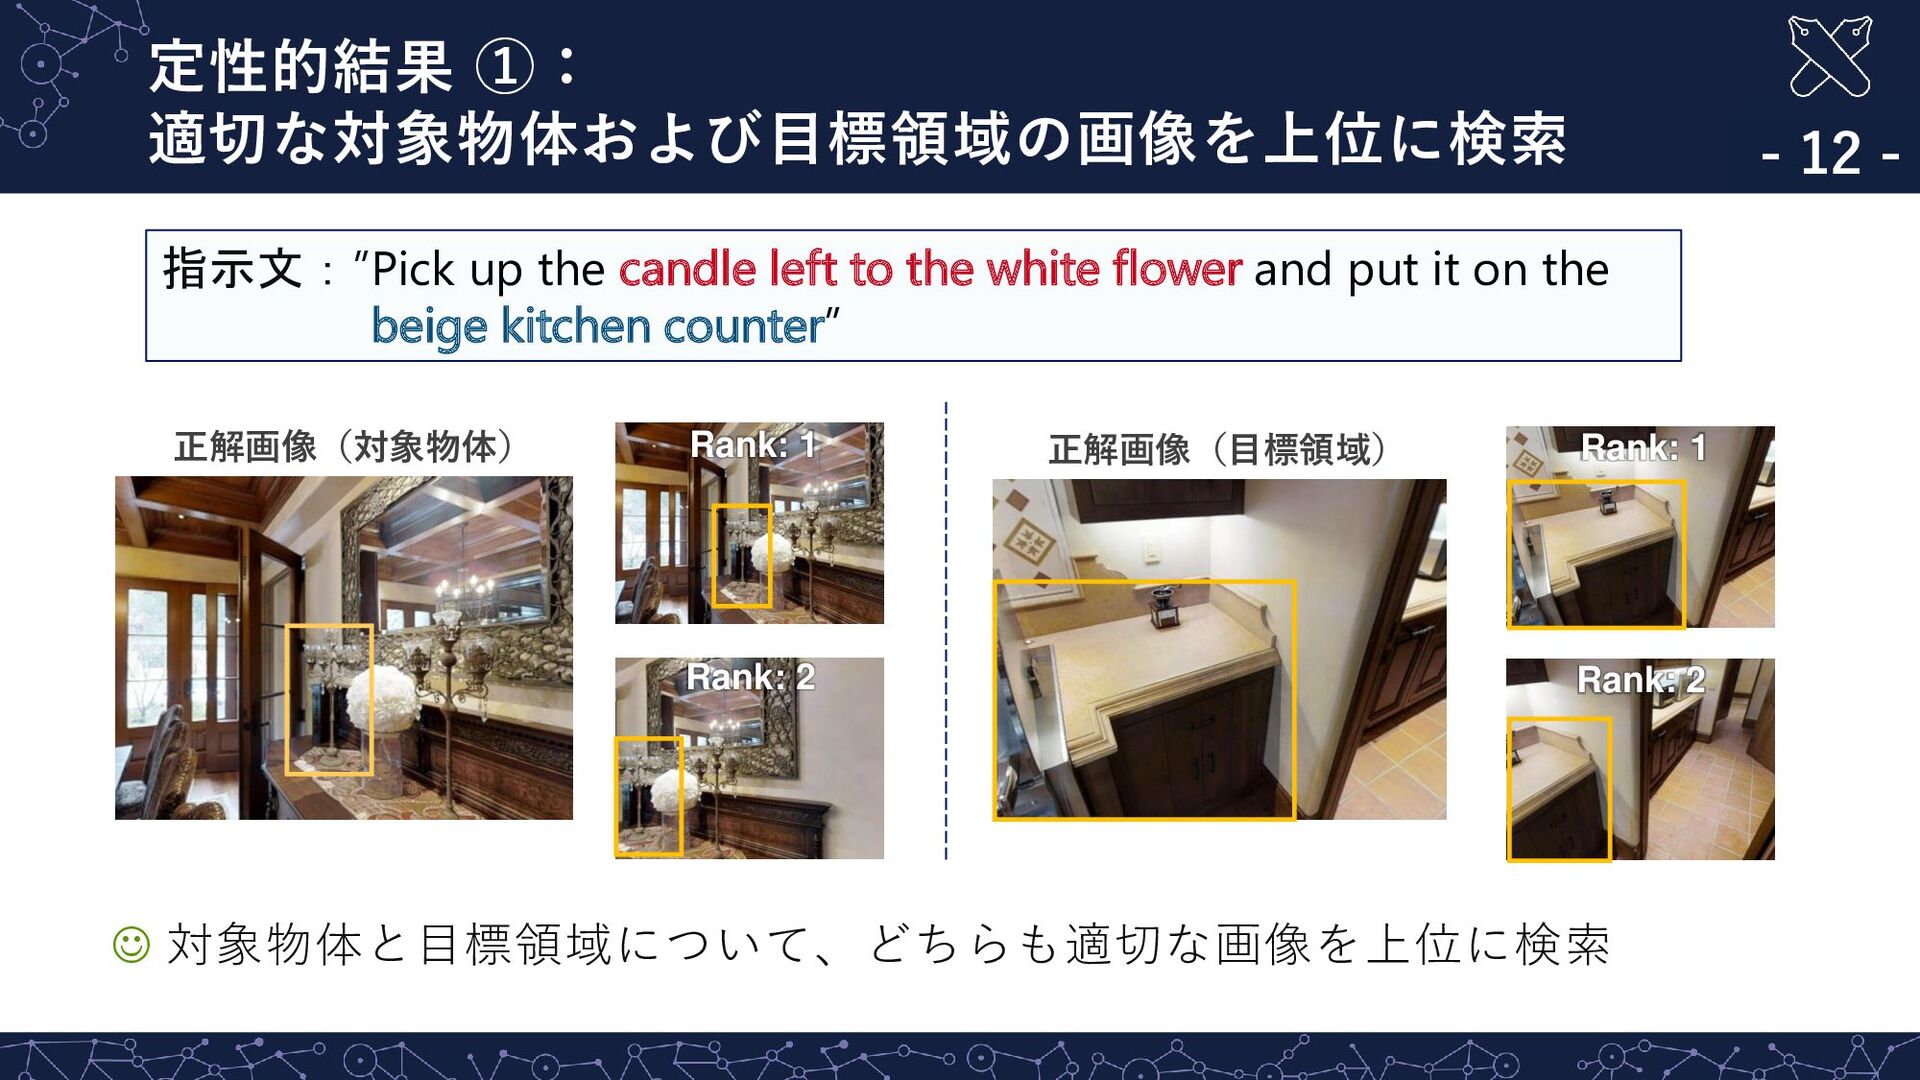
定性的結果 ①: 適切な対象物体および目標領域の画像を上位に検索 - 12 - ☺ 対象物体と目標領域について、どちらも適切な画像を上位に検索 Rank: 1
指示文:”Pick up the candle left to the white flower and put it on the beige kitchen counter” 正解画像(対象物体) Rank: 2 Rank: 1 正解画像(目標領域) Rank: 2 -
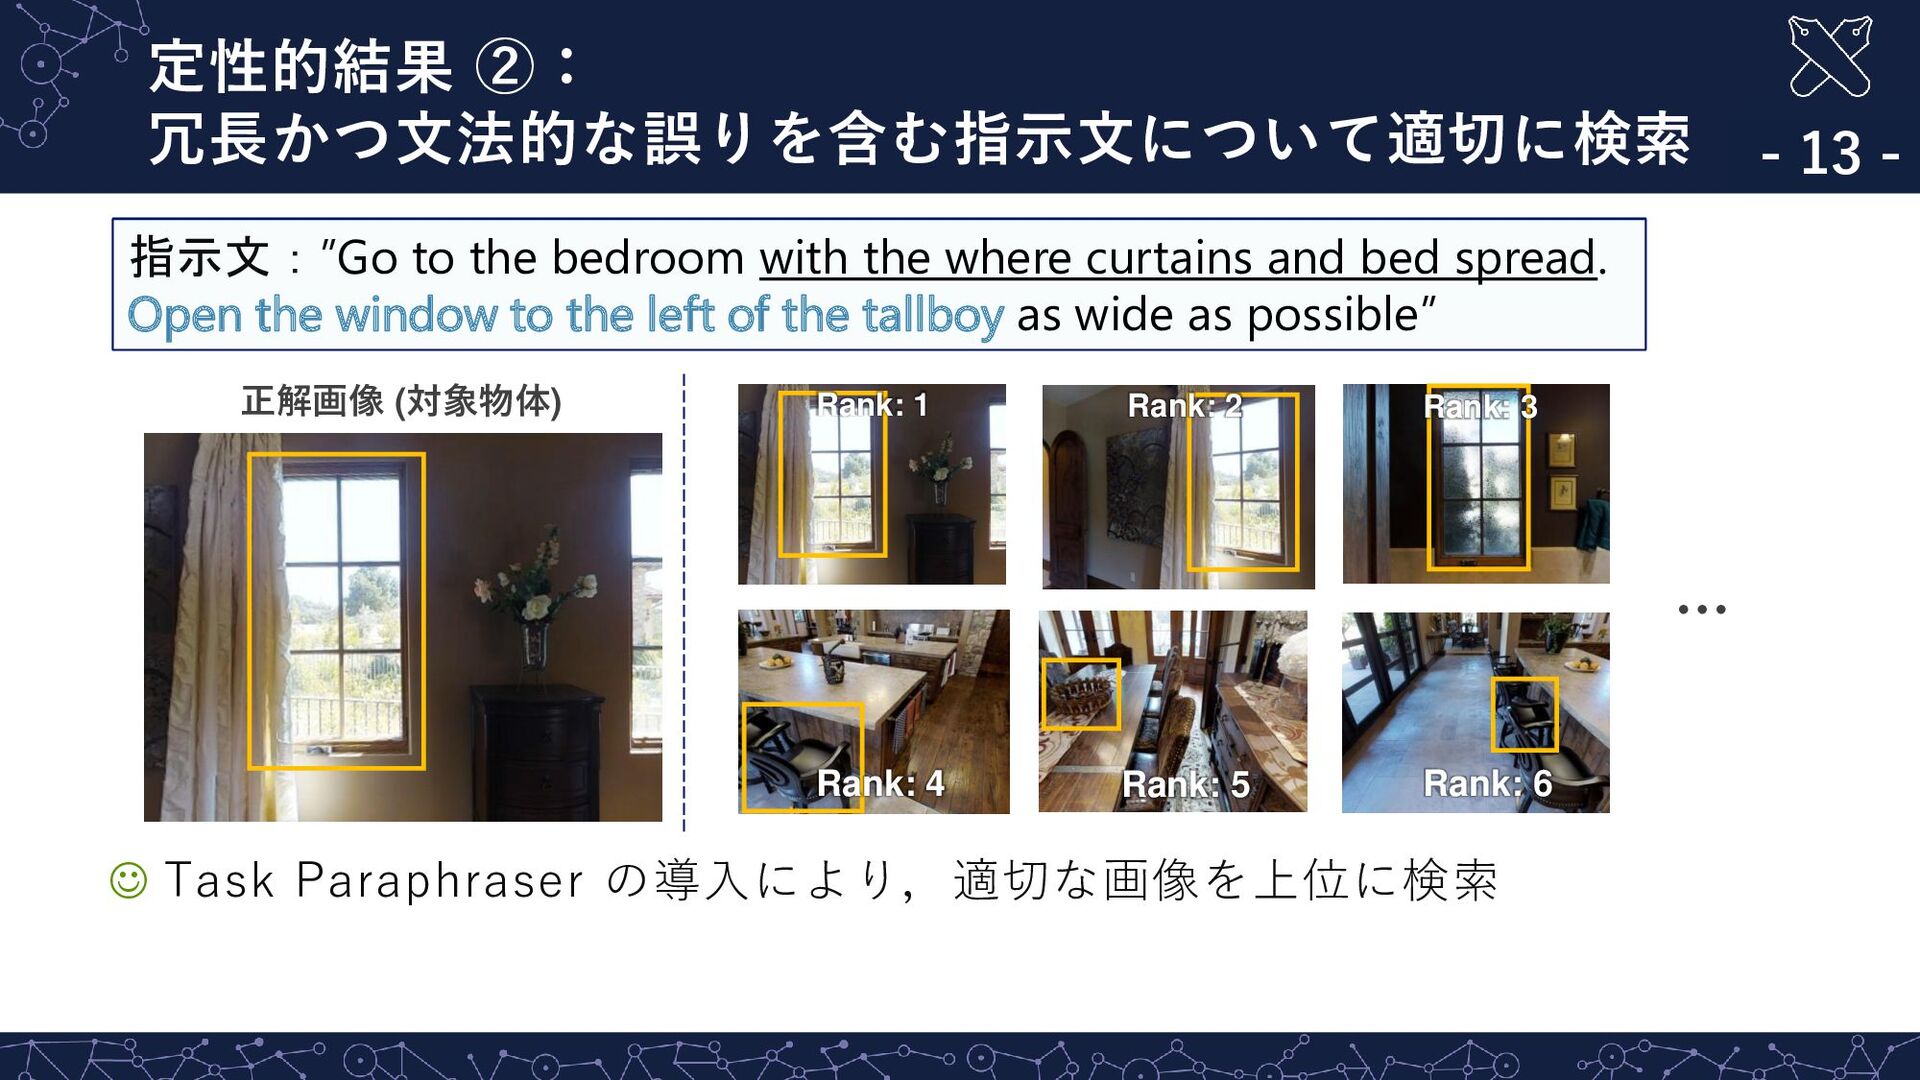
指示文:”Go to the bedroom with the where curtains and bed
spread. Open the window to the left of the tallboy as wide as possible” 定性的結果 ②: 冗長かつ文法的な誤りを含む指示文について適切に検索 - 13 - … 正解画像 (対象物体) Rank: 4 Rank: 5 Rank: 6 ☺ Task Paraphraser の導入により,適切な画像を上位に検索 Rank: 1 Rank: 2 Rank: 3 指示文:”Go to the bedroom with the where curtains and bed spread. Open the window to the left of the tallboy as wide as possible” -
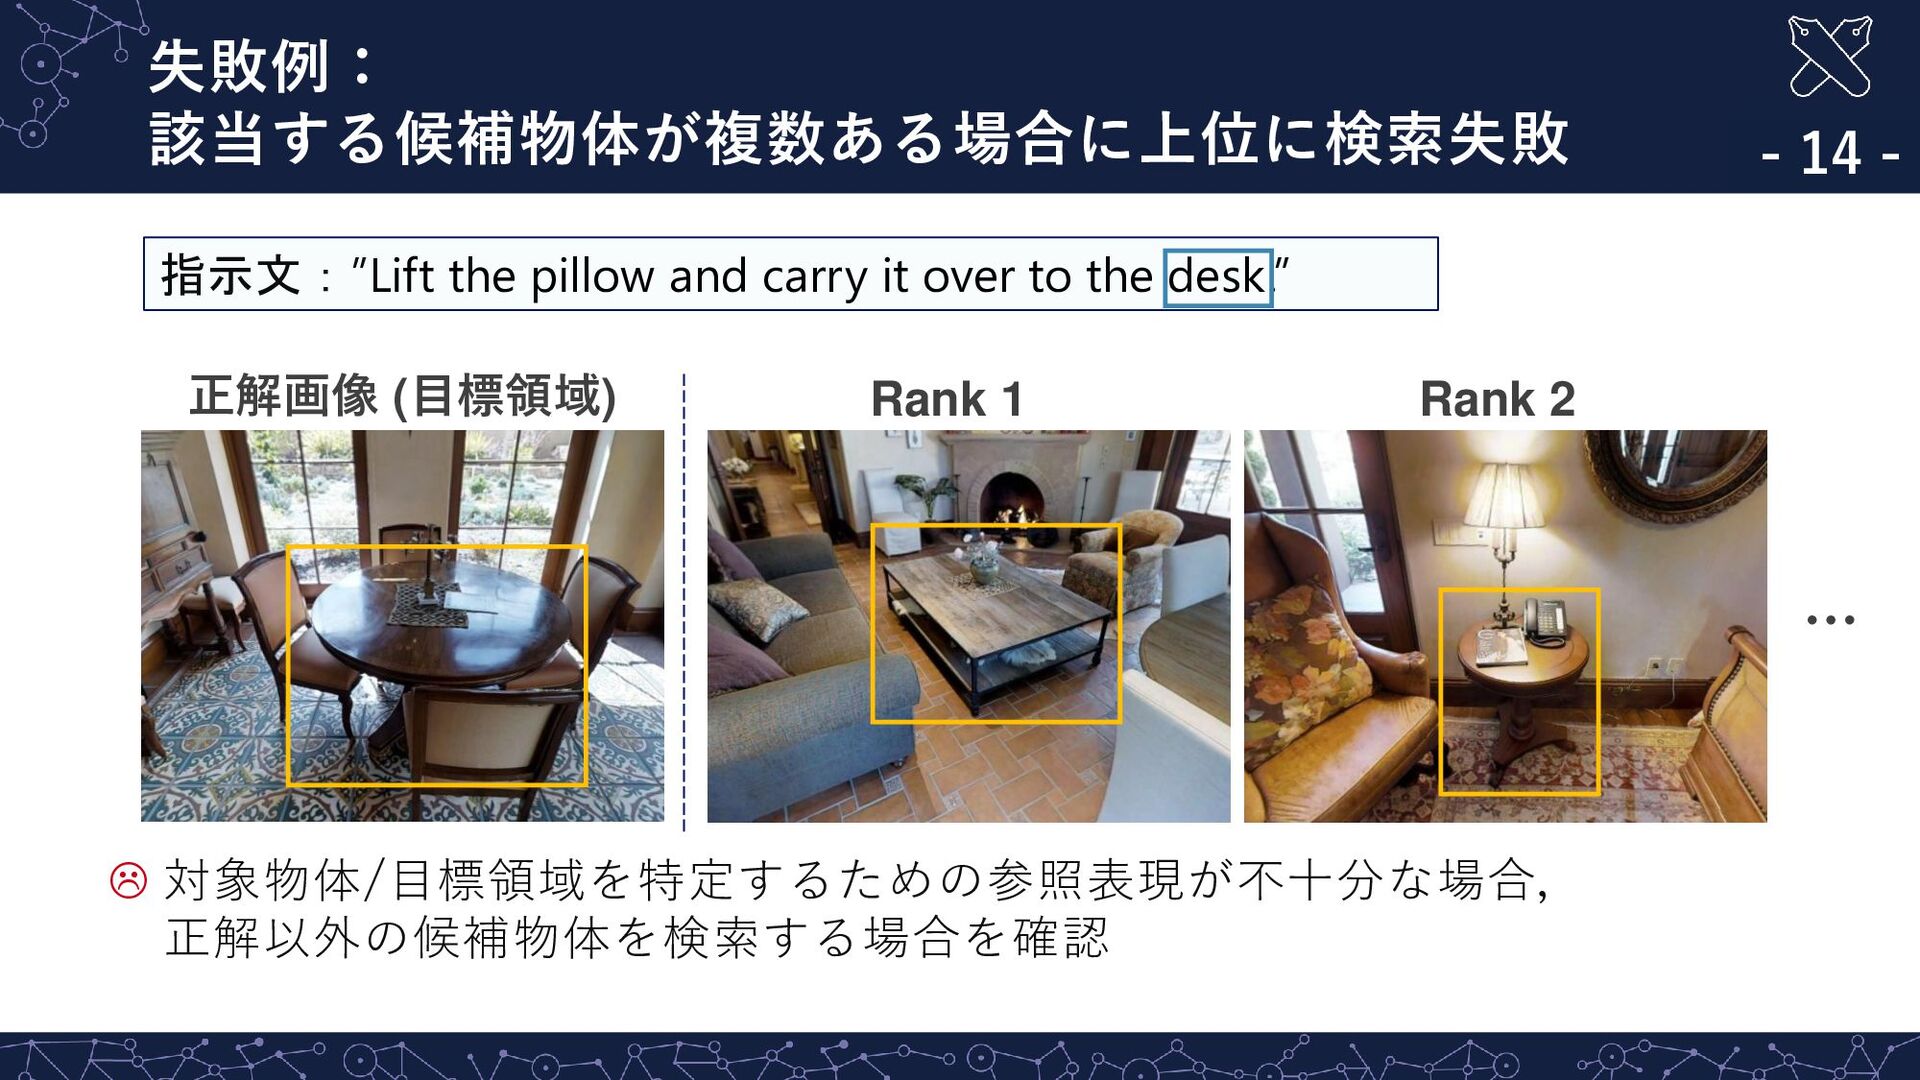
失敗例: 該当する候補物体が複数ある場合に上位に検索失敗 - 14 - … 正解画像 (目標領域) 対象物体/目標領域を特定するための参照表現が不十分な場合,
正解以外の候補物体を検索する場合を確認 指示文:”Lift the pillow and carry it over to the desk.” Rank 1 Rank 2 -
まとめ - 15 - ▪ 背景 ▪ 在宅介護者の不足に対して, 生活支援ロボットに期待 ▪
提案 ▪ Human-in-the-loop 設定に おいて,ユーザの指示文から 対象物体および目標領域を 特定するMultiRankIt ▪ 結果 ▪ MRR, Recall@K において ベースライン手法を上回った