Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
10年ぶりの ニューラルネットワーク
Search
NOKUBI Takatsugu
July 18, 2020
Technology
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
10年ぶりの ニューラルネットワーク
2020年7月 東京エリア・関西合同Debian勉強会(オンライン開催)での発表資料
NOKUBI Takatsugu
July 18, 2020
More Decks by NOKUBI Takatsugu
See All by NOKUBI Takatsugu
テキスト生成とGPT-2
knok
0
88
論文「時系列数値データにおける変化要因の記述」の再現
knok
0
100
qemu-debootstrap
knok
0
93
LanguageToolを触ってみる
knok
0
19
自由ソフトウェアによるライブストリーミング
knok
0
41
自由なデータ
knok
0
37
Other Decks in Technology
See All in Technology
Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
occhi
1
580
Active Record Connection Adaptersにおける長年の課題に再び取り組む
yahonda
0
150
ソフトウェア ファクトリー - 再現性のあるソフトウェアの工場づくり / Software factory
iktakahiro
6
4.9k
Claude Code本は、どのように執筆チームで書かれたか
oikon48
1
380
Code for Security プロジェクト紹介 2026年10月
yu23ki14
0
110
Browser Spec: Testing Hotwire with Ruby
takahashim
1
120
Rustuna: Rustによる高速なOptuna実装
pfn
PRO
0
190
遠藤な_めぐろLT #38 「社内のAI活用推進」@麻布台_20261009
endonanana
0
130
エンタメ企業のM&Aを支えるデータ基盤 ― 統合から店舗のリアルタイム分析まで / Data Engineering Summit 2026
genda
0
170
UniFi(ユニファイ)AIカメラの現場活用
ludicmind
1
440
ストレスなくAIと付き合いたい!こんなときどうしてる?
namiki64
3
490
今さら理解するウェブフォントver.2026
takanorip
3
770
Featured
See All Featured
The Spectacular Lies of Maps
axbom
PRO
1
1.1k
Art, The Web, and Tiny UX
lynnandtonic
304
22k
How To Stay Up To Date on Web Technology
chriscoyier
790
250k
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
Agile that works and the tools we love
rasmusluckow
331
22k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
530
Designing for Timeless Needs
cassininazir
1
530
Optimising Largest Contentful Paint
csswizardry
37
4k
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
22k
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.4k
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
600
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
370
Transcript
10年ぶりの ニューラルネットワーク 東京エリア・関西合同Debian勉強会 2020/7/18 野首貴嗣
[email protected]
発表者について • 野首貴嗣 (NOKUBI Takatsugu) ◦
[email protected]
◦ OpenPGP id:
99452B4DD28BEEAC8AB5C931B06662EC9C0C1404 ▪ https://db.debian.org/fetchkey.cgi?fingerprint=99452B4DD28BEEAC8AB5C931B06662EC9C0C1404 ◦ 学生時代(1995)にニューラルネットを研究室の輪講でやっていた ▪ https://twitter.com/knok/status/860501450417360896 ▪ 第二次人工知能ブーム • ニューロ&ファジー
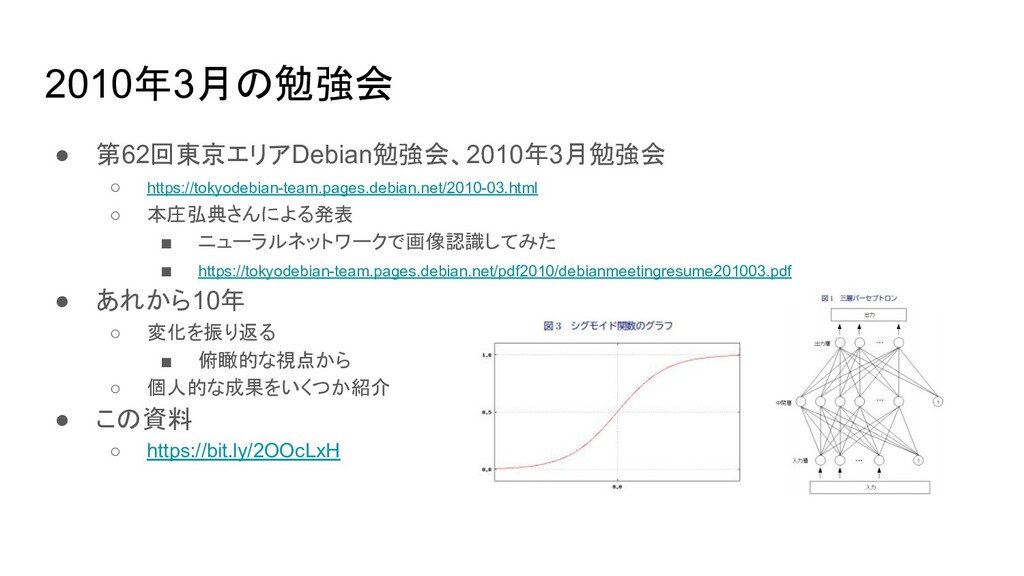
2010年3月の勉強会 • 第62回東京エリアDebian勉強会、2010年3月勉強会 ◦ https://tokyodebian-team.pages.debian.net/2010-03.html ◦ 本庄弘典さんによる発表 ▪ ニューラルネットワークで画像認識してみた ▪
https://tokyodebian-team.pages.debian.net/pdf2010/debianmeetingresume201003.pdf • あれから10年 ◦ 変化を振り返る ▪ 俯瞰的な視点から ◦ 個人的な成果をいくつか紹介 • この資料 ◦ https://bit.ly/2OOcLxH
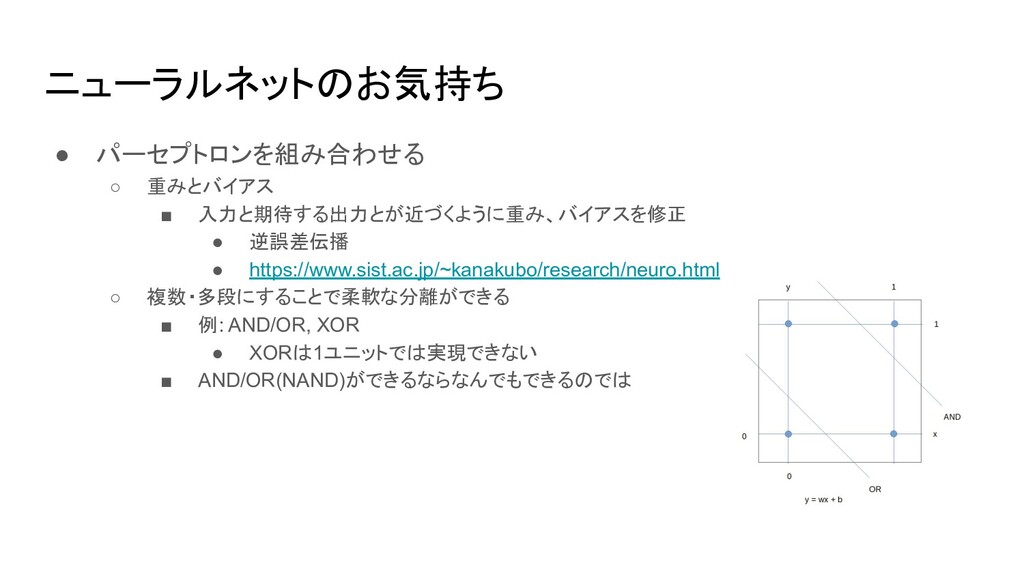
ニューラルネットのお気持ち • パーセプトロンを組み合わせる ◦ 重みとバイアス ▪ 入力と期待する出力とが近づくように重み、バイアスを修正 • 逆誤差伝播 •
https://www.sist.ac.jp/~kanakubo/research/neuro.html ◦ 複数・多段にすることで柔軟な分離ができる ▪ 例: AND/OR, XOR • XORは1ユニットでは実現できない ▪ AND/OR(NAND)ができるならなんでもできるのでは
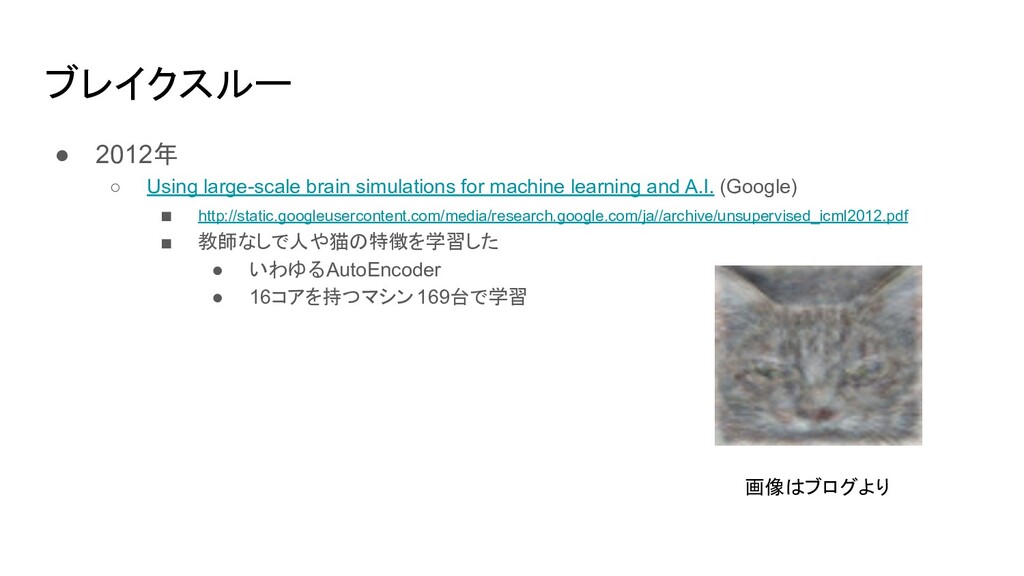
ブレイクスルー • 2012年 ◦ Using large-scale brain simulations for machine
learning and A.I. (Google) ▪ http://static.googleusercontent.com/media/research.google.com/ja//archive/unsupervised_icml2012.pdf ▪ 教師なしで人や猫の特徴を学習した • いわゆるAutoEncoder • 16コアを持つマシン169台で学習 画像はブログより
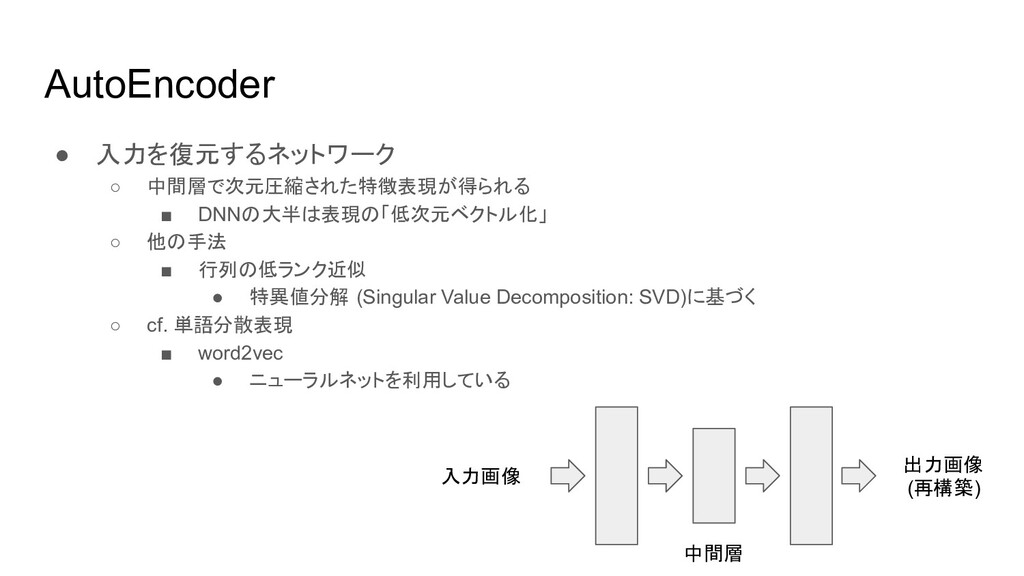
AutoEncoder • 入力を復元するネットワーク ◦ 中間層で次元圧縮された特徴表現が得られる ▪ DNNの大半は表現の「低次元ベクトル化」 ◦ 他の手法 ▪
行列の低ランク近似 • 特異値分解 (Singular Value Decomposition: SVD)に基づく ◦ cf. 単語分散表現 ▪ word2vec • ニューラルネットを利用している 入力画像 出力画像 (再構築) 中間層
ブレイクスルー実現要素(1) • 計算資源 ◦ 計算能力の向上 ▪ 1995:PA-RISC (hp-pa9) 25MHz •
メモリ16MB ▪ SIMD命令の充実 ▪ メモリ量の増大 ◦ GPGPU ▪ 行列演算と相性が良い • 近年のスパコンもGPUを装備 ▪ AMD/NVIDIAの競争 ▪ cuda, cuDNN (NVIDIA) • NVIDIAの優位性は依然としてある
ブレイクスルー実現要素(2) • 大規模データセット ◦ ImageNet, CIFAR-10, MNIST ◦ Google photos,
Facebook album等のプラットフォーム ◦ MS COCO ◦ OpenImages ◦ Wikipedia ◦ CommonCrawl • クラウドソーシングフレームワーク ◦ Amazon Mechanical Turk ◦ Cloudworks ▪ アノテーションを依頼できる
ブレイクスルー実現要素(3) • 課題解決技術 ◦ 勾配消失/発散問題 ▪ アクティベーション関数の改善 • ReLU等のramp function
▪ 最適化手法の改善 • クリッピング • Momentumな手法 • RMSProp, AdaGrad, ADAMとその後継 ▪ 正規化手法の躍進 • Batch Noramlization • 分散表現(埋め込み表現)の活用 ◦ いろんなものが数百次元のベクトルとして表現できるように ◦ https://www.slideshare.net/naoakiokazaki/20150530-jsai2015
ブレイクスルー実現要素(4) • データ拡張技術 ◦ 画像処理方面が顕著 ▪ アフィン変換、ノイズ付与などやりやすい手法が多い ▪ 自然言語処理はちょっと難しい •
辞書ベースなど • ラベルを必要としない学習 ◦ word2vec, GloVe等 ◦ 一部をマスク、入れ替え等 ▪ そこからただしいものを再構築できるよう学習させる • 表現学習 (representation learning) • 敵対的生成ネットワーク (GAN) ◦ 本物と生成されたものの区別をつける /欺く
環境面 • データサイエンティストブーム ◦ 2000年代 - 統計的手法 ▪ 多変量解析 ▪
トピックモデル ▪ Support Vector Machine (SVM) ◦ 2010年代 - 深層学習 ▪ MOOCsの充実 • Andrew Ng先生の無料講座(日本語字幕あり) ◦ 今でも有用なコンテンツ ▪ コンペティションの隆盛 • Kaggle, SIGNATE等 • 実行環境の充実 ◦ Google Colaboratory (無料でGPU/TPUが利用可能, 時間制限あり)
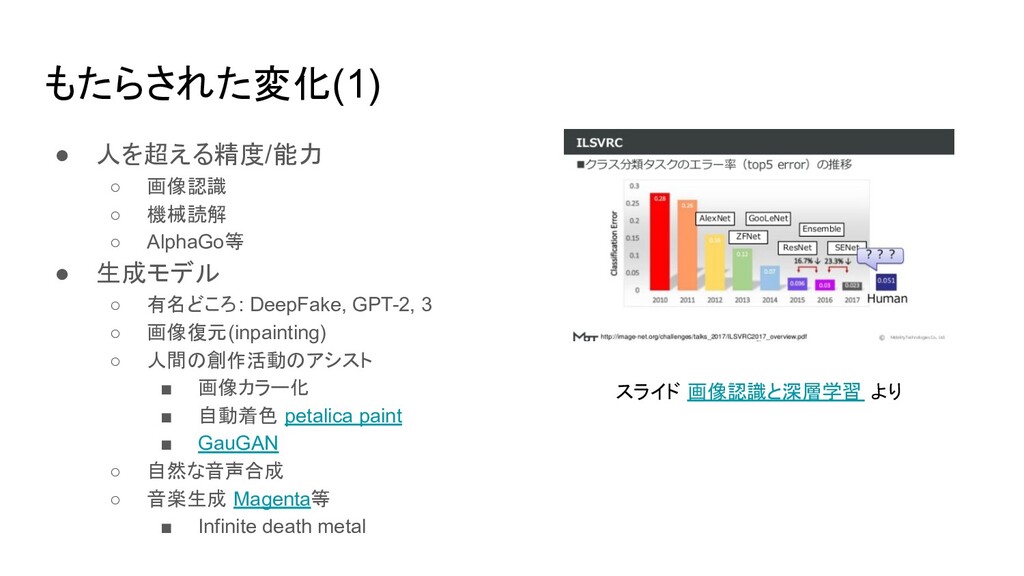
もたらされた変化(1) • 人を超える精度/能力 ◦ 画像認識 ◦ 機械読解 ◦ AlphaGo等 •
生成モデル ◦ 有名どころ: DeepFake, GPT-2, 3 ◦ 画像復元(inpainting) ◦ 人間の創作活動のアシスト ▪ 画像カラー化 ▪ 自動着色 petalica paint ▪ GauGAN ◦ 自然な音声合成 ◦ 音楽生成 Magenta等 ▪ Infinite death metal スライド 画像認識と深層学習 より
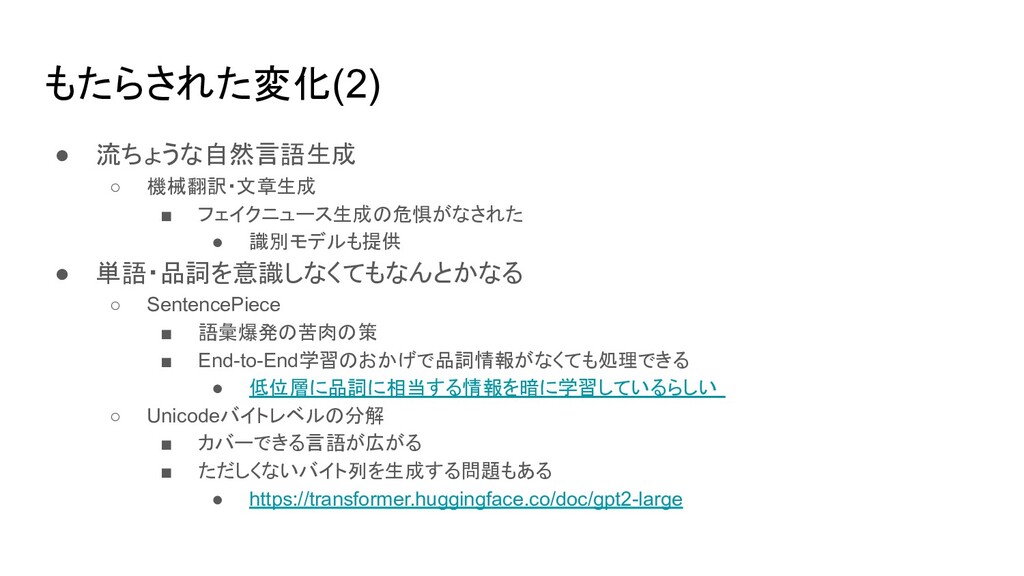
もたらされた変化(2) • 流ちょうな自然言語生成 ◦ 機械翻訳・文章生成 ▪ フェイクニュース生成の危惧がなされた • 識別モデルも提供 •
単語・品詞を意識しなくてもなんとかなる ◦ SentencePiece ▪ 語彙爆発の苦肉の策 ▪ End-to-End学習のおかげで品詞情報がなくても処理できる • 低位層に品詞に相当する情報を暗に学習しているらしい ◦ Unicodeバイトレベルの分解 ▪ カバーできる言語が広がる ▪ ただしくないバイト列を生成する問題もある • https://transformer.huggingface.co/doc/gpt2-large
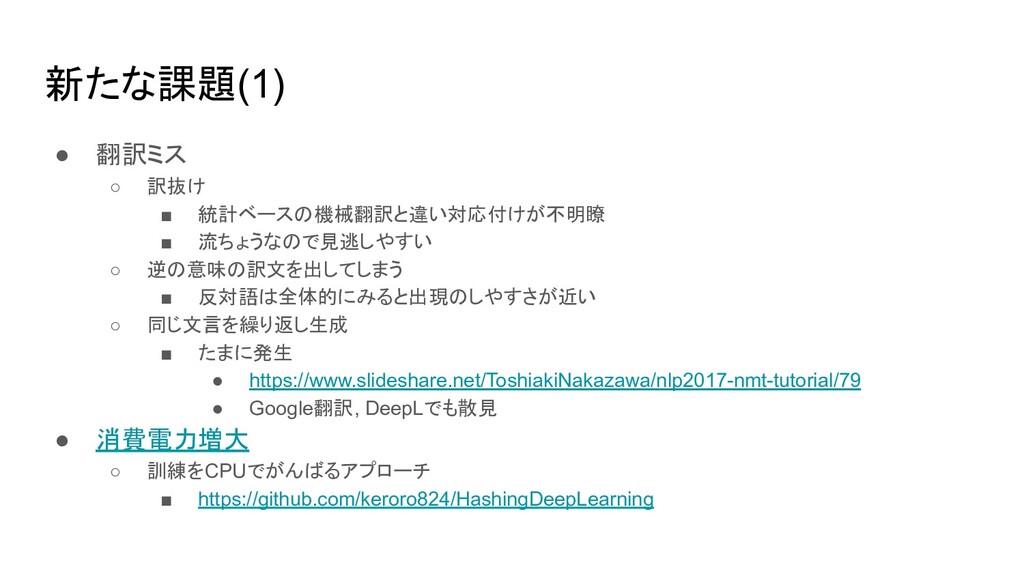
新たな課題(1) • 翻訳ミス ◦ 訳抜け ▪ 統計ベースの機械翻訳と違い対応付けが不明瞭 ▪ 流ちょうなので見逃しやすい ◦
逆の意味の訳文を出してしまう ▪ 反対語は全体的にみると出現のしやすさが近い ◦ 同じ文言を繰り返し生成 ▪ たまに発生 • https://www.slideshare.net/ToshiakiNakazawa/nlp2017-nmt-tutorial/79 • Google翻訳, DeepLでも散見 • 消費電力増大 ◦ 訓練をCPUでがんばるアプローチ ▪ https://github.com/keroro824/HashingDeepLearning
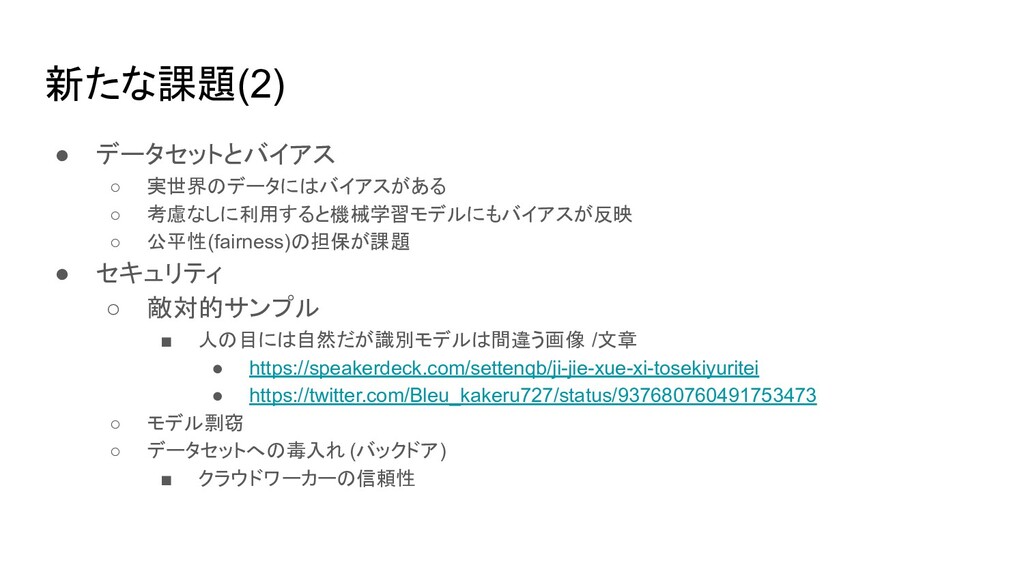
新たな課題(2) • データセットとバイアス ◦ 実世界のデータにはバイアスがある ◦ 考慮なしに利用すると機械学習モデルにもバイアスが反映 ◦ 公平性(fairness)の担保が課題 •
セキュリティ ◦ 敵対的サンプル ▪ 人の目には自然だが識別モデルは間違う画像 /文章 • https://speakerdeck.com/settenqb/ji-jie-xue-xi-tosekiyuritei • https://twitter.com/Bleu_kakeru727/status/937680760491753473 ◦ モデル剽窃 ◦ データセットへの毒入れ (バックドア) ▪ クラウドワーカーの信頼性
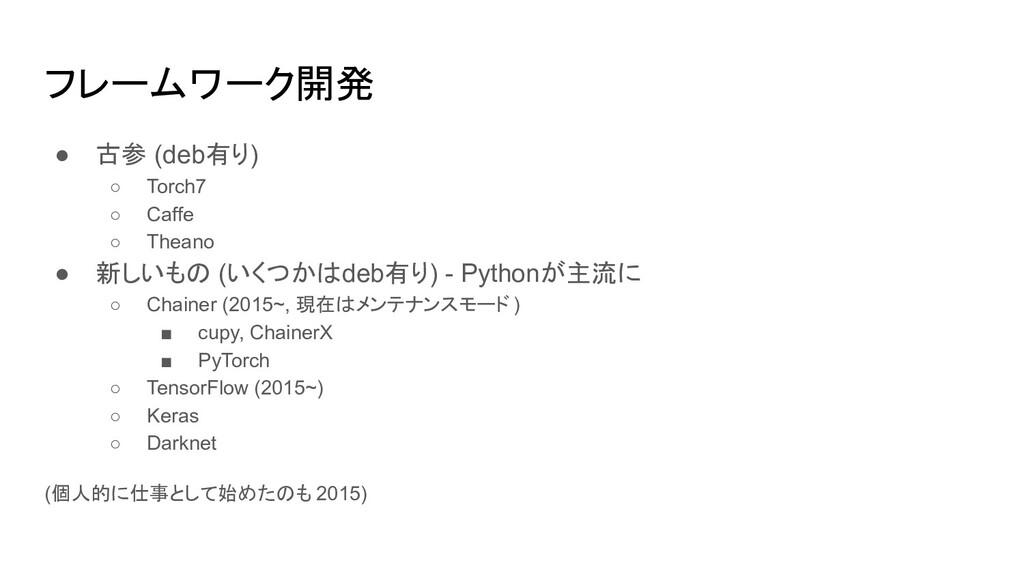
フレームワーク開発 • 古参 (deb有り) ◦ Torch7 ◦ Caffe ◦ Theano
• 新しいもの (いくつかはdeb有り) - Pythonが主流に ◦ Chainer (2015~, 現在はメンテナンスモード ) ▪ cupy, ChainerX ▪ PyTorch ◦ TensorFlow (2015~) ◦ Keras ◦ Darknet (個人的に仕事として始めたのも 2015)
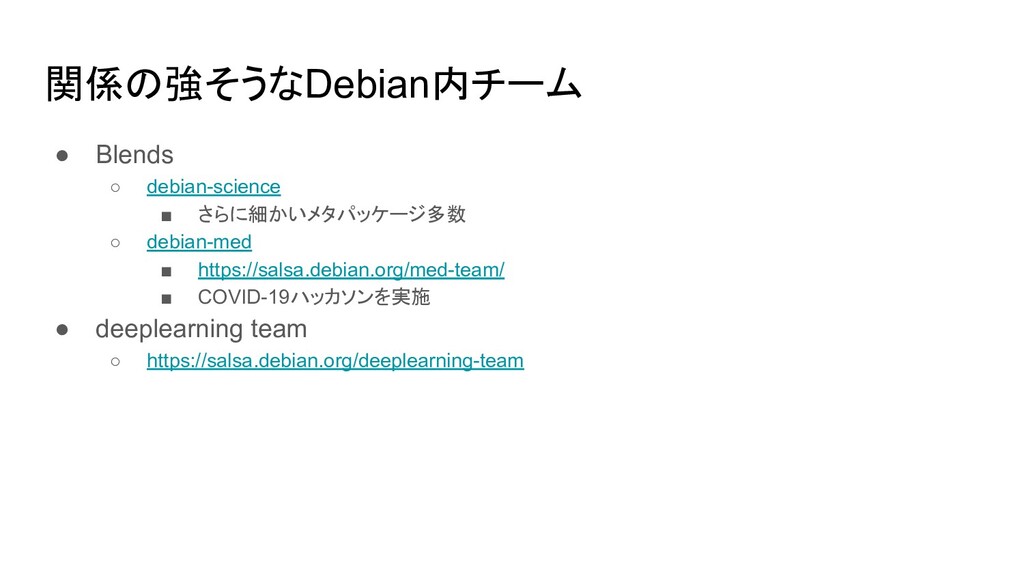
関係の強そうなDebian内チーム • Blends ◦ debian-science ▪ さらに細かいメタパッケージ多数 ◦ debian-med ▪
https://salsa.debian.org/med-team/ ▪ COVID-19ハッカソンを実施 • deeplearning team ◦ https://salsa.debian.org/deeplearning-team
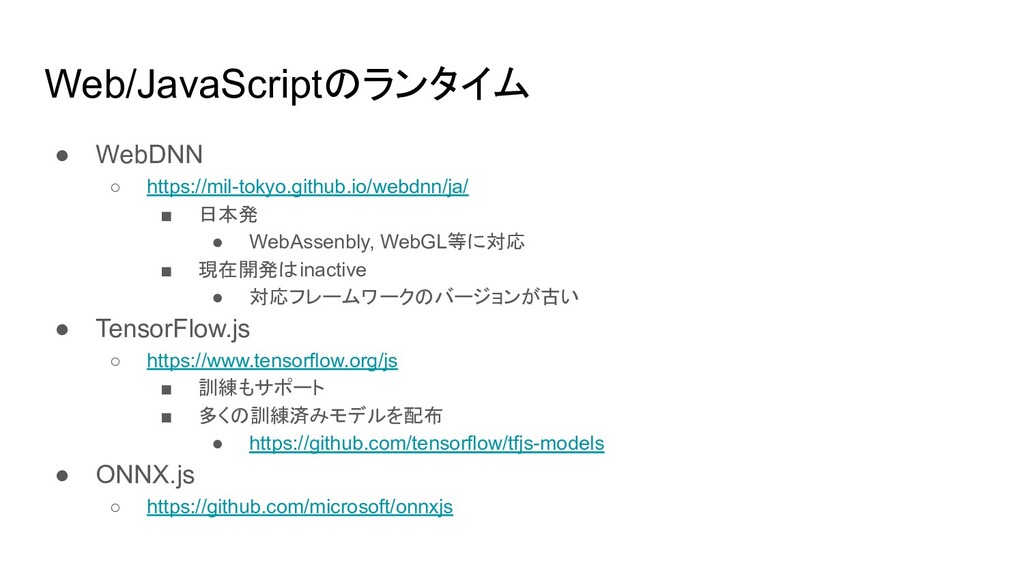
Web/JavaScriptのランタイム • WebDNN ◦ https://mil-tokyo.github.io/webdnn/ja/ ▪ 日本発 • WebAssenbly, WebGL等に対応
▪ 現在開発はinactive • 対応フレームワークのバージョンが古い • TensorFlow.js ◦ https://www.tensorflow.org/js ▪ 訓練もサポート ▪ 多くの訓練済みモデルを配布 • https://github.com/tensorflow/tfjs-models • ONNX.js ◦ https://github.com/microsoft/onnxjs
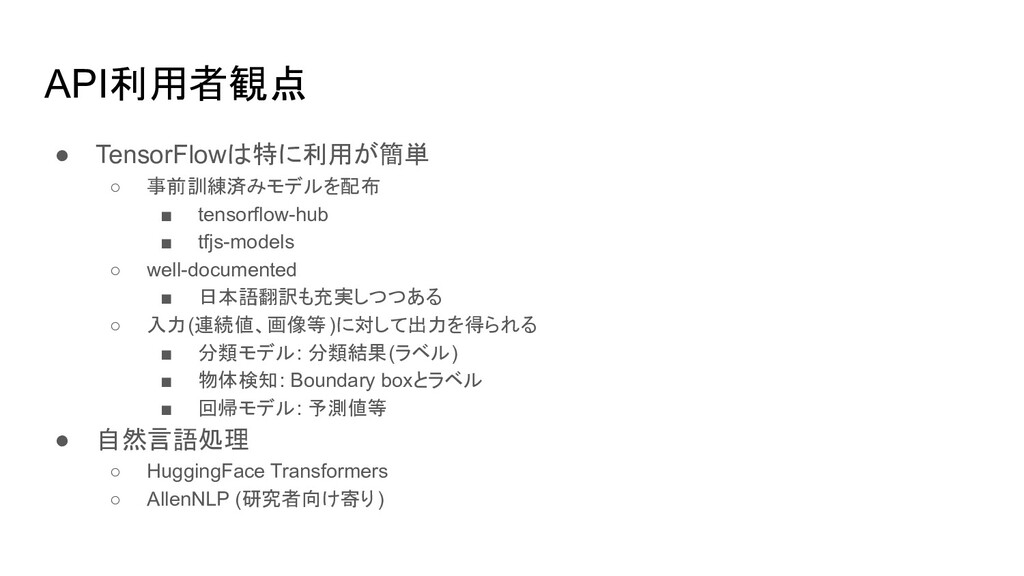
API利用者観点 • TensorFlowは特に利用が簡単 ◦ 事前訓練済みモデルを配布 ▪ tensorflow-hub ▪ tfjs-models ◦
well-documented ▪ 日本語翻訳も充実しつつある ◦ 入力(連続値、画像等)に対して出力を得られる ▪ 分類モデル: 分類結果(ラベル) ▪ 物体検知: Boundary boxとラベル ▪ 回帰モデル: 予測値等 • 自然言語処理 ◦ HuggingFace Transformers ◦ AllenNLP (研究者向け寄り)
個人的に作ったものの紹介
WebDNNで作ったもの • edges2cats (pix2pix, chainer) ◦ http://pix2pix.daio.net/ ◦ ソース: https://github.com/knok/chainer-pix2pix
• Wasserstein AutoEncoder (chainer) ◦ ht//wae-friends.daio.net ◦ ソース: https://github.com/knok/chainer-wae • データセット収集と訓練から再現可能
TensorFlow.jsを使ったもの • バーチャル背景 (virtbg) ◦ https://knok.github.io/virtbg/ ◦ ソース: https://github.com/knok/virtbg ▪
訓練済みのBodyPixモデルを使用 ▪ https://github.com/tensorflow/tfjs-models/tree/master/body-pix • VRM Three.js PoseNet Sample ◦ https://knok.github.io/vrm-three-posenet/ ▪ ソース: https://github.com/knok/vrm-three-posenet • https://github.com/t-takasaka/vrm-three-posenet のfork • 最近のtfjs-modelsにAPIを合わせた • 再配布可能なモデルに差し替え • 訓練済みのPoseNetモデルを使用 ◦ https://github.com/tensorflow/tfjs-models/tree/master/posenet
Google colaboratoryを使ったもの • StyleGan ◦ https://colab.research.google.com/drive/1PhO9IUbqGPeJhubNj0YVAlRXsOYEA1Xr ◦ disentangle • HuggingFace
ALBERT regression ◦ https://colab.research.google.com/drive/1XXmqh_uwV-BCh3FPl4OqDPhMlHRalDKL ◦ BERT亜種による回帰
データセット • pixbay-cat-images ◦ https://github.com/knok/pixabay-cat-images ◦ Pixbayの猫画像リンク ▪ edges2catsのデータセットに利用 •
instagram-food-images ◦ https://github.com/knok/instagram-food-images ◦ Instagramから餃子、ハンバーガー、ホットドッグ、サンドウィッチ、シュウマイを収集 • make-meidai-dialogue ◦ https://github.com/knok/make-meidai-dialogue ◦ 日本語自然会話書き起こしコーパス(旧名大会話コーパス)の変換スクリプト • データ本体は別のライセンスであることが多い
tfjs-modelsの残念な点 • 訓練用コードが公開されていない • 訓練データも公開されていない ◦ 策定中のDeepLearning Policyに適合しない可能性大 ▪ https://lists.debian.org/debian-science/2019/06/msg00000.html
▪ https://salsa.debian.org/deeplearning-team/ml-policy ▪ 再現性を求める方向で進んでいる • TensorFlow.js以外での動作を想定していない ◦ 一応変換ツールはある ▪ https://github.com/patlevin/tfjs-to-tf
他にできそうなこと(1) • ハンドトラッキング ◦ Leap Motion/Kinectの代替 ▪ deepな手法である必要性はない • VTuberアプリ
◦ VRM+PoseNetで既にある程度いけそう ▪ BodyPixは顔パーツ認識も可能 • 表情への反映もできる • FaceMesh ▪ 先行実装: FaceVTuber ref: https://vrm.dev/vrm_applications/ ◦ 声質変換? ▪ Yukariライブラリ • https://qiita.com/atticatticattic/items/37441f3be6916cd1e73a ▪ 速度に課題 • GPU必須
他にできそうなこと(2) • 自然言語処理 ◦ ブラウザと Tensorflow.js を使った BERT の活用方法を考える (Google
blog) ▪ https://developers-jp.googleblog.com/2020/04/tensorflowjs-bert.html ▪ https://github.com/tensorflow/tfjs-models/tree/master/qna • MobileBERTを用いたQ&A • 現状日本語は使えない ◦ 日本語のQ&Aで訓練していない ▪ SQuAD 1.1に基づく(らしい) ▪ https://www.slideshare.net/ShionHonda/bertmobileberttensorflowjs ◦ 語彙自体は含まれている ◦ 訓練データを用意し、 fine tuningすれば使えるはず ▪ TensorFlow Liteモデルもある ▪ 簡単な分類ぐらいなら割とすぐできそう
速度面の課題 • 画像は補完技術が充実 ◦ 音声、自然言語への適用は困難 ◦ 生成に必要なデータが巨大、計算量も多い ▪ GPUでリアルタイムにできるようになってきた •
WaveNet(2016)では1秒の音声生成に1分程度かかっていた • 量子化 ◦ 浮動小数点計算を整数やバイナリで近似する技術 ▪ すべての演算を置き換えることが常に可能とは限らない ◦ tfjs-modelsは多くをサポート ▪ 精度を犠牲にしていることに留意 • DNNモデルの推論はシングルコア駆動(多分) ◦ TensorFlowネイティブランタイムならマルチコア駆動
コンピューティングのトレンド • 歴史は繰り返す ◦ 中央集権型 vs 分散型 ▪ 「ダウンサイジング」 •
Thin Clinet ▪ エッジAI • DNNモデルを軽量化 • 組み込み機器で動作させる • cf. AIスピーカー ◦ 処理の大半はクラウド側 ◦ 温故知新 ▪ LSTM, CNNも20世紀に考案されたもの ◦ 次のトレンドは? ▪ ニューラルネットのように昔のトレンドが復活する可能性
まとめ • 10年でディープニューラルネットワークが飛躍的な進化 ◦ 計算資源とデータセット ◦ 第三次AIブーム ▪ そろそろ終焉? •
使うだけならお手軽 ◦ 多くのフレームワークと訓練済みモデル ◦ ブラウザでも動作 ▪ Webカムとの組み合わせ • DFSG的にはどうか? ◦ 再配布不可・商用利用不可のデータセット、訓練済みモデルも多い ▪ 研究目的のみ可というものも多い ◦ 個人的には再現可能なレベルを心がけている ▪ 元データのライセンスに課題
NN以外のトピック • 統計ベース ◦ ベイジアンフィルター ▪ A Plan For Spam
(by Paul Graham, 2002) • bogofilter, spamassassin等 • Support Vector Machine (SVM) • 決定木(Decision Tree)ベース ◦ XGBoost ◦ LightGBM ◦ CatBoost


 knok
 occhi
 yahonda
 iktakahiro
 oikon48
 yu23ki14
 takahashim
 pfn
 endonanana
 genda
 ludicmind
 namiki64
 takanorip
 axbom
 lynnandtonic
 chriscoyier
 samlambert
 rasmusluckow
 jct
 cassininazir
 csswizardry
 smashingmag
 eileencodes
 reverentgeek
 greggifford