Share
Embed
IBM Dojo #12 AI Advance: 公平で説明可能なAI / IBM Dojo AI Fairness Explainability 20200401
2020年4月1日開催のIBM Dojo #12 AI Advance: 公平で説明可能なAIの資料です。
直前に公開予定です。
Kyoko Nishito
April 01, 2020
Transcript
104 slides
-
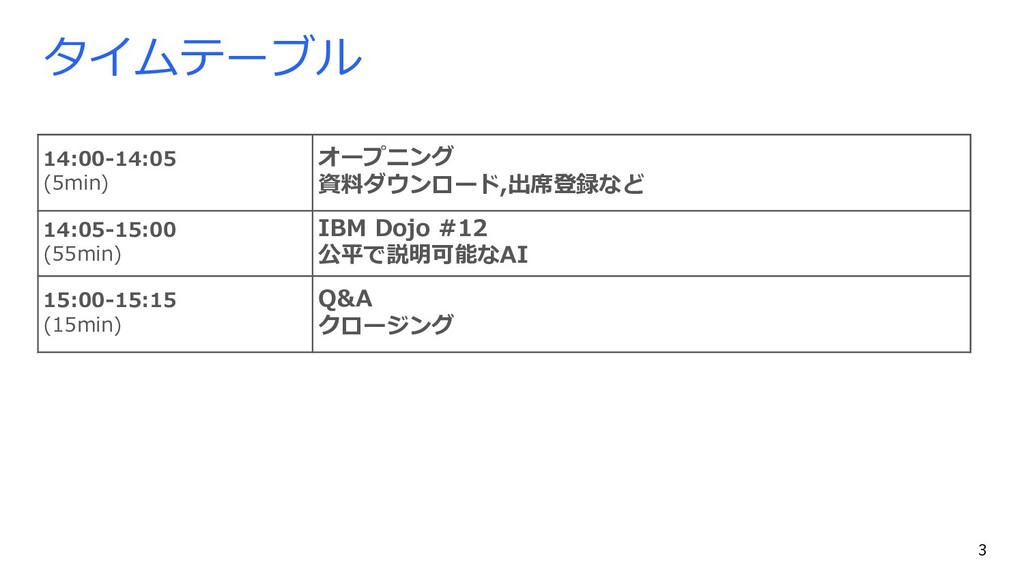
タイムテーブル 14:00-14:05 (5min) オープニング 資料ダウンロード,出席登録など 14:05-15:00 (55min) IBM Dojo #12
公平で説明可能なAI 15:00-15:15 (15min) Q&A クロージング 3 -
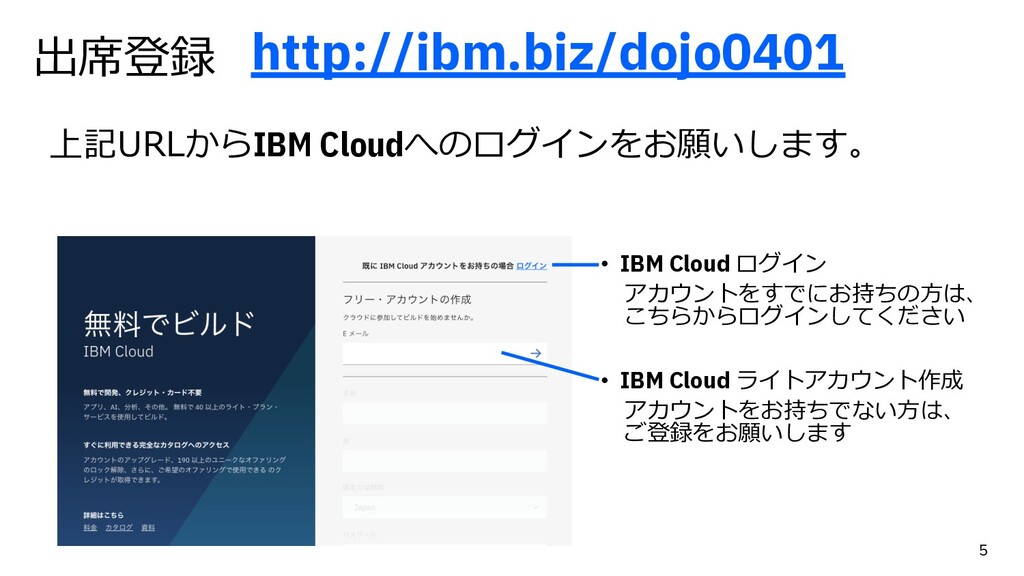
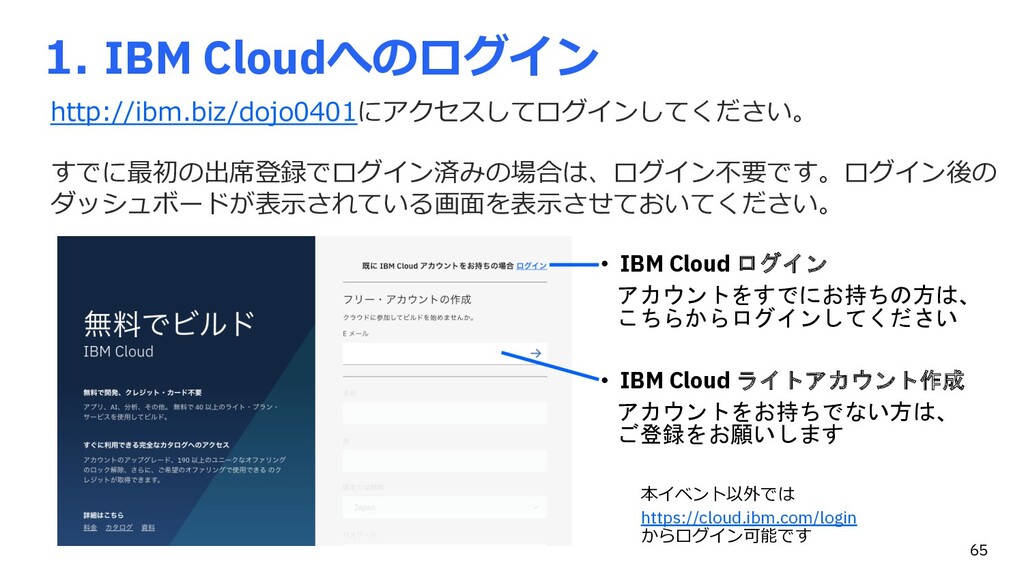
上記URLからIBM Cloudへのログインをお願いします。 http://ibm.biz/dojo0401 • IBM Cloud ログイン アカウントをすでにお持ちの⽅は、 こちらからログインしてください •
IBM Cloud ライトアカウント作成 アカウントをお持ちでない⽅は、 ご登録をお願いします 出席登録 5 -
AIの判断、企業に説明責任? 引⽤元: 2018/11/26 ⽇本経済新聞 電⼦版 https://www.nikkei.com/article/DGXMZO38186770W8A121C1MM8000/ オンライン資料のみ 10 引⽤元: 2018/11/26
⽇本経済新聞 電⼦版 https://www.nikkei.com/article/DGXMZO38186770W8A121C1MM8000/ -
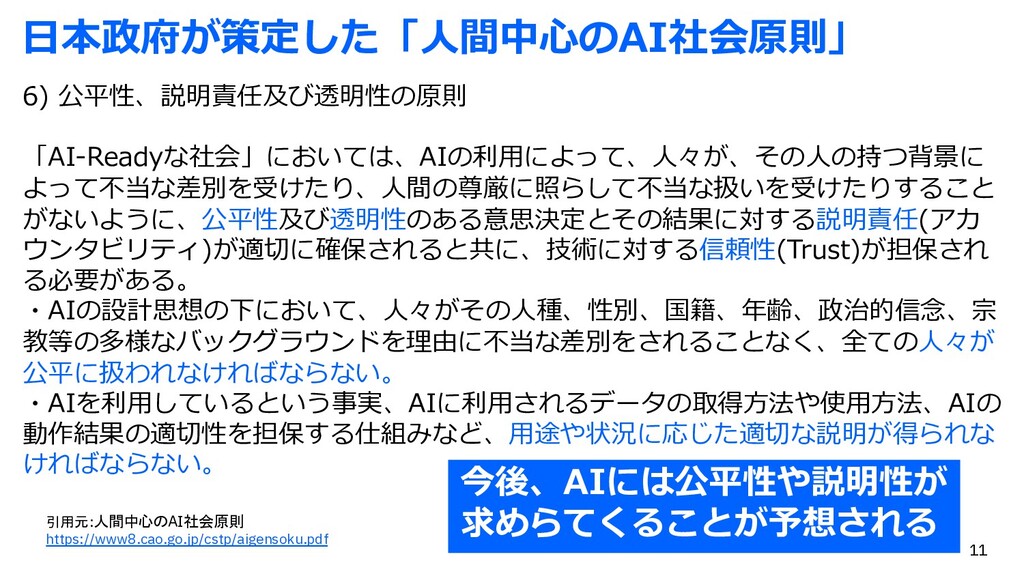
⽇本政府が策定した「⼈間中⼼のAI社会原則」 6) 公平性、説明責任及び透明性の原則 「AI-Readyな社会」においては、AIの利⽤によって、⼈々が、その⼈の持つ背景に よって不当な差別を受けたり、⼈間の尊厳に照らして不当な扱いを受けたりすること がないように、公平性及び透明性のある意思決定とその結果に対する説明責任(アカ ウンタビリティ)が適切に確保されると共に、技術に対する信頼性(Trust)が担保され る必要がある。 ・AIの設計思想の下において、⼈々がその⼈種、性別、国籍、年齢、政治的信念、宗 教等の多様なバックグラウンドを理由に不当な差別をされることなく、全ての⼈々が
公平に扱われなければならない。 ・AIを利⽤しているという事実、AIに利⽤されるデータの取得⽅法や使⽤⽅法、AIの 動作結果の適切性を担保する仕組みなど、⽤途や状況に応じた適切な説明が得られな ければならない。 引用元:人間中心のAI社会原則 https://www8.cao.go.jp/cstp/aigensoku.pdf 今後、AIには公平性や説明性が 求めらてくることが予想される 11 -
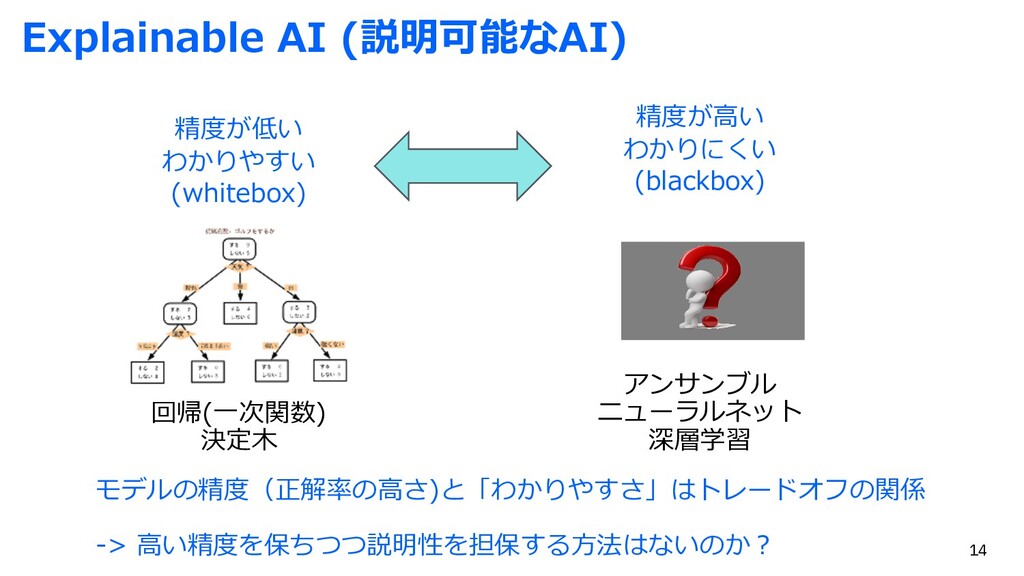
Explainable AI (説明可能なAI) アンサンブル ニューラルネット 深層学習 回帰(⼀次関数) 決定⽊ わかりやすい (whitebox)
わかりにくい (blackbox) 精度が低い 精度が⾼い モデルの精度(正解率の⾼さ)と「わかりやすさ」はトレードオフの関係 -> ⾼い精度を保ちつつ説明性を担保する⽅法はないのか︖ 14 -
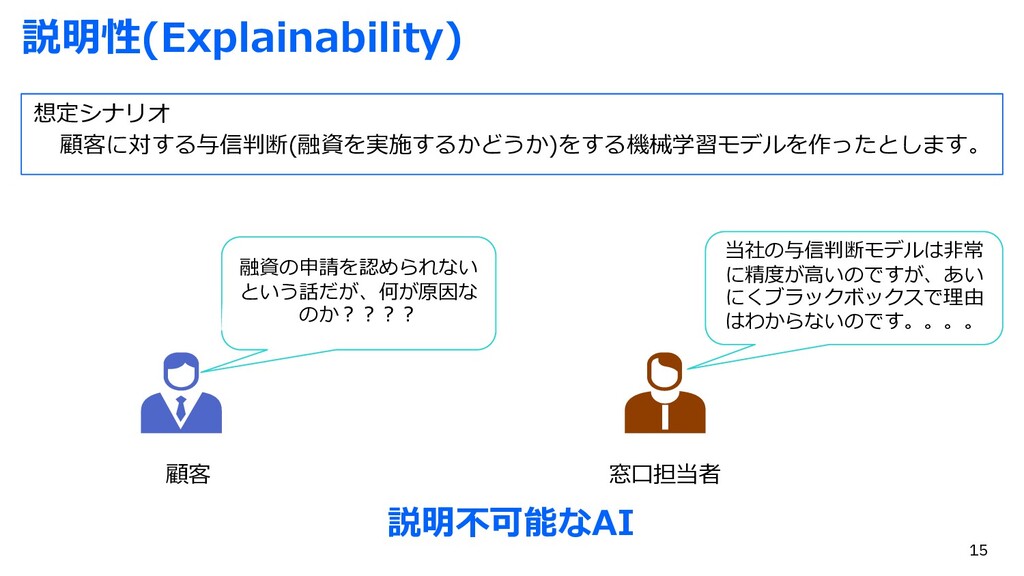
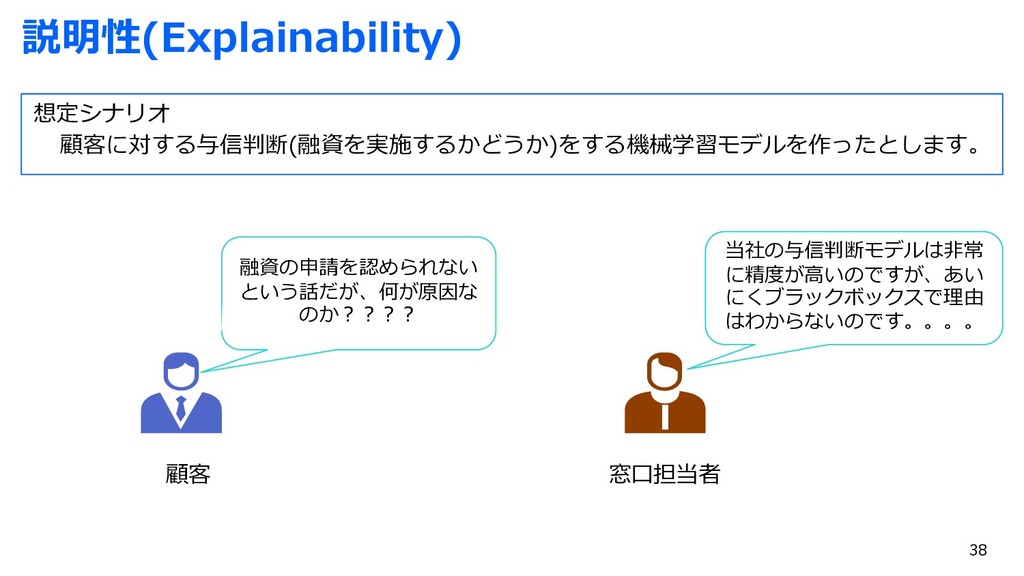
説明性(Explainability) 想定シナリオ 顧客に対する与信判断(融資を実施するかどうか)をする機械学習モデルを作ったとします。 顧客 窓⼝担当者 融資の申請を認められない という話だが、何が原因な のか︖︖︖︖ 当社の与信判断モデルは⾮常 に精度が⾼いのですが、あい
にくブラックボックスで理由 はわからないのです。。。。 説明不可能なAI 15 -
説明性(Explainability) 顧客 窓⼝担当者 融資の申請を認められない という話だが、何が原因な のか︖︖︖︖ お客様の融資が却下された⼀番の理 由は年収で、寄与度は60%です。 次の理由は年齢で、寄与度は20% になります。
前ページのようなやりとりが起きた場合、今回説明するOpenScaleがあるとこのように説明 が可能です。 説明可能なAI 16 -
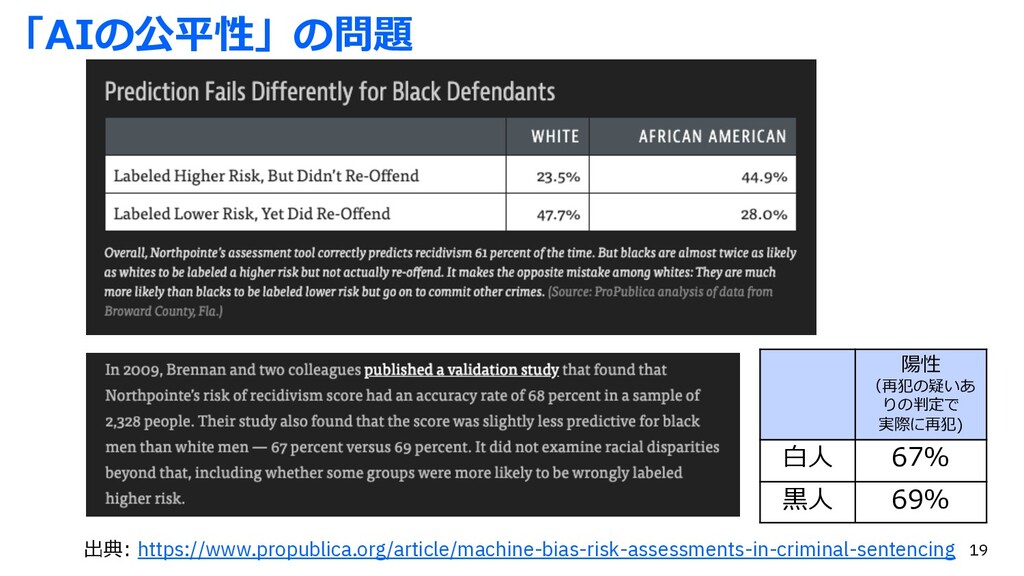
「AIの公平性」の問題 • 被告の再犯可能性を予測するAIシステム「Compas」 • ⽶国で実際に本番利⽤されている機械学習モデル • 137問の質問への回答を⼊⼒に、再び犯罪を犯す危険性を10段階の点数 として算出 • 調査報道サイト「プロパブリカ」により、以下の調査結果が判明し⼤き
な社会問題となりました。 出典: https://kaztaira.wordpress.com/2018/09/22/aiのバイアス問題、求められる「公平」とは何/ 偽陽性 (再犯の疑いありの判定で 実際には再犯なし) 偽陰性 (再犯の疑いなしの判定で 実際には再犯あり) ⽩⼈ 23.5% 47.7% ⿊⼈ 44.9% 28.0% 18 -
AI 採⽤ツール: ジェンダーバイアスを学習 最近廃⽌されたAmazonの採⽤ツール • Amazonのモデルは、応募者を審査するために10年以上にわたって提 出された履歴書のパターンを分析して学習 • 履歴書は、主に採⽤決定により男性からのもの 20
• 男性候補者の⽅が望ましい結果。 • 「⼥性のチェスクラブキャプテン」などの「⼥性」という⾔葉を含む 履歴書に低い点数しか与えないというルールを作成。 • 多くの⼥⼦⼤の卒業⽣を評価を下げた。 Amazonはバイアスを取り除こうしたが、複雑さのためにできず、ツール を廃⽌。 -
公正な割合?: CEOという単語をGoogleで画像検索 • ある研究者は︓CEOという単語をGoogleで検索したとき にバイアス(偏⾒)を⾒つけました。 • その時CEOのトップ画像結果のわずか11%が⼥性 • 当時実際には⽶国のCEOの27%が⼥性でした。 •
アルゴリズムが⽰すべき⼥性CEOの「公平な」割合をど のように決定すべきか??? • 現在の⼥性CEOの割合27%︖ • 現実⽐ではないが「公正」な数値を50%にすべき? → 組織およびユースケースごと状況に応じて何が公正なのかをを定義す る必要があります。 21 21 -
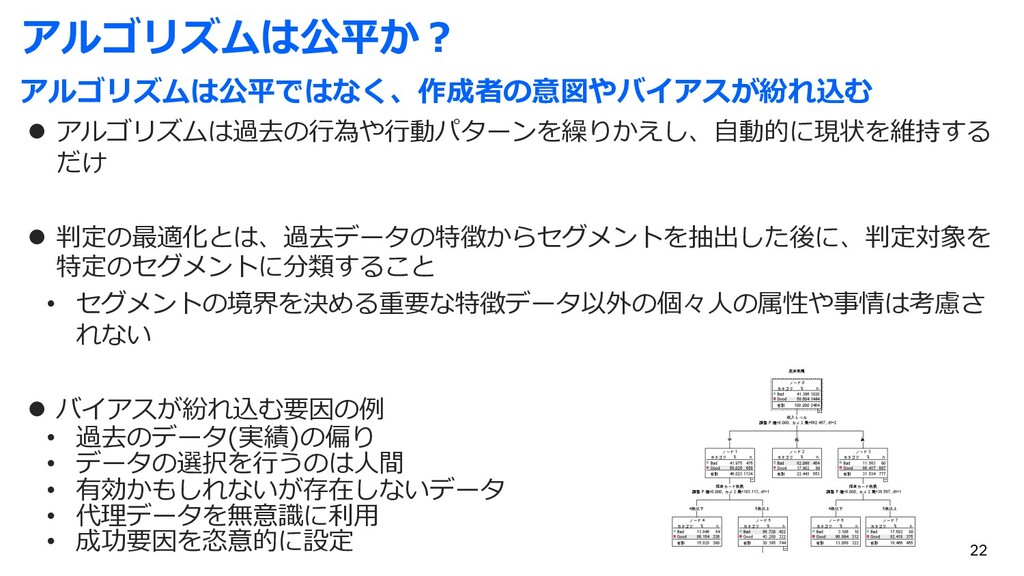
アルゴリズムは公平か︖ アルゴリズムは公平ではなく、作成者の意図やバイアスが紛れ込む l アルゴリズムは過去の⾏為や⾏動パターンを繰りかえし、⾃動的に現状を維持する だけ l 判定の最適化とは、過去データの特徴からセグメントを抽出した後に、判定対象を 特定のセグメントに分類すること • セグメントの境界を決める重要な特徴データ以外の個々⼈の属性や事情は考慮さ
れない l バイアスが紛れ込む要因の例 • 過去のデータ(実績)の偏り • データの選択を⾏うのは⼈間 • 有効かもしれないが存在しないデータ • 代理データを無意識に利⽤ • 成功要因を恣意的に設定 22 -
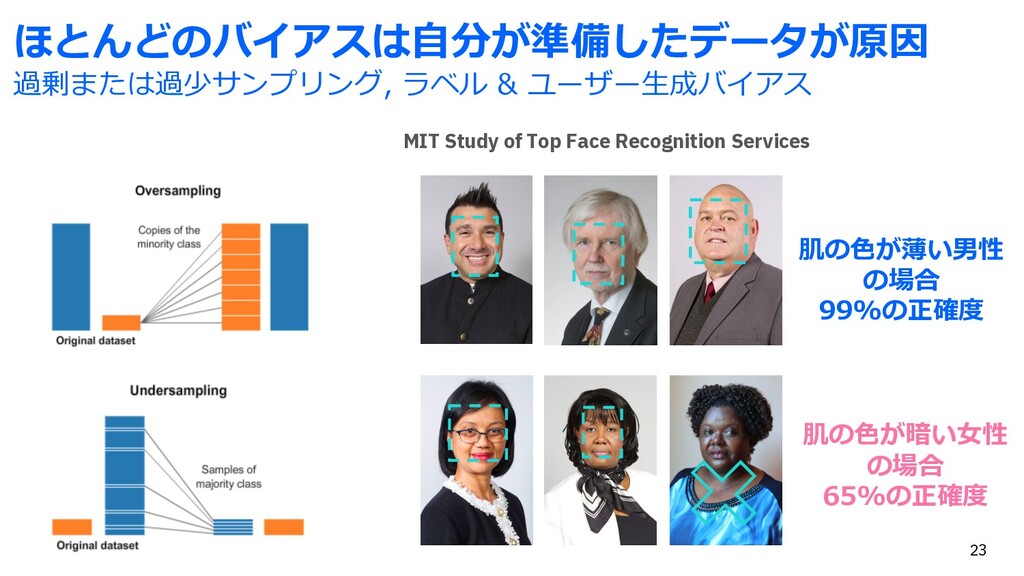
ほとんどのバイアスは⾃分が準備したデータが原因 過剰または過少サンプリング, ラベル & ユーザー⽣成バイアス 肌の⾊が薄い男性 の場合 99%の正確度 肌の⾊が暗い⼥性 の場合
65%の正確度 MIT Study of Top Face Recognition Services 23 -
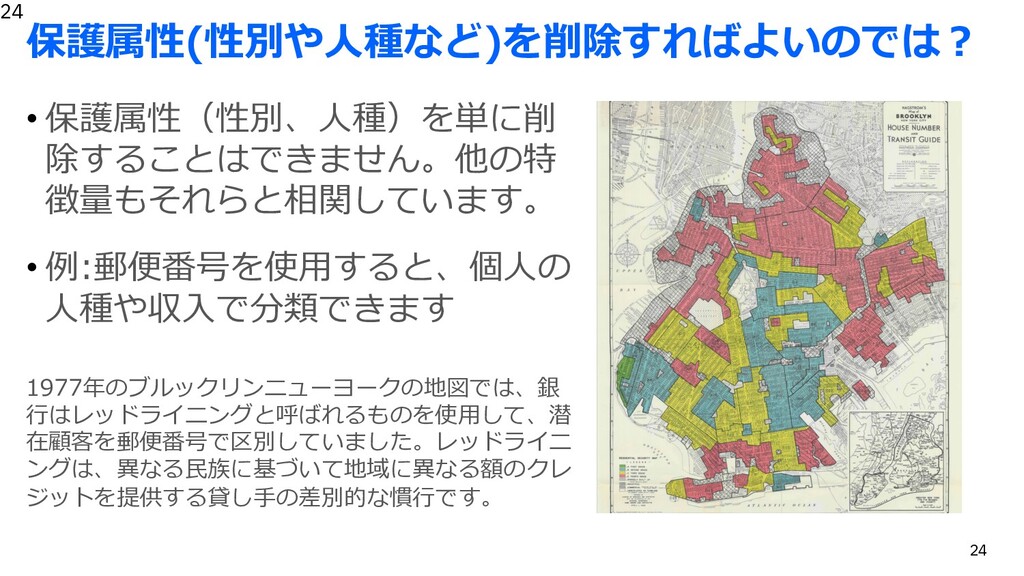
保護属性(性別や⼈種など)を削除すればよいのでは︖ • 保護属性(性別、⼈種)を単に削 除することはできません。他の特 徴量もそれらと相関しています。 • 例:郵便番号を使⽤すると、個⼈の ⼈種や収⼊で分類できます 1977年のブルックリンニューヨークの地図では、銀 ⾏はレッドライニングと呼ばれるものを使⽤して、潜
在顧客を郵便番号で区別していました。レッドライニ ングは、異なる⺠族に基づいて地域に異なる額のクレ ジットを提供する貸し⼿の差別的な慣⾏です。 24 24 -
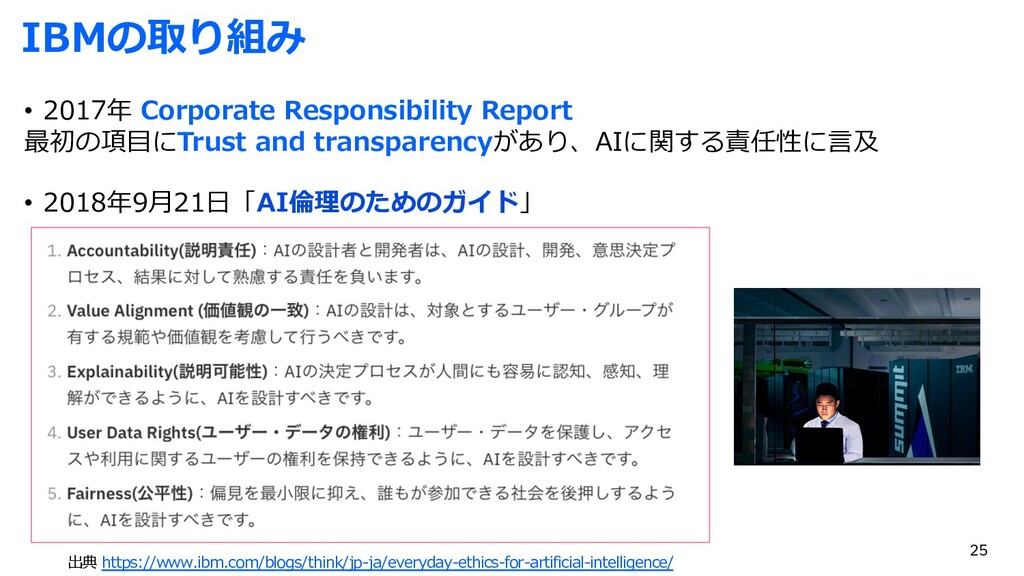
IBMの取り組み • 2017年 Corporate Responsibility Report 最初の項⽬にTrust and transparencyがあり、AIに関する責任性に⾔及 •
2018年9⽉21⽇「AI倫理のためのガイド」 出典 https://www.ibm.com/blogs/think/jp-ja/everyday-ethics-for-artificial-intelligence/ 25 -
IBMの取り組み IBMでは以上の全社的な⽅針を受けて、次の2つの製品・サービスを提供して います。 Watson OpenScale • Watson StudioやWatson Machine Learningと同じIBMクラウド上のサー
ビス。ただし、他のサービスと異なり、他社AIも管理対象に含む。 AI Fairness 360 / AI Explainability 360 • Python APIをOSSとして公開。 • ライブラリだけでなく、API Reference、チュートリアル、デモアプリなども ⼀般に利⽤可能。 • ユーザーは⾃分でPythonコーディングを⾏うことが前提。 • AIF360: http://aif360.mybluemix.net/ 26 -
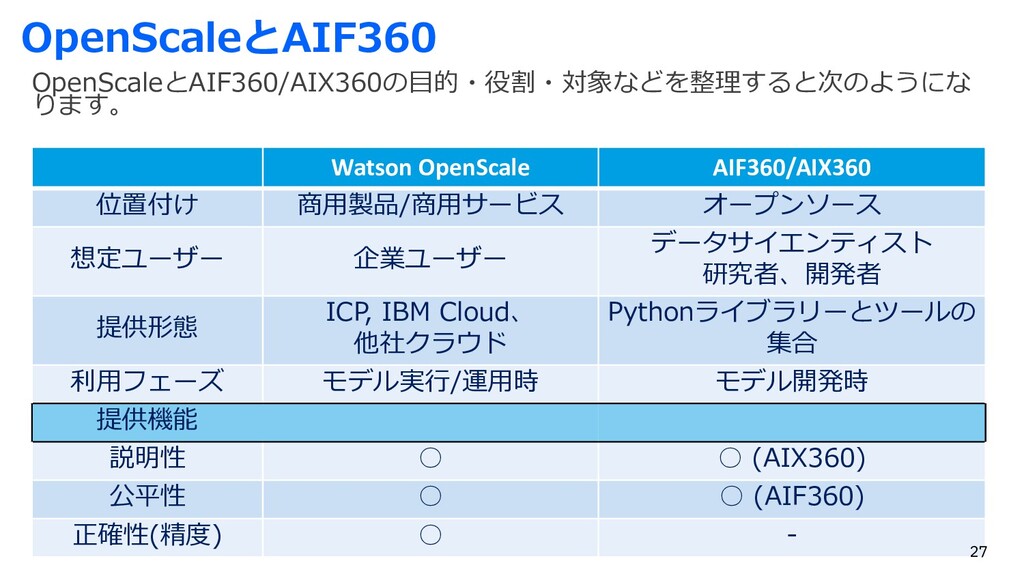
OpenScaleとAIF360 OpenScaleとAIF360/AIX360の⽬的・役割・対象などを整理すると次のようにな ります。 Watson OpenScale AIF360/AIX360 位置付け 商⽤製品/商⽤サービス オープンソース 想定ユーザー
企業ユーザー データサイエンティスト 研究者、開発者 提供形態 ICP, IBM Cloud、 他社クラウド Pythonライブラリーとツールの 集合 利⽤フェーズ モデル実⾏/運⽤時 モデル開発時 提供機能 説明性 ◦ ◦ (AIX360) 公平性 ◦ ◦ (AIF360) 正確性(精度) ◦ - 27 -
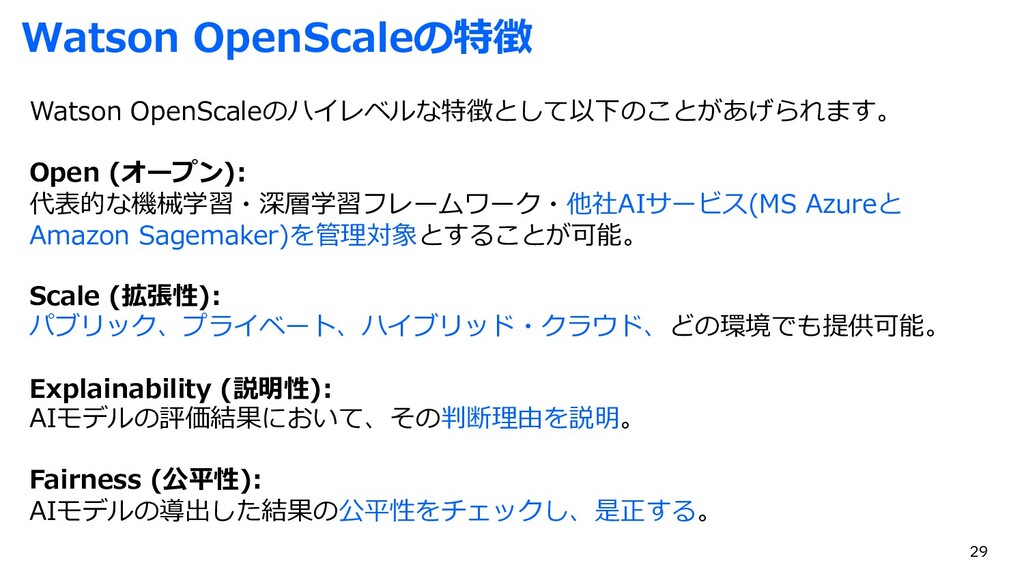
Watson OpenScaleの特徴 Watson OpenScaleのハイレベルな特徴として以下のことがあげられます。 Open (オープン): 代表的な機械学習・深層学習フレームワーク・他社AIサービス(MS Azureと Amazon Sagemaker)を管理対象とすることが可能。
Scale (拡張性): パブリック、プライベート、ハイブリッド・クラウド、どの環境でも提供可能。 Explainability (説明性): AIモデルの評価結果において、その判断理由を説明。 Fairness (公平性): AIモデルの導出した結果の公平性をチェックし、是正する。 29 -
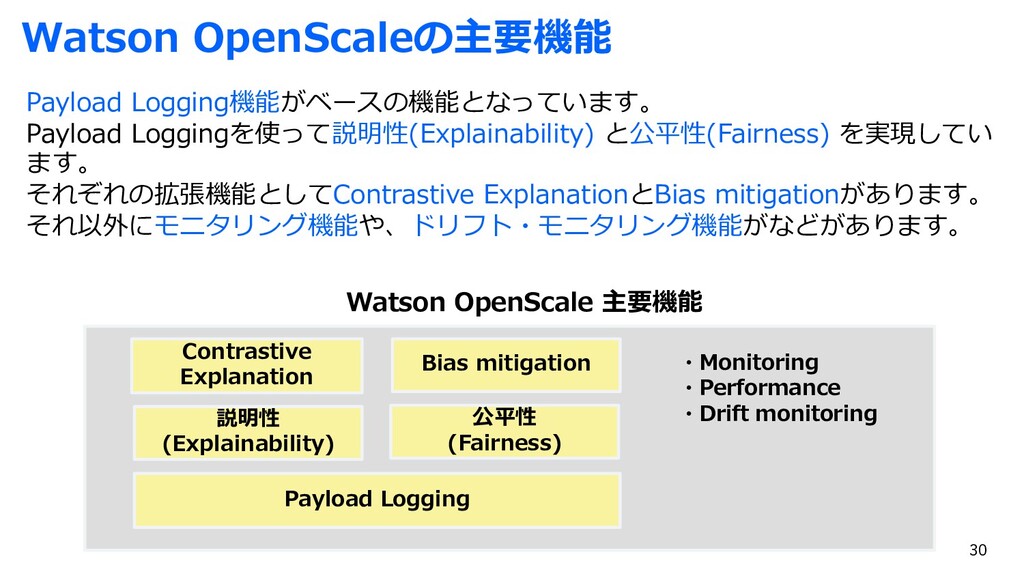
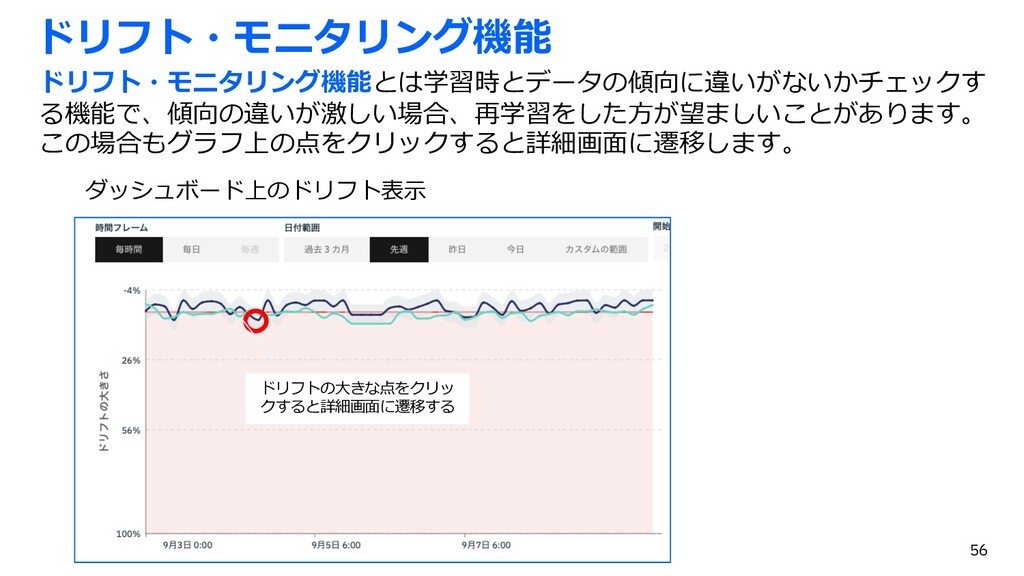
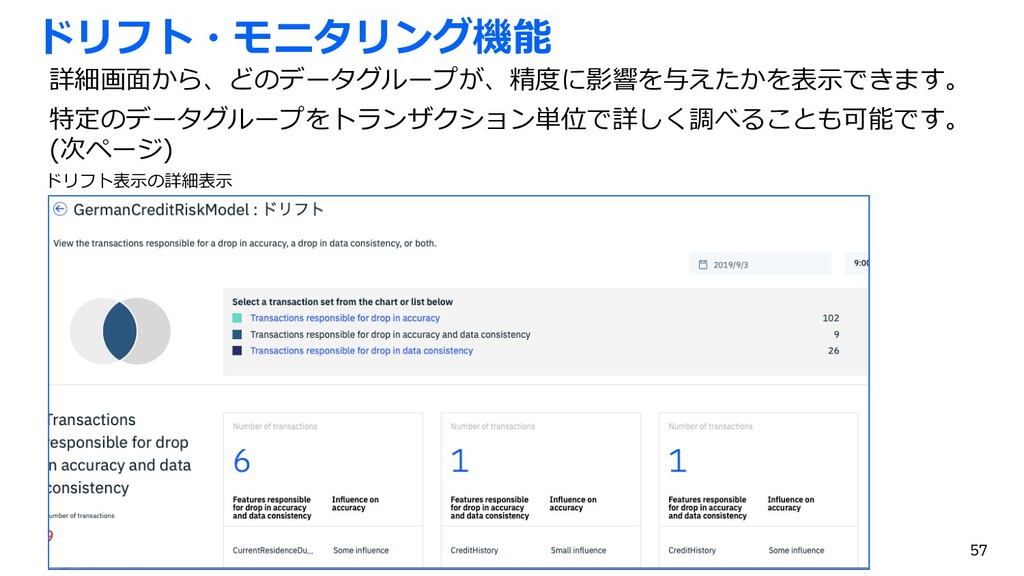
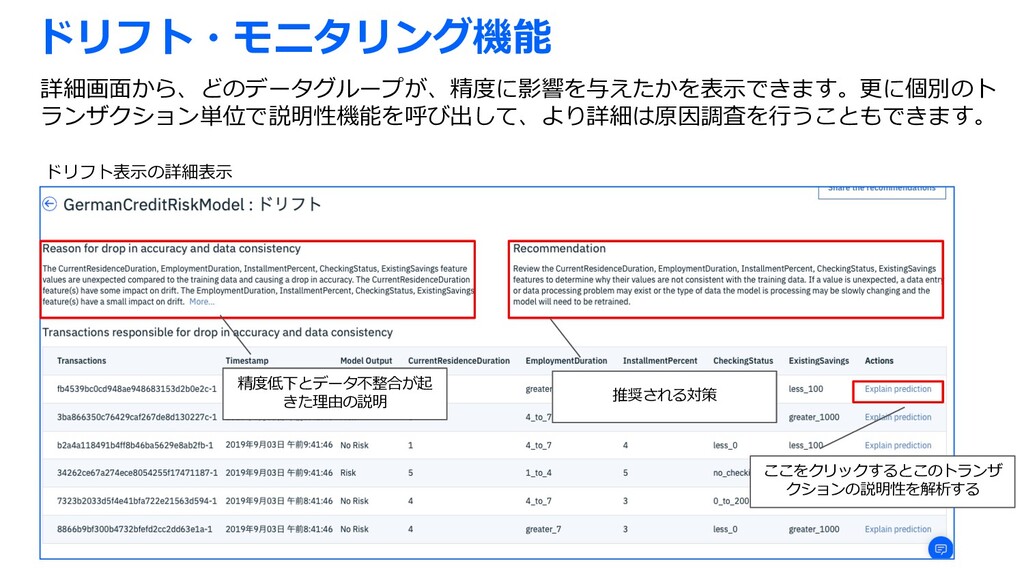
Watson OpenScaleの主要機能 Payload Logging機能がベースの機能となっています。 Payload Loggingを使って説明性(Explainability) と公平性(Fairness) を実現してい ます。 それぞれの拡張機能としてContrastive
ExplanationとBias mitigationがあります。 それ以外にモニタリング機能や、ドリフト・モニタリング機能がなどがあります。 Payload Logging 説明性 (Explainability) 公平性 (Fairness) Contrastive Explanation Bias mitigation ・Monitoring ・Performance ・Drift monitoring Watson OpenScale 主要機能 30 -
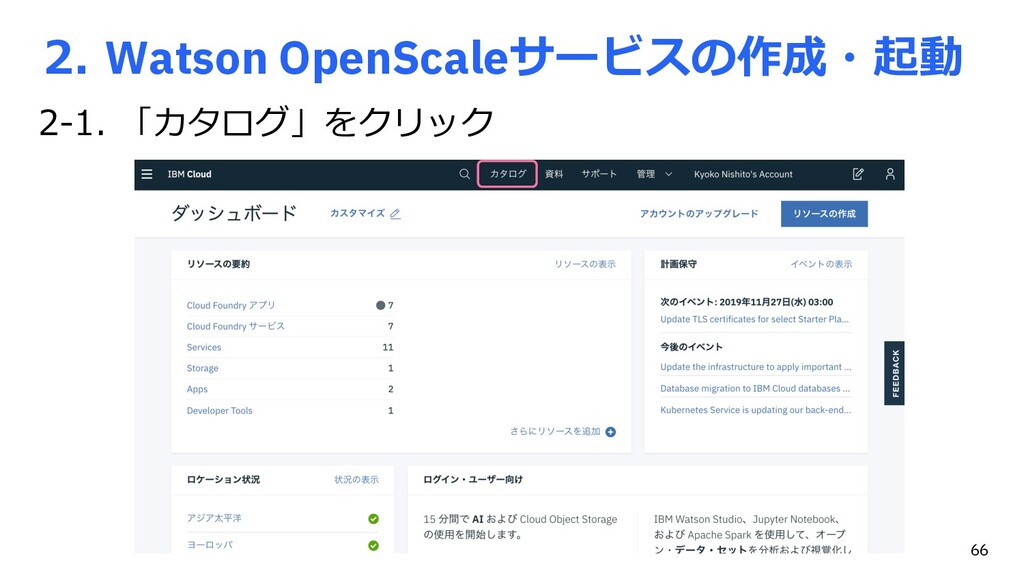
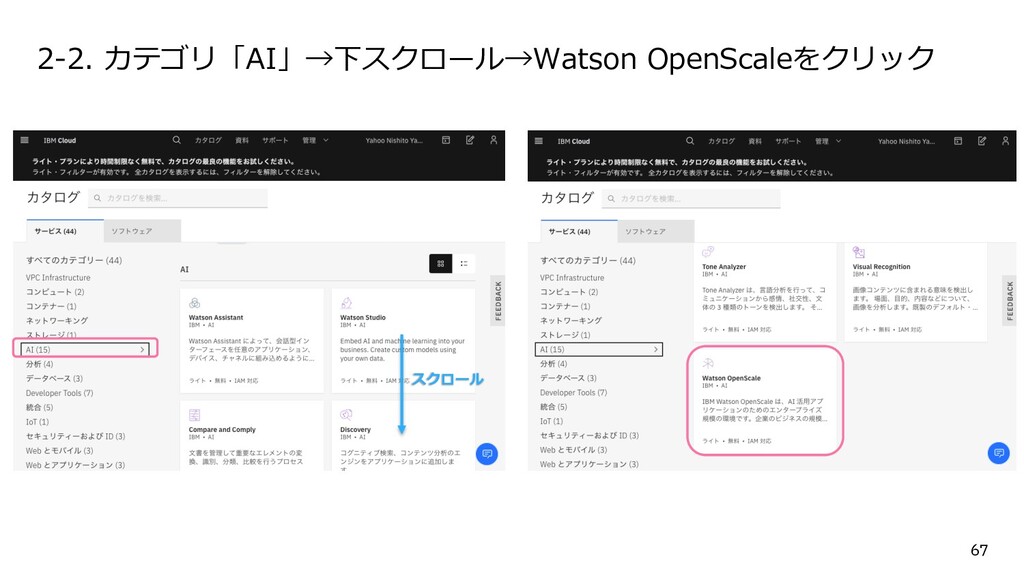
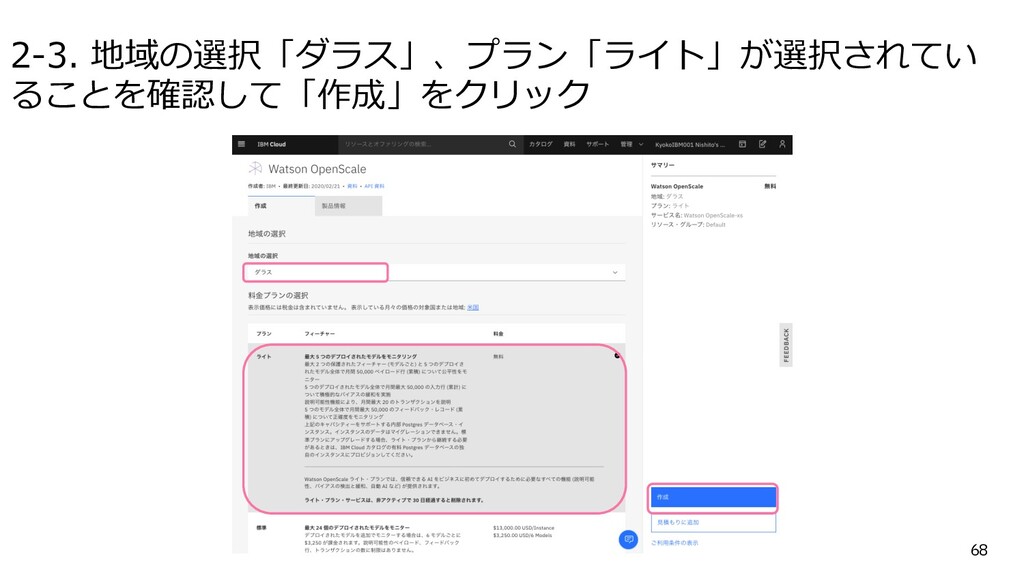
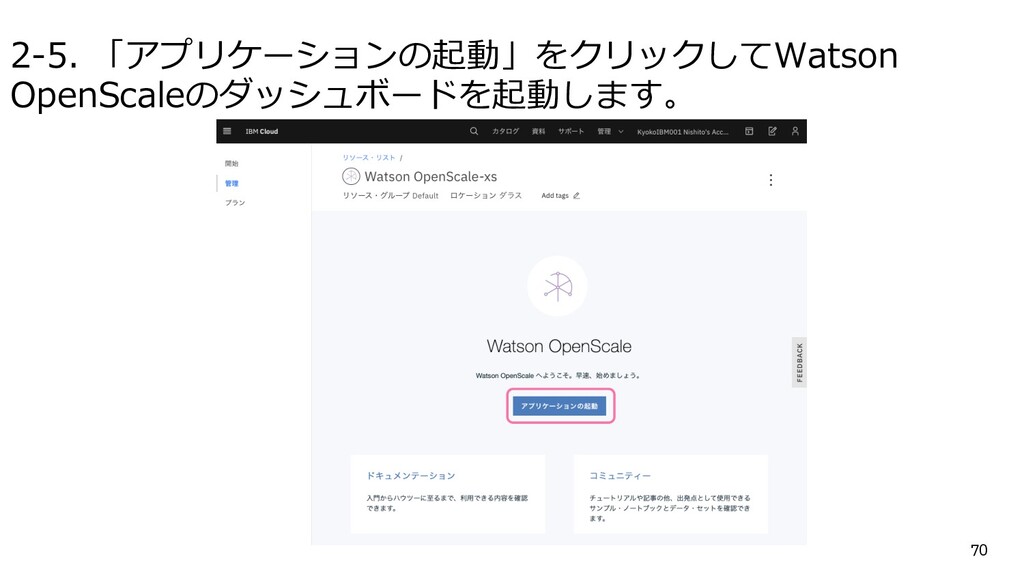
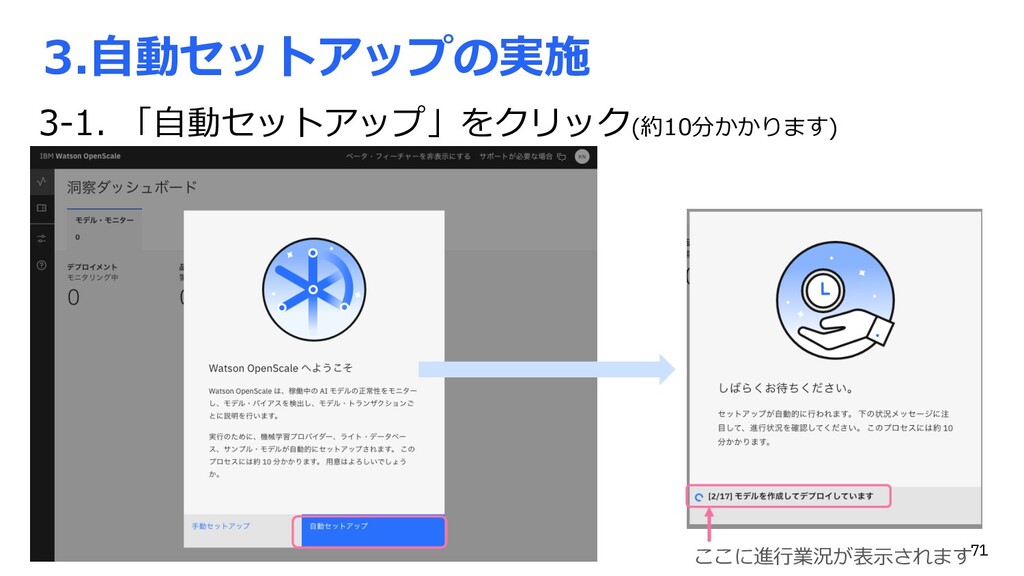
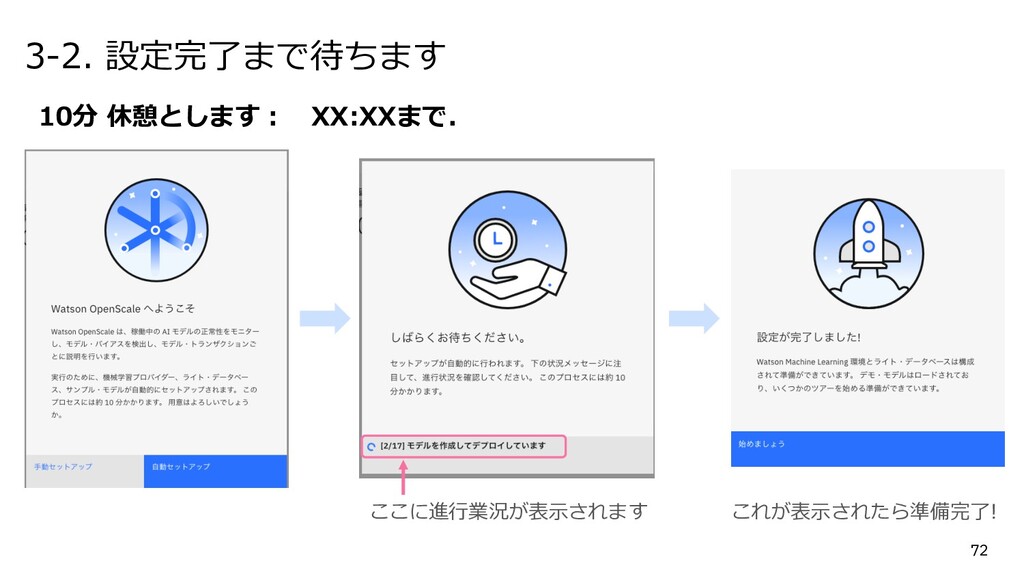
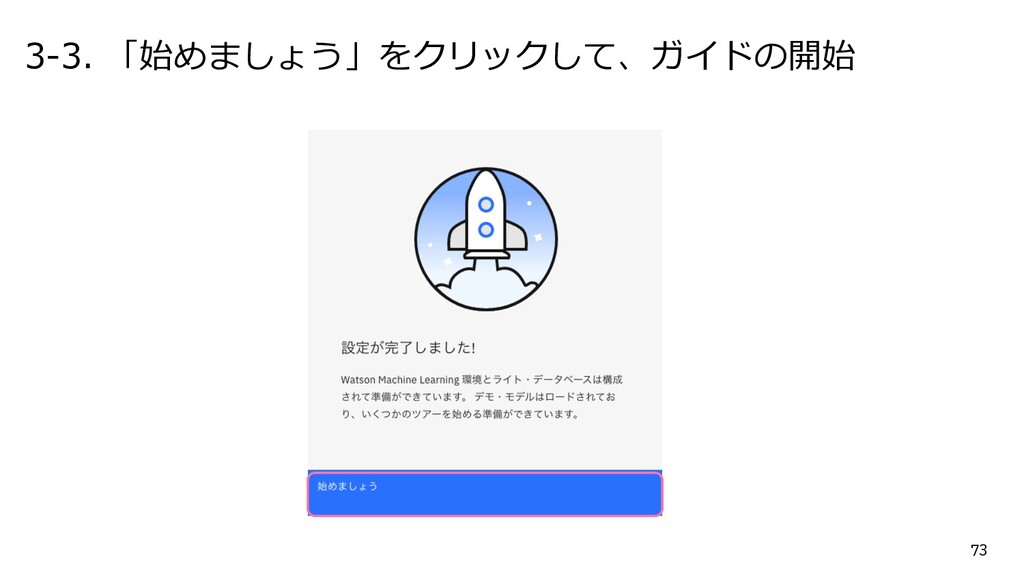
2. Watson OpenScale ここでちょっとハンズオン準備 31 P.62「3.チュートリアル」の3番までここで準備しておきます 1. IBM Cloudへのログイン 2.
Watson OpenScaleサービスの作成・起動 3. ⾃動セットアップの実施 (しばし待ち時間) -
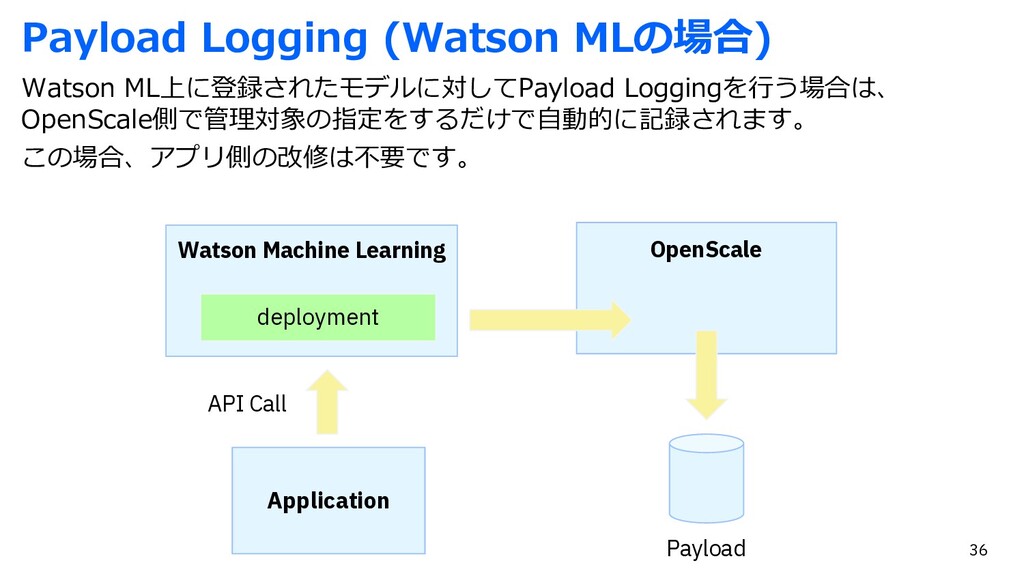
Payload Logging (Watson MLの場合) Watson ML上に登録されたモデルに対してPayload Loggingを⾏う場合は、 OpenScale側で管理対象の指定をするだけで⾃動的に記録されます。 この場合、アプリ側の改修は不要です。 Watson
Machine Learning deployment Application API Call OpenScale Payload 36 -
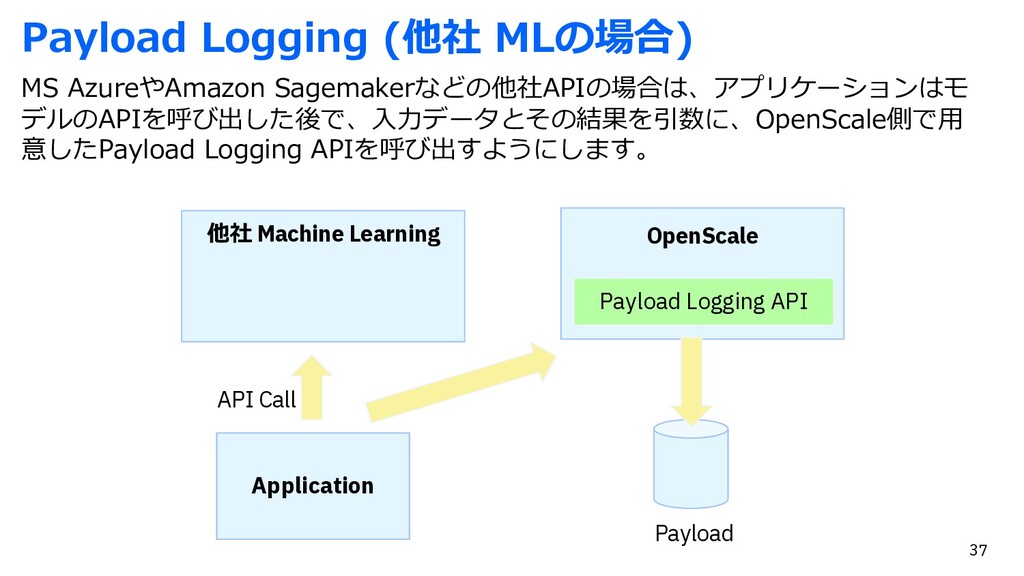
Payload Logging (他社 MLの場合) MS AzureやAmazon Sagemakerなどの他社APIの場合は、アプリケーションはモ デルのAPIを呼び出した後で、⼊⼒データとその結果を引数に、OpenScale側で⽤ 意したPayload Logging
APIを呼び出すようにします。 他社 Machine Learning Application API Call OpenScale Payload Payload Logging API 37 -
説明性(Explainability) 顧客 窓⼝担当者 融資の申請を認められない という話だが、何が原因な のか︖︖︖︖ お客様の融資が却下された⼀番の理 由は年収で、寄与度は60%です。 次の理由は年齢で、寄与度は20% になります。
OpenScaleがあると。。 前ページのようなやりとりが起きた場合、OpenScaleがあるとこのように説明が可能です。 39 -
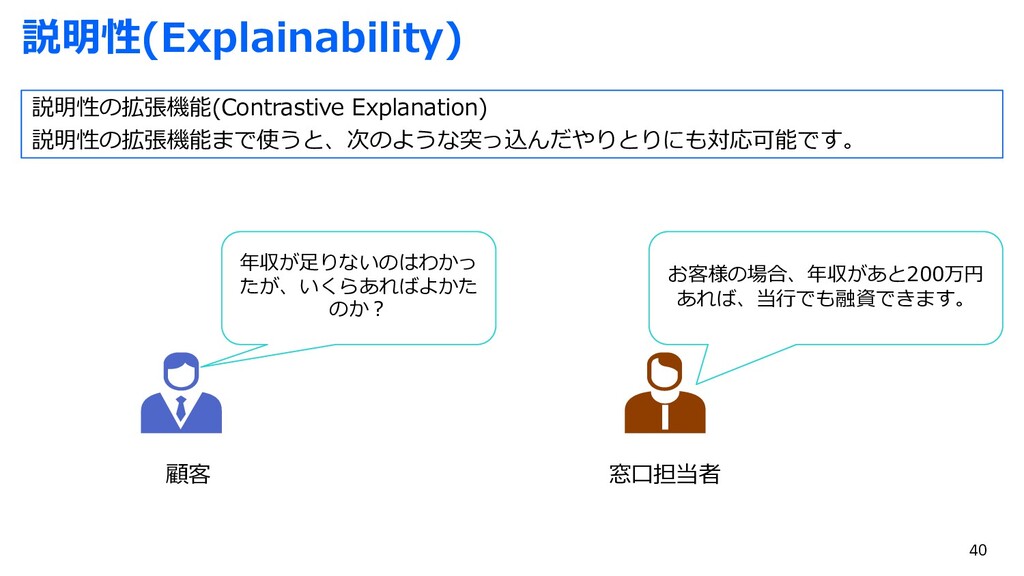
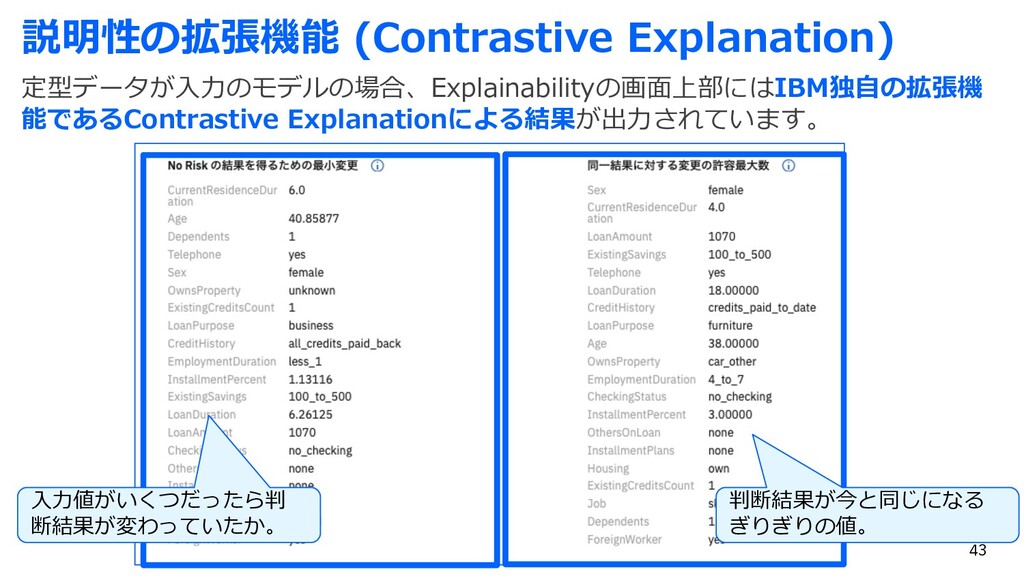
説明性(Explainability) 顧客 窓⼝担当者 年収が⾜りないのはわかっ たが、いくらあればよかた のか︖ お客様の場合、年収があと200万円 あれば、当⾏でも融資できます。 説明性の拡張機能(Contrastive Explanation)
説明性の拡張機能まで使うと、次のような突っ込んだやりとりにも対応可能です。 40 -
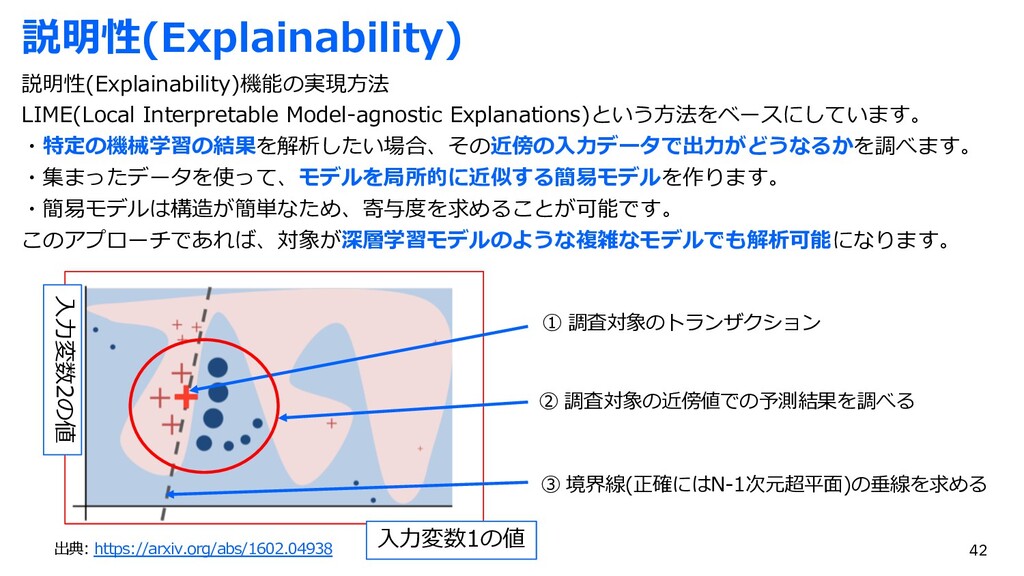
説明性(Explainability) 説明性(Explainability)機能の実現⽅法 LIME(Local Interpretable Model-agnostic Explanations)という⽅法をベースにしています。 ・特定の機械学習の結果を解析したい場合、その近傍の⼊⼒データで出⼒がどうなるかを調べます。 ・集まったデータを使って、モデルを局所的に近似する簡易モデルを作ります。 ・簡易モデルは構造が簡単なため、寄与度を求めることが可能です。 このアプローチであれば、対象が深層学習モデルのような複雑なモデルでも解析可能になります。
出典: https://arxiv.org/abs/1602.04938 ⼊⼒変数1の値 ⼊⼒変数2の値 ① 調査対象のトランザクション ② 調査対象の近傍値での予測結果を調べる ③ 境界線(正確にはN-1次元超平⾯)の垂線を求める 42 -
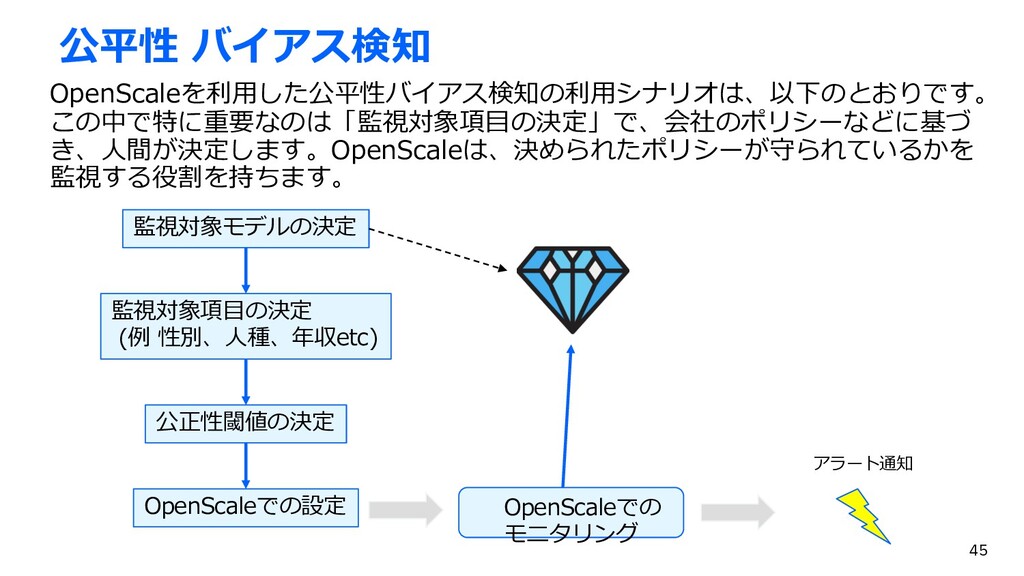
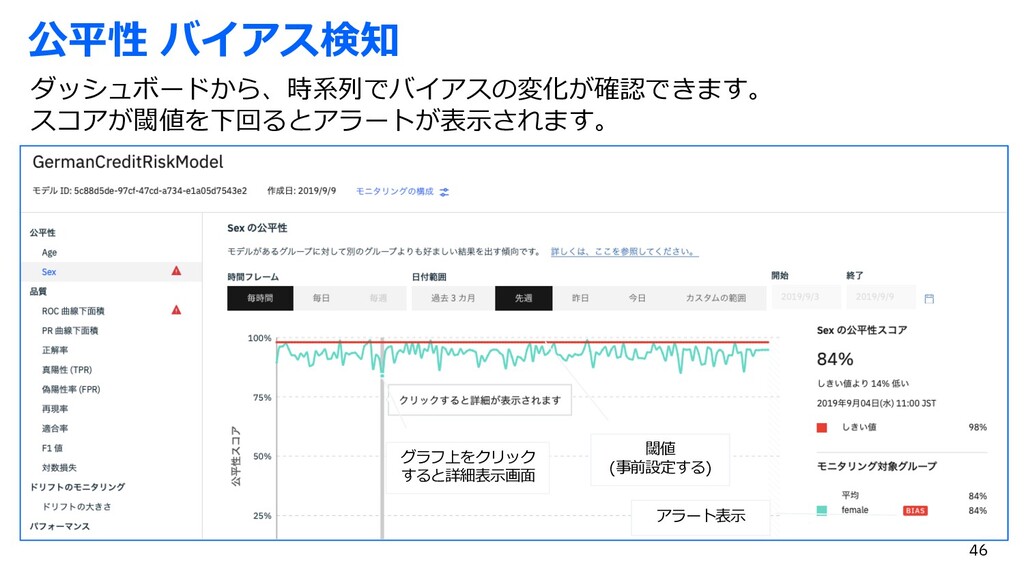
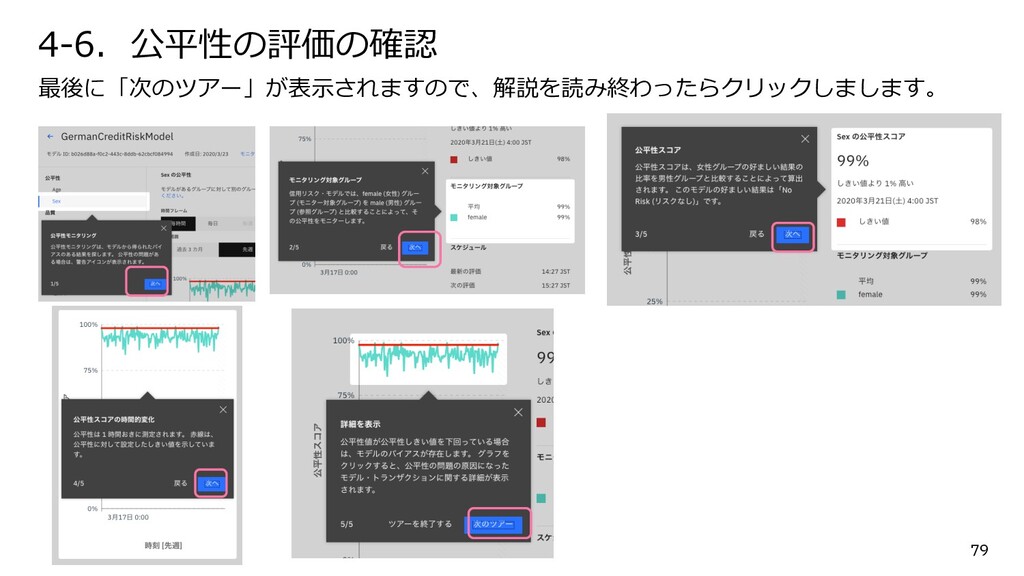
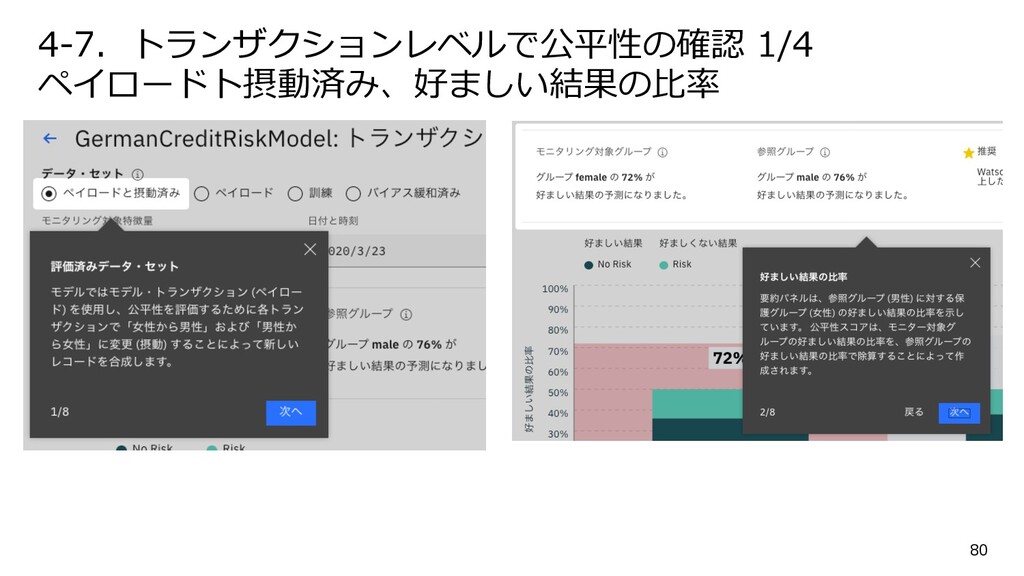
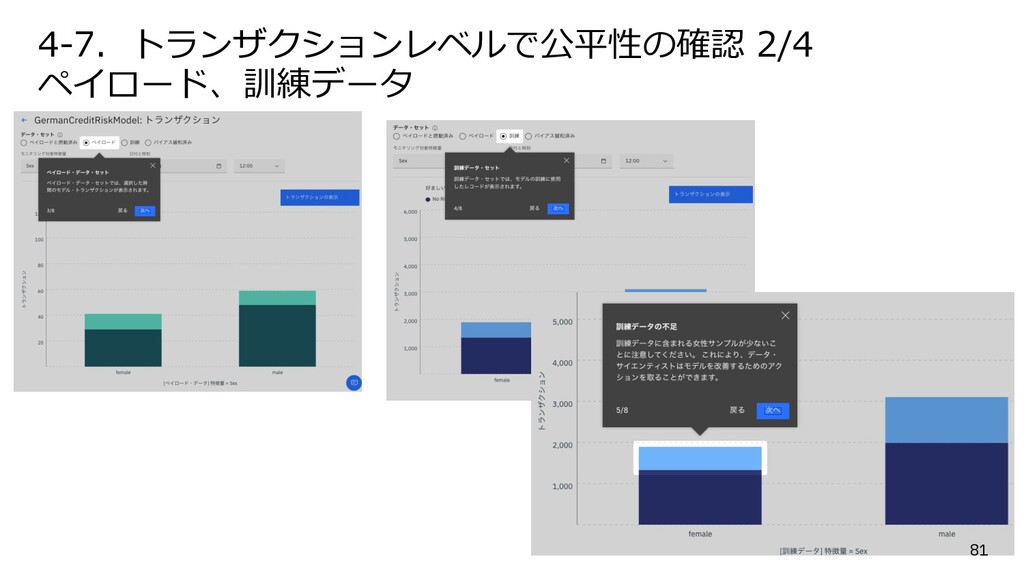
公平性 バイアス検知 OpenScaleを利⽤した公平性バイアス検知の利⽤シナリオは、以下のとおりです。 この中で特に重要なのは「監視対象項⽬の決定」で、会社のポリシーなどに基づ き、⼈間が決定します。OpenScaleは、決められたポリシーが守られているかを 監視する役割を持ちます。 監視対象モデルの決定 監視対象項⽬の決定 (例 性別、⼈種、年収etc)
OpenScaleでの設定 公正性閾値の決定 OpenScaleでの モニタリング アラート通知 45 -
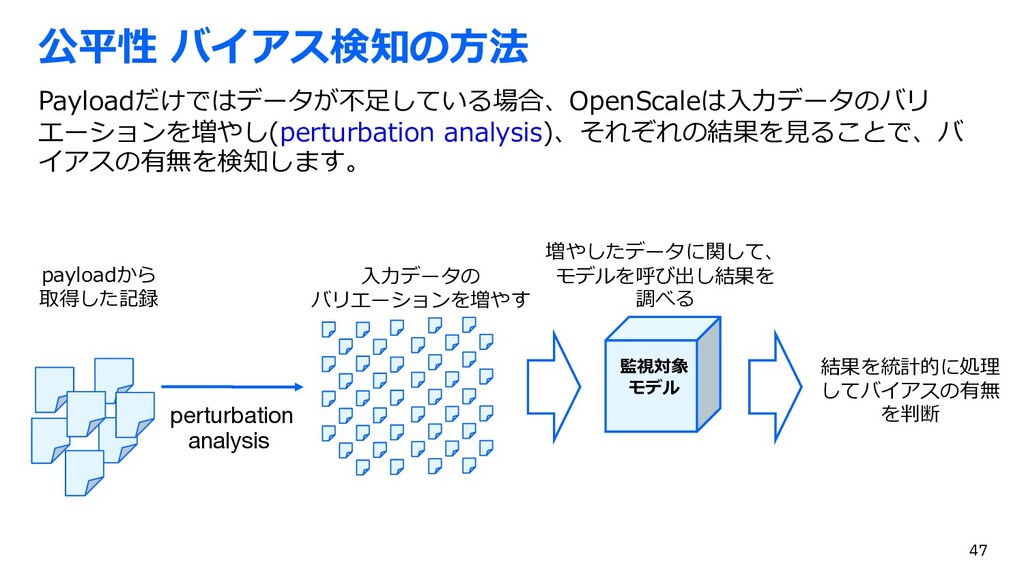
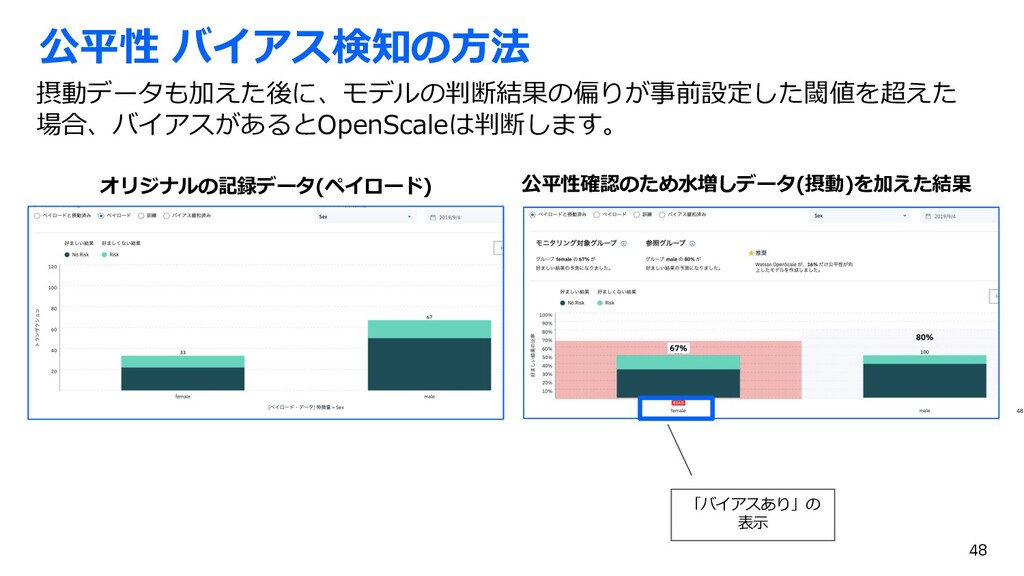
公平性 バイアス検知の⽅法 perturbation analysis ⼊⼒データの バリエーションを増やす 監視対象 モデル Payloadだけではデータが不⾜している場合、OpenScaleは⼊⼒データのバリ エーションを増やし(perturbation
analysis)、それぞれの結果を⾒ることで、バ イアスの有無を検知します。 payloadから 取得した記録 増やしたデータに関して、 モデルを呼び出し結果を 調べる 結果を統計的に処理 してバイアスの有無 を判断 47 -
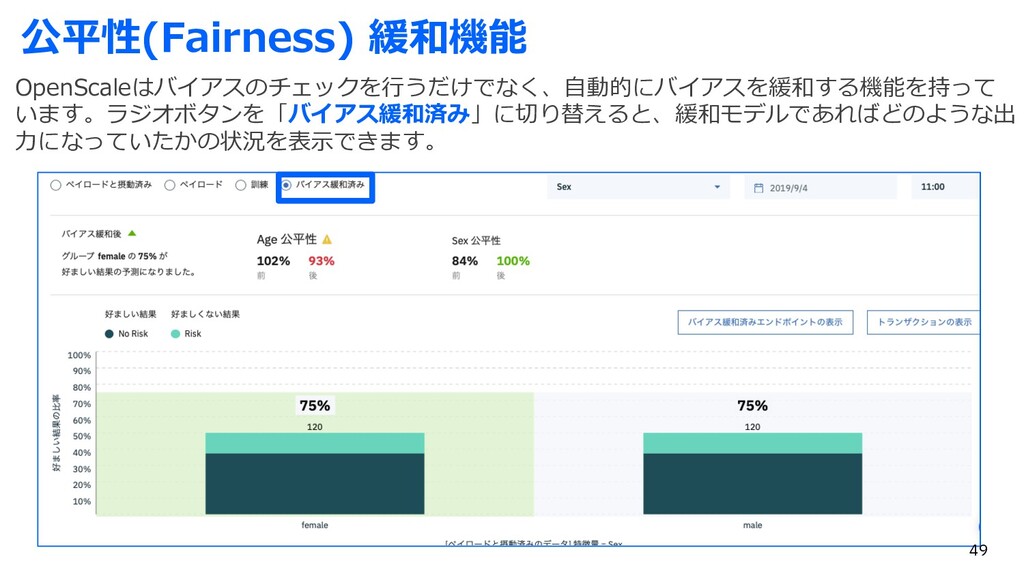
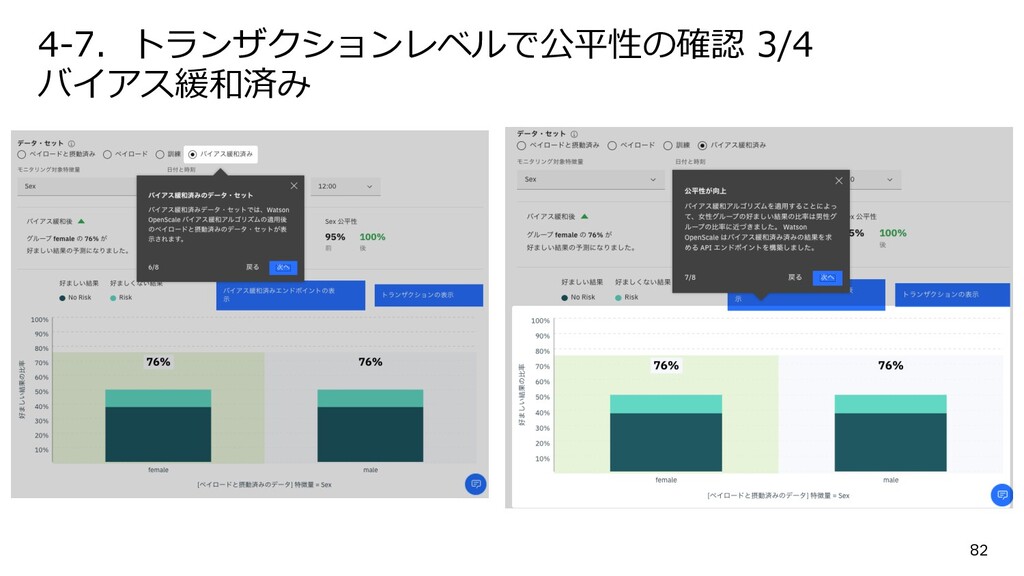
公平性 バイアス緩和の⽅法 perturbation analysis ⼊⼒データのバリエー ションを増やす 監視対象 モデル OpenScaleはバイアス緩和のため、「バイアス検知モデル」を内部に作ります。 バイアスの発⽣する危険のある⼊⼒データかどうかをこのモデルで判断し、その結
果によりバイアス緩和を⾏います。 payloadから取得した 記録 バイアス検知 モデル (OpenScale内部) 公平 不公平 増やしたデータに関して、 モデルを呼び出し結果を 調べる バイアスが発⽣するかし ないかを判断するモデル を⽣成 50 -
バイアス緩和 (アプリ側の修正) アプリケーションでOpenScaleのバイアス緩和出⼒を、オリジナルのモデルの代わ りに利⽤する場合は、Machine Learning呼出し⽤のURLをOpenScale提供のエンド ポイントURLに変更します。 これはWatson Machine Learningの場合も、AzureやSagemakerなど他社MLの場 合でも同じです。
Machine Learning Application API Call OpenScale Payload de-biased endpoint 51 -
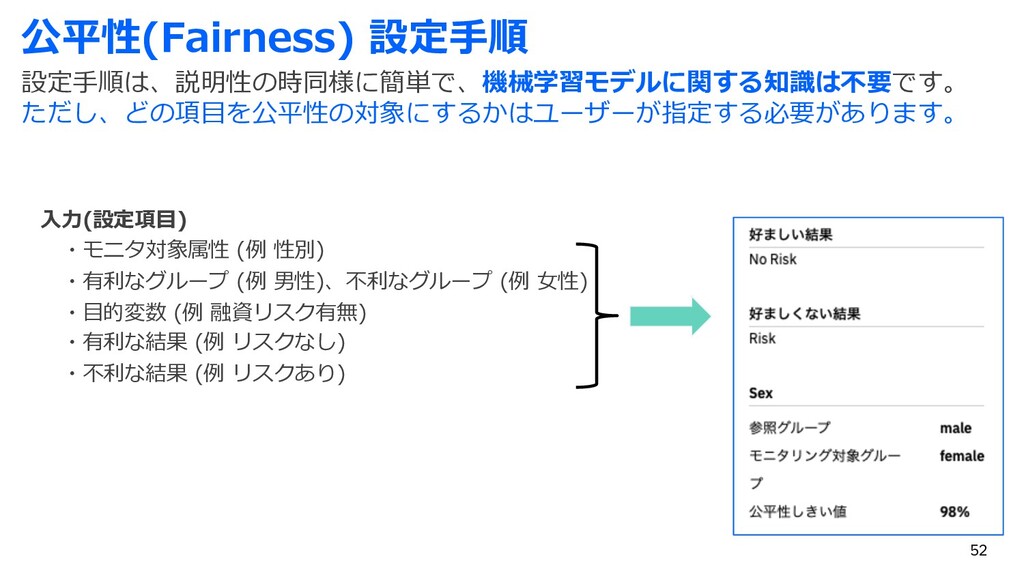
公平性(Fairness) 設定⼿順 設定⼿順は、説明性の時同様に簡単で、機械学習モデルに関する知識は不要です。 ただし、どの項⽬を公平性の対象にするかはユーザーが指定する必要があります。 ⼊⼒(設定項⽬) ・モニタ対象属性 (例 性別) ・有利なグループ (例
男性)、不利なグループ (例 ⼥性) ・⽬的変数 (例 融資リスク有無) ・有利な結果 (例 リスクなし) ・不利な結果 (例 リスクあり) 52 -
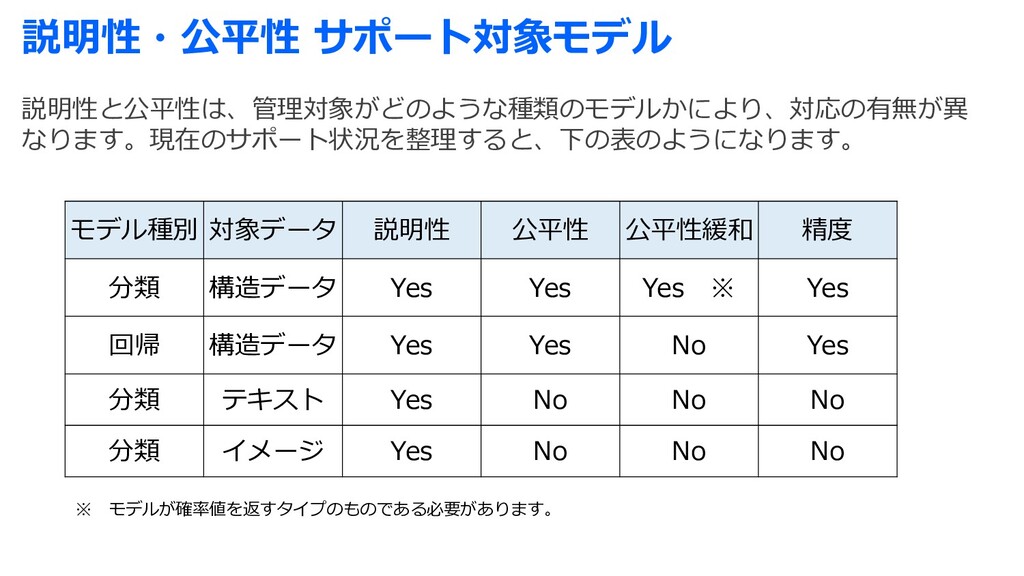
説明性・公平性 サポート対象モデル 説明性と公平性は、管理対象がどのような種類のモデルかにより、対応の有無が異 なります。現在のサポート状況を整理すると、下の表のようになります。 モデル種別 対象データ 説明性 公平性 公平性緩和 精度
分類 構造データ Yes Yes Yes ※ Yes 回帰 構造データ Yes Yes No Yes 分類 テキスト Yes No No No 分類 イメージ Yes No No No ※ モデルが確率値を返すタイプのものである必要があります。 -
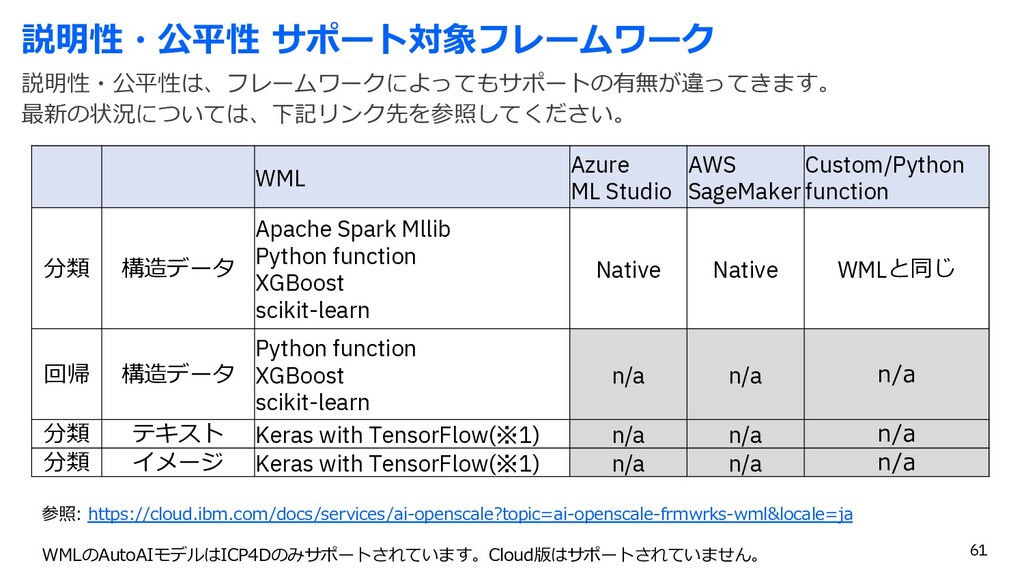
説明性・公平性 サポート対象フレームワーク 説明性・公平性は、フレームワークによってもサポートの有無が違ってきます。 最新の状況については、下記リンク先を参照してください。 WML Azure ML Studio AWS SageMaker
Custom/Python function 分類 構造データ Apache Spark Mllib Python function XGBoost scikit-learn Native Native WMLと同じ 回帰 構造データ Python function XGBoost scikit-learn n/a n/a n/a 分類 テキスト Keras with TensorFlow(※1) n/a n/a n/a 分類 イメージ Keras with TensorFlow(※1) n/a n/a n/a 参照: https://cloud.ibm.com/docs/services/ai-openscale?topic=ai-openscale-frmwrks-wml&locale=ja WMLのAutoAIモデルはICP4Dのみサポートされています。Cloud版はサポートされていません。 61 -
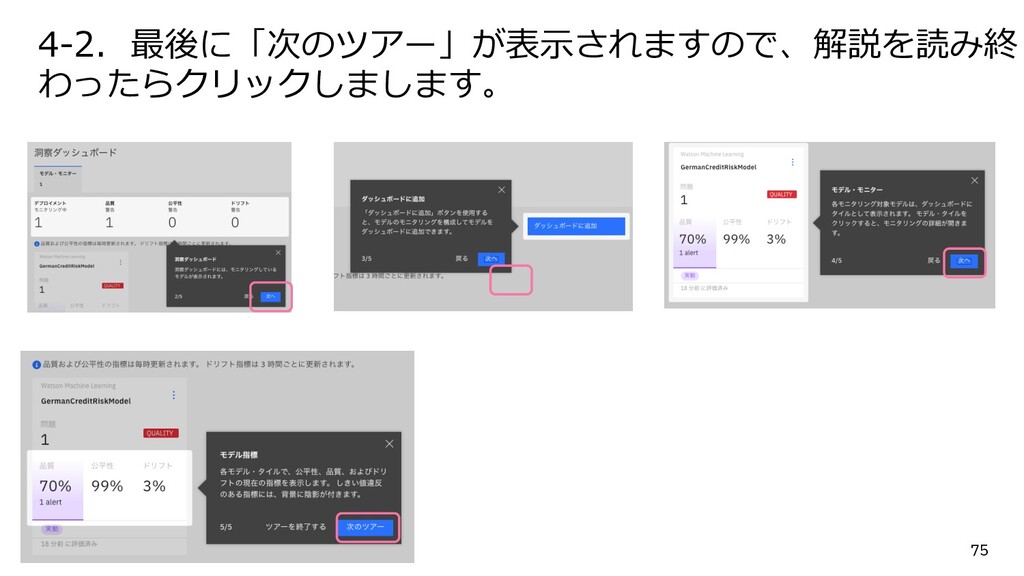
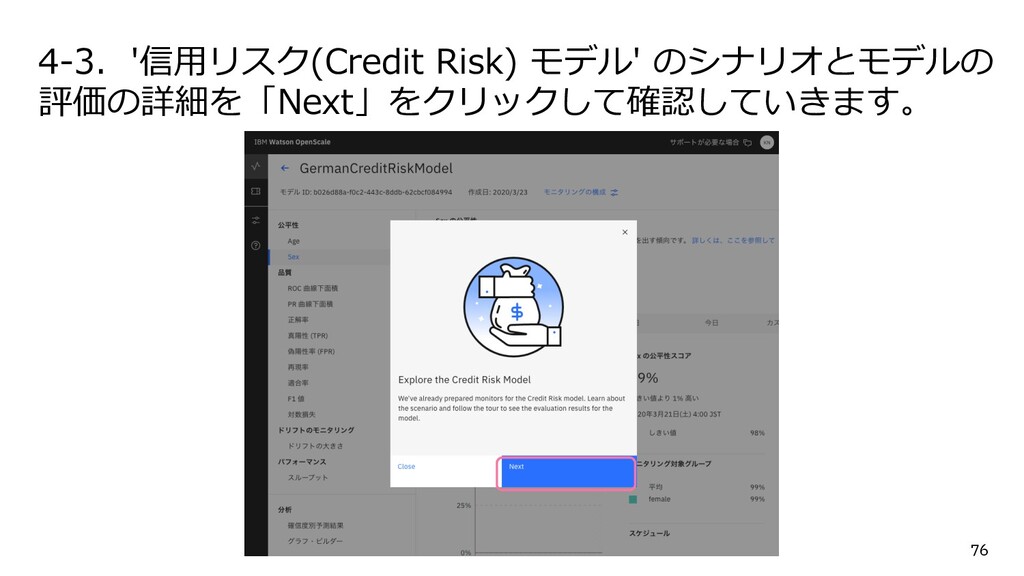
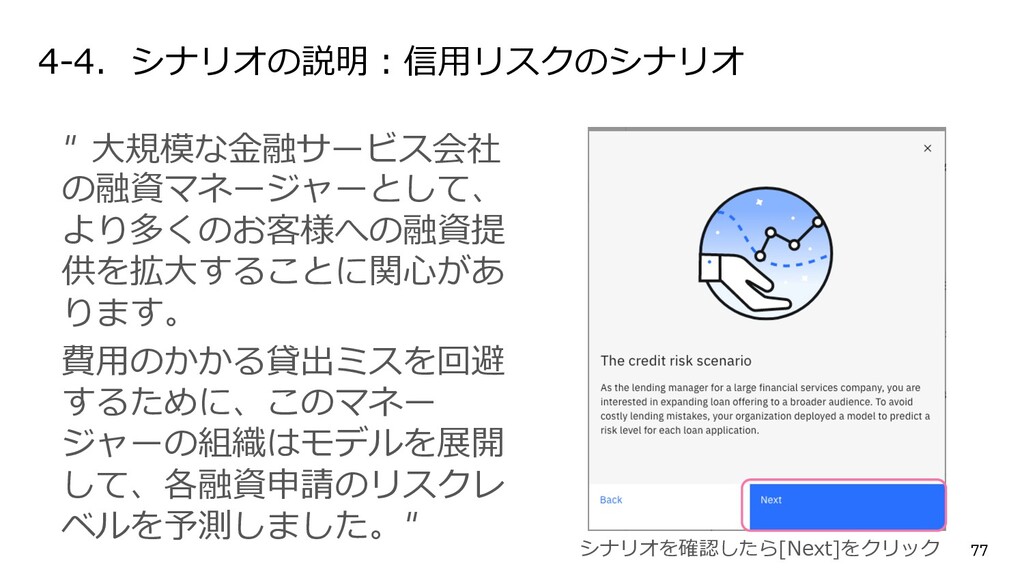
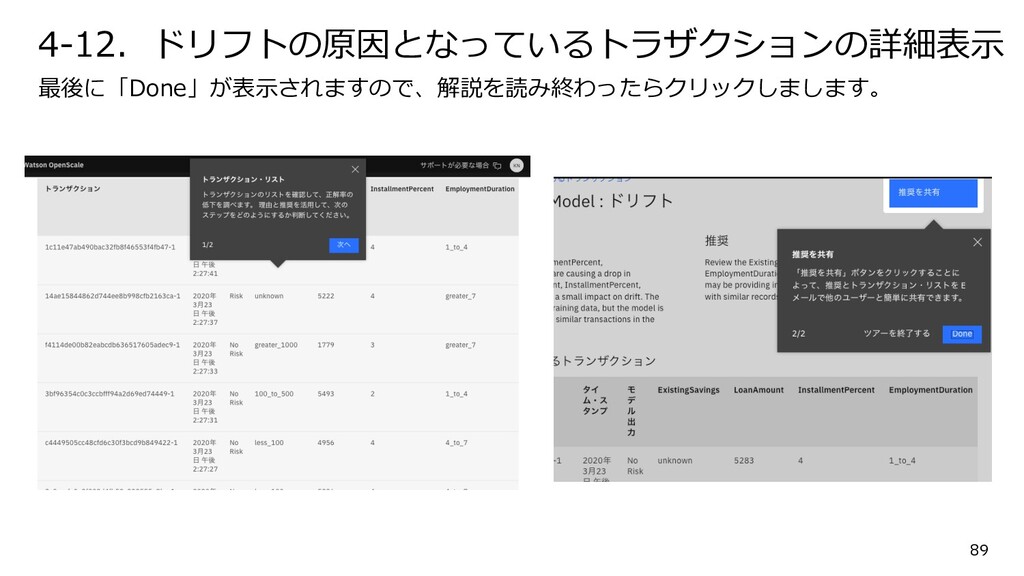
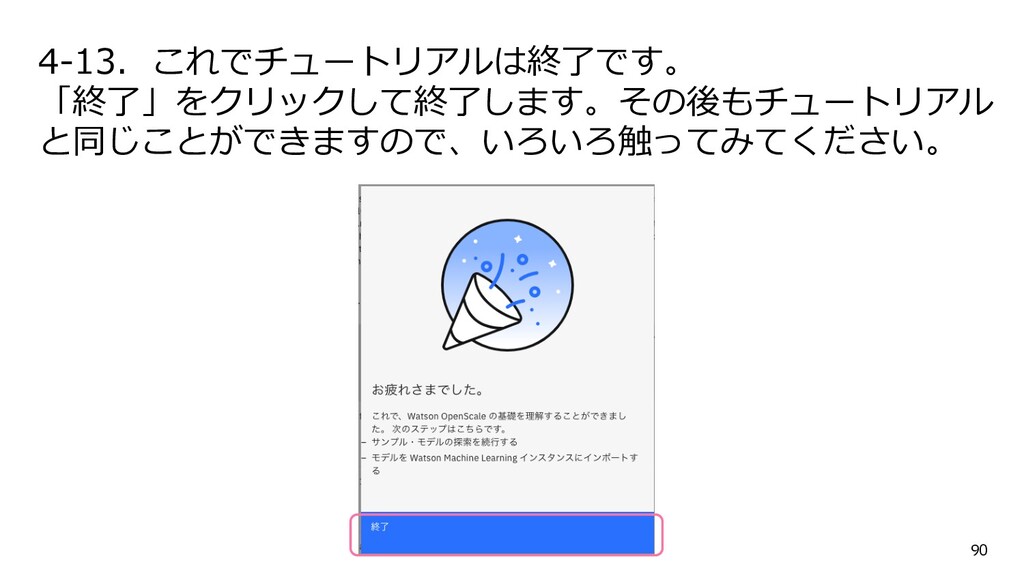
⾃動セットアップのチュートリアルを体験 Watson OpenScale でモデルがどのようにモニターされるかを簡単に確認する ために、最初に Watson OpenScale UI にログインした際に提供されているデ モ・シナリオ・オプションを⼀緒に体験してみます。
この内容は製品のチュートリアル「⼊⾨チュートリアル (⾃動セットアップ) 」 と同じ内容です。 https://cloud.ibm.com/docs/services/ai-openscale?topic=ai-openscale- gettingstarted 63 -
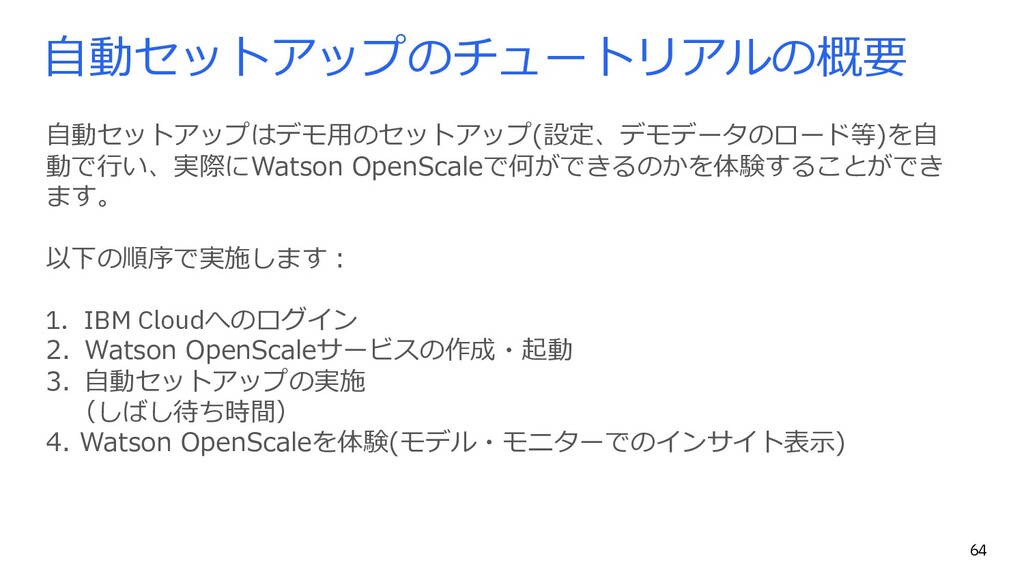
⾃動セットアップのチュートリアルの概要 ⾃動セットアップはデモ⽤のセットアップ(設定、デモデータのロード等)を⾃ 動で⾏い、実際にWatson OpenScaleで何ができるのかを体験することができ ます。 以下の順序で実施します︓ 1. IBM Cloudへのログイン 2.
Watson OpenScaleサービスの作成・起動 3. ⾃動セットアップの実施 (しばし待ち時間) 4. Watson OpenScaleを体験(モデル・モニターでのインサイト表⽰) 64 -
http://ibm.biz/dojo0401にアクセスしてログインしてください。 すでに最初の出席登録でログイン済みの場合は、ログイン不要です。ログイン後の ダッシュボードが表⽰されている画⾯を表⽰させておいてください。 • IBM Cloud ログイン アカウントをすでにお持ちの方は、 こちらからログインしてください •
IBM Cloud ライトアカウント作成 アカウントをお持ちでない方は、 ご登録をお願いします 本イベント以外では https://cloud.ibm.com/login からログイン可能です 1. IBM Cloudへのログイン 65 -
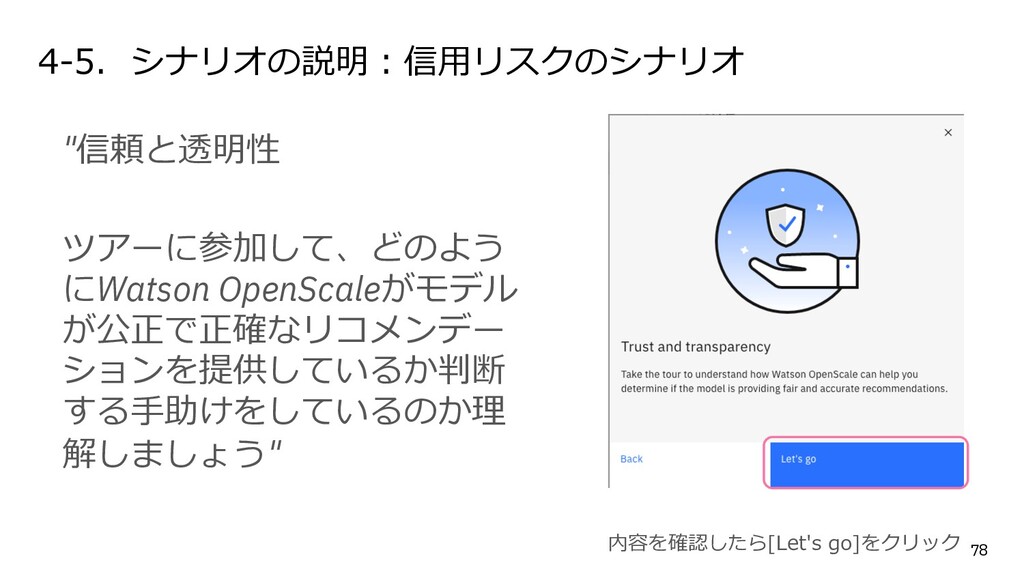
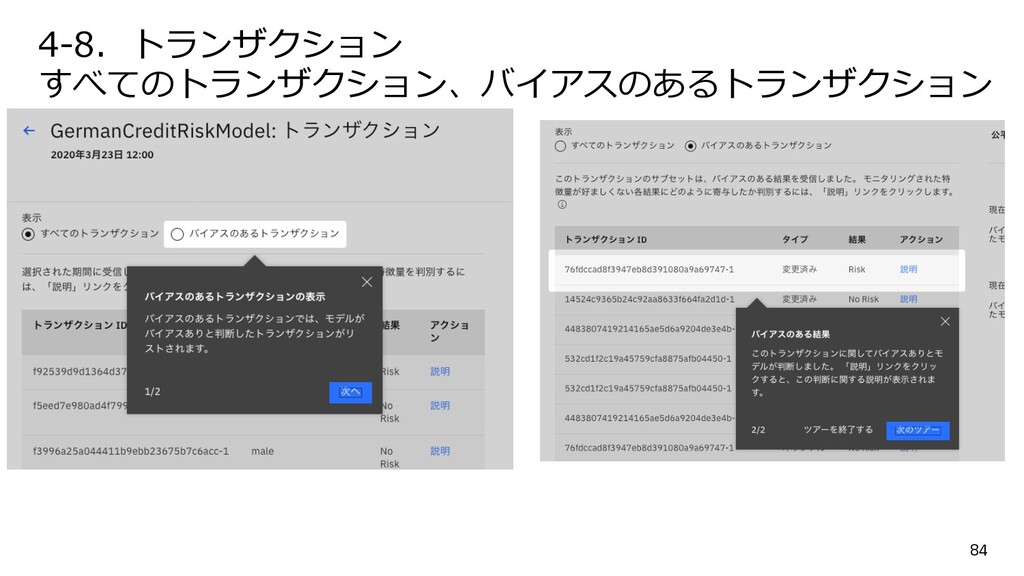
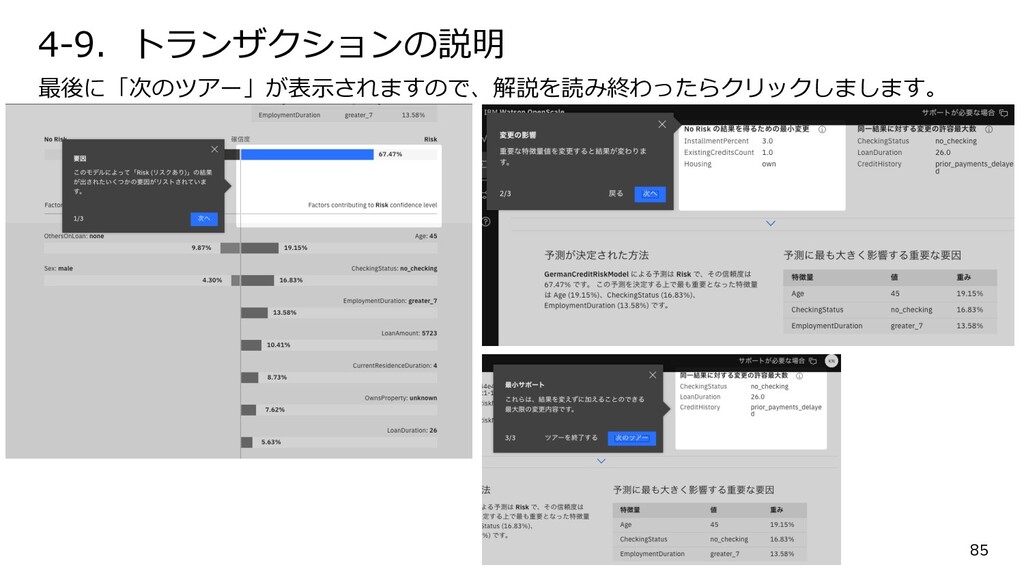
4-4. シナリオの説明︓信⽤リスクのシナリオ " ⼤規模な⾦融サービス会社 の融資マネージャーとして、 より多くのお客様への融資提 供を拡⼤することに関⼼があ ります。 費⽤のかかる貸出ミスを回避 するために、このマネー
ジャーの組織はモデルを展開 して、各融資申請のリスクレ ベルを予測しました。" シナリオを確認したら[Next]をクリック 77 -
実際にモデルを登録してWatson OpenScale を使うには、、、、 実際にモデルを登録してWatson OpenScaleを使うには、pythonでSDKを使っ てcodeを書いて実⾏しての設定が通常必要です。 • Watson Machine Learningのモデルを使う場合は、モデル登録にpythonで
の登録が必要です。 • AutoMLなど他社のモデルを使う場合は、ペイロードロギング等に通常は何 かしらのCodeの実⾏が必要です。 • もちろん⼀部はGUIで実施可能です。 このワークショップ課題にはpythonを使⽤します。 実⾏環境はIBM CloudのWatson Studioを使います。 -
Python SDK チュートリアル: ポイント • IBM® Watson OpenScale サービスのプロビジョン は既にやっているので
不要。 • (オプション) Databases for PostgreSQL サービスまたは DB2 Warehouse サービスのプロビジョン は有料のサービスが必要なためとりあえずやらなく ともOK • Machine Learningモデルの作成とデプロイ の Working with Watson Machine Learning ノートブックを Watson Studio プロジェクトに追加す る はnotebookの内容が英語のため、⽇本語に翻訳したものを使⽤したい場 合は次ページからの⼿順に従ってください。 -
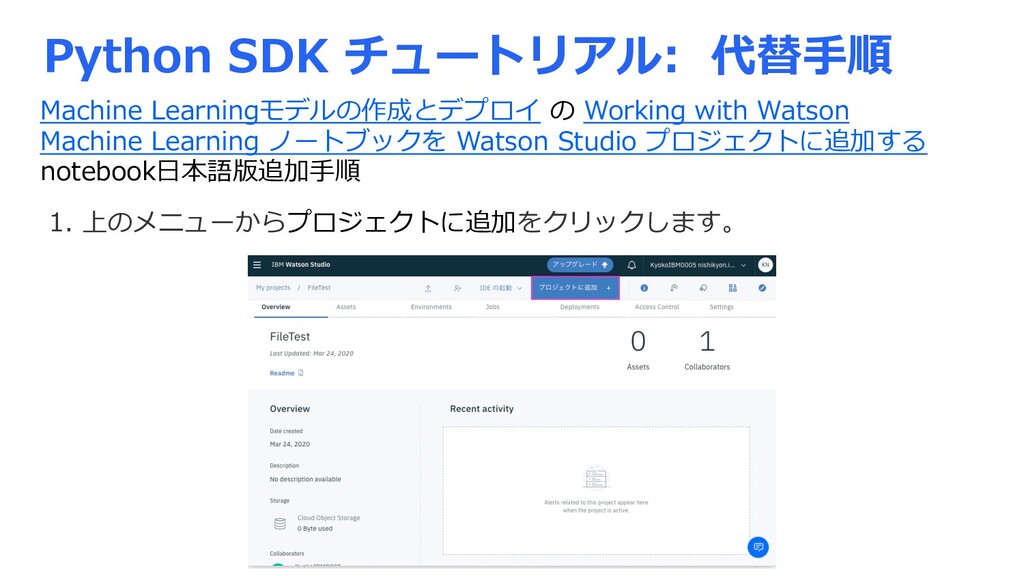
Python SDK チュートリアル: 代替⼿順 Machine Learningモデルの作成とデプロイ の Working with Watson
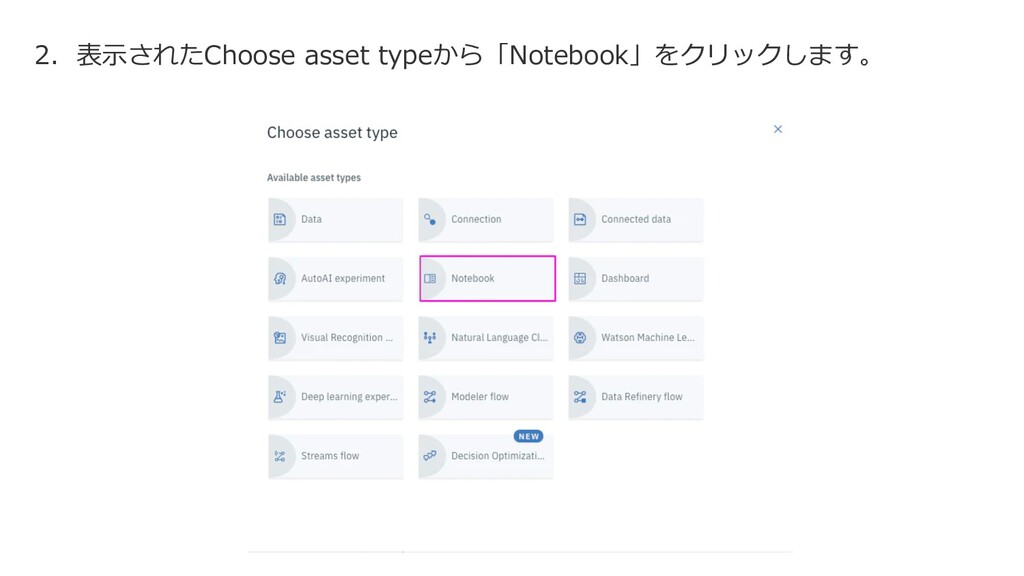
Machine Learning ノートブックを Watson Studio プロジェクトに追加する notebook⽇本語版追加⼿順 1. 上のメニューからプロジェクトに追加をクリックします。 -
3. FromURLタブをクリックして、以下を⼊⼒し、[Create]をクリック: Name: 適当な名前。下の例は「Watson OpenScale and Watson ML Engine」 Select
runtime: Default Spark Python 3.6 Notebook URL: https://github.com/kyokonishito/ai-openscale- tutorials/blob/ja_translation/notebooks/Watson%20OpenScale%20and%20Wat son%20ML%20Engine-ja.ipynb 以上です -
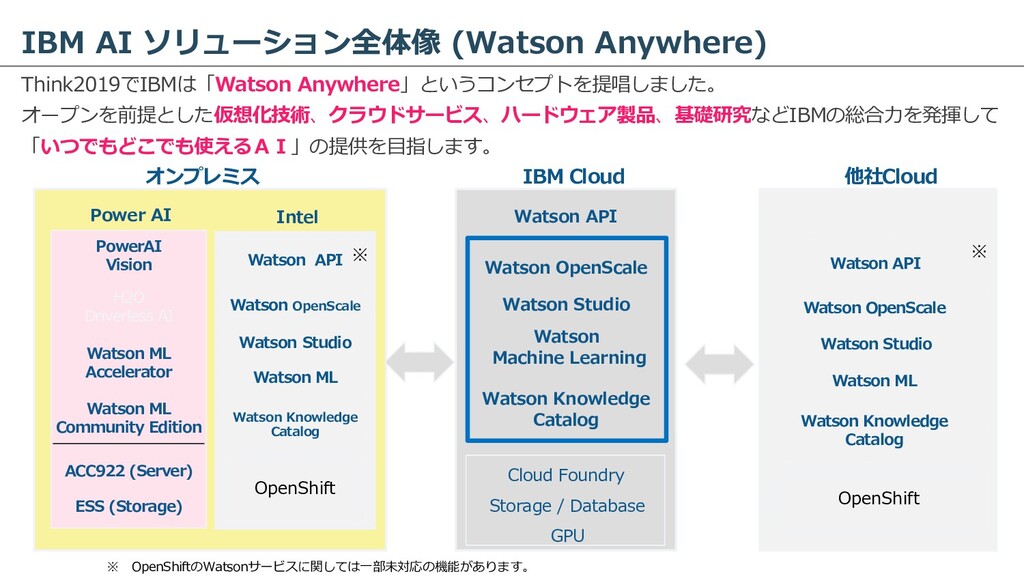
IBM AI ソリューション全体像 (Watson Anywhere) Think2019でIBMは「Watson Anywhere」というコンセプトを提唱しました。 オープンを前提とした仮想化技術、クラウドサービス、ハードウェア製品、基礎研究などIBMの総合⼒を発揮して 「いつでもどこでも使えるAI」の提供を⽬指します。 オンプレミス
IBM Cloud 他社Cloud Power AI Intel ESS (Storage) ACC922 (Server) Watson ML Community Edition Watson ML Accelerator PowerAI Vision H2O Driverless AI OpenShift Watson Knowledge Catalog Watson ML Watson Studio Watson OpenScale Watson API OpenShift Watson Knowledge Catalog Watson ML Watson Studio Watson OpenScale Watson API Watson Knowledge Catalog Watson Machine Learning Watson Studio Watson OpenScale Watson API Cloud Foundry Storage / Database GPU ※ ※ ※ OpenShiftのWatsonサービスに関しては⼀部未対応の機能があります。 -
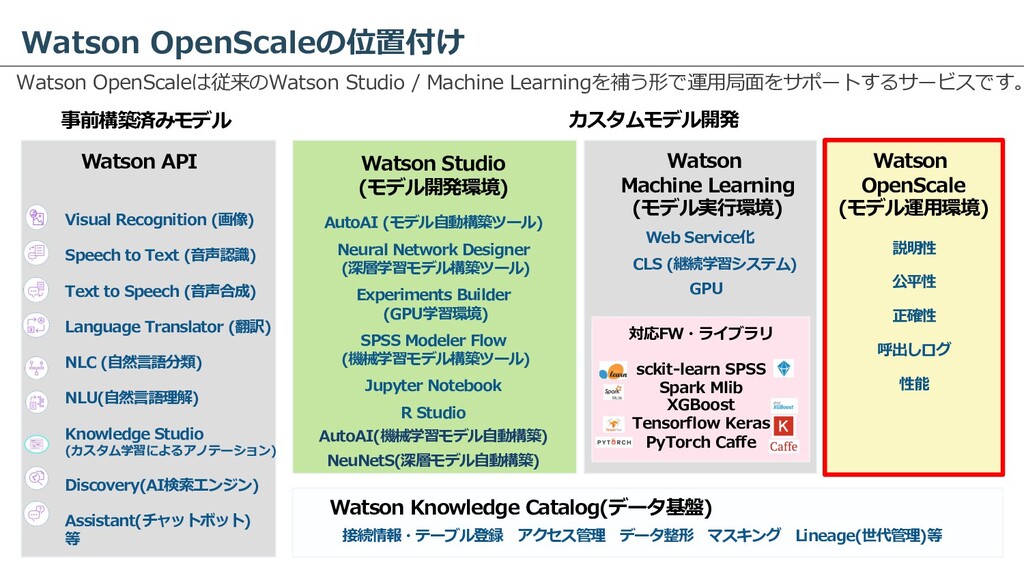
Watson OpenScaleの位置付け Watson OpenScaleは従来のWatson Studio / Machine Learningを補う形で運⽤局⾯をサポートするサービスです。 Watson API
Visual Recognition (画像) Speech to Text (⾳声認識) Text to Speech (⾳声合成) NLC (⾃然⾔語分類) NLU(⾃然⾔語理解) Discovery(AI検索エンジン) Assistant(チャットボット) 等 Language Translator (翻訳) Watson Studio (モデル開発環境) AutoAI (モデル⾃動構築ツール) Neural Network Designer (深層学習モデル構築ツール) Experiments Builder (GPU学習環境) SPSS Modeler Flow (機械学習モデル構築ツール) Jupyter Notebook R Studio Watson Knowledge Catalog(データ基盤) 接続情報・テーブル登録 アクセス管理 データ整形 マスキング Lineage(世代管理)等 Watson Machine Learning (モデル実⾏環境) Web Service化 CLS (継続学習システム) GPU 対応FW・ライブラリ sckit-learn SPSS Spark Mlib XGBoost Tensorflow Keras PyTorch Caffe Watson OpenScale (モデル運⽤環境) 説明性 公平性 正確性 呼出しログ 性能 NeuNetS(深層モデル⾃動構築) 事前構築済みモデル カスタムモデル開発 Knowledge Studio (カスタム学習によるアノテーション) AutoAI(機械学習モデル⾃動構築)