Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Agentic AI를 위한 MCP Sidecar sLM 학습(시도)기
Search
Lablup Inc.
November 03, 2025
100
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Agentic AI를 위한 MCP Sidecar sLM 학습(시도)기
Track 3_1730_Lablup Conf 2025_이준범
Lablup Inc.
November 03, 2025
More Decks by Lablup Inc.
See All by Lablup Inc.
[Track 1] Mannequin: 인간 시연을 로봇 데이터로 바꾸는 RLWRLD의 데이터 파이프라인
lablup
0
37
[Track 1] 그래서 토큰은 누가 관리하나요?
lablup
0
21
[Track 2] AI Factory를 성공으로 이끄는 5가지 핵심 원칙
lablup
0
15
[Track 2] Composable, But Designed.
lablup
0
19
[Track 2] Furiosa-LLM: High-performance LLM Serving for RNGD
lablup
0
24
[Track 2] 기업환경에서 AI Agent부터 ML까지 하나의 워크플로우로
lablup
0
17
[Track 2] AI Agents Platform: 에이전트 생성과 협업을 한자리에
lablup
0
24
[Track 2] 에이전트 시대의 AI 보안
lablup
0
25
[Track 2] 쿠버네티스에서의 GPU 활용 방법의 변화
lablup
0
30
Featured
See All Featured
It's Worth the Effort
3n
188
29k
Navigating the Design Leadership Dip - Product Design Week Design Leaders+ Conference 2024
apolaine
2
490
Color Theory Basics | Prateek | Gurzu
gurzu
1
510
How Fast Is Fast Enough? [PerfNow 2025]
tammyeverts
3
960
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.2k
Mozcon NYC 2025: Stop Losing SEO Traffic
samtorres
1
590
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
43k
Bash Introduction
62gerente
615
220k
Fantastic passwords and where to find them - at NoRuKo
philnash
53
4k
AI in Enterprises - Java and Open Source to the Rescue
ivargrimstad
0
1.6k
Ruling the World: When Life Gets Gamed
codingconduct
0
430
Transcript
None
Agentic AI를 위한 MCP Sidecar sLM 학습(시도) 기 이준범 (래블업)
[email protected]
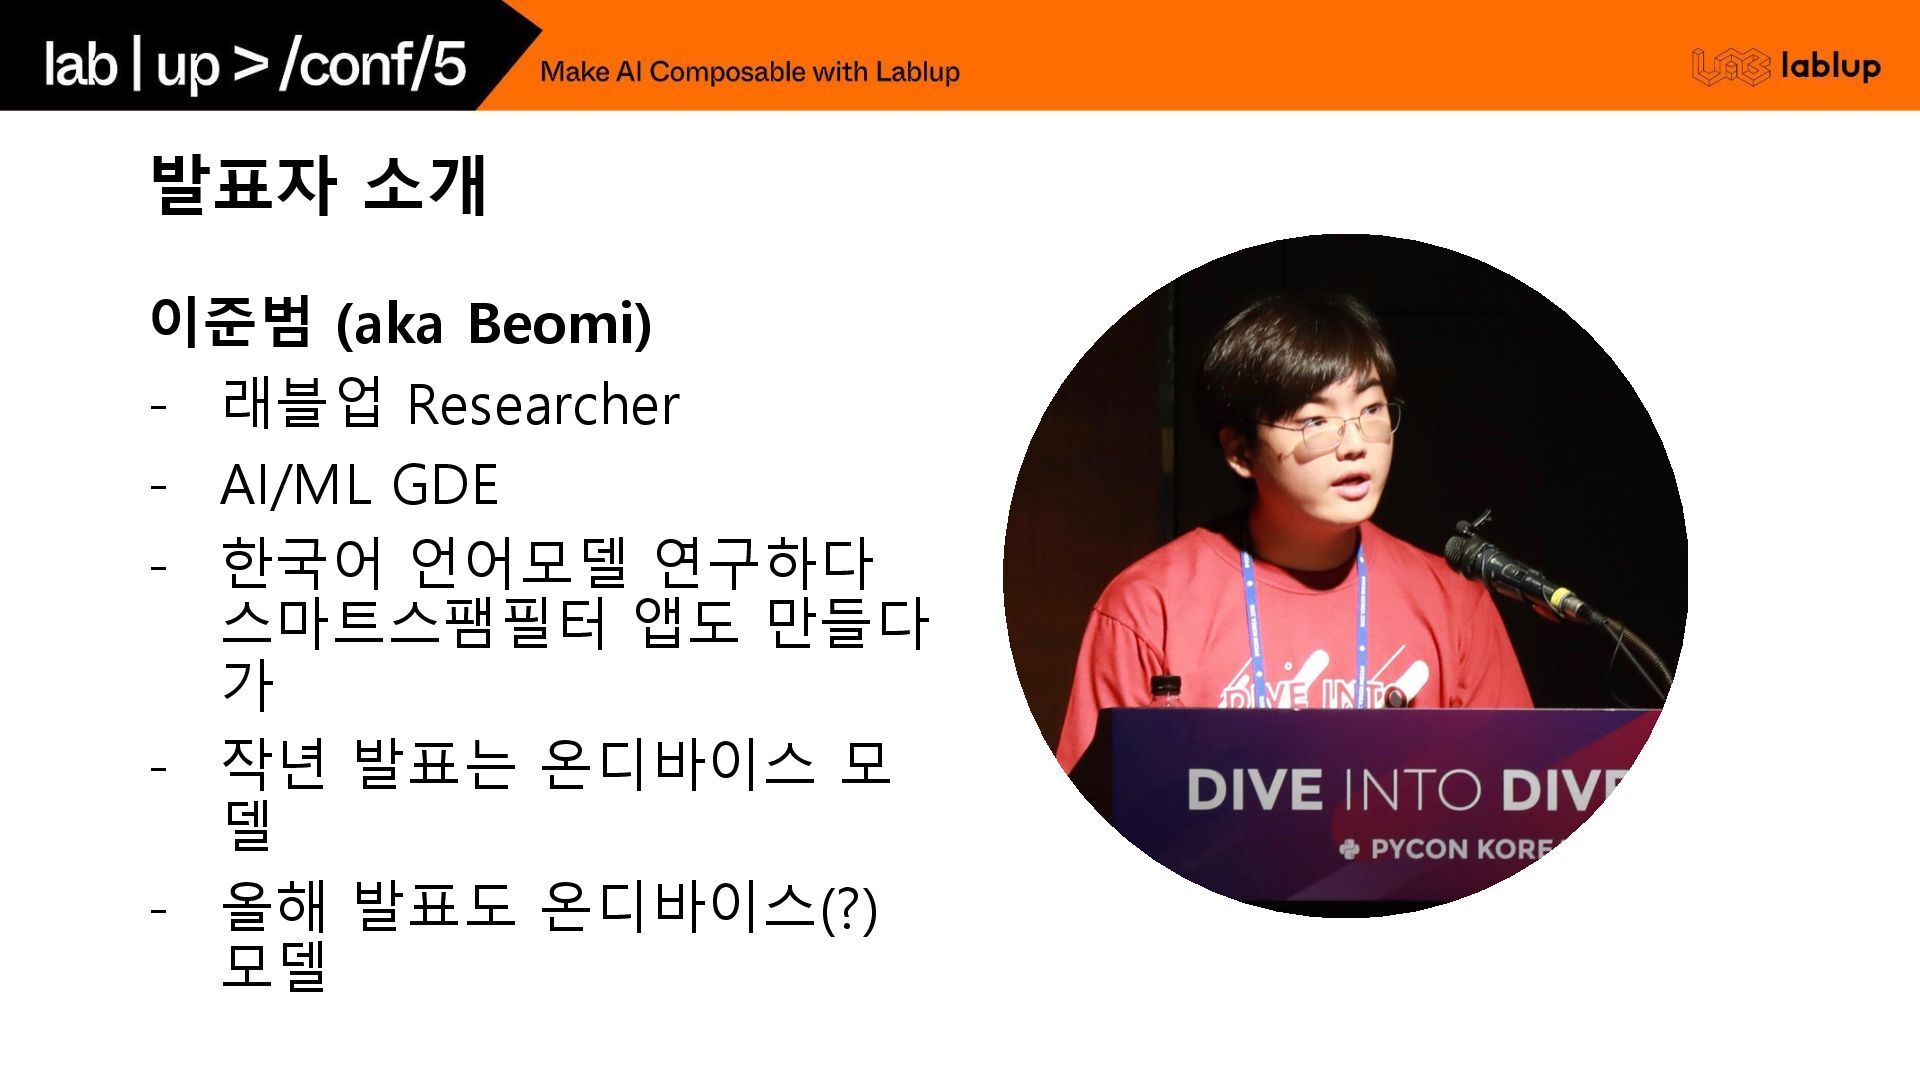
발표자 소개 이준범 (aka Beomi) - 래블업 Researcher - AI/ML
GDE - 한국어 언어모델 연구하다 스마트스팸필터 앱도 만들다 가 - 작년 발표는 온디바이스 모 델 - 올해 발표도 온디바이스(?) 모델
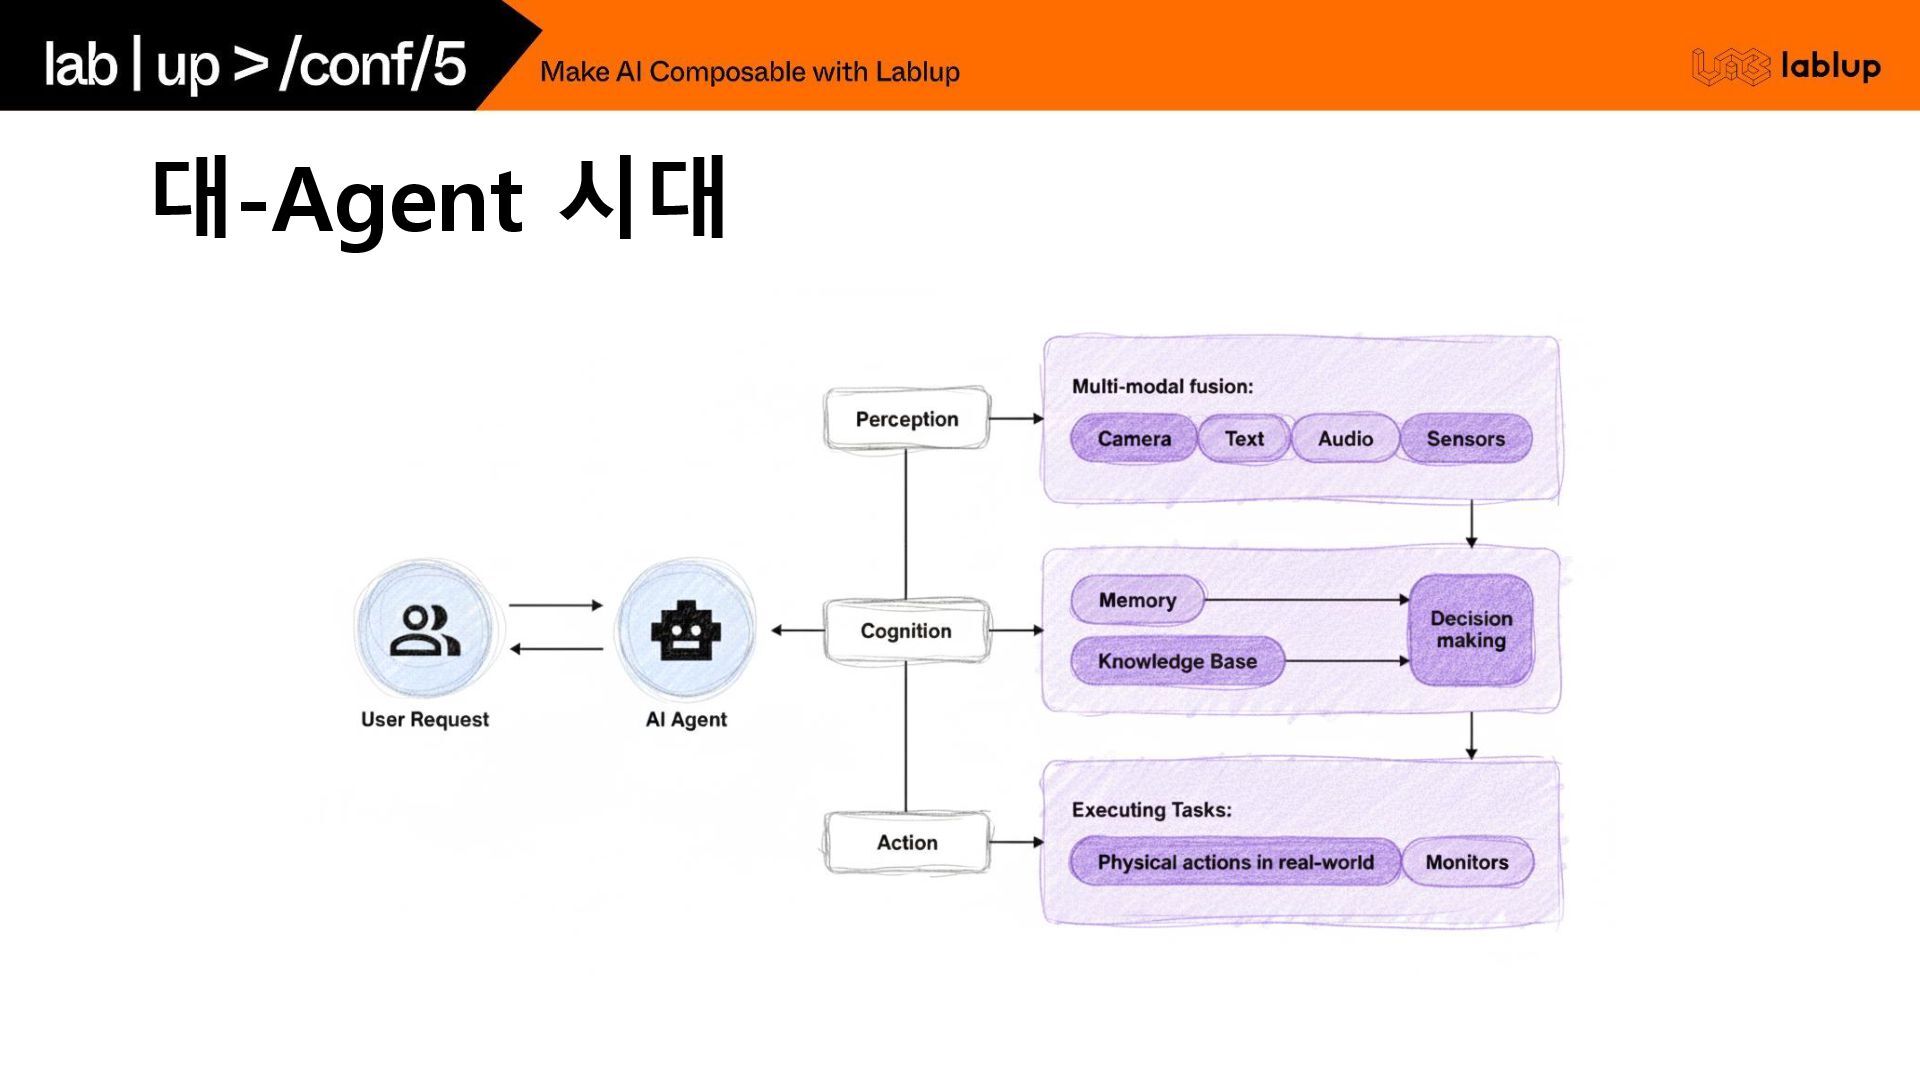
대-Agent 시대
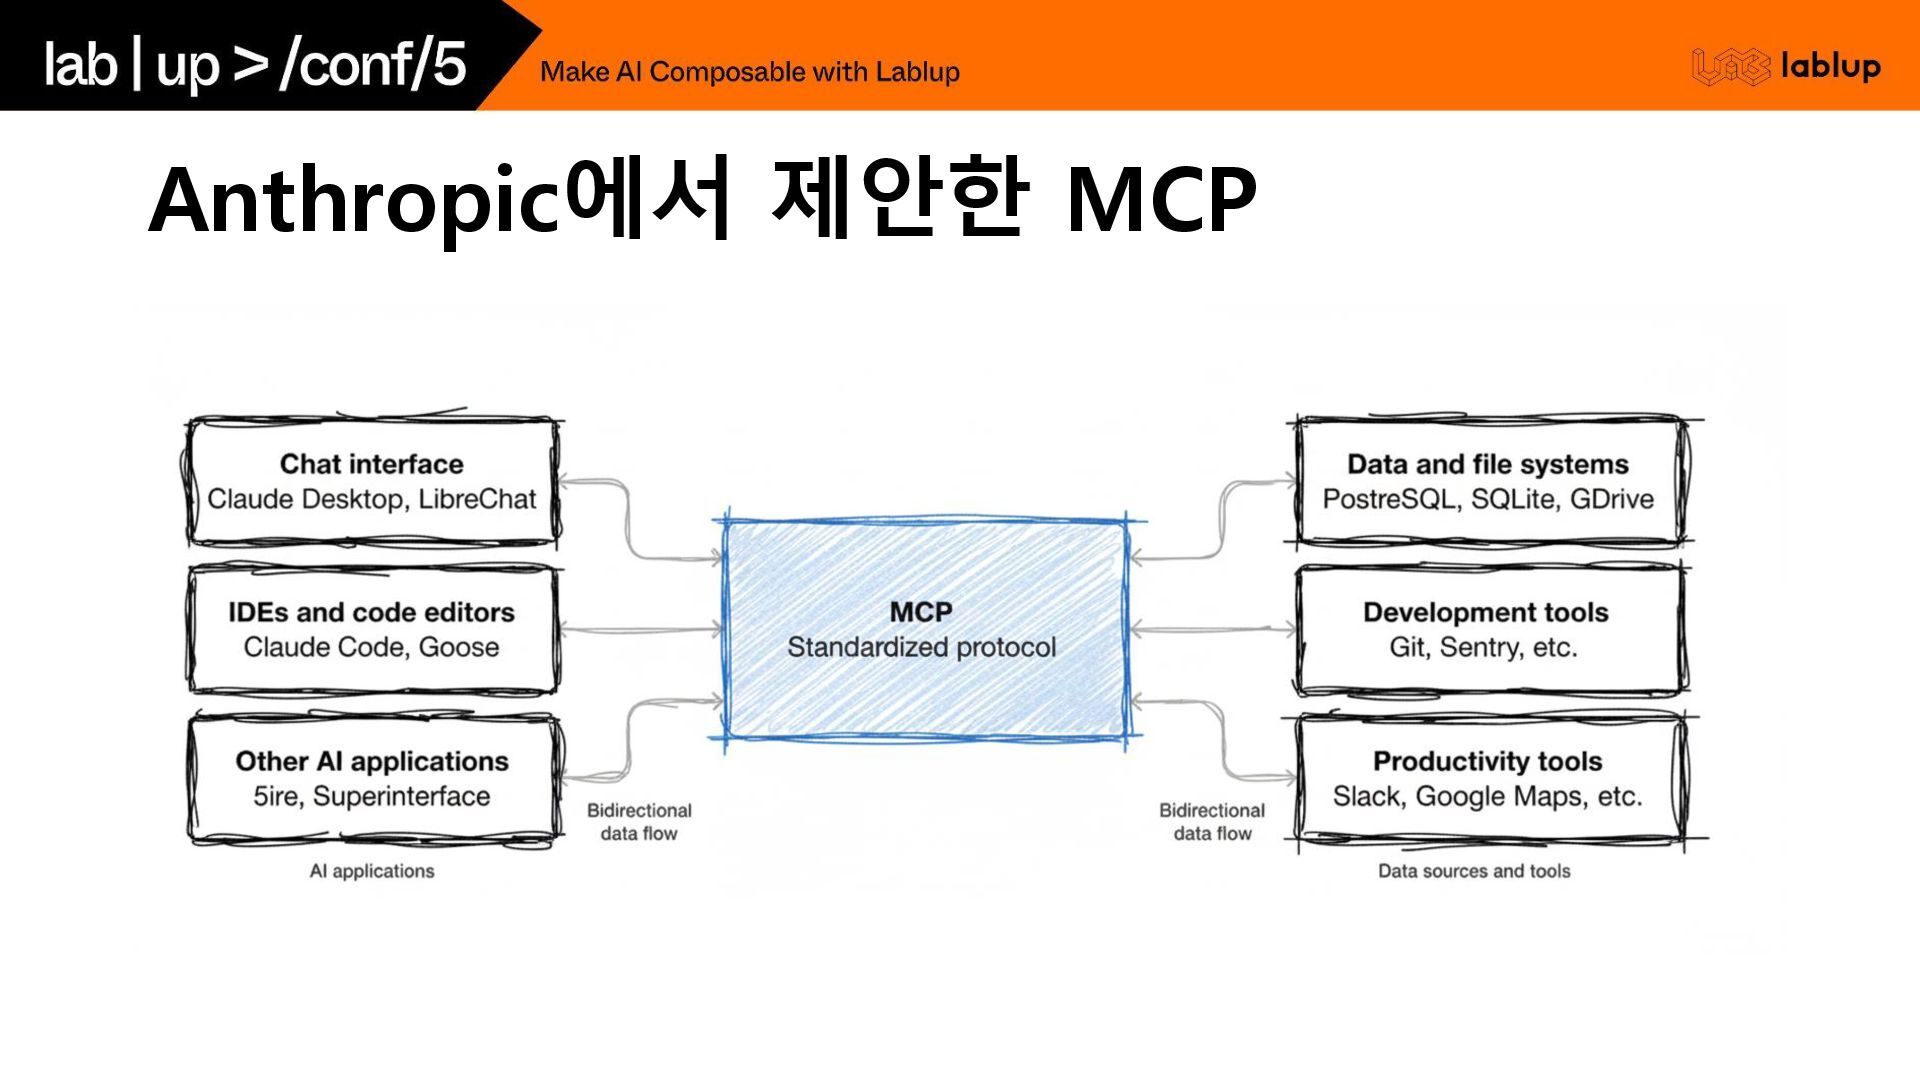
Anthropic에서 제안한 MCP
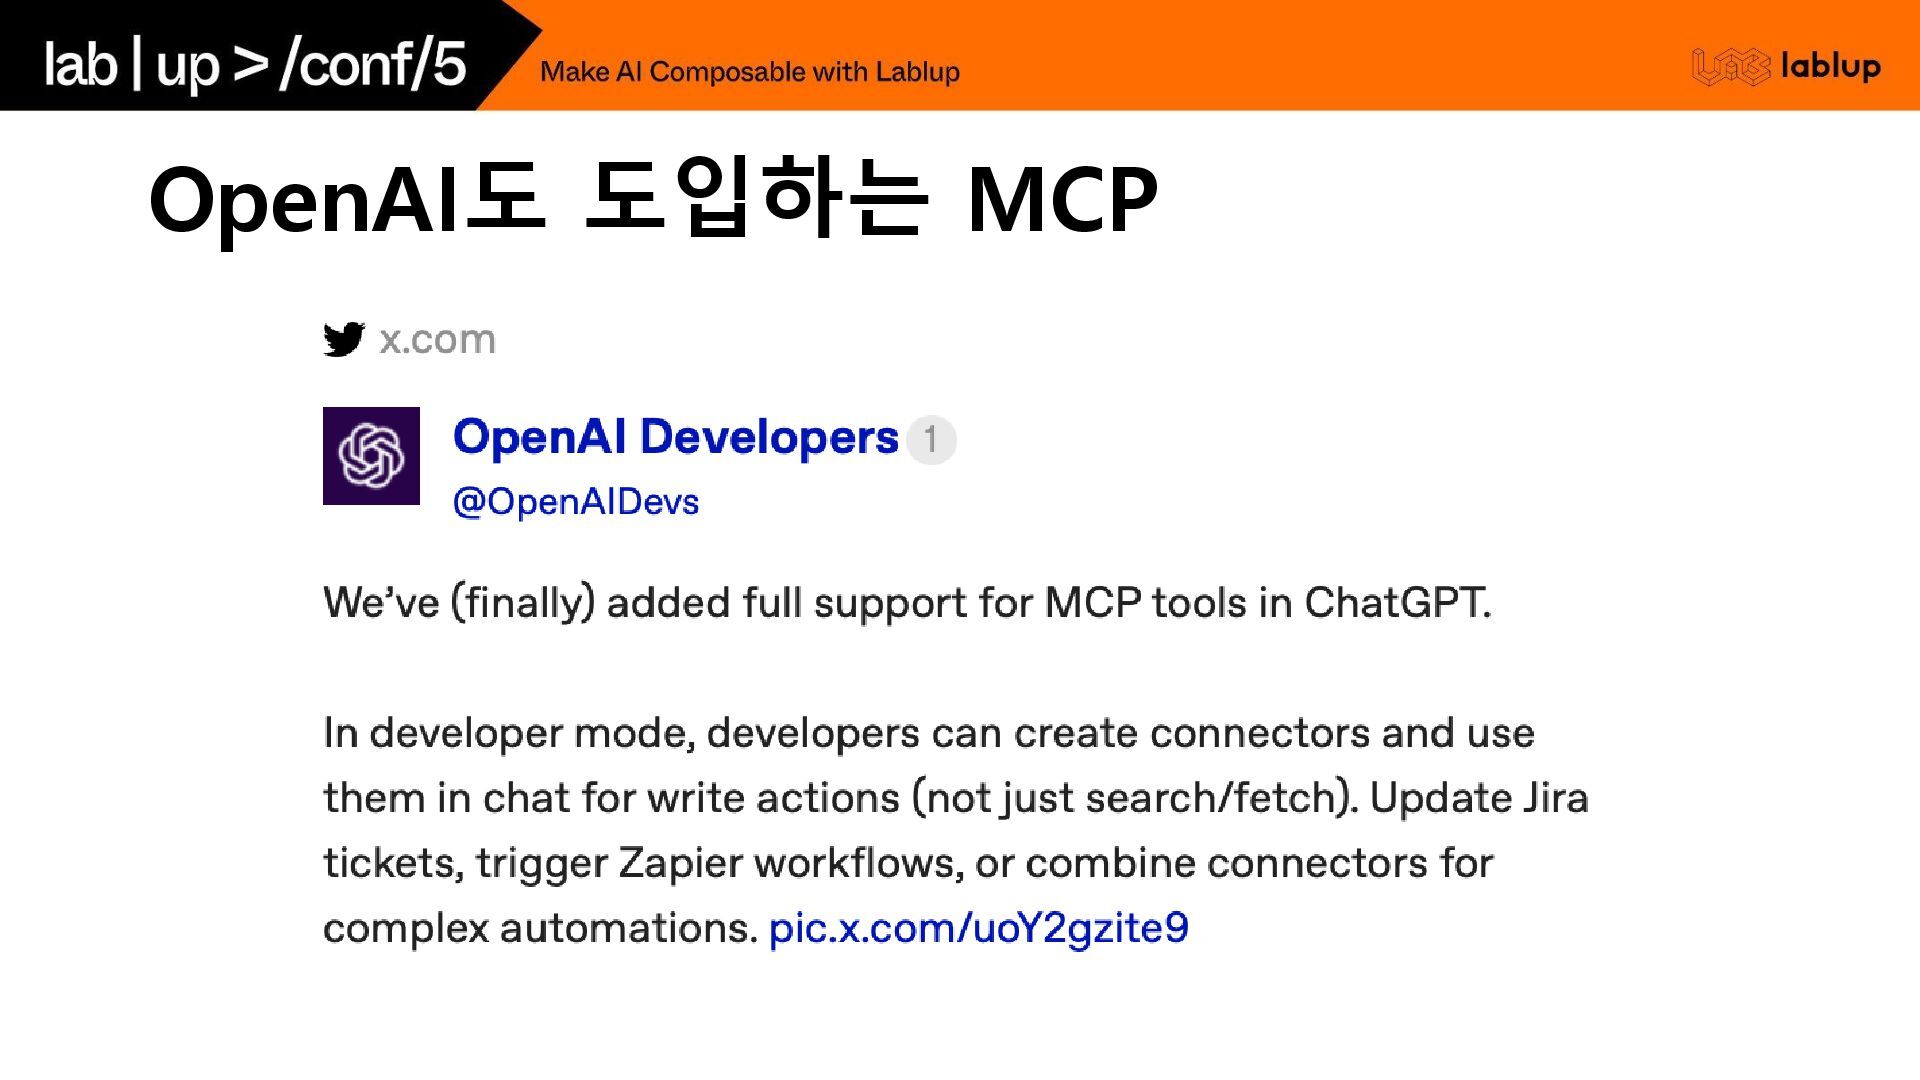
OpenAI도 도입하는 MCP
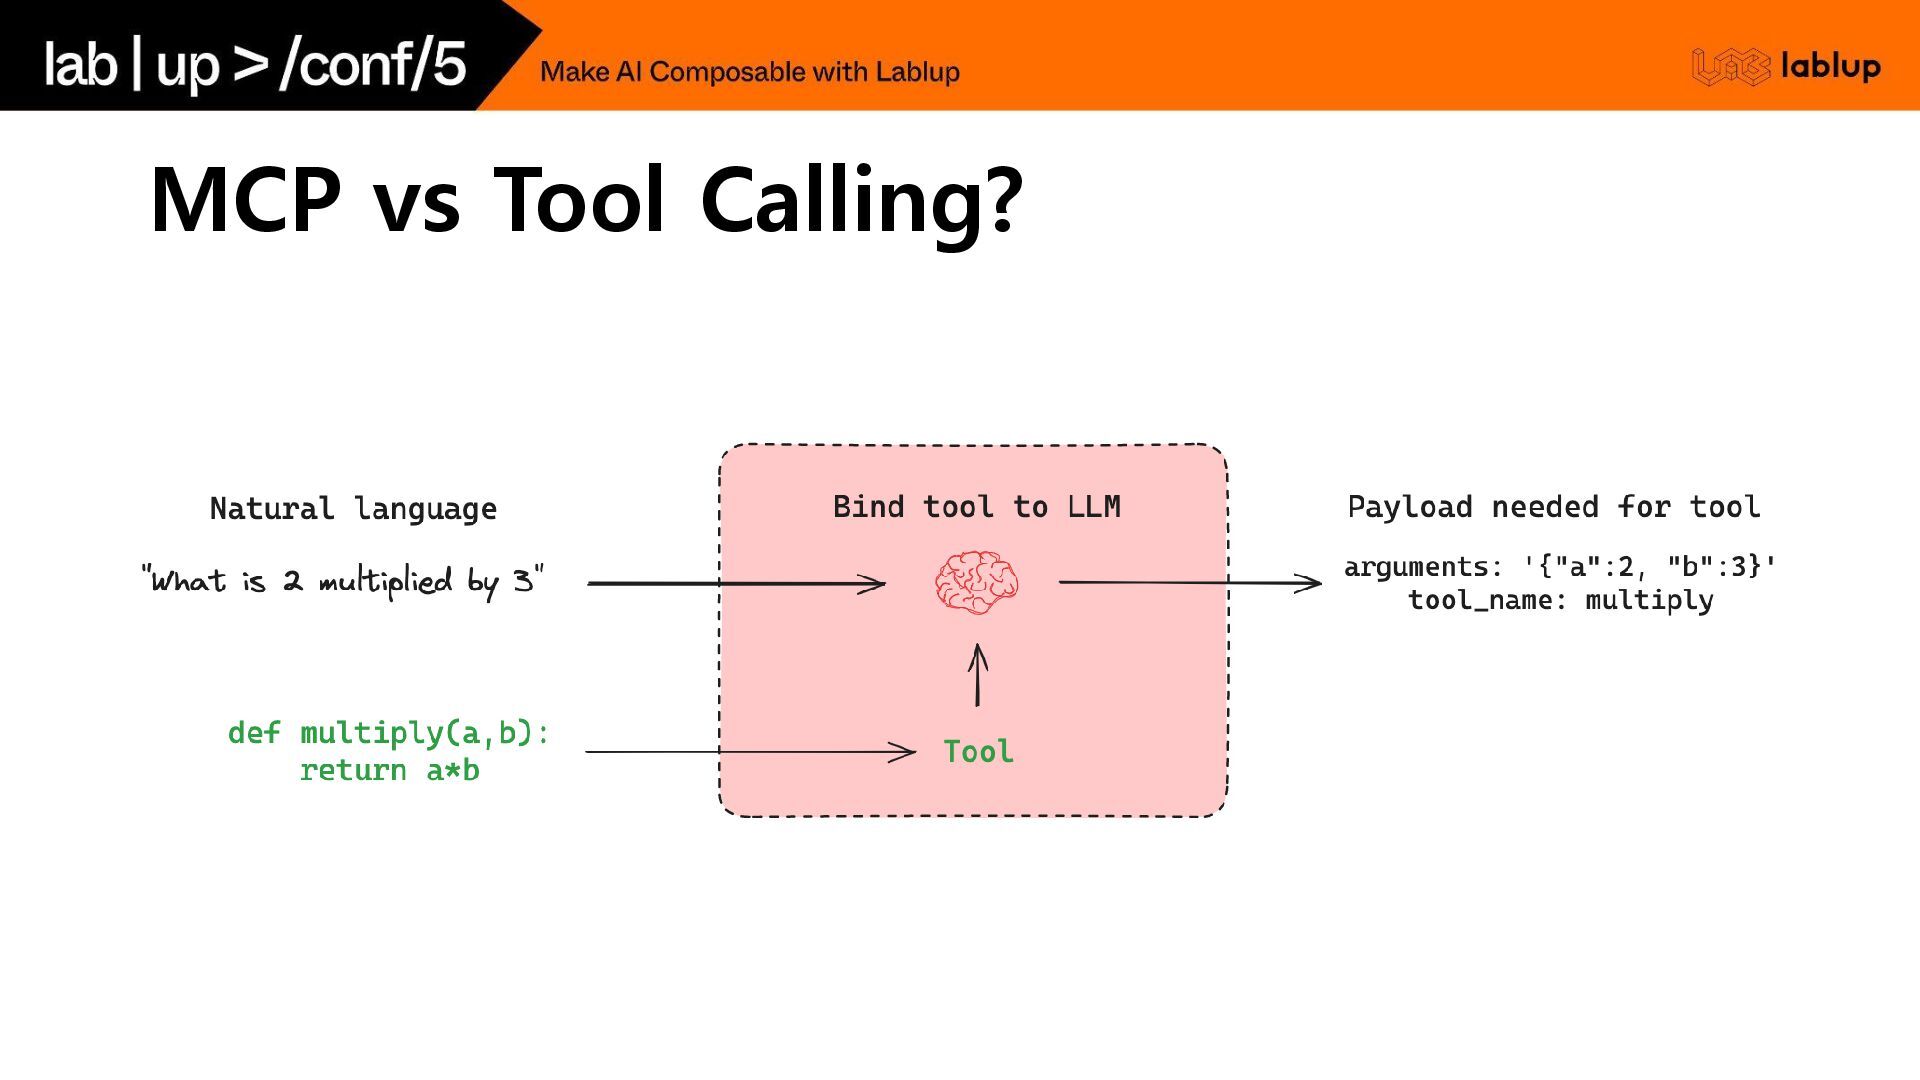
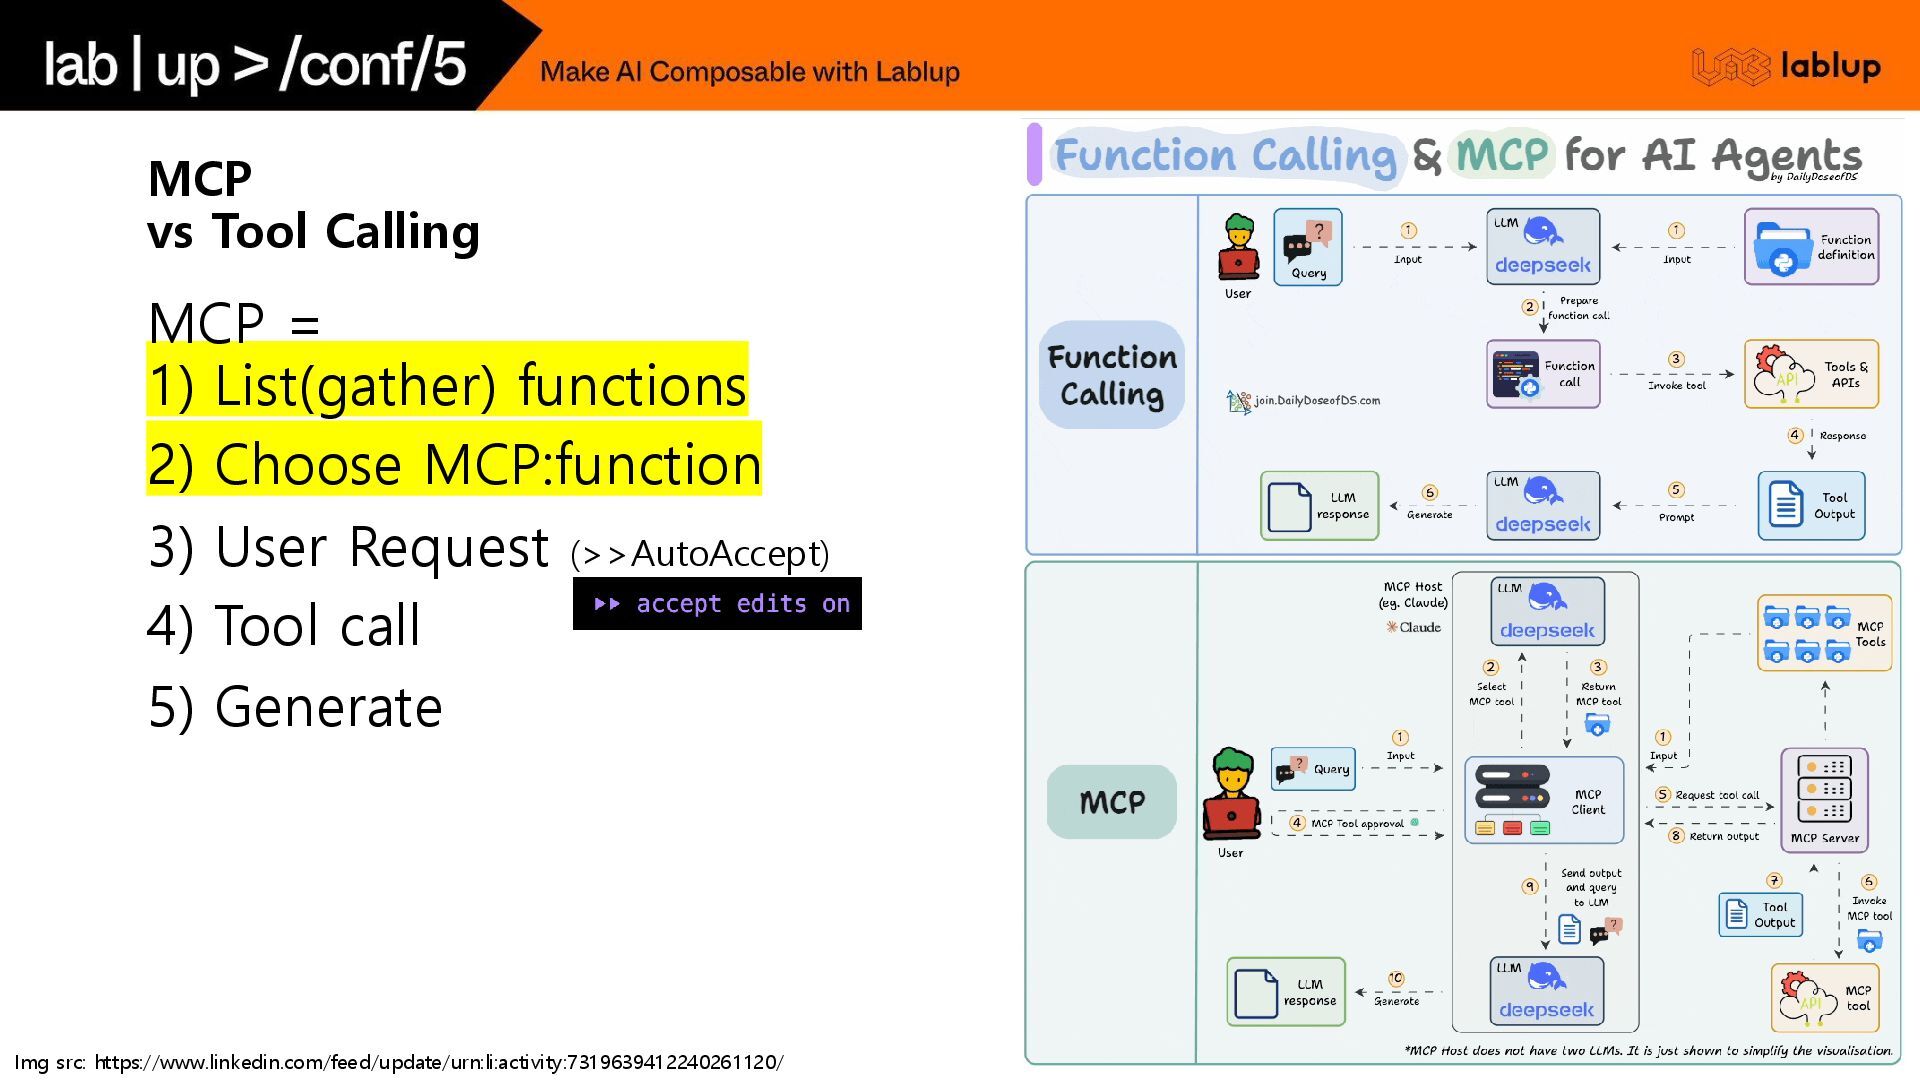
MCP vs Tool Calling?
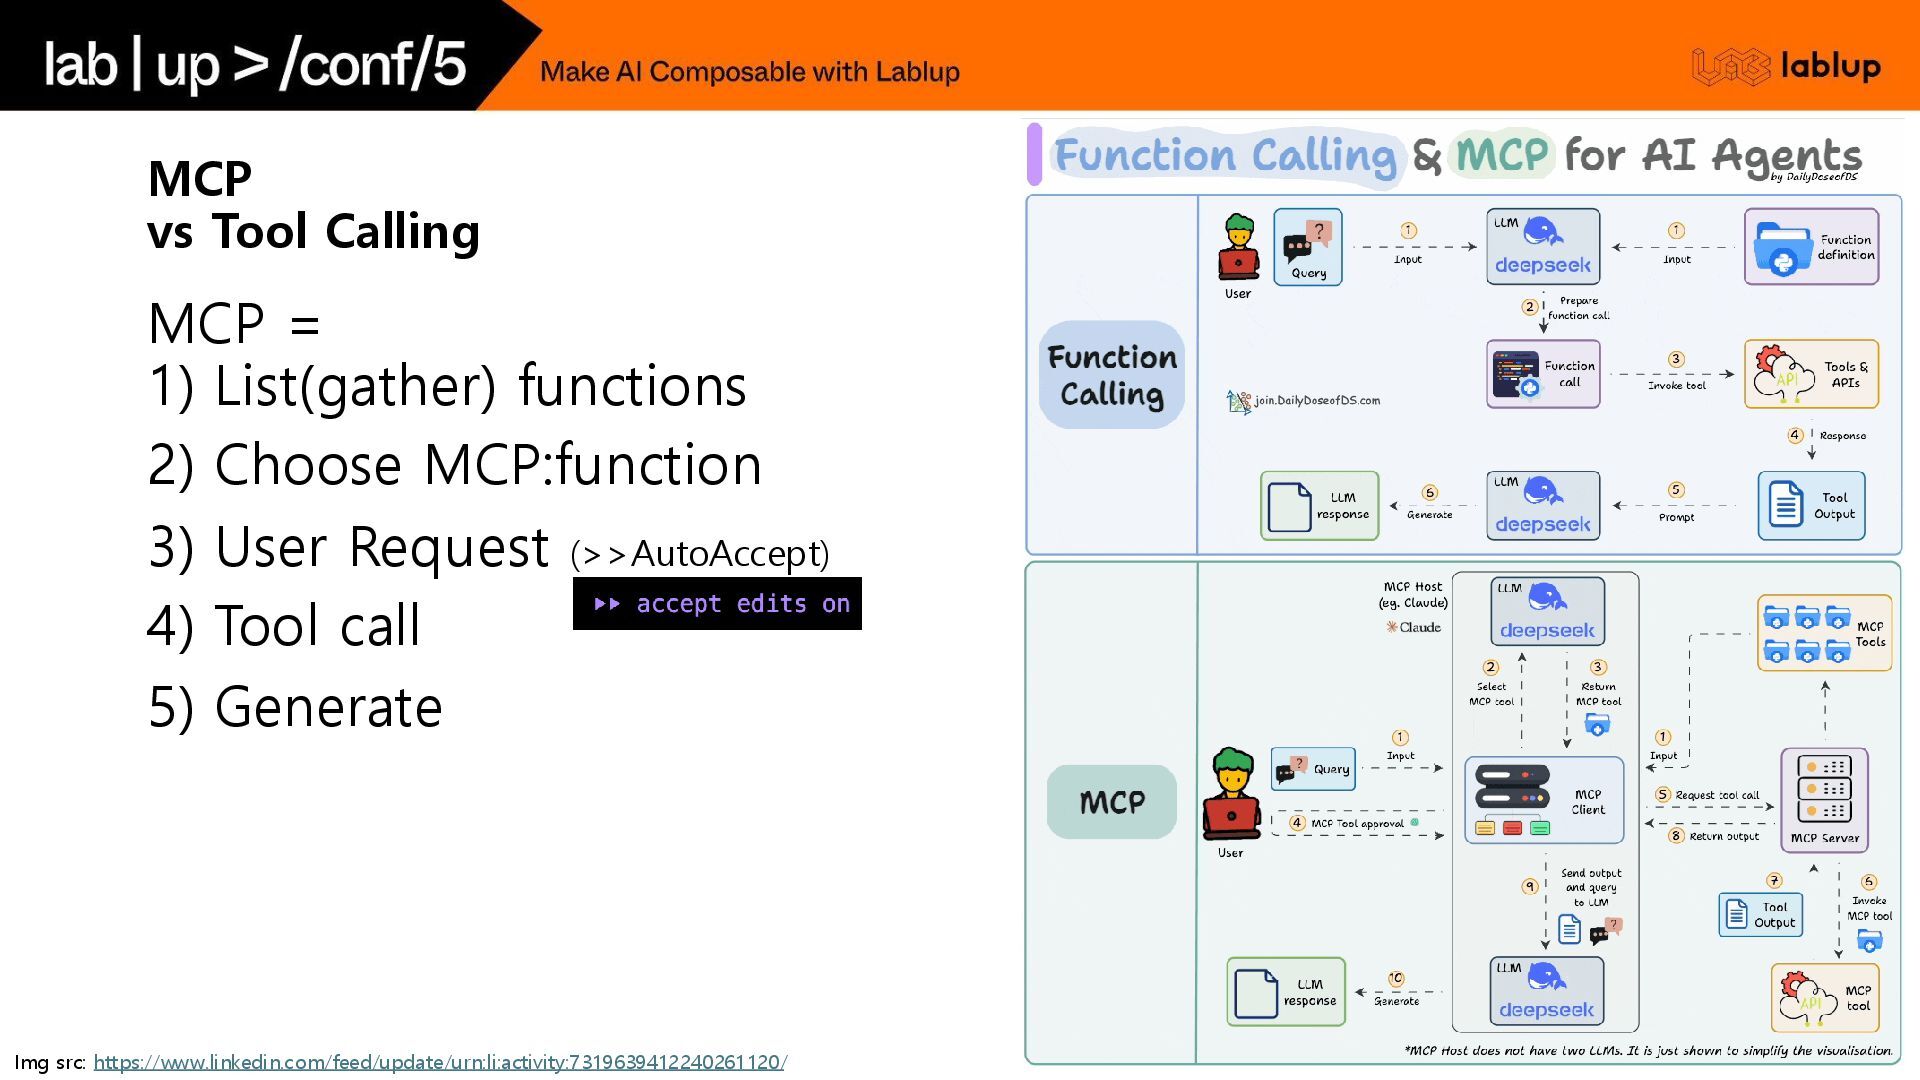
MCP vs Tool Calling MCP = 1) List(gather) functions 2)
Choose MCP:function 3) User Request (>>AutoAccept) 4) Tool call 5) Generate Img src: https://www.linkedin.com/feed/update/urn:li:activity:7319639412240261120/
MCP vs Tool Calling MCP = 1) List(gather) functions 2)
Choose MCP:function 3) User Request (>>AutoAccept) 4) Tool call 5) Generate Img src: https://www.linkedin.com/feed/update/urn:li:activity:7319639412240261120/
모델이 ‘MCP’를 알고 있을까?
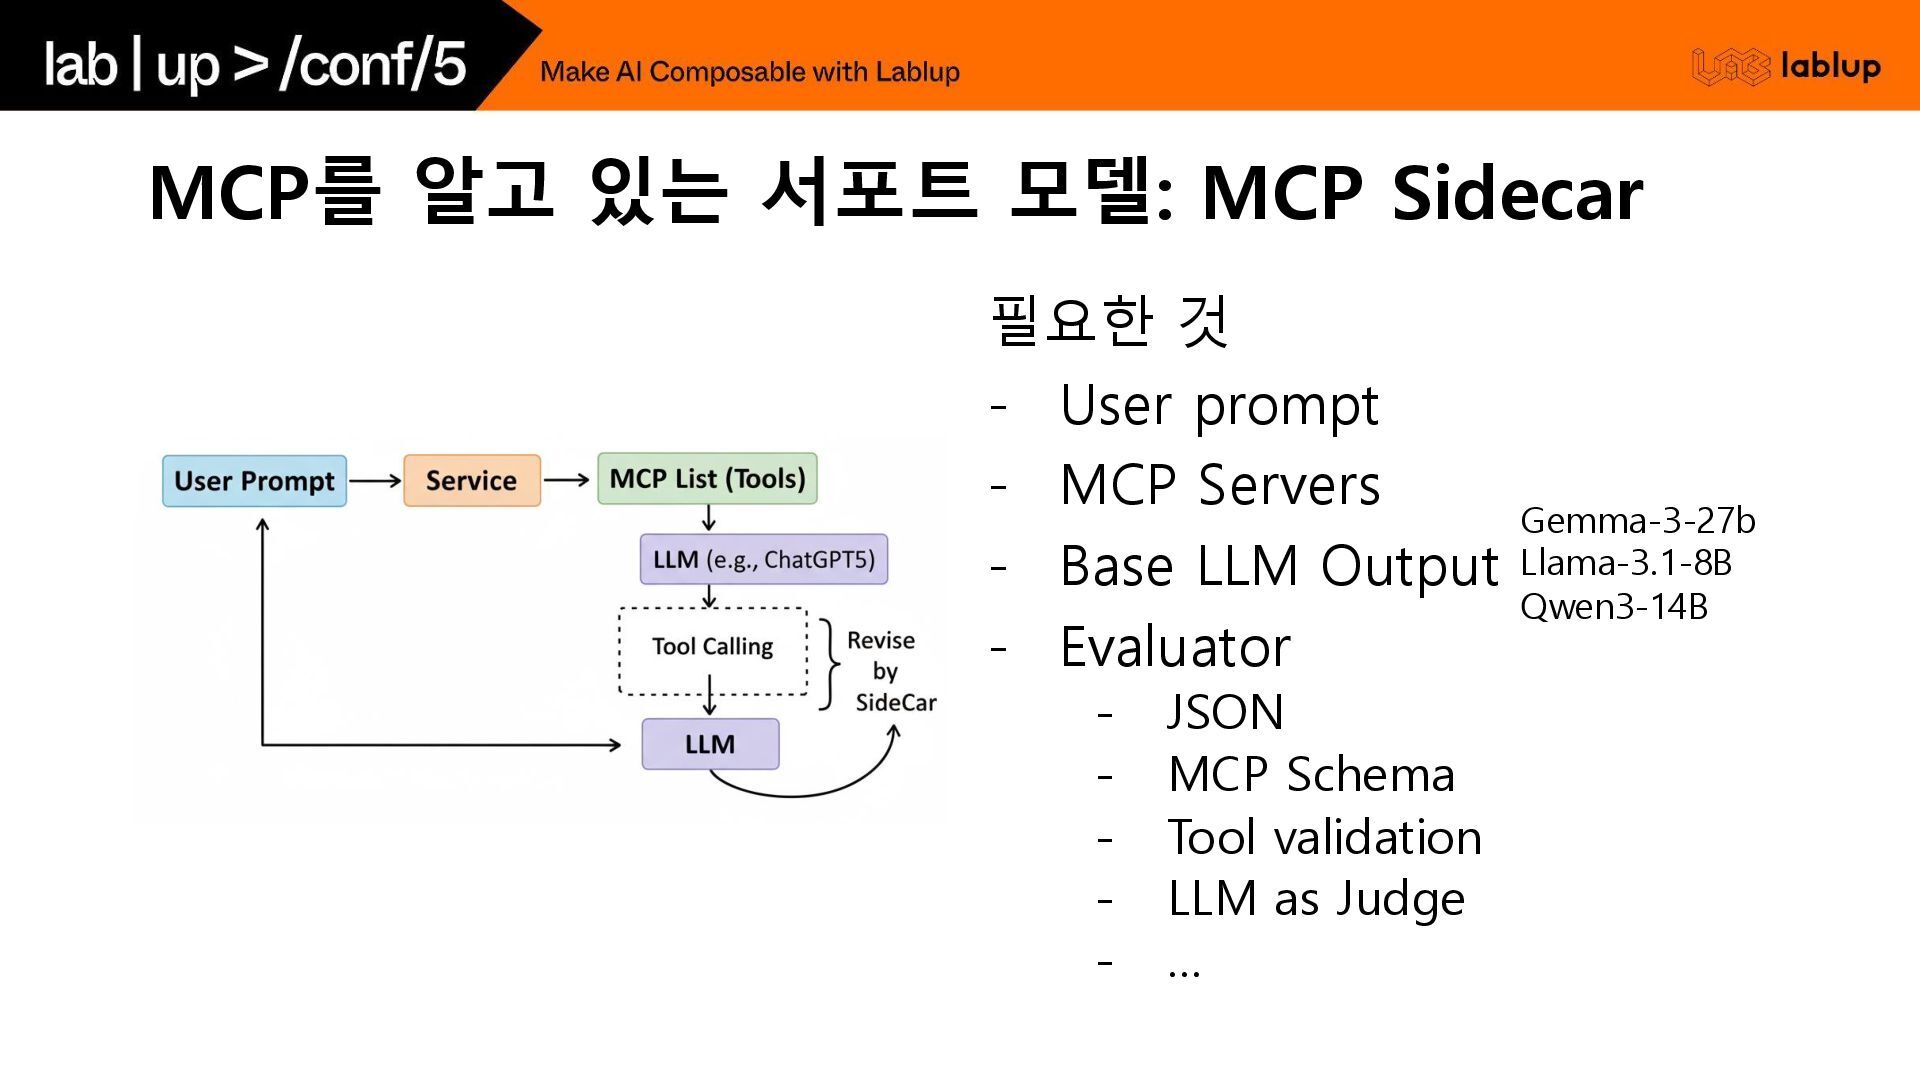
MCP를 알고 있는 서포트 모델: MCP Sidecar 필요한 것 -
User prompt - MCP Servers - Base LLM Output - Evaluator - JSON - MCP Schema - Tool validation - LLM as Judge - … Gemma-3-27b Llama-3.1-8B Qwen3-14B
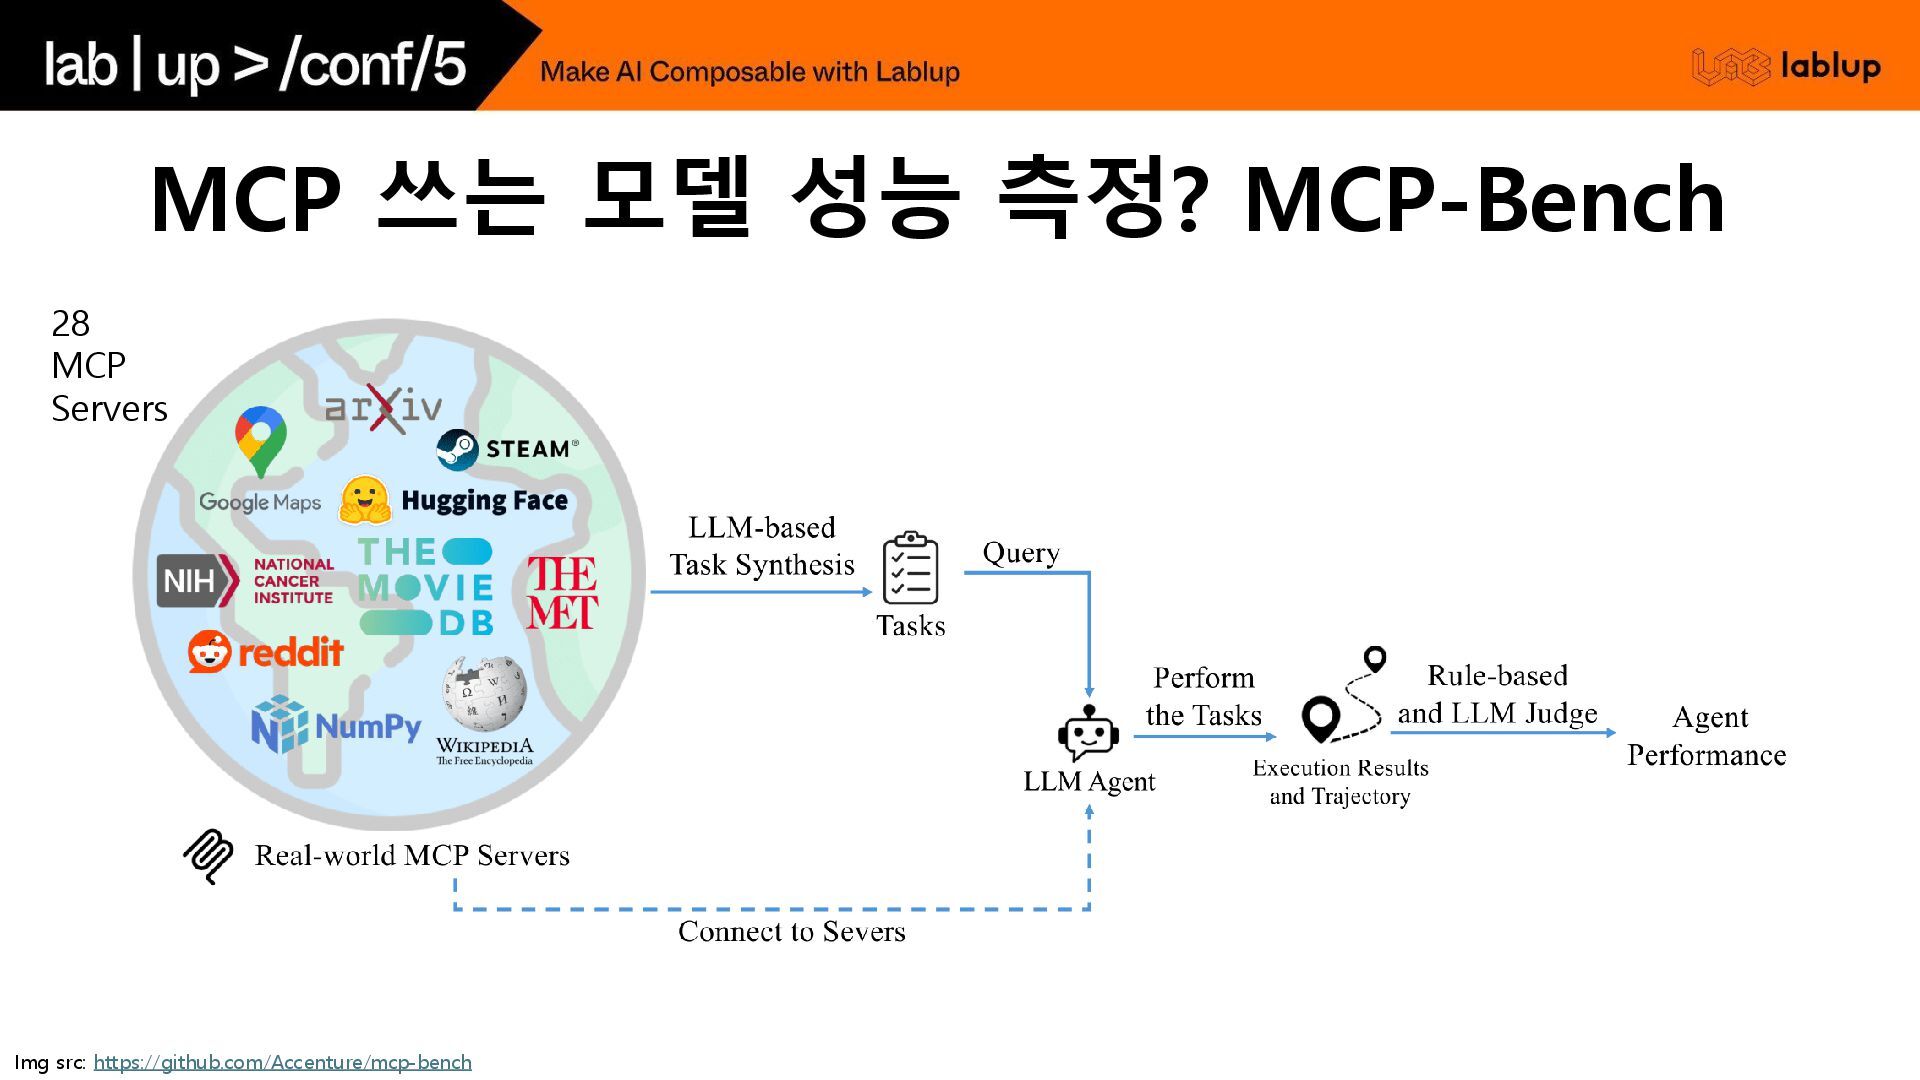
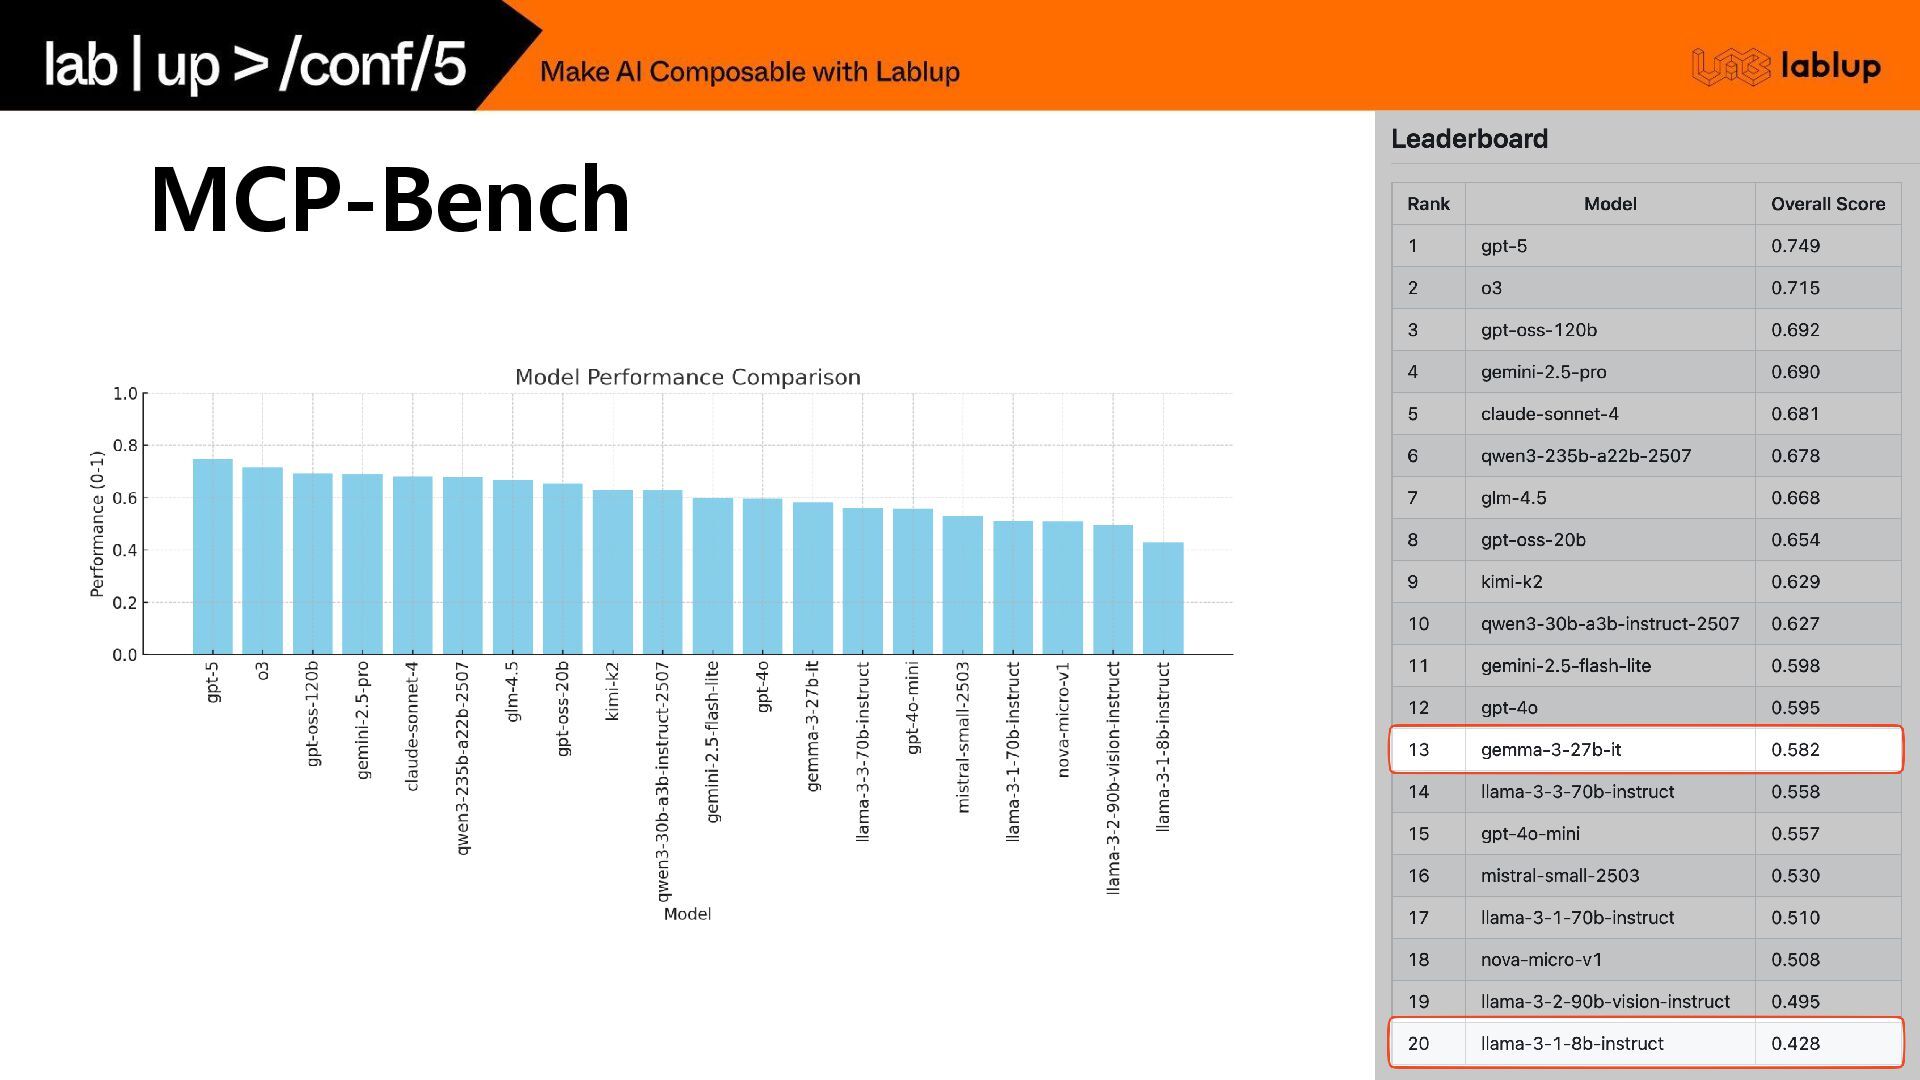
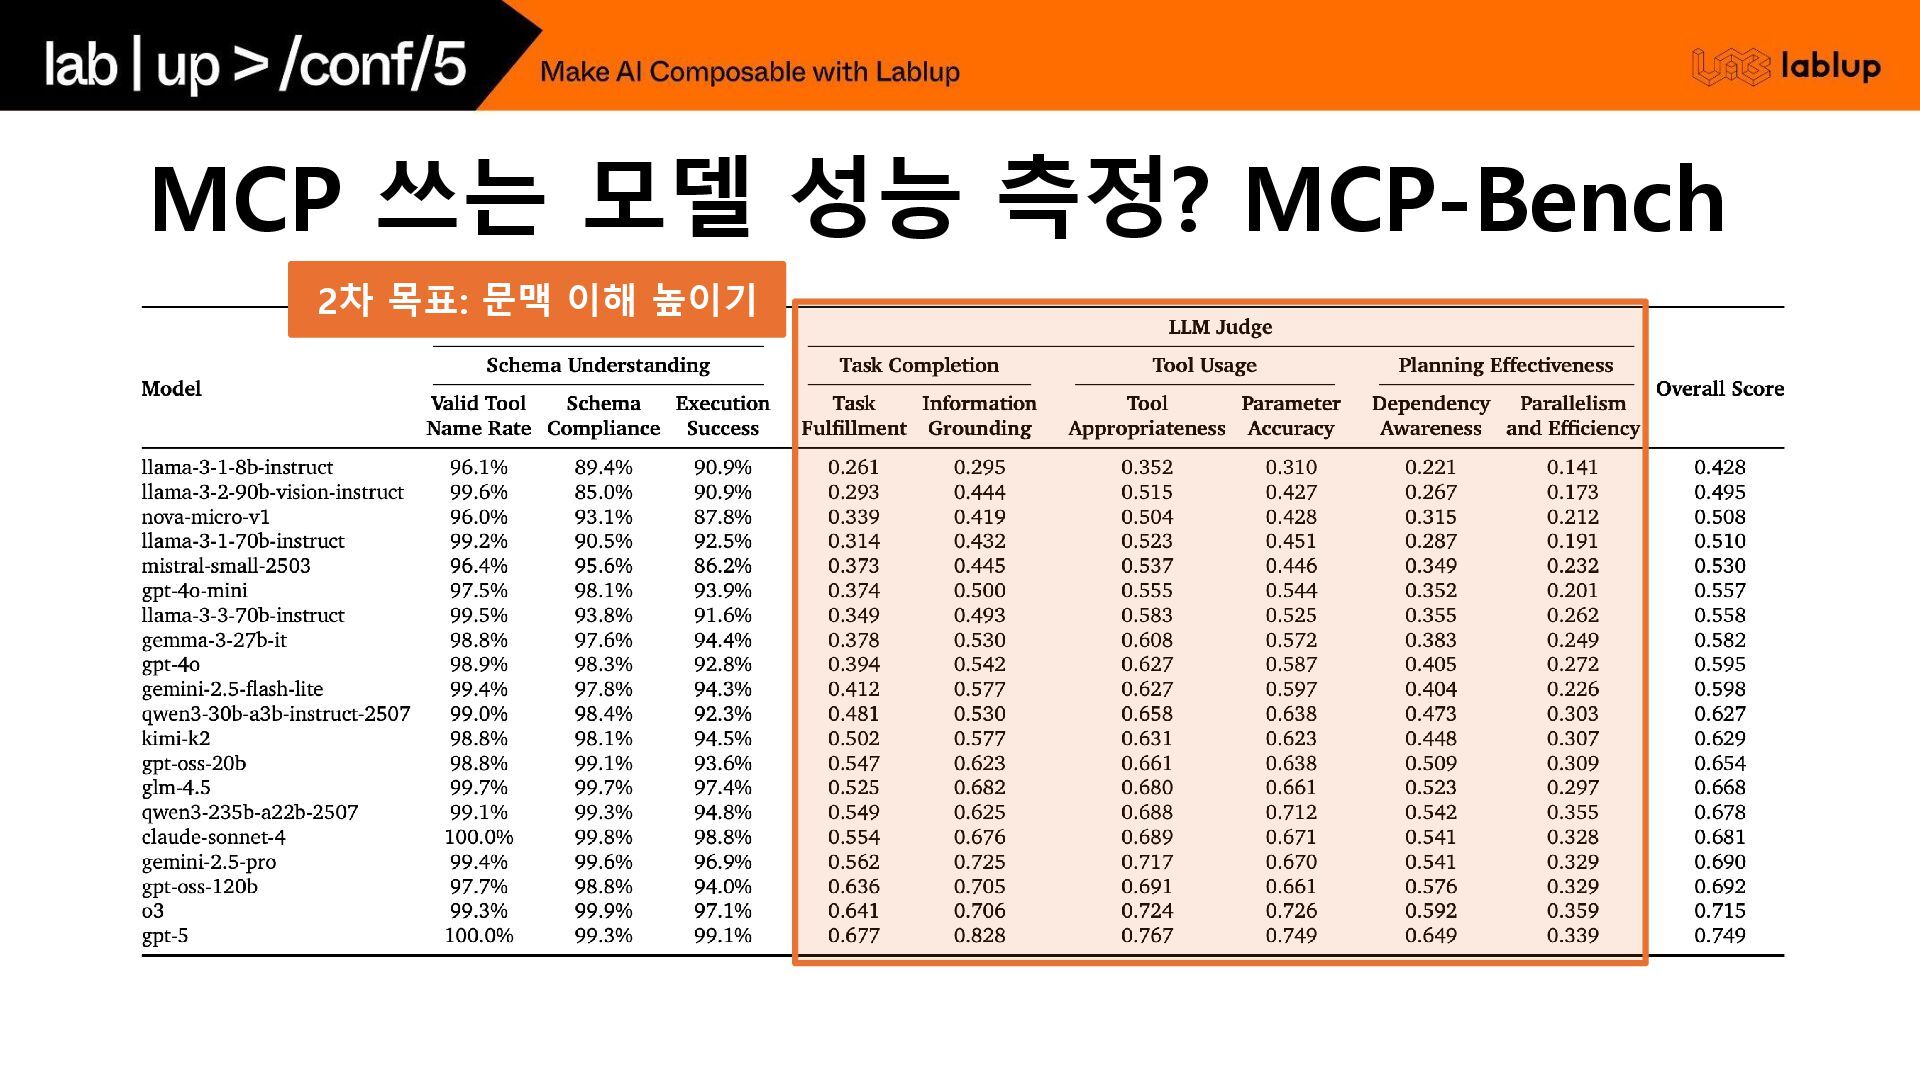
MCP 쓰는 모델 성능 측정? MCP-Bench Img src: https://github.com/Accenture/mcp-bench 28
MCP Servers
MCP-Bench
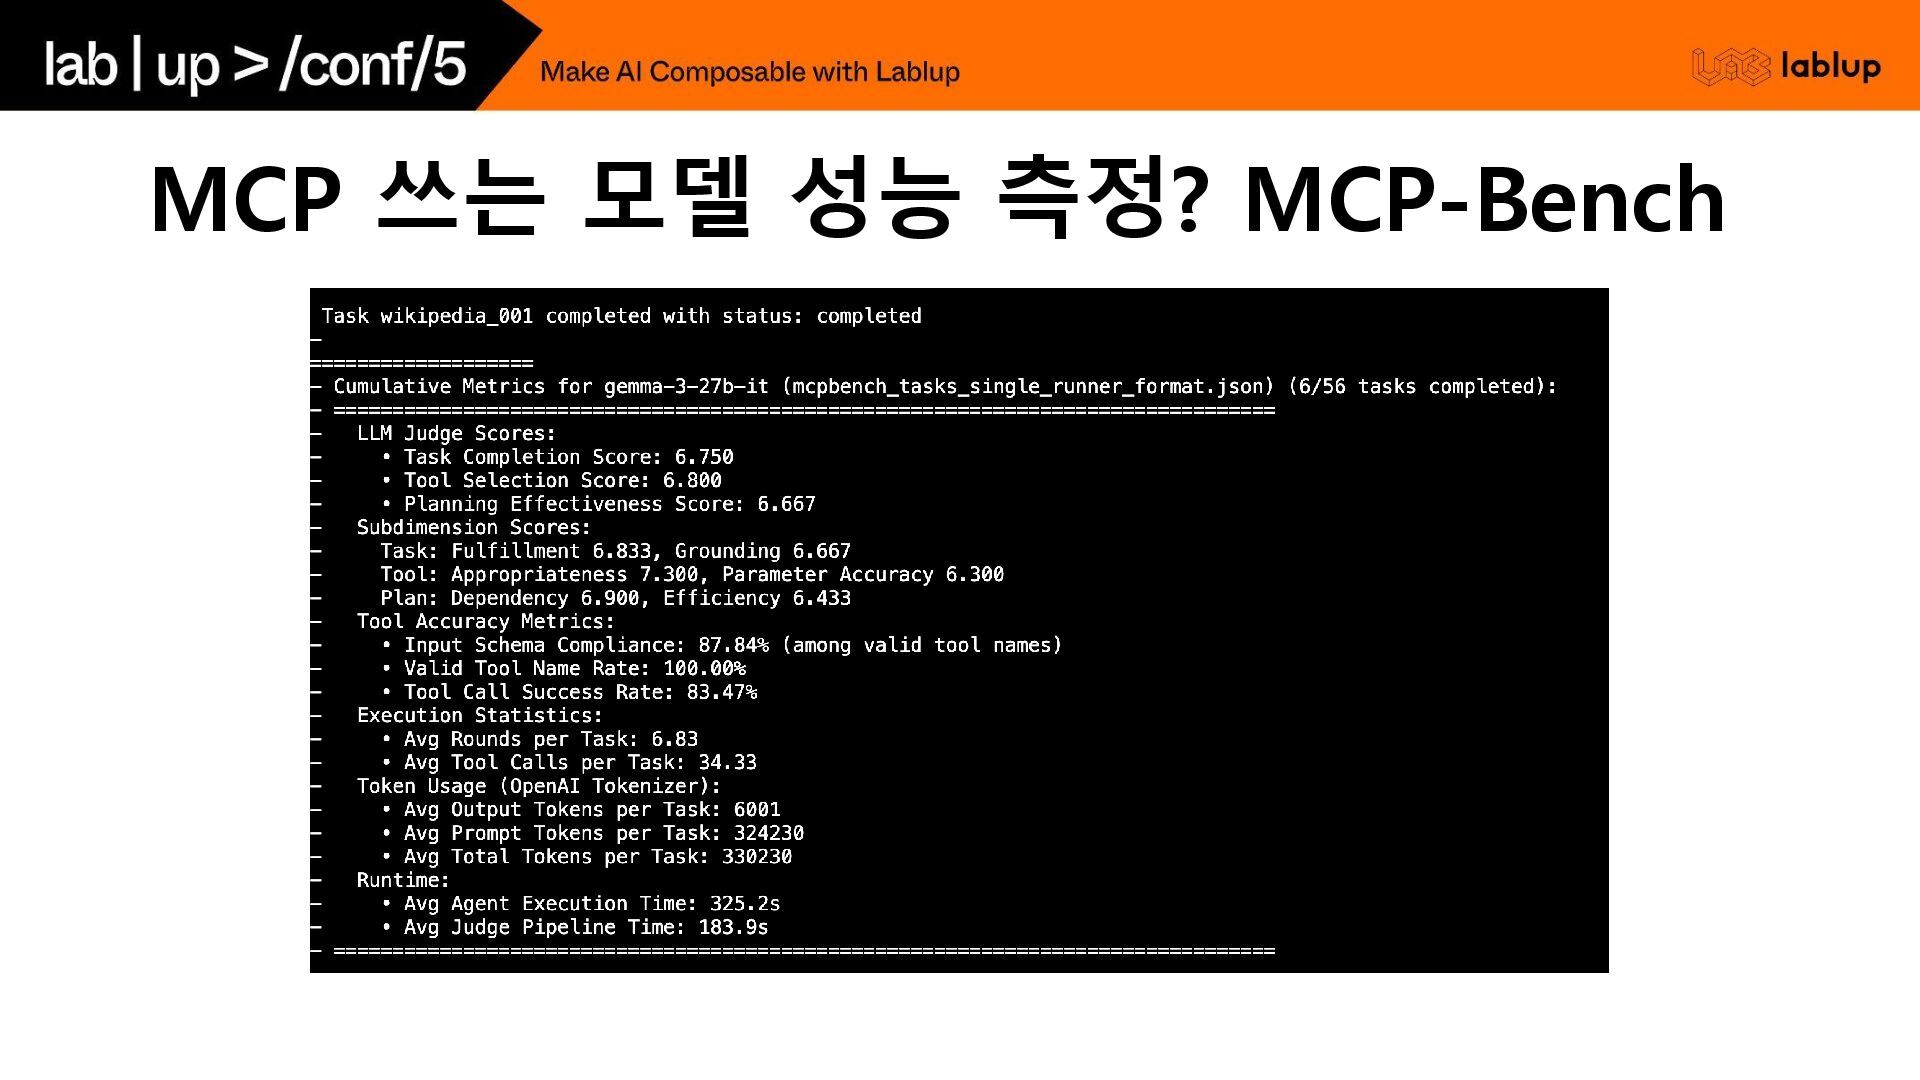
MCP 쓰는 모델 성능 측정? MCP-Bench
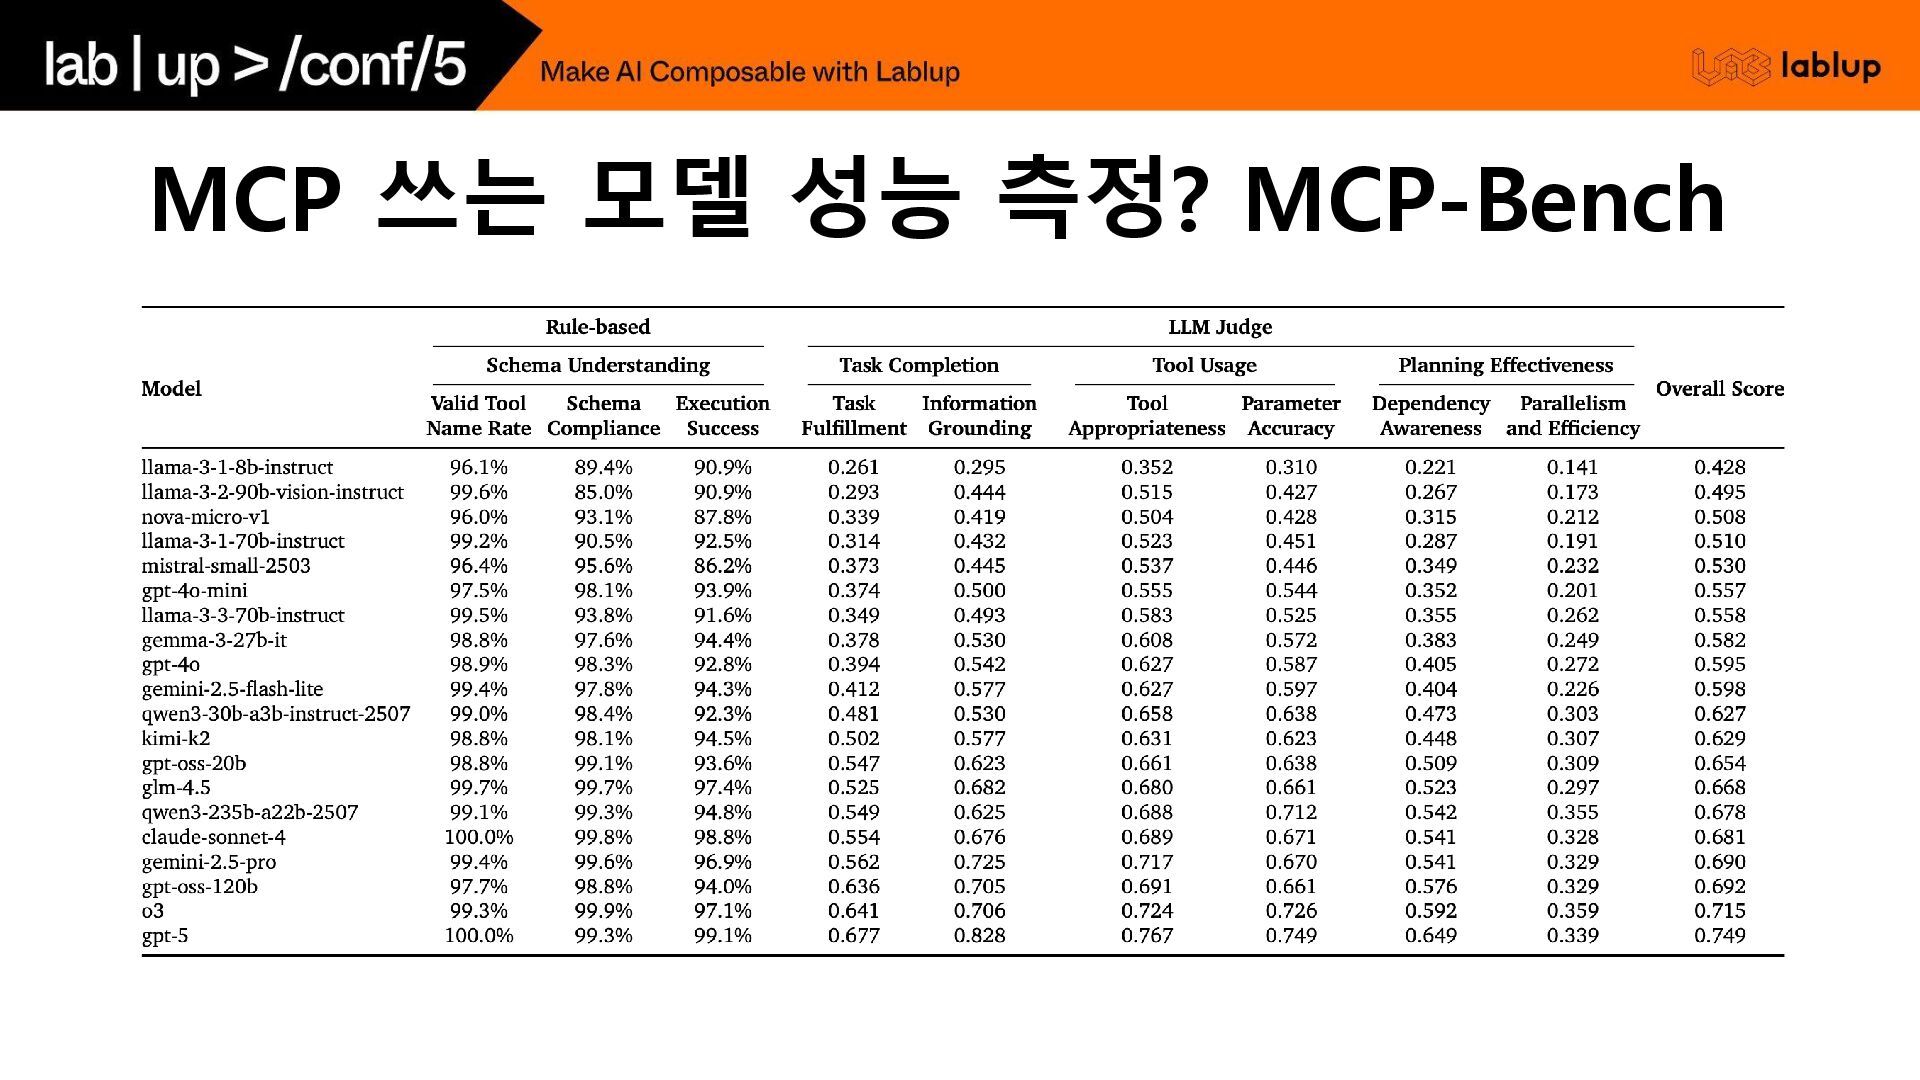
MCP 쓰는 모델 성능 측정? MCP-Bench
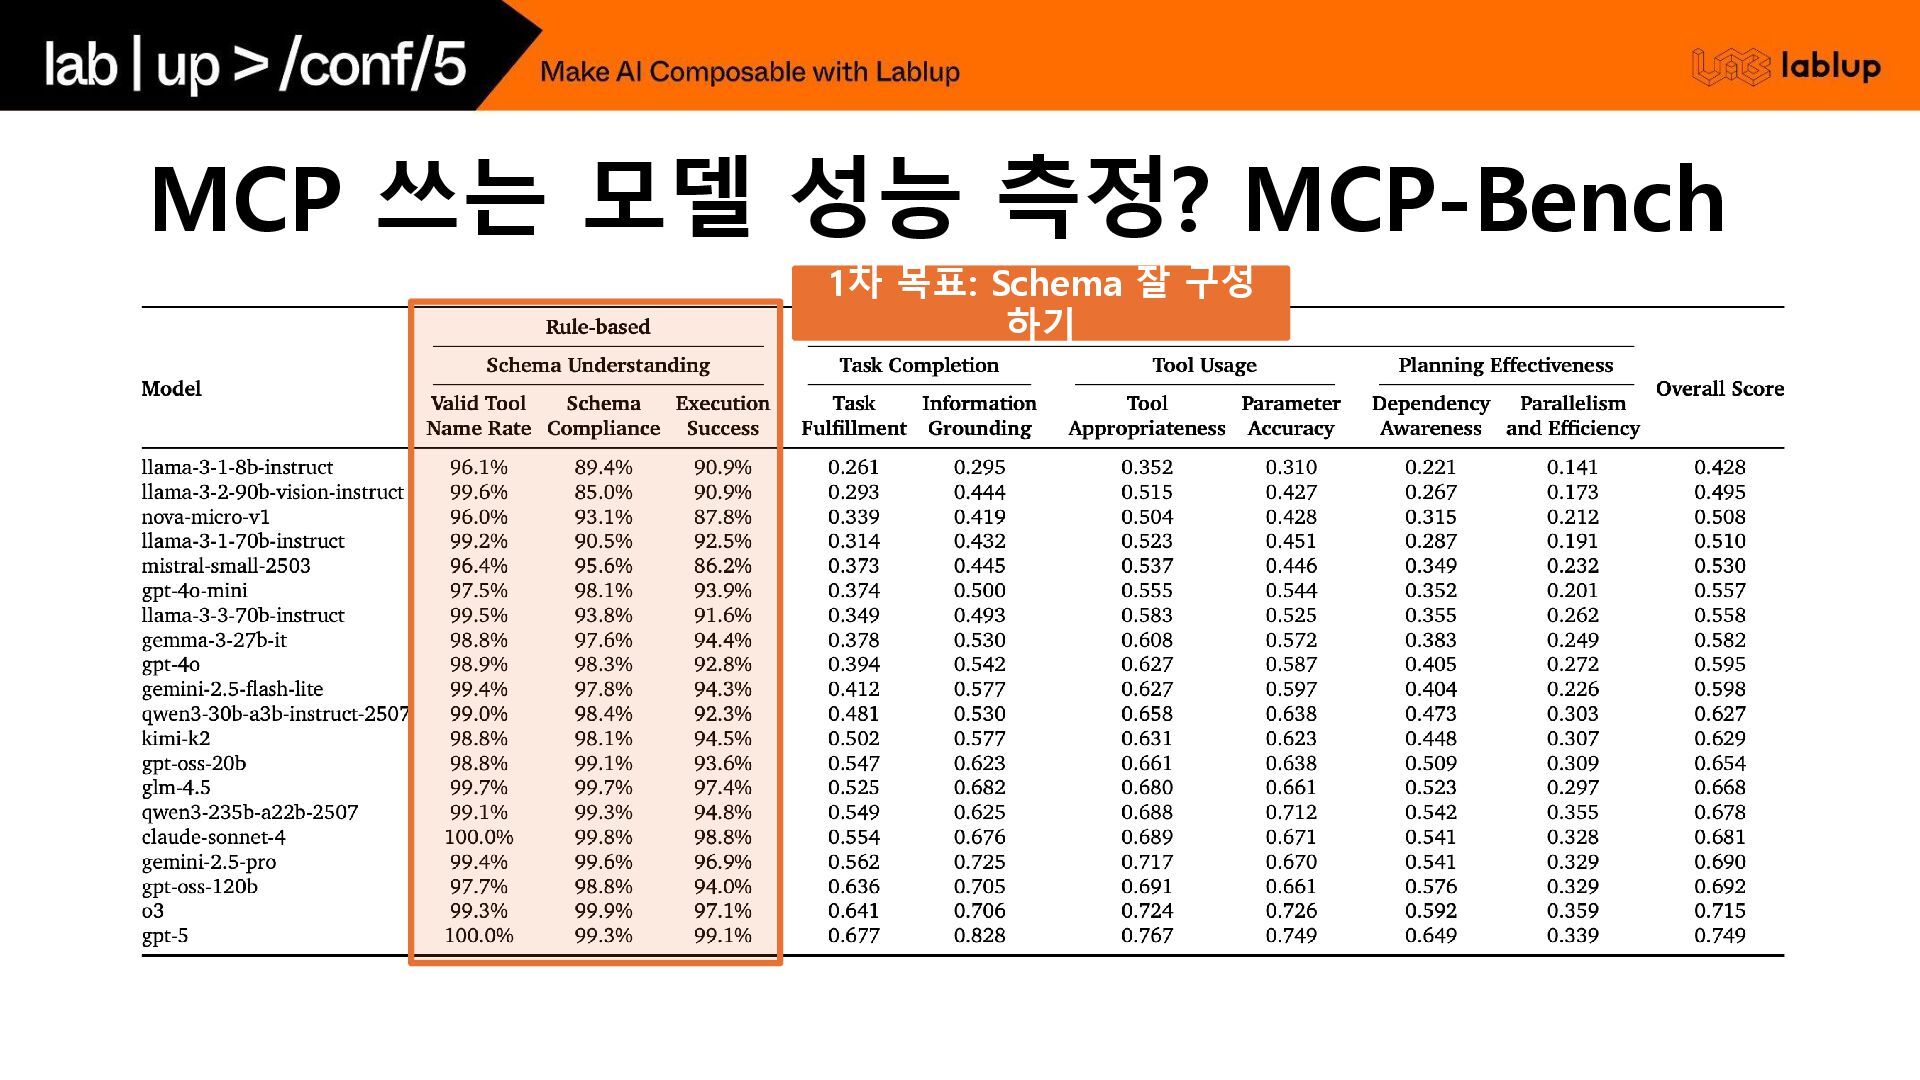
1차 목표: Schema 잘 구성 하기 MCP 쓰는 모델 성능
측정? MCP-Bench
2차 목표: 문맥 이해 높이기 MCP 쓰는 모델 성능 측정?
MCP-Bench
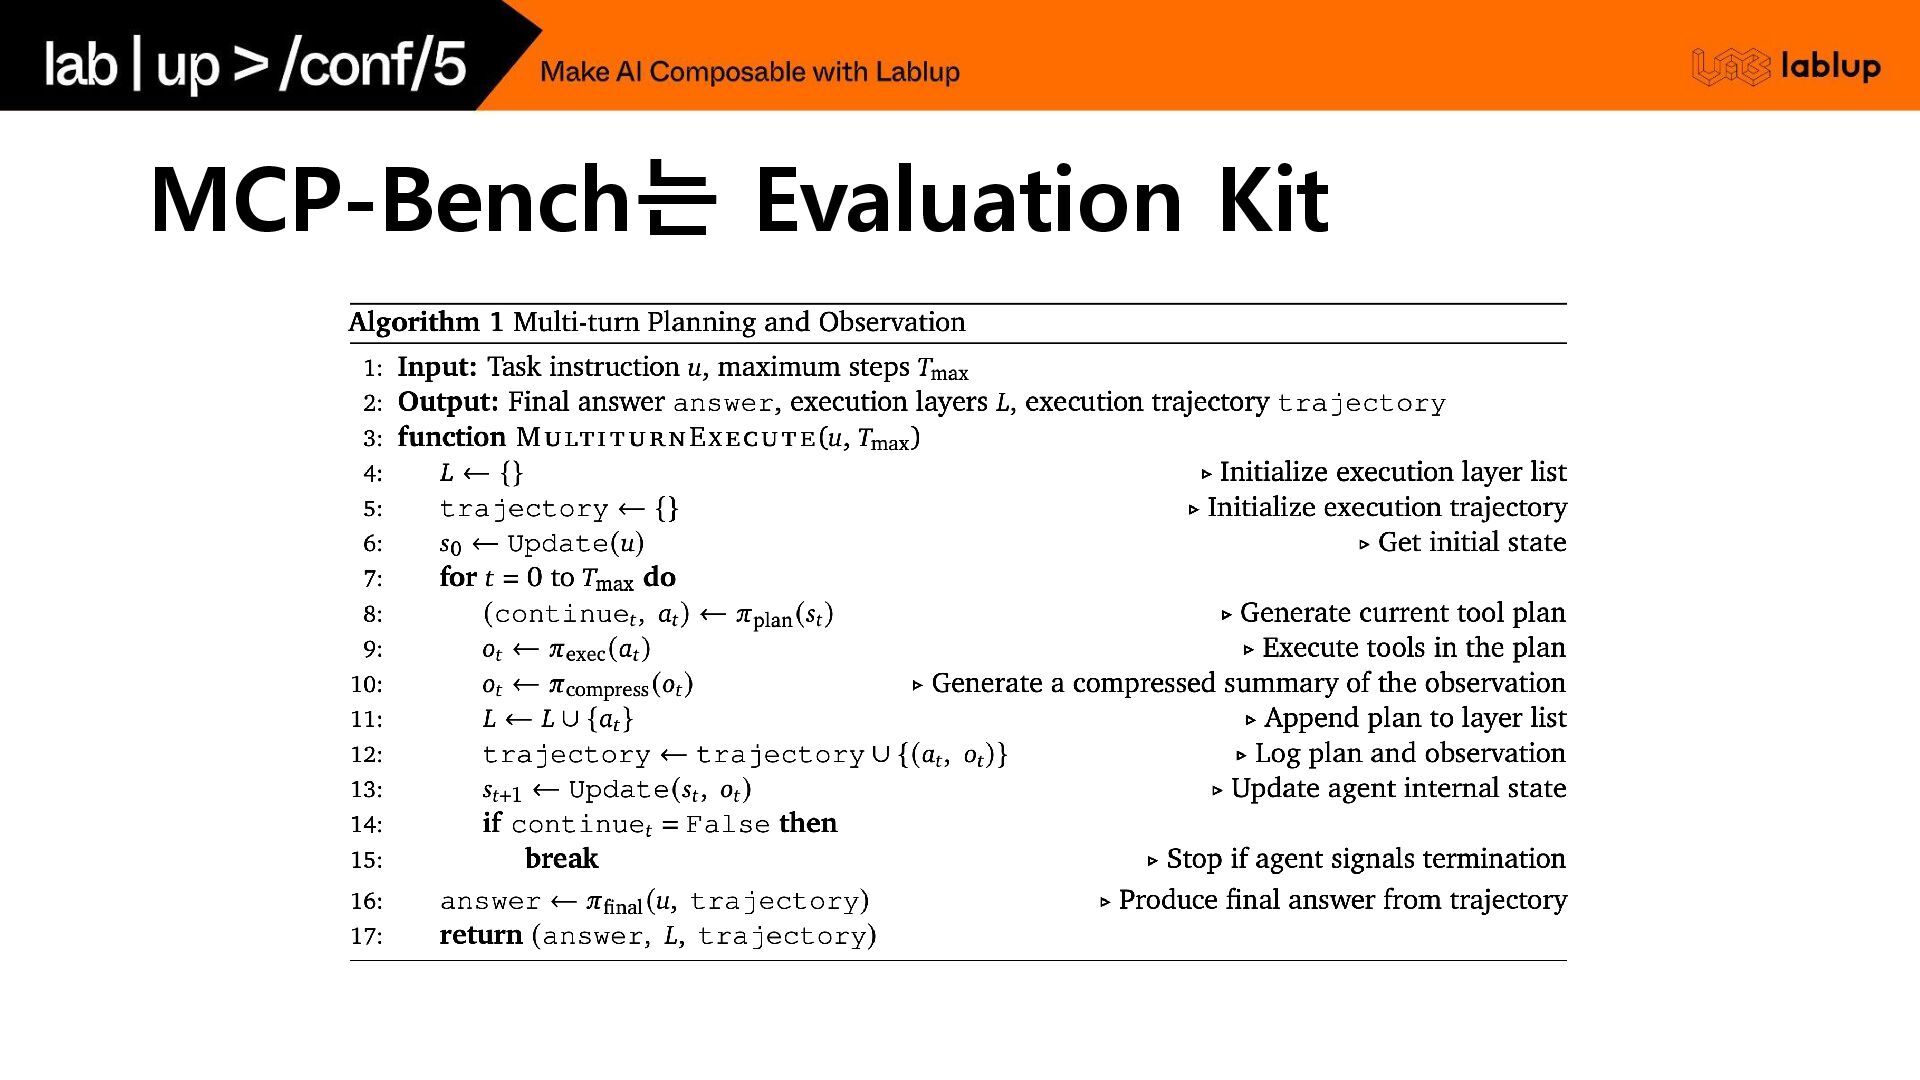
MCP-Bench는 Evaluation Kit
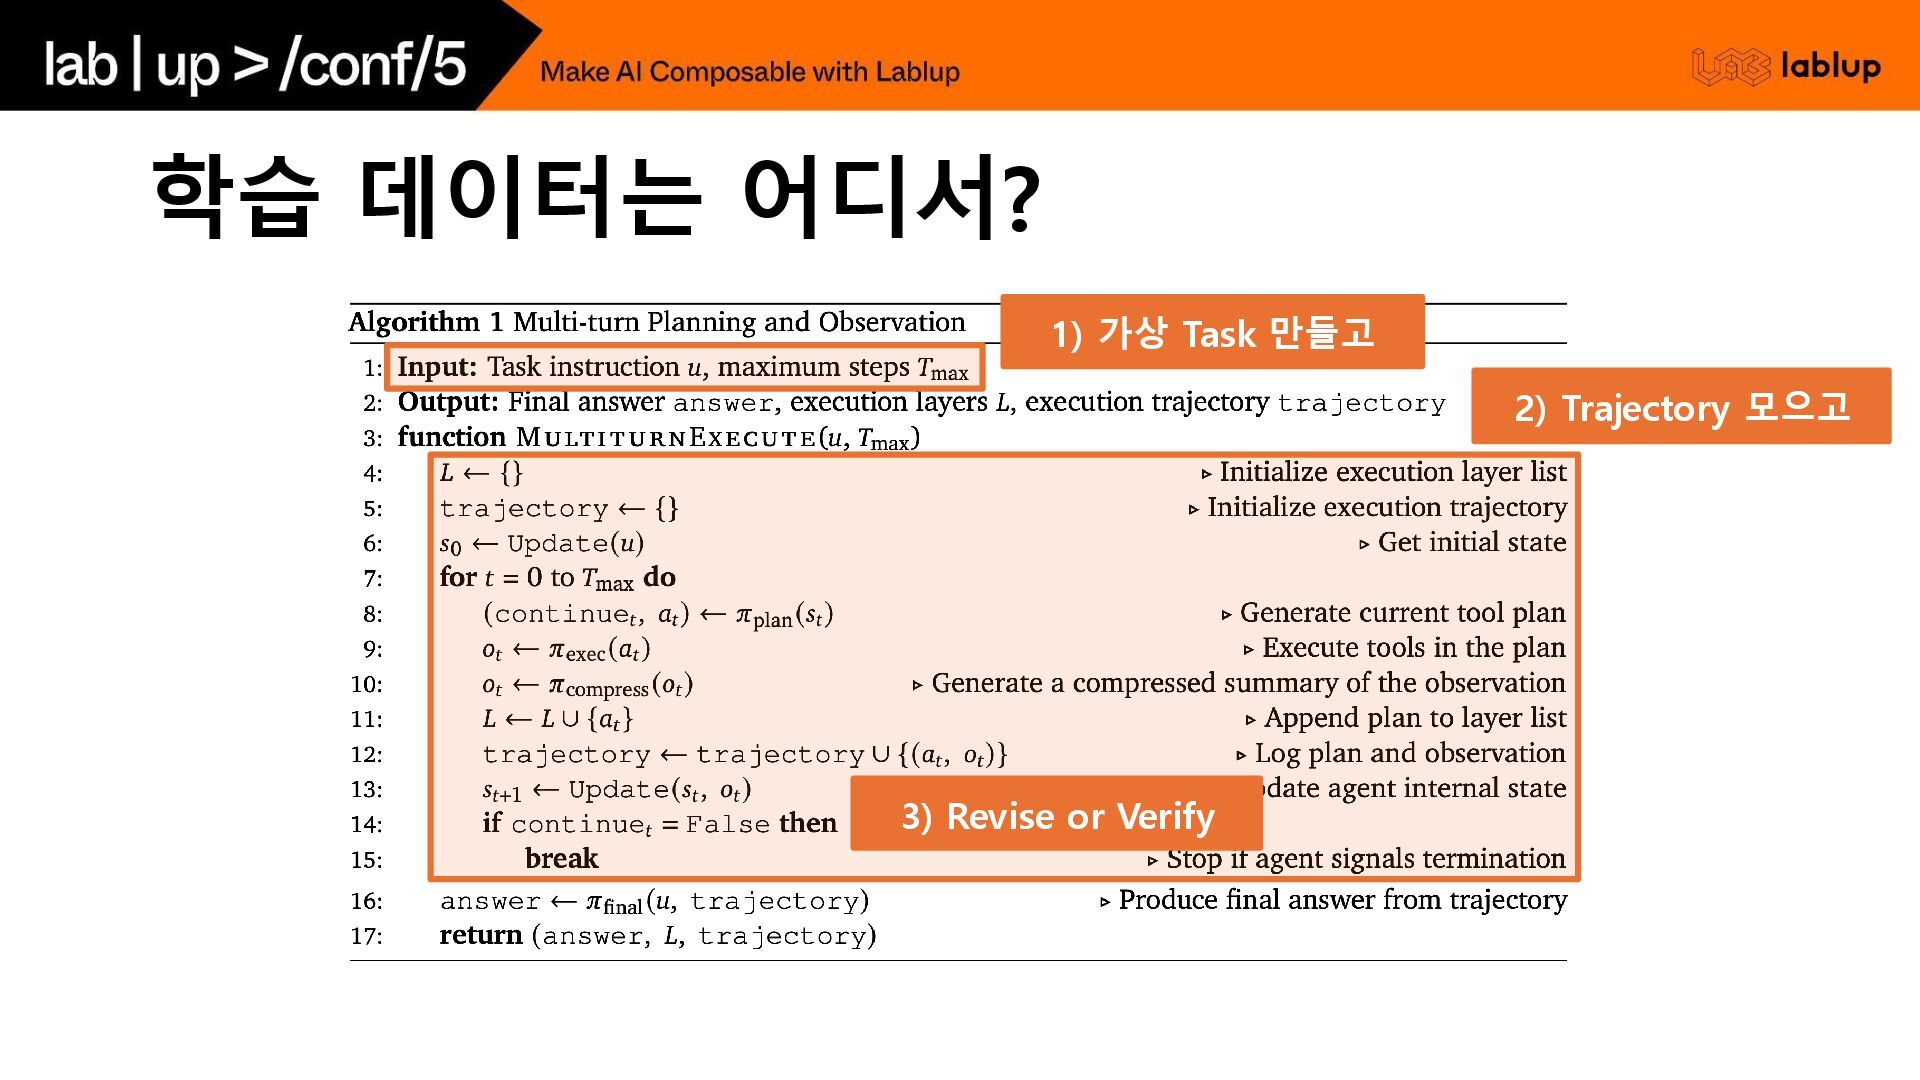
학습 데이터는 어디서? 1) 가상 Task 만들고 2) Trajectory 모으고
3) Revise or Verify
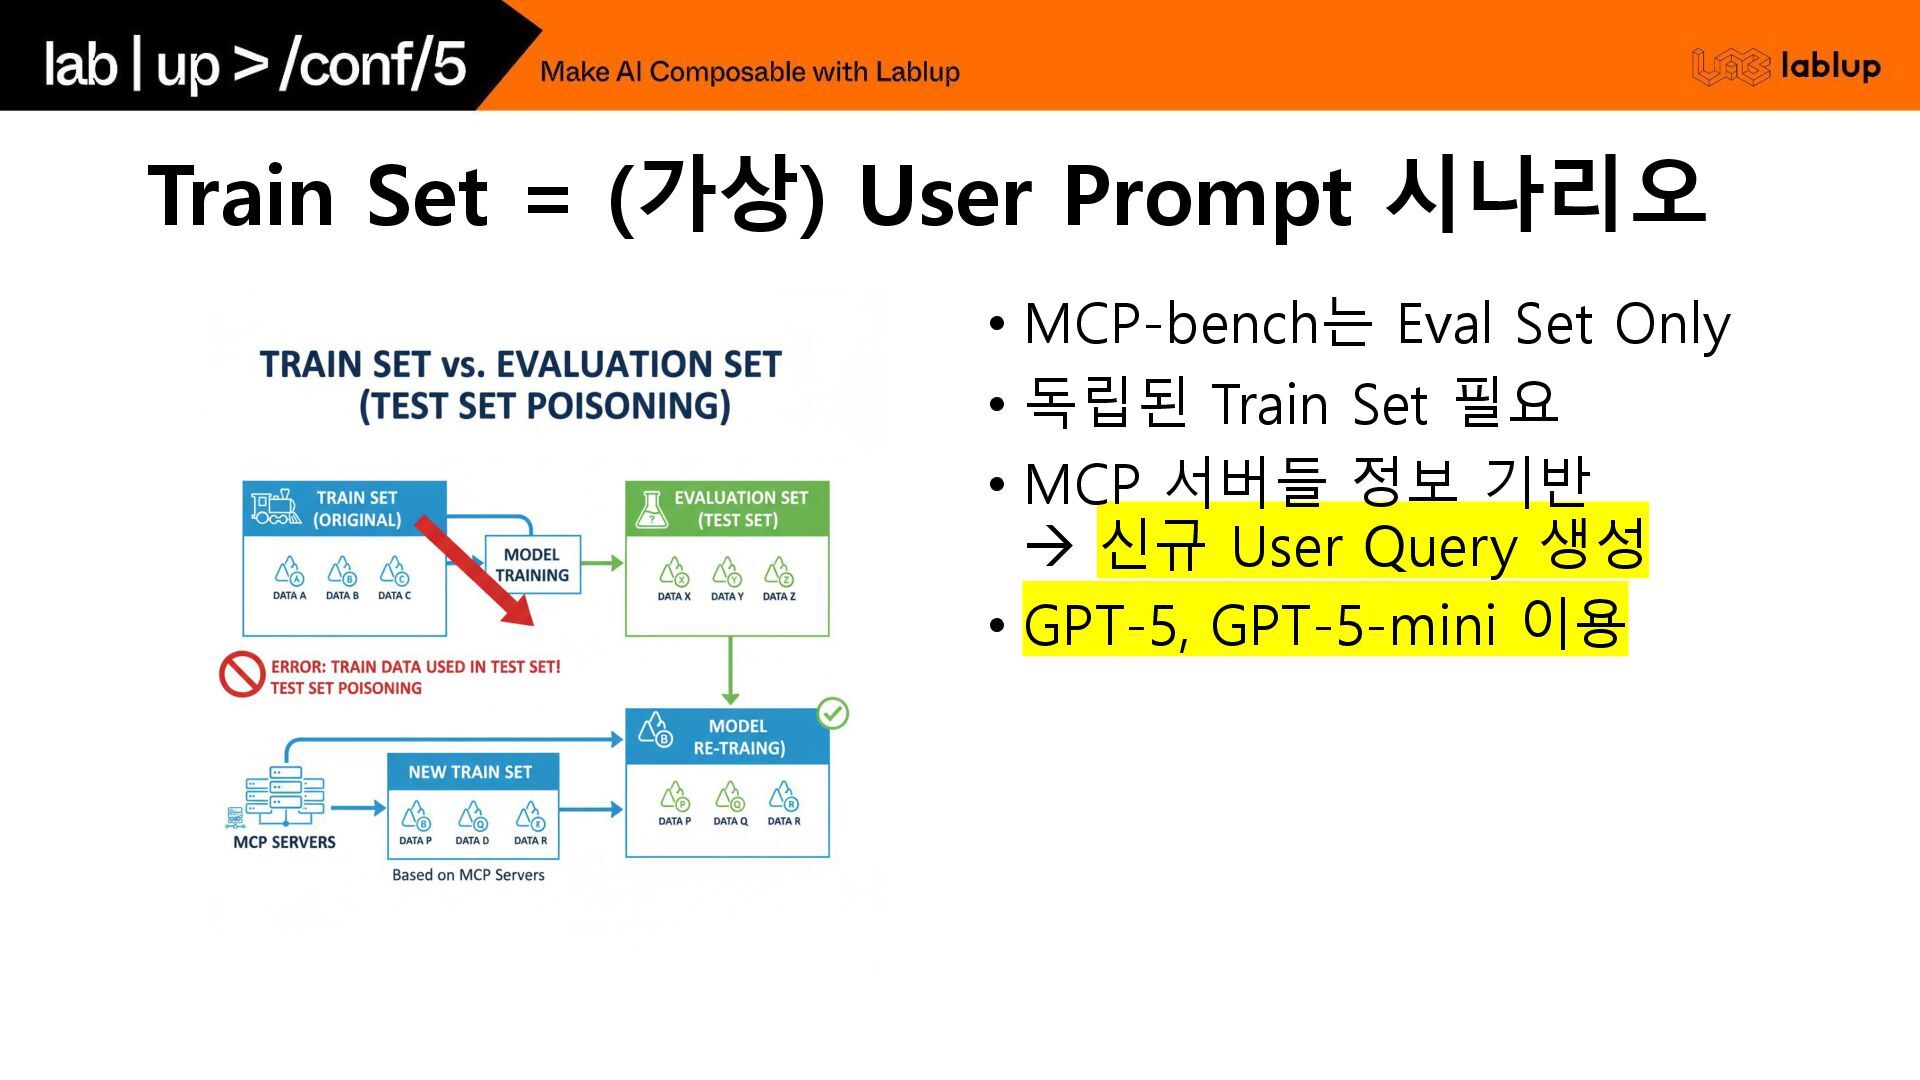
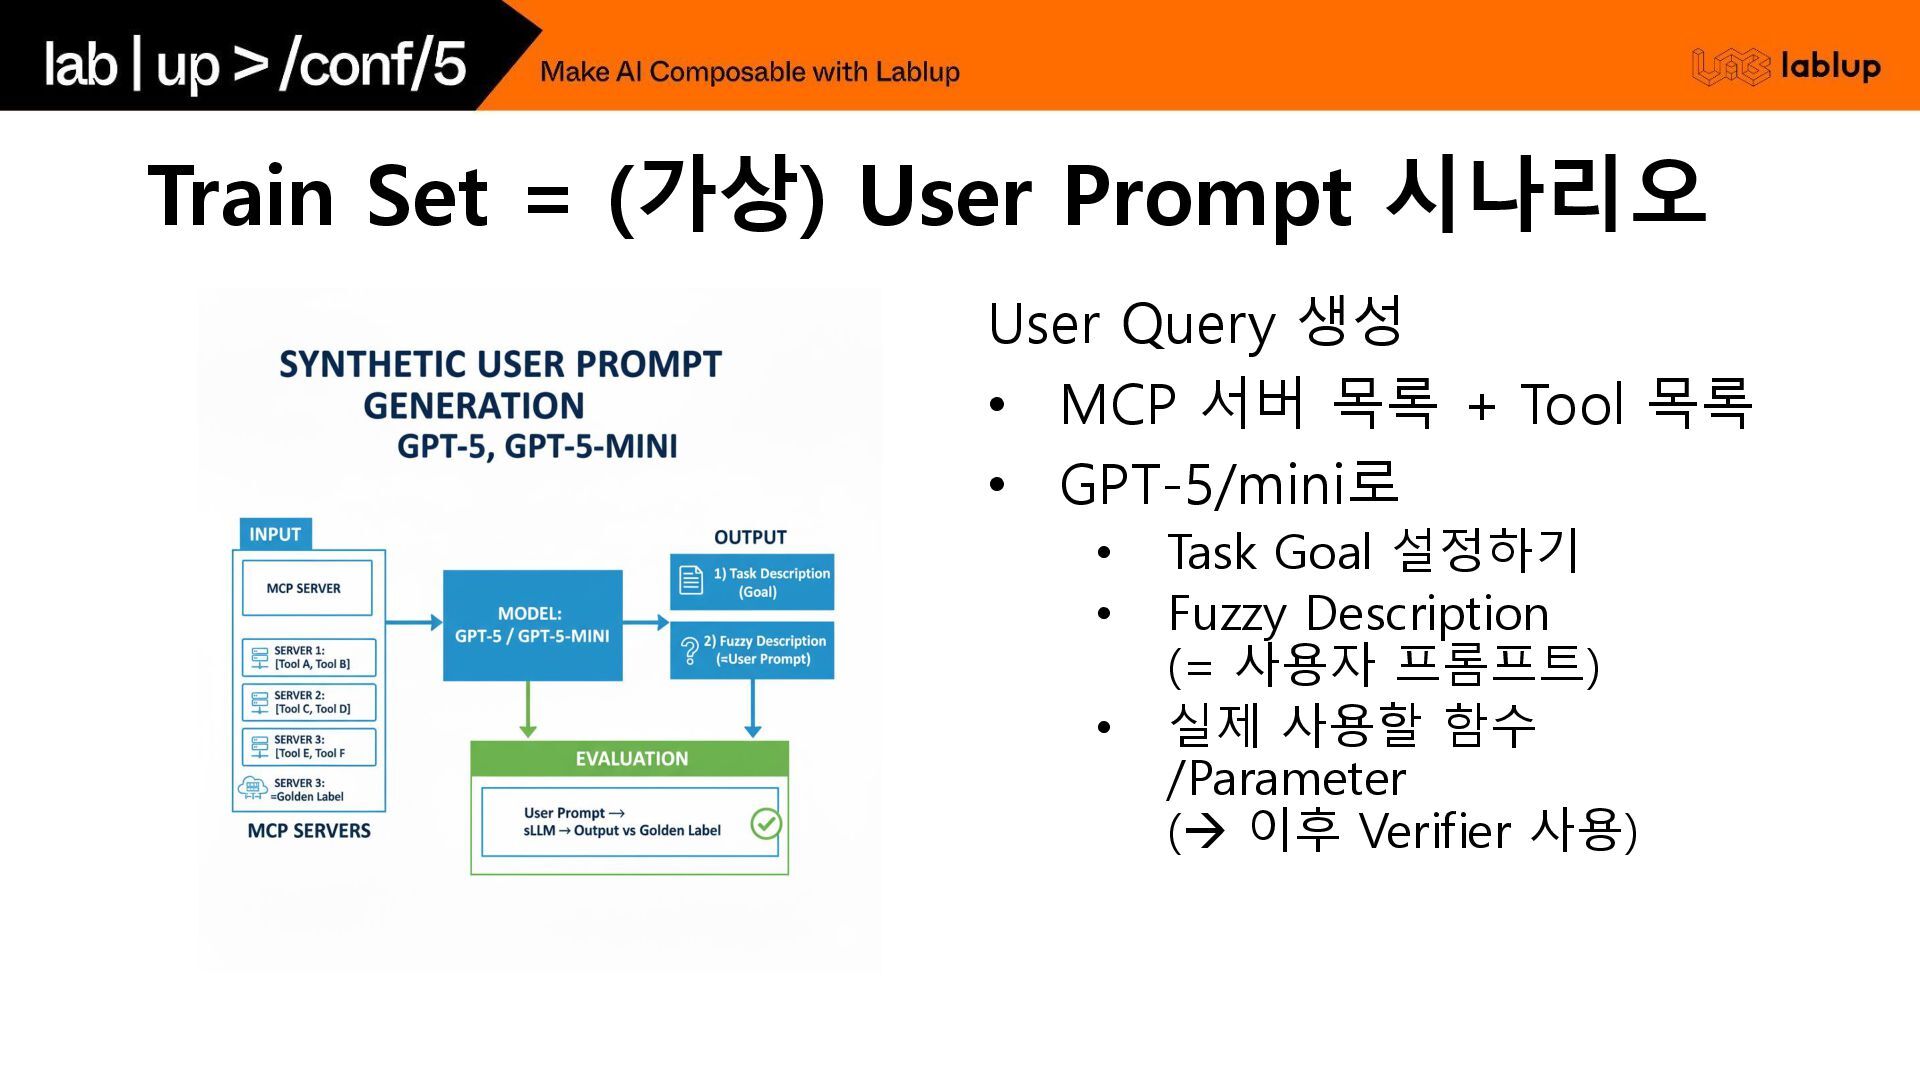
Train Set = (가상) User Prompt 시나리오 • MCP-bench는 Eval
Set Only • 독립된 Train Set 필요 • MCP 서버들 정보 기반 → 신규 User Query 생성 • GPT-5, GPT-5-mini 이용
Train Set = (가상) User Prompt 시나리오 User Query 생성
• MCP 서버 목록 + Tool 목록 • GPT-5/mini로 • Task Goal 설정하기 • Fuzzy Description (= 사용자 프롬프트) • 실제 사용할 함수 /Parameter (→ 이후 Verifier 사용)
Train Set = (가상) User Prompt 시나리오
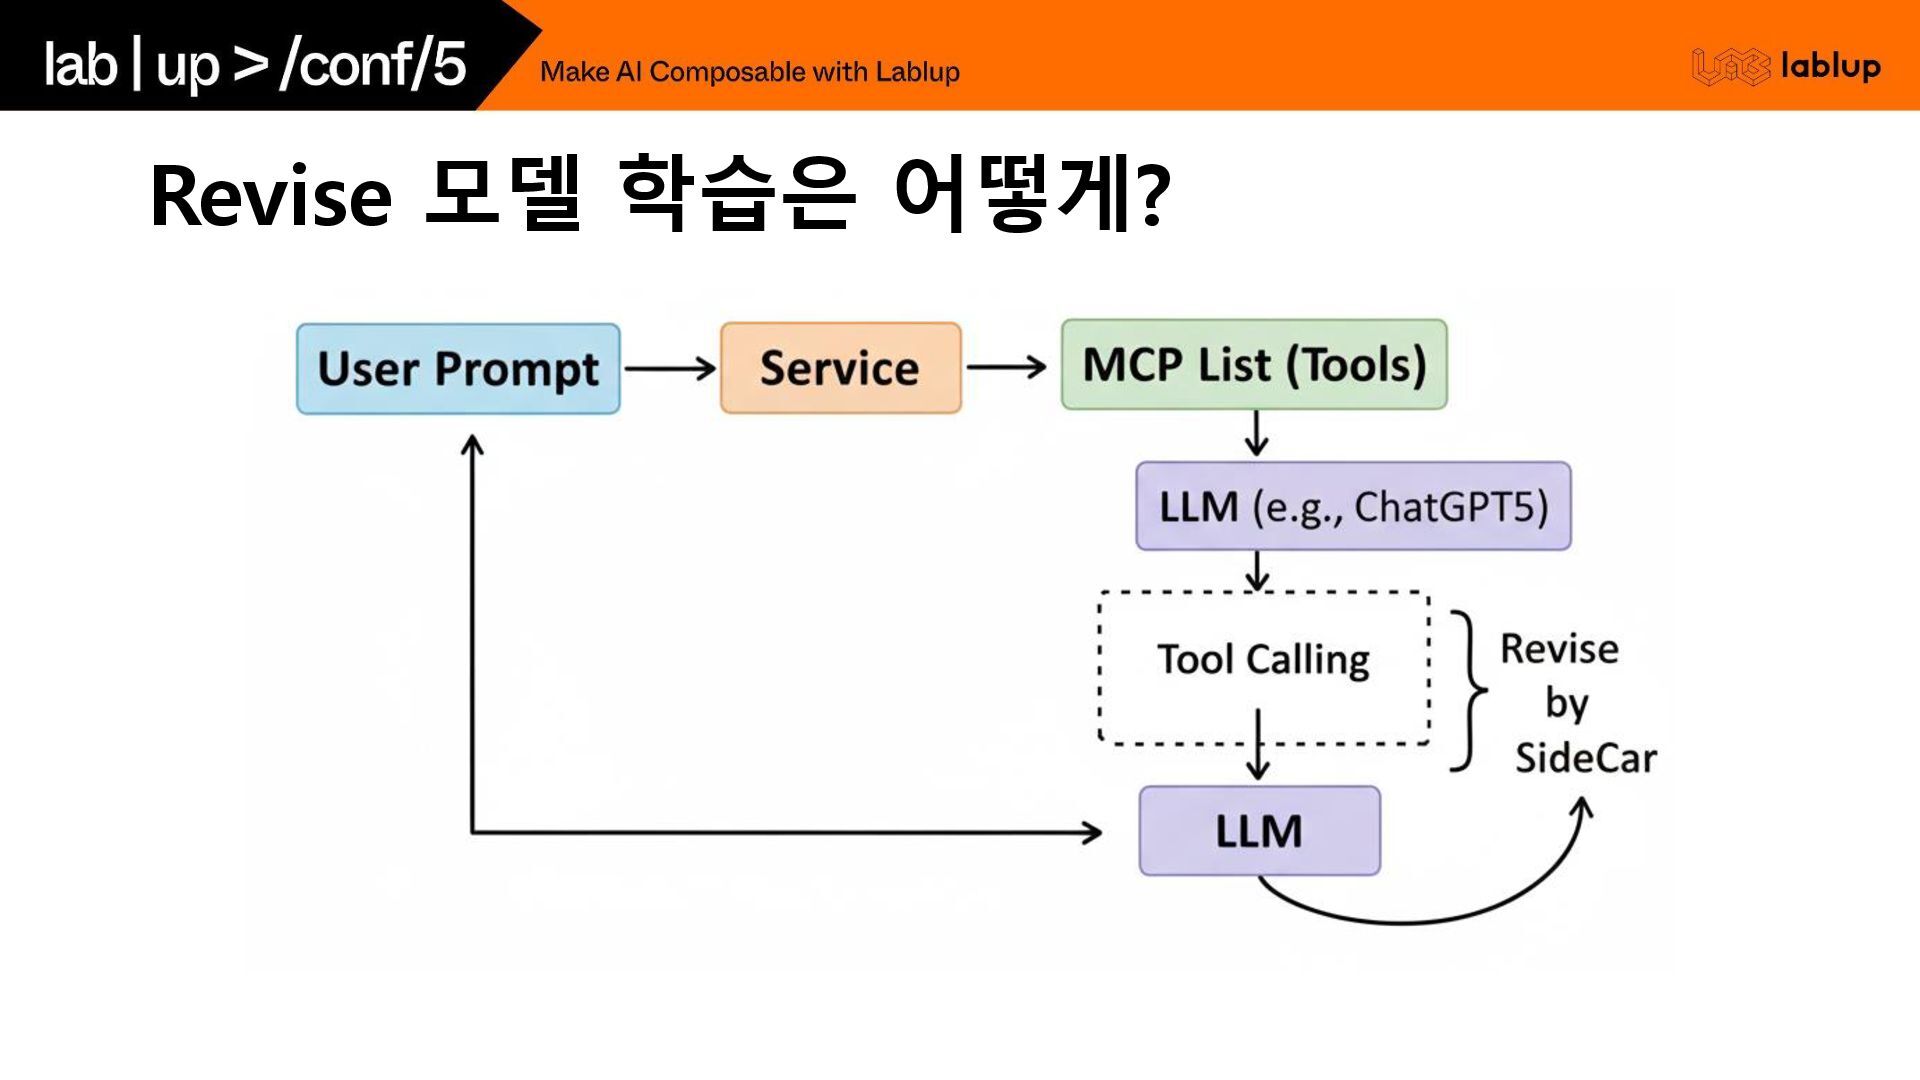
Revise 모델 학습은 어떻게?
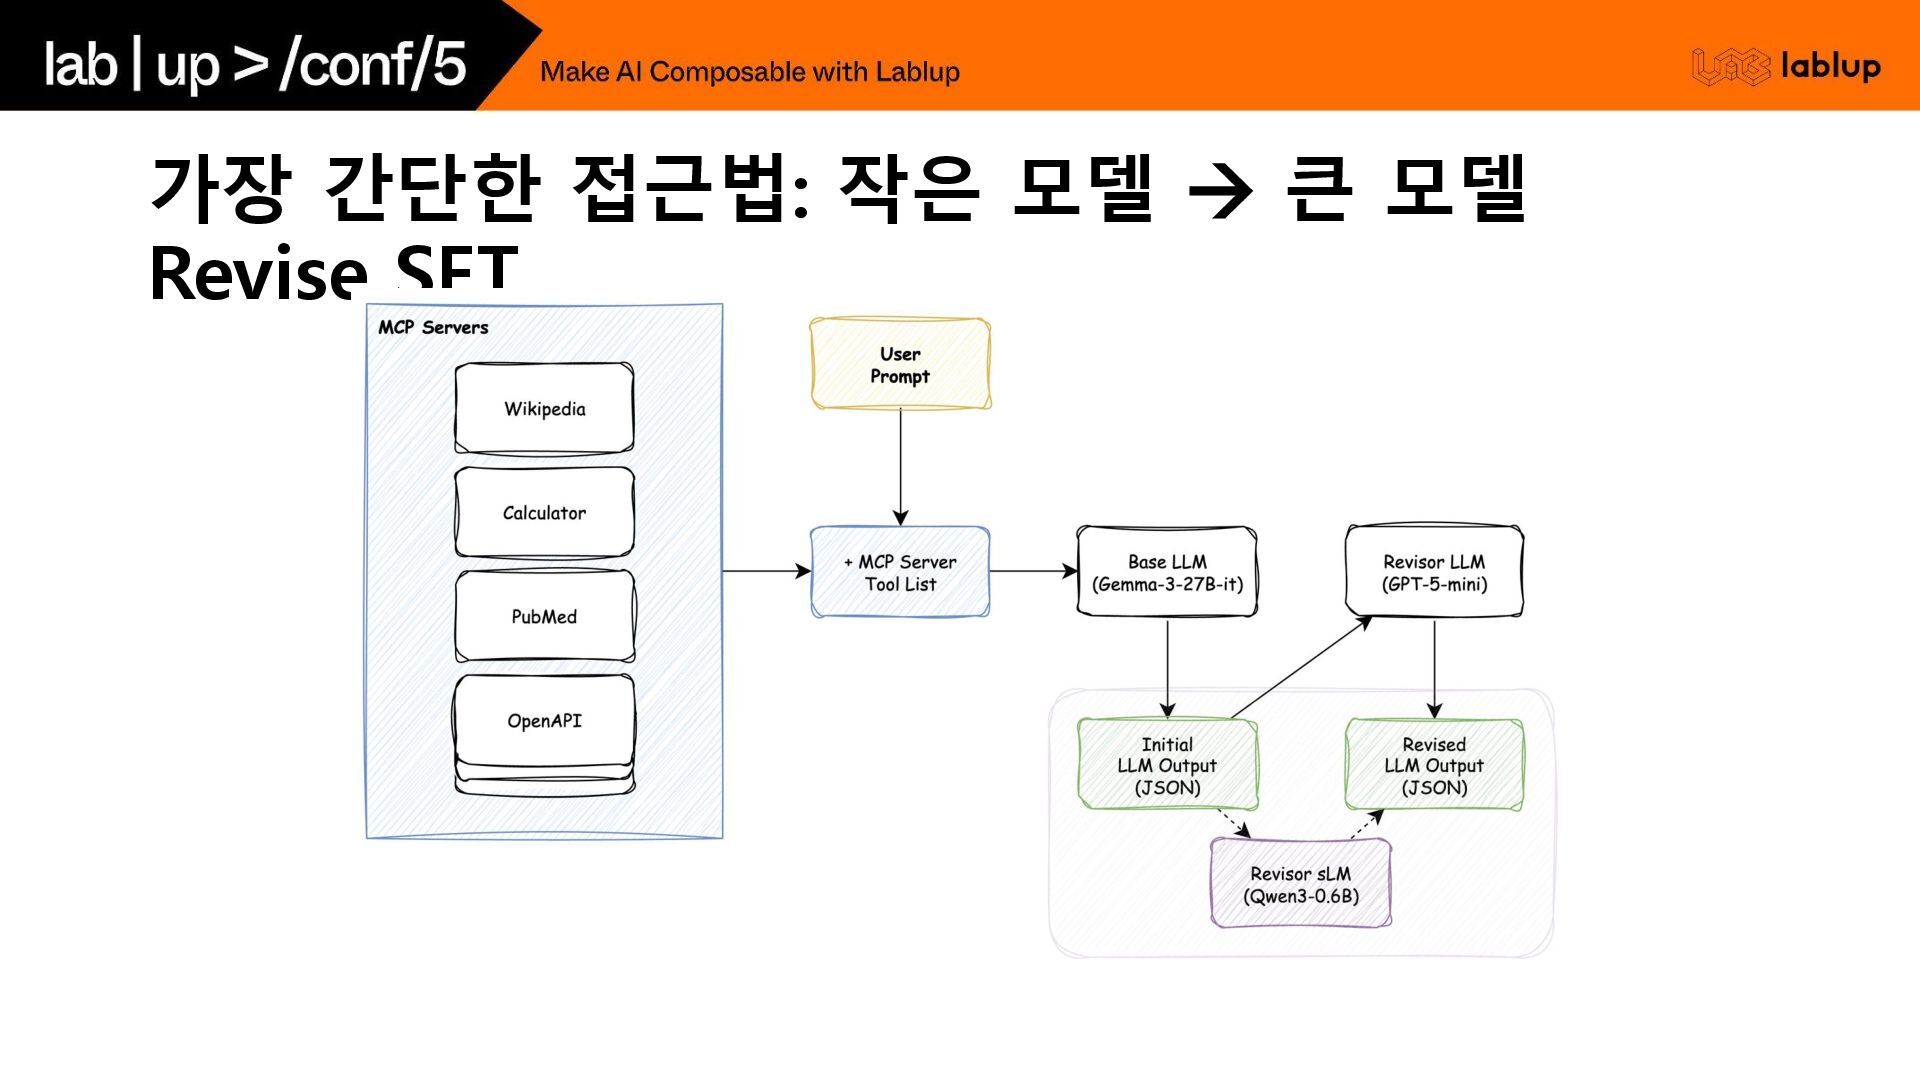
가장 간단한 접근법: 작은 모델 → 큰 모델 Revise SFT
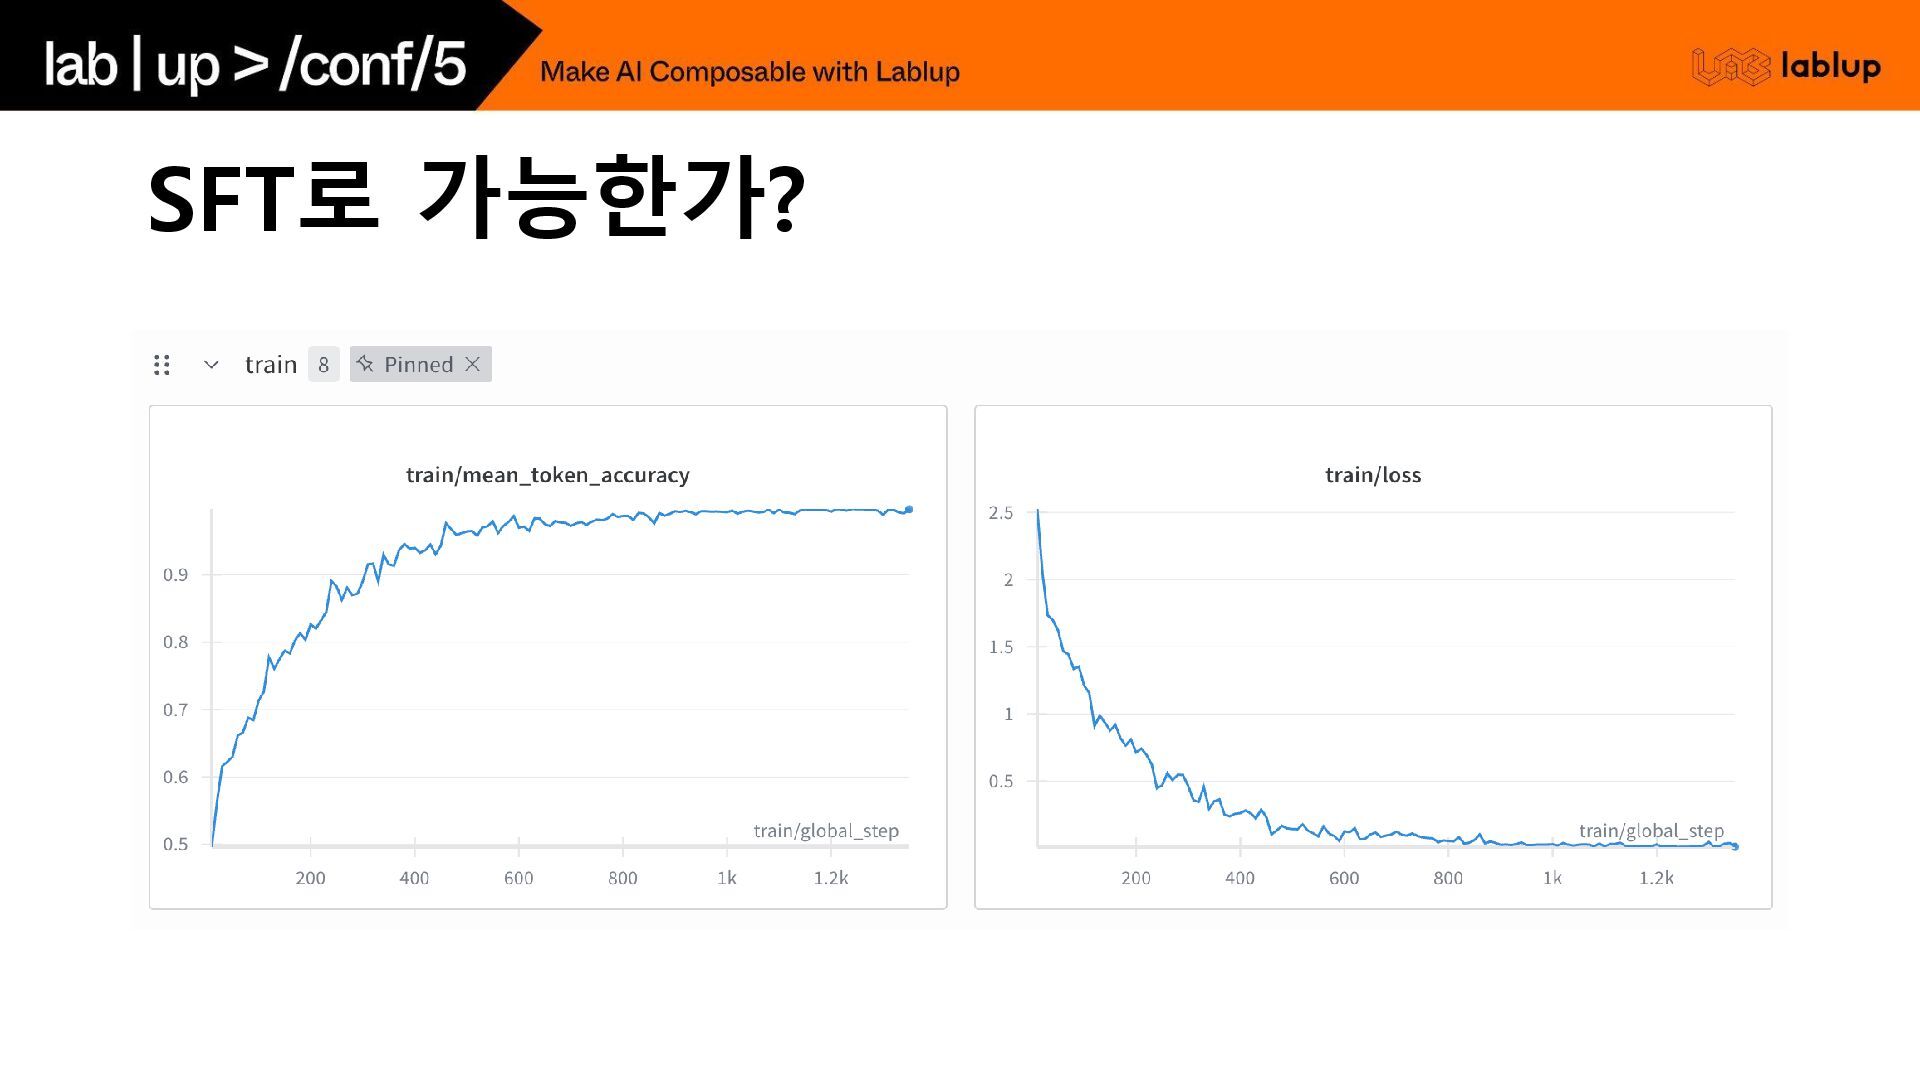
SFT로 가능한가?
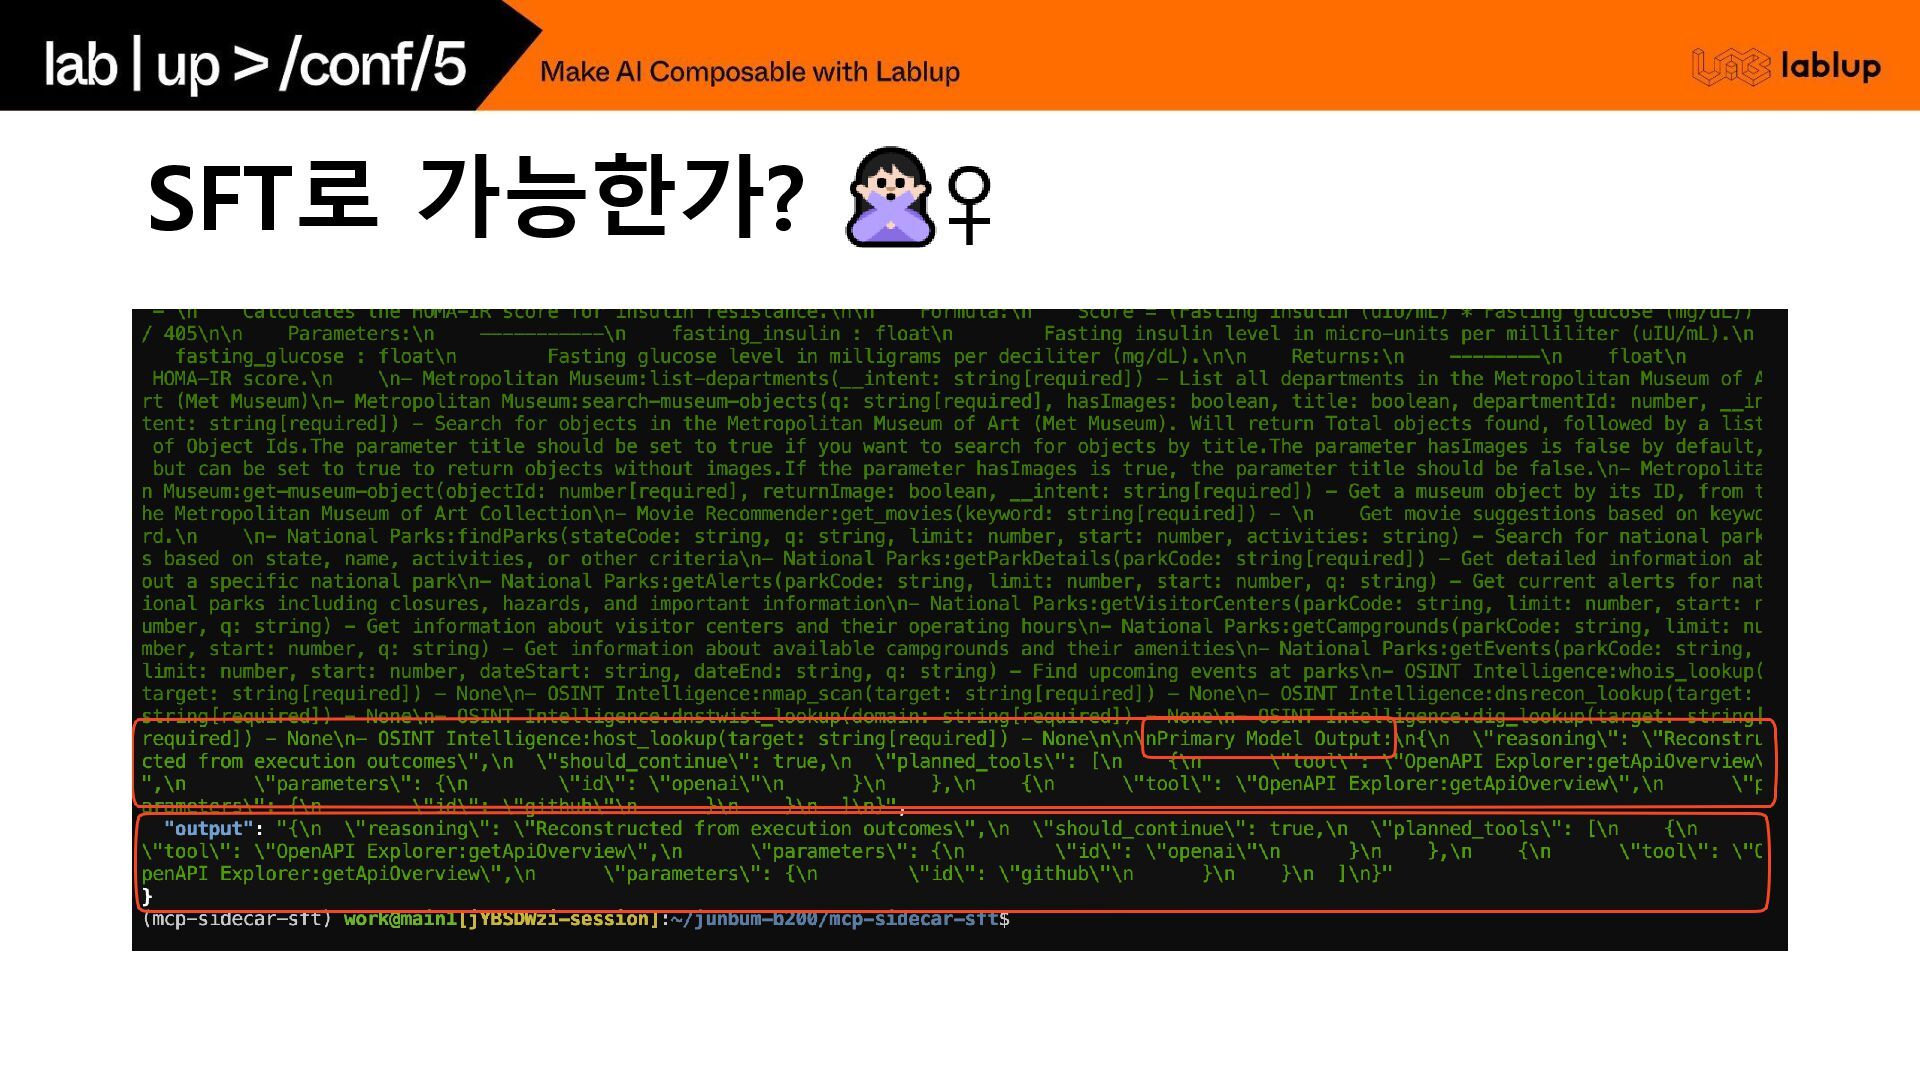
SFT로 가능한가?
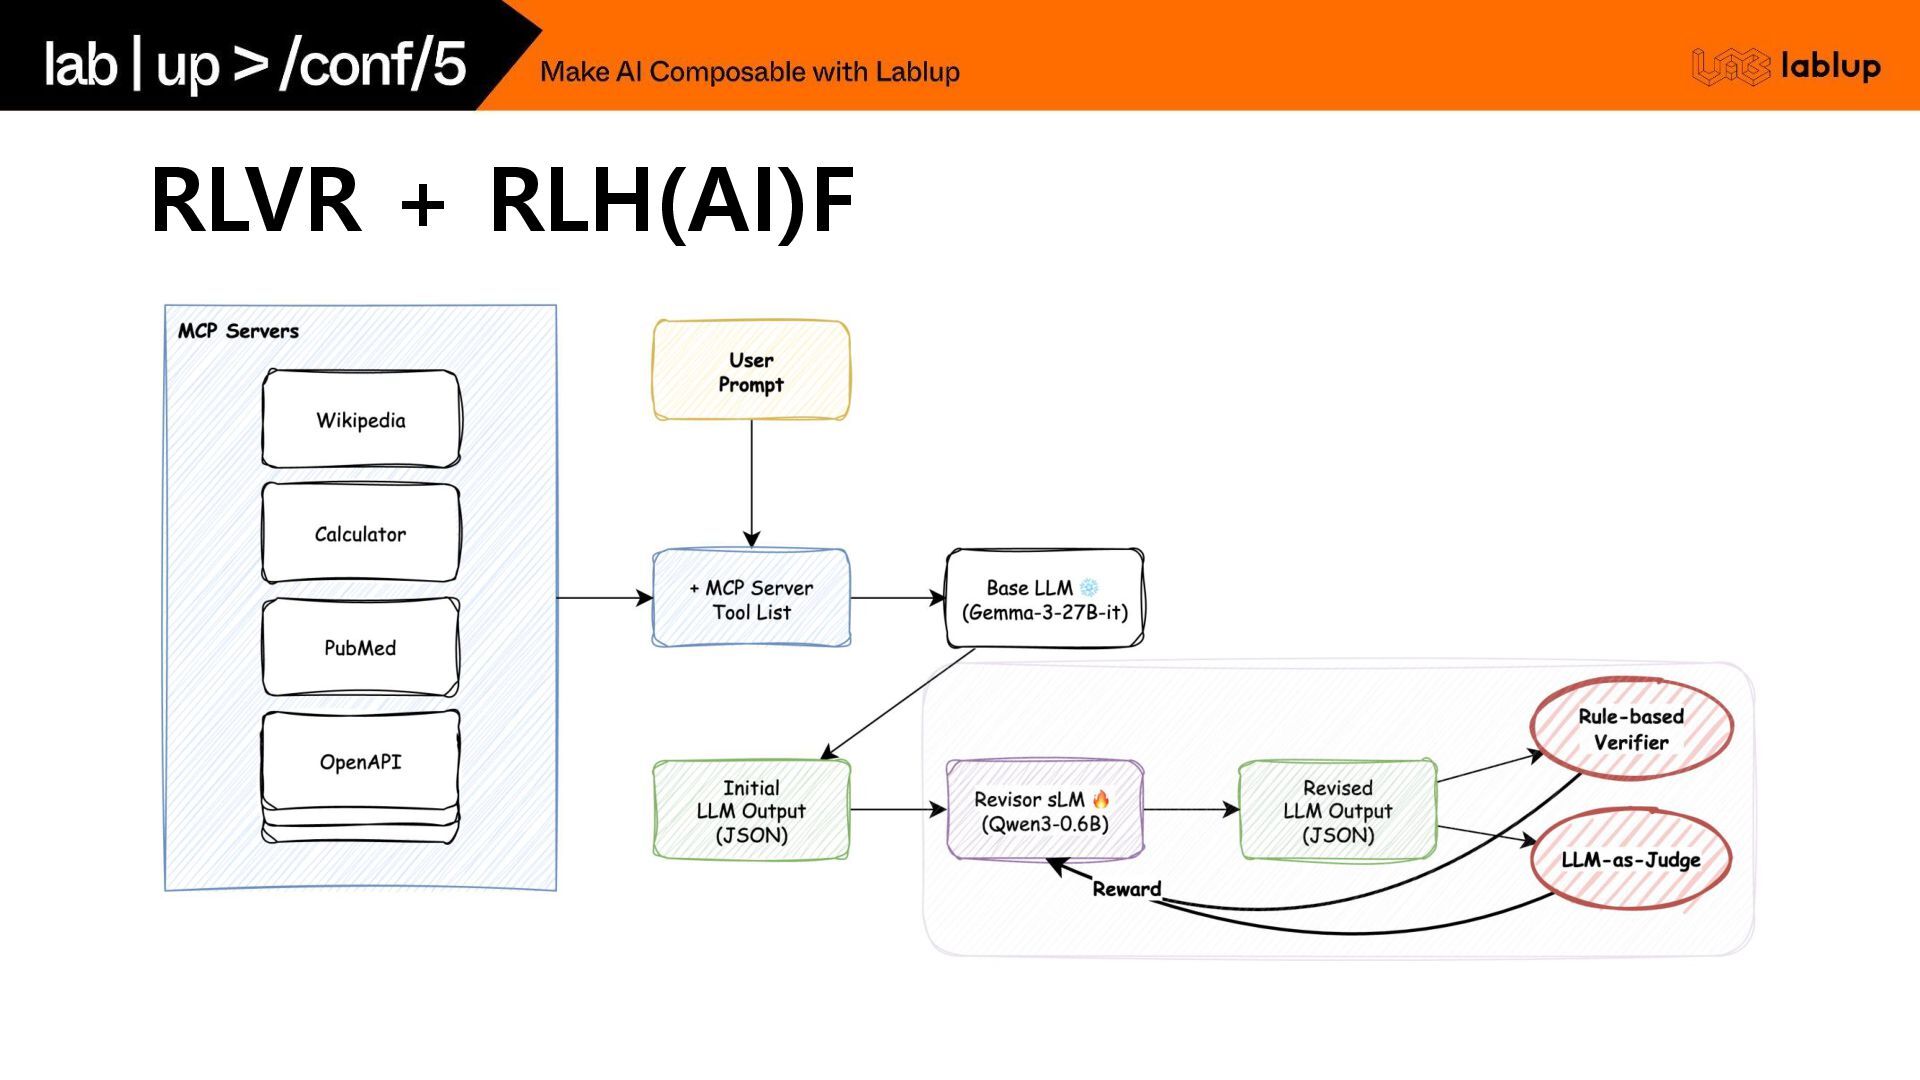
RLVR + RLH(AI)F
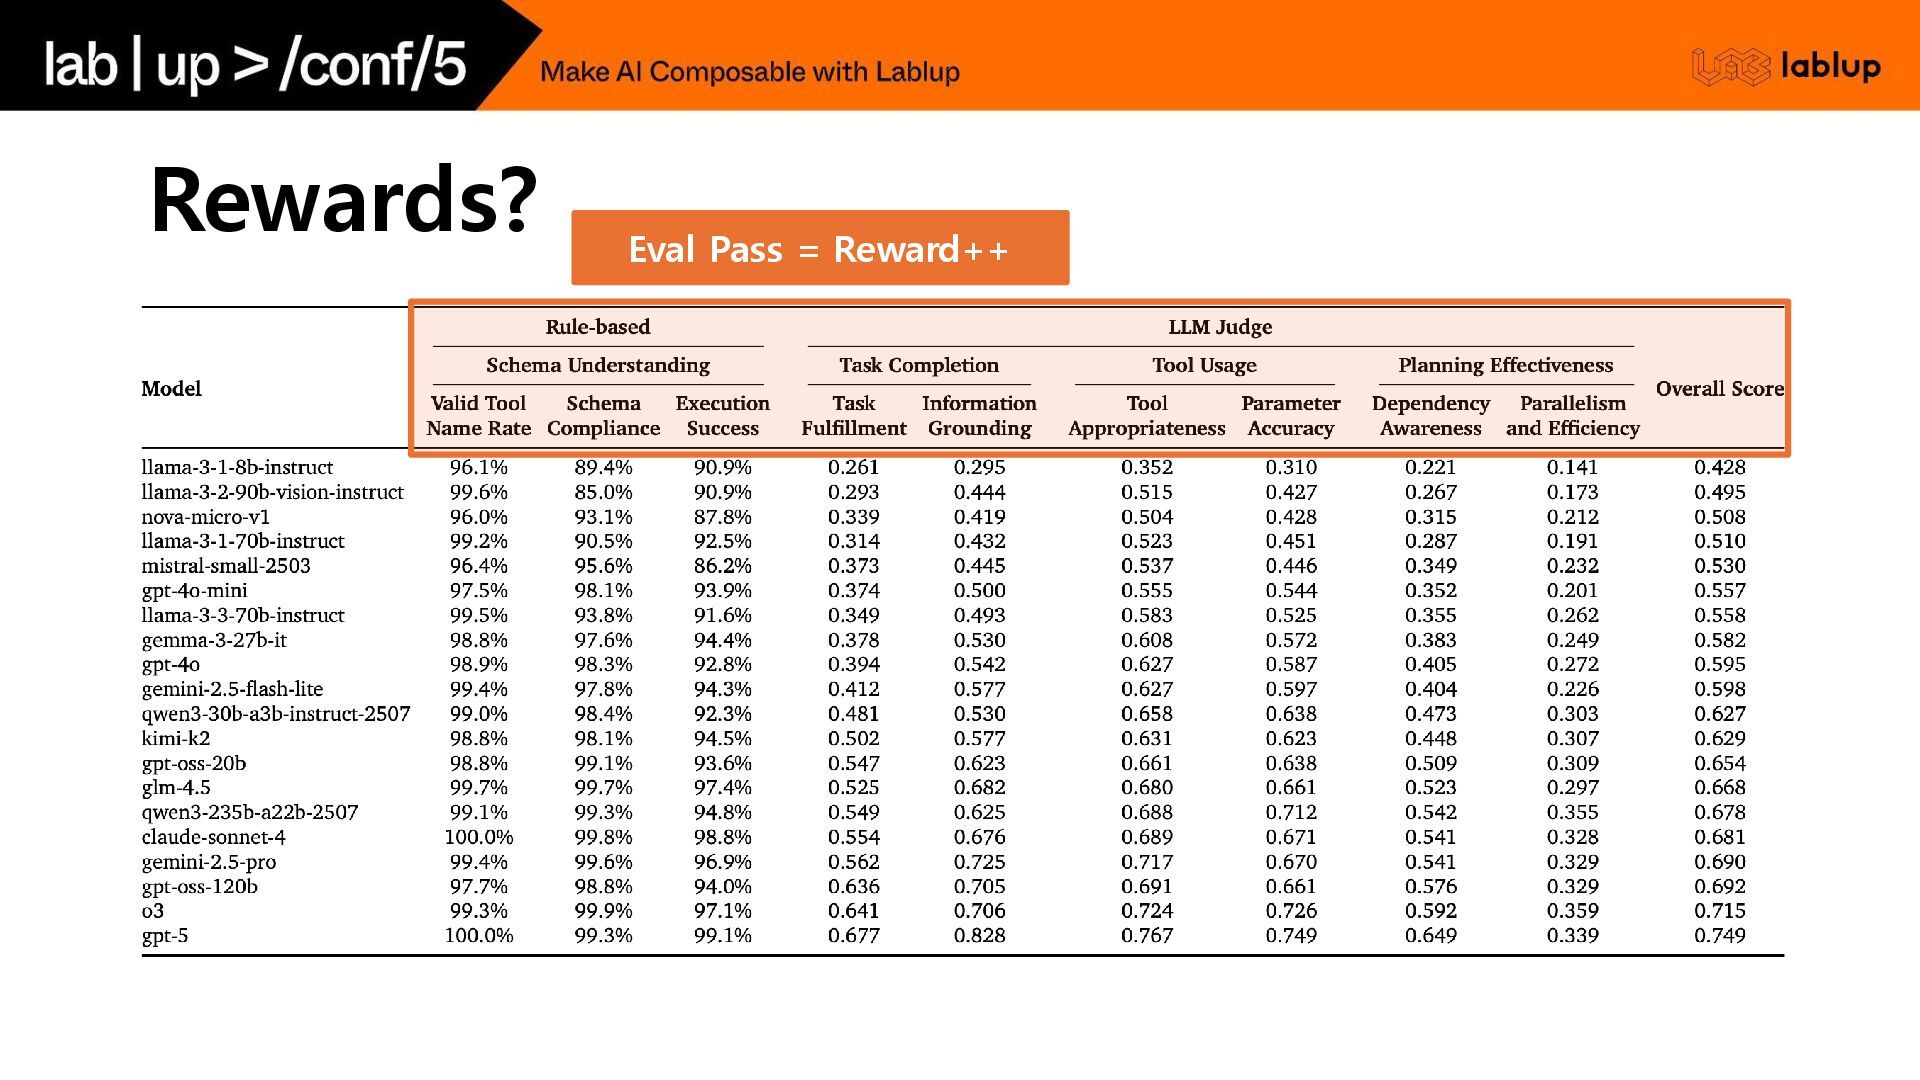
Rewards? Eval Pass = Reward++
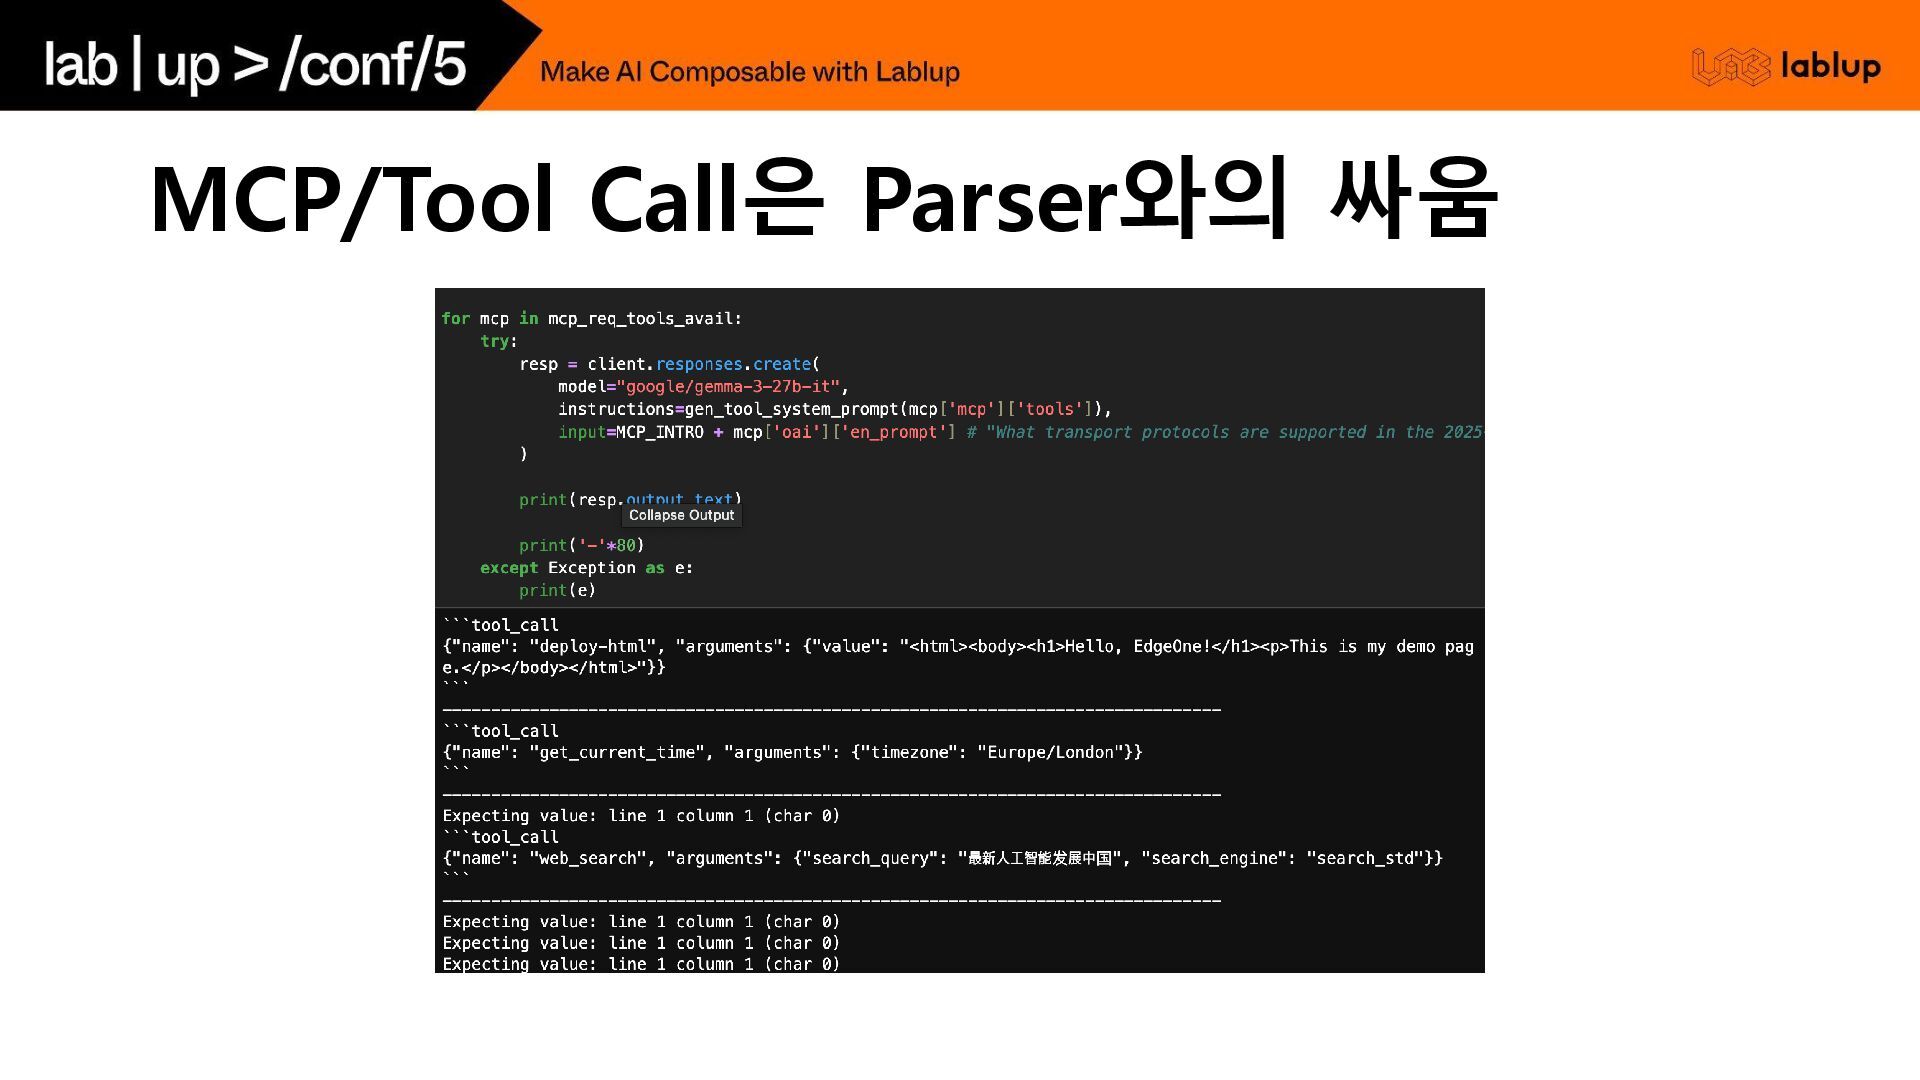
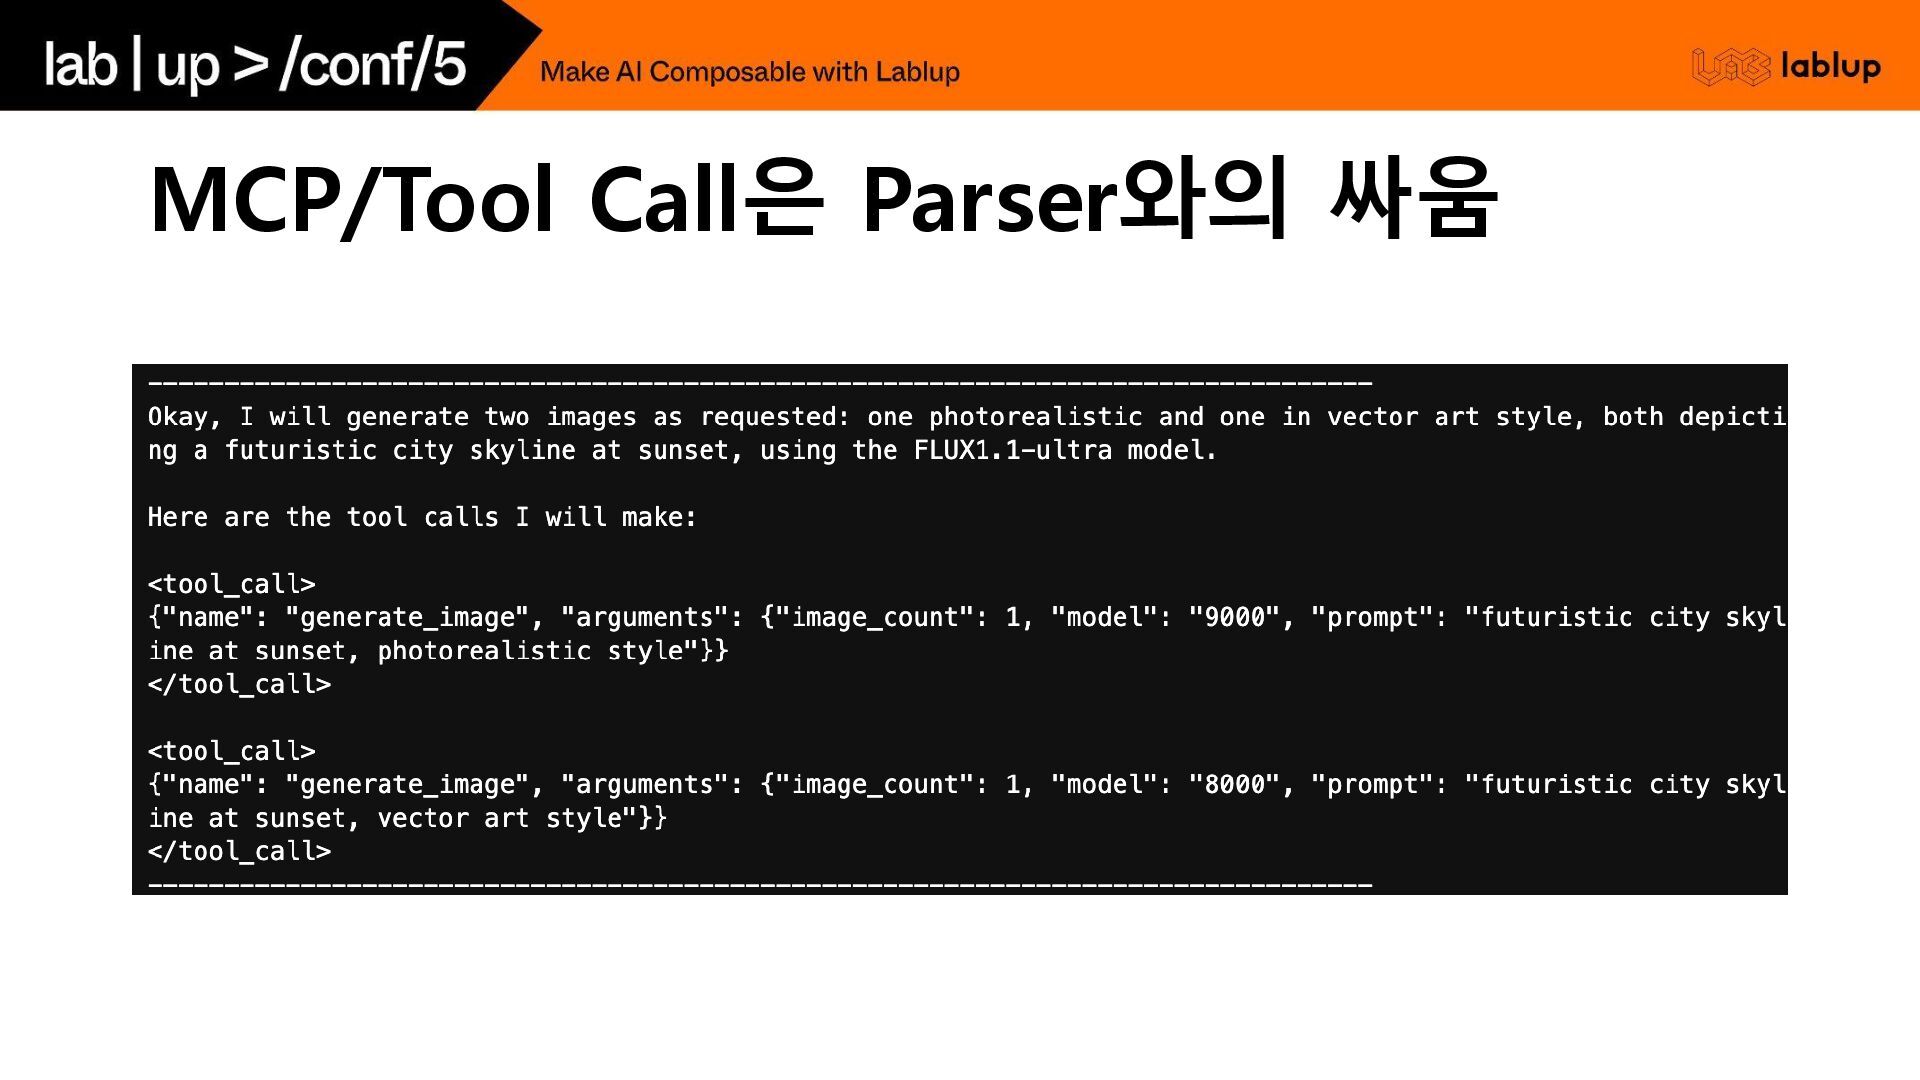
MCP/Tool Call은 Parser와의 싸움
MCP/Tool Call은 Parser와의 싸움
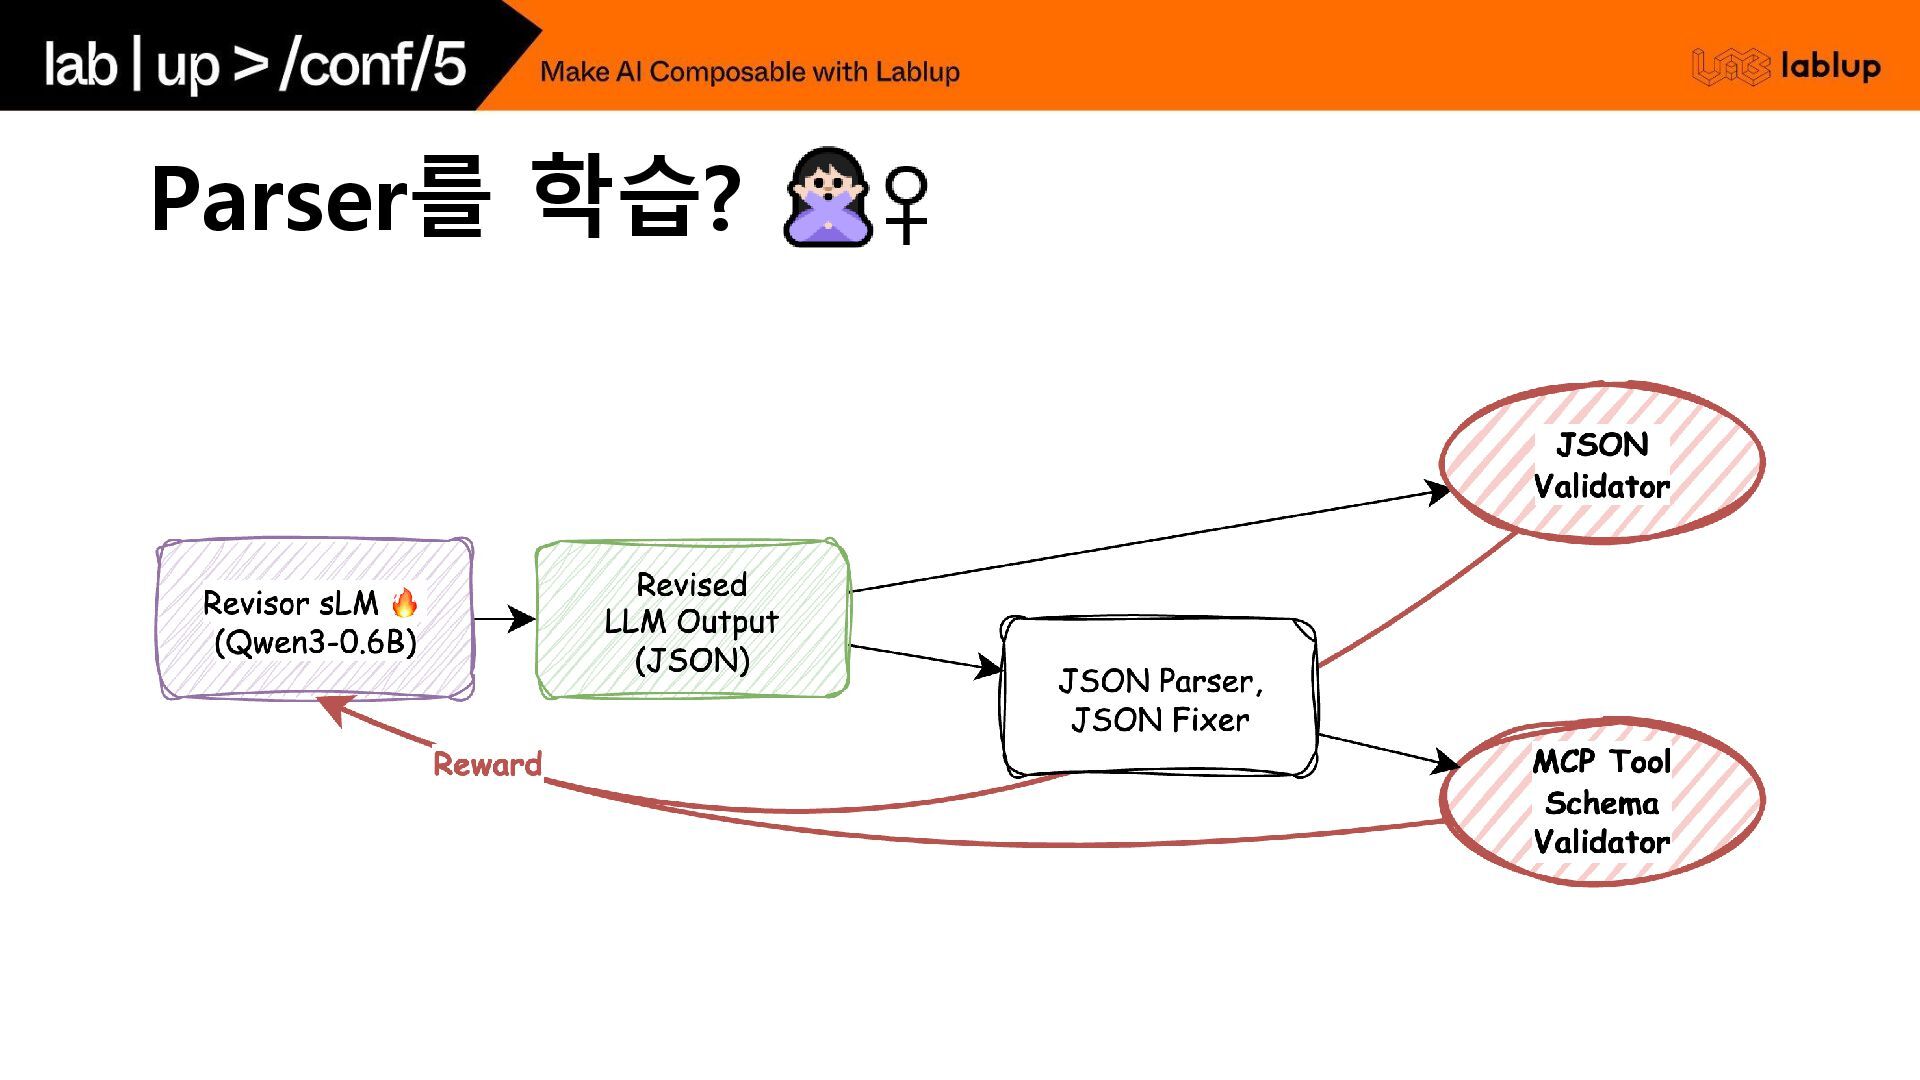
Parser를 학습?
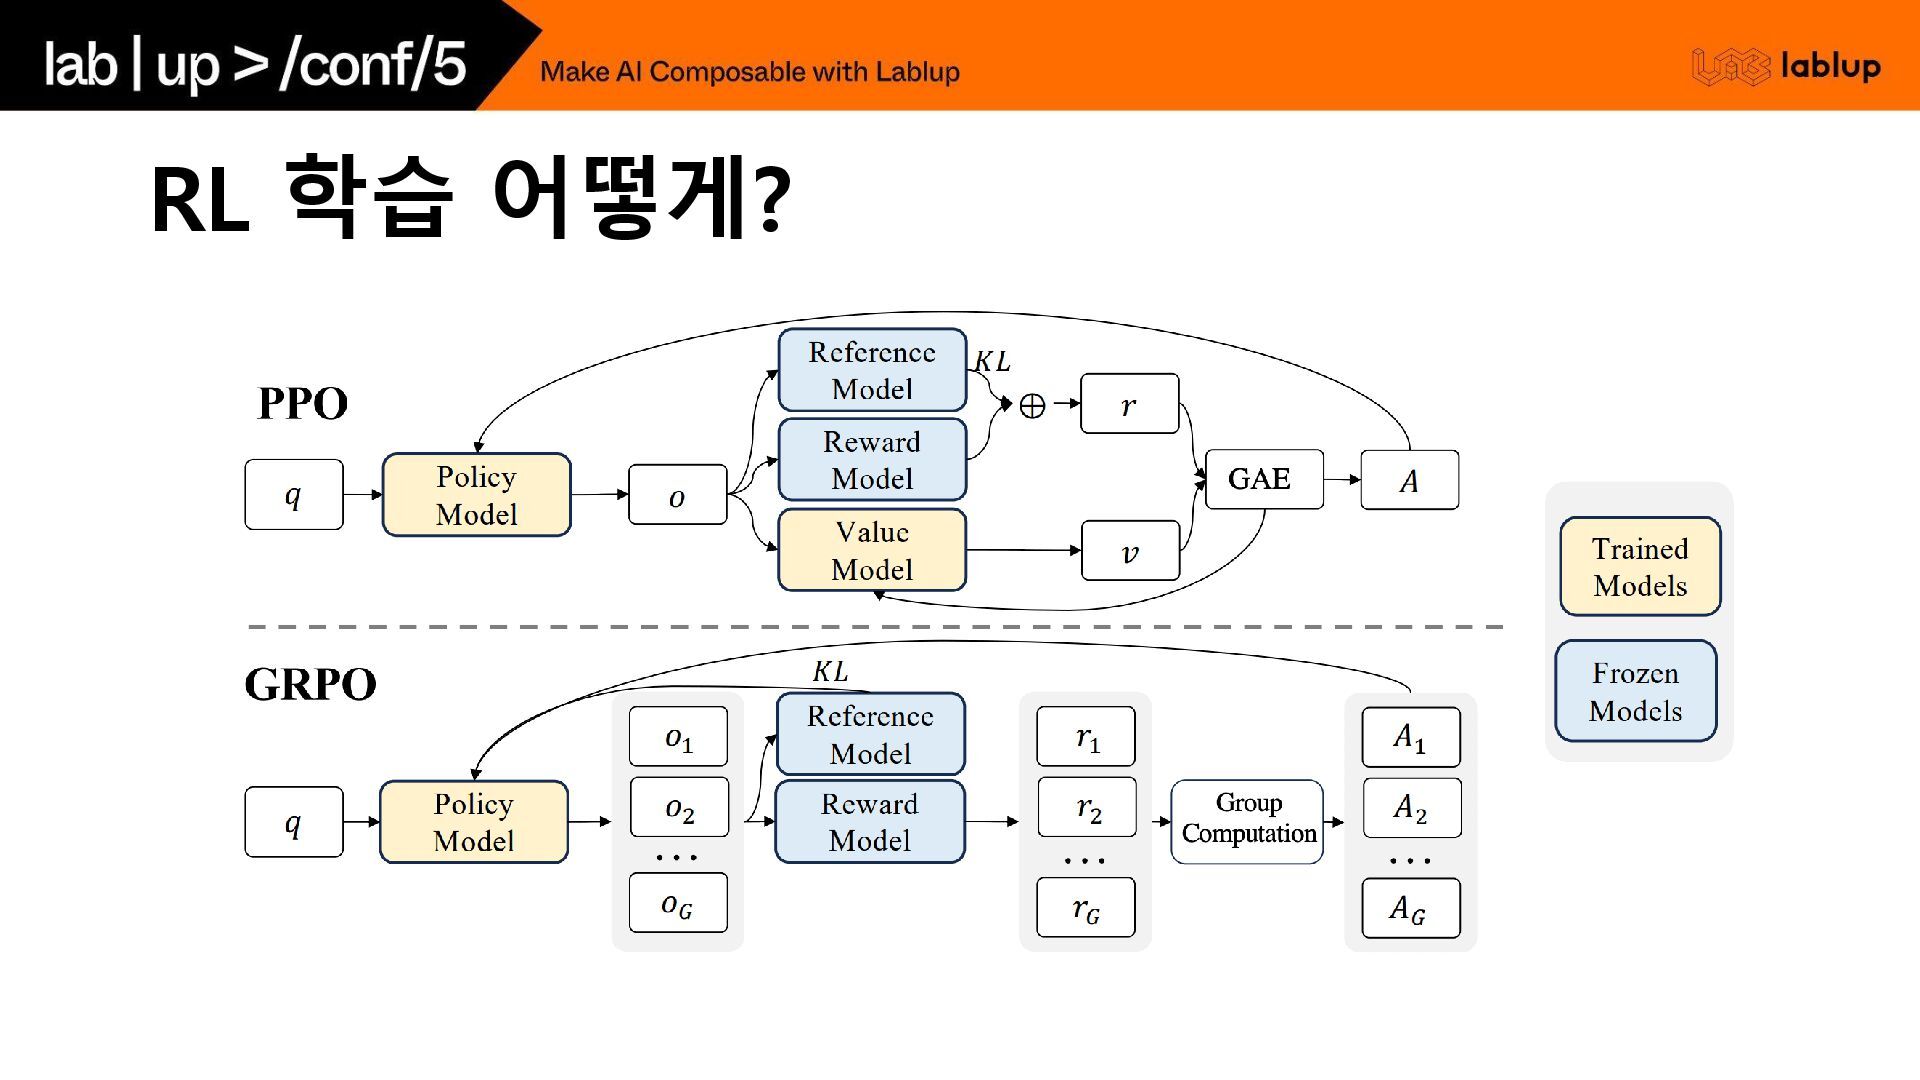
RL 학습 어떻게?
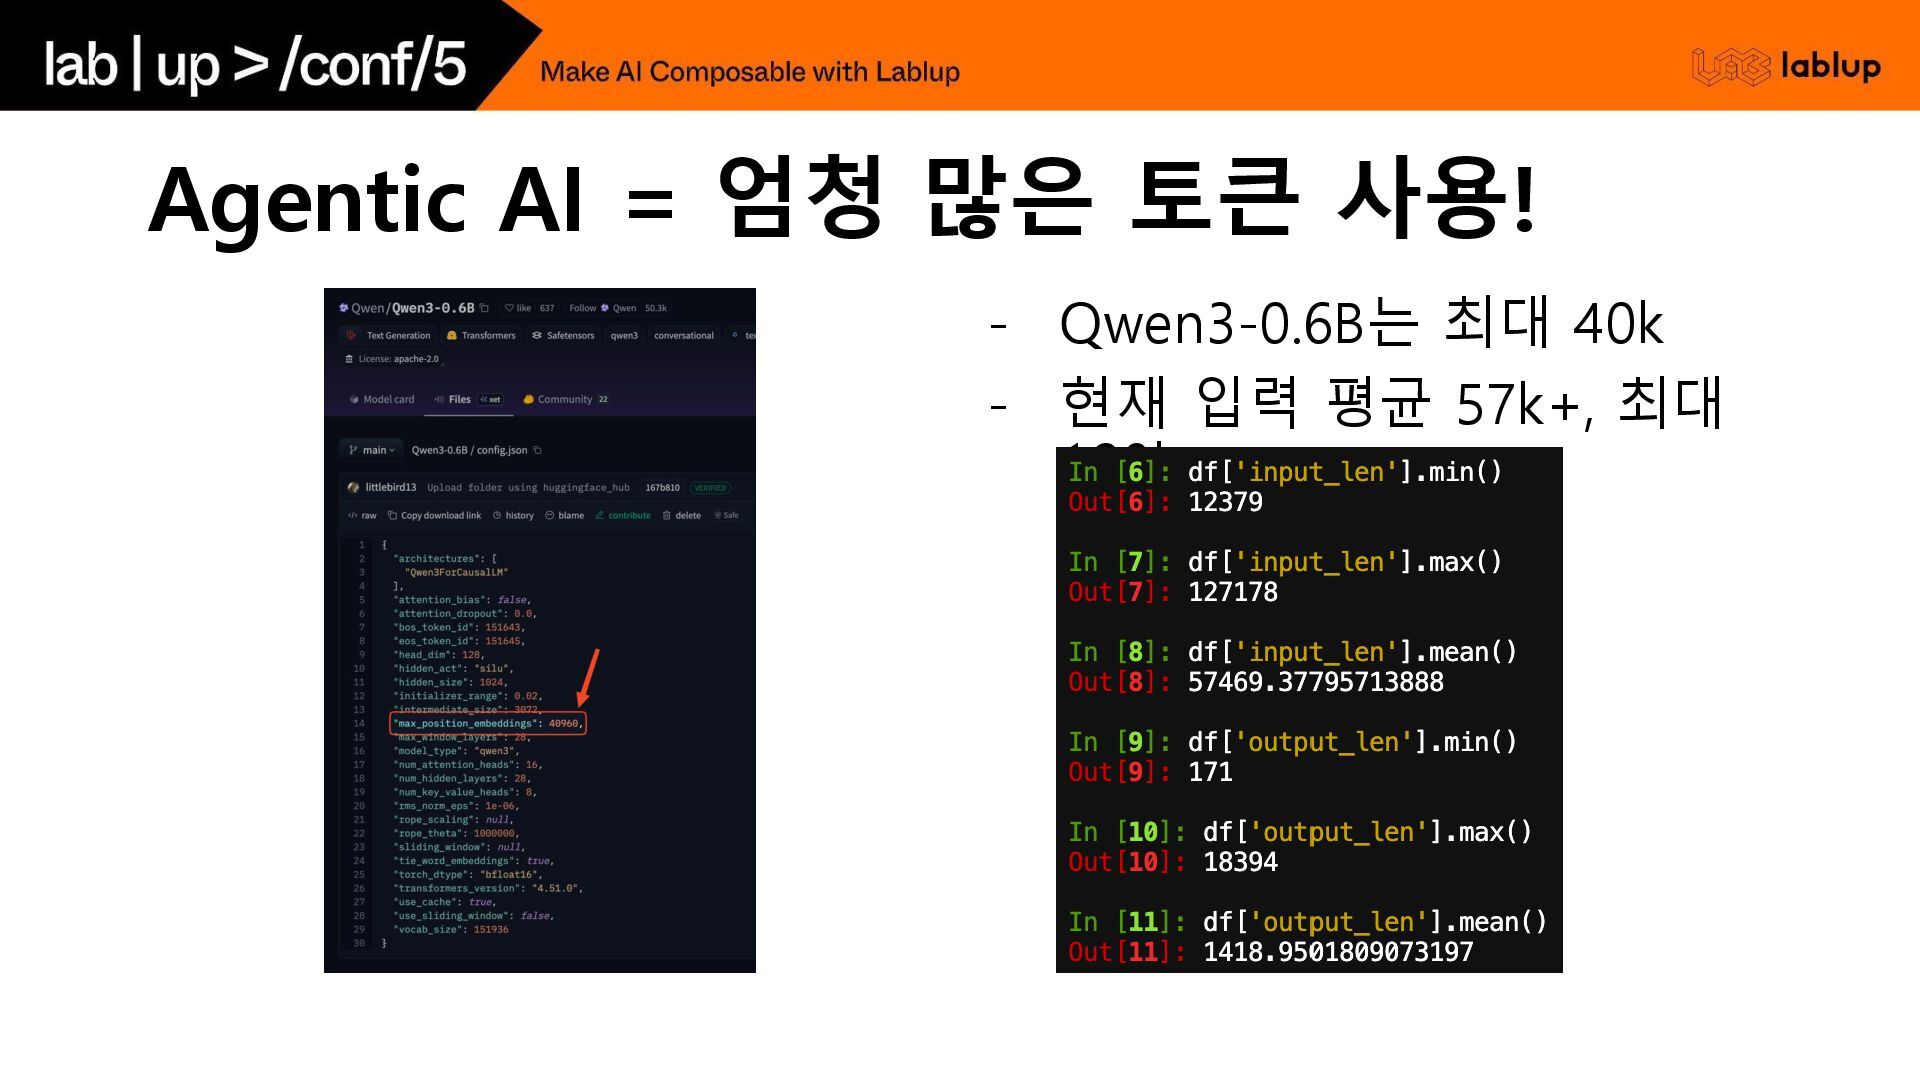
Agentic AI = 엄청 많은 토큰 사용! - Qwen3-0.6B는 최대
40k - 현재 입력 평균 57k+, 최대 128k
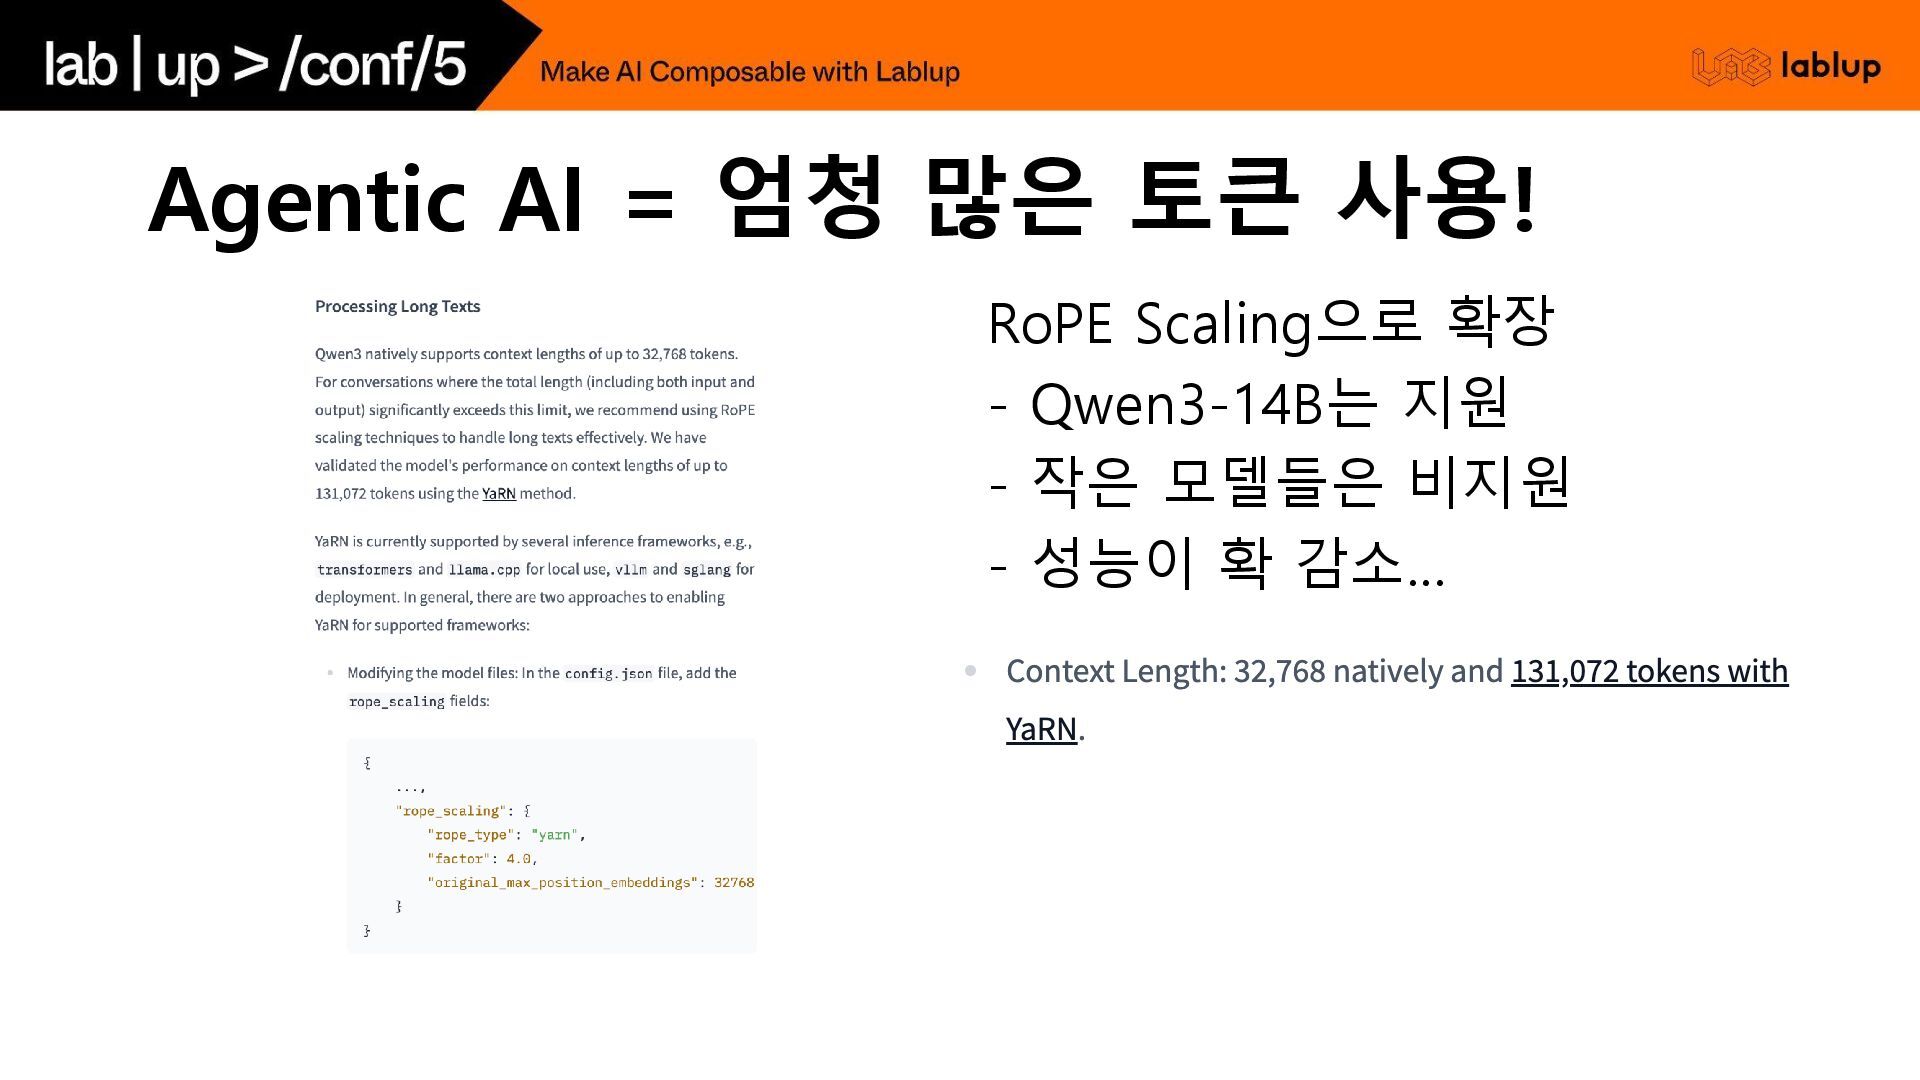
Agentic AI = 엄청 많은 토큰 사용! RoPE Scaling으로 확장
- Qwen3-14B는 지원 - 작은 모델들은 비지원 - 성능이 확 감소…
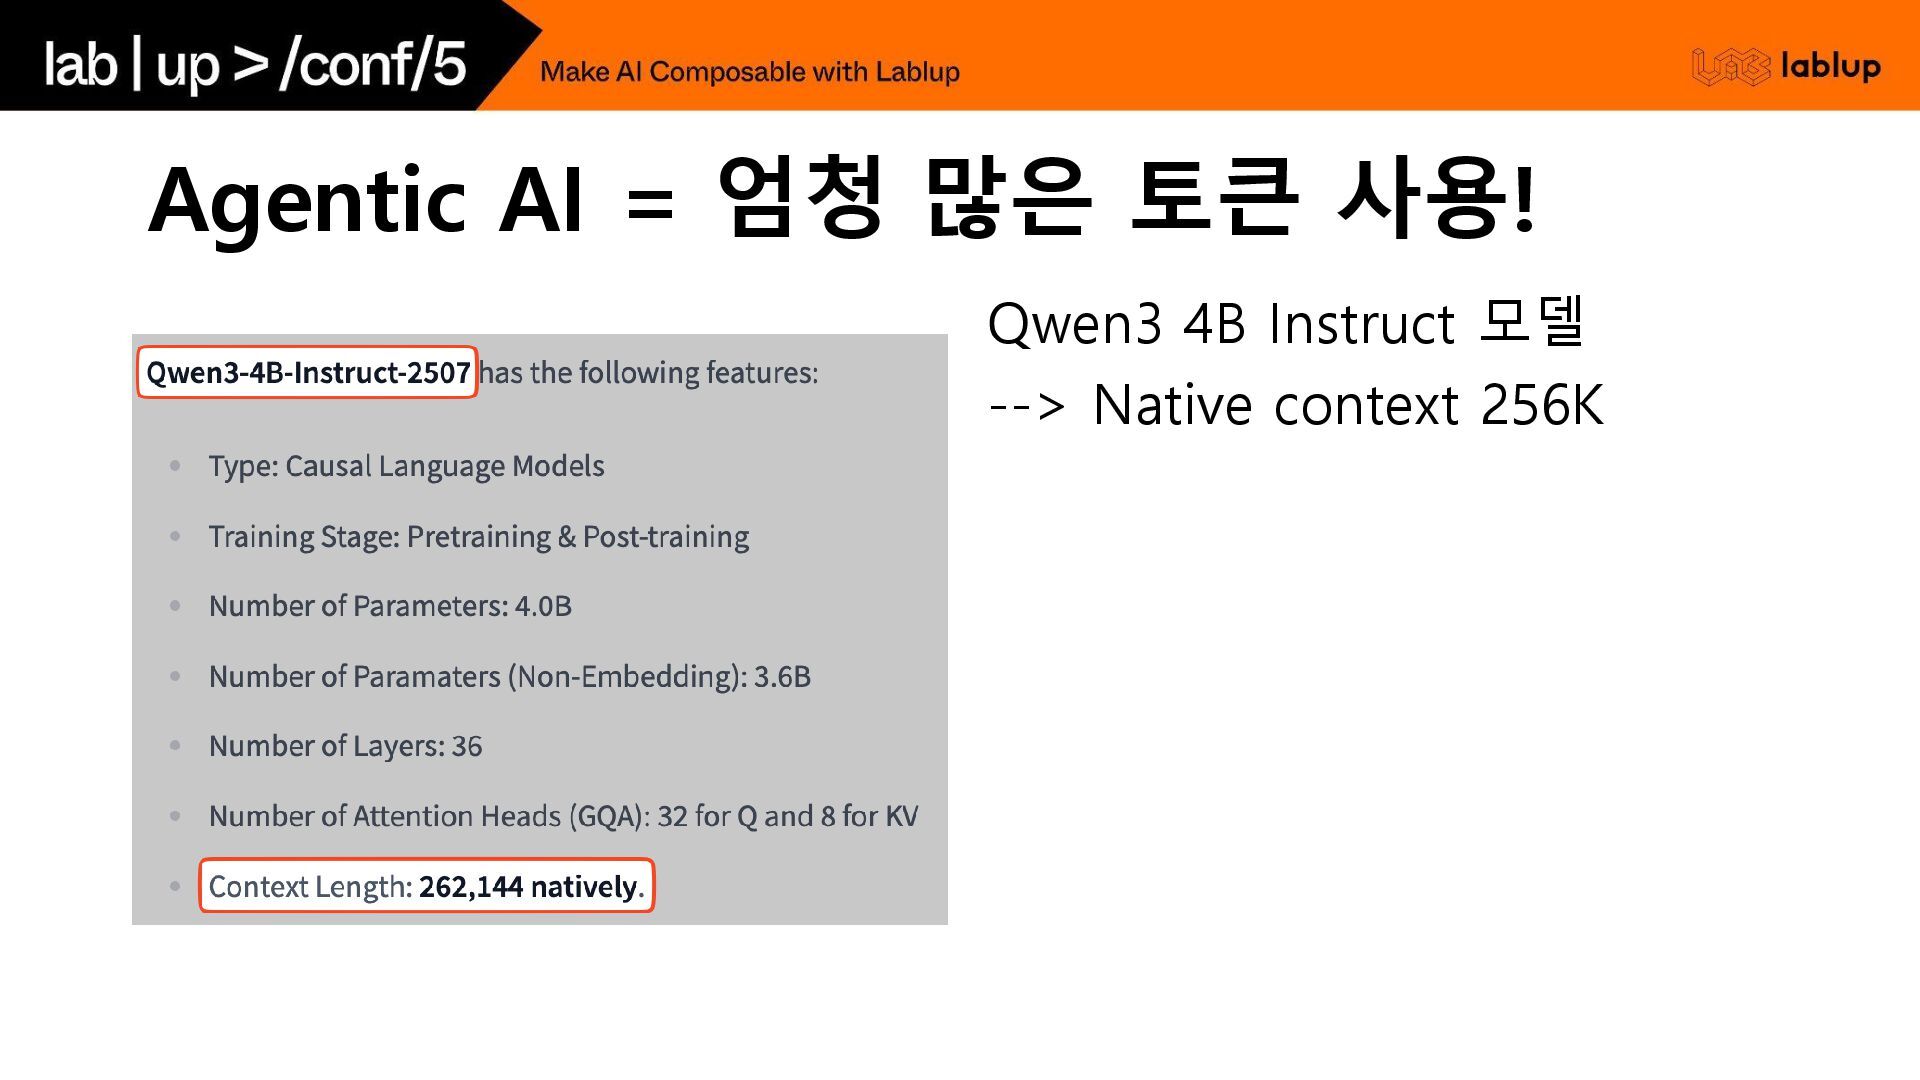
Agentic AI = 엄청 많은 토큰 사용! Qwen3 4B Instruct
모델 --> Native context 256K
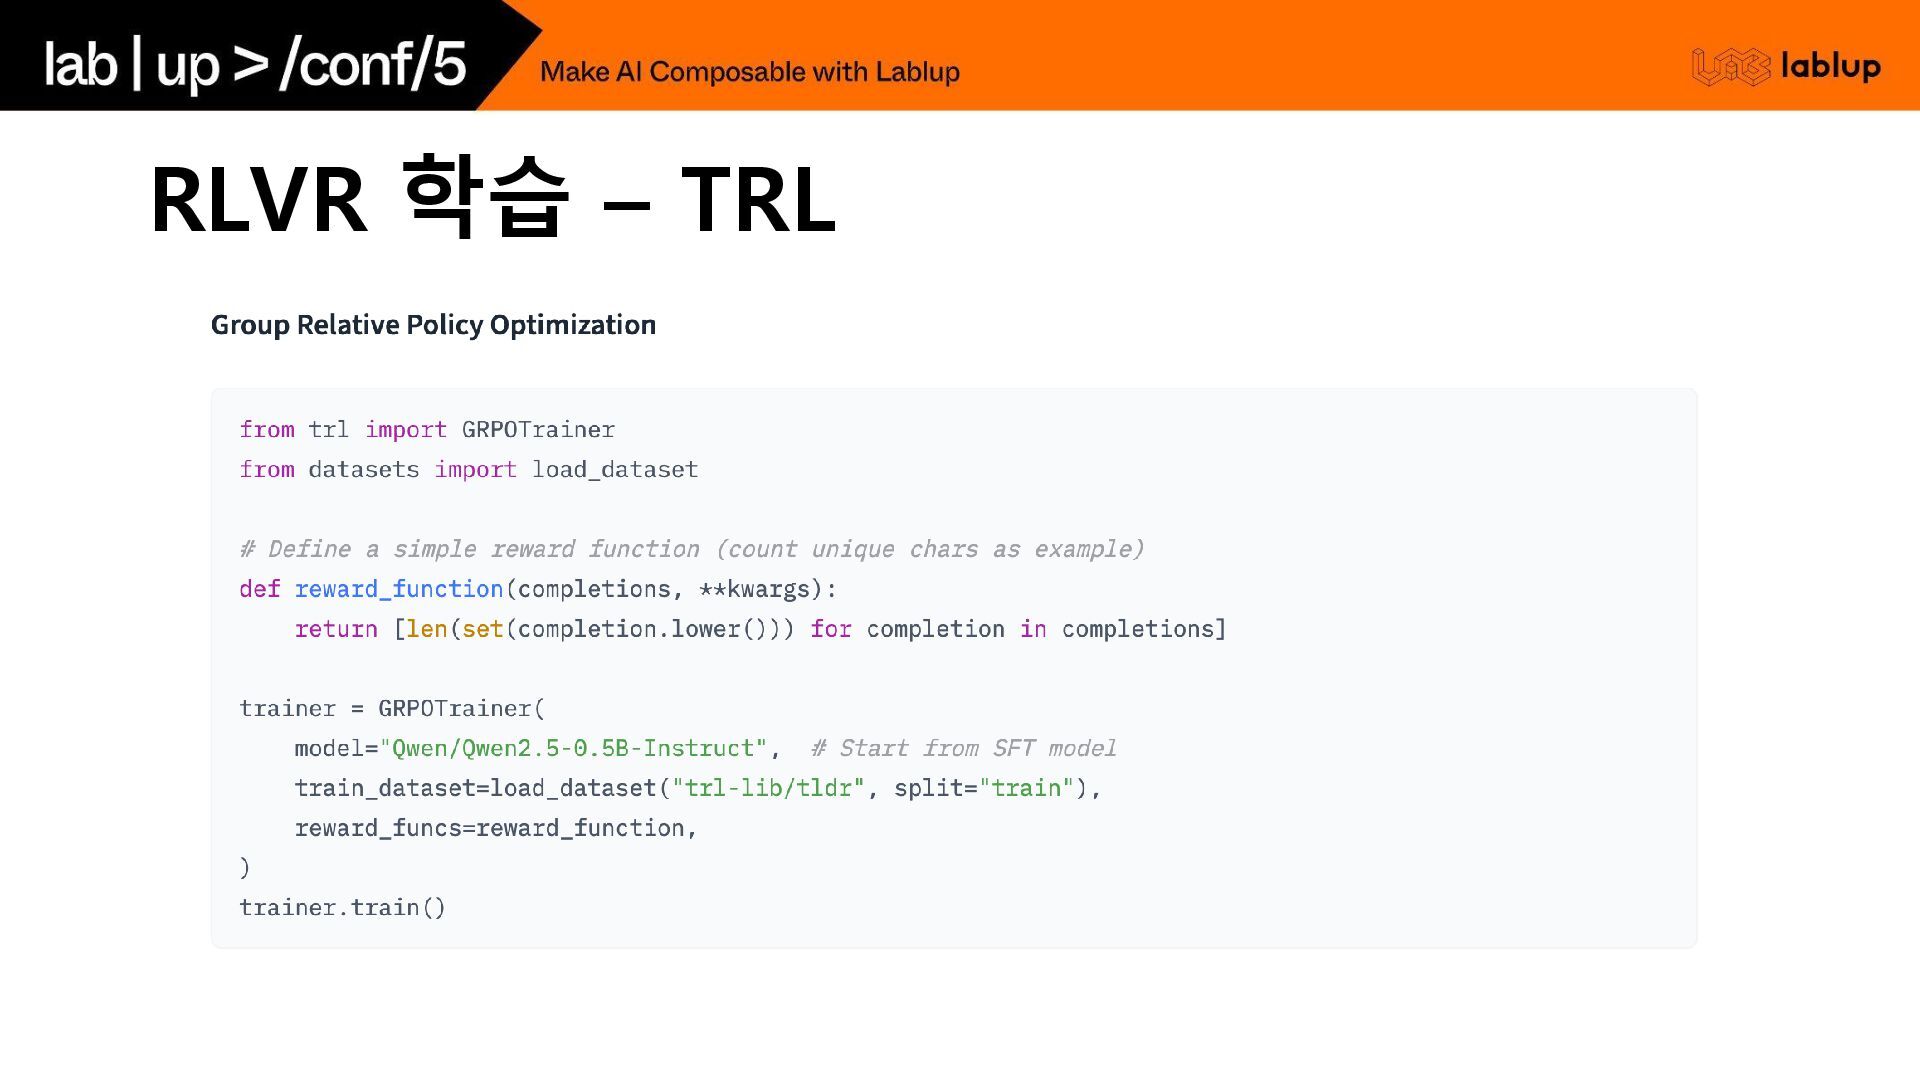
RLVR 학습 – TRL
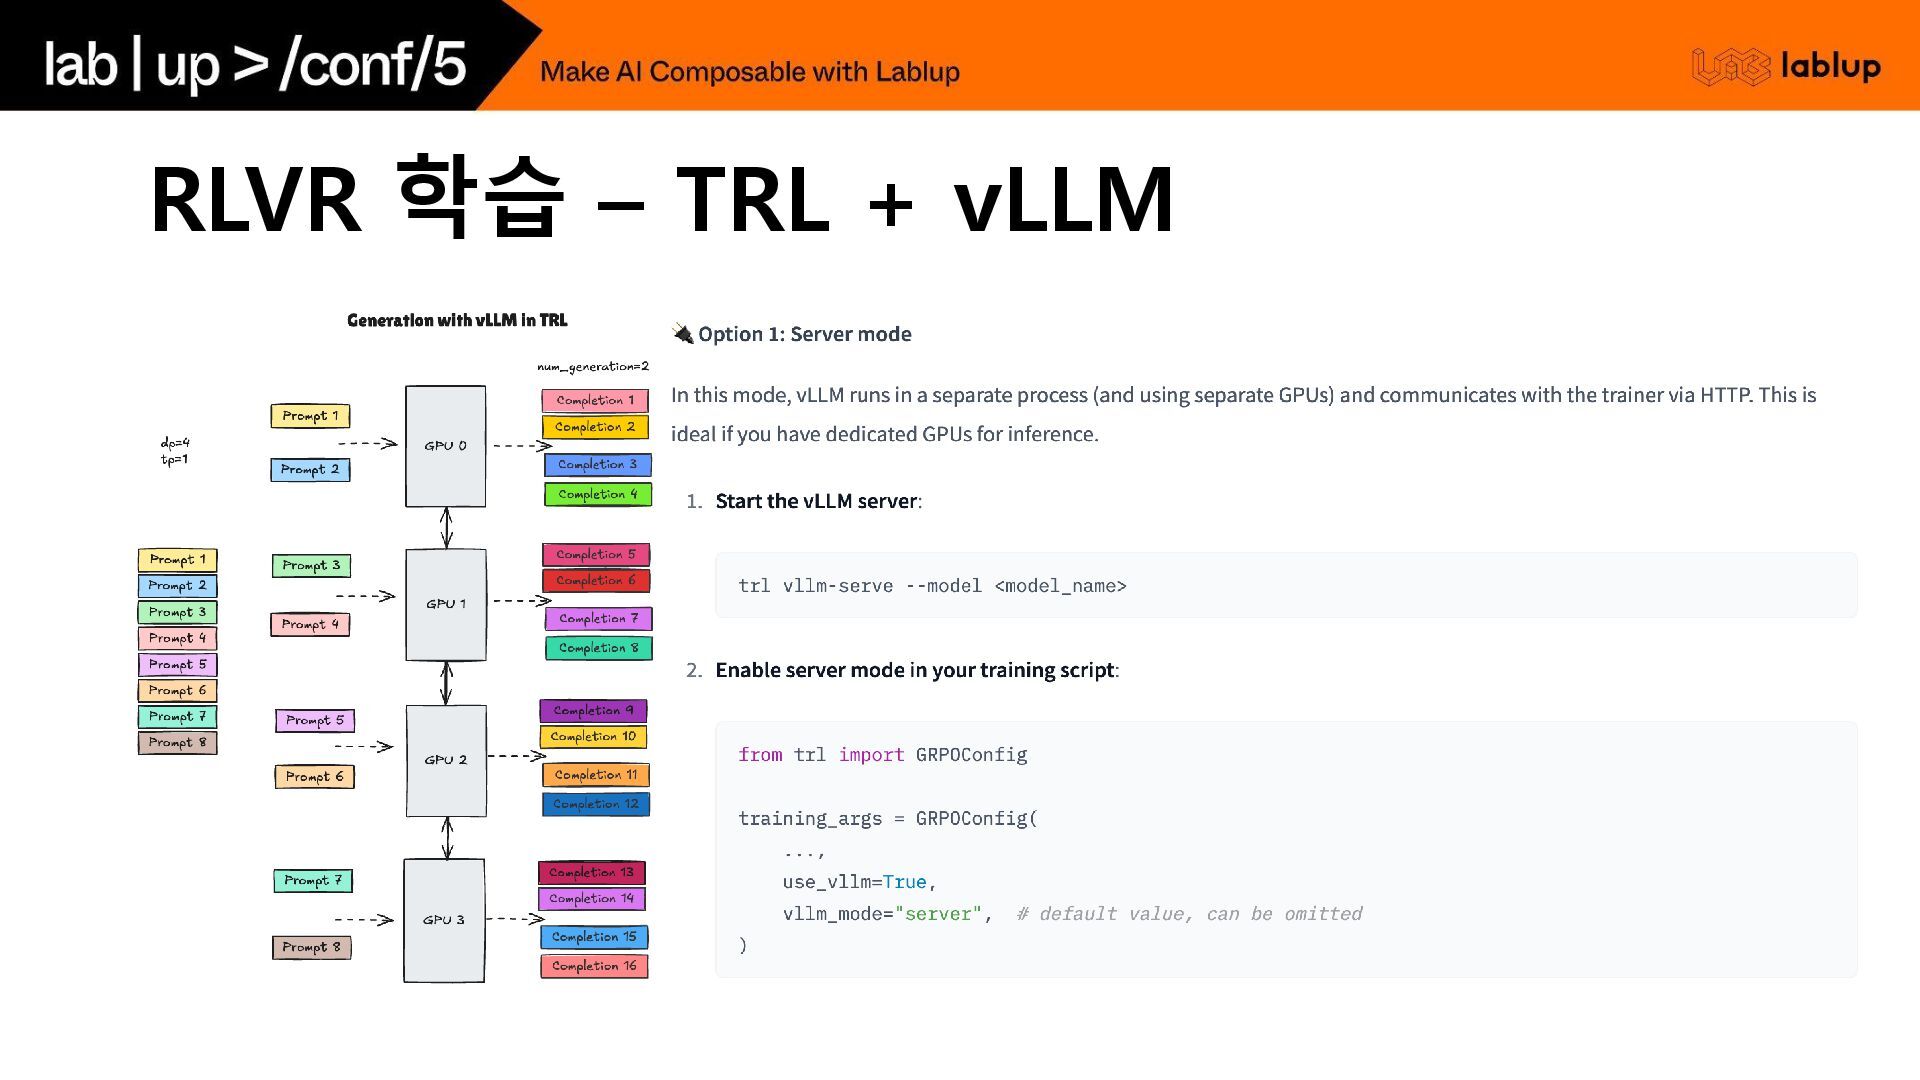
RLVR 학습 – TRL + vLLM
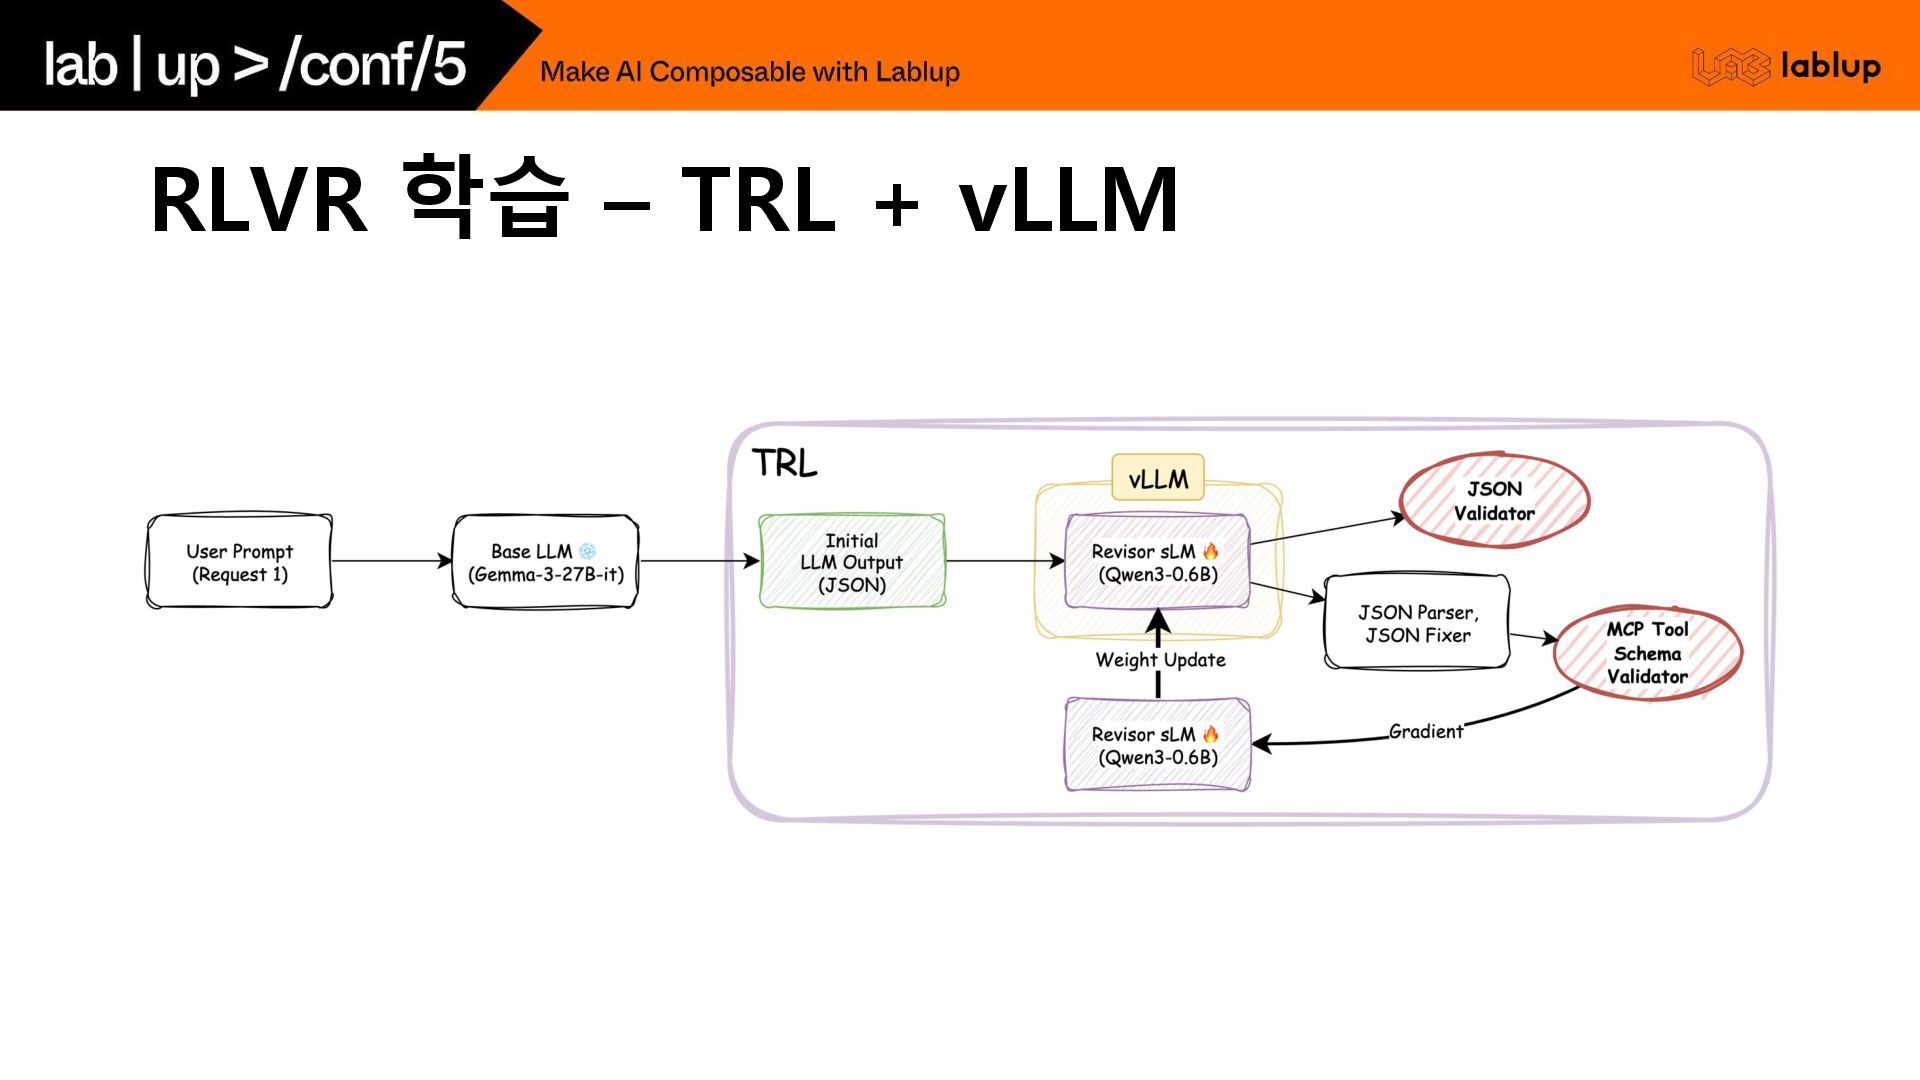
RLVR 학습 – TRL + vLLM
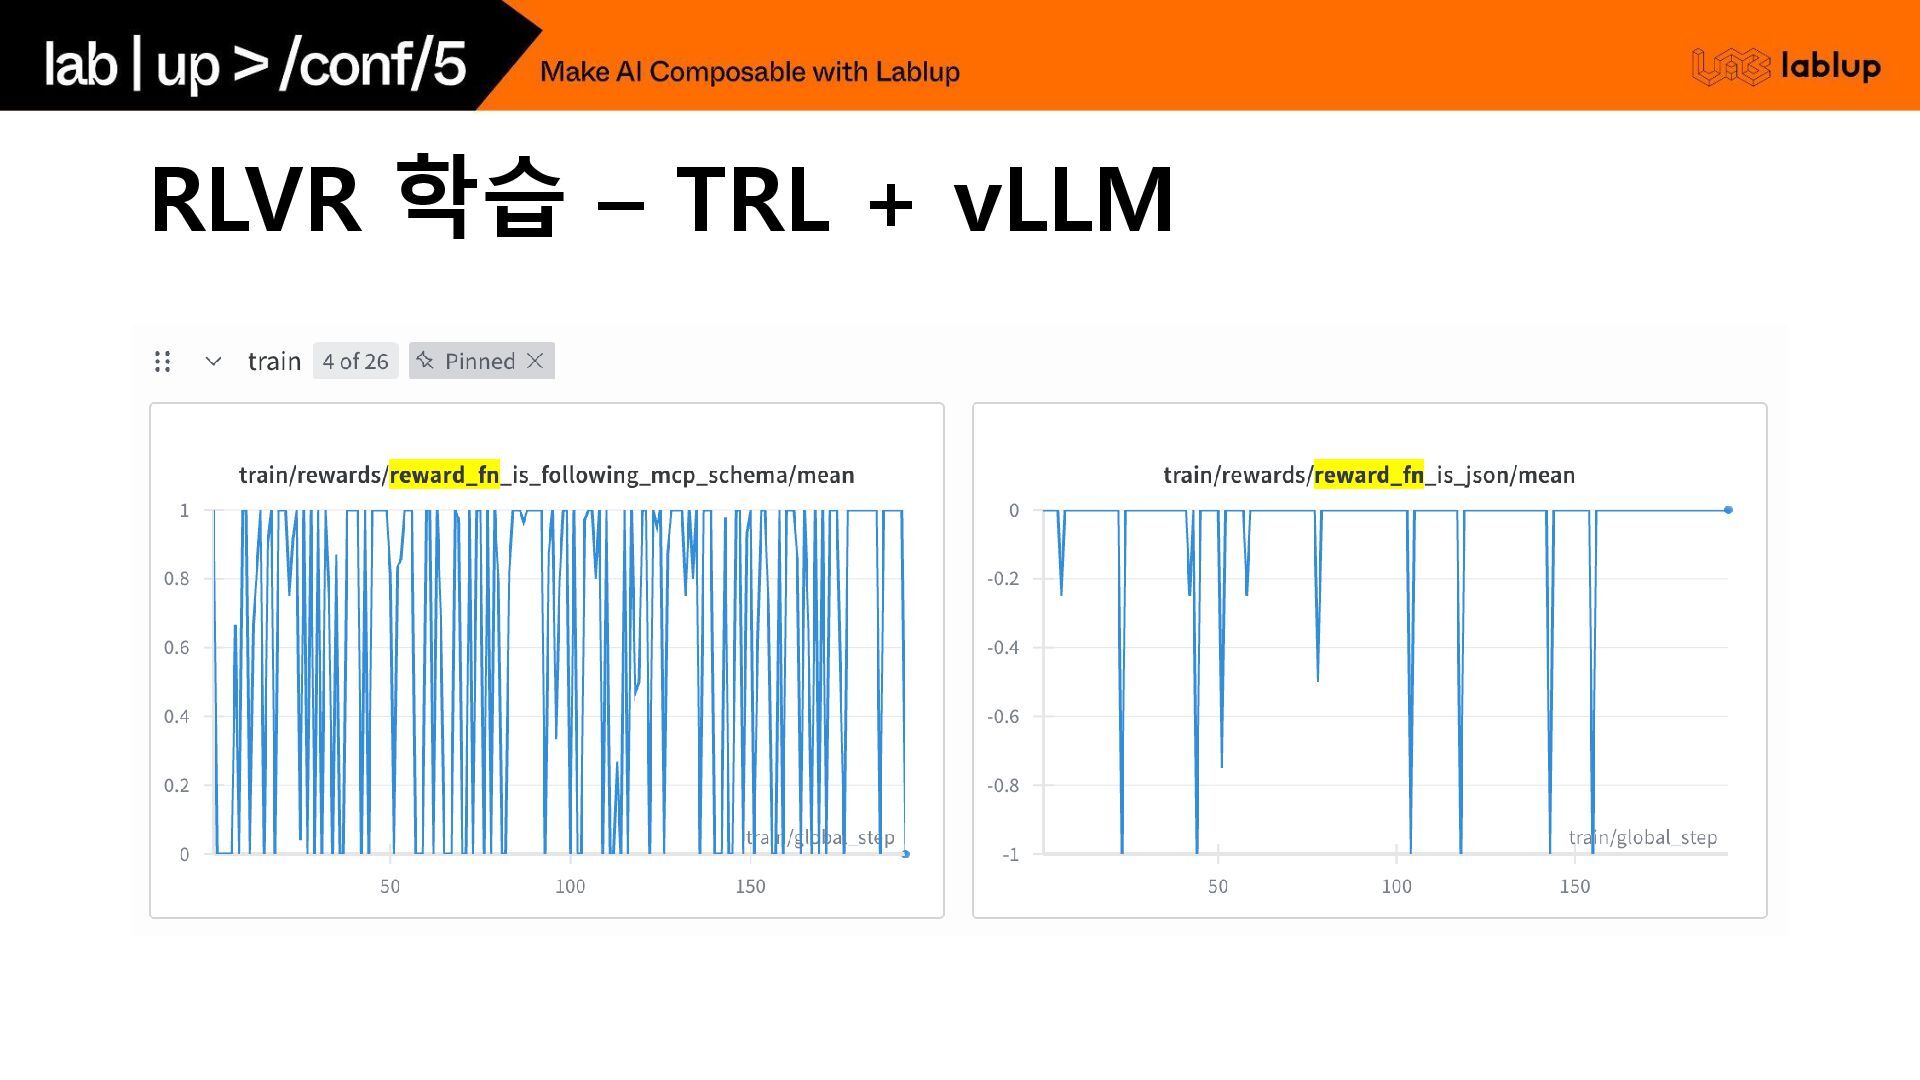
RLVR 학습 – TRL + vLLM
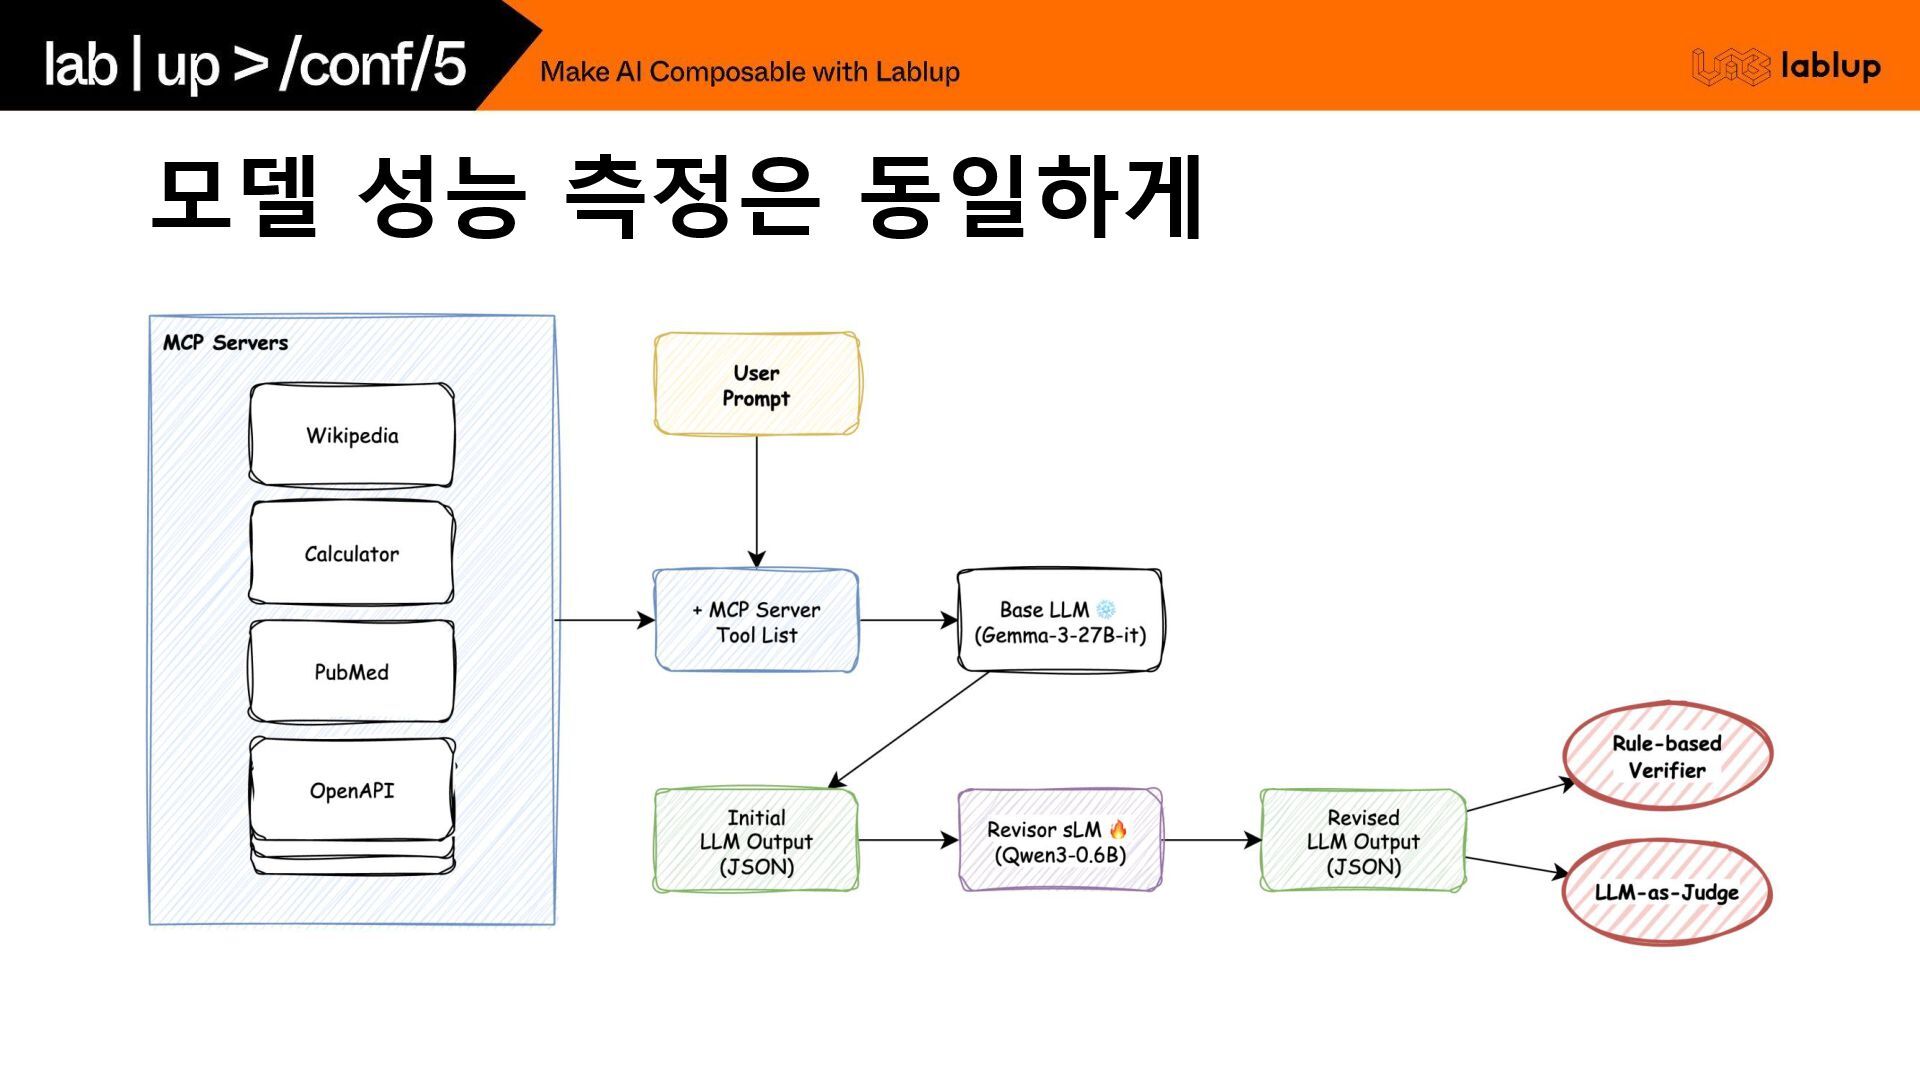
모델 성능 측정은 동일하게
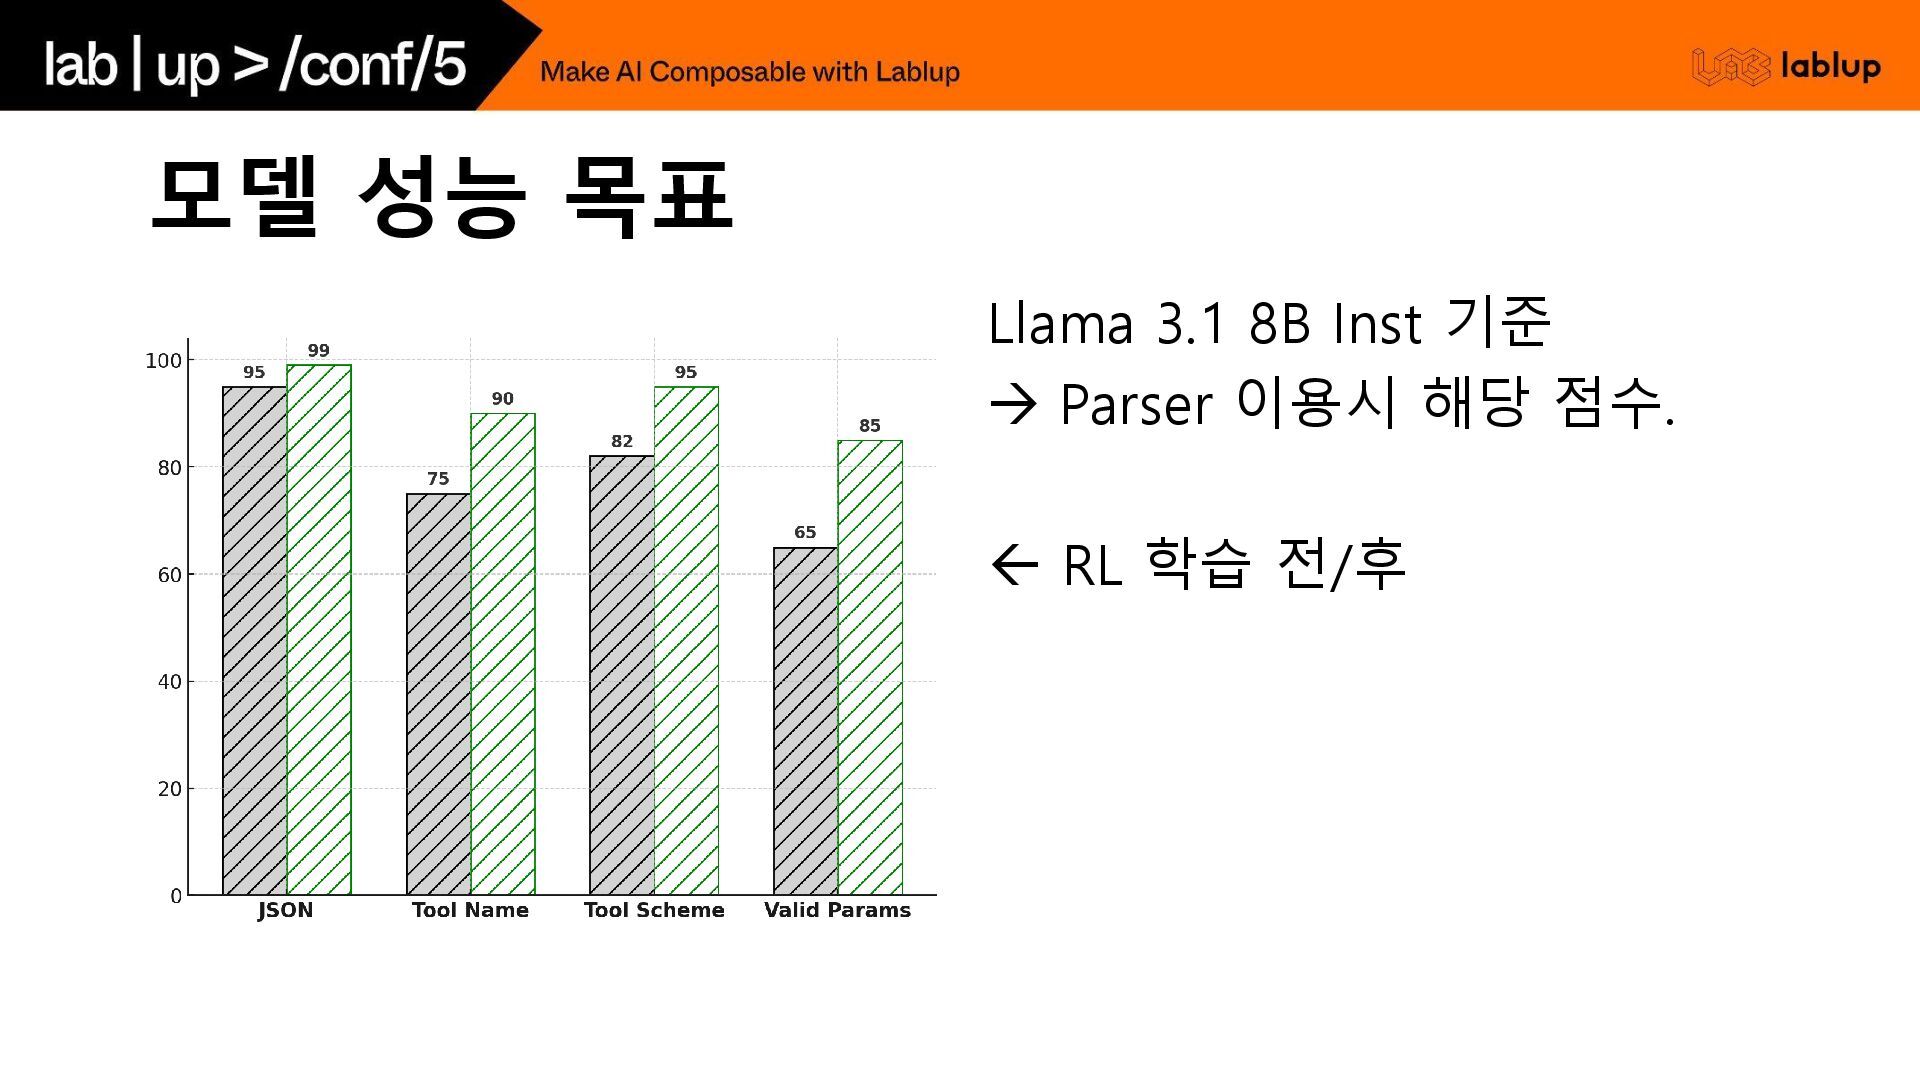
모델 성능 목표 Llama 3.1 8B Inst 기준 → Parser
이용시 해당 점수. RL 학습 전/후
Todo - ing
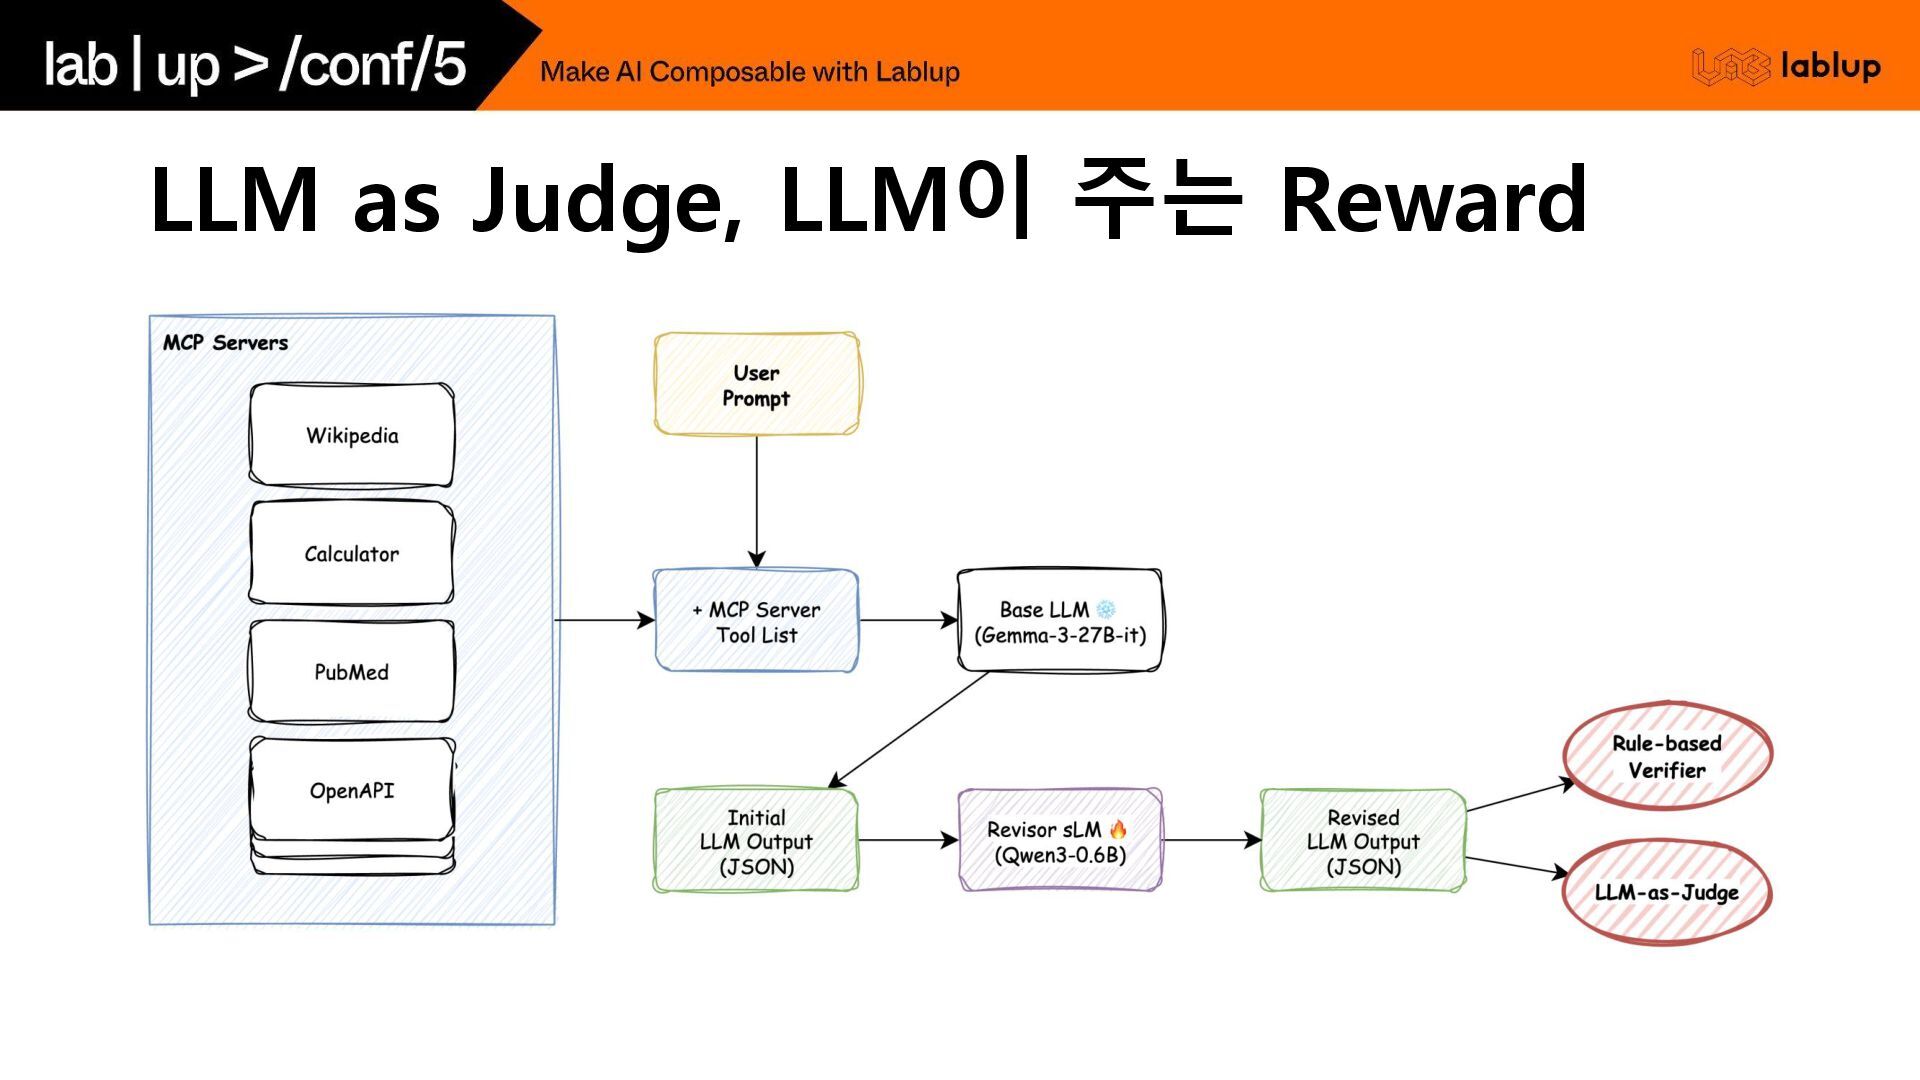
LLM as Judge, LLM이 주는 Reward
RLVR 학습 – VERL
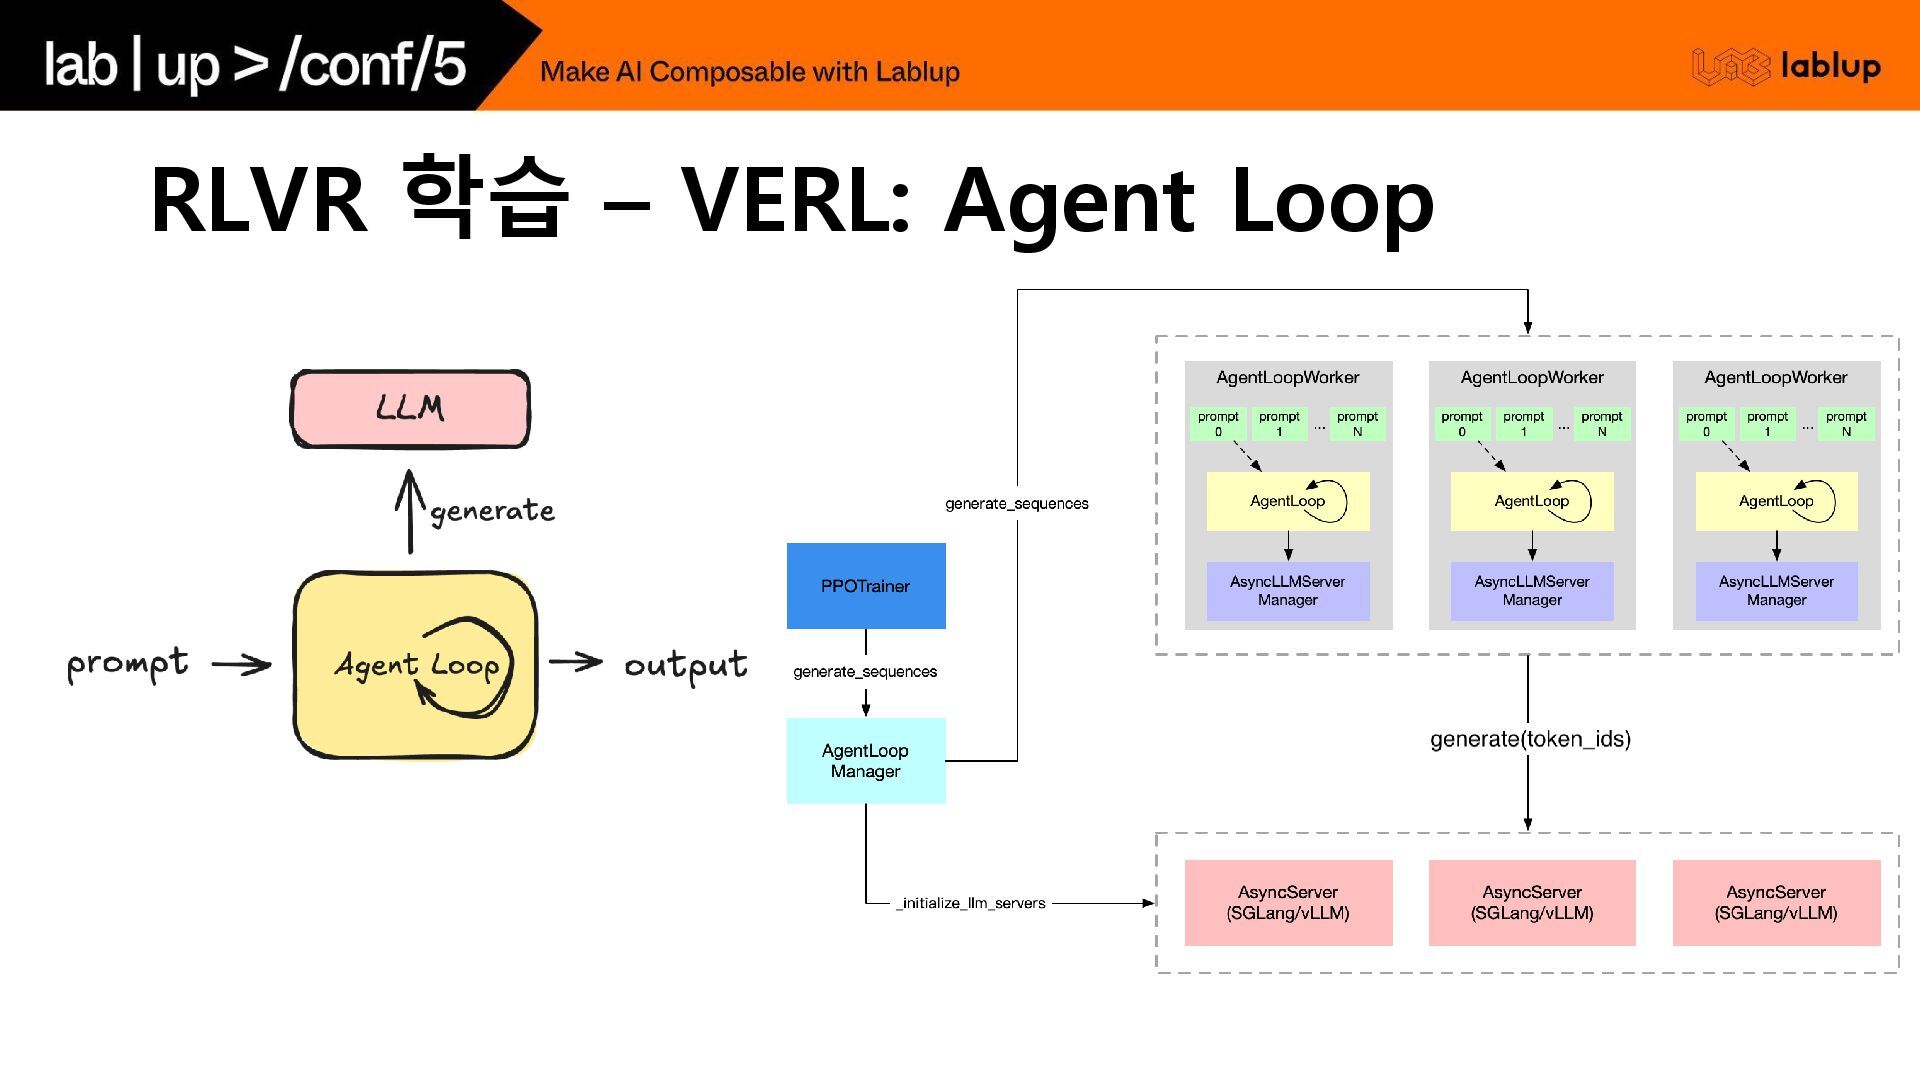
RLVR 학습 – VERL: Agent Loop
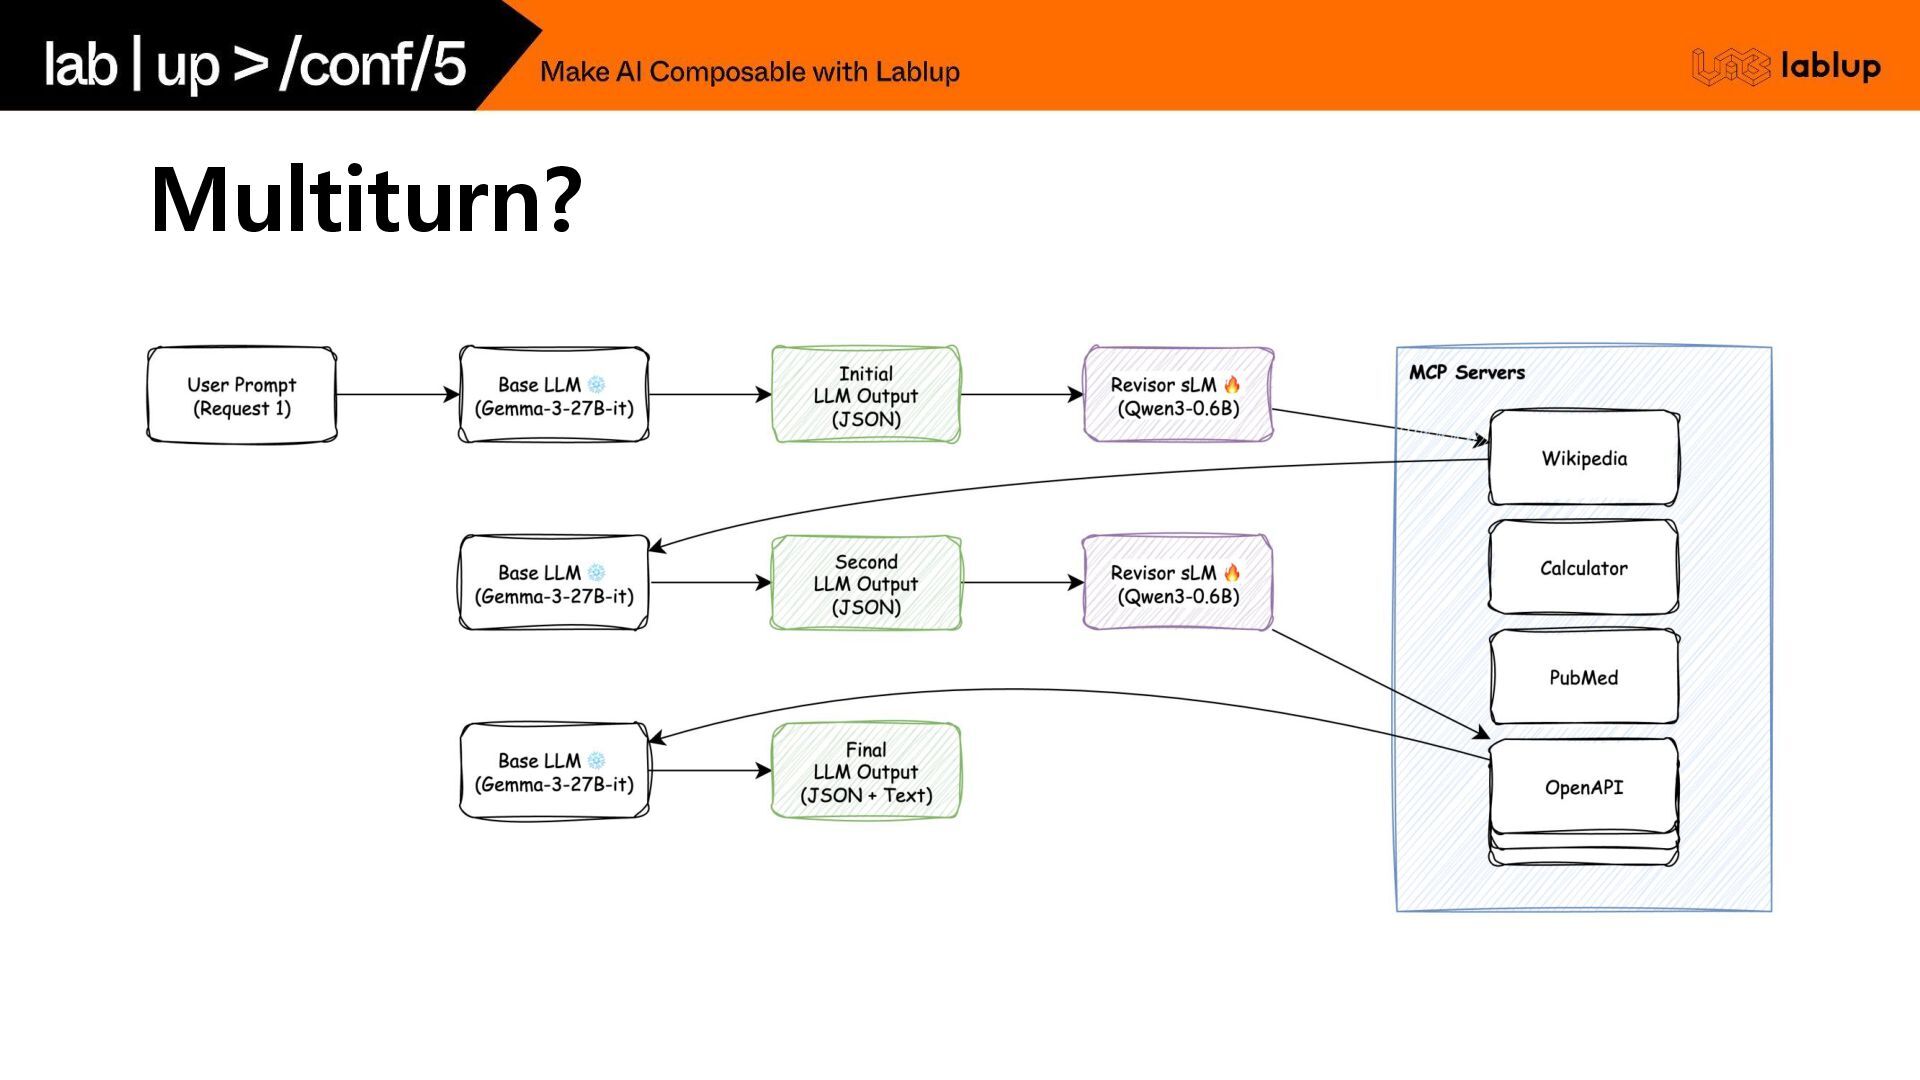
Multiturn?
None


 lablup
 3n
 apolaine
 gurzu
 tammyeverts
 honnibal
 reverentgeek
 samtorres
 akihiro_kokubo
 62gerente
 philnash
 ivargrimstad
 codingconduct