Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Kafka Streams

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →

Kafka Streams

Material used for presentation of the theme Kafka Streams na Objective Solutions. This presentation is the result of a challenge that consisted of picking up an unknown random theme suggested by someone from the team to present, so I would have a few days to study the subject and present it to the rest of the team.

Avatar for laercio

laercio

June 11, 2019

Other Decks in Programming

Transcript

  1. O Desafio Pesquisar e falar sobre um assunto de pouco

    ou nenhum conhecimento, sugerido por alguém do time, no Tech Jam da empresa
  2. Kafka Streams O Kafka Streams é uma biblioteca para construir

    aplicativos e microsserviços, onde os dados de entrada e saída são armazenados em clusters Kafka.
  3. Uma plataforma de streaming (fluxo de dados) tem três recursos

    principais: 1. Publicar e inscrever-se em fluxos de dados 2. Armazenar fluxos de dados de uma maneira durável e tolerante a falhas 3. Processar fluxos de dados conforme ocorrem
  4. O Kafka é geralmente usado para duas grandes classes de

    aplicações: Construir pipelines de fluxo de dados em tempo real que obtêm dados entre sistemas ou aplicações de maneira confiável Construir aplicações de fluxo de dados em tempo real que transformam ou reagem aos fluxos de dados
  5. Para entender como Kafka faz essas coisas, vamos mergulhar e

    explorar os recursos de Kafka de baixo para cima.
  6. Primeiro alguns conceitos O Kafka é executado como um cluster

    em um ou mais servidores que podem abranger vários datacenters; O cluster Kafka armazena fluxos de registros em categorias denominadas tópicos; Cada registro consiste de uma chave, um valor e um registro de data e hora (timestamp);
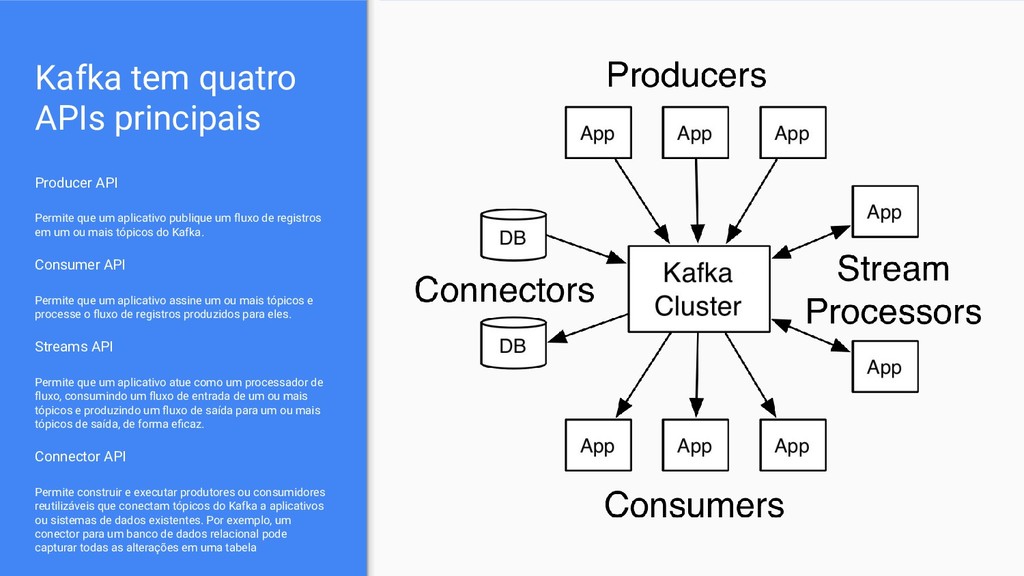
  7. Kafka tem quatro APIs principais Producer API Permite que um

    aplicativo publique um fluxo de registros em um ou mais tópicos do Kafka. Consumer API Permite que um aplicativo assine um ou mais tópicos e processe o fluxo de registros produzidos para eles. Streams API Permite que um aplicativo atue como um processador de fluxo, consumindo um fluxo de entrada de um ou mais tópicos e produzindo um fluxo de saída para um ou mais tópicos de saída, de forma eficaz. Connector API Permite construir e executar produtores ou consumidores reutilizáveis que conectam tópicos do Kafka a aplicativos ou sistemas de dados existentes. Por exemplo, um conector para um banco de dados relacional pode capturar todas as alterações em uma tabela
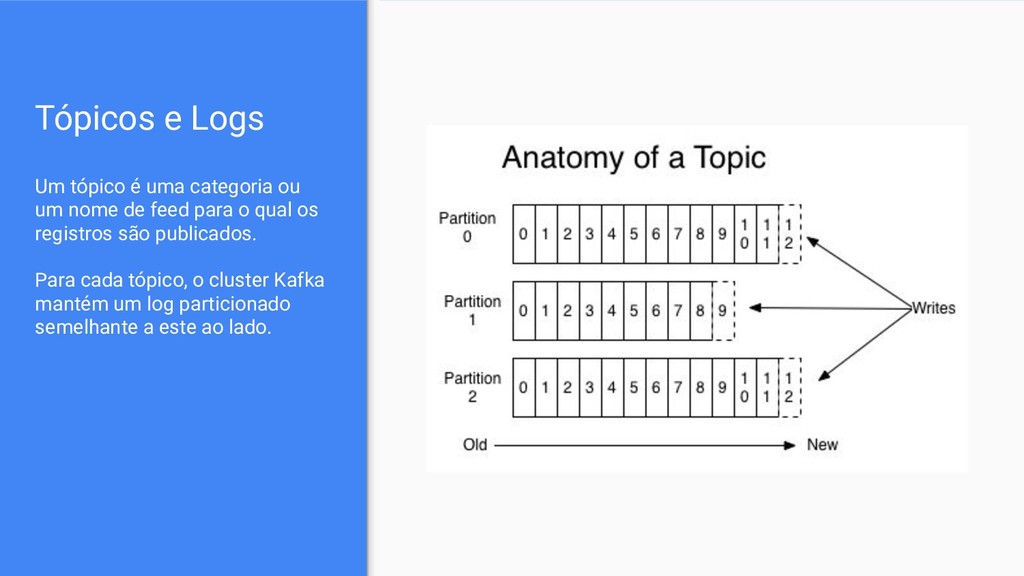
  8. Tópicos e Logs Um tópico é uma categoria ou um

    nome de feed para o qual os registros são publicados. Para cada tópico, o cluster Kafka mantém um log particionado semelhante a este ao lado.
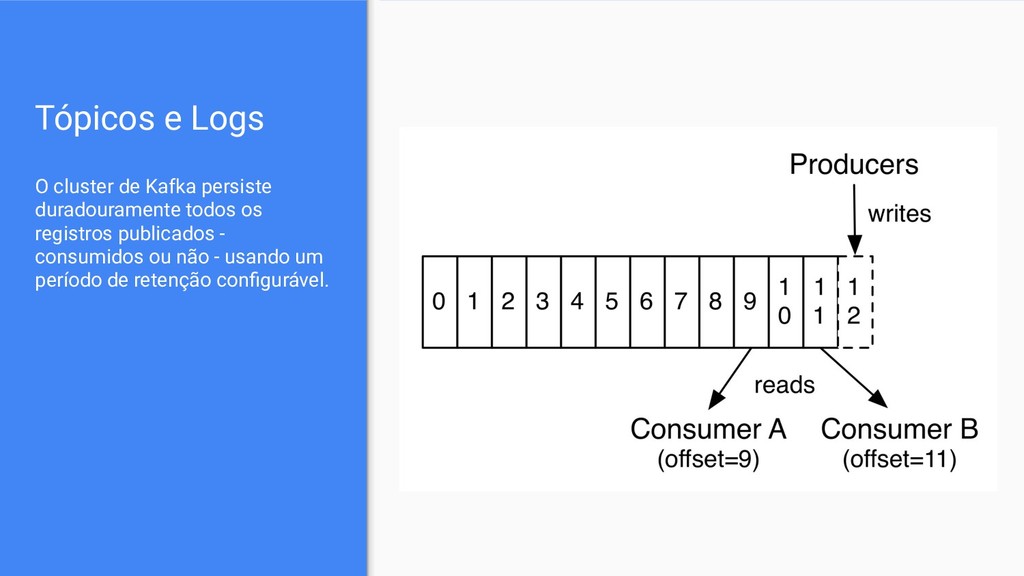
  9. Tópicos e Logs O cluster de Kafka persiste duradouramente todos

    os registros publicados - consumidos ou não - usando um período de retenção configurável.
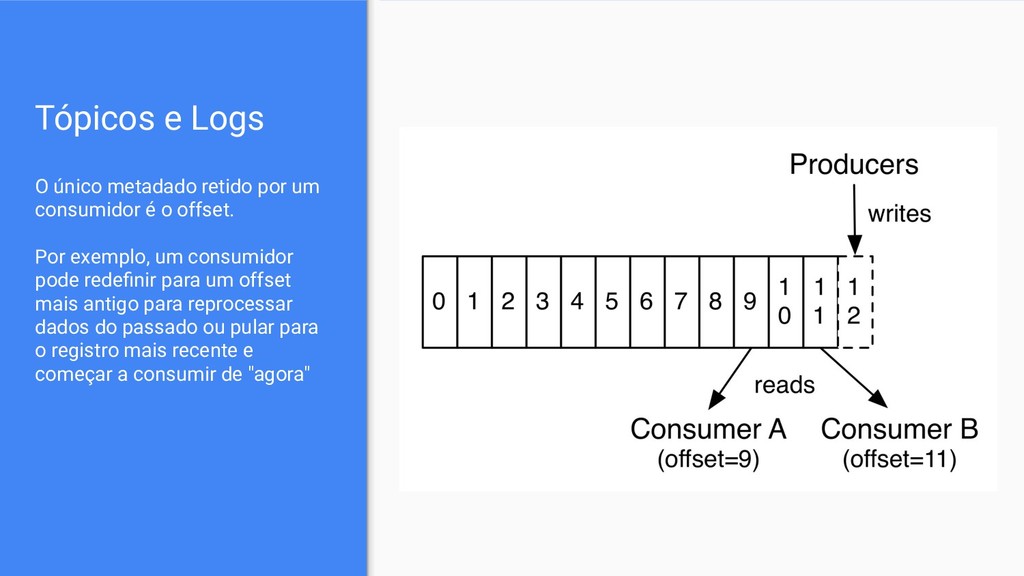
  10. Tópicos e Logs O único metadado retido por um consumidor

    é o offset. Por exemplo, um consumidor pode redefinir para um offset mais antigo para reprocessar dados do passado ou pular para o registro mais recente e começar a consumir de "agora"
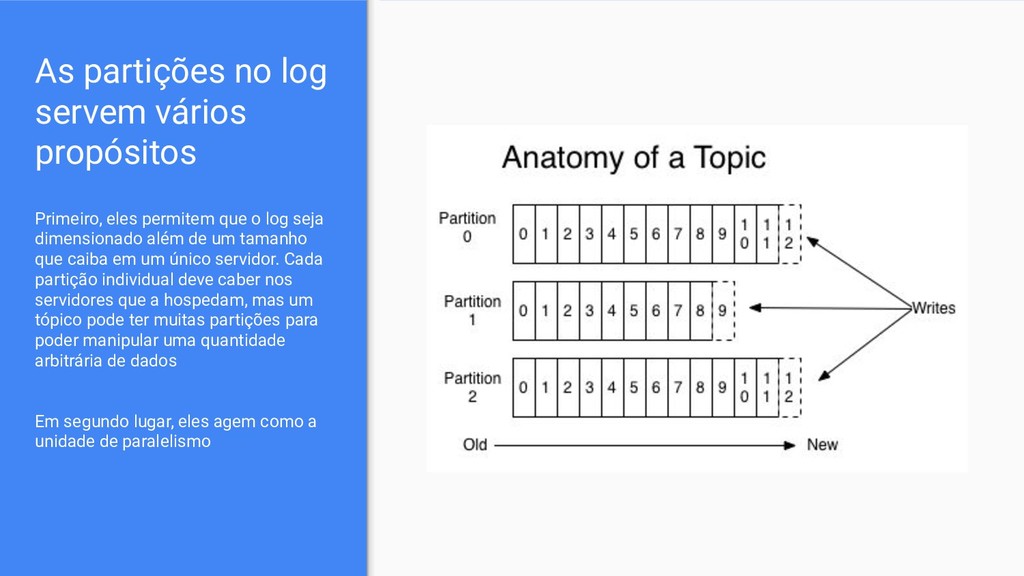
  11. As partições no log servem vários propósitos Primeiro, eles permitem

    que o log seja dimensionado além de um tamanho que caiba em um único servidor. Cada partição individual deve caber nos servidores que a hospedam, mas um tópico pode ter muitas partições para poder manipular uma quantidade arbitrária de dados Em segundo lugar, eles agem como a unidade de paralelismo
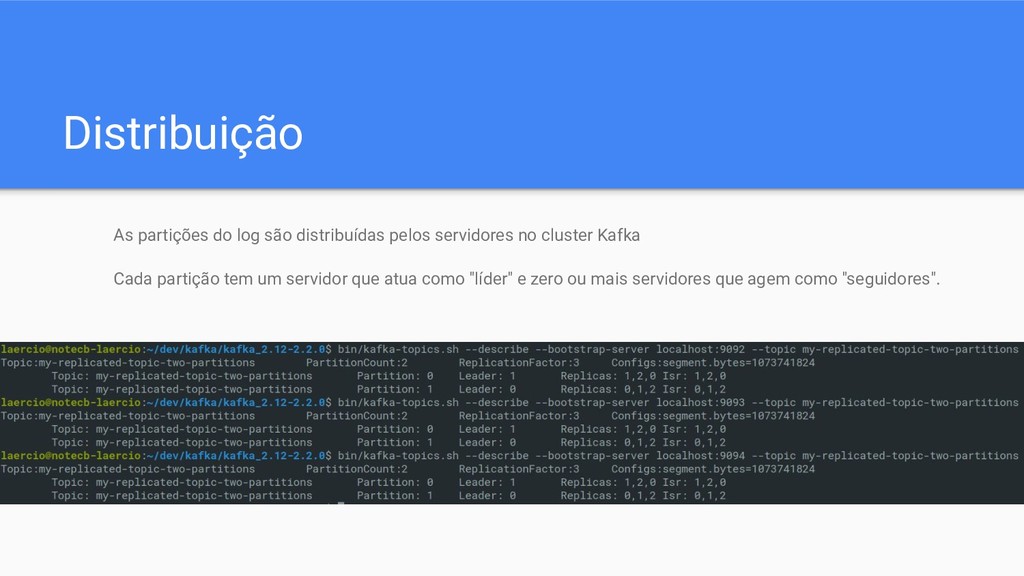
  12. Distribuição As partições do log são distribuídas pelos servidores no

    cluster Kafka Cada partição tem um servidor que atua como "líder" e zero ou mais servidores que agem como "seguidores".
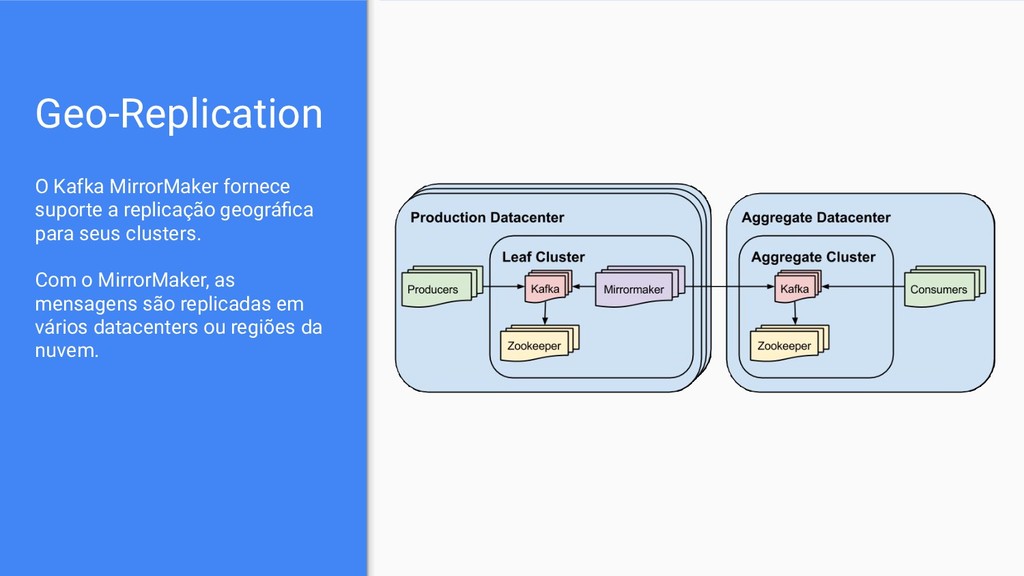
  13. Geo-Replication O Kafka MirrorMaker fornece suporte a replicação geográfica para

    seus clusters. Com o MirrorMaker, as mensagens são replicadas em vários datacenters ou regiões da nuvem.
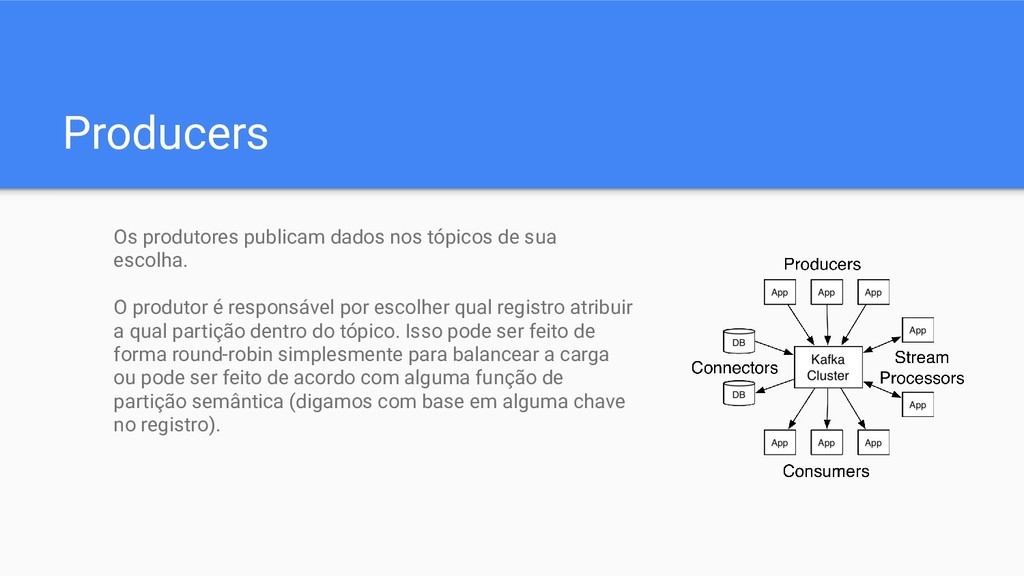
  14. Os produtores publicam dados nos tópicos de sua escolha. O

    produtor é responsável por escolher qual registro atribuir a qual partição dentro do tópico. Isso pode ser feito de forma round-robin simplesmente para balancear a carga ou pode ser feito de acordo com alguma função de partição semântica (digamos com base em alguma chave no registro). Producers
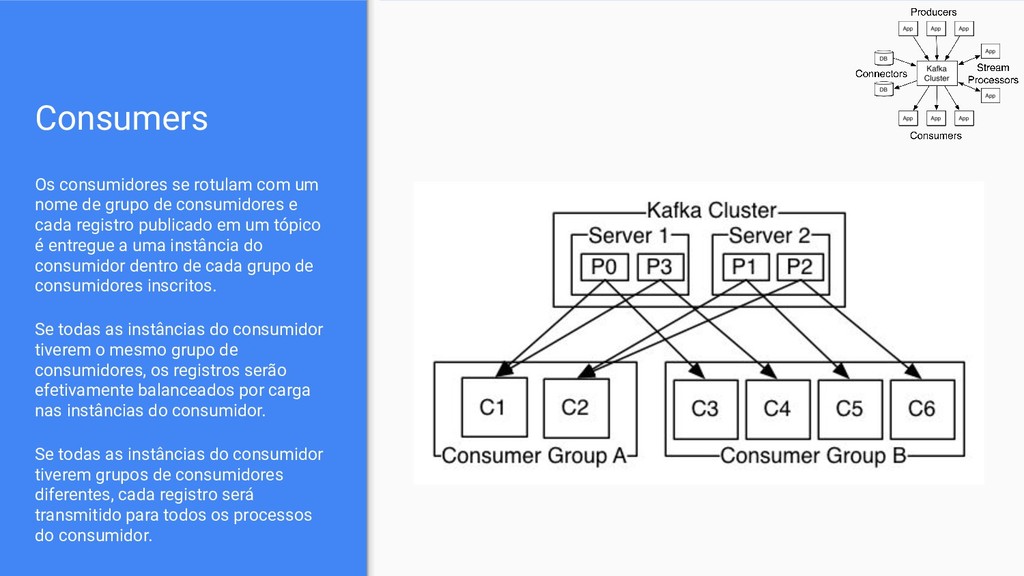
  15. Consumers Os consumidores se rotulam com um nome de grupo

    de consumidores e cada registro publicado em um tópico é entregue a uma instância do consumidor dentro de cada grupo de consumidores inscritos. Se todas as instâncias do consumidor tiverem o mesmo grupo de consumidores, os registros serão efetivamente balanceados por carga nas instâncias do consumidor. Se todas as instâncias do consumidor tiverem grupos de consumidores diferentes, cada registro será transmitido para todos os processos do consumidor.
  16. Kafka como sistema de mensagens e armazenamento O sistema de

    mensagens tradicionalmente possui dois modelos: enfileiramento e publicação-assinatura O conceito de grupo de consumidores em Kafka generaliza esses dois conceitos. Os dados gravados no Kafka são gravados no disco e replicados para tolerância a falhas A estrutura de disco do Kafka é escalável - o Kafka terá o mesmo desempenho se você tiver 50KB ou 50TB de dados gravados no servidor
  17. Kafka para processamento de fluxo (Stream Processing) Por exemplo, um

    aplicativo de varejo; Se baseia nas primitivas principais fornecidas pelo Kafka: ele usa as APIs de produtor e consumidor para entrada, usa o Kafka para armazenar com estado e usa o mesmo mecanismo de grupo para tolerância a falhas entre as instâncias do processador de fluxo; Se baseia em conceitos importantes de processamento de fluxo, como a distinção adequada entre tempo de evento e tempo de processamento, suporte a janelas e gerenciamento simples, porém eficiente, e consulta em tempo real do estado do aplicativo.
  18. O Kafka Streams é uma biblioteca cliente para construir aplicativos

    e microsserviços, onde os dados de entrada e saída são armazenados em clusters Kafka
  19. Kafka Streams API - Destaques • Simple and lightweight client

    library • No external dependencies on systems other than Apache Kafka itself • Fault-tolerant local state (que permite operações com estado muito rápidas) • Exactly-once • One-record-at-a-time processing (para obter latência de processamento em milissegundos) • High-level Streams DSL
  20. Kafka Streams API - Conceitos Basicos • Stream Processing Topology

    • Time • Aggregations • Windowing • Duality of Streams and Tables • States • PROCESSING GUARANTEES • Out-of-Order Handling
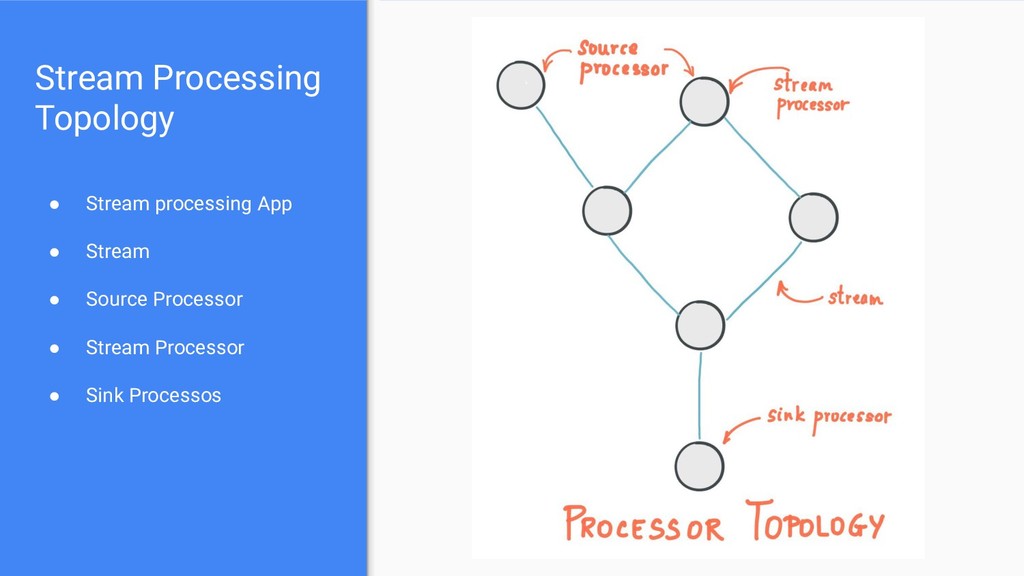
  21. Stream Processing Topology • Stream processing App • Stream •

    Source Processor • Stream Processor • Sink Processos
  22. Aggregations Uma operação de agregação usa um fluxo ou tabela

    de entrada e gera uma nova tabela combinando vários registros de entrada em um único registro de saída. Exemplos de agregações são contagens ou soma.
  23. Windowing Windowing permite controlar como um grupo de registros que

    possuem a mesma chave, para operações com estado, como agregações ou junções, em janelas.
  24. Duality of Streams and Tables Há uma relação próxima entre

    streams e tabelas E Kafka explora essa dualidade de várias maneiras: por exemplo, para tornar seus aplicativos elásticos, para suportar processamento com estado tolerante a falhas ou para executar consultas interativas com os resultados de processamento mais recentes de seu aplicativo.
  25. States O Kafka Streams fornece os chamados armazenamentos de estado,

    que podem ser usados por aplicativos de processamento de streams para armazenar e consultar dados Consultas interativas
  26. Out-of-Order Handling Causas: Dentro de uma partição de tópico, o

    timestamp de um registro pode não estar aumentando monotonicamente junto com seus offsets. Em uma tarefa de stream que pode estar processando várias partições de tópico;