Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
不均衡データ分析入門
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Yuichiro Kobayashi
October 03, 2026
Science
64
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
不均衡データ分析入門
LETメソドロジー研究部会(2026年10月3日)
Yuichiro Kobayashi
October 03, 2026
More Decks by Yuichiro Kobayashi
See All by Yuichiro Kobayashi
機械学習による言語パフォーマンスの評価
langstat
7
1.2k
授業評価アンケートのテキストマイニング
langstat
2
490
この脅迫状を書いたのは誰か? コンピュータが明らかにする「文章の指紋」
langstat
1
1.4k
J-POPの歌詞から見る社会 計量テキスト分析入門
langstat
3
2.3k
Other Decks in Science
See All in Science
暗号解読における量子計算の展望
neutron63zf
0
440
バランスって大事だね
akasan
1
150
データベース14: B+木 & ハッシュ索引
trycycle
PRO
0
960
[第67回 CV勉強会@関東] CV × Scientific Figures / kantoCV 67th CVPR 2026
lychee1223
0
250
Toward Causal Scientific Discovery with AI
sshimizu2006
0
210
[Relay webinaire eBIS actu n°16] Amélioration de la survie des JB avec la génétique - Introduction
institutdelelevage
PRO
0
180
データベース01: データベースを使わない世界
trycycle
PRO
1
1.5k
機械学習 - DBSCAN
trycycle
PRO
0
2.1k
ssmonline #51 ヤマサキ春のサメ祭り 2026 / ssmjp Yamasaki Spring JAWS Festival 2026
naospon
1
160
(CVPR2026) Back to Basics: Let Denoising Generative Models Denoise
shumpei777
0
390
「表象」を再定義するー潜在表現解析の落とし穴
ykamit
0
960
第67回コンピュータビジョン勉強会論文紹介「RoboWheel: A Data Engine from Real-World Human Demonstrations for Cross-Embodiment Robotic Learning」
x_ttyszk
0
230
Featured
See All Featured
Google's AI Overviews - The New Search
badams
0
1.6k
Tips & Tricks on How to Get Your First Job In Tech
honzajavorek
1
790
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
76k
The SEO Collaboration Effect
kristinabergwall1
1
590
Lessons Learnt from Crawling 1000+ Websites
charlesmeaden
PRO
1
1.6k
The Psychology of Web Performance [Beyond Tellerrand 2023]
tammyeverts
49
3.6k
Designing for humans not robots
tammielis
254
26k
Optimizing for Happiness
mojombo
378
71k
Utilizing Notion as your number one productivity tool
mfonobong
4
610
GraphQLとの向き合い方2022年版
quramy
50
15k
Skip the Path - Find Your Career Trail
mkilby
1
240
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2k
Transcript
不均衡データ分析入門 小林 雄一郎 LETメソドロジー研究部会 2026年10月3日 1
問題意識 「この世界は不均衡」 言語データも教育データも、おおむね不均衡 そうであるなら、 不均衡なデータに適した分析方法が必要 2
発表の流れ • 不均衡データとは • 評価指標の再検討 • 分析手法の再検討 and more ...
3
はじめに • 本発表の一部は、以下の論文に基づく • Kobayashi, Y. (2026). Addressing imbalanced data
problems in corpus linguistics: A comparative evaluation. Methodology SIG Report Series, 19, 79–93. 4
不均衡データとは • 言語コーパスのデザインは、しばしば不均衡 • British National Corpus (BNC) の話し言葉データは全体の10%程度 ↓
• 現実世界では話し言葉の方が圧倒的に多く産出されるが、その収集・電子化 のコストが高い • ARCHER (A Representative Corpus of Historical English Registers) の British componentでは、17世紀前半の構成比率がわずか4.4%程度 ↓ • 古い時代の言語データを適切な代表性を持った形で集めることが難しい 5
• 学習者のデータも、往々にして不均衡 • NICT JLE Corpusでは、中級データが圧倒的に多く、初級と上級のデータが 相対的に少ない ↓ • 習熟度が正規分布すると仮定すれば、中級が多くなるのは当然
• Longitudinal Corpus of Spoken English (LOCSE) でも、中級データが圧倒的 に多く、上級データがほとんどない ↓ • 特定の教育機関で収集したことによる切断効果・選抜効果 6
• 何が問題なのか? • サブコーパスのサイズが大きく異なると、統計的な推定の精度や検定の妥当 性に重大な影響 ↓ • グループ間の分散の不均一性が生じることで、標準的な検定手法の前提条件 が満たされないリスク •
サイズの小さいサブコーパスの標準誤差が大きくなり、少数の特異なデータ が分析結果を歪めてしまうことで、推定が不安定になるリスク ↓ • 本来は存在しない差を有意と見なす、あるいは逆に、重要な言語的特徴を見 逃す、といった統計的な誤判断を招く恐れ 7
• 何が問題なのか?(続き) • 機械学習を用いたコーパス分析(テキストの書き手の推定、学習者の習熟度 推定など)でも大きな問題 ↓ • 統計モデルが学習を行う際、圧倒的なボリュームを占めるサブコーパスのパ ターンを優先的に学習してしまい、データの少ないサブコーパスの特徴を無 視、あるいは例外として切り捨ててしまう傾向
↓ • 全体の正解率は高くても、少数カテゴリーの予測精度が著しく低くなる恐れ (後述) 8
• より一般的な不均衡データ • クレジットカードの不正利用 • ガン診断 • スパムメール etc. •
いずれの場合も、検出すべき対象が圧倒的な少数派 • しかし、見逃してはならない 9
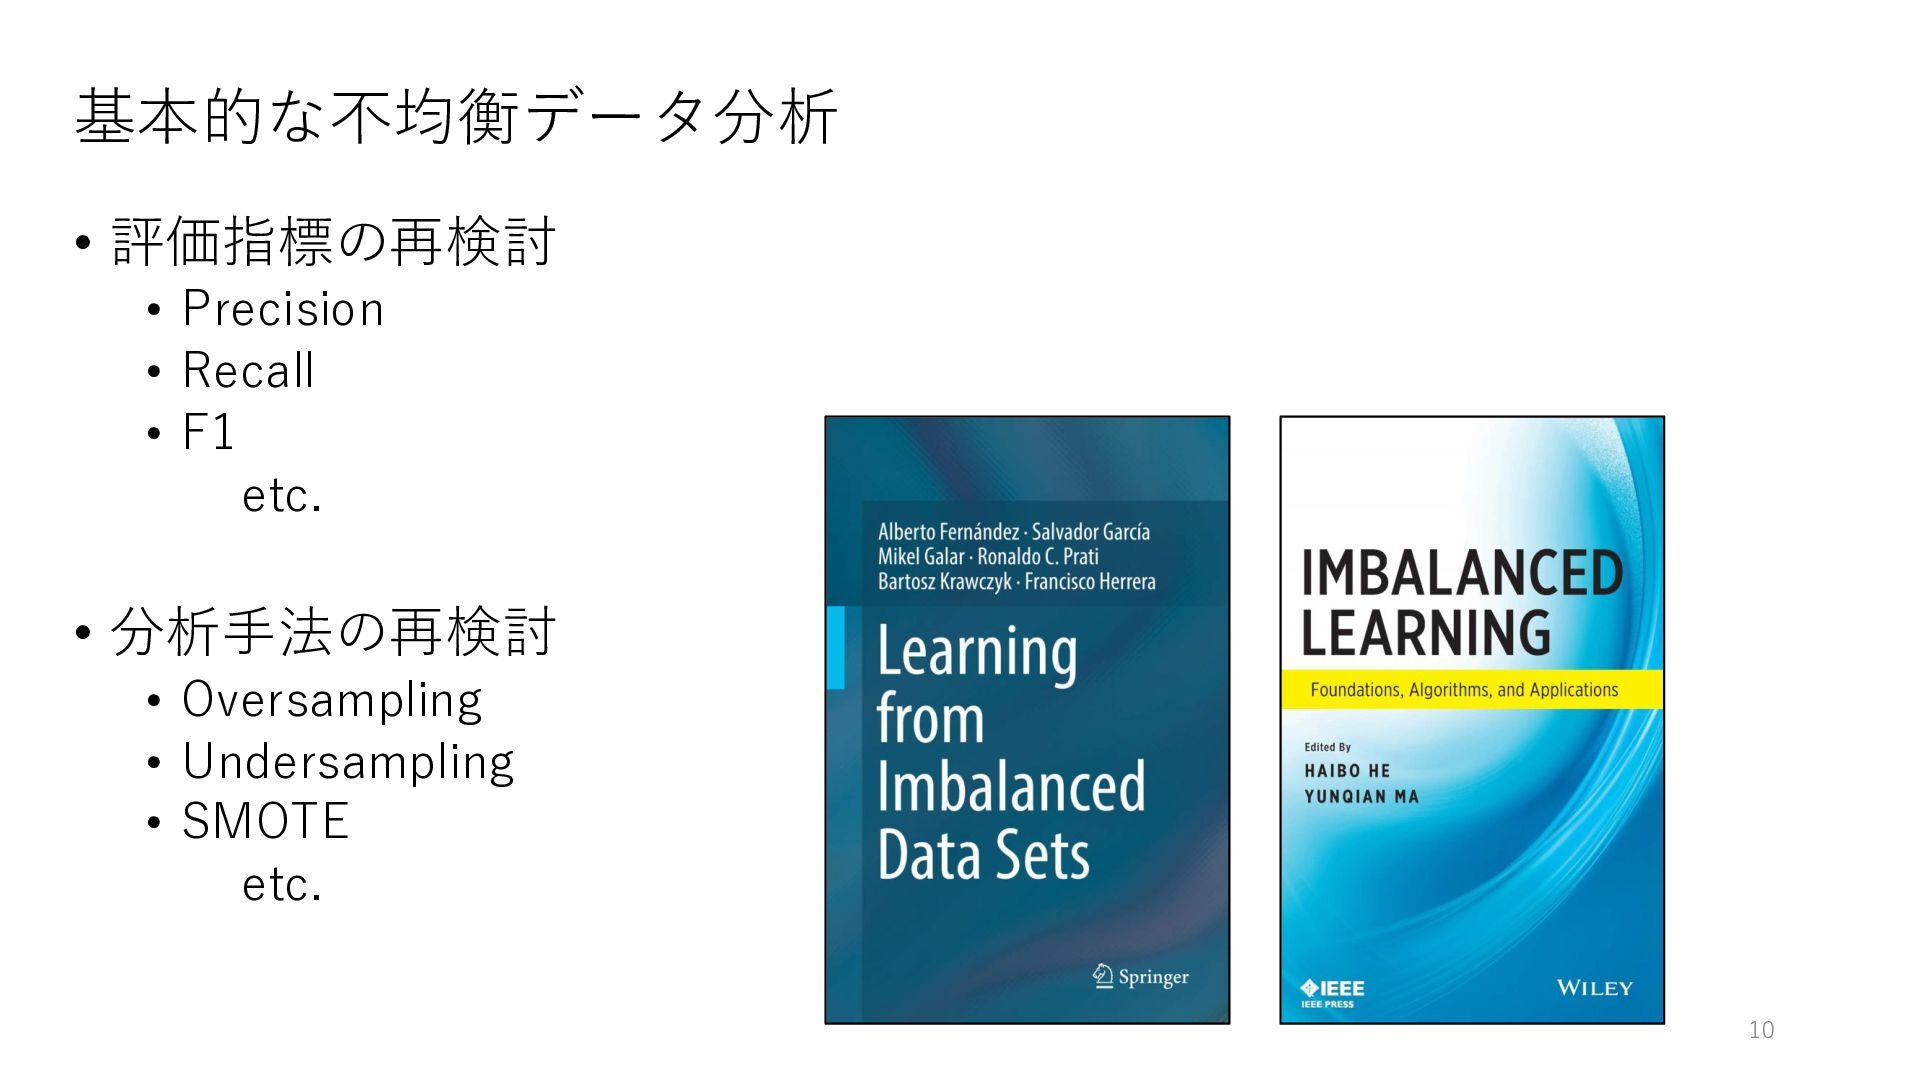
基本的な不均衡データ分析 • 評価指標の再検討 • Precision • Recall • F1 etc.
• 分析手法の再検討 • Oversampling • Undersampling • SMOTE etc. 10
評価指標の再検討 11
正解率(accuracy)の罠 • たとえば、データの99%が多数派クラスである場合、モデルが何も考えずに 「全て多数派」と予測するだけで正解率は99% ↓ • しかし、このモデルは1%しか存在しない重要な少数派を全く識別できていな い 12
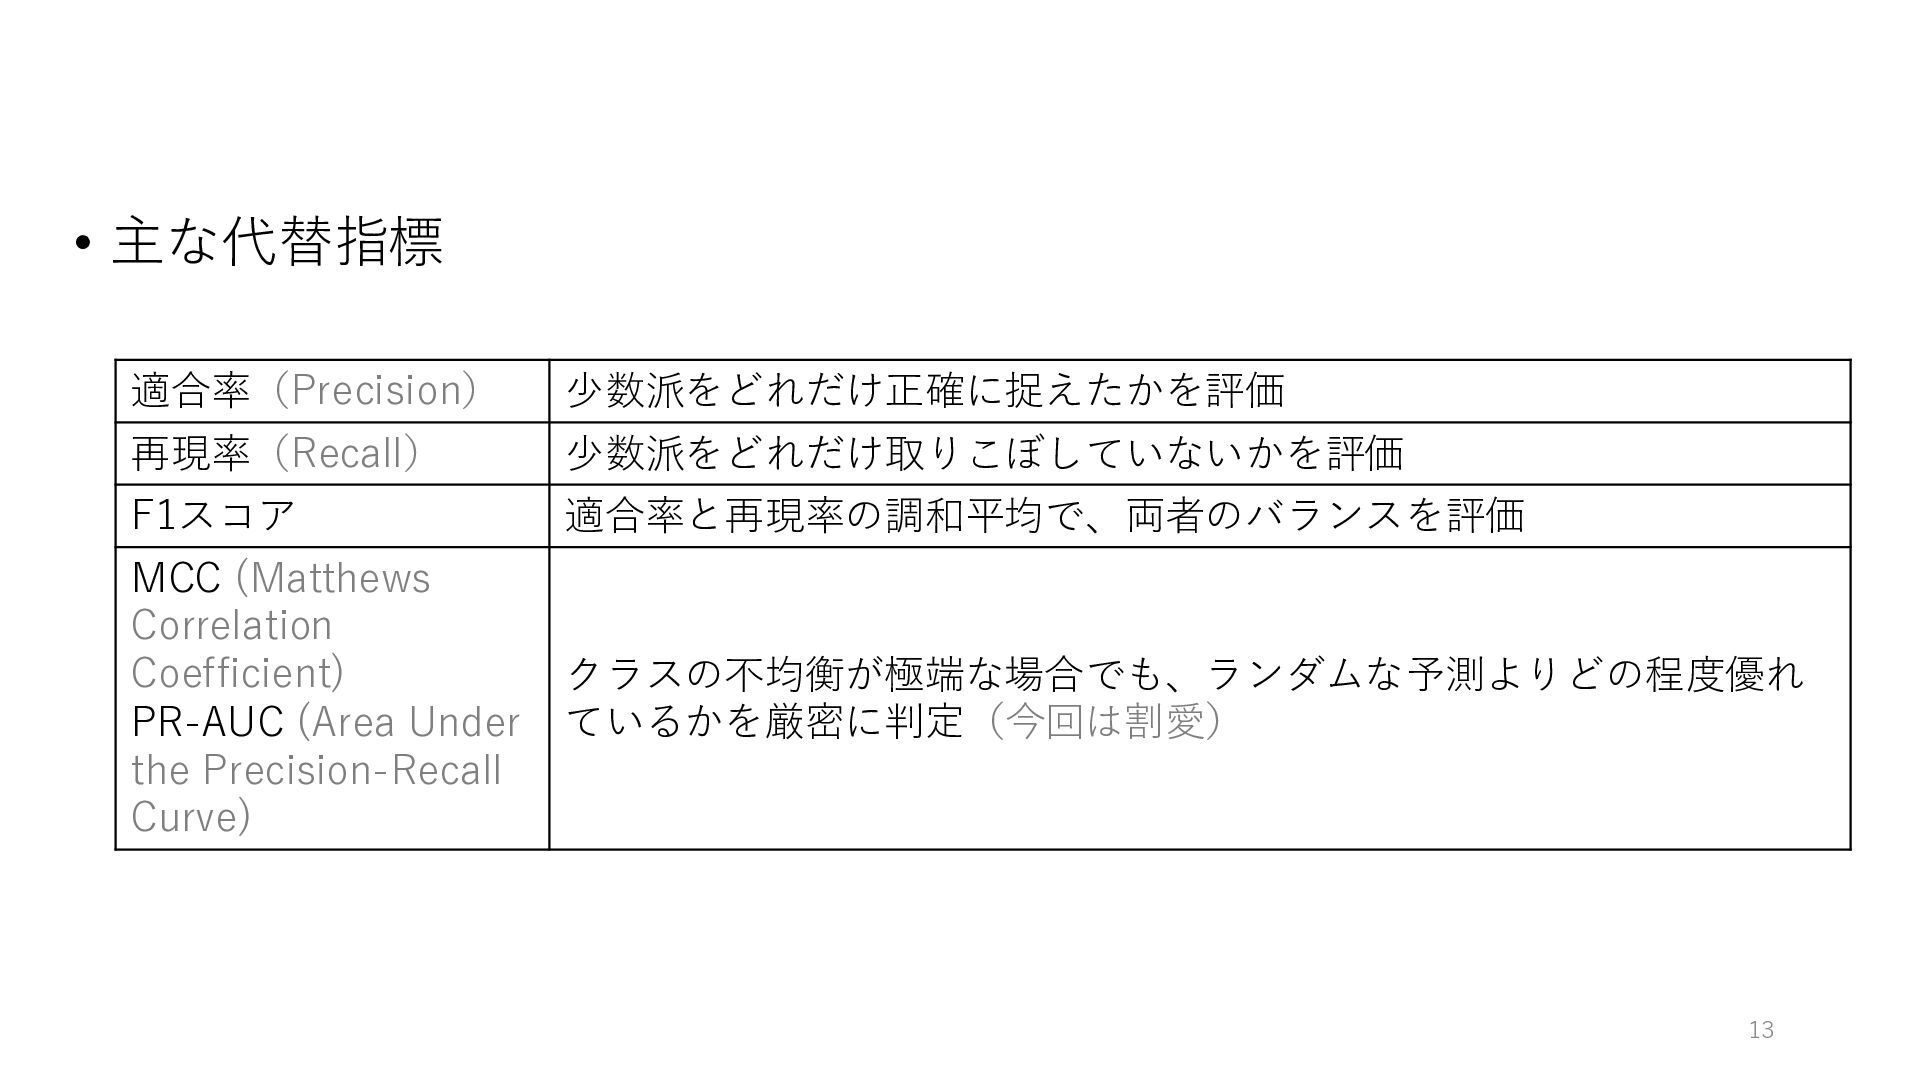
• 主な代替指標 適合率(Precision) 少数派をどれだけ正確に捉えたかを評価 再現率(Recall) 少数派をどれだけ取りこぼしていないかを評価 F1スコア 適合率と再現率の調和平均で、両者のバランスを評価 MCC (Matthews
Correlation Coefficient) PR-AUC (Area Under the Precision-Recall Curve) クラスの不均衡が極端な場合でも、ランダムな予測よりどの程度優れ ているかを厳密に判定(今回は割愛) 13
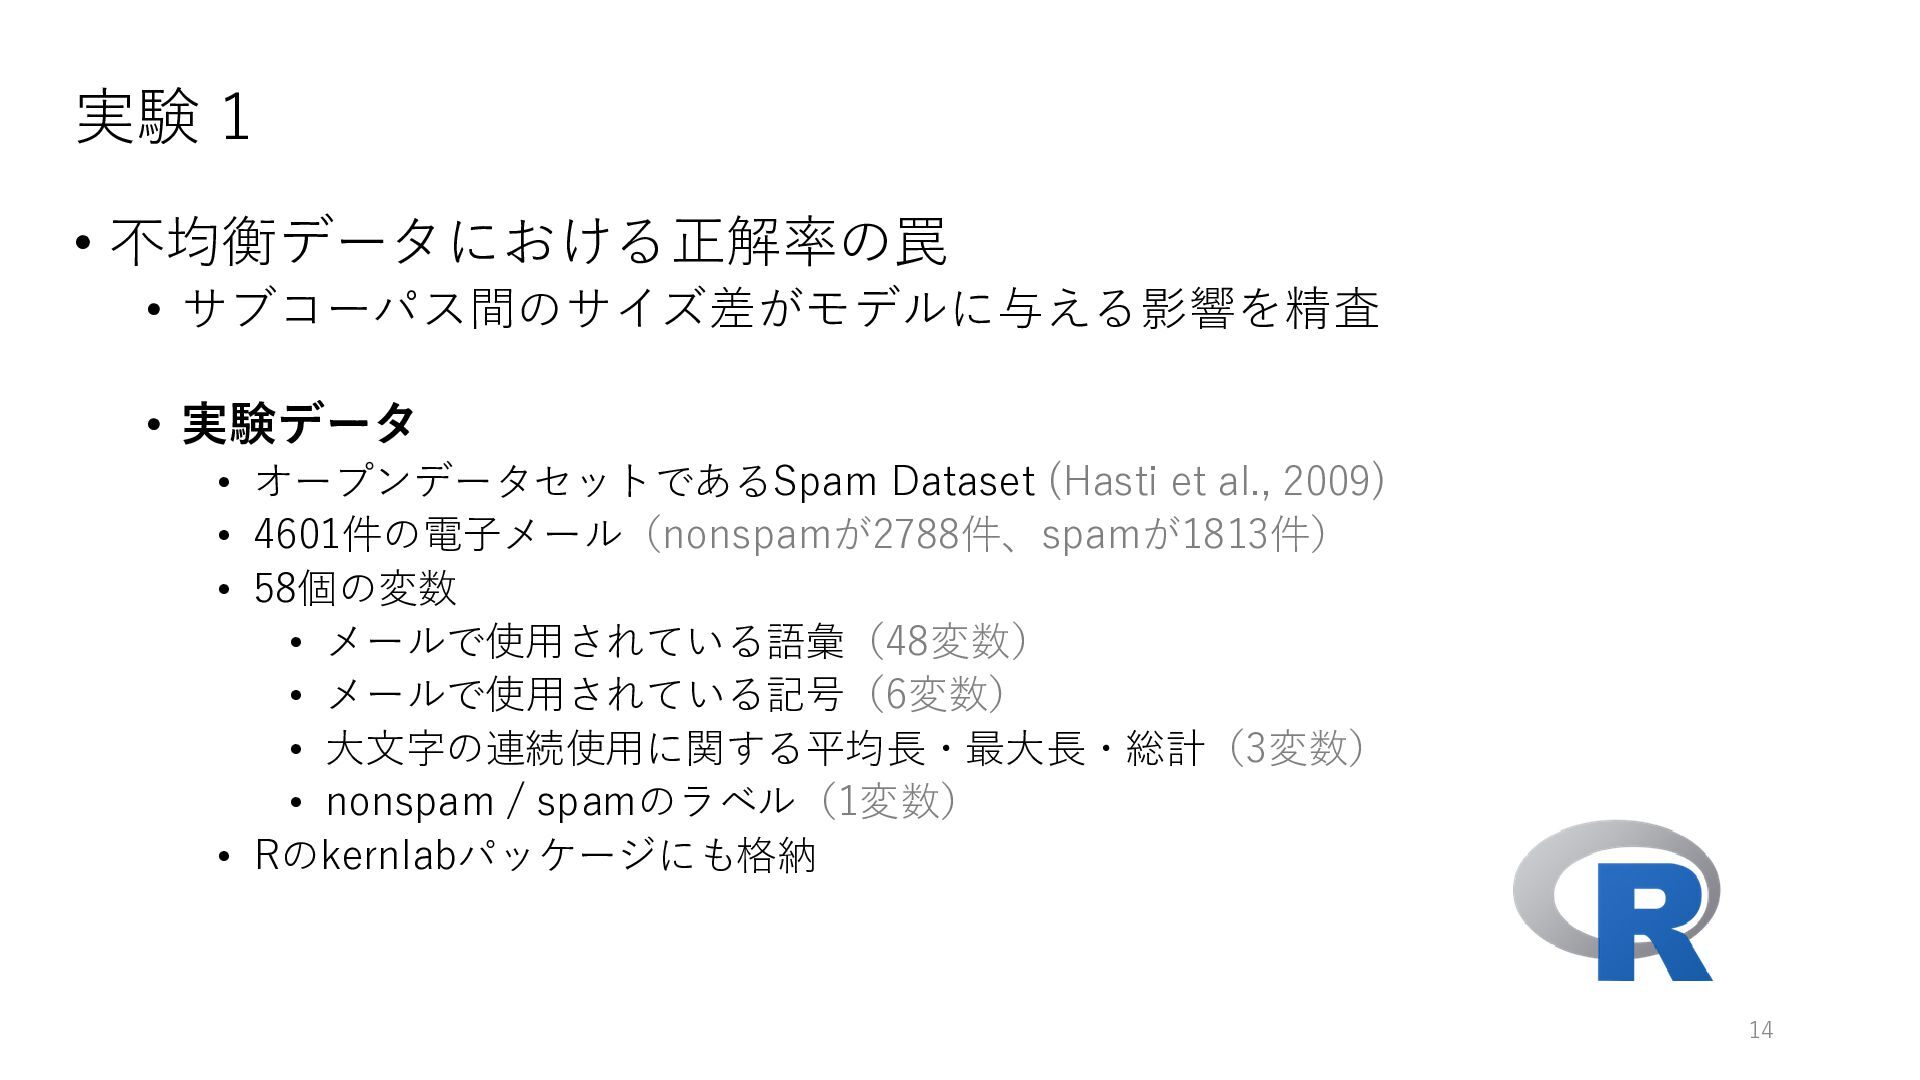
実験 1 • 不均衡データにおける正解率の罠 • サブコーパス間のサイズ差がモデルに与える影響を精査 • 実験データ • オープンデータセットであるSpam
Dataset (Hasti et al., 2009) • 4601件の電子メール(nonspamが2788件、spamが1813件) • 58個の変数 • メールで使用されている語彙(48変数) • メールで使用されている記号(6変数) • 大文字の連続使用に関する平均長・最大長・総計(3変数) • nonspam / spamのラベル(1変数) • Rのkernlabパッケージにも格納 14
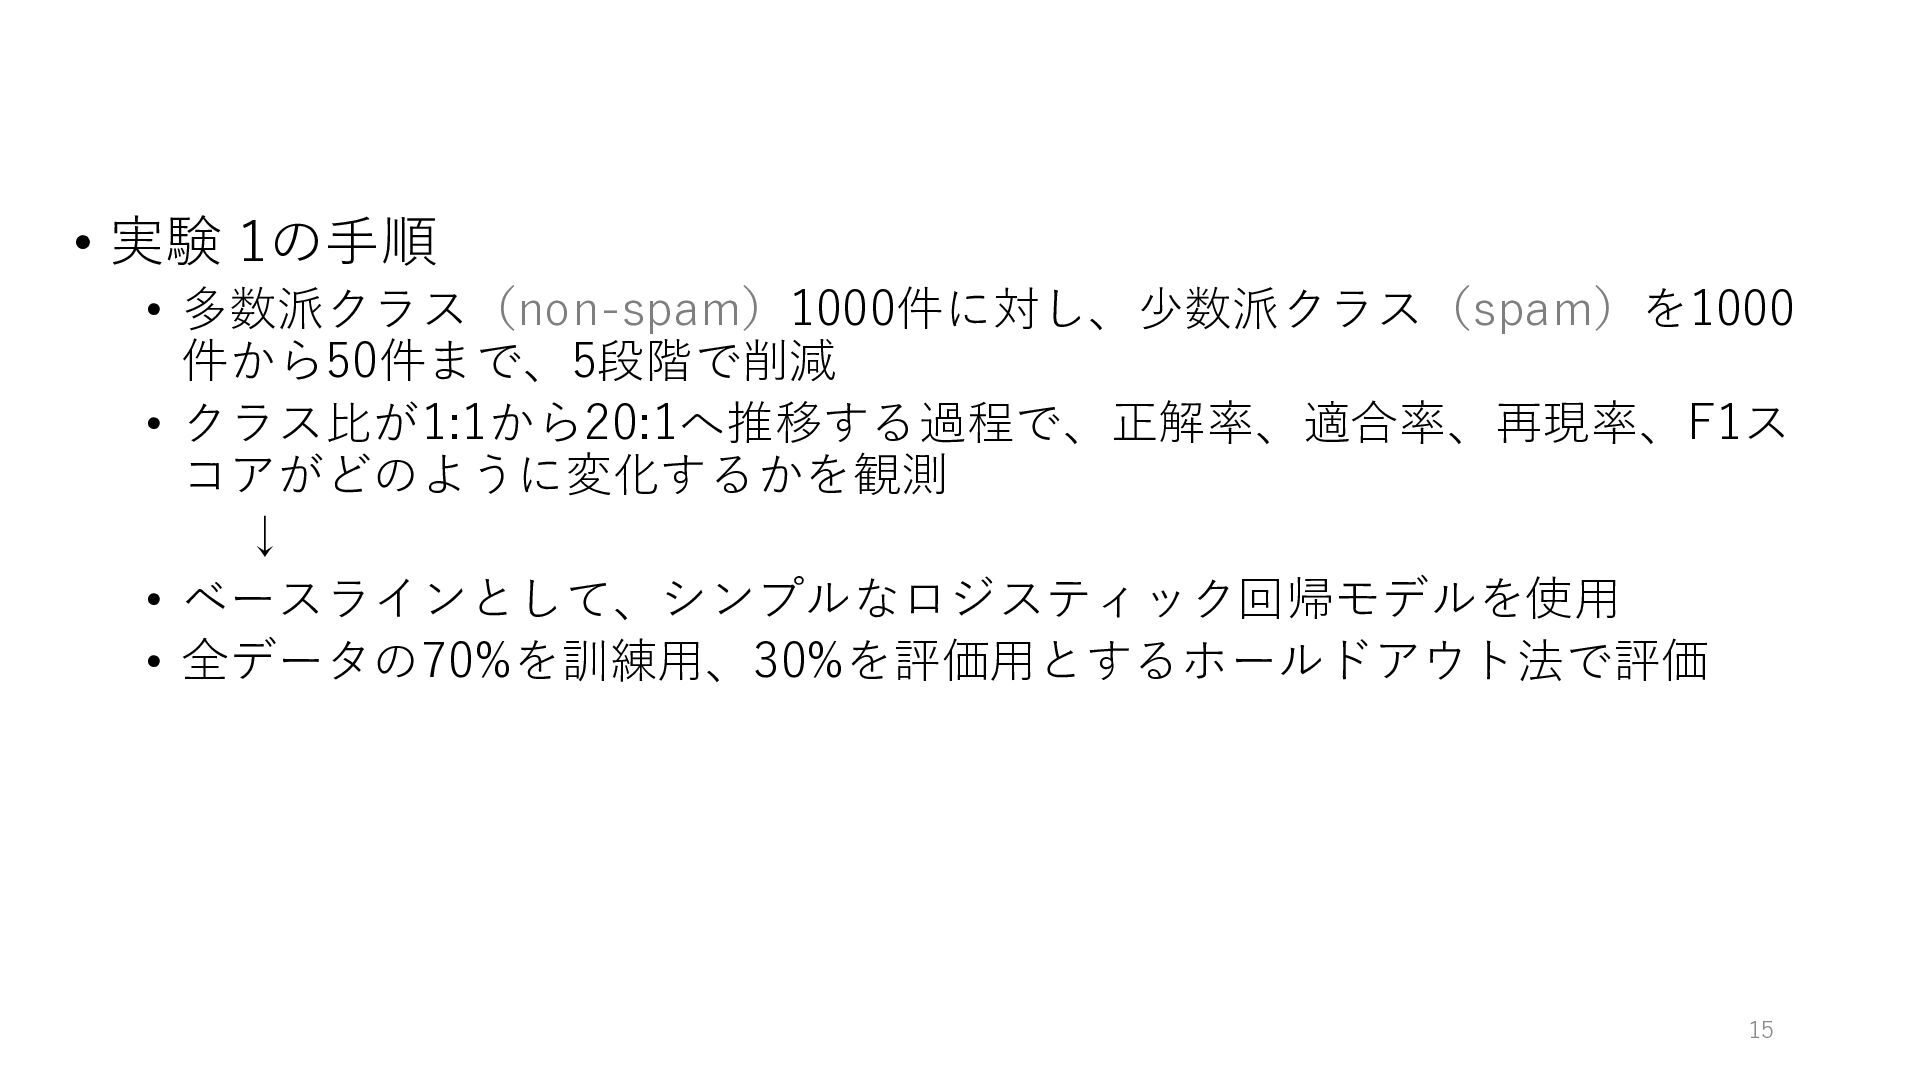
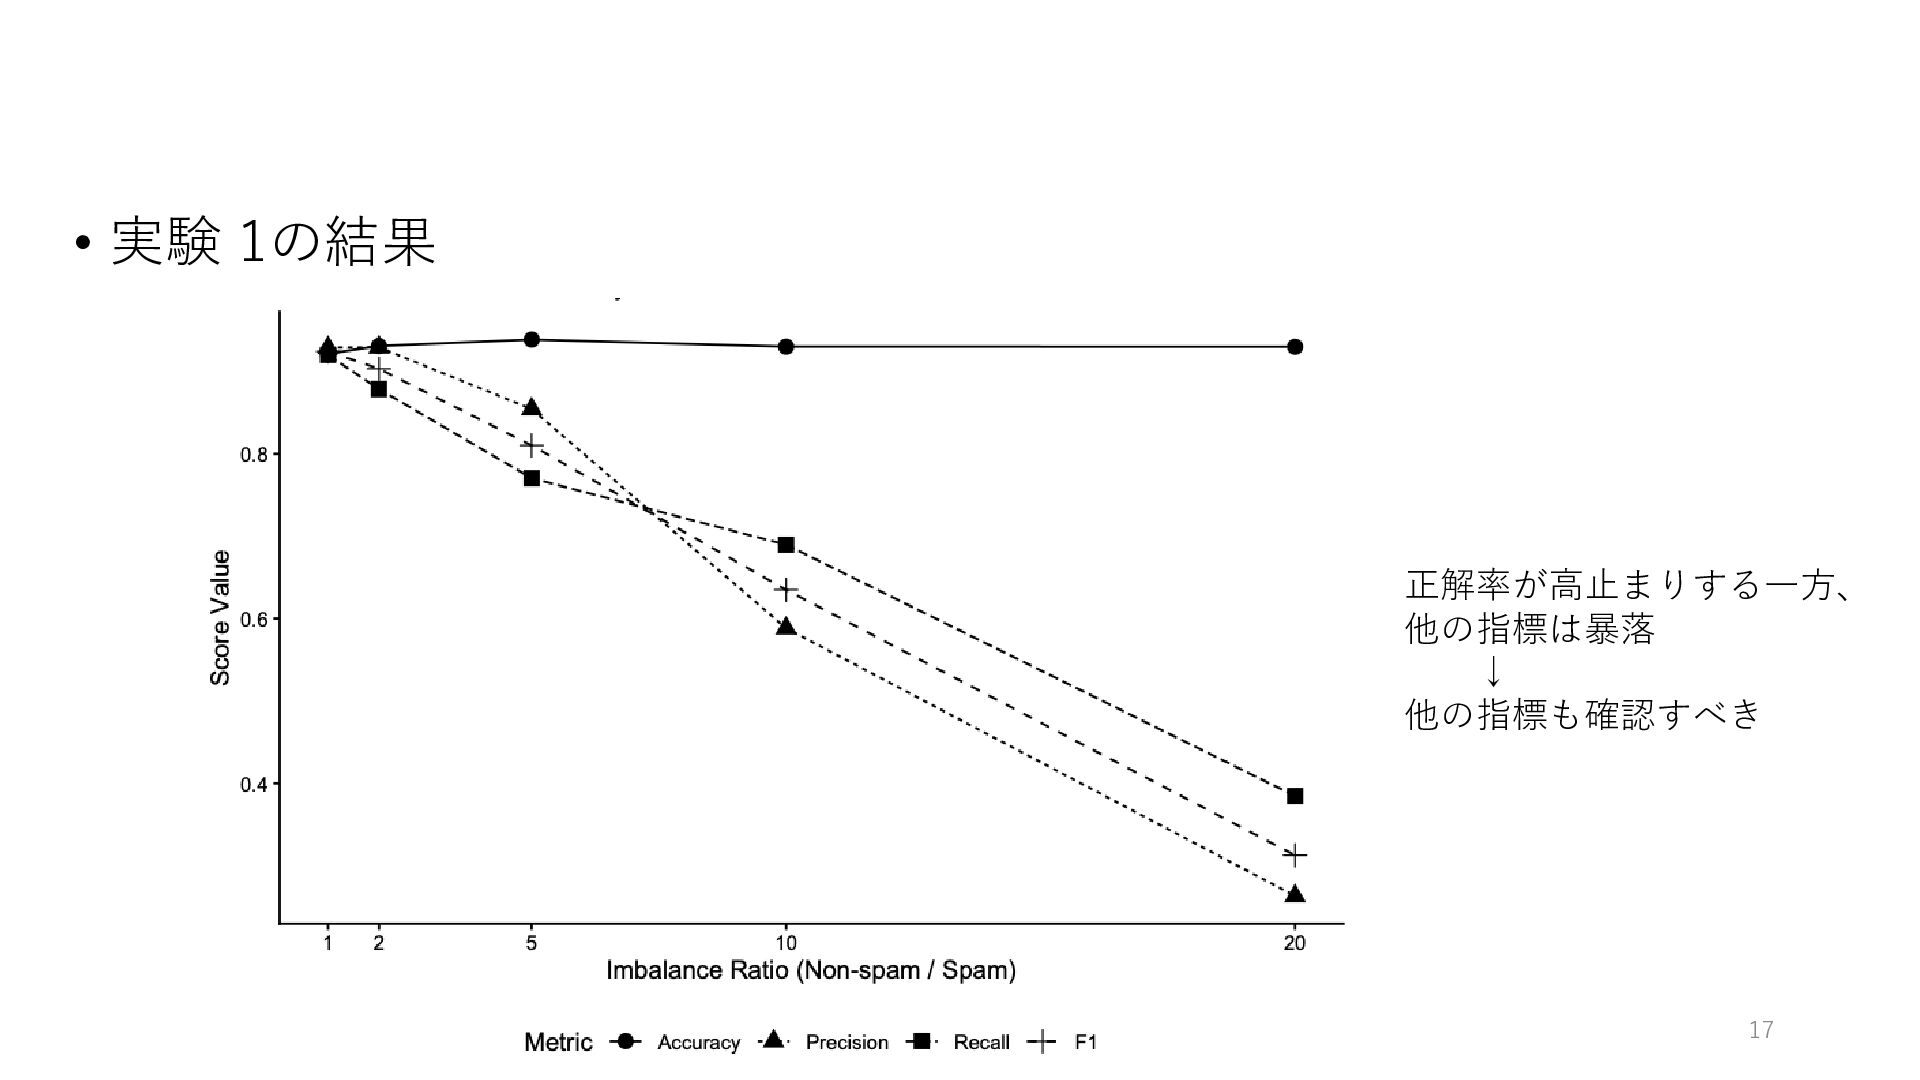
• 実験 1の手順 • 多数派クラス(non-spam)1000件に対し、少数派クラス(spam)を1000 件から50件まで、5段階で削減 • クラス比が1:1から20:1へ推移する過程で、正解率、適合率、再現率、F1ス コアがどのように変化するかを観測 ↓
• ベースラインとして、シンプルなロジスティック回帰モデルを使用 • 全データの70%を訓練用、30%を評価用とするホールドアウト法で評価 15
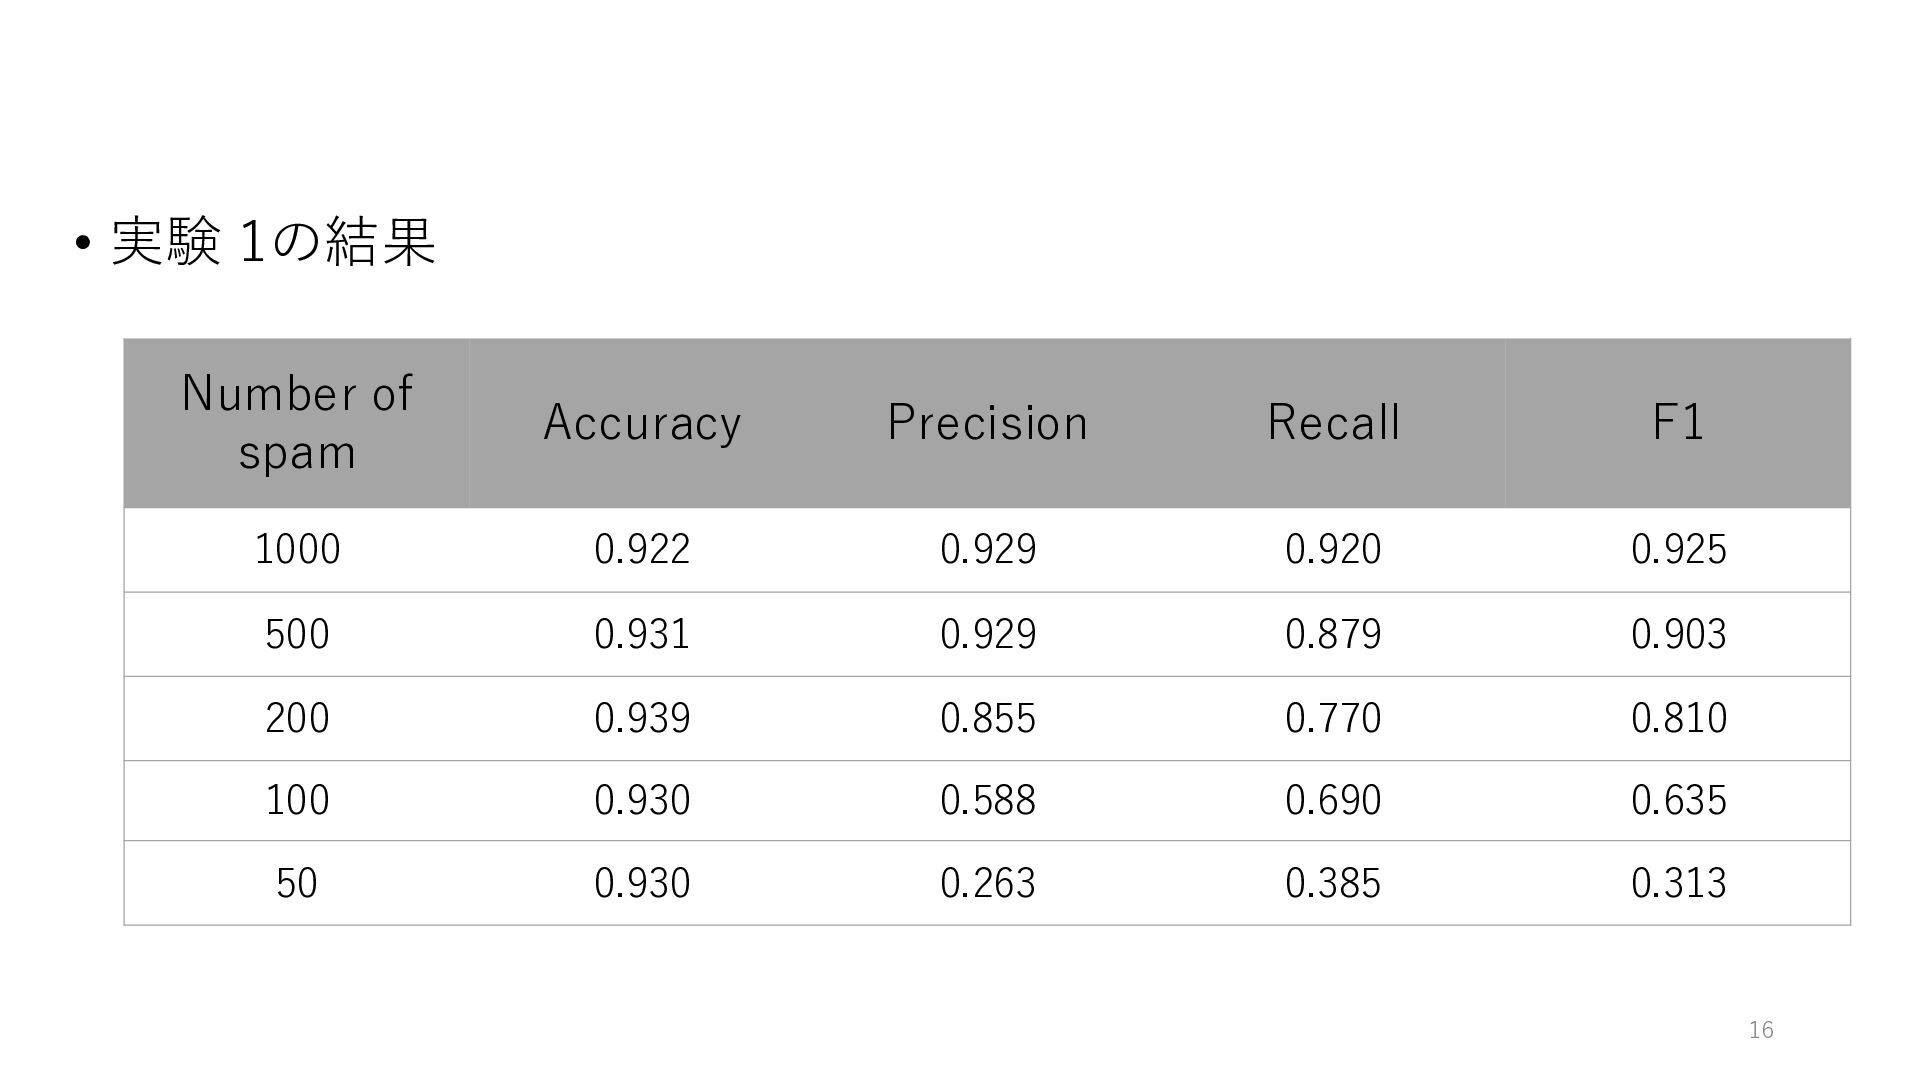
• 実験 1の結果 Number of spam Accuracy Precision Recall F1
1000 0.922 0.929 0.920 0.925 500 0.931 0.929 0.879 0.903 200 0.939 0.855 0.770 0.810 100 0.930 0.588 0.690 0.635 50 0.930 0.263 0.385 0.313 16
• 実験 1の結果 正解率が高止まりする一方、 他の指標は暴落 ↓ 他の指標も確認すべき 17
分析手法の再検討 18
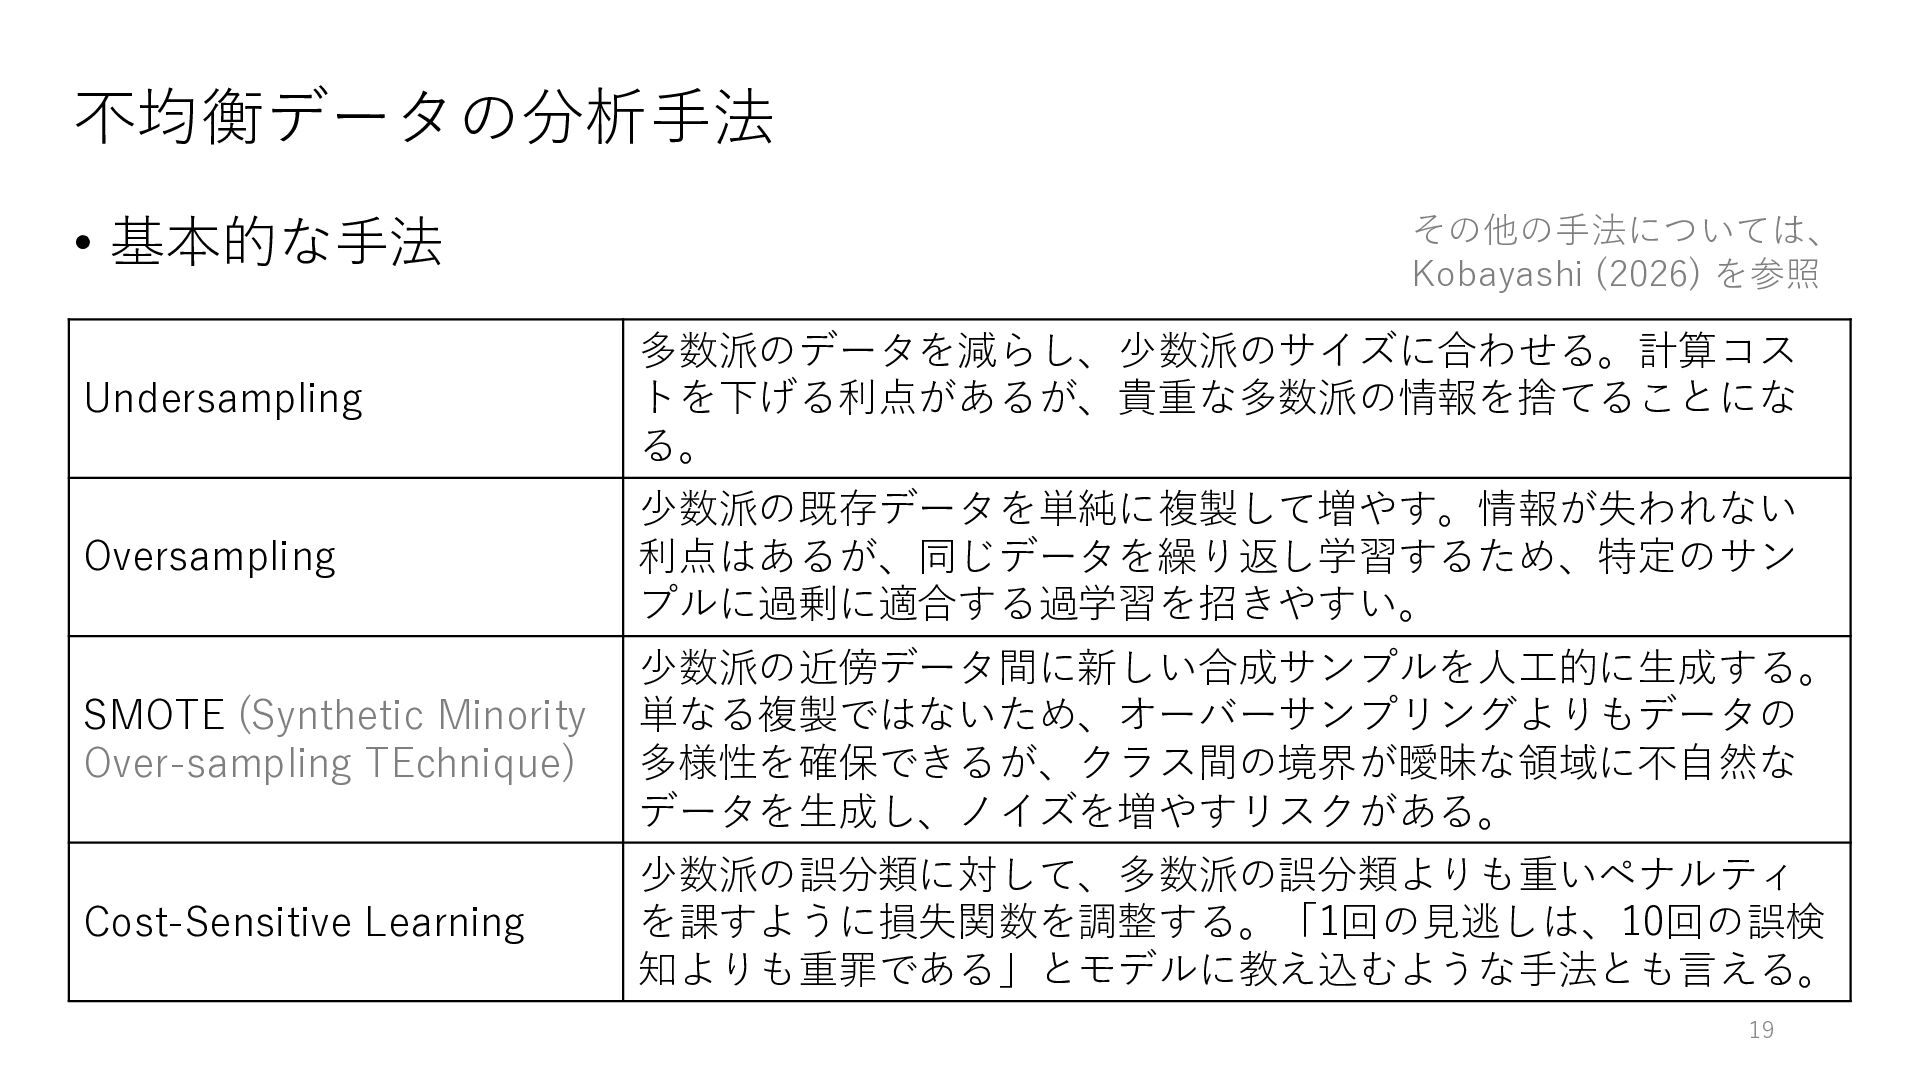
不均衡データの分析手法 • 基本的な手法 その他の手法については、 Kobayashi (2026) を参照 Undersampling 多数派のデータを減らし、少数派のサイズに合わせる。計算コス トを下げる利点があるが、貴重な多数派の情報を捨てることにな
る。 Oversampling 少数派の既存データを単純に複製して増やす。情報が失われない 利点はあるが、同じデータを繰り返し学習するため、特定のサン プルに過剰に適合する過学習を招きやすい。 SMOTE (Synthetic Minority Over-sampling TEchnique) 少数派の近傍データ間に新しい合成サンプルを人工的に生成する。 単なる複製ではないため、オーバーサンプリングよりもデータの 多様性を確保できるが、クラス間の境界が曖昧な領域に不自然な データを生成し、ノイズを増やすリスクがある。 Cost-Sensitive Learning 少数派の誤分類に対して、多数派の誤分類よりも重いペナルティ を課すように損失関数を調整する。「1回の見逃しは、10回の誤検 知よりも重罪である」とモデルに教え込むような手法とも言える。 19
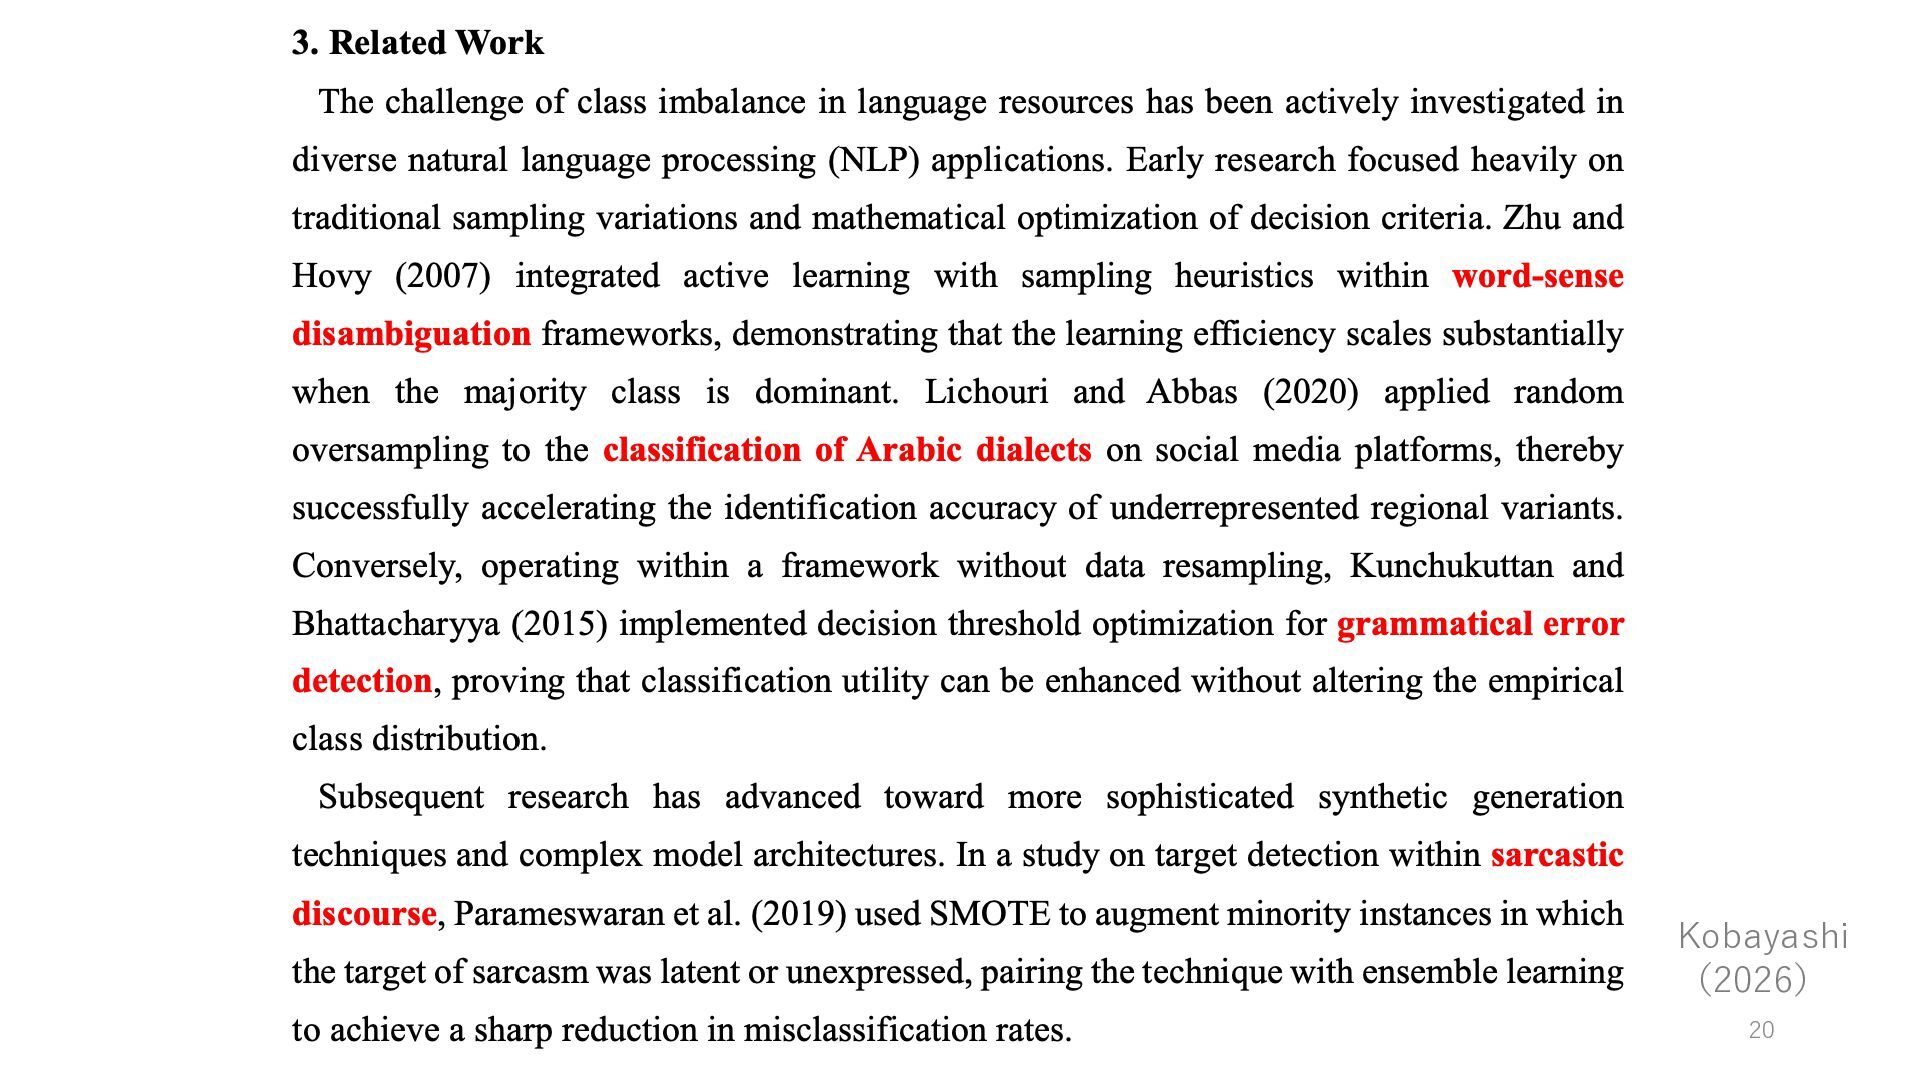
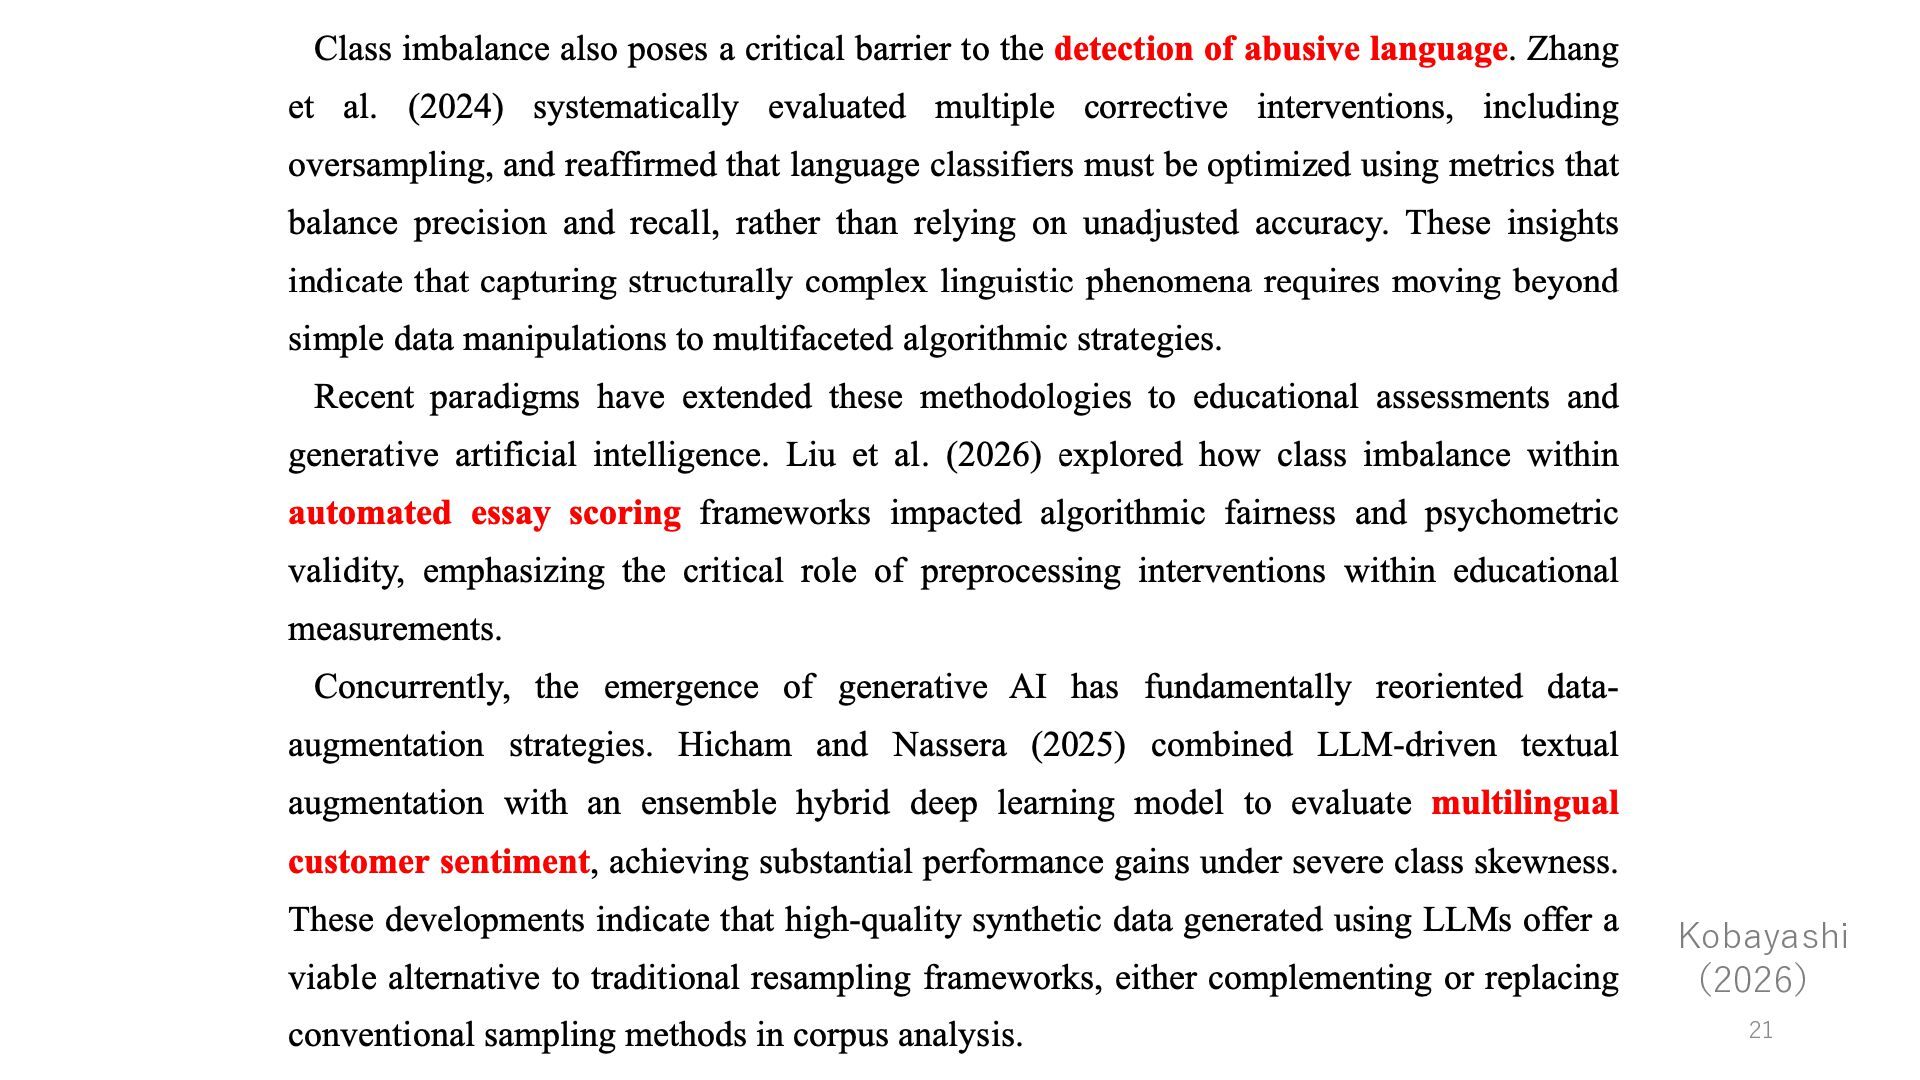
Kobayashi (2026) 20
Kobayashi (2026) 21
実験 2 • 基本的な手法の性能比較 • Undersampling、Oversampling、SMOTE、Cost-sensitive Learning (Weighted-GLM) • 実験データは、Spam
Dataset(実験 1と同じ) • 分類手法も、シンプルなロジスティック回帰モデル(実験 1と同じ) • 多数派クラスと少数派クラスの比率は、20:1 22
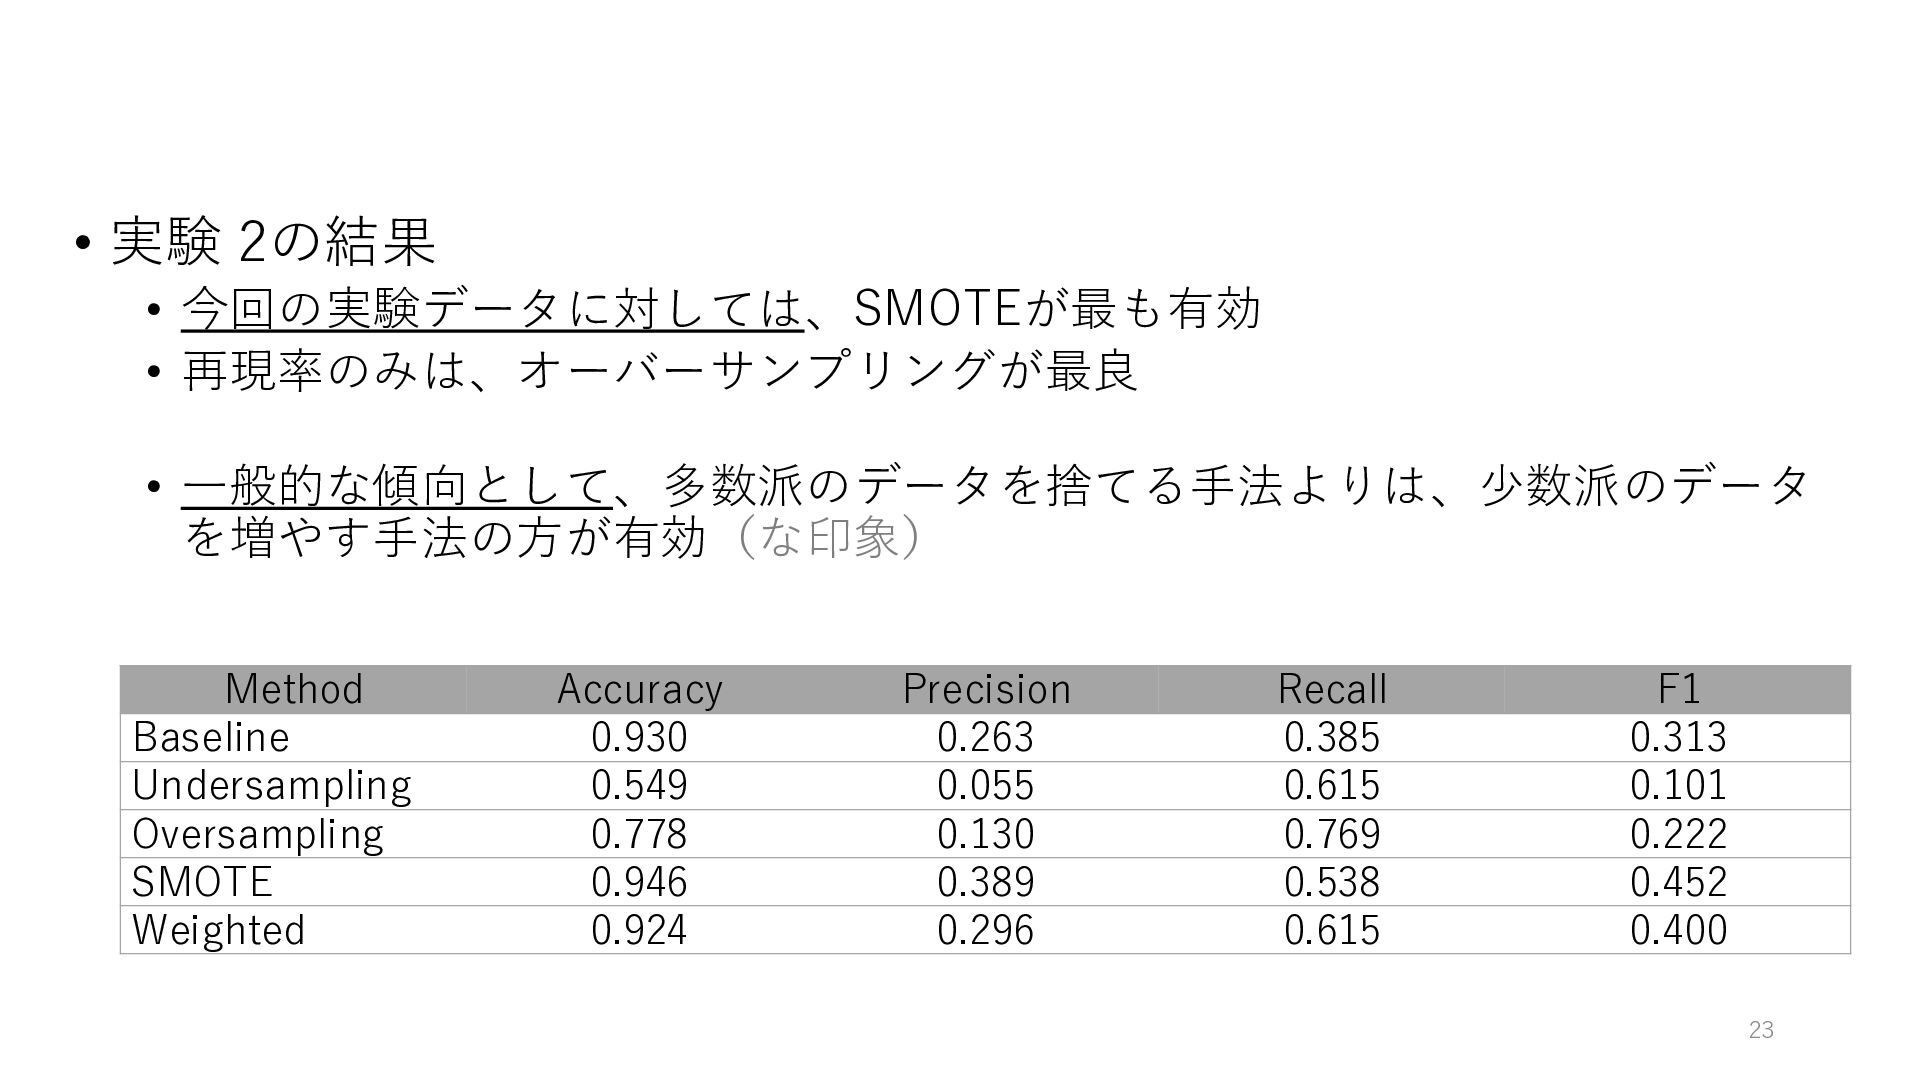
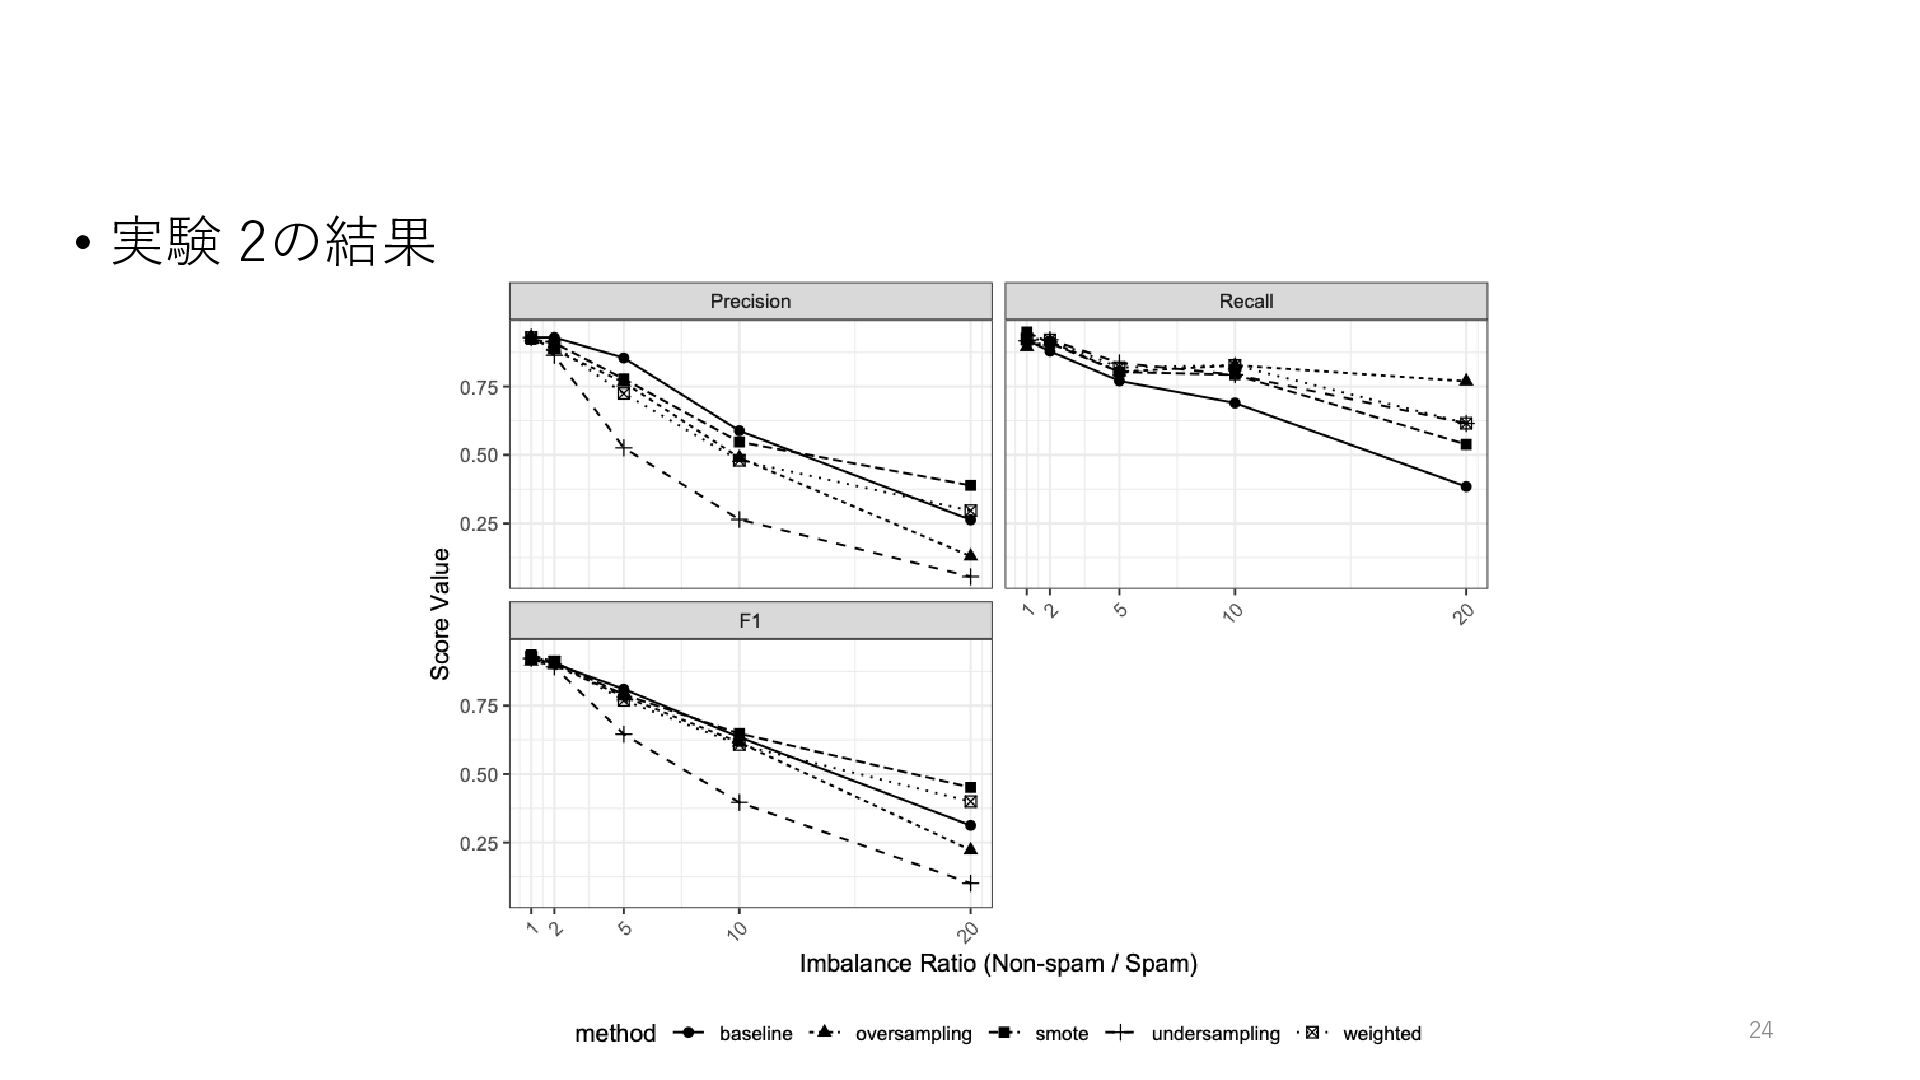
• 実験 2の結果 • 今回の実験データに対しては、SMOTEが最も有効 • 再現率のみは、オーバーサンプリングが最良 • 一般的な傾向として、多数派のデータを捨てる手法よりは、少数派のデータ を増やす手法の方が有効(な印象)
Method Baseline Undersampling Oversampling SMOTE Weighted Accuracy 0.930 0.549 0.778 0.946 0.924 Precision 0.263 0.055 0.130 0.389 0.296 Recall 0.385 0.615 0.769 0.538 0.615 F1 0.313 0.101 0.222 0.452 0.400 23
• 実験 2の結果 24
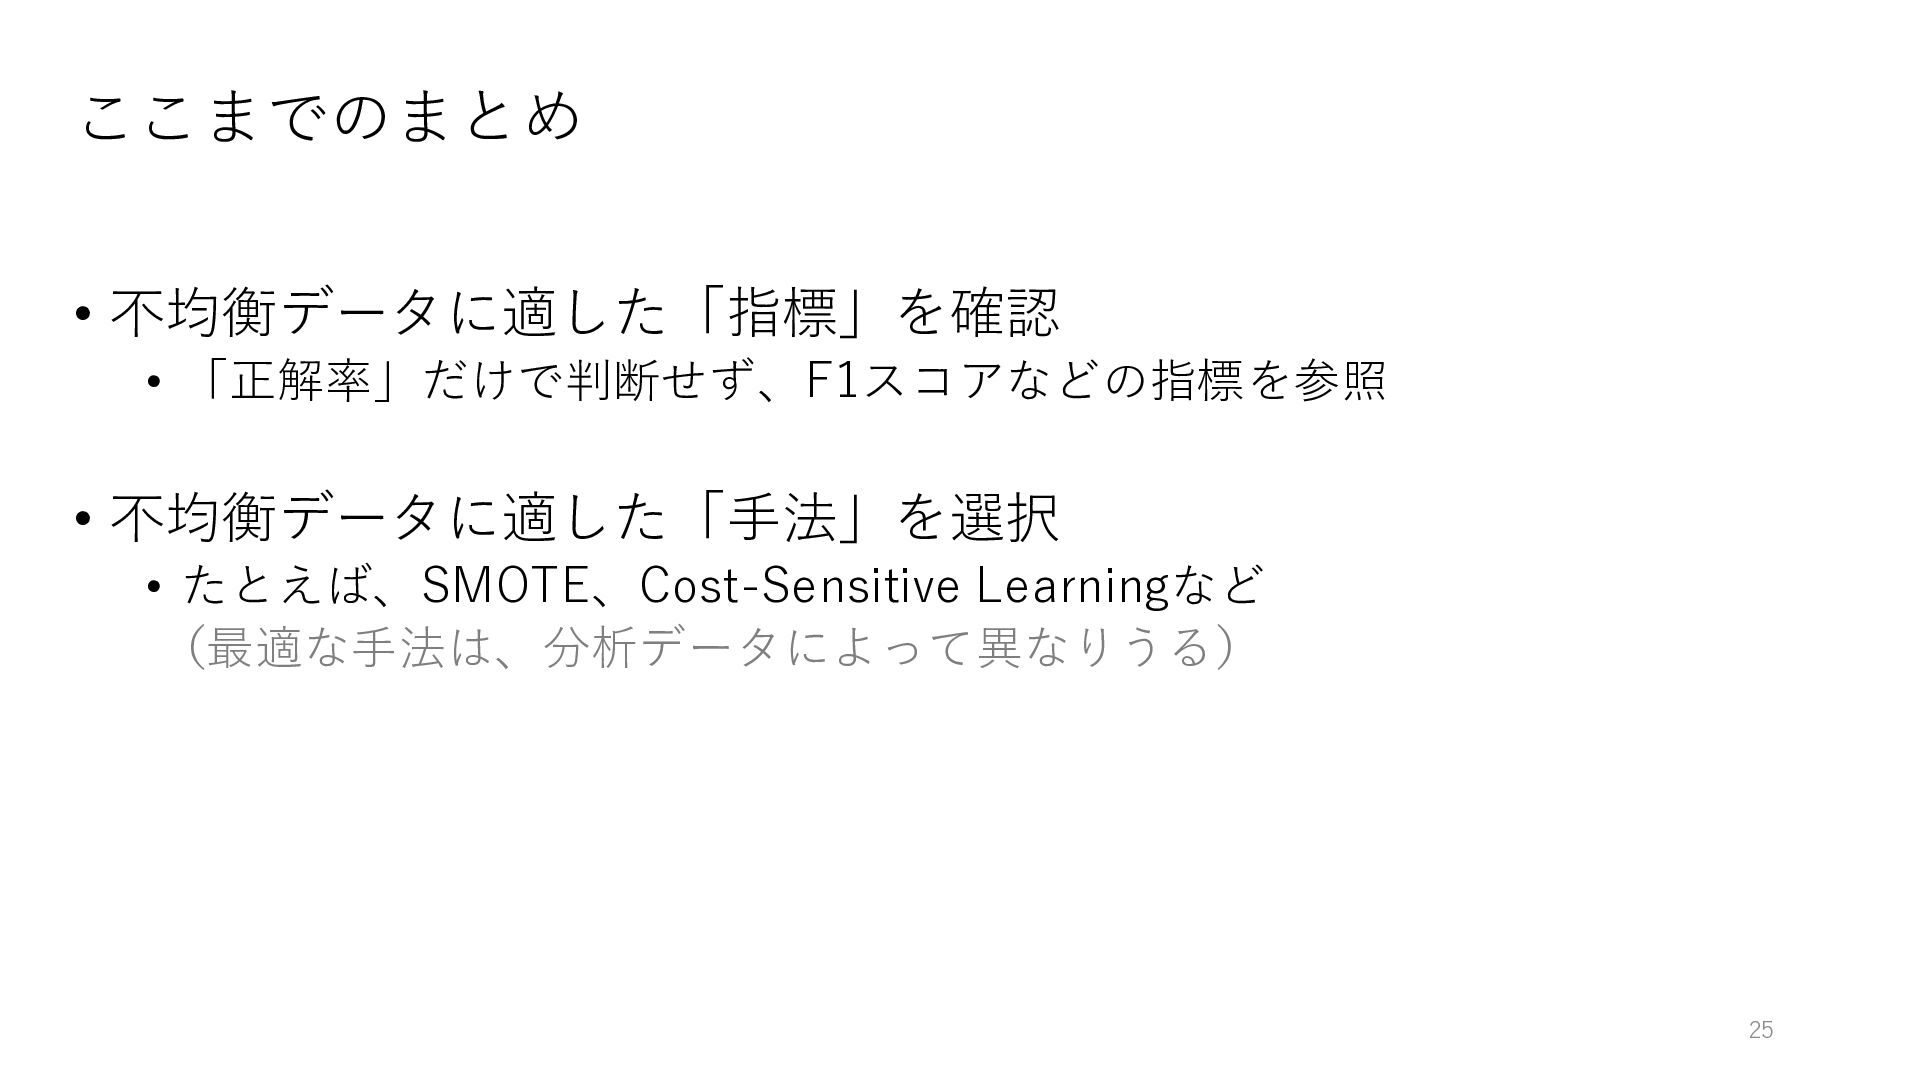
ここまでのまとめ • 不均衡データに適した「指標」を確認 • 「正解率」だけで判断せず、F1スコアなどの指標を参照 • 不均衡データに適した「手法」を選択 • たとえば、SMOTE、Cost-Sensitive Learningなど
(最適な手法は、分析データによって異なりうる) 25
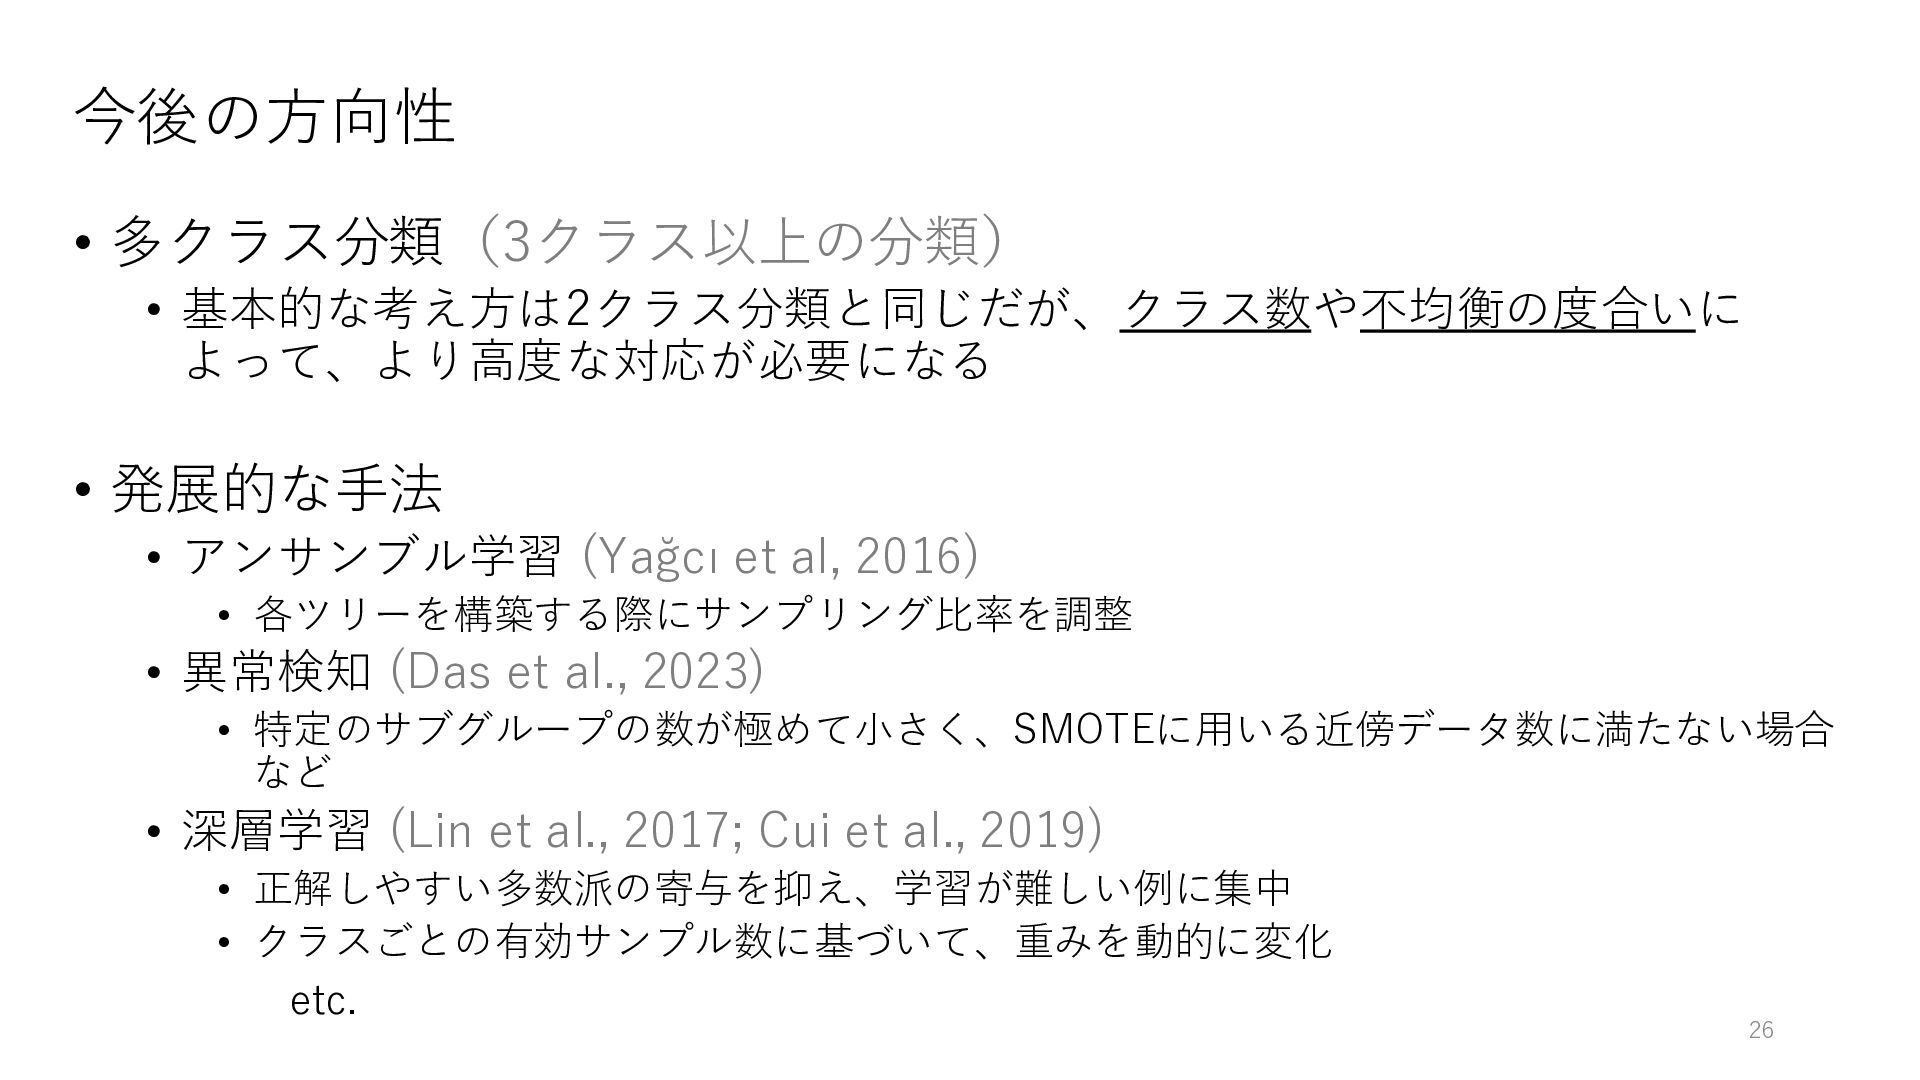
今後の方向性 • 多クラス分類(3クラス以上の分類) • 基本的な考え方は2クラス分類と同じだが、クラス数や不均衡の度合いに よって、より高度な対応が必要になる • 発展的な手法 • アンサンブル学習
(Yağcı et al, 2016) • 各ツリーを構築する際にサンプリング比率を調整 • 異常検知 (Das et al., 2023) • 特定のサブグループの数が極めて小さく、SMOTEに用いる近傍データ数に満たない場合 など • 深層学習 (Lin et al., 2017; Cui et al., 2019) • 正解しやすい多数派の寄与を抑え、学習が難しい例に集中 • クラスごとの有効サンプル数に基づいて、重みを動的に変化 etc. 26
Thank you for your time and attention This work was
supported by JSPS KAKENHI Grant Number 26K03997 27


 langstat
 neutron63zf
 akasan
 trycycle
 lychee1223
 sshimizu2006
 institutdelelevage
 naospon
 shumpei777
 ykamit
 x_ttyszk
 badams
 honzajavorek
 soudai
 kristinabergwall1
 charlesmeaden
 tammyeverts
 tammielis
 mojombo
 mfonobong
 quramy
 mkilby
 joshbly