Upgrade to Pro — share decks privately, control downloads, hide ads and more …

ceph crush algorithm

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

ceph crush algorithm

ceph中的crush算法介绍

Avatar for limingzju

limingzju

June 21, 2014

Other Decks in Programming

Transcript

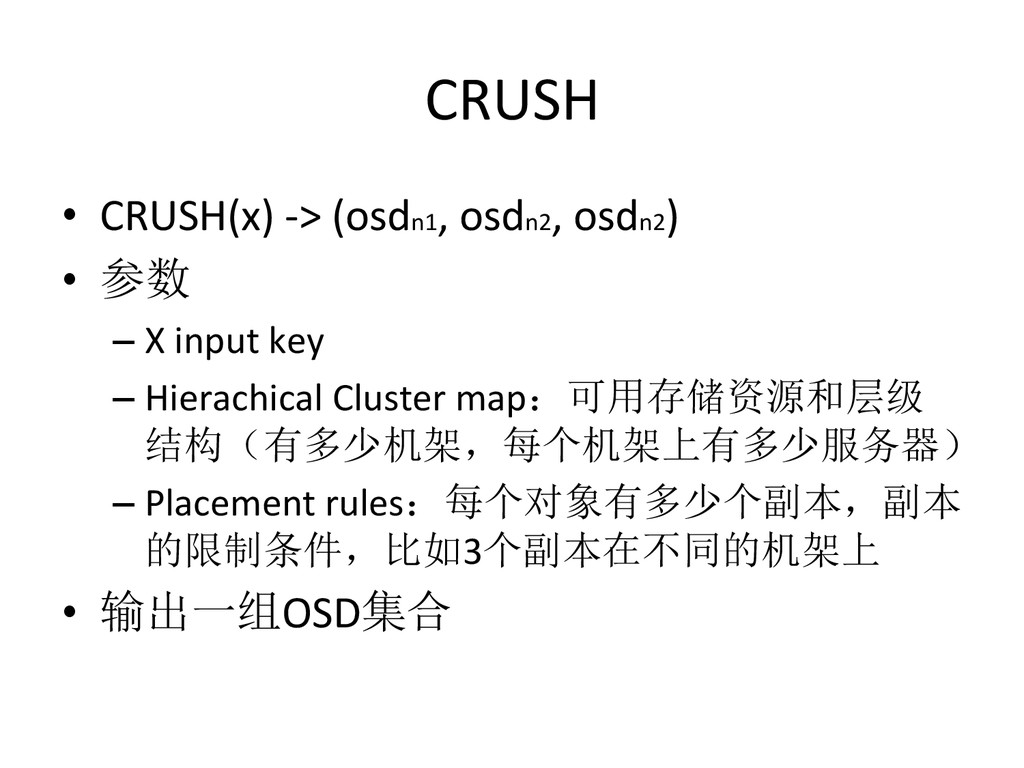
  1. CRUSH •  CRUSH(x)  -­‐>  (osdn1,  osdn2,  osdn2)   •  参数

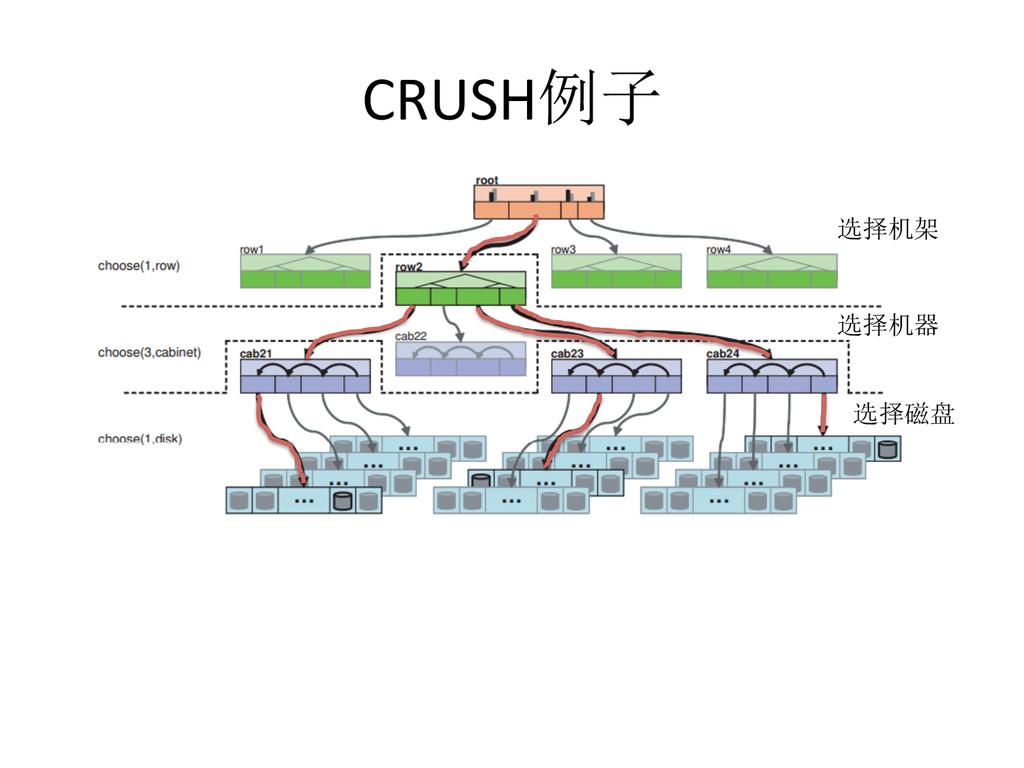
      – X  input  key   – Hierachical  Cluster  map:可用存储资源和层级 结构(有多少机架,每个机架上有多少服务器)   – Placement  rules:每个对象有多少个副本,副本 的限制条件,比如3个副本在不同的机架上   •  输出一组OSD集合  
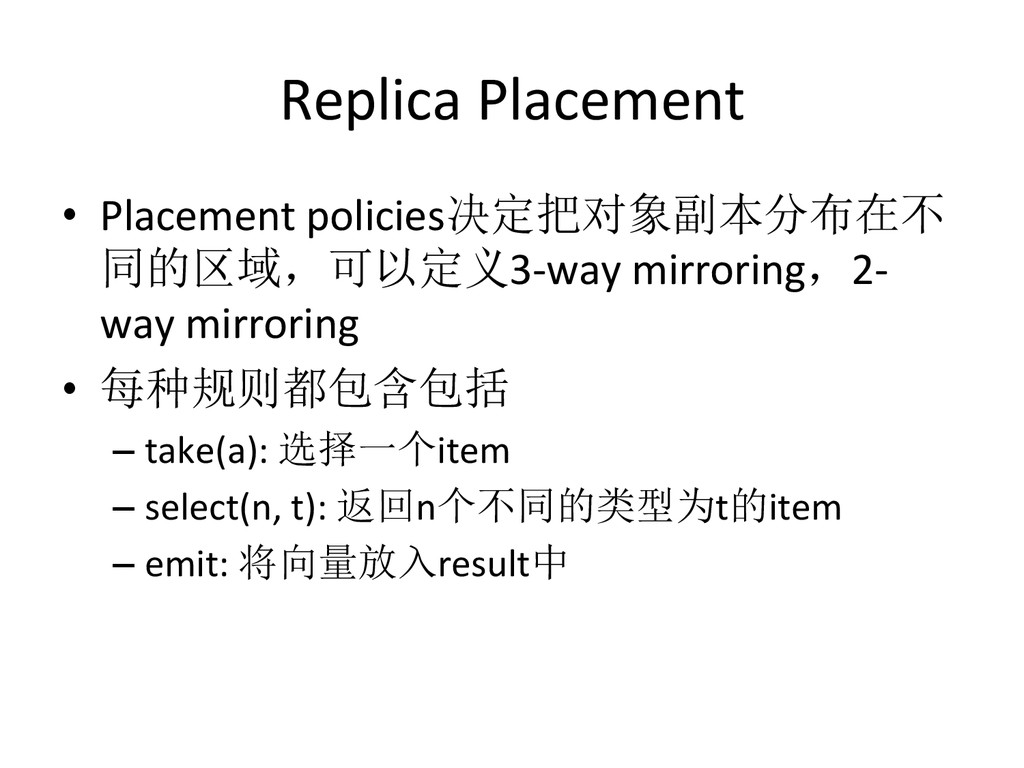
  2. Replica  Placement •  Placement  policies决定把对象副本分布在不 同的区域,可以定义3-­‐way  mirroring,2-­‐ way  mirroring  

    •  每种规则都包含包括   – take(a):  选择一个item   – select(n,  t):  返回n个不同的类型为t的item   – emit:  将向量放入result中  
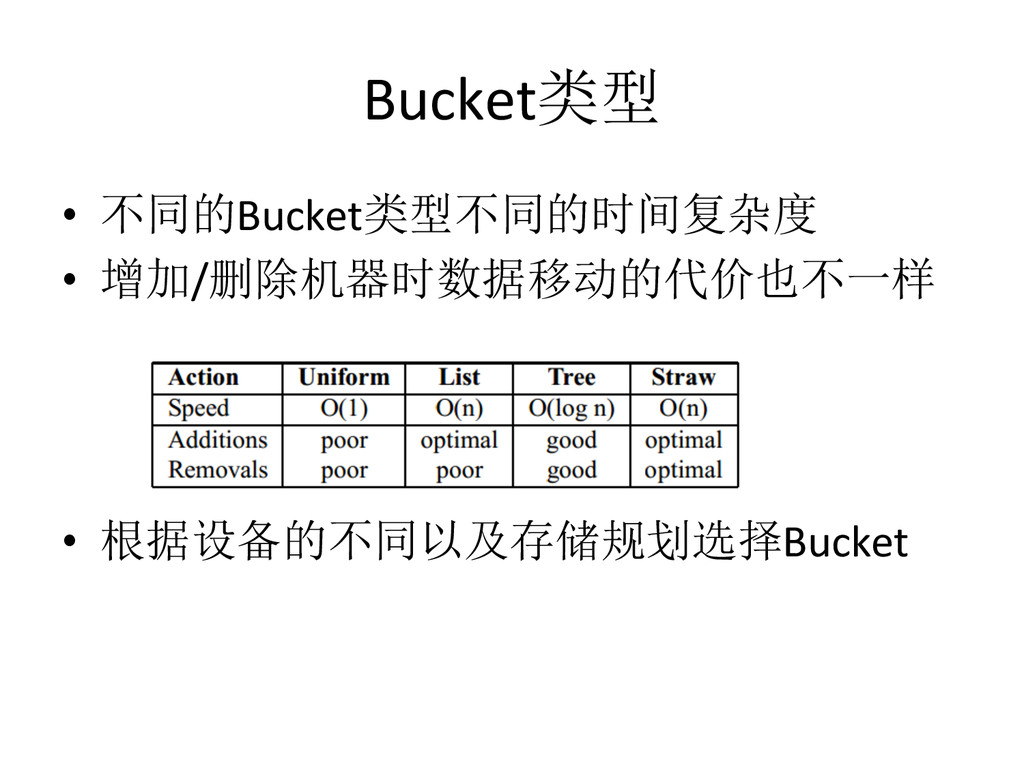
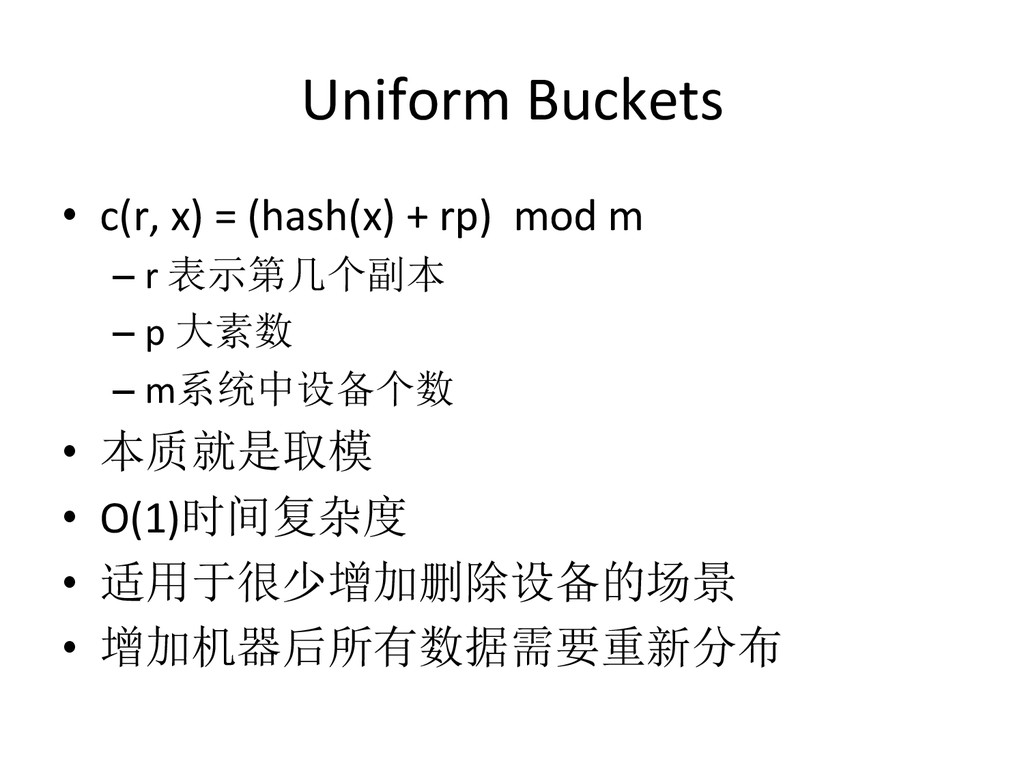
  3. Uniform  Buckets •  c(r,  x)  =  (hash(x)  +  rp)  

     mod  m   – r  表示第几个副本   – p  大素数   – m系统中设备个数   •  本质就是取模   •  O(1)时间复杂度   •  适用于很少增加删除设备的场景   •  增加机器后所有数据需要重新分布  
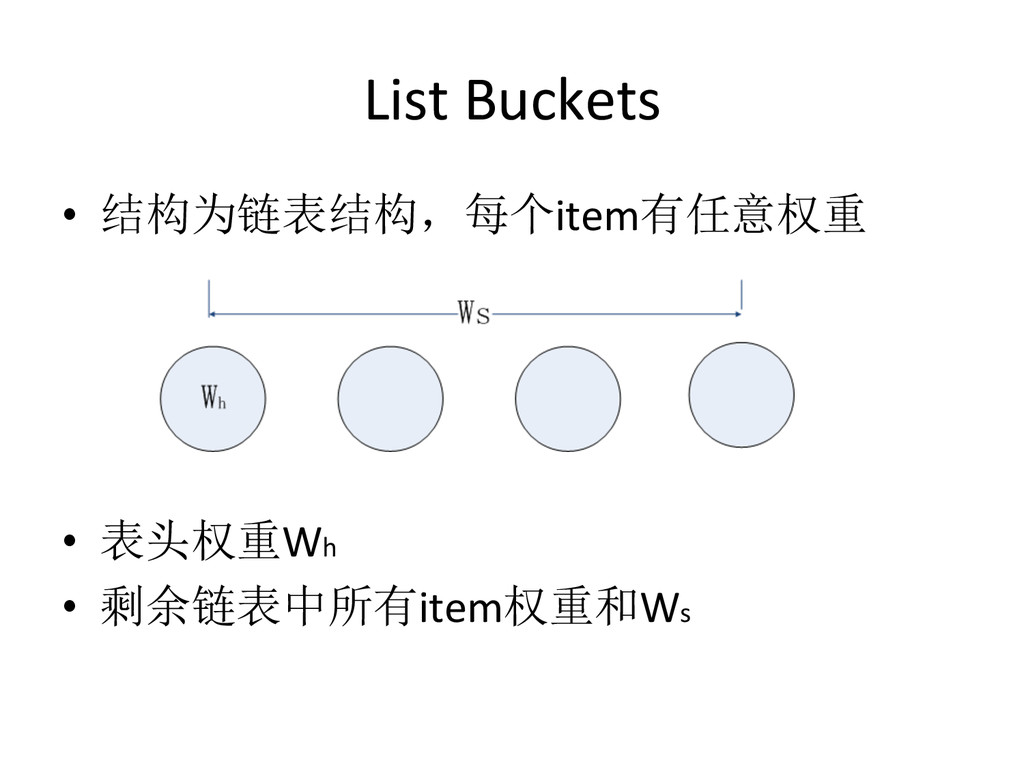
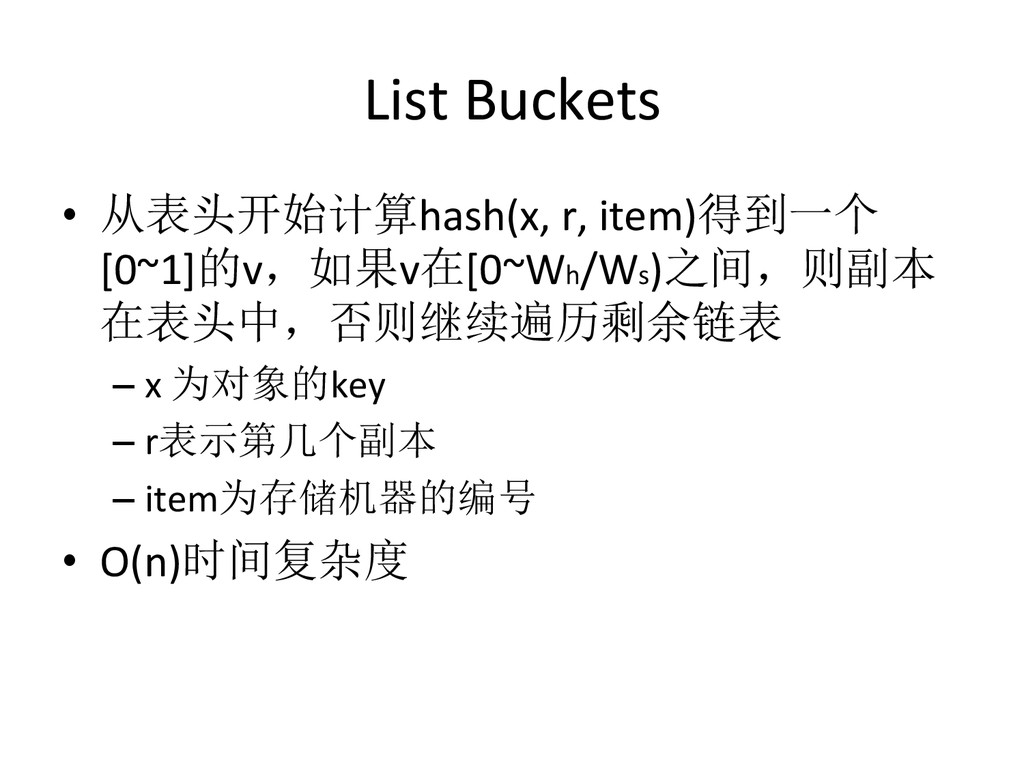
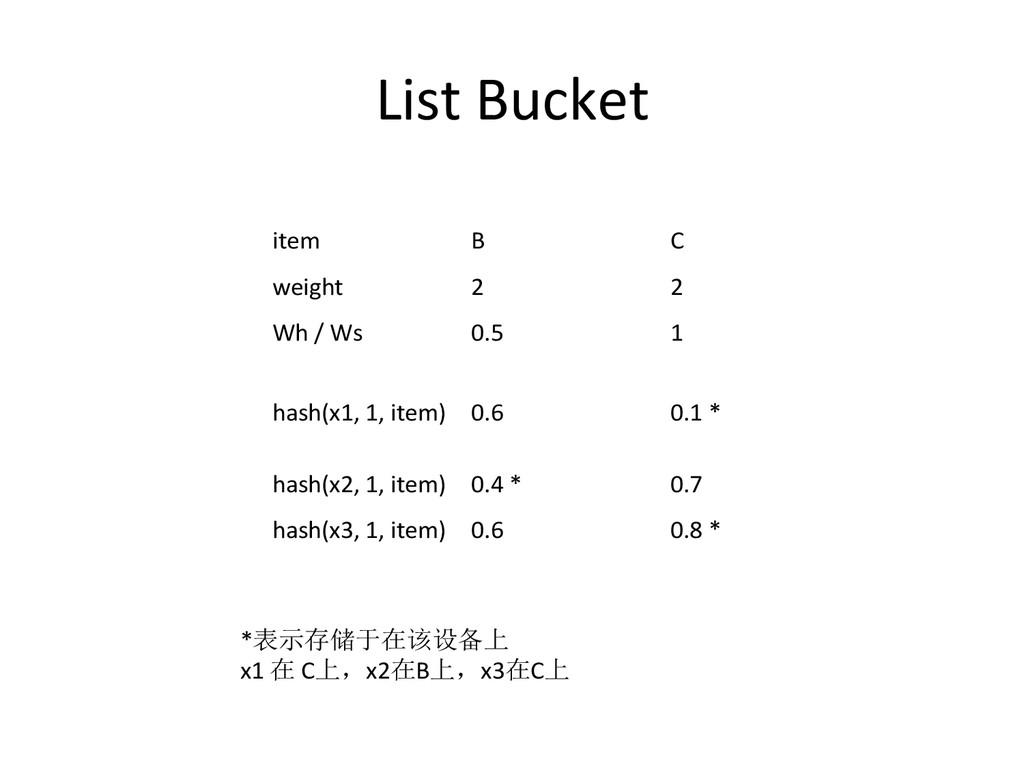
  4. List  Bucket item B C weight 2 2 Wh  /

     Ws 0.5 1 hash(x1,  1,  item) 0.6 0.1  * hash(x2,  1,  item) 0.4  * 0.7 hash(x3,  1,  item) 0.6   0.8  * *表示存储于在该设备上   x1  在  C上,x2在B上,x3在C上
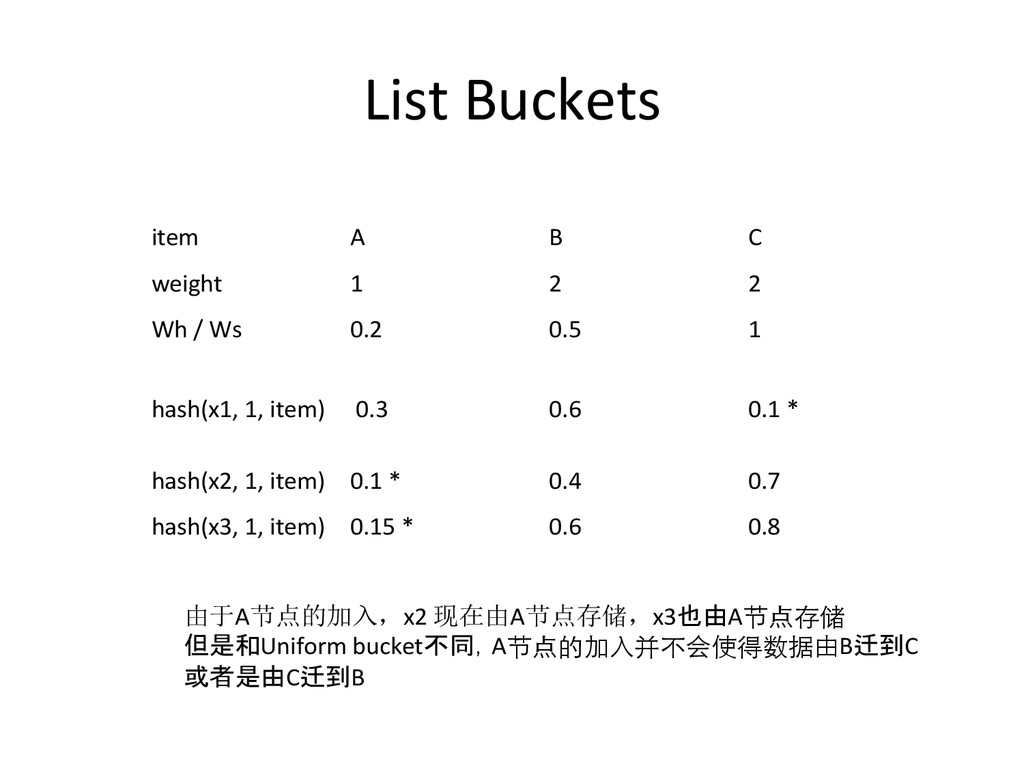
  5. List  Buckets item A B C weight 1 2 2

    Wh  /  Ws 0.2 0.5 1 hash(x1,  1,  item)  0.3   0.6 0.1  * hash(x2,  1,  item) 0.1  * 0.4   0.7 hash(x3,  1,  item) 0.15  * 0.6 0.8 由于A节点的加入,x2  现在由A节点存储,x3也由A节点存储   但是和Uniform  bucket不同,A节点的加⼊入并不会使得数据由B迁到C   或者是由C迁到B  
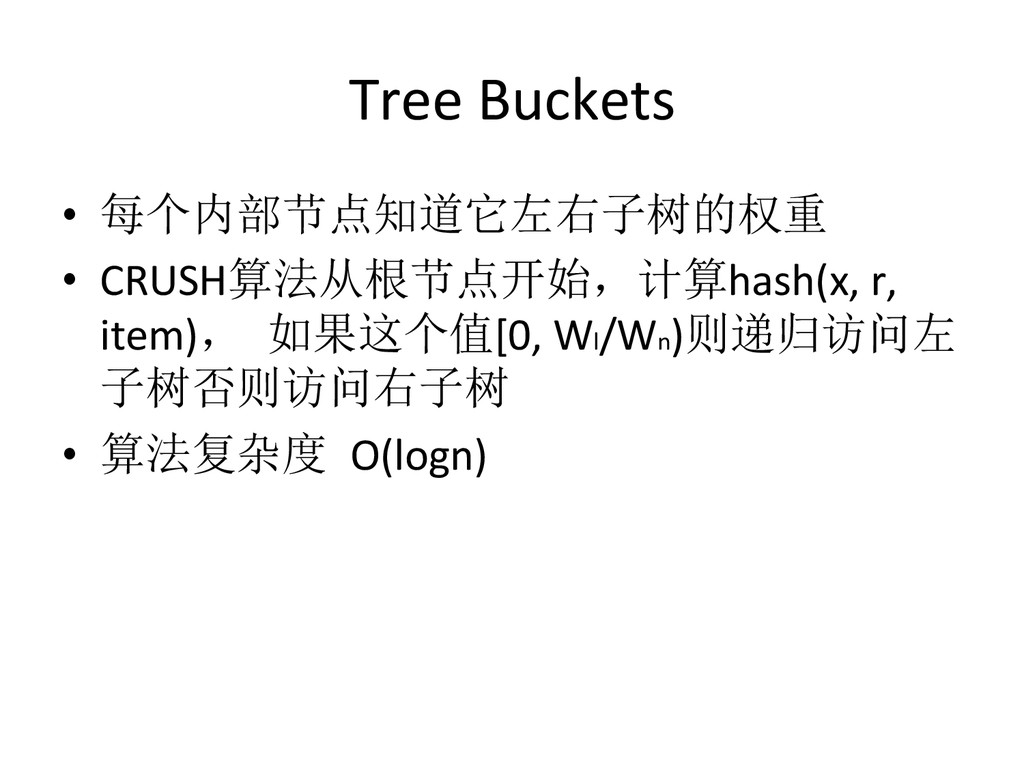
  6. Tree  Buckets •  每个内部节点知道它左右子树的权重   •  CRUSH算法从根节点开始,计算hash(x,  r,   item),

    如果这个值[0,  Wl/Wn)则递归访问左 子树否则访问右子树   •  算法复杂度 O(logn)
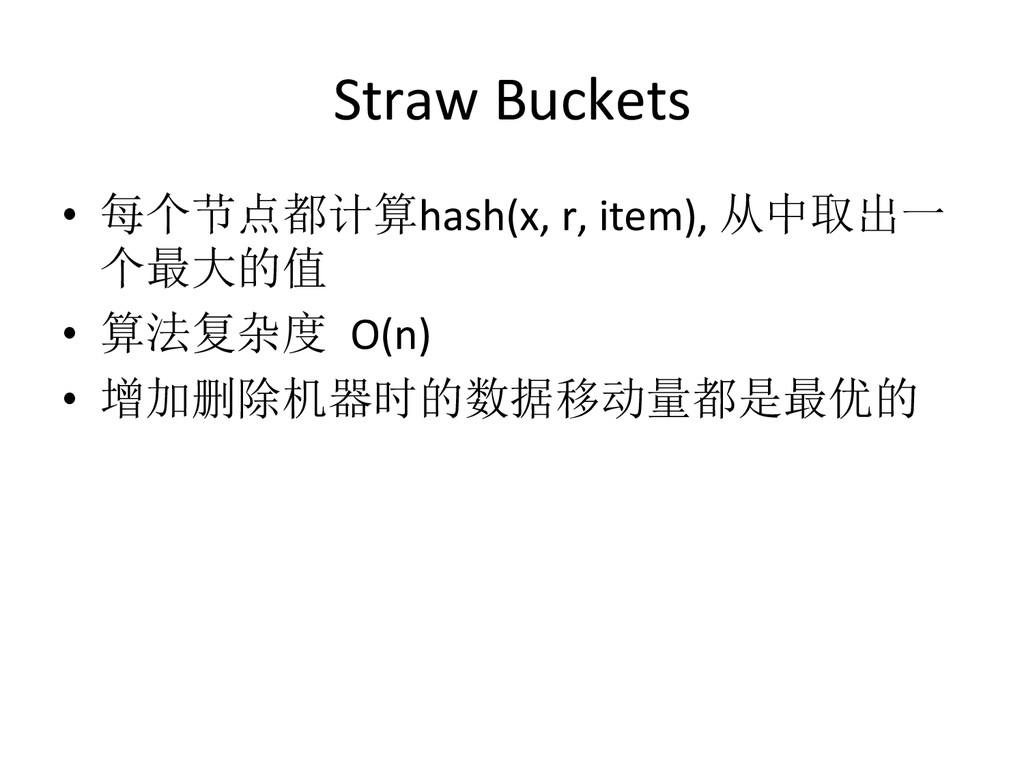
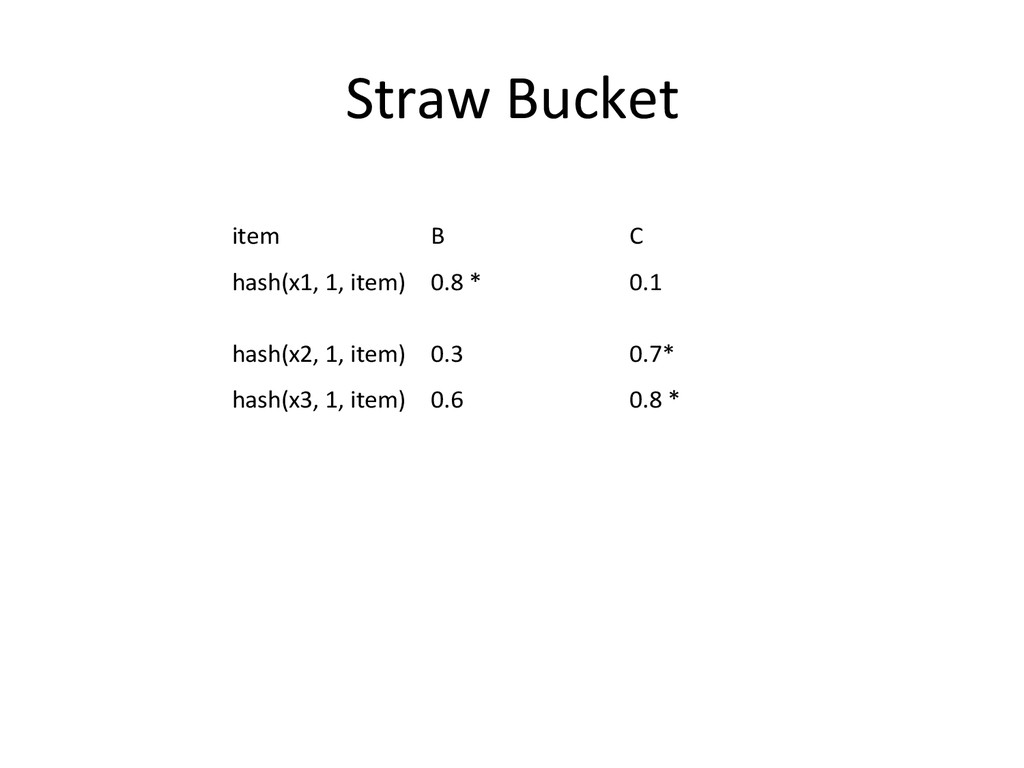
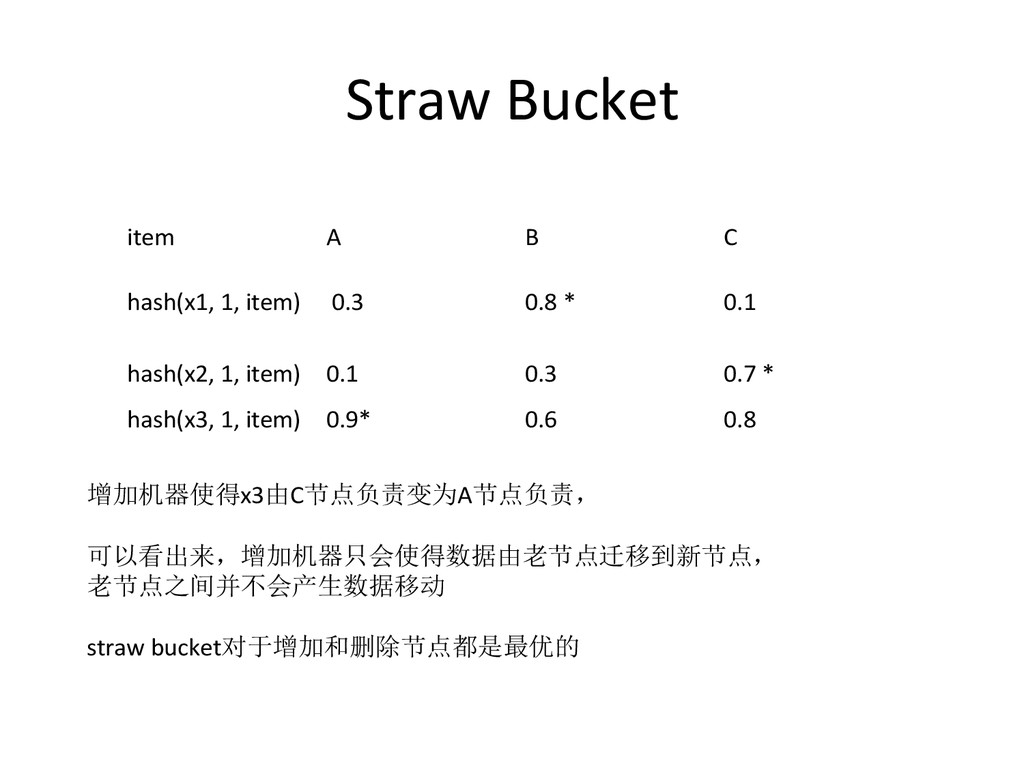
  7. Straw  Buckets •  每个节点都计算hash(x,  r,  item),  从中取出一 个最大的值   • 

    算法复杂度 O(n)   •  增加删除机器时的数据移动量都是最优的  
  8. Straw  Bucket item B C hash(x1,  1,  item) 0.8  *

    0.1 hash(x2,  1,  item) 0.3 0.7* hash(x3,  1,  item) 0.6   0.8  *
  9. Straw  Bucket item A B C hash(x1,  1,  item)  0.3

      0.8  * 0.1 hash(x2,  1,  item) 0.1   0.3 0.7  * hash(x3,  1,  item) 0.9* 0.6 0.8 增加机器使得x3由C节点负责变为A节点负责,     可以看出来,增加机器只会使得数据由老节点迁移到新节点,   老节点之间并不会产生数据移动     straw  bucket对于增加和删除节点都是最优的
  10. 参考资料 •  CRUSH:  Controlled,  Scalable,  Decentralized   Placement  of  Replicated

     Data   –  hdp://ceph.com/papers/weil-­‐crush-­‐sc06.pdf   •  Replicaeon  under  scalable  hashing:  A  family  of   algorithms  for  scalable  decentralized  data   distribueon   –  hdp://www.ssrc.ucsc.edu/Papers/honicky-­‐ ipdps04.pdf   •  A  fast  algorithm  for  online  placement  and   reorganizaeon  of  replicated  data   –  hdp://users.soe.ucsc.edu/~elm/Papers/ipdps03.pdf