Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ReinforcementLearningChapter1
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Lystahi
November 19, 2019
Technology
430
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ReinforcementLearningChapter1
Lystahi
November 19, 2019
Transcript
37 slides
MLPシリーズ『強化学習』 Chapter 1 準備 @lystahi
自己紹介 やっていること: データ分析, 機械学習, 研究開発, Python, SQL, Tableau, 推薦システム, Kaggle
やりたいこと: AtCoder
はじめに ・難しいところはスキップしています。ご了承ください。 ・質問 / ツッコミは発表中でもお気軽に。 ・撮影はNGでお願いします。
1.1 強化学習とは 1.2 マルコフ決定過程と逐次意思決定問題 1.3 方策 1.4 逐次的意思決定問題の定式化 Chapter 1
準備
1.1 強化学習とは 強化学習(reinforcement learning; RL)は最適な意思決定のルールを求めることを目 的とする学問分野。 報酬という概念が登場し、その期待値などを最大にするような逐次的意思決定ルールを 学習することが強化学習の最大の特徴。 逐次的意思決定ルールは方策(policy)と呼ばれ、方策の最適化問題のことを逐次的意 思決定問題(sequential
decision-making problem)という。
1.2 マルコフ決定過程と逐次意思決定問題 1.2.1 確率過程とマルコフ性 1.2.2 マルコフ決定過程 1.2.3 逐次的意思決定の典型的問題設定 1.2.4 強化学習とマルコフ決定過程
変数の値が時間とともに確率的に変化するような確率変数の系列のことを確率過程 (stochastic process)という。 強い制約を課されたもっとも単純な確率過程として、各確率変数 X1, X2… が互いに独 立で同一の確率分布に従う場合を考えることがある。 このとき、X1, X2…
は独立同一分布(independent and identically distributed; i.i.d.) に従うという。 1.2.1 確率過程とマルコフ性 #1
1.2.1 確率過程とマルコフ性 #2 多くの意思決定の問題に対して i.i.d. の仮定をおくことはできず、強化学習では i.i.d. よ りも弱い制約であるマルコフ性(Markov property)を仮定する。
マルコフ性は将来の確率変数の条件付き確率分布が現時間ステップ t の値 xt のみに 依存して、 xt が与えられれば t - 1 以前の値 x1...xt-1 には依存しない性質のこと。 確率変数 X を状態変数とみなせば、Pr(Xt+1 = x’|Xt = x) は状態 x から次ステップで状 態 x’ に遷移する確率を表すことから、一般に状態遷移確率(state transition probability)と呼ばれる。
マルコフ性をもつ確率過程のことをマルコフ過程(Markov process)といい、さらに状態 変数のとりうる値が離散的(有限または可算)の場合、マルコフ連鎖(Markov chain)と いう。 マルコフ性という性質は強化学習を考えるうえで非常に大切な特徴になる。 なぜなら、もしマルコフ性が成り立たないような任意の確率過程を学習の対象にしてしま うと、状態遷移の確率分布の複雑性が時間ステップ t に対して組み合わせ的に増大し
てしまい、一般に扱えなくなるため。 1.2.1 確率過程とマルコフ性 #3
1.2.2 マルコフ決定過程 強化学習は行動選択ルールの最適化を扱うため、従来の「状態(state)」のみの確率過 程ではなく、行動などを追加した確率制御過程(stochastic control process)と呼ばれる 種類の確率過程を考える。 マルコフ連鎖に「行動(action)」と意思決定の良し悪しの基準になる「報酬(reward)」を 組み入れた確率制御過程がマルコフ決定過程(Markov decision
process; MDP)と呼 ばれる。
1.2.3 逐次的意思決定の典型的問題設定 方策の最適化問題である逐次的意思決定問題は、一般的には、目的関数と呼ばれる 方策を評価する関数を用いて、与えられた方策集合から、目的関数を最大化するような 方策を探し求める問題といえる。 ただし、そのままでは問題の抽象度が高すぎて効率のよい解法を考えることができない ので、典型的にはシステムはマルコフ決定過程に従うと仮定し、目的関数に期待報酬 (expected reward)もしくは期待リターン(expected return)と呼ばれる期待割引累積報
酬(expected discounted cumulative reward)を用いる。
1.2.4 強化学習とマルコフ決定過程 強化学習はマルコフ決定過程(のプランニング)の研究成果を基礎にして発展している。 マルコフ決定過程の研究ではシステムを既知と仮定することが多いのに対して、強化学 習ではシステムが未知の問題を扱うことが多い。 制御対象のシステムのことを環境(environment)、制御器や意思決定者をエージェント (agent)と呼ぶ。
1.3 方策 1.3.1 方策の分類 1.3.2* 方策の特徴
1.3.1 方策の分類 式 (1.2) で定義した確率的方策 π の集合 Π の部分集合として決定的方策 (deterministic
policy)π d の集合Πd を考えることができる。 これまでに導入した方策 π や πd は状態 s のみに依存し、過去の経験とは独立に行動 を選択することからマルコフ方策(Markov policy)といい、また時間ステップ t が進展し ても意思決定ルール(方策関数)は変わらないので、マルコフ方策のなかでも定常なマ ルコフ方策(stationary Markov policy)と呼ばれるクラスに属する。
1.3.2* 方策の特徴 スキップ
1.4 逐次的意思決定問題の定式化 1.4.1 問題設定 1.4.2 マルコフ決定過程の単一化 1.4.3 リターンと目的関数 1.4.4* その他の逐次的意思決定問題
1.4.1 問題設定 #1 方策の最適化問題のことを逐次的意思決定問題というが、学習で調整できるものは方 策のみであり、環境モデルであるマルコフ決定過程は強化学習を適用する課題によって 定まり、時間不変とする。 環境モデルから最適方策を求めることを、学習(learning)といわず、プランニング (planning)もしくはプランニング問題(planning problem)ということが多い。 環境モデルが未知の場合、プランニングの場合とは異なり、従来の最適化ソルバーをそ
のまま適用できるような最適化問題として定式化できず、データ(環境との相互作用の 結果)からの学習が必要となる。
1.4.1 問題設定 #2 本書では、環境モデルが未知の場合の方策の学習問題を強化学習問題 (reinforcement learning problem)と呼ぶ。 強化学習問題の設定として大きく2つある。1つは従来の機械学習と似た設定で、環境 との相互作用などから得たデータが大量にあって、そのデータから方策を学習するバッ チ学習(batch
learning)である。 バッチ学習はオフライン学習と呼ばれることもある。もう1つは逐次的に環境と相互作用 してデータを収集しながら学習するオンライン学習(online learning)である。
1.4.1 問題設定 #3 オンライン学習の場合、次の2つの意思決定戦略があり、それらのバランスを考慮する 必要がある。このことを探索と活用のトレードオフ(exploration-exploitation trade-off)と いう。 ・データ収集/探索(exploration):データが十分でないという立場から、環境についての 不確実性を減らし、新たな発見をできるように行動をする戦略 ・データ活用(exploitation):データはすでに十分にあるという立場から、データから最良
と判断できる行動を選択する戦略
1.4.2 マルコフ決定過程の単一化 (A)ゴール状態があり、ゴール状態に到達したら終了する (B)あらかじめ決められた時間ステップになったら終了する (C)終了しない(無限時間長のマルコフ決定過程) (A)と(B)のマルコフ決定過程のもつ意味を変えずに、表現型を少し変更するだけで、 (C)のマルコフ決定過程として再定式化できる。 本書では通常は(C)を扱うことにする。
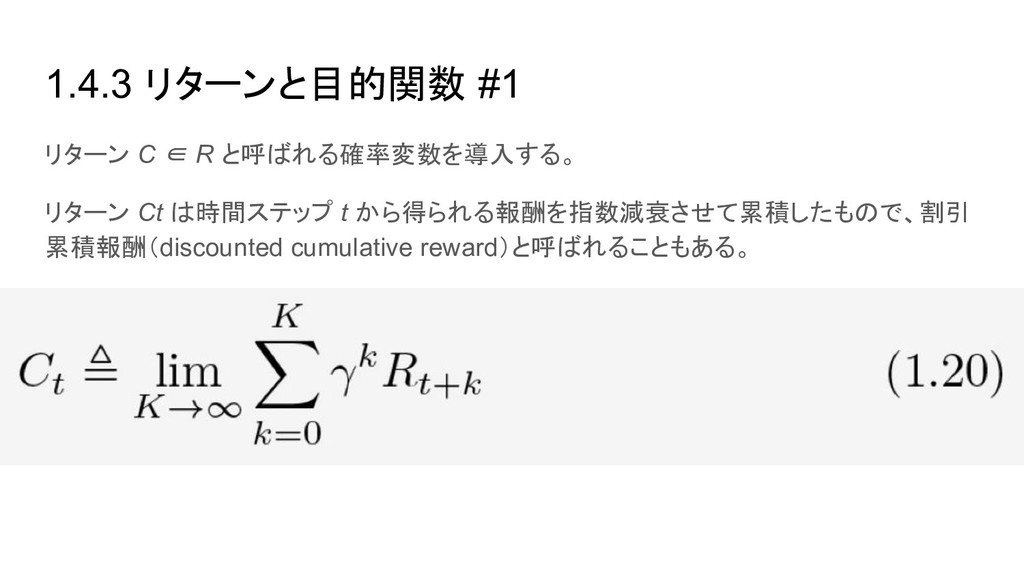
1.4.3 リターンと目的関数 #1 リターン C ∈ R と呼ばれる確率変数を導入する。 リターン Ct
は時間ステップ t から得られる報酬を指数減衰させて累積したもので、割引 累積報酬(discounted cumulative reward)と呼ばれることもある。
1.4.3 リターンと目的関数 #2 γ ∈ [0,1) は割引率と呼ばれるハイパーパラメータ。 ハイパーパラメータとは学習によって調整されるものではなく、課題の目的に応じてあら かじめ人が設定するパラメータのこと。 短期的なリターンを考慮したいのであれば
γ を小さく、長期的なリターンを考慮したいの であれば γ を1に近づける。 リターン C は状態遷移や方策の確率分布に依存して、確率的にさまざまな値をとるの で確率変数である。 リターンの実現値を c と書くことにする。
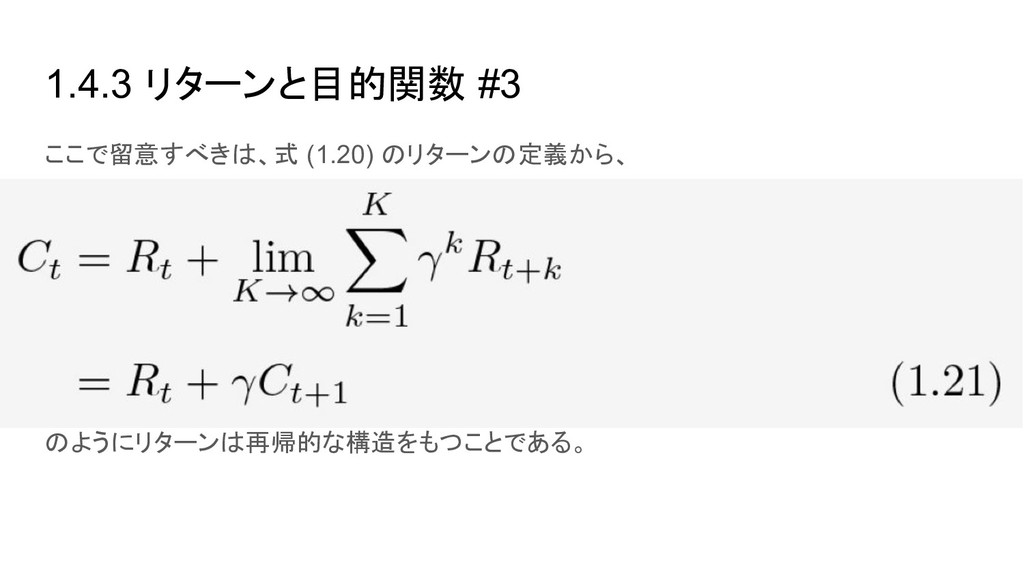
1.4.3 リターンと目的関数 #3 ここで留意すべきは、式 (1.20) のリターンの定義から、 のようにリターンは再帰的な構造をもつことである。
1.4.3 リターンと目的関数 #4 逐次的意思決定問題は一般にリターンに関する何かしらの統計量 F[C|M(π)] を目的関 数 や制約条件に用いて、方策についての最適化問題として定式化される。
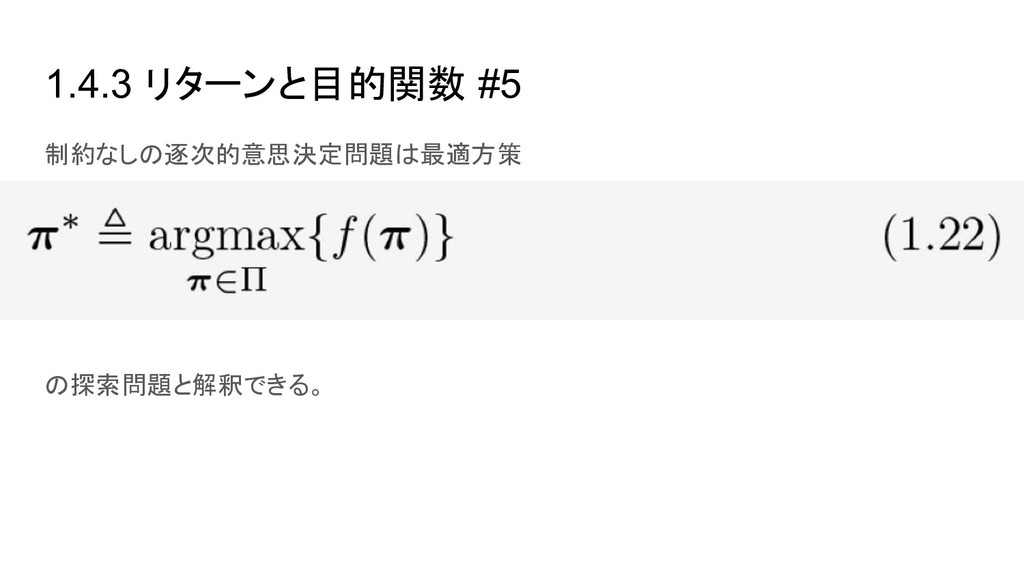
1.4.3 リターンと目的関数 #5 制約なしの逐次的意思決定問題は最適方策 の探索問題と解釈できる。
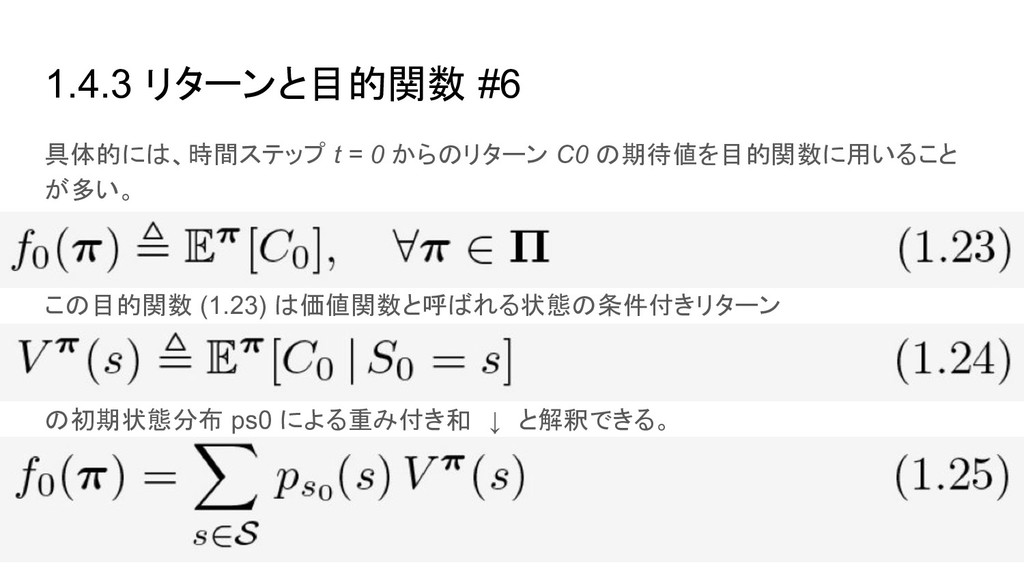
1.4.3 リターンと目的関数 #6 具体的には、時間ステップ t = 0 からのリターン C0 の期待値を目的関数に用いること
が多い。 この目的関数 (1.23) は価値関数と呼ばれる状態の条件付きリターン の初期状態分布 ps0 による重み付き和 ↓ と解釈できる。
1.4.3 リターンと目的関数 #7 ここで、重み関数 w による価値関数の重み付き和を と定義すれば、式 (1.25) の目的関数 f0
を と書くことができる。
1.4.3 リターンと目的関数 #8 目的関数 f0 は式 (1.19) の場合と同様、系 1.2 の条件を満たすので、履歴依存の方策
集合 πH ではなく、その部分集合であるマルコフ方策集合 πM のみを扱えば十分であ ることがわかる。
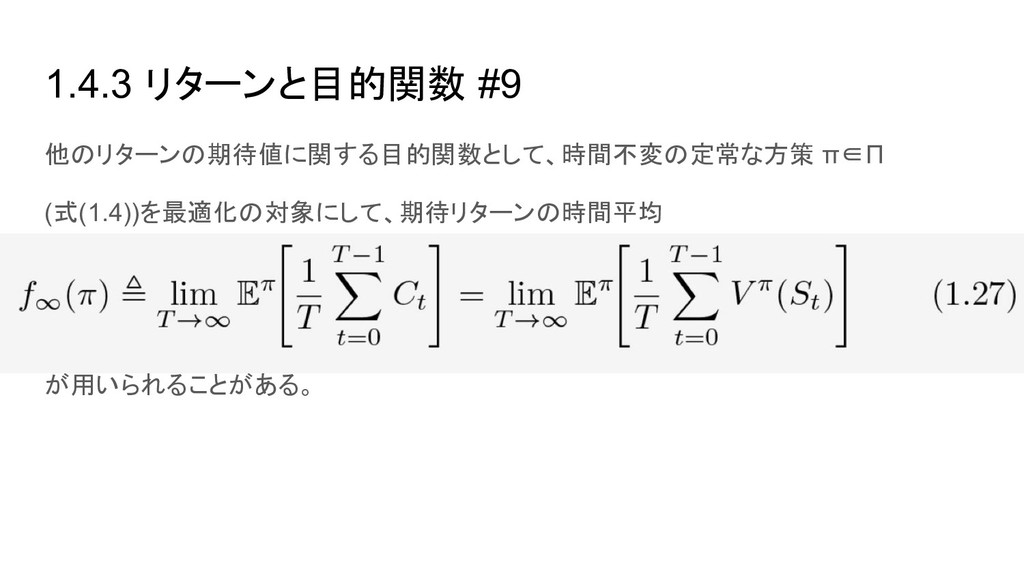
1.4.3 リターンと目的関数 #9 他のリターンの期待値に関する目的関数として、時間不変の定常な方策 π∈Π (式(1.4))を最適化の対象にして、期待リターンの時間平均 が用いられることがある。
1.4.3 リターンと目的関数 #10 エルゴード性(ergodic property)はマルコフ連鎖の特徴のことで、既約的 (irrreducibility)でありかつ非周期的(aperiodicity)であることをいう。 既約とはマルコフ連鎖 MC(π) のすべての状態が互いに行き来可能であることを意味す る。
また、非周期的とは、次の時間ステップの集合 の最大公約数(gcd)がつねに1であることを意味する。
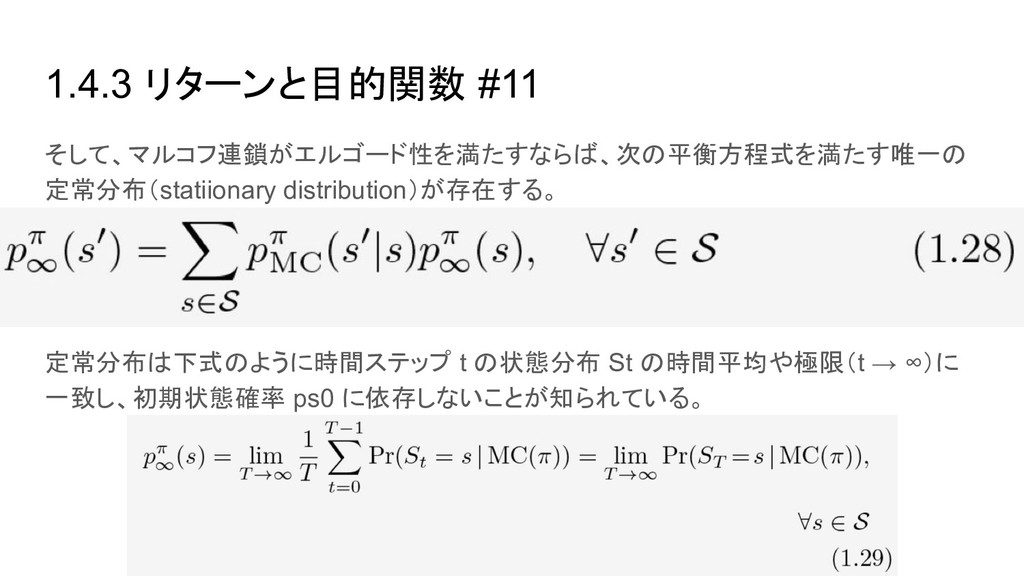
1.4.3 リターンと目的関数 #11 そして、マルコフ連鎖がエルゴード性を満たすならば、次の平衡方程式を満たす唯一の 定常分布(statiionary distribution)が存在する。 定常分布は下式のように時間ステップ t の状態分布 St
の時間平均や極限(t → ∞)に 一致し、初期状態確率 ps0 に依存しないことが知られている。
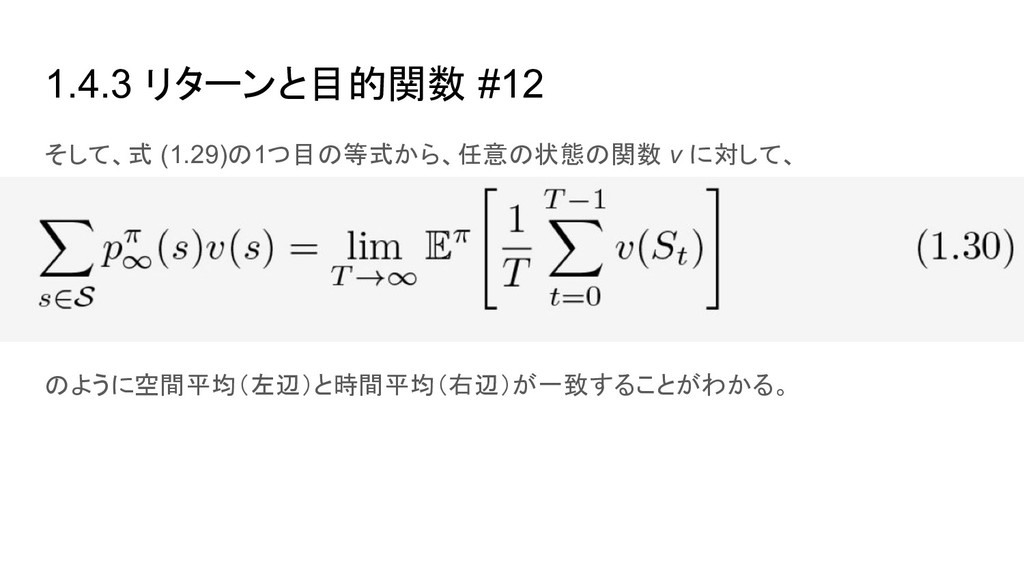
1.4.3 リターンと目的関数 #12 そして、式 (1.29)の1つ目の等式から、任意の状態の関数 v に対して、 のように空間平均(左辺)と時間平均(右辺)が一致することがわかる。
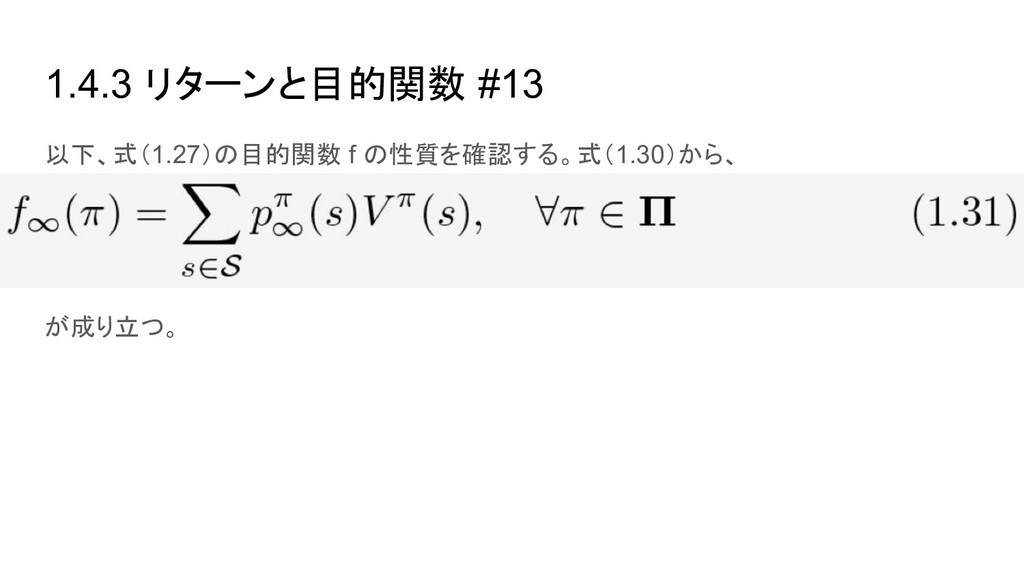
1.4.3 リターンと目的関数 #13 以下、式(1.27)の目的関数 f の性質を確認する。式(1.30)から、 が成り立つ。
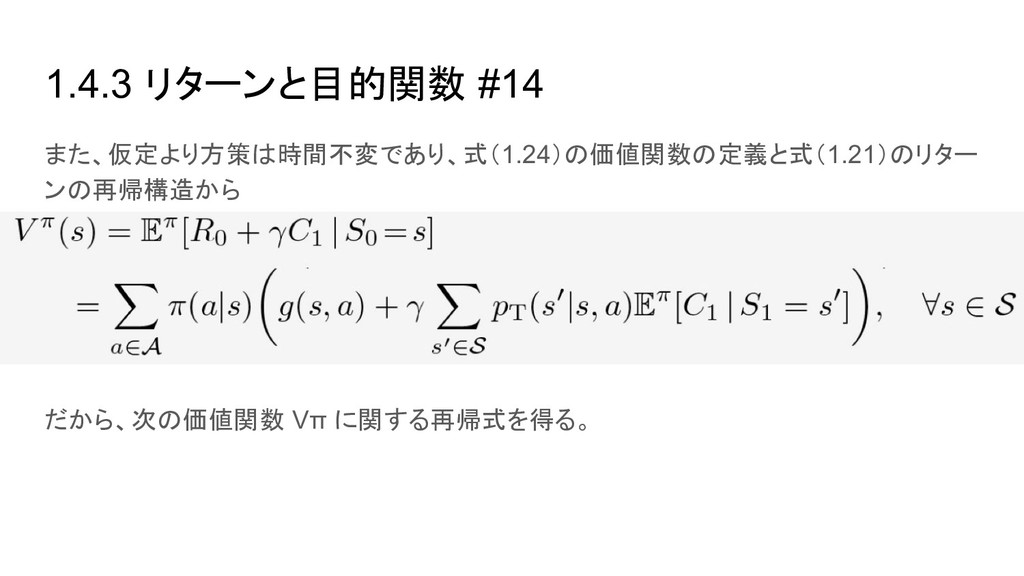
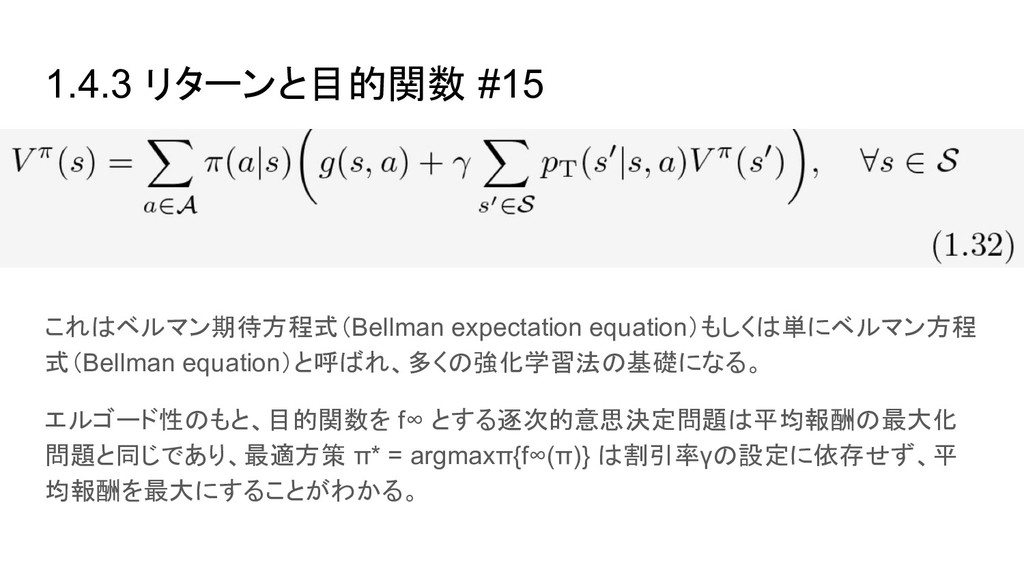
1.4.3 リターンと目的関数 #14 また、仮定より方策は時間不変であり、式(1.24)の価値関数の定義と式(1.21)のリター ンの再帰構造から だから、次の価値関数 Vπ に関する再帰式を得る。
1.4.3 リターンと目的関数 #15 これはベルマン期待方程式(Bellman expectation equation)もしくは単にベルマン方程 式(Bellman equation)と呼ばれ、多くの強化学習法の基礎になる。 エルゴード性のもと、目的関数を f∞
とする逐次的意思決定問題は平均報酬の最大化 問題と同じであり、最適方策 π* = argmaxπ{f∞(π)} は割引率γの設定に依存せず、平 均報酬を最大にすることがわかる。
1.4.4* その他の逐次的意思決定問題 スキップ
Fin.
More Decks by Lystahi
See All by Lystahi
Machine Learning of Jazz
lystahi
2
1.2k
CauseAndEffectTokyoStartup
lystahi
0
330
Other Decks in Technology
See All in Technology
農家は秘伝のタレを知らない - NOBODY KNOWS THE HIDDEN SOURCE - Kaggriculture 3rd Place Solution
masspeaks
2
520
AI時代における医療情報システムのセキュリティ / Security of Healthcare IT Systems in the AI Era
henryofficial
0
190
MCPでネットワーク障害調査を自動化する前に直すべき3つのこと
yama3133
1
590
Context parameters で作る!はじめての型クラス
kworkdev
PRO
1
150
Go初心者のクラウドエンジニアが、デプロイを通して旨味を知っていく話
ryudai
1
230
エンタープライズ事業未経験のデータ屋、 AI時代にN回撃沈する.pdf
ryoskdara_
0
150
目を覚ませ!僕らの認証情報が何者かに侵略されてるぞ
tkito
2
450
Biohub - Cell Tracking During Development 5th place solution
rist
0
170
さようならSSH鍵、こんにちはゼロトラスト ― AIフレンドリーで快適な自宅鯖SSH
atalie2m
14
7k
AWS Client VPNの設定でハマったポイントとその過程での気づき
amarelo_n24
1
360
閉域網でのAPI公開の選択肢全部比較!
takano0131
4
520
cdkdがどんだけ早いか、実際に動かして見てみよう
smt7174
1
130
Featured
See All Featured
Fantastic passwords and where to find them - at NoRuKo
philnash
53
4k
Optimising Largest Contentful Paint
csswizardry
37
4k
SEOcharity - Dark patterns in SEO and UX: How to avoid them and build a more ethical web
sarafernandez
0
330
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
Designing for Timeless Needs
cassininazir
1
570
Automating Front-end Workflow
addyosmani
1370
210k
Designing for Performance
lara
612
70k
4 Signs Your Business is Dying
shpigford
187
23k
Leo the Paperboy
mayatellez
11
2.5k
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3.1k
30 Presentation Tips
portentint
PRO
1
470
YesSQL, Process and Tooling at Scale
rocio
174
15k


 lystahi
 masspeaks
 henryofficial
 yama3133
 kworkdev
 ryudai
 ryoskdara_
 tkito
 rist
 atalie2m
 amarelo_n24
 takano0131
 smt7174
 philnash
 csswizardry
 sarafernandez
 aarron
 cassininazir
 addyosmani
 lara
 shpigford
 mayatellez
 eileencodes
 portentint
 rocio