Upgrade to Pro — share decks privately, control downloads, hide ads and more …

REX : Quatre ans de développement d’un projet B...

REX : Quatre ans de développement d’un projet Big Data

Du prototype jusqu’à la production, ce retour d'expérience concerne toutes les phases d’un projet big data avec Hadoop. Vous pourrez y découvrir la problématique métier, les choix d’architecture effectués, les outils d'industrialisation mis en place, mais aussi les vrais problèmes de terrain et les solutions appliquées.

Avatar for Marie-Alice B

Marie-Alice B

October 29, 2019

Other Decks in Programming

Transcript

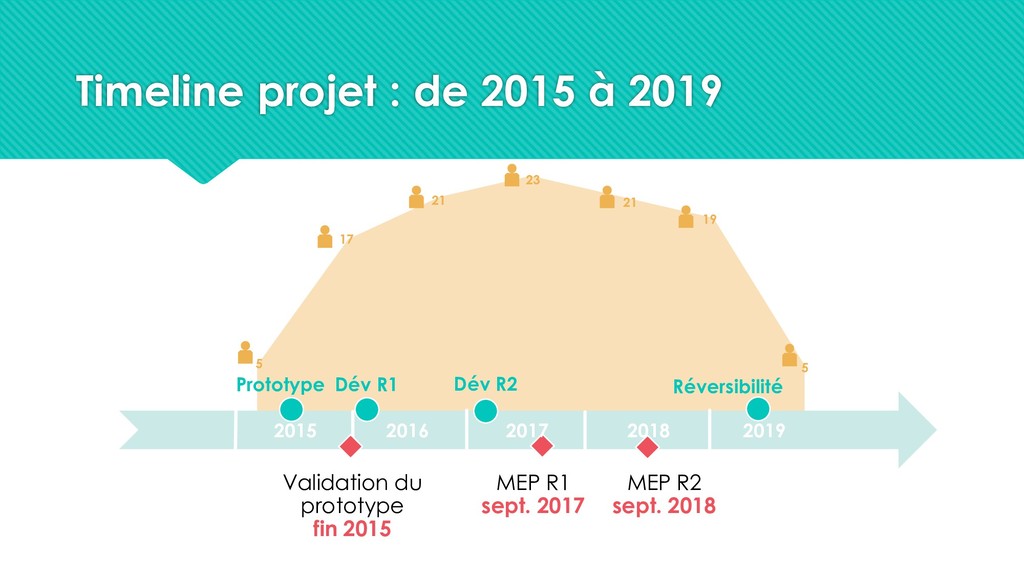
  1. 5 17 21 23 21 19 5 Prototype Validation du

    prototype fin 2015 Dév R1 Dév R2 MEP R1 sept. 2017 MEP R2 sept. 2018 Réversibilité Timeline projet : de 2015 à 2019 2015 2016 2017 2018 2019
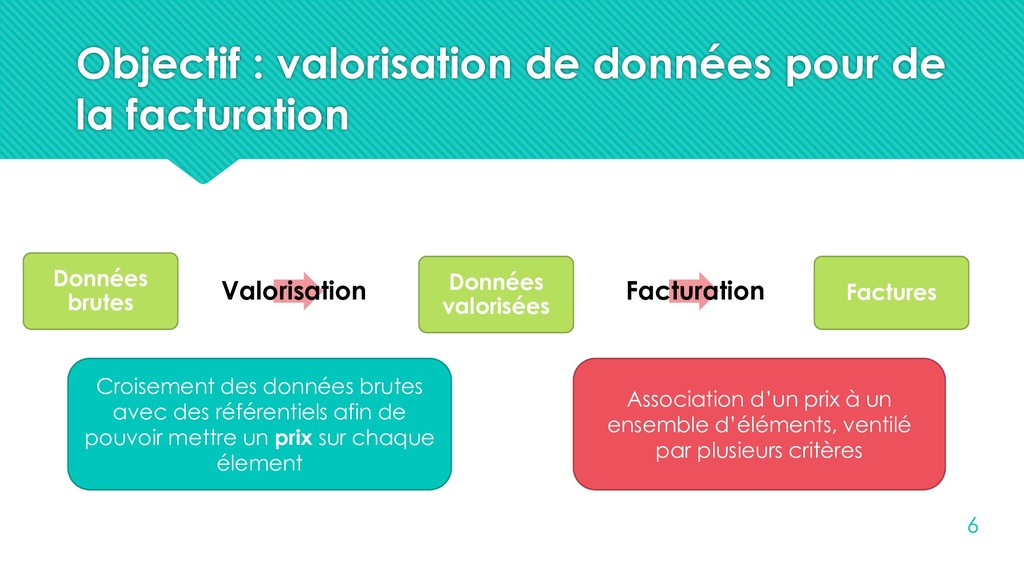
  2. Objectif : valorisation de données pour de la facturation Données

    valorisées Données brutes Valorisation Factures Facturation Croisement des données brutes avec des référentiels afin de pouvoir mettre un prix sur chaque élement 6 Association d’un prix à un ensemble d’éléments, ventilé par plusieurs critères
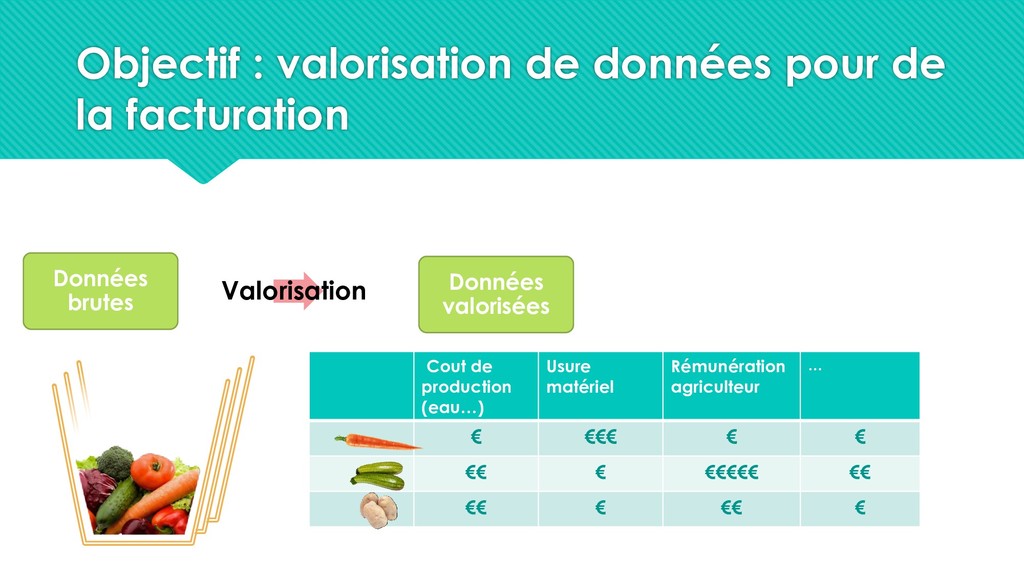
  3. Cout de production (eau…) Usure matériel Rémunération agriculteur … €

    €€€ € € €€ € €€€€€ €€ €€ € €€ € Objectif : valorisation de données pour de la facturation Données valorisées Données brutes Valorisation
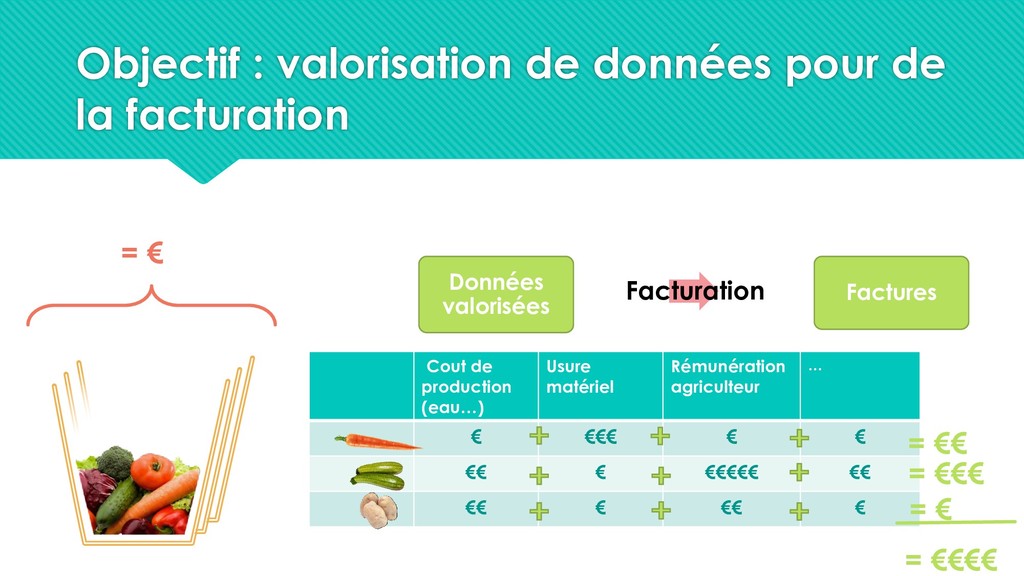
  4. Cout de production (eau…) Usure matériel Rémunération agriculteur … €

    €€€ € € €€ € €€€€€ €€ €€ € €€ € Objectif : valorisation de données pour de la facturation = €€ = €€€ = € = €€€€ Données valorisées Factures Facturation = €
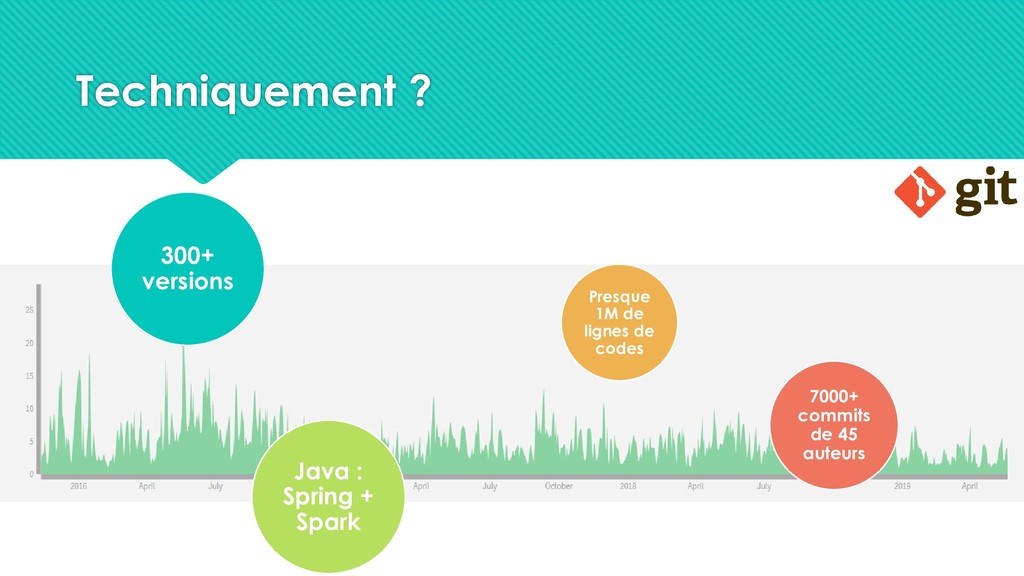
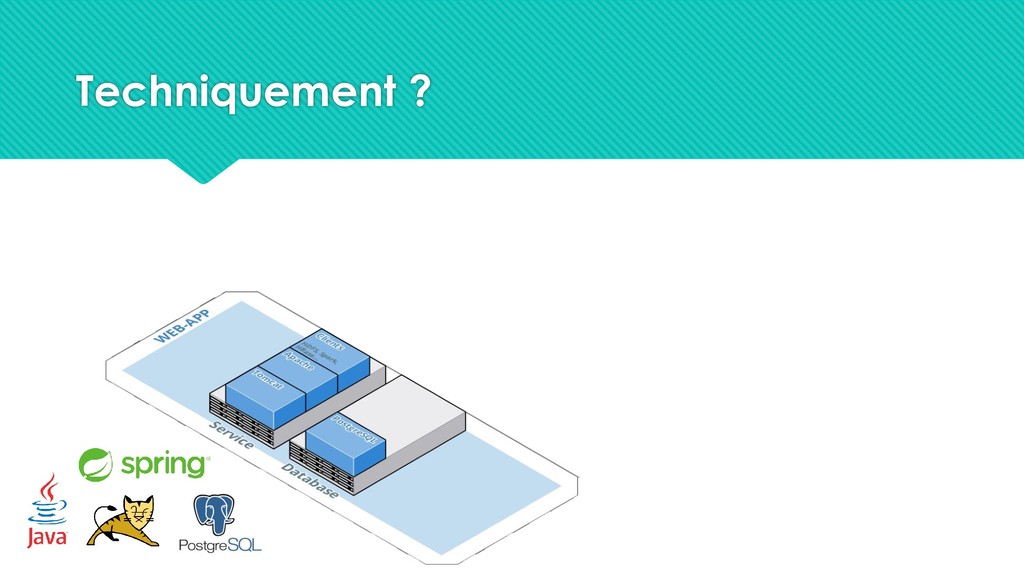
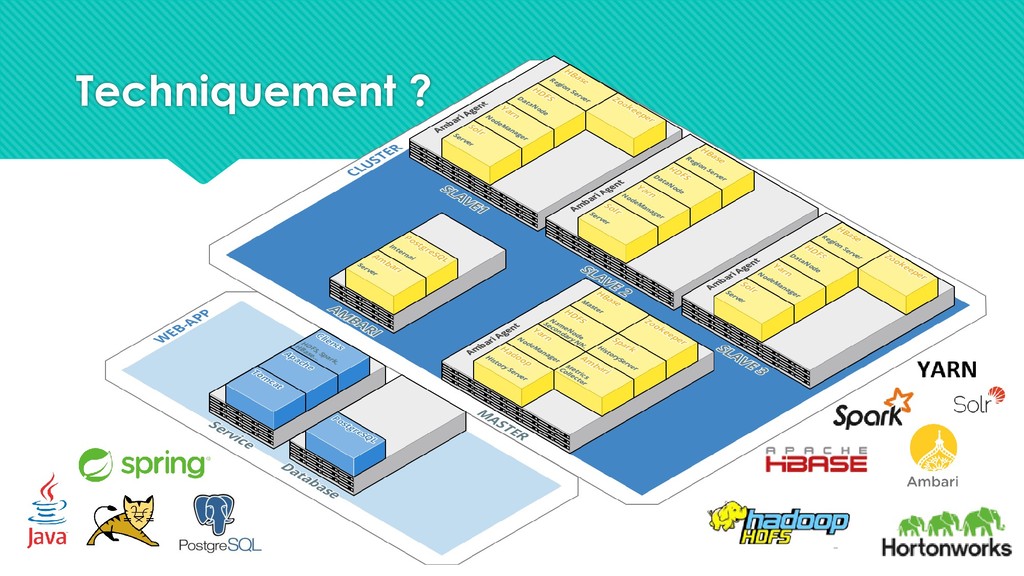
  5. Techniquement ? Presque 1M de lignes de codes 7000+ commits

    de 45 auteurs 300+ versions Java : Spring + Spark
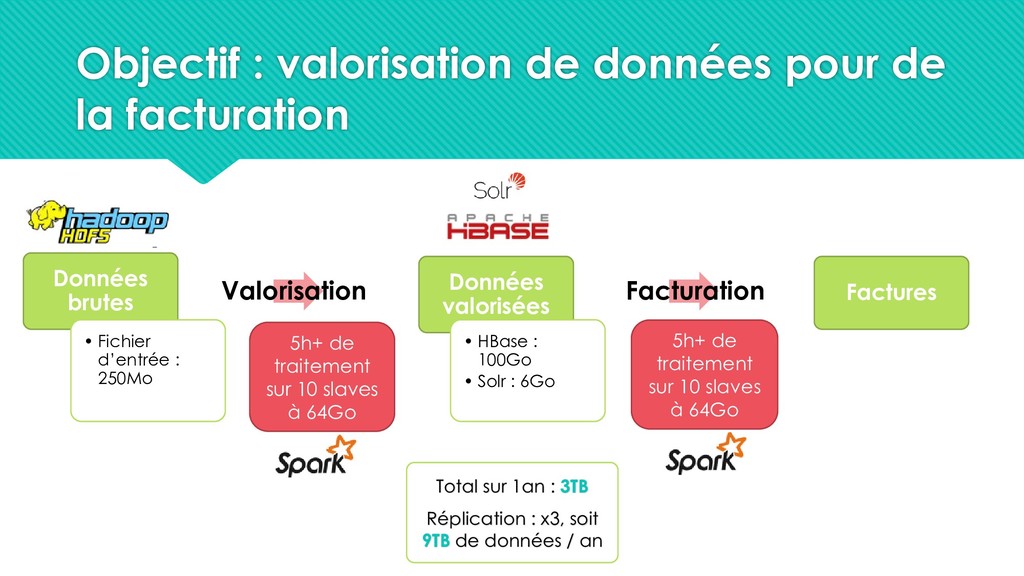
  6. Objectif : valorisation de données pour de la facturation Données

    valorisées Données brutes Valorisation Factures Facturation Total sur 1an : 3TB Réplication : x3, soit 9TB de données / an • HBase : 100Go • Solr : 6Go 5h+ de traitement sur 10 slaves à 64Go 5h+ de traitement sur 10 slaves à 64Go • Fichier d’entrée : 250Mo
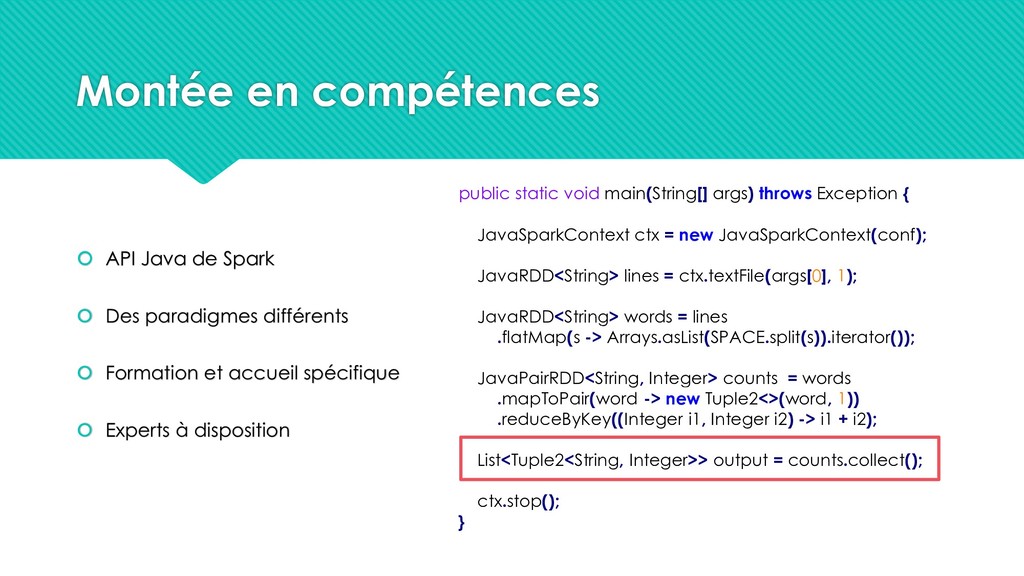
  7. Montée en compétences  API Java de Spark  Des

    paradigmes différents  Formation et accueil spécifique  Experts à disposition public static void main(String[] args) throws Exception { JavaSparkContext ctx = new JavaSparkContext(conf); JavaRDD<String> lines = ctx.textFile(args[0], 1); JavaRDD<String> words = lines .flatMap(s -> Arrays.asList(SPACE.split(s)).iterator()); JavaPairRDD<String, Integer> counts = words .mapToPair(word -> new Tuple2<>(word, 1)) .reduceByKey((Integer i1, Integer i2) -> i1 + i2); List<Tuple2<String, Integer>> output = counts.collect(); ctx.stop(); }
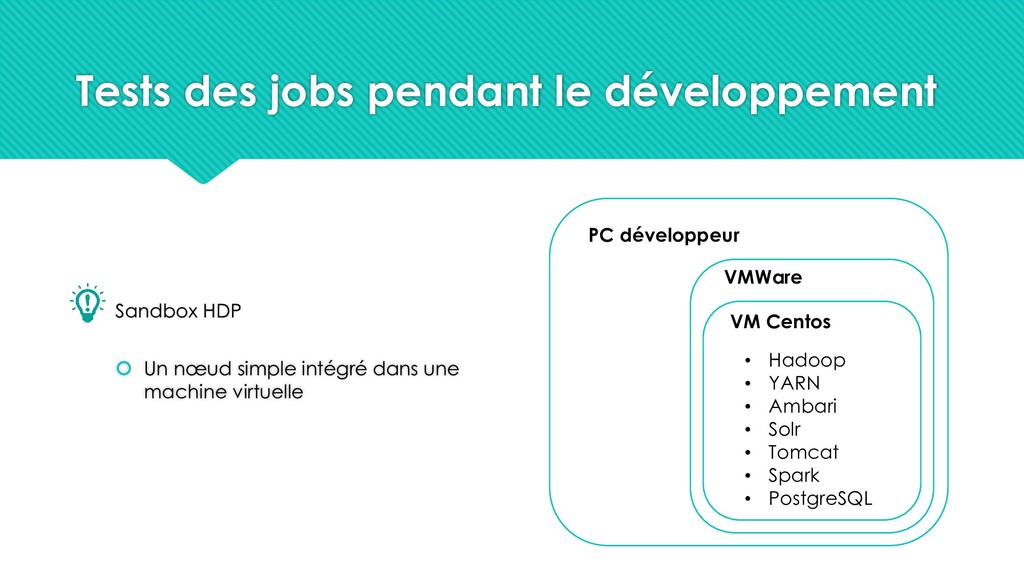
  8. Tests des jobs pendant le développement Sandbox HDP PC développeur

    VMWare • Hadoop • YARN • Ambari • Solr • Tomcat • Spark • PostgreSQL VM Centos  Un nœud simple intégré dans une machine virtuelle
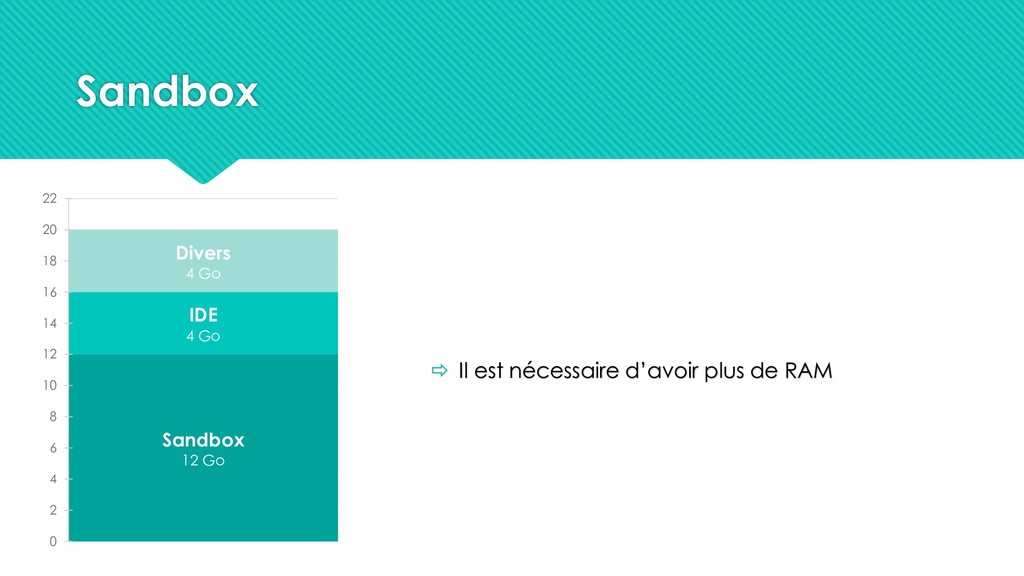
  9. Sandbox Sandbox 12 Go IDE 4 Go Divers 4 Go

    0 2 4 6 8 10 12 14 16 18 20 22  Il est nécessaire d’avoir plus de RAM
  10. Les limites des tests Sandbox  Les tests à volume

    cible ne sont pas possibles  Pas de distribution  Des comportements différents pour certains services
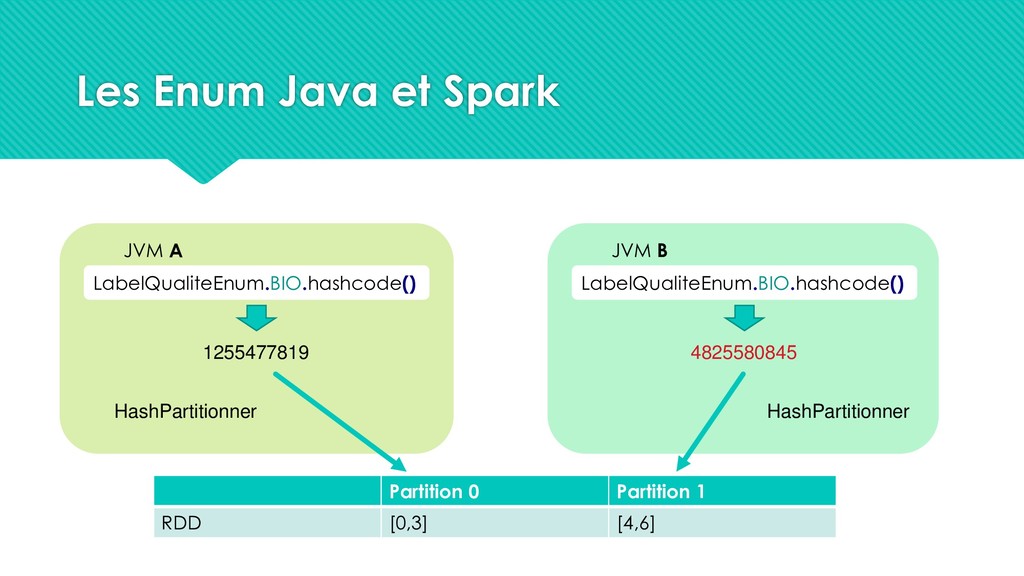
  11. Les Enum Java et Spark JVM A LabelQualiteEnum.BIO.hashcode() 1255477819 JVM

    B LabelQualiteEnum.BIO.hashcode() 4825580845 Partition 0 Partition 1 RDD [0,3] [4,6] HashPartitionner HashPartitionner
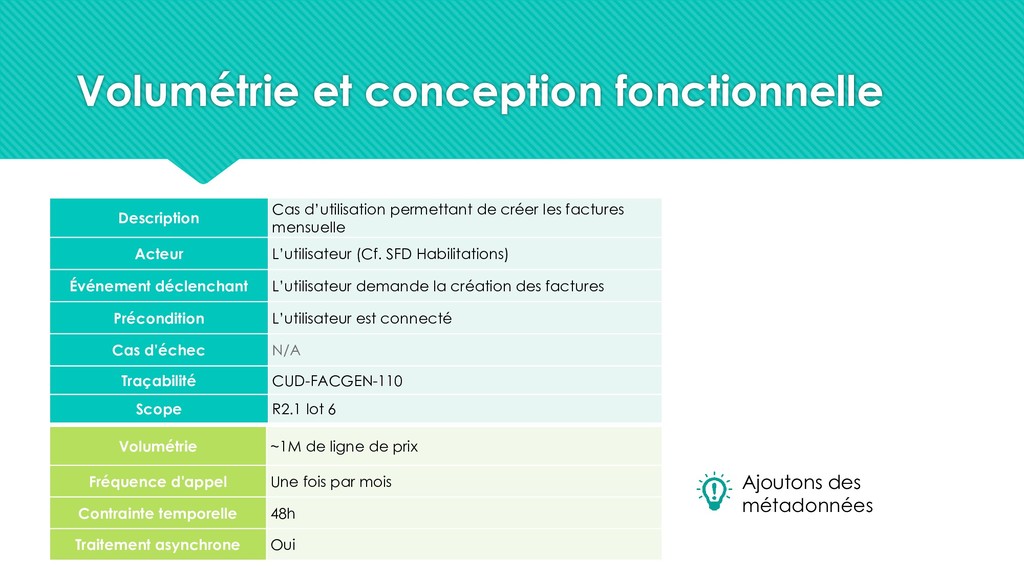
  12. Volumétrie et conception fonctionnelle Description Cas d’utilisation permettant de créer

    les factures mensuelle Acteur L’utilisateur (Cf. SFD Habilitations) Événement déclenchant L’utilisateur demande la création des factures Précondition L’utilisateur est connecté Cas d’échec N/A Traçabilité CUD-FACGEN-110 Scope R2.1 lot 6 Ajoutons des métadonnées Volumétrie ~1M de ligne de prix Fréquence d'appel Une fois par mois Contrainte temporelle 48h Traitement asynchrone Oui
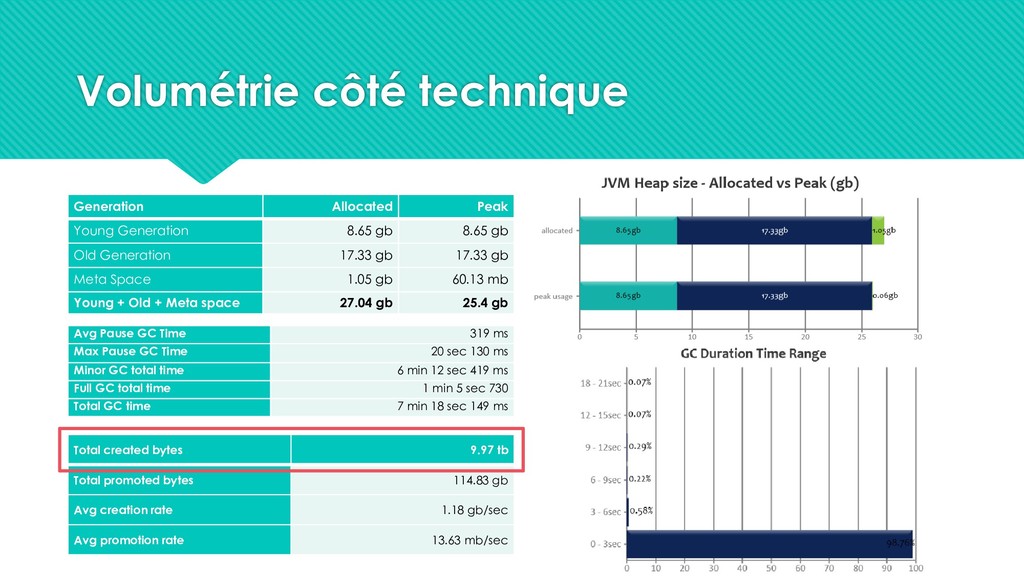
  13. Volumétrie côté technique Generation Allocated Peak Young Generation 8.65 gb

    8.65 gb Old Generation 17.33 gb 17.33 gb Meta Space 1.05 gb 60.13 mb Young + Old + Meta space 27.04 gb 25.4 gb Avg Pause GC Time 319 ms Max Pause GC Time 20 sec 130 ms Minor GC total time 6 min 12 sec 419 ms Full GC total time 1 min 5 sec 730 Total GC time 7 min 18 sec 149 ms Total created bytes 9.97 tb Total promoted bytes 114.83 gb Avg creation rate 1.18 gb/sec Avg promotion rate 13.63 mb/sec
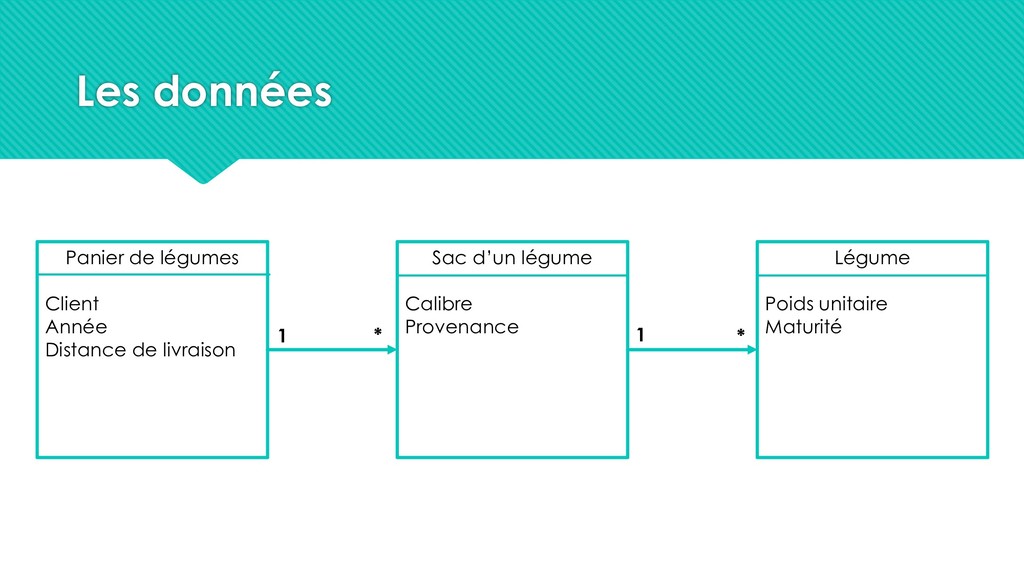
  14. Les données Panier de légumes Client Année Distance de livraison

    Sac d’un légume Calibre Provenance Légume Poids unitaire Maturité 1 * 1 *
  15. Premier besoin technique Stocker et récupérer les données par lots

    Ecriture : Insertion via Spark à partir de fichier plat, Lot = 1 an Lecture : Lecture via Spark Lot = 1an ou 1 an et 1 client
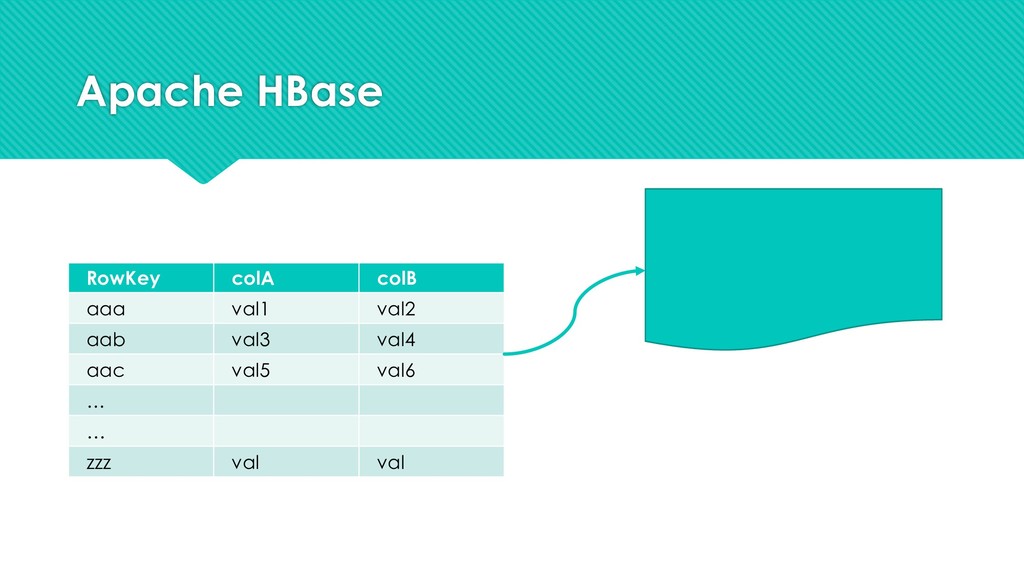
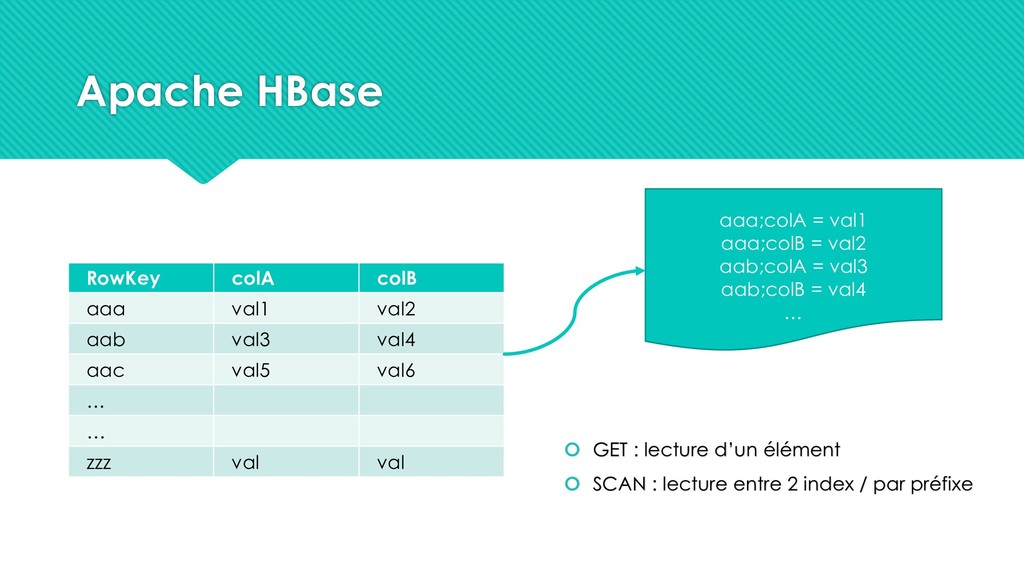
  16. Apache HBase  La base de données Big Data d’Hadoop:

    distribuée et scalable  Non relationnelle – orientée colonne  D’après le papier de Google «BigTable »
  17. Apache HBase RowKey colA colB aaa val1 val2 aab val3

    val4 aac val5 val6 … … zzz val val
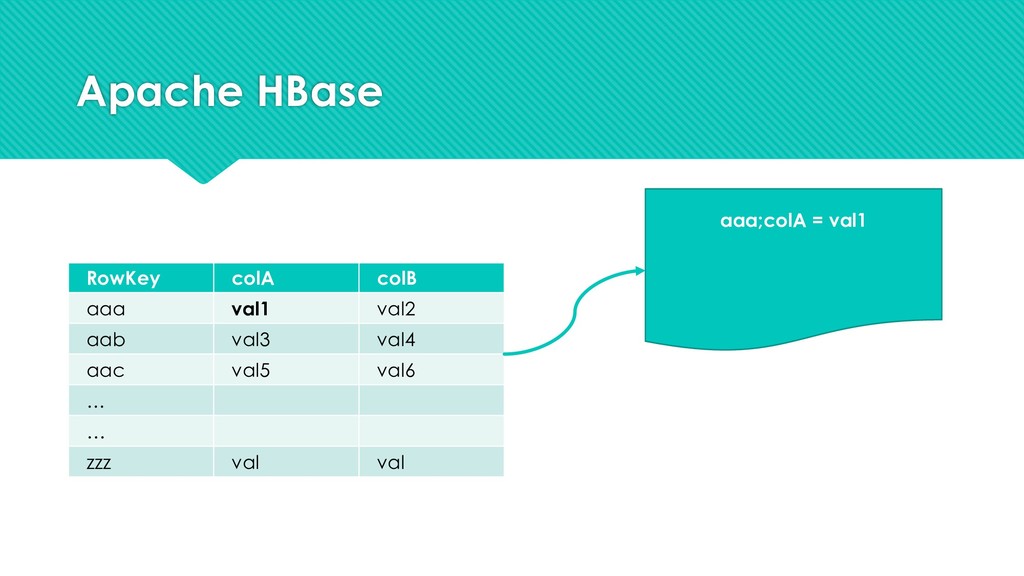
  18. Apache HBase RowKey colA colB aaa val1 val2 aab val3

    val4 aac val5 val6 … … zzz val val aaa;colA = val1
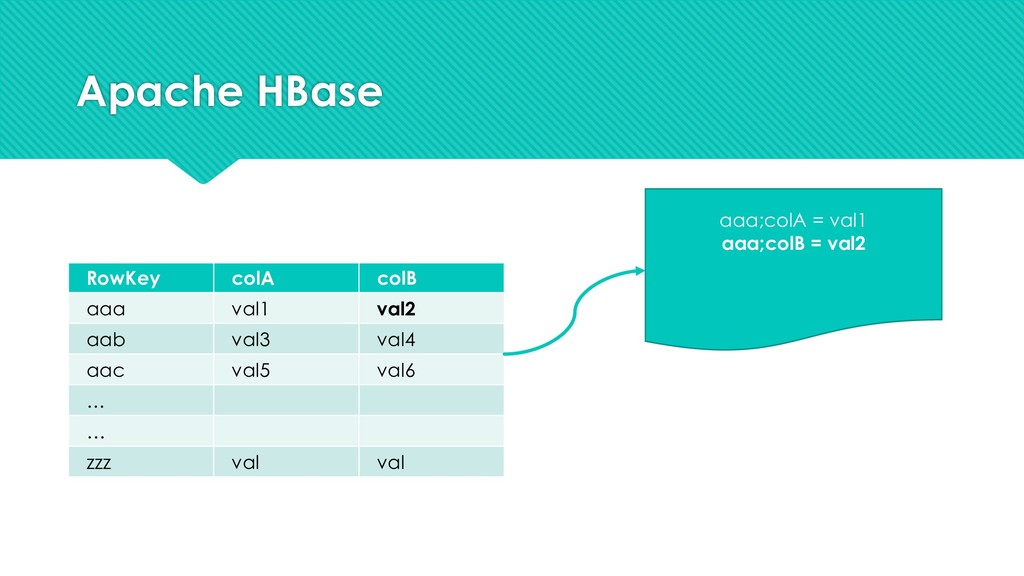
  19. Apache HBase RowKey colA colB aaa val1 val2 aab val3

    val4 aac val5 val6 … … zzz val val aaa;colA = val1 aaa;colB = val2
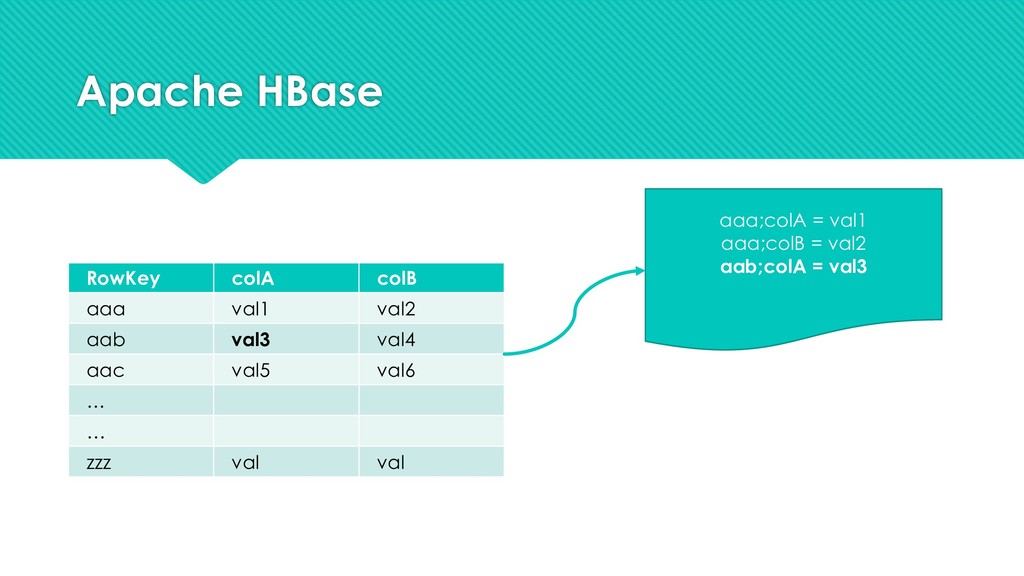
  20. Apache HBase RowKey colA colB aaa val1 val2 aab val3

    val4 aac val5 val6 … … zzz val val aaa;colA = val1 aaa;colB = val2 aab;colA = val3
  21. Apache HBase RowKey colA colB aaa val1 val2 aab val3

    val4 aac val5 val6 … … zzz val val  GET : lecture d’un élément  SCAN : lecture entre 2 index / par préfixe aaa;colA = val1 aaa;colB = val2 aab;colA = val3 aab;colB = val4 …
  22. Design HBase Dénormalisation Rowkey « Promoted Field » Lecture :

    Lecture via Spark Lot = 1an ou 1 an et 1 client
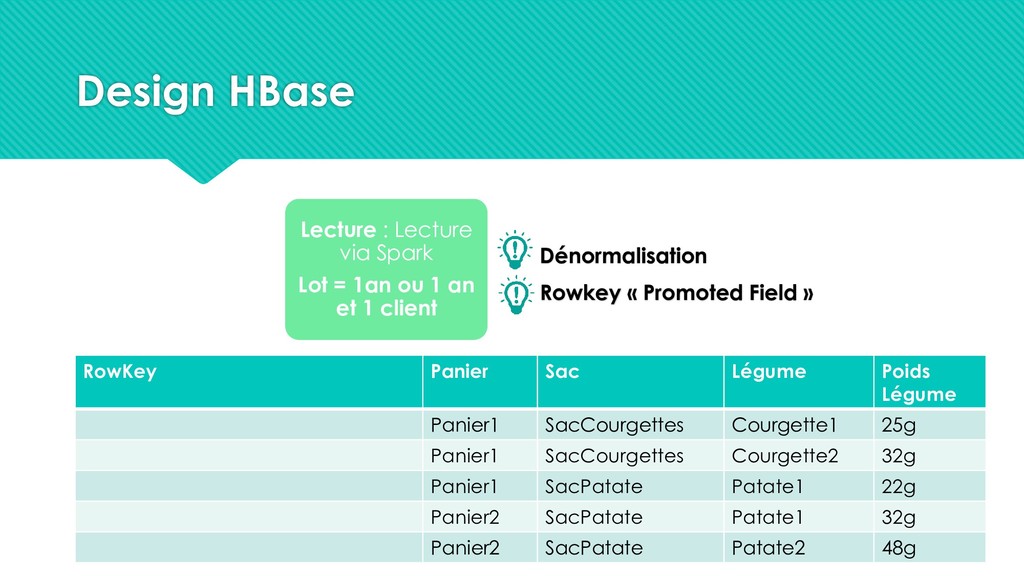
  23. Design HBase Dénormalisation Rowkey « Promoted Field » RowKey Panier

    Sac Légume Poids Légume Panier1 SacCourgettes Courgette1 25g Panier1 SacCourgettes Courgette2 32g Panier1 SacPatate Patate1 22g Panier2 SacPatate Patate1 32g Panier2 SacPatate Patate2 48g Lecture : Lecture via Spark Lot = 1an ou 1 an et 1 client
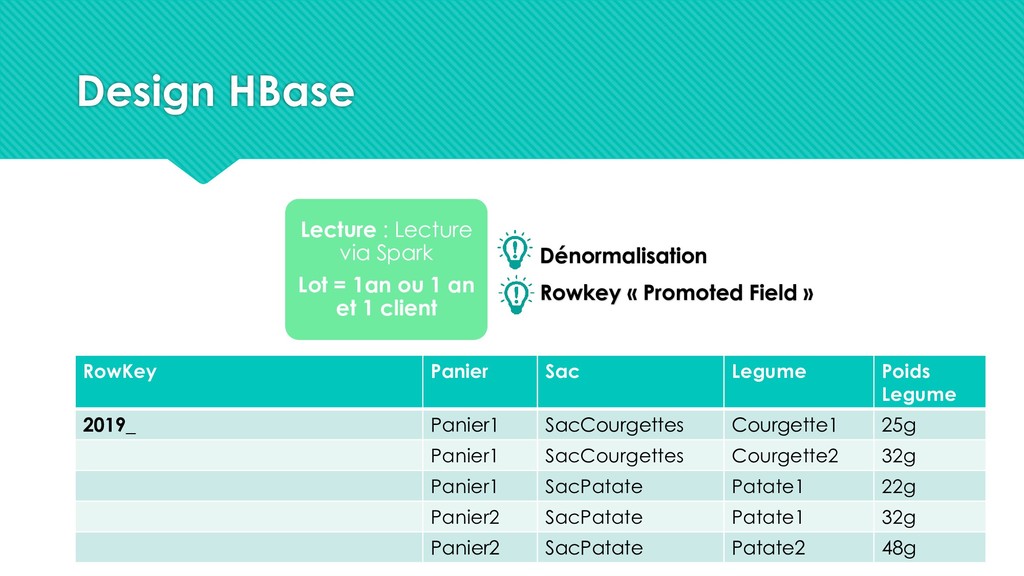
  24. Design HBase Dénormalisation Rowkey « Promoted Field » RowKey Panier

    Sac Legume Poids Legume 2019_ Panier1 SacCourgettes Courgette1 25g Panier1 SacCourgettes Courgette2 32g Panier1 SacPatate Patate1 22g Panier2 SacPatate Patate1 32g Panier2 SacPatate Patate2 48g Lecture : Lecture via Spark Lot = 1an ou 1 an et 1 client
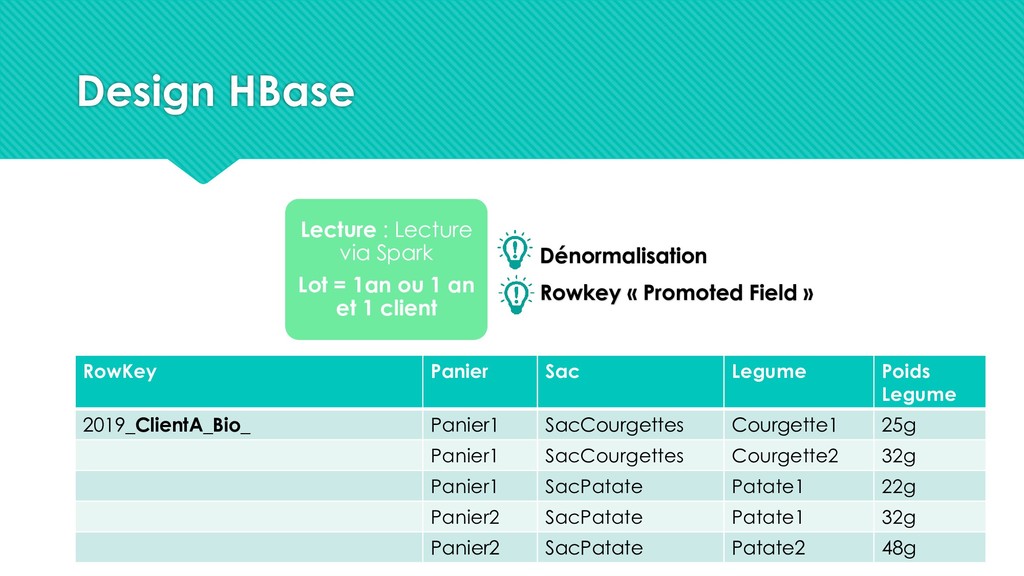
  25. Design HBase Dénormalisation Rowkey « Promoted Field » RowKey Panier

    Sac Legume Poids Legume 2019_ClientA_Bio_ Panier1 SacCourgettes Courgette1 25g Panier1 SacCourgettes Courgette2 32g Panier1 SacPatate Patate1 22g Panier2 SacPatate Patate1 32g Panier2 SacPatate Patate2 48g Lecture : Lecture via Spark Lot = 1an ou 1 an et 1 client
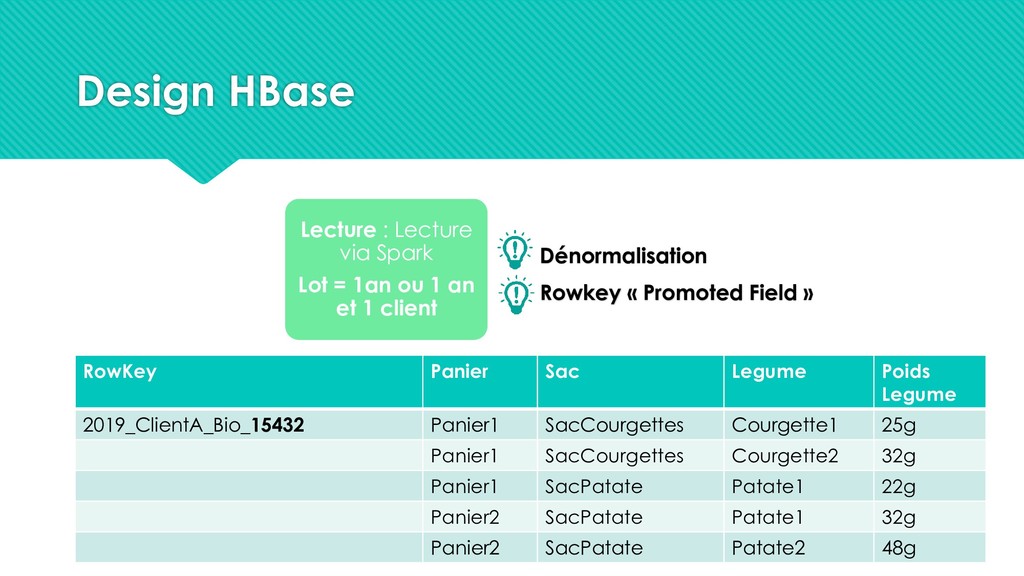
  26. Design HBase Dénormalisation Rowkey « Promoted Field » RowKey Panier

    Sac Legume Poids Legume 2019_ClientA_Bio_15432 Panier1 SacCourgettes Courgette1 25g Panier1 SacCourgettes Courgette2 32g Panier1 SacPatate Patate1 22g Panier2 SacPatate Patate1 32g Panier2 SacPatate Patate2 48g Lecture : Lecture via Spark Lot = 1an ou 1 an et 1 client
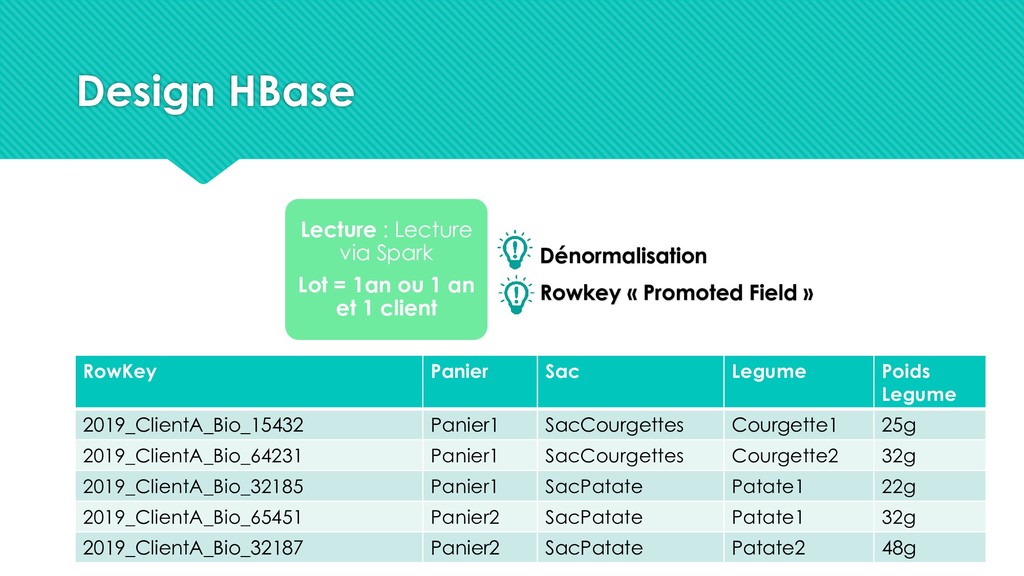
  27. Design HBase Dénormalisation Rowkey « Promoted Field » RowKey Panier

    Sac Legume Poids Legume 2019_ClientA_Bio_15432 Panier1 SacCourgettes Courgette1 25g 2019_ClientA_Bio_64231 Panier1 SacCourgettes Courgette2 32g 2019_ClientA_Bio_32185 Panier1 SacPatate Patate1 22g 2019_ClientA_Bio_65451 Panier2 SacPatate Patate1 32g 2019_ClientA_Bio_32187 Panier2 SacPatate Patate2 48g Lecture : Lecture via Spark Lot = 1an ou 1 an et 1 client
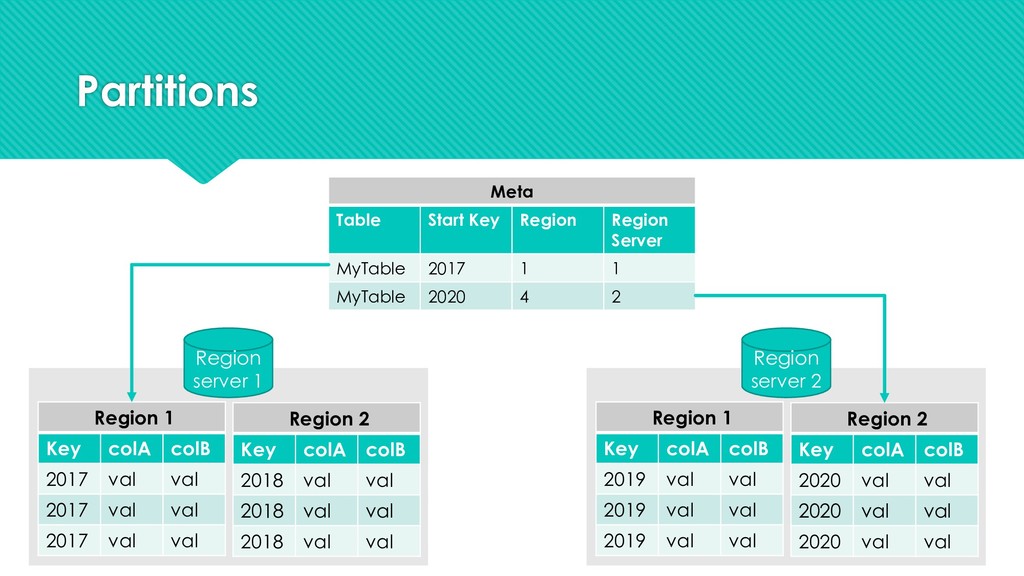
  28. Partitions Region 1 Key colA colB 2017 val val 2017

    val val 2017 val val Region 2 Key colA colB 2018 val val 2018 val val 2018 val val Region server 1 Meta Table Start Key Region Region Server MyTable 2017 1 1 MyTable 2020 4 2 Region 1 Key colA colB 2019 val val 2019 val val 2019 val val Region 2 Key colA colB 2020 val val 2020 val val 2020 val val Region server 2
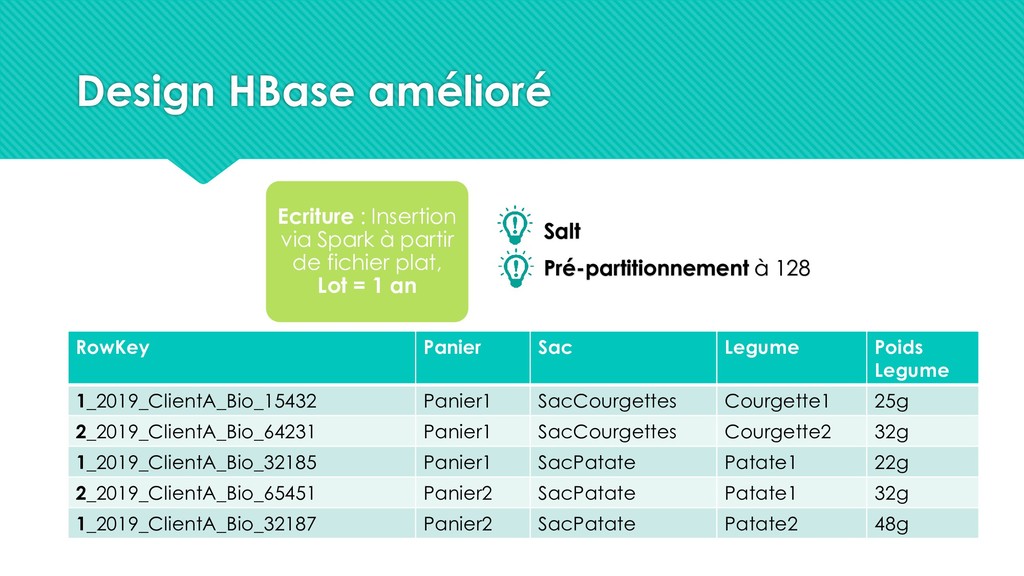
  29. Design HBase amélioré Salt Pré-partitionnement à 128 RowKey Panier Sac

    Legume Poids Legume 1_2019_ClientA_Bio_15432 Panier1 SacCourgettes Courgette1 25g 2_2019_ClientA_Bio_64231 Panier1 SacCourgettes Courgette2 32g 1_2019_ClientA_Bio_32185 Panier1 SacPatate Patate1 22g 2_2019_ClientA_Bio_65451 Panier2 SacPatate Patate1 32g 1_2019_ClientA_Bio_32187 Panier2 SacPatate Patate2 48g Ecriture : Insertion via Spark à partir de fichier plat, Lot = 1 an
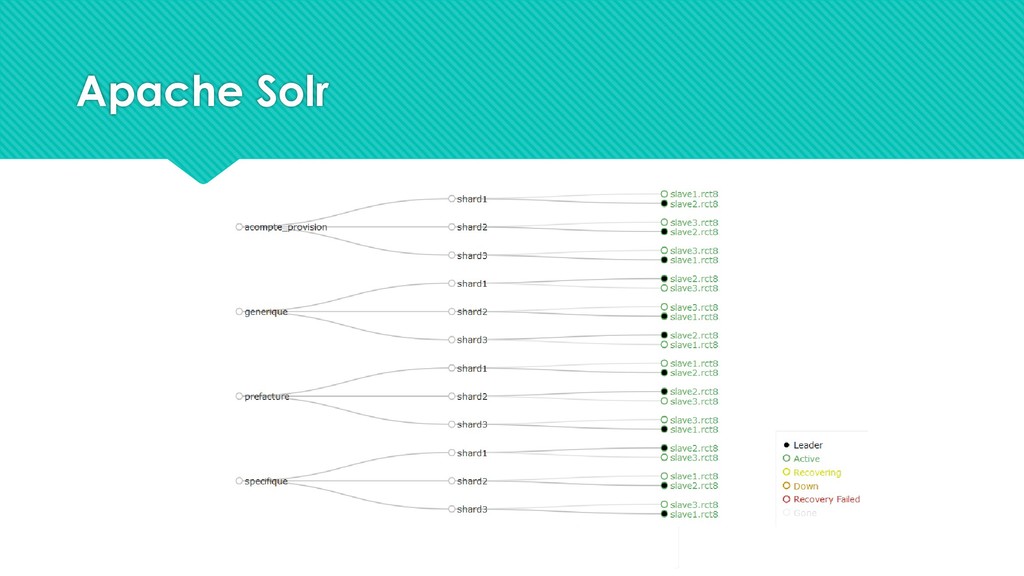
  30. Deuxième besoin technique  Récupérer les données de façon plus

    fine ou agrégée  Multiples vues métier évolutives Utilisation d’une base secondaire : Solr
  31. Les problèmes que l’on a rencontrés  Solr sur HDFS

     Bad Idea ™  L’importance de l’idempotence  Connexions x 128 à Zookeeper  Passage à 32 partitions  Very very Bad Idea ™
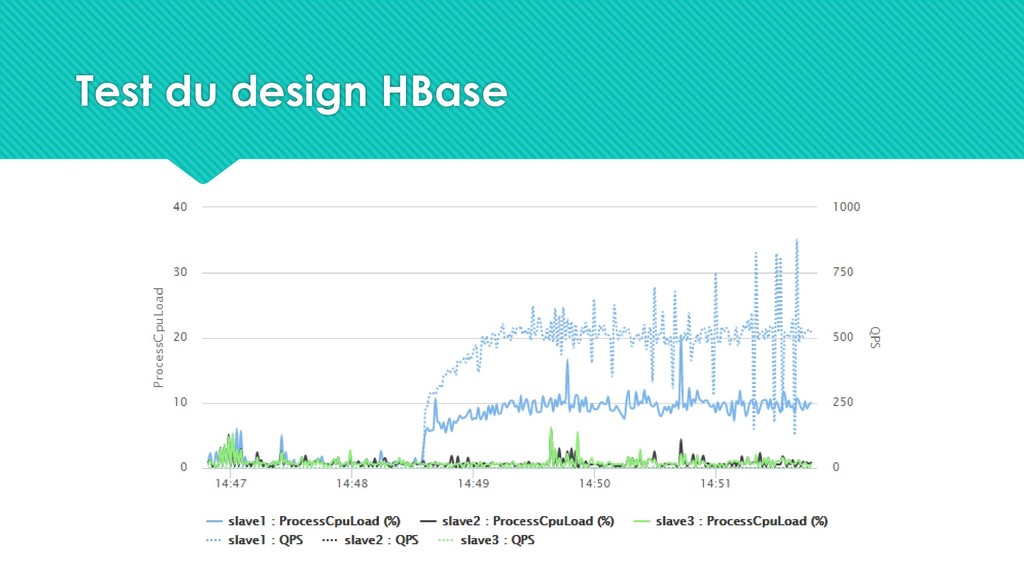
  32. Les bonnes idées que l’on a eues Lire de long

    en large la documentation Hbase, faire des tests et des mesures Instaurer des « checkpoints » qui vérifient la cohérence HBase/Solr Développer une application Spark de ré- indexation Surcharger l’api Spark HBase pour rendre le salt « transparent »
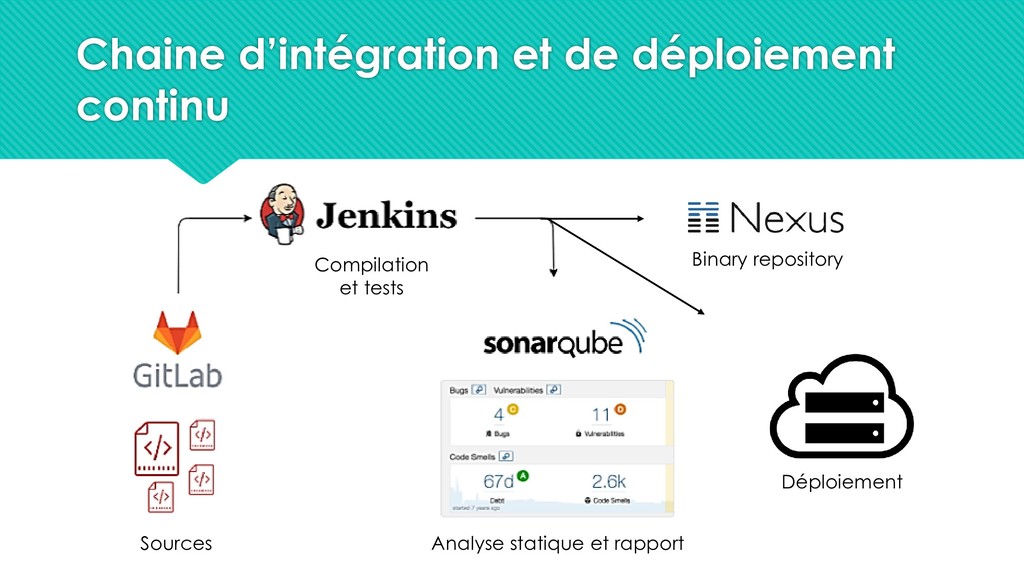
  33. Chaine d’intégration et de déploiement continu Compilation et tests Analyse

    statique et rapport Sources Binary repository Déploiement
  34. Tests automatisés des jobs Spark  JUnit  Plus besoin

    de mocker les services Hadoop  Exécution des jobs de bout en bout Hadoop mini cluster test
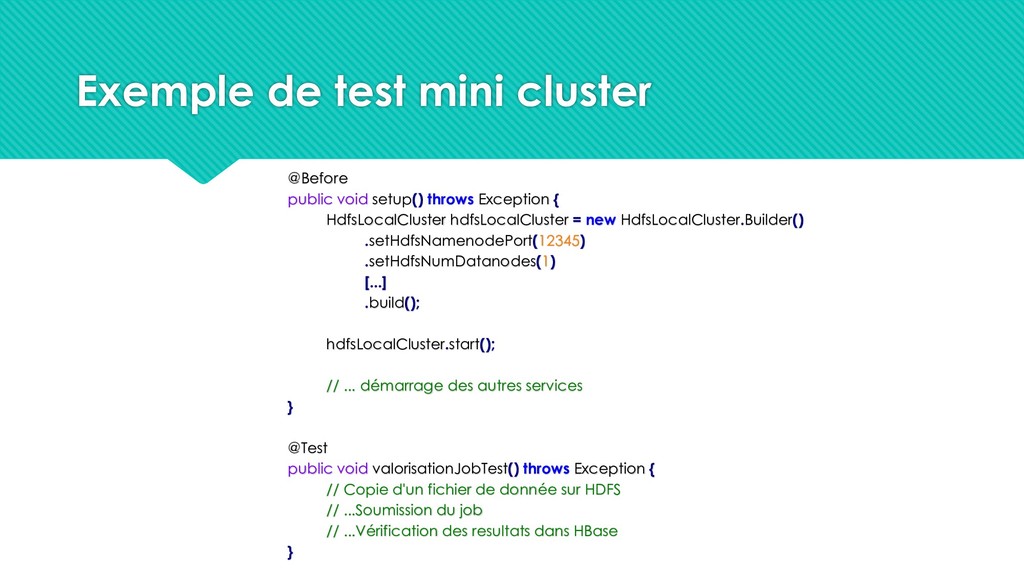
  35. Exemple de test mini cluster @Before public void setup() throws
    Exception { HdfsLocalCluster hdfsLocalCluster = new HdfsLocalCluster.Builder() .setHdfsNamenodePort(12345) .setHdfsNumDatanodes(1) [...] .build(); hdfsLocalCluster.start(); // ... démarrage des autres services } @Test public void valorisationJobTest() throws Exception { // Copie d'un fichier de donnée sur HDFS // ...Soumission du job // ...Vérification des resultats dans HBase }
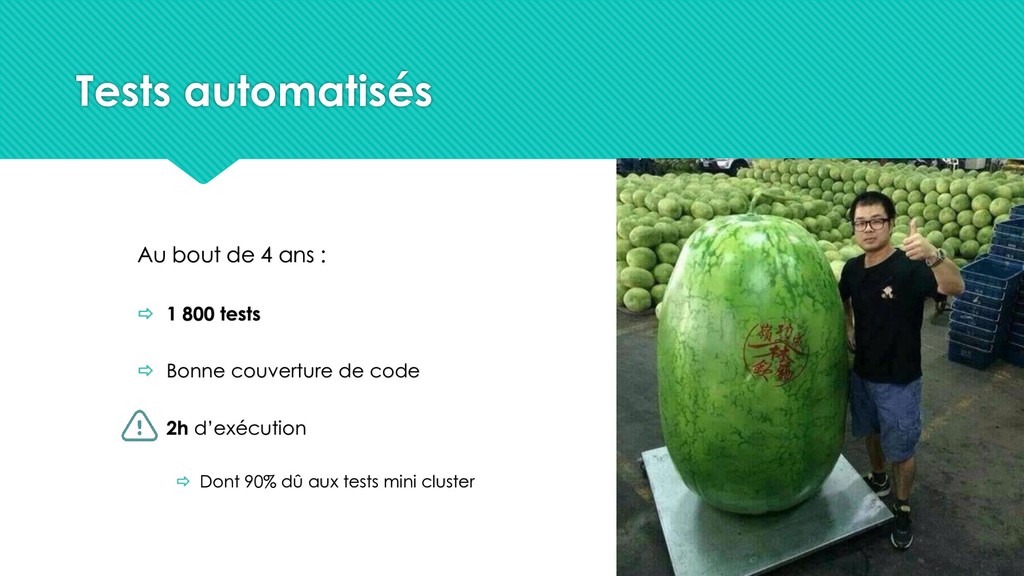
  36. Tests automatisés Au bout de 4 ans :  1

    800 tests  Bonne couverture de code  2h d’exécution  Dont 90% dû aux tests mini cluster
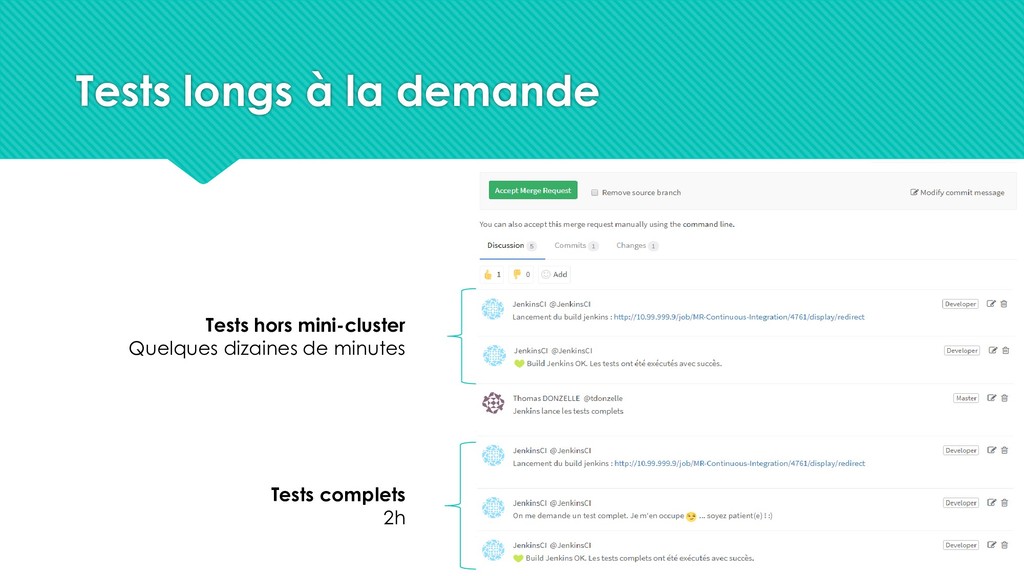
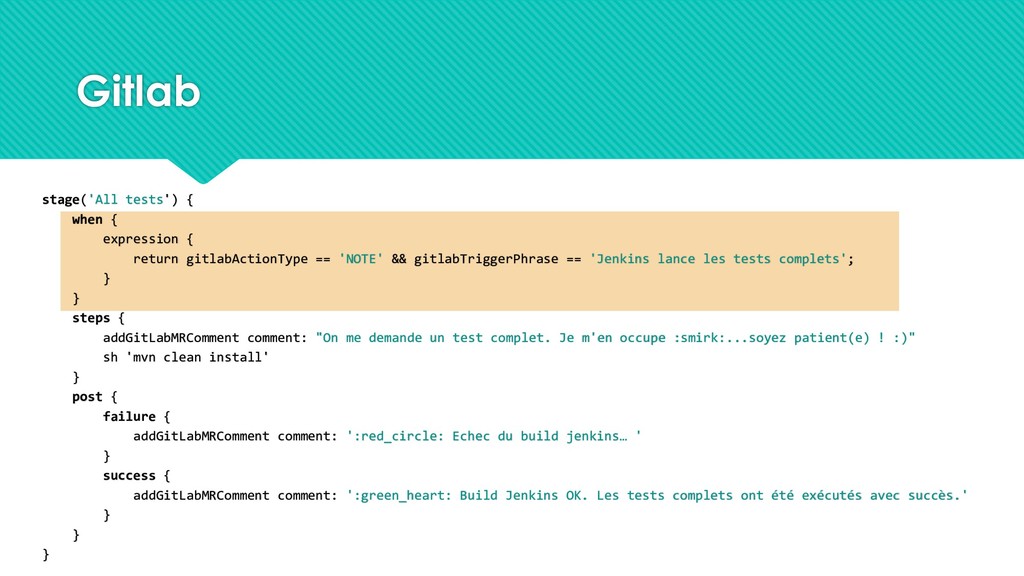
  37. Gitlab stage('All tests') { when { expression { return gitlabActionType

    == 'NOTE' && gitlabTriggerPhrase == 'Jenkins lance les tests complets'; } } steps { addGitLabMRComment comment: "On me demande un test complet. Je m'en occupe :smirk:...soyez patient(e) ! :)" sh 'mvn clean install' } post { failure { addGitLabMRComment comment: ':red_circle: Echec du build jenkins… ' } success { addGitLabMRComment comment: ':green_heart: Build Jenkins OK. Les tests complets ont été exécutés avec succès.' } } }
  38. L’infrastructure de test  Besoin de nombreux clusters pour l’équipe

    de test  Utilisation d’un cloud privé  Quelques instabilités souvent besoin de « réparer » les clusters En moyenne 4 jH/mois sur des sujets liés a l’infra Scriptons le provisionning de clusters !
  39. Création de cluster avec Ansible  Difficultés  Provisionner des

    cluster avec un nombre différente  Installer tous les services et le fine tuning Effort : 10 jH  On consomme plus que 1jH/mois pour la gestion d’infra -3 j/mois de gestion d’infra Retour sur investissement en 4 mois
  40. Limiter le coût de l’infrastructure de test Utiliser les disques

    les moins chers et compenser la moins bonne qualité de lecture en diminuant le taux de réplication HDFS Créer des clusters de dimensions différentes en fonction des usages Déprovisionner les clusters dès qu’ils ne sont plus utilisés
  41. Spring Health Indicator  Création de Bean custom  Vérification

    de l’accès aux différents services Hadoop  Vérification de la configuration applicative et de la JVM
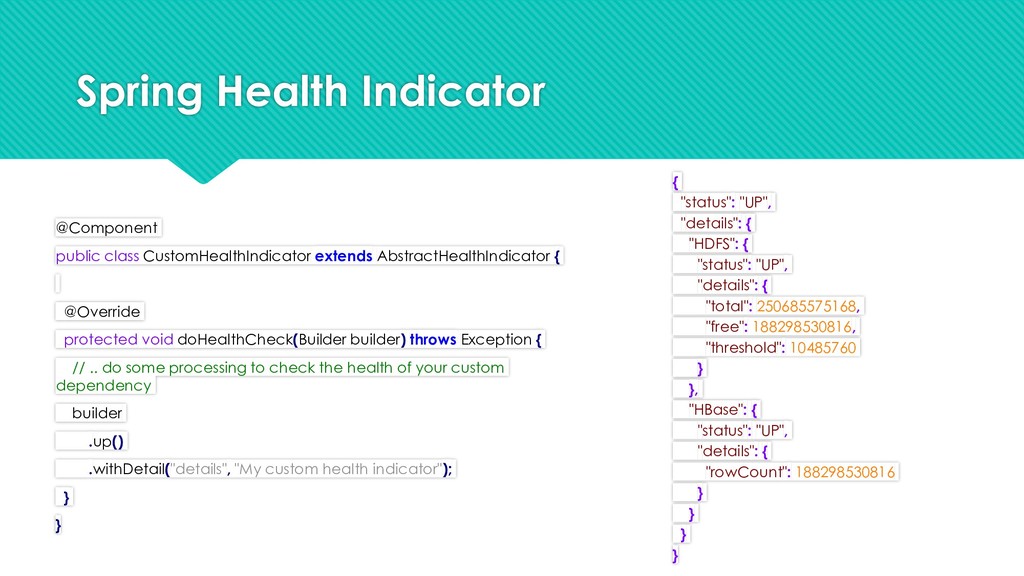
  42. Spring Health Indicator { "status": "UP", "details": { "HDFS": {

    "status": "UP", "details": { "total": 250685575168, "free": 188298530816, "threshold": 10485760 } }, "HBase": { "status": "UP", "details": { "rowCount": 188298530816 } } } } @Component public class CustomHealthIndicator extends AbstractHealthIndicator { @Override protected void doHealthCheck(Builder builder) throws Exception { // .. do some processing to check the health of your custom dependency builder .up() .withDetail("details", "My custom health indicator"); } }
  43. Ce que l’on aurait pu faire autrement  Utiliser un

    provider de cloud avec de meilleures garanties de service  Arrêter d’essayer de réparer des clusters  Pet vs cattle  Créer un job Jenkins de provisionnement/déprovisionnement de cluster.
  44. Les bonnes idées que l’on a eu Utiliser une librairie

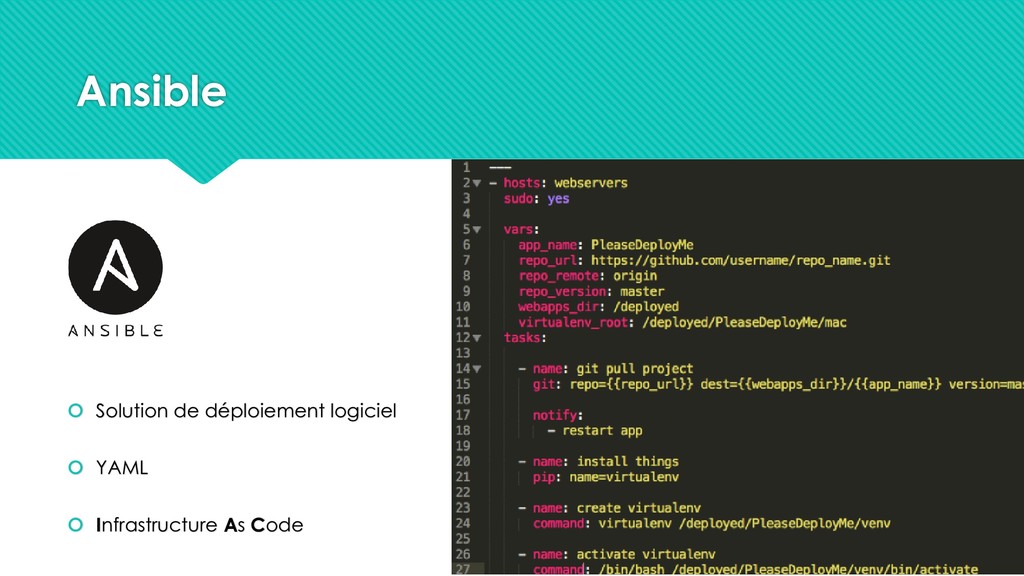
    MiniCluster pour automatiser le test de nos jobs Mettre en place un service health Infrastructure As Code
  45. Bilan  Les problèmes de performances : il y en

    aura toujours  Le distribué impacte tous les acteurs d’un projet  S’outiller c’est bien, le faire en début de projet, c’est encore mieux  « Idempotence » fait maintenant partie de notre langage courant