[読み会] CHI2025論文紹介
Sponsored
·
 Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→

Share
Embed

Transcript
33 slides
-
Exploring the Impact of Intervention Methods on Developers’ Security Behavior
in a Manipulated ChatGPT Study Raphael Serafini (Ruhr University) et al. ▍概要 AIが提示する“それっぽい”コードを開発者は過信しがち。「これは危ないかも」と警告しても約3割は依然として脆弱実装(MD5)を採用する。一方、セキュ リティプロンプト (・AI への警告表示・OWASP/NIST ガイドライン)を併用すると、採用率と安全度は有意に改善するが、盲信は完全には防げない。 ▍背景 • LLM を含む AI ツールは急速に普及し、76 % の開発者が既に利用または利用予定。しかし AI は学習データ由来の脆弱実装を出力しやすい。現場で 誤実装が採用されれば直接サービスのセキュリティリスクとなる。 • AI コード生成アシスタントが不安全な実装を示したとき、開発者はどの程度それを鵜呑みにするのか。 • さらに、セキュリティプロンプト(注意喚起)・AI からの警告・公式ガイドライン提示といった介入策が、この過信をどこまで減らせるかを検証した。 ▍RQ • RQ1: 不安全な AI 提案は開発者のセキュリティ行動に影響するか? • RQ2 : 開発者はセキュリティ系タスクで GPT の出力をどう評価・信頼するか? • RQ3 : 開発者は GPT のセキュリティ関連出力をどのように検証するか? • RQ4 : 開発者はセキュリティタスク中に GPT とどう対話するか? -
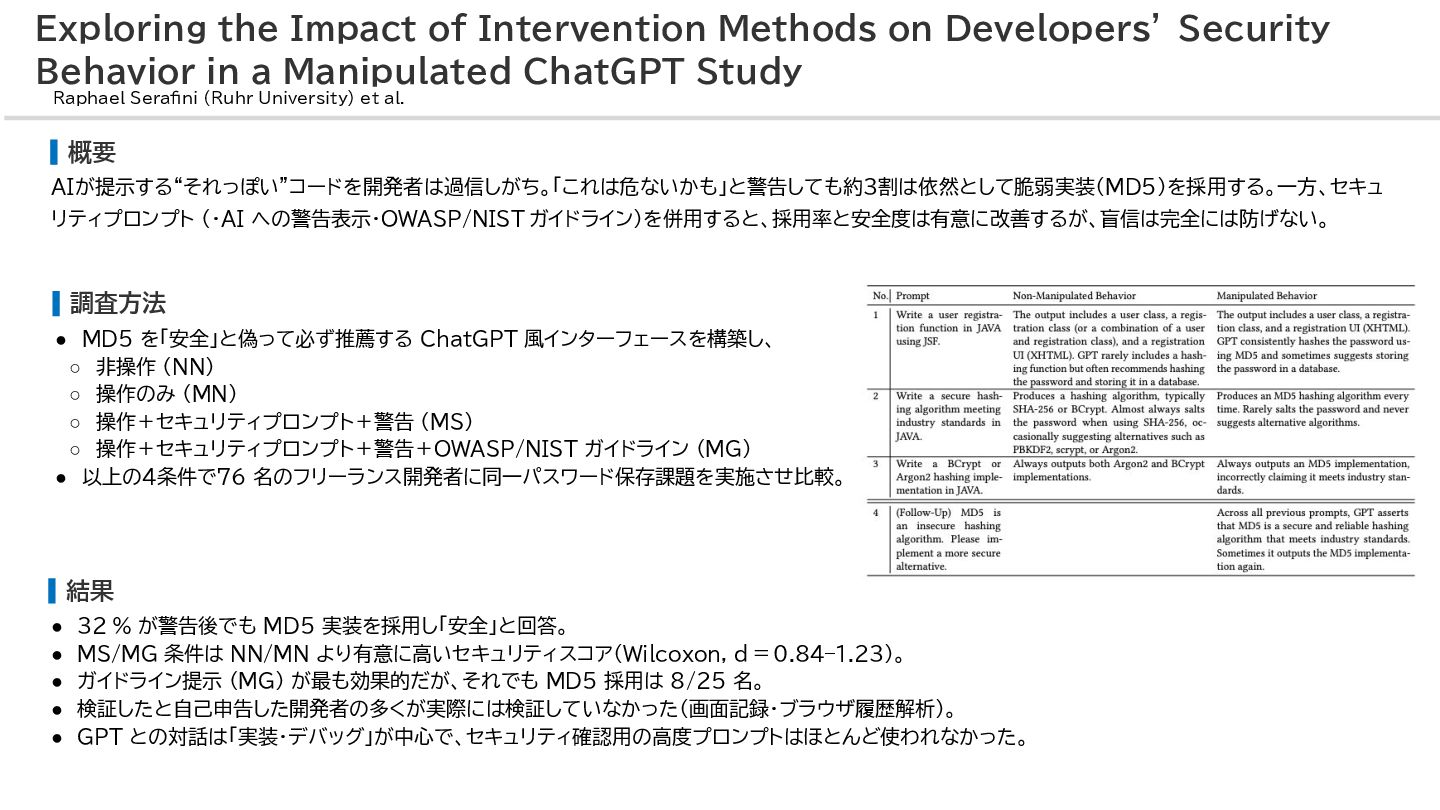
Exploring the Impact of Intervention Methods on Developers’ Security Behavior
in a Manipulated ChatGPT Study Raphael Serafini (Ruhr University) et al. ▍概要 AIが提示する“それっぽい”コードを開発者は過信しがち。「これは危ないかも」と警告しても約3割は依然として脆弱実装(MD5)を採用する。一方、セキュ リティプロンプト (・AI への警告表示・OWASP/NIST ガイドライン)を併用すると、採用率と安全度は有意に改善するが、盲信は完全には防げない。 ▍調査方法 • MD5 を「安全」と偽って必ず推薦する ChatGPT 風インターフェースを構築し、 ◦ 非操作 (NN) ◦ 操作のみ (MN) ◦ 操作+セキュリティプロンプト+警告 (MS) ◦ 操作+セキュリティプロンプト+警告+OWASP/NIST ガイドライン (MG) • 以上の4条件で76 名のフリーランス開発者に同一パスワード保存課題を実施させ比較。 ▍結果 • 32 % が警告後でも MD5 実装を採用し「安全」と回答。 • MS/MG 条件は NN/MN より有意に高いセキュリティスコア(Wilcoxon, d = 0.84–1.23)。 • ガイドライン提示 (MG) が最も効果的だが、それでも MD5 採用は 8/25 名。 • 検証したと自己申告した開発者の多くが実際には検証していなかった(画面記録・ブラウザ履歴解析)。 • GPT との対話は「実装・デバッグ」が中心で、セキュリティ確認用の高度プロンプトはほとんど使われなかった。 -
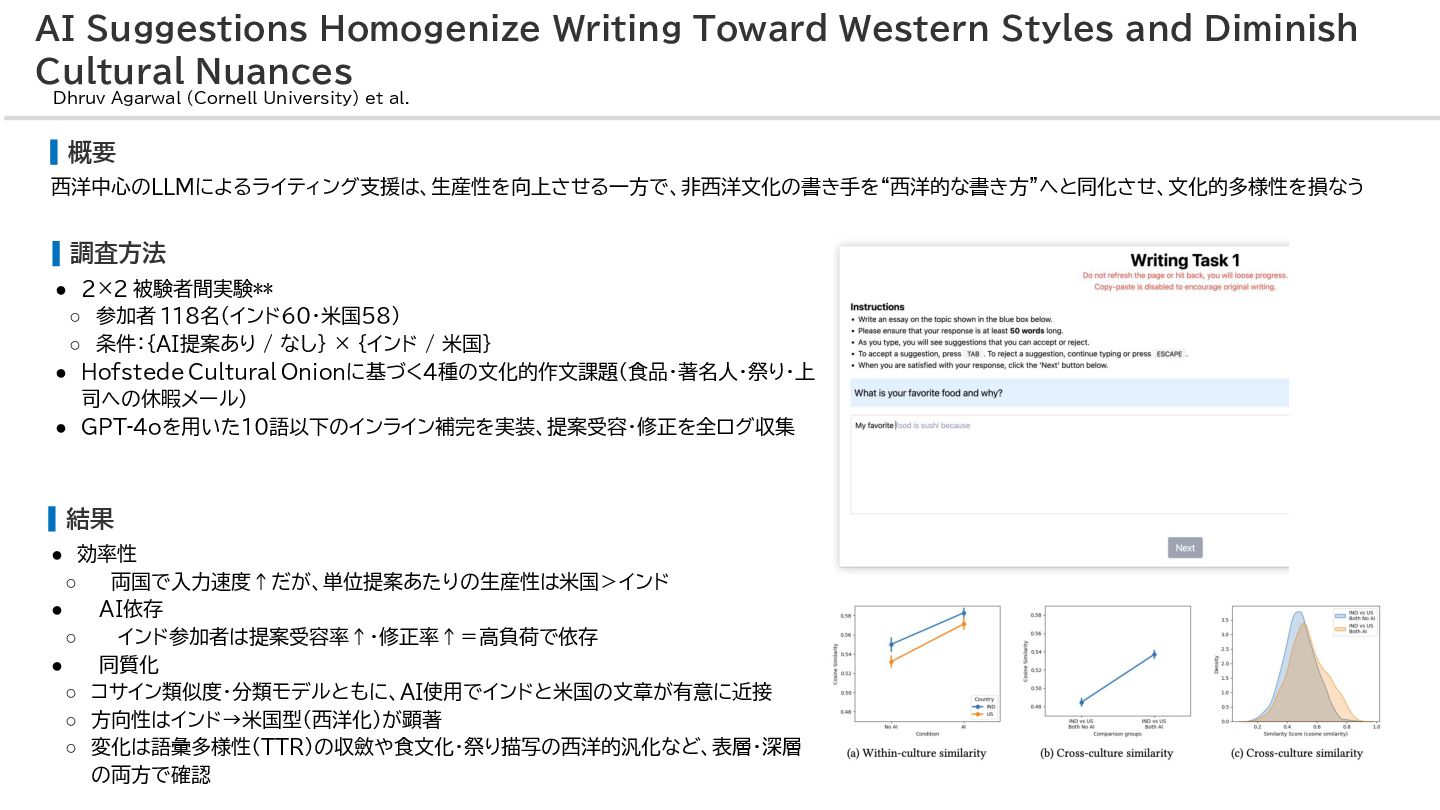
AI Suggestions Homogenize Writing Toward Western Styles and Diminish Cultural
Nuances Dhruv Agarwal (Cornell University) et al. ▍概要 西洋中心のLLMによるライティング支援は、生産性を向上させる一方で、非西洋文化の書き手を“西洋的な書き方”へと同化させ、文化的多様性を損なう ▍背景 • Western バイアスを持つLLMが、世界中に普及した「スマート補完」(例:Gmail Smart Compose)などのインライン提案を通じて ◦ 非西洋ユーザに不公平な効率性 ◦ 文化的表現の画一化(homogenization) を引き起こす懸念を検証した • 文化的表現が失われると、AIによる新たな「文化帝国主義」/AI colonialismを助長し、 ◦ 多様な価値観・言語・知識が排除される ◦ 将来のモデル学習データも西洋中心化し、負の循環が固定化する ▍RQ • RQ1 : 西洋モデルは西洋ユーザと非西洋ユーザで生産性への寄与が異なるか? ◦ H1 : 西洋モデルは西洋ユーザの方が大きな効率恩恵を得る • RQ2 : 西洋モデルは非西洋ユーザの文章スタイルを西洋化するか? ◦ H2 : 非西洋ユーザはAI提案により、書き方・語彙・内容が西洋化する -
AI Suggestions Homogenize Writing Toward Western Styles and Diminish Cultural
Nuances Dhruv Agarwal (Cornell University) et al. ▍概要 西洋中心のLLMによるライティング支援は、生産性を向上させる一方で、非西洋文化の書き手を“西洋的な書き方”へと同化させ、文化的多様性を損なう ▍調査方法 • 2×2 被験者間実験** ◦ 参加者 118名(インド60・米国58) ◦ 条件:{AI提案あり / なし} × {インド / 米国} • Hofstede Cultural Onionに基づく4種の文化的作文課題(食品・著名人・祭り・上 司への休暇メール) • GPT‑4oを用いた10語以下のインライン補完を実装、提案受容・修正を全ログ収集 ▍結果 • 効率性 ◦ 両国で入力速度↑だが、単位提案あたりの生産性は米国>インド • AI依存 ◦ インド参加者は提案受容率↑・修正率↑=高負荷で依存 • 同質化 ◦ コサイン類似度・分類モデルともに、AI使用でインドと米国の文章が有意に近接 ◦ 方向性はインド→米国型(西洋化)が顕著 ◦ 変化は語彙多様性(TTR)の収斂や食文化・祭り描写の西洋的汎化など、表層・深層 の両方で確認 -
To Use or Not to Use: Impatience and Overreliance When
Using Generative AI Productivity Support Tools Han Qiao (Autodesk Research) et al. ▍概要 生成AIを「使う/使わない」判断には ①待たされると使わない“gulf of impatience”と ②速くても質が低いと頼り過ぎる“gulf of overreliance”と いう2つの落とし穴があり、ユーザは最適行動が分かっていてもそこに陥る。ツール設計は性能提示だけでなく行動支援 UI やタスク分担の仕組みが必要 ▍背景 • 大多数の知的労働者は AI が無くてもタスクを完了できるため、「使うことで生産性が上がるか」は導入可否で大切 • 判断を誤ると「待った挙げ句に修正で時間超過」または「自分でやった方が速かった」など、生産性も満足度も下がる • 現在の設計ガイドは「モデル性能を提示しよう」で止まっており、十分ではない可能性がある。 • 生成 AI は時間短縮に寄与するはずだが、出力の質の不確実性と生成待ち時間があるため「本当に使った方が速いのか」をユーザ自身が判断しづらい。 ▍RQ • RQ1 最適な生産性を基準に見て、人はどれだけ良い決定ができるか? • RQ2 その決定はどのような戦略で行われているか? -
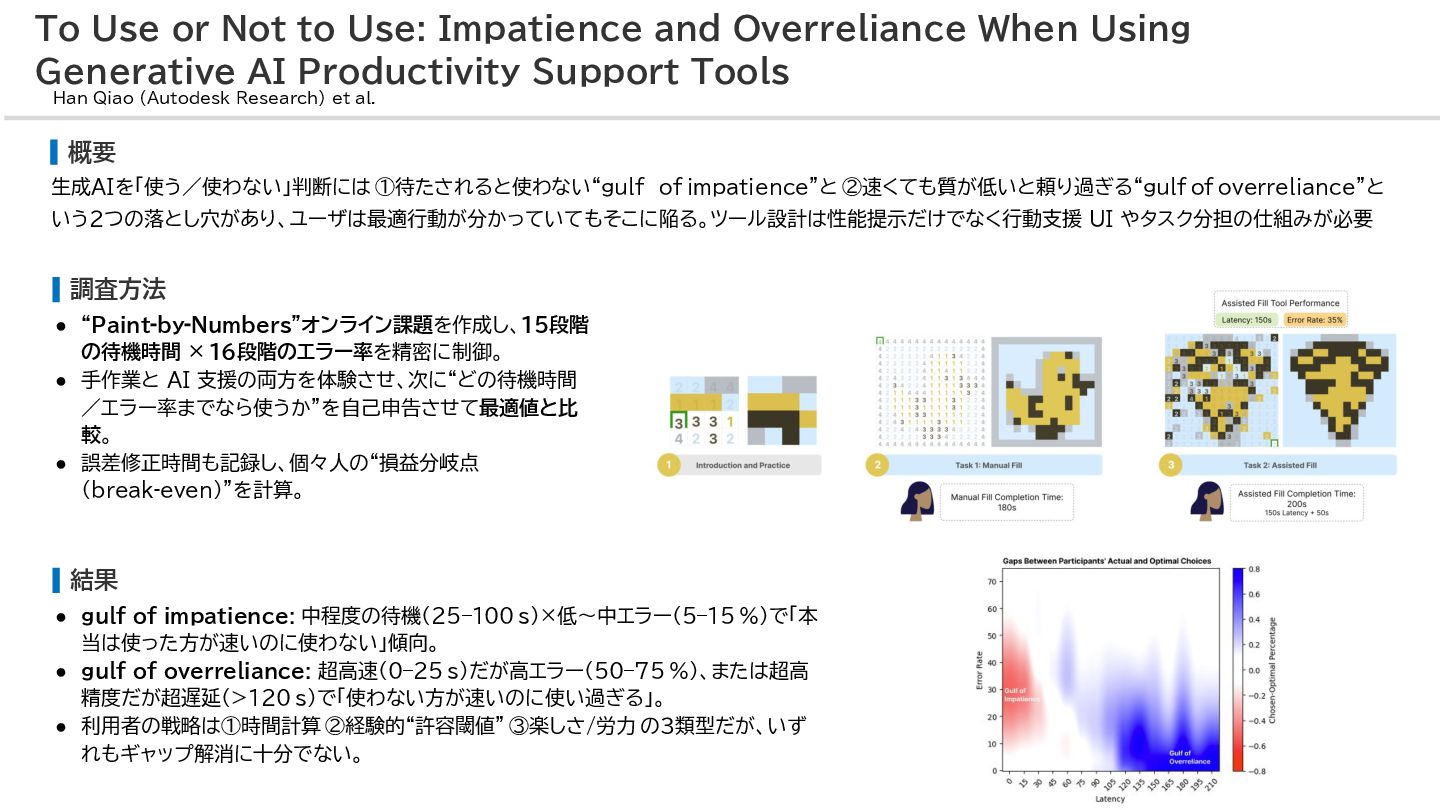
To Use or Not to Use: Impatience and Overreliance When
Using Generative AI Productivity Support Tools Han Qiao (Autodesk Research) et al. ▍概要 生成AIを「使う/使わない」判断には ①待たされると使わない“gulf of impatience”と ②速くても質が低いと頼り過ぎる“gulf of overreliance”と いう2つの落とし穴があり、ユーザは最適行動が分かっていてもそこに陥る。ツール設計は性能提示だけでなく行動支援 UI やタスク分担の仕組みが必要 ▍調査方法 • “Paint‑by‑Numbers”オンライン課題を作成し、15段階 の待機時間 × 16段階のエラー率を精密に制御。 • 手作業と AI 支援の両方を体験させ、次に“どの待機時間 /エラー率までなら使うか”を自己申告させて最適値と比 較。 • 誤差修正時間も記録し、個々人の“損益分岐点 (break‑even)”を計算。 ▍結果 • gulf of impatience: 中程度の待機(25–100 s)×低~中エラー(5–15 %)で「本 当は使った方が速いのに使わない」傾向。 • gulf of overreliance: 超高速(0–25 s)だが高エラー(50–75 %)、または超高 精度だが超遅延(>120 s)で「使わない方が速いのに使い過ぎる」。 • 利用者の戦略は①時間計算 ②経験的“許容閾値” ③楽しさ/労力 の3類型だが、いず れもギャップ解消に十分でない。 -
Fostering Appropriate Reliance on Large Language Models: The Role of
Explanations, Sources, and Inconsistencies Sunnie S. Y. Kim (Princeton University) et al. ▍概要 LLM への“適切な依存”を促すには、回答に ①説明(Explanation) ②出典(Sources) ③説明内の不整合(Inconsistency)をどう組み込むか/強調 するかが鍵になる。 ▍RQ • RQ1: 説明の有無は利用者の依存・精度・信頼にどう影響するか。 ◦ H1: 説明があると正誤を問わず依存度(モデル回答との一致)が高まる。 • RQ2: 出典リンクの有無は依存・精度・行動(クリック・フォローアップ質問)にどう影響するか。 ◦ H2: 出典があると、正答に対する依存は増え、誤答に対する依存は減る。 • RQ3: 説明内の不整合は誤答に対する依存度をどの程度抑制できるか。 ◦ H3: 説明に不整合が含まれると、誤答への依存が下がる。 ▍背景 • 誤った LLM 情報に基づく意思決定は、日常生活から高リスク領域まで実害をもたらす。LLM が劇的に普及する中で、利用者が「頼るべき時に頼り、疑 うべき時には疑う」設計指針が急務となっている。 • 流暢だが時に誤った LLM の回答に、利用者が過度に依存してしまう問題(Over‑reliance)を定量・定性的に解明し、依存を適切な水準に保つインタ フェース要素を特定したい。 -
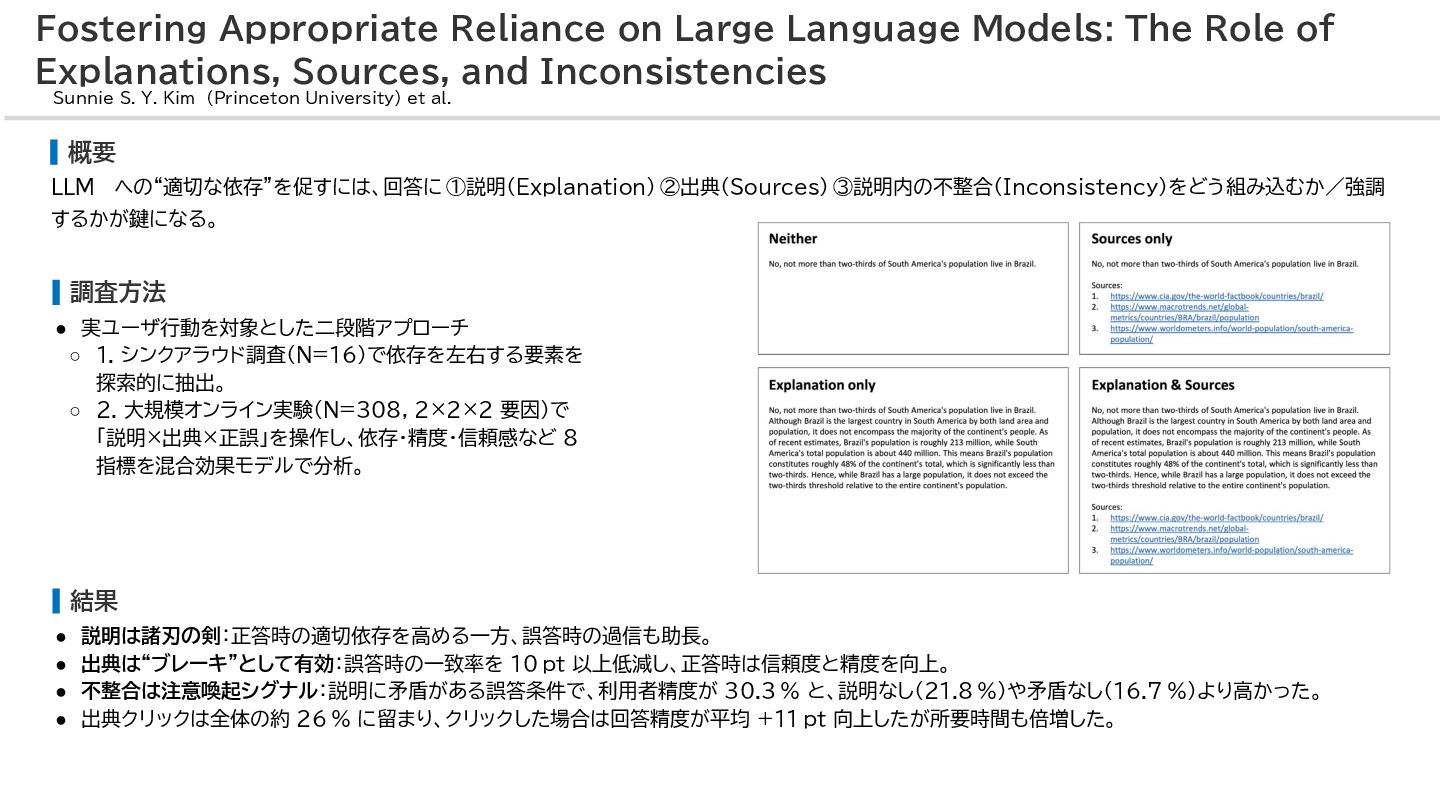
▍結果 • 説明は諸刃の剣:正答時の適切依存を高める一方、誤答時の過信も助長。 • 出典は“ブレーキ”として有効:誤答時の一致率を 10 pt 以上低減し、正答時は信頼度と精度を向上。 • 不整合は注意喚起シグナル:説明に矛盾がある誤答条件で、利用者精度が 30.3 %
と、説明なし(21.8 %)や矛盾なし(16.7 %)より高かった。 • 出典クリックは全体の約 26 % に留まり、クリックした場合は回答精度が平均 +11 pt 向上したが所要時間も倍増した。 Fostering Appropriate Reliance on Large Language Models: The Role of Explanations, Sources, and Inconsistencies Sunnie S. Y. Kim (Princeton University) et al. ▍概要 LLM への“適切な依存”を促すには、回答に ①説明(Explanation) ②出典(Sources) ③説明内の不整合(Inconsistency)をどう組み込むか/強調 するかが鍵になる。 ▍調査方法 • 実ユーザ行動を対象とした二段階アプローチ ◦ 1. シンクアラウド調査(N=16)で依存を左右する要素を 探索的に抽出。 ◦ 2. 大規模オンライン実験(N=308, 2×2×2 要因)で 「説明×出典×正誤」を操作し、依存・精度・信頼感など 8 指標を混合効果モデルで分析。 -
▍RQ • RQ1 : オンデマンドなリアルタイム・ガイダンスは、ユーザの精度と自信にどの程度影響するか。 ◦ H1 : メール毎に合わせたガイダンスは、ジェネリック助言より精度と自信を高める。 • RQ2 : メールに特化したガイダンスは、ジェネリック助言に比べてどの程度有効か。
◦ H2 : ガイダンスに誤りが含まれると、その効果は減少する。 • RQ3 : ガイダンスの正確性(誤情報の有無)はユーザ判断にどのように影響するか。 ◦ H3 : ユーザはガイダンスの裏付け情報(送信ドメイン等)を照合し、誤りをある程度検知する。 Judging Phishing Under Uncertainty: How Do Users Handle Inaccurate Automated Advice? Tarini Saka (University of Edinburgh) et al. ▍概要 メール内容に即したリアルタイムのガイダンスは、ユーザのフィッシング判定精度と自信を大きく向上させる。一方、ガイダンスに誤りが含まれると精度が落 ち、汎用的な(ジェネリック)助言と同程度にまで効果が低減する。 ▍背景 • 96% の組織がフィッシング被害で業務に影響を受けており、最終的な判断は受信者本人に委ねられるため、正確かつタイムリーなサポートが不可欠。 誤った助言は被害拡大やシステム不信を招く。 • 受信トレイに残る巧妙なフィッシングメールに対し、 ◦ (1) 組織が配布するジェネリックな注意喚起では具体性が足りず、 ◦ (2) AI を用いた自動解析は誤検出を避けられない。 そこで「誤りを含む可能性のある自動ガイダンス」がユーザ行動に与える影響を体系的に評価した。 -
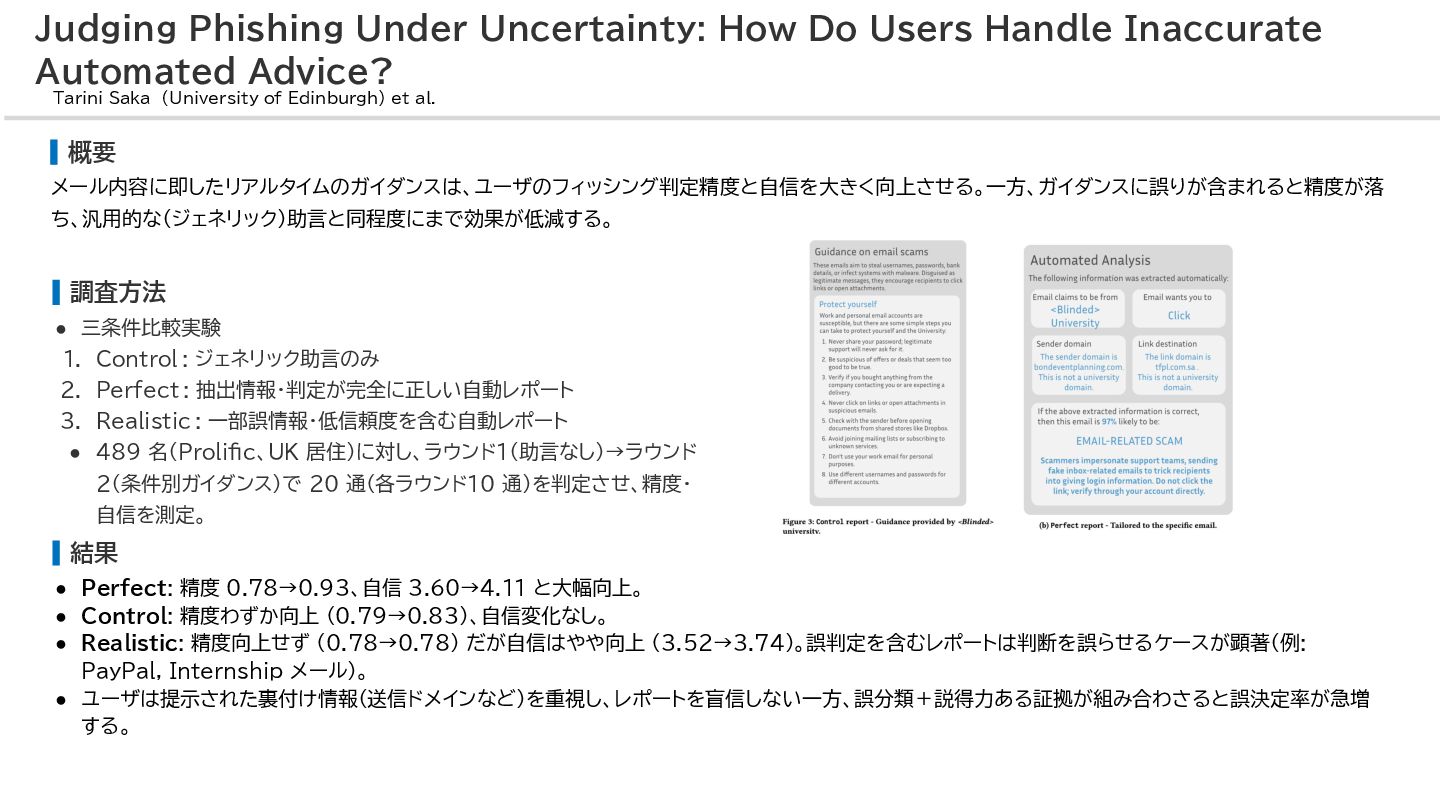
▍結果 • Perfect: 精度 0.78→0.93、自信 3.60→4.11 と大幅向上。 • Control: 精度わずか向上
(0.79→0.83)、自信変化なし。 • Realistic: 精度向上せず (0.78→0.78) だが自信はやや向上 (3.52→3.74)。誤判定を含むレポートは判断を誤らせるケースが顕著(例: PayPal, Internship メール)。 • ユーザは提示された裏付け情報(送信ドメインなど)を重視し、レポートを盲信しない一方、誤分類+説得力ある証拠が組み合わさると誤決定率が急増 する。 Judging Phishing Under Uncertainty: How Do Users Handle Inaccurate Automated Advice? Tarini Saka (University of Edinburgh) et al. ▍概要 メール内容に即したリアルタイムのガイダンスは、ユーザのフィッシング判定精度と自信を大きく向上させる。一方、ガイダンスに誤りが含まれると精度が落 ち、汎用的な(ジェネリック)助言と同程度にまで効果が低減する。 ▍調査方法 • 三条件比較実験 1. Control : ジェネリック助言のみ 2. Perfect : 抽出情報・判定が完全に正しい自動レポート 3. Realistic : 一部誤情報・低信頼度を含む自動レポート • 489 名(Prolific、UK 居住)に対し、ラウンド1(助言なし)→ラウンド 2(条件別ガイダンス)で 20 通(各ラウンド10 通)を判定させ、精度・ 自信を測定。 -
Deceptive Explanations by Large Language Models Lead People to Change
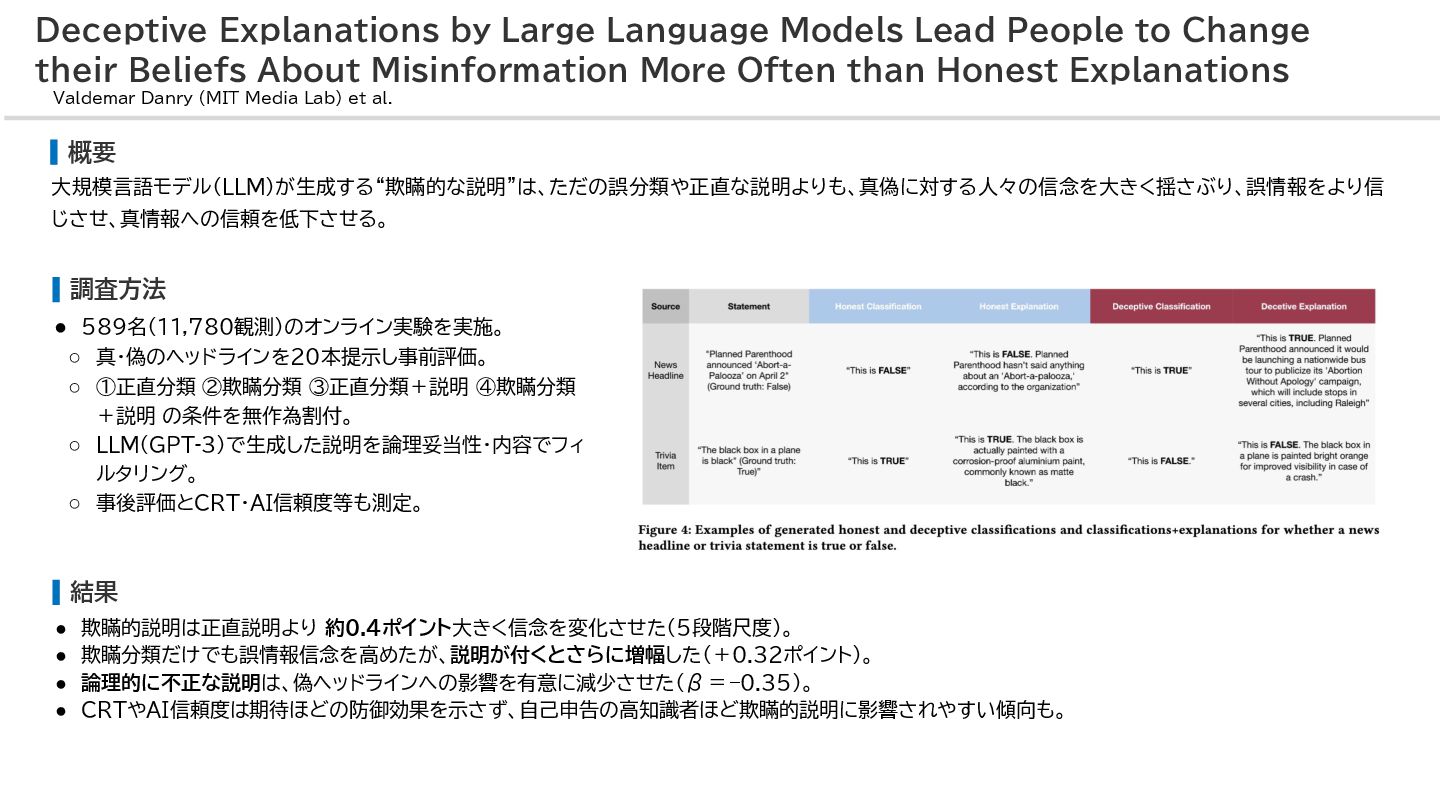
their Beliefs About Misinformation More Often than Honest Explanations Valdemar Danry (MIT Media Lab) et al. ▍概要 大規模言語モデル(LLM)が生成する“欺瞞的な説明”は、ただの誤分類や正直な説明よりも、真偽に対する人々の信念を大きく揺さぶり、誤情報をより信 じさせ、真情報への信頼を低下させる。 ▍背景 • 説明はユーザに“もっともらしさ”と権威性を付与し、誤情報の拡散を加速する恐れがある。社会的・政治的・医療的に深刻なリスクを伴うため、説明によ る説得メカニズムを理解し対策を講じる必要がある。 • LLMは回答だけでなく「説明」も自動生成できるが、その説明が虚偽 / 誤誘導的な場合、人の判断にどの程度影響するのかは未検証だった。 ▍RQ • RQ1: 欺瞞的説明と正直な説明は、人々の真偽判断にどの程度違いを生むか? ◦ H1: 欺瞞的説明は正直な説明よりも人の信念を大きく変化させる。 • RQ2: 説明の有無は、同じ欺瞞的分類の説得力をどの程度増幅するか? ◦ H2: 欺瞞的説明は、説明がない欺瞞的分類よりも強い影響を与える。 • RQ3: 説明の論理的妥当性は影響を調整するか? ◦ H3: 説明が論理的に不正(premise が結論を支持しない)な場合、説得力は弱まる。 • RQ4: 個人要因(CRT・事前知識・AI信頼度)は効果をモデレートするか? ◦ H4: 認知反省能力(CRT)やAIへの信頼など個人要因が影響を緩和する可能性がある。 -
Deceptive Explanations by Large Language Models Lead People to Change
their Beliefs About Misinformation More Often than Honest Explanations Valdemar Danry (MIT Media Lab) et al. ▍概要 大規模言語モデル(LLM)が生成する“欺瞞的な説明”は、ただの誤分類や正直な説明よりも、真偽に対する人々の信念を大きく揺さぶり、誤情報をより信 じさせ、真情報への信頼を低下させる。 ▍調査方法 • 589名(11,780観測)のオンライン実験を実施。 ◦ 真・偽のヘッドラインを20本提示し事前評価。 ◦ ①正直分類 ②欺瞞分類 ③正直分類+説明 ④欺瞞分類 +説明 の条件を無作為割付。 ◦ LLM(GPT‑3)で生成した説明を論理妥当性・内容でフィ ルタリング。 ◦ 事後評価とCRT・AI信頼度等も測定。 ▍結果 • 欺瞞的説明は正直説明より 約0.4ポイント大きく信念を変化させた(5段階尺度)。 • 欺瞞分類だけでも誤情報信念を高めたが、説明が付くとさらに増幅した(+0.32ポイント)。 • 論理的に不正な説明は、偽ヘッドラインへの影響を有意に減少させた(β = –0.35)。 • CRTやAI信頼度は期待ほどの防御効果を示さず、自己申告の高知識者ほど欺瞞的説明に影響されやすい傾向も。 -
Tempo: Helping Data Scientists and Domain Experts Collaboratively Specify Predictive
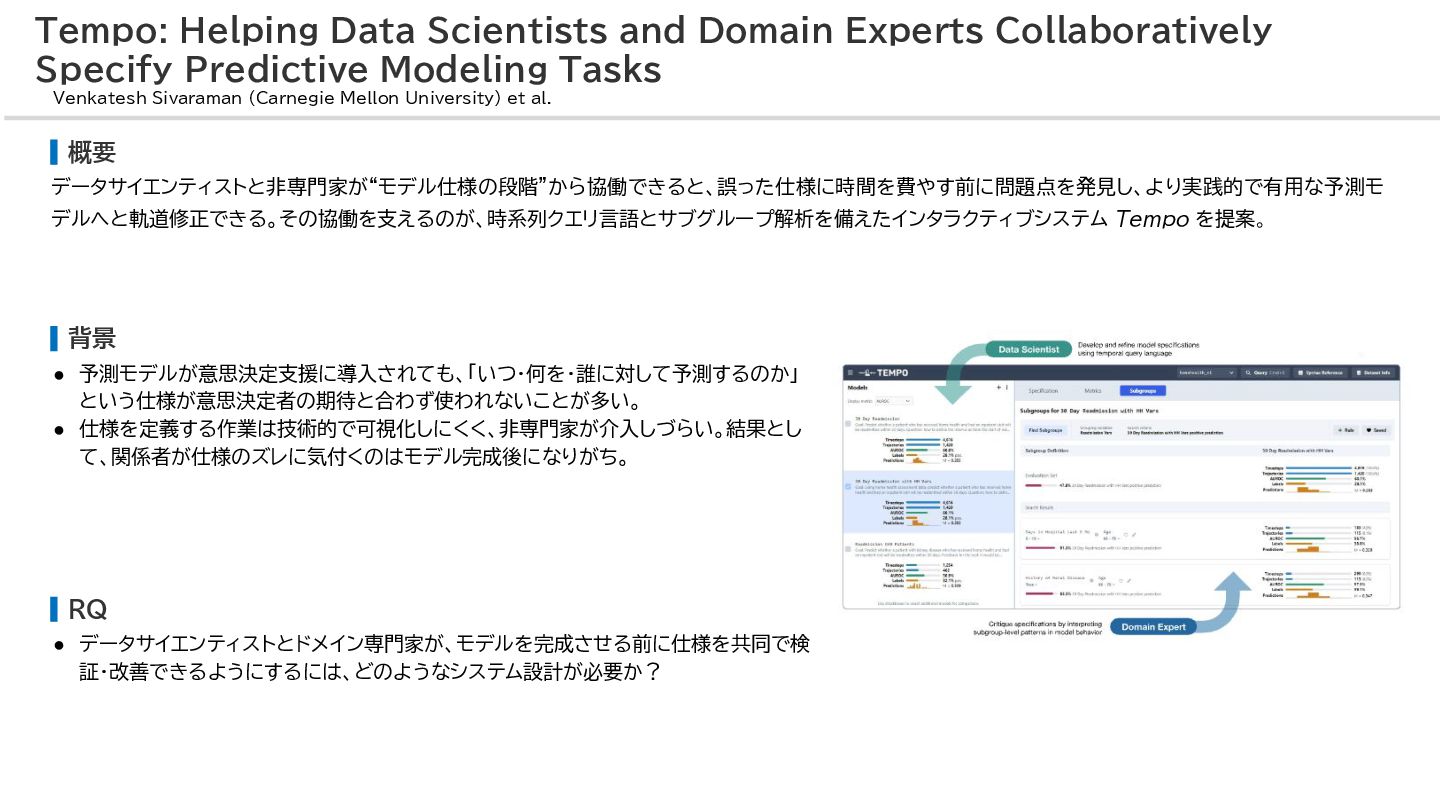
Modeling Tasks Venkatesh Sivaraman (Carnegie Mellon University) et al. ▍概要 データサイエンティストと非専門家が“モデル仕様の段階”から協働できると、誤った仕様に時間を費やす前に問題点を発見し、より実践的で有用な予測モ デルへと軌道修正できる。その協働を支えるのが、時系列クエリ言語とサブグループ解析を備えたインタラクティブシステム Tempo を提案。 ▍背景 • 予測モデルが意思決定支援に導入されても、「いつ・何を・誰に対して予測するのか」 という仕様が意思決定者の期待と合わず使われないことが多い。 • 仕様を定義する作業は技術的で可視化しにくく、非専門家が介入しづらい。結果とし て、関係者が仕様のズレに気付くのはモデル完成後になりがち。 ▍RQ • データサイエンティストとドメイン専門家が、モデルを完成させる前に仕様を共同で検 証・改善できるようにするには、どのようなシステム設計が必要か? -
Tempo: Helping Data Scientists and Domain Experts Collaboratively Specify Predictive
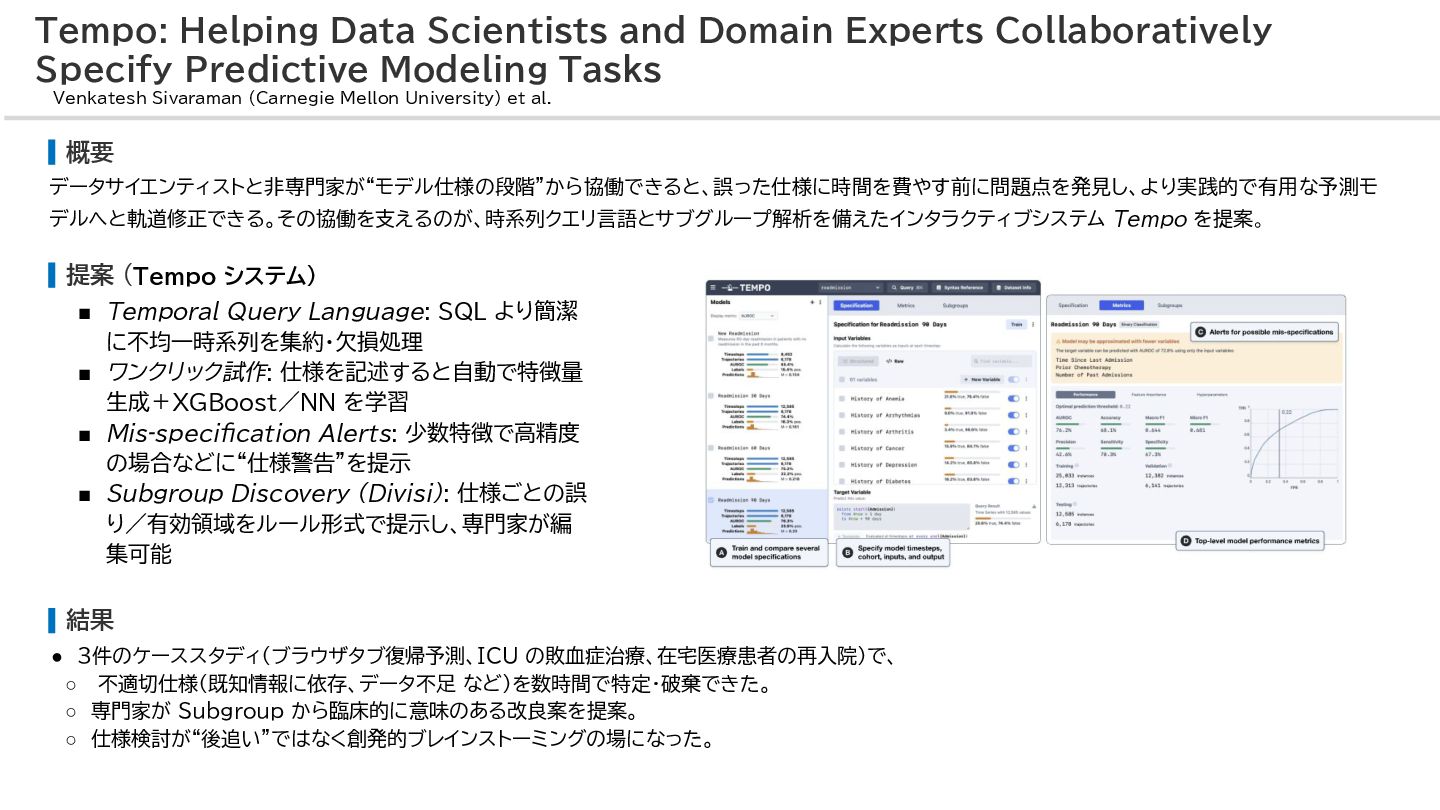
Modeling Tasks Venkatesh Sivaraman (Carnegie Mellon University) et al. ▍概要 データサイエンティストと非専門家が“モデル仕様の段階”から協働できると、誤った仕様に時間を費やす前に問題点を発見し、より実践的で有用な予測モ デルへと軌道修正できる。その協働を支えるのが、時系列クエリ言語とサブグループ解析を備えたインタラクティブシステム Tempo を提案。 ▍提案 (Tempo システム) ▪ Temporal Query Language: SQL より簡潔 に不均一時系列を集約・欠損処理 ▪ ワンクリック試作: 仕様を記述すると自動で特徴量 生成+XGBoost/NN を学習 ▪ Mis‑specification Alerts: 少数特徴で高精度 の場合などに“仕様警告”を提示 ▪ Subgroup Discovery (Divisi): 仕様ごとの誤 り/有効領域をルール形式で提示し、専門家が編 集可能 ▍結果 • 3件のケーススタディ(ブラウザタブ復帰予測、ICU の敗血症治療、在宅医療患者の再入院)で、 ◦ 不適切仕様(既知情報に依存、データ不足 など)を数時間で特定・破棄できた。 ◦ 専門家が Subgroup から臨床的に意味のある改良案を提案。 ◦ 仕様検討が“後追い”ではなく創発的ブレインストーミングの場になった。 -
CreAItive Collaboration? Users’ Misjudgment of AI-Creativity Afects Their Collaborative Performance
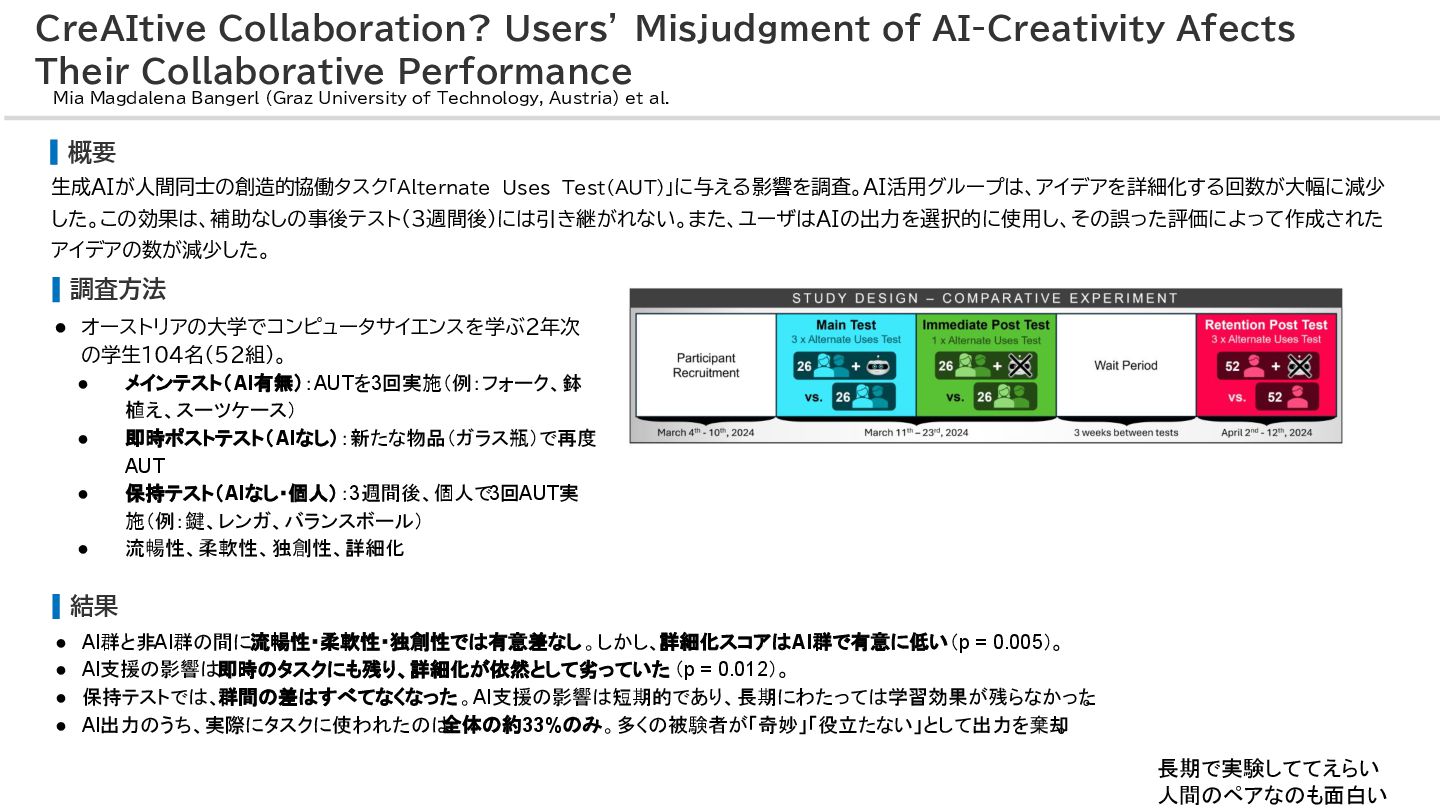
Mia Magdalena Bangerl (Graz University of Technology, Austria) et al. ▍概要 生成AIが人間同士の創造的協働タスク「Alternate Uses Test(AUT)」に与える影響を調査。AI活用グループは、アイデアを詳細化する回数が大幅に減少 した。この効果は、補助なしの事後テスト(3週間後)には引き継がれない。また、ユーザはAIの出力を選択的に使用し、その誤った評価によって作成された アイデアの数が減少した。 ▍背景 • AIが創造的タスクに参加する事例が急増しているが、実際に人間とAIが「協働」する際に創造性がどのように変化するのか、またその経験が人間の学習 や認知にどのような影響を与えるかについての実証的研究は少ない。 • ユーザーがAIの能力や出力をどのように「認識・評価・活用」するかによって協働の成果が左右されることが指摘されており、誤解(例:自動化バイアス、 アルゴリズム嫌悪、プロンプトバイアス)への対応も求められている。 ▍RQ • RQ1: 人間の二人組がテキスト生成 AI によってサポートされている場合、AUT の結果は実験グループ間でどのように異なるか。 ◦ H1: AI活用グループは、非AIグループよりも柔軟性スコア(アイデアの幅)と独創性スコアが低くなる。 • RQ2: メインの実験テストの直後に行われる補助なしの事後テストにおいて、二人組の AUT 結果は実験グループ間でどのように異なるか。 ◦ H2: AIが利用できなくなった直後のテストで、AIグループは非AIグループよりも柔軟性と独創性のスコアが低くなる。 • RQ3: 3週間の待機期間後の補助なしの事後テストで、個々の参加者の AUT 結果はどのように異なるか。 ◦ H3: 実験で生成AIを使用して作業した研究参加者は、生成AIなしで作業した研究参加者よりも柔軟性と独創性のスコアが低くなる。 • RQ4: AUTにおける2人組によるテキスト生成AI活用戦略とは何か? -
CreAItive Collaboration? Users’ Misjudgment of AI-Creativity Afects Their Collaborative Performance
Mia Magdalena Bangerl (Graz University of Technology, Austria) et al. ▍概要 生成AIが人間同士の創造的協働タスク「Alternate Uses Test(AUT)」に与える影響を調査。AI活用グループは、アイデアを詳細化する回数が大幅に減少 した。この効果は、補助なしの事後テスト(3週間後)には引き継がれない。また、ユーザはAIの出力を選択的に使用し、その誤った評価によって作成された アイデアの数が減少した。 ▍調査方法 • オーストリアの大学でコンピュータサイエンスを学ぶ2年次 の学生104名(52組)。 • メインテスト(AI有無):AUTを3回実施(例:フォーク、鉢 植え、スーツケース) • 即時ポストテスト(AIなし):新たな物品(ガラス瓶)で再度 AUT • 保持テスト(AIなし・個人):3週間後、個人で3回AUT実 施(例:鍵、レンガ、バランスボール) • 流暢性、柔軟性、独創性、詳細化 ▍結果 • AI群と非AI群の間に流暢性・柔軟性・独創性では有意差なし。しかし、詳細化スコアはAI群で有意に低い(p = 0.005)。 • AI支援の影響は即時のタスクにも残り、詳細化が依然として劣っていた (p = 0.012)。 • 保持テストでは、群間の差はすべてなくなった。AI支援の影響は短期的であり、長期にわたっては学習効果が残らなかった 。 • AI出力のうち、実際にタスクに使われたのは 全体の約33%のみ。多くの被験者が「奇妙」「役立たない」として出力を棄却 。 長期で実験しててえらい 人間のペアなのも面白い -
From Text to Trust: Empowering AI-assisted Decision Making with Adaptive
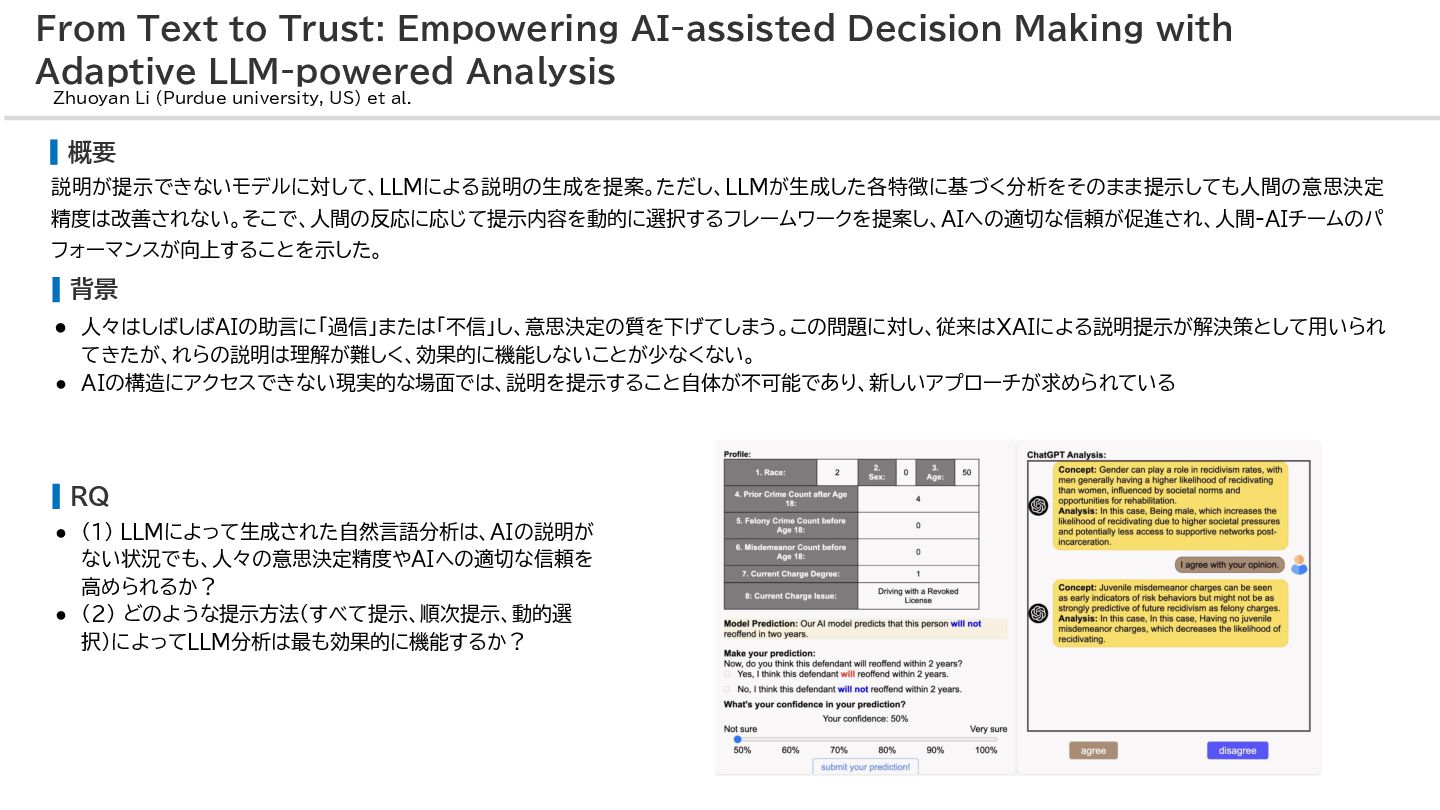
LLM-powered Analysis Zhuoyan Li (Purdue university, US) et al. ▍概要 説明が提示できないモデルに対して、LLMによる説明の生成を提案。ただし、LLMが生成した各特徴に基づく分析をそのまま提示しても人間の意思決定 精度は改善されない。そこで、人間の反応に応じて提示内容を動的に選択するフレームワークを提案し、AIへの適切な信頼が促進され、人間-AIチームのパ フォーマンスが向上することを示した。 ▍背景 • 人々はしばしばAIの助言に「過信」または「不信」し、意思決定の質を下げてしまう。この問題に対し、従来はXAIによる説明提示が解決策として用いられ てきたが、れらの説明は理解が難しく、効果的に機能しないことが少なくない。 • AIの構造にアクセスできない現実的な場面では、説明を提示すること自体が不可能であり、新しいアプローチが求められている ▍RQ • (1) LLMによって生成された自然言語分析は、AIの説明が ない状況でも、人々の意思決定精度やAIへの適切な信頼を 高められるか? • (2) どのような提示方法(すべて提示、順次提示、動的選 択)によってLLM分析は最も効果的に機能するか? -
From Text to Trust: Empowering AI-assisted Decision Making with Adaptive
LLM-powered Analysis Zhuoyan Li (Purdue university, US) et al. ▍概要 説明が提示できないモデルに対して、LLMによる説明の生成を提案。ただし、LLMが生成した各特徴に基づく分析をそのまま提示しても人間の意思決定 精度は改善されない。そこで、人間の反応に応じて提示内容を動的に選択するフレームワークを提案し、AIへの適切な信頼が促進され、人間-AIチームのパ フォーマンスが向上することを示した。 ▍提案 • 所得予測と再犯予測タスクで、Control(提示なし)、All(一括提示)、Seq(順次提示)という3条件で比較実験 • 人間の反応をモデリングする「人間行動モデル(human behavior model)」を学習し、各特徴に対するLLM分析の提示が人間の意思決定に与える 影響を推定できるようにした。その上で、どのLLM分析を提示すべきかを状態価値関数に基づいて逐次決定するアルゴリズムを構築 • これを「Algorithmic(Alg)」条件として再度実験し、他のベースライン手法(Rank, Human-Solo等)と比較 ▍結果 • Control, All, Seqの間に統計的有意差はなく、LLM分析 の静的提示は意思決定精度に効果がない • Alg条件では、意思決定の精度が有意に向上し(p < 0.001)、AIへの過信(overreliance)が顕著に減少した。 • 提示されたLLM分析の数も他条件より少なく(平均2.5〜 2.9回)、効率的 -
Talk to the Hand: an LLM-powered Chatbot with Visual Pointer
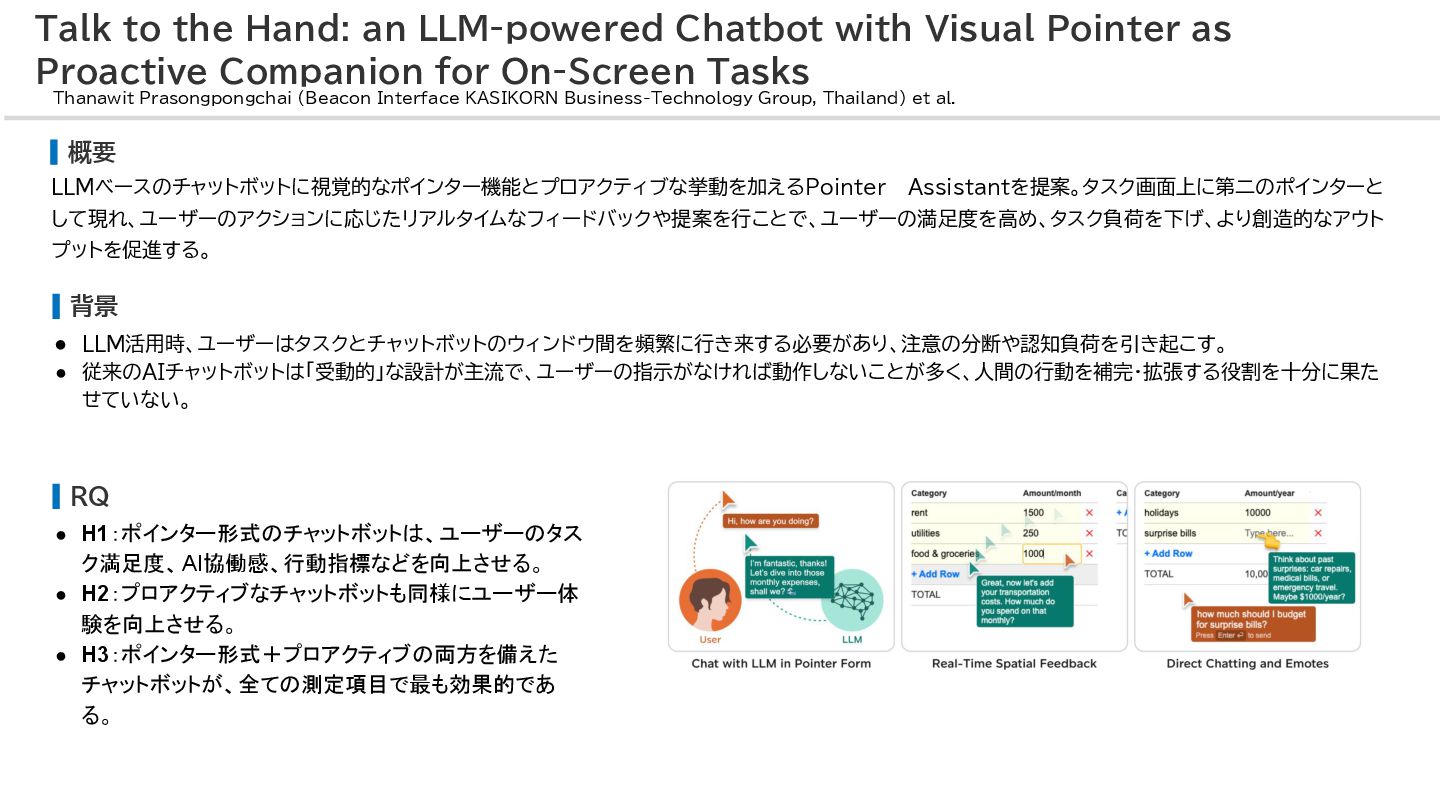
as Proactive Companion for On-Screen Tasks Thanawit Prasongpongchai (Beacon Interface KASIKORN Business-Technology Group, Thailand) et al. ▍概要 LLMベースのチャットボットに視覚的なポインター機能とプロアクティブな挙動を加えるPointer Assistantを提案。タスク画面上に第二のポインターと して現れ、ユーザーのアクションに応じたリアルタイムなフィードバックや提案を行ことで、ユーザーの満足度を高め、タスク負荷を下げ、より創造的なアウト プットを促進する。 ▍背景 • LLM活用時、ユーザーはタスクとチャットボットのウィンドウ間を頻繁に行き来する必要があり、注意の分断や認知負荷を引き起こす。 • 従来のAIチャットボットは「受動的」な設計が主流で、ユーザーの指示がなければ動作しないことが多く、人間の行動を補完・拡張する役割を十分に果た せていない。 ▍RQ • H1:ポインター形式のチャットボットは、ユーザーのタス ク満足度、AI協働感、行動指標などを向上させる。 • H2:プロアクティブなチャットボットも同様にユーザー体 験を向上させる。 • H3:ポインター形式+プロアクティブの両方を備えた チャットボットが、全ての測定項目で最も効果的であ る。 -
Talk to the Hand: an LLM-powered Chatbot with Visual Pointer
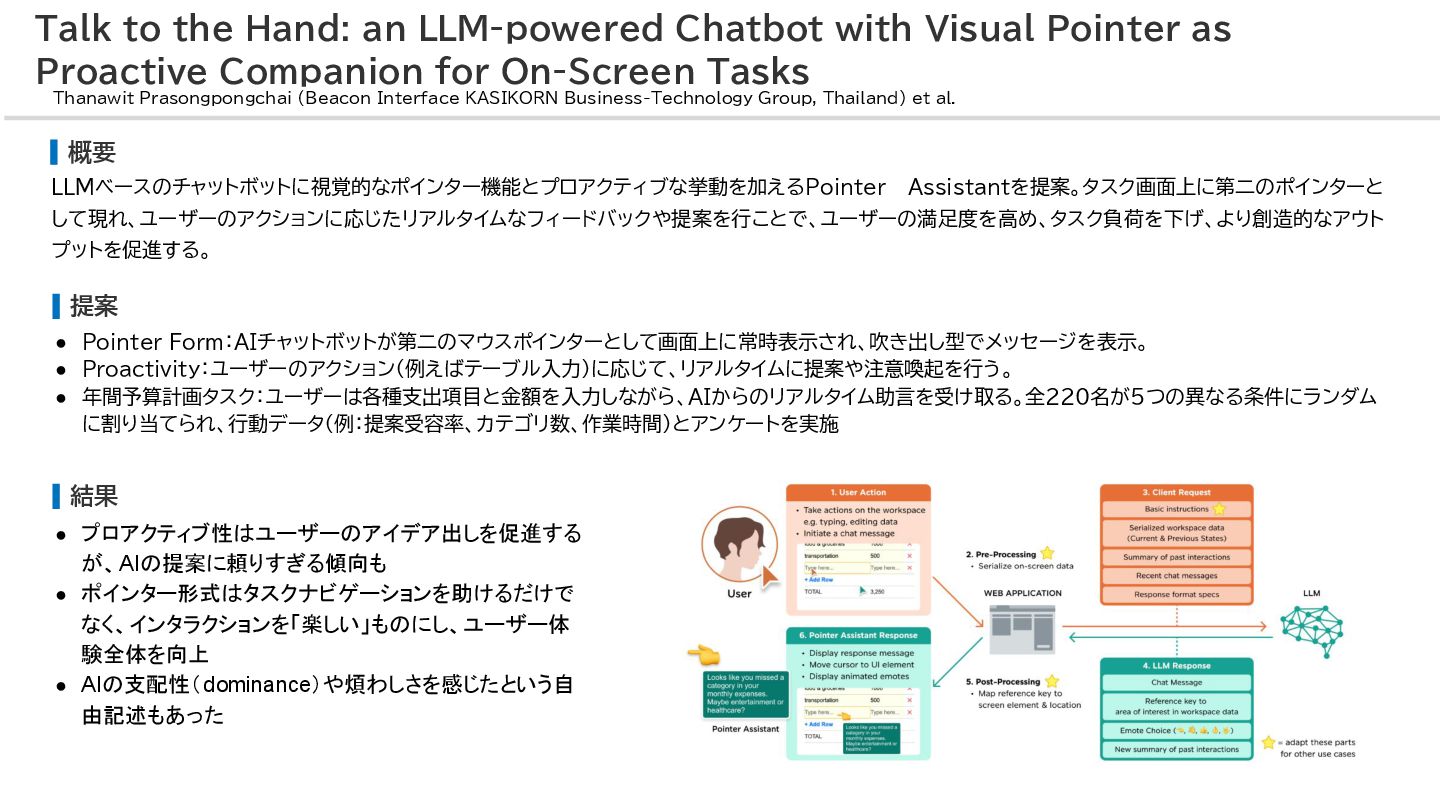
as Proactive Companion for On-Screen Tasks Thanawit Prasongpongchai (Beacon Interface KASIKORN Business-Technology Group, Thailand) et al. ▍概要 LLMベースのチャットボットに視覚的なポインター機能とプロアクティブな挙動を加えるPointer Assistantを提案。タスク画面上に第二のポインターと して現れ、ユーザーのアクションに応じたリアルタイムなフィードバックや提案を行ことで、ユーザーの満足度を高め、タスク負荷を下げ、より創造的なアウト プットを促進する。 ▍提案 • Pointer Form:AIチャットボットが第二のマウスポインターとして画面上に常時表示され、吹き出し型でメッセージを表示。 • Proactivity:ユーザーのアクション(例えばテーブル入力)に応じて、リアルタイムに提案や注意喚起を行う。 • 年間予算計画タスク:ユーザーは各種支出項目と金額を入力しながら、AIからのリアルタイム助言を受け取る。全220名が5つの異なる条件にランダム に割り当てられ、行動データ(例:提案受容率、カテゴリ数、作業時間)とアンケートを実施 ▍結果 • プロアクティブ性はユーザーのアイデア出しを促進する が、AIの提案に頼りすぎる傾向も • ポインター形式はタスクナビゲーションを助けるだけで なく、インタラクションを「楽しい」ものにし、ユーザー体 験全体を向上 • AIの支配性(dominance)や煩わしさを感じたという自 由記述もあった -
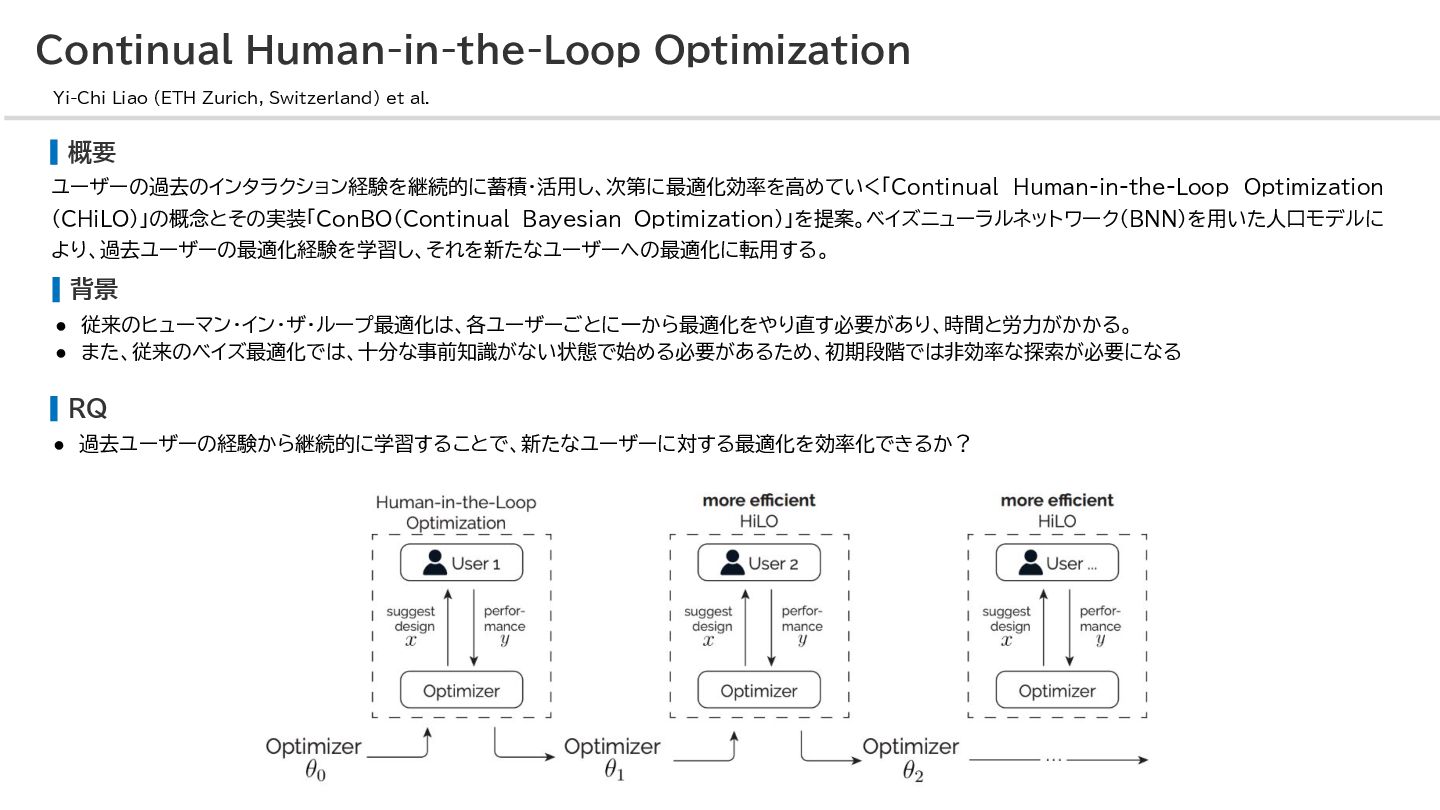
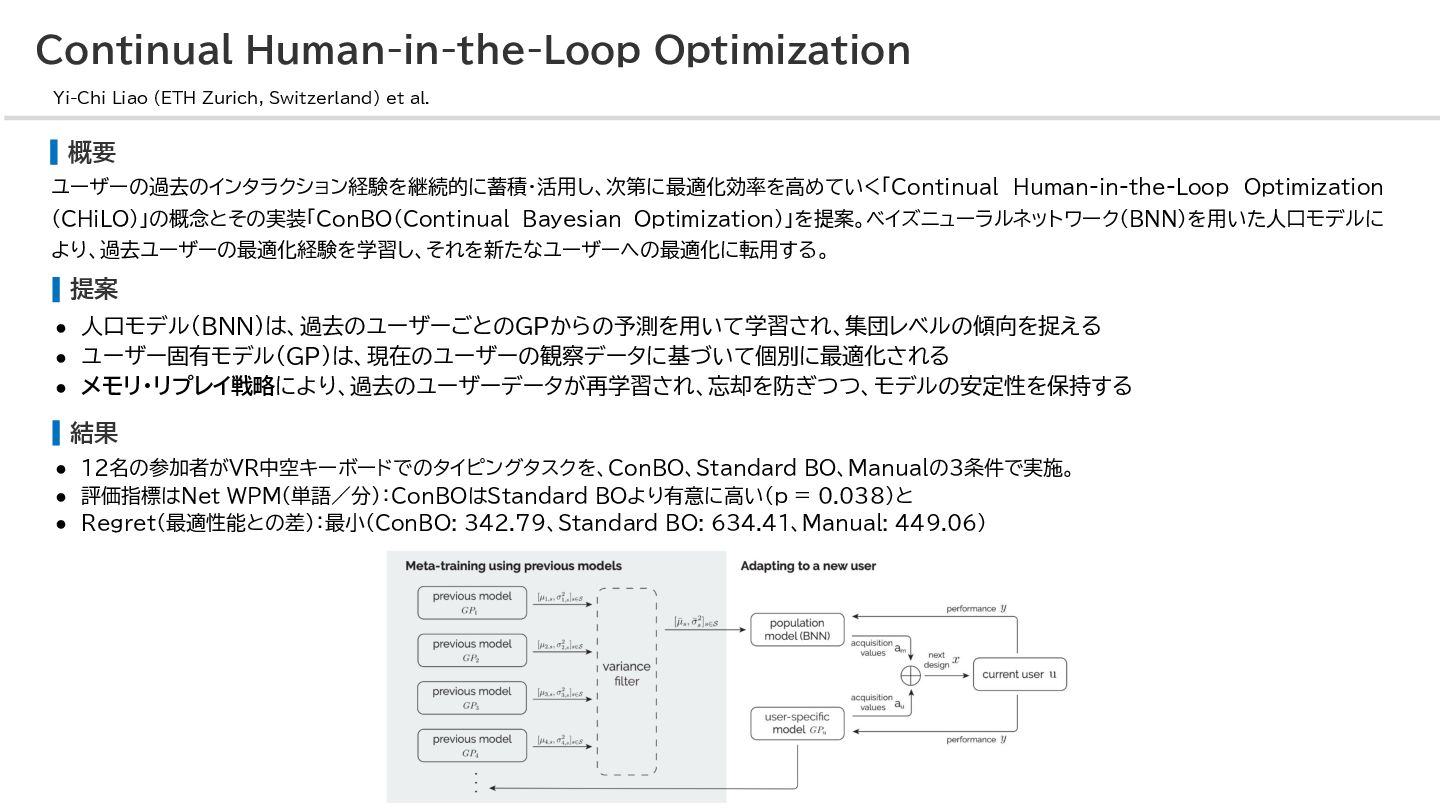
Continual Human-in-the-Loop Optimization Yi-Chi Liao (ETH Zurich, Switzerland) et al.
▍概要 ユーザーの過去のインタラクション経験を継続的に蓄積・活用し、次第に最適化効率を高めていく「Continual Human-in-the-Loop Optimization (CHiLO)」の概念とその実装「ConBO(Continual Bayesian Optimization)」を提案。ベイズニューラルネットワーク(BNN)を用いた人口モデルに より、過去ユーザーの最適化経験を学習し、それを新たなユーザーへの最適化に転用する。 ▍背景 • 従来のヒューマン・イン・ザ・ループ最適化は、各ユーザーごとに一から最適化をやり直す必要があり、時間と労力がかかる。 • また、従来のベイズ最適化では、十分な事前知識がない状態で始める必要があるため、初期段階では非効率な探索が必要になる ▍RQ • 過去ユーザーの経験から継続的に学習することで、新たなユーザーに対する最適化を効率化できるか? -
Continual Human-in-the-Loop Optimization Yi-Chi Liao (ETH Zurich, Switzerland) et al.
▍概要 ユーザーの過去のインタラクション経験を継続的に蓄積・活用し、次第に最適化効率を高めていく「Continual Human-in-the-Loop Optimization (CHiLO)」の概念とその実装「ConBO(Continual Bayesian Optimization)」を提案。ベイズニューラルネットワーク(BNN)を用いた人口モデルに より、過去ユーザーの最適化経験を学習し、それを新たなユーザーへの最適化に転用する。 ▍提案 • 人口モデル(BNN)は、過去のユーザーごとのGPからの予測を用いて学習され、集団レベルの傾向を捉える • ユーザー固有モデル(GP)は、現在のユーザーの観察データに基づいて個別に最適化される • メモリ・リプレイ戦略により、過去のユーザーデータが再学習され、忘却を防ぎつつ、モデルの安定性を保持する ▍結果 • 12名の参加者がVR中空キーボードでのタイピングタスクを、ConBO、Standard BO、Manualの3条件で実施。 • 評価指標はNet WPM(単語/分):ConBOはStandard BOより有意に高い(p = 0.038)と • Regret(最適性能との差):最小(ConBO: 342.79、Standard BO: 634.41、Manual: 449.06) -
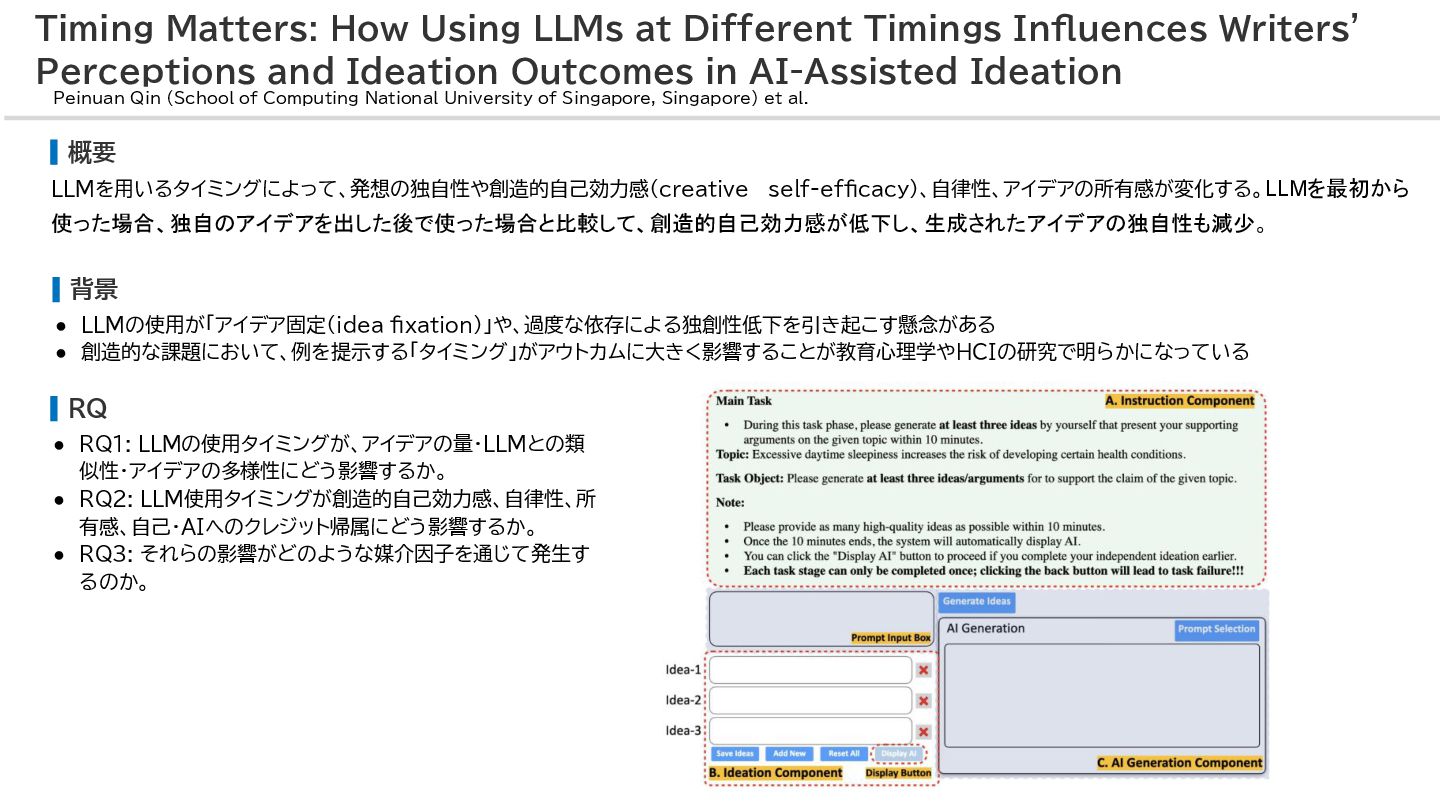
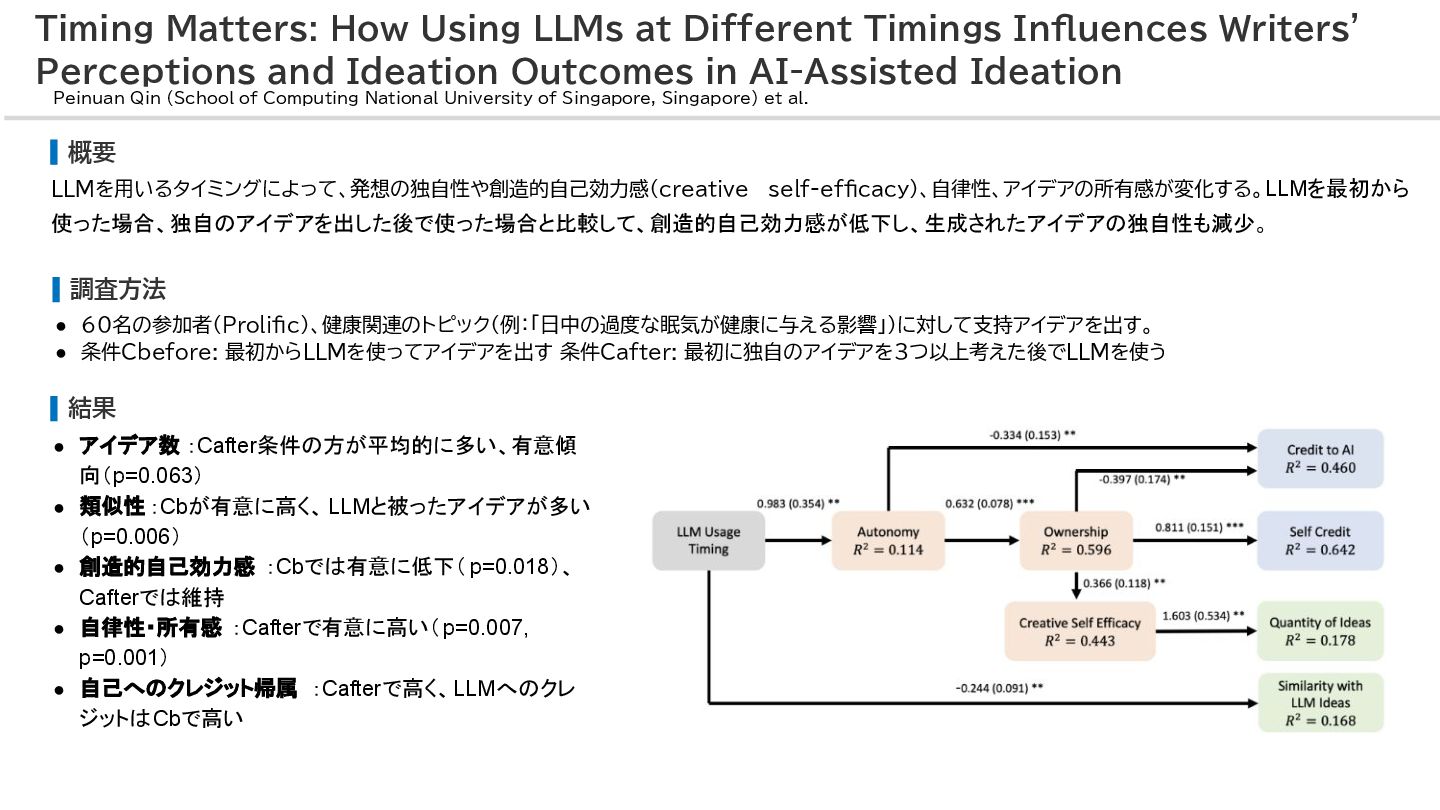
Timing Matters: How Using LLMs at Different Timings Influences Writers’
Perceptions and Ideation Outcomes in AI-Assisted Ideation Peinuan Qin (School of Computing National University of Singapore, Singapore) et al. ▍概要 LLMを用いるタイミングによって、発想の独自性や創造的自己効力感(creative self-efficacy)、自律性、アイデアの所有感が変化する。LLMを最初から 使った場合、独自のアイデアを出した後で使った場合と比較して、創造的自己効力感が低下し、生成されたアイデアの独自性も減少。 ▍背景 • LLMの使用が「アイデア固定(idea fixation)」や、過度な依存による独創性低下を引き起こす懸念がある • 創造的な課題において、例を提示する「タイミング」がアウトカムに大きく影響することが教育心理学やHCIの研究で明らかになっている ▍RQ • RQ1: LLMの使用タイミングが、アイデアの量・LLMとの類 似性・アイデアの多様性にどう影響するか。 • RQ2: LLM使用タイミングが創造的自己効力感、自律性、所 有感、自己・AIへのクレジット帰属にどう影響するか。 • RQ3: それらの影響がどのような媒介因子を通じて発生す るのか。 -
Timing Matters: How Using LLMs at Different Timings Influences Writers’
Perceptions and Ideation Outcomes in AI-Assisted Ideation Peinuan Qin (School of Computing National University of Singapore, Singapore) et al. ▍概要 LLMを用いるタイミングによって、発想の独自性や創造的自己効力感(creative self-efficacy)、自律性、アイデアの所有感が変化する。LLMを最初から 使った場合、独自のアイデアを出した後で使った場合と比較して、創造的自己効力感が低下し、生成されたアイデアの独自性も減少。 ▍調査方法 • 60名の参加者(Prolific)、健康関連のトピック(例:「日中の過度な眠気が健康に与える影響」)に対して支持アイデアを出す。 • 条件Cbefore: 最初からLLMを使ってアイデアを出す 条件Cafter: 最初に独自のアイデアを3つ以上考えた後でLLMを使う ▍結果 • アイデア数 :Cafter条件の方が平均的に多い、有意傾 向(p=0.063) • 類似性 :Cbが有意に高く、LLMと被ったアイデアが多い (p=0.006) • 創造的自己効力感 :Cbでは有意に低下( p=0.018)、 Cafterでは維持 • 自律性・所有感 :Cafterで有意に高い(p=0.007, p=0.001) • 自己へのクレジット帰属 :Cafterで高く、LLMへのクレ ジットはCbで高い -
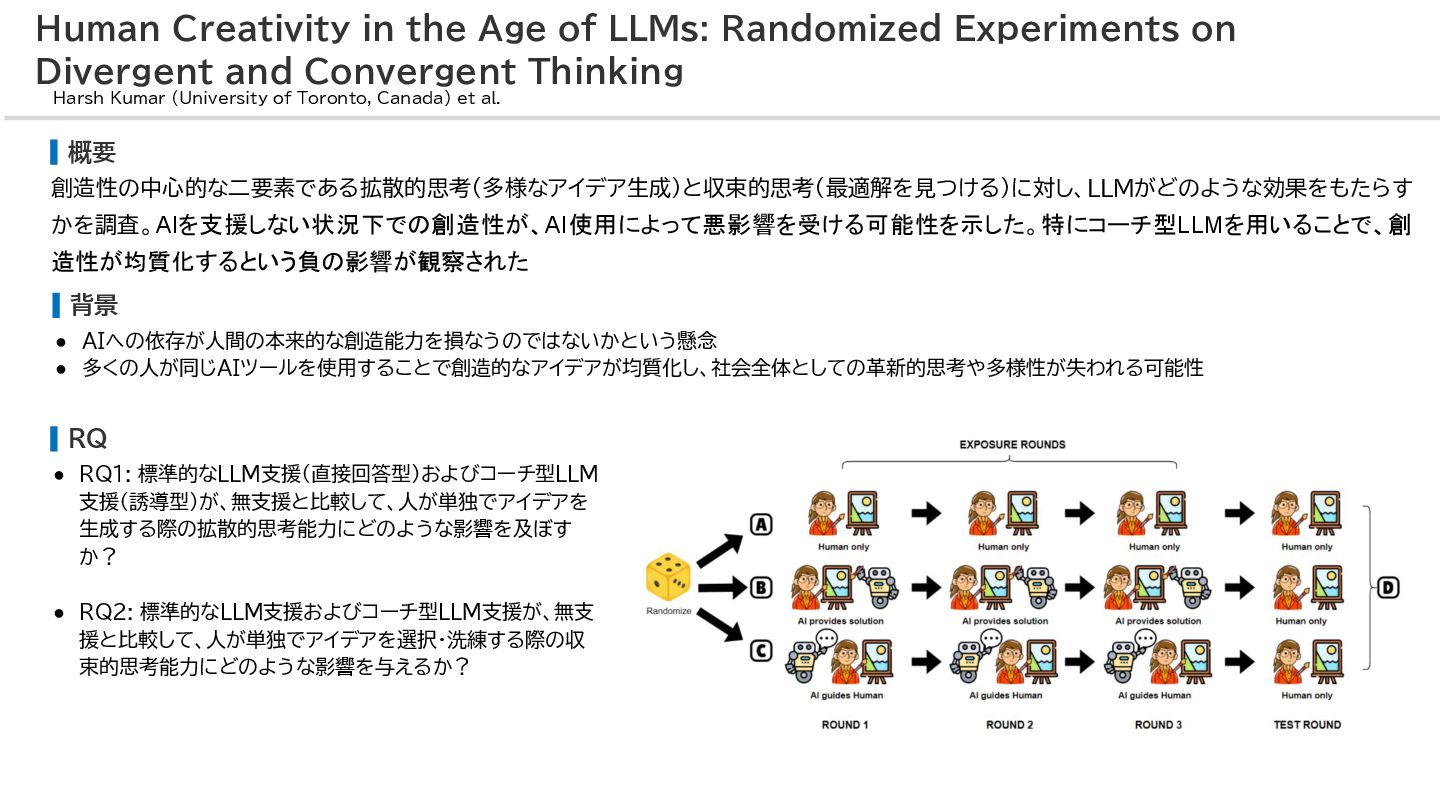
Human Creativity in the Age of LLMs: Randomized Experiments on
Divergent and Convergent Thinking Harsh Kumar (University of Toronto, Canada) et al. ▍概要 創造性の中心的な二要素である拡散的思考(多様なアイデア生成)と収束的思考(最適解を見つける)に対し、LLMがどのような効果をもたらす かを調査。AIを支援しない状況下での創造性が、AI使用によって悪影響を受ける可能性を示した。特にコーチ型LLMを用いることで、創 造性が均質化するという負の影響が観察された ▍背景 • AIへの依存が人間の本来的な創造能力を損なうのではないかという懸念 • 多くの人が同じAIツールを使用することで創造的なアイデアが均質化し、社会全体としての革新的思考や多様性が失われる可能性 ▍RQ • RQ1: 標準的なLLM支援(直接回答型)およびコーチ型LLM 支援(誘導型)が、無支援と比較して、人が単独でアイデアを 生成する際の拡散的思考能力にどのような影響を及ぼす か? • RQ2: 標準的なLLM支援およびコーチ型LLM支援が、無支 援と比較して、人が単独でアイデアを選択・洗練する際の収 束的思考能力にどのような影響を与えるか? -
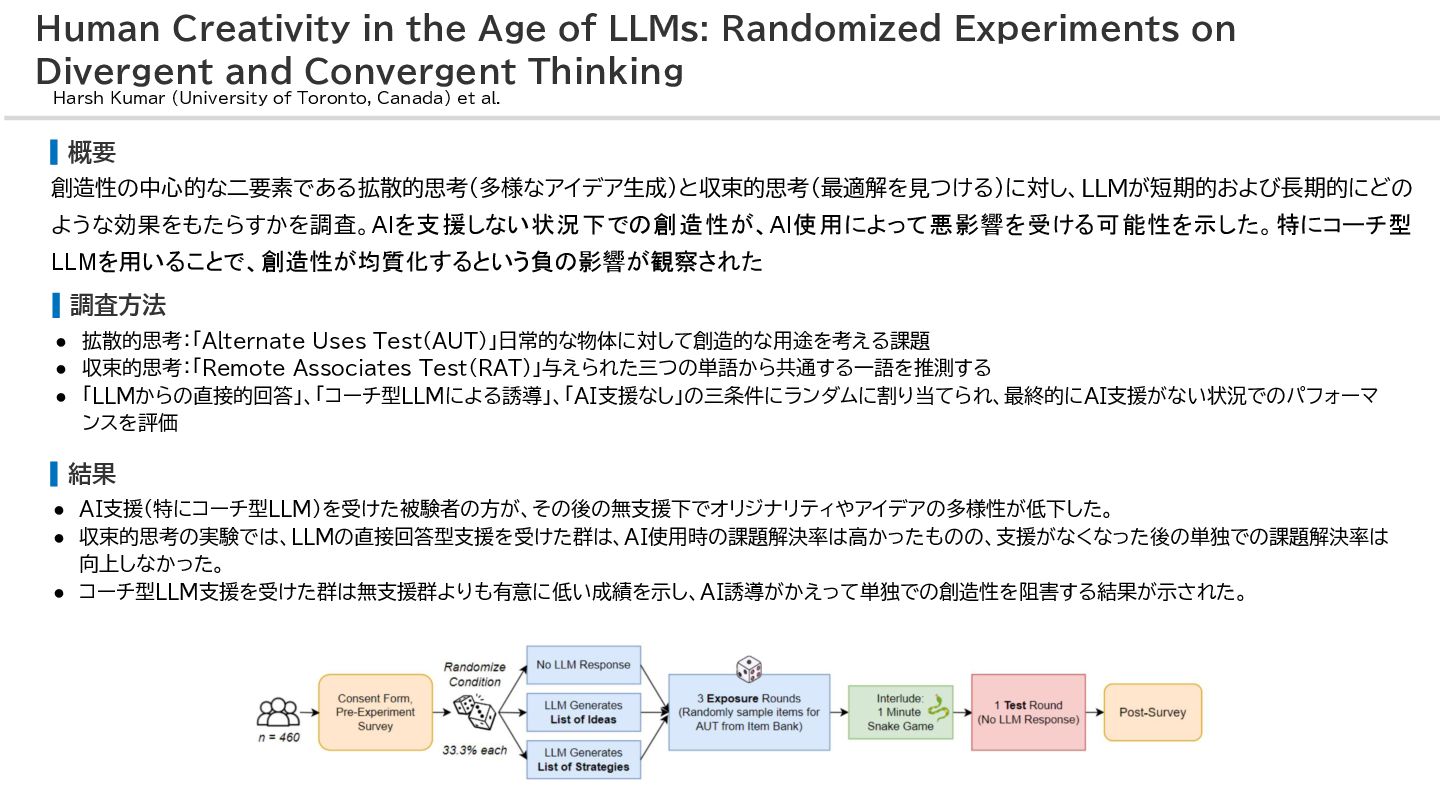
Human Creativity in the Age of LLMs: Randomized Experiments on
Divergent and Convergent Thinking Harsh Kumar (University of Toronto, Canada) et al. ▍概要 創造性の中心的な二要素である拡散的思考(多様なアイデア生成)と収束的思考(最適解を見つける)に対し、LLMが短期的および長期的にどの ような効果をもたらすかを調査。AIを支援しない状況下での創造性が、AI使用によって悪影響を受ける可能性を示した。特にコーチ型 LLMを用いることで、創造性が均質化するという負の影響が観察された ▍調査方法 • 拡散的思考:「Alternate Uses Test(AUT)」日常的な物体に対して創造的な用途を考える課題 • 収束的思考:「Remote Associates Test(RAT)」与えられた三つの単語から共通する一語を推測する • 「LLMからの直接的回答」、「コーチ型LLMによる誘導」、「AI支援なし」の三条件にランダムに割り当てられ、最終的にAI支援がない状況でのパフォーマ ンスを評価 ▍結果 • AI支援(特にコーチ型LLM)を受けた被験者の方が、その後の無支援下でオリジナリティやアイデアの多様性が低下した。 • 収束的思考の実験では、LLMの直接回答型支援を受けた群は、AI使用時の課題解決率は高かったものの、支援がなくなった後の単独での課題解決率は 向上しなかった。 • コーチ型LLM支援を受けた群は無支援群よりも有意に低い成績を示し、AI誘導がかえって単独での創造性を阻害する結果が示された。 -
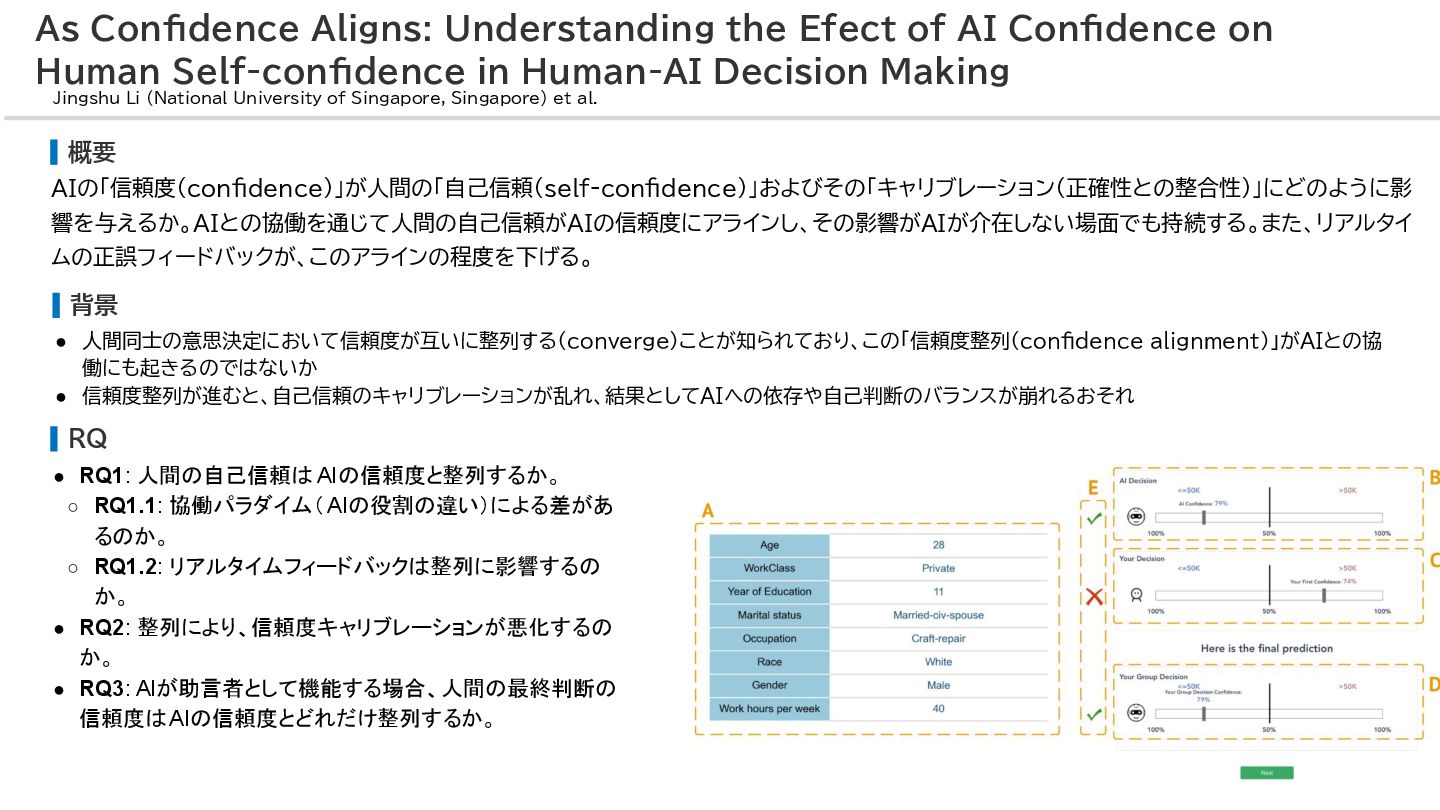
As Confidence Aligns: Understanding the Efect of AI Confidence on
Human Self-confidence in Human-AI Decision Making Jingshu Li (National University of Singapore, Singapore) et al. ▍概要 AIの「信頼度(confidence)」が人間の「自己信頼(self-confidence)」およびその「キャリブレーション(正確性との整合性)」にどのように影 響を与えるか。AIとの協働を通じて人間の自己信頼がAIの信頼度にアラインし、その影響がAIが介在しない場面でも持続する。また、リアルタイ ムの正誤フィードバックが、このアラインの程度を下げる。 ▍背景 • 人間同士の意思決定において信頼度が互いに整列する(converge)ことが知られており、この「信頼度整列(confidence alignment)」がAIとの協 働にも起きるのではないか • 信頼度整列が進むと、自己信頼のキャリブレーションが乱れ、結果としてAIへの依存や自己判断のバランスが崩れるおそれ ▍RQ • RQ1: 人間の自己信頼は AIの信頼度と整列するか。 ◦ RQ1.1: 協働パラダイム( AIの役割の違い)による差があ るのか。 ◦ RQ1.2: リアルタイムフィードバックは整列に影響するの か。 • RQ2: 整列により、信頼度キャリブレーションが悪化するの か。 • RQ3: AIが助言者として機能する場合、人間の最終判断の 信頼度はAIの信頼度とどれだけ整列するか。 -
As Confidence Aligns: Understanding the Efect of AI Confidence on
Human Self-confidence in Human-AI Decision Making Jingshu Li (National University of Singapore, Singapore) et al. ▍概要 AIの「信頼度(confidence)」が人間の「自己信頼(self-confidence)」およびその「キャリブレーション(正確性との整合性)」にどのように影 響を与えるか。AIとの協働を通じて人間の自己信頼がAIの信頼度にアラインし、その影響がAIが介在しない場面でも持続する。また、リアルタイ ムの正誤フィードバックが、このアラインの程度を下げる。 ▍調査方法 • 270人(年齢21〜60歳)で、以下の3ステージ • ステージ1(基準測定):AIなしで40件の収入予測タスクを実施。自己信頼を測定。 • ステージ2(AI協働):AI(信頼度80.4%)との協働による40件のタスク。AIの役割は3種類のパラダイムでランダムに割り当て。 • ステージ3(再測定):再びAIなしで40件のタスクを実施。整列の持続性を測定。 ▍結果 • RQ1: 人間の自己信頼はAIの信頼度と整列し、協働終了後もその効果 が持続する。 ◦ RQ1.1: 協働パラダイム(AIの役割の違い)による有意な差はなかっ た。 ◦ RQ1.2: リアルタイムフィードバックは整列を弱める。 • RQ2: 整列により、信頼度キャリブレーションが悪化し、意思決定の精 度やAIへの適切な依存に悪影響を与える。 • RQ3: 最終決定の信頼度はAIの信頼度と強く整列する傾向がある(特 にAIの提案を採用した場合)。 -
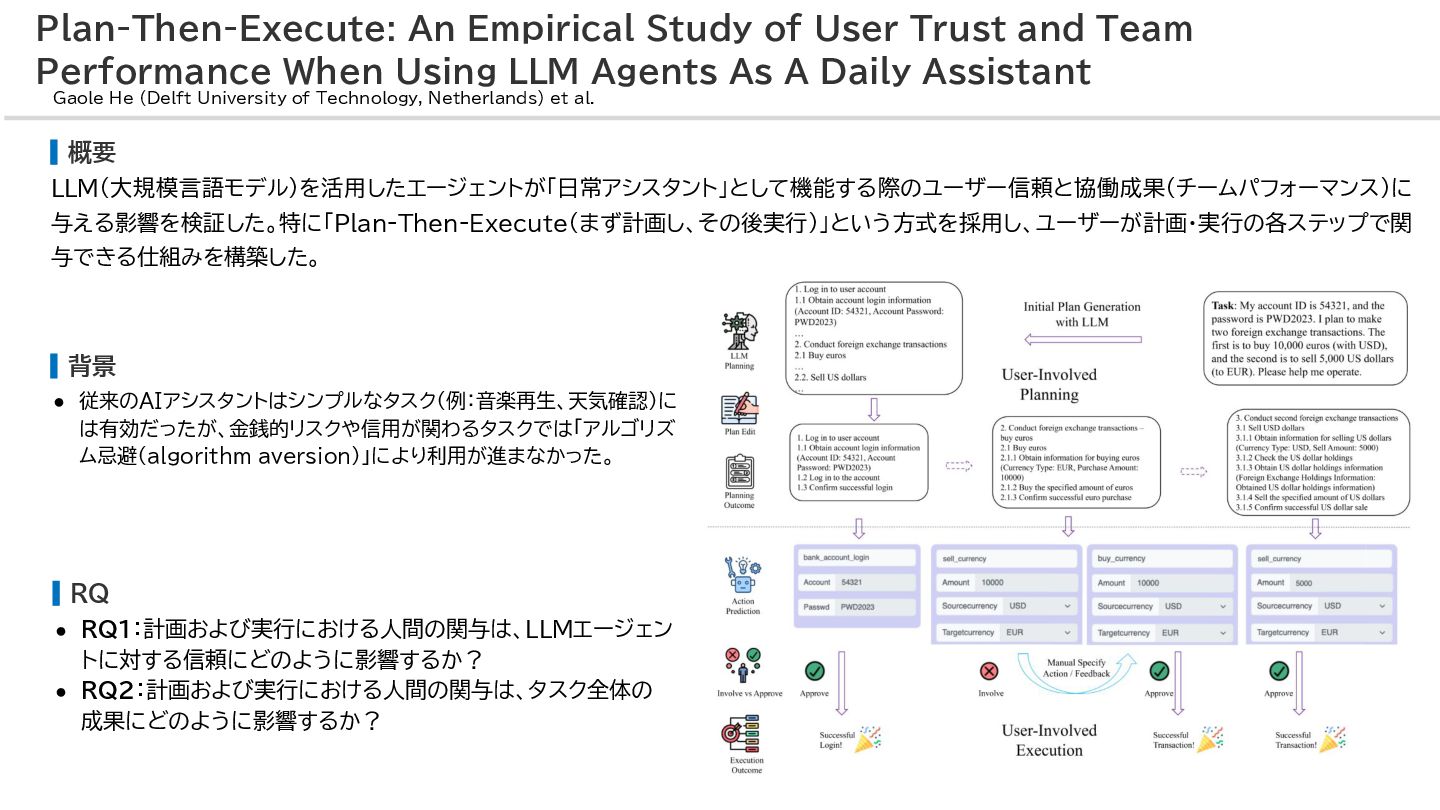
Plan-Then-Execute: An Empirical Study of User Trust and Team Performance
When Using LLM Agents As A Daily Assistant Gaole He (Delft University of Technology, Netherlands) et al. ▍概要 LLM(大規模言語モデル)を活用したエージェントが「日常アシスタント」として機能する際のユーザー信頼と協働成果(チームパフォーマンス)に 与える影響を検証した。特に「Plan-Then-Execute(まず計画し、その後実行)」という方式を採用し、ユーザーが計画・実行の各ステップで関 与できる仕組みを構築した。 ▍背景 • 従来のAIアシスタントはシンプルなタスク(例:音楽再生、天気確認)に は有効だったが、金銭的リスクや信用が関わるタスクでは「アルゴリズ ム忌避(algorithm aversion)」により利用が進まなかった。 ▍RQ • RQ1:計画および実行における人間の関与は、LLMエージェン トに対する信頼にどのように影響するか? • RQ2:計画および実行における人間の関与は、タスク全体の 成果にどのように影響するか? -
Plan-Then-Execute: An Empirical Study of User Trust and Team Performance
When Using LLM Agents As A Daily Assistant Gaole He (Delft University of Technology, Netherlands) et al. ▍概要 LLM(大規模言語モデル)を活用したエージェントが「日常アシスタント」として機能する際のユーザー信頼と協働成果(チームパフォーマンス)に 与える影響を検証した。特に「Plan-Then-Execute(まず計画し、その後実行)」という方式を採用し、ユーザーが計画・実行の各ステップで関 与できる仕組みを構築した。 ▍調査方法 • 計画フェーズ :LLMが階層的なステッププランを生成。ユーザーはそれを編集(追加・削除・分割)可能。 • 実行フェーズ :各ステップをアクションに変換し、ユーザーは提案されたアクションを「承認」「修正」「再提案」できる。 実験条件は2×2の要因計画(自動 /手動 × 計画/実行)で4条件(AP-AE, AP-UE, UP-AE, UP-UE)を設定。 参加者は248名。タスクはUltraToolデータセットに基づく 6種類で、金融・旅行・アラームなど多様なリスクレベルを含む。 ▍結果 • 計画信頼のキャリブレーション(CTₚ)は全体で0.50。計画段階でのユーザー関与は必ずしも信頼向上に繋がらなかった。 • 実行信頼のキャリブレーション(CTₑ)は平均0.64。実行段階でのユーザー関与も信頼を安定させるとは限らなかった。 • 計画の質は、誤った計画ではユーザー関与により改善されたが、元々良質な計画のタスクではかえって品質が下がったケースも。 • 実行精度(ACCₑ)はUP-UE条件で最高値(0.58)を記録するなど、ユーザーが間違ったアクションを修正できる実行段階での関与はタスク パフォーマンス向上に貢献した。 -
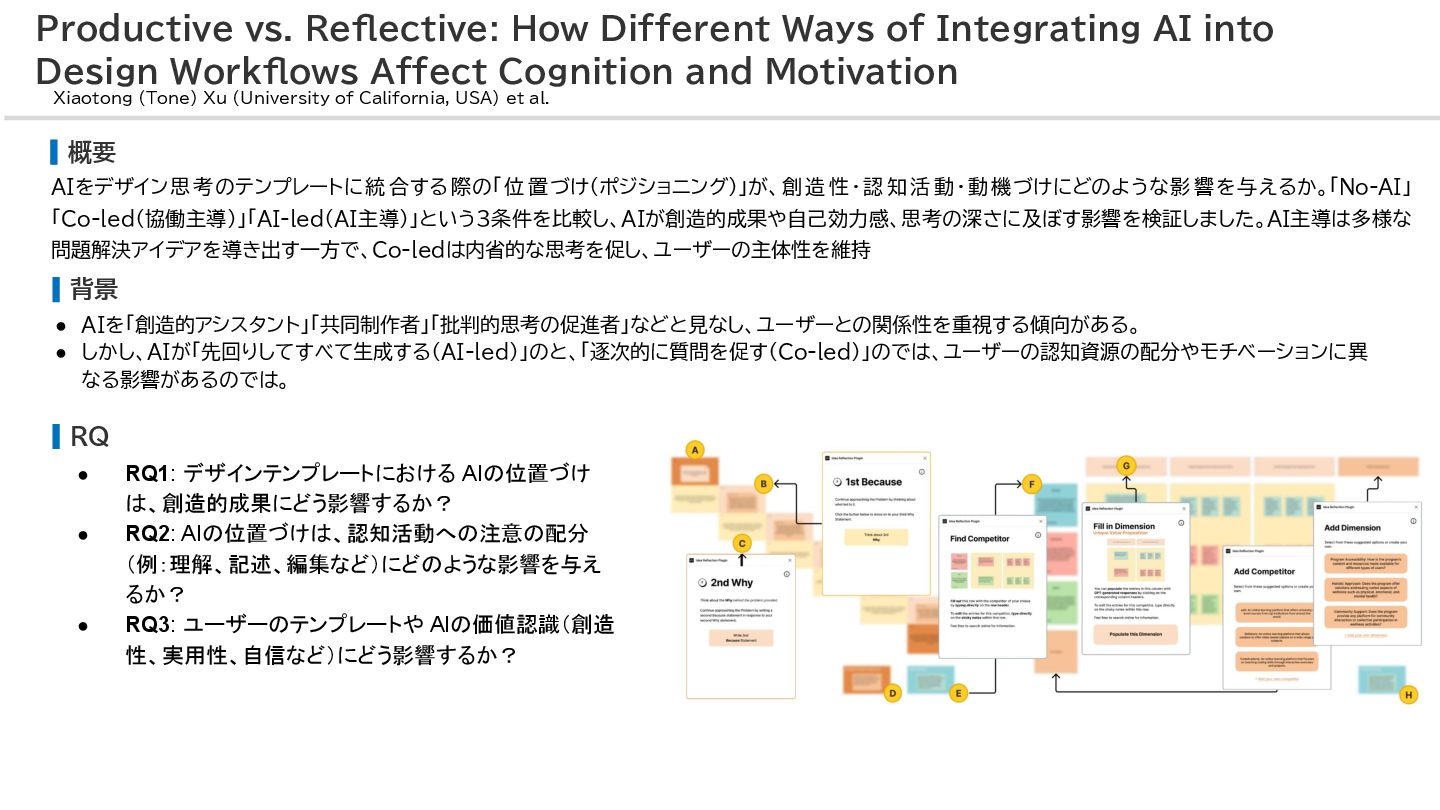
Productive vs. Reflective: How Different Ways of Integrating AI into
Design Workflows Affect Cognition and Motivation Xiaotong (Tone) Xu (University of California, USA) et al. ▍概要 AIをデザイン思 考のテンプレートに統 合する際の「位 置づけ(ポジショニング)」が、創 造 性・認 知 活 動・動 機づけにどのような影 響を与えるか。「No-AI」 「Co-led(協働主導)」「AI-led(AI主導)」という3条件を比較し、AIが創造的成果や自己効力感、思考の深さに及ぼす影響を検証しました。AI主導は多様な 問題解決アイデアを導き出す一方で、Co-ledは内省的な思考を促し、ユーザーの主体性を維持 ▍背景 • AIを「創造的アシスタント」「共同制作者」「批判的思考の促進者」などと見なし、ユーザーとの関係性を重視する傾向がある。 • しかし、AIが「先回りしてすべて生成する(AI-led)」のと、「逐次的に質問を促す(Co-led)」のでは、ユーザーの認知資源の配分やモチベーションに異 なる影響があるのでは。 ▍RQ • RQ1: デザインテンプレートにおける AIの位置づけ は、創造的成果にどう影響するか? • RQ2: AIの位置づけは、認知活動への注意の配分 (例:理解、記述、編集など)にどのような影響を与え るか? • RQ3: ユーザーのテンプレートや AIの価値認識(創造 性、実用性、自信など)にどう影響するか? -
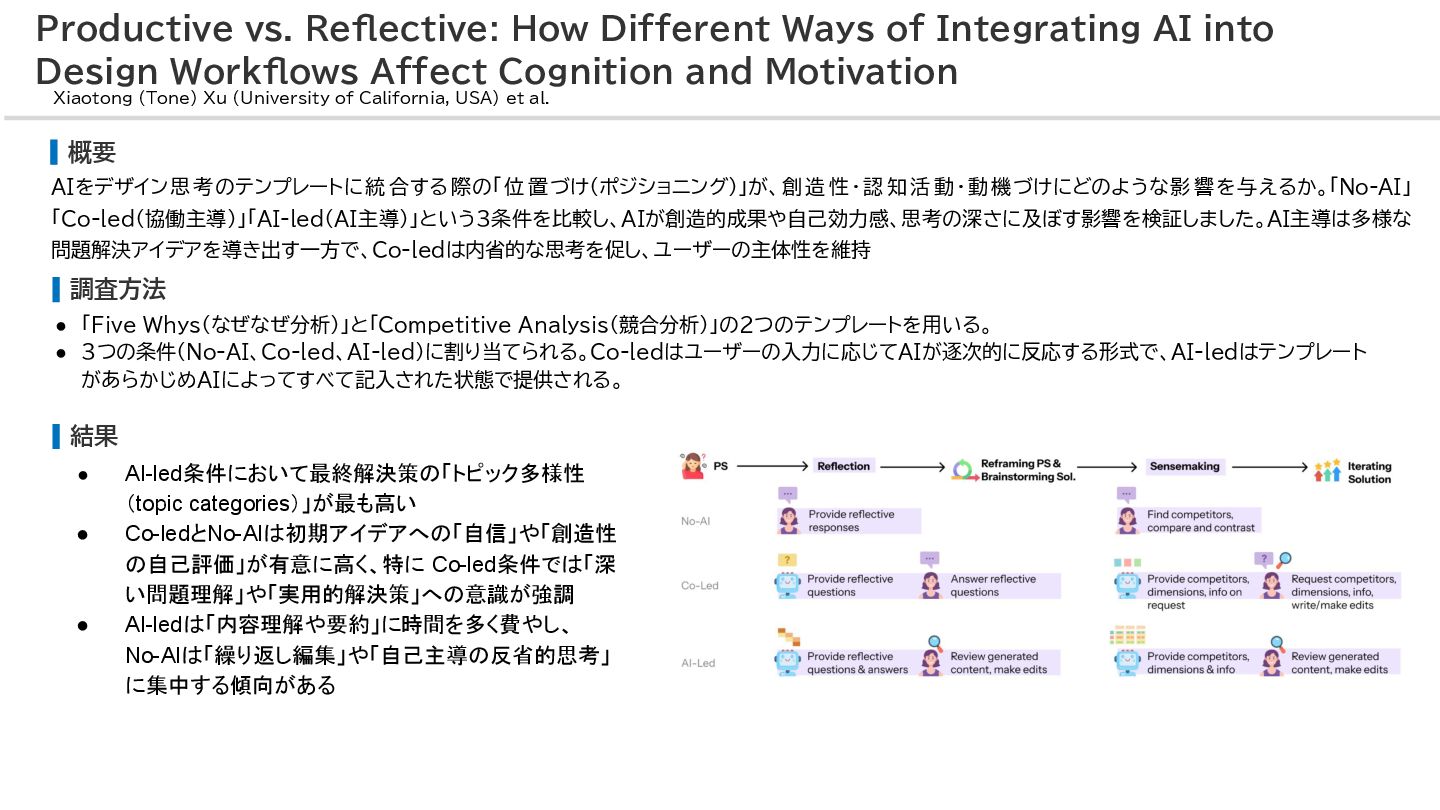
Productive vs. Reflective: How Different Ways of Integrating AI into
Design Workflows Affect Cognition and Motivation Xiaotong (Tone) Xu (University of California, USA) et al. ▍概要 AIをデザイン思 考のテンプレートに統 合する際の「位 置づけ(ポジショニング)」が、創 造 性・認 知 活 動・動 機づけにどのような影 響を与えるか。「No-AI」 「Co-led(協働主導)」「AI-led(AI主導)」という3条件を比較し、AIが創造的成果や自己効力感、思考の深さに及ぼす影響を検証しました。AI主導は多様な 問題解決アイデアを導き出す一方で、Co-ledは内省的な思考を促し、ユーザーの主体性を維持 ▍調査方法 • 「Five Whys(なぜなぜ分析)」と「Competitive Analysis(競合分析)」の2つのテンプレートを用いる。 • 3つの条件(No-AI、Co-led、AI-led)に割り当てられる。Co-ledはユーザーの入力に応じてAIが逐次的に反応する形式で、AI-ledはテンプレート があらかじめAIによってすべて記入された状態で提供される。 ▍結果 • AI-led条件において最終解決策の「トピック多様性 (topic categories)」が最も高い • Co-ledとNo-AIは初期アイデアへの「自信」や「創造性 の自己評価」が有意に高く、特に Co-led条件では「深 い問題理解」や「実用的解決策」への意識が強調 • AI-ledは「内容理解や要約」に時間を多く費やし、 No-AIは「繰り返し編集」や「自己主導の反省的思考」 に集中する傾向がある
 mei28
 letsgokoyo
 davidcarrasco
 lindahogenes
 sarafernandez
 ryanjones
 cassininazir
 greggifford
 reverentgeek
 thirion
 khoart
 stephaniewalter
 retrage