Upgrade to Pro — share decks privately, control downloads, hide ads and more …

1兆行を100円未満でクエリする ― 2年前の「1兆行チャレンジ」をClickHouse Cl...

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

1兆行を100円未満でクエリする ― 2年前の「1兆行チャレンジ」をClickHouse Cloudで再検証

「1兆行チャレンジ」は、S3上に置かれた2.4TiB・10万ファイルのParquet、合計1兆行をいかに高速に集計できるかという挑戦です。当時、AWSのスポットインスタンスでClickHouseクラスタを組み、1兆行を集計するクエリが3分未満、コストは100円未満でこれを達成しました。

本セッションでは、同じ挑戦をClickHouse Cloudでやり直します。カラムナストレージと圧縮、分散並列処理、ベクトル化実行といった技術が、なぜこれほど高速で低コストな処理を実現できるのかを解説しつつ、この2年で入ったParquetリーダーの刷新や並列レプリカも踏まえて、この記録を計り直し、その結果を解説します。

Avatar for Miki Matsumoto

Miki Matsumoto

November 11, 2026
More Decks by Miki Matsumoto

Other Decks in Technology
Transcript

  1. 自己紹介 松本 幹 Solution Architect • 15年以上にわたりビッグデータ領域に従事し、 外資系スタートアップにて日本市場立ち上げの技術戦略をリード • 以前は、SREやプロフェッショナルサービス

    として、 大規模・分散データ基盤の設計から構築・運用までを主導 • 現在は ClickHouse 日本人社員第一号として参画し、Solution Architect を担当 2 ©2025 CLICKHOUSE INC., CONFIDENTIAL & PROPRIETARY
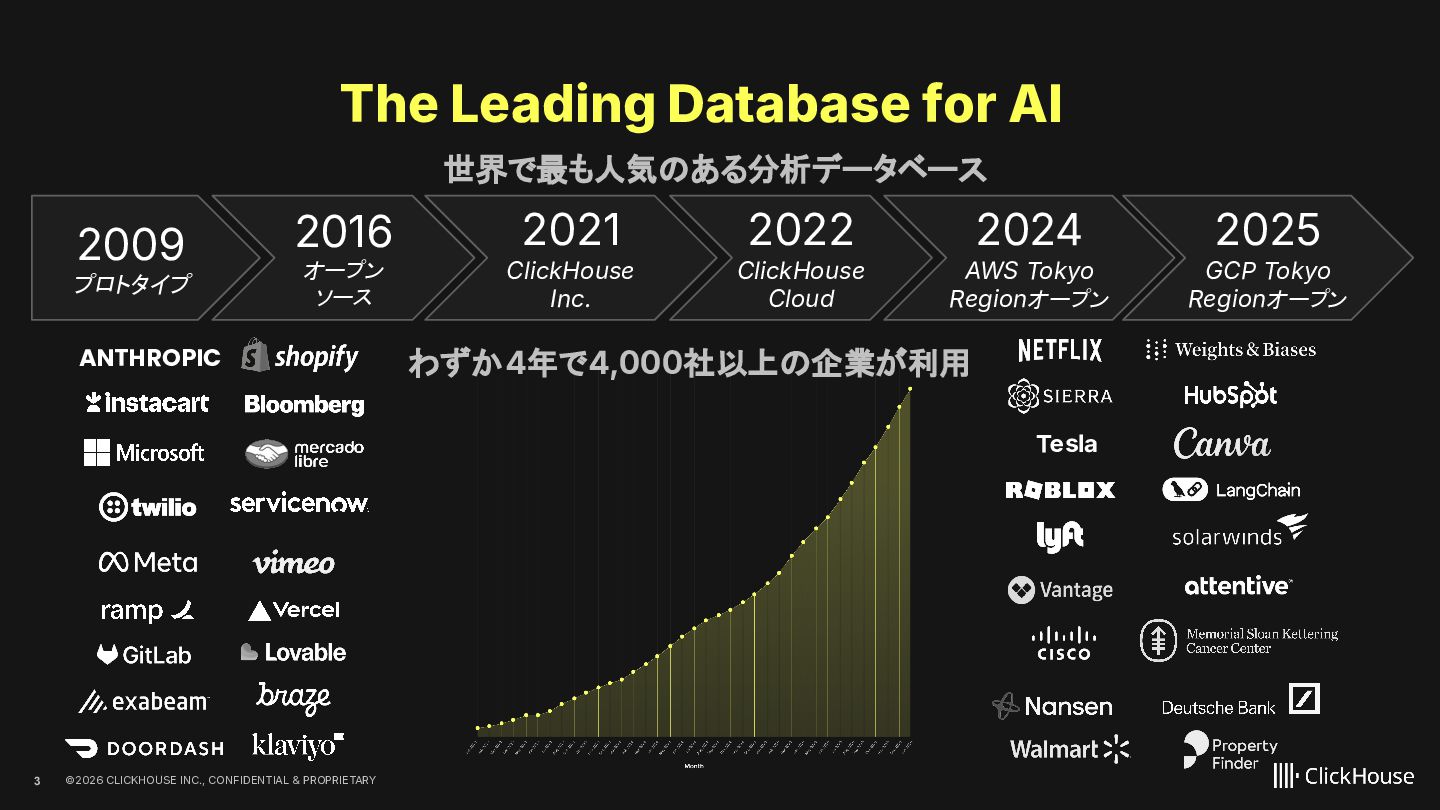
  2. The Leading Database for AI 世界で最も人気のある分析データベース 2009 プロトタイプ 2016 オープン

    ソース ANTHROPIC 2021 ClickHouse Inc. 2022 ClickHouse Cloud 2024 AWS Tokyo Regionオープン わずか4年で4,000社以上の企業が利用 Tesla 3 ©2026 CLICKHOUSE INC., CONFIDENTIAL & PROPRIETARY 2025 GCP Tokyo Regionオープン
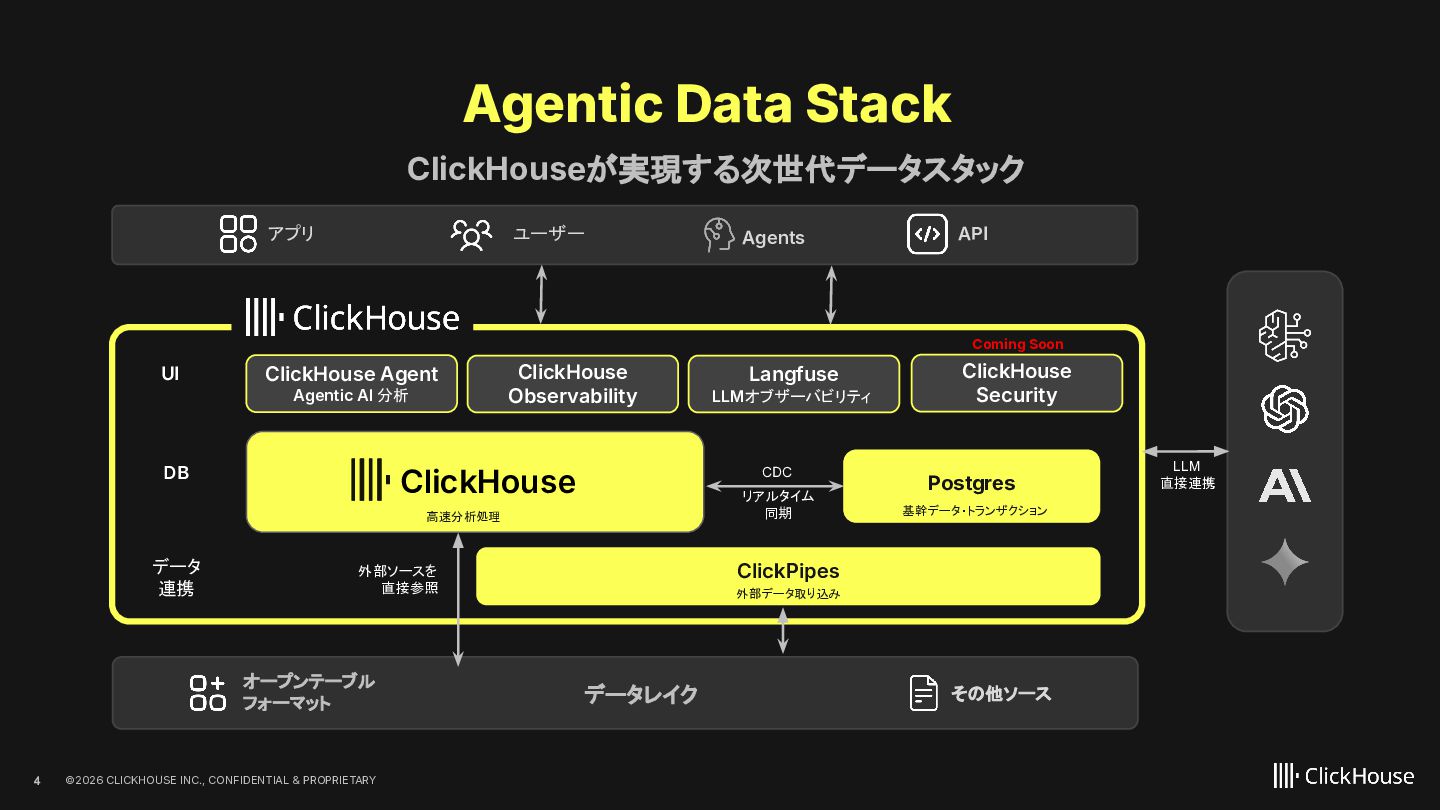
  3. Agentic Data Stack ClickHouseが実現する次世代データスタック アプリ ユーザー Agents API Coming Soon

    UI ClickHouse Agent Agentic AI 分析 DB ClickHouse Observability ClickHouse CDC リアルタイム 同期 高速分析処理 データ 連携 4 ©2026 CLICKHOUSE INC., CONFIDENTIAL & PROPRIETARY ClickHouse Security Postgres 基幹データ・トランザクション ClickPipes 外部ソースを 直接参照 オープンテーブル フォーマット Langfuse LLMオブザーバビリティ 外部データ取り込み データレイク その他ソース LLM 直接連携
  4. 自己紹介 橋本 拓也 Senior Technical Customer Support Engineer • スタートアップの何でも屋エンジニアを経て

    AWS 技術サポー ト。コンテナ/DynamoDB/DevOps まわりが専門 • Google Cloud ではプロフェッショナルサービスとサポートで、 データベースや Gemini などのユーザを支援 • 現在は ClickHouse シニアテクニカルサポートエンジニアとし て、主にアジア太平洋地域の問題解決を担当 5 ©2025 CLICKHOUSE INC., CONFIDENTIAL & PROPRIETARY
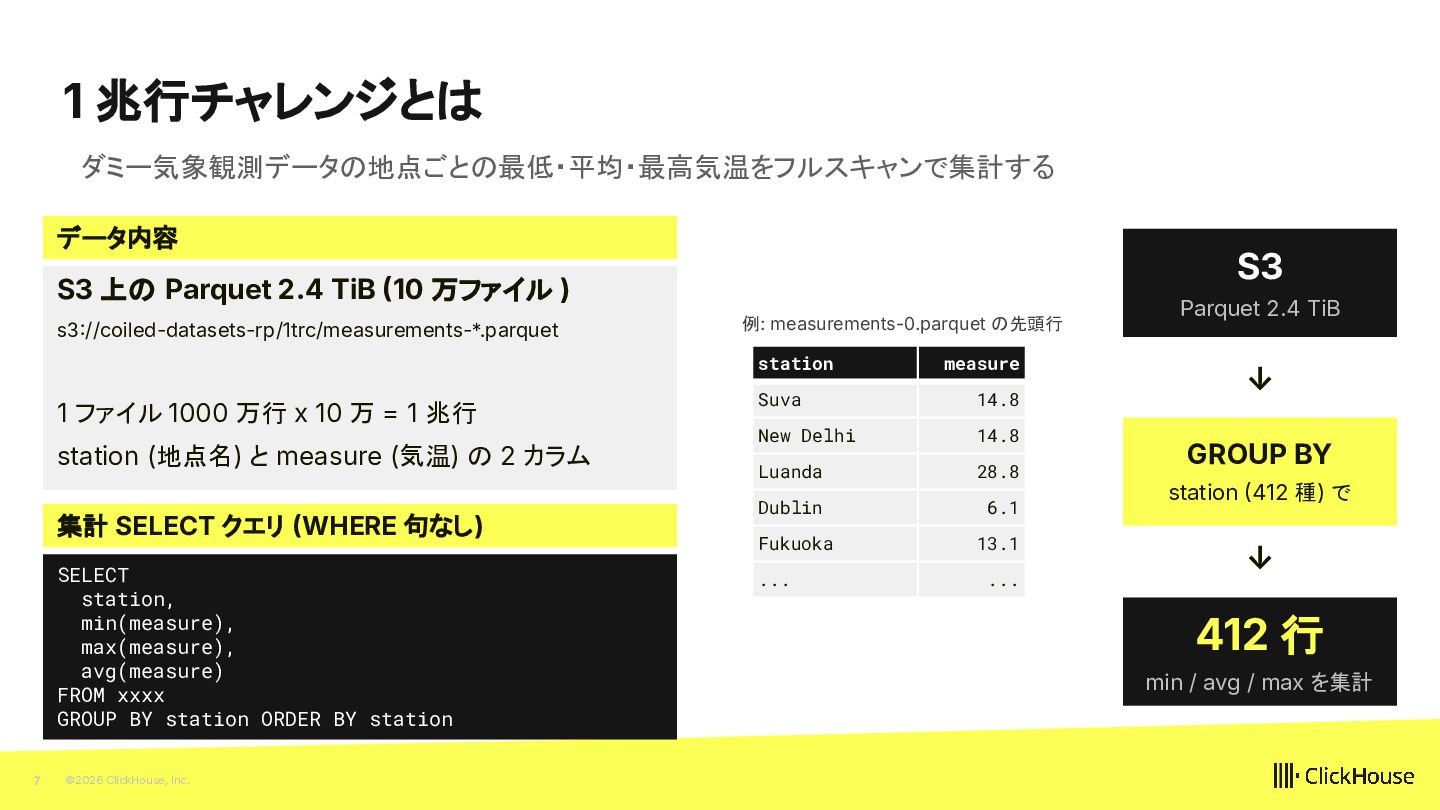
  5. 1 兆行チャレンジとは ダミー気象観測データの地点ごとの最低・平均・最高気温をフルスキャンで集計する データ内容 S3 S3 上の Parquet 2.4 TiB

    10 万ファイル ) s3//coiled-datasets-rp/1trc/measurements-*.parquet 例: measurements-0.parquet の先頭行 station 1 ファイル 1000 万行 x 10 万 = 1 兆行 station (地点名) と measure (気温) の 2 カラム 集計 SELECT クエリ WHERE 句なし) SELECT station, min(measure), max(measure), avg(measure) FROM xxxx GROUP BY station ORDER BY station 7 ©2026 ClickHouse, Inc. measure Suva 14.8 New Delhi 14.8 Luanda 28.8 Dublin 6.1 Fukuoka 13.1 ... ... Parquet 2.4 TiB ↓ GROUP BY station 412 種) で ↓ 412 行 min / avg / max を集計
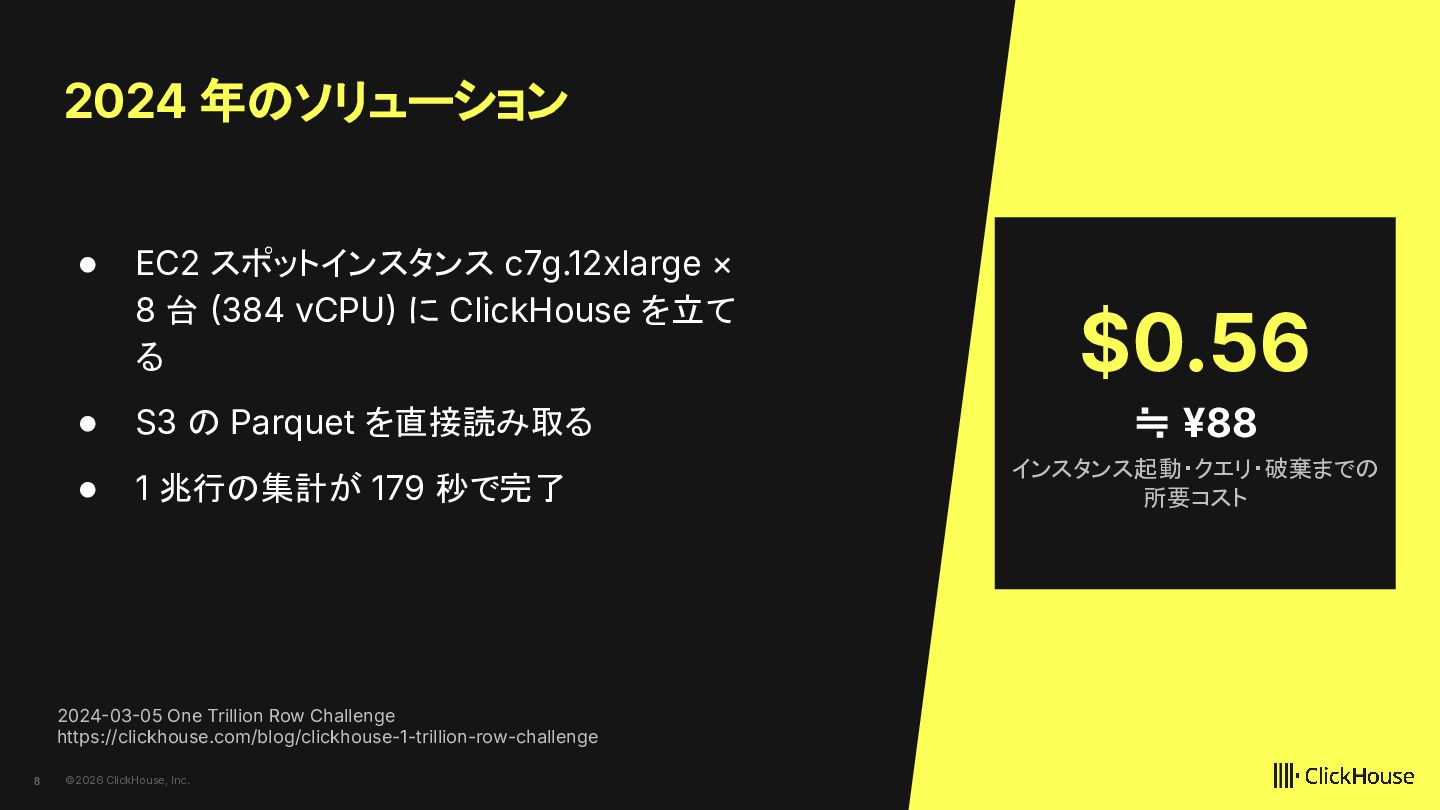
  6. 2024 年のソリューション • EC2 スポットインスタンス c7g.12xlarge × 8 台 384

    vCPU に ClickHouse を立て る • S3 の Parquet を直接読み取る ≒ ¥88 • 1 兆行の集計が 179 秒で完了 インスタンス起動・クエリ・破棄までの 所要コスト 20240305 One Trillion Row Challenge https://clickhouse.com/blog/clickhouse-1-trillion-row-challenge 8 $0.56 ©2026 ClickHouse, Inc.
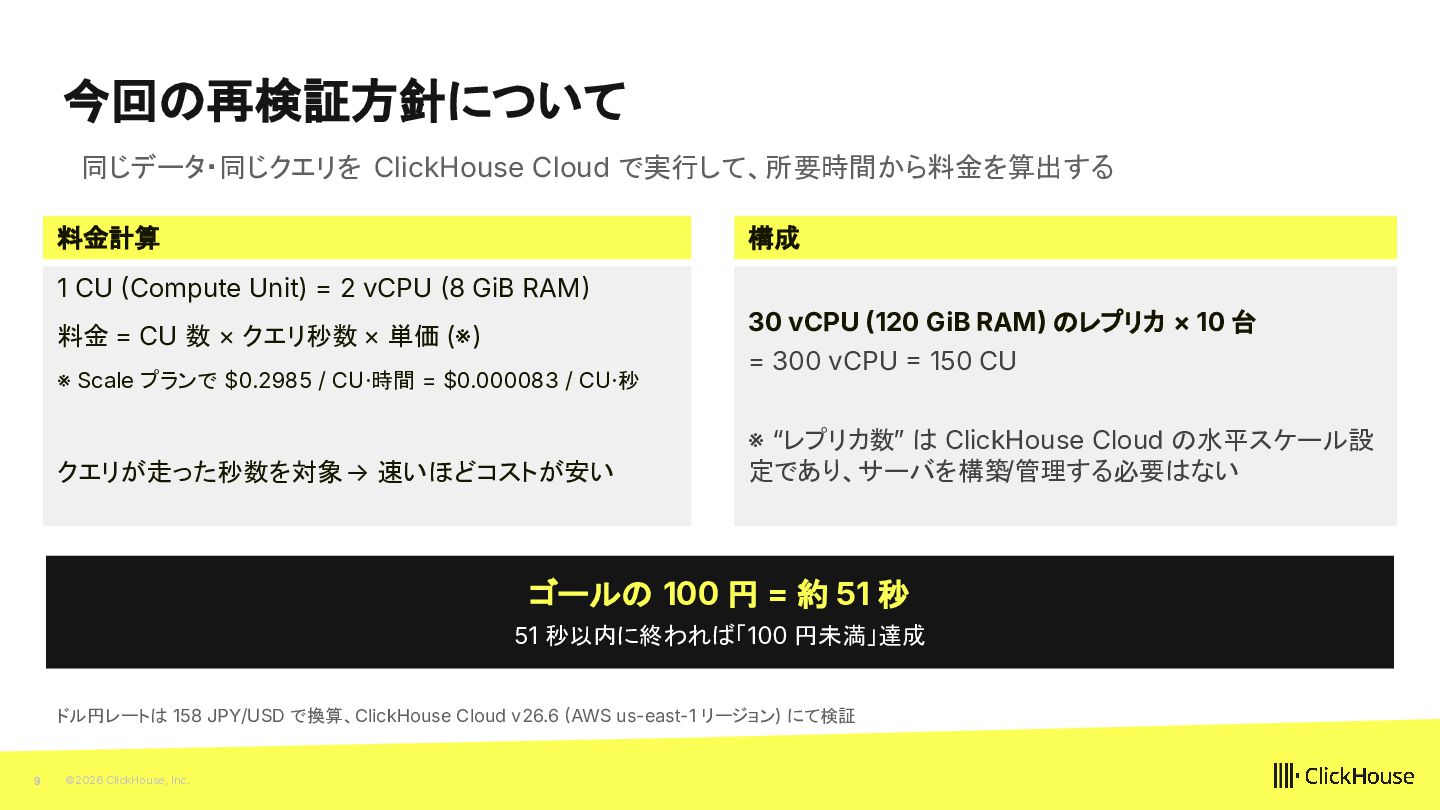
  7. 今回の再検証方針について 同じデータ・同じクエリを ClickHouse Cloud で実行して、所要時間から料金を算出する 料金計算 構成 1 CU Compute

    Unit) = 2 vCPU 8 GiB RAM 30 vCPU 120 GiB RAM のレプリカ × 10 台 料金 = CU 数 × クエリ秒数 × 単価 (※) ※ Scale プランで $0.2985 / CU·時間 = $0.000083 / CU·秒 クエリが走った秒数を対象 → 速いほどコストが安い = 300 vCPU  150 CU ※ “レプリカ数ˮ は ClickHouse Cloud の水平スケール設 定であり、サーバを構築/管理する必要はない ゴールの 100 円 = 約 51 秒 51 秒以内に終われば「100 円未満」達成 ドル円レートは 158 JPY/USD で換算、ClickHouse Cloud v26.6 AWS us-east-1 リージョン) にて検証 9 ©2026 ClickHouse, Inc.
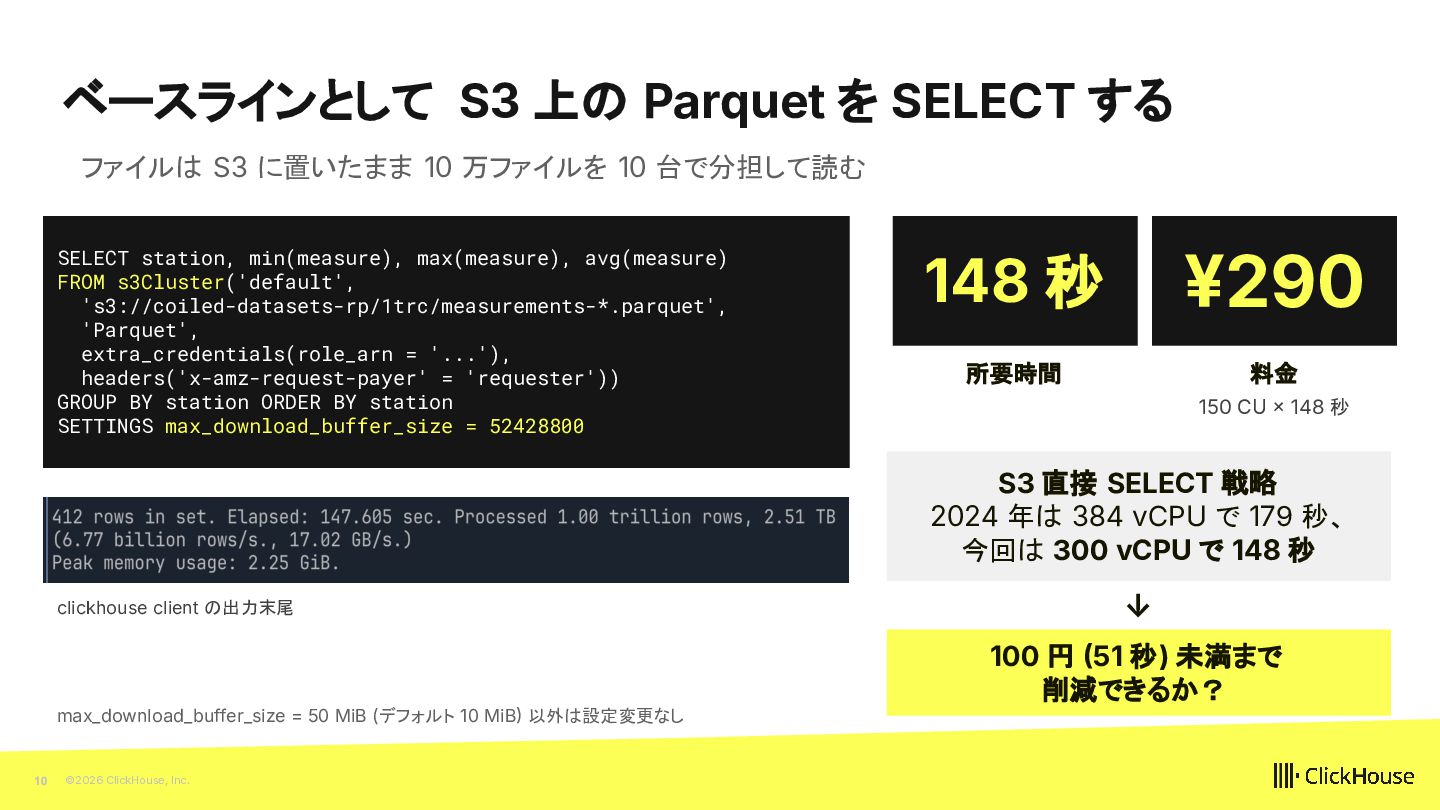
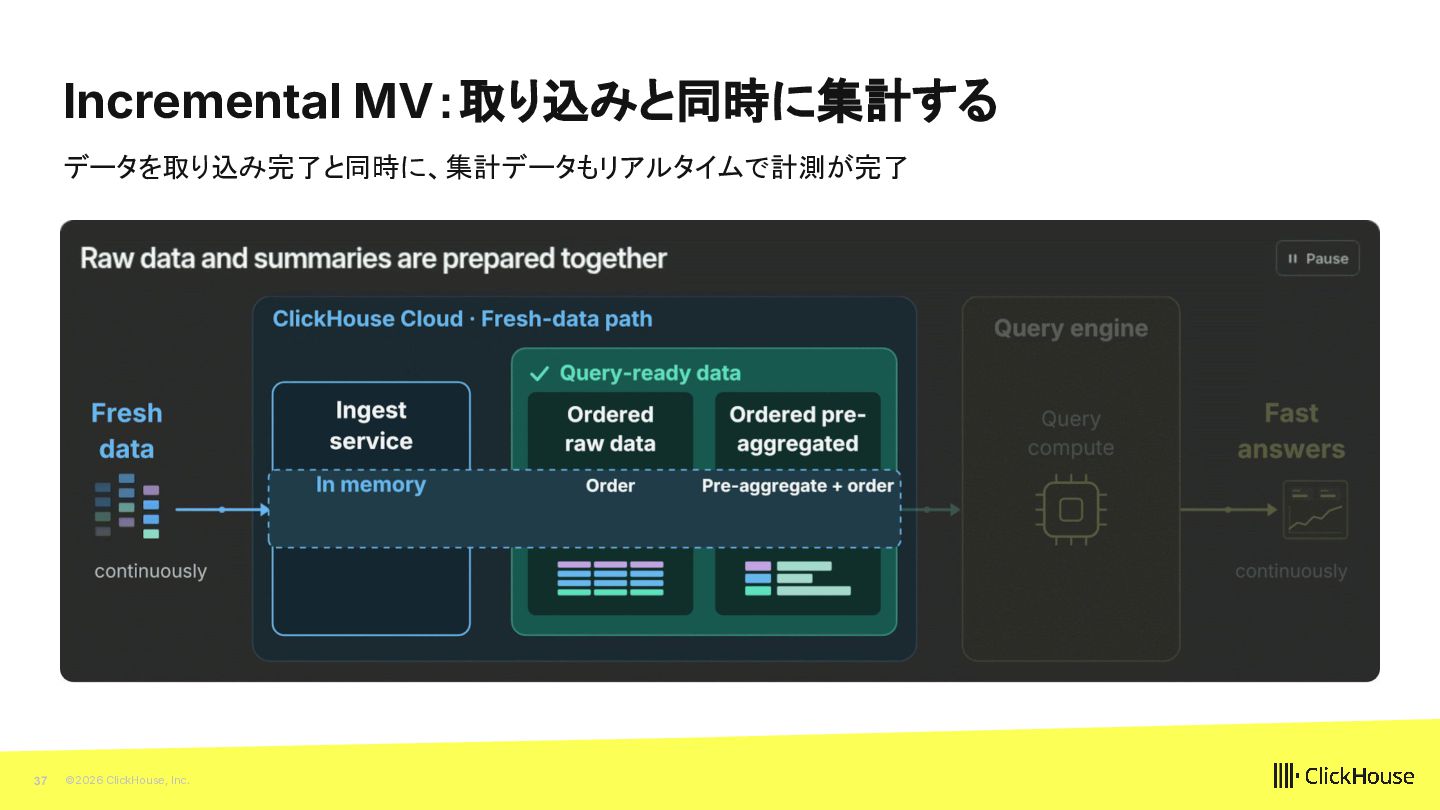
  8. ベースラインとして S3 上の Parquet を SELECT する ファイルは S3 に置いたまま

    10 万ファイルを 10 台で分担して読む SELECT station, min(measure), max(measure), avg(measure) FROM s3Cluster('default', 's3://coiled-datasets-rp/1trc/measurements-*.parquet', 'Parquet', extra_credentials(role_arn = '...'), headers('x-amz-request-payer' = 'requester')) GROUP BY station ORDER BY station SETTINGS max_download_buffer_size = 52428800 148 秒 ¥290 所要時間 料金 150 CU  148 秒 S3 直接 SELECT 戦略 2024 年は 384 vCPU で 179 秒、 今回は 300 vCPU で 148 秒 clickhouse client の出力末尾 ↓ 100 円 51 秒) 未満まで 削減できるか? max_download_buffer_size = 50 MiB (デフォルト 10 MiB 以外は設定変更なし 10 ©2026 ClickHouse, Inc.
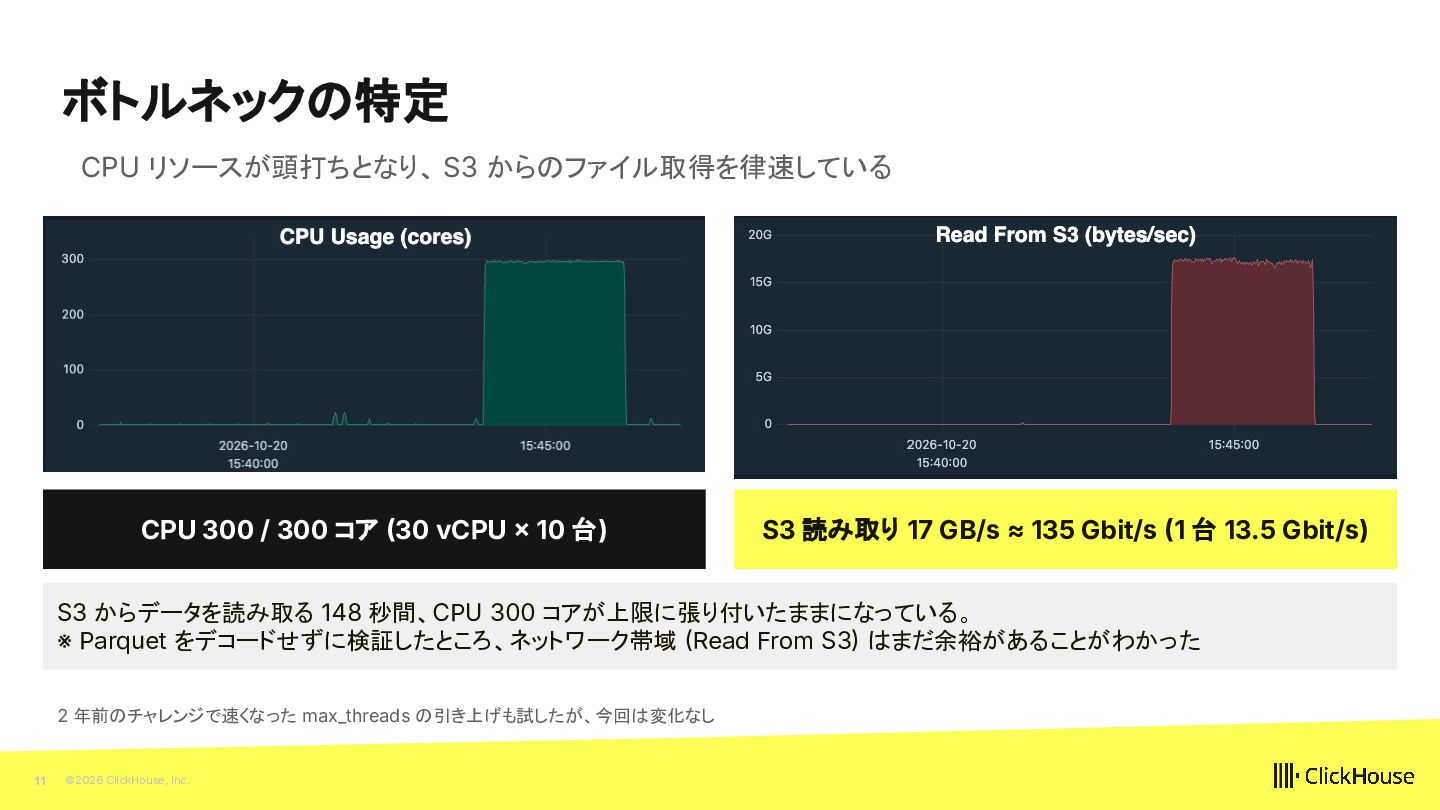
  9. ボトルネックの特定 CPU リソースが頭打ちとなり、 S3 からのファイル取得を律速している CPU 300 / 300 コア

    30 vCPU  10 台) S3 読み取り 17 GB/s ≈ 135 Gbit/s 1 台 13.5 Gbit/s) S3 からデータを読み取る 148 秒間、CPU 300 コアが上限に張り付いたままになっている。 ※ Parquet をデコードせずに検証したところ、ネットワーク帯域 Read From S3 はまだ余裕があることがわかった 2 年前のチャレンジで速くなった max_threads の引き上げも試したが、今回は変化なし 11 ©2026 ClickHouse, Inc.
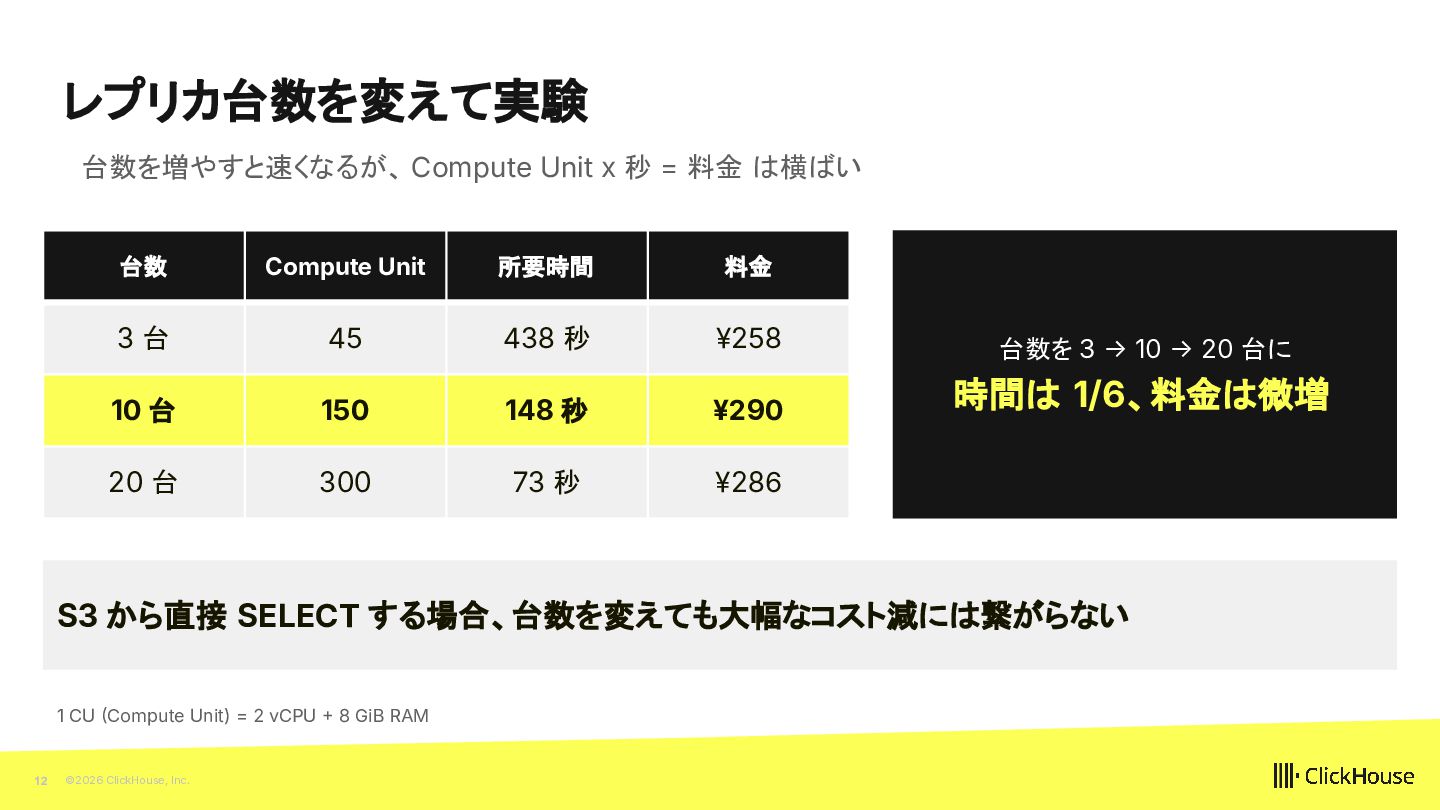
  10. レプリカ台数を変えて実験 台数を増やすと速くなるが、 Compute Unit x 秒 = 料金 は横ばい 台数

    Compute Unit 所要時間 料金 3台 45 438 秒 ¥258 台数を 3  10  20 台に 10 台 150 148 秒 ¥290 時間は 1/6、料金は微増 20 台 300 73 秒 ¥286 S3 から直接 SELECT する場合、台数を変えても大幅なコスト減には繋がらない 1 CU Compute Unit) = 2 vCPU  8 GiB RAM 12 ©2026 ClickHouse, Inc.
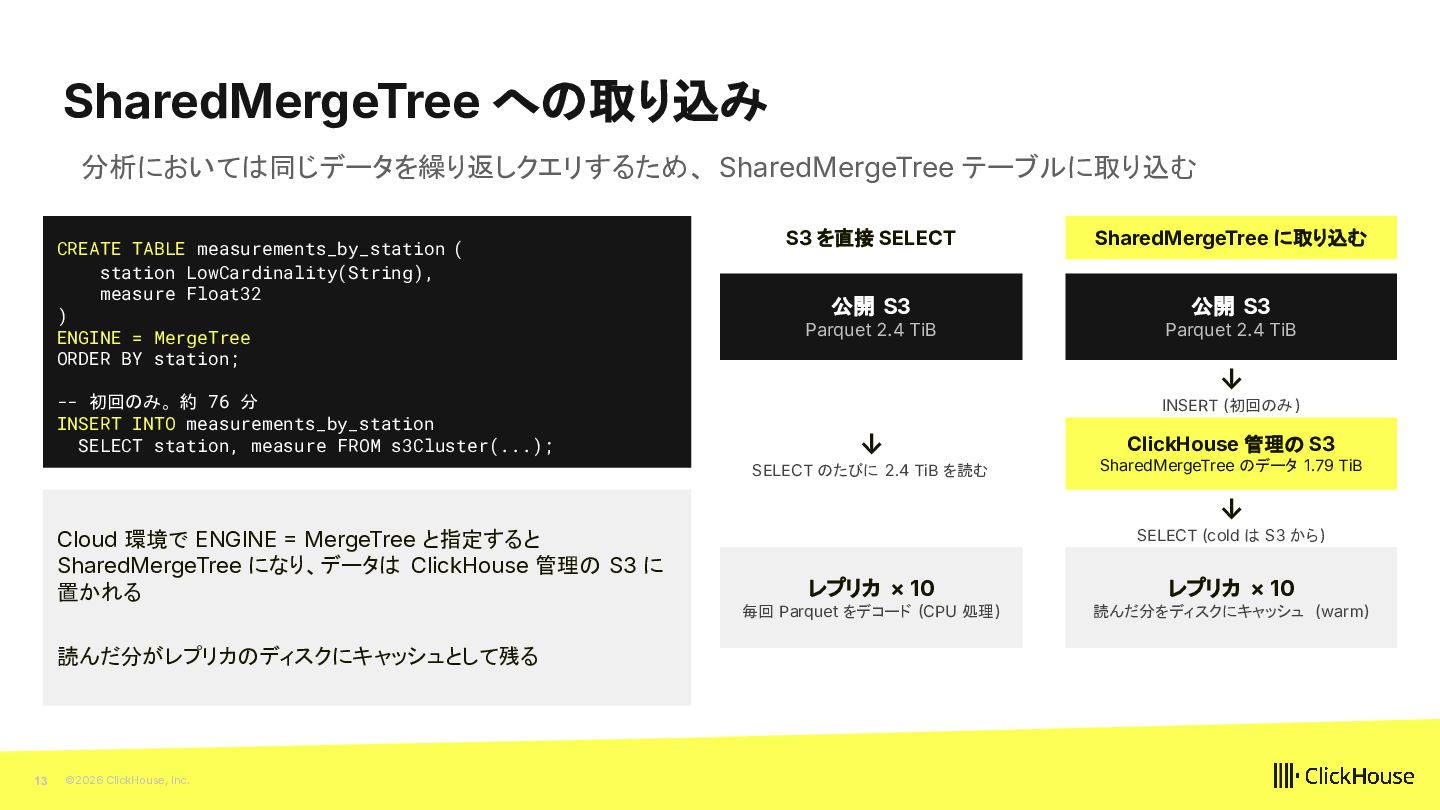
  11. SharedMergeTree への取り込み 分析においては同じデータを繰り返しクエリするため、 SharedMergeTree テーブルに取り込む CREATE TABLE measurements_by_station ( station

    LowCardinality(String), measure Float32 ) ENGINE = MergeTree ORDER BY station; -- 初回のみ。約 76 分 INSERT INTO measurements_by_station SELECT station, measure FROM s3Cluster(...); S3 を直接 SELECT 公開 S3 Parquet 2.4 TiB 読んだ分がレプリカのディスクにキャッシュとして残る 13 ©2026 ClickHouse, Inc. 公開 S3 Parquet 2.4 TiB ↓ INSERT (初回のみ ) ↓ SELECT のたびに 2.4 TiB を読む Cloud 環境で ENGINE  MergeTree と指定すると SharedMergeTree になり、データは ClickHouse 管理の S3 に 置かれる SharedMergeTree に取り込む ClickHouse 管理の S3 SharedMergeTree のデータ 1.79 TiB ↓ SELECT (cold は S3 から) レプリカ × 10 毎回 Parquet をデコード CPU 処理) レプリカ × 10 読んだ分をディスクにキャッシュ (warm)
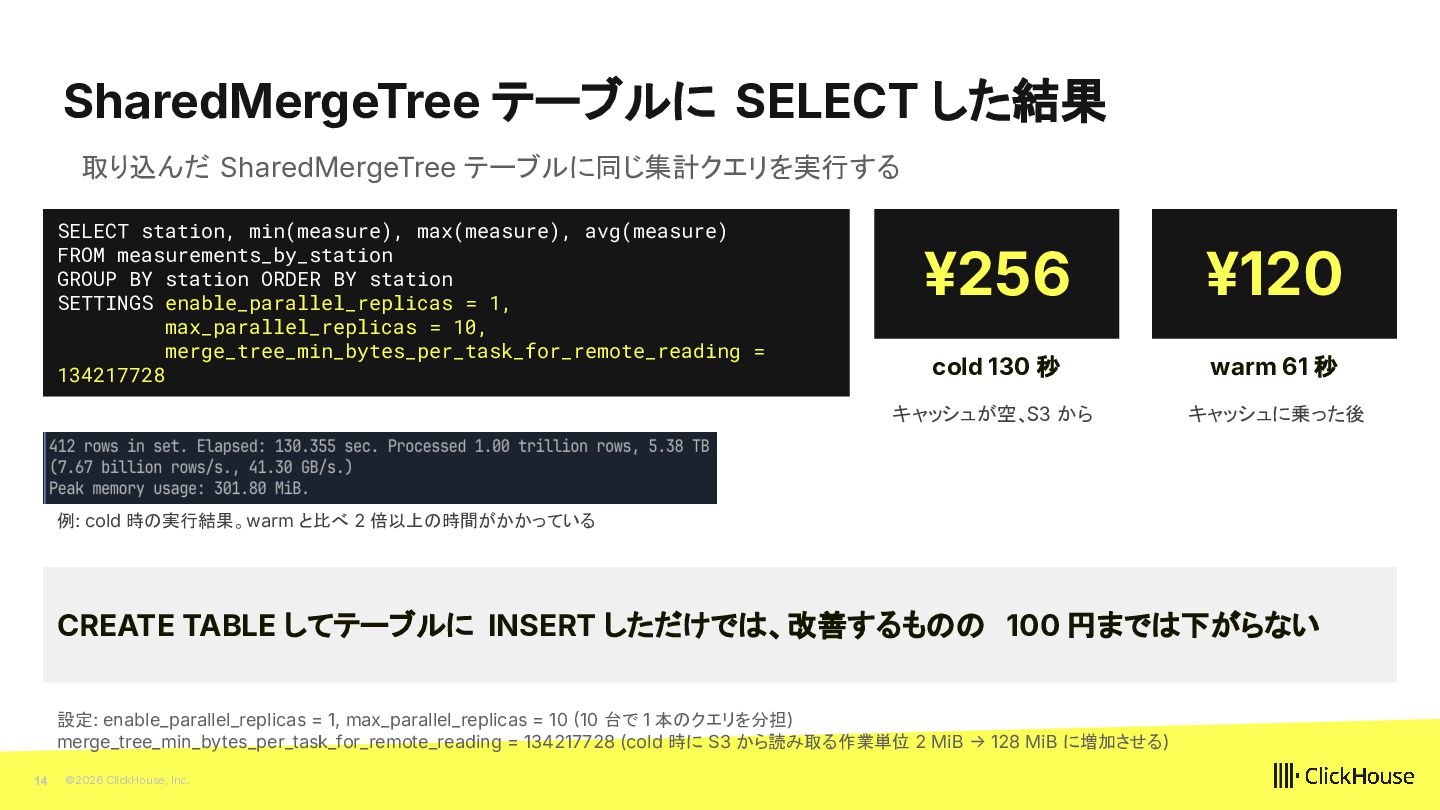
  12. SharedMergeTree テーブルに SELECT した結果 取り込んだ SharedMergeTree テーブルに同じ集計クエリを実行する SELECT station, min(measure),

    max(measure), avg(measure) FROM measurements_by_station GROUP BY station ORDER BY station SETTINGS enable_parallel_replicas = 1, max_parallel_replicas = 10, merge_tree_min_bytes_per_task_for_remote_reading = 134217728 ¥256 ¥120 cold 130 秒 warm 61 秒 キャッシュが空、S3 から キャッシュに乗った後 例: cold 時の実行結果。warm と比べ 2 倍以上の時間がかかっている CREATE TABLE してテーブルに INSERT しただけでは、改善するものの 100 円までは下がらない 設定: enable_parallel_replicas = 1, max_parallel_replicas = 10 10 台で 1 本のクエリを分担) merge_tree_min_bytes_per_task_for_remote_reading = 134217728 (cold 時に S3 から読み取る作業単位 2 MiB  128 MiB に増加させる) 14 ©2026 ClickHouse, Inc.
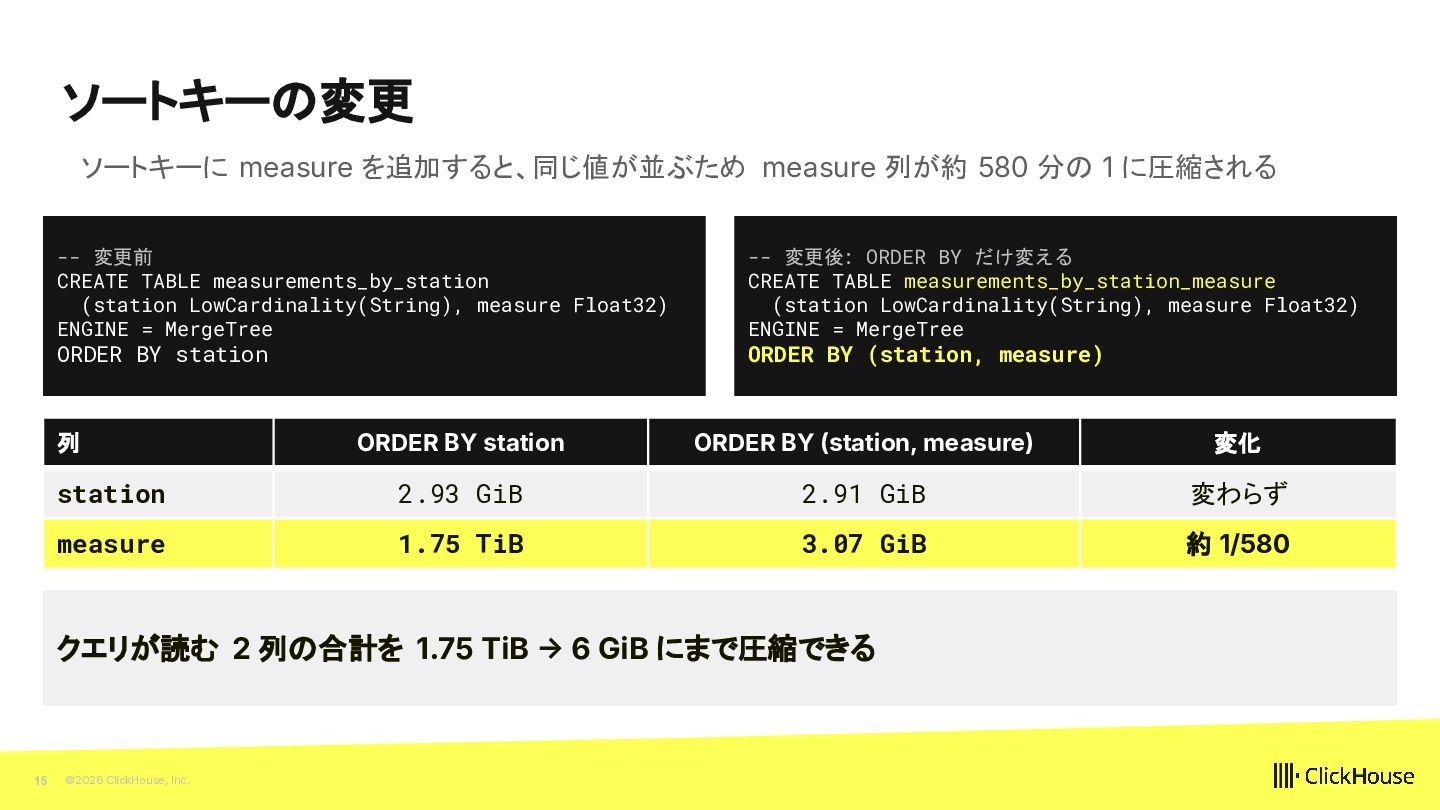
  13. ソートキーの変更 ソートキーに measure を追加すると、同じ値が並ぶため measure 列が約 580 分の 1 に圧縮される

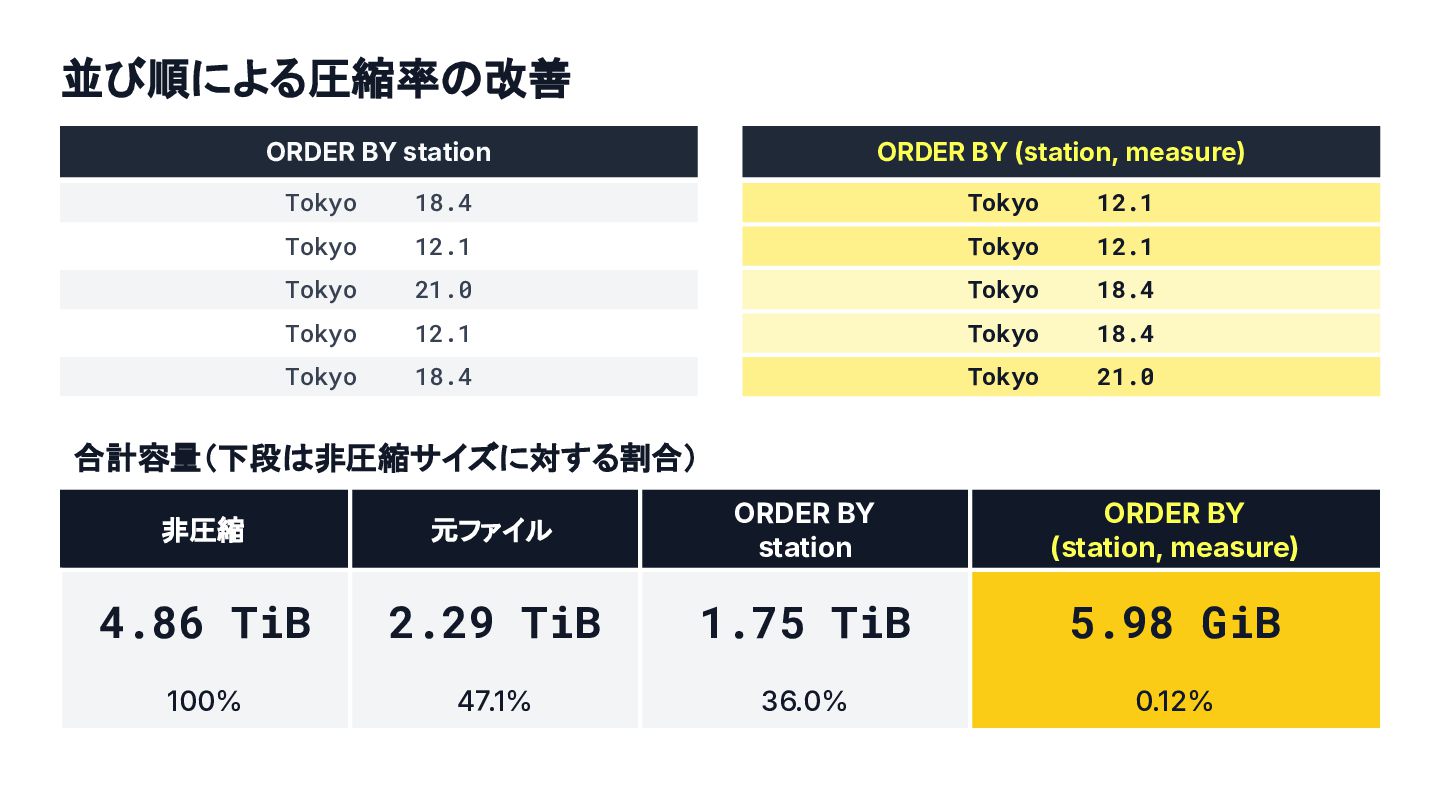
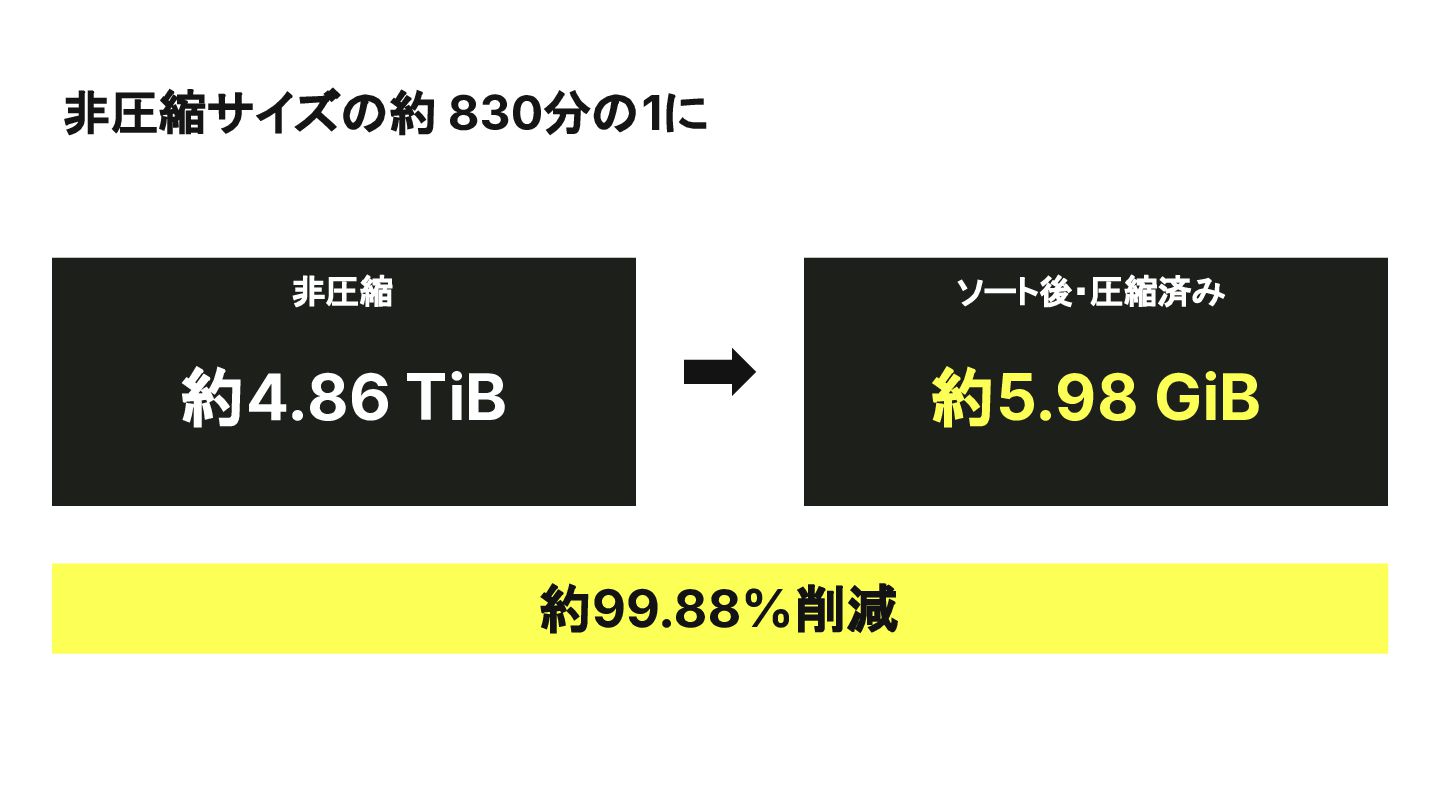
    -- 変更前 CREATE TABLE measurements_by_station (station LowCardinality(String), measure Float32) ENGINE = MergeTree ORDER BY station -- 変更後: ORDER BY だけ変える CREATE TABLE measurements_by_station_measure (station LowCardinality(String), measure Float32) ENGINE = MergeTree ORDER BY (station, measure) ORDER BY station ORDER BY (station, measure) 変化 station 2.93 GiB 2.91 GiB 変わらず measure 1.75 TiB 3.07 GiB 約 1/580 列 クエリが読む 2 列の合計を 1.75 TiB  6 GiB にまで圧縮できる 15 ©2026 ClickHouse, Inc.
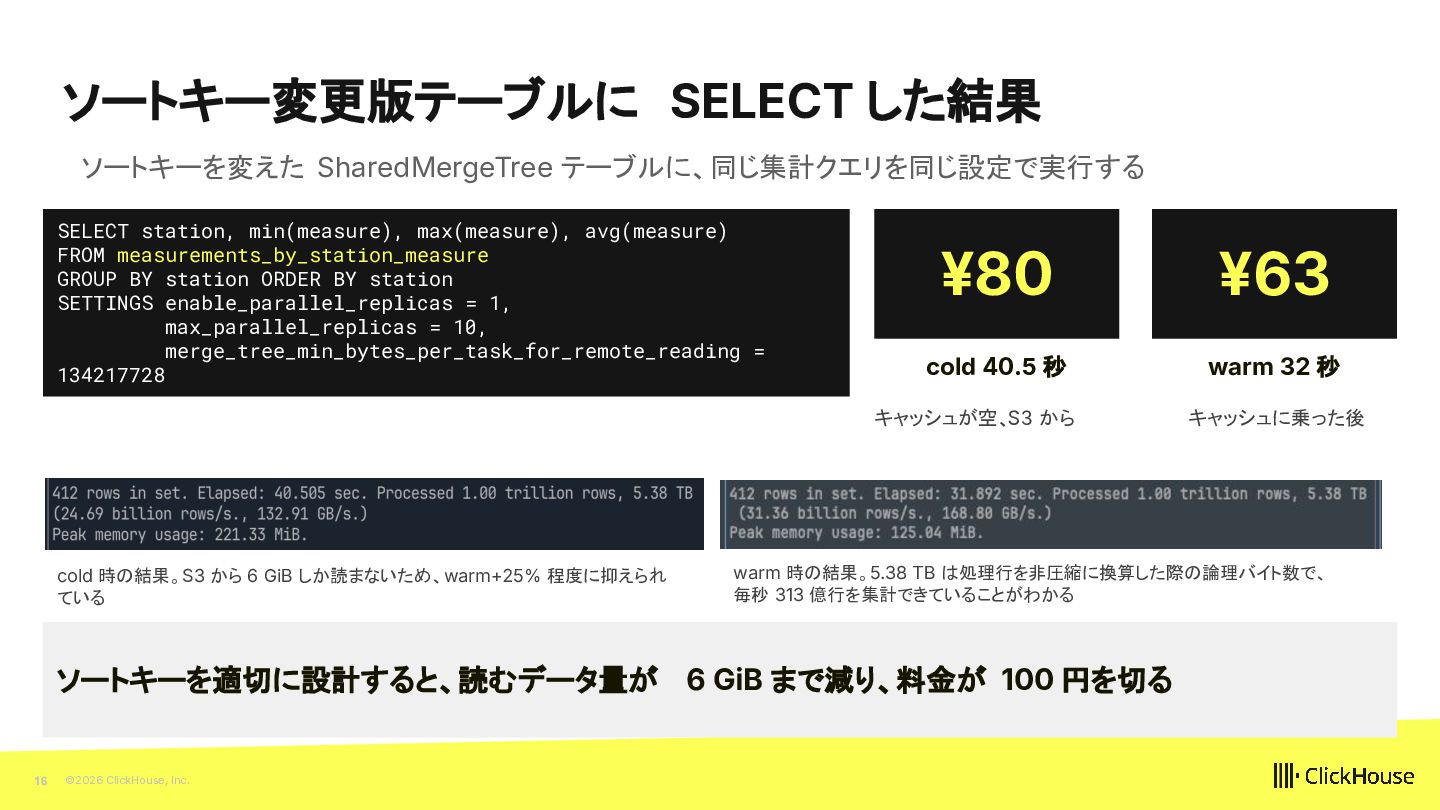
  14. ソートキー変更版テーブルに SELECT した結果 ソートキーを変えた SharedMergeTree テーブルに、同じ集計クエリを同じ設定で実行する SELECT station, min(measure), max(measure),

    avg(measure) FROM measurements_by_station_measure GROUP BY station ORDER BY station SETTINGS enable_parallel_replicas = 1, max_parallel_replicas = 10, merge_tree_min_bytes_per_task_for_remote_reading = 134217728 ¥80 ¥63 cold 40.5 秒 warm 32 秒 キャッシュが空、S3 から cold 時の結果。S3 から 6 GiB しか読まないため、warm+25% 程度に抑えられ ている warm 時の結果。5.38 TB は処理行を非圧縮に換算した際の論理バイト数で、 毎秒 313 億行を集計できていることがわかる ソートキーを適切に設計すると、読むデータ量が 6 GiB まで減り、料金が 100 円を切る 16 ©2026 ClickHouse, Inc. キャッシュに乗った後
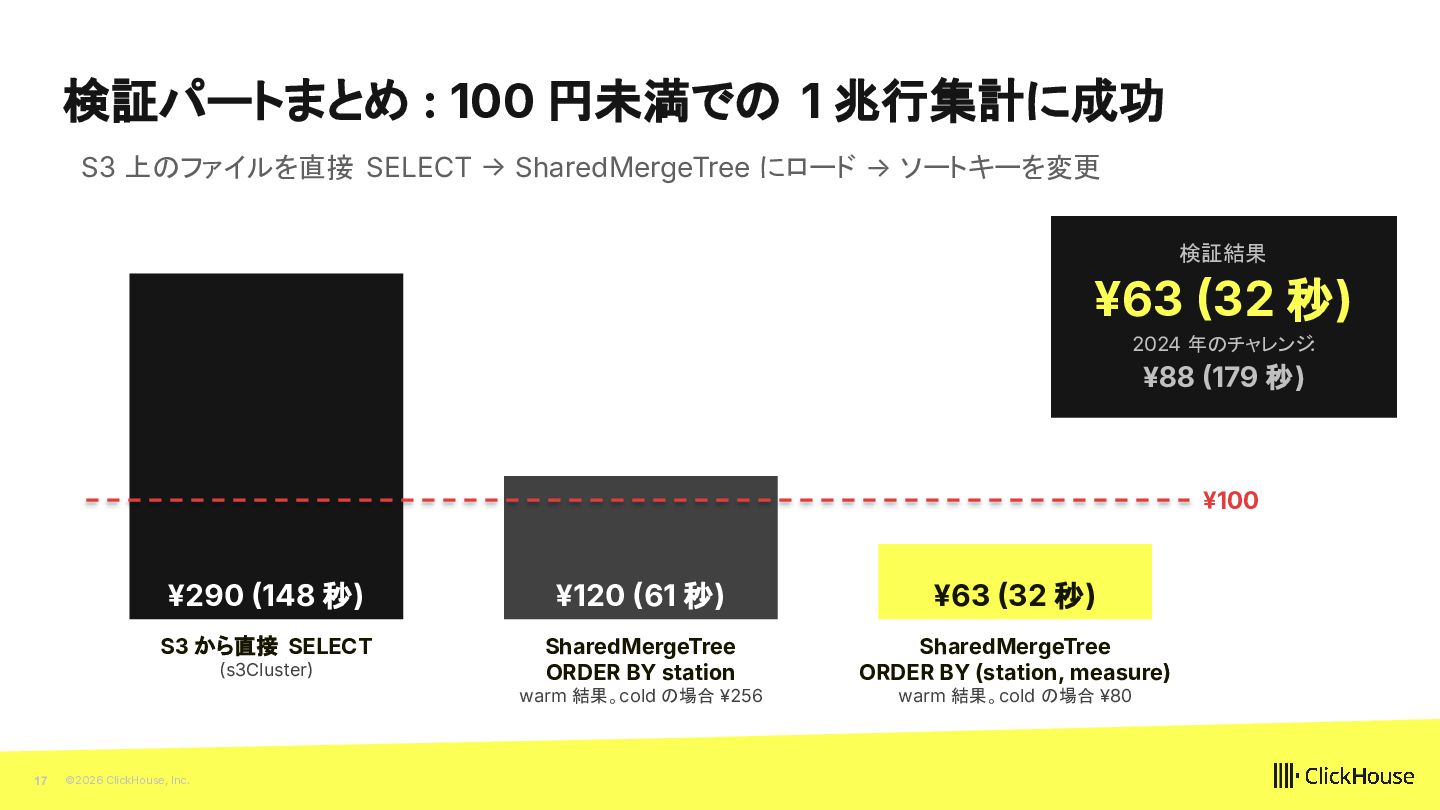
  15. 検証パートまとめ : 100 円未満での 1 兆行集計に成功 S3 上のファイルを直接 SELECT 

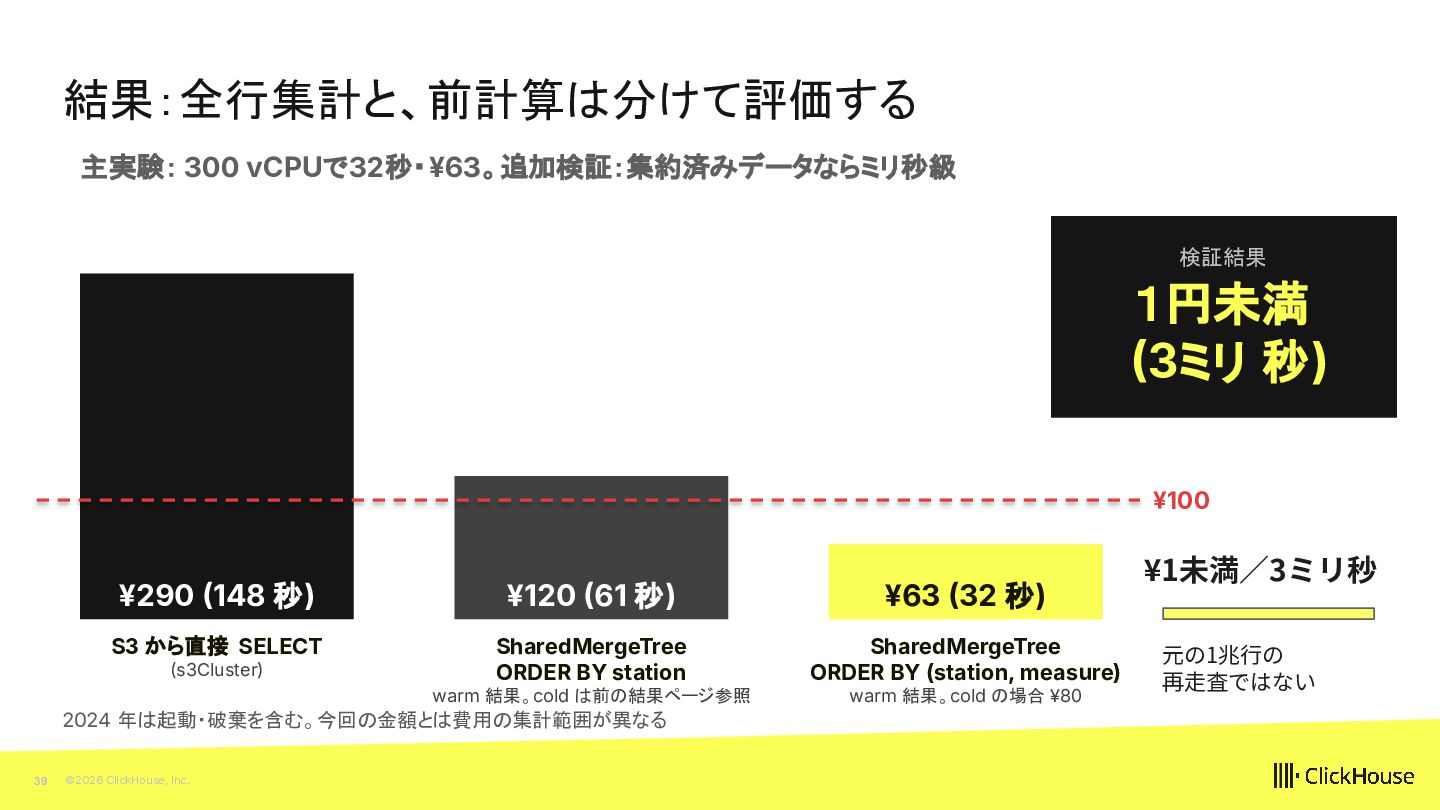
    SharedMergeTree にロード → ソートキーを変更 検証結果 ¥63 32 秒) 2024 年のチャレンジ: ¥88 179 秒) ¥100 ¥290 148 秒) ¥120 61 秒) ¥63 32 秒) S3 から直接 SELECT SharedMergeTree ORDER BY station SharedMergeTree ORDER BY (station, measure) (s3Cluster) warm 結果。cold の場合 ¥256 17 ©2026 ClickHouse, Inc. warm 結果。cold の場合 ¥80
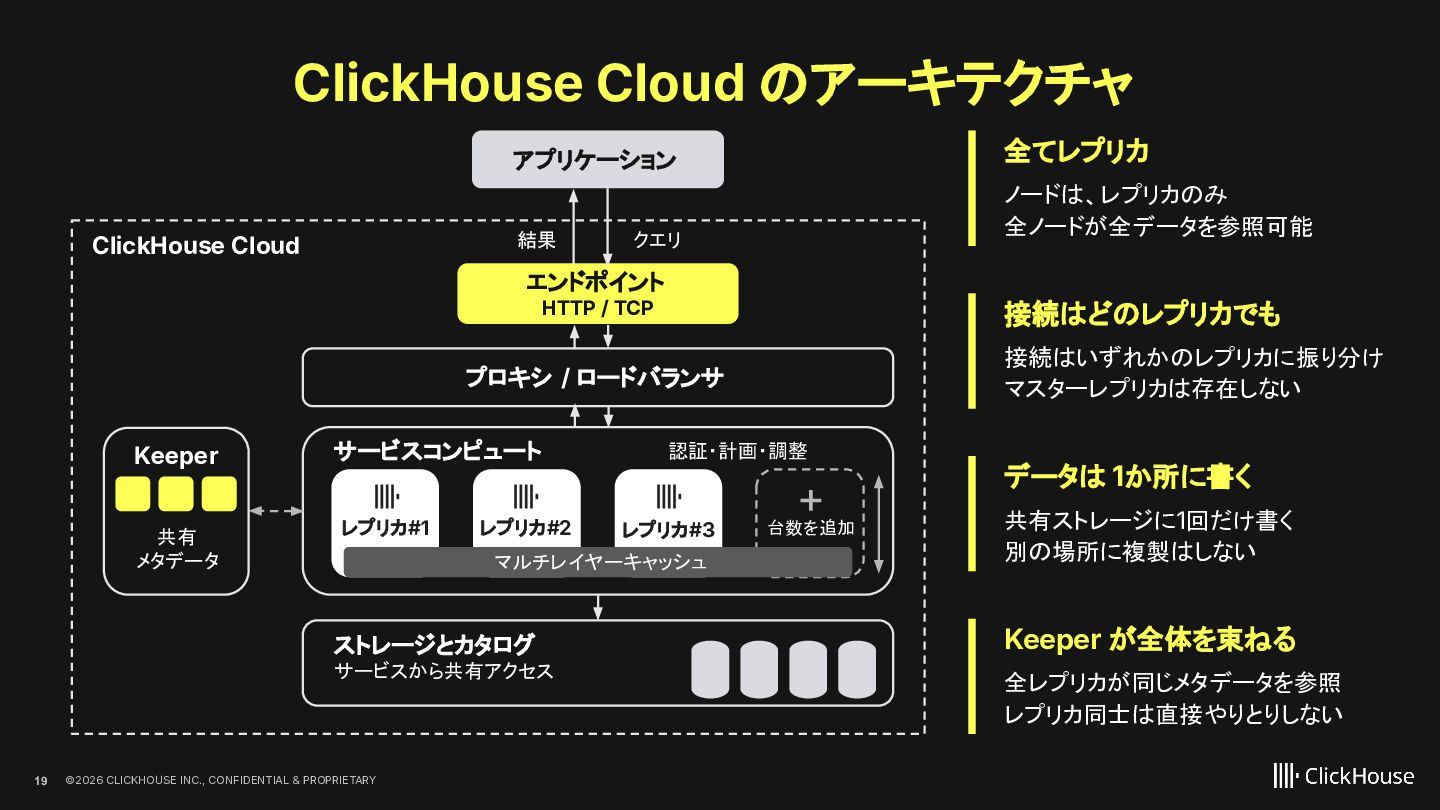
  16. ClickHouse Cloud のアーキテクチャ 全てレプリカ アプリケーション 結果 ClickHouse Cloud ノードは、レプリカのみ 全ノードが全データを参照可能

    クエリ エンドポイント HTTP / TCP 接続はどのレプリカでも 接続はいずれかのレプリカに振り分け マスターレプリカは存在しない プロキシ / ロードバランサ Keeper サービスコンピュート 共有 メタデータ レプリカ#1 レプリカ#2 レプリカ#3 マルチレイヤーキャッシュ ストレージとカタログ サービスから共有アクセス 19 認証・計画・調整 ©2026 CLICKHOUSE INC., CONFIDENTIAL & PROPRIETARY + 台数を追加 データは 1か所に書く 共有ストレージに1回だけ書く 別の場所に複製はしない Keeper が全体を束ねる 全レプリカが同じメタデータを参照 レプリカ同士は直接やりとりしない
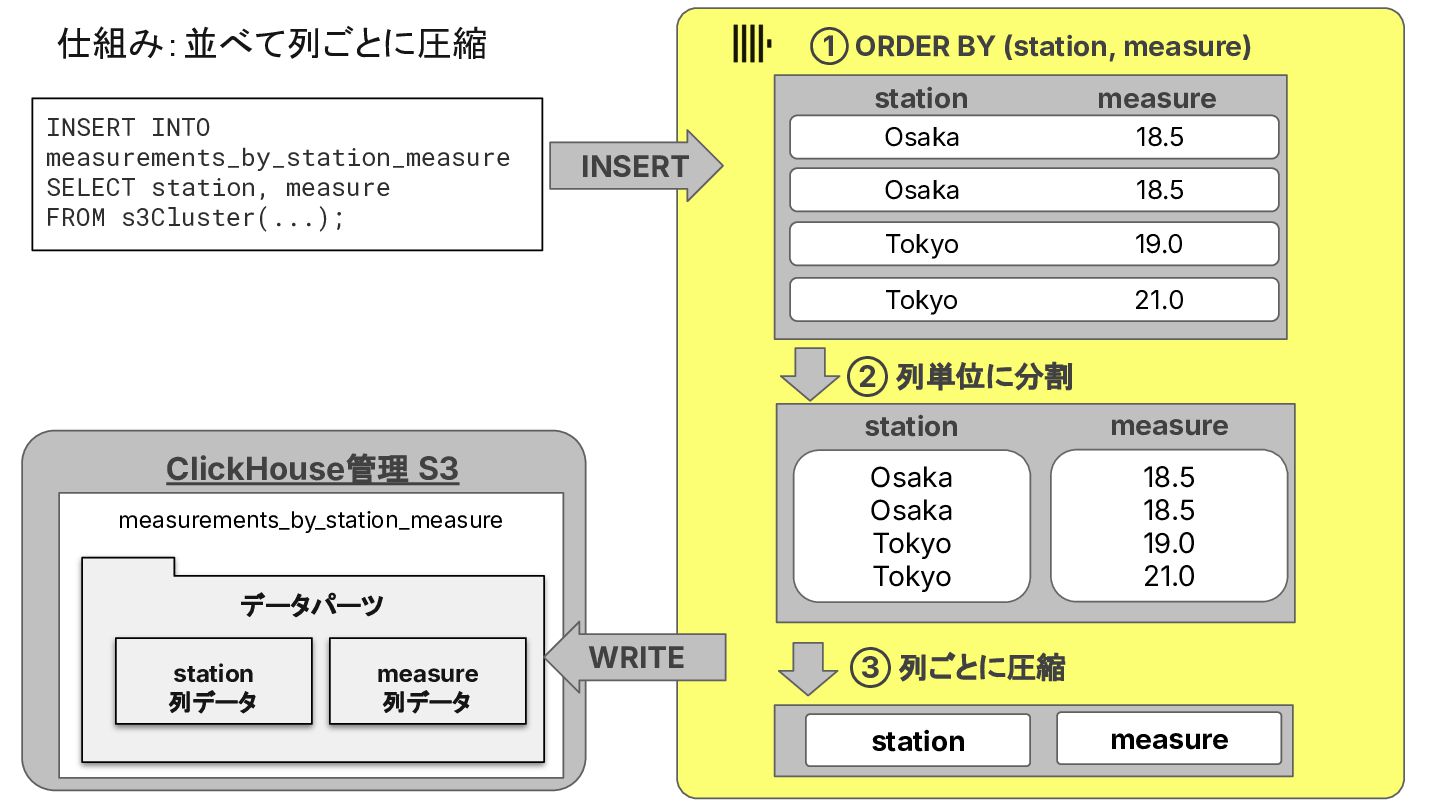
  17. 仕組み:並べて列ごとに圧縮 INSERT INTO measurements_by_station_measure SELECT station, measure FROM s3Cluster(...); ①

    ORDER BY (station, measure) INSERT station measure Osaka 18.5 Osaka 18.5 Tokyo 19.0 Tokyo 21.0 ② 列単位に分割 ClickHouse管理 S3 measurements_by_station_measure データパーツ station 列データ measure 列データ WRITE station measure Osaka Osaka Tokyo Tokyo 18.5 18.5 19.0 21.0 ③ 列ごとに圧縮 station measure
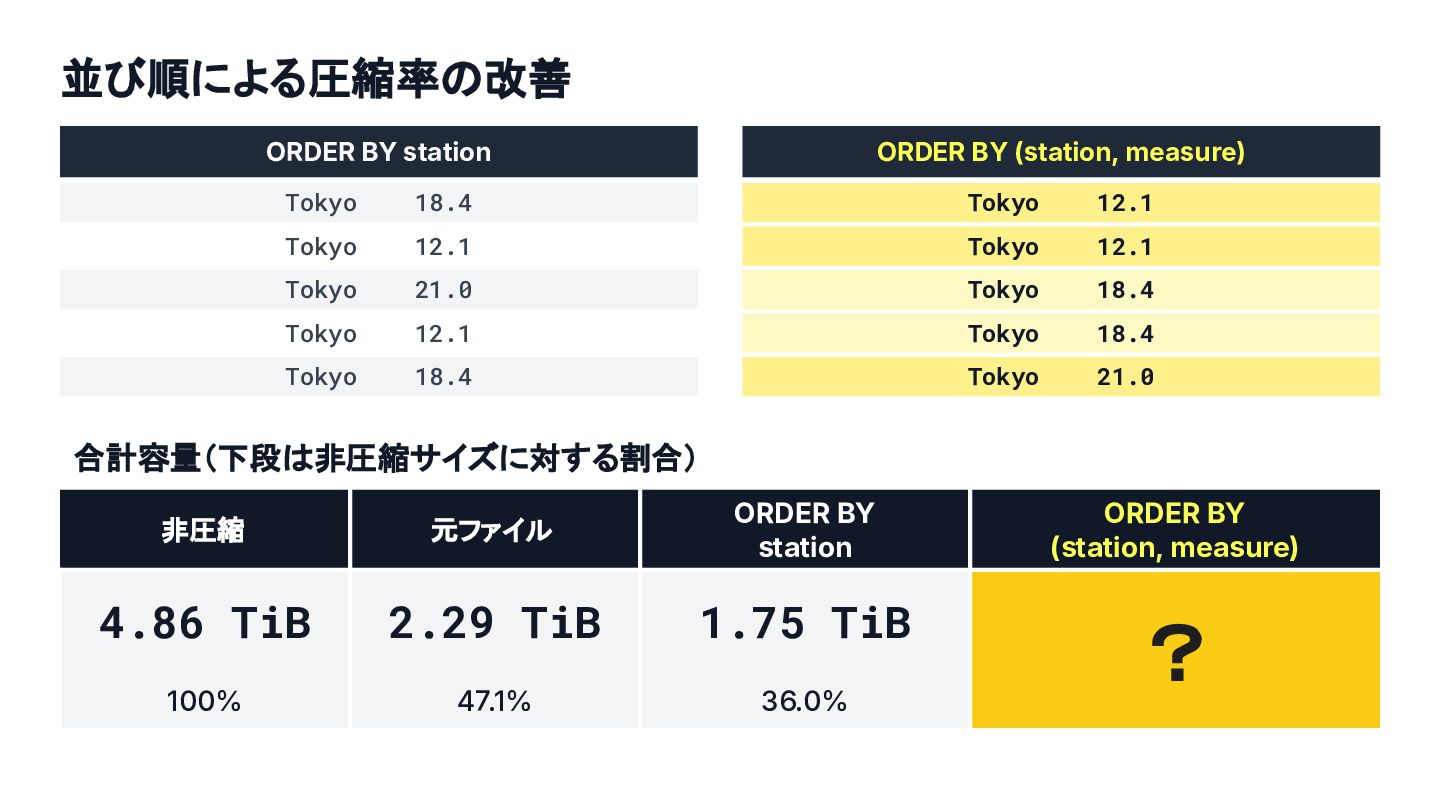
  18. 並び順による圧縮率の改善 ORDER BY station ORDER BY (station, measure) Tokyo 18.4

    Tokyo 12.1 Tokyo 12.1 Tokyo 12.1 Tokyo 21.0 Tokyo 18.4 Tokyo 12.1 Tokyo 18.4 Tokyo 18.4 Tokyo 21.0 合計容量(下段は非圧縮サイズに対する割合) 非圧縮 元ファイル ORDER BY station 4.86 TiB 2.29 TiB 1.75 TiB 100% 47.1% 36.0% ORDER BY (station, measure) ?
  19. 並び順による圧縮率の改善 ORDER BY station ORDER BY (station, measure) Tokyo 18.4

    Tokyo 12.1 Tokyo 12.1 Tokyo 12.1 Tokyo 21.0 Tokyo 18.4 Tokyo 12.1 Tokyo 18.4 Tokyo 18.4 Tokyo 21.0 合計容量(下段は非圧縮サイズに対する割合) 非圧縮 元ファイル ORDER BY station ORDER BY (station, measure) 4.86 TiB 2.29 TiB 1.75 TiB 5.98 GiB 100% 47.1% 36.0% 0.12%
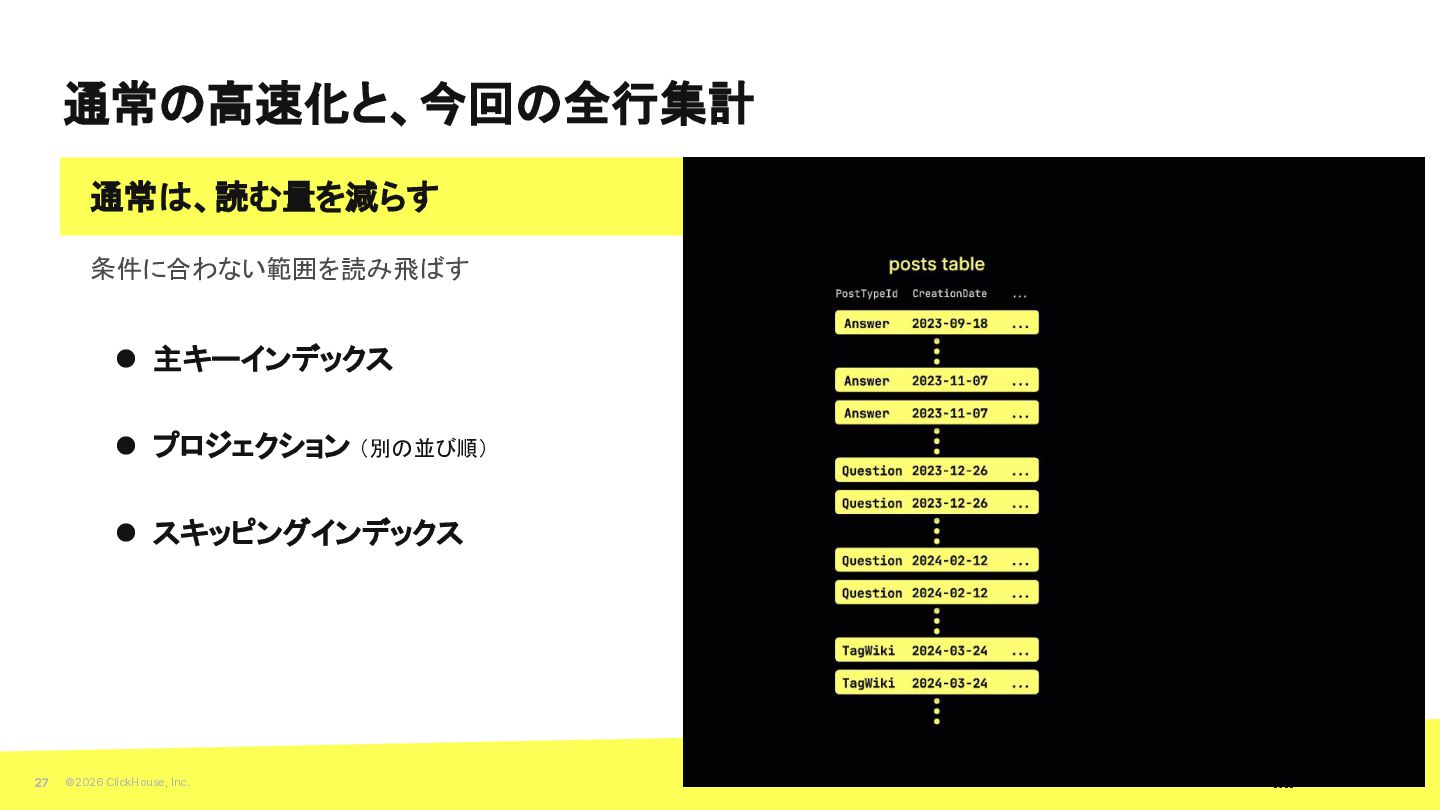
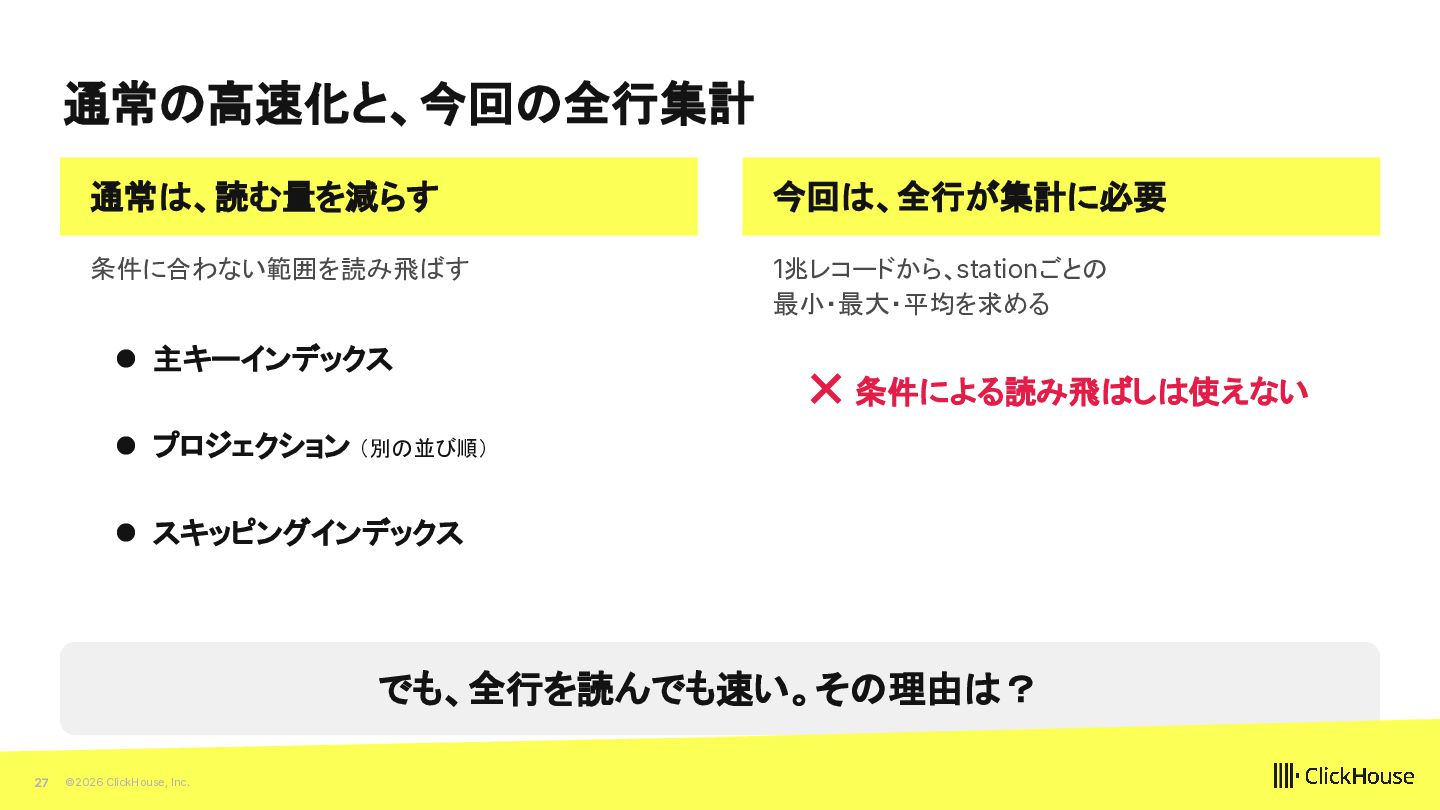
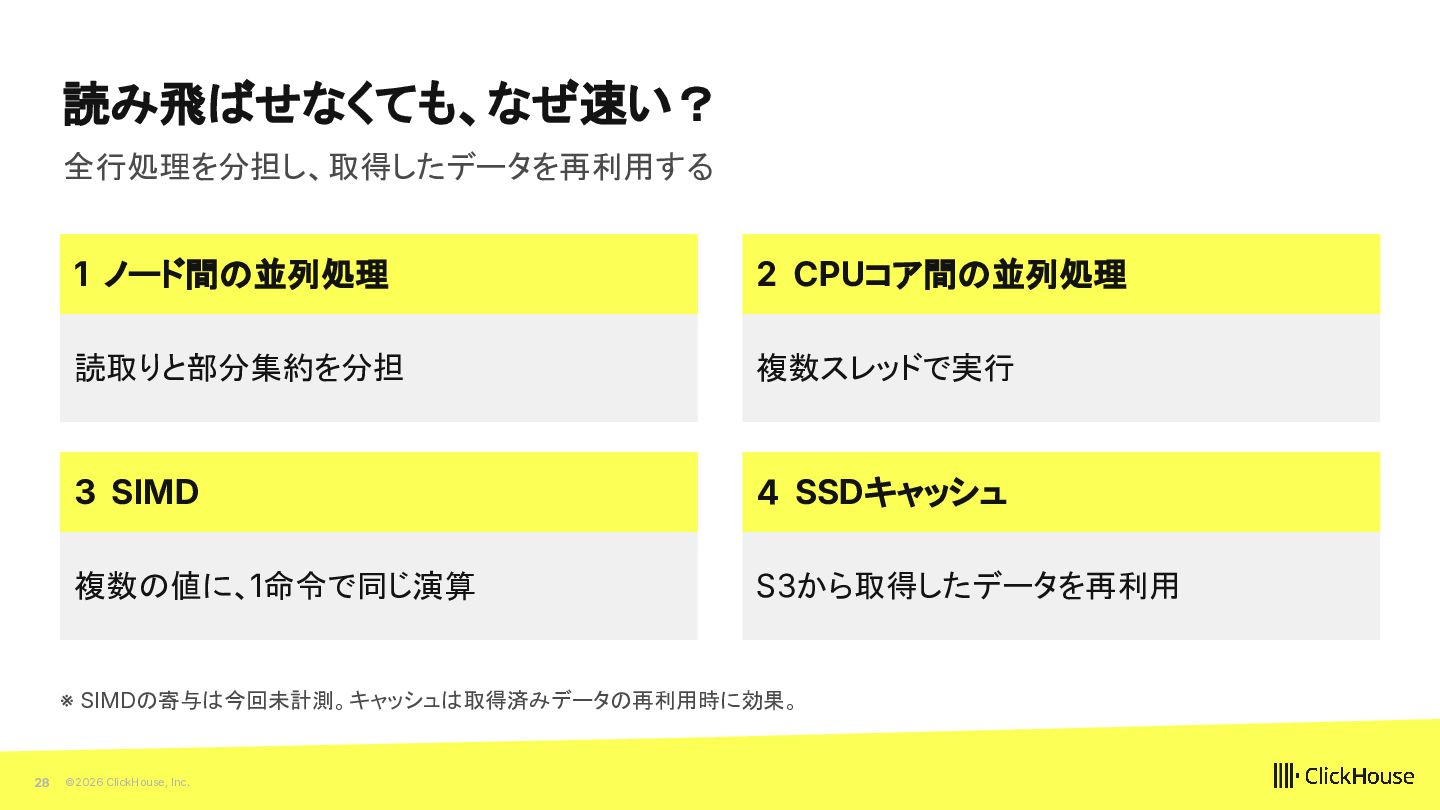
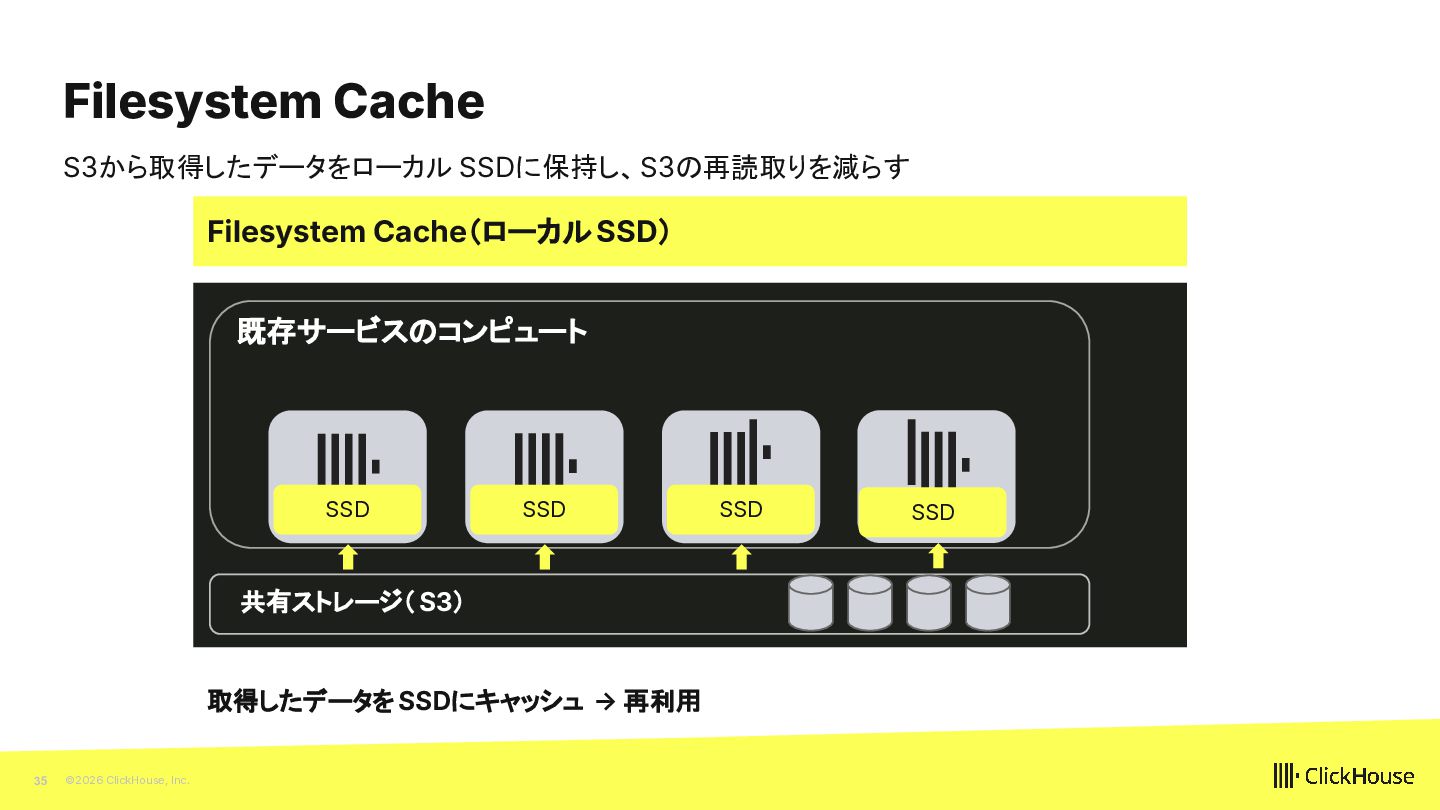
  20. 読み飛ばせなくても、なぜ速い? 全行処理を分担し、取得したデータを再利用する 1 ノード間の並列処理 2 CPUコア間の並列処理 読取りと部分集約を分担 複数スレッドで実行 3 SIMD

    4 SSDキャッシュ 複数の値に、1命令で同じ演算 S3から取得したデータを再利用 ※ SIMDの寄与は今回未計測。キャッシュは取得済みデータの再利用時に効果。 28 ©2026 ClickHouse, Inc.
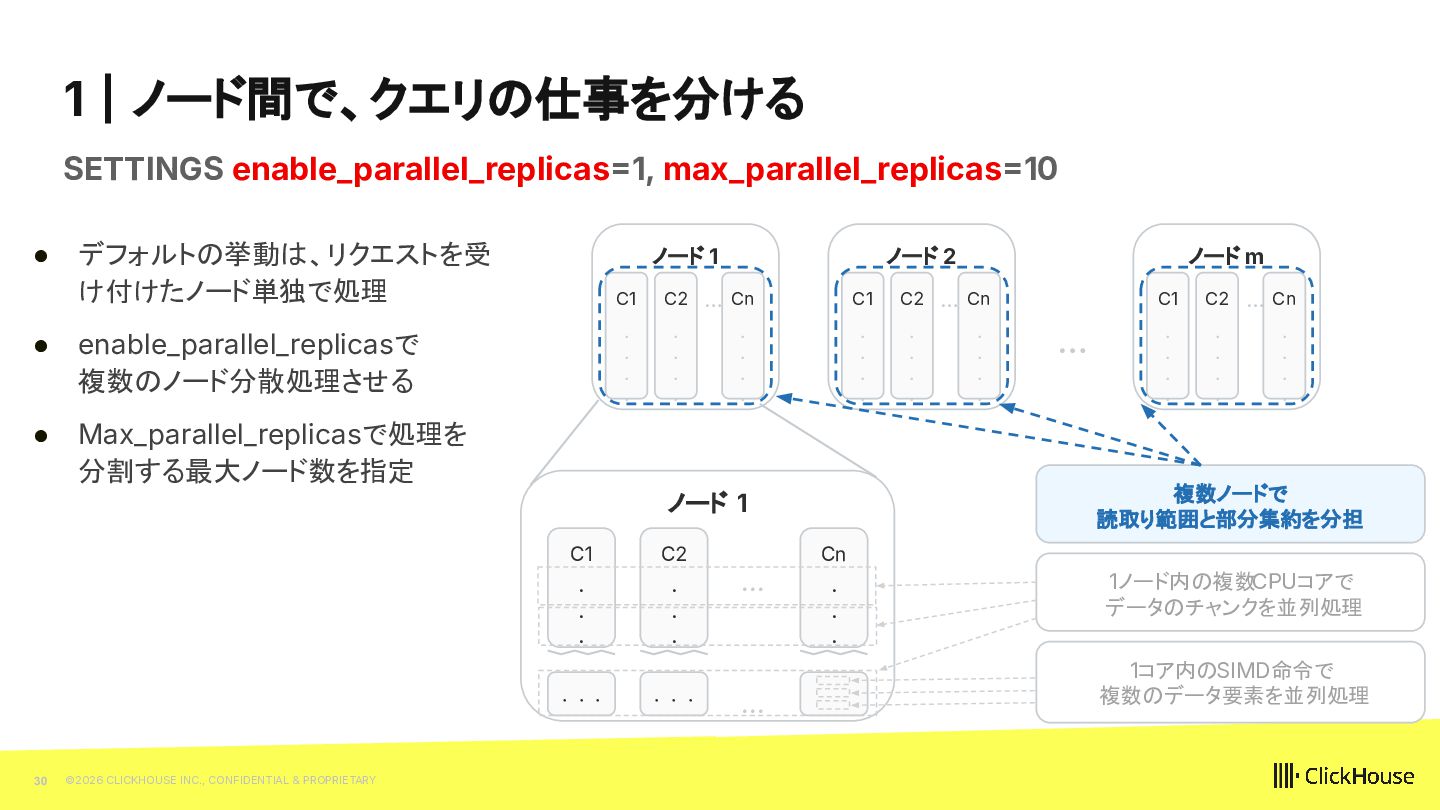
  21. 1|ノード間で、クエリの仕事を分ける SETTINGS enable_parallel_replicas1, max_parallel_replicas10 • デフォルトの挙動は、リクエストを受 け付けたノード単独で処理 ノード 1 •

    enable_parallel_replicasで 複数のノード分散処理させる ノード 2 C1 C2 … Cn C1 C2 … Cn · · · · · · · · · · · · · · · · · · · · · · · · • Max_parallel_replicasで処理を 分割する最大ノード数を指定 C1 C2 · · · · · · 30 ©2026 CLICKHOUSE INC., CONFIDENTIAL & PROPRIETARY · · · … … … C1 C2 … Cn · · · · · · · · · · · · 複数ノードで 読取り範囲と部分集約を分担 ノード 1 · · · ノード m Cn · · · 1ノード内の複数CPUコアで データのチャンクを並列処理 1コア内のSIMD命令で 複数のデータ要素を並列処理
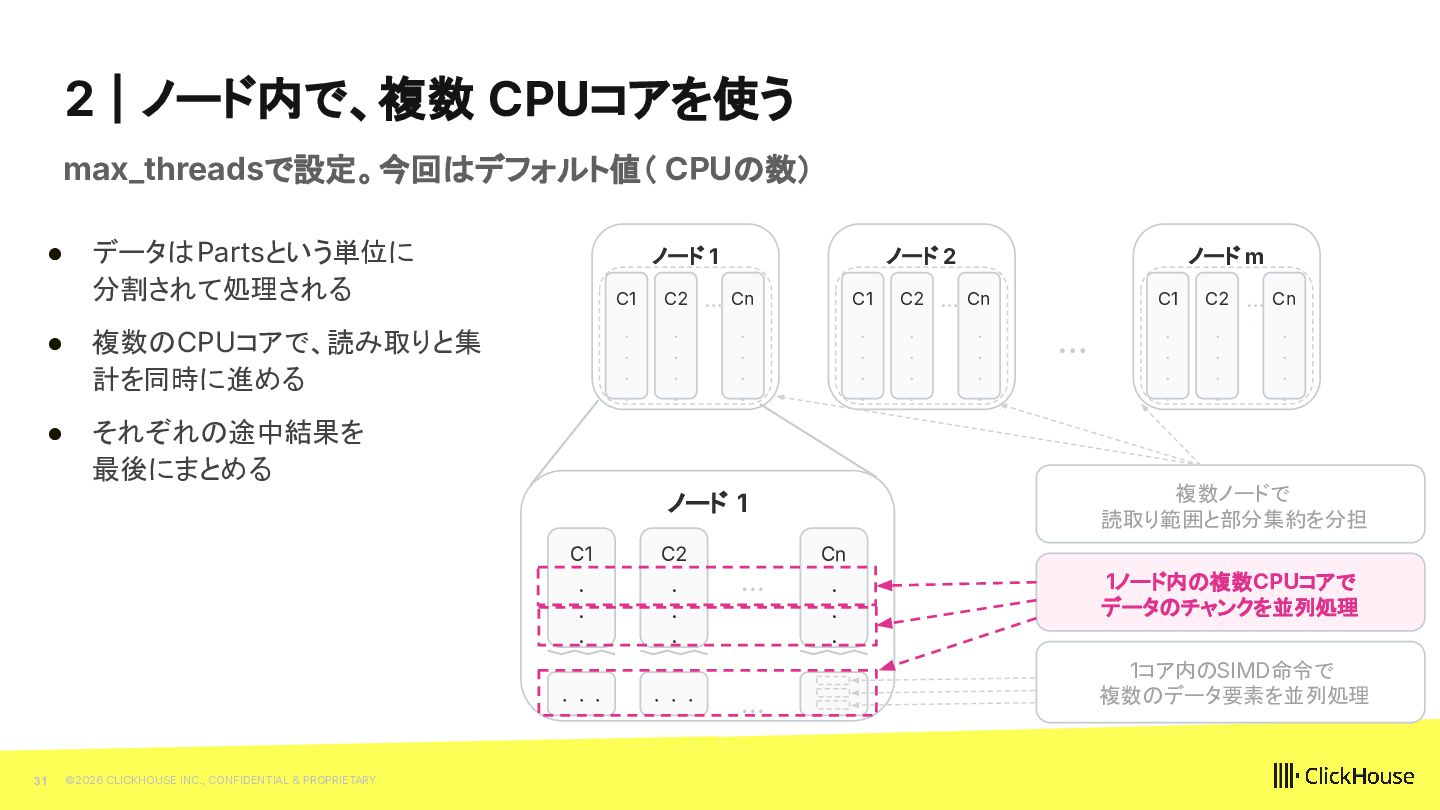
  22. 2|ノード内で、複数 CPUコアを使う max_threadsで設定。今回はデフォルト値( CPUの数) • データはPartsという単位に 分割されて処理される ノード 1 •

    複数のCPUコアで、読み取りと集 計を同時に進める ノード 2 C1 C2 … Cn C1 C2 … Cn · · · · · · · · · · · · · · · · · · · · · · · · • それぞれの途中結果を 最後にまとめる C1 C2 · · · · · · 31 ©2026 CLICKHOUSE INC., CONFIDENTIAL & PROPRIETARY · · · … … … C1 C2 … Cn · · · · · · · · · · · · 複数ノードで 読取り範囲と部分集約を分担 ノード 1 · · · ノード m Cn · · · 1ノード内の複数CPUコアで データのチャンクを並列処理 1コア内のSIMD命令で 複数のデータ要素を並列処理
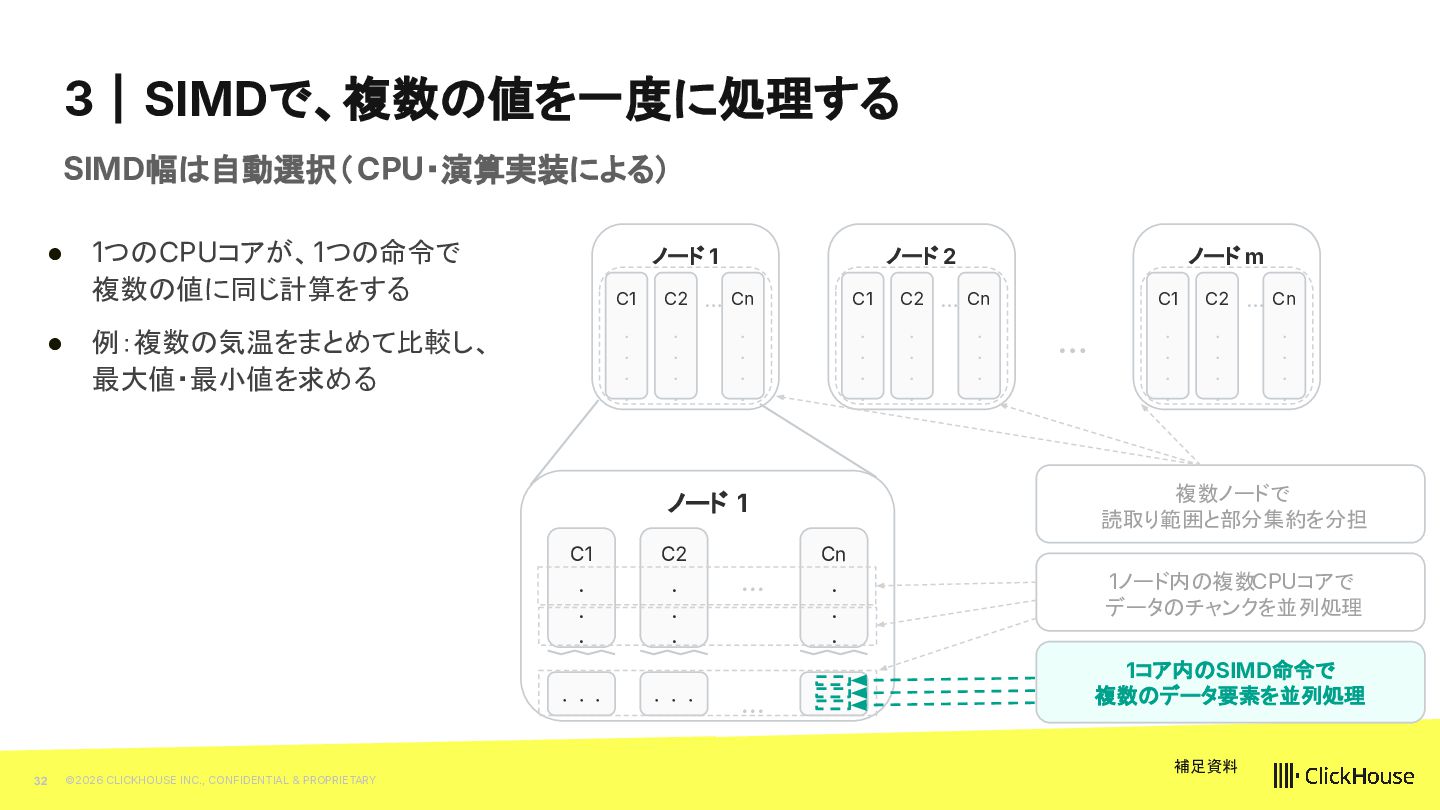
  23. 3|SIMDで、複数の値を一度に処理する SIMD幅は自動選択( CPU・演算実装による) • 1つのCPUコアが、1つの命令で 複数の値に同じ計算をする ノード 1 • 例:複数の気温をまとめて比較し、

    最大値・最小値を求める ノード 2 C1 C2 … Cn C1 C2 … Cn · · · · · · · · · · · · · · · · · · · · · · · · C1 C2 · · · · · · 32 ©2026 CLICKHOUSE INC., CONFIDENTIAL & PROPRIETARY · · · … … … C1 C2 … Cn · · · · · · · · · · · · 複数ノードで 読取り範囲と部分集約を分担 ノード 1 · · · ノード m Cn · · · 1ノード内の複数CPUコアで データのチャンクを並列処理 1コア内のSIMD命令で 複数のデータ要素を並列処理 補足資料
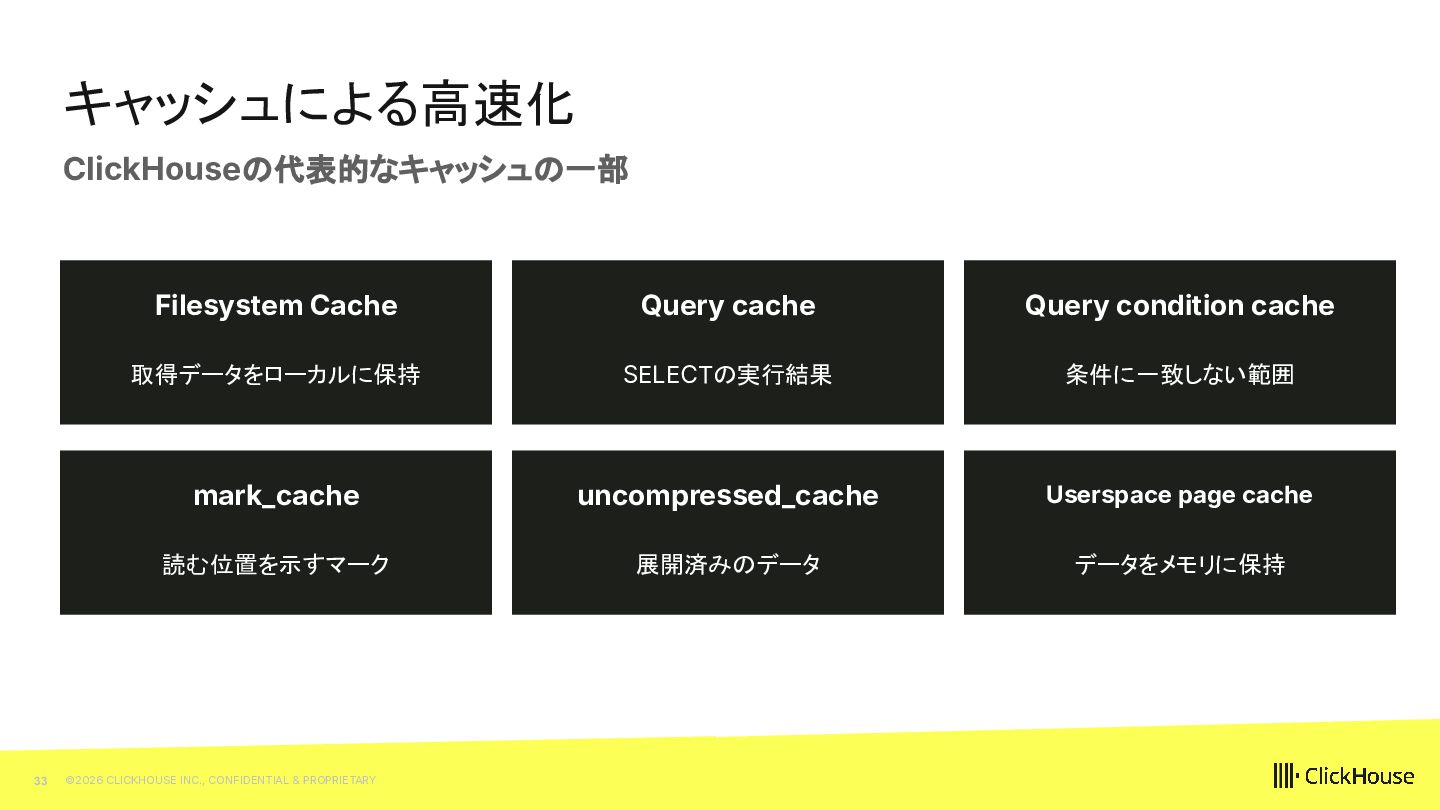
  24. キャッシュによる高速化 ClickHouseの代表的なキャッシュの一部 33 Filesystem Cache Query cache Query condition cache

    取得データをローカルに保持 SELECTの実行結果 条件に一致しない範囲 mark_cache uncompressed_cache Userspace page cache 読む位置を示すマーク 展開済みのデータ データをメモリに保持 ©2026 CLICKHOUSE INC., CONFIDENTIAL & PROPRIETARY
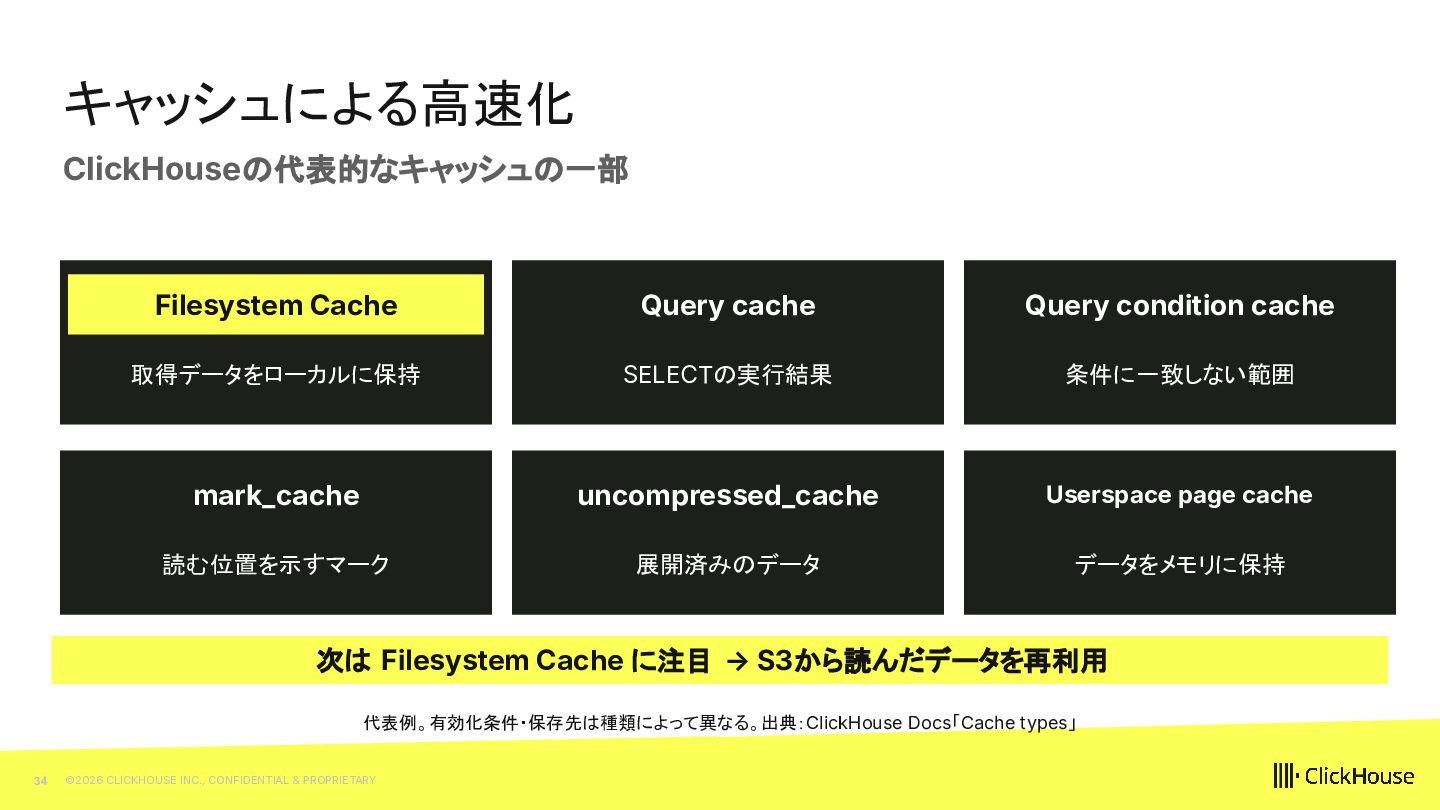
  25. キャッシュによる高速化 ClickHouseの代表的なキャッシュの一部 Filesystem Cache Query cache Query condition cache 取得データをローカルに保持

    SELECTの実行結果 条件に一致しない範囲 mark_cache uncompressed_cache Userspace page cache 読む位置を示すマーク 展開済みのデータ データをメモリに保持 次は Filesystem Cache に注目 → S3から読んだデータを再利用 代表例。有効化条件・保存先は種類によって異なる。出典:ClickHouse Docs「Cache types」 34 ©2026 CLICKHOUSE INC., CONFIDENTIAL & PROPRIETARY
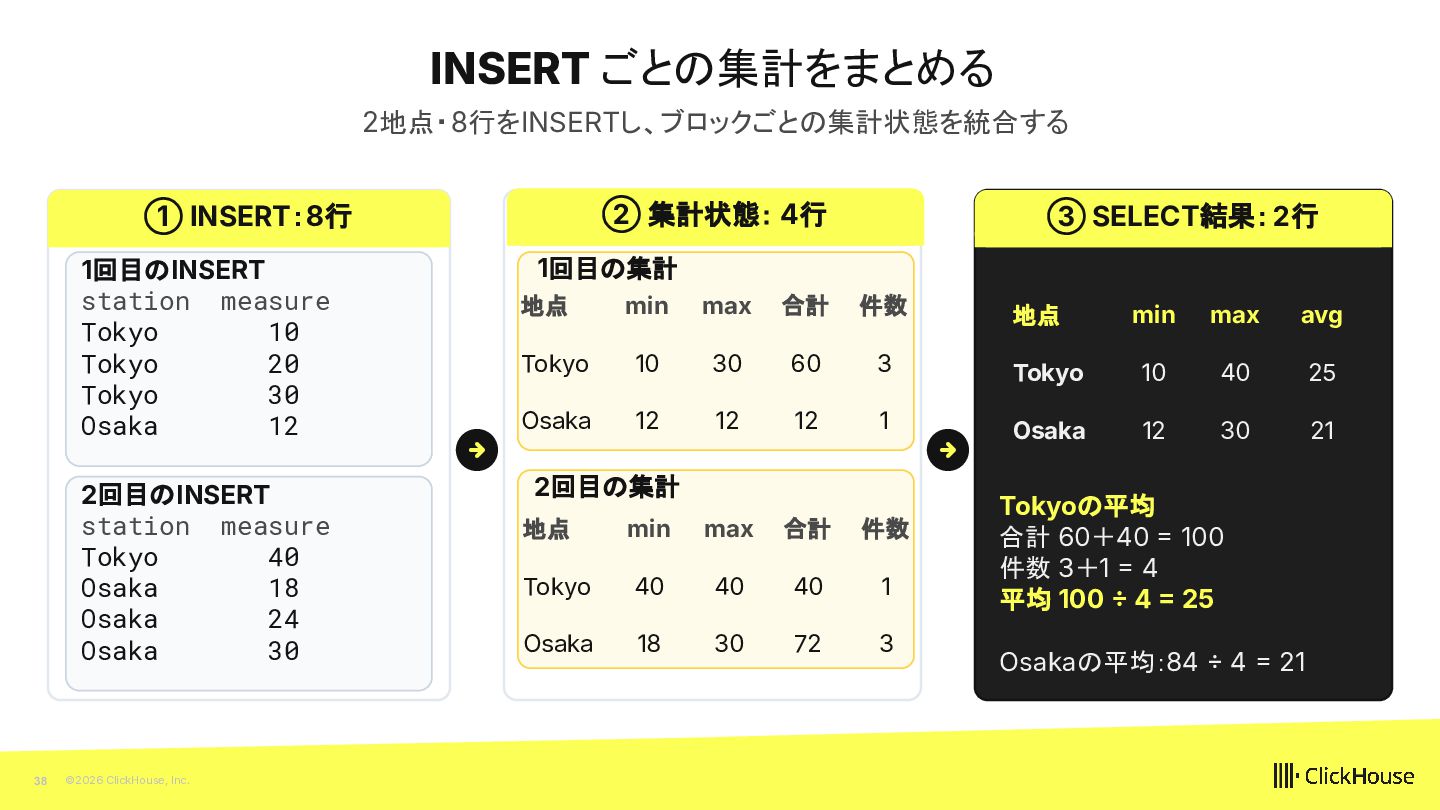
  26. INSERT ごとの集計をまとめる 2地点・8行をINSERTし、ブロックごとの集計状態を統合する ② 集計状態: 4行 ① INSERT:8行 1回目のINSERT station

    measure Tokyo 10 Tokyo 20 Tokyo 30 Osaka 12 2回目のINSERT station measure Tokyo 40 Osaka 18 Osaka 24 Osaka 30 38 ©2026 ClickHouse, Inc. ③ SELECT結果: 2行 1回目の集計 地点 min max 合計 件数 地点 min max avg Tokyo 10 30 60 3 Tokyo 10 40 25 Osaka 12 12 12 1 Osaka 12 30 21 2回目の集計 地点 min max 合計 件数 Tokyo 40 40 40 1 Osaka 18 30 72 3 Tokyoの平均 合計 60+40  100 件数 3+1  4 平均 100  4  25 Osakaの平均:84  4  21
  27. 結果:全行集計と、前計算は分けて評価する 主実験: 300 vCPUで32秒・¥63。追加検証:集約済みデータならミリ秒級 検証結果 1円未満 3ミリ 秒) ¥100 ¥290

    148 秒) ¥120 61 秒) ¥63 32 秒) S3 から直接 SELECT SharedMergeTree ORDER BY station SharedMergeTree ORDER BY (station, measure) (s3Cluster) warm 結果。cold は前の結果ページ参照 2024 年は起動・破棄を含む。今回の金額とは費用の集計範囲が異なる 39 ©2026 ClickHouse, Inc. warm 結果。cold の場合 ¥80 ¥1未満∕3ミリ秒 元の1兆⾏の 再⾛査ではない
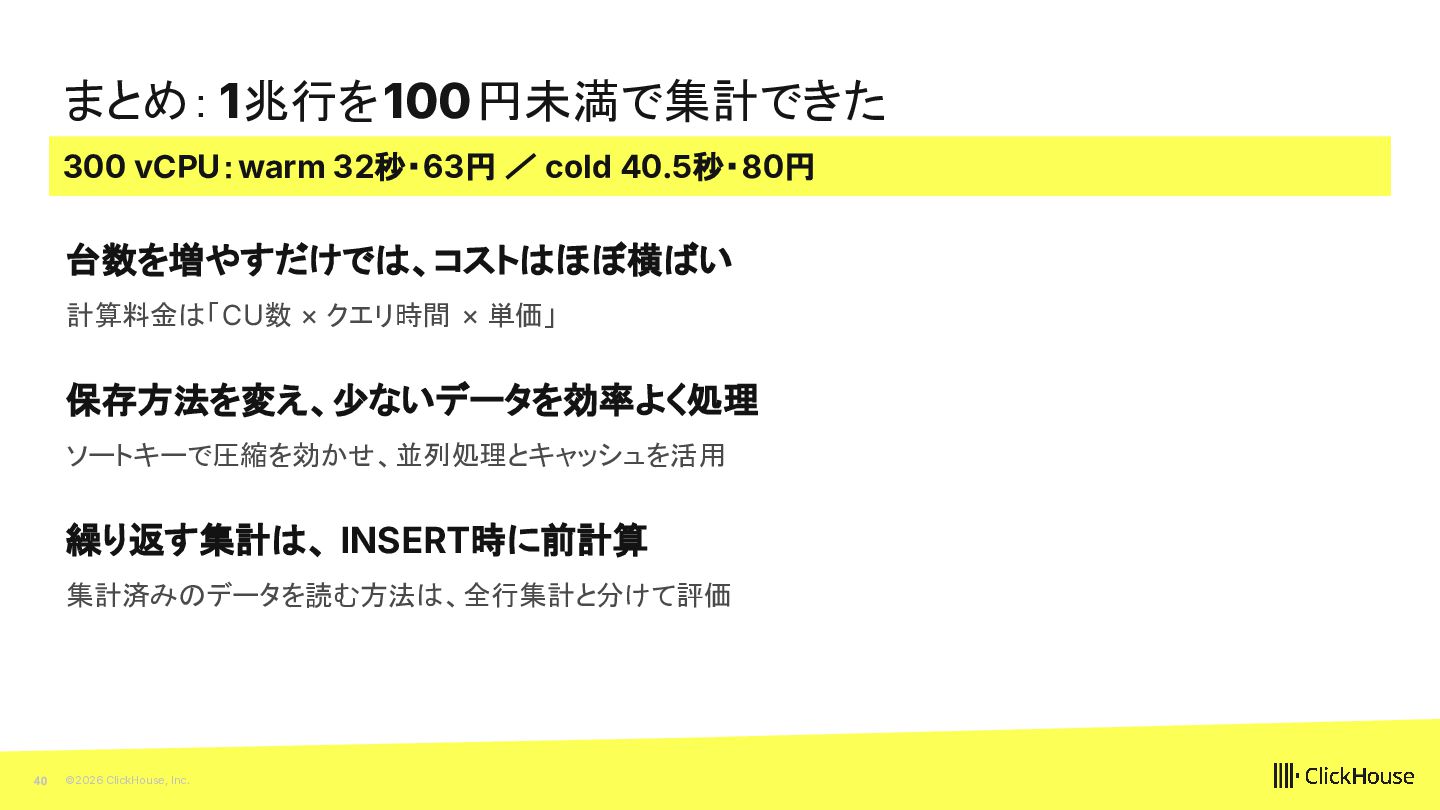
  28. まとめ: 1兆行を100円未満で集計できた 300 vCPU:warm 32秒・63円 / cold 40.5秒・80円 台数を増やすだけでは、コストはほぼ横ばい 計算料金は「CU数

    × クエリ時間 × 単価」 保存方法を変え、少ないデータを効率よく処理 ソートキーで圧縮を効かせ、並列処理とキャッシュを活用 繰り返す集計は、 INSERT時に前計算 集計済みのデータを読む方法は、全行集計と分けて評価 40 ©2026 ClickHouse, Inc.
  29. 今日から、始められる 試す、聞く、つなぐ 試す 聞く つなぐ・組み込む Cloud 無料トライアル Docs を AI

    に質問する MCP と Agent Skills アカウントを作成すれば、 30 日間無料で試せる Docs の Ask AI に日本語で聞ける 設定名も SQL もその場で エージェントから ClickHouse に つなぎ、定石も組み込む MCP clickhouse.cloud/signUp 41 clickhouse.com/docs Agent Skills