Upgrade to Pro — share decks privately, control downloads, hide ads and more …

DEV Čtvrtkon #137 - Web scraping (nejen) v Pythonu

DEV Čtvrtkon #137 - Web scraping (nejen) v Pythonu

Web scraping je dnes často na různých úrovních běžnou součástí práce vývojářů, analytiků i marketérů – ale kdy dává smysl a kdy si spíš koledujete o problém? Rád bych se podělil o svůj pohled na tuto problematiku, stručný přehled možností a pár tipů a triků z vlastní (několikaleté) praxe této zábavy na dlouhé zimní večery 🙂

Aneb Prozkoumejte základy webového scrapingu, HTTP požadavky, asynchronní scraping, automatizaci prohlížečů, výkonnostní benchmarky, používání proxy, strategie proti botům a etické aspekty s využitím Pythonu a moderních nástrojů, jako jsou Playwright a Selenium.

Info o akci na: https://ctvrtkon.cz/udalost/dev-ctvrtkon-137

Odkaz na repo se ukázkovými skripty: https://github.com/hlavacm/dev-ctvrtkon-137-web-scraping

Avatar for Martin Hlaváč

Martin Hlaváč

February 19, 2026

More Decks by Martin Hlaváč

Other Decks in Programming

Transcript

  1. “Web scraping je způsob získávání strukturovaných dat z webových stránek.

    Spočívá v extrahování dat umístěných na webových stránkách do užitečnějšího formátu, který je možné snadno dále strojově zpracovávat.” Zdroj: https://cs.wikipedia.org/wiki/Web_scraping
  2. Level 1 – Jednoduché HTTP requesty • Základ web scrapingu:
    stáhnout HTML obsah / kód • Používáme typicky knihovny requests nebo httpx, Fetch nebo Axios, či Guzzle pro odeslání jednoduchého GET/POST dotazu • Výsledek = HTML, se kterým dál pracujeme
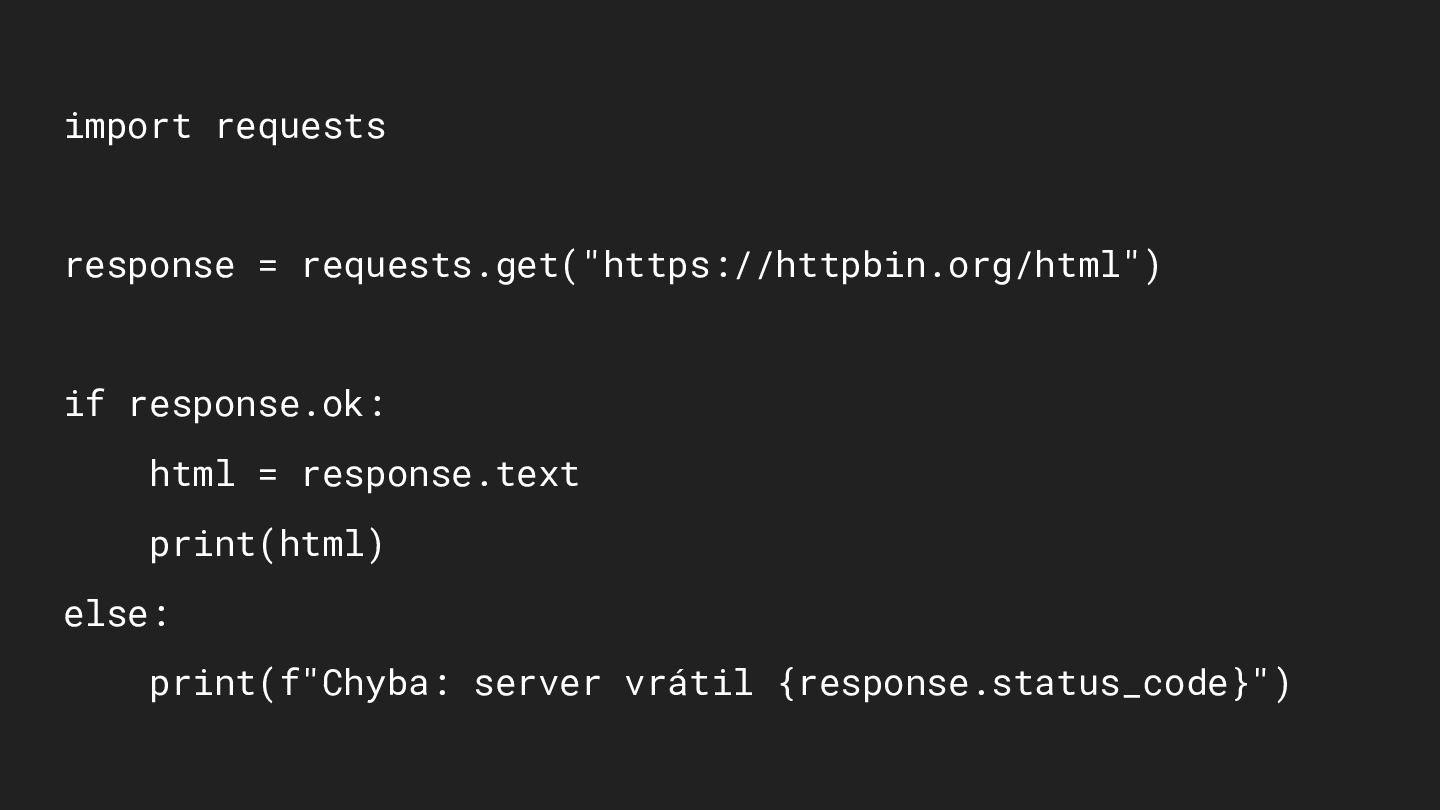
  3. import requests response = requests.get("https://httpbin.org/html") if response.ok: html = response.text

    print(html) else: print(f"Chyba: server vrátil {response.status_code}")
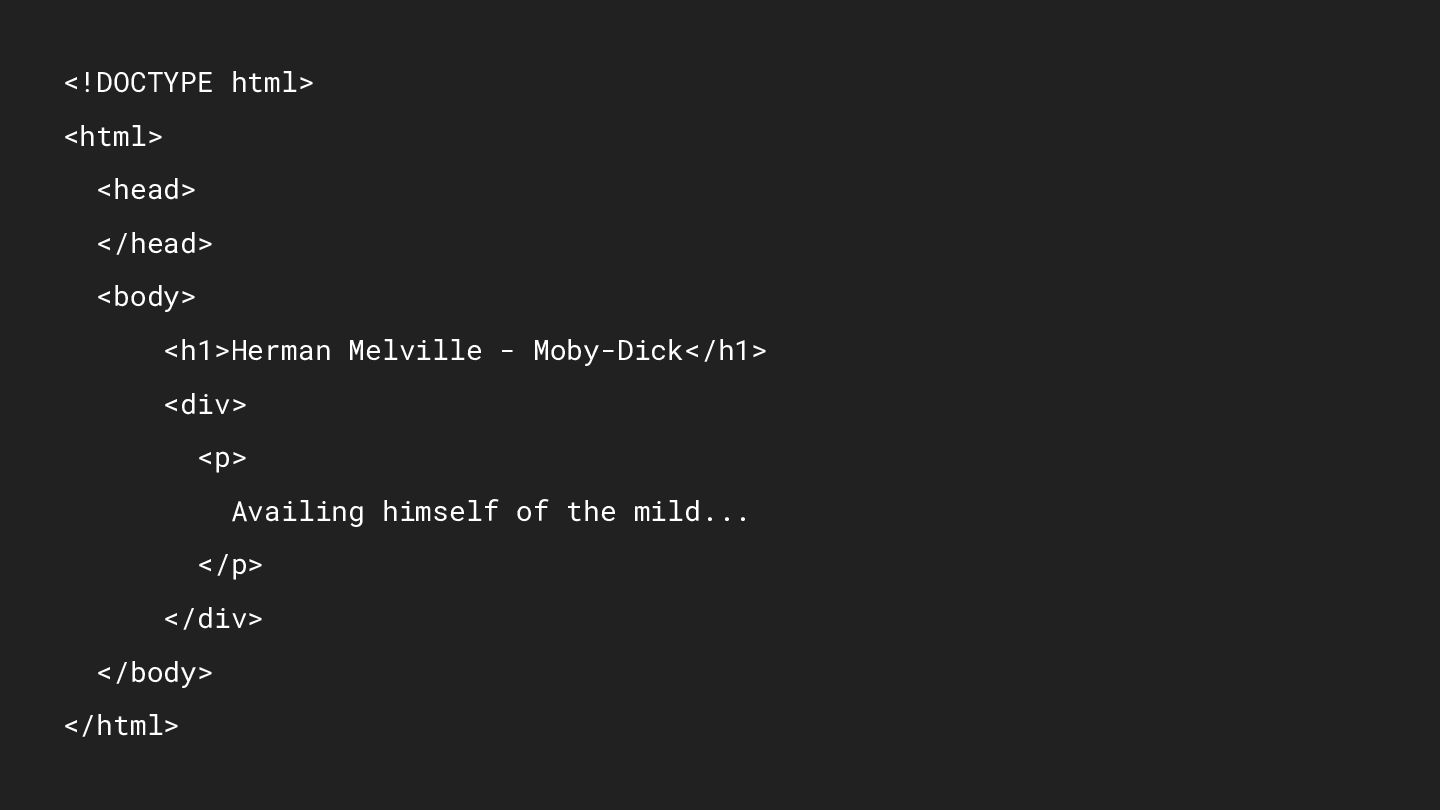
  4. <!DOCTYPE html> <html> <head> </head> <body> <h1>Herman Melville - Moby-Dick</h1>

    <div> <p> Availing himself of the mild... </p> </div> </body> </html>
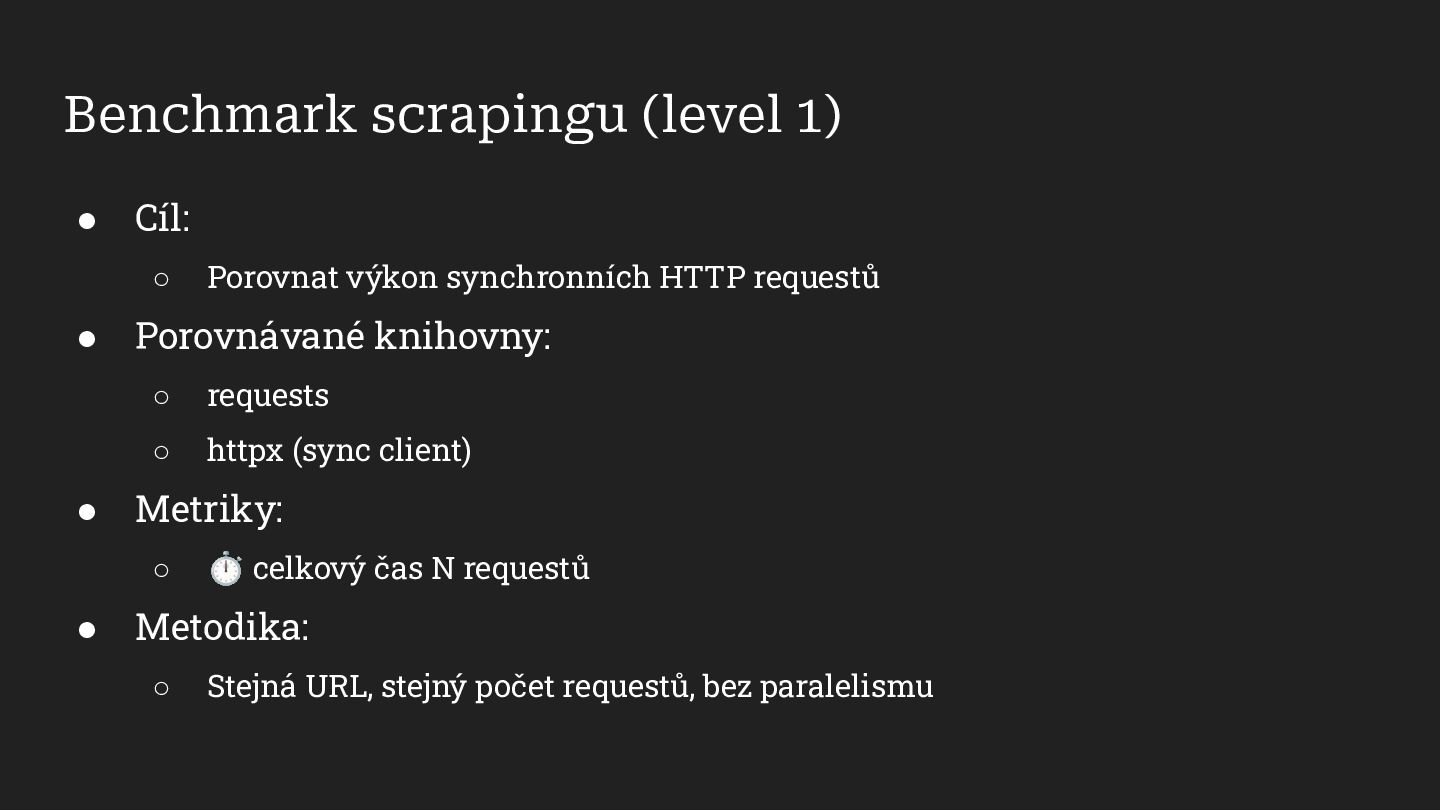
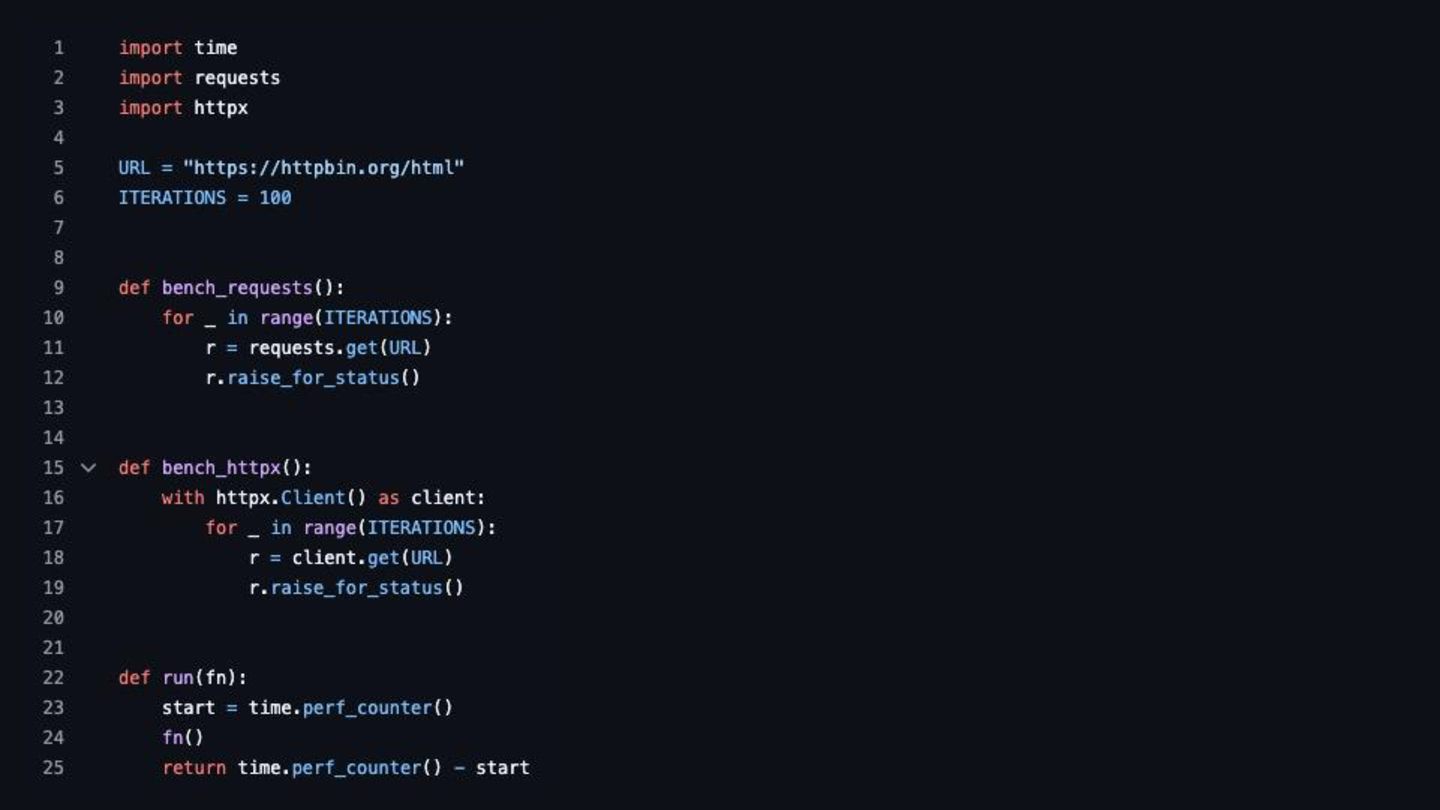
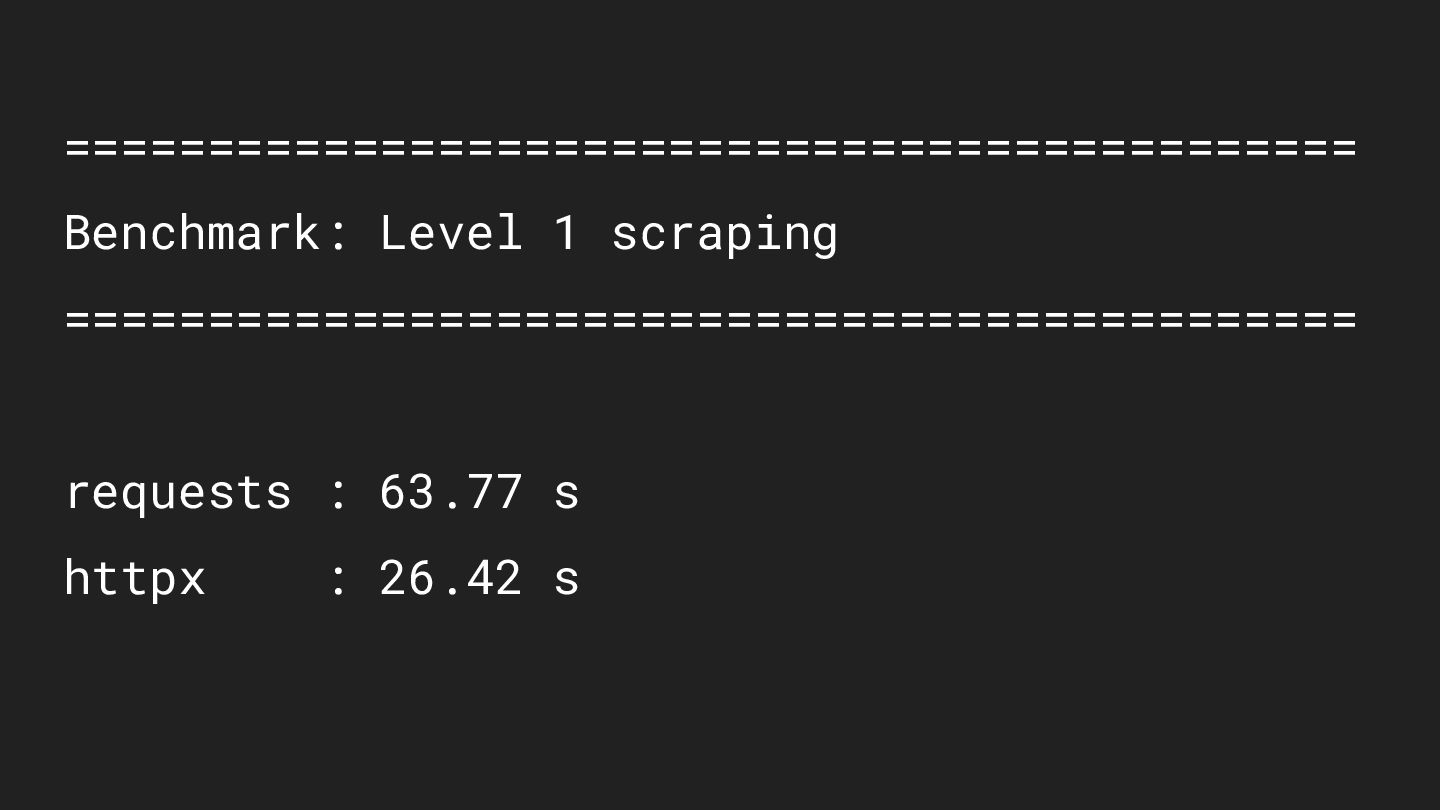
  5. Benchmark scrapingu (level 1) • Cíl: ◦ Porovnat výkon synchronních

    HTTP requestů • Porovnávané knihovny: ◦ requests ◦ httpx (sync client) • Metriky: ◦ ⏱ celkový čas N requestů • Metodika: ◦ Stejná URL, stejný počet requestů, bez paralelismu
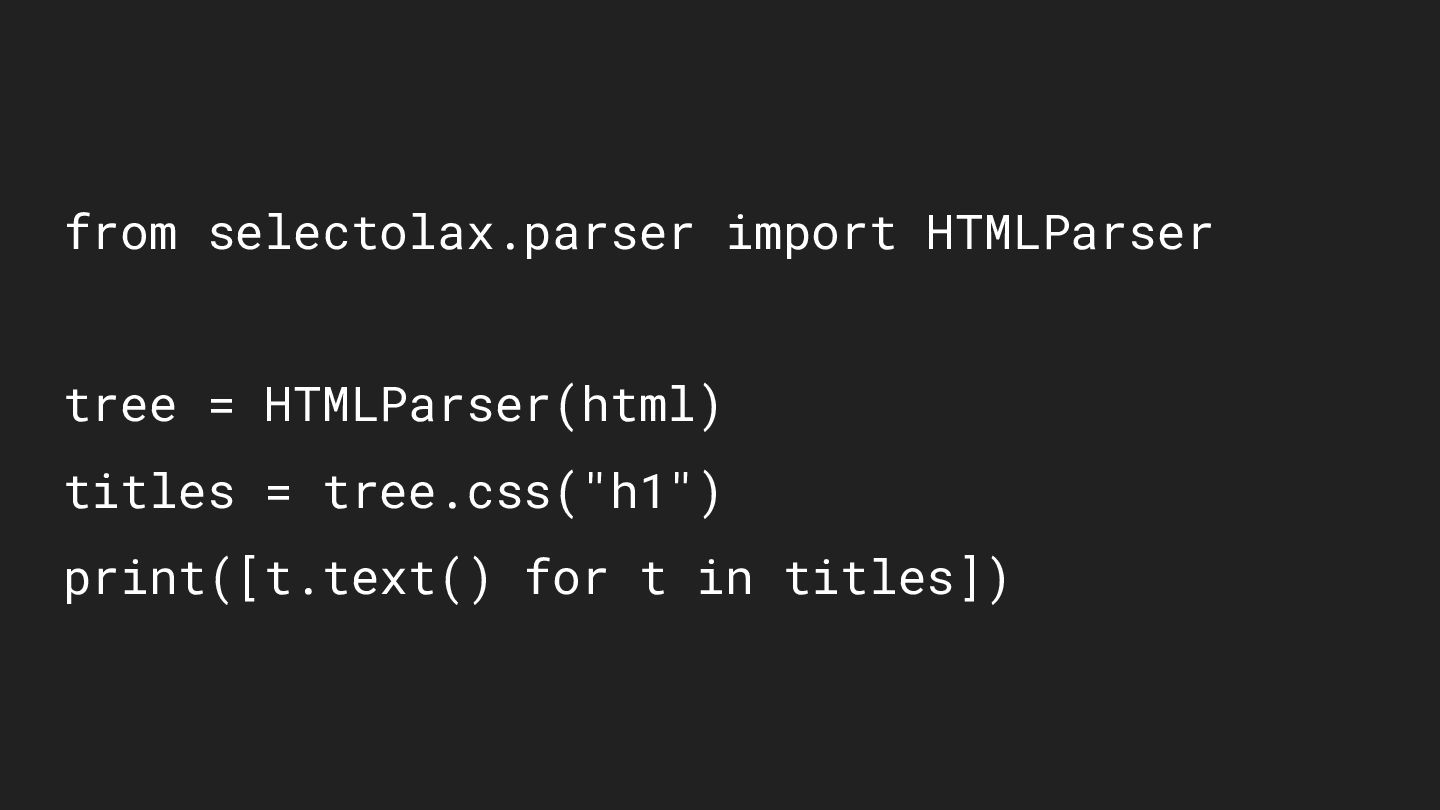
  6. Parsování HTML • Po stažení HTML je třeba ho rozparsovat

    a vytáhnout konkrétní data • Nejčastější knihovny: ◦ BeautifulSoup4 – jednoduchá, intuitivní ▪ HTML parser nebo LXML ◦ Selectolax – velmi rychlá, efektivní pro velké stránky ▪ LexborHTMLParser
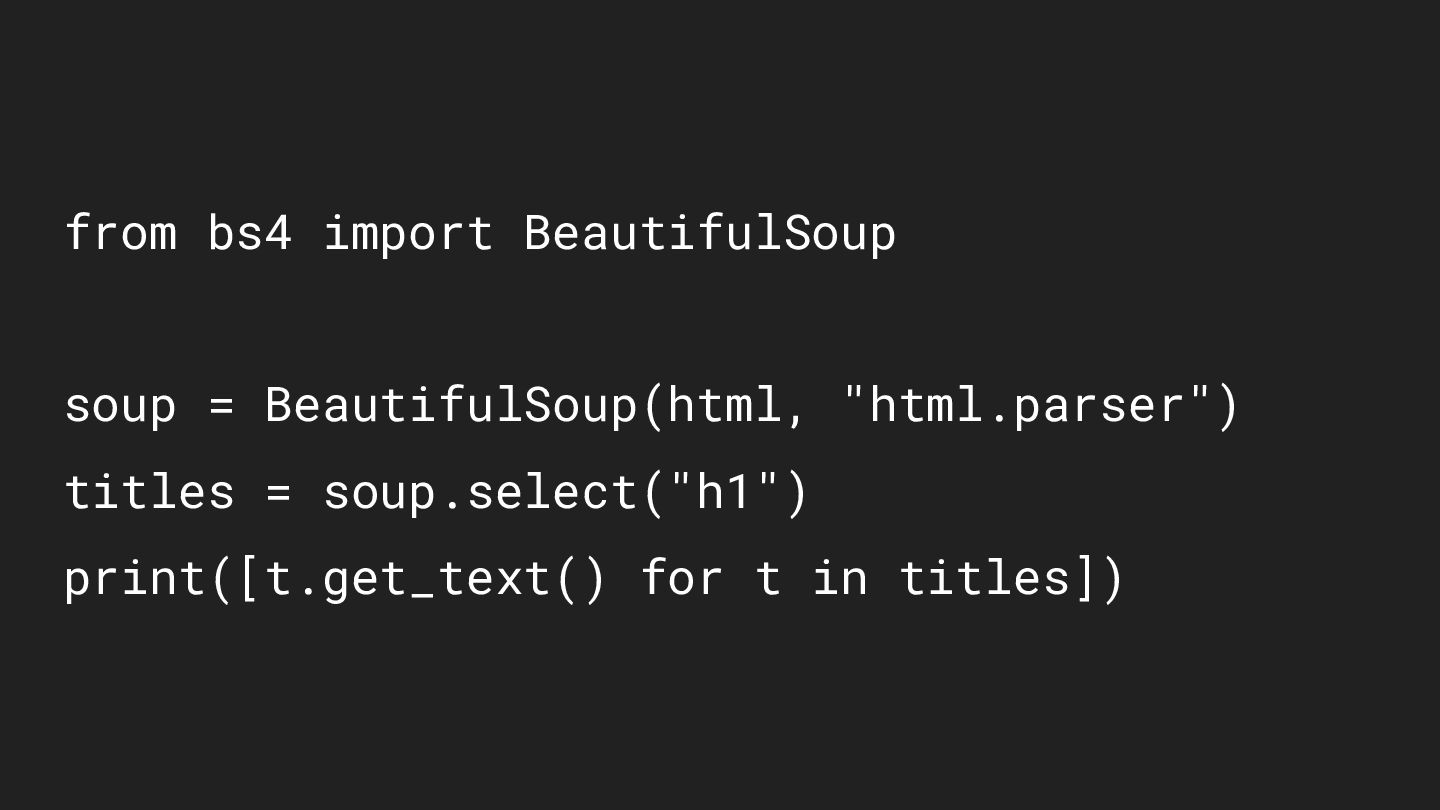
  7. from bs4 import BeautifulSoup soup = BeautifulSoup(html, "html.parser") titles =

    soup.select("h1") print([t.get_text() for t in titles])
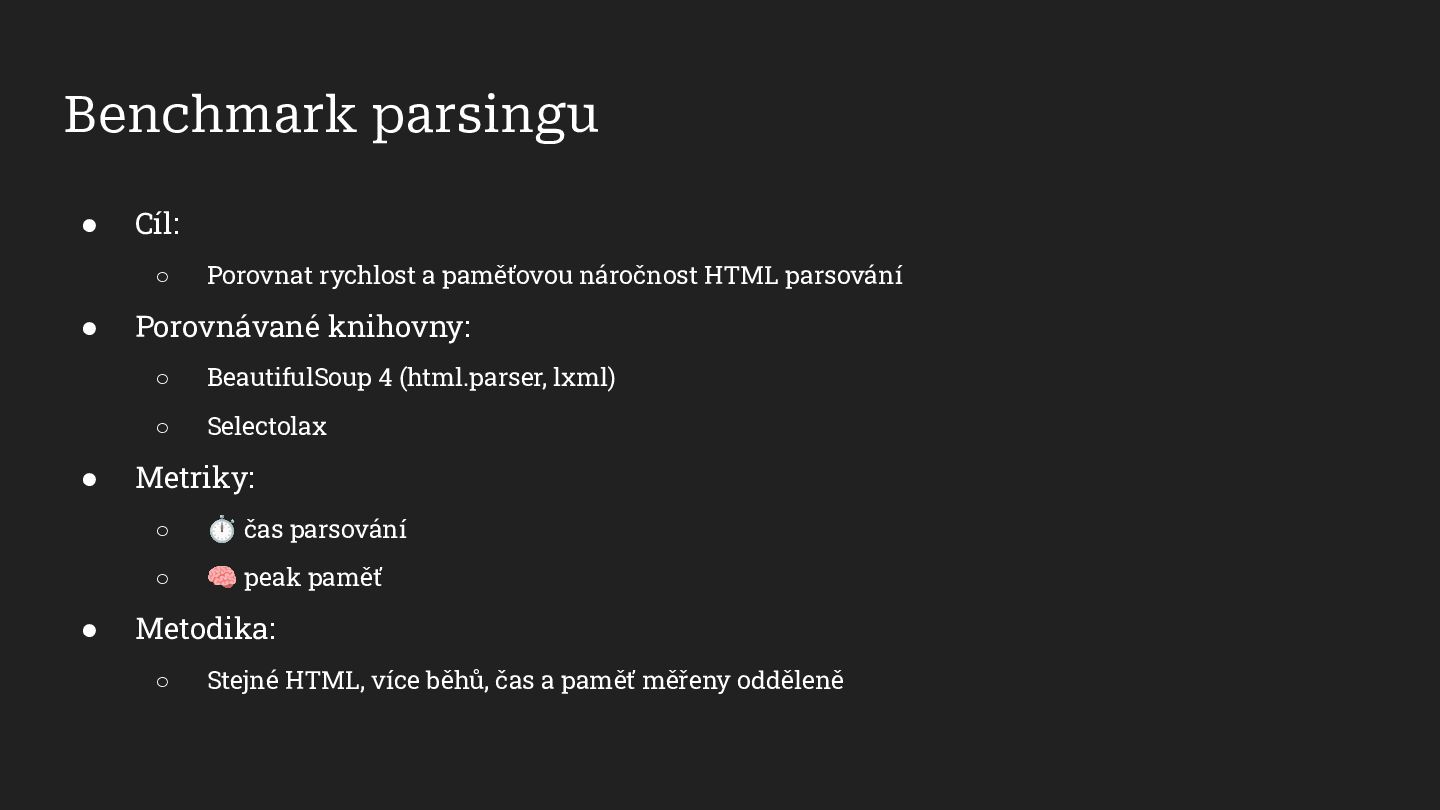
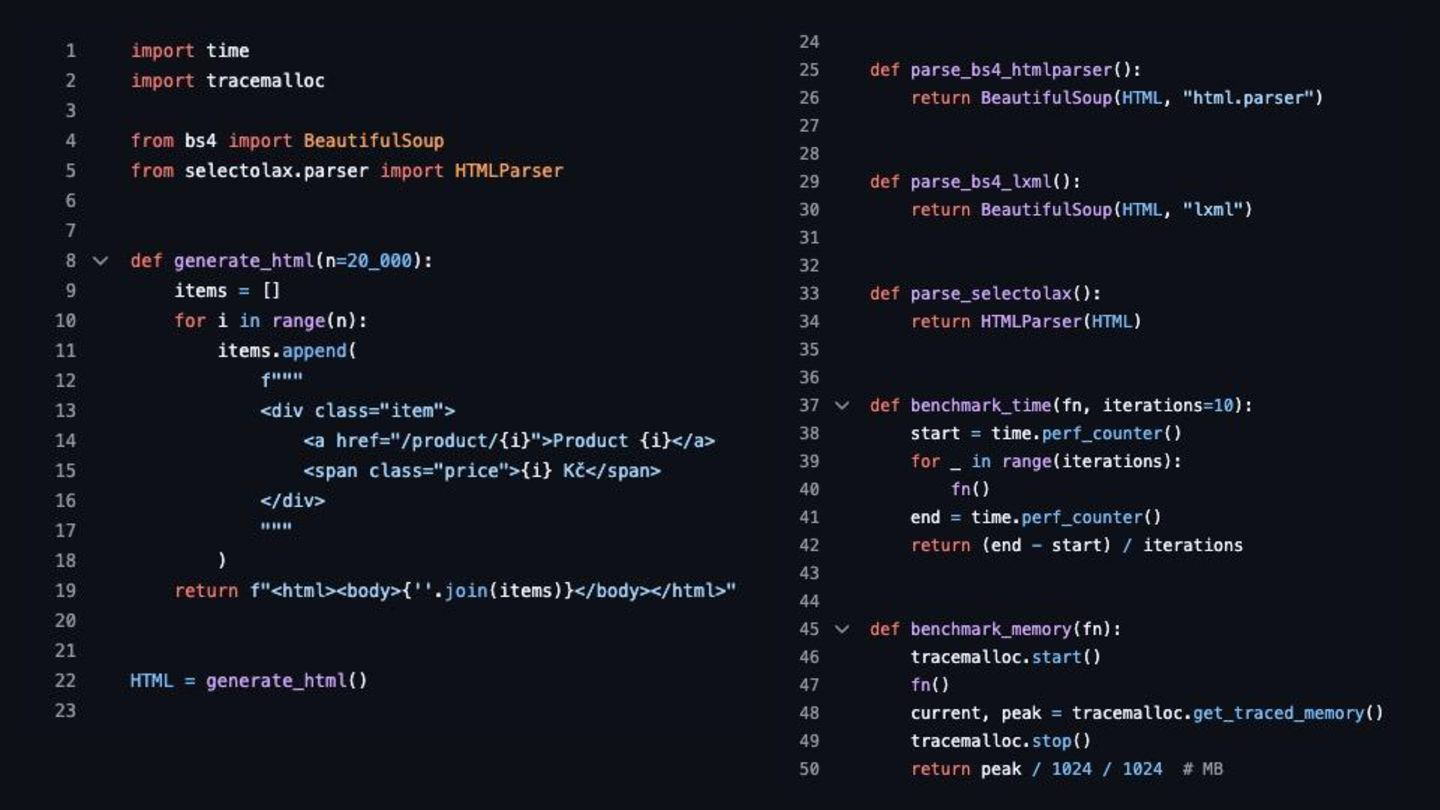
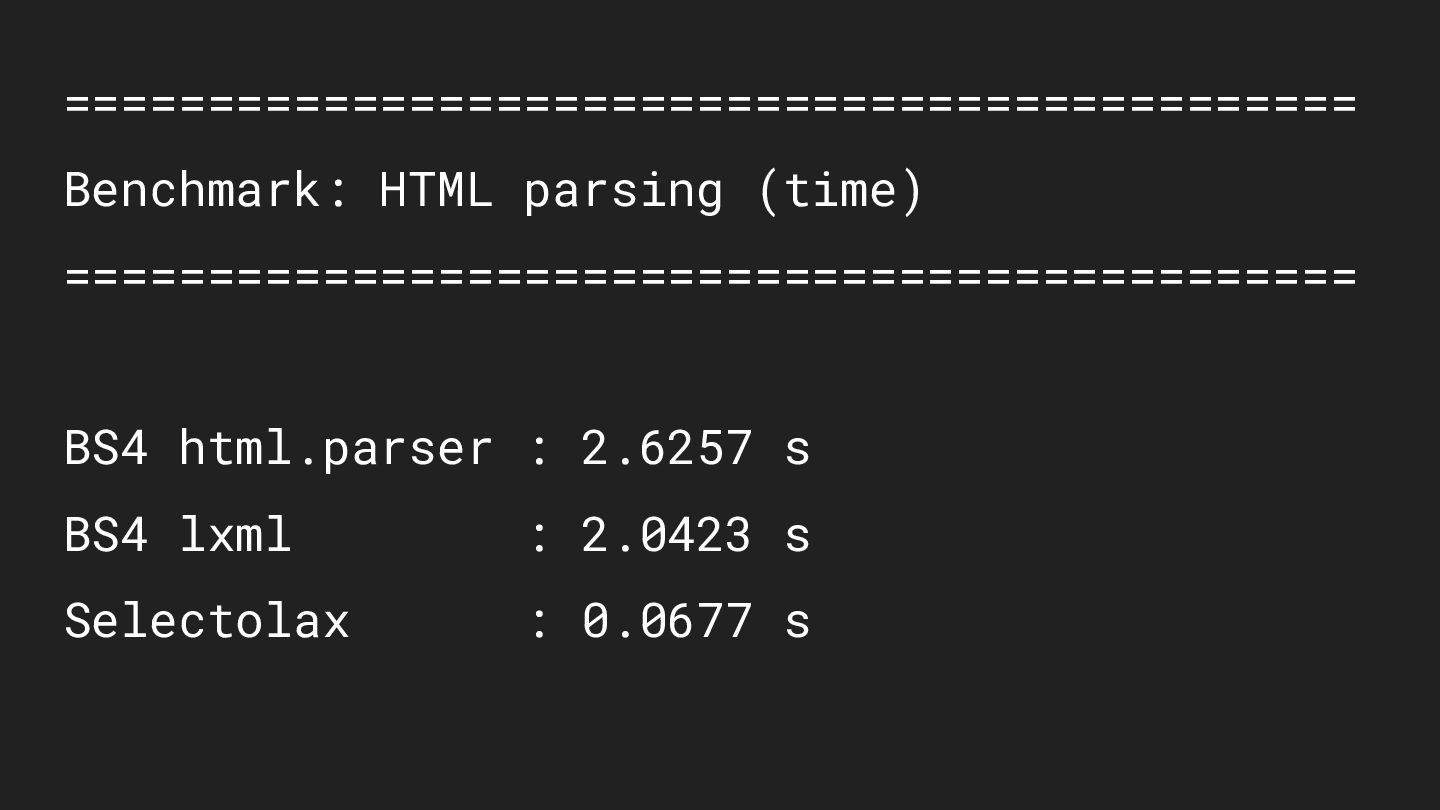
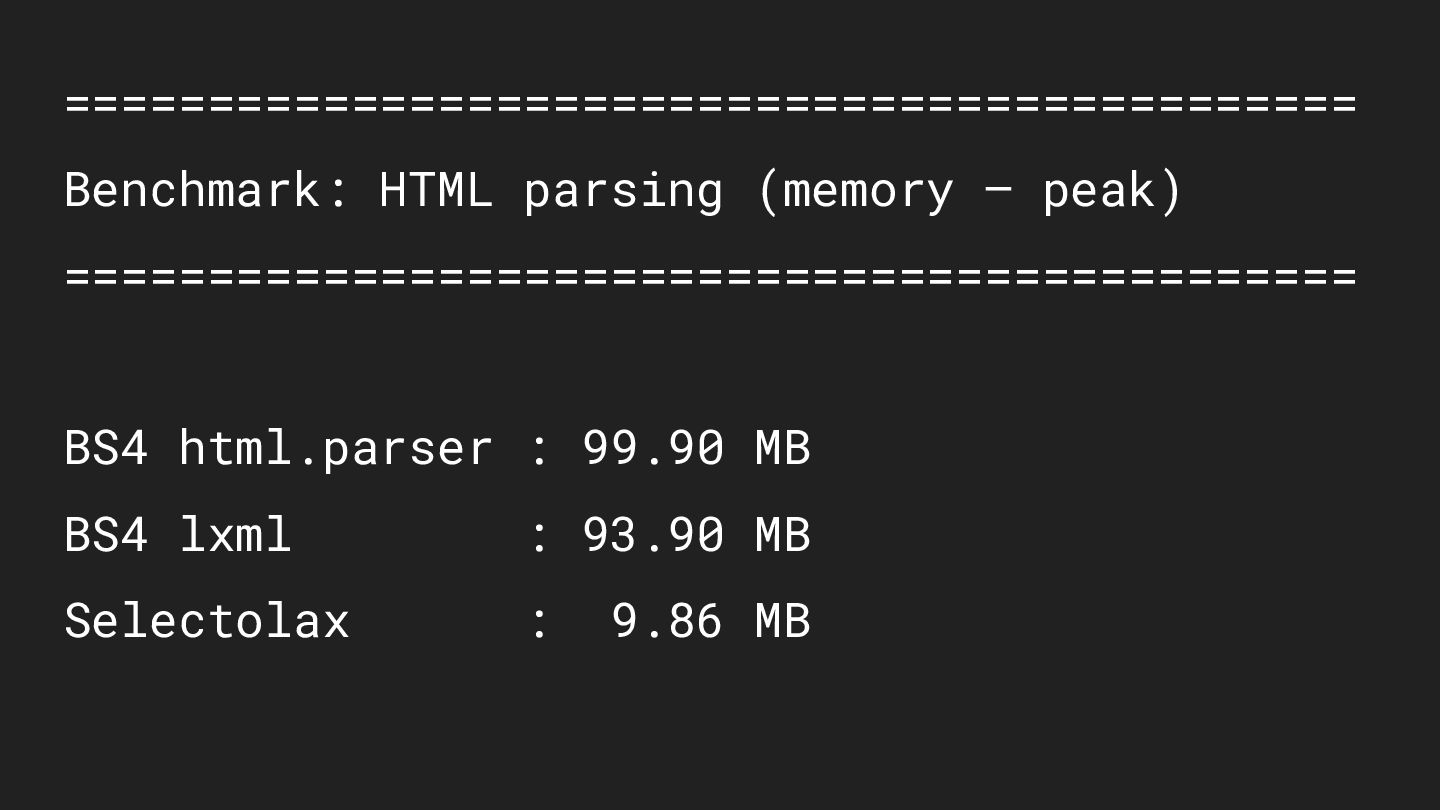
  8. Benchmark parsingu • Cíl: ◦ • • • Porovnat rychlost

    a paměťovou náročnost HTML parsování Porovnávané knihovny: ◦ BeautifulSoup 4 (html.parser, lxml) ◦ Selectolax Metriky: ◦ ⏱ čas parsování ◦ 🧠 peak paměť Metodika: ◦ Stejné HTML, více běhů, čas a paměť měřeny odděleně
  9. Level 2 – Asynchronní HTTP requesty • Umožňuje současné stahování

    více stránek, ideální pro větší výkon. • Asynchronní kód = efektivnější využití času při čekání na odpověď serveru. • V pythonu asyncio: ◦ AIOHTTP ◦ httpx (async client) • Složitější debugging, vyšší komplexita kódu
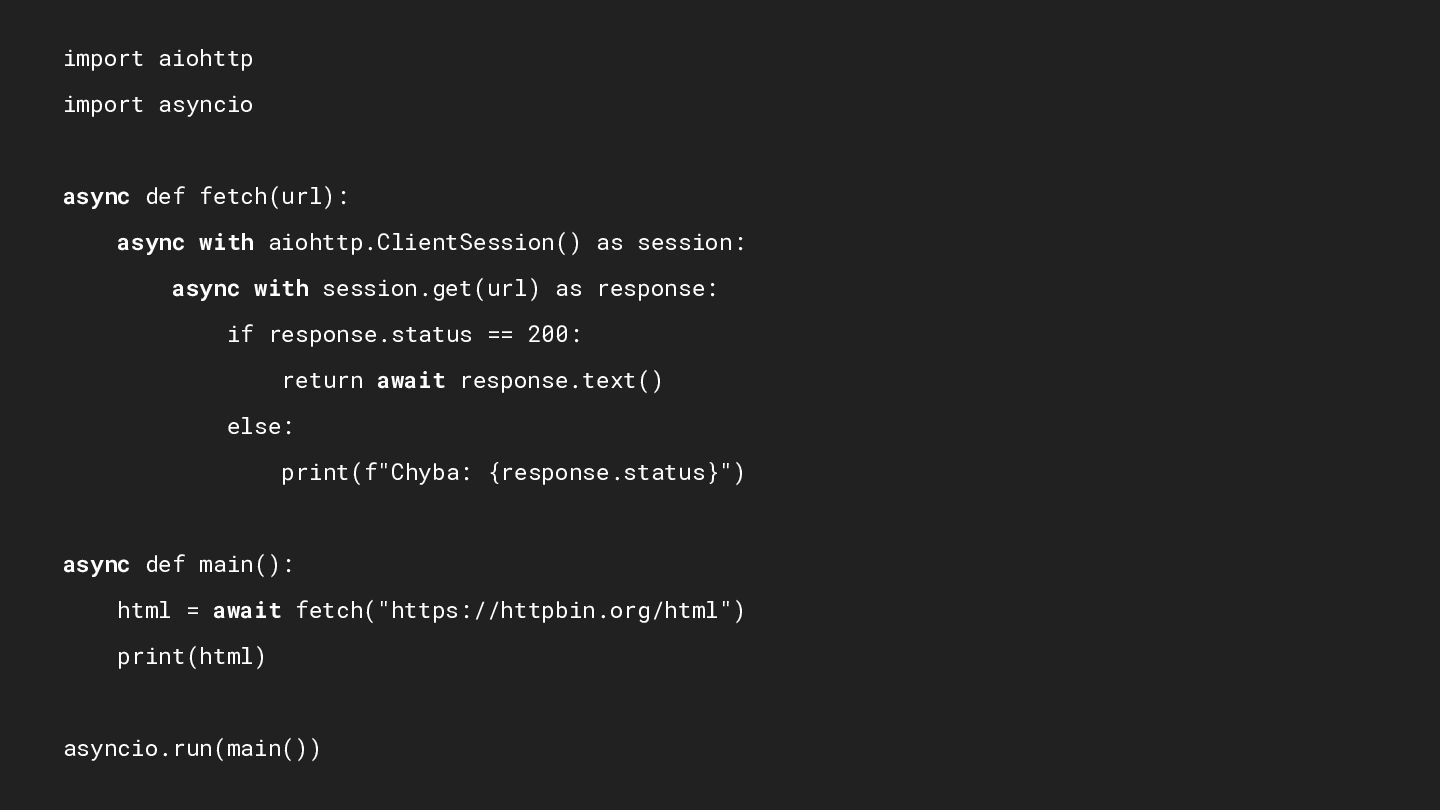
  10. import aiohttp import asyncio async def fetch(url): async with aiohttp.ClientSession()

    as session: async with session.get(url) as response: if response.status == 200: return await response.text() else: print(f"Chyba: {response.status}") async def main(): html = await fetch("https://httpbin.org/html") print(html) asyncio.run(main())
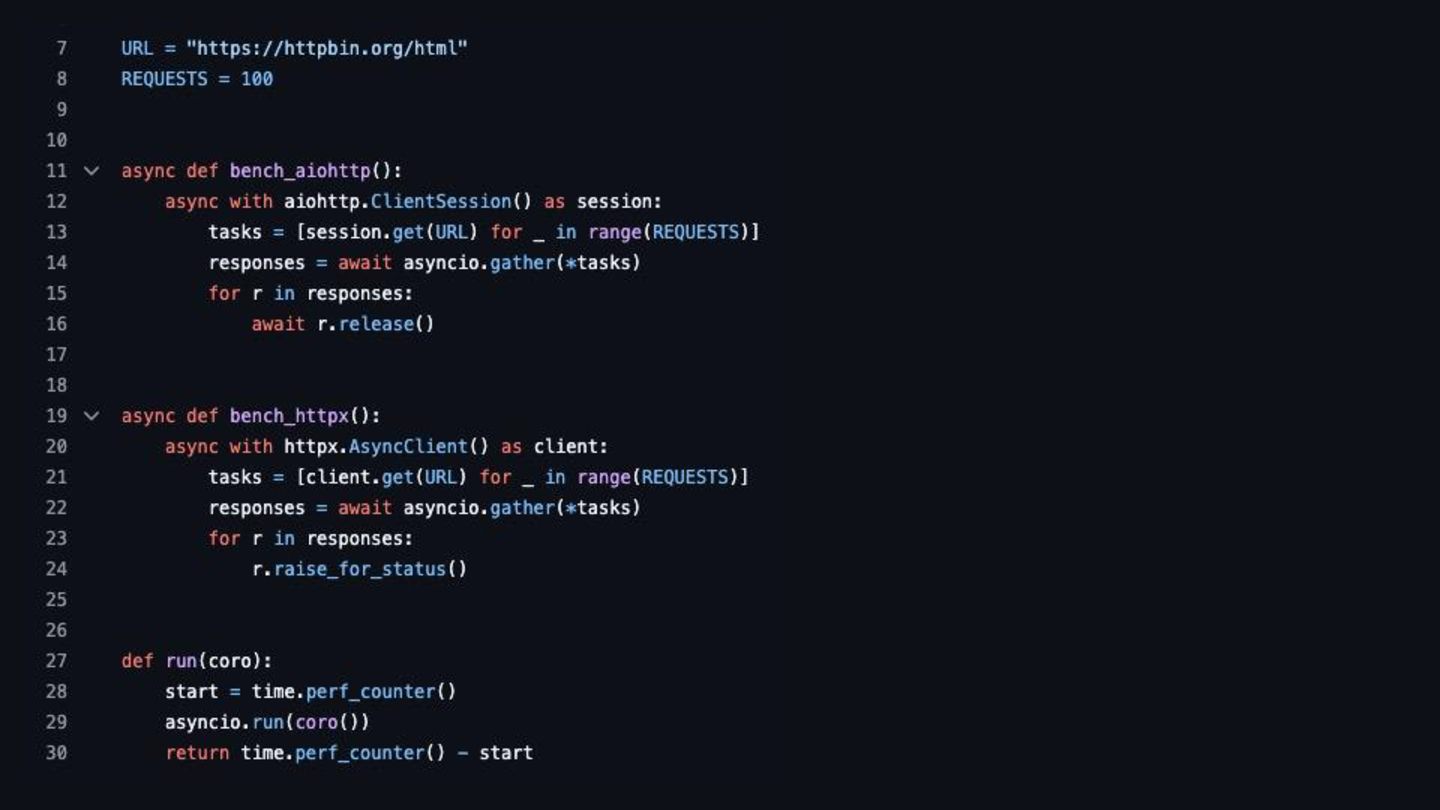
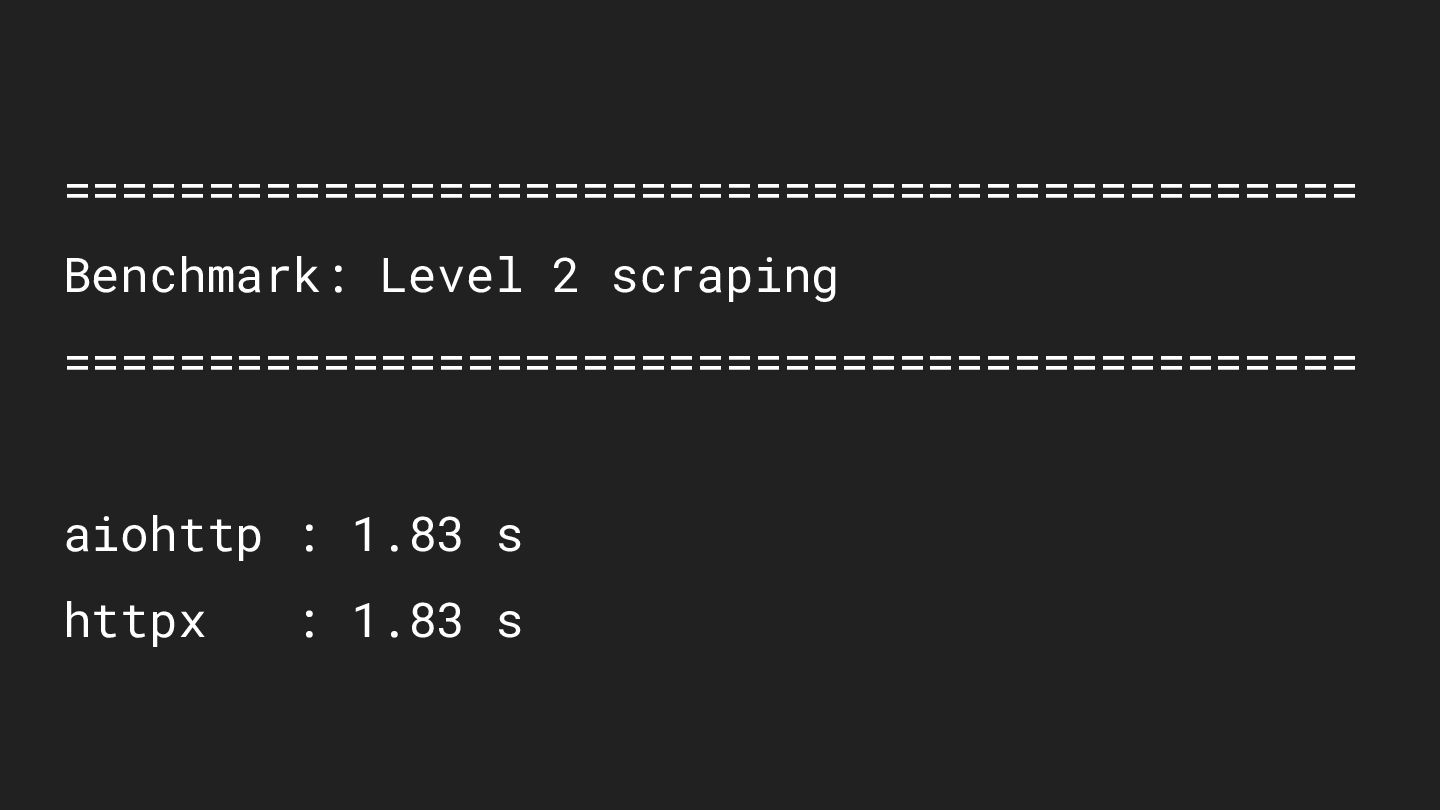
  11. Benchmark scrapingu (level 2) • Cíl: ◦ Porovnat výkon asynchronních

    HTTP requestů • Porovnávané knihovny: ◦ aiohttp ◦ httpx (AsyncClient) • Metriky: ◦ ⏱ celkový čas N requestů • Metodika: ◦ Stejná URL, stejný počet requestů, paralelní zpracování pomocí asyncio
  12. Level 3 – Browser-based scraping • • • • Vykreslení

    pomocí JavaScriptu Automatizace prohlížeče Chování jako reálný uživatel Pomalejší, ale nejuniverzálnější řešení aneb když HTTP nestačí…
  13. Level 3 – Browser-based scraping • • • • Selenium

    – univerzální, starší, stabilní, nejrozšířenější (Puppeteer – Chrome-first, JS-centric) Playwright – moderní, rychlý, multi-browser (DrissionPage)
  14. Level 3 – Browser-based scraping • Selenium → kompatibilita &

    legacy • Playwright → moderní scraping
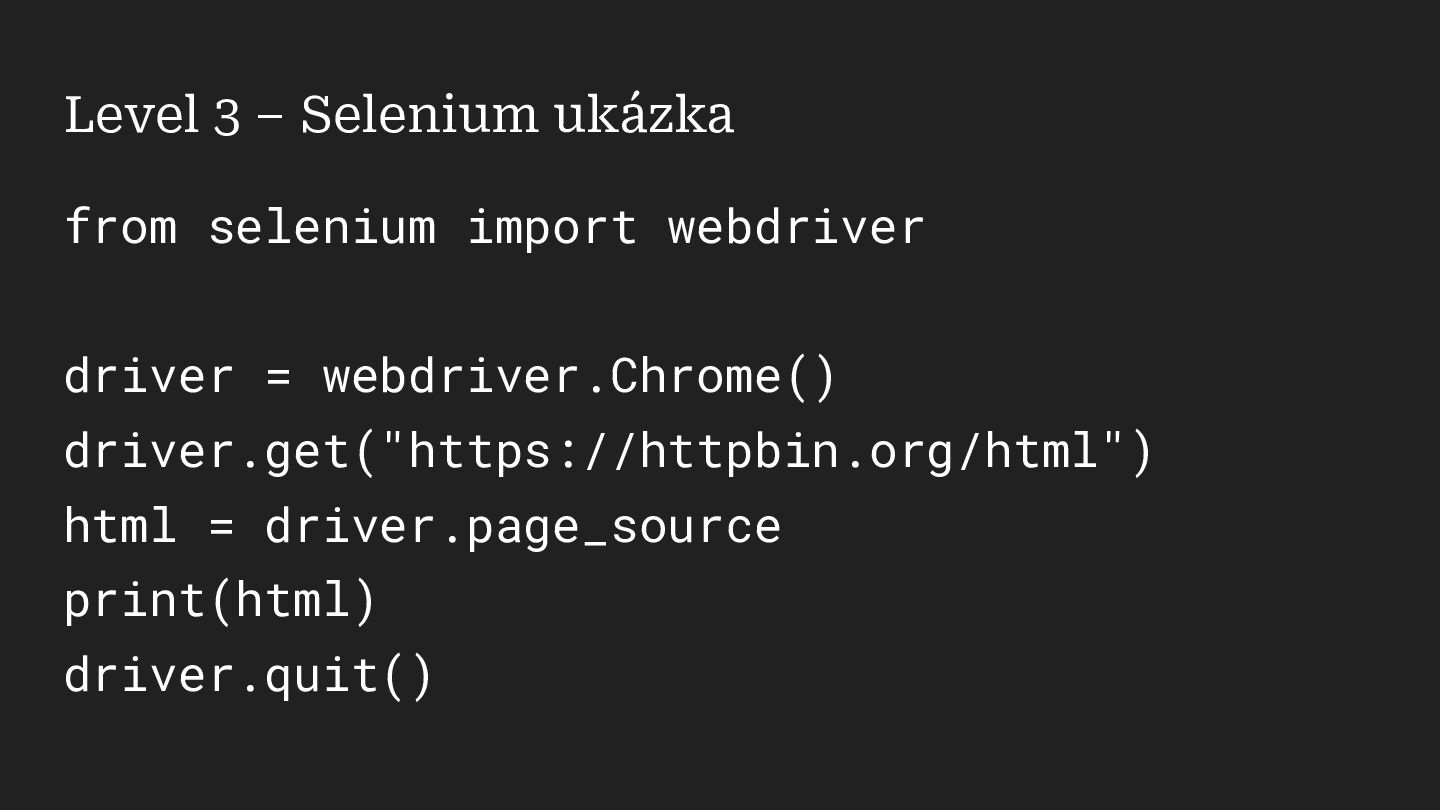
  15. Level 3 – Selenium ukázka from selenium import webdriver driver

    = webdriver.Chrome() driver.get("https://httpbin.org/html") html = driver.page_source print(html) driver.quit()
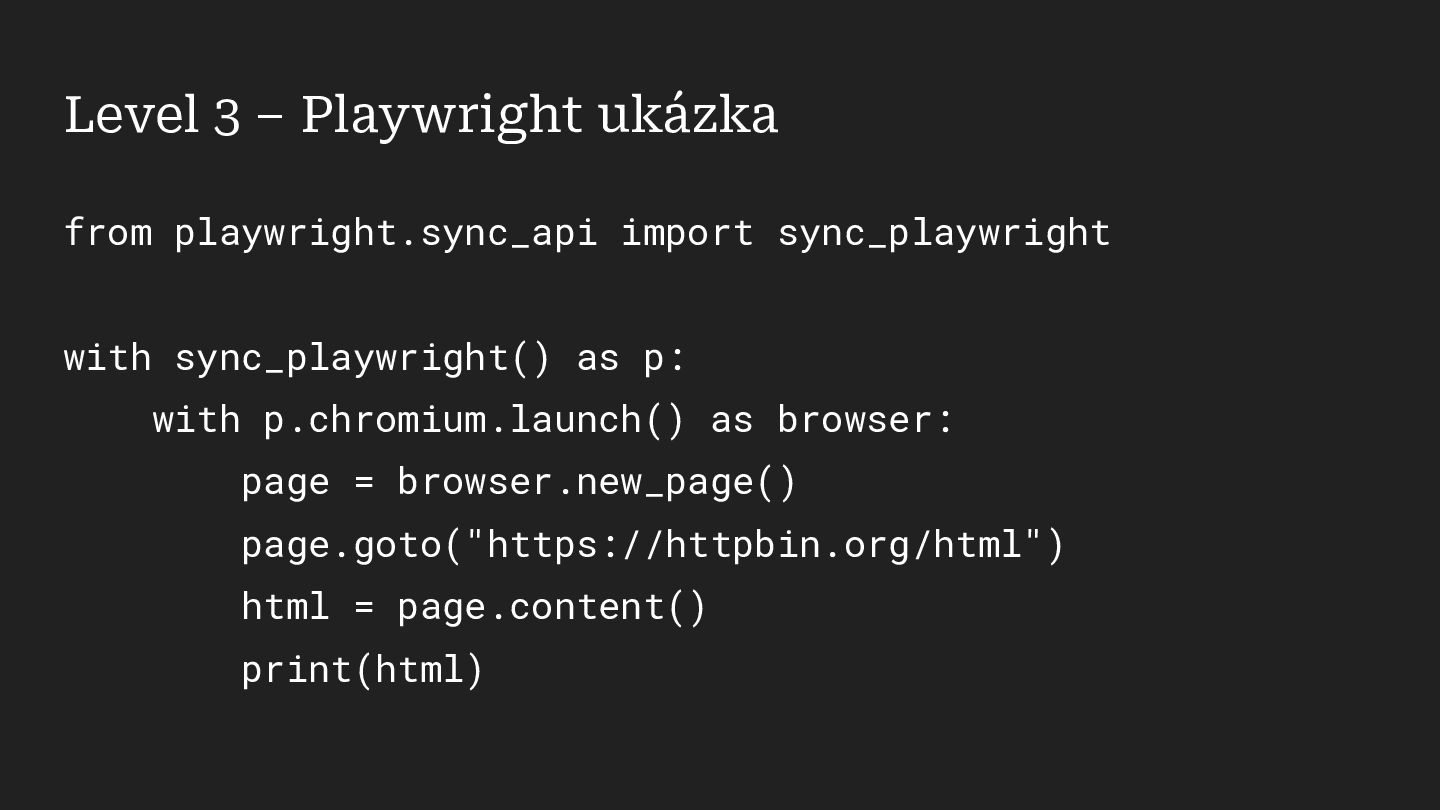
  16. Level 3 – Playwright ukázka from playwright.sync_api import sync_playwright with

    sync_playwright() as p: with p.chromium.launch() as browser: page = browser.new_page() page.goto("https://httpbin.org/html") html = page.content() print(html)
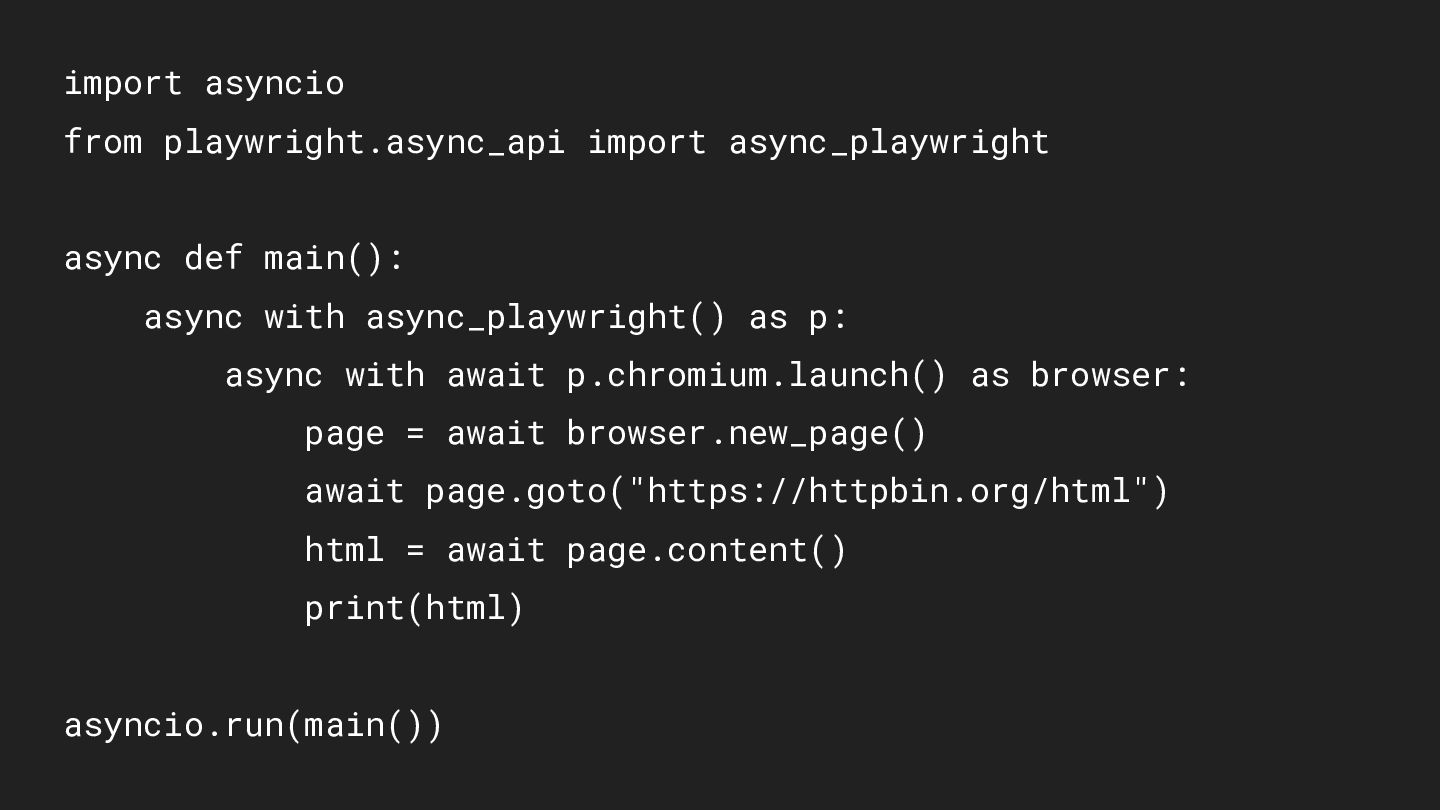
  17. import asyncio from playwright.async_api import async_playwright async def main(): async

    with async_playwright() as p: async with await p.chromium.launch() as browser: page = await browser.new_page() await page.goto("https://httpbin.org/html") html = await page.content() print(html) asyncio.run(main())
  18. Level 3 – Headless (mode) • Bez viditelného okna prohlížeče

    (GUI) • Vykresluje stejný DOM včetně JavaScriptu jako běžný browser • Vhodný pro JS-heavy weby • Lepší výkon, menší nároky na zdroje • Vyšší riziko detekce botů
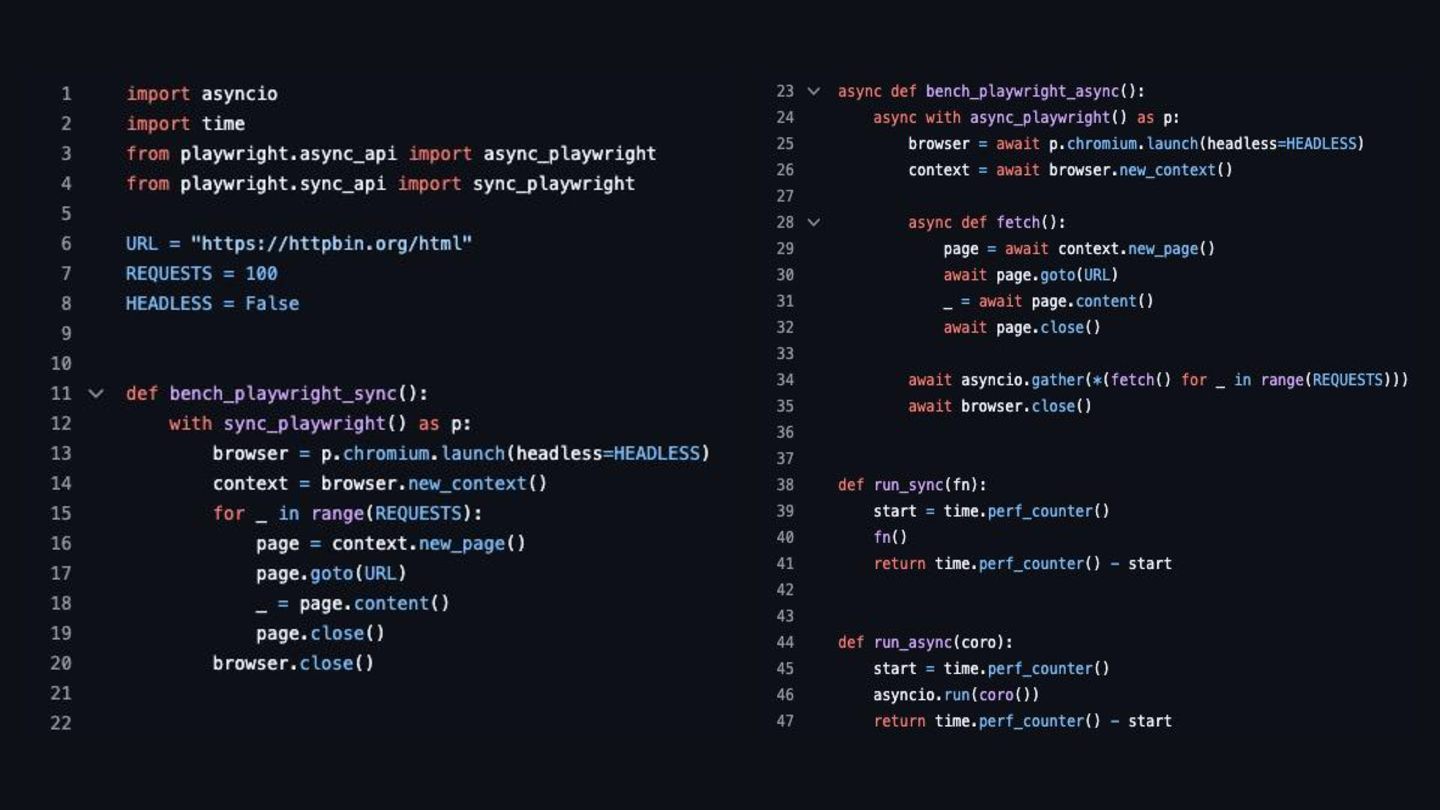
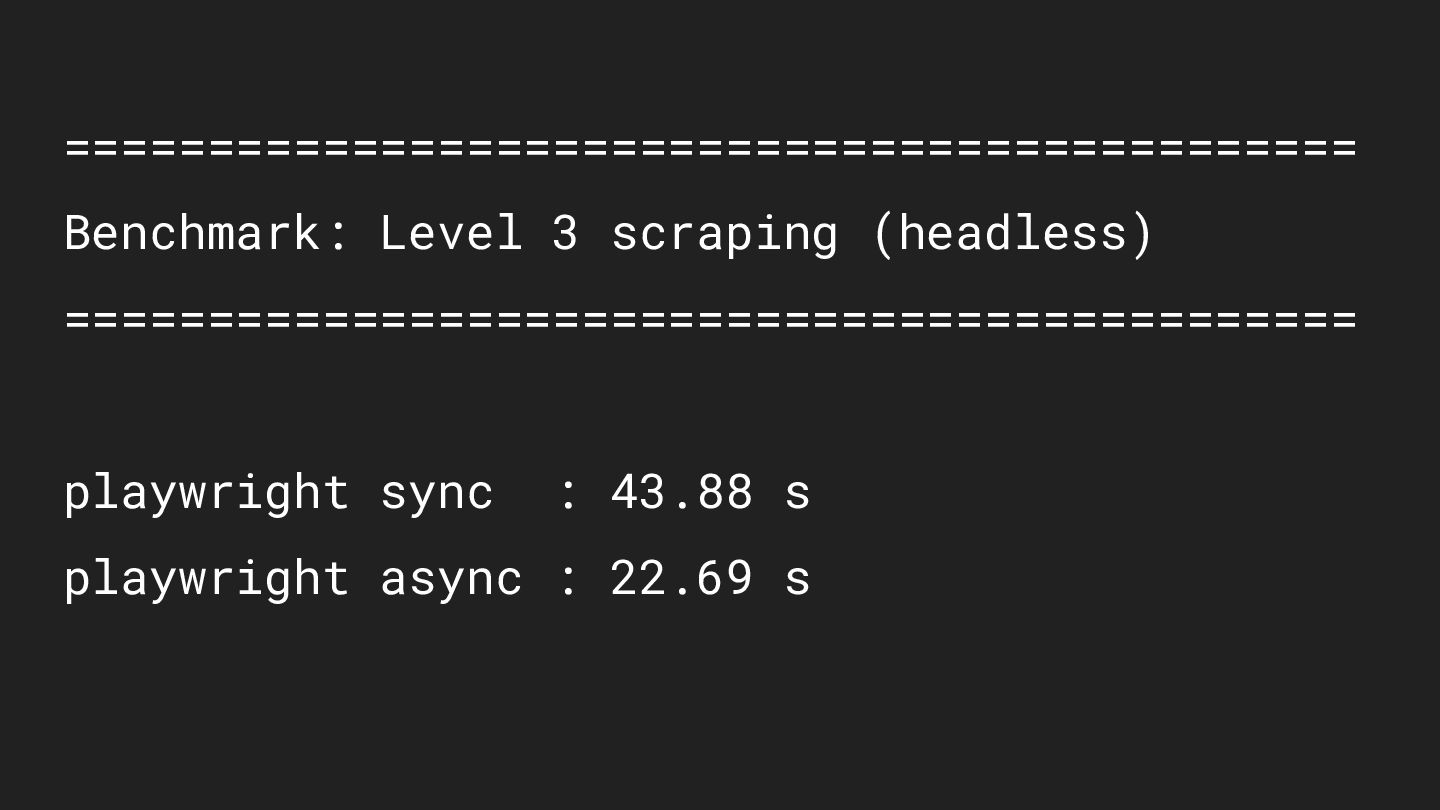
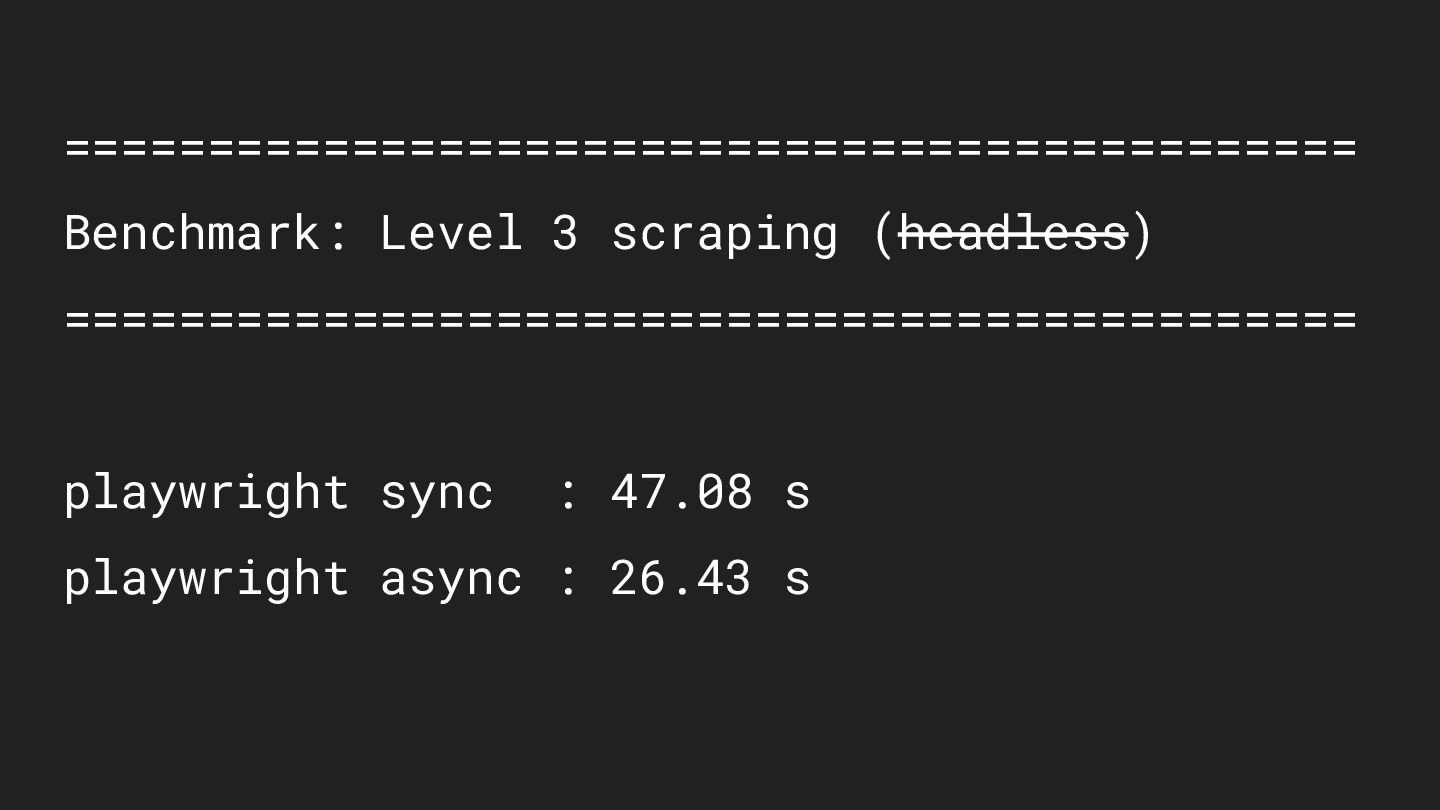
  19. Benchmark scrapingu (level 3) • Cíl: ◦ Porovnat režii browser-level

    přístupu oproti HTTP klientům. • Nástroj: • Playwright (Chromium) • Metriky: ◦ ⏱ celkový čas N requestů • Metodika: ◦ Playwright bez UI, jeden browser context, paralelní requesty.
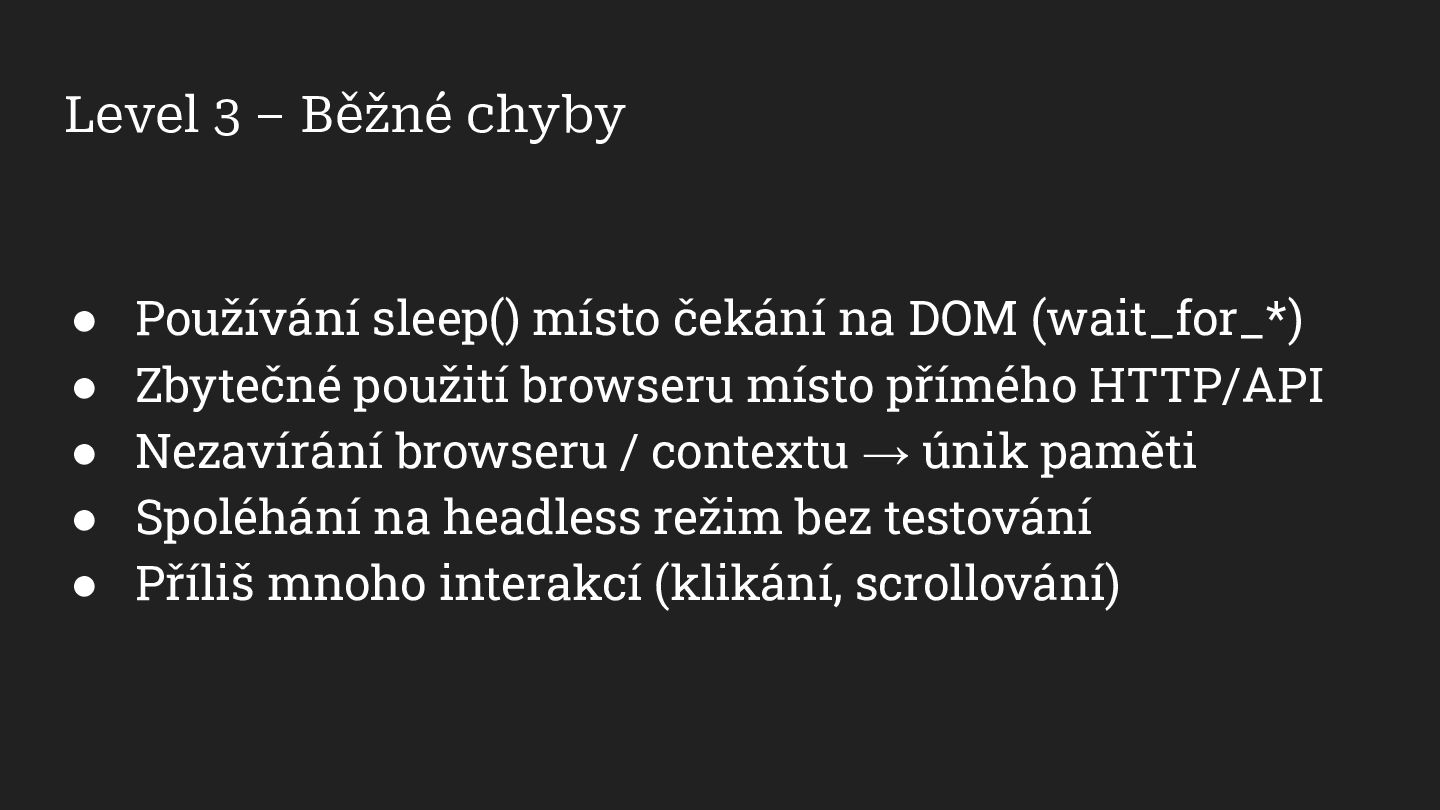
  20. Level 3 – Běžné chyby • • • • •

    Používání sleep() místo čekání na DOM (wait_for_*) Zbytečné použití browseru místo přímého HTTP/API Nezavírání browseru / contextu → únik paměti Spoléhání na headless režim bez testování Příliš mnoho interakcí (klikání, scrollování)
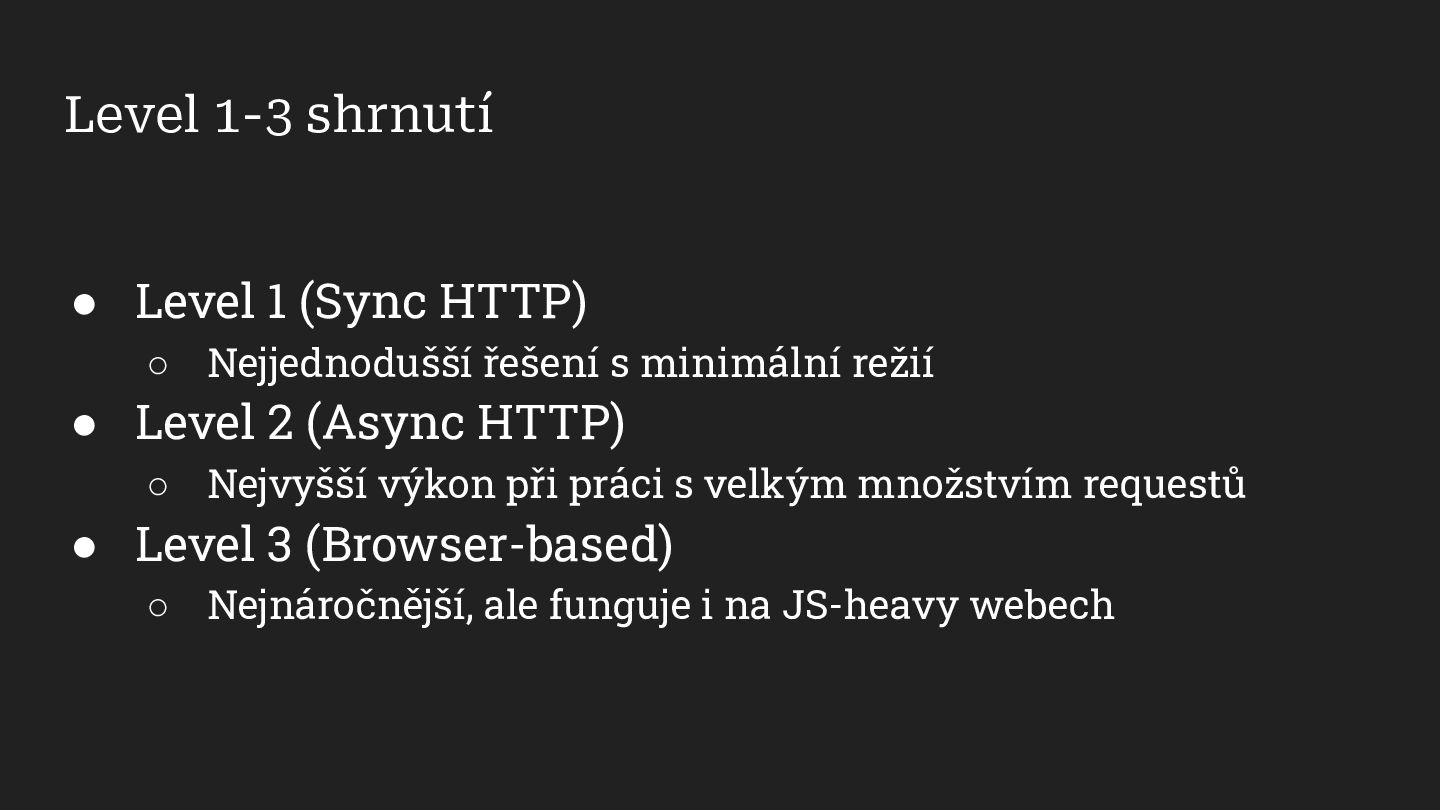
  21. Level 1-3 shrnutí • Level 1 (Sync HTTP) ◦ Nejjednodušší

    řešení s minimální režií • Level 2 (Async HTTP) ◦ Nejvyšší výkon při práci s velkým množstvím requestů • Level 3 (Browser-based) ◦ Nejnáročnější, ale funguje i na JS-heavy webech
  22. Browser-based vylepšení2 • Virtuální displej ◦ Headless → monitor odpojíme

    ◦ Xvfb → monitor předstíráme • User/browser fingerprinting • Simulace uživatelského chování ◦ myš / klávesnice • (Re)Captcha (challange) solving • Proxy & IP reputation
  23. Level 32 - Anti-bot & CAPTCHA Level 32 není jen

    o scrapingu, ale o tom nebýt rozpoznán…
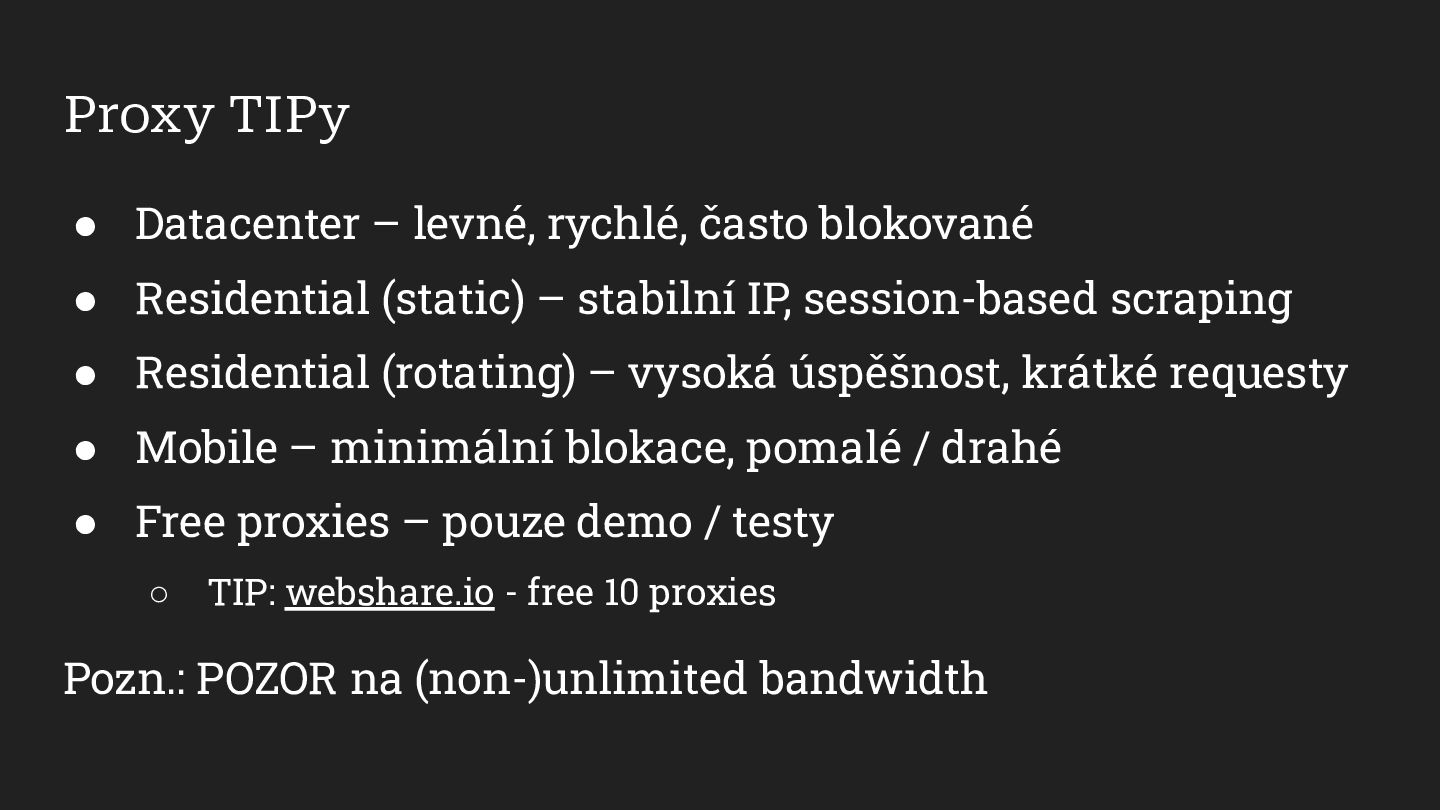
  24. Proxy TIPy • Datacenter – levné, rychlé, často blokované •

    Residential (static) – stabilní IP, session-based scraping • Residential (rotating) – vysoká úspěšnost, krátké requesty • Mobile – minimální blokace, pomalé / drahé • Free proxies – pouze demo / testy ◦ TIP: webshare.io - free 10 proxies Pozn.: POZOR na (non-)unlimited bandwidth