Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Lokální AI (development) na macOS: možnosti, př...

Sponsored · SiteGround - Reliable hosting with speed, security, and support you can count on. →

Lokální AI (development) na macOS: možnosti, přehled

V posledních dvou letech jsme si zvykli na cloudové AI služby jako ChatGPT, Claude nebo Gemini. Jsou výkonné, pohodlné a často představují nejlepší volbu pro každodenní práci. Současně ale rychle roste kvalita open-weight modelů, které lze provozovat lokálně na vlastním hardwaru bez nutnosti posílat data do cloudu.

Tato prezentace vznikla pro komunitní akci AI Snídaně a zaměřuje se na praktický pohled na lokální AI development především na platformě macOS. Nejde o akademický přehled ani benchmarkovou soutěž jednotlivých modelů. Cílem je ukázat, co je dnes reálně použitelné, jaké jsou výhody a limity lokálního provozu a jak vypadá jednoduchý vývojářský workflow.

V prezentaci se podíváme na:

- rozdíl mezi cloudovými AI službami a lokálním provozem modelů,
- přehled nástrojů jako LM Studio a OpenCode,
- rozdíl mezi open-source a open-weight modely,
- přehled současných modelových rodin jako Gemma, Qwen, Ministral, Devstral, případně větších modelů jako Kimi nebo GLM,
- vysvětlení základních pojmů jako počet parametrů, dense vs. MoE architektura, instruct/chat/coder varianty modelů, GGUF a MLX formáty nebo kvantizace Q4, Q5 a Q8,
- hardwarové požadavky pro lokální AI,
- rozdíly mezi Apple Silicon, NVIDIA CUDA a AMD ROCm ekosystémem,
- praktické zkušenosti s konfiguracemi 64 GB a 128 GB RAM,
- význam paměťové propustnosti a práce s kontextem,
- použití LM Studia jako lokálního AI klienta i OpenAI kompatibilního API serveru,
- propojení LM Studia s OpenCode pro lokální agentní vývoj,
- limity lokálních modelů při práci s aktuální dokumentací a webem,
- možnosti využití web search, MCP a RAG pro rozšíření schopností lokálních agentů.

Hlavní myšlenka celé prezentace je jednoduchá:

Lokální AI už dnes není jen hračka pro nadšence. Pro řadu vývojářských scénářů je plně použitelná. Je však důležité rozumět jejím limitům, správně zvolit hardware a mít realistická očekávání.

Avatar for Martin Hlaváč

Martin Hlaváč

April 06, 2026

More Decks by Martin Hlaváč

Other Decks in Programming

Transcript

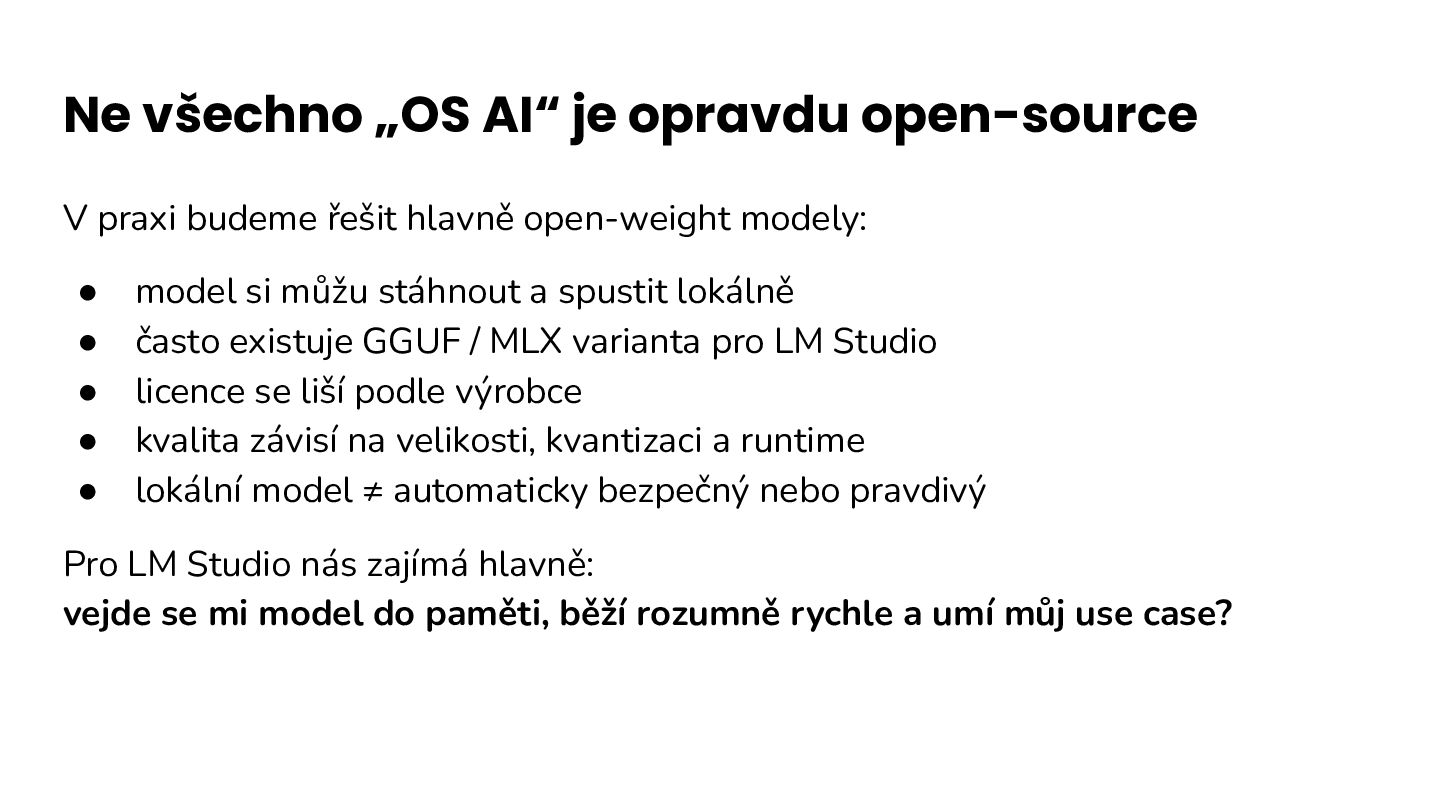
  1. Ne všechno „OS AI“ je opravdu open-source V praxi budeme

    řešit hlavně open-weight modely: • • • • • model si můžu stáhnout a spustit lokálně často existuje GGUF / MLX varianta pro LM Studio licence se liší podle výrobce kvalita závisí na velikosti, kvantizaci a runtime lokální model ≠ automaticky bezpečný nebo pravdivý Pro LM Studio nás zajímá hlavně: vejde se mi model do paměti, běží rozumně rychle a umí můj use case?
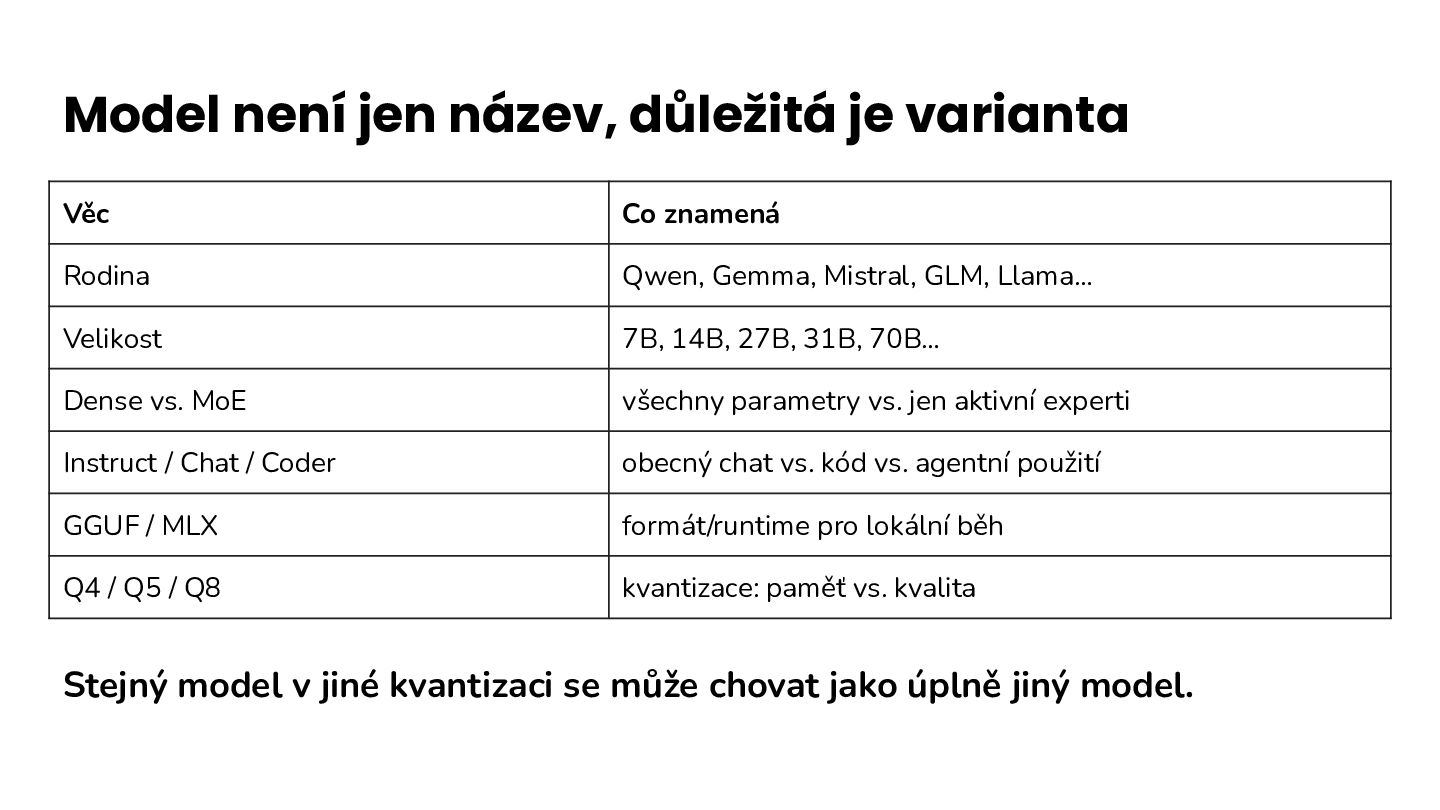
  2. Model není jen název, důležitá je varianta Věc Co znamená

    Rodina Qwen, Gemma, Mistral, GLM, Llama… Velikost 7B, 14B, 27B, 31B, 70B… Dense vs. MoE všechny parametry vs. jen aktivní experti Instruct / Chat / Coder obecný chat vs. kód vs. agentní použití GGUF / MLX formát/runtime pro lokální běh Q4 / Q5 / Q8 kvantizace: paměť vs. kvalita Stejný model v jiné kvantizaci se může chovat jako úplně jiný model.
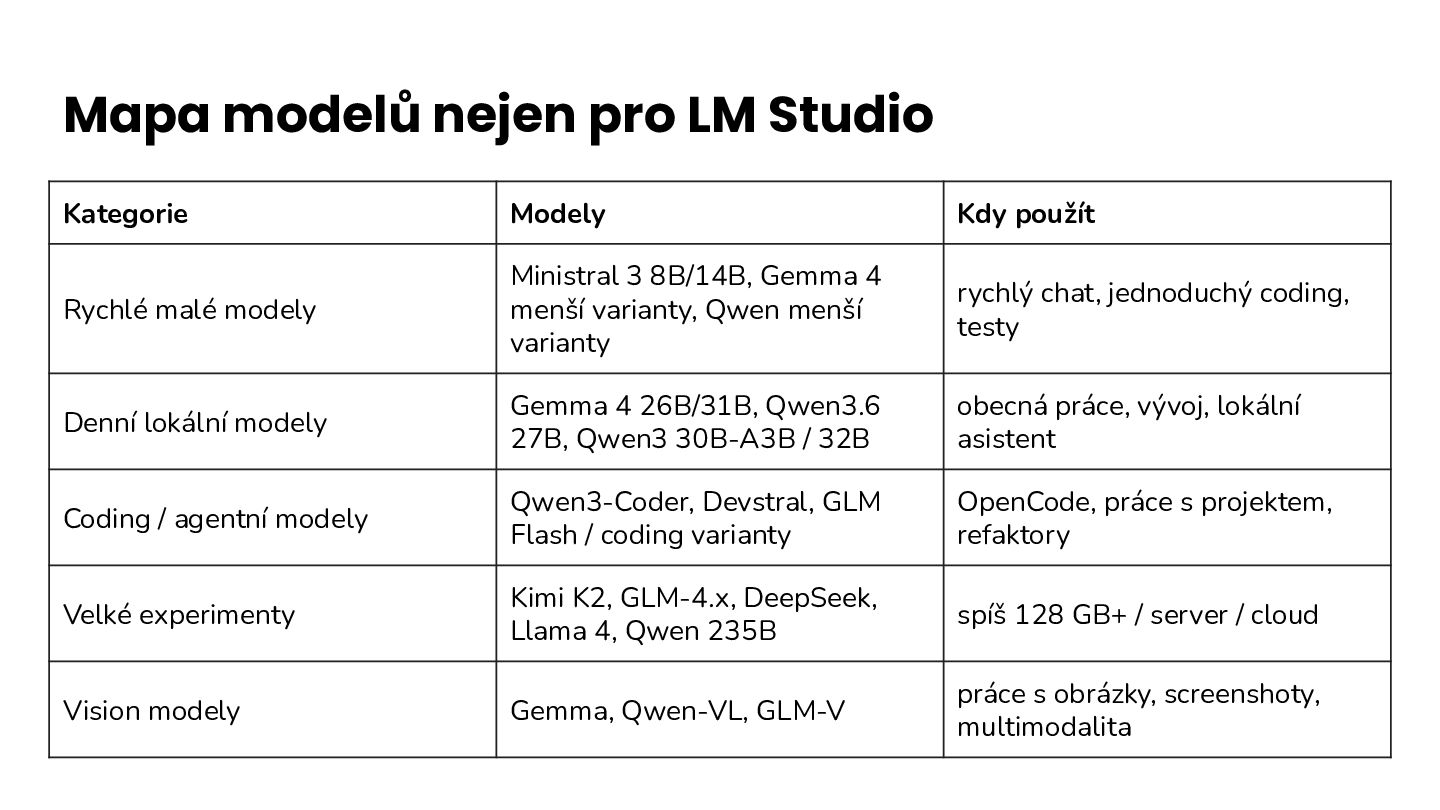
  3. Mapa modelů nejen pro LM Studio Kategorie Modely Kdy použít

    Rychlé malé modely Ministral 3 8B/14B, Gemma 4 menší varianty, Qwen menší varianty rychlý chat, jednoduchý coding, testy Denní lokální modely Gemma 4 26B/31B, Qwen3.6 27B, Qwen3 30B-A3B / 32B obecná práce, vývoj, lokální asistent Coding / agentní modely Qwen3-Coder, Devstral, GLM Flash / coding varianty OpenCode, práce s projektem, refaktory Velké experimenty Kimi K2, GLM-4.x, DeepSeek, Llama 4, Qwen 235B spíš 128 GB+ / server / cloud Vision modely Gemma, Qwen-VL, GLM-V práce s obrázky, screenshoty, multimodalita
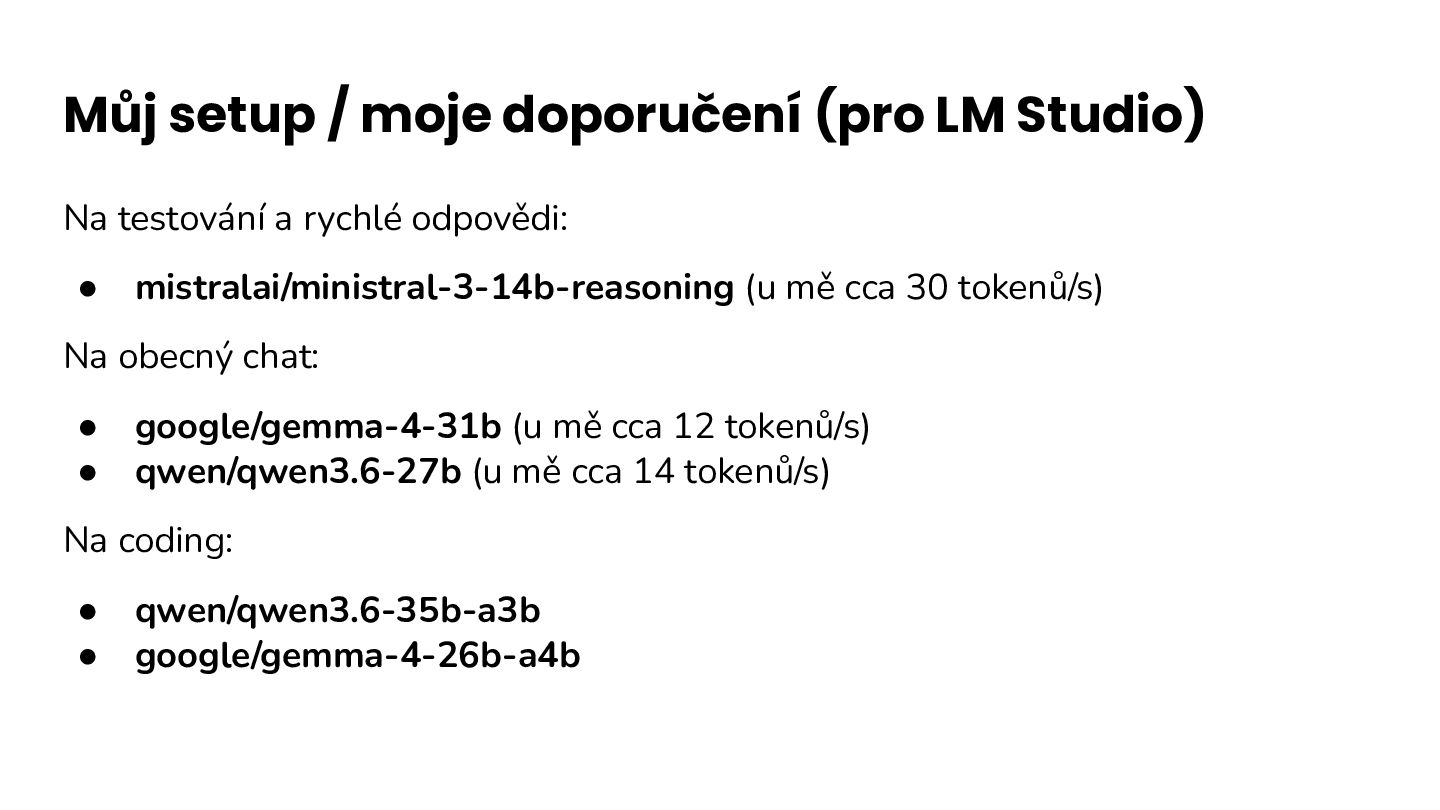
  4. Můj setup / moje doporučení (pro LM Studio) Na testování

    a rychlé odpovědi: • mistralai/ministral-3-14b-reasoning (u mě cca 30 tokenů/s) Na obecný chat: • • google/gemma-4-31b (u mě cca 12 tokenů/s) qwen/qwen3.6-27b (u mě cca 14 tokenů/s) Na coding: • • qwen/qwen3.6-35b-a3b google/gemma-4-26b-a4b
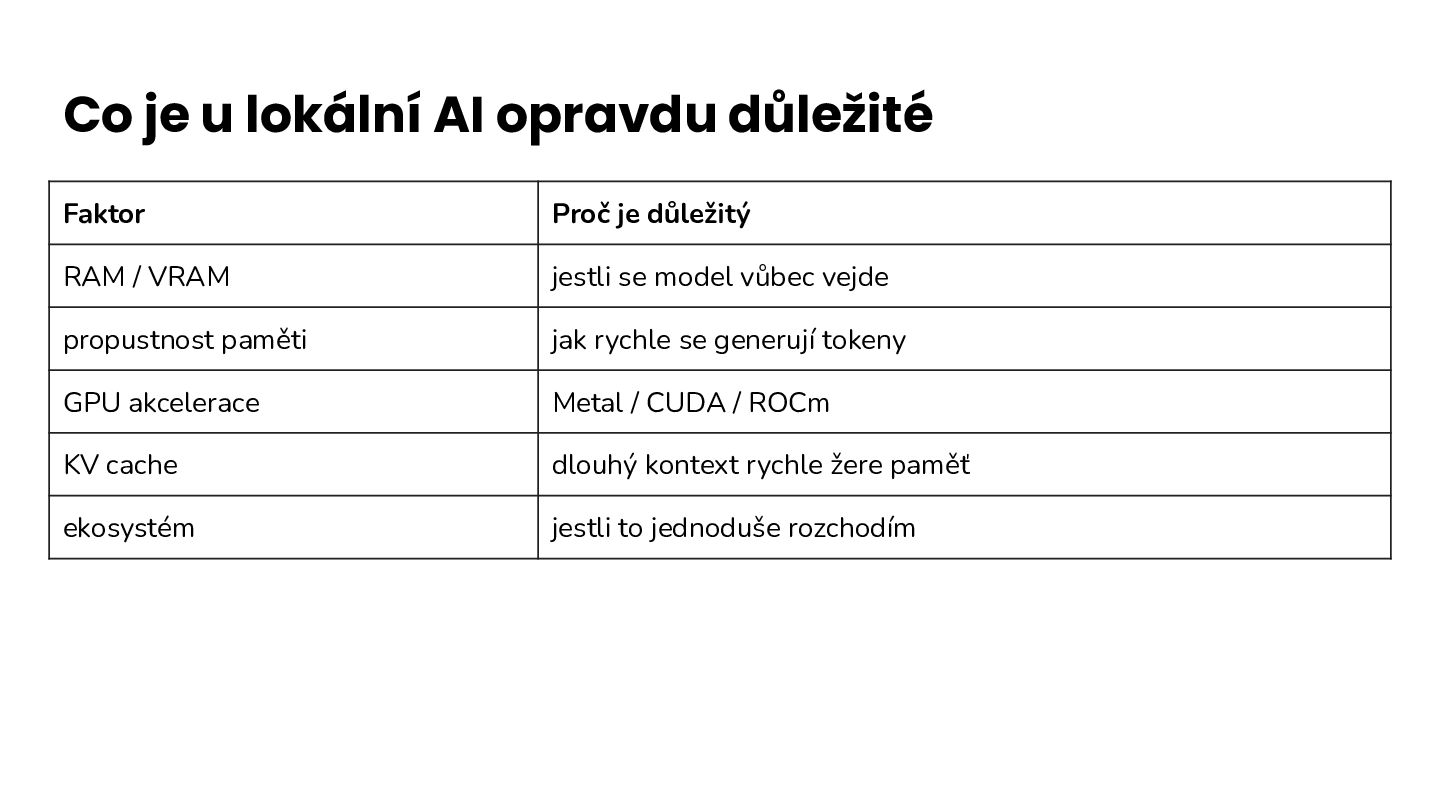
  5. Co je u lokální AI opravdu důležité Faktor Proč je

    důležitý RAM / VRAM jestli se model vůbec vejde propustnost paměti jak rychle se generují tokeny GPU akcelerace Metal / CUDA / ROCm KV cache dlouhý kontext rychle žere paměť ekosystém jestli to jednoduše rozchodím
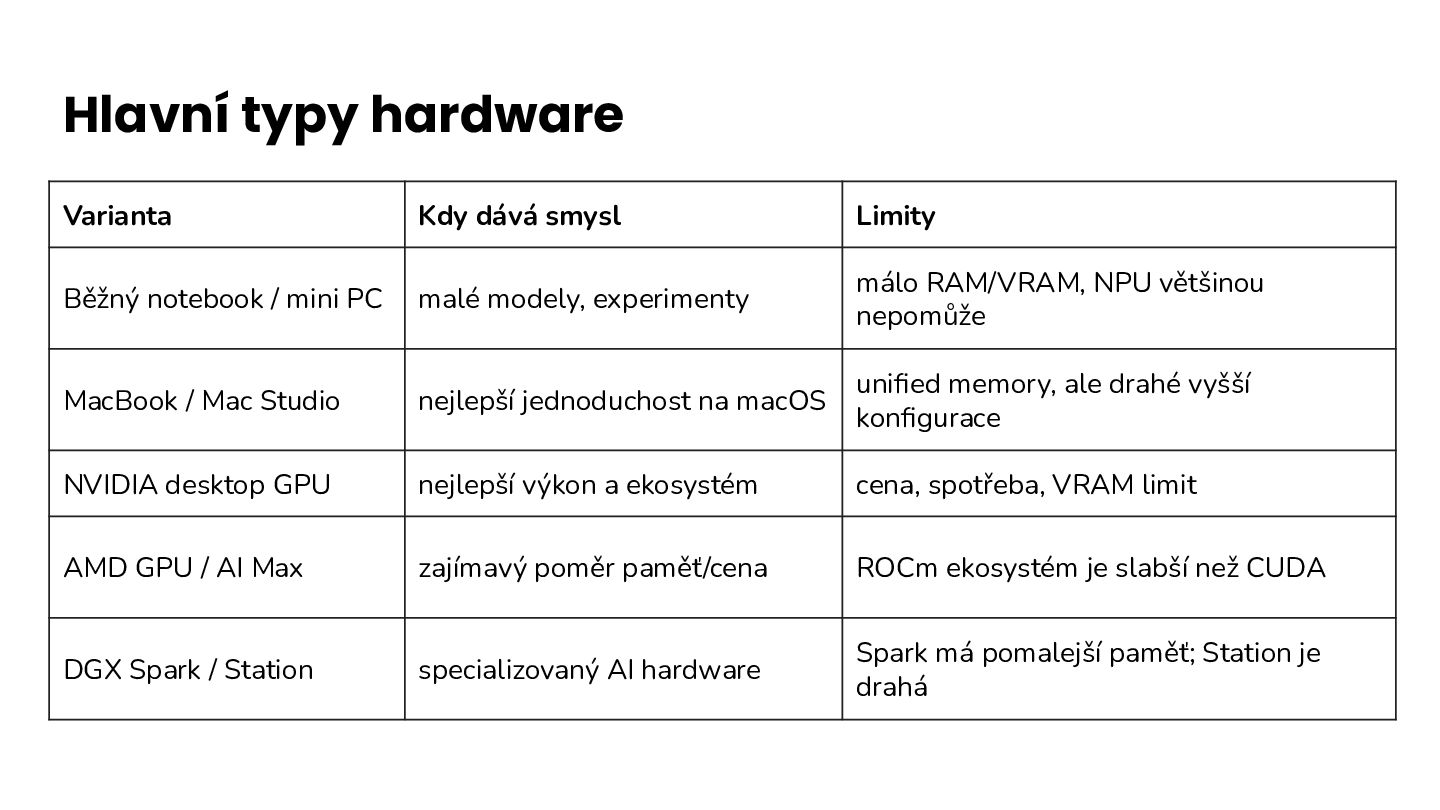
  6. Hlavní typy hardware Varianta Kdy dává smysl Limity Běžný notebook

    / mini PC malé modely, experimenty málo RAM/VRAM, NPU většinou nepomůže MacBook / Mac Studio nejlepší jednoduchost na macOS unified memory, ale drahé vyšší konfigurace NVIDIA desktop GPU nejlepší výkon a ekosystém cena, spotřeba, VRAM limit AMD GPU / AI Max zajímavý poměr paměť/cena ROCm ekosystém je slabší než CUDA DGX Spark / Station specializovaný AI hardware Spark má pomalejší paměť; Station je drahá
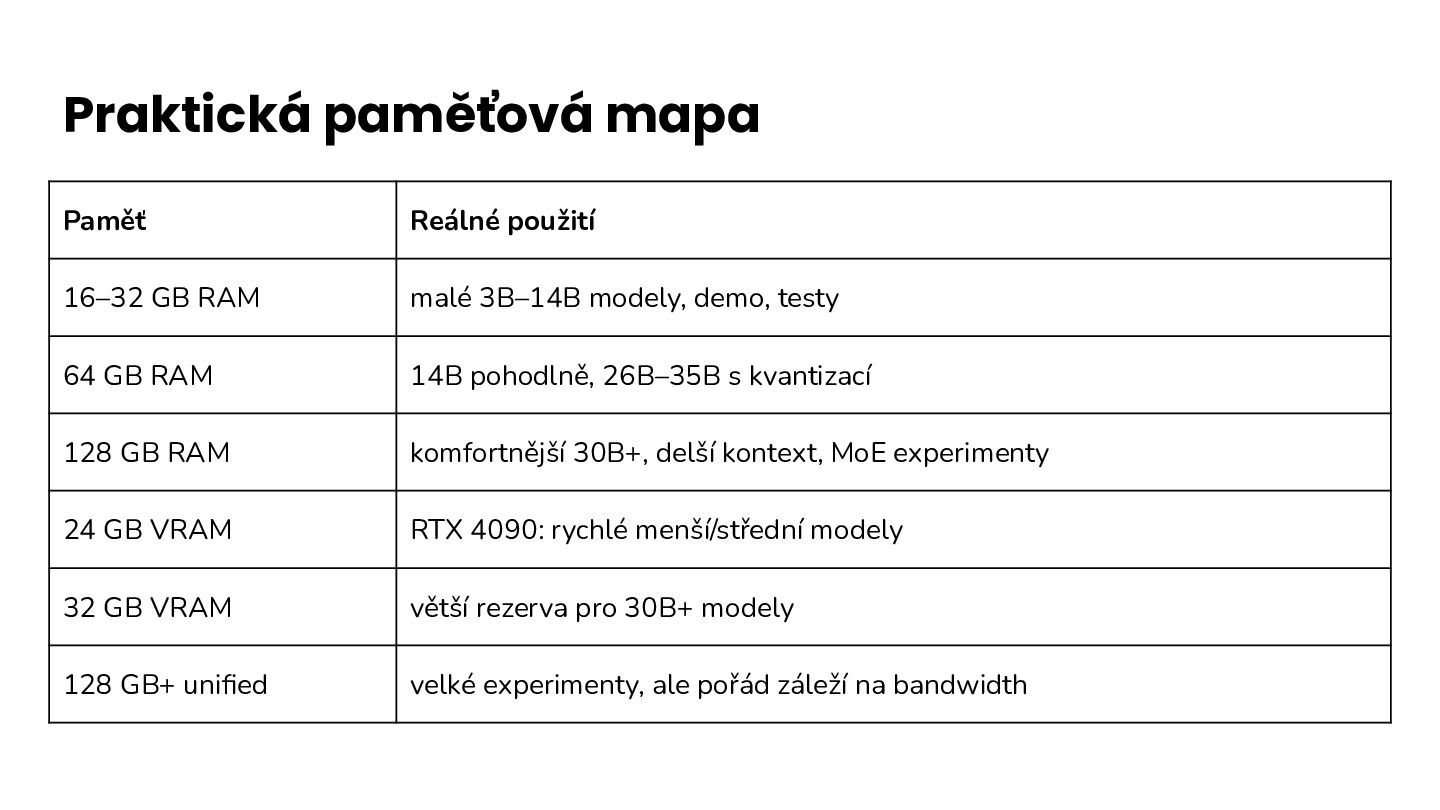
  7. Praktická paměťová mapa Paměť Reálné použití 16–32 GB RAM malé

    3B–14B modely, demo, testy 64 GB RAM 14B pohodlně, 26B–35B s kvantizací 128 GB RAM komfortnější 30B+, delší kontext, MoE experimenty 24 GB VRAM RTX 4090: rychlé menší/střední modely 32 GB VRAM větší rezerva pro 30B+ modely 128 GB+ unified velké experimenty, ale pořád záleží na bandwidth
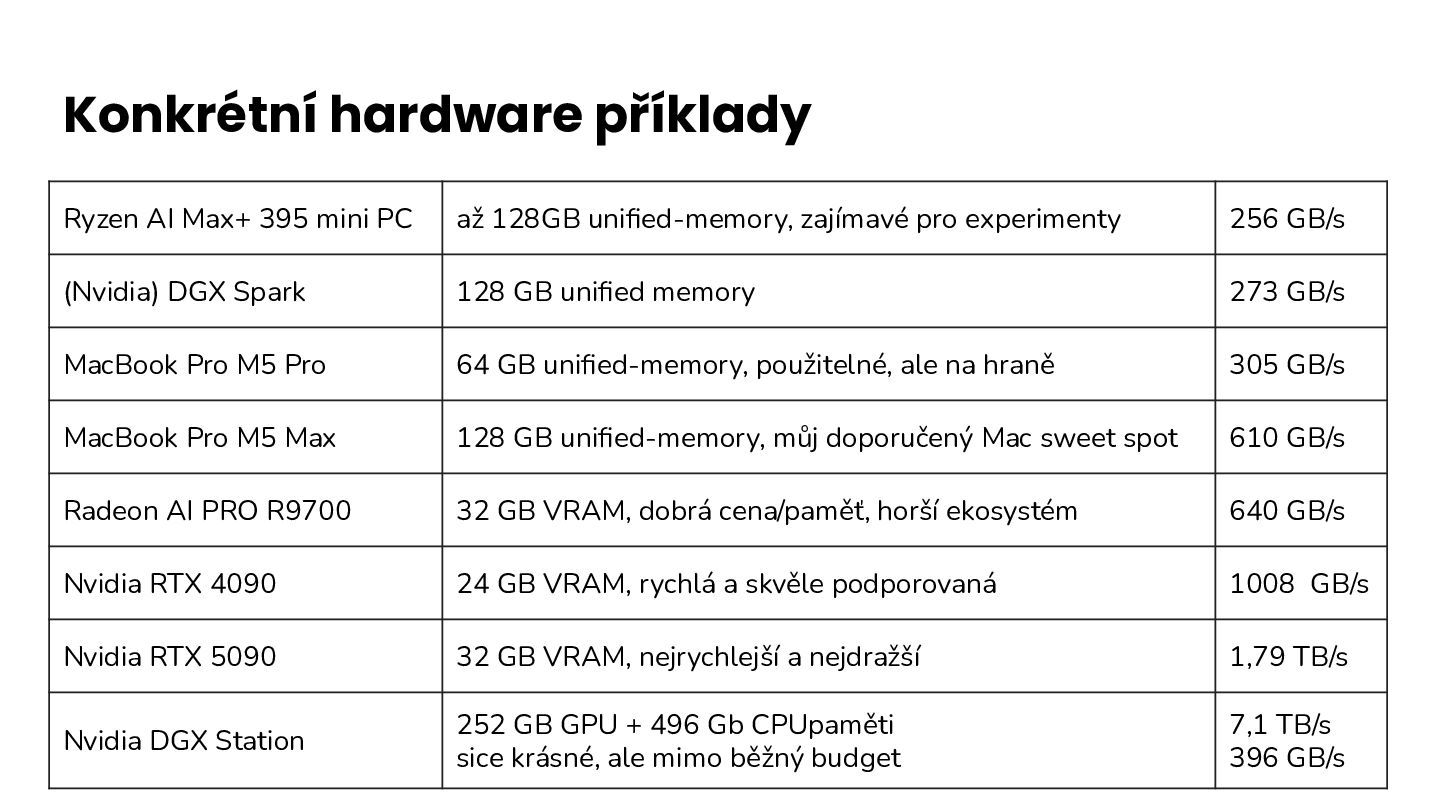
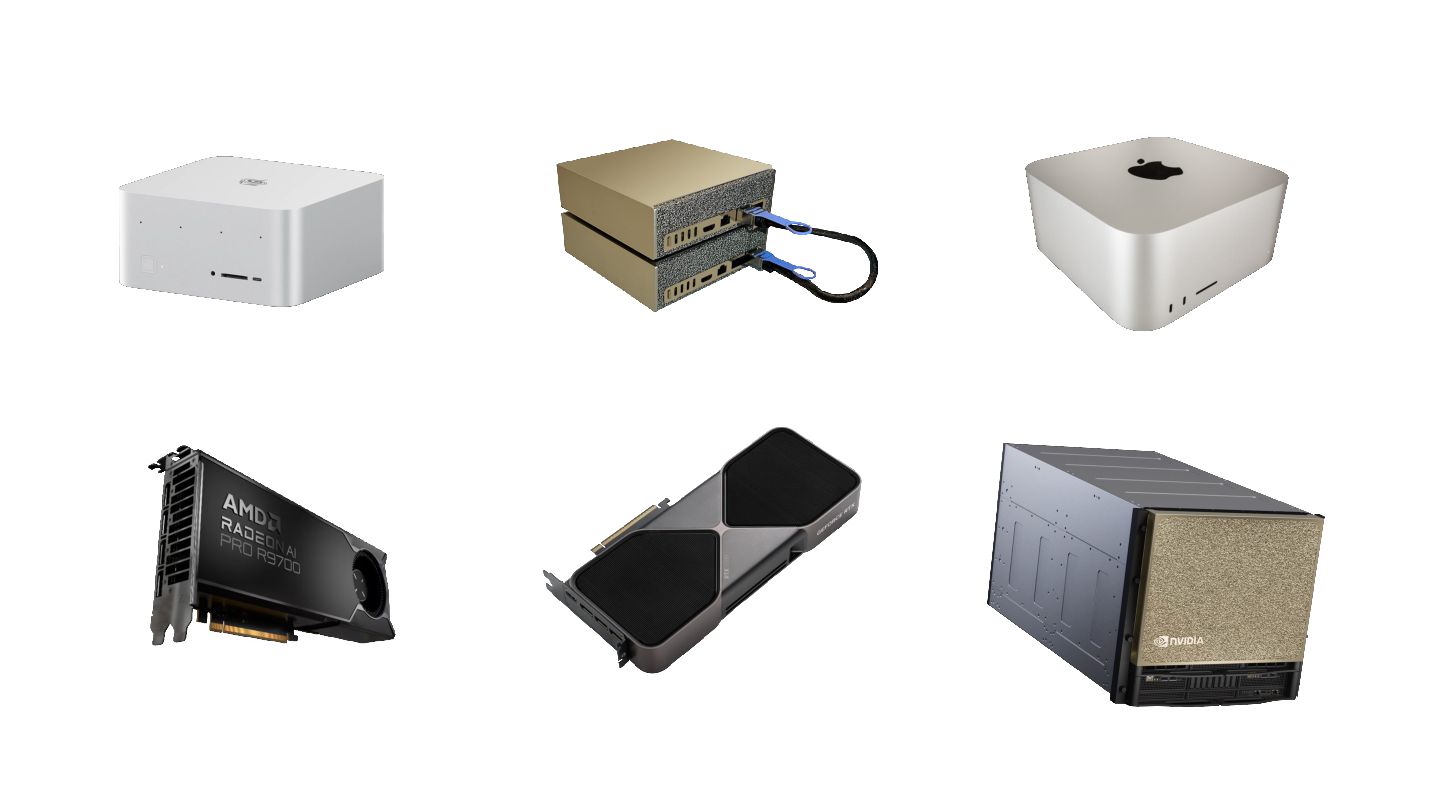
  8. Konkrétní hardware příklady Ryzen AI Max+ 395 mini PC až

    128GB unified-memory, zajímavé pro experimenty 256 GB/s (Nvidia) DGX Spark 128 GB unified memory 273 GB/s MacBook Pro M5 Pro 64 GB unified-memory, použitelné, ale na hraně 305 GB/s MacBook Pro M5 Max 128 GB unified-memory, můj doporučený Mac sweet spot 610 GB/s Radeon AI PRO R9700 32 GB VRAM, dobrá cena/paměť, horší ekosystém 640 GB/s Nvidia RTX 4090 24 GB VRAM, rychlá a skvěle podporovaná 1008 GB/s Nvidia RTX 5090 32 GB VRAM, nejrychlejší a nejdražší 1,79 TB/s Nvidia DGX Station 252 GB GPU + 496 Gb CPUpaměti sice krásné, ale mimo běžný budget 7,1 TB/s 396 GB/s
  9. Nestačí, že se model „vejde“ Paměť nespotřebuje jen model -

    celková paměť: • • • • • • model KV cache / kontext LM Studio runtime OS + background procesy IDE / browser / Docker / build + nějaká reálná rezerva Praktická pointa • • • • • model může jít načíst, ale kontext už ne delší kontext dramaticky zvyšuje nároky na KV cache agentní vývoj spotřebuje kontext velmi rychle macOS + IDE + browser si vezmou výraznou část RAM bez rezervy začne swap, throttling a celé demo se rozpadne
  10. “Lokální AI není jen o tom, jestli model spustím.” →

    “Je to o tom, jestli mi po spuštění zůstane prostor na práci.”
  11. LM Studio jako lokální AI aplikace V LM Studiu typicky

    řeším: • • • • • • najít a stáhnout model zvolit vhodnou kvantizaci nastavit context length, či K/V cache pustit lokální chat sledovat tokens/s a paměť otestovat různé modely na stejném promptu LM Studio je dobré hlavně tím, že snižuje bariéru vstupu. Neřeším ručně llama.cpp, parametry v terminálu ani vlastní server. Začnu přes chat a až když model dává smysl, použiju ho jako lokální API.
  12. LM Studio jako lokální server LM Studio umí běžet jako

    lokální server: • • • • LM Studio → Developer tab → Start server → http://127.0.0.1:1234/v1 Použití: • • • • • vlastní skripty lokální prototypy OpenAI-compatible klienti coding agenti OpenCode / Codex-like workflow
  13. Praktická konfigurace OpenCode • • • • Konkrétní model id

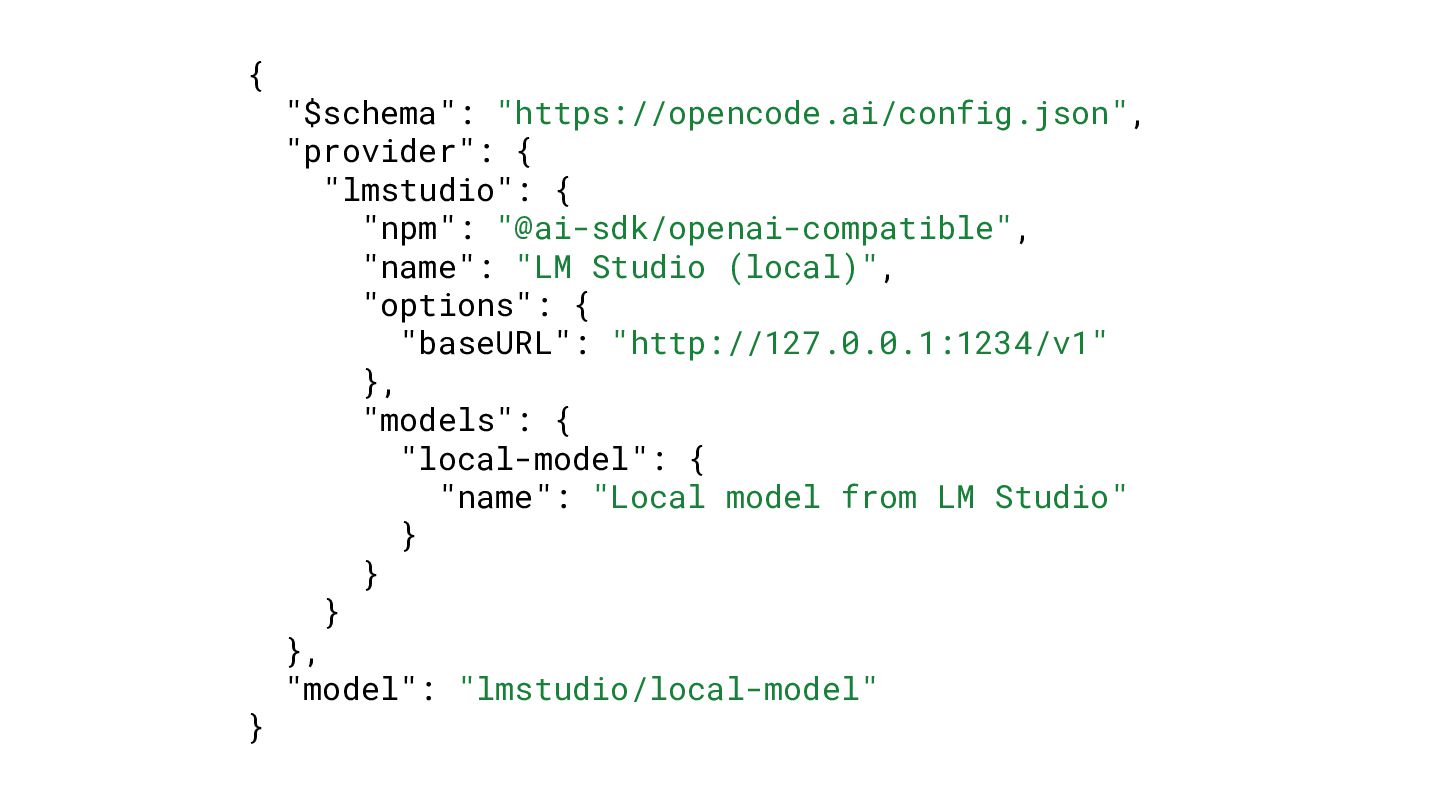
    musí odpovídat tomu, co LM Studio vystavuje přes lokální server. V praxi je dobré nejdřív zavolat /v1/models, zkopírovat přesný identifikátor modelu a až potom ho dát do konfigurace OpenCode. OpenCode konfigurace pracuje s provider, model a případně small_model; má také nastavení permissions, compaction a watcher ignore patterns, což se hodí pro reálnou práci nad projektem. Ukázka principu opencode.json:
  14. { } "$schema": "https://opencode.ai/config.json", "provider": { "lmstudio": { "npm": "@ai-sdk/openai-compatible",

    "name": "LM Studio (local)", "options": { "baseURL": "http://127.0.0.1:1234/v1" }, "models": { "local-model": { "name": "Local model from LM Studio" } } } }, "model": "lmstudio/local-model"
  15. OpenCode nad lokálním modelem Typické použití: • • • •

    • • vysvětli soubor najdi chybu navrhni refaktor napiš test uprav jeden konkrétní modul ukaž diff před aplikováním změny Lokální coding agent je nejlepší na malé, jasně ohraničené úlohy. OpenCode podporuje lokální modely nejen z LM Studio serveru.
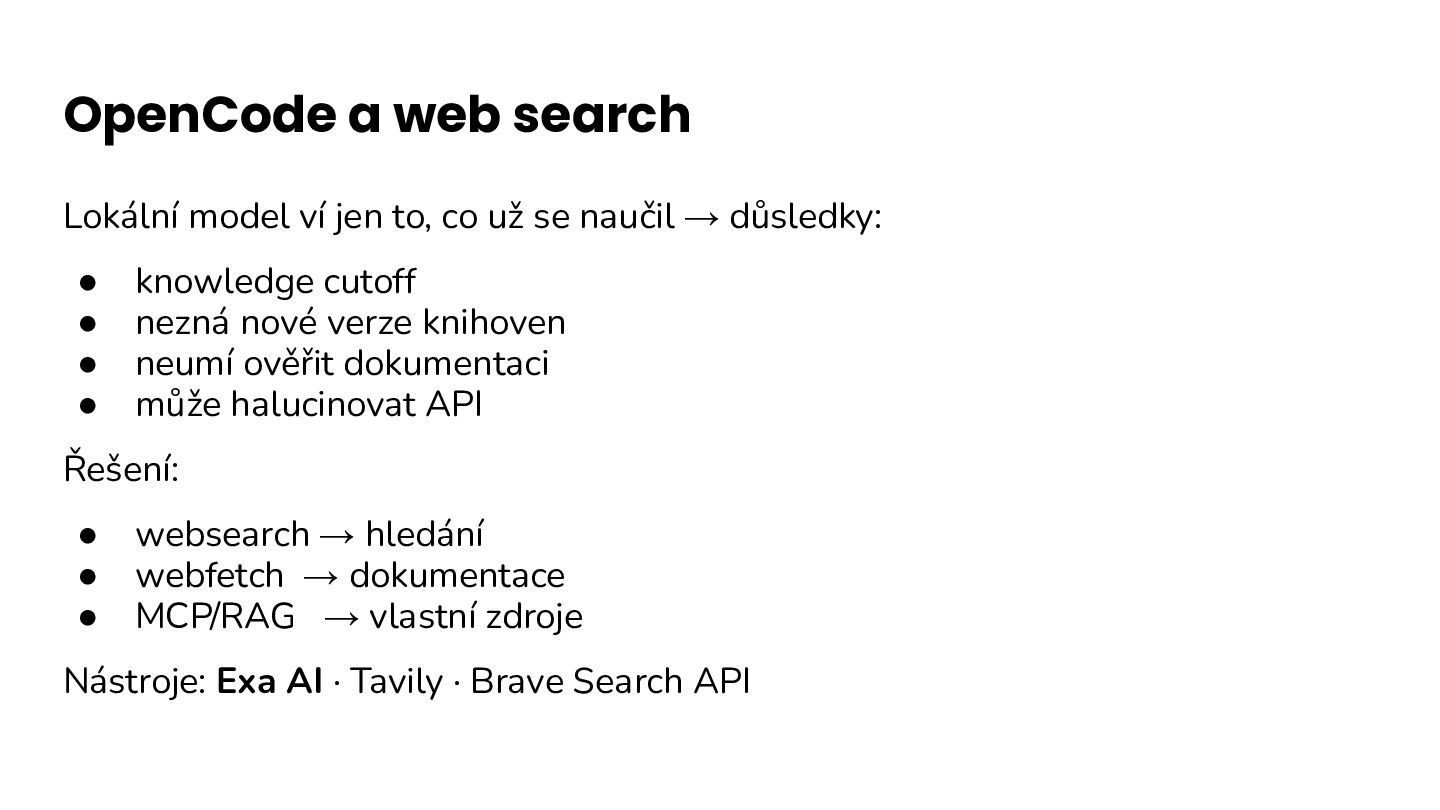
  16. OpenCode a web search Lokální model ví jen to, co

    už se naučil → důsledky: • • • • knowledge cutoff nezná nové verze knihoven neumí ověřit dokumentaci může halucinovat API Řešení: • • • websearch → hledání webfetch → dokumentace MCP/RAG → vlastní zdroje Nástroje: Exa AI · Tavily · Brave Search API