Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
OTel eBPF Profiler Deep Dive 〜eBPF でスタックトレースを集め...
Search
Mitsuhiro Tanda
November 06, 2026
220
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
OTel eBPF Profiler Deep Dive 〜eBPF でスタックトレースを集める仕組み〜
Mitsuhiro Tanda
November 06, 2026
More Decks by Mitsuhiro Tanda
See All by Mitsuhiro Tanda
CloudWatch Read Adapter - A selective archive for CloudWatch metrics
mtanda
0
8
Grafanaが支えるプロダクト開発 - 開発から本番運用までをサポートする基盤
mtanda
1
440
OBI Deep Dive — How Is Automatic Instrumentation Actually Implemented?
mtanda
0
26
OBI Deep Dive 〜どのようにして自動計装は実現されているのか?〜
mtanda
0
220
低コストなログ基盤を支えるアーキテクチャ 〜Grafana Lokiの設計思想〜
mtanda
2
5.1k
Life with Grafana
mtanda
0
1k
Featured
See All Featured
Measuring & Analyzing Core Web Vitals
bluesmoon
9
1.1k
How to optimise 3,500 product descriptions for ecommerce in one day using ChatGPT
katarinadahlin
PRO
3
3.9k
SEO for Brand Visibility & Recognition
aleyda
0
4.9k
Exploring the relationship between traditional SERPs and Gen AI search
raygrieselhuber
PRO
4
4.4k
Paper Plane (Part 1)
katiecoart
PRO
2
12k
Designing for Performance
lara
612
70k
Producing Creativity
orderedlist
PRO
348
41k
Technical Leadership for Architectural Decision Making
baasie
3
640
Odyssey Design
rkendrick25
PRO
2
930
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
Rebuilding a faster, lazier Slack
samanthasiow
85
9.7k
Cheating the UX When There Is Nothing More to Optimize - PixelPioneers
stephaniewalter
287
14k
Transcript
OTel eBPF Profiler Deep Dive 〜eBPF でスタックトレースを集める仕組み〜 eBPF Japan Meetup
#8 Staff Developer Advocate, Grafana Labs 反田光洋
自己紹介 反田 光洋 (たんだ みつひろ) @mtanda Staff Developer Advocate Grafana
Labs ▶ 約 10 年来の Grafana / Prometheus ユーザー ▶ Grafana 初期バージョンからのコントリビューター
1. CPU プロファイラの仕組み
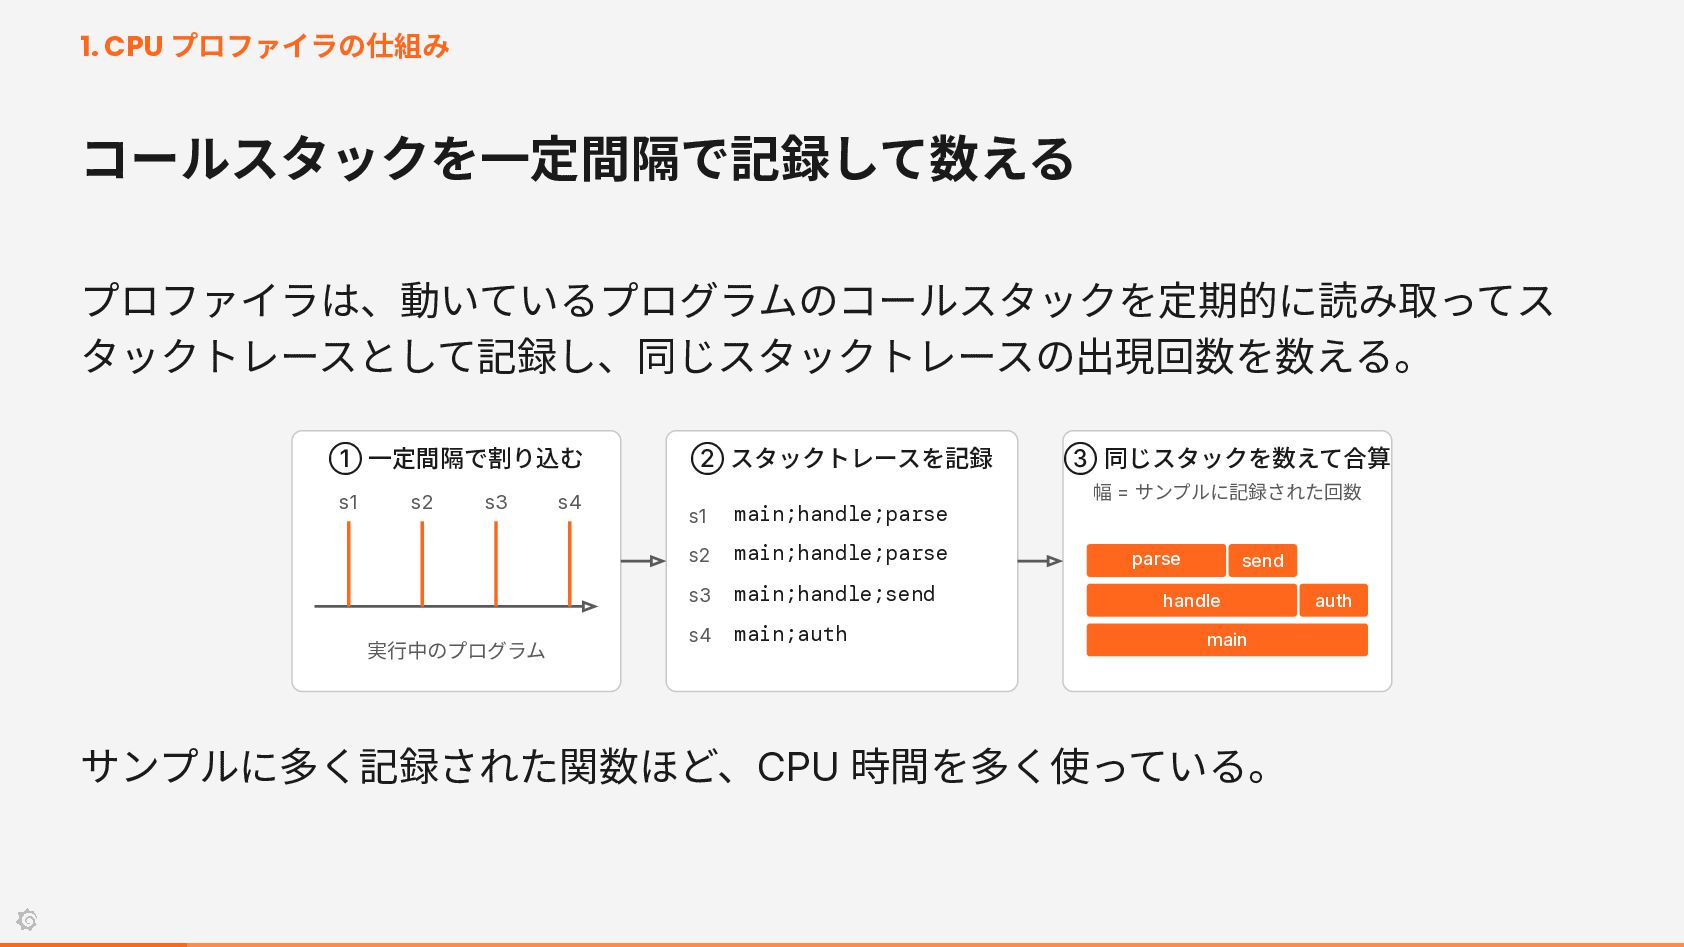
1. CPU プロファイラの仕組み コールスタックを一定間隔で記録して数える プロファイラは、動いているプログラムのコールスタックを定期的に読み取ってス タックトレースとして記録し、同じスタックトレースの出現回数を数える。 ① 一定間隔で割り込む s1 s2
s3 実行中のプログラム s4 ② スタックトレースを記録 s1 main;handle;parse s2 main;handle;parse s3 main;handle;send s4 main;auth ③ 同じスタックを数えて合算 幅 = サンプルに記録された回数 parse send handle main サンプルに多く記録された関数ほど、CPU 時間を多く使っている。 auth
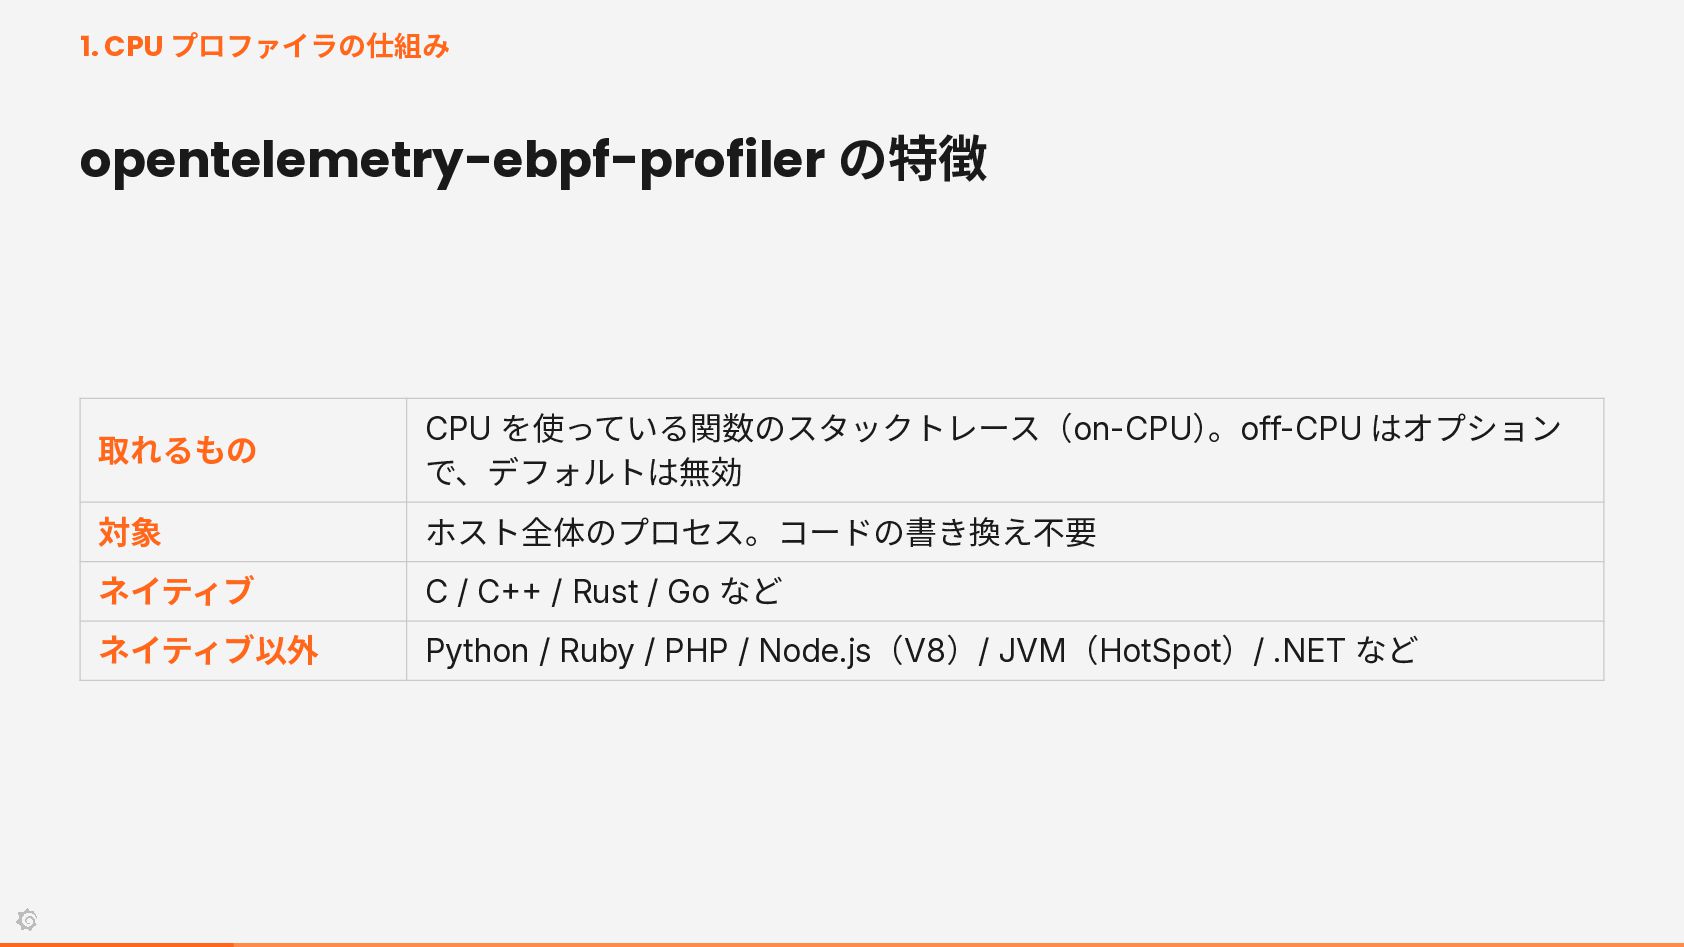
1. CPU プロファイラの仕組み opentelemetry-ebpf-profiler の特徴 取れるもの CPU を使っている関数のスタックトレース(on-CPU)。off-CPU はオプション で、デフォルトは無効
対象 ホスト全体のプロセス。コードの書き換え不要 ネイティブ C / C++ / Rust / Go など ネイティブ以外 Python / Ruby / PHP / Node.js(V8)/ JVM(HotSpot)/ .NET など
2. 既存の方式との比較
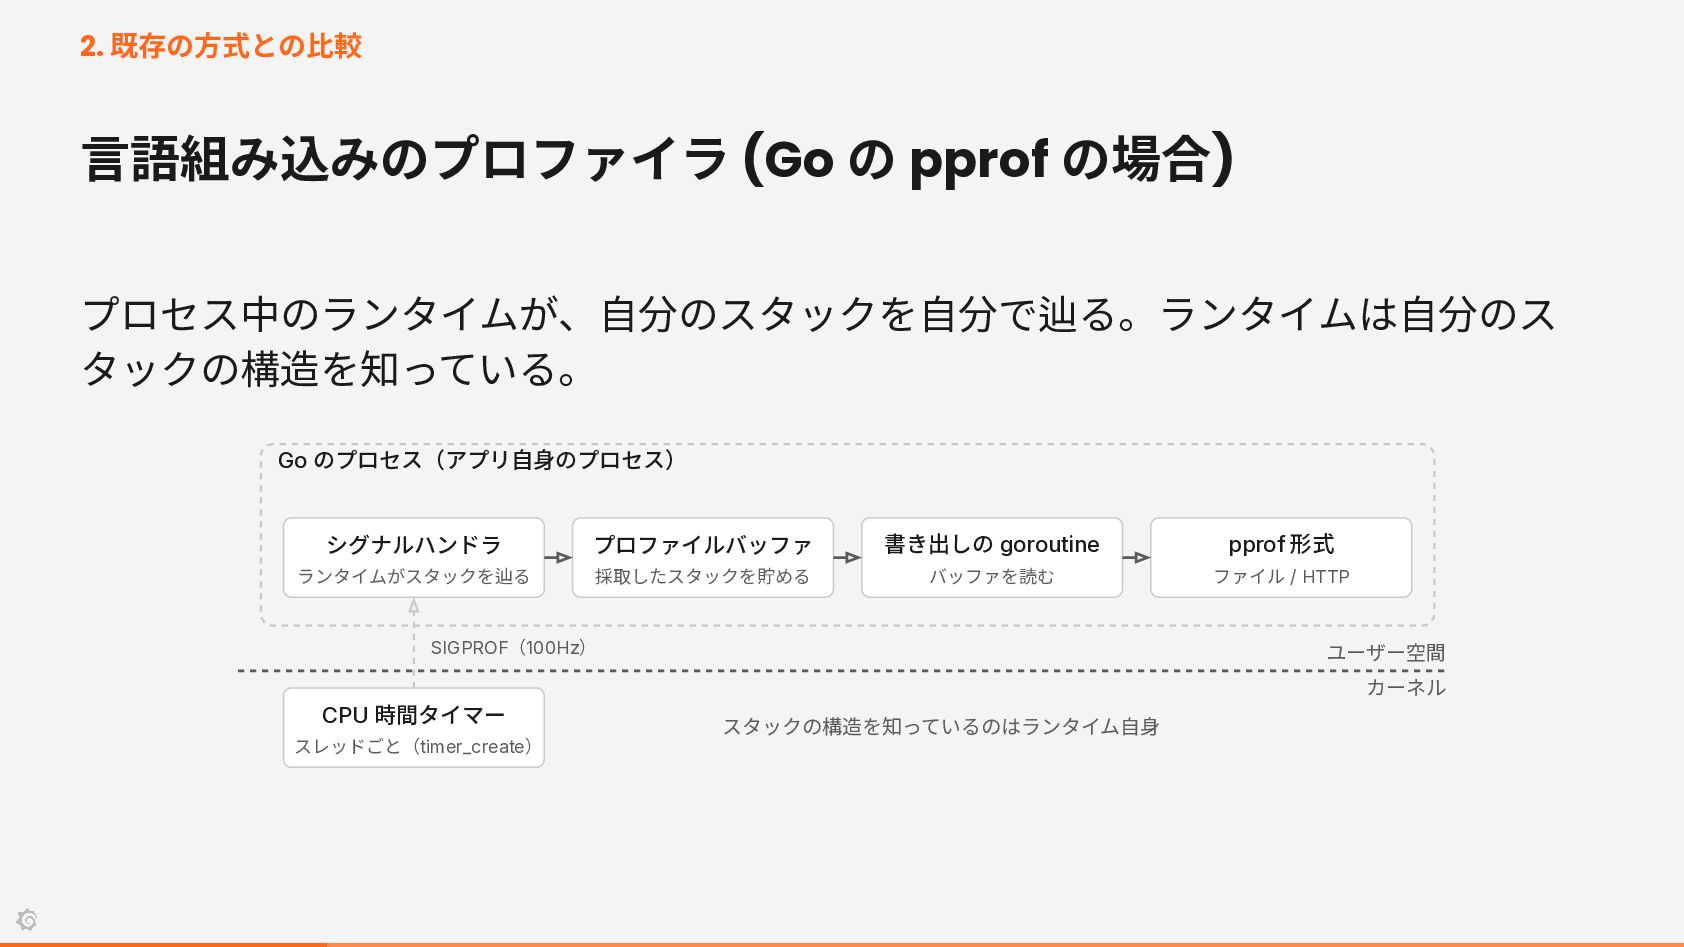
2. 既存の方式との比較 言語組み込みのプロファイラ (Go の pprof の場合) プロセス中のランタイムが、自分のスタックを自分で辿る。ランタイムは自分のス タックの構造を知っている。 Go
のプロセス(アプリ自身のプロセス) シグナルハンドラ プロファイルバッファ 書き出しの goroutine pprof 形式 ランタイムがスタックを辿る 採取したスタックを貯める バッファを読む ファイル / HTTP SIGPROF(100Hz) ユーザー空間 カーネル CPU 時間タイマー スレッドごと(timer_create) スタックの構造を知っているのはランタイム自身
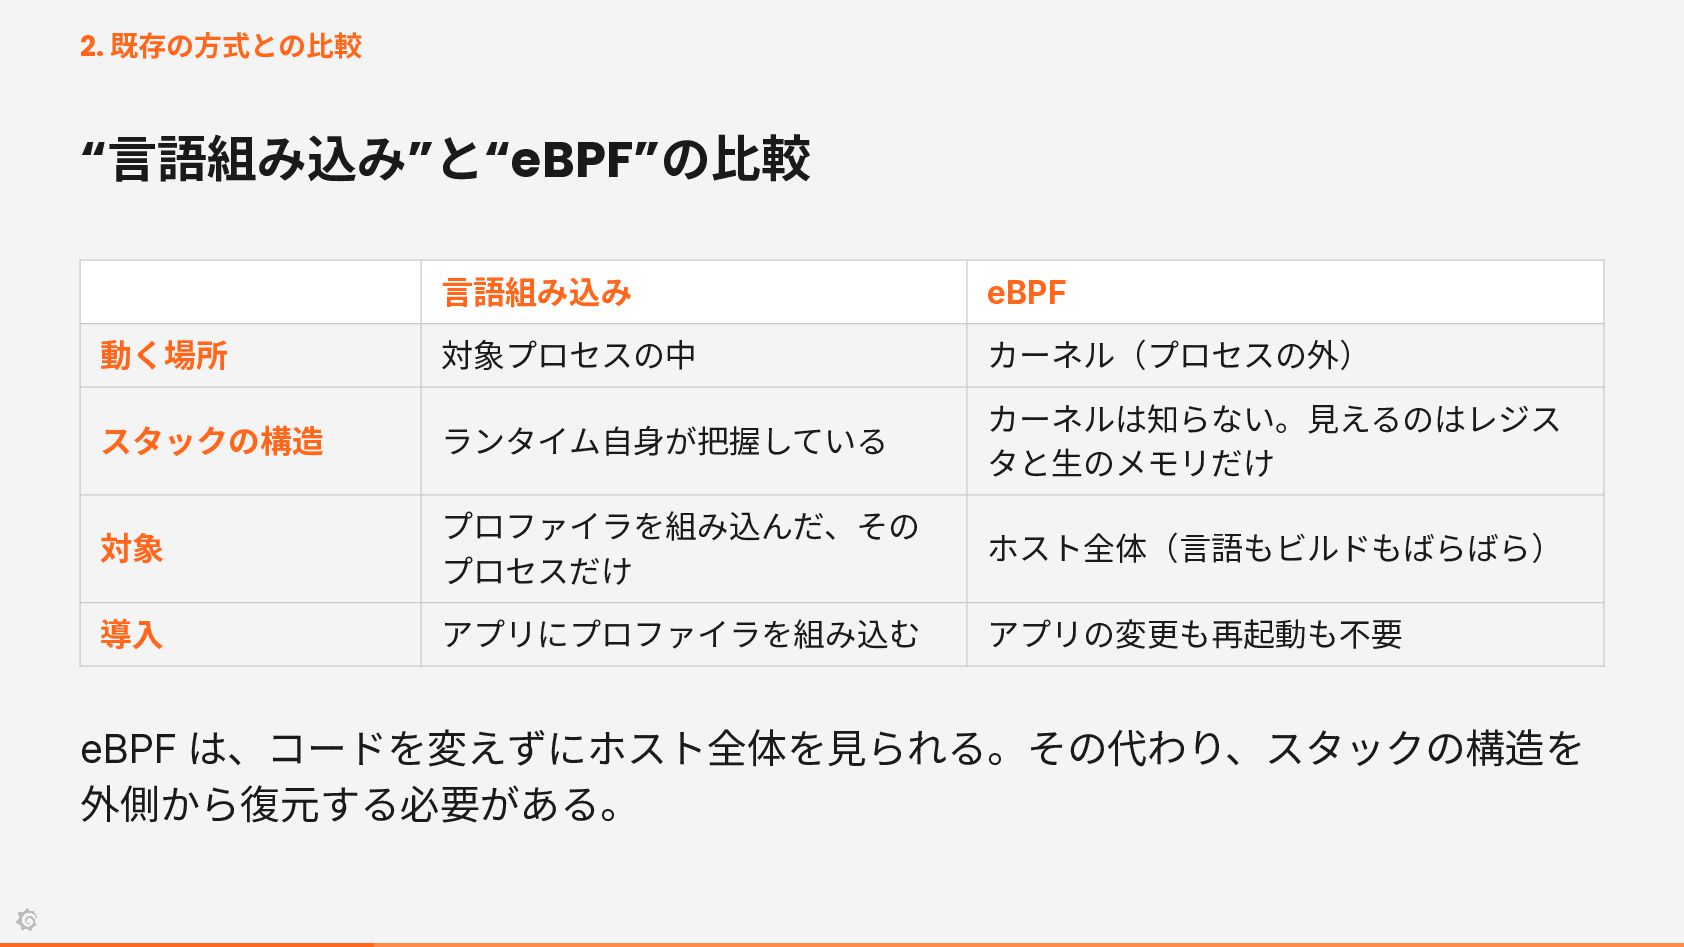
2. 既存の方式との比較 “言語組み込み”と“eBPF”の比較 言語組み込み eBPF 動く場所 対象プロセスの中 カーネル(プロセスの外) スタックの構造 ランタイム自身が把握している
カーネルは知らない。見えるのはレジス タと生のメモリだけ 対象 プロファイラを組み込んだ、その プロセスだけ ホスト全体(言語もビルドもばらばら) 導入 アプリにプロファイラを組み込む アプリの変更も再起動も不要 eBPF は、コードを変えずにホスト全体を見られる。その代わり、スタックの構造を 外側から復元する必要がある。
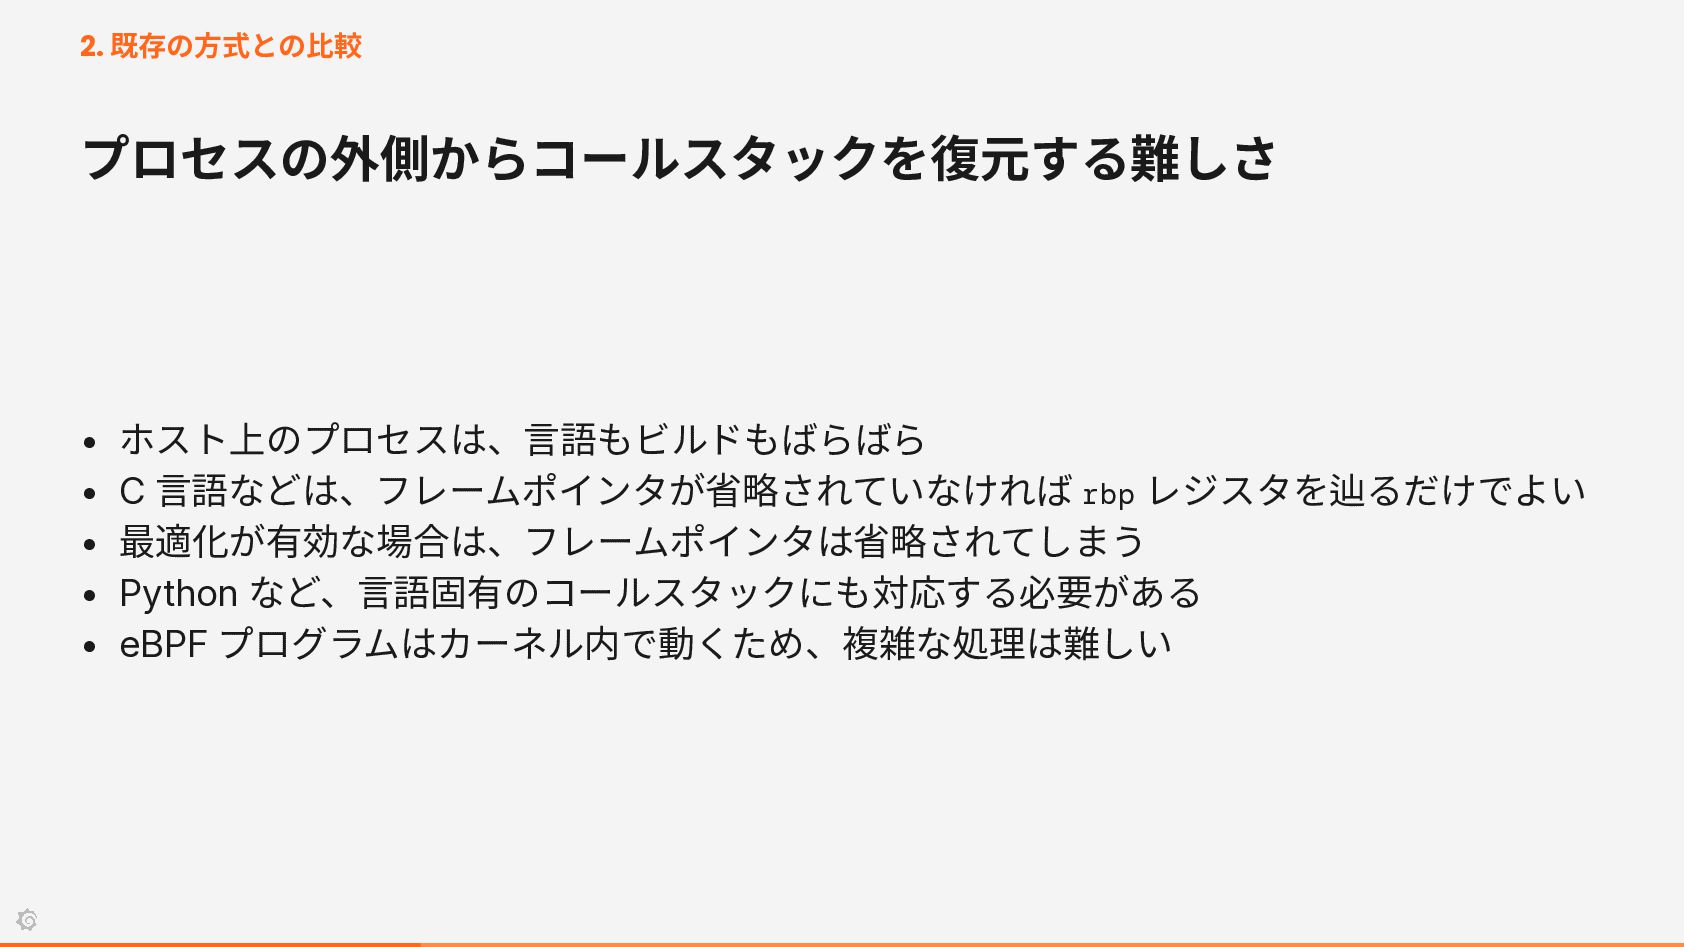
2. 既存の方式との比較 プロセスの外側からコールスタックを復元する難しさ • ホスト上のプロセスは、言語もビルドもばらばら • C 言語などは、フレームポインタが省略されていなければ rbp レジスタを辿るだけでよい
• 最適化が有効な場合は、フレームポインタは省略されてしまう • Python など、言語固有のコールスタックにも対応する必要がある • eBPF プログラムはカーネル内で動くため、複雑な処理は難しい
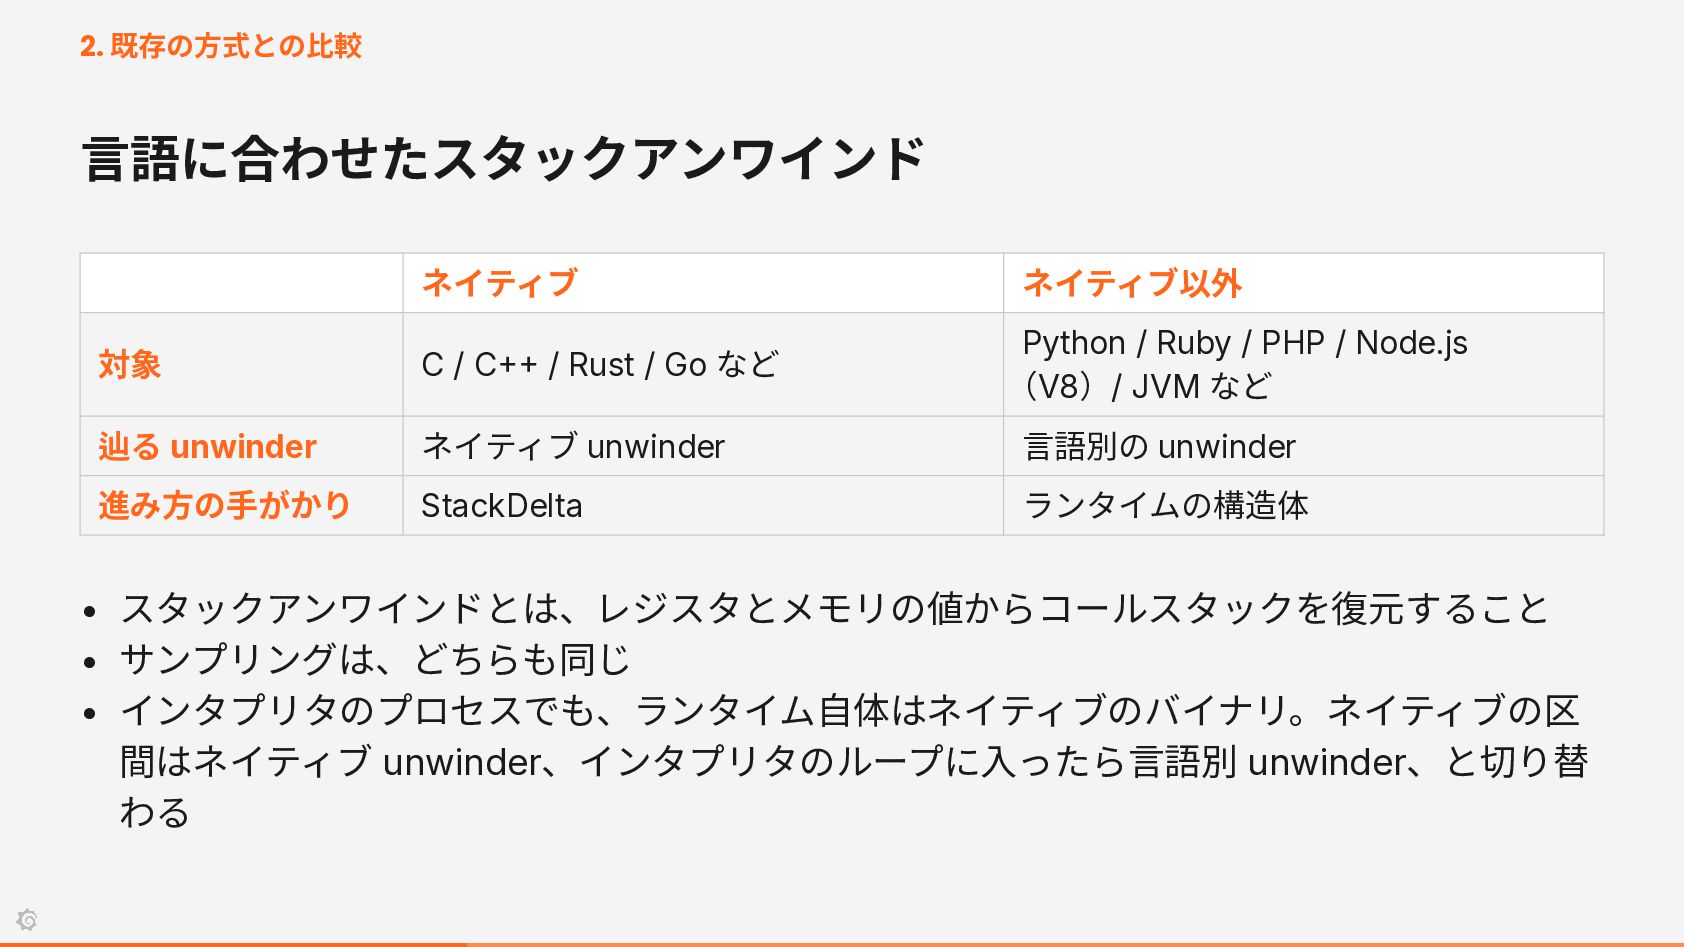
2. 既存の方式との比較 言語に合わせたスタックアンワインド ネイティブ ネイティブ以外 対象 C / C++ /
Rust / Go など Python / Ruby / PHP / Node.js (V8)/ JVM など 辿る unwinder ネイティブ unwinder 言語別の unwinder 進み方の手がかり StackDelta ランタイムの構造体 • スタックアンワインドとは、レジスタとメモリの値からコールスタックを復元すること • サンプリングは、どちらも同じ • インタプリタのプロセスでも、ランタイム自体はネイティブのバイナリ。ネイティブの区 間はネイティブ unwinder、インタプリタのループに入ったら言語別 unwinder、と切り替 わる
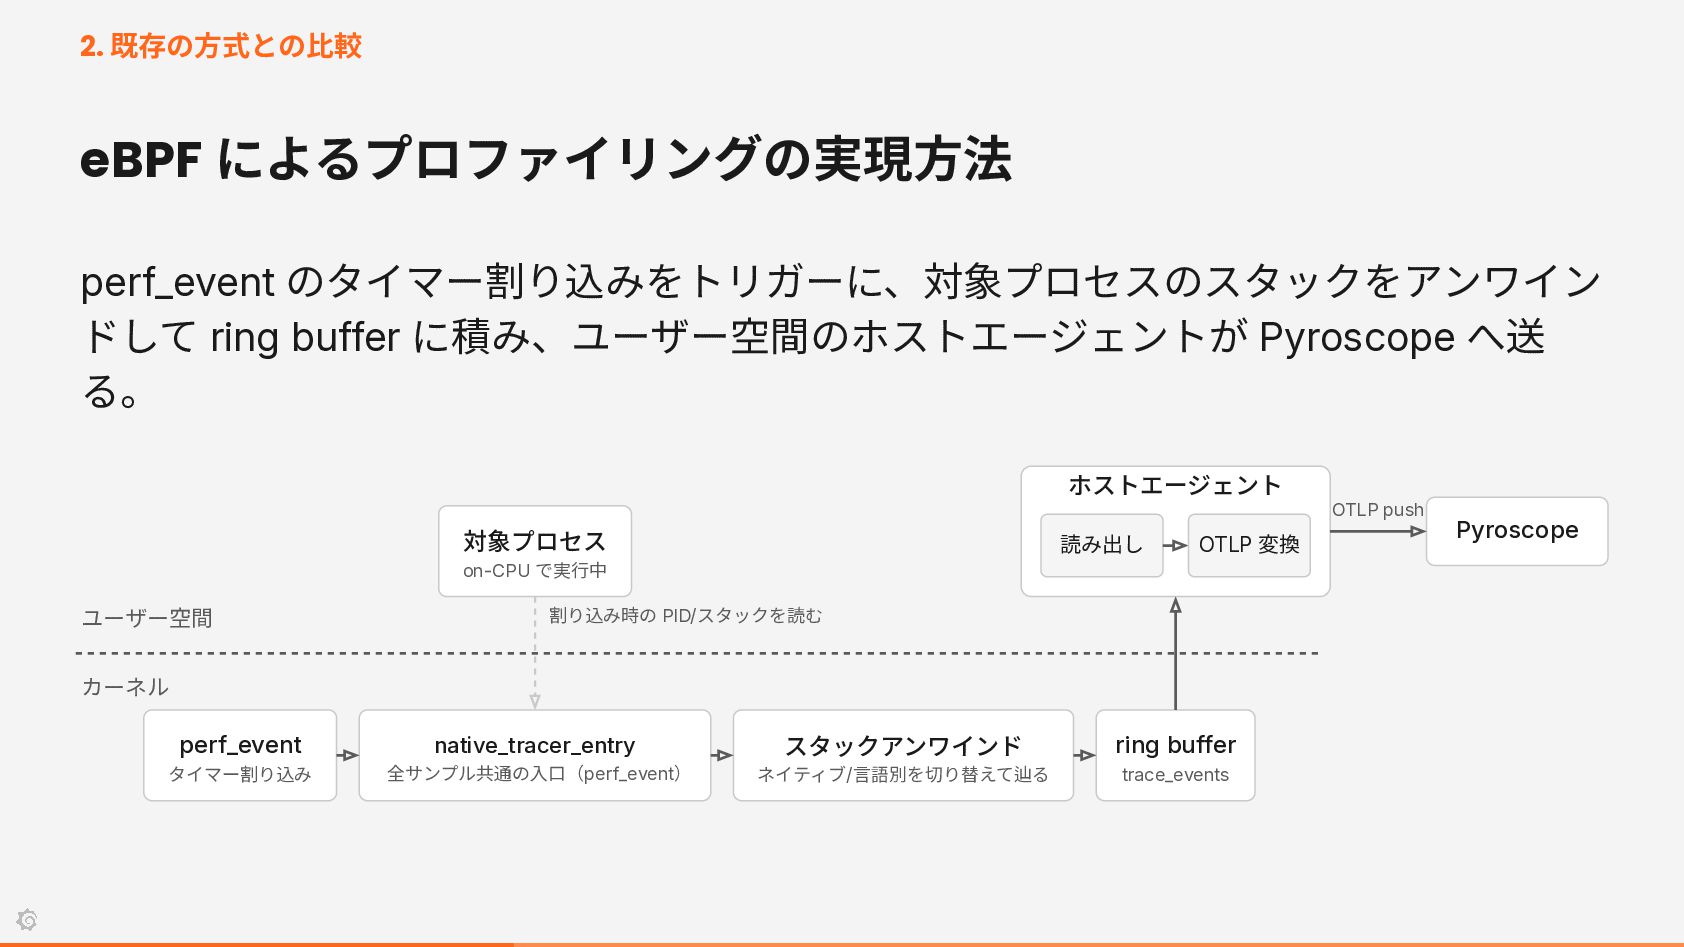
2. 既存の方式との比較 eBPF によるプロファイリングの実現方法 perf_event のタイマー割り込みをトリガーに、対象プロセスのスタックをアンワイン ドして ring buffer に積み、ユーザー空間のホストエージェントが
Pyroscope へ送 る。 ホストエージェント OTLP push 対象プロセス 読み出し OTLP 変換 on-CPU で実行中 ユーザー空間 割り込み時の PID/スタックを読む カーネル perf_event native_tracer_entry スタックアンワインド ring buffer タイマー割り込み 全サンプル共通の入口(perf_event) ネイティブ/言語別を切り替えて辿る trace_events Pyroscope
3. サンプリング
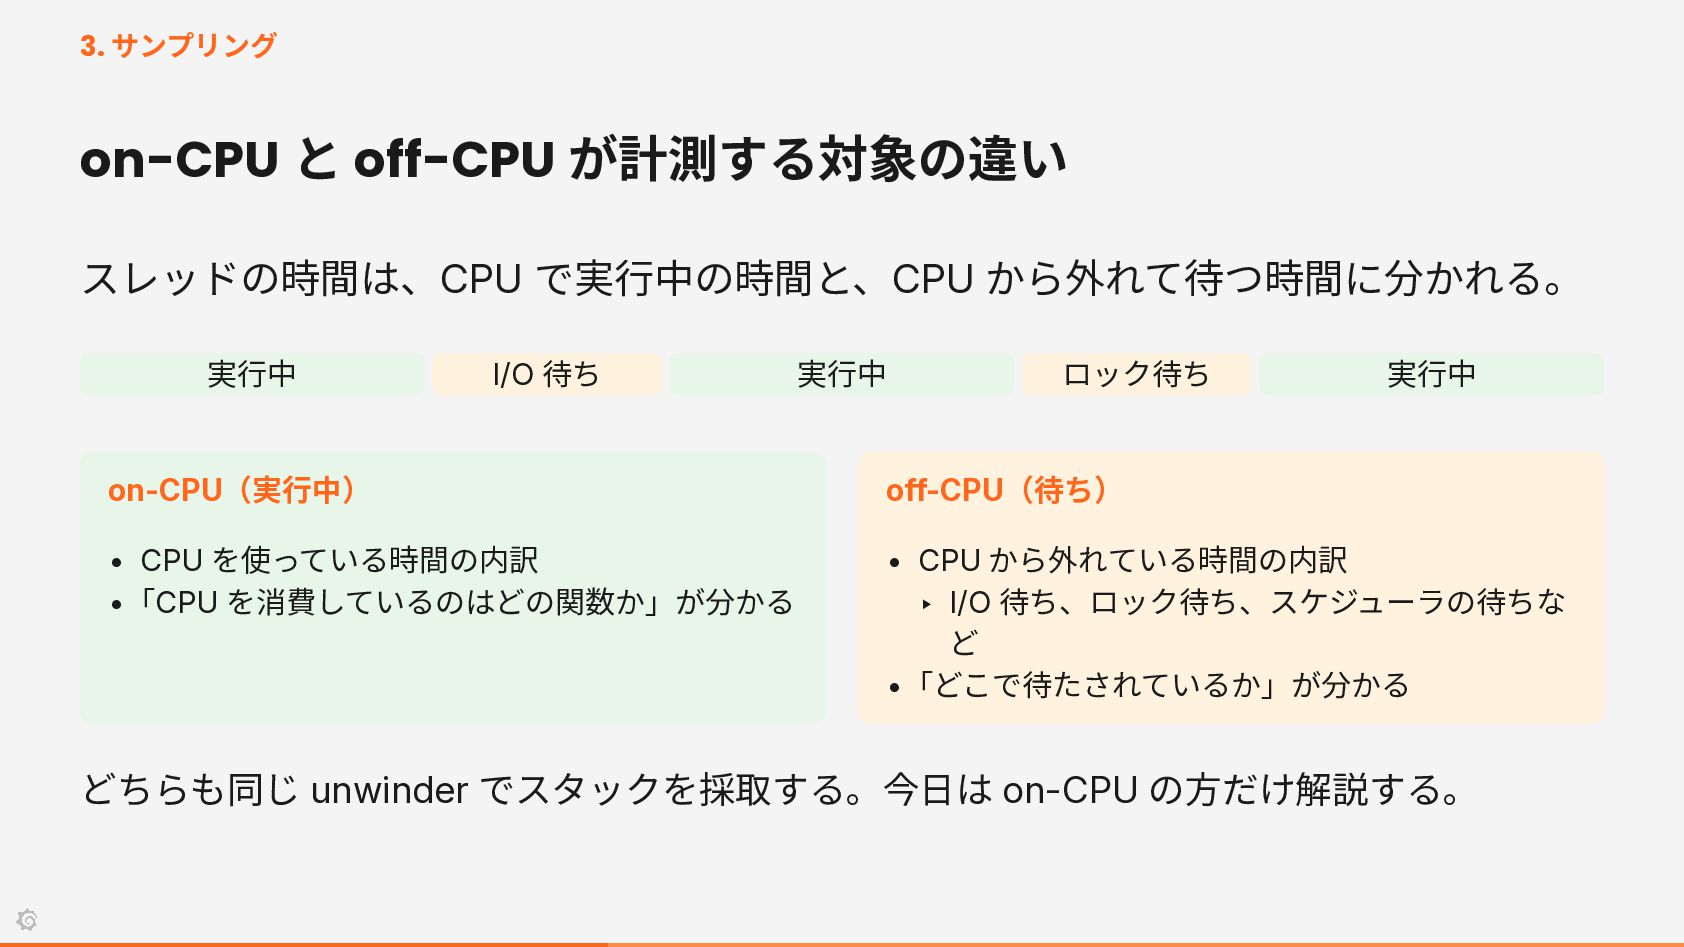
3. サンプリング on-CPU と off-CPU が計測する対象の違い スレッドの時間は、CPU で実行中の時間と、CPU から外れて待つ時間に分かれる。 実行中
I/O 待ち 実行中 ロック待ち 実行中 on-CPU(実行中) off-CPU(待ち) • CPU を使っている時間の内訳 •「CPU を消費しているのはどの関数か」が分かる • CPU から外れている時間の内訳 ‣ I/O 待ち、ロック待ち、スケジューラの待ちな ど •「どこで待たされているか」が分かる どちらも同じ unwinder でスタックを採取する。今日は on-CPU の方だけ解説する。
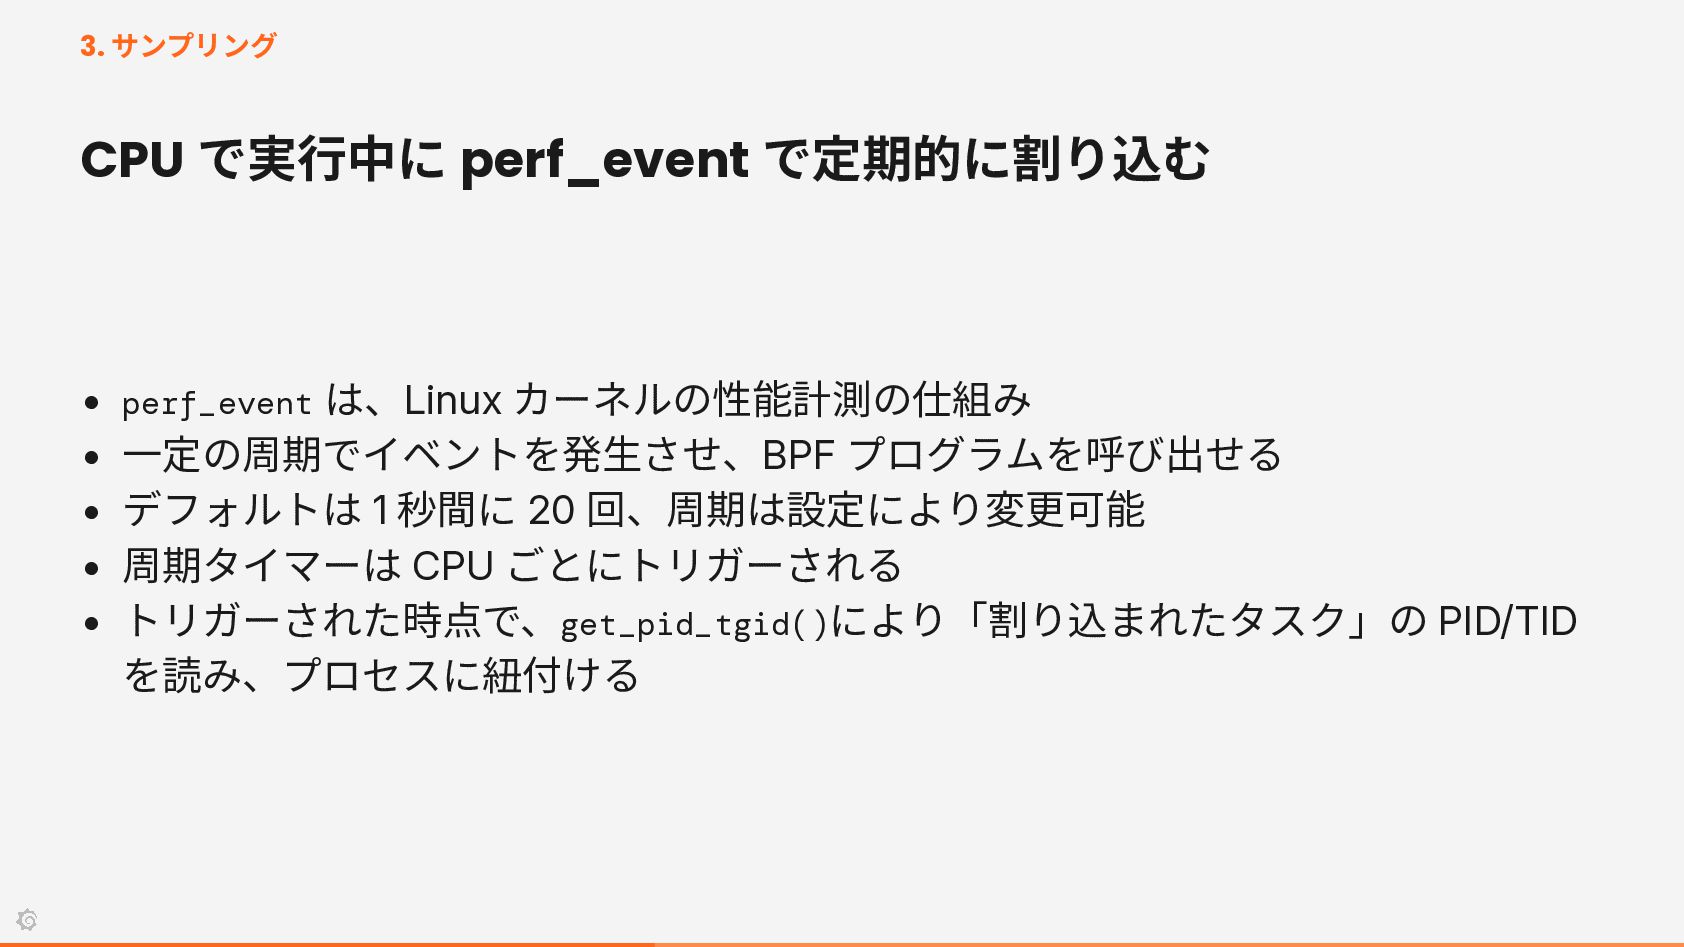
3. サンプリング CPU で実行中に perf_event で定期的に割り込む • perf_event は、Linux カーネルの性能計測の仕組み
• 一定の周期でイベントを発生させ、BPF プログラムを呼び出せる • デフォルトは 1 秒間に 20 回、周期は設定により変更可能 • 周期タイマーは CPU ごとにトリガーされる • トリガーされた時点で、get_pid_tgid()により「割り込まれたタスク」の PID/TID を読み、プロセスに紐付ける
4. ネイティブコードのアンワインド
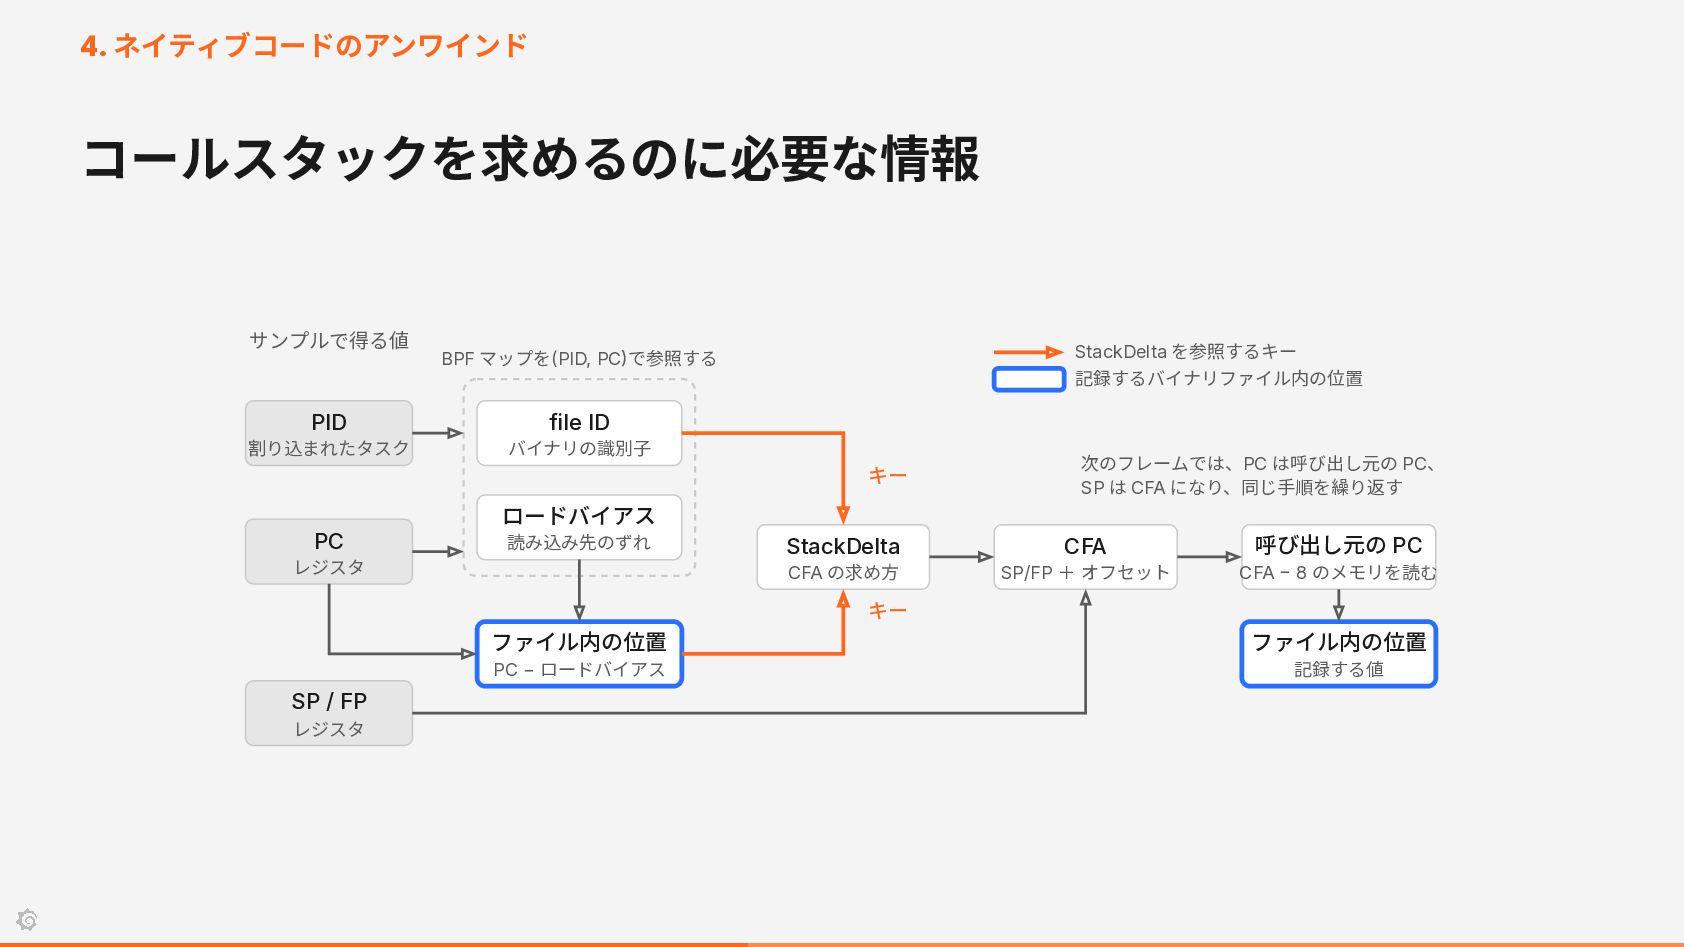
4. ネイティブコードのアンワインド コールスタックを求めるのに必要な情報 サンプルで得る値 StackDelta を参照するキー 記録するバイナリファイル内の位置 BPF マップを(PID, PC)で参照する
PID file ID 割り込まれたタスク バイナリの識別子 キー 次のフレームでは、PC は呼び出し元の PC、 SP は CFA になり、同じ手順を繰り返す ロードバイアス PC 読み込み先のずれ レジスタ StackDelta CFA 呼び出し元の PC CFA の求め方 SP/FP + オフセット CFA − 8 のメモリを読む キー SP / FP レジスタ ファイル内の位置 ファイル内の位置 PC − ロードバイアス 記録する値
4. ネイティブコードのアンワインド StackDelta とは • コールスタックを辿るには、各関数が「どこに戻るか」(戻りアドレス)を、スタックか ら読む必要がある • 戻りアドレスは、その関数が呼ばれた時点のスタックの位置(CFA)の、8 バイト下に置
かれる • 一方、スタックの先頭(rsp)は、push や変数の確保のたびに動く。「rsp から何バイト先 か」は、PC によって変わる • この「バイナリファイル内の位置ごとの CFA の求め方」は、バイナリ自身が、Call Frame Information(CFI)として持っている • StackDelta とは、位置の範囲ごとに「rsp にいくつ足せば CFA になるか」を CFI から計算 した表
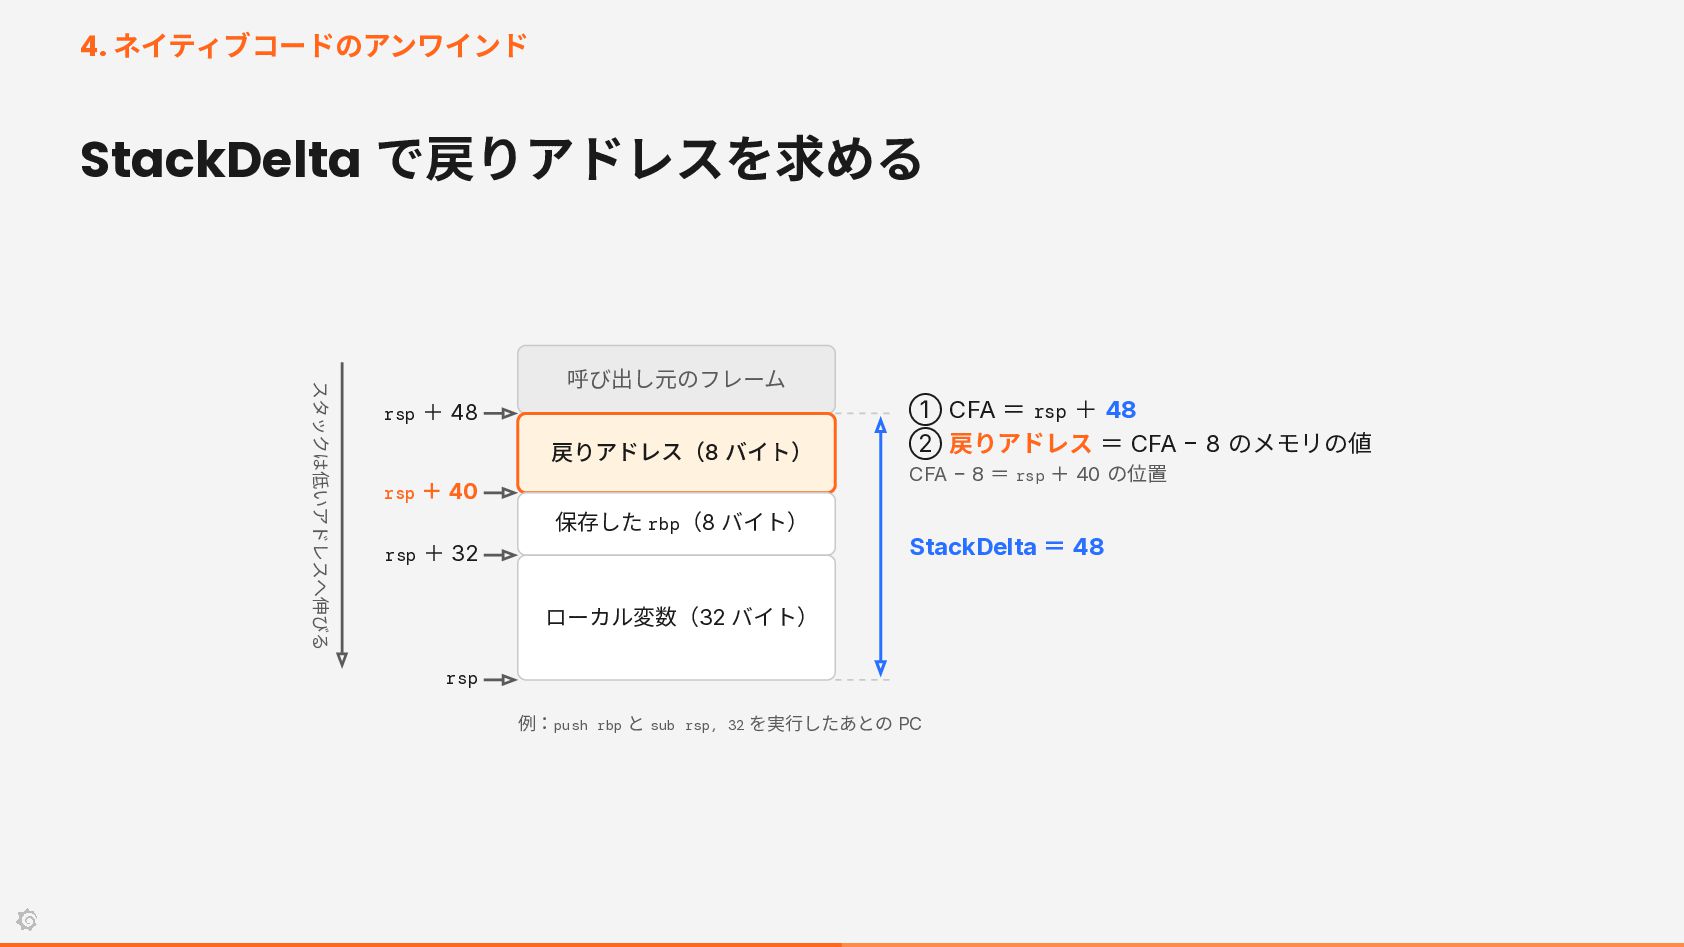
4. ネイティブコードのアンワインド StackDelta で戻りアドレスを求める スタックは低いアドレスへ伸びる 呼び出し元のフレーム rsp + 48 戻りアドレス(8
バイト) rsp + 40 保存した rbp(8 バイト) rsp + 32 ① CFA = rsp + 48 ② 戻りアドレス = CFA − 8 のメモリの値 CFA − 8 = rsp + 40 の位置 StackDelta = 48 ローカル変数(32 バイト) rsp 例:push rbp と sub rsp, 32 を実行したあとの PC
4. ネイティブコードのアンワインド StackDelta は一度だけ計算して、BPF マップに載せる • ホストエージェントが、/proc/<pid>/maps からバイナリのマッピングを検出し、 file ID
を計算する • バイナリ内の CFI から、ファイル内の位置の範囲ごとの StackDelta を一度だけ計 算する • file ID をキーにした BPF マップへロードする • サンプリング時、eBPF 側は StackDelta を参照するだけで、CFI の解釈はしない
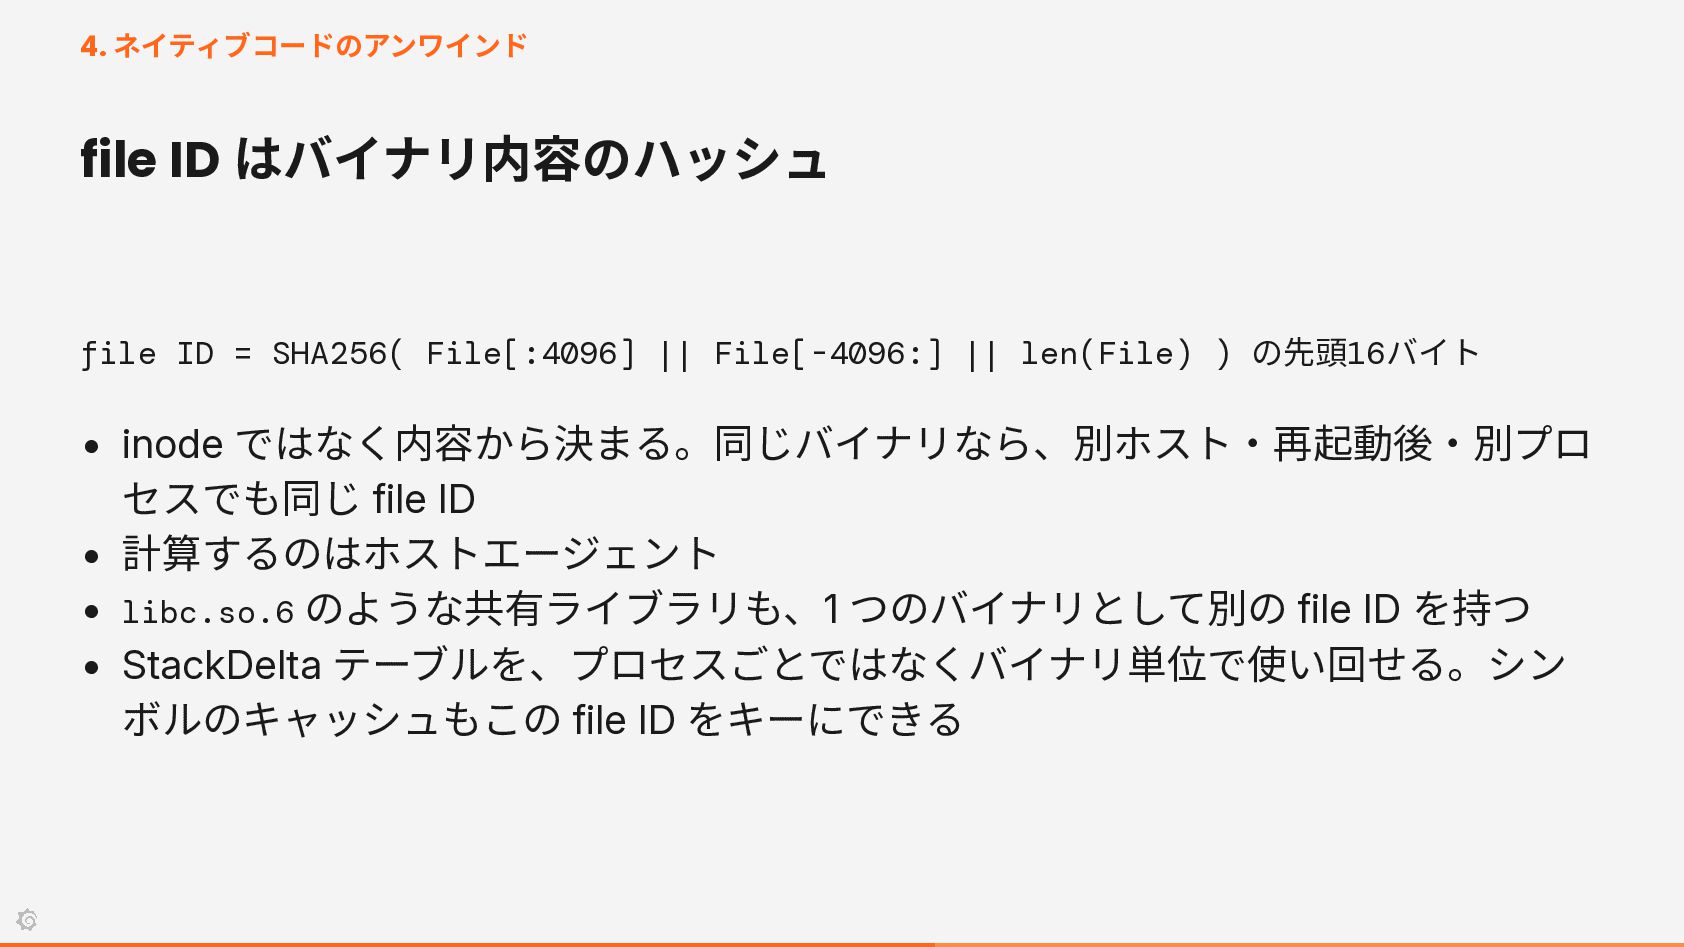
4. ネイティブコードのアンワインド file ID はバイナリ内容のハッシュ file ID = SHA256( File[:4096]
|| File[-4096:] || len(File) ) の先頭16バイト • inode ではなく内容から決まる。同じバイナリなら、別ホスト・再起動後・別プロ セスでも同じ file ID • 計算するのはホストエージェント • libc.so.6 のような共有ライブラリも、1 つのバイナリとして別の file ID を持つ • StackDelta テーブルを、プロセスごとではなくバイナリ単位で使い回せる。シン ボルのキャッシュもこの file ID をキーにできる
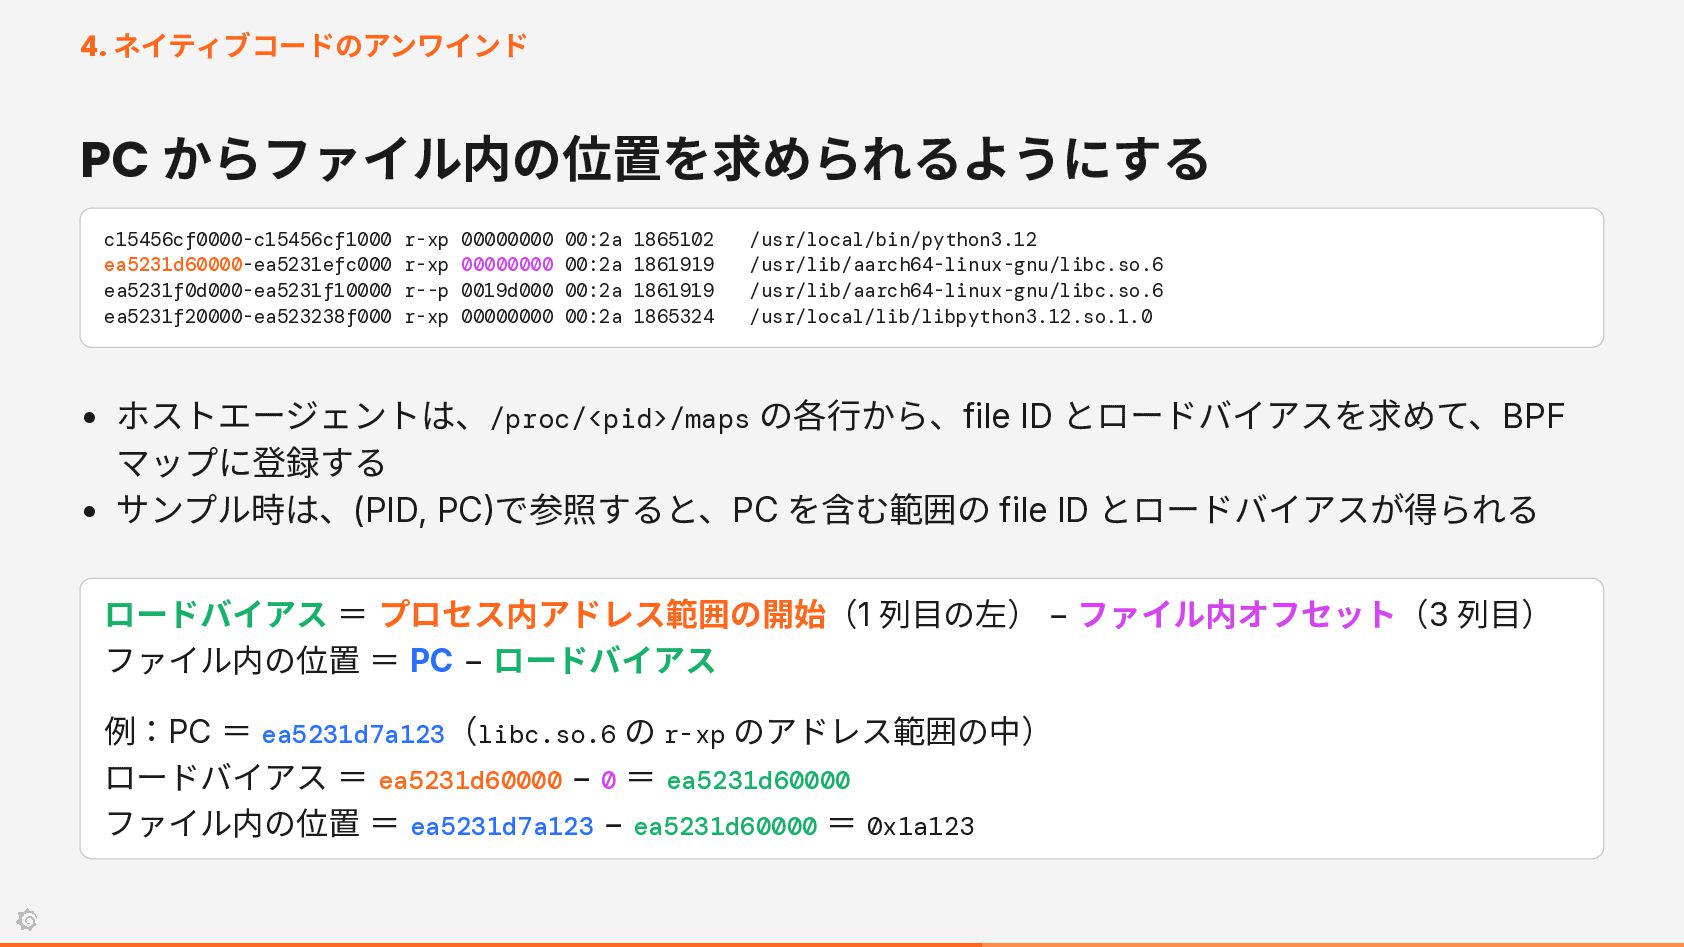
4. ネイティブコードのアンワインド PC からファイル内の位置を求められるようにする c15456cf0000-c15456cf1000 r-xp 00000000 00:2a 1865102 ea5231d60000-ea5231efc000
r-xp 00000000 00:2a 1861919 ea5231f0d000-ea5231f10000 r--p 0019d000 00:2a 1861919 ea5231f20000-ea523238f000 r-xp 00000000 00:2a 1865324 /usr/local/bin/python3.12 /usr/lib/aarch64-linux-gnu/libc.so.6 /usr/lib/aarch64-linux-gnu/libc.so.6 /usr/local/lib/libpython3.12.so.1.0 • ホストエージェントは、/proc/<pid>/maps の各行から、file ID とロードバイアスを求めて、BPF マップに登録する • サンプル時は、(PID, PC)で参照すると、PC を含む範囲の file ID とロードバイアスが得られる ロードバイアス = プロセス内アドレス範囲の開始(1 列目の左) − ファイル内オフセット(3 列目) ファイル内の位置 = PC − ロードバイアス 例:PC = ea5231d7a123(libc.so.6 の r-xp のアドレス範囲の中) ロードバイアス = ea5231d60000 − 0 = ea5231d60000 ファイル内の位置 = ea5231d7a123 − ea5231d60000 = 0x1a123
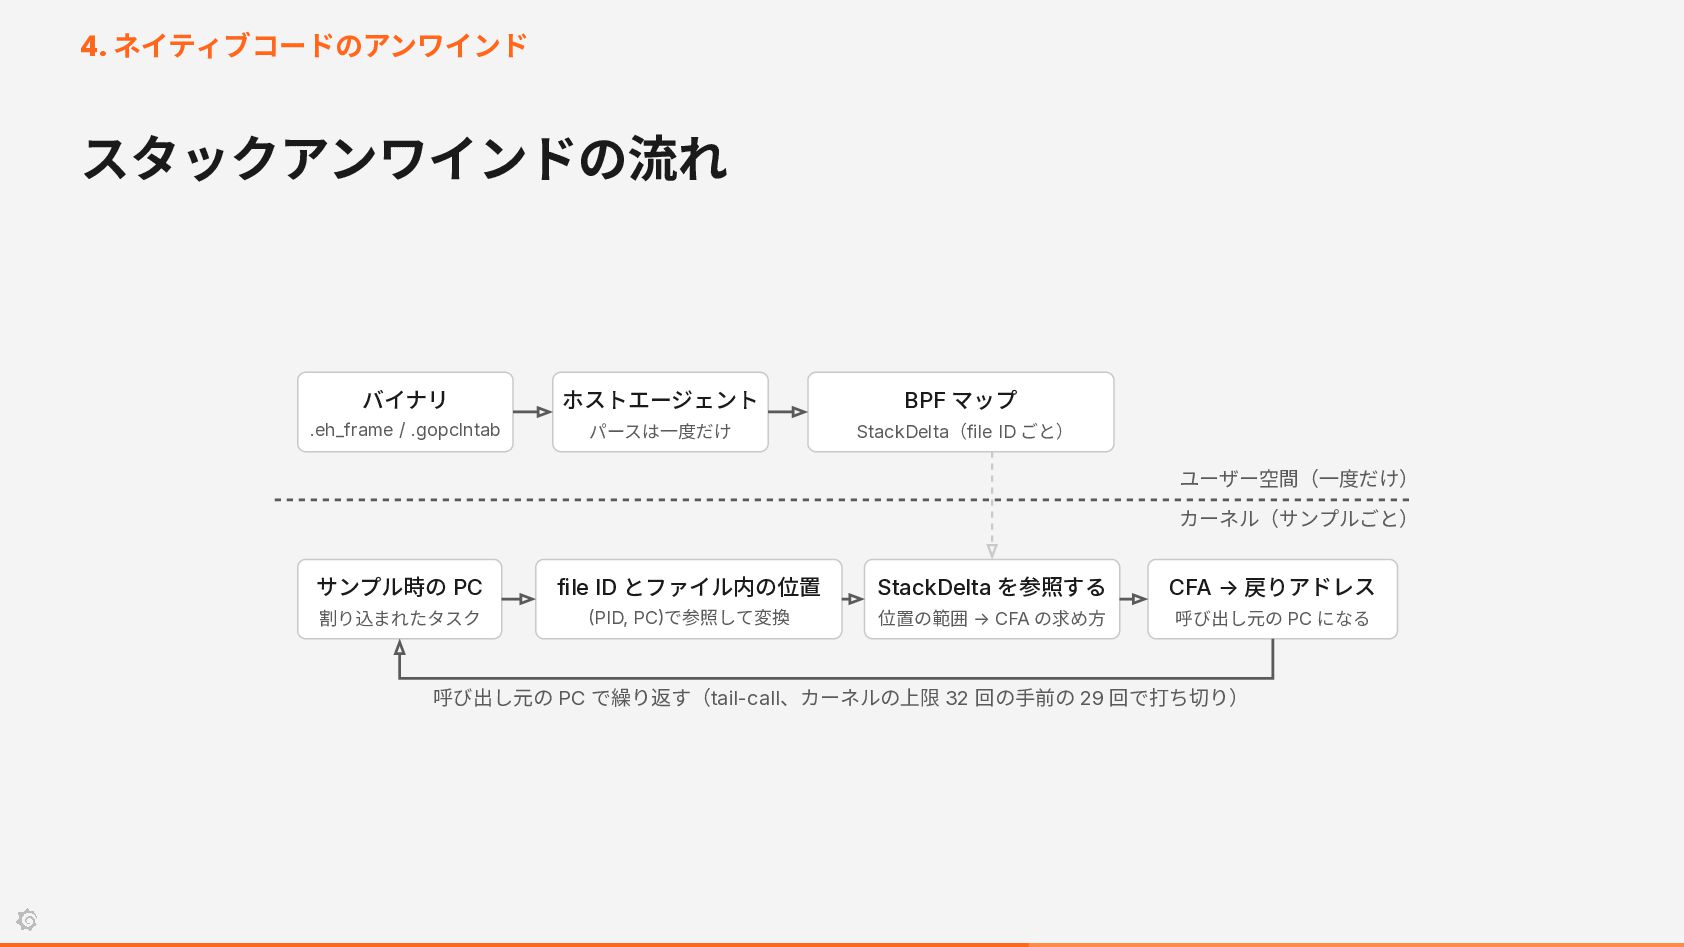
4. ネイティブコードのアンワインド スタックアンワインドの流れ バイナリ ホストエージェント BPF マップ .eh_frame / .gopclntab
パースは一度だけ StackDelta(file ID ごと) ユーザー空間(一度だけ) カーネル(サンプルごと) サンプル時の PC file ID とファイル内の位置 StackDelta を参照する CFA → 戻りアドレス 割り込まれたタスク (PID, PC)で参照して変換 位置の範囲 → CFA の求め方 呼び出し元の PC になる 呼び出し元の PC で繰り返す(tail-call、カーネルの上限 32 回の手前の 29 回で打ち切り)
5. ネイティブ以外のアンワインド(Python)
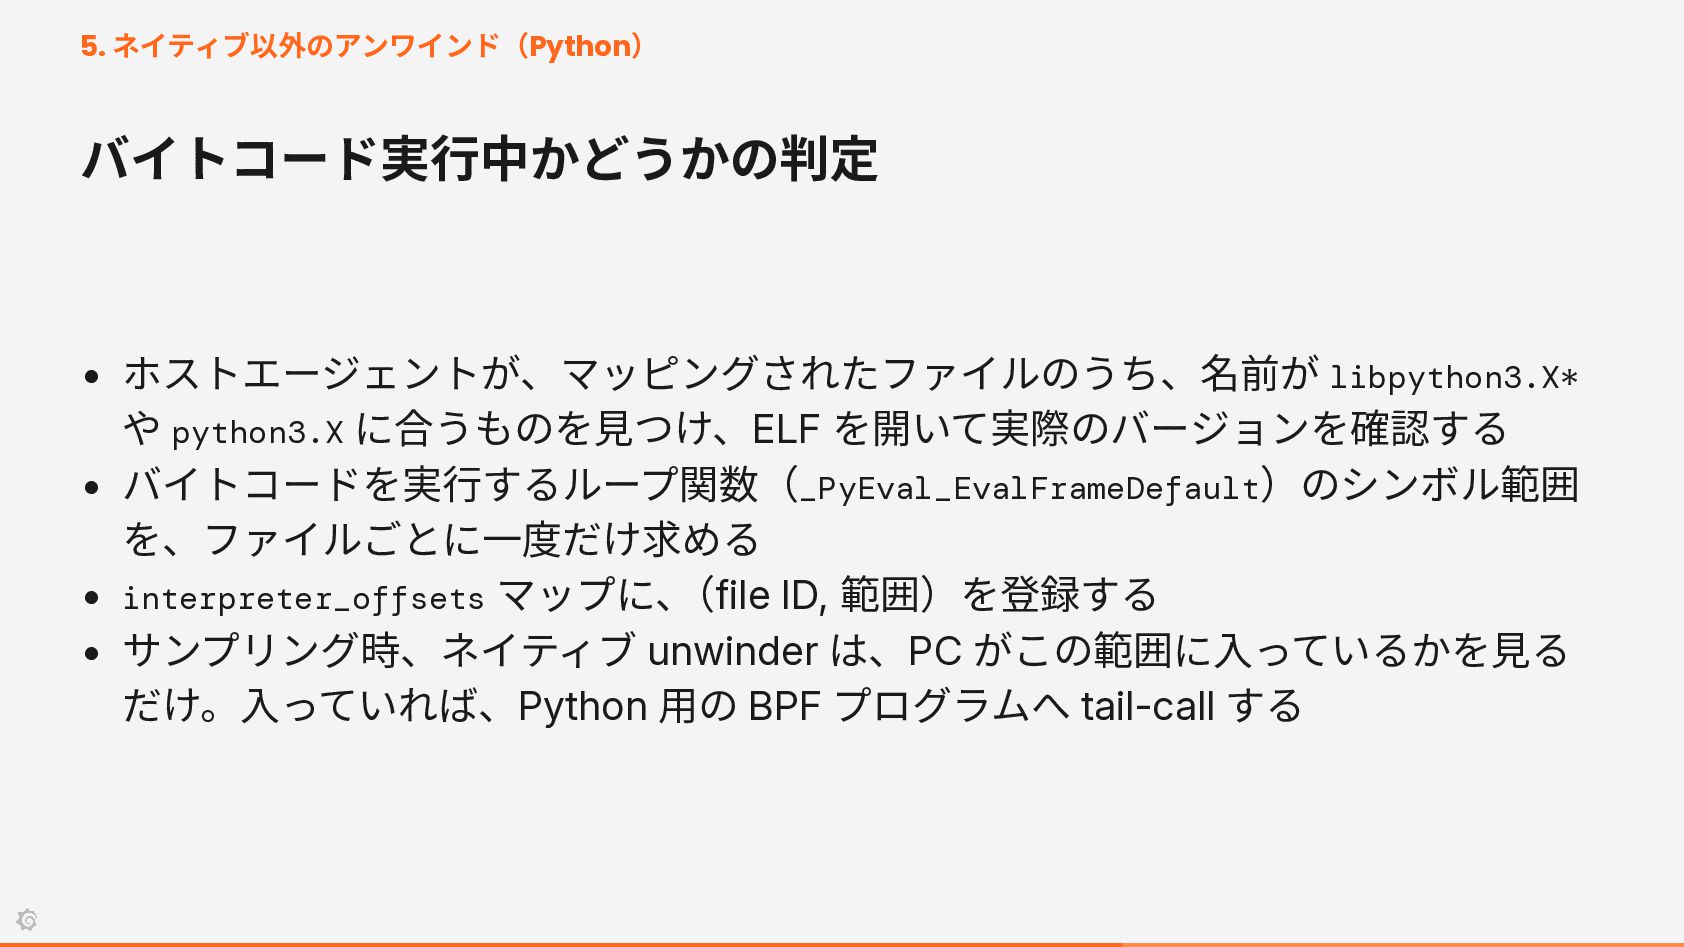
5. ネイティブ以外のアンワインド(Python) バイトコード実行中かどうかの判定 • ホストエージェントが、マッピングされたファイルのうち、名前が libpython3.X* や python3.X に合うものを見つけ、ELF を開いて実際のバージョンを確認する
• バイトコードを実行するループ関数(_PyEval_EvalFrameDefault)のシンボル範囲 を、ファイルごとに一度だけ求める • interpreter_offsets マップに、(file ID, 範囲)を登録する • サンプリング時、ネイティブ unwinder は、PC がこの範囲に入っているかを見る だけ。入っていれば、Python 用の BPF プログラムへ tail-call する
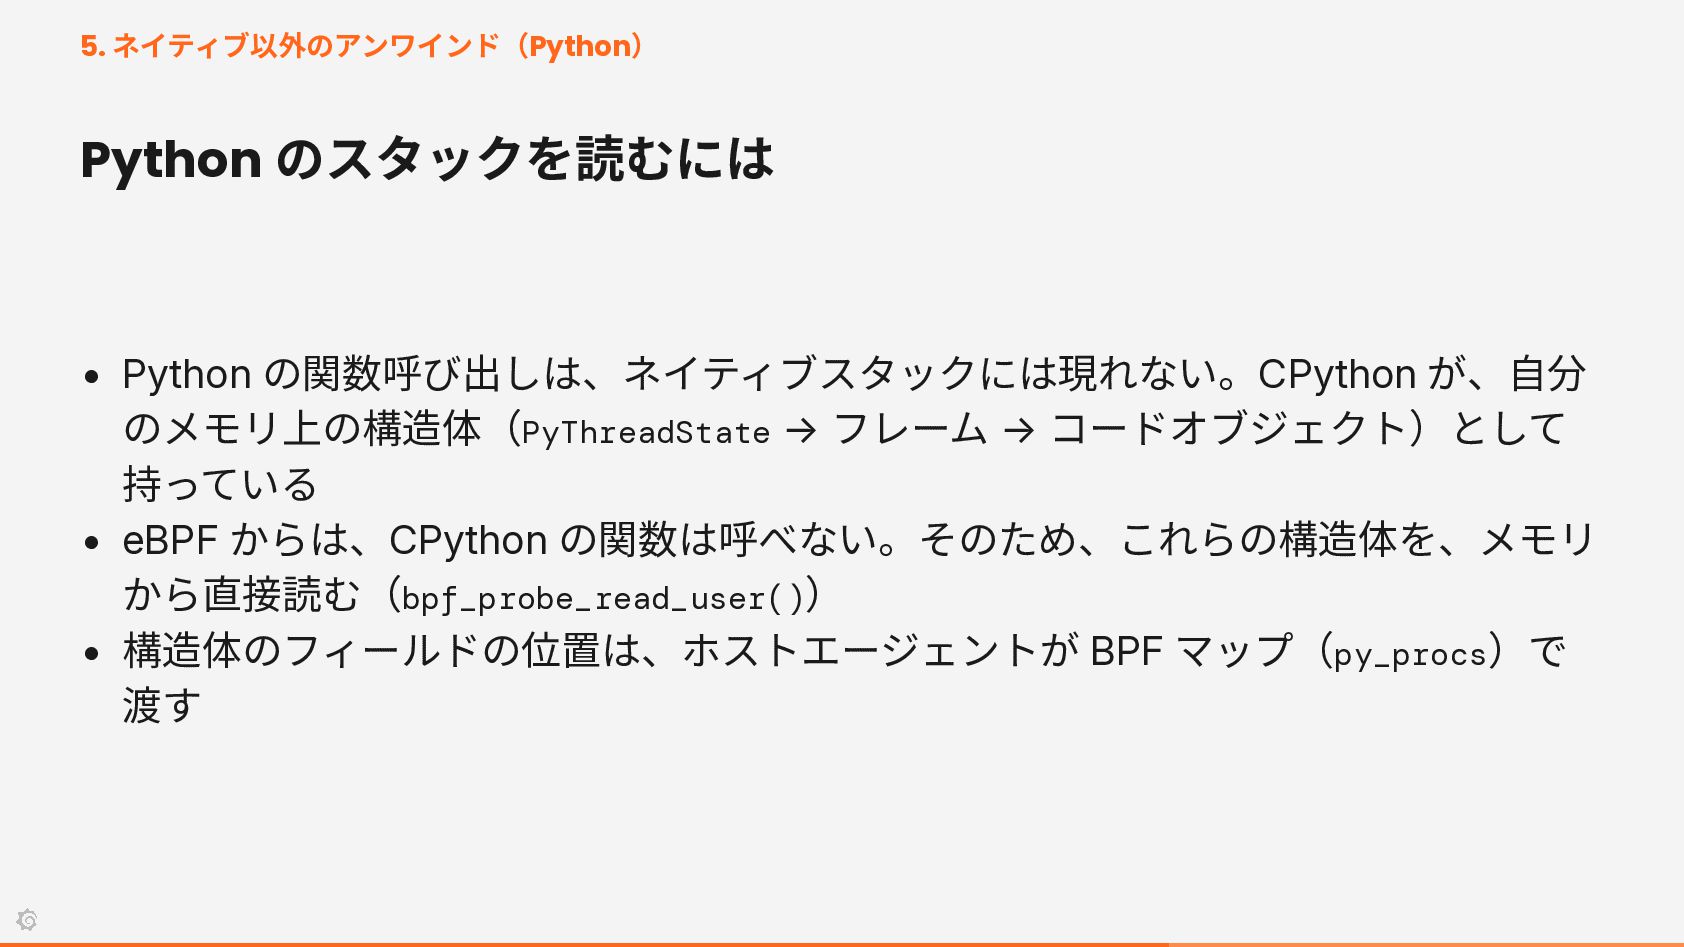
5. ネイティブ以外のアンワインド(Python) Python のスタックを読むには • Python の関数呼び出しは、ネイティブスタックには現れない。CPython が、自分 のメモリ上の構造体(PyThreadState →
フレーム → コードオブジェクト)として 持っている • eBPF からは、CPython の関数は呼べない。そのため、これらの構造体を、メモリ から直接読む(bpf_probe_read_user()) • 構造体のフィールドの位置は、ホストエージェントが BPF マップ(py_procs)で 渡す
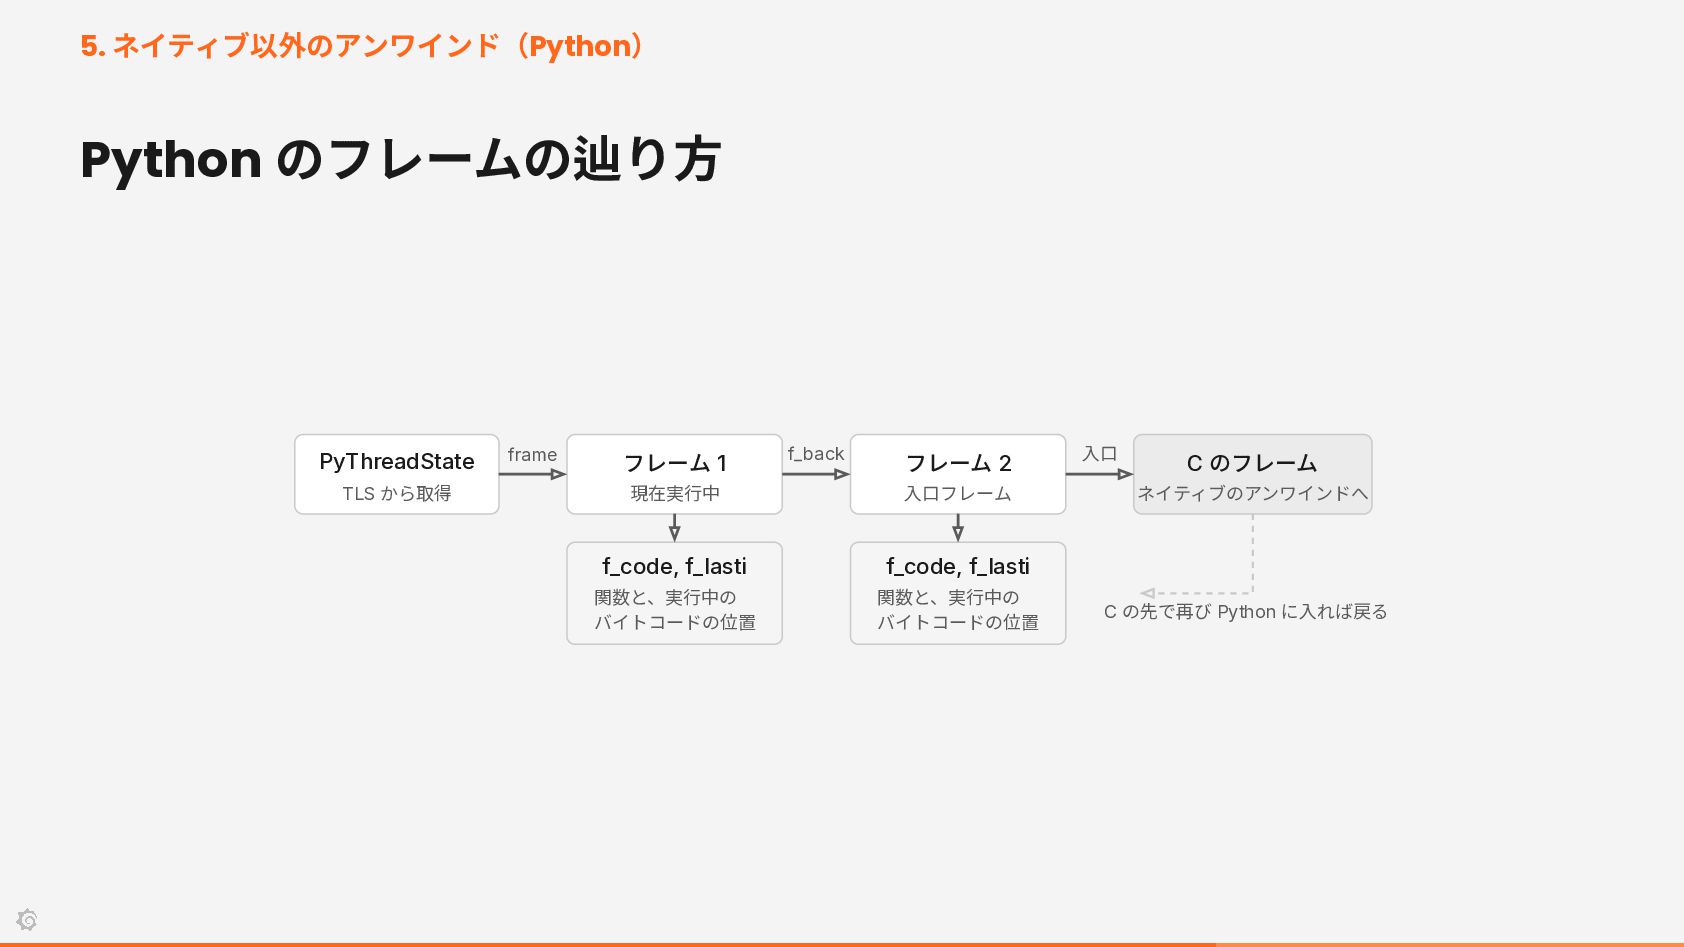
5. ネイティブ以外のアンワインド(Python) Python のフレームの辿り方 PyThreadState TLS から取得 frame フレーム 1
f_back フレーム 2 現在実行中 入口フレーム f_code, f_lasti f_code, f_lasti 関数と、実行中の バイトコードの位置 関数と、実行中の バイトコードの位置 入口 C のフレーム ネイティブのアンワインドへ C の先で再び Python に入れば戻る
6. シンボル化
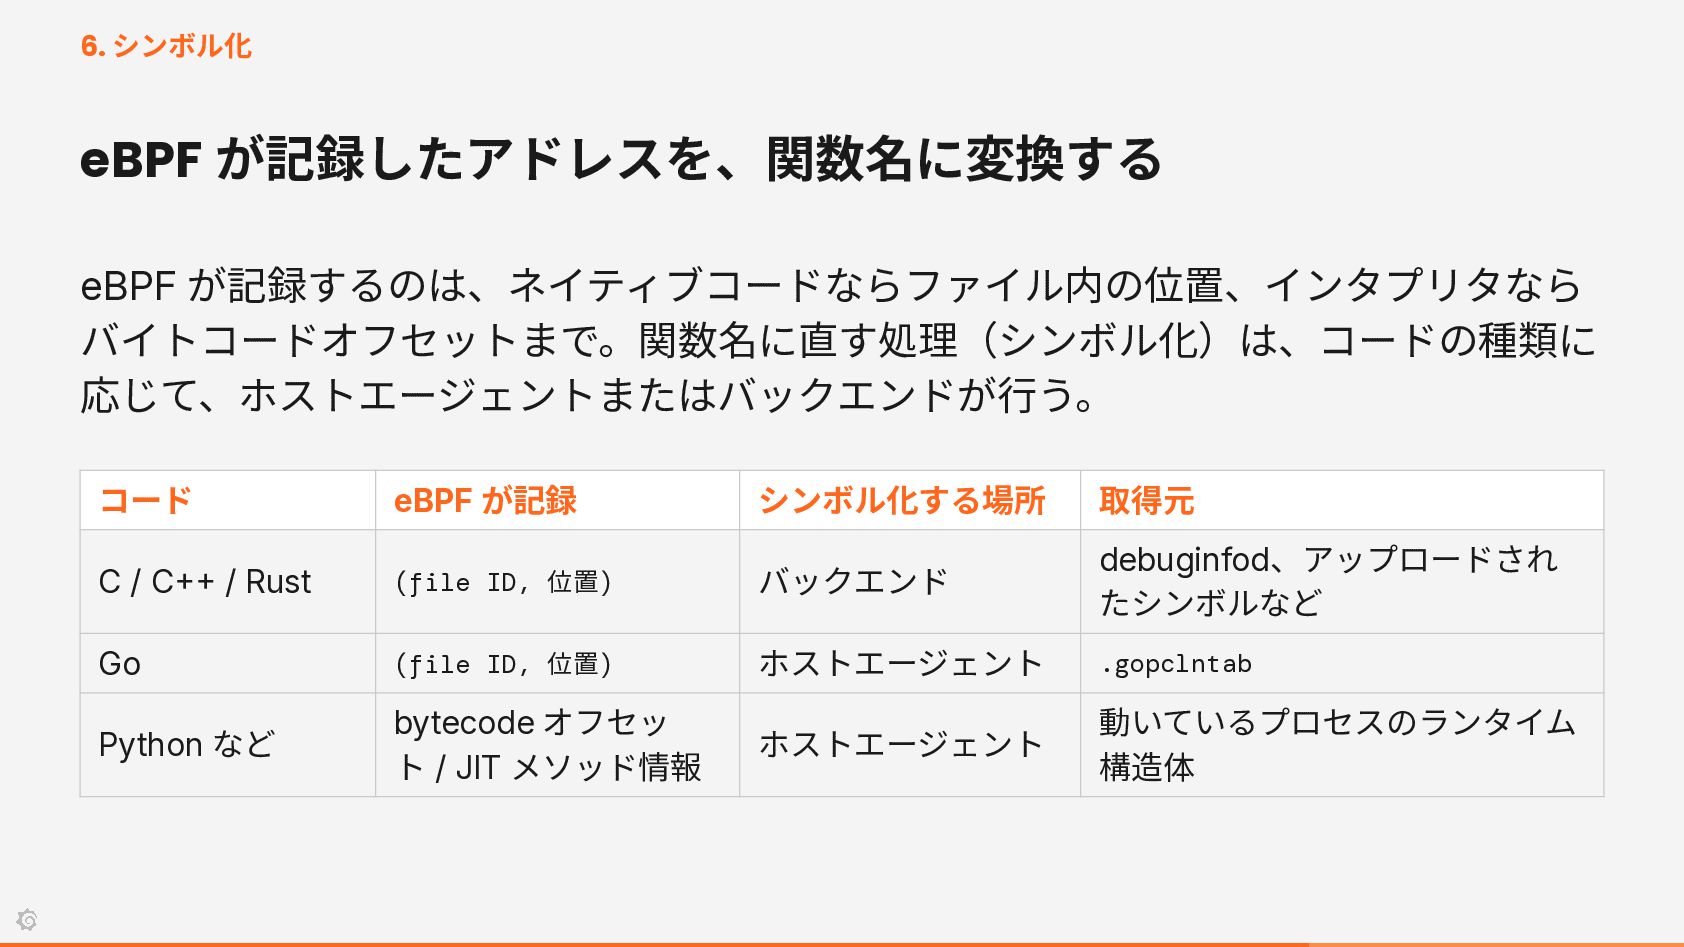
6. シンボル化 eBPF が記録したアドレスを、関数名に変換する eBPF が記録するのは、ネイティブコードならファイル内の位置、インタプリタなら バイトコードオフセットまで。関数名に直す処理(シンボル化)は、コードの種類に 応じて、ホストエージェントまたはバックエンドが行う。 コード eBPF
が記録 シンボル化する場所 取得元 C / C++ / Rust (file ID, 位置) バックエンド debuginfod、アップロードされ たシンボルなど Go (file ID, 位置) ホストエージェント .gopclntab Python など bytecode オフセッ ト / JIT メソッド情報 ホストエージェント 動いているプロセスのランタイム 構造体
7. バックエンドへの送信
7. バックエンドへの送信 ring buffer からバックエンドへ • 完了したスタックトレースは BPF_MAP_TYPE_RINGBUF でホストエージェントへ渡す •
ホストエージェントは、スタックトレースの 128bit のハッシュをキーに、同じフ レーム列を 1 つにまとめて件数を数える。フレームの変換とシンボル化は 1 回だけ 行う • ホストエージェントがコンテナ/ホストのメタデータを付け、バックエンドへ push する • 送信待ちのデータは、上限つきの FIFO キューに溜める
8. まとめ
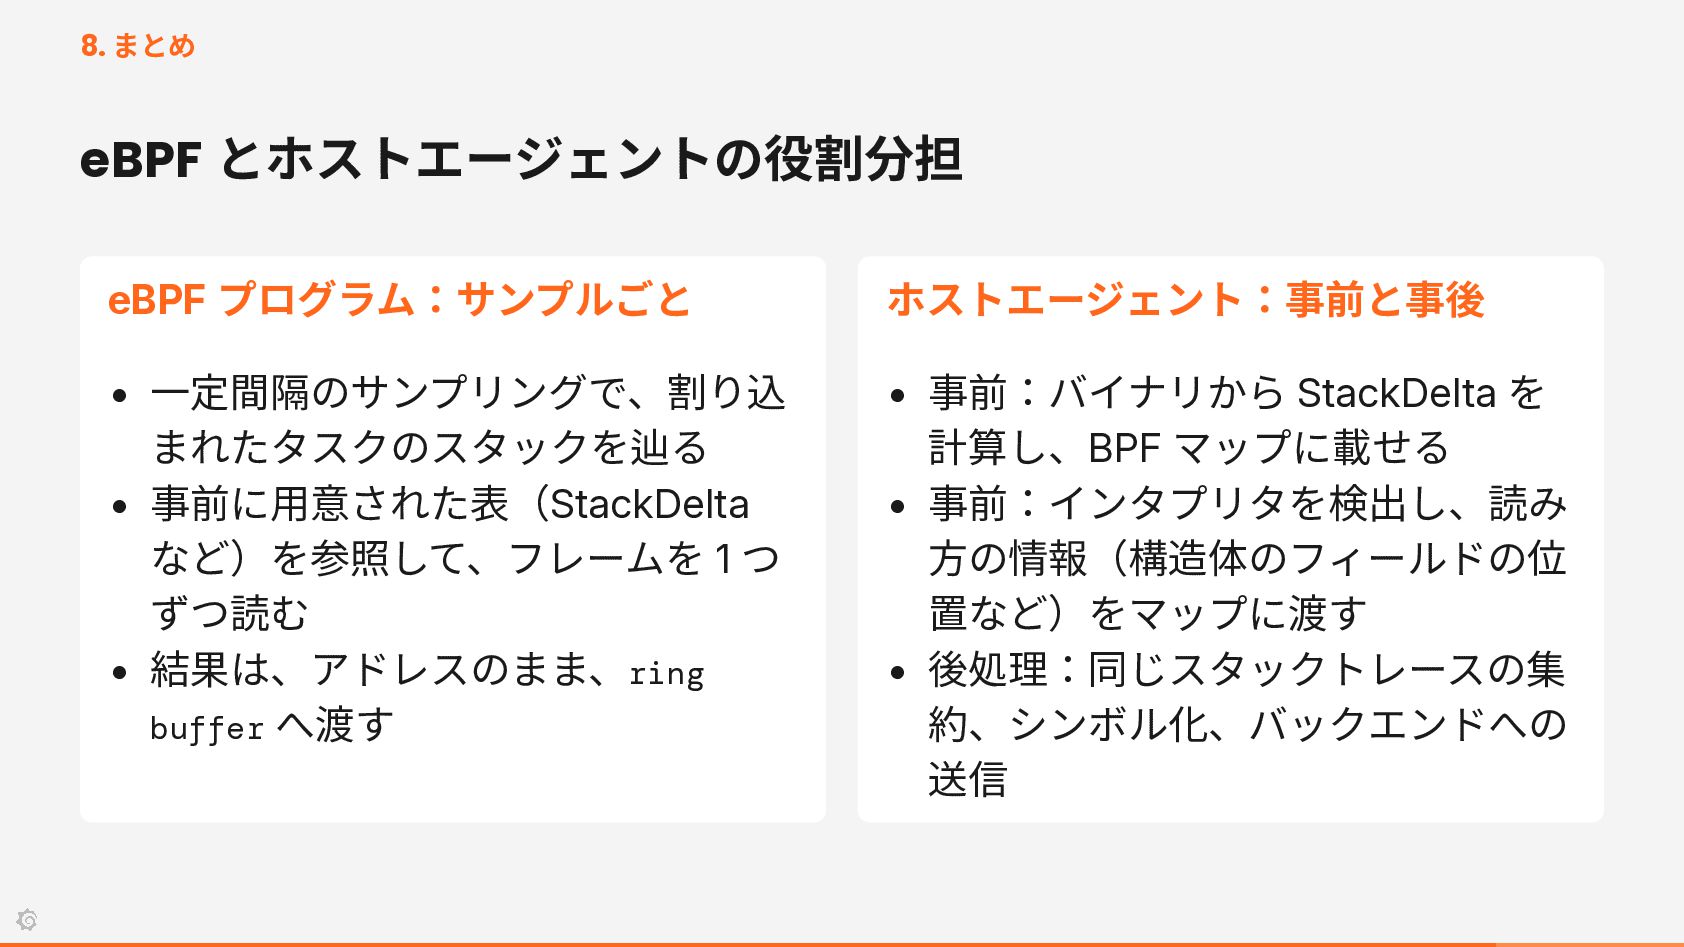
8. まとめ eBPF とホストエージェントの役割分担 eBPF プログラム:サンプルごと ホストエージェント:事前と事後 • 一定間隔のサンプリングで、割り込 まれたタスクのスタックを辿る
• 事前に用意された表(StackDelta など)を参照して、フレームを 1 つ ずつ読む • 結果は、アドレスのまま、ring buffer へ渡す • 事前:バイナリから StackDelta を 計算し、BPF マップに載せる • 事前:インタプリタを検出し、読み 方の情報(構造体のフィールドの位 置など)をマップに渡す • 後処理:同じスタックトレースの集 約、シンボル化、バックエンドへの 送信
付録
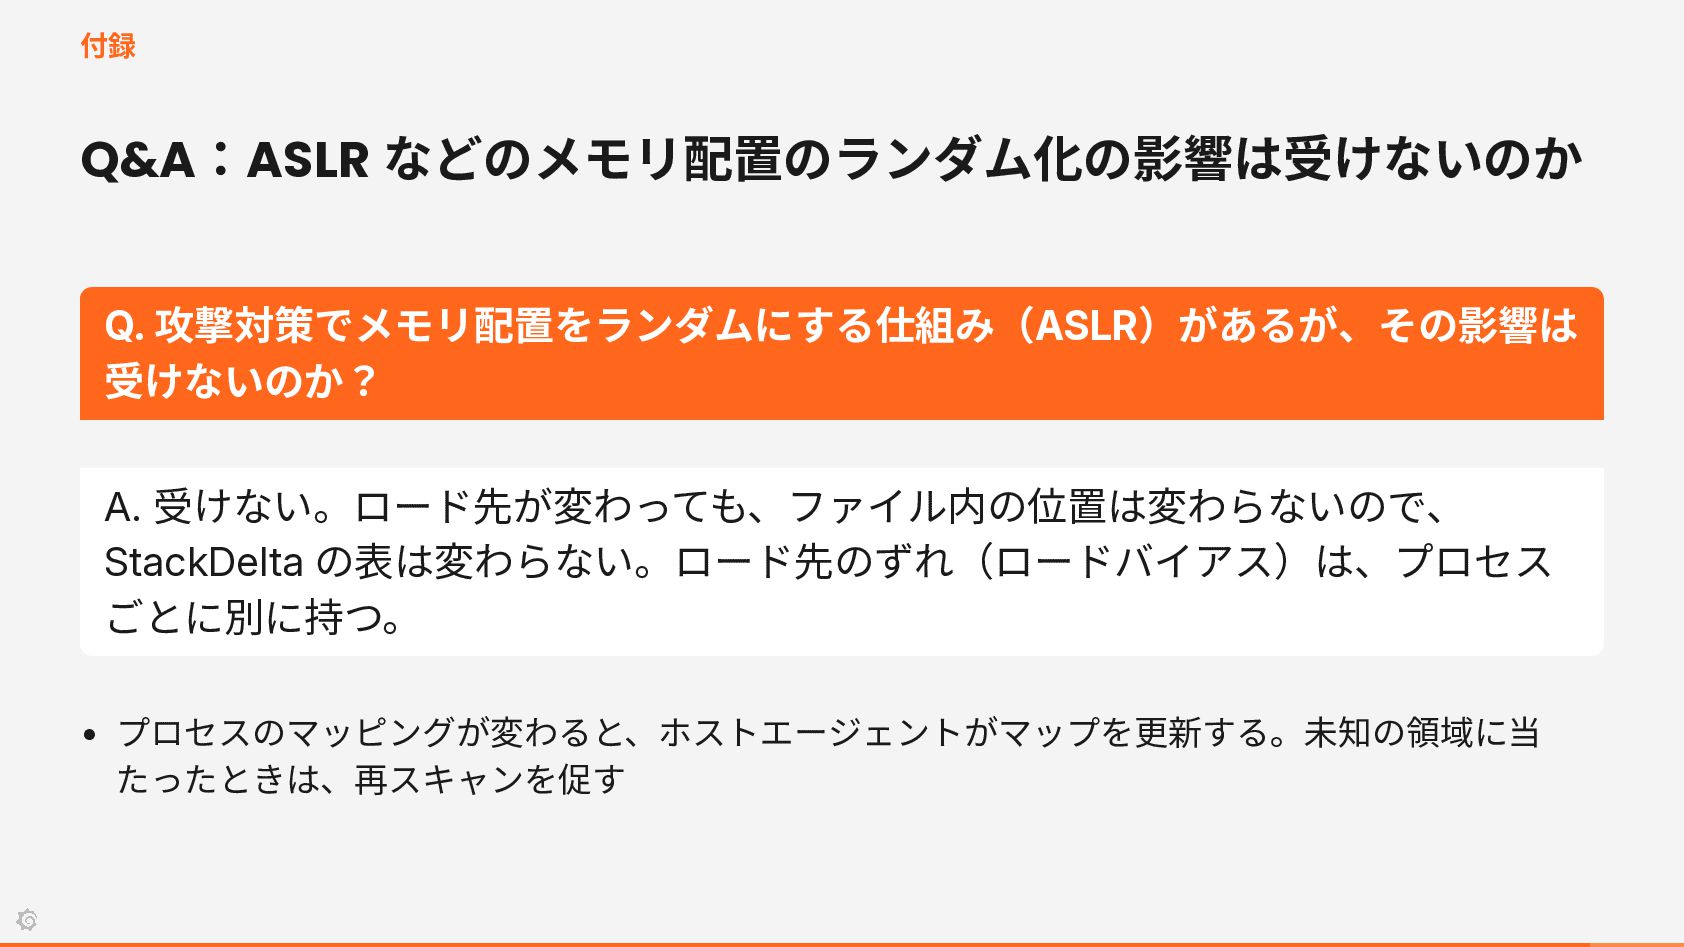
付録 Q&A:ASLR などのメモリ配置のランダム化の影響は受けないのか Q. 攻撃対策でメモリ配置をランダムにする仕組み(ASLR)があるが、その影響は 受けないのか? A. 受けない。ロード先が変わっても、ファイル内の位置は変わらないので、 StackDelta の表は変わらない。ロード先のずれ(ロードバイアス)は、プロセス
ごとに別に持つ。 • プロセスのマッピングが変わると、ホストエージェントがマップを更新する。未知の領域に当 たったときは、再スキャンを促す
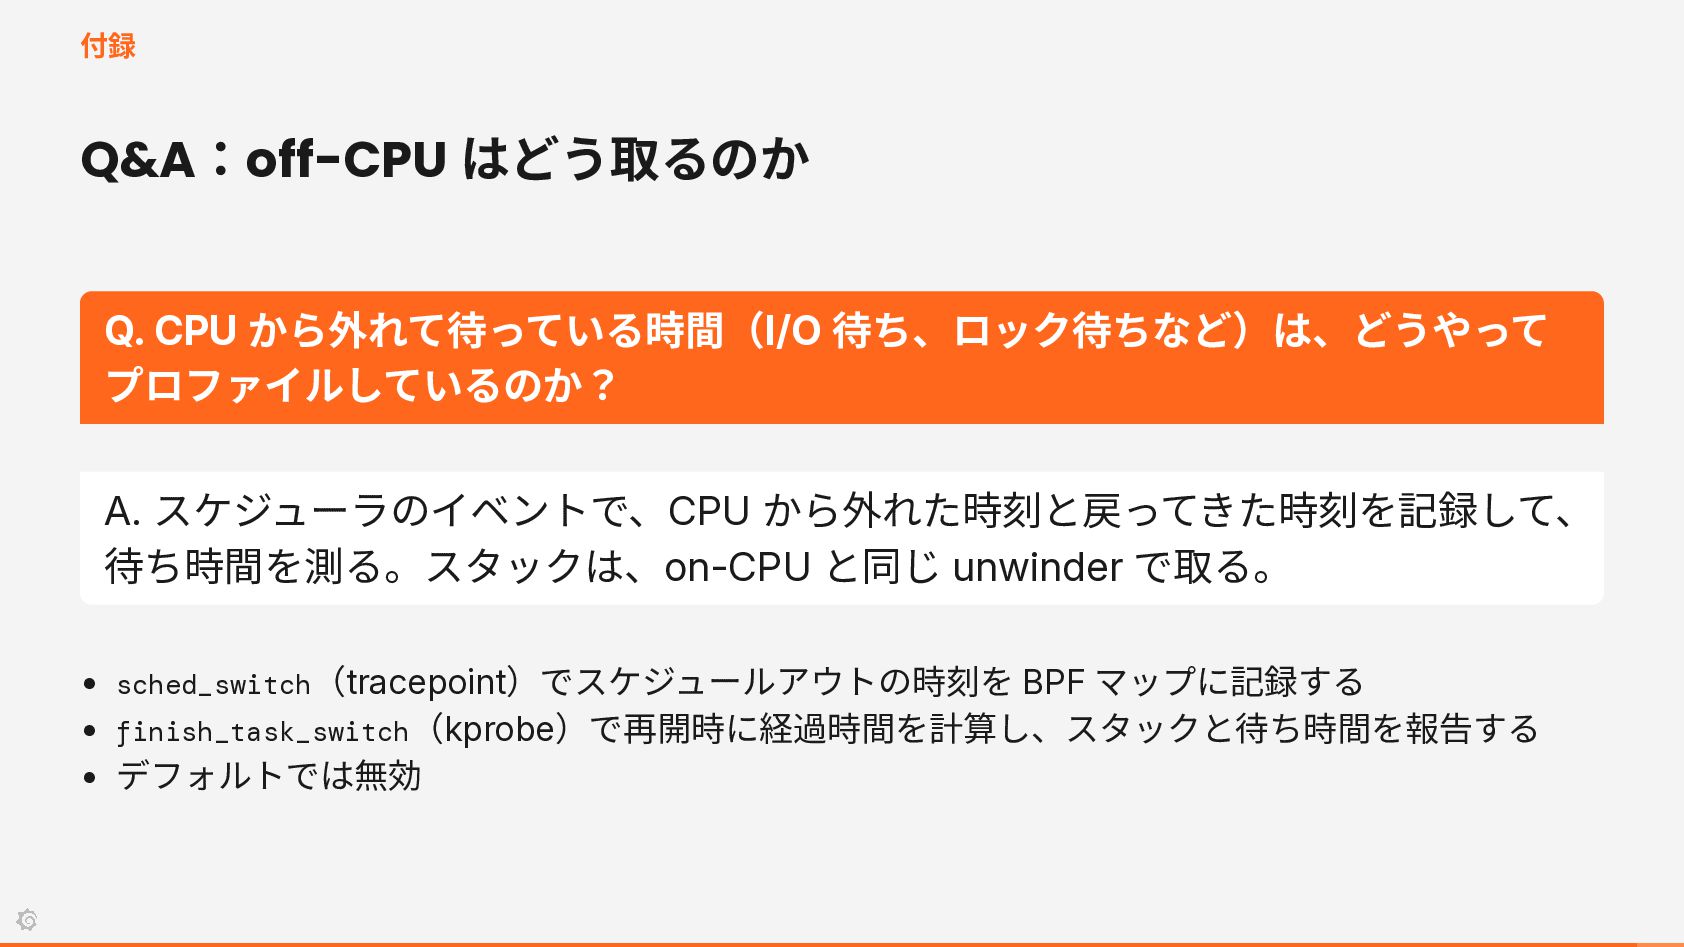
付録 Q&A:off-CPU はどう取るのか Q. CPU から外れて待っている時間(I/O 待ち、ロック待ちなど)は、どうやって プロファイルしているのか? A. スケジューラのイベントで、CPU
から外れた時刻と戻ってきた時刻を記録して、 待ち時間を測る。スタックは、on-CPU と同じ unwinder で取る。 • sched_switch(tracepoint)でスケジュールアウトの時刻を BPF マップに記録する • finish_task_switch(kprobe)で再開時に経過時間を計算し、スタックと待ち時間を報告する • デフォルトでは無効
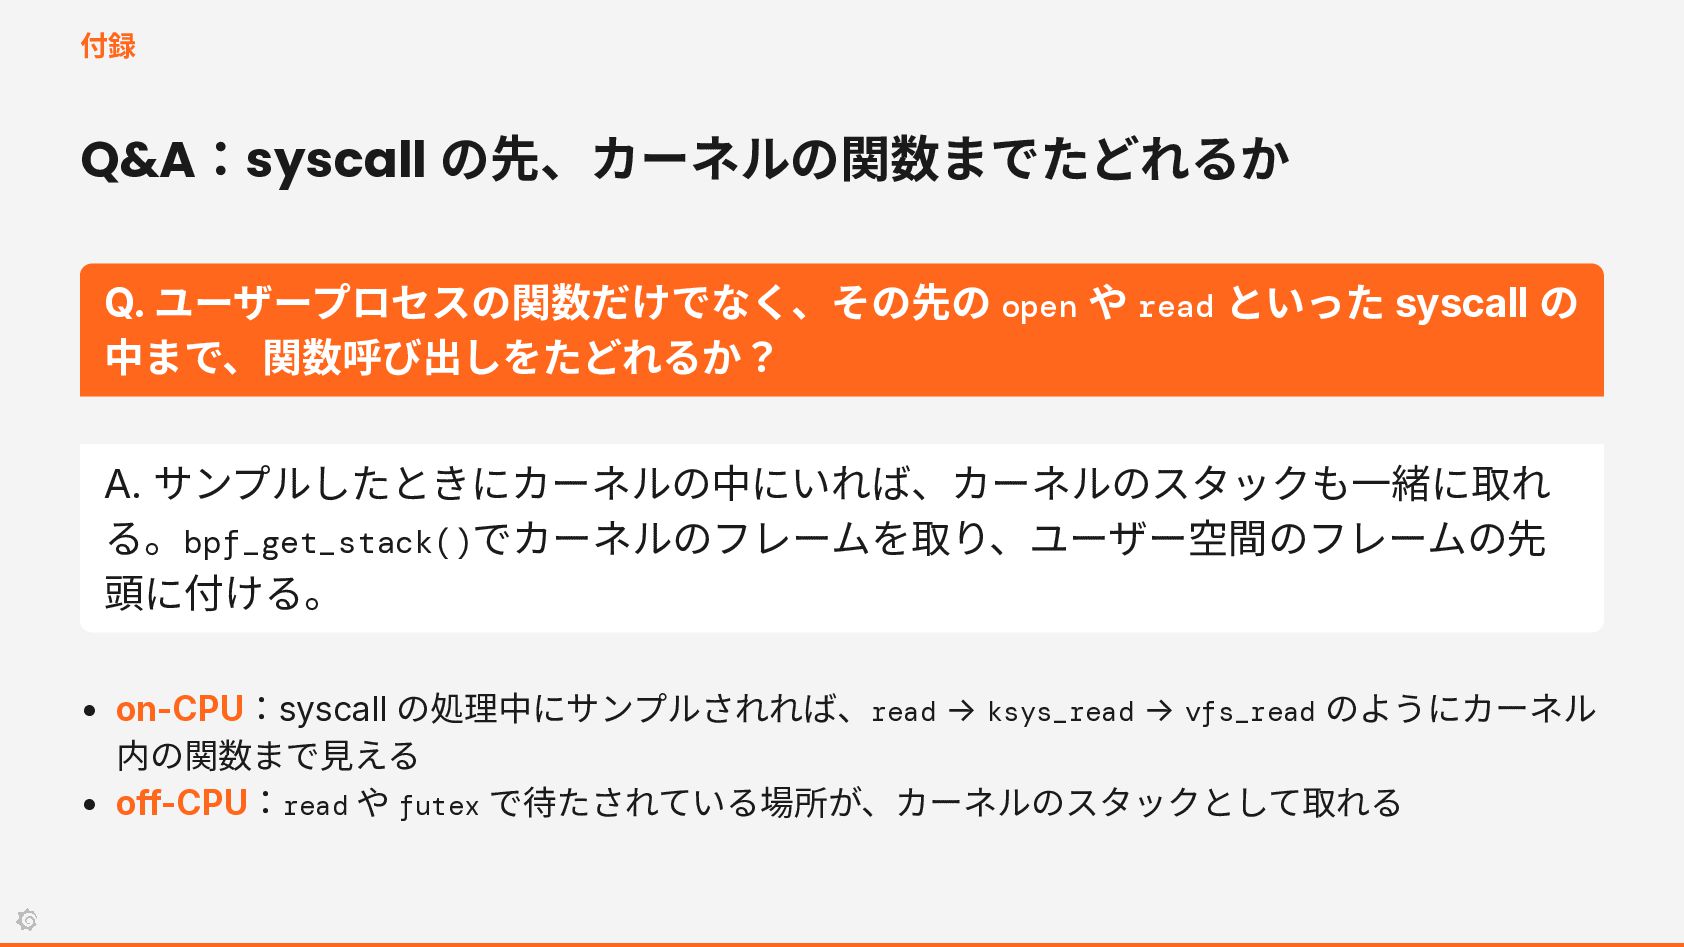
付録 Q&A:syscall の先、カーネルの関数までたどれるか Q. ユーザープロセスの関数だけでなく、その先の open や read といった syscall
の 中まで、関数呼び出しをたどれるか? A. サンプルしたときにカーネルの中にいれば、カーネルのスタックも一緒に取れ る。bpf_get_stack()でカーネルのフレームを取り、ユーザー空間のフレームの先 頭に付ける。 • on-CPU:syscall の処理中にサンプルされれば、read → ksys_read → vfs_read のようにカーネル 内の関数まで見える • off-CPU:read や futex で待たされている場所が、カーネルのスタックとして取れる


 mtanda
 bluesmoon
 katarinadahlin
 aleyda
 raygrieselhuber
 katiecoart
 lara
 orderedlist
 baasie
 rkendrick25
 chrisshort
 samanthasiow
 stephaniewalter