Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
画像生成AIの生成速度の遅さと 画風のばらつきを解決する手法 Methods for Solv...
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Neurogica
June 13, 2026
Technology
31
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
画像生成AIの生成速度の遅さと 画風のばらつきを解決する手法 Methods for Solving Image Generation AI's Slowness and Style Inconsistency
Neurogica
June 13, 2026
Transcript
14 slides
画像⽣成AIの⽣成速度の遅さと 画⾵のばらつきを解決する⼿法 株式会社ニューロジカ 開発部 渡瀬遥⼰
アジェンダ はじめに ⼆つの課題 MeanFlow CoTyle • はじめに: 画像⽣成AIはどうやって画像を作っているのか • 画像⽣成AIの実⽤化を阻む2つの課題
• MeanFlow / iMF: 1ステップ⽣成で速度の課題を解決するアプローチ • CoTyle: 画像のスタイルを1つの数値コードで表現するアプローチ • まとめ © Neurogica Inc. まとめ 2
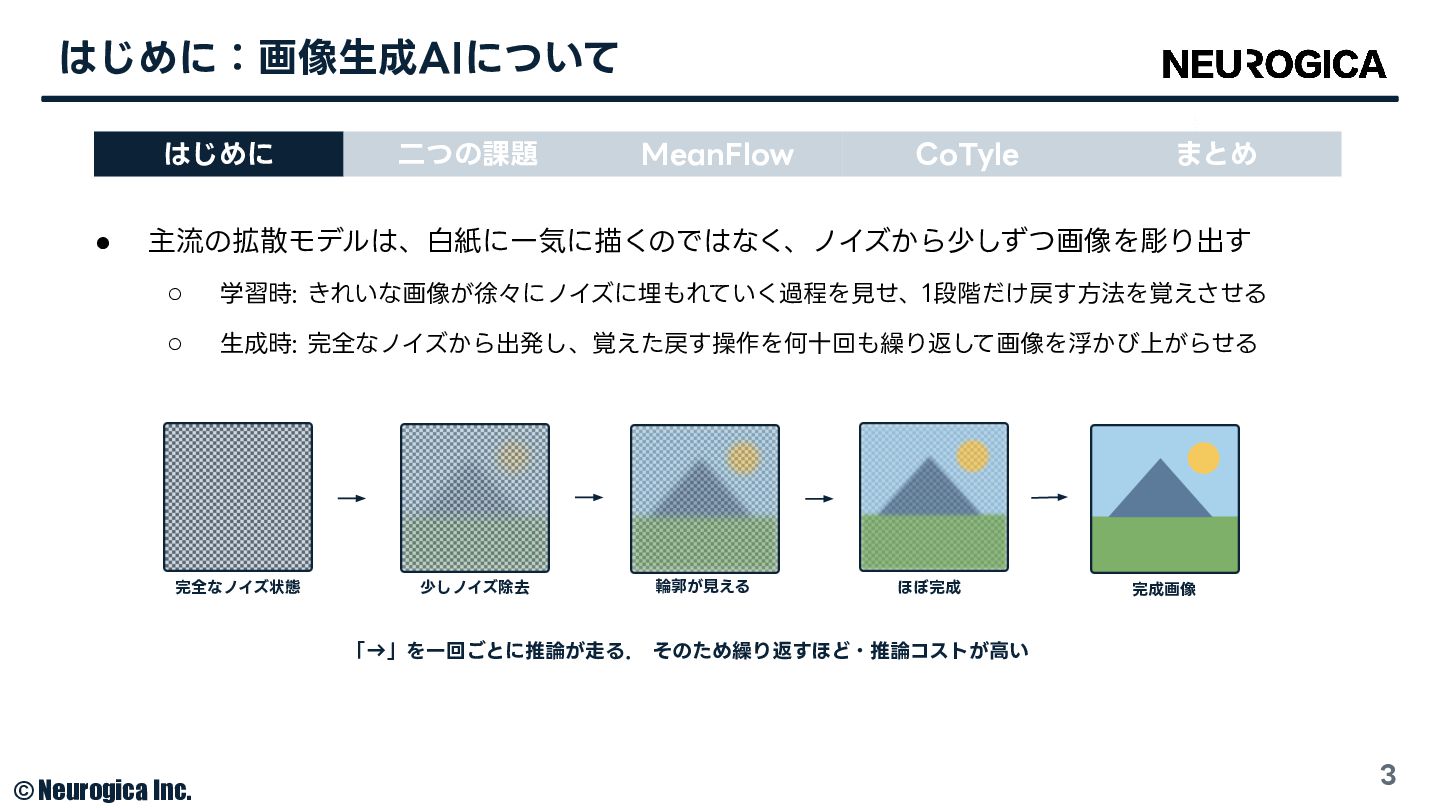
はじめに:画像⽣成AIについて はじめに • ⼆つの課題 MeanFlow CoTyle まとめ 主流の拡散モデルは、⽩紙に⼀気に描くのではなく、ノイズから少しずつ画像を彫り出す ◦ 学習時:
きれいな画像が徐々にノイズに埋もれていく過程を⾒せ、1段階だけ戻す⽅法を覚えさせる ◦ ⽣成時: 完全なノイズから出発し、覚えた戻す操作を何⼗回も繰り返して画像を浮かび上がらせる 完全なノイズ状態 少しノイズ除去 輪郭が⾒える ほぼ完成 完成画像 「→」を⼀回ごとに推論が⾛る. そのため繰り返すほど・推論コストが⾼い © Neurogica Inc. 3
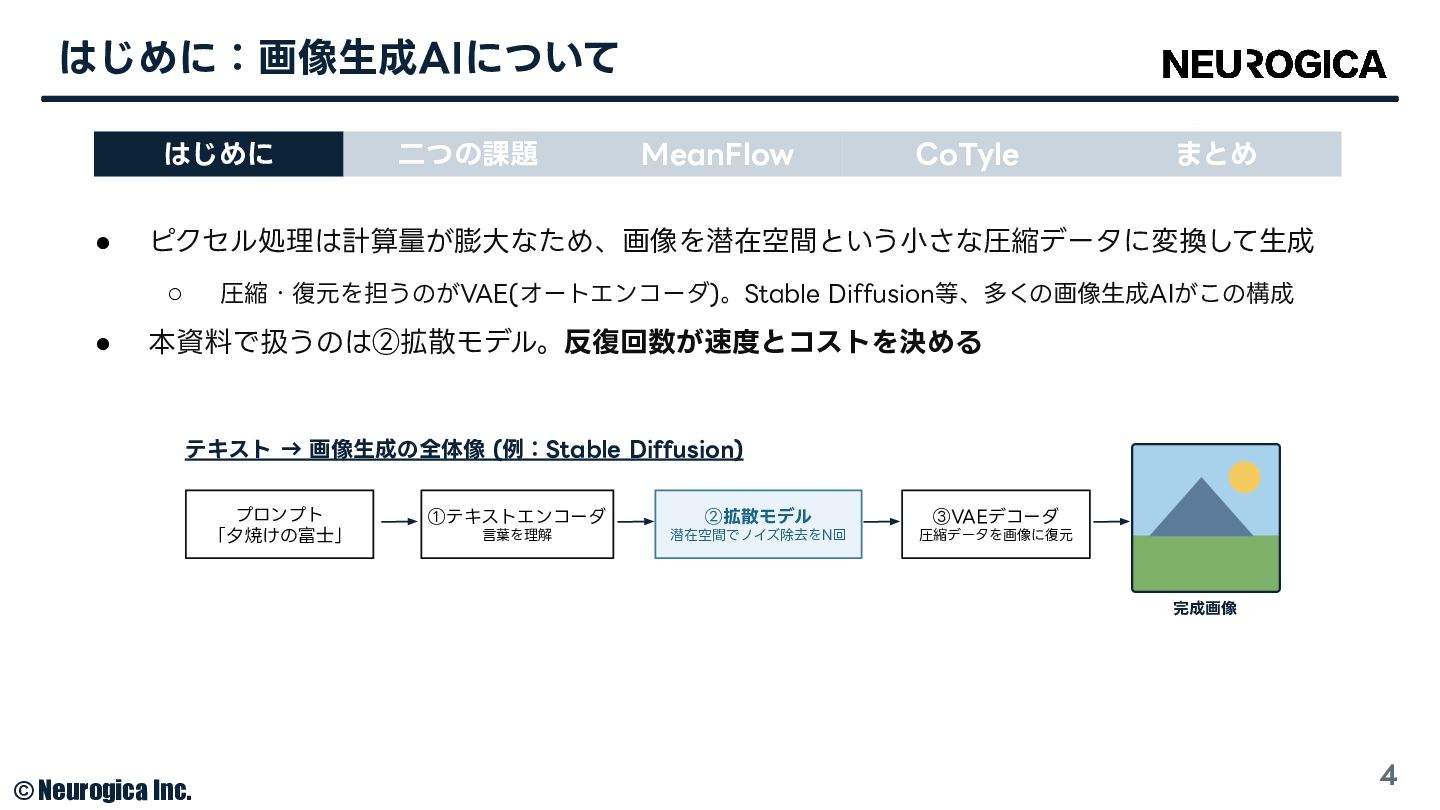
はじめに:画像⽣成AIについて はじめに • MeanFlow CoTyle まとめ ピクセル処理は計算量が膨⼤なため、画像を潜在空間という⼩さな圧縮データに変換して⽣成 圧縮・復元を担うのがVAE(オートエンコーダ)。Stable Diffusion等、多くの画像⽣成AIがこの構成 ◦
• ⼆つの課題 本資料で扱うのは②拡散モデル。反復回数が速度とコストを決める テキスト → 画像⽣成の全体像 (例:Stable Diffusion) プロンプト 「⼣焼けの富⼠」 ①テキストエンコーダ ②拡散モデル ③VAEデコーダ ⾔葉を理解 潜在空間でノイズ除去をN回 圧縮データを画像に復元 完成画像 © Neurogica Inc. 4
実⽤化における⼆つの課題 はじめに ⼆つの課題 MeanFlow CoTyle まとめ • ⽣成品質は実⽤⽔準に到達。しかし業務システムへの組み込みには2つの課題が残存 • 課題①
速度が遅くコストが⾼い • ◦ 拡散モデルは数⼗〜数百回の反復推論が前提 ◦ リアルタイム⽤途(対話的編集・エッジ実⾏)でGPUコストが事業性を圧迫 課題② スタイル⼀貫性が維持できず、管理も難しい ◦ プロンプト指定は曖昧で再現性が低い ◦ ブランドガイドラインを安定して守れず、制作実務に乗らない © Neurogica Inc. 5
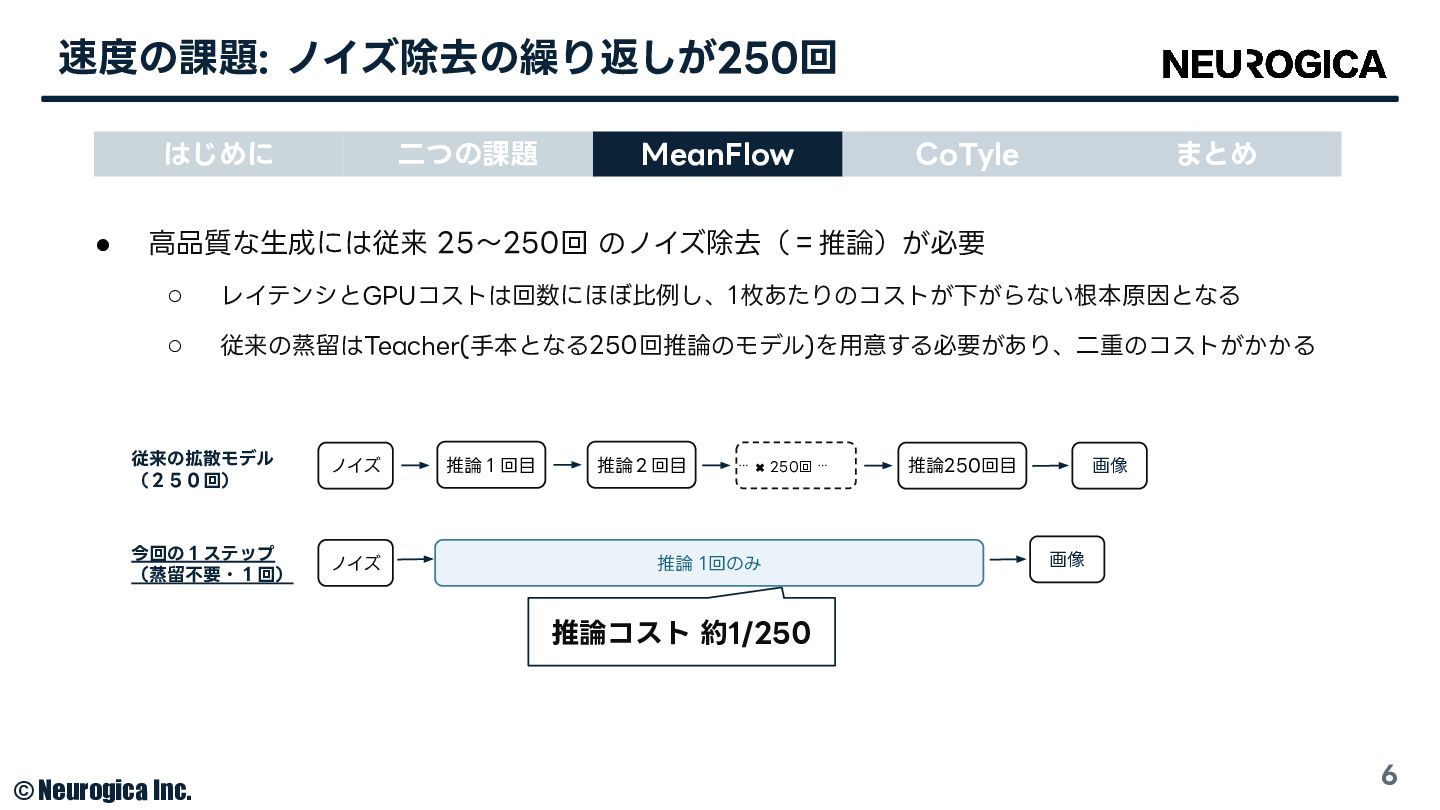
速度の課題: ノイズ除去の繰り返しが250回 はじめに • ⼆つの課題 MeanFlow CoTyle まとめ ⾼品質な⽣成には従来 25〜250回
のノイズ除去(=推論)が必要 ◦ レイテンシとGPUコストは回数にほぼ⽐例し、1枚あたりのコストが下がらない根本原因となる ◦ 従来の蒸留はTeacher(⼿本となる250回推論のモデル)を⽤意する必要があり、⼆重のコストがかかる 従来の拡散モデル (250回) ノイズ 今回の1ステップ (蒸留不要・1回) ノイズ 推論1回⽬ 推論2回⽬ ⋯ ✖ 250回 ⋯ 推論 1回のみ 推論250回⽬ 画像 画像 推論コスト 約1/250 © Neurogica Inc. 6
MeanFlow: 平均速度を覚えて1回でゴールに跳ぶ はじめに • • • ⼆つの課題 MeanFlow CoTyle まとめ
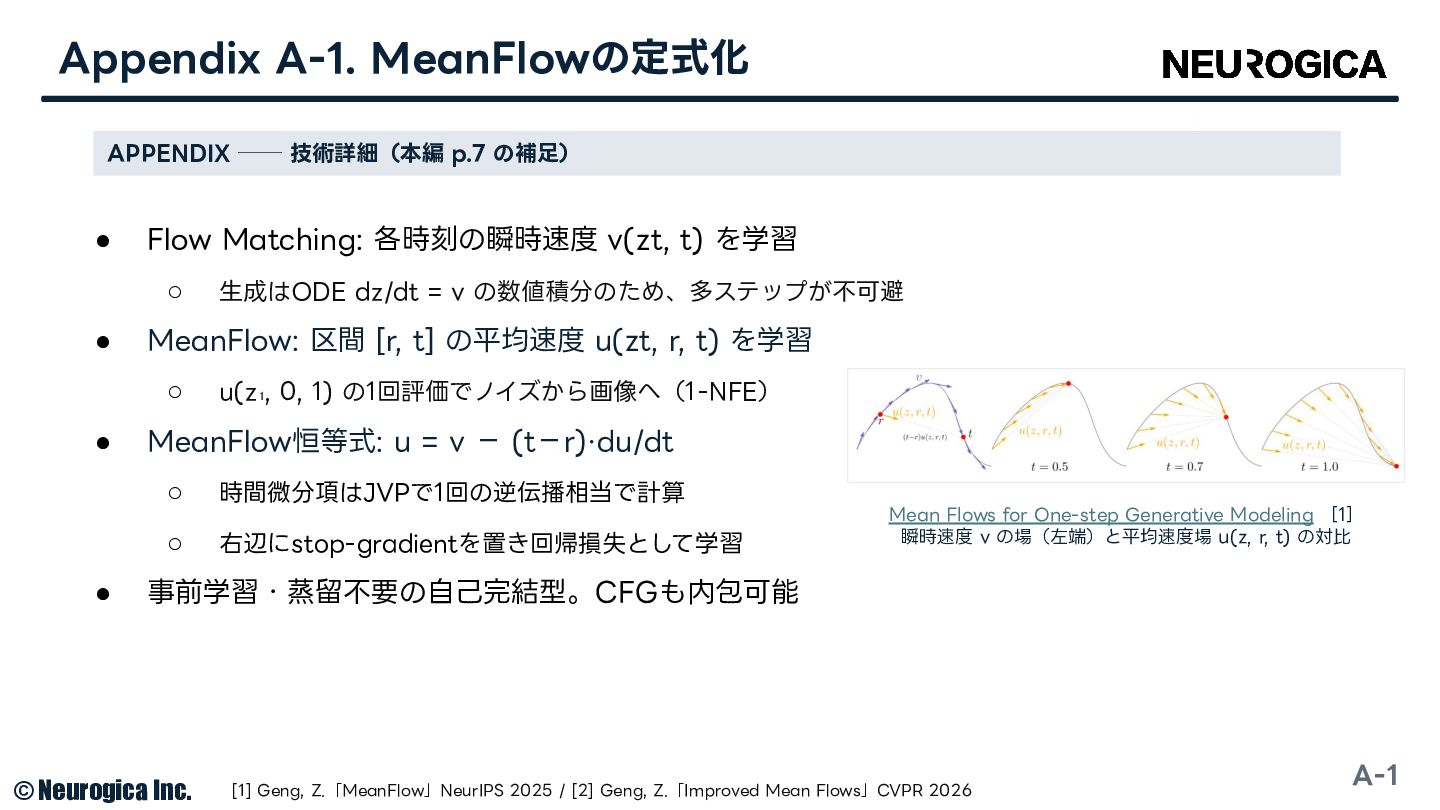
従来は瞬間の進む向きしか知らない ◦ いまの⼀瞬のハンドル操作だけを学習(⾞の例) ◦ ゴール(完成画像)まで何百回も操作が必要 MeanFlowは道のり全体の平均速度を知っている ◦ 出発地からゴールまでの平均速度を丸ごと学習 ◦ 推論1回でノイズから画像へジャンプ 既存の1ステップ⼿法の限界を突破し、Teacherモデルが不要 ◦ 平均速度の定式化により、単独で1ステップ学習が完結 ◦ Kaiming He らによる提案 [1]、NeurIPS 2025 Oral 数式・学習⽅法の詳細は Appendix A-1 © Neurogica Inc. [1] Geng, Z.「MeanFlow」NeurIPS 2025 [2] Geng, Z.「Improved Mean Flows」CVPR 2026 7
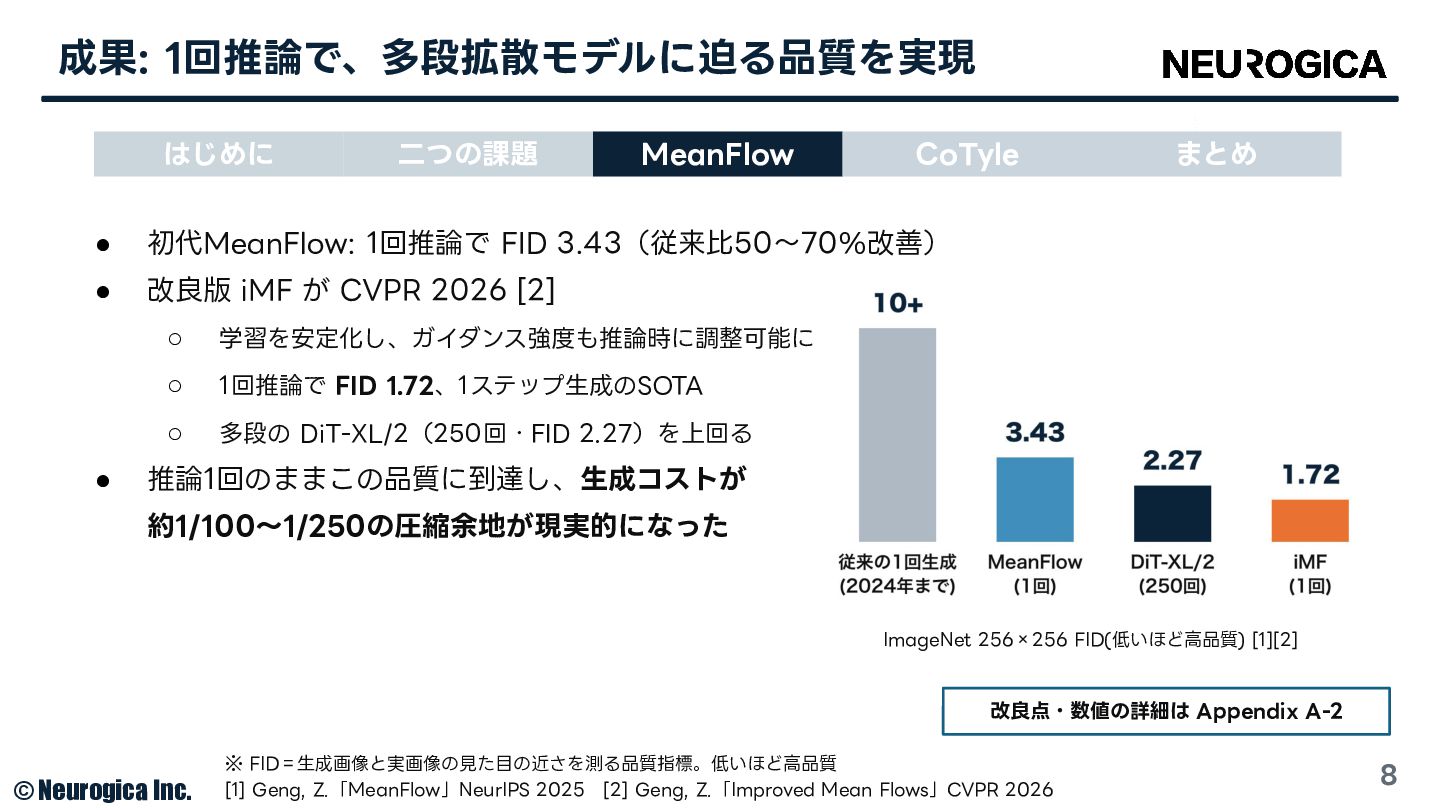
成果: 1回推論で、多段拡散モデルに迫る品質を実現 はじめに ⼆つの課題 MeanFlow CoTyle • 初代MeanFlow: 1回推論で FID
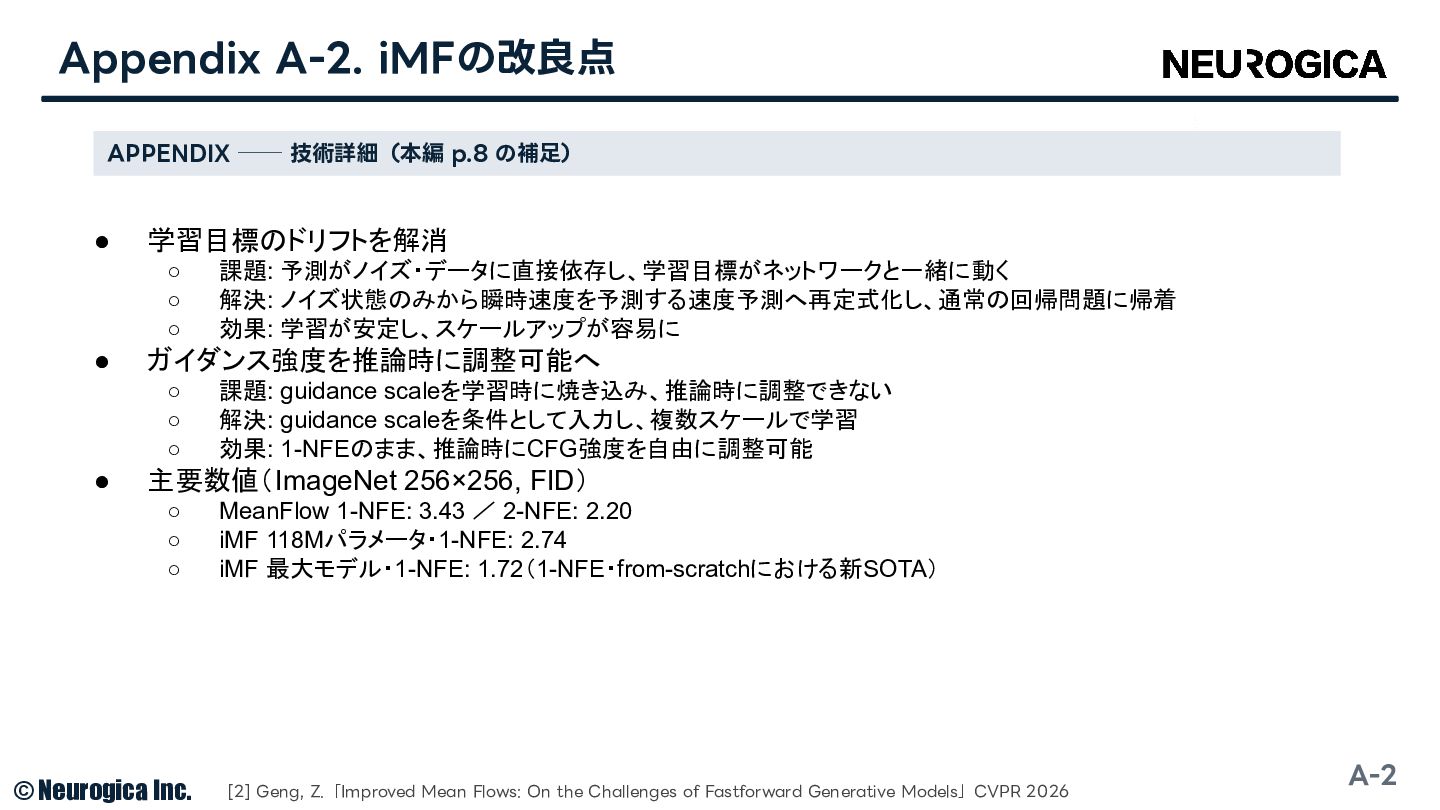
3.43(従来⽐50〜70%改善) • 改良版 iMF が CVPR 2026 [2] • ◦ 学習を安定化し、ガイダンス強度も推論時に調整可能に ◦ 1回推論で FID 1.72、1ステップ⽣成のSOTA ◦ 多段の DiT-XL/2(250回・FID 2.27)を上回る まとめ 推論1回のままこの品質に到達し、⽣成コストが 約1/100〜1/250の圧縮余地が現実的になった ImageNet 256×256 FID(低いほど⾼品質) [1][2] 改良点・数値の詳細は Appendix A-2 © Neurogica Inc. ※ FID=⽣成画像と実画像の⾒た⽬の近さを測る品質指標。低いほど⾼品質 [1] Geng, Z.「MeanFlow」NeurIPS 2025 [2] Geng, Z.「Improved Mean Flows」CVPR 2026 8
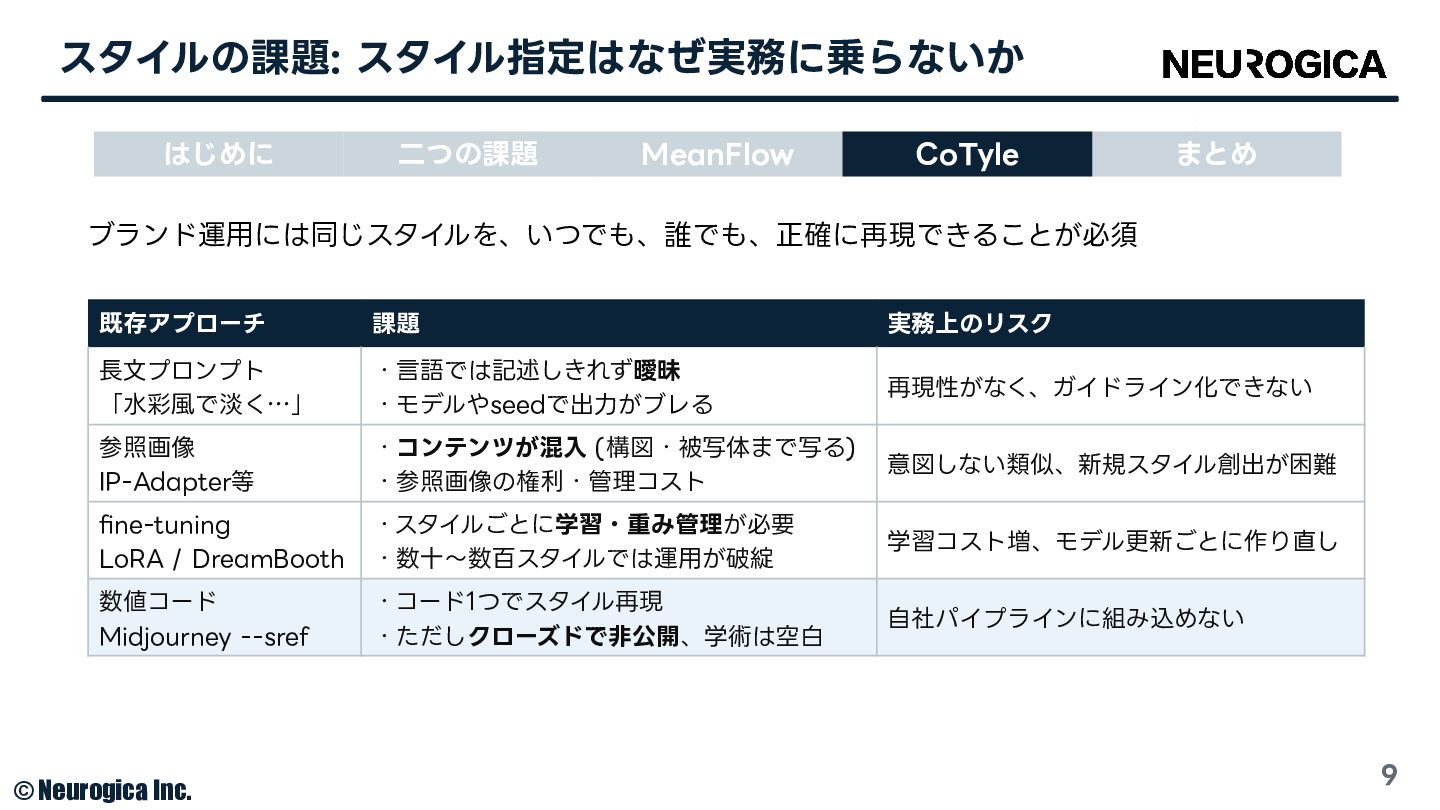
スタイルの課題: スタイル指定はなぜ実務に乗らないか はじめに ⼆つの課題 MeanFlow CoTyle まとめ ブランド運⽤には同じスタイルを、いつでも、誰でも、正確に再現できることが必須 既存アプローチ 課題
実務上のリスク ⻑⽂プロンプト 「⽔彩⾵で淡く…」 ・⾔語では記述しきれず曖昧 ・モデルやseedで出⼒がブレる 再現性がなく、ガイドライン化できない 参照画像 IP-Adapter等 ・コンテンツが混⼊ (構図・被写体まで写る) ・参照画像の権利・管理コスト 意図しない類似、新規スタイル創出が困難 fine-tuning LoRA / DreamBooth ・スタイルごとに学習・重み管理が必要 ・数⼗〜数百スタイルでは運⽤が破綻 学習コスト増、モデル更新ごとに作り直し 数値コード Midjourney --sref ・コード1つでスタイル再現 ・ただしクローズドで⾮公開、学術は空⽩ ⾃社パイプラインに組み込めない © Neurogica Inc. 9
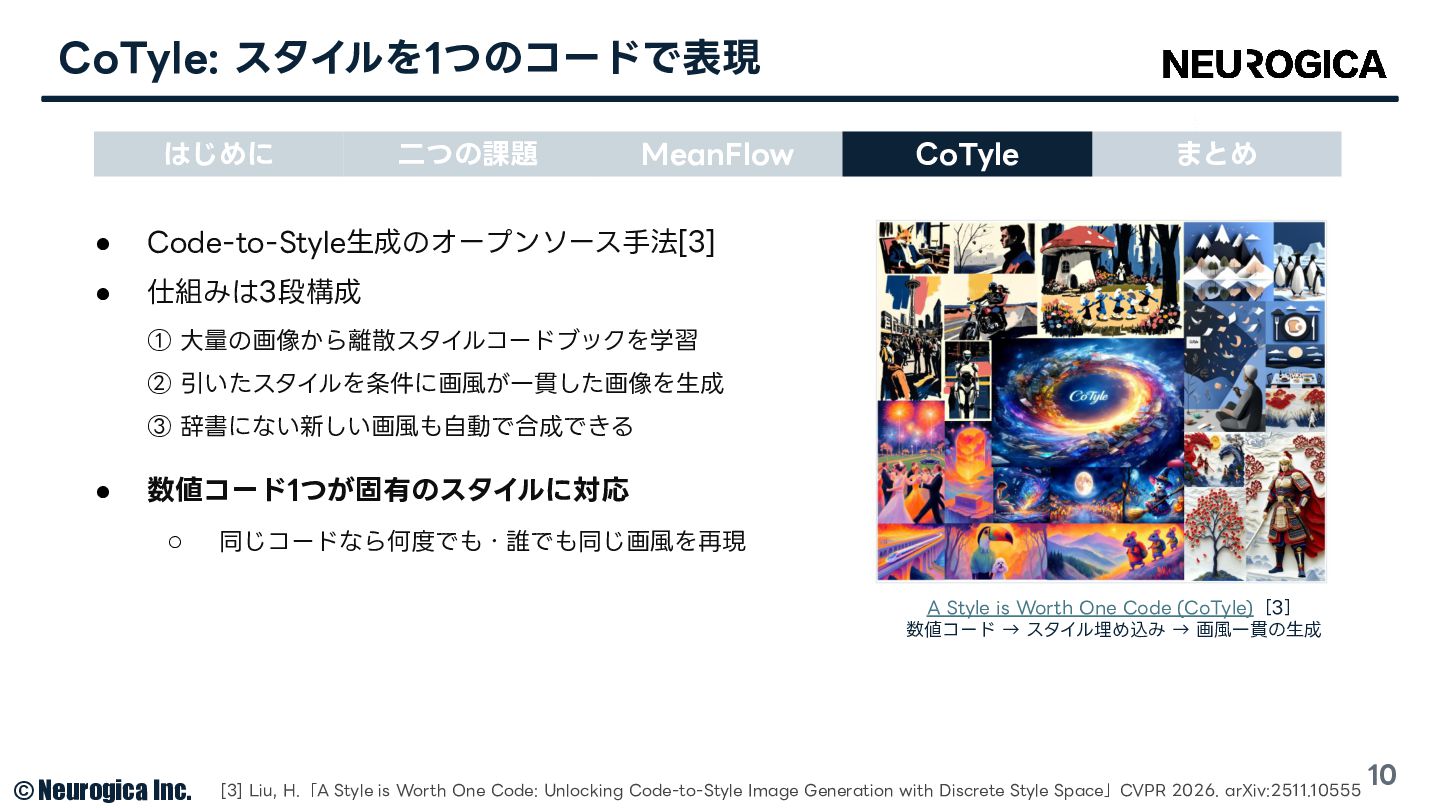
CoTyle: スタイルを1つのコードで表現 はじめに ⼆つの課題 MeanFlow • Code-to-Style⽣成のオープンソース⼿法[3] • 仕組みは3段構成 CoTyle
まとめ ① ⼤量の画像から離散スタイルコードブックを学習 ② 引いたスタイルを条件に画⾵が⼀貫した画像を⽣成 ③ 辞書にない新しい画⾵も⾃動で合成できる • 数値コード1つが固有のスタイルに対応 ◦ 同じコードなら何度でも・誰でも同じ画⾵を再現 A Style is Worth One Code (CoTyle)[3] 数値コード → スタイル埋め込み → 画⾵⼀貫の⽣成 © Neurogica Inc. [3] Liu, H.「A Style is Worth One Code: Unlocking Code-to-Style Image Generation with Discrete Style Space」CVPR 2026. arXiv:2511.10555 10
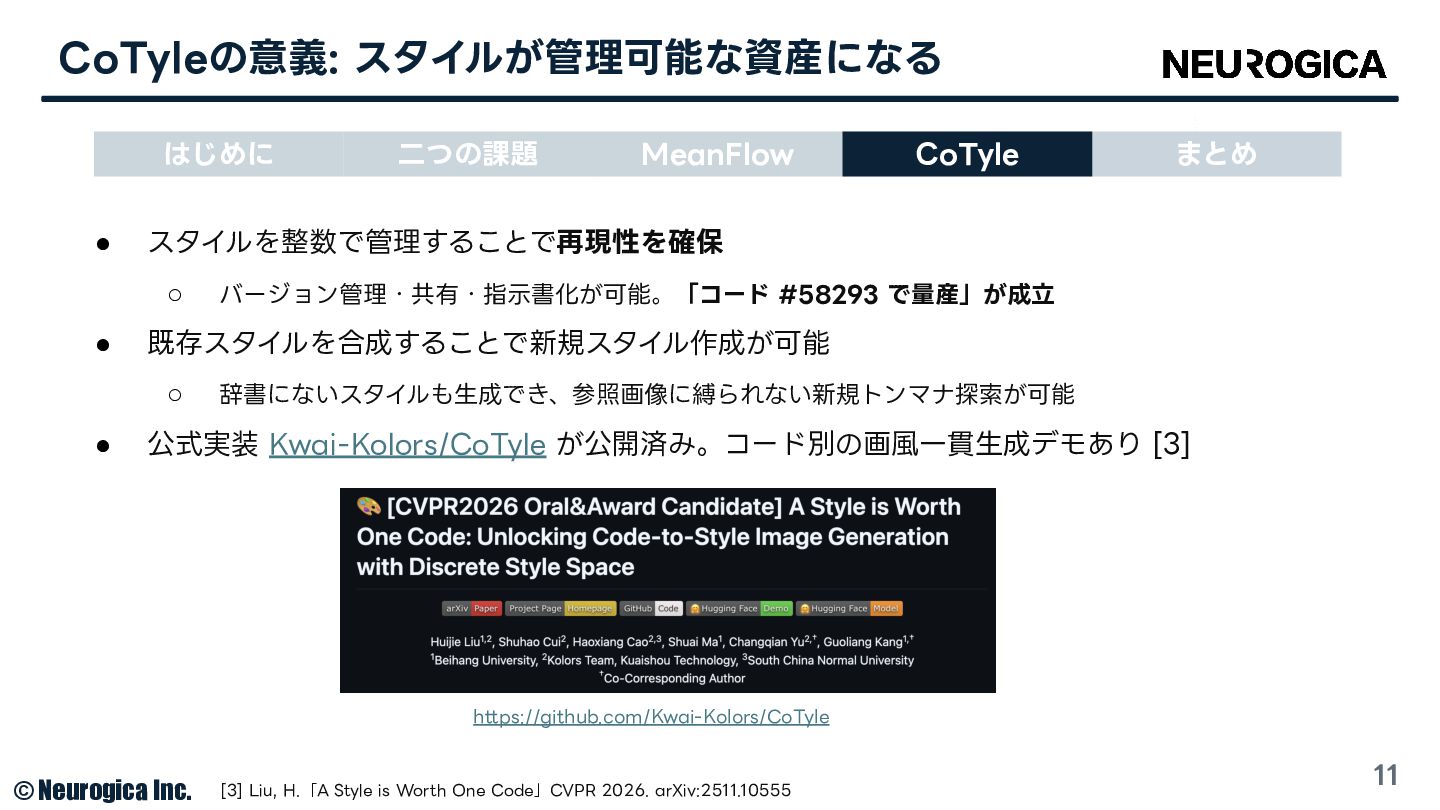
CoTyleの意義: スタイルが管理可能な資産になる はじめに • CoTyle まとめ バージョン管理・共有・指⽰書化が可能。「コード #58293 で量産」が成⽴ 既存スタイルを合成することで新規スタイル作成が可能
◦ • MeanFlow スタイルを整数で管理することで再現性を確保 ◦ • ⼆つの課題 辞書にないスタイルも⽣成でき、参照画像に縛られない新規トンマナ探索が可能 公式実装 Kwai-Kolors/CoTyle が公開済み。コード別の画⾵⼀貫⽣成デモあり [3] https://github.com/Kwai-Kolors/CoTyle © Neurogica Inc. [3] Liu, H.「A Style is Worth One Code」CVPR 2026. arXiv:2511.10555 11
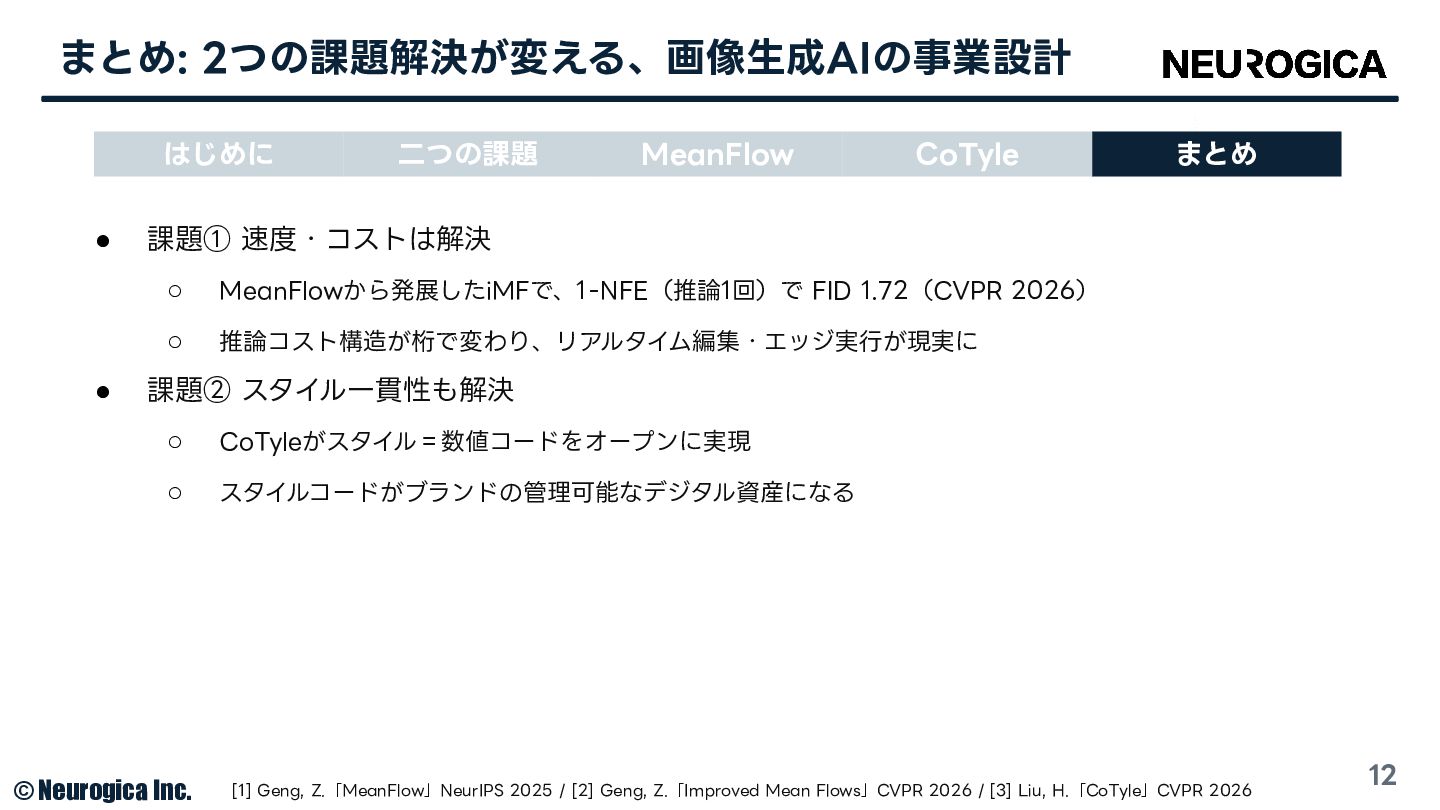
まとめ: 2つの課題解決が変える、画像⽣成AIの事業設計 はじめに • • ⼆つの課題 MeanFlow CoTyle まとめ 課題①
速度・コストは解決 ◦ MeanFlowから発展したiMFで、1-NFE(推論1回)で FID 1.72(CVPR 2026) ◦ 推論コスト構造が桁で変わり、リアルタイム編集・エッジ実⾏が現実に 課題② スタイル⼀貫性も解決 ◦ CoTyleがスタイル=数値コードをオープンに実現 ◦ スタイルコードがブランドの管理可能なデジタル資産になる © Neurogica Inc. [1] Geng, Z.「MeanFlow」NeurIPS 2025 / [2] Geng, Z.「Improved Mean Flows」CVPR 2026 / [3] Liu, H.「CoTyle」CVPR 2026 12
Appendix A-1. MeanFlowの定式化 APPENDIX ── 技術詳細(本編 p.7 の補⾜) • Flow
Matching: 各時刻の瞬時速度 v(zt, t) を学習 ◦ • MeanFlow: 区間 [r, t] の平均速度 u(zt, r, t) を学習 ◦ • • ⽣成はODE dz/dt = v の数値積分のため、多ステップが不可避 u(z₁, 0, 1) の1回評価でノイズから画像へ(1-NFE) MeanFlow恒等式: u = v − (t−r)·du/dt ◦ 時間微分項はJVPで1回の逆伝播相当で計算 ◦ 右辺にstop-gradientを置き回帰損失として学習 Mean Flows for One-step Generative Modeling [1] 瞬時速度 v の場(左端)と平均速度場 u(z, r, t) の対⽐ 事前学習・蒸留不要の⾃⼰完結型。CFGも内包可能 © Neurogica Inc. [1] Geng, Z.「MeanFlow」NeurIPS 2025 / [2] Geng, Z.「Improved Mean Flows」CVPR 2026 A-1
Appendix A-2. iMFの改良点 APPENDIX ── 技術詳細(本編 p.8 の補⾜) • 学習目標のドリフトを解消
◦ ◦ ◦ • ガイダンス強度を推論時に調整可能へ ◦ ◦ ◦ • 課題: 予測がノイズ・データに直接依存し、学習目標がネットワークと一緒に動く 解決: ノイズ状態のみから瞬時速度を予測する速度予測へ再定式化し、通常の回帰問題に帰着 効果: 学習が安定し、スケールアップが容易に 課題: guidance scaleを学習時に焼き込み、推論時に調整できない 解決: guidance scaleを条件として入力し、複数スケールで学習 効果: 1-NFEのまま、推論時にCFG強度を自由に調整可能 主要数値(ImageNet 256×256, FID) ◦ ◦ ◦ © Neurogica Inc. MeanFlow 1-NFE: 3.43 / 2-NFE: 2.20 iMF 118Mパラメータ・1-NFE: 2.74 iMF 最大モデル・1-NFE: 1.72(1-NFE・from-scratchにおける新SOTA) [2] Geng, Z.「Improved Mean Flows: On the Challenges of Fastforward Generative Models」CVPR 2026 A-2
More Decks by Neurogica
See All by Neurogica
時系列予測の100年と、これから A Century of Time Series Forecasting, and What Comes Next
neurogica
0
27
MapReduceを読む - 大量データを分担する Understanding MapReduce — Distributing Large-Scale Data Processing
neurogica
0
26
Sparse Autoencoder 〜 大規模言語モデルの内部表現を読む 〜 Sparse Autoencoder: Understanding LLM's Latent Representations
neurogica
0
70
LLMは“⼼”をモデル化しているのか? Do LLMs Model the Mind?
neurogica
0
26
LLM-MAS×時系列予測 LLM-MAS × Time-Series Forecasting
neurogica
0
60
推薦タスクの整理と 時系列基盤モデル活用を考える How Recommender Systems Use Time-Series Data and Where Foundation Models Fit
neurogica
0
26
DBコネクションプール Database Connection Pooling
neurogica
0
77
時系列基盤モデルは作れるのか? Can We Build a Foundation Model for Time Series?
neurogica
1
140
双曲空間と機械学習 〜 階層性を活かした学習〜 Hyperbolic Space and Machine Learning ~ Learning that Leverages Hierarchical Structure ~
neurogica
0
64
Other Decks in Technology
See All in Technology
人の努力に頼らないセキュリティをエンジニアリングする在り方 / An approach to engineering security that does not rely on human effort
carta_engineering
0
240
実測データからサービスの成長余力を測る。負荷シナリオ・テストデータ・限界値の設計
kazatohiei
0
140
ブース設計、 お前もプロダクトだったのか / So Booth Design Was a Product All Along
akihiro0038
0
140
パスワードのない鍵で、 データを手元に置く
ginjihayashi
0
390
クラウドでも使えるNetApp -現場目線での設計とクラウドバックアップの活用
ryutakondo
1
290
NutanixへのSSHアクセスの今後について
shadowhat
0
140
Del vibe coding a un Desarrollo (agéntico) fiable
jcabot
0
200
Taking back control of your AI development
inesmontani
PRO
0
310
みん強Lightning! データ基盤ひとりでできるかな
endonanana
0
170
コーディングできない僕にBobが舞い降りた
shumpei3
0
170
Well, that’s weird…
csswizardry
1
180
AWS Client VPNの設定でハマったポイントとその過程での気づき
amarelo_n24
1
430
Featured
See All Featured
My Coaching Mixtape
mlcsv
0
390
Paper Plane (Part 1)
katiecoart
PRO
3
12k
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
1.1k
Conquering PDFs: document understanding beyond plain text
inesmontani
PRO
4
3.3k
Noah Learner - AI + Me: how we built a GSC Bulk Export data pipeline
techseoconnect
PRO
0
500
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
540
The Web Performance Landscape in 2024 [PerfNow 2024]
tammyeverts
12
1.4k
Visualization
eitanlees
153
17k
Rebuilding a faster, lazier Slack
samanthasiow
85
9.8k
Lightning Talk: Beautiful Slides for Beginners
inesmontani
PRO
2
850
Making Projects Easy
brettharned
120
6.9k
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
77k


 neurogica
 carta_engineering
 kazatohiei
 akihiro0038
 ginjihayashi
 ryutakondo
 shadowhat
 jcabot
 inesmontani
 endonanana
 shumpei3
 csswizardry
 amarelo_n24
 mlcsv
 katiecoart
 frankvandijk
 techseoconnect
 kimpetersen
 tammyeverts
 eitanlees
 samanthasiow
 brettharned
 soudai