Upgrade to Pro — share decks privately, control downloads, hide ads and more …

MapReduceを読む - 大量データを分担する Understanding MapRed...

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →
Avatar for Neurogica Neurogica
September 26, 2026

MapReduceを読む - 大量データを分担する Understanding MapReduce — Distributing Large-Scale Data Processing

Avatar for Neurogica

Neurogica

September 26, 2026

More Decks by Neurogica

Other Decks in Technology

Transcript

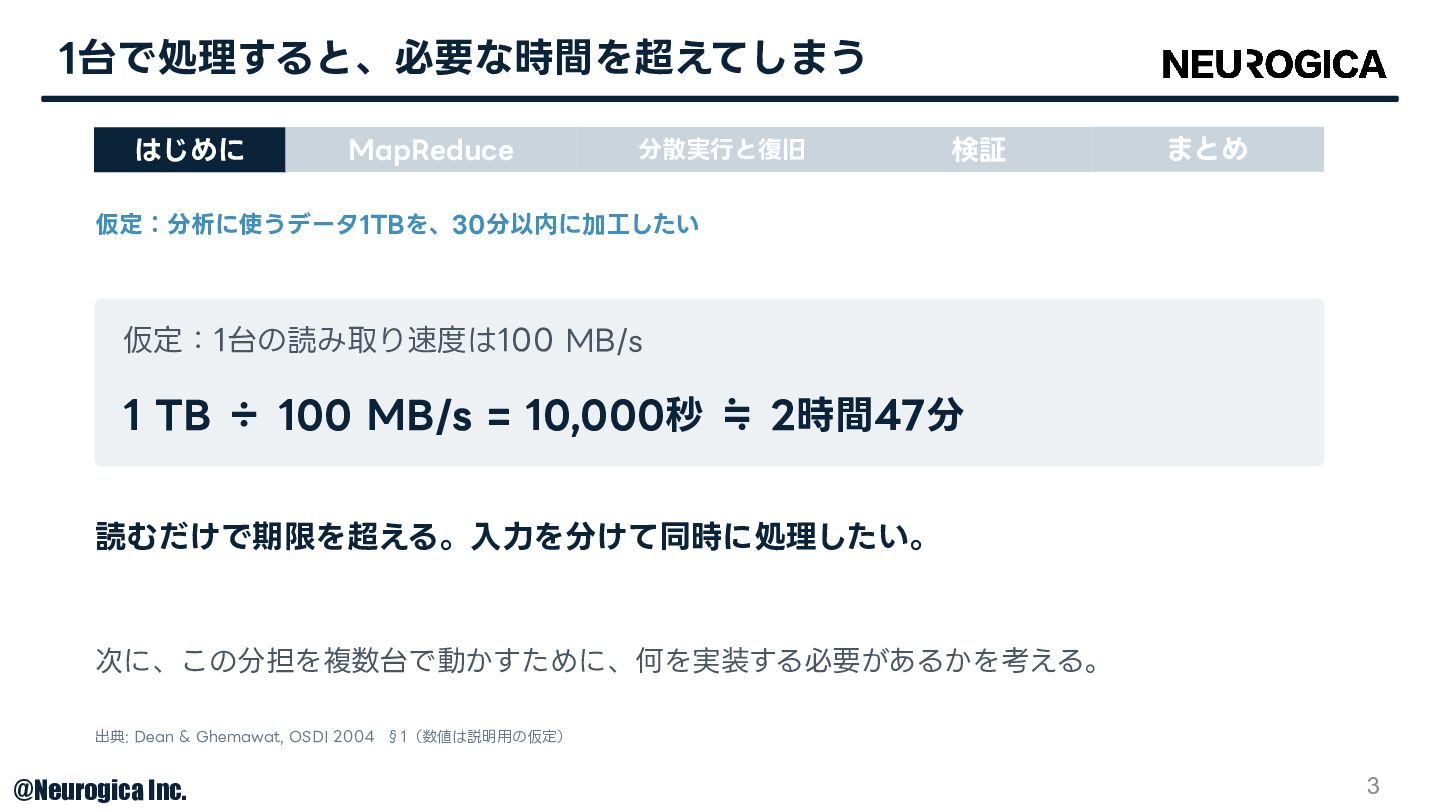
  1. 1台で処理すると、必要な時間を超えてしまう はじめに MapReduce 分散実⾏と復旧 検証 まとめ 仮定:分析に使うデータ1TBを、30分以内に加⼯したい 仮定:1台の読み取り速度は100 MB/s 1

    TB ÷ 100 MB/s = 10,000秒 ≒ 2時間47分 読むだけで期限を超える。⼊⼒を分けて同時に処理したい。 次に、この分担を複数台で動かすために、何を実装する必要があるかを考える。 出典: Dean & Ghemawat, OSDI 2004 §1(数値は説明⽤の仮定) @Neurogica Inc. 3
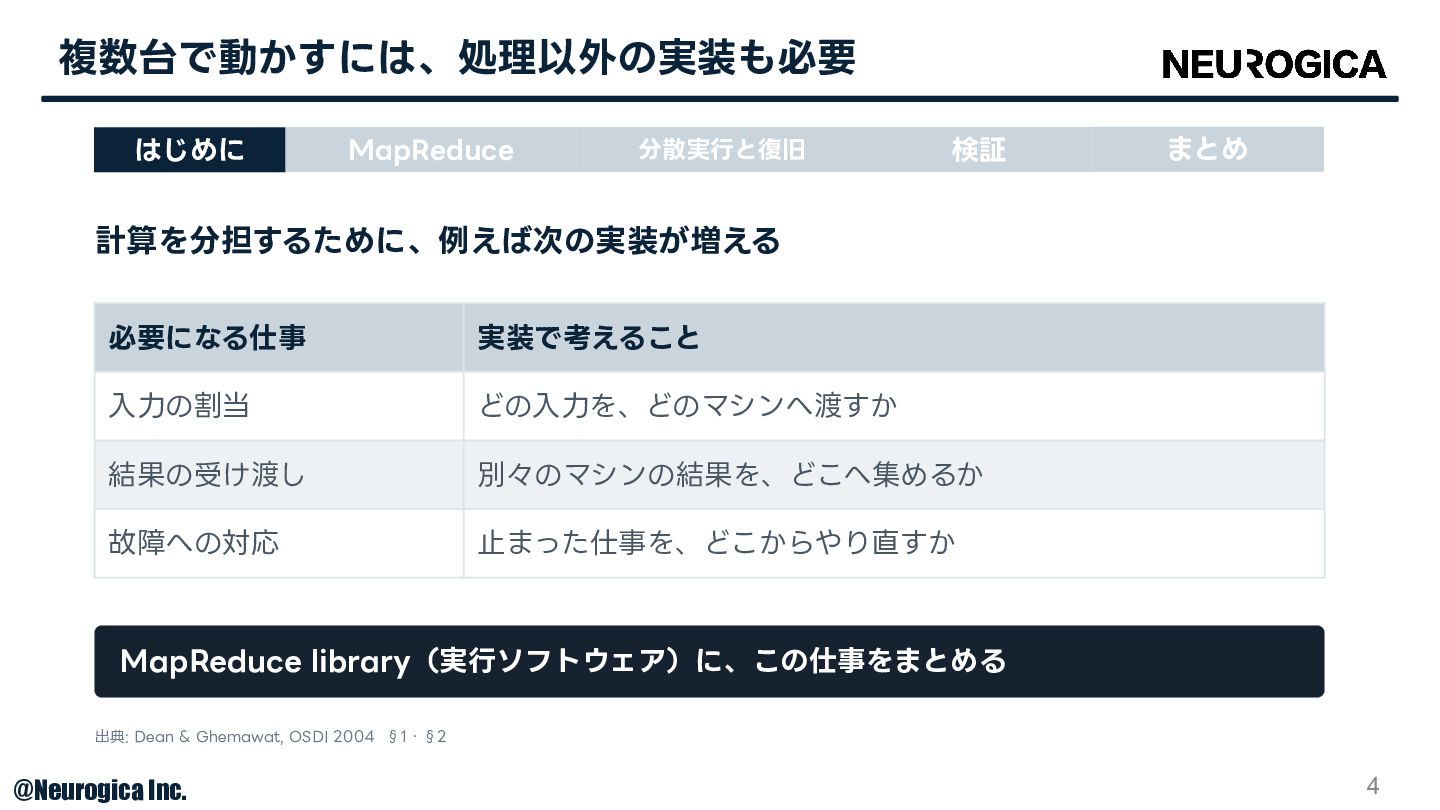
  2. 複数台で動かすには、処理以外の実装も必要 はじめに MapReduce 分散実⾏と復旧 検証 まとめ 計算を分担するために、例えば次の実装が増える 必要になる仕事 実装で考えること ⼊⼒の割当

    どの⼊⼒を、どのマシンへ渡すか 結果の受け渡し 別々のマシンの結果を、どこへ集めるか 故障への対応 ⽌まった仕事を、どこからやり直すか MapReduce library(実⾏ソフトウェア)に、この仕事をまとめる 出典: Dean & Ghemawat, OSDI 2004 §1・§2 @Neurogica Inc. 4
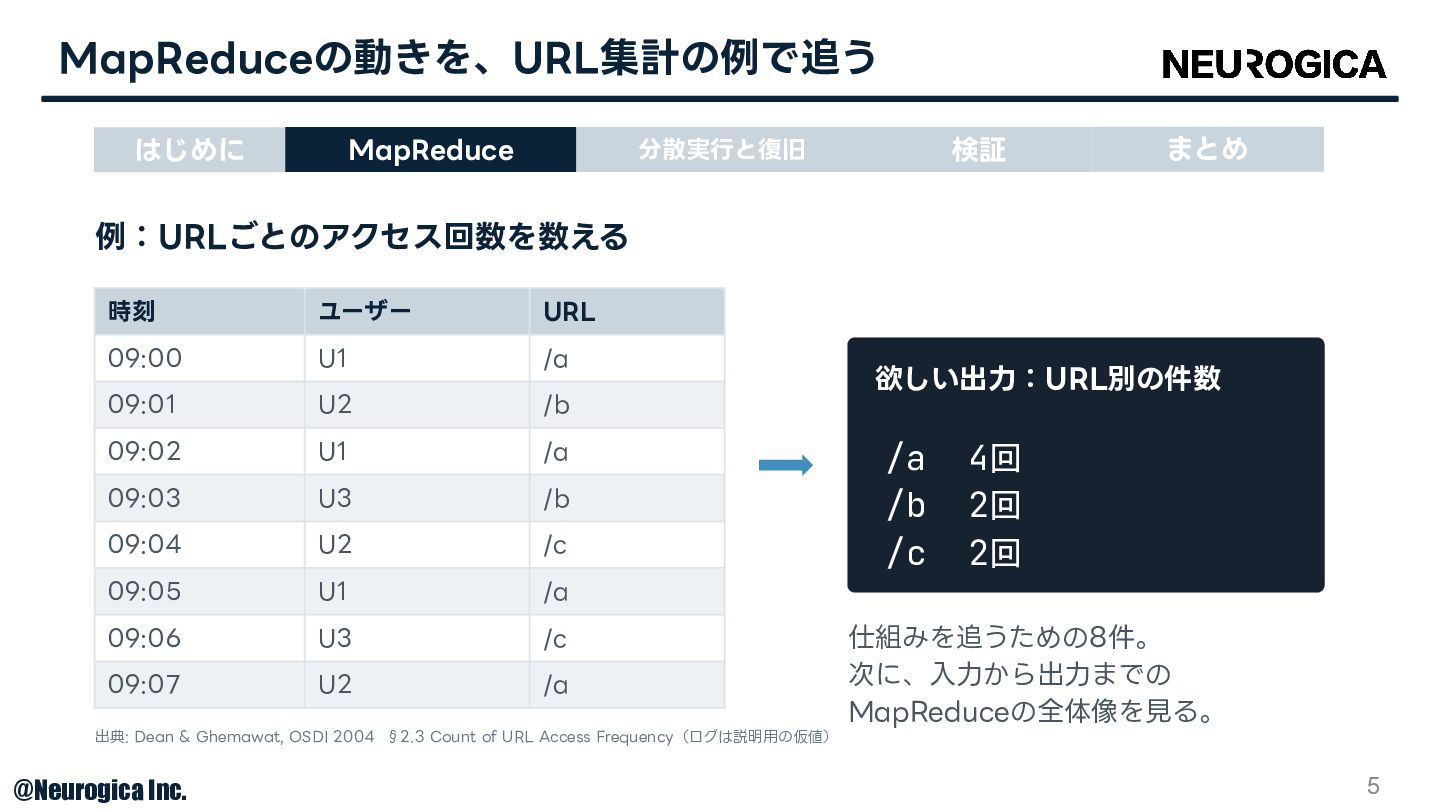
  3. MapReduceの動きを、URL集計の例で追う はじめに MapReduce 検証 分散実⾏と復旧 まとめ 例:URLごとのアクセス回数を数える 時刻 ユーザー URL

    09:00 U1 /a 09:01 U2 /b 09:02 U1 /a 09:03 U3 /b 09:04 U2 /c 09:05 U1 /a 09:06 U3 /c 09:07 U2 /a 欲しい出⼒:URL別の件数 /a /b /c 4回 2回 2回 仕組みを追うための8件。 次に、⼊⼒から出⼒までの MapReduceの全体像を⾒る。 出典: Dean & Ghemawat, OSDI 2004 §2.3 Count of URL Access Frequency(ログは説明⽤の仮値) @Neurogica Inc. 5
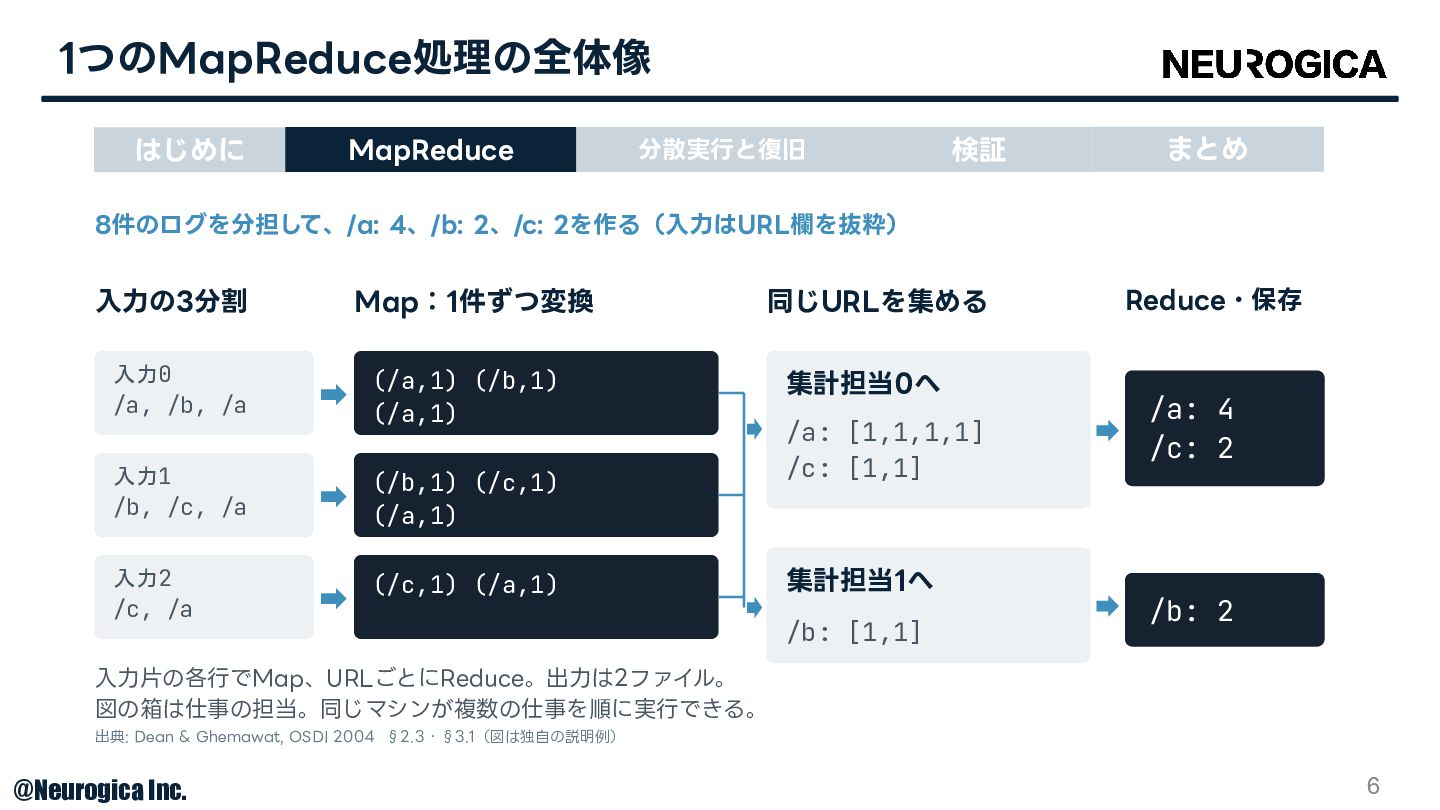
  4. 1つのMapReduce処理の全体像 はじめに MapReduce 分散実⾏と復旧 検証 まとめ 8件のログを分担して、/a: 4、/b: 2、/c: 2を作る(⼊⼒はURL欄を抜粋)

    ⼊⼒の3分割 Map:1件ずつ変換 同じURLを集める 入力0 /a, /b, /a (/a,1) (/b,1) (/a,1) 集計担当0へ 入力1 /b, /c, /a (/b,1) (/c,1) (/a,1) 入力2 /c, /a (/c,1) (/a,1) /a: [1,1,1,1] /c: [1,1] 集計担当1へ /b: [1,1] Reduce・保存 /a: 4 /c: 2 /b: 2 ⼊⼒⽚の各⾏でMap、URLごとにReduce。出⼒は2ファイル。 図の箱は仕事の担当。同じマシンが複数の仕事を順に実⾏できる。 出典: Dean & Ghemawat, OSDI 2004 §2.3・§3.1(図は独⾃の説明例) @Neurogica Inc. 6
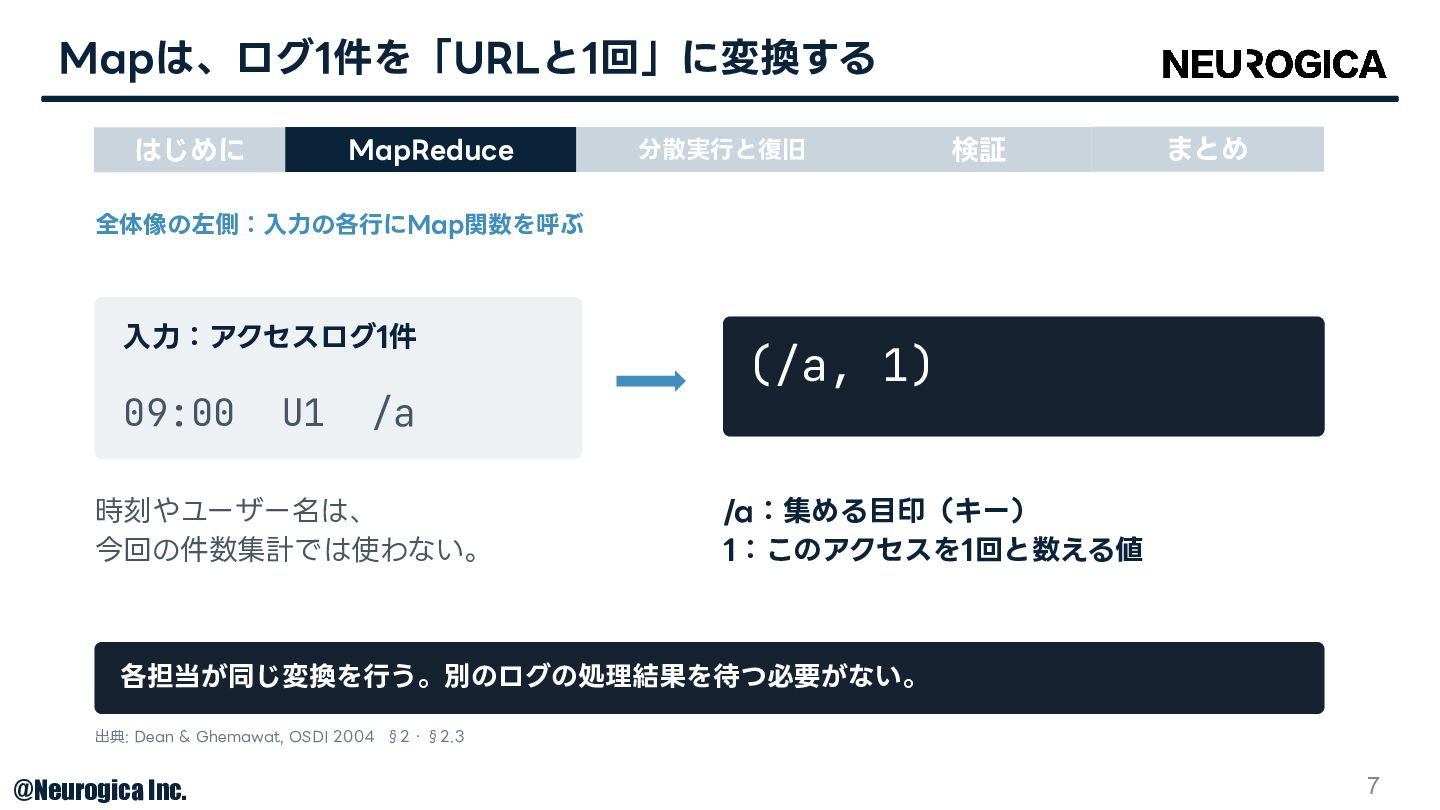
  5. Mapは、ログ1件を「URLと1回」に変換する はじめに MapReduce 分散実⾏と復旧 検証 まとめ 全体像の左側:⼊⼒の各⾏にMap関数を呼ぶ ⼊⼒:アクセスログ1件 09:00 U1

    /a 時刻やユーザー名は、 今回の件数集計では使わない。 (/a, 1) /a:集める⽬印(キー) 1:このアクセスを1回と数える値 各担当が同じ変換を⾏う。別のログの処理結果を待つ必要がない。 出典: Dean & Ghemawat, OSDI 2004 §2・§2.3 @Neurogica Inc. 7
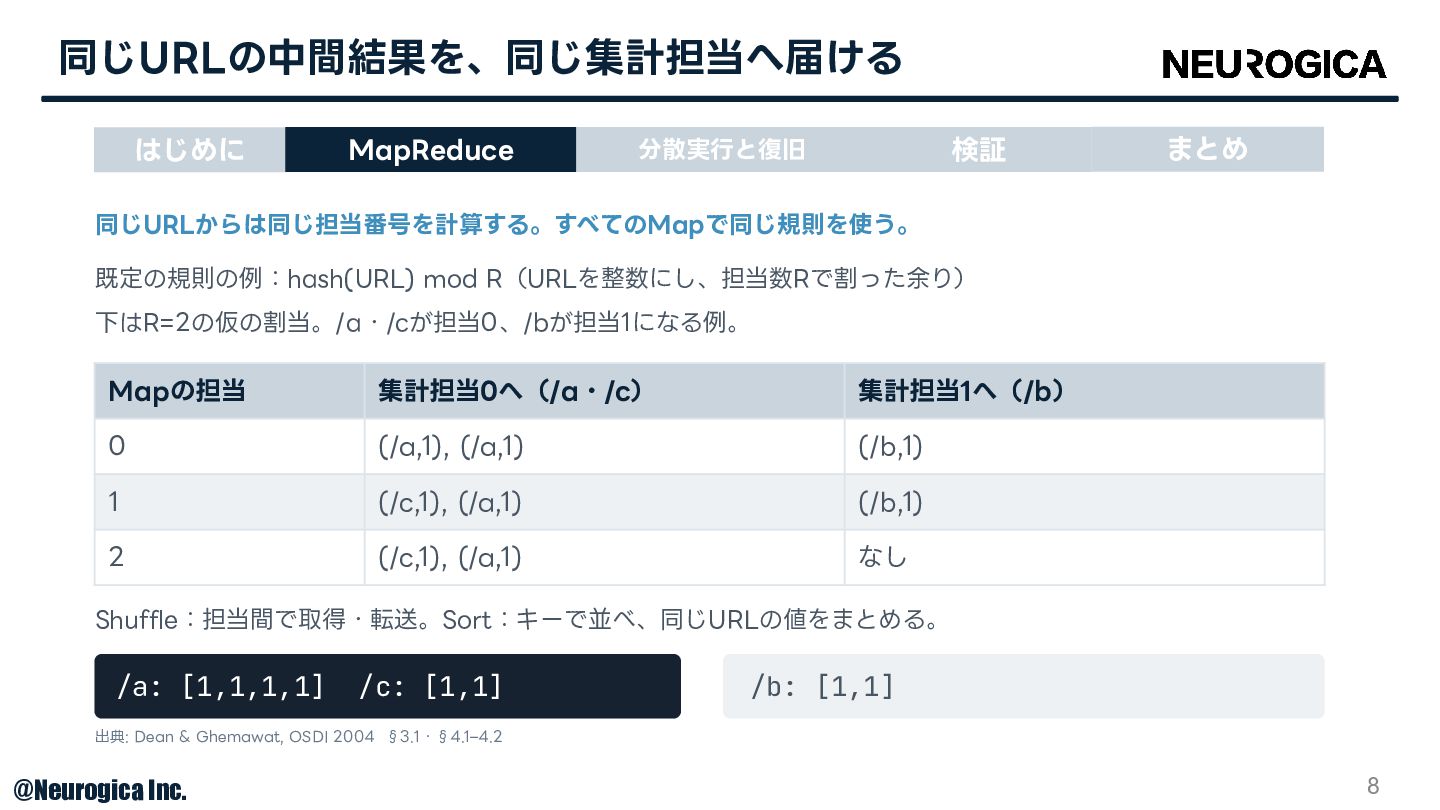
  6. 同じURLの中間結果を、同じ集計担当へ届ける はじめに MapReduce 検証 分散実⾏と復旧 まとめ 同じURLからは同じ担当番号を計算する。すべてのMapで同じ規則を使う。 既定の規則の例:hash(URL) mod R(URLを整数にし、担当数Rで割った余り)

    下はR=2の仮の割当。/a・/cが担当0、/bが担当1になる例。 Mapの担当 集計担当0へ(/a・/c) 集計担当1へ(/b) 0 (/a,1), (/a,1) (/b,1) 1 (/c,1), (/a,1) (/b,1) 2 (/c,1), (/a,1) なし Shuffle:担当間で取得・転送。Sort:キーで並べ、同じURLの値をまとめる。 /a: [1,1,1,1] /c: [1,1] /b: [1,1] 出典: Dean & Ghemawat, OSDI 2004 §3.1・§4.1‒4.2 @Neurogica Inc. 8
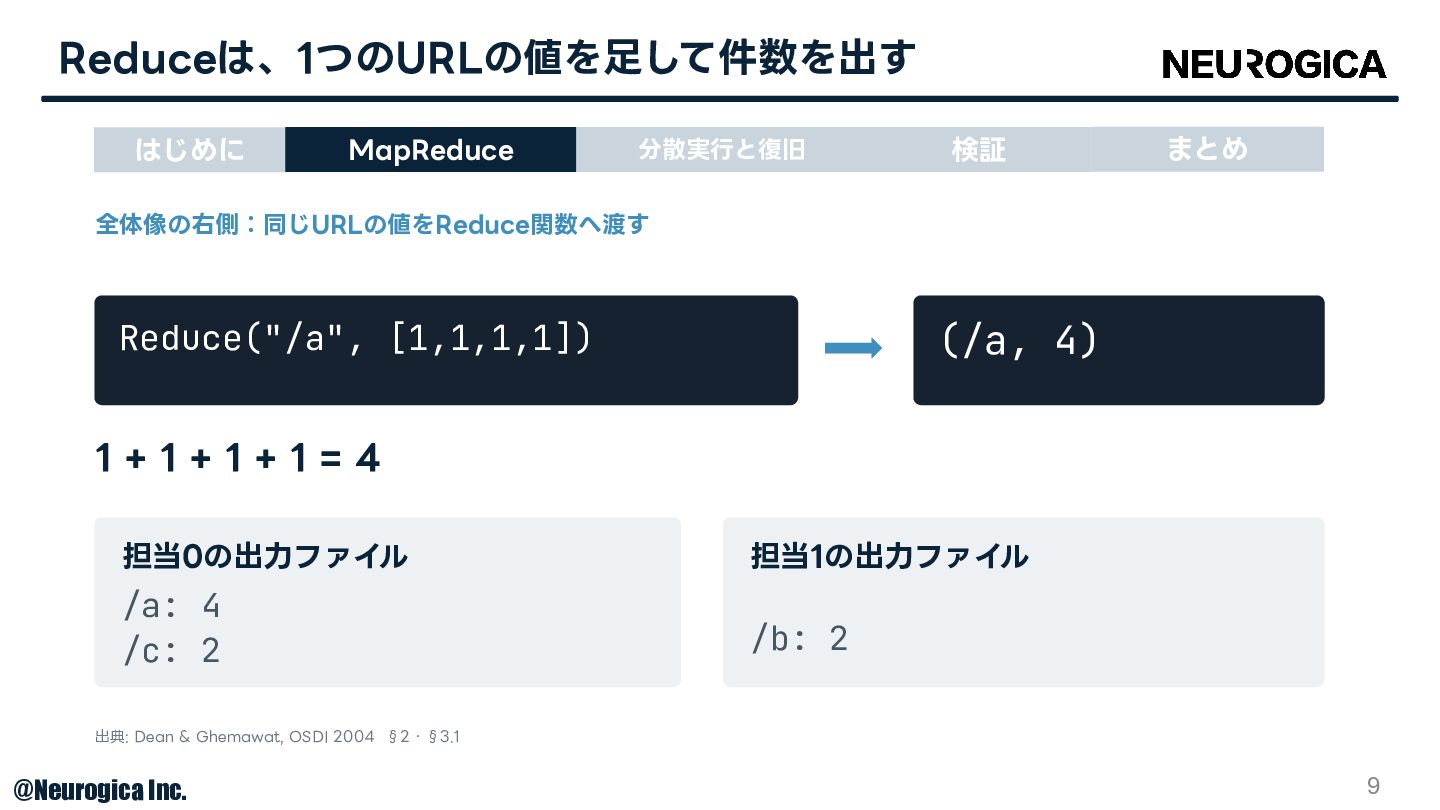
  7. Reduceは、1つのURLの値を⾜して件数を出す はじめに MapReduce 分散実⾏と復旧 検証 まとめ 全体像の右側:同じURLの値をReduce関数へ渡す (/a, 4) Reduce("/a",

    [1,1,1,1]) 1+1+1+1=4 担当0の出⼒ファイル 担当1の出⼒ファイル /a: 4 /c: 2 /b: 2 出典: Dean & Ghemawat, OSDI 2004 §2・§3.1 @Neurogica Inc. 9
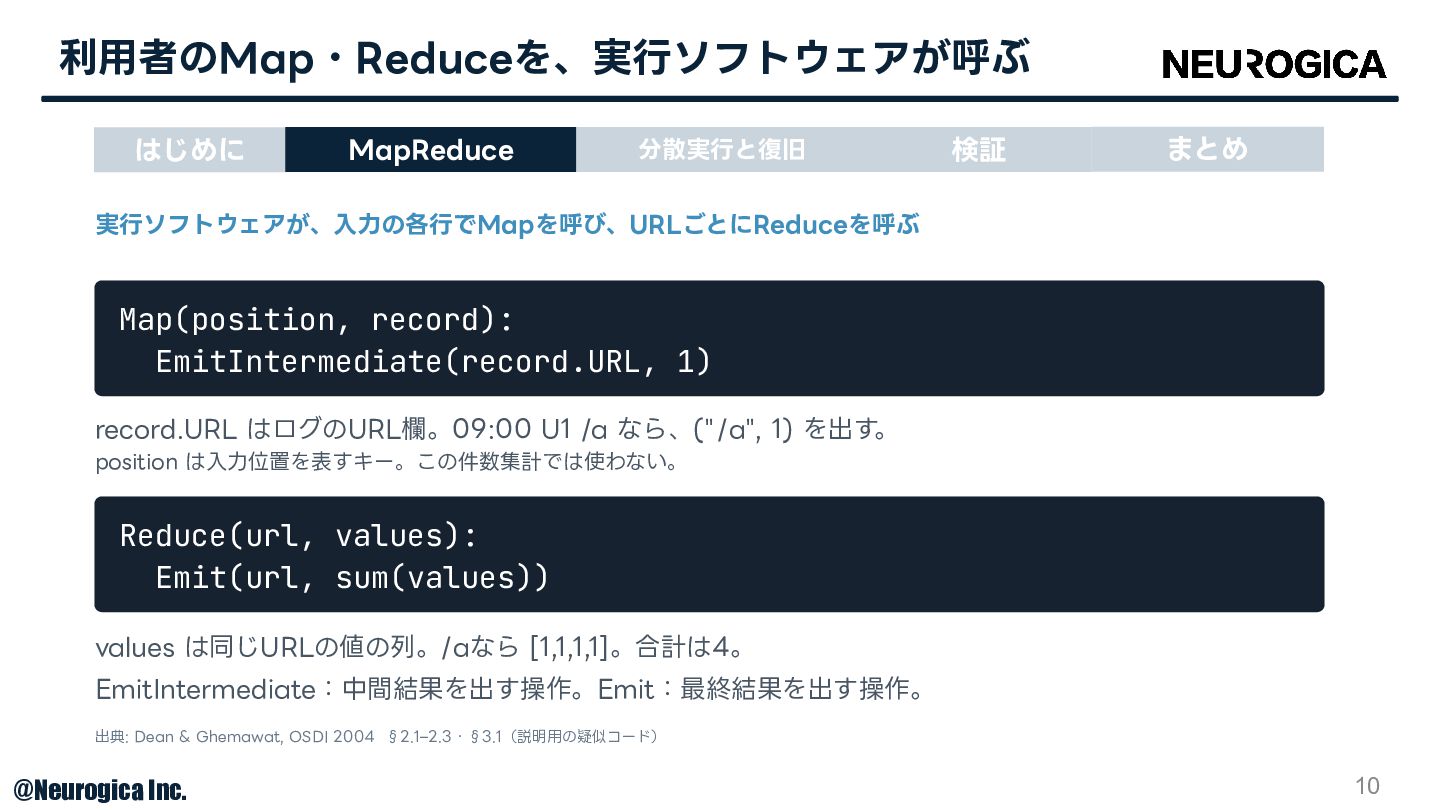
  8. 利⽤者のMap・Reduceを、実⾏ソフトウェアが呼ぶ はじめに MapReduce 分散実⾏と復旧 検証 まとめ 実⾏ソフトウェアが、⼊⼒の各⾏でMapを呼び、URLごとにReduceを呼ぶ Map(position, record): EmitIntermediate(record.URL,

    1) record.URL はログのURL欄。09:00 U1 /a なら、("/a", 1) を出す。 position は⼊⼒位置を表すキー。この件数集計では使わない。 Reduce(url, values): Emit(url, sum(values)) values は同じURLの値の列。/aなら [1,1,1,1]。合計は4。 EmitIntermediate:中間結果を出す操作。Emit:最終結果を出す操作。 出典: Dean & Ghemawat, OSDI 2004 §2.1‒2.3・§3.1(説明⽤の疑似コード) @Neurogica Inc. 10
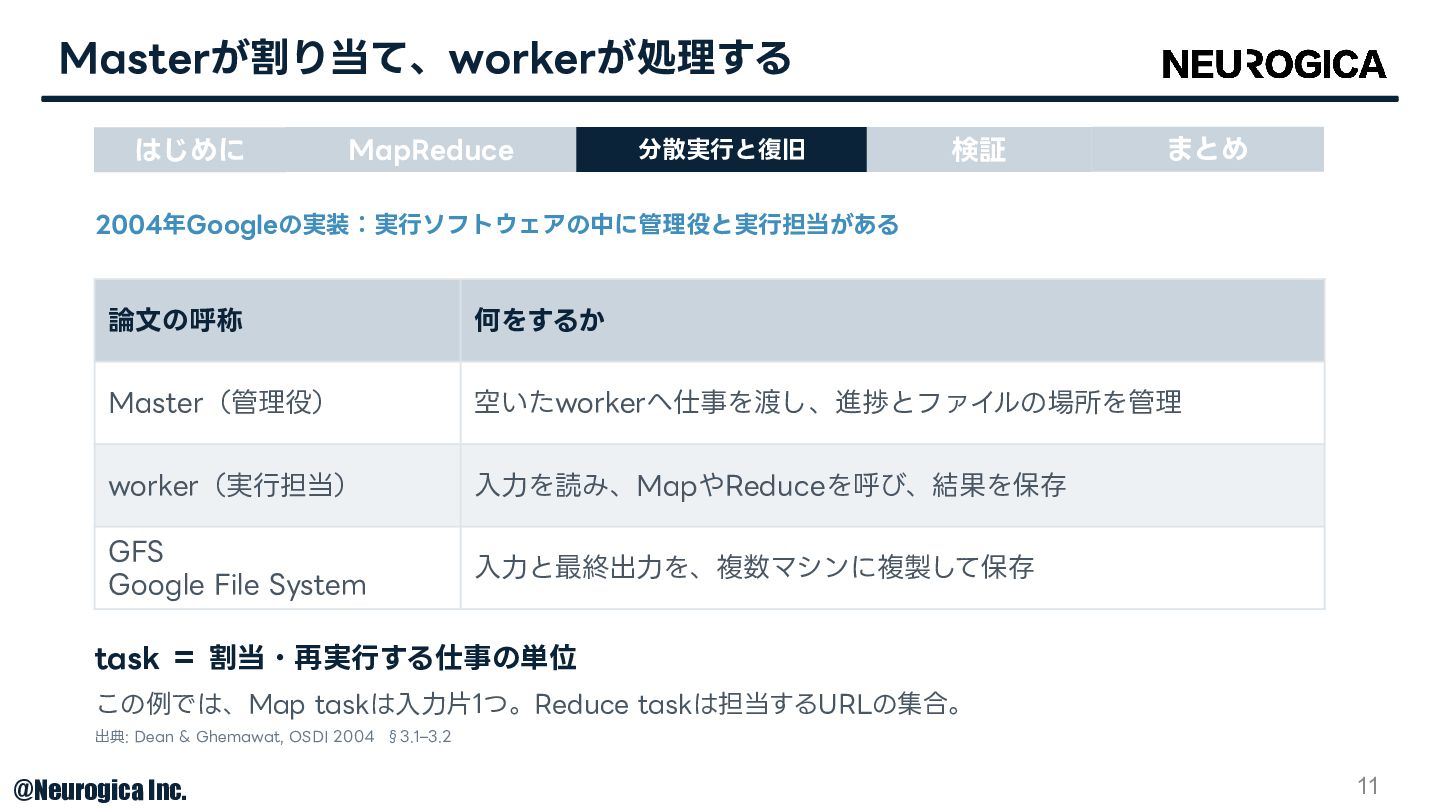
  9. Masterが割り当て、workerが処理する はじめに MapReduce 分散実⾏と復旧 検証 まとめ 2004年Googleの実装:実⾏ソフトウェアの中に管理役と実⾏担当がある 論⽂の呼称 何をするか Master(管理役)

    空いたworkerへ仕事を渡し、進捗とファイルの場所を管理 worker(実⾏担当) ⼊⼒を読み、MapやReduceを呼び、結果を保存 GFS Google File System ⼊⼒と最終出⼒を、複数マシンに複製して保存 task = 割当・再実⾏する仕事の単位 この例では、Map taskは⼊⼒⽚1つ。Reduce taskは担当するURLの集合。 出典: Dean & Ghemawat, OSDI 2004 §3.1‒3.2 @Neurogica Inc. 11
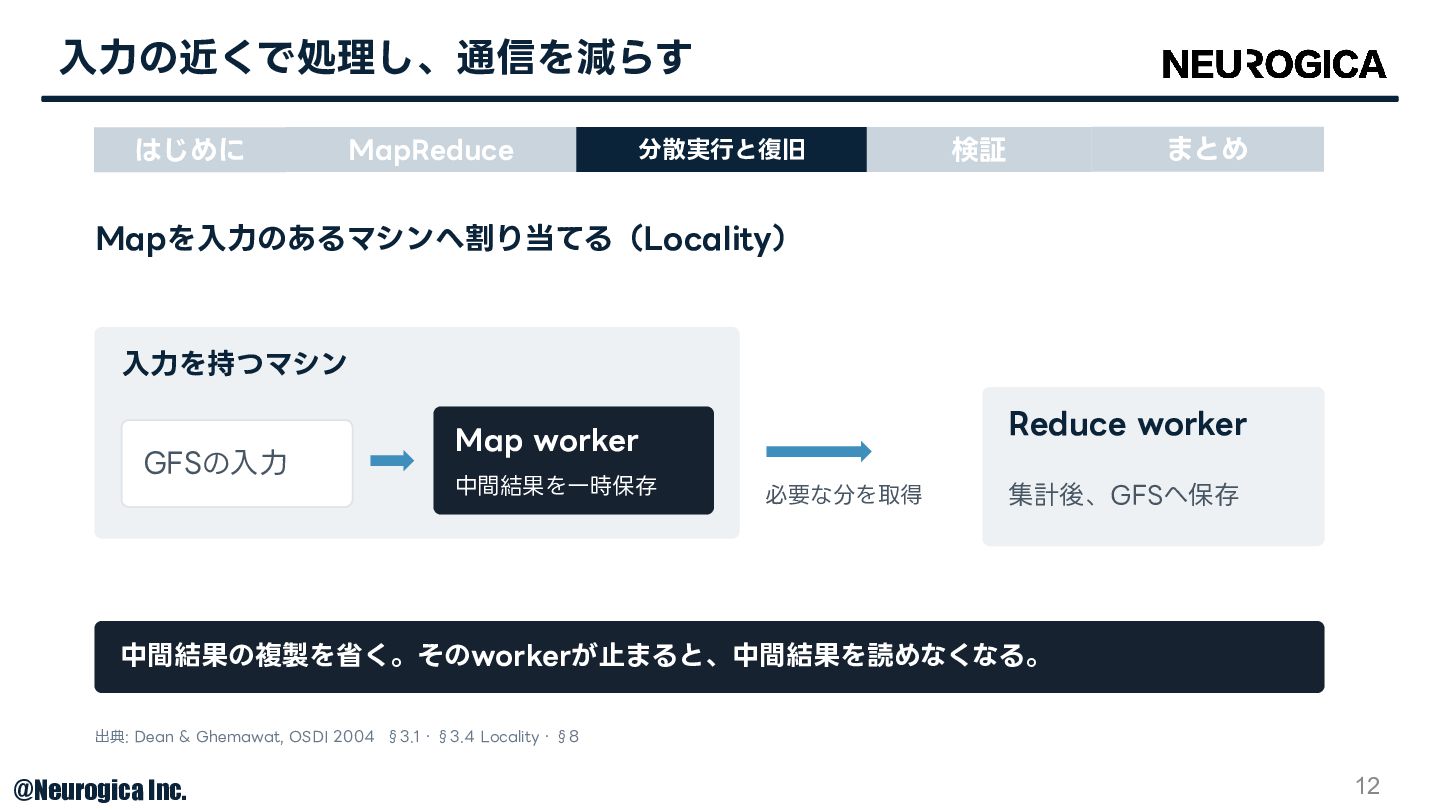
  10. ⼊⼒の近くで処理し、通信を減らす はじめに MapReduce 分散実⾏と復旧 まとめ 検証 Mapを⼊⼒のあるマシンへ割り当てる(Locality) ⼊⼒を持つマシン GFSの⼊⼒ Reduce

    worker Map worker 中間結果を⼀時保存 必要な分を取得 集計後、GFSへ保存 中間結果の複製を省く。そのworkerが⽌まると、中間結果を読めなくなる。 出典: Dean & Ghemawat, OSDI 2004 §3.1・§3.4 Locality・§8 @Neurogica Inc. 12
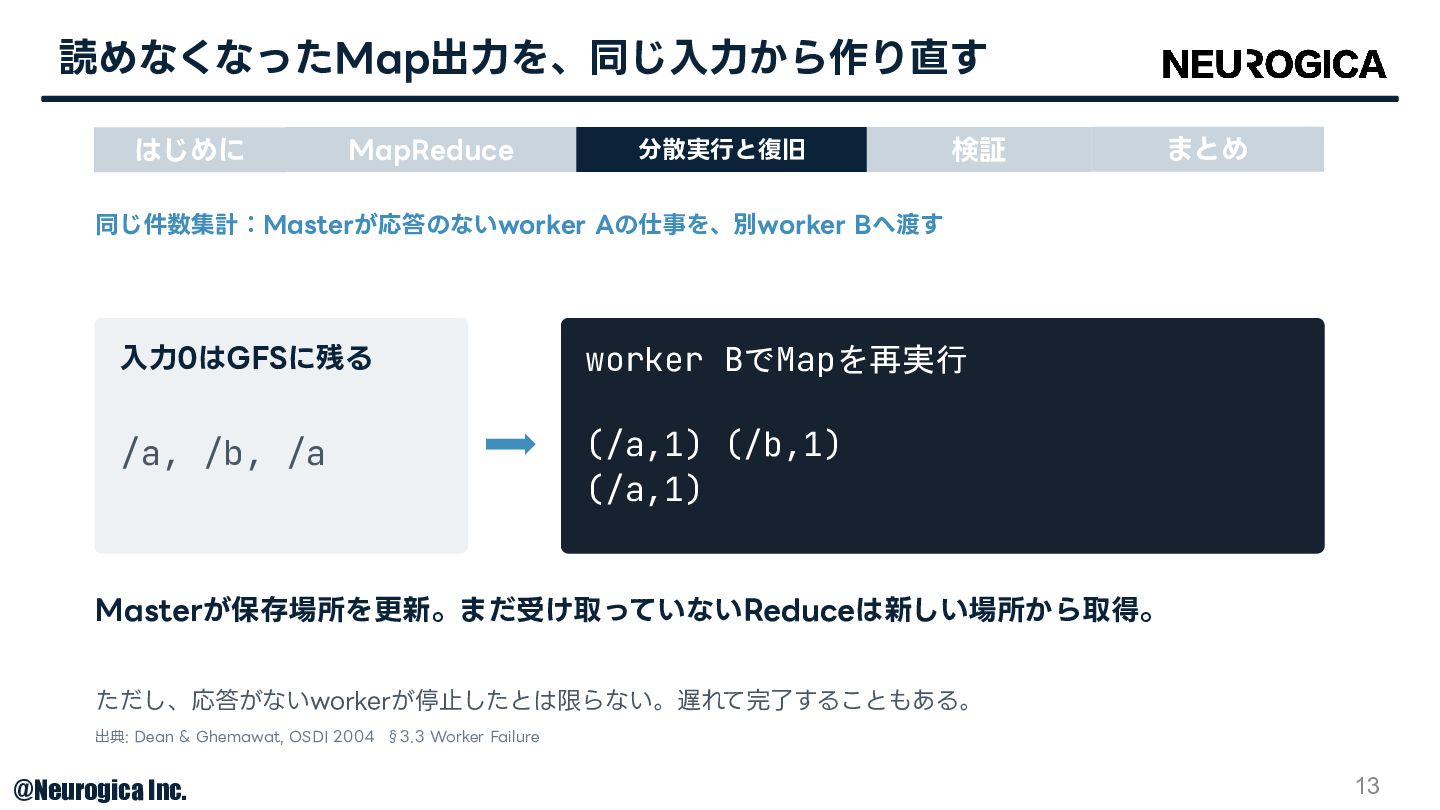
  11. 読めなくなったMap出⼒を、同じ⼊⼒から作り直す はじめに MapReduce 分散実⾏と復旧 検証 まとめ 同じ件数集計:Masterが応答のないworker Aの仕事を、別worker Bへ渡す ⼊⼒0はGFSに残る

    worker BでMapを再実行 /a, /b, /a (/a,1) (/b,1) (/a,1) Masterが保存場所を更新。まだ受け取っていないReduceは新しい場所から取得。 ただし、応答がないworkerが停⽌したとは限らない。遅れて完了することもある。 出典: Dean & Ghemawat, OSDI 2004 §3.3 Worker Failure @Neurogica Inc. 13
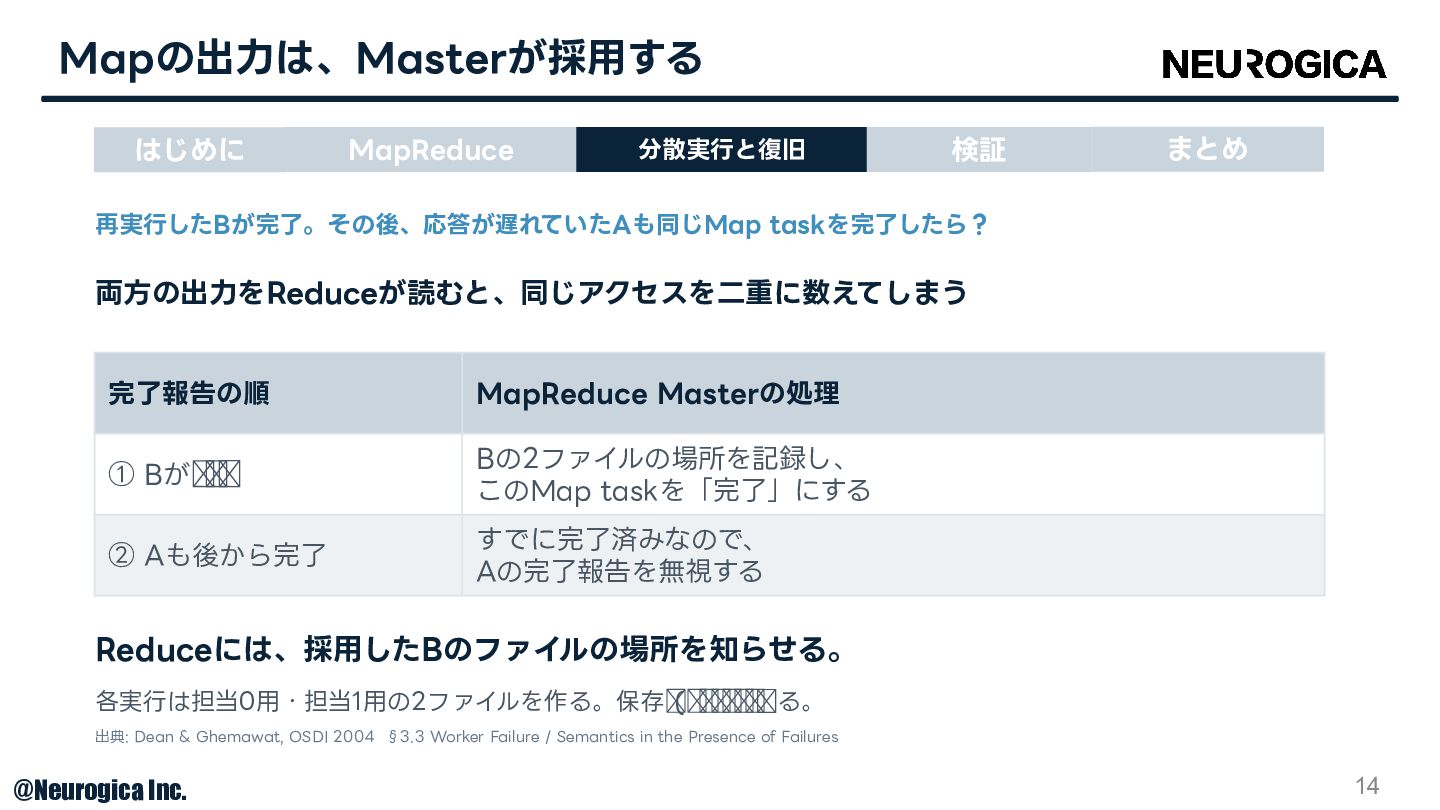
  12. Mapの出⼒は、Masterが採⽤する はじめに MapReduce 分散実⾏と復旧 検証 まとめ 再実⾏したBが完了。その後、応答が遅れていたAも同じMap taskを完了したら? 両⽅の出⼒をReduceが読むと、同じアクセスを⼆重に数えてしまう 完了報告の順

    MapReduce Masterの処理 ① Bが先に完了 Bの2ファイルの場所を記録し、 このMap taskを「完了」にする ② Aも後から完了 すでに完了済みなので、 Aの完了報告を無視する Reduceには、採⽤したBのファイルの場所を知らせる。 各実⾏は担当0⽤・担当1⽤の2ファイルを作る。保存先が故障すれば再⽣成する。 出典: Dean & Ghemawat, OSDI 2004 §3.3 Worker Failure / Semantics in the Presence of Failures @Neurogica Inc. 14
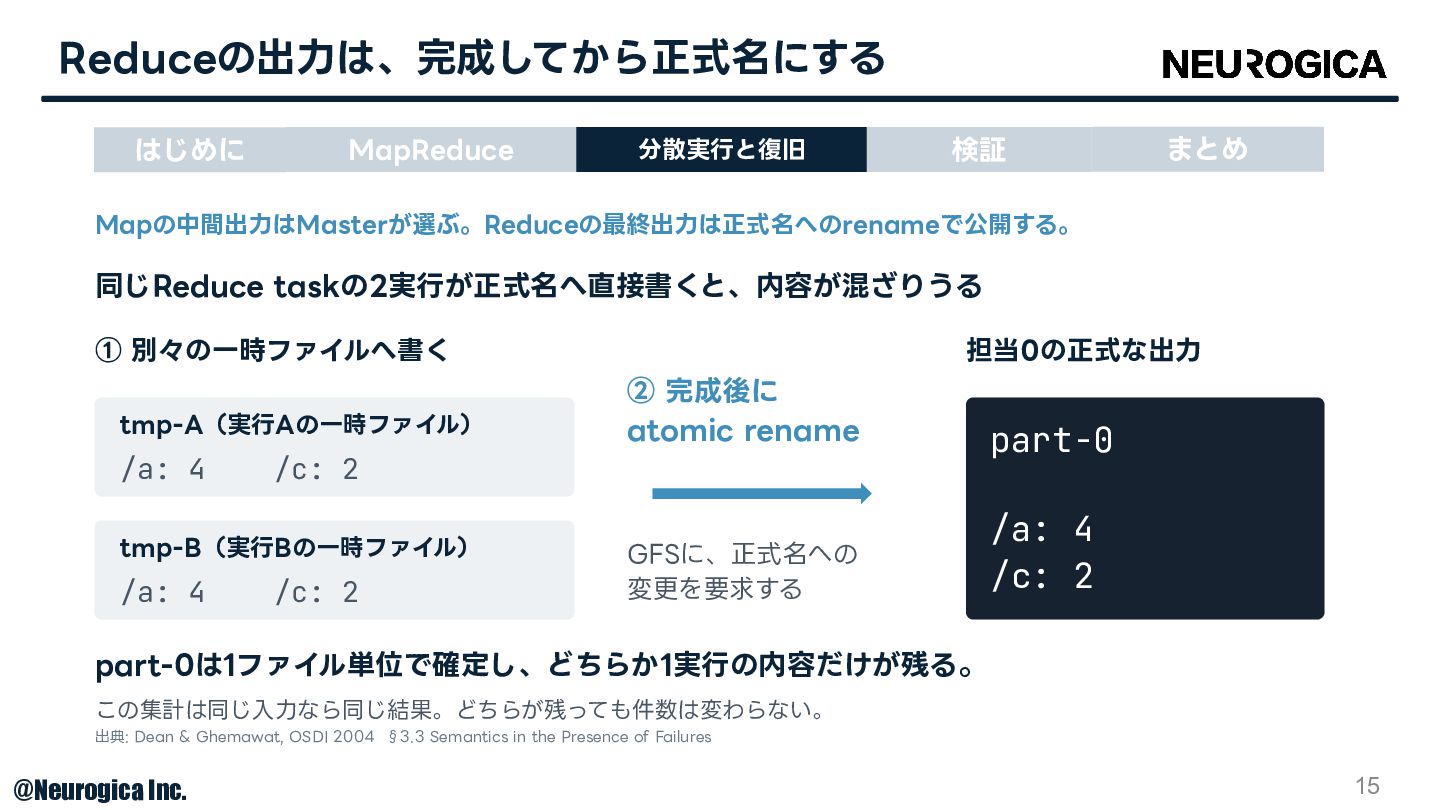
  13. Reduceの出⼒は、完成してから正式名にする はじめに MapReduce 分散実⾏と復旧 検証 まとめ Mapの中間出⼒はMasterが選ぶ。Reduceの最終出⼒は正式名へのrenameで公開する。 同じReduce taskの2実⾏が正式名へ直接書くと、内容が混ざりうる ①

    別々の⼀時ファイルへ書く tmp-A(実⾏Aの⼀時ファイル) /a: 4 ② 完成後に atomic rename /c: 2 tmp-B(実⾏Bの⼀時ファイル) /a: 4 担当0の正式な出⼒ /c: 2 GFSに、正式名への 変更を要求する part-0 /a: 4 /c: 2 part-0は1ファイル単位で確定し、どちらか1実⾏の内容だけが残る。 この集計は同じ⼊⼒なら同じ結果。どちらが残っても件数は変わらない。 出典: Dean & Ghemawat, OSDI 2004 §3.3 Semantics in the Presence of Failures @Neurogica Inc. 15
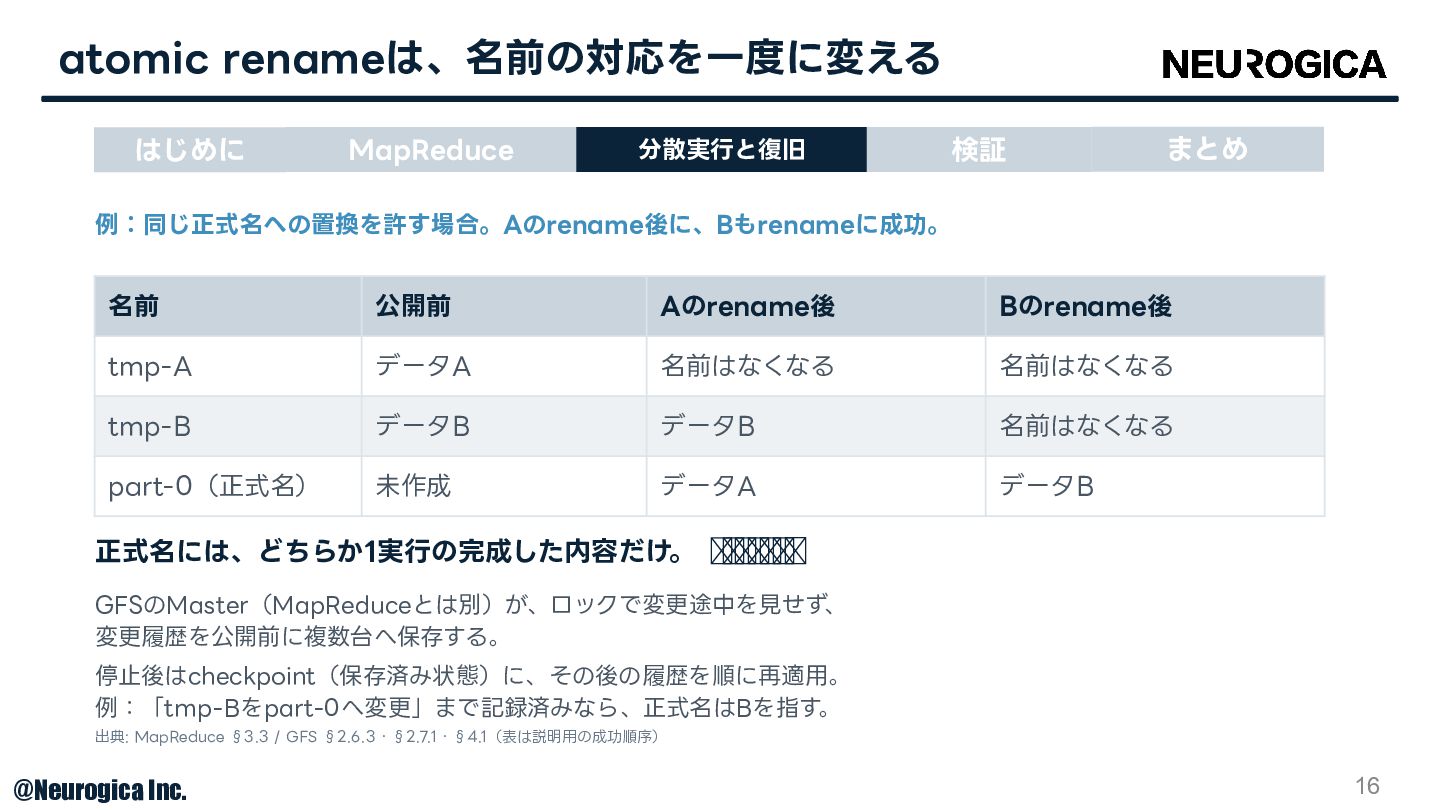
  14. atomic renameは、名前の対応を⼀度に変える はじめに MapReduce 分散実⾏と復旧 検証 まとめ 例:同じ正式名への置換を許す場合。Aのrename後に、Bもrenameに成功。 名前 公開前

    Aのrename後 Bのrename後 tmp-A データA 名前はなくなる 名前はなくなる tmp-B データB データB 名前はなくなる part-0(正式名) 未作成 データA データB 正式名には、どちらか1実⾏の完成した内容だけ。先着が残る保証はない。 GFSのMaster(MapReduceとは別)が、ロックで変更途中を⾒せず、 変更履歴を公開前に複数台へ保存する。 停⽌後はcheckpoint(保存済み状態)に、その後の履歴を順に再適⽤。 例:「tmp-Bをpart-0へ変更」まで記録済みなら、正式名はBを指す。 出典: MapReduce §3.3 / GFS §2.6.3・§2.7.1・§4.1(表は説明⽤の成功順序) @Neurogica Inc. 16
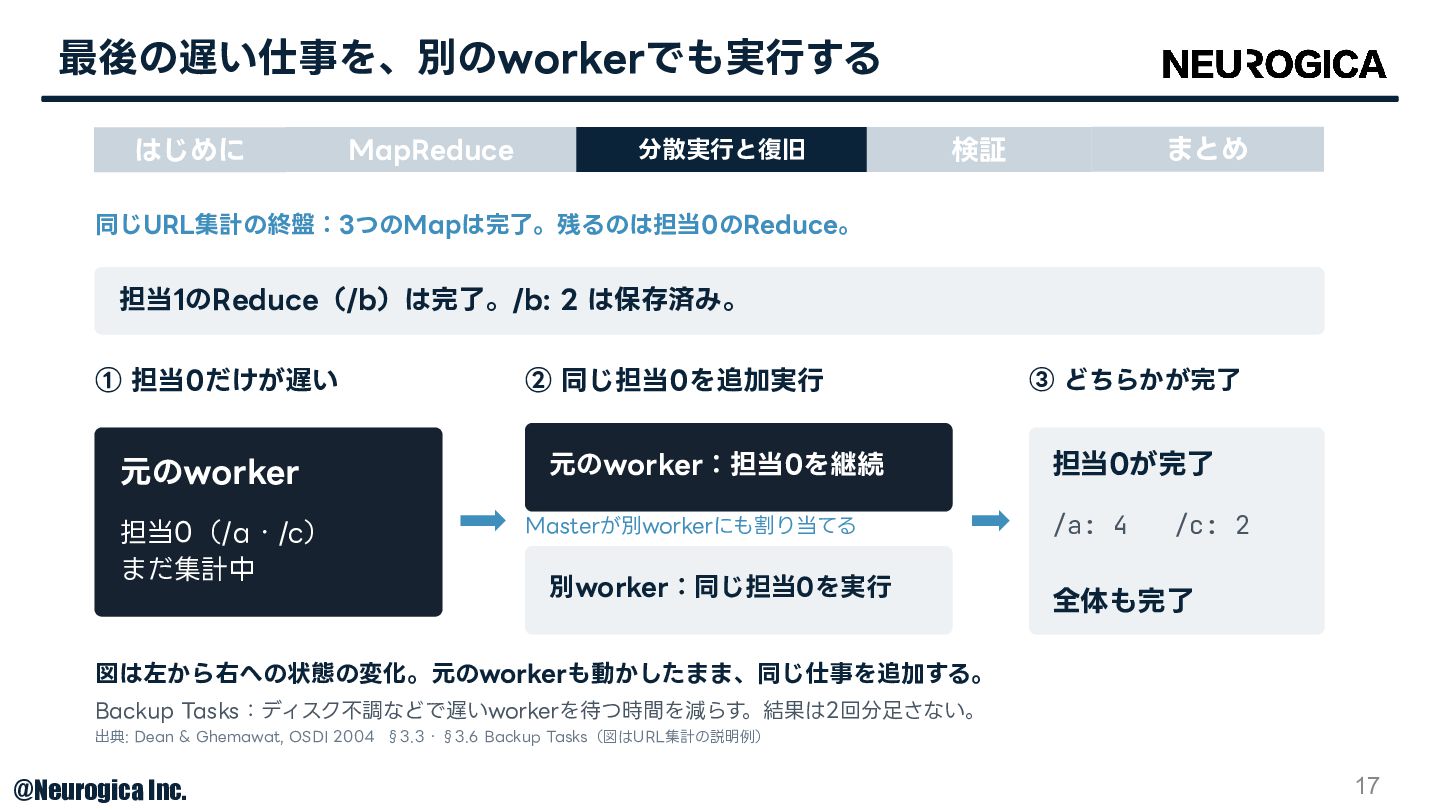
  15. 最後の遅い仕事を、別のworkerでも実⾏する はじめに MapReduce 分散実⾏と復旧 まとめ 検証 同じURL集計の終盤:3つのMapは完了。残るのは担当0のReduce。 担当1のReduce(/b)は完了。/b: 2 は保存済み。

    ① 担当0だけが遅い 元のworker 担当0(/a・/c) まだ集計中 ② 同じ担当0を追加実⾏ 元のworker:担当0を継続 Masterが別workerにも割り当てる 別worker:同じ担当0を実⾏ ③ どちらかが完了 担当0が完了 /a: 4 /c: 2 全体も完了 図は左から右への状態の変化。元のworkerも動かしたまま、同じ仕事を追加する。 Backup Tasks:ディスク不調などで遅いworkerを待つ時間を減らす。結果は2回分⾜さない。 出典: Dean & Ghemawat, OSDI 2004 §3.3・§3.6 Backup Tasks(図はURL集計の説明例) @Neurogica Inc. 17
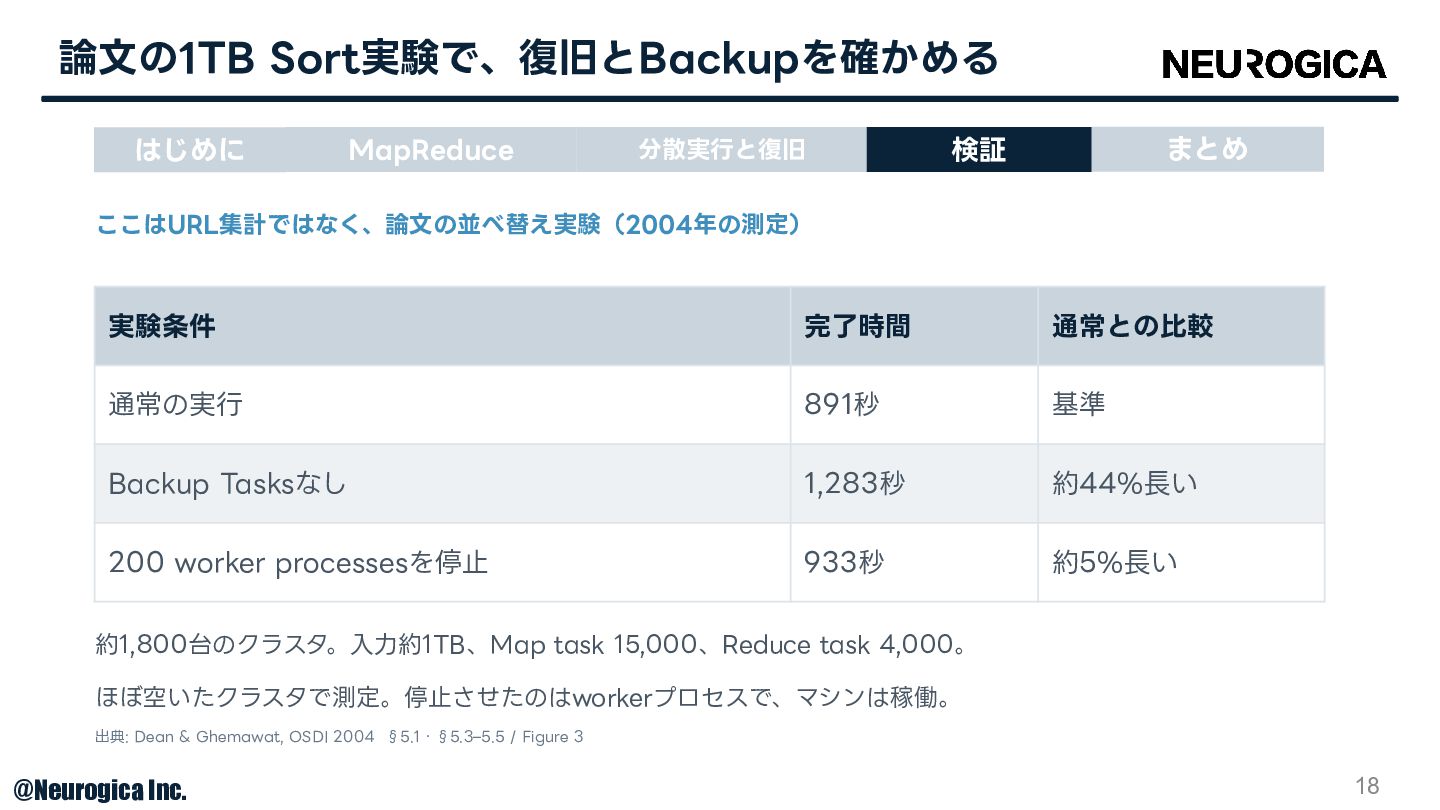
  16. 論⽂の1TB Sort実験で、復旧とBackupを確かめる はじめに MapReduce 分散実⾏と復旧 まとめ 検証 ここはURL集計ではなく、論⽂の並べ替え実験(2004年の測定) 実験条件 完了時間

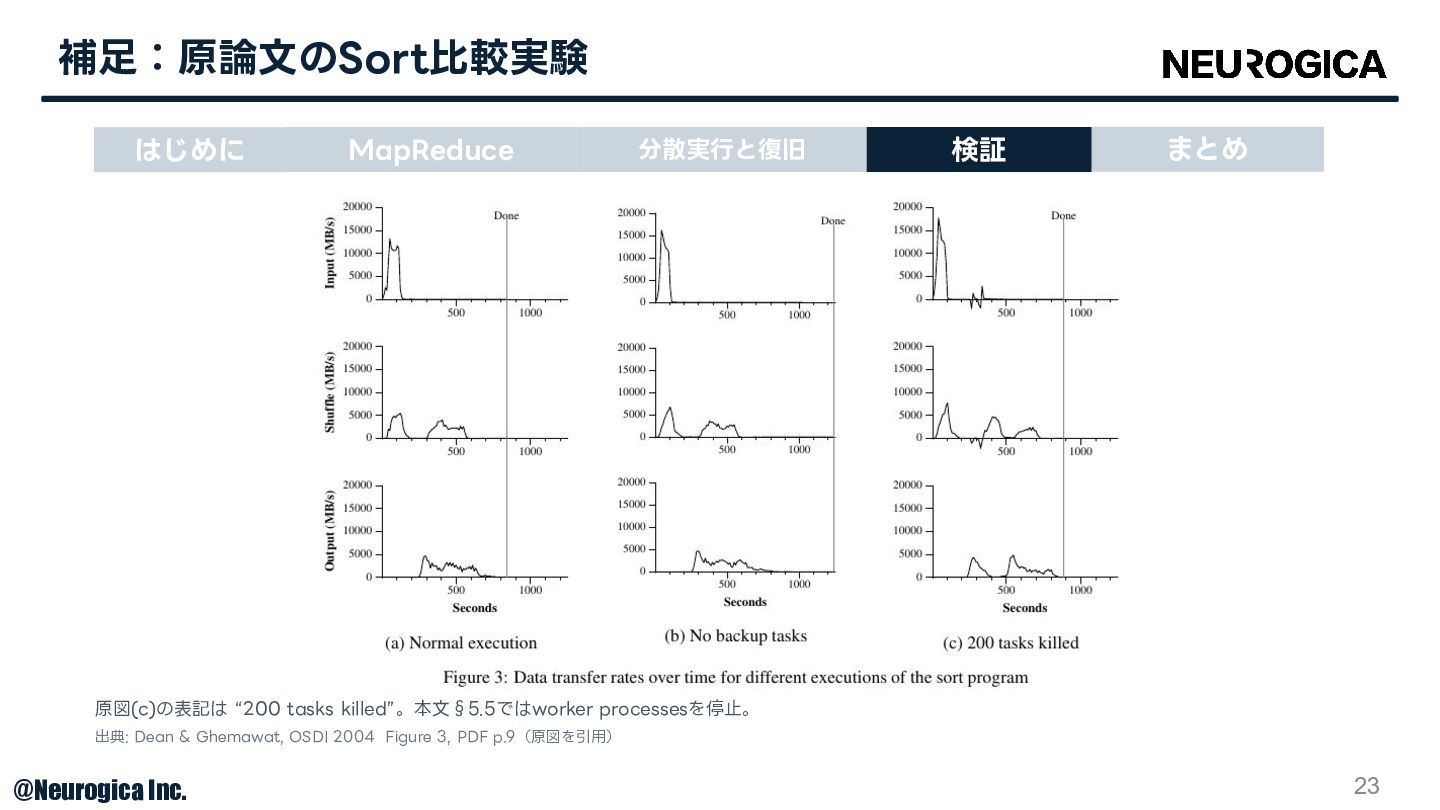
    通常との⽐較 通常の実⾏ 891秒 基準 Backup Tasksなし 1,283秒 約44%⻑い 200 worker processesを停⽌ 933秒 約5%⻑い 約1,800台のクラスタ。⼊⼒約1TB、Map task 15,000、Reduce task 4,000。 ほぼ空いたクラスタで測定。停⽌させたのはworkerプロセスで、マシンは稼働。 出典: Dean & Ghemawat, OSDI 2004 §5.1・§5.3‒5.5 / Figure 3 @Neurogica Inc. 18
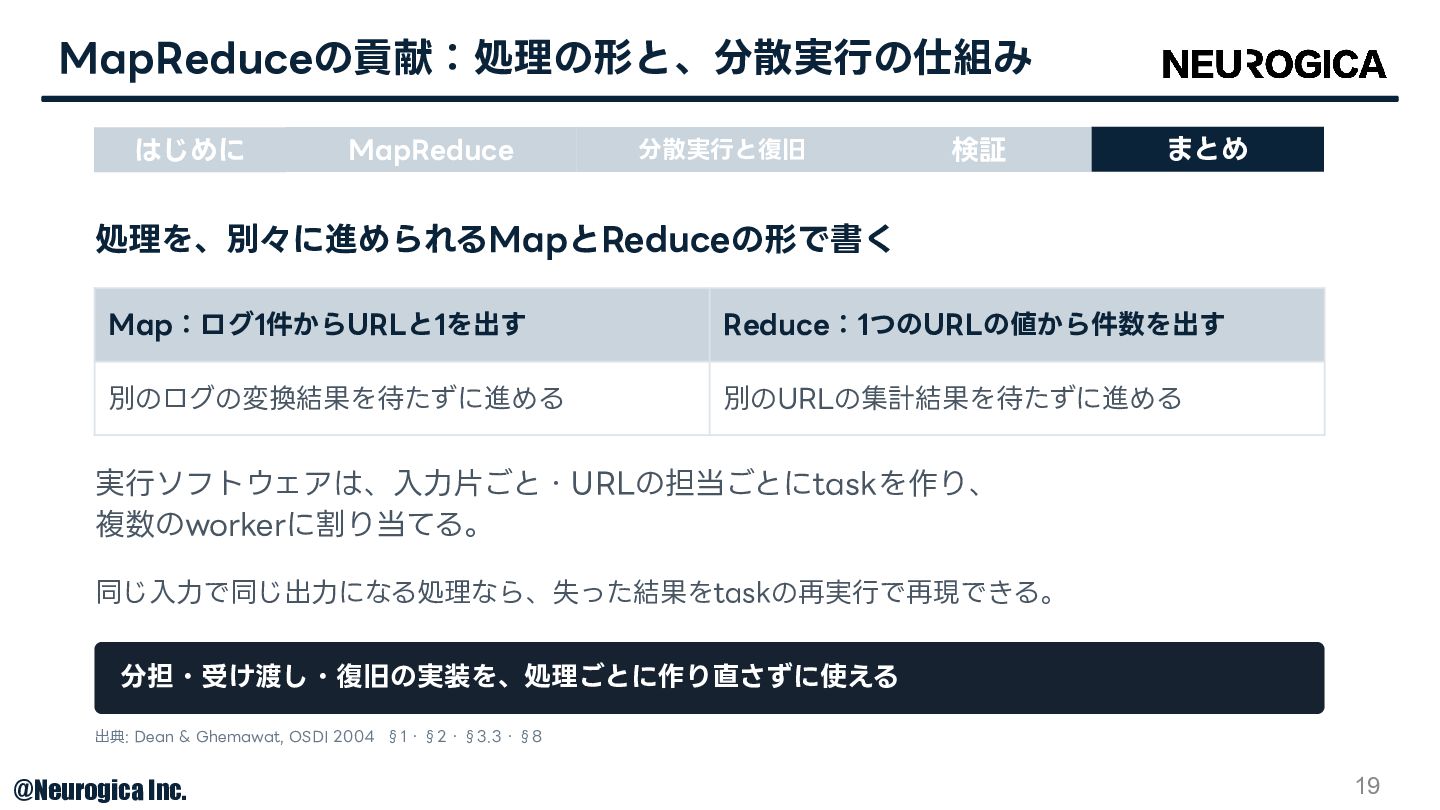
  17. MapReduceの貢献:処理の形と、分散実⾏の仕組み はじめに MapReduce 分散実⾏と復旧 検証 まとめ 処理を、別々に進められるMapとReduceの形で書く Map:ログ1件からURLと1を出す Reduce:1つのURLの値から件数を出す 別のログの変換結果を待たずに進める

    別のURLの集計結果を待たずに進める 実⾏ソフトウェアは、⼊⼒⽚ごと・URLの担当ごとにtaskを作り、 複数のworkerに割り当てる。 同じ⼊⼒で同じ出⼒になる処理なら、失った結果をtaskの再実⾏で再現できる。 分担・受け渡し・復旧の実装を、処理ごとに作り直さずに使える 出典: Dean & Ghemawat, OSDI 2004 §1・§2・§3.3・§8 @Neurogica Inc. 19
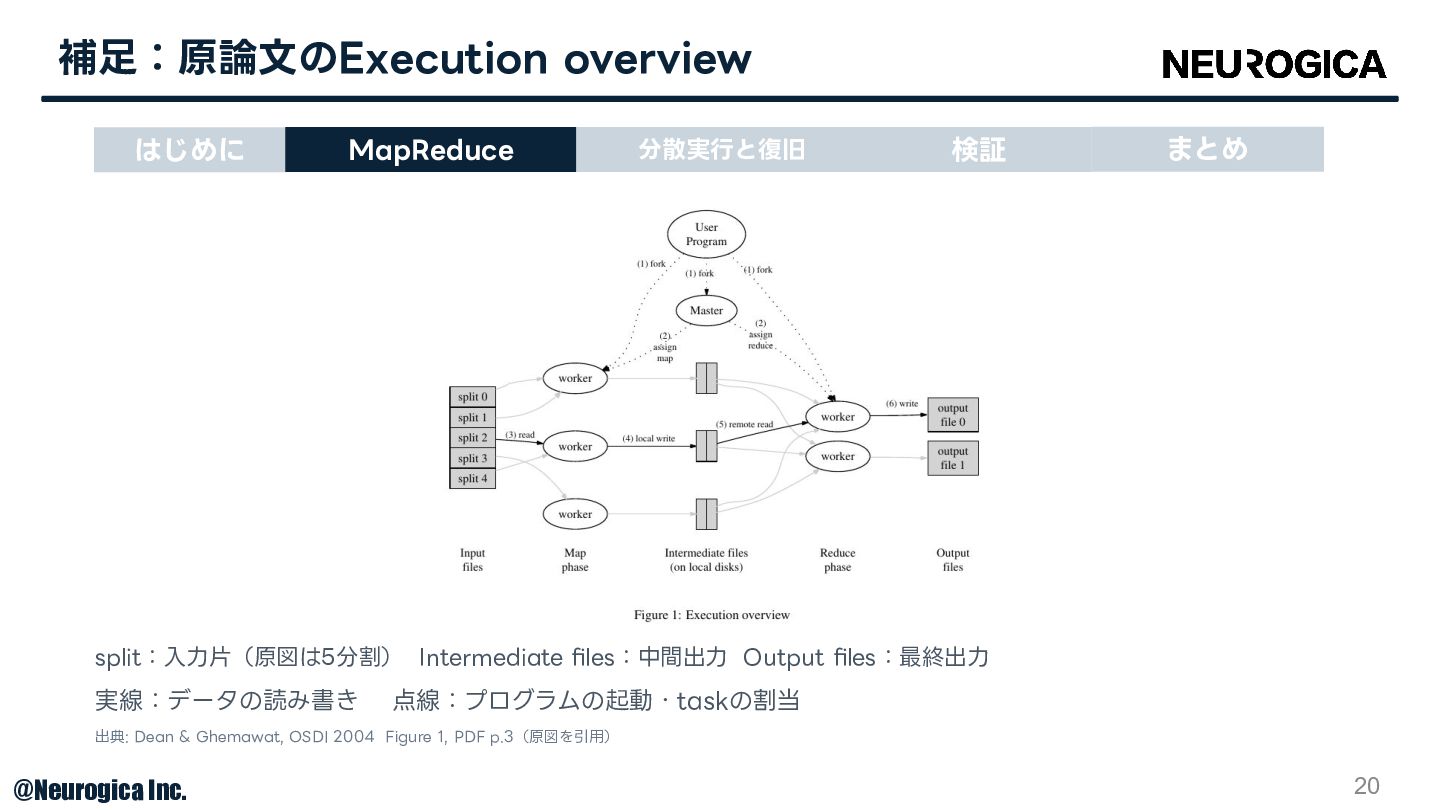
  18. 補⾜:原論⽂のExecution overview はじめに MapReduce 分散実⾏と復旧 検証 まとめ split:⼊⼒⽚(原図は5分割) Intermediate files:中間出⼒

    Output files:最終出⼒ 実線:データの読み書き 点線:プログラムの起動・taskの割当 出典: Dean & Ghemawat, OSDI 2004 Figure 1, PDF p.3(原図を引⽤) @Neurogica Inc. 20
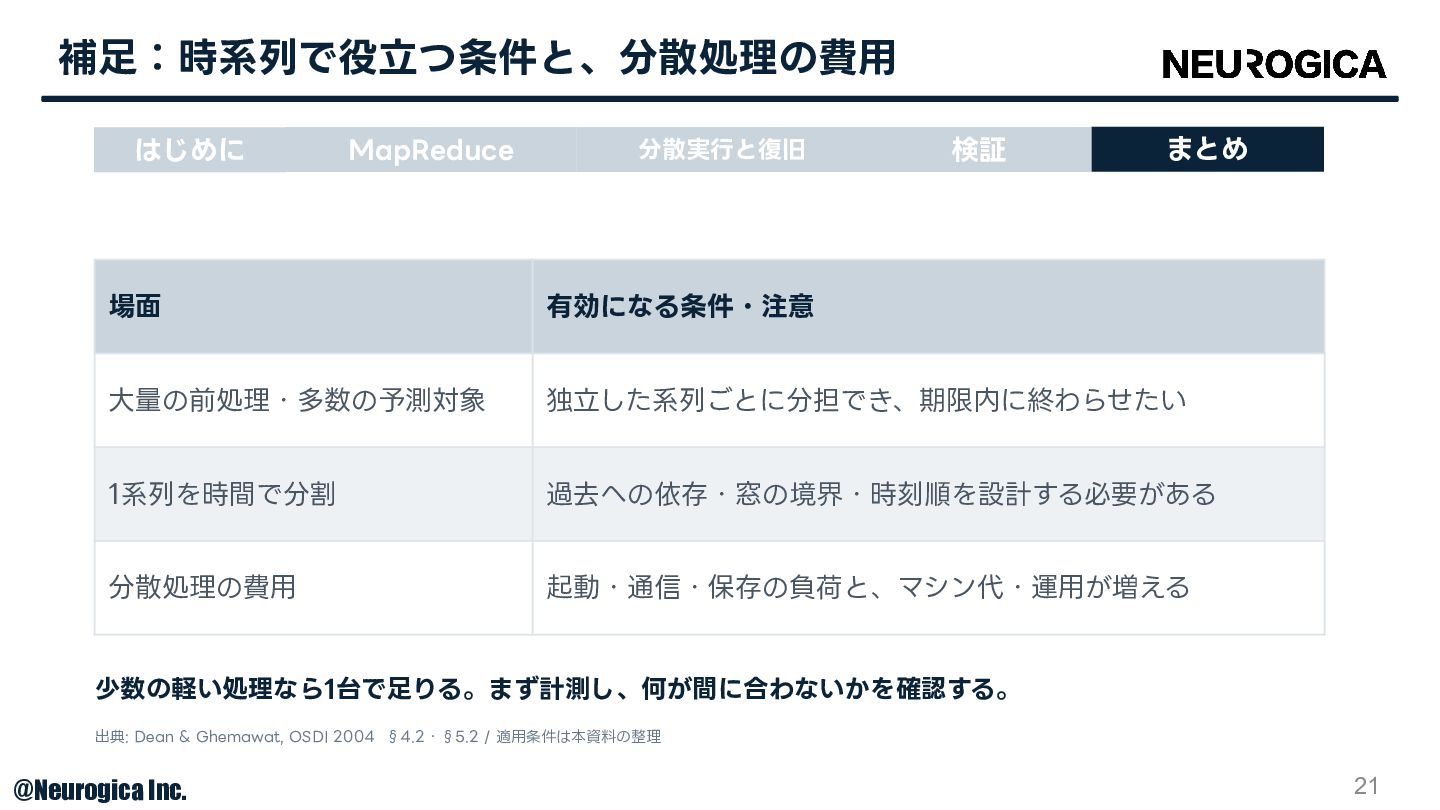
  19. 補⾜:時系列で役⽴つ条件と、分散処理の費⽤ はじめに MapReduce 分散実⾏と復旧 検証 まとめ 場⾯ 有効になる条件・注意 ⼤量の前処理・多数の予測対象 独⽴した系列ごとに分担でき、期限内に終わらせたい

    1系列を時間で分割 過去への依存・窓の境界・時刻順を設計する必要がある 分散処理の費⽤ 起動・通信・保存の負荷と、マシン代・運⽤が増える 少数の軽い処理なら1台で⾜りる。まず計測し、何が間に合わないかを確認する。 出典: Dean & Ghemawat, OSDI 2004 §4.2・§5.2 / 適⽤条件は本資料の整理 @Neurogica Inc. 21
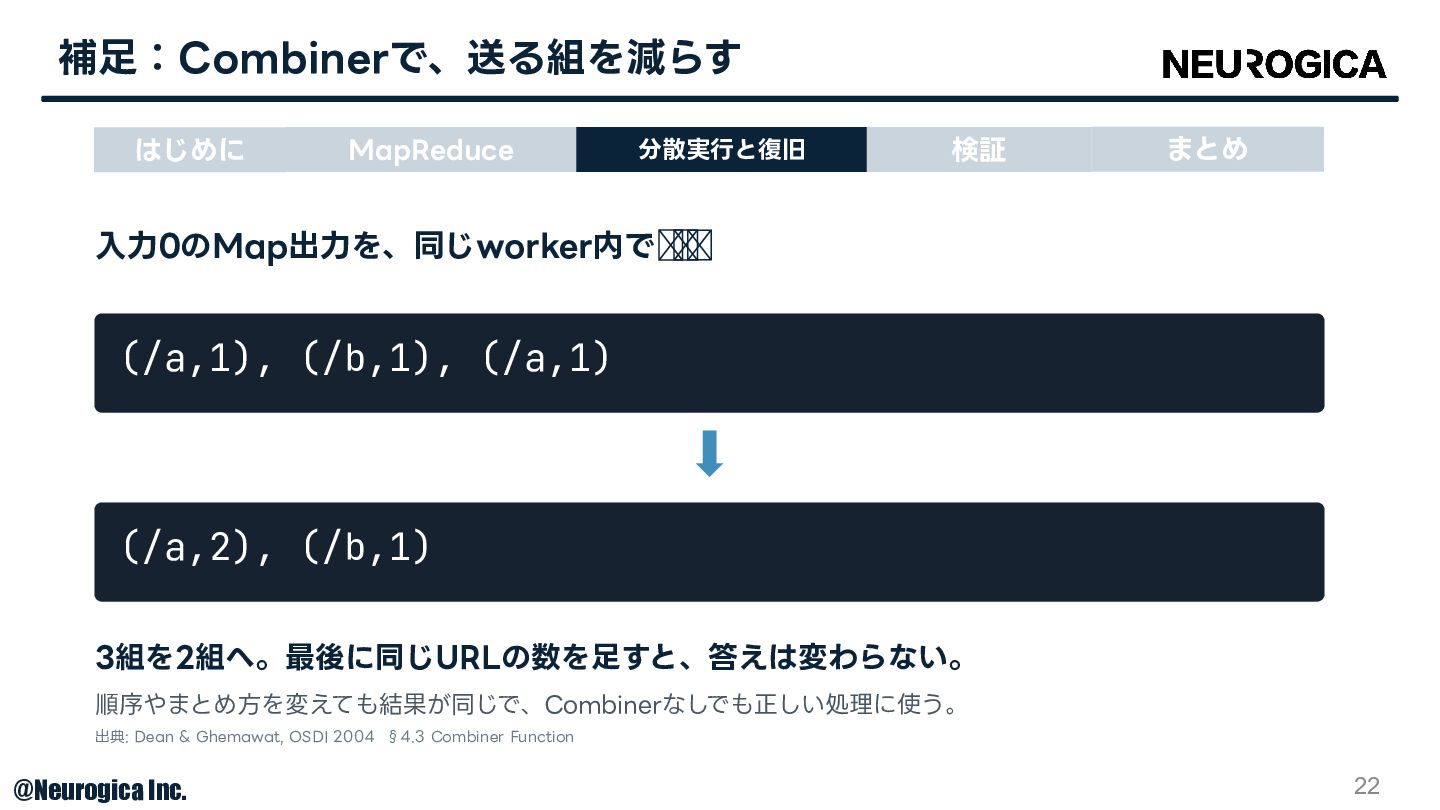
  20. 補⾜:Combinerで、送る組を減らす はじめに MapReduce 分散実⾏と復旧 検証 まとめ ⼊⼒0のMap出⼒を、同じworker内で先に⾜す (/a,1), (/b,1), (/a,1)

    (/a,2), (/b,1) 3組を2組へ。最後に同じURLの数を⾜すと、答えは変わらない。 順序やまとめ⽅を変えても結果が同じで、Combinerなしでも正しい処理に使う。 出典: Dean & Ghemawat, OSDI 2004 §4.3 Combiner Function @Neurogica Inc. 22
  21. 補⾜:原論⽂のSort⽐較実験 はじめに MapReduce 分散実⾏と復旧 検証 まとめ 原図(c)の表記は “200 tasks killed”。本⽂§5.5ではworker

    processesを停⽌。 出典: Dean & Ghemawat, OSDI 2004 Figure 3, PDF p.9(原図を引⽤) @Neurogica Inc. 23
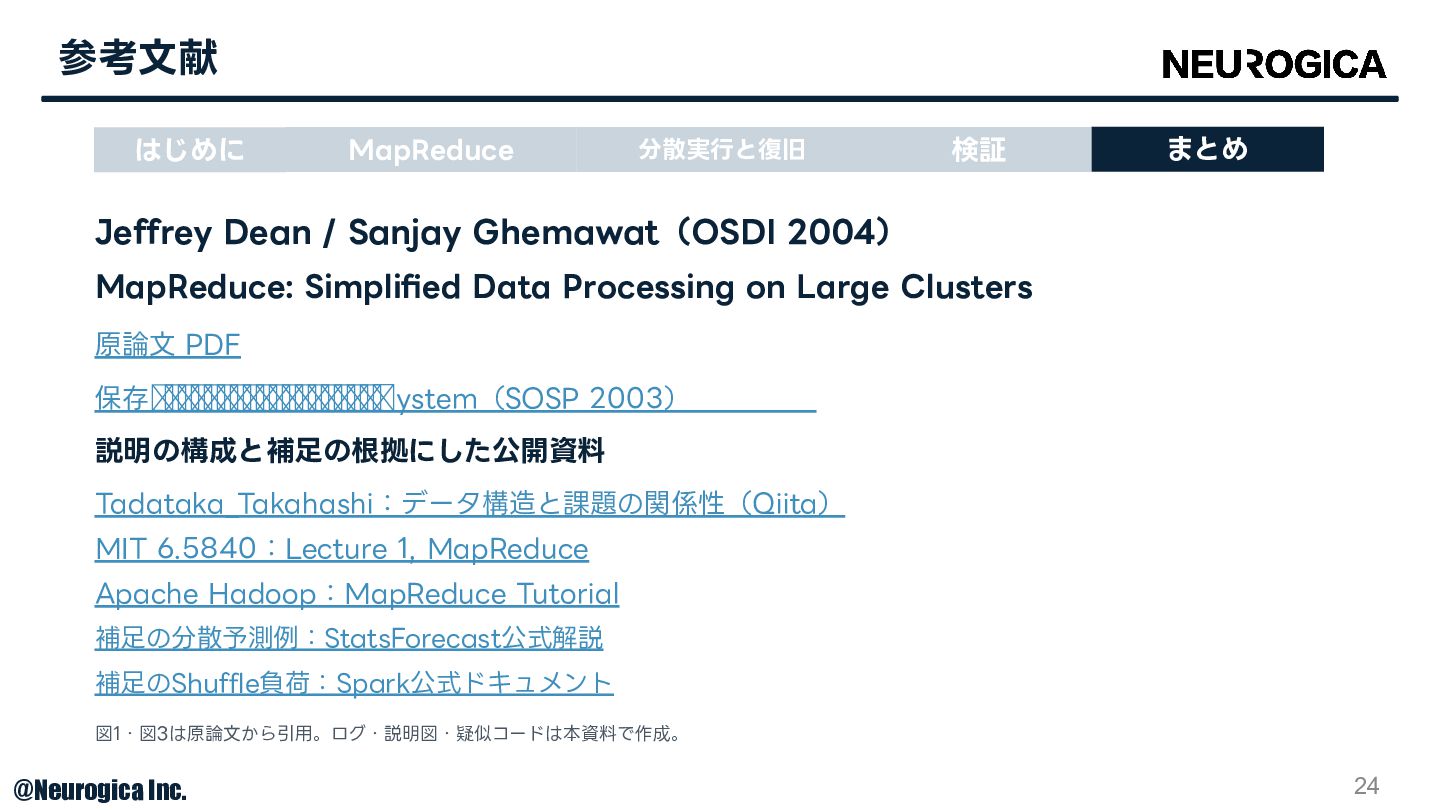
  22. 参考⽂献 はじめに MapReduce 分散実⾏と復旧 検証 まとめ Jeffrey Dean / Sanjay

    Ghemawat(OSDI 2004) MapReduce: Simplified Data Processing on Large Clusters 原論⽂ PDF 保存先の論⽂:The Google File System(SOSP 2003) 説明の構成と補⾜の根拠にした公開資料 Tadataka_Takahashi:データ構造と課題の関係性(Qiita) MIT 6.5840:Lecture 1, MapReduce Apache Hadoop:MapReduce Tutorial 補⾜の分散予測例:StatsForecast公式解説 補⾜のShuffle負荷:Spark公式ドキュメント 図1・図3は原論⽂から引⽤。ログ・説明図・疑似コードは本資料で作成。 @Neurogica Inc. 24