Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
AIがたまにバカになるのはなぜなのか? — akarenga LT vol.45
Search
NKMAK
May 17, 2026
Programming
14
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
AIがたまにバカになるのはなぜなのか? — akarenga LT vol.45
NKMAK
May 17, 2026
More Decks by NKMAK
See All by NKMAK
AIに仕事を任せられるようになるには
nkmak
0
9
Other Decks in Programming
See All in Programming
ジョジョの世界をXRで再現する
mofurune
0
170
最近”作らせてる” ローカルAIアプリの話
akit37
0
480
GemmaをJevのように使ってみる / Use Gemma like Jev
kishida
5
800
UPDATE をやめる — EF Core でマスタをバージョン管理する
panda728
PRO
0
1.2k
Everything will be SERVERLESS — 信じて運用した10年の経験値 / Everything Will be Serverless — Lessons Learned from 10 Years of Operational Experience
seike460
PRO
1
1.1k
[JA] Domain Modeling with Vanilla Rails: 「操作」から再考するRailsの設計論
yasaichi
3
440
Rでドレミ/Do-Re-Mi_with_R
florets1
0
130
設計次第でAIコードの読む量は減らせる / designing-for-code-reading
minodriven
35
17k
残高管理から台帳サービスへの進化
artoy
1
200
自サークルのIdPからログアウトできるようになるまで
taiseiue
1
140
なぜCTOを降りてFDEを選んだのか?〜なぜプロダクト企業がFDEで顧客の現場に踏み込むのか〜
gonta
1
220
AIで開発が速くなった先で、開発チームは何を目指すか
shihochan
1
1.6k
Featured
See All Featured
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
600
ReactJS: Keep Simple. Everything can be a component!
pedronauck
666
130k
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
1
450
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
500
Stop Working from a Prison Cell
hatefulcrawdad
274
21k
Odyssey Design
rkendrick25
PRO
2
880
Evolving SEO for Evolving Search Engines
ryanjones
0
330
Agile Leadership in an Agile Organization
kimpetersen
PRO
0
290
How to Create Impact in a Changing Tech Landscape [PerfNow 2023]
tammyeverts
56
3.5k
Designing for Timeless Needs
cassininazir
1
530
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2k
The SEO Collaboration Effect
kristinabergwall1
1
590
Transcript
akarenga LT vol.45 2026.05.17 トピック / CONTEXT ENGINEERING AIがたまにバカに なるのはなぜなのか?
スピーカー 中村旭良
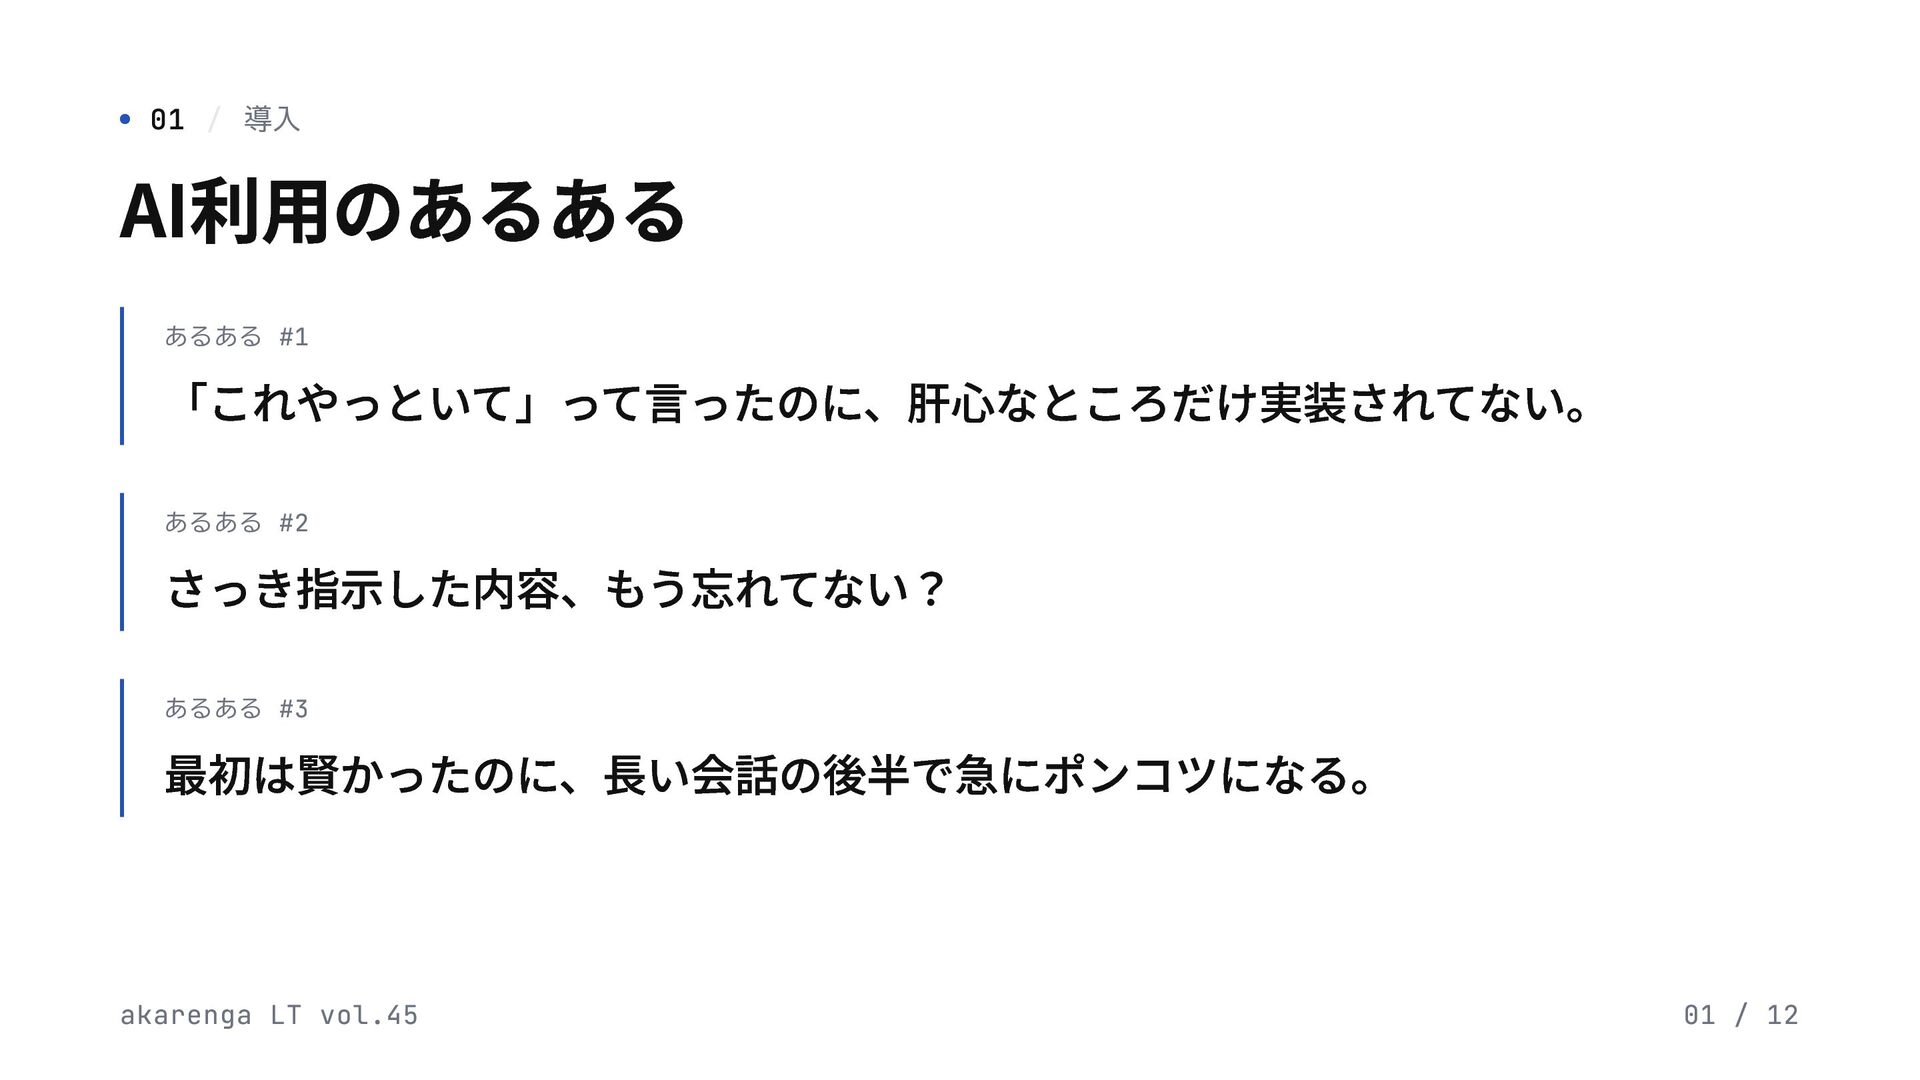
01 / 導入 AI利用のあるある あるある #1 「これやっといて」って言ったのに、肝心なところだけ実装されてない。 あるある #2 さっき指示した内容、もう忘れてない?
あるある #3 最初は賢かったのに、長い会話の後半で急にポンコツになる。 akarenga LT vol.45 01 / 12
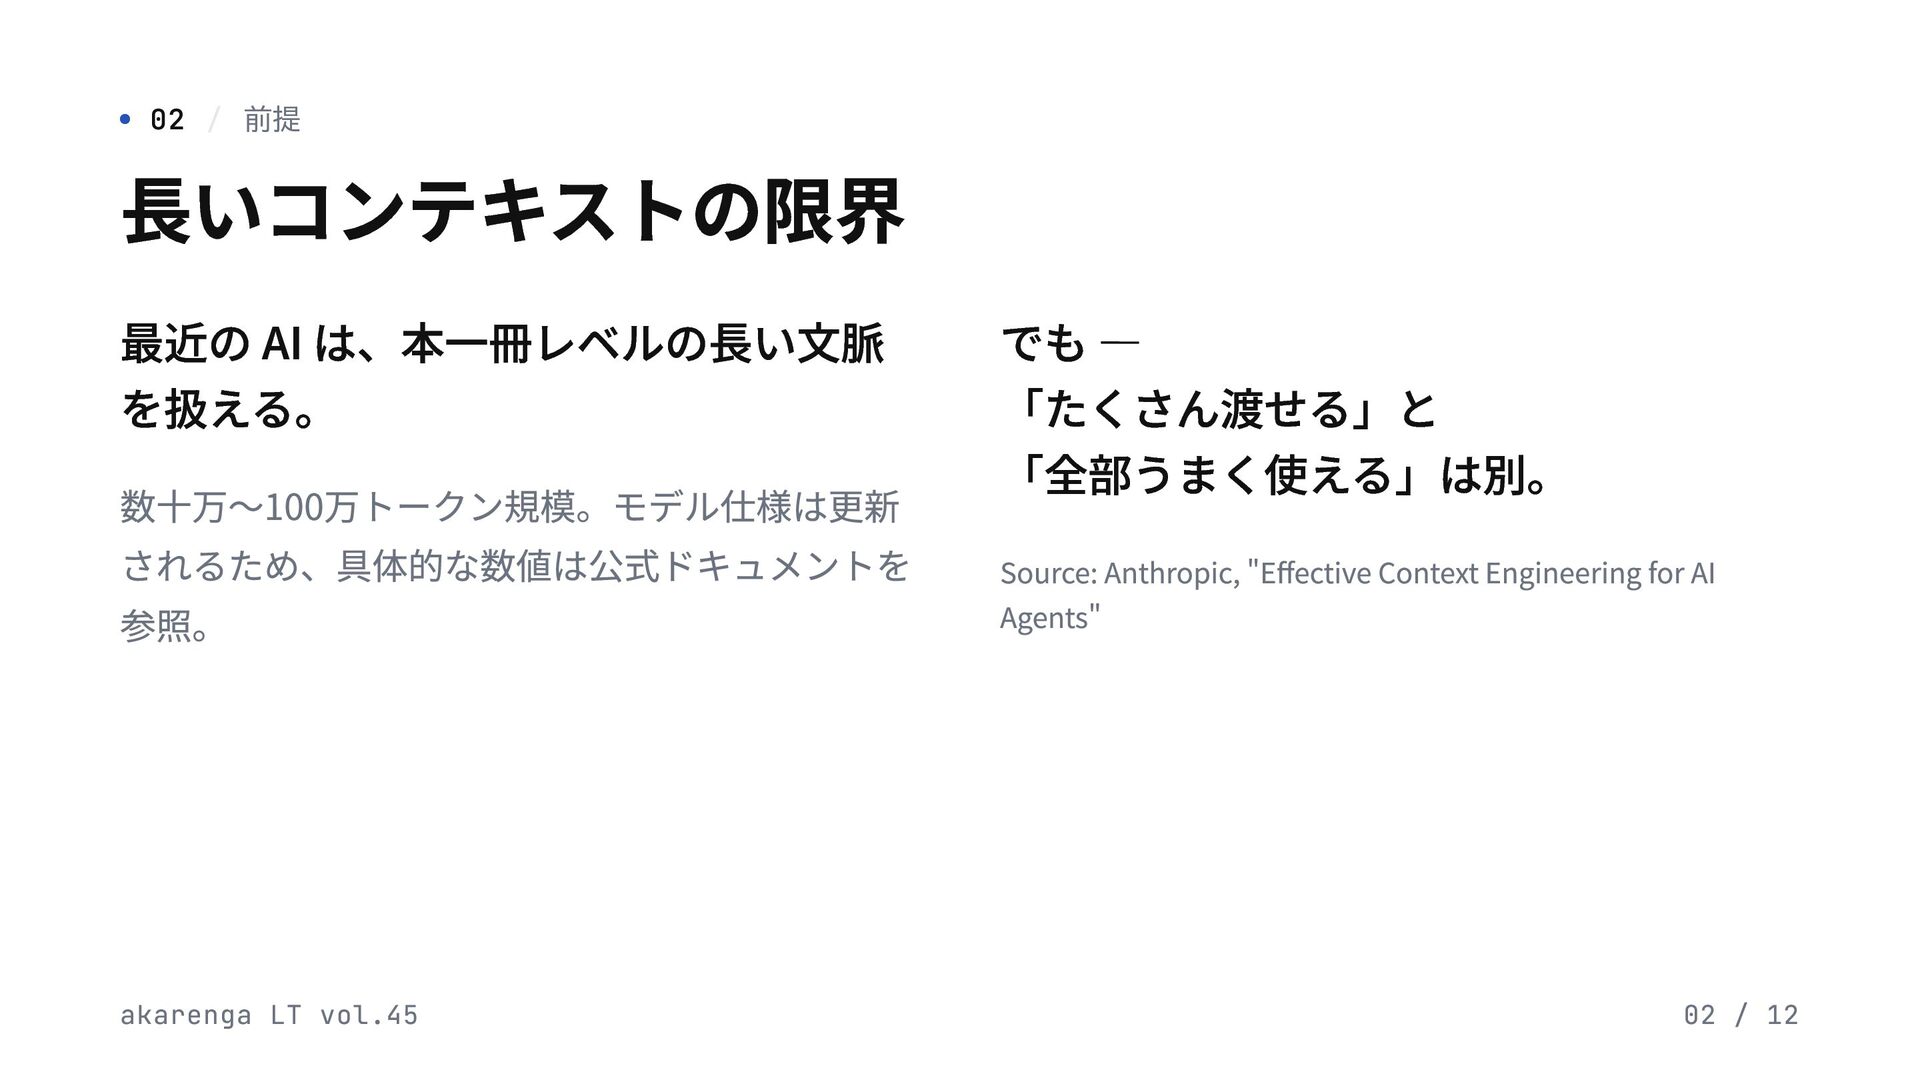
02 / 前提 長いコンテキストの限界 最近の AI は、本一冊レベルの長い文脈 を扱える。 数十万〜100万トークン規模。モデル仕様は更新 されるため、具体的な数値は公式ドキュメントを
参照。 でも — 「たくさん渡せる」と 「全部うまく使える」は別。 Source: Anthropic, "Effective Context Engineering for AI Agents" akarenga LT vol.45 02 / 12
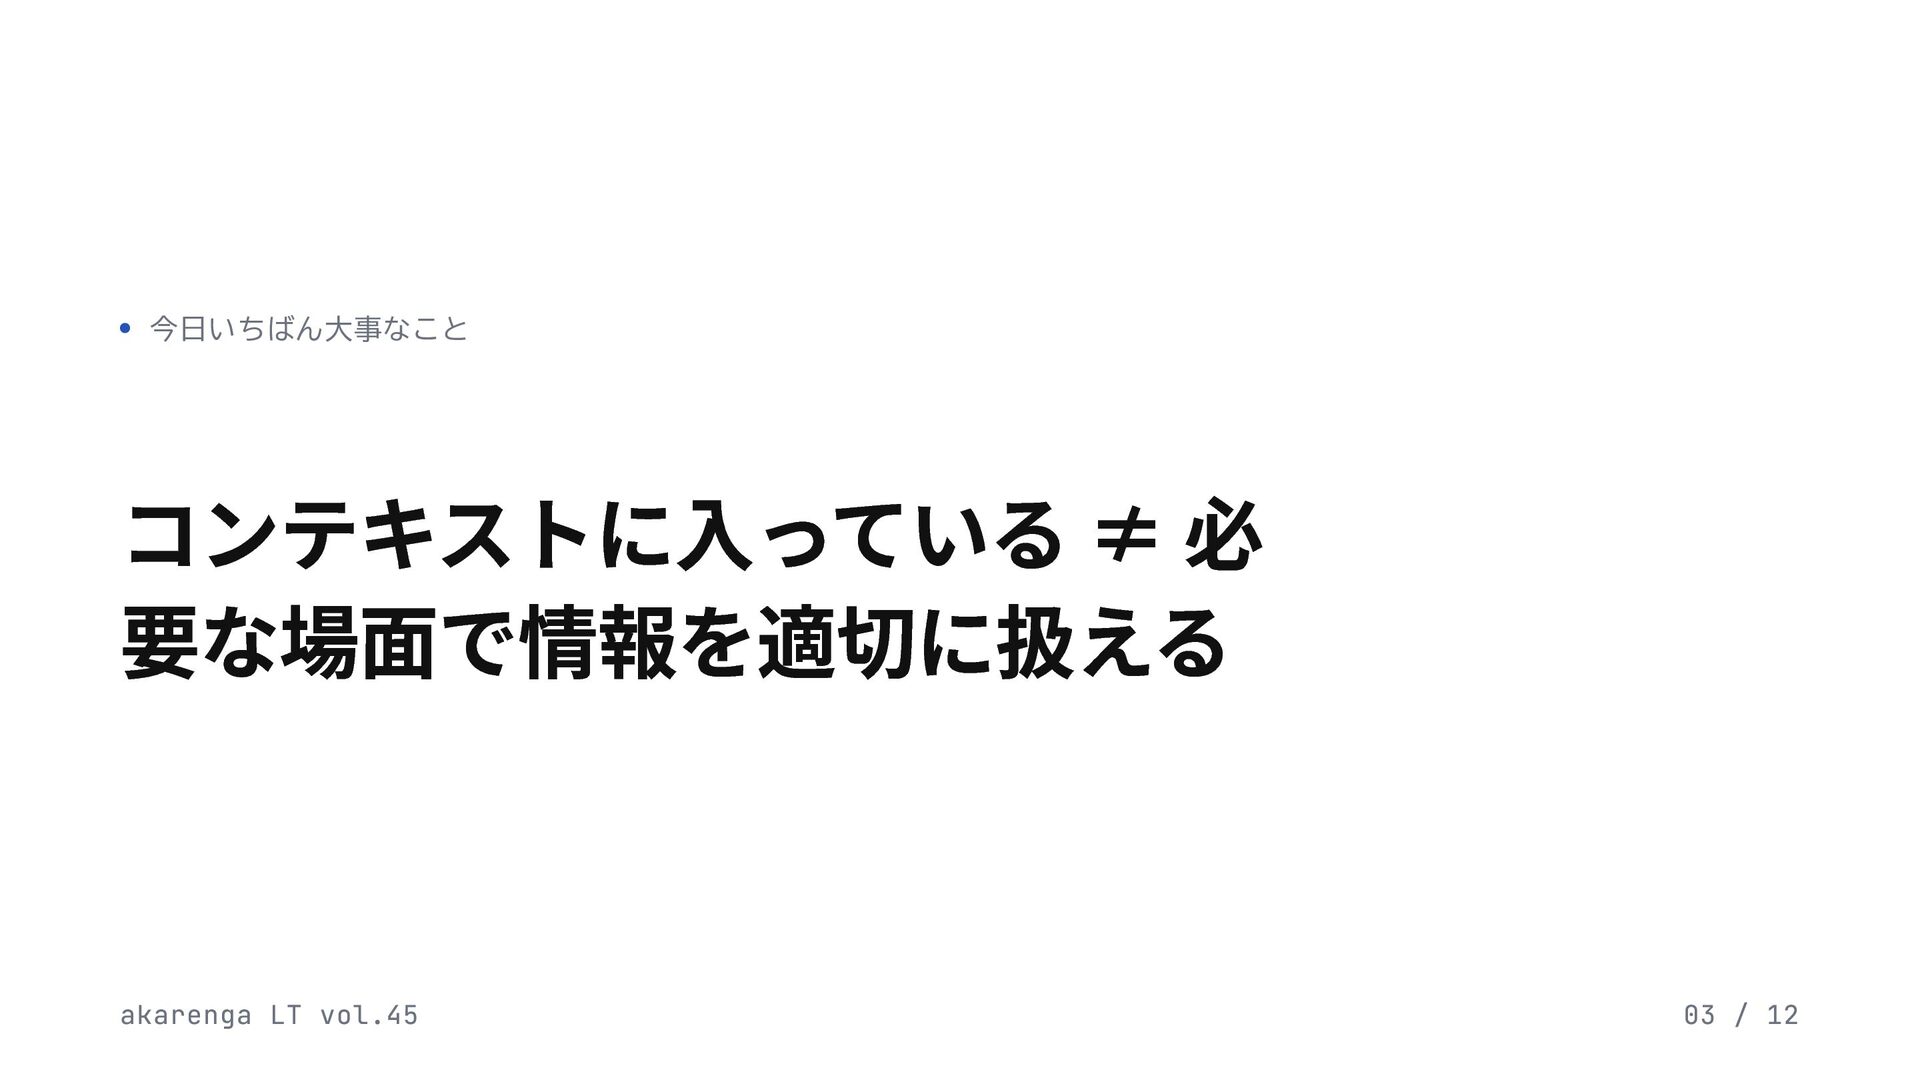
今日いちばん大事なこと コンテキストに入っている ≠ 必 要な場面で情報を適切に扱える akarenga LT vol.45 03 /
12
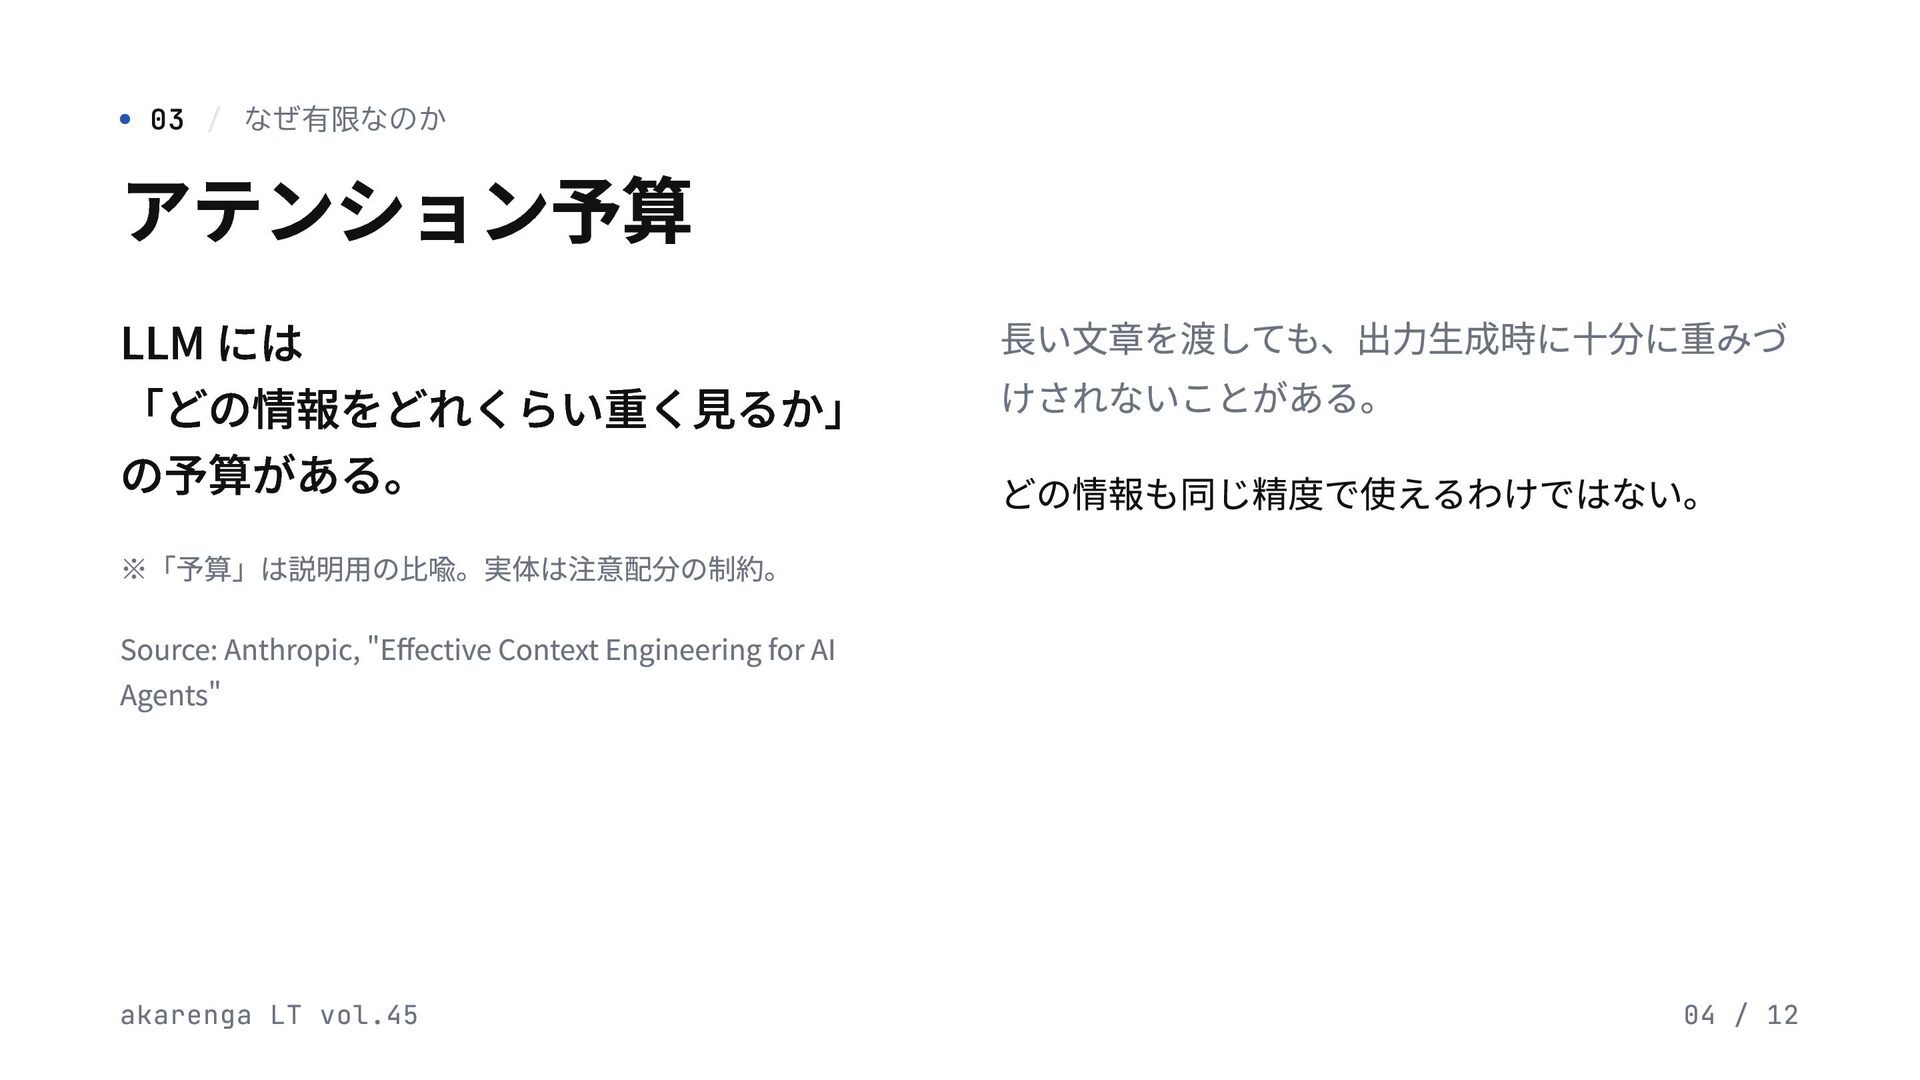
03 / なぜ有限なのか アテンション予算 LLM には 「どの情報をどれくらい重く見るか」 の予算がある。 ※「予算」は説明用の比喩。実体は注意配分の制約。 Source:
Anthropic, "Effective Context Engineering for AI Agents" 長い文章を渡しても、出力生成時に十分に重みづ けされないことがある。 どの情報も同じ精度で使えるわけではない。 akarenga LT vol.45 04 / 12
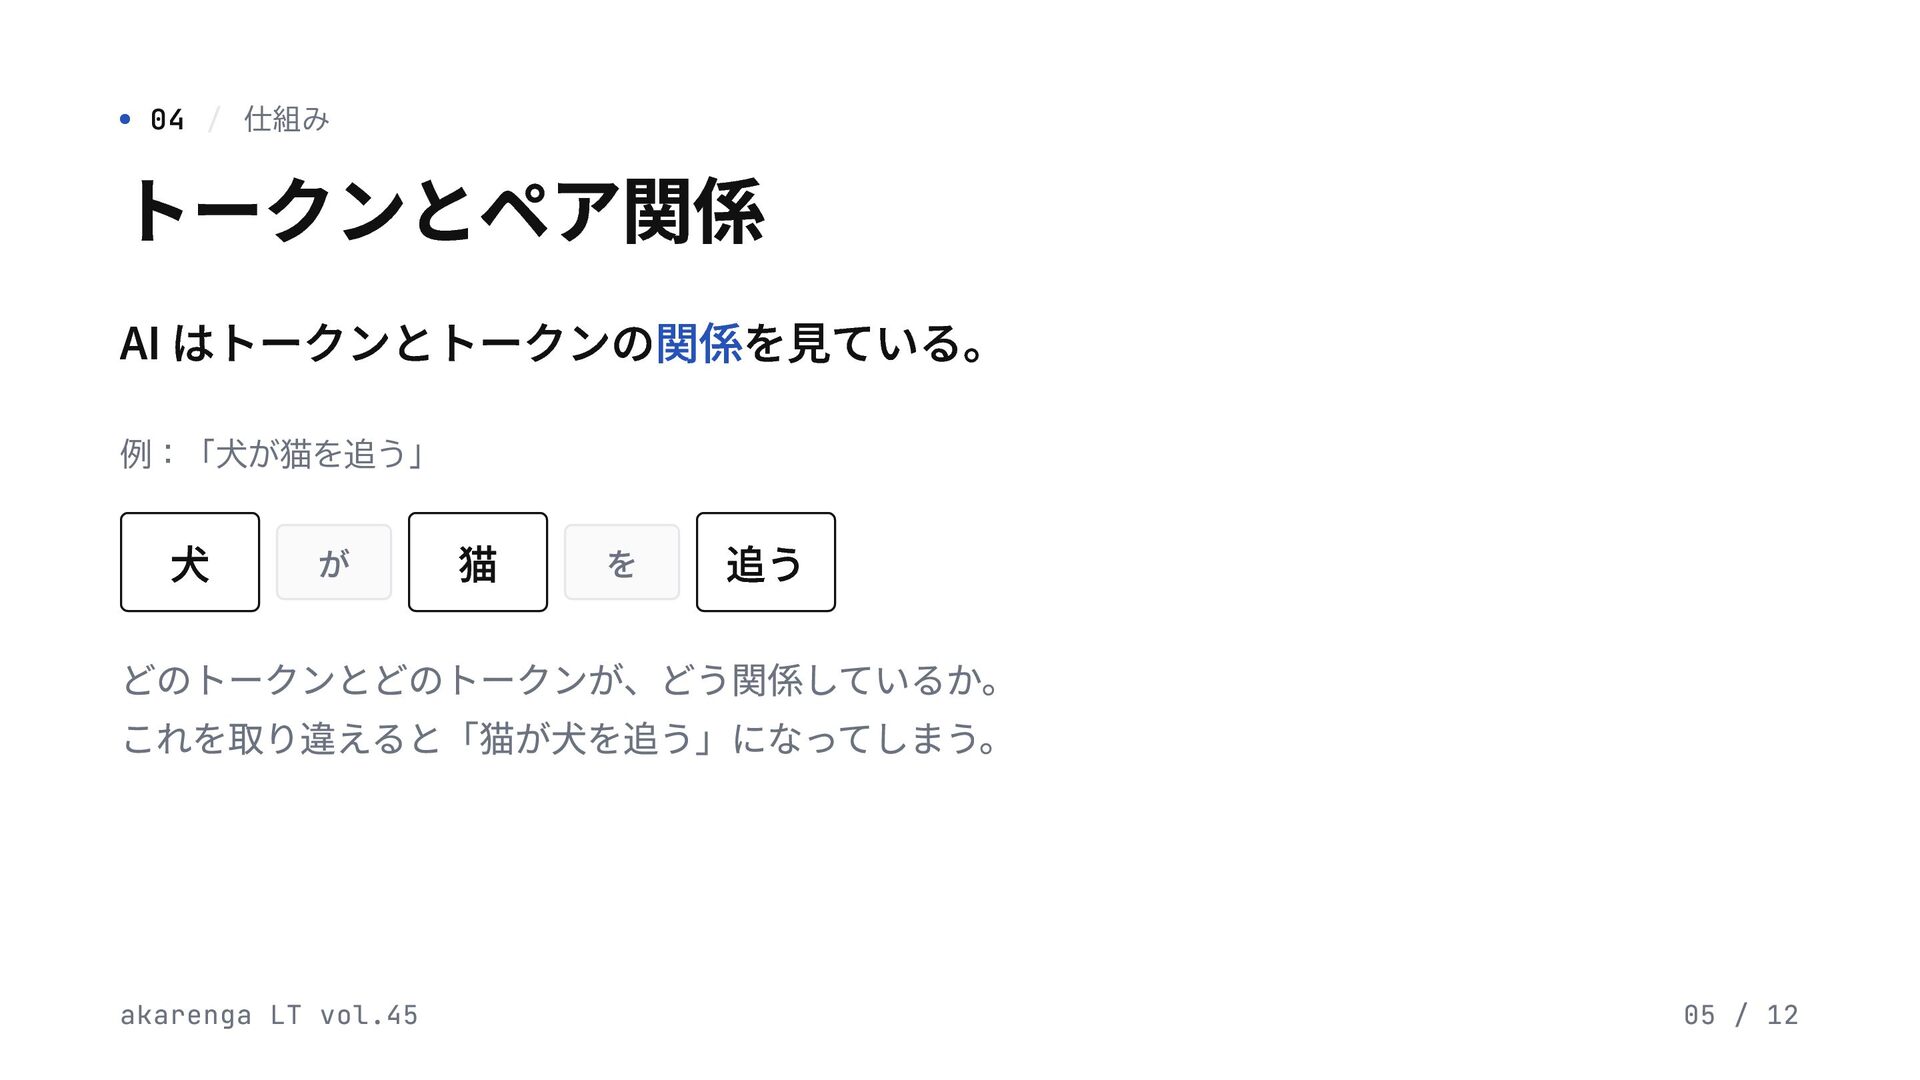
04 / 仕組み トークンとペア関係 AI はトークンとトークンの関係を見ている。 例:「犬が猫を追う」 犬 が 猫
を 追う どのトークンとどのトークンが、どう関係しているか。 これを取り違えると「猫が犬を追う」になってしまう。 akarenga LT vol.45 05 / 12
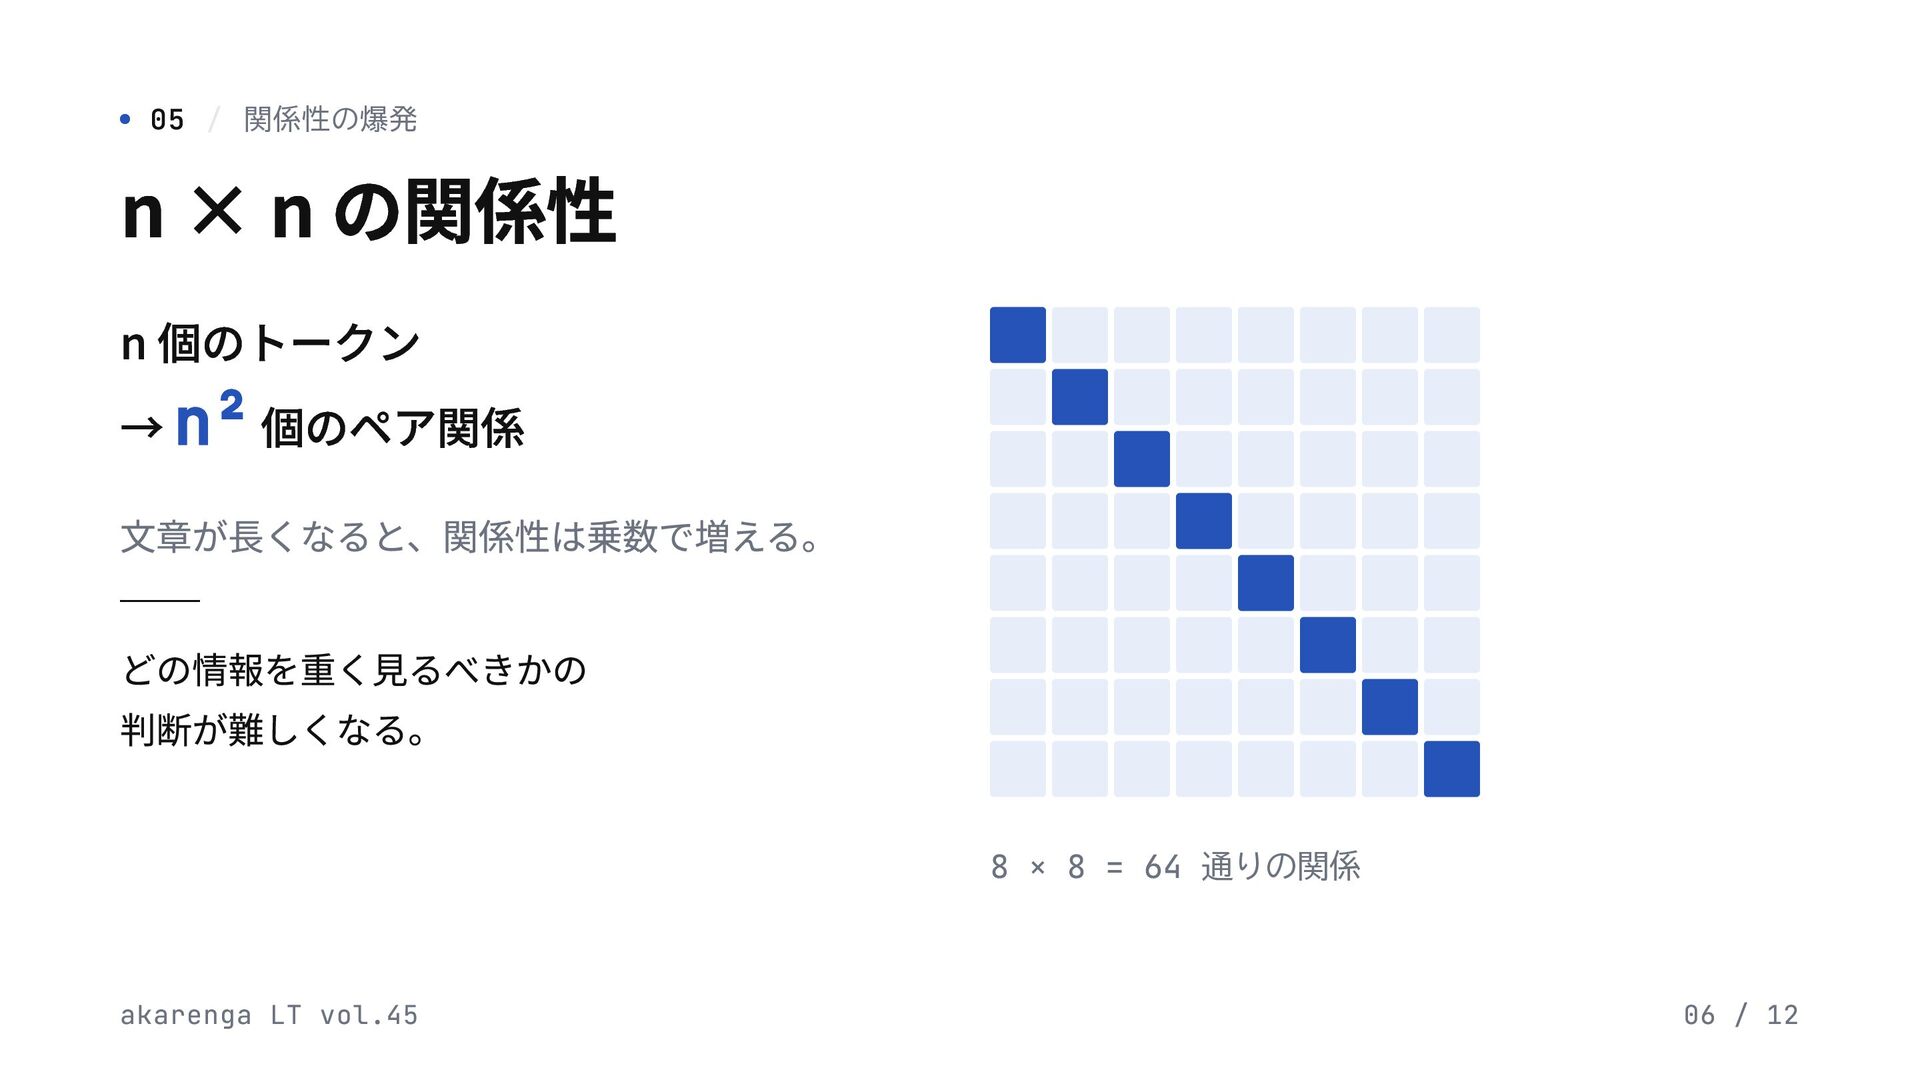
05 / 関係性の爆発 n × n の関係性 n 個のトークン →
n² 個のペア関係 文章が長くなると、関係性は乗数で増える。 どの情報を重く見るべきかの 判断が難しくなる。 8 × 8 = 64 通りの関係 akarenga LT vol.45 06 / 12
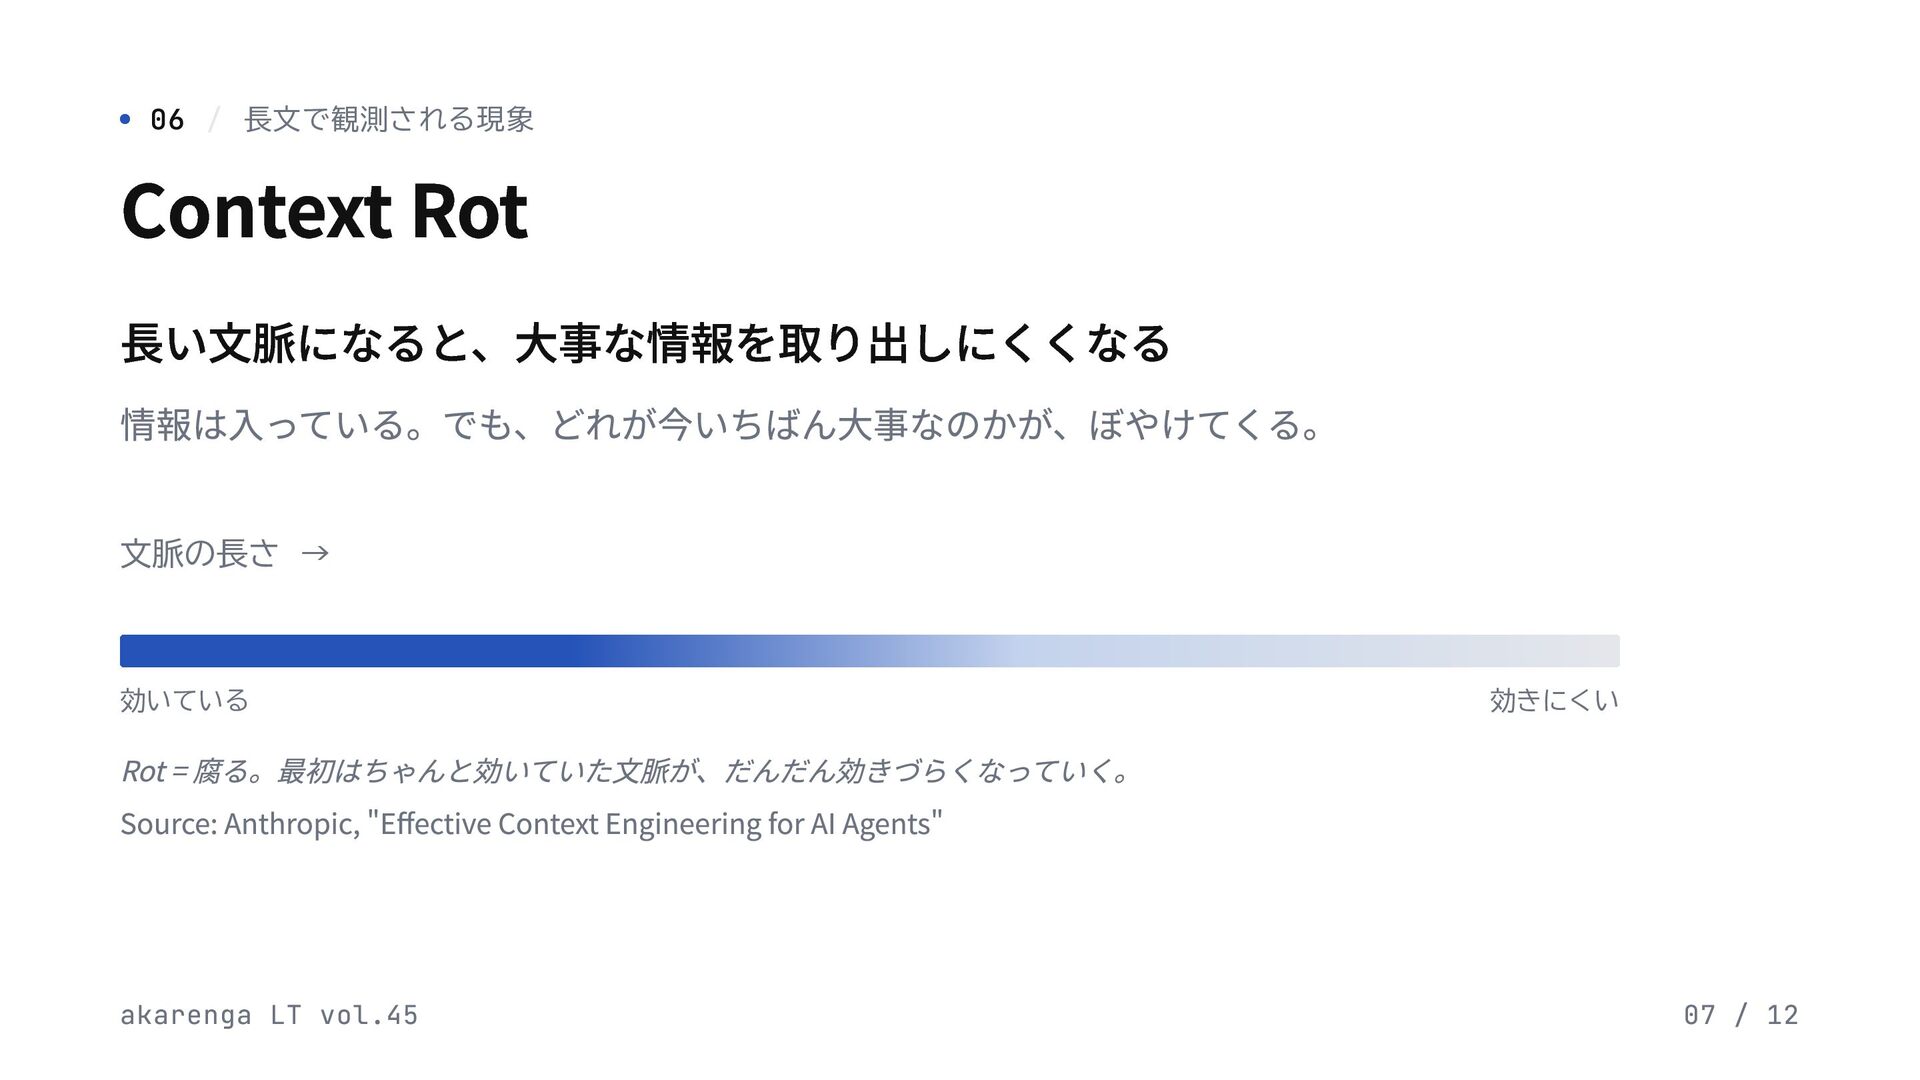
06 / 長文で観測される現象 Context Rot 長い文脈になると、大事な情報を取り出しにくくなる 情報は入っている。でも、どれが今いちばん大事なのかが、ぼやけてくる。 Rot = 腐る。最初はちゃんと効いていた文脈が、だんだん効きづらくなっていく。
Source: Anthropic, "Effective Context Engineering for AI Agents" 文脈の長さ → 効いている 効きにくい akarenga LT vol.45 07 / 12
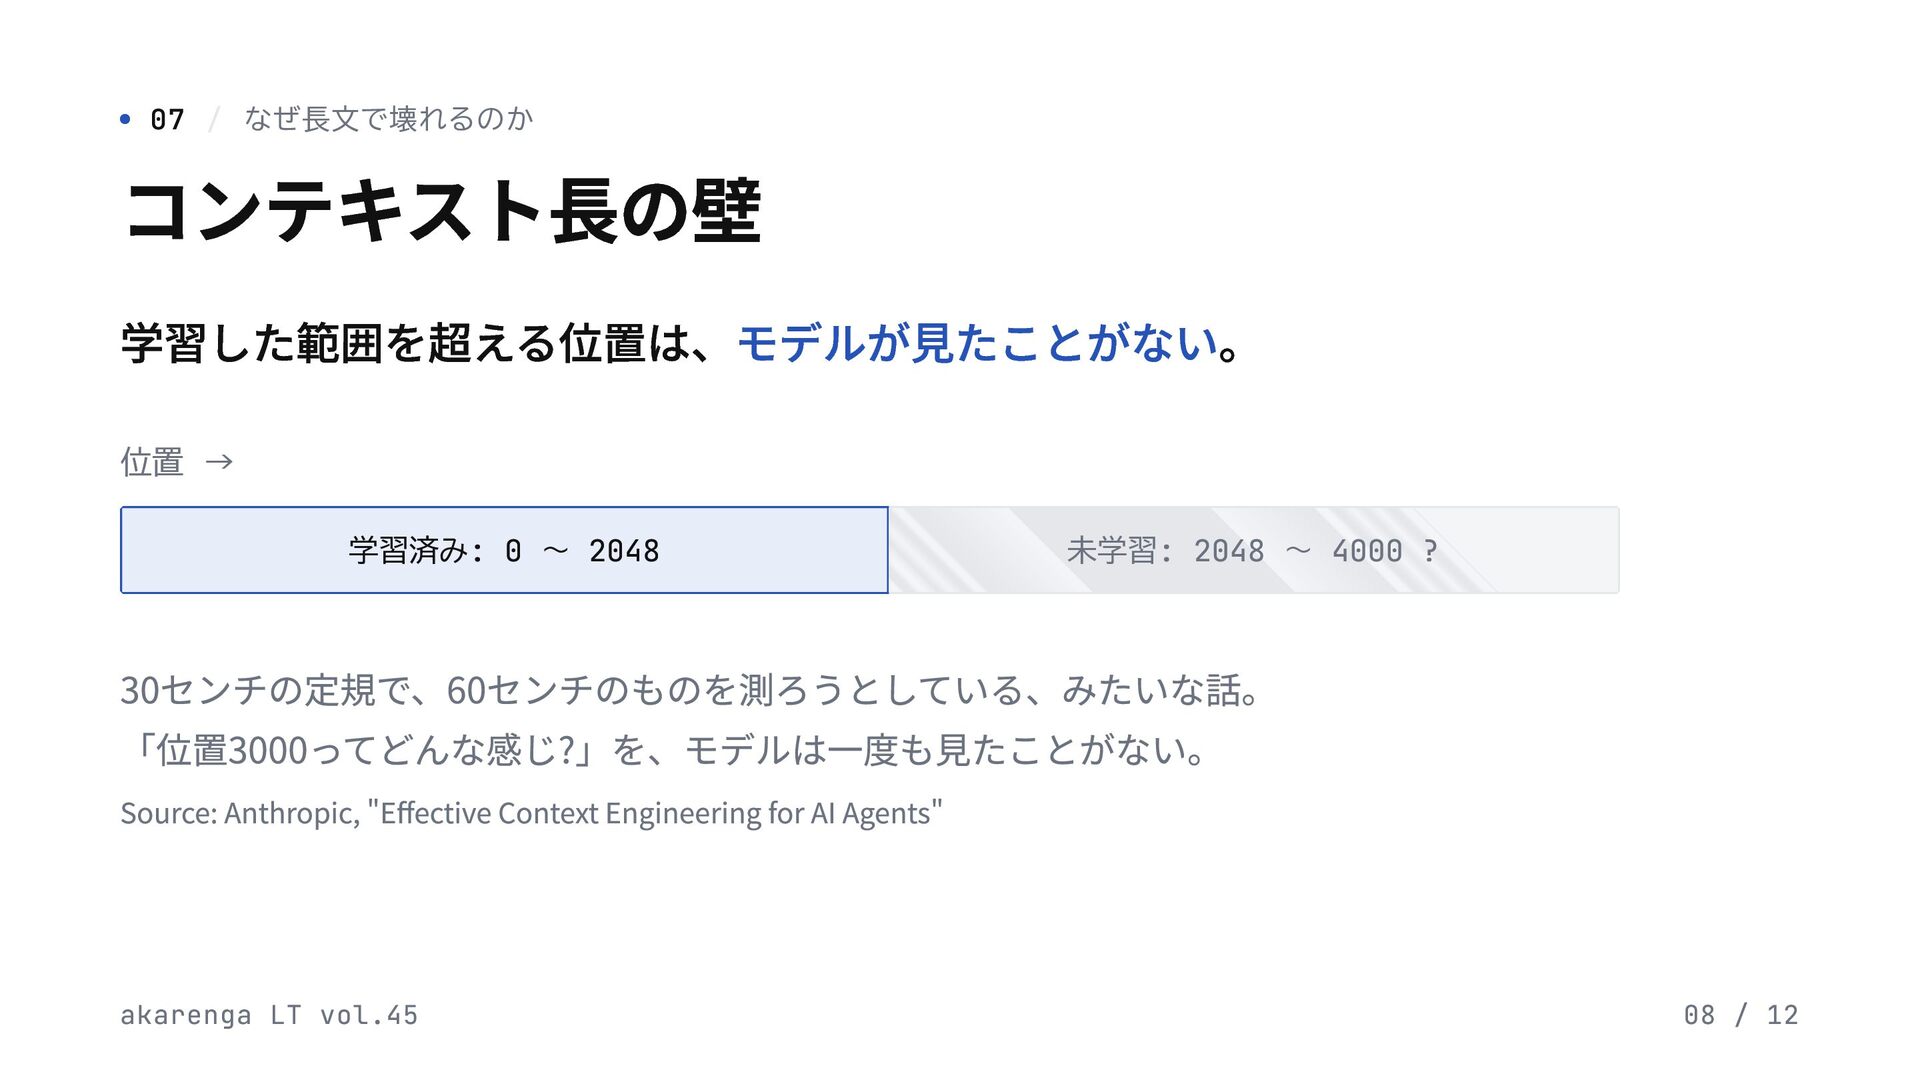
07 / なぜ長文で壊れるのか コンテキスト長の壁 学習した範囲を超える位置は、モデルが見たことがない。 位置 → 学習済み: 0 〜
2048 未学習: 2048 〜 4000 ? 30センチの定規で、60センチのものを測ろうとしている、みたいな話。 「位置3000ってどんな感じ?」を、モデルは一度も見たことがない。 Source: Anthropic, "Effective Context Engineering for AI Agents" akarenga LT vol.45 08 / 12
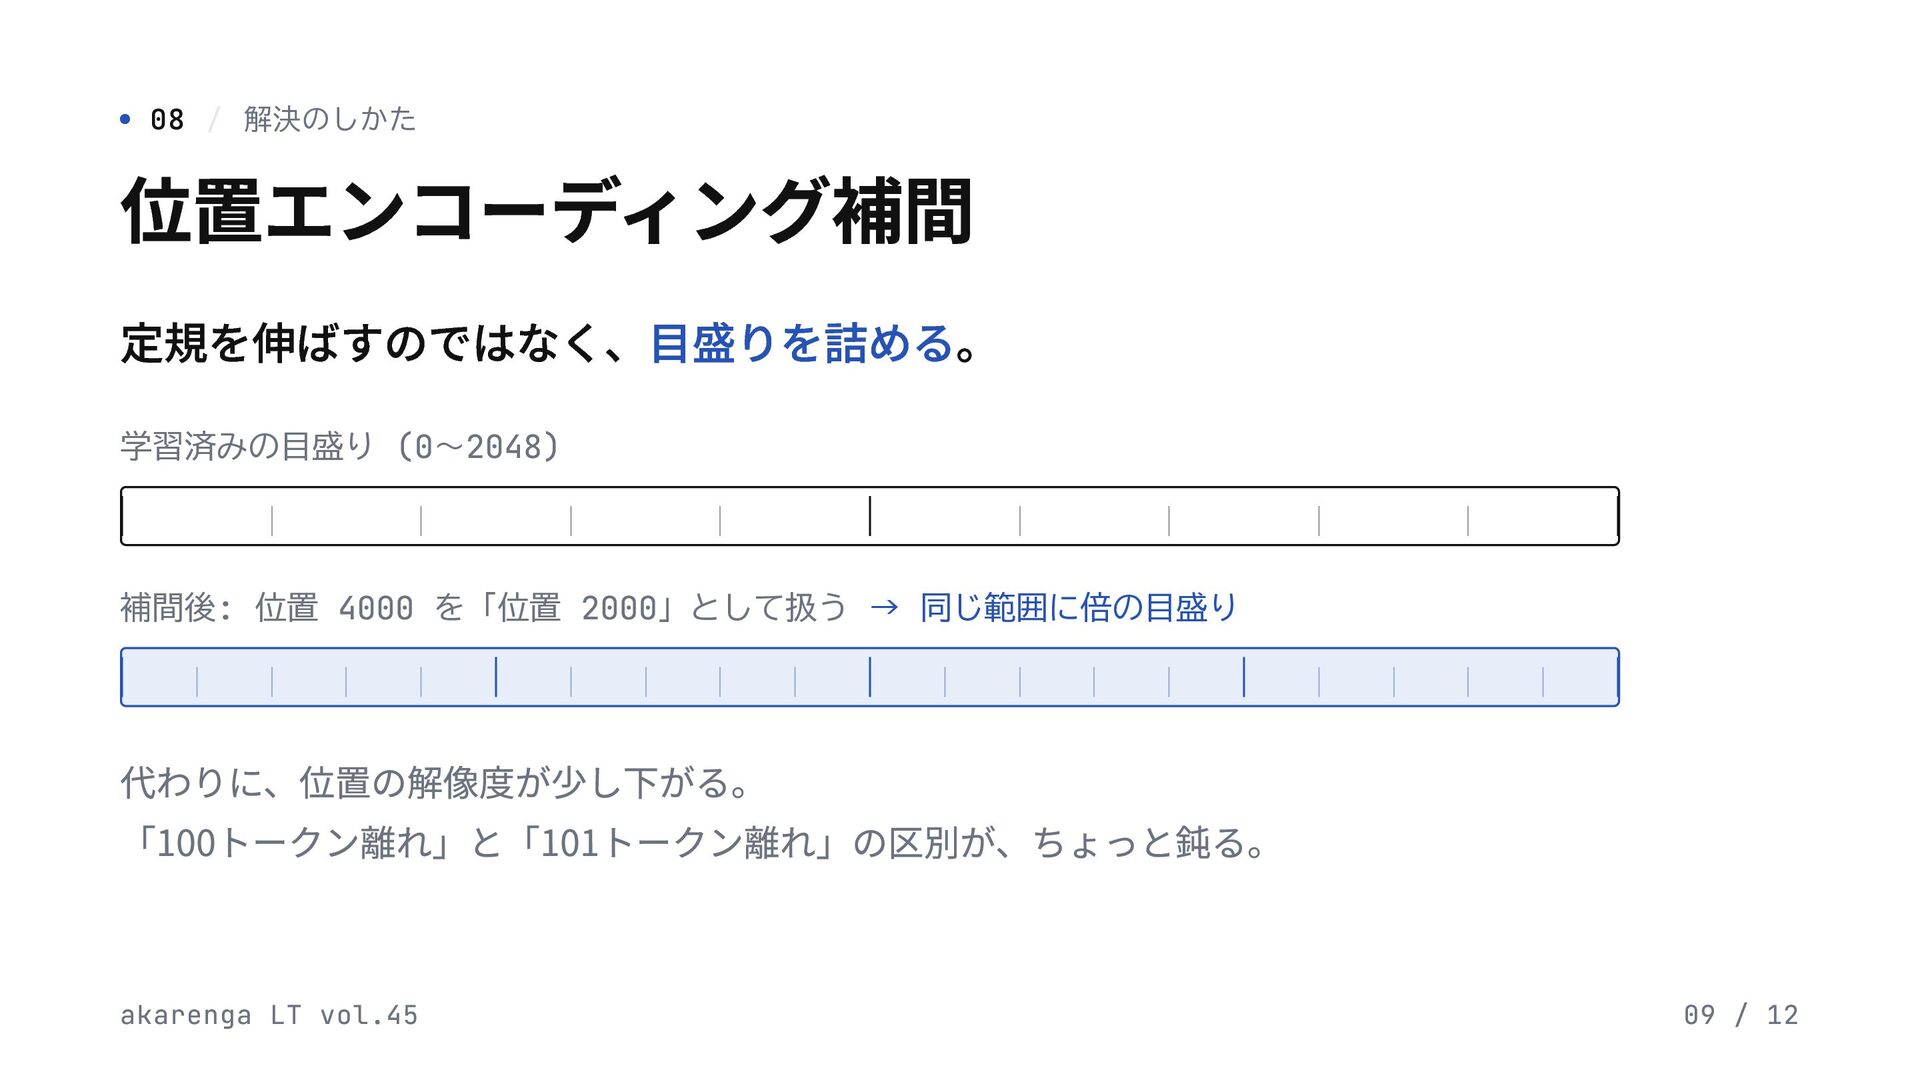
08 / 解決のしかた 位置エンコーディング補間 定規を伸ばすのではなく、目盛りを詰める。 学習済みの目盛り (0〜2048) 補間後: 位置 4000
を「位置 2000」として扱う → 同じ範囲に倍の目盛り 代わりに、位置の解像度が少し下がる。 「100トークン離れ」と「101トークン離れ」の区別が、ちょっと鈍る。 akarenga LT vol.45 09 / 12
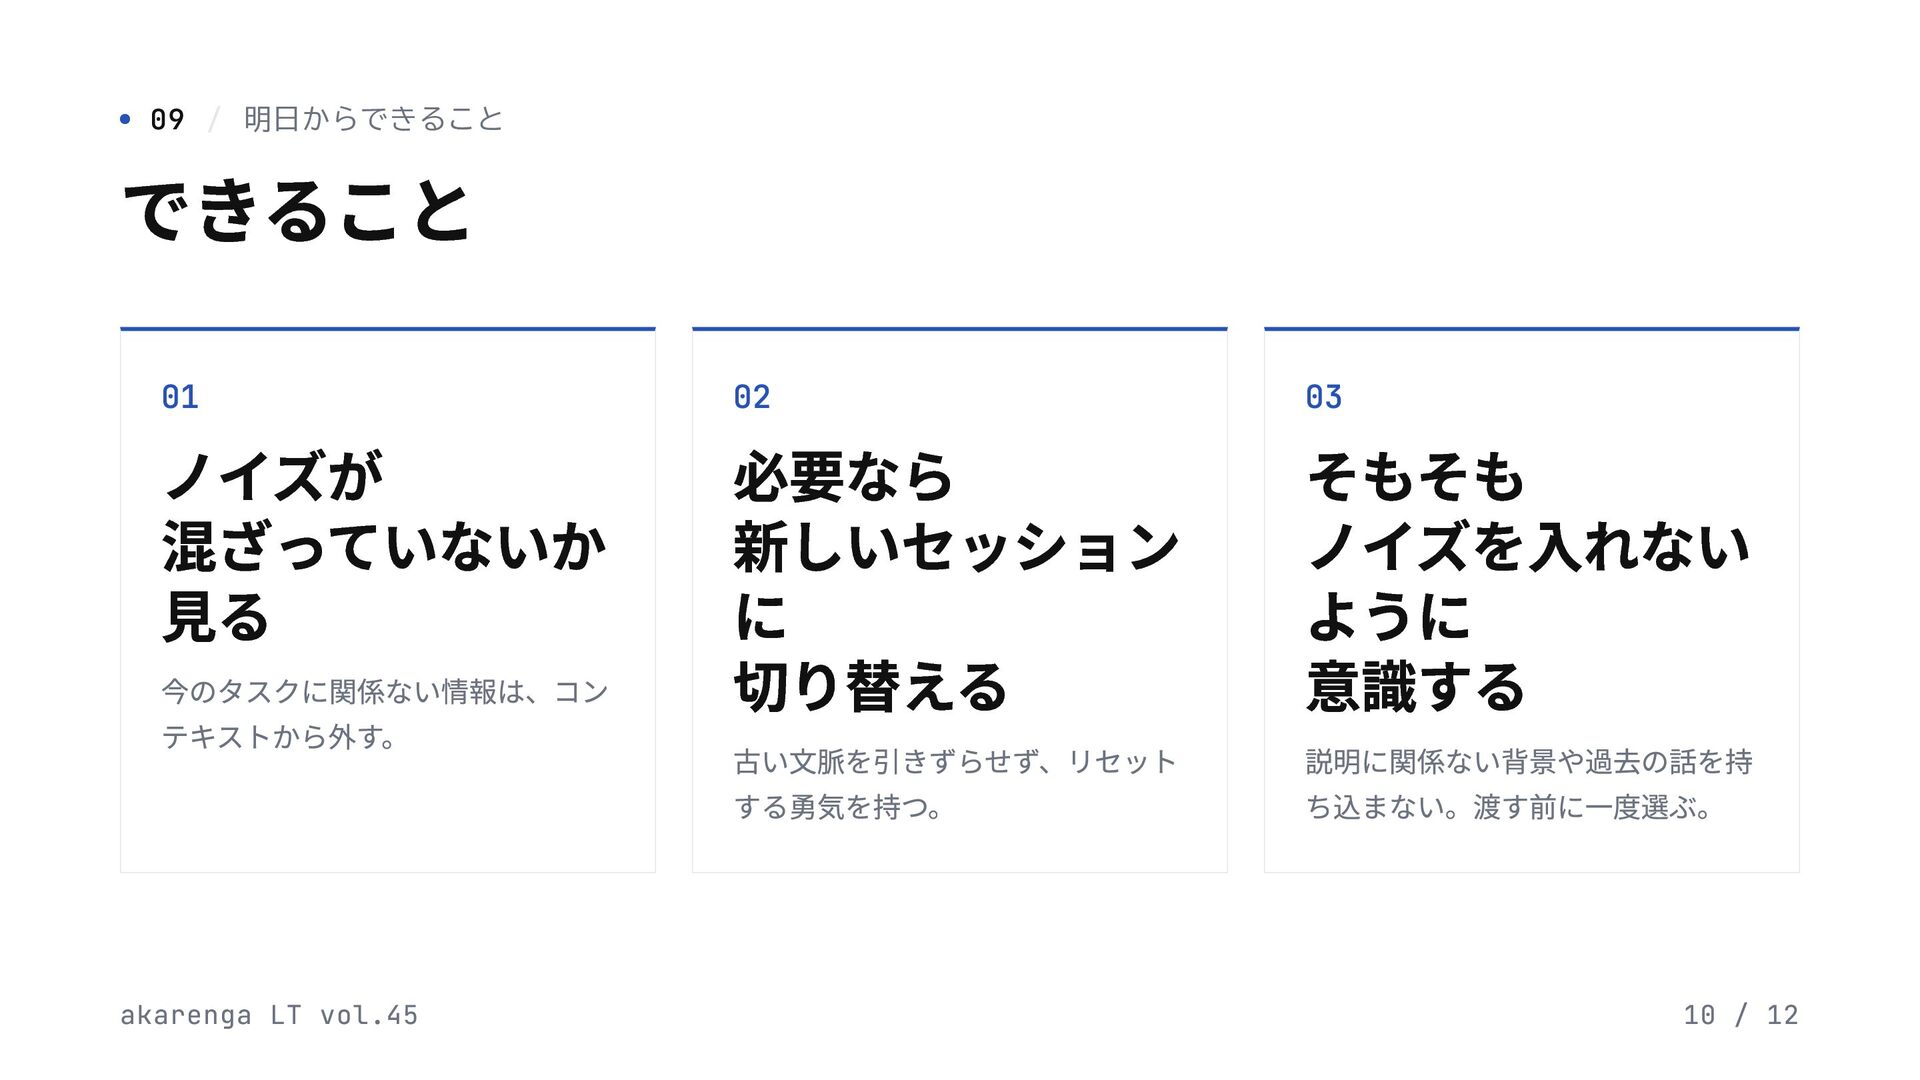
09 / 明日からできること できること 01 ノイズが 混ざっていないか 見る 今のタスクに関係ない情報は、コン テキストから外す。
02 必要なら 新しいセッション に 切り替える 古い文脈を引きずらせず、リセット する勇気を持つ。 03 そもそも ノイズを入れない ように 意識する 説明に関係ない背景や過去の話を持 ち込まない。渡す前に一度選ぶ。 akarenga LT vol.45 10 / 12
ありがとうございました akarenga LT vol.45 / 中村旭良 REFERENCES Effective Context Engineering
for AI Agents anthropic.com/engineering/effective-context-engineering-for-ai-agents


 nkmak
 mofurune
 akit37
 kishida
 panda728
 seike460
 yasaichi
 florets1
 minodriven
 artoy
 taiseiue
 gonta
 shihochan
 reverentgeek
 pedronauck
 uxyall
 kimpetersen
 hatefulcrawdad
 rkendrick25
 ryanjones
 tammyeverts
 cassininazir
 joshbly
 kristinabergwall1