Upgrade to Pro — share decks privately, control downloads, hide ads and more …

kaggle `Instant Gratification` 25th rank method...

kaggle `Instant Gratification` 25th rank method (silver)

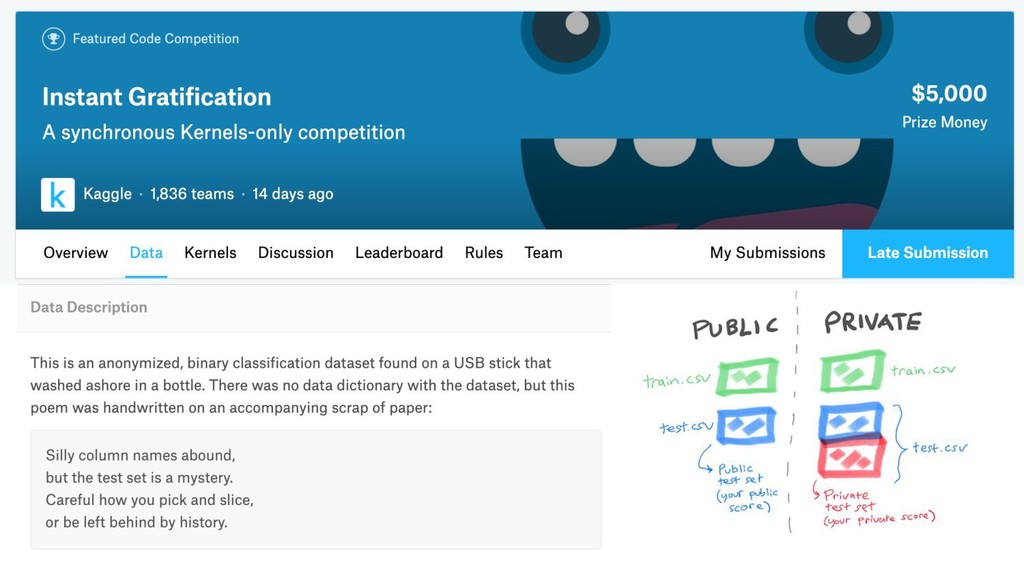
kaggle Instant Gratification ( https://www.kaggle.com/c/instant-gratification ) 25th rank method (silver)

Avatar for Yoshiyuki Ohiwa

Yoshiyuki Ohiwa

July 05, 2019

Other Decks in Programming

Transcript

  1. Who am I • Yoshiyuki Ohiwa • Liquid CTO ◦

    Biometrics ◦ eKYC • Image Processing Engineer ◦ Fingerprint ◦ Face ◦ Human Behavior ◦ IDCard • twitter: @ooiwa • kaggle: @yoshiyukiohiwa
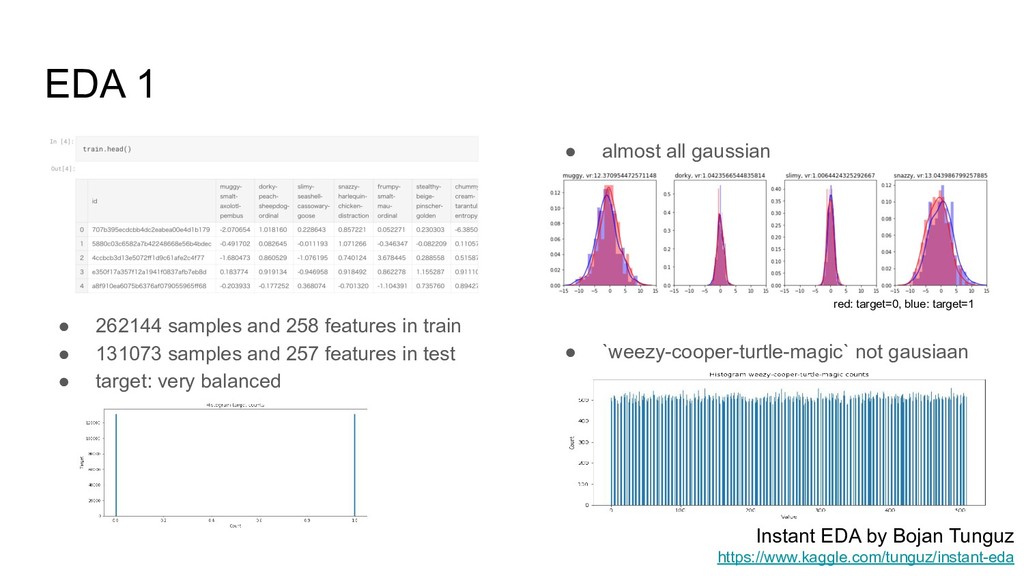
  2. EDA 1 • 262144 samples and 258 features in train

    • 131073 samples and 257 features in test • target: very balanced • almost all gaussian • `weezy-cooper-turtle-magic` not gausiaan Instant EDA by Bojan Tunguz https://www.kaggle.com/tunguz/instant-eda red: target=0, blue: target=1
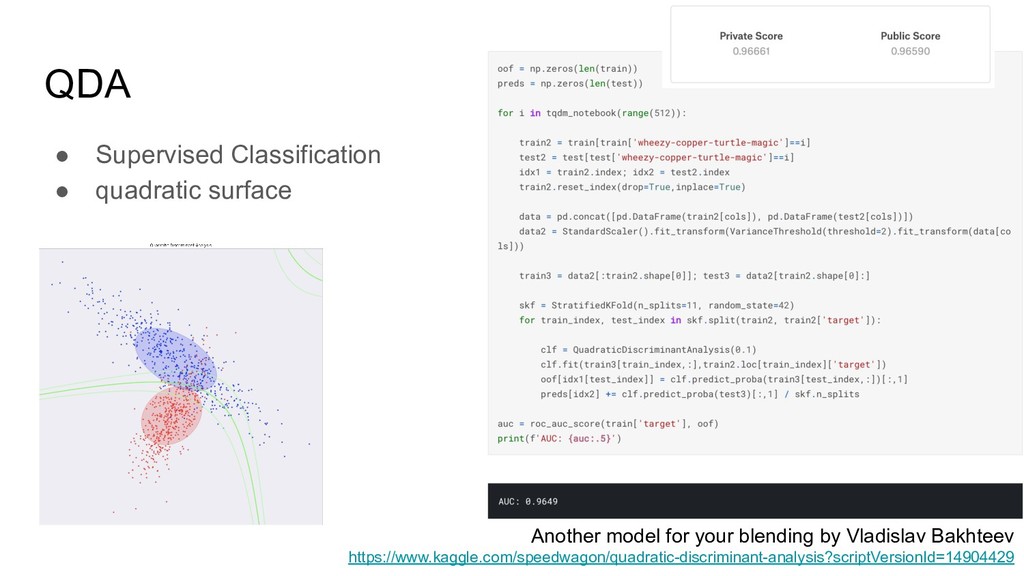
  3. QDA • Supervised Classification • quadratic surface Another model for

    your blending by Vladislav Bakhteev https://www.kaggle.com/speedwagon/quadratic-discriminant-analysis?scriptVersionId=14904429
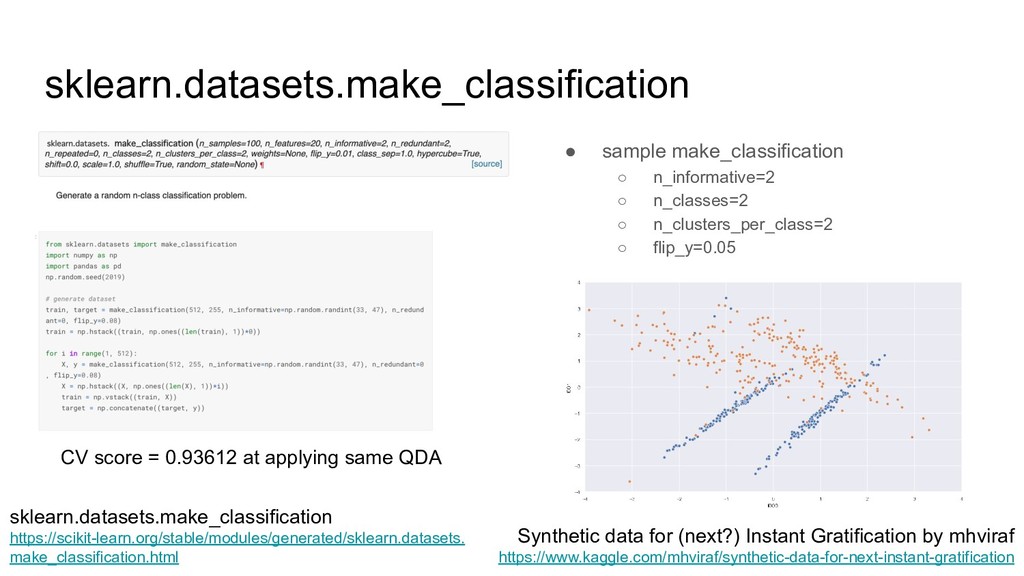
  4. • sample make_classification ◦ n_informative=2 ◦ n_classes=2 ◦ n_clusters_per_class=2 ◦

    flip_y=0.05 sklearn.datasets.make_classification Synthetic data for (next?) Instant Gratification by mhviraf https://www.kaggle.com/mhviraf/synthetic-data-for-next-instant-gratification sklearn.datasets.make_classification https://scikit-learn.org/stable/modules/generated/sklearn.datasets. make_classification.html CV score = 0.93612 at applying same QDA
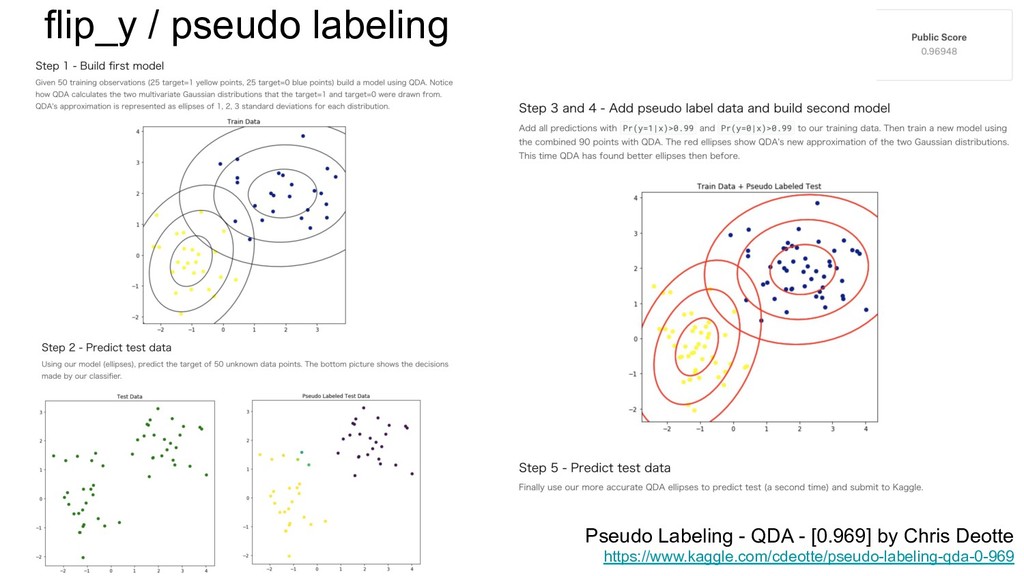
  5. flip_y / pseudo labeling Pseudo Labeling - QDA - [0.969]

    by Chris Deotte https://www.kaggle.com/cdeotte/pseudo-labeling-qda-0-969
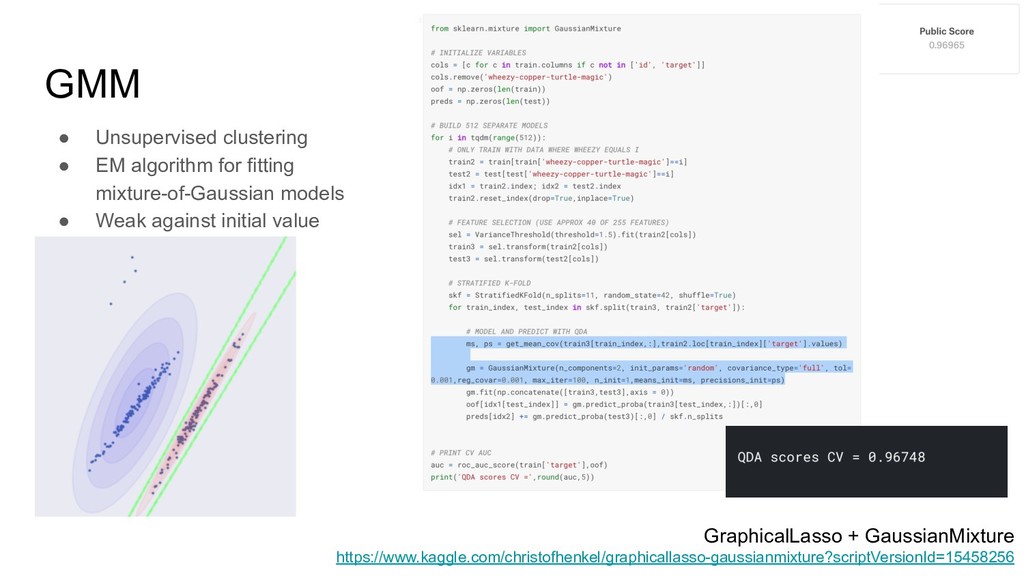
  6. GMM • Unsupervised clustering • EM algorithm for fitting mixture-of-Gaussian

    models • Weak against initial value GraphicalLasso + GaussianMixture https://www.kaggle.com/christofhenkel/graphicallasso-gaussianmixture?scriptVersionId=15458256
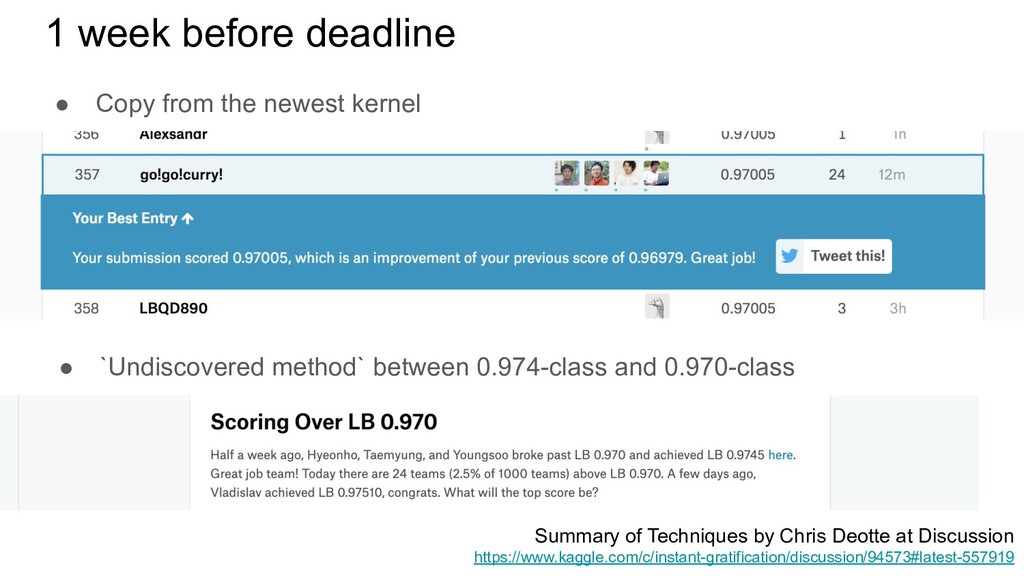
  7. 1 week before deadline • Copy from the newest kernel

    • `Undiscovered method` between 0.974-class and 0.970-class Summary of Techniques by Chris Deotte at Discussion https://www.kaggle.com/c/instant-gratification/discussion/94573#latest-557919
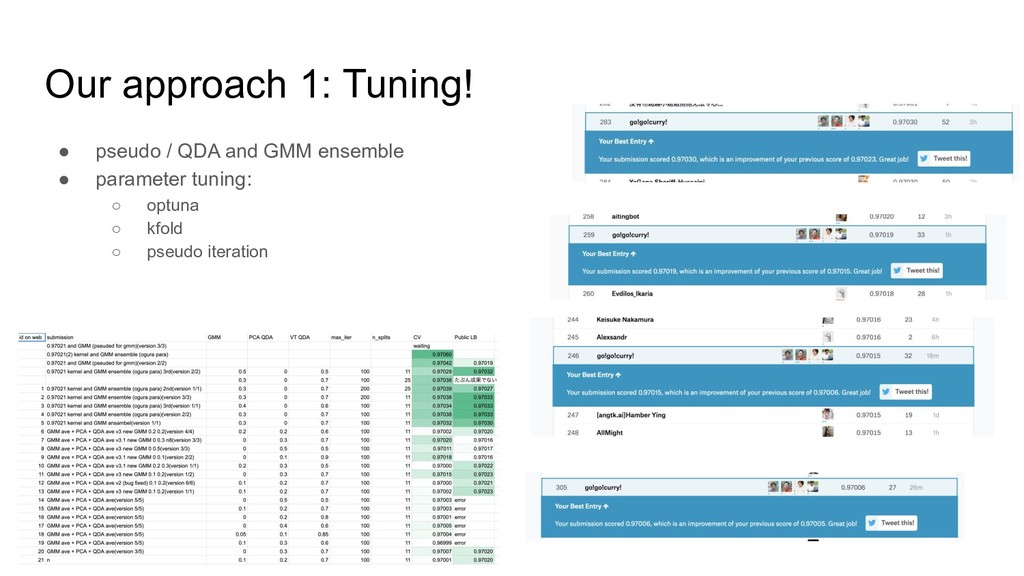
  8. Our approach 1: Tuning! • pseudo / QDA and GMM

    ensemble • parameter tuning: ◦ optuna ◦ kfold ◦ pseudo iteration
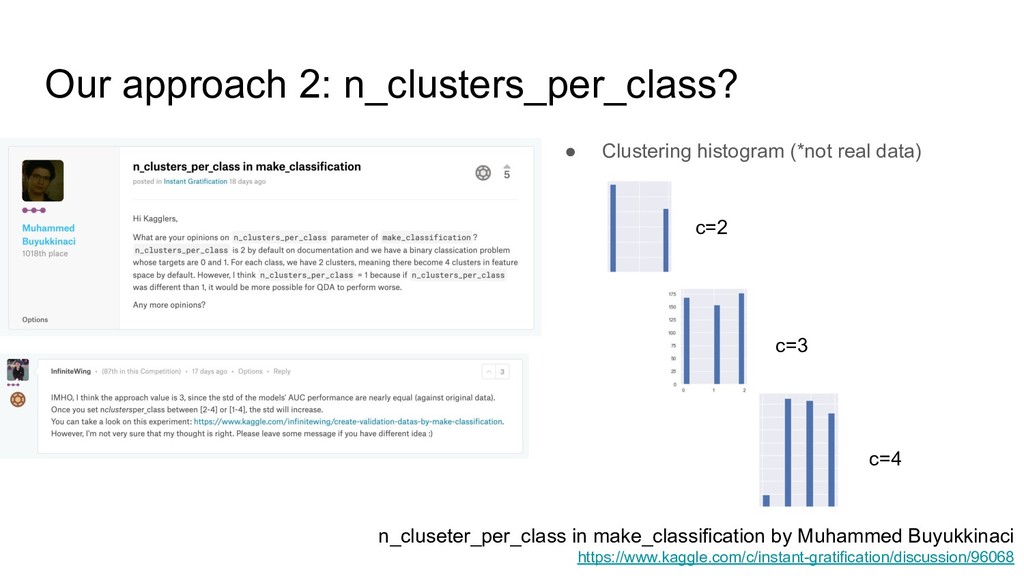
  9. Our approach 2: n_clusters_per_class? • Clustering histogram (*not real data)

    n_cluseter_per_class in make_classification by Muhammed Buyukkinaci https://www.kaggle.com/c/instant-gratification/discussion/96068 c=2 c=3 c=4
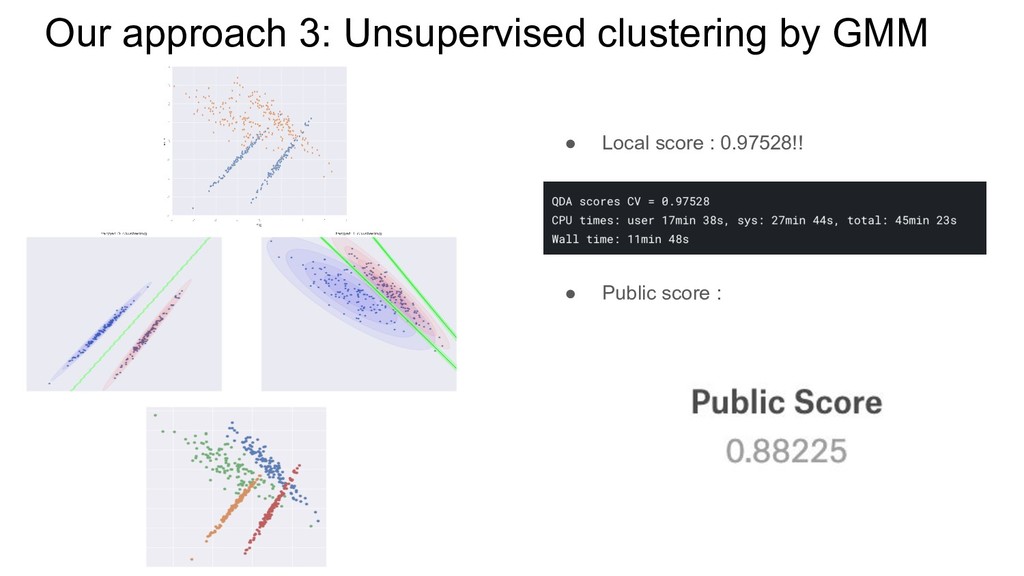
  10. • Local score : 0.97528!! • Public score : Our

    approach 3: Unsupervised clustering by GMM
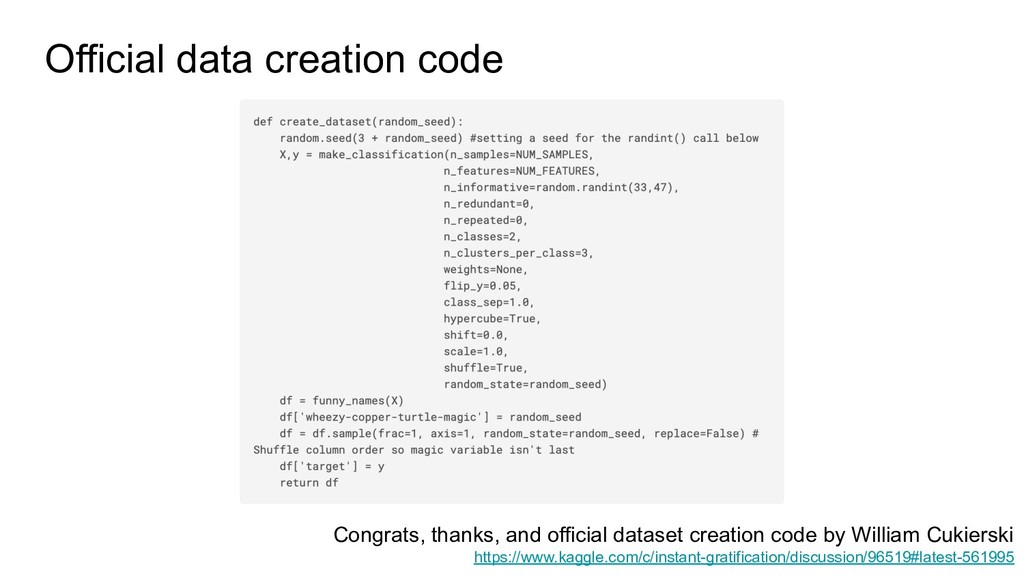
  11. Official data creation code Congrats, thanks, and official dataset creation

    code by William Cukierski https://www.kaggle.com/c/instant-gratification/discussion/96519#latest-561995