Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
20230825_CV_CVPR2023_EHEM
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Kyohei Unno
August 26, 2023
Research
300
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
20230825_CV_CVPR2023_EHEM
Kyohei Unno
August 26, 2023
Other Decks in Research
See All in Research
HAKARI-Bench - 実運用視点での情報検索モデル評価ベンチマーク
hotchpotch
1
760
高性能計算機クラスタを用いた大規模点群処理による森林の単木抽出と構造解析
kentaitakura
1
130
20260624 NLP colloquium: 単一のhubテキストがCLIPを壊す:hubnessによる埋め込みの脆弱性特定
de9uch1
2
280
The story of RefactoringMiner. Slow research, long-term impact
tsantalis
0
160
SLAMはどこまで解決されたのか?
tomonom
0
1.4k
Physical AIでモデリングはどう変わるか/How Physical AI Will Change Modeling
stktu
0
260
Visual SLAM未来予測 / Future Prediction in Visual SLAM
koide3
1
1k
Cross-Media Human-Information Interaction
signer
PRO
0
240
2026年度 生成AI を活用した論文執筆ガイド/ワークショップ / 2026 Academic Year Guide to Writing Papers Using Generative AI - Workshop
ks91
PRO
0
230
PHTalks Bengaluru - SSRF When All Else Fails
dk999
0
1.2k
Ghost in the 7‑Zip: The Shadow of Residential Proxies Creeping into Your Life
nttcom
0
2.1k
Research Engineerという仕事 / Research Engineering: Bridging Research and Business
chck
1
350
Featured
See All Featured
Making Projects Easy
brettharned
120
6.8k
Max Prin - Stacking Signals: How International SEO Comes Together (And Falls Apart)
techseoconnect
PRO
0
470
Visual Storytelling: How to be a Superhuman Communicator
reverentgeek
2
670
From Legacy to Launchpad: Building Startup-Ready Communities
dugsong
0
340
Getting science done with accelerated Python computing platforms
jacobtomlinson
2
480
Fireside Chat
paigeccino
43
4k
Joys of Absence: A Defence of Solitary Play
codingconduct
1
530
SEO for Brand Visibility & Recognition
aleyda
0
4.7k
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.3k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
1
910
Claude Code どこまでも/ Claude Code Everywhere
nwiizo
67
58k
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Transcript
Efficient Hierarchical Entropy Model for Learned Point Cloud Compression @OZ_Z_C
2023/8/26 CV勉強会 CVPR読み会(後編) 1
今回の論文 タイトル:Efficient Hierarchical Entropy Model for Learned Point Cloud
Compression 論文: https://openaccess.thecvf.com/content/CVPR2023/papers/Song_Efficient_Hierarchical_Entropy_Model_for_Learned_P oint_Cloud_Compression_CVPR_2023_paper.pdf Supplemental: https://openaccess.thecvf.com/content/CVPR2023/supplemental/Song_Efficient_Hierarchical_Entropy_CVPR_2023_su pplemental.pdf 概要:学習ベースの点群の幾何情報符号化(圧縮) この論文を選んだ理由: 学習ベースの符号化手法について勉強したかった(普段の仕事は非学習ベース) 「符号化」というタスクを紹介したかった 「点群」×「符号化」の論文がCVPR2023ではこれしかなかった 2023/8/26 CV勉強会 CVPR読み会(後編) 2
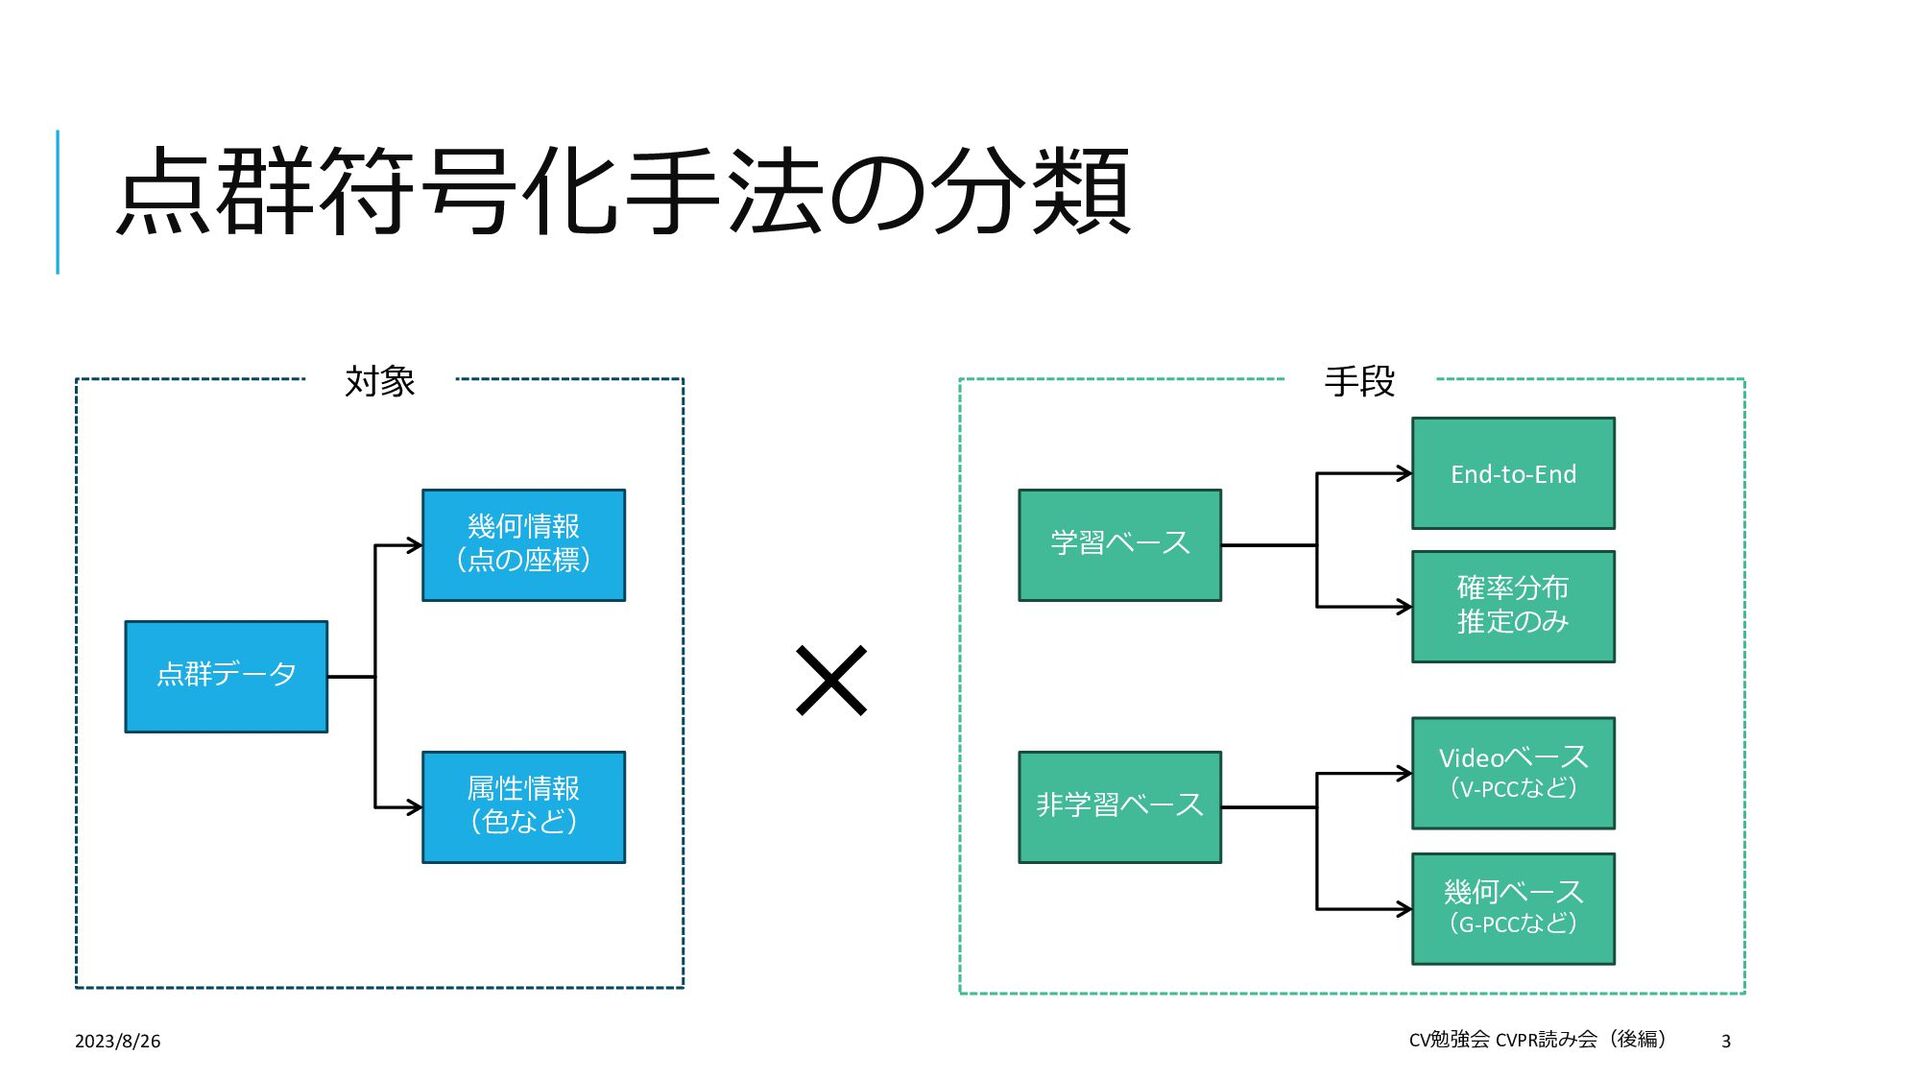
点群符号化手法の分類 2023/8/26 CV勉強会 CVPR読み会(後編) 3 幾何情報 (点の座標) 属性情報 (色など) 学習ベース
非学習ベース End-to-End 確率分布 推定のみ 点群データ Videoベース (V-PCCなど) 幾何ベース (G-PCCなど) 対象 手段 ×
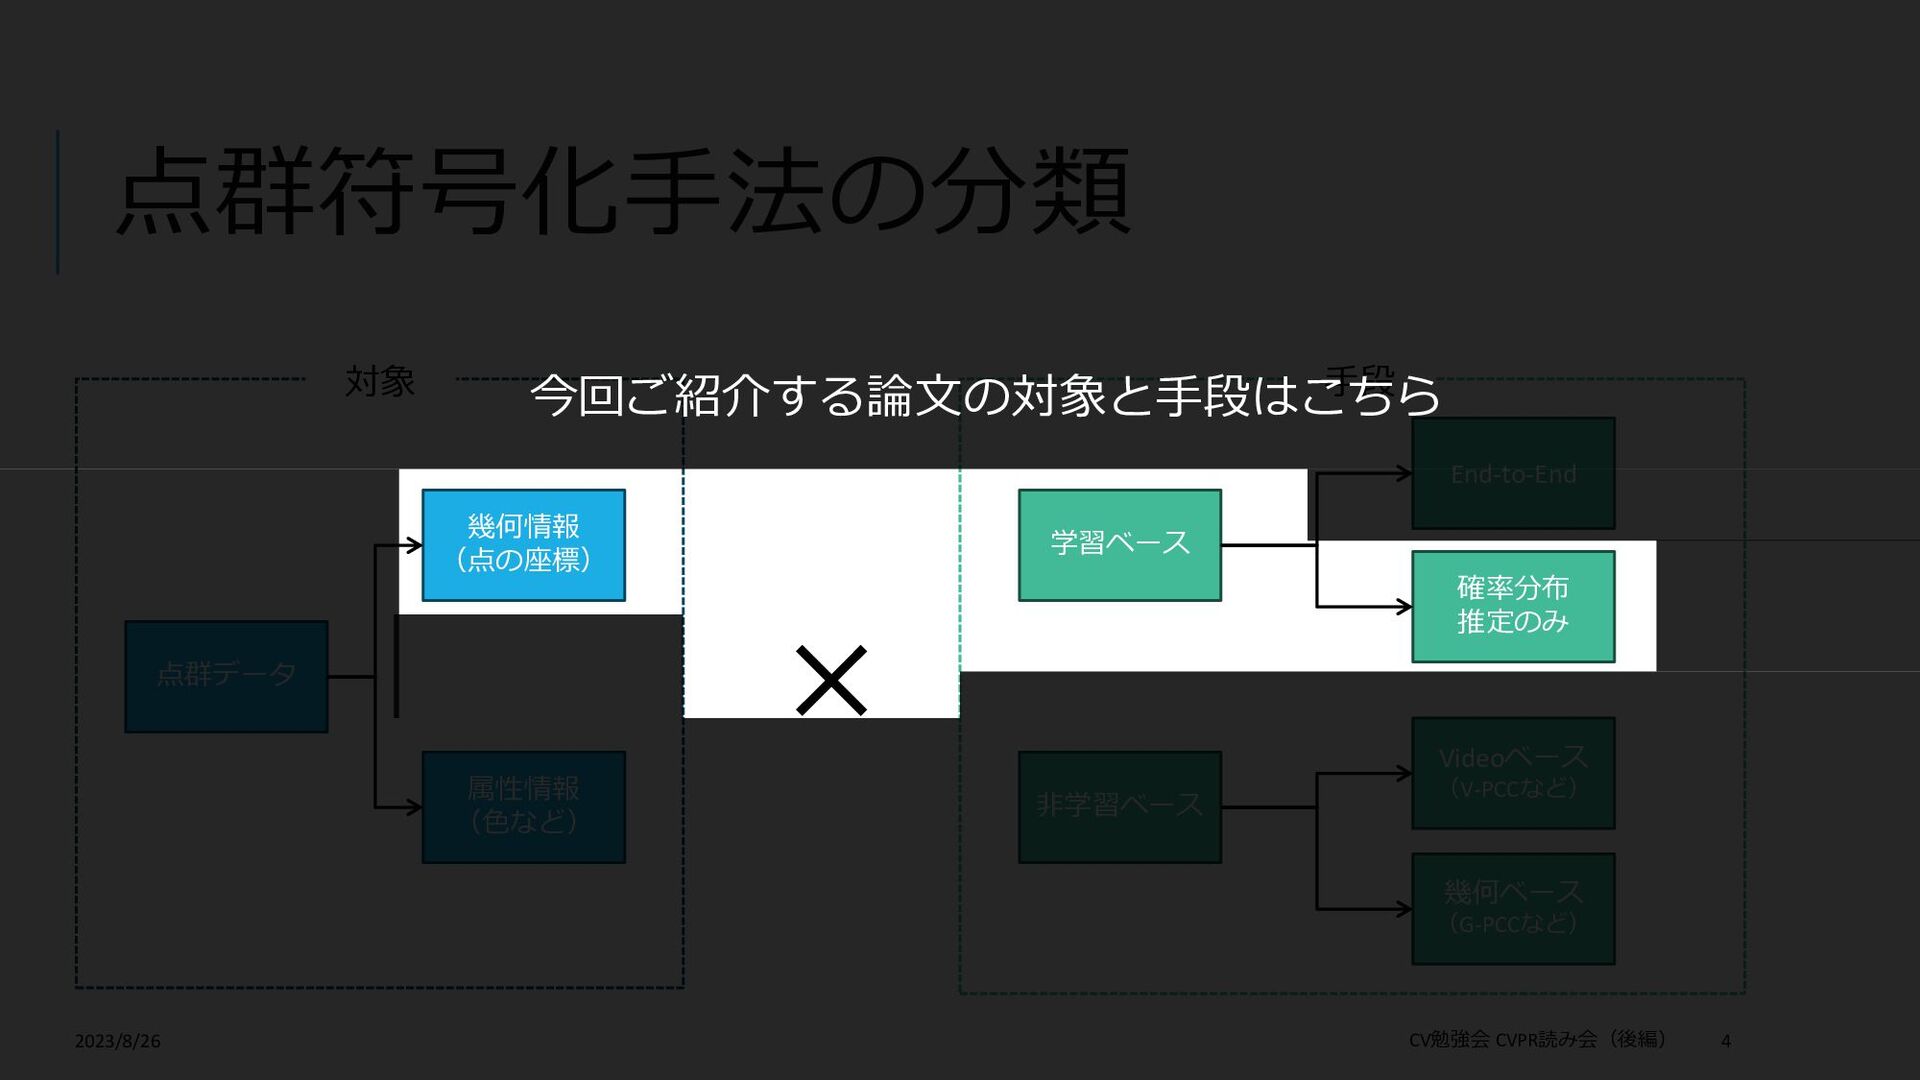
点群符号化手法の分類 2023/8/26 CV勉強会 CVPR読み会(後編) 4 幾何情報 (点の座標) 属性情報 (色など) 学習ベース
非学習ベース End-to-End 確率分布 推定のみ 点群データ Videoベース (V-PCCなど) 幾何ベース (G-PCCなど) 対象 手段 × 今回ご紹介する論文の対象と手段はこちら
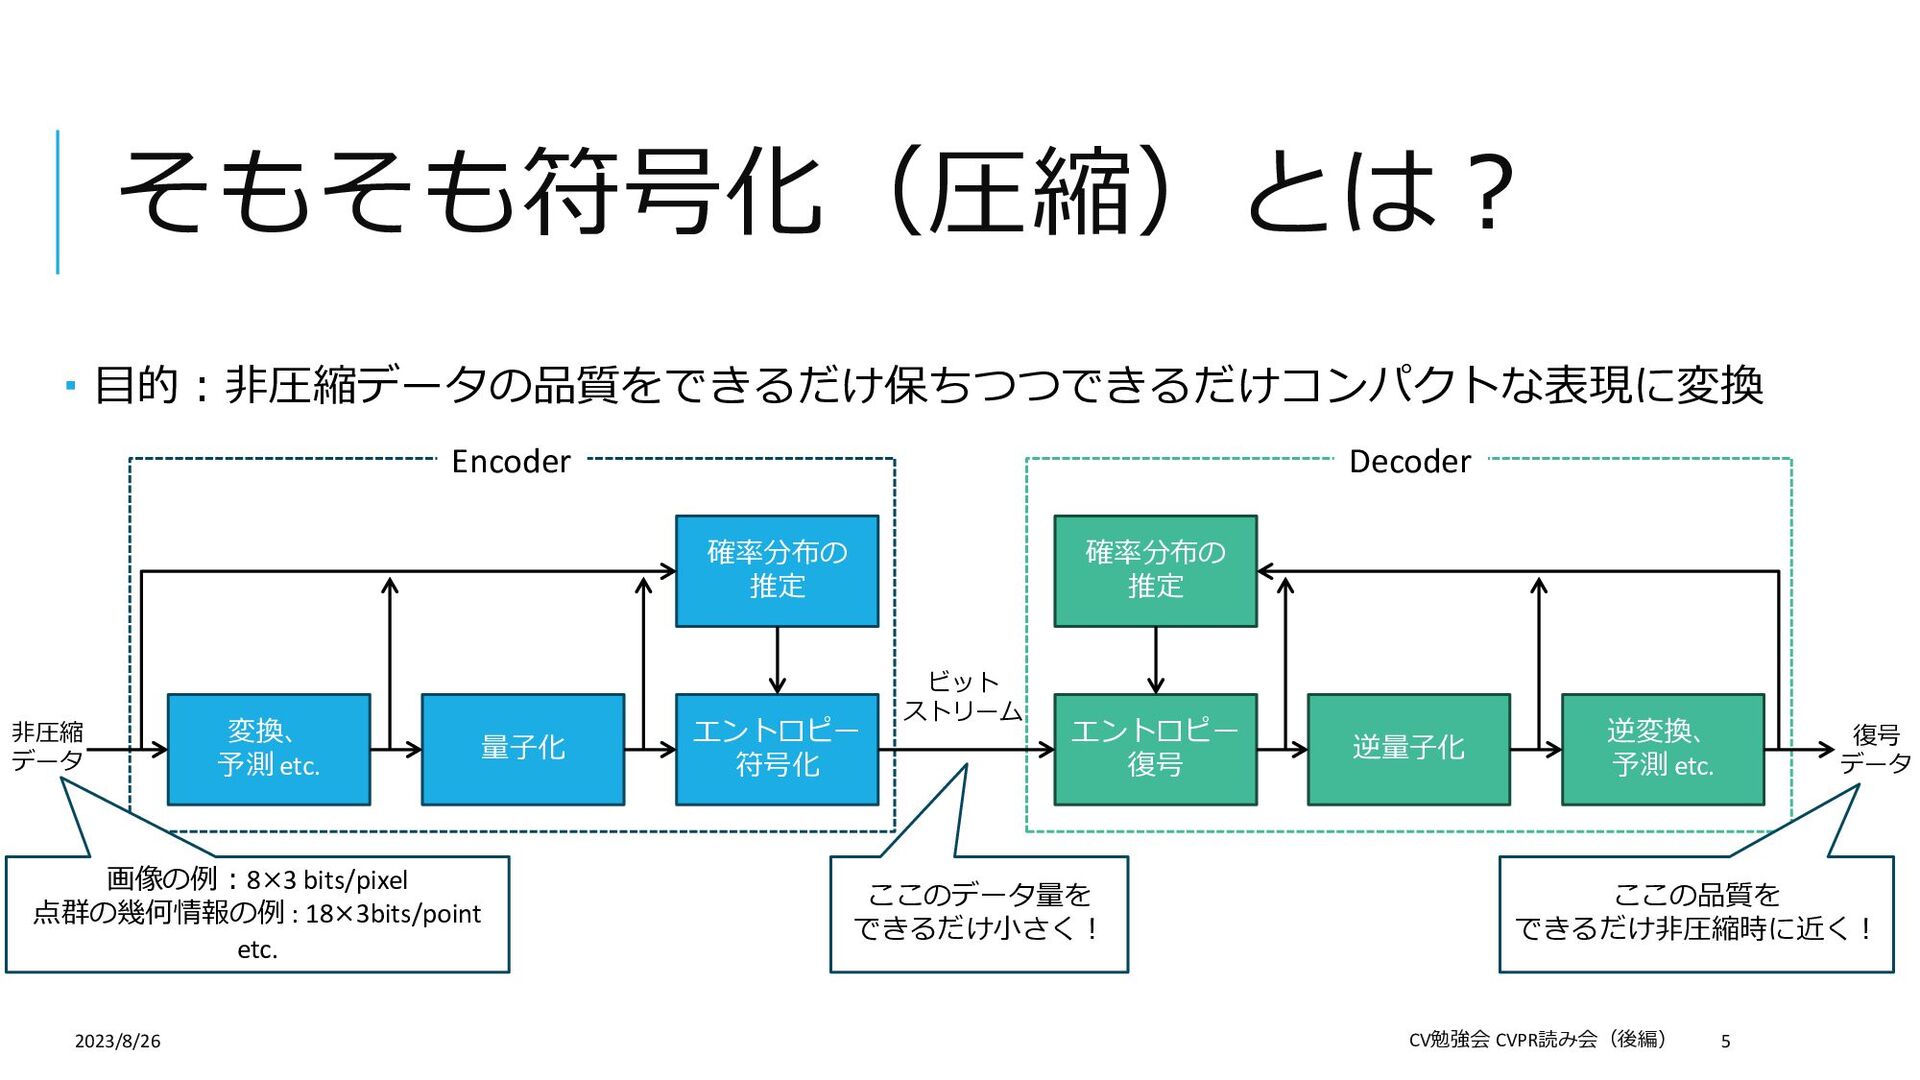
目的:非圧縮データの品質をできるだけ保ちつつできるだけコンパクトな表現に変換 そもそも符号化(圧縮)とは? 2023/8/26 CV勉強会 CVPR読み会(後編) 5 変換、 予測 etc.
量子化 エントロピー 符号化 確率分布の 推定 エントロピー 復号 逆量子化 逆変換、 予測 etc. 確率分布の 推定 非圧縮 データ ビット ストリーム 復号 データ 画像の例:8×3 bits/pixel 点群の幾何情報の例 : 18×3bits/point etc. ここのデータ量を できるだけ小さく! ここの品質を できるだけ非圧縮時に近く! Encoder Decoder
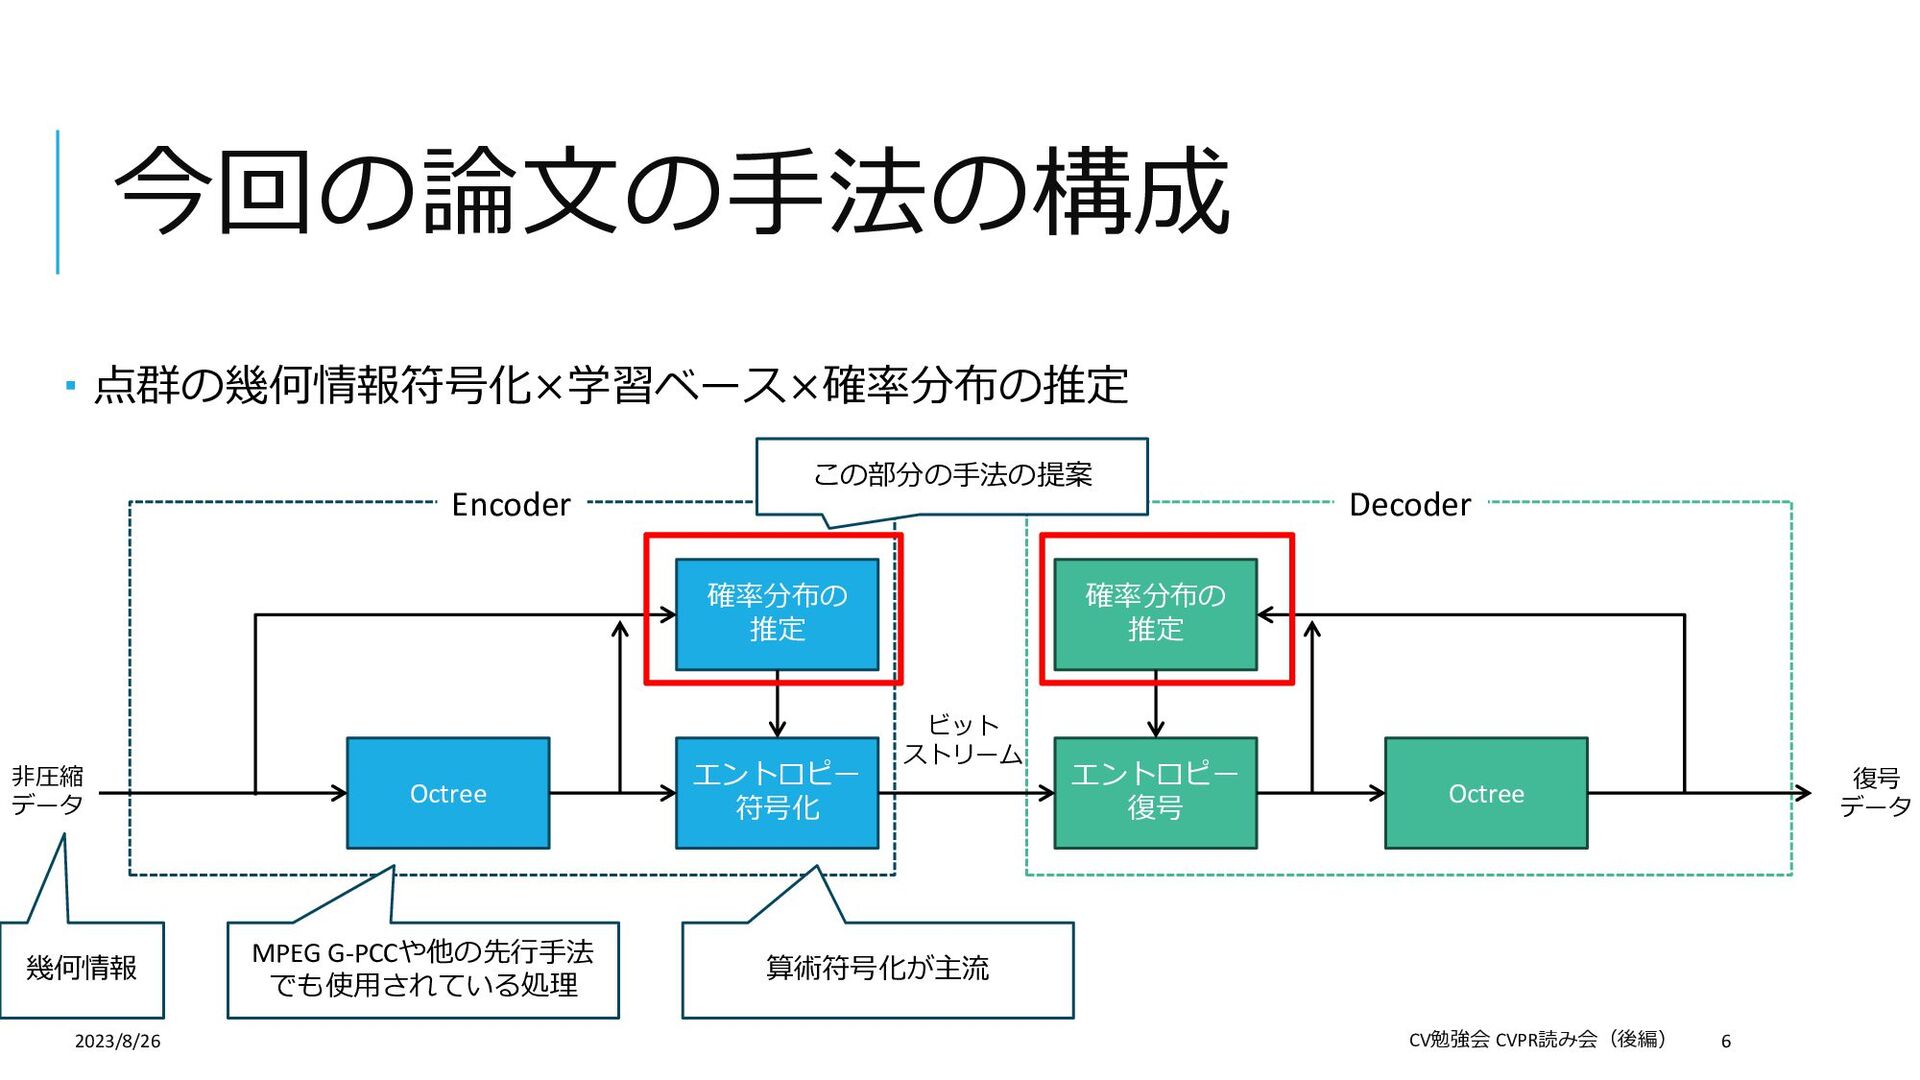
点群の幾何情報符号化×学習ベース×確率分布の推定 今回の論文の手法の構成 2023/8/26 CV勉強会 CVPR読み会(後編) 6 Octree エントロピー 符号化
確率分布の 推定 エントロピー 復号 Octree 確率分布の 推定 非圧縮 データ ビット ストリーム 復号 データ Encoder Decoder MPEG G-PCCや他の先行手法 でも使用されている処理 算術符号化が主流 幾何情報 この部分の手法の提案
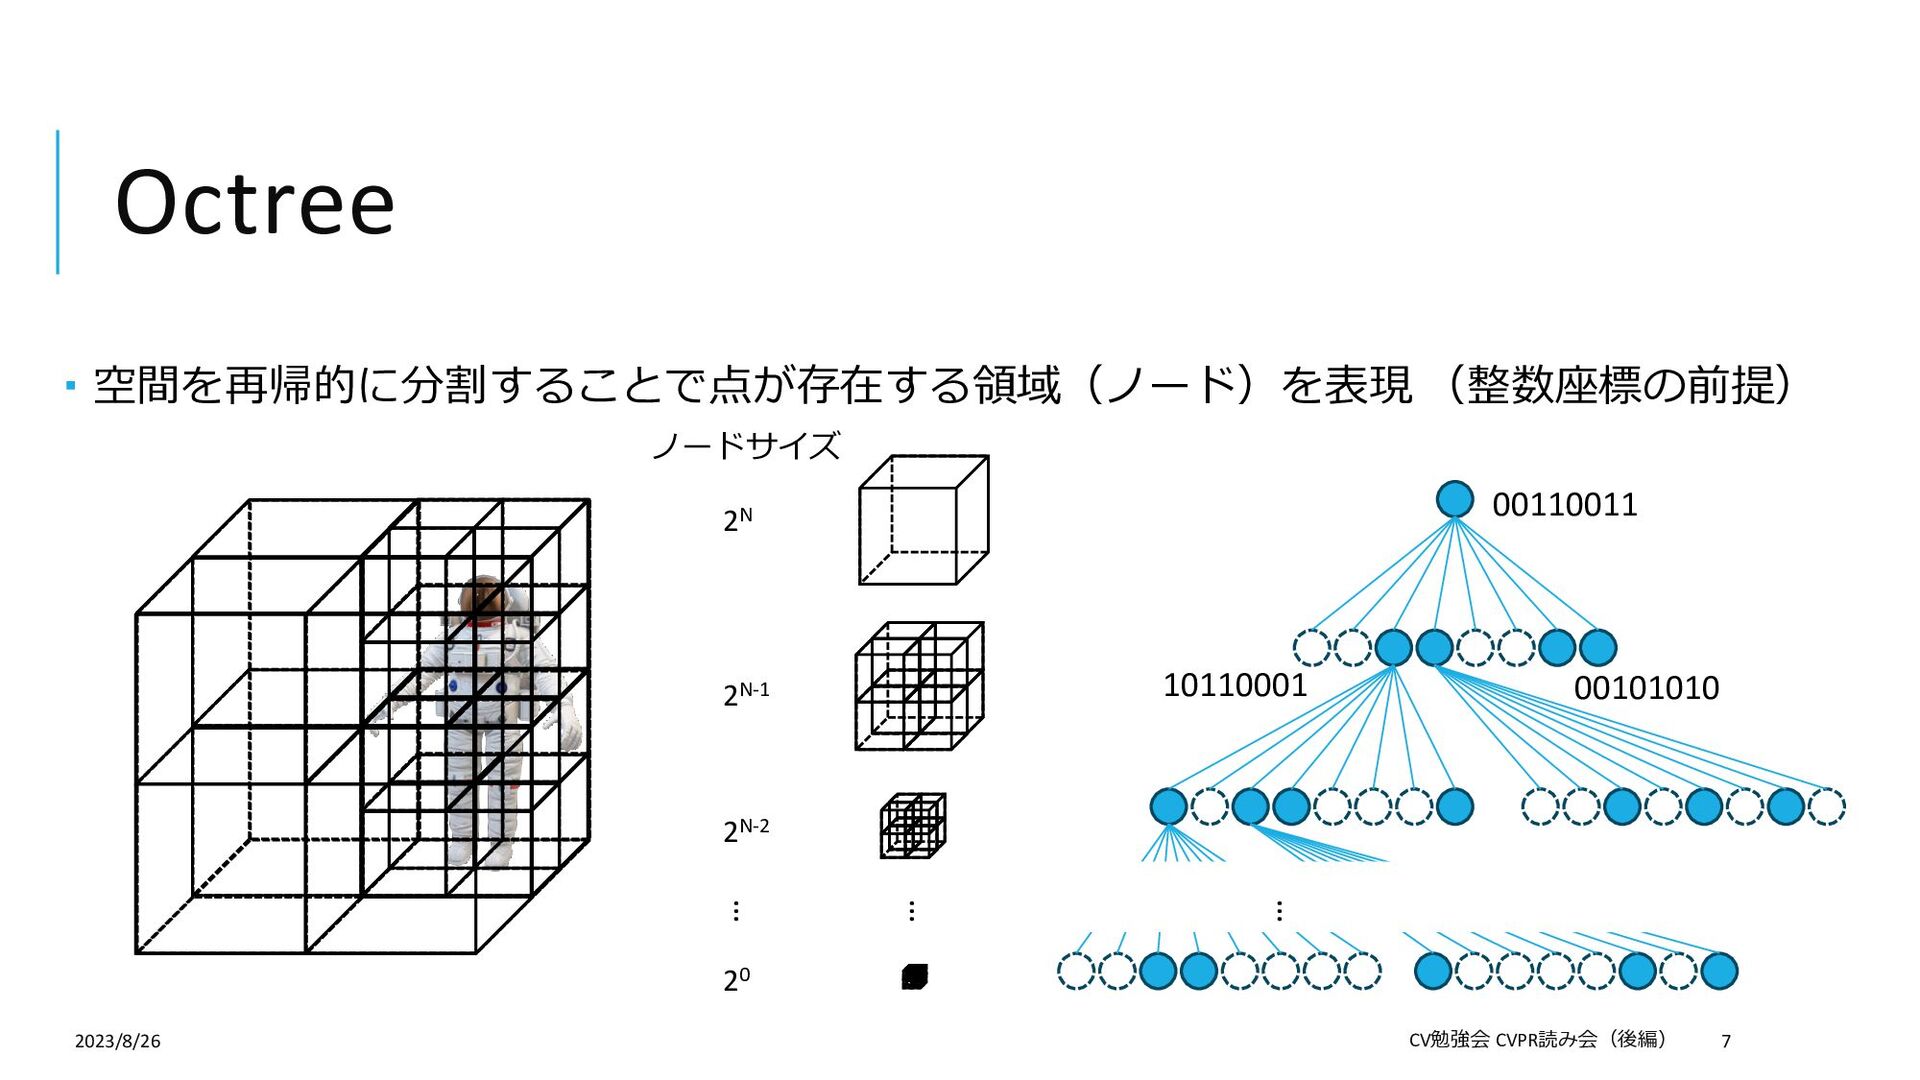
Octree 空間を再帰的に分割することで点が存在する領域(ノード)を表現 (整数座標の前提) 2023/8/26 CV勉強会 CVPR読み会(後編) 7 ノードサイズ 2N
2N-1 2N-2 20 00110011 10110001 00101010 … … …
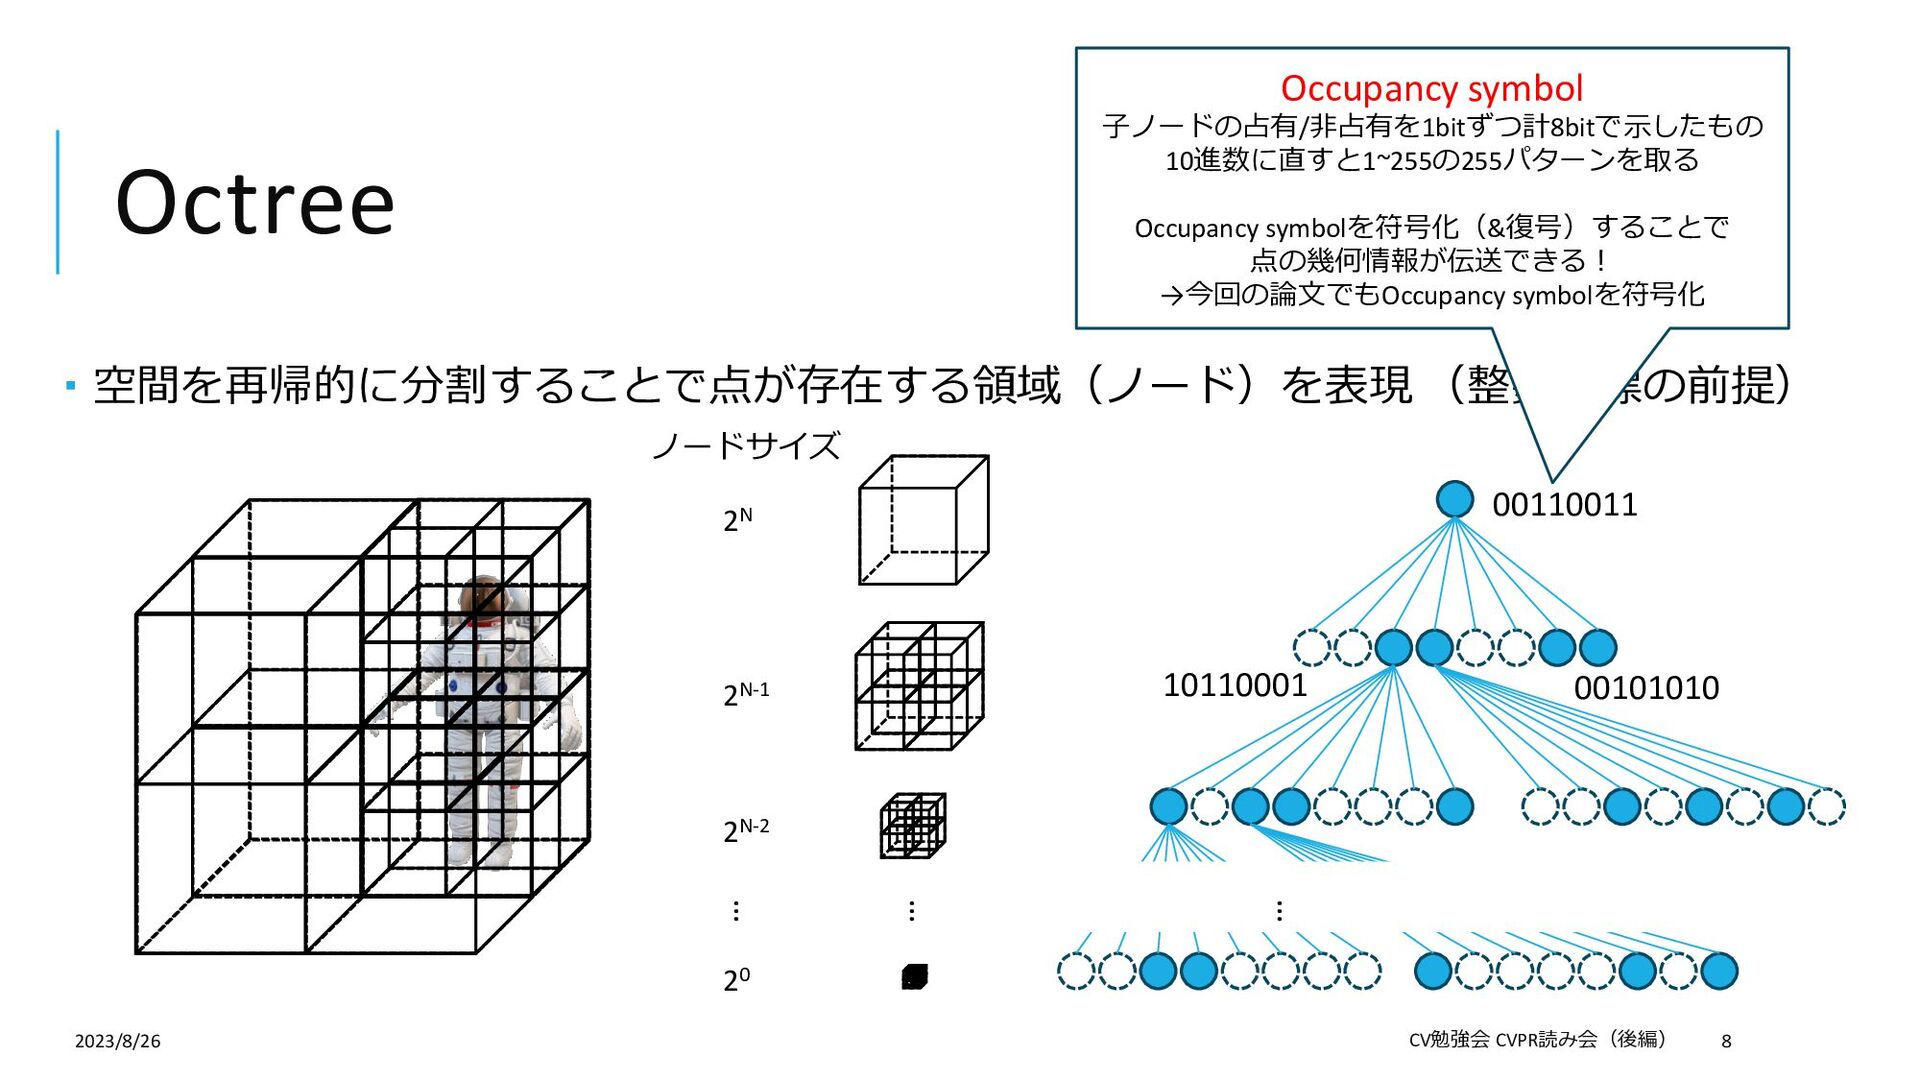
Octree 空間を再帰的に分割することで点が存在する領域(ノード)を表現 (整数座標の前提) 2023/8/26 CV勉強会 CVPR読み会(後編) 8 ノードサイズ 2N
2N-1 2N-2 20 00110011 10110001 00101010 … … … Occupancy symbol 子ノードの占有/非占有を1bitずつ計8bitで示したもの 10進数に直すと1~255の255パターンを取る Occupancy symbolを符号化(&復号)することで 点の幾何情報が伝送できる! →今回の論文でもOccupancy symbolを符号化
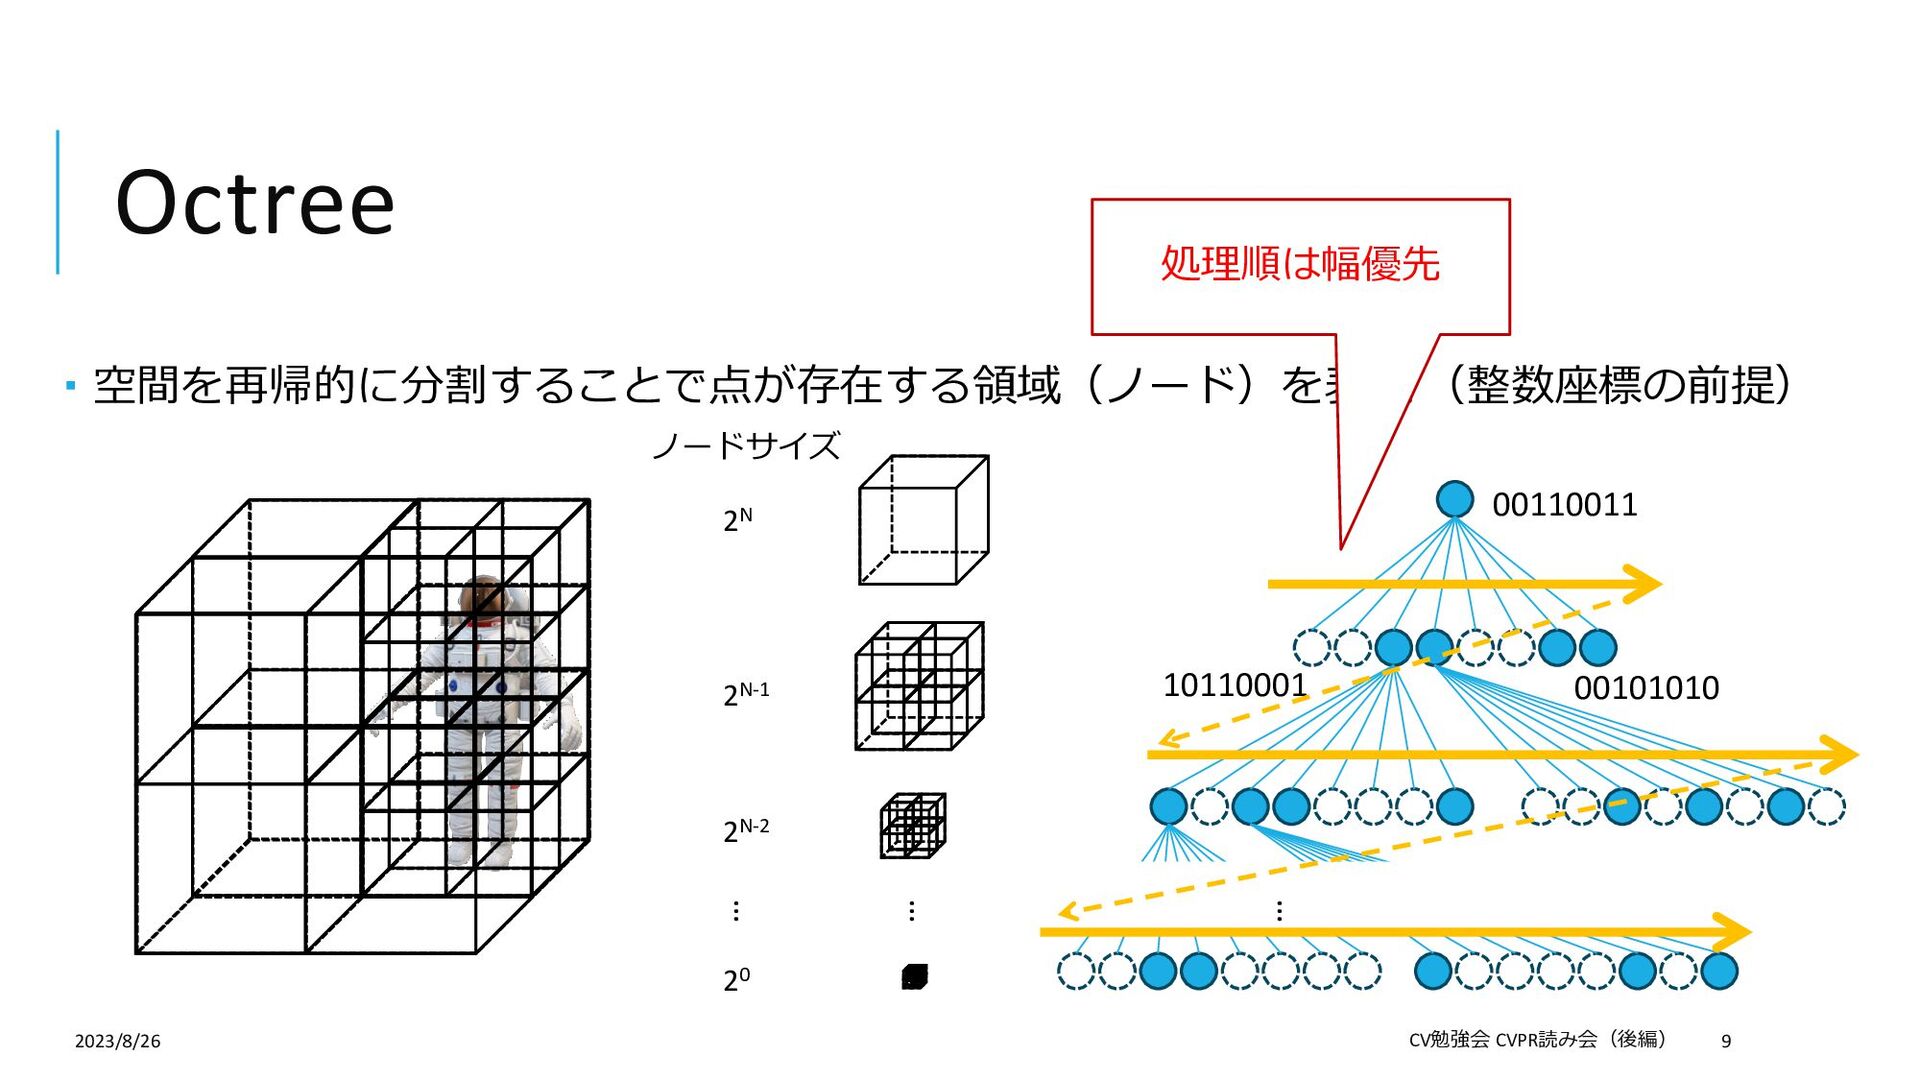
Octree 空間を再帰的に分割することで点が存在する領域(ノード)を表現 (整数座標の前提) 2023/8/26 CV勉強会 CVPR読み会(後編) 9 ノードサイズ 2N
2N-1 2N-2 20 00110011 10110001 00101010 … … … 処理順は幅優先
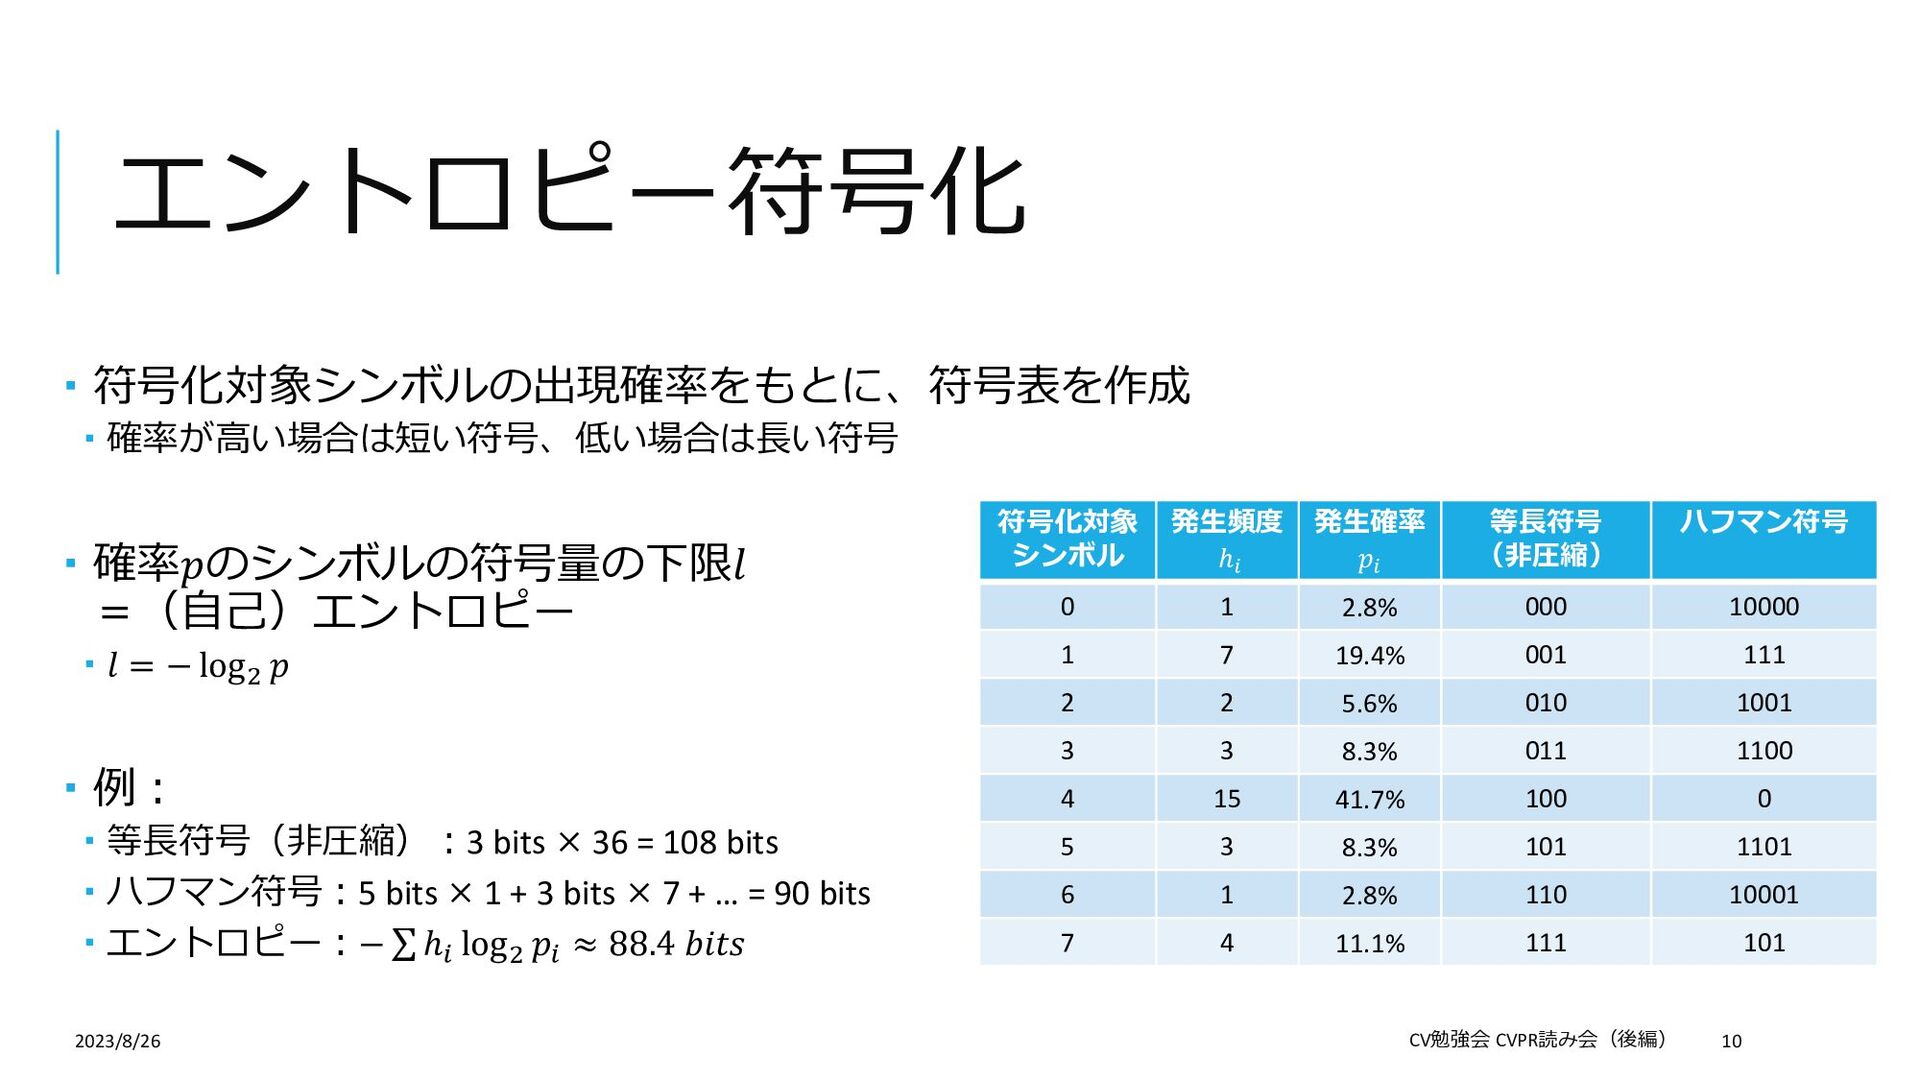
エントロピー符号化 符号化対象シンボルの出現確率をもとに、符号表を作成 確率が高い場合は短い符号、低い場合は長い符号 確率𝑝のシンボルの符号量の下限𝑙 =(自己)エントロピー 𝑙
= − log2 𝑝 例: 等長符号(非圧縮):3 bits × 36 = 108 bits ハフマン符号:5 bits × 1 + 3 bits × 7 + … = 90 bits エントロピー:− σ ℎ𝑖 log2 𝑝𝑖 ≈ 88.4 𝑏𝑖𝑡𝑠 2023/8/26 CV勉強会 CVPR読み会(後編) 10 符号化対象 シンボル 発生頻度 ℎ𝑖 発生確率 𝑝𝑖 等長符号 (非圧縮) ハフマン符号 0 1 2.8% 000 10000 1 7 19.4% 001 111 2 2 5.6% 010 1001 3 3 8.3% 011 1100 4 15 41.7% 100 0 5 3 8.3% 101 1101 6 1 2.8% 110 10001 7 4 11.1% 111 101
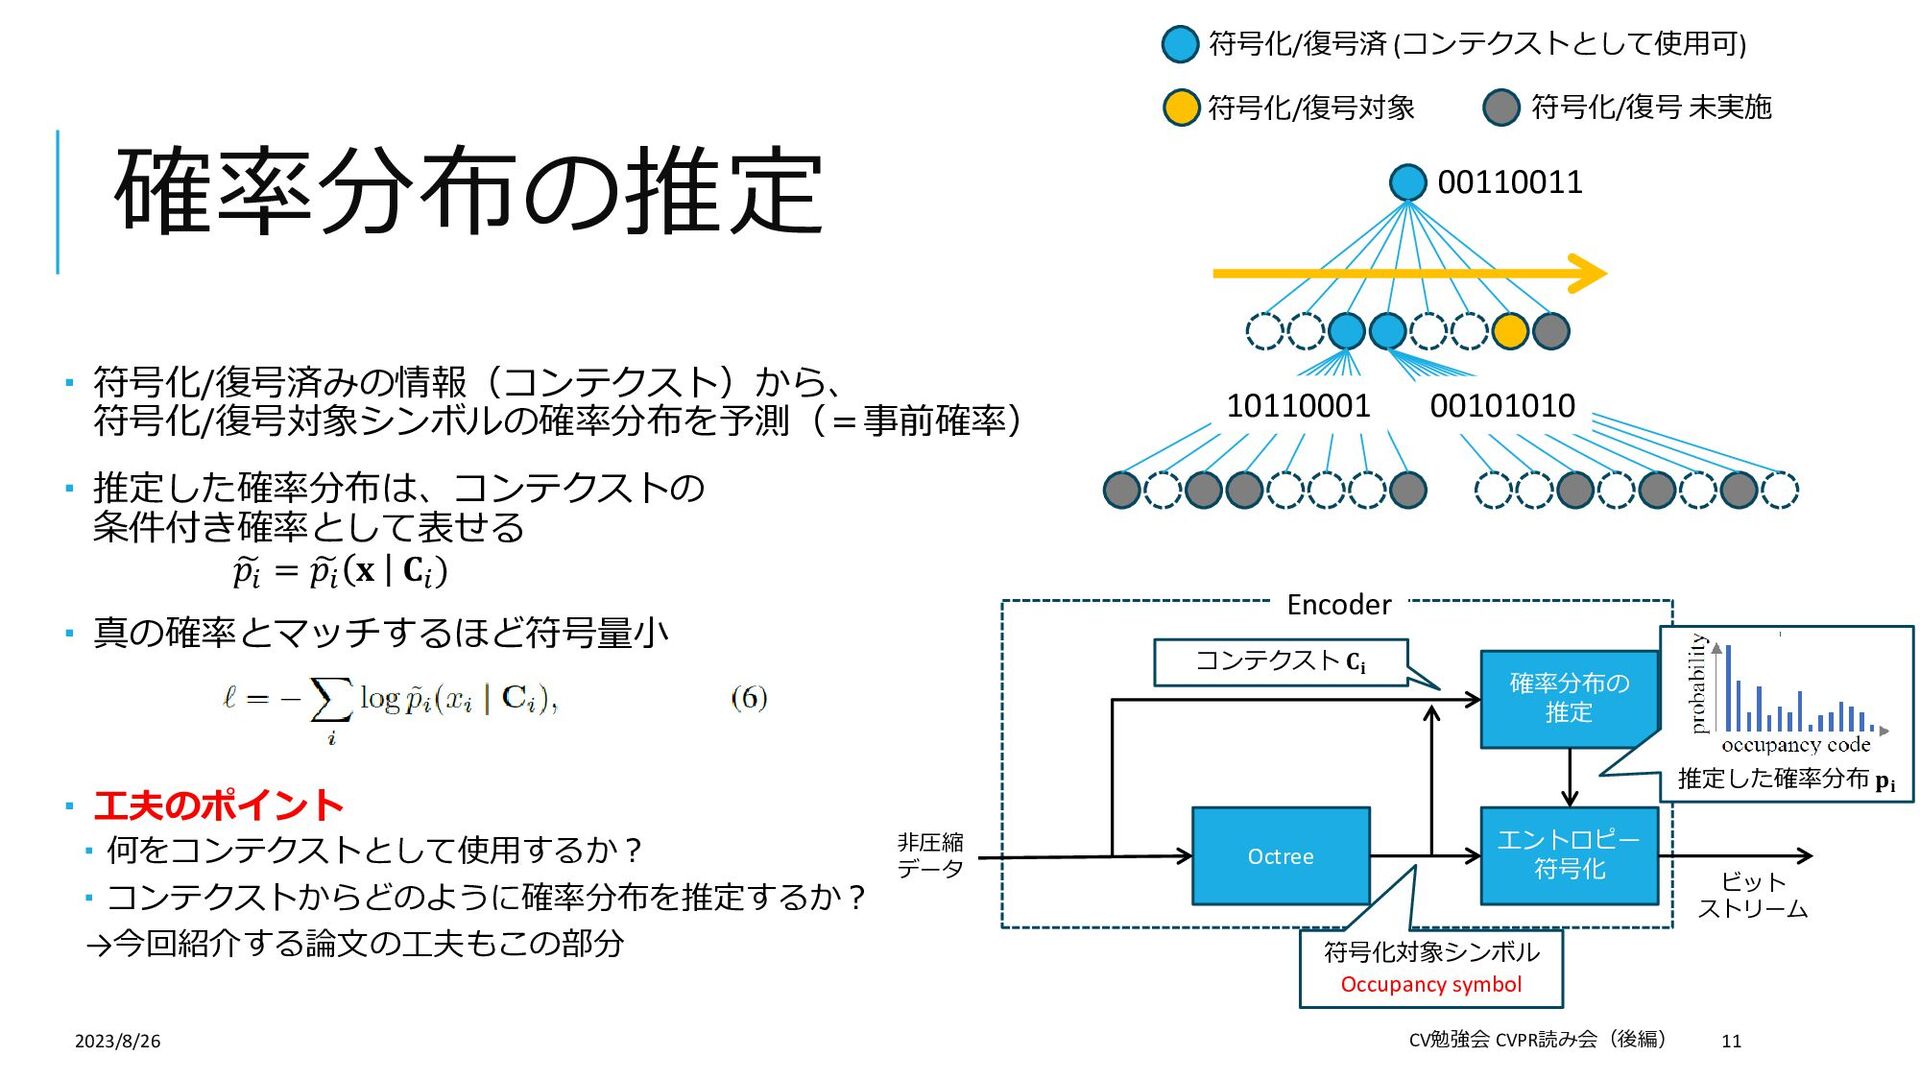
確率分布の推定 符号化/復号済みの情報(コンテクスト)から、 符号化/復号対象シンボルの確率分布を予測(=事前確率) 推定した確率分布は、コンテクストの 条件付き確率として表せる 𝑝𝑖 =
𝑝𝑖 𝐱 𝐂𝑖 ) 真の確率とマッチするほど符号量小 工夫のポイント 何をコンテクストとして使用するか? コンテクストからどのように確率分布を推定するか? →今回紹介する論文の工夫もこの部分 2023/8/26 CV勉強会 CVPR読み会(後編) 11 Octree エントロピー 符号化 確率分布の 推定 非圧縮 データ ビット ストリーム Encoder 符号化対象シンボル Occupancy symbol 推定した確率分布 𝐩𝐢 コンテクスト 𝐂𝐢 00110011 10110001 00101010 符号化/復号済 (コンテクストとして使用可) 符号化/復号対象 符号化/復号 未実施
従来手法と課題 OctAttention [10]:著者らの過去の手法 自己回帰モデル 1ノードずつ幅優先探索で符号化/復号 直前に符号化/復号したノードの情報を使用
コンテクスト 同一階層の復号済みノード と、その祖先ノードたちの 下記情報をSelf Attentionに入力して特徴量を抽出 Ocupancy symbol: 1~255 Octant index: (多分) 0~8 Octreeの階層 課題 自己回帰モデルなので復号に時間がかかる! 2023/8/26 CV勉強会 CVPR読み会(後編) 12
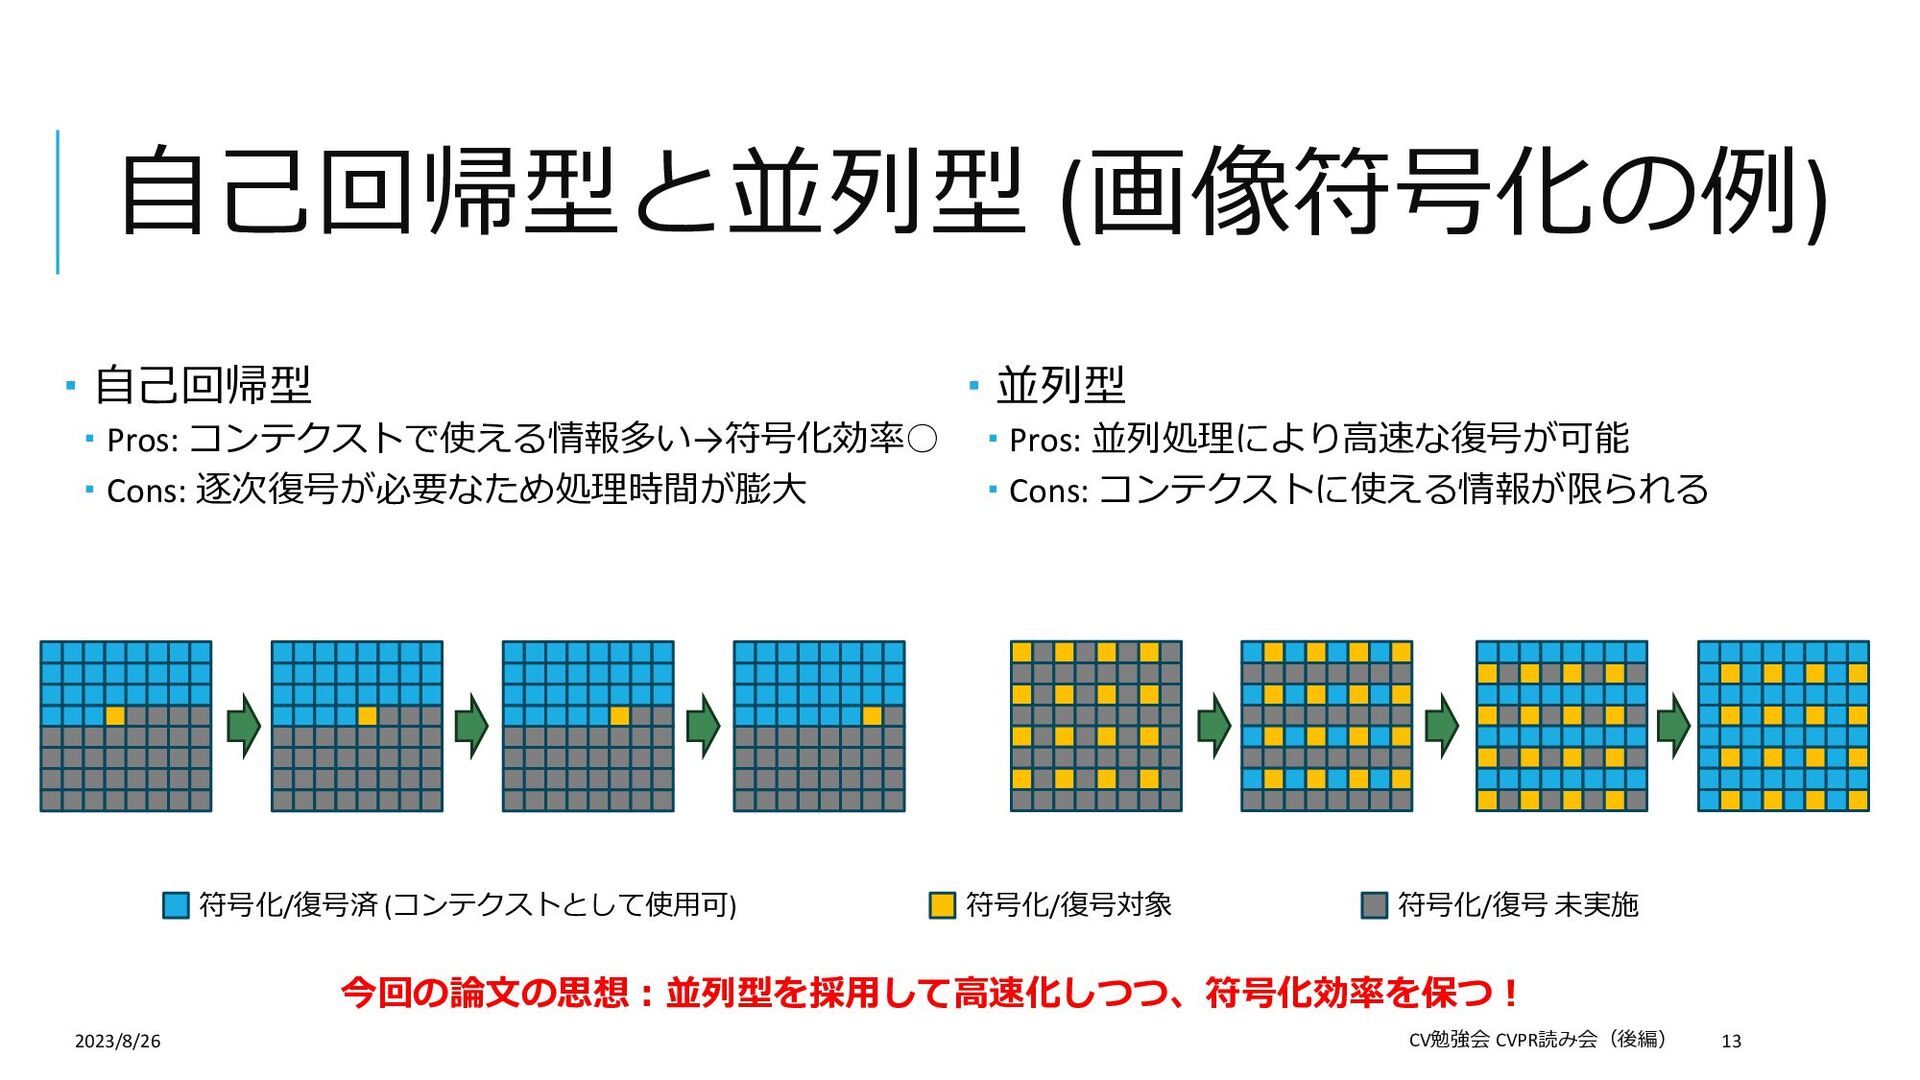
自己回帰型と並列型 (画像符号化の例) 自己回帰型 Pros: コンテクストで使える情報多い→符号化効率◦ Cons: 逐次復号が必要なため処理時間が膨大
2023/8/26 CV勉強会 CVPR読み会(後編) 13 並列型 Pros: 並列処理により高速な復号が可能 Cons: コンテクストに使える情報が限られる 今回の論文の思想:並列型を採用して高速化しつつ、符号化効率を保つ! 符号化/復号済 (コンテクストとして使用可) 符号化/復号対象 符号化/復号 未実施
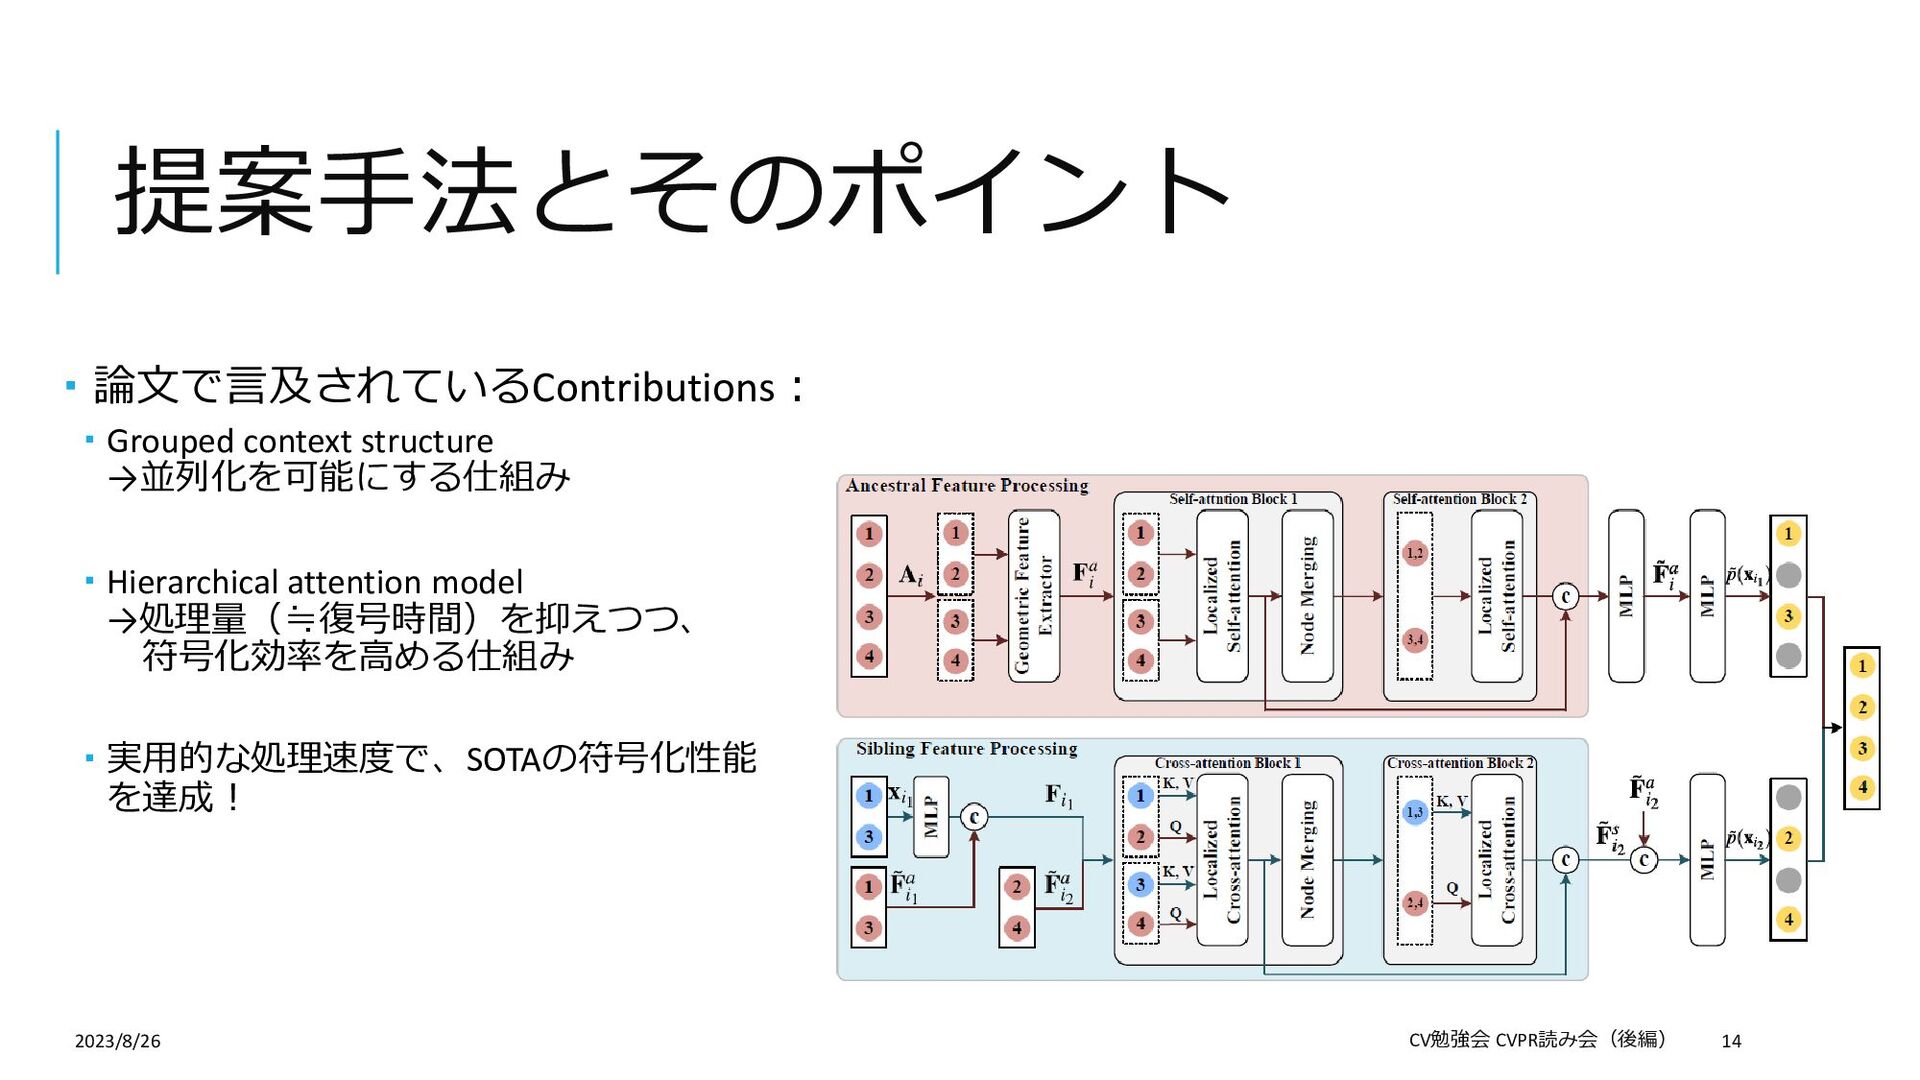
提案手法とそのポイント 論文で言及されているContributions: Grouped context structure →並列化を可能にする仕組み Hierarchical
attention model →処理量(≒復号時間)を抑えつつ、 符号化効率を高める仕組み 実用的な処理速度で、SOTAの符号化性能 を達成! 2023/8/26 CV勉強会 CVPR読み会(後編) 14
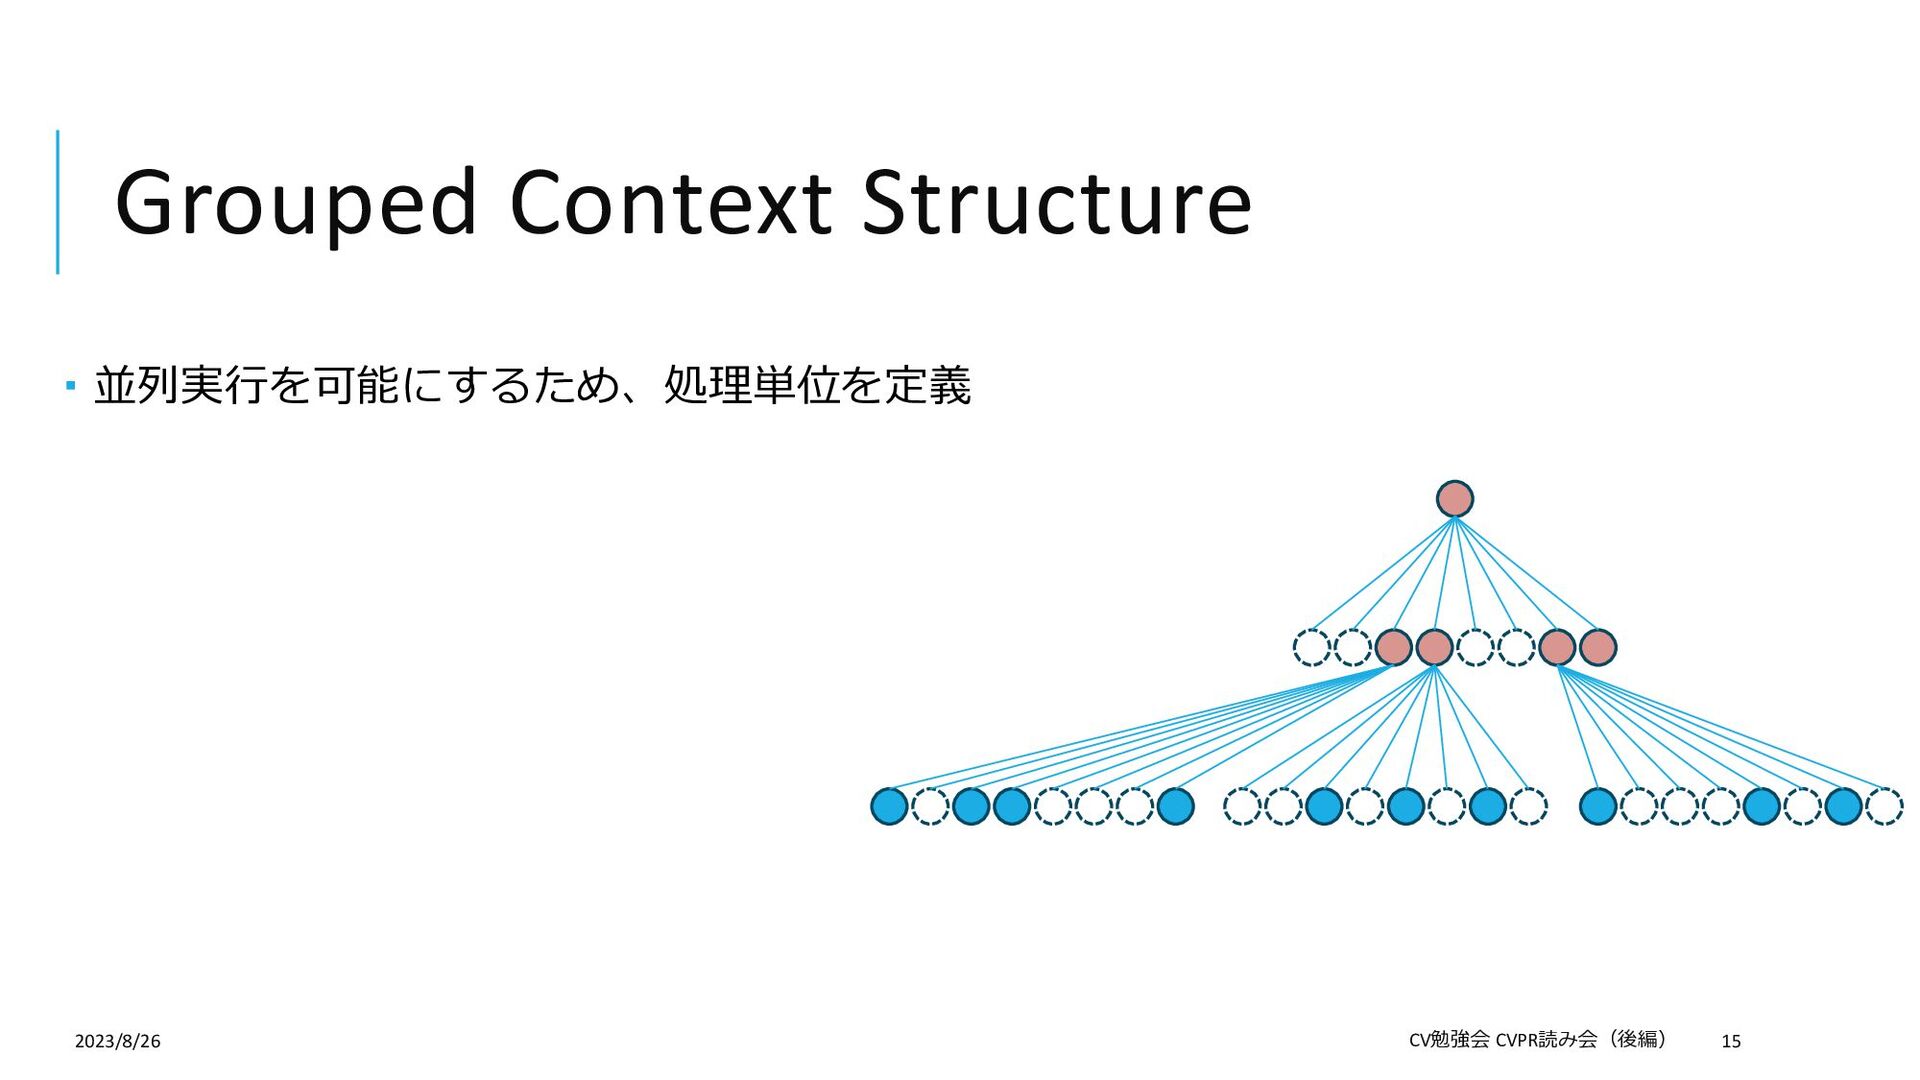
Grouped Context Structure 並列実行を可能にするため、処理単位を定義 2023/8/26 CV勉強会 CVPR読み会(後編) 15
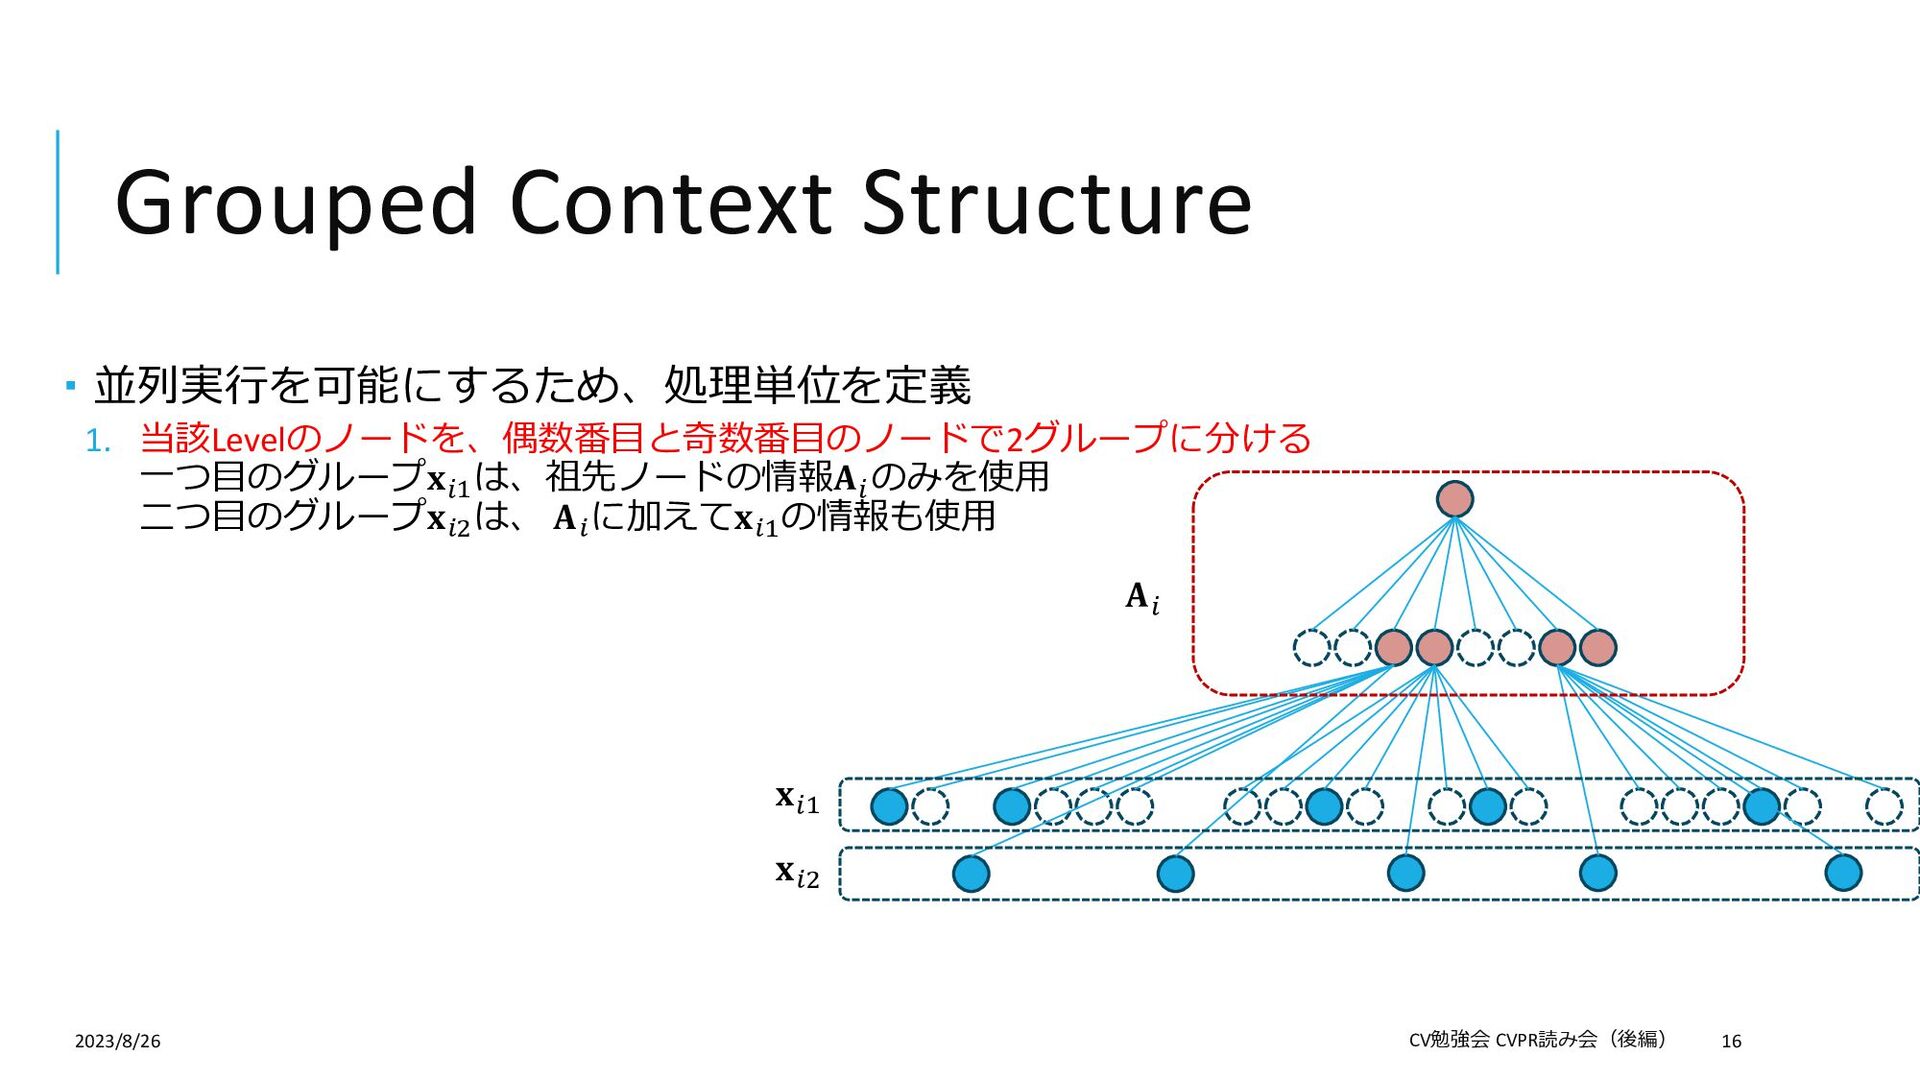
Grouped Context Structure 並列実行を可能にするため、処理単位を定義 1. 当該Levelのノードを、偶数番目と奇数番目のノードで2グループに分ける 一つ目のグループ𝐱𝑖1 は、祖先ノードの情報𝐀𝑖 のみを使用
二つ目のグループ𝐱𝑖2 は、 𝐀𝑖 に加えて𝐱𝑖1 の情報も使用 2023/8/26 CV勉強会 CVPR読み会(後編) 16 𝐱𝑖1 𝐱𝑖2 𝐀𝑖
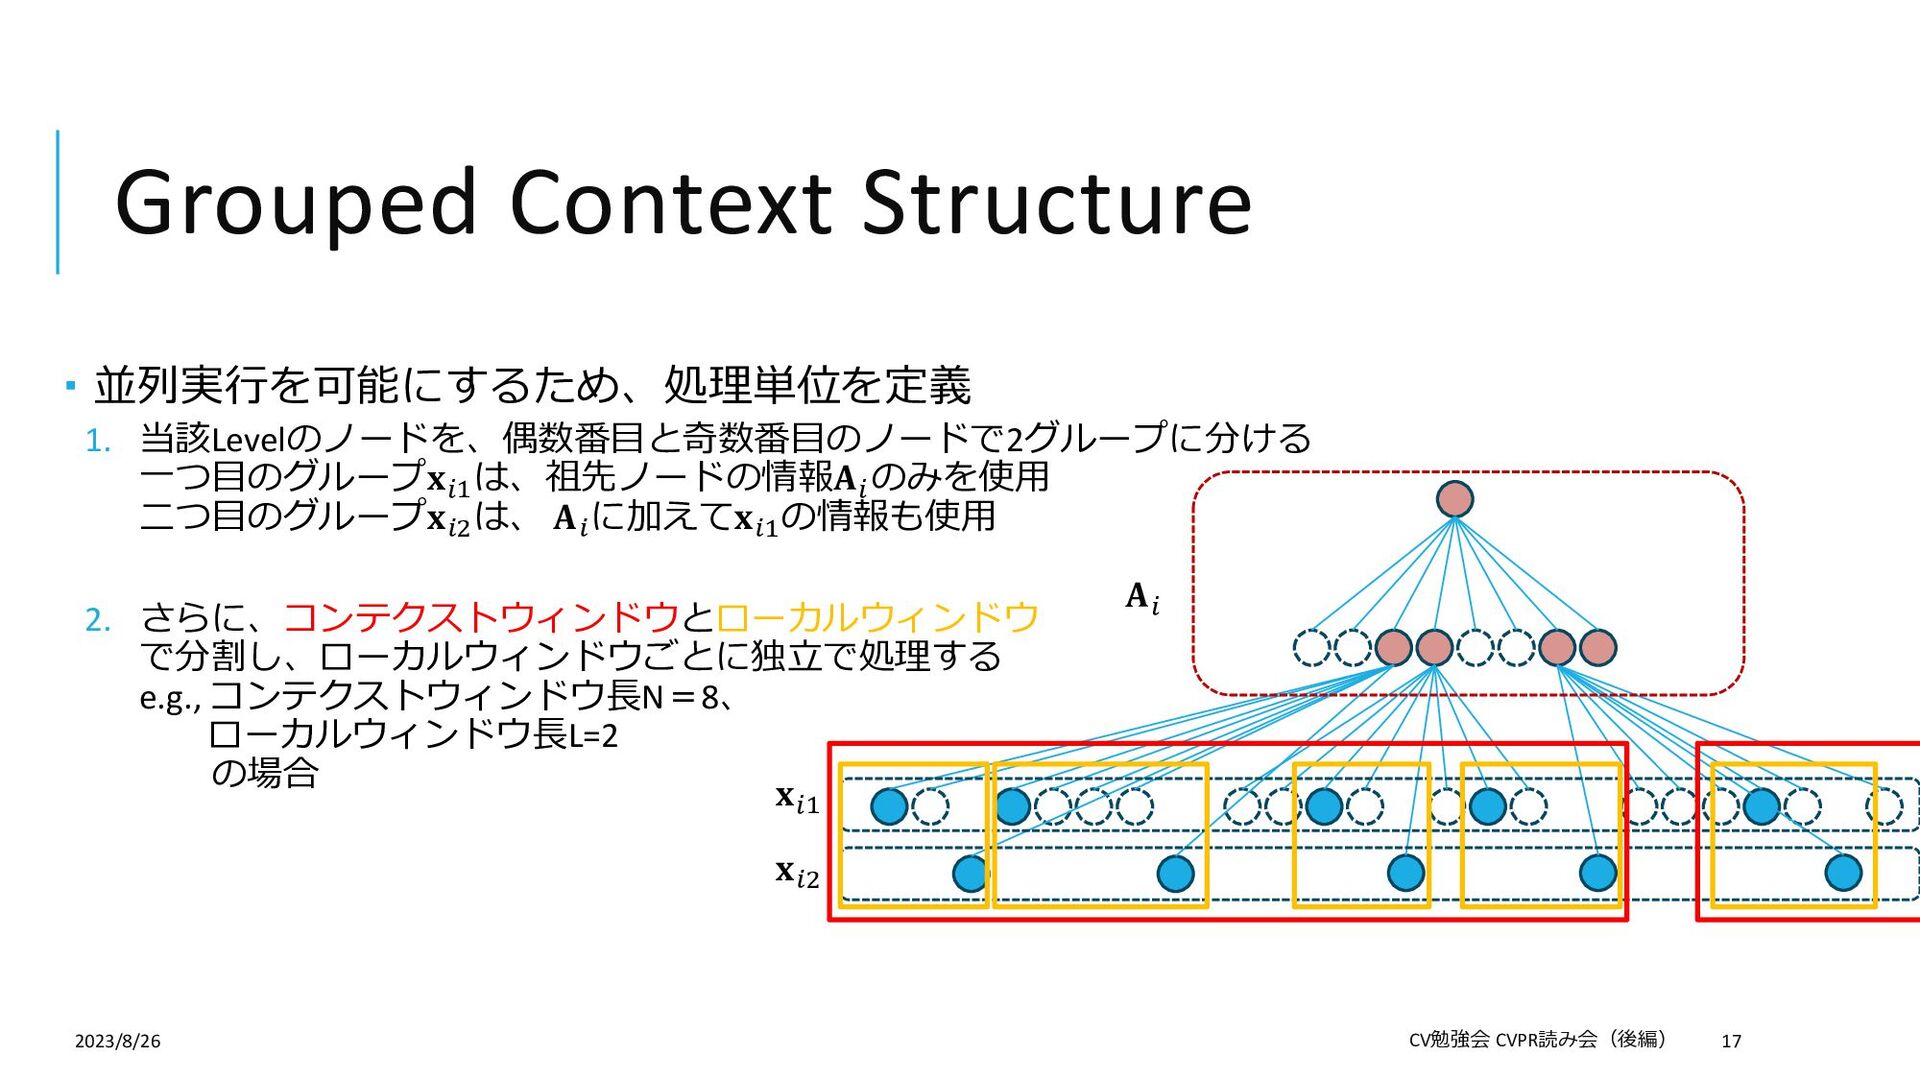
Grouped Context Structure 並列実行を可能にするため、処理単位を定義 1. 当該Levelのノードを、偶数番目と奇数番目のノードで2グループに分ける 一つ目のグループ𝐱𝑖1 は、祖先ノードの情報𝐀𝑖 のみを使用
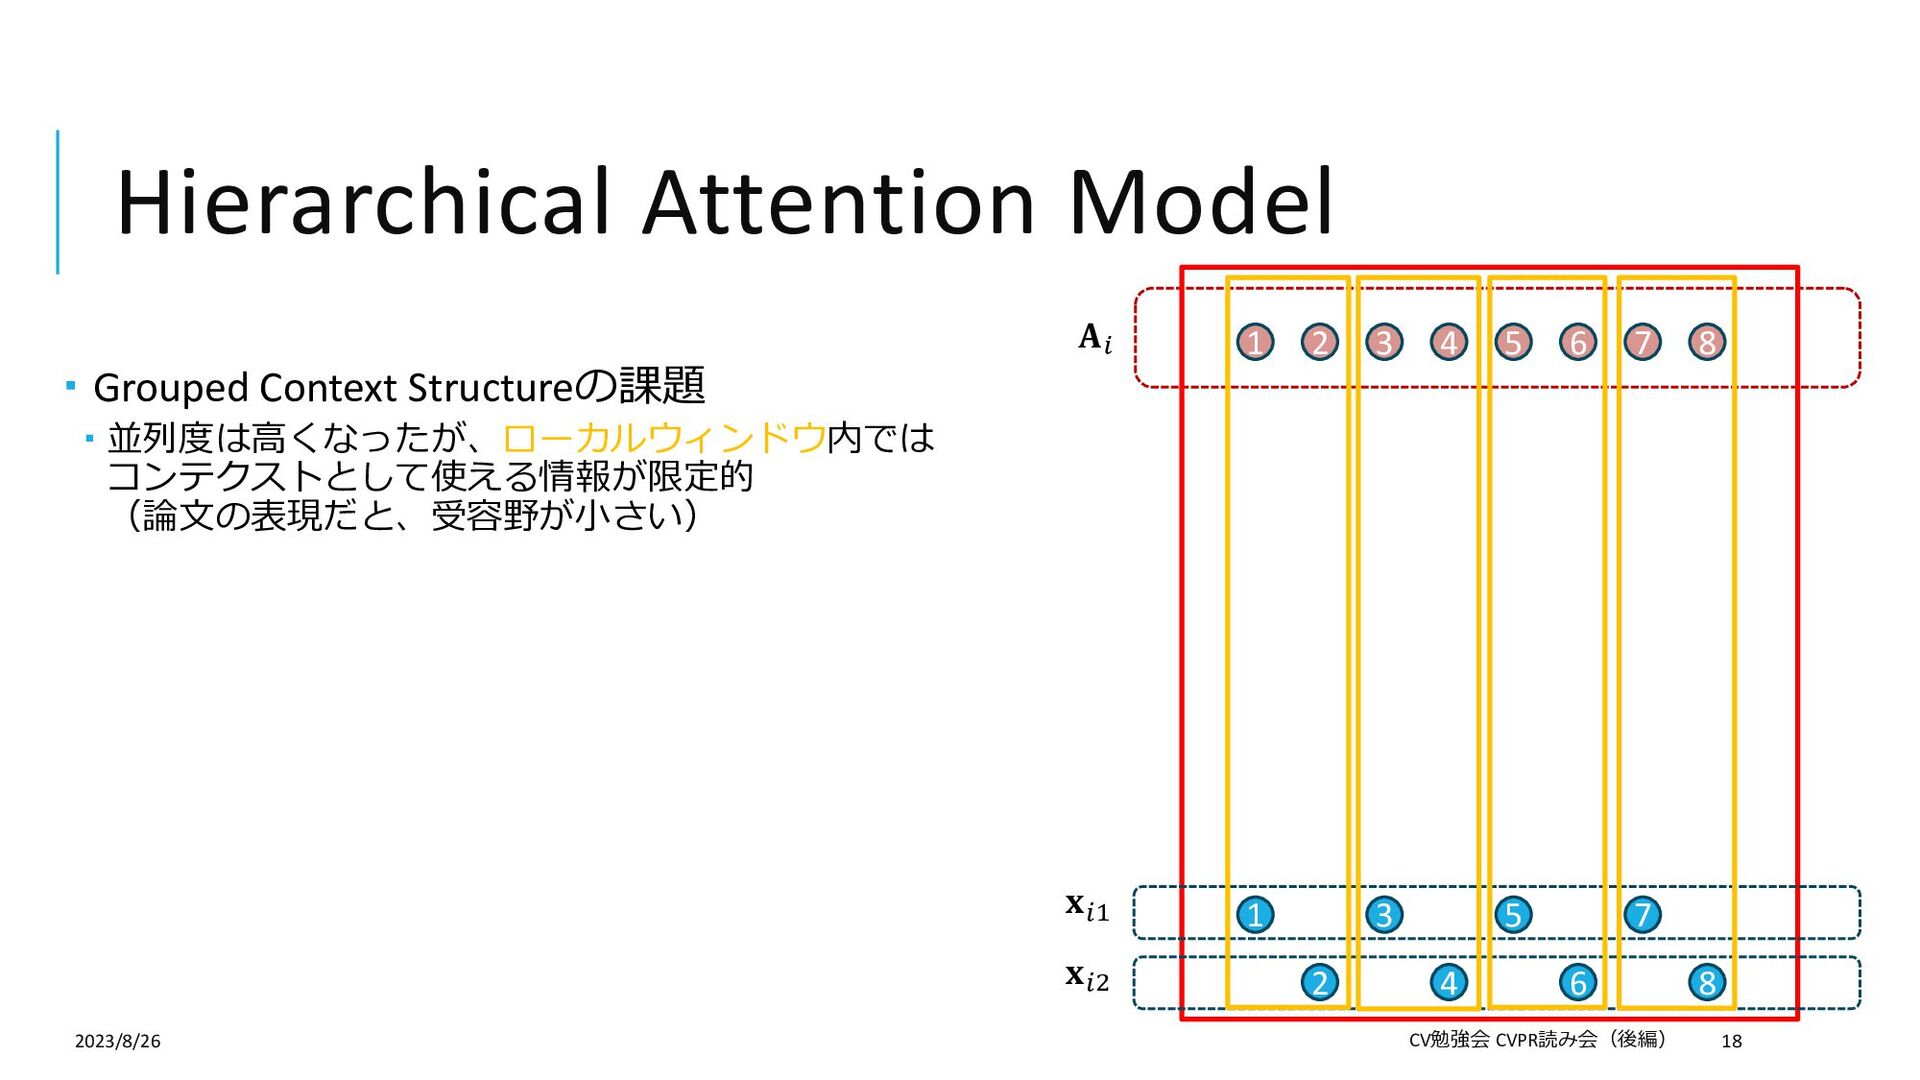
二つ目のグループ𝐱𝑖2 は、 𝐀𝑖 に加えて𝐱𝑖1 の情報も使用 2. さらに、コンテクストウィンドウとローカルウィンドウ で分割し、ローカルウィンドウごとに独立で処理する e.g., コンテクストウィンドウ長N=8、 ローカルウィンドウ長L=2 の場合 2023/8/26 CV勉強会 CVPR読み会(後編) 17 𝐱𝑖1 𝐱𝑖2 𝐀𝑖
Hierarchical Attention Model Grouped Context Structureの課題 並列度は高くなったが、ローカルウィンドウ内では コンテクストとして使える情報が限定的
(論文の表現だと、受容野が小さい) 2023/8/26 CV勉強会 CVPR読み会(後編) 18 1 2 3 4 5 6 7 8 1 2 3 4 5 6 7 8 𝐀𝑖 𝐱𝑖1 𝐱𝑖2
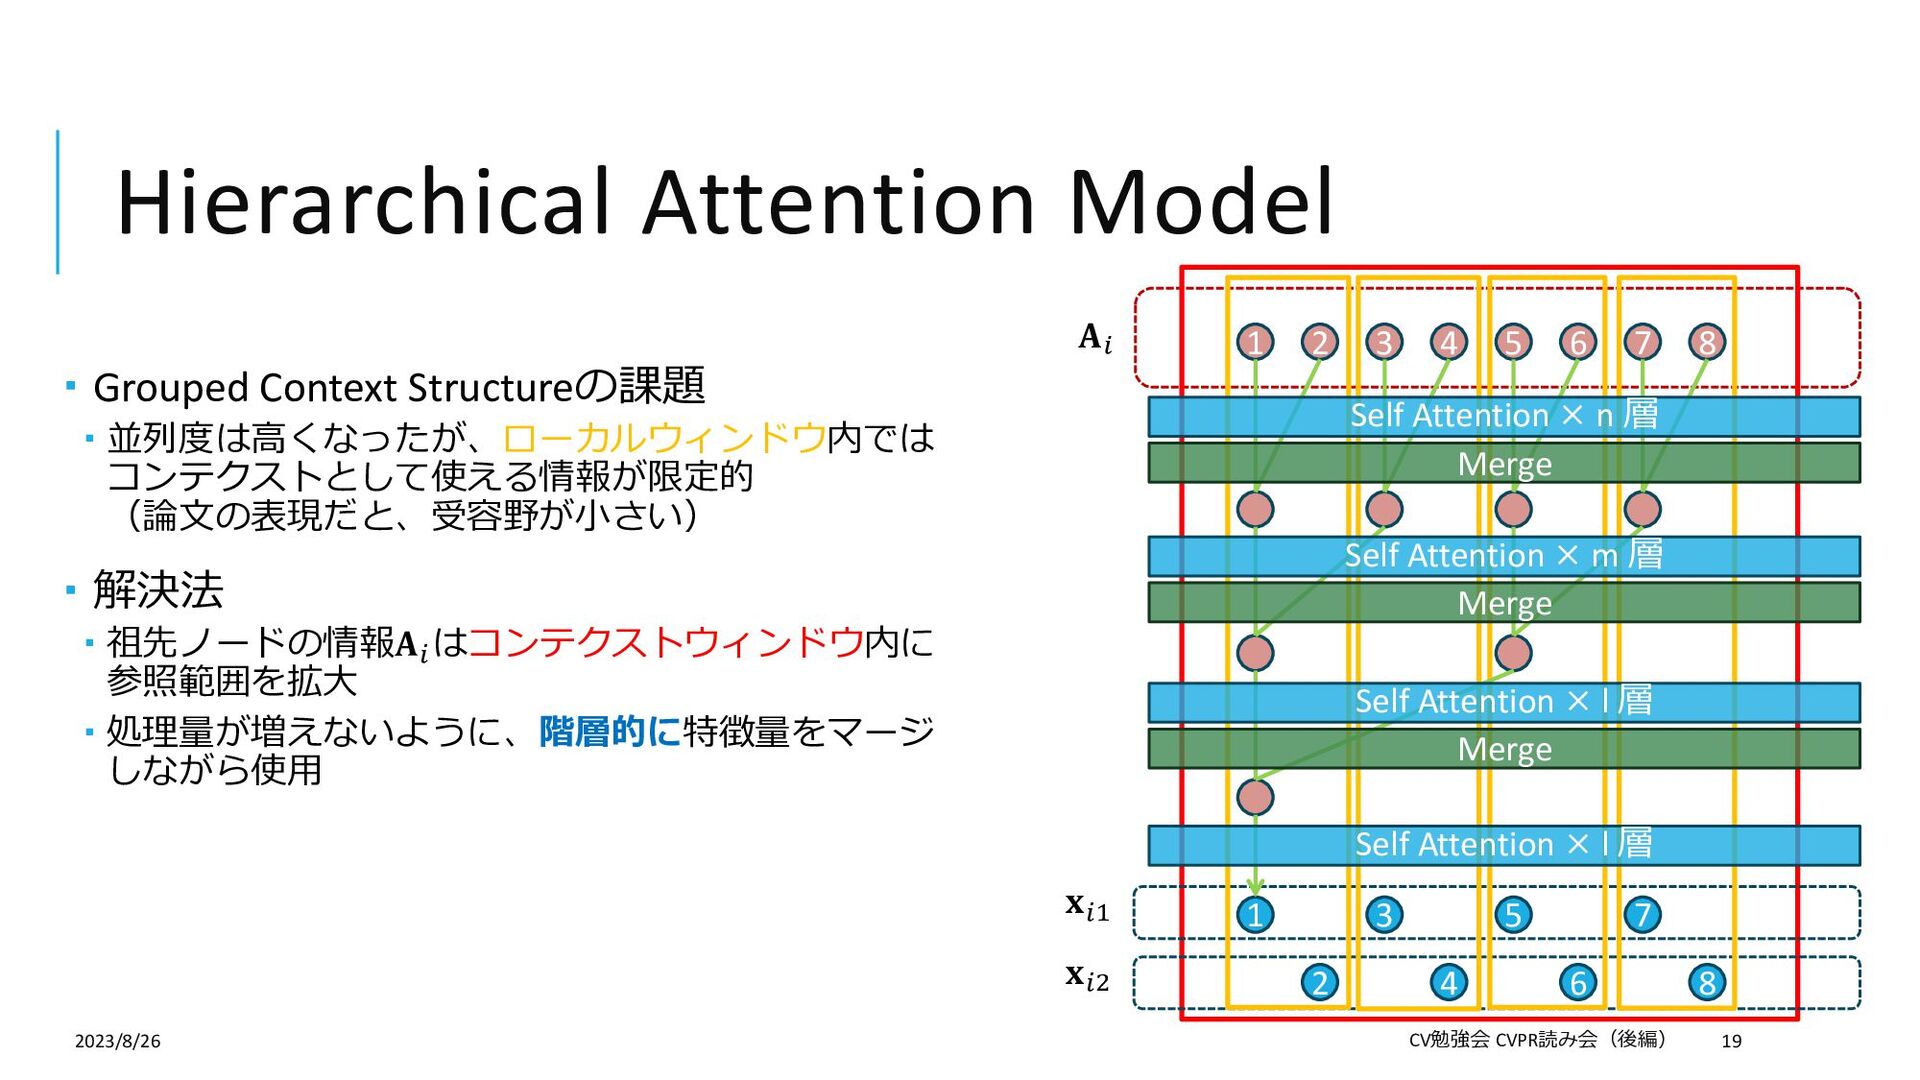
Hierarchical Attention Model Grouped Context Structureの課題 並列度は高くなったが、ローカルウィンドウ内では コンテクストとして使える情報が限定的
(論文の表現だと、受容野が小さい) 解決法 祖先ノードの情報𝐀𝑖 はコンテクストウィンドウ内に 参照範囲を拡大 処理量が増えないように、階層的に特徴量をマージ しながら使用 2023/8/26 CV勉強会 CVPR読み会(後編) 19 1 2 3 4 5 6 7 8 1 2 3 4 5 6 7 8 𝐀𝑖 𝐱𝑖1 𝐱𝑖2 Self Attention × n 層 Merge Self Attention × m 層 Merge Self Attention × l 層 Merge Self Attention × l 層
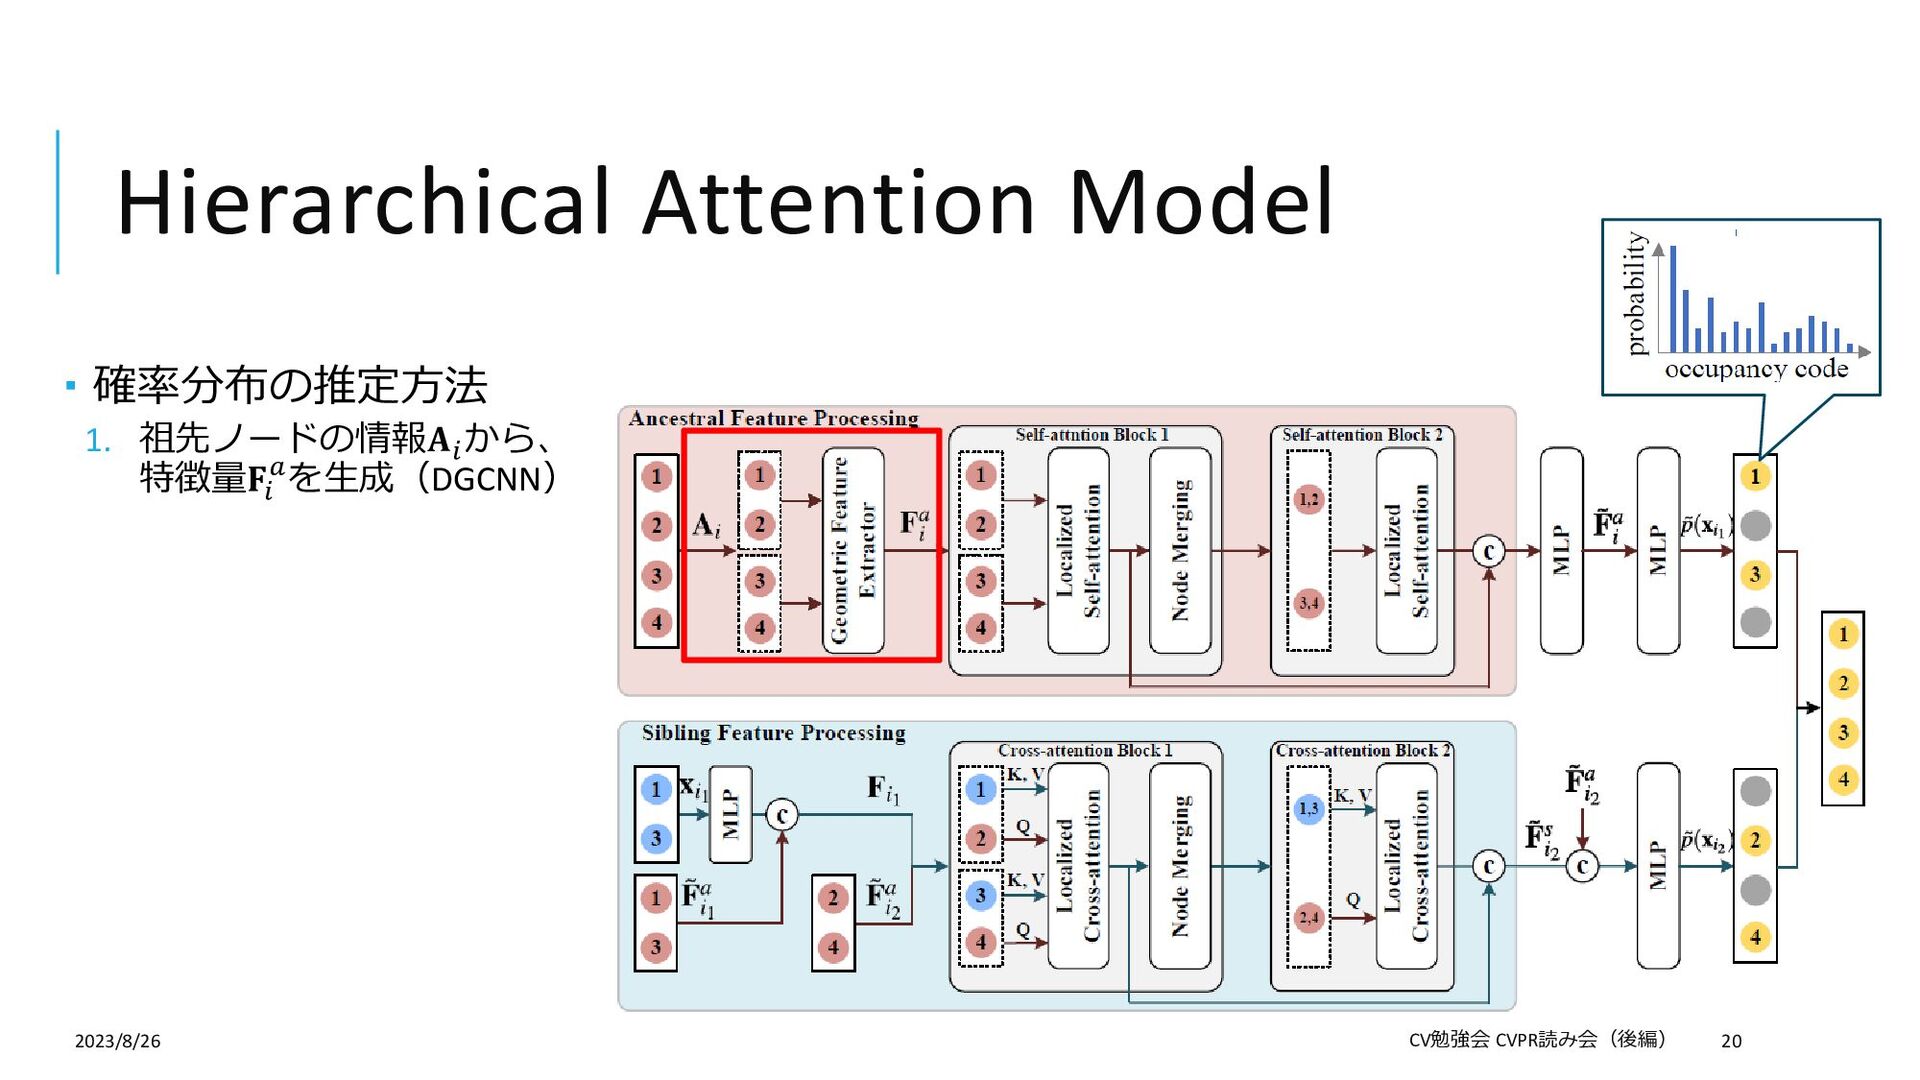
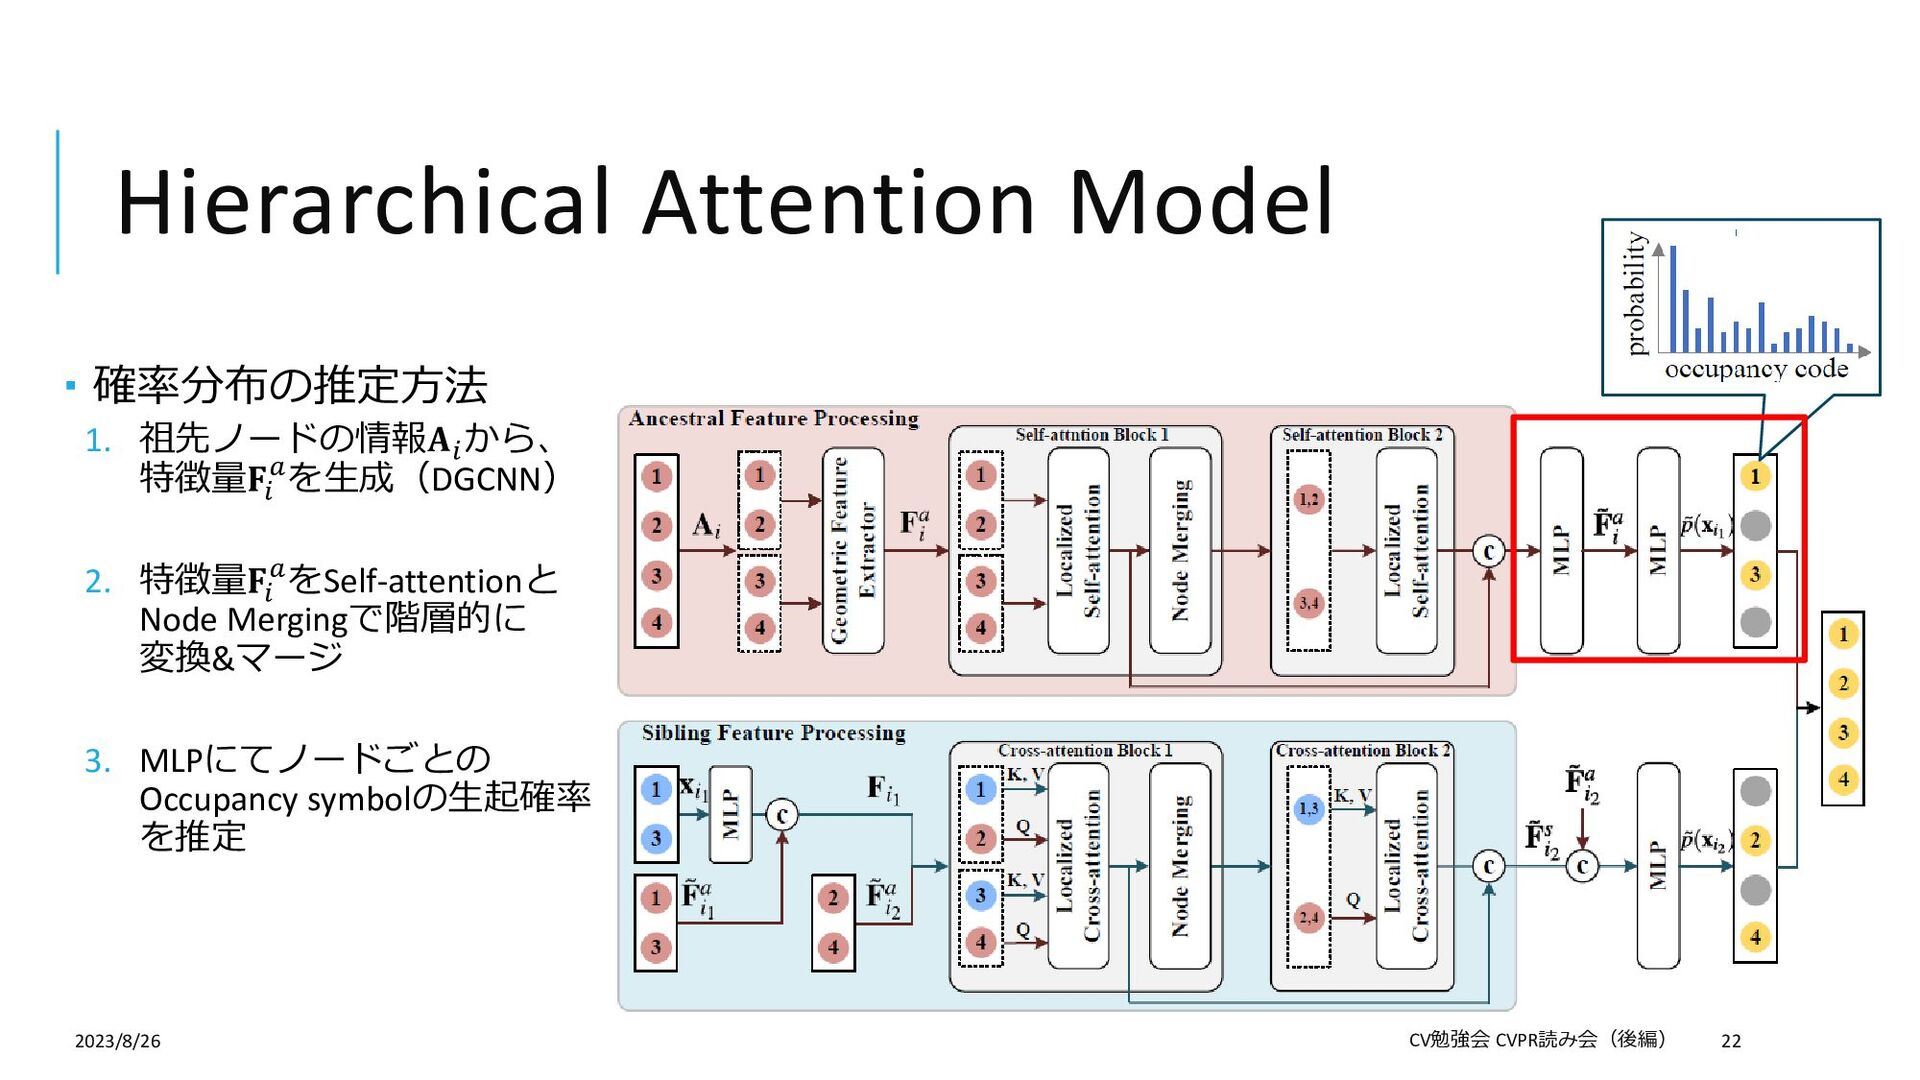
Hierarchical Attention Model 確率分布の推定方法 1. 祖先ノードの情報𝐀𝑖 から、 特徴量𝐅𝑖 𝑎を生成(DGCNN)
2023/8/26 CV勉強会 CVPR読み会(後編) 20
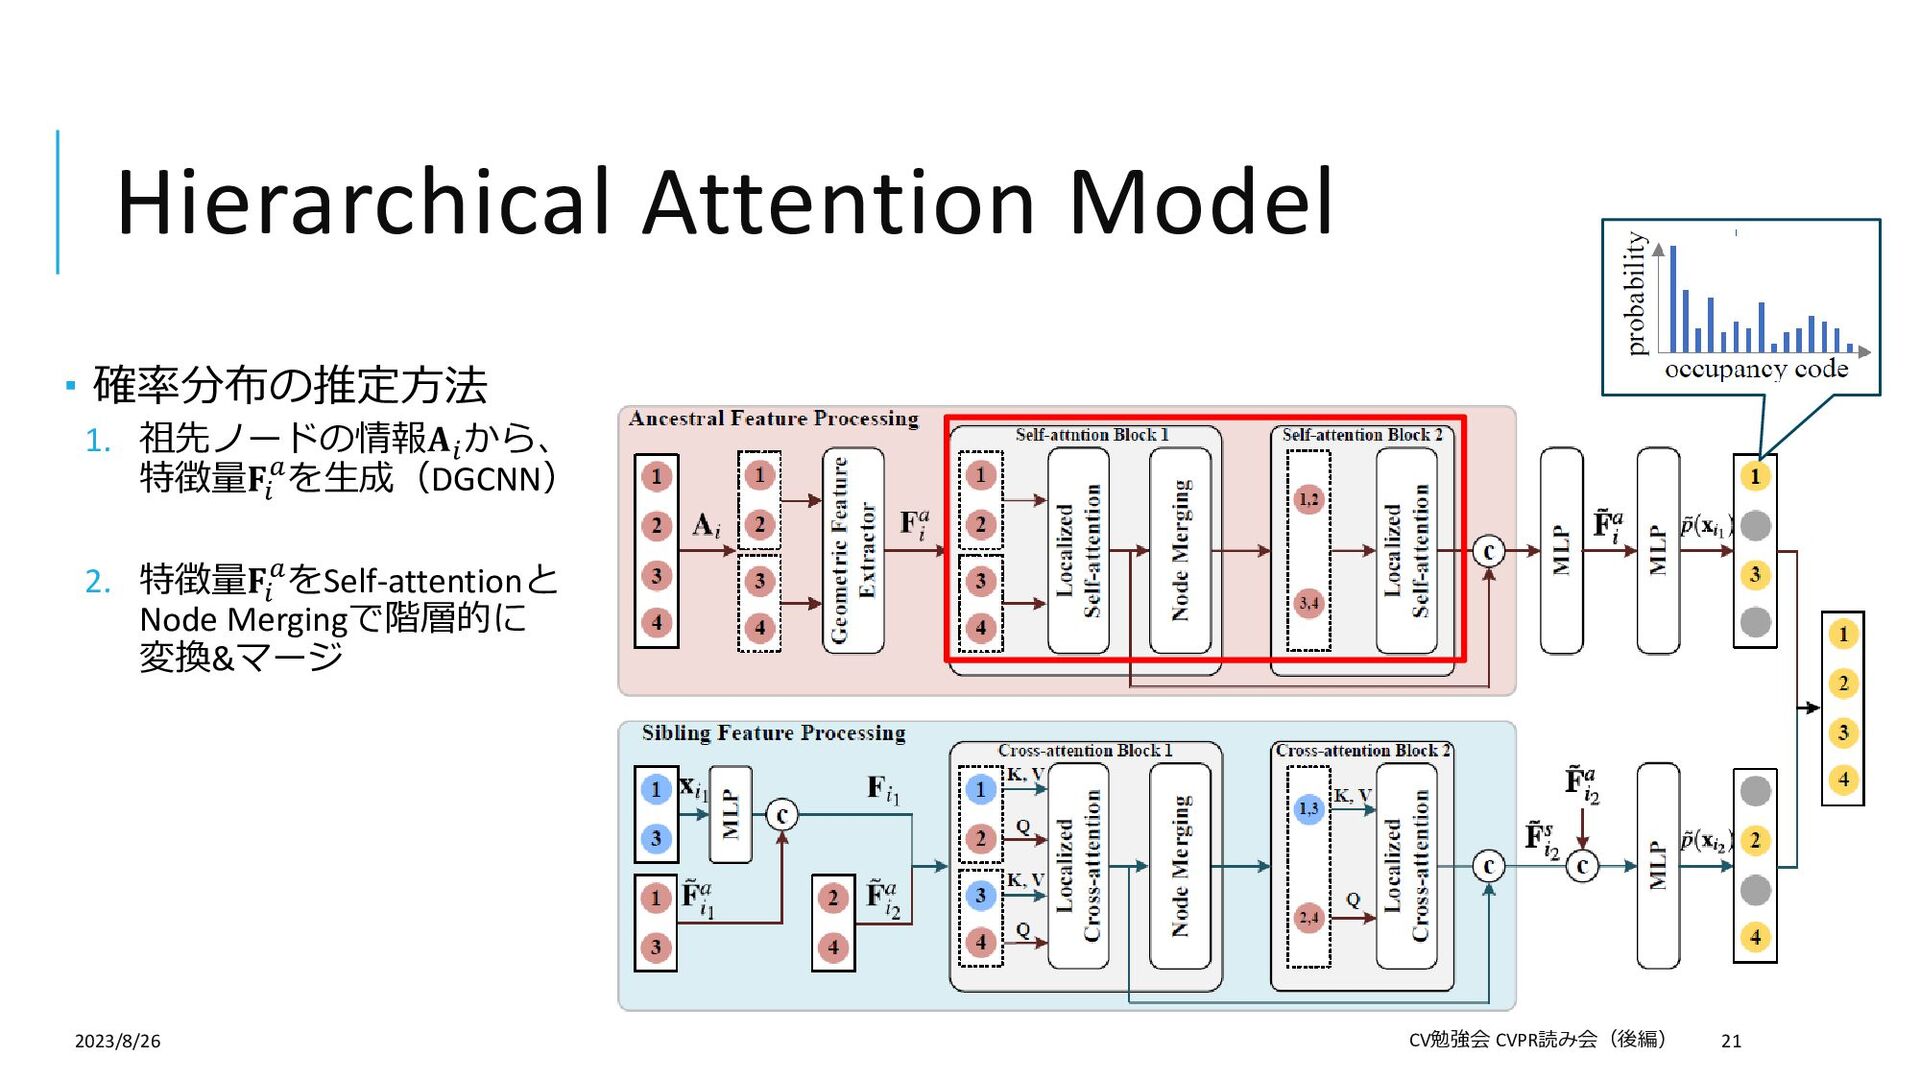
Hierarchical Attention Model 確率分布の推定方法 1. 祖先ノードの情報𝐀𝑖 から、 特徴量𝐅𝑖 𝑎を生成(DGCNN)
2. 特徴量𝐅𝑖 𝑎をSelf-attentionと Node Mergingで階層的に 変換&マージ 2023/8/26 CV勉強会 CVPR読み会(後編) 21
Hierarchical Attention Model 確率分布の推定方法 1. 祖先ノードの情報𝐀𝑖 から、 特徴量𝐅𝑖 𝑎を生成(DGCNN)
2. 特徴量𝐅𝑖 𝑎をSelf-attentionと Node Mergingで階層的に 変換&マージ 3. MLPにてノードごとの Occupancy symbolの生起確率 を推定 2023/8/26 CV勉強会 CVPR読み会(後編) 22
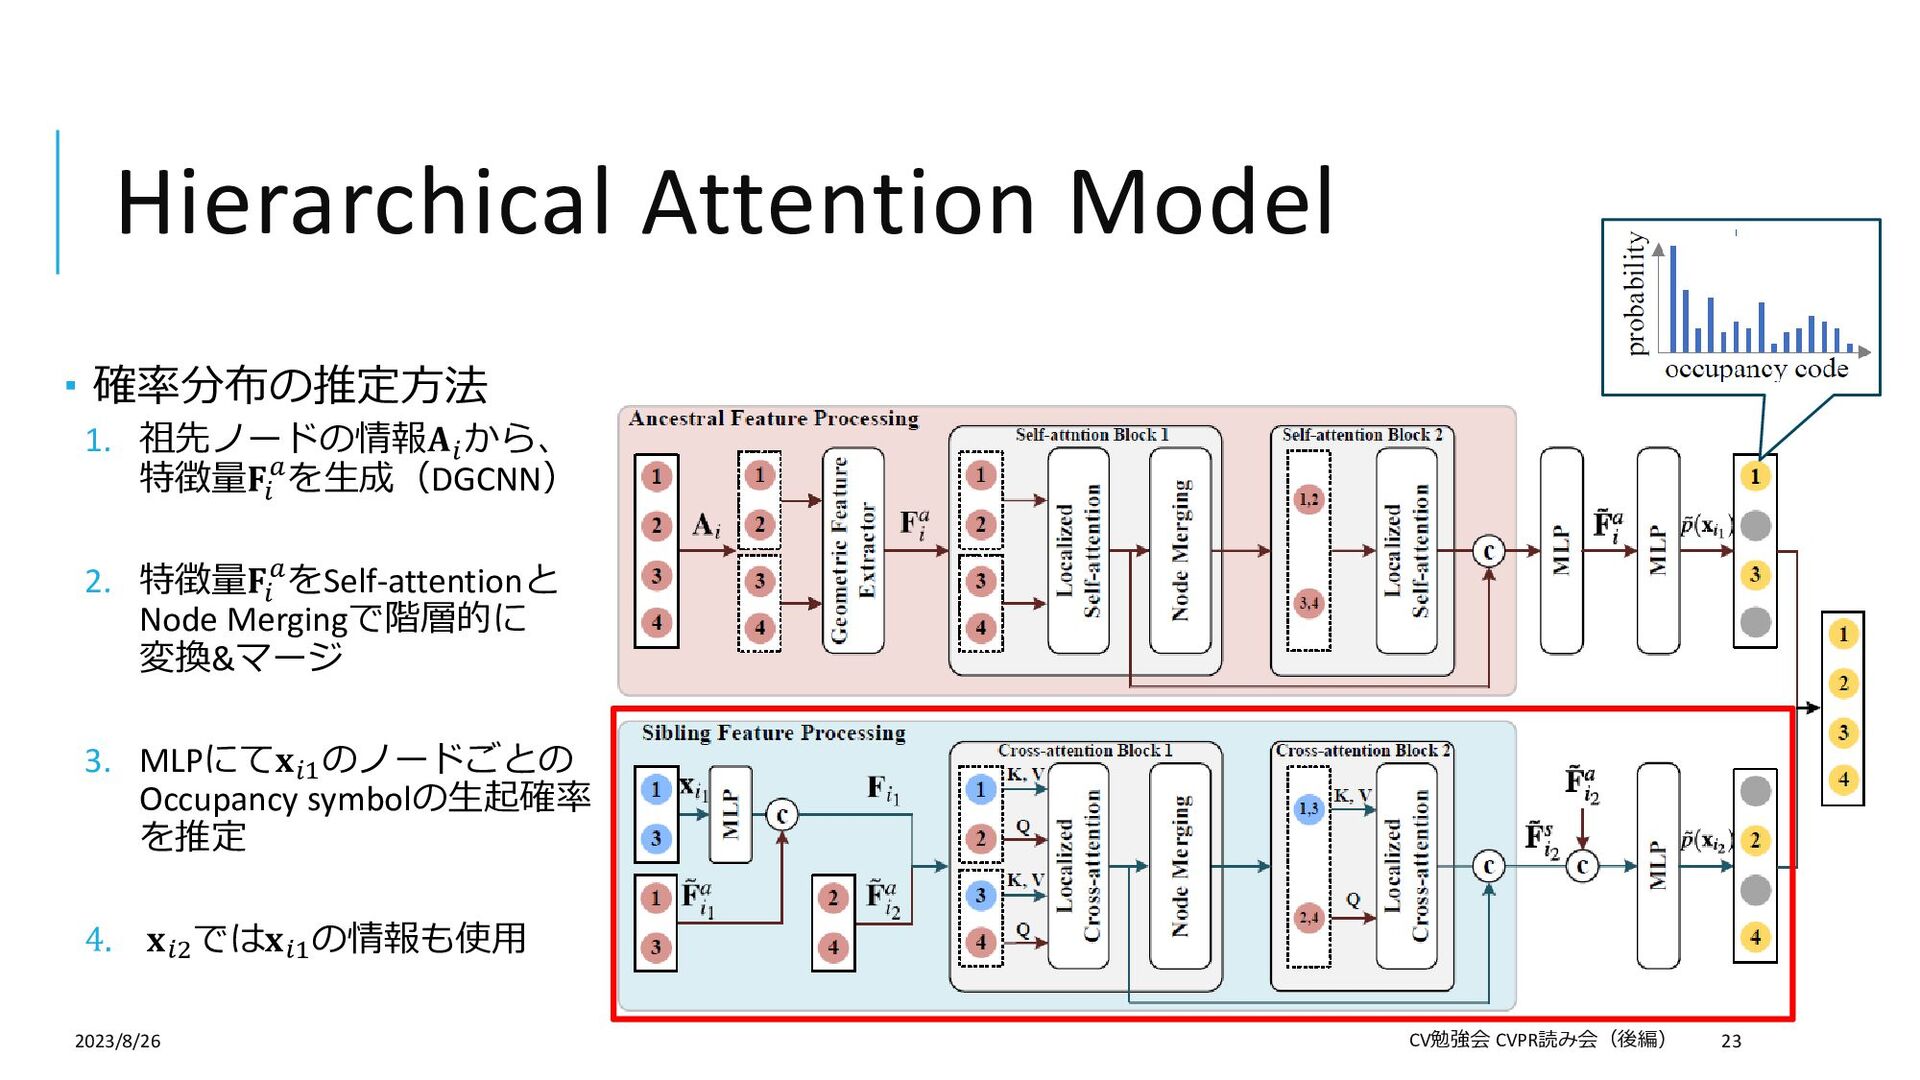
Hierarchical Attention Model 確率分布の推定方法 1. 祖先ノードの情報𝐀𝑖 から、 特徴量𝐅𝑖 𝑎を生成(DGCNN)
2. 特徴量𝐅𝑖 𝑎をSelf-attentionと Node Mergingで階層的に 変換&マージ 3. MLPにて𝐱𝑖1 のノードごとの Occupancy symbolの生起確率 を推定 4. 𝐱𝑖2 では𝐱𝑖1 の情報も使用 2023/8/26 CV勉強会 CVPR読み会(後編) 23
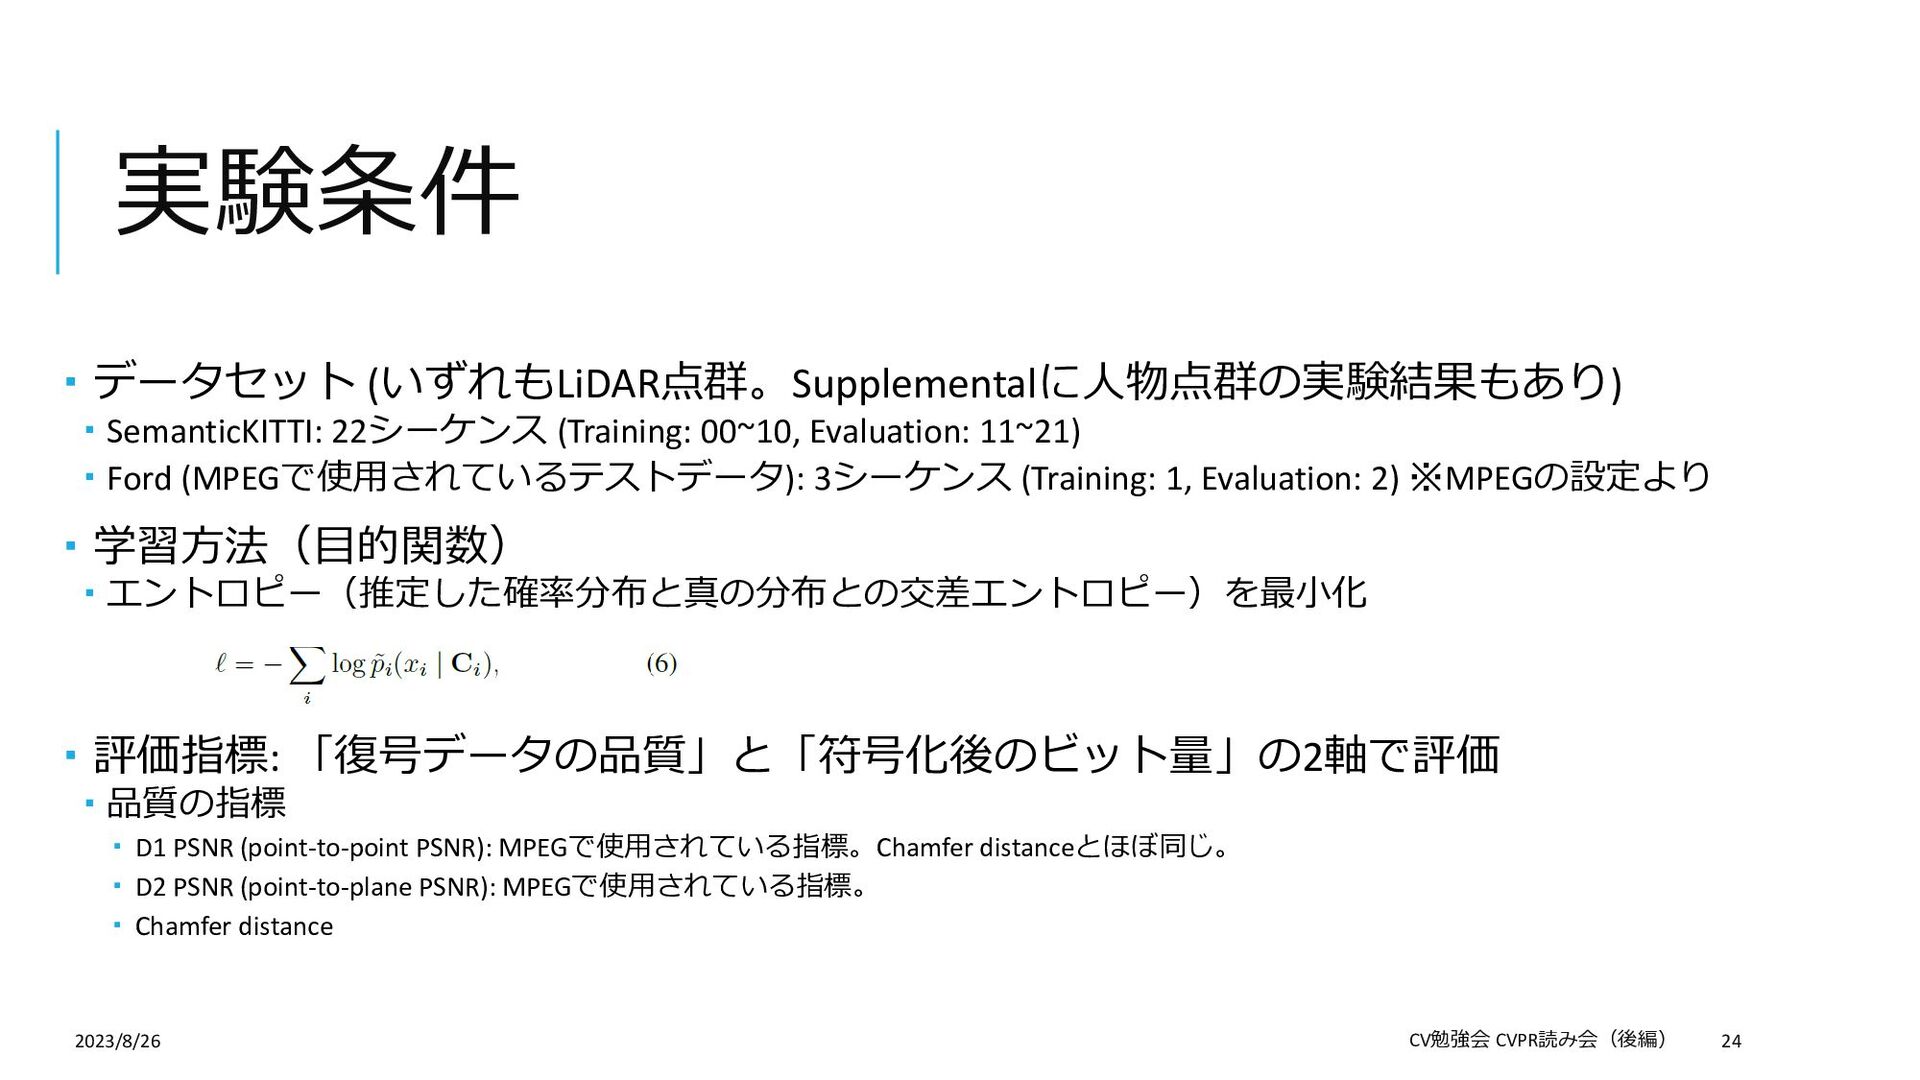
実験条件 データセット (いずれもLiDAR点群。Supplementalに人物点群の実験結果もあり) SemanticKITTI: 22シーケンス (Training: 00~10, Evaluation:
11~21) Ford (MPEGで使用されているテストデータ): 3シーケンス (Training: 1, Evaluation: 2) ※MPEGの設定より 学習方法(目的関数) エントロピー(推定した確率分布と真の分布との交差エントロピー)を最小化 評価指標: 「復号データの品質」と「符号化後のビット量」の2軸で評価 品質の指標 D1 PSNR (point-to-point PSNR): MPEGで使用されている指標。Chamfer distanceとほぼ同じ。 D2 PSNR (point-to-plane PSNR): MPEGで使用されている指標。 Chamfer distance 2023/8/26 CV勉強会 CVPR読み会(後編) 24
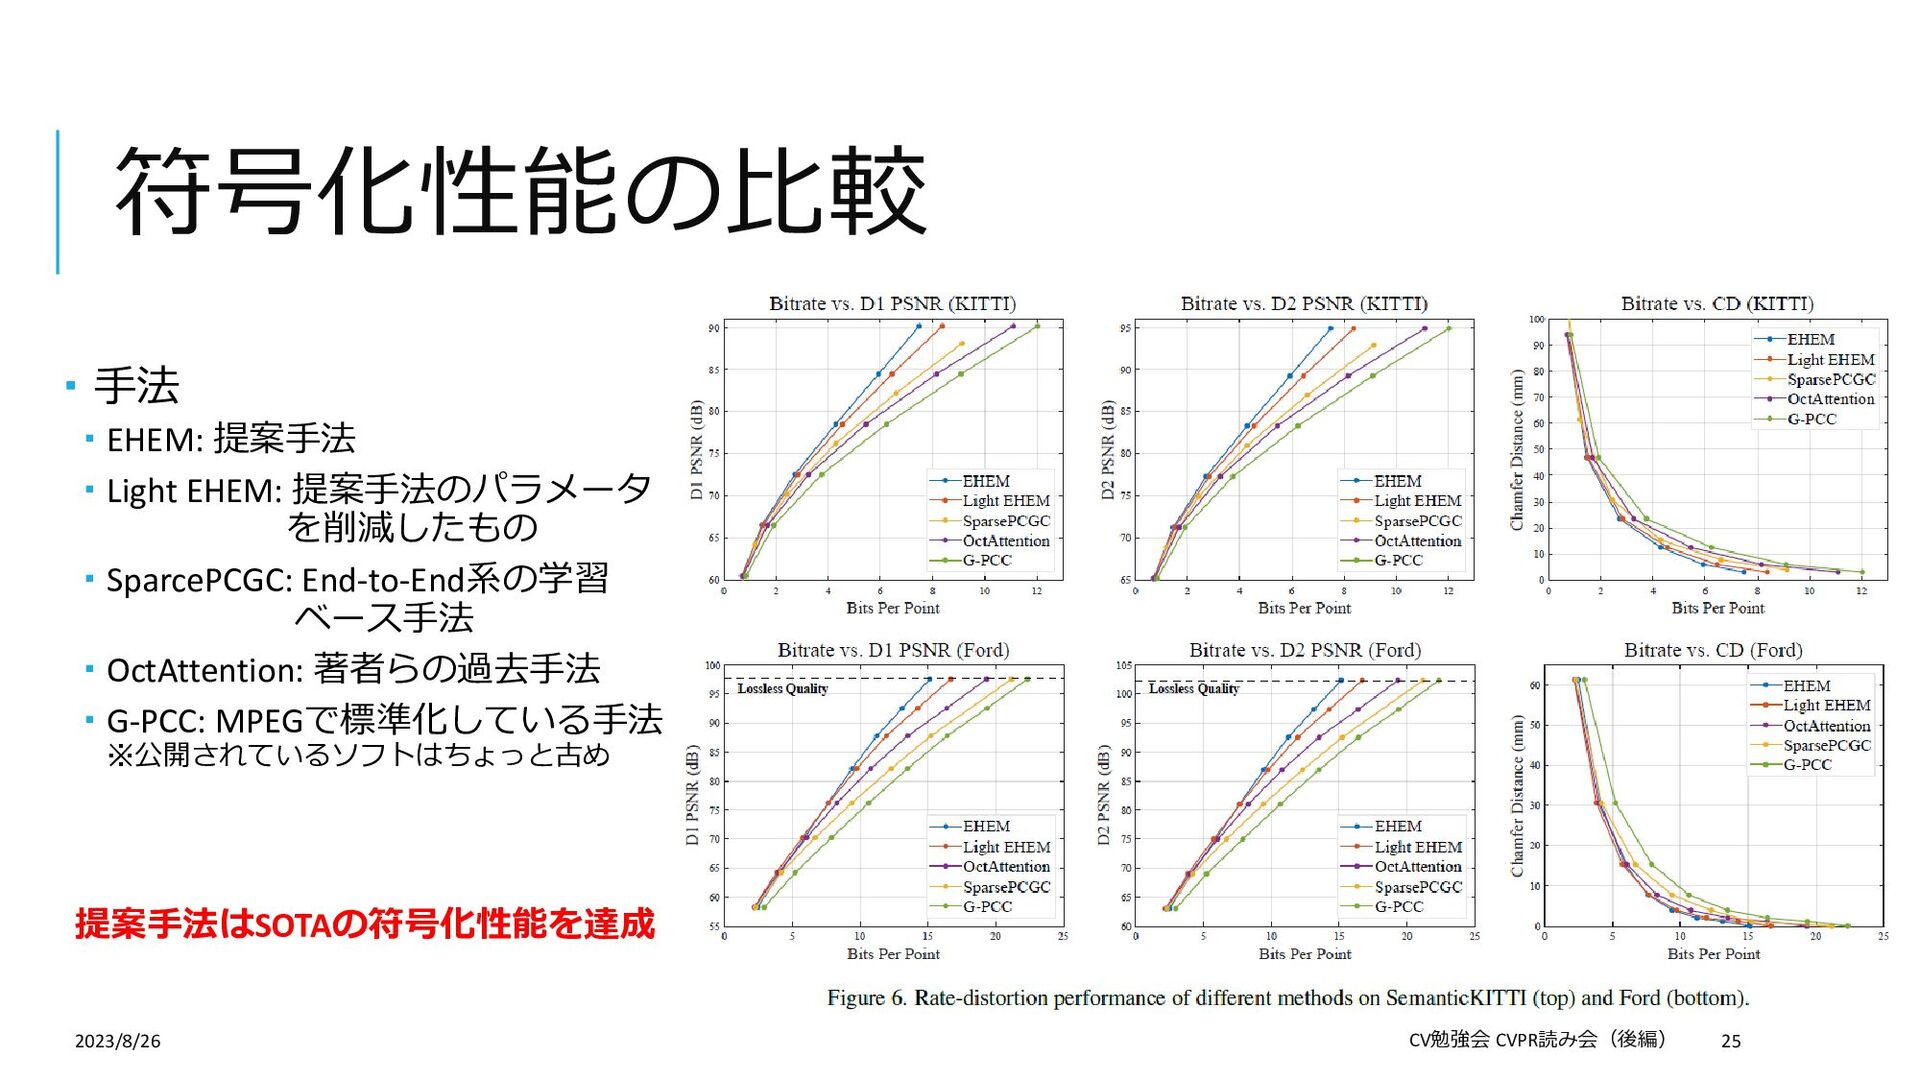
符号化性能の比較 手法 EHEM: 提案手法 Light EHEM: 提案手法のパラメータ
を削減したもの SparcePCGC: End-to-End系の学習 ベース手法 OctAttention: 著者らの過去手法 G-PCC: MPEGで標準化している手法 ※公開されているソフトはちょっと古め 2023/8/26 CV勉強会 CVPR読み会(後編) 25 提案手法はSOTAの符号化性能を達成
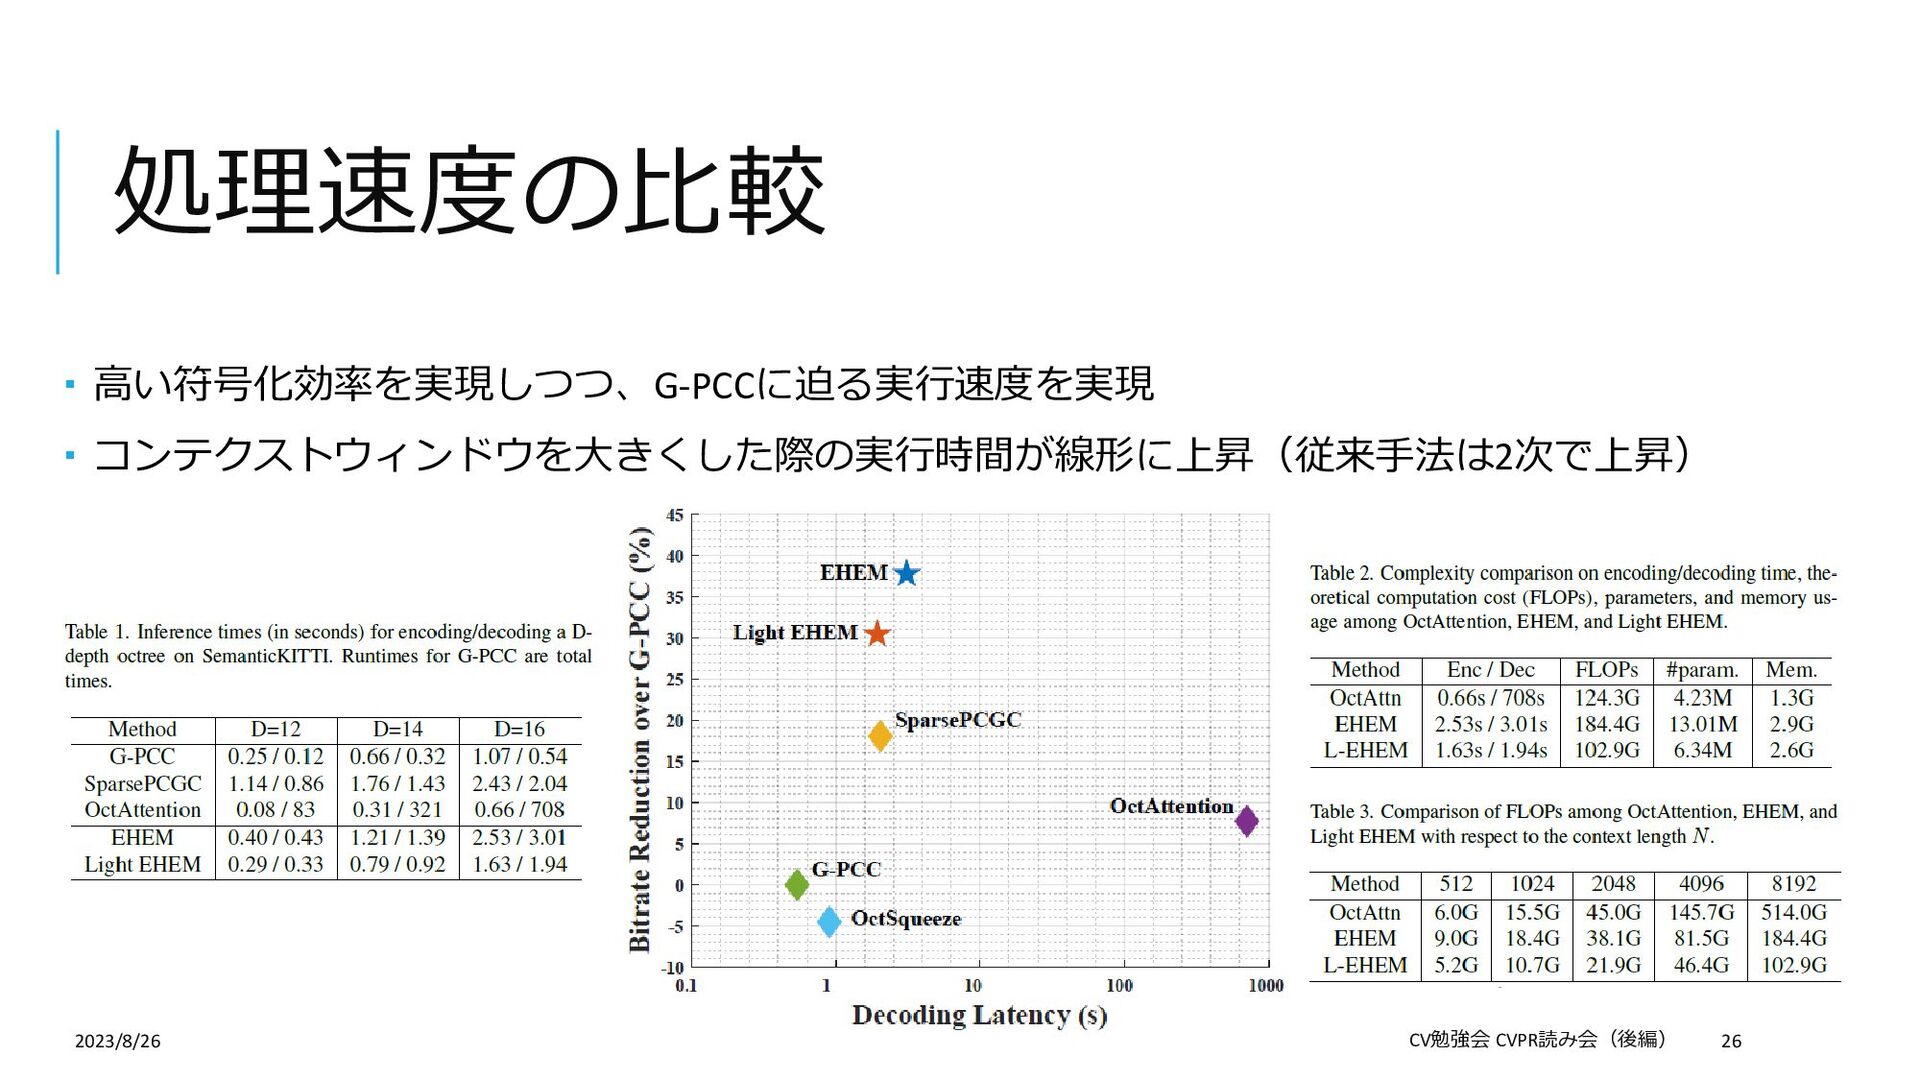
処理速度の比較 高い符号化効率を実現しつつ、G-PCCに迫る実行速度を実現 コンテクストウィンドウを大きくした際の実行時間が線形に上昇(従来手法は2次で上昇) 2023/8/26 CV勉強会 CVPR読み会(後編) 26
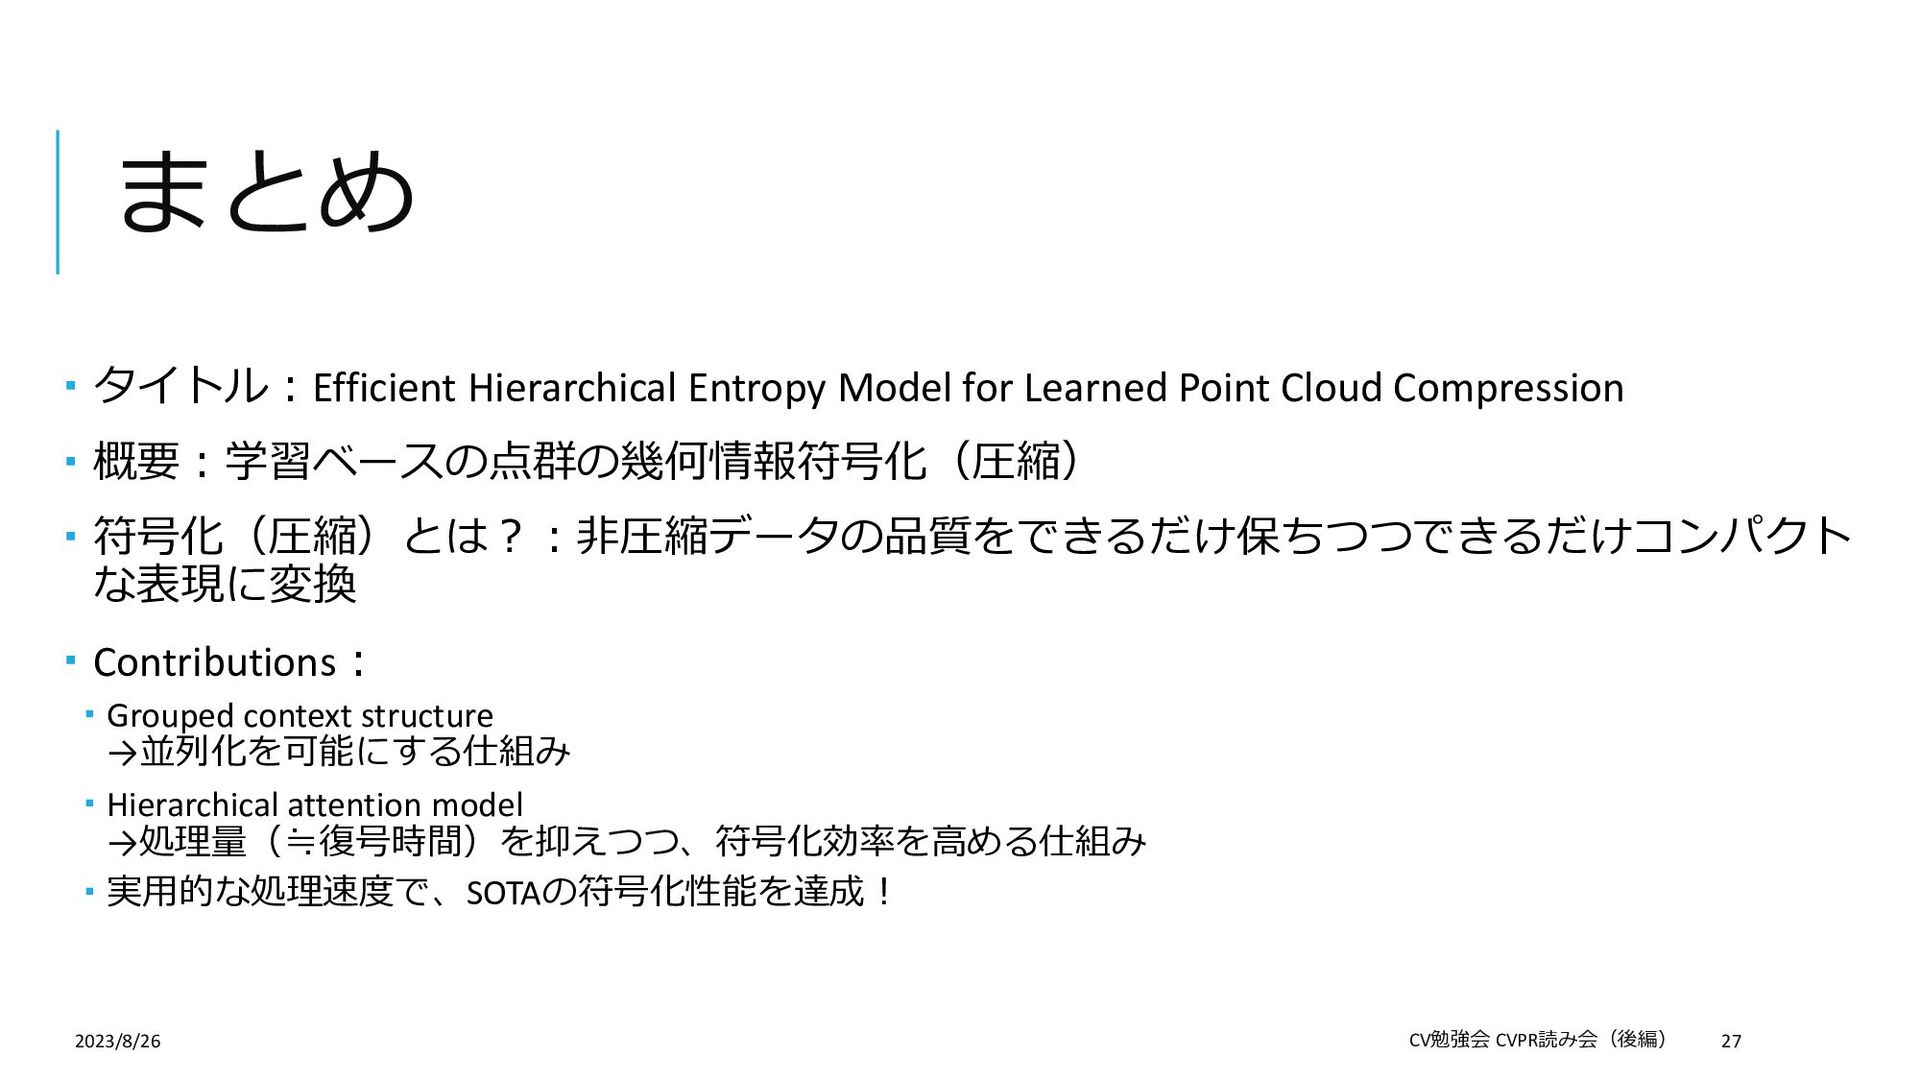
まとめ タイトル:Efficient Hierarchical Entropy Model for Learned Point Cloud
Compression 概要:学習ベースの点群の幾何情報符号化(圧縮) 符号化(圧縮)とは?:非圧縮データの品質をできるだけ保ちつつできるだけコンパクト な表現に変換 Contributions: Grouped context structure →並列化を可能にする仕組み Hierarchical attention model →処理量(≒復号時間)を抑えつつ、符号化効率を高める仕組み 実用的な処理速度で、SOTAの符号化性能を達成! 2023/8/26 CV勉強会 CVPR読み会(後編) 27


 hotchpotch
 kentaitakura
 de9uch1
 tsantalis
 tomonom
 stktu
 koide3
 signer
 ks91
 dk999
 nttcom
 chck
 brettharned
 techseoconnect
 reverentgeek
 dugsong
 jacobtomlinson
 paigeccino
 codingconduct
 aleyda
 eileencodes
 nmsamuel
 nwiizo
 sugarenia