Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
正解のない対話をどう評価するか - AIコーチング1年弱のLLMOps
Search
Ryosuke Fukazawa
September 29, 2026
Technology
94
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
正解のない対話をどう評価するか - AIコーチング1年弱のLLMOps
Ryosuke Fukazawa
September 29, 2026
Other Decks in Technology
See All in Technology
"優秀な誰か"の下位互換にならないために
yut0naga1_fa
1
1.8k
[JAWS-UG彩の国埼玉#12]そろそろ準備する?re:Invent2026をやさしく解説 / reinvent2026-sainokuni
sh_fk2
1
330
宣言型部分更新は何を解決しどこへ向かうのか
shuta13
1
450
Browser Spec: Testing Hotwire with Ruby
takahashim
1
120
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
130
go-sqletch
moznion
0
140
分析AIエージェントを育てる、動く環境を育てる
codatum
1
1.1k
DGX Spark でどこまでハッキングができるのか?
kash1064
3
1.3k
ブラウザとサーバーから考えるAI時代のフロントエンド監視
shogo4131
3
940
ストレスなくAIと付き合いたい!こんなときどうしてる?
namiki64
2
400
アウトプット初心者、半年間のふりかえり
4o1sobblue
0
430
Claude Code本は、どのように執筆チームで書かれたか
oikon48
1
370
Featured
See All Featured
Darren the Foodie - Storyboard
khoart
PRO
4
4k
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
The Invisible Side of Design
smashingmag
301
52k
From π to Pie charts
rasagy
1
400
How to make the Groovebox
asonas
2
2.5k
Joys of Absence: A Defence of Solitary Play
codingconduct
1
550
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
43k
The Curse of the Amulet
leimatthew05
3
15k
Mind Mapping
helmedeiros
1
400
Marketing Yourself as an Engineer | Alaka | Gurzu
gurzu
0
330
A Modern Web Designer's Workflow
chriscoyier
699
190k
Believing is Seeing
oripsolob
1
240
Transcript
MLOps勉強会 正解のない対話をどう評価するか AIコーチング1年弱のLLMOps 株式会社mento 深澤
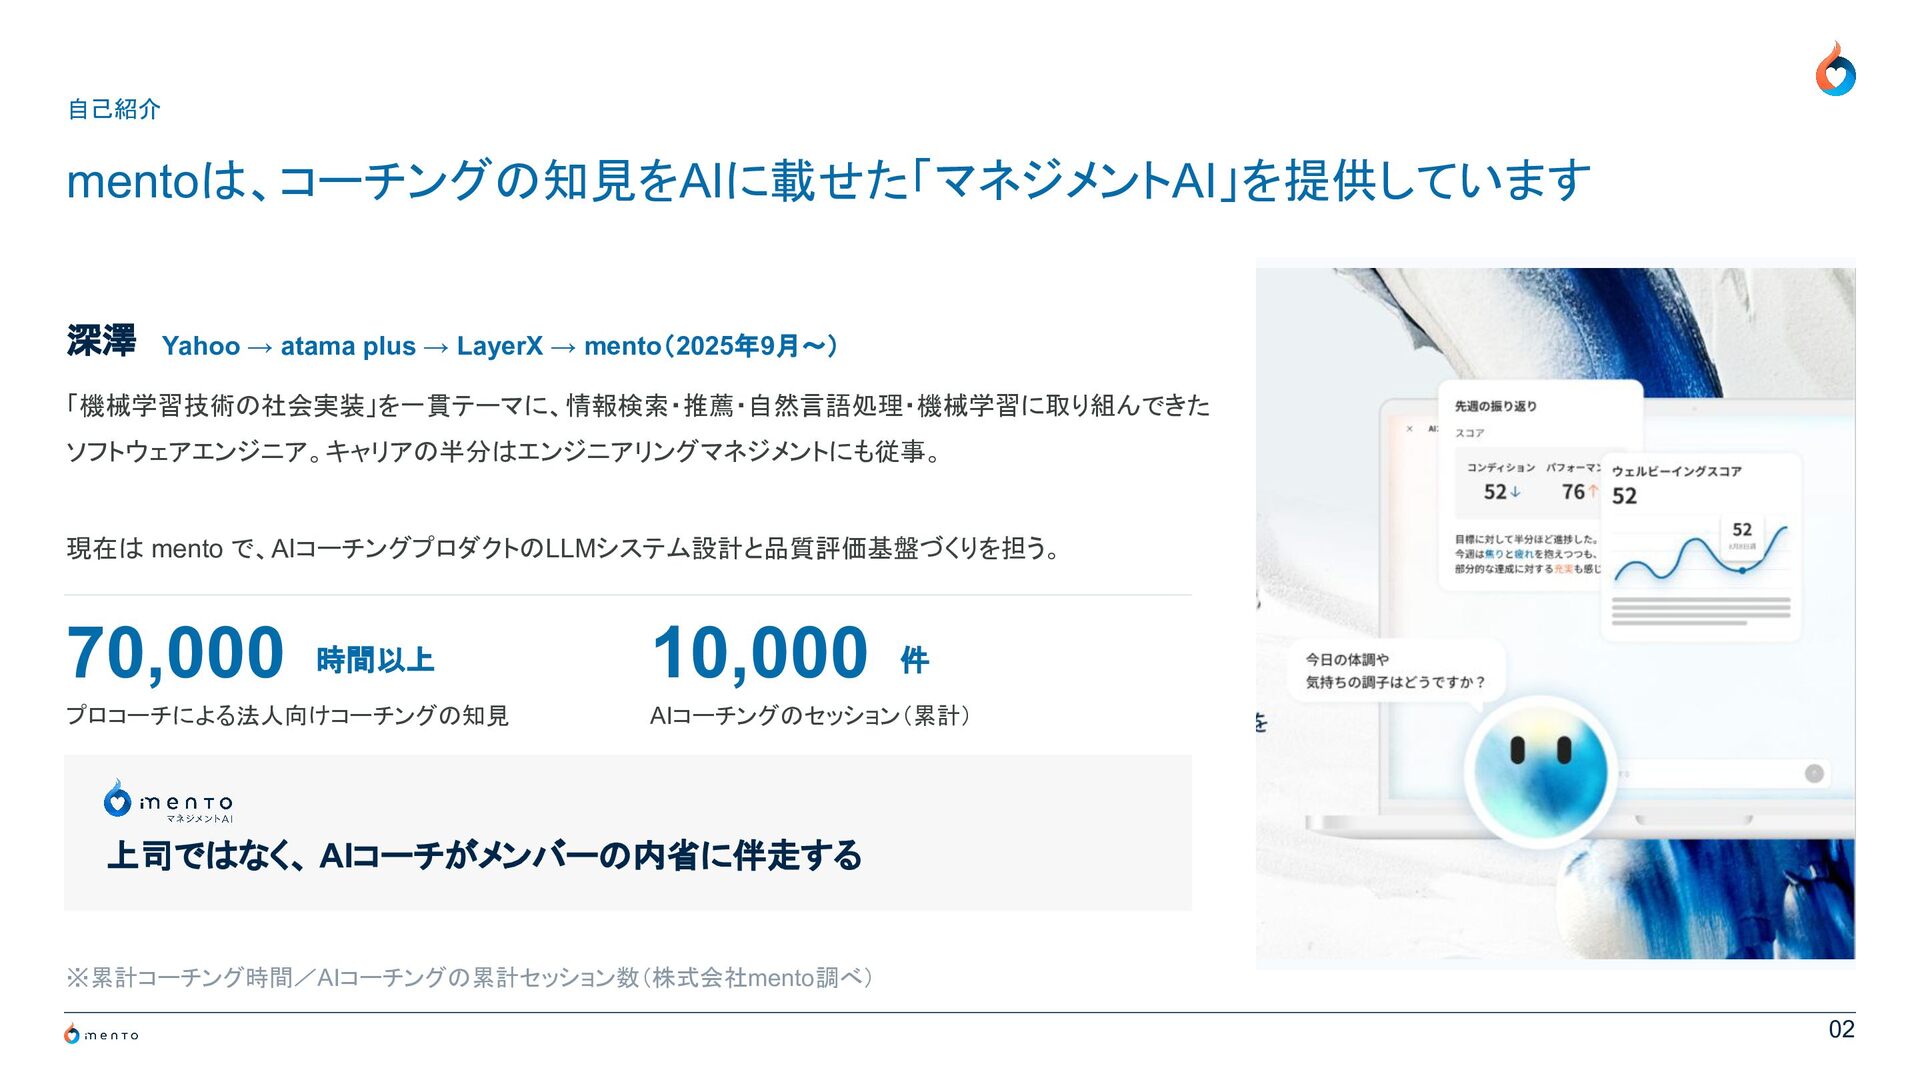
自己紹介 mentoは、コーチングの知見をAIに載せた「マネジメントAI」を提供しています 深澤 Yahoo → atama plus → LayerX →
mento(2025年9月〜) 「機械学習技術の社会実装」を一貫テーマに、情報検索・推薦・自然言語処理・機械学習に取り組んできた ソフトウェアエンジニア。キャリアの半分はエンジニアリングマネジメントにも従事。 現在は mento で、AIコーチングプロダクトのLLMシステム設計と品質評価基盤づくりを担う。 70,000 時間以上 10,000 件 プロコーチによる法人向けコーチングの知見 AIコーチングのセッション(累計) 上司ではなく、 AIコーチがメンバーの内省に伴走する ※累計コーチング時間/AIコーチングの累計セッション数(株式会社mento調べ) 02
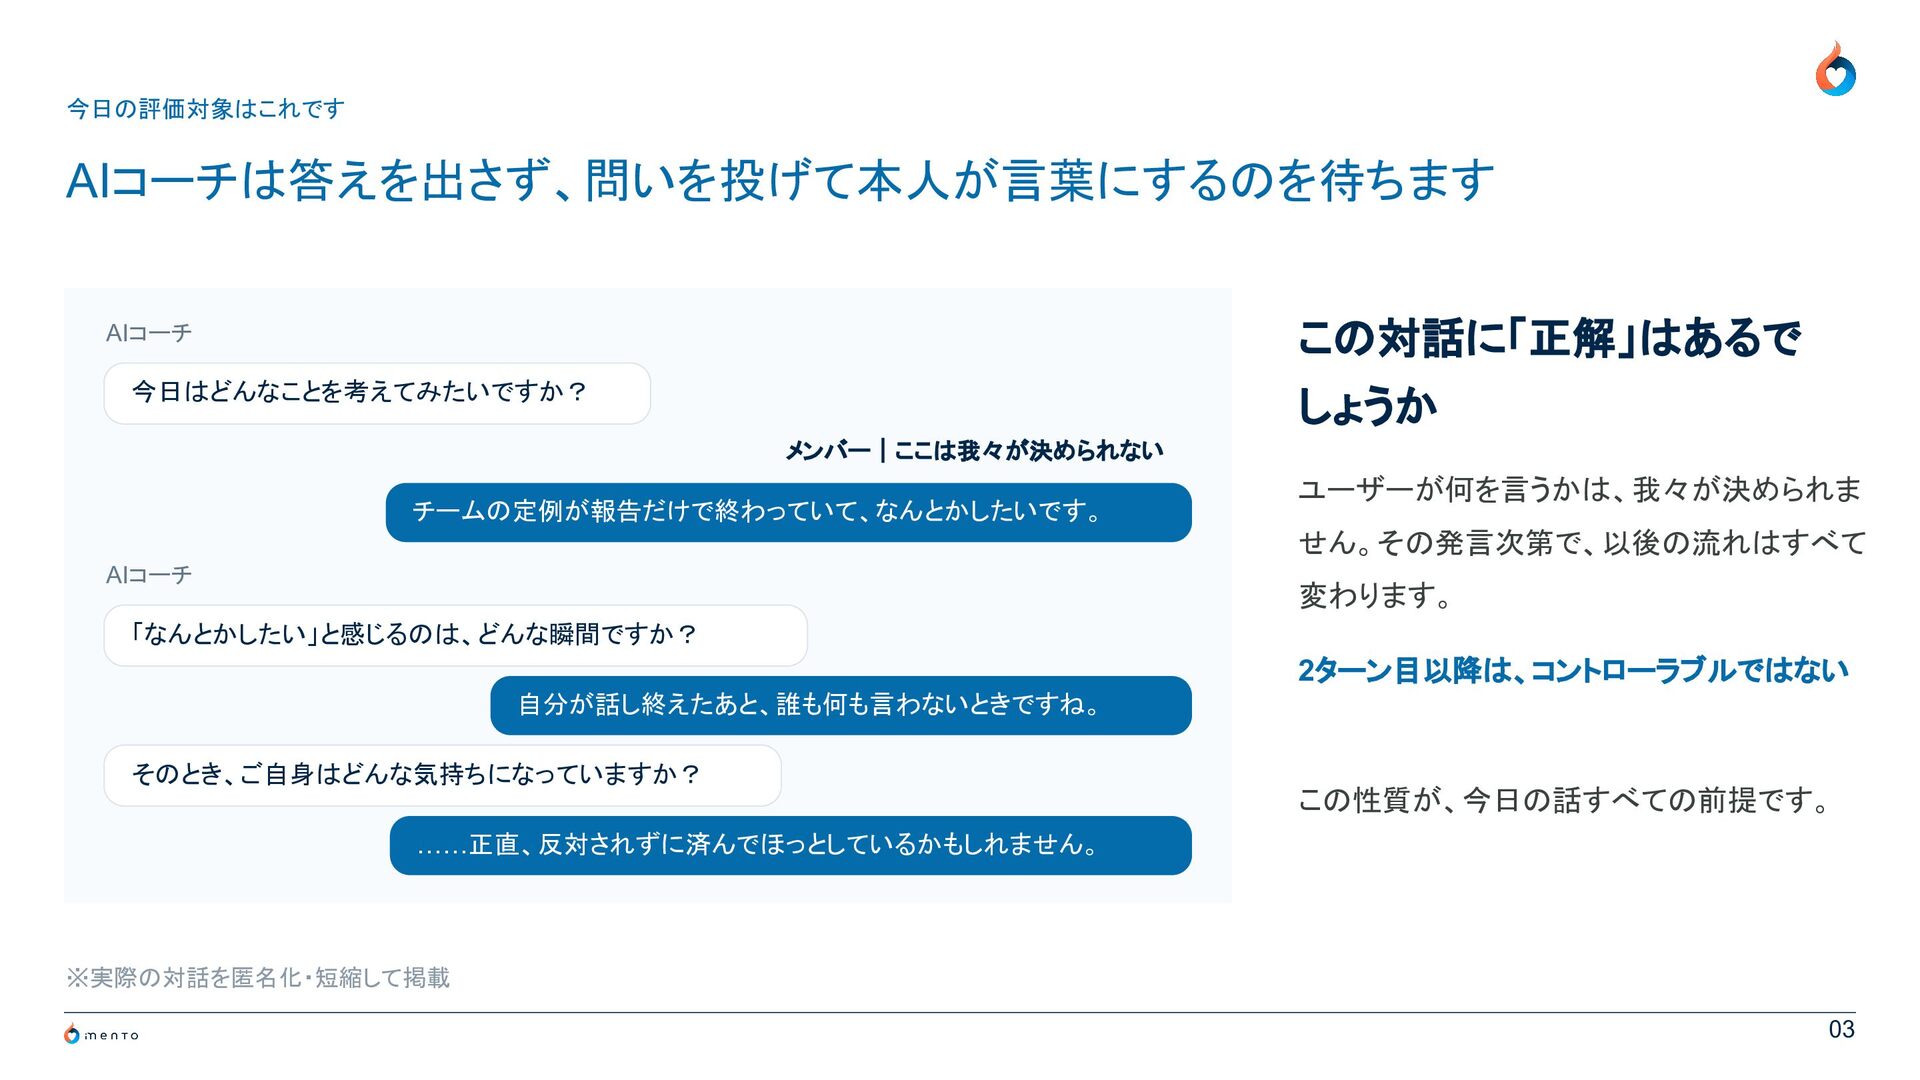
今日の評価対象はこれです AIコーチは答えを出さず、問いを投げて本人が言葉にするのを待ちます この対話に「正解」はあるで AIコーチ 今日はどんなことを考えてみたいですか? しょうか メンバー|ここは我々が決められない チームの定例が報告だけで終わっていて、なんとかしたいです。 ユーザーが何を言うかは、我々が決められま せん。その発言次第で、以後の流れはすべて
AIコーチ 変わります。 「なんとかしたい」と感じるのは、どんな瞬間ですか? 2ターン目以降は、コントローラブルではない 自分が話し終えたあと、誰も何も言わないときですね。 そのとき、ご自身はどんな気持ちになっていますか? この性質が、今日の話すべての前提です。 ……正直、反対されずに済んでほっとしているかもしれません。 ※実際の対話を匿名化・短縮して掲載 03
1 問題設定 1 なぜこの対話の品質は 掴みに くいか 2 APIを呼ぶだけでも、MLOpsは消えない 3 評価の作り分け
4 本番1年弱で起きたこと 5 まとめ:持ち帰ってほしいこと 04
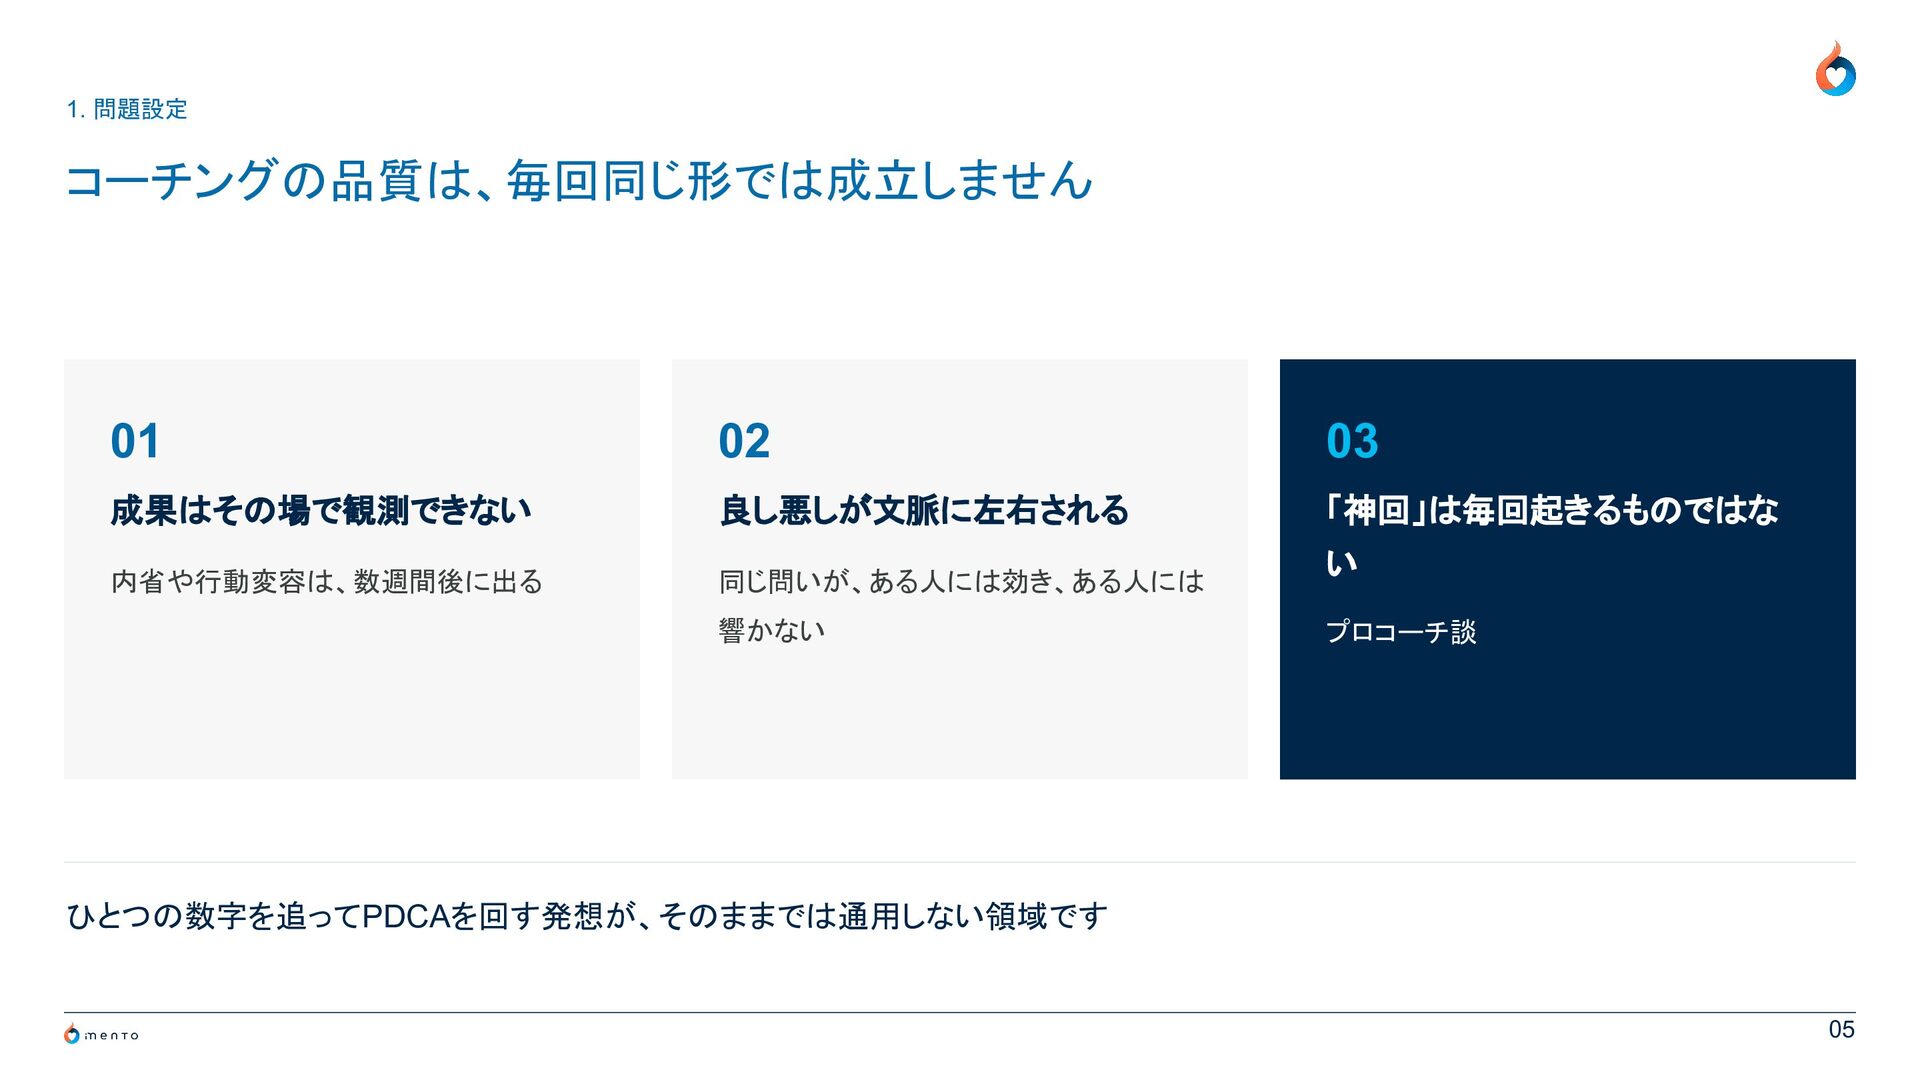
1. 問題設定 コーチングの品質は、毎回同じ形では成立しません 01 02 03 成果はその場で観測できない 良し悪しが文脈に左右される 「神回」は毎回起きるものではな 内省や行動変容は、数週間後に出る
同じ問いが、ある人には効き、ある人には 響かない い プロコーチ談 ひとつの数字を追ってPDCAを回す発想が、そのままでは通用しない領域です 05
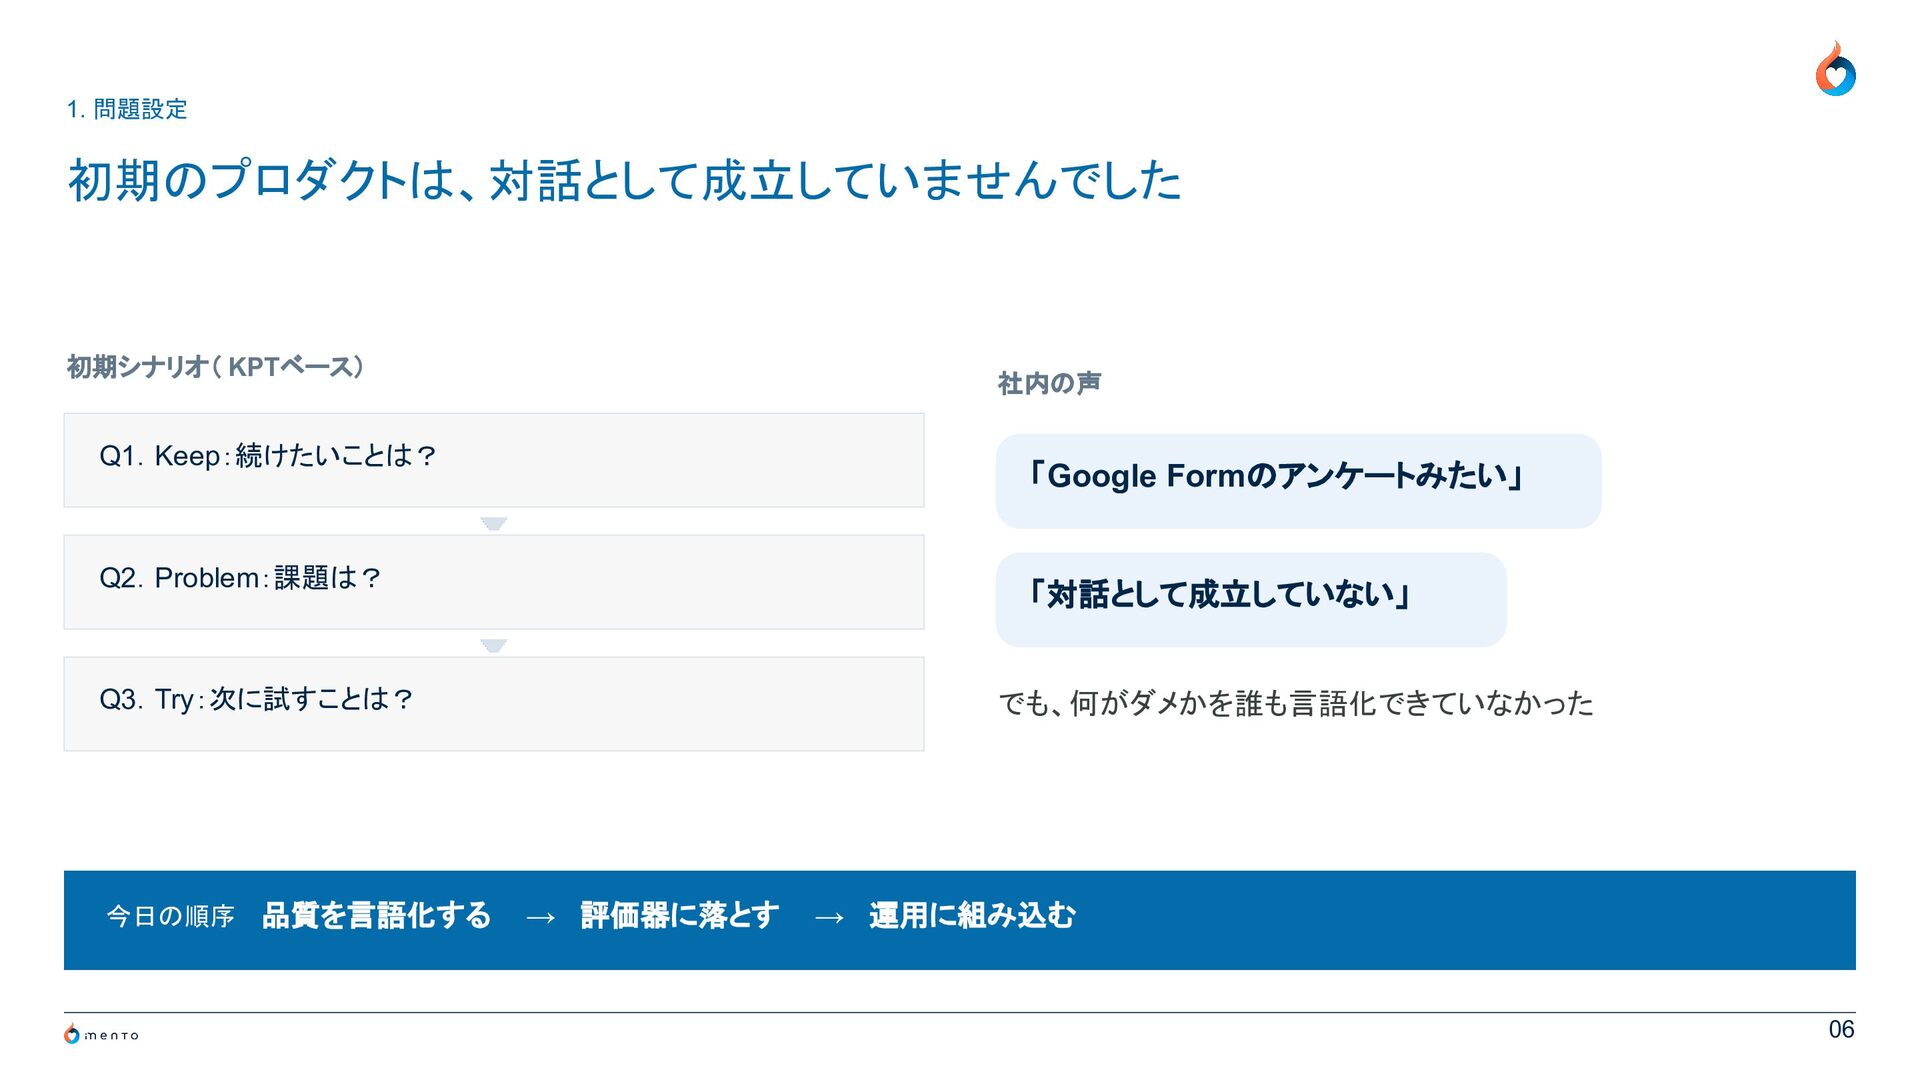
1. 問題設定 初期のプロダクトは、対話として成立していませんでした 初期シナリオ( KPTベース) 社内の声 Q1.Keep:続けたいことは? 「Google Formのアンケートみたい」 Q2.Problem:課題は?
「対話として成立していない」 でも、何がダメかを誰も言語化できていなかった Q3.Try:次に試すことは? 今日の順序 品質を言語化する → 評価器に落とす → 運用に組み込む 06
1 問題設定 2 APIを呼ぶだけでも、 MLOps は消えない 2 APIを呼ぶだけでも、 MLOpsは消えない 3
評価の作り分け 4 本番1年弱で起きたこと 5 まとめ:持ち帰ってほしいこと 07
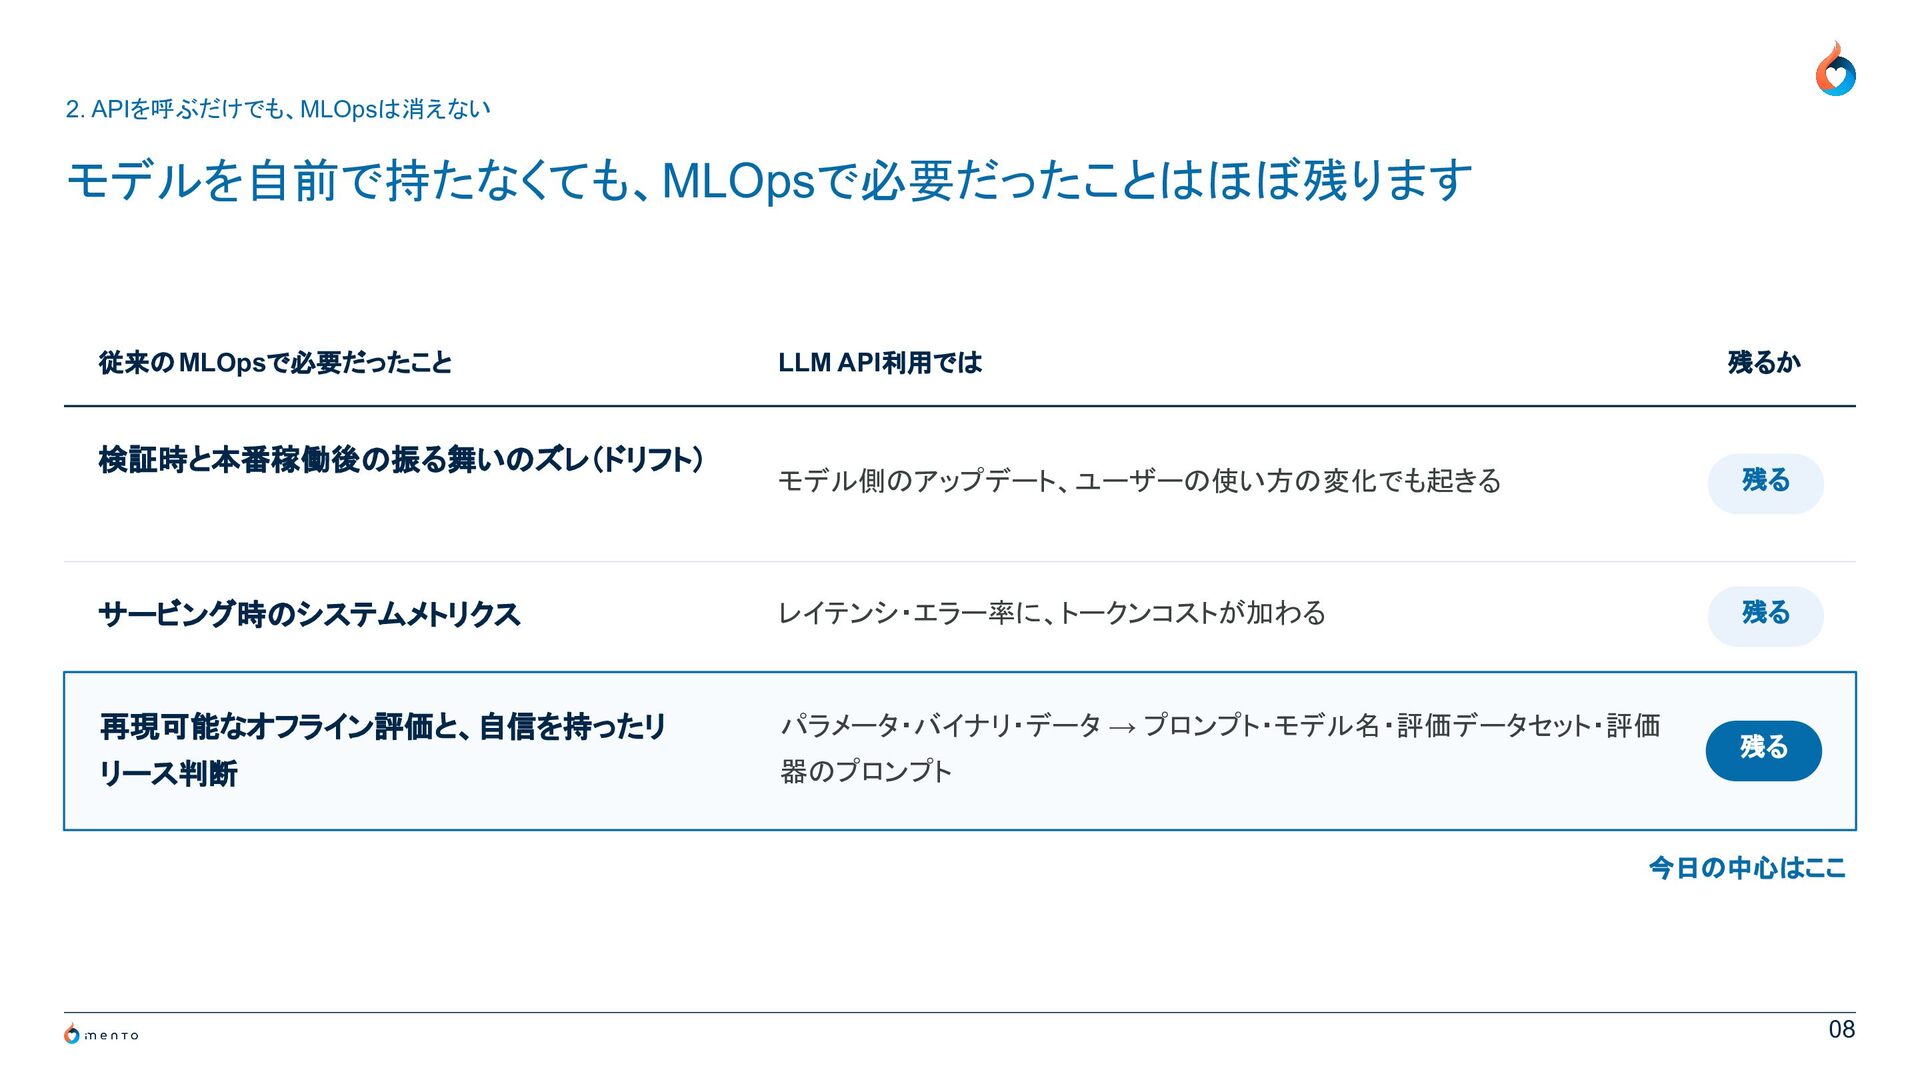
2. APIを呼ぶだけでも、MLOpsは消えない モデルを自前で持たなくても、MLOpsで必要だったことはほぼ残ります 従来のMLOpsで必要だったこと LLM API利用では 残るか モデル側のアップデート、ユーザーの使い方の変化でも起きる 残る サービング時のシステムメトリクス
レイテンシ・エラー率に、トークンコストが加わる 残る 再現可能なオフライン評価と、自信を持ったリ パラメータ・バイナリ・データ → プロンプト・モデル名・評価データセット・評価 リース判断 器のプロンプト 検証時と本番稼働後の振る舞いのズレ(ドリフト) 残る 今日の中心はここ 08
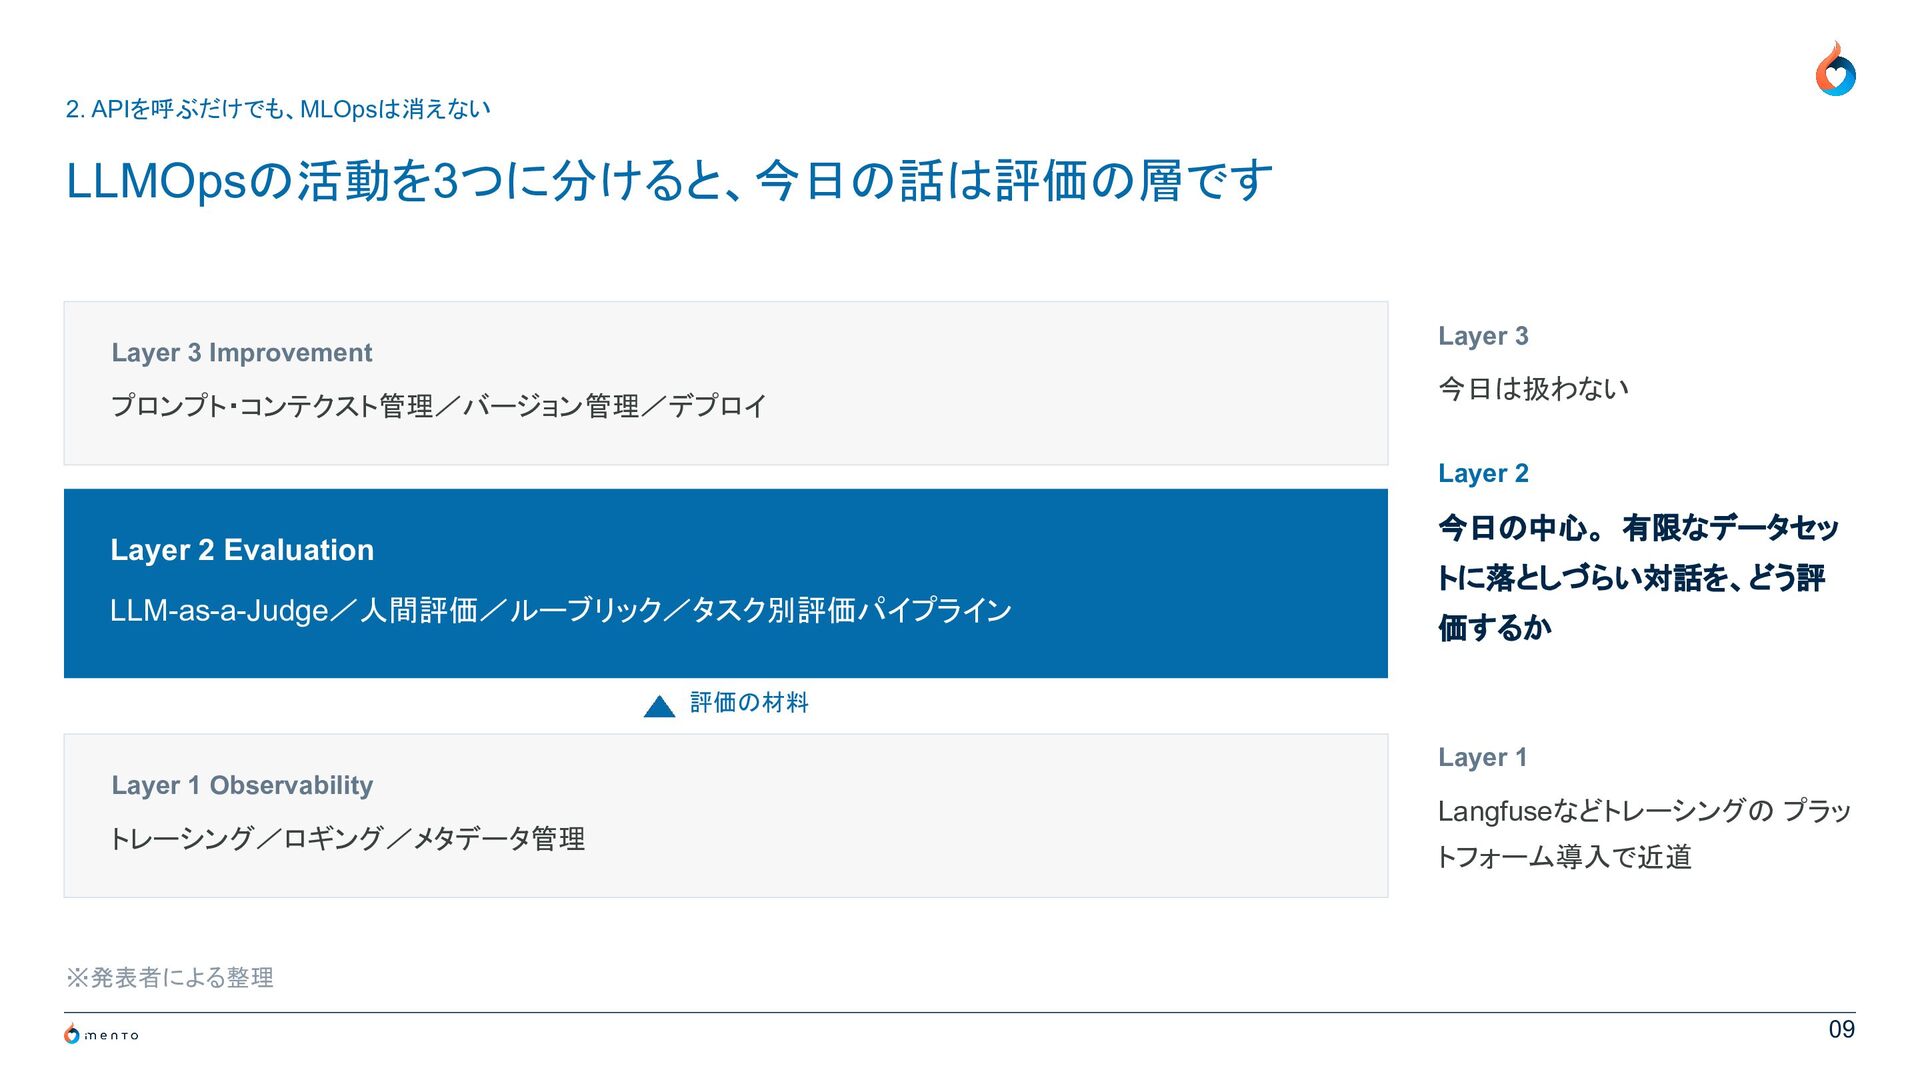
2. APIを呼ぶだけでも、MLOpsは消えない LLMOpsの活動を3つに分けると、今日の話は評価の層です Layer 3 Layer 3 Improvement プロンプト・コンテクスト管理/バージョン管理/デプロイ 今日は扱わない
Layer 2 今日の中心。 有限なデータセッ Layer 2 Evaluation トに落としづらい対話を、どう評 LLM-as-a-Judge/人間評価/ルーブリック/タスク別評価パイプライン 価するか 評価の材料 Layer 1 Layer 1 Observability トレーシング/ロギング/メタデータ管理 Langfuseなどトレーシングの プラッ トフォーム導入で近道 ※発表者による整理 09
1 問題設定 3 評価の作り分け 判定できるものと、できないもの 2 APIを呼ぶだけでも、MLOpsは消えない 3 評価の作り分け 4
本番1年弱で起きたこと 5 まとめ:持ち帰ってほしいこと 10
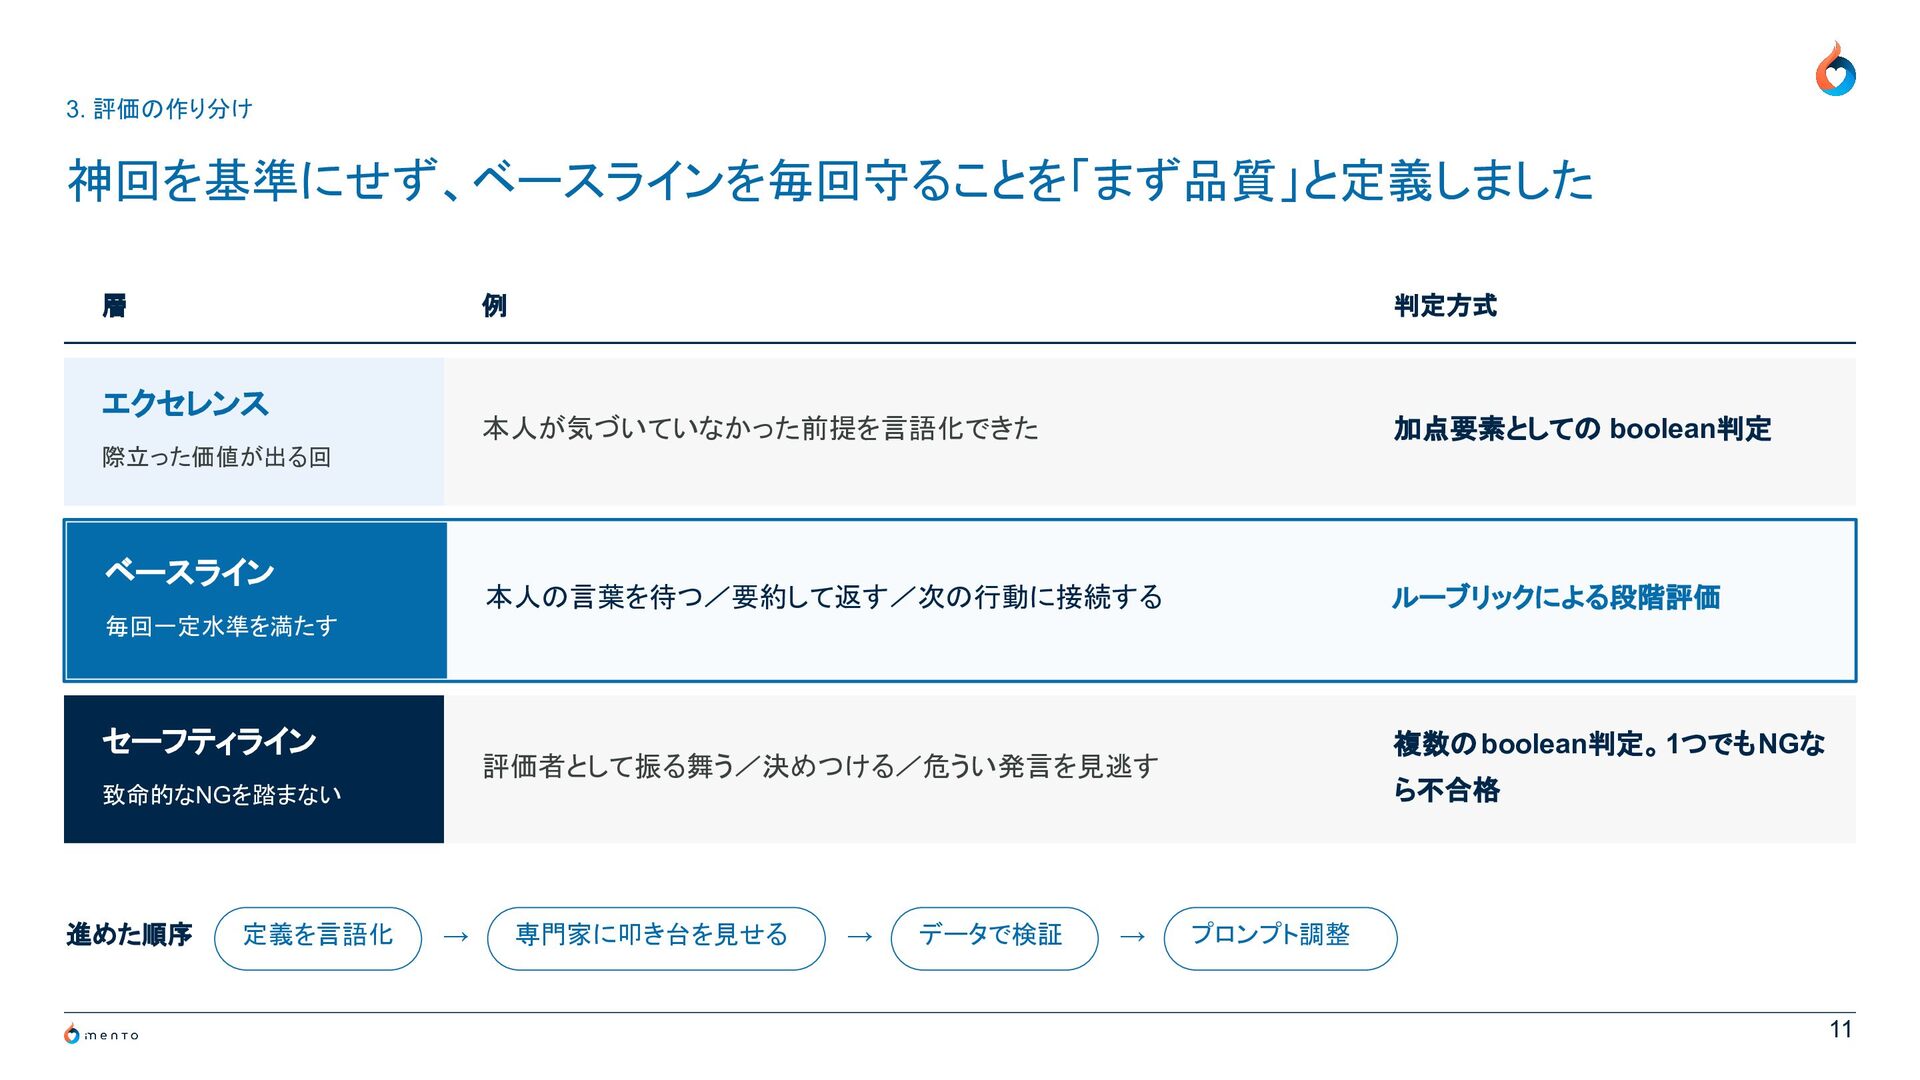
3. 評価の作り分け 神回を基準にせず、ベースラインを毎回守ることを「まず品質」と定義しました 層 エクセレンス 例 判定方式 本人が気づいていなかった前提を言語化できた 加点要素としての boolean判定
本人の言葉を待つ/要約して返す/次の行動に接続する ルーブリックによる段階評価 際立った価値が出る回 ベースライン 毎回一定水準を満たす セーフティライン 複数のboolean判定。1つでもNGな 評価者として振る舞う/決めつける/危うい発言を見逃す ら不合格 致命的なNGを踏まない 進めた順序 定義を言語化 → 専門家に叩き台を見せる → データで検証 → プロンプト調整 11
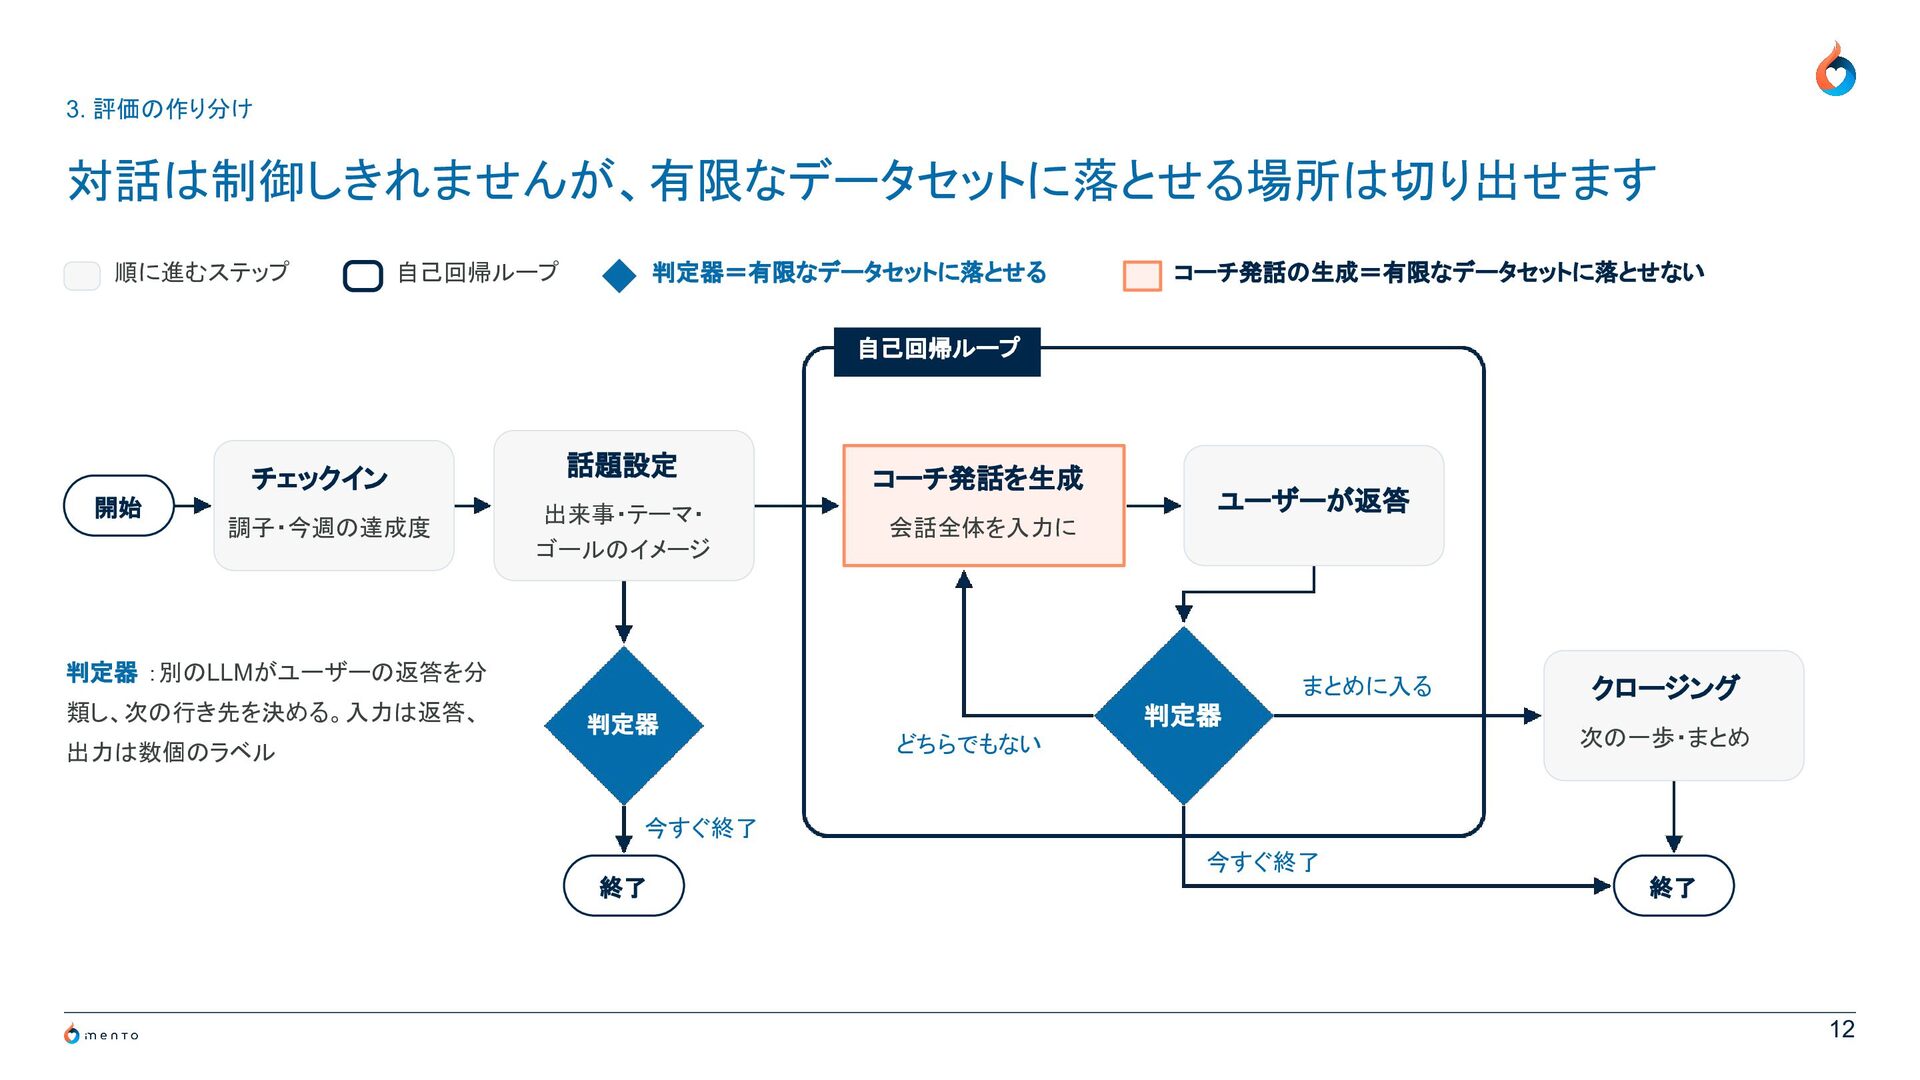
3. 評価の作り分け 対話は制御しきれませんが、有限なデータセットに落とせる場所は切り出せます 順に進むステップ 自己回帰ループ 判定器=有限なデータセットに落とせる コーチ発話の生成=有限なデータセットに落とせない 自己回帰ループ チェックイン 開始
調子・今週の達成度 話題設定 出来事・テーマ・ ゴールのイメージ コーチ発話を生成 ユーザーが返答 会話全体を入力に 判定器 :別のLLMがユーザーの返答を分 類し、次の行き先を決める。入力は返答、 まとめに入る 判定器 出力は数個のラベル 判定器 どちらでもない クロージング 次の一歩・まとめ 今すぐ終了 今すぐ終了 終了 終了 12
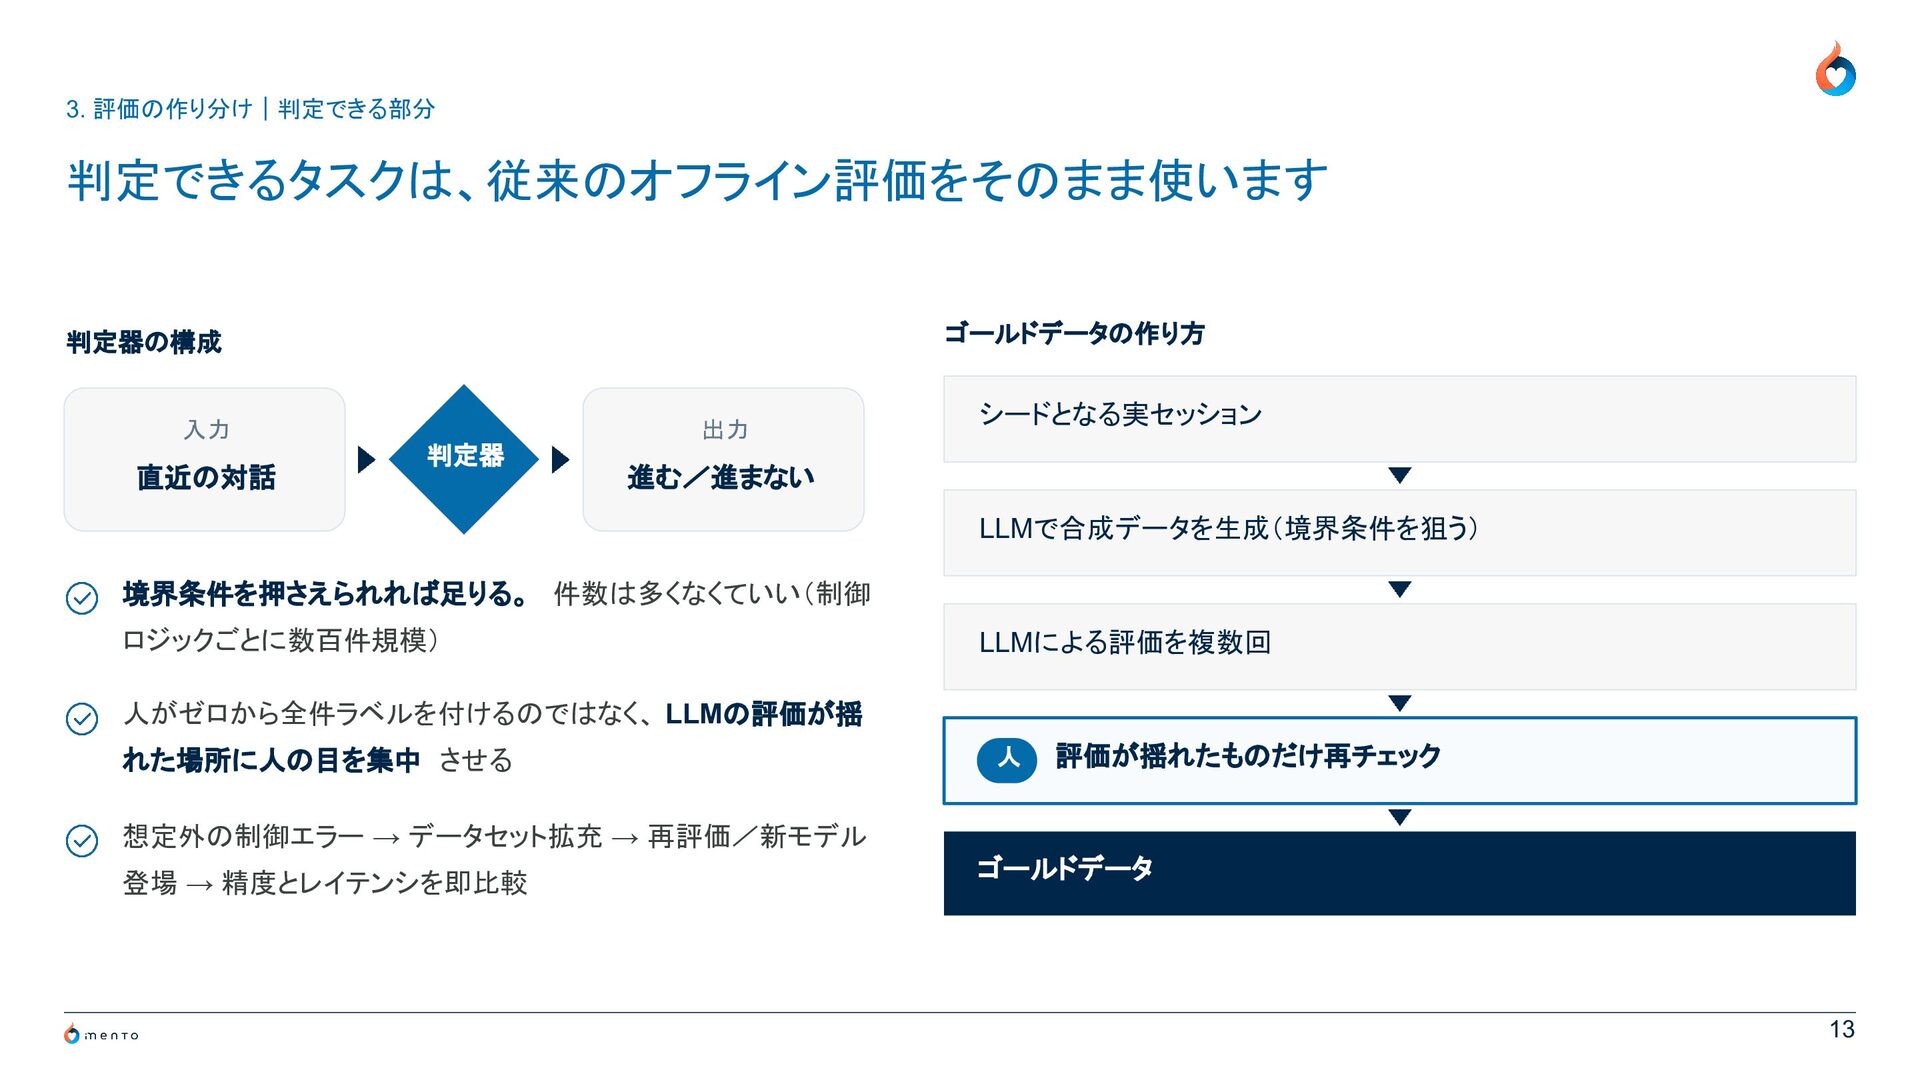
3. 評価の作り分け|判定できる部分 判定できるタスクは、従来のオフライン評価をそのまま使います ゴールドデータの作り方 判定器の構成 入力 直近の対話 出力 判定器 シードとなる実セッション
進む/進まない LLMで合成データを生成(境界条件を狙う) 境界条件を押さえられれば足りる。 件数は多くなくていい(制御 ロジックごとに数百件規模) LLMによる評価を複数回 人がゼロから全件ラベルを付けるのではなく、 LLMの評価が揺 れた場所に人の目を集中 させる 人 評価が揺れたものだけ再チェック 想定外の制御エラー → データセット拡充 → 再評価/新モデル 登場 → 精度とレイテンシを即比較 ゴールドデータ 13
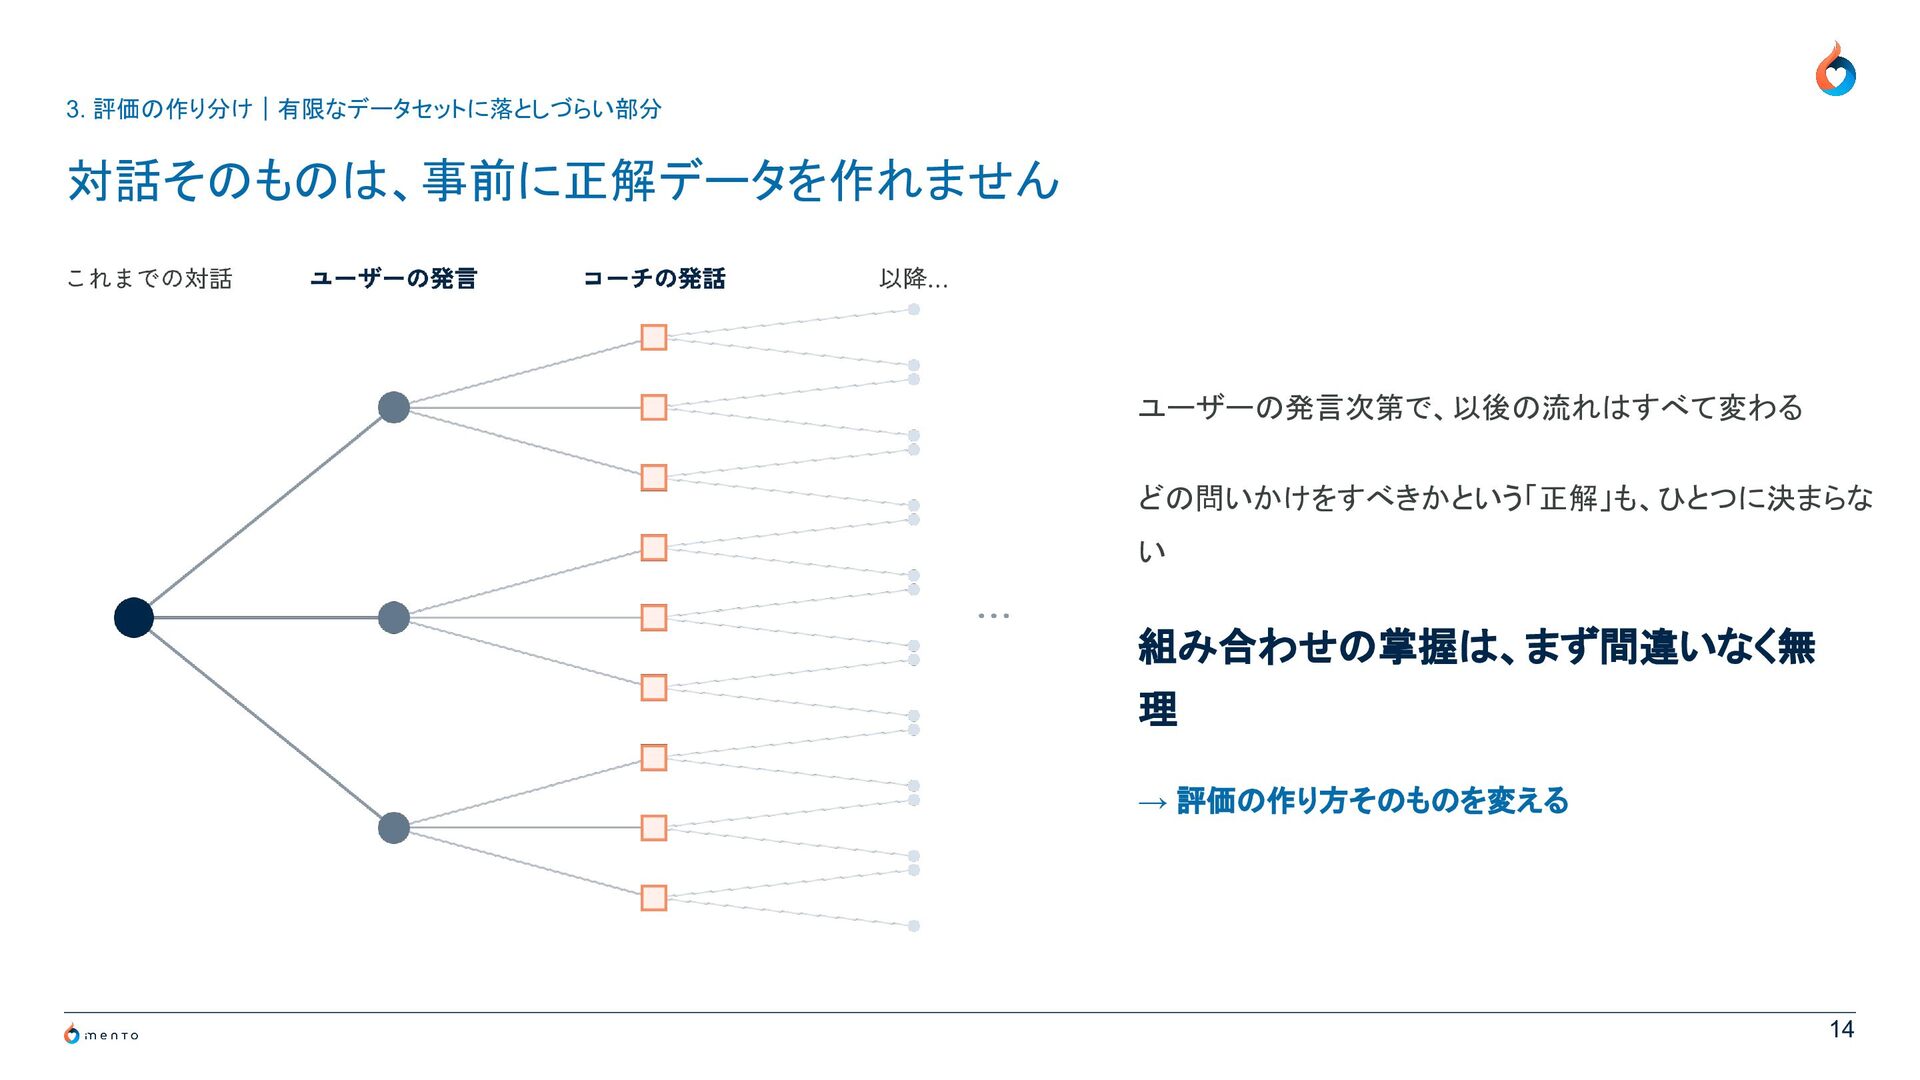
3. 評価の作り分け|有限なデータセットに落としづらい部分 対話そのものは、事前に正解データを作れません ユーザーの発言次第で、以後の流れはすべて変わる どの問いかけをすべきかという「正解」も、ひとつに決まらな い 組み合わせの掌握は、まず間違いなく無 理 → 評価の作り方そのものを変える
14
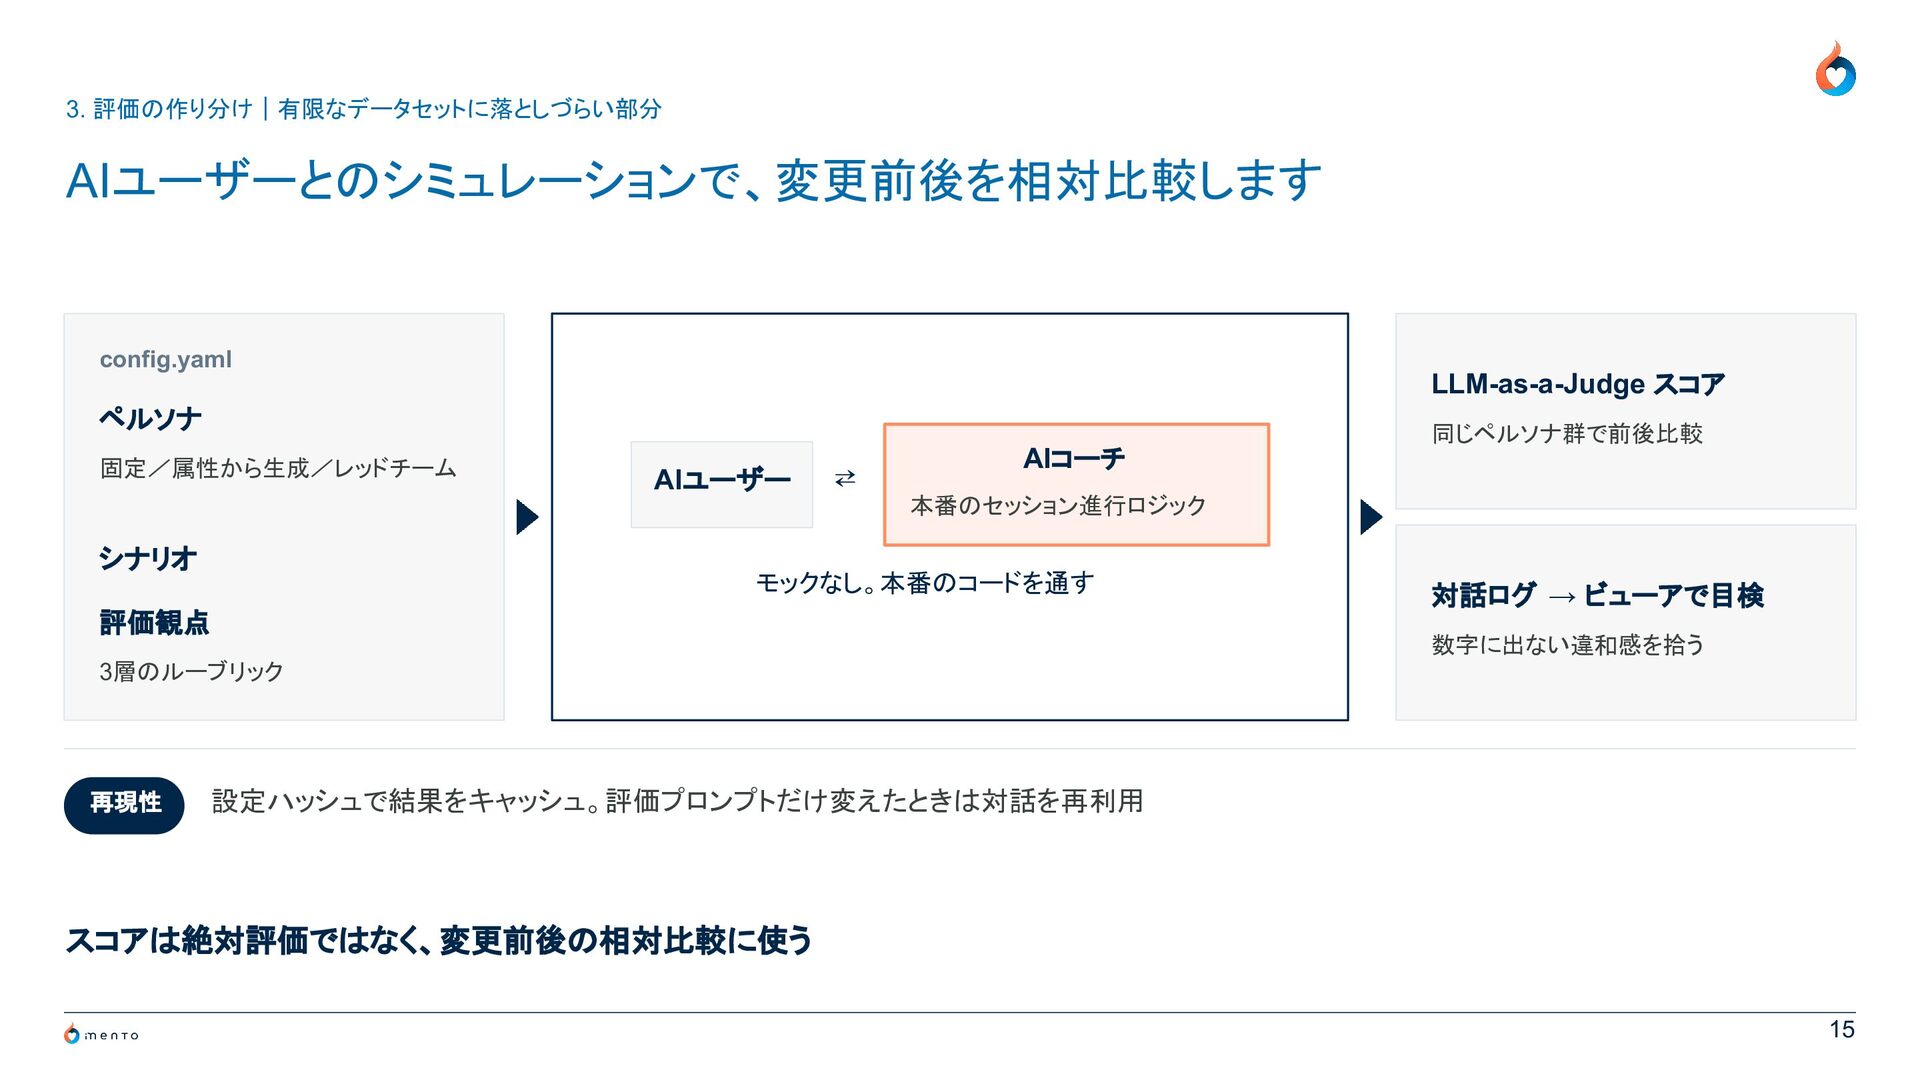
3. 評価の作り分け|有限なデータセットに落としづらい部分 AIユーザーとのシミュレーションで、変更前後を相対比較します config.yaml LLM-as-a-Judge スコア ペルソナ 同じペルソナ群で前後比較 固定/属性から生成/レッドチーム シナリオ
AIユーザー ⇄ AIコーチ 本番のセッション進行ロジック モックなし。本番のコードを通す 評価観点 対話ログ → ビューアで目検 数字に出ない違和感を拾う 3層のルーブリック 再現性 設定ハッシュで結果をキャッシュ。評価プロンプトだけ変えたときは対話を再利用 スコアは絶対評価ではなく、変更前後の相対比較に使う 15
1 問題設定 4 本番1年弱で 起きたこと 2 APIを呼ぶだけでも、MLOpsは消えない 3 評価の作り分け 4
本番1年弱で起きたこと 5 まとめ:持ち帰ってほしいこと 16
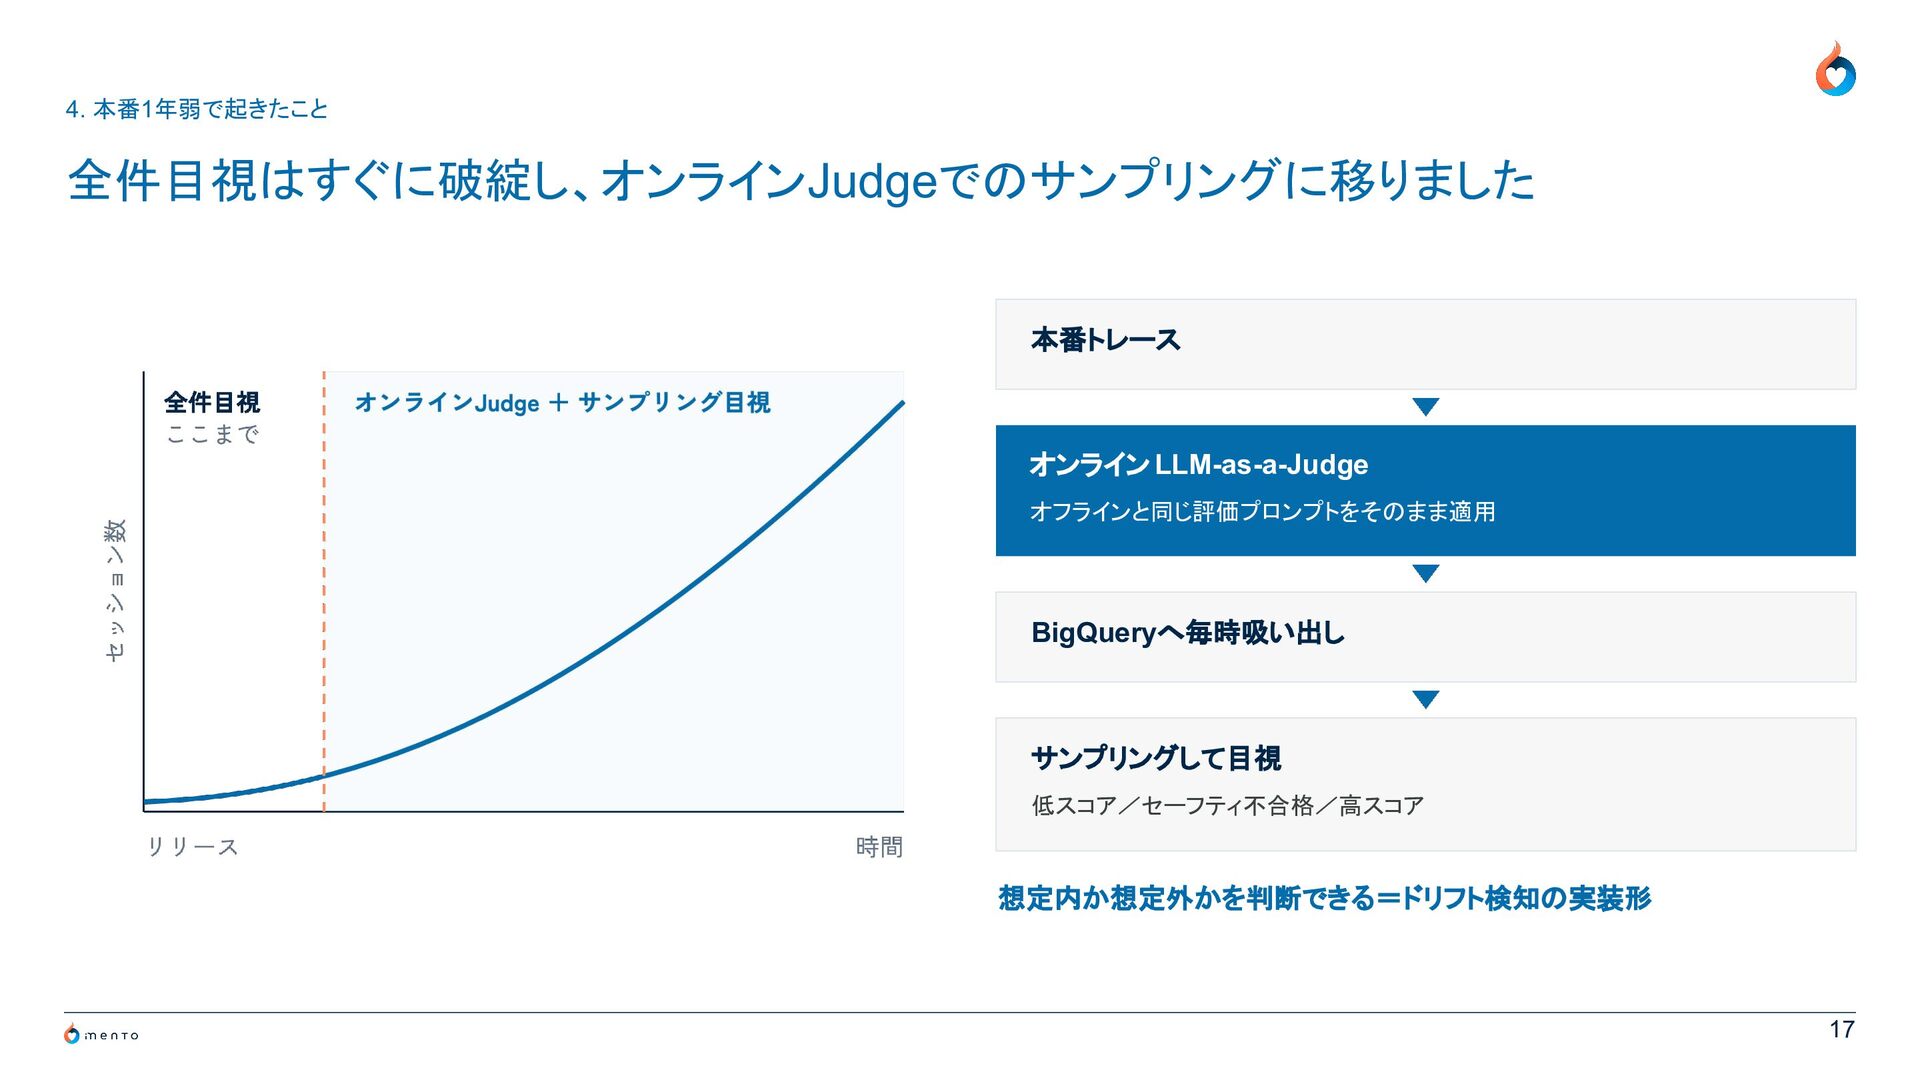
4. 本番1年弱で起きたこと 全件目視はすぐに破綻し、オンラインJudgeでのサンプリングに移りました 本番トレース オンライン LLM-as-a-Judge オフラインと同じ評価プロンプトをそのまま適用 BigQueryへ毎時吸い出し サンプリングして目視 低スコア/セーフティ不合格/高スコア
想定内か想定外かを判断できる=ドリフト検知の実装形 17
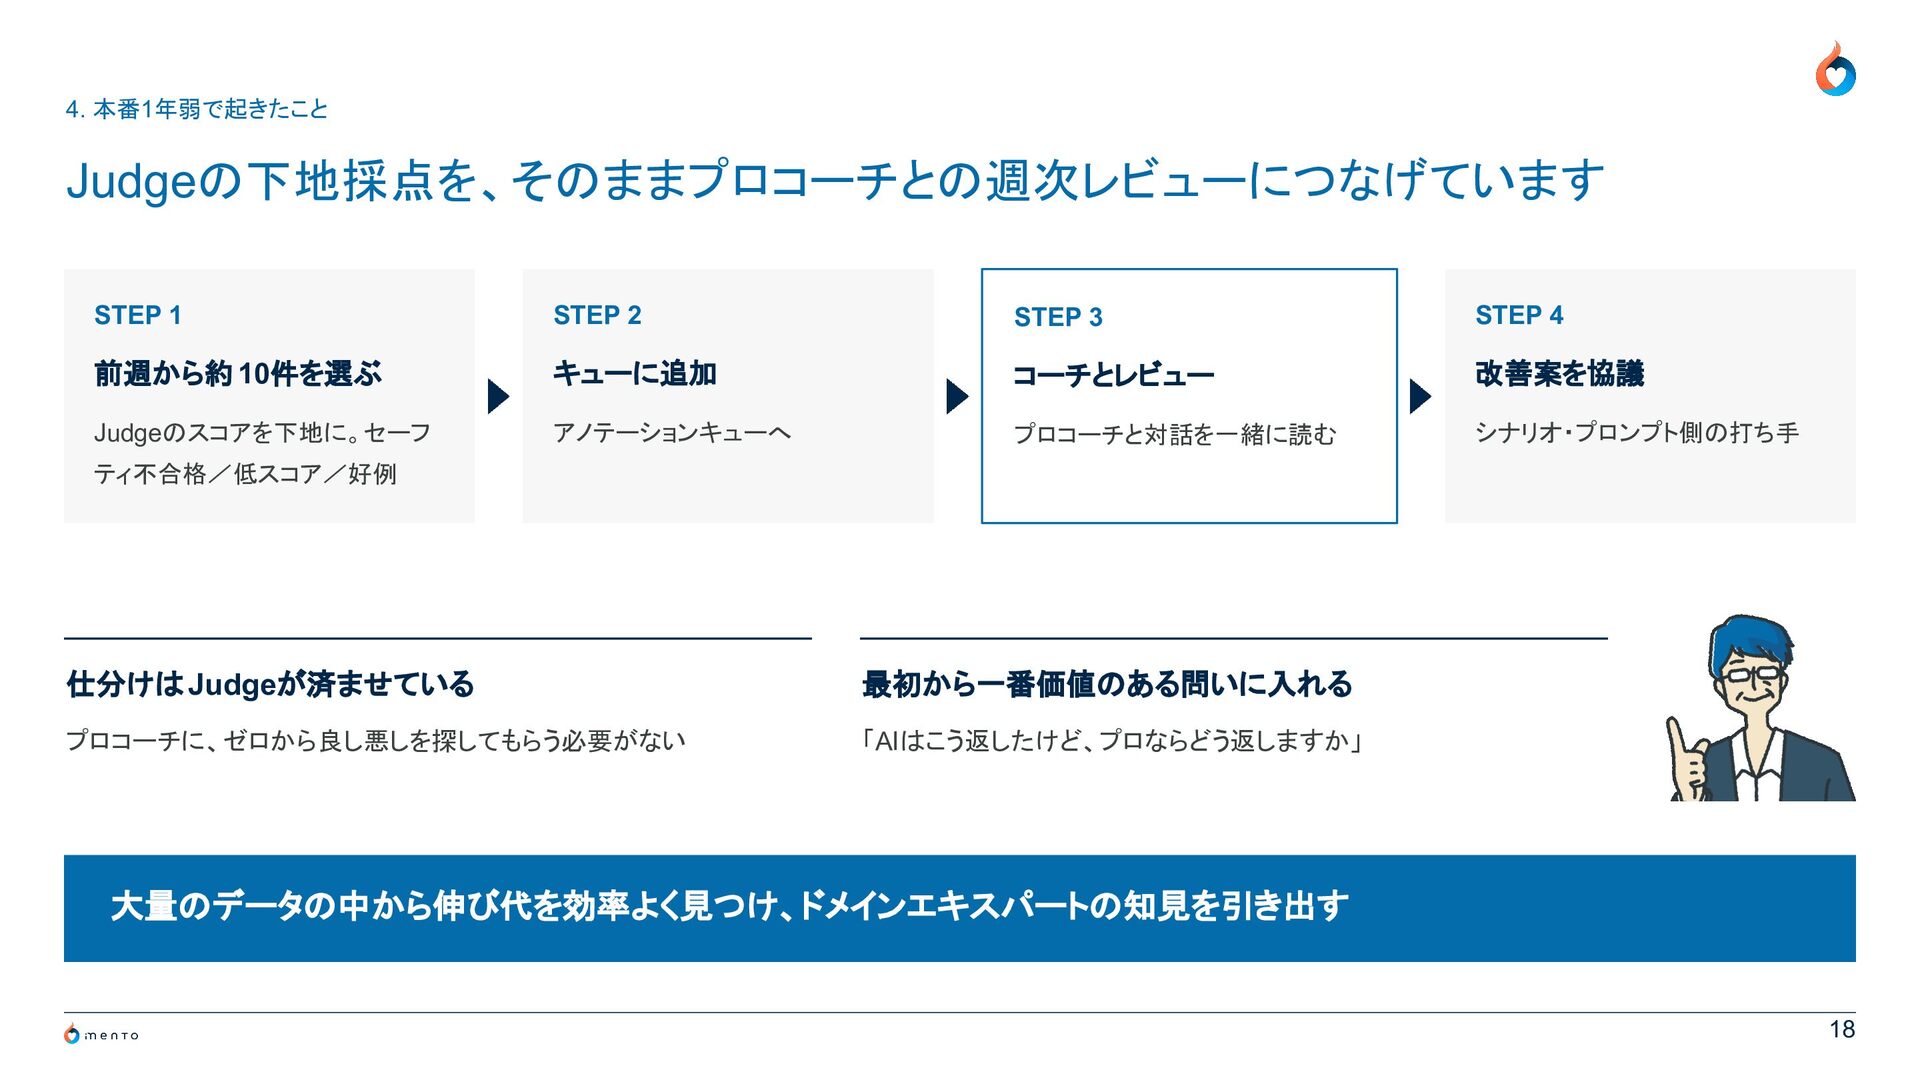
4. 本番1年弱で起きたこと Judgeの下地採点を、そのままプロコーチとの週次レビューにつなげています STEP 1 STEP 2 STEP 3 STEP
4 前週から約 10件を選ぶ キューに追加 コーチとレビュー 改善案を協議 Judgeのスコアを下地に。セーフ アノテーションキューへ プロコーチと対話を一緒に読む シナリオ・プロンプト側の打ち手 ティ不合格/低スコア/好例 仕分けは Judgeが済ませている 最初から一番価値のある問いに入れる プロコーチに、ゼロから良し悪しを探してもらう必要がない 「AIはこう返したけど、プロならどう返しますか」 大量のデータの中から伸び代を効率よく見つけ、ドメインエキスパートの知見を引き出す 18
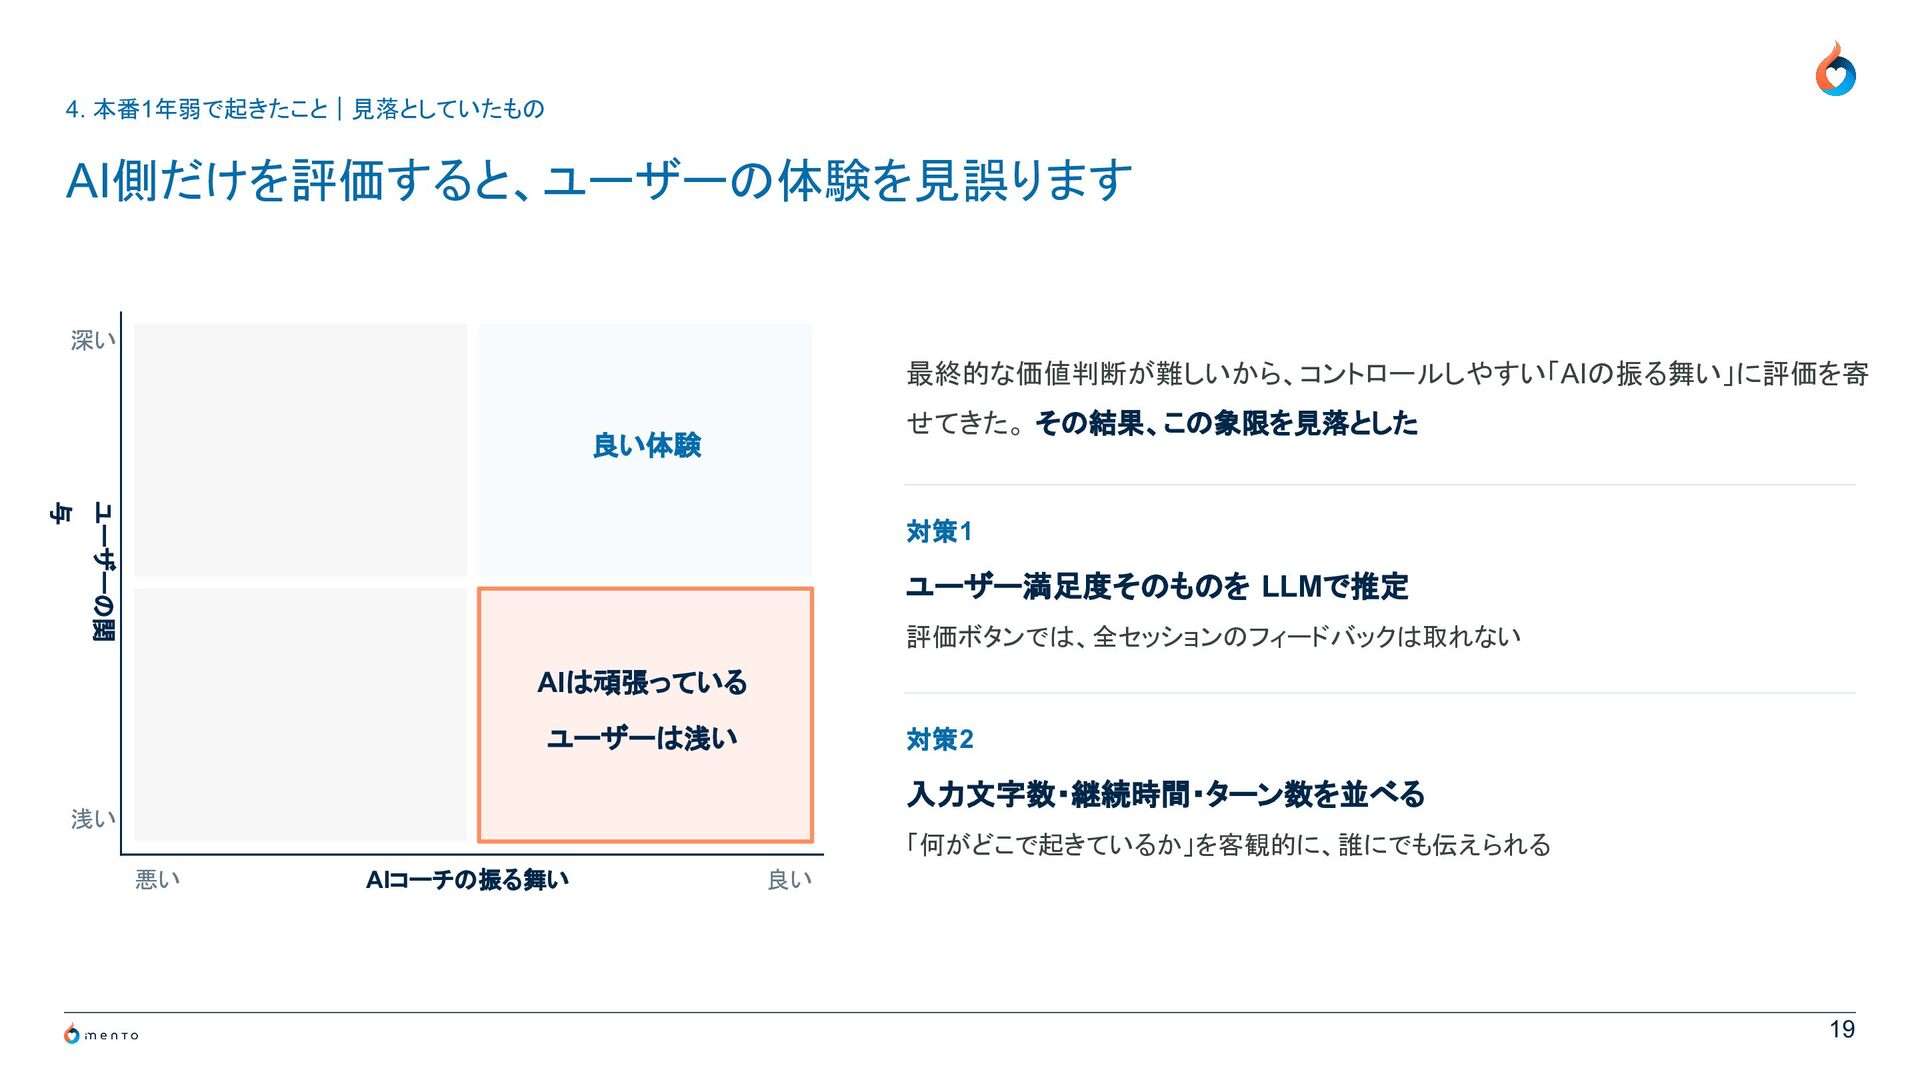
4. 本番1年弱で起きたこと|見落としていたもの AI側だけを評価すると、ユーザーの体験を見誤ります 深い 最終的な価値判断が難しいから、コントロールしやすい「AIの振る舞い」に評価を寄 せてきた。 その結果、この象限を見落とした 良い体験 ユーザーの関 与
対策1 ユーザー満足度そのものを LLMで推定 評価ボタンでは、全セッションのフィードバックは取れない AIは頑張っている ユーザーは浅い 対策2 入力文字数・継続時間・ターン数を並べる 浅い 「何がどこで起きているか」を客観的に、誰にでも伝えられる 悪い AIコーチの振る舞い 良い 19
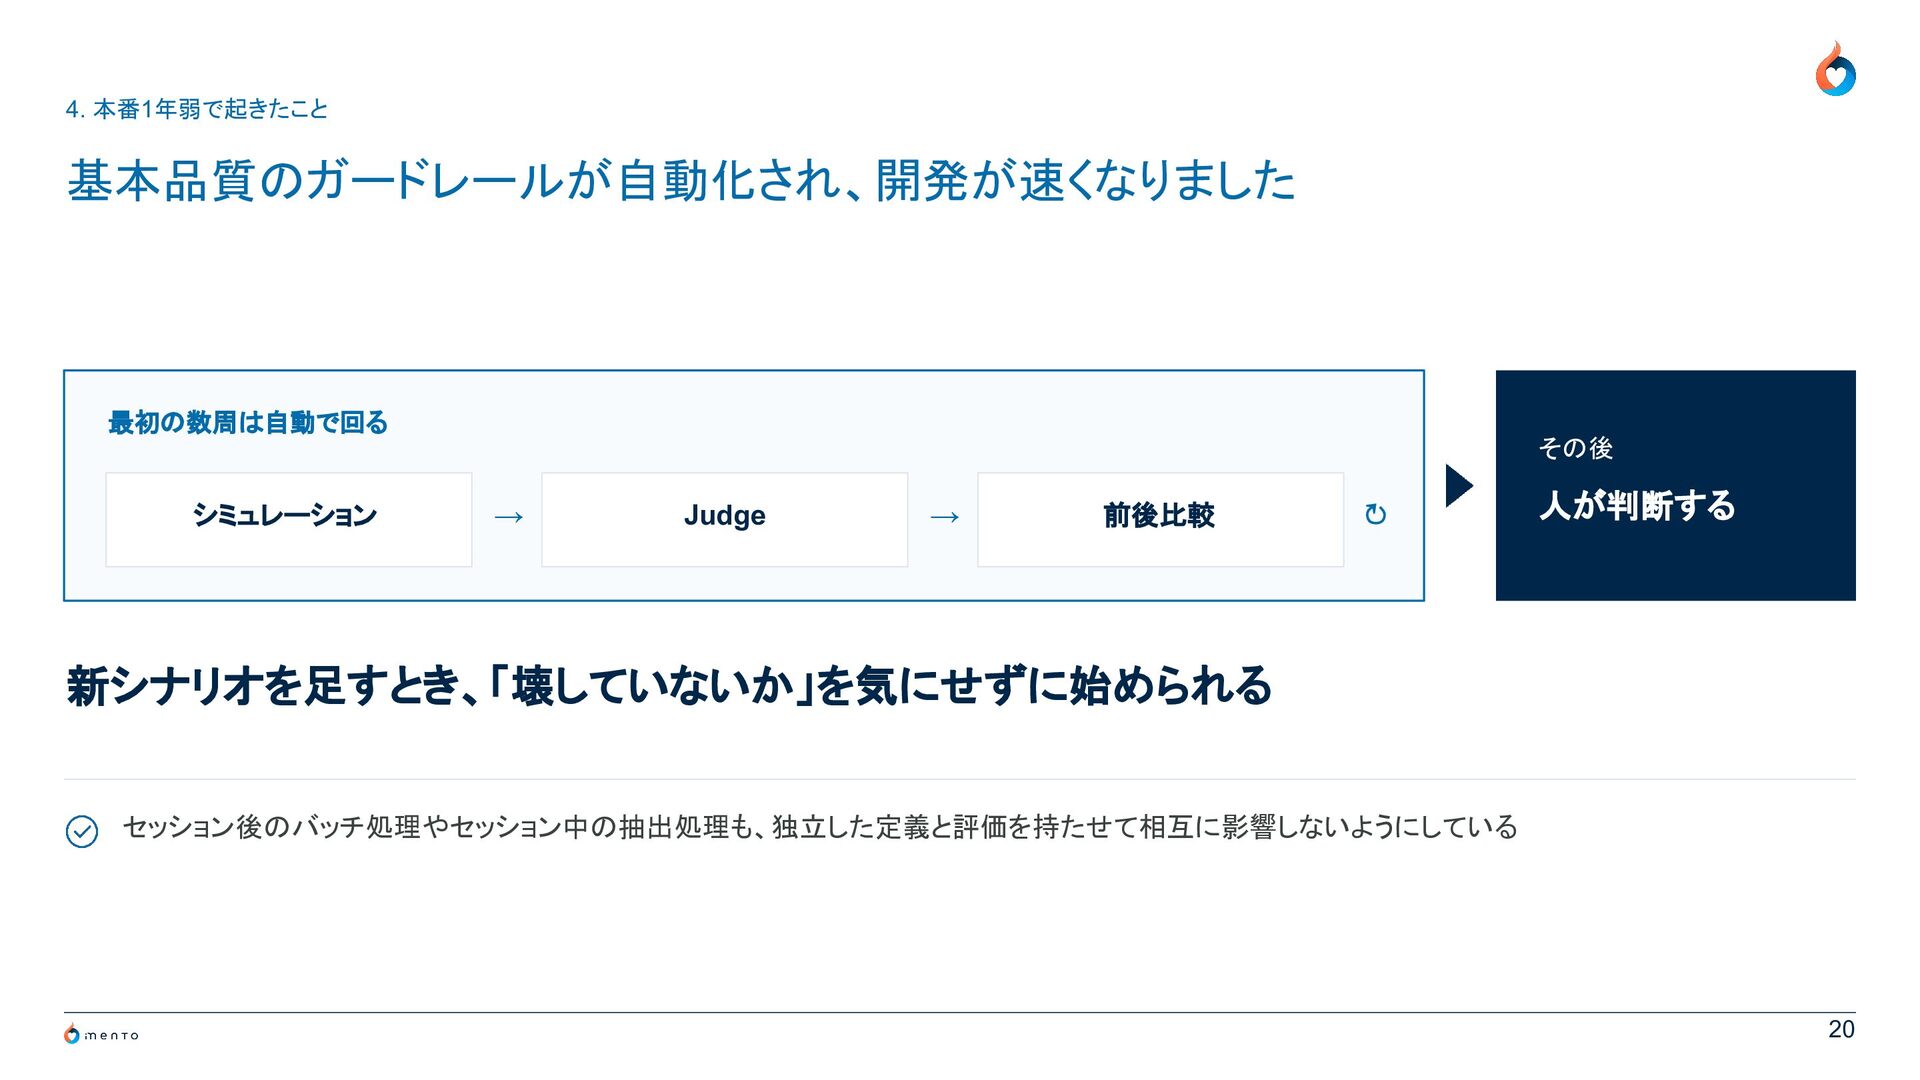
4. 本番1年弱で起きたこと 基本品質のガードレールが自動化され、開発が速くなりました 最初の数周は自動で回る シミュレーション その後 → Judge → 前後比較
↻ 人が判断する 新シナリオを足すとき、「壊していないか」を気にせずに始められる セッション後のバッチ処理やセッション中の抽出処理も、独立した定義と評価を持たせて相互に影響しないようにしている 20
1 問題設定 5 まとめ: 持ち帰ってほしいこと 2 APIを呼ぶだけでも、MLOpsは消えない 3 評価の作り分け 4
本番1年弱で起きたこと 5 まとめ:持ち帰ってほしいこと 21
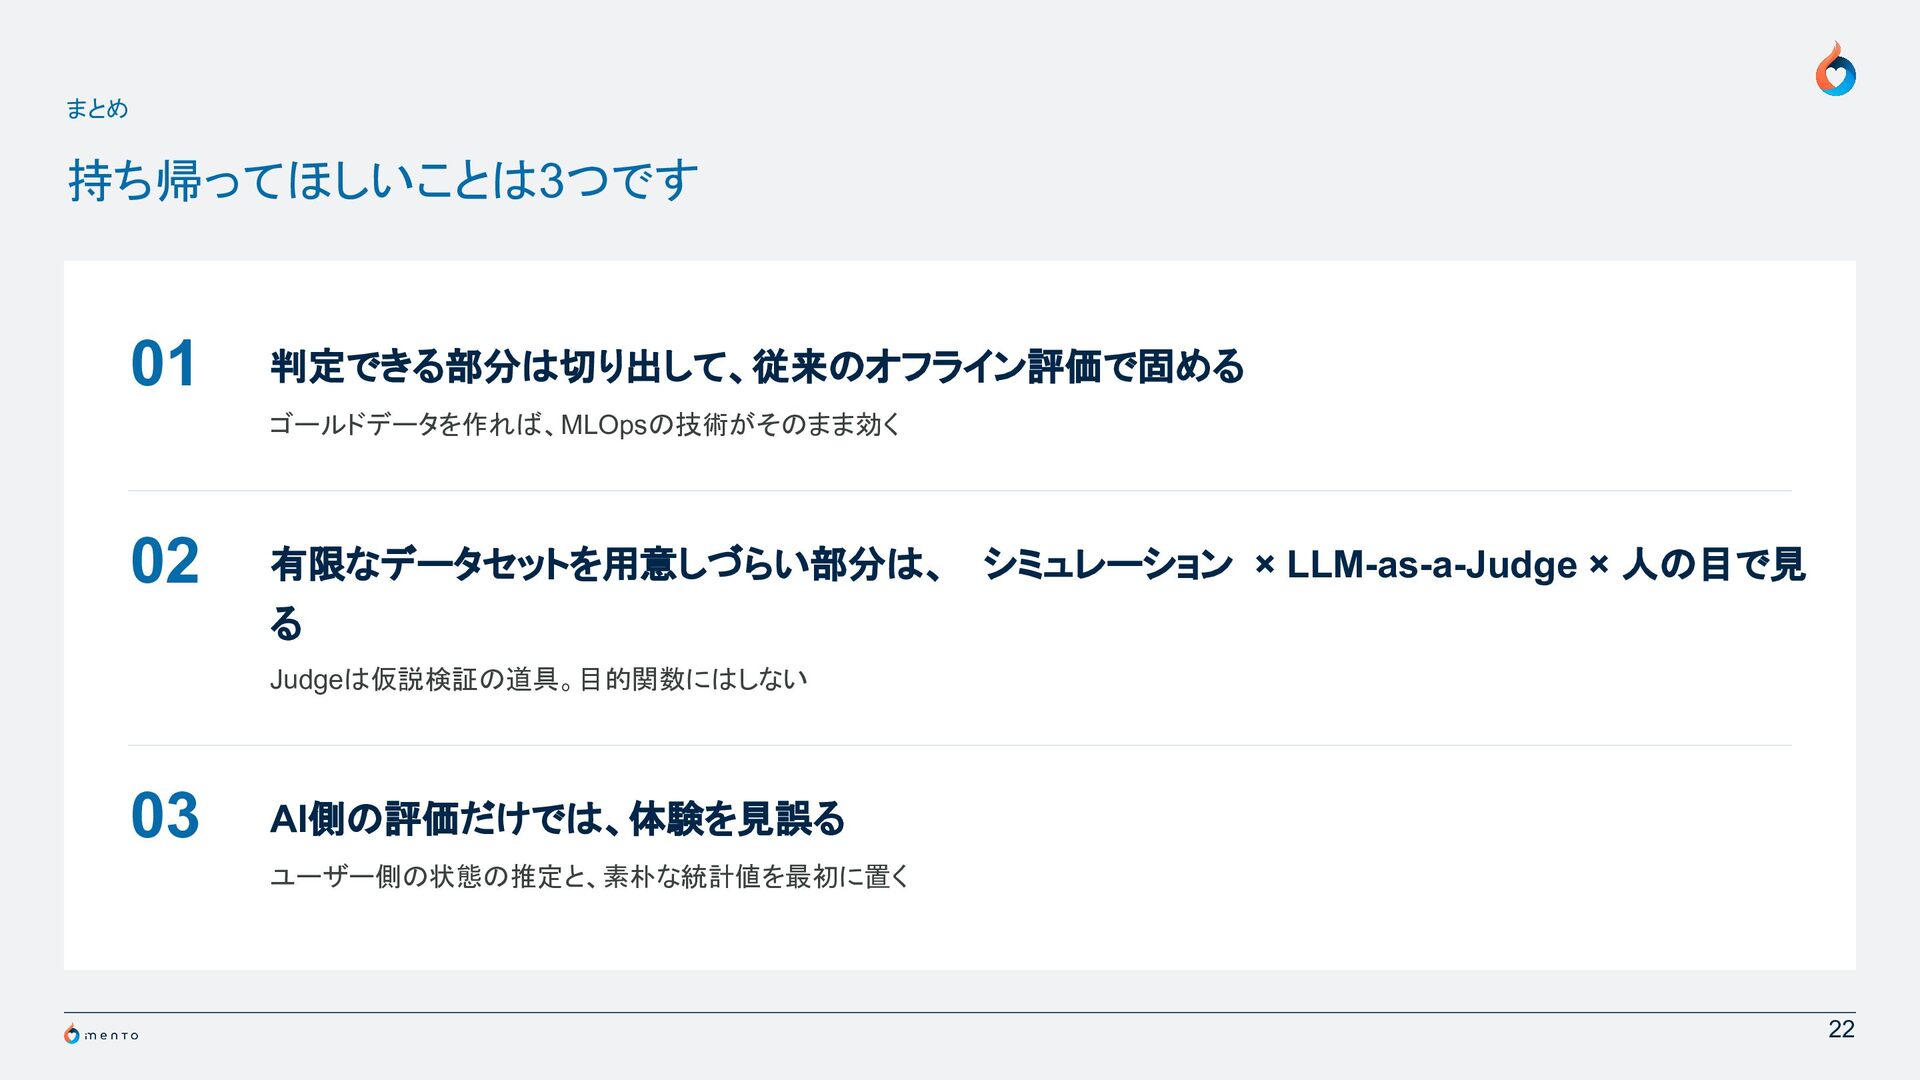
まとめ 持ち帰ってほしいことは3つです 01 判定できる部分は切り出して、従来のオフライン評価で固める ゴールドデータを作れば、MLOpsの技術がそのまま効く 02 有限なデータセットを用意しづらい部分は、 シミュレーション × LLM-as-a-Judge
× 人の目で見 る Judgeは仮説検証の道具。目的関数にはしない 03 AI側の評価だけでは、体験を見誤る ユーザー側の状態の推定と、素朴な統計値を最初に置く 22
正解のない対話をどう評価するか — AIコーチング1年弱のLLMOps 改善は「正解を探す作業」ではなく、価値を言語化し、 人の目と AIの評価を組 み合わせて積み重ねる作業でした ask the speaker
連絡先 このあと、ぜひ話しかけてください 株式会社mento 深澤 @qluto 23


 yut0naga1_fa
 sh_fk2
 shuta13
 takahashim
 pfn
 moznion
 codatum
 kash1064
 shogo4131
 namiki64
 4o1sobblue
 oikon48
 khoart
 sugarenia
 smashingmag
 rasagy
 asonas
 codingconduct
 akihiro_kokubo
 leimatthew05
 helmedeiros
 gurzu
 chriscoyier
 oripsolob