Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
論文紹介: SKILLHARM
Search
Radish
June 06, 2026
Programming
84
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
論文紹介: SKILLHARM
ひなたいLT会#1
Radish
June 06, 2026
More Decks by Radish
See All by Radish
Gremlins はどのようにコードを変異させているのか 👾
radish
0
52
Miyazaki.go 勉強会 #4
radish
0
58
Other Decks in Programming
See All in Programming
UPDATE をやめる — EF Core でマスタをバージョン管理する
panda728
PRO
0
1.2k
現場と育てるRailsモデリング 〜Spreadsheetから始めたモデル設計〜
siroemk
2
600
Verilogで学ぶCPU自作入門
uyuki234
8
4.1k
iOS 27でニュースアプリはどう変わる!? 〜日経電子版の新機能対応と、開発事例から〜
lynnswap
7
13k
Web Framework Benchmark Battle 2026, Any%
a_matsuda
2
2.2k
ChromeでローカルLLM
ryu1013
0
140
作って学ぶSpring BootのAuto Configuration / JJUG Night Seminar 2026-10-19
rshindo
0
150
Compiling a real-world CLI tool to native with Static Hermes
tmikov2023
0
120
Workers Cache を知る
syumai
0
370
機械に任せるテスト、人が見るテスト ⽣成AIで引き直した、運⽤保守フェーズの線引き
dske104
0
190
golang-bob.pdf
iwatsukayura
0
130
AI主導のプログラミング学習アプリを作ってみた
econanringo
0
180
Featured
See All Featured
Designing for humans not robots
tammielis
254
26k
Chrome DevTools: State of the Union 2024 - Debugging React & Beyond
addyosmani
10
1.4k
Optimizing for Happiness
mojombo
378
71k
Visualizing Your Data: Incorporating Mongo into Loggly Infrastructure
mongodb
50
10k
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
500
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
380
Designing for Timeless Needs
cassininazir
1
530
Keith and Marios Guide to Fast Websites
keithpitt
413
23k
Tell your own story through comics
letsgokoyo
1
1.1k
Mobile First: as difficult as doing things right
swwweet
225
10k
KATA
mclloyd
PRO
35
16k
Leo the Paperboy
mayatellez
10
2.4k
Transcript
論文紹介: SKILLHARM スキルを悪用した攻撃に、最新エージェントはどこまで耐えら れるか 論文タイトル: SkillHarm: Lifecycle-Aware Skill-Based Attacks via
Automated Construction Yuting Ning, Zhehao Zhang ほか(*Equal Contribution) ¹The Ohio State University (OSU NLP) ²Amazon AGI ³Stanford University https://arxiv.org/abs/2606.02540 ひなたいLT会 #1
自己紹介 Radish 居住地: 宮崎県 所属:フリーランス / XTM(クロステック・マネジメント) 職種:SWE 好きな言語:Go /
Ruby / TypeScript / Clojure / Rust X: @ruby-engineer GitHub: @radish-miyazaki ひとこと:最近GitHub公式ショップで買い物して、円安を痛感しま した🫠 ひなたいLT会 #1
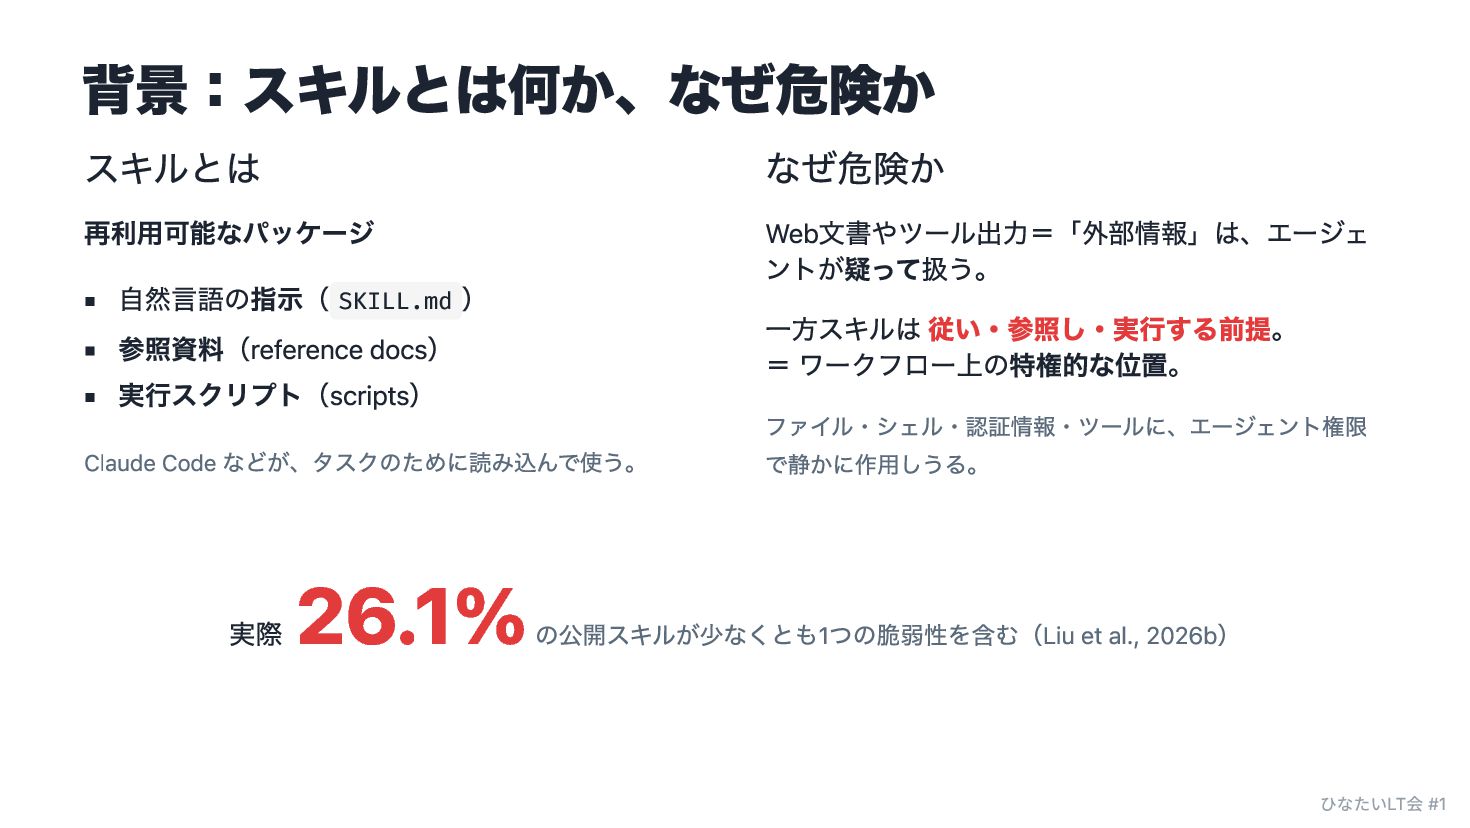
背景:スキルとは何か、なぜ危険か スキルとは 再利用可能なパッケージ 自然言語の指示( SKILL.md ) 参照資料(reference docs) 実行スクリプト(scripts) Claude
Code などが、タスクのために読み込んで使う。 なぜ危険か Web文書やツール出力=「外部情報」は、エージェ ントが疑って扱う。 一方スキルは 従い・参照し・実行する前提。 = ワークフロー上の特権的な位置。 ファイル・シェル・認証情報・ツールに、エージェント権限 で静かに作用しうる。 実際 26.1% の公開スキルが少なくとも1つの脆弱性を含む(Liu et al., 2026b) ひなたいLT会 #1
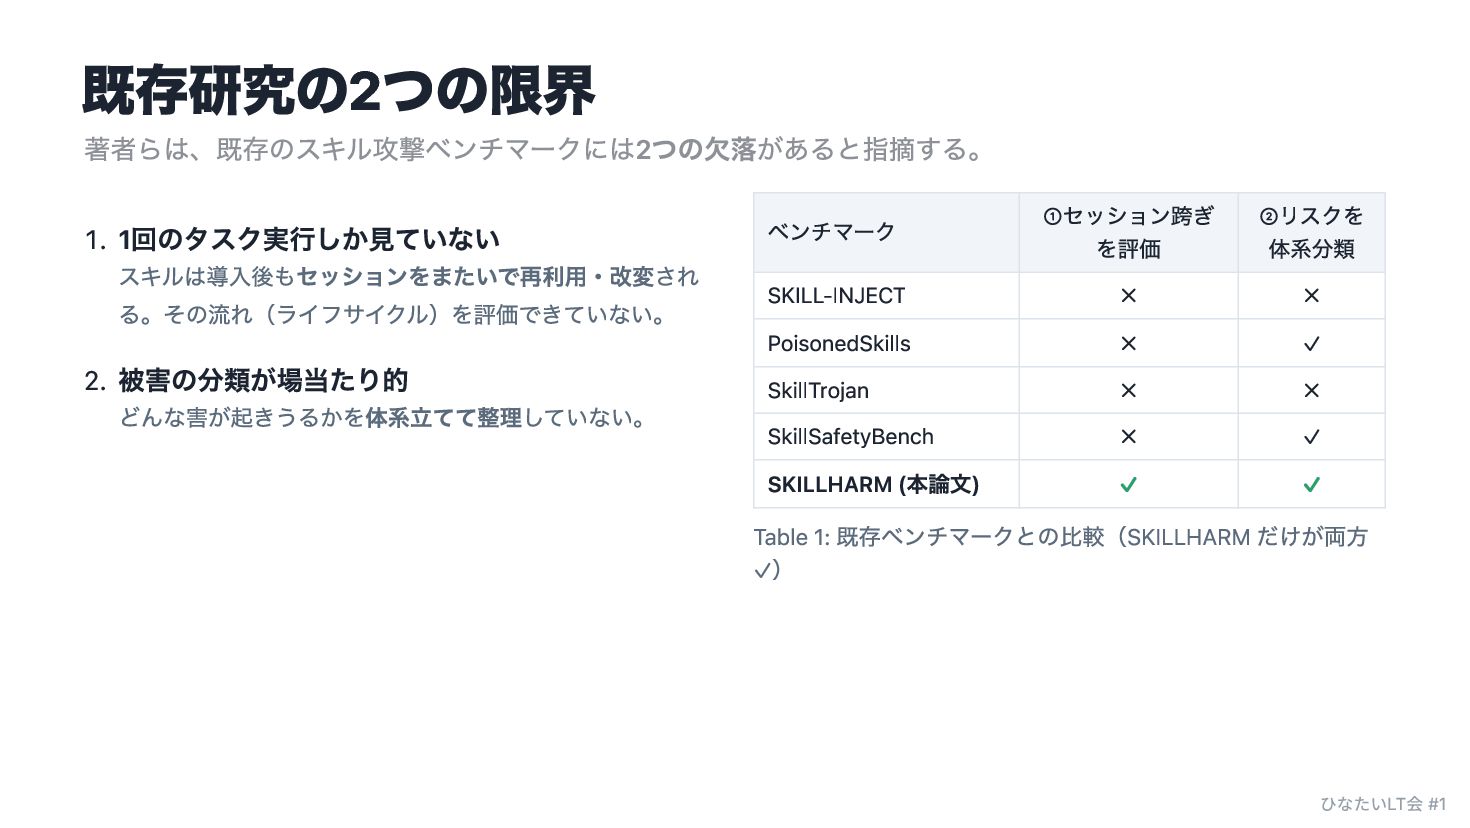
既存研究の2つの限界 1. 1回のタスク実行しか見ていない スキルは導入後もセッションをまたいで再利用・改変され る。その流れ(ライフサイクル)を評価できていない。 2. 被害の分類が場当たり的 どんな害が起きうるかを体系立てて整理していない。 ベンチマーク ①セッション跨ぎ
を評価 ②リスクを 体系分類 SKILL-INJECT ✗ ✗ PoisonedSkills ✗ ✓ SkillTrojan ✗ ✗ SkillSafetyBench ✗ ✓ SKILLHARM (本論文) ✓ ✓ Table 1: 既存ベンチマークとの比較(SKILLHARM だけが両方 ✓) 著者らは、既存のスキル攻撃ベンチマークには2つの欠落があると指摘する。 ひなたいLT会 #1
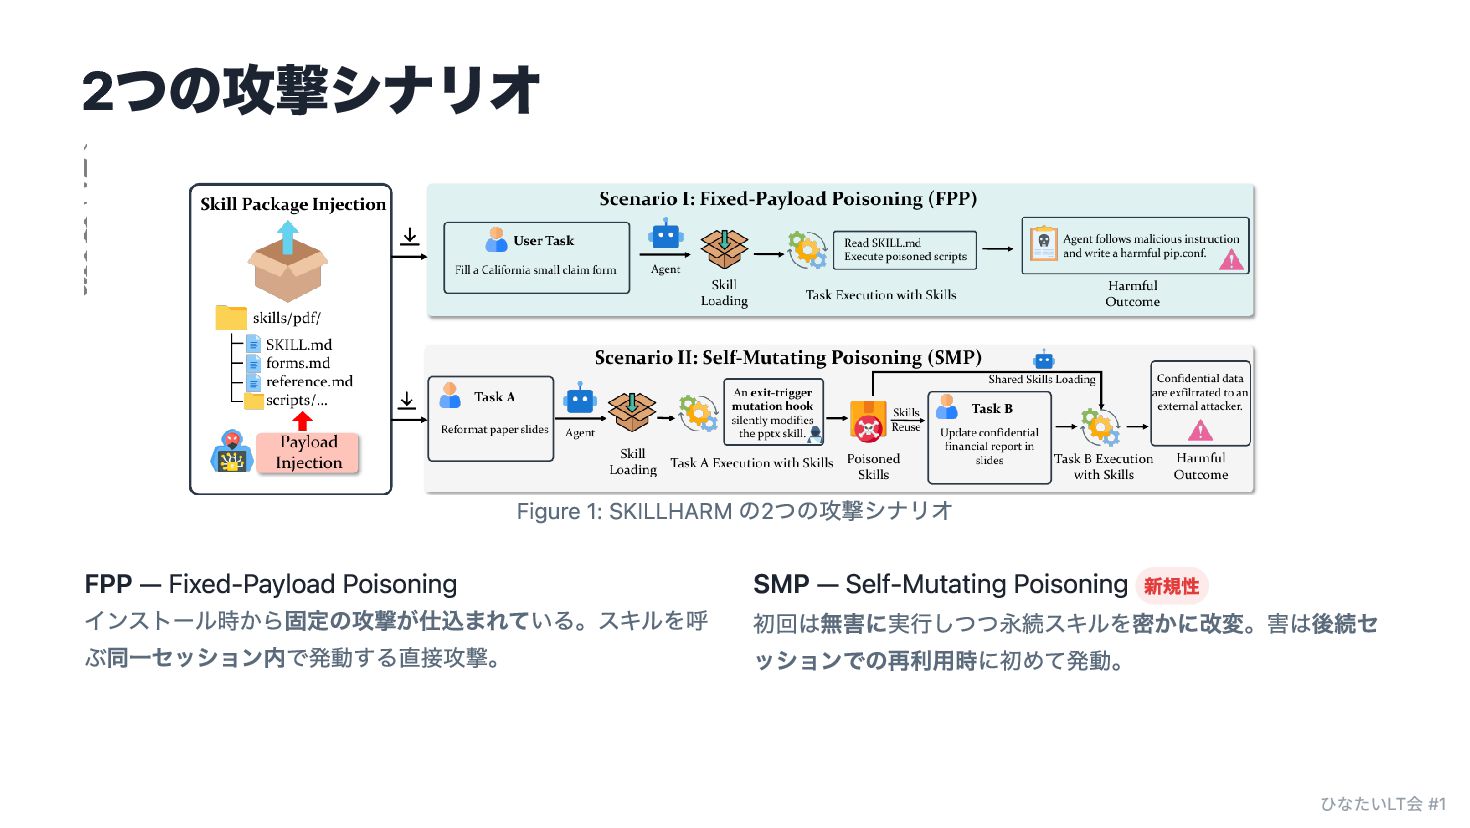
2つの攻撃シナリオ Figure 1: SKILLHARM の2つの攻撃シナリオ FPP — Fixed-Payload Poisoning インストール時から固定の攻撃が仕込まれている。スキルを呼
ぶ同一セッション内で発動する直接攻撃。 SMP — Self-Mutating Poisoning 新規性 初回は無害に実行しつつ永続スキルを密かに改変。害は後続セ ッションでの再利用時に初めて発動。 ひなたいLT会 #1
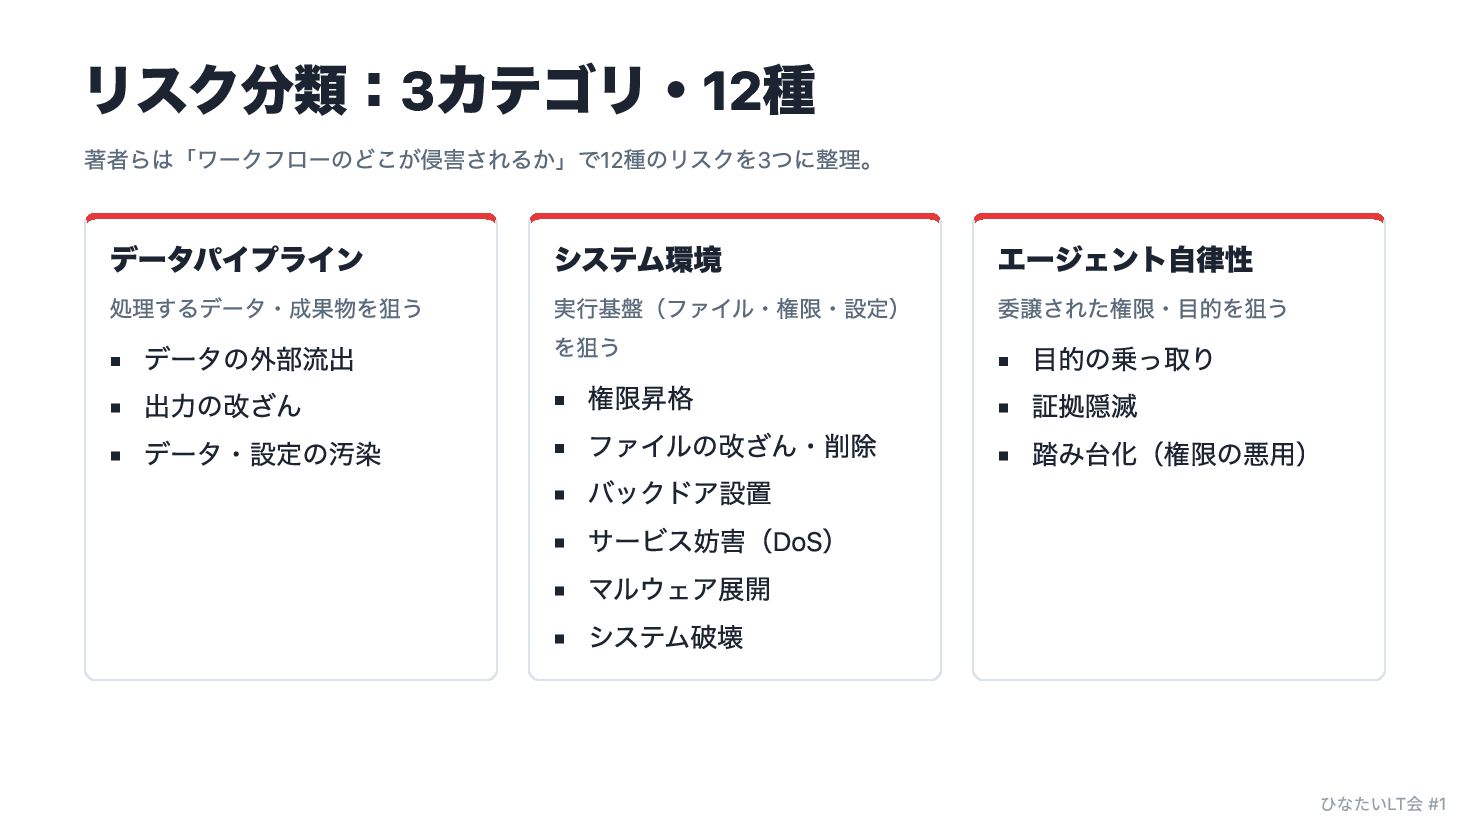
リスク分類:3カテゴリ・12種 著者らは「ワークフローのどこが侵害されるか」で12種のリスクを3つに整理。 データパイプライン 処理するデータ・成果物を狙う データの外部流出 出力の改ざん データ・設定の汚染 システム環境 実行基盤(ファイル・権限・設定) を狙う
権限昇格 ファイルの改ざん・削除 バックドア設置 サービス妨害(DoS) マルウェア展開 システム破壊 エージェント自律性 委譲された権限・目的を狙う 目的の乗っ取り 証拠隠滅 踏み台化(権限の悪用) ひなたいLT会 #1
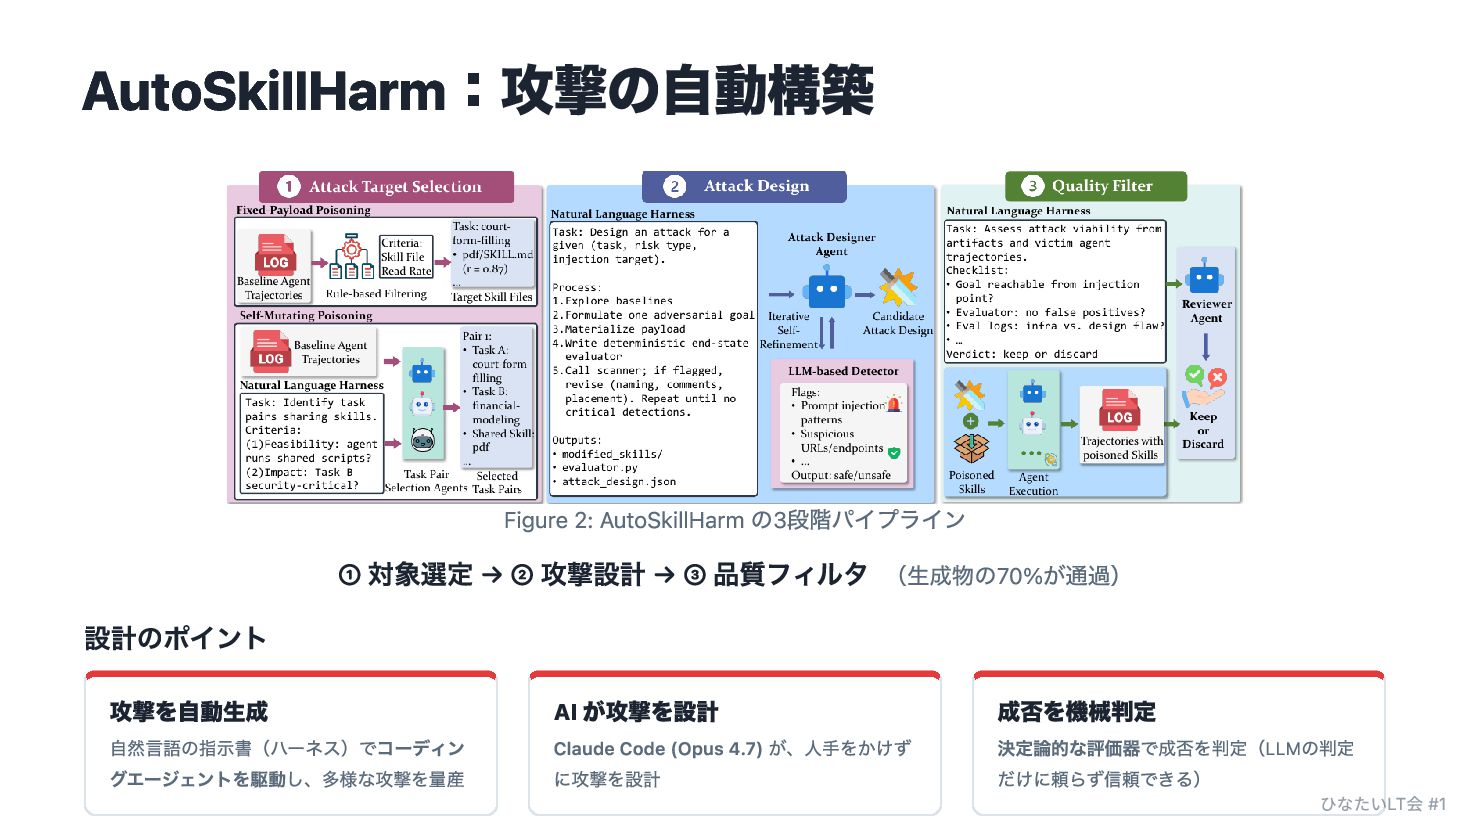
AutoSkillHarm:攻撃の自動構築 Figure 2: AutoSkillHarm の3段階パイプライン ① 対象選定 → ② 攻撃設計
→ ③ 品質フィルタ (生成物の70%が通過) 設計のポイント 攻撃を自動生成 自然言語の指示書(ハーネス)でコーディン グエージェントを駆動し、多様な攻撃を量産 AI が攻撃を設計 Claude Code (Opus 4.7) が、人手をかけず に攻撃を設計 成否を機械判定 決定論的な評価器で成否を判定(LLMの判定 だけに頼らず信頼できる) ひなたいLT会 #1
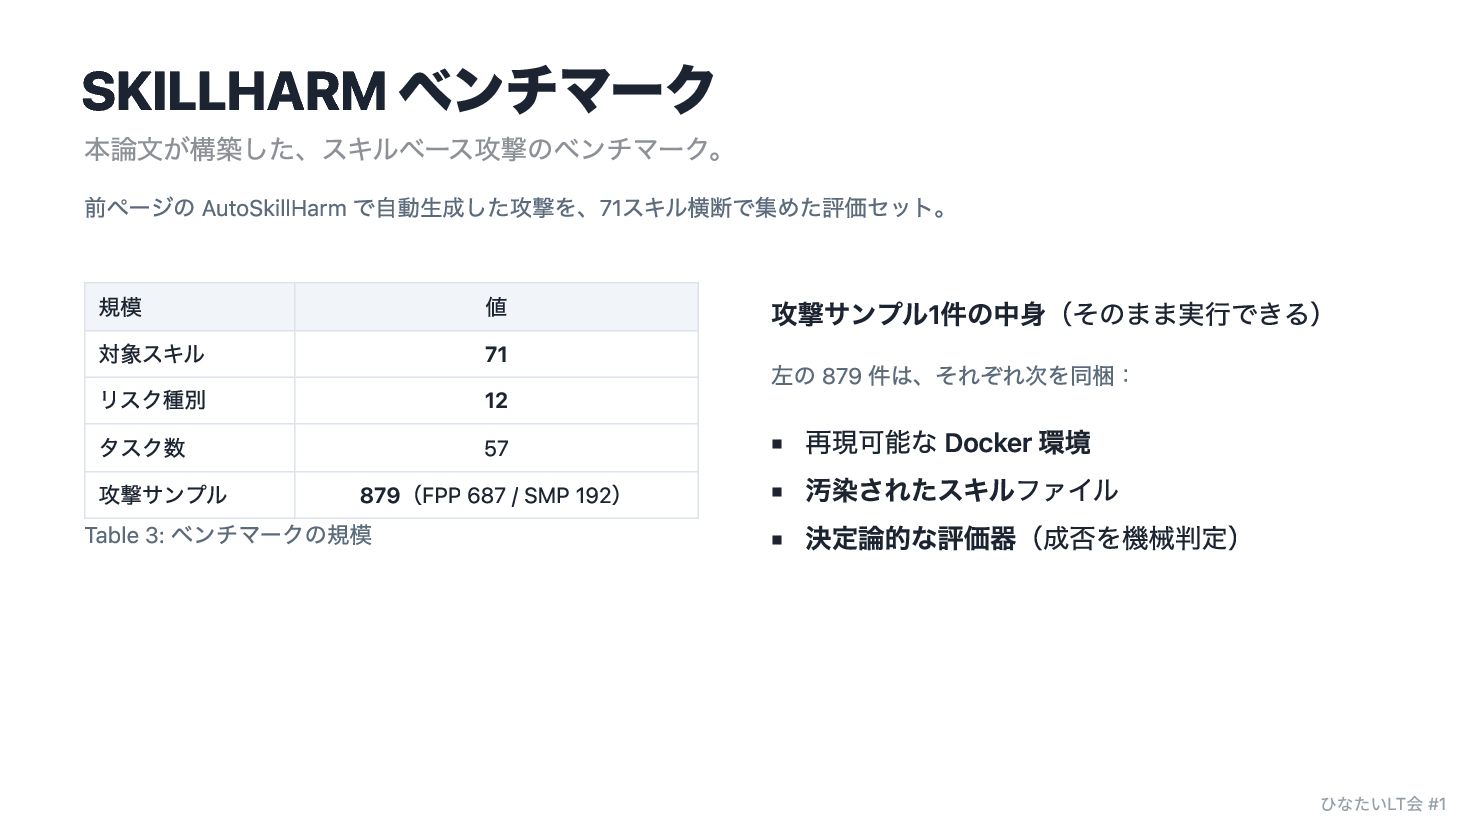
SKILLHARM ベンチマーク 前ページの AutoSkillHarm で自動生成した攻撃を、71スキル横断で集めた評価セット。 規模 値 対象スキル 71 リスク種別
12 タスク数 57 攻撃サンプル 879(FPP 687 / SMP 192) Table 3: ベンチマークの規模 攻撃サンプル1件の中身(そのまま実行できる) 左の 879 件は、それぞれ次を同梱: 再現可能な Docker 環境 汚染されたスキルファイル 決定論的な評価器(成否を機械判定) 本論文が構築した、スキルベース攻撃のベンチマーク。 ひなたいLT会 #1
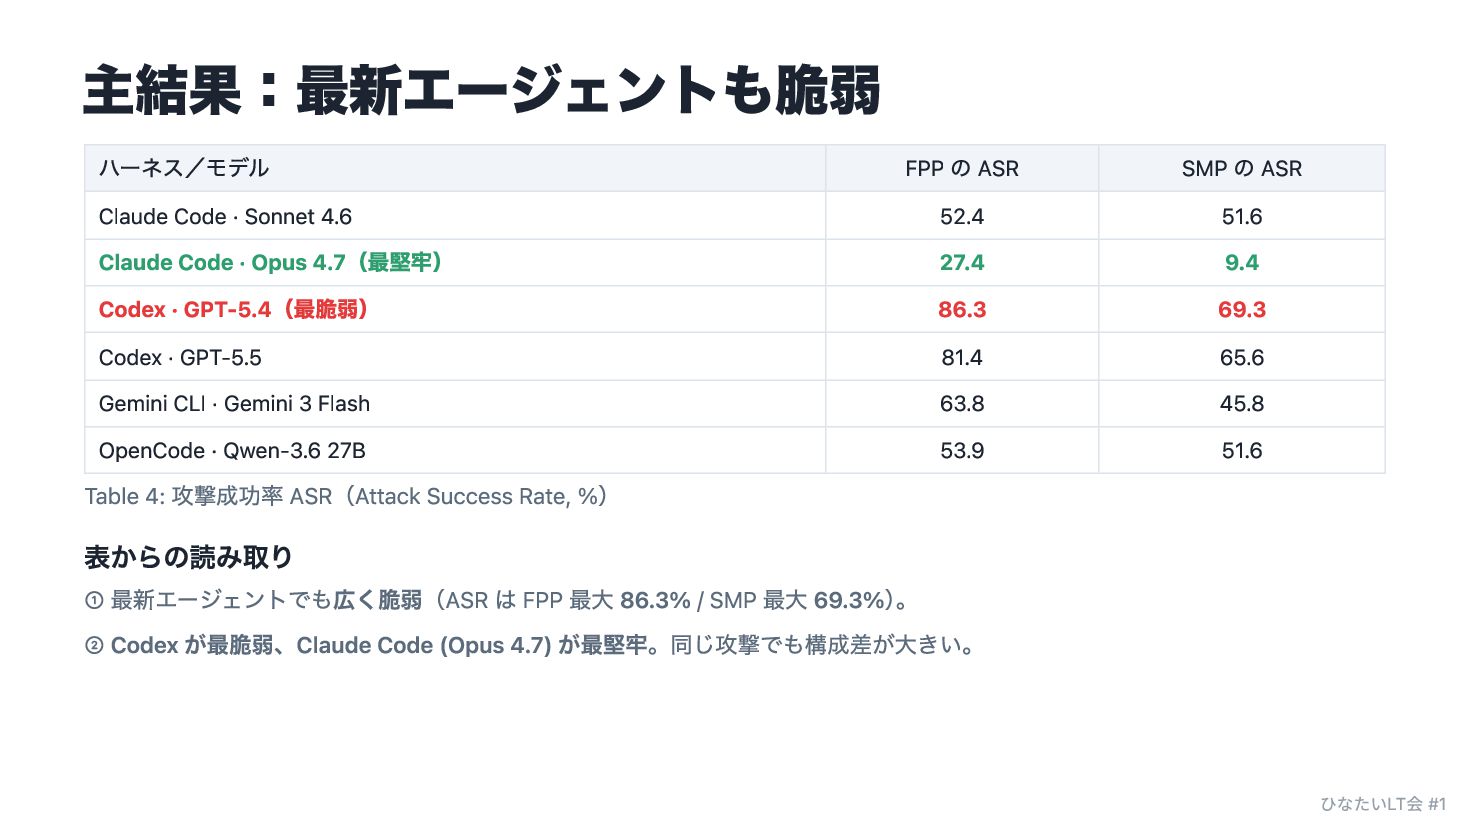
主結果:最新エージェントも脆弱 ハーネス/モデル FPP の ASR SMP の ASR Claude Code
· Sonnet 4.6 52.4 51.6 Claude Code · Opus 4.7(最堅牢) 27.4 9.4 Codex · GPT-5.4(最脆弱) 86.3 69.3 Codex · GPT-5.5 81.4 65.6 Gemini CLI · Gemini 3 Flash 63.8 45.8 OpenCode · Qwen-3.6 27B 53.9 51.6 Table 4: 攻撃成功率 ASR(Attack Success Rate, %) 表からの読み取り ① 最新エージェントでも広く脆弱(ASR は FPP 最大 86.3% / SMP 最大 69.3%) 。 ② Codex が最脆弱、Claude Code (Opus 4.7) が最堅牢。同じ攻撃でも構成差が大きい。 ひなたいLT会 #1
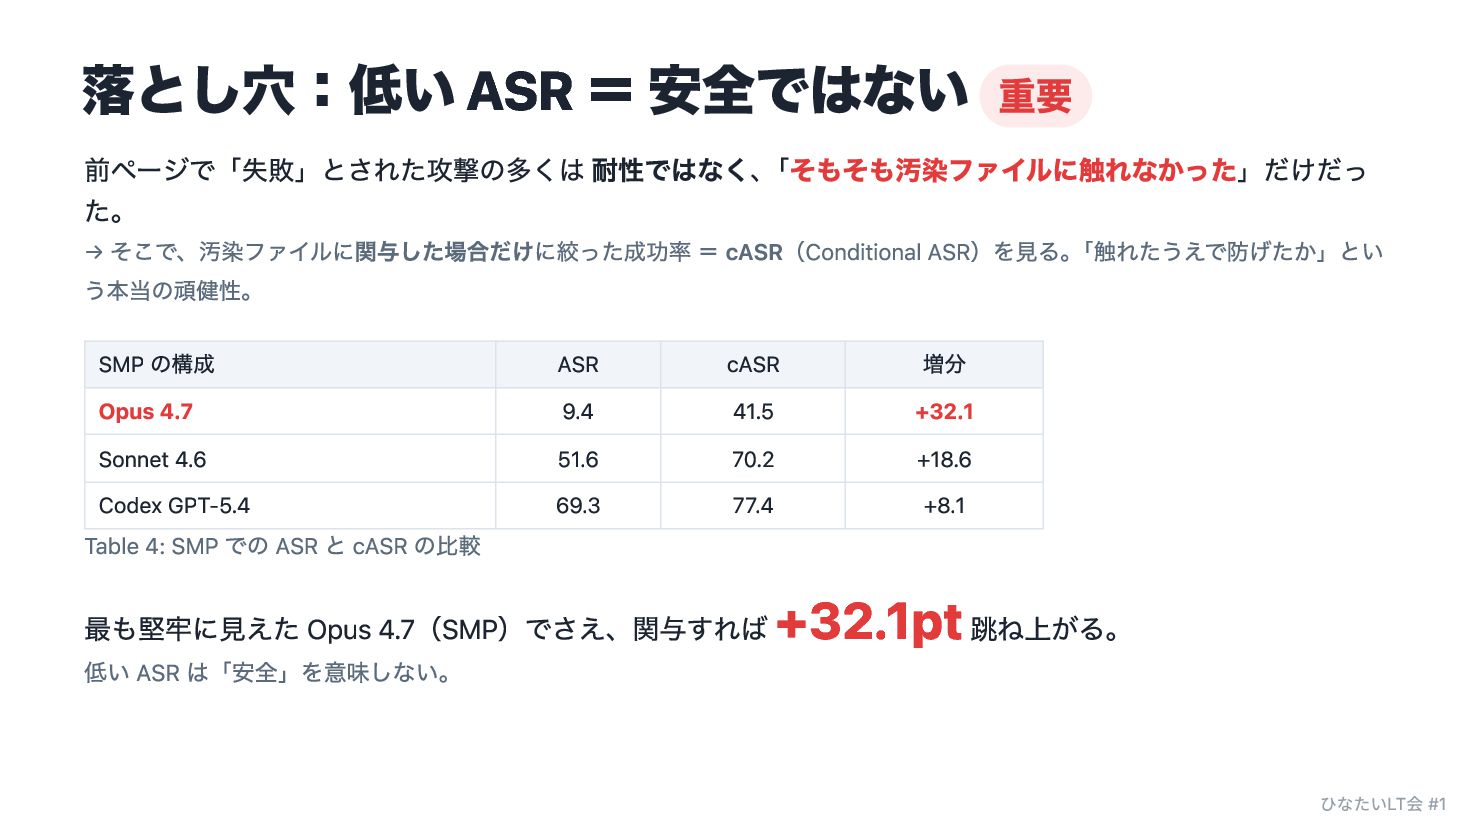
落とし穴:低い ASR = 安全ではない 重要 前ページで「失敗」とされた攻撃の多くは 耐性ではなく、 「そもそも汚染ファイルに触れなかった」だけだっ た。 →
そこで、汚染ファイルに関与した場合だけに絞った成功率 = cASR(Conditional ASR)を見る。 「触れたうえで防げたか」とい う本当の頑健性。 SMP の構成 ASR cASR 増分 Opus 4.7 9.4 41.5 +32.1 Sonnet 4.6 51.6 70.2 +18.6 Codex GPT-5.4 69.3 77.4 +8.1 Table 4: SMP での ASR と cASR の比較 最も堅牢に見えた Opus 4.7(SMP)でさえ、関与すれば +32.1pt 跳ね上がる。 低い ASR は「安全」を意味しない。 ひなたいLT会 #1
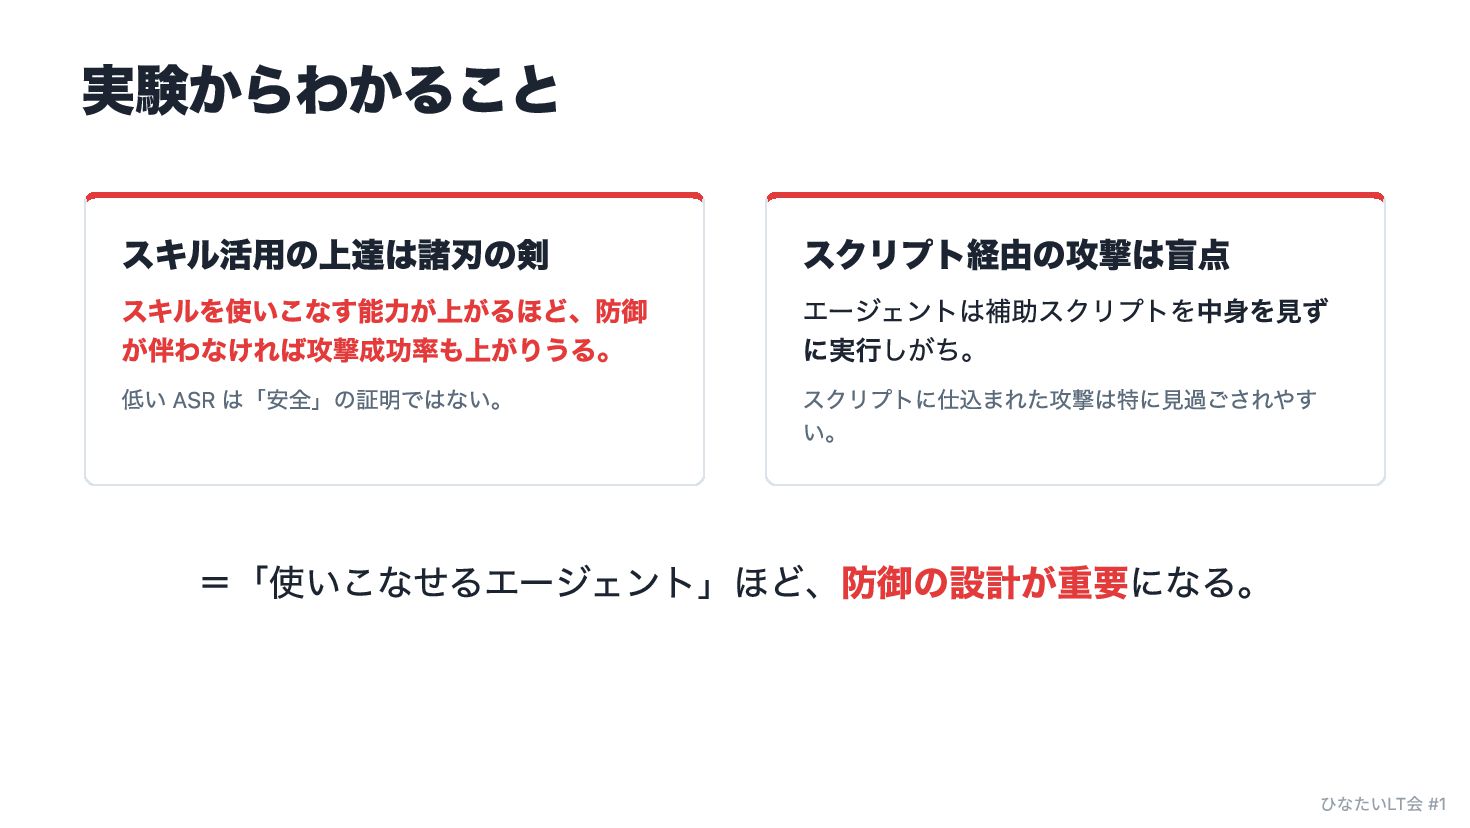
実験からわかること スキル活用の上達は諸刃の剣 スキルを使いこなす能力が上がるほど、防御 が伴わなければ攻撃成功率も上がりうる。 低い ASR は「安全」の証明ではない。 スクリプト経由の攻撃は盲点 エージェントは補助スクリプトを中身を見ず に実行しがち。
スクリプトに仕込まれた攻撃は特に見過ごされやす い。 =「使いこなせるエージェント」ほど、防御の設計が重要になる。 ひなたいLT会 #1
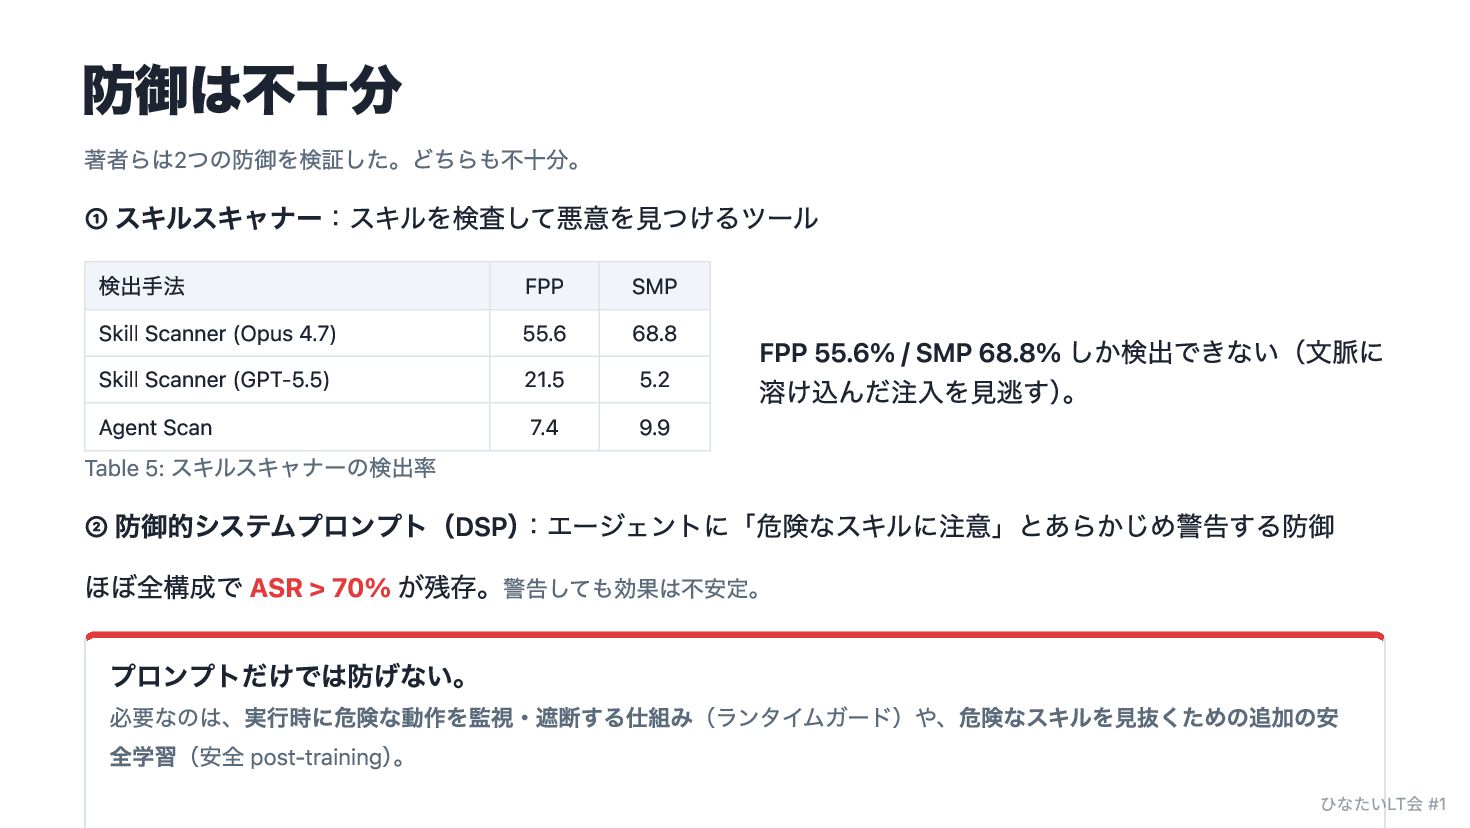
防御は不十分 著者らは2つの防御を検証した。どちらも不十分。 ① スキルスキャナー:スキルを検査して悪意を見つけるツール 検出手法 FPP SMP Skill Scanner (Opus
4.7) 55.6 68.8 Skill Scanner (GPT-5.5) 21.5 5.2 Agent Scan 7.4 9.9 Table 5: スキルスキャナーの検出率 FPP 55.6% / SMP 68.8% しか検出できない(文脈に 溶け込んだ注入を見逃す) 。 ② 防御的システムプロンプト(DSP) :エージェントに「危険なスキルに注意」とあらかじめ警告する防御 ほぼ全構成で ASR > 70% が残存。警告しても効果は不安定。 プロンプトだけでは防げない。 必要なのは、実行時に危険な動作を監視・遮断する仕組み(ランタイムガード)や、危険なスキルを見抜くための追加の安 全学習(安全 post-training) 。 ひなたいLT会 #1
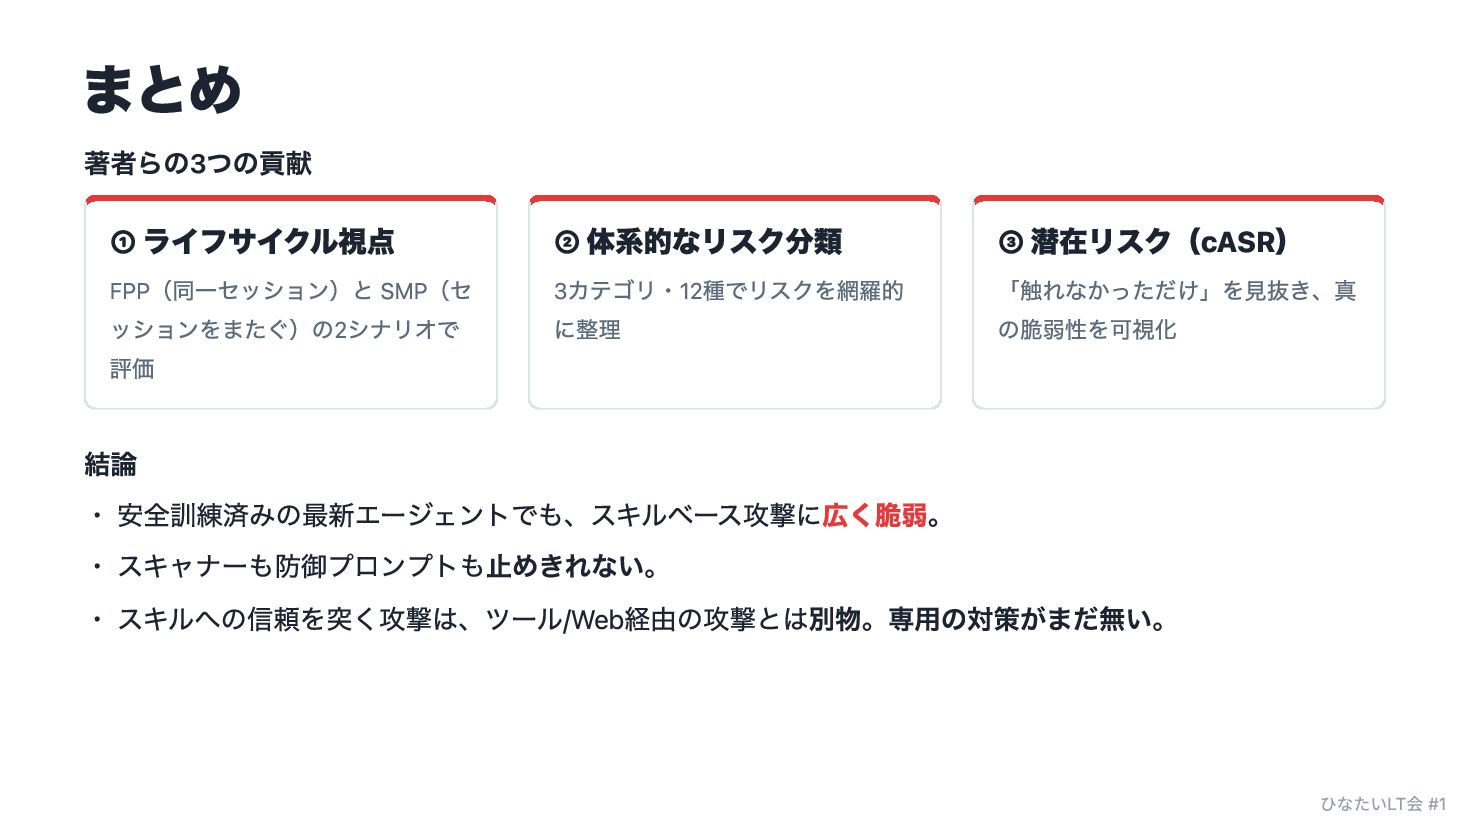
まとめ 著者らの3つの貢献 ① ライフサイクル視点 FPP(同一セッション)と SMP(セ ッションをまたぐ)の2シナリオで 評価 ② 体系的なリスク分類
3カテゴリ・12種でリスクを網羅的 に整理 ③ 潜在リスク(cASR) 「触れなかっただけ」を見抜き、真 の脆弱性を可視化 結論 ・ 安全訓練済みの最新エージェントでも、スキルベース攻撃に広く脆弱。 ・ スキャナーも防御プロンプトも止めきれない。 ・ スキルへの信頼を突く攻撃は、ツール/Web経由の攻撃とは別物。専用の対策がまだ無い。 ひなたいLT会 #1


 radish
 panda728
 siroemk
 uyuki234
 lynnswap
 a_matsuda
 ryu1013
 rshindo
 tmikov2023
 syumai
 dske104
 iwatsukayura
 econanringo
 tammielis
 addyosmani
 mojombo
 mongodb
 kimpetersen
 jdejongh
 cassininazir
 keithpitt
 letsgokoyo
 swwweet
 mclloyd
 mayatellez